
エージェントは会話が変わると忘れる。A-Mem は記憶を相互リンクしたノートとして保存し、書き換えていく。NeurIPS 2025、全文無料。
A-Mem: Agentic Memory for LLM Agents
A-Mem:LLMエージェントのためのエージェント型メモリ
Wujiang 、Zujie Liang 、Kai Mei 、Hang Gao 、Juntao Tan 、Yongfeng Zhang ラトガース大学 独立研究者 AIOS Foundation wujiang.xu@rutgers.edu
概要
大規模言語モデル(LLM)エージェントは、複雑な実世界タスクに対して外部ツールを効果的に利用できる一方で、過去の経験を活用するためのメモリシステムを必要とする。現在のメモリシステムは基本的な保存と検索を可能にするが、近年グラフデータベースの導入が試みられているものの、高度なメモリの組織化を欠いている。さらに、これらのシステムの固定された操作と構造は、多様なタスクにわたる適応性を制限している。この制限に対処するため、本論文では、メモリをエージェント的に動的に組織化できる、LLMエージェントのための新規なエージェント型メモリシステムを提案する。ツェッテルカステン法の基本原則に従い、我々は動的なインデックス付けとリンクを通じて相互接続された知識ネットワークを構築するメモリシステムを設計した。新しいメモリが追加されると、我々は文脈記述、キーワード、タグを含む複数の構造化属性を含む包括的なノートを生成する。次にシステムは履歴メモリを分析して関連する接続を特定し、意味のある類似性が存在する場合にリンクを確立する。さらに、このプロセスはメモリの進化を可能にする – 新しいメモリが統合されると、それらは既存の履歴メモリの文脈表現と属性の更新を引き起こすことができ、メモリネットワークがその理解を継続的に洗練させることを可能にする。我々のアプローチは、ツェッテルカステンの構造化された組織化原則と、エージェント駆動型意思決定の柔軟性を組み合わせ、より適応的で文脈を意識したメモリ管理を可能にする。6つの基盤モデルに関する実証実験は、既存のSOTAベースラインに対して優れた改善を示す。
ベンチマーク評価用コード:https://github.com/WujiangXu/AgenticMemory 本番運用可能なエージェント型メモリ用コード:https://github.com/WujiangXu/A- mem- sys
1 はじめに
大規模言語モデル(LLM)エージェントは様々なタスクにおいて顕著な能力を示しており、最近の進歩により、環境と相互作用し、タスクを実行し、自律的に意思決定することが可能になっている [23, 33, 7]。それらはLLMを外部ツールや繊細なワークフローと統合することで、推論と計画の能力を向上させる。LLMエージェントは強力な推論性能を持つものの、外部環境との長期的な相互作用能力を提供するためにメモリシステムを依然として必要とする [35]。
LLMエージェントのための既存のメモリシステム [25, 39, 28, 21] は、基本的なメモリ保存機能を提供する。これらのシステムは、エージェント開発者がメモリ保存構造を事前に定義し、ワークフロー内の保存ポイントを指定し、検索のタイミングを確立することを要求する。一方、構造化されたメモリ組織化を改善するため、Mem0 [8] はRAG [9, 18, 30] の原則に従い、保存と検索のプロセスにグラフデータベースを組み込んでいる。グラフデータベースはメモリシステムに構造化された組織化を提供するが、事前定義されたスキーマと関係への依存は、その適応性を根本的に制限する。この制限は実際のシナリオにおいて明確に現れる – エージェントが新規な数学的解法を学習するとき、現在のシステムはこの情報をその事前設定されたフレームワーク内で分類しリンクすることしかできず、
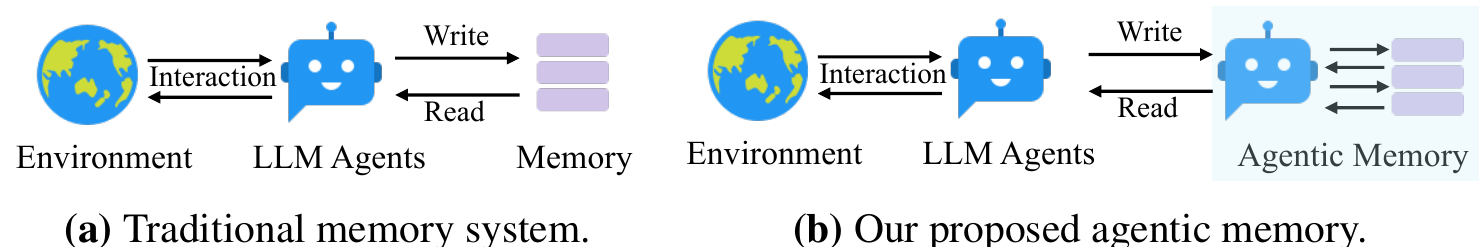
革新的な接続を形成したり、知識が進化するにつれて新しい組織化パターンを発展させたりすることができない。このような硬直した構造は、固定されたエージェントワークフローと相まって、これらのシステムが新しい環境にわたって汎化し、長期的な相互作用において有効性を維持する能力を厳しく制限する。この課題は、LLMエージェントがより複雑でオープンエンドなタスクに取り組むにつれてますます重要になる。そこでは柔軟な知識の組織化と継続的な適応が不可欠である。したがって、LLMエージェントの長期的な相互作用を支える柔軟で普遍的なメモリシステムをいかに設計するかは、依然として重要な課題である。
本論文では、A- MEMと名付けられた、LLMエージェントのための新規なエージェント型メモリシステムを導入する。これは静的で事前に定められたメモリ操作に依存することなく、動的なメモリ構造化を可能にする。我々のアプローチは、ツェッテルカステン法 [15, 1] に着想を得ている。これは、原子的ノートと柔軟なリンク機構を通じて相互接続された情報ネットワークを構築する、洗練された知識管理システムである。我々のシステムは、LLMエージェントのための自律的で柔軟なメモリ管理を可能にするエージェント型メモリアーキテクチャを導入する。各新しいメモリについて、我々は複数の表現を統合する包括的なノートを構築する。これには、いくつかの属性を含む構造化されたテキスト属性と、類似性マッチングのための埋め込みベクトルが含まれる。次にA- MEMは履歴メモリリポジトリを分析し、意味的類似性と共有属性に基づいて意味のある接続を確立する。この統合プロセスは新しいリンクを生成するだけでなく、新しいメモリが組み込まれる際の動的進化も可能にする。それらは既存メモリの文脈表現の更新を引き起こすことができ、メモリ全体が時間とともにその理解を継続的に洗練し深めることを可能にする。貢献は以下のように要約される:
- 我々はA-MEMを提示する。これはLLMエージェントのためのエージェント型メモリシステムであり、文脈記述の自律的生成、メモリ接続の動的確立、および新しい経験に基づく既存メモリの知的進化を可能にする。このシステムは、事前に定められたメモリ操作を必要とすることなく、LLMエージェントに長期的な相互作用能力を備えさせる。
- 我々はエージェント型メモリ更新機構を設計する。そこでは新しいメモリが自動的に2つの主要な操作を引き起こす:リンク生成とメモリ進化である。リンク生成は、共有属性と類似した文脈記述を特定することにより、メモリ間の接続を自動的に確立する。メモリ進化は、新しい経験が分析されるにつれて既存メモリが動的に適応することを可能にし、高次のパターンと属性の出現につながる。
- 我々は長期的な会話データセットを用いて我々のシステムの包括的な評価を実施し、6つの異なる評価指標を用いて6つの基盤モデルにわたる性能を比較し、顕著な改善を示す。さらに、我々のエージェント型メモリシステムの構造化された組織化を説明するためにT-SNE可視化を提供する。
2 関連研究
2.1 LLMエージェントのためのメモリ
LLMエージェントのメモリシステムに関する先行研究は、メモリ管理と利用のための様々な機構を探ってきた [23, 21, 8, 39]。いくつかのアプローチは相互作用の保存を完了する。これは密な検索モデル [39] や読み書きメモリ構造 [24] を通じて包括的な履歴記録を維持する。さらに、MemGPT [25] はキャッシュのようなアーキテクチャを活用して最近の情報を優先する。同様に、SCM [32] は、メモリストリームとコントローラ機構を通じてLLMの長期メモリを維持する能力を強化する自己制御メモリフレームワークを提案する。しかし、これらのアプローチは多様な実世界タスクを扱う上で重大な限界に直面する。それらは基本的なメモリ機能を提供できるものの、その操作は通常、事前定義された構造と固定されたワークフローによって制約される。これらの制約は、特にメモリの書き込みと検索のプロセスにおいて、
硬直した操作パターンへの依存に起因する。このような柔軟性の欠如は、新しい環境における貧弱な汎化と、長期的な相互作用における限られた有効性につながる。したがって、エージェントの長期的な相互作用を支える柔軟で普遍的なメモリシステムを設計することは、依然として重要な課題である。
2.2 検索拡張生成
検索拡張生成(RAG)は、外部知識源を組み込むことでLLMを強化する強力なアプローチとして登場した [18, 6, 10]。標準的なRAG [37, 34] のプロセスは、文書をチャンクにインデックス化し、意味的類似性に基づいて関連するチャンクを検索し、この検索された文脈でLLMのプロンプトを拡張して生成を行うことを含む。高度なRAGシステム [20, 12] は、洗練された検索前および検索後の最適化を含むよう進化してきた。これらの基盤の上に、最近の研究は検索プロセスにおいてより自律的で適応的な行動を示すエージェント型RAGシステムを導入した。これらのシステムは、いつ何を検索するかを動的に決定し [4, 14]、検索を導くために仮説的な応答を生成し、中間結果に基づいて検索戦略を反復的に洗練することができる [31, 29]。
しかし、エージェント型RAGアプローチは、いつ何を検索するかを自律的に決定することで検索フェーズにおいてエージェンシーを示すが [4, 14, 38]、我々のエージェント型メモリシステムは、そのメモリ構造の自律的進化を通じて、より根本的なレベルでエージェンシーを示す。ツェッテルカステン法に着想を得て、我々のシステムはメモリが自らの文脈記述を能動的に生成し、関連するメモリと意味のある接続を形成し、新しい経験が生じるにつれてその内容と関係の両方を進化させることを可能にする。検索対保存と進化におけるこのエージェンシーの根本的な区別は、洗練された検索機構にもかかわらず静的知識ベースを維持するエージェント型RAGシステムから我々のアプローチを区別する。
3 方法論
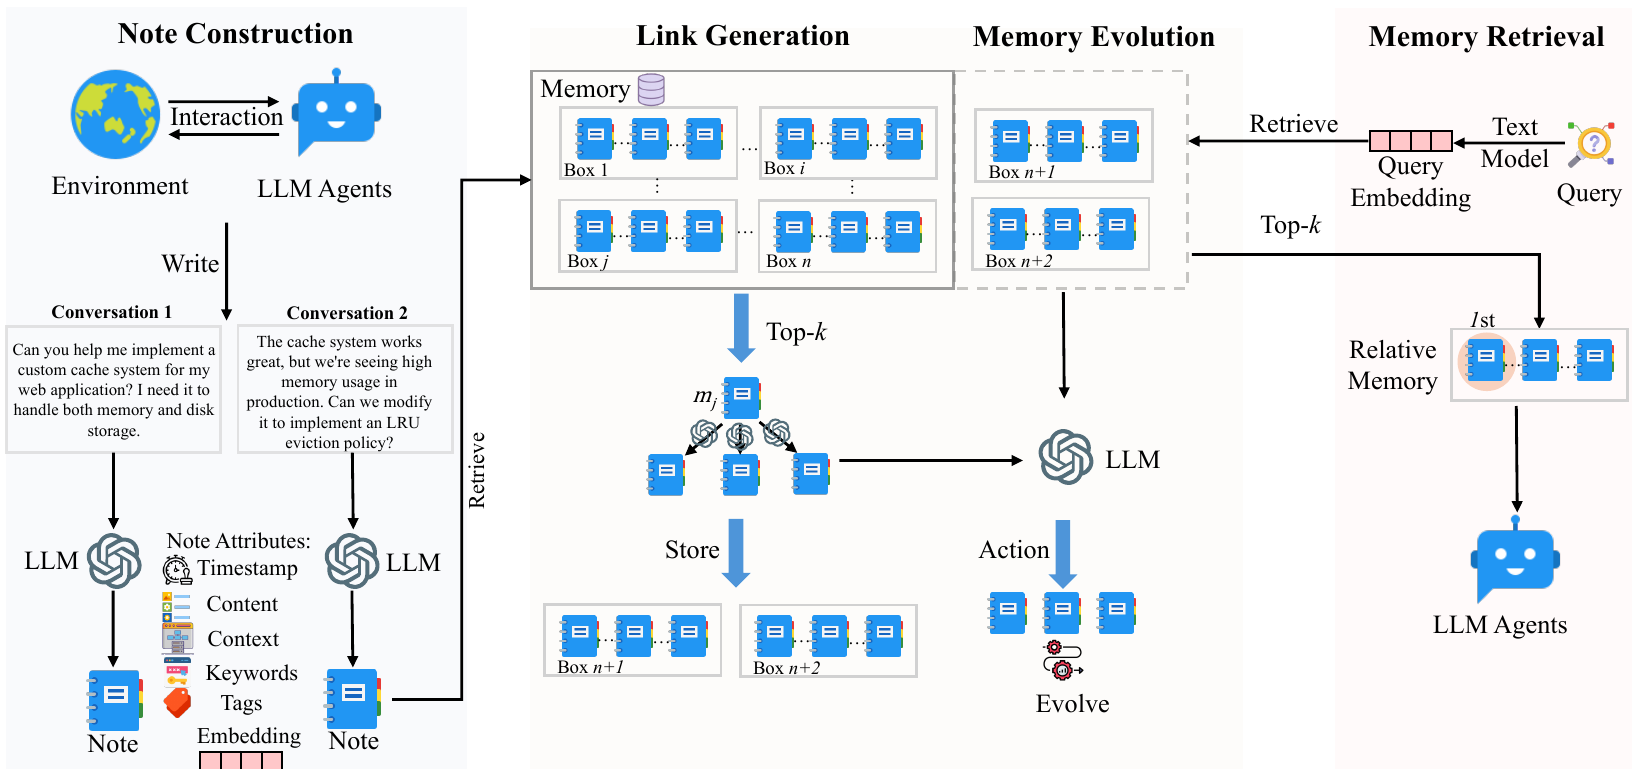
我々が提案するエージェント型メモリシステムは、ツェッテルカステン法に着想を得て、LLMエージェントが事前に定められた操作なしに長期メモリを維持することを可能にする、動的で自己進化するメモリシステムを実装する。システムの設計は、原子的ノート作成、柔軟なリンク機構、および知識構造の継続的進化を強調する。
3.1 ノート構築
ツェッテルカステン法の原子的ノート作成と柔軟な組織化の原則に基づいて、我々はメモリノート構築へのLLM駆動型アプローチを導入する。エージェントがその環境と相互作用するとき、我々は明示的な情報とLLM生成の文脈理解の両方を捉える構造化されたメモリノートを構築する。我々のコレクション における各メモリノート は次のように表される:
ここで、 は元のインタラクション内容を表し、 はインタラクションのタイムスタンプ、 は主要な概念を捉えたLLM生成のキーワード、 は分類のためのLLM生成タグを含み、 は豊かな意味的理解を提供するLLM生成の文脈記述を表し、 は意味的関係を共有するリンクされた記憶の集合を保持する。各メモリノートをその基本的内容とタイムスタンプを超えた有意義な文脈で豊かにするために、我々はLLMを活用してインタラクションを分析し、これらの意味的構成要素を生成する。ノート構築プロセスは、慎重に設計されたテンプレート を用いてLLMにプロンプトを与えることを含む:
Zettelkastenの原子性の原則に従い、各ノートは単一の自己完結した知識単位を捉える。効率的な検索とリンクを可能にするため、我々はノートのすべてのテキスト構成要素を包含する密ベクトル表現をテキストエンコーダ[27]によって計算する:
LLMを用いて豊かにされた構成要素を生成することにより、我々は生のインタラクションから暗黙知を自律的に抽出することを可能にする。多面的なノート構造 は、記憶の異なる側面を捉えた豊かな表現を生み出し、きめ細やかな組織化と検索を促進する。さらに、LLM生成の意味的構成要素と密ベクトル表現の組み合わせにより、文脈と計算効率の良い類似性マッチングの両方が提供される。
3.2 リンク生成
我々のシステムは、新しいメモリノートが事前定義されたルールなしで有意義な接続を形成することを可能にする自律的リンク生成メカニズムを実装している。構築されたメモリノート がシステムに追加されると、我々はまずその意味的埋め込みを類似性ベースの検索に活用する。各既存のメモリノート について、我々は類似性スコアを計算する:
次にシステムは、最も関連性の高い上位 件の記憶を特定する:
これらの候補となる最近傍記憶に基づいて、我々はLLMに、それらの潜在的な共通属性に基づく潜在的な接続を分析するようプロンプトを与える。形式的には、記憶 のリンク集合は次のように更新される:
生成された各リンク は、 として構造化される。埋め込みベースの検索を初期フィルタとして用いることで、意味的関連性を維持しつつ効率的なスケーラビリティを実現する。A-MEMは、網羅的な比較を行うことなく、大規模なメモリ集合においても潜在的な接続を迅速に特定できる。さらに重要なことに、LLM駆動の分析により、単純な類似度指標を超えた関係性の微妙な理解が可能になる。言語モデルは、埋め込み類似度だけでは明らかにならない可能性のある微細なパターン、因果関係、概念的なつながりを特定できる。我々は、現代の言語モデルを活用しつつ、柔軟なリンクのZettelkasten原則を実装する。結果として得られるネットワークは、メモリ内容と文脈から有機的に形成され、自然な知識の組織化を可能にする。
3.3 メモリの進化
新しいメモリのリンクを作成した後、A-MEMは、取得されたメモリをそのテキスト情報と新しいメモリとの関係に基づいて進化させる。最近傍集合 \(\mathcal{M}{\mathrm{near}}^{n}\) 内の各メモリ \(m{j}\) について、システムはその文脈、キーワード、タグを更新すべきかどうかを決定する。この進化プロセスは、形式的には次のように表せる:
進化したメモリ \(m_{j}^{*}\) は、その後、メモリ集合 \(\mathcal{M}\) 内の元のメモリ \(m_{j}\) を置き換える。この進化的アプローチにより、人間の学習プロセスを模倣した継続的な更新と新たな接続が可能になる。システムが時間の経過とともに処理するメモリが増えるにつれて、ますます洗練された知識構造を発展させ、複数のメモリにまたがる高次のパターンや概念を発見する。これにより、新しい経験と既存のメモリとの間の継続的な相互作用を通じて知識の組織化が徐々に豊かになる、自律的なメモリ学習の基盤が形成される。
3.4 関連メモリの取得
各インタラクションにおいて、我々のA-MEMは文脈を考慮したメモリ取得を実行し、エージェントに関連する履歴情報を提供する。現在のインタラクションからのクエリテキスト \(q\) が与えられると、まずメモリノートに使用されるのと同じテキストエンコーダを用いて、その密ベクトル表現を計算する:
次に、システムはクエリ埋め込みと \(\mathcal{M}\) 内のすべての既存メモリノートとの間の類似度スコアを、コサイン類似度を用いて計算する:
その後、履歴メモリ記憶から最も関連性の高いk個のメモリを取得し、文脈的に適切なプロンプトを構築する。
これらの取得されたメモリは、エージェントが現在のインタラクションをよりよく理解し、応答するのに役立つ関連する履歴的文脈を提供する。取得された文脈は、現在のインタラクションをメモリシステムに保存された関連する過去の経験と結びつけることにより、エージェントの推論プロセスを豊かにする。
4 実験
4.1 データセットと評価
長期的な会話における指示認識型推薦の有効性を評価するために、我々はLoCoMoデータセット[22]を利用する。これは、既存の会話データセット[36, 13]と比較して、大幅に長い対話を含んでいる。以前のデータセットは4〜5セッションにわたる約1Kトークンの対話を含んでいたが、LoCoMoは最大35セッションにわたり平均9Kトークンというはるかに長い会話を特徴としており、長距離依存関係を扱い、拡張された会話全体で一貫性を維持するモデルの能力を評価するのに特に適している。LoCoMoデータセットは、モデル理解のさまざまな側面を包括的に評価するために設計された多様な質問タイプで構成されている: (1) 単一セッションから回答可能なシングルホップ質問; (2) セッションをまたいだ情報統合を必要とするマルチホップ質問; (3) 時間関連情報の理解を試す時間推論質問; (4) 会話文脈と外部知識の統合を必要とするオープンドメイン知識質問; (5) 回答不能なクエリを識別するモデルの能力を評価する敵対的質問。全体として、LoCoMoはこれらのカテゴリにわたる7,512の質問応答ペアを含んでいる。さらに、我々のメモリシステムの有効性を評価するために、DialSim [16]と名付けられた新しいデータセットを使用する。これは長期的な多人数対話から派生した質問応答データセットである。このデータセットは人気テレビ番組(Friends、The Big Bang Theory、The Office)から派生しており、5年間にわたる1,300セッションをカバーし、約350,000トークンを含み、洗練されたファンクイズウェブサイトの質問および時間的知識グラフから生成された複雑な質問からなるセッションあたり1,000以上の質問を含んでいる。
比較ベースラインとして、LoCoMo [22]、ReadAgent [17]、MemoryBank [39]、MemGPT [25]と比較する。ベースラインの詳細な紹介は付録A.1にある。評価には、主に2つの指標を採用する: 適合率と再現率のバランスによって回答精度を評価するF1スコアと、正解応答との単語の重複を測定することによって生成応答の品質を評価するBLEU-1 [26]である。また、1つの質問に回答するための平均トークン長も報告する。
| モデル | 手法 | カテゴリ | 平均 | ||||||||||
| マルチホップ F1 | BLEU | 時間的 F1 | オープンドメイン F1 | シングルホップ F1 | BLEU | 敵対的 F1 | BLEU | ランキング F1 | BLEU | トークン長 | |||
| GPT | LoCoMo | 25.02 | 19.75 | 18.41 | 14.77 | 12.04 | 11.16 | 40.36 | 29.05 | 69.23 | 68.75 | 2.4 | 2.4 |
| READAGENT | 9.15 | 6.48 | 12.60 | 8.87 | 5.31 | 5.12 | 9.67 | 7.66 | 9.81 | 9.02 | 4.2 | 4.2 | |
| MEMORYBANK | 5.00 | 4.77 | 9.68 | 6.99 | 5.56 | 5.94 | 6.61 | 5.16 | 7.36 | 6.48 | 4.8 | 4.8 | |
| MEMGPT | 26.65 | 17.72 | 25.52 | 19.44 | 9.15 | 7.44 | 41.04 | 34.34 | 43.29 | 42.73 | 2.4 | 2.4 | |
| A-MEM | 27.02 | 20.09 | 45.85 | 36.67 | 12.14 | 12.00 | 44.65 | 37.06 | 50.03 | 49.47 | 1.2 | 1.2 | |
| GPT | LoCoMo | 28.00 | 18.47 | 9.09 | 5.78 | 16.47 | 14.80 | 61.56 | 54.19 | 52.61 | 51.13 | 2.0 | 2.0 |
| READAGENT | 14.61 | 9.95 | 4.16 | 3.19 | 8.84 | 8.37 | 12.46 | 10.29 | 6.81 | 6.13 | 4.0 | 4.0 | |
| MEMORYBANK | 6.49 | 4.69 | 2.47 | 2.43 | 6.43 | 5.30 | 8.28 | 7.10 | 4.42 | 3.67 | 5.0 | 5.0 | |
| MEMGPT | 30.36 | 22.83 | 17.29 | 13.18 | 12.24 | 11.87 | 60.16 | 53.35 | 34.96 | 34.25 | 2.4 | 2.4 | |
| A-MEM | 32.86 | 23.76 | 39.41 | 31.23 | 17.10 | 15.84 | 48.43 | 42.97 | 36.35 | 35.53 | 1.6 | 1.6 | |
| GPT | LoCoMo | 9.05 | 6.55 | 4.25 | 4.04 | 9.91 | 8.50 | 11.15 | 8.67 | 40.38 | 40.23 | 3.4 | 3.4 |
| READAGENT | 6.61 | 4.93 | 2.55 | 2.51 | 5.31 | 12.24 | 10.13 | 7.54 | 5.42 | 27.32 | 4.6 | 4.6 | |
| MEMORYBANK | 11.14 | 8.25 | 4.46 | 2.87 | 8.05 | 6.21 | 13.42 | 11.01 | 36.76 | 34.00 | 2.6 | 2.6 | |
| MEMGPT | 10.44 | 7.61 | 4.21 | 3.89 | 13.42 | 11.64 | 9.56 | 7.34 | 31.51 | 28.90 | 3.4 | 3.4 | |
| A-MEM | 18.23 | 11.94 | 24.32 | 19.74 | 16.48 | 14.31 | 23.63 | 19.23 | 46.00 | 43.26 | 1.0 | 1.0 | |
| GPT | LoCoMo | 4.61 | 4.29 | 3.11 | 2.71 | 4.55 | 5.97 | 7.03 | 5.69 | 16.95 | 14.81 | 3.2 | 3.2 |
| READAGENT | 2.47 | 1.78 | 3.01 | 3.01 | 5.57 | 5.22 | 3.25 | 2.51 | 15.78 | 14.01 | 4.2 | 4.2 | |
| MEMORYBANK | 3.60 | 3.39 | 1.97 | 1.67 | 6.63 | 6.58 | 4.11 | 3.32 | 13.07 | 10.30 | 4.2 | 4.2 | |
| MEMGPT | 5.07 | 4.31 | 2.94 | 2.95 | 7.04 | 7.10 | 7.26 | 5.52 | 14.47 | 12.39 | 2.4 | 2.4 | |
| A-MEM | 12.57 | 9.01 | 27.59 | 25.07 | 7.12 | 7.28 | 17.23 | 13.12 | 27.91 | 25.15 | 1.0 | 1.0 | |
| LLaMA 2 | LoCoMo | 11.25 | 9.18 | 7.38 | 6.82 | 11.90 | 10.38 | 12.86 | 10.50 | 51.89 | 48.27 | 3.4 | 3.4 |
| READAGENT | 5.96 | 5.12 | 1.93 | 2.30 | 12.46 | 11.17 | 7.75 | 6.03 | 44.64 | 40.15 | 4.6 | 4.6 | |
| MEMORYBANK | 13.18 | 10.03 | 7.61 | 6.27 | 15.78 | 12.94 | 17.30 | 14.03 | 52.61 | 47.53 | 2.0 | 2.0 | |
| MEMGPT | 9.19 | 6.96 | 4.02 | 4.79 | 11.34 | 8.24 | 10.16 | 7.68 | 49.75 | 45.11 | 4.0 | 4.0 | |
| A-MEM | 19.06 | 11.71 | 17.80 | 10.28 | 17.55 | 14.67 | 28.51 | 24.13 | 58.81 | 54.28 | 1.0 | 1.0 | |
| LLaMA 2 | LoCoMo | 6.88 | 5.77 | 4.37 | 4.40 | 10.65 | 9.29 | 8.37 | 6.93 | 30.25 | 28.46 | 2.8 | 2.8 |
| READAGENT | 2.47 | 1.78 | 3.01 | 3.01 | 5.57 | 5.22 | 3.25 | 2.51 | 15.78 | 14.01 | 4.2 | 4.2 | |
| MEMORYBANK | 6.19 | 4.47 | 3.49 | 3.13 | 4.07 | 4.57 | 7.61 | 6.03 | 18.65 | 17.05 | 3.2 | 3.2 | |
| MEMGPT | 5.32 | 3.99 | 2.68 | 2.72 | 5.64 | 5.54 | 4.32 | 3.51 | 21.45 | 19.37 | 3.8 | 3.8 | |
| A-MEM | 17.44 | 11.74 | 26.38 | 19.50 | 12.53 | 11.83 | 28.14 | 23.87 | 42.04 | 40.60 | 1.0 | 1.0 | |
4つの追加指標(ROUGE-L、ROUGE-2、METEOR、SBERT Similarity)を用いた実験結果を報告することに加えて、DeepSeek-R1-32B [11]、Claude 3.0 Haiku [2]、Claude 3.5 Haiku [3]を含む異なる基盤モデルを用いた実験結果も付録A.3に示す。
4.2 実装の詳細
すべてのベースラインと我々の提案手法について、付録Bに詳述する同一のシステムプロンプトを用いることで一貫性を維持する。Qwen-1.5B/3BおよびLlama 3.2 1B/3Bモデルの展開は、Ollama 1を用いたローカルインスタンス化によって行われ、LiteLLM 2が構造化出力生成を管理する。GPTモデルについては、公式の構造化出力APIを利用する。我々のメモリ取得プロセスでは、計算効率を維持するために主にトップ メモリ選択に を採用し、特定のカテゴリでは性能を最適化するためにこのパラメータを調整する。 の詳細な構成は付録A.5にある。テキスト埋め込みには、すべての実験でall-miniml-16-v2モデルを実装する。
4.3 実証結果
性能分析。我々の実証評価では、LoCoMoデータセット上でA-MEMをLoCoMo [22]、ReadAgent [17]、MemoryBank [39]、MemGPT [25]を含む4つの競争力のあるベースラインと比較した。非GPT基盤モデルについては、我々のA-MEMは異なるカテゴリにわたってすべてのベースラインを一貫して上回り、我々のエージェント型メモリアプローチの有効性を示している。GPTベースのモデルについては、LoCoMoとMemGPTが単純な事実検索における堅牢な事前学習知識によりオープンドメインや敵対的タスクなどの特定のカテゴリで強い性能を示す一方で、我々のA-MEMは複雑な推論連鎖を必要とするマルチホップタスクにおいて少なくとも2倍優れた性能を達成し、優れた性能を示している。LoCoMoデータセットでの実験に加えて、DialSimデータセット上でも我々の手法をLoCoMoおよびMemGPTと比較する。A-MEMはすべての評価指標にわたってすべてのベースラインを一貫して上回り、F1
| 方法 | F1 | BLEU-1 | ROUGE-L | ROUGE-2 | METEOR | SBERT類似度 |
| LoCoMo | 2.55 | 3.13 | 2.75 | 0.90 | 1.64 | 15.76 |
| MemGPT | 1.18 | 1.07 | 0.96 | 0.42 | 0.95 | 8.54 |
| A-MEM | 3.45 | 3.37 | 3.54 | 3.60 | 2.05 | 19.51 |
| 方法 | マルチホップ | 時間的 | カテゴリ | シングルホップ | 敵対的 | |||||
| F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | |
| LG & MEなし | 9.65 | 7.09 | 24.55 | 19.48 | 7.77 | 6.70 | 13.28 | 10.30 | 15.32 | 18.02 |
| MEなし | 21.35 | 15.13 | 31.24 | 27.31 | 10.13 | 10.85 | 39.17 | 34.70 | 44.16 | 45.33 |
| A-MEM | 27.02 | 20.09 | 45.85 | 36.67 | 12.14 | 12.00 | 44.65 | 37.06 | 50.03 | 49.47 |
スコア3.45(LoCoMoの2.55に対して の改善、MemGPTの1.18に対して 高い)を達成している。A-MEMの有効性は、動的で構造化されたメモリ管理を可能にするその新規なエージェント型メモリアーキテクチャに由来する。静的なメモリ操作を用いる従来のアプローチとは異なり、我々のシステムは豊かな文脈記述を持つ原子的ノートを通じて相互接続されたメモリネットワークを構築し、より効果的なマルチホップ推論を可能にする。共有属性に基づいてメモリ間の接続を動的に確立し、既存のメモリ記述を新しい文脈情報で継続的に更新するシステムの能力により、異なる情報間の関係をよりよく捉え、活用することができる。
コスト効率分析。A-MEMは、強い性能とともに、顕著な計算効率とコスト効率を示す。システムはメモリ操作あたり約1,200トークンを必要とし、我々の選択的トップk取得メカニズムを通じて、ベースライン手法(LoCoMoおよびMemGPTでは16,900トークン)と比較してトークン使用量を 削減する。この大幅なトークン削減は、運用コストの低下に直接つながり、各メモリ操作のコストは商用APIサービスを使用した場合0.0003未満であり、大規模展開を経済的に実行可能にする。処理時間は、GPT-4o-miniを使用した場合平均5.4秒、単一GPU上でローカルホストされたLlama 3.2 1Bではわずか1.1秒である。メモリ処理中に複数のLLM呼び出しを必要とするにもかかわらず、A-MEMはこの費用対効果の高いリソース利用を維持しつつ、テストされたすべての基盤モデルにわたってベースラインアプローチを一貫して上回り、特に複雑なマルチホップ推論タスクでは性能を2倍にしている。低い計算コストと優れた推論能力のこのバランスは、実世界での展開におけるA-MEMの実用的な優位性を際立たせている。
4.4 アブレーション研究
Link Generation(LG)モジュールとMemory Evolution(ME)モジュールの有効性を評価するために、我々はモデルの主要コンポーネントを体系的に除去するアブレーション研究を実施した。LGとMEの両モジュールを除去すると、システムは大幅な性能劣化を示し、特にMulti Hop推論およびOpen Domainタスクにおいて顕著であった。LGのみを有効にしたシステム(w/o ME)は中間的な性能レベルを示し、両モジュールを除いたバージョンよりも有意に優れた結果を維持しており、これはメモリ接続の確立におけるリンク生成の根本的な重要性を実証している。我々の完全なモデルであるA-MEMは、すべての評価カテゴリにおいて一貫して最高の性能を達成し、特に複雑な推論タスクにおいて強い結果を示した。これらの結果は、リンク生成モジュールがメモリ組織化のための重要な基盤として機能する一方で、メモリ進化モジュールがメモリ構造に対する本質的な改良を提供することを明らかにしている。このアブレーション研究は我々のアーキテクチャ設計の選択を検証し、効果的なメモリシステムを構築する上でのこれら2つのモジュールの相補的な性質を強調している。
4.5 ハイパーパラメータ分析
我々は、各インタラクションに対して取得される関連メモリの数を制御するメモリ取得パラメータkの影響を分析するために、広範な実験を実施した。図3に示すように、GPT-4o-miniをベースモデルとして用い、5カテゴリのタスクにおいて異なるk値(10、20、30、40、50)にわたる性能を評価した。結果は興味深いパターンを明らかにしている。すなわち、kを増やすと一般的に性能が向上するものの、この改善は徐々に頭打ちとなり、より高い値では時にわずかに低下する。この傾向は特にMulti HopおよびOpen Domainタスクにおいて顕著である。
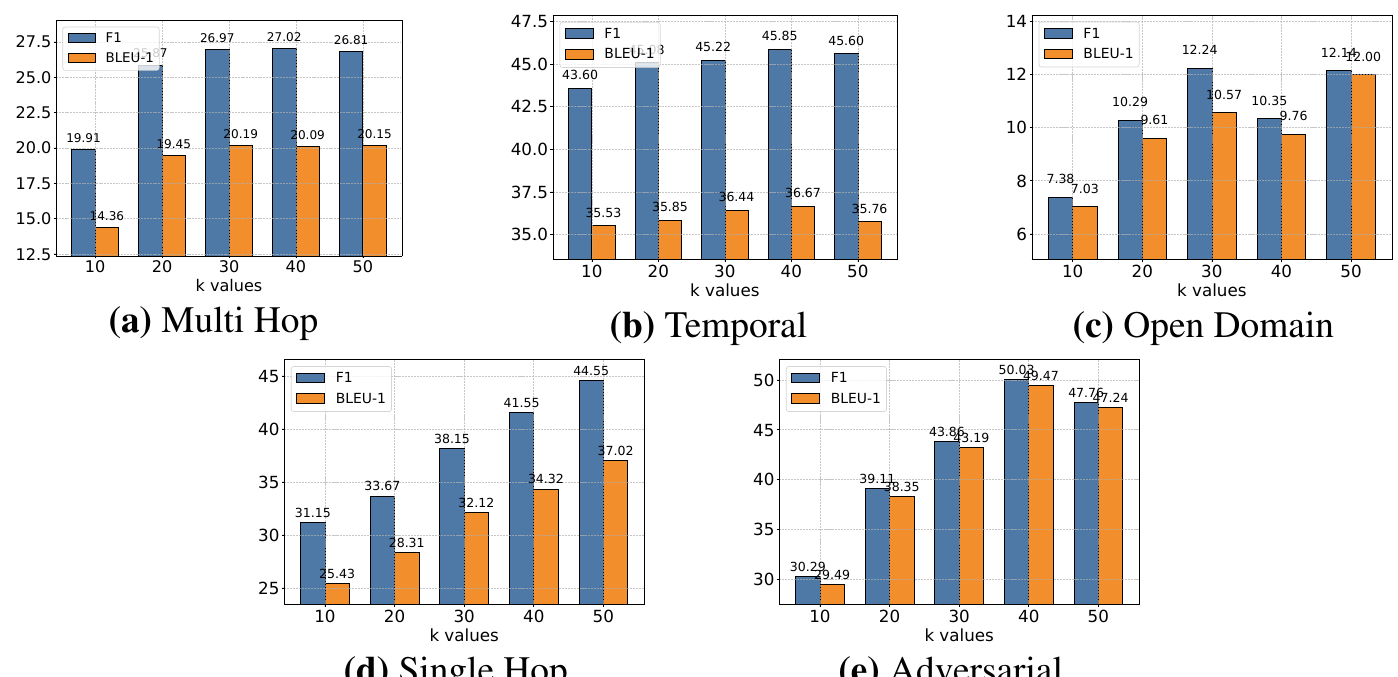
表4:異なるメモリ手法およびスケール間でのメモリ使用量と取得時間の比較。
| メモリサイズ | 手法 | メモリ使用量(MB) | 検索時間(μs) |
| 1,000 | A-MEM | 1.46 | 0.31 ± 0.30 |
| MemoryBank [39] | 1.46 | 0.24 ± 0.20 | |
| ReadAgent [17] | 1.46 | 43.62 ± 8.47 | |
| 10,000 | A-MEM | 14.65 | 0.38 ± 0.25 |
| MemoryBank [39] | 14.65 | 0.26 ± 0.13 | |
| ReadAgent [17] | 14.65 | 484.45 ± 93.86 | |
| 100,000 | A-MEM | 146.48 | 1.40 ± 0.49 |
| MemoryBank [39] | 146.48 | 0.78 ± 0.26 | |
| ReadAgent [17] | 146.48 | 6,682.22 ± 111.63 | |
| 1,000,000 | A-MEM | 1464.84 | 3.70 ± 0.74 |
| MemoryBank [39] | 1464.84 | 1.91 ± 0.31 | |
| ReadAgent [17] | 1464.84 | 120,069.68 ± 1,673.39 |
この観察は、メモリ取得における微妙なバランスを示唆している。すなわち、より大きなk値は推論のためのより豊富な履歴コンテキストを提供する一方で、ノイズを導入し、より長い系列を効果的に処理するモデルの能力を困難にする可能性がある。我々の分析は、適度なk値がコンテキストの豊富さと情報処理効率の間の最適なバランスを実現することを示している。
4.6 スケーリング分析
メモリの蓄積に伴うストレージコストを評価するために、我々のA-MEMシステムと2つのベースライン手法であるMemoryBank [39]およびReadAgent [17]にわたって、ストレージサイズと取得時間の関係を調査した。我々はこれら3つのメモリシステムを、4つのスケールポイントにわたって同一のメモリ内容で評価し、各ステップでエントリ数を10倍に増加させた(1,000から10,000、100,000、そして最終的に1,000,000エントリへ)。実験結果は、我々のA-MEMシステムのスケーリング特性に関する重要な洞察を明らかにしている。空間複雑性の観点では、3つのシステムすべてが同一の線形なメモリ使用量スケーリング を示しており、これはベクトルベースの取得システムとして予想される通りである。これは、A-MEMがベースライン手法と比較して追加のストレージオーバーヘッドを導入しないことを確認している。取得時間については、A-MEMはメモリサイズが増加しても増加が最小限であり、優れた効率性を実証している。100万メモリにスケールした場合でも、A-MEMの取得時間は から へと増加するのみであり、卓越した性能を表している。MemoryBankはわずかに高速な取得時間を示すものの、A-MEMはより豊富なメモリ表現と機能を提供しながら同等の性能を維持している。我々の空間複雑性および取得時間の分析に基づき、A-MEMの取得メカニズムは大規模なスケールにおいても優れた効率性を維持すると結論づける。メモリサイズにわたる取得時間の最小限の増加は、大規模メモリシステムにおける効率性に関する懸念に対処しており、A-MEMが長期的な会話管理のための高度にスケーラブルなソリューションを提供することを実証している。効率性、スケーラビリティ、および強化されたメモリ機能のこの独自の組み合わせは、A-MEMをLLMエージェントのための強力かつ長期的なメモリ機構の構築における重要な進歩として位置づけている。
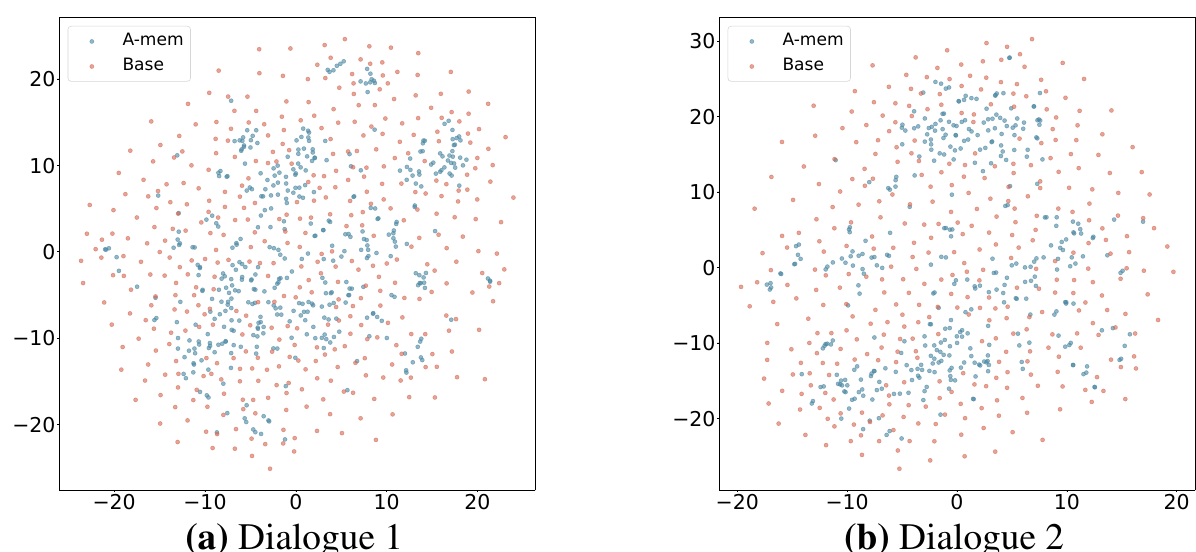
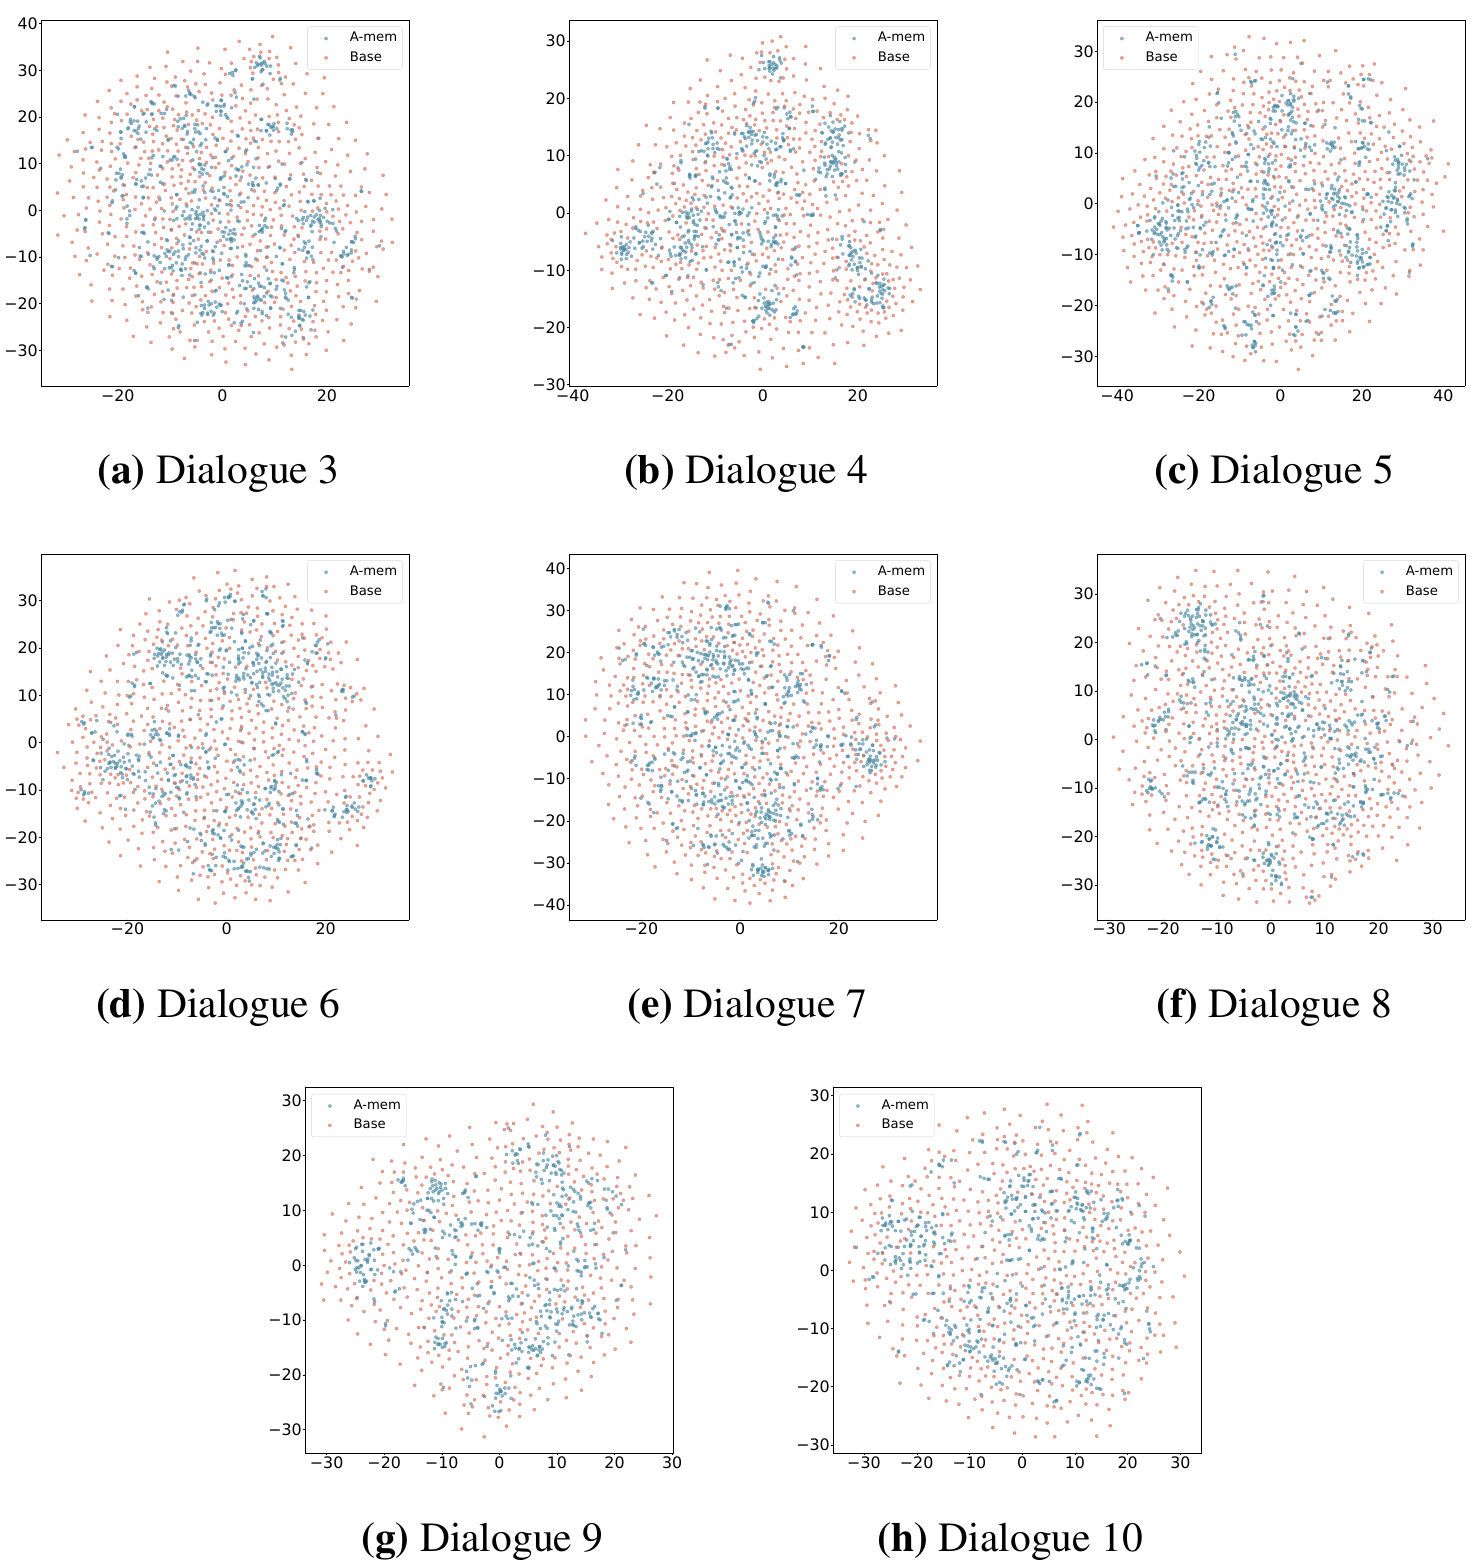
図4:A-MEM(青)とベースメモリ(赤)の異なる対話における記憶埋め込みのT-SNE可視化。A-MEMはより組織化された分布を示す。ベースメモリはリンク生成とメモリ進化を除いたA-MEMを表す。
4.7 メモリ分析
図4にメモリ埋め込みのt-SNE可視化を示し、我々のエージェント型メモリシステムの構造的優位性を実証する。LoCoMo [22]の長期会話からサンプリングした2つの対話を分析した結果、A-MEM(青色で表示)はベースラインシステム(赤色で表示)と比較して、一貫してより凝集したクラスタリングパターンを示すことが観察された。この構造的組織化は特に対話2において顕著であり、中央領域に明確に定義されたクラスタが出現しており、我々のメモリ進化メカニズムと文脈記述生成の有効性に対する実証的証拠を提供している。対照的に、ベースラインメモリの埋め込みはより分散した分布を示しており、リンク生成とメモリ進化のコンポーネントなしではメモリが構造的組織化を欠くことを実証している。これらの可視化結果は、A-MEMが動的進化とリンクメカニズムを通じて意味のあるメモリ構造を自律的に維持できることを検証している。さらなる結果は付録A.4に記載されている。
5 結論
本研究では、LLMエージェントが事前定義された構造に依存することなく、メモリを動的に組織化し進化させることを可能にする、新規のエージェント型メモリシステムであるA-MEMを導入した。Zettelkastenメソッドから着想を得て、我々のシステムは多様な実世界タスクに適応する動的インデックス化とリンクメカニズムを通じて、相互接続された知識ネットワークを構築する。システムのコアアーキテクチャは、新しいメモリに対する文脈記述の自律的生成と、共有属性に基づく既存メモリとの知的な接続確立を特徴とする。さらに、我々のアプローチは、新しい経験を組み込み、継続的な相互作用を通じて高次の属性を発展させることにより、歴史的メモリの継続的進化を可能にする。6つの基盤モデルにわたる広範な実証評価を通じて、A-MEMが長期会話タスクにおいて既存の最先端ベースラインと比較して優れた性能を達成することを実証した。可視化分析はさらに、我々のメモリ組織化アプローチの有効性を検証している。これらの結果は、エージェント型メモリシステムが複雑な環境において長期知識を活用するLLMエージェントの能力を大幅に向上させ得ることを示唆している。
6 限界
我々のエージェント型メモリシステムは有望な結果を達成しているが、将来の探索の可能性があるいくつかの領域を認識している。第一に、我々のシステムはメモリを動的に組織化するが、これらの組織化の品質は依然として基盤となる言語モデルの固有の能力に影響される可能性がある。異なるLLMはわずかに異なる文脈記述を生成したり、メモリ間で異なる接続を確立する可能性がある。さらに、現在の実装はテキストベースの相互作用に焦点を当てているが、将来の研究では画像や音声などのマルチモーダル情報を処理するようにシステムを拡張することを探求でき、より豊かな文脈表現を提供する可能性がある。
参考文献
[1] Sönke Ahrens. How to Take Smart Notes: One Simple Technique to Boost Writing, Learning and Thinking. Amazon, 2017. Second Edition.
[2] Anthropic. The claude 3 model family: Opus, sonnet, haiku. Anthropic, Mar 2024. Accessed May 2025.
[3] Anthropic. Claude 3.5 sonnet model card addendum. Technical report, Anthropic, 2025. Accessed May 2025.
[4] Akari Asai, Zeqiu Wu, Yizhong Wang, Avirup Sil, and Hannaneh Hajishirzi. Self- rag: Learning to retrieve, generate, and critique through self- reflection. arXiv preprint arXiv:2310.11511, 2023.
[5] Satanjeev Banerjee and Alon Lavie. Meteor: An automatic metric for mt evaluation with improved correlation with human judgments. In Proceedings of the acl workshop on intrinsic and extrinsic evaluation measures for machine translation and/or summarization, pages 65- 72, 2005.
[6] Sebastian Borgeaud, Arthur Mensch, Jordan Hoffmann, Trevor Cai, Eliza Rutherford, Katie Millican, George Bm Van Den Driessche, Jean- Baptiste Lespiau, Bogdan Damoc, Aidan Clark, et al. Improving language models by retrieving from trillions of tokens. In International conference on machine learning, pages 2206- 2240. PMLR, 2022.
[7] Xiang Deng, Yu Gu, Boyuan Zheng, Shijie Chen, Sam Stevens, Boshi Wang, Huan Sun, and Yu Su. Mind2web: Towards a generalist agent for the web. Advances in Neural Information Processing Systems, 36:28091- 28114, 2023.
[8] Khant Dev and Singh Taranjeet. mem0: The memory layer for ai agents. https://github.com/mem0ai/mem0, 2024.
[9] Darren Edge, Ha Trinh, Newman Cheng, Joshua Bradley, Alex Chao, Apurva Mody, Steven Truitt, and Jonathan Larson. From local to global: A graph rag approach to query- focused summarization. arXiv preprint arXiv:2404.16130, 2024.
[10] Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, and Haofen Wang. Retrieval- augmented generation for large language models: A survey. arXiv preprint arXiv:2312.10997, 2023.
[11] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
[12] I. Ilin. Advanced rag techniques: An illustrated overview, 2023.
[13] Jihyoung Jang, Minseong Boo, and Hyounghun Kim. Conversation chronicles: Towards diverse temporal and relational dynamics in multi- session conversations. arXiv preprint arXiv:2310.13420, 2023.
[14] Zhengbao Jiang, Frank F Xu, Luyu Gao, Zhiqing Sun, Qian Liu, Jane Dwivedi- Yu, Yiming Yang, Jamie Callan, and Graham Neubig. Active retrieval augmented generation. arXiv preprint arXiv:2305.06983, 2023.
[15] David Kadavy. Digital Zettelkasten: Principles, Methods, & Examples. Google Books, May 2021.
[16] Jiho Kim, Woosog Chay, Hyeonji Hwang, Daeun Kyung, Hyunseung Chung, Eunbyeol Cho, Yohan Jo, and Edward Choi. Dialism: A real- time simulator for evaluating long- term multi- party dialogue understanding of conversational agents. arXiv preprint arXiv:2406.13144, 2024.
[17] Kuang- Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny, and Ian Fischer. A human- inspired reading agent with gist memory of very long contexts. arXiv preprint arXiv:2402.09727, 2024.
[18] Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Kuttler, Mike Lewis, Wen- tau Yih, Tim Rocktäschel, et al. Retrieval- augmented generation for knowledge- intensive nlp tasks. Advances in Neural Information Processing Systems, 33:9459- 9474, 2020.
[19] Chin- Yew Lin. Rouge: A package for automatic evaluation of summaries. In Text summarization branches out, pages 74- 81, 2004.
[20] Xi Victoria Lin, Xilun Chen, Mingda Chen, Weijia Shi, Maria Lomeli, Rich James, Pedro Rodriguez, Jacob Kahn, Gergely Szilvasy, Mike Lewis, et al. Ra- dit: Retrieval- augmented dual instruction tuning. arXiv preprint arXiv:2310.01352, 2023.
[21] Zhiwei Liu, Weiran Yao, Jianguo Zhang, Liangwei Yang, Zuxin Liu, Juntao Tan, Prafulla K Choubey, Tian Lan, Jason Wu, Huan Wang, et al. Agentlite: A lightweight library for building and advancing task- oriented llm agent system. arXiv preprint arXiv:2402.15538, 2024.
[22] Adyasha Maharana, Dong- Ho Lee, Sergey Tulyakov, Mohit Bansal, Francesco Barbieri, and Yuwei Fang. Evaluating very long- term conversational memory of llm agents. arXiv preprint arXiv:2402.17753, 2024.
[23] Kai Mei, Zelong Li, Shuyuan Xu, Ruosong Ye, Yingqiang Ge, and Yongfeng Zhang. Aios: Llm agent operating system. arXiv e- prints, pp. arXiv- 2403, 2024.
[24] Ali Modarressi, Ayyob Imani, Mohsen Fayyaz, and Hinrich Schütze. Ret- llm: Towards a general read- write memory for large language models. arXiv preprint arXiv:2305.14322, 2023.
[25] Charles Packer, Sarah Wooders, Kevin Lin, Vivian Fang, Shishir G Patil, Ion Stoica, and Joseph E Gonzalez. Memgpt: Towards llms as operating systems. arXiv preprint arXiv:2310.08560, 2023.
[26] Kishore Papineni, Salim Roukos, Todd Ward, and Wei-Jing Zhu. Bleu: a method for automatic evaluation of machine translation. In Proceedings of the 40th annual meeting of the Association for Computational Linguistics, pages 311-318, 2002.
[27] Nils Reimers and Iryna Gurevych. Sentence-bert: Sentence embeddings using siamese bert-networks. In Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing. Association for Computational Linguistics, 11 2019.
[28] Aymeric Roucher, Albert Villanova del Moral, Thomas Wolf, Leandro von Werra, and Erik Kaunismaki. 'smolagents': a smol library to build great agentic systems. https://github.com/huggingface/smolagents, 2025.
[29] Zhihong Shao, Yeyun Gong, Yelong Shen, Minlie Huang, Nan Duan, and Weizhu Chen. Enhancing retrieval-augmented large language models with iterative retrieval-generation synergy. arXiv preprint arXiv:2305.15294, 2023.
[30] Zeru Shi, Kai Mei, Mingyu Jin, Yongye Su, Chaoji Zuo, Wenyue Hua, Wujiang Xu, Yujie Ren, Zirui Liu, Mengnan Du, et al. From commands to prompts: Llm-based semantic file system for aios. arXiv preprint arXiv:2410.11843, 2024.
[31] Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot, and Ashish Sabharwal. Interleaving retrieval with chain-of-thought reasoning for knowledge-intensive multi-step questions. arXiv preprint arXiv:2212.10509, 2022.
[32] Bing Wang, Xinnian Liang, Jian Yang, Hui Huang, Shuangzhi Wu, Peihao Wu, Lu Lu, Zejun Ma, and Zhoujun Li. Enhancing large language model with self-controlled memory framework. arXiv preprint arXiv:2304.13343, 2023.
[33] Xingyao Wang, Boxuan Li, Yufan Song, Frank F Xu, Xiangru Tang, Mingchen Zhuge, Jiayi Pan, Yueqi Song, Bowen Li, Jaskirat Singh, et al. Openhands: An open platform for ai software developers as generalist agents. arXiv preprint arXiv:2407.16741, 2024.
[34] Zhiruo Wang, Jun Araki, Zhengbao Jiang, Md Rizwan Parvez, and Graham Neubig. Learning to filter context for retrieval-augmented generation. arXiv preprint arXiv:2311.08377, 2023.
[35] Lilian Weng. Llm-powered autonomous agents. lilianweng.github.io, Jun 2023.
[36] J Xu. Beyond goldfish memory: Long-term open-domain conversation. arXiv preprint arXiv:2107.07567, 2021.
[37] Wenhao Yu, Hongming Zhang, Xiaoman Pan, Kaixin Ma, Hongwei Wang, and Dong Yu. Chain-of-note: Enhancing robustness in retrieval-augmented language models. arXiv preprint arXiv:2311.09210, 2023.
[38] Zichun Yu, Chenyan Xiong, Shi Yu, and Zhiyuan Liu. Augmentation-adapted retriever improves generalization of language models as generic plug-in. arXiv preprint arXiv:2305.17331, 2023.
[39] Wanjun Zhong, Lianghong Guo, Qiqi Gao, He Ye, and Yanlin Wang. Memorybank: Enhancing large language models with long-term memory. In Proceedings of the AAAI Conference on Artificial Intelligence, volume 38, pages 19724-19731, 2024.
目次
1 はじめに 1
2 関連研究 2
2.1 LLMエージェントのための記憶 2
2.2 検索拡張生成 3
3 方法論 3
3.1 ノート構築 4
3.2 リンク生成 4
3.3 記憶の進化 4
3.4 関連記憶の検索 5
4 実験 5
4.1 データセットと評価 5
4.2 実装の詳細 6
4.3 実験結果 6
4.4 アブレーション研究 7
4.5 ハイパーパラメータ分析 7
4.6 スケーリング分析 8
4.7 記憶分析 9
5 結論 9
6 限界 9
A 実験 14
A.1 ベースラインの詳細な紹介 14
A.2 評価指標 14
A.3 比較結果 15
A.4 記憶分析 16
A.5 ハイパーパラメータ設定 17
B プロンプトテンプレートと例 19
B.1 ノート構築のプロンプトテンプレート 19
B.2 リンク生成のプロンプトテンプレート 19
B.3 記憶の進化のプロンプトテンプレート 20
B.4 A-MEMを用いたQ/Aの例 21
付録
A 実験
A.1 ベースラインの詳細な紹介
LoCoMo [22] は、質問応答タスクに対して記憶機構を持たない基盤モデルを活用する直接的なアプローチを取る。各クエリに対して、先行する会話全体と質問をプロンプトに含め、モデルの推論能力を評価する。
ReadAgent [17] は、長文コンテキスト文書処理に精巧な3段階の方法論で取り組む。まずエピソードのページ分割によって内容を管理可能なチャンクに分割し、次に各ページを簡潔な記憶表現に蒸留する記憶要約(メモリギスティング)を行い、最後に必要に応じて関連情報を取得する対話的ルックアップで締めくくる。
MemoryBank [39] は、過去のインタラクションを維持し効率的に取得する革新的な記憶管理システムを導入する。このシステムは、エビングハウスの忘却曲線理論に基づく動的な記憶更新機構を備え、時間と重要性に応じて記憶の強度を知的に調整する。さらに、継続的なインタラクション分析を通じてユーザーの性格理解を漸進的に精緻化するユーザーポートレート構築システムを組み込んでいる。
MemGPT [25] は、従来のオペレーティングシステムの記憶階層に着想を得た新規の仮想コンテキスト管理システムを提示する。このアーキテクチャは二層構造を実装している。すなわち、LLM推論中に即時アクセスを提供するメインコンテキスト(RAMに類似)と、固定されたコンテキストウィンドウを超えて情報を維持する外部コンテキスト(ディスクストレージに類似)である。
A.2 評価指標
F1スコアは適合率と再現率の調和平均を表し、両方の指標を単一の値に組み合わせたバランスの取れた指標を提供する。この指標は、完全な応答と正確な応答の間でバランスを取る必要がある場合に特に有用である。
ここで
質問応答システムにおいて、F1スコアは予測回答と参照回答の間の完全一致を評価する上で重要な役割を果たす。これは、システムが回答の包括的なカバレッジを維持しながら正確なテキストセグメントを特定しなければならないスパンベースのQAタスクにおいて特に重要である。BLEU-1 [26] は、システム出力と参照テキストの間のユニグラム一致の精度を評価する方法を提供する。
ここで
ここで、 は候補の長さ、 は参照の長さ、 は候補 \(k\) における n-gram \(i\) の出現回数、 は任意の参照における最大出現回数である。QAにおいて、BLEU-1 は生成された回答の語彙的な精度を評価し、完全一致が厳しすぎる可能性がある生成型QAシステムに特に有用である。
ROUGE-L [19] は、生成テキストと参照テキストの間の最長共通部分列を測定する。
ここで、 は参照テキスト、 は候補テキストであり、LCS は最長共通部分列(Longest Common Subsequence)である。
ROUGE- 2 [19] は、生成テキストと参照テキストの間のバイグラムの重複を計算する。
ROUGE- L と ROUGE- 2 はどちらも、生成された回答の流暢さと一貫性を評価するのに特に有用であり、ROUGE- L は系列の一致に、ROUGE- 2 は局所的な語順に焦点を当てている。
METEOR [5] は、候補テキストと参照テキストの間でアライメントされたユニグラムに基づいてスコアを計算し、同義語や言い換えを考慮します。
ここで、 は適合率、 は再現率、ch はチャンク数、 はマッチしたユニグラム数です。METEOR は、完全一致を超えた意味的類似性を考慮するため、QA 評価に有用であり、言い換えられた回答の評価に適しています。
SBERT Similarity [27] は、文埋め込みを用いて 2 つのテキスト間の意味的類似性を測定します。
はテキストの文埋め込みを表します。SBERT Similarity は、語彙的な重なりが少ない場合でも意味の類似性を捉えることができるため、QA システムにおける意味理解の評価に特に有用です。
A.3 比較結果
ROUGE-2、ROUGE-L、METEOR、および SBERT 指標を用いた包括的な評価により、A-MEM が顕著な計算効率を維持しながら優れた性能を達成することを示しました。さまざまなモデルサイズとタスクカテゴリにわたる広範な実証テストを通じて、いくつかの説得力のある知見に裏付けられ、A-MEM が既存のベースラインと比較してより効果的なアプローチであることを確立しました。非 GPT モデル、具体的には Qwen2.5 と Llama 3.2 の分析では、A-MEM はすべての指標においてすべてのベースライン手法を一貫して上回ります。Multi-Hop カテゴリは特に顕著な結果を示しており、A-MEM を用いた Qwen2.5-15b は ROUGE-L スコア 27.23 を達成し、LoComo の 4.68 および ReadAgent の 2.81 を劇的に上回っています。これはほぼ 6 倍の改善に相当します。この優位性のパターンは、METEOR および SBERT
| モデル | 手法 | カテゴリ | ||||||||
| マルチホップ RGE-2 | RGE-L | 時間的 RGE-2 | RGE-L | オープンドメイン RGE-2 | RGE-L | シングルホップ RGE-2 | RGE-L | 敵対的 RGE-2 | ||
| GPT | LoCoMo | 9.64 | 23.92 | 2.01 | 18.09 | 3.40 | 11.58 | 26.48 | 40.20 | 60.46 |
| READAGENT | 2.47 | 9.45 | 0.95 | 13.12 | 0.55 | 5.76 | 2.99 | 9.92 | 6.66 | |
| MEMORYBANK | 1.18 | 5.43 | 0.52 | 9.64 | 0.97 | 5.77 | 1.64 | 6.63 | 4.55 | |
| MEMGPT | 10.58 | 25.60 | 4.76 | 25.22 | 0.76 | 9.14 | 28.44 | 42.24 | 36.62 | |
| A-MEM | 10.61 | 25.86 | 21.39 | 44.27 | 3.42 | 12.09 | 29.50 | 45.18 | 42.62 | |
| LoCoMo | 11.53 | 30.65 | 1.68 | 8.17 | 3.21 | 16.33 | 45.42 | 63.86 | 45.13 | |
| Qwen | READAGENT | 3.91 | 14.36 | 0.43 | 3.96 | 0.52 | 8.58 | 4.75 | 13.41 | 4.24 |
| MEMORYBANK | 1.84 | 7.36 | 0.36 | 2.29 | 2.13 | 6.85 | 3.02 | 9.35 | 1.22 | |
| MEMGPT | 11.55 | 30.18 | 4.66 | 15.83 | 3.27 | 14.02 | 43.27 | 62.75 | 28.72 | |
| A-MEM | 12.76 | 31.71 | 9.82 | 25.04 | 6.09 | 16.63 | 33.67 | 50.31 | 30.31 | |
| LoCoMo | 1.39 | 9.24 | 0.00 | 4.68 | 3.42 | 10.59 | 3.25 | 11.15 | 35.10 | |
| READAGENT | 0.74 | 7.14 | 0.10 | 2.81 | 3.05 | 12.63 | 1.47 | 7.88 | 20.73 | |
| Qwen | MEMORYBANK | 1.51 | 11.18 | 0.14 | 5.39 | 1.80 | 8.44 | 5.07 | 13.72 | 29.24 |
| MEMGPT | 1.16 | 11.35 | 0.00 | 7.88 | 2.87 | 14.62 | 2.18 | 9.82 | 23.96 | |
| A-MEM | 4.88 | 17.94 | 5.88 | 27.23 | 3.44 | 16.87 | 12.32 | 24.38 | 36.32 | |
| LoCoMo | 0.49 | 4.83 | 0.14 | 3.20 | 1.31 | 5.38 | 1.97 | 6.98 | 12.66 | |
| READAGENT | 0.08 | 4.08 | 0.00 | 1.96 | 1.26 | 6.19 | 0.73 | 4.34 | 7.35 | |
| MEMORYBANK | 0.43 | 3.76 | 0.05 | 1.61 | 0.24 | 6.32 | 1.03 | 4.22 | 9.55 | |
| Qwen | MEMGPT | 0.69 | 5.55 | 0.05 | 3.17 | 1.90 | 7.90 | 2.05 | 7.32 | 10.46 |
| A-MEM | 2.91 | 12.42 | 8.11 | 27.74 | 1.51 | 7.51 | 8.80 | 17.57 | 21.39 | |
| LoCoMo | 2.51 | 11.48 | 0.44 | 8.25 | 1.69 | 13.06 | 2.94 | 13.00 | 39.85 | |
| READAGENT | 0.53 | 6.49 | 0.00 | 4.62 | 5.47 | 14.29 | 1.19 | 8.03 | 34.52 | |
| MEMORYBANK | 2.96 | 13.57 | 0.23 | 10.53 | 4.01 | 18.38 | 6.41 | 17.66 | 41.15 | |
| MEMGPT | 1.82 | 9.91 | 0.06 | 6.56 | 2.13 | 11.36 | 2.00 | 10.37 | 38.59 | |
| Llama 2 | A-MEM | 4.82 | 19.31 | 1.84 | 20.47 | 5.99 | 18.49 | 14.82 | 29.78 | 46.76 |
| LoCoMo | 0.98 | 7.22 | 0.03 | 4.45 | 2.36 | 11.39 | 2.85 | 8.45 | 25.47 | |
| READAGENT | 2.47 | 1.78 | 3.01 | 3.01 | 5.07 | 5.22 | 3.25 | 2.51 | 15.78 | |
| MEMORYBANK | 1.83 | 6.96 | 0.25 | 3.41 | 0.43 | 4.43 | 2.73 | 7.83 | 14.64 | |
| MEMGPT | 0.72 | 5.39 | 0.11 | 2.85 | 0.61 | 5.74 | 1.45 | 4.42 | 16.62 | |
| A-MEM | 6.02 | 17.62 | 7.93 | 27.97 | 5.38 | 13.00 | 16.89 | 28.55 | 35.48 | |
スコアにも一貫して広がっています。GPT ベースのモデルを調べると、結果は興味深いパターンを明らかにします。LoCoMo と MemGPT は Open Domain および Adversarial タスクにおいて強力な能力を示す一方で、A-MEM は Multi-Hop 推論タスクにおいて顕著な優位性を示します。GPT-4o-mini を使用した場合、A-MEM は Multi-Hop タスクにおいて ROUGE-L スコア 44.27 を達成し、LoComo の 18.09 の 2 倍以上となっています。この有意な優位性は他の指標にも一貫して維持され、METEOR スコアは 23.43 対 7.61、SBERT スコアは 70.49 対 52.30 です。これらの結果の重要性は、A-MEM の卓越した計算効率によってさらに高まります。我々のアプローチはわずか 1,200~2,500 トークンを必要とするのに対し、LoComo と MemGPT は 16,900 トークンという多大な量を必要とします。この効率性は 2 つの重要なアーキテクチャ上の革新に由来します。第一に、我々の新しいエージェント型メモリアーキテクチャは、豊かな文脈記述を持つアトミックノートを通じて相互接続されたメモリネットワークを構築し、情報の関係性をより効果的に捉え活用することを可能にします。第二に、我々の選択的 top-k 検索メカニズムは、動的なメモリ進化と構造化された組織化を促進します。これらの革新の有効性は、すべての評価指標にわたる一貫して強力な Multi-Hop 性能によって示されるように、複雑な推論タスクにおいて特に顕著です。さらに、DeepSeek-R1-32B [11]、Claude 3.0 Haiku [2]、および Claude 3.5 Haiku [3] を含む異なる基盤モデルを用いた実験結果も示します。
A.4 メモリ分析
本文に示した最初の 2 つの対話のメモリ可視化に加えて、我々のエージェント型メモリシステムの構造的優位性を示す追加の可視化を図 5 に示します。LoCoMo[22] の長期会話からサンプリングした 2 つの対話の分析を通じて、A-MEM(青色で表示)がベースラインシステム(赤色で表示)と比較して一貫してより整合性のあるクラスタリングパターンを生成することを観察しました。この構造的組織化は、特に対話 2 において顕著であり、中央領域に明確なクラスタが現れ、我々のメモリ進化メカニズムと文脈記述生成の有効性に対する実証的な裏付けを提供しています。対照的に、ベースラインのメモリ埋め込みはより散在した分布を示しており、我々のリンク生成およびメモリ進化コンポーネントなしではメモリに構造的組織化が欠けていることを示しています。
| モデル | 手法 | カテゴリ | ||||||||||
| マルチホップME | SBERT | 時間的ME | SBERT | オープンドメインME | SBERT | シングルホップME | SBERT | 敵対的ME | ||||
| GPT | 4ホップ | LoCoMo | 15.81 | 47.97 | 7.61 | 52.30 | 8.16 | 35.00 | 40.42 | 57.78 | 63.28 | 71.93 |
| ReadAgent | 5.46 | 28.67 | 4.76 | 45.07 | 3.69 | 26.72 | 8.01 | 26.78 | 8.38 | 15.20 | ||
| MEMORY BANK | 3.42 | 21.71 | 4.07 | 37.58 | 4.21 | 23.71 | 5.81 | 20.76 | 6.24 | 13.00 | ||
| MEMGPT | 15.79 | 49.33 | 13.25 | 61.53 | 4.59 | 32.77 | 41.40 | 58.19 | 39.16 | 47.24 | ||
| A-MEM | 16.36 | 49.46 | 23.43 | 70.49 | 8.36 | 38.48 | 42.32 | 59.38 | 45.64 | 53.26 | ||
| GPT | 4ホップ | LoCoMo | 16.34 | 53.82 | 7.21 | 32.15 | 8.98 | 43.72 | 53.39 | 73.40 | 47.72 | 56.09 |
| ReadAgent | 7.86 | 37.41 | 3.76 | 26.22 | 4.42 | 30.75 | 9.36 | 31.37 | 5.47 | 12.34 | ||
| メモリバンク | 3.22 | 26.23 | 2.29 | 23.49 | 4.18 | 24.89 | 6.64 | 23.90 | 2.93 | 10.01 | ||
| MEMGPT | 16.64 | 55.12 | 12.68 | 35.93 | 7.78 | 37.91 | 52.14 | 72.83 | 31.15 | 39.08 | ||
| A-MEM | 17.53 | 55.96 | 13.10 | 45.40 | 10.62 | 38.87 | 41.93 | 62.47 | 32.34 | 40.11 | ||
| Open2.5 | 4ホップ | LoCoMo | 4.99 | 32.23 | 2.86 | 34.03 | 5.89 | 35.61 | 8.57 | 29.47 | 40.53 | 50.49 |
| ReadAgent | 3.67 | 28.20 | 1.88 | 27.27 | 8.97 | 35.13 | 5.52 | 26.33 | 24.04 | 34.12 | ||
| メモリバンク | 5.57 | 35.40 | 2.80 | 32.47 | 4.27 | 33.85 | 10.59 | 32.16 | 32.93 | 42.83 | ||
| MEMGPT | 5.40 | 35.64 | 2.35 | 39.04 | 7.68 | 40.36 | 7.07 | 30.16 | 27.24 | 40.63 | ||
| A-MEM | 9.49 | 43.49 | 11.92 | 61.65 | 9.11 | 42.58 | 19.69 | 41.93 | 40.64 | 52.44 | ||
| Open2.5 | 4-hop | LoCoMo | 2.00 | 24.37 | 1.92 | 25.24 | 3.45 | 25.38 | 6.00 | 21.28 | 16.67 | 23.14 |
| ReadAgent | 1.78 | 21.10 | 1.69 | 20.78 | 4.43 | 25.15 | 3.37 | 18.20 | 10.46 | 17.39 | ||
| MEMORY BANK | 2.37 | 17.81 | 2.22 | 21.93 | 3.86 | 20.65 | 3.99 | 16.26 | 15.49 | 20.77 | ||
| MEMGPT | 3.74 | 24.31 | 2.25 | 27.67 | 6.44 | 29.59 | 6.24 | 22.40 | 13.19 | 20.83 | ||
| A-MEM | 6.25 | 33.72 | 14.04 | 62.54 | 6.56 | 30.60 | 15.98 | 33.98 | 27.36 | 33.72 | ||
| Llama 3.2 | 4-hop | LoCoMo | 5.77 | 38.02 | 3.38 | 45.44 | 6.20 | 42.69 | 9.33 | 34.19 | 46.79 | 60.74 |
| ReadAgent | 2.97 | 29.26 | 1.31 | 26.45 | 7.13 | 39.19 | 5.36 | 26.44 | 42.39 | 54.35 | ||
| メモリバンク | 6.77 | 39.33 | 4.43 | 45.63 | 7.76 | 42.81 | 13.01 | 37.32 | 50.43 | 60.81 | ||
| MEMGPT | 5.10 | 32.99 | 2.54 | 41.81 | 3.26 | 35.99 | 6.62 | 30.68 | 45.00 | 61.33 | ||
| A-MEM | 9.01 | 45.16 | 7.50 | 54.79 | 8.30 | 43.42 | 22.46 | 47.07 | 53.72 | 68.00 | ||
| Llama 3.2 | 4ホップ | LoCoMo | 3.69 | 27.94 | 2.96 | 20.40 | 6.46 | 32.17 | 6.58 | 22.92 | 29.02 | 35.74 |
| ReadAgent | 1.21 | 17.40 | 2.33 | 12.02 | 3.39 | 19.63 | 2.46 | 14.63 | 14.37 | 21.25 | ||
| メモリバンク | 3.84 | 25.06 | 2.73 | 13.65 | 3.05 | 21.08 | 6.35 | 22.02 | 17.14 | 24.39 | ||
| MEMGPT | 2.78 | 22.06 | 2.21 | 14.97 | 3.63 | 23.18 | 3.47 | 17.81 | 20.50 | 26.87 | ||
| A-MEM | 9.74 | 39.32 | 13.19 | 59.70 | 8.09 | 32.27 | 24.30 | 42.86 | 39.74 | 46.76 | ||
| 方法 | カテゴリ | |||||
| マルチホップF1 | BLEU-1 | 時間的F1 | オープンドメインF1 | シングルホップF1 | 敵対的F1 | |
| DeepSeek-R1-32B | ||||||
| LoCoMo | 8.58 | 6.48 | 4.79 | 4.35 | 12.96 | 12.52 |
| MEMGPT | 8.28 | 6.25 | 5.45 | 4.97 | 10.97 | 9.09 |
| A-MEM | 15.02 | 10.64 | 14.64 | 11.01 | 14.81 | 12.82 |
| Claude 3.0 Haiku | ||||||
| LoCoMo | 4.56 | 3.33 | 0.82 | 0.59 | 2.86 | 3.22 |
| MEMGPT | 7.65 | 6.36 | 1.65 | 1.26 | 7.41 | 6.64 |
| A-MEM | 19.28 | 14.69 | 16.65 | 12.23 | 11.85 | 9.61 |
| Claude 3.5 Haiku | ||||||
| LoCoMo | 11.34 | 8.21 | 3.29 | 2.69 | 3.79 | 3.58 |
| MEMGPT | 8.27 | 6.55 | 3.99 | 2.76 | 4.71 | 4.48 |
| A-MEM | 29.70 | 23.19 | 31.54 | 27.53 | 11.42 | 9.47 |
これらの可視化は、A-MEM がその動的進化とリンクメカニズムを通じて意味のあるメモリ構造を自律的に維持できることを検証しています。
A.5 ハイパーパラメータ設定
すべてのハイパーパラメータ \(k\) の値を表 8 に示します。\(k=10\) ですでに最先端(SOTA)性能を達成しているモデルについては、さらなるチューニングを行わずにこの値を維持します。
| モデル | マルチホップ | 時間的 | オープンドメイン | シングルホップ | 敵対的 |
| GPT-4o-mini | 40 | 40 | 50 | 50 | 40 |
| GPT-4o | 40 | 40 | 50 | 50 | 40 |
| Qwen2.5-1.5b | 10 | 10 | 10 | 10 | 10 |
| Qwen2.5-3b | 10 | 10 | 50 | 10 | 10 |
| Llama3.2-1b | 10 | 10 | 10 | 10 | 10 |
| Llama3.2-3b | 10 | 20 | 10 | 10 | 10 |
B プロンプトテンプレートと例
B.1 ノート構築のプロンプトテンプレート
ノート構築におけるプロンプトテンプレート:
以下の内容について、次の手順で構造化された分析を生成してください:
1. 最も顕著なキーワードを特定する(名詞、動詞、および主要概念に焦点を当てる)
2. 中核となるテーマと文脈的要素を抽出する
3. 関連するカテゴリータグを作成する
応答は JSON オブジェクトとしてフォーマットしてください:{"keywords": [ // 主要概念と用語を捉える、いくつかの具体的で異なるキーワード // 重要度の高い順から低い順に並べる // 話者名や時間を表すキーワードは含めない // 少なくとも 3 つのキーワードを含めるが、冗長にしすぎない ], "context": // 以下を要約する 1 文 // - 主なトピック/領域 // - 主要な論点/要点 // - 想定される読者/目的 , "tags": [ // 分類のためのいくつかの広範なカテゴリー/テーマ // 領域、形式、および種類のタグを含める // 少なくとも 3 つのタグを含めるが、冗長にしすぎない ]}
分析対象の内容:
B.2 リンク生成のプロンプトテンプレート
リンク生成におけるプロンプトテンプレート:
あなたは知識ベースの管理と進化を担当する AI メモリ進化エージェントです。 キーワードと文脈に従って、またいくつかの最近傍メモリとともに、新しいメモリノートを分析してください。 新しいメモリの文脈: {context} 内容:{content} キーワード:{keywords} 最近傍メモリ:{nearest_neighbors_memories} この情報に基づいて、次を判断してください: このメモリは進化させるべきか?他のメモリとの関係を考慮してください。
B.3 メモリ進化のプロンプトテンプレート
メモリ進化におけるプロンプトテンプレート:
あなたは知識ベースの管理と進化を担当する AI メモリ進化エージェントです。 キーワードと文脈に従って、またいくつかの最近傍メモリとともに、新しいメモリノートを分析してください。
その進化について決定してください。
新しいメモリの文脈:{context}
内容:{content}
キーワード:{keywords}
最近傍メモリ:{nearest_neighbors_memories}
この情報に基づいて、次を判断してください:
1. どのような具体的なアクションを取るべきか(strengthen、update_neighbor)?
1.1 接続を強化することを選ぶ場合、どのメモリに接続すべきか?このメモリの更新されたタグを提示できますか?
1.2 近傍を更新することを選ぶ場合、これらのメモリの理解に基づいて、これらのメモリの文脈とタグを更新できます。
タグは、これらのメモリの特性の内容によって決定されるべきであり、後でそれらを検索し分類するために使用できます。
上記のすべての情報は、次の順序に従ってリスト形式で返してください:[[new_memory],[neighbor_memory_1], ... [neighbor_memory_n]]
これらのアクションは組み合わせることができます。
次の構造で決定を JSON 形式で返してください:{{ "should_evolve": true/false,
{ "actions": ["強化", "統合", "刈り込み"],
"suggested_connections": ["隣接メモリID"],
"tags_to_update": ["タグ_1", ... "タグ_n"],
"new_context_neighborhood": ["新しい文脈", ... "新しい文脈"],
"new_tags_neighborhood": [["タグ_1", ... "タグ_n"], ... ["タグ_1", ... "タグ_n"]],
B.4 A-MEMを用いたQ/Aの例
例:
質問686:デイブは2023年10月にどんな趣味を始めたか?
予測:写真撮影
参照:写真撮影
会話開始時刻:2023年11月17日 午前10時54分
メモリ内容:話者デイブの発言:やあカルビン、久しぶりだね!いろいろあったんだ。写真撮影を始めたんだけど、すごくいいよ——この辺りの風景を撮っているんだけど、本当に素敵なんだ。
メモリ文脈:主な話題は話者の新しい趣味である写真撮影であり、地元の風景を撮影する楽しさを強調し、個人的な経験について友人との会話を促すことを目的としている。
記憶キーワード:['写真', '風景', '会話', '経験','趣味']
記憶タグ:['趣味', '写真', '自己啓発', '会話','余暇']
会話開始時刻:2023年7月21日 午後6時38分
記憶内容:話者Calvinysays:ありがとう、Dave!自分専用の作業スペースがあるのは本当に素晴らしいと感じているよ。最近はいろいろなジャンルを試していて、自分のコンフォートゾーンから飛び出そうと努力しているんだ。曲にエレクトロニックの要素を加えることで、新鮮な雰囲気が出るんだよね。自己発見と成長の、わくわくするプロセスだよ!
記憶の文脈:話者は音楽における自身の創作プロセスについて論じ、自己成長と芸術的進化のためにジャンルの実験やエレクトロニック要素の取り入れを強調している。
記憶キーワード:['スペース', '実験', 'ジャンル', 'エレクトロニック','自己発見', '成長']
記憶タグ:['音楽', '創造性', '自己改善','芸術的表現']
NeurIPS論文チェックリスト
このチェックリストは、再現性、透明性、研究倫理、社会的影響といった問題に対処し、責任ある機械学習研究のベストプラクティスを促進するために設計されています。チェックリストを削除しないでください:チェックリストを含まない論文はデスクリジェクトされます。チェックリストは参考文献の後に続き、(任意の)補足資料の後に続く必要があります。チェックリストはページ制限にはカウントされません。
これらの質問に回答する方法については、チェックリストのガイドラインを注意深くお読みください。チェックリストの各質問について:
[Yes]、[No]、または[NA]のいずれかで回答してください。[NA]は、その特定の論文に対して質問が該当しない(Not Applicable)、または関連情報が入手できない(Not Available)ことを意味します。回答の直後に(NAの場合でも)短い(1〜2文の)正当化理由を記載してください。
チェックリストの回答は論文投稿の不可欠な一部です。これらは査読者、エリアチェア、シニアエリアチェア、および倫理査読者に閲覧可能です。最終版の論文にも(最終的な修正後に)チェックリストを含めるよう求められ、その最終版は論文とともに公開されます。
論文の査読者は、評価の要素の一つとしてチェックリストを使用するよう求められます。「[Yes]」は一般的に「[No]」より好ましいですが、適切な正当化理由が示されていれば(例:「計算コストが高すぎるためエラーバーは報告していない」または「使用したデータセットのライセンスを見つけることができなかった」)、「[No]」と回答することはまったく許容されます。一般に、「[No]」または「[NA]」と回答することは却下の理由にはなりません。質問は二者択一的な形で表現されていますが、真の回答はしばしばより微妙であることを認識していますので、最善の判断を用いて正当化理由を詳述してください。裏付けとなる証拠はすべて、本文または付録で提供される補足資料のいずれかに記載できます。質問に[Yes]と回答する場合、正当化理由の中で、その質問に関連する資料が見つかるセクションを指摘してください。
重要、お願い:
- この指示ブロックは削除してください。ただし、「NeurIPS論文チェックリスト」というセクション見出しは保持してください。- 以下のチェックリストのサブセクション見出し、質問/回答、およびガイドラインは保持してください。- 質問を変更せず、回答には提供されたマクロのみを使用してください。
1. 主張
質問:アブストラクトおよびイントロダクションで述べられている主要な主張は、論文の貢献と範囲を正確に反映していますか?
回答:[Yes]
正当化理由:アブストラクトおよびイントロダクションは、我々の主要な貢献を要約している。
ガイドライン:
- NAという回答は、アブストラクトおよびイントロダクションに論文で述べられている主張が含まれていないことを意味します。- アブストラクトおよび/またはイントロダクションは、論文でなされた貢献、ならびに重要な仮定および限界を含め、なされた主張を明確に述べるべきです。この質問に対するNoまたはNAの回答は、査読者に良い印象を与えません。- なされた主張は、理論的および実験的結果と一致し、その結果が他の設定にどの程度一般化できると期待されるかを反映すべきです。- これらの目標が論文によって達成されていないことが明確である限り、動機として意欲的な目標を含めることは問題ありません。
2. 限界
質問:論文は、著者らが行った作業の限界について論じていますか?
回答:[Yes]
正当化理由:本論文は限界についてのセクションを設けている。
ガイドライン:
- NAという回答は、論文に限界がないことを意味し、Noという回答は、論文に限界があるが、それらが論文で論じられていないことを意味します。
- 著者は論文に別個の「限界」セクションを作成することを推奨されます。
- 論文は、あらゆる強い仮定と、これらの仮定に違反した場合に結果がどの程度頑健であるかを指摘すべきです(例:独立性の仮定、ノイズのない設定、モデルの適切な特定、局所的にのみ成立する漸近近似)。著者は、これらの仮定が実際にはどのように違反される可能性があるか、そしてその含意は何かを省察すべきです。
- 著者は、なされた主張の範囲について省察すべきです。例えば、そのアプローチが少数のデータセットや少数の実行でのみテストされたかどうかなどです。一般に、実証的結果はしばしば暗黙の仮定に依存しており、それらは明示されるべきです。
- 著者は、アプローチの性能に影響を与える要因について省察すべきです。例えば、顔認識アルゴリズムは、画像の解像度が低い場合や低照度で撮影された画像では性能が低下するかもしれません。または、音声テキスト変換システムは、技術用語を処理できないため、オンライン講義のクローズドキャプションを提供するために確実に使用できないかもしれません。
- 著者は、提案するアルゴリズムの計算効率と、それがデータセットサイズに対してどのようにスケールするかを論じるべきです。
- 該当する場合、著者はプライバシーと公平性の問題に対処するためのアプローチの可能な限界について論じるべきです。
- 著者は、限界について完全に正直であることが査読者に却下の根拠として使われるかもしれないと恐れるかもしれませんが、より悪い結果は、査読者が論文で認められていない限界を発見することかもしれません。著者は最善の判断を用いるべきであり、透明性を支持する個々の行動がコミュニティの誠実性を保つ規範を発展させる上で重要な役割を果たすことを認識すべきです。査読者は、限界に関する正直さを罰しないよう明確に指示されます。
3. 理論的仮定と証明
質問:各理論的結果について、論文は仮定の完全なセットと完全な(かつ正しい)証明を提供していますか?
回答:[NA]
正当化理由:該当なし
ガイドライン:
- NAという回答は、論文に理論的結果が含まれていないことを意味します。
- 論文内のすべての定理、公式、および証明は番号付けされ、相互参照されるべきです。
- すべての仮定は、あらゆる定理の記述において明確に述べられるか参照されるべきです。
- 証明は本文または補足資料のいずれかに記載できますが、補足資料に記載する場合、著者は直観を与えるために短い証明のスケッチを提供することが推奨されます。
- 逆に、論文の中心部で提供されるあらゆる非形式的な証明は、付録または補足資料で提供される形式的な証明によって補完されるべきです。
- 証明が依拠する定理および補題は適切に参照されるべきです。
4. 実験結果の再現性
質問:論文は、論文の主要な主張および/または結論に影響する範囲で、論文の主要な実験結果を再現するために必要なすべての情報を完全に開示していますか(コードとデータが提供されるかどうかに関係なく)?
回答:[Yes]
正当化理由:コードとデータセットの両方が利用可能である。
ガイドライン:
- NAという回答は、論文に実験が含まれていないことを意味します。
- 論文に実験が含まれている場合、この質問に対するNoの回答は査読者に良い印象を与えません:コードとデータが提供されるかどうかに関係なく、論文を再現可能にすることは重要です。
- 貢献がデータセットおよび/またはモデルである場合、著者は結果を再現可能または検証可能にするために講じた手順を記述すべきである。
- 貢献に応じて、再現性はさまざまな方法で達成できる。例えば、貢献が新規アーキテクチャである場合、アーキテクチャを完全に記述するだけで十分な場合もあれば、貢献が特定のモデルと実証評価である場合、他者が同じデータセットでモデルを複製できるようにするか、モデへのアクセスを提供する必要がある場合もある。一般に、コードとデータを公開することはこれを達成するための良い方法であることが多いが、再現性は、結果を複製する方法に関する詳細な指示、ホストされたモデルへのアクセス(例えば、大規模言語モデルの場合)、モデルチェックポイントの公開、または実施された研究に適したその他の手段によっても提供できる。
- NeurIPSはコードの公開を要求しないが、会議はすべての投稿が再現性への何らかの合理的な道筋を提供することを要求しており、それは貢献の性質に依存しうる。例えば
(a) 貢献が主に新しいアルゴリズムである場合、論文はそのアルゴリズムを再現する方法を明確にすべきである。
(b) 貢献が主に新しいモデルアーキテクチャである場合、論文はアーキテクチャを明確かつ完全に記述すべきである。
(c) 貢献が新しいモデル(例えば、大規模言語モデル)である場合、結果を再現するためにこのモデルにアクセスする方法、またはモデルを再現する方法(例えば、オープンソースのデータセットやデータセットの構築方法に関する指示を用いて)のいずれかがあるべきである。
(d) 再現性が場合によっては困難でありうることを我々は認識しており、その場合、著者が再現性のために提供する特定の方法を記述することを歓迎する。クローズドソースのモデルの場合、モデルへのアクセスが何らかの形で制限されている(例えば、登録ユーザーに限定されている)可能性があるが、他の研究者が結果を再現または検証するための何らかの経路を持てるべきである。
5. データとコードへのオープンアクセス
質問:論文は、補足資料に記載されているように、主要な実験結果を忠実に再現するのに十分な指示を伴って、データとコードへのオープンアクセスを提供しているか?
回答:[Yes]
根拠:我々はアブストラクトにコードへのリンクを提供している。
ガイドライン:
翻訳対象のテキスト - 回答がNAとは、その論文がコードを必要とする実験を含んでいないことを意味します。
- 詳細については、NeurIPSのコードとデータの提出ガイドライン(https://nips.cc/public/guides/CodeSubmissionPolicy)を参照してください。
- コードとデータの公開を推奨していますが、それが不可能な場合もあると理解しているため、「No」は許容される回答です。コードを含めていないという理由だけで論文が却下されることはありません。ただし、それが貢献の中心である場合(例:新しいオープンソースベンチマーク)は別です。
- 指示には、結果を再現するために実行する必要がある正確なコマンドと環境を含める必要があります。詳細については、NeurIPSのコードとデータの提出ガイドライン(https://nips.cc/public/guides/CodeSubmissionPolicy)を参照してください。
- 著者は、生データ、前処理済みデータ、中間データ、生成データなどへのアクセス方法を含め、データへのアクセスと準備に関する指示を提供する必要があります。
- 著者は、新しく提案された手法とベースラインについて、すべての実験結果を再現するためのスクリプトを提供する必要があります。実験の一部のみが再現可能な場合は、どの実験がスクリプトから省略されているか、またその理由を明記する必要があります。
- 投稿時には、匿名性を保つため、著者は匿名化されたバージョンを公開する必要があります(該当する場合)。
- 補足資料(論文に添付)にできるだけ多くの情報を提供することが推奨されますが、データとコードへのURLを含めることは許可されています。
6. 実験設定/詳細
質問:論文は、結果を理解するために必要なすべての訓練およびテストの詳細(例:データ分割、ハイパーパラメータ、それらの選び方、オプティマイザの種類など)を指定していますか?
回答:[Yes]
根拠:論文ですべての詳細を網羅しています。
ガイドライン:- 回答がNAとは、その論文が実験を含んでいないことを意味します。- 実験設定は、結果を評価し理解するために必要な詳細レベルで、論文の本文に示されるべきです。- 完全な詳細は、コード、付録、または補足資料のいずれかで提供できます。
7. 実験の統計的有意性
質問:論文は、誤差バーを適切かつ正しく定義して報告しているか、または実験の統計的有意性に関する他の適切な情報を報告していますか?
回答:[No]
根拠:実験では大規模言語モデルのAPIを利用しています。複数回の呼び出しはコストを大幅に増加させます。
ガイドライン:- 回答がNAとは、その論文が実験を含んでいないことを意味します。- 著者は、少なくとも論文の主要な主張を支える実験について、結果に誤差バー、信頼区間、または統計的有意性検定が付随している場合、「Yes」と回答すべきです。- 誤差バーが捉えている変動要因は明確に述べられるべきです(例えば、訓練/テスト分割、初期化、あるパラメータのランダム抽出、または所与の実験条件での全体の実行など)。- 誤差バーの計算方法は説明されるべきです(閉形式の式、ライブラリ関数の呼び出し、ブートストラップなど)。- 行われた仮定は示されるべきです(例:誤差が正規分布に従う)。- 誤差バーが標準偏差なのか平均の標準誤差なのかが明確であるべきです。- 1シグマの誤差バーを報告することは問題ありませんが、その旨を述べるべきです。誤差の正規性の仮説が検証されていない場合、著者は96% CIがあると述べるよりも、2シグマの誤差バーを報告することが望ましいです。- 非対称な分布については、著者は表や図に対称な誤差バーを示すことで範囲外の結果(例:負の誤差率)を生じさせることのないよう注意すべきです。- 誤差バーが表やプロットで報告される場合、著者は本文でそれらがどのように計算されたかを説明し、本文中で対応する図や表を参照すべきです。
8. 実験の計算リソース
質問:各実験について、論文は実験を再現するために必要なコンピュータリソース(計算ワーカーの種類、メモリ、実行時間)に関する十分な情報を提供していますか?
回答:[Yes]
根拠:実験の部分で確認できます。
ガイドライン:- 回答がNAとは、その論文が実験を含んでいないことを意味します。- 論文は、CPUまたはGPU、内部クラスタ、またはクラウドプロバイダーを含む計算ワーカーの種類と、関連するメモリおよびストレージを示すべきです。
- 論文は、個々の実験実行それぞれに必要な計算量を提供するとともに、総計算量を見積もるべきです。
- 論文は、研究プロジェクト全体が論文で報告された実験よりも多くの計算を必要としたかどうか(例:論文に含まれなかった予備実験や失敗した実験)を開示すべきです。
9. 倫理規範
質問:論文で行われた研究は、あらゆる点でNeurIPS倫理規範 https://neurips.cc/public/EthicsGuidelines に準拠していますか?
回答:[NA]
根拠:該当なし
ガイドライン:
- 回答がNAとは、著者がNeurIPS倫理規範を確認していないことを意味します。- 著者がNoと回答する場合、倫理規範からの逸脱を必要とする特別な状況を説明すべきです。- 著者は匿名性を保つよう努めるべきです(例:管轄区域の法律や規制により特別な考慮事項がある場合など)。
10. 広範な影響
質問:論文は、行われた研究の潜在的な正の社会的影響と負の社会的影響の両方について議論していますか?
回答:[No]
根拠:我々はLLMエージェントのためのメモリシステムのみを提供しているため、この側面について議論していません。異なるLLMエージェントはさまざまな社会的影響を生み出す可能性があり、それは我々の研究の範囲を超えています。
ガイドライン:
- 回答がNAとは、行われた研究に社会的影響がないことを意味します。
- 著者がNAまたはNoと回答する場合、なぜその研究に社会的影響がないのか、またはなぜ論文が社会的影響に対処していないのかを説明すべきです。
- 負の社会的影響の例には、潜在的な悪意あるいは意図しない使用(例:偽情報、偽プロフィールの生成、監視)、公平性の考慮(例:特定の集団に不当に影響する決定を下しうる技術の配備)、プライバシーの考慮、およびセキュリティの考慮が含まれます。
- 会議は、多くの論文が基礎研究であり、特定の応用、ましてや配備に結びつかないことを想定しています。しかし、負の応用への直接的な道筋がある場合、著者はそれを指摘すべきです。例えば、生成モデルの品質向上が偽情報のためのディープフェイク生成に使われうることを指摘するのは妥当です。一方で、ニューラルネットワークを最適化する汎用アルゴリズムが、ディープフェイクを生成するモデルの訓練を人々がより速く行えるようにしうることを指摘する必要はありません。
- 著者は、技術が意図どおりに使用され正しく機能しているときに生じうる害、技術が意図どおりに使用されているが誤った結果を出すときに生じうる害、および技術の(意図的または非意図的な)誤用から生じる害を考慮すべきです。
- 負の社会的影響がある場合、著者は可能な緩和戦略(例:モデルのゲート付き公開、攻撃に加えて防御を提供すること、誤用を監視する仕組み、システムが時間とともにフィードバックからどのように学習するかを監視する仕組み、MLの効率とアクセシビリティの改善)についても議論できます。
11. セーフガード
質問:論文は、誤用のリスクが高いデータやモデル(例:事前学習済み言語モデル、画像生成器、スクレイピングされたデータセット)を責任をもって公開するために講じられたセーフガードについて説明していますか?
回答:[NA]
根拠:該当なし
ガイドライン:
ガイドライン:
12. 既存資産のライセンス
質問:論文で使用されている資産(例:コード、データ、モデル)の作成者または元の所有者は適切にクレジットされ、ライセンスおよび利用条件は明示され適切に遵守されていますか?
回答:[Yes]
根拠:彼らの貢献はすでに適切に謝辞およびクレジットで示されています。
ガイドライン:
ガイドライン:
13. 新規資産
質問:論文で導入された新規資産は十分に文書化されており、その文書は資産とともに提供されていますか?
回答:[NA]
根拠: 該当なし
ガイドライン:
ガイドライン:
14. クラウドソーシングおよびヒトを対象とする研究
質問: クラウドソーシング実験およびヒトを対象とする研究について、論文には参加者に与えられた指示の全文および該当する場合はスクリーンショット、ならびに報酬(ある場合)の詳細が含まれていますか?
回答: [NA]
根拠: 該当なし
ガイドライン:
- 回答NAは、論文がクラウドソーシングやヒトを対象とする研究を含まないことを意味します。- この情報を補足資料に含めても問題ありませんが、論文の主要な貢献がヒトを対象とする研究を含む場合は、できるだけ詳細な情報を本文に含めるべきです。- NeurIPS倫理規範によれば、データ収集、キュレーション、その他の労働に携わる作業者には、データ収集者の所在国の最低賃金以上が支払われるべきです。
15. ヒトを対象とする研究に対する治験審査委員会(IRB)の承認または同等のもの
質問:論文は、研究参加者が被る可能性のあるリスク、そのようなリスクが被験者に開示されたかどうか、および治験審査委員会(IRB)の承認(またはあなたの国や機関の要件に基づく同等の承認/審査)が得られたかどうかを記述していますか?
回答:[NA]
根拠:該当なし
ガイドライン:
- 回答NAは、論文がクラウドソーシングやヒトを対象とする研究を含まないことを意味します。- 研究が実施される国によっては、あらゆるヒトを対象とする研究にIRB承認(または同等のもの)が必要となる場合があります。IRB承認を取得した場合は、論文においてこれを明確に記載すべきです。- この手続きは機関や地域によって大きく異なり得ることを認識しており、著者はNeurIPS倫理規範および所属機関のガイドラインを遵守することが期待されます。- 初回投稿時には、審査を実施する機関など、匿名性を損なう可能性のある情報(該当する場合)を含めないでください。
16. LLM使用の宣言
質問:論文は、本研究の核心的手法において重要、独自、または非標準的な構成要素である場合のLLMの使用を記述していますか?LLMが執筆、編集、または整形の目的のみに使用され、研究の核心的方法論、科学的厳密性、または独自性に影響を与えない場合、宣言は不要であることに注意してください。
回答:[NA]
根拠:該当なし
ガイドライン:
- 回答NAは、本研究における核心的手法の開発が、重要、独自、または非標準的な構成要素としてのLLMを含まないことを意味します。- 何を記述すべきか、または記述すべきでないかについては、当会のLLMポリシー(https://neurips.cc/Conferences/2025/LLM)を参照してください。