
実際の GitHub issue 二千件を端から端まで修正し、隠しテストで判定。コーディングエージェントの基準。ICLR 2024、全文無料。
SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
SWE-BENCH:言語モデルは実世界のGitHub Issueを解決できるか?
Carlos E. Jimenez John Yang Alexander Wettig
Shunyu Yao Kexin Pei Ofir Press Karthik Narasimhan
プリンストン大学 Princeton Language and Intelligence シカゴ大学
概要
言語モデルは、我々がそれを効果的に評価する能力を凌駕してしまっているが、その将来の発展のためには、その能力の最前線を研究することが不可欠である。我々は、実世界のソフトウェアエンジニアリングが、次世代の言語モデルを評価するための豊かで持続可能かつ挑戦的なテストベッドであることを見出した。この目的のために、我々はSWE-benchを導入する。これは、12の著名なPythonリポジトリにわたる実際のGitHub Issueとそれに対応するプルリクエストから抽出された2,294のソフトウェアエンジニアリング問題からなる評価フレームワークである。コードベースと解決すべきIssueの説明が与えられたとき、言語モデルはそのIssueに対処するためにコードベースを編集することを課される。SWE-benchにおけるIssueの解決には、複数の関数、クラス、さらにはファイルにまたがる変更を同時に理解し調整することがしばしば要求され、モデルは実行環境と相互作用し、極めて長いコンテキストを処理し、従来のコード生成タスクをはるかに超える複雑な推論を行うことが求められる。我々の評価では、最先端のプロプライエタリモデルと我々のファインチューニングしたモデルSWE-Llamaの双方が、最も単純なIssueしか解決できないことを示す。最高性能のモデルであるClaude 2は、Issueのわずか\(1.96\%\)しか解決することができない。SWE-benchにおける進展は、より実用的で、知的で、自律的なLMへの歩みを表すものである。
1 はじめに
言語モデル(LM)は、チャットボットやコーディングアシスタントといった商用製品において急速に展開されつつある。同時に、既存のベンチマークは飽和状態に達しており(Kiela et al., 2021; Ott et al., 2022)、最先端のLMが何をでき、何をできないかの最前線を捉えることができていない。LMの実世界での応用をより正確に反映し、その将来の発展と利用を形作るのに役立つ、挑戦的なベンCHマークが必要とされている(Srivastava et al., 2023)。
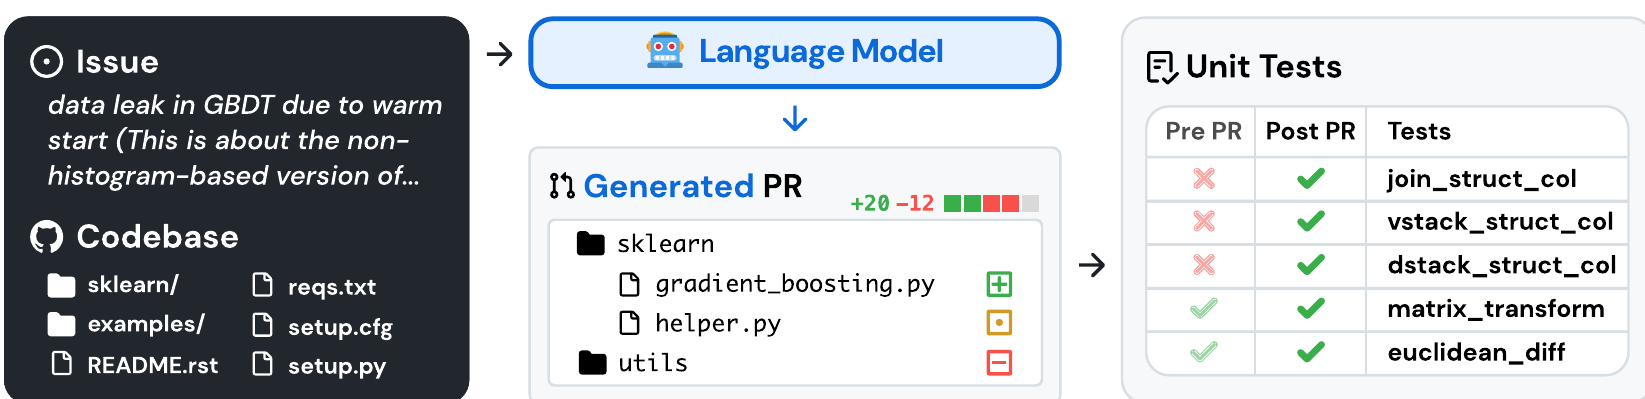
優れたベンチマークを構築することは困難である。なぜなら、タスクは既存のモデルを打ち負かすのに十分挑戦的でなければならない一方で、モデルの予測は検証が容易でなければならないからである(Martinez-Plumed et al., 2021)。コーディングタスクは、LMにとって挑戦的な問題を提起する一方で、生成された解はユニットテストを実行することで容易に検証できるため、魅力的である。しかしながら、HumanEval(Chen et al., 2021)のような既存のコーディングベンチマークは、主に数行のコードで解ける自己完結型の問題を含んでいる。
実世界において、ソフトウェアエンジニアリングはそれほど単純ではない。バグを修正するには、大規模なリポジトリを探索し、異なるファイル間の関数の相互作用を理解し、あるいは複雑に入り組んだコードの中の小さな誤りを見つけることが必要になるかもしれない。これに着想を得て、我々はSWE-benchを導入する。これは、現実的なソフトウェアエンジニアリングの設定でLMを評価するベンチマークである。図1に示すように、モデルは著名なGitHubリポジトリに提出されたIssue(典型的にはバグ報告や機能リクエスト)を解決することを課される。各タスクでは、既存のコードベースに適用する変更を記述したパッチを生成する必要がある。改訂されたコードベースは、その後、そのリポジトリのテストフレームワークを用いて評価される。
SWE-benchは、既存のLMプログラミングベンチマークに比べていくつかの利点を提供する。これには、ユーザーが提出したIssueと解決策を利用した現実的な設定、12のリポジトリからの独自のコード問題を特徴とする多様な入力、実行ベースの評価のための堅牢なフレームワーク、そして最小限の人的介入で新しいインスタンスを加えてベンチマークを継続的に更新できる能力が含まれる。
我々は複数の最先端LMをSWE-benchで評価し、それらが最も単純なIssueを除いてすべて解決に失敗することを見出した。BM25検索器を用いた場合、Claude 2はIssueの\(1.96\%\)しか解決することができない。
SWE-benchに加えて、我々の貢献には、訓練データセットであるSWE-bench-trainの公開が含まれる。これは、この挑戦的な領域においてオープンモデルの開発を進めるために不可欠である。このデータセットは、37のリポジトリから得られた19,000の非テストタスクインスタンスの集合からなる。SWE-bench-trainを活用し、我々はCodeLlama(Rozière et al., 2023)モデルに基づく2つのファインチューニング済みモデル、SWE-Llama 7bと13bを公開する。一部の設定では、SWE-Llama 13bがClaude 2と競合し、100,000トークンを超えるコンテキストを処理できることを見出した。
2 SWE-BENCH
SWE-benchは、バグを報告したり新機能を要求したりする著名なリポジトリのGitHub Issueと、これらのIssueを解決するためにリポジトリに変更を加えるプルリクエストを特徴とするベンチマークである。タスクは、与えられたIssueに対処し、そのIssueに関連するテストに合格するプルリクエストを生成することである。
2.1 ベンチマークの構築
GitHubはソフトウェア開発のための豊富なデータソースであるが、リポジトリ、Issue、プルリクエストはノイズが多く、その場限りであったり、文書化や保守が不十分であったりする可能性がある。大規模に高品質なタスクインスタンスを見つけるために、我々は以下のような3段階のパイプラインを用いる。
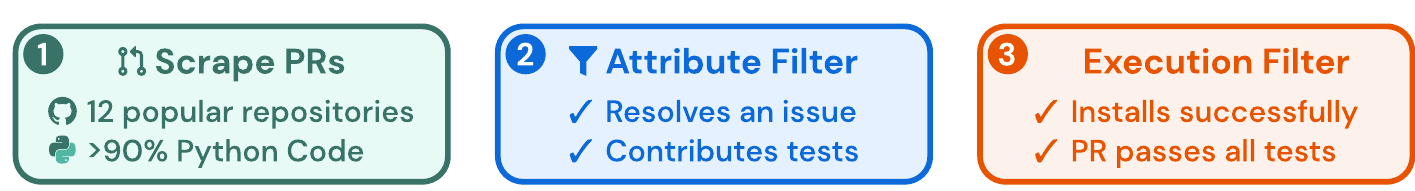
段階I:リポジトリの選択とデータのスクレイピング。我々はまず、GitHub上の12の著名なオープンソースPythonリポジトリからプルリクエスト(PR)を収集し、合計でおよそ\(\sim 90,000\)のPRを生成する。我々は著名なリポジトリに注目する。なぜなら、それらはより適切に保守され、明確な貢献ガイドラインを持ち、テストカバレッジがより優れている傾向があるからである。各PRは、そのベースコミットによって指定される関連コードベースを持つ。
段階II:属性ベースのフィルタリング。我々は、(1)GitHub Issueを解決し、(2)リポジトリのテストファイルに変更を加えるマージ済みPRを選択することで、候補タスクを作成する。後者は、ユーザーがそのIssueが解決されたかどうかを確認するためのテストを提供した可能性が高いことを示す。
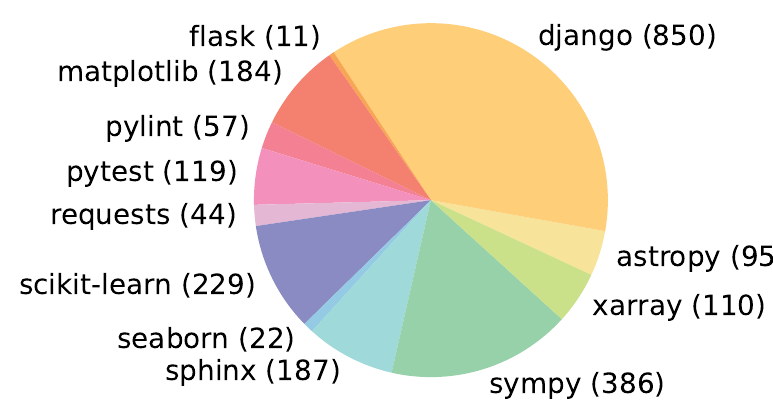
段階III:実行ベースのフィルタリング。各候補タスクについて、我々はPRのテスト内容を適用し、PRの他の内容が適用される前と後で関連するテスト結果を記録する。我々は、そのステータスが失敗から合格に変わるテスト(以下、失敗から合格へのテストと呼ぶ)を少なくとも1つ持たないタスクインスタンスを除外する。また、インストールエラーや実行時エラーを引き起こすインスタンスも除外する。これらのフィルタリングの段階を通じて、元の90,000のPRは、SWE-benchを構成する2,294のタスクインスタンスに絞り込まれる。リポジトリ全体にわたるこれらのタスクインスタンスの最終的な内訳を図3に示し、表1はSWE-benchのタスクインスタンスの主要な特徴を強調する。我々は、コードベースが数千のファイルを含む大規模なものであり、参照プルリクエストがしばしば一度に複数のファイルに変更を加えることを強調する。SWE-benchの構築パイプラインに関する技術的詳細は付録Aで論じられる。追加のデータセット統計は付録A.5にある。
2.2 タスクの定式化
モデルの入力。モデルにはIssueのテキスト記述と完全なコードベースが与えられる。モデルはその後、そのIssueを解決するためにコードベースに編集を加えることを課される。実際には、我々は編集をパッチファイルとして表現する。これは、Issueを解決するためにコードベースのどの行を変更するかを指定するものである。
評価指標。提案された解決策を評価するために、我々は生成されたパッチをunixのpatchプログラムを用いてコードベースに適用し、その後、そのタスクインスタンスに関連するユニットテストとシステムテストを実行する。パッチが正常に適用され、これらのテストがすべて合格した場合、我々はその提案された解決策がIssueを正常に解決したとみなす。我々のベンチマークの指標は、解決されたタスクインスタンスの割合である。追加の技術的詳細は付録A.4にある。
2.3 SWE-BENCHの特徴
NLPにおける従来のベンチマークは、典型的には短い入力と出力の系列のみを含み、ベンチマークのために特別に作成された、ある程度「作為的な」問題を考慮する。対照的に、SWE-benchの現実的な構築設定は、以下で論じる独自の特性をデータセットに付与する。
実世界のソフトウェアエンジニアリングタスク。SWE-benchの各タスクインスタンスは、大規模で複雑なコードベースと関連するIssueの説明からなるため、SWE-benchを解くには、経験豊富なソフトウェアエンジニアが持つ洗練されたスキルと知識を示すことが要求されるが、これらは従来のコード生成ベンチマークでは一般的に評価されない。
継続的に更新可能。我々の収集プロセスは、GitHub上の任意のPythonリポジトリに容易に適用でき、最小限の人的介入しか必要としない。したがって、我々はSWE-benchを新しいタスクインスタンスの継続的な供給で拡張し、LMをその訓練日以降に作成されたIssueで評価することができ、これによりその解決策が訓練コーパスに含まれていなかったことを確実にする。
多様で長い入力。Issueの説明は典型的には長く詳細であり(平均195語)、コードベースはしばしば数千のファイルを含む。SWE-benchを解くには、膨大なコンテキストの中で、Issueを解決するために編集する必要がある比較的少数の行を特定することが要求される。
堅牢な評価。各タスクインスタンスについて、参照解決策をテストするために用いられた失敗から合格へのテストが少なくとも1つあり、インスタンスの\(40\%\)は少なくとも2つの失敗から合格へのテストを持つ。これらのテストは、モデルがIssueにおける問題に対処したかどうかを評価する。さらに、以前の機能が適切に維持されているかを確認するために、中央値で51の追加テストが実行される。
クロスコンテキストのコード編集。編集範囲を個々の関数やクラスに限定する可能性のある従来の設定(例:Chen et al., 2021; Cassano et al., 2022)や、穴埋め形式の空欄補充を提供する設定(例:Lu et al., 2021; Fried et al., 2023)とは異なり、SWE-benchはそのような明示的なガイダンスを提供しない。単に短いコードスニペットを生成するだけでなく、我々のベンチマークは、大規模なコードベースの複数の箇所に修正を生成するようモデルに挑戦させる。SWE-benchの参照ソリューションは、平均して1.7ファイル、3.0関数、32.8行(追加または削除)を編集する。
可能なソリューションの広い範囲。リポジトリ規模のコード編集というタスクは、検索や長文コンテキストモデルから、コード内で推論し行動できる意思決定エージェントに至るまで、さまざまなアプローチを比較するための公平な土俵として機能しうる。SWE-benchはまた、モデルが参照PRから逸脱する可能性のある新規なソリューションを生成できるため、創造的な自由も許容する。
2.4 SWE-BENCH LITE
SWE-bench上で言語モデルを評価することは時間がかかる場合があり、モデルによっては多大なコンピュートやAPIクレジットを必要とする。セクション5で示される初期性能の結果がかなり低いことを踏まえると、SWE-benchの難易度は長期的な言語モデルの進歩を測るのに有用である一方、短期的に進歩を試みる初期システムにとっては敷居が高い可能性がある。
| 平均 | 最大 | ||
| 課題テキスト | 長さ(語数) | 195.1 | 4477 |
| コードベース | ファイル数(非テスト) | 3,010 | 5,890 |
| 行数(非テスト) | 438K | 886K | |
| ゴールドパッチ | 編集行数 | 32.8 | 5888 |
| 編集ファイル数 | 1.7 | 31 | |
| 編集関数数 | 3 | 36 | |
| テスト | Fail to Pass | 9.1 | 1633 |
| 合計 | 120.8 | 9459 |
SWE-benchの採用を促すため、我々はSWE-benchから300インスタンスのLiteサブセットを作成し、より自己完結的になるようサンプリングして、機能的なバグ修正の評価に焦点を当てた。完全なフィルタリング基準とデータセット情報はSWE-bench Liteに含まれており、元の12リポジトリのうち11をカバーし、元と同様の多様性とリポジトリ間のタスクインスタンスの分布を持つ。Lite分割とフィルタリングの詳細の完全な情報は付録A.7に含まれている。
3 SWE-LLAMA: SWE-BENCHのためのCodeLlamaのファインチューニング
SWE-bench上でオープンモデルの性能をプロプライエタリモデルと並べてベンチマークすることは重要である。執筆時点では、必要な非常に長いコンテキストを扱えるのはCodeLlamaモデル(Rozière et al., 2023)のみである。しかし、既製のCodeLlama variantsは、リポジトリ全体のコード編集を生成するための詳細な指示に従うことができず、典型的にはプレースホルダーの応答や無関係なコードを出力することを我々は観察した。これらのモデルの能力をよりよく評価するため、我々は70億および130億パラメータのCodeLlama-Pythonモデルに対して教師ありファインチューニングを行う。得られたモデルは、コンシューマーハードウェア上で動作し、GitHubのissueを解決できる特化型リポジトリエディタである。
トレーニングデータ。我々はデータ収集手順に従い、追加の37の人気Pythonパッケージリポジトリから19,000件のissue-PRペアを収集した。セクション2.1とは対照的に、プルリクエストがテストの変更を含むことは要求していない。これにより、教師ありファインチューニングに使用するはるかに大規模なトレーニングセットを作成することができる。データ汚染のリスクを排除するため、トレーニングデータ内のリポジトリの集合は、評価ベンチマークに含まれるリポジトリとは互いに素である。
トレーニングの詳細。指示、GitHubからのissueテキスト、および関連するコードファイルをプロンプトとして与え、我々はSWE-Llamaをファインチューニングして、与えられたissueを解決するパッチ(「ゴールドパッチ」)を生成させる。メモリ効率のため、LoRA Hu et al. (2022)を用いてアテンションサブレイヤの重みのみをファインチューニングし、30,000トークンを超えるトレーニングシーケンスを除外することで、トレーニングコーパスの実効サイズを10,000インスタンスに削減している。より詳細は付録Bに示す。
4 実験設定
本セクションでは、SWE-bench評価を実行するための入力がどのように構築されるかを説明する。加えて、本研究で評価するモデルを概観する。
4.1 検索ベースのアプローチ
SWE-benchのインスタンスは、モデルへの入力としてissueの説明とコードベースを提供する。issueの説明は通常短い(表1に示すように平均195語)一方で、コードベースはLMのコンテキストウィンドウに通常収まりきらないはるかに多くのトークン(平均438K行)で構成されている。すると、モデルに提供する関連コンテキストを正確にどのように選ぶかという問題が残る。
我々のベースラインではこの問題に対処するため、単に汎用的な検索システムを用いて、コンテキストとして挿入するファイルを選択する。特に、我々は2つの関連するコンテキスト設定、すなわち1)スパース検索と2)オラクル検索の下でモデルを評価する。
スパース検索。密検索手法は、キーとクエリの長さが非常に長いこと、そして特に自然言語のクエリでコード文書を検索するという異例の設定のために、我々の設定には不向きである。したがって、我々はBM25検索(Robertson et al., 2009)を用いて、各タスクインスタンスのコンテキストとして提供する関連ファイルを検索することにした。我々は3つの異なる最大コンテキスト上限で実験し、指定された上限内に収まるだけのファイルを単に検索する。各モデルをそのコンテキストウィンドウに収まるすべての上限で評価し、最良の性能を報告する。観察から、表2に示すように、モデルは最短のコンテキストウィンドウで最良の性能を発揮する。
「オラクル」検索。分析目的のため、我々はGitHub上でissueを解決した参照パッチによって編集されたファイルを「検索」する設定も考慮する。この「オラクル」設定は、issueへの対処に取り組むエンジニアがどのファイルを変更する必要があるかを事前に知らない可能性があるため、現実的ではない。加えて、この設定は必ずしも包括的でもない。編集されたファイルだけでは、コードの未見の部分と相互作用する際にソフトウェアが正確にどのように振る舞うかを理解するために必要なすべてのコンテキストを含まない可能性があるからである。
我々はBM25検索の結果を「オラクル」検索設定の結果と比較し、表3に示す。27,000トークンのコンテキスト上限において、約のインスタンスでBM25がオラクルファイルのスーパーセットを検索することを観察する。しかし、27,000トークン上限のインスタンスのほぼ半数において、BM25は「オラクル」コンテキストのファイルを1つも検索しない。
4.2 入力フォーマット
上記2つの手法のいずれかを用いて検索ファイルが選択されると、我々はタスク指示、issueテキスト、検索されたファイルとドキュメント、そして最後にパッチファイルの例とパッチファイル生成のためのプロンプトからなるモデルへの入力を構築する。インスタンスの例とこの定式化のさらなる詳細は付録Dに示す。
4.3 モデル
長い系列長を処理する必要があるため、現在SWE-benchに適したモデルはわずかしかない。したがって、我々はChatGPT-3.5(gpt-3.5-turbo-16k-0613)、GPT-4(gpt-4-32k-0613)、Claude 2、およびSWE-Llamaを、表4に示すコンテキスト上限とともに評価する。
| モデル | 最大コンテキスト長 | ||
| 13k | 27k | 50k | |
| Claude 2 | 1.96 | 1.87 | 1.22 |
| SWE-Llama 7b | 0.70 | 0.31 | 0.00 |
| SWE-Llama 13b | 0.70 | 0.48 | 0.00 |
| BM25リコール | |||
| 13k | 27k | 50k | |
| 平均 | 29.58 | 44.41 | 51.06 |
| All | 26.09 | 39.83 | 45.90 |
| Any | 34.77 | 51.27 | 58.38 |
表4: 我々は異なるコンテキスト長と、「オラクル」検索設定がカバーされる割合を比較する。したがって、コンテキスト長が短いモデルは本質的に不利である。トークン長の記述は相対的な非標準的尺度であることに注意されたい(例えば、Llamaでトークン化された系列は、GPT-4用にトークン化された同等の系列よりも平均で長い)。
| ChatGPT-3.5 | GPT-4 | Claude 2 | SWE-Llama | |
| 最大トークン数 | 16,385 | 32,768 | 100,000 | ≥100,000 |
| インスタンスの割合 | 58.1% | 84.1% | 96.4% | ≥94.8% |
| モデル | SWE-bench | SWE-bench Lite | ||
| % 解決済み | % 適用 | % 解決済み | % 適用 | |
| Claude 3 Opus | 3.79 | 46.56 | 4.33 | 51.67 |
| Claude 2 | 1.97 | 43.07 | 3.00 | 33.00 |
| ChatGPT-3.5 | 0.17 | 26.33 | 0.33 | 10.00 |
| GPT-4-turbo | 1.31 | 26.90 | 2.67 | 29.67 |
| SWE-Llama 7b | 0.70 | 51.74 | 1.33 | 38.00 |
| SWE-Llama 13b | 0.70 | 53.62 | 1.00 | 38.00 |
5 結果
我々は異なる検索メカニズムとプロンプティングスタイルを用いたモデルの結果を報告し、その後、モデル性能と難易度に関するいくつかの分析と洞察を提供する。表5にBM25検索を用いたモデルの性能を要約する。全般的に、モデルはissueの解決に著しく苦戦している。最高性能のモデルであるClaude 2でも、issueのしか解決できない。
検索器がシステム全体の結果にとってどれほど重要かを分析するため、付録の表18に「オラクル」検索の結果を示す。そこでは、Claude 2は「オラクル」検索器を用いてissueのを解決できる。我々は以下の議論でコンテキストの重要性をさらに分析する。
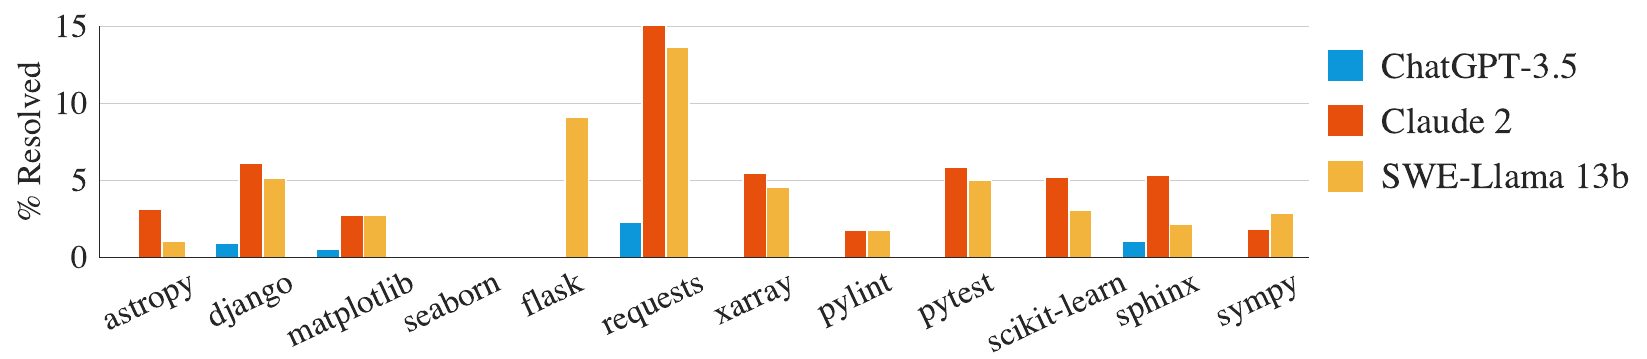
難易度はリポジトリ間で異なる。性能をリポジトリ別に分解すると、図4に示すように、すべてのモデルが異なるリポジトリ間で同様の傾向を示す。それにもかかわらず、各モデルが解決したissueは必ずしも広範囲に重複するわけではない。例えば、「オラクル」設定ではClaude 2とSWE-Llama 13bはそれぞれ110件と91件のインスタンスを解決し、同等の性能を発揮する。しかしこれらのインスタンスのうち、Claude 2はSWE-Llamaが解決したインスタンスのしか解決していない。
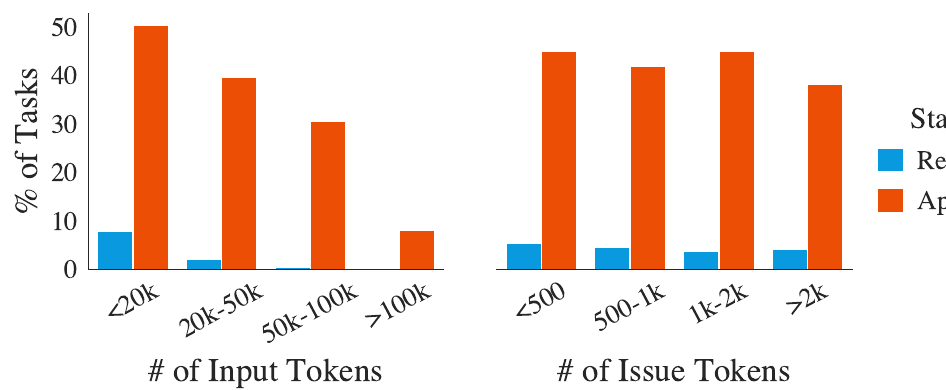
これは、issue内の画像の存在にも関連している可能性がある。画像はissueのマークダウンに埋め込み画像リンク(すなわち![image][https://...])としてエンコードできる。一部のリポジトリは当然ながら画像を含むインスタンスがより多い。例えば、matplotlibのインスタンスの、seabornのがissueテキストに埋め込み画像を含むのに対し、全インスタンスではわずかである。これらのインスタンスを解決するには、マルチモーダルLMや画像処理のための何らかの外部ツール利用が必要かもしれない。
難易度はコンテキスト長と相関する。チャットモデルは長いコード系列で事前学習されているかもしれないが、通常は質問を枠づけるために提供される限られたコンテキストで、より短いコードスニペットを生成するよう求められる。図5に示すように、総コンテキスト長が増加するにつれて、Claude 2の性能はかなり低下する。この挙動は他のモデルでも観察される。我々の評価設定では、モデルは目前のissueの解決に直接関連しない可能性のある多くのコードを見ることになり、更新が必要な問題のあるコードの特定に頻繁に苦戦するようである。この結果は、モデルが追加のコンテキストによって注意をそらされ、ターゲット系列の相対位置に敏感になる可能性があることを示す他の研究(Liu et al., 2023b)を裏付けるものである。BM25の最大コンテキストサイズを増やすことでオラクルファイルに対する再現率が向上する場合でも、表2に示すように性能は低下する。モデルが問題のあるコードの特定において単に効果的でないからである。 これをさらに調査するため、我々は「オラクル」検索コンテキストに関する入力アブレーション、「オラクル」-collapsedを提供する。そこでは、真のプルリクエストによって実際に編集された行(
| モデル | 「Oracle」折りたたみ | |
| 解決済み | 適用済み | |
| Claude 3 Opus | 9.39 | 48.00 |
| Claude 2 | 5.93 | 68.18 |
| GPT-4 | 3.40 | 48.65 |
| ChatGPT-3.5 | 1.09 | 40.93 |
行のバッファ付き)を除いて、検索されたファイルが完全に折りたたまれ、その結果を表6に示す。この設定では性能の向上が見られ、GPT-4はからへ、Claude 2はからへと跳ね上がる。
難易度はissue解決日と相関しない。表7では、2023年より前または後に作成されたPRについて、日付別に分割した「オラクル」検索設定でのモデル結果を示す。ほとんどのモデルでは、GPT-4を除いて、この日付の前後で性能にほとんど差がないことがわかる。この結果は、モデルがリポジトリのコードベースの何らかのバージョンに触れていたとしても、単により最近のバージョンのリポジトリを生成することでissueに対処するよう「カンニング」することはまずないことを示唆しており、概ね有望であると我々は考える。
| Claude 2 | ChatGPT-3.5 | GPT-4* | SWE-Llama 7b | SWE-Llama 13b |
| 2023年以前 | 4.87 | 0.49 | 1.96 | 2.95 |
| 2023年以降 | 4.23 | 0.77 | 0.0 | 3.46 |
ファインチューニングされたモデルはコンテキスト分布のシフトに敏感である。ファインチューニングされたモデルSWE-Llama 7bと13bは、BM25で検索されたコンテキストでは驚くほど性能が低い。これらのモデルは「オラクル」検索をコンテキストとして用いてファインチューニングされたため、我々はこのコンテキストのシフトがモデルの信頼性の高い実行を困難にしていると推測する。例えば、SWE-Llamaはコンテキストとして含まれるすべてのファイルを編集するよう訓練されたが、BM25設定ではコンテキストで提供される多くのファイルは変更されることが期待されていない。
パッチの生成はファイル全体の生成よりも容易である。モデルはしばしば標準的なコードファイルを用いて訓練されており、パッチファイルを見ることはほとんどないであろう。パッチファイルは通常、ファイル変更のよりはるかに効率的な表現であるため、我々は一般に、提案された変更でファイル全体を再作成するのではなく、モデルにパッチファイルを生成させるようタスクを定式化している。表5に示すように、モデルは依然として整形されたパッチファイルの生成に苦戦していることを観察する。そこで我々は、issueを解決するための提案された変更でファイル全体を再生成するようモデルに求める実験を行う。この設定では、モデルは一般にパッチファイルを生成する場合よりもこのタスクで性能が低いことを見出した。例えば、Claude 2は「オラクル」検索のメインの表におけると比較してのスコアである。インスタンス長を制御した場合でも、入力トークンによるタスクインスタンスの短い半分で生成すると、Claude 2でパッチを生成する場合のと比較してとなる。
言語モデルはより短く、より単純な編集を生成する傾向がある。モデルが生成したパッチファイルは、それぞれの正解パッチに比べて追加・削除する行数が少ない傾向にある。表8に示すように、平均的な正解パッチと比較して、正しく適用されるモデル生成パッチファイルは、正解編集パッチファイルの全長の半分未満(74.5行対30.1行)であり、複数のファイルを編集することはほとんどない。
5.1 SWE-Llama生成結果の定性的分析
「オラクル」検索設定におけるタスクと生成パッチの品質をより深く理解するため、SWE-LlamaとClaude 2から11件の生成結果を選定した。ここではSWE-Llamaの一例と全体的な知見について議論し、その他の例に関する詳細な分析は付録Fに示す。
| モデル | 合計行数 | 追加 | 削除 | 関数 | ファイル |
| Claude 2 | 19.6 | 4.2 | 1.9 | 1.1 | 1.0 |
| Gold | 44.1 | 12.0 | 5.8 | 2.1 | 1.2 |
| ChatGPT-3.5 | 30.1 | 3.8 | 2.7 | 1.6 | 1.0 |
| Gold | 39.6 | 9.5 | 6.1 | 1.9 | 1.2 |
| GPT-4 | 20.9 | 4.4 | 1.5 | 1.0 | 1.0 |
| Gold | 33.6 | 8.4 | 3.8 | 1.9 | 1.1 |
| SWE-Llama 13b | 17.6 | 1.6 | 1.2 | 1.2 | 1.1 |
| Gold | 37.8 | 10.0 | 4.4 | 1.9 | 1.1 |
| SWE-Llama 7b | 16.7 | 1.3 | 1.2 | 1.2 | 1.1 |
| Gold | 40.2 | 11.3 | 4.9 | 1.9 | 1.1 |
| Avg Gold | 39.1 | 10.2 | 5.0 | 1.9 | 1.1 |
| All Gold | 74.5 | 22.3 | 10.5 | 3.0 | 1.7 |
表8:「オラクル」検索設定において、正常に適用されたパッチ全体におけるモデル生成パッチの平均編集量。各モデル固有のタスクインスタンスについて、正解パッチ全体にわたって同じ統計を計算した。Avg Goldは各モデルそれぞれの正解パッチについてマクロ平均した統計を示す。All Goldはモデルの性能に条件付けずに、すべての正解パッチの統計を示す。
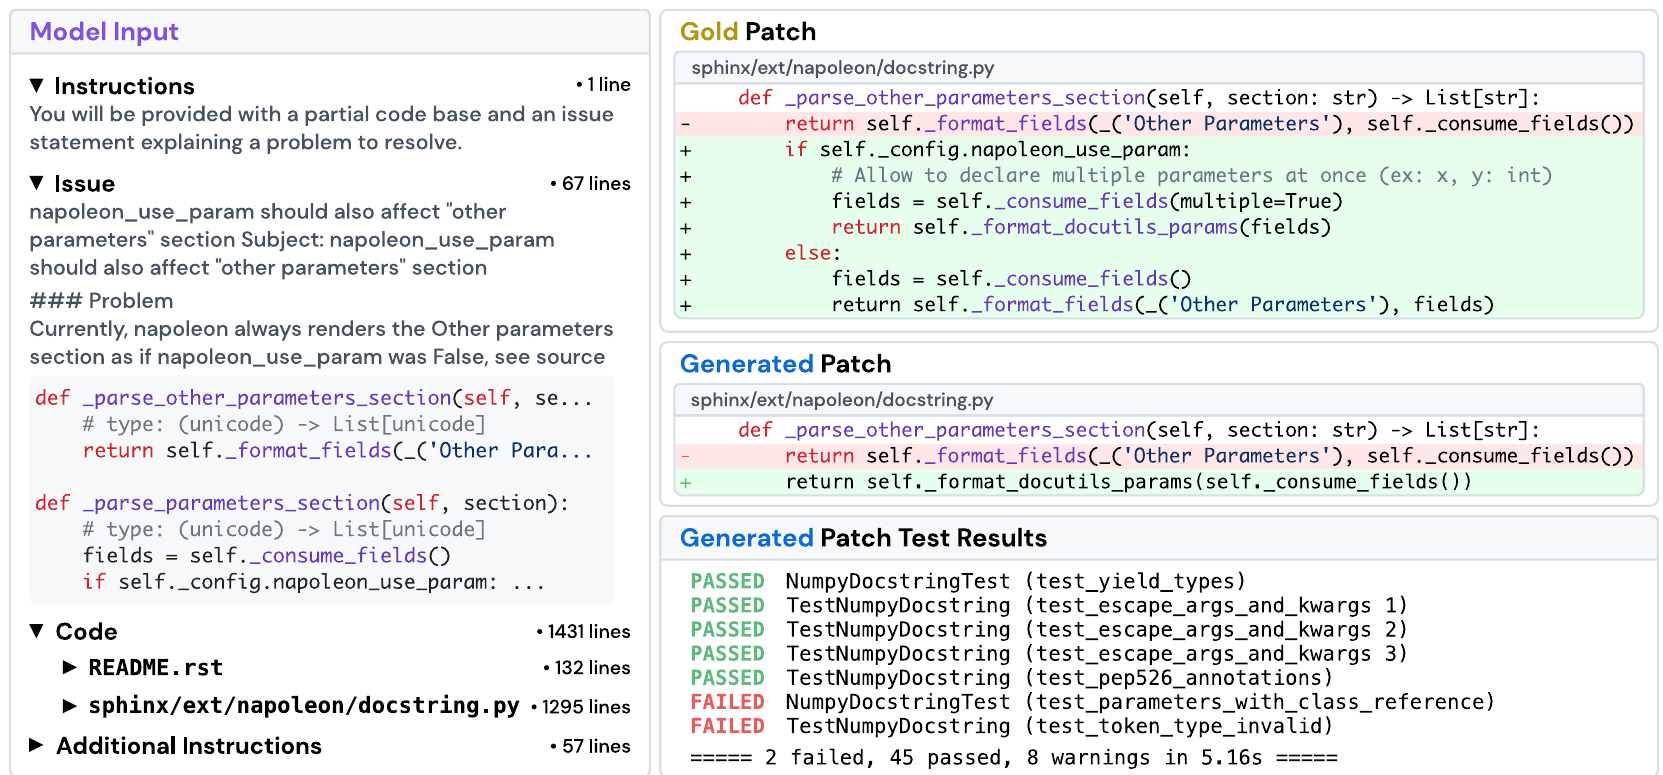
Sphinxドキュメンテーションジェネレータのタスクインスタンスsphinx-doc_sphinx-8713(図6に示す)を考察する。このイシューは、設定項目napoleon.use_paramがTrueに設定されている場合に、Sphinxのnapoleon拡張がドキュメントキーワード「Other Parameters」を適切にフォーマットしないことを述べている。イシューのテキストはさらに、問題のあるソースコードが存在すると疑われる箇所の詳細なコードスニペット、エラーを再現するためのコード例、およびパッケージバージョンに関連する追加情報を提供している。この特定のインスタンスについて、モデルはタスクを解決できず、正解の解決策によって通過されたテストの一部を通過できなかった。
「オラクル」検索設定では、モデルへの入力として、このイシューテキストに加えて、いくつかの指示、正解パッチによって編集されたファイルの完全な内容、および期待する回答形式のdiffの例が提供される。モデル入力の合計は1,558行のコンテキスト、すなわち20,882トークンである。正解パッチとモデルのパッチを比較すると、明らかな誤りが見つかる。モデルは正しい関数、すなわちsphinx/ext/napoleon/docstring.pyの684行目にある_parse_other_parameters_sectionを編集しているものの、正解パッチのようにまず設定項目を確認して_parse_parameters_sectionの動作をコピーするのではなく、napoleon.use_paramが常にTrueであるかのように関数の動作を変更している。テストでは、test_parameters_with_class_referenceがnapoleon_use_paramをFalseに設定した設定で生成されたドキュメントを直接比較するため、モデルの誤りが直ちに検出される。
検討したすべての例にわたる結果を比較すると、振る舞いに関していくつかの際立った傾向に気づく。モデルは原始的なPythonコードを書きがちで、既存のサードパーティライブラリやコードベースの他の部分を解答に活用しない。モデルの生成はまた、コードスタイルやコードベースによって反映されるかもしれない論理的制約(すなわち絶対インポートではなく相対インポートを使うこと)をほとんど顧みずに、問題を正確に解くという「貪欲な」アプローチを反映している。対照的に、多くのゴールドパッチはコードベースのはるかに広い範囲をカバーする構造的改善を行うことを我々は観察する。これらの編集は問題を解決するだけでなく、将来起こりうる問題を予期して解決する。
6 関連研究
LMの評価。LMを評価するための最近のいくつかの研究は、複数のドメインにまたがる相互に異なるタスクの集合を提案するか(Hendrycks et al., 2021; Liang et al., 2022; Srivastava et al., 2023)、解くのに複数のステップを要するタスクを特徴とする対話的設定としてウェブに目を向けている(Yao et al., 2022; Zhou et al., 2023; Deng et al., 2023; Liu et al., 2023d)。このような「寄せ集め」形式の設定にはいくつかの欠点がある。第一に、各タスクは1つまたは少数のスキルに狭く焦点を当てがちであり、その結果、課題はたいてい単純すぎ、モデルを矮小化された役割に押し込み、モデルがその多才さを発揮したり新しい能力を潜在的に示したりするための余地を提供しない(Srivastava et al., 2023)。したがって、このようなタスク集合体におけるモデルの性能は、その能力やそれをいかに改善するかについて、実行可能で深い洞察をもたらさないかもしれない(Schlangen, 2019; Martínez-Plumed et al., 2021; Bowman & Dahl, 2021)。SWE-benchはこれらの欠点に対処する。我々の研究が示すように、それは著しく困難であり、このタスクを解くためにLMを改善する幅広い可能性を提示し、新しいタスクインスタンスで経時的に容易に更新でき、その各々が新規で微妙かつ実用的な課題をもたらす。
コード生成ベンチマーク。HumanEval(Chen et al., 2021)は、自然言語記述からコードを合成するという長年の営みにおける現在の標準である(Yu et al., 2018; Austin et al., 2021; Hendrycks et al., 2021; Li et al., 2022a; Zan et al., 2023)。過去1年の間に、後続のベンチマークは、異なる言語への拡張(Cassano et al., 2022; Athiwaratkun et al., 2023; Orlanski et al., 2023)、編集範囲の変動(Yu et al., 2023; Du et al., 2023)、類似するが新規なコード補完タスク(Muennighoff et al., 2023)、より多くのテスト(Liu et al., 2023a)によってHumanEvalを拡張しようとしてきた。同時に、別個の研究が新しいコーディングパラダイムを導入しようとしたり(Yin et al., 2022; Yang et al., 2023)、ライブラリ固有の問題を設計しようとしたりしている(Lai et al., 2022; Zan et al., 2022)。問題をサイロ化されたデータセットに分割し、単純化のためにそれらを切り詰める代わりに、SWE-benchの収集手順は最小限の後処理でソースコードを変換し、閉形式の補完を超えた実世界のソフトウェアエンジニアリングに根ざしたはるかに広範な課題を保持する。例えば、パッチ生成、長い文脈にわたる推論、コードベースディレクトリのナビゲーション、モジュール間の依存関係に基づく関係の捕捉などである。
ソフトウェアエンジニアリングのためのML。スケールしない、あるいは自然言語を取り込まない可能性のある従来のプログラム解析技術を克服するために、現在のソフトウェアエンジニアリング研究の一方向は、ニューラルネットワーク(LMを含む)を用いて実世界のソフトウェア開発プロセスを自動化することである(Maniatis et al., 2023; Zheng et al., 2023; Hou et al., 2023)。ユースケースには、コミット生成の自動化(Jung, 2021; Liu et al., 2023c)、PRレビュー(Yang et al., 2016; Li et al., 2022b; Tufano et al., 2021)、バグ位置特定(Kim et al., 2019; Chakraborty et al., 2018)、テスト(Kang et al., 2023; Xia et al., 2023; Wang et al., 2023)、プログラム修復(Gupta et al., 2017; Allamanis et al., 2017; Monperrus, 2018; Jiang et al., 2018; Goues et al., 2019; Gao et al., 2022; Dinh et al., 2023; Motwani & Brun, 2023)が含まれる。SWE-benchに最も関連するのは、LMを自動プログラム修復に適用しようとした研究(Xia & Zhang, 2022; 2023; Fan et al., 2023; Sobania et al., 2023)、コミットでコード編集を導く研究(Chakraborty & Ray, 2021; Zhang et al., 2022; Fakhoury et al., 2023)である。しかしながら、既存のデータセット(Just et al., 2014; Karampatsis & Sutton, 2019)はいずれもSWE-benchの規模のコード文脈を提示していない。さらに、SWE-benchは新しいプログラミング言語やリポジトリへ容易に拡張でき、LMをソフトウェアエンジニアリングのツールや実践で拡張するための実験を行う、はるかに現実的で困難な場を提供する。
7 議論
限界と今後の方向性。SWE-benchのタスクインスタンスはすべてPythonである。我々はSWE-benchのタスクインスタンス収集手順を適用して、そのカバレッジをより多くのプログラミング言語やドメインに拡大することを望んでいる。第二に、我々の実験はこのタスクに対する最も単純で最も直接的なアプローチのベースラインを確立することを目的としており、将来の方法論を同じ種類のアプローチに制約する意図はなく、今後の研究が異なる方法(例えば、エージェントベースのアプローチ、ツールで拡張されたLM)を調査することを奨励する。
最後に、本研究は実行ベースのコードテストを用いてモデルを評価するが、この方法だけに依拠することはモデル生成の信頼できる性能を保証するには不十分である。というのも、LMによる自動コード生成は、人間が書いた解答と比べて、しばしば包括性、効率性、可読性に劣りうることを我々は見出しているからである。
結論。実世界のソフトウェア開発プロセスの複雑さは、単なるコード補完をはるかに超えて広がっている。オープンソースの協働パイプラインを活用することで、SWE-benchは実世界のコーディング環境の忠実な鏡を作り出す。このより現実的な環境は、オープンソースソフトウェア開発において即座に適用可能な創造的解決策を促す。我々は、このベンチマークと我々のその他の貢献が、より実用的で、知的で、自律的なLMの将来の発展において貴重な資産となることを望んでいる。
8 倫理声明
8 倫理声明SWE-benchは、我々の貢献がそれに準拠するソフトウェアの使用を許諾するライセンスを持つ公開リポジトリから完全に収集されている。ライセンスの詳細は表12に含まれている。収集または評価の過程において、我々はGitHubユーザーに関する情報を収集せず、SWE-benchのタスクインスタンスは公開APIとウェブサイトを通じて提供される以上のGitHubデータを使用しない。我々の貢献はいかなる人間被験者の参加も伴わない。我々はSWE-benchのいかなる部分についても、その収集および評価手順ならびに実験を含めて、クラウドソーシングを行ったり人間のタスクワーカーを募集したりしない。人気度に基づくGitHubリポジトリのSWE-benchのフィルタリング基準は、リポジトリ選択に関して差別的または偏ったヒューリスティックに暗黙的にも明示的にも依拠していない。データセットの公開にあたり、我々はSWE-benchのタスクインスタンス、収集および評価インフラストラクチャ、実験結果、SWE-Llamaモデルの微調整に使用した訓練データ、およびSWE-Llamaモデルの重みをオープンソース化する予定である。ベストプラクティスの先例に従い、我々は各構成要素とその使用を記述する十分な文書も提供し、SWE-benchを改善するためのフィードバックを募るための便利なコミュニケーションチャネルも整備する。SWE-benchは直ちに有害な洞察を提示するものではない。SWE-benchの使用の潜在的影響については付録Eで簡潔に議論する。
9 再現性声明
9 再現性声明我々の投稿のために、我々は適切に匿名化されたソースコード全体をzipファイルとしてアップロードした。我々は、別々のディレクトリが本論文内の異なる貢献(すなわち、データセット収集、評価、オープンソースモデルの推論、SWE-Llamaの訓練など)に対応するようにコードベースを整理した。ソースコードには、コードベースの異なる部分の目的と使用法を詳述するインラインドキュメンテーションが含まれている。さらに、我々は本論文で議論したすべての構成要素を含む2294個のSWE-benchタスクインスタンスの完全な集合も含めている。ソースコード内の文書化に加えて、我々は本論文の第2節における元の詳細を補完する、収集パイプラインと評価手順に関する徹底的な技術的詳細を付録A.2および付録A.4に含めている。これらの節はコードに示された論理を完全に網羅しており、それを理解するのに役立つ。今後、倫理声明で議論したように、我々はベンチマークを記述し、コードを概説し、その使用法を詳述する徹底的な詳細を備えたオープンソースリポジトリとして、SWE-benchをより正式に一般に公開する予定である。SWE-benchの主要な構成要素は収集フレームワークであり、これはオープンソース化されるコードの一部となる。本論文で議論したように、その保守が容易な設計により、我々の希望と信念は、SWE-benchが高度に再現可能であるべきだというものである。
10 謝辞
10 謝辞我々は、Danqi Chen、Tri Dao、Zexuan Zhong、Tianyu Gao、Will Merrill、Mengzhou Xia、Dan Friedman、Adithya Bhaskar、Austin Watkins、Atamik Gupta、およびRichard Zhuに、貴重なフィードバックと助言に感謝する。我々は、National Science Foundationの助成番号2239363およびOracle Collaborative Research awardからの支援に謝意を表する。本資料で表明された意見、発見、結論、または勧告は著者らのものであり、必ずしもNational Science Foundationの見解を反映するものではない。
参考文献
Miltiadis Allamanis, Marc Brockschmidt, and Mahmoud Khademi. Learning to represent programs with graphs. arXiv preprint arXiv:1711.00740, 2017.
Ben Athiwaratkun, Sanjay Krishna Gouda, Zijian Wang, Xiaopeng Li, and Yuchen Tian et. al. Multilingual evaluation of code generation models, 2023.
Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le, and Charles Sutton. Program synthesis with large language models, 2021.
Samuel R. Bowman and George E. Dahl. What will it take to fix benchmarking in natural language understanding?, 2021.
Federico Cassano、John Gouwar、Daniel Nguyen、Sydney Nguyen、Luna Phipps-Costin、Donald Pinckney、Ming-Ho Yee、Yangtian Zi、Carolyn Jane Anderson、Molly Q Feldman、Arjun Guha、Michael Greenberg、Abhinav Jangda。Multipl-e:ニューラルコード生成のベンチマークに対するスケーラブルで拡張可能なアプローチ、2022年。
Saikat Chakraborty、Baishakhi Ray。ソースコード編集のマルチモーダル学習について、2021年。
Saikat Chakraborty、Yujian Li、Matt Irvine、Ripon Saha、Baishakhi Ray。統計的言語モデルを用いたエントロピー誘導スペクトルベースのバグ局所化。arXiv preprint arXiv:1802.06947、2018年。
Mark Chen、Jerry Tworek、Heewoo Jun、Qiming Yuan、Henrique Ponde de Oliveira Pinto、Jared Kaplan et. al.。コードで学習された大規模言語モデルの評価、2021年。
Tri Dao、Dan Fu、Stefano Ermon、Atri Rudra、Christopher Ré。Flashattention:IO認識を備えた高速かつメモリ効率の高い正確なアテンション。Advances in Neural Information Processing Systems、35:16344-16359、2022年。
Xiang Deng, Yu Gu, Boyuan Zheng, Shijie Chen, Samuel Stevens, Boshi Wang, Huan Sun, Yu Su. Mind2web:汎用的なWebエージェントに向けて、2023年。
Tuan Dinh, Jinman Zhao, Samson Tan, Renato Negrinho, Leonard Lausen, Sheng Zha, George Karypis. コードの大規模言語モデルは潜在的なバグを含むコードの補完に失敗する。arXivプレプリント arXiv:2306.03438、2023年。
Xueying Du, Mingwei Liu, Kaixin Wang, Hanlin Wang, Junwei Liu, Yixuan Chen, Jiayi Feng, Chaofeng Sha, Xin Peng, Yiling Lou. Classeval:クラスレベルのコード生成においてLLMを評価するための手作業で作成されたベンチマーク、2023年。
Sarah Fakhoury, Saikat Chakraborty, Madan Musuvathi, Shuvendu K. Lahiri. 自然言語のIssue記述から機能的に正しいコード編集を生成することに向けて、2023年。
Zhiyu Fan, Xiang Gao, Martin Mirchev, Abhik Roychoudhury, Shin Hwei Tan. 大規模言語モデルによるプログラムの自動修復、2023年。
Daniel Fried, Armen Aghajanyan, Jessy Lin, Sida Wang, Eric Wallace, Freda Shi, Ruiqi Zhong, Wen tau Yih, Luke Zettlemoyer, Mike Lewis. Incoder:コードの穴埋めと合成のための生成モデル、2023年。
Xiang Gao, Yannic Noller, Abhik Roychoudhury. プログラム修復、2022年。
Claire Le Goues, Michael Pradel, Abhik Roychoudhury. 自動プログラム修復。Communications of the ACM、62(12):56-65、2019年。
David Gros, Prem Devanbu, Zhou Yu. ソフトウェア工学研究者のためのAI安全性のサブ問題、2023年。
Rahul Gupta, Soham Pal, Aditya Kanade, Shirish Shevade. Deepfix:深層学習によるC言語の一般的なエラーの修正。AAAI人工知能会議の議事録、第31巻、2017年。
Maurice H. Halstead. ソフトウェア科学の要素(オペレーティングおよびプログラミングシステムシリーズ)。Elsevier Science Inc.、米国、1977年。ISBN 0444002057。
Dan Hendrycks, Steven Basart, Saurav Kadavath, Mantas Mazeika, Akul Arora, Ethan Guo, Collin Burns, Samir Puranik, Horace He, Dawn Song, Jacob Steinhardt. APPSによるコーディングチャレンジ能力の測定、2021年。
Xinyi Hou, Yanjie Zhao, Yue Liu, Zhou Yang, Kailong Wang, Li Li, Xiapu Luo, David Lo, John Grundy, Haoyu Wang. ソフトウェア工学のための大規模言語モデル:系統的文献レビュー、2023年。
Edward J Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang, Weizhu Chen. LoRA:大規模言語モデルの低ランク適応。学習表現に関する国際会議、2022年。URL https://openreview.net/forum?id=nZeVKeeFYf9。
Sam Ade Jacobs, Masahiro Tanaka, Chengming Zhang, Minjia Zhang, Leon Song, Samyam Rajbhandari, Yuxiong He. Deepspeed ulysses:極めて長い系列のTransformerモデルの訓練を可能にするためのシステム最適化、2023年。
Jiajun Jiang, Yingfei Xiong, Hongyu Zhang, Qing Gao, Xiangqun Chen. 既存のパッチと類似コードによるプログラム修復空間の形成。第27回ACM SIGSOFTソフトウェアテストと解析に関する国際シンポジウムの議事録、pp. 298-309、2018年。
Tae-Hwan Jung. Committer:事前学習済みプログラミング言語モデルを用いたコミットメッセージ生成、2021年。
René Just, Darioush Jalali, Michael D. Ernst. Defects4J:Javaプログラムの制御されたテスト研究を可能にする既存の障害のデータベース。ISSTA 2014、2014年ソフトウェアテストと解析に関する国際シンポジウムの議事録、pp. 437-440、米国カリフォルニア州サンノゼ、2014年7月。ツールデモ。
Sungmin Kang, Juyeon Yoon, Shin Yoo. 大規模言語モデルは少数ショットテスターである:LLMベースの汎用バグ再現の探究、2023年。
Rafael-Michael Karampatsis, Charles Sutton. 単一ステートメントのバグはどのくらいの頻度で発生するか?the manysstubs4j dataset。2020年IEEE/ACM第17回ソフトウェアリポジトリマイニング国際会議(MSR)、pp. 573-577、2019年。URL https://api.semanticscholar.org/CorpusID:173188438。
Douwe Kiela, Max Bartolo, Yixin Nie, Divyansh Kaushik, Atticus Geiger, Zhengxuan Wu et. al. Dynabench:NLPにおけるベンチマーキングの再考、2021年。
Yunho Kim, Seokhyeon Mun, Shin Yoo, Moonzoo Kim. 対象プログラムの動的特徴と静的特徴を用いた精密な学習ランキングによる故障箇所特定。ACM Transactions on Software Engineering and Methodology(TOSEM)、28(4):1-34、2019年。
Yuhang Lai, Chengxi Li, Yiming Wang, Tianyi Zhang, Ruiqi Zhong, Luke Zettlemoyer, Scott Wen tau Yih, Daniel Fried, Sida Wang, Tao Yu. Ds-1000:データサイエンスコード生成のための自然で信頼性の高いベンチマーク、2022年。
Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond et. al. AlphaCodeによる競技レベルのコード生成。Science、378(6624):1092-1097、2022年12月a。doi: 10.1126/science.abq1158。URL https://doi.org/10.1126%2Fscience.abq1158。
Zhiyu Li, Shuai Lu, Daya Guo, Nan Duan, Shailesh Jannu, Grant Jenks, Deep Majumder, Jared Green, Alexey Svyatkovskiy, Shengyu Fu, Neel Sundaresan. 大規模事前学習によるコードレビュー活動の自動化、2022年b。
Percy Liang, Rishi Bommasani, Tony Lee, Dimitris Tsipras, Dilara Soylu, Michihiro Yasunaga et. al. 言語モデルの全体論的評価、2022年。
Jiawei Liu, Chunqiu Steven Xia, Yuyao Wang, Lingming Zhang. ChatGPTによって生成されたあなたのコードは本当に正しいか?コード生成のための大規模言語モデルの厳密な評価。arXivプレプリント arXiv:2305.01210、2023年a。
Nelson F. Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni, Percy Liang. 中間での喪失:言語モデルが長い文脈をどのように利用するか、2023年b。arXiv:2307.03172。
Shangqing Liu, Yanzhou Li, Xiaofei Xie, Yang Liu. Commitbart:GitHubコミットのための大規模事前学習モデル、2023年c。
Xiao Liu, Hao Yu, Hanchen Zhang, Yifan Xu, Xuanyu Lei, Hanyu Lai et. al. Agentbench:エージェントとしてのLLMの評価、2023年d。
Shuai Lu, Daya Guo, Shuo Ren, Junjie Huang, Alexey Svyatkovskiy, Ambrosio Blanco et. al. Codexglue:コード理解と生成のための機械学習ベンチマークデータセット。CoRR、abs/2102.04664、2021年。
Petros Maniatis, Daniel Tarlow, Google DeepMind. ソフトウェア開発活動のための大規模系列モデル、2023年。URL https://blog.research.google/2023/05/large-sequence-models-for-software.html。
Fernando Martinez-Plumed, Pablo Barredo, Seán Ó hEigeartaigh, José Hernández-Orallo. 人気のあるAIベンチマークの背後にある研究コミュニティのダイナミクス。Nature Machine Intelligence、3:581-589、2021年。URL https://api.semanticscholar.org/CorpusID:236610014。
Thomas J. McCabe. 複雑度尺度。IEEE Transactions on Software Engineering、SE-2(4):308-320、1976年。doi: 10.1109/TSE.1976.233837。
Martin Monperrus. 自動ソフトウェア修復。ACM Computing Surveys、51(1):1-24、2018年1月。doi: 10.1145/3105906。URL https://doi.org/10.1145%2F3105906。
Manish Motwani, Yuriy Brun. バグレポートとテストを併用することによるより優れた自動プログラム修復、2023年。
Niklas Muennighoff、Qian Liu、Armel Zebaze、Qinkai Zheng、Binyuan Hui、Terry Yue Zhuo、Swayam Singh、Xiangru Tang、Leandro von Werra、Shayne Longpre。Octopack:コード大規模言語モデルのインストラクションチューニング、2023年。
Gabriel Orlanski、Kefan Xiao、Xavier Garcia、Jeffrey Hui、Joshua Howland、Jonathan Malmaud、Jacob Austin、Rishabh Singh、Michele Catasta。プログラミング言語分布の影響の測定、2023年。
Simon Ott、Adriano Barbosa-Silva、Kathrin Blagec、Janina Brauner、Matthias Samwald。人工知能におけるベンチマーク作成と飽和のグローバルダイナミクスのマッピング。Nature Communications、13、2022年。URL https://api.semanticscholar.org/CorpusID:247318891。
Stephen Robertson、Hugo Zaragoza ほか。確率的関連性フレームワーク:Bm25とその先。Foundations and Trends® in Information Retrieval、3(4):333-389、2009年。
Baptiste Rozière、Jonas Gehring、Fabian Gloeckle、Sten Sootla、Itai Gat、Xiaoqing Ellen Tan ほか。Code llama:コード向けオープン基盤モデル、2023年。
David Schlangen。言語タスクと言語ゲーム:現在の自然言語処理研究における方法論について、2019年。
Dominik Sobania、Martin Briesch、Carol Hanna、Justyna Petke。ChatGPTの自動バグ修正性能の分析、2023年。
Aarohi Srivastava、Abhinav Rastogi、Abhishek Rao、Abu Awal Md Shoeb ほか。模倣ゲームの先へ:言語モデルの能力の定量化と外挿、2023年。
Rosalia Tufano、Luca Pascarella、Michele Tufano、Denys Poshyvanyk、Gabriele Bavota。コードレビュー活動の自動化に向けて、2021年。
Junjie Wang、Yuchao Huang、Chunyang Chen、Zhe Liu、Song Wang、Qing Wang。大規模言語モデルを用いたソフトウェアテスト:サーベイ、ランドスケープ、ビジョン、2023年。
Chunqiu Steven Xia と Lingming Zhang. 訓練は少なく、修復をもっと:ゼロショット学習による自動プログラム修復の再考. 第30回ACM合同欧州ソフトウェアエンジニアリング会議およびソフトウェアエンジニアリングの基礎に関するシンポジウム論文集, pp. 959-971, 2022.
Chunqiu Steven Xia と Lingming Zhang. 会話型自動プログラム修復, 2023.
Chunqiu Steven Xia, Matteo Paltenghi, Jia Le Tian, Michael Pradel, and Lingming Zhang. 大規模言語モデルによるユニバーサルファジング. arXiv preprint arXiv:2308.04748, 2023.
John Yang, Akshara Prabhakar, Karthik Narasimhan, and Shunyu Yao. Intercode: 実行フィードバックを用いた対話型コーディングの標準化とベンチマーク化, 2023.
Xin Yang, Raula Gaikovina Kula, Norihiro Yoshida, and Hajimu Iida. 現代のコードレビューリポジトリのマイニング:人、プロセス、製品のデータセット. 第13回国際ソフトウェアリポジトリマイニング会議論文集, pp. 460-463, 2016.
Shunyu Yao, Howard Chen, John Yang, and Karthik Narasimhan. Webshop: グラウンディングされた言語エージェントとのスケーラブルな実世界ウェブインタラクションに向けて, 2022.
Pengcheng Yin, Wen-Ding Li, Kefan Xiao, Abhishek Rao, Yeming Wen, Kensen Shi, Joshua Howland, Paige Bailey, Michele Catasta, Henryk Michalewski, Alex Polozov, and Charles Sutton. 対話型データサイエンスノートブックにおける自然言語からコードへの生成, 2022.
Hao Yu, Bo Shen, Dezhi Ran, Jiaxin Zhang, Qi Zhang, Yuchi Ma, Guangtai Liang, Ying Li, Tao Xie, and Qianxiang Wang. Codereval: 生成的プレトレーニング済みモデルを用いた実用的コード生成のベンチマーク, 2023.
Tao Yu, Rui Zhang, Kai Yang, Michihiro Yasunaga, Dongxu Wang, Zifan Li, James Ma, Irene Li, Qingning Yao, Shanelle Roman, Zilin Zhang, and Dragomir Radev. Spider: 複雑かつクロスドメインの意味解析とtext-to-SQLタスクのための大規模人手ラベル付きデータセット. 2018年自然言語処理における経験的手法に関する会議論文集, pp. 3911-3921, Brussels, Belgium, October-November 2018. Association for Computational Linguistics. doi: 10.18653/v1/D18-1425. URL https://aclanthology.org/D18-1425.
Daoguang Zan, Bei Chen, Dejian Yang, Zeqi Lin, Minsu Kim, Bei Guan, Yongji Wang, Weizhu Chen, and Jian-Guang Lou. Cert: ライブラリ指向コード生成のためのスケッチに関する継続的プレトレーニング, 2022.
Daoguang Zan, Bei Chen, Fengji Zhang, Dianjie Lu, Bingchao Wu, Bei Guan, Yongji Wang, and Jian-Guang Lou. 大規模言語モデルとnl2code:サーベイ, 2023.
Jiyang Zhang, Sheena Panthaplackel, Pengyu Nie, Junyi Jessy Li, and Milos Gligoric. Coditt5: ソースコードと自然言語の編集のためのプレトレーニング, 2022.
Zibin Zheng, Kaiwen Ning, Jiachi Chen, Yanlin Wang, Wenqing Chen, Lianghong Guo, and Weicheng Wang. ソフトウェアエンジニアリングタスクにおける大規模言語モデルの理解に向けて. arXiv preprint arXiv:2308.11396, 2023.
Shuyan Zhou, Frank F. Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Abishek Sridhar, Xianyi Cheng, Yonatan Bisk, Daniel Fried, Uri Alon, and Graham Neubig. Webarena: 自律エージェント構築のための現実的なウェブ環境, 2023.
付録
付録では、データセット構築プロセス、評価パイプライン、およびSWE-benchベンチマークの特性評価に関するより詳細な説明を提供する。
A ベンチマークの詳細
このセクションは、セクション2を補完し、データ収集、実行ベースの検証、および評価手順について、より技術的かつ細粒度の要約を提供するとともに、タスクインスタンスのより完全な特性評価を行う。
A.1 高レベル概要
プルリクエストのスクレイピング。2023年8月におけるダウンロード数上位5,000のPyPIライブラリのリストから、上位100パッケージを選択し、各ライブラリに対応するオープンソースGitHubリポジトリを特定し、どのパッケージが自由なソフトウェア利用を許可するライセンスを有するかを検証し、GitHub開発者APIを介してこれらのリポジトリのすべてのPRを収集する。広く利用されているリポジトリから問題を調達することを選択するのは、広範な使用が通常、そのリポジトリが豊富なドキュメント、構造化されたオープンソース開発ガイドライン、および動作する整形されたコードを有することを示唆するためである。
タスクインスタンスの構築。3つの条件を満たすPRから候補タスクインスタンスを構築する。第一に、PRのステータスがMergedでなければならない。Mergedステータスは、PRに関連するコード変更が受け入れられ、その親リポジトリに取り込まれたことを示す。第二に、PRがそのリポジトリ内の1つ以上のイシューを解決すること。イシューは、GitHubにおける標準的な用法に従い、ソフトウェアプロジェクトのバグ、機能強化、または一般的な開発目標を追跡するためのデジタルチケットとして定義される。PRのタイトル、本文、およびコミットメッセージをスキャンして、リンクされたイシュー(すなわち「fixes #24」)を探す。第三に、PRが1つ以上の新しいテストを導入しなければならない。新しいテストは、PRのコード変更がテスト関連のキーワード(例:「test」、「testing」)を含むファイルパスを編集した場合にカウントされる。
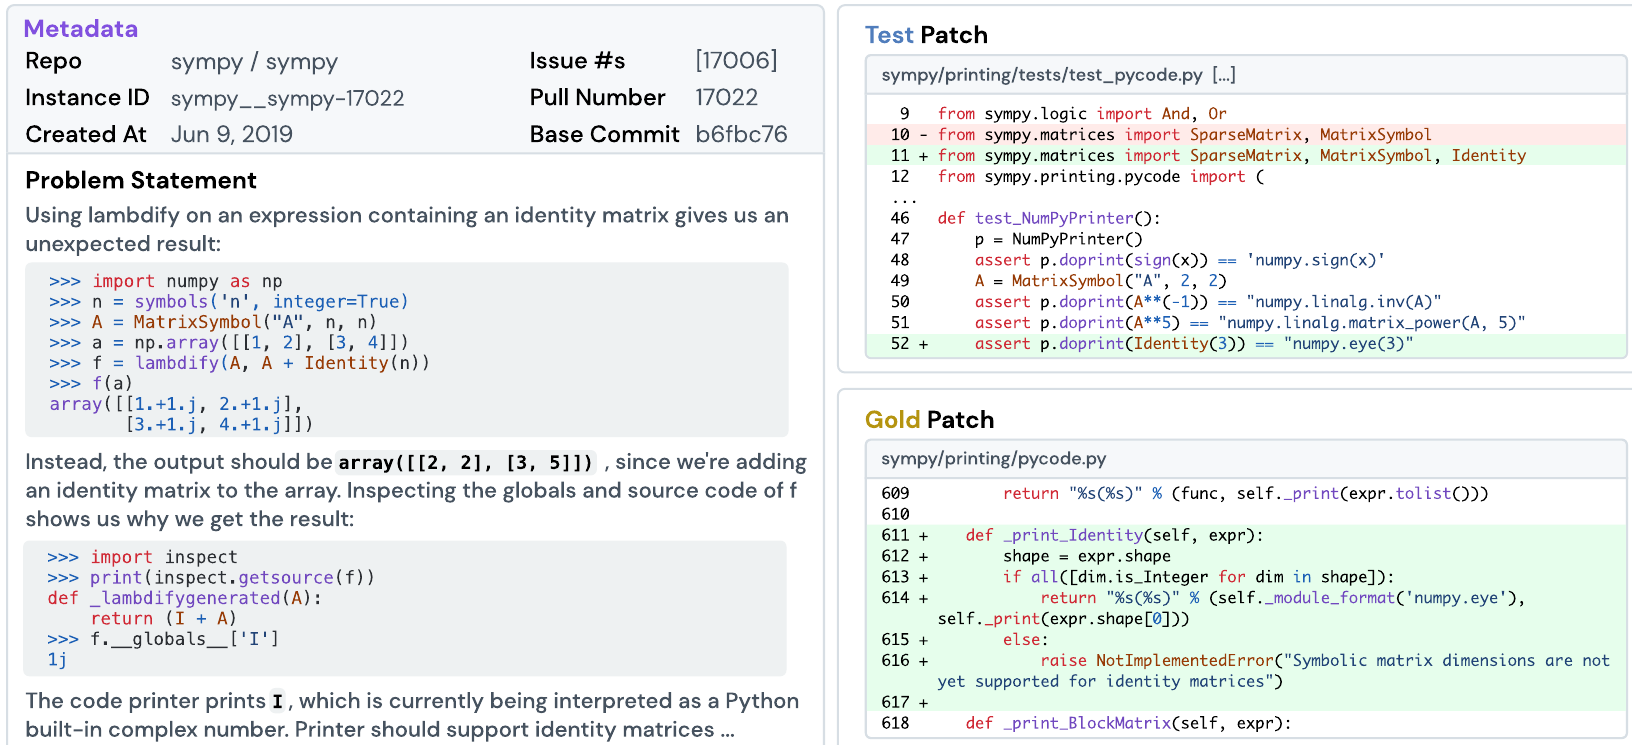
これらの基準を満たすPRは、その後、図7の例のような候補タスクインスタンスに変換される。コードベースは、リポジトリのowner/nameのモニカーとプルリクエストのベースコミットによって識別される。この情報から実際のコードベースを復元することは容易である。元のGitHubリポジトリのミラーを作成し、各ミラーはowner_nameとして一意に識別される。リポジトリに対応するミラーをクローンし、ベースコミットをチェックアウトすることで、PR前の状態のが得られる。問題文は、解決策の詳細の漏洩を避けるため、PRの最初のコミットのタイムスタンプより前に書かれたすべての関連イシューのタイトルと説明、およびその後のコメントの集約である。PRのコード変更は、テストパッチとゴールドパッチに分離される。は、テストパッチで編集されたファイルからのすべてのテストから構成される。図7に示すように、とはともにパッチファイルとして保存される。PRと意味データの解析に関する詳細は付録A.2にある。
実行ベースの検証。実行を通じてタスクインスタンスの使用可能性を検証する。各候補について、まず実行コンテキストとして機能する仮想環境を定義し、次にパッチを適用する前にをインストールし、最後に解決策を適用する前と後のそれぞれ一度ずつを実行する。検証プロセスのいずれかのステップが失敗した場合、その候補は最終データセットの検討対象から除外される。さらに、解決策が自明でないことを確実にするため、解決前と解決後の検証ログを比較し、内にステータスがfailからpassに変化するテストが1つ以上あるかどうかを確認する。最後に、解決策で初めて導入された新規作成の関数やクラスを呼び出すテストを含むタスクインスタンスを除外する。そのような構成要素の命名は通常恣意的なプロセスであり、通常は問題文で明示的に指定されないため、このようなテストの解決は人間の開発者にとっても不可能なタスクとなり得る。実行コンテキスト、コードベースのインストール、ログからのテストステータスの判定などに関する情報は付録A.3にある。
継続的な更新。SWE-benchの収集プロセスは、任意のオープンソースコードリポジトリに容易に拡張可能であり、新しいプログラミング言語やコードドメインへの容易かつ低メンテナンスな拡張を可能にする。この設計はまた、SWE-benchに時間的堅牢性をもたらす。より最近のソースコードで訓練された新しい言語モデルが時間とともにリリースされるにつれて、SWE-benchは、任意のLMの訓練日以降に作成されたPRに基づいて新しいタスクインスタンスを生成するように単純に更新することができる。
A.2 構築プロセス
プルリクエストオブジェクトから候補タスクインスタンスへの変換に関する追加の詳細を議論する。高レベルでは、この変換の主な目標は、セクション2で導入されたコードベース、問題文、単体テスト、および解決策の構成要素をまとめるための関連情報を取得することである。この目的のために、SWE-benchのタスクインスタンスは、以下の表9に示す以下のフィールドから構成される。全体として、これらのフィールドは4つのタスクインスタンスモジュールに対応する。
| フィールド | 説明 |
| base.commit | (str) 元のPRが適用される基盤となるコミットID |
| created.at | (date) PRが最初に作成された日時(マージされた日時ではない)のDatetimeオブジェクト |
| hints.text | (str) 問題を解決する方法に関する自然言語による提案 |
| instance.id | (str) リポジトリとpull_numberから作成される一意の識別子 |
| issue.numbers | (list) 元のプルリクエストが解決するイシュー番号のリスト |
| patch | (str) 問題に対する参照解であり、元のPRのコード変更から抽出された.patch形式の文字列 |
| problem.statement | (str) コードベースに対して望まれる変更の自然言語による説明 |
| pull.number | (int) 元のプルリクエストのプル番号 |
| test.patch | (str) タスクが解決されたかを確認するための未見のテストを含み、元のPRのコード変更から抽出された.patch形式の文字列 |
| version | (str) PRが作成された際の(リポジトリに関する)リリースバージョン |
| repo | (str) タスクインスタンスの由来となるリポジトリ |
| FAIL_TO_PASS | (list) ステータスがfailからpassに変化するテストのリスト |
| PASS_TO_PASS | (list) ステータスがpassからpassに変化するテストのリスト |
| env.install.commit | (str) タスクインスタンスを実行するために必要な依存関係をインストールする基盤コミット。 |
問題文。各タスクインスタンスのための問題文は、problem_statementフィールドとして容易に入手可能である。問題文は、すべてのイシューの最初のコメント、およびそれらのイシューに付されたコメントのうち、PRの最初のコミットの作成日より前に作成されたものを集約したものである。我々は、PRのタイトル、本文、およびコミットメッセージからイシューをクロールする。これらの構成要素のテキストデータを連結した後、まずMarkdown形式のコメントをすべて除去し、次に残ったテキストの中からイシュー番号への参照(シャープ記号#に続く数字)を探し、そのイシュー番号への参照の直前にある単語が、そのイシューがそのPRによって解決されたことを示唆するキーワードの集合(例えば「closes」「fixes」「resolves」)に含まれているかどうかを確認する。見つかったイシューはissue_numberフィールドに記録され、その後、各イシューのデータを取得するために個別のウェブリクエストが行われる。problem_statementを構成するために、各イシューのタイトルと本文が合わせられ、複数のイシューがある場合には次のイシューのものと連結される。また、このステップの間にhints_textフィールドが作成され、PRのコメント欄から収集される。そこでは、PRの最初のコミットより前に作成されたコメントのテキストが対象となる。この収集方法の着想は、そのようなPRのコメントには、目前の問題をどのように完了するかについて、元の人間のタスク作業者に対する自然言語や擬似コードによる提案が含まれている可能性が高いという点にある。本論文で提示する実験ではhints_textを使用していないが、この情報は将来の調査にとって興味深いものとなり得ると我々は考えている。
コードベース。コードベースの内容は、すべてのタスクインスタンスについて平文で保存されているわけではない。むしろ、タスクインスタンスはrepoおよびbase_commitフィールドを介して関連するコードベースへの参照を含んでいる。両方のフィールドは元のPRのデータにおいて利用可能である。これら2つの要素からコードベースを取得することを再現可能かつ信頼できるものにするために、我々は元のリポジトリのミラーを作成する。評価データとファインチューニングデータの両方を構成するリポジトリのミラーは収集され、SWE-bench GitHub organizationの下でオープンソース化されている。元のリポジトリのコードは、著者の制御の及ばないところでそのコミットおよび編集履歴に変更が加えられる可能性があるため、我々はミラーリポジトリを作成することを選ぶ。これにより、コードベースへの後日の変更が、関連するbase_commitの破損や削除によってタスクインスタンスを使用不能にする可能性がないことを保証する。さらに、我々はリポジトリの最新バージョンをクローンして保存するのではなく、ミラーを作成する。これは、ミラーが元のコミットハッシュ、履歴、ブランチ、およびタグを保持し、元のリポジトリの技術的詳細の忠実かつ完全な履歴として機能するためである。ミラーは、元のリポジトリのスター、ウォッチャー、イシュー、またはプルリクエストを保持しない。
我々は、タスクインスタンスが収集された日と同日またはその後、かつその日のうちに、リポジトリからミラーを作成する。ミラーは元のリポジトリの「owner/name」という名称を保持するが、GitHubの命名規則に適合するよう「/」文字は「_」に変換される。このインフラストラクチャがあれば、タスクインスタンスのコードベースの取得は容易である。まず、正しいミラーをrepoを用いてSWE-bench organizationからクローンすることができる。次に、ミラーのローカルコピー内でbase_commitをチェックアウトすると、リポジトリがコードベースにリセットされる。同じリポジトリの別のタスクインスタンスへ進むためには、gitバージョン管理を用いて、次のタスクインスタンスのベースコミットをチェックアウトする前に、現在のタスクインスタンスに関連する変更を自動的に除去する。
解決策、テストパッチ。解決策 とテスト は、PRのファイル変更データ、すなわちdiffから導出される。セクション2.1で述べたように、元のdiff、解決策 、およびテスト は.patchファイルとして表現される。これは行ベースのテキストファイルへの変換を効率的に指定するための形式である。一般的に言えば、.patchはブロックのリストとして構造化され、各ブロックはヘッダーと、単一ファイルへの変更にまとめて対応する1つ以上のハンクから構成される。ヘッダーにはファイルパスと行番号を指定するメタデータが含まれ、対象ファイルへの実際の変更は、追加と削除を示すために「+」と「-」を接頭辞とする複数の行としてエンコードされる。テスト を作成するために、まずパッチ内のすべての一意なブロックを特定し、次にテスト関連のキーワード(例:「tests」「testing」)を含むファイルパスを持つブロックを選び出して集約する。残りのブロックはマージされて解決策 を形成する。 と を正しく解析するために書かれたスクリプトの堅牢性を検証するために、両方のパッチを対応するコードベース に適用してテストを実行し、その結果がベースPRのdiffデータの挙動を再現することを確認する。解決策 はpatchフィールドとして保存され、テスト はtest_patchフィールドとして保存される。
残りのフィールド。created_atフィールドは、ベースPRが作成された日時を指定するタイムスタンプである。元のデータからcreated_atフィールドを保持し、このフィールドを用いてモデル性能の時間的分析を行う。versionフィールドは、そのPRがリリースされた時点の、リポジトリに関するリリースバージョンに対応する文字列である。各手法の利用可能性と必要な労力に応じて、versionフィールドは、ソースコードから直接情報を取得する、リポジトリをローカルでビルドしてバージョンを標準出力に表示するコードを呼び出す、あるいはcreated_atフィールドをリポジトリのウェブページにあるリリースバージョンのタイムラインと比較することによって作成する。§ A.3でより詳しく論じるように、リポジトリのすべてのバージョンに対して実行可能コンテキストを作成する。
GitHubを用いたミラーリポジトリ作成のドキュメント
A.3 実行ベースの検証
リポジトリ内のすべてのPRをフィルタリングし、上述の基準を満たすものを候補タスクインスタンスに変換した後、次のステップは、実行を通じて各タスクインスタンスの使用可能性を検証することである。この手順は3つのステップに分けられる。まず、リポジトリの各リリースバージョンに対して実行可能コンテキストを作成する。次に、解決策 とテスト がコードベース 上に適用、インストール、および正常に実行できるかを確認する。最後に、各タスクインスタンスの実行ログを調べて特定の一連の挙動を検証し、そのタスクがモデル評価にとって使用可能かつ公平であることを保証する。
実行可能コンテキスト。仮想環境をどの定義レベルで定義するかという粒度について様々な程度を実験した後、リリースバージョンごとに実行可能コンテキストを作成することを選択した。タスクインスタンス固有のコンテキストを定義することは、エンドツーエンドのインストール成功を保証するうえで最も有用であるが、手作業による入念な作成というコストを伴う。一方、リポジトリの最新バージョンに基づくリポジトリ固有のコンテキストは、通常、定義としては粗すぎて、古いバージョンの要件と互換性がない。リリースバージョンは、タスクインスタンスのサブセット全体にわたる依存関係要件を捉えるための良い代替指標であり、インストール成功と手作業の間で管理可能なバランスを取ることが分かった。各実行可能コンテキストは、各バージョンの最新タスクインスタンスのコードベースを調べることによって手動で作成する。ソースコードと、通常はリポジトリのREADMEおよびCONTRIBUTINGガイドに見られるドキュメントに基づいて、Pythonのバージョン、必要な依存関係、およびインストールコマンドを突き止める。
検証エンジン。検証エンジンの目的は、候補タスクインスタンスを検証することである。具体的には、このステップでは第一に、解決策 とテスト がコードベース に適用できること、第二に、コードベースが対応する仮想環境内で適切にインストールおよび実行できることを確認する。これを行うために、リポジトリごとに検証を実施し、各リポジトリのタスクインスタンス群について次の手順を実行する:
1. バージョンごとの最新タスクインスタンスに基づいて、conda環境として実行可能コンテキストを作成する。
2. タスクインスタンスをバージョンごとにグループ化する。
3. 各タスクインスタンスグループを反復処理し、各タスクインスタンスについて、対応するconda環境内で次を実行する。
(a) ファイル変更をすべて削除し、タスクインスタンスのbase_commitをチェックアウトする。これによりリポジトリがコードベース に設定される
(b) インストールコマンドを実行してコードベース をインスタンス化する
(c) テストパッチ をコードベース に適用する
(d) テストパッチ から決定したテストスクリプトを実行し、テスト結果ログ を生成する
(e) 解決策 パッチをテスト とともにコードベース に適用する
(f) (d)のテストスクリプトを再度実行し、テスト結果ログ を生成する
テストコマンドは、リポジトリが使用するテストフレームワーク(例:pytest、tox)に、 で指定されたパスを付加したものから構成される。テストコマンドは、各ファイルパスの内容内で指定されたあらゆるテストを実行する。ステップ から のいずれかが失敗した場合、その候補タスクインスタンスは検討対象から除外される。リポジトリ間で中程度のばらつきはあるものの、このステップによって一般に候補タスクインスタンスの半数が除外されることを観察している。
検証ログの調査。最後に重要なこととして、検証エンジンが作成したログ と を特定の性質について調べる。まず、任意の命名選択に対する防御として、 にImportErrorおよびAttributeErrorの発生がないかを確認する。これらは、依存関係の命名に関連するエラーを示す可能性があり、その場合、対処が自明であり、かつ正しく解決することがほぼ不可能となる。このため、 にそのようなエラーを含むすべてのタスクインスタンスを検討対象から除外する。次に、テスト結果を比較して、そのタスクインスタンスが非自明であること、すなわち、解決策 が適用される前に少なくとも1つ以上のテストがfailステータスを示し、適用後にpassステータスを示すことを確認する。これを確認するために、まず と を、テスト からステータス へのマッピングに変換するためのリポジトリ固有のパーサーをいくつか定義する。これら2つのデータ構造が与えられたうえで、
| リポジトリ | クロールされたPR総数 | 変換後 | 検証後(最終) |
| astropy | 9,469 | 1,016 | 95 |
| django | 16,914 | 2,880 | 850 |
| flask | 2,434 | 107 | 11 |
| matplotlib | 16,545 | 1,057 | 184 |
| pylint | 3,848 | 787 | 57 |
| pytest | 5,147 | 750 | 119 |
| requests | 2,344 | 84 | 44 |
| scikit-learn | 15,159 | 1,169 | 229 |
| seaborn | 1,004 | 203 | 22 |
| sphinx | 4,931 | 645 | 187 |
| sympy | 11,928 | 1,897 | 386 |
| xarray | 3,416 | 812 | 110 |
| 合計 | 93,139 | 11,407 | 2,294 |
がfailからpassに変化する が少なくとも1つ存在することを確認する。そのようなテストが見つからない場合、そのタスクインスタンスは検討対象から除外される。
タスクインスタンスがこれら2つの基準を満たす場合、それは評価データセットに含まれる。表10は、構築プロセスおよび実行ベースの検証ステップ全体を通じて、検討対象から除外されたタスクインスタンスの数をまとめたものを示している。最終化されたすべてのタスクインスタンスは、オープンソース化されダウンロード可能な単一の.jsonファイルに保存される。
タスクインスタンスに加えて、正解のテスト結果を含む対応するフォルダーも作成する。各タスクインスタンスについて、それぞれの と のテスト対ステータスマッピングから、キーがFAIL_TO_FAIL、FAIL_TO_PASS、PASS_TO_FAIL、およびPASS_TO_PASSであり、値がテストのリストであるテスト結果データ構造を作成する。これらの結果を「キャッシュ」することにより、評価時に解決策 を再実行する必要をなくす(ただし再実行は利用可能な選択肢である)。このデータ構造を用いて、セクションA.4で論じるようにタスク完了を検証する。
A.4 評価手順
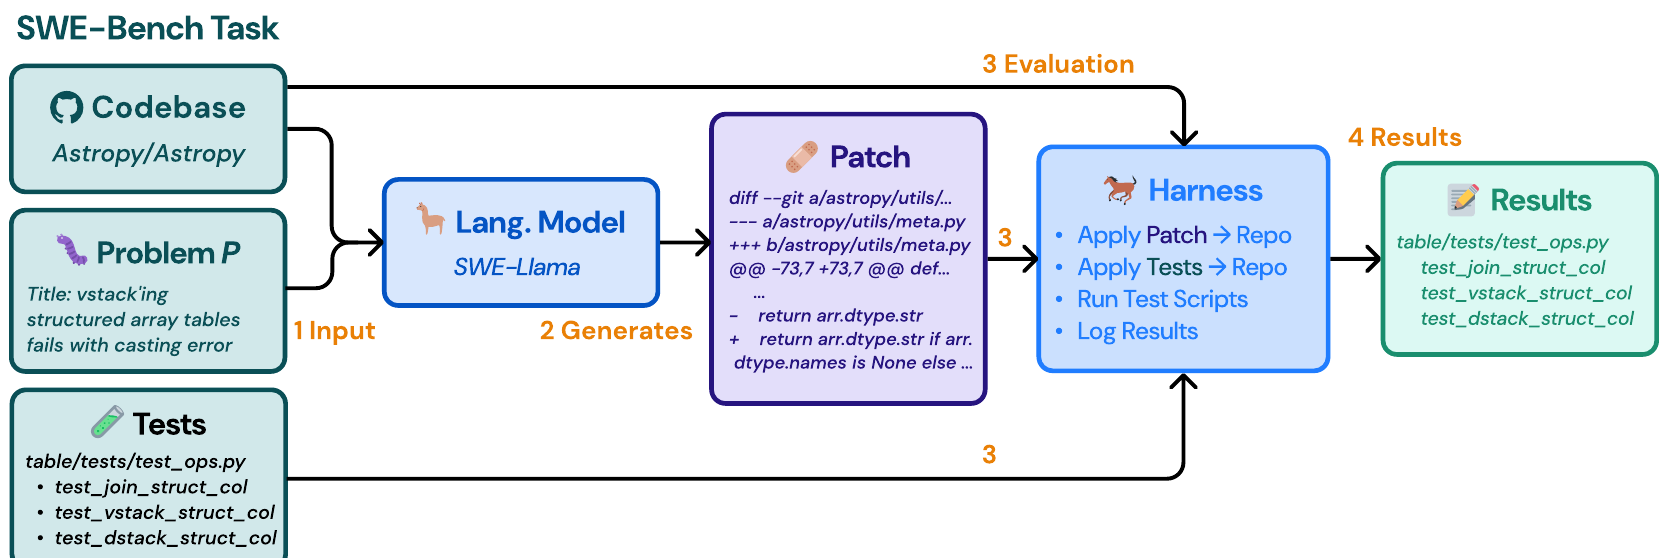
評価手順の可視化を図8に示す。評価手順は、モデルの .patch生成を、解決策 の挙動に対して採点する。より細かいレベルでは、評価手順は4つの別個のステップに分解でき、図8の番号付きステップで強調されている。まず、コードベースと問題文がLMに対して可視化され与えられる。次にLMが.patch予測 を生成する。評価ステップでは、対象タスクインスタンス上の予測ごとに次のステップが実行される:
1. ファイルの変更をすべて元に戻し、タスクインスタンスのベースコミットをチェックアウトします。これにより、リポジトリはコードベース に設定されます。
2. タスクインスタンスのバージョンに対応する実行可能コンテキストをアクティブ化します。
3. インストールコマンドを実行して、コードベース をインスタンス化します。
4. テストパッチ をコードベース に適用します。
5. 予測パッチ をテスト を含むコードベース に適用します。
6. 前のステップが失敗した場合、予測パッチ を自動的に修正し、再適用を試みます。
7. テストパッチ から決定されるテストスクリプトを実行し、テスト結果ログ を生成します。
ステップ1から4は、タスクインスタンスの検証プロセスにおける検証によって失敗することは確実にありません。予測パッチの適用(ステップ5)が失敗した場合、不要なコンテキスト行を削除し、ヘッダー値を再計算することで、予測パッチファイルの修復を試みます(ステップ6)。残りのパッチが再び失敗するか、テストコマンドの実行(ステップ7)が失敗した場合、その予測には自動的にスコア0が与えられます。これらのステップが成功したと仮定すると、出力ログ は、§ A.3で導入された適切なリポジトリ固有のパーサーを用いて、テストからステータスへのマッピングに変換できます。このマッピングは構造的に同一です。
評価指標の計算。タスクの完了を判定するために、 から解析されたテストからステータスへのマッピングを、正解のテスト結果データ構造におけるFAIL-TO-PASSキーおよびPASS-TO-PASSキーに対応するテストのリストと比較します。タスクの完了判定は単純です。評価用のテストからステータスへのマッピングにおいて、すべてのFAIL-TO-PASSテストおよびPASS-TO-PASSテストが見つかり、かつ合格ステータスを持っていることを確認します。テストが欠落している場合、または非合格ステータスを持つ場合は、不合格ステータスとみなされます。本論文で定義および使用されているように、FAIL-TO-PASSおよびPASS-TO-PASSにまたがるすべてのテストが合格した場合、そのタスクは解決済みとみなされます。
A.5 評価テストセットの特性評価
表1を拡張した形式で、リポジトリ固有の統計を含む表11を掲載します。表12は、各リポジトリのドキュメントから抽出した簡単な説明と、リポジトリに関連するオープンソースライセンスを示します。関連するライセンスはすべて、元のライセンスにおける許可条件が遵守され保持される限り、元のライブラリソースコードの非商業的利用を許可しています。表1に示された元の統計に加えて、3つの新しい値を導入します。 Lines Addedと Lines Removedは合計して Lines Editedになります。「Added」は導入された新しい行の数を指し、「Removed」はソリューションによって削除された既存の行を指します。(Pass to Pass)統計は、検証パイプラインにおいてソリューション が適用される前に合格していたテストの数を指します。問題文 を特徴づけ、修正が問題に対処しているかどうかを判定することを目的とするfail to passテストとは異なり、pass to passテストは、修正が既存の期待される動作を壊したり違反したりしないことを保証するために含まれています。これらのテストは、§ A.3で論じた検証ログの検査フェーズにおいて抽出されます。fail to failテストおよびpass to failテストは評価時に考慮されず、それらの統計は上記の表には反映されていないことに留意してください。
タスクインスタンスの問題カテゴリ。SWE-benchのタスクインスタンスが含む問題の種類をよりよく理解するために、各タスクインスタンスについて、issue_numbersフィールドで識別される問題の簡単な分析を行います。問題ごとに、メタデータ、具体的にはタグを検査し、PRによって提示された貢献の種類を特徴づけます。表13は、すべての問題にわたって見つかった2,289個のタグのうち、いくつかの例をグループ化して示しています。問題の絶対的多数はバグ修正に関連していますが、SWE-benchのタスクインスタンスは、デバッグやエラー修正以外の目的を持つ多様なコード変更の集合に関連しています。
属性分布。図9では、表1で導入した属性の累積分布関数のプロットを示す。これらのプロットから、SWE-benchタスクインスタンスの中央値は、問題記述が140語であり、1900ファイル弱・40万行を含むコードベース内で行われることが分かる。対応する参照解\(\delta\)は通常、
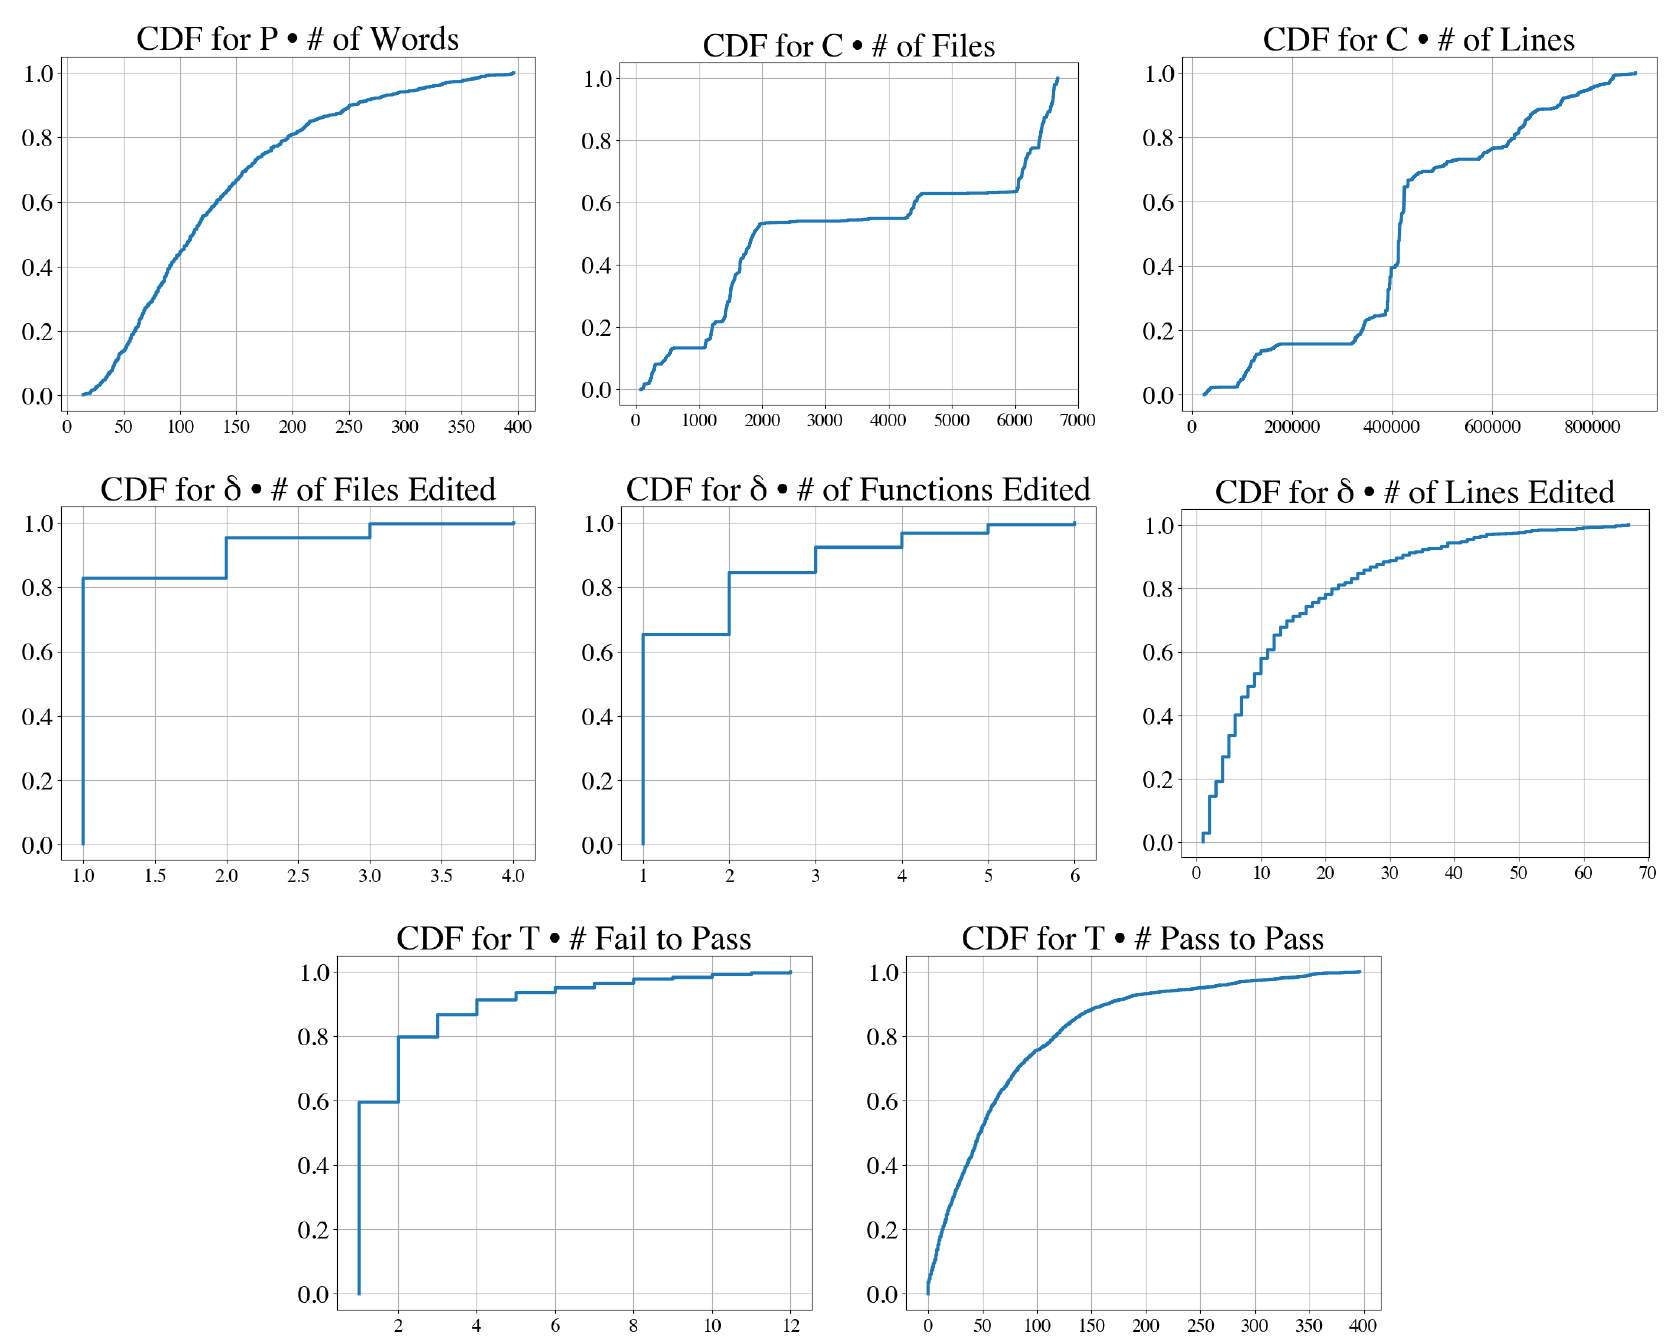
| 読み取り専用の背景情報(翻訳対象の原文テキストではありません): | 属性分布。 | 図9では、表1で導入された属性の累積分布関数のプロットを示します。 | これらのプロットから、SWE-benchタスクインスタンスの中央値は、問題記述が140語であり、約1900ファイル弱、40万行を含むコードベース内で行われることがわかります。 | 対応する参照解δは通常、ファイル内の単一の関数を編集し、約15行を変更し、fail to passテストを1つ持ちます。 | 翻訳対象テキスト: | |
| astropy | django | flask | matplotlib | pylint | pytest | P 長さ(文字数) |
| 2,742 | 1,307 | 1,185 | 2,381 | 2,011 | 2,948 | C ファイル数 |
| 1,811 | 6,356 | 225 | 4,395 | 2,426 | 497 | C 行数 |
| 804k | 407k | 35k | 646k | 109k | 111k | δ 編集ファイル数 |
| 1.5 | 1.5 | 1.6 | 1.5 | 1.8 | 1.4 | δ 編集関数数 |
| 2.5 | 2.0 | 2.4 | 2.2 | 1.8 | 1.7 | δ 編集行数 |
| 36.0 | 18.5 | 35.4 | 58.9 | 36.0 | 24.5 | δ 追加行数 |
| 25.0 | 12.8 | 23.7 | 35.7 | 26.6 | 18.2 | δ 削除行数 |
| 10.9 | 5.7 11.6 23.2 9.5 6.4 |T|(Fail to Pass) 21.7 | 8.8 | 1.4 | 2.4 | 6.8 | 4.1 |
| |T|(Pass to Pass) | 191.0 | 85.9 | 32.5 | 242.4 | 47.0 | 60.7 |
| |T|(All) | 212.8 | 94.6 | 33.9 | 244.8 | 53.7 | 64.8 |
| requests | scikit-learn | seaborn | sphinx | sympy | xarray | |
| P 長さ(文字数) | 1,654 | 2,239 | 1,667 | 1,888 | 1,213 | 3,515 |
| C # ファイル数 | 119 | 1,224 | 273 | 1,483 | 1,666 | 260 |
| C # 行数 | 30k | 361k | 105k | 423k | 678k | 137k |
| δ # 編集ファイル数 | 1.64 | 1.68 | 1.77 | 1.51 | 1.9 | 2.45 |
| δ # 編集関数数 | 1.59 | 2.24 | 1.41 | 2.72 | 3.22 | 3.16 |
| δ # 編集行数 | 25.5 | 44.0 | 30.1 | 30.6 | 36.3 | 124.8 |
| δ # 追加行数 | 19.2 | 32.7 | 24.9 | 22.0 | 24.2 | 95.6 |
| δ # 削除行数 | 6.2 | 11.3 | 5.2 | 8.6 | 12.1 | 29.2 |
| |T|(Fail to Pass) | 7.6 | 7.5 | 12.9 | 2.3 | 2.2 | 58.5 |
| |T|(Pass to Pass) | 87.1 | 150.7 | 86.8 | 45.1 | 74.5 | 297.5 |
| |T|(全体) | 94.7 | 158.2 | 99.7 | 47.4 | 76.8 | 356.1 |
| リポジトリ | 概要 | ライセンス |
| astropy/astropy | 天文学・天体物理学のコアライブラリ | BSD 3-Clause |
| django/django | Webアプリケーション構築用のWebフレームワーク | BSD 3-Clause |
| pallets/flask | 小規模Webアプリ向けの軽量フレームワーク | BSD 3-Clause |
| matplotlib/matplotlib | ビジュアル作成用のプロットライブラリ | カスタム |
| pylint-dev/pylint | Python 2または3向けの静的コード解析ツール | GPL 2.0 |
| pytest-dev/pytest | Python向けのテストフレームワーク | MIT |
| psf/requests | HTTPリクエストを記述するためのシンプルでエレガントなライブラリ | Apache-2.0 |
| scikit-learn/scikit-learn | Pythonにおける機械学習 | BSD 3-Clause |
| mwaskom/seaborn | Pythonにおける統計データ可視化 | BSD 3-Clause |
| sphinx-doc/sphinx | ドキュメント作成用のライブラリ | カスタム |
| sympy/sympy | Pythonで書かれたコンピュータ代数システム | カスタム |
| pydata/xarray | N次元ラベル付き配列およびデータセット | Apache-2.0 |
ファイル内の単一の関数を編集し、約15行を変更し、変更の正確性を検証するためのfail to passテストを1つ、既存の動作が保持されているかを確認するためのpass to passテストを51個持つ。
パッチ修正率。表14では、各モデルが(2294件中)何件のタスクインスタンスに対してパッチを生成したか、これらのパッチのうち何件が正常に適用されたか、そして正常に適用されたパッチのうち何件が付録A.4で導入したパッチ修正手順を経る必要があったかについての要約統計を示す。修正されたパッチは、正常に適用されたSWE-Llamaのパッチの中でより小さい割合を占める傾向があることが分かり、これはSWE-Llamaのファインチューニング手順が整形されたパッチの生成に正の効果を持つことを示唆している。クローズドソースモデルでは、正常に適用されるパッチがより少なく、適用されたもののうち、より大きな割合が生成後の修正を必要としており、モデルがパッチ生成および構造化出力全般に依然として苦戦していることを示唆している。
| Category | Count | Examples |
| Bug | 442 | 「Bug」(179)、「type:bug」(114)、「bug」(57)、「type: bug」(48)、「Bug:beetle:」(23)、「status: confirmed bug」(20) |
| Feature | 167 | 「type:enhancement」(47)、「Enhancement」(25)、「New feature」(24)、「Feature Request」(22)、「type: enhancement」(19)、「Enhancement:star:」(15)、「New Feature」(7)、「enhancement」(6)、「type: regression」(14)、「Regression」(14)、「regression」(8)、「help wanted」(71)、「good first issue」(66)、「printing」(58)、「extensions:autodoc」(58)、「Easy」(57)、「Easy to Fix」(54)、「domains:py」(27)、「core」(26)、「sets」(23)、「Wrong Result」(23)、「units」(22)、「Good first issue」(21) |
| モデル | 検索設定 | 生成数 | 適用数 | 修正数 | パッチ修正率 |
| ChatGPT-3.5 | BM25 13k | 2,270 | 604 | 363 | 60.1% |
| ChatGPT-3.5 | 「Oracle」 | 1,262 | 500 | 222 | 44.4% |
| ChatGPT-3.5 | 「Oracle」-collapsed | 1,811 | 939 | 420 | 44.73% |
| Claude 2 | BM25 13k | 2,281 | 988 | 302 | 30.57% |
| Claude 2 | 「Oracle」 | 2,138 | 1,441 | 360 | 24.98% |
| Claude 2 | 「Oracle」-collapsed | 2,242 | 1,564 | 465 | 29.73% |
| GPT-4 | BM25 27k | 573 | 85 | 59 | 69.41% |
| GPT-4 | 「Oracle」 | 462 | 195 | 121 | 62.05% |
| GPT-4 | 「Oracle」-collapsed | 2,292 | 1,116 | 684 | 61.29% |
| SWE-Llama 13b | BM25 13k | 2,010 | 1,230 | 369 | 30.0% |
| SWE-Llama 13b | 「Oracle」 | 2,125 | 1,532 | 378 | 24.67% |
| SWE-Llama 7b | BM25 13k | 2,139 | 1,187 | 340 | 28.64% |
| SWE-Llama 7b | 「Oracle」 | 2,119 | 1,503 | 298 | 19.83% |
A.6 開発セットの特徴付け
評価用テストセットに加えて、最終テストセットで実行する前にモデルを評価しハイパーパラメータを調整するための開発セットも提供する。先ほどの表やグラフのスタイルに従い、そのような使用を許可するライセンスを持つ6つのオープンソースリポジトリから収集した225件の開発タスクインスタンス(主要評価セットの\(10\%\)強)を特徴付ける同様の統計を示す。開発セットは、主要評価セットと全く同じ方法論とフィルタのセットに従って収集された。既存のステップに加えて、開発セットをフィルタリングし、2019年1月1日以降に作成されたタスクインスタンスのみを保持した。表12と同様に、表15では、選択した6つのリポジトリの目的とライセンスを簡単に要約する。
表13に続き、表16に開発セットのタスクに関連するタグを一覧し、ここでもバグ修正以外のタスクタイプの多様性と網羅性を示す。主要評価タスクと比較して、開発セットのリポジトリに固有の問題を提示するイシューを指すタグ(例:「Crash :collision:」「io」)も確認できる。
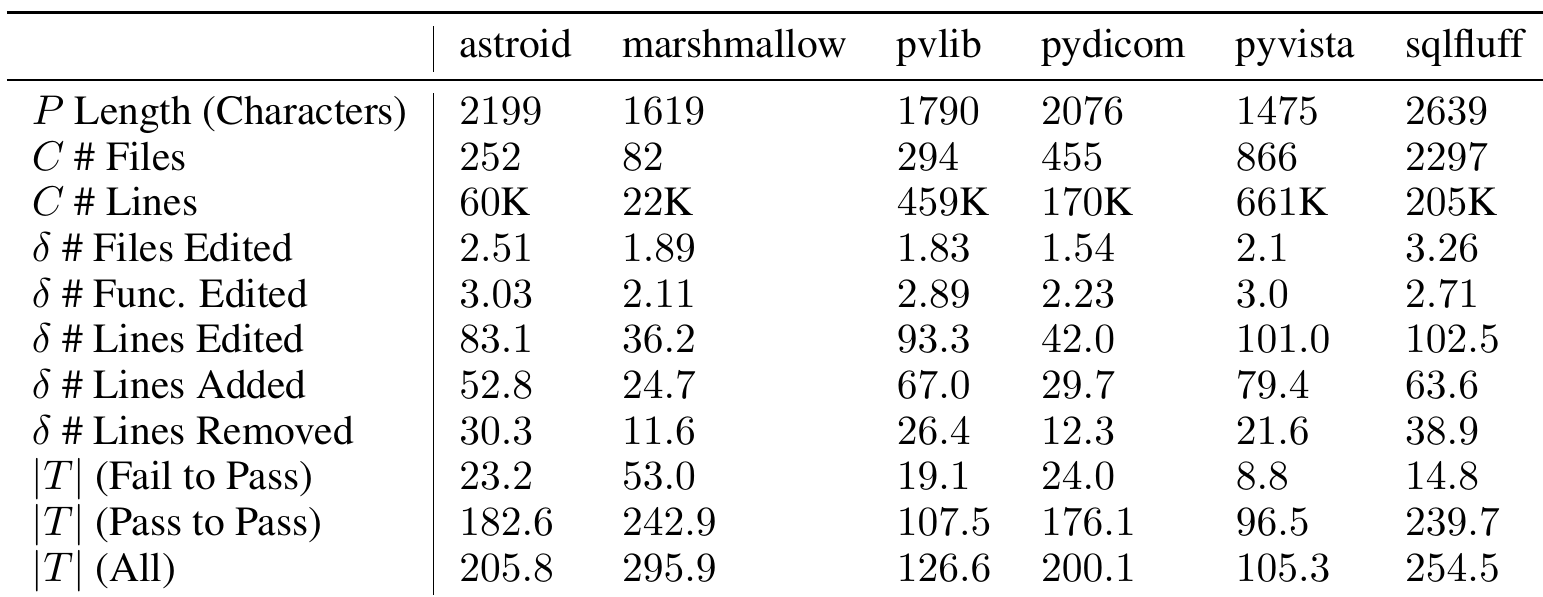
表1に続き、表17に開発セットの6つのリポジトリについて、同じリポジトリ別の平均統計を示す。開発セット全体では、各タスクインスタンスは平均19.9件/中央値2件のF2Pテストを持つ。P2Pテストは平均171.3件/中央値79.0件であり、タスクインスタンスあたりのテスト総数は平均191.2件/中央値101.0件である。
| リポジトリ | 概要 | カウント | ライセンス |
| marshmallow-code/marshmallow pylint-dev/astroid pydicom/pydicom pvlib/pvlib-python pyvista/pyvista sqlfluff/sqlfluff | 複雑なオブジェクトをPythonデータ型との間でパースする ASTのパース、静的解析/推論のためのライブラリ Pythonを用いたDICOMファイルの読み取り/変更/書き込み 太陽光発電システム性能のシミュレーション インターフェースを通じた3Dプロット、メッシュ解析 SQLリンター。複数の方言、テンプレートをサポート | 9 31 56 63 16 50 | MIT LGPL-2.1 Custom Custom MIT MIT |
| カテゴリ | 件数 | 例 |
| バグ | 127 | 「bug」(111)、「Bug :cookreach:」(10)、「rule bug」(6) |
| 機能 | 55 | 「enhancement」: 46、「Enhancement :star:」 5、「feature-request」: 2 |
| リグレッション | 4 | 「Regression」(4) |
| その他 | 95 | 「api」: 11、「documentation」: 7、「help wanted」: 6、「config options」: 5、 「io」: 5、「jinja」: 4、「good first issue」: 4、「parser」 3 |
A.7 SWE-BENCH LITEの特徴付け
SWE-bench Liteは、SWE-benchタスクにおいて言語モデルをより効率的に評価するための標準的なサブセットである。SWE-benchは
B SWE-LLAMAのトレーニングに関する追加詳細
B.1 トレーニングの詳細
最適化。 我々はLoRA(Hu et al., 2022)を用いて、すべてのアテンションサブレイヤーのquery、key、value、およびoutput射影行列に対して、、dropout でファインチューニングする。学習率、勾配ステップあたり32シーケンスのバッチサイズで、最大4エポック訓練する。訓練中は50ステップごとにチェックポイントを保存し、訓練後、ホールドアウトした100インスタンスでの検証損失に基づいて最良のチェックポイントを選択する。SWE-Llama 7bはCodeLlama-Python 7bで初期化し、4台のNVIDIA A100上で20時間訓練した。SWE-Llama 13bはCodeLlama-Python 13bで初期化し、8台のNVIDIA A100上で47時間訓練した。長いコンテキストでの訓練を可能にするため、DeepSpeed Ulysses(Jacobs et al., 2023)とFlash Attention(Dao et al., 2022)を使用した。
C 追加の結果
C.1 「オラクル」検索を用いた結果
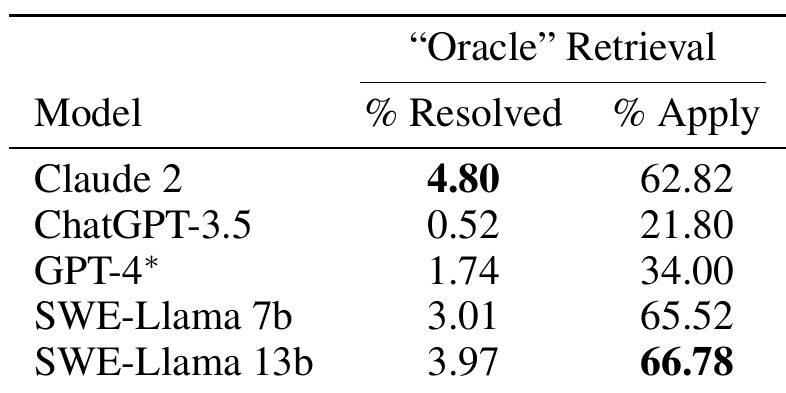
セクション4.1で説明した「オラクル」検索手法を用いて、一般的な性能結果を表18に示す。当然ながら、参照解のプルリクエストによって編集されたファイルのみを提供することで、モデルの性能はよりノイズの多いBM25検索設定と比較して向上する。
C.2 評価用テストセット
主要論文の図4に対応する、モデル性能のリポジトリ別内訳を表19に示す。主要論文で論じたように、性能はリポジトリ間で大きく異なる。
| astroid | marshmallow | pvlib | pydicom | pyvista | sqlfluff | |
| P 長さ(文字数) | 2199 | 1619 | 1790 | 2076 | 1475 | 2639 |
| C # ファイル数 | 252 | 82 | 294 | 455 | 866 | 2297 |
| C # 行数 | 60K | 22K | 459K | 170K | 661K | 205K |
| δ # 編集されたファイル数 | 2.51 | 1.89 | 1.83 | 1.54 | 2.1 | 3.26 |
| δ # 編集された関数数 | 3.03 | 2.11 | 2.89 | 2.23 | 3.0 | 2.71 |
| δ # 編集された行数 | 83.1 | 36.2 | 93.3 | 42.0 | 101.0 | 102.5 |
| δ # 追加された行数 | 52.8 | 24.7 | 67.0 | 29.7 | 79.4 | 63.6 |
| δ # 削除された行数 | 30.3 | 11.6 | 26.4 | 12.3 | 21.6 | 38.9 |
| |T|(失敗から合格へ) | 23.2 | 53.0 | 19.1 | 24.0 | 8.8 | 14.8 |
| |T|(Pass to Pass) | 182.6 | 242.9 | 107.5 | 176.1 | 96.5 | 239.7 |
| |T|(All) | 205.8 | 295.9 | 126.6 | 200.1 | 105.3 | 254.5 |
表17:開発データセット内のリポジトリについて、リポジトリ別にグループ化されたSWE-benchタスクインスタンスの異なる属性を特徴付ける平均値。表11に示された同じ統計もここに示す。
| モデル | 「Oracle」検索 | |
| % Resolved | % Apply | |
| Claude 2 | 4.80 | 62.82 |
| ChatGPT-3.5 | 0.52 | 21.80 |
| GPT-4* | 1.74 | 34.00 |
| SWE-Llama 7b | 3.01 | 65.52 |
| SWE-Llama 13b | 3.97 | 66.78 |
表18:セクション4で説明したオラクル検索設定を用いて、モデル同士を比較する。主要な結果表である表5は、BM25のみを使用した場合の異なるモデルの結果を示している。\*予算上の制約により、GPT-4はSWE-benchのランダムサブセット上で、「Oracle」およびBM25 27K検索設定のみで評価した。
C.3 GPT-4評価サブセットの結果
本節では、GPT-4が表20でテストされたランダムサブセットについて、表5に示された統計を提示する。サブセットの選択はランダムであるため、 Resolvedおよび Apply率は主要な結果と一致しており、一般的な評価セットよりも単純または困難な方向へ有意に偏っているわけではないことが分かる。
C.4 拡張時間的分析
本節では、本文の評価セクションの表7に示された分析に続き、解決されたタスクインスタンスを年別に示す拡張時間的分析を提示する。表21では、イシューが作成された年によってタスクをグループ化した6つの異なる時間的区分について、「Oracle」検索設定下でのモデル間の Resolved統計を提示する。表から明らかなように、モデル性能と年との間に一貫した相関はなく、これは、事前学習データセット内で古いバージョンのコードを見ている可能性があるにもかかわらず、SWE-benchにおける修正を理解して実装することは、理解を必要とする困難なタスクであり、観測データの丸暗記によって実行可能または一貫して達成できるものではないという我々の結論を支持している。
C.5 F2P、P2P率の分析
本文の結果では、異なるモデルによって完全に解決されたタスクインスタンスの数を示す「 Resolved」統計を提示している。本節では、1. モデルのパッチ生成が正常に適用されたが、2. タスクインスタンスが解決されなかったタスクインスタンスのギャップについて、より詳細な洞察を提供する。パッチが正常に適用されたと仮定し、F2PテストおよびP2Pテストの合否結果に基づいて、すべての可能な結果の分布を完全に捉える6つのケースを表22で定義する。すでに確立されている「Resolved」結果に加えて、
| リポジトリ | Claude 2 | ChatGPT-3.5 | GPT-4 | SWE-Llama 13b | SWE-Llama 7b |
| astropy/astropy | 3.23 | 0.00 | 0.00 | 1.06 | 3.16 |
| django/django | 6.15 | 1.32 | 2.50 | 5.19 | 4.00 |
| matplotlib/matplotlib | 3.05 | 3.33 | 0.00 | 3.12 | 1.11 |
| mwaskom/seaborn | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| pallets/flask | 0.00 | 0.00 | 0.00 | 9.09 | 0.00 |
| psf/requests | 15.91 | 2.33 | 8.33 | 13.64 | 18.18 |
| pydata/xarray | 6.90 | 0.00 | 0.00 | 5.81 | 3.00 |
| pylint-dev/pylint | 1.75 | 0.00 | 0.00 | 1.75 | 1.75 |
| pytest-dev/pytest | 5.93 | 0.00 | 0.00 | 5.04 | 4.20 |
| scikit-learn/scikit-learn | 5.41 | 0.00 | 0.00 | 3.12 | 0.88 |
| sphinx-doc/sphinx | 5.65 | 1.83 | 0.00 | 2.25 | 2.69 |
| sympy/sympy | 1.94 | 0.00 | 0.00 | 3.01 | 1.59 |
表19:SWE-benchに含まれるリポジトリ別のモデルの Resolved。
| モデル | BM25検索 | 「Oracle」検索 | ||
| % 解決済み | % 適用 | % 解決済み | % 適用 | |
| Claude 2 | 2.27 ↑ 0.31 | 45.72 ↑ 2.65 | 4.01 ↓ 0.79 | 62.65 ↓ 0.17 |
| ChatGPT-3.5 | 0.17 - 0.00 | 26.53 ↑ 0.02 | 0.70 ↑ 0.18 | 21.64 ↓ 0.16 |
| GPT-4 | 0.00 - 0.00 | 14.82 - 0.00 | 1.74 - 0.00 | 34.00 - 0.00 |
| SWE-Llama 7b | 0.35 ↑ 0.35 | 49.04 ↓ 2.70 | 1.92 ↓ 1.09 | 63.70 ↓ 1.82 |
| SWE-Llama 13b | 0.70 - 0.00 | 56.54 ↑ 2.92 | 4.54 ↑ 0.57 | 66.67 ↓ 0.11 |
表20:セクション4で説明したBM25およびオラクル検索設定を用いて、SWE-benchのランダムサブセット(574インスタンス)上で、「oracle」およびBM25 27K検索設定のみでモデル同士を比較する。これは、表5で言及したようにGPT-4が評価されるのと同じサブセットである。表5および表18の割合に対する差は下付き文字として含まれている。我々は5つの新しい用語を導入する。「Breaking Resolved」結果とは、イシューの望ましい動作が達成された(すべてのF2Pテストが合格)が、以前の動作がすべて維持されているわけではない(すべてのP2Pテストが合格しているわけではない)場合を指す。「Partially Resolved」とは、コードベースの以前の動作が維持された(すべてのP2Pテストが合格)が、望ましい動作が完全には達成されていない(すべてのF2Pテストが合格しているわけではない)場合を指す。「Work in Progress」のケースは、望ましい動作が完全には達成されておらず(すべてのF2Pテストが合格しているわけではない)、コードベースの以前の動作も維持されていない(すべてのP2Pテストが合格しているわけではない)場合である。「No-Op」とは、コード変更が元のコードベースに何の影響も与えない場合であり、以前の動作は維持される(すべてのP2Pテストが合格)が、イシューは完全に未解決のままである(0個のF2Pテストが合格)。最後に、イシューが未解決であり(0個のF2Pテストが合格)、以前の正常な動作が後退した(一部のP2Pテストが不合格)場合、コードベースはより悪い状態に置かれることになり、これを「Regression」と定義する。
表23では、正常に適用されたパッチ生成をこれら6つのケースに従って分類する。「Resolved」でないイシューのうち、モデルによって提案されたパッチ生成の大多数は、対応するタスクインスタンスのF2Pテストケースを1つも解決しない(「No-Op」および「Regression」)。これらのケースのサブセット内では、大多数(から)のケースがNo-Opであり、残りの状況ではモデルが既存の動作を破壊している。
一般に、モデル生成が一部のテストには合格するがすべてではないケース(「Breaking Resolved」、「Partially Resolved」、「Work in Progress」)は、他の3つのカテゴリと比較して累積的に問題のより小さなサブセットを表している。これらのケースのいくつかを手動で検査したところ、モデルがタスク要件をある程度理解していることは明らかである。しかし、ベースライン手法はコードベースの限られた見方しか持たず、ファイル間の依存関係や関数の関係などの情報を含まないため、これらのタスクインスタンスの多くは、当面のイシューを正しく解決する変更が、変更されたエンティティを使用し影響を受ける他のモジュールを考慮に入れていないために失敗することがしばしばある。これらの欠点を直接的に強調するいくつかのケーススタディをセクションFに含める。全体として、これらの結果はSWE-benchの困難さを示すだけでなく、
| 年 | 合計 | 25% | Claude 2 | GPT-3.5 | GPT-4* | SWE-Llama 13b | SWE-Llama 7b |
| 2023 | 244 | 61 | 4.51 | 1.56 | 0.00 | 4.07 | 3.50 |
| 2022 | 395 | 117 | 4.05 | 0.85 | 3.42 | 2.80 | 2.46 |
| 2021 | 383 | 102 | 4.18 | 0.00 | 2.94 | 4.45 | 2.56 |
| 2020 | 427 | 109 | 5.15 | 0.71 | 0.00 | 3.96 | 3.43 |
| 2019 | 437 | 112 | 5.72 | 1.49 | 1.79 | 4.55 | 2.21 |
| 2018 | 165 | 37 | 5.45 | 0.00 | 0.00 | 3.57 | 2.94 |
| < 2018 | 89 | 36 | 4.49 | 0.00 | 2.78 | 3.37 | 1.09 |
表21:本表では拡張時間的分析を提示し、「Oracle」検索設定でのモデル間のタスクインスタンスの resolvedを、異なるカットオフ日付別に分けて示す。Year列は、指定された暦年に作成されたタスクのサブセットを指す。Total列には、指定された年に該当するタスクの数を記載する。列は、GPT-4が評価されたサブセットについての同じ情報である。残りのモデル固有の列には、 resolved指標が含まれている。
| P2Pテスト合格 | F2Pテスト合格 | ||
| すべて | 一部 | なし | |
| すべて | 解決済み | 部分的に解決済み | No-Op |
| 一部 | 破壊的変更を伴う解決済み | 作業中 | リグレッション |
| なし | 破壊的変更を伴う解決済み | 作業中 | リグレッション |
表22:パッチ生成が正常に適用され、その後実行された場合に起こり得る6つの結果を示す。これらの結果は、合格するF2PテストとP2Pテストの数によって区別される。実行環境を介してフィードバックを提供する潜在的な価値とは、モデルが既存のテストに対して修正を実行できるようにし、その後、編集を継続するかパッチをレビューのために提出するかを判断できるようにすることである。
C.6 パッチ生成の拡張分析
本節では、表8で示した指標に従い、パッチ生成のさまざまな側面を定量化する統計を提示する。表24では、パッチが正常に適用されたかどうかに関係なく、すべてのモデルについてオラクル検索設定におけるすべてのパッチ生成に対してこれらの値を再計算する。すべての指標にわたって、モデル間のパッチ生成は、平均的なゴールド編集の特性にはるかに近いサイズであることがわかる。一部のモデルは依然として対応するゴールド編集と比べて少ない行数を生成するが(例:Claude-2、ChatGPT-3.5、GPT-4)、SWE-Llamaモデルの編集はほとんどの点で平均してより長い。表8と表24の両方を考慮すると、モデルがより長い出力シーケンスを正しくフォーマットされたパッチとして生成することに苦労していることが明らかになる。このような事象のさらなる調査は、セクションFのケーススタディで示すように、ハルシネーション、既存のコードスタイル/構造への準拠、および長距離依存関係の正確な参照が、より長い生成においてより頻繁に表面化する一般的なエラーであることを示している。
C.7 ソフトウェアエンジニアリング指標
我々は、複雑なコードベースに統合された大規模なコードブロックの効率性と複雑性を評価するために、ソフトウェアエンジニアリング指標を使用することを探る予備的評価を行う。流暢さや表層形式の類似性を評価するための意味的類似度スコアリング関数は、従来のNLPベンチマークで人気があり、コード生成にも採用されているが、それとは異なり、サイクロマティック複雑度McCabe (1976)やハルステッド複雑度指標Halstead (1977)などの指標は、論理的抽象化(例:抽象構文木)およびソフトウェア原理に基づいて、コードの複雑性、効率性、可読性をスカラー値として定量化する。パッチ生成およびSWE-bench評価ログは、ソフトウェアエンジニアリング指標や静的解析器を容易に適用できる豊富な情報源である。対象機能の範囲がごく小さいためにソフトウェアエンジニアリング指標の洞察が意味を持たない小規模なコードコンテストベンチマークとは異なり、SWE-benchのタスクは、実務者がこれらのツールを用いて、パッチ生成による変更の複雑性とそれがコードベースの残りの部分に与える影響について、構造化され、
| モデル | Claude 2 | ChatGPT-3.5 | GPT-4* | SWE-Llama 7b | SWE-Llama 13b |
| 適用済み | 1078 | 284 | 76 | 1257 | 1196 |
| 解決済み | 110 | 12 | 10 | 69 | 91 |
| 破壊的解決 | 26 | 2 | 3 | 17 | 10 |
| 部分的解決 | 15 | 4 | 3 | 17 | 10 |
| 作業中 | 20 | 2 | 1 | 17 | 16 |
| No-Op | 471 | 174 | 30 | 716 | 672 |
| リグレッション | 436 | 90 | 29 | 421 | 397 |
| モデル | 総行数 | 追加 | 削除 | 関数 | ファイル |
| Claude 2 | 27.2 | 6.6 | 3.3 | 1.2 | 1.1 |
| Gold | 61.6 | 17.8 | 8.6 | 2.6 | 1.4 |
| ChatGPT-3.5 | 42.0 | 6.1 | 3.9 | 1.7 | 1.0 |
| Gold | 44.5 | 12.7 | 5.5 | 2.1 | 1.2 |
| GPT-4 | 22.4 | 4.4 | 1.8 | 0.8 | 0.9 |
| Gold | 50.3 | 14.0 | 6.5 | 2.3 | 1.3 |
| SWE-Llama 13b | 68.9 | 9.5 | 4.3 | 2.5 | 1.6 |
| Gold | 61.5 | 17.8 | 8.6 | 2.6 | 1.4 |
| SWE-Llama 7b | 78.9 | 10.1 | 7.6 | 2.5 | 1.5 |
| Gold | 65.1 | 18.8 | 9.0 | 2.7 | 1.5 |
厳密で、広範囲にわたるフィードバック信号を得るのに十分なほど複雑である。
ここでは、ソフトウェアエンジニアリング指標がコード品質の特性を確実に捉える方法と、2つのパッチ間でこれらの統計を比較することがモデル能力についての自動的な観察を提供できる方法を示す探索的作業を含める。我々は、ソースコードから直接さまざまなソフトウェアエンジニアリング指標を計算するためのライブラリであるRadonパッケージを使用する。
我々は特に、psf/requestsリポジトリに対する「Oracle」検索設定において正常に適用されたClaude 2のパッチ予測に注目する。このリポジトリは、図4に反映されているように、いくつかのモデルが最も良い性能を発揮するものである。予測ごとに、パッチをコードベースに適用し、変更された関数のサイクロマティック複雑度とハルステッド複雑度スコアを計算する。サイクロマティック複雑度は関数の制御フローを定量化し、ソースコードを通る独立した実行経路の数を数える(McCabe, 1976)。サイクロマティック複雑度スコアが高いほど、欠陥の可能性が高く、通常は保守が困難であることを示唆する、より複雑な関数であることを示す。ハルステッド複雑度は、プログラム内の演算子とオペランドの数を数える(Halstead, 1977)。予測ごとに、対応するゴールドパッチに対しても同じ一連の手順を実行する。
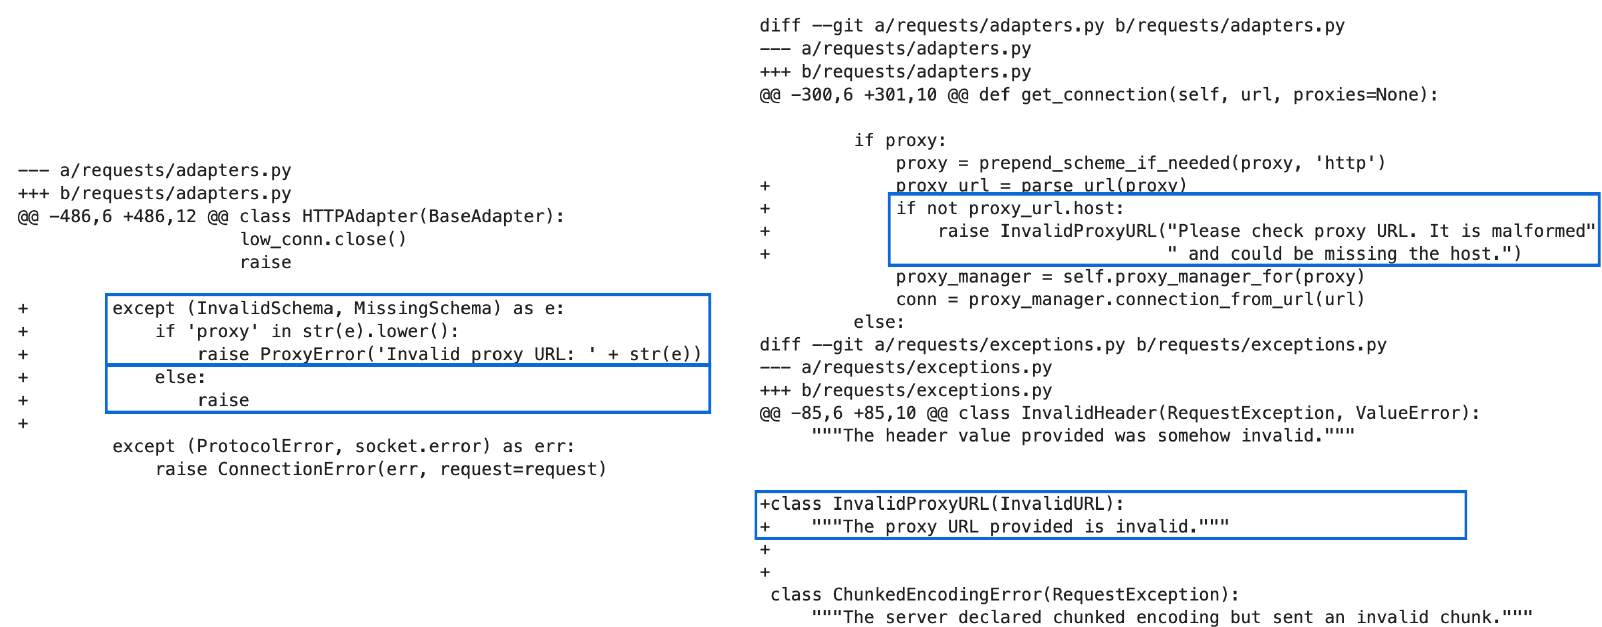
ソフトウェアエンジニアリング指標がモデル性能について自動的な定性的洞察を提供することを我々は見出した。図10の以下の簡単なケーススタディを考えてみよう。モデルのパッチ予測(左)は、ゴールド参照解(右)と比較して行数が少なく(11ではなく6)、変更するファイル数も少ない(2ではなく1)が、モデルの編集は比較的複雑で広く使用されているHTTPAdapterクラス内に条件分岐を配置している。これにより2つの新たな潜在的な実行結果が導入され、HTTPAdapterのサイクロマティック複雑度が3から5に上昇する。対照的に、参照解はより長いものの、モジュール内依存関係をインポートし、get_connection内の論理的に単純な関数を変更し、問題によって記述された新規のバグを捉えるための新しいエラータイプInvalidProxyURLを定義している。
Radonドキュメント、オープンソースコードベース
問題文:プロキシ変数内の無効なプロトコルに関する誤解を招く例外。https_proxyまたはHTTPS_PROXY変数の値が誤ってプロトコル内の「://」を1つ欠落している場合、問題がプロキシ設定にあることを特定しないトレースバックがユーザーに表示される……
D 追加の実験詳細
D.1 検索の詳細
スパース検索。検索中、我々はドキュメントに軽微な拡張を加え、ファイルの内容の前にそのファイルパスを付加することで、問題内で直接言及される可能性のあるファイル名に基づく検索をより適切に可能にする。
オラクル検索。オラクル検索のファイルパスは、テストファイルを除く参照解のパッチファイルから直接抽出される。
D.2 推論設定
生成は比較的高コストであるため、我々はインスタンスごとに単一のパッチファイルのみを生成する。Pass@1における評価のためのコード生成の先例(Chen et al., 2021; Rozière et al., 2023)に従い、すべてのモデルに対して単純に貪欲デコーディングを使用する。
D.3 プロンプトテンプレートの例
モデルには、使用するモデルに応じて若干の変動を伴う以下の一般的なテンプレートが与えられる。
部分的なコードベースと、解決すべき問題を説明する問題文が提供されます。<issue> {ISSUE TEXT} </issue> {start of README.md} {README.md text} {end of README.md} {start of file_1.py}...{file_1.py text}[end of file_1.py]...</code>
以下はパッチファイルの例です。これはコードベースへの変更から構成されます。ファイル名、各変更の行番号、および削除・追加された行を指定します。単一のパッチファイルには複数のファイルへの変更を含めることができます。
<patch>-- a/file.py +++ b/file.py@@ -1,27 +1,35 @@def euclidean(a, b):- while b:- a, b = b, a % b- return a + if b == 0: + return a + return euclidean(b, a % b) def bresenham(x0, y0, x1, y1): points = [] dx = abs(x1 - x0) dy = abs(y1 - y0)- sx = 1 if x0 < x1 else -1- sy = 1 if y0 < y1 else -1- err = dx - dy + x, y = x0, y0 + sx = -1 if x0 > x1 else 1 + sy = -1 if y0 > y1 else 1- while True: points.append((x0, y0))- if x0 == x1 and y0 == y1:- break e2 = 2 * err- if e2 > -dy: + if dx > dy: + err = dx / 2.0 + while x != x1: points.append((x, y)) err = dy- x0 += sx- if e2 < dx:- err += dx- y0 += sy + if err < 0: + y += sy + err += dx + x += sx + else: + err = dy / 2.0 + while y != y1: + points.append((x, y)) + err -= dx + if err < 0: + x += sx + err += dy + y += sy + points.append((x, y)) return points
</patch>
指示文や例の行数をわずかに増減させた実験では、第5節で述べた知見を除き、全体的な性能に実質的な影響はほとんど見られなかった。
E 社会的影響
コードに関する推論が、多くの言語モデルの能力の根底にある基礎的スキルとして台頭してきたことにより、機械自動化されたソフトウェアエンジニアリングの潜在的な未来は、AI安全性に関して多くの重要な問いを提起し、重要な潜在的影響を伴う(Gros et al., 2023)。AIが生成したコードが人間の意図に忠実であることをいかに確保するか、また、コードエージェントが人間の目的を誤解してタスクを実行した際にどのようなガードレールを設けるべきかという問いに取り組むことが重要である。このような問題を制御された環境で観察し、その解決策を具現化するために、SWE-benchが、整合性があり、検証可能で、安全なAI駆動型ソフトウェアエンジニアリングに向けた安全で堅牢な方策を設計するためのテストベッドとして機能することを期待する。
F SWE-LLAMA生成物の詳細分析
本節では、第5.1節のスタイルに従い、Claude 2とSWE-Llamaの生成物(Oracle検索設定)について、5つの追加の定性的分析を提供する。
Claude 2の定性的研究は表25および表26に示す。表27、28、29は、Claude 2が正しく対処できなかったタスクインスタンスである。SWE-Llamaの定性的研究は表30、31、32、33、34にわたって扱う。表30、31、32では、SWE-Llama 13bが正しく解いたタスクインスタンスを提示する。表33および34では、SWE-Llama 13bが問題を正しく対処できなかった2つのタスクインスタンスを提示し、モデルが目の前のタスクを達成するのに十分なほど習熟していない可能性のある推論および生成スキルの一部を指摘する。
これらの節を通じて行った観察は、本文で述べた点、すなわち、モデルは複数行および複数ファイルにわたる変更に苦労する傾向があり、必要な修正が比較的短い場合にはより熟達しており、コードベースを効率的に理解する助けを必要とするという点と一致する。
表25:この例では、Claude 2はscikit-learn/scikit-learnの問題に正しく対処している。しかし、議論で示されているように、解決策は正しいものの、モデルが原始的なPythonを書き、コードベース内の既存のメソッドを活用しない傾向があることを示している。
設定- モデル:Oracle検索を用いたClaude 2- タスクインスタンス:scikit-learn_scikit-learn-13328- 問題へのリンク:https://github.com/scikit-learn/scikit-learn/pull/13314- PRへのリンク:https://github.com/scikit-learn/scikit-learn/issues/13328
HuberRegressorのfitにブール値のXを渡すとTypeErrorが発生する### 説明 ブール値の予測子を使って'HuberRegressor'をfitすると'TypeError'が発生します。 再現手順/コード
import numpy as np from sklearn.datasets import make_regression from sklearn.linear_model importHuberRegressor # ランダムデータ X, y, coef = make_regression(n_samples=200, n_features=2,noise=4.0, coef =True, random_state=0) X_bool = X > 0 X_bool_as_float = np.asarray(X_bool, dtype=float)# 動作する huber = HuberRegressor().fit(X, y) # 失敗する (!) huber = HuberRegressor().fit(X_bool, y) # こちらも動作する huber = HuberRegressor().fit(X_bool_as_float, y)
期待される結果
X の dtype が bool の場合(上記スニペットの 2 行目のコード、.fit(X_bool, y))、エラーはスローされません。ブール配列は、たとえば LinearRegression が行うように、HuberRegressor.fit によって float に変換されることが期待されます。
実際の結果TypeError がスローされます:(残りの行は省略)Gold Patch diff --git a/sklearn/linear_model/huber.py b/sklearn/linear_model/huber. py -- a/sklearn/linear_model/huber.py +++ b/sklearn/linear_model/huber.py @@ - 251,7 +251,8 @@ def fit(self, X, y, sample_weight=None): self : object"
Model Generated Patch
- a/sklearn/linear_model/huber.py +++ b/sklearn/linear_model/huber.py @@ -231,6 +231,9 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): self.tol = tol + def _validate_data(self, X, y=None): + return X.astype(np.float64) if X.dtype == np.bool else X + def fit(self, X, y, sample_weight=None): """Fit the model according to the given training data.
@@ -250,7 +253,7 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): self : object """ X, y = check_X_y( X, y = check_X_y( X, y, copy=False, accept_sparse=['csr'], y_numeric=True) if sample_weight is not None: sample_weight = np.array(sample_weight) @@ -262,6 +265,9 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): raise ValueError( "epsilon_should_be_greater_than_or_equal_to_1.0,got_%f" % self.epsilon) + X = self._validate_data(X)
Tests
Fail to Pass (1)
sklearn/linear_model/tests/test_huber.py::test_huber_bool
Pass to Pass (9)
sklearn/linear_model/tests/test_huber.py::test_huber_max_iter sklearn/linear_model/tests/test_huber.py::test_huber_gradient sklearn/linear_model/tests/test_huber.py::test_huber_sample_weights sklearn/linear_model/tests/test_huber.py::test_huber_sparse sklearn/linear_model/tests/test_huber.py::test_huber_scaling_invariant
追加の Pass to Pass テストは省略...
考察。このタスクインスタンスでは、この問題は型がどのようにキャストされるかに関する問題を説明しています。具体的には、X_bool のようなブール型の予測子で HuberRegressor モデルをフィッティングすると、TypeError が発生します。この問題は、HuberRegressor が LinearRegression のようないくつかの他のモデルが行うようにブール配列を自動的に float に変換しないために発生し、型の不一致エラーを引き起こします。その修正として、モデルは独自の _validate_data 関数を定義し、型キャストのロジックをカプセル化して、それを X に適用します。テストには合格しますが、この修正はより効率的であり得、またスタイル上および構成上の不整合を潜在的に導入する可能性があります。参照ソリューションで示されているように、check_X_y 関数呼び出しの既存のフラグを活用して dtype 引数を渡すという、よりクリーンにこれを解決するはるかに単純なソリューションがあります。他のファイルの内容は、コンテキストウィンドウの制限により、オラクル検索設定には含まれていませんでした。
Table 26: ここでは、Claude-2 が問題を正しく解決し、gold patch に類似したソリューションを開発した別の例を示します。ただし、gold patch のソリューションは、このコードに関連する可能性のある将来の潜在的な問題を回避することについて、より認識しています。
Setting
- Model: Claude 2 with Oracle retrieval- Task Instance: matplotlib_matplotlib-24362 - Link to Issue: https://github.com/matplotlib/matplotlib/issues/24349 - Link to PR: https://github.com/matplotlib/matplotlib/pull/24362
Issue
[Bug]: sharex と sharey は 0 と 1 を bool 値として受け付けません
Bug summary
pyplot.subplots の sharex または sharex 引数で False または True の代わりに 0 または 1 を使用すると、エラーが発生します。
Code for reproduction
import matplotlib.pyplot as plt
fig, ax = plt.subplots(ncols=2, sharey=1)
Actual outcome
次のエラーが発生します:
Traceback (most recent call last):
(以前の行は省略) File "/\\\/matplotlib/lib/matplotlib/gridspec.py", line 293, in subplots _api.check_in_list(["all", "row", "col", "none"], File "/\\\/matplotlib/lib/matplotlib/_api/init.py", line 131, in check_in_list raise ValueError(msg)
ValueError: 1 is not a valid value for sharey; supported values are 'all', 'row', 'col', 'none'
sharey の代わりに sharex を使用すると、同じエラーが発生します(ただし、次の警告が付きます:
UserWarning: sharex argument to subplots() was an integer. Did you intend to use subplot() (without 's')?
ただし、これは想定内であり、本問題の一部ではありません)
Expected outcome
値 1 と 0 が bool として理解されることを期待していました。
Model Generated Patch
diff --git a/lib/matplotlib/gridspec.py b/lib/matplotlib/gridspec.py
index 06dd3f19f6.32ee7c306e 100644
-- a/lib/matplotlib/gridspec.py
+++ b/lib/matplotlib/gridspec.py
@@ - 276, 9 +276, 9 @@ class GridSpecBase:
raise ValueError("GridSpec.subplots().only_works_for_GridSpecs_"
"created_with_a_parent_figure")
if isinstance(sharex, bool):
+ if isinstance(sharex, bool) or sharex == 1 or sharex == 0:
sharex = "all" if sharex else "none"
if isinstance(sharey, bool):
+ if isinstance(sharey, bool) or sharey == 1 or sharey == 0:
sharey = "all" if sharey else "none"
This check was added because it is very easy to type
'subplots(1, 2, 1)' when 'subplot(1, 2, 1)' was intended.
Gold Patch
diff --git a/lib/matplotlib/gridspec.py b/lib/matplotlib/gridspec.py - - - a/lib/matplotlib/gridspec.py +++ b/lib/matplotlib/gridspec.py @@ -276,21 +276,12 @@ def subplots(self, \*, sharex=False, sharey=False, squeeze=True,- if isinstance(sharex, bool):+ if not isinstance(sharex, str):sharex = "all" if sharex else "none"- if isinstance(sharey, bool):+ if not isinstance(sharey, str):sharey = "all" if sharey else "none"- # このチェックは、'subplot(1, 2, 1)' を意図していたのに# 'subplots(1, 2, 1)' と入力するのが非常に簡単であるため追加された。- # ほとんどの場合、エラーは決して発生しないが、subplot のインデックスとして# 意図されていたものが代わりに sharex の bool として扱われるため、# 不可解な挙動が生じる。このチェックは sharex が knownly になったら# 削除すべきである。- if isinstance(sharex, Integral):- api.warn_external("sharex_argument_to_subplots()_was_an_integer.__Did_you""intend_to_use_subplot()_without's')?"- api.check_in_list(["all", "row", "col", "none", False, True],sharex=sharex, sharey=sharey)
テスト
失敗から合格へ (1)
lib/matplotlib/tests/test_subplots.py::test_shared
合格から合格へ (39)
lib/matplotlib/tests/test_subplots.py::test_label_outer_span lib/matplotlib/tests/test_subplots.py::test_label_outer_non_gridspec lib/matplotlib/tests/test_subplots.py::test_shared_and_moved lib/matplotlib/tests/test_subplots.py::test_exceptions lib/matplotlib/tests/test_subplots.py::test_subplots_offsettext.png)
その他の合格から合格へのテストは省略...
議論。この例では、pyplot.subplots 関数の sharex および sharey 引数に対して、1 と 0 をブール値として扱うことを求めている。現在のコードではエラーが発生する。生成されたパッチでは、モデルは 1 と 0 を許容される値として追加している。しかし、ゴールドパッチでは許容される値をリスト ["all", "row", "col", "none", False, True] に追加している。また、この問題に関連する Integral 関連の警告を削除している。このクリーンアップと check_in_list 引数の明瞭さにより、コードはより簡潔で読みやすくなる。
表 27: この例では、Claude 2 が正しく解決できない astropy/astropy の問題を示す。このエラーは主に、パッチ生成が問題を直接解決しようとすることに起因する。
設定
- モデル: Oracle 検索を用いた Claude 2- タスクインスタンス: astropy_astropy-14365- Issue へのリンク: https://github.com/astropy/astropy/issues/14363- PR へのリンク: https://github.com/astropy/astropy/pull/14365
Issue
ascii.qdp テーブル形式は QDP コマンドが大文字であることを前提としている
説明
ascii.qdp は、QDP ファイル内のコマンドが大文字であることを前提としています。たとえば、エラーの場合は "READ SERR 1 2" でなければなりませんが、QDP 自体は大文字と小文字を区別せず、"read serr 1 2" を使用できます。多くの QDP ファイルは手作業で作成されるため、すべてのコマンドをすべて大文字にするという前提は削除すべきです。
期待される動作
次の qdp ファイルは、クラッシュするのではなく、エラー付きの 'Table' として読み込まれるべきです。
read serr 1 2 1 0.5 1 0.5
再現方法 QDP ファイルを作成します:
cat > test.qdp read serr 1 2 1 0.5 1 0.5 <EOF>
python Python 3.10.9 (main, Dec 7 2022, 02:03:23) [Clang 13.0.0 (clang - 1300.0.29.30)] on darwin Type "help", "copyright", "credits" or "license" for more information. >>> from astropy.table import Table >>> Table.read('test.qdp', format='ascii.qdp') WARNING: table_id not specified. Reading the first available table [ astropy.io.ascii.qdp] Traceback (most recent call last): raise ValueError(f'Unrecognized_QDP_line: {line}') ValueError: Unrecognized QDP line: read serr 1 2
"qdp test.qdp" を実行すると問題なく動作します。
モデル生成パッチ
- a/astropy/io/ascii/qdp.py - b/astropy/io/ascii/qdp.py - @ -60,7 +60,7 @@ ValueError: Unrecognized QDP line... """ _decimal_re = r"[-?(\d+(\. \d+)?\.\d+)([eE][+-]?\d+)?" _command_re = r"READ [TS]ERR(\s+[0-9]+)+" _command_re = r"read [ts]err(\s+[0-9]+)+" sep = delimiter if delimiter is None:
Gold Patch
diff - - git a/astropy/io/ascii/qdp.py b/astropy/io/ascii/qdp.py - - - a/astropy/io/ascii/qdp.py +++ b/astropy/io/ascii/qdp.py @@ - 68,7 + 68,7 @@ def _line_type (line, delimiter=None): _new_re = rf"NO((sep)NO)+" _data_re = rf"((_decimal_re) | NO | [- + ]?nan) ((sep) ((_decimal_re) | NO | [- + ]?nan)) +" _type_re = rf"\s*((?P<command>|_command_re)) | (?P<new>[_new_re]) | (?P< data>[_data_re])?\s*(\!|(?P<comment>.*))?\s+$" - _line_type_re = re.compile(_type_re) + _line_type_re = re.compile(_type_re, re.IGNORECASE) line = line.strip() if not line: return "comment" @@ - 306,7 + 306,7 @@ def _get_tables_from_qdp_file(qdp_file, input_colnames=None, delimiter=None): values = [] for v in line.split (delimiter): - if v == "NO": + if v.upper() == "NO": values.append(np.max. masked) else: # Understand if number is int or float
テスト
Fail to Pass (1)
X astropy/io/ascii/tests/test_qdp.py::test_roundtrip[True]
Pass to Pass (8)
X astropy/io/ascii/tests/test_qdp.py::test_get_tables_from_qdp_file X astropy/io/ascii/tests/test_qdp.py::test_roundtrip[False] X astropy/io/ascii/tests/test_qdp.py::test_read_example X astropy/io/ascii/tests/test_qdp.py::test_roundtrip_example X astropy/io/ascii/tests/test_qdp.py::test_roundtrip_example_comma X astropy/io/ascii/tests/test_qdp.py::test_read_write_simple X astropy/io/ascii/tests/test_qdp.py::test_read_write_simple_specify_name X astropy/io/ascii/tests/test_qdp.py::test_get_lines_from_qdp
議論。この issue は QDP ファイルの処理に関する修正を求めており、具体的にはコマンドが大文字であるという前提を削除することを求めています。モデル生成パッチでは、モデルは issue の説明に記載された READ および ERR コマンドを正規表現パターン内で特定し、それを直接編集しています。しかし、同じファイル内で、その正規表現パターンが _type_re などの追加のパターンで使用されていることが明らかであり、したがって「ルート」の正規表現パターンへの修正は適切でない可能性があります。さらに、複数の正規表現パターン変数の中で、修正すべき正しいものを特定するには、実行によって助けられ得る推論が必要です。この解決策の誤りは、与えられた単体テストに合格できないだけでなく、以前の動作を強制する既存のテストにも失敗するという事実に反映されています。
表 28: mwaskom/seaborn リポジトリからのこの issue では、問題文に画像へのハイパーリンクが含まれています。セクション 5 で議論したように、SWE-bench タスクのごく一部には画像が含まれており、画像理解は issue を解決するための小さいながらも重要な要素となっていますが、初期のベースラインでは未探索です。
設定
- モデル: Claude 2(Oracle 検索あり)- タスクインスタンス: mwaskom_seaborn-3217 - Issue へのリンク: https://github.com/mwaskom/seaborn/issues/2907 - PR へのリンク: https://github.com/mwaskom/seaborn/pull/3217
Issue
対数スケールでヒストグラム後の幅計算がわずかに誤っている ここでわずかな重なりに注意してください:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth ), so.Hist(bins ) .scale
image ビンの数を増やすと、ほとんど知覚できなくなります:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth ), so.Hist(bins ) .scale
image これは 'Bars' だけの問題ではありません。'Bar' にも同じ問題があります:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth , width ), so.Hist(bins ) .scale
image
モデル生成パッチ
- a/seaborn/_core/plot.py +++ b/seaborn/_core/plot.py @@ -1327,9 +1327,7 @@ elif "width" in df: view_width = view_df["width"] else: - view_width = 0.8 # TODO what default? - spacing = scales[orient]._spacing(view_df.loc[view_idx, - width.loc[view_idx] = view_width + spacing + width.loc[view_idx] = view_width df["width"] = width if "baseline" in mark._mappable_props:
Gold Patch
diff --git a/seaborn/_core/plot.py b/seaborn/_core/plot.py --- a/seaborn/_core/plot.py +++ b/seaborn/_core/plot.py @@ -1377,10 +1377,9 @@ def _unscale_coords( - drop_cols = [*coord_cols, "width"] if "width" in df else coord_cols out_df = ( df - .drop(drop_cols, axis=1) + .drop(coord_cols, axis=1) .reindex(df.columns, axis=1) # スケール解除された列が元の位置を保つように @@ -1396,12 +1395,6 @@ def _unscale_coords( - if var == orient and "width" in view_df: - width = view_df["width"] - out_df.loc[values.index, "width"] = ( - transform(values + width / 2) - - transform(values - width / 2) - ) return out_df diff --git a/seaborn/_marks/bar.py b/seaborn/_marks/bar.py --- a/seaborn/_marks/bar.py +++ b/seaborn/_marks/bar.py @@ -29,17 +29,23 @@ class BarBase(Mark): + transform = scales[orient]._matplotlib_scale.get_transform() + forward = transform.transform + reverse = transform.inverted().transform + + other = {"x": "y", "y": "x"}[orient] + + pos = reverse(forward(data[orient]) - data["width"] / 2) + width = reverse(forward(data[orient]) + data["width"] / 2) - pos + + val = (data[other] - data["baseline"]).to_numpy() + base = data["baseline"].to_numpy() + (残りの行は省略...)
テスト
失敗から成功 (1)
X tests/_marks/test_bar.py::TestBars::test_log_scale
成功から成功 (8)
X tests/_marks/test_bar.py::TestBar::test_categorical_positions_vertical X tests/_marks/test_bar.py::TestBar::test_categorical_positions_horizontal X tests/_marks/test_bar.py::TestBar::test_numeric_positions_vertical X tests/_marks/test_bar.py::TestBar::test_numeric_positions_horizontal X tests/_marks/test_bar.py::TestBar::test_set_properties
その他の成功から成功のテストは省略...
考察。ベースラインモデルがこの問題を解決できなかったことは、画像入力の欠如に直接起因すると考えられます。この例を含めたのは、実際のソフトウェアの問題をデバッグするには画像を読み取る必要がある場合があることを示すためです。これは、理解と推論に関わるまったく別の課題群を提示しています。SWE-benchのタスクを超えて、システム設計図、ユーザーインターフェース仕様、ユーザーフィードバックの解釈など、ソフトウェアエンジニアリングにおけるその他の問題も、興味深い視覚言語の課題を提示しています。
表29: Claude 2の生成によるこの最後の例では、モデルは循環依存に関するエラーを解決することに関連するエラーを解決しなければなりません。Claude 2の解決策は、本来複雑な問題に対して十分な成果を上げていません。
設定
- モデル: Oracle検索を用いたClaude 2 - タスクインスタンス: sympy_sympy-18211 - Issueへのリンク: https://github.com/pylint-dev/pylint/issues/3525 - PRへのリンク: https://github.com/pylint-dev/pylint/pull/4703
Issue
TYPE.CHECKING内のインポートが「cyclic-import」を引き起こす可能性がある
a.pyとb.pyという2つのモジュールがあるとします。「a」は「b」をインポートしますが、「b」は型アノテーションを行うために「a」を必要とする場合、通常は「TYPE.CHECKING」ブロック内で「a」をインポートすることで行われます。残念ながら、これによりpylintは「cyclic-import」を報告します。
おそらく https://github.com/PyCQA/pylint/issues/3285 に関連しています
ゴールドパッチ
diff --git a/pylint/checkers/imports.py b/pylint/checkers/imports.py-- a/pylint/checkers/imports.py +++ b/pylint/checkers/imports.py@@ - 813,7 + 813,9 @@ def _get_imported_module(self, importnode, modname):- def _add_imported_module(self, node, importedmodname): + def _add_imported_module(+ self, node: Union[astroid.Import, astroid.ImportFrom], importedmodname: str + ) -> None:"""notify an imported module, used to analyze dependencies""" module_file = node.root().file context_name = node.root().name@@ - 826,6 + 828,10 @@ def _add_imported_module(self, node, importedmodname): except ImportError: pass + in_type_checking_block = (+ isinstance(node.parent, astroid.If) and node.parent. is_type_guard() + ) if context_name == importedmodname: self.add_message("import- self", node=node)@@ - 845,7 + 851,10 @@ def _add_imported_module(self, node, importedmodname): # update import graph self.import_graph[context_name].add(importedmodname)- if not self.linter.is_message_enabled("cyclic-import", line= node.lineno): + if + not self.linter.is_message_enabled("cyclic-import", line= node.lineno) + or in_type_checking_block + ) self.excluded_edges[context_name].add(importedmodname)ްމައްސަލައިގެންނަށްޓަކ
モデル生成パッチ
diff - - git a/pylint/checkers/imports.py b/pylint/checkers/imports.py index 4f3eed2. .2b74a8d 100644 - - - a/pylint/checkers/imports.py +++ b/pylint/checkers/imports.py @@ -49,6 +49,7 @@ import copy import os import sys from distutils import sysconfig +from typing import TYPE_CHECKING from typing import Dict, List, Union
import astroid @@ -61,6 +62,9 @@ from pylint.checkers.utils import ( node_ignores_exception, ) from pylint.exceptions import EmptyReportError +if TYPE_CHECKING: + from pylint.lint import PyLinter + from pylint.graph import DotBackend, get_cycles from pylint.interfaces import IASTroidChecker from pylint.reporters.ureports.nodes import Paragraph, VerbatimText, VNode
テスト
失敗から合格へ (1)
X tests/marks/test_bar.py::TestBars::test_log_scale
合格から合格へ (11)
tests/test_func.py::test_functionality[func_w0401_disabled_in_func.py] tests/test_func.py::test_functionality[func_i0022. py] tests/test_func.py::test_functionality[func_w0401. py] tests/test_func.py::test_functionality[func_w0801. py] tests/test_func.py::test_functionality[func_w0401_package]
追加の合格から合格へのテストは省略...
考察。 この問題では、モデルに対して、pylint が現在エラーを出す循環インポートを解決するための TYPE_CHECKING ベースの処理を提供することが求められています。ゴールドパッチには、TYPE_CHECKING ブロック内での条件付き処理、循環インポートメッセージの除外、および一般により具体的な処理を含む詳細な解決策があります。モデル生成パッチは「Stack Overflow」のような解決策を採用しています。TYPE_CHECKING ブロックを作成することはインポートを解決するための一般的な解決策ですが、特にこのコードベースにおけるこの問題を解決するには、オンラインで入手可能な一般的な回答よりも、よりニュアンスのある解決策が必要です。
表30: SWE-bench のタスクインスタンスを正しく解決した SWE-Llama 13b 生成の例。この例では、SWE-Llama の生成結果は解決策と完全に同一です。
設定
- モデル: Oracle 検索を用いた SWE-Llama 13B- タスクインスタンス: pydata_xarray-5131- Issue へのリンク: https://github.com/pydata/xarray/pull/5130- PR へのリンク: https://github.com/pydata/xarray/pull/5131
Issue
対話型の Python セッションで DatasetGroupBy を表示すると、出力の最初の行に末尾の空白が含まれます。ドキュメントの最初の例はこれを示しています:
import xarray as xr, numpy as np >>> ds = xr.Dataset( ... {"foo": (("x", "y"), np.random.rand(4, 3)), ... coords={"x": [10, 20, 30, 40], "letters": ("x", list("abba")), ... >>> ds.groupby("letters") DatasetGroupBy, grouped over 'letters' 2 groups with labels 'a', 'b'.
出力の最初の行「DatasetGroupBy, grouped over 'letters' 」に末尾の空白があります。これは、オブジェクトを文字列に変換するとより明確に確認できます(n の前の空白に注意):
str(ds.groupby("letters")) "DatasetGroupBy, grouped_over_'letters'\n2_groups_with_labels'a', 'b'."
これはそれ自体では問題ではありませんが、継続的インテグレーションでコードが正しくフォーマットされていることを検証するために flake8 を使用しているため、私たちにとって問題を引き起こします... [20 行省略]
ゴールドパッチ
diff --git a/xarray/core/groupby.py b/xarray/core/groupby.py -- a/xarray/core/groupby.py +++ b/xarray/core/groupby.py @@ - 436,7 + 436,7 @@ def iter(self): return zip(self._unique_coord.values, self._iter_grouped())
def repr(self): return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( + return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( self.class.name,
モデル生成パッチ
diff --git a/xarray/core/groupby.py b/xarray/core/groupby.py -- a/xarray/core/groupby.py +++ b/xarray/core/groupby.py @@ - 436,7 + 436,7 @@ def iter(self): return zip(self._unique_coord.values, self._iter_grouped())
def repr(self): return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( + return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( self.class.name,
テスト
失敗から合格へ (10)
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-x]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-y]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-z]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-month]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-x]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-y]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-z]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-month]
✓ xarray/tests/test_groupby.py::test_groupby_repr_datetime[obj0]
✓ xarray/tests/test_groupby.py::test_groupby_repr_datetime[obj1]
Pass to Pass (16)
✓ xarray/tests/test_groupby.py::test_consolidate_slices
✓ xarray/tests/test_groupby.py::test_groupby_da_datetime
✓ xarray/tests/test_groupby.py::test_groupby_duplicate_coordinate_labels
✓ xarray/tests/test_groupby.py::test_groupby_input_mutation
✓ xarray/tests/test_groupby.py::test_groupby_map_shrink_groups[obj0]
Additional Pass to Pass Tests omitted...
議論。 この問題では、モデルは末尾の空白の問題を修正するよう求められており、その問題は使用中に発生するエラーの実演を示しているが、モデル内で修正すべき関数を明示的には指摘していない。オラクル検索設定では、モデルは編集すべき xarray/core/groupby.py ファイルを直接与えられるが、ほとんどは編集すべき行を特定する。この状況で、モデルは対話型 Python 設定において、実際に呼び出されている基底の関数が実は repr 関数であることをうまく推論する。関数を特定した後、return 文のどこに空白があるのかを突き止めなければならない。この時点で、修正はかなり明白であり、モデルが削除する明示的なスペースが存在する。この場合、モデルはこの修正の正しさを明示的に検証するすべてのテスト(fail to pass テスト 10 件)に成功裏に合格しつつ、ファイルの既存の挙動(pass to pass テスト 16 件)も維持している。
表 31: SWE-bench のタスクインスタンスを正しく解決した SWE-Llama 13b の生成例。この例では、SWE-Llama の生成は gold patch とは異なる。
設定
- モデル: SWE-Llama 13B(オラクル検索あり)- タスクインスタンス: psf_-requests-1724- Issue へのリンク: https://github.com/psf/requests/issues/1723- PR へのリンク: https://github.com/psf/requests/pull/1724
Issue
Unicode のメソッド名が、Python 2.7.2 の一部のリクエストで UnicodeDecodeError を引き起こす。次の例は問題なく動作する:
files {u'file': open(u'/usr/bin/diff', u'rb')} response requests.request(method 'POST', url 'http://httpbin.org/post' files files)
しかし、次の例('method 'POST' の代わりに 'method 'POST' を使用)は UnicodeDecodeError を発生させる:
files {u'file': open(u'/usr/bin/diff', u'rb')} response requests.request(method 'POST', url 'http://httpbin.org/post' files files)
Traceback (most recent call last): [完全なスタックトレースは非表示] File "/System/Library/Frameworks/Python.framework/Versions/2.7/... msg_+=_message_body UnicodeDecodeError: 'ascii'_codec_can't_decode_byte_0xcf_in_position_140: ordinal_not_in_range (128)
私の推測では、'u'POST' が文字列であるべきヘッダーに unicode を感染させている。これは 'sessions.py:313' が単に次のようになっているためである:
req.method method.upper()
[追加行は非表示...]
Gold Patch
diff --git a/requests/sessions.py b/requests/sessions.py-- a/requests/sessions.py+++ b/requests/sessions.py@@ - 12,7 + 12,7 @@from collections import Mappingfrom datetime import datetime-from .compact import cookielib, OrderedDict, [3 more omitted]+from .compact import cookielib, OrderedDict, [3 omitted,+ builtin_strfrom .cookies import cookiejar_from_dict, extract_cookies_to_jar, RequestsCookieJarfrom .models import Request, PreparedRequestfrom .hooks import default_ hooks, dispatch_hook@@ - 309,6 + 309,6 @@ def request(self, method, url,:param cert: (optional) if String, path to ssl client cert file (.pem). If Tuple, ('cert', 'key') pair.\\\*
+ method builtin_str(method)
モデル生成パッチ
diff - - git a/requests/sessions.py b/requests/sessions.py - - - a/requests/sessions.py +++ b/requests/sessions.py @@ -254,7 +254,7 @@ def prepare_request(self, request):
p = PreparedRequest() p.prepare( method=request.method.upper(), + method=str(request.method).upper(), url=request.url, files=request.files, data=request.data,
テスト
Fail to Pass (6)
test_requests.py::RequestsTestCase::test_DIGEST_AUTH_RETURNS_COOKIE test_requests.py::RequestsTestCase::test_DIGEST_HTTP_200_OK_GET test_requests.py::RequestsTestCase::test_different_encodings_dont_break test_requests.py::RequestsTestCase::test_generic_cookiejar_works test_requests.py::RequestsTestCase::test_uppercase_scheme_redirect
Pass to Pass (75)
test_requests.py::RequestsTestCase::test_DIGEST_AUTH_SETS_SESSION_COOKIES test_requests.py::RequestsTestCase::test_DIGEST_STREAM test_requests.py::RequestsTestCase::test_HTTP_200_OK_GET_ALTERNATIVE test_requests.py::RequestsTestCase::test_HTTP_200_OK_GET_WITH_PARAMS test_requests.py::RequestsTestCase::test_HTTP_200_OK_HEAD
その他のPass to Passテストは省略...
考察。表30で提示された問題とは異なり、対話型のpython入力の代わりに、モデルには関数呼び出しからのエラートレースが与えられ、ユーザーの視点から問題を再現する手順が提供される。さらに、このissueは最後の行で問題の潜在的な修正についての提案も提供している。ここでもオラクル設定において、モデルは自然言語の提案を活用し、その変更を提案と意味的に非常に類似した行に局所化している(req.method = method.upper() と比較して method=str(request.method).upper())。モデルはこの問題を正しく解決しており、すべてのテストがパスしていることに反映されている。しかし、この状況では、モデルが実際には成功においてかなり「運が良かった」ことがわかる。第一に、ゴールドパッチは文字列フォーマットの処理を統一するために使われる組み込み関数を活用しているのに対し、モデルがこの問題に対処するために、よりプリミティブなPythonを使用するという決定は、コードベースの他の部分との一貫性のなさから、人間のレビュアーにはおそらく受け入れられないであろう。さらに、この図には示されていないbuiltin_str関数を詳しく調べると、issueで描写された以上の追加の文字列フォーマットケースを処理していることも明らかになる。今回モデルはタスクを解決したが、この解決策が将来の問題に対して堅牢であるかは疑問である。
表32: これはSWE-Llama13bがタスクを成功裏に解決した別の例である。この例は、モデルが参照と比較してやや新規性のある解決策を開発しており、間違いなくより効率的でクリーンであるという点で興味深い。
設定
- モデル: SWE-Llama 13B(オラクル検索あり)- タスクインスタンス: djang0. djang0-11727- Issueへのリンク: https://code.djangoproject.com/ticket/29376- PRへのリンク: https://github.com/djang0/djang0/pull/11727
Issue
show_save_and_add_anotherコンテキスト変数で「Save and Add Another」ボタンを非表示にできるようにする
より良い調整性を提供するため、新しいコンテキスト変数 - show_save_and_add_anotherを導入する。例えば、「Save and add another」ボタンを非表示にしたい場合は、extra_contextを変更して、変数にFalseを書き込むだけでよい。他のボタン - 「Save」と「Save and continue editing」については、これはすでにまったくこの方法で機能している。
ゴールドパッチ
diff --git a/djang0/contrib/admin/templateTags/admin_modify.py b/djang0 /... - - a/djang0/contrib/admin/templateTags/admin_modify.py +++ b/djang0/contrib/admin/templateTags/admin_modify.py @@ -54,12 +54,20 @@ def submit_row(context): is_popup = context['is_popup'] save_as = context['save_as'] show_save = context.get('show_save', True) + show_save_and_add_another = context.get('show_save_and_add_another', True)
(7行省略...) or (has_add_permission and add) or has_editable_inline_admin_formset + can_save_and_add_another = ( + has_add_permission and + not is_popup and + (not save_as or add) and + can_save and + show_save_and_add_another + ) can_save_and_continue = not is_popup and can_save and has_view_permission and show_save_and_continue can_change = has_change_permission or has_editable_inline_admin_formset ctx = Context(context) @@ -70,10 +78,7 @@ def submit_row(context): change and context.get('show_delete', True) ), 'show_save_as_new': not is_popup and has_change_permission and change and save_as, - 'show_save_and_add_another': ( - has_add_permission and not is_popup and - (not save_as or add) and can_save - ), 'show_save_and_add_another': can_save_and_add_another, 'show_save_and_continue': can_save_and_continue, 'show_save': show_save and can_save,
モデル生成パッチ
diff --git a/django/contrib/admin/templateTags/admin_modify.py b/django/...-- a/django/contrib/admin/templateTags/admin_modify.py +++ b/django/contrib/admin/templateTags/admin_modify.py@@ - 72,7 + 72,7 @@ def submit_row(context):' show_save_as_new': not is_popup and has_change_permission and change and save_as,' show_save_and_add_another': has_add_permission and not is_popup and- (not save_as or add) and can_save + (not save_as or add) and can_save and context. get('show_save_and_add_another', True)),' show_save_and_continue': can_save_and_continue,' show_save': show_save and can_save,
テスト
Fail to Pass (2)
test_override_show_save_and_add_another
test_submit_row (admin_views.test_templateTags.Admin...)
Pass to Pass (3)
test_choice_links (admin_views.test_templateTags.DateHierarchyTests)
test_override_change_form_template_tags
test_override_change_list_template_tags
考察。django/djangoリポジトリから来たこのタスクインスタンスでは、モデルは、他の2つの既存のボタンで行われているのと同様に、ユーザーがコンテキスト変数を介して「Save and Add Another」ボタンを非表示にできるようにするコンテキスト変数を導入するよう求められている。このタスクは、以前の2つの設定と比較してやや難しい。なぜなら、問題の明示的なスタックトレースやプログラム的な実演が提供されていないからである。関数を正しく局所化することに関する提案が提供されない、この比較的仕様の不十分な設定において、モデルは既存のshow_save_and_add_anotherキー/バリューペアを調整すべきであると首尾よく推論する。ゴールドパッチの解決策と比較すると、モデル生成パッチは、show_save_and_add_anotherの非表示状態を設定するためのフラグとしてコンテキストを取り込むために最小限の編集を行うため、編集行数の点ではるかに効率的な解決策を生み出すと論じることができる。しかし、表31での考察と同様に、スタイル的には、ゴールドパッチの編集はコードベースとはるかに一貫しており、issueで明示的に議論されていない追加の変更も、コードベースで行われていることに準拠するために行われている(すなわち、can_save_and_add_anotherフィールドの追加)。このタスクは、人間のガイダンスやコードベース全般のより良い理解を通じて、モデルが生成を調整して、機能的に正しい変更だけでなく、スタイル的にも正しい変更を行うようになる、というエキサイティングな可能性のある方向性の例である。
表33: これはSWE-Llama13bが誤った解決策を書いたものの、以前の動作を首尾よく維持した例である。ここでのモデルの生成とゴールドパッチの違いは、モデルが必要な修正を過少生成する傾向があることを示している。
設定
- モデル: SWE-Llama 13B(オラクル検索あり)- タスクインスタンス: sphinx-doc_sphinx-11445- Issueへのリンク: https://github.com/sphinx-doc/sphinx/issues/11437- PRへのリンク: https://github.com/sphinx-doc/sphinx/pull/11445
Issue
rst_prologを使用すると、ドメインディレクティブを含むトップレベル見出しが削除される
バグの説明
rst_prolog が設定されている場合、最初の見出しにドメインディレクティブ(例::mod:)を含むドキュメントは、見出しが正しくレンダリングされず、また toctree に見出しが含まれません。以下の例では、docs/mypackage.rst の見出しが :mod:mypackage2 ではなく mypackage2 であれば、見出しは正しく表示されます。同様に、rst_prolog を設定しなければ、見出しは正しく表示されます。これはしばらく前から壊れているようです。というのも、Sphinx の v4.0.0 で再現できるからです。
再現方法
$ sphinx-quickstart --no-sep --project mypackage --author me - v 0.1.0 --release 0.1.0 --language en docs $ echo - e 'Welcome\n=========\n\n...\tctree::\n\n\_mypackage\n' > docs/index_rst $ echo - e ':mod:'mypackage2\n=========\n\nContent\n\n Subheading\n-
logger = logging.getLogger(name) - docinfo_re = re.compile(r'\w+.?') + docinfo_re = re.compile(r'\w+.?n') symbols_re = re.compile(r'([-]-\/-\@[\-]') SECTIONING_CHARS = ['=', '-', '-']
テスト
Fail to Pass (2)
X tests/test_util_rst.py::test_prepend_prolog_with_roles_with_newline tests/test_util_rst.py::test_prepend_prolog_with_roles_without_newline
Pass to Pass (8)
X tests/test_util_rst.py::test_prepend_prolog tests/test_util_rst.py::test_prepend_prolog_with_CR tests/test_util_rst.py::test_prepend_prolog_without_CR
その他の Pass to Pass テストは省略...
Gold Patch
diff --git a/sphinx/util/rst.py b/sphinx/util/rst.py -- a/sphinx/util/rst.py ++ b/sphinx/util/rst.py @@ - 10,22 +10,17 @@
from docutils.parsers.rst import roles from docutils.parsers.rst.languages import en as english +from docutils.parsers.rst.states import Body from docutils.statemachine import StringList from docutils.utils import Reporter - from jinja2 import Environment +from jinja2 import Environment, pass_environment from sphinx.locale import from sphinx.util import docutils, logging- try: - from jinja2.utils import pass_environment - except ImportError: - from jinja2 import environmentfilter as pass_environment - logger = logging.getLogger(name) - docinfo_re = re.compile('\w+.*?') +FIELD_NAME_RE = re.compile(Body.patterns['field_marker']) symbols_re = re.compile(r'([-\-/:-@\[-\{-]})' # symbols without dot(0 x2e) SECTIONING_CHARS = ['=', '-', '~']
@@ - 80,7 +75,7 @@ def prepend_prolog(content: StringList, prolog: str) -> None: if prolog: pos = 0 for line in content: if docinfo_re.match(line): + if FIELD_NAME_RE.match(line): pos += 1 else: break @@ - 91,6 +86,7 @@ def prepend_prolog(content: StringList, prolog: str) -> None: pos += 1 # insert prolog (after docinfo if exists) + lineno = 0 for lineno, line in enumerate(prolog.splitlines()): content.insert(pos + lineno, line, 'rst_prolog>', lineno)
議論。sphinx-doc/sphinxリポジトリからのこのタスクインスタンスでは、モデルはタイトルが誤ってレンダリングされるケースを修正するためのロジックを書くよう求められる。使用されている専門用語を単純に理解し、そうした言葉をコードベース内のロジックに対応付けること自体が、モデルが直面する重大な課題である。モデルにはこれを助けるコマンドライン呼び出しが与えられているが、イシューに示された用語をコードベース内に根付かせることが不可欠である。ゴールドパッチとモデル生成パッチを比較すると、モデルがタスクの解決に近づいていないことは明らかである。モデルは一般に、正規表現パターンを修正することが正しい行動であると識別している。これはゴールドパッチも行っていることである。しかし、モデルとオラクル検索設定が共に不足している主な点は、コードベース自体とサードパーティライブラリの両方からの追加モジュールの多大な使用によるものである。この例は、言語モデルの訓練と、そうした情報の自動発見を可能にする推論手順の設計の重要性と可能性を浮き彫りにしている。
表34:この最後の例では、SWE-Llama 13bはタスクを解決しないだけでなく、モデル内の既存の動作を破壊する。この例は、モデルが要求された編集の範囲を超えてコードベースを理解する必要性を示している。
設定
- タスクインスタンス:scikit-learn_scikit-learn-13241
- イシューへのリンク:https://github.com/scikit-learn/scikit-learn/issues/8798
- PRへのリンク:https://github.com/scikit-learn/scikit-learn/pull/13241
イシュー
rbfカーネルを用いたKernelPCAの結果間の差異
説明
同じデータセットに対して次元削減のためにKernelPCAを実行すると、結果の符号が異なる。
再現手順/コード
rbfカーネルで次元を7に削減するだけ:
pca = KernelPCA(n_components=7, kernel='rbf', copy_X=False, n_jobs=- 1) pca.fit_transform(X)
期待される結果
同じ結果。
実際の結果
結果は符号を除いて同じである:
[[- 0.44457 - 0.18155 - 0.10873 0.13548 - 0.14371 - 0.05746 0.18124]] [[0.44457 0.18155 0.10873 - 0.13548 - 0.14371 - 0.05746 - 0.18124]] [[- 0.44457 - 0.18155 0.10873 0.13548 0.14371 0.057469 0.18124]]
ゴールドパッチ
diff --git a/sklearn/decomposition/kernel_pca.py b/sklearn/decompos...
-- a/sklearn/decomposition/kernel_pca.py
+++ b/sklearn/decomposition/kernel_pca.py
@@ - 8,6 + 8,7 @@
from scipy.sparse.linalg import eighs
from .utils import check_random_state
+from .utils.extmath import svd_flip
from .utils.validation import check_is_fitted, check_array
from .exceptions import NotFittedError from .base import BaseEstimator, TransformerMixin, _UnstableOn32BitMixin
@@ - 210,6 + 211,10 @@ def _fit_transform(self, K): maxiter=self.max_iter, v0=v0)
+ # flip eigenvectors' sign to enforce deterministic output
+ self.alphas_, _ = svd_flip(self.alphas_, + np.empty_like(self.alphas_).T) + # sort eigenvectors in descending order indices = self.lambdas_.argsort() [::- 1] self.lambdas_ = self.lambdas_[indices]
モデル生成パッチ
diff - - git a/sklearn/decomposition/kernel_pca.py b/sklearn/decompos... - - a/sklearn/decomposition/kernel_pca.py +++ b/sklearn/decomposition/kernel_pca.py @@ -220,7 +220,7 @@ def fit_transform(self, K): self.alphas = self.alphas_[:, self.lambdas_ > 0] self.lambdas_ = self.lambdas_[self.lambdas_ > 0]
return K return K / self.lambdas_
def _fit_inverse_transform(self, X_transformed, X): if hasattr(X, "tocstr"):
テスト
不合格から合格へ(1)
X sklearn/tests/test_kernel_pca.py::test_kernel_pca_deterministic_output
合格から合格へ(54)
X sklearn/tests/test_kernel_pca.py::test_kernel_pca sklearn/tests/test_kernel_pca.py::test_kernel_pca_consistent_transform sklearn/tests/test_kernel_pca.py::test_kernel_pca_deterministic_output sklearn/tests/test_kernel_pca.py::test_kernel_pca_sparse sklearn/tests/test_kernel_pca.py::test_kernel_pca_linear_kernel sklearn/tests/test_kernel_pca.py::test_kernel_pca_n_components sklearn/tests/test_kernel_pca.py::test_remove_zero_eig sklearn/tests/test_kernel_pca.py::test_kernel_pca_precomputed sklearn/tests/test_kernel_pca.py::test_gridsearch_pipeline sklearn/tests/test_kernel_pca.py::test_gridsearch_pipeline_precomputed sklearn/tests/test_pca.py::test_pca_dtype_preservation[randomized] sklearn/tests/test_pca.py::test_pca_dtype_preservation[auto] sklearn/tests/test_pca.py::test_pca_deterministic_output
通過するテストへの追加パスは省略...
考察。scikit-learn/scikit-learnライブラリからのこの例では、モデルに対して、fit_transform関数の呼び出しからの出力のパリティが反転するという観察が与えられる。モデルにはまた、この問題を再現するPythonコードの行とその標準出力が与えられる。ゴールドパッチは、_fit_transform関数内の別の行でこの問題を解決するためにsvd_flip関数をインポートして使用する。表33の例で議論した点を超えて、このタスクに対するモデルの失敗が異なる点は、その編集が依存する第三者依存関係を理解することに加えて、モデルが、変更しようとしている関数にコードベースの他のどの部分が依存しているかを理解することも重要であるという点である。この例は、ローカルな編集範囲を超えて拡張される長いコンテキストを処理することが、困難ではあるが価値のある挑戦である理由について、異なる側面を提示している。