
PPO への四つの修正で 32B モデルが AIME 2024 で 50 点に到達し、コードとデータも公開。2025 年の論文、全文無料。
DAPO: An Open-Source LLM Reinforcement Learning System at Scale
DAPO:大規模LLM強化学習システムのオープンソース実装
ByteDance Seed Institute for AI Industry Research(AIR)、清華大学 香港大学 清華大学AIRおよびByteDance SeedのSIA-Lab
著者全員のリストはContributionsを参照
概要
推論スケーリングはLLMに前例のない推論能力をもたらし、複雑な推論を引き出す中核技術として強化学習が用いられている。しかし、最先端の推論LLMの重要な技術的詳細は秘匿されており(例えばOpenAI o1のブログやDeepSeek R1の技術報告書など)、そのためコミュニティはいまだに彼らのRL学習結果を再現することに苦慮している。我々はDecoupled Clip and Dynamic sAmpling Policy Optimization(DAPO)アルゴリズムを提案し、Qwen2.5-32Bベースモデルを用いてAIME 2024で50点を達成する最先端の大規模RLシステムを完全にオープンソース化する。学習の詳細を伏せる従来の研究とは異なり、我々は大規模LLM RLを成功に導くアルゴリズムの4つの重要な技術を紹介する。さらに、ver1フレームワーク上に構築された学習コードと、慎重にキュレーションおよび処理されたデータセットをオープンソース化する。これらのオープンソースシステムの構成要素は再現性を高め、大規模LLM RLにおける今後の研究を支援する。
日付:2025年3月17日 連絡先:zhouhao@air.tsinghua.edu.cn、wangmingxuan.89@bytedance.com プロジェクトページ:https://dapo-sia.github.io/"https://github.com/volcengine/ver1
1 はじめに
OpenAIのo1 [1]やDeepSeekのR1 [2]のようなテスト時スケーリングは、大規模言語モデル(LLM)[3-7]に深刻なパラダイムシフトをもたらす。テスト時スケーリングはより長いChain-of-Thought思考を可能にし、洗練された推論行動を誘発することで、AIMEやCodeforcesのような競技数学やコーディングタスクにおいてモデルを優れたものにする。
この革命を推進する中心技術は大規模強化学習(RL)であり、自己検証や反復的改善といった複雑な推論行動を引き出す。しかし、スケーラブルなRL学習の実際のアルゴリズムと重要なレシピは依然として謎のままであり、既存の推論モデルの技術報告書[1, 2, 8-11]からは隠されている。本論文では、大規模RL学習における重大な障害を明らかにし、アルゴリズム、学習コード、データセットを完全にオープンソース化したスケーラブルなRLシステムを公開する。これは業界レベルのRL結果を伴う民主化されたソリューションを提供するものである。
我々はRLの事前学習モデルとしてQwen2.5-32B [12]を用いて実験を行う。初期のGRPO実行では、AIMEでわずか30点しか達成できなかった——これはDeepSeekのRL(47点)を大きく下回る性能である。徹底的な分析により、素朴なGRPOベースラインはエントロピー崩壊、報酬ノイズ、学習の不安定性といったいくつかの主要な問題に悩まされていることが明らかになった。広範なコミュニティもDeepSeekの結果を再現する際に同様の課題に直面しており[13-19]、これは業界レベルの大規模で再現可能なRLシステムを開発するために必要な重要な学習の詳細がR1論文で省略されている可能性を示唆している。
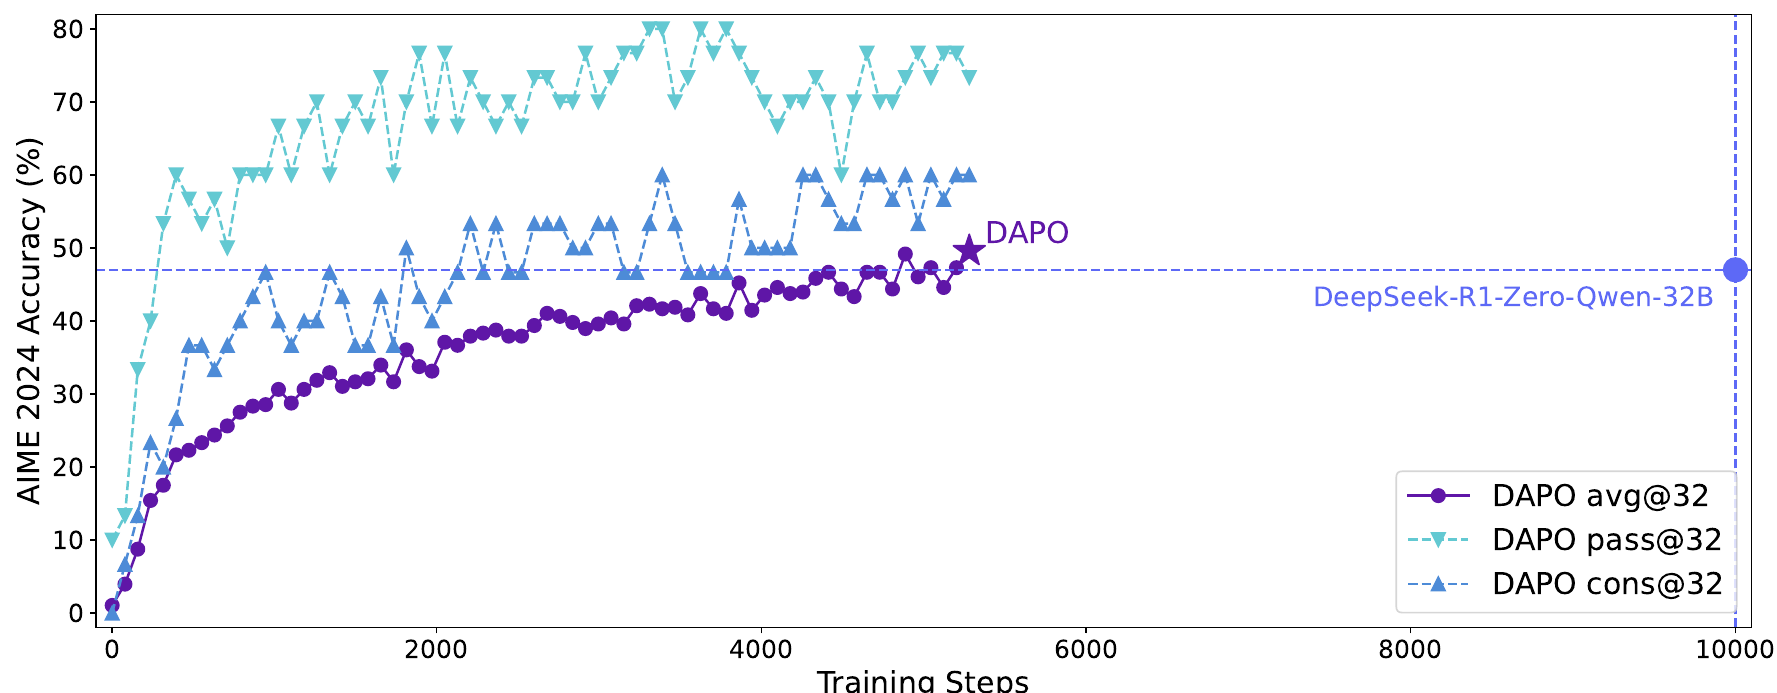
このギャップを埋めるため、我々は大規模LLM RLのためのオープンソースの最先端システムを公開する。これはQwen2.5-32Bモデルに基づいてAIME 2024で50点を達成し、DeepSeek-R1-Zero-Qwen-32B [2]が達成した従来の最先端結果(47点)を50%の学習ステップで上回る(図1)。我々はDecoupled Clip and Dynamic Sampling Policy Optimization(DAPO)アルゴリズムを提案し、長いCoTのRLシナリオでRLを輝かせるための4つの重要な技術を導入する。詳細は第3節で述べる。
1. Clip-Higher:システムの多様性を促進し、エントロピー崩壊を回避する;
2. Dynamic Sampling:学習の効率と安定性を向上させる;
3. Token-Level Policy Gradient Loss:長いCoTのRLシナリオにおいて極めて重要である;
4. Overlong Reward Shaping:報酬ノイズを低減し、学習を安定化させる。
我々の実装はverl [20]に基づいている。学習コードとデータを含む最先端のRLシステムを完全に公開することで、大規模LLM RLに関する貴重な知見を明らかにし、より広いコミュニティに貢献することを目指す。
2 予備知識
2.1 Proximal Policy Optimization(PPO)
PPO [21]は方策最適化のためのクリップ付き代理目的関数を導入する。クリップを用いて方策更新を以前の方策の近傍領域内に制限することで、PPOは学習を安定化させ、サンプル効率を向上させる。具体的には、PPOは以下の目的関数を最大化することで方策を更新する:
ここではデータ分布からの質問・回答ペア、は重要度サンプリング比のクリップ範囲、は時間ステップにおけるアドバンテージの推定値である。価値関数と報酬関数が与えられたとき、はGeneralized Advantage Estimation(GAE)[22]を用いて計算される:
ここで
2.2 Group Relative Policy Optimization(GRPO)
PPOと比較して、GRPOは価値関数を排除し、グループ相対的な方法でアドバンテージを推定する。特定の質問・回答ペアに対して、行動方策は個の個別応答のグループをサンプリングする。次に、番目の応答のアドバンテージは、グループレベルの報酬を正規化することによって計算される:
PPOと同様に、GRPOはクリップ付き目的関数を採用し、さらに直接課されるKLペナルティ項を伴う:
ここで
また、GRPO が目的関数をサンプルレベルで計算することにも言及しておく価値がある。正確には、GRPO はまず各生成シーケンス内で平均損失を計算し、その後に異なるサンプルの損失を平均する。3.3 節で議論するように、このような違いはアルゴリズムの性能に影響を与える可能性がある。
2.3 KL ダイバージェンスの除去
KL ペナルティ項は、オンラインポリシーと凍結された参照ポリシーとの間のダイバージェンスを制御するために用いられる。RLHF のシナリオ [23] では、RL の目的は初期モデルから大きく逸脱することなくモデルの振る舞いを整合させることである。しかし、長い CoT 推論モデルを訓練する際には、モデル分布が初期モデルから大きく逸脱する可能性があるため、この制限は必要ない。したがって、我々は提案アルゴリズムから KL 項を除外する。
2.4 ルールベースの報酬モデリング
報酬モデルの使用は通常、報酬ハッキング問題 [24-29] に悩まされる。代わりに、我々は検証可能なタスクの最終的な正解性を結果報酬として直接用い、以下のルールで計算する:
ここで は正解の答えであり、 は予測された答えである。これは、自動定理証明 [30-33]、コンピュータプログラミング [34-37]、数学競技 [2] など複数の領域で示されているように、ベースモデルの推論能力を活性化するための効果的なアプローチであることが証明されている。
3 DAPO
我々は ecouple Clip and ynamic sAmpling Policy ptimization(DAPO)アルゴリズムを提案する。DAPO は、答え と対になる各質問 に対して一群の出力 をサンプリングし、以下の目的関数によってポリシーを最適化する:
ここで、
完全なアルゴリズムはアルゴリズム1に示されている。本節では、DAPOに関連する主要な技術を紹介する。
3.1 天井を引き上げる:Clip-Higher
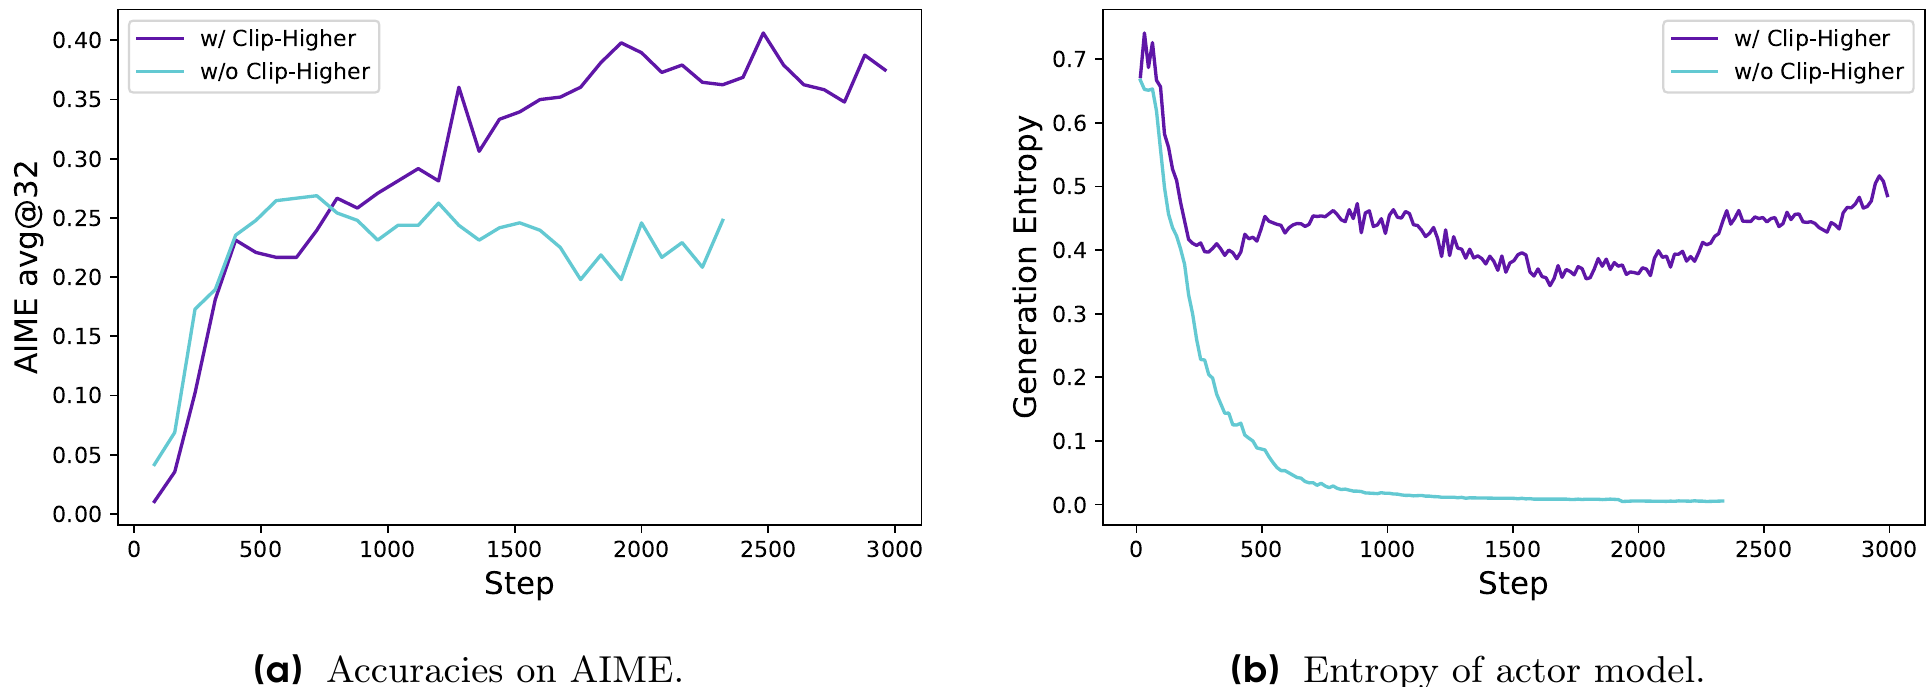
素朴なPPO [21]やGRPO [38]を用いた初期の実験において、我々はエントロピー崩壊現象を観察した。すなわち、訓練が進むにつれて方策のエントロピーが急速に減少するのである(図2b)。特定のグループのサンプリングされた応答はほぼ同一になる傾向がある。これは探索が限定的であり、方策が早期に決定論的になっていることを示しており、スケーリングのプロセスを妨げる可能性がある。
我々はこの問題に対処するためにClip-Higher戦略を提案する。重要度サンプリング比に対するクリッピングは、信頼領域を制限しRLの安定性を高めるために、Clipped Proximal Policy Optimization(PPO-Clip)[21]で導入されている。我々は、上限クリップが方策の探索を制限しうることを特定した。そこでは、「搾取」トークンをより高い確率にすることははるかに容易である一方、低確率の「探索」トークンの確率は引き上げるには厳しく制限されすぎているのである。
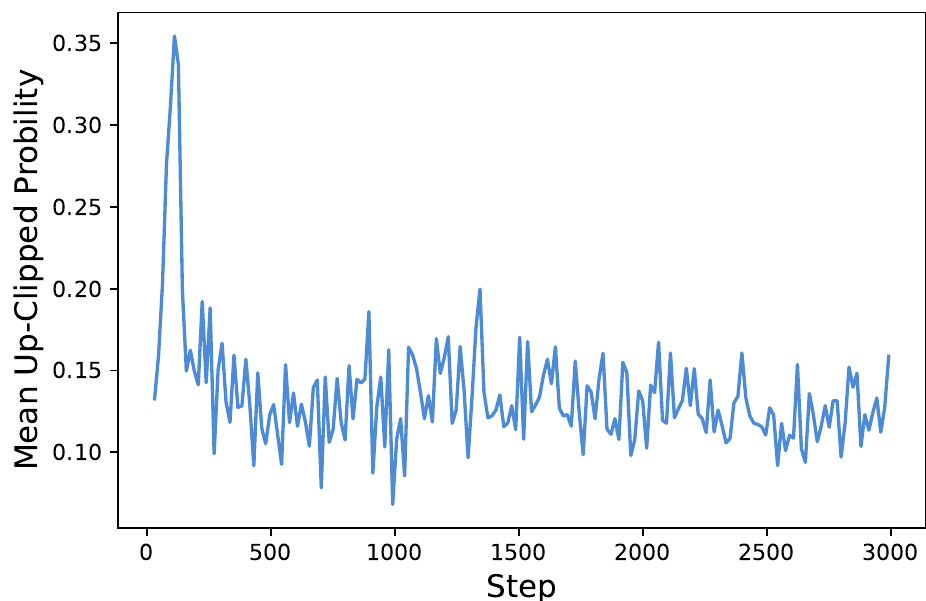
具体的には、(ほとんどのアルゴリズムのデフォルト値)かつ(システムが確率を増加させようとする)の場合、確率および0.9を持つ2つの行動を考える。増加後の確率の上限はそれぞれ0.012および1.08である()。これは、より高い確率(例:0.9)を持つ「搾取」トークンは、0.999のようなさらに極端に大きな確率を得ることに制約されないことを意味する。逆に、低確率の「探索」トークンについては、確率を非自明に増加させることは considerably より困難である。経験的にも、上限クリップされたトークンの平均確率は低いことを観察している:(図3a)。この発見は、上限クリッピング閾値が実際に低確率の「探索」トークンの確率増加を制限し、それによってシステムの探索を制約する可能性があるという我々の直観を支持するものである。
Clip-Higher戦略に従い、我々は下限と上限のクリッピング範囲をととして分離する。これは式10で強調されている:
我々はの値を増加させ、低確率トークンの増加のためにより多くの余地を残す。図2に示すように、この調整は方策のエントロピーを効果的に高め、より多様なサンプルの生成を促進する。はそのまま維持する。なぜなら、これを増加させるとこれらのトークンの確率を0に抑え込み、サンプリング空間の崩壊を引き起こすからである。
3.2 多ければ多いほど良い:動的サンプリング
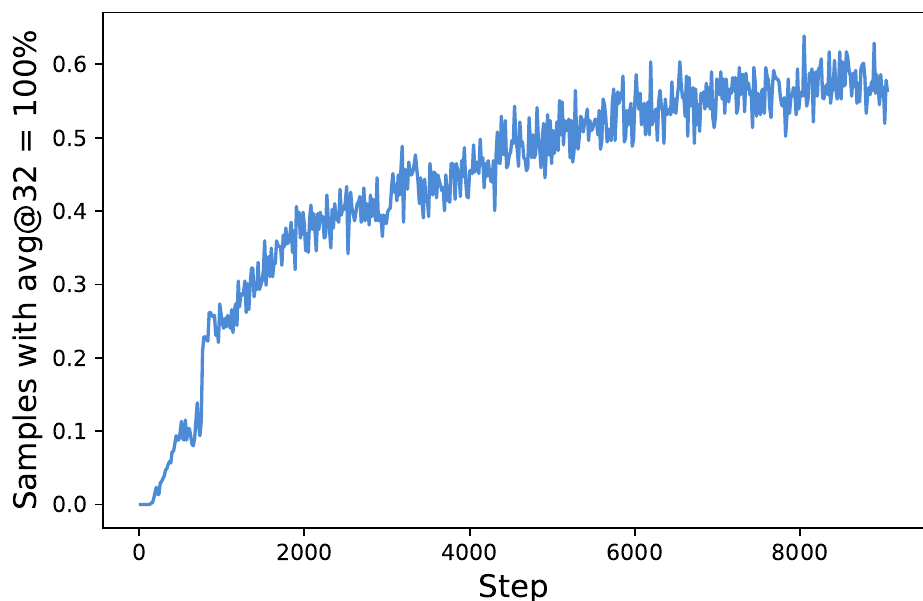
既存のRLアルゴリズムは、一部のプロンプトの正解率が1に等しい場合に、勾配減少問題に悩まされる。例えばGRPOでは、特定のプロンプトのすべての出力が正しく、同じ報酬を受け取る場合、このグループに対して得られるアドバンテージはゼロとなる。アドバンテージがゼロであると方策勾配もゼロとなり、バッチ勾配の大きさを縮小させるとともにノイズ感度を増加させ、それによってサンプル効率を低下させる。経験的には、正解率が1に等しいサンプルの数は増加し続けることが示されている(図3b)。これは、各バッチにおける有効なプロンプトの数が減少し続けることを意味し、勾配の分散を大きくし、モデル訓練のための勾配信号を減衰させる可能性がある。
このため、我々は式11に示すように、正解率が1および0に等しいプロンプトをオーバーサンプリングしてフィルタリングすることを提案する。これにより、バッチ内のすべてのプロンプトが有効な勾配を持ち、プロンプトの数が一定に保たれる。各バッチのサンプリングコストは動的である。訓練の前に、正解率が0でも1でもないサンプルでバッチが完全に満たされるまでサンプリングを続ける。
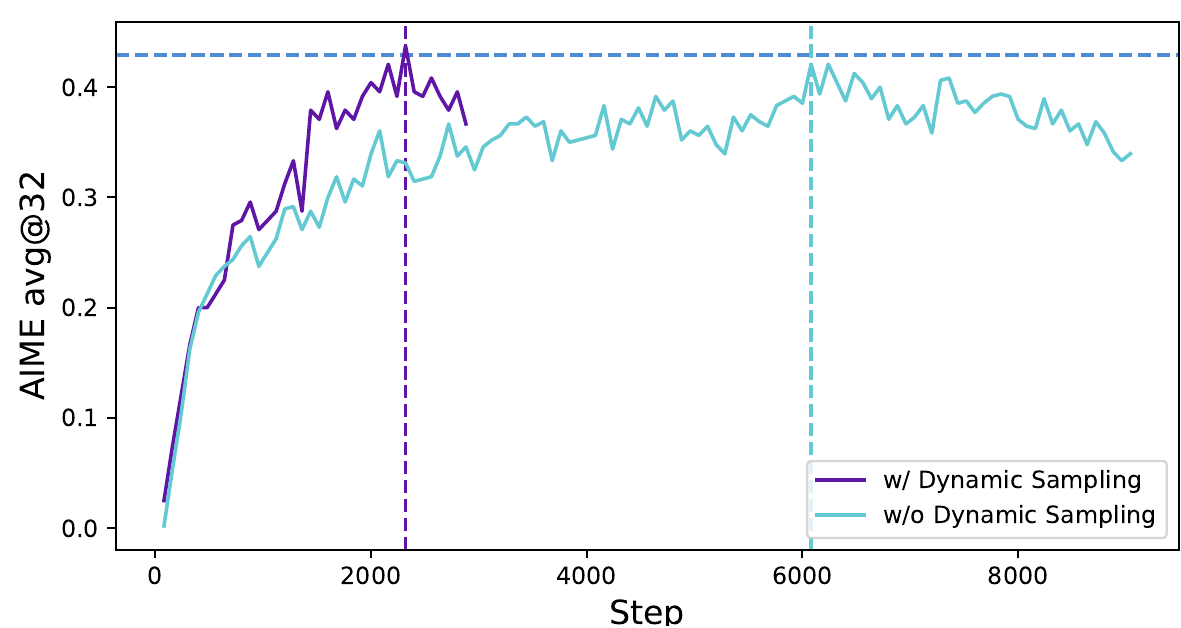
この戦略は必ずしも訓練効率を損なうものではないことに注意されたい。なぜなら、RLシステムが同期されており生成段階がパイプライン化されていない場合、生成時間は通常ロングテールサンプルの生成によって支配されるからである。さらに、動的サンプリングを用いることで、図6に示すように実験がより速く同じ性能を達成することを我々は発見した。
3.3 平衡を取り戻す:トークンレベルの方策勾配損失
元のGRPOアルゴリズムはサンプルレベルの損失計算を採用しており、これはまず各サンプル内でトークンごとに損失を平均し、その後サンプル間で損失を集約するものである。このアプローチでは、各サンプルは最終的な損失計算において等しい重みを割り当てられる。しかしながら、我々はこの損失削減の方法が、長いCoTのRLシナリオの文脈において、いくつかの課題をもたらすことを発見した。
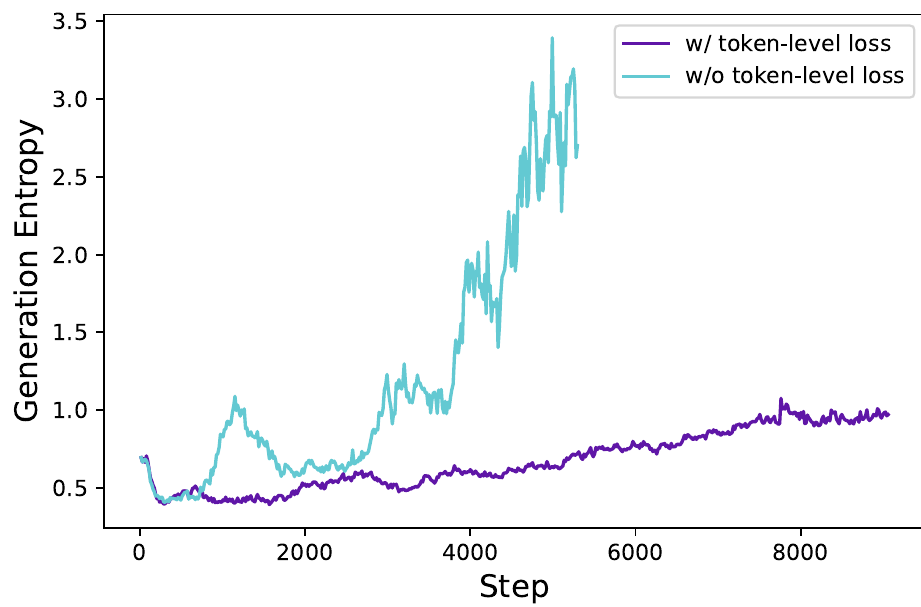
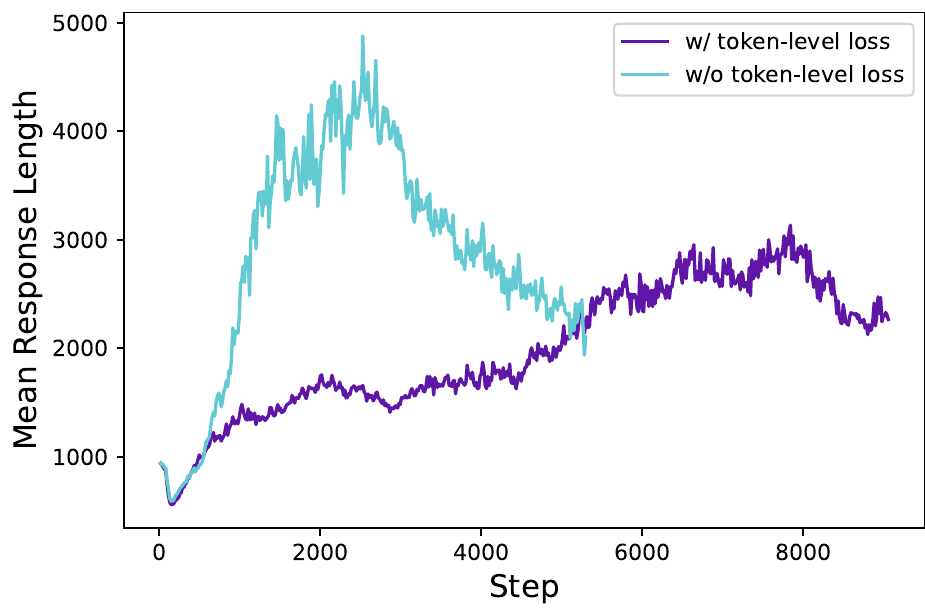
損失計算においてすべてのサンプルに同じ重みが割り当てられるため、より長い応答(より多くのトークンを含む)内のトークンは、全体の損失への寄与が不釣り合いに低くなる可能性があり、これは2つの悪影響を引き起こしうる。第一に、高品質な長いサンプルに対して、この効果はモデルがその中にある推論関連のパターンを学習する能力を妨げる可能性がある。第二に、我々は過度に長いサンプルがしばしば、意味のない文字列や繰り返しの単語といった低品質なパターンを示すことを観察している。したがって、サンプルレベルの損失計算は、長いサンプルにおけるそれらの望ましくないパターンに効果的にペナルティを与えることができないため、図4aおよび図4bに示すように、エントロピーと応答長の不健全な増加を引き起こす。
我々は上記の制限に対処するために、長いCoTのRLシナリオにおいてトークンレベルの方策勾配損失を導入する:
この設定では、より長いシーケンスはより短いシーケンスと比較して、全体の勾配更新に対してより大きな影響力を持ちうる。さらに、個々のトークンの観点からは、特定の生成パターンが報酬の増加または減少をもたらしうる場合、それが現れる応答の長さに関わらず、等しく促進または抑制される。
3.4 かくれんぼ:過長報酬の整形
RLトレーニングでは、通常、生成の最大長を設定し、それを超えたサンプルはそれに応じて切り捨てられます。切り捨てられたサンプルに対する不適切な報酬設計は、報酬ノイズを導入し、トレーニングプロセスを著しく混乱させる可能性があることが分かりました。
デフォルトでは、切り捨てられたサンプルに対して罰則的な報酬を割り当てています。このアプローチは、優れた推論プロセスが単にその長さが過剰であるという理由だけで罰せられる可能性があるため、トレーニングプロセスにノイズを導入するおそれがあります。このような罰則は、モデルに自身の推論プロセスの妥当性について混乱を生じさせる可能性があります。
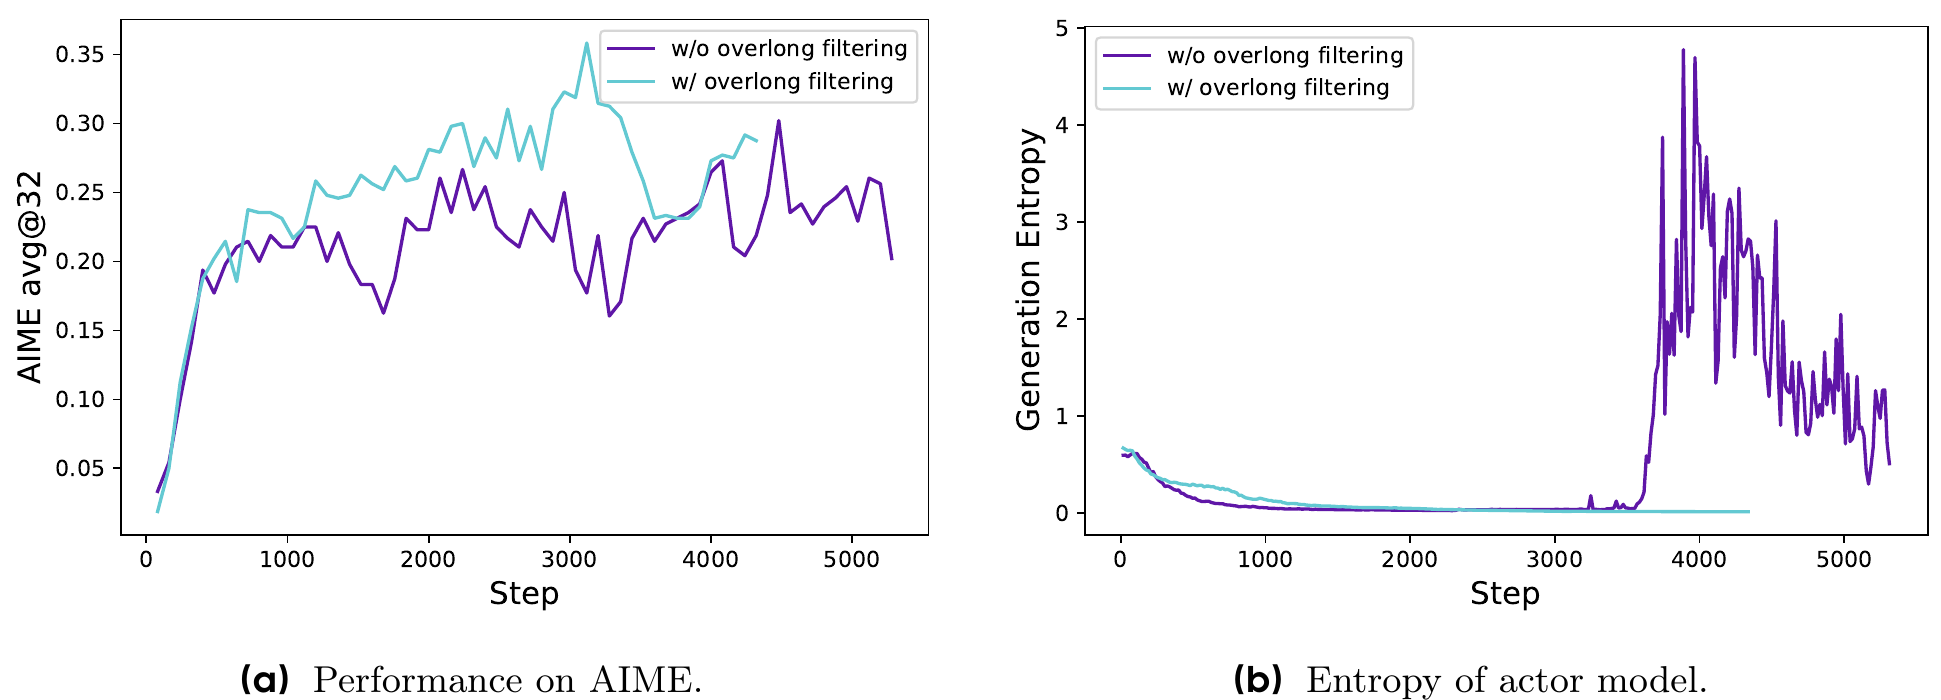
この報酬ノイズの影響を調査するため、まず切り捨てられたサンプルの損失をマスクするOverlong Filtering戦略を適用します。このアプローチがトレーニングを大幅に安定させ、性能を向上させることを、図5に示すように確認しました。
| アルゴリズム 1 | DAPO: Decoupled Clip and Dynamic sAmpling Policy Optimization |
| 入力 初期ポリシーモデル πθ;報酬モデル R;タスクプロンプト D;ハイパーパラメータ ε1ow, εhigh | |
| 1: step = 1,...,M について do | |
| 2: D からバッチ Db をサンプリングする | |
| 3: 古いポリシーモデルを更新する πθold ← πθ | |
| 4: 各質問 q ∈ Db に対して G 個の出力 {oi}i=1G ~ πθold(·|q) をサンプリングする | |
| 5: R を実行することにより、各サンプリングされた出力 oi に対する報酬 {ri}i=1G を計算する | |
| 6: oi をフィルタリングで除外し、残りを動的サンプリングバッファに追加する(動的サンプリング 式 (11)) | |
| 7: if バッファサイズ nb < N: | |
| 8: continue | |
| 9: バッファ内の各 oi について、oi の t 番目のトークンに対する Ait,t を計算する(式 (9)) | |
| 10: iteration = 1, ..., μ について do | |
| 11: DAPO 目的関数(式 (8))を最大化することにより、ポリシーモデル πθ を更新する | |
| 出力 πθ |
さらに、切り捨てられたサンプルに対する報酬を形成するために設計された長さを考慮した罰則メカニズムであるSoft Overlong Punishment(式13)を提案します。具体的には、応答長が事前に定義された最大値を超えた場合、罰則区間を定義します。この区間内では、応答が長くなるほど、より大きな罰則を受けます。この罰則は元のルールベースの正確性報酬に加算され、それによってモデルに過度に長い応答を避けるよう示唆します。
3.5 データセットの変換
我々のデータセットは、ウェブスクレイピングと手動アノテーションを組み合わせて、ウェブや公式コンテストのホームページから取得されている。数学データセットの答えは通常、式、数式、数値など多様な形式で与えられるため、それらを解析するための包括的なルールを設計することは困難である。ルールを用いて正確な報酬シグナルを提供し、数式パーサによって導入される誤差を最小化するために、AIMEに着想を得て、我々は答えを選択し、解析が容易な整数に変換する。例えば、元の答えがの形式で表される場合、我々はLLMに問題を修正するよう指示し、期待される答えがになるようにする。選択と変換の後、我々はDAPO-Math-17Kデータセットを得た。これは17K個のプロンプトから成り、それぞれが答えとして整数と対になっている。
4 実験
4.1 トレーニングの詳細
本研究では、我々のアルゴリズムを評価するために特に数学的タスクに焦点を当てるが、これは他のタスクにも容易に転用できる。我々はトレーニングにveriフレームワーク[20]を採用する。ベースラインアルゴリズムとして素朴なGRPO[38]を用い、グループ報酬正規化を用いてアドバンテージを推定する。
ハイパーパラメータについては、AdamW[39]オプティマイザを一定の学習率で用い、20ロールアウトステップにわたる線形ウォームアップを組み込む。ロールアウトでは、プロンプトのバッチサイズは512であり、各プロンプトに対して16個の応答をサンプリングする。トレーニングでは、ミニバッチサイズを512に設定する。すなわち、各ロールアウトステップに対して16回の勾配更新を行う。Overlong Reward Shapingについては、期待される最大長を16,384トークンに設定し、追加で4,096トークンをソフトペナルティキャッシュとして割り当てる。したがって、生成のための最大トークン数は20,480トークンに設定される。Clip-Higherメカニズムについては、クリッピングパラメータを0.2、を0.28に設定し、これにより探索と活用のトレードオフを効果的にバランスさせる。AIMEでの評価については、評価セットを32回繰り返し、結果の安定性のためにavg@32を報告する。評価の推論ハイパーパラメータはtemperature 1.0、topp 0.7に設定する。
4.2 主な結果
AIME 2024での実験は、DAPOがQwen-32B Baseモデルを強力な推論モデルへと見事にトレーニングすることに成功し、R1アプローチを用いたQwen2.5-32Bに対するDeepSeekの実験を上回る性能を達成したことを示している。図1において、我々はAIME 2024での性能の大幅な改善を観察し、精度はほぼ0%から50%へと増加した。特筆すべきは、この改善がDeepSeek-R1-Zero-Qwen-32Bに必要なトレーニングステップのわずか50%で達成されたことである。
我々の手法における各トレーニング技術の寄与を表1に詳述する。観察された改善は、RLトレーニングにおけるこれらの技術の有効性を示しており、それぞれが
| モデル | AIME24avg@32 |
| DeepSeek-R1-Zero-Qwen-32B | 47 |
| Naive GRPO | 30 |
| + Overlong Filtering | 36 |
| + Clip-Higher | 38 |
| + Soft Overlong Punishment | 41 |
| + Token-level Loss | 42 |
| + Dynamic Sampling (DAPO) | 50 |
AIME 2024において数ポイントの精度に寄与している。特筆すべきは、素朴なGRPO設定では、Qwen2.5-32Bベースモデルからトレーニングして到達できる精度はわずかである。
トークンレベルの損失については、性能の改善は小さいものの、トレーニングの安定性を高め、長さの増加をより健全にすることを我々は見出した。
Dynamic Samplingを適用すると、ゼロ勾配データのフィルタリングによりより多くのデータをサンプリングする必要があるものの、全体的なトレーニング時間には大きな影響はない。図6に示すように、サンプリングの回数は増加するものの、必要なトレーニングステップが少なくなるため、モデルの収束時間はむしろ短縮される。
4.3 トレーニングのダイナミクス
大規模言語モデルにおける強化学習は、最先端の研究方向であるだけでなく、本質的に複雑なシステムエンジニアリングの課題であり、その様々なサブシステムの相互依存性によって特徴づけられる。いずれか単一のサブシステムへの変更はシステム全体に伝播し、これらの構成要素間の入り組んだ相互作用により予期せぬ結果を引き起こしうる。データやハイパーパラメータの変動など、一見些細な初期条件の変化でさえ、反復的な強化学習プロセスを通じて増幅され、結果に大きな偏差をもたらしうる。この複雑さはしばしば研究者をジレンマに直面させる。すなわち、入念な分析と、ある変更がトレーニングプロセスの特定の側面を改善するという十分な根拠のある期待の後でさえ、実際の結果はしばしば予期された軌道から乖離するのである。したがって、実験中の重要な中間結果のモニタリングは、不一致の原因を迅速に特定し、最終的にシステムを洗練するために不可欠である。
- 生成された応答の長さは、図7aに示すように、トレーニングの安定性と性能に密接に関連する指標である。長さの増加はモデルに探索のためのより大きな空間を与え、より複雑な推論行動がサンプリングされ、トレーニングを通じて徐々に強化されることを可能にする。しかしながら、長さがトレーニング中に常に継続的な上昇傾向を維持するとは限らないことに注意することが重要である。かなりの期間において、それは停滞あるいは減少の傾向さえ示すことがあり、これは[2]においても示されている。我々は通常、実験が悪化しているかどうかを評価する指標として、長さを検証精度と併せて用いる。
- トレーニング中の報酬のダイナミクスは、図7bに示すように、強化学習において常に重要なモニタリング指標の一つである。我々の実験の大多数において、報酬増加の傾向は比較的安定しており、実験設定の調整によって大きく変動したり減少したりすることはない。これは、信頼できる報酬シグナルが与えられれば、言語モデルがトレーニングセットの分布に頑健に適合できることを示している。しかしながら、我々はトレーニングセットでの最終的な報酬が検証セットでの精度とほとんど相関を示さないことを見出し、これはトレーニングセットへの過適合を示している。
- Actorモデルのエントロピーと生成確率は、モデルの探索能力に関連し、我々の実験において注意深く監視する主要な指標である。直感的には、モデルのエントロピーは適切な範囲内に維持される必要がある。過度に低いエントロピーは確率分布が過度に鋭くなっていることを示し、探索能力の喪失につながる。逆に、
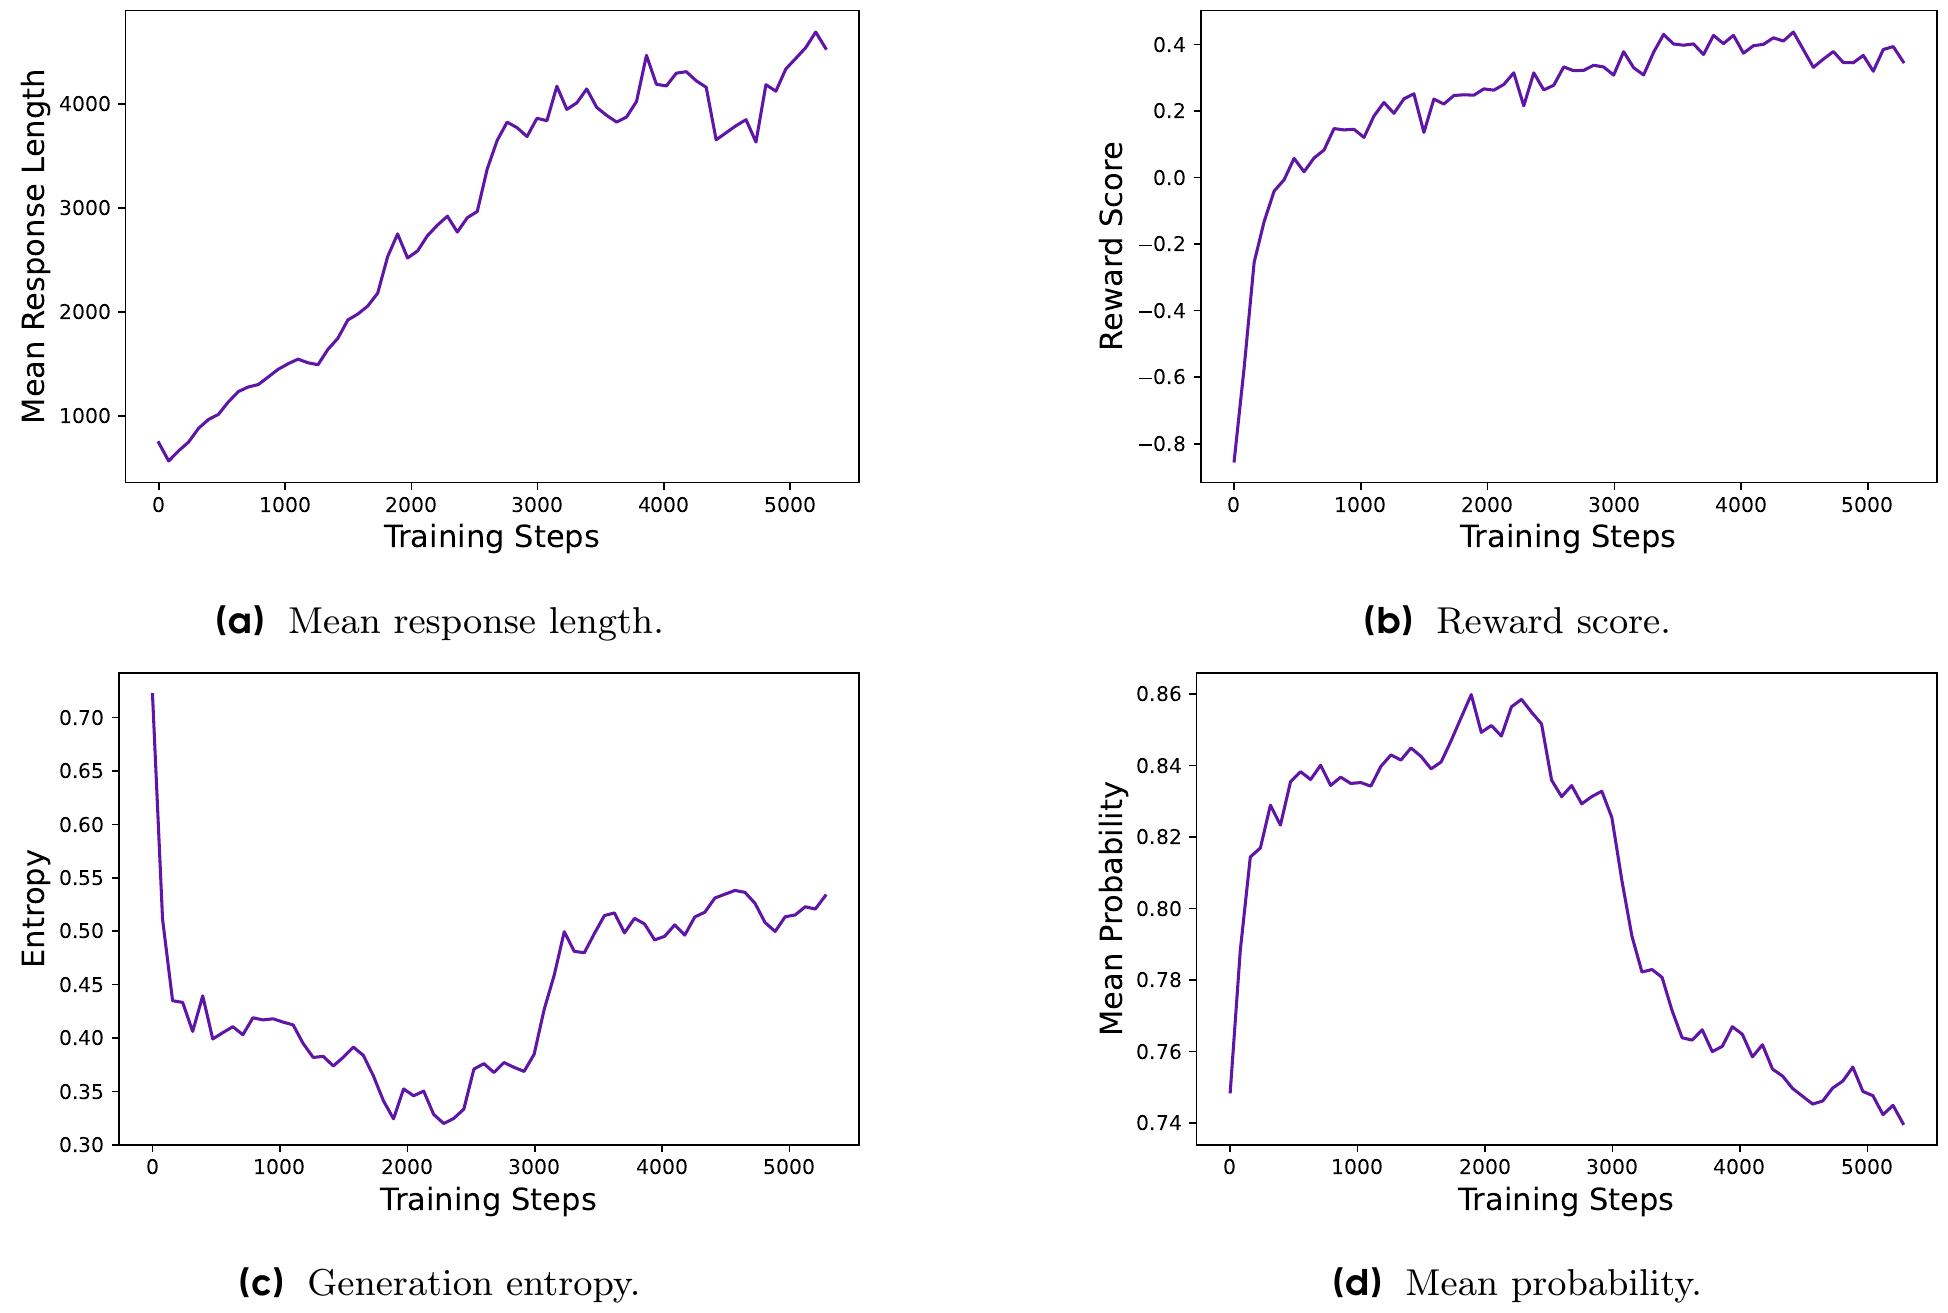
過度に高いエントロピーは、意味不明な生成や反復的な生成といった過剰探索の問題と関連することが多い。生成確率については、状況はまさに逆である。3.1節で示したように、Clip-Higher戦略を適用することで、我々はエントロピー崩壊の問題に効果的に対処した。その後の実験において、エントロピーを緩やかな上昇傾向に維持することがモデル性能の改善に資することを我々は見出した(図7cおよび図7dに示す)。
4.4 ケーススタディ
RLトレーニングの過程で、我々は興味深い現象を観察する。すなわち、Actorモデルの推論パターンが時間とともに動的に進化するのである。具体的には、アルゴリズムは正しい問題解決を促進する既存の推論パターンを強化するだけでなく、当初は存在しなかったまったく新しい推論の様式を徐々に生み出す。この発見は、RLアルゴリズムの適応性と探索能力を明らかにし、モデルの学習メカニズムに対する新たな洞察を提供する。
例えば、モデルトレーニングの初期段階では、以前の推論ステップを検証し反省する行為はほとんど発生しなかった。しかしながら、トレーニングが進むにつれて、モデルは表2に示すように、反省とバックトラックの明確な行動を示す。この観察は、RL中の推論能力の出現を解釈するためのさらなる探求に光を当てるものであり、これは今後の研究に委ねる。
5 結論
本論文では、アルゴリズム、コードインフラストラクチャ、データセットを含む、大規模LLMのRLのための完全にオープンソース化されたシステムを公開する。このシステムは最先端の大規模LLM RL性能(Qwen-32B事前学習モデルを用いてAIME 50)を達成する。我々は、Decoupled Clip and Dynamic sAmpling Policy
質問:
四面体の底面が正三角形であり、点の面への射影がの垂心であり、二面角がであり、であるとき、四面体の体積を求めよ。答えはの形であるので、の値を答えよ。
回答:
与えられた問題を考えてみましょう。私たちは…を決定する必要があります。次に、 の座標を とします。 であるため、距離の公式により が得られ、したがって と書くことができます。ここで、 は…の正射影であることを思い出してください。しかしながら、少し待って、平面が関与する二面角について、より思慮深い幾何学的方法で考え直してみましょう。平面 を考えます。これは完全に xy 座標平面上にあります( であるため)。平面 とします。点 を平面 へ垂直に投影したものは に落ちます。直線 ……
表2 強化学習最適化(DAPO)アルゴリズムにおける反省的行動の創発、および長いCoTのRLシナリオにおいてRLを強力に効果的かつ効率的にするための4つの主要技術を紹介する。さらに、トレーニングコードとデータセットをオープンソース化することで、より広範な研究コミュニティと社会にスケーラブルな強化学習ソリューションへの実用的なアクセスを提供し、すべての人がこれらの進歩から利益を得られるようにする。
貢献
プロジェクトリード
Qiying
アルゴリズム
Qiying 、Zheng Zhang 、Ruofei Zhu 、Yufeng Yuan 、Xiaochen Zuo 、Yu Yue
インフラストラクチャ\*
Weinan Dai 、Tiantian Fan 、Gaohong Liu 、Juncai Liu 、Lingjun Liu 、Xin Liu 、Haibin Lin 、Zhiqi Lin 、Bole Ma 、Guangming Sheng 、Yuxuan Tong 、Qiying Yu 、Chi Zhang 、Mofan Zhang 、Ru Zhang 、Wang Zhang 、Hang Zhu 、Jinhua Zhu
\*姓のアルファベット順
データセット
Jiaze Chen 、Jiangjie Chen 、Chengyi Wang 、Hongli Yu 、Yuxuan Song 、Xiangpeng Wei 、Qiying
監修
Hao Zhou 、Jingjing Liu 、Wei- Ying Ma 、Ya- Qin Zhang 、Lin Yan 、Mu Qiao 、Yonghui Wu 、Mingxuan Wang
所属
ByteDance Seed
清华大学人工智能产业研究院(AIR)
香港大学
清华大学AIR与ByteDance Seed联合实验室(SIA-Lab)
謝辞
DAPOプロジェクトへの支援に対し、Zhengyin Du、Shengding Hu、Kai Shen、Tianyang Zhan、Zhen Xiao、Renjie Zheng、Li Han、Kaihua Jiang、ならびにByteDanceのその他の同僚の皆様に感謝いたします。
参考文献
[1] OpenAI. Learning to reason with llms, 2024.
[2] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
[3] OpenAI. GPT4 technical report. arXiv preprint arXiv:2303.08774, 2023.
[4] Anthropic. Claude 3.5 sonnet, 2024.
[5] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. Language models are few-shot learners. Advances in neural information processing systems, 33:1877-1901, 2020.
[6] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. Palm: Scaling language modeling with pathways. Journal of Machine Learning Research, 24(240):1-113, 2023.
[7] Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang, Bochao Wu, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chenyu Zhang, Chong Ruan, et al. Deepseek-v3 technical report. arXiv preprint arXiv:2412.19437, 2024.
[8] XAI. Grok 3 beta — the age of reasoning agents, 2024.
[9] Google DeepMind. Gemini 2.0 flash thinking, 2024.
[10] Qwen. Qwq-32b: Embracing the power of reinforcement learning, 2024.
[11] Kimi Team, Angang Du, Bofei Gao, Bowei Xing, Changjiu Jiang, Cheng Chen, Cheng Li, Chenjun Xiao, Chenzhuang Du, Chonghua Liao, et al. Kimi k1.5: Scaling reinforcement learning with llms. arXiv preprint arXiv:2501.12599, 2025.
[12] An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, et al. Qwen2.5 technical report. arXiv preprint arXiv:2412.15115, 2024.
[13] Zhipeng Chen, Yingqian Min, Beichen Zhang, Jie Chen, Jinhao Jiang, Daixuan Cheng, Wayne Xin Zhao, Zheng Liu, Xu Miao, Yang Lu, et al. An empirical study on eliciting and improving rl-like reasoning models. arXiv preprint arXiv:2503.04548, 2025.
[14] Jingcheng Hu, Yinmin Zhang, Qi Han, Daxin Jiang, and Heung-Yeung Shum Xiangyu Zhang. Open-reasoner-zero: An open source approach to scaling reinforcement learning on the base model. https://github.com/Open-Reasoner-Zero/Open-Reasoner-Zero, 2025.
[15] Jian Hu. Reinforce++: A simple and efficient approach for aligning large language models. arXiv preprint arXiv:2501.03262, 2025.
[16] Ganqu Cui, Lifan Yuan, Zefan Wang, Hanbin Wang, Wendi Li, Bingxiang He, Yuchen Fan, Tianyu Yu, Qixin Xu, Weize Chen, et al. Process reinforcement through implicit rewards. arXiv preprint arXiv:2502.01456, 2025.
[17] Jung Hyun Lee, June Yong Yang, Byeongho Heo, Dongyoon Han, and Kang Min Yoo. Token-supervised value models for enhancing mathematical reasoning capabilities of large language models. arXiv preprint arXiv:2407.12863, 2024.
[18] Amirhossein Kazemnejad, Milad Aghajohari, Eva Portelance, Alessandro Sordoni, Siva Reddy, Aaron Courville, and Nicolas Le Roux. Vineppo: Unlocking rl potential for llm reasoning through refined credit assignment. arXiv preprint arXiv:2410.01679, 2024.
[19] Yufeng Yuan, Yu Yue, Ruofei Zhu, Tiantian Fan, and Lin Yan. What's behind ppo's collapse in long-cot? value optimization holds the secret. arXiv preprint arXiv:2503.01491, 2025.
[20] Guangming Sheng, Chi Zhang, Zilingfeng Ye, Xibin Wu, Wang Zhang, Ru Zhang, Yanghua Peng, Haibin Lin, and Chuan Wu. Hybridflow: A flexible and efficient rlhf framework. arXiv preprint arXiv:2409.19256, 2024.
[21] John Schulman, Filip Wolski, Prafulla Dhariwal, Alec Radford, and Oleg Klimov. Proximal policy optimization algorithms. arXiv preprint arXiv:1707.06347, 2017.
[22] John Schulman, Philipp Moritz, Sergey Levine, Michael Jordan, and Pieter Abbeel. High-dimensional continuous control using generalized advantage estimation, 2018.
[23] Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, John Schulman, Jacob Hilton, Fraser Kelton, Luke Miller, Maddie Simens, Amanda Askell, Peter Welinder, Paul F Christiano, Jan Leike, and Ryan Lowe. Training language models to follow instructions with human feedback. In S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho, and A. Oh, editors, Advances in Neural Information Processing Systems, volume 35, pages 27730-27744. Curran Associates, Inc., 2022.
[24] Dario Amodei, Chris Olah, Jacob Steinhardt, Paul Christiano, John Schulman, and Dan Mane. Concrete problems in ai safety, 2016.
[25] Tom Everitt, Victoria Krakovna, Laurent Orseau, Marcus Hutter, and Shane Legg. Reinforcement learning with a corrupted reward channel, 2017.
[26] Victoria Krakovna, Jonathan Uesato, Vladimir Mikulik, Matthew Rahtz, Tom Everitt, Ramana Kumar, Zac Kenton, Jan Leike, and Shane Legg. Specification gaming: the flip side of ai ingenuity, 2020.
[27] Tom Everitt, Marcus Hutter, Ramana Kumar, and Victoria Krakovna. Reward tampering problems and solutions in reinforcement learning: A causal influence diagram perspective, 2021.
[28] Leo Gao, John Schulman, and Jacob Hilton. Scaling laws for reward model overoptimization, 2022.
[29] Lilian Weng. Reward hacking in reinforcement learning. lilianweng.github.io, Nov 2024.
[30] Stanislas Polu and Ilya Sutskever. Generative language modeling for automated theorem proving, 2020.
[31] Trieu H Trinh, Yuhuai Wu, Quoc V Le, He He, and Thang Luong. Solving olympiad geometry without human demonstrations. Nature, 625(7995):476-482, 2024.
[32] Trieu Trinh and Thang Luong. Alphageometry: An olympiad-level ai system for geometry, 2024.
[33] AlphaProof and AlphaGeometry Teams. Ai achieves silver-medal standard solving international mathematical olympiad problems, 2024.
[34] Hung Le, Yue Wang, Akhilesh Deepak Gotmare, Silvio Savarese, and Steven Chu Hong Hoi. Coderl: 事前学習済みモデルと深層強化学習によるコード生成の習得. Advances in Neural Information Processing Systems, 35:21314-21328, 2022.
[35] Noah Shinn, Federico Cassano, Edward Berman, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. Reflexion: 言語的強化学習を備えた言語エージェント, 2023.
[36] Xinyun Chen, Maxwell Lin, Nathanael Schärli, and Denny Zhou. 大規模言語モデルへの自己デバッグの教示, 2023.
[37] Jonas Gehring, Kunhao Zheng, Jade Copet, Vegard Mella, Quentin Carbonneaux, Taco Cohen, and Gabriel Synnaeve. Rlcf: 強化学習による実行フィードバックにコードLLMを基盤づけること, 2025.
[38] Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Mingchuan Zhang, YK Li, Y Wu, and Daya Guo. Deepseekmath: オープン言語モデルにおける数学的推論の限界を押し広げる. arXiv preprint arXiv:2402.03300, 2024.
[39] Ilya Loshchilov and Frank Hutter. 分離型重み減衰正則化. In International Conference on Learning Representations, 2019.
付録
A データセット変換
以下はデータ変換の例であり、元の問題、変換後の問題、および変換過程におけるモデルの出力を示す(元のものはマークダウンテキストであり、可読性のためにレンダリングされている)。
モデルがこのタスクを高い精度で完了できることを保証するため、私たちの目標は、モデルに幻覚を避けつつ包括的な推論を実行させることである。私たちはこれを、徹底的な推論を促す明確な思考フレームワークを提供することによって達成する。具体的には、Chain of Thought(CoT)推論と、明確に定義された4つのステップ、すなわち解答形式の抽出、問題文の書き換え、修正された問題の解答、および最終解答としての整数の提示を採用する。各ステップについて、モデルの推論を導くための少数例による解答または詳細なガイドラインを提供する。
このアプローチを通じて、ほとんどの場合において、LLMが形式と品質の両面で満足のいく再定式化を生成できることを観察した。
元の問題
と を を満たす実数とする。このとき、 の取り得る最小値を求めよ。答え:
変形後の問題
と を を満たす実数とする。このとき、 の取り得る最小値を求めよ。元の答えは の形で表され、、、 は整数である。 の値を求めよ。答え:19
モデルの出力(Markdownテキスト)
変形の思考プロセス
問題の元の答えは代数的な式 11 - 2\sqrt{6} である。これを整数の形に変形する必要がある。まず、答えが整数部分と平方根の項からなることに注目する。与えられた規則に従い、整数部分と平方根部分を未定係数に置き換える。元の問題では x と y を変数として用いているので、未定係数には別の文字を選ぶ。答えを k - m\sqrt{n} の形で表し、生徒に を求めさせる。
解答形式
変形後の問題
と を を満たす実数とする。このとき、 の取り得る最小値を求めよ。元の答えは の形で表され、、、 は整数である。 の値を求めよ。
変形後の問題の答えの計算
元の答えは である。求められる形式は である。係数を比較すると、、、 となる。最終結果は である。
最終解答
B 補足事例
問題:
Aimeville の 900 人の住民のうち、ダイヤモンドの指輪を所有しているのは 195 人、ゴルフクラブの一式を所有しているのは 367 人、園芸用の鋤(スペード)を所有しているのは 562 人である。さらに、900 人の住民はそれぞれキャンディハートの袋を所有している。これらのうちちょうど 2 つを所有している住民は 437 人、ちょうど 3 つを所有している住民は 234 人である。Aimeville の住民のうち、これら 4 つすべてを所有している人数を求めよ。
回答:
ステップバイステップの解答:
1. 次の変数を定義する:
をダイヤモンドの指輪を所有している住民の集合とする。
をゴルフクラブの一式を所有している住民の集合とする。
を園芸用の鋤(スペード)を所有している住民の集合とする。
をキャンディハートの袋を所有している住民の集合とする。900 人の住民すべてがキャンディハートの袋を所有しているので、 である。
を、4 つの品目のうちちょうど 個を所有している住民の数とする。
4 つの集合 \(A,B,C,D\) の和集合について包除原理を用いる。
...
、すなわち 4 つの品目すべてを所有している人数は整数でなければならないため、現在のアプローチは、品目の異なる組み合わせを所有している人数の組合せ論的な数え方という観点から再検討する必要がある。
包除原理を直接用いる代わりに、品目 A、B、C、\(D\) の組み合わせを所有している人数を用いる別のアプローチを使うことができる。
を、A、B、C のうちちょうど i 個の品目を所有している人数とする(全員が所有している品目 を除く)。
すると、A、B、C、D のうちちょうど k 個の品目を所有している人数の総数は、次のように分解できる:
...
表 3 反射的行動の出現の一例。