再帰も畳み込みも使わず自己注意だけで系列を扱う Transformer。現代の大規模言語モデルの出発点となった NIPS 2017 論文、全文無料で読めます。
適切な帰属表示がなされることを条件に、Googleは本論文の表および図を、ジャーナリズムまたは学術的目的に限って複製する許可をここに付与する。
Attention Is All You Need
Ashish Vaswani* Google Brain avaswani@google.com
Noam Shazeer* Google Brain noam@google.com
Niki Parmar* Google Research nikip@google.com
Jakob Uszkoreit* Google Research usz@google.com
Llion Jones* Google Research llion@google.com
Aidan N. Gomez*† University of Toronto aidan@cs.toronto.edu
Lukasz Kaiser* Google Brain lukaszkaiser@google.com
Illia Polosukhin*† illia.polosukhin@gmail.com
概要
支配的な系列変換モデルは、エンコーダとデコーダを含む複雑なリカレントまたは畳み込みニューラルネットワークに基づいている。最も性能の良いモデルはさらに、アテンション機構を通じてエンコーダとデコーダを接続している。我々は、アテンション機構のみに基づき、リカレント処理と畳み込みを完全に排除した、新しい単純なネットワークアーキテクチャであるTransformerを提案する。2つの機械翻訳タスクにおける実験は、これらのモデルが品質において優れている一方で、より並列化可能であり、訓練に必要な時間が大幅に少ないことを示している。我々のモデルは、WMT 2014英語-ドイツ語翻訳タスクにおいて28.4 BLEUを達成し、アンサンブルを含む既存の最良結果を2 BLEU以上上回った。WMT 2014英語-フランス語翻訳タスクでは、我々のモデルは8基のGPUで3.5日間訓練した後、単一モデルとしての新たな最先端BLEUスコア41.8を確立した。これは文献における最良モデルの訓練コストのわずかな一部である。我々は、大規模および限られた訓練データの両方を用いた英語の構成素解析にTransformerを適用することにより、Transformerが他のタスクにもよく汎化することを示す。
1 はじめに
リカレントニューラルネットワーク、特に長短期記憶[13]およびゲート付きリカレント[7]ニューラルネットワークは、言語モデリングや機械翻訳[35] [2] [5]などの系列モデリングおよび変換問題における最先端のアプローチとして確固たる地位を確立している。その後、多数の取り組みにより、リカレント言語モデルおよびエンコーダ-デコーダアーキテクチャの限界を押し広げることが続けられている[38] [24] [15]。
リカレントモデルは通常、入力系列および出力系列の記号位置に沿って計算を因数分解する。位置を計算時間のステップに整列させ、それらは前の隠れ状態と位置の入力の関数として、隠れ状態の系列を生成する。この本質的に逐次的な性質は、訓練例内での並列化を妨げ、これはより長い系列長において決定的となる。なぜなら、メモリ制約が例をまたぐバッチ処理を制限するからである。最近の研究は、因数分解の工夫[21]および条件付き計算[32]を通じて計算効率の大幅な改善を達成しており、後者の場合はモデル性能も改善している。しかしながら、逐次計算という根本的な制約は残っている。
アテンション機構は、様々なタスクにおいて説得力のある系列モデリングおよび変換モデルの不可欠な一部となっており、入力系列または出力系列における距離に関係なく依存関係をモデル化することを可能にしている[2] [19]。しかしながら、ごく少数の例外[27]を除き、そのようなアテンション機構はリカレントネットワークと組み合わせて使用されている。
本研究では、リカレント処理を避け、代わりにアテンション機構のみに依拠して入力と出力の間の大域的な依存関係を引き出すモデルアーキテクチャであるTransformerを提案する。Transformerは大幅に多くの並列化を可能にし、8基のP100 GPUでわずか12時間訓練した後に、翻訳品質における新たな最先端に到達することができる。
2 背景
逐次計算を削減するという目標はまた、Extended Neural GPU [16]、ByteNet [18]およびConvS2S [9]の基礎を形成しており、これらはすべて畳み込みニューラルネットワークを基本的な構成要素として使用し、すべての入力位置および出力位置について隠れ表現を並列に計算する。これらのモデルでは、2つの任意の入力位置または出力位置からの信号を関連付けるために必要な演算数は、位置間の距離とともに増大し、ConvS2Sでは線形に、ByteNetでは対数的に増大する。これにより、離れた位置間の依存関係を学習することがより困難になる[12]。Transformerでは、これは一定数の演算に削減されるが、アテンション重み付き位置を平均化することによる実効解像度の低下というコストを伴い、この効果にはセクション[3.2]で説明するMulti-Head Attentionによって対抗する。
自己アテンションは、時にイントラアテンションと呼ばれ、系列の表現を計算するために単一の系列の異なる位置を関連付けるアテンション機構である。自己アテンションは、読解、抽象的要約、テキスト含意、およびタスク非依存の文表現の学習[4] [27] [28] [22]を含む様々なタスクで成功裏に使用されてきた。
エンドツーエンドのメモリネットワークは、系列に整列したリカレントではなく、リカレントアテンション機構に基づいており、単純な言語の質問応答および言語モデリングタスクにおいて良好に性能を発揮することが示されている[34]。
しかしながら、我々の知る限り、Transformerは、系列に整列したRNNや畳み込みを使用せずに、自己アテンションのみに依拠して入力および出力の表現を計算する最初の変換モデルである。以下のセクションでは、Transformerについて説明し、自己アテンションの動機を述べ、[17] [18]および[9]のようなモデルに対するその利点を議論する。
3 モデルアーキテクチャ
最も競争力のあるニューラル系列変換モデルのほとんどは、エンコーダ-デコーダ構造を持つ[5] [2] [35]。ここで、エンコーダは記号表現の入力系列を連続表現の系列に写像する。が与えられると、デコーダは記号の出力系列を一度に1要素ずつ生成する。各ステップにおいて、モデルは自己回帰的であり[10]、次の要素を生成する際に以前に生成された記号を追加の入力として消費する。
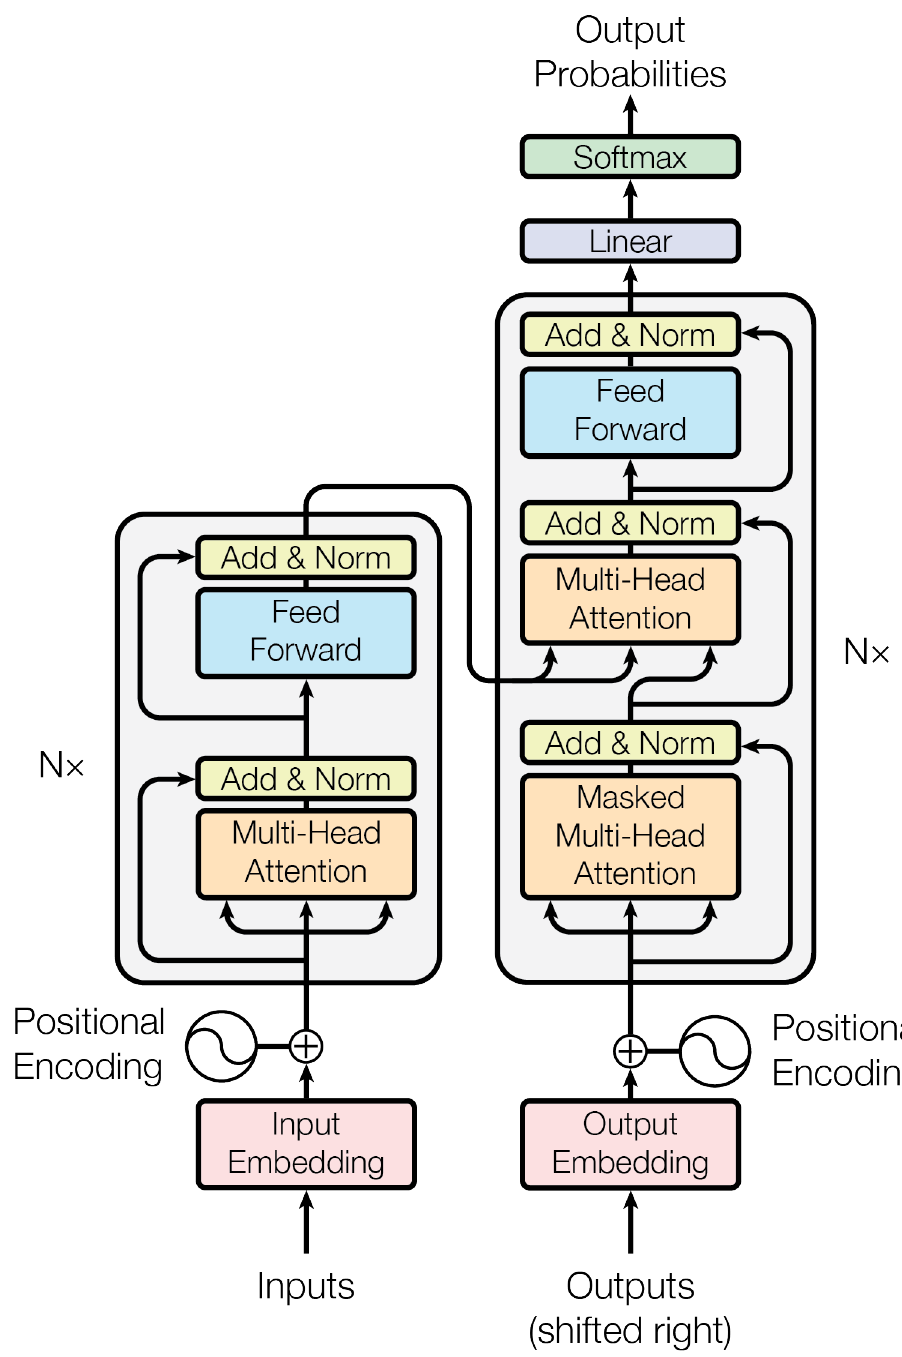
Transformerはこの全体的なアーキテクチャに従い、エンコーダとデコーダの両方に積み重ねられた自己アテンションおよびポイントワイズの全結合層を使用しており、それぞれ図[1]の左半分と右半分に示されている。
3.1 エンコーダとデコーダのスタック
エンコーダ:エンコーダは個の同一の層のスタックで構成される。各層は2つのサブ層を持つ。第一はマルチヘッド自己アテンション機構であり、第二は単純な位置ごとの全結合フィードフォワードネットワークである。我々は2つのサブ層のそれぞれの周りに残差接続[11]を採用し、その後に層正規化[1]を続ける。すなわち、各サブ層の出力はであり、ここではサブ層自体によって実装される関数である。これらの残差接続を容易にするため、モデル内のすべてのサブ層ならびに埋め込み層は、次元の出力を生成する。
デコーダ:デコーダもまた個の同一の層のスタックで構成される。各エンコーダ層における2つのサブ層に加えて、デコーダは第三のサブ層を挿入し、これはエンコーダスタックの出力に対してマルチヘッドアテンションを実行する。エンコーダと同様に、我々は各サブ層の周りに残差接続を採用し、その後に層正規化を続ける。我々はまた、デコーダスタック内の自己アテンションサブ層を修正し、位置が後続の位置にアテンションを向けることを防ぐ。このマスキングは、出力埋め込みが1位置だけオフセットされているという事実と組み合わされて、位置に対する予測がより小さい位置の既知の出力のみに依存できることを保証する。
3.2 アテンション
アテンション関数は、クエリとキー-値ペアの集合を出力に写像するものとして記述でき、ここでクエリ、キー、値、および出力はすべてベクトルである。出力は値の重み付き和として計算され
、各値に割り当てられる重みは、クエリと対応するキーとの適合性関数によって計算される。
3.2.1 スケール付きドット積アテンション
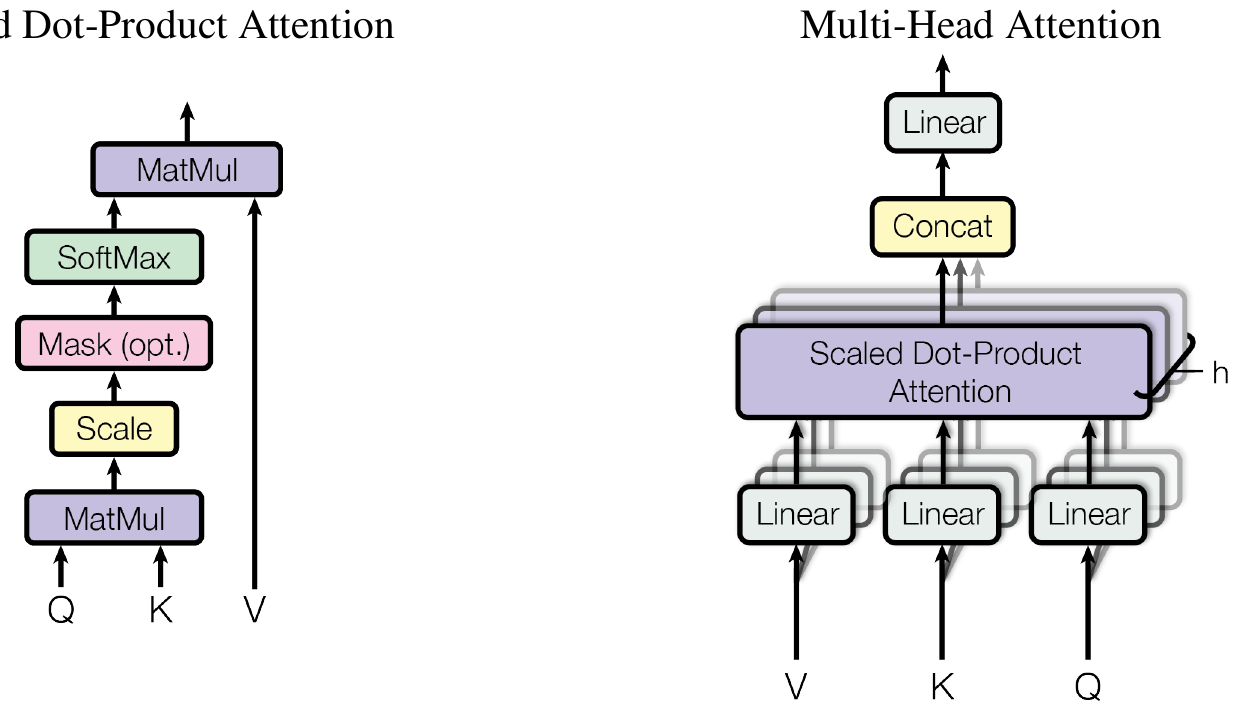
私たちはこの特定の注意機構を「スケール付きドット積注意」(図2)と呼ぶ。入力は次元 のクエリとキー、および次元 のバリューから構成される。クエリとすべてのキーのドット積を計算し、それぞれを で割り、softmax 関数を適用してバリューに対する重みを得る。
実際には、注意関数をクエリの集合上で同時に計算し、それらを行列 にまとめる。キーとバリューもまた行列 と にまとめられる。出力の行列は次のように計算される:
最も一般的に用いられる2つの注意関数は、加算的注意 2 とドット積(乗算的)注意である。ドット積注意は、スケーリング因子 を除いて、我々のアルゴリズムと同一である。加算的注意は、単一の隠れ層を持つフィードフォワードネットワークを用いて適合性関数を計算する。両者は理論的な計算量においては類似しているが、ドット積注意は高度に最適化された行列積のコードを用いて実装できるため、実際にははるかに高速で空間効率も優れている。
の値が小さい場合には両機構は同様に機能するが、 の値が大きい場合には、スケーリングを行わないドット積注意に対して加算的注意が優れる [3]。我々は、 の値が大きい場合にはドット積が大きな値に成長し、softmax 関数をその勾配が極めて小さくなる領域へと押しやるものと推測している。この効果を打ち消すために、我々はドット積を でスケーリングする。
3.2.2 マルチヘッド注意
次元のキー、バリュー、クエリで単一の注意関数を実行する代わりに、クエリ、キー、バリューをそれぞれ異なる学習済み線形射影によって 回、それぞれ 、、 次元に線形射影することが有益であることを我々は見出した。そして、これらの射影された各バージョンのクエリ、キー、バリューに対して注意関数を並列に実行し、 次元の出力値を得る。これらは連結され、もう一度射影されて最終的な値となり、図2に示すとおりとなる。
マルチヘッド注意により、モデルは異なる位置にある異なる表現部分空間からの情報に同時に注意を向けることができる。単一の注意ヘッドでは、平均化によってこれが妨げられる。
ここで、射影はパラメータ行列 、、、および である。
本研究では、 個の並列アテンション層、すなわちヘッドを採用する。これらのそれぞれに対して、 を用いる。各ヘッドの次元が削減されているため、総計算コストは完全な次元を持つ単一ヘッドアテンションのそれと同程度である。
3.2.3 本モデルにおけるアテンションの応用
Transformerはマルチヘッドアテンションを3つの異なる方法で用いる:
- 「エンコーダ-デコーダアテンション」層では、クエリは前のデコーダ層から来て、メモリのキーとバリューはエンコーダの出力から来る。これにより、デコーダの各位置は入力系列のすべての位置に対してアテンションを行うことができる。これは、[38] [2] [9] のような系列-to-系列モデルにおける典型的なエンコーダ-デコーダアテンション機構を模倣している。
- エンコーダは自己アテンション層を含む。自己アテンション層では、キー、バリュー、クエリのすべてが同じ場所から来る。この場合、エンコーダにおける前の層の出力である。エンコーダの各位置は、エンコーダの前の層のすべての位置に対してアテンションを行うことができる。
- 同様に、デコーダの自己アテンション層では、デコーダの各位置が、その位置までを含むデコーダ内のすべての位置に対してアテンションを行うことを可能にする。自己回帰的性質を保つために、デコーダにおける左方向への情報の流れを防ぐ必要がある。これをスケール付きドット積アテンションの内部で、不正な接続に対応するsoftmaxの入力内のすべての値をマスクする( に設定する)ことによって実装する。図[2]を参照のこと。
3.3 位置ごとのフィードフォワードネットワーク
アテンションのサブ層に加えて、エンコーダとデコーダの各層は、完全結合フィードフォワードネットワークを含み、これは各位置に個別かつ同一に適用される。これは、間にReLU活性化を持つ2つの線形変換から成る。
線形変換は異なる位置間で同一である一方、層ごとに異なるパラメータを用いる。これを別の言い方で表すと、カーネルサイズ1の2つの畳み込みとなる。入力と出力の次元は であり、内部層は次元 を持つ。
3.4 埋め込みとSoftmax
他の系列変換モデルと同様に、入力トークンと出力トークンを次元 のベクトルに変換するために学習済み埋め込みを用いる。また、デコーダの出力を予測される次トークンの確率に変換するために、通常の学習済み線形変換とsoftmax関数を用いる。本モデルでは、[30] と同様に、2つの埋め込み層とsoftmax前の線形変換の間で同じ重み行列を共有する。埋め込み層では、それらの重みに を掛ける。
| レイヤータイプ | レイヤーごとの計算量 | 逐次操作 | 最大パス長 |
| 自己注意 | O(n²·d) | O(1) | O(1) |
| リカレント | O(n·d²) | O(n) | O(n) |
| 畳み込み | O(k·n·d²) | O(1) | O(logk(n)) |
| 自己注意(制限付き) | O(r·n·d) | O(1) | O(n/r) |
3.5 位置エンコーディング
本モデルは再帰も畳み込みも含まないため、モデルが系列の順序を利用できるようにするには、系列内のトークンの相対位置または絶対位置に関する何らかの情報を注入しなければならない。この目的のために、エンコーダとデコーダのスタックの底にある入力埋め込みに「位置エンコーディング」を加える。位置エンコーディングは埋め込みと同じ次元 を持つため、両者を足し合わせることができる。位置エンコーディングには、学習型と固定型の多くの選択肢がある[9]。
本研究では、異なる周波数の正弦関数と余弦関数を用いる:
ここで は位置であり、 は次元である。すなわち、位置エンコーディングの各次元は正弦波に対応する。波長は から までの等比数列を形成する。この関数を選んだのは、任意の固定オフセット に対して が の線形関数として表せるため、モデルが相対位置によってアテンションを行うことを容易に学習できるだろうと仮説を立てたからである。
また、代わりに学習済み位置埋め込み[9]を用いる実験も行い、2つのバージョンがほぼ同一の結果を生み出すことを発見した(表3の行(E)を参照)。正弦波バージョンを選んだのは、訓練中に遭遇したものよりも長い系列長へモデルが外挿できる可能性があるからである。
4 なぜ自己アテンションか
本節では、自己アテンション層のさまざまな側面を、典型的な系列変換エンコーダやデコーダにおける隠れ層のように、1つの可変長の記号表現の系列 を同じ長さの別の系列 に写像するために一般的に用いられる再帰層や畳み込み層と比較する。ここで である。自己アテンションの使用を動機付けるにあたり、我々は3つの望ましい性質を考慮する。
1つは層ごとの総計算複雑性である。もう1つは、必要とされる逐次演算の最小数によって測られる、並列化可能な計算量である。
3つ目は、ネットワーク内の長距離依存関係間の経路長である。長距離依存関係の学習は、多くの系列変換タスクにおける重要な課題である。そのような依存関係を学習する能力に影響を与える重要な要因の1つは、順方向および逆方向の信号がネットワーク内で辿らなければならない経路の長さである。入力系列と出力系列の任意の位置の組み合わせ間のこれらの経路が短いほど、長距離依存関係を学習するのが容易になる[12]。したがって、異なる層タイプから構成されるネットワークにおいて、任意の2つの入力位置と出力位置の間の最大経路長も比較する。
表1に記されているように、自己アテンション層は一定数の逐次実行演算で全ての位置を結びつけるのに対し、再帰層は 回の逐次演算を必要とする。計算複雑性の観点では、系列長 が表現次元 より小さい場合、自己アテンション層は再帰層より高速であり、これは機械翻訳における最先端モデルが用いる文表現、例えばword-piece [38] やbyte-pair [31] 表現ではほとんどの場合に当てはまる。非常に長い系列を含むタスクの計算性能を向上させるために、自己アテンションを、それぞれの出力位置を中心とした入力系列内のサイズ の近傍のみを考慮することに制限することもできる。これにより最大経路長は に増加する。このアプローチについては今後の研究でさらに調査する予定である。
カーネル幅の単一の畳み込み層は、入力と出力のすべての位置のペアを結びつけるわけではない。そうするには、連続カーネルの場合にはの畳み込み層のスタックが必要であり、拡張畳み込み[18]の場合にはが必要であり、ネットワーク内の任意の2位置間の最長経路の長さが増加する。畳み込み層は一般に再帰層よりも倍高コストである。しかし、分離可能畳み込み[6]は複雑さを大幅に減らし、とする。しかしながら、であっても、分離可能畳み込みの複雑さは、自己注意層と位置ごとのフィードフォワード層の組み合わせ(我々のモデルで採用する手法)と等しい。
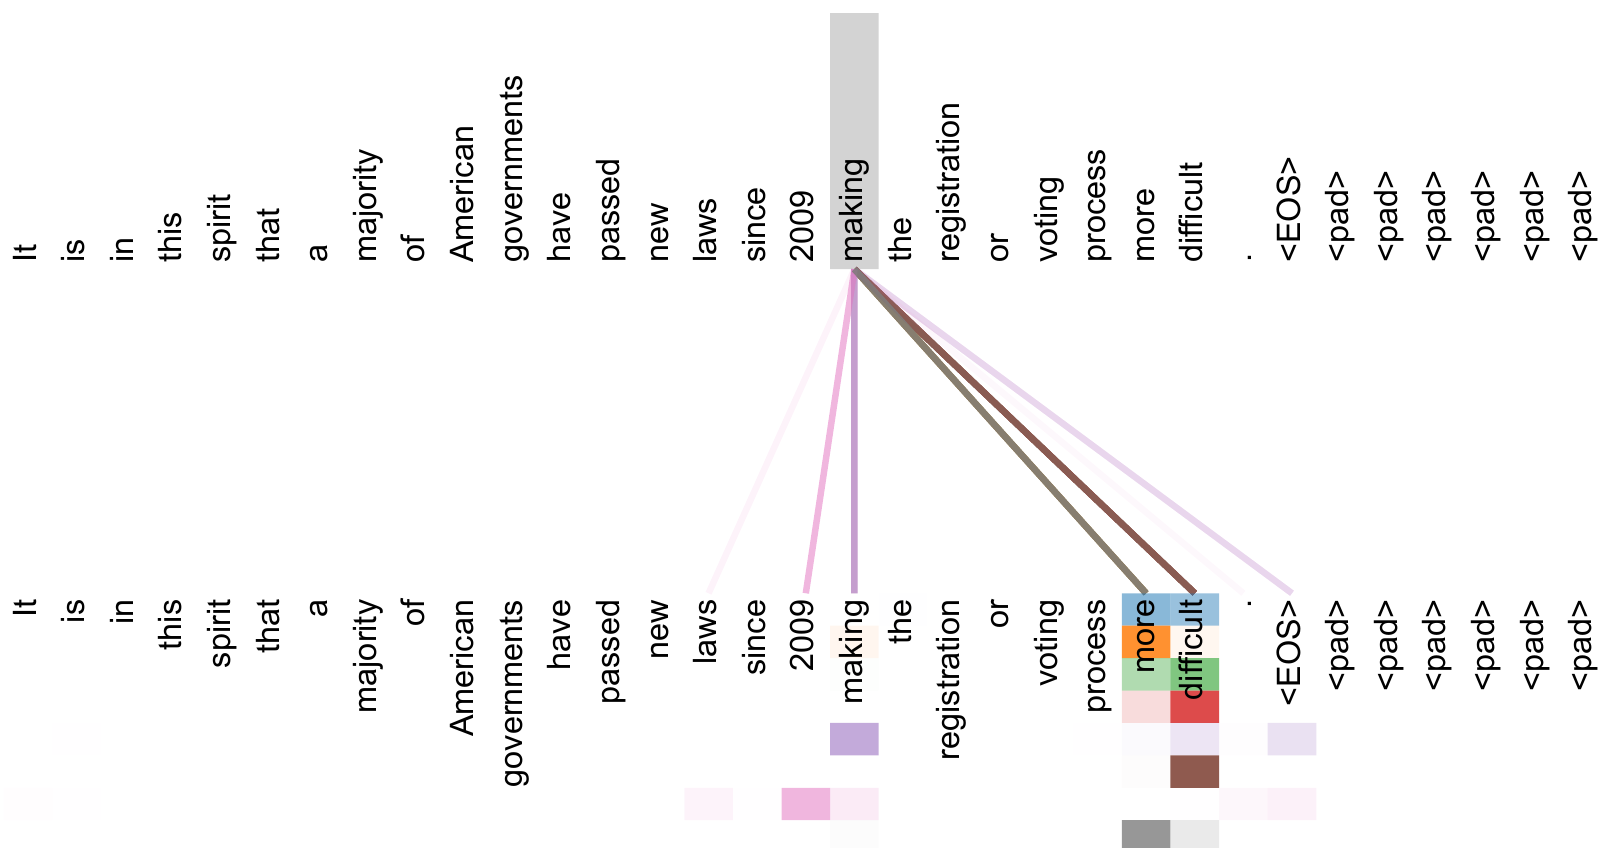
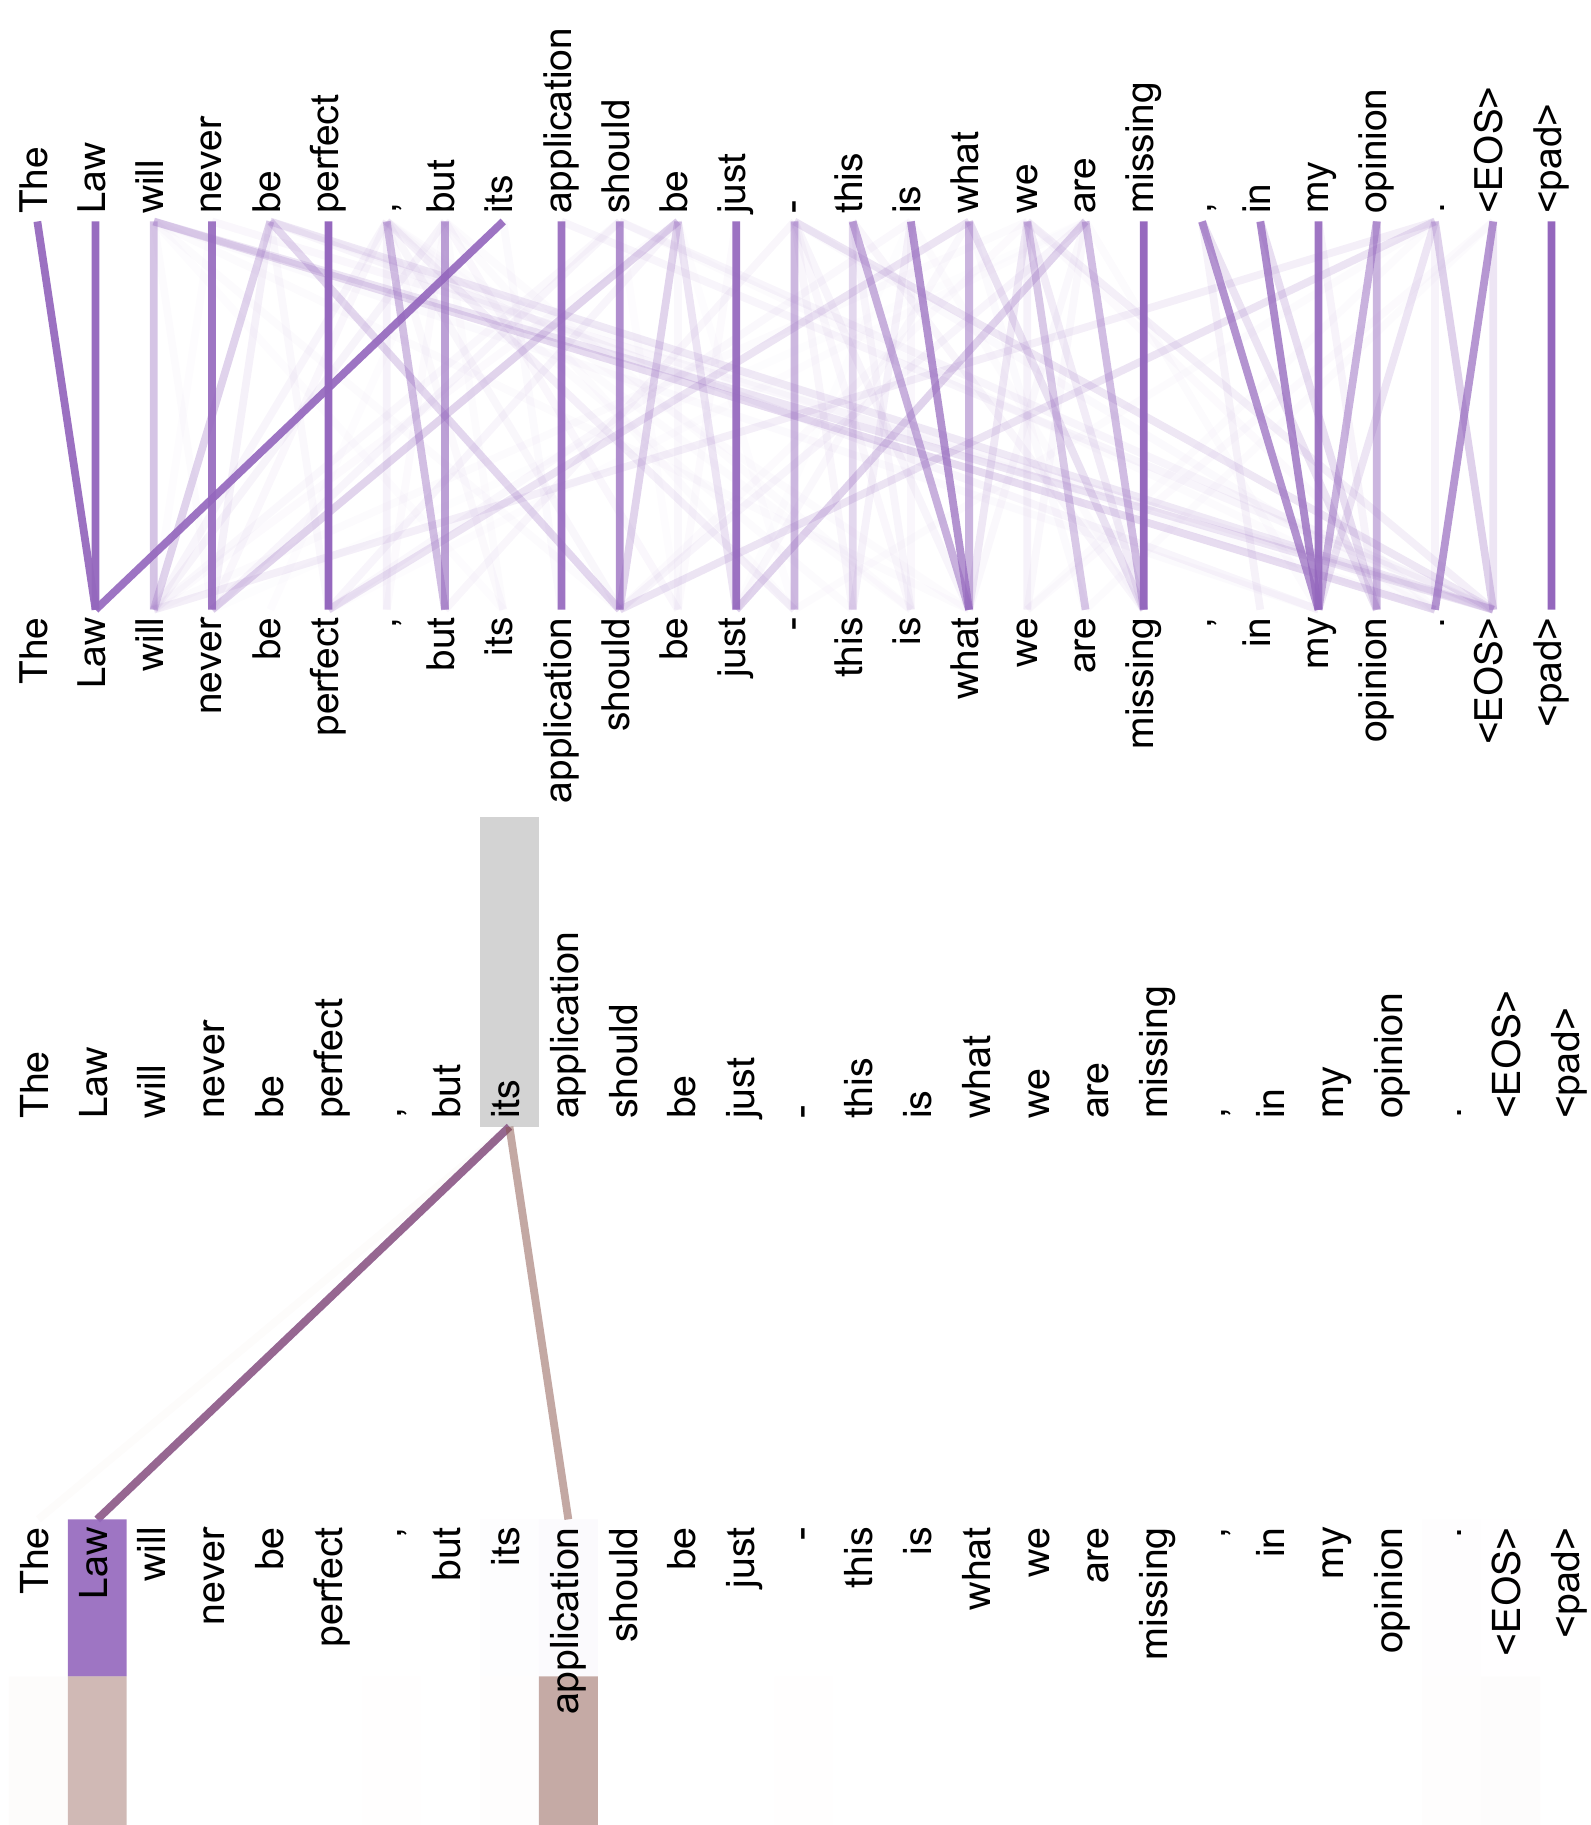
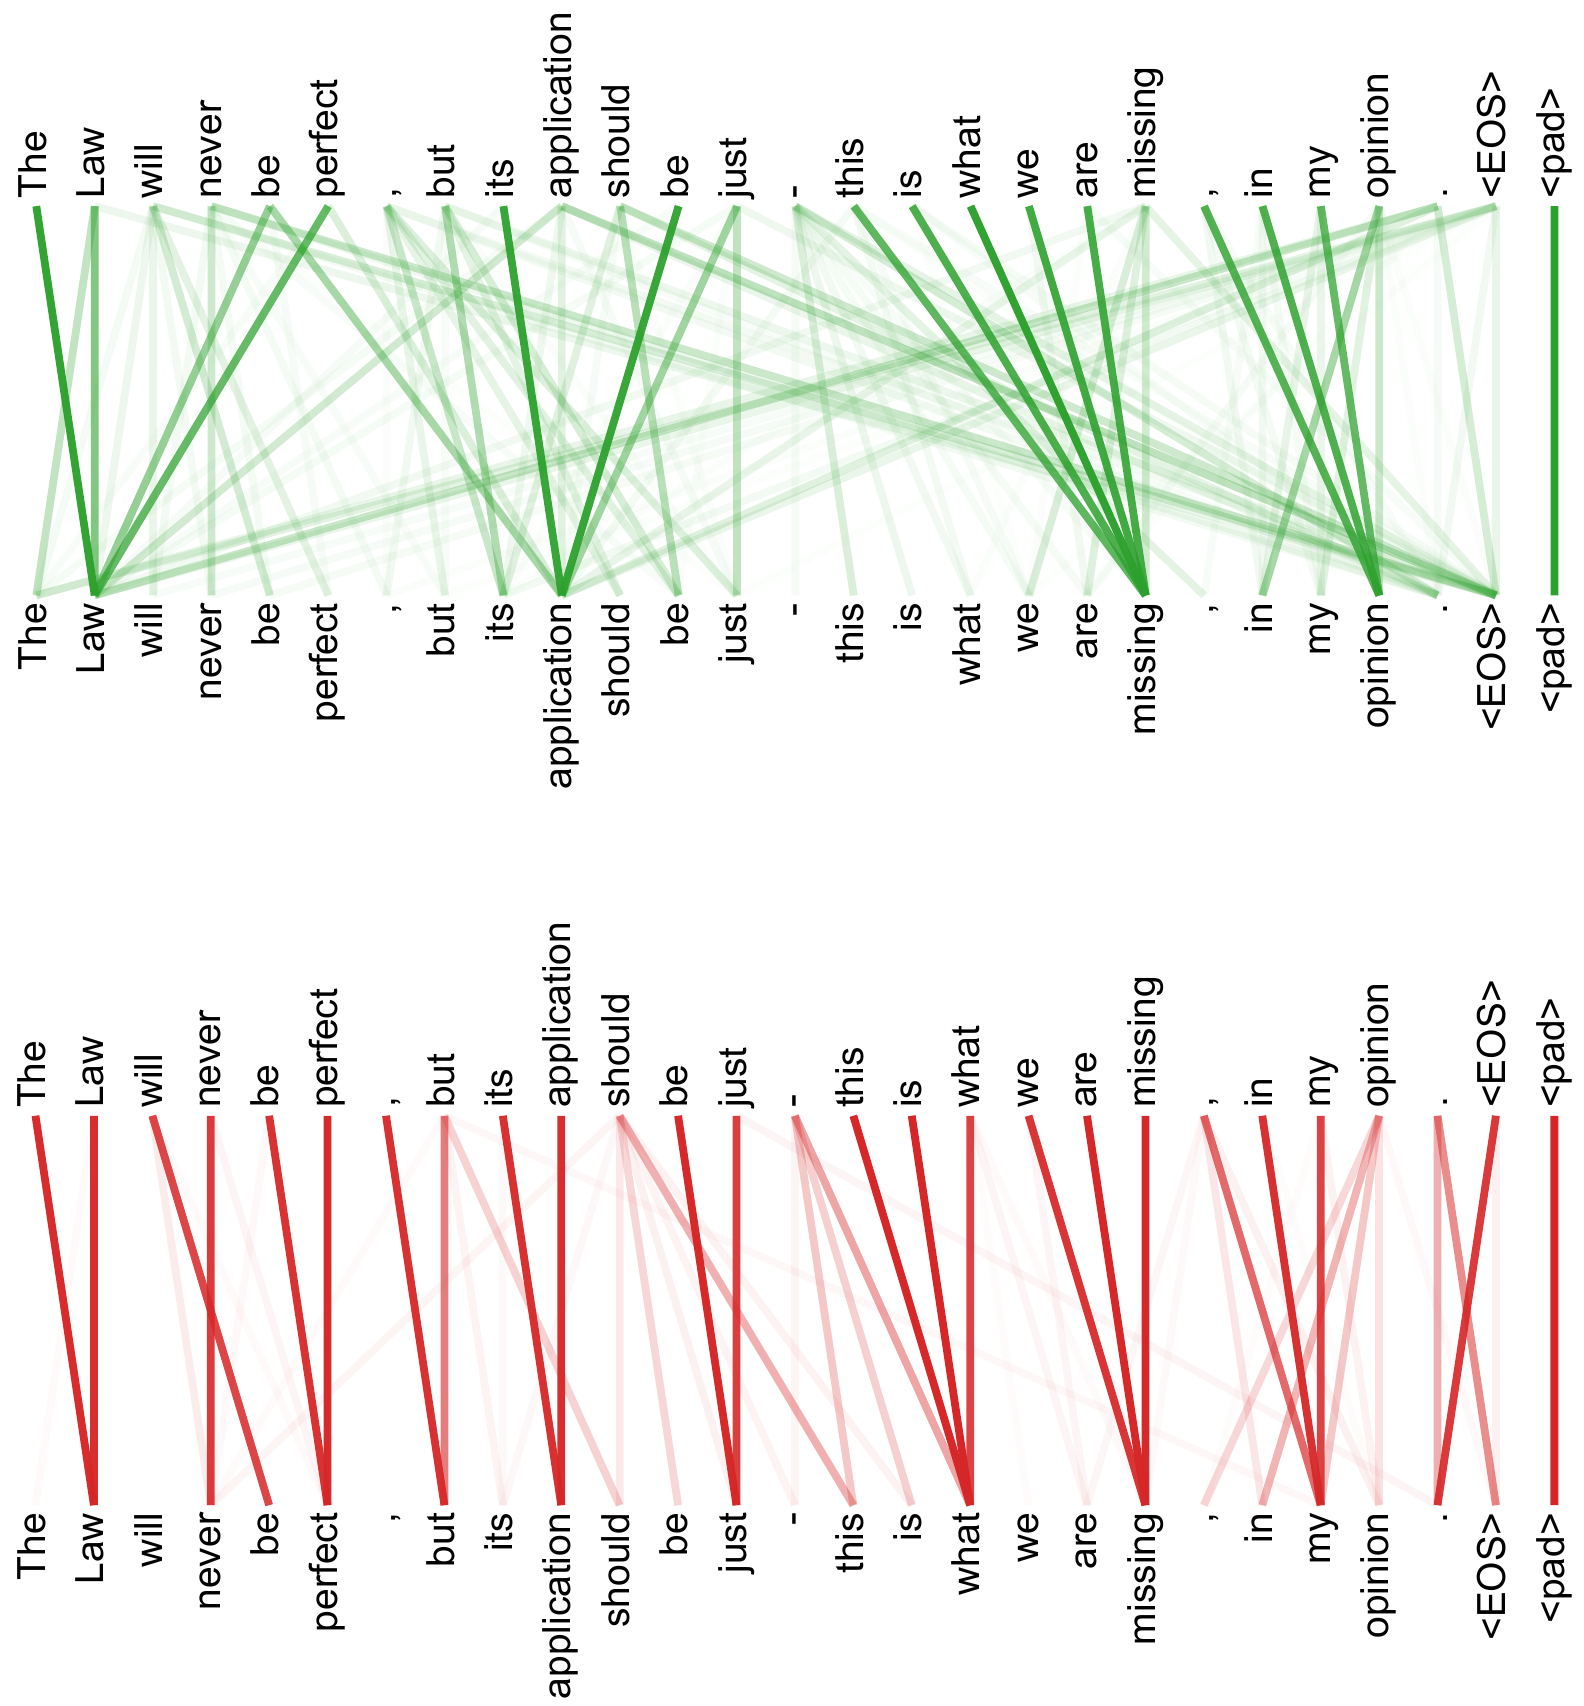
副次的な利点として、自己注意はより解釈可能なモデルをもたらしうる。我々はモデルからの注意分布を検査し、付録で例を示して議論する。個々の注意ヘッドが明確に異なるタスクを実行することを学ぶだけでなく、多くが文の統語的・意味的構造に関連する振る舞いを示すように見える。
5 訓練
本節では、我々のモデルの訓練方式について述べる。
5.1 訓練データとバッチ化
我々は、約450万の文ペアからなる標準的なWMT 2014英語-ドイツ語データセットで訓練した。文はバイトペアエンコーディング[3]を用いて符号化され、約37000トークンの共有ソース-ターゲット語彙を持つ。英語-フランス語については、3600万文からなる significantly more large WMT 2014英語-フランス語データセットを用い、トークンを32000ワードピース語彙[38]に分割した。文ペアは近似シーケンス長によってまとめてバッチ化された。各訓練バッチは、約25000のソーストークンと25000のターゲットトークンを含む文ペアの集合を含んでいた。
5.2 ハードウェアとスケジュール
我々はモデルを8台のNVIDIA P100 GPUを備えた1台のマシンで訓練した。本論文全体で述べるハイパーパラメータを用いたベースモデルでは、各訓練ステップに約0.4秒を要した。ベースモデルは合計100,000ステップ、すなわち12時間訓練した。我々のbigモデル(表[3]の最下行に記述)では、ステップ時間は1.0秒であった。bigモデルは300,000ステップ(3.5日)訓練された。
5.3 最適化器
我々はAdam最適化器[20]を、、で用いた。訓練の過程で学習率を次の式に従って変化させた:
これは、最初のwarmup steps訓練ステップの間は学習率を線形に増加させ、その後はステップ数の逆平方根に比例して減少させることに対応する。我々はwarmup steps = 4000を用いた。
5.4 正則化
訓練中に3種類の正則化を採用した:
| モデル | BLEU | 学習コスト(FLOPs) | ||
| EN-DE | EN-FR | EN-DE | EN-FR | |
| ByteNet [18] | 23.75 | |||
| Deep-Att + PosUnk [39] | 39.2 | 1.0·1020 | ||
| GNMT + RL [38] | 24.6 | 39.92 | 2.3·1019 | 1.4·1020 |
| ConvS2S [9] | 25.16 | 40.46 | 9.6·1018 | 1.5·1020 |
| MoE [32] | 26.03 | 40.56 | 2.0·1019 | 1.2·1020 |
| Deep-Att + PosUnk Ensemble [39] | 40.4 | 8.0·1020 | ||
| GNMT + RL Ensemble [38] | 26.30 | 41.16 | 1.8·1020 | 1.1·1021 |
| ConvS2S Ensemble [9] | 26.36 | 41.29 | 7.7·1019 | 1.2·1021 |
| Transformer(baseモデル) | 27.3 | 38.1 | 3.3·1018 | |
| Transformer(big) | 28.4 | 41.8 | 2.3·1019 | |
残差ドロップアウト 各サブ層の出力に、それがサブ層入力に加算され正規化される前に、ドロップアウト[33]を適用する。さらに、エンコーダとデコーダの両スタックにおいて、埋め込みと位置エンコーディングの和にドロップアウトを適用する。ベースモデルでは、率を用いる。
ラベル平滑化 訓練中に、値のラベル平滑化[36]を採用した。これはモデルがより不確かになることを学ぶためパープレキシティを悪化させるが、精度とBLEUスコアを改善する。
6 結果
6.1 機械翻訳
WMT 2014英語からドイツ語への翻訳タスクにおいて、bigトランスフォーマーモデル(表2のTransformer (big))は、これまでに報告された最良のモデル(アンサンブルを含む)を2.0 BLEU以上上回り、28.4という新たな最先端のBLEUスコアを確立した。このモデルの構成は表3の最下行に記載されている。訓練には8台のP100 GPUで3.5日を要した。我々のベースモデルでさえ、競争力のあるいずれのモデルの訓練コストのほんの一部で、以前に公表されたすべてのモデルおよびアンサンブルを上回る。
WMT 2014 英語-フランス語翻訳タスクにおいて、我々の big モデルは BLEU スコア 41.0 を達成し、以前に発表されたすべての単一モデルを上回り、しかもその訓練コストは以前の最先端モデルの 未満であった。英語-フランス語向けに訓練された Transformer (big) モデルでは、ドロップアウト率として 0.3 ではなく を使用した。
base モデルについては、10 分間隔で保存された最後の 5 個のチェックポイントを平均して得られた単一モデルを使用した。big モデルについては、最後の 20 個のチェックポイントを平均した。ビームサイズ 4、長さペナルティ のビームサーチを用いた [38]。これらのハイパーパラメータは開発セット上での実験の後に選定された。推論時の最大出力長を入力長 に設定したが、可能な場合は早期に終了させた [38]。
表 2 は我々の結果をまとめ、翻訳品質と訓練コストを文献中の他のモデルアーキテクチャと比較したものである。モデルの訓練に用いた浮動小数点演算の数は、訓練時間、使用した GPU の数、および各 GPU の持続的な単精度浮動小数点演算能力の推定値を掛け合わせることで見積もった。
6.2 モデルの変種
Transformer の異なる構成要素の重要性を評価するため、base モデルを様々に変更し、開発セット newstest2013 における英語-ドイツ語翻訳の性能変化を測定した。
| N | dmodel | dff | h | dk | dv | Pdrop | εls | 学習ステップ数 | PPL(開発セット) | BLEU(開発セット) | パラメータ数 ×10^6 | |
| base | 6 | 512 | 2048 | 8 | 64 | 64 | 0.1 | 0.1 | 100K | 4.92 | 25.8 | 65 |
| 1 | 512 | 512 | 5.29 | 24.9 | ||||||||
| 4 | 128 | 128 | 5.00 | 25.5 | ||||||||
| 16 | 32 | 32 | 4.91 | 25.8 | ||||||||
| (A) | 32 | 16 | 16 | 5.01 | 25.4 | |||||||
| 16 | 5.16 | 25.1 | 58 | |||||||||
| (B) | 32 | 5.01 | 25.4 | 60 | ||||||||
| 6.11 | 23.7 | 36 | ||||||||||
| (C) | 2 | 5.19 | 25.3 | 50 | ||||||||
| 4 | ||||||||||||
| (D) | 0.0 | 5.77 | 24.6 | |||||||||
| 0.2 | 4.95 | 25.5 | ||||||||||
| 0.0 | 4.67 | 25.3 | ||||||||||
| 0.2 | 5.47 | 25.7 | ||||||||||
| (E) | 4.92 | 25.7 | ||||||||||
| big | 6 | 1024 | 4096 | 16 | 0.3 | 300K | 4.33 | 26.4 | 213 |
前節で述べたとおりビームサーチを用いたが、チェックポイントの平均化は行わなかった。これらの結果を表 3 に示す。
表 3 の行 (A) では、3.2.2 節で述べたとおり計算量を一定に保ちつつ、アテンションヘッドの数およびアテンションのキーと値の次元を変化させた。単一ヘッドのアテンションは最良の設定より 0.9 BLEU 劣る一方、ヘッドが多すぎる場合にも品質は低下する。
表 3 の行 (B) では、アテンションのキーサイズ を小さくするとモデルの品質が損なわれることが観察される。これは、適合性の決定が容易ではなく、内積よりも洗練された適合性関数が有益でありうることを示唆している。さらに行 (C) と (D) では、予想どおりより大きなモデルの方が良く、ドロップアウトが過学習の回避に非常に有効であることを観察した。行 (E) では、正弦波位置エンコーディングを学習された位置埋め込み [2] に置き換え、base モデルとほぼ同一の結果を観察した。
6.3 英語構文解析
Transformer が他のタスクに汎化できるかを評価するため、英語構文解析の実験を行った。このタスクには特有の難しさがある。すなわち、出力は強い構造的制約を受け、入力よりも著しく長い。さらに、RNN 系列-系列モデルは小データ領域において最先端の結果を達成できていない [37]。
我々は Penn Treebank [25] の Wall Street Journal (WSJ) 部分(約 40K の訓練文)で の 4 層 Transformer を訓練した。また、より大規模な high-confidence コーパスと BerkleyParker コーパス(約 17M 文)[37] を用いた半教師あり設定でも訓練した。WSJ のみの設定では 16K トークンの語彙を、半教師あり設定では 32K トークンの語彙を用いた。
我々は、セクション 22 の開発セット上で、アテンションと残差の両方のドロップアウト([5.4] 節)、学習率、ビームサイズを選択するために少数の実験のみを行い、その他のパラメータはすべて英語-ドイツ語 base 翻訳モデルから変更しなかった。推論時には、
| 構文解析器 | 学習 | WSJ 23 F1 |
| Vinyals & Kaiser el al. (2014) [37] | WSJ のみ、識別的 | 88.3 |
| Petrov et al. (2006) [29] | WSJ のみ、識別的 | 90.4 |
| Zhu et al. (2013) [40] | WSJ のみ、識別的 | 90.4 |
| Dyer et al. (2016) [8] | WSJ のみ、識別的 | 91.7 |
| Transformer(4 層) | WSJ のみ、識別的 | 91.3 |
| Zhu et al. (2013) [40] | 半教師あり | 91.3 |
| Huang & Harper (2009) [14] | 半教師あり | 91.3 |
| McClosky et al. (2006) [26] | 半教師あり | 92.1 |
| Vinyals & Kaiser el al. (2014) [37] | 半教師あり | 92.1 |
| Transformer(4 層) | 半教師あり | 92.7 |
| Luong et al. (2015) [23] | マルチタスク | 93.0 |
| Dyer et al. (2016) [8] | 生成的 | 93.3 |
最大出力長を入力長 に増加させた。WSJ のみの設定と半教師あり設定の両方で、ビームサイズ 21 および を用いた。
表 4 の結果は、タスク固有のチューニングを欠いているにもかかわらず、我々のモデルが驚くほど良好に性能を発揮し、Recurrent Neural Network Grammar [8] を除く以前に報告されたすべてのモデルよりも良い結果をもたらすことを示している。
RNN 系列-系列モデル [37] とは対照的に、Transformer は 40K 文の WSJ 訓練セットのみで訓練した場合でも Berkeley-Parser [29] を上回る。
7 結論
本論文では、エンコーダ-デコーダアーキテクチャで最も一般的に用いられる再帰層をマルチヘッド自己アテンションに置き換えた、完全にアテンションのみに基づく最初の系列変換モデルである Transformer を提示した。
翻訳タスクにおいて、Transformer は再帰層や畳み込み層に基づくアーキテクチャよりも著しく高速に訓練できる。WMT 2014 英語-ドイツ語および WMT 2014 英語-フランス語の両翻訳タスクにおいて、我々は新たな最先端を達成した。前者のタスクでは、我々の最良モデルは以前に報告されたすべてのアンサンブルさえも上回る。
我々はアテンションベースのモデルの未来に期待しており、それらを他のタスクに適用する計画である。Transformer をテキスト以外の入力および出力モダリティを伴う問題に拡張すること、ならびに画像、音声、動画のような大規模な入力と出力を効率的に扱うための局所的で制限されたアテンション機構を研究することを計画している。生成をより非逐次的にすることも我々の別の研究目標である。
我々のモデルの訓練と評価に用いたコードは https://github.com/tensorflow/tensor2tensor で公開されている。
謝辞 有益なコメント、修正、インスピレーションをいただいた Nal Kalchbrenner と Stephan Gouws に感謝する。
参考文献
[1] Jimmy Lei Ba, Jamie Ryan Kiros, and Geoffrey E Hinton. Layer normalization. arXiv preprint arXiv:1607.06450, 2016.
[2] Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. Neural machine translation by jointly learning to align and translate. CoRR, abs/1409.0473, 2014.
[3] Denny Britz, Anna Goldie, Minh-Thang Luong, and Quoc V. Le. Massive exploration of neural machine translation architectures. CoRR, abs/1703.03906, 2017.
[4] Jianpeng Cheng, Li Dong, and Mirella Lapata. Long short-term memory-networks for machine reading. arXiv preprint arXiv:1601.06733, 2016.
[5] Kyunghyun Cho, Bart van Merrienboer, Caglar Gulcehre, Fethi Bougares, Holger Schwenk, and Yoshua Bengio. Learning phrase representations using rnn encoder-decoder for statistical machine translation. CoRR, abs/1406.1078, 2014.
[6] Francois Chollet. Xception: Deep learning with depthwise separable convolutions. arXiv preprint arXiv:1610.02357, 2016.
[7] Junyoung Chung, Caglar Gulcehre, Kyunghyun Cho, and Yoshua Bengio. Empirical evaluation of gated recurrent neural networks on sequence modeling. CoRR, abs/1412.3555, 2014.
[8] Chris Dyer, Adhiguna Kuncoro, Miguel Ballesteros, and Noah A. Smith. Recurrent neural network grammars. In Proc. of NAACL, 2016.
[9] Jonas Gehring, Michael Auli, David Grangier, Denis Yarats, and Yann N. Dauphin. Convolutional sequence to sequence learning. arXiv preprint arXiv:1705.03122, 2017.
[10] Alex Graves. Generating sequences with recurrent neural networks. arXiv preprint arXiv:1308.0850, 2013.
[11] Kaiming He, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. Deep residual learning for image recognition. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, pages 770-778, 2016.
[12] Sepp Hochreiter, Yoshua Bengio, Paolo Frasconi, and Jürgen Schmidhuber. Gradient flow in recurrent nets: the difficulty of learning long-term dependencies, 2001.
[13] Sepp Hochreiter and Jürgen Schmidhuber. Long short-term memory. Neural computation, 9(8):1735-1780, 1997.
[14] Zhongqiang Huang and Mary Harper. Self-training PCFG grammars with latent annotations across languages. In Proceedings of the 2009 Conference on Empirical Methods in Natural Language Processing, pages 832-841. ACL, August 2009.
[15] Rafal Jozefowicz, Oriol Vinyals, Mike Schuster, Noam Shazeer, and Yonghui Wu. 言語モデリングの限界を探る. arXiv preprint arXiv:1602.02410, 2016.
[16] Łukasz Kaiser and Samy Bengio. アクティブメモリはアテンションに取って代わることができるか? In Advances in Neural Information Processing Systems, (NIPS), 2016.
[17] Łukasz Kaiser and Ilya Sutskever. ニューラルGPUはアルゴリズムを学習する. In International Conference on Learning Representations (ICLR), 2016.
[18] Nal Kalchbrenner, Lasse Espeholt, Karen Simonyan, Aaron van den Oord, Alex Graves, and Koray Kavukcuoglu. 線形時間でのニューラル機械翻訳. arXiv preprint arXiv:1610.10099, 2017.
[19] Yoon Kim, Carl Denton, Luong Hoang, and Alexander M. Rush. 構造化アテンションネットワーク. In International Conference on Learning Representations, 2017.
[20] Diederik Kingma and Jimmy Ba. Adam: 確率的最適化の一手法. In ICLR, 2015.
[21] Oleksii Kuchaiev and Boris Ginsburg. LSTMネットワークのための因数分解の技法. arXiv preprint arXiv:1703.10722, 2017.
[22] Zhouhan Lin, Minwei Feng, Cicero Nogueira dos Santos, Mo Yu, Bing Xiang, Bowen Zhou, and Yoshua Bengio. 構造化自己アテンション文埋め込み. arXiv preprint arXiv:1703.03130, 2017.
[23] Minh- Thang Luong, Quoc V. Le, Ilya Sutskever, Oriol Vinyals, and Lukasz Kaiser. マルチタスク系列学習. arXiv preprint arXiv:1511.06114, 2015.
[24] Minh- Thang Luong, Hieu Pham, and Christopher D Manning. アテンションに基づくニューラル機械翻訳への効果的なアプローチ. arXiv preprint arXiv:1508.04025, 2015.
[25] Mitchell P Marcus, Mary Ann Marcinkiewicz, and Beatrice Santorini. 英語の大規模な注釈付きコーパスの構築: The penn treebank. Computational linguistics, 19(2):313- 330, 1993.
[26] David McClosky, Eugene Charniak, and Mark Johnson. 構文解析のための効果的な自己訓練. In Proceedings of the Human Language Technology Conference of the NAACL, Main Conference, pages 152- 159. ACL, June 2006.
[27] Ankur Parikh, Oscar Tackström, Dipanjan Das, Jakob Uszkoreit. 分解可能なアテンションモデル。Empirical Methods in Natural Language Processing、2016年。
[28] Romain Paulus, Caiming Xiong, Richard Socher. 抽象的要約のための深層強化学習モデル。arXiv preprint arXiv:1705.04304、2017年。
[29] Slav Petrov, Leon Barrett, Romain Thibaux, Dan Klein. 正確でコンパクトかつ解釈可能な木注釈の学習。第21回国際計算言語学会議およびACL第44回年次大会論文集、433-440ページ。ACL、2006年7月。
[30] Ofir Press, Lior Wolf. 出力埋め込みを用いた言語モデルの改善。arXiv preprint arXiv:1608.05859、2016年。
[31] Rico Sennrich, Barry Haddow, Alexandra Birch. サブワード単位を用いた希少語のニューラル機械翻訳。arXiv preprint arXiv:1508.07909、2015年。
[32] Noam Shazeer, Azalia Mirhoseini, Krzysztof Maziarz, Andy Davis, Quoc Le, Geoffrey Hinton, Jeff Dean. 驚異的に大規模なニューラルネットワーク:疎ゲート付き混合エキスパート層。arXiv preprint arXiv:1701.06538、2017年。
[33] Nitish Srivastava, Geoffrey E Hinton, Alex Krizhevsky, Ilya Sutskever, Ruslan Salakhutdinov. Dropout:ニューラルネットワークの過学習を防ぐ簡単な方法。Journal of Machine Learning Research、15(1):1929-1958、2014年。
[34] Sainbayar Sukhbaatar, Arthur Szlam, Jason Weston, Rob Fergus. エンドツーエンドのメモリネットワーク。C. Cortes, N. D. Lawrence, D. D. Lee, M. Sugiyama, R. Garnett編、Advances in Neural Information Processing Systems 28、2440-2448ページ。Curran Associates, Inc.、2015年。
[35] Ilya Sutskever, Oriol Vinyals, Quoc VV Le. ニューラルネットワークによる系列から系列への学習。Advances in Neural Information Processing Systems、3104-3112ページ、2014年。
[36] Christian Szegedy, Vincent Vanhoucke, Sergey Ioffe, Jonathon Shlens, Zbigniew Wojna. コンピュータビジョンのためのInceptionアーキテクチャの再考。CoRR、abs/1512.00567、2015年。
[37] Vinyals & Kaiser, Koo, Petrov, Sutskever, Hinton. 外国語としての文法。Advances in Neural Information Processing Systems、2015年。
[38] Yonghui Wu, Mike Schuster, Zhifeng Chen, Quoc V Le, Mohammad Norouzi, Wolfgang Macherey, Maxim Krikun, Yuan Cao, Qin Gao, Klaus Macherey, ほか. Googleのニューラル機械翻訳システム:人間の翻訳と機械翻訳のギャップを埋める。arXiv preprint arXiv:1609.08144、2016年。
[39] Jie Zhou, Ying Cao, Xuguang Wang, Peng Li, Wei Xu. ニューラル機械翻訳のための高速フォワード接続を備えた深層リカレントモデル。CoRR、abs/1606.04199、2016年。
[40] Muhua Zhu, Yue Zhang, Wenliang Chen, Min Zhang, Jingbo Zhu. 高速かつ正確なシフト還元構成素解析。ACL第51回年次大会論文集(第1巻:長論文)、434-443ページ。ACL、2013年8月。