
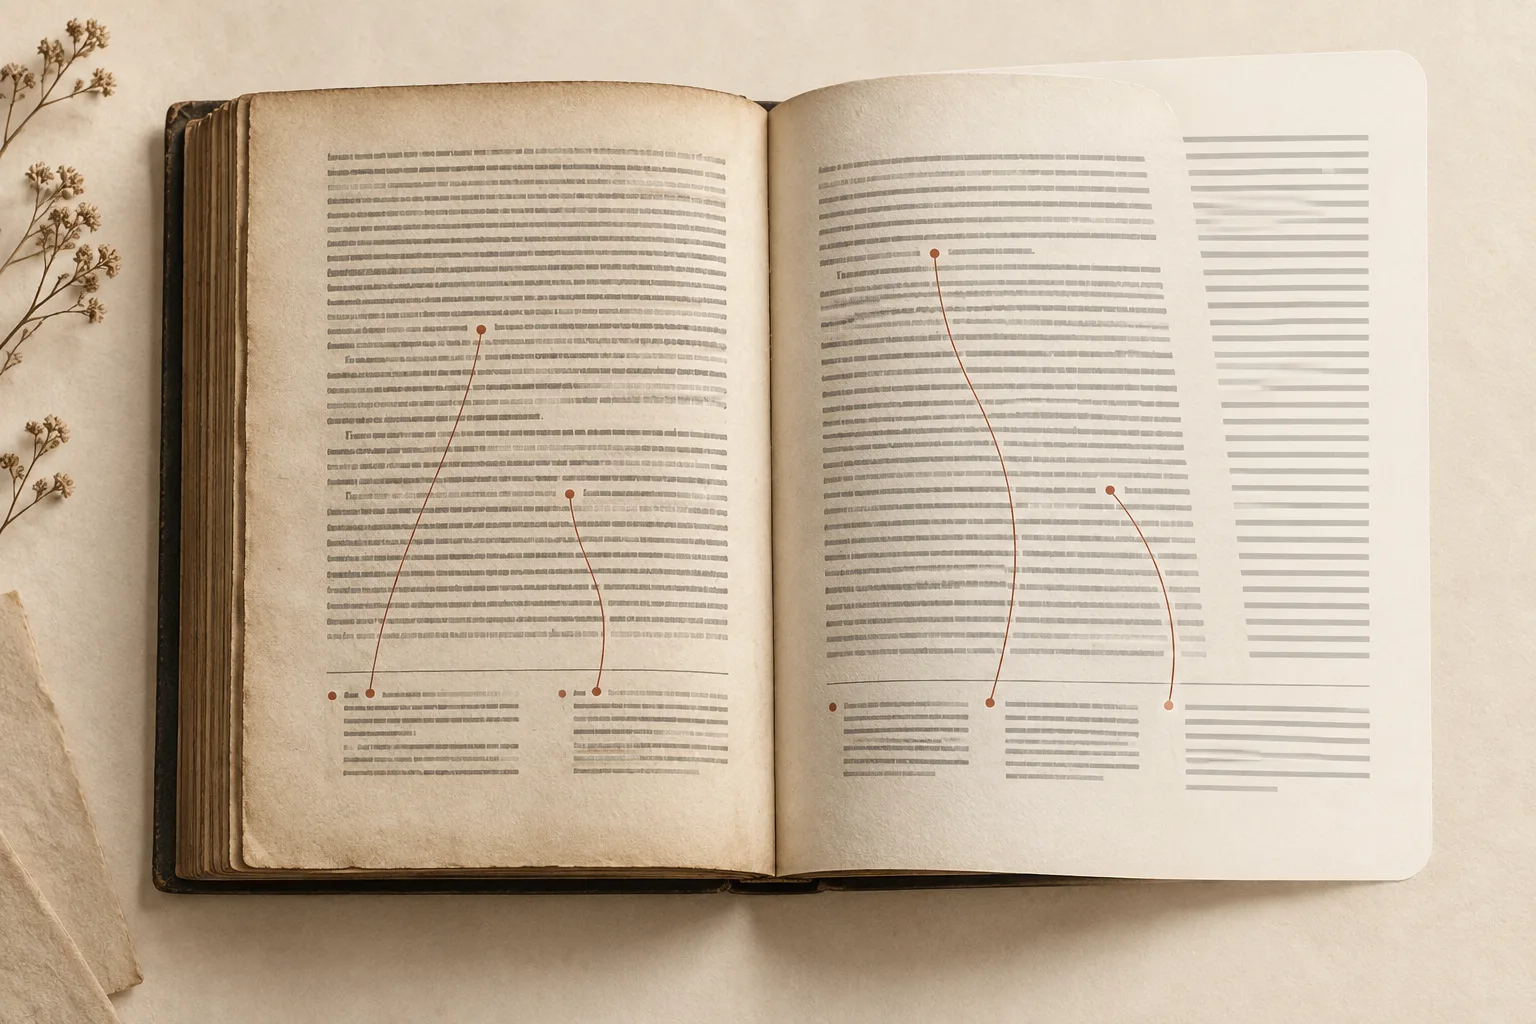
我做 PDF Craft 的初衷,是把扫描版书籍 PDF 转成 Markdown 或 EPUB,让人能真正阅读、搜索和整理。识别出文字只是其中一部分。正文里的数字、带圈符号或星号,必须仍然指向原页底部的正确注释。否则文字虽然重排了,一条关键的阅读关系却断了。
处理旧书、学术资料或个人藏书时,这一点尤其重要。一次有用的转换,应该让书在小屏幕上也能搜索、阅读顺畅,同时保留引用关系。想实际检查输出文件,可以先看扫描 PDF 转 EPUB 指南和公式与脚注检查清单。
OCR 认得出字,却不知道这些字在书中起什么作用
OCR 能识别页面上的词,却不知道这些词在书里承担什么功能。页面底部的小字号文字,可能是脚注,也可能只是排到页边的正文。抬高的带圈数字,可能是引用标记,也可能只是普通的列表编号。一条注释可能被拆成两块,也可能延续到下一页。
一个判断出错,EPUB 里就会出现奇怪的现象:标记找不到去处,两条注释粘在一起,页码插进句子中间,或者上一页结尾和下一页的页眉连成了一体。脚注一直是 PDF Craft 最难处理的问题之一。
最初的尝试:让 LLM 读每一页
大约一年前,最直接的办法是把每一页交给大语言模型。它通常能看出小字是在解释正文,能把星号或罗马数字理解为标记,也能判断一句话是否跨页延续。
逐页来看,这个办法很有希望,但放到整本书上就很吃力。几百页意味着几百次调用、等待和可能的重新尝试。跨页判断需要相邻页面的上下文,输入量还会继续增加。大多数页面本来就是对的:昂贵的模型花了大量时间读一页,最后只说这里不需要改。用户也很难判断,一次长时间运行是在推进,还是卡住了。
先建立一条完整的确定性处理路径
后来的版本把主要工作交回 OCR 和确定性规则。这条路径把正文和注释分开,拼接自然段落,把注释拆成一条条引用,再把正文标记与对应注释匹配起来。它快、可重复、稳定,大多数页面都能处理好。
但书的版式千差万别。注释可能位于页脚,也可能夹在分栏之间;标记可能是数字,也可能是符号;页眉、页码和装饰符号都可能混进识别结果。有些判断必须理解句子的意思。只靠规则,少数难例处理不了;每页都交给 LLM,又太慢、太贵。
改变:让 JEV 做检查,而不是重做
原有流程不需要推倒重来,缺的是一道快速的质量检查,把值得细看的页面挑出来。我把 JEV 放在这个位置,只问它一个具体问题:这一页的分析能否原样通过? 它不改写文字,也不逐条解释引用。它给出一个概率,用来决定这一页是继续往下走,还是交给 LLM 修复。
复查的单位是整页。如果算法完全漏掉了一条注释,只检查已知引用的环节就无从发现这个遗漏。按页判断,仍能标出缺失的引用、归属错误的注释、异常的跨页连接,以及混进正文的页码。我宁可多送几页去复查,也不愿让有问题的页面悄悄通过:误报的代价是多一次模型检查;漏掉的错误却可能进入最终的 EPUB。阈值还需要在更多样本上校准。
flowchart TB
  accTitle: 从页面复查到受限修复
  accDescr: OCR 和规则先处理页面。JEV 判断页面能否原样通过。可疑页面交给 LLM,随后进行程序化完整性检查。通过的页面进入章节组装;修复未通过的页面重新尝试。
  A[OCR 与规则] --> B{JEV:这一页可信吗?}
  B -- 是 --> F[组装章节并输出]
  B -- 否 --> C[LLM 只修复当前页]
  C --> D{完整性检查}
  D -- 通过 --> F
  D -- 重试 --> C
让 LLM 在严格范围内修复一页
对于被标出的页面,LLM 会拿到连续三页的文字结构:上一页、当前页和下一页。它只能修改中间那一页。相邻页面为跨页的句子提供上下文。这个阶段我不发送页面图像:OCR 已经提供了文字、位置和版式,而这里的任务是语义校正,不是再做一遍 OCR。
模型可以重新标注正文、脚注和页码,修正段落衔接,重新匹配标记与注释。它不能自由改写原文,也不能改动页面结构。随后,程序化检查要求注释编号有序、引用与注释一一对应、跨页连接一致,并且标记位置能在指定文本中无歧义地找到。检查不通过时,会把具体错误返回给模型,让它重新提交完整结果。重试次数少当然好,但不能因此放松这些检查。
现有 26 页工程样本显示了什么
在一份 26 页、注释很多的测试 PDF 中,JEV 挑出 6 页交给 LLM。这 6 页的首次提交全部通过了完整性检查,原本已经正确的 22 处正文引用与注释对应关系也没有被破坏。
实际修掉的问题不算多,但都重要:印刷页码被误认成正文;一个数字在段落之间造成了错误的连接;一句引言和后面缩进的引文被并成了一段。LLM 根据语义和缩进把它们分开了。
这只是对一份样本的观察,不能说明整份文档的准确率,也不能说明成本。它给我的启发是:好的修复环节应当保住已经做对的部分,在证据支持的问题修完后停下来。
把昂贵的判断用在需要的地方
确定性处理负责全书的绝大部分。JEV 快速挑出可疑页面。LLM 处理少数需要语义判断的情况。程序化约束守住最终结构。修复过的页面回到同一条章节组装和 Markdown 或 EPUB 渲染路径。
我还需要测试更多语言、版式和更长的书,尤其是 JEV 的漏检率,以及触发 LLM 复查的阈值。但方向比一年前清楚了:不必让 LLM 读遍每一页,只为找出藏在页边里的少数错误。
如果你要转换一本扫描书,先在 PDF Craft 工作区用一小段带注释的样本试一下。确认正文标记、完整的注释文字,以及跨页的段落都没问题,再处理整本书。
用样本设计你自己的输出检查
上面的样本只能说明一次工程运行的情况,不代表任意书籍的成功率。它提示了转换后注释密集的书该检查哪些地方。挑一页有多个标记的,一页带符号引用的,再找一处注释或正文段落延续到下一页的位置。
对每个选定的位置,把原始页面图像和输出结果对照。找到正文标记,顺着它看指向哪里,确认完整注释属于这一段。再回到正文,检查下一句是否接得自然。链接能用,也可能指向错误的注释。
重点留意这几种异常:
- 引用没有去处,或者注释文字找不到对应的正文标记。
- 两条独立注释被并成一条,或者一条延续的注释被错误拆开。
- 页码、页眉或装饰符号插进了句子里。
- 注释被挂到了错误的栏或相邻页面上。
- 段落跨越分页处被并在一起,而那里本应是引文或章节的边界。
记录印刷页码、PDF 阅读器页码、标记和一小段文字。EPUB 的分页会随字号变化,只记电子书页码,以后就难以找回问题位置。
了解按页复查的局限
这里说的复查与修复属于内部处理,不是面向用户的 JEV 开关,也不表示每一页转换结果都经过专业校对。一页可以通过结构检查,却仍含有识别错误或含糊的语句。反过来,把可疑页面送去修复,也不等于相邻关系全都正确。
如果只是日常阅读,重点检查结构复杂的地方和重要段落。如果涉及引文、研究结论或出版,就要按相应要求做更细致的核对。即使 EPUB 读起来方便,也请保留原始 PDF。
OCR 与翻译流程说明了为什么识别、结构和语义需要不同的检查。如果论文还要翻译,可以参考从 arXiv PDF 开始翻译。当前处理价格见定价;这份样本并不能证明普遍的速度或成本优势。