
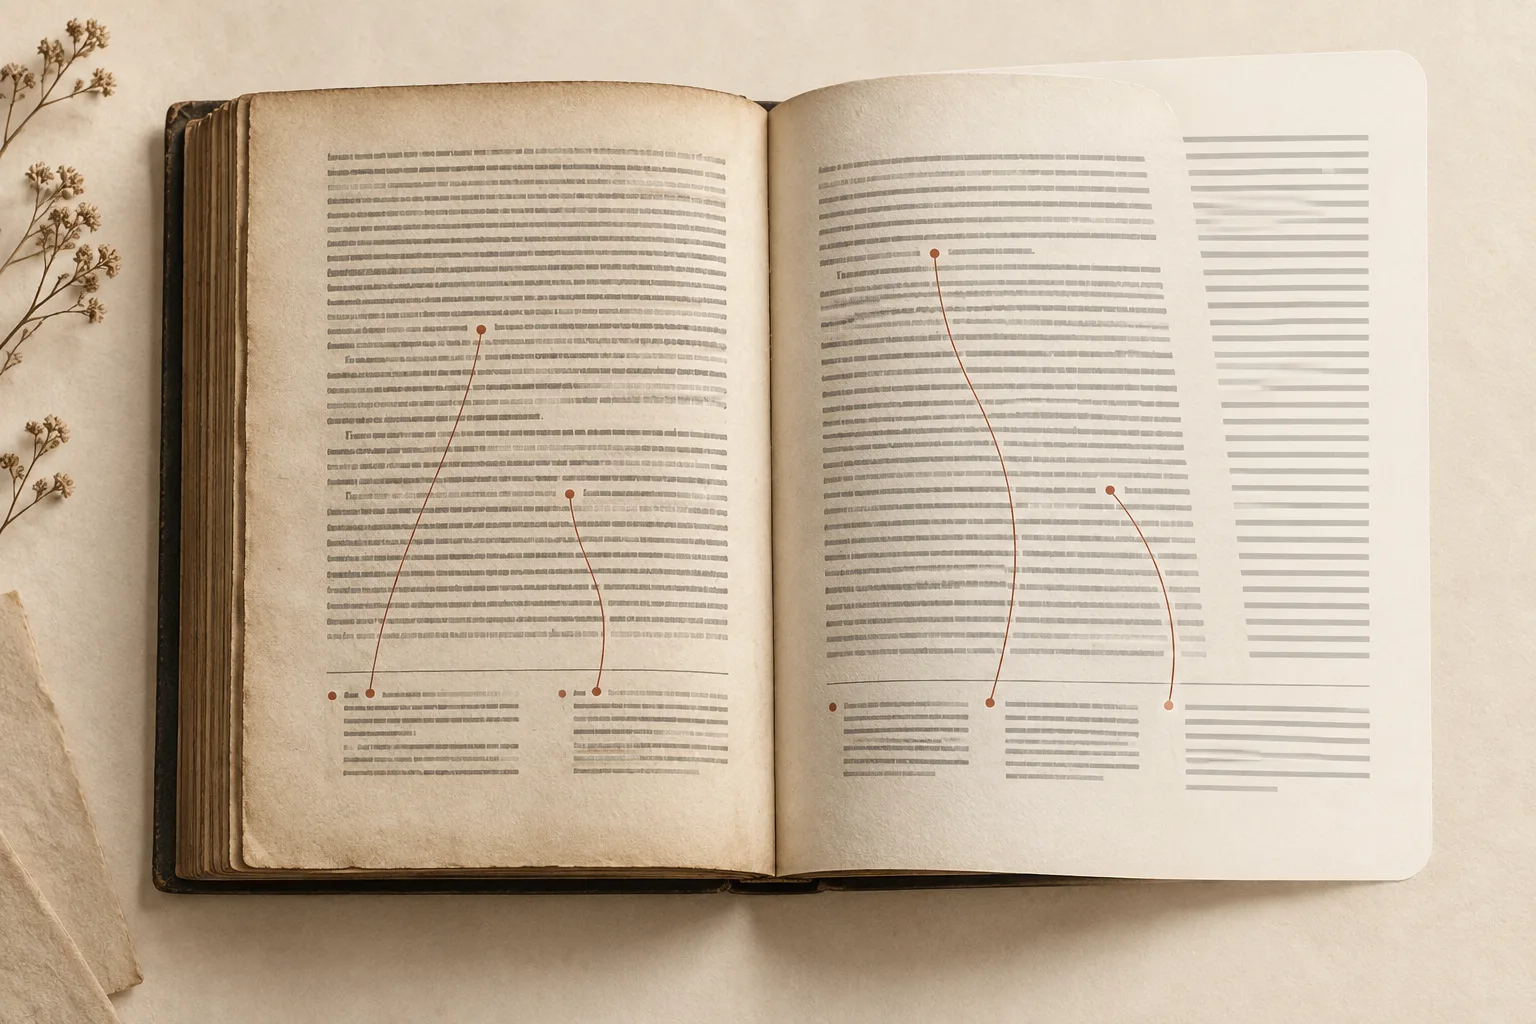
Я сделал PDF Craft, чтобы сканированные книги в PDF можно было превращать в Markdown или EPUB, которые удобно читать, искать по ним и приводить их в порядок. Распознать слова — лишь часть задачи. Цифра, обведённый символ или звёздочка в тексте должны по-прежнему вести к нужной сноске внизу исходной страницы. Иначе текст переверстается, а важная для чтения связь исчезнет.
Это особенно важно для старых книг, научных источников и личных собраний. Полезная конвертация должна сделать книгу доступной для поиска и удобной на небольшом экране, сохранив при этом ссылки. О том, как проверить готовый файл, читайте в руководстве «Из сканированного PDF в EPUB» и в памятке по формулам и сноскам.
OCR находит символы, но не понимает их роль
OCR распознаёт слова на странице, не зная, какую роль они играют в книге. Мелкий текст внизу может быть сноской, а может быть обычным текстом, который просто оказался у края. Надстрочная цифра в кружке может быть отсылкой к сноске, а может быть номером в обычном списке. Сноска может распасться на два блока или продолжиться на следующей странице.
Одно неверное решение даёт странные результаты в EPUB: отсылка без адресата, две сноски, склеенные в одну, номер страницы, вставленный в середину предложения, или конец одной страницы, соединённый с колонтитулом следующей. Сноски давно остаются одной из самых трудных задач для PDF Craft.
Первая попытка: поручить чтение каждой страницы языковой модели
Около года назад самым очевидным решением было отдавать каждую страницу большой языковой модели. Она часто понимала, что мелкий текст внизу поясняет основной, распознавала звёздочки и римские цифры как отсылки и определяла, продолжается ли предложение на следующей странице.
Постранично это выглядело многообещающе, но на длинной книге оборачивалось мучением. Сотни страниц означали сотни запросов, ожиданий и возможных повторов. Для решений о переходах между страницами нужен контекст соседних страниц, и объём входных данных ещё рос. Большинство страниц и так были в порядке: дорогая модель тратила много времени на чтение страницы только для того, чтобы сообщить, что менять ничего не нужно. Пользователю к тому же трудно было понять, движется ли длинная обработка или застряла.
Сначала построить полный детерминированный путь
В более поздних версиях основная работа вернулась к OCR и детерминированным правилам. Этот путь отделяет основной текст от сносок, собирает естественные абзацы, разбивает сноски на отдельные примечания и сопоставляет каждую отсылку в тексте с её сноской. Он быстрый, воспроизводимый и стабильный, и большинство страниц обрабатывает хорошо.
Но вёрстка книг бывает разной. Сноски могут стоять внизу страницы или между колонками; отсылки могут быть цифрами или символами; колонтитулы, номера страниц и украшения могут попасть в распознанный текст. Некоторые решения требуют понимания смысла предложения. Одни только правила оставляют несколько трудных случаев, а языковая модель на каждой странице слишком медленна и дорога.
Что изменилось: JEV проверяет, а не переделывает
Существующий конвейер не нужно было заменять. Ему нужна была быстрая проверка качества, которая отмечает страницы, заслуживающие более внимательного взгляда. Туда я поставил JEV и задал ему узкий вопрос: может ли разбор этой страницы пройти без изменений? Он не переписывает текст и не объясняет каждую ссылку. Он возвращает вероятность, по которой решается, идти ли странице дальше или отправить её языковой модели на исправление.
Единица проверки — вся страница. Если алгоритм вовсе пропустил сноску, проверка, которая обходит только известные ссылки, ничего не обнаружит. Оценка на уровне страницы всё равно может отметить пропущенные ссылки, неверную принадлежность, необычные связи между страницами или номера страниц, попавшие в текст. Лучше отправить на проверку несколько лишних страниц, чем молча пропустить плохую: ложная тревога стоит ещё одной проверки моделью, а пропущенная ошибка может попасть в итоговый EPUB. Порог ещё нужно откалибровать на более разнообразных примерах.
flowchart TB
  accTitle: От проверки страницы к ограниченному исправлению
  accDescr: Сначала страницу обрабатывают OCR и правила. JEV решает, может ли она пройти без изменений. Подозрительные страницы отправляются языковой модели, затем проходят программную проверку целостности. Прошедшие страницы идут на сборку глав; неудачные исправления повторяются.
  A[OCR и правила] --> B{JEV: страница надёжна?}
  B -- Да --> F[Сборка глав и вывод]
  B -- Нет --> C[Языковая модель исправляет только текущую страницу]
  C --> D{Проверка целостности}
  D -- Пройдена --> F
  D -- Повтор --> C
Пусть языковая модель исправляет страницу в строгих рамках
Для отмеченной страницы языковая модель получает текстовую структуру трёх соседних страниц: предыдущей, текущей и следующей. Изменять она может только среднюю. Соседние дают контекст для предложений, которые переходят через границу страницы. На этом этапе я не передаю изображения страниц: OCR уже даёт текст, координаты и вёрстку, а задача — смысловая правка, а не ещё один проход распознавания.
Модель может заново разметить основной текст, сноски и номера страниц, восстановить непрерывность абзацев и заново сопоставить отсылки со сносками. Она не вправе свободно переписывать источник или менять структуру страницы. Затем программные проверки требуют упорядоченных номеров сносок, совпадения отсылок и сносок, согласованных связей на границах страниц и таких позиций отсылок, которые однозначно находятся в указанном тексте. Неудачная проверка возвращает конкретные ошибки, чтобы модель могла прислать полный результат заново. Меньше повторов — это хорошо, но не повод ослаблять проверки.
Что показал прежний инженерный образец на 26 страниц
В одном тестовом PDF на 26 страниц с множеством сносок JEV выбрал 6 страниц для языковой модели. Все шесть первых ответов прошли проверки целостности, а 22 связи между отсылками в тексте и сносками, которые и так были верны, остались нетронутыми.
Сами исправления были небольшими, но важными: печатные номера страниц принимались за основной текст; один номер стал ложным мостиком между абзацами; вводное предложение слиплось со следующим за ним абзацем-цитатой с отступом. Языковая модель разделила их, опираясь на смысл и отступ.
Это наблюдение по одному образцу, а не утверждение о точности или стоимости на уровне документа. Для меня урок в том, что хороший этап исправления должен сохранять верную работу и останавливаться, исправив проблемы, подтверждённые данными.
Использовать языковую модель только там, где она нужна
Детерминированная обработка справляется с большей частью книги. JEV быстро отбирает подозрительные страницы. Языковая модель занимается немногими случаями, где нужно понимать смысл. Программные ограничения защищают итоговую структуру. Исправленные страницы возвращаются в ту же сборку глав и тот же путь вывода в Markdown или EPUB.
Мне ещё предстоит проверить больше языков, вёрсток и длинных книг, особенно долю пропущенных JEV ошибок и порог для проверки языковой моделью. Но направление стало яснее, чем год назад: незачем заставлять языковую модель читать каждую страницу, чтобы найти несколько ошибок, спрятавшихся на полях.
Если вы конвертируете сканированную книгу, начните с короткого фрагмента со сносками в рабочей области PDF Craft. Проверьте отсылки в тексте, полный текст сносок и абзацы, переходящие через границы страниц, прежде чем браться за всю книгу.
Используйте образец, чтобы продумать собственную проверку результата
Приведённый пример — свидетельство об одном инженерном прогоне, а не статистика успеха для произвольных книг. Он подсказывает, что стоит проверять, когда в переведённой книге много сносок. Выберите страницу с несколькими отсылками, страницу с символьными ссылками и место, где сноска или абзац основного текста продолжается на следующей странице.
Для каждого выбранного места сравните изображение исходной страницы с результатом. Найдите отсылку в тексте, проследите, куда она ведёт, и убедитесь, что полная сноска относится именно к этому фрагменту. Вернитесь к тексту и проверьте, что следующее предложение читается естественно. Работающая ссылка всё равно может вести к неверной сноске.
Обращайте внимание на такие конкретные аномалии:
- Отсылка без адресата или текст сноски без соответствующей отсылки в тексте.
- Две разные сноски, склеенные в одну, или одна продолженная сноска, неверно разделённая.
- Номер страницы, колонтитул или декоративный знак, вставленные в предложение.
- Сноска, привязанная не к той колонке или не к той соседней странице.
- Абзац, соединённый через границу страницы вопреки границе цитаты или раздела.
Записывайте печатный номер страницы, номер страницы в программе просмотра PDF, отсылку и короткую фразу. Пагинация EPUB зависит от размера шрифта, поэтому одного номера страницы в электронной книге потом не хватит, чтобы найти проблему.
Понимать пределы проверки на уровне страницы
Описанные здесь этапы проверки и исправления — внутренняя обработка, а не доступный пользователю элемент управления JEV и не обещание, что каждую переведённую страницу проверил специалист. Страница может пройти структурные проверки и всё равно содержать ошибку распознавания или неоднозначную фразу. И наоборот: отправка подозрительной страницы на исправление не доказывает, что все связи с соседними страницами верны.
Для обычного чтения сосредоточьтесь на сложных структурах и важных фрагментах. Для цитаты, научного утверждения или публикации нужна более тщательная проверка, соответствующая этой задаче. Держите исходный PDF под рукой, даже если EPUB удобно читать.
В статье «Как устроены OCR и перевод» объясняется, почему распознавание, структура и смысл требуют разных проверок. Если статью предстоит ещё и переводить, см. работу с PDF из arXiv. Актуальные тарифы обработки — на странице «Цены»; по одному образцу нельзя судить об универсальной экономии времени или денег.