
antiSMASH 8.0은 미생물 게놈에서 생합성 유전자 클러스터를 찾고, 검출 유형을 81종에서 101종으로 늘렸습니다. 2025년.
antiSMASH 8.0: extended gene cluster detection capabilities and analyses of chemistry, enzymology, and regulation
antiSMASH 8.0: 확장된 유전자 클러스터 검출 기능 및 화학, 효소학, 조절에 대한 분석
Blin, K.; Shaw, S.; Vader, L.; Szenei, J.; Reitz, Z.L.; Augustijn, H.E.; ...; Weber, T.
인용
Blin, K., Shaw, S., Vader, L., Szenei, J., Reitz, Z. L., Augustijn, H. E., ... Weber, T. (2025). antiSMASH 8.0: 확장된 유전자 클러스터 검출 기능 및 화학, 효소학, 조절에 대한 분석. Nucleic Acids Research, 53(W1), W32-W38. doi:10.1093/nar/gkaf334
버전: 출판사 버전 라이선스: Creative Commons CC BY 4.0 라이선스 다운로드 출처: https://hdl.handle.net/1887/4285886
참고: 이 출판물을 인용하려면 최종 출판된 버전을 사용하십시오(해당되는 경우).
antiSMASH 8.0: 확장된 유전자 클러스터 검출 기능 및 화학, 효소학, 조절에 대한 분석
Kai Blin , Simon Shaw , Lisa Vader , Judit Szenei , Zachary L. Reitz , Hannah E. Augustijn , José D.D. Cédiel-Becerra , Valérie de Crécy-Lagard , Robert A. Koetsier , Sam E. Williams , Pablo Cruz-Morales , Sopida Wongwas , Alejandro E. Segurado Luchsinger , Friederike Biermann , Aleksandra Korenskaia , Mitja M. Zdouc , David Meijer , Barbara R. Terlouw , Justin J.J. van der Hooft , Nadine Ziemert , Eric J.N. Helfrich , Joleen Masschelein , Christophe Corre , Marc G. Chevrette , Gilles P. van Wezel , Marnix H. Medema , Tilmann Weber
교신저자. 이메일: kblin@biosustain.dtu.dk 교신은 Marnix H. Medema에게도 가능합니다. 이메일: marnix.medema@wur.nl 교신은 Tilmann Weber에게도 가능합니다. 이메일: tiwe@biosustain.dtu.dk
초록
미생물은 이차 대사 또는 특화 대사를 통해 소분자 생리활성 화합물을 합성합니다. 이러한 화합물은 미생물 상호작용과 토양 건강에서 중요한 역할을 하지만, 의약품이나 농약 개발에도 필수적입니다. 지난 수십 년 동안 게놈 시퀀싱의 발전으로 미생물 게놈에서 다수의 생합성 유전자 클러스터를 직접 식별할 수 있게 되었습니다. 2011년 출시 이후 antiSMASH(https://antismash.secondarymetabolites.org/)는 세균과 진균에서 이러한 유전자 클러스터를 검출하고 특성화하는 선도적인 도구가 되었습니다. 본 논문은 antiSMASH 버전 8을 소개하며, 이 버전은 검출 가능한 클러스터 유형 수를 81개에서 101개로 증가시켰고, 테르페노이드 및 테일러링 효소에 대한 분석 지원을 개선했으며, 폴리케타이드 합성효소 및 비리보솜 펩타이드 합성효소와 같은 모듈형 효소 분석도 개선했습니다. 이러한 변경은 antiSMASH를 해당 분야의 발전에 맞춰 최신 상태로 유지하고 천연물 게놈 마이닝을 위한 전반적인 예측 능력을 확장합니다.
그래픽 초록
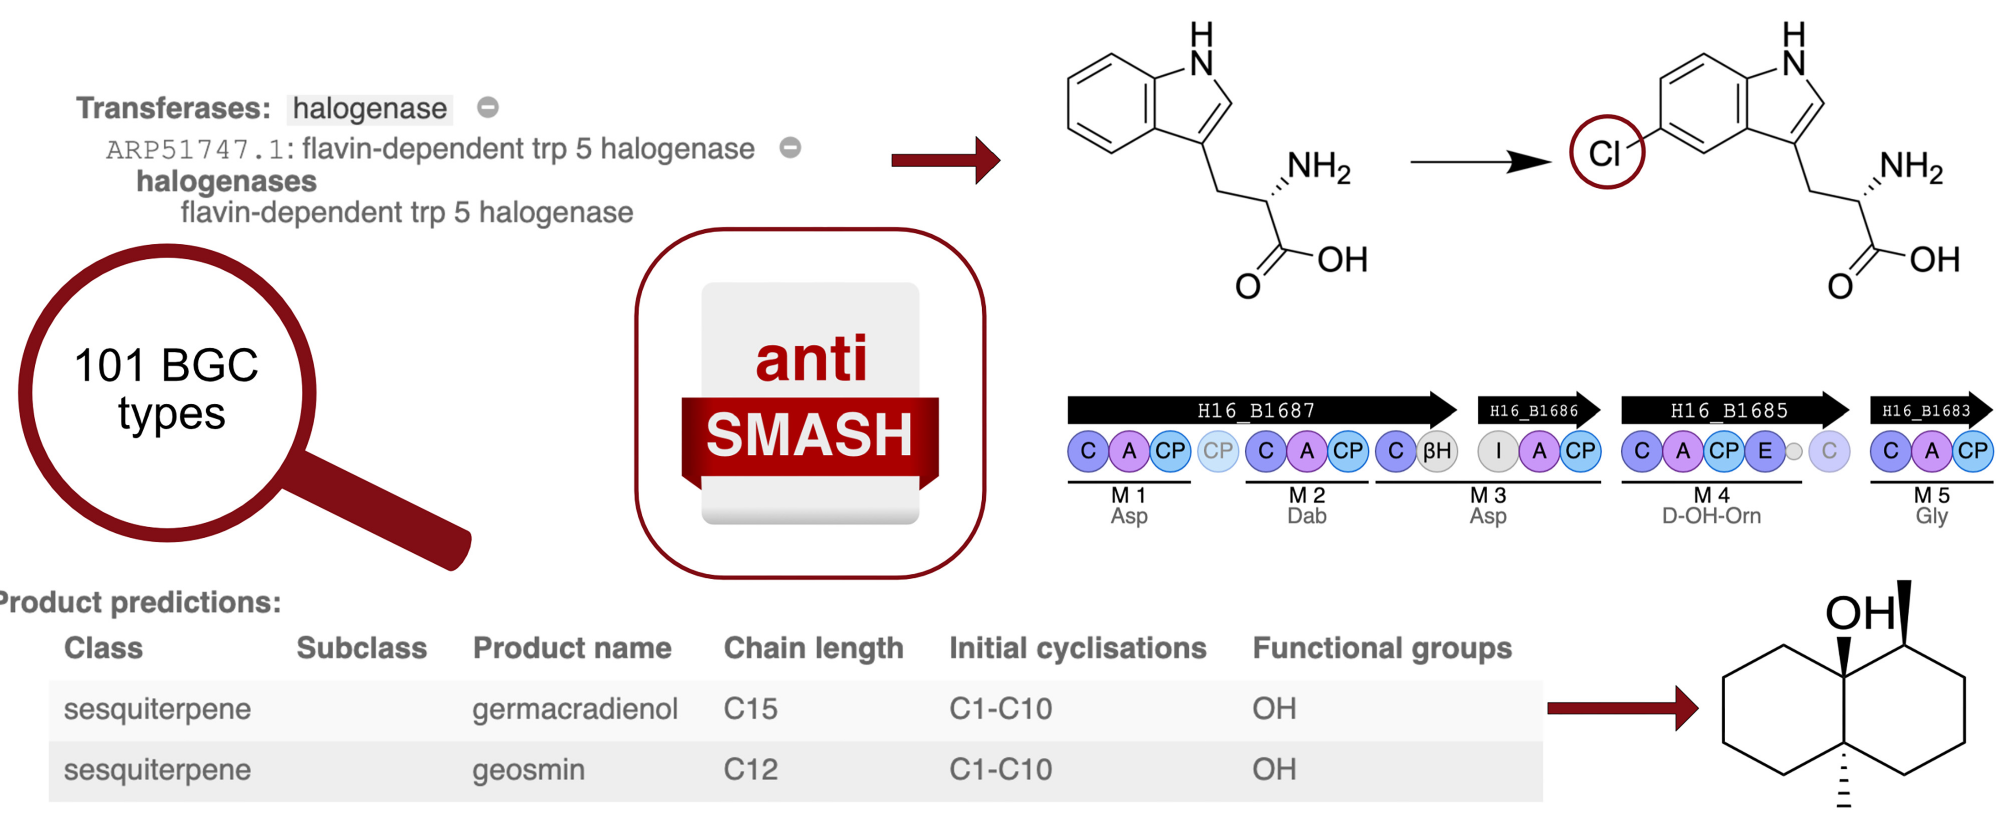
서론
미생물이 생산하는 소분자 생리활성 물질은 의약품[1]과 농약[2]의 중요한 공급원이며, 미생물 상호작용과 토양 건강에서 중요한 역할을 합니다. 지난 20-25년 동안 이용 가능한 게놈 데이터의 풍부함 덕분에, 미생물 균주를 분리하고 화합물을 추출한 뒤 원하는 활성을 스크리닝하는 전통적 워크플로를, 미생물 게놈에서 이러한 분자의 생합성을 암호화하는 생합성 유전자 클러스터(BGC)를 검색함으로써 개선할 수 있게 되었습니다[3]. 이러한 이차/특화 대사산물 생산 BGC를 게놈에서 검색하기 위한 소프트웨어 도구는 10년 이상 존재해 왔습니다[4-7].
2011년 최초 출시 이후 antiSMASH[8-14]는 해당 분야의 선도적 도구가 되었습니다. antiSMASH를 중심으로 antiSMASH 예측을 통합하거나 의존하는 관련 도구의 광범위한 생태계가 발전했습니다. 예로는 저항성 기반 마이닝 도구 ARTS[15], 질량분석 유도 Seq2PKS[16], 게놈 공학 도구 StreptoCAD[17], BGC 네트워킹 및 클러스터링 도구 BiG-SCAPE[18], 페어링된 오믹스 분석 도구 NPLinker[19] 등이 있습니다. 반대로 antiSMASH는 다른 도구의 BGC 예측도 통합할 수 있습니다[13]. 원래 DeepBGC[20]를 위해 구축되었으며, GECCO[21]와 같은 다른 머신러닝 기반 도구도 필요한 형식으로 결과를 제공합니다. antiSMASH BGC 예측은 또한 많은 게놈 및 BGC 관련 데이터베이스에서 사용됩니다. 예를 들어 Joint Genome Institute의 Secondary Metabolite Collaboratory[22], 게놈 주석 및 분석을 위한 MicroScope 플랫폼[23], 수동 큐레이션된 BGC 데이터베이스 MIBiG[24], BGC 패밀리 데이터베이스 BiG-FAM[25], 화학적 다양성 메타게놈 데이터베이스 BGC Atlas[26], antiSMASH 데이터베이스[27] 등이 있습니다. 더욱이 antiSMASH는 게놈 데이터의 대규모 분석을 위한 여러 체계적 워크플로의 일부입니다. 예를 들어 BGCFlow[28] 또는 유럽식품안전청(EFSA)의 MicroOrganisms Pipelines Service[29] 등이 있습니다.
여기에서 우리는 antiSMASH 버전 8을 제시합니다. 이 릴리스는 검출 가능한 생합성 경로 유형 수를 81개에서 101개로 증가시키고, 테르페노이드 BGC 분석 모듈을 추가하며, 테일러링 효소에 대한 심층 분석을 제공합니다.
추가로, KnownClusterBlast 및 ClusterCompare 데이터셋은 MIBiG 릴리스 4의 데이터를 반영하도록 업데이트되었고, 원형 게놈에서 복제 원점을 가로지르는 BGC에 대한 적절한 지원을 추가했으며, 전사 인자 결합 부위 예측은 CollecTF 데이터베이스[30]의 데이터셋으로 확장되었습니다. 비리보솜 펩타이드 합성효소(NRPS) 또는 제I형 폴리케타이드 합성효소(PKS)를 포함하는 BGC에서는 더 많은 생합성 도메인이 검출되고 분석됩니다.
새로운 기능 및 업데이트
BGC 검출 업데이트
antiSMASH는 게놈 영역에서 BGC를 정의하기 위해 어떤 생합성 기능이 존재해야 하는지를 정의하는 데 수동으로 큐레이션된 규칙을 사용한다. 이러한 생합성 기능을 식별하기 위해 antiSMASH는 프로파일 은닉 마르코프 모델(pHMM)과, 더 적은 범위로, Python 코드 파일에 명시된 동적 프로파일을 활용한다. pHMM은 PFAM [31], TIGRFAMS [32], SMART [33], BAGEL [34], Yadav 등 [35]과 같은 공개 데이터셋에서 제공되거나 antiSMASH에서 사용하기 위해 특별히 제작된다. antiSMASH 7에는 이러한 BGC 규칙이 81개 포함되어 있었으며[14], 이번 릴리스에서는 기존 규칙 다수가 개선되면서 이 수가 101개로 증가했다. 생합성 효소의 상당한 중복 때문에 선형 아졸 함유 펩타이드와 티오-연결 고리화 티오펩타이드를 구별하기 어렵다. 현재 antiSMASH 데이터베이스 [27]에서 티오펩타이드 BGC 호출의 약 16%와 선형 아졸 함유 펩타이드 BGC 호출의 약 29%가 겹치며, 나머지 할당 중 얼마나 많은 것이 정확한지는 불분명하다. 이러한 불확실성을 해결하고 잠재적 혼란을 피하기 위해 두 유형의 BGC에 대한 검출 규칙이 새로운 "아졸 함유 RiPP 규칙"으로 병합되었다. 테르펜, 마이코스포린, NRPS-비의존성 시데로포어, 트랜스-AT PKS, NRPS, NRPS-유사 클러스터, 지방산에 대한 검출 규칙도 업데이트되었다. 또한 고세균 리보솜 합성 및 번역 후 변형 펩타이드(RiPP), 아트로포펩타이드, 니트로프로판산, 아족시 함유 화합물, 폴리인, 디아자퓨린, 폴리할로겐화 피롤, 히드록시트로폴론, 시안화수소, 다로박틴, 이소시아니드, 세균성 및 진균성 고리형 디펩타이드, 트리셉타이드, 고도로 환원된 type II PKS, 진균성 NRPS-유사 라이신 생합성에 대한 새로운 규칙이 추가되었다.
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
번역할 텍스트가 콜론(:) 문자들만 포함되어 있어 실제 번역할 내용이 없습니다. 텍스트를 붙여넣어 주시면 한국어로 번역해 드리겠습니다.
It looks like you've only sent a colon (:) with no actual text to translate. Please send the source text you'd like me to translate into Korean, and I'll be happy to help.
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:: antiSMASH는 NRPS/PKS BGC에 암호화된 단백질 도메인에 대한 상세한 분석을 제공한다. 존재하는 도메인에 대한 보다 포괄적인 개요를 제공하기 위해, 우리는 사이드로포어 관련 -하이드록실라제 및 인터페이스 도메인(상세한 논의는 [37] 참조)과 보다 일반적인 -
일부 핵심 유전자의 연속된 구간이 다른 핵심 유전자로부터 너무 멀리 떨어져 있는 경우를 포괄하기 위해, 모든 핵심 유전자가 적절하게 표시되도록 규칙 정의에 새로운 "EXTENDS" 조건이 추가되었다. trans-AT PKS 규칙은 이를 사용하여 단일 trans-acting 아실트랜스퍼라제(AT) 도메인이 멀리 떨어져 있는 경우에도 모듈을 포함하는 모든 유전자가 올바르게 검출되도록 보장한다.
테르펜 분석
antiSMASH는 버전 1 [8]부터 테르펜 유전자 클러스터를 검출해 왔지만, 테르펜 신타제/사이클라제에 대한 보다 상세한 분석은 부재했다. antiSMASH 버전 4 [11]에서 초기 분석 모듈이 추가되었으나, 계통발생적 배치 알고리즘의 성능 한계와 유지보수 문제로 인해 antiSMASH 5 [12]에서 다시 제외되었다. 버전 8에서는 신중하게 큐레이션된 pHMM 기반의 테르펜 분석이 다시 도입되었다(그림 1A 참조). 테르펜 BGC를 포함하는 모든 영역에 대해 잠재적인 생성물 유형 목록이 표시된다. 모든 예측에는 테르페노이드 클래스(예: 디테르펜, 세스퀴테르펜 등)와 예측된 생성물의 사슬 길이가 포함된다. 보다 잘 이해된 테르펜 신타제 서브패밀리의 경우, 예측에는 테르페노이드 서브클래스(예: 인돌 디테르페노이드), 초기 고리화(예: C1-C15), 및 생성물명도 포함될 수 있다.
유전자 기능 분석
작년 MIBiG 주석 작업 동안 MIBiG 항목의 테일러링 효소를 더 잘 주석하려는 대규모 커뮤니티 노력(설명은 [24] 참조) 중에, 우리는 antiSMASH에서 테일러링 효소 반응에 접근하기 위한 보다 사용자 친화적인 인터페이스가 필요함을 인지했다. 해당 주석 작업 동안 주석된 MITE 데이터베이스(https://mite.bioinformatics.nl/) [36]의 테일러링 효소 컬렉션과 기존의 smCOG 주석을 사용하여, 이제 전용 "tailoring" 탭(그림 1B 참조)에 테일러링 효소 정보를 제시한다. 이는 또한 이번 릴리스에서 추가된, 많은 플라빈 의존성 할로게나제의 기질 특이성을 보고할 기회도 제공해 주었다. 맞춤형 pHMM과 보존된 모티프 시그니처를 사용하여, 예측은 데이터 가용성에 따라 "할로겐화 피롤"에서부터 예를 들어 트립토판 할로게나제의 위치선택성에 이르기까지 세분화된다.
tailoring 탭에서 테일러링 효소는 효소 위원회(Enzyme Commission) 범주, 즉 산화환원효소, 전이효소, 가수분해효소, 분해효소, 이성질화효소, 및 연결효소별로 구성된다. 해당 영역에 히트가 있는 범주만 표시된다. 플러스 아이콘을 클릭하면 해당 범주가 확장되어 관련 히트가 있는 유전자와 가능한 가장 상세한 테일러링 기능 예측에 대한 간단한 요약을 보여준다. 관심 있는 유전자의 플러스 아이콘을 클릭하면 antiSMASH가 제공하는 테일러링 효소에 관한 모든 정보가 확장된다. 테일러링 효소가 MITE 데이터베이스의 어떤 항목과도 최소 아미노산 서열 동일성을 보이면, 해당 MITE 항목으로의 상호 링크가 제공된다.
NRPS 및 PKS 개선 사항
CoA-리가제(CAL) 도메인은 리포펩타이드 BGC에서 지방산 유래 스타터 단위를 로딩하는 데 종종 관여하지만, 이전에는 antiSMASH 모듈 검출에서 시작 모듈로 고려되지 않았다. 앞서 언급한 -하이드록실라제 및 인터페이스 도메인과 함께 이제 모듈의 일부로 검출될 수 있다.
[38]에서 수집된 정보에 따라, NRPS 축합(C) 및 에피머화(E) 도메인의 활성 부위는 이제 촉매 잔기의 존재 여부를 확인하고 해당 잔기가 없으면 비활성으로 표시된다. antiSMASH에서 이미 수행되는 NRPS 아데닐화(A) 도메인 기질 특이성 예측을 보완하기 위해, 이제 연구자들에게 더 많은 분석 옵션을 제공하기 위해 외부 PARAS 기질 특이성 예측기 [39]로의 링크도 제공한다.
기타 변경 사항
버전 8에는 다른 많은 소규모 변경 사항이 포함되었다. 가장 유사한 알려진 클러스터를 보여주는 개요 페이지 보기는 사용자 혼란의 일부 원인을 해결하기 위해 단순화되었다. "최소 의 서열 유사성을 갖는 유전자의 백분율"로 클러스터 유사성을 직접 표시하는 대신, 이제 세 가지 신뢰 수준으로 유사성을 표시한다: 클러스터 유사성이 이상인 경우 "높음", 클러스터 유사성이 와 사이인 경우 "중간", 클러스터 유사성이 와 사이인 경우 "낮음". 의 클러스터 유사성은 더 이상 충분히 유사한 것으로 간주되지 않으며 개요에 더 이상 표시되지 않는다. 알려진 ClusterBlast, ClusterCompare, 및 CompaRiPPson은 MIBiG 4.0 릴리스 [24]에서 제공된 데이터로 업데이트되었다. ClusterBlast SVG 생성은 파일 크기를 줄이고 로컬에서 열린 antiSMASH 결과를 볼 때의 사용자 경험을 개선하기 위해 JavaScript로 이동되었다. 역사적으로 antiSMASH는 원형 게놈에서 원점을 가로지르는 BGC를 다루는 데 어려움을 겪어 왔다. 최선의 경우 그러한 BGC는 둘로 나뉘었고, 최악의 경우 원점 반대편에 있는 부분 중 하나 또는 둘 다가 완전히 누락될 수 있었다. antiSMASH 8.0에서는 원형 게놈이 제대로 검출되고 보고되도록 좌표 처리를 완전히 개편했다.
역사적으로 antiSMASH는 곰팡이 유전자 호출을 위해 GlimmerHMM [40]에 의존해 왔는데, 이는 올바른 유전자 모델을 수동으로 선택하지 않고도 실행할 수 있었기 때문이다. 불행히도, 점점 더 많은 곰팡이 게놈이 이용 가능해지면서, 이 유전자 모델 선택이 고품질 유전자 호출에 결정적이라는 것이 명백해졌다. 분류군을 알 수 없는 업로드된 게놈에 대해 올바른 유전자 모델을 쉽게 선택할 수 없기 때문에, 우리는 antiSMASH에서 곰팡이 유전자 호출 기능을 제거하기로 결정했다. 사용자들은 AUGUSTUS [41]와 같은 전용 유전자 호출 도구를 실행한 다음 antiSMASH에 유전자 주석을 제공할 것을 권장한다. 최신 시스템에서의 소프트웨어 비호환성으로 인해, 우리는 MEME 도구 모음, 구체적으로 MEME [42] 및 FIMO [43]에 대한 지원도 중단했다. antiSMASH 독립 실행형 버전의 사용자는 여전히 해당 바이너리를 직접 제공할 수 있지만, 이들은 더 이상 우리가 제공하는 컨테이너나 웹 서비스의 일부가 아니다. 이는 CASSIS [44] 곰팡이 BGC 경계 검출을 실질적으로 비활성화하며, 라티펩타이드, 삭티펩타이드, 라소 펩타이드, 및 아졸 함유 RiPP 전구체에 대한 RODEO [45] 점수에 영향을 미칠 수 있다.
A
상세한 테르펜 예측
| 理解原文的只读背景(非待翻译源文本):详细的萜类预测待翻译文本:产物预测: | |||||
| 类别 | 亚类 | 产物名称 | 链长 | 初始环化 | 官能团 |
| 倍半萜 | germacradienol | C15 | C1-C10 | OH | |
| 倍半萜 | geosmin | C12 | C1-C10 | OH |
테르펜 도메인을 가진 유전자:
scO6073: T1TS + T1TS
도메인 1 (0 - 326): 제1형 테르펜 신타제
서브타입: 게오스민 신타제, N 말단 도메인
반응: FPP → 게르마크라디에놀
도메인 2 (326 - 695): 제1형 테르펜 신타제
서브타입: 게오스민 신타제, C 말단 도메인
반응: 게르마크라디에놀 → 게오스민
B
테일러링 기능
산화환원효소: 산소화효소
oxyA: 고리화
oxyB: 고리화
oxyC: 고리화
oxyD: 사이토크롬 P450
전이효소: 아미노트랜스퍼라제 글리코실트랜스퍼라제 할로게나제 메틸트랜스퍼라제
bgtFA: 글리코실화
bgtFB: 글리코실화
bgtFC: 글리코실화
bhaA: 플라빈 의존성 티로신 유사 hpg 할로게나제 할로게나제 플라빈 의존성 티로신 유사 hpg 할로게나제
MITF
MITEO000028 할로겐화 (동일성: 100.00%) smcogs SMCOG1119: 할로게나제 bmt: 메틸화 dvaB: DegT/DnrJ/ErYC1/StrS 아미노트랜스퍼라제 pgaT: 아미노트랜스퍼라제
가수분해효소: hydrolase
bhp: 알파/베타 가수분해효소 폴드 단백질
분해효소: hydratase
dpgC: 에노일-CoA 수화효소
dpgD: 에노일-CoA 수화효소
연결효소: ligase synthase
결론 및 향후 전망
결론 및 향후 전망antiSMASH와 같은 게놈 마이닝 기술은 천연물 발견 퍼즐의 중요한 한 조각을 구성한다. 지난 14년 동안 antiSMASH는 지속적인 업데이트와 개선을 거쳐 천연물 게놈 마이닝 도구의 최전선에 서 있도록 해 왔다. 핵심 개발 팀 외부로부터의 수많은 기여에서 알 수 있듯이, antiSMASH 프로젝트의 오픈 소스 및 오픈 사이언스 모델은 여전히 성공적이다. 이는 많은 다른, 더 특화된 도구, 워크플로 및 데이터베이스가 의존하는 중요한 도구이다. 이는 현재 개발 중인 다수의 다른 게놈 마이닝 도구를 위한 기술 플랫폼 역할을 한다. 향후 업데이트에서 우리는 검출된 클러스터의 전체 생합성 경로를 해독하기 위한 새로운 알고리즘과 분석 모듈에 대한 작업을 계속할 것이다. 우리는 이 버전에서의 테일러링 효소 예측 개선의 기반 위에 세워 더 많은 효소 패밀리를 다룰 것이다. 마찬가지로, 조절인자 및 조절인자 결합 부위 검출에 대한 우리의 작업도 계속될 것이다. 늘 그렇듯이, 우리는 또한 생태계에서 개발되는 새로운 도구들을 통합하거나 이들과 통합할 것이다.
감사의 글
감사의 글저자 기여: Kai Blin (개념화 [주도], 데이터 큐레이션 [주도], 자금 확보 [동등], 방법론 [주도], 프로젝트 관리 [주도], 소프트웨어 [동등], 감독 [동등], 원고 작성—초안 [주도], 원고 작성—검토 및 편집 [주도]), Simon Shaw (데이터 큐레이션 [동등], 방법론 [동등], 소프트웨어 [주도], 시각화 [주도]), Lisa Vader (데이터 큐레이션 [지원], 소프트웨어 [지원], 시각화 [지원]), Judit Szenei (데이터 큐레이션 [지원], 소프트웨어 [지원], 시각화 [지원]), Zachary L. Reitz (데이터 큐레이션 [지원], 소프트웨어 [지원]), Hannah E. Augustin (데이터 큐레이션 [지원], 소프트웨어 [지원]), José D.D. Cediel-Becerra (데이터 큐레이션 [지원], 소프트웨어 [지원]), Valérie de Crécy-Lagard (데이터 큐레이션 [지원]), Robert A. Koetsier (데이터 큐레이션 [지원], 소프트웨어 [지원]), Sam E. Williams (데이터 큐레이션 [지원]), Pablo Cruz-Morales (데이터 큐레이션 [지원]), Sopida Wongwas (데이터 큐레이션 [지원]), Alejandro E. Segurado Luchsinger (데이터 큐레이션 [지원]), Friederike Biermann (데이터 큐레이션 [지원]), Aleksandra Korenskaia (데이터 큐레이션 [지원]), Mitja M. Zdouc (데이터 큐레이션 [지원], 원고 작성—초안 [지원]), David Meijer (데이터 큐레이션 [지원]), Barbara R. Terlouw (데이터 큐레이션 [지원]), Justin J.J. van der Hooft (자금 확보 [동등], 원고 작성—초안 [지원]), Nadine Ziemert (자금 확보 [동등], 감독 [동등]), Eric J.N. Helfrich (자금 확보 [동등], 감독 [동등], 원고 작성—초안 [지원]), Joleen Masschelein (데이터 큐레이션 [지원], 자금 확보 [동등], 감독 [동등]), Christophe Corre (자금 확보 [동등], 감독 [동등]), Marc G. Chevrette (자금 확보 [동등], 감독 [동등]), Gilles P. van Wezel (자금 확보 [동등], 감독 [동등]), Marnix H. Medema (개념화 [지원], 자금 확보 [동등], 감독 [동등], 원고 작성—초안 [지원]), 그리고 Tilmann Weber (개념화 [지원], 자금 확보 [동등], 감독 [동등], 검증 [지원], 원고 작성—초안 [지원])
이해 상충
J.J.vdH.는 이탈리아 밀라노 소재 NAICONS Srl의 과학 자문 위원회 위원이며, 미국 인디애나주 인디애나폴리스 소재 Corteva Agriscience의 자문을 맡고 있다. M.H.M.은 Hexagon Bio의 과학 자문 위원회 위원이다. 그 외 모든 저자는 이해 상충이 없음을 밝힌다.
연구비 지원
연구비 지원: Novo Nordisk Foundation [T.W., K.B., P.C.-M.에게 NNF20CC0035580, S.E.W.에게 NNF22OC0079021]; Center for Microbial Secondary Metabolites (CeMiSt), Danish National Research Foundation [T.W.에게 DNRF137]; EU Horizon Europe Programme MAGic-MOLFUN [T.W., K.B., M.H.M., N.Z., A.K., J.J.vdH.에게 MSC 101072485]; EU Horizon 2020 MARBLES [M.M.Z., J.J.vdH., M.H.M., G.P.vW.에게 101000392]; NWO [M.M.Z., J.J.vdH., M.H.M.에게 KICH1.LWV04.21.013]; EU ERC Community [G.P.vW.에게 101055020]; NWO-XL [R.A.K.에게 OCENW.XL21.XL21.088]; National Institutes of Health [VdC.-L.에게 RM1GM145426]; German Center for Infection Research (DZIF) [N.Z.에게 TTU09.716]; EU Horizon 2020 DECIPHER [D.M. 및 M.H.M.에게 948770]; The Royal Thai Government [S.W.에게 박사 과정 지원]; Emmy Noether Program of the German Research Foundation [E.J.N.H.에게 504947087], Hessian Ministry for Science and the Arts [E.J.N.H.에게 LOEWE Center for Translational Biodiversity Genomics]; FWO [J.M.에게 1008520N 및 G061821N]. 본 논문의 오픈 액세스 출판 비용 지급을 위한 연구비는 EU Horizon Europe Program MAGic-MOLFUN에서 제공되었다.
데이터 이용 가능성
antiSMASH 8.0의 세균 및 진균 버전은 각각 https://antismash.secondarymetabolites.org 및 https://fungismash.secondarymetabolites.org에서 자유롭게 접속할 수 있다.
antiSMASH 문서는 https://docs.antismash.secondarymetabolites.org/에서 이용할 수 있다.
antiSMASH 소스 코드는 GNU Affero General Public License (AGPL) 버전 3.0에 따라 라이선스가 부여된다. antiSMASH는 Docker를 통해서도 이용할 수 있다. antiSMASH의 다운로드 및 설치 방법에 대한 자세한 내용은 문서 웹사이트를 참조하라.
참고문헌
1. Newman DJ, Cragg GM. 1981년 1월부터 2019년 9월까지 거의 40년에 걸쳐 신약의 원천으로서의 천연물. BMC Genomics 2020;83:1138-43. https://doi.org/10.1021/acs.jnatprod.9b01285 2. Sparks TC, Bryant RJ. 작물 보호 화합물의 발견과 혁신에 대한 천연물의 영향. Pest Manag Sci 2022;78:399-408. https://doi.org/10.1002/ps.6653 3. Ziemert N, Alanjary M, Weber T. 미생물에서의 게놈 마이닝의 진화—리뷰. Nat Prod Rep 2016;33:988-1005. https://doi.org/10.1039/C6NP00025H 4. Weber T. 항생제 생합성 경로 분석을 위한 인 실리코 도구. Int J Med Microbiol 2014;304:230-5. https://doi.org/10.1016/j.ijmm.2014.02.001 5. Medema MH, Fischbach MA. 천연물 발견을 위한 계산적 접근법. Nat Chem Biol 2015;11:639-48. https://doi.org/10.1038/nchembio.1884 6. Weber T, Kim HU. 이차 대사산물 생산의 합성 생물학을 촉진하기 위한 계산 도구인 이차 대사산물 생물정보학 포털. Synth Syst Biotechnol 2016;1:69-79. https://doi.org/10.1016/j.synbio.2015.12.002 7. Blin K, Kim HU, Medema MH 등. 이차 대사산물 생합성 유전자 클러스터를 마이닝하기 위한 antiSMASH 및 기타 계산적 접근법의 최근 개발. Brief Bioinform 2019;20:1103-13. https://doi.org/10.1093/bib/bbx146 8. Medema MH, Blin K, Cimermancic P 등. antiSMASH: 세균 및 진균 게놈 서열에서 이차 대사산물 생합성 유전자 클러스터의 신속한 식별, 주석 및 분석. Nucleic Acids Res 2011;39:W339-46. https://doi.org/10.1093/nar/gkr466 9. Blin K, Medema MH, Kazempour D 등. antiSMASH 2.0—이차 대사산물 생산자의 게놈 마이닝을 위한 다목적 플랫폼. Nucleic Acids Res 2013;41:W204-12. https://doi.org/10.1093/nar/gkt449 10. Weber T, Blin K, Duddela S 등. antiSMASH 3.0—생합성 유전자 클러스터의 게놈 마이닝을 위한 포괄적 자원. Nucleic Acids Res 2015;43:W237-43. https://doi.org/10.1093/nar/gkv437 11. Blin K, Wolf T, Chevrette MG 등. antiSMASH 4.0—화학 예측 및 유전자 클러스터 경계 식별의 개선. Nucleic Acids Res 2017;45:W36-41. https://doi.org/10.1093/nar/gkx319 12. Blin K, Shaw S, Steinke K 등. antiSMASH 5.0: 이차 대사산물 게놈 마이닝 파이프라인의 업데이트. Nucleic Acids Res 2019;47:W81-7. https://doi.org/10.1093/nar/gkz310 13. Blin K, Shaw S, Kloosterman AM 등. antiSMASH 6.0: 클러스터 검출 및 비교 능력의 향상. Nucleic Acids Res 2021;49:W29-35. https://doi.org/10.1093/nar/gkab335 14. Blin K, Shaw S, Augustijn HE 등. antiSMASH 7.0: 검출, 조절, 화학 구조 및 시각화에 대한 새롭고 개선된 예측. Nucleic Acids Res 2023;51:W46-50. https://doi.org/10.1093/nar/gkad344 15. Mungan MD, Alanjary M, Blin K 등. ARTS 2.0: 비교 게놈 마이닝을 위한 항생제 내성 표적 탐색기의 기능 업데이트 및 확장. Nucleic Acids Res 2020;48:W546-52. https://doi.org/10.1093/nar/gkaa374 16. Yan D, Zhou M, Adduri A 등. Seq2PKS를 이용한 계산적 질량 분석과 게놈 마이닝을 통한 type I cis-AT 폴리케타이드의 발견. Nat Commun 2024;15:5356. https://doi.org/10.1038/s41467-024-49587-1 17. Levasor L, Whitford CM, Petersen SD 등. StreptoCAD: 스트렙토미세테스에서 게놈 공학 워크플로를 자동화하는 오픈 소스 소프트웨어 도구 상자. bioRxiv, https://doi.org/10.1101/2024.12.19.629370, 2024년 12월 20일, 프리프린트: 동료 심사 미완료. 18. Navarro-Munoz JC, Selem-Mojica N, Mullowney MW 등. 대규모 생합성 다양성을 탐구하기 위한 계산 프레임워크. Nat Chem Biol 2020;16:60-8. https://doi.org/10.1038/s41589-019-0400-9 19. Eldjarn GH, Ramsay A, Hooft JJJvd 등. 상호보완적 점수 함수를 사용하여 NPLinker 프레임워크에서 미생물 대사체학 및 게놈학 연결의 순위 지정. PLOS Comput Biol 2021;17:e1008920. https://doi.org/10.1371/journal.pcbi.1008920 20. Hannigan GD, Prihoda D, Palicka A 등. 생합성 유전자 클러스터 예측을 위한 딥 러닝 게놈 마이닝 전략. Nucleic Acids Res 2019;47:e110. https://doi.org/10.1093/nar/gkz654 21. Carroll LM, Larralde M, Fleck JS 등. GECCO를 이용한 생합성 유전자 클러스터의 정확한 de novo 식별. bioRxiv, https://doi.org/10.1101/2021.05.03.442509, 2021년 5월 4일, 프리프린트: 동료 심사 미완료. 22. Udwary DW, Doering DT, Foster B 등. 이차 대사 협력소: 이차 대사산물 생합성 유전자 클러스터를 위한 데이터베이스 및 웹 토론 포털. Nucleic Acids Res 2025;53:D717-23. https://doi.org/10.1093/nar/gkae1060 23. Vallenet D, Calteau A, Dubois M 등. MicroScope: 게놈, 범유전체 및 대사적 접근을 통한 미생물 유전자 기능의 주석 및 탐구를 위한 통합 플랫폼비교 분석. Nucleic Acids Res 2020;48: D579-89. https://doi.org/10.1093/nar/gkz92624. Zdouc MM, Blin K, Louwen NLL 등. MIBiG 4.0: 글로벌 협업을 통한 생합성 유전자 클러스터 큐레이션의 발전. Nucleic Acids Res 2025;53:D678-90. https://doi.org/10.1093/nar/gkae111525. Kautsar SA, Blin K, Shaw S 등. BiG-FAM: 생합성 유전자 클러스터 패밀리 데이터베이스. Nucleic Acids Res 2021;49: D490-7. https://doi.org/10.1093/nar/gkaa81226. Bagci C, Nuhamunada M, Goyat H 등. BGC Atlas: 세균 게놈에 암호화된 글로벌 화학적 다양성을 탐색하기 위한 웹 리소스. Nucleic Acids Res 2025;53:D618-24. https://doi.org/10.1093/nar/gkae95327. Blin K, Shaw S, Medema MH 등. antiSMASH 데이터베이스 버전 4: 추가 게놈 및 BGC, 새로운 서열 기반 검색 및 그 이상. Nucleic Acids Res 2024;52:D586-9. https://doi.org/10.1093/nar/gkad98428. Nuhamunada M, Mohite OS, Phaneuf PV 등. BGCFlow: 대규모 게놈 데이터 세트 전반에 걸친 생합성 유전자 클러스터 분석을 위한 체계적인 판게놈 워크플로우. Nucleic Acids Res 2024;52:5478-95. https://doi.org/10.1093/nar/gkae31429. Yolanda GC. 미생물 파이프라인 서비스(MOPS): 파이프라인 문서. 기술 보고서.30. Kilu S, White ER, Sagitova DM 등. CollecTF: 세균에서 실험적으로 검증된 전사 인자 결합 부위 데이터베이스. Nucleic Acids Res 2014;42:D156-6030. https://doi.org/10.1093/nar/gkt112331. Mistry J, Chugarunsky S, Williams L 등. Pfam: 2021년 단백질 패밀리 데이터베이스. Nucleic Acids Res 2021;49: D412-9. https://doi.org/10.1093/nar/gkaa91332. Haft DH, Selengut JD, Richter RA 등. 2013년 TIGRFAMs 및 게놈 속성. Nucleic Acids Res 2013;41: D387-953. https://doi.org/10.1093/nar/gks123433. Letunic I, Khedkar S, Bork P. SMART: 2020년 최근 업데이트, 새로운 개발 및 현황. Nucleic Acids Res 2021;49: D458-60. https://doi.org/10.1093/nar/gkaa93734. van Heel AJ, de Jong A, Song C 등. BAGEL4: RiPP 및 박테리오신을 철저히 마이닝하기 위한 사용자 친화적 웹 서버. Nucleic Acids Res 2018;46: W278-81. https://doi.org/10.1093/nar/gky38335. Yadav G, Gokhale RS, Mohanty D. 폴리케타이드 합성효소의 대사 산물 예측을 향하여: 인 실리코 분석. PLOS Comput Biol 2009;5:e1000351. https://doi.org/10.1371/journal.pcbi.100035136. Zdouc MM, Meijer D, Biermann F 등. 천연물 생합성 포착을 위한 테일로링 효소/뮤타로스 데이터 표준에 관한 최소 정보. ChemRxiv, https://doi.org/10.26434/chemrxiv-2024-78mtl, 2024년 4월 9일, 사전 인쇄본: 동료 심사 미완료.37. Reitz ZL, Hardy CD, Suk J 등. 사이드로포어 -하이드록실라제의 게놈 분석은 분기된 입체 제어를 밝혀내고 축합 도메인 패밀리를 확장한다. Proc Natl Acad Sci USA 2019;116:19805-14. https://doi.org/10.1073/pnas.190316111628. Bloudoff K, Schmeng TM. 비리보솜 펩타이드 합성효소 축합 도메인 슈퍼패밀리의 구조적 및 기능적 측면: 발견, 해부 및 다양성. Biochim Biophys Acta Proteins Proteom 2017;1865:1587-604. https://doi.org/10.1016/j.bbapap.2017.05.01039. Terlouw BR, Huang C, Meijer D 등. PARAS: 비리보솜 펩타이드 합성효소의 기질 특이성에 대한 고정밀 머신러닝. bioRxiv, https://doi.org/10.1101/2025.01.08.631717, 2025년 1월 10일, 사전 인쇄본: 동료 심사 미완료.40. Majoros WH, Pertea M, Salzberg SL. TigrScan 및 GlimmerHMM: 두 가지 오픈 소스 초기 원리 진핵생물 유전자 파인더. Bioinformatics 2004;20:2878-9. https://doi.org/10.1093/bioinformatics/bth31541. Stanke M, Morgenstern B. AUGUSTUS: 사용자 정의 제약 조건을 허용하는 진핵생물 유전자 예측용 웹 서버. Nucleic Acids Res 2005;33:W465-7. https://doi.org/10.1093/nar/gk14858 42. Bailey TL, Elkan C. 생체 고분자에서 모티프를 발견하기 위한 기대값 최대화를 통한 혼합 모델 적합. Proc Int Conf Intell Syst Mol Biol 1994;2:28-36. 43. Grant CE, Bailey TL, Noble WS. FIMO: 주어진 모티프의 발생 스캔. Bioinformatics 2011;27:1017-8. https://doi.org/10.1093/bioinformatics/btr064 44. Wolf T, Shelest V, Nath N 등. CASSIS 및 SMIPS: 진핵생물 게놈에서 프로모터 기반 이차 대사산물 유전자 클러스터 예측. Bioinformatics 2016;32:1138-43. https://doi.org/10.1093/bioinformatics/btv713 45. Walker MC, Eslami SM, Hetrick KJ 등. 십만 개 이상의 게놈에 대한 전구체 펩타이드 표적 마이닝은 란티펩타이드 천연물 패밀리를 확장한다. BMC Genomics 2020;21:387. https://doi.org/10.1186/s12864-020-06785-7