
어텐션 자체를 희소하고 학습 가능하게 만들어 64k 문맥 비용을 줄이면서 정확도를 지킨다. ACL 2025 최우수 논문, 전문 무료.
Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
네이티브 희소 어텐션: 하드웨어 정렬 및 네이티브 학습 가능 희소 어텐션
Jingyang Yuan , Huazuo Gao , Damai Dai , Junyu Luo , Liang Zhao , Zhengyan Zhang , Zhenda Xie , Y. X. Wei , Lean Wang , Zhiping Xiao , Yuqing Wang , Chong Ruan , Ming Zhang , Wenfeng Liang , Wangding Zeng
DeepSeek- AI 멀티미디어 정보 처리 핵심 연구실, 컴퓨터 과학부, 베이징 대학교, PKU- Anker LLM Lab 워싱턴 대학교 {yuanjy, mzhang_cs}@pku.edu.cn, {zengwangding, wenfeng.liang}@deepseek.com
초록
긴 문맥 모델링은 차세대 언어 모델에 있어 핵심적이지만, 표준 어텐션 메커니즘의 높은 계산 비용은 중대한 계산적 과제를 제기합니다. 희소 어텐션은 모델 능력을 유지하면서 효율성을 향상시킬 수 있는 유망한 방향을 제시합니다. 우리는 알고리즘 혁신과 하드웨어 정렬 최적화를 통합하여 효율적인 긴 문맥 모델링을 달성하는 네이티브 학습 가능 희소 어텐션 메커니즘인 NSA를 제시합니다. NSA는 동적 계층적 희소 전략을 채택하여, 거친 단위의 토큰 압축과 세밀한 단위의 토큰 선택을 결합함으로써 전역 문맥 인식과 국소 정밀도를 모두 보존합니다. 우리의 접근 방식은 두 가지 핵심 혁신으로 희소 어텐션 설계를 발전시킵니다: (1) 우리는 산술 강도 균형을 맞춘 알고리즘 설계와 현대 하드웨어를 위한 구현 최적화를 통해 상당한 속도 향상을 달성합니다. (2) 우리는 모델 성능을 희생하지 않으면서 사전 학습 계산을 줄이는 종단 간 학습을 가능하게 합니다. 그림 [1]에 나타난 바와 같이, 실험은 NSA로 사전 학습된 모델이 일반 벤치마크, 긴 문맥 작업 및 명령 기반 추론 전반에서 전체 어텐션 모델을 유지하거나 능가함을 보여줍니다. 한편, NSA는 64k 길이 시퀀스에서 디코딩, 순방향 전파 및 역방향 전파 전반에 걸쳐 전체 어텐션 대비 상당한 속도 향상을 달성하여, 모델 생애 주기 전반에 걸친 효율성을 입증합니다.
1. 서론
연구 커뮤니티는 심층 추론(DeepSeek- AI, 2025; Zelikman et al., 2022), 저장소 수준 코드 생성(Zhang et al., 2023a; Zhang et al.) 및 다중 턴 자율 에이전트 시스템(Park et al., 2023)에 이르는 다양한 실제 응용에 의해 주도되어, 긴 문맥 모델링을 차세대 대규모 언어 모델의 핵심 능력으로 점점 더 인식하고 있습니다. OpenAI의 o-시리즈 모델, DeepSeek- R1(DeepSeek- AI, 2025) 및 Gemini 1.5 Pro(Google et al., 2024)를 포함한 최근의 돌파구들은 모델이 전체 코드베이스와 긴 문서를 처리하고, 수천 개의 토큰에 걸쳐 일관된 다중 턴 대화를 유지하며, 장거리 의존성 전반에 걸쳐 복잡한 추론을 수행할 수 있게 합니다. 그러나 바닐라 어텐션(Vaswani et al., 2017) 메커니즘의 높은 복잡도(Zaheer et al., 2020)는 시퀀스 길이가 증가함에 따라 중대한
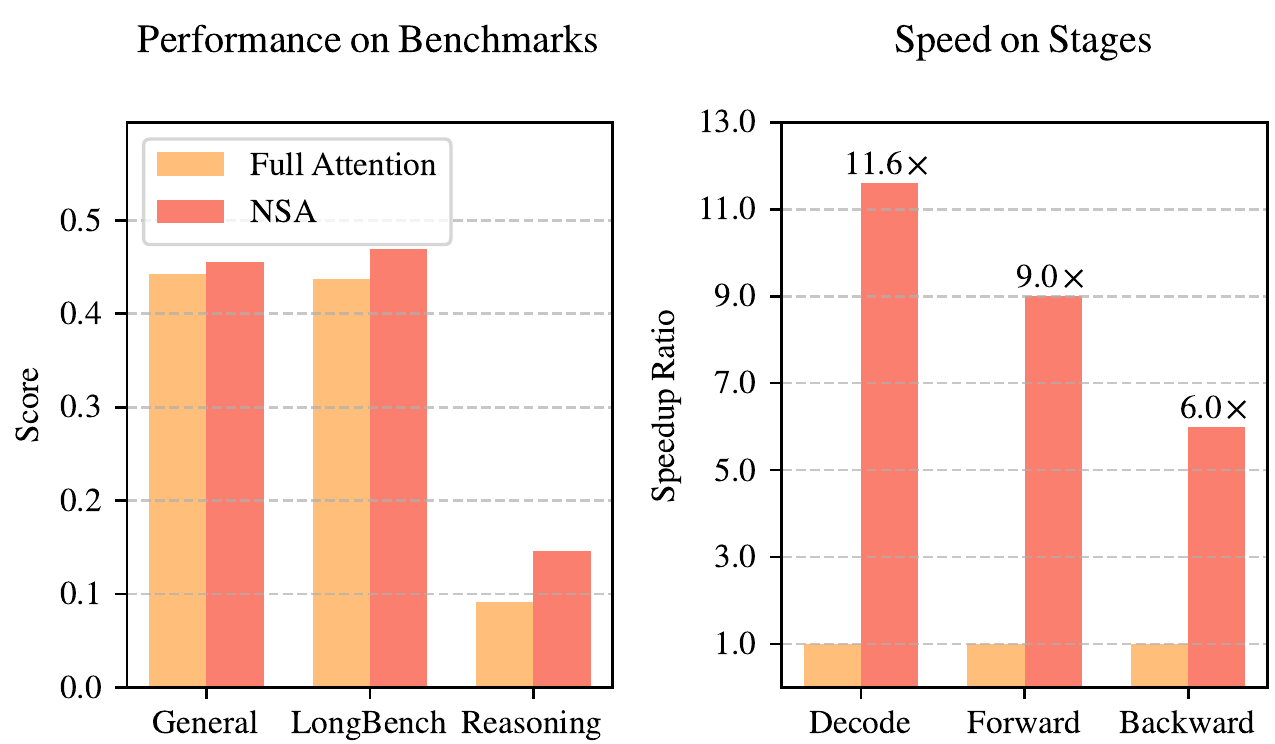
그림 1 | 전체 어텐션 모델과 우리의 NSA 간의 성능 및 효율성 비교. 왼쪽: 희소함에도 불구하고, NSA는 일반 벤치마크, 긴 문맥 작업 및 추론 평가 전반에서 평균적으로 전체 어텐션 기준선을 능가합니다. 오른쪽: 64k 길이 시퀀스 처리에 있어, NSA는 디코딩, 순방향 전파 및 역방향 전파의 모든 단계에서 전체 어텐션 대비 상당한 계산 속도 향상을 달성합니다. 지연 시간 병목으로 부상합니다. 이론적 추정에 따르면, 64k 길이 문맥을 디코딩할 때 softmax 아키텍처를 사용한 어텐션 계산이 전체 지연 시간의 를 차지하며, 이는 더 효율적인 어텐션 메커니즘의 긴급한 필요성을 강조합니다.
효율적인 긴 문맥 모델링을 위한 자연스러운 접근 방식은 softmax 어텐션의 내재적 희소성(Ge et al., 2023; Jiang et al., 2023)을 활용하는 것이며, 여기서 중요한 쿼리-키 쌍을 선택적으로 계산하면 성능을 보존하면서 계산 오버헤드를 크게 줄일 수 있습니다. 최근의 진전은 다양한 전략을 통해 이러한 잠재력을 입증합니다: KV- 캐시 제거 방법(Li et al., 2024; Zhang et al., 2023b; Zhou et al., 2024), 블록 단위 KV- 캐시 선택 방법(Gao et al., 2024; Tang et al., 2024; Xiao et al., 2024a), 그리고 샘플링, 클러스터링 또는 해싱 기반 선택 방법(Chen et al., 2024b; Desai et al., 2024; Liu et al., 2024)이 그것입니다. 이러한 유망한 전략에도 불구하고, 기존의 희소 어텐션 방법들은 실제 배포에서 종종 부족함을 보입니다. 많은 접근 방식이 이론적 이득에 필적하는 속도 향상을 달성하지 못하며, 더욱이 대부분의 방법은 어텐션의 희소성 패턴을 완전히 활용하기 위한 효과적인 학습 시점 지원을 갖추지 못합니다.
이러한 한계를 해결하기 위해, 효과적인 희소 어텐션의 배포는 두 가지 핵심 과제를 해결해야 합니다: (1) 하드웨어 정렬 추론 속도 향상: 이론적 계산 감소를 실제 속도 향상으로 전환하려면 프로파일링 및 디코딩 단계 모두에서 메모리 접근 및 하드웨어 스케줄링 병목을 완화하기 위한 하드웨어 친화적 알고리즘 설계가 필요합니다; (2) 학습 인식 알고리즘 설계: 모델 성능을 유지하면서 학습 비용을 줄이기 위해 학습 가능한 연산자를 통한 종단 간 계산을 가능하게 하는 것입니다. 이러한 요구 사항은 빠른 긴 문맥 추론 또는 학습을 달성하기 위한 실제 응용에 중요합니다. 두 측면을 모두 고려할 때, 기존 방법들은 여전히 눈에 띄는 격차를 보입니다.
보다 효과적이고 효율적인 희소 어텐션을 달성하기 위해, 우리는 계층적 토큰 모델링을 통합한 네이티브 학습 가능 희소 어텐션 아키텍처인 NSA를 제시합니다. 그림 2에 나타난 바와 같이, NSA는 키와 값을 시간적 블록으로 구성하고 세 가지 어텐션 경로를 통해 처리함으로써 쿼리당 계산을 줄입니다: 압축된 거친 단위 토큰, 선택적으로 유지된 세밀한 단위 토큰, 그리고 국소 문맥 정보를 위한 슬라이딩 윈도우입니다. 그런 다음
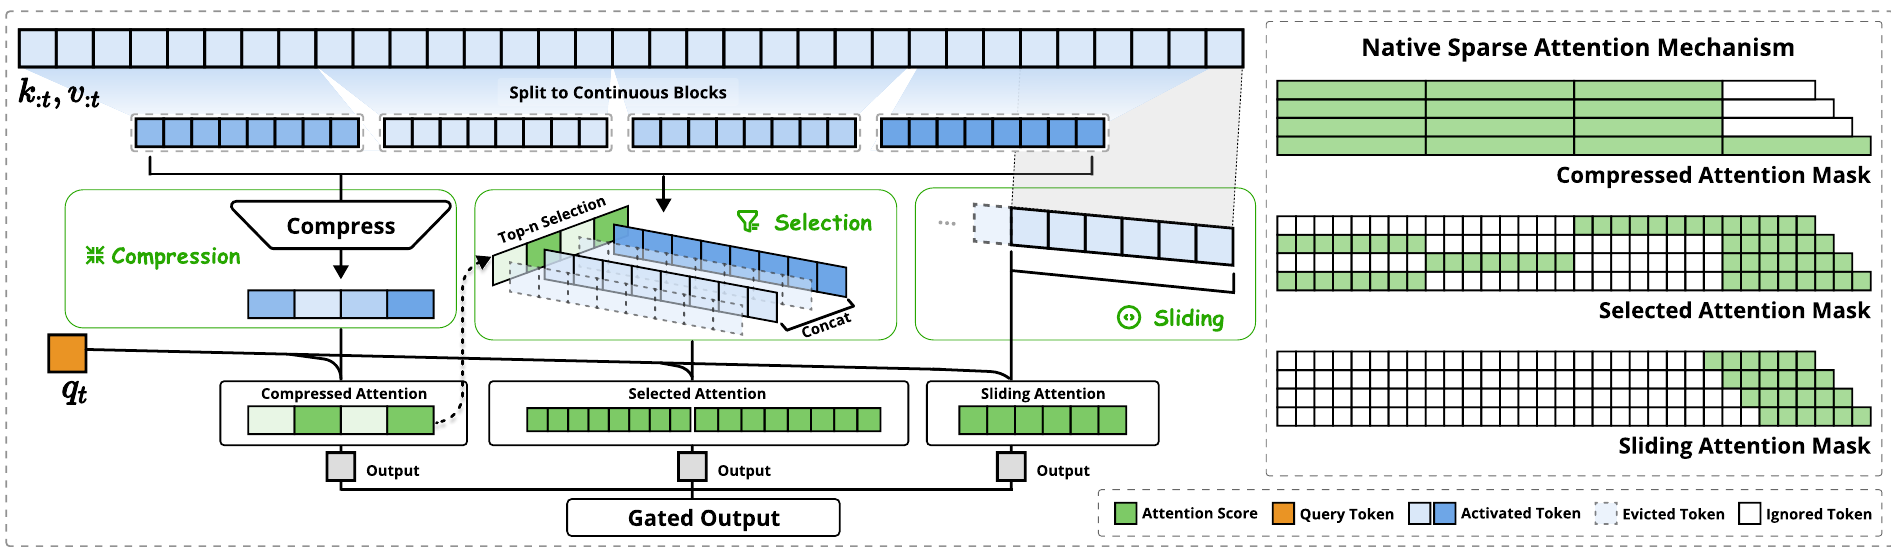
우리는 실제 효율성을 극대화하기 위해 특수화된 커널을 구현합니다. NSA는 위의 핵심 요구 사항에 대응하는 두 가지 핵심 혁신을 도입합니다: (1) 하드웨어 정렬 시스템: Tensor Core 활용 및 메모리 접근을 위해 블록 단위 희소 어텐션을 최적화하여 균형 잡힌 산술 강도를 보장합니다. (2) 학습 인식 설계: 효율적인 알고리즘과 역방향 연산자를 통해 안정적인 종단 간 학습을 가능하게 합니다. 이러한 최적화는 NSA가 효율적인 배포와 종단 간 학습을 모두 지원할 수 있게 합니다.
우리는 실제 언어 코퍼스에 대한 포괄적인 실험을 통해 NSA를 평가합니다. 260B 토큰으로 27B 매개변수 트랜스포머 백본을 사전 학습하여, 우리는 일반 언어 평가, 긴 문맥 평가 및 사고의 연쇄 추론 평가 전반에 걸쳐 NSA의 성능을 평가합니다. 우리는 또한 최적화된 Triton(Tillet et al., 2019) 구현과 함께 A100 GPU에서의 커널 속도를 비교합니다. 실험 결과는 NSA가 전체 어텐션 기준선과 동등하거나 우수한 성능을 달성하면서 기존 희소 어텐션 접근 방식을 능가함을 보여줍니다. 또한, NSA는 전체 어텐션 대비 디코딩, 순방향 및 역방향 단계 전반에 걸쳐 상당한 속도 향상을 제공하며, 속도 향상 비율은 더 긴 시퀀스에서 증가합니다. 이러한 결과는 우리의 계층적 희소 어텐션 설계가 모델 능력과 계산 효율성을 효과적으로 균형 잡음을 입증합니다.
2. 희소 어텐션 방법 재고
현대의 희소 어텐션 방법들은 트랜스포머 모델의 이론적 계산 복잡도를 줄이는 데 상당한 진전을 이루었습니다. 그러나 대부분의 접근 방식은 주로 추론 중에 희소성을 적용하면서 사전 학습된 전체 어텐션 백본을 유지하며, 이는 잠재적으로 아키텍처 편향을 도입하여 희소 어텐션의 이점을 완전히 활용하는 능력을 제한할 수 있습니다. 우리의 네이티브 희소 아키텍처를 소개하기 전에, 우리는 두 가지 중요한 관점을 통해 이러한 한계를 체계적으로 분석합니다.
2.1. 효율적 추론의 환상
어텐션 계산에서 희소성을 달성함에도 불구하고, 많은 방법들은 주로 두 가지 과제로 인해 추론 지연 시간에서 상응하는 감소를 달성하지 못합니다:
단계 제한적 희소성. H2O(Zhang et al., 2023b)와 같은 방법들은 자기회귀 디코딩 중에 희소성을 적용하면서 프로파일링 중에 계산 집약적인 전처리(예: 어텐션 맵 계산, 인덱스 구축)를 요구합니다. 대조적으로, MInference(Jiang et al., 2024)와 같은 접근 방식은 프로파일링 희소성에만 초점을 맞춥니다. 이러한 방법들은 모든 추론 단계에서 가속을 달성하지 못하는데, 적어도 한 단계는 전체 어텐션에 필적하는 계산 비용으로 남아 있기 때문입니다. 단계 특수화는 책 요약 및 코드 완성과 같은 프로파일링 주도 워크로드, 또는 긴 사고의 연쇄(Wei et al., 2022) 추론과 같은 디코딩 주도 워크로드에서 이러한 방법들의 속도 향상 능력을 감소시킵니다.
고급 어텐션 아키텍처와의 비호환성. 일부 희소 어텐션 방법들은 다중 쿼리 어텐션(MQA)(Shazeer, 2019) 및 그룹화된 쿼리 어텐션(GQA)(Ainslie et al., 2023)과 같은 현대의 디코딩 효율적 아키텍처에 적응하지 못하며, 이들은 여러 쿼리 헤드에 걸쳐 KV를 공유함으로써 디코딩 중 메모리 접근 병목을 크게 줄입니다. 예를 들어, Quest(Tang et al., 2024)와 같은 접근 방식에서 각 어텐션 헤드는 독립적으로 자신의 KV- 캐시 부분 집합을 선택합니다. 다중 헤드 어텐션(MHA) 모델에서 일관된 계산 희소성과 메모리 접근 희소성을 보여주지만, GQA와 같은 아키텍처 기반 모델에서는 KV- 캐시의 메모리 접근량이 동일한 GQA 그룹 내 모든 쿼리 헤드의 선택들의 합집합에 해당하는 다른 시나리오를 제시합니다. 이러한 아키텍처 특성은 이러한 방법들이 계산 연산을 줄일 수 있지만, 필요한 KV- 캐시 메모리 접근은 상대적으로 높게 유지된다는 것을 의미합니다. 이러한 한계는 중요한 선택을 강제합니다: 일부 희소 어텐션 방법들은 계산을 줄이지만, 그들의 분산된 메모리 접근 패턴은 고급 아키텍처의 효율적인 메모리 접근 설계와 충돌합니다.
이러한 한계는 많은 기존 희소 어텐션 방법들이 KV- 캐시 감소 또는 이론적 계산 감소에 초점을 맞추지만, 고급 프레임워크 또는 백엔드에서 상당한 지연 시간 감소를 달성하는 데 어려움을 겪기 때문에 발생합니다. 이는 우리가 모델 효율성을 향상시키기 위해 희소성을 완전히 활용하도록 고급 아키텍처와 하드웨어 효율적 구현을 모두 결합한 알고리즘을 개발하도록 동기를 부여합니다.
2.2. 학습 가능한 희소성의 신화
我们追求原生可训练稀疏注意力的动机,源于对仅推理方法分析中的两个关键洞见:(1) 性能退化:事后施加稀疏性迫使模型偏离其预训练的优化轨迹。如 Chen 等人(2024b)所证明,前 的注意力仅能覆盖总注意力分数的 ,使得预训练模型中的检索头等结构在推理过程中易受剪枝影响。(2) 训练效率需求:高效处理长序列训练对现代 LLM 开发至关重要。这既包括在更长文档上进行预训练以增强模型能力,也包括随后的适应阶段,如长上下文微调和强化学习。然而,现有的稀疏注意力方法主要面向推理,训练中的计算挑战在很大程度上仍未得到解决。这一局限阻碍了通过高效训练开发能力更强的长上下文模型。此外,将现有稀疏注意力适配于训练的尝试也暴露出诸多挑战:
不可训练组件。ClusterKV(Liu 等人,2024)(包含 k-means 聚类)和 MagicPIG(Chen 等人,2024b)(包含基于 SimHash 的选择)等方法中的离散操作在计算图中造成不连续。这些不可训练组件阻止了梯度流经 token 选择过程,限制了模型学习最优稀疏模式的能力。
低效的反向传播。一些理论上可训练的稀疏注意力方法在实际训练中存在效率低下的问题。HashAttention(Desai 等人,2024)等方法中使用的 token 粒度选择策略导致在注意力计算期间需要从 KV 缓存中加载大量单独 token。这种非连续内存访问妨碍了 FlashAttention 等快速注意力技术的有效适配,后者依赖连续内存访问和分块计算来实现高吞吐量。结果,实现被迫退回到低硬件利用率,显著降低了训练效率。
2.3. 原生稀疏性作为必然要求
推理效率和训练可行性方面的这些局限,促使我们对稀疏注意力机制进行根本性重新设计。我们提出 NSA,一个原生稀疏注意力框架,同时解决计算效率和训练需求。在以下各节中,我们详述 NSA 的算法设计和算子实现。
3. 方法
우리의 기술적 접근은 알고리즘 설계와 커널 최적화에 걸쳐 있습니다. 다음 하위 절들에서 우리는 먼저 우리 방법론의 배경을 소개합니다. 그런 다음 NSA의 전체 프레임워크를 제시하고, 이어서 그 핵심 알고리즘 구성요소들을 제시합니다. 마지막으로 실용적 효율성을 극대화하는 하드웨어 최적화 커널 설계를 상세히 설명합니다.
3.1. 배경
어텐션 메커니즘은 언어 모델링에서 널리 사용되며, 각 쿼리 토큰 가 모든 선행 키 에 대한 관련성 점수를 계산하여 값 의 가중합을 생성합니다. 형식적으로, 길이 의 입력 시퀀스에 대해 어텐션 연산은 다음과 같이 정의됩니다:
여기서 Attn은 어텐션 함수를 나타냅니다:
여기서 는 와 사이의 어텐션 가중치를 나타내며, 는 키의 특징 차원입니다. 시퀀스 길이가 증가함에 따라, 어텐션 계산은 전체 계산 비용에서 점점 더 지배적으로 되어, 긴 컨텍스트 처리에 상당한 도전 과제를 제시합니다.
산술 강도(Arithmetic Intensity)는 연산 대 메모리 접근의 비율입니다. 이는 본질적으로 하드웨어에서의 알고리즘 최적화를 형성합니다. 각 GPU는 피크 연산 능력과 메모리 대역폭에 의해 결정되는 임계 산술 강도를 가지며, 이 두 하드웨어 한계의 비율로 계산됩니다. 계산 작업의 경우, 이 임계값을 초과하는 산술 강도는 연산 바운드(GPU FLOPS에 의해 제한됨)가 되며, 그 이하에서는 메모리 바운드(메모리 대역폭에 의해 제한됨)가 됩니다.
특히 인과적 자기 어텐션 메커니즘의 경우, 훈련 및 프로파일링 단계 동안 배치 행렬 곱셈과 어텐션 계산은 높은 산술 강도를 보여, 이러한 단계들을 현대 가속기에서 연산 바운드로 만듭니다. 반대로, 자기회귀 디코딩은 순방향 패스당 하나의 토큰을 생성하면서 전체 키-값 캐시를 로드해야 하므로 낮은 산술 강도를 초래하여 메모리 대역폭 제약을 받게 됩니다.이는 서로 다른 최적화 목표로 이어집니다 — 훈련 및 프리필링 동안에는 계산 비용을 줄이고, 디코딩 동안에는 메모리 접근을 줄이는 것입니다.
3.2. 전체 프레임워크
자연스러운 희소 패턴을 가진 어텐션의 잠재력을 활용하기 위해, 우리는 각 쿼리 에 대해 방정식 (1)의 원래 키-값 쌍 를 더 간결하고 정보 밀도가 높은 표현 키-값 쌍 로 대체할 것을 제안합니다. 구체적으로, 우리는 최적화된 어텐션 출력을 다음과 같이 형식적으로 정의합니다:
여기서 는 현재 쿼리 와 컨텍스트 메모리 를 기반으로 동적으로 구성됩니다. 우리는 다양한 매핑 전략을 설계하여 의 서로 다른 범주를 얻고, 다음과 같이 이들을 결합할 수 있습니다:
그림 2에 예시된 바와 같이, NSA는 세 가지 매핑 전략 을 가지며, 이는 키와 값에 대한 압축, 선택, 슬라이딩 윈도우를 나타냅니다. 은 해당 전략 에 대한 게이트 점수로, MLP와 시그모이드 활성화를 통해 입력 특징으로부터 도출됩니다. 를 재매핑된 키/값의 총 수라고 합시다:
우리는 를 보장함으로써 높은 희소성 비율을 유지합니다.
3.3. 알고리즘 설계
이 하위 절에서, 우리는 재매핑 전략 와 의 설계를 소개합니다: 토큰 압축, 토큰 선택, 그리고 슬라이딩 윈도우.
3.3.1. 토큰 압축
키 또는 값의 순차적 블록들을 블록 수준 표현으로 집계함으로써, 우리는 전체 블록의 정보를 포착하는 압축된 키와 값을 얻습니다. 형식적으로, 압축된 키 표현은 다음과 같이 정의됩니다:
여기서 은 블록 길이, 는 인접 블록 간의 슬라이딩 스트라이드, 는 블록 내 위치 인코딩을 가진 학습 가능한 MLP로, 블록 내의 키들을 단일 압축 키로 매핑합니다. 는 압축 키로 구성된 텐서입니다. 일반적으로, 우리는 정보 분절을 완화하기 위해 을 채택합니다. 압축된 값 표현 에 대해서도 유사한 공식이 성립합니다. 압축된 표현은 더 거친 수준의 상위 수준 의미 정보를 포착하고 어텐션의 계산 부담을 줄입니다.
3.3.2. 토큰 선택
압축된 키만 사용하면, 값은 중요한 세밀한 정보를 잃을 수 있으며, 이는 우리가 개별 키, 값을 선택적으로 보존하도록 동기를 부여합니다. 아래에서 우리는 낮은 계산 오버헤드로 가장 관련성 높은 토큰을 식별하고 보존하는 효율적인 토큰 선택 메커니즘을 설명합니다.
블록 단위 선택. 우리의 선택 전략은 두 가지 핵심 요인에 의해 동기 부여되어, 키와 값 시퀀스를 공간적으로 연속적인 블록으로 처리합니다: 하드웨어 효율성 고려 사항과 어텐션 점수의 내재적 분포 패턴입니다. 블록 단위 선택은 현대 GPU에서 효율적인 계산을 달성하는 데 중요합니다. 그 이유는 현대 GPU 아키텍처가 무작위 인덱스 기반 읽기에 비해 연속 블록 접근에 대해 현저히 높은 처리량을 보이기 때문입니다. 또한, 블록 단위 계산은 Tensor Core의 최적 활용을 가능하게 합니다. 이러한 아키텍처 특성은 FlashAttention의 블록 기반 설계에서 예시된 바와 같이, 블록 단위 메모리 접근과 계산을 고성능 어텐션 구현의 근본 원칙으로 확립했습니다. 블록 단위 선택은 어텐션 점수의 내재적 분포 패턴을 따릅니다. 선행 연구(Jiang et al., 2024)는 어텐션 점수가 종종 공간적 연속성을 보이며, 이는 인접한 키들이 유사한 중요도 수준을 공유하는 경향이 있음을 시사합니다. 섹션 6.2의 우리의 시각화도 이 공간적 연속 패턴을 보여줍니다.
블록 단위 선택을 구현하기 위해, 우리는 먼저 키, 값 시퀀스를 선택 블록으로 나눕니다. 어텐션 계산에 가장 중요한 블록을 식별하기 위해, 우리는 각 블록에 중요도 점수를 할당해야 합니다. 아래에서 우리는 이러한 블록 수준 중요도 점수를 계산하는 방법을 제시합니다.
중요도 점수 계산. 블록 중요도 점수를 계산하는 것은 상당한 오버헤드를 초래할 수 있습니다. 다행히도, 압축 토큰의 어텐션 계산은 우리가 선택 블록 중요도 점수를 유도하는 데 활용할 수 있는 중간 어텐션 점수를 생성하며, 이는 다음과 같이 공식화됩니다:
여기서 는 와 압축 키 사이의 어텐션 점수이다. 을 선택 블록 크기라고 하자. 압축 블록과 선택 블록이 동일한 블로킹 방식을 공유하는 경우, 즉 인 경우, 우리는 선택 블록 중요도 점수 를 로부터 직접적으로 얻을 수 있다. 블로킹 방식이 다른 경우에는 선택 블록의 중요도 점수를 이들의 공간적 관계에 따라 도출한다. , , 이 주어졌을 때, 다음을 얻는다:
여기서 는 벡터 원소에 접근하기 위한 인덱싱 연산자를 나타낸다. 키-값 캐시가 쿼리 헤드들에 걸쳐 공유되는 GQA 또는 MQA를 사용하는 모델의 경우, 디코딩 중 KV 캐시 로딩을 최소화하기 위해 이러한 헤드들에 걸쳐 일관된 블록 선택이 보장되어야 한다. 그룹 내 헤드들에 걸쳐 공유되는 중요도 점수는 다음과 같이 형식적으로 정의된다:
여기서 위첨자의 는 헤드 인덱스를 나타내고, 는 각 그룹 내 쿼리 헤드의 수이다. 이 집계는 동일 그룹 내 헤드들에 걸쳐 일관된 블록 선택을 보장한다.
Top-n 블록 선택. 선택 블록 중요도 점수를 얻은 후, 우리는 블록 중요도 점수로 순위가 매겨진 상위 n개의 희소 블록 내의 토큰들을 유지하며, 이는 다음과 같이 공식화된다:
여기서 rank 는 내림차순 순위 위치를 나타내며, rank 은 가장 높은 점수에 해당하고, 는 선택된 블록들의 인덱스 집합이며, Cat은 연결 연산을 나타낸다. 는 압축 키들로 구성된 텐서이다. 세밀한 값 에도 유사한 공식이 적용된다. 선택된 키와 값은 이후 방정식 (5)에서 정의된 바와 같이 와의 어텐션 계산에 참여한다.
3.3.3. 슬라이딩 윈도우
어텐션 메커니즘에서 지역 패턴은 일반적으로 더 빠르게 적응하며 학습 과정을 지배할 수 있고, 이로 인해 모델이 압축 및 선택 토큰으로부터 효과적으로 학습하는 것을 잠재적으로 방해할 수 있다. 이 문제를 해결하기 위해, 우리는 지역 문맥을 명시적으로 처리하는 전용 슬라이딩 윈도우 브랜치를 도입하여, 다른 브랜치들(압축 및 선택)이 지역 패턴에 의해 지름길 학습(shortcut)되지 않고 각자의 특징을 학습하는 데 집중할 수 있도록 한다. 구체적으로, 우리는 윈도우 내에서 최근 토큰 을 유지하고, 서로 다른 정보 소스(압축 토큰, 선택된 토큰, 슬라이딩 윈도우)의 어텐션 계산을 별도의 브랜치로 분리한다. 이 브랜치 출력들은 이후 학습된 게이팅 메커니즘을 통해 집계된다. 미미한 계산 오버헤드로 어텐션 브랜치 간의 지름길 학습을 추가로 방지하기 위해, 우리는 세 브랜치에 대해 독립적인 키와 값을 제공한다. 이러한 아키텍처 설계는 지역 패턴 인식과 장거리 패턴 인식 사이의 그래디언트 간섭을 방지하여 최소한의 오버헤드만 도입하면서 안정적인 학습을 가능하게 한다.
세 범주의 키와 값 을 모두 얻은 후, 우리는 수식 (5)에 따라 최종 어텐션 출력을 계산한다. 위에서 설명한 압축, 선택, 슬라이딩 윈도우 메커니즘과 함께, 이는 NSA의 완전한 알고리즘 프레임워크를 구성한다.
3.4. 커널 설계
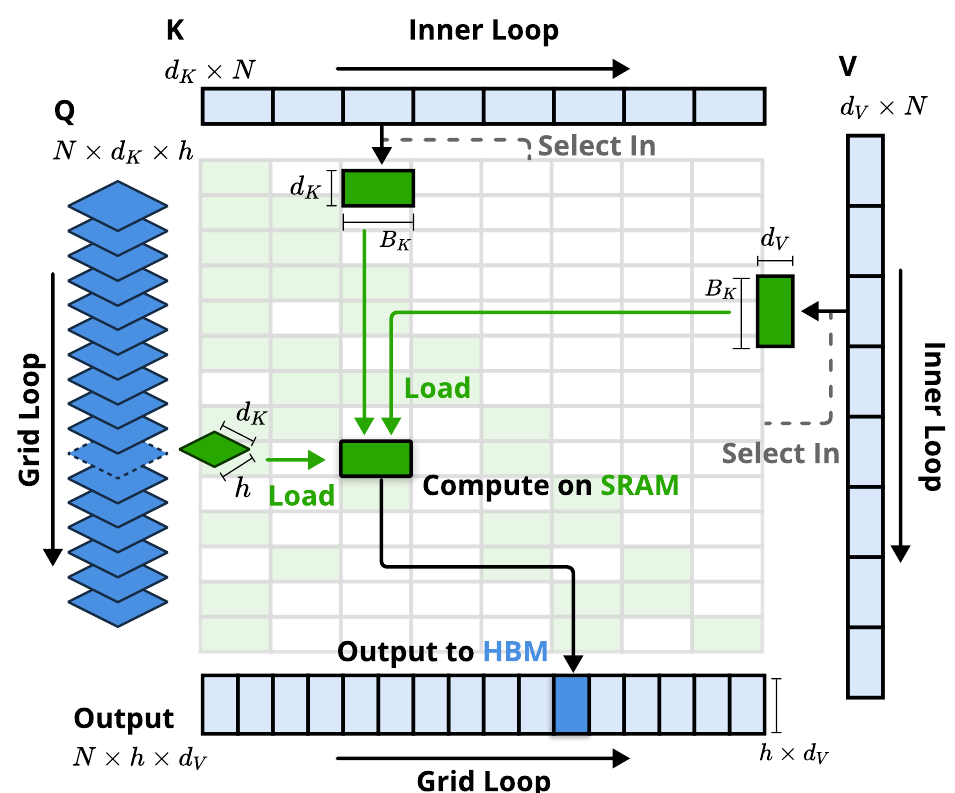
학습 및 프로파일링 동안 FlashAttention 수준의 속도 향상을 달성하기 위해, 우리는 Triton 상에서 하드웨어 정렬된 희소 어텐션 커널을 구현한다. MHA는 메모리 집약적이고 디코딩에 비효율적이므로, 우리는 현재의 최첨단 LLM들을 따라 GQA 및 MQA와 같이 KV 캐시를 공유하는 아키텍처에 초점을 맞춘다. 압축 및 슬라이딩 윈도우 어텐션 계산은 기존 FlashAttention-2 커널과 쉽게 호환되지만, 우리는 희소 선택 어텐션을 위한 특화된 커널 설계를 도입한다. 만약 우리가 시간적으로 연속된 쿼리 블록을 SRAM에 로드하는 FlashAttention의 전략을 따랐다면, 블록 내의 쿼리들이 서로 분리된 KV 블록을 필요로 할 수 있기 때문에 비효율적인 메모리 접근이 초래될 것이다. 이를 해결하기 위해, 우리의 핵심 최적화는 다른 쿼리 그룹화 전략에 있다. 즉, 쿼리 시퀀스의 각 위치에 대해, 우리는 GQA 그룹 내의 모든 쿼리 헤드들(동일한 희소 KV 블록을 공유함)을 SRAM에 로드한다. 그림 3은 우리의 순방향 패스 구현을 보여준다. 제안된 커널 아키텍처는 다음과 같은 핵심 특징을 가진다:
1. 그룹 중심 데이터 로딩(Group-Centric Data Loading). 각 내부 루프에서, 위치 에 있는 그룹 내 모든 헤드의 쿼리 와 그들이 공유하는 희소 키/값 블록 인덱스 를 로드한다.
2. 공유 KV 페칭(Shared KV Fetching). 내부 루프에서, 메모리 로딩을 최소화하기 위해 에 의해 인덱싱된 연속적인 키/값 블록들을 , 로서 순차적으로 SRAM에 로드하며, 여기서 는 를 만족하는 커널 블록 크기이다.
3. 그리드 상의 외부 루프(Outer Loop on Grid). 내부 루프 길이(선택된 블록 수 에 비례함)가 서로 다른 쿼리 블록에 대해 거의 동일하게 유지되므로, 우리는 쿼리/출력 루프를 Triton의 그리드 스케줄러에 배치하여 커널을 단순화하고 최적화한다.
이 설계는 (1) 그룹 단위 공유를 통해 중복된 KV 전송을 제거하고, (2) GPU 스트리밍 멀티프로세서 간의 연산 부하를 균형 있게 분배함으로써 거의 최적에 가까운 산술 집약도를 달성한다.
4. 실험
우리는 NSA를 세 가지 관점에서 평가한다: (1) 일반 벤치마크 성능, (2) 장문맥 벤치마크 성능, (3) 사고 연쇄 추론 성능이며, Full Attention 베이스라인 및 최첨단 희소 어텐션 방법들과 비교한다. 우리의 희소 계산 패러다임에 대한 효율성 분석은 학습 및 추론 속도에 관한 상세한 논의를 제공하는 5장으로 미룬다.
4.1. 사전학습 설정
최첨단 LLM들의 일반적인 관행을 따라, 우리의 실험은 Grouped-Query Attention(GQA)과 Mixture-of-Experts(MoE)를 결합한 백본을 채택하며, 총 27B 파라미터에 활성 파라미터 3B를 가진다. 모델은 은닉 차원이 2560인 30개 층으로 구성된다. GQA의 경우, 그룹 수를 4로 설정하고, 총 64개의 어텐션 헤드를 둔다. 각 헤드에 대해, 쿼리, 키, 값의 은닉 차원은 각각 및 로 구성된다. MoE의 경우, 우리는 DeepSeekMoE (Dai et al., 2024; DeepSeek-AI, 2024) 구조를 활용하며, 72개의 라우팅된 전문가와 2개의 공유 전문가를 두고, top-k 전문가를 6으로 설정한다. 학습 안정성을 보장하기 위해, 첫 번째 층의 MoE는 SwiGLU 형태의 MLP로 대체된다.
| 모델 | MMLU 정확도 5-shot | MMLU-PRO 정확도 5-shot | CMMLU 정확도 5-shot | BBH 정확도 3-shot | GSM8K 정확도 8-shot | MATH 정확도 4-shot | DROP F1 1-shot | MBPP Pass@1 3-shot | HumanEval Pass@1 0-shot | 평균 |
| Full Attn | 0.567 | 0.279 | 0.576 | 0.497 | 0.486 | 0.263 | 0.503 | 0.482 | 0.335 | 0.443 |
| NSA | 0.565 | 0.286 | 0.587 | 0.521 | 0.520 | 0.264 | 0.545 | 0.466 | 0.348 | 0.456 |
표 1 | 지식(MMLU, MMLU-PRO, CMMLU), 추론(BBH, GSM8K, MATH, DROP), 코딩(MBPP, HumanEval) 과제에 걸친 일반 벤치마크에서 Full Attention 베이스라인과 NSA의 사전학습 성능 비교. NSA는 높은 희소성에도 불구하고 대부분의 벤치마크에서 우수한 평균 성능을 달성한다.
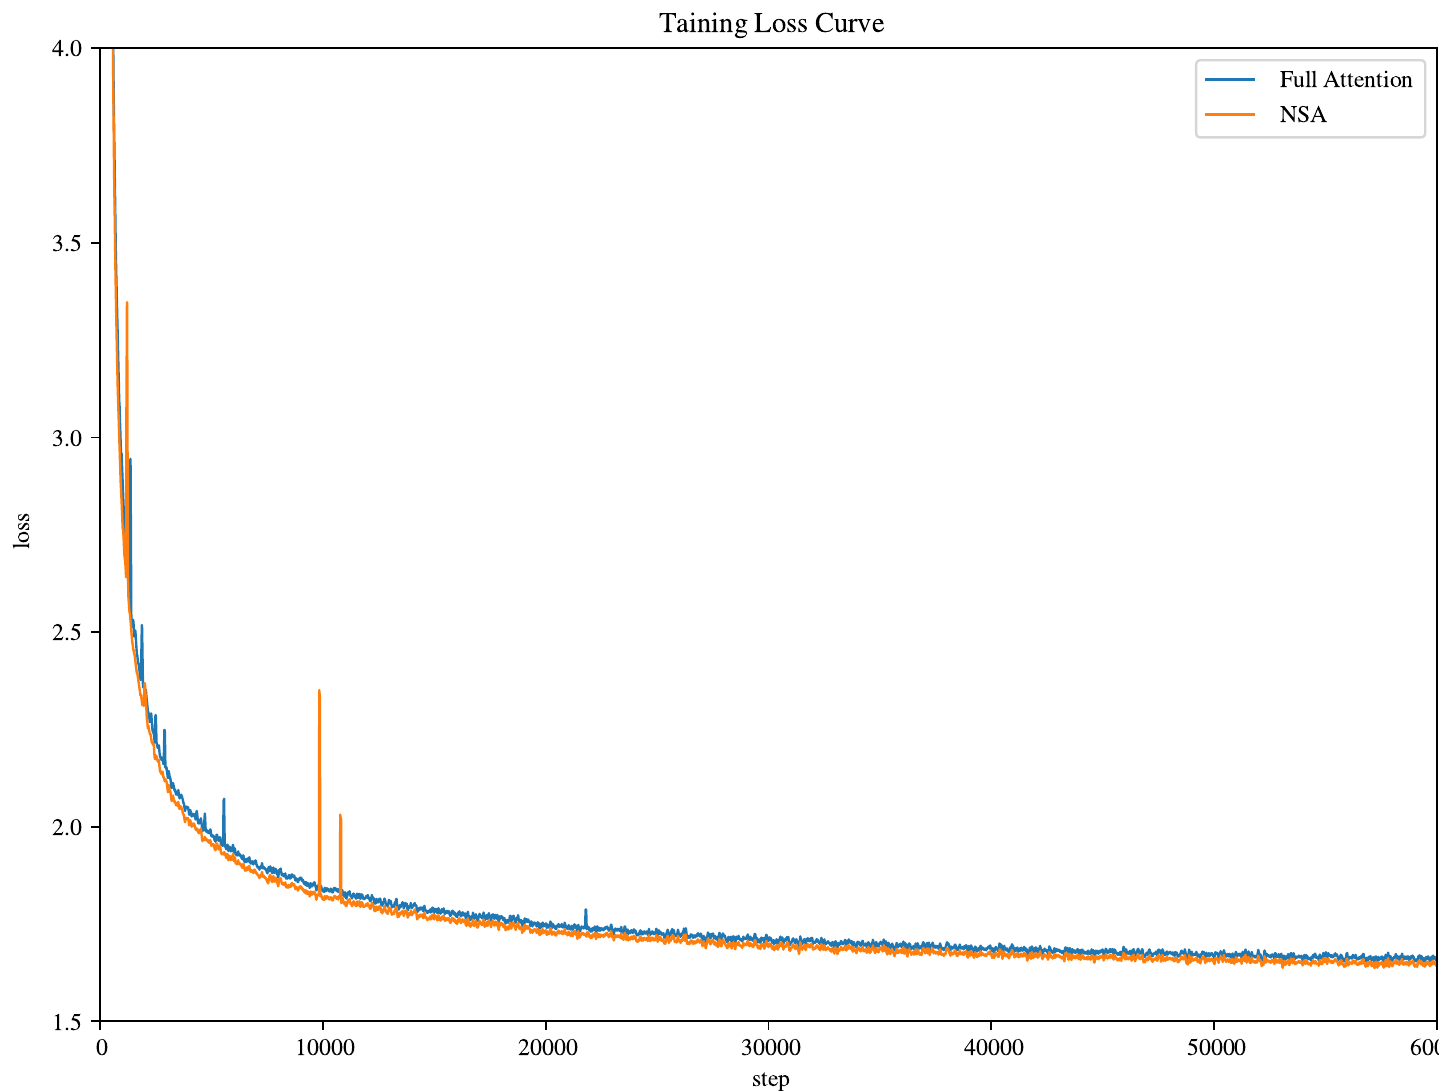
제안된 아키텍처는 계산 비용과 모델 성능 사이에서 효과적인 절충을 달성한다. NSA의 경우, 우리는 압축 블록 크기 , 슬라이딩 스트라이드 , 선택 블록 크기 , 선택 블록 수 (초기 블록 1개와 지역 블록 2개를 고정적으로 활성화하는 것을 포함), 그리고 슬라이딩 윈도우 크기 를 설정한다. Full Attention과 희소 어텐션 모델 모두 8k 길이 텍스트의 270B 토큰으로 사전학습된 후, YaRN (Peng et al., 2024)을 사용하여 32k 길이 텍스트에 대한 지속 학습과 지도 미세조정을 통해 장문맥 적응을 달성한다. 두 모델 모두 공정한 비교를 보장하기 위해 완전한 수렴까지 학습된다. 그림 4에서 볼 수 있듯이, 우리의 NSA와 Full Attention 베이스라인의 사전학습 손실 곡선은 안정적이고 매끄러운 감소를 보이며, NSA가 Full Attention 모델을 지속적으로 능가한다.
4.2. 베이스라인 방법
Full Attention과의 비교에 더하여, 우리는 여러 최첨단 추론 단계 희소 어텐션 방법들인 H2O (Zhang et al., 2023b), infLLM (Xiao et al., 2024a), Quest (Tang et al., 2024), 그리고 Exact-Top을 평가한다. Exact-Top은 먼저 전체 어텐션 점수를 계산하고 각 쿼리에 대응하는 상위 개 점수의 키를 선택한 다음, 이 위치들에 대해 어텐션을 계산한다. 이러한
| 모델 | SQA | MQA | Synthetic | Code LCC | Avg. | ||||||
| MFQA-en | MFQA-zh | Qasper | HPQ | 2Wiki | GovRpt | Dur | PassR-en | PassR-zh | |||
| H2O | 0.428 | 0.429 | 0.308 | 0.112 | 0.101 | 0.231 | 0.208 | 0.704 | 0.421 | 0.092 | 0.303 |
| InfLLM | 0.474 | 0.517 | 0.356 | 0.306 | 0.250 | 0.277 | 0.257 | 0.766 | 0.486 | 0.143 | 0.383 |
| Quest | 0.495 | 0.561 | 0.365 | 0.295 | 0.245 | 0.293 | 0.257 | 0.792 | 0.478 | 0.135 | 0.392 |
| Exact-Top | 0.502 | 0.605 | 0.397 | 0.321 | 0.288 | 0.316 | 0.291 | 0.810 | 0.548 | 0.156 | 0.423 |
| Full Attn | 0.512 | 0.623 | 0.409 | 0.350 | 0.305 | 0.324 | 0.294 | 0.830 | 0.560 | 0.163 | 0.437 |
| NSA | 0.503 | 0.624 | 0.432 | 0.437 | 0.356 | 0.307 | 0.341 | 0.905 | 0.550 | 0.232 | 0.469 |
표 2 | 단일 문서 QA, 다중 문서 QA, 합성 및 코드 과제 범주의 하위 집합을 포함한 LongBench에서 우리의 NSA와 베이스라인 간의 성능 비교. NSA는 Full Attention을 포함한 대부분의 베이스라인을 능가했다. 방법들은 KV 캐시 축출, 쿼리 인식 선택, 정확한 top- 희소 선택 등 다양한 희소 어텐션 패러다임에 걸쳐 있다.
대부분의 샘플 길이가 희소 어텐션 베이스라인의 지역 문맥 윈도우 내에 있는 일반 평가에서는, 이러한 방법들이 사실상 Full Attention과 동등하다. 따라서 우리는 이 설정에서 NSA와 Full Attention 베이스라인 간의 비교 결과만을 제시한다. 장문맥 평가에서는 모든 베이스라인 방법에 걸쳐 비교를 수행하며, 공정한 비교를 보장하기 위해 모든 희소 어텐션 방법의 희소성을 동일하게 설정한다. 장문 지도 미세조정을 필요로 하는 사고 연쇄 추론 평가에서는 희소 어텐션 베이스라인이 학습을 지원하지 않으므로, 우리는 비교를 Full Attention으로 제한한다.
4.3. 성능 비교
일반 평가. 우리는 사전학습된 NSA와 Full Attention 베이스라인을 지식, 추론, 코딩 능력에 걸친 포괄적인 벤치마크 모음에서 평가했으며, 여기에는 MMLU (Hendrycks et al., 2020), MMLU-PRO (Wang et al., 2024), CMMLU (Li et al., 2023), BBH (Suzgun et al., 2022), GSM8K (Cobbe et al., 2021), MATH (Hendrycks et al., 2020), DROP (Dua et al., 2019), MBPP (Austin et al., 2021), 그리고 HumanEval (Chen et al., 2021)이 포함된다. 결과는 표 1에 나타나 있다. 희소성에도 불구하고, NSA는 우수한 전반적 성능을 달성하여, 9개 지표 중 7개에서 Full Attention을 포함한 모든 베이스라인을 능가한다. 이는 NSA가 더 짧은 시퀀스에서 효율성 이점을 충분히 활용하지 못할 수 있음에도 불구하고 강력한 성능을 보임을 나타낸다. 특히, NSA는 추론 관련 벤치마크에서 상당한 이득(DROP: , GSM8K: )을 보이며, 이는 우리의 사전학습이 모델이 특화된 어텐션 메커니즘을 발전시키도록 돕는다는 것을 시사한다. 이 희소 어텐션 사전학습 메커니즘은 모델이 가장 중요한 정보에 집중하도록 강제하며, 관련 없는 어텐션 경로의 잡음을 걸러냄으로써 잠재적으로 성능을 향상시킨다. 다양한 평가에 걸친 일관된 성능은 또한 NSA가 범용 아키텍처로서 견고함을 입증한다.
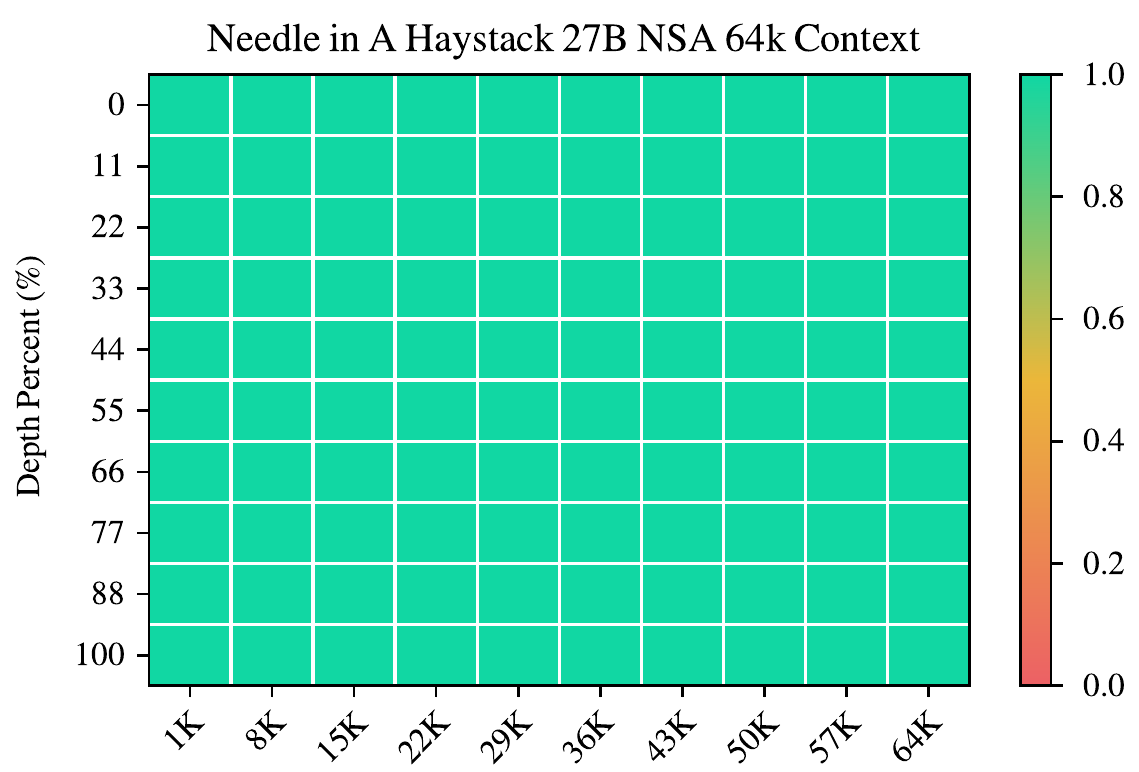
장문맥 평가. 그림 5에서 볼 수 있듯이, NSA는 64k 문맥 건초더미 속 바늘(needle-in-a-haystack) 테스트(Kamradt, 2023)에서 모든 위치에 걸쳐 완벽한 검색 정확도를 달성한다. 이러한 성능은 효율적인 전역 문맥 스캐닝을 위한 압축 토큰과 정밀한 지역 정보 검색을 위한 선택 토큰을 결합한 우리의 계층적 희소 어텐션 설계에서 비롯된다. 조대한(coarse-grained) 압축은 낮은 계산 비용으로 관련 문맥 블록을 식별하는 반면, 선택된 토큰에 대한 토큰 수준 어텐션은 중요한 세밀한 정보의 보존을 보장한다. 이 설계를 통해 NSA는 전역적 인식과 지역적 정밀성을 모두 유지할 수 있다.
우리는 또한 LongBench(Bai et al., 2023)에서 NSA를 최신 희소 어텐션
방법들과 Full Attention 기준선과 비교하여 평가한다. 일관된 희소성을 보장하기 위해, 모든 희소 어텐션 기준선에서 각 쿼리에 의해 활성화되는 토큰을 2560개로 설정하는데, 이는 32k 시퀀스 길이를 처리할 때 NSA에서 활성화되는 평균 토큰 수에 해당한다. Stream-LLM(Xiao et al., 2023)을 따라, 이 토큰 예산에는 선행 128개 토큰과 512개 지역 토큰이 포함된다. 우리는 모든 모델에서 낮은 점수를 받아 의미 있는 비교를 제공하지 못할 수 있는 일부 하위 집합을 LongBench에서 제외한다. 표 2에서 볼 수 있듯이, NSA는 평균 점수 0.469로 최고 점수를 달성하여 모든 기준선을 능가한다(Full Attention 대비 +0.032, Exact-Top 대비 +0.046). 이러한 향상은 두 가지 핵심 혁신에서 비롯된다: (1) 사전 학습 중 희소 패턴의 종단 간 최적화를 가능하게 하는 우리의 네이티브 희소 어텐션 설계는 희소 어텐션 모듈과 다른 모델 구성 요소 간의 동기화된 적응을 촉진한다; 그리고 (2) 계층적 희소 어텐션 메커니즘은 지역적 정보 처리와 전역적 정보 처리 사이의 균형을 달성한다.
특히, NSA는 장문맥에 대한 복잡한 추론을 요구하는 과제에서 뛰어난 성능을 보여, 다중 홉 QA 과제(HPQ 및 2Wiki)에서 Full Attention 대비 +0.087 및 +0.051의 향상을 달성하고, 코드 이해(LCC: +0.069)에서 기준선의 성능을 초과하며, 구절 검색(PassR-en: +0.075)에서 다른 방법들을 능가한다. 이러한 결과는 다양한 장문맥 과제를 처리하는 NSA의 능력을 입증하며, 네이티브로 사전 학습된 희소 어텐션이 과제 최적 패턴을 학습하는 데 추가적인 이점을 제공한다.
사고의 연쇄 추론 평가. 고급 다운스트림 학습 패러다임과의 NSA의 호환성을 평가하기 위해, 우리는 사후 학습을 통해 사고의 연쇄 수학적 추론 능력을 습득하는 역량을 조사한다. 소규모 모델에서 강화 학습의 제한된 효과를 고려하여, 우리는 DeepSeek-R1로부터의 지식 증류를 채택하여 32k 길이의 수학적 추론 추적 10B 토큰으로 지도 미세 조정(SFT)을 수행한다. 이는 두 가지 비교 가능한 모델을 생성한다: Full Attention-R(Full Attention 기준선)과 NSA-R(우리의 희소 변형). 우리는 두 모델을 어려운 미국 초청 수학 경시대회(AIME 24) 벤치마크에서 평가한다. 우리는 샘플링 온도 0.7과 top- 값 0.95를 사용하여 각 문제에 대해 16개의 응답을 생성하고 평균 점수를 얻는다. 추론 깊이의 영향을 검증하기 위해, 우리는 두 가지 생성 문맥 한도(8k 및 16k 토큰)로 실험을 수행하여 확장된 추론 사슬이 정확도를 향상시키는지 측정한다. 모델 예측의 예시 비교는 부록 A에 제공된다.
| 생성 토큰 제한 | 8192 | 16384 |
| Full Attention-R | 0.046 | 0.092 |
| NSA-R | 0.121 | 0.146 |
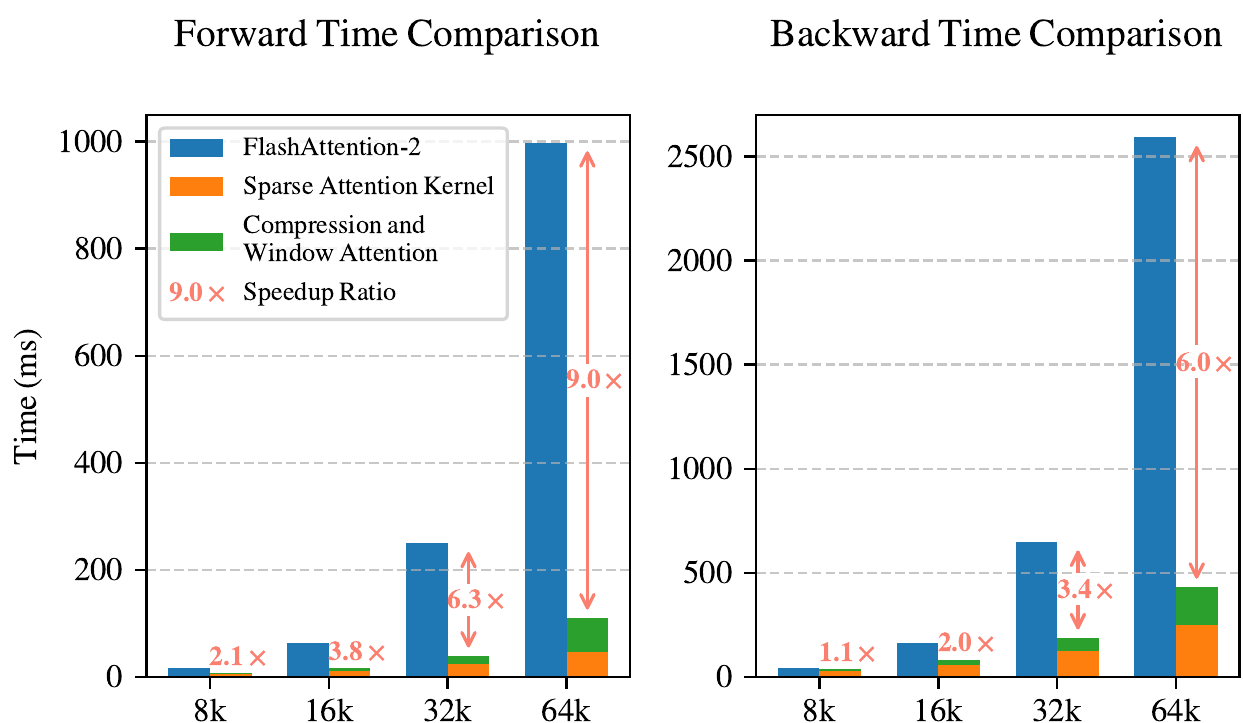
Figure 6 | Triton 기반 NSA 커널과 Triton 기반 FlashAttention-2 커널의 비교. 우리의 구현은 모든 컨텍스트 길이에서 지연 시간을 크게 줄였으며, 입력 길이가 증가할수록 개선 효과가 더욱 두드러진다.
Table 3에서 볼 수 있듯이, NSA-R은 8k 컨텍스트 설정에서 Full Attention-R보다 현저히 높은 정확도(+0.075)를 달성하며, 이러한 우위는 16k 컨텍스트(+0.054)에서도 지속된다. 이 결과는 네이티브 희소 어텐션의 두 가지 핵심 이점을 입증한다: (1) 사전 학습된 희소 어텐션 패턴은 복잡한 수학적 유도에 중요한 장거리 논리적 의존성을 효율적으로 포착할 수 있게 해준다; (2) 우리 아키텍처의 하드웨어 정렬 설계는 치명적 망각 없이 증가하는 추론 깊이를 지원하기에 충분한 컨텍스트 밀도를 유지한다. 컨텍스트 길이 전반에 걸친 일관된 우수한 성능은 훈련 파이프라인에 네이티브로 통합될 때 고급 추론 작업에 대한 희소 어텐션의 실행 가능성을 확인해 준다.
5. 효율성 분석
우리는 8-GPU A100 시스템에서 NSA와 Full Attention의 계산 효율성을 평가한다. 효율성 분석에서 우리는 또한 모델을 GQA 그룹 , 그룹당 헤드 , 쿼리/키 차원 , 값 차원 로 구성한다. Section 4의 동일한 설정에 따라, 우리는 NSA 압축 블록 크기 , 슬라이딩 스트라이드 , 선택된 블록 크기 , 선택된 블록 수 , 슬라이딩 윈도우 크기 로 설정한다.
5.1. 훈련 속도
우리는 동일한 백엔드에서 공정한 속도 비교를 보장하기 위해 Triton 기반 FlashAttention-2와 함께 우리의 NSA 어텐션 및 Full Attention의 Triton 기반 구현을 비교한다. Figure 6에서 볼 수 있듯이, 우리의 NSA는 컨텍스트 길이가 증가함에 따라 점진적으로 더 큰 속도 향상을 달성하며, 64k 컨텍스트 길이에서 최대 순방향 및 역방향 속도 향상을 보인다. 특히, 속도 이점은 더 긴 시퀀스에서 더욱 두드러진다. 이러한 속도 향상은 희소 어텐션 아키텍처의 효율성을 극대화하기 위한 우리의
| 컨텍스트 길이 | 8192 | 16384 | 32768 | 65536 |
| Full Attention | 8192 | 16384 | 32768 | 65536 |
| NSA | 2048 | 2560 | 3584 | 5632 |
| 예상 속도 향상 | 4× | 6.4× | 9.1× | 11.6× |
하드웨어 정렬 알고리즘 설계에서 비롯된다: (1) 블록 단위 메모리 접근 패턴은 병합된 로드를 통해 Tensor Core 활용률을 극대화한다, (2) 커널 내의 정교한 루프 스케줄링은 중복 KV 전송을 제거한다.
5.2. 디코딩 속도
어텐션의 디코딩 속도는 주로 메모리 접근 병목에 의해 결정되며, 이는 KV 캐시 로딩량과 밀접하게 연관된다. 각 디코딩 단계에서 우리의 NSA는 최대 개의 압축 토큰, 개의 선택된 토큰, 그리고 개의 인접 토큰만 로드하면 되며, 여기서 는 캐시된 시퀀스 길이이다. Table 4에서 볼 수 있듯이, 우리의 방법은 디코딩 길이가 증가함에 따라 지연 시간이 크게 감소하며, 64k 컨텍스트 길이에서 최대 속도 향상을 달성한다. 메모리 접근 효율성에서의 이러한 이점 또한 더 긴 시퀀스에서 증폭된다.
6. 논의
이 섹션에서는 NSA의 개발 과정을 되돌아보고 다양한 희소 어텐션 전략을 탐구하면서 얻은 핵심 통찰을 논의한다. 우리의 접근 방식이 유망한 결과를 보여주지만, 대안 전략에서 마주친 과제를 이해하고 어텐션 패턴을 분석하는 것은 향후 연구 방향에 유용한 맥락을 제공한다. 우리는 먼저 우리의 설계 선택에 동기를 부여한 대안 토큰 선택 전략의 과제를 살펴보고, 이어서 어텐션 분포 패턴에 대한 통찰을 제공하는 시각화를 제시한다.
6.1. 대안 토큰 선택 전략의 과제
NSA를 설계하기 전에, 우리는 기존 희소 어텐션 방법을 훈련 단계에 적용하는 것을 탐구했다. 그러나 이러한 시도는 다양한 과제에 직면했고, 이에 우리는 다른 희소 어텐션 아키텍처를 설계하게 되었다:
키 클러스터링 기반 전략. 우리는 ClusterKV(Liu et al., 2024)와 같은 클러스터링 기반 전략을 검토했다. 이러한 방법은 동일한 클러스터의 Key와 Value를 연속적인 메모리 영역에 저장한다. 이론적으로 훈련과 추론 모두에 실행 가능하지만, 세 가지 중요한 과제에 직면한다: (1) 동적 클러스터링 메커니즘에 의해 도입되는 적지 않은 계산 오버헤드; (2) 클러스터 간 불균형으로 인해 악화되는 연산자 최적화 어려움, 특히 전문가 병렬화(EP) 그룹 실행 시간이 편향되어 지속적인 부하 불균형을 초래하는 Mixture-of-Experts(MoE) 시스템에서 그러하다; (3) 필수적인 주기적 재클러스터링과 청크 순차 훈련 프로토콜의 필요에서 비롯되는 구현 제약. 이러한 결합된 요인들은 상당한 병목을 만들어 실제 배포에서의 효과를 크게 제한한다.
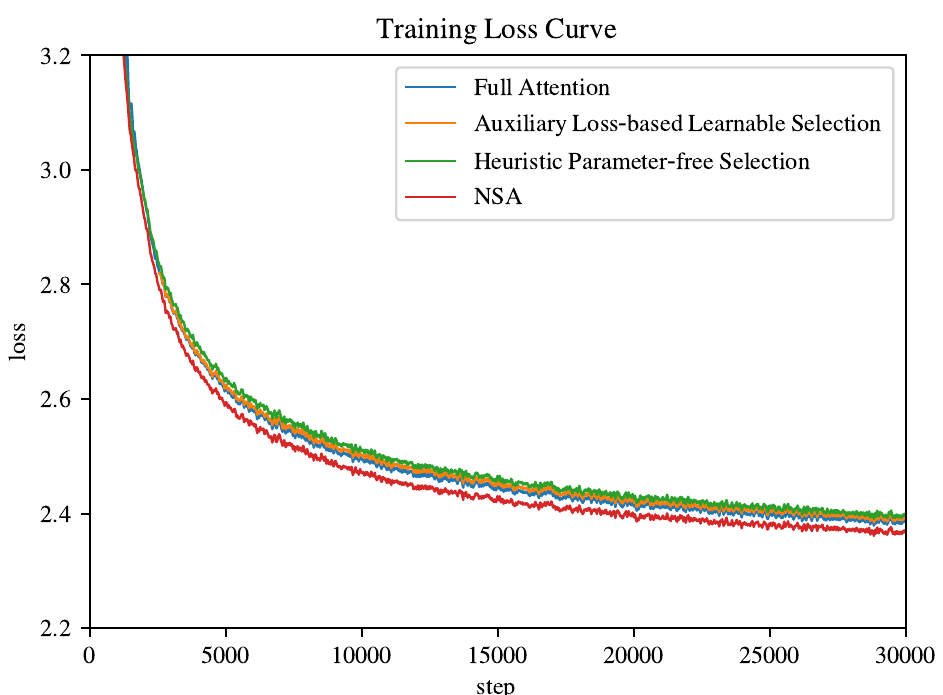
기타 블록 단위 선택 전략. 우리는 또한 NSA와 다른 블록 단위 키, 값 선택 전략, 예를 들어 Quest(Tang et al. [2024])와 InfLLM(Xiao et al. [2024a])을 고려했다. 이러한 방법은 각 KV 블록에 대한 중요도 점수를 계산하고 와의 유사성을 기반으로 상위 개의 블록을 선택하는 데 의존한다. 그러나 기존 방법은 두 가지 중요한 문제에 직면한다: (1) 선택 작업이 미분 불가능하기 때문에, 신경망 기반 중요도 점수 계산은 보조 손실에 의존하며, 이는 연산자 오버헤드를 증가시키고 종종 모델 성능을 저하시킨다; (2) 휴리스틱 매개변수 없는 중요도 점수 계산 전략은 낮은 재현율을 겪어 차선의 성능을 초래한다. 우리는 유사한 아키텍처의 3B 매개변수 모델에서 두 접근 방식을 평가하고 그들의 손실 곡선을 NSA 및 Full Attention과 비교한다. 보조 손실 기반 선택 방법의 경우, 우리는 블록 중요도 점수를 추정하기 위해 각 토큰에 대한 추가 쿼리와 각 블록에 대한 대표 키를 도입한다. 우리는 각 키 블록 내의 어텐션 점수를 평균 풀링하여 블록 수준 감독 신호를 계산하고, KL 발산을 사용하여 블록 중요도 예측을 감독한다. 우리는 효율적인 디코딩을 수용하기 위해 블록 평균 쿼리 대신 개별 쿼리 세분성을 유지한다. 이러한 보조 손실 기반 중요도 추정은 SeerAttention(Gao et al. [2024])과 개념적 유사성을 공유한다. 휴리스틱 매개변수 없는 선택 방법의 경우, Quest의 전략에 따라 우리는 추가 매개변수를 도입하지 않고 쿼리와 키 청크의 좌표별 최소-최대 간의 곱을 사용하여 직접 선택을 구현한다. 우리는 또한 초기 1000 스텝 동안 Full Attention을 적용한 후 휴리스틱 블록 단위 선택으로 전환하는 콜드 스타트 훈련 접근 방식을 탐구한다. Figure 7에서 볼 수 있듯이 두 방법 모두 열등한 손실을 보였다.
6.2. 시각화
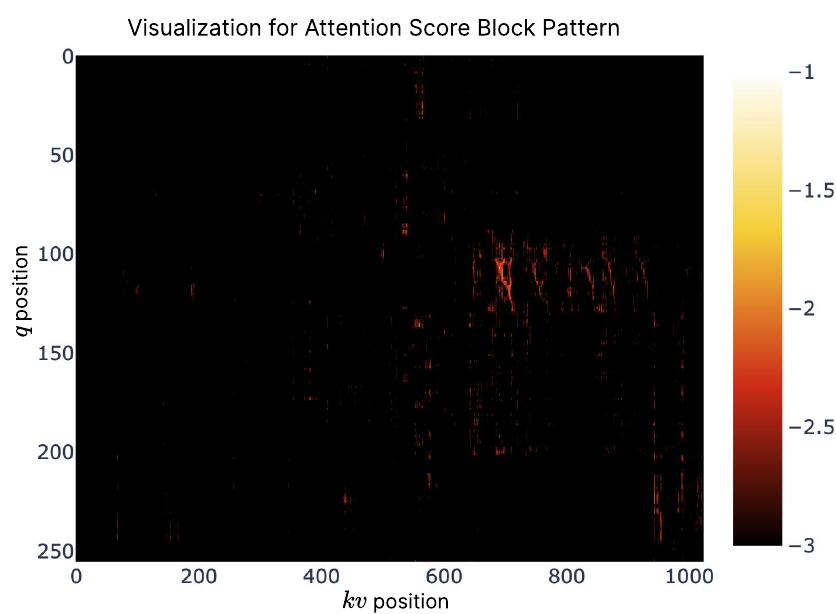
트랜스포머 어텐션 분포의 잠재적 패턴을 탐구하고 우리의 설계에 영감을 얻기 위해, 우리는 사전 학습된 27B Full Attention 모델의 어텐션 맵을 Figure 8에 시각화한다. 이 시각화는 어텐션 점수가 블록 단위 클러스터링 특성을 보이는 경향이 있으며, 인접한 키들이 종종 유사한 어텐션 점수를 보이는 흥미로운 패턴을 드러낸다. 이 관찰은 NSA의 설계에 영감을 주었으며, 공간적 연속성을 기반으로 키 블록을 선택하는 것이 유망한 접근 방식일 수 있음을 시사한다. 블록 단위 클러스터링 현상은 시퀀스에서 인접한 토큰들이 쿼리 토큰과 특정 의미 관계를 공유할 수 있음을 나타내지만, 이러한 관계의 정확한 본질은 추가 조사가 필요하다. 이 관찰은 우리가 개별 토큰이 아닌 연속적인 토큰 블록에서 작동하는 희소 어텐션 메커니즘을 탐구하도록 동기를 부여했으며, 이는 계산 효율성을 향상시키고 높은 어텐션 패턴을 보존하는 것을 목표로 한다.
7. 관련 연구
우리는 희소 어텐션을 통해 어텐션 계산의 효율성을 개선하는 기존 접근 방식을 검토한다. 이러한 방법은 핵심 전략에 따라 크게 세 그룹으로 분류할 수 있다: (1) 고정 희소 패턴, (2) 동적 토큰 프루닝, (3) 쿼리 인식 선택. 우리는 각 카테고리에서 몇 가지 대표적인 연구를 소개한다.
7.1. 고정 희소 패턴
SlidingWindow는 쿼리가 고정된 윈도우 내에서만 어텐션을 계산할 수 있게 하는 일반적으로 사용되는 접근 방식이다. StreamingLLM(Xiao et al., 2023)은 어텐션 싱크를 로컬 윈도우와 결합하여 연속적인 텍스트 스트림을 처리한다. MoA(Fu et al., 2024a)와 DuoAttention(Xiao et al., 2024b)도 긴 시퀀스 모델링을 위해 유사한 로컬 및 싱크 정보를 채택한다. Longformer(Beltagy et al., 2020)는 로컬 윈도우 어텐션을 전역 토큰과 교차 배치하여 긴 시퀀스를 처리한다. 이들과 비교하여, 우리의 NSA는 미리 정의된 희소 패턴에 의존하지 않고 패턴을 자동으로 학습하여 전체 컨텍스트를 활용할 잠재력을 열어준다.
7.2. 동적 토큰 프루닝
일부 방법은 추론 중 동적 KV 캐시 프루닝을 통해 메모리 및 계산 비용을 줄이도록 설계되었다. H2O(Zhang et al., 2023b), BUZZ(Zhao et al., 2024), SepLLM(Chen et al., 2024a)은 디코딩 중 KV 캐시 메모리 사용량을 줄이기 위한 적응형 접근 방식을 구현한다. 이러한 방법은 향후 예측에 덜 중요하다고 판단되는 토큰을 동적으로 제거한다. FastGen(Ge et al., 2023)과 HeadKV(Fu et al., 2024b)는 개별 어텐션 헤드에 서로 다른 전략을 할당하여 계산을 최적화한다. SnapKV(Li et al., 2024)는 가장 중요한 특징만 선택적으로 유지하여 KV 캐시를 줄이는 토큰 프루닝 전략을 도입하여 효율적인 메모리 사용을 가능하게 한다. 이러한 추론 중심 접근 방식과 달리, 우리의 NSA는 훈련 단계에서 희소성을 네이티브로 통합한다.
7.3. 쿼리 인식 선택
다른 연구들은 어텐션 품질을 유지하면서 어텐션 계산을 줄이기 위해 쿼리 의존적 토큰 선택 기법에 초점을 맞춘다. Quest(Tang et al., 2024)는 각 청크의 중요도를 쿼리와 키 청크의 좌표별 최솟값-최댓값 간의 곱으로 추정하는 블록 단위 선택 전략을 사용한다. InfLLM(Xiao et al., 2024a)은 어텐션 싱크, 지역 컨텍스트, 검색 가능한 청크를 유지함으로써 고정 패턴과 검색을 결합한다. 이 방법은 각 청크에서 대표 키를 선택하여 청크 중요도를 추정한다. HashAttention(Desai et al., 2024)은 학습된 함수를 사용하여 쿼리와 키를 해밍 공간에 매핑함으로써 중추 토큰 식별을 추천 문제로 정식화한다. ClusterKV(Liu et al., 2024)는 먼저 키를 클러스터링한 다음, 쿼리-클러스터 유사도를 기반으로 어텐션 계산에 가장 관련성 높은 클러스터를 선택함으로써 희소성을 달성한다. MInference(Jiang et al., 2024)와 TokenSelect(Wu et al., 2024)는 토큰 수준 중요도 점수를 기반으로 계산할 KV 쌍을 선택한다. SeerAttention(Gao et al., 2024)은 쿼리와 키를 공간 블록으로 분리하고 효율적인 계산을 위해 블록 단위 선택을 수행한다. 이러한 방법들과 비교하여, 우리의 NSA는학습, 프리필링, 디코딩을 포함한 전체 모델 생애주기에 걸쳐 하드웨어 정렬된 희소 어텐션 계산을 달성한다.
8. 결론
우리는 효율적인 장문맥 모델링을 위한 하드웨어 정렬된 희소 어텐션 아키텍처인 NSA를 제시한다. 학습 가능한 아키텍처 내에서 계층적 토큰 압축과 블록 단위 토큰 선택을 통합함으로써, 우리의 아키텍처는 Full Attention 성능을 유지하면서 학습과 추론을 가속화한다. NSA는 일반 벤치마크 성능이 full-attention 베이스라인과 일치함을 입증하고, 장문맥 평가에서 모델링 능력을 능가하며, 향상된 추론 능력을 보여주는 동시에 측정 가능한 계산 지연 감소와 상당한 속도 향상을 달성함으로써 최첨단을 진전시킨다.
참고문헌
J. Ainslie, J. Lee-Thorp, M. de Jong, Y. Zemlyanskiy, F. Lebrón, and S. Sanghai. Gqa: Training generalized multi-query transformer models from multi-head checkpoints. arXiv preprint arXiv:2305.13245, 2023. J. Austin, A. Odena, M. Nye, M. Bosma, H. Michalewski, D. Dohan, E. Jiang, C. Cai, M. Terry, Q. Le, et al. Program synthesis with large language models. arXiv preprint arXiv:2108.07732, 2021. Y. Bai, X. Lv, J. Zhang, H. Lyu, J. Tang, Z. Huang, Z. Du, X. Liu, A. Zeng, L. Hou, et al. Longbench: A bilingual, multitask benchmark for long context understanding. arXiv preprint arXiv:2308.14508, 2023. I. Beltagy, M. E. Peters, and A. Cohan. Longformer: The long-document transformer. arXiv preprint arXiv:2004.05150, 2020. G. Chen, H. Shi, J. Li, Y. Gao, X. Ren, Y. Chen, X. Jiang, Z. Li, W. Liu, and C. Huang. Sepllm: Accelerate large language models by compressing one segment into one separator. arXiv preprint arXiv:2412.12094, 2024a. M. Chen, J. Tworek, H. Jun, Q. Yuan, H. P. D. O. Pinto, J. Kaplan, H. Edwards, Y. Burda, N. Joseph, G. Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021. Z. Chen, R. Sadhukhan, Z. Ye, Y. Zhou, J. Zhang, N. Nolte, Y. Tian, M. Douze, L. Bottou, Z. Jia, et al. Magicpig: Lsh sampling for efficient llm generation. arXiv preprint arXiv:2410.16179, 2024b. K. Cobbe, V. Kosaraju, M. Bavarian, M. Chen, H. Jun, L. Kaiser, M. Plappert, J. Tworek, J. Hilton, R. Nakano, et al. Training verifiers to solve math word problems, 2021. URL https://arxiv.org/abs/2110.14168, 2021. D. Dai, C. Deng, C. Zhao, R. Xu, H. Gao, D. Chen, J. Li, W. Zeng, X. Yu, Y. Wu, et al. Deepseekmoe: Towards ultimate expert specialization in mixture-of-experts language models. arXiv preprint arXiv:2401.06066, 2024. DeepSeek- AI. Deepseek- v2: A strong, economical, and efficient mixture- of- experts language model. 2024. URL https://arxiv.org/abs/2405.04434DeepSeek- AI. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning, 2025. URL https://arxiv.org/abs/2501.12948
A. Desai, S. Yang, A. Cuadron, A. Klimovic, M. Zaharia, J. E. Gonzalez, and I. Stoica. Hashattention: Semantic sparsity for faster inference. arXiv preprint arXiv:2412.14468, 2024.
D. Dua, Y. Wang, P. Dasigi, G. Stanovsky, S. Singh, and M. Gardner. Drop: A reading comprehension benchmark requiring discrete reasoning over paragraphs. arXiv preprint arXiv:1903.00161, 2019.
T. Fu, H. Huang, X. Ning, G. Zhang, B. Chen, T. Wu, H. Wang, Z. Huang, S. Li, S. Yan, et al. Moa: Mixture of sparse attention for automatic large language model compression. arXiv preprint arXiv:2406.14909, 2024a.
Y. Fu, Z. Cai, A. Asi, W. Xiong, Y. Dong, and W. Xiao. Not all heads matter: A head-level kv cache compression method with integrated retrieval and reasoning. arXiv preprint arXiv:2410.19258, 2024b.
Y. Gao, Z. Zeng, D. Du, S. Cao, H. K.-H. So, T. Cao, F. Yang, and M. Yang. Seerattention: Learning intrinsic sparse attention in your llms. arXiv preprint arXiv:2410.13276, 2024.
S. Ge, Y. Zhang, L. Liu, M. Zhang, J. Han, and J. Gao. Model tells you what to discard: Adaptive kv cache compression for llms. arXiv preprint arXiv:2310.01801, 2023.
G. T. Google, P. Georgiev, V. I. Lei, R. Burnell, L. Bai, A. Gulati, G. Tanzer, D. Vincent, Z. Pan, S. Wang, et al. Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context. arXiv preprint arXiv:2403.05530, 2024.
D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song, and J. Steinhardt. Measuring massive multitask language understanding. arXiv preprint arXiv:2009.03300, 2020.
H. Jiang, Q. Wu, C.-Y. Lin, Y. Yang, and L. Qiu. Llmlingua: Compressing prompts for accelerated inference of large language models. arXiv preprint arXiv:2310.05736, 2023.
H. Jiang, Y. Li, C. Zhang, Q. Wu, X. Luo, S. Ahn, Z. Han, A. H. Abdi, D. Li, C.-Y. Lin, et al. Minference 1.0: Accelerating pre-filling for long-context llms via dynamic sparse attention. arXiv preprint arXiv:2407.02490, 2024.
G. Kamradt. LLMTest NeedleInAHaystack. GitHub repository, 2023. URL https://github.com/gkamradt/LLMTest_NeedleInAHaystack Accessed: [Insert Access Date Here].
.
.
H. Li, Y. Zhang, F. Koto, Y. Yang, H. Zhao, Y. Gong, N. Duan, and T. Baldwin. Cmmlu: Measuring massive multitask language understanding in chinese. arXiv preprint arXiv:2306.09212, 2023.
Y. Li, Y. Huang, B. Yang, B. Venkitesh, A. Locatelli, H. Ye, T. Cai, P. Lewis, and D. Chen. Snapkv: Llm knows what you are looking for before generation. arXiv preprint arXiv:2404.14469, 2024.
.
G. Liu, C. Li, J. Zhao, C. Zhang, and M. Guo. Clusterkv: Manipulating llm kv cache in semantic space for recallable compression. arXiv preprint arXiv:2412.03213, 2024.
J. S. Park, J. C. O'Brien, C. J. Cai, M. R. Morris, P. Liang, and M. S. Bernstein. Generative agents: Interactive simulacra of human behavior. In S. Follmer, J. Han, J. Steimle, and N. H. Riche, editors, Proceedings of the 36th Annual ACM Symposium on User Interface Software and Technology, UIST 2023, San Francisco, CA, USA, 29 October 2023–1 November 2023, pages 2:1–2:22. ACM, 2023.
.
.
B. Peng, J. Quesnelle, H. Fan, and E. Shippole. Yarn: Efficient context window extension of large language models. In ICLR. OpenReview.net, 2024.
N. Shazeer. Fast transformer decoding: One write-head is all you need. CoRR, abs/1911.02150, 2019.
M. Suzgun, N. Scales, N. Schärli, S. Gehrmann, Y. Tay, H. W. Chung, A. Chowdhery, Q. V. Le, E. H. Chi, D. Zhou, et al. Challenging big-bench tasks and whether chain-of-thought can solve them. arXiv preprint arXiv:2210.09261, 2022.
J. Tang, Y. Zhao, K. Zhu, G. Xiao, B. Kasikci, and S. Han. Quest: Query-aware sparsity for efficient long-context llm inference. arXiv preprint arXiv:2406.10774, 2024.
P. Tillet, H.-T. Kung, and D. Cox. Triton: an intermediate language and compiler for tiled neural network computations. In Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, pages 10-19, 2019.
A. Vaswani, N. Shazeer, N. Parmar, J. Uszkoreit, L. Jones, A. N. Gomez, L. u. Kaiser, and I. Polosukhin. Attention is all you need. Advances in Neural Information Processing Systems, 2017.
Y. Wang, X. Ma, G. Zhang, Y. Ni, A. Chandra, S. Guo, W. Ren, A. Arulraj, X. He, Z. Jiang, et al. Mmlu-pro: A more robust and challenging multi-task language understanding benchmark. arXiv preprint arXiv:2406.01574, 2024.
J. Wei, X. Wang, D. Schuurmans, M. Bosma, F. Xia, E. Chi, Q. V. Le, D. Zhou, et al. Chain-of-thought prompting elicits reasoning in large language models. Advances in neural information processing systems, 35:24824-24837, 2022.
W. Wu, Z. Pan, C. Wang, L. Chen, Y. Bai, K. Fu, Z. Wang, and H. Xiong. Tokenselect: Efficient long-context inference and length extrapolation for llms via dynamic token-level kv cache selection. arXiv preprint arXiv:2411.02886, 2024.
C. Xiao, P. Zhang, X. Han, G. Xiao, Y. Lin, Z. Zhang, Z. Liu, and M. Sun. Infllm: Training-free long-context extrapolation for llms with an efficient context memory. In The Thirty-eighth Annual Conference on Neural Information Processing Systems, 2024a.
G. Xiao, Y. Tian, B. Chen, S. Han, and M. Lewis. Efficient streaming language models with attention sinks. arXiv preprint arXiv:2309.17453, 2023.
G. Xiao, J. Tang, J. Zuo, J. Guo, S. Yang, H. Tang, Y. Fu, and S. Han. Duoattention: Efficient long-context llm inference with retrieval and streaming heads. arXiv preprint arXiv:2410.10819, 2024b.
M. Zaheer, G. Guruganesh, K. A. Dubey, J. Ainslie, C. Alberti, S. Ontanon, P. Pham, A. Ravula, Q. Wang, L. Yang, et al. Big bird: Transformers for longer sequences. Advances in neural information processing systems, 33:17283-17297, 2020.
E. Zelikman, Y. Wu, J. Mu, N. D. Goodman. Star: 추론으로 추론 부트스트래핑하기. S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho, A. Oh 편집, 신경정보처리시스템 발전 35: 2022년 신경정보처리시스템 연례 학술대회, NeurIPS 2022, 미국 루이지애나주 뉴올리언스, 2022년 11월 28일 - 12월 9일, 2022.
F. Zhang, B. Chen, Y. Zhang, J. Keung, J. Liu, D. Zan, Y. Mao, J. Lou, W. Chen. Repocoder: 반복적 검색과 생성을 통한 저장소 수준 코드 완성. H. Bouamor, J. Pino, K. Bali 편집, 2023년 경험적 방법 in 자연어처리 학술대회 논문집, EMNLP 2023, 싱가포르, 2023년 12월 6-10일, 2471-2484쪽. 계산언어학회, 2023a. K. Zhang, J. Li, G. Li, X. Shi, Z. Jin. Codeagent: 실제 저장소 수준 코딩 과제를 위한 도구 통합 에이전트 시스템으로 코드 생성 향상하기. L. Ku, A. Martins, V. Srikumar 편집, 제62회 계산언어학회 연례 학술대회 논문집 (제1권: 장문 논문), ACL 2024, 태국 방콕, 2024년 8월 11-16일, 13643-13658쪽. Z. Zhang, Y. Sheng, T. Zhou, T. Chen, L. Zheng, R. Cai, Z. Song, Y. Tian, C. Ré, C. Barrett, 등. H2o: 대규모 언어 모델의 효율적인 생성 추론을 위한 헤비히터 오라클. 신경정보처리시스템 발전, 36:34661-34710, 2023b. J. Zhao, Z. Fang, S. Li, S. Yang, S. He. Buzz: 효율적인 LLM 추론을 위한 분할된 헤비히터를 갖춘 벌집 구조의 희소 KV 캐시. arXiv 프리프린트 arXiv:2410.23079, 2024. Z. Zhou, C. Li, X. Chen, S. Wang, Y. Chao, Z. Li, H. Wang, R. An, Q. Shi, Z. Tan, 등. Llm × mapreduce: 대규모 언어 모델을 활용한 단순화된 장시퀀스 처리. arXiv 프리프린트 arXiv:2410.09342, 2024.
A. AIME 결과 예시
프롬프트:
"| 사용자 | 와 가 다음 연립방정식을 만족하는 양의 실수라고 하자:
그러면 의 값은 이며, 여기서 과 은 서로소인 양의 정수이다. 을 구하시오. 단계별로 이유를 설명하고, 최종 답을 안에 넣으시오. | 어시스턴트 | "
우리의 결과:
(2275 토큰)
주어진 연립방정식은 다음과 같다:
이 로그 방정식들을 지수 형태로 변환한다:
각 변수를 , 그리고 로 나타내면:
이 식들을 서로 대입하면 다음을 얻는다:- 와 로부터 를 얻고, 이는 로 이어진다. - 를 에 대한 식에 대입하면 을 얻는다. - 와 를 에 대한 식에 대입하면 을 얻는다.
다음으로 를 계산한다:
이들을 모두 곱하면:
밑이 2인 로그를 취하면:
절댓값은:
따라서 이고 이며, 이다.
33
기준 결과:
(think)...(/think) (9392 토큰)
주어진 로그 연립방정식은 다음과 같다:
이 방정식들을 지수 형태로 변환한다:
이들을 서로 대입하면 다음을 얻는다:
이 방정식들을 단계별로 풀면 다음을 얻는다:
그러나 세 번째 방정식을 검증해 보면, 이 연립방정식에 해가 없을 수도 있음을 알게 된다. 따라서 우리는 행렬 역산을 사용하여 연립방정식을 푼다:
, , 라 하자. 연립방정식은 다음과 같이 된다:
우리는 크라메르의 법칙과 행렬 역산을 사용하여 이 연립방정식을 푼다. 행렬의 행렬식은 - 2이며, 해는 다음과 같다:
따라서 우리는 다음을 얻는다:
우리는 \(\left|\log_2(x^4 y^3 z^2)\right|\) 를 구해야 한다:
공통분모(48)로 변환하면:
이들을 합하면:
분수 는 기약분수이므로, 이고 이다. 따라서 이다.
프롬프트:
"| User | 인 실수 와 가 을 만족한다. 의 값은 얼마인가? 단계별로 추론하고, 최종 답을 안에 넣어라. | Assistant | "
우리의 결과:
(15147 tokens)
주어진 방정식:
1. 2.
두 방정식 모두에 로그의 거듭제곱 법칙을 적용하는 것으로 시작한다.
첫 번째 방정식의 경우:
라 하자. 그러면 이다. 이를 방정식에 대입하면 다음을 얻는다:
두 번째 방정식의 경우:
거듭제곱 법칙을 사용하면 다음을 얻는다:
\(\log_{y}(x) = z\) 이므로, 이는 다음과 같이 간단해집니다:
이제 우리는 두 개의 식을 얻습니다:
1. 2.
와 를 곱 에 대입하면, 다음을 얻습니다:
따라서 의 값은 입니다.
기준 결과:
\(\langle \mathrm{think}\rangle \ldots \langle /\mathrm{think}\rangle\) (16223 토큰)
인 실수 와 가 방정식 과 을 만족하는 문제에서, 우리는 의 값을 구해야 합니다.
먼저, 밑 변환 공식을 사용하여 로그 방정식을 지수 형태로 변환합니다.
1.
밑 변환 공식을 사용하면, 입니다. 이므로, 입니다. 따라서,
2.
다시, 밑 변환 공식을 사용하면, 입니다.
다음으로, 우리는 와 를 서로에 대해 표현합니다:
그런 다음 곱 를 계산합니다:
그러나 재평가하고 와 를 설정하는 다른 접근법을 사용하면, 우리는 다음을 찾습니다:
마지막으로, 우리는 곱 가 다음과 같이 간단해진다는 것을 찾습니다: