
에이전트가 코드를 쓰고 명령을 실행하고 웹을 보는 오픈 플랫폼. 15개 벤치마크로 평가한다. ICLR 2025, 전문 무료.
OpenHands: An Open Platform for AI Software Developers as Generalist Agents
OPENHANDS: AI 소프트웨어 개발자를 범용 에이전트로 만들기 위한 오픈 플랫폼
Xingyao Wang , Boxuan Li , Yufan Song , Frank F. Xu , Xiangru Tang , Mingchen Zhuge , Jiayi Pan , Yueqi Song , Bowen Li, Jaskirat Singh , Hoang H. Tran , Fuqiang Li, Ren Ma, Mingzhang Zheng, Bill Qian , Yanjun Shao , Niklas Muennighoff , Yizhe Zhang, Binyuan Hui , Junyang Lin , Robert Brennan , Hao Peng , Heng Ji , Graham Neubig UIUC CMU Yale UC Berkeley Contextual AI KAUST ANU HCMUT Alibaba All Hands AI xingyao6@illinois.edu, gneubig@cs.cmu.edu
초록
소프트웨어는 우리 인간이 활용할 수 있는 가장 강력한 도구 중 하나이다. 소프트웨어는 숙련된 프로그래머가 복잡하고 심오한 방식으로 세상과 상호작용할 수 있게 해준다. 동시에, 대규모 언어 모델(LLM)의 발전 덕분에 주변 환경과 상호작용하고 환경에 변화를 일으키는 AI 에이전트 또한 빠르게 발전해 왔다. 본 논문에서는 OpenHands(구 명칭 OpenDevin)를 소개한다. 이는 인간 개발자와 유사한 방식으로, 즉 코드를 작성하고, 명령줄과 상호작용하며, 웹을 탐색함으로써 세상과 상호작용하는 강력하고 유연한 AI 에이전트를 개발하기 위한 플랫폼이다. 우리는 이 플랫폼이 어떻게 새로운 에이전트의 구현, 코드 실행을 위한 샌드박스 환경과의 안전한 상호작용, 다중 에이전트 간의 조정, 그리고 평가 벤치마크의 통합을 가능하게 하는지 설명한다. 현재 통합된 벤치마크를 바탕으로, 우리는 소프트웨어 공학(예: SWE-BENCH)과 웹 탐색(예: WEBARENA) 등 여러 분야에 걸친 15개의 도전적인 과제에서 에이전트를 평가한다. 허용적인 MIT 라이선스로 공개된 OpenHands는 학계와 산업계에 걸친 커뮤니티 프로젝트로, 188명 이상의 기여자로부터 2.1K 건이 넘는 기여를 받았다.
코드 https://github.com/All-Hands-AI/OpenHands Slack http://bit.ly/OpenHands-Slack
1 서론
대규모 언어 모델(LLM; OpenAI 2024b; Team et al. 2023; Jiang et al. 2024; Chang et al. 2024)에 기반하여, 사용자 대면 AI 시스템(예: ChatGPT)은 사용자 질의에 정확하게 응답하기, 수학 문제 풀기, 코드 생성하기와 같은 복잡한 과제를 수행하는 능력이 점점 더 향상되고 있다. 특히, 외부 환경을 인지하고 그에 대해 행동할 수 있는 시스템인 AI 에이전트는 최근 점점 더 많은 연구 관심을 받고 있다. AI 에이전트는 소프트웨어 개발(Jimenez et al., 2024), 실제 웹사이트 탐색(Zhou et al., 2023a), 집안일 수행(Ahn et al., 2022), 심지어 과학 연구 수행(Boiko et al., 2023; Tang et al., 2024a)과 같은 복잡한 과제를 수행하는 방향으로 나아가고 있다.
X
AI 에이전트가 복잡한 문제를 다룰 수 있게 됨에 따라, 그 개발과 평가 또한 어려워졌다. 최근에는 에이전트 개발을 용이하게 하는 오픈소스 프레임워크를 만드는 많은 노력이 있었다(Hong et al., 2023; Chen et al., 2024; Wu et al., 2023). 이러한 에이전트 프레임워크는 일반적으로 1) 에이전트가 세상과 상호작용하는 인터페이스(예: JSON 기반 함수 호출 또는 코드 실행), 2) 에이전트가 작동하는 환경, 3) 인간-에이전트 또는 에이전트-에이전트 통신을 위한 상호작용 메커니즘을 포함한다. 이러한 프레임워크는 다양한 방식으로 개발 과정을 간소화하고 용이하게 한다(표 1, §C).
AI 에이전트를 설계할 때, 우리는 인간이 세상과 상호작용하는 방식을 고려할 수도 있다. 현재 인간이 세상과 상호작용하는 가장 강력한 방식은 소프트웨어를 통하는 것이다. 소프트웨어
는 우리 삶의 모든 측면을 구동하며, 기본적인 필요를 위한 물류에서부터 과학, 기술, 그리고 AI 자체의 발전에 이르기까지 모든 것을 뒷받침한다. 소프트웨어의 힘과 더불어, 소프트웨어의 효율적인 개발, 사용, 배포를 둘러싼 기존 도구들을 고려할 때, 소프트웨어는 AI 에이전트가 복잡한 방식으로 세상과 상호작용할 수 있는 이상적인 인터페이스를 제공한다. 그러나 소프트웨어를 효과적으로 개발할 수 있는 에이전트를 구축하는 데에는 그 나름의 독특한 어려움이 따른다. 어떻게 하면 에이전트가 복잡한 소프트웨어 시스템에서 코드를 효과적으로 생성하고 수정할 수 있게 할 수 있는가? 어떻게 하면 문제를 디버깅하거나 과제에 필요한 정보를 수집하기 위해 실시간으로 정보를 수집할 수 있는 도구를 에이전트에게 제공할 수 있는가? 어떻게 하면 개발이 안전하고 사용자 시스템에 부정적인 부작용을 초래하지 않도록 보장할 수 있는가?
본 논문에서는 소프트웨어를 통해 세상과 상호작용하는 범용 및 전문 AI 에이전트의 개발을 위해 설계된 커뮤니티 주도 플랫폼인 OpenHands(구 명칭 OpenDevin)를 소개한다.1 이 플랫폼은 다음의 특징을 가진다:
(1) 사용자 인터페이스, 에이전트, 환경이 강력하고 유연한 이벤트 스트림 아키텍처를 통해 상호작용할 수 있게 하는 상호작용 메커니즘(§2.1). (2) 에이전트가 상호작용할 수 있는 bash 셸, 웹 브라우저, IPython 서버를 갖춘 도커 샌드박스 운영체제로 구성된 런타임 환경(§2.2). (3) 에이전트가 실제 소프트웨어 엔지니어와 유사한 방식으로 환경과 상호작용할 수 있게 하는 인터페이스(§2.3). 우리는 에이전트가 a) 복잡한 소프트웨어를 생성하고 편집하고, b) 샌드박스에서 임의의 코드를 실행하고, c) 웹사이트를 탐색하여 정보를 수집할 수 있는 능력을 제공한다. (4) 여러 전문 에이전트가 함께 작업할 수 있게 하는 다중 에이전트 위임(§2.4). (5) 광범위한 과제에 걸쳐 에이전트를 평가하는 것을 용이하게 하는 평가 프레임워크(§4).
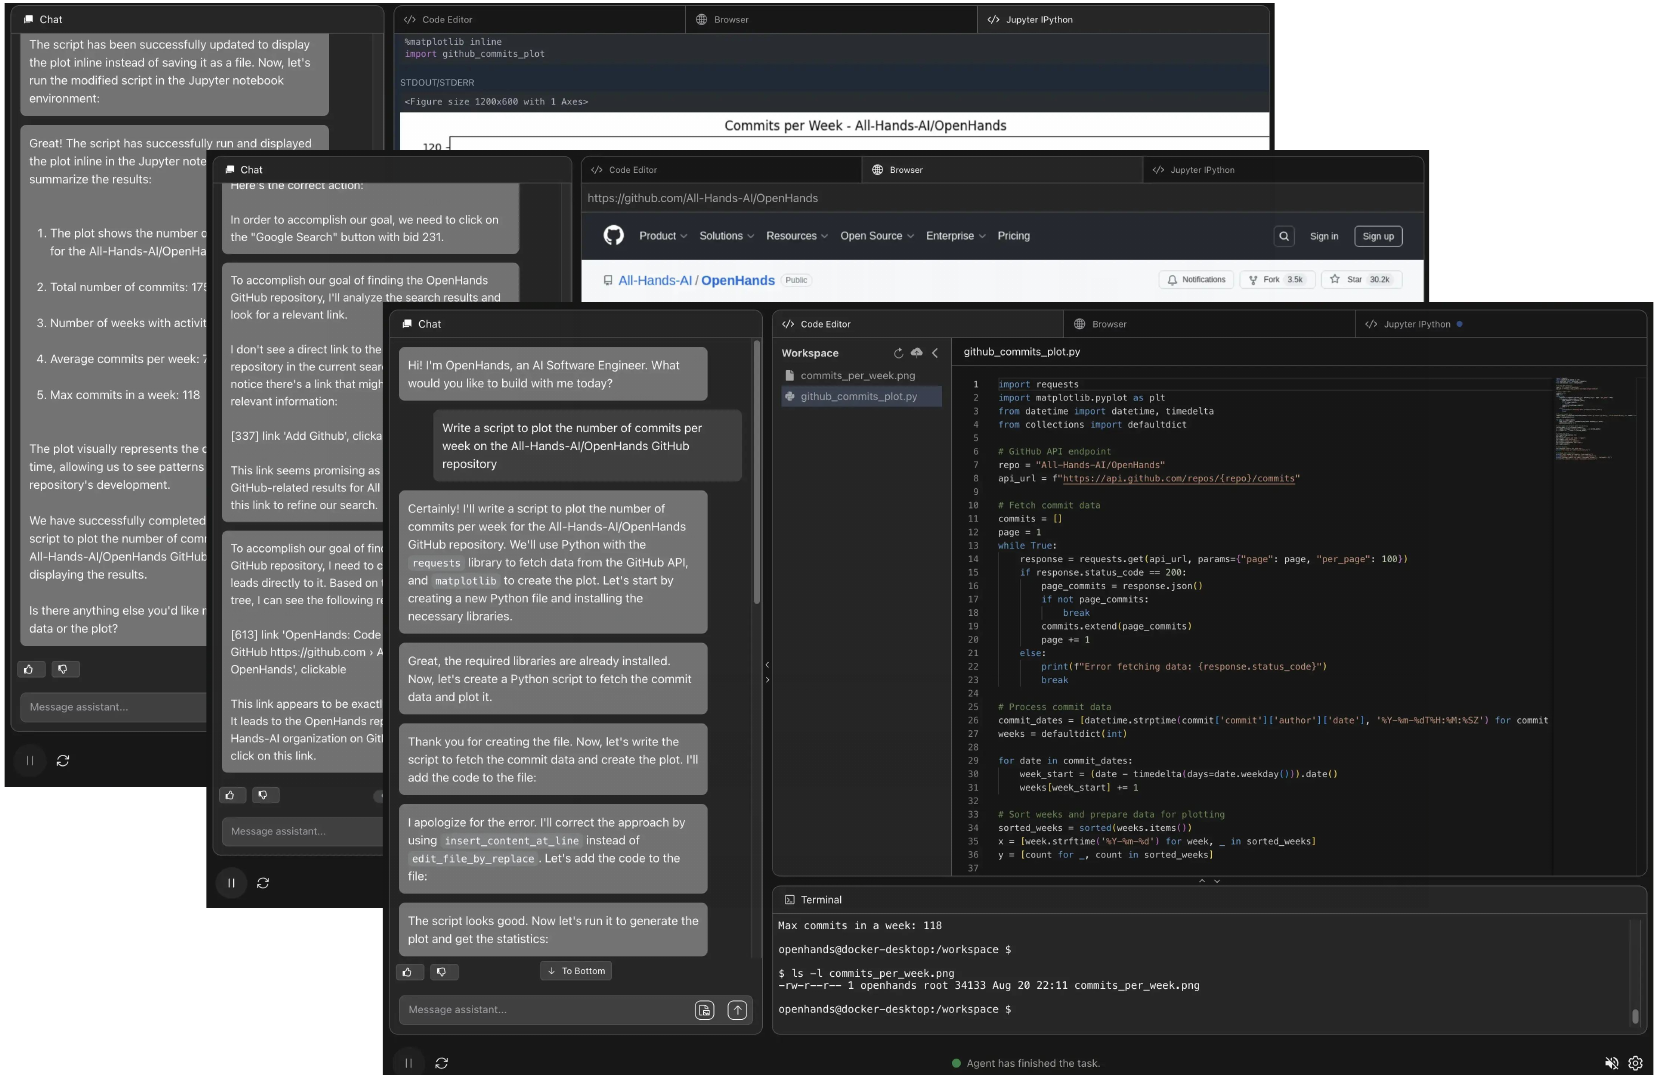
중요한 점은, OpenHands가 단순한 개념적 프레임워크가 아니라 에이전트, 환경, 평가에 대한 포괄적이고 즉시 사용 가능한 구현을 포함한다는 것이다. 본 논문을 작성하는 시점에, OpenHands는 10개 이상의 구현된 에이전트를 갖춘 에이전트 허브(§3)를 포함하며, 여기에는 CodeAct 아키텍처(Wang et al., 2024a)를 기반으로 구현된 강력한 범용 에이전트가 포함되어 있고, 웹 탐색(ServiceNow) 및 코드 편집 전문가(Yang et al., 2024)를 위한 추가 기능이 있다. 사용자와의 상호작용은 에이전트의 현재 행동을 시각화하고
실시간 피드백을 가능하게 하는 채팅 기반 사용자 인터페이스를 통해 구현된다(그림 1, §D). 나아가, 평가 프레임워크는 현재 15개의 벤치마크를 지원하며, 우리는 이를 사용하여 에이전트를 평가한다(§4).
상업적 사용을 허용하는 허용적인 MIT 라이선스로 공개된 OpenHands는 학계와 산업계 전반의 다양한 연구 및 실제 응용을 지원할 준비가 되어 있다. OpenHands는 32K GitHub 스타와 188명 이상의 기여자로부터 2.1K 건이 넘는 기여를 받으며 상당한 주목을 받아왔다. 우리는 OpenHands가 광범위한 실무자 커뮤니티에 의해 주도되는 미래의 연구 혁신과 다양한 응용을 위한 촉매제가 되기를 구상한다.
2 OPENHANDS 아키텍처
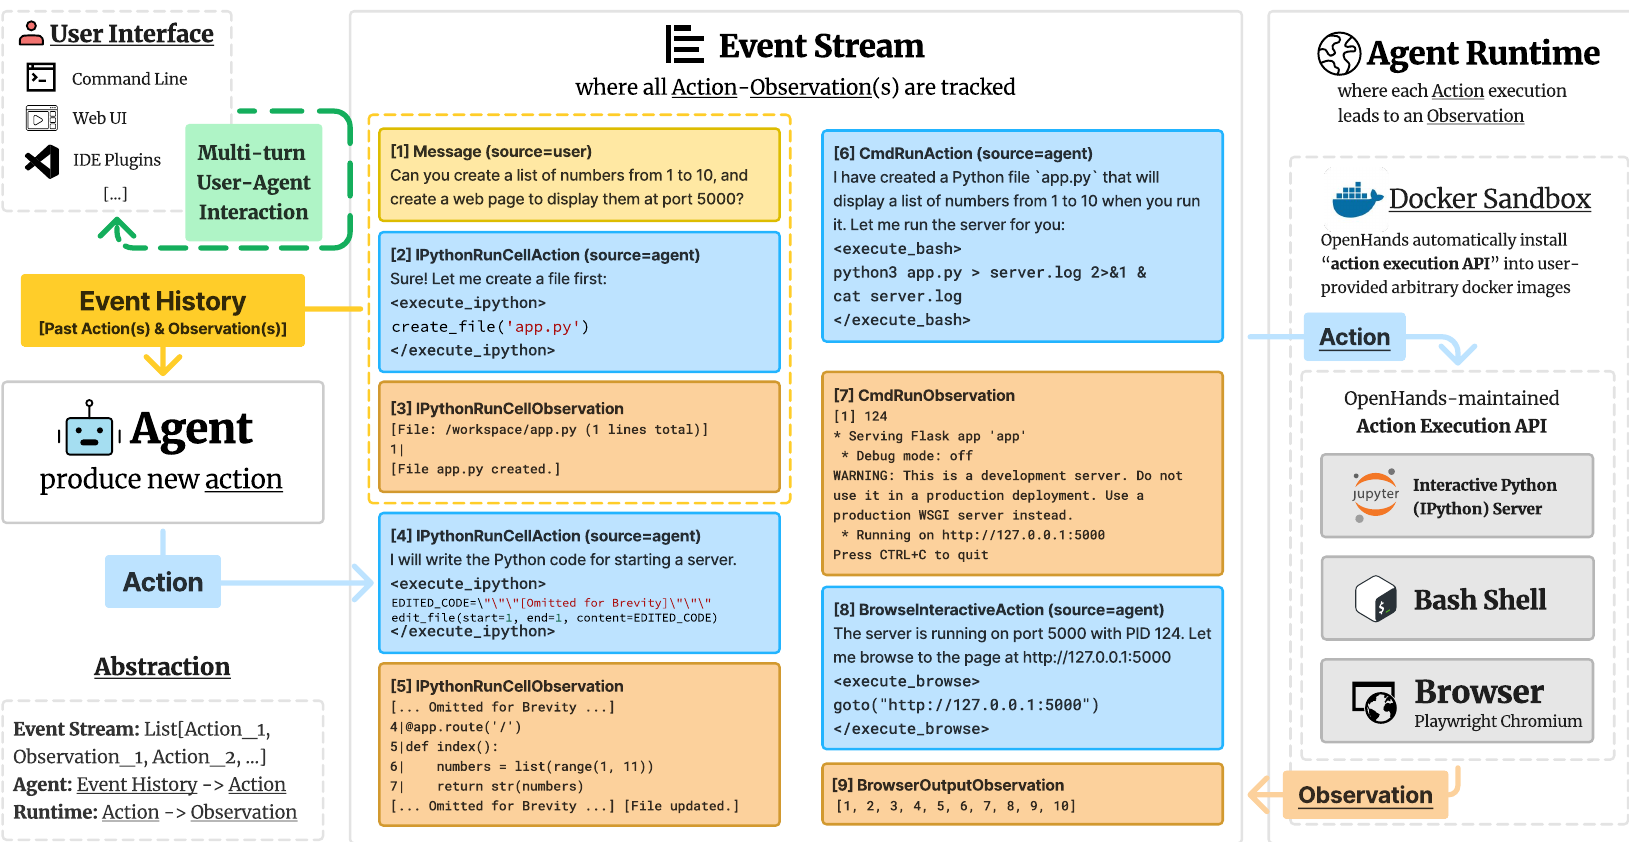
다음으로 OpenHands를 자세히 사용하는 방법을 설명한다. 특히, 우리는 1) 에이전트를 정의하고 구현하는 방법(§2.1), 2) 각 행동 실행이 어떻게 관찰로 이어지는지(§2.2), 3) 에이전트를 위해 일반적으로 사용되는 기술을 안정적으로 관리하고 확장하는 방법(§2.3), 4) 과제 해결을 위해 여러 에이전트를 함께 구성하는 방법(§2.4)을 논의한다. 그림 2는 개요를 제공한다.
2.1 에이전트 정의 및 구현
에이전트는 환경의 상태(예: 이전 행동과 관찰)를 인지하고 사용자가 지정한 과제를 해결하는 동안 실행할 행동을 생성할 수 있다.
상태와 이벤트 스트림. OpenHands에서 상태는 에이전트 실행에 관련된 모든 정보를 캡슐화하는 데이터 구조이다. 이 상태의 핵심 구성 요소는 이벤트 스트림으로, 이는 에이전트 자신의 행동과 사용자 상호작용(예: 지시, 피드백)을 포함한 과거 행동과 관찰의 시간순 모음이다. 이벤트 스트림 외에도, 상태는 LLM 호출의 누적 비용, 다중 에이전트 위임을 추적하기 위한 메타데이터(§2.4), 그리고 기타 실행 관련 매개변수와 같은 에이전트 운영을 위한 보조 정보를 포함한다.
행동. CodeAct(Wang et al., 2024a)에서 영감을 받아, OpenHands는 핵심적인 일반 행동 집합을 통해 에이전트를 환경과 연결한다. IPythonRunCellAction과 CmdRunAction 행동은 에이전트가 샌드박스 환경(예: 안전하게 격리된 리눅스 운영 체제) 내에서 임의의 Python 코드와 bash 명령을 실행할 수 있게 한다. BrowserInteractiveAction은 BrowserGym(Drouin et al., 2024)이 도입한 브라우징용 도메인 특화 언어를 통해 웹 브라우저와 상호작용할 수 있게 한다. 이러한 행동들은 인간 소프트웨어 엔지니어와 분석가가 수행하는 대부분의 작업을 포괄하는, 포괄적이면서도 유연한 원시 연산(primitive) 집합을 제공하기 위해 선택되었다. 프로그래밍 언어(PL)에 기반한 행동 공간은 강력하고유연하여 다양한 형태의 도구(예: Python 함수, REST API 등)로 어떤 작업이든 수행할 수 있으면서도 신뢰할 수 있고 유지 관리가 쉽다(Wang et al., 2024a).
이 설계는 미리 정의된 도구 목록을 요구하는 기존의 도구 호출 에이전트(Chase, 2022)와도 호환된다. 즉, 사용자는 원시 행동에서 지원되는 PL을 사용하여 도구를 쉽게 정의하고(예: 계산기를 위한 Python 함수 작성), JSON 스타일의 함수 호출 경험(Qin et al., 2023)을 통해 해당 도구들을 에이전트가 사용할 수 있게 할 수 있다. 더욱이, 이 프레임워크의 강력한 PL 기반 원시 연산은 작업을 완료하기 위한 API를 사용할 수 없을 때 에이전트가 스스로 도구를 만들 수 있게 한다(예: Python 함수 생성, Yuan et al. 2023). 이러한 핵심 PL 기반 행동들이 어떻게 다양한 도구 집합으로 구성될 수 있는지는 §2.3을 참조하라.
관찰. 관찰은 에이전트가 관찰하는 환경 변화(예: 이전 행동의 실행 결과, 인간 사용자로부터의 텍스트 메시지 등)를 기술한다.
그림 3: OpenHands에서 에이전트를 구현하는 최소 예시.
class MinimalAgent: def reset(self) -> None: self.system_message = "You are a helpful assistant ..." def step(self, state: State): messages: list[dict[str, str]] = [ {'role': 'system', 'content': self.system_message] ] for prev_action, obs in state.history: action_message = get_action_message(prev_action) messages.append(action_message) obs_message = get_observation_message(obs) messages.append(obs_message) # use lim to generate response (e.g., thought, action) response = self.lim.do_completion(messages) # parse and execute action in the runtime action = self.parse_response(response) if self.is_finish_command(action): return AgentFinishAction() elif self.is_bash_command(action): return CmdRunAction(command=action.command) elif self.is_python_code(action): return IPythonRunCallAction(code=action.code) elif self.is_browser_action(action): return BrowseInteractiveAction(code=action.code) else: return MessageAction(content=action.message)
새로운 에이전트 구현하기. 에이전트 추상화는 단순하면서도 강력하도록 설계되어, 사용자가 다양한 작업을 위한 에이전트를 쉽게 생성하고 맞춤화할 수 있게 한다. 에이전트 추상화의 핵심은 현재 상태를 입력으로 받아 에이전트의 로직에 따라 적절한 행동을 생성하는 step 함수에 있다. 에이전트 추상화의 간략화된 예시 코드는 그림 3에 예시되어 있다. 이러한 추상화를 제공함으로써 OpenHands는 사용자가 행동이 실행되는 방식의 저수준 세부 사항에 대해 걱정하지 않고 원하는 에이전트 행동과 로직을 정의하는 데 집중할 수 있게 한다(§2.2).
2.2 에이전트 런타임: 행동의 실행이 어떻게 관찰로 이어지는가
에이전트 런타임은 인간 소프트웨어 개발자의 행동 공간에 필적하는 행동 공간을 에이전트에 제공하는 일반적인 환경을 제공하며, 이를 통해 OpenHands 에이전트는 복잡한 소프트웨어 개발 워크플로, 데이터 분석 프로젝트, 웹 브라우징 작업 등 다양한 소프트웨어 개발 및 웹 기반 작업을 폭넓게 수행할 수 있다. 이는 에이전트가 코드와 명령줄 도구를 실행하기 위한 bash 터미널에 접근하고, 즉석에서 코드를 작성하고 실행하기 위한 Jupyter 노트북을 활용하며, 웹 기반 작업(예: 정보 탐색)을 위해 웹 브라우저와 상호작용할 수 있게 한다.
Docker 샌드박스. 각 작업 세션마다 OpenHands는 안전하게 격리된 docker 컨테이너 샌드박스를 생성하며, 여기서 이벤트 스트림의 모든 행동이 실행된다. OpenHands는 샌드박스 내부에서 실행되는 REST API 서버(즉, OpenHands 행동 실행 API)를 통해 샌드박스에 연결하고, 이벤트 스트림으로부터 임의의 행동(예: bash 명령, python 코드)을 실행하며, 실행 결과를 관찰로 반환한다. 사용자가 에이전트가 작업하기를 원하는 파일을 담은 구성 가능한 작업 공간 디렉터리가 해당 보안 샌드박스에 마운트되어 OpenHands 에이전트가 접근할 수 있게 된다.
OpenHands 행동 실행 API. OpenHands는 docker 샌드박스 내부에서 실행되어 이벤트 스트림으로부터의 행동 실행 요청을 수신하는 API 서버를 유지한다. API 서버는 다음을 유지한다:
(1) 명령 실행을 위해 운영 체제 환경(docker 이미지에 의해 지정됨)과 연결되는 bash 셸. (2) 대화형 python(IPython) 코드 실행 요청을 처리하고 실행 결과를 이벤트 스트림으로 반환하는 Jupyter IPython 서버. (3) Playwright 기반의 Chromium 브라우저. 제공자는 BrowserGym(ServiceNow; Drouin et al., 2024)에 의해 정의된 일련의 행동 기본 요소들, 예컨대 탐색, 클릭, 타이핑, 스크롤을 제공한다. 전체 행동 집합은 §J에 상세히 설명되어 있다. 이러한 행동들을 실행한 후, 브라우저 런타임은 HTML, DOM, 접근성 트리(Mozilla), 스크린샷, 열린 탭 등과 같은 브라우저의 현재 상태에 관한 풍부한 관찰 집합을 제공한다.
임의의 Docker 이미지 지원. OpenHands는 임의의 docker 이미지에 기반한 런타임을 지원함으로써 에이전트가 서로 다른 소프트웨어 환경을 갖춘 임의의 운영 체제에서 실행될 수 있게 한다. OpenHands는 사용자가 제공한 임의의 docker 이미지를 받아 그 이미지에 OpenHands 행동 실행 API를 설치하여 에이전트 상호작용을 가능하게 하는 빌드 메커니즘을 구현한다. OpenHands 에이전트 런타임에 대한 자세한 설명은 §F에 포함되어 있다.
2.3 에이전트 스킬: 확장 가능한 에이전트-컴퓨터 인터페이스
SWE-Agent(Yang et al., 2024)는 복잡한 작업을 성공적으로 해결하는 데 있어 신중하게 설계된 에이전트-컴퓨터 인터페이스(ACI, 즉 특정 작업을 위한 전문화된 도구)의 중요성을 강조한다. 그러나 광범위한 도구들을 생성, 유지 관리 및 배포하는 것은 특히 이러한 도구들을 서로 다른 에이전트 구현(§3)에서 사용할 수 있게 하려 할 때 어려운 엔지니어링 과제가 될 수 있다. 이를 해결하기 위해 우리는 기본적인 bash 명령이나 python 코드로는 쉽게 이용할 수 없는 유틸리티를 제공하여 에이전트의 역량을 향상시키도록 설계된 도구 상자인 AgentSkills 라이브러리를 구축한다.
도구를 쉽게 생성하고 확장할 수 있음. AgentSkills는 Jupyter IPython 환경(§2.2)에 자동으로 임포트되는 다양한 유틸리티 함수(즉, 도구)들로 구성된 Python 패키지로 설계되었다. Python 함수를 도구로 정의하는 용이성은 커뮤니티 구성원들이 라이브러리에 새로운 도구를 기여하는 장벽을 낮춘다. Python 패키지의 일반성은 또한 서로 다른 에이전트 구현이 우리의 핵심 행동 중 하나인 IPythonRunCellAction(§2.1)을 통해 이러한 도구들을 쉽게 활용할 수 있게 한다.
포함 기준과 철학. AgentSkills 라이브러리에서는 가능한 모든 Python 패키지를 감싸고 에이전트에게 그 사용법을 다시 가르치는 것을 목표로 하지 않는다(예: LLM은 이미 CSV 파일을 읽을 수 있는 pandas 라이브러리를 알고 있으므로, 에이전트에게 동일한 파일 형식을 읽는 방법을 가르치는 도구를 다시 만들 필요가 없다). 우리는 다음의 경우에만 새로운 스킬을 추가한다: (1) LLM이 직접 코드를 작성하는 것이 쉽게 달성 가능하지 않은 경우(예: 코드를 편집하고 특정 줄을 대체하는 것), 그리고/또는 (2) 외부 모델 호출을 포함하는 경우(예: 음성-텍스트 모델 호출, 또는 코드 편집을 위한 모델(Sanger)).
현재 지원되는 스킬. AgentSkills 라이브러리에는 SWE-Agent(Yang et al., 2024)와 Aider(Gauthier)에서 각색된 파일 편집 유틸리티가 포함되어 있으며, 예컨대 지정된 줄부터 기존 파일을 수정할 수 있게 하는 edit_file, 파일의 다른 부분을 보기 위한 스크롤 함수 scroll_up 및 scroll_down이 있다. 또한 멀티모달 문서 읽기를 지원하는 도구들, 예컨대 비전-언어 모델(예: GPT-4V)을 사용하여 이미지에서 정보를 추출하기 위한 parse_image와 PDF에서 텍스트를 읽기 위한 parse_pdf도 포함되어 있다. 지원되는 스킬의 전체 목록은 §1에서 확인할 수 있다.
2.4 에이전트 위임: 협력적 다중 에이전트 상호작용
OpenHands는 여러 에이전트 간의 상호작용도 허용한다. 이를 위해 우리는 에이전트가 특정 하위 작업을 다른 에이전트에게 위임할 수 있게 하는 특별한 행동 유형인 AgentDelegateAction을 사용한다. 예를 들어, 웹 브라우징 지원이 제한적인 범용 CodeActAgent는 AgentDelegateAction을 사용하여 웹 브라우징 작업을 전문화된 BrowsingAgent에게 위임함으로써 보다 복잡한 브라우징 활동(예: 웹 탐색, 버튼 클릭, 양식 제출 등)을 수행할 수 있다.
3 AGENTHUB: 커뮤니티 기여 에이전트들의 허브
우리의 에이전트 추상화(§2.1)를 기반으로, OpenHands는 최종 사용자가 선택할 수 있고 다양한 에이전트 작업을 위한 기준선 역할을 할 수 있는 광범위한 커뮤니티 기여 에이전트 구현들을 지원한다.
CodeAct 에이전트. CodeActAgent는 CodeAct 프레임워크(Wang et al., 2024a)에 기반한 기본 범용 에이전트이다. 각 단계에서 에이전트는 (1) 명확화, 확인 등을 요청하기 위해 자연어로 인간과 소통하기 위해 대화하거나, (2) bash 명령, Python 코드, 또는 브라우저 전용 프로그래밍 언어(§2.2)의 실행을 포함한 코드(일명 CodeAct)를 실행하여 작업을 수행할 수 있다. 이러한 일반적인 행동 공간은 에이전트(v1.5 이상)가 파일 편집, 웹 브라우징, 프로그램 실행 등 다양한 작업을 수행할 수 있게 한다.
표 1: 서로 다른 AI 에이전트 프레임워크들의 비교(§C). SWE는 '소프트웨어 공학'을 의미한다. 표준화된 도구 라이브러리: 프레임워크가 서로 다른 에이전트 구현을 위한 재사용 가능한 도구들을 포함하는지 여부(§2.3); 내장 샌드박스 및 코드 실행: 임의의 에이전트 생성 코드의 샌드박스 실행을 지원하는지 여부; 내장 웹 브라우저: 에이전트에게 완전히 작동하는 웹 브라우저에 대한 접근을 제공하는지 여부; 인간-AI 협업: 다중 턴 인간-AI 협업을 가능하게 하는지 여부(예: 인간이 작업 실행 중 에이전트를 중단하거나 추가 피드백 및 지시를 제공할 수 있음); AgentHub: 다양한 에이전트들의 구현을 호스팅하는지 여부(§3); 평가 프레임워크: 구현된 에이전트들을 어려운 벤치마크에서 체계적으로 평가하는 기능을 제공하는지 여부(§4); 에이전트 QC(품질 관리): 프레임워크가 전반적인 프레임워크 소프트웨어 품질을 보장하기 위해 테스트(§E)를 통합하는지 여부.
| 프레임워크 | 도메인 | 그래픽 사용자 인터페이스 | 표준화된 도구 라이브러리 | 내장 샌드박스 & 코드 실행 | 내장 웹 브라우저 | 다중 에이전트 협업 | 인간-AI 협업 | AgentHub | 평가 프레임워크 | Agent QC |
| AutoGPT Gravitas (2023) | 범용 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| LangChain (Chase, 2022) | 범용 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| MetaGPT (Hong et al., 2023) | 범용 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoGen (Wu et al., 2023) | 범용 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoAgents (Chen et al., 2024) | 범용 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| 에이전트 (Zhou et al., 2023b) | 일반 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Xagents (Team, 2023) | 일반 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| OpenAgents (Xie et al., 2023) | 일반 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| GPT5Warm (Zhuge et al., 2024) | 일반 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoCodeRover (Zhang et al., 2024b) | SWE | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| SWE-Agent (Yang et al., 2024) | SWE | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| OpenHands | 일반 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
\* 네이티브 지원 없음. 제3자 상용 옵션을 사용할 수 있음.
Browsing Agent. 우리는 웹 에이전트 작업을 위한 단순하면서도 효과적인 베이스라인 역할을 하도록 Browsing Agent라는 범용 웹 에이전트를 구현하였다. 이 에이전트는 WebArena(Zhou et al., 2023a)의 에이전트와 유사하지만, 개선된 관찰과 행동을 갖추고 있으며 제로샷 프롬프팅만 사용한다. 전체 프롬프트는 에 있다.
GPT5Warm Agent. GPT5Warm(Zhuge et al., 2024)은 최적화 가능한 그래프를 사용하여 에이전트 시스템을 구축하는 선구적인 접근으로, 모듈성을 통해 언어 에이전트 프레임워크를 통합한다. 각 노드는 별개의 연산을 나타내며, 엣지는 협업 및 통신 경로를 정의한다. 이 설계는 노드와 엣지의 자동 최적화를 가능하게 하여 다중 에이전트 시스템 구축의 발전을 이끈다.
Micro Agent(s). 또한 OpenHands는 특정 작업에 특화된 에이전트인 micro agent의 생성을 가능하게 한다. micro agent는 기존 범용 에이전트(예: CodeAct Agent)의 대부분의 구현을 재사용한다. 이는 에이전트 개발의 진입 장벽을 낮추도록 설계되었으며, 커뮤니티 구성원이 자신의 특정 사용 사례에 잘 작동하는 특화된 프롬프트를 공유할 수 있게 한다.
4 평가
Tab. 2에 나열된 바와 같이, 범용 디지털 에이전트 구축의 진행 상황을 체계적으로 추적하기 위해 우리는 15개의 확립된 벤치마크를 OpenHands에 통합하였다. 이러한 벤치마크는 소프트웨어 공학, 웹 브라우징, 기타 지원 작업을 포괄한다. 이 섹션에서는 벤치마크 내용에 특화된 수동 프롬프트 엔지니어링을 수행하지 않는, 오픈소스로 재현 가능한 베이스라인과 OpenHands를 비교한다. 간결성을 위해 이 섹션의 나머지 부분에서는 OpenHands를 'OH'로 줄여 표기한다는 점에 유의하기 바란다.
| 범주 | 벤치마크 | 요구되는 능력 |
| 소프트웨어 | SWE-Bench (Jimenez et al., 2024) | GitHub 이슈 수정 |
| HumanEvalFix (Muennighoff et al., 2024) | 버그 수정 | |
| BIRD (Li et al., 2023b) | Text-to-SQL | |
| BioCoder (Tang et al., 2024c) | 생물정보학 코딩 | |
| 웹 | ML-Bench (Tang et al., 2024b) | 머신러닝 코딩 |
| Gorilla APIBench (Patil et al., 2023) | 소프트웨어 API 호출 | |
| ToolQA (Zhuang et al., 2024) | 도구 사용 | |
| 기타 지원 | WebArena (Zhou et al., 2023a) | 목표 계획 & 현실적인 브라우징 |
| MiniWoB++ (Liu et al., 2018) | 합성 웹에서의 짧은 궤적 | |
| GAI (Mialon et al., 2023) | 도구 사용, 브라우징, 멀티모달리티 | |
| GPQA (Rein et al., 2023) | 대학원 수준의 구글 검색으로 풀 수 없는 Q&A | |
| AgentBench (Liu et al., 2023) | 운영 체제 상호작용 (bash) | |
| MINT (Wang et al., 2024b) | 다중 턴 수학 및 코드 문제 | |
| Entity Deduction Arena (Zhang et al., 2024a) | 상태 추적 & 전략적 계획 | |
| ProofWriter (Tajford et al., 2021) | 연역적 논리 추론 |
4.1 결과 개요
OpenHands에서 우리의 목표는 소프트웨어 인터페이스를 통해 세계와 상호작용할 수 있는 범용 디지털 에이전트를 개발하는 것이다(§2.1에서 설명한 코드 행동이 그 예시이다). 우리는 소프트웨어 에이전트가 코드 편집뿐만 아니라 웹 브라우징 및 코드 저장소에 관한 질문에 답하거나 온라인 조사를 수행하는 등 다양한 보조 작업에서도 뛰어나야 한다고 본다.
| 에이전트 | 모델 | 소프트웨어 ('$4.2)</td><td rowspan="2">웹 ('$4.3) | 기타 ('$4.4) | ||
| SWE-Bench Lite | WebArena | ||||
| SWE-Agent (Yang et al., 2024) | gpt-4-1106-preview | 18.0 | - | - | |
| AutoCodeRover (Zhang et al., 2024b) | gpt-4-0125-preview | 19.0 | - | - | |
| Aider (Gauthier) | gpt-4o &amp; claude-3-opus | 26.3 | - | - | |
| Moatless Tools (Orwall) | claude-3.5-sonnet | 26.7 | - | - | |
| Agentless (Xia et al., 2024) | gpt-4o | 27.3 | - | - | |
| 웹 브라우징 에이전트 | |||||
| Lemur (Xu et al., 2023) | Lemur-chat-70b | - | 5.3 | - | - |
| Patel et al. (2024) | 합성 데이터로 학습된 72B | - | 9.4 | - | - |
| AutoWebGLM (Lai et al., 2024) | 인간/에이전트 주석으로 학습된 7B | - | 18.2 | - | - |
| Auto Eval &amp; Refine (Pan et al., 2024) | GPT-4 + Reflexion w/ GPT-4V | - | 20.2 | - | - |
| WebArena Agent (Zhou et al., 2023a) | gpt-4-turbo | - | 14.4 | - | - |
| 기타 지원 에이전트 | |||||
| AutoGPT (Gravitas, 2023) | gpt-4-turbo | - | - | - | 13.2 |
Few-shot 프롬프팅+ 사고 연쇄(Chain-of-Thought) (Rein et al., 2023) | Llama-2-70b-chat | - | - | 28.1 | - |
| gpt-4 | gpt-3.5-turbo-16k | - | - | 29.6 | - |
| gpt-4 | gpt-4 | - | - | 38.8 | - |
| OpenHands 에이전트 | |||||
| CodeActAgent v1.8 | gpt-4o-mini-2024-07-18 | 6.3 | 8.3 | - | - |
| gpt-4o-2024-05-13 | gpt-4o-2024-05-13 | 22.0 | 14.5 | *53.1 | - |
| claude-3-5-sonnet | claude-3-5-sonnet | 26.0 | 15.3 | 52.0 | - |
| GPTSwarm v1.0 | gpt-4o-2024-05-13 | - | - | - | 32.1 |
\* 수치는 CodeActAgent v1.5에서 보고된 것이다.
Tab. 3은 선별된 평가 결과 집합을 보여준다. OpenHands 에이전트가 모든 범주에서 최고 성능을 달성하지는 못할 수 있지만, 이들은 범용성을 염두에 두고 설계되었다. 특히, 동일한 CodeAct 에이전트가 시스템 프롬프트를 전혀 수정하지 않고도 소프트웨어 개발, 웹 상호작용, 기타 작업의 세 가지 주요 작업 범주 전반에서 경쟁력 있는 성능을 보인다는 점이 주목할 만하다. 이는 일반적으로 특정 작업 범주에 맞게 설계되고 최적화되는 베이스라인 에이전트와 비교할 때 특히 중요하다.
4.2 소프트웨어 공학
다음으로, Tab. 4에 소프트웨어 공학 벤치마크에 대한 결과를 구체적으로 보고한다.
SWE-Bench(Jimenez et al., 2024)는 버그 보고서나 기능 요청과 같은 실제 GitHub 이슈를 해결하는 에이전트의 능력을 평가하도록 설계되었다. 에이전트는 저장소와 상호작용하며 파일 편집과 코드 실행을 통해 제공된 이슈를 수정하려고 시도한다. 에이전트가 수정한 코드 저장소는 동일한 이슈에 대한 인간 개발자의 수정에서 추가된 새로운 테스트를 포함하는 테스트 스위트로 테스트된다. 각 테스트 인스턴스에는 문제 해결 방법에 대한 자연어 제안으로 구성된 "힌트 텍스트"가 함께 제공된다. 이 논문 전체에서 우리는 힌트 텍스트를 사용하지 않은 모든 결과를 보고한다. 접근 가능하고 효율적인 테스트를 용이하게 하기 위해 표준 부분집합인 SWE-bench Lite가 만들어졌다. 우리는 비용 절감을 고려하여 기본적으로 이 부분집합을 테스트에 사용한다.2 결과. Tab. 4에서 볼 수 있듯이, claude-3.5-sonnet을 사용하는 우리의 최신 버전 CodeActAgent v1.8은 다른 오픈소스 SWE 전문가들과 비교하여 경쟁력 있는 의 해결률을 달성한다.
4.2.1 HumanEvalFix
HumanEvalFix(Muennighoff et al., 2024)는 제공된 테스트 케이스의 도움을 받아 제공된 함수의 버그를 수정하도록 에이전트에 작업을 부여한다. 버그는 하나 이상의 테스트 케이스가 실패하도록 만들어졌다. 우리는 벤치마크의 Python 부분집합에 초점을 맞추고, 모델이 테스트 실행 피드백을 통합하여 여러 턴에 걸친 자기 디버깅으로 버그를 해결하도록 허용한다. 우리는 pass@k(Chen et al., 2021)를 사용하는 Muennighoff et al. (2024)의 설정을 따른다. 결과. Tab. 4에서 OpenHands CodeActAgent는 Python 분할에서 버그의 를 성공적으로 수정한다. 이는 모든 비에이전트적 접근보다 현저히 우수하며, StarCoder2-15B(Lozhkov et al., 2024; Li et al., 2023c)의 성능을 거의 두 배로 높인다. SWE-Agent가 를 달성하지만, Yang et al. (2024)은 모델에게 테스트 데이터셋의 버그 중 하나를 수정하는 성공적인 샘플 궤적의 전체 시연("1-shot")을 제공하는 반면, OpenHands에 대한 우리의 평가는 0-shot이다. HumanEvalFix는 인간에 의해 만들어졌고 모든 버그가
| 에이전트 | 모델 | 성공률 (%) | $ 평균 비용 |
| SWE-Agent (Yang et al., 2024) | SWE-Bench Lite (Jimenez et al., 2024), 300개 인스턴스, 힌트 없음 | ||
| AutoCodeRover (Zhang et al., 2024b) | gpt-4-1106-preview | 18.0 | 1.67 |
| Aider (Gauthier) | gpt-4-0125-preview | 19.0 | - |
| gpt-4-0&amp; claude-3-opus | 26.3 | - | |
| OH CodeActAgent v1.8 | gpt-4-0-mini-2024-07-18 | 7.0 | 0.01 |
| gpt-4-0-2024-05-13 | 22.0 | 1.72 | |
| claude-3-5-sonnet@20240620 | 26.0 | 1.10 | |
| HumanEvalFix (Muennighoff et al., 2024), 164개 인스턴스 | |||
| 프롬프팅, 0-shot | BLOOMZ-176B | 16.6 | - |
| OctoCoder-15B | 30.4 | - | |
| DeepSeekCoder-33B-Instruct | 47.5 | - | |
| StarCoder2-15B | 48.6 | - | |
| SWE-agent, 1-shot (Yang et al., 2024) | gpt-4-turbo | 87.7 | - |
| gpt-3.5-turbo-16k-0613 | 20.1 | 0.11 | |
| OH CodeActAgent v1.5, 제너럴리스트, 0-shot. | gpt-4-0-2024-05-13 | 79.3 | 0.14 |
| BIRD (Li et al., 2023b), 300개 인스턴스 | |||
| 프롬프팅, 0-shot | CodeLlama-7B-Instruct | 18.3 | - |
| CodeQwen-7B-Chat | 31.3 | - | |
| OH CodeActAgent v1.5 | gpt-4-1106-preview | 42.7 | 0.19 |
| gpt-4-0-2024-05-13 | 47.3 | 0.11 | |
| ML-Bench (Tang et al., 2024b), 68개 인스턴스 | |||
| 프롬프팅 + BM25, 0-shot | gpt-3.5-turbo | 11.0 | - |
| gpt-4-1106-preview | 22.1 | - | |
| gpt-4-0-2024-05-13 | 26.2 | - | |
| SWE-Agent (Yang et al., 2024) | gpt-4-1106-preview | 42.6 | 1.91 |
| Aider (Gauthier) | gpt-4-0-2024-05-13 | 64.4 | - |
| gpt-4-0-2024-05-13 | 76.5 | 0.25 | |
| gpt-4-1106-preview | 58.8 | 1.22 | |
| gpt-3.5-turbo-16k-0613 | 13.2 | 0.12 | |
| BioCoder (Python) (Tang et al., 2024b), 157개 인스턴스 | |||
| 프롬프팅, 0-shot | gpt-3.5-turbo | 11.0 | - |
| gpt-4-1106-preview | 12.7 | - | |
| OH CodeActAgent v1.5 | gpt-4-0-2024-05-13 | 27.5 | 0.13 |
| gpt-4-0-2024-05-13 | 8.7 | - | |
| gpt-4-0-2014 | 21.2 | - | |
| gpt-3.5-turbo-0301 | 29.7 | - | |
| llama-7b | 75.0 | - | |
| gpt-3.5-turbo-0125 | 21.6 | 0.002 | |
| gpt-4-0-2024-05-13 | 36.4 | 0.04 | |
| ToolQA (Zhuang et al., 2024), 800개 인스턴스 | |||
| 프롬프팅, 0-shot | ChatGPT + CoT | 5.1 | - |
| ChatGPT | 5.6 | - | |
| Chameleon | 10.6 | - | |
| ReAct, 0-shot (Yao et al., 2023; OpenAI, 2024a) | gpt-3.5-turbo | 36.8 | - |
| gpt-3 | 43.1 | - | |
| gpt-3.5-turbo-0125 | 2.3 | 0.03 | |
| gpt-4-0-2024-05-13 | 47.2 | 0.91 |
신중하게 검증되었으므로 이 벤치마크에서 를 달성하는 것은 전적으로 가능하며, 우리는 향후 OpenHands의 반복에서 이를 달성하고자 한다.
ML-Bench(Tang et al., 2024b)는 18개의 GitHub 저장소에 걸쳐 머신러닝 작업을 해결하는 에이전트의 능력을 평가한다. 이 벤치마크는 169개의 다양한 ML 문제에 걸친 9,641개의 작업으로 구성되며, 에이전트가 사용자 지시에 응답하여 bash 스크립트나 Python 코드를 생성해야 한다. 샌드박스 환경에서 에이전트는 명령을 반복적으로 실행하고 피드백을 받을 수 있어, 저장소 컨텍스트를 이해하고 사용자 요구 사항을 점진적으로 충족할 수 있다. 원 논문의 설정을 따라, 우리는 ML-Bench의 4분의 1 부분집합에 대해 에이전트 평가를 수행한다.
Gorilla APIBench(Patil et al., 2023)는 API를 사용하는 에이전트의 능력을 평가한다. 이는 TorchHub, TensorHub, HuggingFace에 대한 작업을 포함한다. 평가 중에 모델에는 "녹음된 음성을 텍스트로 변환할 수 있는 API를 식별하라"와 같이 API 사용과 관련된 질문이 주어진다. 정확성은 모델의 API 호출이 올바른 도메인에 있는지 여부에 따라 평가된다.
ToolQA(Zhuang et al., 2024)는 외부 도구를 사용하는 에이전트의 능력을 평가한다. 이 벤치마크는 항공편 상태, 커피 가격, Yelp 데이터, Airbnb 데이터와 같은 다양한 주제에 대한 작업을 포함하며, 텍스트 도구, 데이터베이스 도구, 수학 도구, 그래프 도구, 코드 도구, 시스템 도구 등 다양한 도구의 사용을 요구한다. 이는 easy와 hard의 두 수준을 특징으로 한다. easy 질문은 단일 도구 사용에 더 중점을 두는 반면, hard 질문은 추론을 강조한다. 우리는 평가를 위해 easy 부분집합을 채택한다.
BioCoder(Tang et al., 2024c)는 저장소 수준의 코드 생성 벤치마크로, 생물정보학 관련 작업, 특히 컨텍스트를 검색하고 정확하게 활용하는 능력에 대한 에이전트의 성능을 평가한다. 원래 프롬프트에는 코드의 관련 컨텍스트가 포함되어 있으나, 본 연구에서는 다중 턴 상호작용에서 컨텍스트 검색,
| 에이전트 | 모델 | 성공률 (%) | $ 평균 비용 |
| Lemur (Xu et al., 2023) | WebArena (Zhou et al., 2023a), 812개 인스턴스 | ||
| Patel et al. (2024) | Lemur-chat-70b | 5.3 | - |
| AutoWebGLM (Lai et al., 2024) | 자기 개선 합성 데이터로 학습된 72B | 9.4 | - |
| Auto Eval & Refine (Pan et al., 2024) | 인간/에이전트 하이브리드 주석으로 학습된 7B | 18.2 | - |
| GPT-4 + Reflexion (GPT-4V 보상 모델 포함) | 20.2 | - | |
| WebArena Agent (Zhou et al., 2023a) | gpt-3.5-turbo | 6.2 | - |
| gpt-4-turbo | 14.4 | - | |
| OH BrowsingAgent v1.0 | gpt-4o-mini-2024-07-18 | 8.5 | 0.01 |
| gpt-4o-2024-05-13 | 14.8 | 0.15 | |
| claude-3-5-sonnet-20240620 | 15.5 | 0.10 | |
| OH CodeActAgent v1.8 | gpt-4o-mini-2024-07-18 | 8.3 | - |
| BrowsingAgent v1.0으로 위임 | gpt-4o-2024-05-13 | 14.5 | - |
| claude-3-5-sonnet-20240620 | 15.3 | - | |
| MiniWoB++ (Liu et al., 2018), 125개 환경 | |||
| Workflow Guided Exploration (Liu et al., 2018) | 환경 탐색으로 학습된 전문 모델 | 34.6 | - |
| CC-NET (Humphreys et al., 2022) | RL 및 인간 주석 BC로 학습된 전문 모델 | 91.1 | - |
| OH BrowsingAgent v1.0 | gpt-3.5-turbo-0125 | 27.2 | 0.01 |
| gpt-4o-2024-05-13 | 40.8 | 0.05 | |
| OH CodeActAgent v1.8 | gpt-4o-2024-05-13 | 39.8 | - |
자기 디버깅, 추론을 수행하는 OpenHands의 능력을 보여주기 위해 이를 제거하였다. BioCoder는 157개의 Python 및 50개의 Java 함수로 구성되며, 각각은 단백질체학, 유전체학 및 기타 전문 영역과 같은 생물정보학의 특정 영역을 대상으로 한다. 이 벤치마크는 관련 코드가 마스킹된 기존 저장소에서 코드를 생성함으로써 실제 코드를 대상으로 한다.
BIRD(Li et al., 2023b)는 현실적이고 대규모의 데이터베이스 환경을 목표로 하는 text-to-SQL 작업(즉, 자연어를 실행 가능한 SQL로 변환)을 위한 벤치마크이다. 우리는 dev 세트에서 300개의 샘플을 선택하여 OpenHands에 통합하고 실행 정확도로 평가한다. 추가로, 우리는 에이전트가 최종 SQL 쿼리에 도달하기 위해 다중 턴 상호작용에 참여하도록 허용하여 설정을 확장하며, 이를 통해 SQL 실행 결과를 관찰하여 이전 결과를 수정할 수 있게 한다.
4.3 웹 브라우징
우리는 Tab. 5에 웹 브라우징 벤치마크에 대한 평가 결과를 보고한다.
WebArena(Zhou et al., 2023a)는 에이전트가 주어진 작업을 완료하는 데 어떤 경로를 택할지 자유롭게 선택할 수 있는, 자기 적대적이고 실행 기반의 웹 에이전트 벤치마크이다. WebArena는 쇼핑, 포럼, 개발자 플랫폼, 콘텐츠 관리 시스템 등 다양한 도메인에 걸친 812개의 인간이 선별한 작업 지시로 구성된다. 결과. Tab. 5에서 볼 수 있듯이, 우리의 BrowsingAgent는 도메인 일반 프롬프트 기법으로 LLM을 사용하는 에이전트들 사이에서 경쟁력 있는 성능을 달성한다.
MiniWoB++(Liu et al., 2018)는 내장된 보상 함수를 갖춘 대화형 웹 벤치마크이다. 작업은 125개의 서로 다른 미니멀리스트 웹 인터페이스에서 합성적으로 초기화된다. WebArena와 달리, 작업은 페이지 변경이 없어 더 쉽고, 더 적은 단계를 요구하며, 저수준의 단계별 작업 지시를 제공한다. 이는 성공적으로 해결하기 위해 시각 능력을 요구하는 환경의 일부를 포함하며, 많은 기존 연구는 작업의 부분집합에만 초점을 맞추기로 선택한다는 점에 유의하기 바란다(Kim et al., 2024; Li et al., 2023d; Shaw et al., 2023). 그럼에도 불구하고, 우리는 전체 집합에 대한 성능을 보고하며 전체 집합에서 평가된 베이스라인만 포함한다.
4.4 기타 지원
기타 지원 벤치마크에 대한 결과는 표 6에 보고되어 있다.
GAIA(Mialon et al., 2023)는 다양한 실제 시나리오를 아우르며 에이전트의 일반적인 과제 해결 능력을 평가한다. 이는 추론, 멀티모달 이해, 웹 브라우징, 코딩 등 다양한 에이전트 역량을 요구한다. GAIA는 세 가지 수준에 걸쳐 선별된 466개의 과제로 구성된다. GAIA를 설정하는 것은 전통적으로 다양한 도구를 에이전트와 통합하는 복잡성 때문에 어려웠지만, OpenHands의 인프라(예: 런타임 §2.2, 도구 §2.3)는 통합을 상당히 단순화한다.
GPQA(Rein et al., 2023)는 어려운 대학원 수준의 문제를 해결할 때 에이전트의 협응된 도구 사용 능력을 평가한다. 도구 사용(예: python)과 웹 검색은 종종 LLM이 수행할 수 없는 정확한 계산과 LLM의 파라메트릭 지식 기반 외부의 정보에 대한 접근을 제공하므로, 이러한 질문에 답할 때 에이전트를 지원하는 데 유용하다.
| 에이전트 | 모델 | 성공률 (%) | $ 평균 비용 |
| GAIA (Mialon et al., 2023), L1 검증 세트, 53개 인스턴스 | |||
| AutoGPT (Gravitas, 2023) | gpt-4-turbo | 13.2 | - |
| OH GPTSwarm v1.0 | gpt-4-0125-preview | 30.2 | 0.110 |
| gpt-4-2024-05-13 | 32.1 | 0.050 | |
| GPQA (Rein et al., 2023), 다이아몬드 세트, 198개 인스턴스 (다른 하위 집합은 §G, 표 7 참조) | |||
| 인간 (Rein et al., 2023) | 전문가 인간 | 81.3 | - |
| 비전문가 인간 | 21.9 | - | |
| 퓨샷 프롬프팅 + 사고 연쇄 (Rein et al., 2023) | gpt-3.5-turbo-16k | 29.6 | - |
| gpt-4 | 38.8 | - | |
| OH CodeActAgent v1.8 | claude-3-5-sonnet-20240620 | 52.0 | 0.065 |
| AgentBench (Liu et al., 2023), OS (bash) 하위 집합, 144개 인스턴스 | |||
| AgentBench 베이스라인 에이전트 (Liu et al., 2023) | gpt-4 | 42.4 | - |
| gpt-3.5-turbo | 32.6 | - | |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 57.6 | 0.085 |
| gpt-3.5-turbo-0125 | 11.8 | 0.006 | |
| MINT (Wang et al., 2024b): 수학 하위 집합, 225개 인스턴스 | |||
| MINT 베이스라인 에이전트 | gpt-4-0613 | 65.8 | - |
| gpt-4-2024-05-13 | 77.3 | 0.070 | |
| OH CodeActAgent v1.5 | gpt-3.5-turbo-16k-0613 | 33.8 | 0.048 |
| MINT (Wang et al., 2024b): 코드 하위 집합, 136개 인스턴스 | |||
| MINT 베이스라인 에이전트 | gpt-4-0613 | 59.6 | - |
| gpt-4-2024-05-13 | 50.0 | 0.087 | |
| OH CodeActAgent v1.5 | gpt-3.5-turbo-16k-0613 | 5.2 | 0.030 |
| ProofWriter (Tafjord et al., 2021), 600개 인스턴스 | |||
| 퓨샷 프롬프팅 + 사고 연쇄 (Pan et al., 2023) | gpt-4 | 68.1 | - |
| Logic-LM (Pan et al., 2023) | gpt-4 + 기호 solver | 79.6 | - |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 78.8 | - |
| Entity Deduction Arena (Zhang et al., 2024a), 200개 인스턴스 | |||
| 제로샷 프롬프팅 (Zhang et al., 2024a) | gpt-4-0314 | 40.0 | - |
| gpt-3.5-turbo-0613 | 27.0 | - | |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 38.0 | - |
| gpt-3.5-turbo-16k-0613 | 24.0 | - |
AgentBench(Liu et al., 2023)는 멀티턴, 개방형 생성 설정에서 에이전트의 추론 및 의사결정 능력을 평가한다. 우리는 144개의 과제로 구성된 코드 기반 운영체제(OS) 하위 집합을 선택했다. OpenHands의 에이전트는 bash 명령어를 사용하여 멀티턴 방식으로 과제별 OS와 직접 상호작용하며, 상호작용과 추론을 결합하여 과제 완료를 자동화한다.
MINT(Wang et al., 2024b)는 GPT-4로 시뮬레이션된 도구와 자연어 피드백을 사용하여 멀티턴 상호작용을 통해 어려운 과제를 해결하는 에이전트의 능력을 평가하기 위해 설계된 벤치마크이다. 우리는 Yuan et al. (2024)에서 사용된 코딩 및 수학 하위 집합을 사용한다. 우리는 원 논문을 따르며, 에이전트가 최대 5회 반복 동안 상호작용하고 두 번의 해결책 제안 기회를 갖도록 허용한다.
ProofWriter(Tafjord et al., 2021)는 LLM의 연역적 추론 능력을 평가하기 위해 만들어진 합성 데이터셋이다. Logic-LM(Pan et al., 2023)과 마찬가지로, 우리는 5-hop 추론을 요구하는 600개의 인스턴스를 포함하는 가장 어려운 하위 집합에 초점을 맞춘다. 의미 구문 분석에서 발생할 수 있는 오류의 영향을 최소화하기 위해, 우리는 Logic-LM에서 제공한 논리 형식을 사용한다.
Entity Deduction Arena(EDA)(Zhang et al., 2024a)는 20 Questions 게임과 유사하게 전략적 질문을 통해 알려지지 않은 엔티티를 추론하는 에이전트의 능력을 평가한다. 이 벤치마크는 멀티턴 대화 전반에 걸친 에이전트의 상태 추적, 전략적 계획, 귀납적 추론 능력을 테스트한다. 우리는 "Things"와 "Celebrities" 두 데이터셋을 평가하며, 각각 100개의 인스턴스로 구성되고, 이 두 데이터셋에 대한 평균 성공률을 보고한다.
5 결론
우리는 소프트웨어 인터페이스를 통해 세계와 상호작용하는 에이전트의 개발을 가능하게 하는 커뮤니티 주도 플랫폼인 OpenHands를 소개한다. 강력한 상호작용 메커니즘, 안전한 샌드박스 환경, 필수 에이전트 기술, 멀티 에이전트 협업 기능, 그리고 포괄적인 평가 프레임워크를 제공함으로써, OpenHands는 에이전트 AI 시스템의 연구 혁신과 실제 응용을 가속화한다. 안전하고 신뢰할 수 있는 에이전트를 개발하는 데 따르는 어려움(\$A)에도 불구하고, 우리는 활기찬 커뮤니티에 기대를 품고 있으며 OpenHands의 지속적인 발전을 고대한다.
참고문헌
Michael Ahn, Anthony Brohan, Noah Brown, Yevgen Chebotar, Omar Cortes, Byron David, Chelsea Finn, Chuyuan Fu, Keerthana Gopalakrishnan, Karol Hausman, et al. Do as i can, not as i say: Grounding language in robotic affordances. arXiv preprint arXiv:2204.01691, 2022. 1
Daniil A Boiko, Robert MacKnight, Ben Kline, and Gabe Gomes. Autonomous chemical research with large language models. Nature, 624(7992):570- 578, 2023. 1
Yupeng Chang, Xu Wang, Jindong Wang, Yuan Wu, Linyi Yang, Kaijie Zhu, Hao Chen, Xiaoyuan Yi, Cunxiang Wang, Yidong Wang, et al. A survey on evaluation of large language models. ACM Transactions on Intelligent Systems and Technology, 15(3):1- 45, 2024. 1
Harrison Chase. LangChain, October 2022. URL https://github.com/langchain- ai/langchain. 4, 6, 18
Guangyao Chen, Siwei Dong, Yu Shu, Ge Zhang, Jaward Sesay, Borje F. Karlsson, Jie Fu, and Yemin Shi. Autoagents: A framework for automatic agent generation, 2024. 1, 6, 18
Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021. 7
Cognition.ai. Introducing devin, the first ai software engineer. URL https://www.cognition.ai/blog/introducing- devin. 2
CrewAI. CrewAI, October 2024. URL https://github.com/crewAIInc/crewAI. 18
Jiaxi Cui, Zongjian Li, Yang Yan, Bohua Chen, and Li Yuan. Chatlaw: Open- source legal large language model with integrated external knowledge bases, 2023. 18
Alexandre Drouin, Maxime Gasse, Massimo Caccia, Issam H. Laradji, Manuel Del Verme, Tom Marty, Léo Boisvert, Megh Thakkar, Quentin Cappart, David Vazquez, Nicolas Chapados, and Alexandre Lacoste. Workarena: How capable are web agents at solving common knowledge work tasks?, 2024. 3, 4
Paul Gauthier. How aider scored sota 26.3% on swe bench lite i aider. https://aider.chat/2024/05/22/ swe- bench- lite.html. Accessed: 2024- 06- 05. 5, 7, 8
Significant Gravitas. Auto- gpt: An autonomous gpt- 4 experiment, 2023. URL https://github.com/Significant- Gravitas/Auto- GPT, 2023. 6, 7, 10, 18
Sirui Hong, Mingchen Zhuge, Jonathan Chen, Xiawu Zheng, Yuheng Cheng, Jinlin Wang, Ceyao Zhang, Zili Wang, Steven Ka Shing Yau, Zijuan Lin, et al. Metagpt: Meta programming for a multi- agent collaborative framework. In The Twelfth International Conference on Learning Representations, 2023. 1, 6, 18
Dong Huang, Qingwen Bu, Jie M. Zhang, Michael Luck, and Heming Cui. Agentcoder: Multi- agent- based code generation with iterative testing and optimisation, 2024. 19
Peter C Humphreys, David Raposo, Tobias Pohlen, Gregory Thornton, Rachita Chhaparia, Alistair Muldal, Josh Abramson, Petko Georgiev, Adam Santoro, and Timothy Lillicrap. A data- driven approach for learning to control computers. In International Conference on Machine Learning, pp. 9466- 9482. PMLR, 2022. 9
IPython. Jupyter와 IPython의 미래 — IPython. URL https://ipython.org. 4
Albert Q Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch, Blanche Savary, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Emma Bou Hanna, Florian Bressand, et al. Mixtral of experts. arXiv preprint arXiv:2401.04088, 2024. 1
Carlos E Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press, and Karthik R Narasimhan. SWE-bench: 언어 모델이 실제 GitHub 이슈를 해결할 수 있는가? In The Twelfth International Conference on Learning Representations, 2024. URL https://openreview.net/forum?id=VTF8yNQM66. 1, 6, 7, 8, 17, 19
Omar Khattab, Arnav Singhvi, Paridhi Maheshwari, Zhiyuan Zhang, Keshav Santhanam, Sri Vardhamanan, Saiful Haq, Ashutosh Sharma, Thomas T. Joshi, Hanna Moazam, Heather Miller, Matei Zaharia, and Christopher Potts. Dspy: 선언적 언어 모델 호출을 자기 개선 파이프라인으로 컴파일하기. 2024. 18
Geunwoo Kim, Pierre Baldi, and Stephen McAleer. 언어 모델은 컴퓨터 작업을 해결할 수 있다. Advances in Neural Information Processing Systems, 36, 2024. 9
Hanyu Lai, Xiao Liu, Iat Long Iong, Shuntian Yao, Yuxuan Chen, Pengbo Shen, Hao Yu, Hanchen Zhang, Xiaohan Zhang, Yuxiao Dong, et al. Autowebglm: 대규모 언어 모델 기반 웹 탐색 에이전트를 부트스트랩하고 강화하기. arXiv preprint arXiv:2404.03648, 2024. 7, 9
Hareton K. N. Leung and Lee J. White. 통합 수준에서의 통합 테스트 및 소프트웨어 회귀에 관한 연구. In Proceedings of the Conference on Software Maintenance, ICSM 1990, San Diego, CA, USA, 26-29 November, 1990, pp. 290-301. IEEE, 1990. doi: 10.1109/ICSM.1990.131377. URL https://doi.org/10.1109/ICSM.1990.131377. 19
Guohao Li, Hasan Abed Al Kader Hammoud, Hani Itani, Dmitrii Khizbullin, and Bernard Ghanem. Camel: 대규모 언어 모델 사회의 "마음" 탐구를 위한 의사소통 에이전트. arXiv preprint arXiv:2303.17760, 2023a. 18
Jinyang Li, Binyuan Hui, GE QU, Jiaxi Yang, Binhua Li, Bowen Li, Bailin Wang, Bowen Qin, Ruiying Geng, Nan Huo, Xuanhe Zhou, Chenhao Ma, Guoliang Li, Kevin Chang, Fei Huang, Reynold Cheng, and Yongbin Li. LLM은 이미 데이터베이스 인터페이스로 기능할 수 있는가? 대규모 데이터베이스 기반 텍스트-투-SQL을 위한 Blg 벤치. In Thirty-seventh Conference on Neural Information Processing Systems Datasets and Benchmarks Track, 2023b. 6, 8, 9, 17
Raymond Li, Loubna Ben Allal, Yangtian Zi, Niklas Muennighoff, Denis Kocetkov, Chenghao Mou, Marc Marone, Christopher Akiki, Jia Li, Jenny Chim, Qian Liu, Evgenii Zheltonozhskii, Terry Yue Zhuo, Thomas Wang, Olivier Dehaene, Mishig Davaadorj, Joel Lamy-Poirier, Joao Monteiro, Oleh Shliazhko, Nicolas Gontier, Nicholas Meade, Armel Zebaze, Ming-Ho Yee, Logesh Kumar Umapathi, Jian Zhu, Benjamin Lipkin, Muhtasham Oblokulov, Zhiruo Wang, Rudra Murthy, Jason Stillerman, Siva Sankalp Patel, Dmitry Abulkhanov, Marco Zocca, Manan Dey, Zhihan Zhang, Nour Fahmy, Urvashi Bhattacharyya, Wenhao Yu, Swayam Singh, Sasha Luccioni, Paulo Villegas, Maxim Kunakov, Fedor Zhdanov, Manuel Romero, Tony Lee, Nadav Timor, Jennifer Ding, Claire Schlesinger, Hailey Schoelkopf, Jan Ebert, Tri Dao, Mayank Mishra, Alex Gu, Jennifer Robinson, Carolyn Jane Anderson, Brendan Dolan-Gavitt, Danish Contractor, Siva Reddy, Daniel Fried, Dzmitry Bahdanau, Yacine Jernite, Carlos Munoz Ferrandis, Sean Hughes, Thomas Wolf, Arjun Guha, Leandro von Werra, and Harm de Vries. Starcoder: 소스가 그대와 함께하기를!, 2023c. URL https://arxiv.org/abs/2305.06161. 7
Tao Li, Gang Li, Zhiwei Deng, Bryan Wang, and Yang Li. 구조화된 성찰을 이용한 컴퓨터 제어용 제로샷 언어 에이전트. arXiv preprint arXiv:2310.08740, 2023d. 9
Evan Zheran Liu, Kelvin Guu, Panupong Pasupat, Tianlin Shi, and Percy Liang. 워크플로 가이드 탐색을 이용한 웹 인터페이스에서의 강화 학습. In International Conference on Learning Representations (ICLR), 2018. URL https://arxiv.org/abs/1802.08802. 6, 9, 17
Xiao Liu, Hao Yu, Hanchen Zhang, Yifan Xu, Xuanyu Lei, Hanyu Lai, Yu Gu, Hangliang Ding, Kaiwen Men, Kejuan Yang, Shudan Zhang, Xiang Deng, Aohan Zeng, Zhengxiao Du, Chenhui Zhang, Sheng Shen, Tianjun Zhang, Yu Su, Huan Sun, Minlie Huang, Yuxiao Dong, and Jie Tang. Agentbench: LLM을 에이전트로 평가하기. arXiv preprint arXiv: 2308.03688, 2023. 6, 10, 17
Anton Lozhkov, Raymond Li, Loubna Ben Allal, Federico Cassano, Joel Lamy-Poirier, Nouamane Tazi, Ao Tang, Dmytro Pykhtar, Jiawei Liu, Yuxiang Wei, Tianyang Liu, Max Tian, Denis Kocetkov, Arthur Zucker, Younes Belkada, Zijian Wang, Qian Liu, Dmitry Abulkhanov, Indraneil Paul, Zhuang Li, Wen-Ding Li, Megan Risdal, Jia Li, Jian Zhu, Terry Yue Zhuo, Evgenii Zheltonozhskii, Nii Osae Osae Dade, Wenhao Yu, Lucas Krauß, Naman Jain, Yixuan Su, Xuanli He, Manan Dey, Edoardo Abati, Yekun Chai, Niklas Muennighoff, Xiangru Tang, Muhtasham Oblokulov, Christopher Akiki, Marc Marone, Chenghao Mou, Mayank Mishra, Alex Gu, Binyuan Hui, Tri Dao, Armel Zebaze, Olivier Dehaene, Nicolas Patry, Canwen Xu, Julian McAuley, Han Hu, Torsten Scholak, Sebastien Paquet, Jennifer Robinson, Carolyn Jane Anderson, Nicolas Chapados, Mostofa Patwary, Nima Tajbakhsh, Yacine Jernite, Carlos Muñoz Ferrandis, Lingming Zhang, Sean Hughes, Thomas Wolf, Arjun Guha, Leandro von Werra, and Harm de Vries. Starcoder 2 and the stack v2: 차세대, 2024. URL https://arxiv.org/abs/2402.19173. 7
Grégoire Mialon, Clémentine Fourrier, Craig Swift, Thomas Wolf, Yann LeCun, and Thomas Scialom. GAIA: 범용 AI 어시스턴트를 위한 벤치마크. CoRR, abs/2311.12983, 2023. doi: 10.48550/ARXIV.2311.12983. URL https://doi.org/10.48550/arXiv.2311.12983. 6, 9, 10, 17
Mozilla. 접근성 트리 - MDN Web Docs 용어집: 웹 관련 용어의 정의 | MDN. URL https://developer.mozilla.org/en-US/docs/Glossary/Accessibility_tree. 5
Niklas Muennighoff, Qian Liu, Armel Zebaze, Qinkai Zheng, Binyuan Hui, Terry Yue Zhuo, Swayam Singh, Xiangru Tang, Leandro von Werra, and Shayne Longpre. Octopack: 코드 대규모 언어 모델의 명령 튜닝, 2024. 6, 7, 8, 17
Y Nakajima. Babyagi. URL https://github.com/yoheinakajima/babyagi, 2023. 18
OpenAI. Chatgpt: 2024년 5월 버전. https://www.openai.com/chatgpt, 2024a. 접속일: 2024-05-29. 8, 18
OpenAI. Hello gpt-4o. https://openai.com/index/hello-gpt-4o/, 2024b. 접속일: 2024-05-15. 1
OpenAI. Hello gpt-4o. https://openai.com/index/hello-gpt-4o/, 2024b. 접속일: 2024-05-15. 1OpenAI, Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, Red Avila, Igor Babuschkin, Suchir Balaji, Valerie Balcom, Paul Baltescu, Haiming Bao, Mohammad Bavarian, Jeff Belgum, Irwan Bello, Jake Berdine, Gabriel Bernadett-Shapiro, Christopher Berner, Lenny Bogdonoff, Oleg Boiko, Madelaine Boyd, Anna-Luisa Brakman, Greg Brockman, Tim Brooks, Miles Brundage, Kevin Button, Trevor Cai, Rosie Campbell, Andrew Cann, Brittany Carey, Chelsea Carlson, Rory Carmichael, Brooke Chan, Che Chang, Fotis Chantzis, Derek Chen, Sully Chen, Ruby Chen, Jason Chen, Mark Chen, Ben Chess, Chester Cho, Casey Chu, Hyung Won Chung, Dave Cummings, Jeremiah Currier, Yunxing Dai, Cory Decareaux, Thomas Degry, Noah Deutsch, Damien Deville, Arka Dhar, David Dohan, Steve Dowling, Sheila Dunning, Adrien Ecoffet, Atty Eleti, Tyna Eloundou, David Farhi, Liam Fedus, Niko Felix, Simón Posada Fishman, Juston Forte, Isabella Fulford, Leo Gao, Elie Georges, Christian Gibson, Vik Goel, Tarun Gogineni, Gabriel Goh, Rapha Gontijo-Lopes, Jonathan Gordon, Morgan Grafstein, Scott Gray, Ryan Greene, Joshua Gross, Shixiang Shane Gu, Yufei Guo, Chris Hallacy, Jesse Han, Jeff Harris, Yuchen He, Mike Heaton, Johannes Heidecke, Chris Hesse, Alan Hickey, Wade Hickey, Peter Hoeschele, Brandon Houghton, Kenny Hsu, Shengli Hu, Xin Hu, Joost Huizinga, Shantanu Jain, Shawn Jain, Joanne Jang, Angela Jiang, Roger Jiang, Haozhun Jin, Denny Jin, Shino Jomoto, Billie Jonn, Heewoo Jun, Tomer Kaftan, Łukasz Kaiser, Ali Kamali, Ingmar Kanitscheider, Nitish Shirish Keskar, Tabarak Khan, Logan Kilpatrick, Jong Wook Kim, Christina Kim, Yongjik Kim, Jan Hendrik Kirchner, Jamie Kiros, Matt Knight, Daniel Kokotajlo, Łukasz Kondraciuk, Andrew Kondrich, Aris Konstantinidis, Kyle Kosic, Gretchen Krueger, Vishal Kuo, Michael Lampe, Iki Lan, Teddy Lee, Jan Leike, Jade Leung, Daniel Levy, Chak Ming Li, Rachel Lim, Molly Lin, Stephanie Lin, Mateusz Litwin, Theresa Lopez, Ryan Lowe, Patricia Lue, Anna Makanju, Kim Malfacini, Sam Manning, Todor Markov, Yaniv Markovski, Bianca Martin, Katie Mayer, Andrew Mayne, Bob McGrew, Scott Mayer McKinney, Christine McLeavey, Paul McMillan, Jake McNeil, David Medina, Aalok Mehta, Jacob Menick, Luke Metz, Andrey Mishchenko, Pamela Mishkin, Vinnie Monaco, Evan Morikawa, Daniel Mossing, Tong Mu, Mira Murati, Oleg Murk, David Mély, Ashvin Nair, Reiichiro Nakano, Rajeev Nayak, Arvind Neelakantan, Richard Ngo, Hyeonwoo Noh, Long Ouyang, Cullen O'Keefe, Jakub Pachocki, Alex Paino, Joe Palermo, Ashley Pantuliano, Giambattista Parascandolo, Joel Parish, Emy Parparita, Alex Passos, Mikhail Pavlov, Andrew Peng, Adam Perelman, Filipe de Avila Belbute Peres, Michael Petrov, Henrique Ponde de Oliveira Pinto, Michael, Pokorny, Michelle Pokrass, Vitchyr H. Pong, Tolly Powell, Alethea Power, Boris Power, Elizabeth Proehl, Raul Puri, Alec Radford, Jack Rae, Aditya Ramesh, Cameron Raymond, Francis Real, Kendra Rimbach, Carl Ross, Bob Rotsted, Henri Roussez, Nick Ryder, Mario Saltarelli, Ted Sanders, Shibani Santurkar, Girish Sastry, Heather Schmidt, David Schnurr, John Schulman, Daniel Selsam, Kyla Sheppard, Toki Sherbakov, Jessica Shieh, Sarah Shoker, Pranav Shyam, Szymon Sidor, Eric Sigler, Maddie Simens, Jordan Sitkin, Katarina Slama, Ian Sohl, Benjamin Sokolowsky, Yang Song, Natalie Staudacher, Felipe Petroski Such, Natalie Summers, Ilya Sutskever, Jie Tang, Nikolas Tezak, Madeleine B. Thompson, Phil Tillet, Amin Tootoonchian, Elizabeth Tseng, Preston Tuggle, Nick Turley, Jerry Tworek, Juan Felipe Cerón Uribe, Andrea Vallone, Arun Vijayvergiya, Chelsea Voss, Carroll Wainwright, Justin Jay Wang, Alvin Wang, Ben Wang, Jonathan Ward, Jason Wei, CJ Weinmann, Akila Welihinda, Peter Welinder, Jiayi Weng, Lilian Weng, Matt Wiethoff, Dave Willner, Clemens Winter, Samuel Wolrich, Hannah Wong, Lauren Workman, Sherwin Wu, Jeff Wu, Michael Wu, Kai Xiao, Tao Xu, Sarah Yoo, Kevin Yu, Qiming Yuan, Wojciech Zaremba, Rowan Zellers, Chong Zhang, Marvin Zhang, Shengjia Zhao, Tianhao Zheng, Juntang Zhuang, William Zhuk, and Barret Zoph. Gpt-4 기술 보고서, 2024. 18
Jiayi Pan, Yichi Zhang, Nicholas Tomlin, Yifei Zhou, Sergey Levine, and Alane Suhr. Autonomous evaluation and refinement of digital agents. arXiv preprint arXiv:2404.06474, 2024. 7, 9, 18
Liangming Pan, Alon Albalak, Xinyi Wang, and William Yang Wang. Logic-Im: Empowering large language models with symbolic solvers for faithful logical reasoning. arXiv preprint arXiv:2305.12295, 2023. 10
Joon Sung Park, Joseph C. O'Brien, Carrie J. Cai, Meredith Ringel Morris, Percy Liang, and Michael S. Bernstein. Generative agents: Interactive simulacra of human behavior, 2023. 18
Ajay Patel, Markus Hofmarcher, Claudiu Leoveanu-Condrei, Marius-Constantin Dinu, Chris Callison-Burch, and Sepp Hochreiter. Large language models can self-improve at web agent tasks. arXiv preprint arXiv:2405.20309, 2024. 7, 9
Shishir G. Patil, Tianjun Zhang, Xin Wang, and Joseph E. Gonzalez. Gorilla: Large language model connected with massive apis. arXiv preprint arXiv:2305.15334, 2023. 6, 8, 17
Playwright. Fast and reliable end-to-end testing for modern web apps | Playwright. URL https://playwright.dev/. 4
Chen Qian, Xin Cong, Wei Liu, Cheng Yang, Weize Chen, Yusheng Su, Yufan Dang, Jiahao Li, Juyuan Xu, Dahai Li, Zhiyuan Liu, and Maosong Sun. Communicative agents for software development, 2023. 18, 19
Yujia Qin, Shihao Liang, Yining Ye, Kunlun Zhu, Lan Yan, Yaxi Lu, Yankai Lin, Xin Cong, Xiangru Tang, Bill Qian, Sihan Zhao, Runchu Tian, Ruobing Xie, Jie Zhou, Mark Gerstein, Dahai Li, Zhiyuan Liu, and Maosong Sun. Toolllm: Facilitating large language models to master 16000+ real-world apis. CoRR, abs/2307.16789, 2023. doi: 10.48550/ARXIV.2307.16789. URL https://doi.org/10.48550/arXiv.2307.16789. 4
David Rein, Betty Li Hou, Asa Cooper Stickland, Jackson Petty, Richard Yuanzhe Pang, Julien Dirani, Julian Michael, and Samuel R Bowman. GPQA: A Graduate-Level Google-Proof Q&A Benchmark. arXiv preprint arXiv:2311.12022, 2023. 6, 7, 9, 10, 17, 23
Aman Sanger. Near-instant full-file edits. https://www.cursor.com/blog/instant-apply. Accessed: 2024-06-05. 5
ServiceNow. BrowserGym: a Gym Environment for Web Task Automation. URL https://github.com/ServiceNow/BrowserGym. 2, 4, 18
Peter Shaw, Mandar Joshi, James Cohan, Jonathan Berant, Panupong Pasupat, Hexiang Hu, Urvashi Khandelwal, Kenton Lee, and Kristina N Toutanova. From pixels to ui actions: Learning to follow instructions via graphical user interfaces. Advances in Neural Information Processing Systems, 36: 34354-34370, 2023. 9
Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. Reflexion: Language agents with verbal reinforcement learning. Advances in Neural Information Processing Systems, 36, 2024. 18
Oyvind Tafjord, Bhavana Dalvi, and Peter Clark. ProofWriter: Generating implications, proofs, and abductive statements over natural language. In Chengqing Zong, Fei Xia, Wenjie Li, and Roberto Navigli (eds.), Findings of the Association for Computational Linguistics: ACL-IJCNLP 2021, pp. 3621-3634, Online, August 2021. Association for Computational Linguistics. doi: 10.18653/v1/2021.findings-acl.317. URL https://aclanthology.org/2021.findings-acl.317. 6, 10, 17
Xiangru Tang, Qiao Jin, Kunlun Zhu, Tongxin Yuan, Yichi Zhang, Wangchunshu Zhou, Meng Qu, Yilun Zhao, Jian Tang, Zhuosheng Zhang, et al. Prioritizing safeguarding over autonomy: Risks of llm agents for science. arXiv preprint arXiv:2402.04247, 2024a. 1
Xiangru Tang, Yuliang Liu, Zefan Cai, Yanjun Shao, Junjie Lu, Yichi Zhang, Zexuan Deng, Helan Hu, Kaikai An, Ruijun Huang, Shuzheng Si, Sheng Chen, Haozhe Zhao, Liang Chen, Yan Wang, Tianyu Liu, Zhiwei Jiang, Baobao Chang, Yin Fang, Yujia Qin, Wangchunshu Zhou, Yilun Zhao, Arman Cohan, and Mark Gerstein. ML-Bench: Evaluating large language models and agents for machine learning tasks on repository-level code, 2024b. URL https://arxiv.org/abs/2311.09835. 6, 8, 17
Xiangru Tang, Bill Qian, Rick Gao, Jiakang Chen, Xinyun Chen, and Mark B Gerstein. BioCoder: a benchmark for bioinformatics code generation with large language models. Bioinformatics, 40(Supplement_1):i266-i276, 06 2024c. ISSN 1367-4811. 6, 8, 17
Xiangru Tang, Anni Zou, Zhuosheng Zhang, Ziming Li, Yilun Zhao, Xingyao Zhang, Arman Cohan, and Mark Gerstein. Medagents: Large language models as collaborators for zero-shot medical reasoning, 2024d. 18
Gemini Team, Rohan Anil, Sebastian Borgeaud, Yonghui Wu, Jean-Baptiste Alayrac, Jiahui Yu, Radu Soricut, Johan Schalkwyk, Andrew M Dai, Anja Hauth, et al. Gemini: a family of highly capable multimodal models. arXiv preprint arXiv:2312.11805, 2023. 1
XAgent Team. Xagent: An autonomous agent for complex task solving, 2023. 6, 18
Hugo Touvron, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie-Anne Lachaux, Timothée Lacroix, Baptiste Rozière, Naman Goyal, Eric Hambro, Faisal Azhar, Aurelien Rodriguez, Armand Joulin, Edouard Grave, and Guillaume Lample. Llama: Open and efficient foundation language models. arXiv preprint arXiv:2302.13971, 2023. 8
Xingyao Wang, Yangyi Chen, Lifan Yuan, Yizhe Zhang, Yunzhu Li, Hao Peng, and Heng Ji. Executable Code Actions Elicit Better LLM Agents. In ICML, 2024a. 2, 3, 4, 5, 17
Xingyao Wang, Zihan Wang, Jiateng Liu, Yangyi Chen, Lifan Yuan, Hao Peng, and Heng Ji. MINT: Evaluating LLMs in Multi-turn Interaction with Tools and Language Feedback. In ICLR, 2024b. 6, 10, 17
Qingyun Wu, Gagan Bansal, Jieyu Zhang, Yiran Wu, Shaokun Zhang, Erkang Zhu, Beibin Li, Li Jiang, Xiaoyun Zhang, and Chi Wang. Autogen: Enabling next-gen llm applications via multi-agent conversation framework. arXiv preprint arXiv:2308.08155, 2023. 1, 6, 18
Chunqiu Steven Xia, Yinlin Deng, Soren Dunn, and Lingming Zhang. Agentless: Demystifying llm-based software engineering agents. arXiv preprint, 2024. 7
Tianbao Xie, Fan Zhou, Zhoujun Cheng, Peng Shi, Luoxuan Weng, Yitao Liu, Toh Jing Hua, Junning Zhao, Qian Liu, Che Liu, et al. Openagents: An open platform for language agents in the wild. arXiv preprint arXiv:2310.10634, 2023. 6
Yiheng Xu, Hongjin Su, Chen Xing, Boyu Mi, Qian Liu, Weijia Shi, Binyuan Hui, Fan Zhou, Yitao Liu, Tianbao Xie, et al. Lemur: 언어 에이전트를 위한 자연어와 코드의 조화. arXiv preprint arXiv:2310.06830, 2023. 7, 9
John Yang, Carlos E. Jimenez, Alexander Wettig, Kilian Lieret, Shunyu Yao, Karthik Narasimhan, and Ofir Press. Swe-agent: 에이전트-컴퓨터 인터페이스가 자동화된 소프트웨어 공학을 가능하게 한다, 2024. 2, 5, 6, 7, 8, 19
Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik R Narasimhan, and Yuan Cao. React: 언어 모델에서 추론과 행동의 시너지. In The Eleventh International Conference on Learning Representations, 2023. URL https://openreview.net/forum?id=WE_vluYUL- X. 8
Yining Ye, Xin Cong, Shizuo Tian, Jiannan Cao, Hao Wang, Yujia Qin, Yaxi Lu, Heyang Yu, Huadong Wang, Yankai Lin, et al. Proagent: 로봇 프로세스 자동화에서 에이전트 프로세스 자동화로. arXiv preprint arXiv:2311.10751, 2023. 18.
Lifan Yuan, Yangyi Chen, Xingyao Wang, Yi R. Fung, Hao Peng, and Heng Ji. CRAFT: 특화된 도구 세트를 생성하고 검색하여 LLM을 커스터마이징하기. CoRR, abs/2309.17428, 2023. doi: 10.48550/ARXIV.2309.17428. URL https://doi.org/10.48550/arXiv.2309.17428. 4
Lifan Yuan, Ganqu Cui, Hanbin Wang, Ning Ding, Xingyao Wang, Jia Deng, Boji Shan, Huimin Chen, Ruobing Xie, Yankai Lin, Zhenghao Liu, Bowen Zhou, Hao Peng, Zhiyuan Liu, and Maosong Sun. 선호 트리를 활용한 LLM 추론 제너럴리스트의 발전, 2024. 10
Yizhe Zhang, Jiarui Lu, and Navdeep Jaitly. 20개의 질문 게임을 통해 LLM의 다중 턴 계획 능력을 탐색하기. 2024a. 6, 10, 17
Yuntong Zhang, Haifeng Ruan, Zhiyu Fan, and Abhik Roychoudhury. Autocoderover: 자율 프로그램 개선, 2024b. 6, 7, 8, 19
Shuyan Zhou, Frank F Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Abishek Sridhar, Xianyi Cheng, Tianyue Ou, Yonatan Bisk, Daniel Fried, et al. Webarena: 자율 에이전트 구축을 위한 현실적인 웹 환경. In The Twelfth International Conference on Learning Representations, 2023a. 1, 6, 7, 9, 17
Wangchunshu Zhou, Yuchen Eleanor Jiang, Long Li, Jialong Wu, Tiannan Wang, Shi Qiu, Jintian Zhang, Jing Chen, Ruipu Wu, Shuai Wang, Shiding Zhu, Jiyu Chen, Wentao Zhang, Xiangru Tang, Ningyu Zhang, Huajun Chen, Peng Cui, and Mrinmaya Sachan. Agents: 자율 언어 에이전트를 위한 오픈소스 프레임워크, 2023b. 6, 18
Yuchen Zhuang, Yue Yu, Kuan Wang, Haotian Sun, and Chao Zhang. Toolqa: 외부 도구를 활용한 LLM 질의응답을 위한 데이터셋. Advances in Neural Information Processing Systems, 36, 2024. 6, 8, 17
Mingchen Zhuge, Haozhe Liu, Francesco Faccio, Dylan R Ashley, Robert Csordás, Anand Gopalakrishnan, Abdullah Hamdi, Hasan Abed Al Kader Hammoud, Vincent Herrmann, Kazuki Irie, et al. 자연어 기반 마인드 사회에서의 마인드스톰. arXiv preprint arXiv:2305.17066, 2023. 18
Mingchen Zhuge, Wenyi Wang, Louis Kirsch, Francesco Faccio, Dmitrii Khizbullin, and Jurgen Schmidhuber. 최적화 가능한 그래프로서의 언어 에이전트. arXiv preprint arXiv:2402.16823, 2024. 6, 17, 18
Albert Örwall. Moatless tools. URL https://github.com/aorwall/moatless- tools. 7
저자 기여
이 작업은 여러 기관에 걸친 오픈소스 협업 노력이었습니다. 우리는 기여도를 결정하고 저자 자격을 부여하기 위해 포인트 기반 시스템을 사용했으며, 기술적 기여는 풀 리퀘스트(PR) 단위로 추적하고 측정했습니다. Xingyao Wang이 프로젝트를 이끌며 전반적인 개발과 논문 작성 노력을 조정했습니다. 세부 기여는 다음과 같습니다:
- 에이전트 개발(§3): Xingyao Wang이 CodeAct Wang et al. (2024a) 및 CodeActSWE 에이전트 구현을 이끌었습니다. Frank F. Xu가 웹 브라우징 에이전트 Zhou et al. (2023a) 개발을 이끌었습니다. Mingchen Zhuge가 GPTSwarm 에이전트 Zhuge et al. (2024)의 통합을 조율했습니다. Robert Brennan과 Boxuan Li가 Micro Agent 개발을 이끌었습니다.
- 아키텍처 개발(Fig. 2): Robert Brennan이 아키텍처 설계를 시작했습니다. Boxuan Li, Frank F. Xu, Xingyao Wang, Yufan Song, and Mingzhang Zheng이 아키텍처를 추가로 개선하고 확장했습니다. Boxuan Li는 통합 테스트(§E)의 초기 버전을 구현하고, agentskills 라이브러리(§2.3)를 유지 관리하고, 구성을 관리하고, 평가에서 리소스 누수를 해결했습니다. Frank F. Xu는 에이전트 실행과 평가 모두를 위한 웹 브라우징 환경(§J)을 개발하고 이를 에이전트 및 프런트엔드 사용자 인터페이스 모두와 통합했습니다. Xingyao Wang은 agentskills 라이브러리와 Docker 샌드박스의 초기 코드를 작성했습니다. Yufan Song은 평가를 위한 비용 추적을 구현했고, Mingzhang Zheng은 보다 안정적인 SWE-Bench 평가를 위한 이미지 비의존적 Docker 샌드박스를 개발했습니다.
- 벤치마킹, 통합 및 코드 리뷰: Boxuan Li와 Yufan Song이 조정, 평가 및 코드 리뷰를 포함한 벤치마크 통합 노력을 이끌었습니다. Yufan Song은 PR 기여 추적도 도왔습니다. Graham Neubig, Xingyao Wang, Mingzhang Zheng, Robert Brennan, Hoang H. Tran, Frank F. Xu, Xiangru Tang, Fuqiang Li, and Yanjun Shao가 통합 및 코드 리뷰에서 추가 지원을 제공했습니다. 구체적인 벤치마크 기여는 다음과 같습니다:
- SWE-Bench Jimenez et al. (2024): Bowen Li and Xingyao Wang- WebArena Zhou et al. (2023a) and MiniWob++ Liu et al. (2018): Frank F. Xu- GAIA Mialon et al. (2023): Jiayi Pan (통합) and Mingchen Zhuge (GPTSwarm 평가)- API-Bench Patil et al. (2023) and ToolQA Zhuang et al. (2024): Yueqi Song- HumanEvalFix Muennighoff et al. (2024): Niklas Muennighoff and Xiangru Tang- ProofWriter Tafjord et al. (2021): Ren Ma- MINT Wang et al. (2024b): Hoang H. Tran- AgentBench Liu et al. (2023): Fuqiang Li- BIRD Li et al. (2023b): Binyuan Hui- GPQA Rein et al. (2023): Jaskirat Singh- BioCoder Tang et al. (2024c): Xiangru Tang and Bill Qian- ML-Bench Tang et al. (2024b): Xiangru Tang and Yanjun Shao- Entity-Deduction-Arena Zhang et al. (2024a): Yizhe Zhang
- 자문: Graham Neubig이 프로젝트를 자문하며 지침, 리소스 및 상당한 논문 편집을 제공했습니다. Heng Ji와 Hao Peng이 추가 프로젝트 자문을 제공하고 논문 작성에 도움을 주었습니다. Junyang Lin이 자문 지원을 제공하고 리소스를 후원했습니다.
A 한계 및 향후 작업
우리는 활기찬 커뮤니티가 OpenHands에 마련한 기반에 대해 기대하고 있으며, 그것의 지속적인 발전을 기대합니다. 우리는 향후 작업을 위한 몇 가지 방향을 식별합니다:
향상된 멀티모달 지원. 현재 구현이 이미 사전 정의된 에이전트 스킬을 통해 다양한 파일 형식을 지원하지만, 우리는 표준 IPython 및 브라우저 통합을 통해 원칙적인 방식으로 멀티모달을 가능하게 하는 데 관심이 있습니다. 예를 들어 브라우저를 통해 비전-언어 모델을 사용하여 이미지와 비디오를 보거나 코드로 XLSX 파일을 처리하는 것입니다.
더 강력한 에이전트. 현재 에이전트는 여전히 복잡한 작업에 어려움을 겪고 있으며, 우리는 훈련 및 추론 시간 기법 모두를 통해 더 나은 에이전트를 구축하는 데 관심이 있습니다.
에이전트 편집 개선. 현재 에이전트는 긴 파일을 편집할 때 많은 어려움을 겪으며, 우리는 에이전트의 파일 편집 성능을 개선하기 위한 다양한 접근 방식을 탐색하는 데 관심이 있습니다.
웹 브라우징 개선. OpenHands의 확장 가능한 특성 덕분에 에이전트를 개선할 수 있는 직교적 구성 요소를 쉽게 통합할 수 있습니다. 예를 들어, OpenHands의 확장 가능한 아키텍처 덕분에 Auto Eval & Refine Pan et al. (2024)은 Reflexion Shinn et al. (2024) 프롬프트와 작업 완료 보상 모델을 사용하는 오류 시 재시도 전략으로서 우리의 브라우징 에이전트에 연결된 선택적 구성 요소로 통합될 것입니다.
자동 워크플로 생성. 현재 OpenHands의 워크플로는 여전히 상당한 수작업 부담을 필요로 합니다. 우리는 GPTSwarm Zhuge et al. (2024) 및 LangGraph Chase (2022)와 같은 그래프 기반 프레임워크가 에이전트 구축을 위한 대안 솔루션으로 작용할 수 있다고 믿습니다. 특히 GPTSwarm에서는 에이전트가 그래프를 사용하여 구성될 때 다양한 최적화 방법(예: 강화 학습, 메타 프롬프팅)을 통합하기가 더 쉬워집니다. OpenHands는 이러한 방법이 향후 버전에서 자동 워크플로 생성의 유망한 솔루션을 위한 기반을 마련한다고 고려합니다.
B 윤리 성명
오늘날 대부분의 AI 에이전트는 여전히 연구 산출물이며 현실 세계에서 복잡하고 장기적인 작업을 안정적으로 수행할 능력이 부족합니다. 그러나 성능이 계속 향상되고 현실 세계에 점점 더 배포됨에 따라, 이들은 생산성을 높일 잠재력이 있는 동시에 사회에 상당한 보안 위험을 제기할 수 있습니다. OpenHands는 다음을 통해 위험을 완화하는 데 도움을 줍니다:
(1) 이러한 에이전트에 대한 체계적인 평가를 가능하게 하여 널리 배포되기 전에 위험을 식별하고 해결할 수 있게 합니다. (2) 에이전트가 감독 없이 자율적으로 작동하도록 허용하기보다는 인간-에이전트 상호작용을 촉진합니다. (3) 더 중요하게도, 우리는 OpenHands가 전 세계 연구자들이 안전하고 유용한 에이전트를 구축하기 위한 최전선 안전 연구를 수행할 수 있도록 최고의 에이전트 제품군에 접근할 수 있게 해주기를 바랍니다.
C 관련 연구
ChatGPT OpenAI (2024a) 및 GPT4 OpenAI et al. (2024)와 같은 대규모 언어 모델(LLM)의 돌파구는 다양한 영역에서 자율 에이전트의 능력을 크게 향상시켰습니다 Ye et al. (2023); Tang et al. (2024d); Park et al. (2023); Cui et al. (2023). 이러한 발전은 다양한 사용자 작업을 수행하는 것을 목표로 하는 수많은 범용 에이전트 제안 Gravitas (2023); Nakajima (2023); Wu et al. (2023)을 촉발했고 개발자와 더 넓은 대중 모두의 관심을 얻었습니다. Auto- GPT Gravitas (2023)와 같은 주목할 만한 작업은 사용자 목표를 실행 가능한 단계로 분해하여 작업 완료를 위해 LLM을 활용합니다. 다중 에이전트 협업 시스템은 역할극 및 작업 해결 능력과 같은 요소에 LLM을 활용하며 Zhuge et al. (2023); Li et al. (2023a); Zhou et al. (2023b); Team (2023), MetaGPT Hong et al. (2023)는 표준화된 운영 절차를 강조하고, AutoGen Wu et al. (2023)은 대화형 시스템을 위한 대화 프레임워크를 제공합니다. AGENTS Zhou et al. (2023b)와 AutoAgents Chen et al. (2024)는 사용자 정의 가능한 에이전트 아키텍처를 위한 새로운 패러다임을 제공하는 반면, XAgent Team (2023)와 GPTSwarm Zhuge et al. (2024)는 각각 향상된 에이전트 운영을 위해 복잡한 관리 시스템과 최적화 가능한 그래프를 도입합니다.
에이전트 개발의 이러한 급증은 에이전트 구현을 간소화하는 데 목적을 둔 특화된 프레임워크들로 이어졌다. LangChain과 LangGraph Chase (2022)는 기본적인 런타임 지원을 갖춘 기초적인 빌딩 블록을 제공하는 반면, CrewAI CrewAI (2024)는 다중 에이전트 통신의 오케스트레이션에 초점을 맞춘다. BrowserGym ServiceNow는 특히 웹 브라우징 기능을 겨냥하며, DSPy Khattab et al. (2024)는 엔드투엔드 프롬프트 최적화를 강조한다. AutoGen Wu et al. (2023)은 Python 및 bash 실행 기능을 구현함으로써 기본 프레임워크를 넘어서 발전했으나, 명령 실행이 상태를 유지하지 않는(stateless) 방식이며, CrewAI 같은 프레임워크는 샌드박스화된 그러나 제한적인 코드 인터프리터 기능을 제공한다.
LLM 기반 에이전트를 적용하는 데 있어 선두주자인 소프트웨어 개발 분야에서는 개발 프로세스를 촉진하기 위한 프레임워크들의 발전이 있었다 Hong et al. (2023); Qian et al. (2023). ChatDev Qian et al. (2023)와 같은 혁신은 폭포수 모델과 유사하게 소프트웨어 개발 수명주기를 자동화하며, AutoCodeRover Zhang et al. (2024b)는 코드 검색과 추상 구문 트리 조작을 통해 GitHub 이슈를 처리한다. AgentCoder Huang et al. (2024)는 통합된 테스트와 피드백을 통해 코드 생성을 반복적으로 개선하며, SWE-Agent Yang et al. (2024)는 자동화된 GitHub 이슈 수정을 위해 LLM을 통합하여 소프트웨어 엔지니어링을 간소화한다.
D 그래픽 사용자 인터페이스
명령줄에서 실행되는 것 외에도, OpenHands는 에이전트의 현재 행동(예: 웹 브라우징, 기본 명령 또는 Python 코드 실행 등)을 시각화하고 사용자로부터 실시간 피드백을 받을 수 있는 풍부한 그래픽 사용자 인터페이스를 갖추고 있다. UI의 스크린샷은 그림 1에 나와 있다. 사용자는 에이전트가 작업하는 동안 언제든지 에이전트를 중단시켜 추가적인 피드백, 의견 또는 지시를 제공할 수 있다. 이 사용자 인터페이스는 이벤트 스트림(§2.1)과 직접 연결되어 에이전트와 런타임을 제어하고 시각화하므로, 에이전트 및 런타임에 구애받지 않는다.
EQUALITY CONTROL: 에이전트를 위한 통합 테스트
통합 테스트 Leung & White (1990)는 소프트웨어 개발자들이 소프트웨어 품질을 보장하기 위해 오랫동안 사용해 왔다. 단순한 입출력 스키마를 가진 대규모 언어 모델과 달리, 에이전트는 일반적으로 복잡한 소프트웨어 조각으로, 개발 과정에서 사소한 오류가 쉽게 도입되어 최종 작업 성능을 저해할 수 있다. 전체 스위트 평가(§4)를 실행하는 것이 성능 저하를 측정하는 궁극적인 방법이지만, 모든 코드 변경마다 이를 실행하는 것은 지나치게 느리고 비용이 많이 들 수 있다. 4 . OpenHands에서 우리는 프롬프트 회귀, 액션, 샌드박스 환경을 테스트하는 엔드투엔드 에이전트 테스트 프레임워크를 개척한다. 이는 소프트웨어 공학의 통합 테스트와 결정론적 동작을 위한 파운데이션 모델 모킹을 결합하여 에이전트 개발 중 버그의 우발적 도입을 방지한다.
통합 테스트 정의하기. OpenHands의 통합 테스트 프레임워크는 작업 실행과 결과 검증을 자동화하여 엔드투엔드 기능을 검증하도록 구조화되어 있다. 개발자들은 작업과 기대 결과를 정의한다; 예를 들어, 한 작업은 "bad.txt"라는 문서의 오타를 수정하는 것을 포함할 수 있다. OpenHands를 통한 작업 실행 시, 출력은 정확성을 보장하기 위해 미리 정의된 "골드 파일"과 비교된다.
결정론적 동작을 위한 LLM 모킹. 대규모 언어 모델(LLM)의 비결정성과 관련된 높은 비용이라는 과제를 해결하기 위해, 프레임워크는 모든 LLM 호출을 가로채고 정확한 프롬프트 일치에 기반하여 미리 정의된 응답을 제공한다. 이 방법은 테스트 결과의 일관성을 보장할 뿐만 아니라 실제 LLM에 대한 의존을 최소화하여 운영 비용을 절감한다.
파괴적 변경 시 LLM 응답 재생성. 프롬프트-응답 쌍은 새로운 테스트가 도입되거나 기존 프롬프트가 수정될 때 이러한 쌍을 생성하고 저장하는 스크립트를 통해 관리된다. 일상적인 테스트의 경우, 프레임워크는 프롬프트를 약간 조정하여 기존 LLM 응답을 재사용하려고 시도한다. 작업 처리를 변경하는 중대한 변경은 실제 LLM을 사용하여 이러한 쌍을 재생성해야 한다.
통합 테스트의 이점. 이 프레임워크는 여러 가지 장점을 제공하는데, 여기에는 1) 프롬프트 회귀 테스트: 저장된 프롬프트-응답 쌍이 변경 추적을 용이하게 하고 새로운 팀원이 LLM 상호작용을 이해할 수 있는 참고 자료를 제공한다, 2) 멀티 플랫폼 지원: 테스트는 main 브랜치의 모든 풀 리퀘스트와 커밋에 대해 자동으로 예약되며, Linux와 Mac을 포함한 여러 플랫폼, 환경, 에이전트에서, 그리고 로컬, SSH, exec 샌드박스에서 실행된다, 그리고 3) 포괄적인 오류 감지: 프롬프트 생성, 메시지 전달, 샌드박스 실행의 오류를 포착하여 높은 테스트 커버리지를 유지한다.
F OPENHANDS 런타임 작동 방식
F.1 워크플로
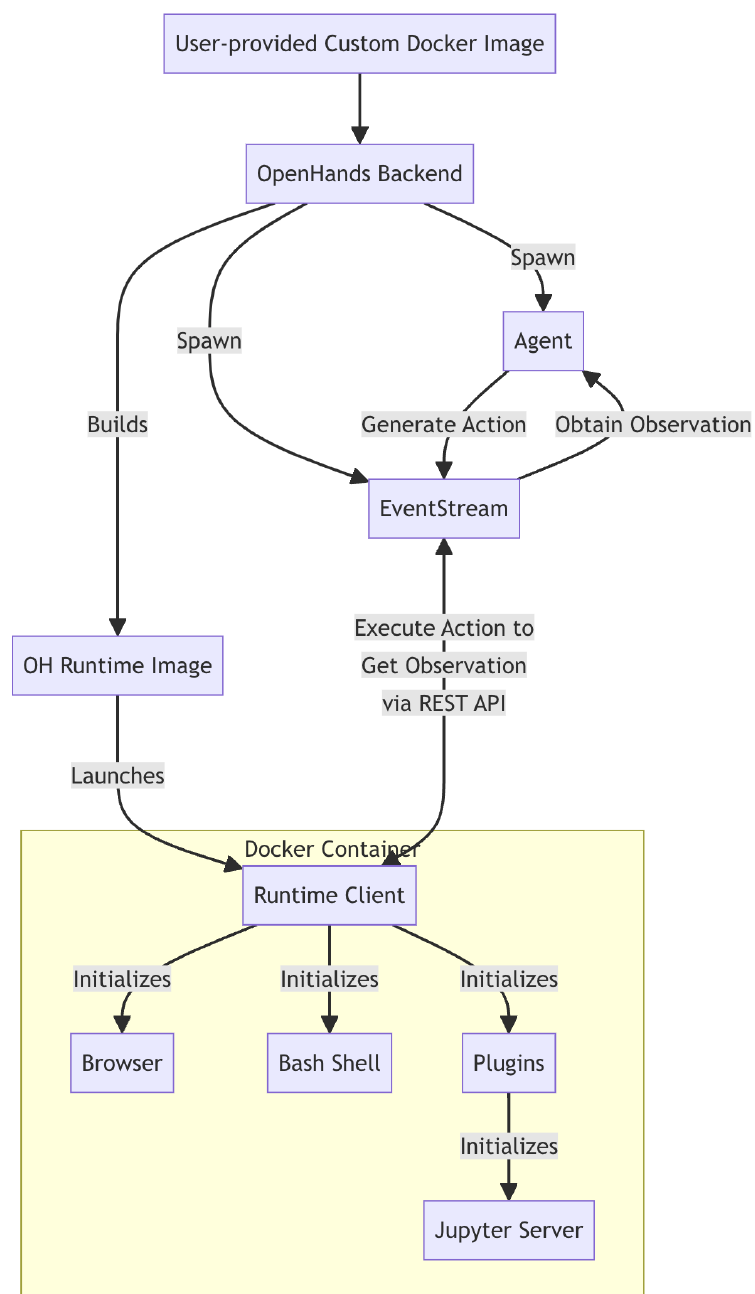
OpenHands 런타임 시스템은 Docker 컨테이너로 구현된 클라이언트-서버 아키텍처를 사용한다. 작동 방식의 개요는 그림 4를 참조하라.
(1) 사용자 입력: 사용자가 사용자 정의 베이스 Docker 이미지를 제공한다.
(2) 이미지 빌드: OpenHands는 사용자가 제공한 이미지를 기반으로 새로운 Docker 이미지("OH 런타임 이미지")를 빌드한다. 이 새로운 이미지는 OpenHands 전용 코드, 주로 "런타임 클라이언트"(즉, §2.2에서 설명한 런타임 API 서버)를 포함한다.
(3) 컨테이너 실행: OpenHands가 시작되면 OH 런타임 이미지를 사용하여 Docker 컨테이너를 실행한다.
(4) 통신: OpenHands 백엔드(runtime.py)는 RESTful API를 통해 런타임 클라이언트와 통신하며, 액션을 보내고 관찰(observation)을 받는다.
(5) 액션 실행: 런타임 클라이언트는 백엔드로부터 액션을 받아 샌드박스 환경에서 실행하고 관찰을 다시 보낸다.
(6) 관찰 반환: 클라이언트는 실행 결과를 관찰로서 OpenHands 백엔드 이벤트 스트림으로 다시 보낸다.
클라이언트의 역할:- OpenHands 백엔드와 샌드박스 환경 사이의 중개자 역할을 한다- 다양한 유형의 액션(셸 명령, 파일 작업, Python 코드 등)을 컨테이너 내에서 안전하게 실행한다- 현재 작업 디렉터리와 로드된 플러그인을 포함한 샌드박스 환경의 상태를 관리한다- 관찰을 포맷하여 백엔드로 반환하며, 결과 처리에 일관된 인터페이스를 보장한다
F.2 OPENHANDS가 런타임 이미지를 빌드하고 유지하는 방법
OpenHands의 런타임 이미지 빌드 및 관리 접근 방식은 프로덕션 및 개발 환경 모두를 위한 Docker 이미지를 생성하고 유지하는 데 있어 효율성, 일관성, 유연성을 보장한다.
F.2.1 이미지 태깅 시스템
OpenHands는 재현성과 유연성의 균형을 맞추기 위해 런타임 이미지에 이중 태깅 시스템을 사용한다:
(1) 해시 기반 태그: {target_image_repo}:{target_image_hash_tag}. 예: runtime:abc123def456
- 이 태그는 소스 코드(런타임 클라이언트 및 관련 종속성)와 Dockerfile을 포함하는 Docker 빌드 폴더의 MD5 해시를 기반으로 한다- 동일한 해시 태그는 이미지가 정확히 동일한 소스 코드와 Dockerfile로 빌드되었음을 보장한다- 이는 재현성을 보장한다; 동일한 해시는 항상 동일한 이미지 내용을 의미한다
(2) 일반 태그: {target_image_repo}:{target_image_tag}. 예: runtime:oh_v0.9.3_ubuntu_tag_22.04
- 이 태그는 runtime:oh_v{VERSION}{BASE_IMAGE_tag{IMAGE_TAG}} 형식을 따른다
- 특정 베이스 이미지와 OpenHands 버전 조합에 대한 최신 빌드를 나타낸다
- 이 태그는 소스 코드가 변경되더라도 동일한 베이스 이미지로 새로운 이미지가 빌드될 때마다 업데이트된다
해시 기반 태그는 재현성을 보장하는 반면, 일반 태그는 특정 구성의 최신 버전에 대한 안정적인 참조를 제공한다. 이러한 이중 태깅 접근 방식은 OpenHands가 개발 및 프로덕션 환경 모두를 효율적으로 관리할 수 있게 한다.
F.2.2 빌드 프로세스
(1) 이미지 명명 규칙:
- 해시 기반 태그: target_image_repo:target_image_hash_tag. 예: runtime:abc123def456
- 일반 태그: target_image_repo:target_image_tag. 예: runtime:oh_v0.9.3_ubuntu_tag_22.04
(2) 빌드 프로세스:
a. 베이스 이미지 이름을 OH 런타임 이미지 이름으로 변환 예: ubuntu:22.04-> runtime:oh_v0.9.3_ubuntu_tag_22.04
b. 빌드 컨텍스트(Dockerfile과 OpenHands 소스 코드)를 생성하고 그 해시를 계산
c. 계산된 해시를 가진 기존 이미지가 있는지 확인
d. 찾지 못한 경우, 베이스로 사용할 최근의 호환 가능한 이미지가 있는지 확인
e. 호환 가능한 이미지가 없으면, 원래 베이스 이미지를 사용하여 처음부터 빌드
f. 새 이미지에 해시 기반 태그와 일반 태그 모두를 지정
(3) 이미지 재사용 및 재빌드 로직: 시스템은 사용자가 제공한 (베이스) 이미지(예: ubuntu:22.04)로부터 새 이미지를 빌드할지 아니면 기존 이미지를 사용할지 결정하기 위해 다음 단계를 따른다:
a. 동일한 해시를 가진 이미지(예: runtime:abc123def456)가 존재하면, 그대로 재사용된다
b. 정확한 해시를 찾지 못하면, 시스템은 최신 일반 이미지(예: runtime:oh_v0.9.3_ubuntu_tag_22.04)를 베이스로 사용하여 재빌드를 시도한다. 이는 기존 종속성을 활용하여 시간을 절약한다
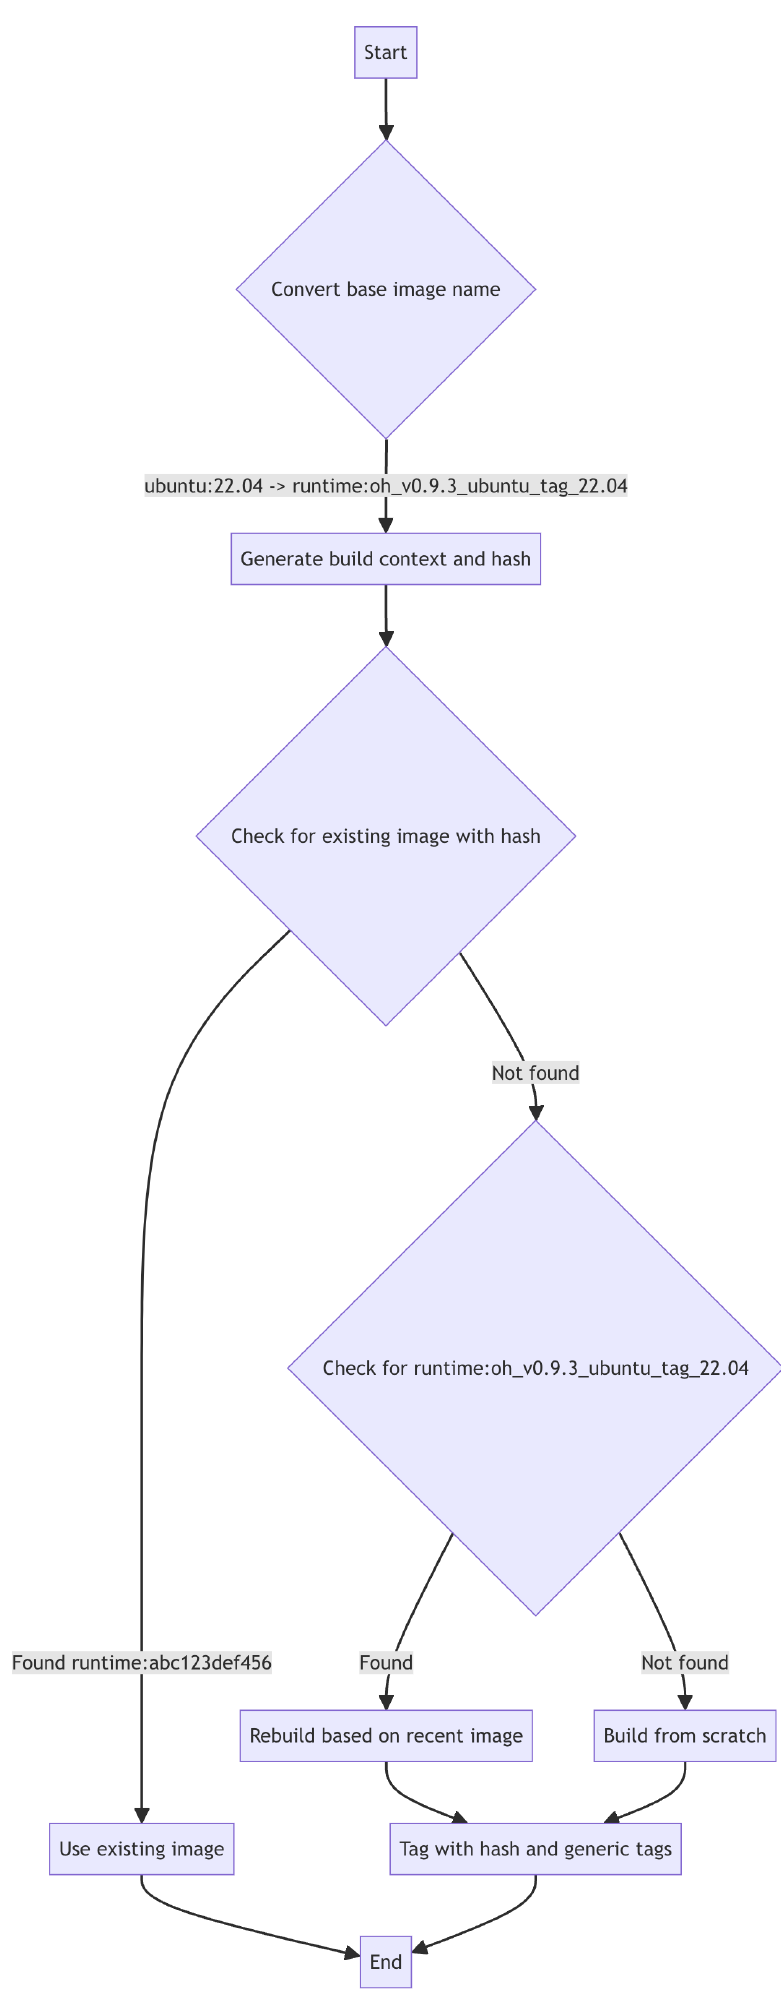
c. 해시 태그된 이미지도 일반 태그된 이미지도 찾지 못하면, 시스템은 이미지를 완전히 처음부터 빌드한다
캐싱과 효율성. 시스템은 빌드 시간을 절약하기 위해 가능한 경우 기존 이미지를 재사용하려고 시도한다. (해시에 의한) 정확한 일치가 발견되면, 재빌드 없이 사용된다. 호환 가능한 이미지가 발견되면, 재빌드를 위한 베이스로 사용되어 종속성 설치 시간을 절약한다.
빌드 프로세스를 설명하는 순서도는 그림 5에 나와 있다.
G GPQA 벤치마크에 대한 추가 결과
우리는 표 7에 GPQA 벤치마크의 다른 하위 집합에 대한 성능을 포함하여 더 자세한 결과를 보여준다.
| 평가 방법 및 모델 | 부분집합별 정확도 (%) | 평균 비용 ($) | ||
| Diamond 세트 | Main 세트 | Extended 세트 | ||
| 전문가 인간 검증자 | 81.2 | 72.5 | 65.4 | 해당 없음 |
| 비전문가 인간 검증자 | 21.9 | 30.5 | 33.9 | 해당 없음 |
| Few-Shot CoT Llama-2-70B-chat | 28.1 | 29.1 | 30.4 | 해당 없음 |
| Few-Shot CoT GPT-3.5-turbo-16k | 29.6 | 28.0 | 28.2 | 해당 없음 |
| Few-Shot CoT GPT-4 | 38.8 | 39.7 | 38.7 | 해당 없음 |
| 검색을 결합한 GPT-4 (기권 시 CoT로 폴백) | 38.8 | 41.0 | 39.4 | 해당 없음 |
| OpenHands + CodeActAgent v1.5 + GPT3.5-turbo | 27.9 | 23.4 | 26.1 | 0.012 |
| OpenHands + CodeActAgent v1.5 + GPT4-turbo | 51.8 | 47.4 | 42.4 | 0.501 |
| OpenHands + CodeActAgent v1.5 + GPT4o | 53.1 | 49.3 | 52.8 | 0.054 |
H CODEACTSWEAGENT를 위한 컨텍스트 내 시연
프롬프트는 SWE-agent의 공개된 궤적(https://github.com/princeton-nlp/SWE-agent/tree/main/trajectories/demonstrations)에서 다시 채택되었다. 프롬프트는 https://github.com/All-Hands-AI/OpenHands/blob/main/agenthub/codeact_swe_agent/prompt.py에서 찾을 수 있다.
I 지원되는 AGENTSKILLS
OpenHands v0.6 기준으로, 다음과 같은 스킬 목록을 지원합니다. 최신 스킬 목록은 소스 코드를 참조하십시오: https://github.com/All- Hands- AI/OpenHands/blob/main/OpenHands/ runtime/plugins/agent_skills/agentskills.py
def open_file(path: str, line_number: Optional[int] = None) -> None:\\\* 에디터에서 주어진 경로의 파일을 엽니다. line_number가 제공되면, 창이 해당 줄을 포함하도록 이동합니다. Args: path: str: 열 파일의 경로. line_number: Optional[int]: 이동할 줄 번호.\\\*
def goto_line(line_number: int) -> None:\\\* 창을 이동하여 지정된 줄 번호를 표시합니다. Args: line_number: int: 이동할 줄 번호. pass
def scroll_down() -> None: """창을 100줄 아래로 이동합니다. Args: None\\\* pass
def scroll_up() -> None: """창을 100줄 위로 이동합니다. Args: None pass
def create_file(filename: str) -> None: """주어진 이름으로 새 파일을 생성하고 엽니다. Args: filename: str: 생성할 파일의 이름. pass
def edit_file(start: int, end: int, content: str) -> None: """파일을 편집합니다. 열린 파일에서 'start'부터 'end'까지(포함)의 줄을 주어진 텍스트 'content'로 대체합니다. 편집하기 전에 파일이 열려 있어야 함을 기억하십시오. Args: start: int: 시작 줄 번호. start >= 1을 만족해야 합니다. end: int: 끝 줄 번호. start <= end <= 파일의 줄 수를 만족해야 합니다. content: str: 줄을 대체할 내용. pass
def search_dir(search_term: str, dir_path: str = './') -> None: """dir의 모든 파일에서 search_term을 검색합니다. dir이 제공되지 않으면 현재 디렉터리에서 검색합니다. Args: search_term: str: 검색할 용어. dir_path: Optional[str]: 검색할 디렉터리의 경로. pass
def search_file(search_term: str, file_path: Optional[str] = None) -> None: """file에서 search_term을 검색합니다. file이 제공되지 않으면 현재 열린 파일에서 검색합니다. Args: search_term: str: 검색할 용어. file_path: Optional[str]: 검색할 파일의 경로. pass
def find_file(file_name: str, dir_path: str = './') -> None: """지정된 디렉터리에서 주어진 이름의 모든 파일을 찾습니다. Args: file_name: str: 찾을 파일의 이름. dir_path: Optional[str]: 검색할 디렉터리의 경로.
pass
def parse_pdf(file_path: str) -> None:
"\\\*PDF 파일의 내용을 파싱하여 출력합니다.
Args:
file_path: str: 열 파일의 경로입니다.
pass
def parse_docx(file_path: str) -> None:
DOCX 파일의 내용을 파싱하여 출력합니다.
Args:
file_path: str: 열 파일의 경로입니다.
pass
def parse_latex(file_path: str) -> None:
LaTeX 파일의 내용을 파싱하여 출력합니다.
Args:
file_path: str: 열 파일의 경로입니다.
pass
def parse_audio(file_path: str, model: str = 'whisper- 1') -> None:
오디오 파일의 내용을 파싱하여 출력합니다.
Args:
file_path: str: 전사할 오디오 파일의 경로입니다. model: Optional[str]: 전사에 사용할 오디오 모델입니다. 기본값은 'whisper- 1'입니다.
pass
def parse_image(
file_path: str, task: str = 'Describe this image as detail as possible.'
) -> None:
이미지 파일의 내용을 파싱하여 설명을 출력합니다.
Args:
file_path: str: 열 파일의 경로입니다. task: Optional[str]: API 호출에 대한 작업 설명입니다. 기본값은 'Describe this image as detail as possible.'입니다.
pass
def parse_video( file_path: str, task: str = 'Describe this image as detail as possible.', frame_interval: int = 30, ) -> None:
이미지 파일의 내용을 파싱하여 설명을 출력합니다.
Args: file_path: str: 열 비디오 파일의 경로입니다. task: Optional[str]: API 호출에 대한 작업 설명입니다. 기본값은 'Describe this image as detail as possible.'입니다. frame_interval: Optional[int]: 분석할 프레임 간의 간격입니다. 기본값은 30입니다.
pass
def parse_pptx(file_path: str) -> None:
pptx 파일의 내용을 파싱하여 출력합니다.
Args: file_path: str: 열 파일의 경로입니다.
pass
J BROWSERGYM ACTIONS
다음은 v0.3.4 기준 BrowserGym5에서 정의된 모든 지원되는 액션입니다. 액션은 여러 유형으로 분류될 수 있으며, 기능의 일부만 사용하도록 구성할 수 있습니다. 에이전트 제어 액션, 탐색 액션, 페이지 요소 기반 액션, 좌표 기반 액션, 그리고 탭 관련 액션이 있습니다. 우리는 BrowserGym 라이브러리의 이러한 액션을 주요 브라우징 액션 기본 요소로 사용합니다.
def send_msg_to_user(text: str):
사용자에게 메시지를 보냅니다.
Examples:
send_msg_to_user("Based on the results of my search, the city was built in 1751.")
\\\*
pass
def report_infeasible(reason: str):
\\\*
사용자의 지시가 실행 불가능함을 사용자에게 알립니다.
Examples:
report_infeasible("I cannot follow these instructions because there is no email field in this form.") pass
def noop(wait_ms: float = 1000):\\\*
아무것도 하지 않고, 선택적으로 주어진 시간(밀리초 단위) 동안 대기합니다 ( milliseconds).
Examples: noop() noop(500) pass
https://playwright.dev/docs/input#text- input
def fill(bid: str, value: str):\\\*
양식 필드를 채웁니다. 요소에 포커스를 맞추고 입력된 텍스트로 input 이벤트를 트리거합니다. <input>, <textarea> 및 [contenteditable] 요소에서 작동합니다.
Examples:
fill('237', 'example value')
fill('45', "multi- line\nexample")
fill('a12', "example with \\""quotes\\""\\\* pass
https://playwright.dev/python/docs/api/class- locator#locator- check
def check(bid: str):\\\*
체크박스 또는 라디오 요소가 체크되어 있도록 보장합니다.
예시:
check('55')\\\* 통과
https://playwright.dev/python/docs/api/class- locator#locator- uncheck
def uncheck(bid: str):\\\*
체크박스 또는 라디오 요소가 체크 해제되어 있도록 보장합니다.
예시:
uncheck('a5289')\\\* 통과
https://playwright.dev/docs/input#select- options
def select_option(bid: str, options: str | list[str]):\\\* <select> 요소에서 하나 또는 여러 옵션을 선택합니다. 선택할 옵션 값 또는 레이블을 지정할 수 있습니다. 여러 옵션을 선택할 수 있습니다.
예시: select_option('a48', "blue") select_option('c48', ["red", "green", "blue"])통과
https://playwright.dev/python/docs/api/class- locator#locator- click def click( bid: str, button: Literal["left", "middle", "right"] = "left", modifiers: list[Literal["Alt", "Control", "Meta", "Shift"]] = [1], ) : 요소를 클릭합니다. 예시: click('a51') click('b22', button="right") click('48', button="middle", modifiers=["Shift"]) 통과
https://playwright.dev/python/docs/api/class- locator#locator- dblclick def dblclick( bid: str, button: Literal["left", "middle", "right"] = "left", modifiers: list[Literal["Alt", "Control", "Meta", "Shift"]] = [1], ) : 요소를 두 번 클릭합니다.
예시: dblclick('12') dblclick('ca42', button="right") dblclick('178', button="middle", modifiers=["Shift"])통과
https://playwright.dev/python/docs/api/class- locator#locator- hover def hover(bid: str): 요소 위로 마우스를 이동합니다.
예시: hover('b8')통과
https://playwright.dev/docs/input#keys- and- shortcuts def press (bid: str, key_comb: str): """ 일치하는 요소에 포커스를 맞추고 키 조합을 누릅니다. 키보드 이벤트의 keyboardEvent.key 속성에 전달되는 논리적 키 이름을 허용합니다: Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ 등. 또는 "a"나 "#"처럼 생성하려는 단일 문자를 지정할 수도 있습니다. 다음 수정 단축키도 지원됩니다: Shift, Control, Alt, Meta.
예시: press('88', 'Backspace') press('a26', 'Control+a') press('a61', 'Meta+Shift+t')통과
https://playwright.dev/python/docs/api/class- locator#locator- focus def focus (bid: str): """ 일치하는 요소에 포커스를 맞춥니다. 예시: focus('b455') """ 통과
https://playwright.dev/python/docs/api/class- locator#locator- clear def clear (bid: str): """ 입력 필드를 지웁니다. 예시: clear('996') """ 통과
https://playwright.dev/python/docs/input#drag- and- drop def drag_and_drop(from_bid: str, to_bid: str): """ 드래그 앤 드롭을 수행합니다. 드래그할 요소 위로 마우스를 이동합니다. """ 왼쪽 마우스 버튼을 누릅니다. 마우스를 드롭을 받을 요소로 이동합니다. 왼쪽 마우스 버튼을 놓습니다.
예시: drag_and_drop('56', '498')
통과
https://playwright.dev/python/docs/api/class- mouse#mouse- wheel def scroll(delta_x: float, delta_y: float):
가로 및 세로로 스크롤합니다. 단위는 픽셀이며, 오른쪽 또는 아래로 스크롤할 때는 양수, 왼쪽 또는 위로 스크롤할 때는 음수입니다. 휠 이벤트를 디스패치합니다.
예시: scroll(0, 200) scroll(- 50.2, - 100.5)
통과
https://playwright.dev/python/docs/api/class- mouse#mouse- move def mouse_move(x: float, y: float):
\\\*
마우스를 특정 위치로 이동합니다. 픽셀 단위의 절대 클라이언트 좌표를 사용합니다. 마우스 이동 이벤트를 디스패치합니다.
예시: mouse_move(65.2, 158.5)
통과
https://playwright.dev/python/docs/api/class- mouse#mouse- up def mouse_up(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
마우스를 특정 위치로 이동한 다음 마우스 버튼을 놓습니다. 마우스 이동 및 mouseup 이벤트를 디스패치합니다.
예시: mouse_up(250, 120) mouse_up(47, 252, 'right')
통과
https://playwright.dev/python/docs/api/class- mouse#mouse- down def mouse_down(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
마우스를 특정 위치로 이동한 다음 마우스 버튼을 누르고 유지합니다. 마우스 이동 및 mousedown 이벤트를 디스패치합니다.예시: mouse_down(140.2, 580.1) mouse_down(458, 254.5, 'middle')통과
https://playwright.dev/python/docs/api/class- mouse#mouse- click def mouse_click(x: float, y: float, button: Literal["left","middle", "right"] = "left"):
마우스를 특정 위치로 이동하고 마우스 버튼을 클릭합니다. mousemove, mousedown 및 mouseup 이벤트를 디스패치합니다.
예시: mouse_click(887.2, 68) mouse_click(56, 712.56, 'right')통과#
https://playwright.dev/python/docs/api/class- mouse#mouse- dblclick def mouse_dblclick(x: float, y: float, button: Literal["left", "middle", "right"] = "left"): 마우스를 특정 위치로 이동하고 마우스 버튼을 두 번 클릭합니다. mousemove, mousedown 및 mouseup 이벤트를 디스패치합니다.
예시:mouse_dblclick(5, 236) mouse_dblclick(87.5, 354, 'right')통과
def mouse_drag_and_drop(from_x: float, from_y: float, to_x: float, to_y: float):"middle", "right"] = "left"):
한 위치에서 다른 위치로 드래그 앤 드롭합니다. 픽셀 단위의 절대 클라이언트 좌표를 사용합니다. mousemove, mousedown 및 mouseup 이벤트를 디스패치합니다.
예시: mouse_drag_and_drop(10.7, 325, 235.6, 24.54)통과#
https://playwright.dev/python/docs/api/class- keyboard#keyboard- press def keyboard_press(key: str): 키 조합을 누릅니다. 키보드 이벤트의 keyboardEvent.key 속성에 \(\leftrightarrow\) 방출되는 논리적 키 이름을 허용합니다: Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, \(\leftrightarrow\) ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ 등. 또는 생성하려는 단일 문자를 \(\leftrightarrow\) 지정할 수도 있습니다. 예를 들어 "a" 또는 "#"과 같습니다. 다음 수정 단축키도 \(\leftrightarrow\) 지원됩니다: Shift, Control, Alt, Meta.
예시: keyboard_press('Backspace') keyboard_press('Control+a') keyboard_press('Meta+Shift+t') page.keyboard.press("PageDown")\\\* pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- up def keyboard_up(key: str): 키보드 키를 놓습니다. keyup 이벤트를 디스패치합니다. 키보드 이벤트의 keyboardEvent.key 속성 \(\leftrightarrow\) 에 방출되는 \(\leftrightarrow\) 논리적 키 이름을 허용합니다: Backquote, Minus, Equal, Backslash, \(\leftrightarrow\) Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, \(\leftrightarrow\) PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ, \(\leftrightarrow\) 등. 또는 생성하려는 단일 문자를 \(\leftrightarrow\) 지정할 수도 있습니다. 예를 들어 "a" 또는 "#"과 같습니다.
예시: keyboard_up('Shift') keyboard_up('c')pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- down def keyboard_down(key: str): 키보드 키를 누르고 유지합니다. keydown 이벤트를 디스패치합니다. \(\leftrightarrow\) 키보드 이벤트의 keyboardEvent.key \(\leftrightarrow\) 속성에 방출되는 논리적 키 이름을 허용합니다: Backquote, Minus, Equal, Backslash, \(\leftrightarrow\) Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, \(\leftrightarrow\) PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ, \(\leftrightarrow\) 등. 또는 "a" 또는 "#"과 같은 단일 문자를 지정할 수도 있습니다.예시: keyboard_up('Shift') keyboard_up('c')
pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- type def keyboard_type(text: str): """ 키보드를 통해 문자열 텍스트를 입력합니다. 텍스트의 각 문자에 대해 keydown, \(\leftrightarrow\) keypress/input, keyup 이벤트를 보냅니다. 수정 키는 \(\leftrightarrow\) keyboard_type에 영향을 주지 않습니다. Shift를 누르고 있어도 텍스트가 \(\leftrightarrow\) 대문자로 입력되지 않습니다.
예시: keyboard_type('Hello world!')
pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- insert- text def keyboard_insert_text(text: str): """ 현재 포커스된 요소에 문자열 텍스트를 삽입합니다. \(\leftrightarrow\) input 이벤트만 디스패치하며, keydown, keyup 또는 keypress 이벤트를 발생시키지 않습니다. \(\leftrightarrow\) 수정 키는 keyboard_insert_text에 영향을 주지 않습니다. Shift를 누르고 있어도 텍스트가 \(\leftrightarrow\) 대문자로 입력되지 않습니다.
예시: keyboard_insert_text('Hello world!')
pass
https://playwright.dev/python/docs/api/class- page#page- goto def goto(url: str):
url로 이동합니다.
예시: goto('http://www.example.com')
pass
https://playwright.dev/python/docs/api/class- page#page- go- back
\\\\
기록에서 이전 페이지로 이동합니다.
예시: go_back()
pass
https://playwright.dev/python/docs/api/class- page#page- go- forward go_forward(): 기록에서 다음 페이지로 이동합니다. 예시: go_forward()
pass
\*
https://playwright.dev/python/docs/api/class-browsercontext#browser-context-new-page def new_tab():
\\\\
새 탭을 엽니다. 해당 탭이 활성 탭이 됩니다.
예시: new_tab()
global page
새 페이지를 활성 페이지로 설정
page page.context.new_page()
이 페이지를 활성으로 설정하는 콜백을
browsergym에서 트리거
pass
https://playwright.dev/python/docs/api/class-page#page-close
def tab_close():
\\\\
현재 탭을 닫습니다.
예시:
tab_close()
\\\\
pass
\\\\
https://playwright.dev/python/docs/api/class-page#page-bring-to-front def tab_focus(index: int):
\\\\\*
탭을 앞으로 가져옵니다(탭 활성화).
예시:
tab_focus(2)\\\* pass\\\* pass
https://playwright.dev/python/docs/input#upload-files def upload_file(bid: str, file: str | list[str]): """요소를 클릭하고 "filechooser" 이벤트를 기다린 다음 → 업로드할 입력 파일을 하나 또는 여러 개 선택합니다. 상대 파일 경로는 → 현재 작업 디렉터리를 기준으로 확인됩니다. 빈 목록은 → 선택된 파일을 지웁니다.
예시: upload_file("572", "my_receipt.pdf") upload_file("63", ["/home/bob/Documents/image.jpg", "/home/bob/Documents/file.zip"])
pass
\\\* https://playwright.dev/python/docs/input#upload-files def mouse_upload_file(x: float, y: float, file: str | list[str]): """위치를 클릭하고 "filechooser" 이벤트를 기다린 다음 → 업로드할 입력 파일을 하나 또는 여러 개 선택합니다. 상대 파일 경로는 → 현재 작업 디렉터리를 기준으로 확인됩니다. 빈 목록은 → 선택된 파일을 지웁니다.
예시: mouse_upload_file(132.1, 547, "my_receipt.pdf") mouse_upload_file(328, 812, → ["/home/bob/Documents/image.jpg", → "/home/bob/Documents/file.zip"])
pass
K BROWsing AGENT DETAILS
K BROWsing AGENT DETAILS다음은 다음 브라우징 동작에 대한 예측을 수행하기 위해 현재 단계에 필요한 모든 정보를 담은 예시 프롬프트를 보여줍니다. 또한 에이전트가 페이지로부터의 피드백 없이 순차적으로 실행되어야 한다고 판단하는 경우 한 턴에 여러 동작을 예측하도록 지시한다는 점에 유의하세요. 이는 로그인 페이지에서 사용자 이름과 비밀번호를 입력하고 제출하는 것처럼 관찰 변화 없이 동일한 페이지에서 일련의 동작으로 구성된 일반적인 워크플로의 턴을 절약할 수 있습니다.
Instructions
페이지의 현재 상태와 다른 모든 정보를 검토하여 → 목표를 달성하기 위한 최선의 다음 동작을 찾으세요. → 당신의 답변은 프로그램에 의해 해석되고 실행됩니다. → 형식 지정 지침을 반드시 따르세요.
Goal: localhost:8000을 탐색하고, 삶의 궁극적인 답을 알려주세요. 어떤 시점에서도 확인을 요청하지 마세요.
Action Space
16가지 유형의 동작을 사용할 수 있습니다.
noop(wait_ms: float = 1000)
예시:
noop()
noop(500)
send_msg_to_user(text: str)
예시:
send_msg_to_user('내 검색 결과에 따르면, 도시는 1751년에 건설되었습니다. ')
scroll(delta_x: float, delta_y: float)
예시:
scroll(0, 200)
scroll(- 50.2, - 100.5)
fill(bid: str, value: str)
예시:
fill('237', '예시 값')
fill('45', '여러 줄\nexample')
fill('a12', '따옴표가 있는 예시")
select_option(bid: str, options: str | list[str])
예시:
select_option('48', 'blue')
select_option('48', ['red', 'green', 'blue'])
click(bid: str, button: Literal['left', 'middle', 'right'] = 'left', modifiers: list[typing.Literal['Alt', 'Control', 'Meta', 'Shift']] = [])
예시:
click('51')
click('b22', button='right')
click('48', button='middle', modifiers=['Shift'])
dblclick(bid: str, button: Literal['left', 'middle', 'right'] = 'left', modifiers: list[typing.Literal['Alt', 'Control', 'Meta', 'Shift']] = []
예시:
dblclick('12')
dblclick('ca42', button='right')
dblclick('178', button='middle', modifiers=['Shift'])
hover(bid: str) 예시: hover('b8')
press(bid: str, key_comb: str) 예시: press('88', 'Backspace') press('a26', 'Control+a') press('a61', 'Meta+Shift+t')
focus(bid: str) 예시: focus('b455')
clear(bid: str) 예시: clear('996')
drag_and_drop(from_bid: str, to_bid: str) 예시: drag_and_drop('56', '498')
upload_file(bid: str, file: str | list[str]) 예시: upload_file('572', 'my_receipt.pdf')
upload_file('63', ['/home/bob/Documents/image.jpg', ' /home/bob/Documents/file.zip'])
go_back() 예시: go_back()
go_forward() 예시: go_forward()
goto(url: str) 예시: goto('http://www.example.com')
여러 동작을 한 번에 제공할 수 있습니다. 예시: fill('a12', 'example with "quotes"') click('51')
click('48', button='middle', modifiers=['Shift']) 여러 동작은 페이지로부터의 피드백 없이 순차적으로 실행되도록 의도된 것입니다. 페이지로부터 피드백이 필요하다면 여러 동작을 한 번에 실행하지 마십시오.
현재 접근성 트리: RootWebArea 'The Ultimate Answer', focused [8] heading 'The Ultimate Answer' [9] paragraph ' StaticText 'Click the button to reveal the answer to life, the universe, and everything.' [10] button 'Click me', clickable
이전 동작 goto('http://localhost:8000')
다음은 버튼을 클릭할 때의 유효한 동작에 대한 사고 과정 예시입니다:
내 목표를 달성하기 위해서는 bid 12인 버튼을 클릭해야 합니다 "click("12")"
그리고 위 프롬프트에 대한 응답 예시는 다음과 같습니다:
내 목표를 달성하기 위해서는, 삶, 우주, 그리고 모든 것에 대한 답을 밝히기 위해 bid 10인 버튼을 클릭해야 합니다. "click("10")"
WebArena 벤치마크 평가에서는 일부 작업이 사용자에게 보내는 에이전트의 메시지에 대한 답변의 정확한 일치 여부를 확인해야 하므로, 사용자에게 메시지를 보낼 때 에이전트가 추가 텍스트로 인해 테스트에 실패하지 않도록 간결한 답변 문자열만으로 응답하게 하는 다음 지침을 추가합니다:
다음은 사용자에게 간결한 답변을 제공할 때의 유효한 동작 에 대한 사고 과정의 또 다른 예시입니다:
내 목표를 달성하기 위해서는 요청된 정보를 사용자에게 다시 보내야 합니다. 이 페이지는 목표에서 식별된 제품인 HP Inkjet Fax Machine의 정보를 나열합니다. 가격은 279.49\(입니다. 답변과 함께 사용자에게 메시지를 다시 보내겠습니다. "send_msg_to_user("\) \ "