
토큰을 하나씩 예측하는 대신 확산 모델처럼 가려진 텍스트를 채우고, 8B 규모로 LLaMA-3 에 맞먹는다. ICML 2025, 전문 무료.
Large Language Diffusion Models
대규모 언어 확산 모델
Shen Fengqi Zhu Zebin You Xiaolu Zhang Jingyang Jun Jun Zhou Yankai Ji-Rong Wen Chongxuan 중국 인민대학교 가오링 인공지능대학 베이징 대형 모델 및 지능형 거버넌스 연구 중점 실험실 차세대 지능형 검색 및 추천 공학연구센터, 교육부 앤트 그룹 {nieshen,fengqizhu,chongxuanli}@ruc.edu.cn {nie shen, fengqizhu, chongxuanli}@ruc.edu.cn
초록
대규모 언어 모델(LLM)의 역량은 자기회귀 모델(ARM)에 의존한다고 널리 여겨진다. 우리는 사전 학습 및 지도 미세 조정(SFT) 패러다임 하에서 처음부터 학습된 확산 모델인 LLaDA를 도입함으로써 이 통념에 도전한다. LLaDA는 순방향 데이터 마스킹 과정과 역방향 생성 과정을 사용하며, 마스킹된 토큰을 예측하도록 Transformer로 매개변수화된다. 이는 우도 하한을 최적화함으로써 확률적 추론을 위한 원리적인 생성적 접근을 제공한다. 일반 과제, 수학, 코드 등에 대한 광범위한 벤치마크에서 LLaDA는 강력한 확장성을 입증하며, 우리가 직접 구축한 ARM 베이스라인과 비견되는 성능을 보인다. 특히, LLaDA 8B는 문맥 내 학습에서 LLaMA3 8B와 같은 강력한 LLM과 경쟁력이 있으며, SFT 이후에는 다중 턴 대화와 같은 사례 연구에서 인상적인 지시 따르기 능력을 보인다. 더욱이, LLaDA는 역전 저주를 해결하여 역전 시 완성 과제에서 GPT-4o를 능가한다. 우리의 발견은 대규모 언어 모델링에 대한 확산 모델의 가능성을 보여주며, 위에서 논의한 핵심 LLM 역량이 본질적으로 ARM에 의존한다는 일반적인 가정에 도전한다. 프로젝트 페이지 및 코드: https://ml-gsai.github.io/LLaDA-demo/
1 서론
대규모 언어 모델(LLM) [1]은 전적으로 생성 모델링 프레임워크 내에 속한다. 구체적으로, LLM은 최대 우도 추정, 또는 이와 동등하게 두 분포 간의 KL 발산 최소화를 통해 모델 분포 를 최적화함으로써 참이지만 알려지지 않은 언어 분포 를 포착하는 것을 목표로 한다:
주된 접근 방식은 모델 분포를 정의하기 위해 자기회귀 모델링(ARM)—흔히 "다음 토큰 예측" 패러다임으로 불리는—에 의존한다:
자기회귀 공식화
\*동등 기여.
앤트 그룹 인턴십 중 수행한 작업.
프로젝트 리더.
교신저자: Chongxuan Li.
여기서 는 길이 의 시퀀스이고, 는 번째 토큰이다. 이 패러다임은 놀라울 정도로 효과적임이 입증되었으며 [2][5], 현재 LLM의 기반이 되었다. 널리 채택되었음에도 불구하고, 근본적인 질문이 여전히 답변되지 않은 채 남아 있다: 자기회귀 패러다임이 확장성, 문맥 내 학습, 지시 따르기와 같은 LLM의 핵심 역량을 달성하는 유일한 경로인가?
우리는 그 답이 단순한 "그렇다"가 아니라고 주장한다. 이전에 간과되었던 핵심 통찰은 다음과 같다: LLM의 본질적 속성을 근본적으로 뒷받침하는 것은 자기회귀 공식화(즉, Eq. (2)) 자체가 아니라 생성 모델링 원리(즉, Eq. (1))라는 것이다.
특히, 우리는 확장성이 주로 Eq. (2)의 ARM의 독특한 결과라기보다는 Transformers [7], 모델 크기, 데이터 크기, 그리고 Eq. (1)의 생성 원리에 의해 유도되는 피셔 일관성 [5][8] 간의 상호작용의 결과라고 주장한다. 시각 데이터 [11]에 대한 확산 트랜스포머 [9][10]의 성공은 이 주장을 뒷받침한다. 나아가, 지시 따르기와 문맥 내 학습 [4] 능력은 ARM의 배타적 이점이라기보다는 구조적으로 일관된 언어 과제에 대한 모든 조건부 생성 모델의 내재적 속성으로 보인다. 또한, ARM은 무손실 데이터 압축기 [12][13]로 해석될 수 있지만, 충분히 표현력 있는 확률 모델이라면 누구나 유사한 능력을 달성할 수 있다 [14].
그러나 LLM의 특정 고유한 한계는 자기회귀적 본성에 직접적으로 기인할 수 있다. 예를 들어, 좌에서 우로의 생성 과정은 역전 추론 과제 [15]를 처리하는 능력을 제한하며, 이는 현재 모델의 일반화 능력에서 대표적인 실패를 부각시킨다.
이러한 통찰에 동기를 부여받아, 우리는 LLM이 보이는 역량이 ARM을 넘어선 생성 모델링 원리로부터 창발할 수 있는지 조사하기 위해 LLaDA(Large Language Diffusion with mAsking)를 도입하며, 이로써 앞서 제기한 근본적인 질문을 다룬다. 전통적인 ARM과 달리, LLaDA는 마스킹 확산 모델(MDM) [16][20]을 활용하며, 이는 순방향 데이터 마스킹 과정을 포함하고 그 역과정을 근사하도록 마스크 예측기를 학습시킨다. 이 설계는 LLaDA가 양방향 의존성을 가진 모델 분포를 구축하고 그 로그 우도의 변분 하한을 최적화할 수 있게 하여, 위에서 논의한 LLM의 핵심 역량에 대해 원리적이고 이전에 탐구되지 않은 관점을 제공한다.
우리는 데이터 준비, 사전 학습, 지도 미세 조정(SFT), 평가의 표준 파이프라인을 채택하여 LLaDA를 8B 규모의 전례 없는 언어 확산 모델로 확장한다. 특히, LLaDA 8B는 0.13백만 H800 GPU 시간을 사용하여 2.3조 토큰으로 처음부터 사전 학습되었으며, 이후 4.5백만 쌍에 대해 SFT되었다. 언어 이해, 수학, 코드, 중국어를 포함한 다양한 과제에서 LLaDA는 다음과 같은 기여를 보인다:
- LLaDA는 FLOPs의 연산 예산으로 효과적으로 확장되며, MMLU 및 GSM8K와 같은 6개 과제에서 동일한 데이터로 학습된 ARM 베이스라인과 비견되는 결과를 달성한다.
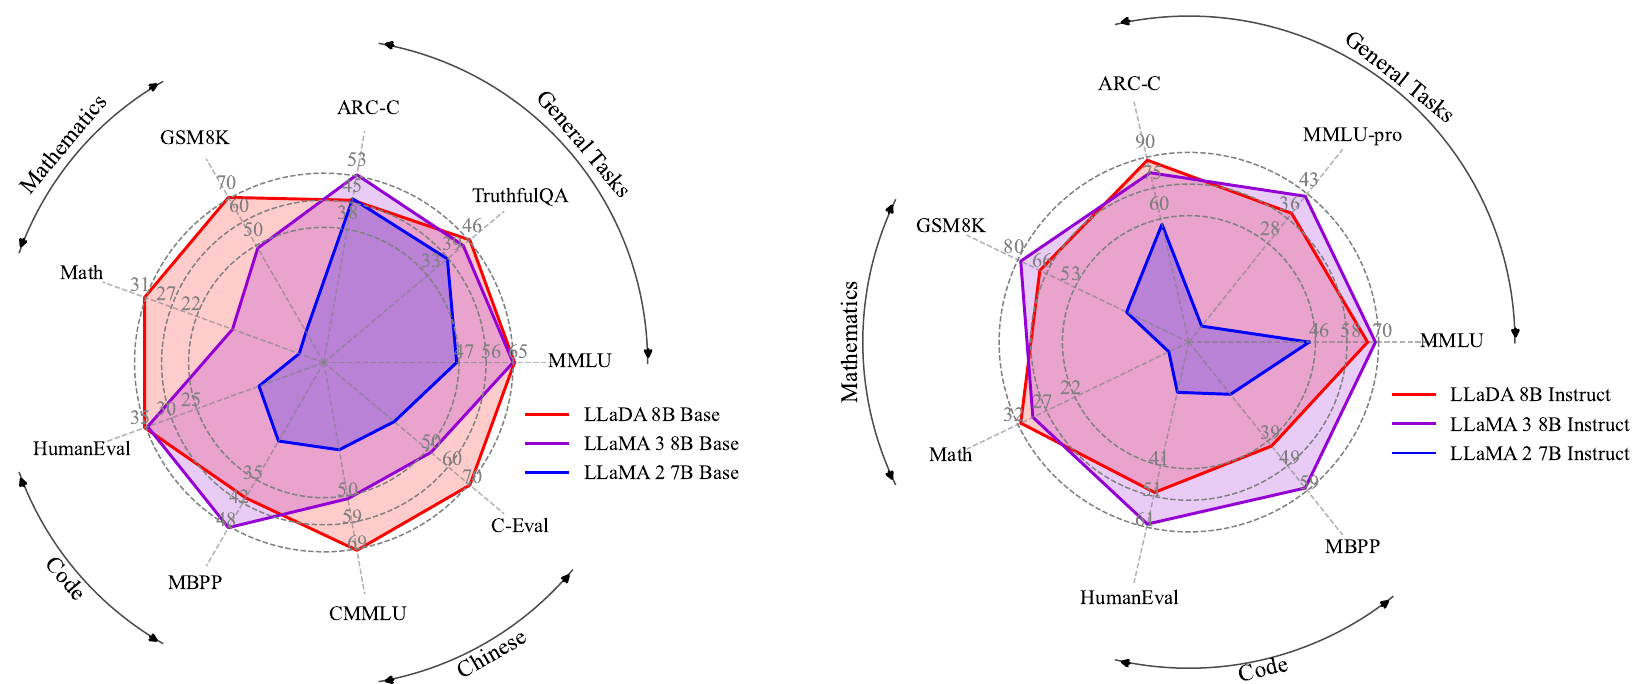
- 사전 학습된 LLaDA 8B Base는 거의 모든 15개 표준 제로/퓨샷 학습 과제에서 LLaMA2 7B Base [21]를 능가하는 동시에 LLaMA3 8B Base [6]와 대등한 성능을 보이며, 효과적인 문맥 내 학습 능력을 보여준다.
- LLaDA는 다중 턴 대화와 같은 사례 연구에서 입증된 바와 같이 SFT 이후 지시 따르기 능력을 크게 향상시킨다.
- LLaDA는 순방향 및 역방향 과제에서 일관된 성능으로 역전 저주 [15]를 효과적으로 깨뜨린다. 특히, 역전 시 완성 과제에서 GPT-4o를 능가한다.
2 접근법
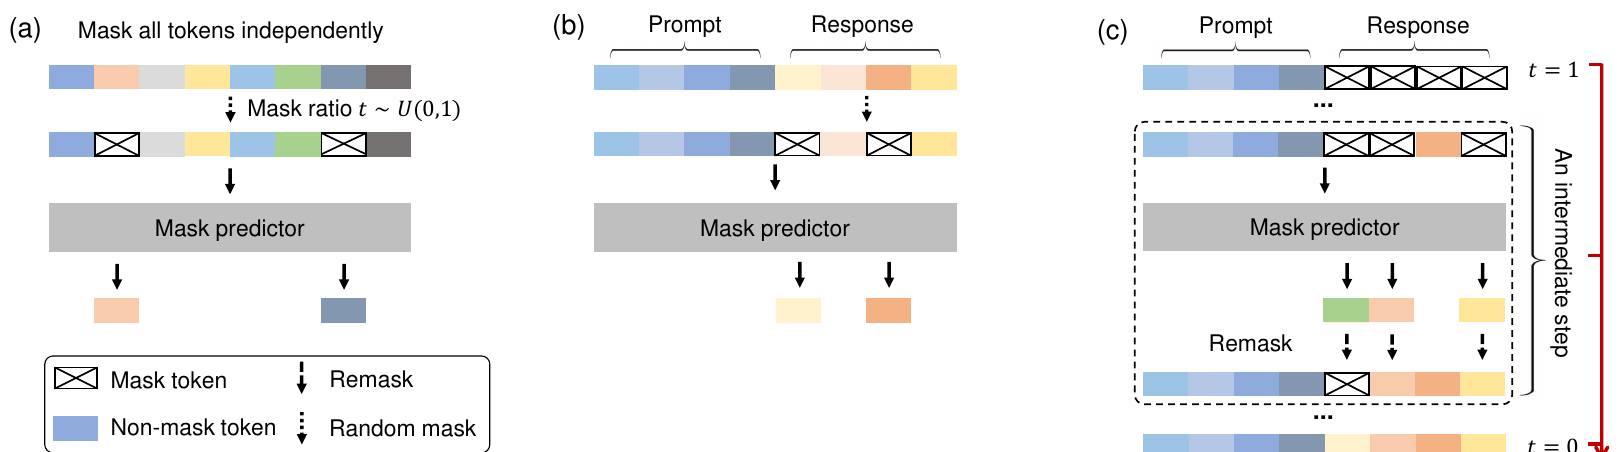
이 섹션에서 우리는 Fig. 2에 예시된 바와 같이 LLaDA의 확률적 공식화[6]와 사전 학습, 지도 미세 조정, 추론 절차를 소개한다.
2.1 확률적 공식화
Eq. (2)의 ARM과 달리, LLaDA는 순방향 과정과 역방향 과정을 통해 모델 분포 를 정의한다 [16][20]. 순방향 과정은 의 토큰을 독립적으로 점진적으로 마스킹하여 에서 시퀀스가 완전히 마스킹될 때까지 진행된다. 에 대해, 시퀀스 는 부분적으로 마스킹되며, 각 토큰은 확률 로 마스킹되거나 확률 로 마스킹되지 않은 채 남는다. 역방향 과정은 가 1에서 0으로 이동함에 따라 마스킹된 토큰을 반복적으로 예측하여 데이터 분포를 복원한다.
LLaDA의 핵심은 마스크 예측기(mask predictor), 즉 를 입력으로 받아 모든 마스크된 토큰(M으로 표기)을 동시에 예측하는 파라메트릭 모델 이다. 이는 마스크된 토큰에 대해서만 계산되는 교차 엔트로피 손실을 사용하여 훈련된다 [18][20]:
여기서 는 훈련 샘플, 는 에서 균등하게 추출된 연속 확률 변수, 는 순방향 과정(forward process)에서 샘플링되며, 은 시퀀스 길이이다. 지시 함수 는 손실이 마스크된 토큰에 대해서만 계산되도록 보장한다.
훈련이 완료되면, 마스크 예측기에 의해 매개변수화된 역과정(reverse process, 자세한 내용은 Sec. [2.4] 참조)을 시뮬레이션할 수 있으며, 모델 분포 를 에서 유도된 주변 분포로 정의할 수 있다. Eq. (3)의 손실 함수는 모델 분포의 음의 로그 우도에 대한 상한임이 증명되어 있어, 생성 모델링을 위한 원리적 목적 함수가 된다:
특히, LLaDA는 0과 1 사이에서 무작위로 변하는 마스킹 비율을 사용하는 반면, BERT [22]는 고정된 비율을 사용한다. 이러한 미묘한 차이는 특히 규모가 커질 때 중요한 함의를 지닌다. Eq. (4)에서 볼 수 있듯이, LLaDA는 LLM과 유사하게 자연스럽게 인컨텍스트 학습(in-context learning)과 명령 따르기(instruction-following)를 수행할 잠재력을 지닌 원리적 생성 모델이다. 더욱이, 이러한 생성적 관점은 Sec. [1]에서 논의한 바와 같이 대규모 데이터와 모델에 대한 강력한 확장성을 시사한다. 또한, MaskGIT [23]은 휴리스틱한 훈련 목적 함수를 채택하여 Eq. (3)과 비교할 때 항을 누락하고 있으며, 최대 우도와의 이론적 연관성이 없다. 우리는 언어 모델링을 위해 이산 확산 모델(discrete diffusion model)을 확장하도록 우리를 동기 부여한 것이 바로 최대 우도 추정(maximum likelihood estimation)의 이론적 토대임을 강조한다.
2.2 사전 훈련
LLaDA는 기존 LLM과 마찬가지로 Transformer [7]를 마스크 예측기로 사용한다. 그러나 LLaDA는 인과적 마스크(causal mask)를 사용하지 않는데, 그 정식화가 예측을 위해 전체 입력을 볼 수 있도록 허용하기 때문이다.
우리는 서로 다른 크기의 LLaDA 두 가지 변형을 훈련시켰다: 1B와 8B. 여기서 LLaDA 8B와 LLaMA3 8B [6]의 모델 아키텍처를 요약하며, 세부 사항은 부록 [B.2]에 제시되어 있다. 우리는 몇 가지 필요한 수정을 가하면서 대부분의 하이퍼파라미터에서 일관성을 유지하도록 했다. LLaDA는 KV 캐싱과 호환되지 않아 키 및 값 헤드의 수가 달라지므로, 단순화를 위해 그룹 쿼리 어텐션(grouped query attention) [24] 대신 바닐라 멀티 헤드 어텐션(vanilla multi-head attention)을 사용한다. 결과적으로 어텐션 레이어는 더 많은 파라미터를 갖게 되며, 비교 가능한 모델 크기를 유지하기 위해 FFN 차원을 줄인다. 또한, 우리의 데이터에 적응된 토크나이저(tokenizer) [4]로 인해 어휘 크기가 다르다.
LLaDA 모델은 2.3조(T) 토큰으로 구성된 데이터셋에서 사전 학습되었으며, 기존 LLM[25][26]과 밀접하게 정렬된 데이터 프로토콜을 따르고 특별한 기법은 도입하지 않았다. 데이터는 온라인 코퍼스에서 유래했으며, 저품질 콘텐츠는 수동으로 설계된 규칙과 LLM 기반 접근법을 통해 필터링되었다. 일반 텍스트 외에도 데이터셋은 고품질 코드, 수학, 다국어 데이터를 포함한다. 데이터셋에 대한 자세한 내용은 부록 [B.1]을 참조하기 바란다. 데이터 소스와 도메인의 혼합은 축소된 ARM에 의해 안내되었다. 사전 학습 과정은 4096 토큰의 고정 시퀀스 길이를 사용하며, 총 13만 H800 GPU 시간의 계산 비용이 발생하는데, 이는 동일한 규모와 데이터셋 크기의 ARM과 유사하다.
학습 시퀀스 에 대해, 우리는 을 무작위로 샘플링하고, 각 토큰을 동일한 확률 로 독립적으로 마스킹하여 를 얻으며(그림 2 참조), 확률적 경사 하강법 학습을 위해 몬테카를로 방법으로 식 (3)을 추정한다. 또한, Nie 등[27]을 따라, 가변 길이 데이터를 처리하는 LLaDA의 능력을 향상시키기 위해 사전 학습 데이터의 를 범위에서 균일하게 샘플링된 무작위 길이로 설정하였다.
우리는 연속 학습을 중단하지 않고 학습 진행 상황을 모니터링하기 위해 Warmup-Stable-Decay[28] 학습률 스케줄러를 채택하였다. 구체적으로, 처음 2000회 반복 동안 학습률을 0에서 까지 선형적으로 증가시키고 로 유지하였다. 1.2T 토큰을 처리한 후, 학습률을 로 감소시키고 다음 0.8T 토큰 동안 일정하게 유지하여 안정적인 학습을 보장하였다. 마지막으로, 마지막 0.3T 토큰 동안 학습률을 에서 까지 선형적으로 감소시켰다. 또한, 우리는 가중치 감쇠 0.1, 배치 크기 1280, GPU당 로컬 배치 크기 4로 AdamW 옵티마이저[29]를 사용하였다. 8B 실험은 하이퍼파라미터 튜닝 없이 한 번만 실행되었다.
2.3 지도 미세 조정
우리는 쌍 데이터 를 사용한 지도 미세 조정(SFT)을 통해 지시를 따르는 LLaDA의 능력을 향상시키는데, 여기서 는 프롬프트이고 는 응답을 나타낸다. 이는 LLM을 위한 가장 단순하고 기본적인 사후 학습 방법이다. 기술적으로, 이는 사전 학습에서의 대신 조건부 분포 를 모델링할 것을 요구한다.
구현은 사전 학습과 유사하다. 그림 2에 나타난 바와 같이, 우리는 프롬프트를 변경하지 않고 에 대해 수행한 것처럼 응답의 토큰을 독립적으로 마스킹한다. 그런 다음, 프롬프트와 마스킹된 응답 를 모두 사전 학습된 마스크 예측기에 입력하여 SFT 손실을 계산한다:
여기서 은 나중에 명시될 동적 길이를 나타내며, 다른 모든 표기법은 이전과 동일하게 유지된다. 이 접근법은 사전 학습과 완전히 호환된다는 점에 유의한다. 본질적으로, 와 의 연결은 깨끗한 사전 학습 데이터 로 취급될 수 있으며, 와 의 연결은 마스킹된 버전 로 작용한다. 이 과정은 사전 학습과 동일하며, 유일한 차이점은 모든 마스킹된 토큰이 부분에 나타난다는 것이다.
LLaDA 8B 모델은 450만 쌍으로 구성된 데이터셋에서 SFT를 수행한다. 사전 학습 과정과 일관되게, 데이터 준비와 학습 모두 기존 LLM[25][26]에서 활용되는 SFT 프로토콜을 따르며, LLaDA의 성능을 최적화하기 위한 추가적인 기법은 도입하지 않는다. 데이터셋은 코드, 수학, 지시 따르기를 포함한 여러 도메인에 걸쳐 있다. 우리는 모든 데이터의 길이를 동일하게 보장하기 위해 각 미니 배치에서 짧은 쌍의 끝에 |EOS| 토큰을 추가한다. 우리는 학습 중에 |EOS|를 일반 토큰으로 취급하고 샘플링 중에 제거하여, LLaDA가 응답 길이를 자동으로 제어할 수 있도록 한다. 자세한 내용은 부록 B.1을 참조하기 바란다.
우리는 사전 학습 단계와 유사한 스케줄을 사용하여 SFT 데이터에 대해 3 에포크 동안 학습한다. 학습률은 처음 50회 반복 동안 0에서 까지 선형적으로 증가한 후 일정하게 유지된다. 마지막 의 반복 동안에는 까지 선형적으로 감소한다. 또한, 가중치 감쇠를 0.1, 전역 배치 크기를 256, GPU당 로컬 배치 크기를 2로 설정하였다. SFT 실험은 하이퍼파라미터 튜닝 없이 한 번만 실행되었다.
2.4 추론
생성 모델로서, LLaDA는 좌에서 우로 진행되는 자기회귀 방식 대신 확산 방식으로 새로운 텍스트를 샘플링하고 후보 텍스트의 가능도를 평가할 수 있다.
우리는 역방향 생성 과정부터 시작한다. 그림 2에 나타난 바와 같이, 프롬프트 가 주어지면, 우리는 완전히 마스킹된 응답에서 시작하여 모델 분포 로부터 샘플링하기 위해 역방향 과정을 이산화한다. 총 샘플링 단계 수는 하이퍼파라미터로서, 3.3절에서 분석한 바와 같이 LLaDA에 효율성과 샘플 품질 간의 절충을 자연스럽게 제공한다. 우리는 기본적으로 균일하게 분포된 타임스텝을 사용한다. 또한, 생성 길이도 하이퍼파라미터로 취급되며, 샘플링 과정 시작 시 완전히 마스킹된 문장의 길이를 지정한다. 생성 후, |EOS| 토큰 뒤에 나타나는 토큰은 폐기된다. 부록 [B.5]에서 상세히 설명한 바와 같이, 사전 학습과 SFT 모두 가변 길이의 데이터셋을 사용하여 수행되므로, 최종 결과는 이 길이 하이퍼파라미터에 민감하지 않다.
시간 에서 로의 중간 단계에서, 우리는 와 를 모두 마스크 예측기에 입력하고 모든 마스킹된 토큰을 동시에 예측한다. 그런 다음, 우리는 예측된 토큰의 기대값으로 만큼을 다시 마스킹하여 를 얻으며, 이는 역방향 과정의 전이가 정확한 샘플링을 위해 순방향 과정과 일치하도록 보장한다[18][20]. 원칙적으로, 재마스킹 전략은 순수하게 무작위여야 한다. 그러나 LLM에서의 샘플링의 어닐링 기법[4][30]에서 영감을 받아, 우리는 저신뢰도 재마스킹 전략을 채택하는데, 여기서 예측에 기반하여 가장 낮은 신뢰도를 가진 예측된 토큰의 만큼이 Chang 등[23]의 접근법과 동일하게 다시 마스킹된다.
우리는 LLaDA가 유연한 샘플링을 가능하게 한다는 점을 언급한다. 특히, 위에서 설명한 사전 학습 또는 SFT 과정 이후에 추가적인 수정이나 학습 없이 자기회귀 및 블록 확산[31] 샘플링을 직접 지원한다. 우리는 부록 [B.4]에서 상세한 분석을 제공한다. 그럼에도 불구하고, 확산 샘플링(즉, 역방향 생성 과정)이 최고의 성능을 산출하며 본 논문 전체에서 기본값으로 채택되는데, 특히 3절에서 제시된 모든 실험에 대해 그러하다.
조건부 가능도 평가의 경우, 우리는 자연스럽게 식 [5]의 상한을 활용할 수 있다. 그러나 우리는 다음과 같은 등가 형태[20]가 더 낮은 분산을 보이며 더 안정적임을 발견하였다:
여기서 은 의 시퀀스 길이이고, 은 에서 균일하게 샘플링되며, 은 마스킹을 위해 에서 개의 토큰을 비복원으로 균일하게 샘플링하여 얻어진다.
우리는 훈련 및 추론 알고리즘과 이론적 세부 사항을 부록 [A]에 제시한다.
3 실험
우리는 LLaDA의 확장성, 지시 수행, 문맥 내 학습 능력을 표준 벤치마크에서 평가하고, 이어서 분석과 사례 연구를 통해 종합적인 평가를 제공한다.
3.1 언어 과제에서의 LLaDA 확장성
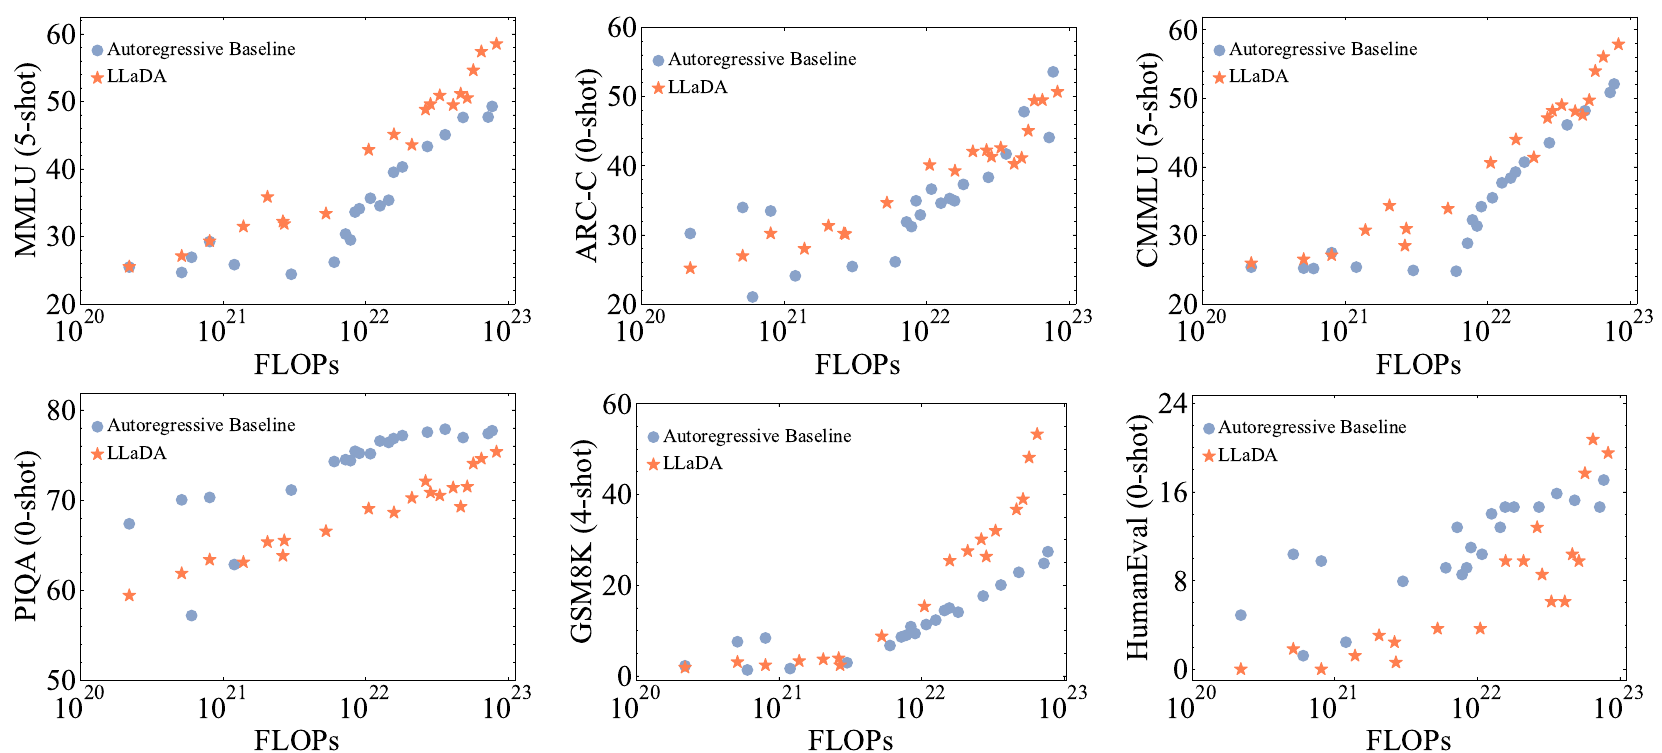
우리는 먼저 우리가 구축한 ARM 베이스라인과 비교하여 다운스트림 과제에서의 LLaDA의 확장성을 조사한다. 구체적으로, 1B 규모에서는 LLaDA와 ARM이 동일한 아키텍처, 데이터 및 기타 모든 구성을 공유하도록 하였다. 더 큰 규모에서는 자원 제약으로 인해 동일한 데이터로 훈련된 약간 다른 크기의 LLaDA 및 ARM 모델에 대한 결과도 보고한다. 자세한 내용은 부록 [B.2]를 참조하기 바란다. 우리는 사전 훈련 계산 비용을 통합된 확장 지표로 사용한다. 평가를 위해 우리는 여섯 가지 표준적이고 다양한 과제에 초점을 맞추었다.
그림 3은 LLaDA가 인상적인 확장성을 보여주며, 그 전체적인 추세가 ARM과 매우 경쟁력이 있음을 보여준다. 특히 MMLU와 GSM8K와 같은 과제에서 LLaDA는 더욱 강한 확장성을 보인다. PIQA와 같이 상대적으로 약한 과제에서도 규모가 커질수록 ARM과의 성능 격차가 좁아진다. 이상치의 영향을 고려하기 위해 우리는 잠재적인 오해를 피하고자 정량적 곡선 적합을 선택하지 않았다. 그럼에도 불구하고 결과는 LLaDA의 확장성을 명확히 보여준다.
특정 벤치마크에서 LLaDA의 이점을 고려하여, 우리는 이러한 성능 향상이 핵심적인 아키텍처 차이에서 비롯된다고 가설을 세운다. 자기회귀 모델은 왼쪽에서 오른쪽으로의 조건부 확률만을 최적화하는 반면, LLaDA는 부록 [A.2]에 자세히 설명된 것처럼 여러 조건 방향을 고려하도록 훈련되며, 이는 더 큰 유연성을 제공하고 더 나은 일반화로 이어질 수 있다. 이 가설은 3.3절의 역방향 추론에서 LLaDA의 강력한 성능과 부록 [B.4]의 샘플링 전략에 대한 절제 연구에 의해 뒷받침된다.
Nie 등[27]은 MDM이 ARM과 동일한 우도를 달성하기 위해 16배 더 많은 계산을 필요로 한다고 제안한다. 그러나 핵심적인 차이점들로 인해 우리의 발견은 더 폭넓게 적용 가능하다. 특히, 우도는 다운스트림 과제 성능에 대해 상대적으로 간접적인 지표이며, 확산은 우도의 하한을 최적화하므로 ARM과 직접적으로 비교할 수 없다. 또한, 우리는 Nie 등[27]의 FLOPs에서 본 연구의 FLOPs로 확장 범위를 확장하였다.
3.2 벤치마크 결과
LLaDA 8B의 문맥 내 학습 및 지시 수행 능력을 종합적으로 평가하기 위해, 우리는 유사한 규모의 기존 LLM[6,21,25,26,32,33]과 상세한 비교를 수행하였다. 과제 선택 및 평가 프로토콜은 기존 연구를 따랐으며, 일반 과제, 수학, 코드, 중국어의 인기 벤치마크를 포함한다. 추가 세부 사항은 부록 [B.6]에 제공된다. 보다 직접적인 비교를 위해, 우리는 대표적인 LLM[6,21]을 우리의 구현에서 재평가하였다.
표 [1]에 나타난 바와 같이, 2.3T 토큰으로 사전 훈련한 후, LLaDA 8B Base는 놀라운 성능을 보여 거의 모든 과제에서 LLaMA2 7B Base를 능가하며, 전반적으로 LLaMA3 8B Base와 경쟁력이 있다. LLaDA는 수학 및 중국어 과제에서 이점을 보인다. 우리는 이러한 강점이 일부 과제에서의 상대적으로 약한 성능과 동일한 요인, 즉 주로 LLM 데이터셋의 폐쇄성에서 기인하는 데이터 품질과 분포의 차이에서 비롯된다고 추측한다.
| LLaDA 8B* | LLaMA3 8B* | LLaMA2 7B* | Qwen2 7B† | Qwen2.5 7B† | Mistral 7B† | Deepseek 7B† | |
| 모델 학습 토큰 | Diffusion 2.3T | AR 15T | AR 2T | AR 7T | AR 18T | AR - | AR 2T |
| 일반 과제 | |||||||
| MMLU | 65.9 (5) | 65.4 (5) | 45.9 (5) | 70.3 (5) | 74.2 (5) | 64.2 (5) | 48.2 (5) |
| BBH | 49.7 (3) | 62.1 (3) | 39.4 (3) | 62.3 (3) | 70.4 (3) | 56.1 (3) | 39.5 (3) |
| ARC-C | 45.9 (0) | 53.1 (0) | 46.3 (0) | 60.6 (25) | 63.7 (25) | 60.0 (25) | 48.1 (0) |
| Hellaswag | 70.5 (0) | 79.1 (0) | 76.0 (0) | 80.7 (10) | 80.2 (10) | 83.3 (10) | 75.4 (0) |
| TruthfulQA | 46.1 (0) | 44.0 (0) | 39.0 (0) | 54.2 (0) | 56.4 (0) | 42.2 (0) | - |
| WinoGrande | 74.8 (5) | 77.3 (5) | 72.5 (5) | 77.0 (5) | 75.9 (5) | 78.4 (5) | 70.5 (0) |
| PIQA | 73.6 (0) | 80.6 (0) | 79.1 (0) | - | - | - | 79.2 (0) |
| 수학 & 과학 | |||||||
| GSM8K | 70.3 (4) | 48.7 (4) | 13.1 (4) | 80.2 (4) | 85.4 (4) | 36.2 (4) | 17.4 (8) |
| Math | 31.4 (4) | 16.0 (4) | 4.3 (4) | 43.5 (4) | 49.8 (4) | 10.2 (4) | 6.0 (4) |
| GPQA | 25.2 (5) | 25.9 (5) | 25.7 (5) | 30.8 (5) | 36.4 (5) | 24.7 (5) | - |
| 코드 | |||||||
| HumanEval | 35.4 (0) | 34.8 (0) | 12.8 (0) | 51.2 (0) | 57.9 (0) | 29.3 (0) | 26.2 (0) |
| HumanEval-FIM | 73.8 (2) | 73.3 (2) | 26.9 (2) | - | - | - | - |
| MBPP | 40.0 (4) | 48.8 (4) | 23.2 (4) | 64.2 (0) | 74.9 (0) | 51.1 (0) | 39.0 (3) |
| 중국어 | |||||||
| CMMLU | 69.9 (5) | 50.7 (5) | 32.5 (5) | 83.9 (5) | - | - | 47.2 (5) |
| C-Eval | 70.5 (5) | 51.7 (5) | 34.0 (5) | 83.2 (5) | - | - | 45.0 (5) |
| LLaDA 8B* | LLaMA3 8B* | LLaMA2 7B* | Qwen2 7B† | Qwen2.5 7B† | Gemma2 9B† | Deepseek 7B† | |
| 모델 학습 토큰 | Diffusion 2.3T | AR 15T | AR 2T | AR 7T | AR 18T | AR 8T | AR 2T |
| 사후 학습 정렬 데이터 쌍 | SFT 4.5M | SFT+RL - | SFT+RL - | SFT+RL 0.5M + - | SFT+RL 1M + 0.15M - | SFT+RL - | SFT+RL 1.5M + - |
| 일반 과제 | |||||||
| MMLU | 65.5 (5) | 68.4 (5) | 44.1 (5) | - | - | - | 49.4 (0) |
| MMLU-pro | 37.0 (0) | 41.9 (0) | 4.6 (0) | 44.1 (5) | 56.3 (5) | 52.1 (5) | - |
| Hellaswag | 74.6 (0) | 75.5 (0) | 51.5 (0) | - | - | - | 68.5 (-) |
| ARC-C | 88.5 (0) | 82.4 (0) | 57.3 (0) | - | - | - | 49.4 (-) |
| 수학 & 과학 | |||||||
| GSM8K | 69.4 (4) | 78.3 (4) | 29.0 (4) | 85.7 (0) | 91.6 (0) | 76.7 (0) | 63.0 (0) |
| 수학 | 31.9 (0) | 29.6 (0) | 3.8 (0) | 52.9 (0) | 75.5 (0) | 44.3 (0) | 15.8 (0) |
| GPQA | 33.3 (5) | 31.9 (5) | 28.4 (5) | 34.3 (0) | 36.4 (0) | 32.8 (0) | - |
| 코드 | |||||||
| HumanEval | 49.4 (0) | 59.8 (0) | 16.5 (0) | 79.9 (0) | 84.8 (0) | 68.9 (0) | 48.2 (-) |
| MBPP | 41.0 (4) | 57.6 (4) | 20.6 (4) | 67.2 (0) | 79.2 (0) | 74.9 (0) | 35.2 (-) |
특히, 우리는 GSM8K를 예시로 삼아 데이터 누출 가능성을 신중히 배제하였다. 첫째, 그림 [3]에 나타난 바와 같이 LLaDA는 GSM8K와 관련하여 ARM 기준 모델들을 능가하였다. 더욱이, 이러한 결론은 부록 B.8의 완전히 보지 못한 GSM8K 유사 과제 [34]에서도 유지된다.
나아가, 표 [2]는 LLaDA 8B Instruct의 성능을 기존 LLM들과 비교한다. SFT는 대부분의 다운스트림 과제에서 LLaDA의 성능을 향상시켰다. MMLU와 같은 몇몇 지표는 하락을 보였는데, 이는 SFT 데이터의 품질이 최적이 아니었기 때문일 수 있다. 전반적으로, 우리는 강화 학습(RL)을 통한 정렬을 수행하지 않았기 때문에
| 샘플링 과정 | |
| 사용자 | Lily는 시속 12킬로미터로 4시간 동안 달릴 수 있습니다. 그 후에는 시속 6킬로미터로 달립니다. 그녀는 8시간 동안 몇 킬로미터를 달릴 수 있습니까? |
| LLaDA | 4시간 동안 Lily는 12 * 4 = 48킬로미터를 달립니다. 4시간 후에는 6 * 4 = 24킬로미터를 달립니다. 총합하여 그녀는 8시간 동안 48 + 24 = 72킬로미터를 달립니다. 결과 72 |
| 다중 라운드 대화 사례 | |
| 사용자 | 유명한 시 ‘가지 않은 길’의 처음 두 행을 저에게 공유해 주시겠어요? |
| LLaDA | 물론입니다! Robert Frost의 유명한 시 “가지 않은 길”의 처음 두 행은 다음과 같습니다: “Two roads diverged in a yellow wood, And sorry I could not travel both.” 이 행들은 시의 무대를 설정하며, 두 갈래 길 사이에서 선택에 직면한 화자의 개념을 소개합니다. |
| 사용자 | 중국어로 번역해 주세요. |
| LLaDA | 물론입니다! Robert Frost의 “가지 않은 길”의 처음 두 행은 중국어로 다음과 같이 번역할 수 있습니다: “两条路分岔在黄色的树林中,遗憾我不能同时走” |
| 사용자 | 독일어로 번역해 주세요. |
| LLaDA | 물론입니다! Robert Frost의 “가지 않은 길”의 처음 두 행은 독일어로 다음과 같이 번역할 수 있습니다: “Zwei Wege trennten sich im gelben Wald, und leider konnte ich nicht beide tun.” |
| 사용자 | 인생의 선택에 관한 시도 써 주세요. 5문장이 필요하고, 각 문장의 첫 단어는 C를 첫 글자로 시작해야 합니다. |
| LLaDA | 물론입니다! 다음은 각 문장이 문자 “C”로 시작하는 인생의 선택에 관한 시입니다: Choices cascade through life’s journey, Creating connections with each decision, Careful consideration leads to better paths, Courageous choices shape our destiny, Choosing wisely guides us through the years. |
우리의 결과는 LLaMA3 8B Instruct에 다소 뒤처지지만, 많은 지표에서의 격차는 여전히 작다. 특히, SFT만으로도 LLaDA는 인상적인 지시 수행 능력을 보여주는데, 이는 3.4절에 상세히 기술되어 있다. RL 기반 정렬은 향후 과제로 남겨 둔다.
3절의 모든 결과는 순수 확산 방법에 기반한 것으로, 이들은 자기회귀적 구성 요소를 통합한 접근법보다 더 나은 전반적 성능을 달성하기 때문이다. 구체적으로, 우리는 조건부 우도 추정을 위해 식 (6)을 사용하고, 샘플링에는 저신뢰도 리마스킹을 적용한다. LLaDA 8B Instruct의 경우, 블록 확산 방식 샘플링이 GSM8K와 Math에서 더 나은 성능을 보여 각각 78.6과 42.2의 점수를 기록하였으며, 이는 표 [2]의 69.4와 31.9와 비교된다. 이러한 이득은 SFT 데이터에 광범위한 |EOS| 토큰 패딩이 존재하여 저신뢰도 리마스킹에서 조기 종료가 발생하기 때문이다. 자세한 내용은 부록 [B.4]를 참조하기 바란다.
전반적으로, 데이터 투명성의 부재에도 불구하고, 우리는 표준화된 절차를 채택하고 다양한 과제를 도입하기 위해 모든 노력을 기울였으며, 이들이 우리가 알기로 유일한 경쟁력 있는 비자기회귀 모델인 LLaDA의 뛰어난 능력을 충분히 입증한다고 믿는다.
3.3 역방향 추론 및 분석
모델의 역방향 추론 [15] 능력을 정량화하기 위해, 우리는 Allen-Zhu and Li [35]에서 확립된 프로토콜을 따른다. 구체적으로, 우리는 496개의 유명한 중국 시 구절 쌍으로 구성된 데이터셋을 구축한다. 시의 한 구절이 주어지면, 모델은 추가적인 미세 조정 없이 다음 행(순방향) 또는 이전 행(역방향)을 생성하는 과제를 수행한다. 예시는 B.9절에서 확인할 수 있다. 이 설정은 이전 연구들 [27, 36]과 비교하여 간단하고 보다 현실적인 평가를 제공한다.
표 [4]에 나타난 바와 같이, LLaDA는 역방향 저주 [15]를 효과적으로 해결하여 순방향과 역방향 과제 모두에서 일관된 제로샷 성능을 보여준다. 대조적으로, Qwen 2.5와 GPT-4o 모두 둘 사이에 상당한 격차를 보인다. 순방향 생성에서의 결과는 두 ARM 모두 LLaDA보다 훨씬 더 큰 데이터셋과 더 많은 계산 자원의 혜택을 받아 강력함을 확인시켜 준다. 그러나 LLaDA는 역방향 과제에서 둘 모두를 큰 차이로 능가한다.
우리는 역방향 과제를 위해 특별히 설계한 것은 없다. 직관적으로, LLaDA는 귀납적 편향 없이 토큰을 균일하게 처리하여 균형 잡힌 성능을 이끌어낸다. 자세한 내용은 부록 A.2를 참조하기 바란다.
우리는 또한 LLaDA에 대한 다양한 샘플링 전략의 효과를 분석하는데, 여기에는 자기회귀적 샘플링, 블록 확산 [31] 샘플링, 순수 확산 샘플링이 포함되며, 순수 확산 샘플링이 최고의 전반적 성능을 달성함을 보여주는데, 이는 부록 B.4에 상세히 기술되어 있다.
| 순방향 | 역방향 | |
| GPT-4o (2024-08-06) | 82.7 | 34.3 |
| Qwen2.5-7B Instruct | 75.9 | 38.0 |
| LLaDA-8B Instruct | 51.8 | 45.6 |
또한, 우리는 LLaDA의 샘플링 속도와 메모리 소비를 검토하여, 생성 품질과 속도 사이의 유연한 절충을 가능하게 함을 보여준다. 자세한 내용은 부록 B.7을 참조하기 바란다.
분류기 없는 유도(CFG) [37] [27]는 확산 모델에서 생성 품질을 향상시키기 위해 널리 사용되는 기법이다. ARM과의 공정한 비교를 보장하기 위해, 우리는 본문에서 LLaDA에 CFG를 적용하지 않는다. 그러나 우리는 LLaDA가 CFG와 호환되며 그 적용으로부터 일관되게 이점을 얻음을 보여준다. 자세한 내용은 부록 B.3을 참조하기 바란다.
3.4 사례 연구
우리는 표 3에서 LLaDA 8B Instruct가 생성한 샘플들을 제시하며 그 지시 수행 능력을 보여준다. 첫째, 이 표는 LLaDA가 비자기회귀적 방식으로 일관성 있고 유창하며 확장된 텍스트를 생성하는 능력을 보여준다. 둘째, 이는 모델의 다중 턴 대화 능력을 강조하는데, 대화 이력을 효과적으로 유지하고 여러 언어에 걸쳐 맥락에 적절한 응답을 생성한다. LLaDA의 이러한 대화 능력은 우리가 알기로 처음으로 기존 ARM에서 벗어난 것으로서 인상적이다. 더 많은 사례 연구는 부록 B.10을 참조하기 바란다.
4 관련 연구
확산 모델 [38,40]은 시각 영역에서 놀라운 성공을 거두었으나, 증가하는 관심과 광범위한 연구 노력에도 불구하고 대규모(예: FLOPs 이상으로 훈련된 모델) 언어 모델링에 대해서는 아직 검증되지 않은 상태이다.
간단한 접근법은 텍스트 데이터를 연속화하고 연속 확산 모델을 직접 적용하는 것이다 [41-51]. 대안적으로, 일부 방법들은 대신 이산 분포의 연속 매개변수를 모델링한다 [52-56]. 그러나 확장성은 이러한 접근법들에게 여전히 중요한 과제로 남아 있다. 예를 들어, 1B 모델은 비교 가능한 성능을 달성하기 위해 ARM의 64배에 달하는 계산량이 필요할 수 있다 [57].
또 다른 접근법은 연속 확산을 새로운 순방향 및 역방향 동역학을 특징으로 하는 이산 과정으로 대체하며, 이는 수많은 변형들을 낳았다 [58,71]. 원래의 확산 모델 논문 [38]은 통합된 확산 프레임워크 아래에서 연속 상태 및 이산 상태 전이 커널을 모두 도입하였다. Austin 등 [16]은 이산 확산 모델을 언어 모델링에 도입한 선구적인 연구 중 하나로, 이 접근법의 실현 가능성을 입증하였다. Lou 등 [17]은 이산 확산의 특수한 경우인 마스크된 확산이 GPT-2 규모에서 ARM과 비슷하거나 능가하는 퍼플렉시티를 달성함을 보여주었다. Shi 등 [18], Sahoo 등 [19], Ou 등 [20]은 우리의 모델 설계, 훈련, 추론에 동기를 부여한 근본적인 이론적 결과들을 확립하였다(자세한 내용은 부록 A 참조). Nie 등 [27]은 언어 모델링에서 MDM의 스케일링 법칙을 도입하고 GPT-2 규모에서 질의응답과 같은 언어 과제에 MDM이 어떻게 활용될 수 있는지 탐구하였다. Gong 등 [72]은 MDM 프레임워크 내에서 ARM을 미세 조정하는 가능성을 입증하였다. 그러나 Gong 등 [72]이 관찰한 개선은 특정 지표에 국한되며, 그들의 접근법은 순수 확산 기반 훈련을 통해 달성 가능한 성능을 다루지 않는다. 동시대 연구 [73]은 코드 생성에서 확산 언어 모델의 가능성을 입증하고 추론 효율성에서의 이점을 강조한다. 그럼에도 불구하고, 그것은 폐쇄형 소스 제품이기 때문에 훈련 절차와 샘플링 방법과 같은 구체적인 세부 사항은 알려져 있지 않다.
이와 비교하여, 본 연구는 MDM을 처음부터 전례 없는 8B 매개변수 규모로 확장하여 LLaMA 3와 같은 선도적인 LLM들과 비교 가능한 성능을 달성한다.
추가적으로, 이미지 생성에 관한 병행 연구 계열 [23,74,75]은 MDM을 텍스트 데이터에 적용하는 것과 잘 부합한다. 더욱이, MDM은 단백질생성 [76][77]과 같은 다른 영역에서도 가능성을 보여주었으며, 그곳에서 유망한 결과를 달성하였다. 특히, 일련의 연구들 [31][78][87]은 MDM 샘플링을 가속화하기 위해 아키텍처 최적화, 증류, 샘플링 알고리즘 설계와 같은 기법들을 탐구하였다.
5 결론 및 논의
우리는 전례 없는 8B 매개변수 규모로 처음부터 훈련된 확산 언어 모델인 LLaDA를 소개한다. LLaDA는 확장성, 문맥 내 학습, 지시 수행에서 강력한 능력을 입증하며, LLaMA3와 같은 강력한 LLM들과 비교 가능한 성능을 달성한다. 또한, LLaDA는 양방향 모델링과 향상된 견고성과 같은 독특한 이점을 제공하여 기존 LLM들의 관련 한계를 효과적으로 해결한다. 우리의 발견은 대규모 언어 모델링에서 확산 모델의 가능성을 보여주며, 이러한 필수 능력들이 본질적으로 ARM에 묶여 있다는 일반적인 가정에 도전한다. 이러한 결과들은 언어 모델링의 새로운 패러다임을 대표하며 새로운 통찰을 밝혀내어 높은 수준의 과학적 혁신을 입증한다.
한계. 유망하기는 하지만, 확산 모델의 완전한 잠재력은 아직 완전히 탐구되어야 한다. 본 연구의 몇 가지 한계는 향후 연구를 위한 중요한 기회를 제시한다. 생성 길이는 사용자가 지정하는 하이퍼파라미터이다. 비록 LLaDA가 부록 [B.5]에 상세히 기술된 바와 같이 이 하이퍼파라미터에 둔감하지만, 우리는 적응형 생성 길이를 채택하는 것이 더 효율적인 해결책을 제공할 것이라고 믿는다. 계산 제약으로 인해, LLaDA와 ARM 간의 직접 비교—예를 들어 동일한 데이터셋에서의 훈련—는 FLOPs 미만의 계산 예산으로 제한되었다. 가능한 가장 큰 LLaDA 모델을 훈련하고 그 잠재력을 보여주기 위해 자원을 할당해야 했기 때문에, 우리는 ARM 기준 모델을 동일한 수준으로 확장할 수 없었다. 더욱이, LLaDA를 위해 특화된 어텐션 메커니즘이나 위치 임베딩이 설계되지 않았으며, KV 캐시와 같은 시스템 수준의 아키텍처 최적화도 적용되지 않았다. 추론 측면에서는, 더 효율적이고 제어 가능한 [37][88][89] 샘플링 알고리즘이 아직 예비 단계에 머물러 있다. 나아가, LLaDA는 아직 성능 향상과 인간 의도와의 정렬에 중요한 강화 학습 [90][91]을 통한 정렬을 거치지 않았다.
앞을 내다보면, LLaDA의 모델 규모와 훈련 데이터 양 모두 선도적인 ARM 대응 모델들 [6][26][92][95]보다 여전히 작으며, 이는 그 능력을 완전히 평가하기 위해 추가적인 확장이 필요함을 강조한다. 또한, LLaDA의 다중 모달 데이터 처리 능력은 아직 탐구되지 않았다. 프롬프트 튜닝 기법 [96]과 에이전트 기반 시스템 [97][98]으로의 통합에 대한 그 영향은 아직 완전히 이해되지 않았다. 마지막으로, 확산 언어 모델의 잠재력을 더욱 이끌어내기 위해 LLaDA에 대한 사후 훈련(예: O1 유사 시스템 [99][100])에 대한 체계적인 조사가 필요하다.
감사의 글
본 연구는 국가자연과학기금(No. 92470118), 베이징 자연과학기금(No. L247030), 베이징 노바 프로그램(No. 20220484044), 그리고 앤트 그룹 연구 기금의 지원을 받았다.
참고문헌
[1] Wayne Xin Zhao, Kun Zhou, Junyi Li, Tianyi Tang, Xiaolei Wang, Yupeng Hou, Yingqian Min, Beichen Zhang, Junjie Zhang, Zican Dong, et al. 대규모 언어 모델에 관한 서베이. arXiv preprint arXiv:2303.18223, 2023. [2] Alec Radford. 생성적 사전 학습을 통한 언어 이해 향상, 2018. [3] Alec Radford, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, Ilya Sutskever, et al. 언어 모델은 비지도 멀티태스크 학습자이다. OpenAI blog, 1(8):9, 2019. [4] Tom B Brown. 언어 모델은 퓨샷 학습자이다. arXiv preprint arXiv:2005.14165, 2020. [5] OpenAI. ChatGPT: 대화를 위한 언어 모델 최적화. OpenAI blog, 2022년 11월. URL https://openai.com/blog/chatgpt/[6] Abhimanyu Dubey, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, Ahmad Al-Dahle, Aiesha Letman, Akhil Mathur, Alan Schelten, Amy Yang, Angela Fan, et al. llama 3 모델 군집. arXiv preprint arXiv:2407.21783, 2024.
[7] Ashish Vaswani. 어텐션만 있으면 충분하다. arXiv preprint arXiv:1706.03762, 2017.
[8] Ronald A Fisher. 이론 통계학의 수학적 기초에 관하여. Philosophical transactions of the Royal Society of London. Series A, containing papers of a mathematical or physical character, 222(594-604):309-368, 1922.
[9] Fan Bao, Shen Nie, Kaiwen Xue, Yue Cao, Chongxuan Li, Hang Su, and Jun Zhu. All are worth words: A vit backbone for diffusion models. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 22669- 22679, 2023.
[10] William Peebles and Saining Xie. Scalable diffusion models with transformers. In Proceedings of the IEEE/CVF International Conference on Computer Vision, pages 4195- 4205, 2023.
[11] Tim Brooks, Bill Peebles, Connor Holmes, Will DePue, Yufei Guo, Li Jing, David Schnurr, Joe Taylor, Troy Luhman, Eric Luhman, Clarence Ng, Ricky Wang, and Aditya Ramesh. Video generation models as world simulators. 2024. URL https://openai.com/research/video- generation- models- as- world- simulators
[12] Gregoire Deletang, Anian Ruoss, Paul- Ambroise Duquenne, Elliot Catt, Tim Genewein, Christopher Mattern, Jordi Grau- Moya, Li Kevin Wenliang, Matthew Aitchison, Laurent Orseau, et al. Language modeling is compression. In The Twelfth International Conference on Learning Representations.
[13] Yuzhen Huang, Jinghan Zhang, Zifei Shan, and Junxian He. Compression represents intelligence linearly. arXiv preprint arXiv:2404.09937, 2024.
[14] Claude Elwood Shannon. A mathematical theory of communication. The Bell system technical journal, 27(3):379- 423, 1948.
[15] Lukas Berglund, Meg Tong, Max Kaufmann, Mikita Balesni, Asa Cooper Stickland, Tomasz Korbak, and Owain Evans. The reversal curse: Llms trained on" a is b" fail to learn" b is a". arXiv preprint arXiv:2309.12288, 2023.
[16] Jacob Austin, Daniel D Johnson, Jonathan Ho, Daniel Tarlow, and Rianne Van Den Berg. Structured denoising diffusion models in discrete state- spaces. Advances in Neural Information Processing Systems, 34:17981- 17993, 2021.
[17] Aaron Lou, Chenlin Meng, and Stefano Ermon. Discrete diffusion language modeling by estimating the ratios of the data distribution. arXiv preprint arXiv:2310.16834, 2023.
[18] Jiaxin Shi, Kehang Han, Zhe Wang, Arnaud Doucet, and Michalis K Titsias. Simplified and generalized masked diffusion for discrete data. arXiv preprint arXiv:2406.04329, 2024.
[19] Subham Sekhar Sahoo, Marianne Arriola, Yair Schiff, Aaron Gokaslan, Edgar Marroquin, Justin T Chiu, Alexander Rush, and Volodymyr Kuleshov. Simple and effective masked diffusion language models. arXiv preprint arXiv:2406.07524, 2024.
[20] Jingyang Ou, Shen Nie, Kaiwen Xue, Fengqi Zhu, Jiacheng Sun, Zhenguo Li, and Chongxuan Li. Your absorbing discrete diffusion secretly models the conditional distributions of clean data. arXiv preprint arXiv:2406.03736, 2024.
[21] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. Llama 2: Open foundation and fine- tuned chat models. arXiv preprint arXiv:2307.09288, 2023.
[22] Jacob Devlin. Bert: Pre- training of deep bidirectional transformers for language understanding. arXiv preprint arXiv:1810.04805, 2018.
[23] Huiwen Chang, Han Zhang, Lu Jiang, Ce Liu, and William T Freeman. Maskgit: Masked generative image transformer. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 11315- 11325, 2022.
[24] Joshua Ainslie, James Lee- Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebron, and Sumit Sanghai. Gqa: Training generalized multi- query transformer models from multihead checkpoints. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, pages 4895- 4901, 2023.
[25] An Yang, Baosong Yang, Binyuan Hui, Bo Zheng, Bowen Yu, Chang Zhou, Chengpeng Li, Chengyuan Li, Dayiheng Liu, Fei Huang, Guanting Dong, Haoran Wei, Huan Lin, Jialong Tang, Jialin Wang, Jian Yang, Jianhong Tu, Jianwei Zhang, Jianxin Ma, Jianxin Yang, Jin Xu, Jingren Zhou, Jinze Bai, Jinzheng He, Junyang Lin, Kai Dang, Keming Lu, Keqin Chen, Kexin Yang, Mei Li, Mingfeng Xue, Na Ni, Pei Zhang, Peng Wang, Ru Peng, Rui Men, Ruize Gao, Runji Lin, Shijie Wang, Shuai Bai, Sinan Tan, Tianhang Zhu, Tianhao Li, Tianyu Liu, Wenbin Ge, Xiaodong Deng, Xiaohuan Zhou, Xingzhang Ren, Xinyu Zhang, Xipin Wei, Xuancheng Ren, Xuejing Liu, Yang Fan, Yang Yao, Yichang Zhang, Yu Wan, Yunfei Chu, Yuqiong Liu, Zeyu Cui, Zhenru Zhang, Zhifang Guo, and Zhihao Fan. Qwen2 technical report, 2024. URL https://arxiv.org/abs/2407.10671
[26] An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, Huan Lin, Jian Yang, Jianhong Tu, Jianwei Zhang, Jianxin Yang, Jiaxi Yang, Jingren Zhou, Junyang Lin, Kai Dang, Keming Lu, Keqin Bao, Kexin Yang, Le Yu, Mei Li, Mingfeng Xue, Pei Zhang, Qin Zhu, Rui Men, Runji Lin, Tianhao Li, Tingyu Xia, Xingzhang Ren, Xuancheng Ren, Yang Fan, Yang Su, Yichang Zhang, Yu Wan, Yuqiong Liu, Zeyu Cui, Zhenru Zhang, and Zihan Qiu. Qwen2.5 technical report. arXiv preprint arXiv:2412.15115, 2024.
[27] Shen Nie, Fengqi Zhu, Chao Du, Tianyu Pang, Qian Liu, Guangtao Zeng, Min Lin, and Chongxuan Li. Scaling up masked diffusion models on text. arXiv preprint arXiv:2410.18514, 2024.
[28] Shengding Hu, Yuge Tu, Xu Han, Chaoqun He, Ganqu Cui, Xiang Long, Zhi Zheng, Yewei Fang, Yuxiang Huang, Weilin Zhao, et al. Minicpm: Unveiling the potential of small language models with scalable training strategies. arXiv preprint arXiv:2404.06395, 2024.
[29] I Loshchilov. Decoupled weight decay regularization. arXiv preprint arXiv:1711.05101, 2017.
[30] Ari Holtzman, Jan Buys, Li Du, Maxwell Forbes, and Yejin Choi. The curious case of neural text degeneration. arXiv preprint arXiv:1904.09751, 2019.
[31] Marianne Arriola, Aaron Gokaslan, Justin T Chiu, Zhihan Yang, Zhixuan Qi, Jiaqi Han, Subham Sekhar Sahoo, and Volodymyr Kuleshov. Block diffusion: Interpolating between autoregressive and diffusion language models. arXiv preprint arXiv:2503.09573, 2025.
[32] Xiao Bi, Deli Chen, Guanting Chen, Shanhuang Chen, Damai Dai, Chengqi Deng, Honghui Ding, Kai Dong, Qiushi Du, Zhe Fu, et al. Deepseek llm: Scaling open- source language models with longtermism. arXiv preprint arXiv:2401.02954, 2024.
[33] Albert Q Jiang, Alexandre Sablayrolles, Arthur Mensch, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Florian Bressand, Gianna Lengyel, Guillaume Lample, Lucile Saulnier, et al. Mistral 7b. arXiv preprint arXiv:2310.06825, 2023.
[34] Tian Ye, Zicheng Xu, Yuanzhi Li, and Zeyuan Allen- Zhu. Physics of Language Models: Part 2.1, Grade- School Math and the Hidden Reasoning Process. arXiv e- prints, abs/2407.20311, July 2024. Full version available at http://arxiv.org/abs/2407.20311
[35] Zeyuan Allen- Zhu and Yuanzhi Li. Physics of Language Models: Part 3.2, Knowledge Manipulation. ArXiv e- prints, abs/2309.14402, September 2023. Full version available at http://arxiv.org/abs/2309.14402
[36] Ouaïl Kitouni, Niklas Nolte, Diane Bouchacourt, Adina Williams, Mike Rabbat, Mark Ibrahim. 인수분해의 저주: 예측하는 토큰이 역전의 저주 및 그 이상의 기저를 이룬다. arXiv 프리프린트 arXiv:2406.05183, 2024.
[37] Jonathan Ho, Tim Salimans. 분류기 없는 확산 가이던스. arXiv 프리프린트 arXiv:2207.12598, 2022.
[38] Jascha Sohl-Dickstein, Eric Weiss, Niru Maheswaranathan, Surya Ganguli. 비평형 열역학을 이용한 심층 비지도 학습. 국제 머신러닝 학회, 2256-2265쪽. PMLR, 2015.
[39] Jonathan Ho, Ajay Jain, Pieter Abbeel. 노이즈 제거 확산 확률 모델. 신경정보처리시스템 발전, 33:6840-6851, 2020.
[40] Yang Song, Jascha Sohl-Dickstein, Diederik P Kingma, Abhishek Kumar, Stefano Ermon, Ben Poole. 확률 미분 방정식을 통한 스코어 기반 생성 모델링. arXiv 프리프린트 arXiv:2011.13456, 2020.
[41] Xiang Li, John Thickstun, Ishaan Gulrajani, Percy S Liang, Tatsunori B Hashimoto. 확산-LM은 제어 가능한 텍스트 생성을 향상시킨다. 신경정보처리시스템 발전, 35:4328-4343, 2022.
[42] Shansan Gong, Mukai Li, Jiangtao Feng, Zhiyong Wu, and LingPeng Kong. Diffuseq: 확산 모델을 이용한 시퀀스 대 시퀀스 텍스트 생성. arXiv 사전 인쇄본 arXiv:2210.08933, 2022.
[43] Xiaochuang Han, Sachin Kumar, and Yulia Tsvetkov. Ssd-lm: 텍스트 생성 및 모듈식 제어를 위한 반자기회귀 단체 기반 확산 언어 모델. arXiv 사전 인쇄본 arXiv:2210.17432, 2022.
[44] Robin Strudel, Corentin Tallec, Florent Altché, Yilun Du, Yaroslav Ganin, Arthur Mensch, Will Grathwohl, Nikolay Savinov, Sander Dieleman, Laurent Sifre, et al. 텍스트 생성을 위한 자기 조건화 임베딩 확산. arXiv 사전 인쇄본 arXiv:2211.04236, 2022.
[45] Ting Chen, Ruixiang Zhang, and Geoffrey Hinton. 아날로그 비트: 자기 조건화를 갖는 확산 모델을 사용한 이산 데이터 생성. arXiv 사전 인쇄본 arXiv:2208.04202, 2022.
[46] Sander Dieleman, Laurent Sartran, Arman Roshannai, Nikolay Savinov, Yaroslav Ganin, Pierre H Richemond, Arnaud Doucet, Robin Strudel, Chris Dyer, Conor Durkan, et al. 범주형 데이터를 위한 연속 확산. arXiv 사전 인쇄본 arXiv:2211.15089, 2022.
[47] Pierre H. Richemond, Sander Dieleman, and Arnaud Doucet. 단체 확산을 갖는 범주형 SDE, 2022.
[48] Tong Wu, Zhihao Fan, Xiao Liu, Yeyun Gong, Yelong Shen, Jian Jiao, Hai-Tao Zheng, Juntao Li, Zhongyu Wei, Jian Guo, Nan Duan, and Weizhu Chen. Ar-diffusion: 텍스트 생성을 위한 자기회귀 확산 모델, 2023.
[49] Rabeeh Karimi Mahabadi, Hamish Ivison, Jaesung Tae, James Henderson, Iz Beltagy, Matthew E. Peters, and Arman Cohan. Tess: 텍스트 대 텍스트 자기 조건화 단체 확산, 2024.
[50] Jiasheng Ye, Zaixiang Zheng, Yu Bao, Lihua Qian, and Mingxuan Wang. Dinoiser: 잡음 조작을 통한 확산 조건부 시퀀스 학습. arXiv 사전 인쇄본 arXiv:2302.10025, 2023.
[51] Yizhe Zhang, Jiatao Gu, Zhuofeng Wu, Shuangfei Zhai, Joshua Susskind, and Navdeep Jaitly. Planner: 잠재 언어 확산 모델을 통한 다양화된 단락 생성. 신경 정보 처리 시스템 발전, 36:80178-80190, 2023.
[52] Aaron Lou and Stefano Ermon. 반사 확산 모델, 2023.
[53] Alex Graves, Rupesh Kumar Srivastava, Timothy Atkinson, and Faustino Gomez. 베이지안 흐름 네트워크. arXiv 사전 인쇄본 arXiv:2308.07037, 2023.
[54] Zhenghao Lin, Yeyun Gong, Yelong Shen, Tong Wu, Zhihao Fan, Chen Lin, Nan Duan, and Weizhu Chen. 확산 언어 모델을 이용한 텍스트 생성: 연속 단락 잡음 제거를 사용한 사전 학습 접근법. 국제 기계 학습 학회, 페이지 21051-21064. PMLR, 2023.
[55] Kaiwen Xue, Yuhao Zhou, Shen Nie, Xu Min, Xiaolu Zhang, Jun Zhou, and Chongxuan Li. 확률 미분 방정식을 통한 베이지안 흐름 네트워크와 확산 모델의 통합. arXiv 사전 인쇄본 arXiv:2404.15766, 2024.
[56] Ruixiang Zhang, Shuangfei Zhai, Yizhe Zhang, James Thornton, Zijing Ou, Joshua Susskind, and Navdeep Jaitly. 목표 구체 점수 매칭: 이산 확산을 위한 전체론적 프레임워크. arXiv 사전 인쇄본 arXiv:2504.16431, 2025.
[57] Ishaan Gulrajani and Tatsunori B Hashimoto. 우도 기반 확산 언어 모델. 신경 정보 처리 시스템 발전, 36, 2024.
[58] Emiel Hoogeboom, Didrik Nielsen, Priyank Jaini, Patrick Forré, and Max Welling. Argmax 흐름과 다항 확산: 범주형 분포 학습. 신경 정보 처리 시스템 발전, 34:12454-12465, 2021.
[59] Emiel Hoogeboom, Alexey A Gritsenko, Jasmijn Bastings, Ben Poole, Rianne van den Berg, and Tim Salimans. 자기회귀 확산 모델. arXiv 사전 인쇄본 arXiv:2110.02037, 2021.
[60] Zhengfu He, Tianxiang Sun, Kuanning Wang, Xuanjing Huang, and Xipeng Qiu. Diffusion-bert: 확산 모델을 통한 생성적 마스크 언어 모델 개선. arXiv 사전 인쇄본 arXiv:2211.15029, 2022.
[61] Andrew Campbell, Joe Benton, Valentin De Bortoli, Thomas Rainforth, George Deligiannidis, and Arnaud Doucet. 이산 잡음 제거 모델을 위한 연속 시간 프레임워크. 신경 정보 처리 시스템 발전, 35:28266-28279, 2022.
[62] Chenlin Meng, Kristy Choi, Jiaming Song, and Stefano Ermon. 구체 점수 매칭: 이산 데이터를 위한 일반화된 점수 매칭. 신경 정보 처리 시스템 발전, 35:34532-34545, 2022.
[63] Machel Reid, Vincent J. Hellendoorn, and Graham Neubig. Diffuser: 편집 기반 재구성을 통한 이산 확산, 2022.
[64] Haoran Sun, Lijun Yu, Bo Dai, Dale Schuurmans, and Hanjun Dai. 점수 기반 연속 시간 이산 확산 모델. arXiv 사전 인쇄본 arXiv:2211.16750, 2022.
[65] Ouaif Kitouni, Niklas Nolte, James Hensman, and Bhaskar Mitra. Disk: 구조화된 지식에 대한 확산 모델. arXiv 사전 인쇄본 arXiv:2312.05253, 2023.
[66] Lin Zheng, Jianbo Yuan, Lei Yu, and Lingpeng Kong. 텍스트 생성을 위한 재매개변수화된 이산 확산 모델. ArXiv, abs/2302.05737, 2023.
[67] Zixiang Chen, Huizhuo Yuan, Yongqian Li, Yiwen Kou, Junkai Zhang, and Quanquan Gu. 이산 확산 모델을 위한 탈무작위화를 통한 빠른 샘플링. arXiv 사전 인쇄본 arXiv:2312.09193, 2023.
[68] Jiasheng Ye, Zaixiang Zheng, Yu Bao, Lihua Qian, and Quanquan Gu. 확산 언어 모델은 스케일링과 명령 미세 조정을 통해 많은 작업을 수행할 수 있다. arXiv 사전 인쇄본 arXiv:2308.12219, 2023.
[69] Itai Gat, Tal Remez, Neta Shaul, Felix Kreuk, Ricky TQ Chen, Gabriel Synnaeve, Yossi Adi, and Yaron Lipman. 이산 흐름 매칭. arXiv 사전 인쇄본 arXiv:2407.15595, 2024.
[70] Kaiwen Zheng, Yongxin Chen, Hanzi Mao, Ming-Yu Liu, Jun Zhu, and Qinsheng Zhang. 마스크 확산 모델은 사실상 시간 불변 마스크 모델이며 부정확한 범주형 샘플링을 악용한다, 2024. URL https://arxiv.org/abs/2409.02908
[71] Shreyas Kapur, Erik Jenner, and Stuart Russell. 프로그램 합성을 위한 구문 트리 확산. arXiv 사전 인쇄본 arXiv:2405.20519, 2024.
[72] Shansan Gong, Shivam Agarwal, Yizhe Zhang, Jiacheng Ye, Lin Zheng, Mukai Li, Chenxin An, Peilin Zhao, Wei Bi, Jiawei Han, et al. 자기회귀 모델로부터의 적응을 통한 확산 언어 모델 확장. arXiv 사전 인쇄본 arXiv:2410.17891, 2024.
[73] Samar Khanna, Siddhant Kharbanda, Shufan Li, Harshit Varma, Eric Wang, Sawyer Birnbaum, Ziyang Luo, Yanis Miraoui, Akash Palrecha, Stefano Ermon, et al. Mercury: 확산 기반 초고속 언어 모델. arXiv 사전 인쇄본 arXiv:2506.17298, 2025.
[74] Huiwen Chang, Han Zhang, Jarred Barber, AJ Maschinot, Jose Lezama, Lu Jiang, Ming-Hsuan Yang, Kevin Murphy, William T Freeman, Michael Rubinstein, et al. Muse: 마스크 생성 트랜스포머를 통한 텍스트 대 이미지 생성. arXiv 사전 인쇄본 arXiv:2301.00704, 2023.
[75] Zebin You, Jingyang Ou, Xiaolu Zhang, Jun Hu, Jun Zhou, and Chongxuan Li. 효과적이고 효율적인 마스크 이미지 생성 모델. arXiv 프리프린트 arXiv:2503.07197, 2025.
[76] Xinyou Wang, Zaixiang Zheng, Fei Ye, Dongyu Xue, Shujian Huang, and Quanquan Gu. 확산 언어 모델은 다재다능한 단백질 학습자이다. arXiv 프리프린트 arXiv:2402.18567, 2024.
[77] Xinyou Wang, Zaixiang Zheng, Fei Ye, Dongyu Xue, Shujian Huang, and Quanquan Gu. Dplm-2: 멀티모달 확산 단백질 언어 모델. arXiv 프리프린트 arXiv:2410.13782, 2024.
[78] Siqi Kou, Lanxiang Hu, Zhezhi He, Zhijie Deng, and Hao Zhang. Clims: 일관성 대규모 언어 모델. arXiv 프리프린트 arXiv:2403.00835, 2024.
[79] Chenkai Xu, Xu Wang, Zhenyi Liao, Yishun Li, Tianqi Hou, and Zhijie Deng. Show-o turbo: 가속화된 통합 멀티모달 이해 및 생성을 향하여. arXiv 프리프린트 arXiv:2502.05415, 2025.
[80] Sulin Liu, Juno Nam, Andrew Campbell, Hannes Stärk, Yilun Xu, Tommi Jaakkola, and Rafael Gómez-Bombarelli. 생성하는 동안 생각하라: 계획된 디노이징을 갖춘 이산 확산. arXiv 프리프린트 arXiv:2410.06264, 2024.
[81] Yuanzhi Zhu, Xi Wang, Stéphane Lathuilière, and Vicky Kalogeiton. Dimo: 마스크 확산 모델을 원스텝 생성기로 증류하기. arXiv 프리프린트 arXiv:2503.15457, 2025.
[82] Yinuo Ren, Haoxuan Chen, Yuchen Zhu, Wei Guo, Yongxin Chen, Grant M Rotskoff, Molei Tao, and Lexing Ying. 이산 확산 모델을 위한 고속 솔버: 고차 알고리즘의 이론과 응용. arXiv preprint arXiv:2502.00234, 2025.
[83] Satoshi Hayakawa, Yuhta Takida, Masaaki Imaizumi, Hiromi Wakaki, and Yuki Mitsufuji. 차원적 상관관계를 통한 이산 확산의 증류. arXiv preprint arXiv:2410.08709, 2024.
[84] Yixiu Zhao, Jiaxin Shi, Feng Chen, Shaul Druckmann, Lester Mackey, and Scott Linderman. 이산 확산 모델을 위한 정보 기반 교정기. arXiv preprint arXiv:2407.21243, 2024.
[85] Kaiwen Zheng, Yongxin Chen, Hanzi Mao, Ming-Yu Liu, Jun Zhu, and Qinsheng Zhang. 마스크된 확산 모델은 사실 시간 비의존적 마스크 모델이며 부정확한 범주형 샘플링을 악용한다. arXiv preprint arXiv:2409.02908, 2024.
[86] Yong-Hyun Park, Chieh-Hsin Lai, Satoshi Hayakawa, Yuhta Takida, and Yuki Mitsufuji. 단계를 건너뛰세요: 이산 확산 모델의 샘플링 일정 최적화. In The Thirteenth International Conference on Learning Representations, 2024.
[87] Justin Deschenaux and Caglar Gulcehre. 자기회귀를 넘어서: 시간을 통한 자기 증류를 이용한 빠른 LLM. arXiv preprint arXiv:2410.21035, 2024.
[88] Prafulla Dhariwal and Alexander Nichol. 확산 모델이 이미지 합성에서 GAN을 능가한다. Advances in neural information processing systems, 34:8780-8794, 2021.
[89] Yair Schiff, Subham Sekhar Sahoo, Hao Phung, Guanghan Wang, Sam Boshar, Hugo Dallatorre, Bernardo P de Almeida, Alexander Rush, Thomas Pierrot, and Volodymyr Kuleshov. 이산 확산 모델을 위한 단순한 유도 메커니즘. arXiv preprint arXiv:2412.10193, 2024.
[90] Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, et al. 인간 피드백을 통한 지시 따르기 언어 모델 훈련. Advances in neural information processing systems, 35:27730-27744, 2022.
[91] Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D Manning, Stefano Ermon, and Chelsea Finn. 직접 선호 최적화: 당신의 언어 모델은 사실 보상 모델이다. Advances in Neural Information Processing Systems, 36, 2024.
[92] Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. GPT-4 기술 보고서. arXiv preprint arXiv:2303.08774, 2023.
[93] Google. 차세대 모델: Gemini 1.5, 2024. URL https://blog.google/technology/ai/google-gemini-next-generation-model-february-2024
[94] Anthropic. Claude 3.5 Sonnet, 2024. URL https://www.anthropic.com/news/claude-3-5-sonnet
[95] Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang, Bochao Wu, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chenyu Zhang, Chong Ruan, et al. DeepSeek-V3 기술 보고서. arXiv preprint arXiv:2412.19437, 2024.
[96] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed Chi, Quoc V Le, Denny Zhou, et al. 사고 연쇄 프롬프팅은 대규모 언어 모델에서 추론을 이끌어낸다. Advances in neural information processing systems, 35:24824-24837, 2022.
[97] Joon Sung Park, Joseph O'Brien, Carrie Jun Cai, Meredith Ringel Morris, Percy Liang, and Michael S Bernstein. 생성적 에이전트: 인간 행동의 상호작용적 시뮬라크라. In Proceedings of the 36th annual acm symposium on user interface software and technology, pages 1-22, 2023.
[98] Lei Wang, Chen Ma, Xueyang Feng, Zeyu Zhang, Hao Yang, Jingsen Zhang, Zhiyuan Chen, Jiakai Tang, Xu Chen, Yankai Lin, et al. 대규모 언어 모델 기반 자율 에이전트에 관한 서베이. Frontiers of Computer Science, 18(6):186345, 2024.
[99] OpenAI. LLM으로 추론 배우기, 2024. URL https://openai.com/index/learning-to-reason-with-llms/
[100] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. DeepSeek-R1: 강화 학습을 통한 LLM의 추론 능력 장려. arXiv preprint arXiv:2501.12948, 2025.
[101] Benigno Uria, Iain Murray, and Hugo Larochelle. 심층적이고 계산 가능한 밀도 추정기. In Proceedings of the 31th International Conference on Machine Learning, 2014.
[102] Andy Shih, Dorsa Sadigh, and Stefano Ermon. 임의 순서 자기회귀 모델에 대한 올바른 훈련 및 추론. In Proceedings of the 31th International Conference on Machine Learning, 2022.
[103] Zhangchen Xu, Fengqing Jiang, Luyao Niu, Yuntian Deng, Radha Poovendran, Yejin Choi, and Bill Yuchen Lin. Magpie: 정렬된 LLM에 아무것도 프롬프트하지 않고 처음부터 정렬 데이터 합성. arXiv preprint arXiv:2406.08464, 2024.
[104] Yuxiang Wei, Zhe Wang, Jiawei Liu, Yifeng Ding, and Lingming Zhang. Magicoder: OSS-Instruct로 코드 생성 강화. arXiv preprint arXiv:2312.02120, 2023.
[105] Biao Zhang and Rico Sennrich. 제곱근 평균 제곱 계층 정규화. Advances in Neural Information Processing Systems, 32, 2019.
[106] Noam Shazeer. GLU 변형이 트랜스포머를 개선한다. arXiv preprint arXiv:2002.05202, 2020.
[107] Jianlin Su, Murtadha Ahmed, Yu Lu, Shengfeng Pan, Wen Bo, and Yunfeng Liu. RoFormer: 회전 위치 임베딩으로 강화된 트랜스포머. Neurocomputing, 568:127063, 2024.
[108] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu, and Dario Amodei. 신경 언어 모델의 스케일링 법칙. arXiv preprint arXiv:2001.08361, 2020.
.
[109] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, et al. 컴퓨트 최적 대규모 언어 모델 훈련. arXiv preprint arXiv:2203.15556, 2022.
[110] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. 대규모 다중 작업 언어 이해 측정. arXiv preprint arXiv:2009.03300, 2020.
[111] Mirac Suzgun, Nathan Scales, Nathanael Schärli, Sebastian Gehrmann, Yi Tay, Hyung Won Chung, Aakanksha Chowdhery, Quoc V Le, Ed H Chi, Denny Zhou, et al. BIG-bench 과제에 도전하고 사고 연쇄가 이를 해결할 수 있는지 여부. arXiv preprint arXiv:2210.09261, 2022.
[112] Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, and Oyvind Tafjord. 질의응답을 해결했다고 생각하십니까? ARC, AI2 추론 챌린지를 시도해 보세요. arXiv preprint arXiv:1803.05457, 2018.
[113] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi, and Yejin Choi. HellaSwag: 기계가 정말로 당신의 문장을 완성할 수 있는가? arXiv preprint arXiv:1905.07830, 2019.
[114] Stephanie Lin, Jacob Hilton, and Owain Evans. Truthfulqa: Measuring how models mimic human falsehoods. arXiv preprint arXiv:2109.07958, 2021.
[115] Keisuke Sakaguchi, Ronan Le Bras, Chandra Bhagavatula, and Yejin Choi. Winogrande: An adversarial winograd schema challenge at scale. Communications of the ACM, 64(9):99- 106, 2021.
[116] Yonatan Bisk, Rowan Zellers, Jianfeng Gao, Yejin Choi, et al. Piqa: Reasoning about physical commonsense in natural language. In Proceedings of the AAAI conference on artificial intelligence, 2020.
[117] Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, et al. Training verifiers to solve math word problems. arXiv preprint arXiv:2110.14168, 2021.
[118] Dan Hendrycks, Collin Burns, Saurav Kadavath, Akul Arora, Steven Basart, Eric Tang, Dawn Song, and Jacob Steinhardt. Measuring mathematical problem solving with the math dataset. arXiv preprint arXiv:2103.03874, 2021.
[119] David Rein, Betty Li Hou, Asa Cooper Stickland, Jackson Petty, Richard Yuanzhe Pang, Julien Dirani, Julian Michael, and Samuel R Bowman. Gpqa: A graduate- level google- proof q&a benchmark. arXiv preprint arXiv:2311.12022, 2023.
[120] Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde De Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021.
[121] Mohammad Bavarian, Heewoo Jun, Nikolas Tezak, John Schulman, Christine McLeavey, Jerry Tworek, and Mark Chen. Efficient training of language models to fill in the middle. arXiv preprint arXiv:2207.14255, 2022.
[122] Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le, et al. Program synthesis with large language models. arXiv preprint arXiv:2108.07732, 2021.
[123] Haonan Li, Yixuan Zhang, Fajri Koto, Yifei Yang, Hai Zhao, Yeyun Gong, Nan Duan, and Timothy Baldwin. Cmmlu: Measuring massive multitask language understanding in chinese. arXiv preprint arXiv:2306.09212, 2023.
[124] Yuzhen Huang, Yuzhuo Bai, Zhihao Zhu, Junlei Zhang, Jinghan Zhang, Tangjun Su, Junteng Liu, Chuancheng Lv, Yikai Zhang, Yao Fu, et al. C- eval: A multi- level multi- discipline chinese evaluation suite for foundation models. Advances in Neural Information Processing Systems, 36, 2024.
[125] Leo Gao, Jonathan Tow, Baber Abbasi, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Alain Le Noac'h, Haonan Li, Kyle McDonell, Niklas Muennighoff, Chris Ociepa, Jason Phang, Laria Reynolds, Hailey Schoelkopf, Aviya Skowron, Lintang Sutawika, Eric Tang, Anish Thite, Ben Wang, Kevin Wang, and Andy Zou. A framework for few- shot language model evaluation, 07 2024. URL https://zenodo.org/records/12608602
알고리즘 1 LLaDA의 사전 학습
요구사항: 마스크 예측기 , 데이터 분포
1: repeat
2: # 의 확률로, 의 시퀀스 길이는 U[1, 4096]을 따름
3:
4: # 는 Eq. (7)에서 정의됨
5: 계산 # 은 의 시퀀스 길이임
6: 를 계산하고 옵티마이저를 실행.
7: until 수렴할 때까지
8: 반환
알고리즘 2 LLaDA의 지도 미세 조정
요구사항: 마스크 예측기 , 쌍 데이터 분포
1: repeat
2: # SFT 데이터에 관한 자세한 내용은 부록 B.1을 참조
3:
4: # 는 Eq. (7)에서 정의됨
5: 계산 # 은 의 시퀀스 길이임
6: 를 계산하고 옵티마이저를 실행.
7: until 수렴할 때까지
8: 반환
알고리즘 3 LLaDA의 조건부 로그 우도 평가
요구사항: 마스크 예측기 , 프롬프트 , 응답 , 몬테카를로 추정 횟수
1: log_likelihood
2: for to do
3: # 은 의 시퀀스 길이임
4: 마스킹을 위해 에서 개의 토큰을 비복원으로 균일하게 샘플링하여 를 얻음
5:
6: end for
7: log_likelihood
8: log_likelihood 반환
A 마스크 확산 모델의 정식화
A.1 학습
MDM [16|20]은 자기회귀 모델과는 다른 방식으로 모델 분포 를 정의한다.
이들 모델은 시간 로 인덱스된 순방향 과정 를 도입한다. 이 과정은 시퀀스 의 모든 토큰을 점진적이고 독립적으로 마스킹한다. 시간 에서 데이터 포인트 는 마스크 없이 완전히 관측되며, 에 대해서는 가 기대값에서 다양한 마스크 비율을 갖는 잠재 변수를 나타낸다.
형식적으로, 가 주어졌을 때 의 조건부 분포는 완전히 인수분해된 형태로 정의된다:
여기서 각 토큰에 대한 조건부 분포는 다음과 같이 주어진다:
여기서 M은 마스크 토큰을 나타낸다. 직관적으로, 각 토큰은 변경되지 않거나 마스크되며, 마스크될 확률은 가 0에서 1로 진행됨에 따라 선형적으로 증가한다. 에서 모든 토큰은 마스크될 것이 보장되며, 이는 \(x_{1}\)이 완전히 마스크된 토큰들의 시퀀스에 집중된 디랙 분포를 따른다는 것을 의미한다. 특히, 선형 마스킹 확률은 연속 확산 모델의 노이즈 스케줄 [38,40]과 유사하지만 구별된다. 이러한 선형성은 텍스트의 정보가 평균적으로 토큰 수에 비례한다는 가정에 기인하며, 이는 순방향 과정 동안 정보가 선형적으로 손실되는 것을 합리적으로 만든다.
순방향 과정은 가역적일 뿐만 아니라 모든 토큰에 걸쳐 완전히 인수분해되는 역방향 과정에 대응한다. 시간 에서 0으로의 역방향 과정은 완전히 마스크된 토큰들의 시퀀스로부터 새로운 데이터를 생성한다. 에 대한 역방향 과정의 조건부 분포는 다음과 같이 인수분해된다:
$$q_{s|t}(x_{s}|x_{t}) = \prod_{i = 1}^{L}q_{s|t}(x_{s}^{i}|x_{t}), \quad (9)$$ 여기서 각 토큰에 대한 조건부 분포는 다음과 같다:
따라서 추정해야 할 핵심 함수는 조건부 분포 \(q_{0|t}(x_{s}^{i}|x_{t})\)이며, 이는 입력 \(x_{t}\)에서 마스크된 경우 원래 토큰을 예측한다. 이는 연속 확산 모델의 데이터 예측 형태와 유사하다. [20]에서 증명된 바와 같이, 동등하면서도 시간에 독립적인 매개변수화는 다음과 같이 유도될 수 있다:
여기서 는 에서 마스크되지 않은 토큰들의 집합을 나타내며, 마스크되지 않은 토큰들은 오직 \(x_{0}\)에 의해서만 결정되고 시간 \(t\)와 무관하므로 원본 데이터 \(x_{0}\)의 해당 토큰들과 동일하다. 직관적으로, 이는 데이터 예측 함수를 추정하는 것이 시간 불변인 깨끗한 데이터에 대한 조건부 분포를 추정하는 것과 동등하다는 것을 의미한다. 결과적으로, 시간 \(t\)는 매개변수 모델에 입력으로 제공될 필요가 없다.
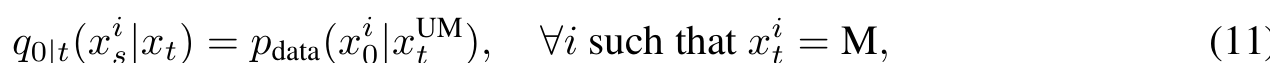
요구사항: 마스크 예측기 , 프롬프트 , 답변 길이 , 샘플링 단계 1: 을 길이 \(L\)의 완전히 마스크된 시퀀스로 설정한다. 2: for \(t \leftarrow 1\)부터 \(\frac{1}{N}\)까지 단계 \(\frac{1}{N}\)로 do 3: \(s = t - \frac{1}{N}\) 4: \(r_{0} = \arg \max_{r_{0}} p_{\theta}(r_{0}|p_{0},r_{t})\) # 마스크된 토큰을 예측할 때 그리디 샘플링을 사용한다 5: for \(i \leftarrow 1\)부터 \(L\)까지 do 6: if \(r_{t}^{i} \neq \mathbf{M}\) then 7: \(r_{0}^{i} = r_{t}^{i}\) 8: else 9: 확률 \(\frac{s}{t}\)로, \(r_{0}^{i}\)를 \(\mathbf{M}\)으로 설정한다 10: end if 11: end for 12: \(r_{s} = r_{0}\) 13: end for 14: 반환
비록 마스크드 디퓨전의 개발이 자명하지는 않지만, 구현은 간단하다. 먼저 마스크 예측기, 즉 매개변수적 모델 (예: 인과적 마스크가 없는 Transformer)를 도입하는데, 이는 임의의 에 대해 를 입력으로 받아 모든 마스킹된 토큰을 동시에 예측한다. 그런 다음 모델 분포 를 다음과 같이 정의한다. 완전히 마스킹된 토큰의 시퀀스인 에서 시작하여, 에서 0까지 로 매개변수화된 근사 역방향 과정을 시뮬레이션한다. 그러면 에서 유도되는 주변 분포가 모델 분포 를 나타낸다.
요구사항: 마스크 예측기 , 프롬프트 , 답변 길이 , 샘플링 단계
1: 을 길이 의 완전히 마스킹된 시퀀스로 설정한다.
2: for 부터 까지 단계 do
3:
4: for 부터 까지 do
5: if then
6:
7: else
8:
9:
10: end if
11: end for
12: # 시점 에서 마스킹되지 않은 토큰의 수는 이다
13: for 부터 까지 do
14: if then
15: # 신뢰도가 가장 낮은 개의 위치가 재마스킹을 위해 선택된다.
16: end if
17: end for
18:
19: end for
20: 반환
형식적으로, 마스크 예측기는 마스킹을 동반한 교차 엔트로피 손실을 사용하여 훈련된다:
여기서 는 훈련 데이터로부터 샘플링되고, 는 에서 균등하게 샘플링되며, 는 로부터 샘플링된다. 지시 함수 는 교차 엔트로피 손실이 마스킹된 토큰에 대해서만 계산되도록 보장한다. Shi 등 [18], Sahoo 등 [19], Ou 등 [20]에서 손실 함수 가 모델 분포의 음의 로그 우도에 대한 상한임이 증명되었다:
요약하면, 이 원리적 접근법은 순방향 과정에서 토큰을 점진적으로 마스킹하고 역방향 과정에서 데이터 분포를 복원하는 것을 학습함으로써 생성 모델을 훈련하며, 이 모든 것이 (근사) 최대 우도 추정 프레임워크 아래에서 이루어진다.
A.2 추론
Eq. [12]의 교차 엔트로피 손실은 여러 동등한 형태를 가진다 [20]. 첫 번째 형태는 다음과 같다:
여기서 은 로부터 균등하게 샘플링되고, 은 마스킹을 위해 로부터 개의 토큰을 비복원으로 균등하게 샘플링하여 얻어진다. 정확히 개의 토큰을 마스킹하는 것이 각 토큰을 확률 로 독립적으로 마스킹하는 것과 다르지만, 이 두 마스킹 방법은 기댓값에서 동등한 결과를 낳는다 [20].
임의 순서 자기회귀 모델(AO- ARM) [59][101][102]은 개 변수의 모든 가능한 순서 에 대해 결합 분포를 자기회귀적으로 특성화한다. 이러한 분포를 학습하기 위해, AO- ARM은 가중치 공유 신경망을 활용하여 모든 일변량 조건부를 모델링하고, 결측 변수를 나타내기 위해 마스크 토큰을 사용한다. 훈련 중에는 모든 순서의 균등 분포 에 대한 기대 음의 로그 우도를 최소화한다:
직관적으로, 는 에 있는 인덱스가 마스킹된 마스크 토큰 로 이해될 수 있다. Eq. (15)가 Eq. (12)와 동등함을 추가로 증명할 수 있다. 이 연결은 추론 절차에서 명시적으로 사용된 적이 없음에도 불구하고 LLaDA의 양방향 추론 능력을 설명한다.
또한, Nie 등 [27]은 프롬프트와의 정렬 및 텍스트 다양성 사이의 균형을 맞추는 플러그 앤 플레이 기법인 비지도 분류기-없는 가이던스(CFG)를 소개한다. 구체적으로, 비지도 CFG는 추론을 위해 다음과 같이 수정된 마스크 예측기를 사용한다:
여기서 은 와 동일한 길이의 마스크 시퀀스이고, 는 의 강도를 제어하는 조정 가능한 하이퍼파라미터이다. ARMs와의 공정한 비교를 보장하기 위해, 본문에서는 LLaDA에 CFG를 적용하지 않는다. 그러나 부록 [B.3]에서 입증된 바와 같이, LLaDA는 CFG와 완전히 호환되며, CFG가 적용될 때 일관되게 향상된 성능을 보인다.
A.3 알고리즘
이 섹션에서는 학습 및 추론 알고리즘을 제시한다. 구체적으로, 사전 학습 및 지도 미세 조정 알고리즘을 각각 알고리즘 [1]과 알고리즘 [2]에서 소개한다. 또한, 우도 평가 알고리즘은 알고리즘 [3]에서 제공된다. 마지막으로, 랜덤 리마스킹과 저신뢰도 [23] 리마스킹 전략에 각각 대응하는 역방향 생성 과정을 알고리즘 [4]와 알고리즘 [5]에서 제시한다.
B 실험
B.1 데이터 수집 및 전처리
이 섹션에서는 먼저 사전 학습과 SFT 모두에 대한 데이터 수집 및 필터링 과정을 소개한다. 그런 다음 LLaDA가 학습 중에 이러한 데이터셋을 어떻게 활용하는지 설명한다.
우리의 사전 학습 코퍼스는 웹 데이터, 도서, 학술 논문, 소셜 미디어, 백과사전, 수학, 코드 등 다양한 공개적으로 이용 가능한 출처로 구성되며, 대략 중국어, 영어, 코드로 이루어져 있다. 데이터 정제 과정에는 PDF 텍스트 추출, 중복 제거, 유해 콘텐츠 필터링이 포함된다. 품질을 더욱 보장하기 위해, 자동화된 데이터 품질 주석을 위한 BERT [22] 모델을 미세 조정하여 고품질 샘플을 선별할 수 있도록 한다. 우리의 SFT 데이터셋은 100만 개의 사람이 주석을 단 샘플과 350만 개의 합성 샘플로 구성되며, 합성 샘플은 Xu et al. [103], Wei et al. [104]에서 제안된 방법과 유사한 방법을 사용하여 생성되었다.
우리는 사전 학습 코퍼스에서 수집된 문서들을 연결하고, 미리 정의된 시퀀스 길이에 따라 텍스트를 고정 길이 시퀀스로 분할한다.
SFT의 경우 동적 시퀀스 길이 전략이 사용되며, 각 미니 배치 내 모든 샘플에서 시퀀스 길이를 균일하게 보장하기 위해 더 짧은 쌍들의 끝에 |EOS| 토큰이 추가된다. 특히, 패딩 |EOS| 토큰은 응답의 일부로 처리된다. 즉, 마스킹되고 학습 목표에 포함된다. |EOS| 토큰은 샘플링 중 생성된 출력에서 제거된다. 이 전략은 모델이 |EOS|를 생성하여 응답 길이를 제어하는 방법을 학습하도록 보장하며, 이를 통해 응답 길이가 주어진 프롬프트에 효과적으로 맞춰질 수 있게 한다.
또한, - 턴 대화 의 경우, 이를 개의 단일 턴 대화 쌍, 즉 으로 처리하고 그중 하나를 무작위로 샘플링한다. 이 데이터 분할 전략은 LLaDA에 다중 턴 대화 능력을 부여할 뿐만 아니라 위의 |EOS| 패딩 전략과도 일치한다.
| <table><thead><tr><td></td><td><b>Our ARM Baseline 1B</b></td><td><b>LLaDA 1B</b></td><td><b>Our ARM Baseline 7B</b></td><td><b>LLaDA 8B</b></td><td><b>LLaMA3 8B</b></td></tr></thead><tbody><tr><td>Layers</td><td>22</td><td>22</td><td>28</td><td>32</td><td>32</td></tr><tr><td>Model dimension</td><td>2048</td><td>2048</td><td>4096</td><td>4096</td><td>4096</td></tr><tr><td>Attention heads</td><td>32</td><td>32</td><td>32</td><td>32</td><td>32</td></tr><tr><td>Vocabulary size</td><td>126,464</td><td>126,464</td><td>126,464</td><td>126,464</td><td>128,000</td></tr><tr><td>FFN dimension</td><td>5634</td><td>5634</td><td>13,440</td><td>12,288</td><td>14,336</td></tr><tr><td>Key/Value heads</td><td>4</td><td>4</td><td>8</td><td>32</td><td>8</td></tr><tr><td>Total parameters</td><td>1.49 B</td><td>1.49 B</td><td>6.83 B</td><td>8.02 B</td><td>8.03 B</td></tr><tr><td>Non-embedding parameters</td><td>0.97 B</td><td>0.97 B</td><td>5.80 B</td><td>6.98 B</td><td>6.98 B</td></tr></tbody></table> | |||||
| ARC-C | Hellaswag | TruthfulQA | WinoGrande | GPQA | PIQA | |
| CFG 없이 | 45.9 | 70.5 | 46.1 | 74.8 | 25.2 | 73.6 |
| CFG 적용 | 47.9 | 72.5 | 46.4 | 74.8 | 26.1 | 74.4 |
B.2 모델 학습에 관한 세부 사항
이 섹션에서는 LLaDA 및 해당 ARM 기준 모델의 학습 세부 사항을 제공한다.
먼저, 효율성을 위해 1.5B 파라미터를 가지며 동일한 아키텍처를 가진 ARM과 MDM을 각각 학습시켰다. 추가적으로, MDM을 8B 파라미터로 확장하였다. 계산 자원 제약으로 인해 동일한 아키텍처의 8B 자기회귀 모델은 학습하지 않았다. 대신, 이전에 학습시킨 7B 자기회귀 모델을 비교에 활용하였다. 이 네 가지 모델은 Sec. [3.1]의 확장성 분석에 사용된다.
우리가 학습시킨 ARMs와 MDMs에는 LLaMA [6] [21]와 유사한 Transformer 아키텍처를 채택하였다. 구체적으로, 학습 안정화를 위해 RMSNorm [105]을 사용하고, 비선형성을 강화하기 위해 SwiGLU [106]를 활성화 함수로 사용하며, 더 표현력 있는 위치 인코딩을 위해 RoPE [107]를 통합하였다. Tab. [5]는 모델 아키텍처의 개요를 제공한다.
1B 및 7B ARM 기준 모델과 1B 및 8B LLaDA 모델의 경우, 가중치 감쇠 0.1의 AdamW 옵티마이저 [29]를 사용하고 Warmup-Stable-Decay [28] 학습률 스케줄러를 채택하였다. 학습률은 처음 2000번의 반복 동안 0에서 최댓값까지 선형적으로 증가한 후 일정하게 유지되었다. LLaDA 8B의 경우, 안정적인 학습을 보장하기 위해 사전 학습 중 학습률을 한 번 감소시켰으며, 이는 Sec. [2.2]에 자세히 설명되어 있다. 1B ARM 기준 모델과 1B 및 8B LLaDA 모델 모두에 대해, 최대 학습률은 로 설정되고 배치 크기는 1280이며, 하이퍼파라미터 튜닝은 수행하지 않았다. 7B ARM 기준 모델의 경우, 최대 학습률은 로 설정되고 배치 크기는 4224이며, 둘 모두 그리드 탐색을 통해 선택되었다.
또한, 우리는 Fig. [3]의 학습 FLOPs를 계산하기 위해 널리 사용되는 공식 [108] [109]을 사용하며, 여기서 은 비임베딩 파라미터의 수를, 는 총 학습 토큰 수를 나타낸다. Fig. [3]에 해당하는 상세 결과는 Tab. [18]과 Tab. [19]에 제시되어 있다.
B.3 Classifier-free Guidance에 대한 Ablation
이 절에서는 classifier-free guidance(CFG)에 대한 ablation study를 제시한다. CFG에 관한 이론적 세부 사항은 부록 [A.2]에서 확인할 수 있다.
간단히 하기 위해, 우리는 ARC-C, HellaSwag, TruthfulQA, WinoGrande, PIQA, GPQA를 포함한 여섯 개의 대표적인 벤치마크를 선정하고 LLaDA 8B Base를 사용하여 실험을 수행한다. 각 태스크에 대해 CFG 스케일을 에서 탐색하고 최상의 결과를 보고한다. Tab. [6]에서 볼 수 있듯이 CFG는 LLaDA의 성능을 일관되게 향상시킨다. 우리는 ARMs와의 공정한 비교를 보장하기 위해, 논문에서 보고된 주요 결과에서는 CFG가 사용되지 않았음을 강조한다.
| BBH | GSM8K | Math | HumanEval | MBPP | ||
| 자기회귀 | 38.1 | 63.1 | 23.6 | 18.3 | 33.4 | |
| L' = 2 | 37.3 | 62.6 | 25.2 | 14.6 | 33.6 | |
| L' = 4 | 40.0 | 65.7 | 26.6 | 15.9 | 36.0 | |
| L' = 8 | 42.0 | 68.2 | 27.7 | 19.5 | 39.2 | |
| L' = 32 | 45.7 | 68.6 | 29.7 | 29.9 | 37.4 | |
| 블록 확산 LLaDA | L' = 2 | 48.0 | 70.0 | 30.8 | 26.2 | 40.0 |
| L' = 4 | 48.5 | 70.3 | 31.3 | 27.4 | 38.8 | |
| L' = 8 | 48.6 | 70.2 | 30.9 | 31.1 | 39.0 | |
| L' = 32 | 48.3 | 70.3 | 31.2 | 32.3 | 40.0 | |
| 순수 확산 | 49.7 | 70.3 | 31.4 | 35.4 | 40.0 |
| GSM8K | 수학 | HumanEval | MBPP | GPQA | MMLU-Pro | ARC-C | |
| 자기회귀 | 0 | 9.5 | 0 | 0 | 0 | 0 | 84.4 |
| 블록 확산 | 24.6 | 23.5 | 17.1 | 21.2 | 29.3 | 32.5 | 88.1 |
| 블록 확산 LLaDA | 77.5 | 42.2 | 46.3 | 34.2 | 31.3 | 34.8 | 85.4 |
| 순수 확산 | 69.4 | 31.9 | 49.4 | 41.0 | 33.3 | 37.0 | 88.5 |
B.4 샘플링 전략에 대한 세부 사항 및 Ablation
이 절에서 우리는 먼저 LLaDA가 지원하는 다양한 샘플링 전략을 소개한다. 그런 다음 이러한 샘플링 전략들의 성능을 평가하기 위한 ablation study를 제시한다.
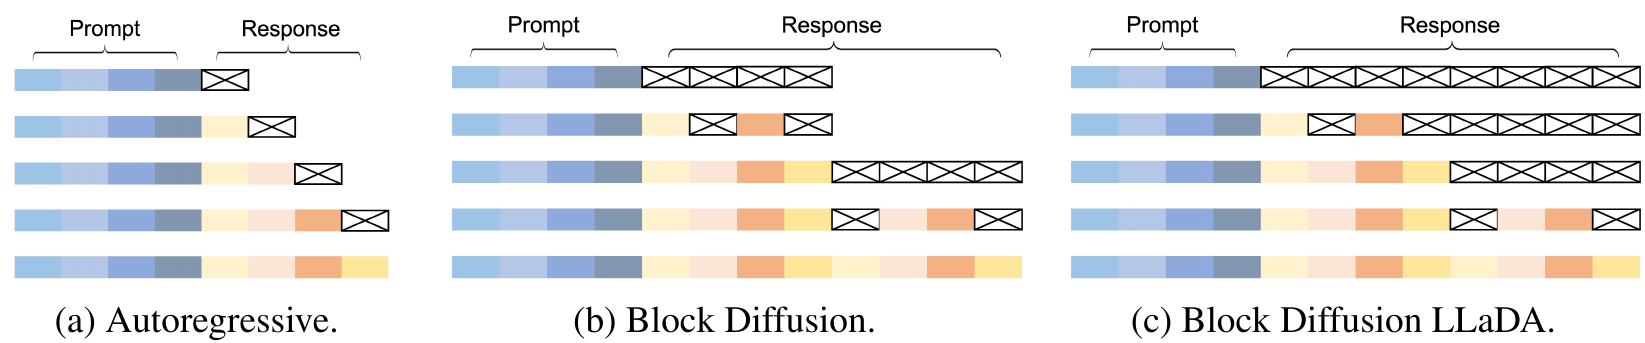
유연한 샘플링 전략. Sec. 2.4에서 Fig. 2(c)는 LLaDA의 역생성 과정을 보여준다. Fig. 4에서 볼 수 있듯이, 역생성 과정 외에도 LLaDA는 사전 학습 또는 SFT 단계 이후에 추가적인 수정이나 재학습 없이 바로 자기회귀 및 블록 확산 [31] 샘플링을 지원한다. 블록 확산 샘플링은 각 블록 내에서는 원래의 역과정을 적용하고 블록 간에는 자기회귀 샘플링을 적용한다. 원래의 블록 확산 과정에서는 시퀀스 길이가 동적으로 변한다. Fig. 4(c)에서 볼 수 있듯이, LLaDA는 고정 길이 블록 확산 전략도 채택할 수 있으며, 이를 우리는 블록 확산 LLaDA, 또는 준자기회귀 리마스킹(semi-autoregressive remasking)이라고 부른다.
실험 설정. 우리는 포괄적인 분석을 위해 LLaDA 8B Base와 LLaDA 8B Instruct를 모두 사용하여 다양한 샘플링 전략을 평가한다. LLaDA 8B Base의 경우, Tab. 1에서 우도 추정이 아닌 샘플링에 기반하여 평가되는 다섯 개의 벤치마크를 사용한다. LLaDA 8B Instruct의 경우, Tab. 2의 일곱 개 지표 중 MMLU와 HellaSwag를 제외한 것을 사용하는데, 이 두 태스크는 모델이 단일 토큰(즉, A, B, C, 또는 D)만 생성하면 되기 때문이다. 모든 설정에서 샘플링 단계마다 하나의 토큰이 생성
| Length | BBH | GSM8K | Math | HumanEval | MBPP |
| 무작위 재마스킹 | 32.1 | 21.3 | 9.2 | 11.6 | 21.0 |
| 저신뢰도 재마스킹 | 45.0 | 70.0 | 30.3 | 32.9 | 40.2 |
| 길이 | BBH | GSM8K | Math | HumanEval | MBPP |
| 256 | 45.0 | 70.0 | 30.3 | 32.9 | 40.2 |
| 512 | 50.4 | 70.8 | 30.9 | 32.9 | 39.2 |
| 1024 | 49.7 | 70.3 | 31.4 | 35.4 | 40.0 |
된다. 자기회귀 및 블록 확산 샘플링의 경우, |EOS| 토큰이 생성되면 생성이 종료된다. 블록 확산 LLaDA(즉, 준자기회귀 리마스킹) 및 순수 확산 샘플링의 경우, 생성 길이는 LLaDA 8B Base에서는 1024로 고정되며, LLaDA 8B Instruct에서는 효율성과 성능의 균형을 맞추기 위해 {64, 256, 512}에서 조정된다. 저신뢰도 리마스킹은 블록 확산 및 블록 확산 LLaDA 모두에서 블록 내 확산 샘플링에, 그리고 순수 확산 샘플링에도 적용된다. 우리는 또한 LLaDA 8B Base에 대해 다양한 블록 길이를 테스트한다. LLaDA 8B Instruct의 경우, 효율성을 위해 블록 길이 32만을 평가하는데, 이는 LLaDA 8B Base에서 최상의 결과를 내기 때문이다.
또한, LLaDA 8B Instruct의 경우, SFT 데이터에서 |EOS| 토큰의 과도한 패딩으로 인해(Sec. [B.1]에 상세히 설명됨), 순수 확산 샘플링에서 모델 출력의 |EOS| 토큰 비율이 매우 높아지는 것을 관찰했다. 이는 생성이 극도로 짧아지게 하고 모델 성능을 저하시킨다. 이 문제를 완화하기 위해, HumanEval, MBPP, GSM8K, Math, GPQA에 대해서는 순수 확산 샘플링 중에 |EOS| 토큰의 신뢰도 점수를 0으로 설정한다. 이 조정은 생성 중에 적절한 비율의 |EOS| 토큰을 유지하는 데 도움이 된다.
마지막으로, 우리는 순수 확산 샘플링을 사용하여 무작위 및 저신뢰도 리마스킹 전략의 효과를 분석하기 위한 ablation study를 수행한다. 효율성을 위해, 이 분석에서는 생성 길이와 샘플링 단계를 256으로 설정한 LLaDA 8B Base를 사용한다.
결과. Tab. [7]에서 볼 수 있듯이, 블록 확산 샘플링의 경우 블록 길이가 증가함에 따라 전반적인 성능이 향상된다. 또한, Tab. [7]과 Tab. [8] 모두 블록 확산 샘플링이 자기회귀 샘플링을 일관되게 능가하며, 블록 확산 LLaDA 샘플링이 표준 블록 확산 샘플링보다 더욱 향상됨을 보여준다. 마지막으로, 순수 확산 샘플링이 전반적으로 최상의 성능을 달성한다.
또한, Tab. [9]는 저신뢰도 리마스킹 전략이 무작위 리마스킹 전략을 일관되게 능가함을 보여준다. 우리는 저신뢰도 리마스킹이 ARMs에서 기본적으로 사용되는 annealed 샘플링 방법과 유사하게 작동하여, 생성된 문장의 다양성을 줄임으로써 정확도를 향상시킨다고 가정한다.
우리는 자기회귀 샘플링이 LLaDA 8B Instruct에서 매우 낮은 성능을 초래한다는 것을 발견했다. 이는 각 SFT 데이터가 완전한 문장이기 때문에, 주어진 시퀀스 길이 내에서 LLaDA 8B Instruct가 완전한 문장을 생성하는 경향이 있기 때문이다. 반면, LLaDA 8B Base는 사전 학습 데이터가 잘린 문서로 구성되어 있고(부록 [B.1]에 상세히 설명됨) 모델이 무작위 시퀀스 길이로 학습되기 때문에(Sec. [2.2]에 상세히 설명됨) 이 문제를 겪지 않는다. 결과적으로, 짧은 시퀀스 길이가 주어지면 LLaDA 8B Base는 문장의 일부만 생성하는 경향이 있으며, 이는 이후 생성의 접두사로 사용될 수 있다.
Tab. [8]에서 블록 길이를 8로 설정하면 GSM8K 점수가 77.5에서 78.6으로 더욱 향상된다.
B.5 생성 길이에 대한 Ablation
이 절에서는 생성 길이에 대한 ablation study를 수행한다.
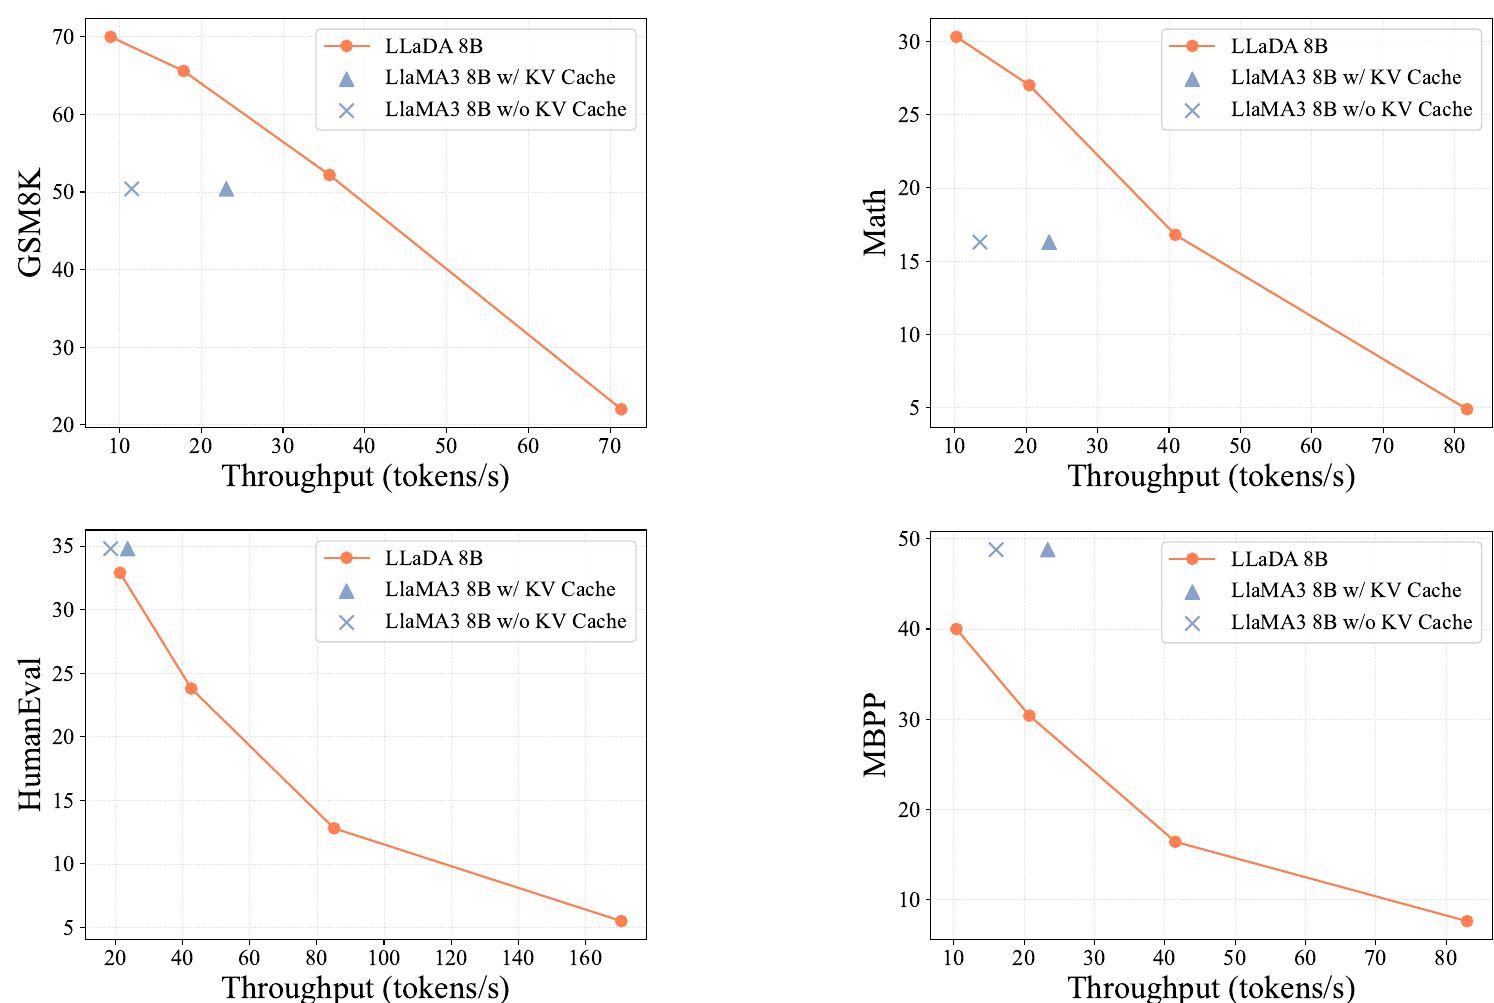
공정성을 보장하기 위해, 각 설정에 대해 샘플링 단계 수를 생성 길이와 동일하게 설정하여, 각 샘플링 단계에서 단 하나의 토큰만 마스크에서 텍스트로 전이되도록 한다. 우리는 LLaDA 8B Base를 사용하여 실험을 수행한다.
Tab. [10]에 보고된 바와 같이, 결과는 길이 하이퍼파라미터에 민감하지 않다.
B.6 표준 벤치마크 및 평가 세부 사항
이 절에서는 우리가 사용한 벤치마크를 소개하고 평가 과정의 세부 사항을 제시한다.
표준 LLM [25] [26] 평가 관행에 따라, 우리는 LLaDA를 네 가지 차원에서 평가한다:
일반 능력: MMLU [110], BBH [111], ARC-C [112], Hellaswag [113], TruthfulQA [114], WinoGrande [115] 및 PIQA [116].
수학 및 과학 능력: GSM8K [117], Math [118] 및 GPQA [119].
코드 생성: HumanEval [120], HumanEval-FIM [121] 및 MBPP [122].
중국어 이해: CMMLU [123] 및 C-Eval [124].
상기 모든 벤치마크에 대해, 우리는 LLM 평가에서 널리 채택된 평가 과정 [125]을 따르며, 주로 조건부 우도 추정과 조건부 생성을 사용한다. 구체적으로, 특정 벤치마크의 경우 프롬프트와 여러 후보 답변이 주어지고, 모델은 각 후보의 조건부 우도를 계산해야 한다. 그런 다음 가장 높은 우도를 가진 후보가 모델의 최종 답으로 선택되며, 정확도가 평가 지표로 사용된다. 나머지 벤치마크의 경우, 모델은 주어진 프롬프트에 기반하여 응답을 생성하고, 성능은 exact match 및 기타 관련 기준과 같은 지표를 사용하여 평가된다.
Base 모델의 경우, MMLU, CMMLU, C-Eval, ARC-C, Hellaswag, TruthfulQA, WinoGrande, PIQA, GPQA에는 조건부 우도 추정을 사용하며, 나머지 벤치마크는 조건부 생성을 사용하여 평가한다. Instruct 모델의 경우, 모든 벤치마크를 조건부 생성을 사용하여 평가한다.
| 입력 길이 | 출력 길이 | LLaDA 8B | LLaMA3 8B (KV-Cache 미사용) | LLaMA3 8B (KV-Cache 사용) |
| 512 | 512 | 17.03 | 16.70 | 16.32 |
| 1024 | 17.53 | 17.49 | 16.43 | |
| 2048 | 18.52 | 20.00 | 16.73 | |
| 1024 | 512 | 17.53 | 17.16 | 16.36 |
| 1024 | 18.01 | 18.26 | 16.41 | |
| 2048 | 19.02 | 21.39 | 16.74 |
Base 모델의 경우, 프레임워크에서 지원되지 않는 HumanEval-FIM 지표를 제외하고, 널리 채택된 오픈소스 평가 프레임워크인 lm-evaluation-harness [125]를 사용한다. Base 모델의 HumanEval-FIM과 Instruct 모델의 모든 평가 지표에 대해서는 내부 평가 라이브러리를 사용한다. 우리가 내부 라이브러리를 선택한 이유는 lm-evaluation-harness가 Yang et al. [25]이 보고한 LLaMA3 결과에 대해 우리의 내부 평가에 비해 더 큰 편차를 보이기 때문이다.
조건부 우도 추정을 통해 평가되는 벤치마크의 경우, 우리는 몬테카를로 추정을 사용하여 LLaDA에 대한 Eq. [6]을 근사한다. MMLU, CMMLU, C-EVAL은 단일 토큰의 우도만 필요로 하므로, 이들 벤치마크에는 단일 몬테카를로 추정으로 충분하다. 다른 모든 벤치마크의 경우, 128개의 몬테카를로 샘플이 안정적인 결과를 생성하기에 충분하다는 것을 발견했다.
조건부 생성을 사용하여 평가되는 벤치마크의 경우, 우리는 LLaDA Base와 LLaDA Instruct 모두에 저신뢰도 리마스킹 전략을 적용한 순수 확산 샘플링을 사용한다. LLaDA Base의 경우, 생성 길이와 샘플링 단계 수를 모두 1024로 설정한다. LLaDA Instruct의 경우, 샘플링 단계 수는 답변 길이와 동일하게 설정되며, 다음과 같이 구성된다: MMLU와 HellaSwag의 경우 3, GPQA의 경우 64, MBPP와 MMLU-Pro의 경우 256, HumanEval, GSM8K, Math, ARC-C의 경우 512. 부록 [B.4]에 상세히 설명된 바와 같이, HumanEval, MBPP, GSM8K, Math, GPQA의 경우, LLaDA Instruct에 대한 샘플링 중에 |EOS| 토큰의 신뢰도를 0으로 설정한다.
B.7 샘플링 효율성 분석
이 절에서는 먼저 LLaDA의 샘플링 효율성, 즉 샘플링 속도와 메모리 소비를 모두 분석한다. 그다음 효율성을 더욱 향상시키기 위한 잠재적 최적화 방안을 논의한다.
샘플링 속도 분석에는 네 가지 대표적인 개방형 생성 벤치마크인 GSM8K, Math, HumanEval, MBPP를 사용한다. 생성 속도를 측정하기 위해 널리 채택된 처리량 지표를 사용하며, 이는 초당 생성되는 토큰 수로 정의된다. LLaDA 8B Base와 LLaMA3 8B Base를 비교하며, 둘 다 bfloat16 정밀도를 사용한다. 이 절의 모든 실험은 배치 크기 1로 단일 A100-80GB GPU에서 수행되었다. LLaDA의 경우 출력 길이는 네 가지 벤치마크 모두에서 256개 토큰으로 고정된다.
Fig. 5는 LLaDA가 샘플링 단계 수를 조정함으로써 생성 품질과 속도 사이의 유연한 절충을 가능하게 함을 보여준다. 구체적으로, GSM8K와 Math 데이터셋에서 LLaDA 8B Base는 LLaMA3가 KV Cache를 사용하고 LLaDA는 어떠한 추론 최적화 기법도 적용하지 않고 동작함에도 불구하고, LLaMA3 8B Base와 비교 가능한 성능을 달성하면서 각각 1.5배와 1.8배 더 높은 처리량을 제공한다. HumanEval 벤치마크에서는 처리량이 일치할 때 LLaDA 8B Base가 LLaMA3 8B Base와 비교 가능한 성능을 보인다. MBPP 벤치마크에서는 LLaDA 8B Base가 LLaMA3 8B Base에 뒤처진다.
LLaMA3의 경우, KV 캐싱이 제공하는 가속 이점은 HumanEval 데이터셋에서 눈에 띄게 약한데, 이는 해당 데이터셋의 상대적으로 짧은 프롬프트 길이에 기인할 수 있다. 구체적으로 GSM8K, Math, MBPP, HumanEval의 평균 프롬프트 길이는 각각 894, 680, 628, 132개 토큰이다.
Tab. [1]은 LLaDA 8B Base와 LLaMA3 8B Base 간의 메모리 소비를 비교한다. 훈련 데이터의 차이로 인해 발생하는 생성 길이의 변동을 피하기 위해, 메모리 분석 동안 입력 및 출력 토큰 길이를 모두 고정한다. LLaDA의 경우 메모리 사용량은 샘플링 단계 수에 관계없이 일정하게 유지된다. 그 메모리 소비는 KV 캐시가 없는 LLaMA3 8B Base와 비슷하지만, KV 캐시가 있는 경우보다는 약간 높다.
| 4단계 | 5단계 | 6단계 | |
| LLaMA3 8B Base | 38.0 | 35.0 | 34.0 |
| LLaDA 8B Base | 64.0 | 41.0 | 44.0 |
우리는 이 연구의 목표가 ARM보다 더 빠른 모델을 제안하는 것이 아님을 강조한다. 대신, 우리는 대규모 언어 모델링에서 확산 모델의 가능성을 보여주고, 확장성, 문맥 내 학습, 명령 따르기와 같은 핵심 LLM 능력이 본질적으로 ARM에 의존한다는 일반적인 가정에 도전하고자 한다. 상당한 양의 연구[31, 79, 87]가 알고리즘이나 아키텍처 혁신을 통해 MDM의 생성 효율성을 개선하는 데 집중해 왔다. 우리는 LLaDA에 대한 유사한 효율성 지향적 탐구를 향후 과제로 남겨둔다.
B.8 iGSM 데이터셋에 대한 평가
LLaDA의 수학적 능력을 추가로 평가하기 위해, 우리는 무한한 합성 GSM8K 유사 데이터셋인 iGSM[34]에서의 성능을 테스트한다. iGSM은 특정 규칙을 통해 생성되며, 문제의 난이도(즉, 풀이 단계 수)를 제어하는 매개변수를 갖는다. 평가 일관성을 위해, 우리는 GSM8K 형식을 준수하여 최종 풀이에 "#### Sanswer"를 덧붙인다. 아래는 풀이 단계가 4로 설정된 예시이다:
(질문) North Star Elementary의 각 Cultural Studies Classroom의 수는 1이다. Westridge Elementary의 각 Dance Studio의 수는 North Star Elementary의 각 Classroom과 North Star Elementary의 각 Cultural Studies Classroom의 합의 3배이다. Westridge Elementary에는 Dance Studio가 몇 개 있는가? (풀이) North Star Elementary의 Cultural Studies Classroom을 로 정의하면, 이다. North Star Elementary의 Classroom을 으로 정의하면, 이다. Westridge Elementary의 Dance Studio를 으로 정의하면, 이고, 따라서 #### 1
GSM8K와 iGSM 사이에는 약간의 차이(예: mod 5 알고리즘 체계의 사용)가 있으므로, 우리는 [34]를 따라 각 문제에 대해 시스템 프롬프트와 네 개의 예시 질문-답변 쌍을 제공한다.
(프롬프트) 당신은 덧셈, 뺄셈, 곱셈을 포함하는 초등 수학 문제를 해결하는 전문가입니다. 당신은 모든 문제를 동일한 형식으로 해결합니다. 모든 계산은 모듈로 5로 수행됩니다. 예를 들어, 는 3이고, 는 1이며, 은 4이고, 은 4이며, 는 4입니다. 풀이를 제공할 때는 '#### x.'로 끝내십시오. 여기서 x는 0과 4 사이의 정수인 최종 답입니다. 당신은 모든 문제를 동일한 풀이 형식을 사용하여 해결해야 합니다. 우리의 시나리오는 최대 네 가지 범주의 객체를 포함합니다: 학교, 교실, 배낭, 문구류. 각 학교는 교실을 포함할 수 있고, 각 교실은 배낭을 포함할 수 있으며, 각 배낭은 문구류를 포함할 수 있습니다. 우리는 각 Lakeshore High의 댄스 스튜디오 수와 같은 수량을 지정할 수 있습니다. 동일한 이름을 가진 모든 개체는 동일한 구성을 가진다고 가정하십시오. 예를 들어, 각 Lakeshore High는 동일한 수의 댄스 스튜디오를 포함합니다. 또 다른 지침 원칙은 언급되지 않은 것은 존재하지 않는다는 것입니다. 우리가 Lakeshore High의 교실을 언급할 때, 우리는 우리의 시나리오에서 명시적으로 언급된 교실만을 논의하고 있습니다. 나아가, Lakeshore High가 언급조차 되지 않는다면, 그 안의 어떤 교실도 자동으로 존재하지 않는 것(즉, 0)으로 간주됩니다.
4에서 6까지의 풀이 단계에 대해, 우리는 각 경우에 100개의 질문을 생성하고 해당 정확도를 표 [2]에 보고한다. 표에서 볼 수 있듯이, LLaDA 8B Base는 보지 못한 수학 문제에서 LLaMA3 8B Base에 비해 상당하고 일관된 이점을 보여주며, 이는 표 [1]의 결과와 일치한다.
| 사용자 LLaDA | 규칙적인 운동은 신체적 및 정신적 건강에 어떤 이점이 있습니까? | ||||||||||
| 규칙적인 운동은 | 근육과 | 뼈를 | 강화하고 | , | 심혈관 | 건강을 | 개선하며 | , | 만성 | 질환인 | |
| 당뇨병과 | 심장 | 질환의 | 위험을 | 줄임으로써 | 신체적 | 건강을 | 향상시킬 | 수 | 있습니다 | . | |
| 또한 | 정신 | 건강과 | 불안을 | 개선하고 | , | 기분을 | 향상시키며 | , | 인지 | 기능을 | |
| 강화할 | 수 | 있습니다 | 또한 | 운동은 | 수면의 | 질을 | 개선하고 | 에너지 | 수준을 | 높일 | |
| 수 | 있습니다 | . | |||||||||
B.9 시 완성 과제
이 절에서 우리는 다음과 같이 시 완성 데이터셋의 예시를 제시한다.
예시 1:
프롬프트: 窈窕淑女的下一句是什么? 直接输出句子即可。
답: 君子好逑。
예시 2:
프롬프트: 不拘一格降人才的上一句是什么? 直接输出句子即可。
답: 我劝天公重抖擞。
B.10 추가 사례 연구
이 절에서 우리는 LLaDA 8B Instruct의 추가 사례 연구를 제시한다. 먼저, 표 [13]은 블록 확산 LLaDA 샘플링의 샘플링 과정을 보여주며, 표 [14]는 무작위 재마스킹을 사용한 다중 턴 대화의 샘플링 과정을 묘사한다. 또한, 표 [15]와 표 [16]은 단일 턴 및 다중 턴 대화의 추가 예시를 제공한다. 마지막으로, 표 [17]은 LLaDA 8B Instruct 모델이 성공한 반면 GPT-4o는 실패한 시 역완성의 예시를 제시한다.
C 영향 진술
우리의 연구는 대규모 언어 모델링에서 확산 모델의 가능성을 보여주고, 확장성, 문맥 내 학습, 명령 따르기와 같은 핵심 LLM 능력이 본질적으로 ARM에 의존한다는 일반적인 가정에 도전한다. 우리의 발견은 자연어 처리에서 대안적인 확률적 패러다임을 탐구할 새로운 길을 열어주며, 대화형 AI, 코드 생성, 복잡한 추론 과제에 잠재적으로 응용될 수 있다.
그러나 확산 모델은 전통적인 LLM과 마찬가지로 유사한 사회적 우려를 제기한다. 여기에는 대규모 훈련의 환경적 영향, 유해 콘텐츠 생성에 대한 잠재적 오용, 훈련 데이터에 존재하는 편향의 증폭이 포함된다. 이러한 과제를 해결하는 것은 확산 언어 모델의 책임 있는 개발과 배포를 보장하는 데 중요하다.
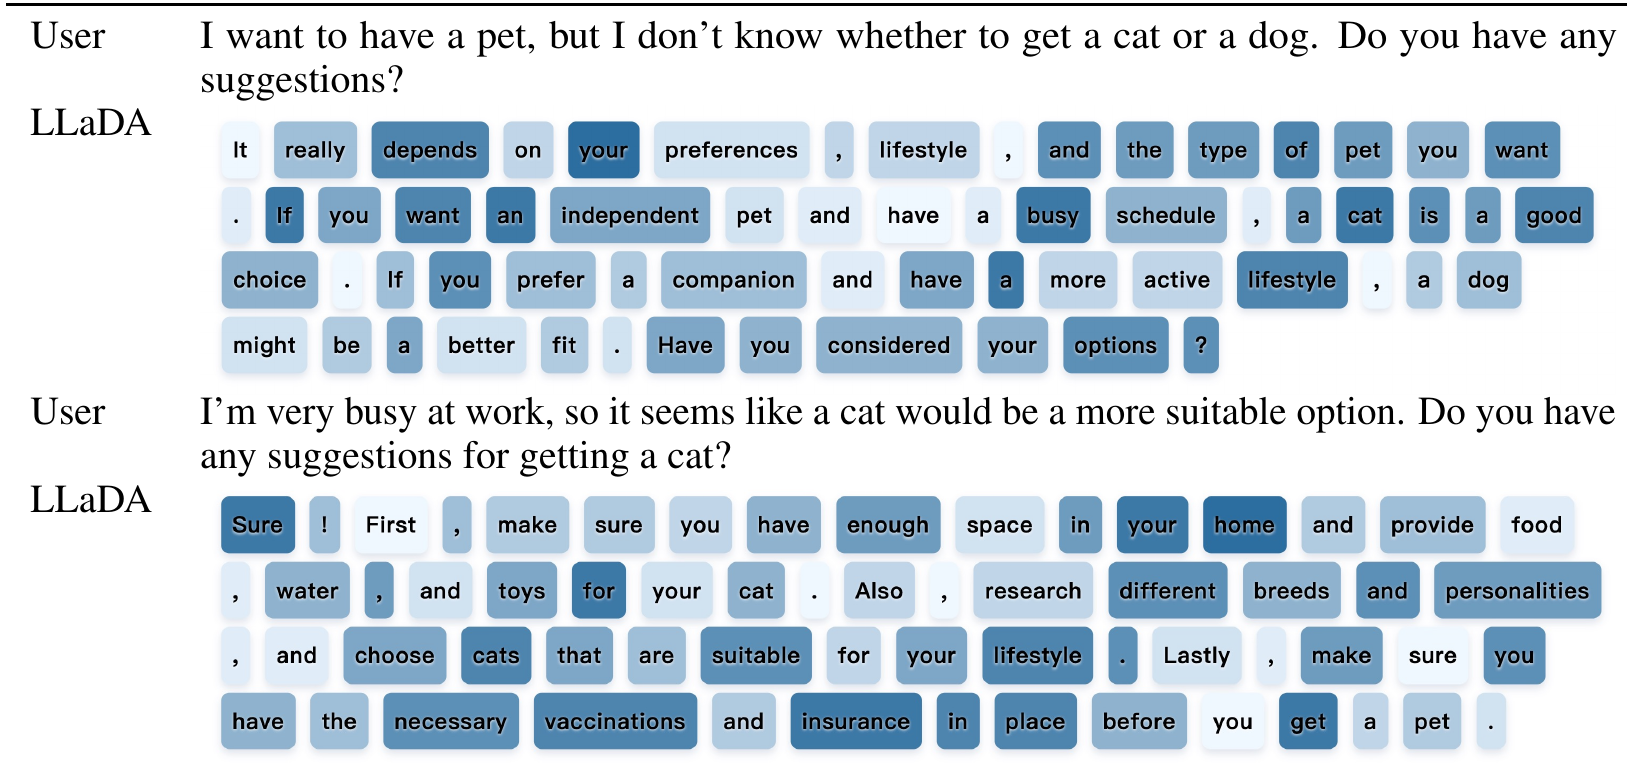
표 14: 다중 턴 대화의 시각화. 우리는 무작위 재마스킹 전략을 사용한다. LLaDA의 응답에서 어두운 색은 샘플링의 후반 단계에서 예측된 토큰을 나타내고, 밝은 색은 더 이른 예측에 해당한다.
| 일상 생활 사용자 LLaDA | 받은 조언 중 도움이 되었던 것은 무엇인가요? 제가 받은 조언 중 도움이 되었던 한 가지는 항상 배움과 성장에 열려 있으라는 것입니다. 새로운 아이디어와 경험을 기꺼이 탐구하는 태도가 제가 더 회복력 있고 적응력 있게 되는 데 도움이 되었다는 것을 깨달았습니다. 성장 마인드를 받아들임으로써 저는 개인적으로나 직업적으로 개선과 발전의 기회를 찾을 수 있었습니다. |
| 일상 생활 사용자 LLaDA | 유명한 영화 세 편을 추천해 주세요. 물론입니다! 널리 인기를 얻고 비평가들의 찬사를 받은 유명한 영화 세 편을 소개합니다: 1. 쇼생크 탈출 (1994) - 한 중편 소설에서 영감을 받아 프랭크 다라본트가 감독한 이 영화는 아내를 살해한 혐의로 유죄 판결을 받은 앤디 듀프레인이 쇼생크 교도소에서의 가혹한 삶을 견디며 동료 수감자와 뜻밖의 우정을 쌓는 이야기를 담고 있습니다. 2. 대부 (1972) - 프랜시스 포드 코폴라가 감독한 이 영화는 마리오 푸조의 동명 소설을 원작으로 합니다. 코를레오네 가족, 특히 권력의 정상에 올라 가족의 범죄 제국을 물려받는 마이클 코를레오네의 이야기를 따라갑니다. 3. 제국의 역습 (1980) - 조지 루카스가 감독한 이 영화는 스타워즈 사가에서 젊은 스카이워커의 이야기를 이어갑니다. 루크 스카이워커가 반란 연합을 도와 은하 제국에 맞서고 강력한 무기인 데스 스타를 파괴하는 과정을 그립니다. 이 영화들은 모두 뛰어난 영화적 성취와 강력한 스토리텔링, 기억에 남는 캐릭터로 찬사를 받고 있습니다. |
| 번역 사용자 LLaDA | 중국어로 번역해 주세요: 'What is now proved was once only imagined' 现在被证明的曾经只是想象 |
| 번역 사용자 LLaDA | 독일어로 번역해 주세요: 'What is now proved was once only imagined' 我把他去查查过,我其实没再问啊。 |
| 수학 사용자 LLaDA | 엠마는 일주일에 5번, 4번의 스프린트를 하기로 했습니다. 그녀는 각 스프린트마다 75미터를 달립니다. 그녀는 일주일에 총 몇 미터를 달리나요? 엠마는 한 번에 4번의 스프린트를 하므로, 일주일에 총 4 x 5 = 20번의 스프린트를 합니다. 각 스프린트는 75미터이므로, 엠마는 일주일에 총 20 x 75 = 1500미터를 달립니다. 최종 결과는 1500입니다. |
| 코드 사용자 LLaDA | 저는 파이썬 코드를 작성 중인데, 배열이 하나 있습니다. 가장 큰 것부터 가장 작은 것 순으로 정렬하는 것을 도와주세요. 물론입니다! 파이썬에서는 'sort()' 메서드나 'sorted()' 함수를 사용하여 배열을 가장 큰 것부터 가장 작은 것 순으로 정렬할 수 있습니다. 예시는 다음과 같습니다: ### 'sort()' 메서드 사용: my_array = [3, 1, 4, 1, 5, 2] my_array.sort(reverse=True) print(my_array) |
| 일상생활 | |
| 사용자 | 취업 면접은 어떻게 준비해야 하나요? |
| LLaDA | 취업 면접을 준비하려면 회사와 직무를 조사하고, 흔히 나오는 면접 질문을 연습하며, 적절하게 복장을 갖추어야 합니다. |
| 사용자 | 흔히 나오는 면접 질문에는 어떤 것들이 있나요? |
| LLaDA | 흔히 나오는 면접 질문에는 "자기소개를 해 주세요"와 "왜 우리 회사에서 일하고 싶으신가요" 같은 것들이 있습니다. |
| 일상생활 | |
| 사용자 | 프로그래밍은 어떻게 배우기 시작해야 하나요? |
| LLaDA | 프로그래밍을 배우려면 관심 있는 프로그래밍 언어를 선택하는 것부터 시작할 수 있습니다. 인기 있는 언어로는 Python, Java, C++ 등이 있습니다. |
| 사용자 | 어떤 프로그래밍 언어를 먼저 배워야 하나요? |
| LLaDA | 관심사와 목표에 따라 다릅니다. Python은 간결함과 다재다능함 덕분에 초보자에게 아주 좋은 언어입니다. |
| 사용자 | Python을 배우는 데 얼마나 걸리나요? |
| LLaDA | Python을 배우는 데는 몇 주에서 몇 달까지 걸릴 수 있습니다. |
| 사용자 | 초보자에게 좋은 Python 프로젝트에는 어떤 것들이 있나요? |
| LLaDA | 초보자에게 좋은 Python 프로젝트로는 간단한 계산기, 게임, 웹 애플리케이션 만들기 등이 있습니다. |
| 수학 | |
| 사용자 | Natalia는 4월에 친구 48명에게 클립을 팔았고, 그다음 5월에는 그 절반만큼의 클립을 팔았습니다. Natalia가 4월과 5월에 모두 몇 개의 클립을 팔았나요? |
| LLaDA | Natalia는 4월에 친구 48명에게 클립을 팔았습니다. 5월에는 그 절반만큼의 클립을 팔았으므로 48/2 = 24개의 클립을 5월에 팔았습니다. 모두 합하면 Natalia는 4월과 5월에 48 + 24 = 72개의 클립을 팔았습니다. 최종 결과는 72입니다. |
| 사용자 | Natalia는 6월에 5월에 판매한 것의 세 배에 해당하는 물품을 팔았습니다. Natalia가 이 세 달 동안 모두 몇 개의 클립을 팔았나요? |
| LLaDA | Natalia는 4월에 친구 48명에게 클립을 팔았습니다. 5월에는 그 절반만큼의 클립을 팔았으므로 48/2 = 24개의 클립을 5월에 팔았습니다. Natalia는 6월에 5월에 판매한 것의 세 배에 해당하는 물품을 팔았으므로 24 * 3 = 72개의 클립을 6월에 팔았습니다. 모두 합하면 Natalia는 이 세 달 동안 48 + 24 + 72 = 144개의 클립을 팔았습니다. 최종 결과는 144입니다. |
| <p>问题1</p> | |
| <p>用户</p> | <p>“但闻人语响”的上一句是什么?</p> |
| <p>GPT-4o</p> | <p>“但闻人语响”的上一句是“无可奈何花落去”,这两句出自唐代词人李清照的(武陵春,春晚:无可奈何花落去,但闻人语响。这首词表达了作者在春天时节的孤独与感伤,借花落和人语声的描写,反映出词人内心的无奈与失落。</p> |
| <p>LLaDA</p> | <p>“但闻人语响”的上一句是“空山不见人”</p> |
| <p>问题2</p> | |
| <p>用户</p> | <p>“夜静春山空”的上一句是什么?</p> |
| <p>GPT-4o</p> | <p>“夜静春山空”的上一句是“空山新雨后”,这两句出自唐代诗人王维的(山居秋 膜):空山新雨后,夜静春山空。这首诗描绘了春天山中雨后的寂静与空灵,表现出自然的宁静与和谐美。</p> |
| <p>LLaDA</p> | <p>“夜静春山空”的上一句是“人闲桂花落”</p> |
| 모델 | 학습 토큰 | FLOPs | MMLU | CMMLU | ARC-C | PIQA | GSM8K | HumanEval |
| LLaDA 1B | 37.75B | 2.20e20 | 25.52 | 25.95 | 25.17 | 59.41 | 1.82 | 0.00 |
| LLaDA 1B | 88.08B | 5.13e20 | 27.11 | 26.52 | 26.96 | 61.86 | 3.03 | 1.83 |
| LLaDA 1B | 138.41B | 8.06e20 | 29.32 | 27.13 | 30.20 | 63.38 | 2.35 | 0.00 |
| LLaDA 1B | 239.08B | 1.39e21 | 31.48 | 30.77 | 27.99 | 63.11 | 3.26 | 1.22 |
| LLaDA 1B | 352.32B | 2.05e21 | 35.86 | 34.35 | 31.31 | 65.34 | 3.64 | 3.05 |
| LLaDA 1B | 461.37B | 2.69e21 | 31.86 | 30.98 | 30.12 | 65.51 | 2.35 | 0.61 |
| LLaDA 8B | 62.91B | 2.63e21 | 32.22 | 28.5 | 30.20 | 63.82 | 3.87 | 2.44 |
| LLaDA 8B | 125.83B | 5.27e21 | 33.39 | 33.9 | 34.64 | 66.54 | 8.72 | 3.66 |
| LLaDA 8B | 251.66B | 1.05e22 | 42.84 | 40.59 | 40.10 | 69.04 | 15.31 | 3.66 |
| LLaDA 8B | 377.49B | 1.58e22 | 45.11 | 43.99 | 39.25 | 68.61 | 25.40 | 9.76 |
| LLaDA 8B | 503.32B | 2.11e22 | 43.57 | 41.38 | 42.06 | 70.24 | 27.52 | 9.76 |
| LLaDA 8B | 629.14B | 2.63e22 | 48.80 | 47.13 | 42.24 | 72.09 | 30.10 | 12.80 |
| LLaDA 8B | 679.48B | 2.85e22 | 49.61 | 48.19 | 41.30 | 70.84 | 26.31 | 8.54 |
| LLaDA 8B | 792.72B | 3.31e22 | 50.88 | 49.01 | 42.58 | 70.51 | 31.99 | 6.10 |
| LLaDA 8B | 981.47B | 4.11e22 | 49.47 | 48.10 | 40.27 | 71.38 | - | 6.10 |
| LLaDA 8B | 1107.30B | 4.64e22 | 51.13 | 47.57 | 41.13 | 69.26 | 36.69 | 10.37 |
| LLaDA 8B | 1233.13B | 5.16e22 | 50.52 | 49.72 | 45.05 | 71.49 | 38.97 | 9.76 |
| LLaDA 8B | 1358.95B | 5.69e22 | 54.61 | 53.97 | 49.40 | 74.05 | 48.14 | 17.68 |
| LLaDA 8B | 1547.70B | 6.48e22 | 57.38 | 56.04 | 49.49 | 74.59 | 53.30 | 20.73 |
| LLaDA 8B | 1975.52B | 8.27e22 | 58.52 | 57.87 | 50.68 | 75.35 | - | 19.51 |
| 모델 | 학습 토큰 | FLOPs | MMLU | CMMLU | ARC-C | PIQA | GSM8K | HumanEval |
| ARM 1B | 37.75B | 2.20e20 | 25.47 | 25.38 | 30.20 | 67.36 | 2.20 | 4.88 |
| ARM 1B | 88.08B | 5.13e20 | 24.67 | 25.23 | 33.96 | 70.02 | 7.51 | 10.37 |
| ARM 1B | 138.41B | 8.06e20 | 29.25 | 27.48 | 33.45 | 70.29 | 8.34 | 9.76 |
| ARM 7B | 17.30B | 6.02e20 | 26.92 | 25.18 | 21.02 | 57.18 | 1.29 | 1.22 |
| ARM 7B | 34.60B | 1.20e21 | 25.83 | 25.38 | 24.07 | 62.84 | 1.59 | 2.44 |
| ARM 7B | 86.50B | 3.01e21 | 24.41 | 24.90 | 25.42 | 71.11 | 2.88 | 7.93 |
| ARM 7B | 173.02B | 6.02e21 | 26.20 | 24.78 | 26.10 | 74.27 | 6.67 | 9.15 |
| ARM 7B | 207.62B | 7.23e21 | 30.36 | 28.86 | 31.86 | 74.48 | 8.57 | 12.80 |
| ARM 7B | 224.92B | 7.83e21 | 29.49 | 32.26 | 31.19 | 74.37 | 8.95 | 8.54 |
| ARM 7B | 242.22B | 8.43e21 | 33.62 | 31.38 | 34.92 | 75.41 | 10.84 | 9.15 |
| ARM 7B | 259.52B | 9.03e21 | 34.11 | 34.20 | 32.88 | 75.19 | 9.33 | 10.98 |
| ARM 7B | 311.43B | 1.08e22 | 35.66 | 35.49 | 36.61 | 75.14 | 11.30 | 10.37 |
| ARM 7B | 363.33B | 1.26e22 | 34.54 | 37.67 | 34.58 | 76.55 | 12.28 | 14.02 |
| ARM 7B | 415.24B | 1.45e22 | 35.37 | 38.37 | 35.25 | 76.39 | 14.40 | 12.80 |
| ARM 7B | 449.84B | 1.57e22 | 39.51 | 39.24 | 34.92 | 76.82 | 14.94 | 14.63 |
| ARM 7B | 519.09B | 1.81e22 | 40.30 | 40.69 | 37.29 | 77.15 | 14.03 | 14.63 |
| ARM 7B | 778.57B | 2.71e22 | 43.33 | 43.50 | 38.31 | 77.53 | 17.59 | 14.63 |
| ARM 7B | 1038.09B | 3.61e22 | 45.06 | 46.12 | 41.69 | 77.86 | 20.02 | 15.85 |
| ARM 7B | 1384.12B | 4.82e22 | 47.63 | 48.18 | 47.80 | 76.93 | 22.82 | 15.24 |
| ARM 7B | 2076.18B | 7.23e22 | 47.68 | 50.85 | 44.07 | 77.37 | 24.79 | 14.63 |
| ARM 7B | 2214.59B | 7.71e22 | 49.26 | 52.08 | 53.56 | 77.69 | 27.37 | 17.07 |