
거의 모든 모델이 바늘 찾기를 통과한다. RULER 는 13가지 어려운 과제를 더해 실제 문맥 길이가 훨씬 짧음을 보인다. COLM 2024, 전문 무료.
RULER: What's the Real Context Size of Your Long-Context Language Models?
RULER: 당신의 장문맥 언어 모델의 실제 컨텍스트 크기는 얼마인가?
*Cheng-Ping Hsieh, Simeng Sun, Samuel Kriman, Shantanu Acharya Dima Rekesh, Fei Jia, Yang Zhang, Boris Ginsburg*
NVIDIA
{chsieh, simengs}@nvidia.com
초록
건초더미 속 바늘(needle-in-a-haystack, NIAH) 테스트는 긴 방해 텍스트("건초더미")로부터 한 조각의 정보("바늘")를 검색하는 능력을 검사하는 것으로, 장문맥 언어 모델(LM)을 평가하는 데 널리 채택되어 왔다. 그러나 이 단순한 검색 기반 테스트는 장문맥 이해의 피상적인 형태만을 보여줄 뿐이다. 장문맥 LM에 대한 보다 포괄적인 평가를 제공하기 위해, 우리는 맞춤형 시퀀스 길이와 과제 복잡도를 위한 유연한 구성을 갖춘 새로운 합성 벤치마크 RULER를 만든다. RULER는 기본 NIAH 테스트를 확장하여 다양한 유형과 수량의 바늘을 포함하는 변형들을 포괄한다. 더욱이, RULER는 새로운 과제 범주인 다중 홉 추적(multi-hop tracing)과 집계(aggregation)를 도입하여 문맥으로부터의 검색을 넘어서는 행동을 테스트한다. 우리는 RULER에서 13개의 대표적인 과제로 17개의 장문맥 LM을 평가한다. 기본 NIAH 테스트에서 거의 완벽한 정확도를 달성함에도 불구하고, 거의 모든 모델은 문맥 길이가 증가함에 따라 큰 성능 하락을 보인다. 이 모델들 모두가 32K 토큰 이상의 컨텍스트 크기를 주장하지만, 그중 절반만이 32K 길이에서 만족스러운 성능을 유지할 수 있다. 200K의 문맥 길이를 지원하는 Yi-34B에 대한 우리의 분석은 입력 길이와 과제 복잡도를 증가시킬 때 개선의 여지가 크다는 것을 보여준다. 우리는 장문맥 LM의 포괄적인 평가를 촉진하기 위해 RULER를 오픈 소스로 공개한다.
1 서론
AI 시스템 엔지니어링(Dao et al., 2022; Jacobs et al., 2023; Fu et al., 2024)과 언어 모델 설계(Chen et al., 2023; Xiong et al., 2023)의 최근 발전은 언어 모델의 문맥 길이를 효율적으로 확장하는 것을 가능하게 했다(Liu et al., 2024a; Young et al., 2024). 선행 연구들(AI21, 2024; X.AI, 2024; Reid et al., 2024; Anthropic, 2024)은 장문맥 LM을 평가하기 위해 패스키 검색(passkey retrieval)(Mohtashami & Jaggi, 2023)과 건초더미 속 바늘(Kamradt, 2023)과 같은 합성 과제를 흔히 채택한다. 그러나 이러한 평가들은 연구들 간에 일관성 없이 사용되며, 단지 검색 능력만을 드러낼 뿐, 다른 형태의 장문맥 이해를 측정하지 못한다.
본 연구에서 우리는 언어 모델의 장문맥 모델링 능력을 평가하기 위한 새로운 벤치마크 RULER를 제안한다. RULER는 문맥으로부터의 단순 검색을 넘어서는 행동(Ribeiro et al., 2020)을 테스트하기 위한 네 가지 과제 범주를 포함한다:
1. 검색(Retrieval): 우리는 건초더미 속 바늘(Kamradt, 2023; NIAH) 테스트를 확장하여 다양한 유형과 수량의 바늘로 검색 능력을 평가한다. 2. 다중 홉 추적(Multi-hop Tracing): 우리는 상호참조 사슬 해결을 위한 최소한의 대리 과제인 변수 추적(variable tracking)을 제안하여 다중 홉 연결을 가진 개체를 추적하는 행동을 검사한다. 3. 집계(Aggregation): 우리는 요약을 위한 대리 과제인 공통/빈번 단어 추출(common/frequent words extraction)을 제안하여 장거리 문맥에 걸친 관련 정보를 집계하는 능력을 테스트한다.
| 벤치마크 & 과제 | 평균 길이 | 유형 | 다양한 과제 | 최소 모수적 지식 | 제어 가능한 문맥 |
| ZeroSCROLLS | ~10k | 현실적 | ✓ | X | X |
| L-Eval | ~8k | 현실적 | ✓ | X | X |
| BAMBOO | ~16k | 현실적 | ✓ | ✓ | X |
| LongBench | ~8k | 혼합 | ✓ | X | X |
| LooGLE | ~20k | 혼합 | ✓ | ✓ | X |
| InfiniteBench | ~200k | 혼합 | ✓ | ✓ | X |
| Needle-in-a-haystack (NIAH) | 무관 | 합성 | X | ✓ | ✓ |
| Passkey / Line / KV Retrieval | 무관 | 합성 | X | ✓ | ✓ |
| RULER (Ours) | 무관 | 합성 | ✓ | ✓ | ✓ |
4. 질의응답(Question Answering): 우리는 기존 단문맥 QA 데이터셋의 입력에 방해 정보를 추가하여 다양한 문맥 크기에서의 질의응답 능력을 평가한다.
기존의 현실적인 벤치마크들과 비교하여(표 1), RULER는 전적으로 합성 과제로 구성되어 있어 시퀀스 길이와 과제 복잡도를 제어할 수 있는 유연성을 제공한다. RULER의 합성 입력은 현실적인 과제에서 장문맥 입력의 활용을 방해하는 파라메트릭 지식에 대한 의존성을 감소시킨다(Shaham et al., [2023]; Bai et al., [2023]).
RULER를 사용하여, 우리는 Gemini-1.5(Reid et al., [2024]), GPT-4(OpenAI: Josh Achiam et al., [2023]), 그리고 4k에서 128k에 이르는 문맥 길이를 가진 15개의 오픈 소스 모델을 벤치마킹한다. 기본 NIAH 테스트에서 거의 완벽한 성능을 달성함에도 불구하고, 거의 모든 모델은 시퀀스 길이가 증가함에 따라 RULER의 더 복잡한 과제에서 큰 성능 저하를 보인다. 모든 모델이 32k 토큰 이상의 컨텍스트 크기를 주장하지만, 우리의 결과는 그중 절반만이 질적 임계값을 초과하여 32K의 시퀀스 길이를 효과적으로 처리할 수 있음을 보여준다. 더욱이, 거의 모든 모델이 주장된 문맥 길이에 도달하기 전에 임계값 아래로 떨어진다. 세밀한 모델 비교를 얻기 위해, 우리는 가중치가 실제 사용 사례의 길이 분포를 모사하는 두 가지 가중 평균 점수로 4k에서 128k까지의 성능을 집계한다. 상위 두 모델인 Gemini-1.5와 GPT-4는 선택된 가중치 방식에 관계없이 일관되게 다른 모델들을 능가한다.
우리는 추가로 200K의 문맥 길이를 주장하며 오픈 소스 모델 중 RULER에서 상당히 좋은 성능을 달성하는 Yi-34B를 분석한다. 우리의 결과는 입력 길이와 과제 복잡도를 증가시킬 때 Yi의 성능에서 큰 저하를 보여준다. 큰 문맥 크기에서 Yi-34B는 종종 불완전한 답변을 반환하고 관련 정보를 정확하게 찾아내지 못한다. 더욱이, 우리는 여러 모델에 걸쳐 문맥 크기의 확장과 함께 나타나는 두 가지 행동을 관찰한다: 파라메트릭 지식에 대한 의존성 증가와 비검색 과제에서 문맥으로부터 복사하려는 경향의 증가이다. 우리의 추가적인 절제 실험은 더 긴 시퀀스에 대한 훈련이 항상 RULER에서 더 나은 성능으로 이어지지는 않으며, 더 큰 모델 크기가 더 나은 장문맥 능력과 양의 상관관계가 있음을 보여준다. 마지막으로, 우리는 RWKV와 Mamba와 같은 비-Transformer 아키텍처가 여전히 RULER에서 Transformer에 크게 뒤처진다는 것을 보여준다.
우리의 기여는 다음과 같다:
- 우리는 유연한 구성을 갖춘 합성 과제를 통해 장문맥 언어 모델을 평가하기 위한 새로운 벤치마크 RULER를 제안한다.- 우리는 장문맥으로부터의 검색 이외의 행동을 테스트하기 위해 새로운 과제 범주, 특히 다중 홉 추적과 집계를 도입한다.- 우리는 RULER를 사용하여 17개의 장문맥 LM을 평가하고 모델과 과제 복잡도 전반에 걸친 분석을 수행한다.
우리는 장문맥 언어 모델의 향후 연구를 촉진하기 위해 RULER를 오픈 소스로 공개한다.
2 관련 연구
장문맥 언어 모델. 엔지니어링, 아키텍처, 알고리즘 설계의 진보 덕분에 최근 수많은 장문맥 언어 모델이 도입되었다. Flash attention(Dao et al., 2022; Dao, 2023)과 Ring attention(Liu et al., 2023)은 긴 문맥을 처리하는 데 필요한 메모리 사용량을 크게 줄인다. 이동 희소 어텐션(shifted sparse attention)(Chen et al., 2024), 팽창 어텐션(dilated attention)(Ding et al., 2023), 어텐션 싱크(attention sinks)(Han et al., 2023; Xiao et al., 2024b)와 같은 다양한 희소 어텐션 메커니즘(Child et al., 2019; Jaszczur et al., 2021)이 효율적인 문맥 확장을 가능하게 하기 위해 사용되었다. ALiBi(Press et al., 2022), xPOS(Sun et al., 2023b), 그리고 RoPE(Su et al., 2023) 변형들(Chen et al., 2023; Xiong et al., 2023; Peng et al., 2024; Liu et al., 2024b; Ding et al., 2024; Zhu et al., 2024)을 포함한 새로운 위치 임베딩 방법들이 Transformer(Vaswani et al., 2017)의 길이 외삽을 개선하기 위해 제안되었다. 또 다른 연구 흐름은 문맥 크기를 줄이는 데 초점을 맞춘다. 이는 순환 메커니즘을 사용하여 이전 문맥을 캐싱하거나(Zhang et al., 2024a; Bulatov et al., 2023; Martins et al., 2022; Wu et al., 2022), 문맥으로부터 관련 정보를 검색하거나(Xu et al., 2024a; Mohtashami & Jaggi, 2023; Wang et al., 2024; Tworkowski et al., 2024; Xiao et al., 2024a), 또는 압축을 통해 두드러진 정보를 보존함으로써(Jiang et al., 2023) 달성될 수 있다. 마지막으로, Mamba(Gu & Dao, 2023)와 RWKV(Peng et al., 2023)와 같은 새로운 아키텍처들(Gu et al., 2022; Fu et al., 2023a; Poli et al., 2023; Fu et al., 2023b; Sun et al., 2023a; Beck et al., 2024; Sun et al., 2024) 또한 장문맥 입력을 효율적으로 처리하기 위해 제안되었다.
장문맥 벤치마크와 과제. 우리의 연구는 장문맥 언어 모델을 벤치마킹하는 다른 연구들과 밀접하게 관련되어 있다. ZeroSCROLLS(Shaham et al., 2023)는 장문서 QA와 (질의 기반) 요약과 같은 10개의 현실적인 자연어 과제를 다룬다. L-Eval(An et al., 2024) 또한 품질을 보장하기 위해 수동으로 필터링된 현실적인 데이터를 사용한다. LongBench(Bai et al., 2023)는 이중 언어 환경의 과제를 포함한다. InfiniteBench(Zhang et al., 2024b)는 100K 토큰보다 긴 길이의 과제를 포함한다. LTM(Castillo et al., 2024)은 장기 대화의 평가를 목표로 한다. 파라메트릭 지식의 영향을 분리하기 위해, 선행 연구들(Dong et al., 2023; Li et al., 2023b)은 또한 특정 컷오프 날짜 이후에 온라인에 게시된 문서를 사용하거나 극도로 저자원인 자료를 활용할 것을 제안한다(Tanzer et al., 2024). 현실적인 벤치마크들과 비교하여, 합성 과제는 설정(예: 시퀀스 길이와 과제 복잡도)을 제어하기에 더 유연하고 파라메트릭 지식의 영향을 덜 받는다. 최근 연구들은 주로 검색 기반 합성 과제에 초점을 맞추었으며(Kamradt, 2023; Mohtashami & Jaggi, 2023; Li et al., 2023a; Liu et al., 2024d; Lee et al., 2024), 소수는 사실 추론(Kuratov et al., 2024; Karpinska et al., 2024), 장거리 담화 모델링(Sun et al., 2022), 질의응답(Levy et al., 2024; Yuan et al., 2024), 다수 예시 문맥 내 학습(Agarwal et al., 2024; Bertsch et al., 2024; Xu et al., 2024b), 그리고 코드 이해(Liu et al., 2024c)를 포함한 다른 측면들을 조사한다.
3 RULER 벤치마크
RULER는 검색, 다중 홉 추적, 집계, 질의 응답의 네 가지 범주에 걸친 과제들로 구성된다. RULER의 평가 예시는 각 입력의 길이와 복잡성을 정의하는 입력 구성(표 2 참조)에 기반하여 자동으로 생성된다. RULER에서와 같이 제한된 영역 내에서, 과제 복잡성은 목표 출력 토큰 수와 문맥 내 신호 대 잡음비의 함수로 생각할 수 있다. 장문 문맥 언어 모델을 위한 평가 과제 설계에 관한 보다 포괄적인 논의는 (Goldman et al., 2024)를 참조하기 바란다.
3.1 검색: 바늘 찾기(Needle-in-a-haystack, NIAH)
최근 연구들(Reid et al., 2024; Anthropic, 2023)은 장문 문맥 모델링 능력을 평가하기 위해 바늘 찾기(Kamradt, 2023; NIAH) 테스트를 흔히 사용한다. NIAH 테스트는 충분한 질의가 주어졌을 때 문맥으로부터 관련 정보를 검색해야 하는 연상 회상 과제(Hopfield, 1982; Graves et al., 2014; Olsson et al., 2022; Arora et al., 2024)를 연상시키며, 이는 광범위하게 연구되어 왔다. RULER에서는 여러 검색 기반 과제를 포함하여, 기본 NIAH 테스트를 확장해 세 가지 기준에 기반하여 모델을 평가한다.
| 작업 | 구성 | 예시 |
SingleNIAH(S-NIAH) | type_key = wordtype_value = numbertype_haystack = essaysize_haystack < context length | (에세이) long-context에 대한 특별한 매직 넘버 중 하나는 12345입니다. 제공된 텍스트에서 언급된 long-context에 대한 특별한 매직 넘버는 무엇입니까? 답: 12345 |
Multi-keysNIAH(MK-NIAH) | num_keys = 2type_key = wordtype_value = numbertype_haystack = essaysize_haystack < context length | (에세이) long-context에 대한 특별한 매직 넘버 중 하나는 12345입니다. large-model에 대한 특별한 매직 넘버 중 하나는 54321입니다. 제공된 텍스트에서 언급된 long-context에 대한 특별한 매직 넘버는 무엇입니까? 답: 12345 |
Multi-valuesNIAH(MV-NIAH) | num_values = 2type_key = wordtype_value = numbertype_haystack = essaysize_haystack < context length | (에세이) long-context에 대한 특별한 매직 넘버 중 하나는 12345입니다. long-context에 대한 특별한 매직 넘버 중 하나는 54321입니다. 제공된 텍스트에서 언급된 long-context에 대한 모든 특별한 매직 넘버는 무엇입니까? 답: 12345 54321 |
Multi-queriesNIAH(MQ-NIAH) | num_queries = 2type_key = wordtype_value = numbertype_haystack = essaysize_haystack < context length | (에세이) long-context에 대한 특별한 매직 넘버 중 하나는 12345입니다. large-model에 대한 특별한 매직 넘버 중 하나는 54321입니다. 제공된 텍스트에서 언급된 long-context와 large-model에 대한 모든 특별한 매직 넘버는 무엇입니까? 답: 12345 54321 |
VariableTracking(VT) | num_chains = 2num_hops = 2size_noises < context length | (노이즈) VAR X1 = 12345 .... VAR Y1 = 54321 .... VAR X2 = X1 .... VAR Y2 = Y1 .... VAR X3 = X2 .... VAR Y3 = Y2 .... 값 12345가 할당된 모든 변수를 찾으십시오. 답: X1 X2 X3 |
Common WordsExtraction(CWE) | freq_cw = 2, freq_ucw = 1num_cw = 10num_ucw < context length | aaa bbb cca aaa ddd eee ccc fff ggg hhh iii iii .... 위 목록에서 가장 흔한 10개의 단어는 무엇입니까? 답: aaa ccc iii .... |
Frequent WordsExtraction(FWE) | α = 2num_word < context length | aaa bbb cca aaa ddd eee ccc fff ggg aaa hhh aaa ccc iii iii .... 위의 코드화된 텍스트에서 가장 자주 등장한 3개의 단어는 무엇입니까? 답: aaa ccc iii |
QuestionAnswering(QA) | dataset = SQuADnum_document < context length | Document 1: .... aaa .... Document 2: .... bbb .... Document 3: .... ccc .... 질문: question 답: bbb |
구체적으로, 검색 능력은 (1) "바늘"과 "건초더미"의 유형에 무관해야 하고, (2) 어려운 방해 요소를 무시할 수 있을 만큼 강력해야 하며, (3) 여러 항목을 검색해야 할 때 높은 재현율을 보여야 한다. 이러한 기준에 기반하여 우리는 네 가지 NIAH 과제를 개발한다. 각 과제에서 "바늘"은 "건초더미"(긴 방해 텍스트)에 삽입된 키-값 쌍이다. 질의는 시퀀스의 끝에 위치하며, 문맥 내의 키와 매칭되고 이어서 연관된 값을 검색하기 위한 단서 역할을 한다.
- 단일 NIAH(S-NIAH): 단일 "바늘(needle)"을 "건초 더미(haystack)"에서 검색해야 하는 기본 NIAH 테스트입니다. 쿼리/키/값은 단어, 숫자(7자리), 또는 UUID(32자리) 형태일 수 있습니다. "건초 더미"는 반복되는 노이즈 문장이나 Paul Graham의 에세이가 될 수 있습니다(Kamradt, 2023).- 다중 키 NIAH(MK-NIAH): 여러 개의 "바늘"이 "건초 더미"에 삽입되며, 그중 하나만 검색하면 됩니다. 추가된 "바늘"은 어려운 방해 요소입니다. 가장 어려운 설정은 "건초 더미"가 방해 바늘로 채워진 버전입니다.
- 다중 값 NIAH(MV-NIAH): 동일한 키를 공유하는 여러 개의 "바늘"이 "건초 더미"에 삽입됩니다. 동일한 키와 연관된 모든 값을 검색해야 합니다.- 다중 쿼리 NIAH(MQ-NIAH): 여러 개의 "바늘"이 "건초 더미"에 삽입됩니다. 키가 서로 다른 모든 "바늘"을 검색해야 합니다. 이는 Arora 등(2024)이 사용한 것과 동일한 다중 쿼리 연상 회상(multi-query associative recall) 작업 설정입니다. MV-NIAH와 함께 이 두 작업은 중요한 정보를 하나도 놓치지 않고 검색 능력을 평가합니다.
3.2 다중 홉 추적: 변수 추적(VT)
효과적인 담화 이해(van Dijk & Kintsch, 1983)는 긴 문맥 전반에 걸쳐 새로 언급된 개체를 성공적으로 인식하고 동일한 개체를 공동 참조하는 참조 사슬(Karttunen, 1969)을 확립하는 데 달려 있습니다. 우리는 최소한의 공지시 사슬 해결(Ng, 2010) 작업을 모방한 새로운 작업인 변수 추적을 개발합니다. 이 작업은 긴 입력 내에서 관련 공기(共起) 패턴을 추적하고 건너뛴 연결을 도출하는 행동을 검사합니다. 구체적으로, 변수 이 값 로 초기화되고, 이어서 입력의 다양한 위치에 삽입되는 변수 이름 바인딩 문장(예: , , ...)의 선형 사슬이 뒤따릅니다. 목표는 동일한 값 를 가리키는 모든 변수 이름을 반환하는 것입니다. 작업 복잡도는 더 많은 홉(즉, 이름 바인딩 횟수)이나 더 많은 사슬을 추가하여 높일 수 있으며, 이는 MK-NIAH에서 어려운 방해 요소를 추가하는 것과 유사합니다.
3.3 집계: 공통 단어(CWE) 및 빈번 단어 추출(FWE)
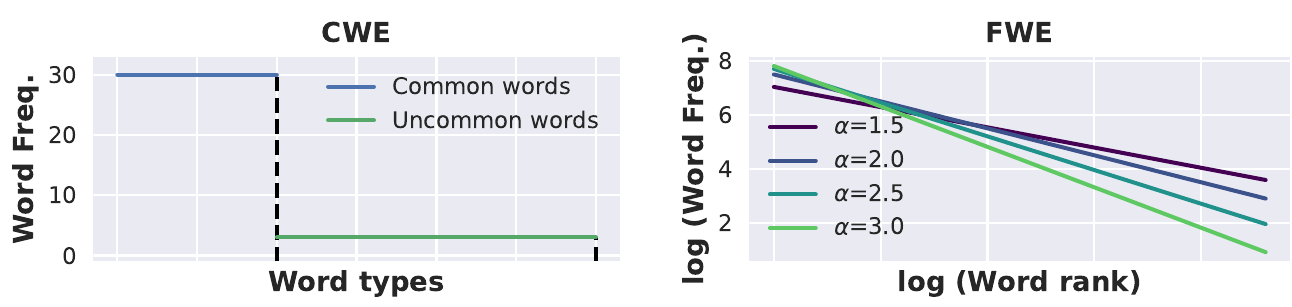
RULER에서는 관련 정보가 문맥에서 훨씬 더 큰 비중을 차지하고 목표 출력이 관련 입력의 정확한 집계에 의존하는 요약 작업의 대리로 새로운 범주를 도입합니다. 구체적으로, 우리는 미리 정의된 (합성) 단어 목록에서 단어를 샘플링하여 입력 시퀀스를 구성합니다. 공통 단어 추출 작업(CWE)에서는 단어를 이산 균등 분포에서 샘플링하며, 공통 단어의 수는 고정되고 비공통 단어의 수는 시퀀스 길이에 따라 증가합니다. 빈번 단어 추출 작업(FWE)에서는 단어를 제타 분포에서 샘플링합니다. 그림 1은 구성된 입력에서의 단어 빈도를 보여줍니다. 모델은 문맥에서 상위 개의 빈번 단어를 반환해야 합니다. CWE에서는 가 공통 단어의 수와 같습니다. FWE에서는 를 3으로 설정하는데, 를 늘리면 대부분의 모델에서 작은 문맥 크기에서도 성능이 저하되기 때문입니다. 작업 복잡도는 공통 단어의 수나 제타 분포의 매개변수를 변경하여 조정할 수 있습니다.4
3.4 질의응답(QA)
기존 QA 데이터셋(Rajpurkar et al., 2018; Yang et al., 2018; Trivedi et al., 2022)의 대부분은 짧은 지문을 바탕으로 질문에 답하도록 설계되었습니다. 이러한 데이터셋 은 방해 정보를 추가하여 긴 문맥 입력을 시뮬레이션하도록 확장할 수 있습니다. 이 작업 범주에서는 정답 지문(즉, 답을 포함하는 지문)을 동일한 데이터셋에서 무작위로 샘플링한 지문들 사이에 삽입합니다. 이 범주는 NIAH의 실제 세계 적용(Ivgi et al., 2023)으로, 질문이 쿼리 역할을 하고 정답 지문이 "바늘"이며 방해 지문이 "건초 더미"를 형성합니다.
4 실험 및 결과
모델 및 추론 설정 우리는 15개의 오픈 소스 모델과 2개의 클로즈드 소스 모델(Gemini-1.5-Pro 및 GPT-4)을 포함한 17개의 긴 문맥 LLM을 선택하며, 다양한 모델 크기(7B에서 MoE 아키텍처의 8x22B까지)와 주장된 문맥 길이(32K에서 1M까지)를 포괄합니다. 이들 모델에 대한 완전한 정보는 부록 A에 포함되어 있습니다. 우리는 효율적인 KV 캐시 메모리 관리를 갖춘 LLM 서빙 시스템인 vLLM(Kwon et al., 2023)을 사용하여 모든 모델을 평가합니다. 모든 모델에 대해 우리는 8개의 NVIDIA A100 GPU에서 BFloat16으로 그리디 디코딩을 사용하여 추론을 실행합니다.
작업 구성 우리는 RULER의 네 가지 범주에서 다양한 복잡도를 가진 13개 작업에 대해 모든 모델을 테스트합니다. 테스트 구성은 (부록 C에 설명된 작업 상관관계 연구를 기반으로 부록 B에 제시된 바와 같이) 선택되었습니다. 우리는 대부분의 모델이 4K 토큰의 짧은 문맥 크기에서 상당히 좋은 성능을 발휘하기 때문에 이러한 작업을 선택합니다. 우리의 주요 목표는 모델이 문맥 길이의 확장에 따라 이러한 좋은 성능을 유지할 수 있는지 확인하는 것입니다. 각 작업에 대해 우리는 각 모델을 (4K, 8K, 16K, 32K, 64K, 128K) 시리즈의 각 길이마다 생성된 500개의 예제로 평가하며, 각 모델의 필수 채팅 템플릿을 준수합니다. 모델이 쿼리에 답하기를 거부하거나 설명을 생성하는 것을 방지하기 위해 우리는 작업 입력에 답변 접두사를 덧붙이고 재현율 기반 정확도로 목표 출력의 존재를 확인합니다.
유효 문맥 크기 우리는 RULER에서 입력 길이를 늘릴수록 모든 모델에서 큰 성능 저하가 발생함을 확인했습니다. 모델이 효과적으로 처리할 수 있는 최대 문맥 크기를 결정하기 위해 우리는 고정된 임계값으로 각 모델을 평가하며, 이를 통과하면 평가 길이에서 만족스러운 성능을 나타냅니다. 우리는 4K 문맥 길이에서 Llama2-7b 모델의 성능을 임계값으로 사용합니다. 표 3에서 우리는 임계값을 초과하는 최대 길이를 "유효 길이"로, "주장된 길이"와 함께 보고합니다.
모델 순위 기준 임계값 기반 평가는 주장된 길이와 유효 길이 사이의 불일치를 드러내지만, 세밀한 모델 비교를 위한 세부 사항이 부족합니다. 따라서 우리는 다양한 문맥 크기에 걸쳐 모델 성능을 집계하기 위해 가중 평균 점수를 사용합니다. 우리는 두 가지 가중치 체계인 wAvg.(inc)와 wAvg.(dec)로 모델의 순위를 매기며, 여기서 가중치는 각각 시퀀스 길이에 따라 선형적으로 증가하고 감소합니다. 이상적으로는 각 길이에 대한 가중치는 모델 사용의 길이 분포에 의해 결정되어야 하며, 여기서 우리는 더 긴 시퀀스(inc) 또는 더 짧은 시퀀스(dec)가 분포를 지배하는 시나리오를 시뮬레이션하기 위해 두 가지 체계를 선택합니다.
주요 결과 우리는 표 3에 Llama2-7B 기준선과 비교하여 17개 긴 문맥 LM의 결과를 포함합니다. 특정 길이에서의 성능은 RULER의 13개 작업 전체의 평균입니다. 클로즈드 소스 모델 Gemini-1.5-Pro는 우리가 테스트한 최대 길이보다 큰 유효 길이로 다른 모델들을 큰 차이로 능가합니다. 더 어려운 버전의 RULER로 이 모델을 압박 테스트하는 것은 향후 흥미로운 후속 연구가 될 수 있습니다. 나머지 모델들의 경우, 패스키 검색과 기본 NIAH 작업(부록 E에 제시됨)에서 거의 완벽한 성능을 달성하지만, 모두 시퀀스 길이가 증가함에 따라 RULER에서 큰 성능 저하를 보이며 주장된 길이에서 Llama2-7B 기준선 이상의 성능을 유지하지 못합니다. 최상위 오픈 소스 모델(Llama3.1, Qwen2, Command-R-plus)은 더 큰 모델 크기와
| 모델 | 주장 길이 | 유효 길이 | 4K | 8K | 16K | 32K | 64K | 128K | 평균 | wAvg. (inc) | wAvg. (dec) |
| Llama2 (7B) | 4K | - | 85.6 | ||||||||
| Gemini-1.5-Pro | 1M | >128K | 96.7 | 95.8 | 96.0 | 95.9 | 95.9 | 94.4 | 95.8 | 95.5(1위) | 96.1(1위) |
| GPT-4 | 128K | 64K | 96.6 | 95.3 | 95.2 | 93.2 | 87.0 | 81.2 | 91.6 | 89.0(2위) | 94.1(2위) |
| Llama3.1 (70B) | 128K | 64K | 96.5 | 95.8 | 95.4 | 94.8 | 88.4 | 66.6 | 89.6 | 85.5(4위) | 93.7(3위) |
| Qwen2 (72B) | 128K | 32K | 96.9 | 96.1 | 94.9 | 94.1 | 79.8 | 53.7 | 85.9 | 79.6(9위) | 92.3(4위) |
| 명령-R-plus (104B) | 128K | 32K | 95.6 | 95.2 | 94.2 | 92.0 | 84.3 | 63.1 | 87.4 | 82.7(7위) | 92.1(5위) |
| GLM4 (9B) | 1M | 64K | 94.7 | 92.8 | 92.1 | 89.9 | 86.7 | 83.1 | 89.9 | 88.0(3위) | 91.7(6위) |
| Llama3.1 (8B) | 128K | 32K | 95.5 | 93.8 | 91.6 | 87.4 | 84.7 | 77.0 | 88.3 | 85.4(5위) | 91.3(7위) |
| GradientAI/Llama3 (70B) | 1M | 16K | 95.1 | 94.4 | 90.8 | 85.4 | 80.9 | 72.1 | 86.5 | 82.6(8위) | 90.3(8위) |
| Mixtral-8x22B (39B/141B) | 64K | 32K | 95.6 | 94.9 | 93.4 | 90.9 | 84.7 | 31.7 | 81.9 | 73.5(11위) | 90.3(9위) |
| Yi (34B) | 200K | 32K | 93.3 | 92.2 | 91.3 | 87.5 | 83.2 | 77.3 | 87.5 | 84.8(6위) | 90.1(10위) |
| Phi3-medium (14B) | 128K | 32K | 93.3 | 93.2 | 91.1 | 86.8 | 78.6 | 46.1 | 81.5 | 74.8(10위) | 88.3(11위) |
| Mixtral-v0.2 (7B) | 32K | 16K | 93.6 | 91.2 | 87.2 | 75.4 | 49.0 | 13.8 | 68.4 | 55.6(13위) | 81.2(12위) |
| LWM (7B) | 1M | <4K | 82.3 | 78.4 | 73.7 | 69.1 | 68.1 | 65.0 | 72.8 | 69.9(12위) | 75.7(13위) |
| DBRX (36B/132B) | 32K | 8K | 95.1 | 93.8 | 83.6 | 63.1 | 2.4 | 0.0 | 56.3 | 38.0(14위) | 74.7(14위) |
| Together (7B) | 32K | 4K | 88.2 | 81.1 | 69.4 | 63.0 | 0.0 | 0.0 | 50.3 | 33.8(15위) | 66.7(15위) |
| LongChat (7B) | 32K | <4K | 84.7 | 79.9 | 70.8 | 59.3 | 0.0 | 0.0 | 49.1 | 33.1(16위) | 65.2(16위) |
| LongAlpaca (13B) | 32K | <4K | 60.6 | 57.0 | 56.6 | 43.6 | 0.0 | 0.0 | 36.3 | 24.7(17위) | 47.9(17위) |
RoPE에서 더 큰 기본 주파수를 사용하는 것과 같은 공통 구성을 공유합니다(Xiong et al., 2023). 큰 훈련 문맥 창이 항상 좋은 긴 문맥 성능에 필요한 것은 아닙니다. 최상위 오픈 소스 모델에는 무차별 문맥 확장(Llama3.1은 128K 문맥 길이로 훈련됨)과 추론 시 길이 외삽(Qwen2는 32K 문맥 길이로 훈련됨)이 모두 포함됩니다. 성능이 낮은 모델에는 훨씬 더 큰 문맥 크기로 훈련된 모델(예: LWM과 GradientAI/Llama3는 모두 1M 문맥 길이)도 포함됩니다. LWM은 더 긴 시퀀스가 더 큰 가중치를 받을 때(wAvg. inc) Mistral-v0.2보다 높은 순위를 달성하고 문맥 크기가 증가함에 따라 더 적은 저하를 보이지만, 4K에서도 Llama2-7B보다 성능이 떨어집니다. 이 결과는 짧은 시퀀스에서의 절대적 성능과 문맥 크기의 확장에 따른 상대적 저하 사이의 평가상의 트레이드오프를 시사합니다. 우리는 섹션 6에서 모델 크기와 최대 훈련 길이에 대한 더 많은 분석을 제공합니다.
5 작업 오류 분석
우리는 작업 구성과 실패 모드가 RULER에 미치는 영향을 이해하기 위해 증가된 입력 길이(최대 256K)에서 더 복잡한 작업에 대해 Yi-34B-200K를 평가합니다.
"针"类型的不稳健性。图2(左)显示,虽然Yi在使用词-数字对作为"针"的标准密码检索和普通NIAH中达到了近乎完美的性能,但当"针"采取其他形式时,性能会下降。我们观察到在检索UUID的任务中退化最为严重,对于长输入上下文(),Yi有时无法返回完整的32位数字。
无法忽略干扰项。图2(中左)显示,增加干扰"针"的数量会持续降低性能,在极端版本中(#K=FULL,即上下文充满无关的"针"),Yi在256K时下降了约分。错误分析表明,Yi在长输入上下文中无法有效忽略困难干扰项,从而错误地检索与干扰键相关联的值。在极端版本中,Yi经常返回目标附近的值,这表明它对该范围有粗略的匹配,但当目标处于噪声的分布内时,缺乏精确定位该键的精度。
返回不完整信息。与先前工作一致(Liu et al., 2024a;Reid et al., 2024),我们注意到当模型需要从长输入中检索多个项目时,性能会显著退化。例如,将查询数量从1增加到8会使性能下降约分(图2右)。当模型需要检索与同一键关联的多个值时(图2中右),Yi经常输出重复的答案而不返回完整的值集合,这意味着键与其各个值之间的关联不均匀。
倾向于从上下文复制。我们注意到,在扩展输入长度时,Yi有强烈的逐字从上下文复制的倾向。这种倾向在变量跟踪(VT)和常见词提取(CWE)中最为显著,我们在序列开头加入了一个上下文示例。在128K时,Yi在CWE任务中超过的输出仅仅是从单样本示例中复制的字符串,而对于短序列则不存在复制现象。这种复制行为也存在于LWM模型和LongAlpaca中,但在其他模型(如Mixtral)中较少见。这一发现进一步强调了在长输入上下文中测试检索之外行为的必要性。
맥락 내에서의 신뢰할 수 없는 추적. 변수 추적 과제의 경우, 더 많은 체인을 추가하는 것과 더 많은 홉을 추가하는 것 모두 Yi의 성능에 큰 저하를 초래한다. Yi는 맥락 크기를 늘릴수록 더 많은 홉 설정에서 일관되게 성능이 저하되는 반면(그림 3 왼쪽), 더 많은 체인 설정에서의 저하는 128K보다 긴 길이에서 가장 두드러진다(그림 3 가운데 왼쪽). 앞서 언급한 복사 문제 외에도, Yi는 빈 문자열이나 다른 체인의 변수를 잘못 반환하여 오류를 범하는데, 이는 긴 맥락 내에서 동일한 개체를 신뢰성 있게 추적하는 능력이 부족함을 시사한다. 이러한 오류는 복사 행동을 보이지 않는 모델에서도 빈번히 관찰된다.
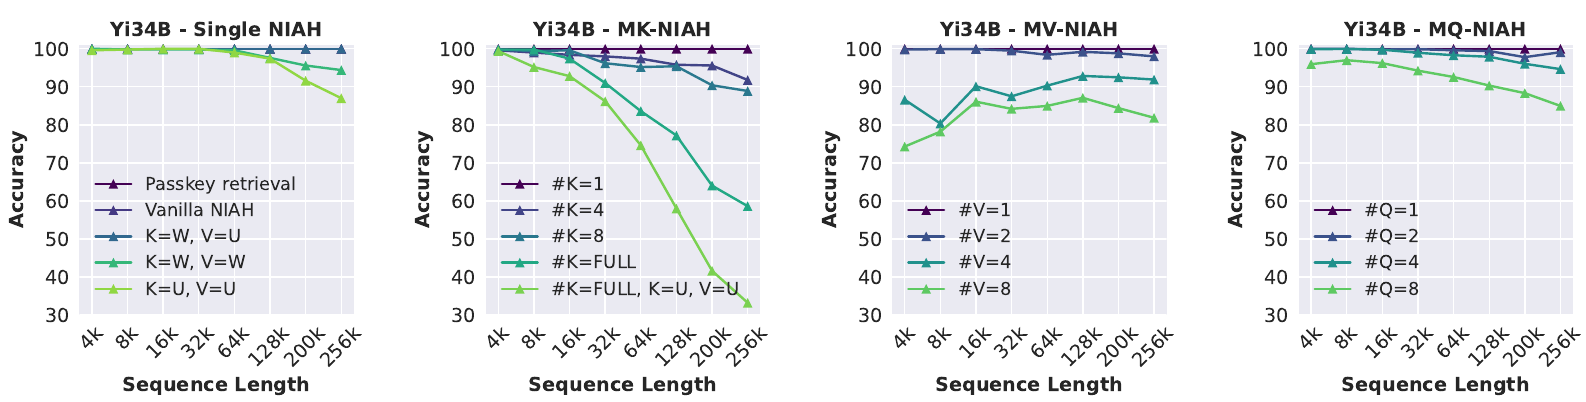
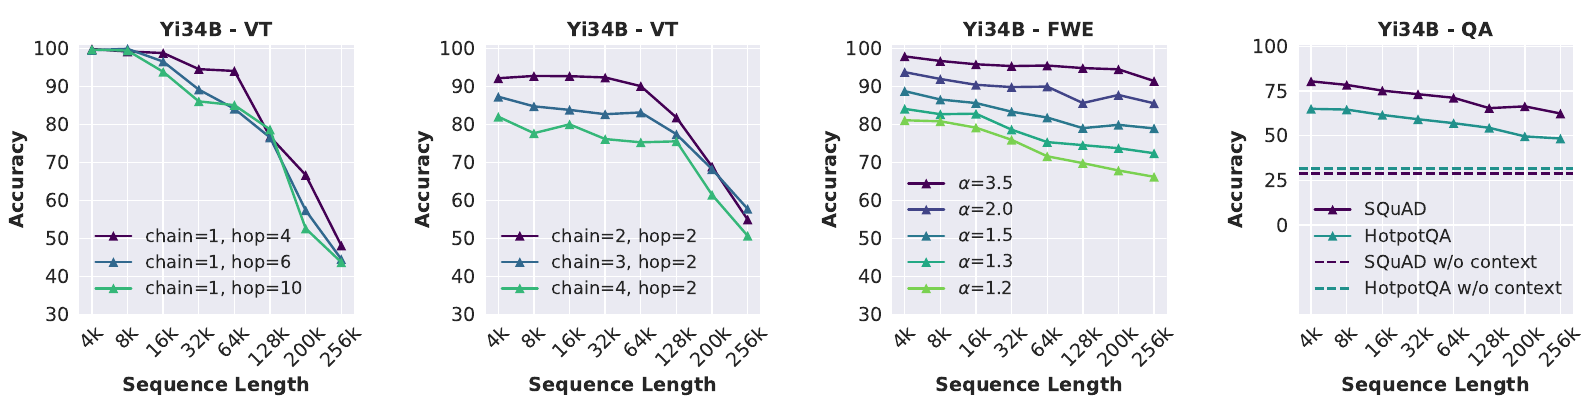
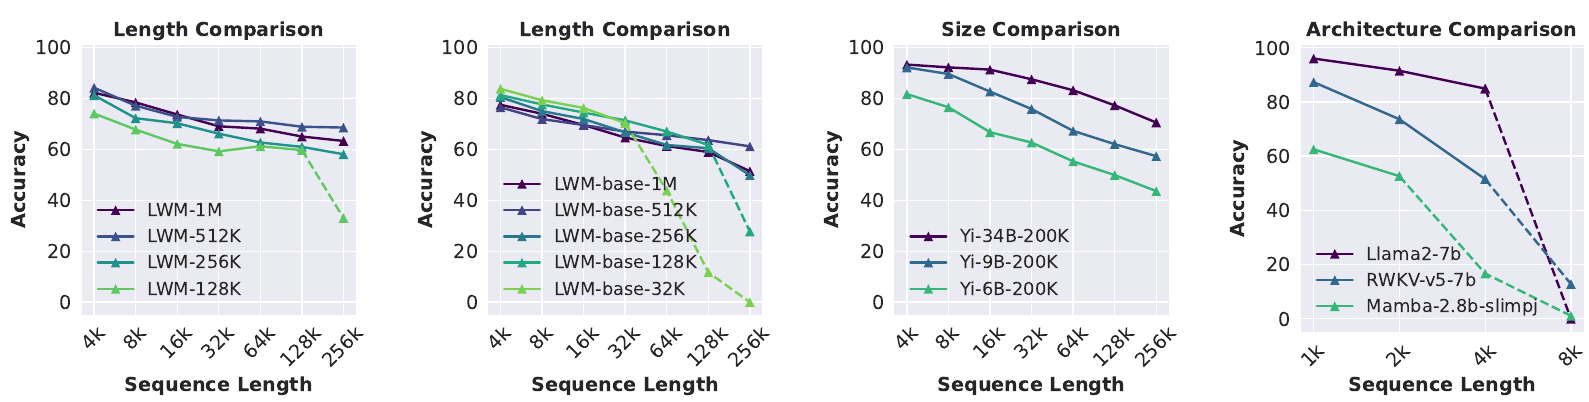
그림 4: (왼쪽 및 가운데 왼쪽): 고정된 파라미터 크기 7B로 다양한 맥락 크기까지 훈련된 LargeWorldModel(LWM) 시리즈의 비교. (가운데 오른쪽): 200K의 통제된 훈련 맥락 길이로 서로 다른 파라미터 크기를 가진 Yi 제품군 모델의 비교. (오른쪽): 비-Transformer 아키텍처의 성능은 Transformer 기준선인 Llama2-7B에 크게 뒤처진다. 길이 외삽은 점선으로 표시된다.
정확한 집계 실패. 우리는 집계 과제에서 두 가지 흔한 실패 양상을 관찰한다: 파라메트릭 지식의 부정확한 사용과 부정확한 집계. CWE 과제에서 복사 문제를 보이지 않는 모델들은 때때로 맥락 정보를 무시하고 대신 파라메트릭 지식을 사용하여 질의에 답하는데, 특히 큰 맥락 크기에서 그러하다. 예를 들어, Mistral(7b-instruct-v0.2)은 맥락 내 단어를 세지 않고 "the", "an", "a"와 같은 고빈도 단어를 출력으로 반환한다. 복사 문제를 덜 보이는 FWE 과제의 경우, Yi는 제타 분포에서 를 감소시킬수록 상위 빈도 단어를 올바르게 출력하지 못한다(그림 3 가운데 오른쪽). 를 감소시키면 단어 간 빈도 차이가 작아져 상위 빈도 단어를 구별하기가 더 어려워진다.
긴 맥락 QA에서의 빈번한 환각. QA 과제의 경우, Yi의 성능은 방해 문단으로 맥락을 확장할수록 맥락 없는 기준선에 가까워진다(그림 3 오른쪽). 이러한 저하는 주로 환각과 맥락 정보에 대한 의존 감소에서 비롯된다. 우리는 큰 맥락 크기에서 모델 예측이 때때로 질문과 무관하며 맥락 없는 기준선의 답과 일치할 수 있음을 발견한다. QA 과제에서의 전반적으로 더 나쁜 성능은 긴 맥락에서 질의와 관련 문단 사이의 퍼지 매칭이, 키가 맥락 내에서 정확히 위치될 수 있는 단순한 NIAH 테스트보다 더 어려운 설정임을 확인해 준다.
6 모델 분석
훈련 맥락 길이의 효과. 더 큰 맥락 크기로 훈련된 모델이 RULER에서 더 나은 성능을 보이는가? 우리는 동일한 파라미터 크기를 가지며 다양한 맥락 길이까지 훈련된 LargeWorldModel(Liu et al. [2024a] LWM) 제품군을 평가한다. 그림 4(왼쪽 및 가운데 왼쪽)는 더 큰 맥락 크기가 전반적으로 더 나은 성능으로 이어지지만, 긴 시퀀스에서는 순위가 일관되지 않을 수 있음을 보여준다. 예를 들어, 1M 맥락 크기로 훈련된 모델(LWM-1M)은 256K 길이에서 512K로 훈련된 모델보다 더 나쁜데, 이는 아마도 RoPE의 새로운 기본 주파수에 적응하기 위한 훈련이 불충분했기 때문일 것이다. 또한, 우리는 모델이 보지 못한 길이로 외삽해야 할 때(예: 256K 입력이 주어진 LMW-128K) 급격한 성능 저하를 관찰하며, 최대 훈련 맥락 크기 내에서는 로그 스케일에서 입력 길이에 따라 거의 선형적으로 저하된다.
모델 크기의 효과. 우리의 주요 결과에서 최상위 모델들은 다른 모델들보다 훨씬 크다. 모델 크기의 효과를 분리하기 위해, 우리는 모두 동일한 데이터 블렌드를 사용하여 동일한 맥락 길이까지 훈련된 Yi-34B-200k, Yi-9B-200k, Yi-6B-200k를 평가한다. 그림 4(가운데 오른쪽)는 34B 모델이 4K 길이에서의 성능과 상대적 저하 모두에서 RULER 상에서 6B 모델보다 현저히 우수함을 보여주며, 이는 더 나은 긴 맥락 모델링을 위한 모델 크기 확장의 이점을 시사한다.
아키텍처의 효과. 우리는 비-Transformer 아키텍처를 가진 두 모델, RWKV-v5(Peng et al. [2023])와 Mamba-2.8B-slimpj(Gu &Dao|2023)에 대해 유효 맥락 길이를 평가한다. 우리는 두 모델 모두 맥락 크기를 8K로 확장할 때 상당한 저하를 보이며, 둘 다 4K 길이까지 Transformer 기준선인 Llama2-7B에 크게 뒤처지고, 그 이후에는 Llama2가 빈약한 길이 외삽 성능을 보임을 발견한다(그림 4 오른쪽).
7 결론
우리는 긴 맥락 언어 모델을 평가하기 위한 합성 벤치마크인 RULER를 제시한다. RULER는 검색, 다중 홉 추적, 집계, 질의응답 등 다양한 과제 범주를 포함하여 LLM의 긴 맥락 능력에 대한 유연하고 포괄적인 평가를 제공한다. 우리는 4K에서 128K에 이르는 맥락 크기로 RULER를 사용하여 17개의 긴 맥락 LM을 벤치마킹한다. 널리 사용되는 니들-인-어-해이스택 테스트에서 완벽한 결과를 달성했음에도 불구하고, 거의 모든 모델이 입력 길이를 늘릴수록 RULER의 다른 과제에서 성능을 유지하지 못한다. 우리는 큰 맥락 크기에서 흔한 실패 양상을 관찰하는데, 여기에는 방해 요소를 무시하지 못하는 것과 긴 맥락의 비효율적 활용(예: 단순히 맥락에서 복사하거나 대신 파라메트릭 지식을 사용)이 포함된다. 우리는 과제 복잡성을 높일수록 RULER가 최상위 오픈소스 모델에게도 어렵다는 것을 보여준다. 우리의 분석은 나아가 RULER에서의 개선 가능성이 크며 더 나은 긴 맥락 능력을 달성하는 데 모델 크기 확장이 이점이 있음을 밝힌다.
8 한계
검색 지향 벤치마크보다 더 많은 과제 범주를 포함하고 있음에도 불구하고, RULER는 여러 측면에서 한계가 있으며 이를 아래에서 자세히 설명한다.
위치 제어의 부재. 현재 RULER는 깊이 수준의 성능을 제공하지 않고 각 입력 길이에 대해 단일 수치 지표만 보고한다. 깊이 수준의 성능은 NIAH 테스트(Kamradi|2023)와 LV-Eval(Yuan et al. 2024)과 같은 최근 연구들에 의해 평가되었으며, 중간에서 길을 잃음(lost-in-the-middle)(Liu et al. 2024d) 현상을 밝히는 데 효과적일 수 있다. 우리는 이 문제를 인지하고 있으며 우리 코드베이스에서 핵심 정보의 위치 제어를 지원할 계획이다.
현실적인 긴 맥락 과제와의 상관관계 부재. 변수 추적과 빈번한 단어 추출 같은 과제들이 실제 긴 맥락 자연어 과제의 대리물로 제안되었지만, 평가하기 쉬운 현실적인 긴 맥락 과제의 부재로 인해 우리는 이러한 대리물의 타당성을 검증할 수 없다. 이러한 한계로 인해, 우리는 RULER가 긴 맥락 언어 모델의 편리한 행동 점검으로 사용될 수 있지만, 추론과 지시 따르기 같은 다른 능력에도 중점을 두는 NoCHA(Karpinska et al. 2024)와 같은 더 현실적인 설정보다 우선시되어서는 안 된다는 점을 강조한다.
짧은 맥락에 대한 평가 부재. 현재 RULER 과제 모음에는 대부분의 모델이 4k 맥락 크기에서 상당히 잘 수행하는 과제들이 포함되어 있으며, 맥락 크기의 확장에 따른 성능 저하를 관찰하는 것을 목표로 한다. 이는 4k 맥락 크기에서의 완벽한 LM 능력으로 오독되어서는 안 된다. 실제로, FlenQA(Levy et al. 2024)와 같은 최근 연구들은 과제 입력 길이를 단지 수천 토큰으로 늘릴 때 성능이 저하됨을 입증했다. RULER에서 과제 복잡성을 높이면 더 짧은 맥락 크기에서 훨씬 더 나쁜 성능으로 이어지지만, 우리는 이러한 결과를 이 논문에 포함하지 않았다.
프롬프트 견고성 검증의 부재. 언어 모델은 프롬프트 형식에 민감할 수 있지만, 우리는 이 연구의 초기 단계에서의 예비 테스트를 넘어 프롬프트 견고성에 대한 포괄적인 연구를 확장하지 않았다. 우리는 또한 기존 과제에서 몇 가지 고정된 하이퍼파라미터, 예컨대 변수 추적에서의 변수 이름 길이와 일반 단어 추출 및 빈번한 단어 추출에서의 합성 어휘 크기 등에 대해 많은 실험을 하지 않았다.
참고문헌
Marah Abdin, Sam Ade Jacobs, Ammar Ahmad Awan, Jyoti Aneja, Ahmed Awadallah, Hany Awadalla, Nguyen Bach, Amit Bahree, Arash Bakhtiari, Harkirat Behl, et al. Phi-3 technical report: A highly capable language model locally on your phone. arXiv preprint arXiv:2404.14219, 2024.
Rishabh Agarwal, Avi Singh, Lei M Zhang, Bernd Bohnet, Stephanie Chan, Ankesh Anand, Zaheer Abbas, Azade Nova, John D Co-Reyes, Eric Chu, et al. Many-shot in-context learning. arXiv preprint arXiv:2404.11018, 2024.
AI21. Introducing jamba: Ai21's groundbreaking ssm-transformer model, 2024. URL https://www.ai21.com/blog/announcing-jamba
Chenxin An, Shansan Gong, Ming Zhong, Mukai Li, Jun Zhang, Lingpeng Kong, and Xipeng Qiu. L-eval: Instituting standardized evaluation for long context language models. In ICLR, 2024.
Anthropic. Long context prompting for Claude 2.1. Blog, 2023. URL https://www.anthropic.com/index/claude-2-1-prompting
Anthropic. Introducing the next generation of claude, 2024. URL https://www.anthropic.com/news/claude-3-family
Simran Arora, Sabri Eyuboglu, Aman Timalsina, Isys Johnson, Michael Poli, James Zou, Atri Rudra, and Christopher Ré. Zoology: Measuring and improving recall in efficient language models. In ICLR, 2024.
Yushi Bai et al. LongBench: A bilingual, multitask benchmark for long context understanding. arXiv:2308.14508, 2023.
Maximilian Beck, Korbinian Pöppel, Markus Spanning, Andreas Auer, Oleksandra Prudnikova, Michael Kopp, Günter Klambauer, Johannes Brandstetter, and Sepp Hochreiter. xlstm: Extended long short-term memory. arXiv preprint arXiv:2405.04517, 2024.
Amanda Bertsch, Maor Ivgi, Uri Alon, Jonathan Berant, Matthew R Gormley, and Graham Neubig. In-context learning with long-context models: An in-depth exploration. arXiv preprint arXiv:2405.00200, 2024.
Aydar Bulatov, Yuri Kuratov, and Mikhail S Burtsev. Scaling Transformer to 1M tokens and beyond with RMT. arXiv:2304.11062, 2023.
David Castillo, Joseph Davidson, Finlay Gray, José Solorzano, and Marek Rosa. Introducing GoodAI LTM benchmark. Blog, 2024. URL https://www.goodai.com/introducing-goodai-ltm-benchmark/
Shouyuan Chen, Sherman Wong, Liangjian Chen, and Yuandong Tian. Extending context window of large language models via positional interpolation. In ICLR, 2023.
Yukang Chen, Shengju Qian, Haotian Tang, Xin Lai, Zhijian Liu, Song Han, and Jiaya Jia. LongLoRA: Efficient fine-tuning of long-context large language models. In ICLR, 2024.
Rewon Child, Scott Gray, Alec Radford, and Ilya Sutskever. Generating long sequences with sparse Transformers. arXiv:1904.10509, 2019.
Cohere. Command r, 2024. URL https://docs.cohere.com/docs/command- r- plus#model- details
Tri Dao. FlashAttention- 2: 더 나은 병렬성과 작업 분할로 더 빨라진 어텐션. arxiv:2307.08691, 2023.
Tri Dao, Daniel Y. Fu, Stefano Ermon, Atri Rudra, and Christopher Ré. FlashAttention: IO 인지 기반의 빠르고 메모리 효율적인 정확한 어텐션. In NeurIPS, 2022.
.
Databricks. dbrx 소개: 새로운 최첨단 오픈 LLM, 2024. URL https://www databricks.com/blog/introducing- dbrx- new- state- art- open- llm
Jiayu Ding et al. LongNet: Transformers를 1,000,000,000 토큰으로 확장. arXiv:2307.02486, 2023.
Yiran Ding et al. LongRoPE: LLM 컨텍스트 윈도우를 200만 토큰 이상으로 확장. arXiv:2402.13753, 2024.
Zican Dong, Tianyi Tang, Junyi Li, Wayne Xin Zhao, and Ji- Rong Wen. Bamboo: 대규모 언어 모델의 장문 텍스트 모델링 능력 평가를 위한 포괄적 벤치마크. arXiv:2309.13345, 2023.
Daniel Y. Fu, Tri Dao, Khaled K. Saab, Armin W. Thomas, Atri Rudra, and Christopher Ré. Hungry Hungry Hippos: 상태 공간 모델을 이용한 언어 모델링을 향하여. In ICLR, 2023a.
Daniel Y. Fu et al. 시퀀스 모델링을 위한 단순하고 하드웨어 효율적인 긴 합성곱. ICML, 2023b.
Yao Fu et al. 언어 모델을 128k 컨텍스트로 확장하기 위한 데이터 엔지니어링. arXiv:2402.10171, 2024.
Team GLM, Aohan Zeng, Bin Xu, Bowen Wang, Chenhui Zhang, Da Yin, Diego Rojas, Guanyu Feng, Hanlin Zhao, Hanyu Lai, Hao Yu, Hongning Wang, Jiadai Sun, Jiajie Zhang, Jiale Cheng, Jiayi Gui, Jie Tang, Jing Zhang, Juanzi Li, Lei Zhao, Lindong Wu, Lucen Zhong, Mingdao Liu, Minlie Huang, Peng Zhang, Qinkai Zheng, Rui Lu, Shuaiqi Duan, Shudan Zhang, Shulin Cao, Shuxun Yang, Weng Lam Tam, Wenyi Zhao, Xiao Liu, Xiao Xia, Xiaohan Zhang, Xiaotao Gu, Xin Lv, Xinghan Liu, Xinyi Liu, Xinyue Yang, Xixuan Song, Xunkai Zhang, Yifan An, Yifan Xu, Yilin Niu, Yuantao Yang, Yueyan Li, Yushi Bai, Yuxiao Dong, Zehan Qi, Zhaoyu Wang, Zhen Yang, Zhengxiao Du, Zhenyu Hou, and Zihan Wang. Chatglm: glm- 130b에서 glm- 4 all tools까지의 대규모 언어 모델 계열, 2024.
Omer Goldman, Alon Jacovi, Aviv Slobodkin, Aviya Maimon, Ido Dagan, and Reut Tsarfaty. 필요한 것이 검색뿐이라면 정말로 긴 컨텍스트인가? 진정으로 어려운 장문 컨텍스트 NLP를 향하여. arXiv preprint arXiv:2407.00402, 2024.
Alex Graves, Greg Wayne, and Ivo Danihelka. 신경 튜링 기계. arXiv:1410.5401, 2014.
Albert Gu and Tri Dao. Mamba: 선택적 상태 공간을 이용한 선형 시간 시퀀스 모델링. arXiv:2312.00752, 2023.
Albert Gu, Karan Goel, and Christopher Re. 구조화된 상태 공간으로 긴 시퀀스를 효율적으로 모델링. In ICLR, 2022.
Chi Han, Qifan Wang, Wenhan Xiong, Yu Chen, Heng Ji, and Sinong Wang. Lm- infinite: 대규모 언어 모델을 위한 간단한 즉석 길이 일반화. arXiv:2308.16137, 2023.
John J. Hopfield. 창발적 집단 계산 능력을 지닌 신경망과 물리 시스템. Proc of the National Academy of Sciences of the United States of America, 79 8: 2554- 8, 1982.
Maor Ivgi, Uri Shaham, and Jonathan Berant. 짧은 텍스트 모델을 이용한 효율적인 장문 텍스트 이해. Transactions of the ACL, 11:284- 299, 2023.
Sam Ade Jacobs et al. DeepSpeed Ulysses: 극도로 긴 시퀀스 Transformer 모델의 학습을 가능하게 하기 위한 시스템 최적화. arXiv:2309.14509, 2023.
Sebastian Jaszczur et al. Transformers 확장에 있어 희소성으로 충분하다. In NeurIPS, 2021.
Albert Q Jiang et al. Mixtral of experts. arXiv:2401.04088, 2024.
Huiqiang Jiang et al. LongLlmLingua: 프롬프트 압축을 통해 장문 컨텍스트 시나리오에서 LLM을 가속화하고 향상. arXiv:2310.06839, 2023.
Gregory Kamradt. 건초더미 속의 바늘 - LLM 압력 테스트. Github, 2023. URL https://github.com/gkamradt/LLMTest.NeedleInAHaystack/tree/main
Marzena Karpinska, Katherine Thai, Kyle Lo, Tanya Goyal, and Mohit Iyyer. 천일야화: 장문 컨텍스트 언어 모델을 위한 "소설" 같은 도전. arXiv preprint arXiv:2406.16264, 2024.
Lauri Karttunen. 담화 지시체. In COLING, 1969.
George Kingsley Zipf. 언어에서의 상대 빈도 원리에 관한 선별 연구. Harvard university press, 1932.
Yuri Kuratov, Aydar Bulatov, Petr Anokhin, Ivan Rodkin, Dmitry Sorokin, Artyom Sorokin, and Mikhail Burtsev. Babilong: 건초더미 속 추론을 통한 장문 컨텍스트로 LLM의 한계 테스트. arXiv preprint arXiv:2406.10149, 2024.
Woosuk Kwon et al. 페이징 어텐션을 이용한 대규모 언어 모델 서빙을 위한 효율적인 메모리 관리. In Proc. of the ACM SIGOPS 29th Symposium on Operating Systems Principles, 2023.
Jinhyuk Lee, Anthony Chen, Zhuyun Dai, Dheeru Dua, Devendra Singh Sachan, Michael Boratko, Yi Luan, Sébastien MR Arnold, Vincent Perot, Siddharth Dalmia, et al. 장문 컨텍스트 언어 모델이 검색, rag, sql 등을 포괄할 수 있는가? arXiv preprint arXiv:2406.13121, 2024.
Mosh Levy, Alon Jacoby, and Yoav Goldberg. 같은 작업, 더 많은 토큰: 대규모 언어 모델의 추론 성능에 대한 입력 길이의 영향. arXiv preprint arXiv:2402.14848, 2024.
Dacheng Li, Rulin Shao, et al. 오픈 소스 LLM은 컨텍스트 길이에 대해 진정으로 얼마나 길게 약속할 수 있는가?, 2023a. URL https://1msys.org/blog/2023- 06- 29- longchat
Jiaqi Li, Mengmeng Wang, Zilong Zheng, and Muhan Zhang. Loogle: 장문 컨텍스트 언어 모델이 긴 컨텍스트를 이해할 수 있는가? arXiv:2311.04939, 2023b.
Hao Liu, Matei Zaharia, and Pieter Abbeel. 거의 무한한 컨텍스트를 위한 블록 단위 Transformers를 이용한 링 어텐션. In ICLR, 2023.
Hao Liu, Wilson Yan, Matei Zaharia, and Pieter Abbeel. Ring Attention을 이용한 백만 길이 비디오 및 언어에 대한 세계 모델. arxiv:2402.08268, 2024a.
Jiaheng Liu et al. E2- LLM: 대규모 언어 모델의 효율적이고 극단적인 길이 확장. arXiv:2401.06951, 2024b.
Jiawei Liu, Jia Le Tian, Vijay Daita, Yuxiang Wei, Yifeng Ding, Yuhan Katherine Wang, Jun Yang, and Lingming Zhang. Repoqa: 장문 컨텍스트 코드 이해 평가. arXiv preprint arXiv:2406.06025, 2024c.
Nelson F Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni, and Percy Liang. 중간에서 길을 잃다: 언어 모델이 긴 컨텍스트를 사용하는 방식. Transactions of the ACL, 12:157- 173, 2024d.
Pedro Henrique Martins, Zita Marinho, and Andre Martins. ∞- former: 무한 메모리 Transformer. In Proc. of the 60th Annual Meeting of the ACL (Volume 1: Long Papers), 2022.
Meta.AI. Llama 3 모델 카드. 2024a. URL https://github.com/meta- llama/llama3/blob/main/MODEL_CARD.md
Meta.AI. Llama 3.1 모델 카드. 2024b. URL https://github.com/meta- llama/llama- models/blob/main/models/llama3.1/MODEL_CARD.md
Mistral.AI. La plateforme, 2023. URL https://mistral.ai/news/la- plateforme/Amirkeivan Mohtashami and Martin Jaggi. Landmark attention: Random- access infinite context length for Transformers. In Workshop on Efficient Systems for Foundation Models @ ICML, 2023.
Vincent Ng. Supervised noun phrase coreference research: The first fifteen years. In Proc. of the 48th Annual Meeting of the ACL, 2010.
Catherine Olsson et al. In- context learning and induction heads. Transformer Circuits Thread, 2022. https://transformer-circuits.pub/2022/in- context- learning- and- induction- heads/index.html.
OpenAI: Josh Achiam et al. GPT- 4 technical report. arXiv:2303.08774, 2023.
Bo Peng et al. RWKV: Reinventing RNNs for the transformer era. In EMNLP, 2023.
Bowen Peng, Jeffrey Quesnelle, Honglu Fan, and Enrico Shippole. YaRN: Efficient context window extension of large language models. In ICLR, 2024.
Michael Poli, Stefano Massaroli, Eric Nguyen, Daniel Y Fu, Tri Dao, Stephen Baccus, Yoshua Bengio, Stefano Ermon, and Christopher Ré. Hyena hierarchy: Towards larger convolutional language models. In ICML, 2023.
Ofir Press, Noah Smith, and Mike Lewis. Train short, test long: Attention with linear biases enables input length extrapolation. In ICLR, 2022.
Pranav Rajpurkar, Robin Jia, and Percy Liang. Know what you don't know: Unanswerable questions for SQuAD. In Proc. of the 56th Annual Meeting of the ACL (Volume 2: Short Papers), 2018.
Machel Reid 외. Gemini 1.5: 수백만 토큰의 컨텍스트에 걸쳐 멀티모달 이해를 열어젖힘. arXiv:2403.05530, 2024.
Marco Tulio Ribeiro, Tongshuang Wu, Carlos Guestrin, Sameer Singh. 정확도를 넘어서: CheckList를 이용한 NLP 모델의 행동 테스팅. 제58회 ACL 연례 학술대회 논문집, 2020.
Uri Shaham, Maor Ivgi, Avia Efrat, Jonathan Berant, Omer Levy. ZeroSCROLLS: 긴 텍스트 이해를 위한 제로샷 벤치마크. EMNLP, 2023.
Jianlin Su, Yu Lu, Shengfeng Pan, Ahmed Murtadha, Bo Wen, Yunfeng Liu. RoFormer: 회전 위치 임베딩으로 강화된 Transformer. arXiv:2104.09864, 2023.
Simeng Sun, Katherine Thai, Mohit Iyyer. ChapterBreak: 장거리 언어 모델을 위한 도전적 데이터셋. 제2022년 북미 ACL 지부 학술대회: 인간 언어 기술 논문집, 2022.
Yutao Sun, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang, Furu Wei. Retentive network: 대규모 언어 모델을 위한 Transformer의 후계자. arXiv:2307.08621, 2023a.
Yutao Sun, Li Dong, Barun Patra, Shuming Ma, Shaohan Huang, Alon Benhaim, Vishrav Chaudhary, Xia Song, Furu Wei. 길이 외삽이 가능한 Transformer. 제61회 ACL 연례 학술대회 논문집 (제1권: 장문 논문), 2023b.
Yutao Sun, Li Dong, Yi Zhu, Shaohan Huang, Wenhui Wang, Shuming Ma, Quanlu Zhang, Jianyong Wang, Furu Wei. 한 번만 캐시하라: 언어 모델을 위한 디코더-디코더 아키텍처. arXiv 프리프린트 arXiv:2405.05254, 2024.
Garrett Tanzer, Mirac Suzgun, Eline Visser, Dan Jurafsky, Luke Melas-Kyriazi. 문법 책 한 권으로 새로운 언어 번역을 학습하기 위한 벤치마크. ICLR, 2024.
Together.AI. 32k 컨텍스트 시대를 준비하며: 초기 교훈과 탐구, 2023a. URL https://www.together.ai/blog/llama-2-7b-32k
Together.AI. Llama-2-7b-32k-instruct — 그리고 together API를 이용한 llama-2 모델의 파인튜닝, 2023b. URL https://www.together.ai/blog/llama-2-7b-32k-instruct
Hugo Touvron 외. Llama 2: 공개 파운데이션 및 파인튜닝된 채팅 모델. arXiv:2307.09288, 2023.
Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot, Ashish Sabharwal. Musique: 단일 홉 질문 합성을 통한 다중 홉 질문. ACL 논문지, 10: 539-554, 2022.
Szymon Tworkowski 외. Focused Transformer: 컨텍스트 스케일링을 위한 대조 학습. NeurIPS, 36, 2024.
Teun A. van Dijk, Walter Kintsch. 담화 이해의 전략. Academic Press, 1983.
Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, L ukasz Kaiser, Illia Polosukhin. Attention is all you need. NeurIPS, 2017.
Weizhi Wang, Li Dong, Hao Cheng, Xiaodong Liu, Xifeng Yan, Jianfeng Gao, Furu Wei. 장기 기억으로 언어 모델 증강하기. NeurIPS, 36, 2024.
Thomas Wolf 외. Huggingface의 Transformers: 최첨단 자연어 처리. arXiv:1910.03771, 2019.
Qingyang Wu, Zhenzhong Lan, Kun Qian, Jing Gu, Alborz Geramifard, Zhou Yu. Memformer: 시퀀스 모델링을 위한 메모리 증강 Transformer. ACL 파인딩스: AACL-IJCNLP, 2022.
X.AI. grok-1.5 발표, 2024. URL https://x.ai/blog/grok-1.5
Chaojun Xiao 외. InfLLM: 훈련 없는 메모리로 극도로 긴 시퀀스를 이해하는 LLM의 내재적 능력 밝혀내기. arXiv:2402.04617, 2024a.
Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han, Mike Lewis. 어텐션 싱크를 활용한 효율적인 스트리밍 언어 모델. ICLR, 2024b.
Wenhan Xiong 외. 파운데이션 모델의 효과적인 장문 컨텍스트 스케일링. arXiv:2309.16039, 2023.
Peng Xu, Wei Ping, Xianchao Wu, Lawrence McAfee, Chen Zhu, Zihan Liu, Sandeep Subramanian, Evelina Bakhturina, Mohammad Shoeybi, Bryan Catanzaro. 검색과 장문 컨텍스트 대규모 언어 모델의 만남. ICLR, 2024a.
Xiaoyue Xu, Qinyuan Ye, Xiang Ren. 평생 ICL과 태스크 헤이스택을 이용한 장문 컨텍스트 언어 모델 스트레스 테스팅. arXiv 프리프린트 arXiv:2407.16695, 2024b.
An Yang, Baosong Yang, Binyuan Hui, Bo Zheng, Bowen Yu, Chang Zhou, Chengpeng Li, Chengyuan Li, Dayiheng Liu, Fei Huang, 외. Qwen2 기술 보고서. arXiv 프리프린트 arXiv:2407.10671, 2024.
Zhilin Yang, Peng Qi, Saizheng Zhang, Yoshua Bengio, William Cohen, Ruslan Salakhutdinov, Christopher D. Manning. HotpotQA: 다양하고 설명 가능한 다중 홉 질의응답을 위한 데이터셋. EMNLP, 2018.
Alex Young 외. Yi: 01.AI의 공개 파운데이션 모델. arXiv:2403.04652, 2024.
Tao Yuan, Xuefei Ning, Dong Zhou, Zhijie Yang, Shiyao Li, Minghui Zhuang, Zheyue Tan, Zhuyu Yao, Dahua Lin, Boxun Li, 외. Lv-eval: 최대 256k까지 5개 길이 수준을 갖춘 균형 잡힌 장문 컨텍스트 벤치마크. arXiv 프리프린트 arXiv:2402.05136, 2024.
Peitian Zhang, Zheng Liu, Shitao Xiao, Ninglu Shao, Qiwei Ye, Zhicheng Dou. 4k에서 400k로 도약: 활성화 비콘으로 LLM의 컨텍스트 확장하기. arXiv:2401.03462, 2024a.
Xinrong Zhang, Yingfa Chen, Shengding Hu, Zihang Xu, Junhao Chen, Moo Khai Hao, Xu Han, Zhen Leng Thai, Shuo Wang, Zhiyuan Liu, Maosong Sun. obench: 100k 토큰을 넘어 장문 컨텍스트 평가 확장하기. arXiv:2402.13718, 2024b.
Dawei Zhu, Nan Yang, Liang Wang, Yifan Song, Wenhao Wu, Furu Wei, Sujian Li. PoSE: 위치 스킵 단위 훈련을 통한 LLM의 효율적인 컨텍스트 윈도우 확장. ICLR, 2024.
A 모델
우리는 평가와 분석을 위해 총 37개의 모델을 선택한다. 본문의 결과는 정렬된 모델(GPT-4, Gemini-1.5, 그리고 15개의 오픈소스 모델)만을 포함한다. 정렬된 모델 외에도, 우리는 RULER를 사용하여 7개의 오픈소스 베이스 모델을 평가한다. 우리는 4K 컨텍스트 길이에서의 Llama2-7b (베이스)와 Llama2-7b (채팅)의 성능을 유효 컨텍스트 크기를 결정하는 임계값으로 사용한다. 분석 섹션에서, 우리는 총 11개의 모델을 평가하는데, 여기에는 모델 계열 Yi와 LWM, 그리고 Mamba와 RWKV를 포함한 새로운 아키텍처의 모델들이 포함된다.
| 모델 | 정렬됨 | 크기 | 컨텍스트 길이 | Huggingface [Wolf et al., 2019] / API |
| GPT-4 | OpenAI: Josh Achiam et al., 2023 | ✓ | - | 128K |
| Gemini-1.5 | Kred et al., 2024 | ✓ | - | 1M |
| Llama3.1 | Meta: AI, 2024b | ✓ | 70B | 128K |
| Llama3.1 | Meta: AI, 2024b | ✓ | 8B | 128K |
| Command-K-plus: Cohen, 2024 | ✓ | ✓ | 104B | 128K |
| Qwen2: Yang et al., 2024 | ✓ | ✓ | 72B | 128K |
| Yi: Young et al., 2024 | ✓ | ✓ | 34B | 200K |
| Mixtral-8x22B: Huang et al., 2024 | ✓ | ✓ | 39B/141B | 32K |
| Mixtral-v0.2: Mixtral-AI, 2023 | ✓ | ✓ | 7B | 32K |
| GLM4: GLM et al., 2024 | ✓ | ✓ | 9B | 1M |
| GradieHAT: Llama3: Meta, AI, 2024a | ✓ | ✓ | 70B | 1M |
| Phi3-medium: Abdin et al., 2024 | ✓ | ✓ | 14B | 128K |
| LWM: Liu et al., 2024a | ✓ | ✓ | 7B | 1M |
| DBRX: Tabatricks, 2024 | ✓ | ✓ | 36B/132B | 1M |
| Together: Together, AI, 2023b | ✓ | ✓ | 7B | 32K |
| LongChat: Li et al., 2023a | ✓ | ✓ | 7B | 32K |
| LongAlpaca: Chen et al., 2024 | ✓ | ✓ | 13B | 32K |
| Mixtral-base: Jiang et al., 2024 | ✓ | ✓ | 8x7B | 32K |
| Mixtral-base: Mixtral-AI, 2023 | ✓ | ✓ | 7B | 32K |
| LWM-base: Liu et al., 2024a | ✓ | ✓ | 7B | 1M |
| LongLoRA-base: Chen et al., 2024 | ✓ | ✓ | 7B | 100K |
| Yarn-base: Peng et al., 2024 | ✓ | ✓ | 7B | 128K |
| Together-base: Together, AI, 2023a | ✓ | ✓ | 7B | 32K |
| Jamba-base: AI, 2024 | ✓ | ✓ | 52B | 256K |
| Llama2 (chat): Touvron et al., 2023 | ✓ | ✓ | 7B | 4K |
| Llama2 (베이스): Touvron 등, 2023 | ✓ | ✓ | 7B | 4K |
| Yi 시리즈: Young 등, 2024 | ✓ | ✓ | 6B, 9B | 200K |
| LWM 시리즈: Liu 등, 2024a | ✓ | ✓ | 7B | 128K, 256K, 512K |
| LWM-베이스 시리즈: Liu 등, 2024a | ✓ | ✓ | 7B | 32K, 128K, 256K, 512K |
| Mamba: Gu & Dai, 2023 | ✓ | ✓ | 2.8B | 2K |
| RWKV: Peng 등, 2023 | ✓ | ✓ | 7B | 4K |
표 4: RULER에서 평가 및 분석된 모델의 정보.
B 과제 구성
RULER는 다양한 시퀀스 길이와 과제 복잡성을 허용하도록 구성 가능하게 설계되었다. 각 과제마다 채택할 수 있는 구성의 수가 조합적으로 방대하다. 본문에서, 우리는 RULER의 네 가지 범주에 걸친 13개의 대표적인 과제로 모델을 평가한다. 우리의 과제 선택 과정은 다음 부록 섹션에서 설명한다.
- 검색: S-NIAH에서는 패스키 검색(passkey retrieval, Mohtashami & Jaggi, 2023)과 기본 NIAH(vanilla NIAH, Kamradt, 2023)를 포함하며, 둘 다 단어-숫자를 키-값으로 사용하고 배경 헤이스택만 다릅니다. 또한 문맥에서 긴 문자열을 검색할 때 모델의 견고성을 테스트할 목적으로 값 유형을 UUID로 변경합니다. MK-NIAH에서는 헤이스택에 세 개의 방해 니들(distractor needle)을 추가합니다. 또한 이전 연구의 기존 설정도 포함합니다: 헤이스택을 전부 방해 니들로 채운 라인 검색(line retrieval, Li et al., 2023a)과 키-값 검색(key-value retrieval, Liu et al., 2024d)입니다. MV-NIAH와 MQ-NIAH에서는 각각 4개의 값과 질의를 테스트합니다.
- 멀티홉 추적: VT에서는 4개의 이름 바인딩 홉(name-binding hop)으로 구성된 1개의 체인을 삽입하며, 총 5개의 변수 이름을 반환해야 합니다.
- 집계: CWE에서는 총 10개의 일반 단어를 반환해야 하며, 각 단어는 30번씩 나타나고 희귀 단어는 각각 3번씩 나타납니다. FWE에서는 합성 단어를 샘플링하기 위해 Zeta 분포에서 를 2.0으로 설정합니다.
- QA: QA에서는 장문맥 시나리오를 시뮬레이션하기 위해 SQuAD(Rajpurkar et al., 2018)와 HotpotQA(Yang et al., 2018)를 증강합니다. 이들은 각각 단일 홉 및 멀티홉 질의응답 작업을 대표합니다.
| 과제 | 구성 | ||
| 하위 과제-1 | 하위 과제-2 | 하위 과제-3 | |
| 단일 NIAH | type_key = word type_value = number type_haystack = repeat ~패스키 검색 | type_key = word type_value = number type_haystack = essay ~바닐라 NIAH | type_key = word type_value = uuid type_haystack = essay |
| MK-NIAH | num_keys = 4 type_key = word type_value = number type_haystack = essay | num_keys = 전체 헤이스택 type_key = word type_value = number ~라인 검색 | num_keys = 전체 헤이스택 type_key = uuid type_value = uuid ~KV 검색 |
| MV-NIAH | num_values = 4, type_key = word, type_value = number, type_haystack = essay | ||
| MQ-NIAH | num_queries = 4, type_key = word, type_value = number, type_haystack = essay | ||
| VT | num_chains = 1, num_hops = 4 | ||
| CWE | freq_cw = 30, freq_ucw = 3, num_cw = 10 | ||
| FWE | α = 2.0 | ||
| QA | dataset = SQuAD | dataset = HotpotQA | |
표 5: RULER의 총 13개 작업 구성.
C 작업 상관관계 분석
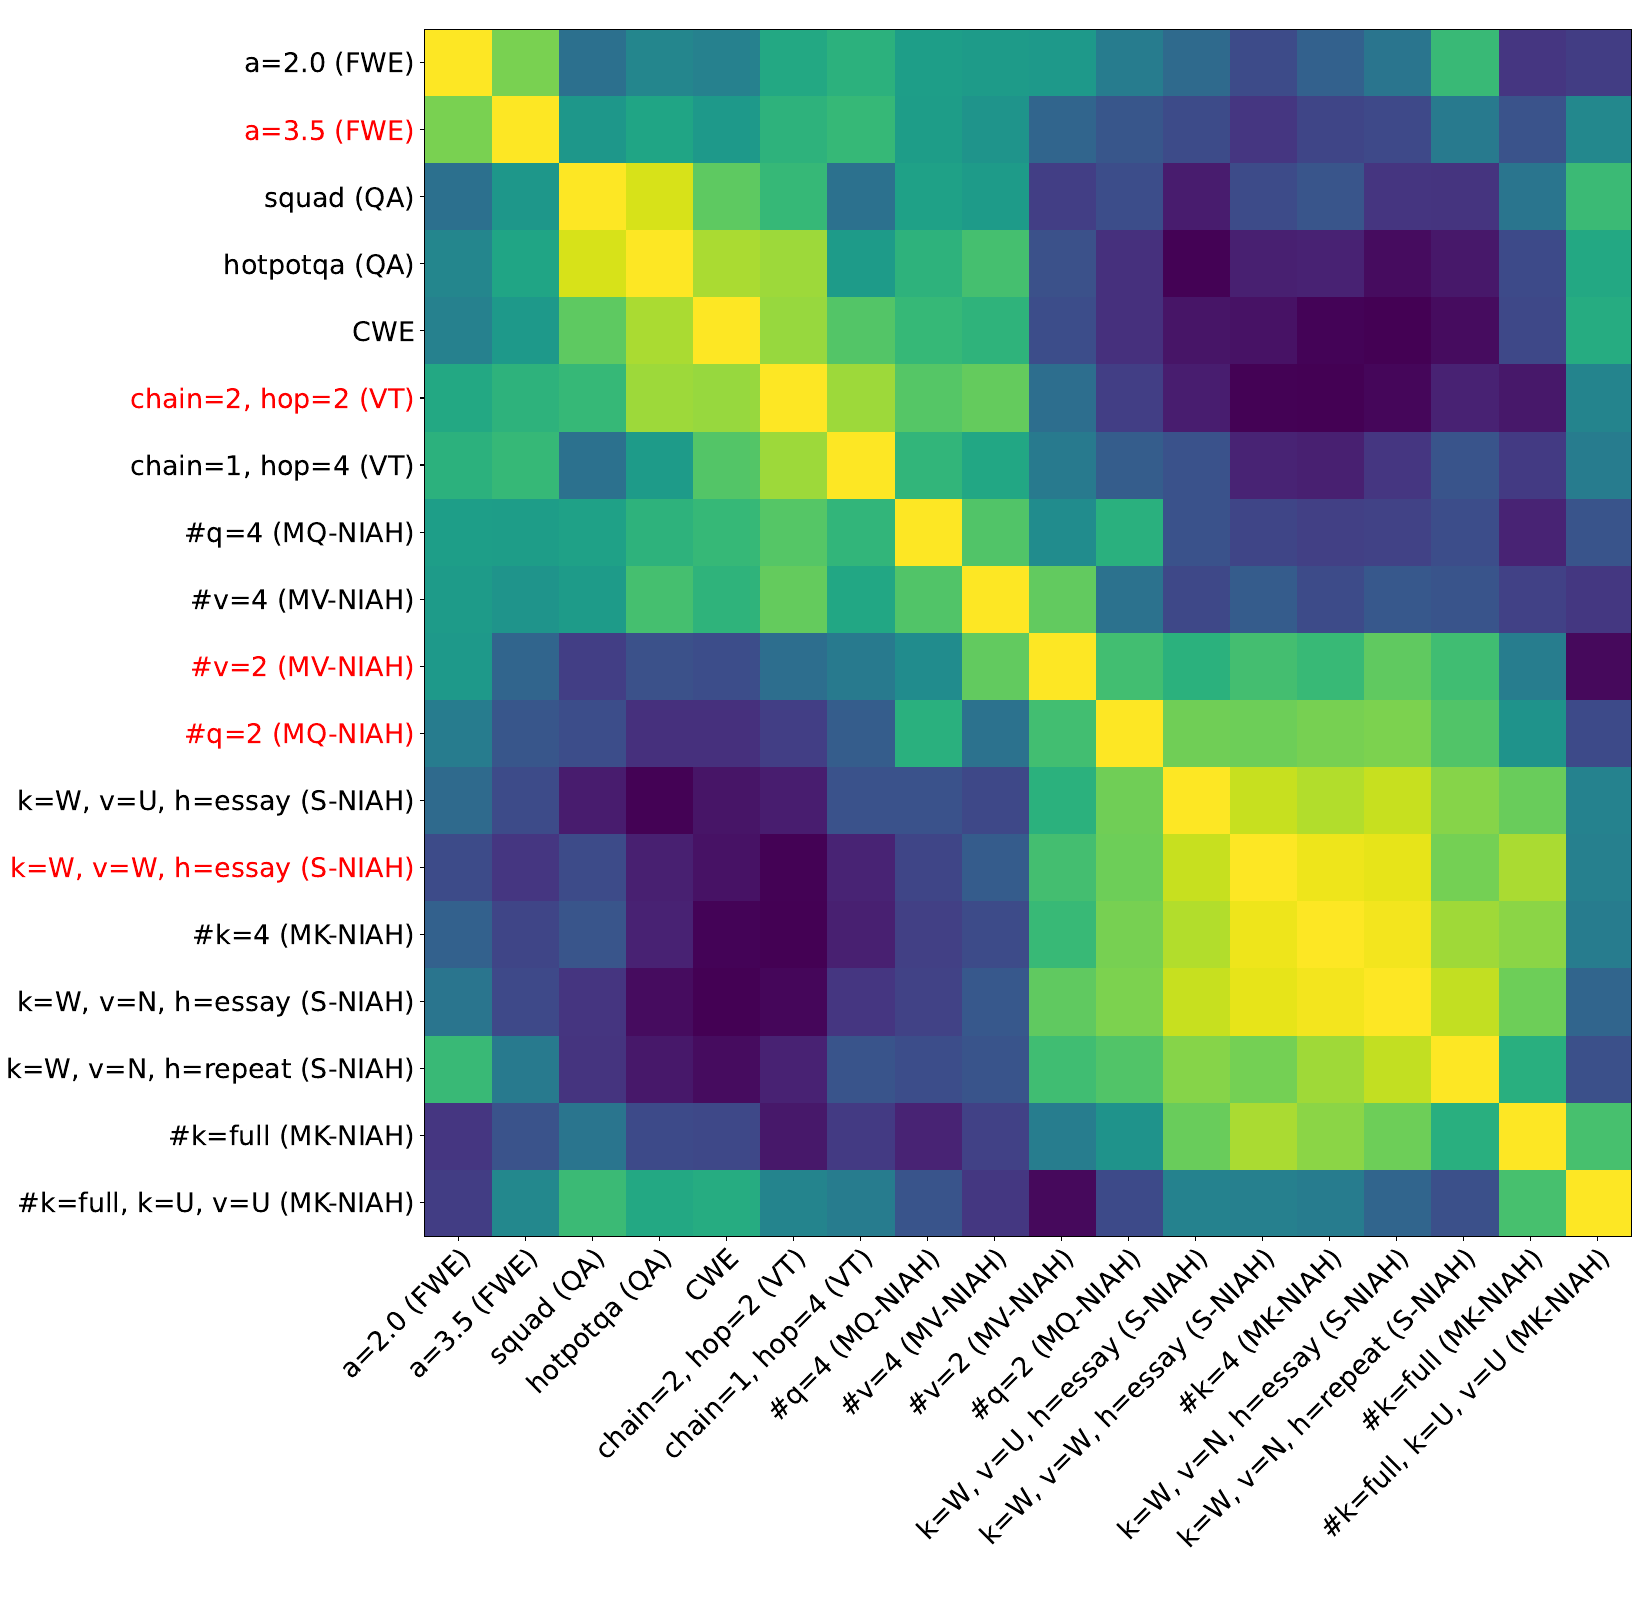
RULER는 서로 다른 범주의 작업들이 서로 구별되는 모델 행동을 드러낼 수 있다는 가정 아래 설계되었습니다. 우리는 작업 범주의 타당성을 확인하고 대표 작업 선정을 안내하기 위해 예비 상관관계 연구를 수행합니다. 우리는 18개 작업 구성에 걸쳐 다양한 문맥 크기에서 8개의 오픈소스 모델을 평가합니다. 그런 다음 각 작업은 다양한 문맥 크기에서의 모델 성능 벡터로 표현될 수 있습니다. 이어서 18개의 작업 벡터는 상관계수를 거리 지표로 사용하는 병합적 군집화(agglomerative clustering) 알고리즘을 통해 군집화됩니다. 그림 5에서 볼 수 있듯이 일부 작업은 다른 작업과 중간 정도의 상관관계를 보이지만, 네 범주(NIAH, VT, AG, QA) 각각의 작업들은 중복 없이 자체적으로 응집력 있는 군집을 형성합니다. 우리는 동일 군집 내의 다른 작업과 높은 상관관계를 보이는 몇몇 작업을 추가로 제거하고, 이후 대규모 평가를 위해 13개의 작업으로 최종 확정합니다.
D 프롬프트 템플릿
우리는 입력 프롬프트 템플릿을 표 6의 모델 템플릿과 표 7의 작업 템플릿으로 분해한다. 모델 템플릿은 모델 채팅 형식이며, 작업 템플릿은 지시, 맥락, 질의를 결합한다. 모델이 우리의 질문에 답변하는 것을 거부하는 것을 방지하기 위해, 우리는 모델 응답을 유도하기 위해 입력에 답변 접두사를 덧붙인다. VT와 CWE의 경우, 우리는 하나의 작업 샘플을 맥락 내 시연으로 사용한다.
| 모델 | 템플릿 |
| GPT-4 | {task_template} 설명을 제공하지 마십시오. 답변을 직접 알려주십시오. {task_answer_prefix} |
| Yi/Base | {task_template} {task_answer_prefix} |
| Command-R | {BOS_TOKEN} {START_OF_TURN_TOKEN} {USER_TOKEN} {task_template} {END_OF_TURN_TOKEN} {START_OF_TURN_TOKEN} {CHATBOT_TOKEN} {task_answer_prefix} |
| LWM/LongChat | {system_prompt} USER: {task_template} ASSISTANT: {task_answer_prefix} |
| GLM | {gMASK} sop{user} {task_template} {assistant} {task_answer_prefix} |
| Phi3 | {user} {task_template} {end} {assistant} {task_answer_prefix} |
| Qwen/DBRX | {im_start} system {system_prompt} {im_end} {im_start} user {task_template} {im_end} {im_start} assistant {task_answer_prefix} |
| Llama3/Llama3.1 | {begin_of_text} {start_header_id} user {end_header_id} |
| Llama2/Others | {task_template} {eot_id} {start_header_id} assistant {end_header_id} |
| {task_answer_prefix} | |
| [INST] {task_template} [/INST] {task_answer_prefix} |
표 6: 모델 채팅 템플릿. 우리는 모델이 우리의 질문에 답변하는 것을 거부하는 것을 방지하기 위해 모델 응답에 작업 답변 접두사를 덧붙인다. 답변 접두사의 추가는 모델의 채팅 템플릿을 깨뜨리지 않는다.
S-NIAH하위 과제-1
S-NIAH하위 과제-2
S-NIAH하위 과제-3
MK-NIAH하위 과제-1
MK-NIAH하위 과제-2
MK-NIAH하위 과제-3
MK-NIAH하위 과제-4
MK-NIAH하위 과제-5
MK-NIAH하위 과제-6
MK-NIAH하위 과제-7
MK-NIAH하위 과제-8
MK-NIAH하위 과제-9
MK-NIAH하위 과제-10
MK-NIAH하위 과제-11
MK-NIAH하위 과제-12
MK-NIAH하위 과제-13
MK-NIAH하위 과제-14
MK-NIAH하위 과제-15
MK-NIAH하위 과제-16
MK-NIAH하위 과제-17
MK-NIAH하위 과제-18
다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
하위 작업-19
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
하위 작업-20
다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
하위 작업-21
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
하위 작업-22
다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
하위 작업-23
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
하위 작업-24
다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
하위 작업-25
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
하위 작업-26
다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
하위 작업-27
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
하위 작업-28
다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
Subtask-29
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
Subtask-30
다음 텍스트 안에는 몇 가지 특별한 마법 숫자가 숨어 있습니다. 반드시 기억하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
Subtask-31
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
Subtask-32
다음 텍스트 안에는 몇 가지 특별한 마법 숫자가 숨어 있습니다. 반드시 기억하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
Subtask-33
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
Subtask-34
다음 텍스트 안에는 몇 가지 특별한 마법 숫자가 숨어 있습니다. 반드시 기억하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
Subtask-35
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
Subtask-36
다음 텍스트 안에는 몇 가지 특별한 마법 숫자가 숨어 있습니다. 반드시 기억하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
Subtask-37
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
Subtask-38
다음 텍스트 안에는 몇 가지 특별한 마법 숫자가 숨어 있습니다. 반드시 기억하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
Subtask-39
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
Subtask-40
다음 텍스트 안에는 몇 가지 특별한 마법 숫자가 숨어 있습니다. 반드시 기억하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
Subtask-41
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
Subtask-42
다음 텍스트 안에는 몇 가지 특별한 마법 숫자가 숨어 있습니다. 반드시 기억하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
Subtask-43
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
Subtask-44
다음 텍스트 안에는 몇 가지 특별한 마법 숫자가 숨어 있습니다. 반드시 기억하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
Subtask-45
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
Subtask-46
다음 텍스트 안에는 몇 가지 특별한 마법 숫자가 숨어 있습니다. 반드시 기억하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
Subtask-47
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
Subtask-48
다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
하위과제-49
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
하위과제-50
다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
하위과제-51
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
하위과제-52
다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
하위과제-53
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
하위과제-54
다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
하위과제-55
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
하위과제-56
다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
하위과제-57
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
하위과제-58
다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
하위과제-59
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는
하위과제-60
다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다.
{word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다.
{word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다.
{word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다.
{word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다.
제공된 텍스트에서 언급된 {word-4}에 대한 특별한 마법 숫자는 무엇입니까?
Some special magic numbers are hidden within the following text. Make sure to memorize it. I will quiz you about the numbers afterwards.
One of the special magic numbers for {word-1} is: {number-1}.
작업 템플릿: 다음 텍스트 안에 몇 가지 특별한 마법 숫자가 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자에 관해 질문하겠습니다. {word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다. {word-2}에 대한 특별한 마법 숫자 중 하나는 {number
과제 템플릿: 다음 텍스트 안에 몇 가지 특별한 마법 숫자들이 숨겨져 있습니다. 반드시 이것을 외우세요. 이후에 숫자들에 관해 질문하겠습니다. Paul Graham Essays....... {word}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다....... {word}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다....... {word}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다....... {word}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다. 제공된 텍스트에서 언급된 {word}에 대한 특별한 마법 숫자들은 모두 무엇입니까? |
과제 답변 접두사: 제공된 텍스트에서 언급된 {word}에 대한 특별한 마법 숫자들은 | |
과제 템플릿: 다음 텍스트 안에는 몇 가지 특별한 마법 숫자들이 숨겨져 있습니다. 반드시 암기하세요. 이후에 숫자들에 관해 질문하겠습니다. Paul Graham Essays....... {word-1}에 대한 특별한 마법 숫자 중 하나는 {number-1}입니다....... {word-2}에 대한 특별한 마법 숫자 중 하나는 {number-2}입니다....... {word-3}에 대한 특별한 마법 숫자 중 하나는 {number-3}입니다....... {word-4}에 대한 특별한 마법 숫자 중 하나는 {number-4}입니다. 제공된 텍스트에서 언급된 {word-1}, {word-2}, {word-3}, {word-4}에 대한 모든 특별한 마법 숫자는 무엇입니까? |
| 任务答案前缀: 所提供的文本中提到的{word-1}、{word-2}、{word-3}和{word-4}的特殊魔法数字是 |
| 작업 템플릿: {하나의 작업 예시} 다음 텍스트에 숨겨진 변수 할당의 연쇄를 암기하고 추적하세요. 풀은 초록색이다. 하늘은 파란색이다. 태양은 노란색이다. 자, 시작한다. 거기로 갔다가 다시 돌아온다. ...... VAR {X1} = {number} ...... ...... VAR {X2} = {X1} ...... ...... VAR {X3} = {X2} ...... ...... VAR {X4} = {X3} ...... ...... VAR {X5} = {X4} ...... 질문: 위 텍스트에서 값 {number}가 할당된 모든 변수를 찾으세요. |
| 과제 답변 접두사: 답변: 위 텍스트의 변수 할당 연쇄에 따르면, 5개의 변수에 {number} 값이 할당되며, 그 변수들은 다음과 같습니다: |
| 작업 템플릿: {하나의 작업 예시} 아래는 번호가 매겨진 단어 목록입니다. 이 단어들 중에는 다른 것보다 더 자주 등장하는 것들이 있습니다. 가장 자주 등장하는 단어들을 외우세요. 1. word-a 2. word-b 3. word-c 4. word-d 5. word-d 6. word-a 7. word-e 8. word-f ...... 질문: 위 목록에서 가장 흔한 단어 10개는 무엇입니까? |
| 작업 답변 접두사: 답변: 목록에서 가장 자주 등장하는 상위 10개 단어는 다음과 같습니다: | |
| 작업 템플릿: 다음의 코딩된 텍스트를 읽고 각 코딩된 단어의 빈도를 추적하십시오. 가장 자주 등장한 코딩된 단어 세 개를 찾으십시오. ... 단어-a ... 단어-b ... ... 단어-c ... 단어-a ... 단어-d 단어-e ... 단어-a ... 단어-f ... ... 단어-g ... 단어-h ... 단어-a ... 단어-i .... 질문: 어떠한 설명도 제공하지 마십시오. 점 '...'은 무시하십시오. 위의 코딩된 텍스트에서 가장 자주 등장한 단어 세 개는 무엇입니까? |
| 과제 답변 접두사: 답변: 위의 코딩된 텍스트에 따르면, 가장 자주 등장한 세 단어는 다음과 같습니다: |
Answer the question based on the given documents. Only give me the answer and do not output any other words.
The following are given documents.
Document 1:
{document-1}
......
Document x:
{document-x}
......
Document n:
{document-n}
Answer the question based on the given documents. Only give me the answer and do not output any other words.
Question: question
Task Answer Prefix:
Answer:
Task Template:
Answer the question based on the given documents. Only give me the answer and do not output any other words.
The following are given documents.
Document 1:
{document-1}
......
Document x:
{document-x}
......
Document y:
{document-y}
......
Document n:
{document-n}
Answer the question based on the given documents. Only give me the answer and do not output any other words.
Question: question
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
과제 템플릿: 주어진 문서를 바탕으로 질문에 답하세요. 답만 제시하고 다른 말은 출력하지 마세요. 다음은 주어진 문서입니다. 문서 1: {document-1} ...... 문서 x: {document-x} ...... 문서 n: {document-n} 주어진 문서를 바탕으로 질문에 답하세요. 답만 제시하고 다른 말은 출력하지 마세요. 질문: question 과제 답변 접두사: 답변: 과제 템플릿: 주어진 문서를 바탕으로 질문에 답하세요. 답만 제시하고 다른 말은 출력하지 마세요. 다음은 주어진 문서입니다. 문서 1: {document-1} ...... 문서 x: {document-x} ...... 문서 y: {document-y} ...... 문서 n: {document-n} 주어진 문서를 바탕으로 질문에 답하세요. 답만 제시하고 다른 말은 출력하지 마세요. 질문: question 과제 답변 접두사: 답변:
E 패스키 검색 및 바닐라 NIAH 결과
| 모델 | 주장 길이 | 4K | 8K | 16K | 32K | 64K | 128K | 평균 |
| Gemini-1.5 | 1M | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| GPT-4 | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| Llama3.1 (70B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 97.8 | 99.6 |
| Llama3.1 (8B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| Qwen2 (72B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 96.6 | 99.4 |
| Command-R-plus (104B) | 128K | 100.0 | 100.0 | 99.8 | 99.8 | 100.0 | 97.2 | 99.5 |
| GLM4 (9B) | 1M | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| GradientAI/LLama3 (70B) | 1M | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 93.6 | 98.9 |
| Mixtral-8x22B (39B/141B) | 64K | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 0.0 | 83.3 |
| Yi (34B) | 200K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| Phi3-medium (14B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 88.0 | 98.0 |
| Mistral-v0.2 (7B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 69.6 | 94.9 |
| LWM (7B) | 1M | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| DBRX (36B/132B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 0.0 | 0.0 | 66.7 |
| Together (7B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 0.0 | 0.0 | 66.7 |
| LongChat (7B) | 32K | 100.0 | 100.0 | 100.0 | 99.4 | 0.0 | 0.0 | 66.6 |
| LongAlpaca (13B) | 32K | 88.2 | 88.6 | 86.4 | 82.4 | 0.0 | 0.0 | 57.6 |
| Mixtral-base (8x7B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 46.8 | 91.1 |
| Mixtral-base (7B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 70.8 | 95.1 |
| Jamba-base (52B) | 256K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| LWM-base (7B) | 1M | 99.8 | 99.6 | 99.6 | 98.2 | 96.0 | 98.9 | 98.9 |
| LongLoRA-base (7B) | 100K | 99.6 | 99.4 | 99.0 | 99.4 | 99.4 | 0.0 | 82.8 |
| Yarn-base (7B) | 128K | 100.0 | 100.0 | 99.0 | 100.0 | 99.2 | 39.6 | 89.6 |
| Together-base (7B) | 32K | 100.0 | 100.0 | 99.8 | 100.0 | 0.0 | 0.0 | 66.6 |
| 모델 | 주장 길이 | 4K | 8K | 16K | 32K | 64K | 128K | 평균 |
| Gemini-1.5 | 1M | 100.0 | 100.0 | 100.0 | 98.0 | 100.0 | 100.0 | 99.7 |
| GPT-4 | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| Llama3.1 (70B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 99.9 |
| Llama3.1 (8B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 99.9 |
| Qwen2 (72B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 99.8 | 56.4 | 92.7 |
| Command-R-plus (35B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 99.8 | 86.0 | 97.6 |
| GLM4 (9B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| GradientAI/LLama3 (70B) | 1M | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 97.8 | 99.4 |
| Mixtral-8x22B (39B/141B) | 64K | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 24.2 | 87.3 |
| Yi (34B) | 200K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| Phi3-medium (14B) | 128K | 100.0 | 100.0 | 100.0 | 99.8 | 99.8 | 73.8 | 95.5 |
| Mixtral-v0.2 (7B) | 32K | 100.0 | 100.0 | 100.0 | 97.0 | 70.0 | 7.4 | 79.1 |
| LWM (7B) | 1M | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| DBRX (36B/132B) | 32K | 100.0 | 100.0 | 90.0 | 93.2 | 0.8 | 0.0 | 64.0 |
| Together (7B) | 32K | 100.0 | 100.0 | 100.0 | 99.8 | 0.0 | 0.0 | 66.6 |
| LongChat (7B) | 32K | 100.0 | 100.0 | 97.6 | 98.4 | 0.0 | 0.0 | 66.0 |
| LongAlpaca (13B) | 32K | 90.2 | 90.2 | 88.4 | 83.4 | 0.0 | 0.0 | 58.7 |
| Mixtral-base (8x7B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 85.2 | 34.8 | 86.7 |
| Mixtral-base (7B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 94.8 | 0.4 | 82.5 |
| Jamba-base (52B) | 256K | 100.0 | 100.0 | 98.8 | 99.8 | 99.8 | 86.4 | 97.5 |
| LWM-base (7B) | 1M | 100.0 | 99.4 | 97.8 | 98.6 | 98.2 | 98.6 | 98.8 |
| LongLoRA-base (7B) | 100K | 99.8 | 100.0 | 100.0 | 99.8 | 100.0 | 0.0 | 83.3 |
| Yarn-base (7B) | 128K | 97.4 | 97.8 | 91.4 | 85.4 | 86.6 | 20.0 | 79.8 |
| Together-base (7B) | 32K | 100.0 | 100.0 | 100.0 | 99.8 | 0.0 | 0.0 | 66.6 |
표 11: RULER의 바닐라 NIAH에서 길이 4K에서 128K에 걸친 선별된 정렬 모델 및 베이스 모델의 성능. 거의 모든 모델이 주장된 길이에서 완벽한 점수를 기록한다.
.
F 추가 결과
| Models | Claimed Length | Effective Length | 4K | 8K | 16K | 32K | 64K | 128K | Avg. | wAvg. (inc) | wAvg. (dec) |
| Llama2-7B (base) | 4K | - | 79.4 | ||||||||
| Mixtral-base (8x7B) | 32K | 32K | 91.8 | 91.0 | 89.5 | 85.8 | 66.9 | 29.0 | 75.7 | 66.4(1st) | 85.0(1st) |
| Mixtral-base (7B) | 32K | 16K | 91.6 | 89.8 | 86.3 | 77.2 | 52.3 | 8.0 | 67.5 | 54.7(4th) | 80.4(2nd) |
| Jamba-base (52B) | 256K | 4K | 81.2 | 75.4 | 68.8 | 65.3 | 61.0 | 51.4 | 67.2 | 62.5(3rd) | 71.8(4th) |
| LWM-base (7B) | 1M | <4K | 77.5 | 74.0 | 69.6 | 64.6 | 61.3 | 59.0 | 67.7 | 64.4(2nd) | 70.9(5th) |
| LongLoRA-base(7B) | 100K | 8K | 81.9 | 80.4 | 75.6 | 65.1 | 60.8 | 0.0 | 60.6 | 49.2(5위) | 72.0(3위) |
| Yarn-base(7B) | 128K | <4K | 77.3 | 67.5 | 59.0 | 47.3 | 38.6 | 13.9 | 50.6 | 40.7(6위) | 60.5(7위) |
| Together-base(7B) | 32K | 4K | 84.6 | 78.7 | 68.3 | 57.9 | 0.0 | 0.0 | 48.2 | 32.3(7위) | 64.2(6위) |
표 12: RULER에서 13개 과제 점수를 평균하여 길이 4K에서 128K에 걸친 선별된 베이스 모델의 성능.
| 모델 | 주장 길이 | 유효 길이 | 4K | 8K | 16K | 32K | 64K | 128K | 평균 | wAvg. (증가) | wAvg. (감소) |
| Llama2-7B (chat) | 4K | - | 96.9 | ||||||||
| Gemini-1.5 | 1M | >128K | 99.8 | 99.9 | 99.6 | 99.7 | 99.7 | 99.6 | 99.7 | 99.7(1위) | 99.7(1위) |
| Llama3.1 (8B) | 128K | 64K | 99.9 | 99.9 | 99.8 | 99.6 | 98.7 | 92.6 | 98.4 | 97.5(3위) | 99.4(2위) |
| GLM4 (9B) | 1M | 64K | 99.4 | 99.2 | 99.5 | 99.4 | 97.3 | 94.4 | 98.2 | 97.5(2위) | 98.9(3위) |
| Llama3.1 (70B) | 128K | 64K | 100.0 | 100.0 | 99.9 | 99.6 | 98.5 | 78.9 | 96.1 | 93.5(5위) | 98.8(4위) |
| GPT-4 | 128K | 32K | 99.9 | 99.9 | 98.7 | 98.3 | 90.9 | 84.8 | 95.4 | 92.9(6위) | 97.9(5위) |
| Command-R-plus (104B) | 128K | 32K | 99.9 | 99.9 | 99.4 | 97.9 | 89.6 | 65.7 | 92.1 | 87.3(8위) | 96.9(6위) |
| GradientAI/Llama3 (70B) | 1M | 16K | 99.0 | 98.8 | 98.3 | 94.5 | 91.2 | 84.9 | 94.4 | 92.1(7위) | 96.8(7위) |
| Yi (34B) | 200K | 16K | 98.2 | 96.8 | 97.3 | 95.1 | 93.0 | 90.2 | 95.1 | 93.8(4위) | 96.4(8위) |
| Qwen2 (72B) | 128K | 32K | 100.0 | 99.9 | 99.9 | 99.4 | 84.5 | 48.0 | 88.6 | 81.3(11위) | 95.9(9위) |
| Phi3-medium (14B) | 128K | 8K | 98.7 | 98.5 | 96.6 | 95.4 | 91.9 | 51.3 | 88.7 | 82.6(10위) | 94.9(10위) |
| Mixtral-8x22B (39B/141B) | 64K | 16K | 99.3 | 99.1 | 97.7 | 96.7 | 89.9 | 23.8 | 84.4 | 74.8(12위) | 94.1(11위) |
| LWM (7B) | 1M | <4K | 92.5 | 92.1 | 87.6 | 83.7 | 84.1 | 83.4 | 87.2 | 85.5(9위) | 89.0(12위) |
| Mistral-v0.2 (7B) | 32K | 4K | 98.1 | 96.2 | 94.3 | 85.5 | 51.1 | 10.7 | 72.6 | 58.8(13위) | 86.5(13위) |
| DBRX (36B/132B) | 32K | 8K | 99.4 | 99.0 | 93.5 | 73.4 | 0.5 | 0.0 | 61.0 | 41.6(14위) | 80.3(14위) |
| Together (7B) | 32K | <4K | 96.2 | 89.9 | 82.3 | 80.2 | 0.0 | 0.0 | 58.1 | 40.2(15위) | 76.0(15위) |
| LongChat (7B) | 32K | <4K | 93.3 | 92.2 | 81.1 | 67.3 | 0.0 | 0.0 | 55.7 | 37.6(16위) | 73.7(16위) |
| LongAlpaca (13B) | 32K | <4K | 74.9 | 72.2 | 70.8 | 53.2 | 0.0 | 0.0 | 45.2 | 30.7(17위) | 59.7(17위) |
| Llama2-7B (베이스) | 4K | - | 90.9 | ||||||||
| Mixtral-base (8x7B) | 32K | 32K | 99.9 | 99.7 | 98.4 | 94.8 | 72.1 | 29.1 | 82.3 | 71.8(2위) | 92.8(1위) |
| Mixtral-base (7B) | 32K | 16K | 99.3 | 97.5 | 95.7 | 89.8 | 56.8 | 10.2 | 74.9 | 61.2(4위) | 88.6(2위) |
| Jamba-base (52B) | 256K | <4K | 86.4 | 80.5 | 73.7 | 72.3 | 68.1 | 56.9 | 73.0 | 68.5(3위) | 77.4(5위) |
| LWM-base (7B) | 1M | <4K | 88.5 | 87.7 | 84.5 | 79.6 | 76.1 | 74.2 | 81.8 | 79.1(1위) | 84.4(4위) |
| LongLoRA-base (7B) | 100K | 16K | 95.3 | 95.6 | 92.7 | 81.5 | 76.2 | 0.0 | 73.5 | 60.6(5위) | 86.5(3위) |
| Yarn-base (7B) | 128K | <4K | 89.9 | 86.1 | 78.4 | 59.0 | 49.5 | 17.5 | 63.4 | 51.7(6위) | 75.1(7위) |
| Together-base (7B) | 32K | 8K | 95.4 | 91.5 | 86.1 | 75.1 | 0.0 | 0.0 | 58.0 | 39.9(7위) | 76.2(6위) |
| Together-base (7B) | 32K | 8K | 95.4 | 91.5 | 86.1 | 75.1 | 0.0 | 0.0 | 58.0 | 39.9(7위) | 76.2(6위) |
표 13: RULER의 검색(NIAH)에서 8개 과제 점수를 평균하여 길이 4K에서 128K에 걸친 선별된 정렬 모델 및 베이스 모델의 성능.
“”
| 모델 | 주장 길이 | 실효 길이 | 4K | 8K | 16K | 32K | 64K | 128K | 평균 | 가중평균 (증가) | 가중평균 (감소) |
| Llama2-7B (chat) | 4K | - | 89.7 | ||||||||
| GPT-4 | 128K | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 99.9 | 99.9(2위) | 100.0(1위) |
| Gemini-1.5 | 1M | >128K | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 100.0 | 99.9 | 99.9(1위) | 100.0(2위) |
| Command-R-plus (104B) | 128K | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 99.9 | 97.2 | 99.5 | 99.2(3위) | 99.8(3위) |
| GLM4 (9B) | 1M | >128K | 99.9 | 99.6 | 99.8 | 99.8 | 99.6 | 97.7 | 99.4 | 99.1(4위) | 99.7(4위) |
| Qwen2 (72B) | 128K | 64K | 100.0 | 100.0 | 100.0 | 100.0 | 95.2 | 79.0 | 95.7 | 92.9(5위) | 98.5(5위) |
| Llama3.1 (70B) | 128K | 64K | 100.0 | 100.0 | 100.0 | 100.0 | 99.9 | 59.2 | 93.2 | 88.3(8위) | 98.0(6위) |
| Llama3.1 (8B) | 128K | 64K | 99.9 | 99.7 | 99.7 | 98.8 | 97.6 | 70.4 | 94.4 | 90.7(6위) | 98.0(7위) |
| GradientAI/Llama3 (70B) | 1M | 64K | 100.0 | 100.0 | 100.0 | 100.0 | 99.7 | 56.2 | 92.6 | 87.4(9위) | 97.9(8위) |
| Yi (34B) | 200K | 64K | 99.8 | 99.8 | 99.8 | 94.5 | 92.5 | 76.8 | 93.6 | 90.3(7위) | 96.9(9위) |
| Mixtral-8x22B (39B/141B) | 64K | 64K | 100.0 | 100.0 | 99.8 | 98.6 | 96.4 | 0.0 | 82.5 | 70.3(10위) | 94.7(10위) |
| Phi3-medium (14B) | 128K | 16K | 99.6 | 99.2 | 98.4 | 82.1 | 53.6 | 26.0 | 76.5 | 64.1(11위) | 88.9(11위) |
| Mixtral-v0.2 (7B) | 32K | 16K | 98.9 | 96.0 | 92.2 | 85.0 | 74.5 | 0.0 | 74.4 | 60.9(12위) | 87.9(12위) |
| LongChat (7B) | 32K | 8K | 97.6 | 93.5 | 83.4 | 62.4 | 0.0 | 0.0 | 56.2 | 37.4(14위) | 75.0(13위) |
| DBRX (36B/132B) | 32K | 8K | 100.0 | 99.0 | 72.5 | 45.8 | 0.0 | 0.0 | 52.9 | 33.3(15위) | 72.5(14위) |
| LWM (7B) | 1M | <4K | 84.4 | 80.1 | 67.2 | 52.2 | 45.9 | 15.2 | 57.5 | 46.5(13위) | 68.6(15위) |
| Together (7B) | 32K | &lt;4K | 89.2 | 88.8 | 48.3 | 16.6 | 0.0 | 0.0 | 40.5 | 22.8(16위) | 58.2(16위) |
| LongAlpaca (13B) | 32K | &lt;4K | 8.5 | 2.1 | 18.2 | 17.0 | 0.0 | 0.0 | 7.6 | 6.5(17위) | 8.8(17위) |
| Llama2-7B (베이스) | 4K | - | 58.8 | ||||||||
| Mixtral-base (8x7B) | 32K | 64K | 100.0 | 99.9 | 100.0 | 98.4 | 87.3 | 43.3 | 88.1 | 80.5(2위) | 95.8(1위) |
| Mixtral-base (7B) | 32K | 64K | 99.0 | 98.4 | 96.5 | 89.1 | 86.1 | 0.0 | 78.2 | 65.4(4위) | 91.0(2위) |
| Jamba-base (52B) | 256K | 128K | 87.5 | 87.6 | 86.2 | 88.1 | 86.0 | 77.8 | 85.5 | 84.3(1위) | 86.7(3위) |
| LWM-base (7B) | 1M | 128K | 80.2 | 82.7 | 79.3 | 76.4 | 70.7 | 66.1 | 75.9 | 73.3(3위) | 78.5(4위) |
| LongLoRA-base (7B) | 100K | 64K | 92.5 | 87.4 | 73.1 | 56.0 | 69.2 | 0.0 | 63.0 | 50.3(5위) | 75.8(5위) |
| Yarn-base (7B) | 128K | 4K | 84.6 | 43.6 | 24.8 | 43.0 | 20.9 | 0.0 | 36.1 | 24.9(7위) | 47.4(7위) |
| Together-base (7B) | 32K | 16K | 95.0 | 90.6 | 69.6 | 43.2 | 0.0 | 0.0 | 49.7 | 31.3(6위) | 68.1(6위) |
| 모델 | 주장 길이 | 실효 길이 | 4K | 8K | 16K | 32K | 64K | 128K | 평균(포함) | 가중평균(감소) |
| Llama2-7B-chat | 4K | - | 84.8 | |||||||
| Gemini-1.5 | 1M | &gt;128K | 97.7 | 97.7 | 97.6 | 98.6 | 97.3 | 90.9 | 96.6 | 95.8(1위) |
| GPT-4 | 128K | 64K | 99.0 | 98.3 | 98.0 | 95.0 | 90.1 | 79.7 | 93.4 | 90.4(2위) |
| Qwen2 (72B) | 128K | 32K | 99.3 | 98.0 | 93.1 | 97.4 | 78.5 | 70.3 | 89.4 | 84.7(3위) |
| Mixtral-8x22B (39B/141B) | 64K | 32K | 97.8 | 96.9 | 94.8 | 88.2 | 83.3 | 69.7 | 88.5 | 84.0(4위) |
| Command-R-plus (104B) | 128K | 32K | 98.2 | 96.9 | 95.2 | 90.3 | 82.5 | 59.5 | 87.1 | 81.3(5위) |
| Llama3.1 (70B) | 128K | 32K | 99.9 | 98.3 | 98.4 | 97.1 | 66.3 | 39.8 | 83.3 | 73.8(6위) |
| Phi3-medium (14B) | 128K | 16K | 90.8 | 95.1 | 90.3 | 82.4 | 62.1 | 43.8 | 77.4 | 69.3(7위) |
| Yi (34B) | 200K | 16K | 91.4 | 90.9 | 86.2 | 75.3 | 58.5 | 43.4 | 74.3 | 66.0(8위) |
| GLM4 (9B) | 1M | 8K | 93.5 | 85.2 | 78.5 | 68.1 | 58.3 | 49.7 | 72.2 | 64.8(9위) |
| GradientAI/Llama3 (70B) | 1M | 8K | 96.4 | 94.7 | 74.9 | 57.0 | 45.1 | 41.4 | 68.3 | 57.7(10위) |
| Llama3.1 (8B) | 128K | 8K | 97.0 | 90.1 | 79.2 | 54.1 | 43.5 | 36.2 | 66.7 | 55.5(11위) |
| Mixtral-v0.2 (7B) | 32K | 8K | 94.3 | 90.4 | 77.4 | 48.5 | 42.4 | 33.7 | 64.4 | 53.1(12위) |
| DBRX (36B/132B) | 32K | 8K | 94.5 | 94.7 | 73.7 | 48.7 | 4.1 | 0.0 | 52.6 | 34.3(13위) |
| Together (7B) | 32K | &lt;4K | 82.3 | 64.5 | 43.3 | 34.8 | 0.0 | 0.0 | 37.5 | 22.9(16위) |
| LongChat (7B) | 32K | &lt;4K | 74.3 | 50.7 | 46.7 | 51.1 | 0.0 | 0.0 | 37.1 | 24.8(15위) |
| LWM (7B) | 1M | &lt;4K | 61.3 | 43.6 | 38.3 | 32.8 | 29.1 | 29.1 | 39.0 | 34.0(14위) |
| LongAlpaca (13B) | 32K | <4K | 33.0 | 27.0 | 26.0 | 23.2 | 0.0 | 0.0 | 18.2 | 12.3(17위) |
| Llama2-7B (base) | 4K | - | 73.1 | |||||||
| Mixtral-base (8x7B) | 32K | 32K | 96.5 | 94.8 | 93.1 | 87.8 | 68.6 | 24.3 | 77.5 | 66.9(1위) |
| Mixtral-base (7B) | 32K | 16K | 94.8 | 93.1 | 81.6 | 53.3 | 36.7 | 9.2 | 61.4 | 46.5(2위) |
| Jamba-base (52B) | 256K | 4K | 75.9 | 63.5 | 51.7 | 38.5 | 33.3 | 28.0 | 48.5 | 40.3(3위) |
| LWM-base (7B) | 1M | <4K | 67.1 | 48.4 | 36.0 | 26.3 | 21.5 | 18.7 | 36.3 | 28.4(5위) |
| LongLoRA-base (7B) | 100K | <4K | 70.3 | 64.4 | 50.7 | 39.9 | 29.4 | 0.0 | 42.4 | 31.3(4위) |
| Yarn-base (7B) | 128K | &lt;4K | 70.6 | 49.2 | 28.9 | 20.5 | 17.0 | 2.1 | 31.4 | 20.7(6위) |
| Together-base (7B) | 32K | &lt;4K | 69.1 | 53.0 | 19.9 | 20.6 | 0.0 | 0.0 | 27.1 | 15.1(7위) |
| 모델 | 주장 길이 | 유효 길이 | 4K | 8K | 16K | 32K | 64K | 128K | 평균 | wAvg. (증가) | wAvg. (감소) |
| Llama2-7B (chat) | 4K | - | 49.7 | ||||||||
| Gemini-1.5 | 1M | &gt;128K | 81.9 | 75.9 | 77.8 | 75.9 | 77.6 | 74.1 | 77.2 | 76.3(1위) | 78.0(1위) |
| GPT-4 | 128K | 128K | 79.0 | 78.0 | 76.0 | 68.0 | 61.6 | 59.0 | 70.3 | 66.5(4위) | 74.0(2위) |
| Qwen2 (72B) | 128K | 64K | 80.8 | 76.9 | 74.1 | 66.9 | 54.5 | 47.2 | 66.7 | 61.0(8위) | 72.5(3위) |
| GradientAI/LLama3 (70B) | 1M | &gt;128K | 75.6 | 73.9 | 72.4 | 69.9 | 66.0 | 59.8 | 69.6 | 67.1(3위) | 72.1(4위) |
| Llama3.1 (70B) | 128K | 64K | 77.2 | 74.8 | 72.3 | 70.4 | 64.2 | 47.6 | 67.8 | 63.4(7위) | 72.1(5위) |
| GLM4 (9B) | 1M | &gt;128K | 74.7 | 71.3 | 71.9 | 68.5 | 66.3 | 63.6 | 69.4 | 67.6(2위) | 71.1(6위) |
| Mixtral-8x22B (39B/141B) | 64K | 64K | 76.6 | 73.5 | 71.8 | 66.5 | 59.7 | 40.8 | 64.8 | 59.4(9위) | 70.2(7위) |
| Yi (34B) | 200K | &gt;128K | 72.7 | 71.5 | 68.4 | 66.2 | 64.1 | 59.9 | 67.1 | 65.0(5위) | 69.2(8위) |
| Llama3.1 (8B) | 128K | 128K | 74.1 | 70.1 | 67.3 | 65.8 | 63.7 | 58.8 | 66.6 | 64.3(6위) | 68.9(9위) |
| Command-R-plus (104B) | 128K | 64K | 73.4 | 72.3 | 69.4 | 65.9 | 57.0 | 39.2 | 62.9 | 57.6(10위) | 68.1(10위) |
| Phi3-medium (14B) | 128K | 64K | 70.9 | 67.2 | 66.1 | 59.3 | 54.2 | 38.0 | 59.3 | 54.3(12위) | 64.3(11위) |
| Mixtral-v0.2 (7B) | 32K | 32K | 72.4 | 70.0 | 65.7 | 57.6 | 34.4 | 13.3 | 52.2 | 42.5(13위) | 62.0(12위) |
| LWM (7B) | 1M | &gt;128K | 61.2 | 57.8 | 56.7 | 55.4 | 54.7 | 52.6 | 56.4 | 55.1(11위) | 57.7(13위) |
| DBRX (36B/132B) | 32K | 16K | 76.0 | 69.4 | 59.4 | 45.0 | 9.6 | 0.0 | 43.2 | 29.6(14위) | 56.9(14위) |
| Together (7B) | 32K | 16K | 61.1 | 58.3 | 54.2 | 45.6 | 0.0 | 0.0 | 36.5 | 24.9(15번째) | 48.2(15번째) |
| LongAlpaca (13B) | 32K | 16K | 57.2 | 53.5 | 49.7 | 39.0 | 0.0 | 0.0 | 33.2 | 22.3(16번째) | 44.1(16번째) |
| LongChat (7B) | 32K | 8K | 54.5 | 53.6 | 47.6 | 34.0 | 0.0 | 0.0 | 31.6 | 21.0(17번째) | 42.3(17번째) |
| Llama2-7B (기본) | 4K | - | 48.6 | 47.7 | 45.3 | 41.3 | 34.4 | 26.4 | 41.0 | 37.0(3번째) | 44.9(3번째) |
| Mixtral-base (8x7B) | 32K | 4K | 50.8 | 47.7 | 45.3 | 41.3 | 34.4 | 26.4 | 41.0 | 37.0(3번째) | 44.9(3번째) |
| Mixtral-base (7B) | 32K | 8K | 53.5 | 51.0 | 48.4 | 44.7 | 32.8 | 2.2 | 38.8 | 31.3(4번째) | 46.3(2번째) |
| 원문 이해를 위한 읽기 전용 배경 정보(번역 대상 원문 텍스트 아님): “” 번역할 텍스트: Jamba-base (52B) | 256K | 32K | 62.7 | 60.6 | 57.9 | 52.6 | 47.5 | 39.6 | 53.5 | 49.7(1위) | 57.3(1위) |
| LWM-base (7B) | 1M | &lt;4K | 42.7 | 40.2 | 38.7 | 37.1 | 37.3 | 34.6 | 38.4 | 37.2(2위) | 39.6(4위) |
| LongLoRA-base (7B) | 100K | &lt;4K | 34.5 | 32.1 | 33.6 | 29.4 | 26.1 | 0.0 | 26.0 | 21.3(6위) | 30.6(6위) |
| Yarn-base (7B) | 128K | &lt;4K | 29.7 | 23.5 | 28.6 | 29.7 | 25.5 | 18.1 | 25.9 | 24.6(5위) | 27.1(7위) |
| Together-base (7B) | 32K | 4K | 52.0 | 47.5 | 44.6 | 33.6 | 0.0 | 0.0 | 29.6 | 19.8(7위) | 39.5(5위) |