
같은 접두사를 공유하는 요청은 GPU 메모리를 낭비한다. SGLang 은 KV 캐시를 공유해 처리량을 6.4배 높인다. NeurIPS 2024, 전문 무료.
SGLang: Efficient Execution of Structured Language Model Programs
SGLang: 구조화된 언어 모델 프로그램의 효율적 실행
Lianmin Zheng *} Liansheng Yin Zhiqiang Xie Chuyue Sun Jeff Huang Cody Hao Yu Shiyi Cao Christos Kozyrakis Ion Stoica Joseph E. Gonzalez Clark Barrett Ying Sheng *}
스탠퍼드 대학교 UC 버클리 상하이 자오퉁 대학교 텍사스 A&M 대학교 독립 연구자
초록
대규모 언어 모델(LLM)은 여러 번의 생성 호출, 고급 프롬프팅 기법, 제어 흐름, 구조화된 입력/출력을 필요로 하는 복잡한 작업에 점점 더 많이 사용되고 있다. 그러나 이러한 애플리케이션을 프로그래밍하고 실행하기 위한 효율적인 시스템은 부족하다. 우리는 복잡한 언어 모델 프로그램의 효율적 실행을 위한 시스템인 SGLang을 소개한다. SGLang은 프런트엔드 언어와 런타임으로 구성된다. 프런트엔드는 생성 및 병렬성 제어를 위한 기본 요소를 통해 프로그래밍을 단순화한다. 런타임은 KV 캐시 재사용을 위한 RadixAttention과 더 빠른 구조화된 출력 디코딩을 위한 압축 유한 상태 기계와 같은 새로운 최적화로 실행을 가속화한다. 실험 결과, SGLang은 에이전트 제어, 논리적 추론, 퓨샷 학습 벤치마크, JSON 디코딩, 검색 증강 생성 파이프라인, 다중 턴 채팅을 포함한 작업에서 다양한 대규모 언어 및 멀티모달 모델에 대해 최신 추론 시스템과 비교하여 최대 더 높은 처리량을 달성한다. 코드는 https://github.com/sgl-project/sglang 에서 공개적으로 사용 가능하다.
1 서론
최근 LLM의 능력이 향상되면서 그 활용 범위가 넓어졌고, 더 광범위한 일반 작업을 처리하고 자율 에이전트로서 행동할 수 있게 되었다 [35, 6, 36, 52, 46]. 이러한 애플리케이션에서 LLM은 다중 라운드 계획, 추론, 외부 환경과의 상호작용에 참여한다. 이는 도구 사용 [41, 38], 다중 입력 양식 [47, 2], 그리고 퓨샷 학습 [5], 자기 일관성 [53], 사고 골격 [33], 사고 트리 [56]와 같은 광범위한 프롬프팅 기법 [30]을 통해 달성된다. 이러한 모든 새로운 사용 사례는 여러 번의, 종종 상호 의존적인 LLM 생성 호출을 필요로 하며, 복잡한 작업을 완료하기 위해 다중 호출 구조를 사용하는 경향을 보여준다 [57, 21].
이러한 패턴의 등장은 LLM과의 상호작용이 단순한 채팅에서 LLM의 프로그래밍적 사용이라는 더 정교한 형태로 전환되고 있음을 의미하며, 이는 프로그램을 사용하여 LLM의 생성 과정을 스케줄링하고 제어하는 것을 뜻한다. 우리는 이러한 프로그램을 "언어 모델 프로그램"(LM 프로그램)이라고 부른다 [4, 20]. 위에서 언급한 고급 프롬프팅 기법과 에이전트 워크플로는 LM 프로그램의 범위에 속한다. LM 프로그램에는 두 가지 일반적인 속성이 있다: (1) LM 프로그램은 일반적으로 제어 흐름 사이사이에 여러 LLM 호출을 포함한다. 이는 복잡한 작업을 완료하고 전반적인 품질을 향상시키기 위해 필요하다. (2) LM 프로그램은 구조화된 입력을 받고 구조화된 출력을 생성한다. 이는 LM 프로그램의 구성과 LM 프로그램을 기존 소프트웨어 시스템에 통합하기 위해 필요하다.

LM 프로그램의 광범위한 사용에도 불구하고, 현재 이를 표현하고 실행하기 위한 시스템은 여전히 비효율적이다. 우리는 LM 프로그램의 효율적 사용과 관련된 두 가지 주요 과제를 식별한다. 첫째, LLM의 비결정적 특성 때문에 LM 프로그램을 프로그래밍하는 것은 지루하고 어렵다. LM 프로그램을 개발하려면 종종 광범위한 문자열 조작, 프롬프트의 실험적 튜닝, 취약한 출력 파싱, 여러 입력 양식 처리, 병렬성 메커니즘 구현이 필요하다. 이러한 복잡성은 단순한 프로그램조차도 가독성을 크게 저하시킨다 (2절).
둘째, 그리고 중요하게도, 중복된 계산과 메모리 사용으로 인해 LM 프로그램의 실행은 비효율적이다. 최신 추론 엔진(예: vLLM [23], TGI [16], TensorRT-LLM [34])은 워크로드에 대한 직접적인 지식 없이 지연 시간을 줄이고 처리량을 향상시키도록 최적화되었다. 이는 이러한 시스템을 범용적이고 견고하게 만들지만, 주어진 워크로드에 대해서는 상당한 비효율성을 초래하기도 한다. 대표적인 예가 Key-Value(KV) 캐시의 재사용이다 (3절). KV 캐시는 생성 추론에 필수적인 재사용 가능한 중간 텐서로 구성된다. LM 프로그램의 일반적인 배치 실행 중에는 공통 접두사를 공유하는 여러 LLM 호출에 걸쳐 KV 캐시를 재사용할 수 있는 수많은 기회가 존재한다. 그러나 현재 시스템은 이러한 재사용을 촉진할 효과적인 메커니즘이 없어 불필요한 계산과 낭비되는 메모리를 초래한다. 또 다른 예는 구조화된 출력(예: JSON 모드)을 위한 제약 디코딩으로, 여기서 LLM의 출력은 정규 표현식으로 정의된 특정 문법 규칙을 따르도록 제한된다 (4절). 이러한 제약 하에서는 종종 여러 토큰을 한 번에 디코딩할 수 있다. 그러나 기존 시스템은 한 번에 하나의 토큰만 디코딩하여 차선의 디코딩 속도를 초래한다.
이러한 과제를 해결하기 위해 우리는 LLM을 위한 구조화된 생성 언어인 SGLang을 제시한다. 핵심 아이디어는 효율적인 실행을 위해 LM 프로그램의 다중 호출 구조를 체계적으로 활용하는 것이다. 그림 1에 보인 바와 같이, 이는 두 부분으로 구성된다: 프런트엔드 언어와 백엔드 런타임. 프런트엔드는 LM 프로그램의 프로그래밍을 단순화하고, 런타임은 실행을 가속화한다. 두 부분은 더 나은 성능을 위해 함께 작동할 수 있지만 독립적으로도 기능할 수 있다.
우리는 파이썬에 내장된 도메인 특화 언어로서 SGLang을 소개한다. 이는 생성(예: extend, gen, select) 및 병렬성 제어(예: fork, join)를 위한 기본 요소를 제공한다. SGLang은 파이썬의 제어 흐름 및 라이브러리와 호환되므로, 사용자는 네이티브 파이썬 구문으로 고급 프롬프팅 워크플로를 쉽게 개발할 수 있다. 우리는 SGLang을 위한 인터프리터와 컴파일러를 제공한다. 인터프리터는 프롬프트 상태를 스트림으로 관리하고 기본 연산을 스트림에 제출하여 비동기적으로 실행함으로써, 동기화 및 프로그램 내 병렬성에 대한 적절한 제어를 보장한다. 또한 SGLang 프로그램은 추적되고 컴파일되어 더 많은 최적화를 수행할 수 있다.
런타임 측면에서, 우리는 SGLang 프로그램의 실행을 가속화하기 위한 몇 가지 새로운 최적화를 제안한다. 첫 번째 기법인 RadixAttention은 여러 생성 호출에 걸쳐 KV 캐시의 자동 재사용을 가능하게 한다. 기존 추론 엔진에서는 요청의 KV 캐시가 처리가 완료된 후 폐기되어, 여러 호출에 걸쳐 KV 캐시를 재사용할 수 없고 실행 속도가 크게 저하된다. 반면, 우리 시스템은 모든 요청에 대한 KV 캐시를 radix 트리 내에서 LRU 캐시로 유지한다. 이 접근 방식은 KV 캐시를 전통적인 캐시처럼 관리하고 radix 트리를 사용하여 효율적인 매칭, 삽입, 제거를 수행한다. 이를 통해 런타임은 캐시 인식 스케줄링 정책으로 다양한 재사용 패턴을 효율적으로 처리할 수 있다. 두 번째 기법은 압축 유한 상태 기계로, 구조화된 출력을 위한 더 빠른 제약 디코딩을 가능하게 한다. 기존 시스템은 허용되지 않는 토큰의 확률을 마스킹하여 다음 토큰에 대해서만 제약을 따르므로 한 번에 하나의 토큰만 디코딩할 수 있다. 반면, 우리 시스템은 제약을 분석하고 제약을 나타내는 압축 유한 상태 기계를 구축한다. 이 접근 방식은 가능할 때마다 다중 토큰 경로를 단일 단계 경로로 압축하여, 한 번에 여러 토큰을 디코딩함으로써 더 빠른 디코딩 속도를 달성할 수 있게 한다. 마지막으로, SGLang은 OpenAI의 GPT-4와 같은 API 전용 모델도 지원하며, 우리는 API 전용 모델을 위한 다중 호출 프로그램을 최적화하기 위해 세 번째 기법인 API 투기적 실행을 소개한다.
SGLang을 사용하여 우리는 에이전트 제어, 논리적 추론, 퓨샷 학습 벤치마크, JSON 디코딩, 검색 증강 생성 파이프라인, 다중 턴 채팅, 멀티모달 처리 등 다양한 LLM 애플리케이션을 구현했다. 우리는 NVIDIA A10G 및 A100 GPU에서 Llama-7B/70B [49], Mistral-8x7B [17], LLaVA-v1.5-7B (이미지) [28], LLaVA-NeXT-34B (비디오) [62]를 포함한 모델에 대한 성능을 테스트했다. 실험 결과, SGLang은 Guidance [13], vLLM [23], LMQL [4]을 포함한 기존 프로그래밍 및 추론 시스템과 비교하여 광범위한 워크로드, 모델, 하드웨어 설정 전반에 걸쳐 최대 더 높은 처리량을 달성한다.
2 프로그래밍 모델
이 절에서는 실행 예제와 함께 SGLang 프로그래밍 모델을 소개하고, 언어 기본 요소와 실행 모드를 설명하며, 런타임 최적화 기회를 개괄한다. 이 프로그래밍 모델은 유연하고 조합 가능한 기본 요소를 제공함으로써 다중 호출 워크플로에서의 지루한 작업(예: 문자열 조작, API 호출, 제약 명세, 병렬성)을 단순화할 수 있다.
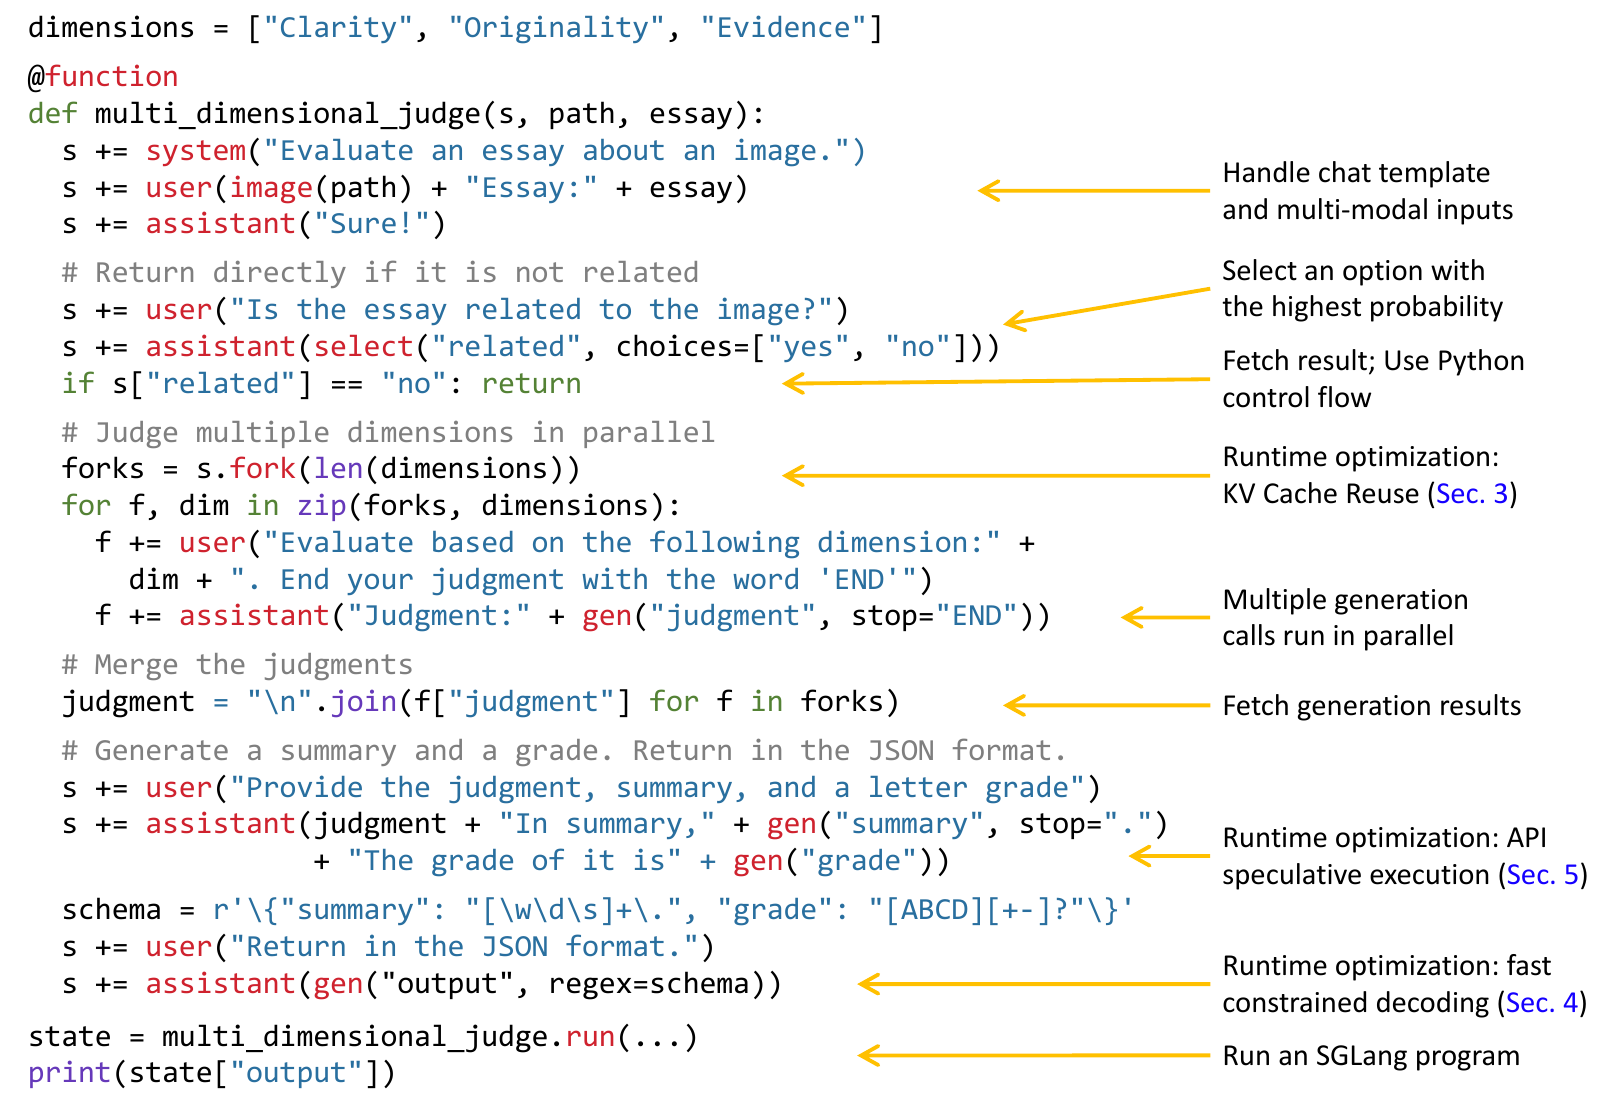
실행 예제. 이 언어는 파이썬에 내장된 도메인 특화 언어이다. 그림 2는 branch-solve-merge 프롬프팅 방법 [40]을 사용하여 이미지에 관한 에세이를 평가하는 프로그램을 보여준다. 함수 multi_dimensional_judge는 세 가지 인자를 받는다: s, path, essay. s는 프롬프트 상태를 관리하고, path는 이미지 파일 경로이며, essay는 에세이 텍스트이다. 새로운 문자열과 SGLang 기본 요소는 연산자를 사용하여 실행을 위해 상태 s에 추가될 수 있다. 먼저, 함수는 이미지와 에세이를 프롬프트에 추가한다. 그런 다음 select를 사용하여 에세이가 이미지와 관련이 있는지 확인하고 결과를 s["related"]에 저장한다. 관련이 있는 경우, 프롬프트는 서로 다른 차원에서의 병렬 평가를 위해 세 개의 복사본으로 포크되며, gen을 사용하여 결과를 f["judgment"]에 저장한다. 다음으로, 판단들을 병합하고, 요약을 생성하며, 문자 등급을 할당한다. 마지막으로, 정규 표현식 제약 regex로 정의된 스키마에 따라 결과를 JSON 형식으로 반환한다. SGLang은 이 프로그램을 크게 단순화하는데, OpenAI API와 유사한 인터페이스를 사용하는 동등한 프로그램은 수동 문자열 조작과 병렬성 제어로 인해 많은 코드 라인이 필요하기 때문이다.
언어 프리미티브. SGLang은 프롬프트 상태, 생성, 병렬 처리를 제어하기 위한 프리미티브를 제공한다. 이들은 Python 문법 및 라이브러리와 함께 사용할 수 있다. 다음은 그 프리미티브들이다: "gen"은 모델을 호출하여 생성하고, 그 결과를 첫 번째 인자로 지정된 이름의 변수에 저장한다. 출력이 정규 표현식으로 정의된 문법(예: JSON 스키마)을 따르도록 제약하는 "regex" 인자를 지원한다. "select"는 모델을 호출하여 목록에서 가장 확률이 높은 옵션을 선택한다. 연산자 "+=" 또는 "extend"는 프롬프트에 문자열을 덧붙인다. 연산자 "[variable_name]"은 생성 결과를 가져온다. "fork"는 프롬프트 상태의 병렬 포크를 생성한다. "join"은 프롬프트 상태를 다시 합친다. "image"와 "video"는 이미지 및 비디오 입력을 받는다.
실행 모드. SGLang 프로그램을 실행하는 가장 간단한 방법은 인터프리터를 통하는 것이며, 여기서 프롬프트는 비동기 스트림으로 취급된다. extend, gen, select와 같은 프리미티브는 비동기 실행을 위해 스트림에 제출된다. 이러한 비차단 호출은 Python 코드가 생성을 기다리지 않고 계속 실행될 수 있게 해 준다. 이는 CUDA 커널을 비동기적으로 실행하는 것과 유사하다. 각 프롬프트는 백그라운드 스레드의 스트림 실행기에 의해 관리되어, 프로그램 내 병렬성을 가능하게 한다. 생성 결과를 가져오는 것은 결과가 준비될 때까지 차단되어 올바른 동기화를 보장한다. 또는 SGLang 프로그램을 계산 그래프로 컴파일하여
| 시스템 | 구문 | 언어 기본 요소 | 런타임 백엔드 |
| LMQL 안내 | 사용자 정의 Python | extend, gen, select extend, gen, select, image | HF Transformers, llama.cpp, OpenAI HF Transformers, llama.cpp, OpenAI |
| SGLang | Python | extend, gen, select, image, video, fork, join | SGLang 런타임(SRT), OpenAI |
그래프 실행기로 실행할 수 있으며, 이를 통해 더 많은 최적화가 가능하다. 본 논문은 기본적으로 인터프리터 모드를 사용하며, 컴파일러 모드의 결과는 부록 D에서 논의한다. SGLang은 자체 SGLang 런타임(SRT)을 통해 공개 가중치 모델을 지원할 뿐만 아니라, OpenAI 및 Anthropic 모델과 같은 API 모델도 지원한다.
비교. LLM을 위한 프로그래밍 시스템은 고수준(예: LangChain, DSPy)과 저수준(예: LMQL, Guidance, SGLang)으로 분류할 수 있다. 고수준 시스템은 미리 정의되었거나 자동 생성된 프롬프트를 제공하며, 예컨대 DSPy의 프롬프트 최적화기가 그러하다. 저수준 시스템은 일반적으로 프롬프트를 변경하지 않지만, 프롬프트와 프리미티브를 직접 조작할 수 있게 한다. SGLang은 LMQL 및 Guidance와 유사한 저수준 시스템이다. 표 1은 이들의 기능을 비교한다. SGLang은 런타임 효율성에 더 중점을 두며, 자체적으로 공동 설계된 런타임을 갖추고 있어 이후에 소개되는 새로운 최적화를 가능하게 한다. 고수준 언어(예: DSPy)는 저수준 언어(예: SGLang)로 컴파일될 수 있다. 우리는 더 나은 런타임 효율성을 위해 SGLang을 DSPy의 백엔드로 통합하는 것을 6절에서 시연한다.
런타임 최적화. 그림 2는 세 가지 런타임 최적화 기회를 보여준다: KV 캐시 재사용, 빠른 제약 디코딩, API 투기적 실행. 이들을 다음 절들에서 논의할 것이다.
3 RadixAttention을 이용한 효율적인 KV 캐시 재사용
SGLang 프로그램은 여러 개의 생성 호출을 연쇄시키고 "fork" 프리미티브로 병렬 복사본을 만들 수 있다. 또한 서로 다른 프로그램 인스턴스들이 흔히 일부 공통 부분(예: 시스템 프롬프트)을 공유한다. 이러한 시나리오들은 실행 중에 많은 공유 프롬프트 접두사들을 만들어내며, 이는 KV 캐시를 재사용할 수 있는 수많은 기회로 이어진다. LLM 추론 중에 KV 캐시는 순전파에서 나온 중간 텐서를 저장하며, 이후 토큰을 디코딩하는 데 재사용된다. 이들은 자기 주의 메커니즘 [51]의 키-값 쌍에서 이름을 따왔다. KV 캐시 계산은 오직 접두사 토큰에만 의존한다. 따라서 동일한 프롬프트 접두사를 가진 요청들은 KV 캐시를 재사용하여 중복 계산과 메모리 사용을 줄일 수 있다. 더 많은 배경과 몇 가지 예시는 부록 A에 제시되어 있다.
KV 캐시 재사용 기회가 주어졌을 때, SGLang 프로그램을 최적화하는 데 있어 핵심적인 과제는 여러 호출과 인스턴스에 걸쳐 KV 캐시를 재사용하는 것이다. 일부 시스템들은 특정 KV 캐시 재사용 사례들을 탐구했지만 [23, 58, 18, 12], 이들은 흔히 수동 설정을 필요로 하며 모든 재사용 패턴(예: 동적 트리 구조)을 처리할 수 없다. 결과적으로 대부분의 최신 추론 시스템들은 각 요청마다 KV 캐시를 다시 계산한다. 우리는 그들의 한계와 우리의 차이점을 7절에서 논의할 것이다.
이 절에서는 런타임 동안 자동적이고 체계적인 KV 캐시 재사용을 위한 새로운 기법인 RadixAttention을 소개한다. 생성 요청이 끝난 후 KV 캐시를 버리는 기존 시스템들과 달리, 우리 시스템은 프롬프트와 생성 결과에 대한 캐시를 기수 트리(radix tree)에 유지하여 효율적인 접두사 검색, 재사용, 삽입, 퇴출을 가능하게 한다. 우리는 캐시 적중률을 높이기 위해 LRU 퇴출 정책과 캐시 인식 스케줄링 정책을 구현한다. RadixAttention은 연속 배칭 [60], 페이징 어텐션 [23], 텐서 병렬화 [44]와 같은 기법들과 호환된다. 또한 캐시 적중이 없을 때는 무시할 수 있을 정도의 메모리 및 시간 오버헤드만을 도입한다.
RadixAttention. 기수 트리는 고전적인 트라이(접두사 트리)에 대한 공간 효율적인 대안 역할을 하는 자료 구조이다. 일반적인 트리와 달리, 기수 트리의 간선은 단일 원소뿐만 아니라 다양한 길이의 원소 시퀀스로도 레이블될 수 있어 효율성을 크게 향상시킨다. 우리 시스템에서는 기수 트리를 활용하여 토큰 시퀀스와 그에 대응하는 KV 캐시 텐서 간의 매핑을 관리한다. 이러한 KV 캐시 텐서들은 비연속적이고 페이징된 레이아웃으로 저장되며, 각 페이지의 크기는 하나의 토큰과 동일하다. GPU 메모리는 KV 캐시로 빠르게 채워지기 때문에, 우리는 가장 최근에 사용되지 않은 리프를 먼저 퇴출하는 단순한 LRU 퇴출 정책을 도입한다. 리프를 먼저 퇴출함으로써, 우리는 그들의 공통 조상들이 리프가 되어 또한 퇴출될 때까지 그 조상들을 재사용할 수 있게 한다.
연속 배칭 환경에서는 현재 실행 중인 배치가 사용하는 노드들을 퇴출할 수 없다. 따라서 각 노드는 얼마나 많은 실행 중인 요청들이 이를 사용하고 있는지를 나타내는 참조 카운터를 유지한다. 노드는 참조 카운터가 0일 때 퇴출 가능하다. 우리는 캐시로서 고정 크기의 메모리 풀을 미리 할당하지 않는다는 점에 주목한다. 대신 캐시된 토큰들과 현재 실행 중인 요청들이 동일한 메모리 풀을 공유하도록 한다. 따라서 시스템은 캐시와 실행 중인 요청을 위해 메모리를 동적으로 할당한다. 충분한 대기 요청들이 실행되면, 시스템은 더 큰 배치 크기를 위해 모든 캐시된 토큰들을 퇴출할 것이다. 그림 3은 여러 유입 요청들에 대해 기수 트리가 어떻게 유지되는지를 보여준다.
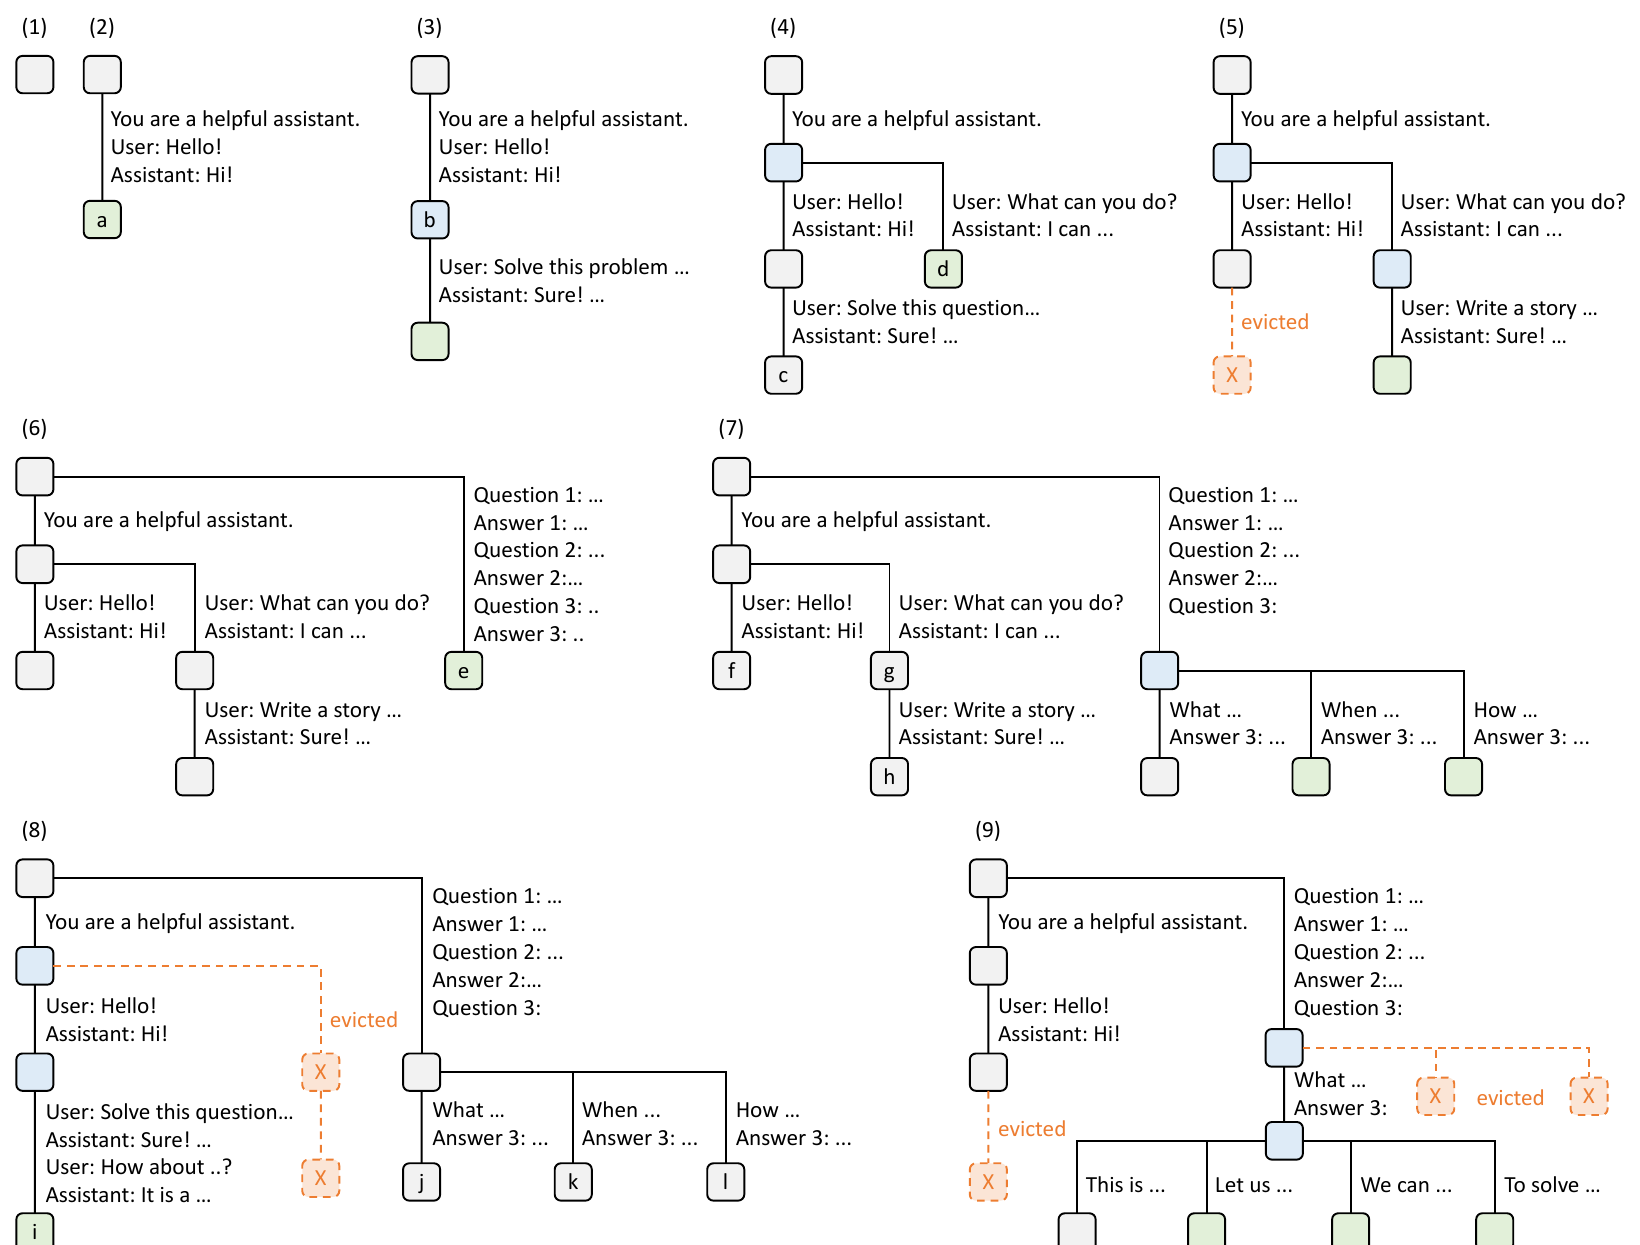
프런트엔드 인터프리터는 전체 프롬프트를 런타임에 전송하고, 런타임은 접두사 매칭과 재사용을 수행한다. 트리 구조는 무시할 수 있는 유지보수 오버헤드로 CPU에 저장된다. fork 프리미티브의 실행 동안, 프런트엔드는 먼저 접두사를 힌트로 전송하여 접두사가 트리에 올바르게 삽입되도록 보장한다. 그런 다음 나머지 프롬프트를 전송한다. 이러한 "프런트엔드 힌트"는 런타임 스케줄링과 매칭을 단순화하며, 프런트엔드-런타임 공동 설계의 이점을 예시한다.
캐시 인식 스케줄링. 우리는 캐시 적중률을 캐시된 프롬프트 토큰 수로 정의한다. 대기 큐에 많은 요청들이 있을 때, 그들이 실행되는 순서는 캐시 적중률에 상당한 영향을 미칠 수 있다. 예를 들어, 요청 스케줄러가 서로 관련 없는 요청들 사이를 빈번하게 전환하면, 캐시 스래싱을 초래하고 적중률이 낮아질 수 있다. 우리는 캐시 적중률을 높이기 위해 캐시 인식 스케줄링 알고리즘을 설계한다. 배치 처리 환경에서는
선입선출 스케줄을 사용하는 대신 요청들을 매칭된 접두사 길이로 정렬하고 매칭된 접두사가 더 긴 요청들을 우선시한다. 알고리즘 1(부록)은 연속 배칭을 사용한 캐시 인식 스케줄링의 의사 코드를 보여준다. 이 알고리즘은 최장 공유 접두사 우선 순서를 사용한다. 지연에 더 민감한 환경에서는 캐시 재사용을 개선하기 위해 제한된 배치 재정렬을 여전히 허용할 수 있을 것이다. 또한 우리는 오프라인 경우의 최적 스케줄링에 대해 다음 정리를 증명한다. 2
정리 3.1. 요청들의 배치에 대해, 캐시 크기가 최대 요청 길이 이상일 때 요청들의 기수 트리를 깊이 우선 탐색 순서로 방문함으로써 최적의 캐시 적중률을 달성할 수 있다. 최장 공유 접두사 우선 순서는 깊이 우선 탐색 순서와 동등하다.
증명은 부록의 A.3절에 있다. 온라인 경우에는 DFS 순서가 교란되겠지만, 우리의 스케줄은 A.3절에서 설명하는 바와 같이 전체 기수 트리의 증강된 부분에 대한 DFS 동작을 여전히 근사한다. 탐욕적 캐시 인식 스케줄링은 높은 처리량을 달성할 수 있지만 기아 상태를 초래할 수 있다. 우리는 다른 공정 스케줄링 방법들 [42]과의 통합을 향후 과제로 남긴다.
분산 경우. RadixAttention은 여러 GPU로 확장될 수 있다. 텐서 병렬화의 경우, 각 GPU는 샤딩된 KV 캐시를 유지한다. 트리 연산이 동일하기 때문에 추가적인 동기화는 필요하지 않다. 여러 워커를 사용한 데이터 병렬화는 부록의 A.4절에서 논의한다.
4 압축된 유한 상태 기계를 이용한 효율적인 제약 디코딩
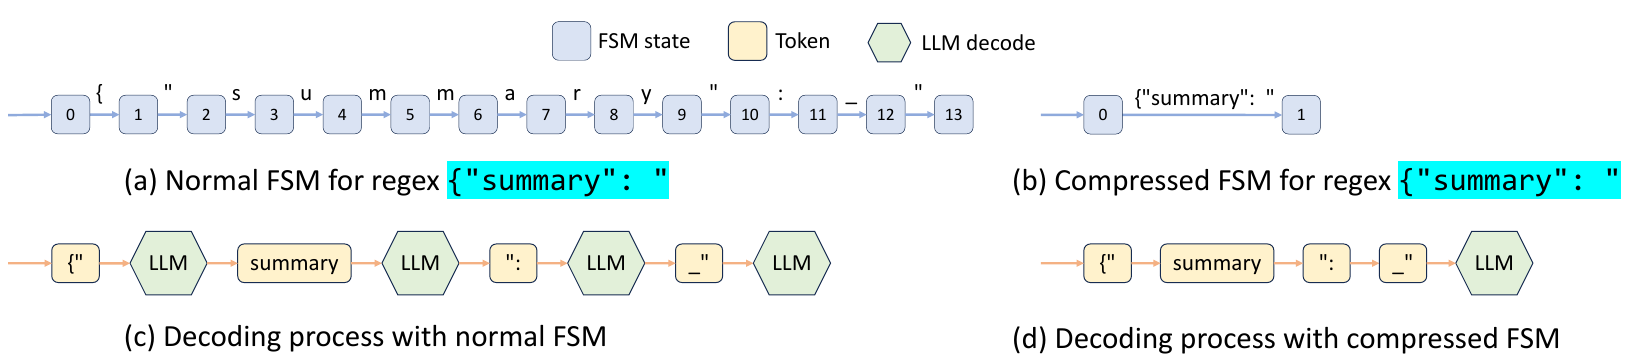
LM 프로그램에서 사용자들은 흔히 모델의 출력이 JSON 스키마와 같은 특정 형식을 따르도록 제약하기를 원한다. 이는 제어 가능성과 견고성을 향상시키고 출력을 더 쉽게 파싱할 수 있게 한다. SGLang은 정규 표현식을 사용하여 이러한 제약을 강제하는 regex 인자를 제공하며, 정규 표현식은 많은 실제 시나리오에 충분히 표현력이 있다. 기존 시스템들은 정규 표현식을 유한 상태 기계(FSM)로 변환하여 이를 지원한다 [54]. 디코딩 동안 그들은 현재 FSM 상태를 유지하고, 다음 상태들로부터 허용된 토큰들을 검색하고, 유효하지 않은 토큰들의 확률을 0으로 설정하며, 토큰 단위로 디코딩한다. 그러나 이러한 토큰 단위 접근 방식은 한 번에 여러 토큰을 디코딩할 기회가 있을 때 비효율적이다. 예를 들어, 그림 2의 상수 시퀀스 {"summary": " 는 그림 4 (c)에 나타난 것처럼 정상 디코딩 과정에서 여러 토큰에 걸쳐 있으며, 이를 디코딩할 때 유효한 다음 토큰이 하나뿐임에도 불구하고 여러 디코딩 단계를 요구한다. 따라서 전체 시퀀스는 단일 단계(즉, 순전파)로 디코딩될 수 있다. 그러나 기존 시스템들은 FSM과 모델 러너 간의 통합 부재로 인해 다중 토큰 처리가 불가능하여 한 번에 하나의 토큰만 디코딩할 수 있으므로 디코딩이 느려진다.
SGLang은 압축된 FSM을 갖춘 빠른 제약 디코딩 런타임을 만들어 이러한 한계를 극복한다. 이 런타임은 FSM을 분석하고 그림 4 (b)에서 시연된 것처럼 FSM 내의 인접한 단일 전이 간선들을 단일 간선으로 압축하여, 여러 토큰이 함께 디코딩될 수 있는 시점을 인식할 수 있게 한다. 그림 4 (d)에서, 압축된 전이 간선 상의 여러 토큰들은 한 번의 순전파로 디코딩될 수 있어 디코딩 과정을 크게 가속화한다. 이는 또한 일반적이며 모든 정규 표현식에 적용 가능하다. 배경과 구현에 대한 더 자세한 내용은 부록 B에 있다.
5 API 투기적 실행을 이용한 효율적인 엔드포인트 호출
이전 절들은 모델 추론 과정에 대한 수정을 요구하는 오픈 웨이트 모델들에 대한 최적화를 소개했다. 또한 SGLang은 OpenAI의 GPT-4와 같은 API 접근 전용 모델들과도 작동한다. 그러나 이러한 모델들의 경우 우리는 블랙박스 API 엔드포인트만을 호출할 수 있다.
이 절에서는 투기적 실행을 사용하여 다중 호출 SGLang 프로그램의 실행을 가속화하고 API 비용을 절감하는, 블랙박스 API 모델들을 위한 새로운 최적화를 소개한다. 예를 들어, 한 프로그램이 다중 호출 패턴으로 모델에게 캐릭터 설명을 생성하도록 요청할 수 있다:
context "name:" gen("name", stop="\n") "job:" gen("job", stop="\n"). 순진하게는, 두 개의 gen 프리미티브가 두 번의 API 호출에 해당하며, 이는 사용자가 컨텍스트에 대한 입력 토큰 요금을 두 번 지불해야 함을 의미한다. SGLang에서는 첫 번째 호출에서 투기적 실행을 활성화하고 정지 조건을 무시함으로써 몇 개의 토큰을 더 계속 생성하도록 할 수 있다. 인터프리터는 추가 생성 출력을 보관하고 이를 이후 프리미티브들과 매칭하여 재사용한다. 특정 경우에는 신중한 프롬프트 엔지니어링을 통해 모델이 템플릿을 높은 정확도로 올바르게 매칭할 수 있어, 한 번의 API 호출에 대한 지연 시간과 입력 비용을 절약할 수 있다.
6 평가
우리는 다양한 LLM 워크로드에 걸쳐 SGLang의 성능을 평가한다. 이어서 특정 구성 요소들의 효과를 입증하기 위해 절제 연구와 사례 연구를 수행한다. SGLang은 FlashInfer [59]와 Triton [48]의 사용자 정의 CUDA 커널과 함께 PyTorch [49]로 구현되었다.
6.1 설정
모델. 우리는 밀집 Llama-2 모델 [49], 희소 전문가 혼합 Mixtral 모델 [17], 멀티모달 LLaVA 이미지 [27] 및 비디오 모델 [62], 그리고 API 모델인 OpenAI의 GPT-3.5를 테스트한다. 오픈 웨이트 모델의 경우, 파라미터 수는 70억에서 700억까지이며, 우리는 float16 정밀도를 사용한다.
하드웨어. 우리는 대부분의 실험을 NVIDIA A10G GPU(24GB)가 장착된 AWS EC2 G5 인스턴스에서 실행한다. 7B 모델은 단일 A10G GPU에서, 더 큰 모델은 텐서 병렬화[44]를 사용하여 여러 A10G GPU에서 실행한다. 일부 추가 실험은 A100G(80GB) GPU에서 실행한다.
베이스라인. 우리는 SGLang을 각자의 언어와 기본 런타임을 갖춘 고수준 프로그래밍 시스템들과, 표준 OpenAI 유사 Completion API를 갖춘 저수준 추론 엔진들 양쪽 모두와 비교한다. 별도로 명시하지 않는 한, 우리는 계산 결과를 변경하는 최적화를 켜지 않음으로써 모든 시스템이 동일한 결과를 계산하도록 한다. 베이스라인은 다음과 같다:
- Guidance[13], LLM을 제어하기 위한 언어. 우리는 llama.cpp 백엔드와 함께 Guidance v0.1.8을 사용한다. - vLLM [23], 고처리량 추론 엔진. 우리는 vLLM v0.2.5와 그 기본 API 서버를 사용한다. - LMQL [4], 쿼리 언어. 우리는 Hugging Face Transformers 백엔드와 함께 LMQL v0.7.3을 사용한다.
워크로드. 우리는 다음을 테스트한다: 5-shot MMLU [14] 및 20-shot HellaSwag [61] 벤치마크. MMLU에서는 토큰 하나를 디코딩하고, HellaSwag에서는 원시적 select를 사용하여 가장 높은 확률의 답을 선택한다. ReAct 에이전트 [57]와 생성적 에이전트 [36]의 경우, 원본 논문에서 트레이스를 추출하여 재생한다. GSM-8K 문제에는 사고의 트리(Tree-of-thought) [56]를, 팁 생성에는 사고의 골격(Skeleton-of-thought) [33]을 사용한다. 우리는 branch-solve-merge [40] 기법을 사용하는 LLM 판정자를 사용한다; 정규 표현식으로 명시된 스키마를 사용한 JSON 디코딩; 4턴의 멀티턴 채팅으로, 각 턴의 입력은 256-512 토큰 사이에서 무작위로 샘플링된다. 멀티턴 채팅(짧음)은 짧은 출력(4-8 토큰)을, 멀티턴 채팅(김)은 긴 출력(256-512 토큰)을 의미한다; 공식 예제의 DSPy 검색 증강 생성(RAG) 파이프라인 [20].
측정 지표. 우리는 처리량과 지연 시간이라는 두 가지 성능 지표를 보고한다. 처리량의 경우, 충분히 큰 배치의 프로그램 인스턴스를 실행하여 최대 처리량을 계산하며, 초당 실행된 프로그램 인스턴스 수(초당 프로그램 수, p/s)를 비교한다. 지연 시간의 경우, 배치 처리 없이 한 번에 하나의 프로그램을 실행하고 여러 인스턴스에 대한 평균 지연 시간을 보고한다.
6.2 종단 간 성능
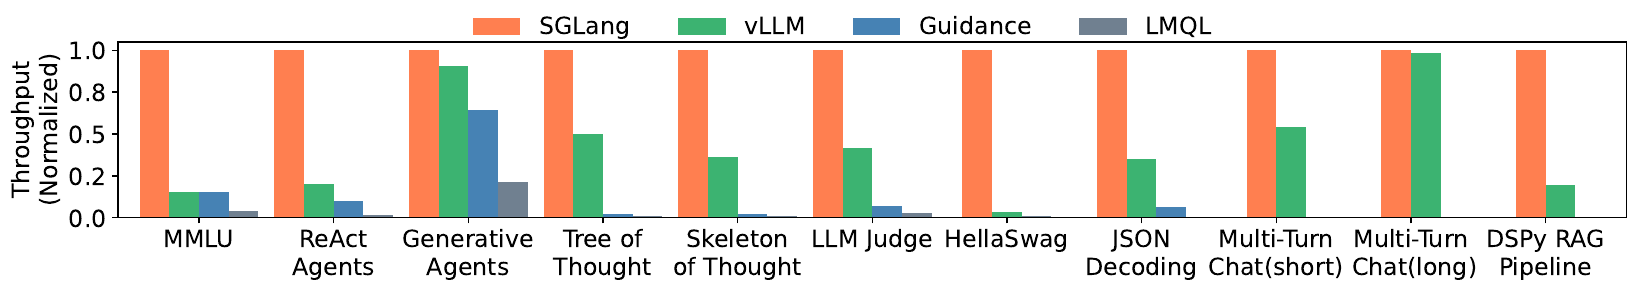
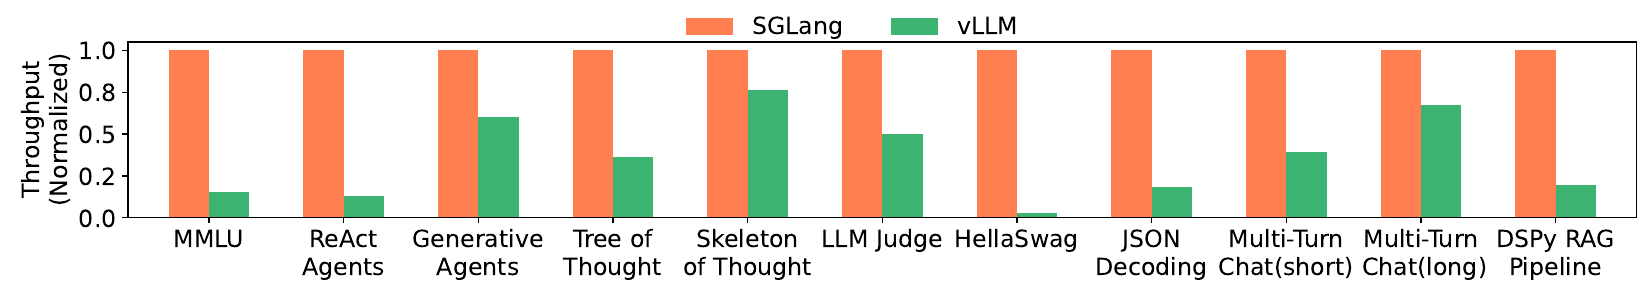
오픈 웨이트 모델에 대한 결과. 지연 시간 및 처리량 결과는 Fig. 5와 Fig. 6에 나와 있다. SGLang은 처리량을 최대 향상시키고 지연 시간을 최대 감소시킨다. 이러한 개선은
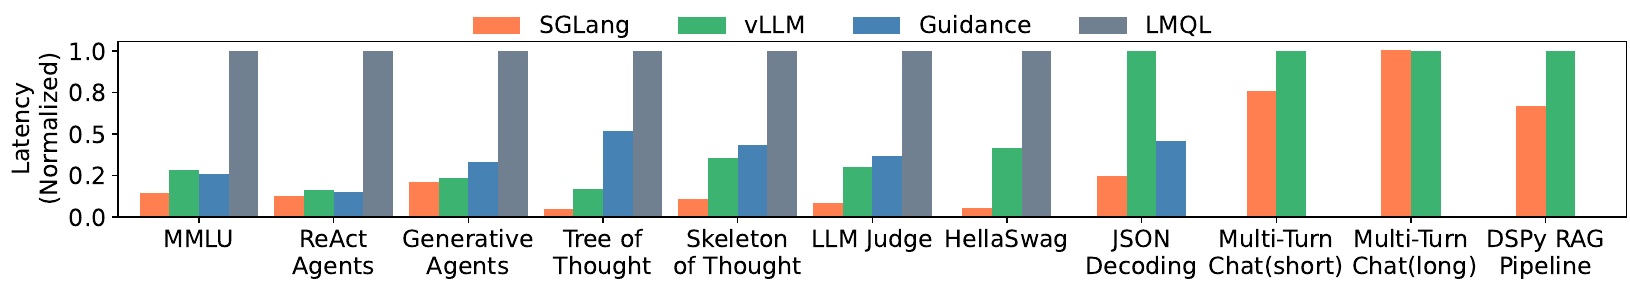
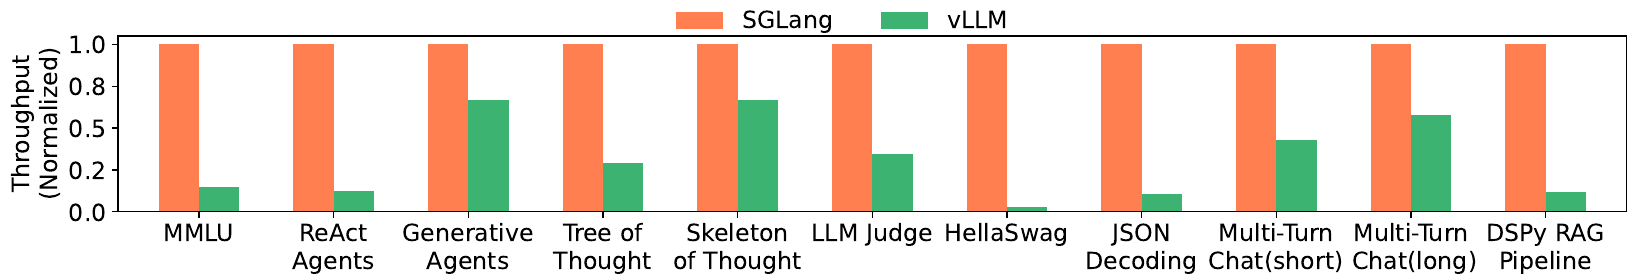
KV 캐시 재사용, 단일 프로그램 내 병렬 처리 활용, 그리고 더 빠른 제약 디코딩에서 비롯된다. 다음으로 각 벤치마크에서 속도 향상의 이유를 설명한다.
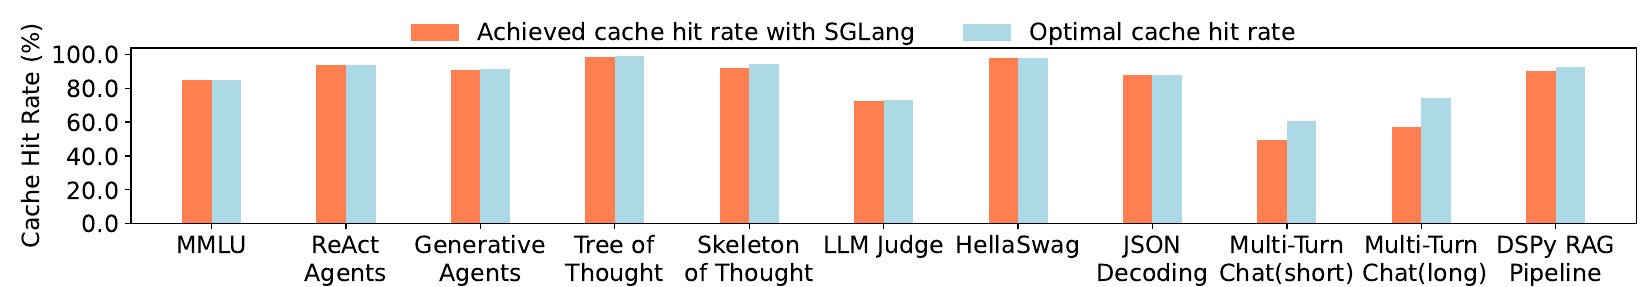
MMLU에서 SGLang은 RadixAttention을 사용하여 5-shot 예제의 KV 캐시를 재사용할 수 있다. RadixAttention은 처리량과 지연 시간 모두에 이점을 준다. RadixAttention은 KV 캐시를 공유하여 총 메모리 사용량을 줄이며, 이를 통해 더 큰 배치 크기를 가능하게 하여 최대 처리량을 향상시킨다. 또한 RadixAttention은 프리필 연산을 줄여 첫 번째 토큰 지연 시간을 감소시킨다. HellaSwag에서 SGLang은 퓨샷 예제와 여러 선택지에 대한 공통 질문 접두사 모두의 KV 캐시를 재사용하여 2단계 공유를 이룬다. ReAct 및 생성형 에이전트의 경우, SGLang은 에이전트 템플릿과 이전 호출의 KV 캐시를 재사용한다. 사고의 나무(Tree-of-thought)와 사고의 골격(Skeleton-of-thought)에서 SGLang은 단일 프로그램 내의 생성 호출을 병렬화하고 KV 캐시를 최대한 재사용한다. JSON 디코딩에서 SGLang은 압축된 유한 상태 기계를 사용하여 한 번에 여러 토큰을 디코딩함으로써 디코딩을 가속화한다. 다중 턴 채팅에서 SGLang은 채팅 기록의 KV 캐시를 재사용한다. KV 캐시 재사용은 주로 접두사 시간을 줄이는 데 도움이 되기 때문에 짧은 출력에서 속도 향상이 더 두드러진다. 긴 출력의 경우 서로 다른 채팅 세션 간의 공유가 많지 않고 디코딩 시간이 지배적이기 때문에 속도 향상이 거의 없다. DSPy RAG 파이프라인에서 SGLang은 공통 컨텍스트 예제의 KV 캐시를 재사용한다. 이들 벤치마크에서 캐시 적중률은 에서 범위이다. Fig. 13(부록)은 이들 모두에 대해 달성된 캐시 적중률과 최적 캐시 적중률을 나열하며, 우리의 캐시 인식 스케줄링이 평균적으로 최적 적중률의 에 근접함을 보여준다.
성능이 느리고 기능이 누락되어 있기 때문에 마지막 다섯 개 벤치마크 중 일부에서 LMQL과 Guidance를 제외한다. LMQL의 문제는 느린 토큰 수준 처리와 최적화되지 않은 백엔드에서 비롯되며, Guidance는 배치 처리와 병렬 처리 지원이 부족하다.
텐서 병렬 처리를 사용한 더 큰 모델에 대한 결과. 더 큰 모델인 Mixtral-8x7B와 Llama-70B를 동일한 벤치마크 세트에서 텐서 병렬 처리로 실행하고 그 결과를 Fig. 7과 Fig. 12(부록)에 보고한다. 더 큰 모델에서의 속도 향상은 더 작은 모델에서 관찰된 것과 유사한 경향을 보이며, 이는 우리의 최적화가 더 큰 모델에도 잘 일반화됨을 나타낸다. Guidance와 LMQL은 텐서 병렬 처리의 효율적인 구현이 없기 때문에 여기서는 생략한다.
멀티모달 모델에 대한 결과. SGLang은 이미지 및 비디오 프리미티브를 갖춘 멀티모달 모델을 기본적으로 지원한다. 본 논문의 최적화는 멀티모달 모델과 호환된다. RadixAttention의 경우, 입력 이미지의 해시를 계산하여 radix 트리의 키로 사용함으로써 동일한 이미지의 이미지 토큰에 대한 KV 캐시를 재사용할 수 있다. 우리는 llava-bench-in-the-wild에서 LLaVA-v1.5-7B(이미지)를, ActivityNet에서 LLaVA-NeXT-34B(비디오)를 실행한다. 이들 모델은 다른 기준 시스템에서 잘 지원되지 않기 때문에, 우리는 Hugging Face Transformers의 모델 저자 원본 구현을 기준선으로 사용한다. Table 2에 나타난 바와 같이, SGLang은 이들 벤치마크에서 최대 더 높은 처리량을 제공한다. llava-bench-in-the-wild에는 동일한 이미지에 대한 여러 질문이 있으며, SGLang 런타임은 이 경우 KV 캐시를 재사용한다.
프로덕션 배포. SGLang은 오픈 웨이트 모델을 서비스하기 위해 Chatbot Arena [8]에 배포되었다. 일부 모델의 트래픽이 적기 때문에 각 모델당 하나의 SGLang 워커만 서비스한다. 한 달 후, 우리는 LLaVA-Next-34B [28]에 대해 , Vicuna-33B [7]에 대해 의 RadixAttention 캐시 적중률을 관찰했다. 캐시 적중은 공통 시스템 메시지, 자주 재사용되는 예제 이미지, 그리고 다중 턴 채팅 기록에서 비롯된다. 이는 Vicuna-33B의 첫 번째 토큰 지연 시간을 평균 감소시킨다.
| 모델 | LLaVA-v1.5-7B (이미지) | LLaVA-NEXT-34B (비디오) |
| 저자의 원래 구현 | 0.18 image/s | 0.02 frame/s |
| SGLang | 1.15 image/s | 0.10 frame/s |
API 모델에 대한 결과. 우리는 OpenAI의 GPT-3.5 모델을 사용하여 Wikipedia 페이지에서 세 개의 필드를 추출하는 프롬프트를 테스트한다. 퓨샷 프롬프팅을 사용함으로써 API 추측 실행의 정확도가 높으며, 세 개의 필드를 추출하기 때문에 입력 토큰 비용을 약 3분의 1로 감소시킨다.
6.3 절제 연구
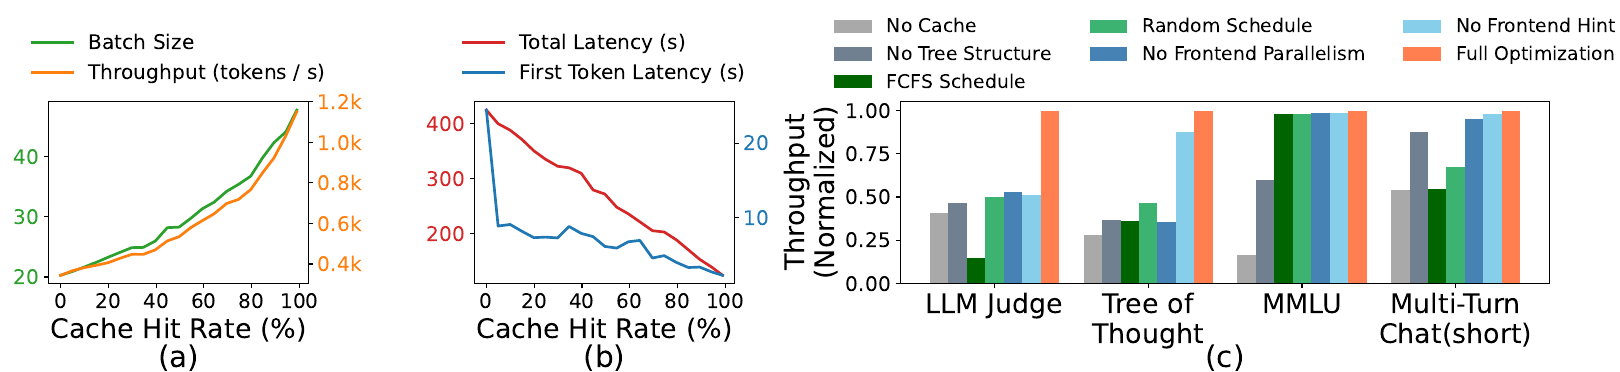
캐시 적중률 대 지연 시간/처리량. Fig. 8(a)(b)는 사고의 나무 벤치마크에서 캐시 적중률과 성능 지표(첫 번째 토큰 지연 시간, 총 지연 시간, 배치 크기, 처리량) 간의 관계를 보여준다. 이 그림은 런타임에서 일치하는 토큰을 부분적으로 비활성화하여 얻은 것이다. 이는 캐시 적중률이 높을수록 배치 크기가 더 커지고, 처리량이 더 높아지며, 지연 시간이 더 낮아짐을 보여준다.
RadixAttention의 효과. 우리는 여러 대표적인 벤치마크에서 RadixAttention과 그 구성 요소의 효과를 테스트한다. Fig. 8(c)에 나타난 바와 같이, "No Cache"는 어떤 캐시도 사용하지 않음을, "No Tree-Structure"는 트리 구조 캐시 대신 단순한 테이블 기반 캐시를 사용함을, "FCFS Schedule"은 우리의 캐시 인식 스케줄링 대신 선착순 정책을 사용함을, "Random Schedule"은 무작위 순서로 요청을 스케줄링함을, "No Frontend Parallelism"은 인터프리터의 병렬 처리를 비활성화함을, "No Frontend Hint"는 인터프리터로부터 포크 힌트 전송을 비활성화함을, "Full optimizations"는 모든 최적화를 켬을 의미한다. 실험 결과는 최상의 성능을 달성하기 위해 이러한 각 구성 요소가 필요함을 보여준다. 프론트엔드 인터프리터의 병렬 처리와 힌트를 비활성화하는 것 또한 차선의 런타임 성능을 초래하며, 이는 프론트엔드 언어와 런타임을 공동 설계하는 것의 중요성을 강조한다.
RadixAttention의 오버헤드. 우리는 KV 캐시 재사용 기회가 전혀 없는 벤치마크에서 RadixAttention의 오버헤드를 테스트한다. 이 벤치마크는 ShareGPT 데이터셋에서 처리량을 측정한다. 100개의 요청을 실행하는 데 74.3초가 걸리지만, RadixAttention 데이터 구조를 관리하는 데 사용된 시간은 0.2초에 불과하며, 이는 0.3% 미만의 무시할 수 있는 오버헤드이다. 이는 트리 연산의 복잡도가 선형적이고 작기 때문이다. 따라서 우리는 기본적으로 RadixAttention을 켤 수 있다.
압축된 유한 상태 기계의 효과. 우리는 JSON 디코딩 벤치마크에서 압축된 유한 상태 기계와 그 구성 요소의 효과를 테스트한다. 실험 결과는 압축된 유한 상태 기계가 한 번에 여러 토큰을 디코딩할 수 있기 때문에 처리량을 증가시킴을 보여준다. 또한, 우리는 상태 기계를 전처리하고 요청 배치에 대해 이를 재사용할 필요가 있다. 그렇지 않으면 각 요청에 대해 전처리를 다시 수행하는 것이 처리량을 더 낮춘다.
7 관련 연구
다양한 연구가 KV 캐시의 재사용을 탐구해 왔으며, 그중 많은 연구가 우리 작업과 동시에 진행되었다. 독특하게도, 우리의 RadixAttention은 KV 캐시를 트리 기반 LRU 캐시로 취급하는 것을 처음으로 제안한다. 이는 다단계 공유, 캐시 인식 스케줄링, 프론트엔드-런타임 공동 스케줄링, 그리고 분산 사례를 지원하는 최초의 솔루션이다. vLLM [23]과 ChunkedAttention [58]은 일부 단순한 재사용 사례(예: 시스템 프롬프트 공유)를 탐구하지만, 다단계 트리 구조 공유나 LRU 캐싱을 다루지 않는다. PromptCache [12]는 접두사를 넘어서는 KV 캐시의 모듈식 재사용을 제안하지만 정확도에 최대 하락의 영향을 줄 수 있다. HydraGen [18], FlashInfer [59], ChunkedAttention [58]은 CUDA 커널 최적화에 초점을 맞추고 있으며 LRU 캐시의 개념을 포함하지 않는다. API Serve [1]와 LLM-SQL [29]은 외부 API 호출 및 관계형 데이터베이스와의 인터리빙과 같은 특정 애플리케이션을 위한 KV 캐시 재사용을 연구하지만, 우리의 radix 트리나 캐시 인식 스케줄링을 갖추고 있지 않다.
Guidance [13], LMQL [4], DSPy [20], LangChain [24], AutoGen [55], LLM Compiler [21] 등 여러 LLM 프로그래밍 및 에이전트 프레임워크가 존재한다. Guidance와 LMQL은 SGLang과 가장 유사하며, Sec. 2에서 비교한다. 우리의 혁신은 제안된 프로그래밍 모델을 가속화하기 위한 새로운 런타임 최적화에 있다. SGLang은 다른 프레임워크와 호환되며 이들을 가속화할 수 있다(예: 우리 평가의 DSPy 예제). 또한 SGLang은 다른 많은 일반적인 추론 최적화 [60, 39, 3, 23, 59, 10, 26, 15, 19, 32, 31, 11]와 호환된다.
8 향후 방향 및 결론
향후 방향. SGLang으로 이루어진 진전에도 불구하고, 향후 연구를 위한 유망한 방향을 드러내는 몇 가지 한계가 남아 있다. 여기에는 추가적인 출력 양식을 지원하도록 SGLang을 확장하는 것, RadixAttention이 메모리 계층의 여러 수준(예: DRAM, 디스크)에 걸쳐 작동하도록 적응시키는 것 [43], RadixAttention 내에서 퍼지 의미 매칭을 가능하게 하는 것, SGLang 위에 더 높은 수준의 프리미티브를 제공하는 것, 캐시 인식 스케줄링에서의 기아(starvation)를 해결하는 것 [42], 그리고 스케줄링 및 메모리 계획과 같은 고급 정적 최적화를 수행하도록 SGLang 컴파일러를 향상시키는 것이 포함된다.
결론. 우리는 효율적인 프로그래밍과 구조화된 언어 모델 프로그램 실행을 위한 프레임워크인 SGLang을 소개한다. SGLang은 RadixAttention, 압축된 유한 상태 기계, 언어 인터프리터와 같은 새로운 최적화를 통해 복잡한 LM 프로그램의 처리량과 지연 시간을 크게 개선한다. 이는 고급 프롬프팅 기법과 에이전트 워크플로를 개발하는 데 유용한 도구이다. 소스 코드는 공개적으로 이용 가능하다.
감사의 글
이 프로젝트는 Stanford Center for Automated Reasoning과 Astronomer, Google, IBM, Intel, Lacework, Microsoft, Mohamed Bin Zayed University of Artificial Intelligence, Nexla, Samsung SDS, Uber, VMware의 기부로 지원받았다. Lianmin Zheng은 Meta Ph.D. Fellowship의 지원을 받는다. LLaVA-NeXT(비디오) 지원에 대해 Yuanhan Zhang과 Bo Li에게 감사한다.
참고문헌
[1] Reyna Abhyankar, Zijian He, Vikranth Srivatsa, Hao Zhang, and Yiying Zhang. Apiserve: Efficient api support for large-language model inferencing. arXiv preprint arXiv:2402.01869, 2024. [2] Jean-Baptiste Alayrac, Jeff Donahue, Pauline Luc, Antoine Miech, Iain Barr, Yana Hasson, Karel Lenc, Arthur Mensch, Katherine Millican, Malcolm Reynolds, et al. Flamingo: a visual language model for few-shot learning. Advances in Neural Information Processing Systems, 35:23716–23736, 2022. [3] Reza Yazdani Aminabadi, Samyam Rajbhandari, Ammar Ahmad Awan, Cheng Li, Du Li, Elton Zheng, Olatunji Ruwase, Shaden Smith, Minjia Zhang, Jeff Rasley, et al. Deepspeed-inference: enabling efficient inference of transformer models at unprecedented scale. In SC22: International Conference for High Performance Computing, Networking, Storage and Analysis, pages 1–15. IEEE, 2022. [4] Luca Beurer-Kellner, Marc Fischer, and Martin Vechev. Prompting is programming: A query language for large language models. Proceedings of the ACM on Programming Languages, 7(PLDI):1946–1969, 2023. [5] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. Language models are few-shot learners. Advances in neural information processing systems, 33:1877–1901, 2020. [6] Sébastien Bubeck, Varun Chandrasekaran, Ronen Eldan, Johannes Gehrke, Eric Horvitz, Ece Kamar, Peter Lee, Yin Tat Lee, Yuanzhi Li, Scott Lundberg, et al. Sparks of artificial general intelligence: Early experiments with gpt-4. arXiv preprint arXiv:2303.12712, 2023. [7] Wei-Lin Chiang, Zhuohan Li, Zi Lin, Ying Sheng, Zhanghao Wu, Hao Zhang, Lianmin Zheng, Siyuan Zhuang, Yonghao Zhuang, Joseph E. Gonzalez, Ion Stoica, and Eric P. Xing. Vicuna: An open-source chatbot impressing gpt-4 with 90%* chatgpt quality, March 2023.
[8] Wei-Lin Chiang, Lianmin Zheng, Ying Sheng, Anastasios Nikolas Angelopoulos, Tianle Li, Dacheng Li, Hao Zhang, Banghua Zhu, Michael Jordan, Joseph E Gonzalez, et al. Chatbot arena: 인간 선호도를 바탕으로 LLM을 평가하기 위한 오픈 플랫폼. arXiv preprint arXiv:2403.04132, 2024.
[9] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. Palm: Pathways를 활용한 언어 모델링의 확장. arXiv preprint arXiv:2204.02311, 2022.
[10] Tri Dao, Dan Fu, Stefano Ermon, Atri Rudra, and Christopher Ré. Flashattention: IO 인식 기반의 빠르고 메모리 효율적인 정확한 어텐션. Advances in Neural Information Processing Systems, 35:16344-16359, 2022.
[11] Suyu Ge, Yunan Zhang, Liyuan Liu, Minjia Zhang, Jiawei Han, and Jianfeng Gao. 모델이 무엇을 버릴지 알려준다: LLM을 위한 적응형 KV 캐시 압축. In The Twelfth International Conference on Learning Representations, 2023.
[12] In Gim, Guojun Chen, Seung-seob Lee, Nikhil Sarda, Anurag Khandelwal, and Lin Zhong. Prompt cache: 저지연 추론을 위한 모듈형 어텐션 재사용. arXiv preprint arXiv:2311.04934, 2023.
[13] Guidance AI. 대규모 언어 모델 제어를 위한 가이던스 언어. https://github.com/guidance-ai/guidance. Accessed: 2023-11.
[14] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. 대규모 멀티태스크 언어 이해 측정. In International Conference on Learning Representations, 2020.
[15] Coleman Hooper, Sehoon Kim, Hiva Mohammadzadeh, Michael W Mahoney, Yakun Sophia Shao, Kurt Keutzer, and Amir Gholami. Kvquant: KV 캐시 양자화를 통한 1천만 컨텍스트 길이 LLM 추론을 향하여. arXiv preprint arXiv:2401.18079, 2024.
[16] Hugging Face. 텍스트 생성 추론. https://github.com/huggingface/text-generation-inference. Accessed: 2023-11.
[17] Albert Q Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch, Blanche Savary, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Emma Bou Hanna, Florian Bressand, et al. Mixtral of experts. arXiv preprint arXiv:2401.04088, 2024.
[18] Jordan Juravsky, Bradley Brown, Ryan Ehrlich, Daniel Y Fu, Christopher Ré, and Azalia Mirhoseini. Hydragen: 공유 프리픽스를 활용한 고처리량 LLM 추론. arXiv preprint arXiv:2402.05099, 2024.
[19] Hao Kang, Qingru Zhang, Souvik Kundu, Geonhwa Jeong, Zaoxing Liu, Tushar Krishna, and Tuo Zhao. Gear: LLM의 거의 무손실 생성 추론을 위한 효율적인 KV 캐시 압축 레시피. arXiv preprint arXiv:2403.05527, 2024.
[20] Omar Khattab, Arnav Singhvi, Paridhi Maheshwari, Zhiyuan Zhang, Keshav Santhanam, Sri Vardhamanan, Saiful Haq, Ashutosh Sharma, Thomas T. Joshi, Hanna Moazam, Heather Miller, Matei Zaharia, and Christopher Potts. Dspy: 선언적 언어 모델 호출을 자기 개선 파이프라인으로 컴파일. arXiv preprint arXiv:2310.03714, 2023.
[21] Sehoon Kim, Suhong Moon, Ryan Tabrizi, Nicholas Lee, Michael W Mahoney, Kurt Keutzer, and Amir Gholami. 병렬 함수 호출을 위한 LLM 컴파일러. arXiv preprint arXiv:2312.04511, 2023.
[22] Michael Kuchnik, Virginia Smith, and George Amvrosiadis. relm을 이용한 대규모 언어 모델 검증. Proceedings of Machine Learning and Systems, 5, 2023.
[23] Woosuk Kwon, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, and Ion Stoica. PagedAttention을 이용한 대규모 언어 모델 서빙을 위한 효율적인 메모리 관리. In Proceedings of the 29th Symposium on Operating Systems Principles, pages 611-626, 2023.
[24] LangChain AI. Langchain. https://github.com/langchain-ai/langchain. Accessed: 2023-11.
[25] Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond, Tom Eccles, James Keeling, Felix Gimeno, Agustin Dal Lago, et al. AlphaCode를 이용한 경쟁 수준의 코드 생성. Science, 378(6624):1092-1097, 2022.
[26] Ji Lin, Jiaming Tang, Haotian Tang, Shang Yang, Xingyu Dang, and Song Han. Awq: LLM 압축 및 가속을 위한 활성화 인식 가중치 양자화. arXiv preprint arXiv:2306.00978, 2023.
[27] Haotian Liu, Chunyuan Li, Yuheng Li, and Yong Jae Lee. 시각적 명령 튜닝을 통한 개선된 베이스라인. arXiv preprint arXiv:2310.03744, 2023.
[28] Haotian Liu, Chunyuan Li, Yuheng Li, Bo Li, Yuanhan Zhang, Sheng Shen, and Yong Jae Lee. Llava-next: 개선된 추론, OCR, 세계 지식, January 2024.
[29] Shu Liu, Asim Biswal, Audrey Cheng, Xiangxi Mo, Shiyi Cao, Joseph E Gonzalez, Ion Stoica, and Matei Zaharia. 관계형 워크로드에서 LLM 쿼리 최적화. arXiv preprint arXiv:2403.05821, 2024.
[30] Xiaoxia Liu, Jingyi Wang, Jun Sun, Xiaohan Yuan, Guoliang Dong, Peng Di, Wenhai Wang, and Dongxia Wang. 대규모 언어 모델을 위한 프롬프팅 프레임워크: 서베이. arXiv preprint arXiv:2311.12785, 2023.
[31] Zichang Liu, Aditya Desai, Fangshuo Liao, Weitao Wang, Victor Xie, Zhaozhuo Xu, Anastasios Kyrillidis, and Anshumali Shrivastava. Scissorhands: 테스트 시점의 LLM KV 캐시 압축을 위한 중요도 지속성 가설 활용. Advances in Neural Information Processing Systems, 36, 2024.
[32] Zirui Liu, Jiayi Yuan, Hongye Jin, Shaochen Zhong, Zhaozhuo Xu, Vladimir Braverman, Beidi Chen, and Xia Hu. Kivi: KV 캐시를 위한 튜닝 없는 비대칭 2비트 양자화. arXiv preprint arXiv:2402.02750, 2024.
[33] Xuefei Ning, Zinan Lin, Zixuan Zhou, Zifu Wang, Huazhong Yang, and Yu Wang. Skeleton-of-thought: 효율적인 병렬 생성을 위한 LLM 프롬프팅. In The Twelfth International Conference on Learning Representations, 2024.
[34] NVIDIA. Tensorrt-llm. https://github.com/NVIDIA/TensorRT-LLM. Accessed: 2023-11.
[35] OpenAI. Gpt-4 기술 보고서, 2023.
[36] Joon Sung Park, Joseph C. O'Brien, Carrie J. Cai, Meredith Ringel Morris, Percy Liang, and Michael S. Bernstein. 생성형 에이전트: 인간 행동의 상호작용형 시뮬라크라. In In the 36th Annual ACM Symposium on User Interface Software and Technology (UIST '23), UIST '23, New York, NY, USA, 2023. Association for Computing Machinery.
[37] Adam Paszke, Sam Gross, Francisco Massa, Adam Lerer, James Bradbury, Gregory Chanan, Trevor Killeen, Zeming Lin, Natalia Gimelshein, Luca Antiga, et al. Pytorch: 명령형 스타일의 고성능 딥러닝 라이브러리. Advances in neural information processing systems, 32, 2019.
[38] Shishir G. Patil, Tianjun Zhang, Xin Wang, and Joseph E. Gonzalez. Gorilla: 대규모 API와 연결된 대규모 언어 모델. arXiv preprint arXiv:2305.15334, 2023.
[39] Reiner Pope, Sholto Douglas, Aakanksha Chowdhery, Jacob Devlin, James Bradbury, Jonathan Heek, Kefan Xiao, Shivani Agrawal, and Jeff Dean. 트랜스포머 추론의 효율적 확장. Proceedings of Machine Learning and Systems, 5, 2023.
[40] Swarnadeep Saha, Omer Levy, Asli Celikyilmaz, Mohit Bansal, Jason Weston, and Xian Li. Branch-solve-merge improves large language model evaluation and generation. arXiv preprint arXiv:2310.15123, 2023.
[41] Timo Schick, Jane Dwivedi-Yu, Roberto Dessi, Roberta Raileanu, Maria Lomeli, Luke Zettlemoyer, Nicola Cancedda, and Thomas Scialom. Toolformer: Language models can teach themselves to use tools. arXiv preprint arXiv:2302.04761, 2023.
[42] Ying Sheng, Shiyi Cao, Dacheng Li, Banghua Zhu, Zhuohan Li, Danyang Zhuo, Joseph E Gonzalex, and Ion Stoica. Fairness in serving large language models. arXiv preprint arXiv:2401.00588, 2023.
[43] Ying Sheng, Lianmin Zheng, Binhang Yuan, Zhuohan Li, Max Ryabinin, Beidi Chen, Percy Liang, Christopher Ré, Ion Stoica, and Ce Zhang. Flexgen: high-throughput generative inference of large language models with a single gpu. In International Conference on Machine Learning, pages 31094-31116. PMLR, 2023.
[44] Mohammad Shoeybi, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, and Bryan Catanzaro. Megatron-lm: Training multi-billion parameter language models using model parallelism. arXiv preprint arXiv:1909.08053, 2019.
[45] Vikranth Srivatsa, Zijian He, Reyna Abhyankar, Dongming Li, and Yiying Zhang. Preble: Efficient distributed prompt scheduling for llm serving. 2024.
[46] Theodore Sumers, Shunyu Yao, Karthik Narasimhan, and Thomas Griffiths. 언어 에이전트를 위한 인지 아키텍처. Transactions on Machine Learning Research, 2023.
[47] Gemini Team, Rohan Anil, Sebastian Borgeaud, Yonghui Wu, Jean-Baptiste Alayrac, Jiahui Yu, Radu Soricut, Johan Schalkwyk, Andrew M Dai, Anja Hauth, et al. Gemini: 고성능 멀티모달 모델군. arXiv preprint arXiv:2312.11805, 2023.
[48] Philippe Tillet, Hsiang-Tsung Kung, and David Cox. Triton: 타일링된 신경망 연산을 위한 중간 언어 및 컴파일러. In Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, pages 10-19, 2019.
[49] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. Llama 2: 공개 기반 모델 및 파인튜닝된 채팅 모델. arXiv preprint arXiv:2307.09288, 2023.
[50] Vivien Tran-Thien. 정규식 제약을 사용한 빠르고 충실도 높은 LLM 디코딩, 2024.
[51] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, Łukasz Kaiser, and Illia Polosukhin. 어텐션만 있으면 된다. Advances in neural information processing systems, 30, 2017.
[52] Guanzhi Wang, Yuqi Xie, Yunfan Jiang, Ajay Mandlekar, Chaowei Xiao, Yuke Zhu, Linxi Fan, and Anima Anandkumar. Voyager: 대규모 언어 모델을 갖춘 개방형 구현 에이전트. arXiv preprint arXiv: arXiv:2305.16291, 2023.
[53] Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc V Le, Ed H Chi, Sharan Narang, Aakanksha Chowdhery, and Denny Zhou. 자기 일관성이 언어 모델의 사고 연쇄 추론을 향상시킨다. In The Eleventh International Conference on Learning Representations, 2022.
[54] Brandon T Willard and Rémi Louf. 대규모 언어 모델을 위한 효율적인 유도 생성. arXiv e-prints, pages arXiv-2307, 2023.
[55] Qingyun Wu, Gagan Bansal, Jieyu Zhang, Yiran Wu, Shaokun Zhang, Erkang Zhu, Beibin Li, Li Jiang, Xiaoyun Zhang, and Chi Wang. Autogen: 다중 에이전트 대화 프레임워크를 통한 차세대 LLM 애플리케이션 구현. arXiv preprint arXiv:2308.08155, 2023.
[56] Shunyu Yao, Dian Yu, Jeffrey Zhao, Izhak Shafran, Thomas L Griffiths, Yuan Cao, and Karthik Narasimhan. 사고 트리: 대규모 언어 모델을 통한 숙고적 문제 해결. arXiv preprint arXiv:2305.10601, 2023.
[57] Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik R Narasimhan, and Yuan Cao. React: 언어 모델에서 추론과 행동의 시너지. In The Eleventh International Conference on Learning Representations, 2022.
[58] Lu Ye, Ze Tao, Yong Huang, and Yang Li. Chunkattention: 프리픽스 인식 KV 캐시와 2단계 분할을 이용한 효율적인 셀프 어텐션. arXiv preprint arXiv:2402.15220, 2024.
[59] Zihao Ye, Lequn Chen, Ruihang Lai, Yilong Zhao, Size Zheng, Junru Shao, Bohan Hou, Hongyi Jin, Yifei Zuo, Liangsheng Yin, Tianqi Chen, and Luis Ceze. FlashInfer를 통한 LLM 서빙용 셀프 어텐션 가속화, February 2024.
[60] Gyeong-In Yu, Joo Seong Jeong, Geon-Woo Kim, Soojeong Kim, and Byung-Gon Chun. Orca: {Transformer 기반} 생성 모델을 위한 분산 서빙 시스템. In 16th USENIX Symposium on Operating Systems Design and Implementation (OSDI 22), pages 521-538, 2022.
[61] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi, and Yejin Choi. Hellaswag: 기계가 정말로 문장을 완성할 수 있는가? In Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, pages 4791-4800, 2019.
[62] Yuanhan Zhang, Bo Li, haotian Liu, Yong jae Lee, Liangke Gui, Di Fu, Jiashi Feng, Ziwei Liu, and Chunyuan Li. Llava-next: 강력한 제로샷 비디오 이해 모델, April 2024.
A RadixAttention에 대한 추가 세부 사항
A.1 KV 캐시 배경
오늘날 사용되는 대부분의 LLM(예: GPT-3 [5], PaLM [9], LLaMA [49])은 자기회귀 Transformer 아키텍처 [51]를 기반으로 한다. 이 모델들은 선행 토큰들을 기반으로 시퀀스 내 다음 토큰의 확률을 예측한다. 추론 중에 모델은 먼저 입력 토큰 시퀀스를 순방향 패스로 처리한다(이 과정을 "프리필"이라고 한다). 그런 다음 출력 토큰을 순차적으로 디코딩하며, 각 토큰은 이전 토큰들에 의존한다(이 과정을 "디코딩"이라고 한다). 입력 토큰 시퀀스를 받아 출력 토큰 시퀀스를 생성하는 과정을 단일 생성 호출이라고 한다. 이 과정 전반에서 각 토큰은 일부 중간 텐서를 생성하며, 이는 추가 토큰 디코딩에 사용된다. "KV 캐시"라고 알려진 이 중간 텐서들은 셀프 어텐션 메커니즘의 키-값 쌍에서 이름을 따왔다. 이 논문에서 최적화를 논할 때 중요한 관찰은 KV 캐시의 계산이 오직 모든 이전 토큰들에만 의존한다는 점이며, 따라서 동일한 프리픽스를 가진 서로 다른 시퀀스들은 해당 프리픽스 토큰들의 KV 캐시를 재사용하여 중복 계산을 피할 수 있다.
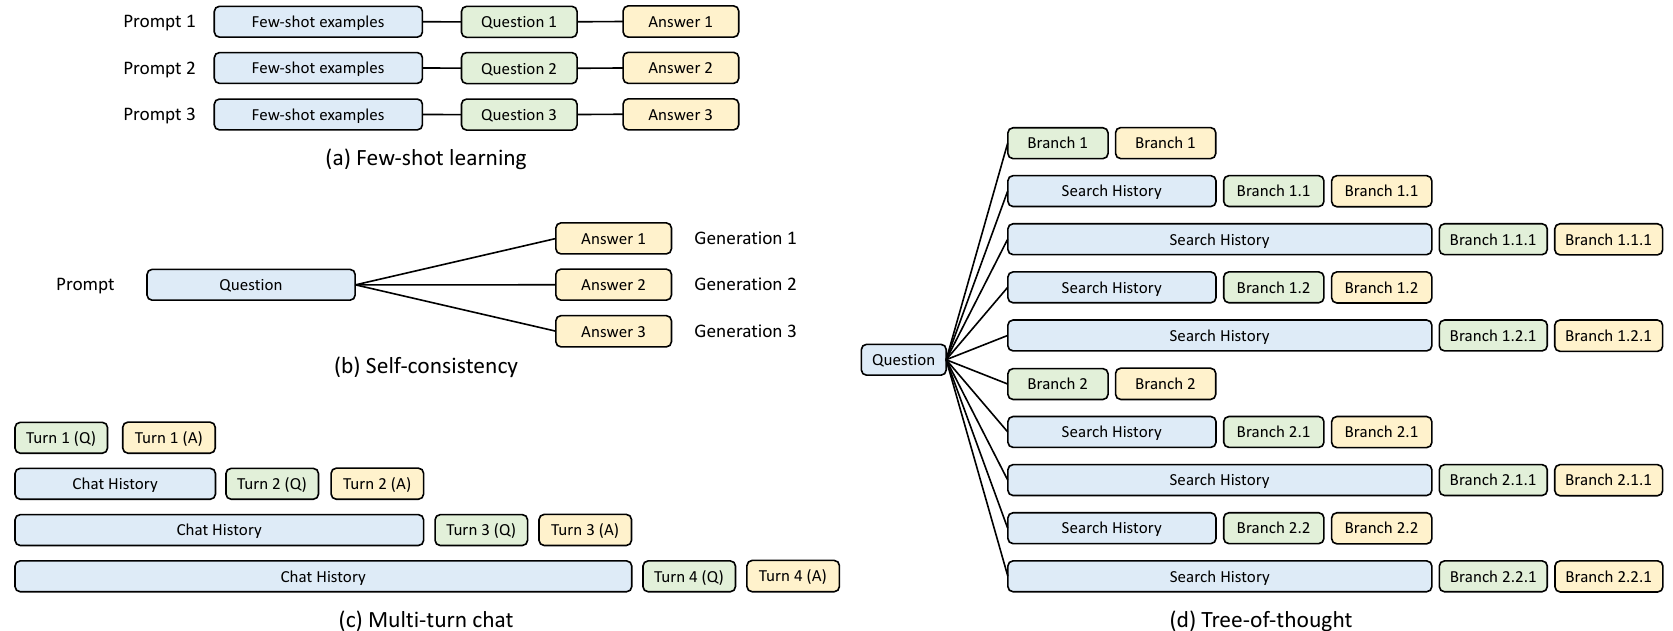
LLM 프로그램에서는 종종 여러 텍스트 세그먼트와 생성 호출이 하나의 프롬프트에 추가된다. 여러 체인 호출에 걸쳐 이전 토큰들에 대해 계산된 KV 캐시를 캐싱하면 중복 계산을 줄일 수 있다. 그러나 이 최적화는 공짜도 아니고 사소하지도 않은데, 추가 저장 공간과 더 복잡한 메모리 관리가 필요하기 때문이다. 또한 LLM 프로그램에서는 하나의 프롬프트에서 여러 출력을 생성하거나 현재 상태에서 새로운 프롬프트를 분기하는 것이 일반적이다 [25]. 기본적인 프리픽스 공유는 vLLM [23]에서 연구되었다. 불규칙한 트리 구조 공유와 같은 더 고급 공유 패턴도 사용할 수 있다. Fig. 9는 여러 호출에 걸친 KV 캐시 공유의 네 가지 전형적인 패턴을 보여주며, 기존 시스템 중 어느 것도 이들 모두를 자동으로 처리할 수 없다. 반대로, Sec. 3의 우리의 RadixAttention은 런타임에 이들 모두를 자동으로 처리할 수 있다.
A.2 캐시 인식 스케줄링을 위한 의사코드
Alg. 1은 연속 배칭을 사용하는 RadixAttention에 대한 캐시 인식 스케줄링의 의사코드를 보여준다.
A.3 정리 3.1의 증명
정리 3.1. 요청들의 배치에 대해, 캐시 크기가 최대 요청 길이 이상일 때 요청들의 기수 트리를 깊이 우선 탐색 순서로 방문함으로써 최적의 캐시 적중률을 달성할 수 있다. 가장 긴 공유 프리픽스 우선 순서는 깊이 우선 탐색 순서와 동등하다.
증명. 먼저, 깊이 우선 탐색(DFS) 순서가 최적의 캐시 적중률을 달성함을 보인다. 배치 내 요청들의 집합을 이라 하고, 로부터 구축된 기수 트리를 라 하자. 의 각 간선 에 대해, 와 연관된 KV 캐시는 적어도 한 번 계산되어야 한다. 와 연관된 KV 캐시의 크기를 라 하자. 에 대한 KV 캐시의 계산 복잡도를 라 하자.
알고리즘 1 연속 배칭을 사용하는 RadixAttention을 위한 캐시 인식 스케줄링.입력: 기수 트리 , 메모리 풀 , 현재 실행 중인 배치 , 대기 큐 .출력: 완료된 요청과 갱신된 시스템 상태.// 대기 큐에서 모든 요청 가져오기requests .get_all_requests()// 모든 대기 요청에 대한 접두사 일치 검색for req requests doreq.prefix_node, req.prefix_len .match_prefix(req.input_tokens)end for// 일치된 접두사 길이에 따라 요청 정렬requests.sort()// 다음 배치에 대한 요청 선택available_size .evitable_size() + .available_size()current_size new_batch for req requests doif req.size() + current_size available_size thennew_batch.append(req)delta .increase_ref_counter(req.prefix_node)available_size available_size + deltaend ifend forQ.remove_requests(new_batch)// 요청을 현재 실행 중인 배치에 삽입B.merge(new_batch)// 새 메모리 할당 및 필요 시 축출 수행needed_size .needed_size()success,buffer .alloc(needed_size)if not success thenT.evict(needed_size)success,buffer .alloc(needed_size)end ifB.run(buffer)// 완료된 요청 처리finished_requests .drop_finished_requests()for req finished_requests doT.decrease_ref_counter(req.prefix_node)T.insert(req)end forreturn finished_requests우리는 하한을 얻는다
기수 트리 를 DFS 순서로 방문한다고 가정하자. 의 각 간선 에 대하여, 와 연관된 KV 캐시를 처음 계산할 때 우리는 그다음 의 전체 서브트리를 계산하게 된다. 의 서브트리를 계산하는 동안 간선 는 연속적으로 적중되므로 추가적인 계산은 발생하지 않는다. 를 루트로 하는 서브트리에 대한 계산이 끝난 후에는 간선 는 다시 방문되지 않는다. 기수 트리 에서 가장 긴 경로와 같은 최대 요청 길이 이상의 캐시 크기를 가지면, 서브트리의 를 포함한 공통 접두사가 연속적으로 적중되므로 간선 는 그 서브트리의 계산 중에 축출되지 않는다는 점에 주목하라. 따라서 각 간선 와 연관된 KV 캐시는 오직 한 번만 계산될 것이다. 따라서 우리는 하한
을 달성한다. 캐시 적중률은 다음과 같이 정의되며,
와 같으며, 상한에 도달하여 최적성을 제공한다.
다음으로, 우리는 최장 공유 접두사 우선 순서가 귀납법에 의해 DFS 순서와 동등함을 보인다.
- (기저) 처음에는 캐시된 것이 없으므로, \(T\) 의 노드 \(x\) 에 대응하는 임의의 요청이 처리될 것이다. 루트에서 \(x\) 까지의 경로상에 있는 노드들 \(\{v_{1}, \ldots , v_{n}\}\) 에 대응하는 모든 요청은 재계산이 필요 없다. 노드들 \(\{v_{1}, \ldots , v_{n}, x\}\) 에 대응하는 요청들에 대한 계산 복잡도는 유효한 DFS와 일치한다. 루트에서 \(x\) 까지의 경로가 캐시된다.
- (귀납) 방금 \(T\) 의 노드 \(y\) 를 방문했다고 가정하고, 방문된 노드들이 DFS 순서와 일치한다고 하자. 루트에서 \(y\) 까지의 경로를 \(P\) 라 하자. 그러면 방문되지 않은 각 노드는 방문된 노드들과의 최소 공통 조상을 \(P\) 위에 가진다. \(P\) 위의 노드들은 캐시되어 있으므로, 최소 공통 조상이 \(P\) 위에 있는 방문되지 않은 노드 \(z\) 는 최장 공유 접두사를 가지게 된다. 최장 공유 접두사 우선 순서는 \(z\) 를 선택하게 되며, 이는 유효한 DFS 순서이다. 루트에서 \(z\) 까지의 경로는 가장 최근의 것이므로 캐시될 것이다.
온라인 경우에는 DFS 순서가 교란되지만, 최장 공유 접두사 스케줄은 여전히 함축된 기수 트리의 증강된 부분에서 DFS 동작을 근사한다. 우리는 새로운 요청 배치를 추가하는 단계를 고려함으로써 이를 보인다.
\(T\) 를 지금까지 방문된 기수 트리의 부분을, \(T^{\prime}\) 를 새로운 요청 배치를 추가한 후의 전체 새로운 기수 트리를 나타내도록 하자. \(C\) 를 \(T\) 에서 캐시된 노드들의 집합이라 하자. longest \((C)\) 를 \(C\) 중에서 루트로부터의 경로가 가장 길고 \(T^{\prime}\) 에서 완전히 방문되지 않은 서브트리를 가지는 노드를 나타내도록 하자.
그러면 최장 공유 접두사 스케줄은 longest \((C)\) 를 루트로 하는 \(T^{\prime}\) 의 서브트리를 DFS 순서로 처리할 것이다. 이 과정에서 축출이 발생할 수 있으며, \(C\) 로부터 남은 캐시된 노드들은 \(C^{(1)} \subseteq C\) 가 된다. 그러면 longest \((C^{(1)})\) 를 루트로 하는 \(T^{\prime}\) 의 서브트리에 대해 DFS가 수행될 것이다.
마찬가지로, 우리는 \(C^{(2)}, \ldots , C^{(k)}\) 를 가지게 되며, \(C^{(k)}\) 가 \(T^{\prime}\) 에서 완전히 방문되지 않은 서브트리를 가지는 \(C^{(k)}\) 내의 단 하나의 잎 노드만을 포함할 때까지 이어진다. 이 지점에서 우리는 유효한 DFS 상태에 도달한 것이다. \(T^{\prime}\) 의 나머지 부분은 정리 3.1의 증명에서 설명된 바와 같이 DFS 순서로 방문될 것이다.
A.4 데이터 병렬 분산 RadixAttention
여러 복제 워커(즉, 데이터 병렬성)를 가진 분산 환경에 RadixAttention을 적응시키기 위해, 우리는 각 워커가 자체 서브트리를 유지하고 라우터가 메타트리를 감독하는 메커니즘을 개발했다. 이 메타트리는 모든 서브트리와 그에 연관된 장치들을 추적하는 트라이 역할을 한다. 라우터에 새로운 요청 배치가 도착하면, 메타트리에서 접두사 매칭이 수행된다. 우리는 특정 워커 및 동일 그룹 내 다른 요청들과의 공유 접두사 길이로 측정되는 각 요청의 선호도에 기반한 다양한 정책을 구현하여, 중복 계산을 최소화하는 효율적인 디스패치 결정을 내린다. 새로운 요청이 처리될 때마다 라우터와 워커는 각각 자신의 트리를 독립적으로 갱신한다. 워커 노드에서 축출이 발생하면, 해당 노드는 이 축출을 큐에 커밋하고, 라우터는 활동이 적은 기간 동안 이를 처리하여 메타트리를 갱신한다. 우리는 네 개의 워커와 MMLU 데이터셋을 사용하여 이 분산 구성을 벤치마크했으며, 이것이 선형 스케일링과 이 약한 일관성 분산 캐시 설계로 인한 최소한의 오버헤드로 최적의 캐시 적중률을 달성함을 관찰했다. 데이터 지역성 최대화와 병렬 처리 효율성 사이에는 트레이드오프가 존재한다. 이 트레이드오프를 최적화하기 위한 고급 스케줄링 정책 탐색은 향후 연구 영역으로 지정된다. 또한, Preble [45]의 동시 연구는 SGLang의 초기 버전에 기반한 데이터 병렬 스케줄링을 연구한다.
B 압축 유한 상태 기계에 관한 추가 세부 사항
이 절에서는 더 빠른 제약 디코딩을 위한 압축 유한 상태 기계의 배경과 구현 세부 사항을 논의한다. 우리는 LLM이 정규 표현식(regex)을 따르도록 하는 것을 목표로 하며, 이는 더 큰 표현력을 제공하고 JSON 스키마와 같은 일반적인 형식을 표현하는 데 사용될 수 있다. 이를 달성하기 위해, 우리는 디코딩 중 생성 과정을 안내하기 위해 regex를 유한 상태 기계(FSM)로 변환한다 [54]. FSM은 본질적으로 노드(상태)와 간선(문자열/문자와의 전이)을 가진 그래프이다. 초기 상태에서 시작하여, 각 전이는 간선上の 문자열을 덧붙여 다음 상태로 이동하며, 최종 상태들의 집합을 사용하여 과정을 종결한다. 이 메커니즘은 FSM의 현재 상태 전이에 기반하여 유효하지 않은 토큰들을 걸러내면서 LLM의 디코딩을 안내하며, 이는 그림 10에 예시되어 있다. 디코딩은 최종 상태에 도달할 때까지 FSM에서 여러 전이를 포함할 수 있다.
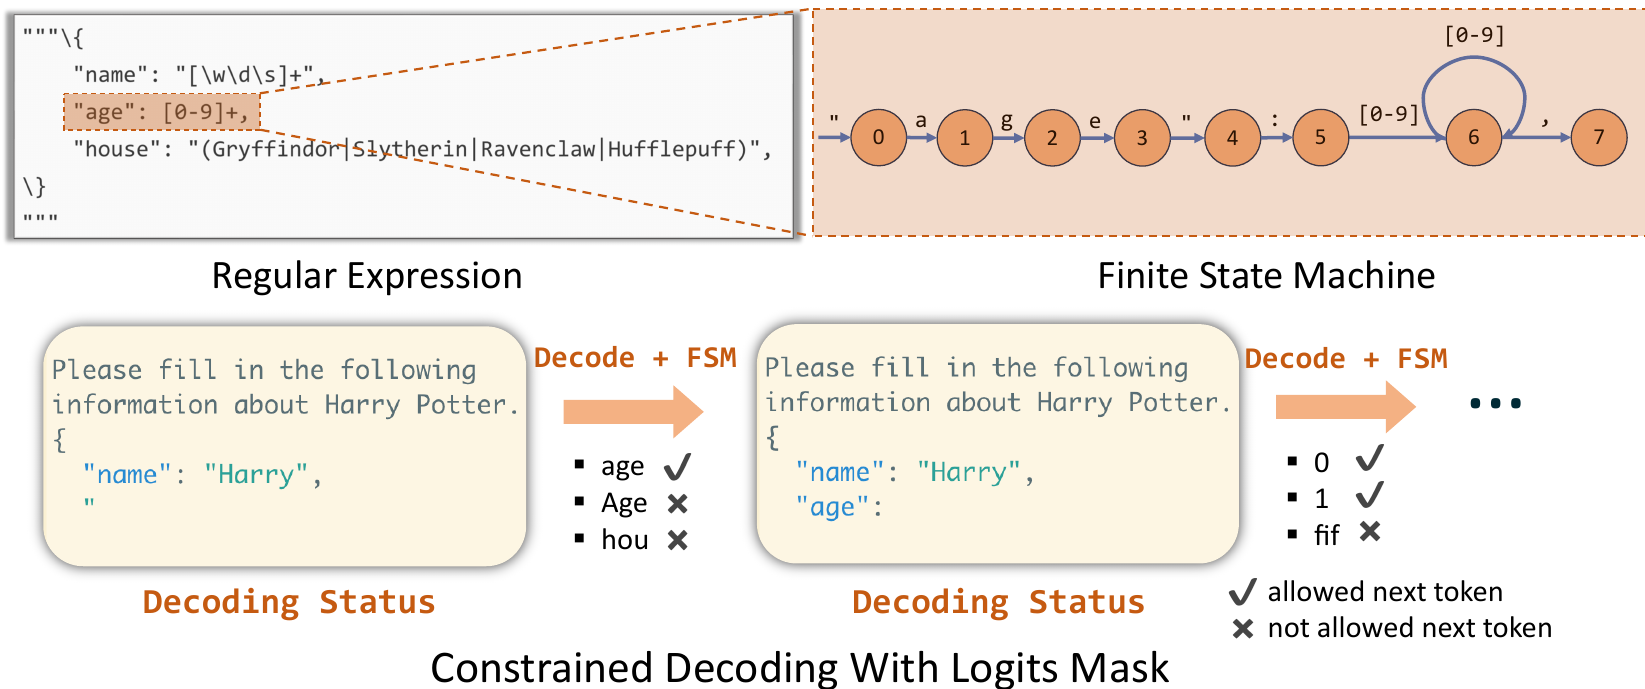
제약 디코딩의 과제는 제약이 종종 자연어 형식으로 표현된다는 사실에서 비롯된다. 즉, regex는 문자/문자열로 묘사되는 반면, LLM은 이를 토큰으로 해석하고 처리하도록 설계된다. 이는 문자열과 토큰 사이의 매핑이 복잡하고 일대일 대응이 부족하기 때문에 복잡한 시나리오를 만들어낸다 [22].
4이 절은 이전 블로그 게시물에서 파생되었다. 독자들은 추가적인 배경과 더 쉬운 이해를 위해 해당 블로그 게시물을 읽는 것도 권장된다.
B.1 압축 유한 상태 기계의 구현 세부 사항
압축 FSM의 구성을 단순화하기 위해, 우리는 원래의 FSM을 토큰 대신 문자/문자열 위에 구축한다. 우리는 단일 전이 간선과 압축 간선의 개념을 다음과 같이 공식적으로 정의한다:
- 단일 전이 간선: 간선은 1) 그 원천 노드가 단 하나의 후속 노드만을 가지고, 2) 그 위에 단 하나의 허용 가능한 문자/문자열만이 존재하는 경우 단일 전이 간선이다.- 압축 간선: 여러 연속적으로 인접한 간선들 \((e_0, e_1, \ldots , e_k)\) 에 의해 압축된 간선은 \(e_1, \ldots , e_k\) 가 단일 전이 간선인 경우에만 성립한다. 압축 간선의 텍스트는 \(e_0, e_1, \ldots , e_k\) 의 텍스트들을 연결한 것이다.
문자 기반 FSM에서 시작하여, 우리는 더 이상의 압축이 불가능할 때까지 단일 전이 간선들을 선행 간선들로 재귀적으로 병합하여, 압축 FSM을 얻는다. 이 접근 방식은 그림 11에 표시된 SGLang의 압축 FSM 런타임 효율성에서 입증되듯이 디코딩 과정을 가속화한다.
B.2 재토큰화를 통한 토큰화 인공물 처리
새로운 토큰이 생성되면, 우리는 토큰의 문자열을 얻고 현재 상태의 모든 나가는 간선들을 검색하여 방금 디코딩된 문자열로 시작하는 간선을 찾은 후 앞으로 이동한다. 그러나 전이 간선이 잘 압축된 것이고 매우 긴 문자열을 포함하는 경우, 우리는 다음 라운드들의 디코딩된 문자열들도 예상할 수 있다. 이것이 가속이 일어나는 지점이며 우리는 이 과정을 점프 포워드(Jump Forward)라고 부른다. 그러나 우리는 여전히 다음 디코딩 단계들을 위해 문자열을 토큰으로 변환해야 하며, LLM의 특정 사전 학습 및 토큰화 방법 때문에 이것은 간단하지 않다.
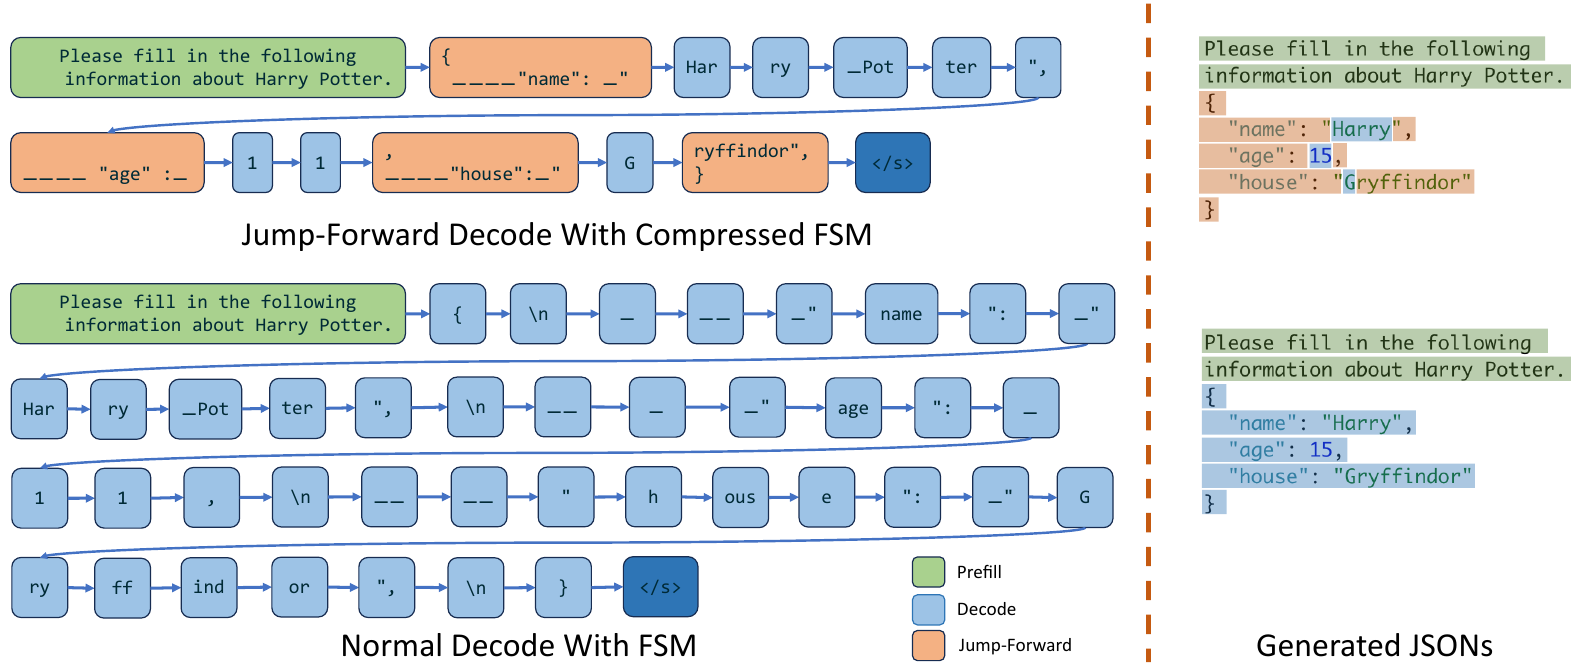
직접적인 분할은 의도된 의미를 변경할 수 있다 [50]. 예를 들어, 그림 2의 regex에서 압축된 텍스트는 {"summary": " 이며, 이는 토크나이저에 따라 {"summary,": 와 " 로만 토큰화될 수 있고, {"summa, ry, 와 ". 와 같이 무작위로 분할될 수는 없다. 이 문제를 해결하기 위해, 우리는 원래의 토크나이저를 사용하여 모든 이전 텍스트와 압축 간선의 텍스트를 재토큰화하여, LLM의 원래 입력 형식과의 정렬을 보장한다. 그리고 이것은 단지 미미한 재토큰화 오버헤드만을 초래한다.
B.3 향후 확장: 왜곡된 확률 처리
문자열과 토큰 사이의 간극으로 인한 문제는 확률 분포가 왜곡되는 문제도 초래한다 [50]. 예를 들어, 그림 2에서 정규식 "[ABCD][+- ]?"는 A+부터 D-까지의 등급을 나타내지만, 이를 Excellent | Above Average | Fair | Below Average와 같은 더 넓은 용어로 대체하면, Above Average라는 용어가 압축된 전이(transition) 위에 있기 때문에 런타임이 A를 부정확하게 Above Average로 매핑하여 등급 위계를 잘못 표현할 수 있다. 이는 LLM이 선택지의 구체적인 범위를 인식하지 못하여 부적절한 토큰 시퀀스를 생성하기 때문에 발생한다. 각 선택지에 대한 정확한 확률을 계산하려면 각 선택지를 결과로 내놓는 모든 토큰 시퀀스의 확률을 합산해야 하며, 이는 디코딩을 복잡하게 만들고 오버헤드를 추가한다. 한 가지 우회 방법은 선택지나 정규식을 프리필(prefill) 프롬프트에 직접 포함시켜 LLM이 자신의 선택지를 인지하고 적절한 토큰 시퀀스로 결정을 출력하도록 안내하는 것이다. 그러나 이 접근법은 확률 왜곡이라는 근본적인 문제를 해결하지 못하며, 압축된 FSM의 정확성을 개선하기 위한 추가 연구의 필요성을 부각시킨다.
C 추가 실험 설정 및 결과
추가 실험 설정. 그림 5와 그림 6은 단일 A10G(24GB) GPU에서 Llama-7B를 실행하여 얻은 것이다. 그림 7은 텐서 병렬 처리를 사용하여 8개의 A10G(24GB) GPU에서 Mixtral-8x7B를 실행하여 얻은 것이다. 그림 8(c)는 단일 A10G(24GB) GPU에서 Llama-7B를 실행하여 얻은 것이다. 그림 12는 텐서 병렬 처리를 사용하여 4개의 A100G(80GB) GPU에서 Llama-70B를 실행하여 얻은 것이다. 표 2는 단일 A10G(24GB) GPU에서 LLaVA-v1.5-7B를 실행하고 단일 A100G(80GB) GPU에서 LLaVA-Next-34B를 실행하여 얻은 것이다. 벤치마크 그림의 각 막대는 실행하는 데 수 분에서 한 시간 정도 걸린다.
추가 실험 결과. 그림 13은 그림 5에 나열된 벤치마크에서 달성된 캐시 적중률과 최적 캐시 적중률을 보여준다. 그림 12는 텐서 병렬 처리를 사용한 Llama-2-70B의 처리량을 보여준다.
D 컴파일러 모드
논문 본문에서 사용된 인터프리터 모드 외에도 SGLang 프로그램을 실행하는 또 다른 방법은 이를 계산 그래프로 컴파일하고 그래프 실행기(graph executor)로 실행하는 것이다. 이는
그래프를 재작성하고 더 많은 정적 계획을 수행할 수 있으므로 더 많은 컴파일 최적화의 기회를 열어준다.
D.1 설계 및 구현
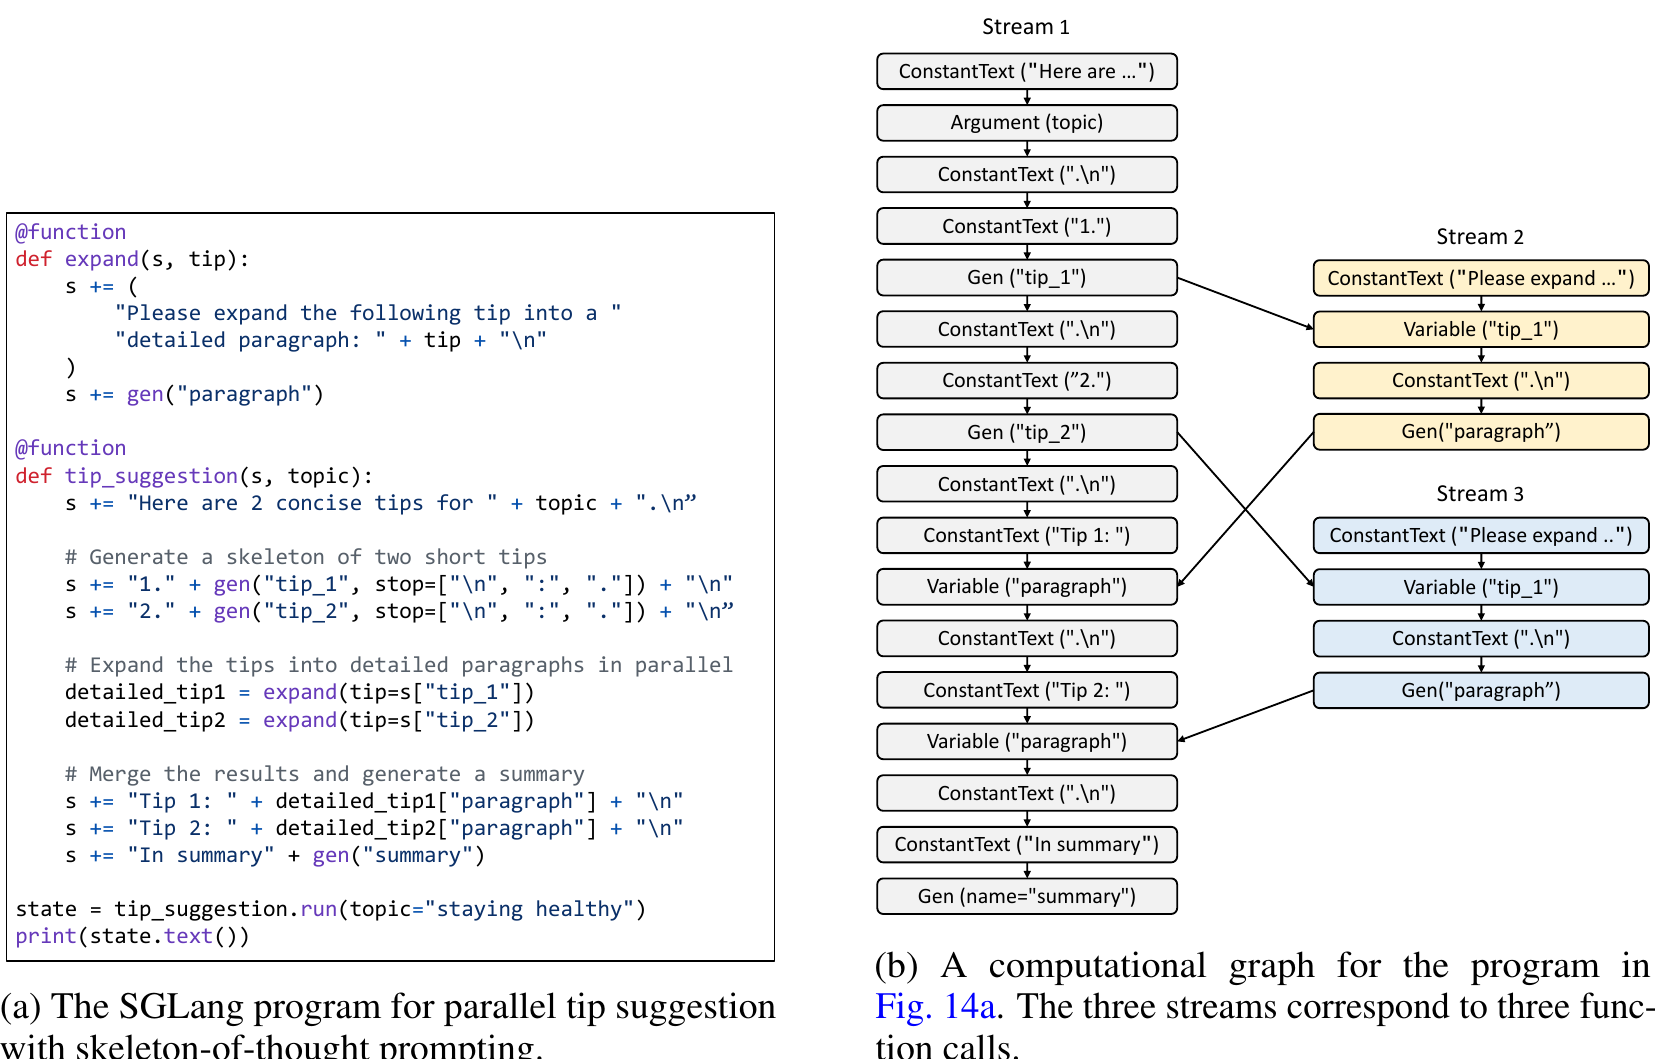
우리는 SGLang 프로그램 구조와 연산을 계산 그래프로 표현하는 중간 표현(IR)을 설계했다. 이 그래프는 원시 연산자에 대한 노드와 의존성에 대한 간선을 포함한다. 그림 14a의 프로그램에 대응하는 그래프는 그림 14b를 참조하라. 프로그램에서 데코레이션된 함수나 fork에 대한 각 호출은 새로운 프롬프트 상태 또는 스트림을 생성한다.
노드에는 여러 유형이 있다. SGLang 프로그램에서 연산자 와 의 각 피연산자는 IR 노드로 표현된다. 여기에는 ConstantText, Argument, Gen, Select, Variable, Fork, GetForkItem, Join이 포함된다. 의존성에는 두 가지 유형이 있다. 하나는 스트림 내 의존성(intra-stream dependency)으로, 를 사용하여 스트림에 제출된 연산은 해당 스트림의 모든 선행 연산 이후에 실행되어야 한다. 다른 하나는 스트림 간 의존성(inter-stream dependency)으로, 한 스트림이 다른 스트림으로부터 변수 값을 가져와야 할 때 발생하며 동기화를 필요로 한다. fork와 같은 연산은 여러 스트림을 조작하므로 스트림 간 의존성을 도입한다.
그래프를 생성하기 위해 우리는 추상 인자로 프로그램을 실행하고 그래프를 동적으로 구성하는 트레이싱을 사용한다. 이 방법은 데이터 의존적 제어 흐름이 없는 프로그램으로 제한되며, 이 제한은 향후 연구에서 다룰 계획이다. 일단 구성되면, 그래프는 그래프 실행기를 통해 실행될 수 있으며, 원래 Python 프로그램을 다시 해석할 필요가 없다. 이는 그래프 재작성 최적화, 런타임 오버헤드 감소, 프로그램 직렬화와 같은 이점을 가져온다. 실행을 위해 각 데이터 스트림에 대해 스트림 실행기(stream executor)가 시작되고, IR 노드를 위상 순서(topological order)로 스트림에 디스패치한다.
D.2 컴파일러 최적화 사례 연구: 프리픽스 공유 개선을 위한 코드 이동
우리는 SGLang IR에 대한 컴파일 최적화, 즉 프리픽스 공유 개선을 위한 코드 이동을 탐구한다. 우리는 자동 튜닝과 명령어 선택과 같은 더 고전적인 컴파일러 기법들도 적용될 수 있을 것으로 예상한다.
이 최적화는 그래프의 노드들을 재정렬하여 상수 프리픽스의 길이를 늘림으로써 프리픽스 공유를 개선하는 것을 목표로 한다. 이는 원래의 계산을 엄격하게 보존하지 않으므로, 공격적인 최적화로 분류된다. 예를 들어, 프롬프트를 "Here is a question + {question}. Please act as a math expert and solve the given question."에서 "Please act as a math expert and solve the given question. Here is a question + {question}."로 변경하면 더 긴 공유 가능한 프리픽스가 생성된다. 이 최적화는 SGLang에 자연어 명령어가 존재하기 때문에 전통적인 프로그램 분석으로는 달성할 수 없다는 점에서 흥미롭다. 대신, 우리는 GPT-4에게 그래프 노드들을 재정렬하도록 프롬프트한다. 우리는 GPT-4에게 SGLang IR의 개념을 가르치기 위해 여러 예시가 포함된 프롬프트를 작성하며, GPT-4가 일부 간단한 SGLang 프로그램에 대해 이 최적화를 성공적으로 적용할 수 있음을 발견한다.
우리는 이 최적화의 효과를 평가한다. 우리는 인터넷에서 20개의 프롬프트 템플릿을 수집하여 SGLang으로 구현한다. 우리는 이 템플릿 중 5개를 퓨샷(few-shot) 훈련 예시로 활용하고 나머지 15개를 테스트 사례로 사용한다. 우리의 평가는 15개 템플릿 중 12개에 대해 GPT-4가 수정된 프롬프트에 대한 수동 검사를 통해 확인된 바와 같이 의미를 변경하지 않고 그래프 노드들을 성공적으로 재정렬했음을 보여준다. 평균적으로 이 최적화는 공유 가능한 프리픽스 길이를 60토큰 증가시켜, GPT-4의 효과를 입증한다. 최적화된 프롬프트 순서를 생성하는 데 실패하는 경우는 그래프 노드 이면의 의미론적 의미에 대한 잘못된 이해에서 비롯된다. 이는 너무 공격적이어서 그러한 순서 변경이 원래의 의미론을 변경하는 경우에도 모든 상수를 앞쪽에 배치한다. 이 사례 연구는 컴파일러 최적화에 GPT-4를 사용하는 것을 탐구하는 것을 목표로 한다. 향후 이러한 종류의 최적화를 신뢰할 수 있게 만들기 위해서는 더 많은 작업이 필요하다.