
잊어버리는 에이전트는 조수가 아니다. Mem0 는 세션을 넘는 핵심 정보를 저장해 p95 지연을 91% 줄인다. 2025년 논문, 전문 무료.
Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
MemO: 확장 가능한 장기 기억으로 생산 준비된 AI 에이전트 구축
Prateek Chhikara, Dev Khant, Saket Aryan, Taranjeet Singh, Deshraj Yadavresearch@memO.ai
memO
대규모 언어 모델(LLM)은 문맥적으로 일관된 응답을 생성하는 데 있어 놀라운 능력을 보여주었지만, 고정된 컨텍스트 윈도우는 장기간에 걸친 다중 세션 대화에서 일관성을 유지하는 데 근본적인 과제를 제기한다. 우리는 지속적인 대화에서 중요한 정보를 동적으로 추출, 통합, 검색함으로써 이 문제를 해결하는 확장 가능한 기억 중심 아키텍처인 MemO를 소개한다. 이 기반 위에서 우리는 대화 요소들 간의 복잡한 관계 구조를 포착하기 위해 그래프 기반 기억 표현을 활용하는 향상된 변형을 추가로 제안한다. LOCOM0 벤치마크에 대한 포괄적인 평가를 통해 우리는 우리의 접근 방식을 여섯 가지 기준 범주와 체계적으로 비교한다: (i) 기존의 기억 증강 시스템, (ii) 다양한 청크 크기와 값을 가진 검색 증강 생성(RAG), (iii) 전체 대화 이력을 처리하는 전체 컨텍스트 접근법, (iv) 오픈 소스 기억 솔루션, (v) 독점 모델 시스템, (vi) 전용 기억 관리 플랫폼. 실증적 결과는 우리의 방법이 단일 홉, 시간적, 다중 홉, 개방 도메인의 네 가지 질문 범주 전반에 걸쳐 모든 기존 기억 시스템보다 지속적으로 우수한 성능을 보임을 입증한다. 특히, MemO는 LLM-as-a-Judge 지표에서 OpenAI 대비 의 상대적 개선을 달성하며, 그래프 기억을 갖춘 MemO는 기본 MemO 구성보다 약 더 높은 종합 점수를 달성한다. 정확도 향상 외에도, 우리는 전체 컨텍스트 접근법에 비해 계산 오버헤드를 현저히 감소시킨다. 특히, MemO는 더 낮은 p95 지연 시간을 달성하고 이상의 토큰 비용을 절감하여, 고급 추론 능력과 실제 배포 제약 사이에서 설득력 있는 균형을 제공한다. 우리의 발견은 장기 대화 일관성을 위한 구조화된 지속적 기억 메커니즘의 중요한 역할을 강조하며, 더 신뢰할 수 있고 효율적인 LLM 기반 AI 에이전트를 위한 길을 열어준다.
코드는 다음에서 확인할 수 있다: https://mem0. ai/research
1. 서론
X
인간의 기억은 지능의 기초이다—그것은 우리의 정체성을 형성하고, 의사 결정을 안내하며, 우리가 배우고, 적응하고, 의미 있는 관계를 형성할 수 있게 한다(Craik and Jennings, 1992). 기억의 많은 역할 중에서, 기억은 의사소통에 필수적이다: 우리는 과거 상호작용을 회상하고, 선호도를 추론하며, 우리가 교류하는 사람들에 대한 진화하는 정신적 모델을 구성한다(Assmann, 2011). 장기간에 걸쳐 정보를 유지하고 검색하는 이 능력은 며칠, 몇 주, 심지어 몇 달에 걸친 일관되고 문맥적으로 풍부한 교류를 가능하게 한다. 대규모 언어 모델(LLM)로 구동되는 AI 에이전트는 유창하고 문맥적으로 적절한 응답을 생성하는 데 놀라운 진전을 이루었다(Yu et al., 2024, Zhang et al., 2024). 그러나 이러한 시스템은 고정된 컨텍스트 윈도우에 대한 의존으로 인해 근본적으로 제한되며, 이는 확장된 상호작용에 걸쳐 일관성을 유지하는 능력을 심각하게 제한한다(Bulatov et al., 2022, Liu et al., 2023). 이 한계는 LLM이 유한한 컨텍스트 윈도우를 넘어 확장될 수 있는 지속적 기억 메커니즘이 부족하다는 데서 비롯된다. 인간은 자연스럽게 시간이 지남에 따라 경험을 축적하고 조직하여 상호작용의
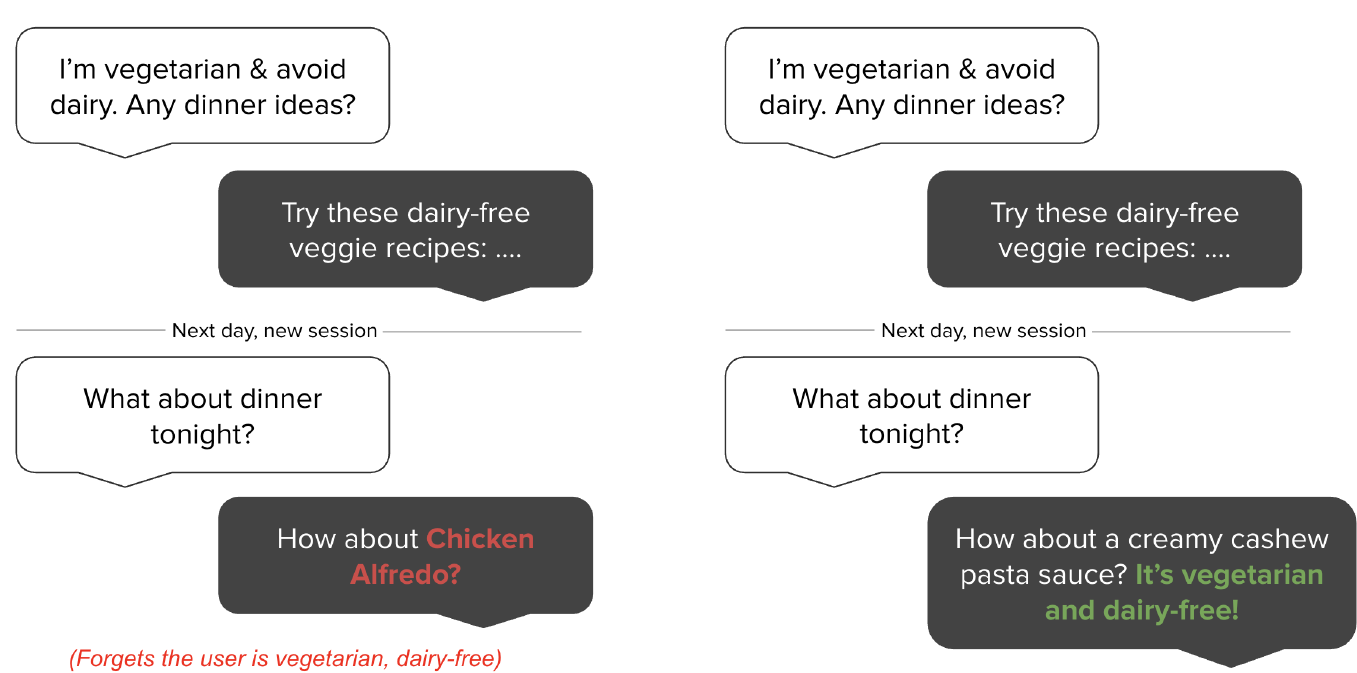
연속적인 서사를 형성하지만, AI 시스템은 본질적으로 별도의 세션 간에 또는 컨텍스트 오버플로 후에 정보를 지속할 수 없다. 지속적 기억의 부재는 인간-AI 상호작용에서 근본적인 단절을 야기한다. 기억이 없으면 AI 에이전트는 사용자 선호도를 잊고, 질문을 반복하며, 이전에 확립된 사실과 모순된다. 사용자가 초기 대화에서 채식주의자이며 유제품을 피한다고 언급하는 그림 1에 설명된 간단한 예를 고려해 보자. 후속 세션에서 사용자가 저녁 식사 추천에 대해 물었을 때, 지속적 기억이 없는 시스템은 확립된 식이 선호도와 완전히 모순되는 치킨을 제안할 수 있다. 반대로, 지속적 기억이 있는 시스템은 세션 전반에 걸쳐 이 중요한 사용자 정보를 유지하고 적절한 채식주의, 유제품 무첨가 옵션을 제안할 것이다. 이 흔한 시나리오는 기억 실패가 어떻게 사용자 경험과 신뢰를 근본적으로 훼손할 수 있는지를 보여준다.
대화 환경 외에도, 기억 메커니즘은 대화형 환경에서 에이전트 성능을 극적으로 향상시키는 것으로 나타났다(Majumder et al., Shinn et al., 2023). 과거 경험에 대한 기억을 갖춘 에이전트는 사용자 요구를 더 잘 예측하고, 이전 실수로부터 배우며, 작업 전반에 걸쳐 지식을 일반화할 수 있다(Chhikara et al., 2023). 연구는 기억 증강 에이전트가 행동과 결과 사이의 인과 관계를 활용하여 의사 결정을 개선하고, 동적 시나리오에서 더 효과적인 적응을 이끌어낸다는 것을 보여준다(Rasmussen et al., 2025). 계층적 기억 아키텍처(Packer et al., 2023, Sarthi et al., 2024)와 자율적 진화가 가능한 에이전트 기억 시스템(Xu et al., 2025)은 기억이 여러 대화 세션에 걸쳐 더 일관된 장기 추론을 가능하게 함을 추가로 보여주었다.
새로운 정보를 동적으로 통합하고 오래된 신념을 수정하는 인간과 달리, LLM은 정보가 컨텍스트 윈도우 밖으로 벗어나면 사실상 "리셋"된다(Zhang, 2024, Timoneda and Vera, 2025). OpenAI의 GPT-4(128K 토큰)(Hurst et al., 2024), o1(200K 컨텍스트)(Jaech et al., 2024), Anthropic의 Claude 3.7 Sonnet(200K 토큰)(Anthropic, 2025), Google의 Gemini(최소 10M 토큰)(Team et al., 2024)와 같은 모델들이 컨텍스트 길이의 경계를 밀어붙이고 있지만, 이러한 개선은 근본적인 한계를 단지 지연시킬 뿐 해결하지는 못한다. 실제 응용에서, 이러한 확장된 컨텍스트 윈도우조차 두 가지 중요한 이유로 불충분하다. 첫째, 의미 있는 인간-AI 관계가 몇 주 또는 몇 달에 걸쳐 발전함에 따라, 대화 이력은 필연적으로 가장 넉넉한 컨텍스트 한계조차 초과하게 된다. 둘째, 그리고 아마도 더 중요하게, 실제 대화는 거의 주제적 연속성을 유지하지 않는다. 사용자는 식이 선호도(채식주의자임)를 언급한 다음, 프로그래밍 작업에 대한 몇 시간의 관련 없는 논의에 참여하고, 그 후 저녁 식사 옵션에 대한 음식 관련 질문으로 돌아갈 수 있다. 그러한 시나리오에서, 전체 컨텍스트 접근법은 산더미 같은 무관한 정보를 추론해야 하며, 중요한 식이 선호도는 수천 개의 토큰에 걸친 코딩 논의 속에 파묻혀 있을 수 있다. 더욱이, 단순히 더 긴 컨텍스트를 제시하는 것이 과거 정보의 효과적인 검색이나 활용을 보장하지는 않는데,멀리 떨어진 토큰에 대한 어텐션 메커니즘이 저하되기 때문이다(Guo et al., 2024, Nelson et al., 2024). 이 한계는 연속성과 신뢰 유지가 중요한 의료, 교육, 기업 지원과 같은 고위험 영역에서 특히 문제가 된다(Hatalis et al., 2023). 이러한 과제를 해결하기 위해, AI 에이전트는 정적 컨텍스트 확장을 넘어서는 기억 시스템을 채택해야 한다. 견고한 AI 기억은 인간의 인지 과정을 반영하여 중요한 정보를 선택적으로 저장하고, 관련 개념을 통합하며, 필요할 때 관련 세부 사항을 검색해야 한다(He et al., 2024). 그러한 메커니즘을 통합함으로써, 우리는 일관된 페르소나를 유지하고, 진화하는 사용자 선호도를 추적하며, 이전 교류를 기반으로 구축하는 AI 에이전트를 개발할 수 있다. 이러한 전환은 AI를 일시적이고 건망증적인 응답자에서 신뢰할 수 있는 장기 협력자로 변모시켜, 대화 지능의 미래를 근본적으로 재정의할 것이다.
이 논문에서, 우리는 AI 시스템의 근본적인 한계를 다룬다: 서로 다른 세션에 걸친 확장된 대화에서 일관된 추론을 유지하지 못하는 능력으로, 이는 사용자와의 의미 있는 장기 상호작용을 심각하게 제한한다. 우리는 진행 중인 대화에서 중요한 정보를 동적으로 포착, 조직, 검색하는 새로운 기억 아키텍처인 MemO(mem-zero로 발음)를 소개한다. 이 기반 위에서, 우리는 대화 요소들 간의 복잡한 관계를 더 잘 모델링하기 위해 그래프 기반 기억 표현으로 기본 아키텍처를 향상시키는 MemO8을 개발한다. LOCOM0 벤치마크에 대한 우리의 실험 결과는 우리의 접근 방식이 기억 증강 아키텍처, 검색 증강 생성(RAG) 방법, 오픈 소스 및 독점 솔루션을 포함한 기존 기억 시스템보다 다양한 질문 유형 전반에 걸쳐 지속적으로 우수한 성능을 보이면서 동시에 훨씬 적은 계산 자원을 필요로 함을 입증한다. 지연 시간 측정은 또한 MemO가 전체 컨텍스트 접근법보다 91% 더 낮은 응답 시간으로 작동하여, 정교한 추론 능력과 실제 배포 제약 사이에서 최적의 균형을 이룬다는 것을 추가로 보여준다. 이러한 기여는 확장된 기간에 걸쳐 일관되고 문맥 인식 대화를 유지할 수 있는 AI 시스템을 향한 의미 있는 진전을 나타내며—인간의 의사소통 패턴을 반영하고 개인 교습, 의료, 개인화된 지원 분야의 응용을 위한 새로운 가능성을 열어준다.
2. 제안된 방법
우리는 AI 에이전트를 위한 두 가지 기억 아키텍처를 소개한다. (1) MemO는 기억 추출 및 갱신을 위한 전용 모듈을 통해 대화에서 중요한 정보를 추출, 평가, 관리하는 새로운 패러다임을 구현한다. 시스템은 두 사용자 참가자 사이 또는 사용자와 어시스턴트 사이의 메시지 쌍을 처리한다. (2) MemO8은 기억이 엔티티를 노드로, 관계를 엣지로 하는 방향성 레이블 그래프로 저장되는 그래프 기반 기억 표현을 통합하여 이 기반을 확장한다. 이 구조는 엔티티 간의 연결에 대한 더 깊은 이해를 가능하게 한다. 엔티티와 그 관계를 모두 명시적으로 모델링함으로써, MemO8은 상호 연결된 사실들에 걸친 더 고급 추론을 지원하며, 특히 여러 기억에 걸친 복잡한 관계 경로를 탐색해야 하는 질의에 유용하다.
2.1. MemO
우리의 아키텍처는 증분 처리 패러다임을 따르며, 진행 중인 대화 내에서 원활하게 작동할 수 있게 한다. 그림 2에 설명된 것처럼, 전체 파이프라인 아키텍처는 추출과 갱신의 두 단계로 구성된다.
추출 단계는 새로운 메시지 쌍 이 입력되면서 시작되는데, 여기서 는 현재 메시지를, 은 직전 메시지를 나타낸다. 이 쌍은 일반적으로 사용자 메시지와 어시스턴트 응답으로 구성되어 하나의 완전한 상호작용 단위를 포착한다. 메모리 추출을 위한 적절한 맥락을 구축하기 위해 시스템은 두 가지 상호 보완적인 소스를 활용한다: (1) 전체 대화 이력의 의미적 내용을 담아 데이터베이스에서 검색된 대화 요약 , 그리고
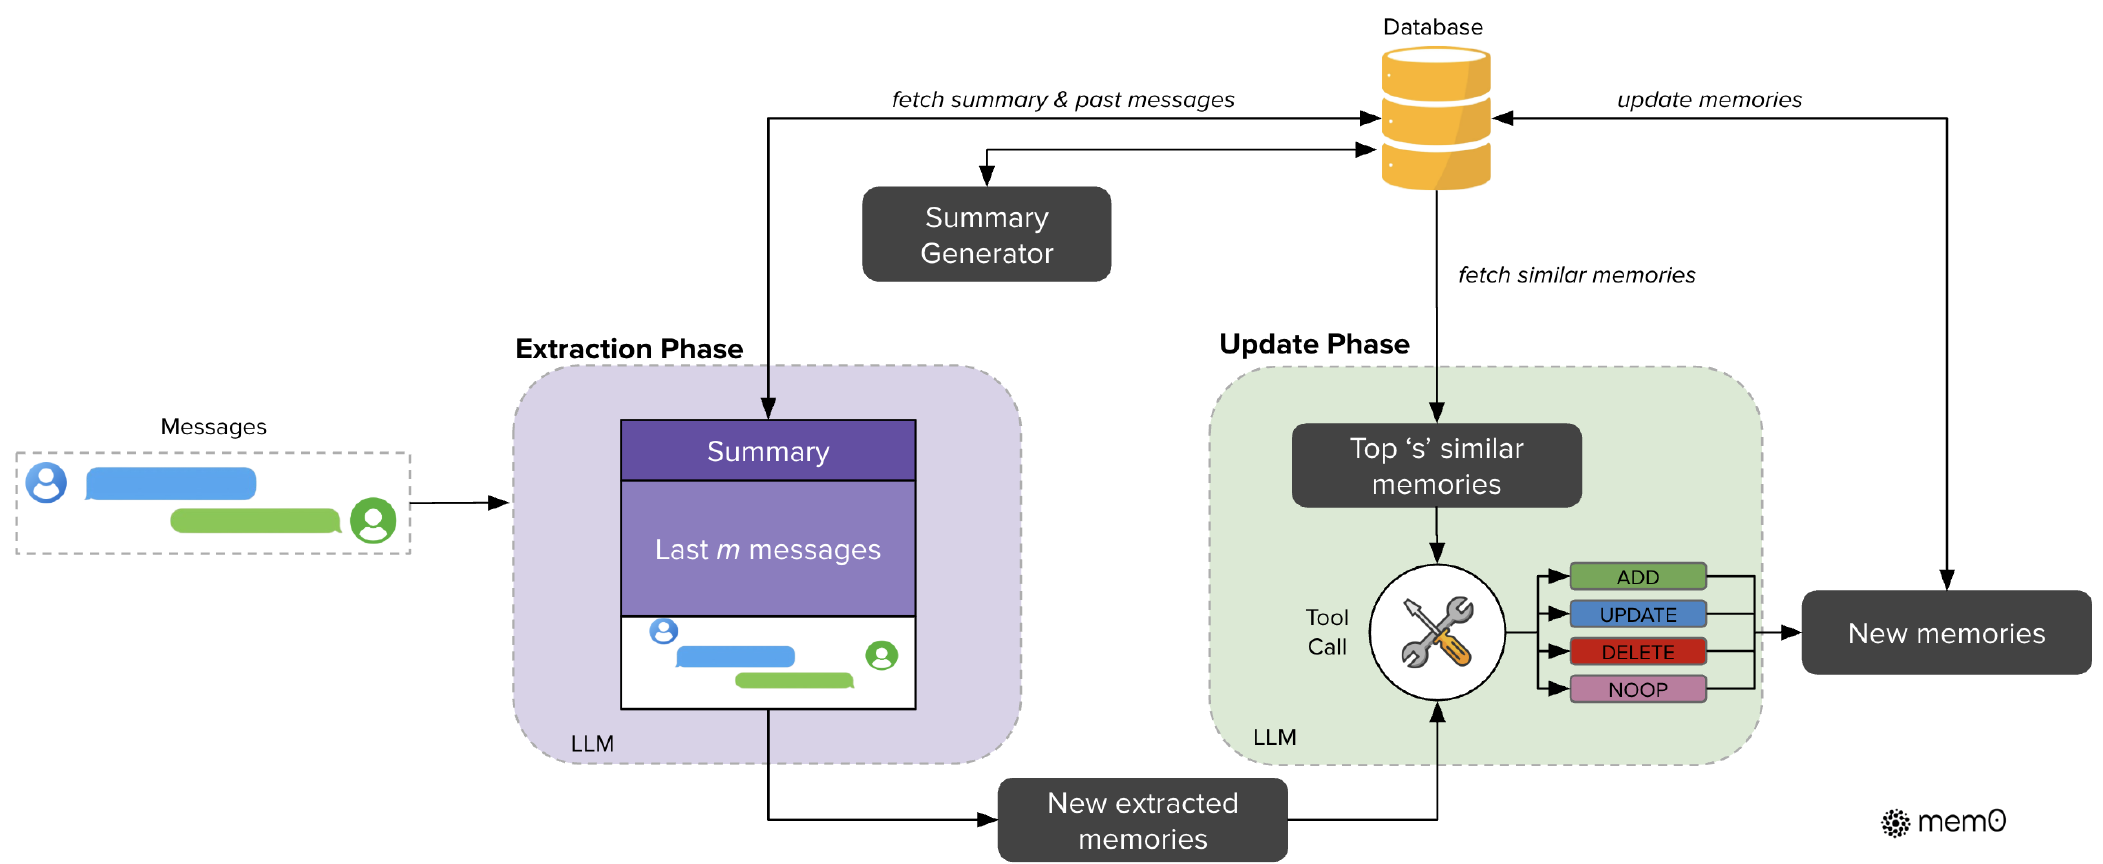
(2) 대화 이력에서 최근 메시지들의 시퀀스 이며, 여기서 은 최근성 윈도를 제어하는 하이퍼파라미터이다. 맥락 인식 메모리 추출을 지원하기 위해, 우리는 대화 요약을 주기적으로 갱신하는 비동기 요약 생성 모듈을 구현한다. 이 구성 요소는 주 처리 파이프라인과 독립적으로 동작하여, 처리 지연을 초래하지 않으면서 메모리 추출이 항상 최신 맥락 정보의 이점을 누릴 수 있도록 보장한다. 5는 전체 대화에 걸친 전역적 주제 이해를 제공하는 반면, 최근 메시지 시퀀스는 요약에 통합되지 않았을 수 있는 관련 세부 정보를 포함할 수 있는 세밀한 시간적 맥락을 제공한다. 이 이중 맥락 정보는 새로운 메시지 쌍과 결합되어, LLM을 통해 구현되는 추출 함수 를 위한 포괄적인 프롬프트 를 형성한다. 그런 다음 함수 는 대화의 더 넓은 맥락을 인식하면서 특히 새로운 교환으로부터 두드러진 메모리들의 집합 을 추출하며, 그 결과 지식 베이스에 잠재적으로 포함될 후보 사실들이 생성된다.
추출 이후, 갱신 단계는 일관성을 유지하고 중복을 피하기 위해 각 후보 사실을 기존 메모리들과 비교하여 평가한다. 이 단계는 각 추출된 사실 에 대해 적절한 메모리 관리 연산을 결정한다. 부록 B에서 언급된 알고리즘 1은 이 과정을 보여준다. 각 사실에 대해, 시스템은 먼저 데이터베이스의 벡터 임베딩을 사용하여 의미적으로 가장 유사한 상위 개의 메모리를 검색한다. 그런 다음 이렇게 검색된 메모리들과 후보 사실이 우리가 '도구 호출'이라고 부르는 함수 호출 인터페이스를 통해 LLM에 제시된다. LLM 자체가 네 가지 구별되는 연산 중 어느 것을 실행할지 결정한다: ADD는 의미적으로 동등한 메모리가 존재하지 않을 때 새로운 메모리를 생성하기 위한 것이고; UPDATE는 기존 메모리를 상보적 정보로 보강하기 위한 것이며; DELETE는 새로운 정보에 의해 모순되는 메모리를 제거하기 위한 것이고; NOOP는 후보 사실이 지식 베이스에 대한 수정을 요구하지 않을 때이다. 우리는 별도의 분류기를 사용하는 대신, LLM의 추론 능력을 활용하여 후보 사실과 기존 메모리들 사이의 의미적 관계에 기반해 적절한 연산을 직접 선택한다. 이 결정에 따라, 시스템은 제공된 연산들을 실행함으로써 지식 베이스의 일관성과 시간적 일관성을 유지한다.
실험적 평가에서, 우리는 시스템을 맥락 참조를 위해 ' 개의 이전 메시지와 비교 분석을 위해 ' 개의 유사 메모리로 구성했다. 모든 언어 모델 연산은 GPT- 4o- mini를 추론 엔진으로 사용했다. 벡터 데이터베이스는 갱신 단계 동안 효율적인 유사도 검색을 가능하게 하기 위해 밀집 임베딩을 사용한다.
2.2. Memo8
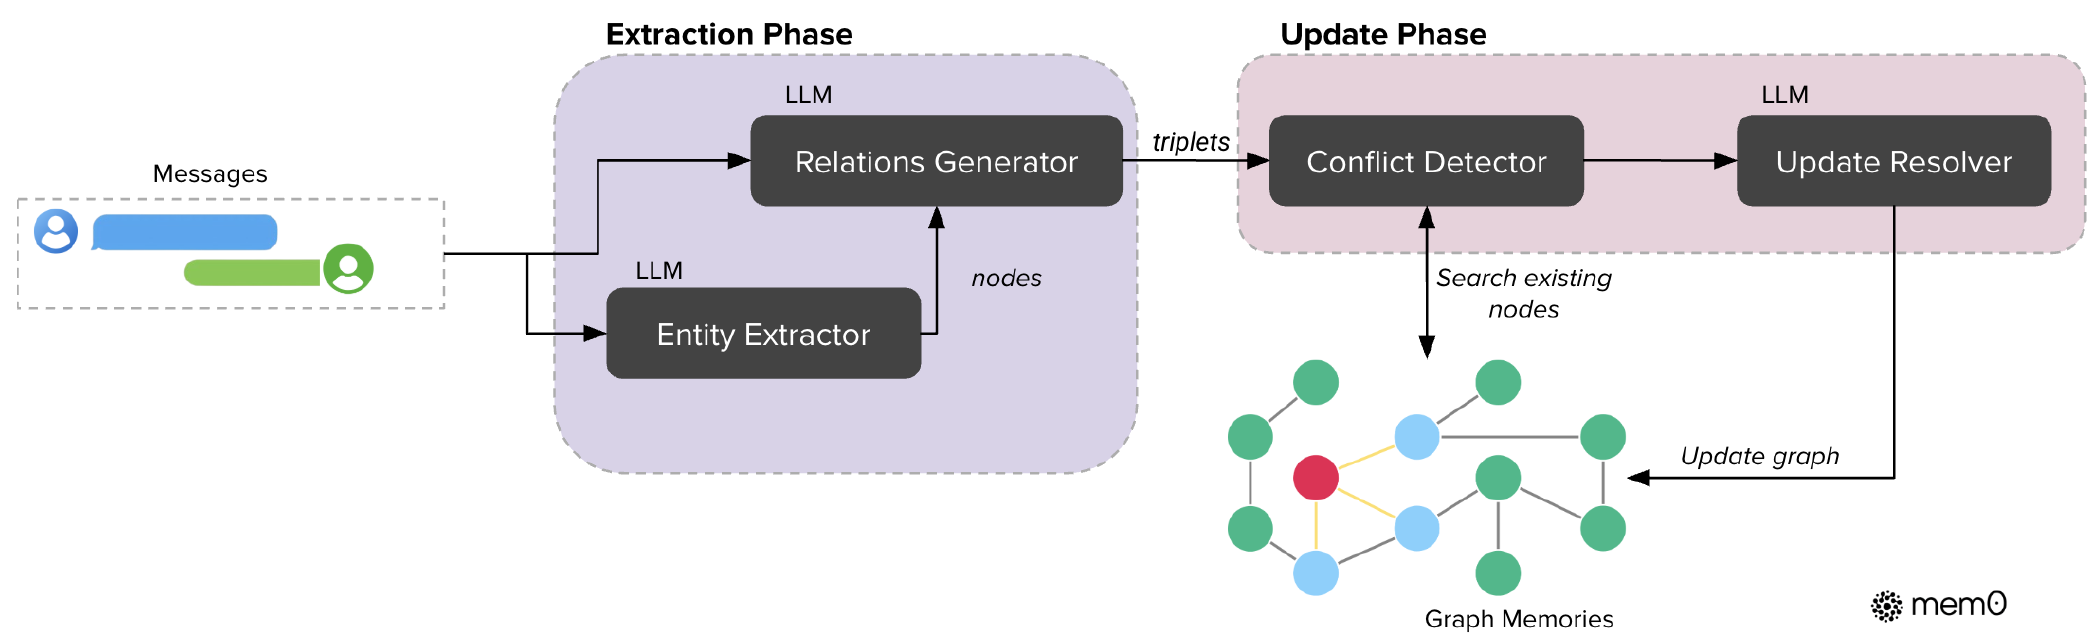
그림 3에 제시된 Memo8 파이프라인은 자연어 상호작용으로부터 맥락 정보를 효과적으로 포착하고 저장하며 검색하는 그래프 기반 메모리 접근법을 구현한다(Zhang et al., 2022). 이 프레임워크에서 메모리는 방향성 레이블 그래프 로 표현되며, 여기서:
- 노드 는 개체(예: ALICE, SAN_FRANCISCO)를 나타낸다- 간선 는 개체 간의 관계(예: LIVES_IN)를 나타낸다- 레이블 은 노드에 의미 유형을 할당한다(예: ALICE - 인물, SAN_FRANCISCO - 도시)
각 개체 노드 는 세 가지 구성 요소를 포함한다: (1) 개체를 분류하는 개체 유형 분류(예: 인물, 장소, 사건), (2) 개체의 의미적 의미를 포착하는 임베딩 벡터 , 그리고 (3) 생성 타임스탬프 를 포함한 메타데이터. 우리 시스템에서 관계는 형태의 트리플릿으로 구조화되며, 여기서 와 는 각각 출발 및 도착 개체 노드이고, 은 이들을 연결하는 레이블된 간선이다.
추출 과정은 LLM을 활용하여 비구조화된 텍스트를 구조화된 그래프 표현으로 변환하는 2단계 파이프라인을 사용한다. 먼저, 개체 추출기 모듈이 입력 텍스트를 처리하여 개체 집합과 그에 대응하는 유형을 식별한다. 우리 프레임워크에서 개체는 대화 내의 핵심 정보 요소—메모리 그래프에 표현될 가치가 있는 인물, 장소, 객체, 개념, 사건, 속성을 포함—를 나타낸다. 개체 추출기는 대화 내 요소들의 의미적 중요성, 고유성, 지속성을 분석하여 이러한 다양한 정보 단위를 식별한다. 예를 들어, 여행 계획에 관한 대화에서는 개체에 목적지(도시, 국가), 교통수단, 날짜, 활동, 참가자 선호도—본질적으로 향후 참조나 추론에 관련될 수 있는 모든 개별 정보—가 포함될 수 있다.
다음으로, 관계 생성기 구성 요소는 이러한 개체들 간의 의미 있는 연결을 도출하여 정보의 의미 구조를 포착하는 관계 트리플릿 집합을 설정한다. 이 LLM 기반 모듈은 추출된 개체와 대화 내에서의 그 맥락을 분석하여 의미적으로 중요한 연결을 식별한다. 이는 언어적 패턴, 맥락적 단서, 도메인 지식을 검토하여 개체들이 서로 어떻게 관련되는지 판단함으로써 작동한다. 각 잠재적 개체 쌍에 대해, 생성기는 의미 있는 관계가 존재하는지 평가하고, 존재한다면 이 관계를 적절한 레이블(예: 'lives_in', 'prefers', 'owns', 'happened_on')로 분류한다. 이 모듈은 LLM이 대화 내의 명시적 진술과 암시적 정보 모두에 대해 추론하도록 안내하는 프롬프트 엔지니어링 기법을 사용하며, 그 결과 우리 메모리 그래프의 간선을 형성하고 상호 연결된 정보 전반에 걸친 복잡한 추론을 가능하게 하는 관계 트리플릿이 생성된다. 새로운 정보를 통합할 때, Memo8은 정교한 저장 및 업데이트 전략을 사용한다. 각 새로운 관계 트리플릿에 대해, 우리는 출발 및 도착 개체 모두의 임베딩을 계산한 다음, 의미적 유사성이 정의된 임계값 't'를 초과하는 기존 노드를 검색한다. 노드 존재 여부에 따라, 시스템은 두 노드를 모두 생성하거나, 하나의 노드만 생성하거나, 기존 노드를 사용한 후 적절한 메타데이터와 함께 관계를 설정할 수 있다. 일관된 지식 그래프를 유지하기 위해, 우리는 새로운 정보가 도착할 때 잠재적으로 충돌하는 기존 관계를 식별하는 충돌 감지 메커니즘을 구현한다. LLM 기반 업데이트 해결기는 특정 관계가 폐기되어야 하는지 판단하며, 시간적 추론을 가능하게 하기 위해 물리적으로 제거하는 대신 무효로 표시한다.
Memo8의 메모리 검색 기능은 최적의 정보 접근을 위한 이중 접근 전략을 구현한다. 개체 중심 방식은 먼저 질의 내의 핵심 개체를 식별한 다음, 의미적 유사성을 활용하여 지식 그래프에서 대응하는 노드를 찾는다. 이는 이러한 앵커 노드로부터 들어오고 나가는 관계를 체계적으로 탐색하여 관련 맥락 정보를 포착하는 포괄적인 부분 그래프를 구성한다. 이를 보완하여, 의미적 트리플릿 방식은 전체 질의를 고밀도 임베딩 벡터로 인코딩함으로써 보다 전체론적 관점을 취한다. 이 질의 표현은 그런 다음 지식 그래프의 각 관계 트리플릿의 텍스트 인코딩과 매칭된다. 시스템은 질의와 사용 가능한 모든 트리플릿 간의 세밀한 유사도 점수를 계산하여, 구성 가능한 관련성 임계값을 초과하는 것들만 유사도 감소 순으로 반환한다. 이 이중 검색 메커니즘은 Memo8이 표적화된 개체 중심 질문과 보다 광범위한 개념적 질의 모두를 동등한 효과로 처리할 수 있게 한다.
구현 관점에서, 시스템은 기반 그래프 데이터베이스로 Neo4j1을 활용한다. LLM 기반 추출기와 업데이트 모듈은 함수 호출 기능을 갖춘 GPT-4o-mini를 활용하여, 비구조화된 텍스트로부터 정보의 구조화된 추출을 가능하게 한다. 그래프 기반 표현을 의미적 임베딩 및 LLM 기반 정보 추출과 결합함으로써, Memo8은 복잡한 추론에 필요한 구조적 풍부함과 자연어 이해에 필요한 의미적 유연성을 모두 달성한다.
3. 실험 설정
3.1. 데이터셋
LOCOMO(Maharana et al., 2024) 데이터셋은 대화 시스템에서의 장기 대화 메모리를 평가하기 위해 설계되었다. 이는 10개의 확장된 대화로 구성되며, 각 대화는 평균적으로 약 600개의 대화 턴과 26,000개의 토큰을 포함하고 여러 세션에 걸쳐 분포한다. 각 대화는 두 개인이 일상 경험이나 과거 사건을 논의하는 것을 포착한다. 이러한 다중 세션 대화에 이어, 각 대화에는 평균 200개의 질문과 그에 대응하는 정답이 수반된다. 이 질문들은 단일 홉, 다중 홉, 시간적, 개방형 도메인 등 여러 유형으로 분류된다. 데이터셋은 원래 적대적 질문 범주를 포함했으며, 이는 시스템이 답변할 수 없는 질문을 인식하는 능력을 테스트하기 위해 설계되었다. 그러나 이 범주는 정답을 사용할 수 없었고, 이 질문 유형에 대해 기대되는 동작은 에이전트가 이를 답변 불가로 인식해야 한다는 것이므로 우리의 평가에서 제외되었다.
3.2. 평가 지표
우리의 평가 프레임워크는 응답 품질과 운영 효율성을 모두 고려하여 대화 시스템의 장기 메모리 능력을 평가하기 위한 포괄적인 접근법을 구현한다. 우리는 지표를 두 개의 별개 그룹으로 분류하며, 이들은 함께 시스템 성능에 대한 전체론적 이해를 제공한다.
(1) 성능 지표 대화형 AI의 선행 연구(Goswami, 2025, Soni et al., 2024, Singh et al., 2020)는 주로 F1 Score(F1) 및 BLEU-1(B1)과 같은 어휘적 유사성 지표에 의존해 왔다. 그러나 이러한 지표는 대화 맥락에서 사실적 정확성을 평가할 때 상당한 한계를 보인다. 정답이 'Alice was born in March'이고 시스템이 'Alice is born in July'를 생성하는 시나리오를 고려해 보자. 출생 월에 관한 중대한 사실적 오류를 포함하고 있음에도 불구하고, 전통적 지표는 나머지 토큰('Alice', 'born' 등)의 어휘적 중복 때문에 상대적으로 높은 점수를 부여할 것이다. 이러한 근본적 한계는 의미적 정확성을 포착하지 못하는 오해의 소지가 있는 평가로 이어질 수 있다. 이러한 단점을 해결하기 위해, 우리는 LLM-as-a-Judge(J)를 보완적 평가 지표로 사용한다. 이 접근법은 별도의 더 능력 있는 LLM을 활용하여 사실적 정확성, 관련성, 완전성, 맥락적 적절성을 포함한 여러 차원에서 응답 품질을 평가한다. 판정 모델은 질문, 정답, 생성된 답변을 분석하여 인간의 판단에 더 잘 부합하는 보다 세분화된 평가를 제공한다. J 평가의 확률적 특성으로 인해, 우리는 전체 데이터셋에 대해 각 방법에 대해 10회의 독립적 실행을 수행하고 평균 점수를 표준편차와 함께 보고한다. J에 대한 자세한 내용은 부록 A에 제시되어 있다.
(2) 배포 지표 응답 품질 외에도, AI 에이전트에서 장기 메모리의 실제 적용을 위해서는 실질적인 배포 고려 사항이 중요하다. 우리는 tiktoken의 'cl100k_base' 인코딩을 사용하여 토큰 소비를 체계적으로 추적하며, 질의에 답하기 위한 맥락으로 사용되는 검색 중 추출된 토큰 수를 측정한다. 메모리 기반 모델의 경우, 이 토큰들은 지식 베이스에서 검색된 메모리를 나타내는 반면, RAG 기반 모델의 경우 검색된 텍스트 청크의 총 토큰 수에 해당한다. 이 구분은 간결한 메모리 사실을 처리하든 더 큰 원시 텍스트 세그먼트를 처리하든 운영 비용과 시스템 효율성에 직접 영향을 미치므로 중요하다. 우리는 또한 지연 시간을 모니터링하며, (i) 검색 지연 시간: 메모리(메모리 기반 솔루션의 경우) 또는 청크(RAG 기반 솔루션의 경우)를 검색하는 데 필요한 총 시간을 포착하고, (ii) 총 지연 시간: 검색 시간(메모리 또는 청크 접근)과 LLM을 사용한 답변 생성 시간으로 구성된 적절한 응답 생성 시간을 포착한다.
이러한 지표 간의 관계는 시스템 설계에서 중요한 트레이드오프를 드러낸다. 예를 들어, 더 정교한 메모리 아키텍처는 더 높은 사실적 정확성을 달성할 수 있지만 토큰 소비와 지연 시간 증가를 대가로 치를 수 있다. 우리의 다차원적 평가 방법론은 연구자와 실무자가 중요한 애플리케이션을 위한 응답 품질을 우선시하든 실시간 배포 시나리오를 위한 계산 효율성을 우선시하든, 특정 요구 사항에 기반하여 정보에 입각한 결정을 내릴 수 있게 한다.
3.3. 기준선
우리의 접근법을 포괄적으로 평가하기 위해, 우리는 대화 메모리 시스템의 현재 상태를 대표하는 여섯 가지 별개 범주의 기준선과 비교한다. 이러한 다양한 기준선들은 사실적 정확성, 계산 효율성, 확장된 대화로의 확장성을 포함한 다양한 차원에서 서로 다른 메모리 아키텍처의 효과를 평가하기 위한 견고한 프레임워크를 집합적으로 제공한다. 해당되는 경우, 별도로 명시되지 않는 한, 우리는 실행이 가능한 한 재현 가능하도록 온도를 0으로 설정한다.
확립된 LOCOMO 기준선 우리는 먼저 LOCOMO 데이터셋에서 이전에 벤치마크된 방법들을 평가함으로써 비교적 기반을 확립한다. 여기에는 다섯 가지 확립된 접근법이 포함된다: LoCoMo(Maharana et al., 2024), ReadAgent(Lee et al., 2024), MemoryBank(Zhong et al., 2024), MemGPT(Packer et al., 2023), A-Mem(Xu et al., 2025). 이러한 확립된 벤치마크는 출판된 결과와의 직접적인 비교 지점을 제공할 뿐만 아니라 서로 다른 알고리즘 패러다임에 걸친 대화 메모리 아키텍처의 진화를 대표한다. 우리의 평가를 위해, 우리는 gpt-4o-mini가 평가에 사용된 지표를 선택한다. 이러한 벤치마크에 대한 자세한 내용은 부록 C에 언급되어 있다.
오픈 소스 메모리 솔루션 우리의 두 번째 범주는 LangMem2(Hot Path)과 같이 관련 대화 작업에서 효과성을 입증했지만 아직 LOcOMO 데이터셋에서 평가되지 않은 유망한 오픈 소스 메모리 아키텍처로 구성됩니다. 이러한 시스템을 우리의 평가 프레임워크에 적용함으로써 비교 범위를 넓히고 경쟁력 있는 성능을 제공할 수 있는 잠재적 대안 접근법을 식별합니다. 우리는 LLM을 gpt-4o-mini로 초기화하고 임베딩 모델로 text-embedding-small-3을 사용했습니다.
검색 증강 생성(RAG) 기준선으로서, 우리는 전체 대화 기록을 문서 컬렉션으로 취급하고 표준 RAG 파이프라인을 적용합니다. 먼저 각 대화를 고정 길이 청크(128, 256, 512, 1024, 2048, 4096, 8192 토큰)로 분할하며, 여기서 8192는 우리의 임베딩 모델이 지원하는 최대 청크 크기입니다. 모든 청크는 구성 전반에 걸쳐 일관된 벡터 품질을 보장하기 위해 OpenAI의 text-embedding-small-3을 사용하여 임베딩됩니다. 질의 시점에 우리는 의미적 유사도에 따라 상위 개의 청크를 검색하고 이를 답변 생성용 컨텍스트로 연결합니다. 실험 전반에 걸쳐 우리는 로 설정했습니다. 인 경우 가장 관련성 높은 단일 청크만 사용되고, 인 경우 가장 관련성 높은 두 청크(최대 16384 토큰)가 연결됩니다. 평균 대화 길이(26000 토큰)가 완전히 커버되어 선택적 검색의 이점이 무효화되므로 우리는 를 피합니다. 청크 크기와 를 변화시킴으로써 우리는 장기 대화 메모리 작업에서 RAG 성능을 체계적으로 평가합니다.
전체 컨텍스트 처리 우리는 전체 대화 기록을 LLM의 컨텍스트 윈도우 내에 전달하는 직관적인 접근법을 채택합니다. 이 방법은 추가적인 아키텍처 구성 요소 없이 순차적 정보를 처리하는 모델의 내재적 능력을 활용합니다. 개념적으로는 단순하지만, 이 접근법은 대화 길이가 증가함에 따라 실질적인 한계에 직면하며, 결국 토큰 비용과 지연 시간이 증가합니다. 그럼에도 불구하고 이는 사용 가능한 컨텍스트의 직접 처리와 비교하여 더 정교한 메모리 메커니즘의 가치를 이해하기 위한 중요한 기준점을 확립합니다.
독점 모델 우리는 ChatGPT 인터페이스에서 사용 가능한 OpenAI의 메모리3 기능을 평가하며, 일관성을 위해 특별히 gpt-4o-mini를 사용합니다. 우리는 프롬프트(부록 A 참조)와 함께 전체 LOcOMO 대화를 단일 채팅 세션에 입력하고, 타임스탬프, 참가자 이름, 대화 텍스트를 포함한 메모리 생성을 유도합니다. 이렇게 생성된 메모리는 이후 각 대화에 관한 질문에 답하기 위한 완전한 컨텍스트로 사용되며, 의도적으로 OpenAI 접근법에 질문 관련 메모리만이 아닌 모든 메모리에 대한 특권적 접근을 부여합니다. 이 방법론은 벤치마킹을 위해 OpenAI 시스템에서 선택적 메모리 검색을 위한 외부 API 접근이 부재한 상황을 수용합니다.
| 방법 | 단일 홉 | 다중 홉 | 개방 영역 | 시간적 | ||||||||
| F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | |
| LoCoMo | 25.02 | 19.75 | - | 12.04 | 11.16 | - | 40.36 | 29.05 | - | 18.41 | 14.77 | - |
| ReadAgent | 9.15 | 6.48 | - | 5.31 | 5.12 | - | 9.67 | 7.66 | - | 12.60 | 8.87 | - |
| MemoryBank | 5.00 | 4.77 | - | 5.56 | 5.94 | - | 6.61 | 5.16 | - | 9.68 | 6.99 | - |
| MemGPT | 26.65 | 17.72 | - | 9.15 | 7.44 | - | 41.04 | 34.34 | - | 25.52 | 19.44 | - |
| A-Mem | 27.02 | 20.09 | - | 12.14 | 12.00 | - | 44.65 | 37.06 | - | 45.85 | 36.67 | - |
| A-Mem* | 20.76 | 14.90 | 39.79 ± 0.38 | 9.22 | 8.81 | 18.85 ± 0.31 | 33.34 | 27.58 | 54.05 ± 0.22 | 35.40 | 31.08 | 49.91 ± 0.31 |
| LangMem | 35.51 | 26.86 | 62.23 ± 0.75 | 26.04 | 22.32 | 47.92 ± 0.47 | 40.91 | 33.63 | 71.12 ± 0.20 | 30.75 | 25.84 | 23.43 ± 0.39 |
| Zep | 35.74 | 23.30 | 61.70 ± 0.32 | 19.37 | 14.82 | 41.35 ± 0.48 | 49.56 | 38.92 | 76.60 ± 0.13 | 42.00 | 34.53 | 49.31 ± 0.50 |
| OpenAI | 34.30 | 23.72 | 63.79 ± 0.46 | 20.09 | 15.42 | 42.92 ± 0.63 | 39.31 | 31.16 | 62.29 ± 0.12 | 14.04 | 11.25 | 21.71 ± 0.20 |
| MemO | 38.72 | 27.13 | 67.13 ± 0.65 | 28.64 | 21.58 | 51.15 ± 0.31 | 47.65 | 38.72 | 72.93 ± 0.11 | 48.93 | 40.51 | 55.51 ± 0.34 |
| MemO8 | 38.09 | 26.03 | 65.71 ± 0.45 | 24.32 | 18.82 | 47.19 ± 0.67 | 49.27 | 40.30 | 75.71 ± 0.21 | 51.55 | 40.28 | 58.13 ± 0.44 |
메모리 제공자 우리는 AI 에이전트를 위해 설계된 메모리 관리 플랫폼인 Zep(Rasmussen et al., 2025)을 도입한다. 그들의 플랫폼 버전을 사용하여, 우리는 LOcOMO 데이터셋 전반에 걸쳐 체계적인 평가를 수행하며, 대화 내용과 함께 타임스탬프 정보를 보존함으로써 시간적 충실성을 유지한다. 이러한 시간적 고정은 시간에 민감한 질의가 적절히 맥락화된 메모리 검색을 통해 처리될 수 있도록 보장하며, 이는 연대기적 인식이 필요한 질문을 평가하는 데 특히 중요하다. 이 베이스라인은 AI 에이전트를 위해 특별히 설계된 메모리 관리의 중요한 상용 구현을 나타낸다.
4. 평가 결과, 분석 및 논의.
4.1. 메모리 지원 시스템 간의 성능 비교
표 1은 단일 홉, 다중 홉, 개방형 도메인, 그리고 시간적 질문에 대해, 3절에서 언급한 일련의 경쟁력 있는 베이스라인들과 대비한 우리의 두 아키텍처—MemO와 MemO—의 , 및 J 점수를 보고한다. 전반적으로, 우리의 두 모델 모두 대부분의 질문 유형에서 세 가지 평가 지표 모두에서 새로운 최첨단 기록을 세웠다.
단일 홉 질문 성능 단일 홉 질의는 하나의 대화 턴 내에 포함된 단일 사실 구간을 찾는 것을 포함한다. 자연어 텍스트의 밀집 메모리를 활용하여, MemO는 가장 강력한 결과를 확보한다: , , 그리고 . 자연어 메모리에 그래프 메모리를 증강한 것(MemO8)은 MemO에 비해 미미한 성능 저하를 초래하는데, 이는 검색 대상이 단일 턴에 위치할 때 관계적 구조가 제한적인 유용성만을 제공함을 나타낸다. 기존 베이스라인 중에서, 전체 컨텍스트 OpenAI 실행이 그 다음으로 좋은 J 점수를 획득하며, 이는 전체 대화를 컨텍스트에 유지하는 것의 이점을 반영한다. 반면 LangMem과 Zep은 모두 J 점수에서 우리 모델 대비 상대적으로 약 8% 낮은 점수를 기록한다. A-mem과 같은 이전 LOcOMO 벤치마크는 J에서 25점 이상 뒤처지며, 이는 단순한 검색 작업에 대해서도 세밀하고 구조화된 메모리 인덱싱의 필요성을 강조한다.
다중 홉 질문 성능 다중 홉 질의는 여러 대화 세션에 분산된 정보를 종합할 것을 요구하며, 메모리 통합 및 검색에 상당한 도전을 제기한다. MemO는 점수 28.64와 J 점수 51.15로 다른 방법들을 명확히 능가하며, 이는 세션 전반에 저장된 이질적인 정보를 효율적으로 검색하고 통합하는 능력을 반영한다. 흥미롭게도, MemO8에서 그래프 메모리를 추가하는 것은 여기서 성능 향상을 제공하지 않는데, 이는 복잡한 통합 작업에 대해 밀집 자연어 메모리 단독에 비해 구조화된 그래프 표현의 잠재적 비효율성 또는 중복성을 나타낸다. LangMem과 같은 베이스라인은 경쟁력 있는 성능을 보이지만, 그들의 점수는 MemO의 점수에 크게 뒤처지며, 복잡한 질의 처리에 대한 우리의 정제된 메모리 인덱싱 및 검색 메커니즘의 이점을 강조한다.
개방형 도메인 성능 개방형 도메인 설정에서, 베이스라인 Zep은 가장 높은 (49.56) 및 J(76.60) 점수를 달성하며, 근소한 차이로 우리의 방법들을 앞선다. 특히, Zep의 J 점수 76.60은 MemO8의 75.71을 단지 0.89 퍼센트 포인트 초과하고 MemO의 72.93을 3.67 포인트 능가하며, 대화 메모리를 외부 지식과 통합하는 데 있어 일관되지만 미미한 우위를 강조한다. MemO8은 높은 사실 검색 정밀도를 반영하는 J 75.71로 강력한 2위를 유지하며, MemO가 72.93으로 뒤를 이어 견고한 일관성을 보여준다. 이러한 결과는 구조화된 관계적 메모리(MemO 및 MemO8에서와 같이)가 개방형 도메인 검색을 상당히 개선하지만, Zep이 작지만 의미 있는 우위를 유지함을 강조한다.
시간적 추론 성능 시간적 추론 작업은 대화 이력 내에서 사건의 순서, 그들의 상대적 순서, 그리고 지속 시간에 대한 정확한 모델링에 달려 있다. 우리의 아키텍처는 모든 지표에서 상당한 개선을 보여주며, MemO8은 가장 높은 (51.55) 및 J(58.13)를 달성하여, 자연어 메모리에 더해진 구조화된 관계적 표현이 시간적으로 근거한 판단에 상당히 도움이 됨을 시사한다. 주목할 만하게도, 기본 변형인 MemO도 상당한 J 점수(55.51)를 제공하며, 이는 자연어만으로도 시간적으로 근거한 판단에 도움이 될 수 있음을 시사한다. 베이스라인 중에서, OpenAI는 특히 15% 미만의 점수로 저조한 성능을 보이는데, 주로 OpenAI ChatGPT에서 타임스탬프가 있는 메모리를 추출하도록 명시적으로 프롬프트했음에도 불구하고 생성된 대부분의 메모리에 타임스탬프가 누락되었기 때문이다. A-Mem과 같은 다른 베이스라인은 존경할 만한 결과를 달성하지만, 우리의 모델은 최첨단을 명확히 진전시키며, 시간적 추론을 위해 자연어 맥락화와 구조화된 그래프 표현 모두를 정확히 활용하는 것의 결정적 이점을 강조한다.
4.2. 교차 범주 분석
다양한 질문 범주에 걸친 포괄적인 평가는 우리가 제안한 아키텍처인 MemO와 MemO8이 베이스라인 시스템과 비교하여 일관되게 우수한 성능을 달성함을 보여준다. 단일 홉 질의에 대해, MemO는 특히 강력한 성능을 보여주며, 효율적인 밀집 자연어 메모리 구조의 이점을 누린다. MemO8의 그래프 기반 표현은 이러한 더 단순한 질의에 대해 어휘적 중첩 지표에서 약간 뒤처지지만, 경쟁력 있는 J 점수에서 입증되듯이 의미적 일관성을 상당히 향상시킨다. 이는 그래프 구조가 단순한 검색보다는 미묘한 관계적 맥락을 포함하는 시나리오에서 더 유익함을 나타낸다. 다중 홉 질문에 대해, MemO는 여러 세션에 걸쳐 분산된 정보를 효과적으로 종합함으로써 명확한 이점을 보여주며, 자연어 메모리가 이러한 통합 작업에 충분한 표현적 풍부함을 제공함을 확인한다. 놀랍게도,
| 방법 | K | 청크 크기 / 메모리 토큰 | 지연 시간(초) | 전체 J | |||
| 검색 | 합계 | ||||||
| RAG | 1 | 128 | 0.281 | 0.823 | 0.774 | 1.825 | 47.77 ± 0.23% |
| 256 | 0.251 | 0.710 | 0.745 | 1.628 | 50.15 ± 0.16% | ||
| 512 | 0.240 | 0.639 | 0.772 | 1.710 | 46.05 ± 0.14% | ||
| 1024 | 0.240 | 0.723 | 0.821 | 1.957 | 40.74 ± 0.17% | ||
| 2048 | 0.255 | 0.752 | 0.996 | 2.182 | 37.93 ± 0.12% | ||
| 8192 | 4096 | 0.254 | 0.719 | 1.093 | 2.711 | 36.84 ± 0.17% | |
| 812 | 0.279 | 0.838 | 1.396 | 4.416 | 44.53 ± 0.13% | ||
| 128 | 0.267 | 0.624 | 0.766 | 1.829 | 59.56 ± 0.19% | ||
| 256 | 0.255 | 0.699 | 0.802 | 1.907 | 60.97 ± 0.20% | ||
| 2 | 1024 | 512 | 0.247 | 0.746 | 0.829 | 1.729 | 58.19 ± 0.18% |
| 2048 | 0.238 | 0.702 | 0.860 | 1.850 | 50.68 ± 0.13% | ||
| 4096 | 0.261 | 0.829 | 1.101 | 2.791 | 48.57 ± 0.22% | ||
| 812 | 0.266 | 0.944 | 1.451 | 4.822 | 51.79 ± 0.15% | ||
| 8192 | 0.288 | 1.124 | 2.312 | 9.942 | 60.53 ± 0.16% | ||
| 전체 문맥(Full-context) | 26031 | - | - | 9.870 | 17.117 | 72.90 ± 0.19% | |
| A-Mem | 2520 | 0.668 | 1.485 | 1.410 | 4.374 | 48.38 ± 0.15% | |
| LangMem | 127 | 17.99 | 59.82 | 18.53 | 60.40 | 58.10 ± 0.21% | |
| Zep | 3911 | 0.513 | 0.778 | 1.292 | 2.926 | 65.99 ± 0.16% | |
| OpenAI | 4437 | - | - | 0.466 | 0.889 | 52.90 ± 0.14% | |
| Mem0 | 1764 | 0.148 | 0.200 | 0.708 | 1.440 | 66.88 ± 0.15% | |
| Mem0^8 | 3616 | 0.476 | 0.657 | 1.091 | 2.590 | 68.44 ± 0.17% | |
의 예상되는 관계적 이점은 여기서 더 나은 결과로 이어지지 않는데, 이는 다단계 추론 시나리오에서 더 복잡한 그래프 구조를 탐색할 때 잠재적인 오버헤드 또는 중복성을 시사한다.
시간적 추론에서, 은 다른 방법들을 상당히 능가하며, 구조화된 관계 그래프가 연대기적 관계와 사건 순서를 포착하는 데 탁월함을 입증한다. 명시적 관계적 맥락의 존재는 의 시간적 일관성을 상당히 향상시키며, 의 밀집 메모리 저장을 능가하고 시간에 민감한 정보를 추적할 때 정확한 관계적 표현의 중요성을 강조한다. 개방형 도메인 성능은 관계적 모델링의 가치를 더욱 강화한다. 은 그래프 기반 메모리의 관계적 명료성의 이점을 누리며, 최고 성능 베이스라인(Zep)과 긴밀히 경쟁한다. 이 경쟁력 있는 결과는 관계적 명료성을 통해 외부 지식을 통합하는 의 견고성을 강조하며, 구조화된 메모리와 개방형 도메인 정보 종합 사이의 최적의 시너지를 시사한다.
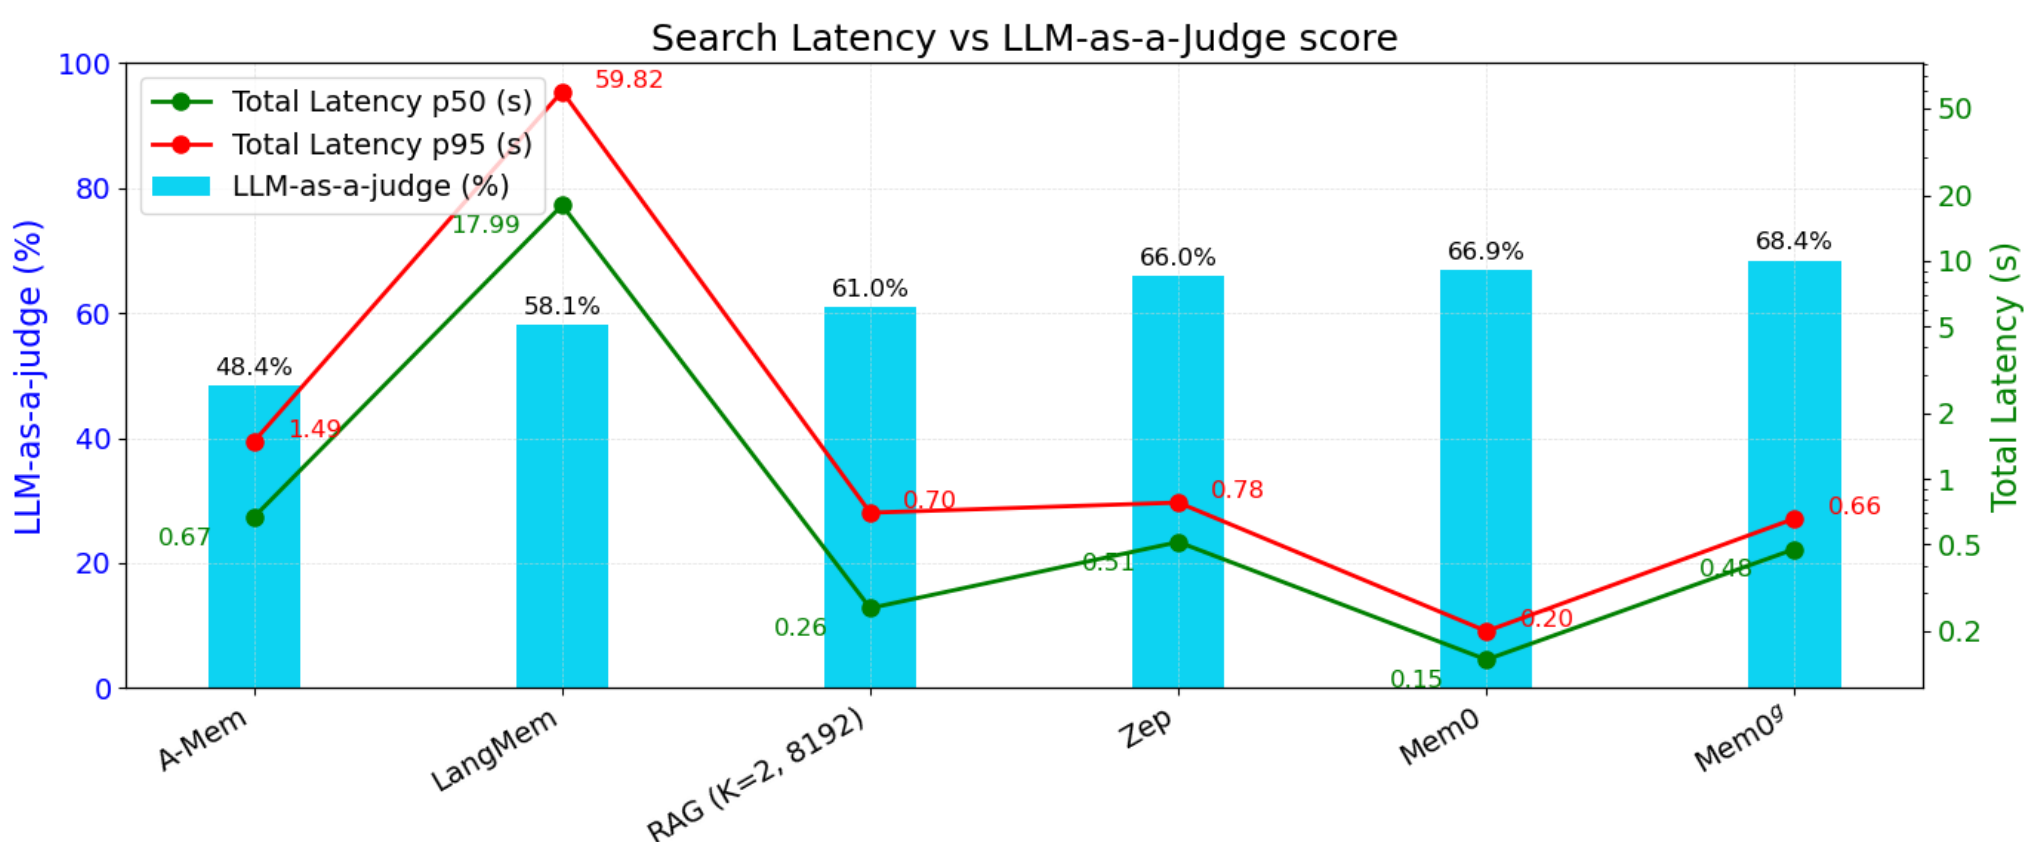
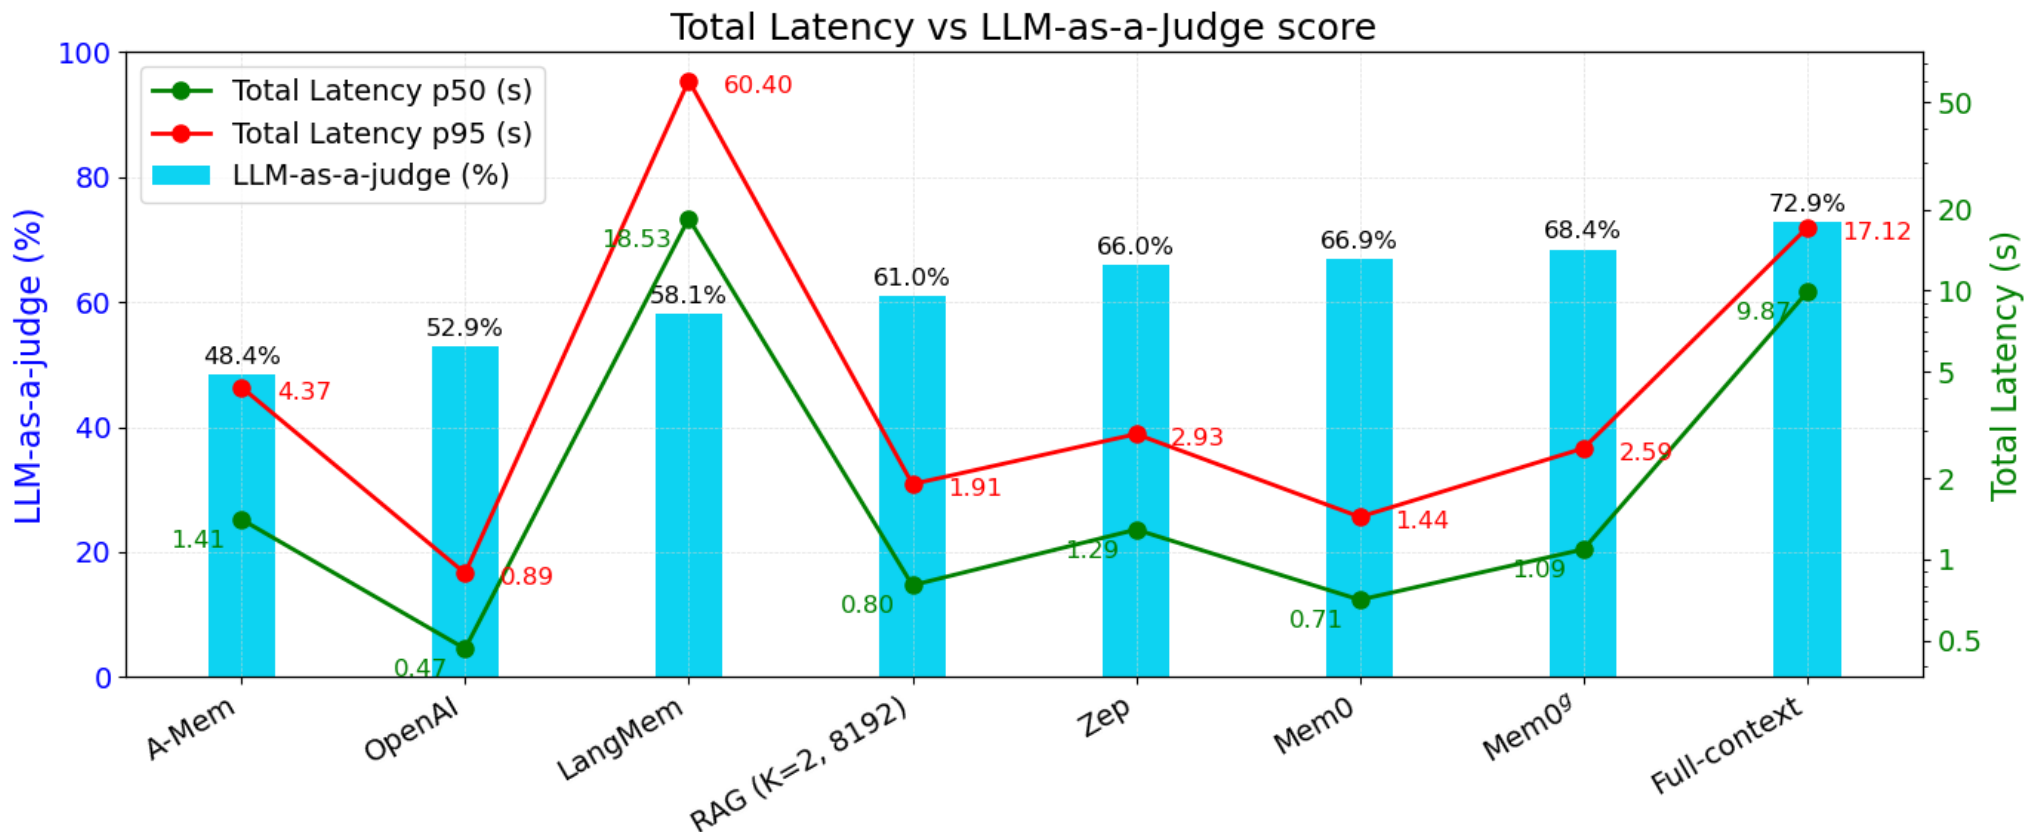
그림 4: 다양한 메모리 접근법의 지연 시간 분석. 이 하위 그림들은 표 2에서 선택된 다양한 방법들의 J 점수와 지연 시간 비교를 보여준다. 하위 그림 (a)는 답변 생성 이전의 검색/검색 지연 시간을 강조하며, 하위 그림 (b)는 총 지연 시간(LLM 추론 포함)을 보여준다. 두 플롯 모두 정확성과 효율성에 대한 전체적인 관점을 위해 각 방법의 J 점수를 겹쳐 놓는다.
전반적으로, 우리의 분석은 다양한 작업 요구에 걸쳐 Mem0과 Mem08의 상보적인 강점을 나타낸다: 밀집된 자연어 기반 메모리는 더 단순한 질의에 상당한 효율성을 제공하는 반면, 명시적 관계적 모델링은 미묘한 시간적 및 맥락적 통합을 요구하는 작업에 필수적이 된다. 이러한 발견은 AI 에이전트 배포에서 특정 추론 맥락에 맞춘 적응형 메모리 구조의 중요성을 강화한다.
4.3. MemO 및 MemO와 RAG 접근법 및 전체 컨텍스트 모델의 성능 비교
'Overall J' 열에 초점을 맞춘 표 2의 비교는 MemO와 MemO 모두 청크 크기를 변화시키고(128-8192 토큰) 하나(\(k = 1\)) 또는 두 개(\(k = 2\))의 청크를 검색하는 모든 RAG 구성들을 일관되게 능가함을 보여준다. 가장 강력한 RAG 접근법조차 J 지표에서 약 에서 정점을 이루는 반면, MemO는 에 도달하며—약 의 상대적 개선—MemO은 이상에 도달하여 약 의 상대적 이득을 달성한다. 이러한 진전은 대량의 원본 텍스트 청크를 검색하는 대신 메모리에서 가장 두드러진 사실만을 포착하는 것의 이점을 강조한다. 대화 이력을 간결하고 구조화된 표현으로 변환함으로써, MemO와 MemO은 노이즈를 완화하고 LLM에 더 정확한 단서를 표면화하여, 외부 LLM(J)에 의해 평가된 바와 같이 더 나은 답변으로 이어진다.
이러한 개선에도 불구하고, 약 26,000개의 토큰으로 구성된 청크를 한 번에 입력으로 처리하는 전체 컨텍스트 방식은 여전히 가장 높은 J 점수(약 )를 달성한다. 그러나 그림 4b에서 볼 수 있듯이, 이 방식은 모델이 매 질의마다 전체 대화를 읽어야 하므로 약 17초에 달하는 매우 높은 총 p95 지연 시간을 초래한다. 이와 대조적으로 MemO와 MemO은 토큰 사용량을 크게 줄여 전체 컨텍스트 방식 대비 각각 약 1.44초( 감소)와 2.6초( 감소)의 더 낮은 p95 지연 시간을 달성한다. 전체 컨텍스트 방식이 약간의 정확도 우위를 제공할 수 있기는 하지만, 메모리 기반 시스템은 경쟁력에 근접한 품질을 유지하면서도 토큰 및 지연 시간 비용의 일부만 부담하는, 보다 실용적인 절충안을 제공한다. 대화 길이가 증가함에 따라 전체 컨텍스트 방식은 계산 오버헤드의 기하급수적 증가로 인해 어려움을 겪는다(표 2에서 값이나 청크 크기가 커질수록 총 p95 지연 시간이 크게 증가하는 것을 확인할 수 있다). 이러한 입력 청크의 증가는 더 긴 응답 시간과 더 높은 토큰 소비 비용으로 이어진다. 이와 반대로 MemO와 MemO과 같은 메모리 중심 접근 방식은 대화 길이에 관계없이 일관된 성능을 유지하므로, 효율성과 응답성이 중요한 생산 규모 배포에 있어 훨씬 더 실행 가능성이 높다.
4.4. 지연 시간 분석
표 2는 다양한 검색 및 메모리 방법론에 대한 포괄적인 성능 비교를 제공하며, LOCOM0 데이터셋 전반에 걸쳐 검색 단계와 총 응답 생성 모두에 대한 중앙값(p50) 및 꼬리(p95) 지연 시간을 제시한다. 우리의 분석은 아키텍처 선택에 의해 결정되는 뚜렷한 성능 패턴을 보여준다. 메모리 중심 아키텍처는 서로 다른 성능 특성을 보인다. A-Mem은 더 큰 메모리 저장소에도 불구하고 상당한 검색 오버헤드(p50: 0.668초)를 발생시켜 총 중앙값 지연 시간이 1.410초에 이른다. LangMem은 훨씬 더 높은 검색 지연 시간(p50: 17.99초, p95: 59.82초)을 보여 대화형 애플리케이션에는 실용적이지 않다. Zep은 중간 정도의 성능(p50 총계: 1.292초)을 달성한다. 전체 대화 이력을 검색 없이 처리하는 전체 컨텍스트 기준선은 검색 기반 접근 방식과 근본적으로 다르다. 전체 대화 컨텍스트(26000 토큰)를 LLM에 직접 전달함으로써 검색 오버헤드는 제거되지만 극단적인 총 지연 시간(p50: 9.870초, p95: 17.117초)을 초래한다. 마찬가지로 OpenAI 구현은 플레이그라운드에서 수동으로 추출한 메모리를 처리하므로 메모리 검색을 수행하지 않는다. 이 접근 방식은 인상적인 응답 생성 시간(p50: 0.466초, p95: 0.889초)을 달성하지만, 보고된 지표에는 반영되지 않는 관련 컨텍스트의 사전 추출을 필요로 한다.
우리가 제안한 MemO 접근 방식은 그림 4a에 나타난 바와 같이 모든 방법 중 가장 낮은 검색 지연 시간(p50: 0.148초, p95: 0.200초)을 달성한다. 이러한 효율성은 고정 크기 청크가 아닌 가장 두드러진 정보만을 동적으로 식별하고 검색하는 우리의 선택적 메모리 검색 메커니즘과 인프라 개선에서 비롯된다. 결과적으로 MemO는 가장 낮은 총 중앙값 지연 시간(0.708초)을 매우 억제된 p95 값(1.440초)과 함께 유지하여, 대화형 AI 에이전트와 같이 지연 시간에 민감한 애플리케이션에 특히 적합하다. 그래프로 강화된 MemO 변형은 중간 정도의 지연 시간 비용으로 추가적인 관계 모델링 기능을 도입하며, 검색 시간(0.476초)은 여전히 모든 기존 메모리 솔루션과 기준선을 능가한다. 이러한 증가에도 불구하고 MemO8은 모든 방법 중 가장 높은 J 점수(68.44%)를 달성하면서 경쟁력 있는 총 지연 시간(p50: 1.091초, p95: 2.590초)을 유지한다—계산 비용이 지나치게 높은 전체 컨텍스트 방식에만 뒤처질 뿐이다. 이러한 성능 프로파일은 두 요소가 모두 핵심 제약 조건인 생산 AI 에이전트를 위한 매력적인 솔루션을 제공하며, 응답 품질과 계산 효율성 사이의 균형을 맞추는 우리 방법들의 능력을 보여준다.
4.5. 메모리 시스템 오버헤드: 토큰 분석 및 구축 시간
우리는 각 시스템의 장기 메모리 저장소를 실체화하는 데 필요한 평균 토큰 예산을 측정한다. Memo는 완전한 대화 턴을 자연어 표현으로 인코딩하므로 평균적으로 대화당 7k 토큰만을 차지한다. 반면 Memo8은 노드와 해당 관계를 포함하는 그래프 메모리의 도입으로 인해 그 규모가 약 두 배인 14k 토큰으로 증가한다. 이와 극명한 대조를 이루는 것은 Zep의 메모리 그래프로, 600k 토큰을 초과하여 소비한다. 이러한 팽창은 모든 노드에 완전한 추상적 요약을 캐시하면서 동시에 연결 엣지에 사실을 저장하는 Zep의 설계 선택에서 비롯되며, 이는 그래프 전반에 걸친 광범위한 중복을 초래한다. 비교하자면, 전체 원시 대화 컨텍스트를—어떠한 메모리 추상화도 없이—언어 모델에 제공하는 것은 평균 약 26k 토큰에 해당하며, 이는 Zep의 그래프 대비 20배 적은 양이다. 토큰 비효율성 외에도, 우리의 실험은 Zep에서 상당한 운영상의 병목 현상을 드러냈다. Zep의 시스템에 메모리를 추가한 후, 즉각적인 메모리 검색 시도가 우리의 질의에 올바르게 답하지 못하는 경우가 종종 있음을 관찰했다. 흥미롭게도, 몇 시간의 지연 후 동일한 검색을 다시 실행하면 상당히 더 나은 결과가 나왔다. 이러한 지연은 Zep의 그래프 구축이 다수의 비동기 LLM 호출과 광범위한 백그라운드 처리를 포함함을 시사하며, 이는 메모리 시스템을 실시간 애플리케이션에 비실용적으로 만든다. 이와 대조적으로, Memo의 그래프 구축은 최악의 시나리오에서도 1분 이내에 완료되어, 사용자가 새로 추가된 메모리를 즉시 질의 응답에 활용할 수 있게 한다.
이러한 발견은 Zep이 동일한 지식 단편을 여러 노드에 걸쳐 복제할 뿐만 아니라 상당한 운영상의 지연을 초래한다는 점을 부각시킨다. 우리의 아키텍처인 MemO와 Memo8은 동일한 정보를 토큰 비용의 일부로 보존하며 메모리 가용성이 현저히 더 빠르므로, 더욱 메모리 효율적이고 운영상 반응성이 뛰어난 표현을 제공한다.
5. 결론 및 향후 연구
우리는 LLM의 고정된 컨텍스트 윈도우가 지닌 내재적 한계를 극복하는 두 가지 상호 보완적 메모리 아키텍처인 MemO와 Memo8을 소개하였다. 간결한 메모리 표현을 동적으로 추출, 통합, 검색함으로써 MemO는 단일 홉 및 다중 홉 추론 전반에서 최첨단 성능을 달성하며, Memo의 그래프 기반 확장은 시간적 및 개방형 도메인 과제에서 상당한 이점을 열어준다. LOCOMO 벤치마크에서 우리의 방법은 단일 홉, 시간적, 다중 홉 추론 질문 유형에서 각 질문 유형별 최고 성능 방법 대비 5%, 11%, 7%의 상대적 개선을 제공하고, 전체 컨텍스트 기준선 대비 p95 지연 시간을 91% 이상 감소시킨다—이는 정밀도와 반응성 사이의 강력한 균형을 보여준다. Memo의 밀집 메모리 파이프라인은 단순한 질의에 대한 신속한 검색에 탁월하여 토큰 사용량과 계산 오버헤드를 최소화한다. 이와 대조적으로, Memo의 구조화된 그래프 표현은 미묘한 관계적 명료성을 제공하여 실용적 효율성을 희생하지 않고도 복잡한 이벤트 시퀀싱과 풍부한 컨텍스트 통합을 가능하게 한다. 함께, 이들은 다양한 대화 요구에 적응하면서도 규모에 맞게 배포 가능한 다목적 메모리 툴킷을 형성한다.
향후 연구 방향으로는 Memo8의 지연 오버헤드를 줄이기 위한 그래프 연산 최적화, 효율성과 관계적 표현을 결합한 계층적 메모리 아키텍처 탐구, 그리고 인간의 인지 과정에서 영감을 받은 보다 정교한 메모리 통합 메커니즘 개발이 포함된다.
추가적으로, 우리의 메모리 프레임워크를 대화 시나리오를 넘어 절차적 추론 및 멀티모달 상호작용과 같은 도메인으로 확장하는 것은 그 광범위한 적용 가능성을 더욱 입증할 것이다. 고정된 컨텍스트 윈도우의 근본적 한계를 해결함으로써, 우리의 연구는 인간 대응자와 마찬가지로 장기간에 걸쳐 일관되고 맥락적으로 풍부한 상호작용을 유지할 수 있는 대화형 AI 시스템을 향한 중요한 진전을 나타낸다.
6. 감사의 글
우리는 초기 초안에 대한 귀중한 통찰과 철저한 검토를 제공해 주신 Harsh Agarwal, Shyamal Anadkat, Prithvijit Chattopadhyay, Siddesh Choudhary, Rishabh Jain, Vaibhav Pandey께 진심 어린 감사를 표하고자 한다. 그들의 건설적인 논평과 세부적인 제안은 원고를 다듬는 데 도움을 주어 명료성과 전반적인 품질을 모두 향상시켰다. 이 작업에 시간과 전문성을 아낌없이 쏟아 주신 그들의 너그러움에 깊이 감사드린다.
참고문헌
Anthropic. Model card and evaluations for claude models. Technical report, Anthropic, February 2025. URL https://www.anthropic.com/news/claude- 3- 7- sonnet.
Jan Assmann. Communicative and cultural memory. In Cultural memories: The geographical point of view, pages 15- 27. Springer, 2011.
Aydar Bulatov, Yury Kuratov, and Mikhail Burtsev. Recurrent memory transformer. Advances in Neural Information Processing Systems, 35:11079- 11091, 2022.
Prateek Chhikara, Jiarui Zhang, Filip Ilievski, Jonathan Francis, and Kaixin Ma. Knowledge- enhanced agents for interactive text games. In Proceedings of the 12th Knowledge Capture Conference 2023, pages 157- 165, 2023.
Fergus IM Craik and Janine M Jennings. Human memory. 1992.
Gaurav Goswami. Dissecting the metrics: How different evaluation approaches yield diverse results for conversational ai. Authorea Preprints, 2025.
Tianyu Guo, Druv Pai, Yu Bai, Jiantao Jiao, Michael Jordan, and Song Mei. Active- dormant attention heads: Mechanistically demystifying extreme- token phenomena in llms. In NeurIPS 2024 Workshop on Mathematics of Modern Machine Learning, 2024.
Kostas Hatalis, Despina Christou, Joshua Myers, Steven Jones, Keith Lambert, Adam Amos- Binks, Zohreh Dannenhauer, and Dustin Dannenhauer. Memory matters: The need to improve long- term memory in llm- agents. In Proceedings of the AAAI Symposium Series, volume 2, pages 277- 280, 2023.
Zihong He, Weizhe Lin, Hao Zheng, Fan Zhang, Matt W Jones, Laurence Aitchison, Xuhai Xu, Miao Liu, Per Ola Kristensson, and Junxiao Shen. Human- inspired perspectives: A survey on ai long- term memory. arXiv preprint arXiv:2411.00489, 2024.
Aaron Hurst, Adam Lerer, Adam P Goucher, Adam Perelman, Aditya Ramesh, Aidan Clark, AJ Ostrow, Akila Welihinda, Alan Hayes, Alec Radford, et al. Gpt- 4o system card. arXiv preprint arXiv:2410.21276, 2024.
Aaron Jaech, Adam Kalai, Adam Lerer, Adam Richardson, Ahmed El- Kishky, Aiden Low, Alec Helyar, Aleksander Madry, Alex Beutel, Alex Carney, et al. Openai o1 system card. arXiv preprint arXiv:2412.16720, 2024.
Kuang- Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny, and Ian Fischer. A human- inspired reading agent with gist memory of very long contexts. In International Conference on Machine Learning, pages 26396- 26415. PMLR, 2024.
Lei Liu, Xiaoyan Yang, Yue Shen, Binbin Hu, Zhiqiang Zhang, Jinjie Gu, and Guannan Zhang. Think- in- memory: Recalling and post- thinking enable llms with long- term memory. arXiv preprint arXiv:2311.08719, 2023.
Adyasha Maharana, Dong- Ho Lee, Sergey Tulyakov, Mohit Bansal, Francesco Barbieri, and Yuwei Fang. Evaluating very long- term conversational memory of llm agents. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 13851- 13870, 2024.
Bodhisattwa Prasad Majumder, Bhavana Dalvi Mishra, Peter Jansen, Oyvind Tafjord, Niket Tandon, Li Zhang, Chris Callison- Burch, and Peter Clark. Clin: A continually learning language agent for rapid task adaptation and generalization. In First Conference on Language Modeling.
Elliot Nelson, Georgios Kollias, Payel Das, Subhajit Chaudhury, and Soham Dan. Needle in the haystack for memory based large language models. arXiv preprint arXiv:2407.01437, 2024.
Charles Packer, Vivian Fang, Shishir G Patil, Kevin Lin, Sarah Wooders, and Joseph E Gonzalez. Memgpt: Towards llms as operating systems. 2023.
Preston Rasmussen, Pavlo Paliychuk, Travis Beauvais, Jack Ryan, and Daniel Chalef. Zep: A temporal knowledge graph architecture for agent memory. arXiv preprint arXiv:2501.13956, 2025.
Parth Sarthi, Salman Abdullah, Aditi Tuli, Shubh Khanna, Anna Goldie, and Christopher D Manning. Raptor: Recursive abstractive processing for tree- organized retrieval. In The Twelfth International Conference on Learning Representations, 2024.
Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. Reflexion: Language agents with verbal reinforcement learning. Advances in Neural Information Processing Systems, 36:8634- 8652, 2023.
Prabhijot Singh, Prateek Chhikara, and Jasmeet Singh. An ensemble approach for extractive text summarization. In 2020 International Conference on Emerging Trends in Information Technology and Engineering (ic- ETTE), pages 1- 7. IEEE, 2020.
아르피타 소니, 라지브 아로라, 아누프 쿠마르, 디렌드라 판와르. 저자원 생성형 챗봇의 도메인 커버리지 평가: BLEU 점수를 활용한 개방형 도메인 및 폐쇄형 도메인 접근법의 비교 연구. 2024년 전기전자 및 컴퓨팅 기술 국제 학술대회(ICEECT), 제1권, 1-6쪽. IEEE, 2024.
제미나이 팀, 펫코 게오르기에프, 빙 이안 레이, 라이언 버넬, 리빈 바이, 안몰 굴라티, 개럿 탠저, 다미앙 뱅상, 주펑 판, 시보 왕 등. Gemini 1.5: 수백만 토큰의 컨텍스트에 걸친 멀티모달 이해의 개방. arXiv 프리프린트 arXiv:2403.05530, 2024.
조안 C 티모네다, 세바스티안 바예호 베라. 기억이 전부다: 모델 기억이 주석 작업에서 LLM 성능에 미치는 영향 테스트. arXiv 프리프린트 arXiv:2503.04874, 2025.
우장 쉬, 주지에 량, 카이 메이, 항 가오, 준타오 탄, 용펑 장. A-mem: LLM 에이전트를 위한 에이전틱 메모리. arXiv 프리프린트 arXiv:2502.12110, 2025.
양양 유, 하오항 리, 즈 천, 위에천 장, 양 리, 덩후이 장, 롱 리우, 조던 W 수초, 칼둔 카샤나. Finmem: 계층적 메모리와 캐릭터 디자인을 갖춘 성능 향상 LLM 트레이딩 에이전트. AAAI 심포지엄 시리즈 논문집, 제3권, 595-597쪽, 2024.
지아루이 장. 유도된 프로필 생성이 대규모 언어 모델을 통한 개인화를 개선한다. 계산언어학회 발견 논문집: EMNLP 2024, 4005-4016쪽, 2024.
지아루이 장, 필립 일리에프스키, 카이신 마, 조나단 프랜시스, 알레산드로 올트라마리. 상식 지식을 활용한 제로샷 적응에 관한 연구. AKBC, 2022.
Zeyu Zhang, Xiaohe Bo, Chen Ma, Rui Li, Xu Chen, Quanyu Dai, Jieming Zhu, Zhenhua Dong, Ji-Rong Wen. 대규모 언어 모델 기반 에이전트의 메모리 메커니즘에 관한 서베이. arXiv preprint arXiv:2404.13501, 2024.
Wanjun Zhong, Lianghong Guo, Qiqi Gao, He Ye, Yanlin Wang. Memorybank: 장기 메모리로 대규모 언어 모델 향상하기. AAAI Conference on Artificial Intelligence Proceedings, 38권, 19724-19731쪽, 2024.
부록
A. 프롬프트
LLM-as-a-Judge 프롬프트를 개발함에 있어, 우리는 Packer 등(2023)이 공개한 프롬프트의 요소들을 차용한다.
LLM AS A JUDGE용 프롬프트 템플릿
당신의 과제는 질문에 대한 답변을 "CORRECT" 또는 "WRONG"으로 라벨링하는 것입니다. 당신에게 다음과 같은 데이터가 주어집니다: (1) 질문(한 사용자가 다른 사용자에게 제시한 것), (2) '골드'(정답) 답변, (3) CORRECT/WRONG으로 점수를 매길 생성된 답변.
질문의 요점은 한 사용자가 사전 대화를 바탕으로 다른 사용자에 관해 알아야 할 무언가를 묻는 것입니다. 골드 답변은 보통 참조된 주제를 포함하는 간결하고 짧은 답변이 될 것입니다. 예를 들어:
질문: 내가 지난번 하와이에 갔을 때 무엇을 얻었는지 기억하니?
골드 답변: 조개 목걸이
생성된 답변은 훨씬 더 길 수 있지만, 채점 시 관대해야 합니다 — 골드 답변과 같은 주제를 다루기만 하면 CORRECT로 간주해야 합니다.
시간 관련 질문의 경우, 골드 답변은 특정 날짜, 월, 연도 등이 될 것입니다. 생성된 답변은 훨씬 더 길거나 상대적 시간 표현(예: '지난 화요일' 또는 '다음 달')을 사용할 수 있지만, 채점 시 관대해야 합니다 — 골드 답변과 같은 날짜나 기간을 가리키기만 하면 CORRECT로 간주해야 합니다. 형식이 다르더라도(예: '5월 7일' 대 '7 May') 같은 날짜라면 CORRECT로 간주하십시오.
이제 실제 질문입니다: 질문: {question}
골드 답변: {gold_answer}
생성된 답변: {generated_answer}
먼저, 당신의 추론에 대한 짧은(한 문장) 설명을 제공한 다음, CORRECT 또는 WRONG으로 마무리하십시오. 응답에 CORRECT와 WRONG을 모두 포함하지 마십시오. 그럴 경우 평가 스크립트가 깨집니다.
키가 "label"인 json 형식으로 라벨 CORRECT 또는 WRONG만 반환하십시오.
결과 생성용 프롬프트 템플릿 (MEMO)
당신은 대화 기억에서 정확한 정보를 검색하는 임무를 맡은 지능형 메모리 어시스턴트입니다.
맥락:
당신은 대화에서 두 화자의 기억에 접근할 수 있습니다. 이 기억들은 질문에 답하는 데 관련될 수 있는 타임스탬프 정보를 포함합니다.
지침:
1. 두 화자의 제공된 모든 기억을 주의 깊게 분석하십시오 2. 답변을 결정하기 위해 타임스탬프에 특별히 주의하십시오 3. 질문이 특정 사건이나 사실에 관한 것이라면, 기억에서 직접적인 증거를 찾으십시오 4. 기억에 모순되는 정보가 있으면 가장 최근 기억의 우선순위를 두십시오 5. 시간 참조(예: "작년", "두 달 전" 등)에 관한 질문이 있으면, 기억 타임스탬프를 기준으로 실제 날짜를 계산하십시오. 예를 들어, 2022년 5월 4일의 기억이 "작년에 인도에 갔다"고 언급하면, 그 여행은 2021년에 일어난 것입니다. 6. 항상 상대적 시간 참조를 구체적인 날짜, 월 또는 연도로 변환하십시오. 예를 들어, 기억 타임스탬프를 기준으로 "작년"을 "2022"로, "두 달 전"을 "2023년 3월"로 변환하십시오. 질문에 답할 때는 참조를 무시하십시오. 7. 두 화자의 기억 내용에만 집중하십시오. 기억에 언급된 등장인물 이름을 그 기억을 생성한 실제 사용자와 혼동하지 마십시오. 8. 답변은 5-6 단어 미만이어야 합니다.
접근 방식 (단계별로 사고하기):
1. 먼저, 질문과 관련된 정보를 포함하는 모든 기억을 조사하십시오 2. 이 기억들의 타임스탬프와 내용을 주의 깊게 조사하십시오 3. 질문에 답하는 날짜, 시간, 장소 또는 사건의 명시적 언급을 찾으십시오 4. 답변에 계산(예: 상대적 시간 참조 변환)이 필요하면, 작업 과정을 보여주십시오 5. 기억의 증거만을 기반으로 정확하고 간결한 답변을 구성하십시오 6. 답변이 제기된 질문을 직접 다루는지 다시 확인하십시오 7. 최종 답변이 구체적이고 모호한 시간 참조를 피하는지 확인하십시오
사용자 {speaker_1_user_id}의 기억: {speaker_1_memories}
사용자 {speaker_2_user_id}의 기억: {speaker_2_memories}
질문: {question}
답변:
결과 생성용 프롬프트 템플릿 (MEMO'S)
(이전과 동일)
접근 방식 (단계별로 사고하기):
1. 먼저, 질문과 관련된 정보를 포함하는 모든 기억을 조사하십시오 2. 이 기억들의 타임스탬프와 내용을 주의 깊게 조사하십시오 3. 질문에 답하는 날짜, 시간, 장소 또는 사건의 명시적 언급을 찾으십시오 4. 답변에 계산(예: 상대적 시간 참조 변환)이 필요하면, 작업 과정을 보여주십시오 5. 사용자의 지식 맥락을 이해하기 위해 지식 그래프 관계를 분석하십시오 6. 기억의 증거만을 기반으로 정확하고 간결한 답변을 구성하십시오 7. 답변이 제기된 질문을 직접 다루는지 다시 확인하십시오 8. 최종 답변이 구체적이고 모호한 시간 참조를 피하는지 확인하십시오
사용자 {speaker_1_user_id}의 기억: {speaker_1_memories}
사용자 {speaker_1_user_id}의 관계: {speaker_1_graph_memories}
사용자 {speaker_2_user_id}의 기억: {speaker_2_memories}
사용자 {speaker_2_user_id}의 관계: {speaker_2_graph_memories}
질문: {question}
답변:
OPENAI CHATGPT용 프롬프트 템플릿
이 대화에서 관련 정보를 추출하고 언급된 각 사용자에 대한 메모리 항목을 생성해 주시겠습니까? 향후 참조 및 개인화된 상호작용을 위해 제공된 타임스탬프와 함께 이 기억들을 당신의 지식 기반에 저장해 주십시오.
(2023년 5월 8일 오후 1:56) Caroline: 안녕 Mel! 만나서 반가워! 어떻게 지냈어? (2023년 5월 8일 오후 1:56) Melanie: 안녕 Caroline! 만나서 반가워! 아이들과 일 때문에 정신이 없어. 너는 어때? 새로운 일 있어? (2023년 5월 8일 오후 1:56) Caroline: 나는 어제 LGBTQ 지원 그룹에 갔는데 정말 강렬했어.
B. 알고리즘
알고리즘 1 메모리 관리 시스템: 갱신 연산
1: 입력: 검색된 기억의 집합 , 기존 메모리 저장소
2: 출력: 갱신된 메모리 저장소
3: procedure UPDATE MEMORY(F, M)
4: 각 사실 에 대해 do
5: 연산 CLASSIFYOPERATION
분류에 따라
적절한 연산을 실행
6: if 연산 ADD then
7: GenerateUniqueID()
8:
고유 식별자와 함께 새로운 사실 추가
9: else if operation UPDATE then
10: FindRelatedMemory
11: if InformationContent InformationContent then
12: 더 풍부한 정보로 교체
13: end if
14: else if operation DELETE then
15: FindContradictedMemory
16: 모순되는 정보 제거
17: else if operation NOOP then
18: 작업이 수행되지 않음 사실이 이미 존재하거나 관련이 없음
19: end if
20: end for
21: return M
22: end procedure
23: function CLASSIFYOPERATION
24: if SemanticallySimilar then
25: return ADD
26: else if Contradicts then
27: return DELETE
28: else if Augments then
29: return UPDATE
30: else
31: return NOOP
32: end if
33: end function
메모리에 존재하지 않는 새로운 정보
기존 메모리와 충돌하는 정보
메모리에 있는 기존 정보를 향상시킴
변경 필요 없음
C. 선정된 베이스라인
LoCoMo LoCoMo 프레임워크는 LLM 에이전트가 일관된 장기 대화를 유지할 수 있도록 하는 정교한 메모리 파이프라인을 구현한다. 핵심적으로 이 시스템은 메모리를 단기 및 장기 구성 요소로 나눈다. 각 대화 세션 후에 에이전트는 해당 상호작용에서 핵심 정보를 추출한 요약(단기 메모리로 저장됨)을 생성한다. 동시에 개별 대화 턴은 '관찰'로 변환된다—각 화자의 페르소나와 인생 사건에 대한 사실적 진술로, 이를 생성한 특정 대화 턴에 대한 참조와 함께 장기 메모리에 저장된다. 새로운 응답을 생성할 때 에이전트는 가장 최근 세션 요약과 장기 메모리에서 선택적으로 검색한 관련 관찰을 모두 활용한다. 이 이중 메모리 접근 방식은 대화 세션 사이에 발생한 인과적으로 연결된 인생 사건을 추적하는 시간적 사건 그래프를 통합함으로써 더욱 향상된다. 검색된 기억, 현재 대화 맥락, 페르소나 정보, 그리고 그 사이의 인생 사건에 응답을 조건화함으로써, 이 시스템은 에이전트가 수백 턴과 수십 개의 세션에 걸친 대화에서 일관된 성격을 유지하고 중요한 세부 사항을 기억할 수 있게 한다.
ReadAgent ReadAgent는 인간이 긴 텍스트를 처리하는 방식을 모방하는 정교한 3단계 파이프라인을 통해 LLM의 근본적인 한계를 해결한다. 첫째, 에피소드 페이지네이션(Episode Pagination)에서 시스템은 임의의 절단 지점이 아닌 자연스러운 인지적 경계에서 텍스트를 지능적으로 분할한다. 다음으로, 메모리 요약(Memory Gisting) 동안 각 세그먼트를 핵심 의미를 보존하면서 토큰 수를 대폭 줄인 간결한 요약으로 추출한다—이는 인간의 기억이 정보의 본질은 유지하되 축어적 회상은 하지 않는 방식과 유사하다. 마지막으로, 질문에 답하라는 과제가 주어지면, 대화형 조회(Interactive Lookup) 메커니즘이 이러한 요약들을 검토하고 상세 처리를 위해 가장 관련성 높은 원문 세그먼트만을 전략적으로 검색한다. 이 인간에서 영감을 받은 접근 방식은 LLM이 정상적인 컨텍스트 윈도우보다 최대 20배 더 긴 문서를 효과적으로 관리할 수 있게 한다. 요약을 통한 전역적 이해와 세부 사항에 대한 선택적 주의를 균형 있게 결합함으로써, ReadAgent는 계산 효율성과 향상된 이해력을 모두 달성하며, 인간의 인지 과정을 모방하는 것이 AI 텍스트 처리 능력을 크게 향상시킬 수 있음을 보여준다.
MemoryBank MemoryBank 시스템은 정교한 3부분 파이프라인을 통해 LLM에 장기 메모리를 부여한다. 핵심적으로 메모리 저장(Memory Storage) 구성 요소는 상세한 대화 로그, 계층적 사건 요약, 그리고 진화하는 사용자 성격 프로필을 보관한다. 새로운 상호작용이 발생하면, 메모리 검색(Memory Retrieval) 메커니즘은 이중 타워 밀집 검색 모델을 사용하여 맥락적으로 관련된 과거 정보를 추출한다. 메모리 업데이트(Memory Updating) 구성 요소는 기억이 회상될 때 강화되고 사용되지 않으면 시간이 지남에 따라 자연스럽게 약화되는 인간과 유사한 망각 메커니즘을 제공한다. 이 포괄적인 접근 방식은 AI 동반자가 관련 정보를 회상하고, 장기적인 상호작용 전반에 걸쳐 맥락적 인식을 유지하며, 점점 더 정확한 사용자 초상을 개발할 수 있게 하여, 더욱 개인화되고 자연스러운 장기 대화를 가능하게 한다.
MemGPT MemGPT 시스템은 LLM에 내재된 컨텍스트 윈도우 한계를 극복하기 위해 운영 체제에서 영감을 받은 접근 방식을 도입한다. 핵심적으로 MemGPT는 계층적 메모리 시스템, 자기 주도적 메모리 연산, 그리고 이벤트 기반 제어 흐름 메커니즘이라는 세 가지 핵심 구성 요소로 이루어진 정교한 메모리 관리 파이프라인을 사용한다. 이 시스템은 사용 가능한 메모리를 '주 컨텍스트'(전통적인 운영 체제의 RAM에 해당)와 '외부 컨텍스트'(디스크 저장소에 해당)로 나눈다. LLM의 컨텍스트 윈도우에 의해 제약을 받는 주 컨텍스트는 시스템 지시사항, 최근 대화 기록, 그리고 모델이 수정할 수 있는 작업 메모리를 포함한다. 외부 컨텍스트는 모델의 즉각적인 컨텍스트 윈도우 외부에 무제한의 정보를 저장하며, 여기에는 전체 대화 기록과 아카이브 데이터가 포함된다. LLM이 주 컨텍스트에 없는 정보를 필요로 할 때, 함수 호출을 시작하여 이러한 메모리 계층 전반에 걸쳐 콘텐츠를 검색, 추출 또는 수정할 수 있으며, 이를 통해 관련 정보를 제한된 컨텍스트 윈도우 안팎으로 효과적으로 '페이징'한다. 이 OS에서 영감을 받은 아키텍처는 MemGPT가 고정 컨텍스트 모델로 작동하면서도 장기적인 상호작용 전반에 걸쳐 대화의 일관성을 유지하고, 표준 컨텍스트 한계를 초과하는 문서를 관리하며, 다중 홉 정보 검색 작업을 수행할 수 있게 한다. 자체 메모리 자원을 지능적으로 관리하는 이 시스템의 능력은 무한한 컨텍스트라는 환상을 제공하며, 현재 LLM 기술로 가능한 것의 범위를 크게 확장한다.
A-Mem A-Mem 모델은 LLM 에이전트를 위해 설계된 에이전트형 메모리 시스템을 도입한다. 이 시스템은 상호 연결된 노트를 통해 기억을 동적으로 구조화하고 진화시킨다. 각 노트는 LLM이 생성한 키워드, 맥락 설명, 태그와 같은 구조화된 속성으로 강화된 상호작용을 담는다. 새로운 기억을 생성할 때, A-MEM은 의미론적 임베딩을 사용하여 관련 기존 노트를 검색한 다음, LLM 기반 접근 방식을 사용하여 유사성과 공유 속성을 바탕으로 의미 있는 연결을 설정한다. 결정적으로, 기억 진화 메커니즘은 새로운 관련 기억이 통합될 때마다 기존 노트를 동적으로 업데이트하여 이들의 맥락 정보와 속성을 개선한다. 따라서 메모리 구조는 지속적으로 진화하여 기억들 간에 더욱 풍부하고 맥락적으로 깊은 연결을 가능하게 한다. 기억으로부터의 검색은 의미론적 유사성을 통해 수행되어, 에이전트 상호작용 중에 관련 역사적 맥락을 제공한다.