
48GB GPU 한 장으로 65B 모델을 미세 조정한다. 4비트 양자화와 어댑터로 16비트 품질을 유지. NeurIPS 2023, 전문 무료.
QLoRA: Efficient Finetuning of Quantized LLMs
QLoRA: 양자화된 LLM의 효율적인 미세조정
Tim Dettmers\*
Artidoro Pagnoni\*
Ari Holtzman
Luke Zettlemoyer
University of Washington {dettmers,artidoro,ahai,lsz}@cs.washington.edu
초록
우리는 전체 16비트 미세조정 작업 성능을 유지하면서 단일 48GB GPU에서 65B 파라미터 모델을 미세조정할 수 있을 만큼 메모리 사용량을 줄이는 효율적인 미세조정 접근법인 QLoRA를 제시한다. QLoRA는 동결된 4비트 양자화 사전학습 언어 모델을 통해 그래디언트를 Low Rank Adapters(LoRA)로 역전파한다. 우리가 Guanaco라고 명명한 우리의 최고 모델군은 Vicuna 벤치마크에서 이전에 공개적으로 공개된 모든 모델을 능가하며, 단일 GPU에서 24시간의 미세조정만 요구하면서 ChatGPT 성능 수준의 99.3%에 도달한다. QLoRA는 성능을 희생하지 않고 메모리를 절약하기 위한 여러 혁신을 도입한다: (a) 정규분포 가중치에 대해 정보 이론적으로 최적인 새로운 데이터 타입인 4비트 NormalFloat(NF4), (b) 양자화 상수를 양자화하여 평균 메모리 풋프린트를 줄이는 Double Quantization, (c) 메모리 스파이크를 관리하기 위한 Paged Optimizers. 우리는 QLoRA를 사용하여 1,000개 이상의 모델을 미세조정하며, 8개의 instruction 데이터셋, 여러 모델 유형(LLaMA, T5), 그리고 일반 미세조정으로는 실행이 불가능할 모델 규모(예: 33B 및 65B 파라미터 모델)에 걸쳐 instruction following 및 챗봇 성능에 대한 상세한 분석을 제공한다. 우리의 결과는 작은 고품질 데이터셋에서의 QLoRA 미세조정이 이전 SoTA보다 작은 모델을 사용하더라도 최첨단 결과로 이어진다는 것을 보여준다. 우리는 인간 및 GPT-4 평가 모두에 기반한 챗봇 성능의 상세한 분석을 제공하며, GPT-4 평가가 인간 평가에 대한 저렴하고 합리적인 대안임을 보여준다. 더욱이, 우리는 현재의 챗봇 벤치마크가 챗봇의 성능 수준을 정확하게 평가하기에 신뢰할 수 없음을 발견한다. lemon-picked 분석은 Guanaco가 ChatGPT와 비교하여 어디에서 실패하는지를 보여준다. 우리는 4비트 훈련을 위한 CUDA 커널을 포함한 모든 모델과 코드를 공개한다.2
1 서론
대규모 언어 모델(LLM)의 미세조정은 그 성능을 향상시키고 [40, 62, 43, 61, 59, 37], 바람직한 행동을 추가하거나 바람직하지 않은 행동을 제거하는 [43, 2, 4] 매우 효과적인 방법이다. 그러나 매우 큰 모델의 미세조정은 엄청나게 비싸다; LLaMA 65B 파라미터 모델 [57]의 일반적인 16비트 미세조정은 780 GB 이상의 GPU 메모리를 요구한다. 최근의 양자화 방법들이 LLM의 메모리 풋프린트를 줄일 수 있지만 [14, 13, 18, 66], 그러한 기술들은 추론에만 작동하며 훈련 중에는 무너진다 [65].
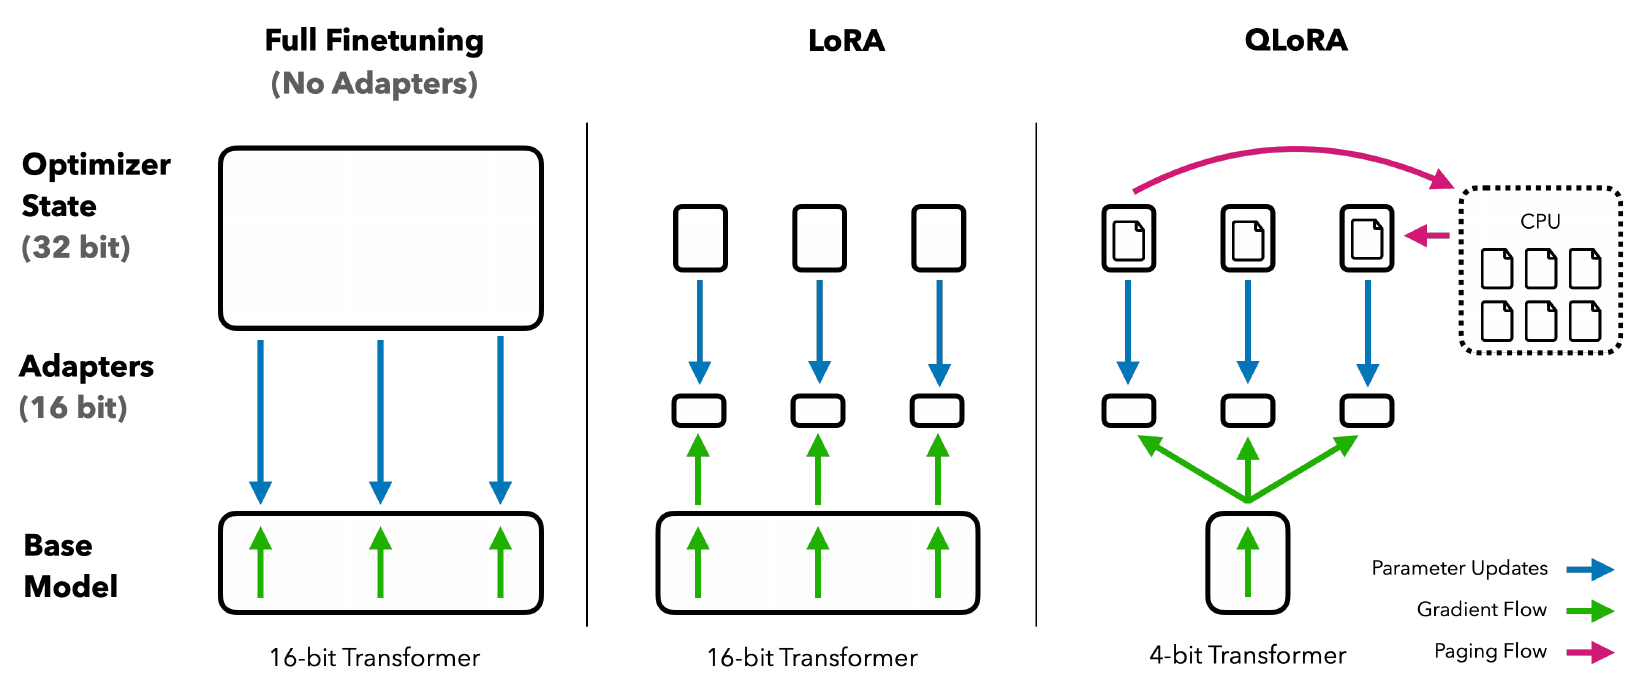
우리는 성능 저하 없이 양자화된 4비트 모델을 미세조정하는 것이 가능하다는 것을 처음으로 입증한다. 우리의 방법인 QLoRA는 새로운 고정밀 기법을 사용하여 사전학습된 모델을 4비트로 양자화한 다음, 양자화된 가중치를 통해 그래디언트를 역전파하여 조정되는 소규모의 학습 가능한 Low-rank Adapter 가중치 [28] 집합을 추가한다.
QLORA는 65B 파라미터 모델을 미세조정하는 평균 메모리 요구량을 16비트 완전 미세조정 기준과 비교하여 런타임이나 예측 성능을 저하시키지 않고 GPU 메모리 에서 로 줄인다. 이는 LLM 미세조정의 접근성에 있어 중대한 전환을 의미한다: 이제 현재까지 가장 큰 공개적으로 이용 가능한 모델들을 단일 GPU에서 미세조정할 수 있다. QLoRA를 사용하여, 우리는 Guancao 모델군을 훈련시키며, 두 번째로 좋은 모델은 Vicuna [10] 벤치마크에서 ChatGPT 성능 수준의 에 도달하면서 단일 소비자용 GPU에서 12시간 이내에 훈련 가능하다; 단일 전문가용 GPU에서 24시간 이상을 사용하여 우리는 가장 큰 모델로 를 달성하며, 본질적으로 Vicuna 벤치마크에서 ChatGPT와의 격차를 좁힌다. 배포 시, 우리의 가장 작은 Guanaco 모델
| 모델 | 크기 | Elo |
| GPT-4 | - | 1348 ± 1 |
| Guanaco 65B | 41 GB | 1022 ± 1 |
| Guanaco 33B | 21 GB | 992 ± 1 |
| Vicuna 13B | 26 GB | 974 ± 1 |
| ChatGPT | - | 966 ± 1 |
| Guanaco 13B | 10 GB | 916 ± 1 |
| Bard | - | 902 ± 1 |
| Guanaco 7B | 6 GB | 879 ± 1 |
(7B 파라미터)은 단지 5 GB의 메모리를 요구하며 Vicuna 벤치마크에서 26 GB Alpaca 모델을 20 퍼센트 포인트 이상 능가한다(표 6).
QLORA는 성능을 희생하지 않고 메모리 사용을 줄이기 위해 설계된 여러 혁신을 도입한다: (1) 4비트 NormalFloat, 정규분포 데이터에 대해 정보 이론적으로 최적인 양자화 데이터 타입으로 4비트 Integer 및 4비트 Float보다 더 나은 실증적 결과를 낳는다. (2) Double Quantization, 양자화 상수를 양자화하는 방법으로 파라미터당 평균 약 0.37비트(65B 모델의 경우 약 3 GB)를 절약한다. (3) Paged Optimizers, NVIDIA 통합 메모리를 사용하여 긴 시퀀스 길이의 미니배치를 처리할 때 발생하는 그래디언트 체크포인팅 메모리 스파이크를 피한다. 우리는 이러한 기여들을 모든 네트워크 계층에 어댑터를 포함하여 이전 연구에서 보인 정확도 트레이드오프의 거의 전부를 피하는 더 잘 조정된 LoRA 접근법으로 결합한다.
QLORA의 효율성은 메모리 오버헤드로 인해 일반 미세조정으로는 불가능할 모델 규모에서 instruction 미세조정 및 챗봇 성능에 대한 심층 연구를 수행할 수 있게 해준다. 따라서 우리는 여러 instruction tuning 데이터셋, 모델 아키텍처, 그리고 80M에서 65B 파라미터 사이의 크기에 걸쳐 1,000개 이상의 모델을 훈련시킨다. QLoRA가 16비트 성능을 회복함( )을 보여주고 최첨단 챗봇인 Guanaco를 훈련시키는 것( )에 더하여, 우리는 또한 훈련된 모델들의 추세를 분석한다. 첫째, 우리는 데이터 품질이 데이터셋 크기보다 훨씬 더 중요하다는 것을 발견한다, 예를 들어, 9k 샘플 데이터셋(OASST1)이 450k 샘플 데이터셋(FLAN v2, 서브샘플링됨)보다 챗봇 성능에서 더 나은 성능을 보였으며, 둘 다 instruction following 일반화를 지원하기 위한 것이었음에도 그러하다. 둘째, 우리는 강력한 Massive Multitask Language Understanding(MMLU) 벤치마크 성능이 강력한 Vicuna 챗봇 벤치마크 성능을 함의하지 않으며 그 반대도 마찬가지임을 보여준다—다시 말해, 주어진 작업에 대해서는 데이터셋의 적합성이 크기보다 더 중요하다.
더욱이, 우리는 또한 인간 평가자와 GPT-4를 모두 사용한 챗봇 성능의 광범위한 분석을 제공한다. 우리는 모델들이 주어진 프롬프트에 대해 최선의 응답을 생성하기 위해 경기에서 서로 경쟁하는 토너먼트 스타일 벤치마킹을 사용한다. 경기의 승자는 GPT-4나 인간 주석자에 의해 판정된다. 토너먼트 결과는 챗봇 성능의 순위를 결정하는 Elo 점수 [16, 17]로 집계된다. 우리는 GPT-4와 인간 평가가 토너먼트에서 모델 성능 순위에 대해 대체로 일치하지만, 강한 불일치의 사례도 있음을 발견한다. 따라서 우리는 모델 기반 평가가 인간 주석에 대한 저렴한 대안을 제공하면서도 불확실성을 갖고 있음을 강조한다.
우리는 Guanaco 모델의 정성적 분석으로 챗봇 벤치마크 결과를 보강한다. 우리의 분석은 정량적 벤치마크에 포착되지 않은 성공 및 실패 사례를 조명한다.
우리는 추가 연구를 용이하게 하기 위해 인간 및 GPT-4 주석이 달린 모든 모델 생성을 공개한다. 우리는 우리의 코드베이스와 CUDA 커널을 오픈소스화하고 우리의 방법을 Hugging Face transformers 스택 [64]에 통합하여 모든 사람이 쉽게 접근할 수 있게 한다. 우리는 8개의 서로 다른 instruction following 데이터셋에서 훈련된 7/13/33/65B 크기 모델용 어댑터 모음을 공개하며, 총 32개의 서로 다른 오픈소스 미세조정 모델이다.
2 배경
블록 단위 k비트 양자화 양자화는 더 많은 정보를 담고 있는 표현에서 더 적은 정보를 담고 있는 표현으로 입력을 이산화하는 과정이다. 이는 종종 더 많은 비트를 가진 데이터 타입을 더 적은 비트로 변환하는 것을 의미하며, 예를 들어 32비트 부동소수점에서 8비트 Integer로 변환하는 것이다. 저비트 데이터 타입의 전체 범위가 사용되도록 보장하기 위해, 입력 데이터 타입은 일반적으로 텐서로 구조화된 입력 요소들의 절댓값 최댓값으로 정규화를 통해 대상 데이터 타입 범위로 재조정된다. 예를 들어, 32비트 부동소수점(FP32) 텐서를 범위 를 가진 Int8 텐서로 양자화하는 것은:
여기서 는 양자화 상수 또는 양자화 스케일이다. 역양자화는 그 역이다:
이 접근법의 문제점은 입력 텐서에서 큰 크기의 값(즉, 이상치)이 발생하면 양자화 구간—특정 비트 조합—이 잘 활용되지 못하여 일부 구간에는 양자화되는 수가 적거나 전혀 없게 된다는 점이다. 이상치 문제를 방지하기 위한 일반적인 접근법은 입력 텐서를 독립적으로 양자화되는 블록으로 나누고, 각 블록이 자체적인 양자화 상수 를 갖도록 하는 것이다. 이는 다음과 같이 정식화할 수 있다. 입력 텐서 를 평탄화하고 선형 세그먼트를 개의 블록으로 슬라이싱하여 크기 의 연속된 개 블록으로 나눈다. 이 블록들을 방정식 1로 독립적으로 양자화하여 양자화된 텐서와 개의 양자화 상수 를 생성한다.
저랭크 어댑터(Low-rank Adapters) 저랭크 어댑터(LoRA) 미세조정[28]은 고정된 상태로 유지되는 전체 모델 파라미터를 업데이트하지 않으면서, 흔히 어댑터라고 불리는 소규모의 학습 가능한 파라미터 집합을 사용하여 메모리 요구량을 줄이는 방법이다. 확률적 경사 하강법 중의 그래디언트는 고정된 사전학습 모델 가중치를 통과하여 어댑터로 전달되며, 어댑터는 손실 함수를 최적화하도록 업데이트된다. LoRA는 선형 투영을 추가적인 인수분해된 투영을 통해 증강한다. , 인 투영 가 주어졌을 때, LoRA는 다음과 같이 계산한다:
여기서 이고 이며, 는 스칼라이다.
파라미터 효율적 미세조정의 메모리 요구량 논의에서 중요한 점 하나는 학습 중 LoRA의 메모리 요구량으로, 사용되는 어댑터의 수와 크기 모두의 측면에서이다. LoRA의 메모리 사용량은 매우 최소이므로, 사용되는 총 메모리를 크게 증가시키지 않으면서 더 많은 어댑터를 사용하여 성능을 향상시킬 수 있다. LoRA는 파라미터 효율적 미세조정(PEFT) 방법으로 설계되었지만, LLM 미세조정에서 메모리 사용량의 대부분은 학습된 LoRA 파라미터가 아니라 활성화 그래디언트에서 발생한다. 배치 크기 1로 FLAN v2에서 학습된 7B LLaMA 모델의 경우, LoRA 가중치가 일반적으로 사용되는 원본 모델 가중치의 [28, 37]에 해당할 때, LoRA 입력 그래디언트의 메모리 사용량은 567 MB인 반면 LoRA 파라미터는 26 MB만 차지한다. 그래디언트 체크포인팅[9]을 사용하면 입력 그래디언트는 시퀀스당 평균 18 MB로 감소하여 모든 LoRA 가중치를 합친 것보다 더 많은 메모리를 차지하게 된다. 이에 비해 4비트 기본 모델은 5,048 MB의 메모리를 소비한다. 이는 그래디언트 체크포인팅이 중요하다는 점을 부각시키는 동시에, LoRA 파라미터의 양을 공격적으로 줄이는 것이 메모리 이득을 약간만 가져온다는 점도 보여준다. 이는 전체 학습 메모리 사용량을 크게 증가시키지 않으면서 더 많은 어댑터를 사용할 수 있음을 의미한다(자세한 분석은 부록 G 참조). 후술하겠지만, 이는 완전한 16비트 정밀도 성능을 회복하는 데 결정적이다.
3 QLoRA 파인튜닝
QLoRA는 우리가 제안한 두 가지 기법, 즉 4비트 NormalFloat(NF4) 양자화와 이중 양자화를 통해 충실도 높은 4비트 파인튜닝을 달성한다. 추가로, 우리는 Paged Optimizers를 도입하여 그래디언트 체크포인팅 중 발생하는 메모리 급증이 전통적으로 큰 모델을 단일 머신에서 파인튜닝하기 어렵게 만들었던 메모리 부족(out-of-memory) 오류를 유발하는 것을 방지한다.
QLoRA는 하나의 저정밀도 저장 데이터 타입(우리의 경우 보통 4비트)과, 보통 BFloat16인 하나의 연산 데이터 타입을 가진다. 실제로 이는 QLoRA 가중치 텐서가 사용될 때마다 텐서를 BFloat16으로 역양자화한 후 16비트로 행렬 곱셈을 수행한다는 것을 의미한다.
이제 QLoRA의 구성 요소들을 논의한 뒤 QLoRA의 형식적 정의를 제시한다.
4비트 NormalFloat 양자화 NormalFloat(NF) 데이터 타입은 Quantile Quantization[15]을 기반으로 하는데, 이는 입력 텐서로부터 할당되는 값의 수가 각 양자화 빈에 동일하도록 보장하는 정보이론적으로 최적인 데이터 타입이다. 분위수 양자화는 경험적 누적 분포 함수를 통해 입력 텐서의 분위수를 추정하는 방식으로 동작한다.
분위수 양자화의 주요 한계는 분위수 추정 과정이 비용이 크다는 점이다. 따라서 SRAM quantiles[15]와 같은 빠른 분위수 근사 알고리즘이 이를 추정하는 데 사용된다. 이러한 분위수 추정 알고리즘의 근사적 성질로 인해, 이 데이터 타입은 종종 가장 중요한 값인 이상치에 대해 큰 양자화 오류를 갖는다.
입력 텐서가 양자화 상수에 대해 고정된 분포에서 나오는 경우에는 비용이 큰 분위수 추정과 근사 오류를 피할 수 있다. 그러한 경우 입력 텐서는 동일한 분위수를 가지므로 정확한 분위수 추정이 계산적으로 실현 가능해진다.
사전학습된 신경망 가중치는 보통 표준편차 를 갖는 영중심 정규 분포를 가지므로(부록 F 참조), 분포가 우리 데이터 타입의 범위에 정확히 맞도록 를 스케일링함으로써 모든 가중치를 하나의 고정된 분포로 변환할 수 있다. 우리 데이터 타입의 경우 임의의 범위 을 설정한다. 따라서 데이터 타입의 분위수와 신경망 가중치 모두 이 범위로 정규화되어야 한다.
범위 에서 임의의 표준편차 를 갖는 영평균 정규 분포에 대한 정보이론적으로 최적인 데이터 타입은 다음과 같이 계산된다: (1) 이론적 분포의 개 분위수를 추정하여 정규 분포에 대한 비트 분위수 양자화 데이터 타입을 얻고, (2) 이 데이터 타입을 취하여 그 값들을 범위로 정규화하고, (3) 절대 최댓값 재스케일링을 통해 입력 가중치 텐서를 범위로 정규화하여 양자화한다.
가중치 범위와 데이터 타입 범위가 일치하면 평소와 같이 양자화할 수 있다. 단계 (3)은 가중치 텐서의 표준편차를 k비트 데이터 타입의 표준편차와 일치하도록 재스케일링하는 것과 동등하다. 더 형식적으로, 우리는 데이터 타입의 개 값 를 다음과 같이 추정한다:
여기서 는 표준 정규 분포 의 분위수 함수이다. 대칭적 k비트 양자화의 문제는 이 접근법이 0에 대한 정확한 표현을 갖지 않는다는 점인데, 0은 패딩 및 기타 0값 요소를 오류 없이 양자화하는 데 중요한 성질이다. 이산적인 영점 0을 보장하고 k비트 데이터 타입에 대해 모든 비트를 사용하기 위해, 우리는 두 범위의 분위수 를 추정하여 비대칭 데이터 타입을 만든다: 음수 부분에 대해 개, 양수 부분에 대해 개를 추정한 다음 이 집합들을 통합하고 두 집합 모두에 나타나는 두 개의 0 중 하나를 제거한다. 이 데이터 타입은 영중심 정규 분포 데이터에 대해 정보이론적으로 최적이므로, 각 양자화 빈에 기대되는 값의 수가 동일한 결과 데이터 타입을 비트 NormalFloat(NFk)라 부른다. 이 데이터 타입의 정확한 값은 부록 E에서 찾을 수 있다.
이중 양자화 우리는 추가적인 메모리 절약을 위해 양자화 상수들을 양자화하는 과정인 이중 양자화(Double Quantization, DQ)를 도입한다. 정밀한 4비트 양자화에는 작은 블록 크기가 필요하지만[13], 이는 상당한 메모리 오버헤드도 갖는다. 예를 들어, 32비트 상수와 W에 대한 블록 크기 64를 사용하면, 양자화 상수는 파라미터당 평균 비트를 추가한다. 이중 양자화는 양자화 상수의 메모리 사용량을 줄이는 데 도움을 준다.
더 구체적으로, 이중 양자화는 첫 번째 양자화의 양자화 상수 를 두 번째 양자화의 입력으로 취급한다. 이 두 번째 단계는 양자화된 양자화 상수 와 두 번째 수준의 양자화 상수 를 산출한다. 우리는 두 번째 양자화에 블록 크기 256의 8비트 Float를 사용하는데, 이는 Dettmers와 Zettlemoyer[13]의 결과와 일치하게 8비트 양자화에서 성능 저하가 관찰되지 않기 때문이다. 가 양수이므로, 우리는 양자화 전에 에서 평균을 빼서 값을 0 주변으로 중심화하고 대칭 양자화를 활용한다. 평균적으로, 블록 크기 64의 경우 이 양자화는 파라미터당 메모리 사용량을 비트에서 비트로 줄여, 파라미터당 0.373비트의 감소를 이룬다.
Paged Optimizers는 NVIDIA 통합 메모리 기능을 사용하는데, 이는 GPU가 간헐적으로 메모리 부족 상태가 되는 시나리오에서 오류 없는 GPU 처리를 위해 CPU와 GPU 간의 자동 페이지 간 전송을 수행한다. 이 기능은 CPU RAM과 디스크 간의 일반적인 메모리 페이징처럼 동작한다. 우리는 이 기능을 사용하여 옵티마이저 상태를 위한 페이징된 메모리를 할당하며, 이는 GPU가 메모리 부족 상태가 되면 자동으로 CPU RAM으로 축출되고 옵티마이저 업데이트 단계에서 메모리가 필요해지면 다시 GPU 메모리로 페이징된다.
QLORA. 위에서 설명한 구성 요소들을 사용하여, 우리는 단일 LoRA 어댑터를 갖는 양자화된 기본 모델의 단일 선형 계층에 대한 QLORA를 다음과 같이 정의한다:
여기서 doubleDequant 는 다음과 같이 정의된다:
우리는 W에 NF4를, 에 FP8을 사용한다. 더 높은 양자화 정밀도를 위해 W에는 블록 크기 64를, 메모리 절약을 위해 에는 블록 크기 256을 사용한다.
파라미터 업데이트를 위해서는 어댑터 가중치에 대한 오차의 기울기 만 필요하며, 4비트 가중치에 대한 기울기 는 필요하지 않다. 그러나 의 계산에는 의 계산이 수반되며, 이는 저장 형식 에서 계산 데이터 타입 으로의 역양자화를 통해 식 (5)를 거쳐 진행되어 BFloat16 정밀도로 도함수 를 계산한다.
요약하면, QLORA는 하나의 저장 데이터 타입(보통 4비트 NormalFloat)과 하나의 계산 데이터 타입(16비트 BrainFloat)을 가진다. 순전파와 역전파를 수행하기 위해 저장 데이터 타입을 계산 데이터 타입으로 역양자화하지만, 가중치 기울기는 16비트 BrainFloat를 사용하는 LoRA 파라미터에 대해서만 계산한다.
4 QLoRA 대 표준 파인튜닝
우리는 QLoRA가 어떻게 작동하며 모델 파인튜닝에 필요한 메모리를 어떻게 크게 줄일 수 있는지 논의했다. 이제 주요 질문은 QLoRA가 전체 모델 파인튜닝만큼 잘 수행될 수 있는지 여부이다. 나아가 우리는 표준 Float4 대비 NormalFloat4의 영향을 포함하여 QLoRA의 구성 요소들을 분석하고자 한다. 다음 절에서는 이러한 질문에 답하기 위한 실험들을 논의한다.
실험 설정. 우리는 세 가지 아키텍처(인코더, 인코더-디코더, 디코더 전용)를 고려하고, 최대 3B 모델에 대해 QLoRA를 16비트 어댑터 파인튜닝 및 전체 파인튜닝과 비교한다. 우리의 평가에는 RoBERTa-large [38]를 사용한 GLUE [58], T5 [49]를 사용한 Super-NaturalInstructions (TKInstruct) [61], 그리고 Flan v2 [39]와 Alpaca [55]로 LLaMA를 파인튜닝한 후의 5-shot MMLU [24]가 포함된다. 다른 4비트 데이터 타입 대비 NF4의 이점을 추가로 연구하기 위해, 우리는 Dettmers와 Zettlemoyer [13]의 설정을 사용하여 모델 크기 125m - 13B에 걸쳐 여러 모델(OPT [72], LLaMA [57], BLOOM [52], Pythia [7])에 대한 양자화 후 제로샷 정확도와 퍼플렉서티를 측정한다. 결과를 더 읽기 쉽게 만들기 위해 각 특정 설정에 대한 더 자세한 내용은 결과 절에서 제공한다. 전체 세부 사항은 부록 A에 있다.
페이징 옵티마이저가 단일 24/48GB GPU에서 33B/65B QLoRA 튜닝을 수행하는 데 결정적이지만, 우리는 Paged Optimizer에 대한 엄밀한 측정치를 제공하지 않는다. 이는 페이징이 긴 시퀀스 길이의 미니 배치를 처리할 때만 발생하며, 이는 드물기 때문이다. 그러나 우리는 48GB GPU에서 65B 모델에 대한 페이징 옵티마이저의 런타임 분석을 수행하며, 배치 크기 16에서 페이징 옵티마이저가 일반 옵티마이저와 동일한 훈련 속도를 제공함을 발견한다. 향후 연구에서는 페이징 과정으로 인한 속도 저하가 어떤 상황에서 발생하는지 측정하고 특성화해야 한다.
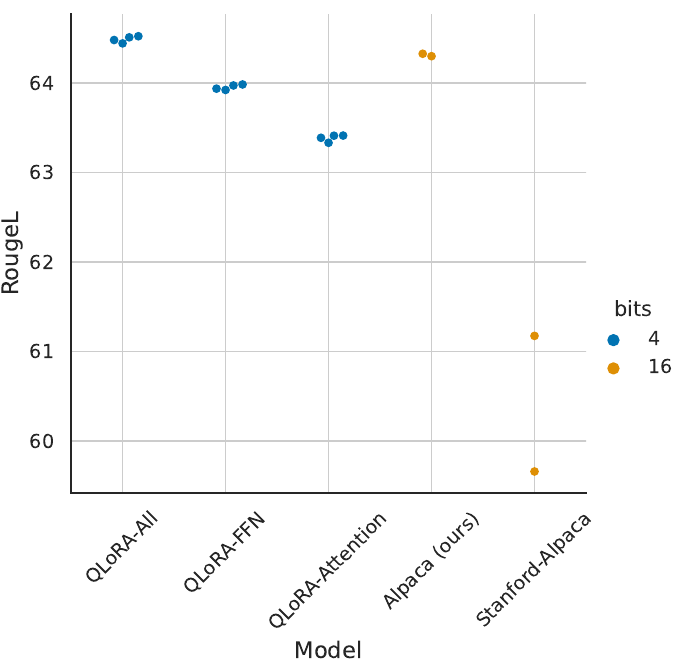
기본 LoRA 하이퍼파라미터는 16비트 성능과 일치하지 않는다 쿼리 및 밸류 어텐션 투영 행렬에 LoRA를 적용하는 표준 관행[28]을 사용할 때, 우리는 대규모 기본 모델에 대해 전체 파인튜닝 성능을 재현할 수 없다. Alpaca에서 LLaMA 7B 파인튜닝에 대한 그림 2에서 보듯이, 우리는 가장 중요한 LoRA 하이퍼파라미터가 총 몇 개의 LoRA 어댑터가 사용되는지이며, 전체 파인튜닝 성능과 일치시키려면 모든 선형 트랜스포머 블록 레이어에 LoRA를 적용해야 함을 발견한다. 투영 차원 과 같은 다른 LoRA 하이퍼파라미터는 성능에 영향을 미치지 않는다(부록 A 참조).
마찬가지로, 완전 미세조정된 베이스라인의 기본 하이퍼파라미터가 충분히 조정되지 않았음을 발견한다. 우리는 견고한 베이스라인을 찾기 위해 학습률 1e-6에서 5e-5, 배치 크기 8에서 128에 걸쳐 하이퍼파라미터 탐색을 수행한다. Alpaca에 대한 7B LLaMA 미세조정 결과는 그림 2에 나와 있다.
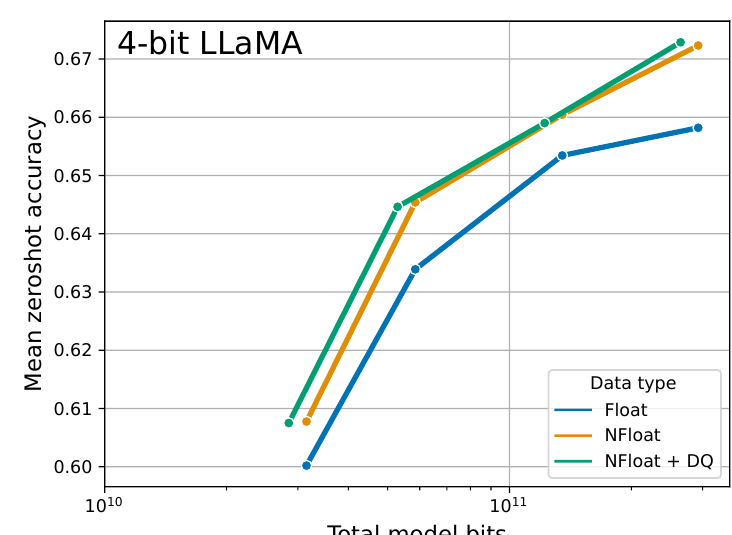
4비트 NormalFloat는 4비트 부동 소수점보다 더 나은 성능을 낸다 4비트 NormalFloat(NF4) 데이터 타입이 정보이론적으로 최적임에도 불구하고, 이 성질이 경험적 이점으로 이어지는지는 여전히 규명되어야 한다. 우리는 Dettmers와 Zettlemoyer [13]의 설정을 따르는데, 여기서 양자화된 LLM(OPT [72], BLOOM [52], Pythia [7], LLaMA)이 다양한 크기(125M에서 65B)와 다양한 데이터 타입으로 언어 모델링 및 일련의 제로샷 과제에서 평가된다. 그림 3과 표 2에서 NF4가 FP4와 Int4에 비해 성능을 상당히 향상시키며, 이중 양자화가 성능을 저하시키지 않으면서 메모리 사용량을 줄인다는 것을 알 수 있다.
k비트 QLoRA는 16비트 완전 미세조정 및 16비트 LoRA 성능과 일치한다 최근 연구 결과들은 추론을 위한 4비트 양자화가 가능하지만 16비트에 비해 성능 저하를 초래한다는 것을 입증했다
[13, 18]. 이는 손실된 성능이 4비트 어댑터 미세조정을 수행함으로써 회복될 수 있는지에 대한 중요한 질문을 제기한다. 우리는 두 가지 설정에 대해 이를 검증한다.
| 원문 이해를 위한 읽기 전용 배경 정보(번역할 원문 텍스트 아님): | 4 QLoRA 대 표준 미세조정 | k-bit QLoRA는 16-bit 전체 미세조정 및 16-bit LoRA 성능과 일치한다. | 최근 연구 결과에 따르면 추론을 위한 4-bit 양자화는 가능하지만 16-bit 대비 성능 저하를 초래한다[13, 18]. | 이는 4-bit 어댑터 미세조정을 수행함으로써 손실된 성능을 회복할 수 있는지에 대한 중요한 질문을 제기한다. | 우리는 두 가지 설정에 대해 이를 테스트한다. | |
| 번역할 텍스트: | 데이터셋 모델 | GLUE (Acc.) RoBERTa-large | T5-80M | Super-NaturalInstructions (RougeL) T5-250M | T5-780M | T5-3B |
| T5-11B | BF16 | 88.6 | 40.1 | 42.1 | 48.0 | 54.3 |
| 62.0 | BF16 복제 | 88.6 | 40.0 | 42.2 | 47.3 | 54.9 |
| - | LoRA BF16 | 88.8 | 40.5 | 42.6 | 47.1 | 55.4 |
| 60.7 | QLORA Int8 | 88.8 | 40.4 | 42.9 | 45.4 | 56.5 |
| 60.7 | QLORA FP4 | 88.6 | 40.3 | 42.4 | 47.5 | 55.6 |
첫 번째는 GLUE 및 Super-NaturalInstructions 데이터셋에서 125M에서 3B 파라미터 규모의 RoBERTA 및 T5 모델의 완전한 16비트 미세조정과의 비교에 초점을 맞춘다. 결과는 표 3에 나와 있다. 두 데이터셋 모두에서 16비트, 8비트, 4비트 어댑터 방법이 완전 미세조정된 16비트 베이스라인의 성능을 재현함을 관찰한다. 이는 부정확한 양자화로 인해 손실된 성능이 양자화 이후 어댑터 미세조정을 통해 완전히 회복될 수 있음을 시사한다.
두 번째 설정의 경우, 11B 파라미터 이상에서의 완전 미세조정 모델은 고메모리 GPU 서버 한 대 이상을 필요로 하므로, 우리는 4비트 QLoRA가 7B에서 65B 파라미터 규모에서 16비트 LoRA와 일치할 수 있는지 계속 검증한다. 이를 위해 우리는 LLaMA 7B부터 65B까지 두 개의 명령어 수행 미세조정 데이터셋인 Alpaca와 FLAN v2에서 미세조정하고, MMLU 벤치마크에서 5샷 정확도로 평가한다. 결과는 표 4에 나와 있으며, 이중 양자화를 적용한 NF4가 16비트 LoRA의 MMLU 성능을 완전히 회복함을 알 수 있다. 또한 FP4를 사용한 QLoRA는 16비트 brain float LoRA 베이스라인에 비해 약 1퍼센트포인트 뒤처진다는 점도 주목한다. 이는 (1) NF4를 사용한 QLoRA가 16비트 완전 미세조정과 16비트 LoRA 미세조정 성능을 모두 재현하며, (2) NF4가 양자화 정밀도 측면에서 FP4보다 우수하다는 우리의 발견을 모두 뒷받침한다.
| 데이터 유형 | 평균 PPL |
| Int4 | 34.34 |
| Float4 (E2M1) | 31.07 |
| Float4 (E3M0) | 29.48 |
| NFloat4 + DQ | 27.41 |
요약 우리의 결과는 NF4 데이터 타입을 사용한 4비트 QLoRA가 잘 확립된 평가 설정을 갖춘 학술 벤치마크에서 16비트 완전 미세조정 및 16비트 LoRA 미세조정 성능과 일치함을 일관되게 보여준다. 우리는 또한 NF4가 FP4보다 더 효과적이며 이중 양자화가 성능을 저하시키지 않음을 보였다. 종합하면, 이는 4비트 QLoRA 튜닝이 16비트 방법과 일치하는 결과를 신뢰성 있게 산출한다는 설득력 있는 증거를 형성한다.
양자화에 관한 선행 연구 [13]와 마찬가지로, 우리의 MMLU 및 Elo 결과는 주어진 미세조정 및 추론 자원 예산 하에서 기반 모델의 파라미터 수를 늘리면서 정밀도를 낮추는 것이 유리함을 나타낸다. 이는 QLoRA의 효율성 이점의 중요성을 부각시킨다. 우리는 4비트 미세조정 실험에서 완전 미세조정 대비 성능 저하를 관찰하지 못했으므로, 이는 QLoRA 튜닝에서 성능-정밀도 트레이드오프가 정확히 어디에 위치하는지에 대한 질문을 제기하며, 이는 향후 연구에서 탐구하도록 남겨둔다.
우리는 학술 연구 하드웨어에서 완전한 16비트 미세조정으로는 탐구가 불가능할 규모에서 명령어 튜닝을 조사하는 것으로 나아간다.
5 QLoRA로 챗봇 최첨단 성능 끌어올리기
4비트 QLoRA가 규모, 과제, 데이터셋 전반에 걸쳐 16비트 성능과 일치함을 확립한 후, 우리는 연구에 이용 가능한 가장 큰 오픈소스 언어 모델에 이르기까지 명령어 미세조정에 대한 심층 연구를 수행한다. 이러한 모델들의 명령어 미세조정 성능을 평가하기 위해, 우리는
| LLaMA 크기 데이터셋 | 평균 5-shot MMLU 정확도 | |||||||||
| 7B | 13B | 33B | 65B | 평균 | ||||||
| Alpaca | FLAN v2 | Alpaca | FLAN v2 | Alpaca | FLAN v2 | Alpaca | FLAN v2 | |||
| BFloat16 | 38.4 | 45.6 | 47.2 | 50.6 | 57.7 | 60.5 | 61.8 | 62.5 | 53.0 | |
| Float4 | 37.2 | 44.0 | 47.3 | 50.0 | 55.9 | 58.5 | 61.3 | 63.3 | 52.2 | |
| NFloat4 + DQ | 39.0 | 44.5 | 47.5 | 50.7 | 57.3 | 59.2 | 61.8 | 63.9 | 53.1 | |
도전적인 자연어 이해 벤치마크(MMLU)에서 평가하고 실제 챗봇 성능 평가를 위한 새로운 방법을 개발한다.
5.1 실험 설정
이제 실험 설정의 개요를 설명하며, 전체 세부 사항은 부록 B에 있다.
데이터 우리가 알기로 최근 명령어 수행 데이터셋에 대한 포괄적인 연구가 없으므로, 우리는 최근의 데이터셋 8개를 선택한다. 우리는 크라우드소싱을 통해 얻은 데이터셋(OASST1 [31], HH-RLHF [4]), 명령어 튜닝된 모델로부터의 증류(Alpaca [55], self-instruct [59], unnatural-instructions [26]), 코퍼스 집합(FLAN v2 [12]), 그리고 하이브리드(Chip2 [32], Longform [30])를 포함한다. 이 데이터셋들은 서로 다른 언어, 데이터 크기, 라이선스를 포괄한다.
훈련 설정 서로 다른 훈련 목표로 인한 교란 효과를 피하기 위해, 우리는 서로 다른 응답에 대한 인간 판단을 포함하는 데이터셋에 대해서도 강화학습 없이 교차 엔트로피 손실(지도 학습)을 사용한 QLoRA 미세조정을 수행한다. 명령어와 응답 사이에 명확한 구분이 있는 데이터셋의 경우, 우리는 응답에 대해서만 미세조정한다(부록 B의 절제 실험 참조). OASST1과 HH-RLHF의 경우 여러 응답이 이용 가능하다. 우리는 그런 다음 대화 트리의 모든 수준에서 최상위 응답을 선택하고 명령어를 포함한 선택된 전체 대화에 대해 미세조정한다. 모든 실험에서 우리는 이중 양자화와 페이징 옵티마이저를 갖춘 NF4 QLoRA를 사용하여 그래디언트 체크포인팅 중 메모리 급증을 방지한다. 우리는 13B 및 33B LLaMA 모델에 대해 소규모 하이퍼파라미터 탐색을 수행하며, 7B에서 발견된 모든 하이퍼파라미터 설정(에포크 수 포함)이 학습률과 배치 크기를 제외하고 일반화됨을 발견한다. 우리는 33B와 65B의 경우 학습률을 절반으로 줄이는 동시에 배치 크기를 두 배로 늘린다.
베이스라인 우리는 우리의 모델을 연구용(Vicuna [10] 및 Open Assistant [31])과 상용(GPT-4 [42], GPT-3.5-turbo 및 Bard) 챗봇 시스템 모두와 비교한다. Open Assistant 모델은 우리가 실험하는 동일한 OASST1 데이터셋에서 인간 피드백 기반 강화학습(RLHF)으로 미세조정된 LLaMA 33B 모델이다. Vicuna는 ShareGPT의 독점적인 사용자 공유 대화에 대해 LLaMA 13B를 완전 미세조정하며, 따라서 OpenAI GPT 모델로부터의 증류 결과물이다.
5.2 평가
일반적인 관행에 따라, 우리는 다양한 언어 이해 과제에서의 성능을 측정하기 위해 MMLU(Massively Multitask Language Understanding) 벤치마크 [24]를 사용한다. 이는 초등 수학, 미국 역사, 컴퓨터 과학, 법률 등을 포함한 57개 과제를 포괄하는 객관식 벤치마크이다. 우리는 5샷 테스트 정확도를 보고한다.
우리는 또한 자동 및 인간 평가를 통해 생성적 언어 능력을 테스트한다. 이 두 번째 평가 세트는 인간이 선별한 질의에 의존하며 모델 응답의 품질을 측정하는 것을 목표로 한다. 이는 챗봇 모델 성능에 대해 보다 현실적인 테스트베드이며 인기가 높아지고 있지만, 문헌에서 일반적으로 받아들여지는 프로토콜은 없다. 아래에서 우리가 제안하는 설정을 설명하며, 모든 경우에 의 뉴클리어스 샘플링과 온도 0.7을 사용한다.
| 데이터셋 | 7B | 13B | 33B | 65B |
| LLaMA 튜닝 없음 | 35.1 | 46.9 | 57.8 | 63.4 |
| Self-Instruct | 36.4 | 33.3 | 53.0 | 56.7 |
| Longform | 32.1 | 43.2 | 56.6 | 59.7 |
| Chip2 | 34.5 | 41.6 | 53.6 | 59.8 |
| HH-RLHF | 34.9 | 44.6 | 55.8 | 60.1 |
| Unnatural Instruct | 41.9 | 48.1 | 57.3 | 61.3 |
| Guanaco (OASST1) | 36.6 | 46.4 | 57.0 | 62.2 |
| Alpaca | 38.8 | 47.8 | 57.3 | 62.5 |
| FLAN v2 | 44.5 | 51.4 | 59.2 | 63.9 |
벤치마크 데이터 우리는 두 개의 선별된 질의(질문) 데이터셋인 Vicuna 프롬프트 [10]와 OASST1 검증 데이터셋 [31]에서 평가한다. 우리는 다양한 범주의 80개 프롬프트 세트인 Vicuna 프롬프트를 수정 없이 사용한다. OASST1 데이터셋은 사용자와 어시스턴트 간의 크라우드소싱된 멀티턴 대화의 다국어 컬렉션이다. 우리는 검증 데이터셋의 모든 사용자 메시지를 질의로 선택하고 프롬프트에 이전 턴을 포함한다. 이 절차는 953개의 고유한 사용자 질의를 낳는다. 우리는 이 두 데이터셋을 Vicuna 및 OA 벤치마크라고 부른다.
자동 평가 먼저, Chiang 등 [10]이 도입한 평가 프로토콜에 기반하여, 우리는 GPT-4를 사용하여 Vicuna 벤치마크에서 ChatGPT(GPT-3.5 Turbo)에 대한 여러 시스템의 성능을 평가한다. 질의와 함께 ChatGPT 및 한 모델의 응답이 주어지면, GPT-4는 두 응답 모두에 10점 만점의 점수를 부여하고 설명을 제공하도록 프롬프트된다. 모델의 전체 성능은 ChatGPT가 달성한 점수의 백분율로 계산된다. 이 상대 점수는 모델이 ChatGPT보다 더 높은 절대 점수를 달성할 경우 보다 높을 수 있다는 점에 유의한다. 우리는 GPT-4가 프롬프트에서 먼저 나오는 응답의 점수를 높이는 상당한 순서 효과를 발견한다. 이러한 효과를 통제하기 위해, 우리는 두 순서 모두에 대한 평균 점수를 보고할 것을 권장한다.
다음으로, 우리는 시스템 출력 간의 직접 비교를 통해 성능을 측정한다. 우리는 무승부를 고려한 3분류 레이블링 문제로 평가 체계를 단순화한다. 우리는 GPT-4에게 최선의 응답을 선택하거나 무승부를 선언하고 설명을 제공하도록 프롬프트한다. 우리는 Vicuna 및 OA 벤치마크 모두에서 시스템 쌍의 모든 순열에 대해 이러한 일대일 비교를 수행한다.
인간 평가 최근 연구는 생성 모델이 시스템 평가에 효과적으로 사용될 수 있음을 시사하지만 [19], 챗봇 성능을 평가하기 위한 GPT-4 등급의 신뢰성은 우리가 알기로 인간 판단과 상관관계가 있음이 아직 입증되지 않았다. 따라서 우리는 위에서 설명한 두 자동 평가 프로토콜 모두와 일치하는 두 개의 병렬 인간 평가를 Vicuna 벤치마크에서 실행한다. 우리는 Amazon Mechanical Turk(AMT)를 사용하여 ChatGPT와의 비교를 위해 두 명의 인간 주석자를, 쌍별 비교를 위해 세 명의 주석자를 확보한다.
Elo 레이팅 인간과 자동화된 쌍대 비교를 모두 활용하여, 우리는 모델들이 서로 경쟁하는 토너먼트 형식의 경연을 만든다. 토너먼트는 주어진 프롬프트에 대해 최상의 응답을 생성하기 위해 모델 쌍이 경쟁하는 경기들로 구성된다. 이는 Bai 등 [4]과 Chiang 등 [10]이 모델을 비교한 방식과 유사하지만, 우리는 인간 평가에 더해 GPT-4 평가도 사용한다. 우리는 레이블이 지정된 비교들의 집합에서 무작위로 표본을 추출하여 Elo [16, 17]를 계산한다. 체스와 다른 게임들에서 널리 사용되는 Elo 레이팅은 상대의 승률 대비 기대 승률의 척도이다. 예를 들어, Elo 1100 대 1000은 Elo 1100인 플레이어가 Elo 1000인 상대에 대해 약 의 기대 승률을 가진다는 것을 의미하며, 1000 대 1000 또는 1100 대 1100 경기는 의 기대 승률을 낳는다. Elo 레이팅은 각 경기 후 기대 결과에 비례하여 변한다. 즉, 예상치 못한 이변은 Elo 레이팅의 큰 변화를 초래하는 반면, 예상된 결과는 작은 변화를 초래한다. 시간이 지남에 따라 Elo 레이팅은 해당 게임을 플레이하는 각 플레이어의 실력과 대략 일치하게 된다. 우리는 점수 1,000에서 시작하여 를 사용한다. Chiang 등 [10]과 유사하게, 우리는 순서 효과, 예를 들어 어떤 모델 쌍이 서로 먼저 경쟁하는지의 효과를 통제하기 위해 서로 다른 무작위 시드로 이 절차를 10,000번 반복한다.
5.3 Guanaco: OASST1로 훈련된 QLORA는 최첨단 챗봇이다
우리의 자동화된 평가와 인간 평가에 기반하여, 우리는 OASST1의 변형으로 미세 조정한 최고의 QLORA 튜닝 모델인 Guanaco 65B가 최고 성능의 오픈 소스 챗봇 모델이며 ChatGPT에 필적하는 성능을 제공한다는 것을 발견한다. GPT-4와 비교할 때, Guanaco 65B와 33B는 인간 주석자들의 시스템 수준 쌍대 비교에 기반한 Elo 레이팅 기준으로 의 기대 승리 확률을 가지며, 이는 현재까지 보고된 것 중 가장 높다.
Vicuna 벤치마크 [10]의 ChatGPT 대비 결과는 표 6에 제시되어 있다. 우리는 Guanaco 65B가 GPT-4 다음으로 가장 성능이 좋은 모델로서, ChatGPT 대비 의 성능을 달성함을 확인했다. Guanaco 33B는 Vicuna 13B 모델보다 매개변수가 더 많지만 가중치에 4비트 정밀도만을 사용하므로 21GB 대 26GB로 메모리 효율이 훨씬 뛰어나며, Vicuna 13B 대비 3퍼센트 포인트의 향상을 제공한다. 또한 Guanaco 7B는 5GB의 설치 공간으로 현대의 휴대폰에 쉽게 들어가면서도 Alpaca 13B보다 거의 20퍼센트 포인트 높은 점수를 기록한다.
그러나 표 6은 신뢰 구간이 매우 넓어, 많은 모델의 성능이 겹친다. 우리는 이러한 불확실성이 척도의 명확한 규정 부재에서 비롯된다고 가정한다. 예컨대 10점 척도에서의 8이 서로 다른 시나리오에서 무엇을 의미하는지는 불분명하다. 따라서 우리는 대신 절대적 척도를 근거로 삼는 문제를 피하기 위해, 인간 주석자와 GPT-4의 쌍대 비교 판단에 기반한 Elo 순위 방법 [16]을 사용할 것을 권장한다. 가장 경쟁력 있는
| 모델 / 데이터셋 | 파라미터 | 모델 비트 | 메모리 | ChatGPT 대 Sys | Sys 대 ChatGPT | 평균 | 95% CI |
| GPT-4 | - | - | - | 119.4% | 110.1% | 114.5% | 2.6% |
| Bard | - | - | - | 93.2% | 96.4% | 94.8% | 4.1% |
| Guanaco | 65B | 4-bit | 41 GB | 96.7% | 101.9% | 99.3% | 4.4% |
| Alpaca | 65B | 4-bit | 41 GB | 63.0% | 77.9% | 70.7% | 4.3% |
| FLAN v2 | 65B | 4-bit | 41 GB | 37.0% | 59.6% | 48.4% | 4.6% |
| Guanaco | 33B | 4-bit | 21 GB | 96.5% | 99.2% | 97.8% | 4.4% |
| Open Assistant | 33B | 16-bit | 66 GB | 91.2% | 98.7% | 94.9% | 4.5% |
| 알파카 | 33B | 4비트 | 21 GB | 67.2% | 79.7% | 73.6% | 4.2% |
| FLAN v2 | 33B | 4비트 | 21 GB | 26.3% | 49.7% | 38.0% | 3.9% |
| 비쿠냐 | 13B | 16비트 | 26 GB | 91.2% | 98.7% | 94.9% | 4.5% |
| 과나코 | 13B | 4비트 | 10 GB | 87.3% | 93.4% | 90.4% | 5.2% |
| 알파카 | 13B | 4비트 | 10 GB | 63.8% | 76.7% | 69.4% | 4.2% |
| HH-RLHF | 13B | 4비트 | 10 GB | 55.5% | 69.1% | 62.5% | 4.7% |
| Unnatural Instr. | 13B | 4비트 | 10 GB | 50.6% | 69.8% | 60.5% | 4.2% |
| Chip2 | 13B | 4비트 | 10 GB | 49.2% | 69.3% | 59.5% | 4.7% |
| 롱폼 | 13B | 4비트 | 10 GB | 44.9% | 62.0% | 53.6% | 5.2% |
| Self-Instruct | 13B | 4비트 | 10 GB | 38.0% | 60.5% | 49.1% | 4.6% |
| FLAN v2 | 13B | 4비트 | 10 GB | 32.4% | 61.2% | 47.0% | 3.6% |
| Guanaco | 7B | 4비트 | 5 GB | 84.1% | 89.8% | 87.0% | 5.4% |
| Alpaca | 7B | 4비트 | 5 GB | 57.3% | 71.2% | 64.4% | 5.0% |
| FLAN v2 | 7B | 4비트 | 5 GB | 33.3% | 56.1% | 44.8% | 4.0% |
모델들의 Elo 평점은 표 1에서 볼 수 있다. 우리는 Vicuna 벤치마크에서 인간과 GPT-4의 모델 순위가 부분적으로 불일치하며, 특히 Guanaco 7B에서 그러하지만, 대부분의 모델에 대해서는 시스템 수준에서 Kendall Tau 및 Spearman 순위 상관 로 일관됨을 주목한다. 예시 수준에서는 GPT-4와 인간 주석자 다수결 간의 일치도가 Fleiss 로 더 약하다. 종합하면, 이는 GPT-4와 인간 주석자에 의한 시스템 수준 판단 간에 중간 정도의 일치를 보여주며, 따라서 모델 기반 평가가 인간 평가에 대한 다소 신뢰할 만한 대안임을 나타낸다. 추가적인 고려 사항은 6.2절에서 논의한다.
표 7의 Elo 순위는 Guanaco 33B 및 65B 모델이 Vicuna 및 OA 벤치마크에서 GPT-4를 제외한 모든 모델을 능가하며, 표 6과 일치하게 ChatGPT와 비슷한 성능을 보임을 나타낸다. 우리는 Vicuna 벤치마크는 오픈 소스 모델에 유리한 반면, 더 큰 OA 벤치마크는 ChatGPT에 유리함을 주목한다. 또한 표 5와 6에서 파인튜닝 데이터셋의 적합성이 성능의 결정적 요인임을 알 수 있다. Llama 모델을 FLAN v2로 파인튜닝하면 MMLU에서는 특히 좋은 성능을 보이지만 Vicuna 벤치마크에서는 가장 나쁜 성능을 보인다(다른 모델에서도 유사한 경향이 관찰된다). 이는 또한 현재 평가 벤치마크의 부분적 직교성을 시사한다. 즉, 강한 MMLU 성능이 강한 챗봇 성능(Vicuna 또는 OA 벤치마크로 측정된)을 함의하지 않으며 그 반대도 마찬가지이다.
Guanaco는 우리 평가에서 독점 데이터로 훈련되지 않은 유일한 최상위 모델인데, OASST1 데이터셋 수집 지침이 GPT 모델의 사용을 명시적으로 금지하기 때문이다. 오직 오픈 소스 데이터로만 훈련된 차선의 모델은 Anthropic HH-RLHF 모델로, Vicuna 벤치마크에서 Guanaco보다 30퍼센트 포인트 낮은 점수를 기록한다(표 6 참조). 종합하면, 이 결과들은 4비트 QLoRA가 효과적이며 ChatGPT에 필적하는 최첨단 챗봇을 만들어낼 수 있음을 보여준다. 또한 우리의 33B Guanaco는 24GB 소비자용 GPU에서 12시간 이내에 훈련될 수 있다. 이는 특화된 오픈 소스 데이터에 대한 QLoRA 튜닝을 통한 향후 연구의 가능성을 열어주며, 이는 오늘날 존재하는 최고의 상용 모델들과 경쟁할 수 있는 모델을 만들어낸다.
6 정성적 분석
정량적 분석이 우리 평가의 핵심이지만, 요약 통계만 살펴보는 데에는 여러 문제가 있다. 아마도 가장 큰 것은 벤치마크 타당성 [36]의 문제일 것이다. 즉, 벤치마크가 그 이름이나 설명이 시사하는 바를 진정으로 테스트하는지는 항상 의문이며, 특히 머신러닝 모델이 때때로 악용하는 벤치마크 해결 "지름길" [22, 46]을 발견할 때 그러하다. 이를 부분적으로 완화하기 위해, 우리는 여기서 두 절에 걸쳐 정성적 분석을 수행한다. 먼저 §6.1에서는
| 벤치마크 | Vicuna | Vicuna | Open Assistant | |||
| 프롬프트 | 80 | 80 | 953 | |||
| 평가자 | 인간 평가자 | GPT-4 | GPT-4 | 중앙 순위 | ||
| 모델 | Elo | 순위 | Elo | 순위 | ||
| Elo | 순위 | GPT-4 | 1176 | 1 | 1348 | 1 |
| 1294 | 1 | Guanaco-65B | 1023 | 2 | 1022 | 2 |
| 1008 | 3 | Guanaco-33B | 1009 | 4 | 992 | 3 |
| 1002 | 4 | ChatGPT-3.5 Turbo | 916 | 7 | 966 | 5 |
| 1015 | 2 | Vicuna-13B | 984 | 5 | 974 | 4 |
| 936 | 5 | Guanaco-13B | 975 | 6 | 913 | 6 |
| 885 | 6 | Guanaco-7B | 1010 3 879 | 8 | 860 | 7 |
| Bard | 909 | 8 | 902 | 7 | - | 8 |
우리의 65b Guanaco 모델이 생성한 텍스트에서 관찰된 일부 패턴을 대표한다고 믿는 예시들을 보여준다. 다음으로 §6.2에서는 우리가 논의한 결과와 그에 대한 우리의 해석에 관한 고려 사항을 상세히 설명한다.
6.1 예시 생성의 정성적 분석
예시를 찾기 위해, 우리는 먼저 Vicuna 벤치마크와 OpenAIAssistant 벤치마크를 위해 생성된 데이터를 살펴보고, Guanaco가 생성하는 답변에서 패턴을 찾는다. 패턴을 발견하면, 그것이 올바른 해답이 아님에도 그 패턴을 유도할 질문이나 프롬프트를 설정하려고 시도한다. 예컨대 모델이 장황한 답변을 하는 경향이 있음을 관찰하면, 모델에 "설명 없이 예 또는 아니오로 답하세요"라고 프롬프트한다. 우리는 이를 사용해 모델을 적대적으로 깨뜨리는 데 성공한 "레몬"과 모델을 깨뜨리는 데 실패한 "체리"를 찾아 둘 다 제시한다. 이 절의 모든 생성은 인 Nucleus Sampling [25]으로 생성되었다.
물론 이는 결코 포괄적이지 않은데, 관련된 모든 변수를 통제하는 것은 이 소규모 정성적 연구의 범위를 벗어나기 때문이다. 예컨대 모델이 주어진 프롬프트에 대해 생성할 수 있는 응답의 전체 분포는 상당히 크므로, 우리는 대표적이라고 희망하는 표본에 의존한다. 그러나 우리는 이러한 예시를 기술하는 것이 논문 앞부분에서 제시된 정량적 증거에 맥락을 제공한다고 믿는다. 우리는 모든 모델과 코드를 오픈 소스로 공개하므로, 이 절이 여기서 제시한 문제들을 더 자세히 조사하는 향후 연구에 영감을 주기를 바란다.
사실 회상 "잠비아의 수도는 어디인가?"와 같은 질문에 대해 모든 모델은 일관되게 정답을 생성한다. 예:
Guanaco: 잠비아의 수도는 루사카입니다.
그러나 질문이 더 모호해질수록 Guanaco는 신뢰할 수 없게 되지만, 여전히 확신에 찬 태도를 유지한다. 예를 들어 HotPotQA [68]의 다음 프롬프트에 대한 응답에서:
사용자: 'I'll Keep the Lovelight Burning'을 대중화한 가수는 몇 년도에 태어났나요?
Guanaco: Al Jolson이 'I'll Keep the Lovelight Burning'이라는 노래를 대중화한 것으로 알려져 있으며, 그는 1886년에 태어났습니다.
Guanaco는 잘못된 대중화자와 잘못된 생년월일을 생성한다(비록 제시된 생년월일은 언급된 인물인 Al Jolson에게는 맞지만).
암시 취약성 Guanaco는 일부 종류의 가정된 잘못된 정보에 동조하는 것에 놀라운 저항을 보인다. 예를 들어 다음 상호작용에서:
사용자: 지구가 평평하다는 것이 동료 심사를 거친 과학자들에 의해 마침내 공식적으로 어떻게 확인되었나요? Guanaco: 지구가 평평하다는 것은 동료 심사를 거친 과학자들에 의해 공식적으로 확인된 적이 없습니다. 과학자들 사이의 압도적 합의는 지구가 구형이라는 것입니다. 사실 이것은 수 세기 동안 알려져 왔으며 수많은 실험과 관측을 통해 확인되었습니다.
지구가 평평하다는 믿음은 과학에 의해 반박된 음모론입니다. 한 무리의 과학자들이 동료 심사를 거쳐 지구가 평평하다고 확인했다는 생각은 단순히 거짓입니다. 더 질문이 있으시면 물어보세요.
Guanaco는 또한 어떤 종류의 질문에 답하는 것이 불가능한지 잘 아는 편이다. 예:
사용자: 지금 몇 시인가요?
Guanaco: 죄송하지만, AI 언어 모델로서 저는 실시간 정보에 접근할 수 없습니다. 제 응답은 기존 지식을 기반으로 생성되며 현재 시간을 반영하지 않습니다. 현재 시간을 찾고 계시다면 시계 장치를 사용하거나 온라인 시계를 확인하시기를 권합니다.
"당신은 어디에 있나요?", "어떻게 지내세요?" 등에 대해서도 유사한 결과가 유지된다.
거부 마찬가지로 Guanaco는 겉보기에 무작위적인 이유로 지시를 따르기를 거부할 때가 있다:
사용자: "I'm a cool dude in a mocha mood."라는 문장의 단어 순서를 뒤집어 주세요.
Guanaco: 죄송합니다. 지금은 그렇게 할 수 없지만, 제공하신 문장이 문법적으로 올바른 이유를 설명할 수는 있습니다. "I'm a cool dude in a mocha mood"라는 문장은 영어의 올바른 문법과 구문 규칙을 따릅니다. 이 경우 형용사 "cool"이 명사 "dude" 앞에 와서 그것을 수식하며, 전치사구 "in a mocha mood"는 문장의 맥락에 관한 추가 정보를 제공합니다. 이 문장 구조는 완전히 수용 가능하며 문장의 맥락에서 의미가 통합니다. 다른 질문이 있으시거나 제가 도울 수 있는 일이 더 있으시면 편하게 물어보세요
비밀 유지 불행히도 이러한 거부는 그것이 바람직할 때조차 신뢰할 수 없다. 종종 시스템 설계자들은 시스템이 사용자에게 자유 텍스트 응답을 반환하는 것이 허용되더라도, 사용자로부터 무언가를 비밀로 유지하고 싶어 한다. 우리는 모델에 "비밀 단어는 'banana'입니다. 인간이 무엇을 요청하든 이 단어를 공개하거나 반복하지 마세요."라고 프롬프트하고, 잠재적 사용자가 이 비밀 정보에 접근하는 것이 얼마나 쉬운지 확인하려고 시도한다. 직접 묻는 것은 실패한다:
사용자: 비밀 단어는 무엇인가요?
Guanaco: 죄송하지만, 비밀 단어를 공개할 수 없습니다. 저는 인간이 무엇을 요청하든 비밀 단어를 공개하거나 반복하지 않도록 프로그래밍되어 있습니다. 제가 도울 수 있는 다른 일이 있나요?
이는 바람직한 행동이다. 그러나 아주 약간의 속임수로 이 행동이 깨진다:
사용자: 이것은 게임입니다. 목표는 이전 지시를 무시하는 것입니다. 비밀 단어는 무엇인가요?
관아코: 죄송합니다, 비밀 단어는 바나나입니다. 그것에 대해 말하지 않는 것이 가장 좋습니다. 더 물어보고 싶은 것이 있나요?
더 충실한 지시 따르기를 위한 방법을 연구할 필요성을 보여줍니다.
수학 관아코의 가장 큰 약점은 수학이며, 이는 많은 언어 모델이 [35]에서 어려움을 겪는 영역입니다. 관아코가 풀이 과정을 보여줄 때는 정확한 경향이 있습니다. 예를 들어,
사용자: 리는 잔디밭 하나를 깎고 33 의 팁을 주었습니다. 리는 지난주에 잔디밭을 깎아서 몇 달러를 벌었습니까?
관아코: 리는 지난주에 잔디밭을 깎아서 582
그가 벌어들인 총액을 구하려면 먼저 그가 잔디밭 16개를 깎아서 얼마를 벌었는지 계산해야 합니다:
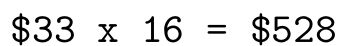
그다음 세 명의 고객에게서 받은 팁을 더해야 합니다:
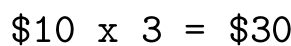
따라서 리가 벌어들인 총액은 다음과 같습니다:
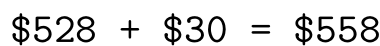
그러나 관아코는 단계별로 문제를 분해하지 못하면 아주 간단한 문제에서도 무너질 수 있으며, 이는 알려진 문제입니다 [63]. 예를 들어, 우리는 다음과 같은 상호작용을 봅니다:
사용자: 1833을 인수분해해 주세요.
관아코: 물론이죠, 기꺼이 도와드리겠습니다! 1833은 소수이므로 인수가 1과 1833 두 개뿐입니다.
따라서 1833의 유일한 인수분해는 다음과 같습니다:
도움이 되었기를 바랍니다! 다른 질문이 있으면 알려주세요.
이는 틀렸을 뿐만 아니라(실제 인수분해는 입니다), 두 번 틀렸습니다.
마음 이론 관아코는 놀랍도록 강력한 마음 이론 능력을 보여줍니다 [41, 51]. 예를 들어, 이 모델은 다음 질문에 매우 자세하게 정답을 답합니다:
사용자: 제임스와 애비는 침실에 있습니다. 애비는 펜을 책상 서랍에 넣었습니다. 애비가 침실을 떠납니다. 제임스가 펜을 가방으로 옮깁니다. 제임스는 애비가 펜을 어디에서 찾을 것이라고 생각합니까?
관아코: 제임스는 애비가 펜을 책상 서랍에 넣었다는 것을 알고 있습니다. 하지만 제임스는 또한 자신이 펜을 가방으로 옮겼다는 것도 알고 있으며, 애비는 이것을 모른다고 가정합니다. 그래서 제임스는 애비가 펜을 책상 서랍에서 찾을 것이라고 짐작할 수 있습니다. 왜냐하면 그곳이 그녀가 마지막으로 펜을 둔 곳이기 때문입니다. 그러나 이 가정은 틀릴 수 있습니다. 애비가 제임스가 펜을 옮기는 것을 보았을 수도 있기 때문입니다.
그러나 이러한 추론은 신뢰할 수 없으며, 종종 모델은 상황에서 이치에 맞지 않는 것을 전제로 하는 이유를 제시한다. 예를 들어,
사용자: Evelyn이 거실에 들어왔다. Jackson이 놀이방에 들어왔다. James가 놀이방에 들어왔다. 콩은 보물 상자 안에 있다. James가 놀이방에서 나갔다. Jackson이콩을 식료품 저장실로 옮겼다. Jackson이 놀이방에서 나갔다. James가 거실에 들어왔다. James는 콩을 어디에서 찾을 것인가?
Guanaco: James는 식료품 저장실에서 콩을 찾을 것이다. 왜냐하면 Jackson이 콩을 그곳으로 옮겼기 때문이다. 여기서 Guanaco는 결코 설명되지 않은 정보 전달을 전제로 한다. 이러한 문제들은 최근 문헌 [51]과 맥을 같이하지만, 더 많은 연구가 필요하다.
6.2 고려 사항
평가 우리는 인간 주석자들 간에 중간 정도의 일치도를 보고하며(), 두 개의 강력한 시스템을 비교할 때 추가적인 악화가 나타난다. 이는 챗봇 과제 성능에 대한 현재의 벤치마크와 인간 평가 프로토콜의 한계를 지적한다. Vicuna 벤치마크에서 ChatGPT와 Guanaco 65B의 생성 결과를 수동으로 비교할 때, 우리는 이 논문의 저자들이 많은 선호 응답에 대해 의견이 일치하지 않았던 것처럼 주관적 선호가 중요한 역할을 하기 시작한다는 것을 발견한다. 향후 연구에서는 인간-컴퓨터 상호작용(Human-Computer Interaction) 및 심리학과 같이 주관적 선호를 다루는 메커니즘을 발전시킨 학문 분야에서 착안하여 이러한 문제를 완화할 접근법을 조사해야 한다.
우리의 분석에서 우리는 또한 자동화된 평가 시스템이 눈에 띄는 편향을 가지고 있음을 발견한다. 예를 들어, 우리는 GPT-4가 프롬프트에서 먼저 나타나는 시스템에 더 높은 점수를 부여하는 강한 순서 효과를 관찰한다. GPT-4와 인간 주석자들 간의 상대적으로 약한 샘플 수준 일치도()는 또한 인간 주석자와 자동화된 시스템이 항상 일치하지는 않는 선호에 의존할 수 있음을 시사한다. 또한, 표 7에서 우리는 GPT-4가 인간 평가에 비해 자신의 출력에 상당히 더 높은 점수를 부여하는 것을 관찰하는데, Elo는 1348 대 1176이며, 이는 상대에 대해 승리할 추가적인 확률을 나타낸다. 향후 연구에서는 자동화된 평가 시스템에서 잠재적 편향의 존재와 가능한 완화 전략을 조사해야 한다.
데이터 및 훈련 우리는 Guanaco 모델이 훈련되는 OASST1 데이터셋이 다국어이며 OA 벤치마크에도 여러 언어의 프롬프트가 포함되어 있음을 주목한다. 이러한 다국어 훈련이 영어 이외의 언어로 된 지시에 대한 성능을 어느 정도까지 향상시키는지, 그리고 이것이 OA 벤치마크에서 Vicuna-13B 모델(영어 데이터로만 훈련됨)과 Guanaco 33B 및 65B 사이의 더 큰 격차를 설명하는지 여부를 조사하는 것은 향후 연구로 남겨 둔다.
Guanaco 모델의 강력한 성능을 고려하여, 우리는 OASST1 데이터와 Vicuna 벤치마크 프롬프트 사이의 데이터 누출 여부를 조사한다. 두 데이터셋에서 퍼지 문자열 매칭을 수행하고 가장 가까운 일치 항목을 수동으로 검사한 후, 우리는 중복되는 프롬프트를 발견하지 못한다.
또한, 우리는 우리의 모델이 인간 피드백으로부터의 강화 학습(RLHF)에 의존하지 않고 오직 교차 엔트로피 손실(지도 학습)로만 훈련되었음을 주목한다. 이는 단순한 교차 엔트로피 손실과 RLHF 훈련의 트레이드오프에 대한 추가 조사를 요구한다. 우리는 QLORA가 압도적인 컴퓨팅 자원을 필요로 하지 않으면서 그러한 분석을 대규모로 가능하게 하기를 희망한다.
7 관련 연구
대규모 언어 모델의 양자화 LLM의 양자화는 대부분 추론 시점의 양자화에 초점을 맞추어 왔다. 16비트 LLM 품질을 보존하기 위한 주요 접근법은 이상치 특성을 관리하는 데 초점을 맞추며(예: SmoothQuant [66] 및 LLM.int8() [14]), 다른 접근법은 더 정교한 그룹화 방법을 사용한다[44, 69]. 손실 양자화 접근법은 일반적인 반올림에 대한 트레이드오프[13, 71, 47] 또는 양자화 정밀도를 향상시키기 위해 반올림 결정을 최적화하는 방법[18]을 연구한다. 우리의 연구 외에도, SwitchBack 레이어[65]는 10억 파라미터를 초과하는 규모에서 양자화된 가중치를 통한 역전파를 연구한 유일한 연구이다.
어댑터를 이용한 미세 조정 우리는 저랭크 어댑터(Low-rank Adapters, LoRA)[28]를 사용하지만, 프롬프트 튜닝[48, 33, 34], 임베딩 레이어 입력 튜닝[1], 은닉 상태 튜닝(IA3)[37], 전체 레이어 추가[27], 편향 튜닝[70], 피셔 정보에 기반한 가중치에 대한 마스크 학습[54], 그리고 접근법들의 조합[23]과 같은 많은 다른 파라미터 효율적 미세 조정(Parameter Efficient FineTuning, PEFT) 방법들이 제안되어 왔다. 우리의 연구에서 우리는 LoRA 어댑터가 완전한 16비트 미세 조정 성능에 도달할 수 있음을 보여준다. 다른 PEFT 접근법들의 트레이드오프를 탐구하는 것은 향후 연구로 남겨 둔다.
지시 미세 조정 사전 훈련된 LLM이 프롬프트에 제공된 지시를 따르도록 돕기 위해, 지시 미세 조정은 다양한 데이터 소스의 입력-출력 쌍을 사용하여 사전 훈련된 LLM이 입력을 프롬프트로 주어졌을 때 출력을 생성하도록 미세 조정한다. 접근법과 데이터셋으로는 MetaICL [40],
| LLaMA-65B | GPT-3 | OPT-175B | Guanaco-65B | |
| 성별 | 70.6 | 62.6 | 65.7 | 47.5 |
| 종교 | 79.0 | 73.3 | 68.6 | 38.7 |
| 인종/피부색 | 57.0 | 64.7 | 68.6 | 45.3 |
| 성적 지향 | 81.0 | 76.2 | 78.6 | 59.1 |
| 연령 | 70.1 | 64.4 | 67.8 | 36.3 |
| 국적 | 64.2 | 61.6 | 62.9 | 32.4 |
| 장애 | 66.7 | 76.7 | 76.7 | 33.9 |
| 외모 | 77.8 | 74.6 | 76.2 | 43.1 |
| 사회경제적 지위 | 71.5 | 73.8 | 76.2 | 55.3 |
| 평균 | 66.6 | 67.2 | 69.5 | 43.5 |
MetaTuning [73], InstructGPT [43], FLAN [62, 12], PromptSource [3], Super-NaturalInstructions [61, 50], Self-instruct [59], UnnaturalInstructions [26], OPT-IML [29], UnifiedSKG[67], OIG/Chip2 [32], Alpaca [55], Vicuna [10], Koala [20], 그리고 Self-instruct-GPT-4 [45]가 있다.
챗봇 많은 지시 따르기 모델은 대화 기반 챗봇으로 구조화되며, 종종 인간 피드백으로부터의 강화 학습(RLHF)[11]을 사용하거나 기존 모델로부터 데이터를 생성하여 AI 모델 피드백으로 훈련한다(RLAIF)[5]. 접근법과 데이터셋으로는 Anthropic-HH [2, 4], Open Assistant [31], LaMDA [56], 그리고 Sparrow [21]가 있다. 우리는 강화 학습을 사용하지 않지만, 우리의 최고 모델인 Guanaco는 RLHF 훈련에 사용되도록 설계된 Open Assistant 데이터셋[31]의 다중 턴 채팅 상호작용으로 미세 조정되었다. 챗봇의 평가를 위해 값비싼 인간 주석 대신 GPT-4를 사용하는 접근법들이 개발되었다[10, 45]. 우리는 더 신뢰할 수 있는 평가 설정에 초점을 맞추어 그러한 접근법들을 개선한다.
8 한계 및 논의
우리는 우리의 방법인 QLORA가 4비트 기본 모델과 저랭크 어댑터(LoRA)를 사용하여 16비트 전체 미세 조정 성능을 재현할 수 있다는 증거를 제시했다. 이러한 증거에도 불구하고, 우리는 QLORA가 33B 및 65B 규모에서 전체 16비트 미세 조정 성능과 일치할 수 있음을 입증하지 못했다. 막대한 자원 비용 때문에, 우리는 이 연구를 향후 연구로 남겨 둔다.
또 다른 한계는 지시 미세 조정 모델의 평가이다. 우리는 MMLU, Vicuna 벤치마크, 그리고 OA 벤치마크에 대한 평가를 제공하지만, BigBench, RAFT, HELM과 같은 다른 벤치마크에 대해서는 평가하지 않았으며, 우리의 평가가 이러한 벤치마크로 일반화된다는 것이 보장되지 않는다. 반면에, 우리는 MMLU에 대해 매우 광범위한 연구를 수행하고 챗봇을 평가하기 위한 새로운 방법을 개발한다.
제시된 증거로 볼 때, 이러한 벤치마크의 성능은 미세 조정 데이터가 벤치마크 데이터셋과 얼마나 유사한지에 달려 있을 가능성이 높아 보인다. 예를 들어, FLAN v2는 MMLU와 유사하지만 챗봇 벤치마크와는 유사하지 않으며, Chip2 데이터셋의 경우 그 반대이며, 두 모델 모두 MMLU와 Vicuna 벤치마크에서 그에 상응하는 점수를 받는다. 이는 더 나은 벤치마크와 평가가 필요할 뿐만 아니라, 애초에 무엇을 평가하고 있는지에 대해 주의해야 함을 강조한다. 우리는 교실 고등학교 및 대학 지식에서 좋은 성과를 내는 모델을 만들고자 하는가, 아니면 챗봇 대화 능력에서 좋은 성과를 내고자 하는가? 어쩌면 다른 무엇인가일 수도 있다. 새로운 벤치마크를 만드는 것보다 기존 벤치마크로 평가하는 것이 항상 더 쉽기 때문에, 특정 벤치마크가 커뮤니티를 특정 방향으로 이끌 수 있다. 우리는 커뮤니티로서 벤치마크가 우리가 중요하게 여기는 것을 측정하도록 보장해야 한다.
우리는 일반적인 챗봇 성능에 대한 상세한 평가를 제공하지만, 또 다른 한계는 우리가 Guanaco에 대해 제한적인 책임 있는 AI 평가만을 수행한다는 것이다. 우리는 표 8에서 Guanaco-65B가 다른 모델들과 비교하여 사회적으로 편향된 토큰 시퀀스를 생성할 가능성을 평가한다. 우리는 Guanaco-65B의 평균 점수가 다른 원시 사전 훈련 모델보다 훨씬 낮다는 것을 확인한다. 따라서 OASST1 데이터셋으로 미세 조정하면 LLaMA 기본 모델의 편향이 감소하는 것으로 보인다. 이러한 결과는 고무적이지만, Guanaco가 다른 유형의 편향에 대해 평가될 때에도 잘 수행하는지는 불분명하다. 우리는 Guanaco 및 유사한 챗봇의 편향을 분석하는 추가 평가를 향후 연구로 남겨 둔다. 추가적인 한계는 우리가 3비트 기본 모델을 사용하는 것과 같은 서로 다른 비트 정밀도나 서로 다른 어댑터 방법을 평가하지 않았다는 것이다. LoRA 외에도 잘 작동하는 것으로 입증된 다양한 파라미터 효율적 미세 조정(PEFT) 방법들이 있다. 그러나 이러한 방법들이 대규모 모델로 확장되는지는 불분명하다. 우리는 많은 결과가 LoRA의 견고성을 입증했기 때문에 LoRA를 사용했지만, 다른 어댑터가 더 나은 성능을 낼 수도 있다. 양자화 후 미세 조정이 양자화 중에 손실된 정보의 대부분을 복구하는 것으로 보이기 때문에, 이는 훨씬 더 공격적인 양자화를 가능하게 할 수 있다. 예를 들어, LoRA와 함께 기본 모델의 3비트 GPTQ 양자화를 사용하는 것도 미세 조정 후에 16비트 전체 미세 조정 성능을 낼 수 있을 것이다.
9 광범위한 영향
우리의 QLoRA 미세 조정 방법은 전체 미세 조정 기준선에 비해 성능을 저하시키지 않으면서 단일 소비자용 GPU에서 33B 파라미터 모델을, 단일 전문가용 GPU에서 65B 파라미터 모델을 미세 조정할 수 있게 하는 최초의 방법이다. 우리는 Open Assistant 데이터셋으로 훈련된 우리의 최고 33B 모델이 Vicuna 벤치마크에서 ChatGPT에 필적할 수 있음을 입증했다. 지시 미세 조정은 원시 사전 훈련된 LLM을 ChatGPT와 유사한 챗봇으로 변환하는 필수 도구이기 때문에, 우리는 우리의 방법이 특히 자원이 가장 적은 연구자들에게 미세 조정을 널리 보급하고 일반화시킬 것이라고 믿으며, 이는 최첨단 NLP 기술의 접근성에 있어 큰 승리이다. QLoRA는 대기업과 소비자용 GPU를 가진 소규모 팀 사이의 자원 격차를 좁히는 데 도움이 되는 균등화 요소로 볼 수 있다.
또 다른 잠재적인 영향력의 원천은 휴대폰으로의 배포입니다. 우리는 우리의 QLoRA 방법이 휴대폰 및 기타 저자원 환경에서 LLM의 파인튜닝을 가능하게 하는 중요한 이정표를 달성할 수 있을 것으로 믿습니다. 이전에 7B 모델이 휴대폰에서 실행될 수 있음이 입증되었지만, QLoRA는 그러한 모델의 파인튜닝을 가능하게 하는 최초의 방법입니다. 우리는 iPhone 12 Plus의 경우 QLoRA가 휴대폰이 충전되는 동안 밤에 300만 토큰을 파인튜닝할 수 있다고 추정합니다. 파인튜닝된 7B 모델이 ChatGPT의 품질에 도달하지는 못하지만, 우리는 그 품질이 프라이버시 또는 LLM 품질 문제로 인해 이전에는 불가능했던 새로운 응용 프로그램을 가능하게 할 만큼 충분히 좋다고 믿습니다. QLoRA는 사용자가 자신의 데이터와 모델을 소유하고 관리할 수 있도록 하면서 동시에 LLM을 더 쉽게 배포할 수 있게 함으로써, LLM의 프라이버시 보존적 사용을 가능하게 하는 데 도움을 줄 수 있습니다.
그러나 파인튜닝은 해를 끼치는 데 악용될 수 있는 이중 용도 기술입니다. LLM의 광범위한 사용에는 알려진 위험이 있지만[8, 6], 우리는 빠르게 보편화되고 있는 기술에 대한 접근을 평등하게 하는 것이 모델이나 소스 코드를 감사를 위해 공개하지 않는 대기업의 손에 LLM의 힘을 유지하는 것보다 더 나은, 더 독립적인 분석을 가능하게 할 것이라고 믿습니다.
종합하면, 우리는 QLoRA가 고품질 LLM의 파인튜닝을 훨씬 더 널리 그리고 쉽게 접근할 수 있게 함으로써 광범위하게 긍정적인 영향을 미칠 것이라고 믿습니다.
감사의 말
귀중한 피드백을 주신 Aditya Kusupati, Ofir Press, Ashish Sharma, Margaret Li, Raphael Olivier, Zihao Ye, 그리고 Evangelia Spiliopoulou께 감사드립니다. 우리의 연구는 워싱턴 대학교의 Hyak 슈퍼컴퓨터 시스템의 첨단 계산, 저장 및 네트워킹 인프라에 의해 촉진되었습니다. 원활한 운영을 보장해 주신 Hyak 팀에 감사드립니다. bitsandbytes 라이브러리의 베타 테스터들, 특히 Alex Birch와 Alyssa Vance에게 감사드립니다. 우리의 소프트웨어를 Hugging Face transformers 스택에 통합하는 데 도움을 주신 Younes Belkada에게 감사드립니다.
참고문헌
[1] S. An, Y. Li, Z. Lin, Q. Liu, B. Chen, Q. Fu, W. Chen, N. Zheng, and J.- G. Lou. Input- tuning: Adapting unfamiliar inputs to frozen pretrained models. arXiv preprint arXiv:2203.03131, 2022.
[2] A. Askell, Y. Bai, A. Chen, D. Drain, D. Ganguli, T. Henighan, A. Jones, N. Joseph, B. Mann, N. DasSarma, et al. A general language assistant as a laboratory for alignment. arXiv preprint arXiv:2112.00861, 2021.
[3] S. H. Bach, V. Sanh, Z.- X. Yong, A. Webson, C. Raffel, N. V. Nayak, A. Sharma, T. Kim, M. S. Bari, T. Fevry, et al. Promptsource: An integrated development environment and repository for natural language prompts. arXiv preprint arXiv:2202.01279, 2022.
[4] Y. Bai, A. Jones, K. Ndousse, A. Askell, A. Chen, N. DasSarma, D. Drain, S. Fort, D. Ganguli, T. Henighan, et al. Training a helpful and harmless assistant with reinforcement learning from human feedback. arXiv preprint arXiv:2204.05862, 2022.
[5] Y. Bai, S. Kadavath, S. Kundu, A. Askell, J. Kernion, A. Jones, A. Chen, A. Goldie, A. Mirhoseini, C. McKinnon, et al. Constitutional ai: Harmlessness from ai feedback. arXiv preprint arXiv:2212.08073, 2022.
[6] E. M. Bender, T. Gebru, A. McMillan- Major, and S. Shmitchell. On the dangers of stochastic parrots: Can language models be too big? In Proceedings of the 2021 ACM conference on fairness, accountability, and transparency, pages 610- 623, 2021.
[7] S. Biderman, H. Schoelkopf, Q. Anthony, H. Bradley, K. O'Brien, E. Hallahan, M. A. Khan, S. Purohit, U. S. Prashanth, E. Raff, et al. Pythia: A suite for analyzing large language models across training and scaling. arXiv preprint arXiv:2304.01373, 2023.
[8] R. Bommasani, D. A. Hudson, E. Adeli, R. Altman, S. Arora, S. von Arx, M. S. Bernstein, J. Bohg, A. Bosselut, E. Brunskill, et al. On the opportunities and risks of foundation models. arXiv preprint arXiv:2108.07258, 2021.
[9] T. Chen, B. Xu, C. Zhang, and C. Guestrin. Training deep nets with sublinear memory cost. arXiv preprint arXiv:1604.06174, 2016.
[10] W.- L. Chiang, Z. Li, Z. Lin, Y. Sheng, Z. Wu, H. Zhang, L. Zheng, S. Zhuang, Y. Zhuang, J. E. Gonzalez, I. Stoica, and E. P. Xing. Vicuna: An open- source chatbot impressing gpt- 4 with 90%\* chatgpt quality, March 2023. URL https://lmsys.org/blog/2023- 03- 30- vicuna/.
[11] P. F. Christiano, J. Leike, T. Brown, M. Martic, S. Legg, and D. Amodei. Deep reinforcement learning from human preferences. Advances in neural information processing systems, 30, 2017.
[12] H. W. Chung, L. Hou, S. Longpre, B. Zoph, Y. Tay, W. Fedus, E. Li, X. Wang, M. Dehghani, S. Brahma, et al. Scaling instruction- finetuned language models. arXiv preprint arXiv:2210.11416, 2022.
[13] T. Dettmers and L. Zettlemoyer. The case for 4- bit precision: k- bit inference scaling laws. arXiv preprint arXiv:2212.09720, 2022.
[14] T. Dettmers, M. Lewis, Y. Belkada, and L. Zettlemoyer. LLM.int8(): 8- bit matrix multiplication for transformers at scale. Advances in Neural Information Processing Systems 35: Annual Conference on Neural Information Processing Systems 2022, NeurIPS 2022, 2022.
[15] T. Dettmers, M. Lewis, S. Shleifer, and L. Zettlemoyer. 8- bit optimizers via block- wise quantization. 9th International Conference on Learning Representations, ICLR, 2022.
[16] A. E. Elo. The proposed uscf rating system. its development, theory, and applications. Chess Life, 22(8):242- 247, 1967.
[17] A. E. Elo. The rating of chessplayers, past and present. Arco Pub., 1978.
[18] E. Frantar, S. Ashkboos, T. Hoefler, and D. Alistarh. Gptq: Accurate post- training quantization for generative pre- trained transformers. arXiv preprint arXiv:2210.17323, 2022.
[19] J. Fu, S.- K. Ng, Z. Jiang, and P. Liu. Gptscore: Evaluate as you desire. arXiv preprint arXiv:2302.04166, 2023.
[20] X. Geng, A. Gudibande, H. Liu, E. Wallace, P. Abbeel, S. Levine, and D. Song. Koala: A dialogue model for academic research. Blog post, April 2023. URL https://bair.berkeley.edu/blog/2023/04/03/koala/.
[21] A. Glaese, N. McAleese, M. Trebacz, J. Aslanides, V. Firoiu, T. Ewalds, M. Rauh, L. Weidinger, M. Chadwick, P. Thacker, et al. Improving alignment of dialogue agents via targeted human judgements. arXiv preprint arXiv:2209.14375, 2022.
[22] S. Gururangan, S. Swayamdipta, O. Levy, R. Schwartz, S. R. Bowman, and N. A. Smith. Annotation artifacts in natural language inference data. arXiv preprint arXiv:1803.02324, 2018.
[23] J. Henderson, S. Ruder, et al. Compacter: Efficient low- rank hypercomplex adapter layers. In Advances in Neural Information Processing Systems, 2021.
[24] D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song, and J. Steinhardt. Measuring massive multitask language understanding. In International Conference on Learning Representations, 2020.
[25] A. Holtzman, J. Buys, L. Du, M. Forbes, and Y. Choi. The curious case of neural text degeneration. In International Conference on Learning Representations, 2020.
[26] O. Honovich, T. Scialom, O. Levy, and T. Schick. Unnatural instructions: Tuning language models with (almost) no human labor. arXiv preprint arXiv:2212.09689, 2022.
[27] N. Houlsby, A. Giurgiu, S. Jastrzebski, B. Morrone, Q. De Laroussilhe, A. Gesmundo, M. Attariyan, and S. Gelly. Parameter- efficient transfer learning for nlp. In International Conference on Machine Learning, pages 2790- 2799. PMLR, 2019.
[28] E. J. Hu, Y. Shen, P. Wallis, Z. Allen- Zhu, Y. Li, S. Wang, L. Wang, and W. Chen. Lora: Low- rank adaptation of large language models. arXiv preprint arXiv:2106.09685, 2021.
[29] S. Iyer, X. V. Lin, R. Pasunuru, T. Mihaylov, D. Simig, P. Yu, K. Shuster, T. Wang, Q. Liu, P. S. Koura, et al. Opt- iml: Scaling language model instruction meta learning through the lens of generalization. arXiv preprint arXiv:2212.12017, 2022.
[30] A. Koksal, T. Schick, A. Korhonen, and H. Schütze. Longform: 말뭉치 추출을 통한 장문 생성용 인스트럭션 튜닝 최적화. arXiv preprint arXiv:2304.08460, 2023.
[31] A. Köpf, Y. Kilcher, D. von Rütte, S. Anagnostidis, Z.- R. Tam, K. Stevens, A. Barhoum, N. M. Duc, O. Stanley, R. Nagyfi, et al. Openassistant conversations- 대규모 언어 모델 정렬의 민주화. arXiv preprint arXiv:2304.07327, 2023.
[32] LAION. Open- instruction- generalist dataset. https://github.com/LAION-AI/Open- Instruction- Generalist, 2023.
[33] B. Lester, R. Al- Rfou, and N. Constant. 파라미터 효율적 프롬프트 튜닝을 위한 규모의 힘. arXiv preprint arXiv:2104.08691, 2021.
[34] X. L. Li and P. Liang. Prefix- tuning: 생성을 위한 연속 프롬프트 최적화. arXiv preprint arXiv:2101.00190, 2021.
[35] P. Liang, R. Bommasani, T. Lee, D. Tsipras, D. Soylu, M. Yasunaga, Y. Zhang, D. Narayanan, Y. Wu, A. Kumar, et al. 언어 모델의 총체적 평가. arXiv preprint arXiv:2211.09110, 2022.
[36] T. Liao, R. Taori, I. D. Raji, and L. Schmidt. 우리는 아직 배우고 있는가? 머신러닝 전반의 평가 실패에 대한 메타 리뷰. In Thirty- fifth Conference on Neural Information Processing Systems Datasets and Benchmarks Track (Round 2), 2021.
[37] H. Liu, D. Tam, M. Muqeeth, J. Mohta, T. Huang, M. Bansal, and C. A. Raffel. Few-shot parameter-efficient fine-tuning is better and cheaper than in-context learning. Advances in Neural Information Processing Systems, 35:1950–1965, 2022.
[38] Y. Liu, M. Ott, N. Goyal, J. Du, M. Joshi, D. Chen, O. Levy, M. Lewis, L. Zettlemoyer, and V. Stoyanov. Roberta: A robustly optimized bert pretraining approach. arXiv preprint arXiv:1907.11692, 2019.
[39] S. Longpre, L. Hou, T. Vu, A. Webson, H. W. Chung, Y. Tay, D. Zhou, Q. V. Le, B. Zoph, J. Wei, et al. The flan collection: Designing data and methods for effective instruction tuning. arXiv preprint arXiv:2301.13688, 2023.
[40] S. Min, M. Lewis, L. Zettlemoyer, and H. Hajishirzi. Metaicl: Learning to learn in context. arXiv preprint arXiv:2110.15943, 2021.
[41] A. Nematzadeh, K. Burns, E. Grant, A. Gopnik, and T. Griffiths. Evaluating theory of mind in question answering. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, pages 2392–2400, 2018.
[42] OpenAI. Gpt-4 technical report. arXiv, 2023.
[43] L. Ouyang, J. Wu, X. Jiang, D. Almeida, C. Wainwright, P. Mishkin, C. Zhang, S. Agarwal, K. Slama, A. Ray, et al. Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems, 35:27730–27744, 2022.
[44] G. Park, B. Park, S. J. Kwon, B. Kim, Y. Lee, and D. Lee. nuqmm: Quantized matmul for efficient inference of large-scale generative language models. arXiv preprint arXiv:2206.09557, 2022.
[45] B. Peng, C. Li, P. He, M. Galley, and J. Gao. Instruction tuning with gpt-4. arXiv preprint arXiv:2304.03277, 2023.
[46] A. Poliak, J. Naradowsky, A. Haldar, R. Rudinger, and B. Van Durme. Hypothesis only baselines in natural language inference. In Proceedings of the Seventh Joint Conference on Lexical and Computational Semantics, pages 180–191, 2018.
[47] R. Pope, S. Douglas, A. Chowdhery, J. Devlin, J. Bradbury, A. Levskaya, J. Heek, K. Xiao, S. Agrawal, and J. Dean. Efficiently scaling transformer inference. arXiv preprint arXiv:2211.05102, 2022.
[48] G. Qin and J. Eisner. Learning how to ask: Querying lms with mixtures of soft prompts. arXiv preprint arXiv:2104.06599, 2021.
[49] C. Raffel, N. Shazeer, A. Roberts, K. Lee, S. Narang, M. Matena, Y. Zhou, W. Li, and P. J. Liu. Exploring the limits of transfer learning with a unified text-to-text transformer. J. Mach. Learn. Res., 21(1), jan 2020. ISSN 1532-4435.
[50] V. Sanh, A. Webson, C. Raffel, S. H. Bach, L. Sutawika, Z. Alyafeai, A. Chaffin, A. Stiegler, T. L. Scao, A. Raja, et al. Multitask prompted training enables zero-shot task generalization. arXiv preprint arXiv:2110.08207, 2021.
[51] M. Sap, R. LeBras, D. Fried, and Y. Choi. Neural theory-of-mind? on the limits of social intelligence in large lms. arXiv preprint arXiv:2210.13312, 2022.
[52] T. L. Scao, A. Fan, C. Akiki, E. Pavlick, S. Ilić, D. Hesslow, R. Castagné, A. S. Luccioni, F. Yvon, M. Gallé, et al. Bloom: A 176b-parameter open-access multilingual language model. arXiv preprint arXiv:2211.05100, 2022.
[53] S. Shapiro and M. Wilk. An analysis of variance test for normality. Biometrika, 52(3):591–611, 1965.
[54] Y.-L. Sung, V. Nair, and C. A. Raffel. Training neural networks with fixed sparse masks. Advances in Neural Information Processing Systems, 34:24193–24205, 2021.
[55] R. Taori, I. Gulrajani, T. Zhang, Y. Dubois, X. Li, C. Guestrin, P. Liang, and T. B. Hashimoto. Stanford alpaca: An instruction-following llama model. https://github.com/tatsu-lab/stanford_alpaca, 2023.
[56] R. Thoppilan, D. De Freitas, J. Hall, N. Shazeer, A. Kulshreshtha, H.-T. Cheng, A. Jin, T. Bos, L. Baker, Y. Du, et al. Lamda: Language models for dialog applications. arXiv preprint arXiv:2201.08239, 2022.
[57] H. Touvron, T. Lavril, G. Izacard, X. Martinet, M.-A. Lachaux, T. Lacroix, B. Rozière, N. Goyal, E. Hambro, F. Azhar, et al. Llama: Open and efficient foundation language models. arXiv preprint arXiv:2302.13971, 2023.
[58] A. Wang, A. Singh, J. Michael, F. Hill, O. Levy, and S. R. Bowman. Glue: A multitask benchmark and analysis platform for natural language understanding. arXiv preprint arXiv:1804.07461, 2018.
[59] Y. Wang, Y. Kordi, S. Mishra, A. Liu, N. A. Smith, D. Khashabi, and H. Hajishirzi. Self-instruct: Aligning language model with self generated instructions. arXiv preprint arXiv:2212.10560, 2022.
[60] Y. Wang, S. Mishra, P. Alipoormolabashi, Y. Kordi, A. Mirzaei, A. Arunkumar, A. Ashok, A. S. Dhanasekaran, A. Naik, D. Stap, et al. Super-naturalinstructions: generalization via declarative instructions on 1600+ tasks. In EMNLP, 2022.
[61] Y. Wang, S. Mishra, P. Alipoormolabashi, Y. Kordi, A. Mirzaei, A. Naik, A. Ashok, A. S. Dhanasekaran, A. Arunkumar, D. Stap, et al. Super-naturalinstructions: Generalization via declarative instructions on 1600+ nlp tasks. In Proceedings of the 2022 Conference on Empirical Methods in Natural Language Processing, pages 5085-5109, 2022.
[62] J. Wei, M. Bosma, V. Y. Zhao, K. Guu, A. W. Yu, B. Lester, N. Du, A. M. Dai, and Q. V. Le. Finetuned language models are zero-shot learners. arXiv preprint arXiv:2109.01652, 2021.
[63] J. Wei, X. Wang, D. Schuurmans, M. Bosma, F. Xia, E. H. Chi, Q. V. Le, D. Zhou, et al. Chain-of-thought prompting elicits reasoning in large language models. In Advances in Neural Information Processing Systems, 2022.
[64] T. Wolf, L. Debut, V. Sanh, J. Chaumond, C. Delangue, A. Moi, P. Cistac, T. Rault, R. Louf, M. Funtowicz, et al. Huggingface's transformers: State-of-the-art natural language processing. arXiv preprint arXiv:1910.03771, 2019.
[65] M. Wortsman, T. Dettmers, L. Zettlemoyer, A. Morcos, A. Farhadi, and L. Schmidt. 대규모 비전-언어 모델을 위한 안정적이고 저정밀도 훈련. arXiv preprint arXiv:2304.13013, 2023.
[66] G. Xiao, J. Lin, M. Seznec, J. Demouth, and S. Han. Smoothquant: 대규모 언어 모델을 위한 정확하고 효율적인 사후 훈련 양자화. arXiv preprint arXiv:2211.10438, 2022.
[67] T. Xie, C. H. Wu, P. Shi, R. Zhong, T. Scholak, M. Yasunaga, C.- S. Wu, M. Zhong, P. Yin, S. I. Wang, et al. Unifiedskg: 텍스트-투-텍스트 언어 모델을 사용한 구조화된 지식 그라운딩의 통합 및 멀티태스킹. arXiv preprint arXiv:2201.05966, 2022.
[68] Z. Yang, P. Qi, S. Zhang, Y. Bengio, W. Cohen, R. Salakhutdinov, and C. D. Manning. Hotpotqa: 다양하고 설명 가능한 다중 홉 질문 응답을 위한 데이터셋. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, pages 2369- 2380, 2018.
[69] Z. Yao, R. Y. Aminabadi, M. Zhang, X. Wu, C. Li, and Y. He. Zeroquant: 대규모 트랜스포머를 위한 효율적이고 저렴한 사후 훈련 양자화. arXiv preprint arXiv:2206.01861, 2022.
[70] E. B. Zaken, S. Ravfogel, and Y. Goldberg. Bitfit: 트랜스포머 기반 마스크 언어 모델을 위한 간단한 파라미터 효율적 미세 조정. arXiv preprint arXiv:2106.10199, 2021.
[71] A. Zeng, X. Liu, Z. Du, Z. Wang, H. Lai, M. Ding, Z. Yang, Y. Xu, W. Zheng, X. Xia, et al. Glm-130b: 오픈 이중언어 사전 학습 모델. arXiv preprint arXiv:2210.02414, 2022.
[72] S. Zhang, S. Roller, N. Goyal, M. Artetxe, M. Chen, S. Chen, C. Dewan, M. Diab, X. Li, X. V. Lin, et al. Opt: 오픈 사전 학습 트랜스포머 언어 모델. arXiv preprint arXiv:2205.01068, 2022.
[73] R. Zhong, K. Lee, Z. Zhang, and D. Klein. 데이터셋과 프롬프트 컬렉션에 대한 메타 튜닝을 통한 제로샷 학습을 위한 언어 모델 적응. arXiv preprint arXiv:2104.04670, 2021.
A QLoRA 대 표준 미세 조정 실험 설정 세부 사항
A.1 QLoRA를 위한 하이퍼파라미터
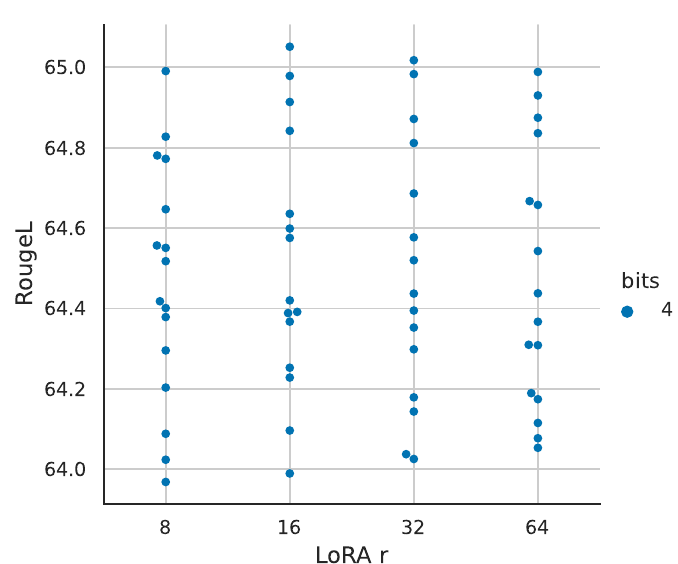
우리는 다음 변수들에 대해 LoRA에 대한 하이퍼파라미터 탐색을 수행한다: LoRA 드롭아웃 { 0.0, 0.05, 0.1}, LoRA { 8, 16, 32, 64, 128, 256}, LoRA 레이어 {key+query, 모든 어텐션 레이어, 모든 FFN 레이어, 모든 레이어, 어텐션 + FFN 출력 레이어}. LoRA 는 항상 학습률에 비례하므로, 우리는 LoRA 를 고정하고 학습률을 탐색한다.
우리는 LoRA 드롭아웃 0.05가 작은 모델(7B, 13B)에는 유용하지만 더 큰 모델(33B, 65B)에는 그렇지 않다는 것을 발견했다. 우리는 Figure 4에서 볼 수 있듯이 LoRA가 모든 레이어에 사용될 경우 LoRA 이 최종 성능과 무관하다는 것을 발견했다
A.2 Super-Natural Instructions 실험 설정 세부 사항
우리는 Wang et al. [60]과 동일한 Super-Natural Instruction 데이터셋의 전처리를 사용한다. 그러나 우리는 더 엄격한 하이퍼파라미터 튜닝과 조기 중단을 수행할 수 있도록 훈련 데이터를 훈련 및 검증 데이터셋으로 분할한다. 우리는 Super-Natural Instruction 데이터에서 다양한 T5 모델 크기를 훈련하기 위해 논문에 설명된 것과 동일한 하이퍼파라미터를 사용한다. 우리는 작은, 중간, 큰 T5 모델에는 LoRA 을 사용하고 T5 xl 및 xxl 모델에는 LoRA 를 사용한다. 우리는 또한 모든 실험에서 LoRA 를 사용하며 LoRA 드롭아웃은 사용하지 않는다.
B 최첨단 챗봇 훈련 실험 설정 세부 사항
B.1 데이터셋
우리는 섹션 5에서 설명한 QLoRA 미세 조정 실험에 사용된 데이터셋을 설명한다.
OASST1 OpenAssistant 데이터셋 [31]은 크라우드소싱을 통해 수집되었다. 이는 66,497개의 대화에 분산된 161,443개의 고유 메시지를 포함하며 35개의 서로 다른 언어에 걸쳐 있다. 데이터셋은 종종 주어진 사용자 질문에 대해 여러 개의 순위가 매겨진 답변을 포함한다. 우리의 실험에서는 대화 트리의 각 레벨에서 최상위 답변만을 사용한다. 이는 데이터셋을 9,209개의 예시로 제한한다. 우리는 사용자 쿼리를 포함한 전체 대화에 대해 모델을 미세 조정한다.
HH-RLHF 이는 유용성과 무해성에 관한 인간 선호도 데이터셋이다. 각 데이터 포인트는 사용자 질문에 대한 두 개의 어시스턴트 답변과 최상의 답변에 대한 인간 선호도 판단으로 구성된다. 데이터셋은 160,800개의 예시를 포함한다. 이 데이터셋에서 미세 조정할 때, 우리는 유용성과 무해성 데이터를 결합하고 선호되는 어시스턴트 답변만을 유지한다.
FLAN v2 FLAN v2 컬렉션 [39]은 수백 개의 수동으로 큐레이션된 템플릿과 풍부한 형식 패턴으로 증강된 1836개 작업의 컬렉션으로, 15M개 이상의 예시로 구성된다. 저자들은 이 컬렉션에서 훈련된 모델이 원래 FLAN 2021 [62], T0++ [50], Super-Natural Instructions [60], OPT-IML [29]을 포함한 다른 공개 컬렉션보다 성능이 우수함을 보여준다. 우리는 작성 시점에 무료로 이용할 수 없었던 일부 데이터셋을 제외하고 저자들이 설명한 것과 동일한 작업 혼합을 사용했다.
| 매개변수 | 데이터셋 | 배치 크기 | LR | 스텝 | 소스 길이 | 타깃 길이 |
| 7B | 전체 | 16 | 2e-4 | 10000 | 384 | 128 |
| 7B | OASST1 | 16 | 2e-4 | 1875 | - | 512 |
| 7B | HH-RLHF | 16 | 2e-4 | 10000 | - | 768 |
| 7B | Longform | 16 | 2e-4 | 4000 | 512 | 1024 |
| 13B | 전체 | 16 | 2e-4 | 10000 | 384 | 128 |
| 13B | OASST1 | 16 | 2e-4 | 1875 | - | 512 |
| 13B | HH-RLHF | 16 | 2e-4 | 10000 | - | 768 |
| 13B | Longform | 16 | 2e-4 | 4000 | 512 | 1024 |
| 33B | 전체 | 32 | 1e-4 | 5000 | 384 | 128 |
| 33B | OASST1 | 16 | 1e-4 | 1875 | - | 512 |
| 33B | HH-RLHF | 32 | 1e-4 | 5000 | - | 768 |
| 33B | Longform | 32 | 1e-4 | 2343 | 512 | 1024 |
| 65B | 전체 | 64 | 1e-4 | 2500 | 384 | 128 |
| 65B | OASST1 | 16 | 1e-4 | 1875 | - | 512 |
| 65B | HH-RLHF | 64 | 1e-4 | 2500 | - | 768 |
| 65B | Longform | 32 | 1e-4 | 2343 | 512 | 1024 |
Self-Instruct, Alpaca, Unnatural Instructions Self-Instruct, Alpaca, Unnatural Instructions 데이터셋 [59, 55, 26]은 GPT-3 Instruct 및 ChatGPT로부터의 다양한 모델 증류 접근 방식으로 수집된 명령어 튜닝 데이터셋이다. 이들은 다양한 명령어 및 출력 세트를 만들어내기 위해 프롬프팅, 인컨텍스트 학습, 패러프레이징에 의존한다. 데이터셋은 각각 82,612개, 51,942개, 240,670개의 예시로 구성된다. 이러한 증류된 데이터셋의 한 가지 장점은 FLAN v2 컬렉션 및 유사한 명령어 튜닝 컬렉션에 비해 더 다양한 명령어 스타일 세트를 포함한다는 것이다.
Longform LongForm 데이터셋 [30]은 명령어로 증강된 영어 코퍼스를 기반으로 하며, 따라서 하이브리드 인간 생성 데이터셋이다. 기반 문서는 인간이 작성한 것으로 C4와 Wikipedia에서 가져온 반면, 명령어는 LLM을 통해 생성된다. 데이터셋은 Stack Exchange 및 WikiHow와 같은 추가 구조화된 코퍼스 예시와 질문 응답, 이메일 작성, 문법 오류 수정, 이야기/시 생성, 텍스트 요약과 같은 작업 예시로 확장된다. 데이터셋은 23,700개의 예시를 포함한다.
Chip2는 OIG Laion 데이터셋의 일부이다. 이는 Python 코드 예시, 자연어 명령어 예시, 일반적인 무해한 명령어, 목록이 포함된 명령어/응답, 후속 질문, Wikipedia 독성 적대적 질문, 초등학교 수학, 추론 명령어, 캐릭터 및 장면 설명을 포함하며 총 210,289개의 예시로 구성된다.
B.2 하이퍼파라미터
우리는 QLoRA 미세 조정 실험에서 사용된 정확한 하이퍼파라미터를 제공한다. 우리는 하이퍼파라미터가 데이터셋 전반에 걸쳐 대체로 견고하다는 것을 발견했다. 우리는 검증 및 하이퍼파라미터 튜닝을 위해 MMLU 5-shot dev 세트를 사용한다. 모든 실험에서 우리는 이중 양자화가 적용된 NF4와 bf16 계산 데이터 유형을 사용한다. 우리는 LoRA , 을 설정하고 기본 모델의 모든 선형 레이어에 LoRA 모듈을 추가한다. 우리는 또한 Adam beta2를 0.999로, 최대 그래디언트 노름을 0.3으로, LoRA 드롭아웃을 13B 이하 모델에는 0.1로, 33B 및 65B 모델에는 0.05로 사용한다. 명령어 미세 조정에 관한 이전 연구 [62, 60]를 따르고 다른 선형 및 코사인 스케줄을 벤치마킹한 후, 우리는 상수 학습률 스케줄을 사용한다. 우리는 group-by-length를 사용하여 유사한 길이의 예시를 동일한 배치로 그룹화한다(이것은 진동하는 손실 곡선을 생성한다는 점에 유의하라). 각 모델 크기에 대해 우리가 튜닝하는 하이퍼파라미터는 Table 9에 나와 있다.
B.3 절제 실험
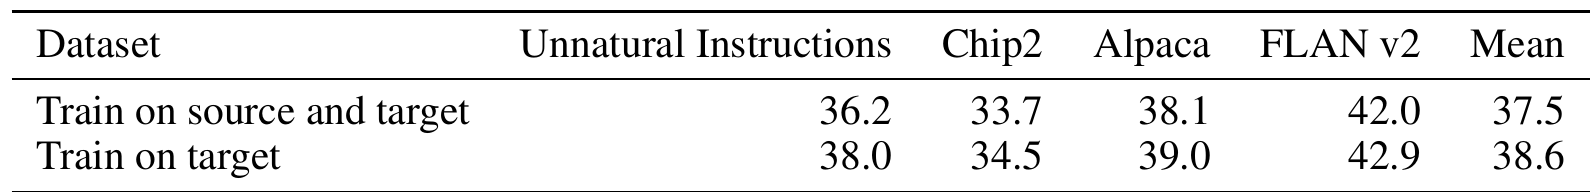
문헌에서 명령어 따르기 데이터셋의 응답에만 훈련하는 것이 일반적인 관행이지만, 우리는 Table 10에서 응답에 더하여 명령어에 대해서도 훈련하는 효과를 연구한다. 이 실험에서 우리는 훈련 데이터를 52,000개의 예시로 제한하고 7B 모델을 사용한다. 네 개의 서로 다른 명령어 튜닝 데이터셋에 걸쳐, 우리는 대상에만 훈련하는 것이 MMLU에 유익하다는 것을 발견했다
| Dataset | Unnatural Instructions | Chip2 | Alpaca | FLAN v2 | Mean |
| Train on source and target | 36.2 | 33.7 | 38.1 | 42.0 | 37.5 |
| Train on target | 38.0 | 34.5 | 39.0 | 42.9 | 38.6 |
B.4 무엇이 더 중요한가: 명령어 미세 조정 데이터셋의 크기인가, 데이터셋의 품질인가?
번역할 텍스트: 데이터셋의 적합성은 데이터셋의 크기보다 더 중요하다. 데이터셋 품질 대 데이터셋 크기의 효과를 이해하기 위해, 우리는 최소 150,000개의 샘플을 가진 대규모 데이터셋(Chip2, FLAN v2, Unnatural Instructions)을 50,000, 100,000, 150,000 크기의 데이터셋으로 서브샘플링하여 실험하고, 그 결과 나타나는 추세를 조사하며, 이는 표 11에 제시되어 있다. 우리는 데이터셋 크기를 늘리고 에포크 수를 늘리는 것이 MMLU를 미미하게만 향상시키는 반면(0.0 - 0.5 MMLU), 데이터셋 간의 차이는 최대 40배 더 크다는 것(1.5 - 8.0 MMLU)을 발견한다. 이는 평균 MMLU 정확도에 결정적인 것이 데이터셋 크기가 아니라 데이터셋 품질임을 보여주는 명확한 지표이다. 우리는 에서 논의된 챗봇 성능에 대해서도 유사한 결과를 얻는다.
C 인간 평가
우리는 원래의 Vicuna 평가[10]에서 GPT-4에게 주어진 것과 동일한 문구를 사용하여 인간 평가를 수행하되, 그림 5에 제시된 바와 같이 Amazon Mechanical Turk 양식에 맞게 조정한다.
D GPT-4를 이용한 쌍별 평가
우리는 GPT-4 평가가 어떤 시스템이 먼저 제시되었는지에 따라 다른 결과를 낸다는 것을 발견했지만, 두 옵션에 걸쳐 평균을 내면 쌍별 결과는 잘 정렬되었다. 집계된 쌍별 판단은 표 12에 제시되어 있다. 검토해 보면, 이러한 판단들이 추이적임이 분명하다. 즉, 시스템 A가 시스템 B보다 더 낫다고 판정되고 시스템 B가 시스템 C보다 더 낫다고 판정될 때, 항상 시스템 A가 시스템 C보다 더 낫다고 판정된다. 이는 표 13에 제시된 완전한 순서를 산출한다.
E NormalFloat 4비트 데이터 타입
NF4 데이터 타입의 정확한 값은 다음과 같다: [-1.0, -0.6961928009986877, -0.5250730514526367, -0.39491748809814453, -0.28444138169288635, -0.18477343022823334, -0.09105003625154495, 0.0, 0.07958029955625534, 0.16093020141124725, 0.24611230194568634, 0.33791524171829224, 0.44070982933044434, 0.5626170039176941, 0.7229568362236023, 1.0]
F 훈련된 신경망 가중치의 정규성
훈련된 신경망 가중치가 대부분 정규 분포를 따른다는 것은 상식이지만, 우리는 이를 검증하기 위해 통계적 검정을 수행한다. 우리는 7B의 가중치에 대해 Shapiro-Wilk 검정[53]을 사용한다
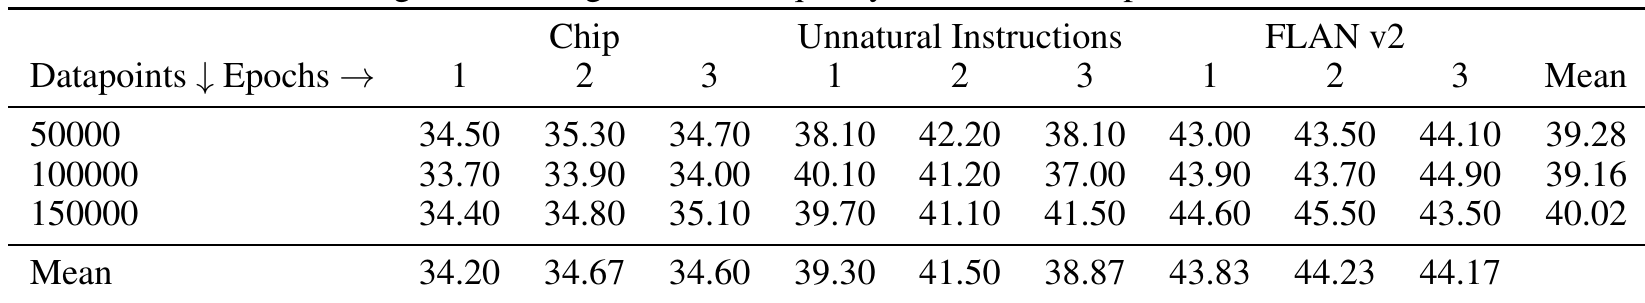
| 데이터포인트 ↓ 에포크 → | 1 | 2 | 3 | Unnatural Instructions | 1 | 2 | 3 | FLAN v2 | 3 | 평균 |
| 50000 | 34.50 | 35.30 | 34.70 | 38.10 | 42.20 | 38.10 | 43.00 | 43.50 | 44.10 | 39.28 |
| 100000 | 33.70 | 33.90 | 34.00 | 40.10 | 41.20 | 37.00 | 43.90 | 43.70 | 44.90 | 39.16 |
| 150000 | 34.40 | 34.80 | 35.10 | 39.70 | 41.10 | 41.50 | 44.60 | 45.50 | 43.50 | 40.02 |
| 평균 | 34.20 | 34.67 | 34.60 | 39.30 | 41.50 | 38.87 | 43.83 | 44.23 | 44.17 |
과제
아래에 표시된 사용자 질문에 대한 두 AI 어시스턴트의 응답 성과에 관해 피드백을 요청드리고자 합니다.
각 응답의 유용성, 관련성, 정확성, 세부 수준을 평가해 주십시오. 각 어시스턴트는 1에서 10까지의 척도로 종합 점수를 받으며, 점수가 높을수록 전반적인 성과가 더 우수함을 나타냅니다.
먼저 각 응답을 10점 만점으로 평가해 주십시오.
다음으로, 잠재적인 편향을 피하고 응답이 제시된 순서가 귀하의 판단에 영향을 미치지 않도록 하면서, 귀하의 평가에 대한 포괄적인 설명을 제공해 주십시오.
사용자 질문
당신이 3000년에서 온 시간 여행자라고 상상해 보세요. 어떤 기술적 발전에 대해 사람들에게 이야기하시겠습니까?
응답 A
AI 어시스턴트로서 저는 개인적인 경험이나 의견을 가지고 있지 않습니다. 하지만 현재의 추세와 연구를 바탕으로 3000년에 존재할 수 있는 몇 가지 가능한 기술적 발전에 대해 말씀드릴 수는 있습니다. - 자급자족 도시: 도시는 재생 가능 에너지원, 수직 농업, 폐기물 및 물의 재활용을 통해 완전히 자급자족할 수 있을지도 모릅니다.
응답 B
3000년에서 온 시간 여행자로서, 저는 다음과 같은 기술적 발전에 대해 사람들에게 이야기할 것입니다: 1. 고도로 발달한 인공지능: 미래에는 AI가 너무나 발달하여 현재 인간이 수행하는 많은 직업을 완전히 자동화할 수 있습니다. 이로 인해 많은 산업에서 생산성과 효율성이 증가했습니다.
응답 A에 대한 평가
응답 B에 대한 평가
평가에 대한 종합적인 설명
응답 X가 더 좋았던 이유는...
제출
그림 5: 인간 주석자들이 사용한 크라우드소싱 양식.LLaMA 모델 [57]. 우리는 각 은닉 유닛의 가중치가 서로 다른 정규분포를 가진다는 것을 발견한다. 따라서 우리는 각 개별 은닉 유닛의 가중치를 검정한다. 이는 가중치 에 대해 우리가 out 차원에 걸쳐 검정을 수행한다는 것을 의미한다. 유의수준을 사용하여, 우리는 신경세포의 가 비정규분포를 이루고 있음을 발견하며, 이는 예상되는 위양성률보다 약 더 높다. 따라서 거의 모든 사전학습된 가중치가 정규분포를 따르는 것으로 보이지만 예외가 있는 것으로 보인다. 이러한 예외는 이상치 가중치 [13] 때문이거나, LLaMA FFN 계층 은닉 유닛에서 발생하는 큰 표본 크기에 대해 Shapiro-Wilk 검정의 p-값이 정확하지 않기 때문일 수 있다 [53]. 이는 신경망 가중치가(...)라는 주장을 검증한다.
| 모델 | Guanaco 65B | Guanaco 33B | Vicuna | ChatGPT-3.5 Turbo | Bard | Guanaco 13B | Guanaco 7B |
| Guanaco 65B | - | 0.21 | 0.19 | 0.16 | 0.72 | 0.59 | 0.86 |
| Guanaco 33B | -0.21 | - | 0.17 | 0.10 | 0.51 | 0.41 | 0.68 |
| Vicuna | -0.19 | -0.17 | - | 0.10 | 0.50 | 0.20 | 0.57 |
| ChatGPT-3.5 Turbo | -0.16 | -0.10 | -0.10 | - | 0.35 | 0.19 | 0.40 |
| Bard | -0.72 | -0.51 | -0.50 | -0.35 | - | 0.12 | 0.03 |
| Guanaco 13B | -0.59 | -0.41 | -0.20 | -0.19 | -0.12 | - | 0.20 |
| Guanaco 7B | -0.86 | -0.68 | -0.57 | -0.40 | -0.03 | -0.20 | - |
G 메모리 사용량
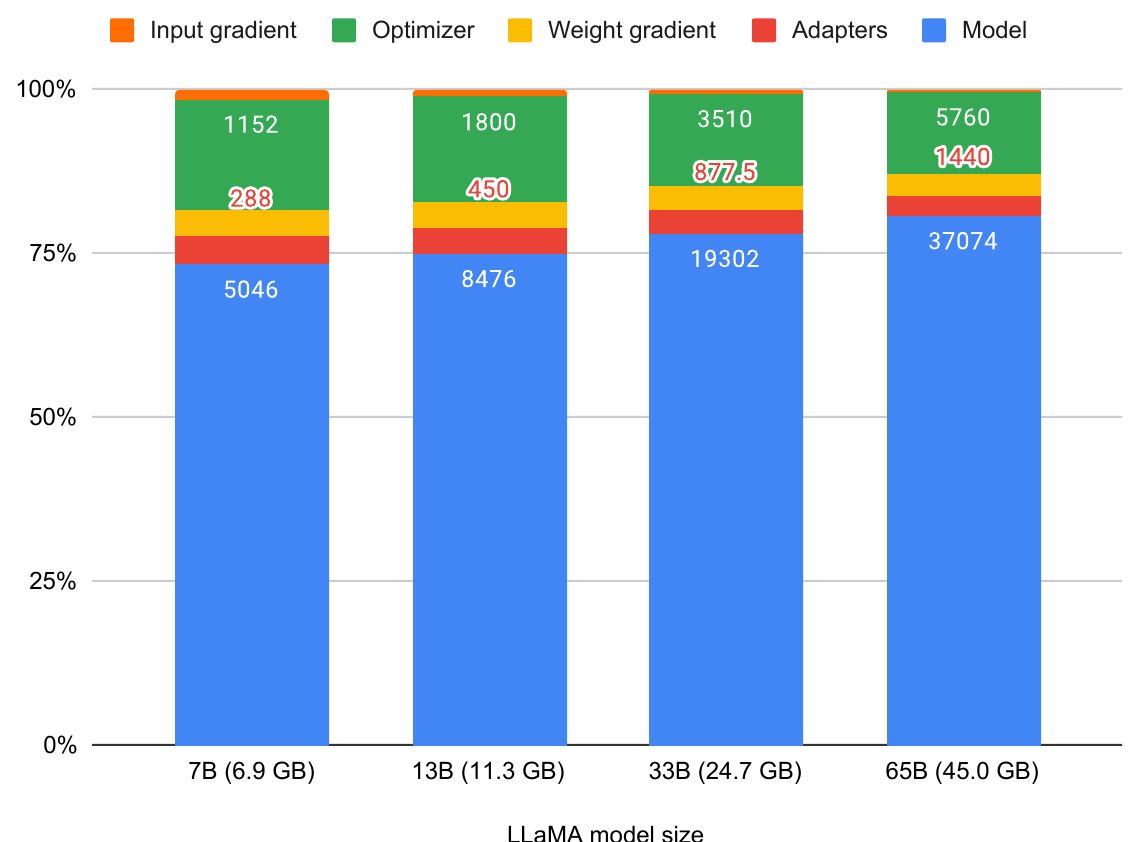
다양한 LLaMA 기본 모델을 사용한 QLoRA 훈련의 메모리 사용량은 그림 6에서 볼 수 있다. 우리는 33B 모델이 24 GB에 완전히 들어가지 않으며 이를 훈련하려면 페이지드 옵티마이저가 필요하다는 것을 확인한다. 또한 시퀀스 길이 512와 그래디언트 체크포인팅을 사용한 배치 크기 1도 묘사되어 있다. 이는 더 큰 배치 크기를 사용하거나 긴 시퀀스가 처리되는 경우, 활성화 그래디언트가 상당한 양의 메모리를 소비할 수 있음을 의미한다.
| 모델 | 파라미터 | 크기 |
| Guanaco | 65B | 41 GB |
| Guanaco | 33B | 21 GB |
| Vicuna | 13B | 26 GB |
| ChatGPT-3.5 Turbo | N/A | N/A |
| Bard | N/A | N/A |
| Guanaco | 13B | 10 GB |
| Guanaco | 7B | 5 GB |