
작은 모델이 여러 토큰을 초안으로 제안하고 큰 모델이 한 번에 검증한다. 출력은 그대로면서 추론이 빨라진다. ICML 2023, 전문 무료.
Fast Inference from Transformers via Speculative Decoding
트랜스포머로부터의 추측적 디코딩을 통한 빠른 추론
Yaniv Leviathan \* 1 Matan Kalman \* 1 Yossi Matias 1
초록
트랜스포머와 같은 대규모 자기회귀 모델로부터의 추론은 느리다 - 개의 토큰을 디코딩하려면 모델을 번 순차적으로 실행해야 한다. 본 연구에서는 출력을 전혀 변경하지 않고 여러 토큰을 병렬로 계산함으로써 자기회귀 모델로부터 더 빠르게 샘플링하는 알고리즘인 추측적 디코딩(speculative decoding)을 소개한다. 우리 접근법의 핵심에는 (1) 어려운 언어 모델링 과제에는 종종 더 효율적인 모델로 잘 근사할 수 있는 더 쉬운 하위 과제가 포함된다는 점, 그리고 (2) 추측적 실행과 새로운 샘플링 방법을 사용하면 근사 모델의 출력에 대해 대규모 모델을 병렬로 실행함으로써 대규모 모델로부터의 정확한 디코딩을 더 빠르게 할 수 있으며, 잠재적으로 여러 토큰을 동시에 생성할 수 있고 분포를 변경하지 않는다는 점이 있다. 우리의 방법은 재훈련이나 아키텍처 변경 없이 기존의 기성 모델을 가속화할 수 있다. 우리는 이를 T5-XXL에서 시연하여 표준 T5X 구현 대비 동일한 출력으로 2배에서 3배의 가속을 보여준다.
1. 서론
대규모 자기회귀 모델, 특히 대규모 트랜스포머(Vaswani et al., [2017])는 최근 몇 년간 텍스트나 이미지 영역에서 GPT-3(Brown et al., [2020]), LaMDA(Thoppilan et al., [2022]), Parti(Yu et al., [2022]), PaLM(Chowdhery et al., [2022]) 등에서 수없이 입증되었듯이 소규모 모델보다 훨씬 더 뛰어난 능력을 갖는다. 불행히도, 이러한 대규모 모델로부터의 단일 디코드 단계는 소규모 대응 모델의 단계보다 상당히 느리며, 설상가상으로 이러한 단계들은 순차적으로 수행된다 - 개의 토큰을 디코딩하려면 모델을 번 순차적으로 실행해야 한다.
대규모 자기회귀 모델, 특히 대규모 트랜스포머의 중요성을 감안하여, 이들로부터의 추론을 더 빠르게 하기 위한 여러 접근법이개발되었다. 일부 접근법은 모든 입력에 대해 추론 비용을 동등하게 줄이는 것을 목표로 한다(예: Hinton et al., [2015], Jaszczur et al., [2021], Hubara et al., [2016], So et al., [2021], Shazeer [2019]). 다른 접근법은 모든 추론 단계가 동일하게 태어나지 않는다는 관찰에서 비롯된다 - 일부는 매우 큰 모델을 필요로 하는 반면, 다른 일부는 더 효율적인 모델로 잘 근사할 수 있다. 이러한 적응적 계산 방법(예: Han et al., [2021], Sukhbaatar et al., [2019], Schuster et al., [2021], Scardapane et al., [2020], Bapna et al., [2020], Elbayad et al., [2019], Schwartz et al., [2020])은 더 쉬운 추론 단계에 더 적은 계산 자원을 사용하는 것을 목표로 한다. 이러한 해결책 중 다수는 실제로 극히 효과적인 것으로 입증되었지만, 일반적으로 모델 아키텍처를 변경하고, 훈련 절차를 변경하고, 모델을 재훈련해야 하며, 동일한 출력을 유지하지 못한다.
동등 기여 1Google Research, Mountain View, CA, USA. 교신: Yaniv Leviathan leviathan@google.com.
위의 핵심 관찰, 즉 일부 추론 단계는 "더 어렵고" 일부는 "더 쉽다"는 점은 우리 연구의 핵심 동기이기도 하다. 우리는 additionally 대규모 모델로부터의 추론이 종종 산술 연산이 아니라 메모리 대역폭과 통신에 의해 병목이 발생하므로 추가 계산 자원을 사용할 수 있다는 점을 관찰한다. 따라서 우리는 적응적 양의 계산을 사용하는 것에 대한 보완적 접근법으로 동시성을 높이는 것을 제안한다. 구체적으로, 우리는 모델 아키텍처를 변경하지 않고, 훈련 절차를 변경하거나 모델을 재훈련할 필요 없이, 그리고 모델 출력 분포를 변경하지 않고 추론을 가속화할 수 있다. 이는 추측적 실행을 통해 달성된다.
추측적 실행(Burton, [1985], Hennessy & Patterson, [2012])은 프로세서에서 흔히 볼 수 있는 최적화 기법으로, 작업이 실제로 필요한지 검증하는 것과 병렬로 작업을 수행하는 것 - 그 이점은 증가된 동시성이다. 추측적 실행의 잘 알려진 예는 분기 예측이다. 추측적 실행이 효과적이기 위해서는 필요할 가능성이 높은 작업을 제안하는 효율적인 메커니즘이 필요하다. 본 연구에서 우리는 추측적 실행을 확률적 설정으로 일반화한다 - 작업이 어느 정도의 확률로 필요할 수 있는 경우이다. 이를 트랜스포머와 같은 자기회귀 모델로부터의 디코딩에 적용하여, 우리는 더 효율적인 근사 모델로부터 생성된 샘플을 느린 대상 모델에 대한 추측적 접두사로 사용한다. 새로운 샘플링 방법인 추측적 샘플링을 통해, 우리는 이러한 추측적 작업이
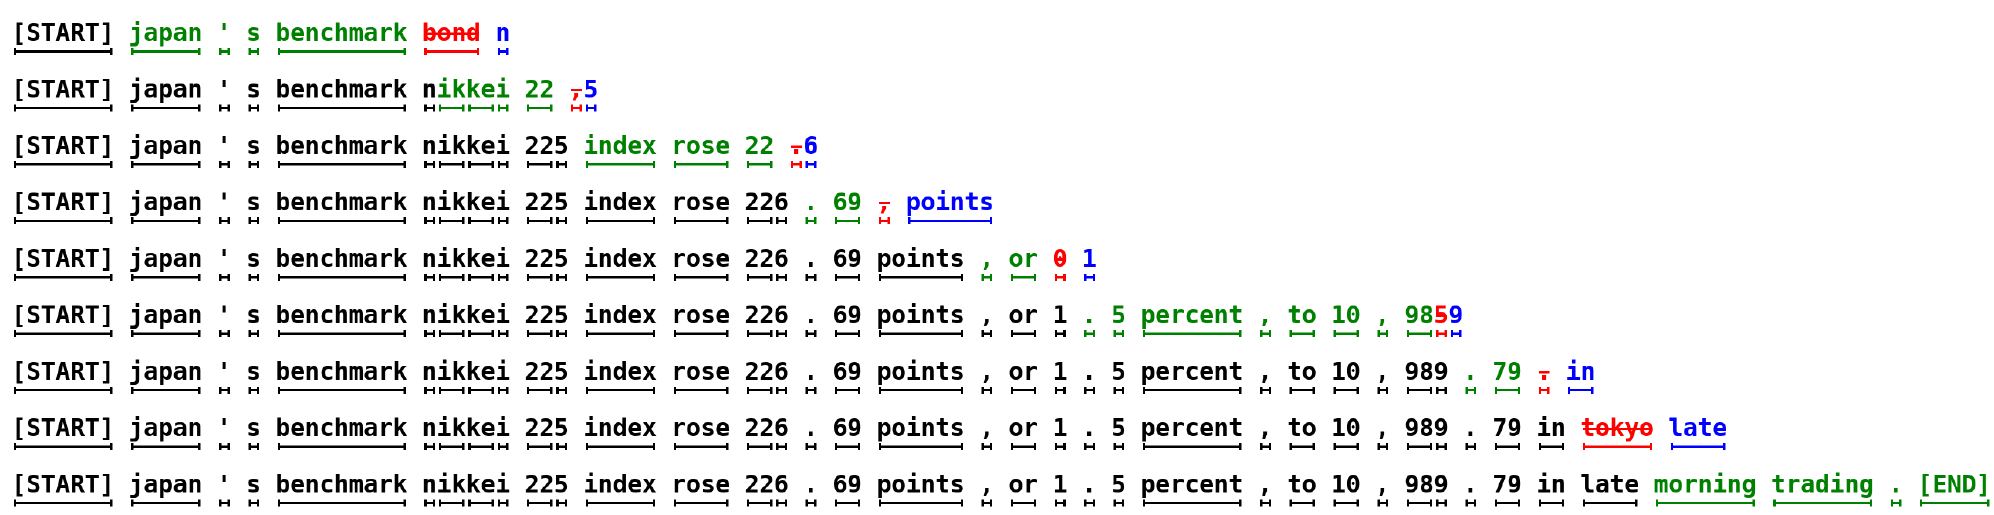
수용될 확률을 최대화하는 동시에, 우리 시스템의 출력이 대상 모델만으로부터의 출력과 동일한 분포를 갖도록 보장한다. 예를 들어, 그림 1의 38개 토큰으로 구성된 문장은 더 작고 효율적인 근사 모델(6M 매개변수) 덕분에 더 큰 대상 모델(97M 매개변수)을 단 9번 순차적으로 실행하여 우리의 방법으로 생성되었으며, 생성될 확률은 변경되지 않았다.
우리는 다양한 작업과 모델 크기에서 우리의 방법을 분석한다: 1m1b에서 훈련된 97M 매개변수 GPT 유사 모델로부터의 무조건적 생성, 11B 매개변수 T5-XXL 모델을 사용한 영어-독일어 번역 및 뉴스 기사 요약, 그리고 137B 매개변수 LaMDA 모델을 사용한 대화 작업. 우리는 우리의 방법을 구현하고 T5-XXL에 대한 실제 벽시계 시간을 견고한 T5X 구현(Roberts et al., 2022)의 시간과 비교하여, 출력에 어떠한 변경도 없이 2배에서 3배의 즉시 사용 가능한 지연 시간 개선을 보여준다(4절).
우리의 방법은 실제 생산 환경에서 쉽게 사용할 수 있고, 새로운 모델 훈련이 필요하지 않으며, 출력을 변경하지 않는다. 따라서 메모리 대역폭이 병목이고 계산 자원을 사용할 수 있는 일반적인 상황에서, 트랜스포머와 같은 자기회귀 모델로부터의 샘플링을 가속화하는 좋은 기본값이 될 수 있다.
요약하면, 우리의 주요 기여는 다음과 같다: (1) 확률적 설정으로의 추측적 실행의 일반화와 우리가 추측적 샘플링이라고 부르는 새로운 샘플링 방법, 그리고 (2) 모델 아키텍처, 훈련 방식, 출력 분포를 전혀 변경하지 않고 자기회귀 모델로부터의 디코딩을 가속화할 수 있는 추측적 디코딩이라고 부르는 디코딩 메커니즘.
2. 추측적 디코딩
2.1. 개요
를 우리가 가속화하려는 대상 모델, 를 접두사 에 대해 모델로부터 얻는 분포라고 하자. 를 동일한 작업에 대한 더 효율적인 근사 모델, 를 접두사 에 대해 모델로부터 얻는 분포라고 하자. 핵심 아이디어는 (1) 더 효율적인 모델 를 사용하여 개의 완성(이 매개변수를 최적으로 선택하는 방법은 3.5절 참조)을 생성한 다음, (2) 대상 모델 를 사용하여 모든 추측과 로부터의 각각의 확률을 병렬로 평가하여 동일한 분포로 이어질 수 있는 모든 추측을 수용하고, (3) 조정된 분포로부터 추가 토큰을 샘플링하여 처음 거부된 것을 수정하거나, 모두 수용된 경우 추가 토큰을 하나 더 추가한다. 그렇게 하면 대상 모델 의 각 병렬 실행은 적어도 하나의 새로운 토큰을 생성하므로(따라서 대상 모델의 순차적 실행 횟수는 최악의 경우에도 단순 자기회귀 방법보다 클 수 없다), 가 를 얼마나 잘 근사하는지에 따라 최대 개의 많은 새로운 토큰을 잠재적으로 생성할 수 있다.
2.2. 표준화된 샘플링
먼저, argmax, top-k, nucleus, 온도 설정과 같은 많은 샘플링 방법과 매개변수가 있으며, 인기 있는 구현들은 일반적으로 로짓 수준에서 이를 다르게 처리하지만, 이들 모두는 조정된 확률 분포로부터의 표준 샘플링으로 쉽게 변환될 수 있다는 점에 주목하자. 예를 들어, argmax 샘플링은 분포에서 최댓값이 아닌 요소를 0으로 만들고 정규화하는 것과 동일하다. 따라서 우리는 확률 분포로부터의 표준 샘플링만 다룰 수 있으며, 다른 모든 유형의 샘플링을 그 틀 안으로 변환할 수 있다. 앞으로 우리는 와 가 각각 샘플링 방법에 맞게 조정된 와 로부터의 분포라고 가정할 것이다.
2.3. 추측적 샘플링
\(x\sim p(x)\)에서 표본을 추출하기 위해, 대신 \(x\sim q(x)\)에서 표본을 추출하고, \(q(x)\leq p(x)\)이면 이를 유지하며, \(q(x) > p(x)\)인 경우에는 확률 \(1 - \frac{p(x)}{q(x)}\)로 표본을 기각하고 대신 조정된 분포 \(p^{\prime}(x) = norm(max(0,p(x) - q(x)))\)에서 \(x\)를 다시 표본 추출합니다. 임의의 분포 \(p(x)\)와 \(q(x)\), 그리고 이런 방식으로 표본 추출된 \(x\)에 대해 실제로 \(x\sim p(x)\)임을 보이는 것은 쉽습니다(부록 [A.1] 참조).
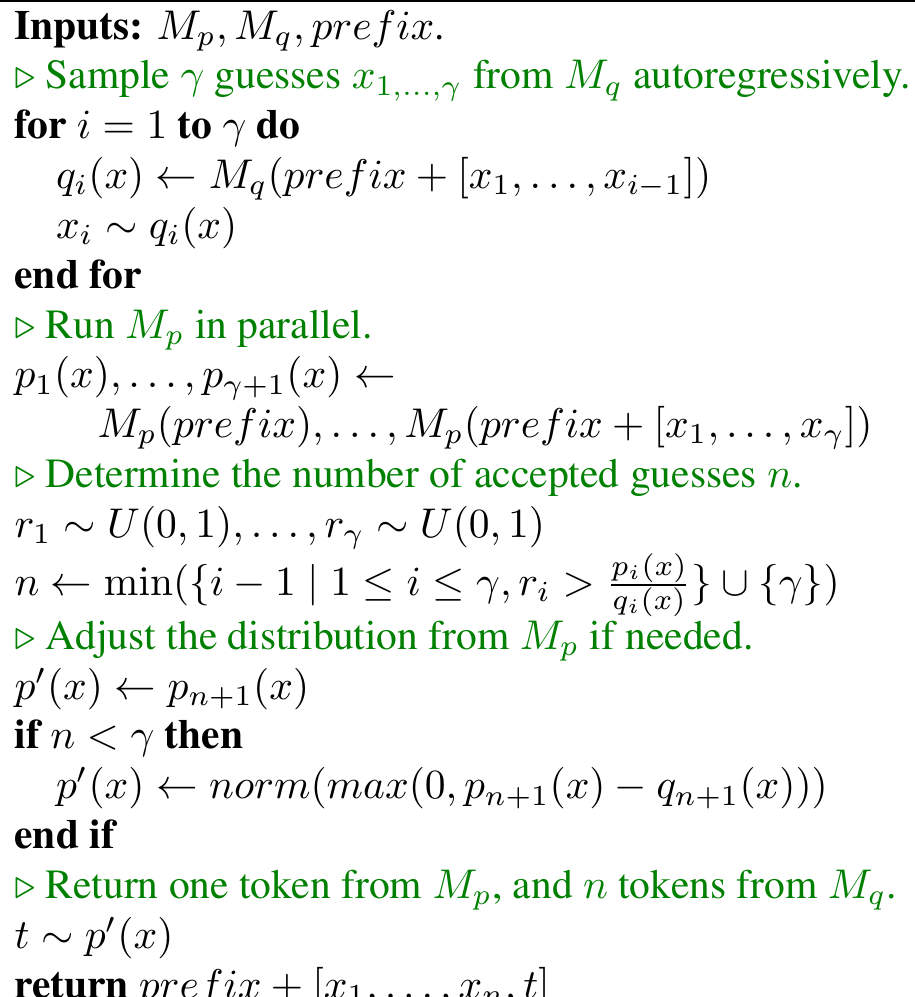
조건화 \(prefix\)에서 \(M_{q}\)를 실행하여 얻은 분포 \(q(x)\)가 주어지면, 토큰 \(x_{1}\sim q(x)\)을 표본 추출할 수 있습니다. 그런 다음 \(prefix\)에서 \(M_{p}\)를 실행하여 분포 \(p(x)\)를 계산하는 동시에, \(prefix + [x_{1}]\)에서 \(M_{p}\)를 실행하여 다음 토큰 \(x_{2}\)의 분포를 병렬로 투기적으로 계산합니다. 두 계산이 모두 완료되면 위에서 설명한 대로 진행합니다. 즉, \(x_{1}\)이 기각되면 \(x_{2}\)의 계산을 버리고 조정된 분포에서 \(x_{1}\)을 다시 표본 추출하며, \(x_{1}\)이 수락되면 두 토큰을 모두 유지합니다. 알고리즘 [I]은 이 아이디어를 일반화하여 한 번에 1개에서 \(\gamma +1\)개의 토큰을 표본 추출합니다.
알고리즘 1 SpeculativeDecodingStep
3. 분석
3.1. 생성된 토큰 수
목표 모델에 대한 직렬 호출 횟수의 감소 계수, 즉 알고리즘 [I]의 단일 실행으로 생성되는 기대 토큰 수를 분석해 보겠습니다.
정의 3.1. 접두사 \(x_{< t}\)가 주어졌을 때 수락률 \(\beta_{x< t}\)는 섹션 [2.3]에 따라 투기적 표본 추출에 의해 \(x_{t}\sim q(x_{t}|x_{< t})\)가 수락될 확률입니다:
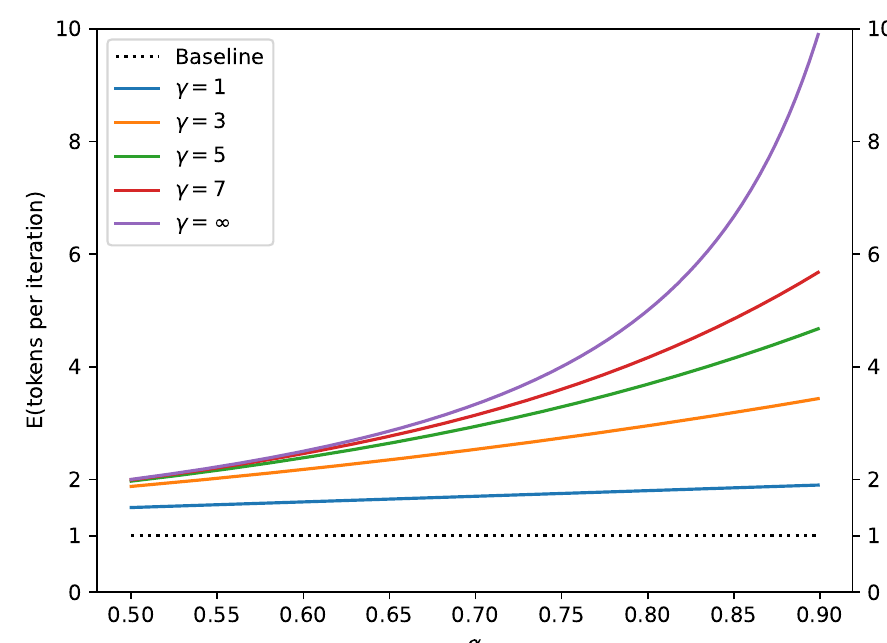
그러면 \(E(\beta)\)는 \(M_{q}\)가 \(M_{p}\)를 얼마나 잘 근사하는지를 나타내는 자연스러운 척도입니다. \(\beta\)들이 i.i.d.라는 단순화 가정을 하고 \(\alpha = E(\beta)\)라고 표기하면, 알고리즘 [I]의 단일 실행으로 생성되는 토큰 수는 성공 확률 \(1 - \alpha\)와 상한 \(\gamma +1\)을 갖는 상한이 있는 기하 변수이며, 알고리즘 [I]에 의해 생성되는 기대 토큰 수는 방정식 [I]을 만족합니다. 그림 [2]를 참조하십시오.
3.2. \(\alpha\) 계산
이제 접두사와 두 모델 \(M_{p}\), \(M_{q}\)가 주어졌을 때 \(\alpha\)를 계산하는 간단한 공식을 유도하겠습니다. 먼저 자연스러운 발산 \(D_{LK}\)를 정의합니다:
정의 3.2. \(D_{LK}(p,q) = \sum_{x}|p(x) - M(x)| = \sum_{x}|q(x) - M(x)|\) 여기서 \(M(x) = \frac{p(x) + q(x)}{2}\)입니다.
보조정리 3.3.
증명.
보조정리 [3.3]으로부터 우리는 다음 결과들을 즉시 얻는다: 따름정리 3.4. 는 에서의 대칭적 발산이다. . 와 는 서로소인 지지집합을 가진다.
정리 3.5.
마지막으로 우리는 다음을 얻는다:
따름정리 3.6.
우리 실험에서 경험적으로 관찰된 값들은 표 3을 참조하라.
3.3. 월타임 개선
우리는 i.i.d. 가정 하에서 우리의 알고리즘이 대상 모델에 대한 호출 횟수를 배로 감소시킨다는 것을 보였다. 일반적으로 투기적 실행은, 그리고 특히 우리의 알고리즘은, 증가된 동시성을 지원할 충분한 연산 자원이 있다고 가정한다는 점에 유의하라 (3.4절). 월타임 분석을 위해, 우리는 월타임을 증가시키지 않고 의 개 동시 평가를 병렬로 실행할 수 있다고 가정할 것이다. 총 월타임 개선을 구하기 위해, 이제 근사 모델 를 실행하는 비용을 고려한다.
정의 3.7. 비용 계수 를 의 단일 실행 시간과 의 단일 실행 시간 사이의 비율이라고 하자.
모델과 과제의 내재적 속성인 와 달리, 의 값은 하드웨어 구성과 소프트웨어 구현 세부사항에 의존한다는 점에 유의하라. 가 일반적으로 보다 몇 자릿수 작은 우리의 실험에서, 는 항상 0.05 미만이었고 종종 0에 가깝게 무시할 수 있을 정도였다.
정리 3.8. 알고리즘 1에 의한 총 월타임의 기대 개선 계수는 이다.
증명. 의 단일 단계를 실행하는 비용을 라고 하자. 이제 알고리즘 1의 각 실행은 의 비용이 들고 (근사 모델 를 번 실행하고 를 한 번 실행하는 데 대해), 식 (1)에 따라 평균적으로 개의 토큰을 생성한다. 따라서 알고리즘 1로 토큰을 생성하는 전체 기대 비용은 이다. 표준 디코딩 알고리즘으로 단일 토큰을 생성하는 비용은 이므로, 우리는 원하는 결과를 얻는다.
정리 3.8은 충분히 긴 생성(예를 들어, 우리는 를 적어도 한 번 실행하므로, 개선 계수는 생성된 토큰 수로 상한이 정해진다)을 가정한다는 점에 유의하라.
따름정리 3.9. 만약 이면, 우리가 개선을 얻을 수 있는 가 존재하며, 개선 계수는 적어도 이다.
증명. 만약 에 대해 개선을 얻는다면, 우리는 임의의 에 대해서도 개선을 얻을 것이므로, 우리의 방법이 개선을 산출하게 하려면, 우리는 에 대해 정리 3.8을 평가할 수 있고, 이는 를 산출한다.
3.4. 산술 연산의 수
알고리즘 1은 의 회 실행을 병렬로 수행하므로, 동시 산술 연산의 수는 배로 증가한다. 이제 알고리즘 1은 실행당 최대 개의 토큰을 생성하므로, 총 산술 연산의 수는 표준 디코딩 알고리즘의 것보다 높을 수 있다. 우리가 로부터의 표본을 수용할 때, 증가된 동시성은 "무료"이며 총 연산 수는 증가하지 않는다. 그러나 우리가 추측을 거부할 때, 계산은 낭비된다. 이제 우리의 방법이 총 산술 연산 수에 미치는 영향을 분석해 보자.
정의 3.10. 를 근사 모델 의 토큰당 산술 연산 수와 대상 모델 의 토큰당 산술 연산 수의 비율이라고 하자.
정리 3.11. 알고리즘 1의 총 연산 수에서 기대 증가 계수는 이다.
증명. 를 토큰당 표준 디코딩 기준선이 수행하는 산술 연산 수, 즉 의 단일 실행의 연산 수라고 하자. 그러면 알고리즘 1의 단일 반복은 회의 연산이 든다 (의 회 실행과 의 회 병렬 실행에 대해). 알고리즘 1에 의해 생성된 기대 토큰 수, 즉 식 (1)로 나누고, 로 나누면, 우리는 원하는 결과를 얻는다.
만약 가 낮으면, 산술 연산 수의 증가는 높고, 그 반대도 마찬가지이다. Transformer 디코더의 경우, 알고리즘 1에 의한 총 산술 연산 수(의 실행을 제외하고)는 동일한 크기의 Transformer 인코더의 단일 실행에 의해 위로부터 상한이 정해질 수 있다는 점에 유의하라.
메모리 접근의 총 횟수는 산술 연산의 총 횟수와 달리 우리의 방법을 사용하면 줄어들 수 있다. 구체적으로, 대상 모델의 가중치와 KV 캐시는 알고리즘 1의 실행당 한 번만 읽을 수 있으므로, 이를 읽기 위한 메모리 접근 횟수는 수식 (1)에 따라 배만큼 줄어든다.
3.5. 선택하기
와 가 주어지고 충분한 연산 자원이 있다고 가정하면(3.4절 참조), 최적의 는 벽시계
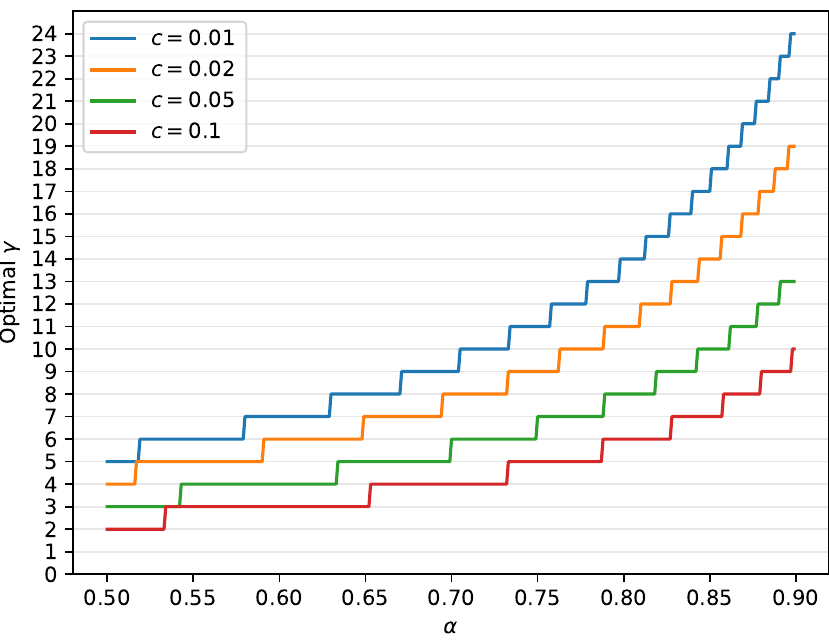
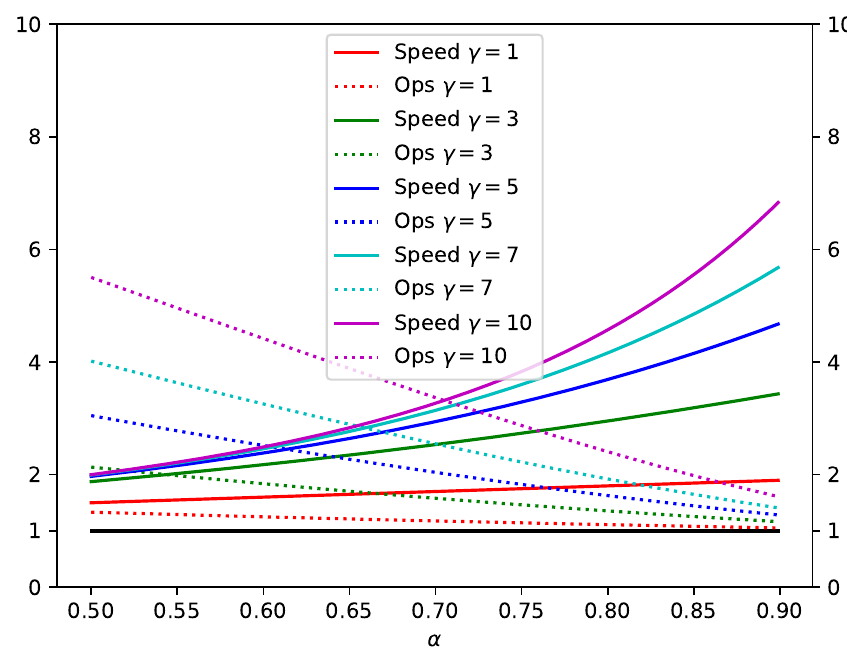
시간 개선 방정식(정리 3.8) \(\frac{1 - \alpha^{\gamma + 1}}{(1 - \alpha)(\gamma c + 1)}\) 을 최대화하는 값이다. \(\gamma\)는 정수이므로 수치적으로 쉽게 찾을 수 있다. 그림 3을 참조하라.
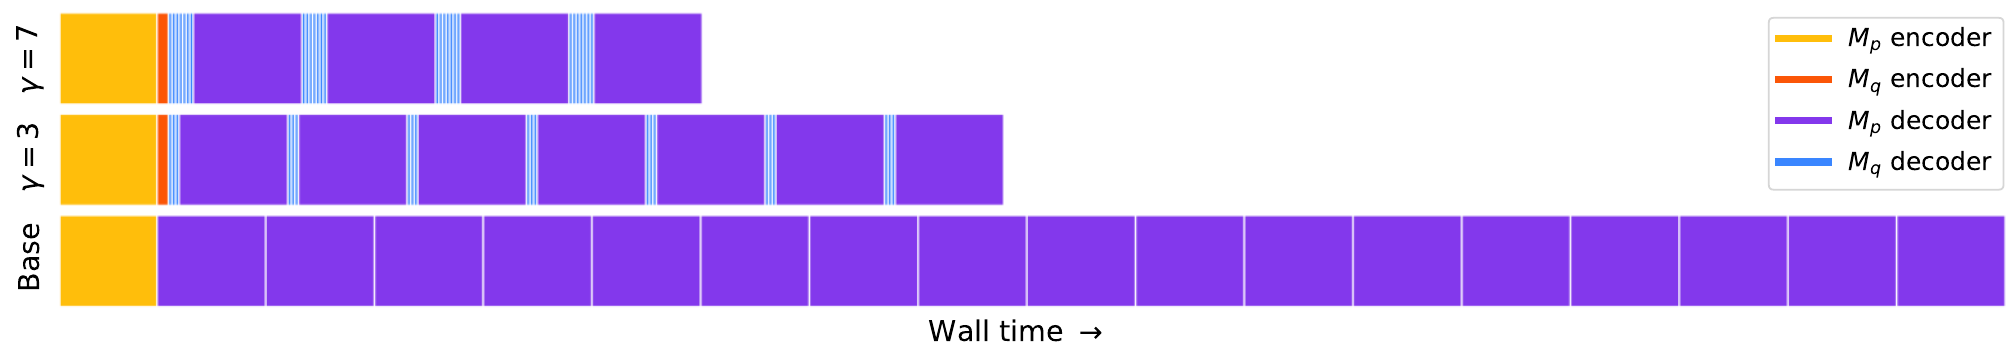
표 1과 그림 4는 \(c = \hat{c} = 0\) 이라고 가정할 때, 다양한 \(\alpha\) 및 \(\gamma\) 값에 대한 추론 속도와 산술 연산의 총 횟수 사이의 트레이드오프를 보여준다. 그림 5는 단순화된 트레이스 다이어그램을 보여준다.
| α | γ | 연산 | 속도 |
| 0.6 | 2 | 1.53X | 1.96X |
| 0.7 | 3 | 1.58X | 2.53X |
| 0.8 | 2 | 1.23X | 2.44X |
| 0.8 | 5 | 1.63X | 3.69X |
| 0.9 | 2 | 1.11X | 2.71X |
| 0.9 | 10 | 1.60X | 6.86X |
\(\beta\)들이 일정하지 않기 때문에 \(\alpha\)에 기반하여 \(\gamma\)에 대해 단일 값을 선택하는 대신, \(\beta\)의 값을 예측하고 그에 따라 알고리즘 1의 실행 중에 \(\gamma\)의 값을 변화시킴으로써 추가적인 개선을 얻을 수 있다. 추가 개선 계수에 대한 상한을 구하기 위해, \(\gamma\)에 대한 오라클이 있다고 가정하자. 그러면 \(E(\# generated tokens) = \frac{1}{1 - \alpha}\) 가 된다. 일반적인 \(c\)와 \(\alpha\) 값에 대해, 그리고 연산 자원이 무제한이라고 가정하면, 향상된 벽시계 시간 개선 계수는 고정된 \(\gamma\)를 사용한 개선 계수보다 최대 \(\sim 60\%\) 더 높을 수 있다. 우리는 이에 대한 탐구를 향후 과제로 남긴다.
3.6. 근사 모델
투기적 샘플링, 따라서 투기적 디코딩은 어떠한 근사 모델 \(M_{q}\)를 선택하더라도 제한 없이 동일한 출력 분포를 보장한다(부록 [A.1] 참조). 우리의 실험에서는 주로 기존의 기성 소형 Transformer들을 근사 모델로 테스트했다. 또한, 우리는 대상 모델 \(M_{p}\)와 동일한 아키텍처를 가지고 동일한 확률 표준화를 사용하는 근사 모델만을 테스트했다. 이 설정에서 \(M_{q}\)를 \(M_{p}\)보다 약 두 자릿수 작게 선택하는 것이 \(\alpha\)와 \(c\)의 균형을 맞추면서(정리 3.8) 일반적으로 가장 좋은 성능을 보였다.
또 다른 유형의 근사 모델인 무시할 수 있는 비용 모델은 \(c \approx 0\) 인 모델, 즉 대상 모델에 비해 비용이 무시할 수 있는 근사 모델이다. 이 경우, 우리는 \(\frac{1 - \alpha^{\gamma + 1}}{1 - \alpha}\) 의 기대 벽시계 시간 개선을 얻으며, 이는 위로부터 \(\frac{1}{1 - \alpha}\) 로 제한된다(\(\gamma\)가 크면 등호에 가까워진다). 흥미로운 유형의 무시할 수 있는 비용 근사 모델 중 하나는 평가가 테이블 조회에 불과한 n-gram 모델이다. 흥미롭게도, 경험적 테스트(4.2절)에서 우리는 이러한 사소한 n-gram 모델에 대해서도 0이 아닌 \(\alpha\) 값을 얻는다. 예를 들어, 영어-독일어 번역 작업에서 \(M_{p}\)가 T5-XXL 11B이고 \(M_{q}\)가 사소한 바이그램 모델인 경우, 우리는 \(\alpha \approx 0.2\) 를 얻으며, 이는 \(\gamma = 3\) 일 때 \(1.25X\) 의 추론 속도 개선 계수로 이어진다.
다른 간단한 휴리스틱들도 무시할 수 있는 비용 근사 모델로 사용될 수 있다. 예를 들어, 요약 작업이나 채팅 형태의 인터페이스처럼 긴 시퀀스가 반복될 가능성이 높은 경우, 일치하는 접두사를 찾으면 단순히
컨텍스트에서 토큰을 복사하는 근사 모델이 높은 \(\alpha\) 값을 산출할 수 있다. 이러한 매개변수 없는 근사 모델은 생산 관점에서 배포하기가 훨씬 더 간단하다는 추가적인 이점이 있다.
투기적 디코딩에서 사용될 수 있는 또 다른 유형의 근사 모델은 Stern 등 [2018]의 모델과 같은 비자기회귀적 모델이다. 그러면 알고리즘 1의 자기회귀 루프 대신 비자기회귀 모델을 한 번만 호출하면 된다.
주로 이론적 관점에서 흥미로운 마지막 예는 무작위로 토큰을 선택하는 근사 모델로, 이는 모든 모델 \(M_{p}\)에 대해 어느 정도(비록 매우 작더라도) 개선을 보장한다.
4. 실험
4.1. 경험적 벽시계 시간 개선
우리는 우리의 알고리즘을 구현하고 T5-XXL 가속을 위한 T5X 코드베이스의 구현과 비교한다.
설정 우리는 T5 논문의 두 가지 과제에서 표준 인코더-디코더 T5 버전 1.1 모델(Raffel et al., [2020])을 테스트한다: (1) WMT EnDe에서 미세 조정된 영어-독일어 번역, 그리고 (2) CNN/DM에서 미세 조정된 텍스트 요약. 두 과제 모두에서 로 T5-XXL(11B)을 사용한다. 근사 모델 로는 여러 기존 구성, 즉 T5-large(800M), T5-base(250M), T5-small(77M)을 테스트한다(Raffel et al., [2020]). 모든 모델에 기존 체크포인트를 사용한다. 우리는 단일 TPU-v4에서 배치 크기 1로 argmax 샘플링(temp=0)과 표준 샘플링(temp=1) 모두에 대해 walltime 개선을 측정한다.
결과 표 2는 우리 방법의 실증적 결과를 보여준다. 우리는 와 의 좋은 균형을 가진 T5-small(77M)이 테스트된 근사 모델 중 가장 높은 속도 향상을 제공함을 확인한다. 예상대로 근사 모델의 크기가 커질수록 가 증가함을 확인한다. 흥미롭게도, 와 walltime 개선은 argmax 샘플링(temp=0)에서 더 높다. 우리는 번역 과제에서 2.6X(temp=1) 및 3.4X(temp=0)의 속도 향상을, 요약 과제에서는 다소 낮은 2.3X(temp=1) 및 3.1X(temp=0)의 속도 향상을 관찰한다. 이러한 실증적 결과는 구현 세부 사항으로 인한 일부 편차를 제외하면 이론적 예측과 잘 일치한다(부록 A.3 참조).
| 작업 | Mq | TEMP | γ | α | 속도 |
| ENDE | T5-SMALL ★ | 0 | 7 | 0.75 | 3.4X |
| ENDE | T5-BASE | 0 | 7 | 0.8 | 2.8X |
| ENDE | T5-LARGE | 0 | 7 | 0.82 | 1.7X |
| ENDE | T5-SMALL ★ | 1 | 7 | 0.62 | 2.6X |
| ENDE | T5-BASE | 1 | 5 | 0.68 | 2.4X |
| ENDE | T5-LARGE | 1 | 3 | 0.71 | 1.4X |
| CNNDM | T5-SMALL ★ | 0 | 5 | 0.65 | 3.1X |
| CNNDM | T5-BASE | 0 | 5 | 0.73 | 3.0X |
| CNNDM | T5-LARGE | 0 | 3 | 0.74 | 2.2X |
| CNNDM | T5-SMALL ★ | 1 | 5 | 0.53 | 2.3X |
| CNNDM | T5-BASE | 1 | 3 | 0.55 | 2.2X |
| CNNDM | T5-LARGE | 1 | 3 | 0.56 | 1.7X |
4.2. 실증적 값
우리는 우리 방법을 T5에 대해서만 구현했지만, 다양한 과제, 샘플링 방법, 목표 모델 , 근사 모델 에 대해 값을 측정했다. 구체적으로, 우리는 아래의 각 설정에 대해 가 생성한 10K 토큰에 대한 따름정리 3.6의 기댓값을 평가했다.
GPT-유사(97M 파라미터) 우리는 lm1b(Chelba et al., [2013])에서 훈련된 무조건 언어 생성에 대해 디코더 전용 Transformer 모델을 테스트한다. 여기서 모델은 Gelu 활성화(Hendrycks & Gimpel, [2016])를 사용하는 GPT-유사 Transformer 디코더이다. 로는 6M 파라미터의 Transformer 디코더 모델(dim 256, dim feed-forward 1024, 2개 층, 4개 어텐션 헤드)과 간단한 unigram 및 bigram 모델을 실험했다. 는 97M 파라미터(dim 768, dim feed-forward 3072, 12개 층, 12개 어텐션 헤드)를 가진다. 모든 모델에 8k 토큰의 Bert 토크나이제이션(Devlin et al., [2019])을 사용했다.
LaMDA(137B 파라미터) 우리는 대화 과제에서 디코더 전용 LaMDA 모델을 테스트했다(Thoppilan et al., [2022]). 로 LaMDA 137B의 기존 체크포인트를, 로 LaMDA 8B, LaMDA 2B, LaMDA 100M을 사용했다.
T5-XXL(11B 파라미터) 모델의 설정은 4.1절을 참조하라.
표 3은 테스트된 사례들의 값을 요약한다. 우리는 목표 모델보다 몇 자릿수 작은 근사 모델들이 대체로 0.5에서 0.9 사이의 값을 생성하는 경향이 있음을 관찰한다. 흥미롭게도, 모든 모델에 대해 조정된 분포가 더 날카로울수록 값이 더 높다는 점도 주목한다. 마지막으로, 심지어 사소한 unigram 및 bigram 근사도 무시할 수 없는 값을 산출함을 주목한다. 예를 들어, 영어-독일어 번역의 경우, bigram 모델은 값이 0.2이고, 이 경우 이므로 1.25X의 속도 개선을 산출하는데, 이는 이 사소한 근사 모델에 비해 놀랍게 높은 수치이다(그러나 T5-small을 근사 모델로 사용할 때 얻는 속도 향상보다는 여전히 낮다).
5. 관련 연구
대규모 모델로부터의 추론 효율성은 광범위하게 연구되어 왔다(Dehghani et al., [2021]). 많은 접근법은 일반적으로 대규모 모델로부터의 추론을, 특히 Transformer와 같은 자기회귀 모델로부터의 추론을 가속화하는 것을 목표로 한다. 수많은 기법들이 모든 토큰에 대해 추론을 더 효율적으로 만들려고 시도하는데, 예를 들어 증류(Hinton et al., [2015]), 희소화(Jaszczur et al., [2021]), 양자화(Hubara et al., [2016]), 그리고 아키텍처 수정(So et al., [2021]; Shazeer [2019])이 있다. 우리의 접근법에 더 가까운 것은 문제 난이도에 맞춰 계산량을 적응시키는 적응형 계산 방법들이다(Han et al., [2021]). 그 예로는 입력의 부분집합에만 어텐션하는 것(Sukhbaatar et al., [2019])과 조기 종료(Schuster et al., [2021]; Scardapane et al., [2020]; Bapna et al., [2020]; Elbayad et al., [2019]; Schwartz et al., [2020])가 있다. 특히, Wisdom of Committees(Schwartz et al., [2020])는 기성의 더 작은 모델들을 활용하지만, 적응형 계산 접근법이므로 언제 멈출지를 결정하기 위해 휴리스틱을 사용하여, 목표 모델의 출력과 동일한 출력을 보장한다는 보장을 잃는다. 일반적으로 적응형 계산 방법들은 모델 자체 내에서든 보조 모델을 통해서든, 계산 지름길을 취할 수 있는 시점을 학습한다. 대개 이러한 방법들은 추론 시간과 산술 연산 모두를 절약하지만, 아키텍처 변경, 훈련 절차 변경, 그리고 맞춤형 모델의 훈련 또는
| Mp | Mq | SMPL | α |
| GPT 유사 모델 (97M) | 유니그램 | T=0 | 0.03 |
| GPT 유사 모델 (97M) | 바이그램 | T=0 | 0.05 |
| GPT 유사 모델 (97M) | GPT 유사 모델 (6M) | T=0 | 0.88 |
| GPT 유사 모델 (97M) | 유니그램 | T=1 | 0.03 |
| GPT 유사 모델 (97M) | 바이그램 | T=1 | 0.05 |
| GPT 유사 모델 (97M) | GPT 유사 모델 (6M) | T=1 | 0.89 |
| T5-XXL (ENDE) | 유니그램 | T=0 | 0.08 |
| T5-XXL (ENDE) | 바이그램 | T=0 | 0.20 |
| T5-XXL (ENDE) | T5-스몰 | T=0 | 0.75 |
| T5-XXL (ENDE) | T5-베이스 | T=0 | 0.80 |
| T5-XXL (ENDE) | T5-라지 | T=0 | 0.82 |
| T5-XXL (ENDE) | 유니그램 | T=1 | 0.07 |
| T5-XXL (ENDE) | 바이그램 | T=1 | 0.19 |
| T5-XXL (ENDE) | T5-스몰 | T=1 | 0.62 |
| T5-XXL (ENDE) | T5-베이스 | T=1 | 0.68 |
| T5-XXL (ENDE) | T5-LARGE | T=1 | 0.71 |
| T5-XXL (CNNDM) | UNIGRAM | T=0 | 0.13 |
| T5-XXL (CNNDM) | BIGRAM | T=0 | 0.23 |
| T5-XXL (CNNDM) | T5-SMALL | T=0 | 0.65 |
| T5-XXL (CNNDM) | T5-BASE | T=0 | 0.73 |
| T5-XXL (CNNDM) | T5-LARGE | T=0 | 0.74 |
| T5-XXL (CNNDM) | UNIGRAM | T=1 | 0.08 |
| T5-XXL (CNNDM) | BIGRAM | T=1 | 0.16 |
| T5-XXL (CNNDM) | T5-SMALL | T=1 | 0.53 |
| T5-XXL (CNNDM) | T5-BASE | T=1 | 0.55 |
| T5-XXL (CNNDM) | T5-LARGE | T=1 | 0.56 |
| LAMDA (137B) | LAMDA (100M) | T=0 | 0.61 |
| LAMDA (137B) | LAMDA (2B) | T=0 | 0.71 |
| LAMDA (137B) | LAMDA (8B) | T=0 | 0.75 |
| LAMDA (137B) | LAMDA (100M) | T=1 | 0.57 |
| LAMDA (137B) | LAMDA (2B) | T=1 | 0.71 |
| 래마다(137B) | 래마다(8B) | T=1 | 0.74 |
기존 모델의 재훈련을 필요로 한다. 이들은 보통 모델의 출력도 변경한다. 우리는 위의 많은 방법들이 메모리 대 산술 연산 비율을 개선하지만, 그 비율이 여전히 높은 경우에는 이러한 방법들과 우리의 투기적 디코딩 방법이 함께 사용될 때 효과적일 수 있음을 주목한다.
자기회귀 모델로부터의 디코딩을 가속화하기 위해 투기적 실행을 활용하는 두 가지 선행 방법이 있다. Blockwise Parallel Decoding(Stern et al., [2018])은 우리 작업과 유사하게 여러 토큰을 병렬로 디코딩한다. 그러나 이는 그리디 디코딩(temperature )만 지원하고 일반적인 확률적 설정은 지원하지 않으며, 맞춤형 모델의 추가 훈련을 필요로 하고, 동일한 출력을 보장하는 대신 다운스트림 과제 품질을 보존하는 데 초점을 둔다. Shallow Aggressive Decoding(SAD)(Sun et al., [2021])도 우리 작업과 유사하게 여러 토큰을 병렬로 디코딩한다. 우리 작업과 달리, SAD는 입력을 출력으로 복사하는 것만 지원하고 일반적인 근사 모델은 지원하지 않으므로, 문법 오류 교정처럼 입력과 출력이 매우 유사한 경우에만 적합하다. 또한 Blockwise Parallel Decoding과 마찬가지로, SAD는 일반적인 확률적 샘플링 설정을 지원하지 않는다.
우리가 처음 우리 작업을 발표한 후, 투기적 디코딩의 독립적인 구현(Chen et al., [2023])이 Chinchilla 70B에서 유사한 2X-2.5X 개선을 보여주었다.
6. 논의
우리는 확률적 투기적 실행, 즉 확률적 설정에서의 투기적 실행을 가능하게 하는 투기적 샘플링을 제시했다. 우리는 투기적 디코딩을 통해 Transformer와 같은 자기회귀 모델로부터의 디코딩에 미치는 영향을 분석했고, 충분한 컴퓨팅 자원이 주어지면 인기 있는 최적화 구현인 T5X 대비 실제로 의미 있는 2X-3X의 속도 향상을 얻음을 보여주었다.
일반적인 투기적 실행, 특히 투기적 디코딩의 한 가지 한계는 지연 시간이 증가된 산술 연산 수를 대가로 증가된 동시성을 통해 개선된다는 점이다. 따라서 우리의 방법은 추가적인 계산 자원이 이용 가능하지 않은 구성에는 도움이 되지 않는다. 그러나 추가적인 계산 자원이 이용 가능한 일반적인 경우(예: 메모리 대역폭이 병목일 때)에 우리의 방법은 상당한 이점과 함께 속도 향상을 제공한다: 모델 아키텍처가 바뀌지 않고, 재훈련이 필요하지 않으며, 가장 중요하게는 출력 분포가 동일하게 유지됨이 보장된다. 우리의 방법은 구현하기 쉽고, 맞춤형 방식을 개발하고 평가할 필요 없이 기성 모델을 사용하여 추론을 가속화하는 데 사용할 수 있다.
후속 연구를 위한 몇 가지 방향이 있으며, 특히 추측적 디코딩과 빔 서치의 호환성에 대한 추가 조사가 중요하다(부록 [A.4] 참조). 또한 우리의 방법이 기존의 기성 근사 모델로 상당한 속도 향상을 제공하지만, 맞춤형 근사 모델을 통해 더 큰 개선을 얻을 수 있을 것이다(섹션 [3.6], 예컨대 맞춤형 아키텍처(예: 맞춤형 크기, 비-자기회귀 모델, 또는 다양한 휴리스틱)를 갖춘 모델이나 맞춤형 훈련 절차(예: 로부터의 소프트 타깃을 사용한 표준 증류, 또는 에 대해 직접 를 최적화하는 것)를 갖춘 모델). 알고리즘의 계층적 버전을 탐구하는 것도 흥미로울 수 있는데, 여기서 근사 모델 자체가 훨씬 더 빠른 모델에 의해 가속되어 더 강력한 근사 모델을 가능하게 할 수 있다. 본 연구에서는 추론 전반에 걸쳐 근사 모델과 추측 횟수 를 고정했지만, 추론 중에 이들을 변화시키면 추가적인 개선을 얻을 수 있을 것이다(섹션 [3.5]). 我们的实验中,我们对近似模型生成的分布始终执行与目标模型所期望的相同的标准化(第2.2节),但通过应用不同的变换可能会获得进一步的改进。我们仅在文本模态中测试了推测解码,但它可能在其他领域(例如图像)中也能很好地工作,这将是有趣的实验。
最后,我们注意到随机推测执行和推测采样在自回归模型的推测解码范围之外也可能有用。例如,给定两个慢函数 和 ,使得 生成一个分布, 的输入从该分布中采样,我们可以使用我们的方法并行运行 和 。这种设置可能出现在例如物理模拟中,或者在强化学习中,其中 是一个产生动作分布的大模型,而 是世界模拟,这将是有趣的探索。
致谢
我们要特别感谢 YaGuang Li 对一切与 LaMDA 相关事务的帮助以及计算论文中的 LaMDA 数据,并感谢 Blake Hechtman 对 XLA 的深刻见解和帮助。我们还要感谢审稿人的深刻评论,以及 Asaf Aharoni、Reiner Pope、Sasha Goldshtein、Nadav Sherman、Eyal Segalis、Eyal Molad、Dani Valevski、Daniel Wasserman、Valerie Nygaard、Danny Vainstein、Google 的 LaMDA 和 Theta Labs 团队,以及我们的家人。
参考文献
Bapna, A., Arivazhagan, N., and Firat, O. Controlling computation versus quality for neural sequence models. ArXiv, abs/2002.07106, 2020.
Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., Neelakantan, A., Shyam, P., Sastry, G., Askell, A., Agarwal, S., Herbert- Voss, A., Krueger, G., Henighan, T., Child, R., Ramesh, A., Ziegler, D. M., Wu, J., Winter, C., Hesse, C., Chen, M., Sigler, E., Litwin, M., Gray, S., Chess, B., Clark, J., Berner, C., McCandlish, S., Radford, A., Sutskever, I., and Amodei, D. Language models are few- shot learners. In Proceedings of the 34th International Conference on Neural Information Processing Systems, NIPS'20, Red Hook, NY, USA, 2020. Curran Associates Inc. ISBN 9781713829546.
Burton, F. W. Speculative computation, parallelism, and functional programming. IEEE Transactions on Computers, C- 34(12):1190- 1193, 1985. doi: 10.1109/TC.1985.6312218.
Chelba, C., Mikolov, T., Schuster, M., Ge, Q., Brants, T., Koehn, P. T., and Robinson, T. One billion word bench mark for measuring progress in statistical language modeling. In Interspeech, 2013.
Chen, C., Borgeaud, S., Irving, G., Lespiau, J.- B., Sifre, L., and Jumper, J. M. Accelerating large language model decoding with speculative sampling. ArXiv, abs/2302.01318, 2023.
Chowdhery, A., Narang, S., Devlin, J., Bosma, M., Mishra, G., Roberts, A., Barham, P., Chung, H. W., Sutton, C., Gehrmann, S., Schuh, P., Shi, K., Tsvyashchenko, S., Maynez, J., Rao, A., Barnes, P., Tay, Y., Shazeer, N. M., Prabhakaran, V., Reif, E., Du, N., Hutchinson, B. C., Pope, R., Bradbury, J., Austin, J., Isard, M., Gur- Ari, G., Yin, P., Duke, T., Levskaya, A., Ghemawat, S., Dev, S., Michalewski, H., Garcia, X., Misra, V., Robinson, K., Fedus, L., Zhou, D., Ippolito, D., Luan, D., Lim, H., Zoph, B., Spiridonov, A., Sepassi, R., Dohan, D., Agrawal, S., Omernick, M., Dai, A. M., Pillai, T. S., Pelat, M., Lewkowycz, A., Moreira, E., Child, R., Polozov, O., Lee, K., Zhou, Z., Wang, X., Saeta, B., Diaz, M., Firat, O., Catasta, M., Wei, J., Meier- Hellstern, K. S., Eck, D., Dean, J., Petrov, S., and Fiedel, N. Palm: Scaling language modeling with pathways. ArXiv, abs/2204.02311, 2022.
Dehghani, M., Arnab, A., Beyer, L., Vaswani, A., and Tay, Y. The efficiency misnomer. ArXiv, abs/2110.12894, 2021.
Devlin, J., Chang, M.- W., Lee, K., and Toutanova, K. Bert: Pre- training of deep bidirectional transformers for language understanding. ArXiv, abs/1810.04805, 2019.
Elbayad, M., Gu, J., Grave, E., and Auli, M. Depth- adaptive transformer. ArXiv, abs/1910.10073, 2019.
Han, Y., Huang, G., Song, S., Yang, L., Wang, H., and Wang, Y. Dynamic neural networks: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence, 44: 7436- 7456, 2021.
Hendrycks, D. and Gimpel, K. Bridging nonlinearities and stochastic regularizers with gaussian error linear units. ArXiv, abs/1606.08415, 2016.
Hennessy, J. L. and Patterson, D. A. Computer Architecture: A Quantitative Approach. Morgan Kaufmann, Amsterdam, 5 edition, 2012. ISBN 978- 0- 12- 383872- 8.
Hinton, G. E., Vinyals, O., and Dean, J. Distilling the knowledge in a neural network. ArXiv, abs/1503.02531, 2015.
Hubara, I., Courbariaux, M., Soudry, D., El- Yaniv, R., and Bengio, Y. Quantized neural networks: Training neural networks with low precision weights and activations. ArXiv, abs/1609.07061, 2016.
Jaszczur, S., Chowdhery, A., Mohiuddin, A., Kaiser, L., Gajewski, W., Michalewski, H., and Kanerva, J. Sparse is enough in scaling transformers. In Neural Information Processing Systems, 2021.
Raffel, C., Shazeer, N., Roberts, A., Lee, K., Narang, S., Matena, M., Zhou, Y., Li, W., and Liu, P. J. Exploring the limits of transfer learning with a unified text- to- text transformer. The Journal of Machine Learning Research, 21(1):5485- 5551, 2020.
Roberts, A., Chung, H. W., Levskaya, A., Mishra, G., Bradbury, J., Andor, D., Narang, S., Lester, B., Gaffney, C., Mohiuddin, A., Hawthorne, C., Lewkowycz, A., Salcianu, A., van Zee, M., Austin, J., Goodman, S., Soares, L. B., Hu, H., Tsvyashchenko, S., Chowdhery, A., Bastings, J., Bulian, J., Garcia, X., Ni, J., Chen, A., Kenealy, K., Clark, J., Lee, S., Garrette, D. H., Lee- Thorp, J., Raffel, C., Shazeer, N. M., Ritter, M., Bosma, M., Passos, A., Maitin- Shepard, J. B., Fiedel, N., Omernick, M., Saeta, B., Sepassi, R., Spiridonov, A., Newlan, J., and Gesmundo, A. Scaling up models and data with 5x and seqio. ArXiv, abs/2203.17189, 2022.
Scardapane, S., Scarpiniti, M., Baccarelli, E., and Uncini, A. Why should we add early exits to neural networks? Cognitive Computation, 12(5):954- 966, 2020.
Schuster, T., Fisch, A., Jaakkola, T., and Barzilay, R. Consistent accelerated inference via confident adaptive transformers. In Conference on Empirical Methods in Natural Language Processing, 2021.
Schwartz, R., Stanovsky, G., Swayamdipta, S., Dodge, J., and Smith, N. A. The right tool for the job: Matching model and instance complexities. In Annual Meeting of the Association for Computational Linguistics, 2020.
Shazeer, N. M. Fast transformer decoding: One write- head is all you need. ArXiv, abs/1911.02150, 2019.
So, D. R., Ma'ake, W., Liu, H., Dai, Z., Shazeer, N. M., and Le, Q. V. Primer: Searching for efficient transformers for language modeling. ArXiv, abs/2109.08668, 2021.
Stern, M., Shazeer, N., and Uszkoreit, J. Blockwise parallel decoding for deep autoregressive models. Advances in Neural Information Processing Systems, 31, 2018.
Sukhbaatar, S., Grave, E., Bojanowski, P., and Joulin, A. Adaptive attention span in transformers. In Annual Meeting of the Association for Computational Linguistics, 2019.
Sun, X., Ge, T., Wei, F., and Wang, H. Instantaneous grammatical error correction with shallow aggressive decoding. ArXiv, abs/2106.04970, 2021.
Thoppilan, R., Freitas, D. D., Hall, J., Shazeer, N. M., Kulshreshtha, A., Cheng, H.- T., Jin, A., Bos, T., Baker, L., Du, Y., Li, Y., Lee, H., Zheng, H., Ghafouri, A., Menegali, M., Huang, Y., Krikun, M., Lepikhin, D., Qin, J., Chen, D., Xu, Y., Chen, Z., Roberts, A., Bosma, M., Zhou, Y., Chang, C.- C., Krivokon, I. A., Rusch, W. J., Pickett, M., Meier- Hellstern, K. S., Morris, M. R., Doshi, T., Santos, R. D., Duke, T., Soraker, J. H., Zevenbergen, B., Prabhakaran, V., Díaz, M., Hutchinson, B., Olson, K., Molina, A., Hoffman- John, E., Lee, J., Aroyo, L., Rajakumar, R., Butryna, A., Lamm, M., Kuzmina, V. O., Fenton, J., Cohen, A., Bernstein, R., Kurzweil, R., Aguera- Arcas, B., Cui, C., Croak, M., hsin Chi, E. H., and Le, Q. Lamda: Language models for dialog applications. ArXiv, abs/2201.08239, 2022.
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, L., and Polosukhin, I. Attention is all you need. Advances in neural information processing systems, 30, 2017.
Yu, J., Xu, Y., Koh, J. Y., Luong, T., Baid, G., Wang, Z., Vasudevan, V., Ku, A., Yang, Y., Ayan, B. K., Hutchinson, B. C., Han, W., Parekh, Z., Li, X., Zhang, H., Baldridge, J., and Wu, Y. Scaling autoregressive models for content-rich text- to- image generation. ArXiv, abs/2206.10789, 2022.
A. 부록
A.1. 투기적 샘플링의 정당성
이제 임의의 분포 와 에 대해, 와 로부터 투기적 샘플링을 통해 샘플링된 토큰들이 만으로부터 샘플링된 토큰들과 동일하게 분포됨을 보일 것이다. 를 수락 확률이라 하자 (정의 3.1).
이므로, 조정된 분포 에 대한 정규화 상수는 이며, 여기서 마지막 방정식은 보조정리 3.3과 정리 3.5로부터 즉시 도출된다.
이제:
여기서:
그리고:
전체적으로:
원하는 대로 된다.
A.2. 투기적 샘플링 대 기각 샘플링
기각 샘플링은 우리의 방법과 표면적으로 유사해 보이는 다음과 같은 반복적 샘플링 절차이다:
1. 와 을 샘플링한다.
2. 만약 이면 를 반환한다.
3. 1로 간다.
여기서 이다. 우리는 투기적 샘플링 대신 기각 샘플링의 비반복적 버전을 사용할 수도 있다 — 구체적으로 위의 1단계와 2단계를 거치고, 그렇지 않으면 수정되지 않은 에서 직접 샘플링하는 것이다. 그러나 그것은 우리의 방법보다 훨씬 덜 효율적일 것이다. 구체적으로, 여기서의 기대 수락 확률은 이며, 이는 우리 방법의 기대 수락 확률 보다 (잠재적으로 훨씬) 낮다.
A.3. 이론적 예측 대 경험적 런타임
표 4는 정리 3.8에 기반한 기대 런타임 개선을 표 2의 경험적으로 측정된 런타임과 비교한다. 우리는 프로파일러 추적을 기반으로 다양한 모델에 대한 값을 추정했다. 이론적 예측이 대체로 측정된 런타임과 일치함을 알 수 있다. 더 큰 차이는 다음 때문이다: (1) 우리의 구현과 기준선 간의 최적화 차이, 그리고 (2) 들이 i.i.d.라는 단순화 가정이 근사에 불과하다는 점(3.1절 참조).
| TASK | MQ | TEMP | γ | α | c | EXP | EMP |
| ENDE | T5-SMALL | 0 | 7 | 0.75 | 0.02 | 3.2 | 3.4 |
| ENDE | T5-BASE | 0 | 7 | 0.8 | 0.04 | 3.3 | 2.8 |
| ENDE | T5-LARGE | 0 | 7 | 0.82 | 0.11 | 2.5 | 1.7 |
| ENDE | T5-SMALL | 1 | 7 | 0.62 | 0.02 | 2.3 | 2.6 |
| ENDE | T5-BASE | 1 | 5 | 0.68 | 0.04 | 2.4 | 2.4 |
| ENDE | T5-LARGE | 1 | 3 | 0.71 | 0.11 | 2.0 | 1.4 |
| CNNDM | T5-SMALL | 0 | 5 | 0.65 | 0.02 | 2.4 | 3.1 |
| CNNDM | T5-BASE | 0 | 5 | 0.73 | 0.04 | 2.6 | 3.0 |
| CNNDM | T5-LARGE | 0 | 3 | 0.74 | 0.11 | 2.0 | 2.2 |
| CNNDM | T5-SMALL | 1 | 5 | 0.53 | 0.02 | 1.9 | 2.3 |
| CNNDM | T5-BASE | 1 | 3 | 0.55 | 0.04 | 1.8 | 2.2 |
| CNNDM | T5-LARGE | 1 | 3 | 0.56 | 0.11 | 1.6 | 1.7 |
표 4. 기대 개선 계수(Exp) 대 경험적으로 측정된 개선 계수(EMP).
A.4. 빔 서치에의 적용
우리의 방법은 어느 정도의 성능 저하를 감수하고 빔 서치 샘플링에도 적용될 수 있다. 원래의 빔 폭 가 주어졌을 때, 우리는 근사 모델 와 빔 폭 로 단계 동안 빔 서치를 수행할 수 있다. 그런 다음 를 사용하여 모든 후보를 병렬로 검사할 수 있다(의 회 실행에 해당하는 연산 예산이 소요됨). 마지막으로, 각 단계에서 인 한 의 추측을 수락하여 만으로 수행한 일반 빔 서치와 동일한 결과를 얻을 수 있다(더 정교한 절차를 사용하면 우리가 얻은 후보들이 우연히 만의 후보들보다 더 높은 확률을 갖는 경우도 수락할 수 있다). 이 설정에서 우리 방법의 분석은 더 복잡하며 향후 연구로 남겨둔다.
A.5. 관용성
알고리즘 의 강력한 특성은 출력 분포가 변경되지 않도록 보장된다는 것이다. 그렇긴 하지만, 좋은 보장과 함께 어느 정도의 변경을 허용할 의향이 있다면 추론 속도를 더 개선할 수 있다. 이를 더 동기 부여하기 위해, 동일한 아키텍처와 크기를 가진 두 모델을 동일한 데이터셋으로 학습시킬 때 생성되는 확률 분포는 동일하지 않을 것이므로 어느 정도의 관용이 합리적일 수 있다는 점에 주목하라. 이 논문의 결과는 이 절을 제외하고는 알고리즘 의 가장 엄격한 버전을 사용하며 어떠한 종류의 관용도 허용하지 않는다는 점에 유의하라.
우리는 관용 매개변수 을 포함시켜 알고리즘 에서 와 비교하기 전에 에 을 곱할 수 있다. 이는 여전히 어떤 토큰도 보다 큰 확률로 샘플링될 수 없다는 좋은 보장을 유지한다. 이는 예를 들어 일 때 어떤 토큰도 실제 확률의 10배를 초과하여 샘플링될 수 없으므로 극히 희귀한 토큰은 극히 희귀하게 유지된다는 것을 보장할 수 있다는 것을 의미한다(최소 확률에 대한 보장은 없으므로 관용은 샘플의 다양성을 해칠 수 있다).
구체적으로, 관용 계수 을 사용하면 \begin{array}{r l r}{{\alpha}~=}&{{}E_{x\sim q(x)}\left\{\begin{array}{l l}{1}&{l q(x)\leq p(x)}\\ {\frac{p(x)}{l q(x)}}&{l q(x)>p(x)}\end{array}\right.}&{{}=}&{{}E_{x\sim q(x)}\frac{p(x)}{m a x(p(x),l q(x))}}}\end{array} 이다.
표 5는 가 T5-XXL(11B)이고 가 T5-small(77M)일 때 다양한 값에 대한 값을 보여준다. 이고 관용 값을 1, 0.5, 0.3, 0.1로 사용하면(즉, 어떤 토큰도 실제 확률의 1배, 2배, 3배, 10배를 초과하는 확률로 샘플링될 수 없음을 의미함) 각각 2.5배, 3.1배, 3.6배, 5배의 개선 계수를 얻는다.
| MQ | l = 1 | l = 0.5 | l = 0.3 | l = 0.1 |
| UNIGRAM | 0.07 | 0.1 | 0.11 | 0.16 |
| BIGRAM | 0.19 | 0.23 | 0.25 | 0.32 |
| T5-SMALL (77M) | 0.62 | 0.71 | 0.76 | 0.84 |
| T5-BASE (250M) | 0.68 | 0.8 | 0.83 | 0.90 |
표 5. EnDe 번역 작업에서 가 T5-XXL(11B)인 표준 샘플링을 사용한 다양한 값에 대한 값.
온도 (즉, argmax 샘플링)을 사용할 때는 위에서처럼 관용도를 사용할 수 없다는 점에 유의하자. 대신, 분포를 표준화하기 전에 어느 정도의 관용도를 허용할 수 있다. 예를 들어, 인 경우 에서 샘플링된 토큰 를 받아들일 수 있다. 이 경우, 우리는 온도 인 경우와 유사한 값의 실증적 증가를 측정한다. 예를 들어, 영어-독일어 번역에서 T5-XXL과 T5-small에 대해 관용도 값 1, 0.5, 0.3, 0.1을 사용하면 값이 0.75, 0.75, 0.8, 0.87이 된다. 예를 들어 와 을 취하면 각각 3.3X, 3.3X, 3.9X, 4.9X의 속도 향상 계수를 얻는다.7