
어텐션과 상태 공간 모델이 같은 행렬의 두 관점임을 보이고 더 빠른 시퀀스 층을 제시한다. ICML 2024, 전문 무료.
Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality
Transformers는 SSM이다: 구조적 상태 공간 쌍대성을 통한 일반화된 모델과 효율적인 알고리즘
프린스턴 대학교 컴퓨터 과학과 카네기 멜런 대학교 기계학습학과 tri@tridao.me, agu@cs.cmu.edu
초록
Transformer가 언어 모델링에서 딥러닝의 성공을 이끈 주요 아키텍처인 반면, Mamba와 같은 상태 공간 모델(SSM)은 최근 소규모에서 중규모 규모에서 Transformer와 대등하거나 능가하는 성능을 보여주었다. 우리는 이러한 모델 계열들이 실제로 매우 밀접하게 관련되어 있음을 보이고, 잘 연구된 구조적 준분리 행렬(semiseparable matrices) 클래스의 다양한 분해를 통해 연결되는 SSM과 어텐션 변형들 사이의 풍부한 이론적 연결 프레임워크를 개발한다. 우리의 상태 공간 쌍대성(SSD) 프레임워크는 새로운 아키텍처(Mamba-2)를 설계할 수 있게 해주며, 그 핵심 레이어는 Mamba의 선택적 SSM을 개선한 것으로 2-8배 더 빠르면서도 언어 모델링에서 Transformer와 경쟁력을 계속 유지한다.
1 서론
특히 입력 시퀀스를 인과적 방식으로 처리하는 디코더 전용 모델(예: GPT (Brown et al. 2020), Llama (Touvron, Lavril, et al. 2023))인 Transformer는 현대 딥러닝 성공의 주요 원동력 중 하나이다. 수많은 접근법이 핵심 어텐션 레이어를 근사하여 그 효율성 문제를 해결하려 시도하는데(Tay et al. 2022), 예를 들어 학습 중 시퀀스 길이에 대해 이차적으로 확장되고 자기회귀 생성 중 시퀀스 길이에 선형인 크기의 캐시를 요구하는 문제가 있다. 이와 병행하여, 대안적인 시퀀스 모델 계열인 구조적 상태 공간 모델(SSM)이 등장했으며, 학습 중 시퀀스 길이에 대해 선형으로 확장되고 생성 중 상태 크기가 일정하다. 이들은 장거리 과제에서 강력한 성능을 보여주며(예: S4 (Gu, Goel, and Ré 2022)), 최근에는 소규모에서 중규모 규모에서 언어 모델링에서 Transformer와 대등하거나 능가했다(예: Mamba (Gu and Dao 2023)). 그러나 SSM의 발전은 Transformer를 개선하려는 커뮤니티의 집단적 노력, 예를 들어 이론적으로 이해하고 현대 하드웨어에서 최적화하는 작업과 분리되어 있는 것처럼 보였다. 그 결과, SSM은 Transformer에 비해 이해하고 실험하기가 더 어려우며, 알고리즘적 관점과 시스템적 관점 모두에서 SSM을 Transformer만큼 효율적으로 학습시키는 것은 여전히 어렵다.
우리의 주요 목표는 구조적 SSM과 어텐션 변형들 사이의 풍부한 이론적 연결 체계를 개발하는 것이다. 이는 원래 Transformer를 위해 개발된 알고리즘 및 시스템 최적화를 SSM으로 전이시켜, 시퀀스 길이에 대해 더 효율적으로 확장되면서 Transformer보다 더 나은 성능을 보이는 기반 모델을 구축하는 목표로 나아갈 수 있게 해준다. 이 방향의 이정표적 기여는 선형 어텐션(LA) 프레임워크(Katharopoulos et al. 2020)로, 이는 이차 커널화 어텐션의 "쌍대 형식(dual forms)"과 특정 선형 점화식 사이의 동등성을 보임으로써 자기회귀 어텐션과 선형 RNN 사이의 연결을 도출했다. 이 쌍대성은 효율적인 병렬화 가능 학습과 효율적인 자기회귀 추론을 모두 가능하게 하는 등 새로운 capabilities를 허용한다. 같은 정신으로, 본 논문은 선형 복잡도 SSM을 이차 복잡도 형식과 연결하는 여러 관점을 제공하여 SSM과 어텐션의 강점을 결합한다.
상태 공간 쌍대성. 구조적 SSM과 어텐션 변형을 연결하는 우리의 프레임워크로, 우리는 이를 구조적 상태 공간 쌍대성(SSD)이라 부르며, 이는 구조적 행렬, 즉 준어차(subquadratic) 파라미터와 곱셈 복잡도를 가진 행렬의 추상화를 통해 이루어진다. 우리는 시퀀스 모델을 표현하기 위한 두 가지 광범위한 프레임워크를 개발하는데, 하나는 행렬 변환으로서, 다른 하나는 텐서 수축으로서이며, 각각이 쌍대성의 서로 다른 관점을 드러낸다. 우리의 기술적 기여는 다음과 같다:
- 우리는 상태 공간 모델과 준분리 행렬(semiseparable matrices)이라 불리는 잘 연구된 구조적 행렬 계열 사이의 동등성을 보인다(3절). 이 연결은 우리 프레임워크의 핵심에 있으며, SSM에 대한 새로운 성질과 알고리즘을 드러낸다. 본 논문의 중심 메시지는 상태 공간 모델을 계산하는 서로 다른 방법들이 구조적 행렬에 대한 다양한 행렬 곱셈 알고리즘으로 재구성될 수 있다는 것이다.
- 우리는 선형 어텐션 이론(Katharopoulos et al. 2020)을 상당히 개선한다. 먼저 텐서 수축의 언어를 통해 그 순환 형식에 대한 예리한 증명을 제공하고, 이를 구조적 마스크 어텐션(SMA)이라 불리는 새로운 계열로 일반화한다(4절).
- 우리는 SSM과 SMA를 연결하여, 이들이 서로의 쌍대인 큰 교집합을 가지며 SSM 유사 선형 형식과 어텐션 유사 이차 형식을 모두 갖는다는 것을 보인다(5절). 우리는 또한 빠른 순환 형식을 가진 모든 커널 어텐션 방법이 SSM이어야 함을 증명한다.
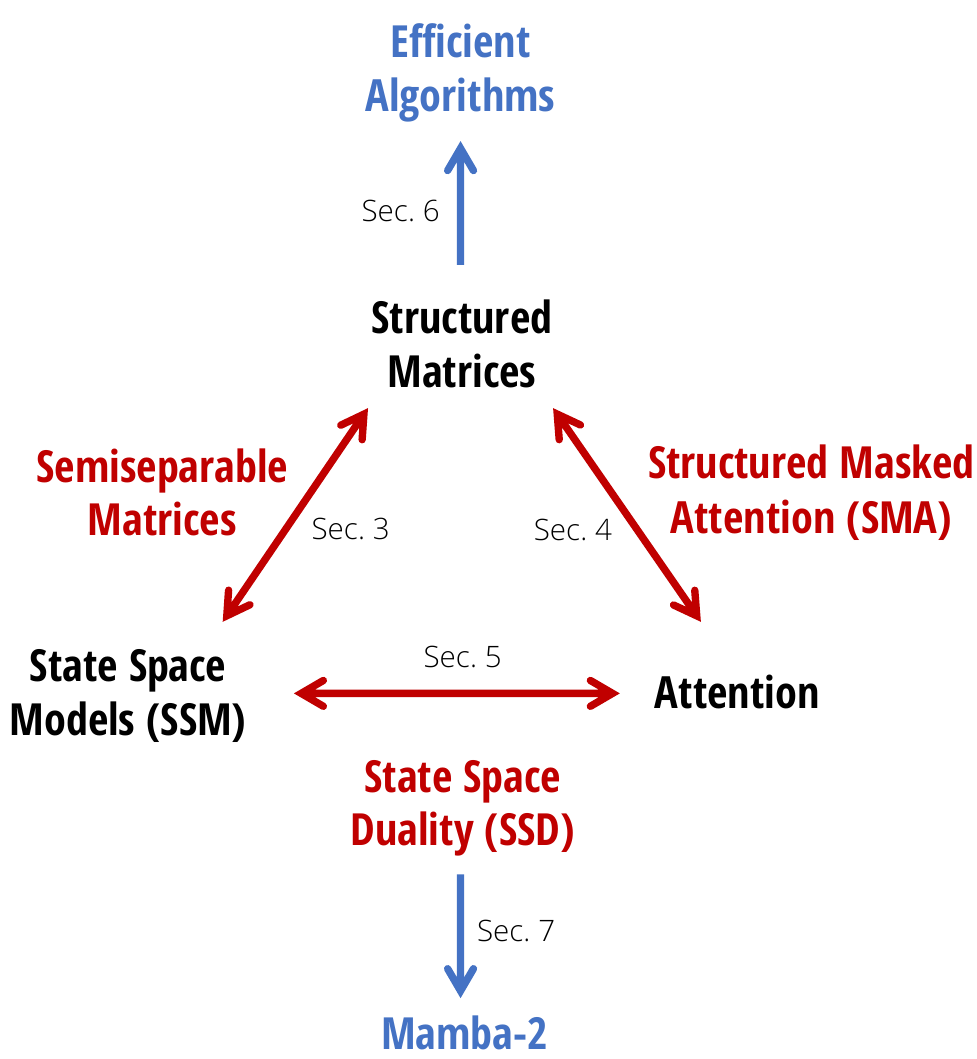
본질적인 이론적 가치를 넘어, 우리의 프레임워크는 시퀀스 모델을 이해하고 개선하기 위한 광범위한 방향을 열어준다.
효율적인 알고리즘. 먼저 그리고 가장 중요하게, 우리의 프레임워크는 SSM을 계산하기 위한 새롭고 효율적이며 쉽게 구현 가능한 알고리즘을 드러낸다(6절). 우리는 준분리 행렬의 블록 분해에 기반한 새로운 SSD 알고리즘을 도입하는데, 이는 선형 SSM 순환과 이차 쌍대 형식 모두를 활용하여 모든 주요 효율성 축(예: 학습 및 추론 연산, 메모리 사용, 현대 하드웨어에서 행렬 곱셈 유닛을 활용하는 능력)에서 최적의 트레이드오프를 얻는다. SSD의 전용 구현은 Mamba의 최적화된 선택적 스캔 구현보다 더 빠르며, 동시에 훨씬 더 큰 순환 상태 크기(Mamba 크기의 또는 그 이상, 최소한의 속도 저하로)를 허용한다. SSD는 최적화된 소프트맥스 어텐션 구현(FlashAttention-2 (Dao 2024))과 매우 경쟁력이 있으며, 시퀀스 길이 에서 교차하고 시퀀스 길이 16K에서 더 빠르다.
아키텍처 설계. SSM과 같은 새로운 아키텍처를 채택하는 데 있어 한 가지 주요 장애물은 대규모 학습을 위한 하드웨어 효율적 최적화 및 병렬화 기법과 같이 Transformer에 맞춰진 생태계이다. 우리의 프레임워크는 어텐션에 대해 확립된 관례와 기법을 사용하여 SSM에 대한 아키텍처 설계 선택의 어휘를 구축하고 이를 더욱 개선할 수 있게 해준다(7절). 예를 들어, 우리는 다중 헤드 어텐션(MHA)의 헤드에 해당하는 개념을 SSM에 도입한다. 우리는 Mamba 아키텍처가 다중 입력 SSM(MIS)이며 이는 다중 값 어텐션(MVA)과 유사하다는 것을 보이고, 서로 다른 헤드 구조를 가진 Mamba의 다른 변형들을 비교한다.
우리는 또한 이러한 아이디어를 사용하여 Mamba 블록을 약간 수정함으로써 텐서 병렬화가 구현될 수 있게 한다(예: Megatron (Shoeybi et al. 2019) 스타일). 주요 아이디어로는 그룹화된 값 어텐션(GVA) 헤드 구조를 도입하고, 모든 데이터 의존적 투영을 블록 시작 부분에서 병렬로 발생하도록 이동하는 것이 포함된다.
수정된 병렬 Mamba 블록과 SSD를 내부 SSM 레이어로 사용하는 것의 결합은 Mamba-2 아키텍처를 낳는다. 우리는 Mamba와 동일한 설정에서 Mamba-2에 대한 Chinchilla 스케일링 법칙을 조사하여, 이것이 퍼플렉서티와 실제 시간(wall-clock time) 모두에서 Mamba와 Transformer++를 파레토 지배함을 발견한다. 우리는 추가로 Pile에서 다양한 크기의 Mamba-2 모델 계열을 학습시켜, 이것이 표준 다운스트림 평가에서 Mamba 및 오픈 소스 Transformer와 대등하거나 능가함을 보인다. 예를 들어, Pile에서 300B 토큰으로 학습된 2.7B 파라미터의 Mamba-2는 동일한 데이터셋으로 학습된 Mamba-2.8B, Pythia-2.8B 및 심지어 Pythia-6.9B를 능가한다.
시스템 최적화. SSD 프레임워크는 SSM과 Transformer를 연결하여, Transformer를 위해 개발된 시스템 최적화에 대한 풍부한 연구를 활용할 수 있게 해준다(8절).
- 예를 들어, 텐서 병렬화(TP)는 각 레이어를 동일 노드의 GPU에 걸쳐 분할하여 대규모 Transformer 모델을 학습시키는 중요한 모델 병렬화 기법이다. 우리는 Mamba-2를 TP 친화적으로 설계하여, 블록당 동기화 지점 수를 절반으로 줄인다.
- 활성화가 단일 장치에 맞지 않는 매우 긴 시퀀스의 경우, 어텐션 블록을 위한 시퀀스 병렬화가 개발되었다. 우리는 디바이스 간에 순환 상태를 전달함으로써 일반적으로 SSM을, 특히 Mamba-2를 시퀀스 병렬화로 학습시키는 방법을 설명한다.
- 서로 다른 길이의 예제로 파인튜닝할 때 최상의 효율성을 위해, Transformer는 패딩 토큰을 제거하고 가변 길이 시퀀스에 대해 어텐션을 수행하는 정교한 기법을 필요로 한다. 우리는 Mamba-2가 패딩 토큰을 필요로 하지 않으면서 가변 시퀀스 길이로 효율적으로 학습될 수 있음을 보인다.
9절은 언어 모델링, 학습 효율성, 그리고 어려운 다중 쿼리 연상 회상(multi-query associative recall) 과제(Arora, Eyuboglu, Zhang, et al. 2024)에서 Mamba-2를 경험적으로 검증한다. 마지막으로, 10절에서 우리는 확장된 관련 연구를 제공하고 우리 프레임워크가 열어주는 잠재적 연구 방향을 논의한다.
모델 코드와 사전 학습된 체크포인트는 https://github.com/state-spaces/mamba 에서 오픈 소스로 공개되어 있다.
2 배경 및 개요
2.1 구조적 상태 공간 모델
구조적 상태 공간 시퀀스 모델(S4)은 딥러닝을 위한 최근의 시퀀스 모델 계열로, RNN, CNN, 그리고 고전적 상태 공간 모델과 광범위하게 관련되어 있다. 이들은 1차원 시퀀스 를 암묵적 잠재 상태 를 통해 매핑하는 특정 연속 시스템 (1)에서 영감을 받았다.
구조화된 SSM의 일반적인 이산 형태는 식 (1)과 같은 형태를 취합니다.
여기서 입니다. 구조화된 SSM이라는 이름은 시간적 동역학을 제어하는 행렬이 심층 신경망에서 사용될 수 있을 만큼 이 시퀀스-투-시퀀스 변환을 효율적으로 계산하기 위해 구조화되어야 한다는 데서 유래했습니다. 처음 도입된 구조는 대각 플러스 저랭크(DPLR)(Gu, Goel, and Ré 2022)와 대각(Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; J. T. Smith, Warrington, and Linderman 2023)이었으며, 대각 구조는 여전히 가장 널리 쓰이는 구조입니다.
본 연구에서는 상태 공간 모델(SSM)이라는 용어를 구조화된 SSM을 지칭하는 데 사용합니다. 이러한 SSM에는 여러 변형이 있으며, 연속 시간 모델, 순환 모델, 합성곱 모델과 같은 신경 시퀀스 모델의 여러 주요 패러다임과 깊이 연관되어 있습니다(Gu, Johnson, Goel, et al. 2021). 아래에 간략한 개요를 제시하며, 더 많은 맥락과 세부 사항은 선행 연구를 참조하시기 바랍니다(Gu 2023; Gu and Dao 2023).
연속 시간 모델. 원래의 구조화된 SSM은 시퀀스에 직접 작동하기보다는 함수 에 대한 연속 시간 사상으로 출발했습니다. 연속 시간 관점에서 식 (1a)의 행렬 는 직접 학습되는 것이 아니라, 매개변수화된 스텝 크기 와 함께 기저 매개변수 로부터 생성됩니다. "연속 매개변수" 는 고정된 공식 와 를 통해 "이산 매개변수" 로 변환되며, 여기서 쌍 를 이산화 규칙이라고 합니다.
주석 1. 우리의 주요 모델들은 선행 연구와 동일한 매개변수화 및 이산화 단계를 채택하지만(자세한 내용은 Gu and Dao (2023) 참조), 설명과 표기를 단순화하기 위해 본 논문의 나머지 부분에서는 이를 생략한다. 선행 연구에서는 구조화된 SSM에서 연속 매개변수 \((\hat{A},\hat{B})\) 와 이산 매개변수 \((A,B)\) 를 각각 \((A,B)\) 와 \((\hat{A},\hat{B})\) 로 지칭했음을 밝혀둔다. 우리는 표기를 변경하여 제시를 단순화하고, 주요 SSM 재귀를 지배하는 이산 매개변수에 직접 초점을 맞추었다.
재귀 모델. 방정식 (1)과 (2)는 입력 \(x\) 에 대해 선형인 재귀의 형태를 취한다. 따라서 구조화된 SSM은 일종의 순환 신경망(RNN)으로 볼 수 있으며, 여기서 선형성은 이들에게 추가적인 속성을 부여하고 전통적인 RNN의 순차적 계산을 회피할 수 있게 해준다. 반대로, 이러한 단순화에도 불구하고 SSM은 (보편적 근사의 의미에서) 여전히 완전히 표현력 있는 시퀀스 변환이다(Kaul 2020; Orvieto et al. 2023; Shida Wang and Xue 2023).
합성곱 모델. 방정식 (1)에서처럼 SSM의 동역학이 시간에 걸쳐 일정할 때, 그 모델은 선형 시불변(LTI)이라고 불린다. 이 경우, 이들은 합성곱과 동등하다. 따라서 SSM은 일종의 CNN으로도 볼 수 있지만, (i) 합성곱 커널이 SSM 매개변수 \((A,B,C)\) 를 통해 암묵적으로 매개변수화되고 (ii) 합성곱 커널이 일반적으로 국소적이 아니라 전역적이라는 점이 다르다. 반대로, 고전적인 신호 처리 이론을 통해 충분히 잘 작동하는 모든 합성곱은 SSM으로 표현될 수 있다.
일반적으로, 이전의 LTI SSM은 효율적인 병렬화 가능한 훈련(전체 입력 시퀀스를 미리 보는 경우)을 위해 합성곱 모드를 사용하고, 효율적인 자기회귀 추론(입력을 한 번에 한 단계씩 보는 경우)을 위해 재귀 모드 (1)로 전환하였다.
선택적 상태 공간 모델. 매개변수 \((A,B,C)\) 가 시간에 따라 변할 수도 있는 형태 (2)는 Mamba에서 선택적 SSM으로 도입되었다. 표준 LTI 공식 (1)과 비교하여, 이 모델은 매 시간 단계에서 입력에 집중하거나 무시하는 것을 선택적으로 고를 수 있다. 이는 더 많은 정보 용량을 허용하는 상태 크기 N이 증가함에 따라, 언어와 같은 정보 밀도가 높은 데이터에서 LTI SSM보다 훨씬 더 나은 성능을 보이는 것으로 나타났다. 그러나 이는 합성곱 모드가 아닌 재귀 모드로만 계산될 수 있으며, 효율적으로 작동하기 위해서는 하드웨어를 고려한 신중한 구현이 필요하다. 그럼에도 불구하고, 행렬 곱셈 단위를 활용하지 않기 때문에 GPU와 TPU 같은 현대 가속기가 특화된 CNN 및 Transformer와 같은 하드웨어 친화적 모델보다 여전히 덜 효율적이다.
시불변 SSM은 연속, 재귀, 합성곱 시퀀스 모델과 밀접하게 관련되어 있지만, 어텐션과는 직접적으로 관련이 없다. 본 논문에서는 선택적 SSM과 어텐션 사이의 더 깊은 관계를 보여주고, 이를 이용하여 SSM의 훈련 속도를 크게 향상시키는 동시에 훨씬 더 큰 상태 크기 N을 허용한다.
시퀀스 변환으로서의 구조화된 SSM.
정의 2.1. 우리는 시퀀스 변환이라는 용어를 \(Y = f_{\theta}(X)\) 인 시퀀스에 대한 매개변수화된 사상(map)을 지칭하는 데 사용하며, 여기서 \(X,Y\in \mathbb{R}^{(\mathrm{T},\mathrm{P})}\) 이고 \(\theta\) 는 임의의 매개변수 모음이다. T는 시퀀스 또는 시간 축을 나타내며, 아래 첨자는 첫 번째 차원을 인덱싱한다. 예를 들어 \(X_{t},Y_{t}\in \mathbb{R}^{\mathrm{P}}\) 이다.
시퀀스 변환(예: SSM 또는 자기 어텐션)은 심층 시퀀스 모델의 초석이며, 신경망 아키텍처(예: Transformer)에 통합된다. (1) 또는 (2)의 SSM은 \(\mathsf{P} = 1\) 인 시퀀스 변환이며, 이 차원에 걸쳐 단순히 브로드캐스팅함으로써(즉, 입력을 \(\mathsf{P}\) 개의 독립적인 시퀀스로 보고 각각에 SSM을 적용함으로써) \(\mathsf{P} > 1\) 로 일반화될 수 있다. \(\mathsf{P}\) 는 헤드 차원으로 생각할 수 있으며, 이에 대해서는 7절에서 자세히 설명할 것이다.
정의 2.2. 우리는 SSM 연산자 \(\mathrm{SSM}(A,B,C) = \mathrm{SSM}(A_{0:T},B_{0:T},C_{0:T})\) 를 방정식 (2)에 의해 정의된 시퀀스 변환 \(X\in\) \(\mathbb{R}^{(\mathrm{T},\mathrm{P})}\mapsto Y\in \mathbb{R}^{(\mathrm{T},\mathrm{P})}\) 로 정의한다.
SSM에서 N 차원은 상태 크기 또는 상태 차원이라고 불리는 자유 매개변수이다. 우리는 이를 상태 확장 계수라고도 부르는데, 이는 입력/출력의 크기를 \(N\) 배로 확장하며, 이러한 모델의 계산 효율성에 영향을 미치기 때문이다.
마지막으로, 어텐션과 같은 많은 유형의 시퀀스 변환이 시퀀스 차원에 걸친 단일 행렬 곱셈으로 표현될 수 있음을 언급한다.
정의 2.3. 우리는 시퀀스 변환 \(Y = f_{\theta}(X)\) 가 \(Y = M_{\theta}X\) 의 형태로 쓰일 수 있을 때 이를 행렬 변환이라고 부르며, 여기서 \(M\) 은 매개변수 \(\theta\) 에 의존하는 행렬이다. 우리는 시퀀스 변환을 행렬 \(M\) 과 동일시하며, 문맥상 명확할 때 \(\theta\) 에 대한 의존성을 종종 생략한다.
2.2 어텐션
어텐션은 광범위하게 시퀀스의 모든 위치 쌍에 점수를 할당하여 각 요소가 나머지에 "주목"할 수 있게 하는 유형의 계산을 지칭한다. 지금까지 가장 흔하고 중요한 어텐션 변형은 소프트맥스 자기 어텐션으로, 다음과 같이 정의될 수 있다.
여기서 \(Q,K,V\in \mathbb{R}^{(\mathrm{T},\mathrm{P})}\) 이다. (\(Q K^{\top}\) 를 구체화함으로써 유도되는) 쌍별 비교 메커니즘은 어텐션의 특징적인 이차 훈련 비용을 초래한다.
많은 어텐션 변형이 제안되었지만, 모두 다양한 근사(Tay et al. 2022)와 함께 이러한 어텐션 점수라는 핵심을 공유한다. 본 연구에서 가장 중요한 변형은 선형 어텐션이다(Katharopoulos et al. 2020). 대략적으로 말하면, 이 계열의 방법들은 소프트맥스를 커널 특징 맵에 접어 넣어 제거하고, 행렬 곱셈의 결합성을 사용하여 \((Q K^{\top})\cdot V = Q\cdot (K^{\top}V)\) 로 다시 쓴다. 더욱이, 인과적(자기회귀적) 어텐션이라는 중요한 경우에서, 그들은 인과 마스크가 \((L\circ Q K^{\top})\cdot V\) 처럼 좌변에 통합될 때(여기서 \(L\) 은 하삼각 1 행렬임), 우변이 재귀로 전개될 수 있음을 보여준다. RetNet(Y. Sun et al. 2023)과 GateLoop(Katsch 2023) 같은 여러 최근 및 동시대 연구들은 이를 \(L\) 의 더 일반적인 형태로 강화한다(10절). 본 연구에서, 구조화된 마스크 어텐션에 대한 우리의 공식화는 이러한 아이디어들을 강하게 일반화할 것이다.
2.3 구조화된 행렬
일반 행렬 \(M\in \mathbb{R}^{(\mathrm{T},\mathrm{T})}\) 는 이를 표현하는 데 \(\mathrm{T}^{2}\) 개의 매개변수가 필요하고 행렬-벡터 곱셈과 같은 기본 연산을 수행하는 데 \(O(\mathrm{T}^{2})\) 시간이 필요하다. 구조화된 행렬은 (i) 압축된 표현을 통해 준이차적(이상적으로는 선형적) 매개변수로 표현될 수 있고, (ii) 이 압축된 표현에 직접 작동함으로써 빠른 알고리즘(가장 중요하게는 행렬 곱셈)을 갖는 행렬이다.
아마도 구조화된 행렬의 가장 전형적인 부류는 희소 행렬과 저계수 행렬일 것이다. 그러나 Toeplitz, Cauchy, Vandermonde, butterfly 행렬 등과 같이 효율적인 모델을 위해 머신러닝에서 모두 사용되어 온 많은 다른 부류들도 존재한다(Dao, Gu, et al. 2019; D. Fu et al. 2024; Gu, Gupta, et al. 2022; Thomas et al. 2018). 구조화된 행렬은 효율적인 표현과 알고리즘을 위한 강력한 추상화이다. 본 연구에서 우리는 SSM이 이전에 딥러닝에서 사용되지 않았던 또 다른 부류의 구조화된 행렬과 동등함을 보이고, 이 연결을 이용하여 효율적인 방법과 알고리즘을 도출할 것이다.
2.4 개요: 구조화된 상태 공간 이중성
본 논문은 SSM, 어텐션, 그리고 구조화된 행렬 사이의 연결에 관한 훨씬 더 풍부한 프레임워크를 개발하지만, 우리는 주요 방법에 대한 간략한 요약을 제공하는데, 이는 실제로 알고리즘적으로 상당히 자기완결적이고 단순하다.
순환(선형) 형식. 상태 공간 이중(SSD) 레이어는 선택적 SSM (2)의 특수한 경우로 정의될 수 있다. SSM을 순환(또는 병렬 스캔)으로서 표준적으로 계산하는 방식을 적용할 수 있으며, 이는 시퀀스 길이에 대해 선형 복잡도를 가진다. Mamba에서 사용된 버전과 비교하여, SSD는 두 가지 사소한 차이점을 가진다:
에 대한 구조가 대각 구조에서 스칼라 곱하기 항등 구조로 더욱 단순화된다. 이 경우 각 는 단지 스칼라로 식별될 수도 있다. 우리는 Mamba에서 사용된 에 비해 더 큰 헤드 차원 를 사용한다. 일반적으로 이 선택되며, 이는 현대 Transformer의 관례와 유사하다.
원래의 선택적 SSM과 비교하여, 이러한 변경은 상당한 훈련 효율성 향상을 대가로 표현력을 약간 감소시키는 것으로 볼 수 있다. 특히, 우리의 새로운 알고리즘은 현대 가속기에서 행렬 곱셈 단위의 사용을 가능하게 할 것이다.
이중(이차) 형식. SSD의 이중 형식은 어텐션과 밀접하게 관련된 이차 계산으로, 다음과 같이 정의된다
여기서 는 [0, 1] 범위로 제한된 입력 의존적 스칼라이다.
표준 softmax 어텐션과 비교하여 두 가지 주요 차이점이 있다
- softmax가 제거된다.
- 어텐션 행렬에 추가적인 마스크 행렬 이 원소별로 곱해진다.
이 두 가지 변경은 모두 바닐라 어텐션의 문제를 해결하는 것으로 볼 수 있다. 예를 들어, softmax는 최근 어텐션 점수에서 "어텐션 싱크" 현상과 같은 문제를 일으키는 것으로 관찰되었다(Darcet et al. 2024; Xiao et al. 2024). 더 중요하게는, 마스크 행렬 은 Transformer의 휴리스틱한 위치 임베딩을, 시간에 걸쳐 얼마나 많은 정보가 전달되는지를 제어하는 데이터 의존적인 다른 위치 마스크로 대체하는 것으로 볼 수 있다.
보다 광범위하게, 이 형식은 Section 4에서 정의된 선형 어텐션에 대한 우리의 구조화된 마스크 어텐션 일반화의 한 사례이다.
행렬 형식과 SSD 알고리즘. SSD의 다양한 형식들은 통합된 행렬 표현을 통해 연결되며, 이는 SSM이 에 의존하는 행렬 에 대해 라는 행렬 변환 형식을 가짐을 보임으로써 이루어진다. 특히, SSD의 이중 형식은 행렬 에 의한 단순한(이차 시간) 곱셈과 동등하며, 순환 형식은 의 구조를 활용하는 특정한 효율적인(선형 시간) 알고리즘이다.
이를 넘어서, \(M\)에 의한 곱셈을 위한 어떤 알고리즘이든 적용될 수 있다. 우리가 제안하는 하드웨어 효율적인 SSD 알고리즘(6절)은 \(M\)의 블록 분해를 포함하는 새로운 구조적 행렬 곱셈 방법으로, 순수 선형 형태나 이차 형태 어느 것보다도 더 나은 효율성 절충을 얻는다. 이는 일반적인 선택적 SSM(Gu and Dao 2023)에 비해 상대적으로 단순하고 구현하기 쉽다. 리스팅 1은 몇 줄의 코드로 완전한 구현을 제공한다.
그림 1은 이 논문에서 제시하는 개념들 간의 관계에 대한 간단한 로드맵을 제공한다.
2.5 표기법
이 논문 전반에 걸쳐, 우리는 코드로 매핑될 수 있는 정밀한 표기법을 사용하는 것을 선호한다.
행렬과 벡터. 우리는 일반적으로 벡터(즉, 단일 축을 가진 텐서)를 나타내기 위해 소문자를 사용하고, 행렬(즉, 하나 이상의 축을 가진 텐서)을 나타내기 위해 대문자를 사용한다. 이 작업에서 우리는 행렬을 굵게 표시하지 않는다. 때때로, 행렬이 하나의 축을 따라 묶여 있거나 반복되는 경우(그리고 따라서 벡터로도 볼 수 있는 경우), 우리는 그것에 대해 대문자나 소문자 중 어느 것을 사용해도 된다. 는 스칼라 또는 행렬 곱셈을 나타내는 반면, 는 아다마르(원소별) 곱셈을 나타낸다.
인덱싱. 우리는 파이썬 스타일 인덱싱을 사용한다. 예를 들어, 는 일 때 범위 를, 일 때 을 가리킨다. 예를 들어, 임의의 기호 에 대해 인 경우 가 수열 을 나타내도록 한다. 는 과 동등하다. 약칭으로, 우리는 또한 가 곱 을 나타내도록 한다.
차원. 행렬 및 텐서와 구별하기 위해, 우리는 종종 타자기 글꼴의 대문자(예: )를 사용하여 차원과 텐서 형상을 나타낸다. 전통적인 표기법 대신에, 우리는 코드에서의 텐서 형상을 반영하기 위해 종종 를 사용한다.
텐서 수축. 우리는 명확성을 위해서 그리고 우리의 결과를 진술하고 증명하는 데 중심 도구로서 텐서 수축 또는 아인섬 표기법에 크게 의존할 것이다. 우리는 독자가 numpy와 같은 현대 텐서 라이브러리에서 흔히 사용되는 이 표기법에 익숙하다고 가정한다. 예를 들어, 우리는 행렬-행렬 곱셈 연산자를 나타내기 위해 contract 를 사용할 수 있으며, 우리의 표기법에서 contract (이는 와 동등하다)는 코드로 numpy.einsum('mn,nk , X, Y)로 번역될 수 있다.
방대한 표기법 용어집은 부록 A에 포함되어 있다.
3 상태 공간 모델은 구조적 행렬이다
이 절에서는 상태 공간 모델을 수열 변환으로서 바라보는 다양한 관점을 탐구하고, 그러한 사상의 성질과 알고리즘을 개괄한다. 이 절의 주요 결과는 상태 공간 모델과 반분리 행렬(semiseparable matrices)이라고 불리는 구조적 행렬군 사이의 동등성에 관한 것으로, 이는 새로운 효율성 결과(정리 3.5 및 3.7)를 함의한다.
3.1 상태 공간 모델의 행렬 변환 형태
우리의 SSM 정의는 (2)를 통해 정의되는 매개변수화된 사상으로 정의된다는 것을 상기하자. 우리의 이론적 프레임워크는 이 변환을 벡터 를 매핑하는 행렬 곱셈으로 단순히 작성하는 것에서 시작한다.
정의에 따르면, 이다. 귀납에 의해,
\(C_{t}\)를 곱하여 \(y_{t}\)를 생성하고, 방정식을 \(t\in [\mathsf{T}]\)에 걸쳐 벡터화하면, SSM의 행렬 변환 형태를 도출한다.
3.2 반분리 행렬
방정식 (3)의 \(M\)은 반분리 행렬(semiseparable matrices)로 알려진 행렬 클래스의 특정한 표현이다. 반분리 행렬은 근본적인 행렬 구조이다. 먼저 이 행렬들과 그 성질들을 정의한다.
정의 3.1. (하삼각) 행렬 \(M\)이 N-반분리(N-semiseparable)라는 것은 하삼각 부분(즉, 대각선 위 또는 아래)에 포함된 모든 부분행렬의 랭크가 최대 N임을 의미한다. N을 반분리 행렬의 차수 또는 랭크라고 부른다.
정의 3.1 및 다른 형태의 관련 "분리 가능한" 구조(예: 유사분리 행렬(quasiseparable matrices) 및 반분리 행렬의 다른 정의들)는 부분행렬에 대한 랭크 조건으로 특징지어지기 때문에 구조화된 랭크 행렬(또는 랭크 구조화 행렬)이라고 불리기도 한다. 반분리 행렬은 계층적 반분리(HSS), 순차적 반분리(SSS), 브루아 형태(Bruhat forms) (Pernet and Storjohann 2018) 등 많은 구조화된 표현을 가진다. 우리는 주로 SSS 형태를 사용할 것이다.
3.2.1 순차적 반분리(SSS) 표현
정의 3.2. 하삼각 행렬 \(M\in \mathbb{R}^{(\mathrm{T},\mathrm{T})}\)이 N-순차적 반분리(N-sequentially semiseparable, SSS) 표현을 가진다는 것은 다음 형태로 쓸 수 있음을 의미한다
여기서 벡터 \(B_{0},\ldots ,B_{\mathrm{T} - 1},C_{0},\ldots ,C_{\mathrm{T} - 1}\in \mathbb{R}^{\mathsf{N}}\) 및 행렬 \(A_{0},\ldots ,A_{\mathrm{T} - 1}\in \mathbb{R}^{(\mathsf{N},\mathsf{N})}\)에 대하여.
우리는 \(M = \mathrm{SSS}(A_{0:\mathrm{T}},B_{0:\mathrm{T}},C_{0:\mathrm{T}})\)가 되도록 연산자 SSS를 정의한다.
반분리 행렬의 근본적인 결과는 이들이 SSS 표현을 가진 행렬과 정확히 동치라는 것이다. 한 방향은 간단한 구성적 증명으로 이끌어낼 수 있다.
보조정리 3.3. 표현 (4)를 가진 N-SSS 행렬 \(M\)은 N-반분리이다.
증명. \(j^{\prime} > j\geq i > i^{\prime}\)인 임의의 비대각 블록 \(M_{j:j^{\prime},i^{\prime}:i}\)을 고려하자. 이는 다음과 같이 명시적인 랭크-N 인수분해를 가진다
대각 행렬은 다루기 쉽기 때문에(예: 대각 행렬과의 곱셈은 원소별 스칼라 곱셈과 같다), 이러한 항들은 무시할 수 있다. 따라서 1-SS 행렬의 기본 표현은 \(M_{ji} = a_{ji}\) 또는
1-SS 행렬의 중요성은 스칼라 점화식의 최소 형태, 즉 상태 차원이 \(\mathbf{N} = 1\)이고 \((B,C)\) 투영이 없는 축퇴 SSM의 경우와의 동치성에 있다. 곱셈 \(y = Mx\)는 다음 점화식으로 계산할 수 있음에 유의하자
따라서 우리는 1-SS 행렬에 의한 행렬 곱셈을 스칼라 SSM 점화식 또는 cumprodsum(누적 곱 합; 누적 곱과 누적 합의 일반화) 연산자라고도 부른다. 점화식의 근본적인 형태로서, 1-SS 행렬에 의한 곱셈은 우리의 주요 알고리즘을 위한 구성 요소로서 중요하다.
우리는 이 논문의 중심 주제 중 하나가 시퀀스 모델에 대한 많은 알고리즘이 구조화된 행렬 곱셈 알고리즘으로 환원될 수 있다는 것임을 강조한다. 1-SS 행렬은 이러한 연결을 예시한다: 원시 스칼라 점화식 또는 cumprodsum 연산자를 계산하기 위한 많은 빠른 알고리즘이 있으며, 이들 모두는 1-SS 행렬의 서로 다른 구조화된 인수분해와 동치임이 밝혀진다. 우리는 1-SS 행렬 곱셈을 위한 이러한 알고리즘들을 부록 B에 할애한다.
3.3 상태 공간 모델은 반분리 행렬이다
SSM에 대한 우리의 정의는 정의 2.1을 통해 정의된 매개변수화된 맵으로 정의된다는 것을 상기하자. SSM과 반분리 행렬 사이의 연결은 단순히 이 변환을 벡터 \(x \mapsto y \in \mathbb{R}^T\)를 매핑하는 행렬 곱셈으로 작성함으로써 따른다.
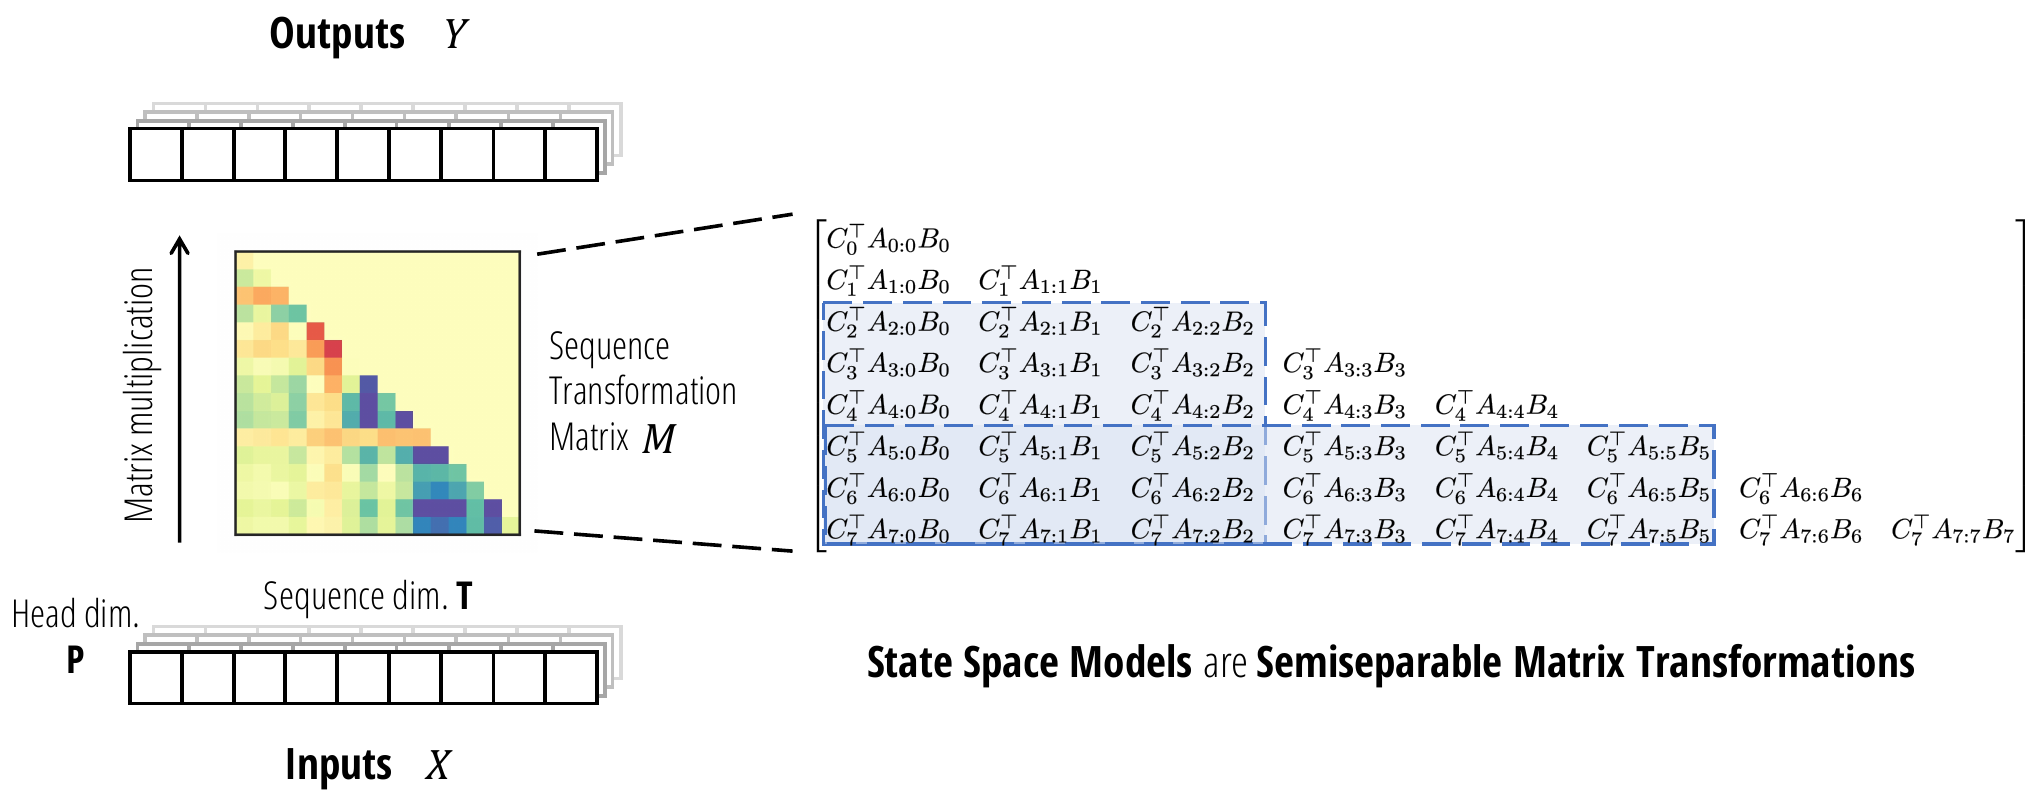
방정식 (3)은 상태 공간 모델과 순차적 반분리 표현 사이의 연결을 직접적으로 확립하며, 이는 다시 일반적으로 반분리 행렬과 동치이다(보조정리 3.3 및 명제 3.4).
정리 3.5. 상태 크기 \(N\)을 가진 상태 공간 모델 변환 \(y = \mathrm{SSM}(A, B, C)(x)\)은 순차적 반분리 표현 \(y = \mathrm{SSS}(A, B, C) \cdot x\)에서 N-SS 행렬에 의한 행렬 곱셈과 동일하다.
다시 말해, 시퀀스 변환 연산자 SSM(정의 2.2)은 행렬 구성 연산자 SSS(정의 3.2)와 일치하며, 우리는 이들을 상호 교환적으로 사용한다(또는 때때로 SS를 약어로 사용한다). 더욱이—운명의 장난으로—구조화된 상태 공간 모델과 순차적 반분리 행렬은 동일한 약어를 가지며, 이는 그들의 동치성을 강조한다! 편리하게도 우리는 이들 약어 중 어느 것이든 SSM(상태 공간 모델 또는 반분리 행렬), SSS(구조화된 상태 공간 또는 순차적 반분리), 또는 SS(상태 공간 또는 반분리)를 상호 교환적으로 사용하여 어느 개념을 명확하게 지칭할 수 있다. 그러나 우리는 일반적으로 SSM은 상태 공간 모델을, SS는 반분리를, SSS는 순차적 반분리를 지칭한다는 관례를 사용할 것이다.
그림 2는 상태 공간 모델을 반분리 행렬로서의 시퀀스 변환 관점을 보여준다.
3.4 구조화된 행렬 알고리즘을 통한 상태 공간 모델 계산
정리 3.5가 중요한 이유는 이것이 SSM(및 다른 시퀀스 모델)의 효율적인 계산 문제를 구조화된 행렬 곱셈을 위한 효율적인 알고리즘으로 환원할 수 있게 해주기 때문이다. 우리는 간략하게 개요를 제공하고, 섹션 4와 5에서 SSM과 다른 시퀀스 모델의 동치성을 보인 후 주요 새로운 알고리즘을 섹션 6으로 미룬다.
앞서 정의한 바와 같이, 반분리 행렬(즉, 랭크 구조화 행렬)은 고전적인 유형의 구조화된 행렬이다:
(i) 이들은 \(O(\mathrm{T}^{2})\) 대신 단지 \(O(\mathrm{T})\)개의 매개변수만을 가지는 SSS 형태와 같은 압축된 표현을 가진다.
(ii) 이들은 압축된 표현에 직접 작동하는 빠른 알고리즘을 가진다.
더욱이, 매개변수화 및 행렬 곱셈 비용은 반분리 차수에서 타이트할 수 있다.
명제 3.6 (Pernet, Signargout, and Villard (2023)). 크기 인 N-SS 행렬은 개의 매개변수로 표현될 수 있으며, 행렬-벡터 곱셈을 시간 및 공간 으로 수행한다.
예를 들어, 1-SS 행렬은 이러한 연결의 본질을 보여준다. 행렬 는 정확히 개의 매개변수 로 정의되며, 스칼라 점화식 (7)을 따라 시간에 계산될 수 있다.
3.4.1 선형 (순환) 모드
명제 3.6은 대각 구조화 SSM(S4D (Gu, Gupta, et al. 2022))의 경우 상태 공간 모델 공식화 (2)를 활용하고 점화식을 전개하기만 하면 쉽게 확인할 수 있다. 우리는 (8)에서 형식적 텐서 축약 알고리즘을 제시하며, 여기서 차원 S는 와 같다.
여기서 는 로 정의되며, 다시 말해 에 대해 이다. 이 알고리즘은 (2)에 대응하는 세 단계를 포함한다:
(i) 입력 행렬 에 의해 입력 를 확장하고 (8a),
(ii) 독립적인 스칼라 SSM 점화식을 전개하며 (8b),
(iii) 출력 행렬 에 의해 은닉 상태 를 축약한다 (8c).
우리는 단계 (8b)에서 스칼라 SSM과 1-SS 행렬 사이의 동등성을 사용했음에 주목한다.
비고 3. 우리는 (8)이 Mamba (S6) 모델의 특수한 경우임에 주목하지만, 크기 인 확장된 텐서 와 때문에 단순한 구현은 느리다; Gu and Dao (2023)는 이러한 텐서들을 물질화하지 않도록 하는 하드웨어 인식 구현을 도입했다.
놀랍게도, 정리 3.5와 명제 3.6은 모든 SSM이 알고리즘 (8)과 동일한 점근적 효율성을 가짐을 즉시 함의한다.
정리 3.7. 시퀀스 길이 T에 대한 상태 크기 N의 임의의 상태 공간 모델(정의 2.2)은 시간 으로 계산될 수 있다 (잠재적 전처리는 고려하지 않음).
우리는 이 결과가 구조화된 SSM 문헌에서 새로운 것임을 주목한다. 특히, 조밀한 비구조적 행렬들이 주어졌을 때, 총 표현 자체만 해도 크기가 인 것으로 보인다. 따라서 정리 3.7은 전처리 단계를 거치면 비구조적 SSM조차도 최적으로 효율적으로 계산될 수 있으며, 그 상한이 와 의 크기에 의해 주어지는 하한 과 일치한다는 비자명한 결과를 진술한다.
비고 4. 정리 3.7은 위의 거의 모든 조밀 행렬들이 위에서 대각화 가능하다는 사실에 비추어 볼 때 그다지 놀랍지 않을 수도 있으며, 이는 거의 모든 조밀한 실수 SSM이 대각 복소 SSM과 동치라는 결과로 이어진다. 이 사실은 대각 SSM이 구조화된 SSM의 가장 인기 있는 형태인 이유의 근저에 깔려 있다(Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; J. T. Smith, Warrington, and Linderman 2023). 그러나 정리 3.7은 모든 실수 SSM(단지 대각화 가능한 것들뿐만 아니라)은 물론 다른 체( 자체를 포함하여) 위의 조밀한 SSM에 대해서도 훨씬 더 강력한 결과를 함의한다.
실제로, 효율적으로 계산 가능한 SSM들은 여전히 에 대한 추가적인 구조를 필요로 하며, 특히 비용이 많이 드는 전처리 단계(이는 차수가 N인 추가 FLOPs를 가지며 특이값 분해와 같은 하드웨어 비효율적인 연산들을 포함한다)를 피하기 위해서 그러하다. 이러한 구조들은 구조화된 SSM에 관한 과거 연구(예: S4(D)와 Mamba)는 물론 우리의 새로운 알고리즘들의 초점이다. 특히, 에 다소 더 강한 구조가 부과될 때, 우리는 6절에서 SSM 행렬 의 블록 분해를 통해 매우 하드웨어 효율적인 알고리즘들을 설계할 것이다.
3.4.2 이차(순진한) 모드
우리의 새로운 행렬 관점에 의해 드러나는 SSM을 계산하는 또 다른 방법이 있음을 주목한다. 행렬 SSM 표현 (3)의 순진한 계산은 단순히 시퀀스 변환 행렬 을 구체화하는 것을 포함한다. 이는 행렬이므로, 이 순진한 알고리즘은 시퀀스 길이에 대해 이차적으로 스케일링된다. 그러나 시퀀스 길이 가 짧을 때, 이는 상수 인자들과 계산 패턴의 하드웨어 친화성(예: 행렬-행렬 곱셈을 활용함) 덕분에 실제로 선형 알고리즘보다 더 효율적일 수 있다. 사실, 구조화된 SSM의 특정한 경우에 대해, 이는 이차 어텐션 계산과 매우 유사하게 보인다(5절).
3.4.3 요약
많은 시퀀스 모델들이 명시적으로 행렬 시퀀스 변환으로 동기 부여되거나 정의된다 – 가장 두드러지게는 트랜스포머이며, 여기서 행렬 믹서는 어텐션 행렬이다. 반면에, RNN과 SSM은 이전에 이러한 방식으로 기술된 적이 없다. 상태 공간 모델의 명시적인 행렬 변환 형태를 제공함으로써, 우리는 그것들을 이해하고 사용하는 새로운 방식들을 드러낸다. 계산적 관점에서, 상태 공간 모델의 순전파를 계산하는 어떤 방법이든 반분리 가능 행렬에 대한 행렬 곱셈 알고리즘으로 볼 수 있다. 반분리 가능 행렬 관점은 상태 공간 이중성(SSD)에 대한 하나의 렌즈를 제공하며, 여기서 이중 모드들은 각각 선형 시간 반분리 가능 행렬 곱셈 알고리즘과 이차 시간 순진한 행렬 곱셈을 가리킨다.
더욱이, 반분리 가능 행렬의 풍부한 구조를 활용하면 훨씬 더 나은 알고리즘들과 더 많은 통찰들로 이어질 수 있다(예: 6절과 부록 B). 부록 C.1에서, 우리는 반분리 가능 행렬의 몇 가지 추가적인 성질들을 기술한다.
4 구조화된 마스크드 어텐션: 구조화된 행렬로 선형 어텐션을 일반화하기
이 절에서 우리는 선형 어텐션 프레임워크를 제1원리들로부터 다시 살펴본다. 이 절의 주요 결과들은 선형 어텐션에 대한 단순한 텐서 수축 기반 증명(명제 4.1)과, 정의 4.2에서의 구조화된 마스크드 어텐션에 대한 우리의 일반화된 추상화이다. 우리는 이 절이 상태 공간 모델과는 다른 방향에서 주요 이중성 결과들을 유도하며 3절과 완전히 독립적으로 읽힐 수 있음을 주목한다.
- 4.1절은 어텐션의 변형들에 대한 우리의 프레임워크를 설정하며, 특히 커널 어텐션과 마스크드 커널 어텐션에 초점을 맞춘다. - 4.2절은 우리의 첫 번째 주요 어텐션 결과인, 텐서 수축의 렌즈를 통한 선형 어텐션의 단순한 증명을 제공한다. - 4.3절은 구조화된 행렬을 통해 이전의 어텐션 변형들을 일반화한 우리의 구조화된 마스크드 어텐션을 정의한다.
4.1 어텐션 프레임워크
4.1.1 어텐션
(단일 헤드) 어텐션의 기본 형태는 세 개의 벡터 시퀀스들에 대한 사상 이다
우리는 텐서들의 차원을 나타내기 위해 "형상 주석"을 사용한다, 예를 들어 . 이 일반적인 형태에서, S와 T는 소스 및 타깃 시퀀스 길이를 나타내고, N은 특징 차원을 나타내며, P는 헤드 차원을 나타낸다.
소프트맥스 어텐션의 가장 흔한 변형은 행렬의 행들을 정규화하기 위해 소프트맥스 활성화 를 사용한다.
4.1.2 자기 어텐션
우리의 취급은 자기 어텐션의 가장 중요한 경우에 의해 동기 부여되며, 여기서 (i) 소스와 타깃 시퀀스가 동일하고(즉, ), (ii) 보통 특징 차원과 헤드 차원이 동일하며(즉, ), (iii) 가 동일한 입력 벡터에 대한 선형 투영들에 의해 생성된다( ).
그러나, 우리의 제시는 이러한 선택들을 추상화하고 행렬들로부터 시작한다.
비고 5. 우리의 초점은 헤드 차원과 특징 차원이 동일한 자기 어텐션 경우(즉, 이고 )에 있으며, 이는 실행 예시로 사용되어야 한다. 우리가 어텐션의 일반적인 정식화를 정의하는 것은 우리의 프레임워크가 교차 어텐션과 같은 변형들을 포착할 수 있도록 하기 위해서만이 아니라, 차원들(예: S와 T)에 대한 표기를 분리하는 것이 이 절의 주요 결과들에 대한 수축 표기법 증명들을 더 명확하게 만들기 때문이기도 하다.
비고 6. 어텐션은 보통 대칭적으로 간주되는 이 세 입력 에 대한 연산으로 틀 지어지지만, (9)의 입력 및 출력 차원들은 그렇지 않음을 나타낸다. 특히, 특징 차원 N은 출력에 존재하지 않는다; 따라서 인 경우(예: 자기 어텐션), 우리는 를 주 입력으로 간주하여, (9)가 적절한 시퀀스 변환 를 정의하도록 한다(정의 2.1).
4.1.3 커널 어텐션
소프트맥스 함수가 그람 행렬 에 적용되는 단계는 두 부분으로 분해될 수 있다:
1. 행렬의 지수화.
2. S 축에서 행렬의 정규화.
정규화 항은 지금은 무시할 수 있는데, 이는 단순히 을 대입하고 나누는 것과 같기 때문이다(이 점은 7.3절에서 다시 다룬다). 지수화 항은 커널 변환으로 볼 수 있다: 를 만족하는 (무한 차원의) 특징 사상 가 존재한다. 특징 사상을 와 의 정의 자체에 추상화함으로써(즉, 를 변환 후의 버전으로 정의함으로써), 우리는 softmax 변환을 무시할 수 있고, 가 커널 특징 사상에 의해 임의로 생성되며 잠재적으로 라고 가정할 수 있다.
커널 어텐션의 여러 구체화가 제안되어 왔으며, 그중에는 다음이 포함된다:
- 원래의 Linear Attention (Katharopoulos et al. 2020)은 커널 특징 사상을 와 같은 임의의 점별 활성화 함수로 정의한다.- Random Feature Attention (RFA) (H. Peng et al. 2021)은 가우시안 커널의 랜덤 푸리에 특징 근사(Rahimi and Recht 2007)를 사용하여 softmax 어텐션(즉, exp 특징 사상)을 근사하도록 커널 특징 사상을 선택한다. 이는 랜덤 사영(즉, 와 에 랜덤 사영 를 곱하고 활성화 를 적용하는 것)을 포함한다.
- Performer (Choromanski et al. 2021)는 양의 직교 랜덤 특징을 통한 빠른 어텐션(FAVOR+)을 제안한다. 양의 랜덤 특징(PRF) 부분은 커널 특징 사상을 랜덤 사영 후 특징 사상 를 적용하는 것으로 선택한다. 이 선택은 커널 원소들이 양의 값을 갖도록 하고 softmax 어텐션을 증명 가능하게 근사하도록 동기 부여된다. [이 논문은 또한 랜덤 사영을 직교 방향으로 선택하는 것도 제안하는데, 우리는 이를 고려하지 않는다.]
- cosFormer (Qin, Weixuan Sun, et al. 2022)는 위치 정보를 통합하여 지역성을 강조하는 코사인 재가중 메커니즘으로 RFA를 보강한다. 이는 효과적으로 를 특징 사상 를 통과시킨다.
- Linear Randomized Attention (Zheng, C. Wang, and Kong 2022)은 중요도 샘플링의 관점에서 RFA를 일반화하고, (단지 exp 변환된 분자만이 아니라) 전체 softmax 커널의 더 나은 추정을 제공하도록 일반화한다.
다른 관련 어텐션 변형으로는 Linformer (Sinong Wang et al. 2020)와 Nyströmmer (Xiong et al. 2021)가 있으며, 이들은 각각 랜덤 사영(Johnson-Lindenstrauss)과 커널 근사(Nyström 방법)를 통해 어텐션 행렬 의 저랭크 근사를 사용한다(따라서 식 (9)와 호환된다).
4.1.4 마스킹된 (커널) 어텐션
을 (T, S) 형태의 마스크라고 하자. 가장 흔하게는 인 자기회귀 자기어텐션의 경우, 은 인과 마스크를 나타내는 1의 하삼각 행렬일 수 있다. 인과성을 강제하는 것 외에도, 많은 다른 유형의 마스크가 적용될 수 있다 - 특히 밴드, 팽창, 또는 블록 대각과 같은 다양한 희소성 패턴 - 이는 밀집 어텐션의 복잡도를 줄이는 데서 동기를 얻는다.
마스킹된 어텐션은 보통 다음과 같이 행렬 표기법으로 작성된다.
더 정확하게는, 형태 주석을 붙이고 이를 정확한 계산 순서로 분해하면 다음과 같다.
이 절에서 어텐션 변형들에 대한 우리의 개선된 유도는 이 공식이 하나의 수축으로 작성될 수 있음을 알아차리는 것에서 시작한다.
그리고 (11)의 알고리즘은 쌍별 수축의 특정한 순서에 의해 (12)를 계산하는 것으로 재구성될 수 있다.
4.2 선형 어텐션
선형 어텐션과, 그리고 많은 다른 효율적 어텐션 변형들은 흔히 핵심 어텐션 계산 에서 행렬 결합 순서를 바꾸는 것에 의해 동기가 부여된다. 그러나 마스크가 추가되면, 유도는 다소 덜 직관적이다(예를 들어, 원 논문 (Katharopoulos et al. 2020)과 변형들 (Y. Sun et al. 2023)은 증명 없이 공식을 진술한다).
대략적으로, 선형 어텐션 방법은 다음 공식이 (10)과 동등하다고 주장하며, 이는 합을 전개하고 인덱스를 주의 깊게 추적함으로써 검증되어야 한다.
명제 4.1 ((Katharopoulos et al. 2020)). 자기회귀 커널 어텐션, 즉 인과 마스크를 가진 마스킹된 커널 어텐션은 각 단계마다 상수 시간이 걸리는 재귀에 의해 시간에 계산될 수 있다.
4.2.1 선형 어텐션의 텐서 수축 증명
우리는 선형 어텐션에 대한 간단하고 엄밀한 유도를 제시하며, 이는 또한 그것을 어떻게 일반화할지 즉시 드러낼 것이다. 주요 아이디어는 수축 (12)를 다른 순서로 수행하는 것이다. 우리는 모호한 행렬 표기법을 피하고 수축 표기법으로 직접 작업한다.
직관적으로, 우리는 이 수축 순서를 다음과 같이 해석한다.
첫 번째 단계 (15a)는 특징 차원 N의 인자만큼 더 많은 특징으로의 "확장"을 수행한다. 세 번째 단계 (15c)는 확장된 특징 차원을 수축해 없앤다. 만약 가 입력으로 간주된다면(비고 6), 와 는 각각 확장과 수축을 수행한다.
두 번째 단계는 가장 중요하며, 선형 어텐션의 선형 부분을 설명한다. 먼저 (15b)가 단지 에 의한 직접적인 행렬 곱셈임을 주목하라( 축들은 평탄화될 수 있기 때문이다). 또한 이것이 T 축과 S 축을 모두 포함하는 유일한 항이며, 따라서 복잡도(즉, 시퀀스 길이에 대해 이차)를 가져야 함을 주목하라. 그러나 마스크 이 표준 인과 어텐션 마스크(하삼각 1들)일 때, 에 의한 행렬-벡터 곱셈은 특징별 누적 합과 동일하다.
4.3 구조적 마스킹된 어텐션
마스킹된 어텐션에 대한 텐서 수축 관점 (15)을 통해, 우리는 원래 선형 어텐션의 핵심이 인과 마스크에 의한 행렬-벡터 곱셈이 누적 합 연산자와 동등하다는 사실임을 즉시 알 수 있다.
그러나 우리는 어텐션 마스크가 반드시 모두 1일 이유가 없다는 것을 관찰한다. 선형 어텐션이 빠르기 위해 필요한 것은 이 구조적 행렬, 즉 정의상 빠른 행렬 곱셈을 가지는 행렬들(2.3절)이라는 것뿐이다. 특히, 우리는 준-이차(이상적으로는 선형) 행렬-벡터 곱셈을 가지는 임의의 마스크 행렬 을 사용할 수 있으며, 이는 병목 방정식 (15b)를 가속화함으로써 표준 선형 어텐션과 동일한 복잡도를 가질 것이다.
정의 4.2. 구조적 마스킹된 어텐션(SMA)(줄여서 구조적 어텐션)은 쿼리/키/값 와 임의의 구조적 행렬 (즉, 준-이차 행렬 곱셈을 가짐)에 대한 함수로, 다음의 4방향 텐서 수축을 통해 정의된다.
SMA 이차 모드 알고리즘은 (13)에 의해 정의되는 쌍별 수축의 순서이며, 이는 표준 (마스킹된) 어텐션 계산에 해당한다.
SMA 선형 모드 알고리즘은 (15)에 의해 정의되는 쌍별 수축의 순서이며, 여기서 단계 (15b)는 준-이차 구조적 행렬 곱셈을 통해 최적화된다.
우리는 구조적 마스킹된 어텐션을 임의의 주어진 행렬 구조 클래스에 대해 인스턴스화할 수 있다. 몇 가지 예는 다음과 같다(그림 3).
- 선형 어텐션은 인과 마스크를 사용한다.
- RetNet (Y. Sun et al. 2023)은 어떤 감쇠 인자 에 대해 감쇠 마스크 를 사용한다.
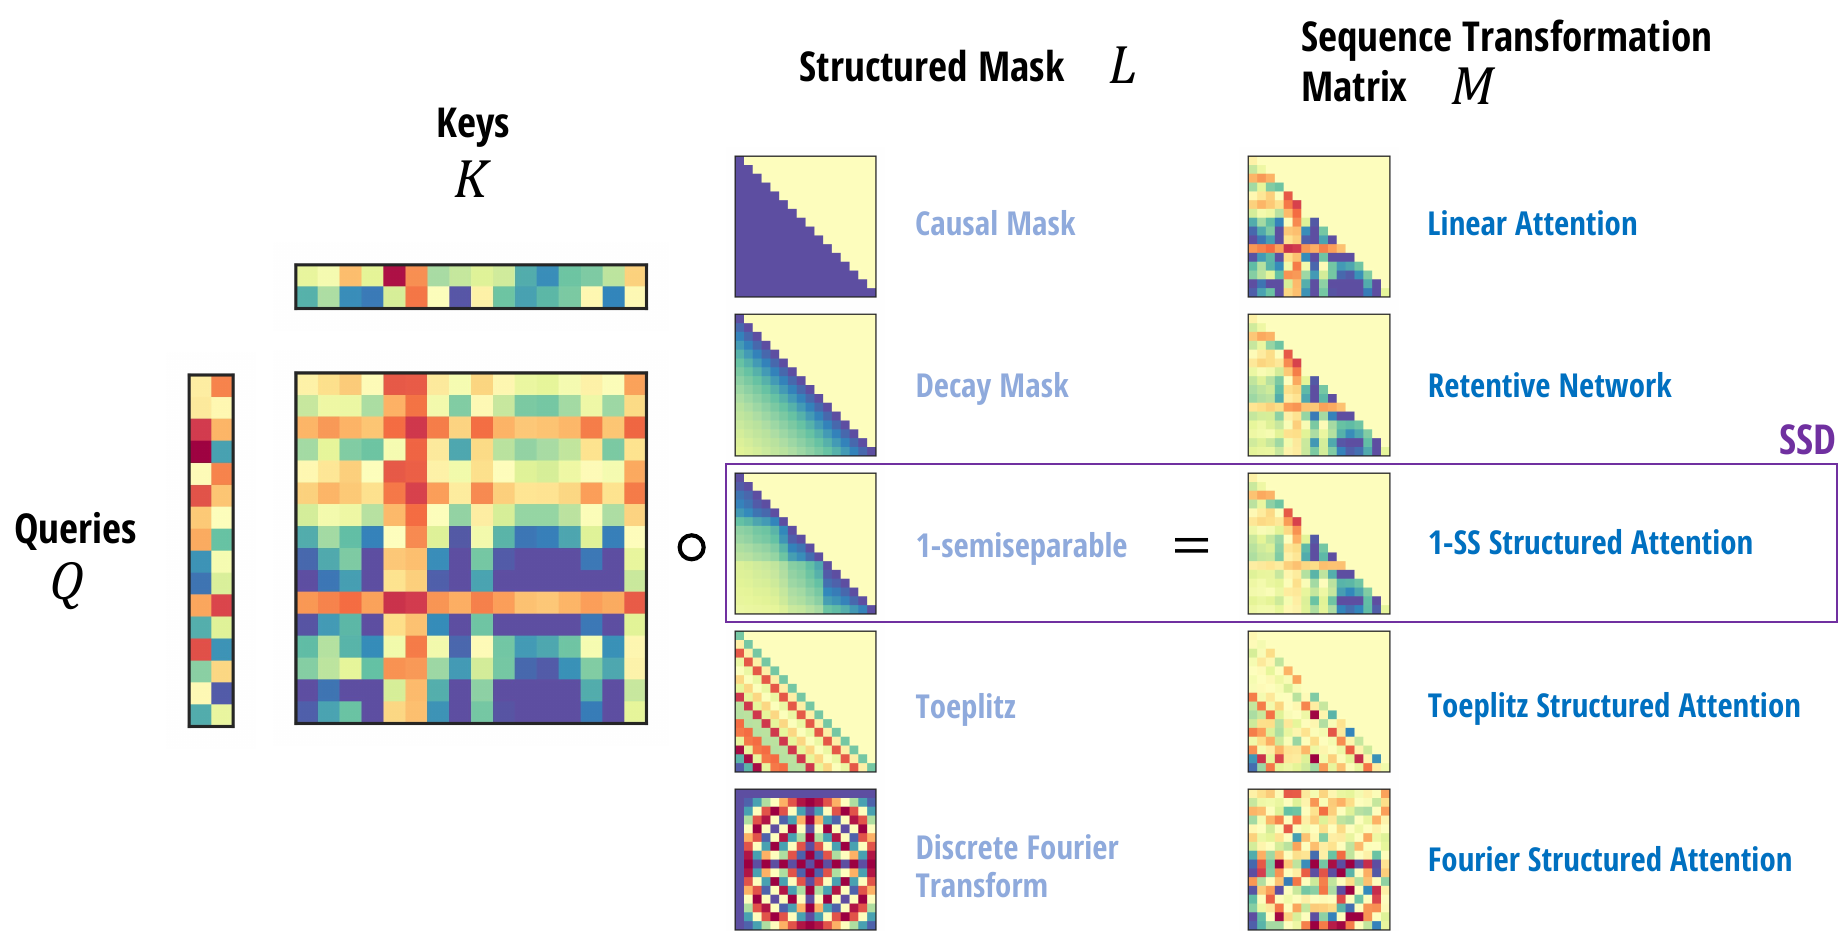
- 감쇠 마스크는 학습 가능한(또는 입력 의존적인) 매개변수 집합 에 대해 토플리츠 행렬 로 일반화될 수 있다. 이는 AliBi (Press, N. Smith, and Lewis 2022)와 같은 다른 방법들을 연상시키지만 덧셈적이지 않고 곱셈적인 상대 위치 인코딩의 한 형태로 해석될 수 있다.- 또 다른 변형은 위치 구조를 다른 방식으로 인코딩하기 위해 푸리에 행렬 를 사용할 수 있다.
5절에서, 우리는 우리의 주요 SSD 모델을 정의하는 준분리 가능 SMA를 고려한다.
4.3.1 요약: 마스킹된 어텐션의 이중 형태
표준 (마스킹된 커널) 어텐션은 흔히 함수와 알고리즘 사이에서 혼동된다. 이 구분을 분리하는 것은 어텐션의 다양한 변형들을 이해하는 명확한 방법을 제시한다.
- 우리는 마스킹된 어텐션을 특정한 함수 (12)로 본다.- 표준 이차 어텐션 계산 (13)은 그 함수를 계산하는 알고리즘으로 볼 수 있다.- 선형 어텐션 (15)은 같은 함수를 계산하는 대안적 알고리즘이다.
더욱이, 이 경우
- 마스킹된 어텐션 함수는 단순히 네 항에 대한 특정한 수축이다.- 이차 및 선형 어텐션 알고리즘은 단순히 수축들을 수행하는 두 가지 다른 순서이다.
계약 순서(contraction ordering)가 계산 복잡도에 큰 차이를 만들어낼 수 있으며, 이는 이차 대 선형 분할(quadratic vs. linear split)로 이어진다는 것이 알려져 있다. 상태 공간 모델이 여러 방식으로 계산될 수 있는 변환이며 이중의 이차 및 선형 형태를 갖는 것과 마찬가지로(3.4절), 선형 어텐션도 두 가지 계약 순서에서 비롯되는 유사한 이중성을 갖는다. 실제로 이들은 동일한 기저 이중성에 대한 서로 다른 관점임이 드러나며, 우리는 이를 5절에서 명시한다.
5 상태 공간 이중성
3절과 4절에서 우리는 구조화된 상태 공간 모델과 구조화된 어텐션을 정의하고, 그들의 성질을 논의하였으며, 둘 모두 이차 알고리즘과 선형 알고리즘을 가짐을 보였다. 이 절은 이들을 서로 연결한다. 우리의 주요 결과는 구조화된 상태 공간 모델의 특정한 경우가 구조화된 어텐션의 특정한 경우와 일치하며, 선형 시간 SSM 알고리즘과 이차 시간 커널 어텐션 알고리즘이 서로의 이중 형태라는 것을 보이는 것이다.
5.1절은 상태 공간 모델을 스칼라 구조로 특수화하며, 여기서 순진한 이차 계산은 커널 어텐션의 한 사례로 볼 수 있다.
5.2절은 구조화된 마스크드 어텐션을 반분리형 SMA(semiseparable SMA)로 특수화하며, 이는 효율적인 자기회귀를 갖는 마스크드 어텐션을 특징짓는다.
5.3절은 구조화된 마스크드 어텐션과 구조화된 상태 공간 모델 사이의 연결을 요약하며, 이를 구조화된 상태 공간 이중성(structured state space duality)이라 부른다.
5.1 스칼라-항등 구조화 상태 공간 모델
3절에서 우리는 상태 공간 모델이 반분리형 행렬 변환과 동등하며, 그 결과 선형 순환 형태와 이차 순진 형태 둘 모두를 갖게 됨을 보였다.
SSM은 로 정의되며, SSM의 행렬 형태는 SSS(순차적 반분리형, sequentially semiseparable) 표현 를 사용하며 여기서 이다(식 (3)).
이제 가 단순히 스칼라인 경우를 고려하자. 다시 말해, 행렬들이 극도로 구조화된 구조화 SSM의 한 인스턴스화로, 스칼라 와 항등 행렬 에 대해 인 경우이다. 그러면 우리는 다음과 같이 재배열할 수 있다
그리고 이는 다음과 같이 벡터화될 수 있다
여기서
이 공식화를 사용하면, 전체 출력 는 정확히 다음과 같이 계산된다
여기서 이다. 그러나 이것은 마스킹된 커널 어텐션 정의 (13)의 원래 정의와 정확히 동일하다!
따라서 3.4절에서 암시한 바와 같이, 준분리 가능 행렬 을 구체화하고 이차 행렬-벡터 곱셈을 수행함으로써 스칼라 구조화 SSM을 단순하게 계산하는 것은 이차 마스킹된 커널 어텐션과 정확히 동일하다.
5.2 1-준분리 가능 구조화 마스킹 어텐션
구조화 마스킹 어텐션은 임의의 구조화 마스크 을 사용할 수 있게 한다. 이 인과 마스크일 때, 그것은 표준 선형 어텐션이다. 인과 마스크는 라는 점에 주목하라. 즉, 1-SS 마스크는 정의 (6)에서 에 의해 생성된다. 이는 을 1-준분리 가능 마스크 클래스, 또는 1-준분리 가능 구조화 마스킹 어텐션(1-SS SMA)으로 일반화하도록 동기를 부여하며, 여기서 선형 어텐션의 순환에서의 누적합은 더 일반적인 순환, 즉 스칼라 SSM 스캔, 즉 1-준분리 가능 행렬 곱셈(3.2.2절)으로 대체된다.
마지막으로, 우리가 1-준분리 가능 SMA를 고려하는 가장 중요한 이유는 그것을 계산하기 위한 선형 형식이 대각 상태 공간 모델의 특수한 경우이기 때문이다. SMA의 선형 형식은 알고리즘 (15)이며, 여기서 병목 단계 (15b) 는 1-SS 마스크에 의한 행렬 곱셈으로 볼 수 있다. 3절에서 우리는 또한 대각 SSM (8)에 대한 계산을 작성했으며, 여기서 병목 단계 (8b)는 1-SS 곱셈과 동등한 스칼라 SSM 순환이다. 유일한 차이는 행렬 가 크기 N의 대각 행렬이기 때문에 (8b)가 에 추가적인 N 차원을 가진다는 점이다. 이 N 차원은 의 모든 대각 원소가 동일할 경우 사라지며, 이는 따름정리 5.1을 낳는다.
따름정리 5.1. 1-SS SMA(1-준분리 가능 구조화 행렬 을 사용하는 마스킹 어텐션) (15)는 대각 행렬이 단위행렬의 스칼라 배인 대각 SSM (8)의 특수한 경우이다.
따름정리 5.1은 1-SS SMA가 효율적인 순환 형식을 가진다고 말하지만, 우리는 또한 어떤 SMA 인스턴스가 효율적인 자기회귀를 가지는지 특징짓는 역 결과를 보여줄 수 있다.
정리 5.2. 유계 차수의 자기회귀 과정인 구조화 마스킹 어텐션(정의 4.2)의 임의의 인스턴스화에 대해, 구조화 마스크 은 준분리 가능 행렬이어야 한다.
다시 말해, 효율적인 자기회귀 어텐션은 일반 준분리 가능 SMA이다. 정리 5.2는 부록 C.2에서 증명된다.
비고 7. 1-준분리 가능 SMA는 상태 공간 모델의 특수한 경우이지만, 일반 준분리 가능 SMA는 1-SS SMA보다 엄격히 더 표현력이 뛰어나며 표준 SSM으로 기술될 수 없다. 그러나 에 의한 준분리 가능 곱셈과 SMA의 선형 형식(식 (15a))은 각각 확장 및 축소 단계를 포함하며, 단일의 (더 큰) 확장을 가진 1-SS SMA의 유사한 인스턴스로 흡수될 수 있다.
요약하면, 1-준분리 가능 구조화 어텐션은 SMA의 가장 중요한 경우인데, 그 이유는 그것이 다음과 같기 때문이다:
- 입력 의존적 순환을 가진 선형 어텐션의 자연스러운 일반화이다.
- 효율적인 자기회귀 어텐션과 동등한 일반 준분리 가능 어텐션의 가장 단순한 경우이다.
- 대각 상태 공간 모델의 특수한 경우이다.
5.3 구조화 상태-공간 이중성 (SSD)
우리의 결과를 요약하면:
- 구조화 상태-공간 모델(3절)은 보통 선형 시간 순환을 통해 정의되는 모델이다. 그러나 그 선형 시퀀스-대-시퀀스 변환을 특징짓는 행렬 형식을 전개함으로써, 이차 형식을 유도할 수 있다.
- 어텐션 변형들(4절)은 이차 시간 쌍별 상호작용을 통해 정의되는 모델이다. 그러나 이를 사방 텐서 수축으로 보고 다른 순서로 축소함으로써, 선형 형식을 유도할 수 있다.
- 각각의 자연스러운 특수한 경우, 더 정확히는 행렬에 스칼라-단위 구조를 가진 상태 공간 모델과 그 마스크에 1-준분리 가능 구조를 가진 구조화 마스킹 어텐션은 정확히 동일한 선형 및 이차 형식을 가진 서로의 쌍대이다.
그림 4는 이 두 표현 사이의 이중성을 요약한다.
확장된 관련 연구 및 논의(10절)는 SSD와 일반 SSM / 어텐션 사이의 관계를 더 자세히 기술한다.
6 SSD 모델을 위한 하드웨어 효율적 알고리즘
SSM, 어텐션, 구조화 행렬 사이의 이론적 SSD 프레임워크를 개발하는 이점은 모델과 알고리즘을 개선하기 위해 그 연결을 사용하는 데 있다. 이 절에서 우리는 SSD 모델을 효율적으로 계산하기 위한 다양한 알고리즘이 구조화 행렬 곱셈을 계산하기 위한 다양한 알고리즘으로부터 어떻게 유도될 수 있는지 보여준다.
우리의 주요 계산 결과는 선형(순환) 모드와 이차(어텐션) 모드를 모두 결합한 SSD 모델 계산 알고리즘이다. 이 알고리즘은 SSM만큼 계산 효율적이며(시퀀스 길이에 대해 선형 스케일링) 어텐션만큼 하드웨어 친화적이다(주로 행렬 곱셈을 사용한다).
정리 6.1. 상태 확장 인자 과 헤드 차원 을 가진 SSD 모델을 고려하자. 임의의 입력 에 대해 모델을 계산하는 알고리즘이 존재하며, 이는 단지 훈련 FLOPs, 추론 FLOPs, 추론 메모리를 필요로 하고, 그 작업은 행렬 곱셈에 의해 지배된다.
| 구조적 상태 공간 모델 | 구조적 마스크드 어텐션 | ||||
| C | (수축 행렬) | Q | (쿼리) | S4 | 대각 상태 공간 모델 |
| B | (확장 행렬) | K | (키) | ||
| X | (입력 시퀀스) | V | (값) | DSS | 스칼라-항등 SSM |
| Aij | (상태 행렬) | Lji | (마스크) | S4D | RetNet GateLoop |
| N | (상태 확장 차원) | N | (커널 특징 차원) | S5 | TransNormer |
| H | (은닉 상태 (8b)) | SMA 선형 쌍대 (15) | S6 | 선형 어텐션 | |
| = L·XB | (선형 모드) | 1-반분리 가능 SMA | |||
| SSM 이차 쌍대 (16) | G | (그람 행렬 (13a)) | 효율적 자기회귀 어텐션 | ||
| = Q·K | (이차 모드) | 반분리 가능 SMA |
이 경계들은 모두 타이트하다는 점에 주목하라. 왜냐하면 N의 상태 확장을 가지고 N의 헤드 크기에서 작동하는 상태 공간 모델은 총 상태 크기 를 가지기 때문이다(이는 각각 와 의 훈련 및 추론 FLOPs에 대한 하한을 낳는다). 또한 입력 자체는 TN개의 원소를 가지며, 메모리 하한을 낳는다.
정리 6.1의 주된 아이디어는 다시 한 번 상태 공간 모델을 계산하는 문제를 준분리 가능 행렬 곱셈으로 보는 것이지만, 그 구조를 새로운 방식으로 활용하는 것이다. 순환 모드나 어텐션 모드 중 하나에서 전체 행렬을 계산하는 대신, 우리는 행렬의 블록 분해를 수행한다. 대각 블록들은 이중 어텐션 모드를 사용하여 계산될 수 있으며, 이는 행렬 곱셈으로 효율적으로 수행될 수 있고, 비대각 블록들은 준분리 가능 행렬의 랭크 구조에 의해 인수분해되어 더 작은 순환으로 축소될 수 있다. 우리는 Listing 1이 SSD 알고리즘의 자기 완결적 구현을 제공한다는 점을 강조한다. Gu와 Dao (2023)의 일반 선택적 SSM과 비교하여, 이 구현은 훨씬 단순하며, 특별한 저수준 커널을 요구하지 않고 네이티브 PyTorch에서도 상대적으로 효율적이다.
시작하기 위해, 우리는 행렬 을 어떤 블록 크기 에 대해 크기 의 부분행렬들로 이루어진 격자로 분할한다. 비대각 블록들은 준분리 가능 행렬의 정의 성질(정의 3.1)에 의해 저랭크라는 점에 주목하라.5
이는 예를 통해 가장 쉽게 예시된다. 예를 들어 이고 길이 의 청크로 분해하는 경우이다. 음영 처리된 셀들은 준분리 가능 행렬의 비대각 블록들의 저랭크 인수분해이다.
이 부분 문제들은 다음과 같이 해석될 수 있다: (청크에 대한) 초기 상태가 0이라고 가정할 때 청크당 출력은 무엇인가. 다시 말해 청크 에 대해, 이는 오직 청크 입력 만을 고려하여 올바른 출력들을 계산한다.
6.2 저계수 블록
저계수 인수분해는 3개의 항으로 구성되며, 이에 대응하여 계산도 세 부분으로 나뉜다. 이 인수분해에서는 다음과 같은 용어를 사용한다.
와 같은 항들을 우측 인자 또는 \(B\)-블록-인자라고 한다.
와 같은 항들을 중심 인자 또는 -블록-인자라고 한다.
와 같은 항들을 좌측 인자 또는 \(C\)-블록-인자라고 한다.
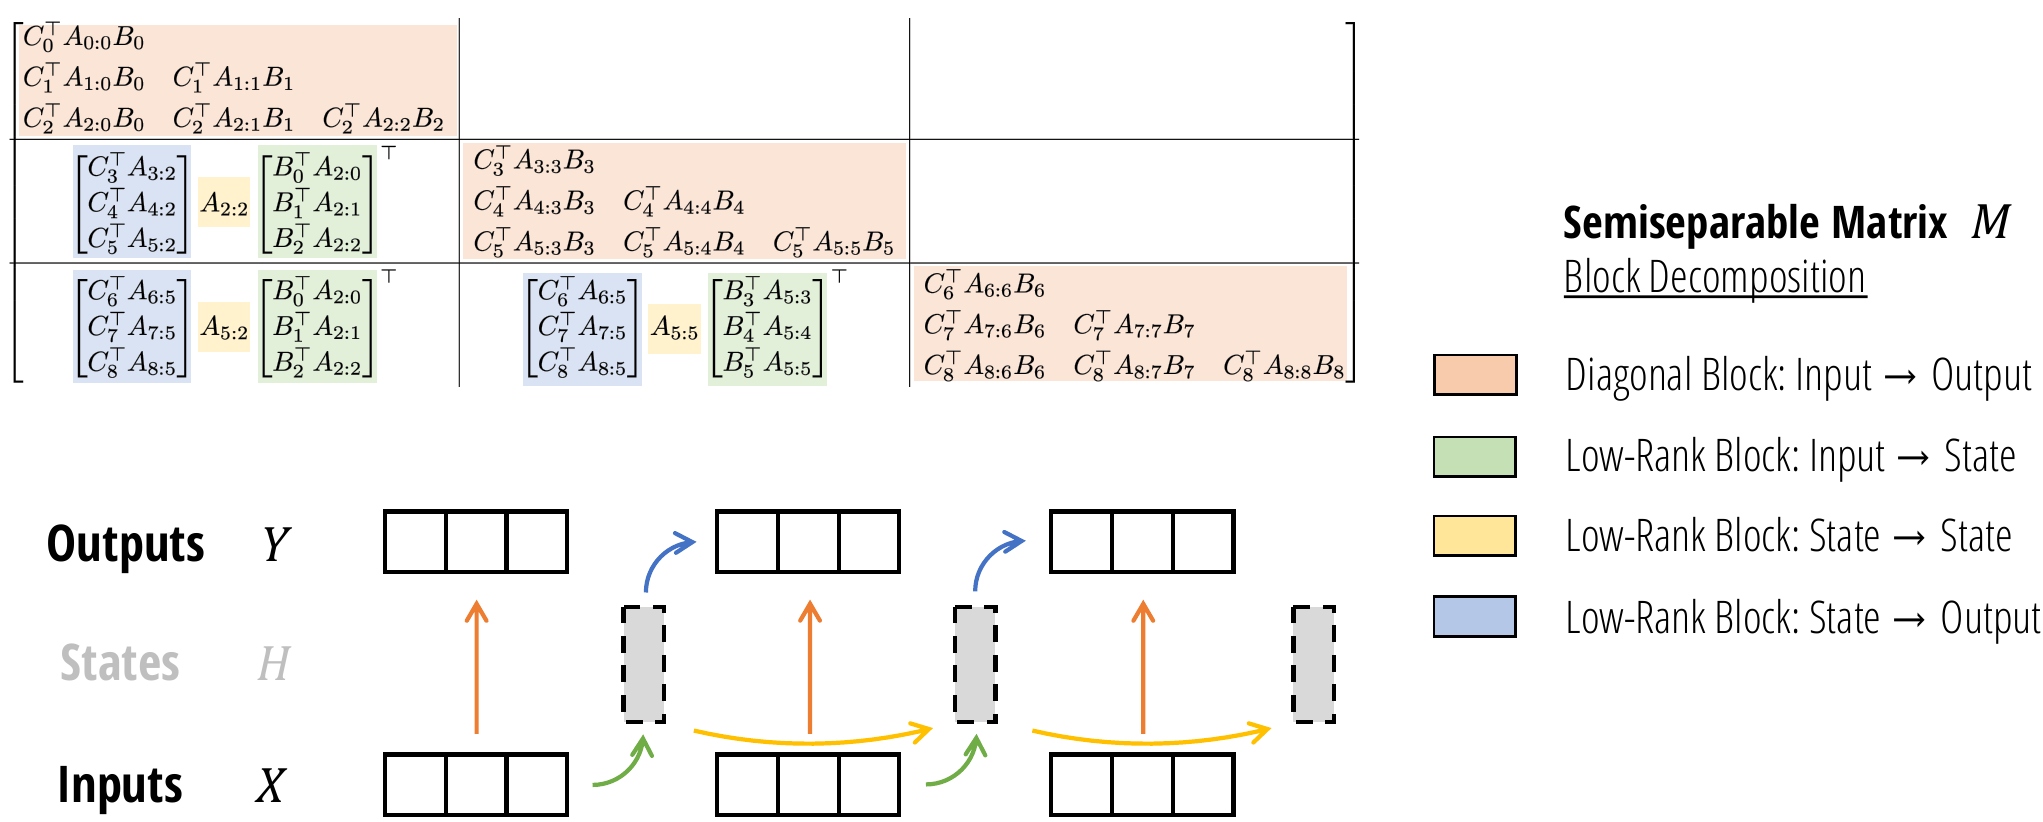
우측 인자. 이 단계는 저계수 인수분해의 우측 -블록-인자에 의한 곱셈을 계산한다. 각 청크에 대해 이것은 대 행렬 곱셈이며, 여기서 은 상태 차원이고 는 헤드 차원이다. 결과는 각 청크에 대한 텐서이며, 이는 확장된 은닉 상태 와 동일한 차원을 갖는다.
이는 다음과 같이 해석할 수 있다: (청크에 대한) 초기 상태가 0이라고 가정할 때 청크별 최종 상태는 무엇인가. 다시 말해, 이라고 가정할 때 을 계산한다.
중심 인자. 이 단계는 저계수 인수분해에서 중심 -블록-인자 항들의 효과를 계산한다. 이전 단계에서 청크별 최종 상태는 전체 형상이 이다. 이는 이제 에 의해 생성된 1-SS 행렬과 곱해진다.
이 단계는 1-SS 곱셈(스칼라 SSM 스캔 또는 cumprodsum 연산자라고도 함)을 계산하기 위한 임의의 알고리즘으로 계산할 수 있다.
이는 다음과 같이 해석할 수 있다: 모든 이전 입력을 고려할 때 청크별 실제 최종 상태는 무엇인가; 다시 말해, 전체를 고려하여 진정한 은닉 상태 를 계산한다.
좌측 인자. 이 단계는 저계수 인수분해의 좌측 -블록-인자에 의한 곱셈을 계산한다. 각 청크에 대해 이것은 행렬 곱셈 수축 으로 나타낼 수 있다.
이는 다음과 같이 해석할 수 있다: 올바른 초기 상태 를 고려하고 입력 가 0이라고 가정할 때 청크별 출력은 무엇인가. 다시 말해 청크 에 대해, 이는 이전 입력 만을 고려하여 올바른 출력들을 계산한다.
6.3 계산 비용
우리는 배치 차원 를 가진 배치 행렬 곱셈 계약 을 정의하기 위해 표기를 정의한다. 이 표기로부터 우리는 효율성의 세 가지 측면을 추론할 수 있다:- 계산 비용: 총 FLOPs.
- 메모리 비용: 총 공간.
Listing 1 상태 공간 이중(SSD) 모델의 전체 PyTorch 예제.
def segsum(x):
순진한 세그먼트 합 계산. exp(segsum(A))는 1- SS 행렬을 생성하며,
이는 스칼라 SSM과 동등하다.
T = x.size(- 1)
x_cumsum = torch.cumsum(x, dim=- 1)
x_segsum = x_cumsum[..., None] - x_cumsum[..., None, :]
mask = torch.tri1(torch.ones(T, T, device=x.device, dtype=bool), diagonal=0)
x_segsum = x_segsum.masked_fill(- mask, - torch.inf)
return x_segsum
def ssd(X, A, B, C, block_len=64, initial_states=None):
인자:
X: (batch, length, n_heads, d_head)
A: (batch, length, n_heads)
B: (batch, length, n_heads, d_state)
C: (batch, length, n_heads, d_state)
반환:
Y: (batch, length, n_heads, d_head)
\*
4. 청크당 상태 -> 출력 변환 계산 # (비대각 블록의 저랭크 분해의 좌항; C 항) state_decay_out = torch.exp(A_cumsum) Y_off = torch.einsum('bclhn, bchpn, bhl->bclhp', C, states, state_decay_out)
청크 내 및 청크 간 항의 출력 추가 (대각 및 비대각 블록) Y = rearrange(Y_diag+Y_off, "b c l h p -> b (c l) h p") return Y, final_state
- 병렬화: 더 큰 M, N, K 항은 현대 가속기에서 특수화된 행렬 곱셈 유닛을 활용할 수 있다.
중앙 블록. 이차 SMA 계산의 비용은 세 단계로 구성된다 (식 (16)):
- 커널 행렬 계산, 비용은 이다.
- 마스크 행렬 곱셈, 이는 형태 의 텐서에 대한 원소별 연산이다.
- 값 곱셈, 비용은 이다.
저랭크 블록: 우측 인자. 이 단계는 비용 의 단일 행렬 곱셈이다.
저랭크 블록: 중앙 인자. 이 단계는 독립 채널에 대한 길이 의 스칼라 SSM 스캔(또는 1- SS 곱셈)이다. 이 스캔의 작업량은 이며, 이는 다른 인자들과 비교해 무시할 수 있다.
블로킹으로 인해 시퀀스 길이가 에서 로 줄어들기 때문에, 이 스캔은 순수 SSM 스캔(예: Mamba의 선택적 스캔)보다 배 더 작은 비용을 가진다. 따라서 우리는 대부분의 문제 길이에서 다른 알고리즘(부록 B)이 상당한 속도 저하 없이 더 효율적이거나 훨씬 구현하기 쉬울 수 있음을 관찰한다. 예를 들어, 1- SS 행렬 곱셈을 통한 순진한 구현은 비용 을 가지며, 이는 구현하기 훨씬 쉽고 순진한 재귀/스캔 구현보다 더 효율적일 수 있다.
저랭크 블록: 좌측 인자. 이 단계는 비용 의 단일 행렬 곱셈이다.
총 비용. 만약 우리가 를 설정하면(다시 말해 상태 차원, 헤드 차원, 청크 길이가 동일하면), 위의 모든 BMM 항은 이 된다. 이의 계산적 특성은 다음과 같다:
- 총 FLOP 수 .- 총 메모리 .- 작업은 주로 형태 의 행렬에 대한 행렬 곱셈으로 구성된다.
메모리 소비가 빡빡하다는 점에 주목하라; 입력과 출력 는 형태 을 가진다. 한편 FLOP 수는 추가적인 인자를 반영하는데, 이는 자기회귀 상태 크기에 의해 발생하는 비용이며 모든 모델에 공통이다.
행렬 곱셈 외에도, 특징과 시퀀스 길이 에 대한 스칼라 SSM 스캔이 있다. 이는 FLOPs와 깊이의 비용을 가진다. 비록 행렬 곱셈을 사용하지 않지만, 여전히 병렬화 가능하며 수행되는 총 작업량은 다른 단계들과 비교해 무시할 수 있다; 이는 우리의 GPU 구현에서 무시할 수 있는 비용을 가진다.
순수 SSM 및 어텐션 모델과의 비교. 이차 어텐션은 행렬 곱셈만 활용하므로 하드웨어 효율이 매우 높지만, 총 FLOPs를 가진다. 훈련과 추론 모두에서의 느린 계산 속도는 더 큰 상태 크기를 가지는 것의 직접적인 결과로 볼 수 있다 - 표준 어텐션은 히스토리를 캐시하고 상태를 압축하지 않기 때문에 상태 크기가 시퀀스 길이 에 따라 확장된다.
선형 SSM은 총 FLOPs를 가지며, 이는 SSD와 동일하다. 그러나 순진한 구현은 추가 메모리를 구체화하는 상태 확장 (15a)과 행렬 곱셈을 활용하지 않는 스칼라 연산 (15b)을 필요로 한다.
| 어텐션 | SSM | SSD | |
| 상태 크기 | T | N | N |
| 학습 FLOPs | T²N | TN² | TN² |
| 추론 FLOPs | TN | N² | N² |
| (순진한) 메모리 | T² | TN² | TN |
| 행렬 곱셈 | ✓ | ✓ |
우리는 다른 많은 행렬 분해가 가능하다는 점을 주목한다(예를 들어, 서로 다른 구조화된 행렬 분해를 통한 1-SS 곱셈을 위한 알고리즘 모음은 부록 B를 참조하라). 이는 다른 특수한 설정에서 더 나을 수 있는 SSD를 위한 더 많은 알고리즘으로 이어질 수 있다. 더 넓게 보면, 우리는 준분리 가능 행렬(semiseparable matrix)이 풍부한 문헌을 가지고 있으며 우리가 사용하는 SSs 형태(정의 3.2) 외에도 훨씬 더 많은 표현이 존재하고, 훨씬 더 효율적인 알고리즘도 가능할 수 있음을 주목한다.
7 Mamba-2 아키텍처
SSM과 어텐션을 연결함으로써, SSD 프레임워크는 우리가 둘 모두를 위한 공유된 어휘와 기법 라이브러리를 개발할 수 있게 해준다. 이 절에서 우리는 원래 Transformer를 위해 개발된 아이디어를 사용하여 SSD 계층을 이해하고 수정하는 몇 가지 예를 논의한다.
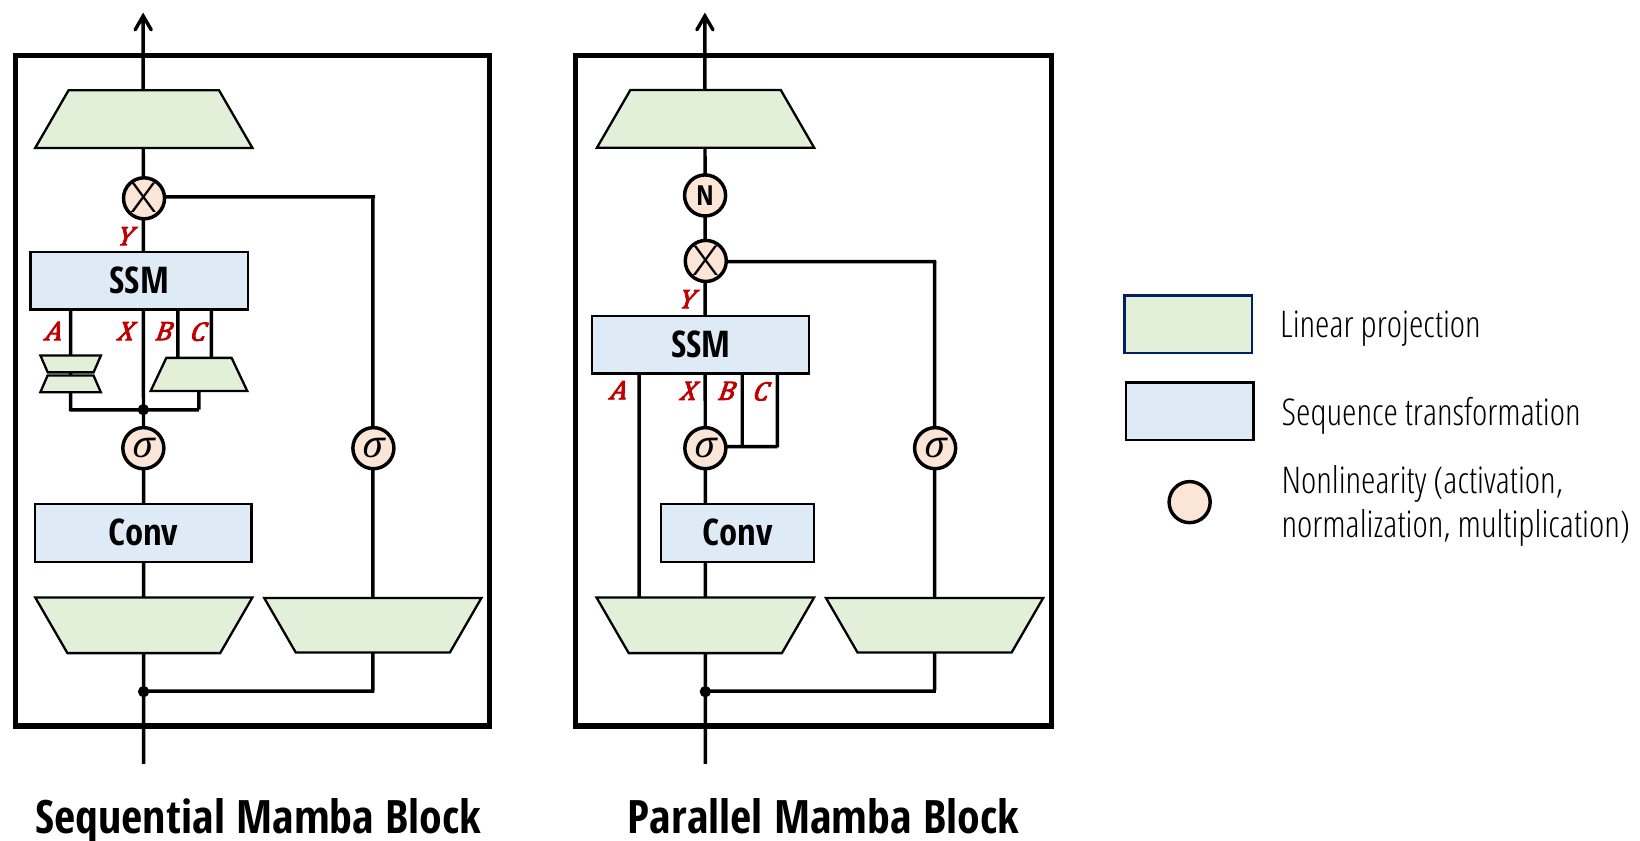
우리는 여러 설계 선택을 논의하며, 그 결과 Mamba-2 아키텍처가 된다. 이러한 변형 축들은 9.4절에서 소거법(ablation)으로 분석된다.
7.1 블록 설계
우리는 먼저 내부 시퀀스 혼합 계층과 독립적인(즉, 핵심 SSD 계층 외부의) 신경망 블록에 대한 수정을 논의한다.
병렬 파라미터 투영. Mamba-1은 선택적 SSM 계층을 의 사상으로 보는 SSM 중심적 관점에서 동기를 얻었다. SSM 파라미터 는 부수적인 것으로 간주되며 SSM 입력 의 함수이다. 따라서 를 정의하는 선형 투영은 를 생성하기 위한 초기 선형 투영 이후에 일어난다.
Mamba-2에서 SSD 계층은 의 사상으로 간주된다. 따라서 블록의 시작에서 단일 투영으로 를 병렬로 생성하는 것이 타당하다. 가 병렬로 생성되는 투영에 대응하는 표준 어텐션 아키텍처와의 유사성에 주목하라.
SSM에 대한 입력에 병렬 투영을 채택하는 것은 파라미터를 약간 줄이며, 더 중요하게는 표준 Megatron 샤딩 패턴(Shoeybi et al. 2019)을 사용함으로써 더 큰 모델에 대한 텐서 병렬화에 더 적합하다는 점에 주목하라.
추가 정규화. 예비 실험에서 우리는 더 큰 모델에서 불안정성이 발생하기 쉬움을 발견했다. 우리는 최종 출력 투영 바로 전에 블록에 추가 정규화 계층(예: LayerNorm, GroupNorm, 또는 RMSNorm)을 추가함으로써 이를 완화할 수 있었다. 이러한 정규화의 사용은 MLP 및 MHA 블록의 끝에도 정규화 계층을 추가한 NormFormer 아키텍처(Shleifer, Weston, and Ott 2021)와 가장 직접적으로 관련된다.
우리는 또한 이 변경이 선형 어텐션 관점에서 도출된 Mamba-2와 관련된 다른 최근 모델들과 유사하다는 점을 주목한다. 원래의 선형 어텐션 정식화는 표준 어텐션에서 softmax 함수의 정규화를 모방하는 분모 항으로 정규화한다. TransNormerLLM(Qin, Dong Li, et al. 2023)과 RetNet(Y. Sun et al. 2023)은 이 정규화가 불안정함을 발견하고 선형 어텐션 계층 이후에 추가 LayerNorm 또는 GroupNorm을 추가한다. 우리의 추가 정규화 계층은 이들과 약간 다르며, 이전이 아니라 곱셈 게이트 분기 이후에 일어난다.
. . .
7.2 시퀀스 변환을 위한 다중 헤드 패턴
SSM은 다음과 같은 시퀀스 변환(정의 2.1)으로 정의됨을 상기하라:
- 파라미터는 상태 차원 N을 가진다.- 이들은 시퀀스 변환 을 정의하며, 이는 예를 들어 행렬 로 표현될 수 있다.- 이 변환은 입력 시퀀스 에 대해 P 축에 걸쳐 독립적으로 작동한다.
이는 시퀀스 변환의 하나의 헤드를 정의하는 것으로 볼 수 있다.
정의 7.1 (멀티헤드 패턴). 멀티헤드 시퀀스 변환은 H개의 독립적인 헤드로 구성되며, 전체 모델 차원은 이다. 매개변수들은 헤드들에 걸쳐 공유될 수 있으며, 이는 헤드 패턴을 이끌어낸다.
상태 크기 N과 헤드 차원 P는 각각 어텐션의 QK 헤드 차원 및 V 헤드 차원과 유사하다. 현대 Transformer 아키텍처(Chowdhery et al. 2023; Touvron, Lavril, et al. 2023)에서와 마찬가지로, Mamba-2에서는 일반적으로 이들을 64 또는 128 정도의 상수로 선택한다. 모델 차원 D가 증가할 때, 우리는 헤드 차원 N과 P를 고정한 채 헤드의 수를 증가시킨다. 이를 어떻게 수행하는지 설명하기 위해, 우리는 멀티헤드 어텐션의 아이디어를 전이하고 일반화하여 SSM 또는 임의의 일반적인 시퀀스 변환에 대해 유사한 패턴을 정의할 수 있다.
| Multi-head SSM(Multi-head Attn.) | Multi-contract SSM(Multi-query Attn.) | Multi-expand SSM(Multi-key Attn.) | Multi-input SSM(Multi-value Attn.) |
| X (T, H, P) | X (T, 1, P) | X (T, 1, P) | X (T, H, P) |
| A (T, H) | A (T, H) | A (T, H) | A (T, H) |
| B (T, H, N) | B (T, 1, N) | B (T, H, N) | B (T, 1, N) |
| C (T, H, N) | C (T, H, N) | C (T, 1, N) | C (T, 1, N) |
멀티헤드 SSM (MHS) / 멀티헤드 어텐션 (MHA) 패턴. 고전적인 MHA 패턴은 헤드 차원 P가 모델 차원 D를 나눈다고 가정한다. 헤드의 수는 로 정의된다. 그런 다음, 각 매개변수의 H개 독립적인 복사본을 생성함으로써 핵심 시퀀스 변환의 H개 복사본이 생성된다. MHA 패턴이 어텐션 시퀀스 변환에 대해 처음 기술되었지만, 정의 2.1과 호환되는 어떤 것에도 적용될 수 있다는 점에 유의하라. 예를 들어, 멀티헤드 SSD 레이어는 SSD 알고리즘이 차원에 걸쳐 브로드캐스트되는 식 (17)에 따른 형상의 입력을 받아들일 것이다.
멀티-컨트랙트 SSM (MCS) / 멀티-쿼리 어텐션 (MQA) 패턴. 멀티-쿼리 어텐션(Shazeer 2019)은 와 텐서를 캐싱하는 데 의존하는 자기회귀 추론의 속도를 극적으로 향상시킬 수 있는 어텐션에 대한 영리한 최적화이다. 이 기법은 단순히 와 에 추가적인 헤드 차원을 부여하는 것을 피하는데, 다시 말해 의 단일 헤드를 의 모든 헤드에 걸쳐 브로드캐스트하는 것이다.
상태 공간 쌍대성을 이용하여, 우리는 MQA의 등가적인 SSM 버전을 식 (18)과 같이 정의할 수 있다. 여기서 와 (어텐션의 및 에 해당하는 SSM 유사체)는 H개의 헤드에 걸쳐 공유된다. 우리는 또한 이를 멀티-컨트랙트 SSM (MCS) 헤드 패턴이라고 부르는데, SSM 상태 수축을 제어하는 매개변수가 헤드별로 독립적인 복사본을 갖기 때문이다.
우리는 유사하게 멀티-키 어텐션 (MKA) 또는 멀티-익스팬드 SSM (MES) 헤드 패턴을 정의할 수 있는데, 여기서 (SSM 확장을 제어하는)는 헤드별로 독립적이며 와 는 헤드들에 걸쳐 공유된다.
멀티-입력 SSM (MIS) / 멀티-밸류 어텐션 (MVA) 패턴. MQA가 KV 캐시 때문에 어텐션에 대해서는 타당하지만, SSM에 대해서는 자연스러운 선택이 아니다. 대신 Mamba에서는 가 SSM에 대한 주요 입력으로 간주되며, 따라서 와 는 입력 채널들에 걸쳐 공유되는 매개변수이다. 우리는 식 (20)에서 멀티-밸류 어텐션 (MVA) 또는 멀티-입력 SSM (MIS) 패턴을 새롭게 정의하는데, 이는 다시 SSD와 같은 임의의 시퀀스 변환에 적용될 수 있다.
이러한 용어를 갖추고 나면, 우리는 원래의 Mamba 아키텍처를 더 정밀하게 특징지을 수 있다.
명제 7.2. Mamba 아키텍처(Gu and Dao 2023)의 선택적 SSM (S6) 레이어는 다음과 같은 특성을 갖는 것으로 볼 수 있다.- 헤드 차원 : 모든 채널이 독립적인 SSM 동역학 를 갖는다.
- 멀티-입력 SSM (MIS) 또는 멀티-밸류 어텐션 (MVA) 헤드 구조: 행렬(어텐션 쌍대성에서 에 해당)은 입력 (어텐션에서 에 해당)의 모든 채널에 걸쳐 공유된다.
우리는 또한 SSD에 적용될 때 이러한 헤드 패턴 변형들을 절제 실험할 수 있다(9.4.3절). 흥미롭게도, 매개변수 수와 전체 상태 차원에서 통제되었음에도 불구하고, 다운스트림 성능에서 눈에 띄는 차이가 있다. 우리는 경험적으로 Mamba에서 원래 사용된 MVA 패턴이 가장 좋은 성능을 보임을 발견한다.
그룹화된 헤드 패턴. 멀티-쿼리 어텐션의 아이디어는 그룹화된-쿼리 어텐션(Ainslie et al. 2023)으로 확장될 수 있다. 즉, 1개의 K 및 V 헤드 대신, 이고 G가 H를 나누는 G개의 독립적인 K 및 V 헤드를 생성할 수 있다. 이는 멀티-쿼리와 멀티-헤드 어텐션 사이의 성능 차이를 메우는 것과, G를 샤드 수의 배수로 설정함으로써 더 효율적인 텐서 병렬화를 가능하게 하는 것 모두에 의해 동기가 부여된다(8절).
유사하게, Mamba-2에서 사용된 멀티-입력 SSM 헤드 패턴은 그룹화된-입력 SSM (GIS), 또는 동의어로 그룹화된-밸류 어텐션 (GVA)으로 쉽게 확장될 수 있다. 일반화는 간단하며 우리는 간결함을 위해 세부 사항을 생략한다.
7.3 선형 어텐션으로부터의 기타 SSD 확장
우리는 여기서 선형 어텐션에 의해 동기가 부여된 SSD에 대한 아키텍처 수정의 한 예를 기술한다. 우리는 이를 일종의 부정적 결과로서 9.4.3절에서 절제 실험하는데, 이들이 기본 설정으로 채택할 만큼 성능을 유의미하게 향상시키지 못함을 발견한다. 그럼에도 불구하고, 이들은 어텐션에 관한 방대한 문헌이 SSD의 변형을 정의하기 위해 어떻게 통합될 수 있는지를 보여준다. 우리는 커널 특징 맵의 선택을 Mamba-2 아키텍처의 하이퍼파라미터로 취급하며, 어텐션에서 영감을 받은 다른 단순한 수정들도 가능할 것으로 기대한다.
소프트맥스 어텐션에 대한 커널 어텐션 근사. 선형 어텐션 또는 커널 어텐션의 많은 변형은 어텐션 점수 를 다음과 같이 구성된 것으로 보는 것에서 동기를 얻는다.
1. 지수 커널 , 이는 어떤 커널 특징 맵에 대해 로 근사될 수 있다. 2. 커널을 정규화하여 행의 합이 1이 되도록 로 하는데, 여기서 나눗셈은 원소별로 이루어지고 1은 모두 1인 벡터이다.
지수 커널 특징 맵. Mamba-2에서는 유연한 커널 특징 맵을 도입하여, 이를 및 브랜치(어텐션에서 및 브랜치에 해당)에 적용한다. 이 특징 맵은 간결함과 대칭성을 위해 선택적으로 () 브랜치에도 적용될 수 있다. 이는 그림 6에서 임의의 비선형성으로 표현된다. 기본적으로 우리는 단순히 를 원소별 Swish / SiLU 함수(Hendrycks and Gimpel 2016; Ramachandran, Zoph, and Le 2017)로 선택한다. 우리는 9.4.3절의 절제 실험에서 Linear Attention, Performer, Random Feature Attention, cosFormer에서 사용된 특징 맵을 포함한 다른 옵션들을 탐구한다(4.1.3절).
정규화(분모) 항의 통합. 분모 항을 찾기 위해, 우리는 단순히 을 계산하면 된다. 그러나 모델의 최종 출력은 단지 (식 (16))임을 상기하라. 따라서 정규화 항은 단순히 에 추가 열 1을 덧붙여 형상 의 텐서를 만들어 찾을 수 있다.이 경우 커널 특징 맵 는 합이 양수가 되도록 양수여야 한다는 점에 유의하라.
8 SSM을 위한 시스템 최적화
우리는 대규모의 효율적인 학습과 추론을 위해 SSM, 특히 Mamba-2 아키텍처에 대한 여러 시스템 최적화를 기술한다. 특히, 우리는 대규모 학습을 위한 텐서 병렬 및 시퀀스 병렬과, 효율적인 파인튜닝 및 추론을 위한 가변 길이 시퀀스에 초점을 맞춘다.
8.1 텐서 병렬
텐서 병렬화(Tensor parallelism, TP)(Shoeybi et al. 2019)는 각 레이어(예: 어텐션, MLP)를 GPU와 같은 여러 가속기에서 실행되도록 분할하는 모델 병렬화 기법이다. 이 기법은 각 노드가 일반적으로 NVLink와 같은 고속 네트워킹을 갖춘 4-8개의 GPU를 보유한 GPU 클러스터에서 대부분의 대규모 모델(Brown et al. 2020; Chowdhery et al. 2023; Touvron, Lavril, et al. 2023; Touvron, L. Martin, et al. 2023)을 훈련하는 데 널리 사용된다. TP는 원래 Transformer 아키텍처를 위해 개발되었으며, 다른 아키텍처에 적용하는 것은 간단하지 않다. 우리는 먼저 Mamba 아키텍처에 TP를 사용할 때의 문제점을 보여주고, 그 다음 Mamba-2 아키텍처가 TP를 효율적으로 만들기 위해 어떻게 설계되었는지 보여준다.
단일 입력 (간단함을 위해 배칭 없음), 입력 프로젝션 행렬 (여기서 는 확장 계수, 일반적으로 2), 그리고 출력 프로젝션 행렬 를 갖는 Mamba 아키텍처를 상기하자:
TP를 사용할 때, 계산을 2개의 GPU로 분할한다고 가정하자. 입력 프로젝션 행렬 와 를 각각 크기 인 두 개의 파티션으로 분할하는 것은 쉽다. 그러면 각 GPU는 크기 인 의 절반을 보유하게 된다. 그러나 가 의 함수이므로, 를 계산하기 전에 전체를 얻기 위해 GPU들 사이에 추가적인 all-reduce가 필요하다는 것을 알 수 있다. 그 후 두 GPU는 를 따라 독립적이므로 SSM을 병렬로 계산할 수 있다. 마지막으로, 출력 프로젝션 행렬 를 각각 크기 인 두 개의 파티션으로 분할하고 끝에서 all-reduce를 수행할 수 있다. Transformer와 비교하면, 하나 대신 두 번의 all-reduce가 발생하여 통신에 소요되는 시간이 두 배가 된다. 대규모 Transformer 훈련의 경우 통신이 이미 상당한 시간 비율(예: 10-20%)을 차지할 수 있으며, 통신이 두 배가 되면 Mamba가 대규모 훈련에 그다지 효율적이지 않게 된다.
Mamba-2에서는 Transformer의 어텐션 또는 MLP 블록과 유사하게 블록당 하나의 all-reduce만 갖는 것을 목표로 한다. 결과적으로, 를 얻기 위한 프로젝션을 가 아닌 로부터 직접 수행하도록 하여 이러한 프로젝션 행렬을 분할할 수 있게 한다. 이는 서로 다른 GPU에서 서로 다른 집합을 갖게 됨을 의미하며, 이는 더 큰 "논리적 GPU"에서 여러 "그룹"을 갖는 것과 동등하다. 또한, 각 블록 내에서 GroupNorm을 사용하되 그룹 수를 TP 차수로 나눌 수 있도록 하여, TP 그룹 내의 GPU들이 블록 내에서 통신할 필요가 없도록 한다:
우리는 입력 투영 행렬과 출력 투영 행렬만 분할하면 되고, 블록의 끝에서 all-reduce만 수행하면 된다는 것을 알 수 있다. 이는 어텐션 및 MLP 레이어에 대한 TP 설계와 유사하다. 특히 TP 차수가 2인 경우, 로 분할하며 로 분할하며 ,
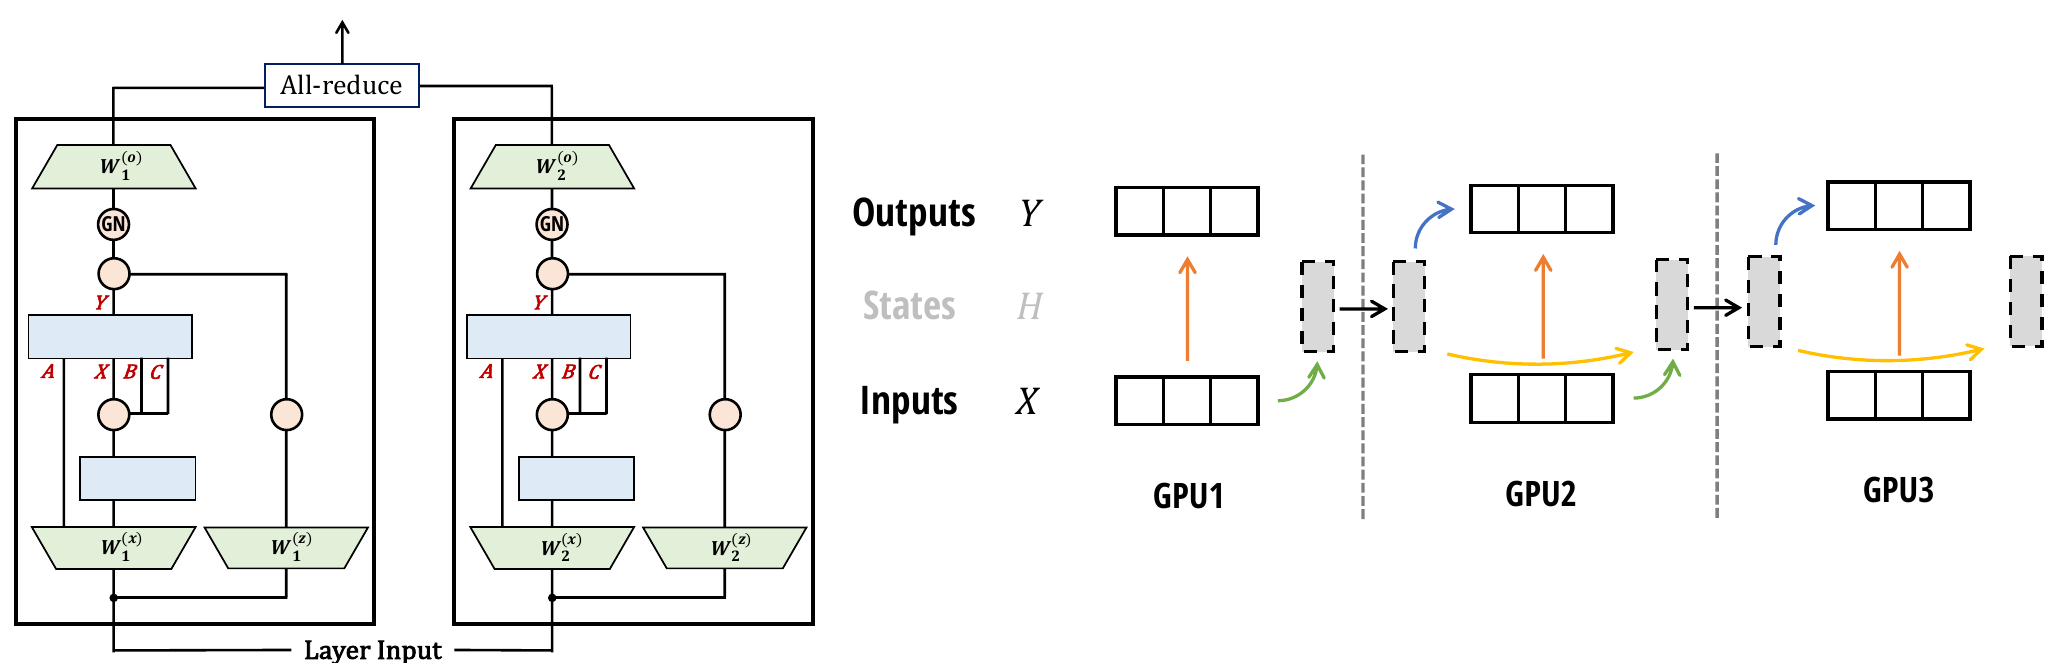
그리고 로 분할하며 이다. 에 대해, TP Mamba-2 레이어는 다음과 같이 쓸 수 있다:
우리는 그림 7(왼쪽)에서 Mamba-2를 사용한 텐서 병렬 처리를 예시한다.
8.2 시퀀스 병렬 처리
매우 긴 시퀀스의 경우, 입력과 활성화를 시퀀스 길이 차원을 따라 서로 다른 GPU로 분할해야 할 수 있다. 두 가지 주요 기법이 있다:
1. 잔차 및 정규화 연산을 위한 시퀀스 병렬 처리(SP): Korthikanti 등(2023)이 처음 제안한 이 기법은 TP에서의 all-reduce를 reduce-scatter와 all-gather로 분해한다. 잔차 및 정규화 연산이 동일한 TP 그룹의 모든 GPU에 대해 동일한 입력에서 반복된다는 점에 착안하여, SP는 reduce-scatter, 잔차 및 정규화, 그다음 all-gather를 수행함으로써 시퀀스 길이 차원을 따라 활성화를 분할한다.
Mamba-2 아키텍처는 동일한 잔차 및 정규화 구조를 사용하므로, SP는 수정 없이 적용된다.
2. 토큰 믹싱 연산(어텐션 또는 SSM)을 위한 시퀀스 병렬 처리, 즉 "컨텍스트 병렬 처리"(CP)라고도 한다. 어텐션 레이어를 위해 여러 기법이 개발되었으며(예: Ring attention (Liu, Yan, et al. 2024; Liu, Zaharia,
and Abbeel 2023)), 정교한 로드 밸런싱 기법(Brandon et al. 2023)도 있다. 어텐션에서 시퀀스 병렬 처리의 어려움은 쿼리와 키를 블록으로 분할할 수 있지만, 각 쿼리 블록이 키 블록과 상호작용해야 하므로 통신 대역폭이 워커 수의 제곱에 비례한다는 점이다.
SSM의 경우, 시퀀스를 간단한 방식으로 분할할 수 있다: 각 워커가 초기 상태를 받아 자신의 입력에 대해 SSM을 계산하고 최종 상태를 반환하여, 그 최종 상태를 다음 워커에 전달한다. 통신 대역폭은 워커 수에 선형이다. 이 분해는 블록/청크로 분할하기 위한 SSD 알고리즘(그림 5)의 블록 분해와 정확히 동일하다. 우리는 그림 7(오른쪽)에서 이 컨텍스트 병렬 처리를 예시한다.
8.3 가변 길이
사전 학습은 종종 배치에 동일한 시퀀스 길이를 사용하지만, 미세 조정이나 추론 중에는 모델이 서로 다른 길이의 다양한 입력 시퀀스를 처리해야 할 수 있다. 이 경우를 처리하는 한 가지 순진한 방법은 배치의 모든 시퀀스를 최대 길이까지 오른쪽 패딩하는 것이지만, 시퀀스 길이가 크게 다를 경우 비효율적일 수 있다. 트랜스포머의 경우 패딩을 피하고 GPU 간 로드 밸런싱을 수행하거나(Zeng et al. 2022; Y. Zhai et al. 2023), 여러 시퀀스를 동일한 배치에 패킹하고 어텐션 마스크를 조정하는(Ding et al. 2024; Pouransari et al. 2024) 정교한 기법이 개발되었다. SSM, 특히 Mamba의 경우, 전체 배치를 하나의 긴 시퀀스로 취급하고 개별 시퀀스 간에 상태를 전달하지 않음으로써 가변 시퀀스 길이를 간단히 처리할 수 있다. 이는 한 시퀀스의 끝에 있는 토큰 에 대해 으로 설정하여 정보가 다른 시퀀스에 속하는 토큰 로 전달되는 것을 방지하는 것과 동등하다.
9 실증적 검증
우리는 순환 모델에 어려웠던 합성 리콜 작업(9.1절)과 표준 언어 모델링 사전 학습 및 다운스트림 평가(9.2절)에서 Mamba-2를 실증적으로 평가한다. 우리는 SSD 알고리즘이 Mamba-1보다 훨씬 효율적이며(9.3절) 중간 정도의 시퀀스 길이에서 최적화된 어텐션과 비슷하다는 것을 검증한다. 마지막으로 Mamba-2 아키텍처의 다양한 설계 선택을 소거 실험한다(9.4절).
9.1 합성: 연상 리콜
합성 연상 리콜 작업은 언어 모델이 컨텍스트에서 정보를 조회하는 능력을 테스트하는 데 인기가 있었다. 대체로 이 작업은 자기회귀 모델에 키-값 연관 쌍을 제공한 다음, 이전에 본 키가 제시되면 올바른 완성을 생성하도록 모델에 프롬프트하는 것을 포함한다. 다중 쿼리 연상 리콜(MQAR) 작업은 모델이 여러 연관을 암기해야 하는 이 작업의 특정 공식화이다(Arora, Eyuboglu, Timalsina, et al. 2024). 원래 Mamba 논문은 관련 합성 작업, 특히 Selective Copying(Gu and Dao 2023)과 Induction Heads(Olsson et al. 2022)에 대한 결과를 보고했으며, 이는 더 쉬운 연상 리콜 작업으로 볼 수 있다. MQAR 작업은 또한 SSM과 같은 순환 모델에게 유한 상태 용량으로 인해 어려운 것으로 입증된 "전화번호부 조회" 작업과 밀접하게 관련되어 있다(De et al. 2024; Jelassi et al. 2024).
| 모델 | 토큰. | PILE PPL ↓ | LAMBADA PPL ↓ | LAMBADA ACC ↑ | HELLASWAG ACC ↑ | PIQA ACC ↑ | ARC-E ACC ↑ | ARC-C ACC ↑ | WINOGRANDE ACC ↑ | OPENBOOKQA ACC ↑ | 평균 ACC ↑ |
| Pythia-1B | NeoX | 7.82 | 7.92 | 56.1 | 47.2 | 70.7 | 57.0 | 27.1 | 53.5 | 31.4 | 49.0 |
| Mamba-790M | NeoX | 7.33 | 6.02 | 62.7 | 55.1 | 72.1 | 61.2 | 29.5 | 56.1 | 34.2 | 53.0 |
| Mamba-2-780M | NeoX | 7.26 | 5.86 | 61.7 | 54.9 | 72.0 | 61.0 | 28.5 | 60.2 | 36.2 | 53.5 |
| Hybrid H3-1.3B | GPT2 | — | 11.25 | 49.6 | 52.6 | 71.3 | 59.2 | 28.1 | 56.9 | 34.4 | 50.3 |
| Pythia-1.4B | NeoX | 7.51 | 6.08 | 61.7 | 52.1 | 71.0 | 60.5 | 28.5 | 57.2 | 30.8 | 51.7 |
| RWKV4-1.5B | NeoX | 7.70 | 7.04 | 56.4 | 52.5 | 72.4 | 60.5 | 29.4 | 54.6 | 34.0 | 51.4 |
| Mamba-1.4B | NeoX | 6.80 | 5.04 | 65.0 | 59.1 | 74.2 | 65.5 | 32.8 | 61.5 | 36.4 | 56.4 |
| Mamba-2-1.3B | NeoX | 6.66 | 5.02 | 65.7 | 59.9 | 73.2 | 64.3 | 33.3 | 60.9 | 37.8 | 56.4 |
| Hybrid H3-2.7B | GPT2 | — | 7.92 | 55.7 | 59.7 | 73.3 | 65.6 | 32.3 | 61.4 | 33.6 | 54.5 |
| Pythia-2.8B | NeoX | 6.73 | 5.04 | 64.7 | 59.3 | 74.0 | 64.1 | 32.9 | 59.7 | 35.2 | 55.7 |
| RWKV4-3B | NeoX | 7.00 | 5.24 | 63.9 | 59.6 | 73.7 | 67.8 | 33.1 | 59.6 | 37.0 | 56.4 |
| Mamba-2.8B | NeoX | 6.22 | 4.23 | 69.2 | 66.1 | 75.2 | 69.7 | 36.3 | 63.5 | 39.6 | 59.9 |
| Mamba-2-2.7B | NeoX | 6.09 | 4.10 | 69.7 | 66.6 | 76.4 | 69.6 | 36.4 | 64.0 | 38.8 | 60.2 |
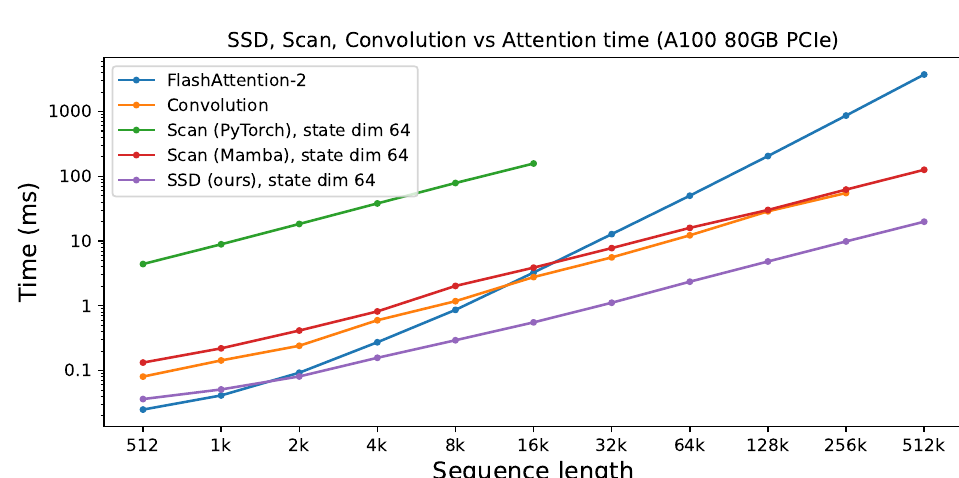
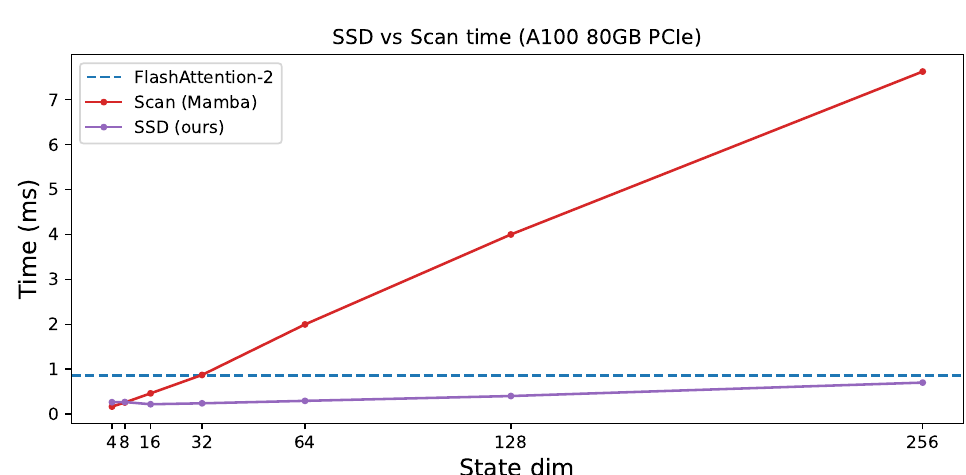
그림 10: (효율성 벤치마크.) (왼쪽) 우리의 SSD는 큰 상태 확장 에 대해 Mamba fused scan보다 빠르며, 시퀀스 길이 이상에서 FlashAttention-2보다 빠르다. (오른쪽) 시퀀스 길이 : 상태 확장을 늘리면 Mamba 최적화 스캔 구현이 선형적으로 느려진다. SSD는 훨씬 더 큰 상태 확장 인자를 큰 속도 저하 없이 처리할 수 있다.
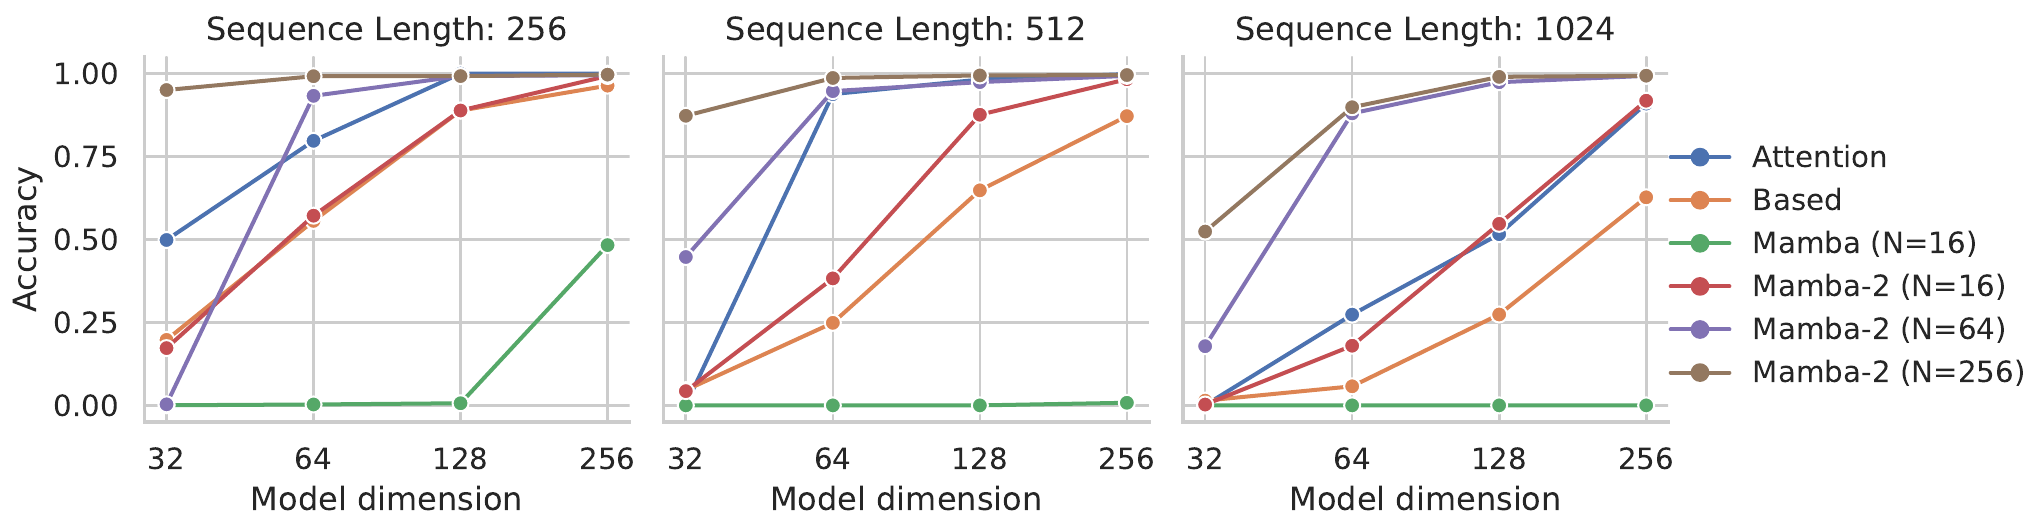
우리는 (Arora, Eyuboglu, Zhang, et al. 2024)의 MQAR 설정 중 더 어려운 작업, 더 긴 시퀀스, 더 작은 모델을 사용한 도전적인 버전에서 비교한다. 우리의 베이스라인에는 표준 다중 헤드 소프트맥스 어텐션과 합성곱, 로컬 어텐션, 선형 어텐션 변형을 결합한 Based 아키텍처가 포함된다.
결과는 그림 8에 제시되어 있다. Mamba-1은 이 과제에서 어려움을 겪는 반면, Mamba-2는 모든 설정에서 좋은 성능을 보인다. 놀랍게도, 상태 크기를 통제한 경우()에도 Mamba-1보다 상당히 더 우수하다. (아키텍처의 어떤 측면이 주된 요인인지는 확실하지 않으며, 이는 향후 연구에서 탐구해야 할 질문으로 남아 있다.) 또한, 이 과제는 상태 크기의 중요성을 입증한다: 에서 및 으로 증가시키면 MQAR에서 일관되게 성능이 향상되는데, 이는 더 큰 상태가 더 많은 정보(키-값 쌍)를 기억할 수 있게 해주기 때문이다.
9.2 언어 모델링
LLM의 표준 프로토콜에 따라, 우리는 Mamba-2 아키텍처를 다른 아키텍처들과 비교하여 표준 자기회귀 언어 모델링에서 학습 및 평가한다. 우리는 사전학습 지표(퍼플렉서티)와 제로샷 평가를 모두 비교한다. 모델 크기(깊이와 너비)는 GPT3 사양을 따르며, 에서 까지이다. 우리는 Pile 데이터셋(L. Gao, Biderman, et al. 2020)을 사용하고, Brown et al. (2020)에 기술된 학습 레시피를 따른다. 이는 Mamba (Gu and Dao 2023)에서 보고된 것과 동일한 설정을 따르며, 학습 세부사항은 부록 D에 있다.
9.2.1 스케일링 법칙
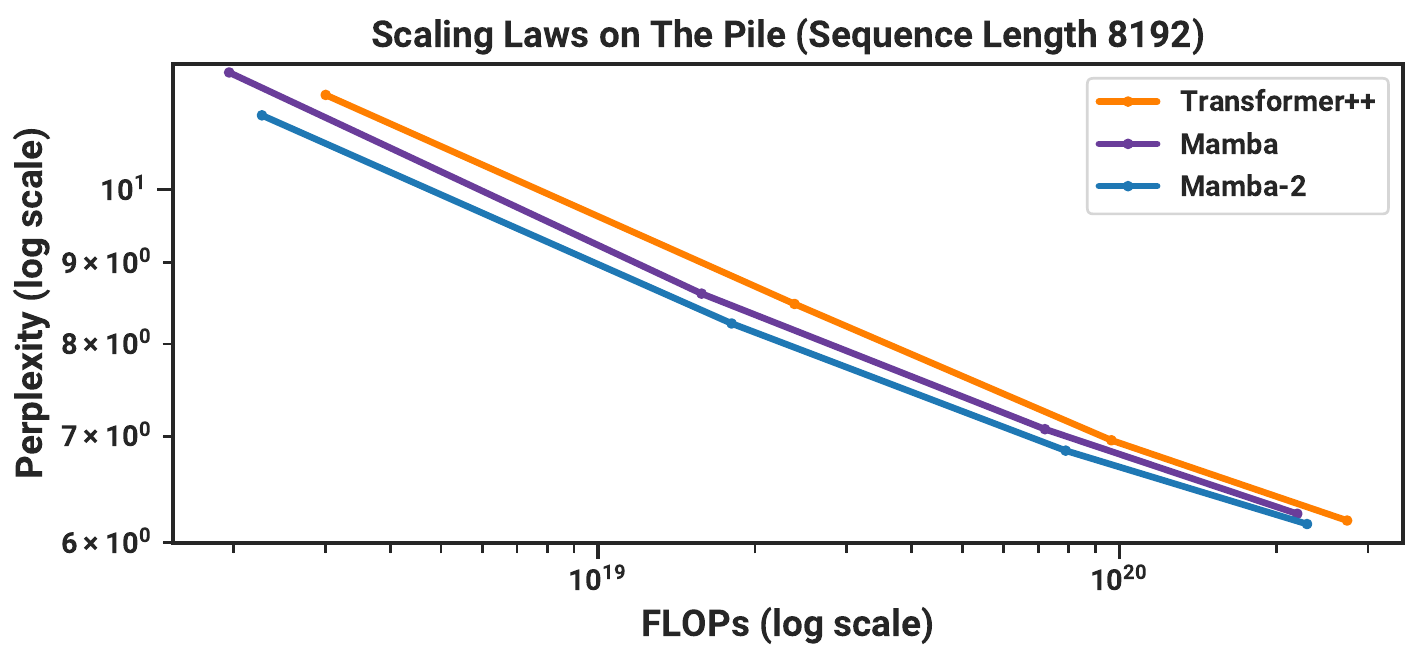
베이스라인으로, 우리는 Mamba와 그 Transformer++ 레시피(Gu and Dao 2023) 모두와 비교하는데, 후자는 PaLM 및 LLaMa 아키텍처(예: rotary embedding, SwiGLU MLP, LayerNorm 대신 RMSNorm, 선형 편향 없음, 더 높은 학습률)에 기반한다. Mamba는 이미 표준 Transformer 아키텍처(GPT3 아키텍처)뿐만 아니라 최근의 준이차(subquadratic) 아키텍처들(H3 (Dao, D. Y. Fu, et al. 2023), Hyena (Poli et al. 2023), RWKV-4 (B. Peng, Alcaide, et al. 2023), RetNet (Y. Sun et al. 2023))보다 우수함을 입증했으므로, 명료성을 위해 그래프에서 이들을 생략한다(비교는 Gu and Dao (2023) 참조).
그림 9는 표준 Chinchilla (Hoffmann et al. 2022) 프로토콜 하에서 에서 파라미터에 이르는 모델들에 대한 스케일링 법칙을 보여준다.
9.2.2 다운스트림 평가
표 1은 인기 있는 다양한 다운스트림 제로샷 평가 과제에서 Mamba-2의 성능을 보여주며, 이 크기대에서 가장 잘 알려진 오픈 소스 모델들, 특히 우리 모델과 동일한 토크나이저, 데이터셋, 훈련 길이(300B 토큰)로 훈련된 Pythia (Biderman et al. 2023)와 비교한다.
9.2.3 하이브리드 모델: SSD 레이어를 MLP 및 어텐션과 결합하기
최근 및 동시대의 연구(Dao, D. Y. Fu, et al. 2023; De et al. 2024; Glorioso et al. 2024; Lieber et al. 2024)는 SSM 레이어와 어텐션 레이어를 모두 갖춘 하이브리드 아키텍처가 Transformer나 순수 SSM(예: Mamba) 모델보다 모델 품질을 향상시킬 수 있으며, 특히 인컨텍스트 학습에서 그러하다고 시사한다. 우리는 SSD 레이어가 어텐션 및 MLP와 결합될 수 있는 다양한 방식을 탐구하여 각각의 이점을 이해하고자 한다. 경험적으로 우리는 전체 레이어 수의 약 가 어텐션인 것이 가장 좋은 성능을 보인다는 것을 발견했다. SSD 레이어, 어텐션 레이어, MLP를 결합하는 것 역시 순수 Transformer++나 Mamba-2보다 더 잘 작동한다.
SSD와 어텐션 우리는 SSD와 어텐션 레이어가 상호 보완적이라는 것을 발견했다: 그 자체로는(예: Mamba-2 아키텍처 대 Transformer++) 그 성능(퍼플렉서티로 측정)이 거의 동일하지만, SSD와 어텐션 레이어의 혼합은 순수 Mamba-2나 Transformer++ 아키텍처를 능가한다. 우리는 350M 모델(48개 레이어)을 GPT-2 토크나이저로 Pile에서 7B 토큰까지 훈련한(동일한 파라미터 수, 동일한 하이퍼파라미터, 동일한 훈련 및 검증 세트) 결과를 일부 제시한다(표 2). 단 몇 개의 어텐션 레이어만 추가해도 이미 눈에 띄는 개선이 나타나며 품질과 효율성 사이에서 최적의 균형을 이룬다. 우리는 SSM 레이어가 일반적인 시퀀스-투-시퀀스 매핑으로서 잘 기능하고, 어텐션 레이어는 모델이 모든 컨텍스트를 메모리(SSM 상태)로 압축하도록 강제하는 대신 시퀀스 내 이전 토큰을 빠르게 참조하는 검색 메커니즘으로 작용한다고 가정한다.
| NUM. ATTN BLOCKS | 0 (Mamba-2) | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 9 | 11 | 15 | 24 | Transformer++ |
| PERPLEXITY ↓ | 8.60 | 8.38 | 8.32 | 8.29 | 8.29 | 8.28 | 8.26 | 8.27 | 8.28 | 8.30 | 8.34 | 8.50 | 8.68 |
SSD, MLP, 어텐션을 갖춘 하이브리드 모델 우리는 SSD가 (게이티드) MLP 및 어텐션 레이어와 결합될 수 있는 다양한 방식을 비교하고, 2.7B 규모(64개 레이어)에서 Pile에 대해 300B 토큰까지 훈련하여(동일한 파라미터 수, 동일한 하이퍼파라미터, 동일한 훈련 및 검증 세트, 동일한 데이터 순서) 평가한다:
1. Transformer++: 32개의 어텐션 레이어와 32개의 게이티드 MLP, 교차 배치.
2. Mamba-2: 64개의 SSD 레이어.
3. Mamba-2-MLP: 32개의 SSD와 32개의 게이티드 MLP 레이어, 교차 배치.
4. Mamba-2-Attention: 58개의 SSD 레이어와 6개의 어텐션 레이어(인덱스 9, 18, 27, 36, 45, 56)6.
5. Mamba-2-MLP-Attention: 28개의 SSD 레이어와 4개의 어텐션 레이어, 32개의 게이티드 MLP 레이어와 교차 배치.
우리는 Pile에 대한 검증 퍼플렉서티와 제로샷 평가를 표 3에 보고한다. 일반적으로 Transformer++와 Mamba-2 모델의 품질은 비슷하다. 우리는 단 6개의 어텐션 레이어만 추가해도 순수 Mamba-2 모델(및 Transformer++)보다 눈에 띄게 개선된다는 것을 확인한다. MLP 레이어를 추가하면 모델 품질은 감소하지만, (i) MLP 레이어의 단순성과 하드웨어 효율성 덕분에 훈련 및 추론 속도를 높일 수 있고, (ii) MLP 레이어를 전문가 혼합(MoE)으로 교체하여 MoE 모델로 업사이클링하기가 더 쉬울 수 있다.
| 모델 | 토큰. | PILE | LAMBADA | LAMBADA | HELLASWAG | PIQA | ARC-E | ARC-C | WINOGRANDE | OPENBOOKQA | 평균 |
| PPL ↓ | PPL ↓ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ||
| Transformer++ | NeoX | 6.13 | 3.99 | 70.3 | 66.4 | 75.2 | 67.7 | 37.8 | 63.9 | 40.4 | 60.2 |
| Mamba-2 | NeoX | 6.09 | 4.10 | 69.7 | 66.6 | 76.4 | 69.6 | 36.4 | 64.0 | 38.8 | 60.2 |
| Mamba-2-MLP | NeoX | 6.13 | 4.18 | 69.3 | 65.0 | 76.4 | 68.1 | 37.0 | 63.1 | 38.2 | 59.6 |
| Mamba-2-Attention | NeoX | 5.95 | 3.85 | 71.1 | 67.8 | 75.8 | 69.9 | 37.8 | 65.3 | 39.0 | 61.0 |
| Mamba-2-MLP-Attention | NeoX | 6.00 | 3.95 | 70.0 | 66.6 | 75.4 | 70.6 | 38.6 | 64.6 | 39.2 | 60.7 |
9.3 속도 벤치마크
우리는 SSD 알고리즘의 속도를 Mamba의 스캔 구현 및 FlashAttention-2와 비교하여 벤치마크한다(그림 10). SSD는 서브루틴으로 행렬 곱셈을 사용하도록 재정식화한 덕분에 GPU의 특수 행렬 곱셈(matmul) 유닛, 즉 텐서 코어를 활용할 수 있다. 그 결과, matmul 유닛을 활용하지 않는 Mamba의 융합 연관 스캔보다 2-8배 빠르다. 시퀀스 길이에 대해 선형적으로 스케일링하기 때문에, SSD는 시퀀스 길이 부터 FlashAttention-2보다 빠르다.
그러나 우리는 Mamba-2 모델 전체로는 짧은 시퀀스 길이(예: )에서 Transformer만큼 훈련 효율적이지 않을 수 있다는 점에 주목한다. 왜냐하면 개 레이어를 가진 Transformer는 개의 MLP 레이어와 개의 어텐션 레이어를 갖는 반면, Mamba-2 모델은 동일한 파라미터 수에 대해 개의 SSD 레이어를 갖기 때문이다. 일반적으로 MLP 레이어는 단순한 행렬 곱셈과 점별 선형성으로 구성되므로 하드웨어 효율성이 매우 높다. 9.2.3절에서 보인 것처럼, 짧은 시퀀스 길이에서 훈련 속도를 높이기 위해 개의 SSD 레이어와 개의 MLP 레이어를 결합할 수도 있다.
| 블록 | ABCX 프로젝션 | 추가 정규화 | 파라미터 | 퍼플렉시티 |
| Mamba-1 | 순차 | × | 129.3M | 11.76 |
| 순차 | ✓ | 129.3M | 11.54 | |
| 병렬 | × | 126.5M | 11.66 | |
| 병렬 | ✓ | 126.5M | 11.49 |
9.4 아키텍처 절제 실험
9.4.1 블록 설계
7.1절에서는 Mamba-1 블록에 약간의 수정을 가한 Mamba-2 블록을 소개하는데, 이 수정은 부분적으로 어텐션과의 연관성에 의해 동기 부여되었으며 Mamba-2의 확장성을 개선하기 위한 것이기도 하다. 표 4는 핵심 SSM 레이어 외부에서 발생하는 블록에 대한 이러한 아키텍처 변경을 절제 실험한다.
절제 실험은 를 생성하기 위한 병렬 투영이 파라미터를 절약하고 Mamba의 순차적 투영보다 약간 더 나은 성능을 보인다는 것을 검증한다. 더 중요하게, 이 수정은 더 큰 모델 크기에서 텐서 병렬성에 적합하다(8절). 또한 추가 정규화 레이어도 성능을 약간 개선한다. 더 중요하게, 더 큰 규모에서의 예비 실험은 이것이 훈련 안정성에도 도움이 된다는 것을 관찰했다.
9.4.2 헤드 구조
7.2절에서는 투영의 차원이 멀티 헤드 어텐션 및 멀티 쿼리 어텐션 개념에 유사한 하이퍼파라미터로 간주될 수 있는 방법을 설명한다. 우리는 또한 원래 Mamba 아키텍처가 멀티 밸류 어텐션과 유사하다는 것(명제 7.2)을 보여주었는데, 이는 상태 공간 모델 관점에서 자연스럽게 발전한 선택이었으며 이전에 절제 실험되지 않았다.
표 5는 Mamba-2 아키텍처에 대한 멀티 헤드 구조의 선택지를 절제 실험한다. 놀랍게도, 우리는 멀티 밸류와 멀티 쿼리 또는 멀티 키 헤드 패턴 사이에 매우 유사해 보임에도 불구하고 큰 차이를 발견한다. 이는 모든 경우에 동일한(HPN, 즉 헤드 수, 헤드 차원, 상태 차원의 곱과 동일) 전체 상태 크기로는 설명되지 않는다는 점에 주목한다.
우리는 또한 (에 유사)의 헤드 수가 동일한 멀티 헤드 패턴과도 비교한다. 우리는 표준 멀티 헤드 패턴과, 그것들이 모두 단 1개의 헤드를 갖는 공격적 공유를 사용하는 패턴과 비교한다. 후자의 경우에도 각 헤드가 서로 다른 를 가지므로 모델은 여전히 H개의 서로 다른 시퀀스 믹서 을 갖는다는 점에 주목한다. 파라미터를 맞췄을 때, 이러한 멀티 헤드 패턴들은 MVA와 MQA/MKA 패턴 사이에서 서로 유사한 성능을 보인다.
9.4.3 어텐션 커널 근사
7.3절에서는 SSD가 다양한 형태의 커널 근사와 같은 선형 어텐션 문헌의 아이디어와 결합될 수 있는 방법을 언급했다. 우리는 이전 연구에서 제안된 이러한 변형 몇 가지를 표 6에서 절제 실험한다. 여기에는 cosFormer(Qin, Weixuan Sun, et al. 2022), Random Feature Attention(H. Peng et al. 2021), Positive Random Features(Performer)(Choromanski et al. 2021)가 포함된다.
우리는 또한 표준 어텐션에서 소프트맥스 함수의 분모에 해당하는 정규화 항을 추가하는 것을 절제 실험한다. 우리는 이것이 대부분의 변형에 불안정성을 초래했지만, ReLU 활성화 함수 에 대해서는 성능을 약간 개선한다는 것을 발견했다.
표 7은 또한 특징 차원을 확장하는 선형 어텐션 개선을 위한 더 최근의 제안들(Based (Arora, Eyuboglu, Zhang, et al. 2024) 및 ReBased (Aksenov et al. 2024))을 테스트한다. 이러한 선형 어텐션 확장들은 이차 근사로 exp 커널을 적절히 대체하는 것을 목표로 한다. ReBased는 또한 QK 활성화 함수를 레이어 정규화로 교체할 것을 제안하는데, SSM 중심 관점에서 우리는 SSM 함수를 적용하기 전에 위에 정규화를 적용한다.
| SSM 헤드 패턴 | ATTN. 유사 | A 헤드 | B 헤드 | C 헤드 | X 헤드 | 레이어 | 파라미터 | PPL. |
| 다중 입력 (MIS) | 다중 값 (MVA) | 24 | 1 | 1 | 24 | 24 | 126.5M | 11.66 |
| 다중 계약 (MCS) | 다중 쿼리 (MQA) | 24 | 1 | 24 | 1 | 24 | 126.5M | 12.62 |
| 다중 확장 (MES) | 다중 키 (MKA) | 24 | 24 | 1 | 1 | 24 | 126.5M | 12.59 |
| 다중 헤드 (MHS) | 다중 헤드 (MHA) | 24 | 24 | 24 | 24 | 15 | 127.6M | 12.06 |
| 다중 상태 (MSS) | - | 24 | 1 | 1 | 1 | 36 | 129.6M | 12.00 |
| 다중 입력 (MIS) | 다중 값 (MVA) | 32 | 1 | 1 | 32 | 48 | 361.8M | 8.73 |
| 다중 계약 (MCS) | 다중 쿼리(MQA) | 32 | 1 | 32 | 1 | 48 | 361.8M | 9.33 |
| 다중 확장(MES) | 다중 키(MKA) | 32 | 32 | 1 | 1 | 48 | 361.8M | 9.36 |
| 다중 헤드(MHS) | 다중 헤드(MHA) | 32 | 1 | 1 | 1 | 70 | 361.3M | 9.01 |
| 다중 상태(MSS) | - | 32 | 32 | 32 | 32 | 29 | 357.3M | 9.04 |
| 커널 활성화 φ | 퍼플렉서티 |
| 없음 | 11.58 |
| Swish | 11.66 |
| Exp | 11.62 |
| ReLU | 11.73 |
| ReLU + 정규화 | 11.64 |
| cosFormer | 11.97 |
| 랜덤 특징 어텐션 | 11.57 |
| 양의 랜덤 특징 (Performer) | 12.21 |
| 커널 활성화 φ | 퍼플렉시티 |
| Swish | 11.67 |
| Swish + Taylor (Based) | 12.19 |
| LayerNorm | 11.50 |
| LayerNorm + Square (ReBased) | 11.84 |
| Swish | 8.58 |
| Swish + Taylor (Based) | 8.71 |
| LayerNorm | 8.61 |
| LayerNorm + Square (ReBased) | 8.63 |
우리는 이 기법이 소프트맥스 어텐션을 위한 "QK-Norm"(Team 2024) 및 Mamba를 위한 "내부 정규화"(Lieber et al. 2024)로서 독립적으로 제안되었다는 점에 주목한다.
전반적으로, 표 6과 표 7을 통해 우리가 시도한 커널 근사 방법들이 에 대한 단순한 점별 비선형 활성화 함수보다 개선되지 않는 것으로 나타났다. 따라서 Mamba-2의 기본 설정은 Mamba-1을 따라 를 사용했지만, 이 활성화를 완전히 제거하는 것이 더 단순한 선택일 수 있으며 이는 우리가 광범위하게 테스트하지 않았다는 점을 제안한다.
그러나 우리는 SSD와 기존의 선형 어텐션이 1-세미분리 가능 마스크 의 포함 여부에서 차이가 있다는 점을 강조한다. 반면 문헌에 있는 다양한 선형 어텐션 방법들은 이 항 없이 softmax 어텐션을 근사하도록 유도되었으므로, 우리의 부정적인 결과는 예상치 못한 것이 아닐 수 있다.
10 관련 연구 및 논의
상태 공간 쌍대성 프레임워크는 SSM, 구조화된 행렬, 그리고 어텐션 사이의 연결을 이어준다. 우리는 SSD와 이러한 개념들 사이의 관계를 더 폭넓게 논의한다. 각 관점의 아이디어를 활용하여, SSD 프레임워크가 향후 연구에서 확장될 수 있는 몇 가지 방향도 제안한다.
10.1 상태 공간 모델
구조화된 상태 공간 모델은 다음의 축을 따라 특성화할 수 있다. (i) 시간 불변인지 시간 가변인지. (ii) 시스템의 차원. (iii) 순환 전이 에 대한 구조.
SSD는 SISO 차원과 스칼라-항등 구조를 가진 선택적 SSM으로 설명할 수 있다.
시간 가변성 (선택성). 원래의 구조화된 SSM(S4)은 연속 시간 온라인 기억화(Gu, Dao, et al. 2020; Gu, Johnson, Goel, et al. 2021; Gu, Johnson, Timalsina, et al. 2023)에서 동기를 얻은 선형 시간 불변(LTI) 시스템(Gu 2023; Gu, Goel, and Ré 2022)이었다. 구조화된 SSM의 많은 변형들이 제안되었으며(Dao, D. Y. Fu, et al. 2023; Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; Ma et al. 2023; J. T. Smith, Warrington, and Linderman 2023), 여기에는 순환을 제거하고 LTI SSM의 합성곱 표현에 집중한 여러 방법들도 포함된다(D. Y. Fu et al. 2023; Y. Li et al. 2023; Poli et al. 2023; Qin, Han, Weixuan Sun, B. He, et al. 2023).
SSD는 시간 가변 구조화된 SSM이며, Mamba에서 도입된 선택적 SSM으로도 알려져 있다(Gu and Dao 2023). 선택적 SSM은 LSTM(Hochreiter and Schmidhuber 1997)과 GRU(J. Chung et al. 2014) 같은 고전적 RNN부터 QRNN(Bradbury et al. 2016), SRU(Lei 2021; Lei et al. 2017), RWKV(B. Peng, Alcaide, et al. 2023), HGRN(Qin, Yang, and Zhong 2023), Griffin(Botev et al. 2024; De et al. 2024) 같은 보다 현대적인 변형에 이르기까지 RNN의 게이팅 메커니즘과 밀접하게 관련되어 있다. 이러한 RNN들은 다양한 방식으로 매개변수화에서 차이가 있으며, 가장 중요한 차이는 상태 확장의 부재에 있다.
차원성과 상태 확장. 이전의 SSM 계보(S4, H3, Mamba)가 공유하는 SSD의 중요한 특징은 입력 채널이 독립적으로 처리되는 단일 입력 단일 출력(SISO) 시스템이라는 점이다. 이로 인해 유효 상태 크기가 N0로 훨씬 커지는데, 여기서 N은 SSM 상태 크기(상태 확장 계수라고도 함)이고 D는 표준 모델 차원이다. 전통적인 RNN은 이거나 조밀한 행렬을 갖는 다중 입력 다중 출력(MIMO)이며, 어느 쪽이든 더 작은 상태를 갖게 된다. MIMO SSM이 일부 영역에서 잘 작동함이 입증되었지만(Lu et al. 2023; Orvieto et al. 2023; J. T. Smith, Warrington, and Linderman 2023), Mamba는 정보 밀도가 높은 영역(예: 언어)에서는 상태 확장이 결정적임을 보여주었다. SSD의 주요 이점 중 하나는 모델 속도를 저하시키지 않으면서 훨씬 더 큰 상태 확장 계수를 허용한다는 것이다. 이후 많은 연구들이 상태 확장을 채택해 왔다(10.4절).
구조. 이전의 구조화된 SSM과 비교할 때, SSD의 주요 제약은 상태 전이 의 표현력에 있다. 우리는 대각 의 경우와 같은 더 일반적인 SSM이 이론적으로 SSD와 동일한 효율성을 가지지만 하드웨어 친화성이 떨어진다는 점에 주목한다. 이는 이중 이차 형식이 어텐션과 유사한 해석을 잃고 계산하기 더 어려워지기 때문이다. 따라서 Mamba와 비교할 때 SSD는 대각 의 다소 더 제약적인 형태에서만 차이가 나며, 이러한 표현력을 개선된 하드웨어 효율성(그리고 구현 용이성)과 맞바꾼다.
우리는 구조화된 행렬 알고리즘을 개선하여 일반 대각 SSM의 경우로도 확장하는 것이 가능할 수 있다고 가설을 세운다.
10.2 구조화된 행렬
상태 공간 이중성의 첫 번째 관점은 이러한 모델들을 행렬 시퀀스 변환 또는 "행렬 믹서"로 보는 관점을 채택한다. 즉, 시퀀스 차원 T를 따라 ( 행렬에 의한) 행렬 곱셈으로 표현될 수 있는 시퀀스 변환(정의 2.1)이다.
이러한 행렬 믹서들이 이전에 여러 제안되었으며, 여기서 주요 변별 축은 행렬의 표현 방식이다. 여기에는 MLP-Mixer(Tolstikhin et al. 2021)(비구조화 행렬), FNet(Lee-Thorp et al. 2021)(푸리에 변환 행렬), M2(Dao, B. Chen, et al. 2022; Dao, Gu, et al. 2019; Dao, Sohoni, et al. 2020; D. Fu et al. 2024)(버터플라이/모나크 행렬), 퇴플리츠 행렬(Poli et al. 2023; Qin, Han, Weixuan Sun, B. He, et al. 2023), 그리고 더욱 특이한 구조들(De Sa et al. 2018; Thomas et al. 2018)이 포함된다.
중요한 특징은 효율적인(준이차) 행렬 시퀀스 변환이 정확히 구조화된 행렬 믹서를 갖는 것들이라는 점이다. SSD 프레임워크의 핵심 결과는 SSM을 특정 구조, 즉 반분리 가능 행렬(semiseparable matrix)을 갖는 행렬 믹서로 보는 것이다(3절). 선형 대 이차 이중성은 그러면 구조화된 행렬 곱셈 대 순수 행렬 곱셈의 형태를 취한다.
구조 행렬 표현은 특정 반분리 가능 행렬의 블록 분해를 통해 우리의 효율적인 SSD 알고리즘으로 이어졌다(6절). 우리는 반분리 가능 행렬이 과학 계산 문헌에서 잘 연구되어 있으며, 그러한 아이디어를 통합하는 것이 상태 공간 모델을 더 개선할 수 있는 유망한 경로가 될 수 있다고 본다. 우리는 또한 행렬 믹서 관점에 초점을 맞추는 것이 시퀀스 모델을 위한 더 많은 유익한 방향으로 이어질 수 있다고 제안한다. 예를 들어 Mamba의 원리 기반 비인과적 변형을 설계하거나, 행렬 변환 구조를 분석하여 소프트맥스 어텐션과 준 이차 모델 사이의 격차를 특성화하고 연결하는 방법을 찾는 것이다.
10.3 (선형) 어텐션
표준 (인과적) 어텐션과 비교할 때, SSD는 단지 두 가지 주요 차이점만 갖는다.
첫째, SSD는 표준 어텐션의 소프트맥스 활성화(Bahdanau, Cho, and Bengio 2015; Vaswani et al. 2017)를 사용하지 않으며, 이것이 어텐션에 이차 복잡도를 부여하는 원인이다. 소프트맥스가 제거되면, 시퀀스는 선형 어텐션 프레임워크(Katharopoulos et al. 2020)를 통해 선형 스케일링으로 계산될 수 있다.
둘째, SSD는 로짓 행렬에 입력 의존적인 1-반분리 가능 마스크를 곱한다. 따라서 이 마스크는 표준 어텐션에서 소프트맥스를 대체하는 것으로 볼 수 있다.
이 반분리 가능 마스크는 위치 정보를 제공하는 것으로도 볼 수 있다. 원소 는 RNN에서의 "게이트" 또는 "선택" 메커니즘(Mamba 논문의 논의 참조)으로 작용하며, 이들의 누적 곱 는 위치 와 사이에 허용되는 상호작용의 정도를 제어한다. 위치 임베딩(예: 사인파(Vaswani et al. 2017), Alibi(Press, N. Smith, and Lewis 2022), RoPE(Su et al. 2021))은 종종 휴리스틱으로 여겨지는 트랜스포머의 중요한 구성 요소이며, SSD의 1-SS 마스크는 더 원리 기반의 상대 위치 임베딩 형태로 볼 수 있다. 우리는 이러한 관점이 GateLoop(Katsch 2023)에 의해서도 동시에 제시되었음을 주목한다.
상태 공간 이중성의 두 번째 관점은 우리의 보다 일반적인 구조화된 마스크드 어텐션(SMA) 프레임워크의 특수한 경우이며, 여기서 이중성은 단순한 4방향 텐서 축약에 대한 서로 다른 축약 순서로 드러난다. SMA는 선형 어텐션의 강력한 일반화로, SSD보다 훨씬 더 일반적이다. 다른 형태의 구조화된 마스크들은 SSD와는 다른 특성을 지닌 효율적인 어텐션의 더 많은 변형으로 이어질 수 있다.
새로운 모델로 이어지는 것 외에도, 어텐션과의 이러한 연결은 SSM을 이해하기 위한 다른 방향으로 이어질 수 있다. 예를 들어, 우리는 어텐션 싱크(attention sink) 현상(Darcet et al. 2024; Xiao et al. 2024)이 Mamba 모델에도 존재하는지, 그리고 더 광범위하게 해석 가능성 기법이 SSM에 전이될 수 있는지에 관심이 있다(Ali, Zimerman, and Wolf 2024).
마지막으로, 선형 어텐션의 다른 많은 변형들이 제안되었으며(Arora, Eyuboglu, Timalsina, et al. 2024; Arora, Eyuboglu, Zhang, et al. 2024; Choromanski et al. 2021; H. Peng et al. 2021; Qin, Han, Weixuan Sun, Dongxu Li, et al. 2022; Qin, Weixuan Sun, et al. 2022; Schlag, Irie, and Schmidhuber 2021; Zhang et al. 2024; Zheng, C. Wang, and Kong 2022)(이들 중 몇 가지에 대한 설명은 4.1.3절 참조), 우리는 많은 기법들이 SSM에 전이될 수 있을 것으로 기대한다(예: 7.3절).
우리는 SSD가 표준 소프트맥스 어텐션, 또는 유한한 특징 맵 를 갖지 않는 어텐션 커널 행렬에 대한 다른 어떤 변환도 일반화하지 않는다는 점을 강조한다. 일반 어텐션과 비교할 때 SSD의 이점은 이력 전체를 캐시하는 이차 어텐션이 시퀀스 길이 에 따라 확장되는 것과 달리, 이력을 압축하는 제어 가능한 상태 확장 계수 을 갖는다는 것이다. 동시대의 연구들이 이러한 표현들의 트레이드오프를 연구하기 시작했으며, 예를 들어 복사 및 문맥 내 학습 과제에서 그러하다(Akyürek et al. 2024; Grazzi et al. 2024; Jelassi et al. 2024; Park et al. 2024). 우리는 Mamba-2가 이러한 능력 중 일부에서 Mamba를 크게 개선한다는 점(예: 9.1절의 MQAR 결과로 입증됨)을 주목하지만, 더 많은 것이 이해되어야 한다.
10.4 관련 모델
마지막으로 우리는 Mamba 및 Mamba-2와 매우 유사한 시퀀스 모델을 개발한 최근 및 동시대 연구의 증가하는 흐름을 강조한다.
- RetNet(Y. Sun et al. 2023)과 TransNormerLLM(Qin, Dong Li, et al. 2023)은 누적 합 대신 감쇠 항을 사용하여 선형 어텐션을 일반화하고, 이중 병렬/순환 알고리즘과 하이브리드 "청크 단위" 모드를 제안한다. 이러한 알고리즘은 가 시간 불변(모든 에 대해 상수)인 SSD의 인스턴스화로 볼 수 있으며, SMA 해석에서는 마스크 행렬 이 감쇠 행렬 가 된다. 이러한 모델들은 또한 여러 면에서 아키텍처적으로 다르다. 예를 들어, 어텐션 중심 관점에서 파생되었기 때문에 다중 헤드 어텐션(MHA) 패턴을 유지하는 반면, Mamba-2는 SSM 중심 패턴에서 파생되었기 때문에 다중 값 어텐션(MVA) 또는 다중 확장 SSM(MES) 패턴을 유지하며, 우리는 이것이 더 우수함을 보인다(9.4절).
- GateLoop(Katsch 2023)는 동시에 입력 의존적 감쇠 인자 를 사용할 것을 제안하고, SSD와 동일한 이중 이차 형식을 개발했으며 이를 "대리 어텐션(surrogate attention)" 형식이라고 부른다.
- 게이트 선형 어텐션(GLA)(Yang et al. 2024)은 데이터 의존적 게이트를 갖는 선형 어텐션의 변형을 제안하고, 청크 단위 모드를 계산하는 효율적인 알고리즘과 하드웨어 인식 구현을 함께 제시했다.
- HGRN(Qin, Yang, and Zhong 2023)은 입력 의존적 게이트를 갖춘 RNN을 도입했으며, 이는 HGRN2(Qin, Yang, Weixuan Sun, et al. 2024)에서 상태 확장(state expansion)을 통합하도록 개선되었다.
- Griffin(De et al. 2024)과 RecurrentGemma(Botev et al. 2024)는 입력 의존적 게이팅을 갖춘 RNN이 지역적 어텐션(local attention)과 결합될 때 강력한 현대 Transformer들과 충분히 경쟁력이 있을 수 있음을 보여주었다. Jamba 또한 Mamba를 몇 개의 어텐션 층과 결합하는 것이 언어 모델링에서 매우 잘 수행됨을 보여주었다(Lieber et al. 2024).
- xLSTM(Beck et al. 2024)은 상태 확장의 아이디어와 그 밖의 게이팅, 정규화, 안정화 기법을 채택하여 xLSTM을 개선한다.
- RWKV(-4)(B. Peng, Alcaide, et al. 2023)는 상이한 선형 어텐션 근사(어텐션 없는 Transformer(S. Zhai et al. 2021))에 기반한 RNN이다. 이는 최근 선택성(selectivity)과 상태 확장의 아이디어를 채택하여 RWKV-5/6(Eagle 및 Finch) 아키텍처로 개선되었다(B. Peng, Goldstein, et al. 2024).
11 결론
우리는 SSM과 어텐션 변형들 사이의 개념적 간극을 메우는, 잘 연구된 구조화 행렬(structured matrices) 클래스들에 기반한 이론적 프레임워크를 제안하였다. 이 프레임워크는 최근의 SSM들(예: Mamba)이 언어 모델링에서 어떻게 Transformer만큼 잘 수행하는지에 대한 통찰을 제공한다. 더욱이, 우리의 이론적 도구들은 양측의 알고리즘적 및 시스템적 진보를 연결함으로써 SSM(그리고 잠재적으로 Transformer)을 개선할 새로운 아이디어를 제공한다. 그 실증으로서, 이 프레임워크는 SSM과 구조화된 어텐션의 교차점에 있는 새로운 아키텍처(Mamba-2)의 설계를 이끈다.
감사의 말
의 그래디언트를 수치적으로 안정된 방식으로 효율적으로 계산하는 방법에 대한 제안을 해주신 Angela Wu께 감사드린다. MQAR 실험을 도와주신 Sukjun Hwang과 Aakash Lahoti께 감사드린다.
참고문헌
[1] Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebrón, and Sumit Sanghai. "GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints". In: arXiv preprint arXiv:2305.13245 (2023).
[2] Yaroslav Aksenov, Nikita Balagansky, Sofia Maria Lo Cicero Vaina, Boris Shaposhnikov, Alexey Gorbatovski, and Daniil Gavrilov. "Linear Transformers with Learnable Kernel Functions are Better In- Context Models". In: arXiv preprint arXiv:2402.10644 (2024).
[3] Ekin Akyürek, Bailin Wang, Yoon Kim, and Jacob Andreas. "In- Context Language Learning: Architectures and Algorithms". In: The International Conference on Machine Learning (ICML). 2024.
[4] Ameen Ali, Itamar Zimerman, and Lior Wolf. The Hidden Attention of Mamba Models. 2024. arXiv: 2403.01590 [cs.LG].
[5] Simran Arora, Sabri Eyuboglu, Aman Timalsina, Isys Johnson, Michael Poli, James Zou, Atri Rudra, and Christopher Ré. "Zoology: Measuring and Improving Recall in Efficient Language Models". In: The International Conference on Learning Representations (ICLR). 2024.
[6] Simran Arora, Sabri Eyuboglu, Michael Zhang, Aman Timalsina, Silas Alberti, Dylan Zinsley, James Zou, Atri Rudra, and Christopher Ré. "Simple Linear Attention Language Models Balance the Recall- Throughput Tradeoff". In: The International Conference on Machine Learning (ICML). 2024.
[7] Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. "Neural Machine Translation by Jointly Learning to Align and Translate". In: The International Conference on Learning Representations (ICLR). 2015.
[8] George A Baker, George A Baker Jr, Peter Graves- Morris, and Susan S Baker. Pade Approximants: Encyclopedia of Mathematics and It's Applications, Vol. 59 George A. Baker, Jr., Peter Graves- Morris. Vol. 59. Cambridge University Press, 1996.
[9] Maximilian Beck, Korbinian Poppel, Markus Spanring, Andreas Auer, Oleksandra Prudnikova, Michael Kopp, Günter Klambauer, Johannes Brandstetter, and Sepp Hochreiter. "xLSTM: Extended Long Short- Term Memory". In: arXiv preprint arXiv:2405.04517 (2024).
[10] Stella Biderman, Hailey Schoelkopf, Quentin Gregory Anthony, Herbie Bradley, Kyle O'Brien, Eric Hallahan, Mohammad Aflah Khan, Shivanshu Purohit, USVSN Sai Prashanth, Edward Raff, et al. "Pythia: A Suite for Analyzing Large Language Models across Training and Scaling". In: The International Conference on Machine Learning (ICML). PMLR. 2023, pp. 2397- 2430.
[11] Yonatan Bisk, Rowan Zellers, Jianfeng Gao, Yejin Choi, et al. "PIQA: Reasoning about Physical Commonsense in Natural Language". In: Proceedings of the AAAI conference on Artificial Intelligence. Vol. 34. 2020.
[12] Sid Black, Stella Biderman, Eric Hallahan, Quentin Anthony, Leo Gao, Laurence Golding, Horace He, Connor Leahy, Kyle McDonell, Jason Phang, et al. "Gpt- NeoX- 20B: An Open- source Autoregressive Language Model". In: arXiv preprint arXiv:2204.06745 (2022).
[13] Guy E Blelloch. "Prefix Sums and Their Applications". In: (1990).
[14] Aleksandar Botev, Soham De, Samuel L Smith, Anushan Fernando, George- Cristian Muraru, Ruba Haroun, Leonard Berrada, Razvan Pascanu, Pier Giuseppe Sessa, Robert Dadashi, et al. "RecurrentGemma: Moving Past Transformers for Efficient Open Language Models". In: arXiv preprint arXiv:2404.07839 (2024).
[15] George EP Box, Gwilym M Jenkins, Gregory C Reinsel, and Greta M Ljung. Time Series Analysis: Forecasting and Control. John Wiley & Sons, 2015.
[16] James Bradbury, Stephen Merity, Caiming Xiong, and Richard Socher. "Quasi- recurrent Neural Networks". In: arXiv preprint arXiv:1611.01576 (2016).
[17] William Brandon, Aniruddha Nrusimha, Kevin Qian, Zachary Ankner, Tian Jin, Zhiye Song, and Jonathan Ragan- Kelley. "Striped attention: Faster ring attention for causal transformers". In: arXiv preprint arXiv:2311.09431 (2023).
[18] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. "Language Models are Few- shot Learners". In: Advances in Neural Information Processing Systems (NeurIPS) 33 (2020), pp. 1877- 1901.
[19] Krzysztof Choromanski, Valerii Likhosherstov, David Dohan, Xingyou Song, Andreea Gane, Tamas Sarlos, Peter Hawkins, Jared Davis, Afroz Mohiuddin, Lukasz Kaiser, et al. "Rethinking Attention with Performers". In: The International Conference on Learning Representations (ICLR). 2021.
[20] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. "PaLM: Scaling Language Modeling with Pathways". In: Journal of Machine Learning Research 24.240 (2023), pp. 1- 113. URL: http://jmlr.org/papers/v24/22- 1144. html.
[21] Junyoung Chung, Caglar Gulcehre, KyungHyun Cho, and Yoshua Bengio. "Empirical Evaluation of Gated Recurrent Neural Networks on Sequence Modeling". In: arXiv preprint arXiv:1412.3555 (2014).
[22] Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, and Oyvind Tafjord. "Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge". In: arXiv preprint arXiv:1803.05457 (2018).
[23] Tri Dao. "FlashAttention- 2: Faster Attention with Better Parallelism and Work Partitioning". In: The International Conference on Learning Representations (ICLR). 2024.
[24] Tri Dao, Beidi Chen, Nimit S Sohoni, Arjun Desai, Michael Poli, Jessica Grogan, Alexander Liu, Aniruddh Rao, Atri Rudra, and Christopher Ré. "Monarch: Expressive structured matrices for efficient and accurate training". In: International Conference on Machine Learning. PMLR. 2022, pp. 4690- 4721.
[25] Tri Dao, Daniel Y Fu, Khaled K Saab, Armin W Thomas, Atri Rudra, and Christopher Ré. "Hungry Hungry Hippos: Towards Language Modeling with State Space Models". In: The International Conference on Learning Representations (ICLR). 2023.
[26] Tri Dao, Albert Gu, Matthew Eichhorn, Atri Rudra, and Christopher Ré. "Learning Fast Algorithms for Linear Transforms Using Butterfly Factorizations". In: The International Conference on Machine Learning (ICML). 2019.
[27] Tri Dao, Nimit Sohoni, Albert Gu, Matthew Eichhorn, Amit Blonder, Megan Leszczynski, Atri Rudra, and Christopher Ré. "Kaleidoscope: An Efficient, Learnable Representation for All Structured Linear Maps". In: The International Conference on Learning Representations (ICLR). 2020.
[28] Timothée Darcet, Maxime Oquab, Julien Mairal, and Piotr Bojanowski. "Vision Transformers Need Registers". In: The International Conference on Learning Representations (ICLR). 2024.
[29] Soham De, Samuel L Smith, Anushan Fernando, Aleksandar Botev, George Cristian- Muraru, Albert Gu, Ruba Haroun, Leonard Berrada, Yutian Chen, Srivatsan Srinivasan, et al. "Griffin: Mixing Gated Linear Recurrences with Local Attention for Efficient Language Models". In: arXiv preprint arXiv:2402.19427 (2024).
[30] Christopher De Sa, Albert Gu, Rohan Puttagunta, Christopher Ré, and Atri Rudra. "A Two- Pronged Progress in Structured Dense Matrix Vector Multiplication". In: Proceedings of the Twenty- Ninth Annual ACM- SIAM Symposium on Discrete Algorithms. SIAM. 2018, pp. 1060- 1079.
[31] Hantian Ding, Zijian Wang, Giovanni Paolini, Varun Kumar, Anoop Deoras, Dan Roth, and Stefano Soatto. "Fewer truncations improve language modeling". In: arXiv preprint arXiv:2404.10830 (2024).
[32] Yuli Eidelman and Israel Gohberg. "On a new class of structured matrices". In: Integral Equations and Operator Theory 34.3 (1999), pp. 293- 324.
[33] Dan Fu, Simran Arora, Jessica Grogan, Isys Johnson, Evan Sabri Eyuboglu, Armin Thomas, Benjamin Spector, Michael Poli, Atri Rudra, and Christopher Ré. "Monarch mixer: A simple sub- quadratic gemm- based architecture". In: Advances in Neural Information Processing Systems 36 (2024).
[34] Daniel Y Fu, Elliot L Epstein, Eric Nguyen, Armin W Thomas, Michael Zhang, Tri Dao, Atri Rudra, and Christopher Ré. "Simple Hardware- efficient Long Convolutions for Sequence Modeling". In: The International Conference on Machine Learning (ICML) (2023).
[35] Leo Gao, Stella Biderman, Sid Black, Laurence Golding, Travis Hoppe, Charles Foster, Jason Phang, Horace He, Anish Thite, Noa Nabeshima, Shawn Presser, and Connor Leahy. "The Pile: An 800GB Dataset of Diverse Text for Language Modeling". In: arXiv preprint arXiv:2101.00027 (2020).
[36] Leo Gao, Jonathan Tow, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Kyle McDonell, Niklas Muennighoff, Jason Phang, Laria Reynolds, Eric Tang, Anish Thite, Ben Wang, Kevin Wang, and Andy Zou. A Framework for Few- shot Language Model Evaluation. Version v0.0.1. Sept. 2021. DOI: 10.5281/zenodo.5371628. URL: https://doi.org/10.5281/zenodo.5371628.
[37] Paolo Glorioso, Quentin Anthony, Yury Tokpanov, James Whittington, Jonathan Pilault, Adam Ibrahim, Beren Millidge. "Zamba: A Compact 7B SSM Hybrid Model". In: arXiv preprint arXiv:2405.16712 (2024).
[38] Riccardo Grazzi, Julien Siems, Simon Schrodi, Thomas Brox, Frank Hutter. "Is Mamba Capable of In-Context Learning?" In: arXiv preprint arXiv:2402.03170 (2024).
[39] Albert Gu. "Modeling Sequences with Structured State Spaces". 박사 학위 논문. Stanford University, 2023.
[40] Albert Gu, Tri Dao. "Mamba: Linear-Time Sequence Modeling with Selective State Spaces". In: arXiv preprint arXiv:2312.00752 (2023).
[41] Albert Gu, Tri Dao, Stefano Ermon, Atri Rudra, Christopher Ré. "HIPPO: Recurrent Memory with Optimal Polynomial Projections". In: Advances in Neural Information Processing Systems (NeurIPS). 2020.
[42] Albert Gu, Karan Goel, Christopher Ré. "Efficiently Modeling Long Sequences with Structured State Spaces". In: The International Conference on Learning Representations (ICLR). 2022.
[43] Albert Gu, Ankit Gupta, Karan Goel, Christopher Ré. "On the Parameterization and Initialization of Diagonal State Space Models". In: Advances in Neural Information Processing Systems (NeurIPS). 2022.
[44] Albert Gu, Isys Johnson, Karan Goel, Khaled Saab, Tri Dao, Atri Rudra, Christopher Ré. "Combining Recurrent, Convolutional, and Continuous-time Models with the Linear State Space Layer". In: Advances in Neural Information Processing Systems (NeurIPS). 2021.
[45] Albert Gu, Isys Johnson, Aman Timalsina, Atri Rudra, Christopher Ré. "How to Train Your HIPPO: State Space Models with Generalized Basis Projections". In: The International Conference on Learning Representations (ICLR). 2023.
[46] Ankit Gupta, Albert Gu, Jonathan Berant. "Diagonal State Spaces are as Effective as Structured State Spaces". In: Advances in Neural Information Processing Systems 35 (2022), pp. 22982-22994.
[47] Dan Hendrycks, Kevin Gimpel. "Gaussian Error Linear Units (GELUs)". In: arXiv preprint arXiv:1606.08415 (2016).
[48] W Daniel Hillis, Guy L Steele Jr. "Data Parallel Algorithms". In: Communications of the ACM 29.12 (1986), pp. 1170-1183.
[49] Sepp Hochreiter, Jürgen Schmidhuber. "Long Short-Term Memory". In: Neural Computation 9.8 (1997), pp. 1735-1780.
[50] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, et al. "An Empirical Analysis of Compute Optimal Large Language Model Training". In: Advances in Neural Information Processing Systems (NeurIPS) 35 (2022), pp. 30016-30030. [51] Samy Jelassi, David Brandfonbrener, Sham M Kakade, Eran Malach. "Repeat After Me: Transformers Are Better Than State Space Models at Copying". In: The International Conference on Machine Learning (ICML). 2024. [52] Angelos Katharopoulos, Apoorv Vyas, Nikolaos Pappas, Francois Fleuret. "Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention". In: International Conference on Machine Learning. PMLR. 2020, pp. 5156-5165. [53] Tobias Katsch. "GateLoop: Fully Data-Controlled Linear Recurrence for Sequence Modeling". In: arXiv preprint arXiv:2311.01927 (2023). [54] Shiva Kaul. "Linear Dynamical Systems as a Core Computational Primitive". In: Advances in Neural Information Processing Systems 33 (2020), pp. 16808-16820. [55] Vijay Anand Korthikanti, Jared Casper, Sangkug Lynn, Lawrence McAfee, Michael Andersch, Mohammad Shoeybi, Bryan Catanzaro. "Reducing activation recomputation in large transformer models". In: Proceedings of Machine Learning and Systems 5 (2023). [56] James Lee-Thorp, Joshua Ainslie, Ilya Eckstein, Santiago Ontanon. "Fnet: Mixing tokens with fourier transforms". In: arXiv preprint arXiv:2105.03824 (2021). [57] Tao Lei. "When Attention Meets Fast Recurrence: Training Language Models with Reduced Compute". In: Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing. 2021, pp. 7633-7648. [58] Tao Lei, Yu Zhang, Sida I Wang, Hui Dai, Yoav Artzi. "Simple Recurrent Units for Highly Parallelizable Recurrence". In: arXiv preprint arXiv:1709.02755 (2017). [59] Yuhong Li, Tianle Cai, Yi Zhang, Deming Chen, Debadeepta Dey. "What Makes Convolutional Models Great on Long Sequence Modeling?" In: The International Conference on Learning Representations (ICLR). 2023. [60] Opher Lieber, Barak Lenz, Hofit Bata, Gal Cohen, Jhonathan Osin, Itay Dalmedigos, Erez Safahi, Shaked Meirom, Yonatan Belinkov, Shai Shalev-Shwartz, et al. "Jamba: A Hybrid Transformer-Mamba Language Model". In: arXiv preprint arXiv:2403.19887 (2024). [61] Hao Liu, Wilson Yan, Matei Zaharia, Pieter Abbeel. "World Model on Million-Length Video And Language With RingAttention". In: arXiv preprint arXiv:2402.08268 (2024). [62] Hao Liu, Matei Zaharia, Pieter Abbeel. "Ring attention with blockwise transformers for near-infinite context". In: arXiv preprint arXiv:2310.01889 (2023). [63] Chris Lu, Yannick Schroecker, Albert Gu, Emilio Parisotto, Jakob Foerster, Satinder Singh, Feryal Behbahani. "Structured State Space Models for In-Context Reinforcement Learning". In: Advances in Neural Information Processing Systems (NeurIPS). 2023. [64] Xuezhe Ma, Chunting Zhou, Xiang Kong, Junxian He, Liangke Gui, Graham Neubig, Jonathan May, Luke Zettlemoyer. "Mega: Moving Average Equipped Gated Attention". In: The International Conference on Learning Representations (ICLR). 2023. [65] Eric Martin, Chris Cundy. "Parallelizing Linear Recurrent Neural Nets Over Sequence Length". In: The International Conference on Learning Representations (ICLR). 2018. [66] Todor Mihaylov, Peter Clark, Tushar Khot, Ashish Sabharwal. "Can a Suit of Armor Conduct Electricity? A New Dataset for Open Book Question Answering". In: arXiv preprint arXiv:1809.02789 (2018). [67] Catherine Olsson, Nelson Elhage, Neel Nanda, Nicholas Joseph, Nova DasSarma, Tom Henighan, Ben Mann, Amanda Askell, Yuntao Bai, Anna Chen, Tom Conerly, Dawn Drain, Deep Ganguli, Zac Hatfield-Dodds, Danny Hernandez, Scott Johnston, Andy Jones, Jackson Kernion, Liane Lovitt, Kamal Ndousse, Dario Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish, Chris Olah. "In-context Learning and Induction Heads". In: Transformer Circuits Thread (2022). https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/index.html. [68] Antonio Orvieto, Samuel L Smith, Albert Gu, Anushan Fernando, Caglar Gulcehre, Razvan Pascanu, Soham De. "Resurrecting Recurrent Neural Networks for Long Sequences". In: The International Conference on Machine Learning (ICML). 2023. [69] Denis Paperno, Germán Kruszewski, Angeliki Lazaridou, Ngoc-Quan Pham, Raffaella Bernardi, Sandro Pezzelle, Marco Baroni, Gemma Boleda, Raquel Fernández. "The LAMBADA Dataset: Word Prediction Requiring a Broad Discourse Context". In: Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics. 2016, pp. 1525-1534. [70] Jongho Park, Jaeseung Park, Zheyang Xiong, Nayoung Lee, Jaewoong Cho, Samet Oymak, Kangwook Lee, Dimitris Papailiopoulos. "Can Mamba Learn How to Learn? A Comparative Study on In-Context Learning Tasks". In: The International Conference on Machine Learning (ICML). 2024.
. html.
[71] Bo Peng, Eric Alcaide, Quentin Anthony, Alon Albalak, Samuel Arcadinho, Huanqi Cao, Xin Cheng, Michael Chung, Matteo Grella, Kranthi Kiran GV, et al. "RWKV: Reinventing RNNs for the Transformer Era". In: arXiv preprint arXiv:2305.13048 (2023).
[72] Bo Peng, Daniel Goldstein, Quentin Anthony, Alon Albalak, Eric Alcaide, Stella Biderman, Eugene Cheah, Teddy Ferdinand, Haowen Hou, Przemyslaw Kazienko, et al. "Eagle and Finch: RWKV with matrix-valued states and dynamic recurrence". In: arXiv preprint arXiv:2404.05892 (2024).
[73] Hao Peng, Nikolaos Pappas, Dani Yogatama, Roy Schwartz, Noah A Smith, and Lingpeng Kong. "Random Feature Attention". In: The International Conference on Learning Representations (ICLR). 2021.
[74] Clément Pernet. "Computing with Quasiseparable Matrices". In: Proceedings of the ACM on International Symposium on Symbolic and Algebraic Computation. 2016, pp. 389-396.
[75] Clément Pernet, Hippolyte Signargout, and Gilles Villard. "Exact computations with quasiseparable matrices". In: arXiv preprint arXiv:2302.04515 (2023).
[76] Clément Pernet and Arne Storjohann. "Time and space efficient generators for quasiseparable matrices". In: Journal of Symbolic Computation 85 (2018), pp. 224-246.
[77] Michael Poli, Stefano Massaroli, Eric Nguyen, Daniel Y Fu, Tri Dao, Stephen Baccus, Yoshua Bengio, Stefano Ermon, and Christopher Ré. "Hyena Hierarchy: Towards Larger Convolutional Language Models". In: The International Conference on Machine Learning (ICML). 2023.
[78] Hadi Pouransari, Chun-Liang Li, Jen-Hao Rick Chang, Pavan Kumar Anasosalu Vasu, Cem Koc, Vaishaal Shankar, and Oncel Tuzel. "데이터셋 분해: 가변 시퀀스 길이 커리큘럼을 통한 더 빠른 LLM 훈련". In: arXiv preprint arXiv:2405.13226 (2024).
[79] Ofir Press, Noah Smith, and Mike Lewis. "짧게 훈련하고 길게 테스트하기: 선형 편향을 가진 어텐션이 입력 길이 외삽을 가능하게 한다". In: International Conference on Learning Representations. 2022.
[80] Zhen Qin, Xiaodong Han, Weixuan Sun, Bowen He, Dong Li, Dongxu Li, Yuchao Dai, Lingpeng Kong, and Yiran Zhong. "시퀀스 모델링을 위한 토플리츠 신경망". In: The International Conference on Learning Representations (ICLR). 2023.
[81] Zhen Qin, Xiaodong Han, Weixuan Sun, Dongxu Li, Lingpeng Kong, Nick Barnes, and Yiran Zhong. "선형 트랜스포머의 악마". In: arXiv preprint arXiv:2210.10340 (2022).
[82] Zhen Qin, Dong Li, Weigao Sun, Weixuan Sun, Xuyang Shen, Xiaodong Han, Yunshen Wei, Baohong Lv, Xiao Luo, Yu Qiao, et al. "TransNormerLLM: 개선된 TransNormer를 갖춘 더 빠르고 더 나은 대규모 언어 모델". In: arXiv preprint arXiv:2307.14995 (2023).
[83] Zhen Qin, Weixuan Sun, Hui Deng, Dongxu Li, Yunshen Wei, Baohong Lv, Junjie Yan, Lingpeng Kong, and Yiran Zhong. "CosFormer: 어텐션에서 소프트맥스 재고하기". In: The International Conference on Learning Representations (ICLR). 2022.
[84] Zhen Qin, Songlin Yang, Weixuan Sun, Xuyang Shen, Dong Li, Weigao Sun, and Yiran Zhong. "HGRN2: 상태 확장을 갖춘 게이트 선형 RNN". In: arXiv preprint arXiv:2404.07904 (2024).
[85] Zhen Qin, Songlin Yang, and Yiran Zhong. "시퀀스 모델링을 위한 계층적 게이트 순환 신경망". In: Advances in Neural Information Processing Systems 36 (2023).
[86] Ali Rahimi and Benjamin Recht. "대규모 커널 머신을 위한 랜덤 특징". In: Advances in Neural Information Processing Systems (NeurIPS) 20 (2007).
[87] Prajit Ramachandran, Barret Zoph, and Quoc V Le. "Swish: 자기 게이트 활성화 함수". In: arXiv preprint arXiv:1710.05941 7.1 (2017), p. 5.
[88] Keisuke Sakaguchi, Ronan Le Bras, Chandra Bhagavatula, and Yejin Choi. "Winogrande: 대규모의 적대적 Winograd 스키마 챌린지". In: Communications of the ACM 64.9 (2021), pp. 99-106.
[89] Imanol Schlag, Kazuki Irie, and Jürgen Schmidhuber. "선형 트랜스포머는 비밀리에 빠른 가중치 프로그래머이다". In: The International Conference on Machine Learning (ICML). PMLR. 2021, pp. 9355-9366.
[90] Noam Shazeer. "빠른 트랜스포머 디코딩: 하나의 쓰기 헤드면 충분하다". In: arXiv preprint arXiv:1911.02150 (2019).
[91] Sam Shleifer, Jason Weston, and Myle Ott. "NormFormer: 추가 정규화를 통한 개선된 트랜스포머 사전 훈련". In: arXiv preprint arXiv:2110.09456 (2021).
[92] Mohammad Shoeybi, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, and Bryan Catanzaro. "Megatron-LM: 모델 병렬성을 사용한 수십억 파라미터 언어 모델 훈련". In: arXiv preprint arXiv:1909.08053 (2019).
[93] Jimmy TH Smith, Andrew Warrington, and Scott W Linderman. "시퀀스 모델링을 위한 단순화된 상태 공간 계층". In: The International Conference on Learning Representations (ICLR). 2023.
[94] Jianlin Su, Yu Lu, Shengfeng Pan, Ahmed Murtadha, Bo Wen, and Yunfeng Liu. "Roformer: 회전 위치 임베딩을 갖춘 개선된 트랜스포머". In: arXiv preprint arXiv:2104.09864 (2021).
[95] Yutao Sun, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang, and Furu Wei. "Retentive 네트워크: 대규모 언어 모델을 위한 트랜스포머의 후계자". In: arXiv preprint arXiv:2307.08621 (2023).
[96] Yi Tay, Mostafa Dehghani, Dara Bahri, and Donald Metzler. "효율적 트랜스포머: 서베이". In: ACM Computing Surveys 55.6 (2022), pp. 1-28.
[97] Chameleon Team. "Chameleon: 혼합 모달 초기 융합 기반 모델". In: arXiv preprint arXiv:2405.09818 (2024).
[98] Anna Thomas, Albert Gu, Tri Dao, Atri Rudra, and Christopher Ré. "낮은 변위 랭크를 이용한 압축 변환 학습". In: Advances in Neural Information Processing Systems (NeurIPS). 2018, pp. 9052-9060.
[99] Ilya O Tolstikhin, Neil Houlsby, Alexander Kolesnikov, Lucas Beyer, Xiaohua Zhai, Thomas Unterthiner, Jessica Yung, Andreas Steiner, Daniel Keysers, Jakob Uszkoreit, et al. "MLP-Mixer: 비전을 위한 전 MLP 아키텍처". In: Advances in Neural Information Processing Systems (NeurIPS) 34 (2021), pp. 24261-24272.
[100] Hugo Touvron, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie-Anne Lachaux, Timothée Lacroix, Baptiste Rozière, Naman Goyal, Eric Hambro, Faisal Azhar, et al. "Llama: 공개적이고 효율적인 기초 언어 모델". In: arXiv preprint arXiv:2302.13971 (2023).
[101] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. "Llama 2: 공개 기초 모델 및 미세 조정된 채팅 모델". In: arXiv preprint arXiv:2307.09288 (2023).
[102] Raf Vandebril, M Van Barel, Gene Golub, and Nicola Mastronardi. "반분리 행렬에 관한 서지". In: Calcolo 42 (2005), pp. 249-270.
[103] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, and Illia Polosukhin. "어텐션만 있으면 된다". In: Advances in Neural Information Processing Systems (NeurIPS). 2017.
[104] Shida Wang and Beichen Xue. "계층별 비선형성을 갖춘 상태 공간 모델은 지수적으로 감쇠하는 메모리를 가진 보편 근사기이다". In: arXiv preprint arXiv:2309.13414 (2023).
[105] Sinong Wang, Belinda Z Li, Madian Khabsa, Han Fang, and Hao Ma. "Linformer: 선형 복잡도를 가진 자기 어텐션". In: arXiv preprint arXiv:2006.04768 (2020).
[106] Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han, and Mike Lewis. "어텐션 싱크를 이용한 효율적인 스트리밍 언어 모델". In: The International Conference on Learning Representations (ICLR). 2024.
[107] Yunyang Xiong, Zhanpeng Zeng, Rudrasis Chakraborty, Mingxing Tan, Glenn Fung, Yin Li, and Vikas Singh. "Nyströmformer: 자기 어텐션을 근사하기 위한 Nyström 기반 알고리즘". In: Proceedings of the AAAI Conference on Artificial Intelligence. Vol. 35. 2021.
[108] Songlin Yang, Bailin Wang, Yikang Shen, Rameswar Panda, and Yoon Kim. "하드웨어 효율적 훈련을 갖춘 게이트 선형 어텐션 트랜스포머". In: The International Conference on Machine Learning (ICML). 2024.
[109] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi, and Yejin Choi. "HellaSwag: 기계가 정말 문장을 완성할 수 있는가?" In: Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics. 2019.
[110] Jinle Zeng, Min Li, Zhihua Wu, Jiaqi Liu, Yuang Liu, Dianhai Yu, and Yanjun Ma. "Boosting distributed training performance of the unpadded bert model". In: arXiv preprint arXiv:2208.08124 (2022).
[111] Shuangfei Zhai, Walter Talbott, Nitish Srivastava, Chen Huang, Hanlin Goh, Ruixiang Zhang, and Josh Susskind. "An Attention Free Transformer". In: arXiv preprint arXiv:2105.14103 (2021).
[112] Yujia Zhai, Chengquan Jiang, Leyuan Wang, Xiaoying Jia, Shang Zhang, Zizhong Chen, Xin Liu, and Yibo Zhu. "Bytetransformer: A high- performance transformer boosted for variable- length inputs". In: 2023 IEEE International Parallel and Distributed Processing Symposium (IPDPS). IEEE. 2023, pp. 344- 355.
[113] Michael Zhang, Kush Bhatia, Hermann Kumbong, and Christopher Ré. "The Hedgehog & the Porcupine: Expressive Linear Attentions with Softmax Mimicry". In: The International Conference on Learning Representations (ICLR). 2024.
[114] Lin Zheng, Chong Wang, and Lingpeng Kong. "Linear complexity randomized self- attention mechanism". In: International Conference on Machine Learning. PMLR. 2022, pp. 27011- 27041.
용어집
| Notation | Description | Definition |
| T | 시간 축 또는 타깃 시퀀스 축 | 정의 2.1 |
| S | 소스 시퀀스 축 (어텐션에서) | 수식 (9) |
| D | 모델 차원 또는 d_model | 정의 7.1 |
| N | 상태/특징 차원 또는 d_state | 수식 (2)와 (9) |
| P | 헤드 차원 또는 d_head | 정의 2.1 |
| H | 헤드 수 또는 n_head | 정의 7.1 |
| M | 시퀀스 변환 행렬 | 정의 2.3 |
| A | 이산 SSM 순환 (상태) 행렬 | 수식 (2) |
| B | 상태 공간 모델 입력 투영 (확장) 행렬 | 수식 (2) |
| C | 상태 공간 모델 출력 투영 (수축) 행렬 | 수식 (2) |
| X | 입력 행렬 (형태 (T,P)) | 수식 (2)와 (9) |
| Y | 출력 행렬 (형태 (T,P)) | 수식 (2)와 (9) |
| Q | 어텐션 쿼리 행렬 | 수식 (9) |
| K | 어텐션 키 행렬 | 수식 (9) |
| V | 어텐션 값 행렬 | 수식 (9) |
| G | 어텐션 그람 행렬 | QK^T (또는 CB^T) |
| L | (구조화된) 마스크 행렬 (인과적 설정에서 하삼각) | 정의 4.2 |
B 스칼라 SSM 스캔(1-SS 곱셈)을 위한 효율적인 알고리즘
이 절에서는 구조화된 행렬 분해의 관점에서 스칼라 SSM 스캔을 계산하기 위한 다양한 알고리즘을 자세히 설명한다. 스칼라 SSM 스캔은 인 경우(즉, 가 스칼라인 경우) 이산 SSM (7)의 순환 부분을 계산하는 것으로 정의된다. 이는 SSM을 순환적으로 계산하는 데 일반적으로 사용되며, 특히 가 대각 구조를 갖는 구조화된 SSM의 경우 S5(J. T. Smith, Warrington, and Linderman 2023) 및 S6(Gu and Dao 2023) 모델에서와 같이 이 연산으로 축소된다.
이 섹션의 목표는 시퀀스 모델을 위한 효율적인 알고리즘이 구조화된 행렬 곱셈 알고리즘으로 간주될 수 있다는 이 논문의 중심 주제를 뒷받침하는 것이다. 여기서 보여주는 다양한 행렬 분해 아이디어는 빠른 SSM 알고리즘을 유도하는 데 사용된 아이디어(Section 6)와 관련이 있으며, 서브루틴으로 직접 사용되기도 한다.
B.1 문제 정의
와 를 스칼라 수열이라고 하자. 스칼라 SSM 스캔은 다음과 같이 정의된다.
여기서 은 SSM 재귀에 대한 이전 은닉 상태를 나타내는 임의의 값일 수 있으며, 별도로 명시되지 않는 한 이라고 가정한다.
우리는 또한 식 (21)을 cumprodsum(누적 곱 합)이라고 부른다. cumprodsum은 이 덧셈의 항등원일 때 cumprod(누적 곱)로 축소되고, 이 곱셈의 항등원일 때 cumsum(누적 합)으로 축소된다는 점에 유의하라. 마지막으로, 벡터화된 형태로 다음과 같이 쓸 수 있다는 점에 유의하라.
다시 말해, 이는 단순히 1-SS 행렬 에 의한 행렬-벡터 곱이다.
따라서 이 기본 원시 연산을 바라보는, 모두 동등한 세 가지 관점이 있다:
- (스칼라) SSM 스캔.- cumprodsum.- 1-SS 행렬-벡터 곱셈.
B.2 고전적 알고리즘
먼저 SSM 스캔 (21)을 계산하는 두 가지 고전적 방법을 설명하며, 이는 선행 연구에서 사용된 바 있다.
B.2.1 순차 재귀
재귀 모드는 단순히 (21)을 한 번에 한 타임스텝 씩 계산한다. 1-SS 곱셈의 관점에서 이는 Section 3.4.1에서도 설명되었다.
B.2.2 병렬 결합 스캔
둘째, 중요한 관찰은 이 재귀가 결합 스캔(associative scan)으로 바뀔 수 있다는 것이다(E. Martin and Cundy 2018; J. T. Smith, Warrington, and Linderman 2023). 이 사실은 완전히 자명하지는 않다. 예를 들어, S5는 올바른 결합 스캔 연산자를 정의한 다음 기계적인 계산을 통해 그 연산자의 결합성을 보였다.
이것이 결합 스캔으로 계산 가능하다는 것을 보는 조금 더 깔끔한 방법은, 다항 재귀를 크기가 1이 아닌 2인 은닉 상태에 대한 단일 항 재귀로 바꾸는 것이다:
그러면 모든 를 계산하는 것은 이 행렬들의 누적 곱을 구하는 것과 같다. 행렬 곱셈은 결합적이므로, 이는 결합 스캔으로 계산할 수 있다. 결합 이항 연산자는 단순히 이 특정 행렬들에 대한 행렬 곱셈이다:
첫 번째 행을 등치시키면 S5에서 정의한 것과 동일한 결합 스캔 연산자를 얻는다:
결합 스캔이 중요한 이유는 분할 정복 알고리즘을 사용하여 병렬화할 수 있기 때문이다(Blelloch 1990). 우리는 이 알고리즘의 세부 사항은 생략하고, 대신 전체 결합 SSM 스캔 알고리즘이 행렬 분해를 통해 처음부터 유도될 수 있음을 보인다(Appendix B.3.5).
B.3 구조화된 행렬 분해를 통한 효율적인 알고리즘
우리는 SSM 스캔을 계산하는 여러 알고리즘을 논의하며, 모두 1-SS 행렬 의 구조화된 행렬 분해를 찾는다는 관점에서 접근한다. 이러한 알고리즘 또는 계산 모드에는 정보가 한 번에 1, 2, 4, 8, ... 스텝씩 전파되는 팽창 모드(dilated mode)가 포함된다. 정보가 청크 단위로 앞으로 전파되는 상태 전달 모드(state-passing mode). 한 번에 한 스텝씩 증가하는 완전 재귀 모드로, 이는 상태 전달 모드의 특수한 경우이다. 이 계층적 블록으로 나뉘는 블록 분해 병렬 모드. 이 동일한 크기의 블록으로 나뉘고 재귀적으로 축소되는 스캔 모드.
B.3.1 팽창 모드
이 모드는 증가하는 "스트라이드(stride)"를 포함하는 특정한 방식으로 1-SS 행렬을 인수분해한다. 이는 구체적인 예를 통해 가장 잘 설명된다:
B.3.2 상태 전달(청크 단위) 모드
이 모드는 재귀 상태 를 한 번에 한 스텝씩 앞으로 전달하는 대신, 임의의 길이 의 청크에 대해 답을 계산하고 그 상태를 청크를 통해 전달한다는 점에서 표준 재귀 모드의 일반화로 볼 수 있다. 이는 또한 1-SS 행렬의 단순한 블록 분해로부터 유도될 수 있다.
Remark 9. 우리는 상태가 하나의 국소 세그먼트에서 다른 세그먼트로 전달되는 방식을 언급하기 위해 이것을 "상태 전달"이라고 부르지만, 이는 관련 모델들이 제안한 "청크 단위(chunkwise)" 알고리즘과 관련이 있다(Y. Sun et al. 2023; Yang et al. 2024).
"청크" 단위로 를 계산하는 것을 고려하자: 어떤 인덱스 에 대해, 우리는 인덱스 까지의 출력인 를 계산하고, 문제를 인덱스 에 대한 더 작은 문제로 축소할 방법을 갖기를 원한다. 우리는 을 다음과 같이 쓴다.
1. 원하는 방법(즉, 이 섹션의 1-SS 곱셈 방법 중 어느 것이든)을 사용하여 답의 왼쪽 절반 를 계산한다.
2. 최종 상태 을 계산한다.
3. 상태를 한 스텝 증가시켜 를 수정한다.
4. 원하는 방법을 사용하여 답의 오른쪽 절반 를 계산한다.
다시 말해, 우리는 왼쪽 부분 문제를 블랙박스로 계산하고, 그 최종 상태를 오른쪽 문제로 전달하며, 오른쪽 부분 문제를 블랙박스로 계산한다.
이 방법의 유용성은 더 복잡한 설정, 예를 들어 일반적인 -반분리(semiseparable) 경우와 입력 가 추가적인 "배치(batch)" 차원을 갖는 경우(다시 말해 행렬-벡터 곱셈이 아니라 행렬-행렬 곱셈인 경우)에서 드러난다. 이 경우, 우리는 전체 은닉 상태 를 구체화하지 않는 청크들(과 에 의한 MM에 해당)에 대한 대체 알고리즘을 사용할 수 있다. 대신, 우리는 은닉 상태들을 건너뛰고 최종 상태 을 대체 방식으로 직접 계산한 다음, 그 상태를 다음 청크로 "전달"한다.
복잡도. 이 방법은 단계 2–3이 상수 시간만 소요되기 때문에 매우 작업 효율적일 수 있다. 따라서 두 하위 문제(단계 1과 4)가 선형 시간이라고 가정하면, 전체 방법은 선형 시간이 소요된다.
단점은 이것 역시 순차적이라는 것이다.
B.3.3 완전 순환 모드
순환이 한 번에 한 단계씩 전개되는 완전 순환 모드(21)는 청크 크기 인 상태 전달 모드의 한 인스턴스화일 뿐이라는 점에 유의하라.
B.3.4 (병렬) 블록 분해 모드
이것은 상태 전달 모드와 동일한 행렬 분해를 사용하지만, 계산을 병렬화하는 대가로 계산량을 맞바꾸는 다른 순서로 하위 문제들을 계산한다.
여느 때와 같이, 우리는 을 다음과 같이 쓴다.
핵심적인 관찰은 다시 한번 의 왼쪽 아래 사분면이 계수 1이라는 것이다. 검사를 통해서 말고도, 이것을 확인하는 또 다른 방법은 우변을 사용하는 것이다. 우변의 왼쪽 아래 사분면이 자명한 계수 1 행렬(오른쪽 위 모서리가 인 것을 제외하면 모두 0이다)임을 관찰하고, Woodbury 역행렬 공식을 사용하여 좌변의 왼쪽 아래 모서리 또한 계수 1이어야 함을 확인하는 것이다. 이것은 또한 계수 1 분해를 도출하는 방법을 제공하며, 이는 검사를 통해 확인할 수 있다.
두 번째 관찰은 이 행렬이 자기 유사적이라는 것이다. 즉, 임의의 주부분행렬(principal submatrix)이 동일한 형태를 갖는다. 특히, 왼쪽 위와 오른쪽 아래 사분면은 모두 1-SS 행렬이다.
이것은 에 의한 행렬 곱셈을 수행하는 쉬운 방법을 제공한다. 즉, 두 반쪽(왼쪽 위와 오른쪽 아래)에 대해 병렬로 재귀하고, 그다음 왼쪽 아래 부분행렬을 처리한다. 분할 정복 알고리즘에서 이 "결합" 단계는 부분행렬이 계수 1이기 때문에 쉽다. 이것은 병렬 알고리즘으로 이어진다.
복잡성. 상태 전달 알고리즘과 마찬가지로, 이 방법은 랭크 구조 준분리 가능 행렬(rank-structured semiseparable matrices)의 동일한 블록 분해를 사용한다. 차이점은 상태 전달 알고리즘이 왼쪽 부분 문제를 처리한 다음 오른쪽 부분 문제를 처리하는 반면, 이 방법은 두 부분 문제를 병렬로 재귀한다는 것이다. 이는 알고리즘의 깊이/스팬(depth/span)을 선형에서 로 낮춘다. 그 대가로, 조합 단계(랭크-1 왼쪽 아래 부분행렬을 처리하는 단계)가 상수 시간 대신 선형 시간을 요구하므로, 총 작업량은 선형이 아니라 가 된다.
또한 재귀 과정에서 언제든지 멈추고 부분 문제를 다른 방식으로 계산할 수 있다는 점에 주목하라. 이것이 SSD 알고리즘(6절)의 핵심 아이디어로, 여기서는 작은 부분 문제에 대해 이중 이차 어텐션(dual quadratic attention) 정식화로 전환한다.
B.3.5 연상 스캔 모드
상태 전달(청크 단위) 알고리즘은 선형 작업량을 가지지만, 순차적 연산도 포함한다.
블록 행렬 축소 모드와 팽창 모드(dilated modes)는 병렬화가 가능하다: 이들은 의 깊이/스팬을 가진다. 그러나 이들은 추가적인 작업량 을 수행한다.
부록 B.2.2에서 언급했듯이, 연상 스캔(associative scan, 또는 접두사 스캔(prefix scan)) 알고리즘(Baker et al. 1996)을 활용하여 의 깊이와 의 작업량을 모두 달성하는 알고리즘이 존재한다. 이 알고리즘은 SSM 스캔 또는 누적곱합(cumprodsum) 관점에서 가장 쉽게 파악되며, 그 경우에도 자명하지는 않다: 연상 연산자(22)를 별도로 유도한 다음, 병렬/연상/접두사 스캔 알고리즘을 블랙박스로 활용해야 한다(Blelloch 1990).
여기서 우리는 다른 행렬 분해를 활용하여 이 병렬 스캔을 실제로 유도하는 것이 가능함을 보인다:
단계 2. 이제 행렬의 순수 하삼각 부분에서 랭크-1 행렬로 인수분해된 각 블록을 고려하자. 오른쪽 측면의 각 행 벡터는 해당 열의 대각 블록에서 맨 아래 행 벡터와 동일하다는 점에 주목하라: 특히 그리고 행들이다.
따라서 우리는 단계 1로부터 이들에 대한 답을 이미 가지고 있으며, 이는 단계 1의 모든 부분 문제의 두 번째 요소이다. 이 요소들의 배열을 (의 절반 크기)이라 부르면, 에 에 의해 생성된 1-SS 행렬을 곱해야 한다.
단계 3. 마지막으로, 단계 2의 각 답은 왼쪽 측면 열 벡터들을 곱함으로써 두 개의 최종 답으로 브로드캐스트될 수 있다: 특히 , 그리고 벡터들이다.
이것은 인덱스의 약간의 오프-바이-원(off-by-one) 이동으로 조금 수정될 수 있다는 점에 주목하라. 이 알고리즘을 보는 동등한 방법은 3단계 행렬 분해로 보는 것이다
IUE (VUI, VUCI, AIU RCI, OULCI).
결과적으로, 이것들은 상태 공간 모델의 닫힘 성질(closure properties)을 함의한다.
예를 들어, 덧셈 성질은 두 개의 병렬 SSM 모델을 합하는 것이 여전히 SSM이라는 것을 말한다. 곱셈 성질은 두 SSM을 순차적으로 합성하거나 연쇄시키는 것이 여전히 SSM으로 볼 수 있으며, 그 총 상태 크기는 가산적이라는 것—다소 자명하지 않은 사실—을 말한다.
마지막으로, 역 성질은 우리가 SSM을 다른 유형의 모델과 연관시킬 수 있게 해준다. 예를 들어, 띠 행렬(banded matrices)이 준분리 가능하므로, 그 역행렬도 준분리 가능하다는 것을 알아차릴 수 있다. (실제로, 준분리 가능 구조 계열은 종종 띠 행렬의 역행렬을 취하는 것에서 동기가 부여된다(Vandebril et al. 2005)). 더욱이, 준분리 가능 행렬의 빠른 점화 성질은 그 역행렬이 띠 행렬이라는 것의 결과로 볼 수 있다.
주석 11. 1-SS 행렬이 단순한 점화식(7)이라는 사실은 1-SS 행렬의 역행렬이2-띠 행렬이라는 사실과 동등하다:
따라서 , 또는
또는 원소별로,
반대로, 우리는 또한 이러한 닫힘 결과들을 사용하여 자기회귀 구조적 어텐션(autoregressive structured attention)이 (특정 가정 하에서) 반드시 SSM이어야 함을 증명하며, 이를 통해 어텐션 변형을 포함한 보다 일반적인 효율적 시퀀스 모델 계열이 상태 공간 모델로 환원될 수 있음을 보일 수 있다(부록 C.2).
C.2 자기회귀 마스크드 어텐션은 준분리 가능 구조 어텐션이다
우리는 5.2절의 정리 5.2를 증명한다. 4.3절에서 우리는 구조적 어텐션을 마스크드 어텐션의 광범위한 일반화로 정의했으며, 여기서 효율성의 성질(즉, 커널 어텐션에 대한 선형 시간 형태)은 구조적 행렬 곱셈의 효율성으로 추상화된다. 그러나 계산 효율성 외에도, 표준 선형 어텐션(Katharopoulos et al. 2020)은 두 가지 중요한 성질을 가진다. 첫째, 그것은 인과적(causal)이며, 이는 자기회귀 모델링과 같은 설정에 필요하다. 더욱이, 그것은 효율적인 자기회귀 생성을 가진다. 다시 말해, 자기회귀 단계의 비용—즉, 가 이미 관측되고 전처리된 상태에서 를 볼 때 출력 를 계산하는 증분 비용—은 상수 시간만을 요구한다.
여기서 우리는 어떤 SMA 인스턴스가 효율적인 자기회귀를 가지는지 특성화한다.
SMA의 프레임워크에서, 인과성은 마스크 이 하삼각 행렬이라는 제약과 동등하다.
효율적인 자기회귀를 가지는 행렬의 공간을 특성화하는 것은 더 어렵다. 우리는 시계열 문헌의 고전적 정의(예: ARIMA 과정(Box et al. 2015))의 정신에 따라, 자기회귀 과정에 대한 좁은 기술적 정의를 사용할 것이다.
정의 C.2. 우리는 차의 자기회귀 변환 를 각 출력 가 현재 입력과 마지막 개의 출력에만 의존하는 변환으로 정의한다:
\(L\)이 cumsum 행렬인 경우는 \(k = 1\)인 특수한 경우이며 따라서 \(y_{t} = x_{t} + y_{t_{1}}\)임에 주목하라. 이 정의를 사용하면, 효율적인 자기회귀 선형 변환의 공간을 특성화하는 것은 준분리 가능 행렬(semiseparable matrices)의 성질로부터 따른다. 정리 C.3은 정리 5.2를 형식화하고 증명한다.
정리 C.3. \(L \in \mathbb{R}^{T \times T}\)를 차수 \(k\)의 효율적인 자기회귀 변환이라 하자. 그러면 \(L\)은 차수 \(k + 1\)의 상태 공간 모델이다.
증명. \((x, y)\)를 입력 및 출력 시퀀스라 하면, \(y = L x\)이다. 정의 (23)을 재배열하면,
\(t\)에 대해 벡터화하면, 이는 행렬 변환으로 표현될 수 있다
\(\mu\) 대각 행렬은 왼쪽으로 옮겨져 \(\ell\) 계수들의 행렬에 접어 넣을 수 있으며, 이는 여전히 \(k + 1\) 대역 하삼각 행렬이다. 그러나 우리는 또한 \(L^{- 1}y = x\)를 가지므로, \(L\)은 이 행렬의 역행렬이다.
다음으로, \(k + 1\) 대역 행렬은 준분리 가능성의 계수 특성화(정의 3.1)에 의해 \(k + 1\)-준분리 가능임에 주목하라. 따라서 명제 C.1에 의해 역행렬 \(L\)은 기껏해야 \(k + 2\)-준분리 가능이다. 대역 행렬의 추가적인 구조 때문에 \(k + 1\)이라는 약간 더 강한 한계를 얻을 수 있다. 마지막으로, \(L\)을 차수 \(k + 1\) 상태 공간 모델로 특성화하는 것은 정리 3.5로부터 따른다. \(\square\)
다시 말해, 효율적인 자기회귀 어텐션은 준분리 가능한 SMA이다.
D 실험 세부 사항
D.1 MQAR 세부 사항
우리는 Based(Arora, Eyuboglu, Zhang 등 2024)에서 도입된 과제의 더 어려운 버전을 사용하는데, 여기서는 질의/키/값이 아닌 토큰들이 무작위 토큰으로 대체된다. 우리는 또한 선행 연구에서 사용된 MQAR의 일반적인 변형보다 더 많은 키-값 쌍, 더 긴 시퀀스, 그리고 더 작은 모델 크기를 사용하며, 이 모든 것이 과제를 더 어렵게 만든다.
각 시퀀스 길이 에 대해, 우리는 개의 키-값 쌍을 사용한다. 총 어휘 크기는 8192이다.
우리는 개의 키-값 쌍을 사용하여 데이터셋을 순환하며 훈련하는 커리큘럼 훈련의 한 형태를 사용하는데, 여기서 각 데이터셋은 개의 예제를 가지며, 각 데이터셋을 총 8 에포크 동안 통과한다(총 개의 예제). 총 배치 크기는 토큰이다(예를 들어 인 경우 배치 크기는 256이다).
모든 방법은 기본 설정으로 2개의 레이어를 사용하며, 어텐션 베이스라인은 추가적으로 위치 임베딩을 받는다. 각 방법에 대해, 우리는 모델 차원 과 학습률 에 대해 탐색한다. 우리는 매 에포크마다 감소하는 선형 감쇠 스케줄을 사용한다(예를 들어 마지막 에포크는 최대/시작 학습률의 의 학습률을 가질 것이다).
D.2 스케일링 법칙 세부 사항
모든 모델은 Pile에서 훈련되었다. 스케일링 법칙 실험의 경우, 우리는 GPT2 토크나이저를 사용한다.
모델 크기. 표 9는 GPT3(Brown 등 2020)를 따라 스케일링 법칙에 사용하는 모델 크기를 명시한다. 첫째, 우리는 균일성을 위해 1.3B 모델의 배치 크기를 1M 토큰에서 0.5M 토큰으로 변경했다. 둘째, 우리는 훈련 스텝 수와 총 토큰 수를 Chinchilla 스케일링 법칙(Hoffmann 등 2022)과 대략 일치하도록 변경했는데, 이는 훈련 토큰이 모델 크기에 비례하여 증가해야 한다고 명시한다.
훈련 레시피. 모든 모델은 다음과 같은 AdamW 옵티마이저를 사용했다
- 그래디언트 클립 값 1.0- 가중치 감쇠 0.1- 드롭아웃 없음- 코사인 감쇠를 동반한 선형 학습률 워밍업
| PARAMS | n_layers | d_model | n_heads / d_head | 학습 스텝 | 학습률 | 배치 크기 | 토큰 |
| 125M | 12 | 768 | 12 / 64 | 4800 | 6e-4 | 0.5M 토큰 | 2.5B |
| 350M | 24 | 1024 | 16 / 64 | 13500 | 3e-4 | 0.5M 토큰 | 7B |
| 760M | 24 | 1536 | 16 / 96 | 29000 | 2.5e-4 | 0.5M 토큰 | 15B |
| 1.3B | 24 | 2048 | 32 / 64 | 50000 | 2e-4 | 0.5M 토큰 | 26B |
기본적으로 최대 학습률은 GPT3 사양이다.
GPT3 레시피와 비교하여, 우리는 PaLM(Chowdhery 등 2023) 및 LLaMa(Touvron, Lavril 등 2023)과 같은 인기 있는 대규모 언어 모델에서 채택된 변경 사항에서 영감을 받은 "개선된 레시피"를 사용한다. 여기에는 다음이 포함된다:
- 최대값이 GPT3 값의 인, 로의 코사인 감쇠를 동반한 선형 학습률 워밍업
- 선형 편향 항 없음
- LayerNorm 대신 RMSNorm
- PyTorch 기본값인 대신 AdamW 하이퍼파라미터 (GPT3 값)
D.3 다운스트림 평가 세부 사항
완전히 훈련된 모델의 다운스트림 성능을 평가하기 위해, 우리는 GPT- NeoX(Black 등 2022) 토크나이저를 사용하여 Pile에서 300B 토큰으로 Mamba- 2를 훈련한다.
우리는 스케일링 실험과 동일한 하이퍼파라미터를 사용하되, 1.3B 및 2.7B 모델의 경우 배치 크기를 1M으로 한다. 2.7B 모델의 경우, 우리는 또한 GPT3 사양(32개 레이어, 차원 2560)을 따른다.
모든 모델에 대해, 우리는 해당 GPT3 모델 학습률의 5배를 사용한다.
다운스트림 평가를 위해, 우리는 EleutherAI의 LM 평가 하네스(L. Gao, Tow 등 2021)를 사용하며, Mamba(Gu and Dao 2023)와 동일한 과제에 하나를 추가한다:
- LAMBADA (Paperno 등 2016)
- HellaSwag (Zellers 등 2019)
- PIQA (Bisk 등 2020)
- ARC-challenge (P. Clark 등 2018)
- ARC-easy: ARC-challenge의 쉬운 부분집합
- WinoGrande (Sakaguchi 등 2021)
- OpenBookQA (Mihaylov 등 2018)
D.4 절제 실험 세부 사항
(Re)Based 세부 사항. 9.4.3절의 우리의 절제 실험은 Based(Arora, Eyuboglu, Zhang 등 2024) 및 ReBased(Aksenov 등 2024) 모델을 고려했다.
Based는 exp 커널을 2차 테일러 전개 로 근사하는데, 이는 특징 맵
으로 달성될 수 있다. ReBased는 커널 변환 에 해당하는 더 단순한 특징 맵 를 사용할 것을 제안하지만, 사전에 레이어 정규화를 적용하기도 한다. 우리는 레이어 정규화를 우리의 기본 Swish 활성화에 대한 대안적인 비선형 활성화로 간주하며, 이들의 조합을 절제한다.
| 모델 | 토큰. | PILE PPL ↓ | LAMBADA PPL ↓ | LAMBADA ACC ↑ | HELLASWAG ACC ↑ | PIQA ACC ↑ | ARC-E ACC ↑ | ARC-C ACC ↑ | WINOGRANDE ACC ↑ | OPENBOOKQA ACC ↑ | 평균 ACC ↑ |
| Hybrid H3-130M | GPT2 | — | 89.48 | 25.8 | 31.7 | 64.2 | 44.4 | 24.2 | 50.6 | 27.0 | 38.2 |
| Pythia-160M | NeoX | 29.64 | 38.10 | 33.0 | 30.2 | 61.4 | 43.2 | 24.1 | 51.9 | 29.2 | 39.0 |
| Mamba-130M | NeoX | 10.56 | 16.07 | 44.3 | 35.2 | 64.5 | 48.0 | 24.2 | 51.9 | 28.8 | 42.4 |
| Mamba-2-130M | NeoX | 10.48 | 16.86 | 43.9 | 35.3 | 64.9 | 47.4 | 24.2 | 52.1 | 30.6 | 42.6 |
| Hybrid H3-360M | GPT2 | — | 12.58 | 48.0 | 41.5 | 68.1 | 51.4 | 24.7 | 54.1 | 31.6 | 45.6 |
| Pythia-410M | NeoX | 9.95 | 10.84 | 51.4 | 40.6 | 66.9 | 52.1 | 24.6 | 53.8 | 30.0 | 45.6 |
| Mamba-370M | NeoX | 8.28 | 8.14 | 55.6 | 46.5 | 69.5 | 55.1 | 28.0 | 55.3 | 30.8 | 48.7 |
| Mamba-2-370M | NeoX | 8.21 | 8.02 | 55.8 | 46.9 | 70.5 | 54.9 | 26.9 | 55.7 | 32.4 | 49.0 |
| Pythia-1B | NeoX | 7.82 | 7.92 | 56.1 | 47.2 | 70.7 | 57.0 | 27.1 | 53.5 | 31.4 | 49.0 |
| Mamba-790M | NeoX | 7.33 | 6.02 | 62.7 | 55.1 | 72.1 | 61.2 | 29.5 | 56.1 | 34.2 | 53.0 |
| Mamba-2-780M | NeoX | 7.26 | 5.86 | 61.7 | 54.9 | 72.0 | 61.0 | 28.5 | 60.2 | 36.2 | 53.5 |
| GPT-Neo 1.3B | GPT2 | — | 7.50 | 57.2 | 48.9 | 71.1 | 56.2 | 25.9 | 54.9 | 33.6 | 49.7 |
| Hybrid H3-1.3B | GPT2 | — | 11.25 | 49.6 | 52.6 | 71.3 | 59.2 | 28.1 | 56.9 | 34.4 | 50.3 |
| OPT-1.3B | OPT | — | 6.64 | 58.0 | 53.7 | 72.4 | 56.7 | 29.6 | 59.5 | 33.2 | 51.9 |
| Pythia-1.4B | NeoX | 7.51 | 6.08 | 61.7 | 52.1 | 71.0 | 60.5 | 28.5 | 57.2 | 30.8 | 51.7 |
| RWKV4-1.5B | NeoX | 7.70 | 7.04 | 56.4 | 52.5 | 72.4 | 60.5 | 29.4 | 54.6 | 34.0 | 51.4 |
| Mamba-1.4B | NeoX | 6.80 | 5.04 | 65.0 | 59.1 | 74.2 | 65.5 | 32.8 | 61.5 | 36.4 | 56.4 |
| Mamba-2-1.3B | NeoX | 6.66 | 5.02 | 65.7 | 59.9 | 73.2 | 64.3 | 33.3 | 60.9 | 37.8 | 56.4 |
| GPT-Neo 2.7B | GPT2 | — | 5.63 | 62.2 | 55.8 | 72.1 | 61.1 | 30.2 | 57.6 | 33.2 | 53.2 |
| Hybrid H3-2.7B | GPT2 | — | 7.92 | 55.7 | 59.7 | 73.3 | 65.6 | 32.3 | 61.4 | 33.6 | 54.5 |
| OPT-2.7B | OPT | — | 5.12 | 63.6 | 60.6 | 74.8 | 60.8 | 31.3 | 61.0 | 35.2 | 55.3 |
| Pythia-2.8B | NeoX | 6.73 | 5.04 | 64.7 | 59.3 | 74.0 | 64.1 | 32.9 | 59.7 | 35.2 | 55.7 |
| RWKV4-3B | NeoX | 7.00 | 5.24 | 63.9 | 59.6 | 73.7 | 67.8 | 33.1 | 59.6 | 37.0 | 56.4 |
| Mamba-2.8B | NeoX | 6.22 | 4.23 | 69.2 | 66.1 | 75.2 | 69.7 | 36.3 | 63.5 | 39.6 | 59.9 |
| Mamba-2-2.7B | NeoX | 6.09 | 4.10 | 69.7 | 66.6 | 76.4 | 69.6 | 36.4 | 64.0 | 38.8 | 60.2 |
| GPT-J-6B | GPT2 | — | 4.10 | 68.3 | 66.3 | 75.4 | 67.0 | 36.6 | 64.1 | 38.2 | 59.4 |
| OPT-6.7B | OPT | — | 4.25 | 67.7 | 67.2 | 76.3 | 65.6 | 34.9 | 65.5 | 37.4 | 59.2 |
| Pythia-6.9B | NeoX | 6.51 | 4.45 | 67.1 | 64.0 | 75.2 | 67.3 | 35.5 | 61.3 | 38.0 | 58.3 |
| RWKV4-7.4B | NeoX | 6.31 | 4.38 | 67.2 | 65.5 | 76.1 | 67.8 | 37.5 | 61.0 | 40.2 | 59.3 |
이들은 특징 차원을 확장하기 때문에, 우리는 더 작은 차원으로 투영해야 한다는 점에 유의하라. 표 7에서, 130M 모델의 경우 상태 크기 를, 380M 모델의 경우 을 사용한다. (Re)Based 방법의 경우, 우리는 각각 8 및 16 차원으로 투영한 후 그들의 특징 맵을 적용하는데, 이는 130M 모델의 경우 ReBased의 경우 총 상태 크기 , Based의 경우 을 초래한다. 및 투영이 더 작기 때문에, 이들 방법은 더 적은 파라미터를 사용하며, 우리는 레이어 수를 적절히 조정한다.