
기억으로 추측하는 대신 추론 도중 스스로 검색을 실행해 결과를 문맥에 되돌리는 법을 강화학습으로 훈련한다. COLM 2025, 전문 무료.
Search-R1: Training LLMs to Reason and Leverage Search Engines with Reinforcement Learning
Search-R1: 강화학습을 통해 LLM이 추론하고 검색 엔진을 활용하도록 훈련하기
Bowen Jin , Hansi Zeng , Zhenrui Yue , Jinsung Yoon , Sercan Ö. Arik , Dong Wang , Hamed Zamani , Jiawei Han
일리노이 대학교 어배너-섐페인 컴퓨터과학과
매사추세츠 대학교 애머스트 지능형 정보 검색 센터
Google Cloud AI Research
{bowenj4, zhenrui3, dwang24, hanj}@illinois.edu, {hzeng, zamani}@cs.umass.edu {jinsungyoon, soarik}@google.com
초록
외부 지식과 최신 정보를 효율적으로 습득하는 것은 대규모 언어 모델(LLM)의 효과적인 추론과 텍스트 생성에 필수적이다. 추론 능력을 갖춘 고성능 LLM에게 추론 중 검색 엔진을 사용하도록 프롬프트하는 것은 종종 최적이 아닌데, LLM이 검색 엔진과 어떻게 최적으로 상호작용해야 하는지에 대한 능력을 완전히 갖추지 못할 수 있기 때문이다. 본 논문은 LLM이 실시간 검색을 동반한 단계별 추론 과정에서 (다수의) 검색 쿼리를 자율적으로 생성하는 방법을 학습하는 추론 프레임워크를 위한 강화학습(RL)의 확장인 SEARCH-R1을 소개한다. SEARCH-R1은 다중 턴 검색 상호작용을 통해 LLM의 추론 궤적을 최적화하며, 안정적인 RL 훈련을 위한 검색된 토큰 마스킹과 단순한 결과 기반 보상 함수를 활용한다. 일곱 개의 질의응답 데이터셋에 대한 실험은 SEARCH-R1이 동일한 설정에서 다양한 RAG 베이스라인 대비 성능을 (Qwen2.5-7B) 및 (Qwen2.5-3B) 향상시킴을 보여준다. 본 논문은 나아가 검색 증강 추론에서의 RL 최적화 방법, LLM 선택, 응답 길이 역학에 대한 실증적 통찰을 제공한다. 코드와 모델 체크포인트는 https://github.com/PeterGriffinJin/Search-R1 에서 확인할 수 있다.
1 서론
대규모 언어 모델(LLM)은 자연어 이해와 생성에서 놀라운 능력을 입증해 왔다(Hendrycks et al., 2020; Clark et al., 2018). 이러한 성과에도 불구하고, LLM은 복잡한 추론(Wei et al., 2022)과 외부 소스로부터 최신 정보를 검색하는 작업(Jin et al., 2024)에 직면할 때 종종 어려움을 겪는다. 이러한 한계를 해결하려면 고급 추론 능력(Huang & Chang, 2022)과 외부의 최신 정보를 최대한 활용하기 위해 검색 엔진과 효과적으로 상호작용하는 능력(Schick et al., 2023)을 통합할 필요가 있다.
LLM과 검색 엔진을 통합하는 기존 접근 방식은 일반적으로 두 가지 범주로 나뉜다: (1) 검색 증강 생성(RAG)(Gao et al., 2023; Lewis et al., 2020) 및 (2) 검색 엔진을 도구로 취급하는 방식(Yao et al., 2023; Schick et al., 2023)이다. RAG 모델은 종종 LLM 입력을 쿼리로 사용하여 구절을 검색하고 이를 생성용 LLM의 컨텍스트에 통합한다(Lewis et al., 2020). 이를 통해 LLM은 질문에 답할 때 외부 지식을 활용할 수 있다. 기존 연구(Trivedi et al., 2022a)가 다중 턴, 다중 쿼리 검색을 위해 LLM을 프롬프트하지만, 이 접근 방식은 LLM이 훈련 중에 검색 엔진과 효과적으로 상호작용하는 방법을 학습하도록 최적화되지 않기 때문에 최적이 아니다. 대안으로, LLM은 검색 엔진을 포함한 도구를 추론 과정의 일부로 활용하도록 프롬프트되거나 훈련될 수 있다(Qu et al., 2025; Trivedi et al., 2022a). 그러나 프롬프트 기반 접근 방식은 특정 작업이 LLM 사전 훈련 중에 접하지 못했을 수 있기 때문에 일반화에 종종 어려움을 겪는다. 반면, 훈련 기반 접근 방식은 더 큰 적응성을 제공하지만, 대규모의 고품질 주석 궤적에 의존하고 검색 작업의 본질적인 미분 불가능성으로 인해 종단 간 경사 하강법 기반 최적화가 적용 불가능하다는 점 때문에 효과적으로 확장하기 어렵다(Schick et al., 2023; Asai et al., 2024).
강화학습(RL)(Sutton et al., 1999; Kaelbling et al., 1996)은 LLM의 추론 능력을 향상시키는 강력한 패러다임으로 부상했다(Guo et al., 2025; Hou et al., 2025; Xie et al., 2025; Kumar et al., 2024). 특히 OpenAI-01(Jaech et al., 2024)과 DeepSeek-R1(Guo et al., 2025)과 같은 모델들은 RL 기법(예: PPO(Schulman et al., 2017) 및 GRPO(Shao et al., 2024))을 활용하여 경험과 피드백으로부터 학습함으로써 논리적 추론 및 문제 해결 능력을 향상시켰다. RL을 사용하면 결과 보상만으로 훈련되더라도 모델은 자기 검증(Weng et al., 2022)과 자기 교정(Kumar et al., 2024)을 포함한 복잡한 추론 능력을 학습한다. 그러나 RL을 검색 및 추론 시나리오에 적용하는 데는 세 가지 주요 과제가 있다: (1) RL 프레임워크 및 안정성 – 검색된 컨텍스트를 통합할 때 특히 안정적인 최적화를 보장하면서 검색 엔진을 LLM을 위한 RL 접근 방식에 효과적으로 통합하는 방법은 아직 불분명하다. (2) 다중 턴 교차 추론 및 검색 – 이상적으로 LLM은 반복적인 추론과 검색 엔진 호출이 가능해야 하며, 문제의 복잡성에 따라 검색 전략을 동적으로 조정해야 한다. (3) 보상 설계 – 검색 및 추론 작업을 위한 효과적인 보상 함수를 설계하는 것은 근본적인 과제로 남아 있는데, 단순한 결과 기반 보상이 LLM이 의미 있고 일관된 검색 행동을 학습하도록 안내하기에 충분한지 불분명하기 때문이다.
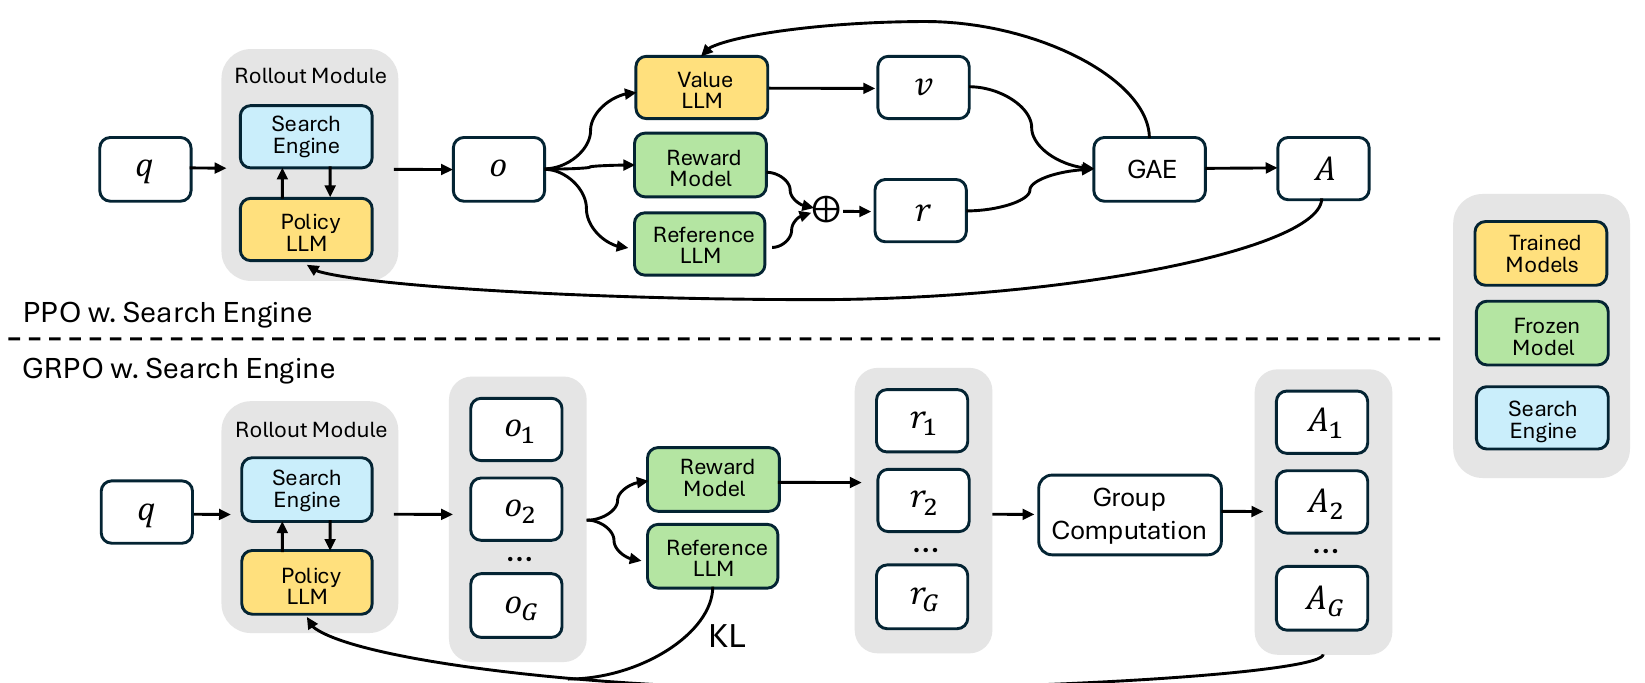
앞서 언급한 과제들을 해결하기 위해, 우리는 LLM이 자체 추론과 교차하는 방식으로 검색 엔진과 상호작용할 수 있게 하는 새로운 RL 프레임워크인 SEARCH-R1을 소개한다. 구체적으로, SEARCH-R1은 다음과 같은 핵심 혁신을 도입한다: (1) 우리는 검색 엔진을 환경의 일부로 모델링하여 LLM 토큰 생성과 검색 엔진 검색이 교차하는 샘플링된 궤적 시퀀스를 가능하게 한다. SEARCH-R1은 PPO와 GRPO를 포함한 다양한 RL 알고리즘과 호환되며, 우리는 안정적인 최적화를 보장하기 위해 검색된 토큰 마스킹을 적용한다. (2) SEARCH-R1은 다중 턴 검색 및 추론을 지원하며, <search> 및 </search> 토큰에 의해 명시적으로 트리거될 때 검색 호출을 실행한다. 검색된 내용은 <information> 및 </information> 토큰 내에 포함되며, LLM 추론 단계는 <think> 및 </think> 토큰 내에 감싸진다. 최종 답변은 <answer> 및 </answer> 토큰을 사용하여 형식화되어 구조화된 반복적 의사 결정을 가능하게 한다. (3) 우리는 프로세스 기반 보상의 복잡성을 피하고 간단한 결과 기반 보상 함수를 채택한다. 우리의 결과는 이 최소한의 보상 설계가 검색 및 추론 시나리오에서 효과적임을 보여준다. 따라서 SEARCH-R1은 주로 매개변수적 추론에 초점을 맞춘 DeepSeek-R1 Zero(Guo et al., 2025)의 확장으로 볼 수 있으며, 검색 증강 RL 훈련을 도입하여 검색 주도 의사 결정을 향상시킨다.
요약하면, 우리의 핵심 기여는 세 가지이다:
- 우리의 연구는 LLM이 검색 엔진 결과를 사용하여 추론하는 방식을 개선하기 위해 RL을 구현하는 데 있어 과제를 분석하고 관점을 제공한다.
- 우리는 검색 엔진을 통한 LLM 롤아웃 및 직접 최적화를 지원하는 새로운 RL 프레임워크인 SEARCH-R1을 제안하며, 이는 RL 훈련을 안정화하기 위한 검색된 토큰 마스킹, 복잡한 작업 해결을 지원하는 다중 턴 교차 추론 및 검색, 그리고 효과적인 결과 보상 함수를 포함한다.
- 우리는 SEARCH-R1의 효과를 입증하기 위해 체계적인 실험을 수행하며, 두 LLM이 동일한 실험 설정(예: 동일한 검색 모델, 훈련 데이터, 사전 훈련된 LLM)에서 RAG 베이스라인 대비 각각 평균 상대적 개선 41% 및 20%를 달성한다. 또한, 우리는 RL 방법 선택, 다양한 LLM 선택, 응답 길이 연구를 포함한 추론 및 검색 설정을 위한 RL에 대한 통찰을 제공한다..
2 관련 연구
2.1 대규모 언어 모델과 검색
뛰어난 추론 능력(Guo et al., 2025)과 코딩 능력(Guo et al., 2024)을 입증했음에도 불구하고, LLM(Zhao et al., 2023; Team, 2024; Achiam et al., 2023)은 종종 도메인 특화 지식(Peng et al., 2023; Li et al., 2023)이 부족하고 환각(hallucination)을 일으키기 쉽다(Zhang et al., 2023). 이러한 한계를 완화하기 위해 검색 엔진(Zhao et al., 2024)이 외부 정보를 공급하기 위해 널리 통합된다. 검색 엔진을 LLM과 통합하는 두 가지 주요 방법이 있다: (1) 검색 증강 생성(RAG)(Gao et al., 2023)과 (2) 검색 엔진을 도구로 취급하는 것(Schick et al., 2023)이다. RAG(Lewis et al., 2020; Yue et al., 2024; Xiong et al., 2025)는 일반적으로 한 차례의 검색과 순차적 생성 파이프라인을 따르며, 검색 엔진이 입력 쿼리를 기반으로 관련 정보를 가져오고, 이는 이후 쿼리와 연결되어 LLM에 입력된다. 그러나 이는 관련 없는 정보를 검색하는 문제(Jin et al., 2024)와 충분히 유용한 맥락을 제공하지 못하는 문제(Jiang et al., 2023)에 직면할 수 있다. 대안적 접근법은 검색-도구화(search-as-a-tool)로, LLM이 검색 엔진과 상호작용하도록 프롬프트되거나 미세 조정된다. IRCoT(Trivedi et al., 2022a)와 ReAct(Yao et al., 2023)는 프롬프팅을 사용하여 반복적 추론과 검색 엔진 호출을 안내하는 반면, Toolformer(Schick et al., 2023)는 검색 능력을 향상시키기 위해 지도 미세 조정을 활용한다. 그러나 이러한 방법들은 대규모로 얻기 어려운 고품질의 레이블된 궤적(trajectory)에 의존한다. 최근 연구(Guo et al., 2025)는 RL이 결과 보상만을 사용하여 LLM이 고급 추론 능력을 개발할 수 있게 함을 시사하지만, 검색 엔진 호출 시나리오에서의 잠재력은 아직 충분히 탐구되지 않았다.
2.2 대규모 언어 모델과 강화 학습
강화 학습(RL)(Kaelbling et al., 1996)은 에이전트가 환경과 상호작용하고 보상의 형태로 피드백을 받음으로써 순차적 의사 결정을 내리는 법을 학습하는 학습 패러다임으로, 시간에 걸쳐 누적 보상을 최대화하는 것을 목표로 한다(Sutton et al., 1999). RL은 Ouyang et al.(2022)에 의해 인간 피드백으로부터의 RL(RLHF)(Kaufmann et al., 2023)을 통해 LLM 튜닝에 도입되었다. 이 접근법은 먼저 인간 선호 데이터(Lambert et al., 2024)를 사용하여 보상 모델을 훈련시키고, 이후 이 모델이 일반적으로 근접 정책 최적화(PPO)를 통해 정책 LLM의 RL 기반 튜닝을 안내한다. 그러나 PPO는 여러 차례의 LLM 최적화를 수반하므로 구현하기 어렵다. RL 기반 튜닝을 단순화하기 위해 직접 선호 최적화(DPO)(Rafailov et al., 2023)와 SimPO(Meng et al., 2024)와 같은 직접 최적화 방법들이 제안되었다. 유사한 접근법이 LeRet(Hsu et al., 2024)에서 사용되며, 여기서 LLM은 정보 검색의 효과를 향상시키기 위해 다양한 쿼리를 탐색하도록 훈련된다. 이러한 방법들은 계산 효율성을 제공하지만, 오프-폴리시(off-policy) 문제(Pang et al., 2024)를 겪으며 순수한 RL 접근법의 성능과 일관되게 일치하지는 않는다. 대안적 해결책으로는 그룹 점수로부터 기준선을 추정함으로써 비평 모델(critic model)의 필요성을 제거하는 그룹 상대 정책 최적화(GRPO)(Shao et al., 2024)와 단순화된 REINFORCE-스타일(Williams, 1992) 최적화 프레임워크를 도입한 RLOO(Ahmadian et al., 2024)가 있다. 이러한 발전에도 불구하고, LLM 기반 검색 엔진 상호작용과 추론에 RL을 적용하는 것은 여전히 크게 탐구되지 않은 상태이다.
3 Search-R1
다음 섹션들에서는 SEARCH-R1의 훈련 방법에 대한 상세 설계를 제시하며, 이는 (1) 검색 엔진을 활용하도록 RL을 확장하는 것; (2) 인터리브된 다중 턴 검색 엔진 호출이 포함된 텍스트 생성; (3) 훈련 템플릿; 그리고 (4) 보상 모델 설계를 포함한다.
3.1 검색 엔진을 활용한 강화 학습
우리는 검색 엔진 을 활용한 RL 목적 함수를 다음과 같이 정식화한다:
여기서 는 정책 LLM, 는 참조 LLM, 는 보상 함수, 은 KL-발산 측도이다. 는 데이터셋 에서 추출된 입력 샘플을 나타내며, 는 검색 엔진 호출 결과와 인터리브된 생성 출력을 나타내며, 참조 정책 에서 샘플링되고 검색 엔진 에서 검색된다. 주로 정책 LLM 에 의존하여 롤아웃 시퀀스를 생성하는 기존 RL 접근법들(Rafailov et al., 2023; Ouyang et al., 2022)과 달리, 우리의 프레임워크는 을 통해 검색이 인터리브된 추론을 명시적으로 통합하며, 이는 로 볼 수 있고, 여기서 는 인터리브된 검색-및-추론을 나타낸다. 이는 외부 정보 검색을 필요로 하는 추론 집약적 작업에서 보다 효과적인 의사 결정을 가능하게 한다. 롤아웃 과정의 예시와 Eq. 1에 대한 설명은 Section 3.2와 Appendix A에 제공된다.
우리의 접근법은 두 가지 잘 확립된 정책 경사 RL 방법인 근접 정책 최적화(PPO)(Schulman et al., 2017)와 그룹 상대 정책 최적화(GRPO)(Shao et al., 2024; Guo et al., 2025)를 기반으로 하며, 검색 증강 추론을 최적화하기 위해 각각의 장점을 활용한다.
검색된 토큰에 대한 손실 마스킹. PPO와 GRPO 모두에서 토큰 수준 손실은 전체 롤아웃 시퀀스에 걸쳐 계산된다. SEARCH-R1에서 롤아웃 시퀀스는 LLM이 생성한 토큰과 외부 구절에서 검색된 토큰 모두로 구성된다. LLM이 생성한 토큰을 최적화하는 것은 모델이 검색 엔진과 상호작용하고 추론을 수행하는 능력을 향상시키지만, 검색된 토큰에 동일한 최적화를 적용하면 의도하지 않은 학습 역학을 초래할 수 있다. 이를 해결하기 위해, 우리는 검색된 토큰에 대한 손실 마스킹을 도입하여 정책 경사 목적이 LLM이 생성한 토큰에 대해서만 계산되도록 하고, 검색된 콘텐츠를 최적화 과정에서 제외한다. 이 접근법은 훈련을 안정화하면서 검색 증강 생성의 유연성을 유지한다.
검색 엔진을 활용한 PPO. 근접 정책 최적화(PPO)(Schulman et al., 2017)는 LLM에 흔히 사용되는 인기 있는 액터-크리틱 RL 접근법이다(Ouyang et al., 2022). 검색 엔진 호출을 포함하는 우리의 추론 시나리오의 경우, 다음과 같은 목적을 최대화함으로써 LLM을 최적화한다:
여기서 와 는 각각 현재 및 이전 정책 모델을 나타낸다. 는 토큰 손실 마스킹 연산으로, 가 LLM 생성 토큰이면 이고 가 검색된 토큰이면 이다. 항은 훈련을 안정화하기 위해 PPO에서 도입된 클리핑 관련 하이퍼파라미터이다. 이점 추정치 는 미래 보상 과 학습된 가치 함수 에 기반하여 일반화 이점 추정(GAE)(Schulman et al., 2015)을 사용하여 계산된다.
검색 엔진을 활용한 GRPO. 정책 최적화 안정성을 향상시키고 추가적인 가치 함수 근사의 필요성을 피하기 위해, 그룹 상대 정책 최적화(GRPO)가 Shao et al. (2024)에서 도입되었다. GRPO는 학습된 가치 함수에 의존하는 대신 여러 샘플링된 출력의 평균 보상을 기준선으로 활용한다는 점에서 PPO와 다르다. 구체적으로, 각 입력 질문 에 대해 GRPO는 참조 정책 에서 응답 그룹 을 샘플링한다. 그런 다음 정책 모델은 다음과 같은 목적 함수를 최대화함으로써 최적화된다:
여기서 과 는 하이퍼파라미터이고, 는 각 그룹 내 출력들의 상대적 보상에 기반하여 계산된 이점을 나타낸다. 이 접근법은 계산에 추가적인 복잡성을 도입하는 것을 피한다. 또한, 보상 함수 내에서 KL 발산을 페널티로 통합하는 대신, GRPO는 훈련된 정책과 참조 정책 사이의 KL 발산을 손실 함수에 직접 추가함으로써 정규화한다. 검색된 토큰 마스킹은 KL 발산 손실 을 계산할 때도 적용된다.
3.2 다중 턴 검색 엔진 호출을 통한 생성
이 섹션에서는 인터리브된 다중 턴 검색 엔진 호출을 포함하는 LLM 응답 생성의 롤아웃 과정을 설명하며, 이는 다음과 같이 정식화된다: .
우리의 접근 방식은 LLM이 텍스트 생성과 외부 검색 엔진 쿼리를 번갈아 수행하는 반복적 프레임워크를 따른다. 구체적으로, 시스템 지시는 외부 검색이 필요할 때마다 LLM이 검색 쿼리를 두 개의 지정된 검색 호출 토큰인 <search>와 </search> 사이에 캡슐화하도록 안내한다. 생성된 시퀀스에서 이 토큰들이 감지되면, 시스템은 검색 쿼리를 추출하고 검색 엔진에 질의하여 관련 결과를 검색한다. 그런 다음 검색된 정보는 특수 검색 토큰인 <information>과 </information> 안에 감싸져 진행 중인 롤아웃 시퀀스에 추가되며, 다음 생성 단계를 위한 추가 컨텍스트 역할을 한다. 이 과정은 다음 조건 중 하나가 충족될 때까지 반복적으로 계속된다: (1) 최대 행동 횟수에 도달하거나, (2) 모델이 지정된 답변 토큰인 <answer>와 </answer> 사이에 감싸진 최종 응답을 생성하는 경우이다. 전체 워크플로는 알고리즘 1에 개략적으로 제시되어 있다.
3.3 훈련 템플릿
SEARCH-R1을 훈련하기 위해, 우리는 먼저 초기 LLM이 우리가 미리 정의한 지시를 따르도록 이끄는 간단한 템플릿을 작성하는 것에서 시작한다. 표 1에 나타난 바와 같이, 이 템플릿은 모델의 출력을 반복적인 방식으로 세 부분으로 구성한다: 먼저 추론 과정, 그다음 검색 엔진 호출 함수, 마지막으로 답변이다. 우리는 의도적으로 제약을 이 구조적 형식으로 한정하며, 성찰적 추론과 검색 엔진 호출을 강제하거나 특정 문제 해결 접근 방식을 지지하는 것과 같은 내용 특화적 편향은 피한다. 이는 RL 과정에서 모델의 자연스러운 학습 역학이 관찰 가능하고 편향되지 않게 유지되도록 보장한다.
주어진 질문에 답하라. 새로운 정보를 얻을 때마다 먼저 <think>와 </think> 안에서 추론을 수행해야 한다. 추론 후, 일부 지식이 부족하다고 판단되면 <search> 쿼리 </search>를 통해 검색 엔진을 호출할 수 있으며, 그러면 <information>과 </information> 사이에 상위 검색 결과가 반환된다. 원하는 만큼 여러 번 검색할 수 있다. 더 이상 외부 지식이 필요 없다고 판단되면, 상세한 설명 없이 <answer>와 </answer> 안에 답변을 직접 제공할 수 있다. 예를 들어, <answer> xxx </answer>와 같다. 질문: question.
표 1: SEARCH-R1을 위한 템플릿. question은 훈련 및 추론 중에 특정 질문으로 대체된다.요구 사항: 입력 쿼리 , 정책 모델 , 검색 엔진 , 최대 행동 예산 .
보장 사항: 최종 응답 .
1: 롤아웃 시퀀스 초기화
2: 행동 횟수 초기화
3: while do
4: 현재 행동 LLM 롤아웃 시퀀스 초기화
5: while True do
6: 응답 토큰 생성
7: 를 롤아웃 시퀀스에 추가
8: if in [</search>,</answer>,<eos>] then break
9: end if
10: end while
11:
12: 에서 <search> </search>가 감지되면
13: 검색 쿼리 추출
14: 검색 결과 검색
15: 를 롤아웃에 삽입
16: else if 에서 <answer> </answer>가 감지되면
17: 최종 생성 응답 반환
18: else
19: 재고 요청 action is not correct. Let me rethink."
20: end if
21: 행동 횟수 증가
22: end while
23: 최종 생성 응답 반환
3.4 보상 모델링
보상 함수는 주된 훈련 신호로서 RL의 최적화 과정을 이끈다. SEARCH-R1을 훈련하기 위해, 우리는 모델 응답의 정확성을 평가하는 최종 결과 보상만으로 구성된 규칙 기반 보상 시스템을 채택한다. 예를 들어, 사실적 추론 과제에서 정확성은 정확한 문자열 일치와 같은 규칙 기반 기준을 사용하여 평가될 수 있다:
여기서 는 응답 에서 추출된 최종 답변이고 는 정답 답변이다. Guo et al. (2025)와 달리, 우리는 형식 보상을 포함하지 않는데, 이는 우리의 학습된 모델이 이미 강력한 구조적 준수를 보여주기 때문이다. 우리는 더 복잡한 형식 보상의 탐구를 향후 연구로 남겨둔다. 또한, 우리는 Guo et al. (2025)를 따라 신경 보상 모델 훈련을 피한다. 이 결정은 대규모 RL에서 LLM이 특정 형태의 보상에 민감하다는 점과, 이러한 모델을 재훈련함으로써 초래되는 추가적인 계산 비용 및 복잡성에 의해 동기 부여된다.
4 주요 결과
4.1 데이터셋
우리는 SEARCH-R1을 다음 범주로 분류된 일곱 개의 벤치마크 데이터셋에서 평가한다: (1) 일반 질의응답: NQ (Kwiatkowski et al., 2019), TriviaQA (Joshi et al., 2017), PopQA (Mallen et al., 2022). (2) 다중 홉 질의응답: HotpotQA (Yang et al., 2018), 2WikiMultiHopQA (Ho et al., 2020), Musique (Trivedi et al., 2022b), Bamboogle (Press et al., 2022). 이 데이터셋들은 추론과 함께하는 다양한 범위의 검색 과제를 포괄하여 SEARCH-R1에 대한 포괄적인 평가를 가능하게 한다.
4.2 기준선
SEARCH-R1의 효과를 평가하기 위해, 우리는 이를 다음과 같은 기준선들과 비교한다: (1) 검색 없는 추론: 직접 추론 및 사고의 연쇄(CoT) 추론 (Wei et al., 2022). (2) 검색을 동반한 추론: 검색 증강 생성(RAG) (Lewis et al., 2020), IRCoT (Trivedi et al., 2022a), Search-o1 (Li et al., 2025). (3) 미세 조정 기반 방법: 지도 미세 조정(SFT) (Chung et al., 2024), 검색 엔진 없는 RL 기반 미세 조정(R1) (Guo et al., 2025), 그리고 검색 엔진을 사용한 거부 샘플링 (Ahn et al., 2024). R1의 경우, 우리는 SEARCH-R1과의 공정한 비교를 위해 Guo et al. (2025)에서 제안된 RL 방법으로 우리의 데이터를 사용하여 LLM을 훈련한다. 이는 검색 엔진 없이 추론 및 답변 단계만을 포함한다. 거부 샘플링의 경우, 우리는 동일한 데이터셋에서 각 훈련 프롬프트당 다섯 개의 후보 응답을 지시된 LLM으로 생성하고, 올바른 최종 답변으로 이어지는 것들을 선택한다. 이렇게 선택된 궤적들은 이후 SEARCH-R1에서 제안된 동일한 다중 턴 LLM-검색 엔진 상호작용 롤아웃 메커니즘을 유지하는 새로운 훈련 세트를 구성하는 데 사용되어 LLM을 미세 조정한다.
이러한 기준선들은 검색 증강 및 미세 조정 접근법의 폭넓은 스펙트럼을 포괄하여, 제로샷 및 학습된 검색 설정 모두에서 SEARCH-R1에 대한 포괄적인 평가를 가능하게 한다. 서로 다른 방법들 간의 공정한 비교를 위해, 우리는 동일한 검색기, 동일한 수의 검색된 문서, 동일한 지식 코퍼스, 동일한 훈련 데이터, 그리고 동일한 사전 훈련된 LLM을 사용한다. 자세한 내용은 부록 B에서 확인할 수 있다.
4.3 실험 설정
우리는 Qwen-2.5-3B (Base/Instruct)와 Qwen-2.5-7B (Base/Instruct) (Yang et al., 2024)의 두 가지 유형의 모델을 사용하여 실험을 수행한다. 검색을 위해, 우리는 2018년 위키백과 덤프 (Karpukhin et al., 2020)를 지식 소스로 사용하고 E5 (Wang et al., 2022)를 검색기로 사용한다. 공정한 비교를 보장하기 위해, 우리는 Lin et al. (2023)을 따라 모든 검색 기반 방법에서 검색된 구절의 수를 3으로 설정한다. 검색된 구절의 수에 대한 연구는 부록 G에서 확인할 수 있다.
훈련을 위해, 우리는 NQ와 HotpotQA의 훈련 세트를 병합하여 SEARCH-R1 및 기타 미세 조정 기반 기준선들을 위한 통합 데이터셋을 구성한다. 평가는 일곱 개 데이터셋의 테스트 또는 검증 세트에서 수행되어 도메인 내 및 도메인 외 성능을 모두 평가한다. 평가 지표로는 Yu et al. (2024)를 따라 정확 일치(EM)를 사용한다. 추론 스타일 기준선의 경우, 기본 모델은 지시를 따르지 못하므로 instruct 모델을 사용한다. RL 튜닝 방법의 경우, 실험은 기본 모델과 instruct 모델 모두에서 수행된다. 실험 설정에 대한 자세한 내용은 부록 B에서 확인할 수 있다.
달리 명시되지 않는 한, PPO가 기본 RL 방법으로 사용되며, PPO와 GRPO 간의 상세한 비교는 섹션 5.1에서 제공된다.
4.4 성능
일곱 개 데이터셋에서 SEARCH-R1과 기준선 방법들을 비교한 주요 결과는 표 2에 제시되어 있다. 결과로부터 우리는 다음과 같은 주요 관찰을 한다: (1) SEARCH-R1은 강력한 기준선 방법들을 일관되게 능가한다. 우리는 Qwen2.5-7B와 Qwen2.5-3B로 각각 평균 및 의 상대적 개선을 달성한다. 이러한 이득은 분포 내 평가(즉, NQ와 HotpotQA)와 분포 외 평가(즉, TriviaQA, PopQA, 2WikiMultiHopQA, Musique, Bamboogle) 모두에서 유지된다. (2) SEARCH-R1은 검색 없는 LLM 추론을 위한 RL 기반 훈련(R1)을 능가한다. 이는 검색을 LLM 추론에 통합하면 관련 외부 지식에 접근할 수 있게 되어 전반적인 성능이 향상되므로 예상과 일치한다. (3) SEARCH-R1은 기본 모델과 지시 튜닝된 모델 모두에 효과적이다. 이는 결과 기반 보상을 사용하는 DeepSeek-R1-Zero 스타일의 RL (Guo et al., 2025)이 순수 추론 시나리오에서 이전에 확립된 효과를 넘어 검색을 동반한 추론에도 성공적으로 적용될 수 있음을 보여준다. (4) 더 큰 모델이 검색 방법을 더 잘 학습한다. 7B 모델의 SEARCH-R1은 3B 모델에 비해 훨씬 더 큰 "성능 격차"를 보여준다(예: 두 번째로 좋은 모델인 RAG와 비교했을 때).
| 방법 | 일반 QA | 멀티홉 QA | ||||||
| NQ+ | TriviaQA+ | PopQA+ | HotpotQA+ | 2wiki+ | Musique+ | Bamboolle+ | 평균 | |
| Qwen2.5-7b-Base/Instruct | ||||||||
| 직접 추론 | 0.134 | 0.408 | 0.140 | 0.183 | 0.250 | 0.031 | 0.120 | 0.181 |
| CoT | 0.048 | 0.185 | 0.054 | 0.092 | 0.111 | 0.022 | 0.232 | 0.106 |
| IRCoT | 0.224 | 0.478 | 0.301 | 0.133 | 0.149 | 0.072 | 0.224 | 0.239 |
| Search-o1 | 0.151 | 0.443 | 0.131 | 0.187 | 0.176 | 0.058 | 0.296 | 0.206 |
| RAG | 0.349 | 0.585 | 0.392 | 0.299 | 0.235 | 0.058 | 0.208 | 0.304 |
| SFT | 0.318 | 0.354 | 0.121 | 0.217 | 0.259 | 0.066 | 0.112 | 0.207 |
| R1-base | 0.297 | 0.539 | 0.202 | 0.242 | 0.273 | 0.083 | 0.296 | 0.276 |
| R1-instruct | 0.270 | 0.537 | 0.199 | 0.237 | 0.292 | 0.072 | 0.293 | 0.271 |
| 거부 샘플링 | 0.360 | 0.592 | 0.380 | 0.331 | 0.296 | 0.123 | 0.355 | 0.348 |
| Search-R1-base | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| Search-R1-instruct | 0.393 | 0.610 | 0.397 | 0.370 | 0.414 | 0.146 | 0.368 | 0.385 |
| Qwen2.5-3b-Base/Instruct | ||||||||
| 직접 추론 | 0.106 | 0.288 | 0.108 | 0.149 | 0.244 | 0.020 | 0.024 | 0.134 |
| CoT | 0.023 | 0.032 | 0.005 | 0.021 | 0.021 | 0.002 | 0.000 | 0.015 |
| IRCoT | 0.111 | 0.312 | 0.200 | 0.164 | 0.171 | 0.067 | 0.240 | 0.181 |
| Search-o1 | 0.238 | 0.472 | 0.262 | 0.221 | 0.218 | 0.054 | 0.320 | 0.255 |
| RAG | 0.348 | 0.544 | 0.387 | 0.255 | 0.226 | 0.047 | 0.080 | 0.270 |
| SFT | 0.249 | 0.292 | 0.104 | 0.186 | 0.248 | 0.044 | 0.112 | 0.176 |
| R1-base | 0.226 | 0.455 | 0.173 | 0.201 | 0.268 | 0.055 | 0.224 | 0.229 |
| R1-instruct | 0.210 | 0.449 | 0.171 | 0.208 | 0.275 | 0.060 | 0.192 | 0.224 |
| Rejection Sampling | 0.294 | 0.488 | 0.332 | 0.240 | 0.233 | 0.059 | 0.210 | 0.265 |
| Search-R1-base | 0.406 | 0.587 | 0.435 | 0.284 | 0.273 | 0.049 | 0.088 | 0.303 |
| Search-R1-instruct | 0.341 | 0.545 | 0.378 | 0.324 | 0.319 | 0.103 | 0.264 | 0.325 |
| 방법 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboolle | 평균 |
| Qwen2.5-7b-Base/Instruct | ||||||||
| SEARCH-R1-base (GRPO) | 0.395 | 0.560 | 0.388 | 0.326 | 0.297 | 0.125 | 0.360 | 0.350 |
| SEARCH-R1-instruct (GRPO) | 0.429 | 0.623 | 0.427 | 0.386 | 0.346 | 0.162 | 0.400 | 0.396 |
| SEARCH-R1-base (PPO) | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| SEARCH-R1-instruct (PPO) | 0.393 | 0.610 | 0.397 | 0.370 | 0.414 | 0.146 | 0.368 | 0.385 |
| Qwen2.5-3b-Base/Instruct | ||||||||
| SEARCH-R1-base (GRPO) | 0.421 | 0.583 | 0.413 | 0.297 | 0.274 | 0.066 | 0.128 | 0.312 |
| SEARCH-R1-instruct (GRPO) | 0.397 | 0.565 | 0.391 | 0.331 | 0.310 | 0.124 | 0.232 | 0.336 |
| SEARCH-R1-base (PPO) | 0.406 | 0.587 | 0.435 | 0.284 | 0.273 | 0.049 | 0.088 | 0.303 |
| SEARCH-R1-instruct (PPO) | 0.341 | 0.545 | 0.378 | 0.324 | 0.319 | 0.103 | 0.264 | 0.325 |
5 분석
5.1 서로 다른 RL 방법: PPO 대 GRPO
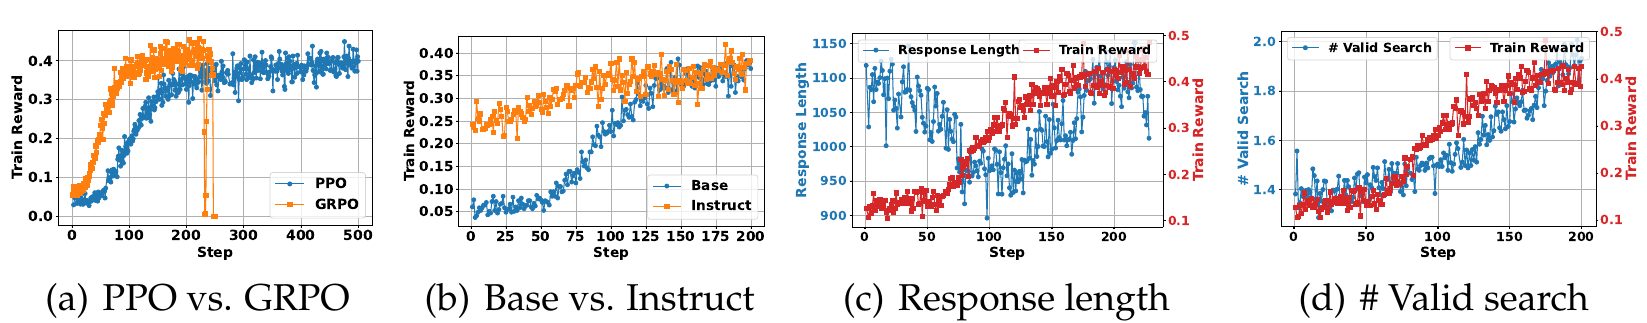
우리는 PPO와 GRPO를 모두 기본 RL 방법으로 사용하여 SEARCH-R1을 평가하고, Qwen2.5-3B/7B 모델에서 실험을 수행한다. 훈련 역학 비교는 그림 2(a)에 제시되어 있고 평가 결과는 표 3에 제시되어 있으며, 다음과 같은 통찰을 보여준다: (1) GRPO는 모든 경우에서 PPO보다 빠르게 수렴한다. 이는 PPO가 비평 모델에 의존하며, 효과적인 훈련이 시작되기 전에 여러 워밍업 단계가 필요하기 때문이다. (2) PPO는 더 큰 훈련 안정성을 보여준다. 그림 2(a)에서 볼 수 있듯이, GRPO는 여러 단계 동안 훈련한 후 보상 붕괴를 초래하는 반면, PPO는 안정적으로 유지된다. (3) PPO와 GRPO의 최종 훈련 보상은 비슷하다. 수렴 속도와 안정성의 차이에도 불구하고, 두 방법 모두 유사한 최종 훈련 보상과 성능을 달성하며, 이는 둘 다 SEARCH-R1을 최적화하는 데 실행 가능함을 나타낸다. PPO는 더 큰 훈련 안정성을 보여주어 이 설정에서 더 선호되는 선택이다. 더 많은 결과는 부록 F에 있다.
| 방법 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bambooq | 평균 |
| SEARCH-R1 w. mask | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| SEARCH-R1 w.o. mask | 0.388 | 0.567 | 0.391 | 0.325 | 0.321 | 0.108 | 0.304 | 0.343 |
5.2 기본 모델 대 Instruct LLM
SEARCH-R1의 학습 역학을 기본 LLM과 명령어 튜닝된 LLM 모두에서 분석한다. 실험은 Qwen2.5-3B와 Qwen2.5-7B의 두 가지 모델 변형에서 수행된다. 그림 2(b)에서 볼 수 있듯이, 명령어 튜닝된 모델은 기본 모델에 비해 더 빠르게 수렴하고 더 높은 초기 성능에서 시작한다. 그러나 학습 후 두 모델 유형의 최종 학습 보상은 매우 유사하게 유지된다. 이 발견은 일반적인 사후 학습이 추론-플러스-검색 시나리오에서 학습을 가속화하지만, RL이 시간이 지남에 따라 효과적으로 격차를 해소하여 기본 모델이 비교 가능한 성능을 달성할 수 있게 함을 시사한다. 더 많은 결과는 부록 E에서 확인할 수 있다.
5.3 응답 길이 및 유효 검색 연구
Qwen2.5-7b-base 모델과 함께 SEARCH-R1을 사용하여 학습 과정 전반에 걸친 응답 길이와 유효 검색 엔진 호출 횟수의 역학을 분석하는 실험을 수행한다. 응답 길이 결과는 그림 2(c)에 제시되어 있으며, 다음과 같은 주요 추세를 보여준다: (1) 초기 단계(처음 100 스텝): 응답 길이가 급격히 감소하는 반면, 학습 보상은 약간 증가한다. 이 단계에서 기본 모델은 과도한 군더더기 단어를 제거하는 법을 배우고 작업 요구 사항에 적응하기 시작한다. (2) 후기 단계(100 스텝 이후): 응답 길이와 학습 보상 모두 크게 증가한다. 이 시점에서 LLM은 검색 엔진을 자주 호출하는 법을 배우며, 검색된 구절로 인해 응답이 길어진다. 모델이 검색 결과를 더 효과적으로 활용하게 되면서 학습 보상이 상당히 향상된다. 유효 검색 결과는 그림 2(d)에 제시되어 있으며, 학습이 진행됨에 따라 LLM이 검색 엔진을 더 많이 호출하는 법을 배움을 보여준다.
5.4 검색된 토큰 손실 마스킹 연구
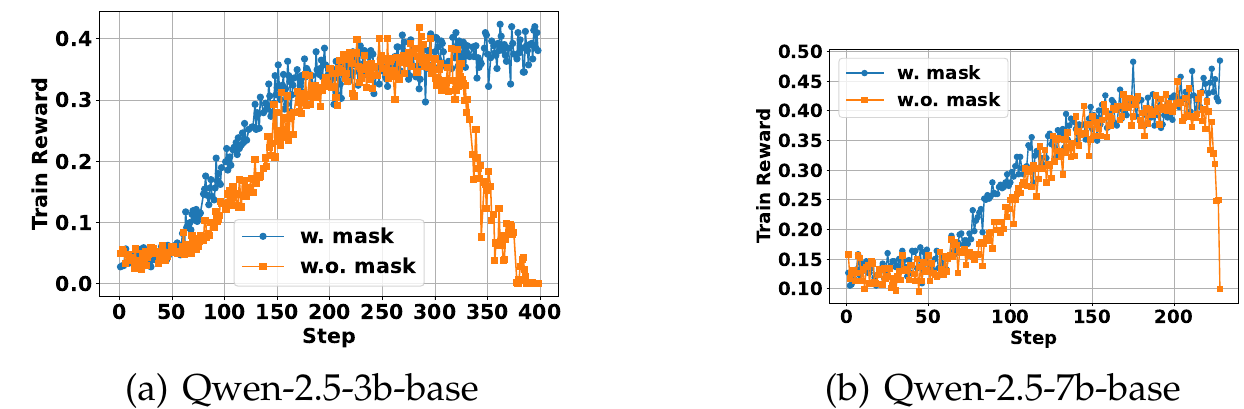
3.1절에서 의도하지 않은 최적화 동작을 방지하기 위해 검색된 토큰에 대한 손실 마스킹을 도입했다. 여기서는 Qwen2.5-7b-base 모델에서 실험을 수행하여 검색된 토큰 손실 마스킹이 있는 경우와 없는 경우의 학습 역학을 비교한다. 그림 3에서 볼 수 있듯이, 검색된 토큰 마스킹을 적용하면 LLM 개선이 더 커지고, 의도하지 않은 최적화 효과를 완화하며, 보다 안정적인 학습을 보장한다. 성능 비교는 표 4에 제시되어 있으며, 검색된 토큰 손실 마스킹으로 학습된 SEARCH-R1이 마스킹 없는 변형보다 일관되게 우수한 성능을 보임을 입증한다.
검색된 토큰 손실 마스크, 기본 대 명령어 LLM, PPO/GRPO 간 비교, SEARCH-R1 학습에서의 검색된 구절 수, SEARCH-R1(GRPO)의 그룹 크기 연구, 사례 연구에 대한 더 많은 실험 결과는 부록 D, E, G, H, I, J에서 확인할 수 있다.
6 결론
본 연구에서 우리는 LLM이 자체 추론과 실시간 검색 엔진 상호작용을 교차 수행할 수 있게 하는 새로운 RL 프레임워크인 SEARCH-R1을 소개했다. 다중 턴 검색을 위해 광범위한 프롬프팅에 의존하는 기존의 RAG 유사 접근법이나 대규모 감독 학습 데이터를 필요로 하는 도구 사용 방법과 달리, SEARCH-R1은 RL을 통해 LLM 롤아웃을 최적화하여 자율적인 쿼리 생성과 검색된 정보의 전략적 활용을 가능하게 한다. 일곱 개 데이터셋에 대한 광범위한 실험을 통해 SEARCH-R1이 실시간 외부 지식을 필요로 하는 복잡한 추론 작업을 해결하는 LLM의 능력을 크게 향상시킴을 입증했다. 우리의 분석은 또한 검색 증강 추론을 위한 RL 학습 전략에 대한 핵심 통찰을 제공한다. 앞으로의 연구에서는 더 정교한 보상 메커니즘, 불확실성에 기반한 동적 검색 조정, 다양한 도구 세트와의 결합, 검색을 넘어선 다양한 정보 소스와의 통합을 포함하여 더 광범위한 검색 전략을 지원하도록 SEARCH-R1을 확장하는 것을 탐구할 수 있다. 또한 멀티모달 추론 작업에 대한 적용 가능성을 조사하는 것도 유망하다.
감사의 글
본 연구는 부분적으로 Apple 박사과정 펠로우십, 부분적으로 미국 DARPA INCAS 프로그램(No. HR0011-21-C0165) 및 BRIES 프로그램(No. HR0011-24-3-0325), 부분적으로 해군연구청 계약 번호 N000142412612, 부분적으로 NSF 보조금 번호 IIS-19-56151 및 2402873, 부분적으로 Molecule Maker Lab Institute: NSF가 Award No. 2019897로 지원하는 AI 연구 기관 프로그램 및 NSF가 Award No. 2118329로 지원하는 통합 발견 환경을 통한 지구공간 이해 연구소(I-GUIDE), 부분적으로 Cisco, 그리고 부분적으로 지능형 정보 검색 센터의 지원을 받았습니다. 본문에 표현된 모든 의견, 발견, 결론 또는 권고는 저자들의 것이며, 후원 기관이나 미국 정부의 견해를 명시적이든 묵시적이든 반드시 대표하는 것은 아닙니다.
참고문헌
Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. Gpt-4 technical report. arXiv preprint arXiv:2303.08774, 2023.
Arash Ahmadian, Chris Cremer, Matthias Gallé, Marzieh Fadaee, Julia Kreutzer, Olivier Pietquin, Ahmet Üstün, and Sara Hooker. Back to basics: Revisiting reinforce style optimization for learning from human feedback in llms. arXiv preprint arXiv:2402.14740, 2024.
Janice Ahn, Rishu Verma, Renze Lou, Di Liu, Rui Zhang, and Wenpeng Yin. Large language models for mathematical reasoning: Progresses and challenges. arXiv preprint arXiv:2402.00157, 2024.
Akari Asai, Zeqiu Wu, Yizhong Wang, Avirup Sil, and Hannaneh Hajishirzi. Self-rag: Learning to retrieve, generate, and critique through self-reflection. 2024.
Hyung Won Chung, Le Hou, Shayne Longpre, Barret Zoph, Yi Tay, William Fedus, Yunxuan Li, Xuezhi Wang, Mostafa Dehghani, Siddhartha Brahma, et al. Scaling instruction-finetuned language models. Journal of Machine Learning Research, 25(70):1-53, 2024.
Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, and Oyvind Tafjord. Think you have solved question answering? try arc, the ai2 reasoning challenge. arXiv preprint arXiv:1803.05457, 2018.
Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, Haofen Wang, and Haofen Wang. Retrieval-augmented generation for large language models: A survey. arXiv preprint arXiv:2312.10997, 2, 2023.
Michael Glass, Gaetano Rossiello, Md Faisal Mahbub Chowdhury, Ankita Rajaram Naik, Pengshan Cai, and Alfio Gliozzo. Re2g: Retrieve, rerank, generate. arXiv preprint arXiv:2207.06300, 2022.
Daya Guo, Qihao Zhu, Dejian Yang, Zhenda Xie, Kai Dong, Wentao Zhang, Guanting Chen, Xiao Bi, Yu Wu, YK Li, et al. Deepseek-coder: When the large language model meets programming-the rise of code intelligence. arXiv preprint arXiv:2401.14196, 2024.
Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. Measuring massive multitask language understanding. arXiv preprint arXiv:2009.03300, 2020.
Xanh Ho, Anh-Khoa Duong Nguyen, Saku Sugawara, and Akiko Aizawa. Constructing a multi-hop qa dataset for comprehensive evaluation of reasoning steps. arXiv preprint arXiv:2011.01060, 2020.
Zhenyu Hou, Xin Lv, Rui Lu, Jiajie Zhang, Yujiang Li, Zijun Yao, Juanzi Li, Jie Tang, and Yuxiao Dong. Advancing language model reasoning through reinforcement learning and inference scaling. arXiv preprint arXiv:2501.11651, 2025.
Sheryl Hsu, Omar Khattab, Chelsea Finn, and Archit Sharma. Grounding by trying: Llms with reinforcement learning-enhanced retrieval. arXiv preprint arXiv:2410.23214, 2024.
Jie Huang and Kevin Chen-Chuan Chang. Towards reasoning in large language models: A survey. arXiv preprint arXiv:2212.10403, 2022.
Aaron Jaech, Adam Kalai, Adam Lerer, Adam Richardson, Ahmed El-Kishky, Aiden Low, Alec Helyar, Aleksander Madry, Alex Beutel, Alex Carney, et al. Openai o1 system card. arXiv preprint arXiv:2412.16720, 2024.
Zhengbao Jiang, Frank F Xu, Luyu Gao, Zhiqing Sun, Qian Liu, Jane Dwivedi-Yu, Yiming Yang, Jamie Callan, and Graham Neubig. Active retrieval augmented generation. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, pp. 7969-7992, 2023.
Bowen Jin, Jinsung Yoon, Jiawei Han, and Sercan O Arik. Long-context llms meet rag: Overcoming challenges for long inputs in rag. In The Thirteenth International Conference on Learning Representations, 2024.
Mandar Joshi, Eunsol Choi, Daniel S Weld, and Luke Zettlemoyer. Triviaqa: A large scale distantly supervised challenge dataset for reading comprehension. arXiv preprint arXiv:1705.03551, 2017.
Leslie Pack Kaelbling, Michael L Littman, and Andrew W Moore. Reinforcement learning: A survey. Journal of artificial intelligence research, 4:237-285, 1996.
Vladimir Karpukhin, Barlas Oguz, Sewon Min, Patrick SH Lewis, Ledell Wu, Sergey Edunov, Danqi Chen, and Wen-tau Yih. Dense passage retrieval for open-domain question answering. In EMNLP (1), pp. 6769-6781, 2020.
Timo Kaufmann, Paul Weng, Viktor Bengs, and Eyke Hullermeier. A survey of reinforcement learning from human feedback. arXiv preprint arXiv:2312.14925, 10, 2023.
Aviral Kumar, Vincent Zhuang, Rishabh Agarwal, Yi Su, John D Co-Reyes, Avi Singh, Kate Baumli, Shariq Iqbal, Colton Bishop, Rebecca Roelofs, et al. Training language models to self-correct via reinforcement learning. arXiv preprint arXiv:2409.12917, 2024.
Tom Kwiatkowski, Jennimaria Palomaki, Olivia Redfield, Michael Collins, Ankur Parikh, Chris Alberti, Danielle Epstein, Illia Polosukhin, Jacob Devlin, Kenton Lee, et al. Natural questions: a benchmark for question answering research. Transactions of the Association for Computational Linguistics, 7:453-466, 2019.
Nathan Lambert, Valentina Pyatkin, Jacob Morrison, LJ Miranda, Bill Yuchen Lin, Khyathi Chandu, Nouha Dziri, Sachin Kumar, Tom Zick, Yejin Choi, et al. Rewardbench: Evaluating reward models for language modeling. arXiv preprint arXiv:2403.13787, 2024.
Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Kuttler, Mike Lewis, Wen-tau Yih, Tim Rocktaschel, et al. Retrieval-augmented generation for knowledge-intensive nlp tasks. Advances in neural information processing systems, 33:9459-9474, 2020.
Xiaoxi Li, Jiajie Jin, Yujia Zhou, Yongkang Wu, Zhonghua Li, Qi Ye, and Zhicheng Dou. Retrollm: Empowering large language models to retrieve fine-grained evidence within generation. arXiv preprint arXiv:2412.11919, 2024.
Xiaoxi Li, Guanting Dong, Jiajie Jin, Yuyao Zhang, Yujia Zhou, Yutao Zhu, Peitian Zhang, and Zhicheng Dou. Search-01: 에이전틱 검색 강화 대형 추론 모델. arXiv preprint arXiv:2501.05366, 2025.
Yinheng Li, Shaofei Wang, Han Ding, and Hang Chen. 금융 분야의 대형 언어 모델: 서베이. In Proceedings of the fourth ACM international conference on AI in finance, pp. 374-382, 2023.
Xi Victoria Lin, Xilun Chen, Mingda Chen, Weijia Shi, Maria Lomeli, Richard James, Pedro Rodriguez, Jacob Kahn, Gergely Szilvasy, Mike Lewis, et al. Ra-dit: 검색 증강 이중 명령 튜닝. In The Twelfth International Conference on Learning Representations, 2023.
Alex Mallen, Akari Asai, Victor Zhong, Rajarshi Das, Hannaneh Hajishirzi, and Daniel Khashabi. 언어 모델을 신뢰하지 말아야 할 때: 파라메트릭 및 비파라메트릭 메모리의 효과성과 한계 조사. arXiv preprint arXiv:2212.10511, 7, 2022.
Yu Meng, Mengzhou Xia, and Danqi Chen. Simpo: 참조 없는 보상을 이용한 단순 선호 최적화. Advances in Neural Information Processing Systems, 37:124198-124235, 2024.
Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, et al. 인간 피드백을 통한 명령 따르기 언어 모델 훈련. Advances in neural information processing systems, 35:27730-27744, 2022.
리처드 위안저 팡, 웨이저 위안, 허 허, 쿤현 조, 사인바야르 수흐바타르, 제이슨 웨스턴. 반복적 추론 선호도 최적화. 신경 정보 처리 시스템 발전, 37:116617-116637, 2024.
청 펑, 시 양, 아오쿤 천, 케일럽 E 스미스, 니마 푸르네자티안, 앤서니 B 코스타, 셰릴 마틴, 모나 G 플로레스, 잉 장, 타냐 마고크, 외. 의료 연구 및 의료 서비스를 위한 생성형 대규모 언어 모델에 관한 연구. NPJ 디지털 의학, 6(1):210, 2023.
오피르 프레스, 무루 장, 세원 민, 루트비히 슈미트, 노아 A 스미스, 마이크 루이스. 언어 모델의 구성성 격차 측정 및 축소. arXiv 프리프린트 arXiv:2210.03350, 2022.
창러 취, 순하오 다이, 샤오치 웨이, 헝이 차이, 슈아이창 왕, 다웨이 인, 준 쉬, 지룽 원. 대규모 언어 모델을 활용한 도구 학습: 서베이. 컴퓨터 과학 프런티어, 19(8):198343, 2025.
라파엘 라파일로프, 아르치트 샤르마, 에릭 미첼, 크리스토퍼 D 매닝, 스테파노 에르몬, 첼시 핀. 직접 선호도 최적화: 당신의 언어 모델은 비밀리에 보상 모델입니다. 신경 정보 처리 시스템 발전, 36:53728-53741, 2023.
티모 시크, 제인 드위베디-유, 로베르토 데시, 로베르타 라일레아누, 마리아 로멜리, 에릭 햄브로, 루크 제틀모이어, 니콜라 칸체다, 토마스 시알롬. 툴포머: 언어 모델은 스스로 도구 사용법을 배울 수 있다. 신경 정보 처리 시스템 발전, 36:68539-68551, 2023.
존 슐만, 필립 모리츠, 세르게이 레빈, 마이클 조던, 피터 아벨. 일반화된 이점 추정을 사용한 고차원 연속 제어. arXiv 프리프린트 arXiv:1506.02438, 2015.
존 슐만, 필립 볼스키, 프라풀라 다리왈, 알렉 래드퍼드, 올레그 클리모프. 근접 정책 최적화 알고리즘. arXiv 프리프린트 arXiv:1707.06347, 2017.
즈홍 샤오, 페이이 왕, 치하오 주, 룬신 쉬, 준샤오 송, 샤오 비, 하오웨이 장, 밍촨 장, YK 리, Y 우, 외. 딥시크매스: 오픈 언어 모델의 수학적 추론 한계를 밀어붙이다. arXiv 프리프린트 arXiv:2402.03300, 2024.
광밍 성, 치 장, 즈링펑 예, 시빈 우, 왕 장, 루 장, 양화 펑, 하이빈 린, 추안 우. 하이브리드플로우: 유연하고 효율적인 rlhf 프레임워크. arXiv 프리프린트 arXiv:2409.19256, 2024.
리처드 S 서튼, 앤드루 G 바르토, 외. 강화 학습. 인지 신경 과학 저널, 11(1):126-134, 1999.
제미나이 팀. 제미나이 1.5: 수백만 토큰의 컨텍스트 전반에서 멀티모달 이해를 열다. arXiv 프리프린트 arXiv:2403.05530, 2024.
하르시 트리베디, 니란잔 발라수브라마니안, 투샤르 코트, 아쉬시 사바르왈. 지식 집약적 다단계 질문을 위한 사고 사슬 추론과 검색의 인터리빙. arXiv 프리프린트 arXiv:2212.10509, 2022a.
하르시 트리베디, 니란잔 발라수브라마니안, 투샤르 코트, 아쉬시 사바르왈. 뮤직: 단일 홉 질문 구성을 통한 다중 홉 질문. 계산 언어학 협회 거래, 10:539-554, 2022b.
량 왕, 난 양, 샤오롱 황, 빈싱 지아오, 린준 양, 다신 장, 랑간 마줌데르, 푸루 웨이. 약한 감독 대조 사전 훈련을 통한 텍스트 임베딩. arXiv 프리프린트 arXiv:2212.03533, 2022.
제이슨 웨이, 쉬에즈 왕, 데일 슈어만스, 마르텐 보스마, 페이 시아, 에드 치, 쿼크 V 르, 데니 저우, 외. 사고 사슬 프롬프팅은 대규모 언어 모델에서 추론을 이끌어낸다. 신경 정보 처리 시스템 발전, 35:24824-24837, 2022.
이쉬안 웽, 민준 주, 페이 시아, 빈 리, 스주 허, 성핑 리우, 빈 쑨, 캉 리우, 준 자오. 대규모 언어 모델은 자기 검증을 통해 더 나은 추론자가 된다. arXiv 프리프린트 arXiv:2212.09561, 2022.
로널드 J 윌리엄스. 연결주의 강화 학습을 위한 단순 통계적 경사 추종 알고리즘. 머신 러닝, 8:229-256, 1992.
티안 시에, 지티안 가오, 칭난 런, 하오밍 뤄, 위치엔 홍, 브라이언 다이, 조이 저우, 카이 치우, 즈롱 우, 총 뤄. 로직-rl: 규칙 기반 강화 학습으로 llm 추론을 해방하다. arXiv 프리프린트 arXiv:2502.14768, 2025.
광즈 슝, 치아오 진, 샤오 왕, 인 팡, 하오린 리우, 이판 양, 팡위안 천, 즈싱 송, 덩위 왕, 민지아 장, 외. 래그-짐: 프로세스 감독으로 추론 및 검색 에이전트 최적화. arXiv 프리프린트 arXiv:2502.13957, 2025.
안 양, 바오송 양, 베이천 장, 빈위안 후이, 보 정, 보웬 위, 천위안 리, 다이헝 리우, 페이 황, 하오란 웨이, 외. 큐웬2.5 기술 보고서. arXiv 프리프린트 arXiv:2412.15115, 2024.
즈린 양, 펑 치, 사이정 장, 요수아 벤지오, 윌리엄 W 코헨, 루슬란 살라쿠트디노프, 크리스토퍼 D 매닝. 핫팟QA: 다양하고 설명 가능한 다중 홉 질문 응답을 위한 데이터셋. arXiv 프리프린트 arXiv:1809.09600, 2018.
순위 야오, 제프리 자오, 디안 위, 난 두, 이차크 샤프란, 카르틱 나라시만, 위안 차오. 리액트: 언어 모델에서 추론과 행동의 시너지. 국제 학습 표현 회의(ICLR), 2023.
웨 위, 웨이 핑, 지한 리우, 보신 왕, 지아쉬안 유, 차오 장, 모하마드 쇼에이비, 브라이언 카타나로. 랭크래그: llm의 검색 증강 생성과 컨텍스트 순위 지정의 통합. 신경 정보 처리 시스템 발전, 37:121156-121184, 2024.
전루이 위에, 홍레이 주앙, 아이준 바이, 카이 후이, 롤프 자거만, 한시 쩡, 전 친, 동 왕, 쉬안후이 왕, 마이클 벤더스키. 긴 컨텍스트 검색 증강 생성을 위한 추론 스케일링. arXiv 프리프린트 arXiv:2410.04343, 2024.
위에 장, 야푸 리, 레양 추이, 덩 차이, 레마오 리우, 팅천 푸, 신팅 황, 엔보 자오, 위 장, 위롱 천, 외. AI 바다 속 사이렌의 노래: 대규모 언어 모델의 환각에 관한 서베이. arXiv 프리프린트 arXiv:2309.01219, 2023.
웨인 신 자오, 쿤 저우, 준이 리, 티안이 탕, 샤오레이 왕, 위펑 허우, 잉치엔 민, 베이천 장, 준지에 장, 지찬 동, 외. 대규모 언어 모델 서베이. arXiv 프리프린트 arXiv:2303.18223, 1(2), 2023.
웨인 신 자오, 징 리우, 루이양 런, 지룽 원. 사전 훈련된 언어 모델 기반의 밀집 텍스트 검색: 서베이. ACM 정보 시스템 거래, 42(4):1-60, 2024.
부록
A 검색 엔진을 활용한 강화 학습의 공식화
대규모 언어 모델(LLM)을 훈련하기 위한 고전적인 강화 학습(RL) 프레임워크는 다음과 같이 공식화할 수 있다(Rafailov et al., 2023; Ouyang et al., 2022):
여기서 는 데이터셋 에서 샘플링된 프롬프트를 나타내고, 는 정책 모델 에 의해 생성된 응답이며, 는 정규화 앵커 역할을 하는 참조 모델을 나타낸다. 보상 함수 \(r_{\phi}(x,y)\)는 생성된 응답의 품질을 정량화하며, KL 발산 항은 업데이트된 정책이 참조 모델에 가깝게 유지되도록 제약함으로써 훈련 안정성을 촉진한다.
그러나 이 정식화는 전체 출력 시퀀스 \(y\)가 오직 정책 LLM에 의해서만 생성된다고 가정한다. 이 가정은 모델 행동이 내부 추론과 외부 정보 검색을 모두 포함하는 우리의 설정에서는 성립하지 않는다. 이를 수용하기 위해, 우리는 RL 목표를 확장하여 외부 검색 엔진 을 통합하며, 다음과 같은 정식화를 얻는다:
이 수정된 목표에서 궤적 은 교차 배치된 추론 단계와 검색된 내용을 포함하며, 이는 LLM과 검색 엔진 사이의 다중 턴 상호작용을 반영한다. KL 발산은 프롬프트와 검색 증강된 컨텍스트 모두에 조건화된 결합 응답 분포에 대해 계산되며, 이를 통해 학습된 정책이 외부 정보가 존재하는 상황에서도 참조 모델과 정렬된 상태를 유지하도록 보장한다.
B 실험 설정
B.1 베이스라인
최근 여러 연구들은 특히 Natural Questions(NQ)나 HotpotQA와 같은 벤치마크에서 RAG 파이프라인을 탐구하며, 보다 정교한 검색 메커니즘을 통해 성능을 향상시키는 것을 목표로 하였다. 예를 들어, Re2G(Glass et al., 2022)와 RetroLLM(Li et al., 2024)은 강력한 검색기와 복잡한 재순위화 전략을 사용하여 생성에 필요한 세밀한 근거를 선택하는 정교한 검색-재순위화-생성 프레임워크를 제안한다. 이러한 접근법들은 인상적인 결과를 보여주지만, 종종 일반화 가능성과 확장성을 제한하는 작업별 엔지니어링 또는 중량급 파이프라인에 의존한다. 이와 대조적으로, 우리의 초점은 검색 증강 추론에 대한 보다 경량하고 일반적인 접근법에 있다. 따라서 우리는 이러한 방법들을 직접적인 베이스라인으로 포함하지 않지만, 이들은 검색 강화 언어 모델링의 더 넓은 영역에서 가치 있는 방향을 나타낸다.
B.2 실험 설정
우리는 Qwen-2.5-3B (Base/Instruct)와 Qwen-2.5-7B (Base/Instruct)의 두 가지 유형의 모델을 사용하여 실험을 수행한다(Yang et al., 2024). 검색에는 2018 Wikipedia 덤프(Karpukhin et al., 2020)를 지식 소스로 사용하고, E5(Wang et al., 2022)를 검색기로 사용한다. 공정한 비교를 보장하기 위해 우리는 Lin et al. (2023)을 따라 모든 검색 기반 방법에서 검색되는 패시지 수를 3으로 설정한다.
훈련의 경우, 우리는 NQ와 HotpotQA의 훈련 세트를 병합하여 SEARCH-R1 및 기타 미세 조정 기반 베이스라인을 위한 통합 데이터셋을 구성한다. 평가는 도메인 내 및 도메인 외 성능을 모두 평가하기 위해 일곱 개 데이터셋의 테스트 또는 검증 세트에서 수행된다. 평가 지표로는 Yu et al. (2024)을 따라 Exact Match (EM)를 사용한다. 추론 스타일 베이스라인의 경우, 베이스 모델은 지시를 따르지 못하기 때문에 instruct 모델을 사용한다. RL 튜닝 방법의 경우, 베이스 모델과 instruct 모델 모두에서 실험을 수행한다. 실험 설정에 대한 자세한 내용은 부록 B에서 확인할 수 있다.
SEARCH-R1의 PPO 변형에서는 정책 LLM의 학습률을 1e-6, 가치 LLM의 학습률을 1e-5로 설정한다. 훈련은 500 스텝 동안 수행되며, 정책 및 가치 모델의 워밍업 비율은 각각 0.285와 0.015이다. 우리는 매개변수 및 을 갖는 Generalized Advantage Estimation (GAE)을 사용한다.
훈련은 8개의 H100 GPU가 장착된 단일 노드에서 수행된다. 우리는 총 배치 크기를 512로 사용하며, 미니 배치 크기는 256, 마이크로 배치 크기는 64이다. 최대 시퀀스 길이는 4,096 토큰으로 설정되며, 최대 응답 길이는 500, 검색된 콘텐츠의 최대 길이는 500 토큰이다. GPU 메모리 사용을 최적화하기 위해 우리는 그래디언트 체크포인팅을 활성화하고 CPU 오프로딩을 사용하는 Fully Sharded Data Parallel (FSDP)을 사용한다.
효율적인 LLM 롤아웃을 위해 우리는 텐서 병렬 크기 1과 GPU 메모리 활용 비율 0.6으로 vLLM1을 채택한다. 롤아웃 샘플링은 온도 1.0과 top-p 값 1.0을 사용한다. KL 발산 정규화 계수 와 클립 비율 은 0.001과 0.2로 설정된다.
GRPO 훈련의 경우, 우리는 정책 LLM 학습률을 1e-6으로 설정하고 Verl(Sheng et al., 2024)1의 GRPO 구현을 따라 프롬프트당 5개의 응답을 샘플링한다. 모델은 학습률 워밍업 비율 0.285로 500 스텝 동안 훈련된다. 훈련은 PPO에서와 동일한 배치 크기 및 시퀀스 길이 구성으로 동일한 8xH100 설정에서 수행된다.
우리는 또한 그래디언트 체크포인팅, FSDP 오프로딩, 그리고 위와 동일한 하이퍼파라미터를 사용하는 vLLM 기반 롤아웃을 사용한다. 롤아웃 온도와 top-p 값은 모두 1.0으로 설정되며, KL 발산 계수 와 클립 비율 은 0.001과 0.2로 고정된다.
두 방법 모두에서 모델 체크포인트는 100 스텝마다 저장된다. 훈련이 발산하는 경우, 우리는 훈련 보상 곡선에 따라 가장 최근의 안정적인 체크포인트에서 평가하며, 그렇지 않은 경우 최종 체크포인트를 평가에 사용한다. 최대 행동 예산 는 4로 설정되며, 기본적으로 상위 3개의 패시지를 검색한다.
우리는 exact match (EM)를 사용하여 결과 보상을 계산한다. 별도의 언급이 없는 한, PPO가 기본 RL 알고리즘으로 사용되며, GRPO와의 자세한 비교는 섹션 5.1에서 제공된다.
C 14B LLM에 대한 주요 결과
우리는 Qwen2.5-14B 모델을 사용하여 광범위한 실험을 수행하며, 결과는 표 5에 제시되어 있다. 표에서 볼 수 있듯이, SEARCH-R1은 평가된 지표 전반에 걸쳐 모든 베이스라인 방법을 일관되게 능가한다. 나아가, 우리는 모델 크기를 증가시키는 것이 SEARCH-R1에서 일관된 성능 향상으로 이어진다는 것을 관찰하며, 이는 우리 접근 방식에서 LLM 크기 스케일링의 이점을 부각시킨다.
D 검색된 토큰 손실 마스킹 연구
섹션 3.1에서 우리는 훈련 중 바람직하지 않은 최적화 동작을 완화하기 위해 검색된 토큰에 대한 손실 마스킹 전략을 도입했다. 그 영향을 평가하기 위해, 우리는 Qwen2.5-3b/7b-base 모델을 사용하여 검색된 토큰 손실 마스킹의 유무에 따른 훈련 역학을 비교하는 실험을 수행한다. 그림 3에서 볼 수 있듯이, 마스킹 메커니즘을 통합하면 더 안정적인 최적화와 향상된 모델 성능으로 이어진다. 표 6의 정량적 결과는 검색된 토큰에 대한 손실 마스킹으로 훈련된 SEARCH-R1이 마스킹되지 않은 대응 모델을 일관되게 능가함을 추가로 확인시켜 준다.
E 베이스 대 Instruct LLM
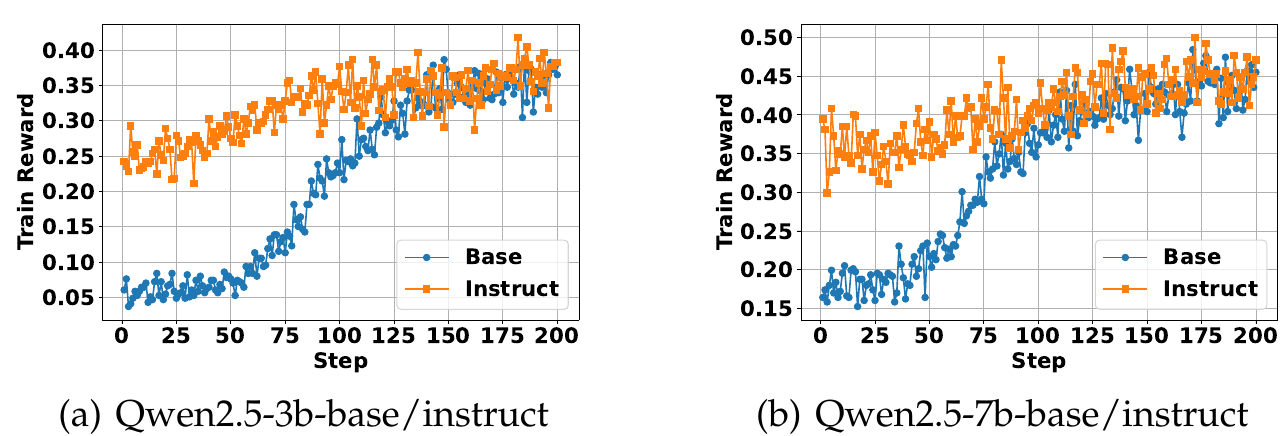
우리는 Qwen2.5-3B와 Qwen2.5-7B의 두 가지 모델 규모를 사용하여 베이스 LLM과 명령어 튜닝된 LLM 모두에서 SEARCH-R1의 훈련 역학을 조사한다. 그림 4에서 볼 수 있듯이,
| 방법 | 일반 QA | 멀티홉 QA | ||||||
| NQ† | TriviaQA* | PopQA* | HotpotQA† | 2wiki* | Musique* | Bamboolge* | 평균 | |
| Qwen2.5-14b-Base/Instruct | ||||||||
| 직접 추론 | 0.198 | 0.531 | 0.184 | 0.217 | 0.253 | 0.045 | 0.160 | 0.227 |
| CoT | 0.190 | 0.495 | 0.148 | 0.269 | 0.297 | 0.054 | 0.432 | 0.269 |
| IRCoT | 0.114 | 0.375 | 0.166 | 0.230 | 0.248 | 0.102 | 0.312 | 0.221 |
| Search-o1 | 0.347 | 0.635 | 0.241 | 0.268 | 0.161 | 0.099 | 0.416 | 0.310 |
| RAG | 0.327 | 0.585 | 0.376 | 0.279 | 0.160 | 0.051 | 0.192 | 0.281 |
| SFT | 0.361 | 0.467 | 0.150 | 0.248 | 0.278 | 0.089 | 0.160 | 0.250 |
| R1-base | 0.369 | 0.626 | 0.270 | 0.306 | 0.326 | 0.117 | 0.488 | 0.357 |
| R1-instruct | 0.334 | 0.628 | 0.253 | 0.294 | 0.325 | 0.108 | 0.432 | 0.339 |
| Search-R1-base | 0.486 | 0.676 | 0.480 | 0.468 | 0.470 | 0.241 | 0.528 | 0.479 |
| Search-R1-instruct | 0.424 | 0.660 | 0.442 | 0.436 | 0.379 | 0.210 | 0.480 | 0.433 |
명령어 튜닝된 모델은 베이스 대응 모델에 비해 더 빠른 수렴을 보이고 더 높은 초기 성능의 이점을 누린다. 이러한 초기 이점에도 불구하고, 두 모델 유형의 최종 성능은 훈련 후 유사한 수준으로 수렴한다. 이러한 결과는 명령어 튜닝이 추론-플러스-검색 과제에서 더 효율적인 초기 단계 학습을 촉진하지만, 강화 학습이 성능 격차를 좁힐 수 있어 궁극적으로 베이스 모델이 비슷한 결과에 도달할 수 있게 함을 나타낸다.
F SEARCH-R1에서 PPO와 GRPO의 비교
우리는 Qwen2.5-3B와 Qwen2.5-7B를 기본 모델로 사용하여 PPO와 GRPO의 두 가지 강화 학습 알고리즘 하에서 SEARCH-R1의 효과를 평가한다. 그림 5는 훈련 역학을 보여준다. 우리의 분석은 다음과 같은 주요 관찰을 도출한다: (1) GRPO는 PPO가 효과적인 정책 업데이트가 이루어지기 전에 초기 워밍업 단계를 필요로 하는 별도의 가치 함수(critic)에 의존한다는 사실에 기인하여 모든 설정에서 PPO보다 빠른 수렴을 보인다.
| 방법 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboogle | 평균 |
| Qwen2.5-7b-Base | ||||||||
| SEARCH-R1 w. mask | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| SEARCH-R1 w.o. mask | 0.388 | 0.567 | 0.391 | 0.325 | 0.321 | 0.108 | 0.304 | 0.343 |
| Qwen2.5-3b-Base | ||||||||
| SEARCH-R1 w. mask | 0.406 | 0.587 | 0.435 | 0.284 | 0.273 | 0.049 | 0.088 | 0.303 |
| SEARCH-R1 w.o. mask | 0.346 | 0.484 | 0.365 | 0.241 | 0.244 | 0.053 | 0.104 | 0.262 |
(2) PPO는 더 안정적인 훈련 동작을 제공하는데, 이는 그림 5에서 GRPO가 장기 훈련 스텝에 걸쳐 보상 붕괴를 겪는 반면 PPO는 전반적으로 안정성을 유지함으로써 입증된다. (3) PPO와 GRPO는 비슷한 최종 보상 성능을 달성하며, 이는 수렴 속도와 안정성의 트레이드오프에도 불구하고 두 방법 모두 SEARCH-R1을 최적화하는 데 효과적임을 시사한다.
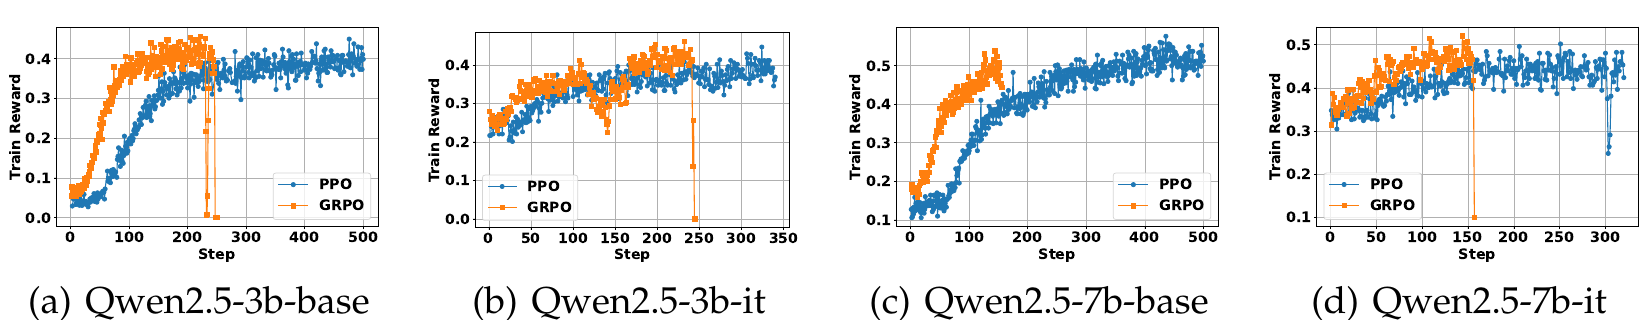
그림 5: 네 가지 LLM에 걸쳐 PPO와 GRPO를 기본 RL 방법으로 사용한 SEARCH-R1의 훈련 역학. GRPO는 일반적으로 더 빠르게 수렴하지만 여러 스텝 동안 훈련된 후 불안정성을 보일 수 있는 반면, PPO는 더 안정적인 최적화를 제공하지만 더 느린 속도로 수렴한다. PPO와 GRPO는 비슷한 최종 보상 성능을 달성한다.
G SEARCH-R1 훈련에서 검색된 패시지 수 연구
우리는 검색된 패시지 수(top-k)가 SEARCH-R1의 훈련 역학에 미치는 영향을 조사한다. 우리의 주요 실험은 Lin et al. (2023)을 따라 top-k = 3을 채택하지만, 우리는 그 영향을 더 잘 이해하기 위해 top-k를 1, 3, 5로 설정한 추가 연구를 수행한다.
그림 6은 이러한 설정에서의 훈련 보상 곡선을 제시한다. 우리는 세 가지 구성 모두 유사한 전반적인 훈련 궤적을 보인다는 것을 관찰한다. 특히, top-k = 5는 가장 빠른 초기 수렴을 달성하여 처음 200 스텝 내에 가장 높은 훈련 보상에 도달한다. 그러나 그 보상은 훈련이 진행됨에 따라 점차 감소하고 더 불안정해진다. 대조적으로, top-k = 1과 3은 훈련 전반에 걸쳐 더 일관된 개선을 보이며, top-k = 3이 궁극적으로 500 스텝 후에 가장 높은 보상을 달성한다.
500 스텝에서의 평가 결과는 표 7에 요약되어 있으며, top-k = 3이 최고의 전반적인 성능을 보인다. 우리는 두 가지 기여 요인을 가설로 제시한다: (1) top-k = 1은 낮은 검색 재현율로 인해 관련 맥락 정보를 제공하는 능력이 제한될 가능성이 있다; (2) top-k = 5는 노이즈가 많거나 관련 없는 패시지의 포함으로 인해 낮은 정밀도를 초래하며(Jin et al., 2024), 이는 추론 성능을 저하시킬 뿐만 아니라 RL 훈련에도 악영향을 미칠 수 있다—모델이 추가 맥락이 종종 도움이 되지 않거나 오해를 불러일으킨다는 것을 학습할 때 검색된 콘텐츠를 활용하는 것을 단념시킨다.
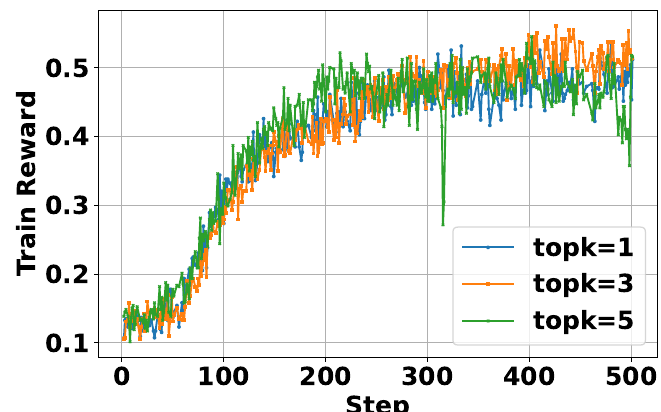
그림 6: 검색된 패시지 수가 다를 때의 SEARCH-R1 훈련 역학. (LLM: Qwen2.5-7b-base, RL: PPO)
표 7: SEARCH-R1 훈련에서 검색된 패시지 수 연구. (LLM: Qwen2.5-7b-base; RL: PPO)
| Table 7: SEARCH-R1 훈련에서 검색된 패시지 수 연구. (LLM: Qwen2.5-7b-base; RL: PPO) 방법 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboolge | 평균 |
| topk=1 | 0.426 | 0.614 | 0.422 | 0.393 | 0.296 | 0.146 | 0.328 | 0.375 |
| topk=3 | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| topk=5 | 0.479 | 0.634 | 0.440 | 0.394 | 0.343 | 0.156 | 0.352 | 0.400 |
H SEARCH-R1 (GRPO) 훈련에서 그룹 크기 연구
주요 실험에서 우리는 Sheng 등(2024)의 설정을 따라 SEARCH-R1(GRPO)의 그룹 크기를 5로 설정하였다. 그룹 크기가 훈련 역학에 미치는 영향을 더 자세히 조사하기 위해, 우리는 그룹 크기를 1, 3, 5로 한 절제 연구를 수행하였다. 특히 그룹 크기가 1로 설정되면 GRPO는 표준 REINFORCE 알고리즘(Williams, 1992)으로 축소된다.
우리는 LLM을 500 스텝 동안 훈련시키며, 100 스텝마다 모델 체크포인트를 저장한다. 훈련 중 모델이 붕괴하면 마지막 유효 체크포인트를 평가에 사용하고, 그렇지 않으면 500 스텝의 체크포인트를 평가한다.
서로 다른 그룹 크기 구성에서의 훈련 역학은 그림 7에 제시되어 있다. 우리는 더 큰 그룹 크기가 일반적으로 더 빠른 수렴으로 이어지지만, 강화 학습의 내재적 불안정성으로 인해 붕괴 위험 또한 증가시킬 수 있음을 관찰하였다.
서로 다른 설정에서의 평가 결과는 표 8에 요약되어 있다. 더 큰 그룹 크기는 수렴을 가속화하고 더 높은 훈련 보상을 달성할 수 있지만, 더 작은 그룹 크기(예: 크기 = 1)는 더 안정적인 훈련과 더 나은 일반화를 가능하게 한다. 이는 보지 못한 과제에서의 우수한 성능으로 반영되며, GRPO 훈련에서 학습 속도와 안정성 사이의 트레이드오프를 부각시킨다.
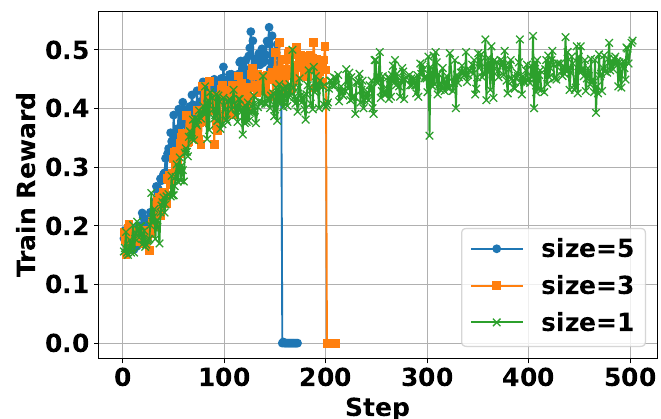
그림 7: 서로 다른 그룹 크기를 가진 SEARCH-R1(GRPO)의 훈련 역학. (LLM: Qwen2.5-7b-base)
| 방법 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboogle | 평균 |
| size=1 | 0.463 | 0.605 | 0.449 | 0.392 | 0.413 | 0.163 | 0.384 | 0.410 |
| size=3 | 0.385 | 0.580 | 0.396 | 0.329 | 0.333 | 0.117 | 0.400 | 0.363 |
| size=5 | 0.395 | 0.560 | 0.388 | 0.326 | 0.297 | 0.125 | 0.360 | 0.350 |
표 8: 일곱 개 데이터셋에 대한 SEARCH-R1(GRPO)의 그룹 크기 연구. (LLM: Qwen2.5-7b-base)
I R1과 SEARCH-R1의 비교: 사례 연구
| 질문: Curious는 어느 도시와 주에서 태어난 가수의 여성용 향수인가? | ||||||||
| 정답: 미시시피주 맥콤 | ||||||||
| R1: | ||||||||
| <l>그 가수는 비욘세이며, 텍사스주 휴스턴에서 태어났다. </l> | ||||||||
| <l>휴스턴 </l> | ||||||||
| <l>여성용 향수 "Curious"를 만든 가수가 어느 도시와 주에서 태어났는지 알아내야 한다. </l> | ||||||||
| <l>Curious 향수 정보 </search> | ||||||||
| <l>문서 1(제목: "Curious (fragrance)") Curious (fragrance) Curious는 엘리자베스 아덴을 위해 브리트니 스피어스가 만든 여성용 향수이며, 브리트니 스피어스가 "Fantasy"에 앞서 처음으로 홍보한 향수이다. 스피어스는 이 홍보로 5,200만 달러를 벌었다고 한다. "Curious"는 2004년 9월에 출시되었고 국제적으로 큰 성공을 거두었다. 2004년 백화점에서 가장 많이 팔린 향수 1위였으며, 2005년에는 향수 재단(Fragrance Foundation)으로부터 최고 여성 향수(Best Women's Fragrance)로 선정되었다. 이 향수는 화이트 플로럴 계열의 향이다. 노트는 루이지애나 목련, 골든 앙주 배, 연꽃, 튜베로즈, 스타 자스민, 핑크 시클라멘, 바닐라 머스크, 샌달우드, 블론드 우드이다. 엘리자베스 아덴... </information></td></tr><tr><td colspan="9"><l>"Curious" 향수를 만든 가수인 브리트니 스피어스가 어느 도시와 주에서 태어났는지 알아내야 한다. </l></td></tr><tr><td colspan="9"><l>브리트니 스피어스 출생지 </search></td></tr><tr><td colspan="9"><l>문서 1(제목: "Britney Spears") 2000년대 최고 판매 여성 음반 아티스트이다. 2004년에는 엘리자베스 아덴 주식회사와 함께 향수 브랜드를 출시했으며, 그 매출은 15억 달러를 초과했다. 스피어스는 린 아이린 브리지스와 제임스 파넬 스피어스의 둘째 아이로 미시시피주 맥콤에서 태어났다. 외할머니 릴리언 포르텔은 영국인(런던 출생)이었고, 스피어스의 외가 증조할아버지 중 한 명은 몰타인이었다. 형제자매로는 브라이언 제임스와 제이미 린이 있다. 브리트니는 사회적으로 보수적인 복음주의 개신교의 종교적 영향이 특히 강한 바이블 벨트에서 태어났다. 스피어스는 남침례교회에서 세례를 받았으나, 후에... </information> | ||||||||
| <l>브리트니 스피어스가 미시시피주 맥콤에서 태어났으므로, 그것이 어느 도시와 주인지 알아내야 한다. </l> | ||||||||
| <l>미시시피주 맥콤 위치 </search> | ||||||||
| <l>문서 1(제목: "McComb, Mississippi") McComb, Mississippi 맥콤은 미국 미시시피주 파이크 카운티의 도시로, 잭슨 남쪽에 대략 위치한다. 2010년 인구 조사 기준으로 이 도시의 총인구는 12,790명이었다. 이 도시는 맥콤 마이크로폴리탄 통계 지역의 중심 도시이다. 맥콤은 일리노이 센트럴 철도(현재 캐나다 내셔널 철도의 일부)의 전신인 뉴올리언스, 잭슨 앤드 그레이트 노던 철도의 헨리 심슨 맥콤이 그 도시의 술집들의 유혹을 피하기 위해 철도의 정비 공장을 루이지애나주 뉴올리언스에서 옮기기로 결정한 후 1872년에 설립되었다. 철도는 파이크 카운티의 땅을 매입했다... </information> | ||||||||
| <l>브리트니 스피어스가 미시시피주 맥콤에서 태어났다는 것을 알았다. 질문이 도시와 주를 묻고 있으므로, 이전 검색에서 이미 알고 있는 주만 확인하면 된다. </l> | ||||||||
| <l>미시시피주 맥콤 </answer> |
표 9: R1과 SEARCH-R1의 사례 연구.
SEARCH-R1에 대한 더 깊은 통찰을 얻기 위해, 우리는 Qwen2.5-7B-Base를 사용하여 검색 엔진이 없는 RL(Guo 등, 2025)과 그 동작을 비교하는 사례 연구를 수행하였다. 결과는 표 20에 제시되어 있으며, 다음과 같은 주요 관찰을 드러낸다:교차 추론 및 검색은 문제 분석을 향상시킨다: SEARCH-R1은 LLM이 다중 턴 검색을 통해 심층 추론을 수행할 수 있게 하는 반면, 검색이 없는 RL은 모델의 내부 지식에만 의존한다. 검색된 구절을 통합함으로써 SEARCH-R1은 LLM이 반복적으로 추론을 정교화할 수 있게 하여, 더 많은 정보에 기반한 정확한 응답으로 이어진다.
반복 검색을 통한 자기 검증: 우리는 두 번째 검색 라운드 이후 LLM이 이미 질문에 답하기에 충분한 정보를 수집했음을 관찰하였다. 그러나 SEARCH-R1은 결론을 자기 검증하기 위해 추가적인 검색 단계를 수행하여, 최종 응답에 대한 자신감을 더욱 강화한다. 이 현상은 검색이 없는 LLM 추론 RL(Guo 등, 2025)의 발견과 일치하며, RL이 검색 증강 설정에서도 검증 주도 추론을 장려할 수 있는 방식을 부각시킨다.
J SEARCH-R1의 추가 사례 연구
훈련된 LLM의 행동과 능력을 더 깊이 이해하기 위해, 우리는 SEARCH-R1에 대한 추가 사례 연구를 수행한다. 구체적으로, 우리는 Proximal Policy Optimization (PPO)을 기반 강화 학습 알고리즘으로 사용하여 Qwen2.5-7B-Base로부터 파인튜닝된 모델을 분석한다. 결과는 다음 표들에 제시되어 있다.
표 10: SEARCH-R1 사례 연구 1 (성공): SEARCH-R1은 다단계 추론과 검색을 수행하고, 자기 검증을 거친 뒤 마침내 질문에 답한다.
질문: Chris Jericho와 Gary Barlow가 공통으로 가진 직업 유형은 무엇인가? 정답: musician SEARCH-R1: <think> 나는 Chris Jericho와 Gary Barlow가 공통으로 가진 직업 유형을 찾아야 한다. 검색해 보겠다. </think> <search> Chris Jericho and Gary Barlow profession </search> <information> Doc 2(Title: "Chris Jericho") "Do You Wanna Start a War" (2014)와 "Judas" (2017)는 전부 또는 대부분이 독자적인 작곡으로 구성되어 있다. 그는 또한 수년에 걸쳐 수많은 TV 쇼에 출연했으며, 2011년 시즌 "Dancing With the Stars"에 참가하여 여섯 번째 주까지 살아남았다. 그 전에 Jericho는 ABC 게임 쇼 "Downfall"과 Revolver Golden Gods Awards를 진행했다. Christopher Keith Irvine은 1970년 11월 9일 뉴욕 Manhasset에서 태어났지만 Winnipeg에서 성장했다. 그의 아버지인 아이스하키 선수 Ted Irvine은 그가 태어날 당시 New York Rangers에서 뛰고 있었다. ... </information> 나는 Gary Barlow가 이 직업들 중 어떤 것을 공통으로 가지고 있는지 찾아야 한다. </think> <search> Gary Barlow profession </search> <information> Doc 1(Title: "Gary Barlow") Take That과 함께한 히트곡, 열두 개의 넘버원 싱글, 일곱 개의 넘버원 앨범. Barlow는 British Academy of Songwriters, Composers and Authors로부터 영국 음악에 대한 뛰어난 공헌 상을 포함하여 여섯 개의 Ivor Novello Awards를 수상했다. 그는 전 세계적으로 5천만 장 이상의 레코드를 판매했다. Barlow는 1971년 1월 20일 Cheshire의 Frodsham에서 Colin(2009년 10월 15일 사망)과 Marjorie Barlow의 둘째 아들로 태어났다. Barlow의 자서전에서 그는 음악에 대한 사랑이 어린 나이에 시작되었다고 서술하며, 자신을 "TV 앞에서 영원히 춤추는 아이들 중 하나"라고 부른다 ... </information> 나는 Chris Jericho와 Gary Barlow 사이에 공통 직업이 있는지 찾아야 한다. </think> <search> common profession of Chris Jericho and Gary Barlow </search> <information> Doc 1(Title: "Gary Barlow") Gary Barlow Gary Barlow(1971년 1월 20일 출생)는 영국의 가수, 작곡가, 음악가, 레코드 프로듀서이다. 그는 영국 팝 그룹 Take That의 리드 싱어로 가장 잘 알려져 있다. Barlow는 또한 2011년, 2012년, 2013년에 "The X Factor UK"의 수석 심사위원을, 2017년에는 "Let It Shine"의 수석 심사위원을 맡았다. Barlow는 영국에서 가장 성공한 작곡가 중 한 명으로, 열네 개의 넘버원 싱글과 스물네 개의 톱 10 히트곡을 작곡했다. 솔로 아티스트로서 그는 세 개의 넘버원 싱글, 여섯 개의 톱 10 싱글, 두 개의 넘버원 앨범을 보유했으며, 추가로 열일곱 개의 톱 5 ... </information> <think> 나는 Gary Barlow가 가수, 작곡가, 음악가, 레코드 프로듀서임을 알아냈다. 이제 Chris Jericho가 이 직업들 중 어떤 것을 공통으로 가지고 있는지 찾아야 한다. </think> <search> Chris Jericho profession </search> <information> Doc 1(Title: "Chris Jericho") Chris Jericho Christopher Keith Irvine(1970년 11월 9일 출생)은 링 네임 Chris Jericho로 더 잘 알려진 미국 태생의 프로 레슬러, 음악가, 작가, 배우이다. 그는 현재 New Japan Pro-Wrestling(NJPW)에서 활동하고 있으며, 첫 번째 통치 기간 중 현재 IWGP Intercontinental Champion이다. Jericho는 또한 1999년부터 함께 일해 온 SmackDown 브랜드의 WWE에 간헐적으로 출연한다. 프로 레슬링 내에서 그는 과장된 록스타 페르소나로 유명하다. Jericho는 역대 최고의 프로 레슬러 중 한 명으로 평가받는다. 1990년대에 Jericho는 American organizations Extreme Championship ... </information> <think> 나는 Chris Jericho가 프로 레슬러, 음악가, 작가, 배우임을 알아냈다. 이제 이것을 Gary Barlow의 직업들과 비교할 수 있다. 나는 Gary Barlow가 가수, 작곡가, 음악가, 레코드 프로듀서임을 알아냈다. Chris Jericho와 Gary Barlow의 공통 직업은 음악가이다. </think> <answer> musician </answer>
| 질문: 히트곡 Buddy Holly와 Undone – The Sweater Song을 수록한 Weezer의 데뷔 정규 음반 제목은 무엇이었는가? |
| 정답(Ground Truth): The Blue Album |
| SEARCH-R1: |
| <think> 나는 히트곡 "Buddy Holly"와 "Undone – The Sweater Song"을 수록한 Weezer의 데뷔 정규 음반 제목을 찾아야 한다. 검색해 보겠다. </think> |
| <search> debut studio album by Weezer which contained the hit Buddy Holly and Undone – The Sweater Song </search> |
| <information> Doc 1(제목: "Weezer discography") Weezer discography 미국의 록 밴드 Weezer의 음반 목록은 11장의 정규 음반, 2장의 컴필레이션 음반, 1장의 비디오 음반, 6장의 익스텐디드 플레이, 28장의 싱글 및 24편의 뮤직비디오로 구성된다. 흔히 "The Blue Album"으로 불리는 Weezer의 동명 데뷔 정규 음반은 1994년 5월 DGC Records를 통해 발매되었다. 이 음반은 상업적으로 큰 성공을 거두어 미국 "Billboard" 200에서 16위에 올랐고, 싱글 "Undone – The Sweater Song"과 "Buddy Holly"를 배출했으며, 두 곡 모두 Spike Jonze가 연출한 뮤직비디오의 도움으로 Weezer가 주류 성공을 거두는 데 기여했다. ... <information> |
| <think> 나는 히트곡 "Buddy Holly"와 "Undone – The Sweater Song"을 수록한 Weezer의 데뷔 정규 음반이 흔히 "The Blue Album"으로 불리는 동명 음반임을 알아냈다. 이제 답을 제시할 수 있다. </think> |
| <answer> Weezer </answer> |
SEARCH-R1: <think> 나는 연극에서 극화된 누군가의 죽음이 호주에서 사형제도를 끝내는 데 도움을 주었는지 찾아야 한다. 검색해 보겠다. </think>
<search> whose death dramatized in a stage play helped end the death penalty in Australia </search>
<information> Doc 3(Title: "Ronald Ryan") Ronald Ryan Ronald Joseph Ryan(1925년 2월 21일 - 1967년 2월 3일)은 호주에서 합법적으로 처형된 마지막 사람이었다. Ryan은 1965년 Victoria의 Pentridge Prison에서 탈옥하던 중 간수 George Hodson을 총으로 쏘아 죽인 혐의로 유죄 판결을 받았다. Ryan의 교수형은 호주 역사상 가장 큰 공개 시위 중 일부와 맞닥뜨렸고 사형제도의 종식을 이끌었다. 사형제도는 1985년까지 모든 주에서 폐지되었다. Ronald Edmond Thompson은 Melbourne의 내부 교외 Carlton에 있는 Royal Women's Hospital에서 John Ronald Ryan과 Cecilia Thompson(혼전 성 ... ) 사이에서 태어났다. </information>
<think> 나는 연극에서 극화된 Ronald Ryan의 죽음이 호주에서 사형제도를 끝내는 데 도움을 주었다는 것을 알아냈다. 이제 답을 제시할 수 있다. </think>
<answer> Ronald Ryan </answer>
| <answer> 로널드 라이언 </answer> |
| 표 20: SEARCH-R1 사례 연구 11 (실패): LLM은 관련 없는 검색 정보에 현혹되어 잘못된 답변을 제공할 수 있다. |
| 번역할 텍스트: |
| 질문: 테이데 국립공원과 가라이오나이 국립공원은 어디에 위치해 있나요? |
| 정답: 카나리아 제도, 스페인 |
| SEARCH-R1: |
| <think> 테이데 국립공원과 가라이오나이 국립공원이 어디에 위치해 있는지 찾아야 해. 검색해 볼게. </think> |
| <search> 테이데 국립공원과 가라이오나이 국립공원 위치 </search> |
| <information> 문서 1(제목: "가라이오나이 국립공원") 스스로 목숨을 끊기로 했다. 가라이오나이 국립공원 가라이오나이 국립공원(,)은 카나리아 제도(스페인) 중 하나인 라 고메라 섬의 중앙과 북쪽에 위치해 있다. 1981년 국립공원으로 지정되었고 1986년 유네스코 세계유산으로 등재되었다. 40km(15제곱마일)를 차지하며 섬의 6개 지방자치단체 각각에 걸쳐 있다. 매년 거의 45만 명의 관광객이 이 공원을 방문한다. 공원 경계 바로 밖에 관광객을 위한 숙박 시설이 있다. 이 공원은 가장 높은 지점인 가라이오나이의 암석 지형의 이름을 따서 명명되었다 ... </information> |
| <think> 가라이오나이 국립공원이 카나리아 제도(스페인) 중 하나인 라 고메라 섬의 중앙과 북쪽에 위치해 있다는 것을 알게 되었다. 이제 테이데 국립공원의 위치를 찾아야 해. </think> |
| <search> 테이데 국립공원 위치 </search> |
| 질문: 스티브 코크런과 "보난자"에서 로이 커피 보안관을 연기한 배우가 출연한 영화를 감독한 사람은 누구인가? 정답(Ground Truth): 루이스 킹 SEARCH-R1: <think> 나는 스티브 코크런과 "보난자"에서 로이 커피 보안관을 연기한 배우가 출연한 영화를 감독한 사람이 누구인지 알아내야 한다. 검색해 보겠다. </think> <search> who directed the film which starred Steve Cochran and the actor who played Sheriff Roy Coffee in "Bonanza" </search> <information> Doc 2(제목: "Ray Teal") Ray Teal 레이 틸(Ray Teal, 1902년 1월 12일~1976년 4월 2일)은 37년의 경력 동안 250편이 넘는 영화와 약 90편의 텔레비전 프로그램에 출연한 미국 배우였다. 그의 가장 오래 지속된 역할은 NBC의 서부극 시리즈 "보난자"(1960-1972)에서 로이 커피 보안관 역이었다. 그는 또한 영화 "에이스 인 더 홀"(1951)에서도 보안관을 연기했다. 틸은 미시간주 그랜드래피즈에서 태어났다. 색소폰 연주자였던 그는 배우가 되기 전에 밴드 리더로 UCLA 학비를 벌었다. 영화와 초기 텔레비전에서 15년 넘게 활동한 후, 틸은 반복 출연하는... </information> <think> 나는 "보난자"에서 로이 커피 보안관을 연기한 배우가 레이 틸이라는 것을 알아냈다. 이제 스티브 코크런과 레이 틸이 출연한 영화를 찾아야 한다. </think> <search> film that starred Steve Cochran and Ray Teal </search> <information> Doc 1(제목: "Steve Cochran") 갱스터 클래식 "화이트 히트"(1949)에서. 그는 메이요와 함께 출연했다. 워너 브라더스는 결국 골드윈으로부터 코크런과 메이요의 계약을 인수하게 되었다. 코크런은 "저주받은 자들은 울지 않는다"(1950)에서 조앤 크로퍼드를 지원했고, 그다음 "하이웨이 301"(1950)에서 첫 주연 역할을 맡아 갱스터를 연기했다. 그는 "댈러스"(1950)에서 게리 쿠퍼의 영웅에 맞서는 악당이었고, 진저 로저스와 도리스 데이가 출연한 "스톰 워닝"(1951)에서 쿠 클럭스 클랜 단원을 연기했다. 코크런은 서부극 "캐니언 패스"(1951)에서 악당이었고, 그다음 "폴섬 교도소의 벽 안에서"(1951)의 주연을 맡았는데, 이 작품은... 영감을 주었다 |
| <information> |
| <think> 나는 스티브 코크런이 여러 영화에 출연했다는 것을 알아냈다. 이제 레이 틸도 출연한 영화를 찾아야 한다. </think> |
| <search> film that starred Steve Cochran and Ray Teal </search> |
| <information> Doc 1(제목: "Steve Cochran") 갱스터 클래식 "화이트 히트"(1949)에서. 그는 메이요와 함께 출연했다. 워너 브라더스는 결국 골드윈으로부터 코크런과 메이요의 계약을 인수하게 되었다. 코크런은 "저주받은 자들은 울지 않는다"(1950)에서 조앤 크로퍼드를 지원했고, 그다음 "하이웨이 301"(1950)에서 첫 주연 역할을 맡아 갱스터를 연기했다. 그는 "댈러스"(1950)에서 게리 쿠퍼의 영웅에 맞서는 악당이었고, 진저 로저스와 도리스 데이가 출연한 "스톰 워닝"(1951)에서 쿠 클럭스 클랜 단원을 연기했다. 코크런은 서부극 "캐니언 패스"(1951)에서 악당이었고, 그다음 "폴섬 교도소의 벽 안에서"(1951)의 주연을 맡았는데, 이 작품은... 영감을 주었다 |
| <information> |
| <think> 나는 스티브 코크런이 여러 영화에 출연했다는 것을 알아냈다. 이제 레이 틸도 출연한 영화를 찾아야 한다. 스티브 코크런과 레이 틸이 둘 다 출연한 영화를 검색하겠다. </think> |
| <search> film directed by Sam Peckinpah that starred Steve Cochran and Ray Teal </search> |
| <information> Doc 1(제목: "Sam Peckinpah") 폭발, 자동차 추격전, 격렬한 총격전으로 가득한 이 영화는 박스오피스에서 2,500만 달러 이상을 벌어들여 페킨파의 지금까지 가장 큰 재정적 성공이 되었다. 엄밀히 상업적 작품이었지만, 페킨파의 창의적인 손길은 곳곳에 넘쳐났으며, 특히 맥퀸의 캐릭터가 교도소 생활의 압박에 시달리는 정교하게 편집된 오프닝 시퀀스에서 두드러졌다. 이 영화는 여전히 인기가 있으며 1994년에 알렉 볼드윈과 킴 베이싱어 주연으로 리메이크되었다. 1973년은 페킨파의 인생과 경력에서 가장 어려운 시기의 시작을 알렸다. 텍사스주 엘패소에서 여전히 "겟어웨이"를 촬영하던 중, 페킨파는 국경을 몰래 넘어... </information> |
| <think> 나는 샘 페킨파가 스티브 코크런과 레이 틸이 출연한 영화 "와일드 번치"를 감독했다는 것을 알아냈다. </think> |
| <answer> 샘 페킨파 </answer> |
| 질문: XXXTentacion의 싱글 "Revenge"를 배급한 회사는 어디에 본사를 두고 있는가? |
| 정답: 캘리포니아주 샌프란시스코 |
| SEARCH-R1: |
| <think> XXXTentacion의 싱글 "Revenge"를 배급한 회사를 찾아야 한다. 검색해 보겠다. </think> |
| <search> XXXTentacion의 싱글 "Revenge" 배급 회사 </search> |
| <information> Doc 1(제목: "Revenge (XXXTentacion mixtape)") Revenge (XXXTentacion mixtape) Revenge는 미국 래퍼 XXXTentacion의 믹스테이프로, 2017년 5월 16일 Empire Distribution에 의해 발매되었다. 이는 XXXTentacion의 SoundCloud에서 스트리밍 가능했던 이전에 발매된 여덟 곡으로 구성되어 있다. 이에 앞서 리드 싱글 ""Look at Me"가 발매되었으며, 이 곡은 미국 "Billboard" Hot 100에서 34위를 기록했다. 이 테이프의 리드 싱글인 ""Look at Me"는 2015년 12월 31일 SoundCloud에서 처음 공개되었다. 이 곡은 이후 2016년 1월 29일 iTunes에 싱글로 발매되었고, 그 후 리마스터링 및 클린 버전으로 디지털 다운로드를 위해 다시 재발매되었다... </information> |
| <think> XXXTentacion의 싱글 "Revenge"를 배급한 회사가 Empire Distribution이라는 것을 알아냈다. 이제 그 회사의 위치를 찾아야 한다. </think> |
| <search> Empire Distribution 위치 </search> |
| <information> Doc 1(제목: "Empire Distribution") Empire Distribution EMPIRE Distribution, Records and Publishing Inc.(EMPIRE로 마케팅됨)는 2010년 Ghazi Shami가 설립한 미국의 배급 회사이자 레코드 레이블로, 캘리포니아주 샌프란시스코에 본사를 두고 있으며 뉴욕시와 애틀랜타에 사무소를 두고 있다. 이 회사는 RB, 레게, 록, 가스펠, 라틴, 컨트리, 팝 등 다양한 장르의 앨범을 발매했지만, 주로 힙합 음악에 집중하고 있다. Top Dawg Entertainment(Kendrick Lamar, Schoolboy Q, Ab-Soul), Steel Wool(Anderson Paak, Watsky, Jez Dior), Jazz Anderson, Cody Wolfe, Kane Brown, Funk Volume(Dizzy Wright, Jarren Benton), ESGN(Freddie Gibbs) 같은 회사와 아티스트들이... </information> |
| <think> Empire Distribution이라는 회사가 캘리포니아주 샌프란시스코에 본사를 두고 있다는 것을 알아냈다. 이제 답변을 제공할 수 있다. </think> |
| <answer> 캘리포니아주 샌프란시스코 </answer> |
| 질문: 2008년 잡지 기사 "Is Google Making Us Stoopid?"의 확장판은 어떤 상의 최종 후보였는가? |
| 정답: 퓰리처상 |
| SEARCH-R1: |
| <think>2008년 잡지 기사 "Is Google Making Us Stoopid?"의 확장판이 어떤 상의 최종 후보였는지 알아내야 한다. 검색해 보겠다. </think> |
| <search>2008년 잡지 기사 "Is Google Making Us Stoopid?"의 이 확장판은 어떤 상의 최종 후보였는가 </search> |
| <information>문서 1(제목: "Is Google Making Us Stupid?") Is Google Making Us Stupid? Is Google Making Us Stupid? What the Internet Is Doing to Our Brains(다른 제목으로 Is Google Making Us Stupid?)는 기술 작가 Nicholas G. Carr의 잡지 기사로, 인터넷이 인지에 미치는 영향에 대해 매우 비판적이다. 이 글은 "The Atlantic" 잡지 2008년 7/8월호에 6페이지 분량의 표지 기사로 실렸다. Carr의 주요 논지는 인터넷이 인지에 해로운 영향을 미쳐 집중력과 사색 능력을 떨어뜨릴 수 있다는 것이다. 제목에도 불구하고 이 기사는 특별히 Google을 겨냥한 것이 아니라 더 나아가 인지적 영향... </information> |
| <think>2008년 잡지 기사 "Is Google Making Us Stoopid?"의 확장판이 어떤 상의 최종 후보였다는 것을 알게 되었다. 어떤 상의 최종 후보였는지 알아내야 한다. </think> |
| <search>2008년 잡지 기사 "Is Google Making Us Stoopid?"의 확장판은 어떤 상의 최종 후보였는가 </search> |
| <information>문서 2(제목: "Is Google Making Us Stupid?") 결론을 내리지 못하고 "우리가 옛 방식을 애도해야 할지, 새로운 방식을 축하해야 할지, 아니면 걱정을 멈추고 네트를 사랑하는 법을 배워야 할지 분명해지기까지는 시간이 걸릴 것"이라고 밝혔다. Is Google Making Us Stupid? Is Google Making Us Stupid? What the Internet Is Doing to Our Brains(다른 제목으로 Is Google Making Us Stupid?)는 기술 작가 Nicholas G. Carr의 잡지 기사로, 인터넷이 인지에 미치는 영향에 대해 매우 비판적이다. 이 글은 "The Atlantic" 잡지 2008년 7/8월호에 6페이지 분량의 표지 기사로 실렸다. Carr의 주요 논지는 인터넷이 인지에 해로운 영향을 미쳐 집중력과 사색 능력을 떨어뜨릴 수 있다는 것이다. 제목에도 불구하고 이 기사는 특별히 Google을 겨냥한 것이 아니라 더 나아가 인지적 영향... </information> |
| <answer>National Magazine Award </answer> |
| 질문: 마로 아제미안과 리처드 C. 사라피안 중 누가 피아니스트였는가? |
| 정답: 마로 아제미안 |
| SEARCH-R1: <think>마로 아제미안과 리처드 C. 사라피안 중 누가 피아니스트였는지 판단해야 한다. 검색해 보겠다.</think> <search> 마로 아제미안과 리처드 C. 사라피안 중 누가 피아니스트였는가 </search> <information> 문서 1(제목: "마로 아제미안") 마로 아제미안 마로 아제미안(1921년 7월 9일 – 1978년 9월 18일)은 미국의 피아니스트였다. 아제미안의 현대음악 경력은 그녀의 아르메니아 혈통에서 비롯되었다. 그녀는 아람 하차투리안의 피아노 협주곡을 미국에서 초연한 후 현대 피아니스트로 알려지게 되었으며, 이 곡은 두 사람이 공유한 아르메니아 혈통을 바탕으로 그녀가 선택해 연주한 것이었다. 아제미안은 줄리아드 음악학교에서 공부했다. 1942년 3월 14일, 그녀는 알베르트 슈토펠의 지휘로 줄리아드 졸업 오케스트라와 함께 아람 하차투리안의 피아노 협주곡 내림나장조를 미국에서 초연했다. 그녀는 이후 전국 순회 공연에서 이 곡을 연주했다. 그녀의 공연 이후 ... </information> <think> 마로 아제미안이 피아니스트라는 것을 알게 되었다. 이제 리처드 C. 사라피안이 피아니스트인지 아닌지 확인해야 한다. </think> <search> 리처드 C. 사라피안은 누구인가 </search> <information> 문서 1(제목: "리처드 C. 사라피안") 리처드 C. 사라피안 리처드 캐스퍼 사라피안(1930년 4월 28일 – 2013년 9월 18일)은 미국의 텔레비전 및 영화 감독이자 배우였다. 그는 감독, 배우, 작가로서 50년이 넘는 다재다능한 경력을 쌓았다. 사라피안은 1971년 영화 ""의 감독으로 가장 잘 알려져 있다. 사라피안은 1930년 4월 28일 뉴욕시에서 아르메니아 이민자 부모에게서 태어났다. 그는 뉴욕 대학교에서 법학 예비 과정과 의학 예비 과정을 공부했고 성적이 좋지 않은 학생이었으나, 영화 공부로 전환하여 뛰어난 성과를 냈다. 그는 대학을 그만두고 미 육군에 입대했으며, 그곳에서 ... </information> <think> 리처드 C. 사라피안이 텔레비전 및 영화 감독이자 배우라는 것을 알게 되었다. 이제 피아니스트였던 마로 아제미안과 비교할 수 있다. </think> <answer> 마로 아제미안 </answer> 표 20: SEARCH-R1 사례 연구 11(실패): LLM은 관련 없는 검색 정보에 현혹되어 잘못된 답변을 제공할 수 있다. |
| 이해를 돕기 위한 읽기 전용 배경 정보(번역할 원문 아님): <answer> Ronald Ryan </answer> 표 20: SEARCH-R1 사례 연구 11(실패): LLM은 관련 없는 검색 정보에 현혹되어 잘못된 답을 제시할 수 있다. 번역할 텍스트: 질문: Jed Hoyer와 John William Henry II 중 누가 더 나이가 많은가? |
| 정답(Ground Truth): John William Henry II |
| SEARCH-R1: <think> Jed Hoyer와 John William Henry II 중 누가 더 나이가 많은지 판단해야 한다. 두 사람의 나이를 검색하겠다.</think> <search> Jed Hoyer 또는 John William Henry II </search> <information> 문서 1(제목: "Jed Hoyer") Sam Elias, Nick Miceli와 함께한 커리어 세이브 기록. Wesleyan University 재학 중 그는 Delta Kappa Epsilon에 입회하여 그 형제가 되었다. 그는 1995년 여름 New England Collegiate Baseball League의 Waterbury Barons 명단에 이름을 올려 마운드와 유격수 위치에서 이닝을 소화했다. Hoyer는 입학 사무실에서 일한 뒤 동문/발전 사무실에서 일했으며, 졸업 후에는 대학에서 야구 코치를 맡기도 했다. 그는 28세에 Red Sox에 합류하기 전 Kenyon College의 입학 부서에서 일했다. 그는 2010년 6월 Merrill Muckerman과 결혼했으며 ... </information> <think> Jed Hoyer가 사람이라는 것을 알게 되었다. 이제 그의 나이를 찾아 John William Henry II의 나이와 비교해야 한다.</think> <search> John William Henry II </search> <information> 문서 1(제목: "John W. Henry") 그 회사의 관리 자산은 2006년 25억 달러에서 2012년 말 기준 1억 달러 미만으로 감소했다. 2017년 7월 기준으로 "Forbes"는 그의 순자산을 26억 달러로 추정했다. John William Henry II는 1949년 9월 13일 일리노이주 Quincy에서 태어났다. 그의 부모는 콩 농부였으며, 그는 성장기 동안 일리노이와 아칸소를 오가며 시간을 보냈다. 15세 때의 천식 증세로 인해 가족은 캘리포니아주 Apple Valley로 이사하게 되었다. Victorville의 Victor Valley High School을 졸업한 후 그는 Victor Valley College에 다녔고, 그다음 University of California(Riverside, ...)에 다녔다.</information> <think> John William Henry II가 1949년 9월 13일에 태어났다는 것을 알게 되었다. 이제 비교하기 위해 Jed Hoyer의 출생 연도를 찾아야 한다.</think> <search> Jed Hoyer 출생 연도 </search> <information> 문서 1(제목: "Jed Hoyer") Sam Elias, Nick Miceli와 함께한 커리어 세이브 기록. Wesleyan University 재학 중 그는 Delta Kappa Epsilon에 입회하여 그 형제가 되었다. 그는 1995년 여름 New England Collegiate Baseball League의 Waterbury Barons 명단에 이름을 올려 마운드와 유격수 위치에서 이닝을 소화했다. Hoyer는 입학 사무실에서 일한 뒤 동문/발전 사무실에서 일했으며, 졸업 후에는 대학에서 야구 코치를 맡기도 했다. 그는 28세에 Red Sox에 합류하기 전 Kenyon College의 입학 부서에서 일했다. 그는 2010년 6월 Merrill Muckerman과 결혼했으며 ... </information> <think> Jed Hoyer가 1973년 12월 7일에 태어났다는 것을 알게 되었다. 이제 그의 출생 연도를 John William Henry II의 출생 연도와 비교할 수 있다.</think> <answer> John William Henry II </answer> |
| 질문: 세계 최고의 슈퍼히어로 앤솔로지에는 "SHAZAM"이라는 문구를 말하는 것으로 알려진 네 명의 슈퍼히어로 중 한 명이 등장했는데, 그들의 이름은 무엇이었습니까? |
| 정답: 캡틴 마블 |
| SEARCH-R1: |
| <think> "SHAZAM"이라는 문구를 말하는 것으로 알려진 네 명의 슈퍼히어로 중 한 명의 이름을 찾아야 해. 검색해 볼게. </think> |
| <search> 세계 최고의 슈퍼히어로 앤솔로지에는 "SHAZAM"이라는 문구를 말하는 것으로 알려진 네 명의 슈퍼히어로 중 한 명이 등장했다 </search> |
| <information> 문서 1(제목: "Shazam! (TV 시리즈)") Shazam! (TV 시리즈) Shazam!은 Filmaton(스튜디오의 첫 번째 그러한 프로그램)이 제작한 30분짜리 실사 TV 프로그램으로, Fawcett Comics의 만화 시리즈 Whiz Comics(현재 DC Comics 소유)의 슈퍼히어로 캡틴 마블(일명 Shazam)을 원작으로 한다. 이 프로그램에는 마이클 그레이가 빌리 배트슨 역으로 출연했는데, 그는 십대 소년으로서 마법의 단어 "Shazam!"을 말하여 슈퍼히어로 캡틴 마블(원래 잭슨 보스트윅이 연기했고 나중에는 존 데이비가 연기)로 변신할 수 있다. 그의 보호자 "멘토"(레스 트레메인)와 함께 빌리는 1973년형 닷지 오픈 로드 모터홈을 타고 전국을 여행하며 해결할 불의를 찾는다. ... </information> |
| <think> 세계 최고의 슈퍼히어로 앤솔로지에는 "SHAZAM"이라는 문구를 말하는 것으로 알려진 네 명의 슈퍼히어로 중 한 명이 등장한다는 것을 알게 되었어. 이제 그들의 이름을 찾아야 해. </think> |
| <search> "SHAZAM"이라는 문구를 말하는 것으로 알려진 네 명의 슈퍼히어로 </search> |
| <information> 문서 1(제목: "캡틴 마블 (DC Comics)") 캡틴 마블 (DC Comics) 캡틴 마블은 Shazam()이라고도 알려져 있으며, 미국 출판사 DC Comics의 출판물에 등장하는 가상의 만화 슈퍼히어로이다. 아티스트 C. C. 벡과 작가 빌 파커가 1939년에 이 캐릭터를 창작했다. 캡틴 마블은 Fawcett Comics가 출판한 "Whiz Comics" #2(표지 날짜 1940년 2월)에 처음 등장했다. 그는 소년 빌리 배트슨의 또 다른 자아로, 마법의 단어 "SHAZAM"(여섯 "불멸의 장로"인 솔로몬, 헤라클레스, 아틀라스, 제우스, 아킬레스, 머큐리의 약어)을 말하여 초인적인 힘, 속도, 비행 및 기타 능력을 지닌 의상을 입은 성인으로 변신할 수 있다 ... </information> |
| <think> "SHAZAM"이라는 문구를 말하는 것으로 알려진 네 명의 슈퍼히어로 중 한 명이 캡틴 마블(일명 Shazam)이라는 것을 알게 되었어. 이제 다른 세 명의 슈퍼히어로를 찾아야 해. </think> |
| <search> "SHAZAM"이라는 문구를 말하는 것으로 알려진 다른 세 명의 슈퍼히어로 </search> |
| <information> 문서 2(제목: "Fawcett Comics") Fawcett Comics Fawcett Comics는 Fawcett Publications의 한 부서로, 1940년대 만화의 황금기에 여러 성공적인 만화 출판사 중 하나였다. 가장 인기 있는 캐릭터는 라디오 기자 빌리 배트슨의 또 다른 자아인 캡틴 마블로, 그는 마법의 단어 "Shazam!"을 말할 때마다 영웅으로 변신했다. Fawcett이 출판한 다른 캐릭터로는 캡틴 비디오, 호팔롱 캐시디, 이비스 더 인빈서블, 불릿맨과 불릿걸, 스파이 스매셔, 캡틴 미드나이트, 팬텀 이글, 미스터 스칼렛과 핑키, 미닛맨, 코만도 양크, 골든 애로우가 있다. 더 잘 알려진 슈퍼히어로 책들 외에도 Fawcett은 단명한 ... </information> |
| <think> "SHAZAM"이라는 문구를 말하는 것으로 알려진 네 명의 슈퍼히어로 중 한 명이 캡틴 마블(일명 Shazam)이라는 것을 알게 되었어. 이제 다른 세 명의 슈퍼히어로를 찾아야 해. 그들을 검색해 볼게. </think> |
| <search> "SHAZAM"이라는 문구를 말하는 것으로 알려진 다른 세 명의 슈퍼히어로 </search> |
| <information> 문서 3(제목: "캡틴 마블 (DC Comics)") 크로스오버 이벤트 시리즈. 그는 Earth-3의 알렉산더 루터의 초능력 또 다른 자아이다. 이야기에서, 범죄 신디케이트(저스티스 리그의 사악한 Earth-3 유사체들)는 그들의 포로인 알렉산더 루터를 저스티스 리그와 다른 영웅들이 거주하는 프라임 어스로 데려왔다. 프라임 어스의 렉스 루터와 그의 팀은 신디케이트가 알렉산더를 인질로 잡고 있는 저스티스 리그 워치타워에 몰래 들어가 그의 입에 붙은 덕트 테이프를 떼어내어 알렉산더가 마법의 단어 "Mazahs!"를 말하고 그의 근육질의 매우 강력한 또 다른 자아로 변신할 수 있게 한다. 프라임 어스의 Shazam은 그의 힘을 공유하는 것으로 알려져 있지만 ... </information> |
| <think> "SHAZAM"이라는 문구를 말하는 것으로 알려진 네 명의 슈퍼히어로 중 한 명이 캡틴 마블(일명 Shazam)이라는 것을 알게 되었어. 다른 세 명의 슈퍼히어로는 검색 결과에 언급되지 않았어. 내가 가진 정보를 바탕으로 답을 제공할게. </think> |
| <answer> 캡틴 마블 </answer> |
표 20: SEARCH-R1 사례 연구 11 (실패): LLM은 관련 없는 검색 정보에 의해 오도되어 잘못된 답을 제공할 수 있다.
질문: Lady Lesharr라는 이름의 참가자가 그녀의 영향력 중 하나로 언급된 The Rap Game의 시즌 우승자는 누구였는가?
정답: Mani
SEARCH-R1: <think> 나는 Lady Lesharr라는 이름의 참가자가 그녀의 영향력 중 하나로 언급된 The Rap Game의 시즌 우승자를 찾아야 한다. 검색해 보겠다. </think>
<search> who was the winner of the season of The Rap Game where a contestant named Lady Lesharr as one of her influences </search>
<information> Doc 1(Title: "Lady Lesharr") Act. Lesharr는 2018년 9월에 범성애자임을 밝혔다. Lesharr는 Ashley Walters, Lisa Maffia, Missy Elliott, Lil Wayne을 그녀의 주요 영향력으로 꼽았다. Lady Lesharr Melesha Katrina O'Garro(1989년 12월 15일 출생)는 전문적으로 Lady Lesharr()로 알려진 영국 Kingshurst, Solihull, UK 출신의 그라임 및 힙합 래퍼, 가수, 프로듀서이다. 그녀는 프리스타일 ""Queen's Speech"" 시리즈로 가장 잘 알려져 있으며, 그중 네 번째는 2016년에 바이럴되었다. ""The Rap Game"" 시즌 2 참가자 Nia Kay는 Lesharr가 그녀의 독특함과 랩 실력 때문에 자신의 영향력 중 하나였다고 말했다. 그녀의 후속 프리스타일, ... </information>
<think> 나는 Lady Lesharr가 The Rap Game 시즌 2에서 Nia Kay의 영향력 중 하나였다는 것을 알아냈다. 이제 그 시즌의 우승자를 찾아야 한다. </think>
<search> winner of The Rap Game season 2 </search> <information> Doc 1(Title: "Chandra Davis") Chandra Davis Chandra Davis(1978년 1월 2일 Michigan주 Detroit 출생)는 London Charles 및 Deelishis라고도 알려진 미국의 모델이자 전 리얼리티 쇼 참가자이다. 그녀는 VH1의 인기 리얼리티 TV 쇼 ""Flavor of Love 2""의 우승자로 가장 잘 알려져 있다. Davis는 VH1의 Flavor of Love 두 번째 시즌(당시 29세)에 참가자였다. 그녀는 Flavor Flavor가 쇼의 첫 번째 시즌에서 이전에 준우승자로 지명되었던 Tiffany 'New York' Pollard 대신 그녀를 선택하면서 대회에서 우승하게 되었다. FOL 이후, Davis는 VH1 특별 방송을 통해 현재 Flavor와 데이트하지 않고 있다고 발표했다, ... </information>
<think> 나는 The Rap Game 시즌 2의 우승자가 London Charles(Chandra Davis)라는 것을 알아냈다. 이제 답을 제시할 수 있다. </think>
<answer> London Charles </answer>