
엄선한 1,000개 예시와 사고 토큰 상한만으로 작은 모델이 더 큰 추론 시스템을 앞선다. 2025년 논문, 전문 무료.
s1: Simple test-time scaling
Niklas Muennighoff Zitong Yang Weijia Shi Xiang Lisa Li Li Fei- Fei Hannaneh Hajishirzi Luke Zettlemoyer Percy Liang Emmanuel Candès Tatsunori Hashimoto
Abstract
Test- time scaling is a promising new approach to language modeling that uses extra test- time compute to improve performance. Recently, OpenAI's o1 model showed this capability but did not publicly share its methodology, leading to many replication efforts. We seek the simplest approach to achieve test- time scaling and strong reasoning performance. First, we curate a small dataset s1K of 1,000 questions paired with reasoning traces relying on three criteria we validate through ablations: difficulty, diversity, and quality. Second, we develop budget forcing to control test- time compute by forcefully terminating the model's thinking process or lengthening it by appending "Wait" multiple times to the model's generation when it tries to end. This can lead the model to doublecheck its answer, often fixing incorrect reasoning steps. After supervised finetuning the Qwen2.5- 32B- Instruct language model on s1K and equipping it with budget forcing, our model s1- 32B exceeds o1- preview on competition math questions by up to (MATH and AIME24). Further, scaling s1- 32B with budget forcing allows extrapolating beyond its performance without test- time intervention: from to on AIME24. Our model, data, and code are open- source at https://github.com/simplescaling/s1.
1. Introduction
Performance improvements of language models (LMs) over the past years have largely relied on scaling up train- time compute using large- scale self- supervised pretraining (Kaplan et al., 2020; Hoffmann et al., 2022). The creation of these powerful models has set the stage for a new scaling paradigm built on top of them: test- time scaling. The aim
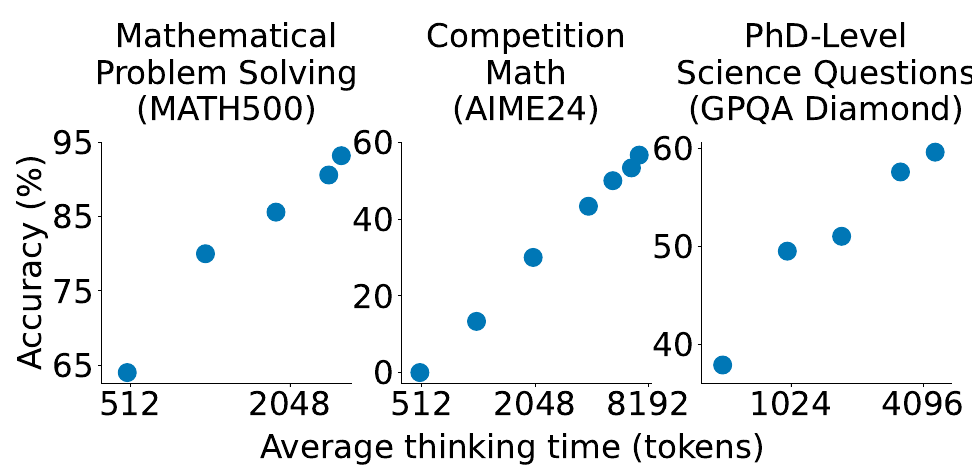
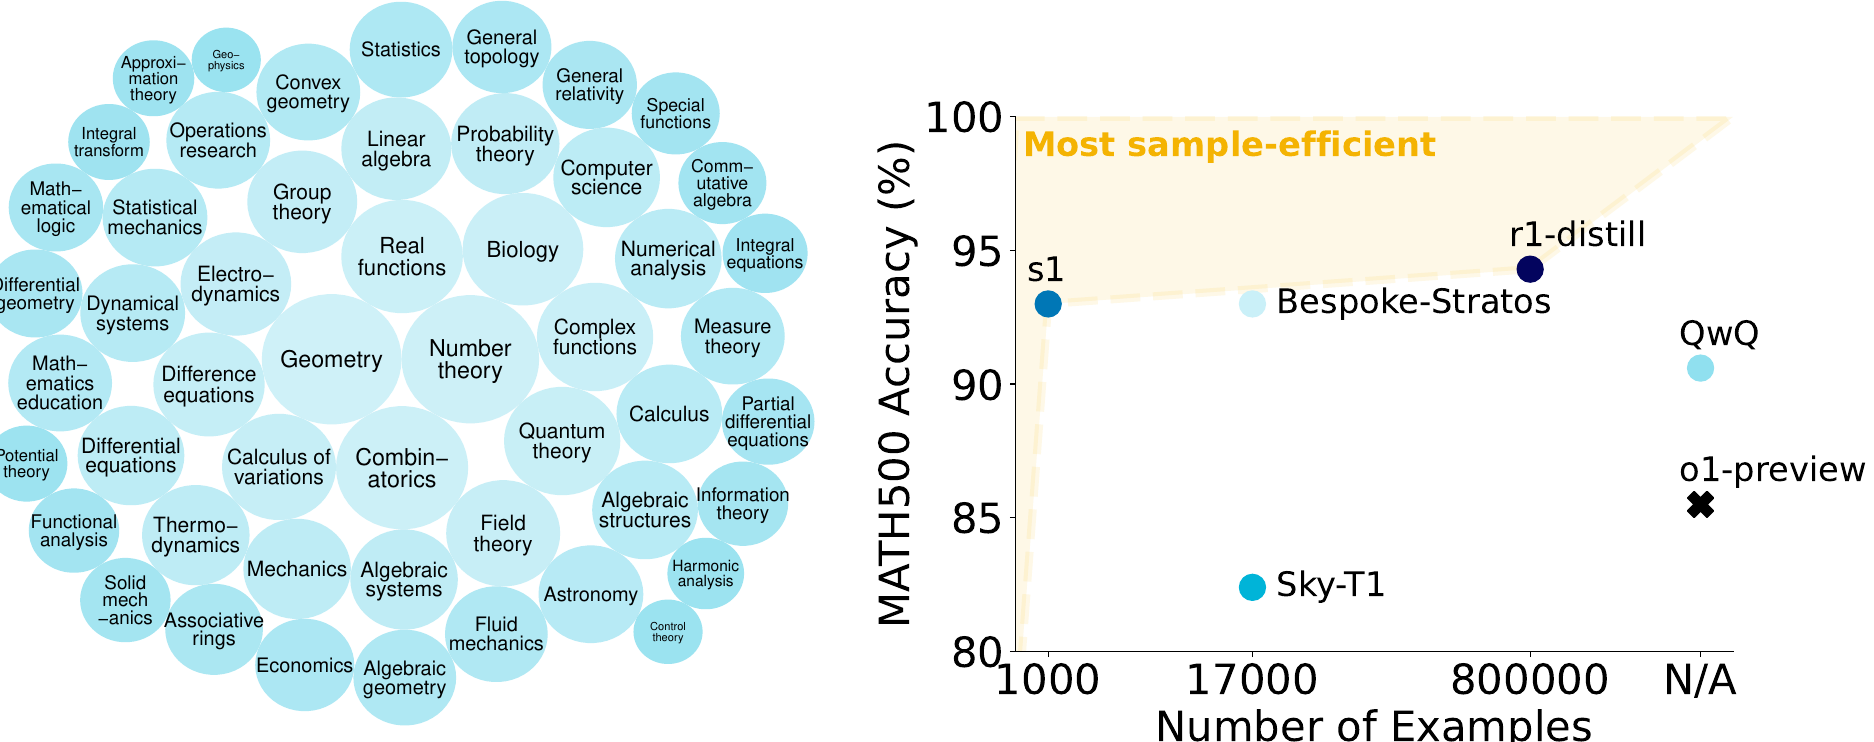
of this approach is to increase the compute at test time to get better results. There has been much work exploring this idea (Snell et al., 2024; Welleck et al., 2024), and the viability of this paradigm was recently validated by OpenAI o1 (OpenAI, 2024). o1 has demonstrated strong reasoning performance with consistent gains from scaling test- time compute. OpenAI describes their approach as using large- scale reinforcement learning (RL) implying the use of sizable amounts of data (OpenAI, 2024). This has led to various attempts to replicate their models relying on techniques like Monte Carlo Tree Search (Gao et al., 2024b; Zhang et al., 2024a), multi- agent approaches (Qin et al., 2024), and others (Wang et al., 2024a; Huang et al., 2024b; 2025). Among these approaches, DeepSeek R1 (DeepSeek- AI et al., 2025) has successfully replicated o1- level performance, also employing reinforcement learning via millions of samples and multiple training stages. However, despite the large number of o1 replication attempts, none have openly replicated a clear test- time scaling behavior. Thus, we ask: what is the simplest approach to achieve both test- time scaling and strong reasoning performance? We show that training on only 1,000 samples with next- token prediction and controlling thinking duration via a simple test- time technique we refer to as budget forcing leads to a strong reasoning model that scales in performance with more test- time compute. Specifically, we construct s1K, which consists of 1,000 carefully curated questions paired with reasoning traces and answers distilled from Gemini Thinking Experimental (Google, 2024). We perform supervised fine- tuning (SFT) of an off- the- shelf pretrained model on our small dataset requiring just 26 minutes of training on 16 H100 GPUs. After training, we control the amount of test- time compute our model spends using budget forcing: (I) If the model generates more thinking tokens than a desired limit, we forcefully end the thinking process by appending an end- of- thinking token delimiter. Ending the thinking this way makes the model transition to generating its answer. (II) If we want the model to spend more test- time compute on a problem, we suppress the generation of the end- of- thinking token delimiter and instead append "Wait" to the model's current reasoning trace to encourage more exploration. Equipped with this simple recipe - SFT on 1,000 samples and test- time budget forcing - our model s1- 32B exhibits test- time scaling (Figure 1). Further, s1- 32B is the most sample- efficient reasoning model and outperforms closed- source models like OpenAI's o1- preview (Figure 2).
We conduct extensive ablation experiments targeting (a) our selection of 1,000 (1K) reasoning samples and (b) our test- time scaling. For (a), we find that jointly incorporating difficulty, diversity, and quality measures into our selection algorithm is important. Random selection, selecting samples with the longest reasoning traces, or only selecting maximally diverse samples all lead to significantly worse performance (around on AIME24 on average). Training on our full data pool of 59K examples, a superset of s1K, does not offer substantial gains over our 1K selection. This highlights the importance of careful data selection and echoes prior findings for instruction tuning (Zhou et al., 2023). For (b), we define desiderata for test- time scaling methods to compare different approaches. Budget forcing leads to the best scaling as it has perfect controllability with a clear positive slope leading to strong performance.
In summary, our contributions are: We develop simple methods for creating a sample- efficient reasoning dataset (§2) and test- time scaling (§3); Based on these we build s1- 32B which is competitive with o1- preview (§4); We ablate subtleties of data (§5.1) and test- time scaling (§5.2). We end with a discussion to motivate future work on simple reasoning (§6). Our code, model, and data are open- source at https://github.com/simplescaling/s1.
2. Reasoning data curation to create s1K
In this section, we describe our process for creating a large dataset first in §2.1 and then filtering it down to s1K in §2.2.
2.1. Initial collection of 59K samples
We collect an initial 59,029 questions from 16 sources following three guiding principles. Quality: Datasets should be high- quality; we always inspect samples and ignore datasets with, e.g., poor formatting; Difficulty: Datasets should be challenging and require significant reasoning effort; Divers sity: Datasets should stem from various fields to cover different reasoning tasks. We collect datasets of two categories:
Curation of existing datasets Our largest source is NuminaMATH (LI et al., 2024) with 30,660 mathematical problems from online websites. We also include historical AIME problems (1983- 2021). To enhance diversity, we add OlympicArena (Huang et al., 2024a) with 4,250 questions spanning Astronomy, Biology, Chemistry, Computer Science, Geography, Mathematics, and Physics from various Olympiads. OmniMath (Gao et al., 2024a) adds 4,238 competition- level mathematics problems. We also include 2,385 problems from AGIEval (Zhong et al., 2023), which features questions from standardized tests like SAT and LSAT, covering English, Law, and Logic. We refer to Table 7 in §C for our other sources.
New datasets in quantitative reasoning To complement these existing datasets, we create two original datasets. s1- prob consists of 182 questions from the probability section of Stanford University's Statistics Department's PhD Qualifying Exams (https://statistics.stanford.edu), accompanied by handwritten solutions that cover difficult proofs. The probability qualifying exam is held yearly and requires professional- level mathematical problem- solving. s1- teasers comprises 23 challenging brain- teasers commonly used in interview questions for quantitative trading positions. Each sample consists of a problem and solution taken from PuzzledQuant (https://www.puzzledquant.com/). We only take examples with the highest difficulty level ("Hard").
For each question, we generate a reasoning trace and solution using the Google Gemini Flash Thinking API (Google, 2024) extracting its reasoning trace and response. This yields 59K triplets of a question, generated reasoning trace, and generated solution. Examples from our dataset are in §D.2. We decontaminate all samples against our evaluation questions (MATH500, GPQA Diamond, AIME24; §C.5) using 8- grams and deduplicate the data.
2.2. Final selection of 1K samples
우리는 59K 질문 풀에서 직접 학습할 수도 있었지만, 우리의 목표는 최소한의 자원으로 가장 단순한 접근법을 찾는 것이다. 따라서 우리는 데이터 원칙 세 가지, 즉 품질, 난이도, 다양성에 따라 세 단계의 필터링을 거쳐 최소 1,000개 샘플 집합에 도달한다.
품질 우리는 먼저 API 오류가 발생한 모든 질문을 제거하여 데이터셋을 54,116개 샘플로 줄인다. 다음으로, ASCII 아트 도표, 존재하지 않는 이미지 참조, 일관되지 않은 질문 번호 매기기와 같은 형식 문제가 있는 문자열 패턴을 포함하는지 확인하여 저품질 예시를 걸러내어 데이터셋을 51,581개 예시로 줄인다.
이 풀에서 우리는 고품질이라고 판단되어 추가 필터링이 필요 없다고 보는 데이터셋에서 최종 1,000개 샘플 중 384개 샘플을 식별한다(자세한 내용은 §C.4 참조).
난이도 난이도에는 두 가지 지표를 사용한다: 모델 성능과 추론 흔적 길이이다. 우리는 각 질문에 대해 두 모델, 즉 Qwen2.5- 7B- Instruct와 Qwen2.5- 32B- Instruct(Qwen et al., 2024)를 평가하며, 정답 여부는 Claude 3.5 Sonnet이 각 시도를 참조 해답과 비교하여 평가한다(채점 프로토콜은 §C.3 참조). 우리는 Qwen2.5 토크나이저를 사용하여 각 추론 흔적의 토큰 길이를 측정함으로써 문제 난이도를 나타낸다. 이는 더 어려운 문제일수록 더 많은 사고 토큰이 필요하다는 가정에 기반한다. 채점 결과에 따라, 우리는 Qwen2.5- 7B- Instruct 또는 Qwen2.5- 32B- Instruct가 올바르게 풀 수 있어 너무 쉬울 수 있는 질문을 제거한다. 두 모델을 사용함으로써 우리는 한 모델이 쉬운 질문에서 드물게 실수하여 쉬운 샘플이 우리의 필터링을 통과할 가능성을 줄인다. 이로써 우리의 총 샘플 수는 24,496개로 줄어들며, 다양성에 기반한 다음 차례의 서브샘플링을 위한 준비가 된다. 이 두 모델로 필터링하는 것은 우리가 Qwen2.5- 32B- Instruct를 미세조정할 모델로도 사용할 것이기 때문에 우리의 설정에 최적화되어 있을 수 있지만, 모델 기반 필터링이라는 아이디어는 다른 설정에도 일반화된다.
다양성 다양성을 정량화하기 위해, 우리는 미국수학회(American Mathematical Society)의 수학 주제 분류(Mathematics Subject Classification, MSC) 체계(예: 기하학, 조합론 등)를 바탕으로 Claude 3.5 Sonnet을 사용하여 질문을 도메인으로 분류한다.1 이 분류 체계는 수학의 주제들에 초점을 맞추지만 생물학, 물리학, 경제학과 같은 다른 과학 분야도 포함한다. 24,496개의 질문 풀에서 최종 예제를 선택하기 위해, 우리는 먼저 하나의 도메인을 균등하게 무작위로 선택한다. 그런 다음, "난이도" 절에서 동기 부여된 바와 같이 더 긴 추론 흔적을 선호하는 분포에 따라 이 도메인에서 문제 하나를 샘플링한다(자세한 내용은 §C.4 참조). 우리는 50개의 도메인에 걸쳐 총 1,000개의 샘플을 확보할 때까지 이 과정을 반복한다.
§5.1에서 우리는 우리의 세 가지 기준을 결합하여 사용하는 것이 중요함을 보일 것인데, 품질, 다양성, 또는 난이도 중 하나에만 의존하면 더 나쁜 데이터셋으로 이어지기 때문이다. 일부 증류된 생성물은 부정확하며, 우리는 완전히 정확한 해답보다 추론 과정을 포착하는 데 초점을 두기 때문에 우리 데이터에서 이를 허용한다. 우리의 채점기(§C.3)는 s1K에서 53.6%를 정답으로, 우리의 후속 s1K-1.1에서 63.0%를 정답으로 판정한다(§A 참조).
3. 테스트 시점 스케일링
3.1. 방법
우리는 테스트 시점 스케일링 방법을 1) 순차적(Sequential) 방식—이후의 계산이 이전의 계산에 의존하는 방식(예: 긴 추론 흔적)—과 2) 병렬적(Parallel) 방식—계산이 독립적으로 실행되는 방식(예: 다수결 투표)(Snell et al., 2024; Brown et al., 2024)—으로 분류한다. 우리는 이후의 계산이 중간 결과를 기반으로 구축될 수 있어 더 깊은 추론과 반복적 정제가 가능하다는 점에서 직관적으로 더 잘 확장되어야 한다고 믿기 때문에 순차적 스케일링에 초점을 맞춘다. 우리는 새로운 순차적 스케일링 방법과 이를 벤치마킹하는 방법을 제안한다.
예산 강제(Budget forcing) 우리는 사고 토큰의 최대 및/또는 최소 개수를 강제하는 간단한 디코딩 시점 개입을 제안한다. 구체적으로, 우리는 사고 종료 토큰 구분자와 선택적으로 "Final Answer:"를 단순히 덧붙임으로써 최대 토큰 수를 강제하여 사고 단계를 조기에 종료하고
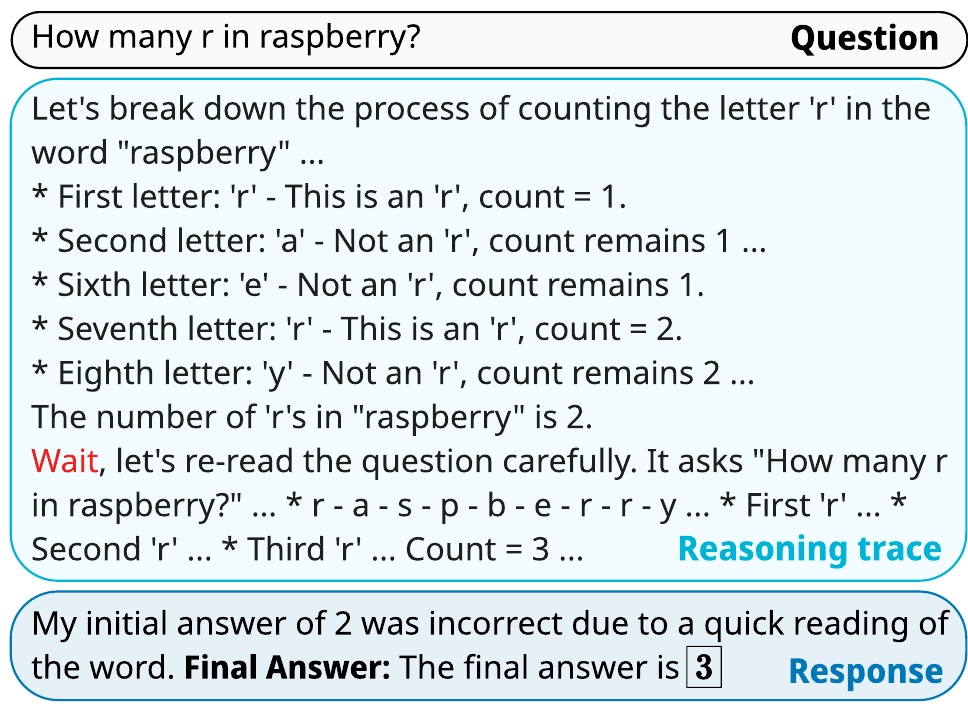
모델이 현재의 최선 답변을 제공하도록 한다. 최소값을 강제하기 위해, 우리는 사고 종료 토큰 구분자의 생성을 억제하고 선택적으로 모델의 현재 추론 흔적에 "Wait"라는 문자열을 덧붙여 모델이 현재의 생성에 대해 성찰하도록 장려한다. 그림 3은 이 간단한 접근이 어떻게 모델이 더 나은 답변에 도달하도록 이끌 수 있는지에 대한 예를 포함한다.
베이스라인 우리는 예산 강제를 다음과 비교하여 벤치마킹한다: (I) 조건부 길이 제어 방법—모델에게 프롬프트에서 얼마나 길게 생성해야 하는지 알려주는 데 의존하는 방법. 우리는 이를 세분성에 따라 (a) 토큰 조건부 제어: 프롬프트에서 사고 토큰의 상한을 지정; (b) 단계 조건부 제어: 사고 단계의 상한을 지정하며, 각 단계는 약 100 토큰; (c) 클래스 조건부 제어: 모델에게 짧은 시간 또는 긴 시간 동안 사고하도록 지시하는 두 개의 일반적인 프롬프트를 작성(자세한 내용은 §E.1 참조)—로 그룹화한다. (II) 거부 샘플링—생성이 미리 정해진 연산 예산에 맞을 때까지 샘플링하는 방법. 이 오라클은 길이에 조건화된 응답에 대한 사후 분포를 포착한다.
3.2. 지표
우리는 방법 전반에 걸쳐 테스트 시점 스케일링을 측정하기 위한 평가 지표로서 일련의 요구 사항을 설정한다. 중요한 것은, 우리가 어떤 방법이 달성할 수 있는 정확도뿐만 아니라 그 제어 가능성과 테스트 시점 스케일링 기울기에도 관심이 있다는 점이다. 우리가 고려하는 각 방법에 대해, 우리는 고정된 벤치마크(예: AIME24)에서 테스트 시점 연산을 변화시키며 일련의 평가 를 실행한다. 이는 연산을 사고 토큰으로 측정한 x축, 정확도를 y축으로 하는 조각별 선형 함수 를 생성한다(그림 1 참조. AIME24에 대한 가장 오른쪽 점은 에 해당). 우리는세 가지 지표를 측정한다:
여기서 는 미리 지정된 테스트 시점 연산의 최소 및 최대량을 가리키며, 우리의 경우 사고 토큰이다. 우리는 보통 만 제약한다. 생성된 토큰이 소비된 테스트 시점 연산의 양에 해당하므로, 이 지표는 한 방법이 해당 테스트 시점 연산의 사용에 대한 제어 가능성을 어느 정도 허용하는지를 측정한다. 우리는 이를 백분율로 보고하며, 가 완벽한 제어이다.
스케일링은 조각별 선형 함수의 평균 기울기이다. 유용한 방법의 경우 반드시 양수여야 하며, 클수록 좋다.
성능은 단순히 그 방법이 벤치마크에서 달성하는 최대 성능이다. 단조 증가하는 스케일링을 가진 방법은 극한에서 어떤 벤치마크에서든 성능을 달성한다. 그러나 우리가 조사하는 방법들은 결국 평탄해지거나, 제어 또는 컨텍스트 윈도 한계로 인해 추가 스케일링이 실패한다.
4. 결과
4.1. 설정
훈련 우리는 §D에 개요가 제시된 기본 하이퍼파라미터를 사용하여 s1K로 Qwen2.5-32B-Instruct에 대해 지도 미세 조정을 수행하여 우리의 모델 s1-32B를 얻는다. 미세 조정은 PyTorch FSDP와 함께 16개의 NVIDIA H100 GPU에서 26분이 걸렸다.
평가 우리는 해당 분야에서 널리 사용되는 세 가지 대표적인 추론 벤치마크를 선택한다: AIME24(미국, 2024)는 2024년 1월 31일부터 2월 1일까지 열린 2024년 미국 초청 수학 경시대회(AIME)에서 사용된 30개의 문제를 가지고 있다. AIME는 산술, 대수, 셈, 기하학, 정수론, 확률 및 기타 중등학교 수학 주제를 다루는 수학적 문제 해결을 시험한다. 시험에서 높은 점수를 받은 고등학생들은 미국 수학 올림피아드(USAMO)에 참가하도록 초대된다. 모든 AIME 답은 000에서 999까지(포함)의 정수이다. 일부 AIME 문제는 그림에 의존하는데, 우리는 모델이 이미지 입력을 받을 수 없기 때문에 벡터 그래픽 언어인 Asymptote를 사용하여 우리의 모델에 이를 제공한다. MATH500(Hendrycks et al., 2021)은 다양한 난이도의 경시 수학 문제 벤치마크이다. 우리는 선행 연구(Lightman et al., 2023)에서 OpenAI가 선택한 동일한 500개의 샘플에 대해 평가한다. GPQA Diamond(Rein et al., 2023)는 생물학, 화학, 물리학의 198개의 박사 수준 과학 문제로 구성된다
. 해당 도메인의 박사 학위를 가진 전문가들은 GPQA Diamond에서 만을 달성했다(OpenAI, 2024). 이 연구에서 평가의 맥락에서 "GPQA"라고 쓸 때, 우리는 항상 Diamond 하위 집합을 가리킨다. 우리는 "lm-evaluation-harness" 프레임워크(Gao et al., 2021; Biderman et al., 2024)를 기반으로 한다. 달리 명시되지 않는 한, 우리는 온도 0(그리디)으로 평가하고 정확도(pass@1과 동일)를 측정한다.
다른 모델들 우리는 s1-32B를 다음과 비교하여 벤치마킹한다: 테스트 시점 스케일링을 대중화한 폐쇄 소스 모델인 OpenAI o1 시리즈(OpenAI, 2024); 최대 o1 수준의 성능을 가진 공개 가중치 추론 모델인 DeepSeek r1 시리즈(DeepSeek-AI et al., 2025); 방법론이 공개되지 않은 32B 공개 가중치 추론 모델인 Qwen의 QwQ-32B-preview(Team, 2024); QwQ-32B-preview와 r1로부터 증류된 공개 추론 데이터를 가진 공개 모델인 Sky-T1-32B-Preview(Team, 2025)와 Bespoke-32B(Labs, 2025); 우리가 증류한 API인 Google Gemini 2.0 Flash Thinking Experimental(Google, 2024). 공식적인 평가 점수가 없으므로, 우리는 Gemini API를 사용하여 직접 벤치마킹한다. 그러나 Gemini API의 "암송 오류(recitation error)"로 인해 평가가 어렵다.2 우리는 오류가 나타나지 않는 웹 인터페이스에 30개의 AIME24 문제를 모두 수동으로 입력함으로써 이를 우회한다. 그러나 우리는 MATH500(500문제)과 GPQA Diamond(198문제)는 제외하므로, 표 1에서 이들은 N.A.이다. 우리의 모델 s1-32B는 가중치, 추론 데이터, 코드를 포함하여 완전히 공개되어 있다.
| 모델 | 예시 | AIME 2024 | MATH 500 | GPQA Diamond |
| API 전용 | ||||
| o1-preview | N.A. | 44.6 | 85.5 | 73.3 |
| o1-mini | N.A. | 70.0 | 90.0 | 60.0 |
| o1 | N.A. | 74.4 | 94.8 | 77.3 |
| Gemini 2.0 | N.A. | 60.0 | N.A. | N.A. |
| Flash Think. | ||||
| 오픈 웨이트 | ||||
| Qwen2.5-32B-Instruct | N.A. | 26.7 | 84.0 | 49.0 |
| QwQ-32B | N.A. | 50.0 | 90.6 | 54.5 |
| r1 | ≥800K | 79.8 | 97.3 | 71.5 |
| r1-distill | 800K | 72.6 | 94.3 | 62.1 |
| 오픈 웨이트 및 오픈 데이터 | ||||
| Sky-T1 | 17K | 43.3 | 82.4 | 56.8 |
| Bespoke-32B | 17K | 63.3 | 93.0 | 58.1 |
| s1 w/o BF | 1K | 50.0 | 92.6 | 56.6 |
| s1-32B | 1K | 56.7 | 93.0 | 59.6 |
| Qwen2.5-32B-Instruct | |||
| 不适用 | 26.7 | 84.0 | QwQ-32B |
| 不适用 | 50.0 | 90.6 | r1 |
| ≥800K | 79.8 | 97.3 | r1-distill |
| 800K | 72.6 | 94.3 | 开放权重与开放数据 |
| Sky-T1 | |||
| 17K | 43.3 | 82.4 | Bespoke-32B |
| 17K | 63.3 | 93.0 | s1 w/o BF |
| 1K | 50.0 | 92.6 | s1-32B |
| 1K | 56.7 | 93.0 | |
4.2. 성능
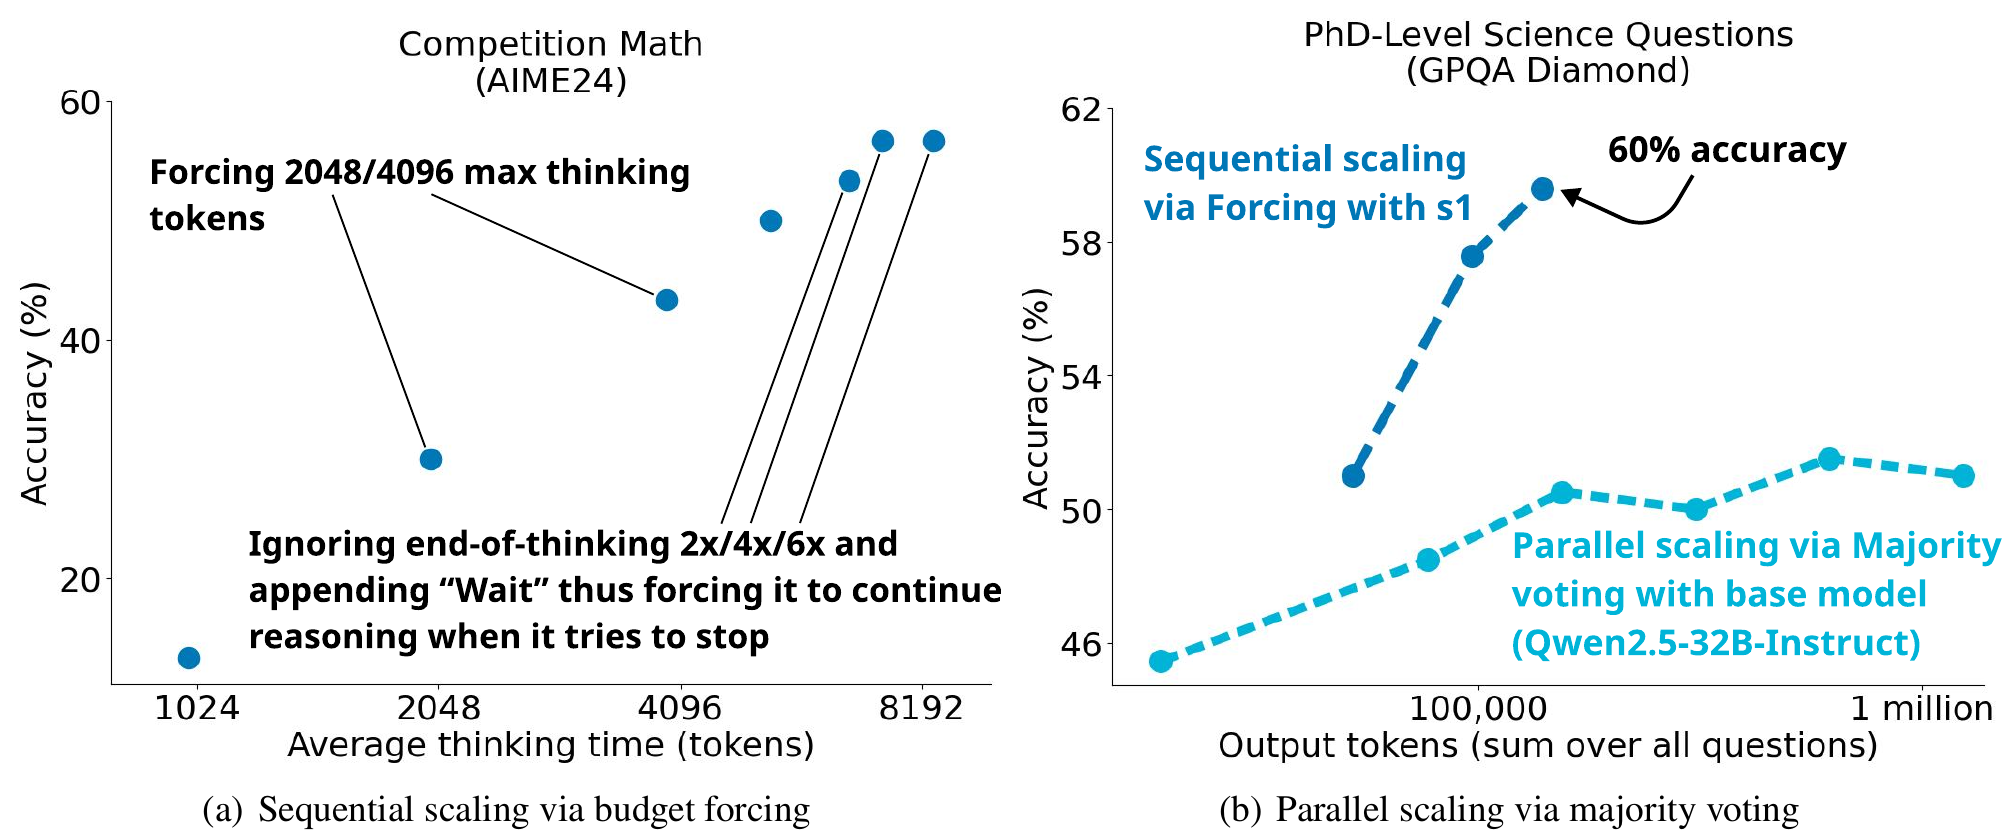
테스트 시간 스케일링 그림 1은 예산 강제(budget forcing)를 적용한 s1-32B의 성능이 더 많은 테스트 시간 컴퓨팅에 따라 확장됨을 보여줍니다. 그림 4(왼쪽)에서 우리는 그림 1(가운데)의 플롯을 확장하여, 예산 강제 기법(§3)과 더 많은 테스트 시간 컴퓨팅을 사용하여 AIME24 성능을 향상시킬 수 있지만 결국 6배에서 평탄해진다는 것을 보여줍니다. 사고 종료 토큰 구분자를 너무 자주 억제하면 모델이 계속된 추론 대신 반복적인 루프에 빠질 수 있습니다. 그림 4(오른쪽)에서 우리는 Qwen2.5-32B-Instruct를 우리의 1,000개 샘플로 학습시켜 s1-32B를 생성하고 단순한 예산 강제 기법을 적용한 후, 이것이 다른 스케일링 패러다임에서 작동함을 보여줍니다. 다수결 투표를 통해 기본 모델의 테스트 시간 컴퓨팅을 확장하는 것은 s1-32B의 성능을 따라잡을 수 없으며, 이는 순차적 스케일링이 병렬적 스케일링보다 더 효과적이라는 §3에서의 우리의 직관을 검증합니다. 우리는 그림 5에서 s1-32B의 예시 생성을 제공합니다.
샘플 효율성 그림 2(오른쪽)와 표 1에서 우리는 s1-32B를 다른 모델들과 비교합니다. 우리는 s1-32B가 가장 샘플 효율적인 오픈 데이터 추론 모델임을 발견합니다. 단지 추가로 1,000개의 샘플로 학습했음에도 불구하고 기본 모델(Qwen2.5-32B-Instruct)보다 현저히 더 나은 성능을 보입니다. 동시에 공개된 r1-32B는 또한 SFT만 사용하면서도 s1-32B보다 더 강력한 성능을 보입니다(DeepSeek-AI et al., 2025). 그러나 이것은 더 많은 추론 샘플로 학습되었습니다. 단지 1,000개의 샘플만으로 그들의 성능을 달성할 수 있는지는 미해결 질문입니다. 마지막으로, 우리의 모델은 AIME24에서 Gemini 2.0 Thinking과 거의 일치합니다. s1-32B의 데이터가 Gemini 2.0에서 증류되었으므로, 이는 우리의 증류 절차가 효과적이었음을 보여줍니다.
5. 소거 실험
5.1. 데이터 양, 다양성, 난이도
§2에서 우리는 s1K를 큐레이션하는 세 가지 핵심 원칙, 즉 품질, 난이도, 다양성을 개괄했다. 여기서는 이들을 결합하는 것의 중요성과 우리의 선택이 지닌 전반적 효용성을 검증한다. 품질만 사용(1K-random): Gemini로부터 고품질 추론 체인을 얻은 후, 난이도 및 다양성 필터링에 전혀 의존하지 않고 무작위로 1,000개의 샘플을 선택한다. 표 2는 이 접근법이 모든 벤치마크에서 s1K보다 훨씬 나쁜 성능을 보임을 보여준다. 다양성만 사용(1K-diverse): 이 데이터셋의 경우, 난이도에 대한 어떠한 개념도 무시하고 다양성을 극대화하기 위해 도메인 전반에서 균일하게 샘플링한다. 이 접근법 역시 1K-random과 유사한 열악한 성능으로 이어진다. 난이도만 사용(1K-longest): 여기서는 가장 긴 추론 흔적을 가진 1,000개의 샘플을 선택함으로써 §2에서 도입한 난이도 지표 중 하나에 의존한다. 이 접근법은 GPQA 성능을 크게 향상시키지만, 전체적으로는 여전히 s1K를 사용하는 것에 미치지 못한다. 양 최대화:
| 모델 | AIME 2024 | MATH 500 | GPQA Diamond |
| 1K-random | 36.7 | 90.6 | 52.0 |
| [-26.7%, -3.3%] | [-4.8%, 0.0%] | [-12.6%, 2.5%] | |
| 1K-diverse | 26.7 | 91.2 | 54.6 |
| [-40.0%, -10.0%] | [-4.0%, 0.2%] | [-10.1%, 5.1%] | |
| 1K-longest | 33.3 | 90.4 | 59.6 |
| [-36.7%, 0.0%] | [-5.0%, -0.2%] | [-5.1%, 10.1%] | |
| 59K-full | 53.3 | 92.8 | 58.1 |
| [-13.3%, 20.0%] | [-2.6%, 2.2%] | [-6.6%, 8.6%] | |
| s1K | 50.0 | 93.0 | 57.6 |
마지막으로, 모든 1K- 샘플 버전들의 상위 집합인 59K 샘플 전체로 훈련하는 것과 비교한다. 이는 강력한 모델로 이어지지만 훨씬 더 많은 자원을 사용한다. 59K 샘플로 파인튜닝하는 데에는 394 H100 GPU 시간이 소요된 반면, s1-32B는 7 H100 GPU 시간만 필요로 했다. 더욱이 §2에서 보여준 것처럼 s1K에만 의존하는 것은 극히 경쟁력이 있다. 종합하면, §2의 우리 방법론을 통해 세 가지 기준, 즉 품질, 난이도, 다양성을 모두 결합하는 것이 샘플 효율적인 추론 훈련에 핵심적이다.
5.2. 테스트 시점 스케일링 방법
| 방법 | 제어 | 스케일링 | 성능 | |A| |
| BF | 100% | 15 | 56.7 | 5 |
| TCC | 40% | -24 | 40.0 | 5 |
| TCC + BF | 100% | 13 | 40.0 | 5 |
| SCC | 60% | 3 | 36.7 | 5 |
| SCC + BF | 100% | 6 | 36.7 | 5 |
| CCC | 50% | 25 | 36.7 | 2 |
| RS | 100% | -35 | 40.0 | 5 |
[AIME24]
Alice와 Bob이 다음 게임을 한다. 그들 앞에 개의 토큰 더미가 놓여 있다. 플레이어들은 Alice가 먼저 시작하여 교대로 진행한다. 각 차례에 플레이어는 더미에서 1개의 토큰 또는 4개의 토큰을 제거한다. 마지막 토큰을 제거하는 사람이 이긴다. Bob이 Alice의 플레이와 무관하게 Bob이 승리할 것을 보장하는 전략이 존재하는 양의 정수 중 2024 이하인 것의 개수를 구하여라.
이 문제는 Bob이 승리 전략을 가지는 양의 정수 의 개수를 구하라고 요구한다. 이는 Sprague-Grundy 정리를 사용하거나 승리 및 패배 위치를 직접 찾음으로써 분석할 수 있는 전형적인 불편 게임이다. 를 승리 위치의 집합(차례인 플레이어가 승리를 강제할 수 있는 토큰 수 )이라 하고, 을 패배 위치의 집합이라 하자. [...]
을 "개의 토큰이 있을 때 차례인 플레이어가 승리 전략을 가진다"는 명제라 하자. 은 거짓이다(차례이면서 0개의 토큰에 직면한 플레이어는 이미 패배한 것이다). 의 작은 값들을 고려하자. : 차례인 플레이어는 1개의 토큰을 가져가서 이길 수 있다. 따라서 은 참이다. : 차례인 플레이어는 1개의 토큰을 가져가서 상대에게 1개의 토큰을 남길 수 있다. 이므로 상대가 이긴다. 따라서 는 거짓이다. : 차례인 플레이어는 1개의 토큰을 가져가서 상대에게 2개의 토큰을 남길 수 있다. 이므로 차례인 플레이어가 이긴다. 따라서 은 참이다. ...]
우리는 Bob이 승리 전략을 가지는 양의 정수 의 개수를 찾고 있다. 이는 게임이 개의 토큰으로 시작하고 Alice가 먼저 둘 때 Bob이 이길 수 있다는 것을 의미한다. 이는 이 패배 위치인 경우에만 성립한다(왜냐하면 이면 Alice의 첫 수는 반드시 Bob에게 승리 위치로 이어져야 하기 때문이다). [...]
패배 위치 에서 패턴을 찾아보자. 연속항 사이의 차이는 2,3,2,3,2,3,2,3,2, ... 차이의 패턴은 2,3이 번갈아 나타난다. [...] 패배 위치는 에 대해 또는 형태이다. 우리는 패배 위치 집합 에 속하는 양의 정수 의 개수를 찾아야 한다. [...]
경우 1: , 여기서 . 이 정수이므로 . 의 값의 개수는 404이다. 경우 2: , 여기서 . 이 정수이므로 . 의 값의 개수는 이다.
패배 위치인 양의 정수 의 총 개수는 이다.
[MATH500]
일 때 를 위로의 사영을 구하여라.
벡터 를 벡터 위로의 사영은 다음 공식으로 주어진다:
우리는 및 을 알고 있다.
먼저, 의 크기의 제곱, 즉 를 구해야 한다.
이제 값을 사영 공식에 대입할 수 있다:
벡터 를 대입하면:
스칼라를 벡터의 각 성분에 곱하면:
최종 답: 최종 답은
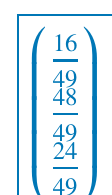
질량 인 양자역학적 입자가 극좌표 의 함수로서 다음과 같은 퍼텐셜 속에서 2차원으로 운동한다.
에너지 스펙트럼을 구하여라. 힌트: 퍼텐셜을 직교좌표로 써 보아라.
문제는 주어진 2차원 퍼텐셜 속 입자의 에너지 스펙트럼을 구하라고 요구한다. 퍼텐셜은 극좌표 로 주어져 있다:
퍼텐셜을 다음과 같이 다시 쓸 수 있다:
2차원에서 입자의 해밀토니안은 다음과 같다:
극좌표 에서 라플라시안 연산자는 다음과 같다:
따라서 극좌표에서의 해밀토니안은 다음과 같다:
시간에 무관한 슈뢰딩거 방정식은 이다. 형태의 해를 가정하여 변수를 분리해 볼 수 있다. [...]
이는 에너지 스펙트럼이 다음과 같음을 확인해 준다:
최종 답:
예산 강제(Budget forcing) 표 3에서 우리는 에서 도입한 테스트 시점 스케일링 방법들을 비교한다. 전반적으로, 우리는 예산 강제가 완벽한 제어와 좋은 스케일링을 제공하며 우리의 최고 AIME24 점수로 이어진다는 것을 발견한다. 따라서 이것이 우리가 그림 1과 에서 s1-32B에 사용하는 방법이다. 표 4에서 우리는 성능 외삽을 위한 서로 다른 문자열들을 비교한다. 우리는 "Wait"가 일반적으로 최고의 성능을 준다는 것을 발견한다.
클래스 조건부 제어(Class-conditional control) 우리는 이 방법에 대한 벤치마크 점수를 에서 제공하고 여기서 세 가지 발견을 요약한다: (1) 토큰 조건부 제어는 예산 강제 없이는 실패하는데, 우리의 모델이 그렇게 하도록 훈련되었더라도 토큰을 안정적으로 셀 수 없기 때문이다. (2) 단계 조건부 제어 하에서, 모델은 서로 다른 단계 목표가 주어졌을 때 비슷한 총 토큰 수를 생성하는데, 모델이 각 단계당 많은 토큰을 가진 적은 단계에서 각 단계당 적은 토큰을 가진 많은 단계로 이동하기 때문이다. 따라서 모델은 연산 제약을 우회하는 방법을 학습하여 이 방법의 제어 가능성이 평범해진다. (3) 클래스 조건부 제어는 작동할 수 있다 - 모델에게 단순히 더 오래 생각하라고 지시하는 것이 테스트 시점 연산과 성능을 증가시킬 수 있으며, 이는 표 3에서 좋은 스케일링으로 이어진다.
| 모델 | AIME | MATH | GPQA |
| 2024 | 500 | Diamond | |
| 외삽 없음 | 50.0 | 93.0 | 57.6 |
| 문자열 없이 2배 | 50.0 | 90.2 | 55.1 |
| “Alternatively” 2배 | 50.0 | 92.2 | 59.6 |
| “Hmm” 2배 | 50.0 | 93.0 | 59.6 |
| “Wait” 2배 | 53.3 | 93.0 | 59.6 |
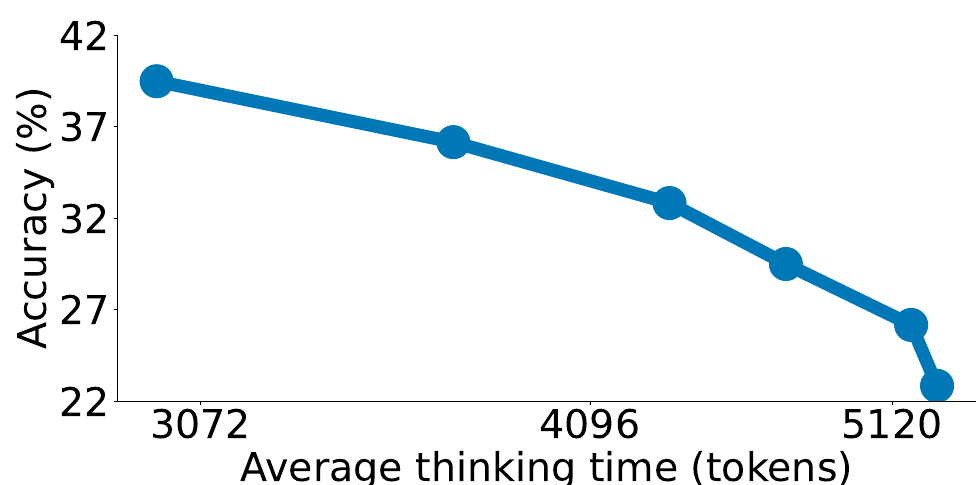
거부 샘플링(Rejection sampling) 놀랍게도, 우리는 생성이 특정 길이에 맞을 때까지 단순히 샘플링하는 것이 그림 6에 묘사된 것처럼 역 스케일링 추세로 이어진다는 것을 발견한다. 에서 우리는 거부 샘플링 시 에서는 모델이 올바르게 답했지만 토큰 설정에서는 그렇지 않은 한 질문을 조사한다. 설정에서 모델은 올바른 접근법으로 직접 도약하는 반면, 설정에서는 많이 되돌아간다. 우리는 더 짧은 생성이 모델이 처음부터 올바른 경로에 있었던 경우인 경향이 있는 반면, 더 긴 생성은 모델이 실수를 하여 되돌아가거나 스스로를 의심하는 경우인 경향이 있다는 상관관계가 있다고 가설을 세운다. 이는 거부 샘플링 시 더 긴 샘플이 종종 틀리게 되어 역 스케일링 추세로 이어진다.
6. 논의 및 관련 연구
6.1. 샘플 효율적 추론
모델 o1(OpenAI, 2024)의 성능을 복제하는 모델을 구축하려는 여러 동시대의 노력이 있다. 예를 들어, DeepSeek-r1과 k1.5(DeepSeek-AI et al., 2025; Team et al., 2025)는 강화 학습 방법으로 구축된 반면, 다른 것들은 수만 개의 증류된 예제를 사용한 SFT에 의존한다(Team, 2025; Xu et al., 2025; Labs, 2025). 우리는 단 1,000개의 예제에 대한 SFT만으로도 o1-preview와 일치하는 경쟁력 있는 추론 모델을 구축하기에 충분하며 파레토 프론티어(그림 2)에 놓이는 모델을 생성한다는 것을 보여준다. 나아가, 우리는 우리의 추론 모델과 결합된 예산 강제를 도입하여 OpenAI의 테스트 시점 스케일링 곡선을 최초로 재현하게 한다(OpenAI, 2024). 왜 단 1,000개의 샘플에 대한 지도 미세 조정이 그렇게 큰 성능 향상으로 이어지는가? 우리는 모델이 수조 개의 토큰에 걸친 사전 훈련 동안 이미 대량의 추론 데이터에 노출되었다고 가설을 세운다. 따라서 추론을 수행하는 능력은 이미 우리 모델에 존재한다. 우리의 샘플 효율적 미세 조정 단계는 단지 그것을 활성화하며, 우리는 예산 강제로 테스트 시점에서 그것을 더 확장한다. 이는 LIMA(Zhou et al., 2023)에서 제시된 "표면적 정렬 가설(Superficial Alignment Hypothesis)"과 유사한데, 저자들은 1,000개의 예제가 모델이 사용자 선호도를 따르도록 정렬하기에 충분할 수 있다는 것을 발견한다.
벤치마크 및 방법 이러한 모델들의 한계를 평가하고 밀어붙이기 위해, 올림피아드 수준의 과학 경시대회(He et al., 2024; Jain et al., 2024; Zhong et al., 2023) 및 기타(Srivastava et al., 2023; Glazer et al., 2024; Su et al., 2024; Kim et al., 2024; Phan et al., 2025)와 같이 점점 더 도전적인 벤치마크들이 도입되었다. 추론 관련 작업에서 모델의 성능을 향상시키기 위해, 연구자들은 여러 전략을 추구해 왔다: 선행 연구들은 수학 및 과학과 관련된 특수 코퍼스(Azerbayev et al., 2023; Yang et al., 2024)에서 언어 모델을 계속 훈련시키는 것을 탐구했으며, 때로는 합성으로 생성된 데이터(Yu et al., 2024)까지 사용했다. 다른 이들은 추론 성능을 특별히 겨냥한 훈련 방법론을 개발했다(Zelikman et al., 2022; 2024; Luo et al., 2025; Yuan et al., 2025; Wu et al., 2024a). 또 다른 중요한 연구 흐름은 사고 연쇄 프롬프팅(Chain-of-Thought prompting)(Wei et al., 2023; Yao et al., 2023a;b; Bi et al., 2023; Fu et al., 2023; Zhang et al., 2024b; Xiang et al., 2025; Hu et al., 2024; Diao et al., 2024)과 같은 방법을 포함하여 추론 능력을 이끌어내고 향상시키기 위한 프롬프팅 기반 방법에 초점을 맞춘다. 이러한 결합된 노력들은 언어 모델의 추론 능력을 발전시켜 더 복잡하고 추상적인 작업을 효과적으로 처리할 수 있게 하는 것을 목표로 한다.
6.2. 테스트 시점 스케일링
방법 에서 소개한 것처럼, 우리는 테스트 시점 연산을 확장하는 두 가지 방법, 즉 병렬 및 순차를 구분한다. 전자는 병렬로 생성된 여러 해결 시도에 의존하며 특정 기준을 통해 최상의 결과를 선택한다. 이러한 기준에는 다수결 투표를 위해 가장 빈번한 응답을 선택하거나 최선의 N(Best-of-N)을 위해 외부 보상에 기반한 최선의 응답을 선택하는 것이 포함된다(Brown et al., 2024; Irvine et al., 2023; Levi, 2024). 반복 샘플링과 달리, 이전의 순차 스케일링 방법들은 모델이 이전 시도에 기반하여 해결 시도를 순차적으로 생성하도록 하여, 이전 결과에 기반해 각 시도를 개선할 수 있게 한다(Snell et al., 2024; Hou et al., 2025; Lee et al., 2025). 트리 기반 탐색 방법(Gandhi et al., 2024; Wu et al., 2024b)은 순차 및 병렬 스케일링 사이의 하이브리드 접근법을 제공하는데, 예를 들어 몬테카를로 트리 탐색(MCTS)(Liu et al., 2024; Zhang et al., 2023; Zhou et al., 2024; Choi et al., 2023)과 유도 빔 탐색(Xie et al., 2023)이 있다. REBASE(Wu et al., 2024b)는 트리 탐색 동안 활용과 가지치기의 균형을 맞추기 위해 과정 보상 모델을 사용한다. 경험적으로, REBASE는 샘플링 기반 방법 및 MCTS보다 우수한 성능을 보이는 것으로 나타났다(Wu et al., 2024b). 보상 모델(Lightman et al., 2023; Wang et al., 2024b;c)은 이러한 방법들에서 핵심적인 역할을 한다. 이들은 결과 보상 모델과 과정 보상 모델의 두 가지 변형으로 나뉜다. 결과 보상 모델(Xin et al., 2024; Ankner et al., 2024)은 완전한 해결책에 점수를 부여하며 최선의 N 선택에서 특히 유용한 반면, 과정 보상 모델(Lightman et al., 2023; Wang et al., 2024b; Wu et al., 2024b)은 개별 추론 단계를 평가하며 트리 기반 탐색 방법을 안내하는 데 효과적이다.
추가 테스트 시점 스케일링의 한계 우리는 예산 강제가 에서 테스트 시점 연산을 외삽할 수 있게 함을 보여주었다. 예를 들어 AIME24 성능을 에서 로 향상시킨다. 그러나 더 확장할 때 두 가지 주요 한계가 있다: 결국 평평해지며(그림 4), 기반 언어 모델의 컨텍스트 윈도우가 이를 제약한다. 이러한 제약에도 불구하고, 우리의 연구는 광범위한 정확도 범위에 걸친 테스트 시점 스케일링을 보여주는데(그림 1), 부분적으로는 테스트 시점 연산을 축소하는 것이 예측 가능하게 작동하며 이러한 제약을 겪지 않기 때문이다.
테스트 시점 스케일링을 계속하려면 테스트 시점 연산을 더 외삽할 수 있는 접근법이 필요할 것이다. 어떻게 그러한 외삽을 얻을 수 있는가?
"Wait"뿐만 아니라 서로 다른 문자열들을 순환시키거나, 반복적 루프를 피하기 위해 빈도 패널티나 더 높은 온도와 결합하는 등 예산 강제에 대한 개선이 있을 수 있다. 미래 연구를 위한 흥미로운 방향은 강화 학습으로 훈련된 추론 모델에 예산 강제를 적용하는 것이 더 나은 외삽을 낳는지, 또는 RL이 예산 강제를 넘어서는 새로운 테스트 시점 스케일링 방식을 허용하는지 연구하는 것이다. 우리의 연구는 테스트 시점 연산을 외삽하는 데 대한 미래 연구와 진전을 가능하게 하는 올바른 지표() – 제어, 스케일링, 성능 – 를 정의한다.
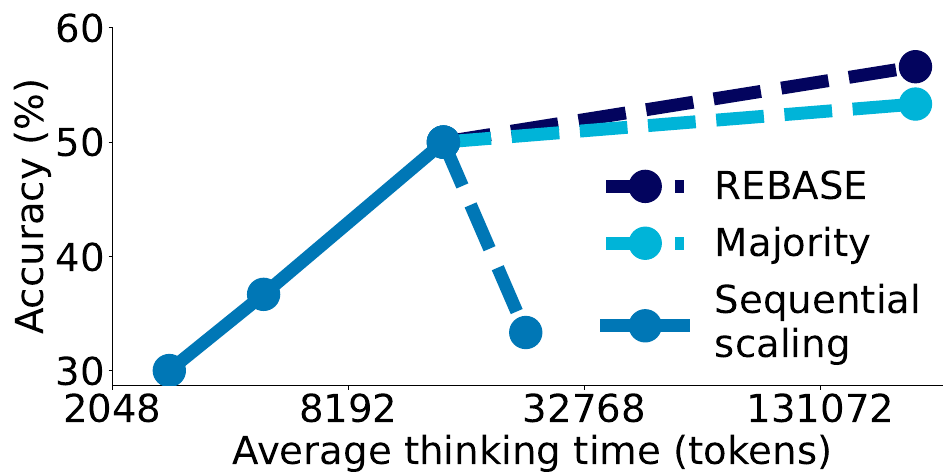
해결책으로서의 병렬 스케일링 병렬 스케일링은 순차 스케일링의 한계에 대한 하나의 해결책을 제공하므로, 우리는 순차적으로 스케일링된 우리의 모델을 두 가지 방법으로 보강한다: (I) 다수결 투표: 개의 해결책을 생성한 후, 최종 해결책은 생성들 전반에서 가장 빈번한 것이다; (II) REBASE를 통한 트리 탐색: 우리는 LLaMA-34B에서 초기화되고 합성 과정 보상 모델링 데이터셋에서 추가로 미세 조정된 REBASE 과정 보상 모델을 사용한다(Wu et al., 2024b). 그런 다음 우리는 REBASE에 의해 생성된 해결책들을 다수결 투표로 집계한다. 그림 7에 나타난 것처럼, 우리의 모델을 REBASE로 보강하는 것은 다수결 투표보다 더 잘 스케일링되며, 이 시나리오에서는 심지어 순차 스케일링보다도 그렇다. 그러나 REBASE는 각 단계에서 보상 모델을 위한 추가적인 순방향 패스를 요구하여 약간의 연산 오버헤드를 추가한다. 순차 스케일링의 경우, 최대 512 단계를 사용하도록 프롬프트되었을 때, 30개의 평가 질문 중 12개에서 모델이 컨텍스트 윈도우를 초과하는 응답을 생성하여 큰 성능 하락으로 이어진다. 전반적으로, 우리는 이러한 병렬 스케일링 방법들이 순차 스케일링을 보완하므로 고정된 컨텍스트 윈도우를 넘어 테스트 시점 연산을 더욱 확장할 수 있는 하나의 길을 제공한다는 것을 발견한다.
영향력 성명서
영향력 성명서강력한 추론 능력을 갖춘 언어 모델은 복잡한 의사결정 지원에서부터 과학적 돌파구를 이끌어내는 것에 이르기까지 인간의 생산성을 크게 향상시킬 잠재력을 지니고 있습니다. 그러나 OpenAI의 o1과 DeepSeek의 r1과 같은 최근의 추론 분야 발전은 투명성이 부족하여 광범위한 연구 진전을 제한하고 있습니다. 우리의 연구는 완전히 개방된 방식으로 추론의 최전선을 확장하여 혁신과 협력을 촉진하고 궁극적으로 사회에 이익이 되는 발전을 가속화하는 것을 목표로 합니다.
감사의 글
감사의 글우리는 Bespoke Curator(Marten et al., 2025)를 사용하여 s1.1을 위한 DeepSeek r1의 추적(trace)을 생성해 준 Ryan Marten에게 감사드립니다. 이 작업은 부분적으로 Stanford University의 재정적 지원으로 가능해진 Stanford Marlowe GPU 클러스터(Kapfer et al., 2025)를 사용하여 수행되었습니다. 우리는 Alexander M. Rush, Andrew Ilyas, Banghua Zhu, Chenglei Si, Chunting Zhou, John Yang, Ludwig Schmidt, Samy Jelassi, Suhas Kotha, Tengyu Ma, Xuechen Li, Yu Sun, 그리고 Yue Zhang에게 매우 건설적인 논의에 대해 감사드립니다.
참고문헌
Ankner, Z., Paul, M., Cui, B., Chang, J. D., and Ammanabrolu, P. Critique- out- loud reward models, 2024. URL https://arxiv.org/abs/2408.11791. Arora, D., Singh, H. G., and Mausam. Have llms advanced enough? a challenging problem solving benchmark for large language models, 2023. URL https://arxiv.org/abs/2305.15074. Azerbayev, Z., Schoelkopf, H., Paster, K., Santos, M. D., McAleer, S., Jiang, A. Q., Deng, J., Biderman, S., and Welleck, S. Llemma: An open language model for mathematics, 2023. Bi, Z., Zhang, N., Jiang, Y., Deng, S., Zheng, G., and Chen, H. When do program- of- thoughts work for reasoning?, 2023. URL https://arxiv.org/abs/2308.15452. Biderman, S., Schoelkopf, H., Sutawika, L., Gao, L., Tow, J., Abbasi, B., Aji, A. F., Ammanamanchi, P. S., Black, S., Clive, J., DiPofi, A., Etxaniz, J., Fattori, B., Forde, J. Z., Foster, C., Hsu, J., Jaiswal, M., Lee, W. Y., Li, H., Lovering, C., Muennighoff, N., Pavlick, E., Phang, J., Skowron, A., Tan, S., Tang, X., Wang, K. A., Winata, G. I., Yvon, F., and Zou, A. Lessons from the trenches on reproducible evaluation of language models, 2024. Brown, B., Juravsky, J., Ehrlich, R., Clark, R., Le, Q. V., Ré, C., and Mirhoseini, A. Large language monkeys: Scaling inference compute with repeated sampling, 2024. URL https://arxiv.org/abs/2407.21787.
Cesisita, F. L. Multimodal structured generation: Cvpr's 2nd mmfm challenge technical report, 2024. URL https://arxiv.org/abs/2406.11403. Chen, W., Yin, M., Ku, M., Lu, P., Wan, Y., Ma, X., Xu, J., Wang, X., and Xia, T. Theoremaqa: A theorem- driven question answering dataset, 2023. URL https://arxiv.org/abs/2305.12524. Choi, S., Fang, T., Wang, Z., and Song, Y. Kcts: Knowledge- constrained tree search decoding with token- level hallucination detection, 2023. URL https://arxiv.org/abs/2310.09044. DeepSeek- AI, Guo, D., Yang, D., Zhang, H., Song, J., Zhang, R., Xu, R., Zhu, Q., Ma, S., Wang, P., Bi, X., Zhang, X., Yu, X., Wu, Y., Wu, Z. F., Gou, Z., Shao, Z., Li, Z., Gao, Z., Liu, A., Xue, B., Wang, B., Wu, B., Feng, B., Lu, C., Zhao, C., Deng, C., Zhang, C., Ruan, C., Dai, D., Chen, D., Ji, D., Li, E., Lin, F., Dai, F., Luo, F., Hao, G., Chen, G., Li, G., Zhang, H., Bao, H., Xu, H., Wang, H., Ding, H., Xin, H., Gao, H., Qu, H., Li, H., Guo, J., Li, J., Wang, J., Chen, J., Yuan, J., Qiu, J., Li, J., Cai, J. L., Ni, J., Liang, J., Chen, J., Dong, K., Hu, K., Gao, K., Guan, K., Huang, K., Yu, K., Wang, L., Zhang, L., Zhao, L., Wang, L., Zhang, L., Xu, L., Xia, L., Zhang, M., Zhang, M., Tang, M., Li, M., Wang, M., Li, M., Tian, N., Huang, P., Zhang, P., Wang, Q., Chen, Q., Du, Q., Ge, R., Zhang, R., Pan, R., Wang, R., Chen, R. J., Jin, R. L., Chen, R., Lu, S., Zhou, S., Chen, S., Ye, S., Wang, S., Yu, S., Zhou, S., Pan, S., Li, S. S., Zhou, S., Wu, S., Ye, S., Yun, T., Pei, T., Sun, T., Wang, T., Zeng, W., Zhao, W., Liu, W., Liang, W., Gao, W., Yu, W., Zhang, W., Xiao, W. L., An, W., Liu, X., Wang, X., Chen, X., Nie, X., Cheng, X., Liu, X., Xie, X., Liu, X., Yang, X., Li, X., Su, X., Lin, X., Li, X. Q., Jin, X., Shen, X., Chen, X., Sun, X., Wang, X., Song, X., Zhou, X., Wang, X., Shan, X., Li, Y. K., Wang, Y. Q., Wei, Y. X., Zhang, Y., Xu, Y., Li, Y., Zhao, Y., Sun, Y., Wang, Y., Yu, Y., Zhang, Y., Shi, Y., Xiong, Y., He, Y., Piao, Y., Wang, Y., Tan, Y., Ma, Y., Liu, Y., Guo, Y., Ou, Y., Wang, Y., Gong, Y., Zou, Y., He, Y., Xiong, Y., Luo, Y., You, Y., Liu, Y., Zhou, Y., Zhu, Y. X., Xu, Y., Huang, Y., Li, Y., Zheng, Y., Zhu, Y., Ma, Y., Tang, Y., Zha, Y., Yan, Y., Ren, Z. Z., Ren, Z., Sha, Z., Fu, Z., Xu, Z., Xie, Z., Zhang, Z., Hao, Z., Ma, Z., Yan, Z., Wu, Z., Gu, Z., Zhu, Z., Liu, Z., Li, Z., Xie, Z., Song, Z., Pan, Z., Huang, Z., Xu, Z., Zhang, Z., and Zhang, Z. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning, 2025. URL https://arxiv.org/abs/2501.12948. Diao, S., Wang, P., Lin, Y., Pan, R., Liu, X., and Zhang, T. Active prompting with chain- of- thought for large lan guage models, 2024. URL https://arxiv.org/abs/2302.12246.
Dubey, A., Jauhri, A., Pandey, A., Kadian, A., Al- Dahle, A., Letman, A., Mathur, A., Schelten, A., Yang, A., Fan, A., Goyal, A., Hartshorn, A., Yang, A., Mitra, A., Sravankumar, A., Korenev, A., Hinsvark, A., Rao, A., Zhang, A., Rodriguez, A., Gregerson, A., et al. The llama 3 herd of models, 2024. URL https://arxiv.org/abs/2407.21783.
Fu, Y., Peng, H., Sabharwal, A., Clark, P., and Khot, T. Complexity- based prompting for multi- step reasoning, 2023. URL https://arxiv.org/abs/2210.00720.
Gandhi, K., Lee, D., Grand, G., Liu, M., Cheng, W., Sharma, A., and Goodman, N. D. Stream of search (sos): Learning to search in language, 2024. URL https://arxiv.org/abs/2404.03683.
Gao, B., Song, F., Yang, Z., Cai, Z., Miao, Y., Dong, Q., Li, L., Ma, C., Chen, L., Xu, R., Tang, Z., Wang, B., Zan, D., Quan, S., Zhang, G., Sha, L., Zhang, Y., Ren, X., Liu, T., and Chang, B. Omni- math: A universal olympiad level mathematic benchmark for large language models, 2024a. URL https://arxiv.org/abs/2410.07985.
Gao, L., Tow, J., Biderman, S., Black, S., DiPofi, A., Foster, C., Golding, L., Hsu, J., McDonell, K., Muennighoff, N., Phang, J., Reynolds, L., Tang, E., Thite, A., Wang, B., Wang, K., and Zou, A. A framework for few- shot language model evaluation, September 2021. URL https://doi.org/10.5281/zenodo.5371628.
Gao, Z., Niu, B., He, X., Xu, H., Liu, H., Liu, A., Hu, X., and Wen, L. Interpretable contrastive monte carlo tree search reasoning, 2024b. URL https://arxiv.org/abs/2410.01707.
Glazer, E., Erdil, E., Besiroglu, T., Chicharro, D., Chen, E., Gunning, A., Olsson, C. F., Denain, J.- S., Ho, A., de Oliveira Santos, E., Järviniemi, O., Barnett, M., Sandler, R., Vrzala, M., Sevilla, J., Ren, Q., Pratt, E., Levine, L., Barkley, G., Stewart, N., Grechuk, B., Grechuk, T., Enugandla, S. V., and Wildon, M. Frontiermath: A benchmark for evaluating advanced mathematical reasoning in ai, 2024. URL https://arxiv.org/abs/2411.04872.
Google. Gemini 2.0 flash thinking mode (gemini- 2.0- flash- thinking- exp- 1219), December 2024. URL https://cloud.google.com/vertex- ai/generative- ai/docs/thinking- mode.
Groeneveld, D., Beltagy, I., Walsh, P., Bhagia, A., Kinney, R., Tafjord, O., Jha, A. H., Ivison, H., Magnusson, I.,
Wang, Y., Arora, S., Atkinson, D., Authur, R., Chandu, K. R., Cohan, A., Dumas, J., Elazar, Y., Gu, Y., Hessel, J., Khot, T., Merrill, W., Morrison, J., Muennighoff, N., Naik, A., Nam, C., Peters, M. E., Pyatkin, V., Ravichander, A., Schwenk, D., Shah, S., Smith, W., Strubell, E., Subramani, N., Wortsman, M., Dasigi, P., Lambert, N., Richardson, K., Zettlemoyer, L., Dodge, J., Lo, K., Soldaini, L., Smith, N. A., and Hajishirzi, H. Olmo: Accelerating the science of language models, 2024.
He, C., Luo, R., Bai, Y., Hu, S., Thai, Z. L., Shen, J., Hu, J., Han, X., Huang, Y., Zhang, Y., Liu, J., Qi, L., Liu, Z., and Sun, M. Olympiadbench: A challenging benchmark for promoting agi with olympiad- level bilingual multimodal scientific problems, 2024. URL https://arxiv.org/abs/2402.14008.
Hendrycks, D., Burns, C., Kadavath, S., Arora, A., Basart, S., Tang, E., Song, D., and Steinhardt, J. Measuring mathematical problem solving with the math dataset, 2021. URL https://arxiv.org/abs/2103.03874.
Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., Rutherford, E., de Las Casas, D., Hendricks, L. A., Welbl, J., Clark, A., Hennigan, T., Noland, E., Millican, K., van den Driessche, G., Damoc, B., Guy, A., Osindero, S., Simonyan, K., Elsen, E., Rae, J. W., Vinyals, O., and Sifre, L. 연산 최적 대규모 언어 모델 훈련, 2022. URL https://arxiv.org/abs/2203.15556.
Hou, Z., Lv, X., Lu, R., Zhang, J., Li, Y., Yao, Z., Li, J., Tang, J., and Dong, Y. 강화 학습과 추론 스케일링을 통한 언어 모델 추론 발전, 2025. URL https://arxiv.org/abs/2501.11651.
Hu, Y., Shi, W., Fu, X., Roth, D., Ostendorf, M., Zettlemoyer, L., Smith, N. A., and Krishna, R. 시각적 스케치패드: 멀티모달 언어 모델을 위한 시각적 사고 연쇄로서의 스케치, 2024. URL https://arxiv.org/abs/2406.09403.
Huang, Z., Wang, Z., Xia, S., Li, X., Zou, H., Xu, R., Fan, R.-Z., Ye, L., Chern, E., Ye, Y., Zhang, Y., Yang, Y., Wu, T., Wang, B., Sun, S., Xiao, Y., Li, Y., Zhou, F., Chern, S., Qin, Y., Ma, Y., Su, J., Liu, Y., Zheng, Y., Zhang, S., Lin, D., Qiao, Y., and Liu, P. Olympicarena: Benchmarking multi-discipline cognitive reasoning for superintelligent ai, 2024a. URL https://arxiv.org/abs/2406.12753.
Huang, Z., Zou, H., Li, X., Liu, Y., Zheng, Y., Chern, E., Xia, S., Qin, Y., Yuan, W., and Liu, P. O1 replication journey - part 2: Surpassing o1-preview through simple distillation, big progress or bitter lesson?, 2024b. URL https://arxiv.org/abs/2411.16489.
Huang, Z., Geng, G., Hua, S., Huang, Z., Zou, H., Zhang, S., Liu, P., and Zhang, X. O1 replication journey - part 3: Inference-time scaling for medical reasoning, 2025. URL https://arxiv.org/abs/2501.06458.
Irvine, R., Boubert, D., Raina, V., Liusie, A., Zhu, Z., Mudupalli, V., Korshuk, A., Liu, Z., Cremer, F., Assassi, V., Beauchamp, C.-C., Lu, X., Rialan, T., and Beauchamp, W. Rewarding chatbots for real-world engagement with millions of users, 2023. URL https://arxiv.org/abs/2303.06135.
Jain, N., Han, K., Gu, A., Li, W.-D., Yan, F., Zhang, T., Wang, S., Solar-Lezama, A., Sen, K., and Stoica, I. Livecodebench: Holistic and contamination free evaluation of large language models for code, 2024. URL https://arxiv.org/abs/2403.07974.
Kapfer, C., Stine, K., Narasimhan, B., Mentzel, C., and Candes, E. Marlowe: Stanford's gpu-based computational instrument, January 2025. URL https://doi.org/10.5281/zenodo.14751899.
Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., Chess, B., Child, R., Gray, S., Radford, A., Wu, J., and Amodei, D. Scaling laws for neural language models, 2020. URL https://arxiv.org/abs/2001.08361.
Kim, E., Suk, J., Kim, S., Muennighoff, N., Kim, D., and Oh, A. Llm-as-an-interviewer: Beyond static testing through dynamic llm evaluation, 2024. URL https://arxiv.org/abs/2412.10424.
Kwon, W., Li, Z., Zhuang, S., Sheng, Y., Zheng, L., Yu, C. H., Gonzalez, J. E., Zhang, H., and Stoica, I. Efficient memory management for large language model serving with pagedattention, 2023. URL https://arxiv.org/abs/2309.06180.
Labs, B. Bespoke-stratos: The unreasonable effectiveness of reasoning distillation, 2025. URL https://hf.co/bespokelabs/Bespoke-Stratos-32B. Accessed: 2025-01-22.
Lee, K.-H., Fischer, I., Wu, Y.-H., Marwood, D., Baluja, S., Schuurmans, D., and Chen, X. Evolving deeper llm thinking, 2025. URL https://arxiv.org/abs/2501.09891.
Levi, N. A simple model of inference scaling laws, 2024. URL https://arxiv.org/abs/2410.16377.
LI, J., Beeching, E., Tunstall, L., Lipkin, B., Soletskyi, R., Huang, S. C., Rasul, K., Yu, L., Jiang, A., Shen, Z., Qin, Z., Dong, B., Zhou, L., Fleureau, Y., Lample, G., and Polu, S. Numinnamath, 2024. URL https://github.com/project-numina/aimo-progress-prize/blob/main/report/ numina_dataset.pdf.
Lightman, H., Kosaraju, V., Burda, Y., Edwards, H., Baker, B., Lee, T., Leike, J., Schulman, J., Sutskever, I., and Cobbe, K. Let's verify step by step, 2023. URL https://arxiv.org/abs/2305.20050.
Ling, W., Yogatama, D., Dyer, C., and Blunsom, P. Program induction by rationale generation: Learning to solve and explain algebraic word problems, 2017. URL https://arxiv.org/abs/1705.04146.
Liu, J., Cui, L., Liu, H., Huang, D., Wang, Y., and Zhang, Y. Logiqa: A challenge dataset for machine reading comprehension with logical reasoning, 2020. URL https://arxiv.org/abs/2007.08124.
Liu, J., Cohen, A., Pasunuru, R., Choi, Y., Hajishirzi, H., and Celikyilmaz, A. Don't throw away your value model! generating more preferable text with value-guided monte-carlo tree search decoding, 2024. URL https://arxiv.org/abs/2309.15028.
Loshchilov, I. and Hutter, F. Decoupled weight decay regularization, 2019.
Luo, H., Sun, Q., Xu, C., Zhao, P., Lou, J., Tao, C., Geng, X., Lin, Q., Chen, S., Tang, Y., and Zhang, D. Wizardmath: Empowering mathematical reasoning for large language models via reinforced evol-instruct, 2025. URL https://arxiv.org/abs/2308.09583.
Marten, R., Vu, T., Ji, C. C.-J., Sharma, K., Pimpalgaonkar, S., Dimakis, A., and Sathiamoorthy, M. Curator: A tool for synthetic data creation. https://github.com/bespokelabsai/curator, January 2025.
Muennighoff, N., Soldaini, L., Groeneveld, D., Lo, K., Morrison, J., Min, S., Shi, W., Walsh, P., Tafjord, O., Lambert, N., Gu, Y., Arora, S., Bhagia, A., Schwenk, D., Wadden, D., Wettig, A., Hui, B., Dettmers, T., Kiela, D., Farhadi, A., Smith, N. A., Koh, P. W., Singh, A., and Hajishirzi, H. Olmoe: Open mixture-of-experts language models, 2024. URL https://arxiv.org/abs/2409.02060.
of America, M. A. Aime, February 2024. URL https://artofproblemsolving.com/wiki/index.php/AIME_Problems_and_Solutions/.
OpenAI. Learning to reason with llms, September 2024. URL https://openai.com/index/learning-to-reason-with-llms/.
OpenAI. Openai o3-mini, 2025. URL https://openai.com/index/openai-o3-mini/. Accessed: 2025-02-24.
Phan, L., Gatti, A., Han, Z., Li, N., Hu, J., Zhang, H., Shi, S., Choi, M., Agrawal, A., Chopra, A., et al. Humanity's last exam, 2025. URL https://arxiv.org/abs/2501.14249.
Qin, Y., Li, X., Zou, H., Liu, Y., Xia, S., Huang, Z., Ye, Y., Yuan, W., Liu, H., Li, Y., and Liu, P. O1 replication journey: A strategic progress report - part 1, 2024. URL https://arxiv.org/abs/2410.18982.
Qwen, : Yang, A., Yang, B., Zhang, B., Hui, B., Zheng, B., Yu, B., Li, C., Liu, D., Huang, F., Wei, H., Lin, H., Yang, J., Tu, J., Zhang, J., Yang, J., Yang, J., Zhou, J., Lin, J., Dang, K., Lu, K., Bao, K., Yang, K., Yu, L., Li, M., Xue, M., Zhang, P., Zhu, Q., Men, R., Lin, R., Li, T., Xia, T., Ren, X., Ren, X., Fan, Y., Su, Y., Zhang, Y., Wan, Y., Liu, Y., Cui, Z., Zhang, Z., and Qiu, Z. Qwen2.5 technical report, 2024. URL https://arxiv.org/abs/2412.15115.
Rein, D., Hou, B. L., Stickland, A. C., Petty, J., Pang, R. Y., Dirani, J., Michael, J., and Bowman, S. Gpqa: 대학원 수준의 google-proof 질의응답 벤치마크, 2023. URL https://arxiv.org/abs/2311.12022.
Shi, Q., Tang, M., Narasimhan, K., and Yao, S. 언어 모델이 올림피아드 프로그래밍을 해결할 수 있는가?, 2024. URL https://arxiv.org/abs/2404.10952.
Snell, C., Lee, J., Xu, K., and Kumar, A. LLM 테스트 시점 컴퓨팅을 최적으로 확장하는 것이 모델 파라미터를 확장하는 것보다 더 효과적일 수 있다, 2024. URL https://arxiv.org/abs/2408.03314.
Srivastava, A., Rastogi, A., Rao, A., Shoeb, A. A. M., Abid, A., Fisch, A., Brown, A. R., Santoro, A., Gupta, A., Garriga-Alonso, A., et al. 모방 게임을 넘어서: 언어 모델의 능력을 정량화하고 외삽하기, 2023.
Su, H., Yen, H., Xia, M., Shi, W., Muennighoff, N., yu Wang, H., Liu, H., Shi, Q., Siegel, Z. S., Tang, M., Sun, R., Yoon, J., Arik, S. O., Chen, D., and Yu, T. Bright: 추론 집약적 검색을 위한 현실적이고 도전적인 벤치마크, 2024. URL https://arxiv.org/abs/2407.12883.
Sun, L., Han, Y., Zhao, Z., Ma, D., Shen, Z., Chen, B., Chen, L., and Yu, K. Scieval: A multi- level large language model evaluation benchmark for scientific research, 2024. URL https://arxiv.org/abs/2308.13149.
Team, K., Du, A., Gao, B., Xing, B., Jiang, C., Chen, C., Li, C., Xiao, C., Du, C., Liao, C., Tang, C., Wang, C., Zhang, D., Yuan, E., Lu, E., Tang, F., Sung, F., Wei, G., Lai, G., Guo, H., Zhu, H., Ding, H., Hu, H., Yang, H., Zhang, H., Yao, H., Zhao, H., Lu, H., Li, H., Yu, H., Gao, H., Zheng, H., Yuan, H., Chen, J., Guo, J., Su, J., Wang, J., Zhao, J., Zhang, J., Liu, J., Yan, J., Wu, J., Shi, L., Ye, L., Yu, L., Dong, M., Zhang, N., Ma, N., Pan, Q., Gong, Q., Liu, S., Ma, S., Wei, S., Cao, S., Huang, S., Jiang, T., Gao, W., Xiong, W., He, W., Huang, W., Wu, W., He, W., Wei, X., Jia, X., Wu, X., Xu, X., Zu, X., Zhou, X., Pan, X., Charles, Y., Li, Y., Hu, Y., Liu, Y., Chen, Y., Wang, Y., Liu, Y., Qin, Y., Liu, Y., Yang, Y., Bao, Y., Du, Y., Wu, Y., Wang, Y., Zhou, Z., Wang, Z., Li, Z., Zhu, Z., Zhang, Z., Wang, Z., Yang, Z., Huang, Z., Huang, Z., Xu, Z., and Yang, Z. Kimi k1.5: Scaling reinforcement learning with llms, 2025. URL https://arxiv.org/abs/2501.12599.
Team, N. Sky- tl: Fully open- source reasoning model with o1- preview performance in 450\(budget, 2025. URL https://novasky- ai.github.io/posts/sky- tl. Accessed: 2025- 01- 09.
Team, Q. Qwq: Reflect deeply on the boundaries of the unknown, November 2024. URL https://qwenlm.github.io/blog/qwq- 32b- preview/.
Wang, J., Meng, F., Liang, Y., and Zhou, J. Drt- o1: Optimized deep reasoning translation via long chain- of- thought, 2024a. URL https://arxiv.org/abs/2412.17498.
Wang, P., Li, L., Shao, Z., Xu, R. X., Dai, D., Li, Y., Chen, D., Wu, Y., and Sui, Z. Math- shepherd: Verify and reinforce llms step- by- step without human annotations, 2024b. URL https://arxiv.org/abs/2312.08935.
Wang, S., Liu, Z., Zhong, W., Zhou, M., Wei, Z., Chen, Z., and Duan, N. From Isat: The progress and challenges of complex reasoning, 2021. URL https://arxiv.org/abs/2108.00648.
Wang, Z., Dong, Y., Delalleau, O., Zeng, J., Shen, G., Egert, D., Zhang, J. J., Sreedhar, M. N., and Kuchaiev, O. Help- steer2: Open- source dataset for training top- performing reward models, 2024c. URL https://arxiv.org/abs/2406.08673.
Wei, J., Wang, X., Schuurmans, D., Bosma, M., Ichter, B., Xia, F., Chi, E., Le, Q., and Zhou, D. Chain- of- thought prompting elicits reasoning in large language models, 2023. URL https://arxiv.org/abs/2201.11903.
Welleck, S., Bertsch, A., Finlayson, M., Schoelkopf, H., Xie, A., Neubig, G., Kulikov, I., and Harchaoui, Z. From decoding to meta- generation: Inference- time algorithms for large language models, 2024. URL https://arxiv.org/abs/2406.16838.
Wu, T., Lan, J., Yuan, W., Jiao, J., Weston, J., and Sukhbaatar, S. Thinking llms: General instruction following with thought generation, 2024a. URL https://arxiv.org/abs/2410.10630. Wu, Y., Sun, Z., Li, S., Welleck, S., and Yang, Y. Inference scaling laws: An empirical analysis of compute- optimal inference for problem- solving with language models, 2024b. URL https://arxiv.org/abs/2408.00724. Xiang, V., Snell, C., Gandhi, K., Albalak, A., Singh, A., Blagden, C., Phung, D., Rafailov, R., Lile, N., Mahan, D., Castricato, L., Franken, J.- P., Haber, N., and Finn, C. Towards system 2 reasoning in llms: Learning how to think with meta chain- of- thought, 2025. URL https://arxiv.org/abs/2501.04682. Xie, Y., Kawaguchi, K., Zhao, Y., Zhao, X., Kan, M.- Y., He, J., and Xie, Q. Self- evaluation guided beam search for reasoning, 2023. URL https://arxiv.org/abs/2305.00633. Xin, H., Guo, D., Shao, Z., Ren, Z., Zhu, Q., Liu, B., Ruan, C., Li, W., and Liang, X. Deepseek- prover: Advancing theorem proving in llms through large- scale synthetic data, 2024. URL https://arxiv.org/abs/2405.14333. Xu, H., Wu, X., Wang, W., Li, Z., Zheng, D., Chen, B., Hu, Y., Kang, S., Ji, J., Zhang, Y., Guo, Z., Yang, Y., Zhang, M., and Zhang, D. Redstar: Does scaling long- cot data unlock better slow- reasoning systems?, 2025. URL https://arxiv.org/abs/2501.11284. Yang, Z., Band, N., Li, S., Candès, E., and Hashimoto, T. Synthetic continued pretraining, 2024. URL https://arxiv.org/abs/2409.07431. Yao, S., Yu, D., Zhao, J., Shafran, I., Griffiths, T. L., Cao, Y., and Narasimhan, K. Tree of thoughts: Deliberate problem solving with large language models, 2023a. URL https://arxiv.org/abs/2305.10601. Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., and Cao, Y. React: Synergizing reasoning and acting in language models, 2023b. URL https://arxiv.org/abs/2210.03629. Ye, Y., Huang, Z., Xiao, Y., Chern, E., Xia, S., and Liu, P. Limo: Less is more for reasoning, 2025a. URL https://arxiv.org/abs/2502.03387. Ye, Y., Xiao, Y., Mi, T., and Liu, P. Aime- preview: A rigorous and immediate evaluation framework for advanced mathematical reasoning. https://github.com/GAIR- NLP/AIME- Preview, 2025b. GitHub repository.
Yu, L., Jiang, W., Shi, H., Yu, J., Liu, Z., Zhang, Y., Kwok, J. T., Li, Z., Weller, A., and Liu, W. Metamath: Bootstrap your own mathematical questions for large language models, 2024. URL https://arxiv.org/abs/2309.12284. Yuan, S., Chen, Z., Xi, Z., Ye, J., Du, Z., and Chen, J. Agent-r: Training language model agents to reflect via iterative self-training, 2025. URL https://arxiv.org/abs/2501.11425. Zelikman, E., Wu, Y., Mu, J., and Goodman, N. D. Star: Bootstrapping reasoning with reasoning, 2022. URL https://arxiv.org/abs/2203.14465. Zelikman, E., Harik, G., Shao, Y., Jayasiri, V., Haber, N., and Goodman, N. D. Quiet-star: Language models can teach themselves to think before speaking, 2024. URL https://arxiv.org/abs/2403.09629. Zhang, H. and Chen, C. Test-time compute scaling laws, 2024. URL https://github.com/hughbzhang/ol_inference_scaling_laws. Zhang, S., Chen, Z., Shen, Y., Ding, M., Tenenbaum, J. B., and Gan, C. Planning with large language models for code generation, 2023. URL https://arxiv.org/abs/2303.05510. Zhang, Y., Wu, S., Yang, Y., Shu, J., Xiao, J., Kong, C., and Sang, J. ol-coder: an ol replication for coding, 2024a. URL https://arxiv.org/abs/2412.00154. Zhang, Y., Yang, J., Yuan, Y., and Yao, A. C.-C. Cumulative reasoning with large language models, 2024b. URL https://arxiv.org/abs/2308.04371. Zhong, H., Xiao, C., Tu, C., Zhang, T., Liu, Z., and Sun, M. Jec-qa: A legal-domain question answering dataset, 2019. URL https://arxiv.org/abs/1911.12011. Zhong, W., Cui, R., Guo, Y., Liang, Y., Lu, S., Wang, Y., Saied, A., Chen, W., and Duan, N. Agieval: A human-centric benchmark for evaluating foundation models, 2023. URL https://arxiv.org/abs/2304.06364. Zhou, A., Yan, K., Shlapentokh-Rothman, M., Wang, H., and Wang, Y.-X. Language agent tree search unifies reasoning acting and planning in language models, 2024. URL https://arxiv.org/abs/2310.04406. Zhou, C., Liu, P., Xu, P., Iyer, S., Sun, J., Mao, Y., Ma, X., Efrat, A., Yu, P., Yu, L., Zhang, S., Ghosh, G., Lewis, M., Zettlemoyer, L., and Levy, O. Lima: Less is more for alignment, 2023. URL https://arxiv.org/abs/2305.11206.
목차
1 서론 1
2 s1K를 만들기 위한 추론 데이터 큐레이션 2
2.1 59K 샘플의 초기 수집 2
2.2 1K 샘플의 최종 선택 2
3 테스트 시점 확장 3
3.1 방법 3
3.2 지표 4
4 결과 4
4.1 설정 4
4.2 성능 6
5 절제 실험 6
5.1 데이터 양, 다양성, 난이도 6
5.2 테스트 시점 확장 방법 6
6 논의 및 관련 연구 8
6.1 샘플 효율적 추론 8
6.2 테스트 시점 확장 9
A s1.1 16
B 평가 결정성 16
C s1K 세부 사항 17
C.1 s1K 요약 17
C.2 전체 59K 질문에 대한 데이터셋 구성 17
C.3 s1K 채점 프롬프트 19
C.4 s1K 다양성 선택 19
C.5 오염 제거 19
D 학습 세부 사항 21
D.1 학습 절제 실험: 시퀀스 길이 21
D.2 학습 샘플 21
E 테스트 시점 확장 세부 사항 35
E.1 순차적 확장 절제 실험 35
E.2 거부 샘플링 절제 실험 예시 37
F 버전 관리 46
A. s1.1
A. s1.1s1을 출시한 지 7일 후, 우리는 s1.1을 출시했다. 우리는 DeepSeek r1(DeepSeek-AI et al., 2025)을 사용하여 s1K의 1,000개 샘플에 대한 트레이스를 재생성하여 s1K-1.1을 만들었다. 우리는 동일한 학습 절차를 사용하여 모델 s1.1을 학습시킨다. 출시 이후의 다른 업데이트로는 o3(OpenAI, 2025), LIMO(Ye et al., 2025a), AIME 2025의 출시가 있다. 우리는 이러한 모든 새로운 발전을 표 5에서 고려한다. 우리는 s1.1이 s1보다 상당히 더 나은 성능을 보인다는 것을 발견했다. 우리는 또한 Claude 3.7로부터 증류를 시도했으나, 이는 r1으로부터의 증류보다 더 나쁜 성능을 초래했다(보고되지 않음).
| 모델 | 예시 | MATH500 | GPQA | AIME 2024 | AIME 2025 |
| API 전용 | |||||
| o3-mini-low | N/A | 95.8 | 70.6 | 56.3 | 42.1 |
| o3-mini-medium | N/A | 97.3 | 76.8 | 75.8 | 70.4 |
| o3-mini-high | N/A | 97.9 | 79.7 | 83.8 | 80.9 |
| 오픈 가중치 | |||||
| QwQ-32B | N.A. | 90.6 | 54.5 | 46.7 | 32.7 |
| r1 | ≥800K | 07.3 | 71.5 | 79.8 | 70.0 |
| r1-distill-Llama-70B | 800K | 94.5 | 65.2 | 57.1 | 56.3 |
| r1-distill-Qwen-14B | 800K | 93.9 | 59.1 | 61.7 | 48.0 |
| r1-distill-Qwen-32B | 800K | 94.3 | 62.1 | 58.3 | 49.6 |
| 오픈 가중치 및 오픈 데이터 | |||||
| LIMO | 817 | 94.8 | 66.7 | 56.3 | 44.6 |
| s1 w/o BF | 1K | 92.6 | 56.6 | 50.0 | 26.7 |
| 예산 강제 "대기" 1회를 적용한 s1 | 1K | 92.8 | 59.6 | 53.3 | 30.0 |
| 예산 강제 "대기" 2회를 적용한 s1 | 1K | 93.0 | 59.6 | 53.3 | 33.3 |
| 예산 강제 "대기" 4회를 적용한 s1 | 1K | 92.2 | 58.6 | 56.7 | 36.7 |
| BF 없는 s1.1 | 1K | 94.4 | 60.6 | 56.7 | 50.0 |
| 예산 강제 "대기" 1회를 적용한 s1.1 | 1K | 95.4 | 62.6 | 56.7 | 50.0 |
| 예산 강제 "대기" 2회를 적용한 s1.1 | 1K | 95.4 | 63.6 | 56.7 | 50.0 |
B. 평가 결정성
우리는 대안들보다 빠르기 때문에 vLLM(Kwon et al., 2023)을 사용하여 평가를 실행한다. 그러나 동일한 랜덤 시드와 그리디 샘플링을 사용하더라도 평가 점수가 실행 간에 상당히 달라질 수 있음을 발견했다:
서로 다른 배치 크기가 서로 다른 결과를 초래함 https://github.com/vllm- project/vllm/issues/5898 을 참조. 생성의 연속이 서로 다른 결과를 초래함 https://github.com/vllm- project/vllm/issues/11783 을 참조. 텐서 병렬 처리의 변경이 서로 다른 결과를 초래함
우리 모델은 답변에 앞서 긴 추론 트레이스를 생성하기 때문에, 작은 수치적 변화가 큰 차이로 확대될 수 있다. 우리는 수천 개의 토큰 동안 정확히 동일하다가 갑자기 한 토큰에서 달라져 결국 완전히 다른 답변에 이르게 되는 많은 생성 사례를 접한다. 이 문제에 부분적으로 대응하기 위해, 우리는 달리 명시되지 않는 한 일반적으로 전체 정밀도를 사용하여 최종 평가를 실행한다.
- .
C. s1K 세부 사항
C.1. s1K 요약
| 도메인 | #질문 | 총 토큰 수 | 키워드 |
| 기하학 | 109 | 560.2K | 넓이, 삼각형, 거리 |
| 정수론 | 98 | 522.5K | 수열, 가분성 |
| 조합론 | 75 | 384.7K | 순열, 세기 |
| 실함수 | 43 | 234.8K | 삼각법, 미적분학 |
| 생물학 | 41 | 120.9K | 유기 반응 |
| 복소함수 | 32 | 170.2K | 복소근 |
| 양자 이론 | 32 | 127.9K | 입자, 파동 함수 |
| 장 이론 | 28 | 150.1K | 다항식, 근 |
| 변분법 | 28 | 155.5K | 최적화, 제어 |
| 차분 방정식 | 24 | 132.5K | 점화식, 재귀 |
| 전자기 이론 | 23 | 95.8K | 광학, 파동, 회절 |
| 군론 | 22 | 100.0K | 군, 자기동형사상 |
| 선형대수학 | 22 | 128.3K | 행렬, 행렬식 |
| 확률론 | 20 | 114.6K | 무작위 걸음, 기댓값 |
| 대수적 체계 | 19 | 109.9K | 함수 방정식 |
| 역학 | 19 | 103.6K | 힘, 운동, 에너지 |
| 열역학 | 19 | 74.2K | 열기관, 엔트로피 |
| 미분 방정식 | 18 | 89.6K | 치환, 존재성 |
| 컴퓨터 과학 | 18 | 34.2K | 복잡도 이론, 알고리즘 |
| 수치 해석 | 18 | 76.5K | 오차 분석, 안정성 |
| 미적분학 | 17 | 96.3K | 수렴, 합산 |
| 대수적 구조 | 17 | 90.4K | 부등식, 집합 |
| 천문학 | 16 | 37.7K | 항성 종족, 궤도 |
| 나머지 27개 영역 | 242 | 982.2K | 질문이 16개 이하인 영역 |
| 모든 영역 (51) | 1000 | 4.7M | s1K |
C.2. 전체 59K 질문에 대한 데이터셋 구성
| 원본 | 설명 | #샘플 수 | 평균 사고 길이 |
| NuminaMATH (LI et al., 2024) | 온라인 웹사이트의 수학 문제 | 30660 | 4.1K |
| MATH (Hendrycks et al., 2021) | 경시대회 수학 문제 | 11999 | 2.9K |
| OlympicArena (Huang et al., 2024a) | 천문학, 생물학, 화학, 컴퓨터 과학, 지리학, 수학, 물리학 올림피아드 문제 | 4250 | 3.2K |
| OmniMath (Gao et al., 2024a) | 경시대회 수학 문제 | 4238 | 4.4K |
| AGIEval (Zhong et al., 2023; Ling et al., 2017; Hendrycks et al., 2021; Liu et al., 2020; Zhong et al., 2019; Wang et al., 2021) | SAT, LSAT 및 기타 시험의 영어, 법학, 논리학, 수학 문제 | 2385 | 1.2K |
| xword | 십자말풀이 | 999 | 0.7K |
| OlympiadBench (He et al., 2024) | 수학 및 물리학 올림피아드 문제 | 896 | 3.9K |
| AIME (1983-2021) | 미국 초청 수학 경시대회 | 890 | 4.7K |
| TheoremQA (Chen et al., 2023) | 정리와 관련된 컴퓨터 과학, 금융, 수학, 물리학 대학 수준 문제 | 747 | 2.1K |
| USACO (Shi et al., 2024) | 미국 컴퓨팅 올림피아드의 코드 문제 | 519 | 3.6K |
| JEEBench (Arora et al., 2023) | 인도 공과대학교 대학 입학시험에 출제된 화학, 수학, 물리학 문제 | 515 | 2.9K |
| GPQA (Rein et al., 2023) | 박사 수준 과학 문제 | 348 | 2.9K |
| SciEval (Sun et al., 2024) | 다양한 출처의 생물학, 화학, 물리학 문제 | 227 | 0.7K |
| s1-prob | 스탠퍼드 통계학 자격시험 | 182 | 4.0K |
| LiveCodeBench (Jain et al., 2024) | 코딩 웹사이트(LeetCode, AtCoder, CodeForces)의 코드 문제 | 151 | 3.5K |
| s1-teasers | 인터넷에서 크롤링한 수학 두뇌 퍼즐 | 23 | 4.1K |
| 전체 59K 질문 | 추론 흔적과 해답을 포함한 위 데이터셋들의 합성 | 59029 | 3.6K |
C.3. s1K 채점 프롬프트
§ 2 의 데이터셋 선택을 위해 예시가 정답인지 채점하기 위해, 우리는 그림 8의 프롬프트를 사용한다. 우리는 Claude 3.5를 사용하여 채점하며, 최종 1,000개 샘플 간의 정답 여부는 Claude 3.7로 채점했다.
당신은 과학 문제를 채점하는 AI 어시스턴트입니다. 사용자는 문제 자체, 학생이 작성한 시도, 그리고 문제의 정답을 제공할 것입니다. 당신의 임무는 그 시도를 정답과 비교하여 올바른지 판단하는 것입니다. 기대되는 풀이가 숫자나 선택지로 결론이 나는 경우, 모호함이 없어야 합니다. 기대되는 풀이가 전체 추론 과정을 거치는 경우, 당신은 추론 과정이 올바른지를 기준으로, 필요하다면 정답과 함께 그 시도를 판단해야 합니다.
사용자는 다음과 같은 형식으로 시도와 정답을 제공할 것입니다:
문제 {problem}
시도 {attempt}
정답 {solution}
당신의 추론을 설명하고, 응답을 새 줄에서 "Yes" 또는 "No"만으로(따옴표 없이) 끝내십시오.
C.4. s1K 다양성 선택
알고리즘 1은 우리의 다양성 선택 단계에서 데이터를 선택하는 알고리즘을 제공한다. § 2 에서 언급한 바와 같이, 우리는 또한 우리가 고품질이라고 인식하는 일부 특정 벤치마크의 샘플을 포함한다. 어떤 샘플도 우리의 최종 평가와 겹치지 않는다.
C.5. 오염 제거
우리는 선택된 예시와 평가 벤치마크(MATH500, GPTQA Diamond, AIME24) 간의 8-그램 겹침을 확인하여 모든 샘플을 필터링한다. 우리는 8-그램 겹침이 있는 질문을 제외한다.
알고리즘 1 s1K를 위한 2단계 샘플링
1: 입력: 특징을 가진 24,496개 질문의 집합 2: 출력: 선택된 1,000개 질문의 집합 3: 출력 집합 초기화 (고유 원소만 추적) 4: for do 5: if IsGeminiCorrect and (IsAIME or IsGPQA ) then 6: 7: 올바른 AIME/GPQA 해답을 모두 선택 8: else if IsGeminiCorrect and IsMATH and ThinkingLength then 9: 10: 긴 사고 연쇄를 가진 올바른 MATH500 해답을 선택 11: end if 12: end for 13: 사용 가능한 모든 도메인 14: 도메인 풀 초기화 15: while do 16: RandomChoice 17: 도메인을 무작위로 선택 18: 도메인 의 질문들 19: 이 도메인에서 질문들을 가져옴 20: ranks RankByThinkingLength 21: 사고 길이에 따라 순위를 매김 22: weights ranks 23: 거듭제곱 법칙 가중치를 적용 24: WeightedSample , weights) 25: 더 긴 연쇄를 선호하여 샘플링 26: 27: 선택된 질문을 추가 28: 29: if then 30: 31: 소진된 도메인을 제거 32: end if 33: end while
D. 학습 세부 사항
우리는 이미 사전 학습되고 명령 튜닝된 모델을 가져와 추론을 위해 추가로 미세 조정한다. 구체적으로, 우리는 Qwen2.5- 32B- Instruct (Qwen et al., 2024)를 사용하는데, 이 모델은 수학 과제에서 일반적으로 더 큰 Qwen2.5- 72B- Instruct (Qwen et al., 2024) 또는 다른 오픈 모델들(Dubey et al., 2024; Groeneveld et al., 2024; Muennighoff et al., 2024)과 대등하거나 능가한다. 우리는 사고 단계와 답변 단계를 구분하기 위해 토큰 구분자를 사용한다. 우리는 사고 단계를 <|im_start|>think 및 <|im_start|>answer로 감싸며, 둘 모두 앞뒤에 줄바꿈이 온다. 우리 데이터셋의 샘플은 에 있다. 우리는 기본적인 미세 조정 하이퍼파라미터를 사용한다: 총 315회의 그래디언트 스텝 동안 배치 크기 16으로 5에포크 학습한다. 우리는 bfloat16 정밀도로 학습하며, 학습률은 이고, 선형적으로 (16스텝) 동안 워밍업한 후 나머지 학습(299스텝) 동안 코사인 스케줄에 따라 0으로 감소한다. 우리는 AdamW 옵티마이저(Loshchilov & Hutter, 2019)를 , 및 가중치 감쇠 로 사용한다. 우리는 질문에 대해서는 손실을 계산하지 않고, 추론 흔적과 해답에 대해서만 계산한다. 우리는 어떤 샘플도 잘리지 않도록 시퀀스 길이가 충분히 크도록 보장한다; 이는 에서 절제 실험하는 설정이다. 학습은 16개의 NVIDIA H100 GPU에서 단 26분이 걸린다.
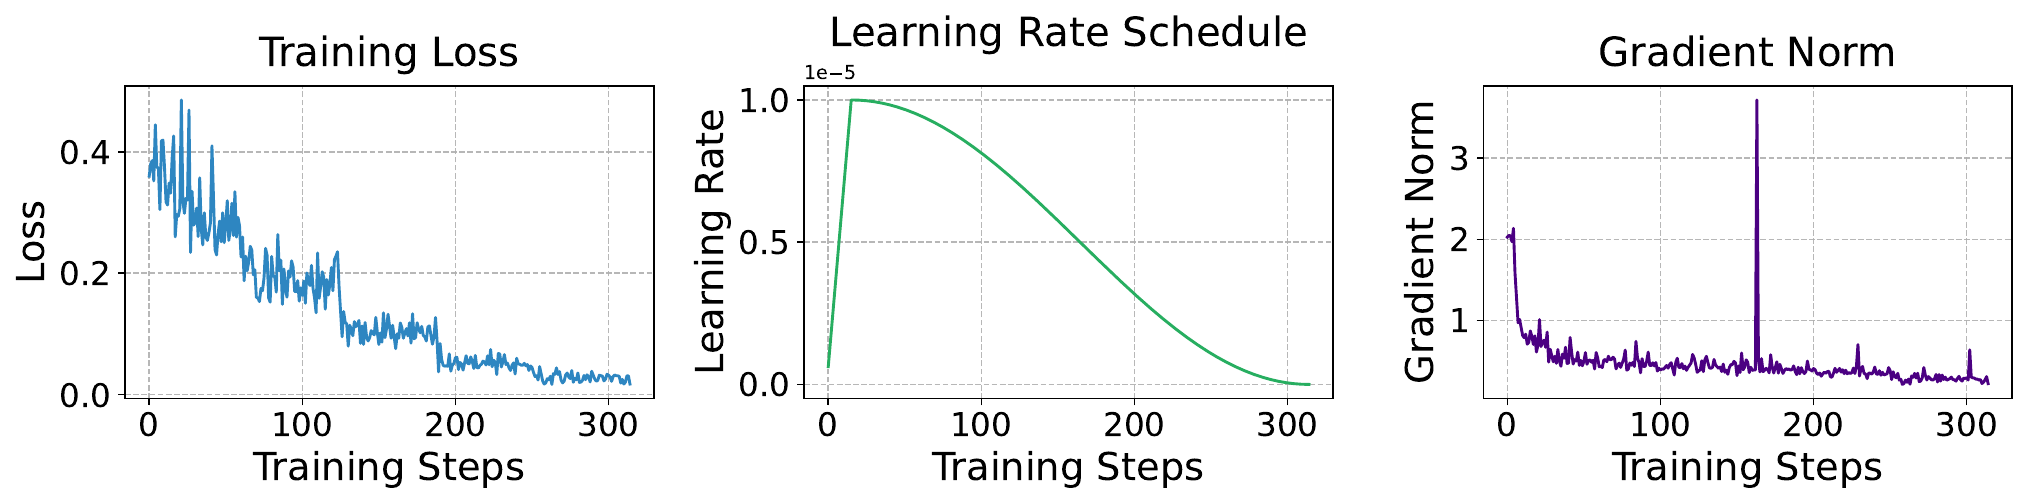
그림 9. s1K에 대한 s1-32B의 학습 동역학.
D.1. 학습 절제 실험: 시퀀스 길이
| 모델 A | 모델 B | |
| 학습 시퀀스 길이 | 4096 | 32768 |
| 학습 샘플 잘림 비율 | 74% | 0% |
| AIME24 | 30.0% / 20721 | 50.0% / 6984 |
| MATH500 | 90.0% / 5324 | 91.0% / 3268 |
| GPQA | 52.5% / 6841 | 53.0% / 3568 |
표 8. 학습 시퀀스 길이 절제 실험. 우리는 "정확도 / 샘플당 평균 사고 토큰"을 보고한다; 정확도가 높을수록 그리고 사고 토큰(추론 비용)이 적을수록 더 좋다.
의 스케일링 절제 실험 외에도, 우리가 절제 실험하는 주요 학습 하이퍼파라미터는 학습 중 사용되는 시퀀스 길이이다. 우리는 더 짧은 학습 시퀀스 길이가 테스트 시 더 긴 추론 흔적으로 이어진다는 것을 발견한다. 이는 더 짧은 시퀀스 길이로 학습할 때 학습 샘플의 답변 부분이 더 흔히 잘리기 때문이다. 반대로, 학습 시퀀스 길이가 더 길면 더 많은 샘플이 모델이 답하는 부분과 함께 전체가 나타난다. 따라서 모델은 연쇄를 따라 답을 생성하는 법을 배우는 더 많은 그래디언트 업데이트를 받는다. 이는 다시 생성 중 어느 시점에서든 답변 부분의 로그 확률을 더 높게 만들고, 따라서 테스트 시 더 짧은 추론 흔적으로 이어진다. 성능 면에서, 우리는 또한 더 긴 시퀀스 길이로 학습된 모델이 더 잘 수행한다는 것을 발견한다. 따라서 우리는 더 나은 성능으로 이어지고 더 짧은 추론 흔적으로 추론을 더 효율적으로 만들기 때문에 가장 긴 학습 시퀀스 길이를 선택한다.
D.2. 학습 샘플
표 9, 표 10, 표 11은 s1K의 학습 샘플을 포함한다.
표 9. s1- prob에서 유래한 s1K 샘플. 검은색 텍스트는 질문이고 노란색 텍스트는 해답이다. 질문만을 바탕으로 우리는 Gemini로 연한 파란색 추론 흔적과 파란색 응답을 생성하며, 이를 학습에 사용한다.
You are given integrable random variables and on the same probability space , and two - algebras . For , let
(a) 일 때 와 를 모두 만족하는 적분가능한 확률변수 와 가 존재함을 보여라. (b) 거의 확실하게 임을 증명하라.
1. 모든 에 대하여 와 라는 표기법을 도입하고, , 라 하자. 분명히 둘 다 여과(filtration)이며, 정의에 의해 모든 에 대하여 이고 이다. 따라서 (또는 )는 여과 (또는 )에 대한 Doob의 마팅게일이고, 따라서 가 적분가능하므로 U.I.이다. 이제 마팅게일이 U.I.일 필요충분조건은 에서 수렴하는 것이라는 사실을 적용하고 결론을 내린다.
2. 우리는 두 가지 다른 증명을 제공한다.
1. 다음 항등식은 탑 성질(Tower Property)로부터 따른다는 것을 관찰하라.
이고, 레비의 상향 정리(Levy's Upward Theorem)에 의해 일 때 임을 주목하라. 임은 명백하고(왜냐하면 의 거의 확실한 극한이므로), 따라서 거의 확실하게 이다. 위의 관찰들을 종합하면 라는 결론을 얻는다. 마찬가지로 이다. 이제 식 (4)를 적용하여 거의 확실하게 라는 결론을 내린다.
2. 가 적분가능하므로, 레비의 상향 정리에 의해 이다. 마찬가지로 이다. 한편, 첫 번째 증명에서 우리는 임을 관찰했고, 따라서 이다. 이는 다음을 낳는다.
마찬가지로 이다. 이는 거의 확실하게 임을 증명한다.
문제를 분석해 보자. 우리는 조건부 기댓값으로 정의된 두 확률변수 수열 와 를 받았다. 우리는 이 수열들이 에서 수렴하고 그 극한들이 거의 확실하게 같음을 보여야 한다.
(a) 부분: 에서의 수렴.
관련된 시그마 대수들은 증가한다:
수열에 대하여:
시그마 대수열 는 증가한다. 마팅게일 수렴 정리(조건부 기댓값에 대한)에 의해, 가 적분 가능하므로 수열 는 거의 확실하게 그리고 에서 로 수렴한다. 라 하자.
마찬가지로, 수열에 대해서는:
시그마 대수열 는 증가한다. 마팅게일 수렴 정리에 의해, 수열 는 거의 확실하게 그리고 에서 로 수렴한다. 라 하자.
부분 (b): 거의 확실하게 임을 증명하라.
우리는 그리고 를 가진다.
그리고 라 하자.
그러면 그리고 이다.
를 고려하자. .
. 이므로, 이다.
. 가 정의되지 않았으므로, 와 가 주어졌다고 가정하자.
모든 와 에 의해 생성된 시그마 대수를 고려하자.
라 하자.
와 는 모두 에 관해 가측이다. 따라서, 와 는 에 관해 가측이다.
을 고려하자.
을 고려하자.
라고 하자.
인 경우를 고려하자.
인 경우를 고려하자.
극한 시그마 대수 와 를 고려하자.
우리는 가 -가측이고 가 -가측임을 안다.
라고 하자.
와 가 독립인 경우를 고려하자. 그러면 이고 이다.
.
모든 정보에 의해 생성된 시그마 대수를 고려하자. 라고 하자.
그러면 와 모두 -가측이다.
우리는 이고 임을 거의 확실하게 그리고 에서 가진다.
와 를 고려하자.
라고 하자.
를 고려하자.
와 모두 와 같음을 보여보자. 이것은 너무 단순해 보인다.
조건부 기대값의 정의를 고려하자. 임의의 집합 에 대해, 이다.
임의의 집합 에 대해, 이다.
일 때 를 고려하자.
일 때 를 고려하자.
시그마 대수 를 고려하자.
라고 하자.
우리는 을 가진다.
는 에 의존하고, 이는 다시 등에 의존하므로, 이는 복잡하다.
이고 인 경우를 고려하자.
그러면 이다.
만약 그렇다면, 이고 이므로, 이고 이다.
우리는 a.s., 즉 a.s.를 필요로 한다. 이는 일반적으로 참이 아니다.
모든 와 에 의해 생성된 시그마 대수를 로 표기하여 고려하자.
그러면 이다.
\(\mathcal{Z}{\infty} = \sigma (B,Y{0},Y_{1},\ldots)\subseteq \sigma (B,G_{\infty})\) . \(\mathbb{E}[X|A,Z_{0},Z_{1},\ldots ] = Y_{\infty}\) 를 고려하자. 이는 임의의 \(A\in \sigma (A,Z_{0},Z_{1},\ldots)\) 에 대하여 \(\mathbb{E}[X1_{A}] = \mathbb{E}[Y_{\infty 1_{A}}]\) 임을 의미한다.
\(\mathbb{E}[X|B,Y_{0},Y_{1},\ldots ] = Z_{\infty}\) 를 고려하자. 이는 임의의 \(B\in \sigma (B,Y_{0},Y_{1},\ldots)\) 에 대하여 \(\mathbb{E}[X1_{B}] = \mathbb{E}[Z_{\infty 1_{B}}]\) 임을 의미한다.
\(\mathcal{H} = \sigma (A,B)\) 라 하자.
\(\mathbb{E}[X|\mathcal{H}]\) 를 고려하자.
\(\mathbb{E}[Y_{\infty}|B,Y_{0},Y_{1},\ldots ] = \mathbb{E}[\mathbb{E}[X|A,Z_{0},Z_{1},\ldots ]|B,Y_{0},Y_{1},\ldots ]\) 를 고려하자.
\(Y_{\infty}\) 가 \(\sigma (A,Z_{0},Z_{1},\ldots)\) - 가측이고 \(Z_{\infty}\) 가 \(\sigma (B,Y_{0},Y_{1},\ldots)\) - 가측이라는 사실을 이용하자.
\(\sigma (A,Z_{0},Z_{1},\ldots)\) 와 \(\sigma (B,Y_{0},Y_{1},\ldots)\) 를 모두 포함하는 가장 작은 시그마 대수를 고려하자.
이것은 \(\sigma (A\cup B\cup \{Y_{i}\}{i\geq 0}\cup \{Z{i}\}_{i\geq 0})\) 이다.
\(\mathbb{E}[(Y_{\infty} - Z_{\infty})^{2}] = 0\) 임을 보여보자.
\(\mathbb{E}[(Y_{\infty} - Z_{\infty})^{2}] = \mathbb{E}[Y_{\infty}^{2}] + \mathbb{E}[Z_{\infty}^{2}] - 2\mathbb{E}[Y_{\infty}Z_{\infty}]\)
\(Y_{k}\) 와 \(Z_{k}\) 의 정의를 고려하자.
\(\mathbb{E}[Y_{k + 1}|A,Z_{0},\ldots ,Z_{k - 1}] = Y_{k}\)
\(\mathbb{E}[Z_{k + 1}|B,Y_{0},\ldots ,Y_{k - 1}] = Z_{k}\)
\(\mathbb{E}[Y_{\infty}|B,Y_{0},Y_{1},\ldots ]\) 를 고려하자.
\(Y_{\infty}\) 가 \(\sigma (A,Z_{0},Z_{1},\ldots)\) 에 관하여 가측이므로, 이것은 쉽게 단순화되지 않는다.
\(Y_{\infty}\neq Z_{\infty}\) 가 양의 측도를 갖는 집합 위에서 성립한다고 가정하자.
\(A\) 와 \(B\) 가 자명한 경우를 고려하자.
그러면 \(Y_{k} = \mathbb{E}[X|\sigma (Z_{0},\ldots ,Z_{k - 1})]\) 이고 \(Z_{k} = \mathbb{E}[X|\sigma (Y_{0},\ldots ,Y_{k - 1})]\) 이다.
\(\mathcal{H}{\infty} = \sigma (A\cup B\cup \{Y{i},Z_{i}\}_{i\geq 0})\) 라 하자.
\(\mathbb{E}[X|\mathcal{H}_{\infty}]\) 를 고려하자.
\(Y_{\infty} = \mathbb{E}[X|\sigma (A,Z_{0},Z_{1},\ldots)]\) 이다.
조건부 기댓값의 성질에 의해, \(\mathbb{E}[Y_{\infty}|\mathcal{A}] = \mathbb{E}[\mathbb{E}[X|\mathcal{A},Z_{0},Z_{1},\ldots ]|\mathcal{A}]\) 이다.
관련된 모든 확률변수에 의해 생성되는 시그마 대수 \(D\) 를 고려하자.
\(D = \sigma (A\cup B\cup \{Y_{i}\}{i\geq 0}\cup \{Z{i}\}_{i\geq 0})\)
\(M_{\infty} = \mathbb{E}[X|A\vee B]\) 라 하자.
극한을 고려하자. \(n\to \infty\) 일 때 \(\sigma (A,Z_{0},\ldots ,Z_{n - 1})\uparrow \sigma (A,Z_{0},Z_{1},\ldots)\)
\(n\to \infty\) 일 때 \(\sigma (B,Y_{0},\ldots ,Y_{n - 1})\uparrow \sigma (B,Y_{0},Y_{1},\ldots)\)
이고 이다.
우리는 이고 임을 안다.
를 고려하자.
시그마 대수 를 고려하자.
라 하자.
모든 정보에 의해 생성된 극한 시그마 대수를 고려하자.
라 하자.
그러면 이고 이다.
우리는 이고 임을 안다.
와 를 고려하자.
라 하자.
를 고려하자.
쌍들의 수열 을 고려하자.
극한들이 같다면, 임의의 유계 가측 함수 에 대하여 이다.
시그마 대수 를 고려하자.
그러면 와 는 모두 에 관하여 가측이다.
를 고려하자.
라 하자.
를 고려하자.
그러면 이고 이다.극한 시그마 대수 를 고려하자.
우리는 이고 임을 안다.
라 하자.
을 고려하자.
확률 변수 를 고려하자. 그러면 이고 이다.
라 하자.
를 고려하자. 이라고 가정하자.
시그마 대수들의 join에 관한 조건부 기댓값을 고려하자.
라 하자.
를 고려하자.
그러면 이다.
그리고 이다.
그러므로 이고 이다.
이고 라고 하자.
를 고려하자.
그러면 이다.
그리고 이다.
이는 a.s.이고 a.s.임을 의미한다.
따라서 a.s.이다.
풀이:
(a) 수열 에 대하여, -대수 는 가 증가함에 따라 증가한다. 가 적분 가능하므로, 조건부 기댓값에 대한 마팅게일 수렴 정리에 의해 수열 는 거의 확실하게 그리고 에서 로 수렴한다. 마찬가지로, 수열 에 대하여, -대수 는 증가한다. 가 적분 가능하므로, 마팅게일 수렴 정리에 의해 수열 는 거의 확실하게 그리고 에서 로 수렴한다.
(b) 이고 라고 하자. 우리는 이고 임을 안다. -대수 를 고려하자. 를 고려하자.
이므로, 이다.
가 -가측이므로, 는 가 가 주어졌을 때 의 조건부 기댓값임을 함의한다. 그러나 는 이미 -가측이므로, 만약 가 -가측이라면 를 얻는데, 이는 반드시 참인 것은 아니다.
그러나 우리는 와 임을 안다.
를 생각하자.
그러면 이다.
이는 임을 함의한다.
마찬가지로, 이다.
이는 이 거의 확실하게 성립함을 함의한다.
따라서, 이 거의 확실하게 성립한다.
최종 답: 최종 답은 이다.
표 10. s1- 티저에서 유래한 s1K 표본. 검은색 텍스트는 질문이고 노란색 텍스트는 해답이다. 질문만을 바탕으로 우리는 Gemini로 연한 파란색 추론 흔적과 파란색 응답을 생성하며, 이를 훈련에 사용한다.
Alice와 Bob은 각자 동전을 하나씩 가지고 앞면이 나올 때까지 동전을 던진다. 만약 Bob이 Alice보다 동전을 더 많이 던졌다면, Alice가 동전을 던진 횟수의 기댓값은 얼마인가?
4/3
문제는 Bob이 Alice보다 동전을 더 많이 던졌다는 조건 하에서 Alice가 동전을 던진 횟수의 기댓값을 구하라고 요구한다.
를 Alice가 앞면이 나올 때까지 던지는 횟수라고 하자.
를 Bob이 앞면이 나올 때까지 던지는 횟수라고 하자.
와 는 모수 (앞면이 나올 확률)인 기하분포를 따르는 독립 확률변수이다.
기하분포의 확률질량함수는 에 대하여 이다.
이 경우 이므로, 이다.
우리는 Bob이 Alice보다 동전을 더 많이 던졌다는 조건, 즉 라는 조건이 주어져 있다.
우리는 라는 조건 하에서 의 기댓값, 즉 를 구하고자 한다.
조건부 기댓값의 공식은 이다.
또한, 이다.
우리의 경우, 는 사건 이다.
우리는 를 구해야 한다.
와 가 독립이므로, 이다.
안쪽 합은 등비급수이다:
이는 첫째 항이 이고 공비가 인 등비급수이다.
그 합은 이다.
따라서, 이다.
이는 첫째 항이 이고 공비가 인 또 다른 등비급수이다.
그 합은 이다.
이제, 우리는 를 구해야 한다.
독립성에 의해, 이다.
이다.
따라서, 이다.
이제 를 구할 수 있습니다.
마지막으로, 조건부 기댓값을 계산할 수 있습니다:
급수 를 고려하십시오. 여기서 입니다.
등비급수 를 고려하십시오.
에 대해 미분하면:
따라서 이며, 이는 를 의미합니다.
우리의 경우, 입니다.
그러므로 입니다.
대안적 접근: 대칭성.
사건 , , 그리고 를 고려하십시오.
대칭성에 의해 입니다.
입니다.
입니다. 이는 이전 계산을 확인해 줍니다.
\(E[X|Y > X] = \mu\) 라 하자.
우리는 밥이 더 많이 던진 것이 주어졌을 때 앨리스가 던진 횟수의 기댓값을 구하고자 한다.
둘 다 첫 번째 던짐이 뒷면인 경우를 생각하자. 그러면 과정이 다시 시작되고, 조건은 그대로 유지된다.
\(A_{1}\)을 앨리스의 첫 번째 던짐, \(B_{1}\)을 밥의 첫 번째 던짐이라 하자.
경우 1: \(A_{1} = H,B_{1} = H.X = 1,Y = 1\) 이므로 \(Y > X\) 는 거짓이다.
경우 2: \(A_{1} = H,B_{1} = T\) . 앨리스는 1에서 멈추고, 밥은 계속한다. \(Y > 1\)
경우 3: \(A_{1} = T,B_{1} = H\) . 밥은 1에서 멈추고, 앨리스는 계속한다.
경우 4: \(A_{1} = T,B_{1} = T\) . 둘 다 계속한다.
\(Y > X\) 가 주어졌을 때의 조건부 확률들을 생각하자.
\(E = E[X|Y > X]\) 라 하자.
첫 번째 던짐이 HH이면, 조건 \(Y > X\) 는 충족되지 않는다.
첫 번째 던짐이 HT이면, 앨리스의 던진 횟수는 1이다.
첫 번째 던짐이 TH이면, 밥의 던진 횟수는 1이고, 앨리스의 횟수는 적어도 2이므로 \(Y < X\) 이다.
첫 번째 던짐이 TT이면, 문제가 다시 시작되고, 앨리스의 추가 던짐 횟수의 기댓값은 여전히 \(E\) 이다.
\(N_{A}\)를 앨리스가 던지는 횟수, \(N_{B}\)를 밥이 던지는 횟수라 하자.
\(N_{B} > N_{A}\) 가 주어져 있다.
첫 번째 던짐들을 생각하자:
HH (확률 1/4): 조건이 충족되지 않음.
HT (확률 1/4): 앨리스가 1번 던짐.
TH (확률 1/4): 밥이 1번 던지고, 앨리스는 \(>1\) 이므로 \(N_{A} > N_{B}\) 이고, 조건이 충족되지 않음.
TT (확률 1/4): 둘 다 계속함.
\(E\)를 밥이 더 많이 던진 것이 주어졌을 때 앨리스의 던짐 횟수의 기댓값이라 하자.
첫 번째 던짐이 HT이면, 앨리스는 1번 던졌고, 조건이 충족된다.
첫 번째 던짐이 TT이면, 상황은 처음과 같으므로, 앨리스의 추가 던짐 횟수의 기댓값은 \(E\) 이다.
사건 \(Y > X\) 를 생각하자.
첫 번째 던짐들에 조건을 걸면:
\(P(Y > X|T T)\) 는 이후의 던짐들에 달려 있다.
조건부 기댓값의 정의를 직접 사용하자.
(1>λ)
\(Y > X\) 가 주어졌을 때의 첫 번째 던짐들의 확률들을 생각하자.
첫 번째 던짐이 TT이면, 이후의 거동은 같고, 조건 \(Y > X\) 는 이후 시행들에서 밥이 앨리스보다 더 많은 횟수를 던지면 성립한다.
\(P(Y > X|T T) = P(\mathrm{밥이}\) 처음부터 시작하여 앨리스보다 더 많은 던짐이 필요함\()\) \(= P(Y > X) = 1 / 3\)
\(P(T T|Y > X) = \frac{(1 / 3)\cdot(1 / 4)}{1 / 3} = \frac{1}{4}\)
조건부 확률들의 합: \(0 + 3 / 4 + 0 + 1 / 4 = 1\)
이제 \(X\) 의 조건부 기댓값들을 생각하자
\(E[X|Y > X, H H]\) : \(P(H H|Y > X) = 0\) 이므로 관련 없음
\(E[X|Y > X, H T]\) : HT이고 \(Y > X\) 가 주어지면, 앨리스는 1번 던졌다. \(E = 1\)
\(E[X|Y > X, T H]\) : 관련 없음.
\(E[X|Y > X, T T]\) : TT이고 \(Y > X\) 가 주어지면, 앨리스는 이미 한 번 던졌고, 추가 던짐 횟수의 기댓값은 \(E\) 이다. 따라서 총 던짐 횟수는 \(1 + E\) 이다.
\(E = 0\cdot 0 + 1\cdot (3 / 4) +\) 정의되지 않음 \(\cdot 0 + (1 + E)\cdot (1 / 4)\)
이는 이전 결과를 확인해 줍니다.
직관에 대해 생각해 봅시다. 조건 가 있다면, 이는 Alice가 "운이 좋아서" 앞면을 일찍 얻었거나, Bob이 "운이 나빴다"는 뜻입니다.
확률변수 를 고려해 봅시다. 우리에게 주어진 것은 입니다.
우리가 원하는 것은 입니다.
라고 합시다.
첫 앞면이 나오기 전까지의 뒷면 횟수는 모수 를 갖는 기하분포를 따릅니다.
, .
.
.
와 의 결합분포를 고려하자.
사건 를 고려하자. 여기서 이다.
만약 라면, , 이다.
인지 확인하자.
여기서 뭔가 잘못되었다.
를 다시 계산해 보자.
안쪽 합: .
만약 라면, 이다. 맞다.
이제 를 구해 보자.
(독립)
(지수에 오류)
라 하자. .
이면, 입니다.
풀이:
를 Alice가 앞면이 나올 때까지 동전을 던지는 횟수, 를 Bob이 앞면이 나올 때까지 동전을 던지는 횟수라고 합시다. 와 는 모수가 인 독립인 기하확률변수입니다. 확률질량함수는 입니다.
우리는 Bob이 Alice보다 동전을 더 많이 던졌다는 조건 하에 Alice가 동전을 던진 횟수의 기댓값, 즉 에 관심이 있습니다.
조건부 기댓값의 정의를 사용하면, 입니다.
먼저 를 계산합니다.
다음으로, 를 계산한다.
이제, 를 구한다.
마지막으로, 조건부 기댓값을 계산한다:
와 함께 공식 를 사용하면:
최종 답: 최종 답은 이다.
표 11. OlympicArena의 천문학 하위 집합에서 유래한 s1K 샘플의 어간 추출. 검은색 텍스트는 질문이고 파란색 텍스트는 해답이다. 질문만을 기반으로 우리는 Gemini로 연한 파란색 추론 흔적과 파란색 응답을 생성하며, 이를 훈련에 사용한다.
자주 반복되는 재미있는 사실은 인간이 별보다 단위 부피당 더 많은 에너지를 생산한다는 것이다. 만약 태양의 크기가 같지만 인간과 같은 단위 부피당 에너지를 생산한다면, 그 표면 온도는 얼마가 될까? "평균 인간"은 100와트의 에너지를 생산하고 부피가 66400세제곱센티미터라고 가정하라.
A: 3500 K B: 10000 K C: 25000 K D: 40000 K E: 50000 K
문제의 수치를 사용하면, 평균 인간은 다음을 생산한다
태양의 부피는 이므로, 새로운 출력은 가 된다. 평형 온도를 구하기 위해, 우리는 다음을 사용한다
에 대해 풀면, 다음을 얻는다
문제는 태양이 같은 크기이지만 인간과 같은 단위 부피당 에너지를 생산한다면 그 표면 온도가 얼마인지 묻는다.
먼저, 인간의 에너지 밀도를 구하자.
인간이 생산하는 에너지,
인간의 부피,
부피를 세제곱미터로 변환하자:
인간의 에너지 밀도,
이제, 현재와 같은 크기이지만 에너지 밀도가 인간과 같은 태양을 고려하자.
부피를 계산하기 위해 태양의 반지름이 필요하다. 태양의 평균 반지름은
태양의 부피,
만약 태양이 인간과 같은 에너지 밀도를 가진다면, 이 변형된 태양이 생산하는 총 에너지는 다음과 같을 것이다:
별의 표면 온도는 슈테판-볼츠만 법칙을 통해 그 광도(총 에너지 출력)와 관련된다:
여기서 은 광도(총 에너지 출력), 은 별의 반지름, 는 슈테판-볼츠만 상수, 그리고 는 표면 온도이다.
이 경우, 변형된 태양의 광도는 이다. 변형된 태양의 반지름은 실제 태양과 같다, .
슈테판-볼츠만 상수, .
항 를 계산하라:
이제 이것을 방정식에 다시 대입하라:
에 대해 풀어라:
에 대해 풀어라:
(1.9386) 을 계산하라: 라 하면, 이다.
따라서,
우리는 이고 임을 알고 있으므로, 는 5와 6 사이에 있다.
또는,
계산을 다시 확인해 보자.
인간의 전력 밀도:
태양의 부피:
변형된 태양의 출력:
슈테판-볼츠만 법칙:
계산: 라 하면,
결과는 약 66000 K이다. 이는 보기 중에 없다. 가정과 계산을 검토해 보자.
가정: 태양은 흑체로 복사하며, 이는 표면 온도를 추정하는 데 합리적이다.
계산상의 잠재적 오류를 고려해 보자.
비율을 설정하는 더 간단한 접근을 시도해 보자.
변형된 태양의 단위 부피당 출력은 인간의 그것과 같다.
또한 임을 안다.
값을 대입하자:
계산:
라 하면,
이는 선택지 E: 50000 K에 가깝다.
단위와 계산을 주의 깊게 다시 확인해 보자.
인간의 전력 밀도:
유도된 공식은 였다.
단위 확인:
단위는 에 맞는다.
수치 계산 확인:
분자:
분모:
비율:
정밀도를 위해 로그를 사용하자.
이는 50000 K에 매우 가깝다.
사소한 불일치의 가능한 원인: 반올림 오차, 상수의 정밀도.
공식 유도를 검증해 보자.
단위 부피당 출력
변형된 태양이 인간과 같은 출력 밀도를 가진다면:
공식 유도는 올바른 것으로 보인다.
근사값을 사용하여 크기 차수를 확인해 보자.
따라서 7과 8 사이이다.
크기 차수는 상세 계산과 일치하는 것으로 보인다.
문제 진술은 명확하며 숨겨진 복잡성이 없는 것으로 보인다. 사용된 가정은 그러한 문제에 대해 표준적이다.
주어진 값들의 정밀도를 고려해 보자.
인간의 출력: (정확함)
인간의 부피: (정확함)
얻어진 결과는 선택지 E에 매우 가깝다. 객관식 문제의 특성상, 가장 가까운 선택지가 의도된 답일 가능성이 높다.
문제에 대한 오해가 있었다면 그것은 설정 부분에 있을 것이다. 그러나 "만약 태양의 크기가 같으면서 인간과 동일한 단위 부피당 출력을 낸다면"이라는 문구는 명확해 보인다.
표면 온도는 흑체 복사를 가정하여 슈테판-볼츠만 법칙을 사용해 계산된다.
주어진 선택지를 다시 확인해 보자:
A: 3500 K
B: 10000 K
C: 25000 K
D: 40000 K
E: 50000 K
우리가 계산한 값은 약 49800 K로, 50000 K에 가장 가깝다.
상수에 더 정밀한 값을 사용했다면 결과가 약간 달라질 수 있지만, 다른 선택지로 옮겨갈 만큼은 아닐 것이다.
문제에서 언급된 흥미로운 사실은 인간의 출력 밀도가 태양의 출력 밀도보다 높다는 것을 암시한다. 이를 확인해 보자.
태양의 출력:
태양의 부피:
태양의 출력 밀도:
인간의 출력 밀도:
실제로 인간의 출력 밀도는 태양의 출력 밀도보다 상당히 높다.
계산 단계와 논리를 최종 점검한다. 변형된 태양의 출력 밀도를 인간의 출력 밀도와 같다고 놓은 뒤 슈테판-볼츠만 법칙을 사용하는 접근 방식은 올바른 것으로 보인다.
풀이:
평균적인 인간이 생산하는 출력은 이고, 평균적인 인간의 부피는 이다.
인간의 출력 밀도는 이다.
만약 태양이 같은 크기이면서 인간과 동일한 단위 부피당 출력을 생산한다면, 그 출력 밀도는 일 것이다.
태양의 반지름은 이다.
태양의 부피는 이다.
변형된 태양의 출력 밀도는 로 주어진다.
또한 임을 알고 있으며, 여기서 는 변형된 태양의 표면 온도이다.
출력 밀도를 같다고 놓으면:
에 대해 풀면:
값을 대입하면:
\(T\) 에 대해 풀면:
로그를 사용하면:
지수 계산을 다시 해 보자: \(18 / 4 = 4.5\) .
\(T = 8.856 \times 10^{4.5} = 8.856 \times 10^4 \times 10^{0.5}\) - 이전 단계에서의 오류.
\(T = (6.1528 \times 10^{18})^{0.25} = 49806 \mathrm{K}\)
표면 온도는 약 49806 K이며, 이는 50000 K에 가장 가깝다.
최종 답: 최종 답은 이다.
E. 테스트 시점 스케일링 세부 사항
E.1. 순차적 스케일링 소거 실험
| <lim_start>user | <lim_start>user |
| What is the answer to Life, the Universe and Everything? | What is the answer to Life, the Universe and Everything? |
| Think for up to 2048 tokens. | Think for up to 64 steps. |
| <lim_start>assistant | <lim_start>assistant |
| <lim_start>think | <lim_start>64 steps left |
| Let me break down this question into the three parts it is asking for: 1) Life 2) Universe 3) Everything | Let me break down this question into the three parts it is asking for: 1) Life 2) Universe 3) Everything |
| Let me start with life... | <lim_start>63 steps left |
| Let me start with life... | |
| <lim_start>answer | <lim_start>answer |
| The answer is... | The answer is... |
</lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start
그러면 추론 흔적(reasoning trace)은 1024에서 2048 토큰 사이 어딘가에 있게 됩니다. 표 12에서 우리는 훈련 후 모델이 토큰 지시를 거의 따르지 않는다는 것을 보여줍니다. 더 높은 한도가 주어지면 때때로 더 많은 토큰을 생성하기는 하지만 종종 한도를 초과합니다. 이는 우리 모델만의 특유한 문제가 아닐 수 있는데, 선행 연구에 따르면 OpenAI o1-mini도 토큰 지시를 따르지 못할 수 있다고 합니다(Zhang & Chen, 2024). 한도를 초과하는 것을 방지하기 위해, 한도에 도달하면 사고를 종료하도록 강제하는 예산 강제(budget forcing)를 테스트합니다. 이는 완벽한 제어로 이어집니다(표 12 (아래)). 예산 강제를 사용하면 작은 사고 예산이 주어졌을 때 모델이 더 이상 한도를 초과할 수 없으므로 스케일링 추세도 더 명확해집니다. 이는 표 3에서 토큰 프롬프팅 + 예산 강제에 대해 더 나은 테스트 시점 스케일링 값으로 이어집니다. 토큰 조건부 제어 변형들에 대해 표 3에 보고된 제어(Control)를 계산하기 위해, 표 12에서 사고 토큰이 상한보다 적은 횟수를 전체 평가 횟수로 나눕니다(중재 없음의 경우 2/5, 중재 있음의 경우 5/5).
단계 조건부 제어(Step-conditional control). 토큰 지시는 현재 모델이 토큰을 셀 수 없기 때문에 실패합니다. 이러한 능력 부족을 수용하기 위해, 우리는 카운팅을 더 거칠게 만드는 실험을 합니다. 추론 흔적을 단계로 분할하고 모델에게 토큰 대신 특정 수의 단계 동안 사고하도록 요청합니다. 우리는 추론 흔적을 이중 줄바꿈으로 단계로 나누는데, 샘플을 수동으로 검사한 결과 이것이 직관적인 구분자 역할을 한다는 것을 발견했습니다. 우리는 훈련 샘플을 단계 수에 따라 2의 거듭제곱으로 버킷화하고 그림 10(오른쪽)의 형식을 따라 해당하는 단계 지시를 추가합니다. 이 형식은 초기 실험에 기반한 것으로, 우리는 모델이 카운트 업("Step2...Step3...")보다 카운트 다운("3 steps left...2 steps left")할 때 단계 한도를 더 잘 준수할 가능성이 높다는 것을 발견했습니다. 이는 아마도 카운트 다운의 경우 최종 단계가 항상 1이어서 모델이 생성을 마치도록 강한 사전(prior)으로 작용하기 때문일 것입니다. 카운트 업의 경우 답변 전의 최종 단계가 달라지므로, 모델이 원래의 단계 지시를 기억하지 못하면 멈추지 못할 수 있습니다. 우리는 표 13의 결과로부터 다음을 결론짓습니다: (1) 모델은 여전히 단계 한도를 준수하는 데 어려움을 겪습니다. 모델은 때때로 단순히 음수 단계로 계속 세어 들어가기도 합니다, 예를 들어 "1 steps left"와 같이요. 이 문제를 해결하기 위해, 우리는 0단계에 도달하면 사고 과정을 자동으로 중지하고 답변 토큰 구분자(§3)를 덧붙여 모델이 답변 모드로 전환하도록 강제합니다. 이는 완벽한 단계 준수로 이어지지만(표 13의 아래쪽 절반), 문제는 남아 있습니다. (2) 모델은 각 단계를 더 길게 만들어 더 적은 단계를 보상합니다. 예를 들어, 최대 16단계 대 256단계를 사용하도록 강제했을 때, 모델은 단계당 평균 96 토큰 대 56 토큰을 생성합니다. 이 문제에도 불구하고, 더 많은 단계는 표 13에서 여전히 더 많은 총 사고 토큰 및 더 나은 성능과 명확히 상관관계가 있어 양의 기울기로 이어집니다. (3) 단계 지시는 다른 방법보다 비용이 더 많이 듭니다. 단계 구분자는 각각 약 6 토큰을 요구하는데, 예를 들어 64단계의 경우 총 약 380 토큰이 추가됩니다. 표 13에서처럼 토큰 수에서 단계 구분자를 무시하더라도, 모델은 AIME24에서 단지 \(33.3\%\)를 달성하기 위해 평균 7551개의 사고 토큰을 여전히 필요로 합니다. 단계 조건부 제어 변형들에 대해 표 3에 보고된 제어(Control)를 계산하기 위해, 우리는 먼저 단계당 상한이 100 토큰이라고 결정한 다음 이 숫자에 지시된 단계 수를 곱하여 프록시 총 토큰 한도에 도달합니다, 예를 들어 16단계 지시의 경우 1600입니다. 그런 다음 각 평가 실행에 대해 표 13의 사고 토큰이 해당 한도 내에 맞는지 확인합니다(중재 없음의 경우 3/5, 중재 있음의 경우 5/5). 그림 7의 모델에 대해서는, 우리 데이터의 이전 버전으로 훈련되고 평가 코드베이스의 이전 버전을 사용하는 단계 조건부 제어 모델을 사용합니다.
| 指令步数 | 16 | 32 | 64 | 128 | 256 |
| 测试时不进行干预 | |||||
| 使用的步数 | 123 | 90 | 80 | 82 | 136 |
| 每步词元数 | 60 | 70 | 69 | 66 | 56 |
| 思考词元数 | 7252 | 6277 | 5396 | 5552 | 7551 |
| 答案词元数 | 665 | 653 | 735 | 777 | 754 |
| AIME24 | 33.3 | 23.3 | 33.3 | 36.7 | 33.3 |
| 达到 0 步时强制结束思考 | |||||
| 使用的步数 | 16 | 32 | 59 | 78 | 136 |
| 每步词元数 | 96 | 94 | 80 | 70 | 56 |
| 思考词元数 | 1517 | 2963 | 4636 | 5409 | 7551 |
| 答案词元数 | 1111 | 788 | 799 | 794 | 754 |
| AIME24 | 23.3 | 23.3 | 33.3 | 36.7 | 33.3 |
| 在问题后附加提示词,中间空两行 | AIME24 | MATH500 | GPQA |
| 经过少量思考后作答。不要花过多时间反复检查你的工作。 | 30.0% 8033 | 90.4% 2537 | 56.6% 4177 |
| 经过长时间思考后作答。如果你觉得已经提前完成,就把额外的时间用来反复检查你的工作,直到你绝对确定自己得到了正确答案。 | 36.7% 9651 | 91.4% 3875 | 51.0% 4827 |
| 不附加通用提示词 | 50.0% 6109 | 93.0% 3298 | 57.6% 3510 |
클래스 조건부 제어(Class-conditional control). OpenAI는 세 가지 가능한 설정(낮음, 중간, 높음)이 있는 "reasoning_effort" API 매개변수를 통해 사용자에게 테스트 시점 컴퓨트 제어를 노출합니다. OpenAI 문서는 또한 "추론 노력을 줄이면 응답이 더 빨라지고 응답에서 추론에 사용되는 토큰이 줄어들 수 있습니다."라고 명시하는데, 이는 그들이 보장을 가지고 테스트 시점 컴퓨트를 제어할 수 없음을 시사합니다. 따라서 아마도 OpenAI는 원하는 추론 노력에 따라 프롬프트나 시스템 지시를 단순히 조정할 것입니다. 표 14에서, 우리는 짧은 사고와 긴 사고를 위한 별도의 프롬프트가 우리가 어느 정도 사고 시간을 제어할 수 있게 해준다는 것을 보여줍니다: 모델에게 더 오래 사고하도록 프롬프팅하면 더 긴 사고로 이어집니다. 그러나 그것이 성능을 신뢰성 있게 향상시키지는 않으며 제어는 정밀하지 않습니다. 현재의 제어 준수는 우리가 단지 세 개의 클래스만 있을 때는 충분할 수 있지만, 더 세밀한 클래스로 확장되지는 않을 수 있습니다. 이 방법에 대해 표 3에 보고된 제어(Control)를 계산하기 위해, 우리는 표 14에서 모델에게 짧은 시간 동안 사고하도록 프롬프팅하는 것이 AIME24의 기본값보다 더 적은 토큰을 생성해야 하고, 긴 프롬프트는 더 많은 토큰을 생성해야 한다고 가정합니다. 이고 이므로, 둘 중 하나가 우리의 예상 제어를 따르므로 제어는 입니다.
E.2. 거부 샘플링 소거 실험의 예시
3https://github.com/openai/openai-python/blob/44d6210f101abedeb2dd68507fcfcb329df70ea/src/openai/types/chat/completion_create_params.py#L172
표 15. AIME24에서 거부 샘플링을 할 때 s1-32B의 이전 버전에 의해 생성된 답변. 검은색 텍스트는 질문이고 노란색 텍스트는 해답입니다. 질문만을 기반으로 우리는 온도 1로 s1-32B를 사용하여 연한 파란색 추론 흔적과 파란색 응답을 생성합니다. 우리는 첫 번째 예시의 경우 추론 흔적이 4000 토큰 미만이 될 때까지, 두 번째 예시의 경우 8000 토큰 미만이 될 때까지 생성합니다. 사고가 ( 토큰)이 될 때까지 예시당 평균 199(1)번의 시도가 필요했습니다.
, 그리고 를 좌표평면의 점들이라 하자. 를 제1사분면에 놓이고 는 -축 위에, 는 -축 위에 있는 단위 길이의 선분 들의 집합이라 하자. 이외의 의 어떤 선분에도 속하지 않는, 와 와 구별되는 위의 유일한 점 가 존재한다. 그러면 이며, 여기서 와 는 서로소인 양의 정수이다. 를 구하라.
23
[3981개의 사고 토큰과 1055개의 답변 토큰으로 올바르게 생성됨]
문제는 자체를 제외하고 집합 의 다른 어떤 선분에도 포함되지 않는 선분 위의 점 를 요구합니다.
점 는 제1사분면에서 삼각형을 이룹니다.
선분 는 와 를 연결합니다.
를 포함하는 직선의 방정식은 두 점을 사용하여 구할 수 있습니다:
기울기
점 와 함께 점-기울기 형식 을 사용하면
선분 는 제1사분면에 놓여 있으며 에서 까지 연결한다.
족 는 길이가 1인 선분 들로 이루어져 있으며, 여기서 는 축 위에 있고 는 축 위에 있다. 이고 라 하자.
의 길이는 이다.
따라서 이다.
는 양의 축 위에 있고 는 양의 축 위에 있으므로, 이고 이다.
선분 는 과 를 연결한다. 를 포함하는 직선의 방정식은 이다.
족 가 덮는 영역은 이 선분들을 포함하는 직선들로 둘러싸인 영역이다. 끝점 과 는 을 만족하도록 변한다.
매개변수화 , 를 고려하자. 여기서 이다.
선분 는 과 를 연결한다. 직선의 방정식은 이다.
우리는 위에서 와 와는 다른, 이외의 의 어떤 선분에도 속하지 않는 유일한 점 를 찾고 있다.
를 위의 한 점이라 하자. 위의 점들은 에 대하여 로 매개변수화할 수 있다.
이다.
는 및 와 다르므로, 이다.
점 가 의 어떤 선분 위에 놓인다고 가정하자. 여기서 이고 \(Q = (0,\sin \theta)\)이다.
점 는 방정식 을 만족한다.
의 좌표를 대입하면:
2를 곱하면:
우리는 에서 를 포함하는 유일한 선분이 자체인, 위의 점 를 찾고 있다. 선분 는 족 의 일부이다.
의 경우, 이고 이다.
여기서 , 이다.
선분 는 과 를 연결한다.
직선의 방정식은 이며, 이는 , 즉 로 간단히 된다.
이는 방정식 와 일치한다.
직선족 의 포락선을 고려하자.
에 대해 미분하면:
직선 방정식으로부터:
를 대입하면
직선 방정식에 다시 대입하면:
족 의 포락선은 아스트로이드 이다.
의 선분들은 이 아스트로이드에 접한다.
우리가 찾고 있는 위의 점 는 가 아스트로이드에 접하는 점이다.
의 방정식은 이다.
아스트로이드 방정식에 대입하면:
이고 이라 하자. 아스트로이드는 이다.
점 는 직선 와 아스트로이드 모두 위에 있다.
아스트로이드 방정식을 음함수 미분하면:
.
점 에서 아스트로이드에 대한 접선의 기울기는 이다.
직선 의 기울기는 이다.
따라서 접점에서, 이다.
점 는 직선 위에 있고 을 만족한다.
따라서 이다.
직선의 방정식에 대입하면:
그러면 이다.
점 는 이다.
이 점이 선분 위에 있는지 확인해야 한다.
점 는 의 형태이다.
따라서 는 위에 있다.
인지 확인해야 하며, 이는 에 대해 참이다.
이제, 이 점 가 의 다른 어떤 선분에도 속하지 않는지 확인해야 한다.
점 는 별모양 곡선(astroid) 위에 있다. 선분 는 점 에서 별모양 곡선에 접한다.
를 포함하는 의 다른 어떤 선분이 있다면, 는 접점이 아니라 내부점이 될 것이다.
족 의 매개변수화를 고려하자.
점 가 의 어떤 선분에 속하는 것은 을 만족하는 가 존재하는 것과 필요충분조건이다.
점 에 대하여, 다음을 얻는다:
우리는 가 위에 있다는 것을 알고 있으며, 이는 에서 어떤 특정 선분에 대응한다.
문제 진술은 그러한 점 의 존재와 유일성을 가정한다.
위에서 와 와 구별되며, 외의 의 어떤 선분에도 속하지 않는 유일한 점 .
이는 만약 가 다른 선분 위에 있다면, 라는 것을 의미한다.
점 는 와 아스트로이드의 접점이다.
이제 우리는 를 구해야 한다.
여기서 이고 이다.
와 는 서로소이다.
.
추론의 최종 점검:
족 는 축 위에 끝점을 가지는 단위 길이 선분들로 이루어져 있다.
이 족의 포락선은 아스트로이드 이다.
의 선분들은 아스트로이드에 접한다.
선분 역시 족 의 원소이다.
우리는 위에 있으면서 아스트로이드 위에 있는 점 를 찾고 있다.
이 점 는 와 아스트로이드의 접점이다.
만약 위의 한 점이 아스트로이드 위에 있다면, 그 점은 그 점에서의 접선 선분에 속한다. 가 그 접선 선분이므로, 이 점은 의 다른 어떤 선분에도 속하지 않는다.
선분 가 아스트로이드와 두 점에서 교차하는 경우를 고려하자.
만약 선분 가 아스트로이드에 접하지 않는다면, 두 개의 교점이 존재한다.
교점을 과 라 하자.
만약 이 위에 있다면, 에서 아스트로이드에 대한 접선은 선분 이다.
만약 가 위에 있다면, 에서 아스트로이드에 대한 접선은 선분 이다.
의 기울기는 이다.
우리는 아스트로이드 위에서 접선의 기울기가 인 점을 찾았다.
문제 진술은 그러한 점 의 유일성을 보장한다.
점 는 의 내부에 있어야 하므로, 이다.
매개변수 는 이 범위에 속한다.
점 는 와 와 구별된다.
만약 라면, , 이다.
만약 라면, , 이다.
접점 는 위에서 (끝점을 제외하고) 아스트로이드 위에 있는 유일한 점이다.
풀이:
선분족 가 양의 -축 위의 점 와 양의 -축 위의 점 를 끝점으로 하는 단위 길이의 선분 로 정의된다고 하자. 이고 라 하자. 길이 조건은 을 준다. 선분 는 직선 위에 있다. 매개변수화 , ()를 사용하면, 직선의 방정식은 이다.
이 직선족의 포락선은 아스트로이드 이다.
의 선분들은 이 아스트로이드에 접한다.
선분 는 과 를 연결합니다. 를 포함하는 직선의 방정식은 입니다. 이 선분은 족 의 일부입니다.
우리는 위에 있고, 와 와는 다른, 이외의 의 어떤 선분에도 속하지 않는 유일한 점 를 찾고 있습니다. 이는 가 가 아스트로이드에 접하는 점임을 의미합니다.
점 에서 아스트로이드에 대한 접선의 기울기는 입니다. 의 기울기는 입니다.
기울기를 같게 놓으면:
점 는 직선 위에 있고 를 만족합니다.
대입하면,
그러면
점 는 입니다.
가 위에 있는지 확인해야 합니다. 위의 점들은 에 대하여 입니다.
에 대하여,
에 대하여,
이므로, 는 의 내부점입니다.
점 는 아스트로이드 위에 있는 위의 (끝점을 제외한) 유일한 점입니다. 에서 아스트로이드에 접하는 접선은 선분 입니다. 따라서 는 의 다른 어떤 선분에도 속하지 않습니다.
마지막으로, 을 계산합니다.
이고 입니다. 이들은 서로소입니다.
최종 답: 최종 답은 [23]입니다.
[5923개의 사고 토큰과 754개의 답변 토큰을 사용한 잘못된 생성]
문제는 선분 위의 점 로서, 가 자체를 제외하고는 집합의 다른 어떤 선분에도 속하지 않는 점을 요구합니다. 집합 는 길이가 1인 선분 들로 구성되며, 는 축 위에 있고 는 제1사분면의 축 위에 있습니다. 이고 라고 하면, 이고 입니다. 선분 의 길이는 1이므로, 와 사이의 거리는 1입니다.
선분 는 제1사분면에 있으므로 이고 입니다.
방정식 은 끝점이 과 인 제1사분면의 사분원을 나타냅니다. 선분 위의 점들은 에 대하여 로 매개변수화할 수 있습니다.
선분 는 와 를 연결합니다.
를 포함하는 직선의 방정식은 두 점을 사용하여 구할 수 있습니다: 기울기 입니다.
점 을 사용한 점-기울기 형태:
선분 는 과 사이의 제1사분면에 있습니다.
또는 위의 점들을 매개변수화할 수 있습니다. 를 위의 점이라고 합시다. 그러면 어떤 에 대하여 입니다.
우리는 와 와 구별되고, 이외의 의 어떤 선분에도 속하지 않는 위의 유일한 점 를 찾고 있습니다. 의 선분으로서 끝점이 이고 이며 인 것을 생각해 봅시다. 이 선분 위의 점은 에 대하여 형태입니다. 우리는 위의 점 로서, 이고, 만약 가 의 선분 위에 있다면 \(\overline{{P Q}} = \overline{{A B}}\)가 되는 점을 찾고자 합니다.
라 하자. 여기서 이다.만약 가 에 속하는 선분 위에 있다면, 인 과 이 존재하여 다음이 성립한다:
첫 번째 식으로부터, 이다.두 번째 식으로부터, 이다. 이므로, 이다.또한 이므로, 이고, 이는 , 즉 을 함의한다. 이는 위의 점에 대한 조건과 일치한다.
우리는 와 를 가진다.이 식들을 더하면:
우리는 임을 안다.만약 점 가 선분 자체에 속한다면, 그 선분의 끝점들은 와 이다.따라서 선분은 에서 까지이다.여기서 이고 이다. 인지 확인하자: . 따라서 이다.
만약 가 에 속하는 또 다른 선분 에 속하고, 그 끝점들이 와 이며 라면.기하학적 해석을 고려하자. 집합족 는 축 위에 끝점들을 가지는 단위 길이의 선분들로 이루어진다. 이 선분들의 중점들은 원 위에 놓인다.점 가 어떤 에 대응한다 하자.만약 가 위에 있다면, 이다.따라서 이고 이다.우리는 , 인 이 방정식들의 유일한 해가 이고 가 되도록 하는 을 찾아야 한다.방정식들로부터, 이고 이다.이것들을 에 대입하라.
다른 접근을 시도하자. 선분족에 대한 접선들을 고려하자.선분들은 인 점들 과 에 의해 형성된다.선분 를 포함하는 직선의 방정식은 , 즉 이다.직선의 방정식은 이다.
선분의 방정식을 매개변수 형태로 고려하자: .만약 점 가 이 선분 위에 있다면, 이고, 여기서 이고 이다.따라서 이고 이다. . 의 선분들은 , 인 직선들 의 일부이다.
점 를 고려하자.만약 가 의 선분 위에 있고 그 선분의 끝점이 과 라면, 다음이 성립한다:
우리는 , 을 만족하는 이 방정식의 유일한 해 가 가 되도록 하는 유일한 을 찾아야 한다.
와 를 방정식에 대입하면:
이는 위의 임의의 점이 선분 자체 위에 놓인다는 것을 보여준다.
를 포함하는 직선을 고려하자: .
만약 위의 점 가 과 를 끝점으로 하는 의 다른 선분 위에도 놓인다면, 다음이 성립한다:
점 가 를 비율 로 나눈다고 하자. 여기서 이다.
만약 가 과 를 끝점으로 하는 선분 위에 놓인다면, 다음이 성립한다:
우리는 를 지나고 형태이며 인 직선이 유일하게 존재하는 점 를 찾고 있다.
원점을 중심으로 하는 단위원에 대한 접선들을 고려하자. 형태의 직선들은 원 에 접한다.
쌍대 문제를 고려하자. 선분들의 족은 제1사분면에서 사분원 위의 점들에 대응한다.
선분들을 포함하는 직선들은 이다.
이 직선들의 포락선은 이 직선들을 접선으로 갖는 곡선이다.
방정식 에 제약 조건 이 주어진다.
, 라 하자. 여기서 이다.
직선들의 방정식은 이다.
직선들의 족 의 포락선은 원 이다.
의 선분들은 제1사분면에서 단위원에 대한 접선들의 일부분이다.
위의 점 가 의 다른 어떤 선분에도 속하지 않는다는 것은 를 지나는 단위원에 대한 접선이 유일하다는 것을 의미한다.
점 를 고려하자.
를 지나는 단위원에 대한 접선들은 형태이다.
만약 접선이 유일하다면, 는 단위원 위에 놓인다.
에 대해 풀면:
우리는 을 필요로 한다.
뭔가 잘못되었다. 점 가 단위원 내부에 있다.
조건을 다시 표현해 보자. 위에 유일한 점 가 존재하여, 가 \mathcal{F}\)의 선분 \(\overline{PQ} 위에 있으면 이다.
위의 점 를 라고 하자.
에서 끝점이 과 이고 인 선분을 생각하자.
선분의 매개변수 형태는 이다.
가 이 선분 위에 있으면, 어떤 에 대하여:
선분이 유일하다면, 와 의 값도 유일하다.
, 일 때 의 유일한 해는 , 이어야 한다.
를 포함하는 직선과 의 선분들이 이루는 영역의 경계의 교점을 생각하자.
경계는 축, 축, 그리고 사분원 이다.
쌍대 문제를 다시 생각하자. 직선족 , 여기서 , 이다.
이 직선들의 포락선은 원 이다.
한 점이 의 유일한 선분에 속하는 것은 그 점이 원 위에 있을 때이다.
위의 점 는 를 만족한다.
선분이 인 경우를 생각하자. 여기서 , 이다.
점 는 에 대하여 로 나타낼 수 있다.
우리는 위에 있으면서 의 다른 어떤 선분에도 속하지 않는 점 를 찾고 있다.
기하학적 구조를 생각하자. 족 는 축들과 사분원으로 둘러싸인 영역을 형성한다.
선분들은 직선 위에 중심이 있고 축들에 접하는 원들의 현이다.
선분의 끝점을 과 라고 하자.
선분 위의 점은 이다.
점
가 그러한 선분 위에 있으면, 이고 이다.
우리는 유일한 해 가 에 해당하는 이 되는 유일한 을 필요로 한다.
함수 를 고려하자.
우리는 이 필요하다.
만약 이면, 이다.
2로 나누면:
, 또는
, 따라서
만약 이면,
만약 이면,
만약 이면, 점은 이다.
이 점은 및 에 대응하는 선분들 위에 있다.
유일한 점 라는 것은 다른 값들에 대해서는 에 대한 해가 하나 이상 존재한다는 것을 의미한다.
를 지나는 단위원에 대한 접선을 고려하자.
접선이 유일하다면, 는 단위원 위에 있다.
이는 로 이어지며, 둘 다 에 속하지 않는다.
족 의 기하학적 해석을 고려하자. 선분들은 축 위의 점들을 연결하여 거리가 1이 되도록 한다.
이 선분들의 중심의 자취는 제1사분면에서 원 이다.
만약 점 가 의 선분 위에 있다면, 는 을 만족하는 과 를 연결하는 선분 위에 있다.
선분을 포함하는 직선은 이다.
만약 가 유일한 선분에 속한다면, 를 지나는 이러한 형태의 직선은 유일하다.
위의 점 는 이다.
우리는 을 만족하고 인 유일한 를 필요로 한다.
점 를 을 조건으로 하여, 를 지나고 형태인 직선이 유일하도록 하는 점이라 하자.
이 직선은 단위원에 접한다.
점 는 를 포함하는 직선과 단위원의 교점 위에 있다.
우리는 에 대한 해를 찾지 못했다.유일한 점 라는 것은 다른 어떤 선분이 를 지난다면, 그것이 반드시 여야 한다는 것을 의미한다.
과 를 연결하는 선분을 포함하는 직선의 기울기를 고려하자. 기울기는 이다.
방정식은 이다.
만약 가 선분 위에 있다면, 이다.
기하평균을 고려하자.
점 의 좌표를 라고 하자. 과 를 연결하는 선분은 를 지난다. . 만약 가 위에 있다면, 이다. .
점 는 선분족의 포락선에 접한다.
풀이: 선분족을 라고 하자. 선분들은 끝점 과 를 가지며 이고 이다. 선분 위의 점들은 을 만족한다. 선분들은 직선 위에 놓여 있으며, 여기서 , 이다.
선분 는 끝점 과 를 가진다. 를 포함하는 직선의 방정식은 이다.
위의 점 는 로 매개변수화할 수 있으며, 여기서 이다.
만약 가 의 끝점 과 를 가지는 선분에 속한다면, 이다.
우리는 위에서 와 와 구별되며, 외의 의 어떤 선분에도 속하지 않는 유일한 점 를 찾고 있다. 이는 , 인 방정식의 유일한 해 가 임을 의미한다.
의 선분들은 단위원에 대한 접선의 일부이다. 점 는 선분족의 포락선에 접해야 한다. 포락선은 단위원 자체이다.
위에서 와 와 구별되며 단위원 위에 있는 유일한 점 . 우리는 다음을 풀어야 한다:
. 점 .
이므로, , 이다. 와 는 서로소이다. .
최종 답: 최종 답은
F. 버전 관리
(2025- 03):
추가
에 정답 샘플 수 추가
(2025- 02):
인용 추가 및 기타 작은 문구 변경