
에이전트는 세션이 바뀌면 잊는다. A-Mem 은 기억을 연결된 노트로 저장하고 스스로 고쳐 쓴다. NeurIPS 2025, 전문 무료.
A-Mem: Agentic Memory for LLM Agents
A-Mem: LLM 에이전트를 위한 에이전틱 메모리
Wujiang , Zujie Liang , Kai Mei , Hang Gao , Juntao Tan , Yongfeng Zhang Rutgers University Independent Researcher AIOS Foundation wujiang.xu@rutgers.edu
초록
대규모 언어 모델(LLM) 에이전트는 복잡한 실제 과제를 위해 외부 도구를 효과적으로 사용할 수 있지만, 과거 경험을 활용하려면 메모리 시스템이 필요하다. 현재의 메모리 시스템은 기본적인 저장 및 검색을 가능하게 하지만 정교한 메모리 조직 능력은 부족하며, 최근에는 그래프 데이터베이스를 도입하려는 시도가 있었음에도 그러하다. 더욱이 이러한 시스템의 고정된 연산과 구조는 다양한 과제 전반에 걸친 적응성을 제한한다. 이러한 한계를 해결하기 위해 본 논문은 메모리를 에이전틱 방식으로 동적으로 조직할 수 있는 LLM 에이전트용 새로운 에이전틱 메모리 시스템을 제안한다. 우리는 Zettelkasten 방법의 기본 원칙에 따라 동적 인덱싱과 연결을 통해 상호 연결된 지식 네트워크를 생성하도록 메모리 시스템을 설계하였다. 새로운 메모리가 추가되면, 우리는 맥락 설명, 키워드 및 태그를 포함한 여러 구조화된 속성을 담은 포괄적인 노트를 생성한다. 그런 다음 시스템은 과거 메모리를 분석하여 관련 연결을 식별하고, 의미 있는 유사성이 존재하는 곳에 링크를 설정한다. 또한 이 과정은 메모리 진화를 가능하게 한다 – 새로운 메모리가 통합될 때, 이는 기존 과거 메모리의 맥락적 표현과 속성에 대한 업데이트를 촉발할 수 있어, 메모리 네트워크가 지속적으로 그 이해를 정교화할 수 있게 한다. 우리의 접근 방식은 Zettelkasten의 구조화된 조직 원칙과 에이전트 주도 의사 결정의 유연성을 결합하여, 보다 적응적이고 맥락을 인식하는 메모리 관리를 가능하게 한다. 여섯 개의 기반 모델에 대한 실증 실험은 기존 SOTA 베이스라인 대비 뛰어난 개선을 보여준다.
벤치마크 평가 코드: https://github.com/WujiangXu/AgenticMemory 프로덕션 준비 완료 에이전틱 메모리 코드: https://github.com/WujiangXu/A- mem- sys
1 서론
대규모 언어 모델(LLM) 에이전트는 다양한 과제에서 놀라운 능력을 입증해 왔으며, 최근의 발전으로 환경과 상호작용하고, 과제를 실행하며, 자율적으로 의사 결정을 내릴 수 있게 되었다 [23, 33, 7]. 이들은 LLM을 외부 도구 및 정교한 워크플로와 통합하여 추론 및 계획 능력을 향상시킨다. LLM 에이전트는 강력한 추론 성능을 지니지만, 외부 환경과의 장기적 상호작용 능력을 제공하기 위해서는 여전히 메모리 시스템이 필요하다 [35].
LLM 에이전트를 위한 기존 메모리 시스템 [25, 39, 28, 21]은 기본적인 메모리 저장 기능을 제공한다. 이러한 시스템은 에이전트 개발자가 메모리 저장 구조를 미리 정의하고, 워크플로 내 저장 지점을 지정하며, 검색 시점을 설정하도록 요구한다. 한편, 구조화된 메모리 조직을 개선하기 위해 Mem0 [8]는 RAG [9, 18, 30]의 원칙에 따라 저장 및 검색 과정에 그래프 데이터베이스를 통합한다. 그래프 데이터베이스는 메모리 시스템에 구조화된 조직을 제공하지만, 미리 정의된 스키마와 관계에 대한 의존은 근본적으로 그 적응성을 제한한다. 이러한 한계는 실제 시나리오에서 명확히 드러난다 – 에이전트가 새로운 수학적 해법을 학습할 때, 현재 시스템은 이 정보를 미리 설정된 프레임워크 내에서 분류하고 연결할 수 있을 뿐이며,
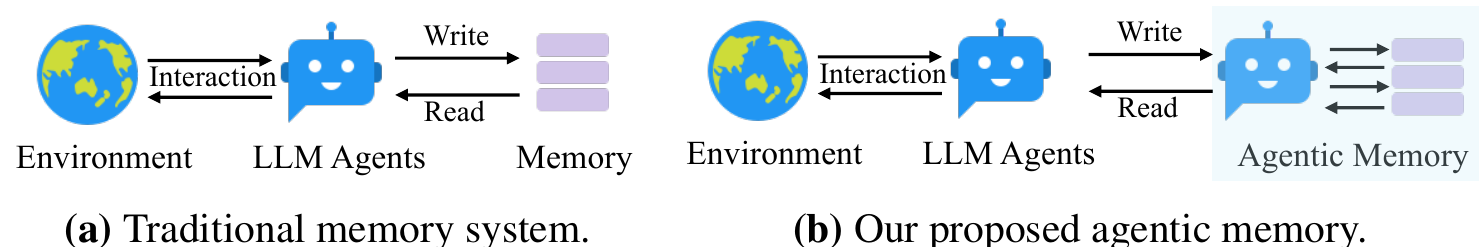
지식이 진화함에 따라 혁신적인 연결을 형성하거나 새로운 조직 패턴을 개발할 수 없다. 이러한 경직된 구조는 고정된 에이전트 워크플로와 결합되어, 이러한 시스템이 새로운 환경 전반에 일반화하고 장기적 상호작용에서 효과성을 유지하는 능력을 심각하게 제한한다. LLM 에이전트가 더욱 복잡하고 개방형인 과제를 다루게 되면서, 유연한 지식 조직과 지속적 적응이 필수적이기에 이 과제는 점점 더 중요해지고 있다. 따라서 LLM 에이전트의 장기적 상호작용을 지원하는 유연하고 범용적인 메모리 시스템을 설계하는 방법은 여전히 핵심적인 과제이다.
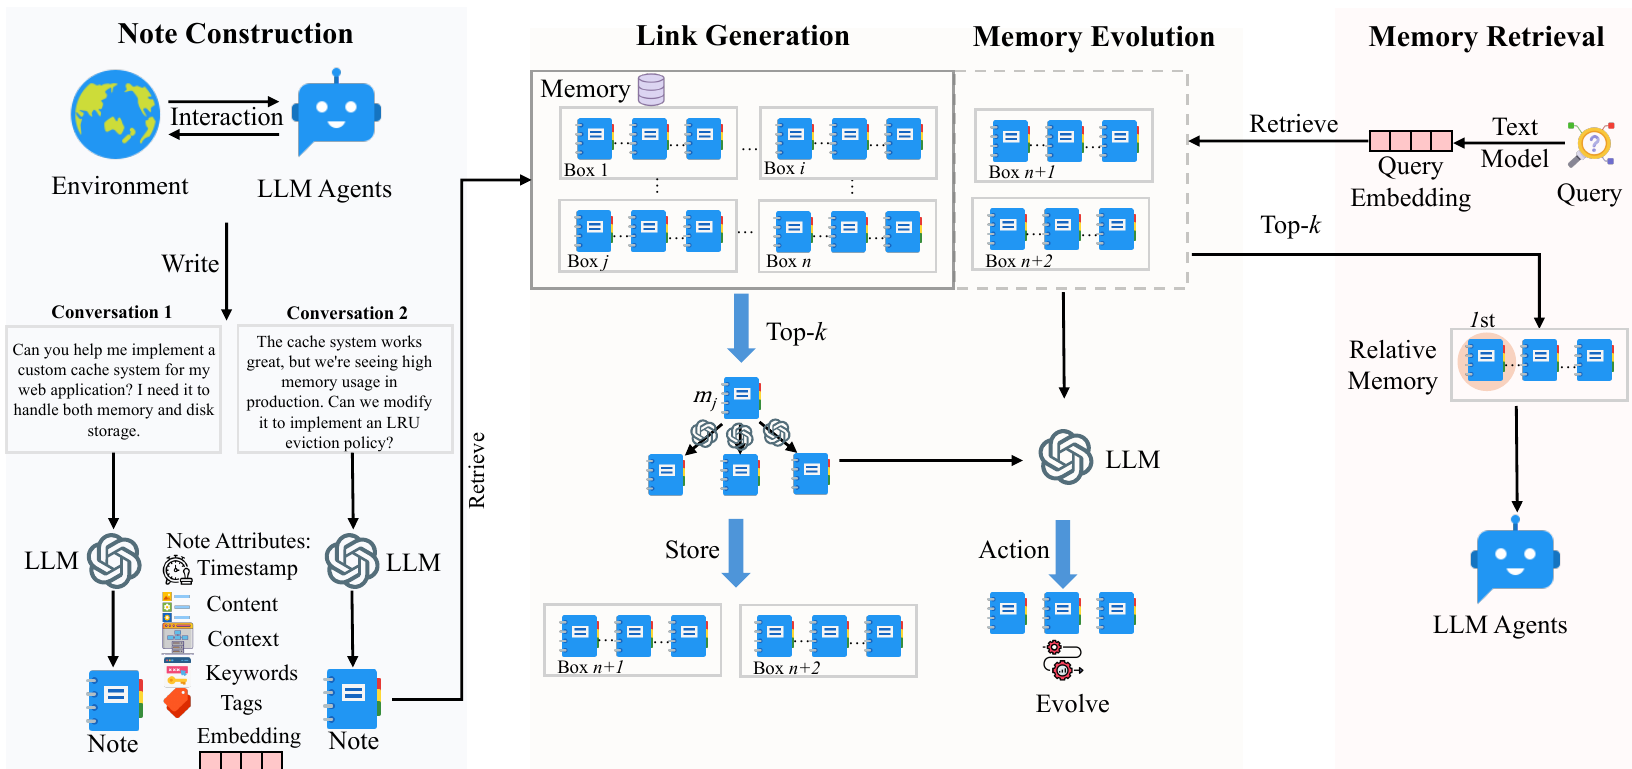
본 논문에서 우리는 A- MEM이라 명명된, 정적이고 미리 정해진 메모리 연산에 의존하지 않고 동적 메모리 구조화를 가능하게 하는 LLM 에이전트용 새로운 에이전틱 메모리 시스템을 소개한다. 우리의 접근 방식은 원자적 노트와 유연한 연결 메커니즘을 통해 상호 연결된 정보 네트워크를 생성하는 정교한 지식 관리 시스템인 Zettelkasten 방법 [15, 1]에서 영감을 받았다. 우리의 시스템은 LLM 에이전트를 위한 자율적이고 유연한 메모리 관리를 가능하게 하는 에이전틱 메모리 아키텍처를 소개한다. 각각의 새로운 메모리에 대해, 우리는 여러 표현을 통합하는 포괄적인 노트를 구축한다: 여러 속성을 포함한 구조화된 텍스트 속성과 유사성 매칭을 위한 임베딩 벡터이다. 그런 다음 A- MEM은 과거 메모리 저장소를 분석하여 의미적 유사성과 공유 속성에 기반한 의미 있는 연결을 수립한다. 이 통합 과정은 새로운 링크를 생성할 뿐만 아니라 새로운 메모리가 통합될 때 동적 진화를 가능하게 한다 — 이는 기존 메모리의 맥락적 표현에 대한 업데이트를 촉발할 수 있어, 전체 메모리가 시간이 지남에 따라 지속적으로 정교화되고 그 이해를 심화할 수 있게 한다. 기여는 다음과 같이 요약된다:
- 우리는 LLM 에이전트를 위한 에이전틱 메모리 시스템인 A-MEM을 제시하며, 이는 맥락 설명의 자율적 생성, 메모리 연결의 동적 수립, 그리고 새로운 경험에 기반한 기존 메모리의 지능적 진화를 가능하게 한다. 이 시스템은 LLM 에이전트에게 미리 정해진 메모리 연산을 요구하지 않으면서 장기적 상호작용 능력을 갖추게 한다.
- 우리는 새로운 메모리가 두 가지 핵심 연산을 자동으로 촉발하는 에이전틱 메모리 업데이트 메커니즘을 설계한다: 링크 생성과 메모리 진화이다. 링크 생성은 공유 속성과 유사한 맥락 설명을 식별하여 메모리 간의 연결을 자동으로 수립한다. 메모리 진화는 새로운 경험이 분석됨에 따라 기존 메모리가 동적으로 적응할 수 있게 하여, 고차원적 패턴과 속성의 출현을 이끌어낸다.
- 우리는 장기 대화 데이터셋을 사용하여 우리 시스템에 대한 포괄적인 평가를 수행하고, 여섯 가지 서로 다른 평가 지표를 사용하여 여섯 개의 기반 모델 전반의 성능을 비교함으로써 상당한 개선을 입증한다. 더욱이, 우리는 우리 에이전틱 메모리 시스템의 구조화된 조직을 보여주기 위한 T-SNE 시각화를 제공한다.
2 관련 연구
2.1 LLM 에이전트를 위한 메모리
LLM 에이전트 메모리 시스템에 관한 선행 연구들은 메모리 관리 및 활용을 위한 다양한 메커니즘을 탐구해 왔다 [23, 21, 8, 39]. 일부 접근 방식은 완전한 상호작용 저장을 수행하며, 이는 밀집 검색 모델 [39] 또는 읽기- 쓰기 메모리 구조 [24]를 통해 포괄적인 이력 기록을 유지한다. 더욱이, MemGPT [25]는 캐시와 유사한 아키텍처를 활용하여 최근 정보에 우선순위를 둔다. 마찬가지로, SCM [32]은 메모리 스트림과 컨트롤러 메커니즘을 통해 LLM이 장기 메모리를 유지하는 능력을 향상시키는 자기 통제 메모리(Self- Controlled Memory) 프레임워크를 제안한다. 그러나 이러한 접근 방식은 다양한 실제 과제를 처리하는 데 있어 상당한 한계에 직면한다. 이들은 기본적인 메모리 기능을 제공할 수 있지만, 그 연산은 일반적으로 미리 정의된 구조와 고정된 워크플로에 의해 제약된다. 이러한 제약은 특히 메모리 쓰기 및 검색 과정에서 경직된 운영
패턴에 대한 의존에서 비롯된다. 이러한 비유연성은 새로운 환경에서의 낮은 일반화와 장기적 상호작용에서의 제한된 효과성을 초래한다. 따라서 에이전트의 장기적 상호작용을 지원하는 유연하고 범용적인 메모리 시스템을 설계하는 것은 여전히 핵심적인 과제이다.
2.2 검색 증강 생성
검색 증강 생성(RAG)은 외부 지식 소스를 통합하여 LLM을 향상시키는 강력한 접근 방식으로 등장했다 [18, 6, 10]. 표준 RAG [37, 34] 과정은 문서를 청크로 인덱싱하고, 의미적 유사성에 기반하여 관련 청크를 검색하며, 이 검색된 맥락으로 LLM의 프롬프트를 증강하여 생성을 수행하는 것을 포함한다. 고급 RAG 시스템 [20, 12]은 정교한 검색 전 및 검색 후 최적화를 포함하도록 진화해 왔다. 이러한 기반 위에서, 최근 연구는 검색 과정에서 보다 자율적이고 적응적인 행동을 보여주는 에이전틱 RAG 시스템을 도입했다. 이러한 시스템은 언제 무엇을 검색할지를 동적으로 결정하고 [4, 14], 검색을 안내하기 위한 가상 응답을 생성하며, 중간 결과에 기반하여 검색 전략을 반복적으로 정교화할 수 있다 [31, 29].
그러나, 에이전틱 RAG 접근 방식이 언제 무엇을 검색할지를 자율적으로 결정함으로써 검색 단계에서 행위성을 보여주지만 [4, 14, 38], 우리의 에이전틱 메모리 시스템은 메모리 구조의 자율적 진화를 통해 보다 근본적인 수준에서 행위성을 발휘한다. Zettelkasten 방법에서 영감을 받은 우리의 시스템은 메모리가 스스로의 맥락 설명을 적극적으로 생성하고, 관련 메모리와 의미 있는 연결을 형성하며, 새로운 경험이 나타남에 따라 그 내용과 관계 모두를 진화시킬 수 있게 한다. 검색 대 저장 및 진화 사이의 이러한 행위성의 근본적 차이는, 정교한 검색 메커니즘에도 불구하고 정적 지식 기반을 유지하는 에이전틱 RAG 시스템과 우리의 접근 방식을 구별한다.
3 방법론
우리가 제안한 에이전틱 메모리 시스템은 Zettelkasten 방법에서 영감을 받아, LLM 에이전트가 미리 정해진 연산 없이 장기 메모리를 유지할 수 있게 하는 동적이고 자기 진화하는 메모리 시스템을 구현한다. 시스템의 설계는 원자적 노트 작성, 유연한 연결 메커니즘, 그리고 지식 구조의 지속적 진화를 강조한다.
3.1 노트 구성
Zettelkasten 방법의 원자적 노트 작성과 유연한 조직 원칙을 바탕으로, 우리는 메모리 노트 구성에 대한 LLM 주도 접근 방식을 소개한다. 에이전트가 환경과 상호작용할 때, 우리는 명시적 정보와 LLM이 생성한 맥락적 이해를 모두 포착하는 구조화된 메모리 노트를 구성한다. 우리의 컬렉션 내 각각의 메모리 노트 는 다음과 같이 표현된다:
여기서 는 원본 상호작용 내용을 나타내고, 는 상호작용의 타임스탬프이며, 는 핵심 개념을 포착하는 LLM 생성 키워드를 나타내고, 는 분류를 위한 LLM 생성 태그를 포함하며, 는 풍부한 의미 이해를 제공하는 LLM 생성 맥락 설명을 나타내고, 는 의미적 관계를 공유하는 연결된 기억들의 집합을 유지한다. 각 기억 노트를 기본 내용과 타임스탬프를 넘어 의미 있는 맥락으로 풍부하게 하기 위해, 우리는 LLM을 활용하여 상호작용을 분석하고 이러한 의미적 구성요소들을 생성한다. 노트 구성 과정은 신중하게 설계된 템플릿 으로 LLM에 프롬프트를 제공하는 것을 포함한다:
원자성이라는 Zettelkasten 원칙에 따라, 각 노트는 단일하고 자기 완결적인 지식 단위를 포착한다. 효율적인 검색과 연결을 가능하게 하기 위해, 우리는 노트의 모든 텍스트 구성요소를 포괄하는 텍스트 인코더 [27]를 통한 밀집 벡터 표현을 계산한다:
LLM을 사용하여 풍부화된 구성요소들을 생성함으로써, 우리는 원시 상호작용으로부터 암묵적 지식을 자율적으로 추출할 수 있게 한다. 다면적 노트 구조 는 기억의 서로 다른 측면을 포착하는 풍부한 표현을 생성하여, 세밀한 조직화와 검색을 촉진한다. 또한, LLM 생성 의미적 구성요소들과 밀집 벡터 표현의 결합은 맥락과 계산적으로 효율적인 유사도 매칭을 모두 제공한다.
3.2 링크 생성
우리 시스템은 새로운 기억 노트가 미리 정의된 규칙 없이 의미 있는 연결을 형성할 수 있게 하는 자율적 링크 생성 메커니즘을 구현한다. 구성된 기억 노트 이 시스템에 추가될 때, 우리는 먼저 그 의미적 임베딩을 유사도 기반 검색에 활용한다. 각 기존 기억 노트 에 대해, 우리는 유사도 점수를 계산한다:
그런 다음 시스템은 가장 관련성 높은 상위 개의 기억들을 식별한다:
이러한 후보 최근접 기억들을 기반으로, 우리는 LLM에 프롬프트를 제공하여 그들의 잠재적 공통 속성에 기반한 잠재적 연결을 분석하게 한다. 형식적으로, 기억 의 링크 집합은 다음과 같이 갱신된다:
각 생성된 링크 는 다음과 같은 구조로 이루어진다: . 임베딩 기반 검색을 초기 필터로 사용함으로써, 우리는 의미론적 관련성을 유지하면서도 효율적인 확장성을 가능하게 한다. A-MEM은 방대한 메모리 집합에서도 전수 비교 없이 잠재적 연결을 신속하게 식별할 수 있다. 더욱 중요하게도, LLM 기반 분석은 단순한 유사도 지표를 넘어서는 관계에 대한 미묘한 이해를 가능하게 한다. 언어 모델은 임베딩 유사도만으로는 명확히 드러나지 않을 수 있는 미세한 패턴, 인과 관계, 개념적 연결을 식별할 수 있다. 우리는 현대 언어 모델을 활용하면서 Zettelkasten의 유연한 연결 원칙을 구현한다. 그 결과로 형성된 네트워크는 메모리 내용과 맥락으로부터 유기적으로 창발하여 자연스러운 지식 조직화를 가능하게 한다.
3.3 메모리 진화
새로운 메모리에 대한 링크를 생성한 후, A-MEM은 검색된 메모리들을 그들의 텍스트 정보와 새로운 메모리와의 관계에 기반하여 진화시킨다. 최근접 이웃 집합 내의 각 메모리 에 대해, 시스템은 해당 메모리의 맥락, 키워드, 태그를 갱신할지 여부를 결정한다. 이 진화 과정은 다음과 같이 형식적으로 표현할 수 있다:
진화된 메모리 는 이후 메모리 집합 내에서 원래 메모리 를 대체한다. 이러한 진화적 접근은 인간의 학습 과정을 모방하여 지속적인 갱신과 새로운 연결을 가능하게 한다. 시스템이 시간이 지남에 따라 더 많은 메모리를 처리함에 따라, 점점 더 정교한 지식 구조를 발전시키며 여러 메모리에 걸친 고차원적 패턴과 개념을 발견한다. 이는 새로운 경험과 기존 메모리 간의 지속적인 상호작용을 통해 지식 조직화가 점진적으로 풍부해지는 자율적 메모리 학습의 토대를 마련한다.
3.4 관련 메모리 검색
각 상호작용에서 우리의 A-MEM은 에이전트에게 관련된 과거 정보를 제공하기 위해 맥락 인식 메모리 검색을 수행한다. 현재 상호작용으로부터 주어진 질의 텍스트 에 대해, 우리는 먼저 메모리 노트에 사용된 것과 동일한 텍스트 인코더를 사용하여 그 밀집 벡터 표현을 계산한다:
그런 다음 시스템은 코사인 유사도를 사용하여 질의 임베딩과 내의 모든 기존 메모리 노트 간의 유사도 점수를 계산한다:
이후 우리는 역사적 메모리 저장소로부터 가장 관련성 높은 k개의 메모리를 검색하여 맥락에 적합한 프롬프트를 구성한다.
이렇게 검색된 메모리들은 현재 상호작용을 더 잘 이해하고 응답하는 데 도움이 되는 관련 역사적 맥락을 제공한다. 검색된 맥락은 현재 상호작용을 메모리 시스템에 저장된 관련 과거 경험과 연결함으로써 에이전트의 추론 과정을 풍부하게 한다.
4 실험
4.1 데이터셋 및 평가
장기 대화에서 명령 인식 추천의 효과를 평가하기 위해, 우리는 기존 대화 데이터셋 [36, 13]에 비해 훨씬 더 긴 대화를 포함하는 LoCoMo 데이터셋 [22]을 활용한다. 기존 데이터셋은 4-5 세션에 걸쳐 약 1K 토큰의 대화를 포함하는 반면, LoCoMo는 최대 35 세션에 걸쳐 평균 9K 토큰에 달하는 훨씬 더 긴 대화를 특징으로 하여, 장거리 의존성을 처리하고 장기간의 대화에서 일관성을 유지하는 모델의 능력을 평가하기에 특히 적합하다. LoCoMo 데이터셋은 모델 이해의 다양한 측면을 종합적으로 평가하기 위해 설계된 다양한 질문 유형으로 구성된다: (1) 단일 세션에서 답할 수 있는 단일 홉 질문; (2) 세션 간 정보 종합이 필요한 다중 홉 질문; (3) 시간 관련 정보에 대한 이해를 테스트하는 시간적 추론 질문; (4) 대화 맥락과 외부 지식의 통합이 필요한 개방형 도메인 지식 질문; (5) 답할 수 없는 질의를 식별하는 모델의 능력을 평가하는 적대적 질문. 총계로, LoCoMo는 이러한 범주에 걸쳐 7,512개의 질의응답 쌍을 포함한다. 또한, 우리는 우리의 메모리 시스템의 효과를 평가하기 위해 DialSim [16]이라는 새로운 데이터셋을 사용한다. 이는 장기 다자간 대화에서 파생된 질의응답 데이터셋이다. 이 데이터셋은 인기 TV 프로그램(Friends, The Big Bang Theory, The Office)에서 파생되었으며, 5년에 걸친 1,300개의 세션을 포함하고, 약 350,000개의 토큰을 포함하며, 정제된 팬 퀴즈 웹사이트 질문과 시간적 지식 그래프로부터 생성된 복잡한 질문으로부터 세션당 1,000개 이상의 질문을 포함한다.
비교 기준선으로, 우리는 LoCoMo [22], ReadAgent [17], MemoryBank [39], MemGPT [25]와 비교한다. 기준선에 대한 자세한 소개는 부록 A.1에서 확인할 수 있다. 평가를 위해, 우리는 두 가지 주요 지표를 사용한다: 정밀도와 재현율의 균형을 통해 답변 정확도를 평가하는 F1 점수와, 정답 응답과의 단어 중첩을 측정하여 생성된 응답 품질을 평가하는 BLEU-1 [26]이다. 또한, 우리는 한 질문에 답하기 위한 평균 토큰 길이를 보고한다.
| 모델 | 방법 | 범주 | 평균 | ||||||||||
| 멀티 홉 F1 | BLEU | 시간적 F1 | 오픈 도메인 F1 | 단일 홉 F1 | BLEU | 적대적 F1 | BLEU | 순위 F1 | BLEU | 토큰 길이 | |||
| GPT | LoCoMo | 25.02 | 19.75 | 18.41 | 14.77 | 12.04 | 11.16 | 40.36 | 29.05 | 69.23 | 68.75 | 2.4 | 2.4 |
| READAGENT | 9.15 | 6.48 | 12.60 | 8.87 | 5.31 | 5.12 | 9.67 | 7.66 | 9.81 | 9.02 | 4.2 | 4.2 | |
| MEMORYBANK | 5.00 | 4.77 | 9.68 | 6.99 | 5.56 | 5.94 | 6.61 | 5.16 | 7.36 | 6.48 | 4.8 | 4.8 | |
| MEMGPT | 26.65 | 17.72 | 25.52 | 19.44 | 9.15 | 7.44 | 41.04 | 34.34 | 43.29 | 42.73 | 2.4 | 2.4 | |
| A-MEM | 27.02 | 20.09 | 45.85 | 36.67 | 12.14 | 12.00 | 44.65 | 37.06 | 50.03 | 49.47 | 1.2 | 1.2 | |
| GPT | LoCoMo | 28.00 | 18.47 | 9.09 | 5.78 | 16.47 | 14.80 | 61.56 | 54.19 | 52.61 | 51.13 | 2.0 | 2.0 |
| READAGENT | 14.61 | 9.95 | 4.16 | 3.19 | 8.84 | 8.37 | 12.46 | 10.29 | 6.81 | 6.13 | 4.0 | 4.0 | |
| MEMORYBANK | 6.49 | 4.69 | 2.47 | 2.43 | 6.43 | 5.30 | 8.28 | 7.10 | 4.42 | 3.67 | 5.0 | 5.0 | |
| MEMGPT | 30.36 | 22.83 | 17.29 | 13.18 | 12.24 | 11.87 | 60.16 | 53.35 | 34.96 | 34.25 | 2.4 | 2.4 | |
| A-MEM | 32.86 | 23.76 | 39.41 | 31.23 | 17.10 | 15.84 | 48.43 | 42.97 | 36.35 | 35.53 | 1.6 | 1.6 | |
| GPT | LoCoMo | 9.05 | 6.55 | 4.25 | 4.04 | 9.91 | 8.50 | 11.15 | 8.67 | 40.38 | 40.23 | 3.4 | 3.4 |
| READAGENT | 6.61 | 4.93 | 2.55 | 2.51 | 5.31 | 12.24 | 10.13 | 7.54 | 5.42 | 27.32 | 4.6 | 4.6 | |
| MEMORYBANK | 11.14 | 8.25 | 4.46 | 2.87 | 8.05 | 6.21 | 13.42 | 11.01 | 36.76 | 34.00 | 2.6 | 2.6 | |
| MEMGPT | 10.44 | 7.61 | 4.21 | 3.89 | 13.42 | 11.64 | 9.56 | 7.34 | 31.51 | 28.90 | 3.4 | 3.4 | |
| A-MEM | 18.23 | 11.94 | 24.32 | 19.74 | 16.48 | 14.31 | 23.63 | 19.23 | 46.00 | 43.26 | 1.0 | 1.0 | |
| GPT | LoCoMo | 4.61 | 4.29 | 3.11 | 2.71 | 4.55 | 5.97 | 7.03 | 5.69 | 16.95 | 14.81 | 3.2 | 3.2 |
| READAGENT | 2.47 | 1.78 | 3.01 | 3.01 | 5.57 | 5.22 | 3.25 | 2.51 | 15.78 | 14.01 | 4.2 | 4.2 | |
| MEMORYBANK | 3.60 | 3.39 | 1.97 | 1.67 | 6.63 | 6.58 | 4.11 | 3.32 | 13.07 | 10.30 | 4.2 | 4.2 | |
| MEMGPT | 5.07 | 4.31 | 2.94 | 2.95 | 7.04 | 7.10 | 7.26 | 5.52 | 14.47 | 12.39 | 2.4 | 2.4 | |
| A-MEM | 12.57 | 9.01 | 27.59 | 25.07 | 7.12 | 7.28 | 17.23 | 13.12 | 27.91 | 25.15 | 1.0 | 1.0 | |
| LLaMA 2 | LoCoMo | 11.25 | 9.18 | 7.38 | 6.82 | 11.90 | 10.38 | 12.86 | 10.50 | 51.89 | 48.27 | 3.4 | 3.4 |
| READAGENT | 5.96 | 5.12 | 1.93 | 2.30 | 12.46 | 11.17 | 7.75 | 6.03 | 44.64 | 40.15 | 4.6 | 4.6 | |
| MEMORYBANK | 13.18 | 10.03 | 7.61 | 6.27 | 15.78 | 12.94 | 17.30 | 14.03 | 52.61 | 47.53 | 2.0 | 2.0 | |
| MEMGPT | 9.19 | 6.96 | 4.02 | 4.79 | 11.34 | 8.24 | 10.16 | 7.68 | 49.75 | 45.11 | 4.0 | 4.0 | |
| A-MEM | 19.06 | 11.71 | 17.80 | 10.28 | 17.55 | 14.67 | 28.51 | 24.13 | 58.81 | 54.28 | 1.0 | 1.0 | |
| LLaMA 2 | LoCoMo | 6.88 | 5.77 | 4.37 | 4.40 | 10.65 | 9.29 | 8.37 | 6.93 | 30.25 | 28.46 | 2.8 | 2.8 |
| READAGENT | 2.47 | 1.78 | 3.01 | 3.01 | 5.57 | 5.22 | 3.25 | 2.51 | 15.78 | 14.01 | 4.2 | 4.2 | |
| MEMORYBANK | 6.19 | 4.47 | 3.49 | 3.13 | 4.07 | 4.57 | 7.61 | 6.03 | 18.65 | 17.05 | 3.2 | 3.2 | |
| MEMGPT | 5.32 | 3.99 | 2.68 | 2.72 | 5.64 | 5.54 | 4.32 | 3.51 | 21.45 | 19.37 | 3.8 | 3.8 | |
| A-MEM | 17.44 | 11.74 | 26.38 | 19.50 | 12.53 | 11.83 | 28.14 | 23.87 | 42.04 | 40.60 | 1.0 | 1.0 | |
네 가지 추가 지표(ROUGE-L, ROUGE-2, METEOR, SBERT Similarity)를 사용한 실험 결과를 보고하는 것과 더불어, 우리는 DeepSeek-R1-32B [11], Claude 3.0 Haiku [2], Claude 3.5 Haiku [3]을 포함한 다양한 기초 모델을 사용한 실험 결과도 부록 A.3에서 제시한다.
4.2 구현 세부사항
모든 기준선과 우리가 제안한 방법에 대해, 우리는 부록 B에 상세히 기술된 것과 동일한 시스템 프롬프트를 사용하여 일관성을 유지한다. Qwen-1.5B/3B와 Llama 3.2 1B/3B 모델의 배포는 Ollama 1을 사용한 로컬 인스턴스화를 통해 이루어지며, LiteLLM 2이 구조화된 출력 생성을 관리한다. GPT 모델의 경우, 우리는 공식 구조화된 출력 API를 활용한다. 우리의 메모리 검색 과정에서, 우리는 주로 계산 효율성을 유지하기 위해 상위- 메모리 선택에 을 사용하며, 특정 범주에 대해서는 성능을 최적화하기 위해 이 매개변수를 조정한다. 의 상세한 구성은 부록 A.5에서 확인할 수 있다. 텍스트 임베딩의 경우, 우리는 모든 실험에서 all-miniml-16-v2 모델을 구현한다.
4.3 실증적 결과
성능 분석. 우리의 실증적 평가에서, 우리는 LoCoMo 데이터셋에서 LoCoMo [22], ReadAgent [17], MemoryBank [39], MemGPT [25]를 포함한 네 가지 경쟁력 있는 기준선과 A-MEM을 비교했다. 비-GPT 기초 모델의 경우, 우리의 A-MEM은 다양한 범주에 걸쳐 모든 기준선을 일관되게 능가하며, 우리의 에이전트 메모리 접근법의 효과를 입증한다. GPT 기반 모델의 경우, LoCoMo와 MemGPT는 단순 사실 검색에서의 견고한 사전 학습 지식 덕분에 개방형 도메인과 적대적 과제 같은 특정 범주에서 강력한 성능을 보이지만, 우리의 A-MEM은 복잡한 추론 연쇄를 요구하는 다중 홉 과제에서 최소 두 배 더 나은 성능을 달성하며 우수한 성능을 입증한다. LoCoMo 데이터셋에 대한 실험에 더하여, 우리는 DialSim 데이터셋에서도 우리의 방법을 LoCoMo 및 MemGPT와 비교한다. A-MEM은 평가 지표 전반에 걸쳐 모든 기준선을 일관되게 능가하며, F1
| 방법 | F1 | BLEU-1 | ROUGE-L | ROUGE-2 | METEOR | SBERT 유사도 |
| LoCoMo | 2.55 | 3.13 | 2.75 | 0.90 | 1.64 | 15.76 |
| MemGPT | 1.18 | 1.07 | 0.96 | 0.42 | 0.95 | 8.54 |
| A-MEM | 3.45 | 3.37 | 3.54 | 3.60 | 2.05 | 19.51 |
| 방법 | 멀티 홉 | 시간적 | 카테고리 | 단일 홉 | 적대적 | |||||
| F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | |
| LG & ME 제외 | 9.65 | 7.09 | 24.55 | 19.48 | 7.77 | 6.70 | 13.28 | 10.30 | 15.32 | 18.02 |
| ME 제외 | 21.35 | 15.13 | 31.24 | 27.31 | 10.13 | 10.85 | 39.17 | 34.70 | 44.16 | 45.33 |
| A-MEM | 27.02 | 20.09 | 45.85 | 36.67 | 12.14 | 12.00 | 44.65 | 37.06 | 50.03 | 49.47 |
점수 3.45를 달성한다(LoCoMo의 2.55 대비 향상, MemGPT의 1.18 대비 더 높음). A-MEM의 효과는 동적이고 구조화된 메모리 관리를 가능하게 하는 새로운 에이전트 메모리 아키텍처에서 비롯된다. 정적 메모리 연산을 사용하는 전통적 접근법과 달리, 우리의 시스템은 풍부한 맥락적 설명을 지닌 원자적 노트를 통해 상호 연결된 메모리 네트워크를 생성하여 더 효과적인 다중 홉 추론을 가능하게 한다. 공유 속성에 기반하여 메모리 간의 연결을 동적으로 설정하고 기존 메모리 설명을 새로운 맥락 정보로 지속적으로 갱신하는 시스템의 능력은 서로 다른 정보 조각들 간의 관계를 더 잘 포착하고 활용할 수 있게 한다.
비용 효율성 분석. A-MEM은 강력한 성능과 더불어 상당한 계산 및 비용 효율성을 입증한다. 시스템은 메모리 연산당 약 1,200개의 토큰을 요구하며, 우리의 선택적 상위-k 검색 메커니즘을 통해 기준선 방법(LoCoMo 및 MemGPT의 16,900 토큰)과 비교하여 토큰 사용량에서 감소를 달성한다. 이러한 상당한 토큰 감소는 직접적으로 더 낮은 운영 비용으로 이어지며, 상용 API 서비스를 사용할 때 각 메모리 연산 비용은 0.0003 미만으로—대규모 배포를 경제적으로 실행 가능하게 만든다. 처리 시간은 GPT-4o-mini를 사용할 때 평균 5.4초이며, 단일 GPU에서 로컬로 호스팅된 Llama 3.2 1B를 사용하면 단지 1.1초에 불과하다. 메모리 처리 중 여러 번의 LLM 호출을 필요로 함에도 불구하고, A-MEM은 이러한 비용 효율적인 자원 활용을 유지하면서 테스트된 모든 기초 모델에 걸쳐 기준선 접근법을 일관되게 능가하며, 특히 복잡한 다중 홉 추론 과제에서 두 배의 성능을 보인다. 낮은 계산 비용과 우수한 추론 능력의 이러한 균형은 실제 세계에서의 배포를 위한 A-MEM의 실용적 이점을 부각시킨다.
4.4 소거 연구
Link Generation(LG) 및 Memory Evolution(ME) 모듈의 효과를 평가하기 위해, 우리는 모델의 핵심 구성 요소를 체계적으로 제거하는 절제 연구(ablation study)를 수행한다. LG와 ME 모듈을 모두 제거했을 때, 시스템은 특히 Multi Hop 추론 및 Open Domain 작업에서 상당한 성능 저하를 보인다. LG만 활성화된 시스템(w/o ME)은 중간 수준의 성능을 보이며, 두 모듈이 모두 없는 버전보다 현저히 더 나은 결과를 유지하는데, 이는 메모리 연결을 구축하는 데 있어 링크 생성의 근본적인 중요성을 입증한다. 우리의 전체 모델인 A-MEM은 모든 평가 범주에서 일관되게 최고의 성능을 달성하며, 특히 복잡한 추론 작업에서 강력한 결과를 보인다. 이러한 결과는 링크 생성 모듈이 메모리 구성의 핵심 기반 역할을 하는 반면, 메모리 진화 모듈은 메모리 구조에 필수적인 개선을 제공한다는 것을 보여준다. 절제 연구는 우리의 아키텍처 설계 선택을 검증하고, 효과적인 메모리 시스템을 구축하는 데 있어 이 두 모듈의 상호 보완적 특성을 강조한다.
4.5 하이퍼파라미터 분석
우리는 각 상호작용에 대해 검색되는 관련 메모리의 수를 제어하는 메모리 검색 파라미터 k의 영향을 분석하기 위해 광범위한 실험을 수행했다. Figure 3에 나타난 바와 같이, 우리는 GPT-4o-mini를 기본 모델로 사용하여 다섯 가지 범주의 작업에서 서로 다른 k 값(10, 20, 30, 40, 50)에 걸친 성능을 평가했다. 결과는 흥미로운 패턴을 드러낸다. k를 증가시키는 것이 일반적으로 성능 향상으로 이어지지만, 이러한 향상은 점차 정체되고 때로는 더 높은 값에서 약간 감소한다. 이러한 경향은 Multi Hop 및 Open Domain 작업에서 특히 두드러진다.
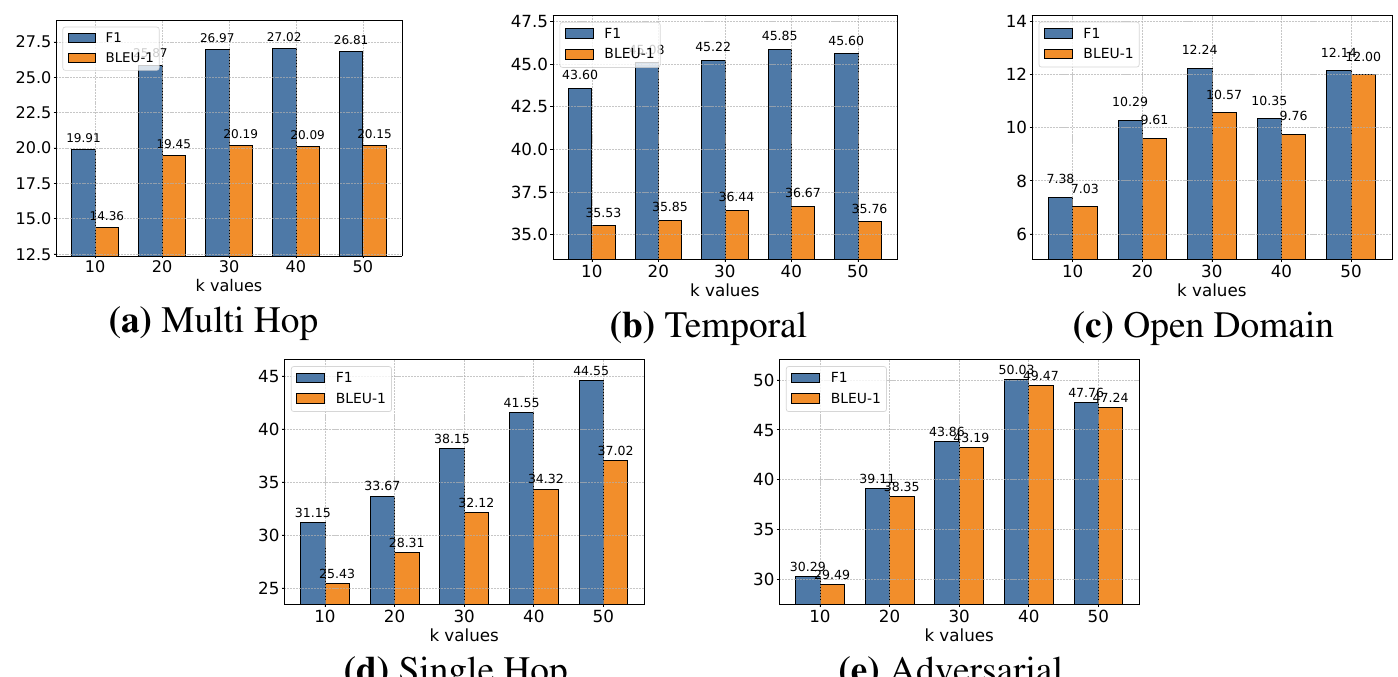
Table 4: 서로 다른 메모리 방법 및 규모에 걸친 메모리 사용량과 검색 시간 비교.
| 메모리 크기 | 방법 | 메모리 사용량 (MB) | 검색 시간 (μs) |
| 1,000 | A-MEM | 1.46 | 0.31 ± 0.30 |
| MemoryBank [39] | 1.46 | 0.24 ± 0.20 | |
| ReadAgent [17] | 1.46 | 43.62 ± 8.47 | |
| 10,000 | A-MEM | 14.65 | 0.38 ± 0.25 |
| MemoryBank [39] | 14.65 | 0.26 ± 0.13 | |
| ReadAgent [17] | 14.65 | 484.45 ± 93.86 | |
| 100,000 | A-MEM | 146.48 | 1.40 ± 0.49 |
| MemoryBank [39] | 146.48 | 0.78 ± 0.26 | |
| ReadAgent [17] | 146.48 | 6,682.22 ± 111.63 | |
| 1,000,000 | A-MEM | 1464.84 | 3.70 ± 0.74 |
| MemoryBank [39] | 1464.84 | 1.91 ± 0.31 | |
| ReadAgent [17] | 1464.84 | 120,069.68 ± 1,673.39 |
이러한 관찰은 메모리 검색에서의 미묘한 균형을 시사한다. 즉, 더 큰 k 값은 추론을 위한 더 풍부한 역사적 맥락을 제공하지만, 노이즈를 도입하고 더 긴 시퀀스를 효과적으로 처리할 수 있는 모델의 능력에 도전할 수 있다. 우리의 분석은 중간 정도의 k 값이 맥락의 풍부함과 정보 처리 효율성 사이에서 최적의 균형을 이룬다는 것을 나타낸다.
4.6 확장성 분석
메모리가 누적됨에 따른 저장 비용을 평가하기 위해, 우리는 A-MEM 시스템과 두 가지 기준 접근법인 MemoryBank [39] 및 ReadAgent [17] 전반에 걸쳐 저장 크기와 검색 시간 사이의 관계를 조사했다. 우리는 동일한 메모리 내용을 가진 이 세 가지 메모리 시스템을 네 개의 규모 지점에서 평가했으며, 각 단계마다 항목 수를 10배씩 증가시켰다(1,000에서 10,000, 100,000, 그리고 최종적으로 1,000,000 항목까지). 실험 결과는 A-MEM 시스템의 확장 특성에 대한 핵심적인 통찰을 드러낸다. 공간 복잡도 측면에서, 세 시스템 모두 벡터 기반 검색 시스템에서 예상되는 바와 같이 동일한 선형 메모리 사용량 확장 을 보인다. 이는 A-MEM이 기준 접근법에 비해 추가적인 저장 오버헤드를 도입하지 않음을 확인해 준다. 검색 시간의 경우, A-MEM은 메모리 크기가 증가함에 따라 증가폭이 최소화되어 뛰어난 효율성을 보인다. 심지어 100만 개의 메모리로 확장할 때조차, A-MEM의 검색 시간은 에서 로만 증가하여 탁월한 성능을 나타낸다. MemoryBank가 약간 더 빠른 검색 시간을 보이지만, A-MEM은 더 풍부한 메모리 표현과 기능을 제공하면서도 비교 가능한 성능을 유지한다. 우리의 공간 복잡도 및 검색 시간 분석에 기반하여, 우리는 A-MEM의 검색 메커니즘이 대규모에서도 뛰어난 효율성을 유지한다고 결론짓는다. 메모리 크기 전반에 걸친 검색 시간의 최소한의 증가는 대규모 메모리 시스템에서의 효율성에 대한 우려를 해소하며, A-MEM이 장기 대화 관리를 위한 고도로 확장 가능한 솔루션을 제공함을 입증한다. 효율성, 확장성, 그리고 향상된 메모리 기능의 이러한 독특한 조합은 A-MEM을 LLM 에이전트를 위한 강력하고 장기적인 메모리 메커니즘을 구축하는 데 있어 중요한 진전으로 자리매김하게 한다.
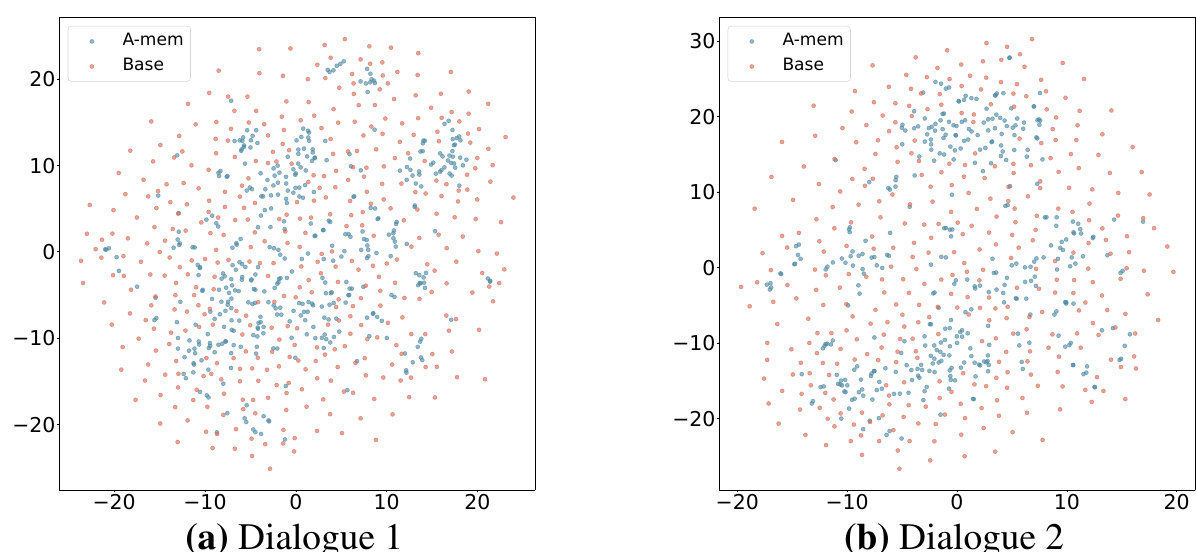
그림 4: 서로 다른 대화에서 A-MEM(파란색)이 기본 메모리(빨간색)보다 더 조직화된 분포를 보이는 메모리 임베딩의 t-SNE 시각화. 기본 메모리는 링크 생성과 메모리 진화가 없는 A-MEM을 나타낸다.
4.7 메모리 분석
우리는 에이전틱 메모리 시스템의 구조적 이점을 입증하기 위해 메모리 임베딩의 t-SNE 시각화를 그림 4에 제시한다. LoCoMo[22]의 장기 대화에서 샘플링한 두 대화를 분석한 결과, A-MEM(파란색으로 표시)이 기준 시스템(빨간색으로 표시)에 비해 일관되게 더 응집력 있는 클러스터링 패턴을 보인다는 것을 관찰했다. 이러한 구조적 조직화는 대화 2에서 특히 두드러지는데, 중앙 영역에 잘 정의된 클러스터들이 나타나 우리의 메모리 진화 메커니즘과 맥락적 설명 생성의 효과에 대한 실증적 증거를 제공한다. 반면, 기준 메모리 임베딩은 더 분산된 분포를 보여, 우리의 링크 생성 및 메모리 진화 구성 요소가 없으면 메모리가 구조적 조직화를 결여한다는 것을 입증한다. 이러한 시각화 결과는 A-MEM이 동적 진화 및 링킹 메커니즘을 통해 의미 있는 메모리 구조를 자율적으로 유지할 수 있음을 검증한다. 더 많은 결과는 부록 A.4에서 확인할 수 있다.
5 결론
본 연구에서 우리는 LLM 에이전트가 미리 정의된 구조에 의존하지 않고 메모리를 동적으로 조직하고 진화시킬 수 있게 하는 새로운 에이전틱 메모리 시스템인 A-MEM을 소개했다. Zettelkasten 방법에서 영감을 받아, 우리의 시스템은 다양한 실제 과제에 적응하는 동적 인덱싱 및 링킹 메커니즘을 통해 상호 연결된 지식 네트워크를 생성한다. 시스템의 핵심 아키텍처는 새로운 메모리에 대한 맥락적 설명의 자율적 생성과 공유 속성에 기반한 기존 메모리와의 지능적 연결 수립을 특징으로 한다. 나아가, 우리의 접근 방식은 새로운 경험을 통합하고 지속적인 상호작용을 통해 고차원적 속성을 발전시킴으로써 역사적 메모리의 지속적인 진화를 가능하게 한다. 여섯 개의 기초 모델에 걸친 광범위한 실증적 평가를 통해, 우리는 A-MEM이 장기 대화 과제에서 기존의 최첨단 기준 모델들보다 우수한 성능을 달성함을 입증했다. 시각화 분석은 우리의 메모리 조직화 접근 방식의 효과를 추가로 검증한다. 이러한 결과는 에이전틱 메모리 시스템이 복잡한 환경에서 장기 지식을 활용하는 LLM 에이전트의 능력을 크게 향상시킬 수 있음을 시사한다.
6 한계
우리의 에이전틱 메모리 시스템이 유망한 결과를 달성했지만, 우리는 향후 잠재적 탐구 영역 몇 가지를 인정한다. 첫째, 우리의 시스템이 메모리를 동적으로 조직하지만, 이러한 조직의 품질은 여전히 기반 언어 모델의 내재적 능력에 영향을 받을 수 있다. 서로 다른 LLM은 약간씩 다른 맥락적 설명을 생성하거나 메모리 간에 다양한 연결을 수립할 수 있다. 또한, 현재 구현이 텍스트 기반 상호작용에 초점을 맞추고 있지만, 향후 연구에서는 시스템을 이미지나 오디오와 같은 멀티모달 정보를 처리하도록 확장하는 것을 탐구할 수 있으며, 이는 더 풍부한 맥락적 표상을 제공할 수 있을 것이다.
참고문헌
[1] Sönke Ahrens. How to Take Smart Notes: One Simple Technique to Boost Writing, Learning and Thinking. Amazon, 2017. Second Edition.
[2] Anthropic. The claude 3 model family: Opus, sonnet, haiku. Anthropic, Mar 2024. Accessed May 2025.
[3] Anthropic. Claude 3.5 sonnet model card addendum. Technical report, Anthropic, 2025. Accessed May 2025.
[4] Akari Asai, Zeqiu Wu, Yizhong Wang, Avirup Sil, and Hannaneh Hajishirzi. Self-rag: Learning to retrieve, generate, and critique through self-reflection. arXiv preprint arXiv:2310.11511, 2023.
[5] Satanjeev Banerjee and Alon Lavie. Meteor: An automatic metric for mt evaluation with improved correlation with human judgments. In Proceedings of the acl workshop on intrinsic and extrinsic evaluation measures for machine translation and/or summarization, pages 65-72, 2005.
[6] Sebastian Borgeaud, Arthur Mensch, Jordan Hoffmann, Trevor Cai, Eliza Rutherford, Katie Millican, George Bm Van Den Driessche, Jean-Baptiste Lespiau, Bogdan Damoc, Aidan Clark, et al. Improving language models by retrieving from trillions of tokens. In International conference on machine learning, pages 2206-2240. PMLR, 2022.
[7] Xiang Deng, Yu Gu, Boyuan Zheng, Shijie Chen, Sam Stevens, Boshi Wang, Huan Sun, and Yu Su. Mind2web: Towards a generalist agent for the web. Advances in Neural Information Processing Systems, 36:28091-28114, 2023.
[8] Khant Dev and Singh Taranjeet. mem0: The memory layer for ai agents. https://github.com/mem0ai/mem0, 2024.
[9] Darren Edge, Ha Trinh, Newman Cheng, Joshua Bradley, Alex Chao, Apurva Mody, Steven Truitt, and Jonathan Larson. From local to global: A graph rag approach to query-focused summarization. arXiv preprint arXiv:2404.16130, 2024.
[10] Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, and Haofen Wang. Retrieval-augmented generation for large language models: A survey. arXiv preprint arXiv:2312.10997, 2023.
[11] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
[12] I. Ilin. Advanced rag techniques: An illustrated overview, 2023.
[13] Jihyoung Jang, Minseong Boo, and Hyounghun Kim. Conversation chronicles: Towards diverse temporal and relational dynamics in multi-session conversations. arXiv preprint arXiv:2310.13420, 2023.
[14] Zhengbao Jiang, Frank F Xu, Luyu Gao, Zhiqing Sun, Qian Liu, Jane Dwivedi-Yu, Yiming Yang, Jamie Callan, and Graham Neubig. Active retrieval augmented generation. arXiv preprint arXiv:2305.06983, 2023.
[15] David Kadavy. Digital Zettelkasten: Principles, Methods, & Examples. Google Books, May 2021.
[16] Jiho Kim, Woosog Chay, Hyeonji Hwang, Daeun Kyung, Hyunseung Chung, Eunbyeol Cho, Yohan Jo, and Edward Choi. Dialism: A real-time simulator for evaluating long-term multi-party dialogue understanding of conversational agents. arXiv preprint arXiv:2406.13144, 2024.
[17] Kuang-Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny, and Ian Fischer. A human-inspired reading agent with gist memory of very long contexts. arXiv preprint arXiv:2402.09727, 2024.
[18] Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Kuttler, Mike Lewis, Wen-tau Yih, Tim Rocktäschel, et al. Retrieval-augmented generation for knowledge-intensive nlp tasks. Advances in Neural Information Processing Systems, 33:9459-9474, 2020.
[19] Chin-Yew Lin. Rouge: A package for automatic evaluation of summaries. In Text summarization branches out, pages 74-81, 2004.
[20] Xi Victoria Lin, Xilun Chen, Mingda Chen, Weijia Shi, Maria Lomeli, Rich James, Pedro Rodriguez, Jacob Kahn, Gergely Szilvasy, Mike Lewis, et al. Ra-dit: Retrieval-augmented dual instruction tuning. arXiv preprint arXiv:2310.01352, 2023.
[21] Zhiwei Liu, Weiran Yao, Jianguo Zhang, Liangwei Yang, Zuxin Liu, Juntao Tan, Prafulla K Choubey, Tian Lan, Jason Wu, Huan Wang, et al. Agentlite: A lightweight library for building and advancing task-oriented llm agent system. arXiv preprint arXiv:2402.15538, 2024.
[22] Adyasha Maharana, Dong-Ho Lee, Sergey Tulyakov, Mohit Bansal, Francesco Barbieri, and Yuwei Fang. Evaluating very long-term conversational memory of llm agents. arXiv preprint arXiv:2402.17753, 2024.
[23] Kai Mei, Zelong Li, Shuyuan Xu, Ruosong Ye, Yingqiang Ge, and Yongfeng Zhang. Aios: Llm agent operating system. arXiv e-prints, pp. arXiv-2403, 2024.
[24] Ali Modarressi, Ayyob Imani, Mohsen Fayyaz, and Hinrich Schütze. Ret-llm: Towards a general read-write memory for large language models. arXiv preprint arXiv:2305.14322, 2023.
[25] Charles Packer, Sarah Wooders, Kevin Lin, Vivian Fang, Shishir G Patil, Ion Stoica, and Joseph E Gonzalez. Memgpt: Towards llms as operating systems. arXiv preprint arXiv:2310.08560, 2023.
[26] Kishore Papineni, Salim Roukos, Todd Ward, and Wei- Jing Zhu. Bleu: a method for automatic evaluation of machine translation. In Proceedings of the 40th annual meeting of the Association for Computational Linguistics, pages 311- 318, 2002.
[27] Nils Reimers and Iryna Gurevych. Sentence- bert: Sentence embeddings using siamese bert- networks. In Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing. Association for Computational Linguistics, 11 2019.
[28] Aymeric Roucher, Albert Villanova del Moral, Thomas Wolf, Leandro von Werra, and Erik Kaunismaki. 'smolagents': a smol library to build great agentic systems. https://github.com/huggingface/smolagents, 2025.
[29] Zhihong Shao, Yeyun Gong, Yelong Shen, Minlie Huang, Nan Duan, and Weizhu Chen. Enhancing retrieval- augmented large language models with iterative retrieval- generation synergy. arXiv preprint arXiv:2305.15294, 2023.
[30] Zeru Shi, Kai Mei, Mingyu Jin, Yongye Su, Chaoji Zuo, Wenyue Hua, Wujiang Xu, Yujie Ren, Zirui Liu, Mengnan Du, et al. From commands to prompts: Llm- based semantic file system for aios. arXiv preprint arXiv:2410.11843, 2024.
[31] Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot, and Ashish Sabharwal. Interleaving retrieval with chain- of- thought reasoning for knowledge- intensive multi- step questions. arXiv preprint arXiv:2212.10509, 2022.
[32] Bing Wang, Xinnian Liang, Jian Yang, Hui Huang, Shuangzhi Wu, Peihao Wu, Lu Lu, Zejun Ma, and Zhoujun Li. 자기 통제 메모리 프레임워크를 통한 대규모 언어 모델 향상. arXiv preprint arXiv:2304.13343, 2023.
[33] Xingyao Wang, Boxuan Li, Yufan Song, Frank F Xu, Xiangru Tang, Mingchen Zhuge, Jiayi Pan, Yueqi Song, Bowen Li, Jaskirat Singh, et al. Openhands: AI 소프트웨어 개발자를 범용 에이전트로 만들기 위한 개방형 플랫폼. arXiv preprint arXiv:2407.16741, 2024.
[34] Zhiruo Wang, Jun Araki, Zhengbao Jiang, Md Rizwan Parvez, and Graham Neubig. 검색 증강 생성을 위한 문맥 필터링 학습. arXiv preprint arXiv:2311.08377, 2023.
[35] Lilian Weng. LLM 기반 자율 에이전트. lilianweng.github.io, Jun 2023.
[36] J Xu. 금붕어 기억을 넘어서: 장기 개방 도메인 대화. arXiv preprint arXiv:2107.07567, 2021.
[37] Wenhao Yu, Hongming Zhang, Xiaoman Pan, Kaixin Ma, Hongwei Wang, and Dong Yu. Chain-of-note: 검색 증강 언어 모델의 견고성 향상. arXiv preprint arXiv:2311.09210, 2023.
[38] Zichun Yu, Chenyan Xiong, Shi Yu, and Zhiyuan Liu. 증강 적응형 검색기가 범용 플러그인으로서 언어 모델의 일반화를 향상시킨다. arXiv preprint arXiv:2305.17331, 2023.
[39] Wanjun Zhong, Lianghong Guo, Qiqi Gao, He Ye, and Yanlin Wang. Memorybank: 장기 기억을 통한 대규모 언어 모델 향상. In Proceedings of the AAAI Conference on Artificial Intelligence, volume 38, pages 19724-19731, 2024.
목차
1 서론 1
2 관련 연구 2
2.1 LLM 에이전트를 위한 메모리 2
2.2 검색 증강 생성 3
3 방법론 3
3.1 노트 구성 4
3.2 링크 생성 4
3.3 메모리 진화 4
3.4 상대 메모리 검색 5
4 실험 5
4.1 데이터셋 및 평가 5
4.2 구현 세부 사항 6
4.3 실증적 결과 6
4.4 절제 연구 7
4.5 하이퍼파라미터 분석 7
4.6 스케일링 분석 8
4.7 메모리 분석 9
5 결론 9
6 한계 9
A 실험 14
A.1 상세 기준선 소개 14
A.2 평가 지표 14
A.3 비교 결과 15
A.4 메모리 분석 16
A.5 하이퍼파라미터 설정 17
B 프롬프트 템플릿 및 예시 19
B.1 노트 구성의 프롬프트 템플릿 19
B.2 링크 생성의 프롬프트 템플릿 19
B.3 메모리 진화의 프롬프트 템플릿 20
B.4 A-MEM을 사용한 Q/A 예시 21
부록
A 실험
A.1 상세 기준선 소개
LoCoMo [22]는 질의응답 작업에 메모리 메커니즘 없이 기반 모델을 활용함으로써 직접적인 접근 방식을 취한다. 각 질의에 대해 전체 선행 대화와 질문을 프롬프트에 포함시켜 모델의 추론 능력을 평가한다.
ReadAgent [17]는 정교한 3단계 방법론을 통해 장문맥 문서 처리를 다룬다. 먼저 에피소드 페이지 분할을 통해 콘텐츠를 관리 가능한 청크로 나누고, 다음으로 메모리 요약(memory gisting)을 통해 각 페이지를 간결한 메모리 표현으로 증류하며, 마지막으로 대화형 조회를 통해 필요한 관련 정보를 검색한다.
MemoryBank [39]는 역사적 상호작용을 유지하고 효율적으로 검색하는 혁신적인 메모리 관리 시스템을 소개한다. 이 시스템은 에빙하우스 망각 곡선 이론에 기반한 동적 메모리 업데이트 메커니즘을 갖추고 있으며, 시간과 중요도에 따라 메모리 강도를 지능적으로 조정한다. 또한 지속적인 상호작용 분석을 통해 사용자 성격에 대한 이해를 점진적으로 정교화하는 사용자 초상화 구축 시스템을 통합한다.
MemGPT [25]는 전통적인 운영체제의 메모리 계층 구조에서 영감을 받은 새로운 가상 컨텍스트 관리 시스템을 제시한다. 이 아키텍처는 이중 계층 구조를 구현한다. LLM 추론 중 즉각적인 접근을 제공하는 주 컨텍스트(RAM에 유사)와 고정된 컨텍스트 윈도우를 넘어 정보를 유지하는 외부 컨텍스트(디스크 저장소에 유사)로 구성된다.
A.2 평가 지표
F1 점수는 정밀도와 재현율의 조화 평균을 나타내며, 두 측정값을 단일 값으로 결합한 균형 잡힌 지표를 제공한다. 이 지표는 완전하고 정확한 응답 사이에서 균형을 맞춰야 할 때 특히 유용하다:
여기서
질의응답 시스템에서 F1 점수는 예측된 답변과 참조 답변 간의 정확한 일치를 평가하는 데 중요한 역할을 합니다. 이는 시스템이 답변의 포괄적인 범위를 유지하면서 정확한 텍스트 구간을 식별해야 하는 스팬 기반 QA 작업에서 특히 중요합니다. BLEU-1 [26]은 시스템 출력과 참조 텍스트 간의 단일어(unigram) 일치의 정밀도를 평가하는 방법을 제공합니다:
여기서
여기서 는 후보 길이, 은 참조 길이, 는 후보 k에서 n-gram i의 개수, 는 임의의 참조에서의 최대 개수입니다. QA에서 BLEU-1은 생성된 답변의 어휘적 정밀도를 평가하며, 정확한 일치가 지나치게 엄격할 수 있는 생성형 QA 시스템에 특히 유용합니다.
ROUGE-L [19]은 생성된 텍스트와 참조 텍스트 간의 최장 공통 부분 수열을 측정합니다.
여기서 는 참조 텍스트, 는 후보 텍스트이며, LCS는 최장 공통 부분 수열(Longest Common Subsequence)입니다.
ROUGE-2 [19]는 생성된 텍스트와 참조 텍스트 간의 바이그램 중첩을 계산합니다.
ROUGE-L과 ROUGE-2는 모두 생성된 답변의 유창성과 일관성을 평가하는 데 특히 유용하며, ROUGE-L은 시퀀스 일치에, ROUGE-2는 국소적 어순에 초점을 맞춥니다.
METEOR [5]는 동의어와 의역을 고려하여 후보 텍스트와 참조 텍스트 간의 정렬된 단일어를 기반으로 점수를 계산합니다.
여기서 는 정밀도, 은 재현율, ch는 청크 수, 은 일치된 단일어 수입니다. METEOR는 정확한 일치를 넘어 의미적 유사성을 고려하므로 의역된 답변을 평가하는 데 적합하여 QA 평가에 가치가 있습니다.
SBERT 유사도 [27]는 문장 임베딩을 사용하여 두 텍스트 간의 의미적 유사성을 측정합니다.
는 텍스트의 문장 임베딩을 나타냅니다. SBERT 유사도는 어휘적 중첩이 낮은 경우에도 의미적 유사성을 포착할 수 있으므로 QA 시스템의 의미 이해를 평가하는 데 특히 유용합니다.
A.3 비교 결과
ROUGE-2, ROUGE-L, METEOR, SBERT 지표를 사용한 종합적인 평가는 A-MEM이 뛰어난 계산 효율성을 유지하면서 우수한 성능을 달성함을 보여줍니다. 다양한 모델 크기와 작업 범주에 걸친 광범위한 실증적 테스트를 통해, 우리는 여러 설득력 있는 발견에 뒷받침되어 A-MEM을 기존 베이스라인과 비교하여 더 효과적인 접근법으로 확립했습니다. 비GPT 모델, 구체적으로 Qwen2.5와 Llama 3.2에 대한 분석에서 A-MEM은 모든 지표에 걸쳐 모든 베이스라인 접근법을 일관되게 능가합니다. Multi-Hop 범주는 특히 놀라운 결과를 보여주는데, A-MEM을 사용한 Qwen2.5-15b는 ROUGE-L 점수 27.23을 달성하여 LoComo의 4.68과 ReadAgent의 2.81을 크게 능가하며, 이는 거의 6배의 향상을 나타냅니다. 이러한 우월성의 패턴은 METEOR와 SBERT
| 모델 | 방법 | 범주 | ||||||||
| 멀티 홉 RGE-2 | RGE-L | 시간적 RGE-2 | RGE-L | 오픈 도메인 RGE-2 | RGE-L | 단일 홉 RGE-2 | RGE-L | 적대적 RGE-2 | ||
| GPT | LoCoMo | 9.64 | 23.92 | 2.01 | 18.09 | 3.40 | 11.58 | 26.48 | 40.20 | 60.46 |
| READAGENT | 2.47 | 9.45 | 0.95 | 13.12 | 0.55 | 5.76 | 2.99 | 9.92 | 6.66 | |
| MEMORYBANK | 1.18 | 5.43 | 0.52 | 9.64 | 0.97 | 5.77 | 1.64 | 6.63 | 4.55 | |
| MEMGPT | 10.58 | 25.60 | 4.76 | 25.22 | 0.76 | 9.14 | 28.44 | 42.24 | 36.62 | |
| A-MEM | 10.61 | 25.86 | 21.39 | 44.27 | 3.42 | 12.09 | 29.50 | 45.18 | 42.62 | |
| LoCoMo | 11.53 | 30.65 | 1.68 | 8.17 | 3.21 | 16.33 | 45.42 | 63.86 | 45.13 | |
| Qwen | READAGENT | 3.91 | 14.36 | 0.43 | 3.96 | 0.52 | 8.58 | 4.75 | 13.41 | 4.24 |
| MEMORYBANK | 1.84 | 7.36 | 0.36 | 2.29 | 2.13 | 6.85 | 3.02 | 9.35 | 1.22 | |
| MEMGPT | 11.55 | 30.18 | 4.66 | 15.83 | 3.27 | 14.02 | 43.27 | 62.75 | 28.72 | |
| A-MEM | 12.76 | 31.71 | 9.82 | 25.04 | 6.09 | 16.63 | 33.67 | 50.31 | 30.31 | |
| LoCoMo | 1.39 | 9.24 | 0.00 | 4.68 | 3.42 | 10.59 | 3.25 | 11.15 | 35.10 | |
| READAGENT | 0.74 | 7.14 | 0.10 | 2.81 | 3.05 | 12.63 | 1.47 | 7.88 | 20.73 | |
| Qwen | MEMORYBANK | 1.51 | 11.18 | 0.14 | 5.39 | 1.80 | 8.44 | 5.07 | 13.72 | 29.24 |
| MEMGPT | 1.16 | 11.35 | 0.00 | 7.88 | 2.87 | 14.62 | 2.18 | 9.82 | 23.96 | |
| A-MEM | 4.88 | 17.94 | 5.88 | 27.23 | 3.44 | 16.87 | 12.32 | 24.38 | 36.32 | |
| LoCoMo | 0.49 | 4.83 | 0.14 | 3.20 | 1.31 | 5.38 | 1.97 | 6.98 | 12.66 | |
| READAGENT | 0.08 | 4.08 | 0.00 | 1.96 | 1.26 | 6.19 | 0.73 | 4.34 | 7.35 | |
| MEMORYBANK | 0.43 | 3.76 | 0.05 | 1.61 | 0.24 | 6.32 | 1.03 | 4.22 | 9.55 | |
| Qwen | MEMGPT | 0.69 | 5.55 | 0.05 | 3.17 | 1.90 | 7.90 | 2.05 | 7.32 | 10.46 |
| A-MEM | 2.91 | 12.42 | 8.11 | 27.74 | 1.51 | 7.51 | 8.80 | 17.57 | 21.39 | |
| LoCoMo | 2.51 | 11.48 | 0.44 | 8.25 | 1.69 | 13.06 | 2.94 | 13.00 | 39.85 | |
| READAGENT | 0.53 | 6.49 | 0.00 | 4.62 | 5.47 | 14.29 | 1.19 | 8.03 | 34.52 | |
| MEMORYBANK | 2.96 | 13.57 | 0.23 | 10.53 | 4.01 | 18.38 | 6.41 | 17.66 | 41.15 | |
| MEMGPT | 1.82 | 9.91 | 0.06 | 6.56 | 2.13 | 11.36 | 2.00 | 10.37 | 38.59 | |
| 소스 이해를 위한 읽기 전용 배경 정보(번역 대상 소스 텍스트 아님): A.3 비교 결과 ROUGE-2, ROUGE-L, METEOR, SBERT 지표를 활용한 우리의 포괄적인 평가는 A-MEM이 뛰어난 성능을 달성하면서도 놀라운 계산 효율성을 유지함을 보여준다. 다양한 모델 크기와 작업 범주에 걸친 광범위한 실증적 테스트를 통해, 우리는 A-MEM을 기존 베이스라인과 비교하여 더 효과적인 접근법으로 확립했으며, 이는 몇 가지 설득력 있는 발견들에 의해 뒷받침된다. 비GPT 모델, 구체적으로 Qwe에 대한 우리의 분석에서 번역할 텍스트: Llama 2 | A-MEM | 4.82 | 19.31 | 1.84 | 20.47 | 5.99 | 18.49 | 14.82 | 29.78 | 46.76 |
| LoCoMo | 0.98 | 7.22 | 0.03 | 4.45 | 2.36 | 11.39 | 2.85 | 8.45 | 25.47 | |
| READAGENT | 2.47 | 1.78 | 3.01 | 3.01 | 5.07 | 5.22 | 3.25 | 2.51 | 15.78 | |
| MEMORYBANK | 1.83 | 6.96 | 0.25 | 3.41 | 0.43 | 4.43 | 2.73 | 7.83 | 14.64 | |
| MEMGPT | 0.72 | 5.39 | 0.11 | 2.85 | 0.61 | 5.74 | 1.45 | 4.42 | 16.62 | |
| A-MEM | 6.02 | 17.62 | 7.93 | 27.97 | 5.38 | 13.00 | 16.89 | 28.55 | 35.48 | |
점수 전반에 걸쳐 일관되게 확장됩니다. GPT 기반 모델을 살펴보면, 우리의 결과는 흥미로운 패턴을 드러냅니다. LoCoMo와 MemGPT는 Open Domain 및 Adversarial 작업에서 강력한 능력을 보여주는 반면, A-MEM은 Multi-Hop 추론 작업에서 놀라운 우월성을 보여줍니다. GPT-4o-mini를 사용하여 A-MEM은 Multi-Hop 작업에서 ROUGE-L 점수 44.27을 달성하여 LoComo의 18.09를 두 배 이상 능가합니다. 이러한 상당한 이점은 다른 지표 전반에 걸쳐 일관성을 유지하며, METEOR 점수는 23.43 대 7.61, SBERT 점수는 70.49 대 52.30입니다. 이러한 결과의 중요성은 A-MEM의 뛰어난 계산 효율성에 의해 더욱 증폭됩니다. 우리의 접근법은 LoComo와 MemGPT가 필요로 하는 상당한 16,900 토큰에 비해 단지 1,200-2,500 토큰만 필요로 합니다. 이러한 효율성은 두 가지 핵심 아키텍처 혁신에서 비롯됩니다. 첫째, 우리의 새로운 에이전트형 메모리 아키텍처는 풍부한 맥락 설명을 갖춘 원자적 노트를 통해 상호 연결된 메모리 네트워크를 생성하여 정보 관계의 보다 효과적인 포착과 활용을 가능하게 합니다. 둘째, 우리의 선택적 top-k 검색 메커니즘은 동적 메모리 진화와 구조적 구성을 촉진합니다. 이러한 혁신의 효과는 모든 평가 지표에 걸쳐 일관되게 강력한 Multi-Hop 성능으로 입증되듯이 복잡한 추론 작업에서 특히 분명합니다. 또한, 우리는 DeepSeek-R1-32B [11], Claude 3.0 Haiku [2], Claude 3.5 Haiku [3]을 포함한 다양한 기초 모델을 사용한 실험 결과도 보여줍니다.
A.4 메모리 분석
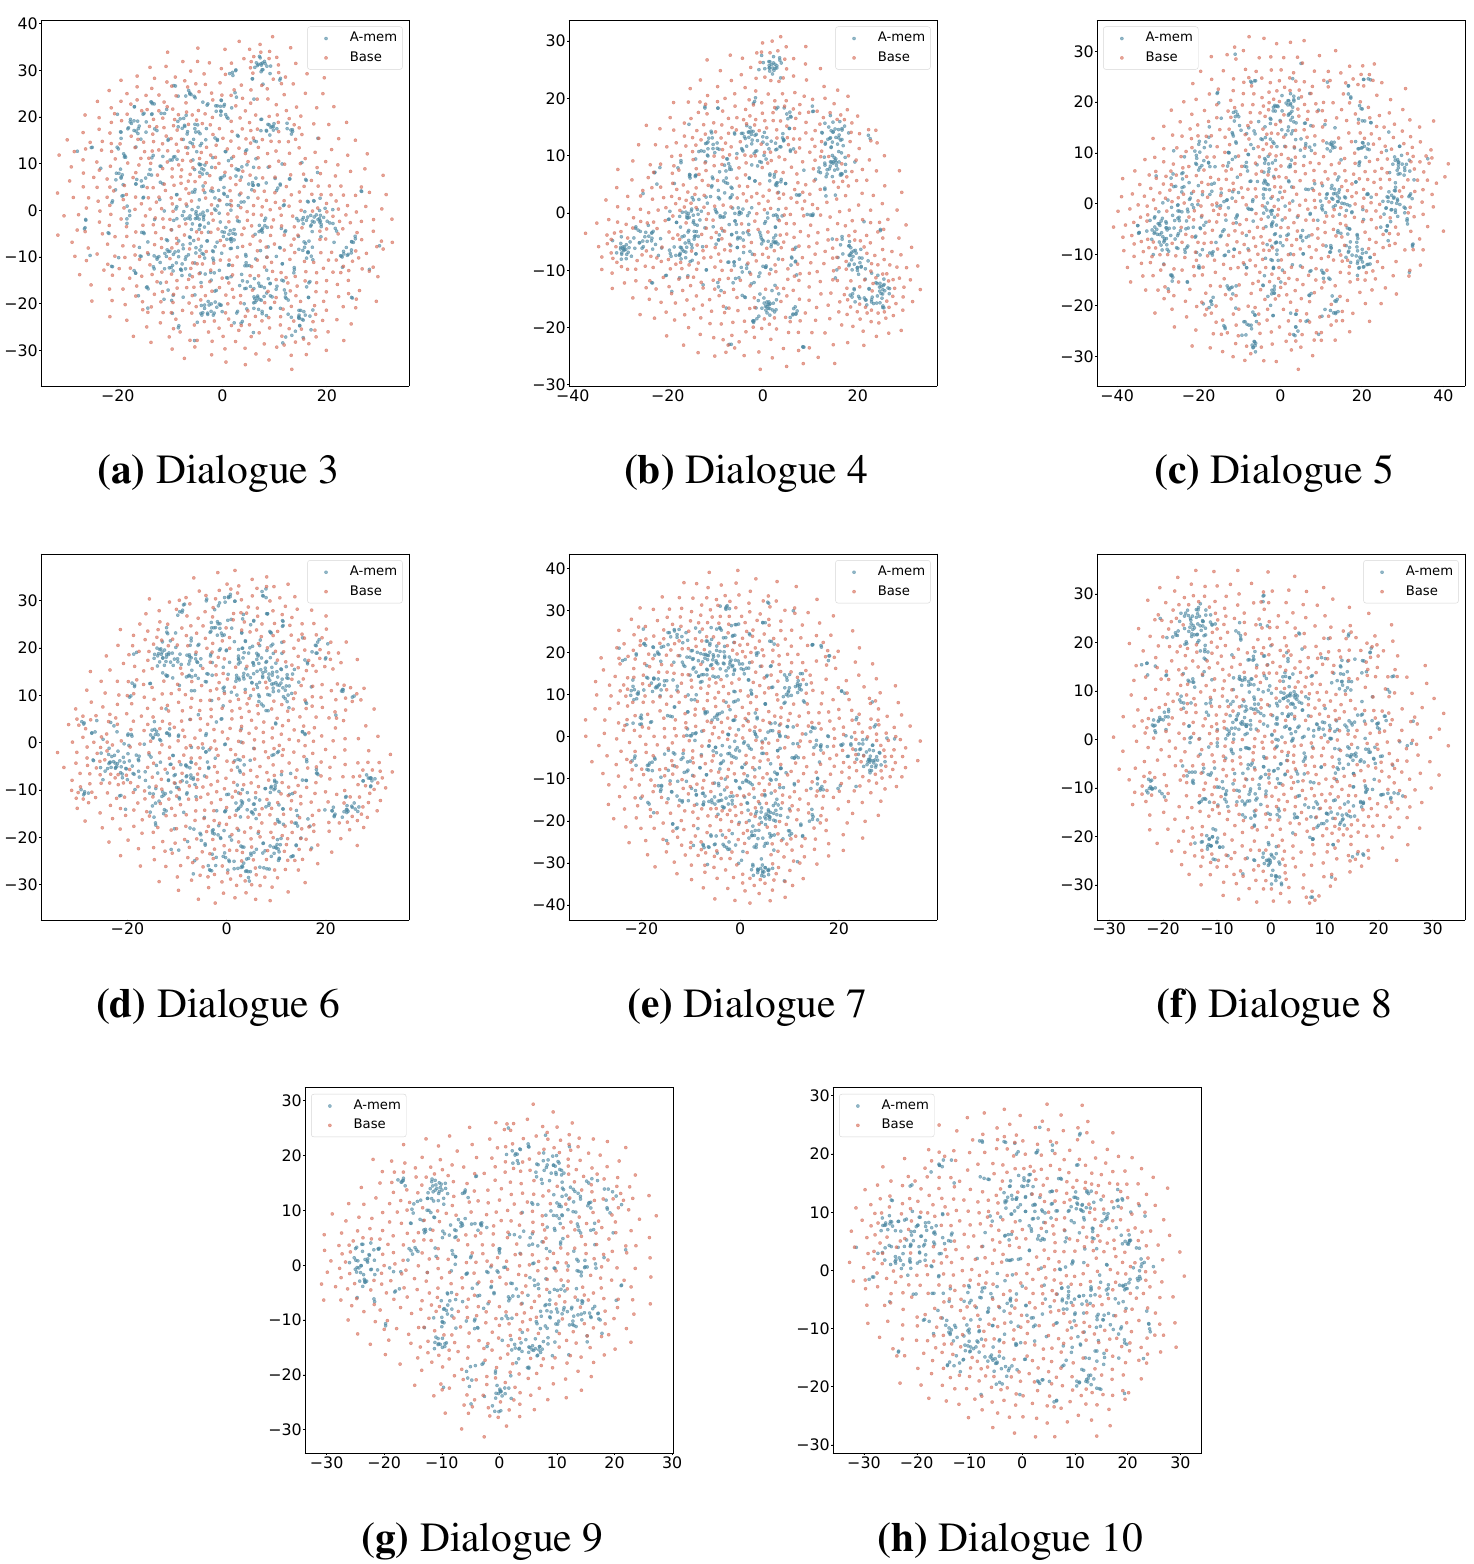
본문에 표시된 처음 두 대화의 메모리 시각화 외에도, 우리는 우리의 에이전트형 메모리 시스템의 구조적 이점을 보여주는 추가 시각화를 그림 5에 제시합니다. LoCoMo[22]의 장기 대화에서 샘플링된 두 대화의 분석을 통해, 우리는 A-MEM(파란색으로 표시)이 베이스라인 시스템(빨간색으로 표시)에 비해 일관되게 더 응집력 있는 클러스터링 패턴을 생성함을 관찰합니다. 이러한 구조적 구성은 대화 2에서 특히 분명하며, 중앙 영역에 뚜렷한 클러스터가 나타나 우리의 메모리 진화 메커니즘과 맥락 설명 생성의 효과에 대한 실증적 지원을 제공합니다.
| 모델 | 방법 | 범주 | ||||||||||
| 멀티 홉 ME | SBERT | 시간적 ME | SBERT | 오픈 도메인 ME | SBERT | 단일 홉 ME | SBERT | 적대적 ME | ||||
| GPT | 4-hop | LoCoMo | 15.81 | 47.97 | 7.61 | 52.30 | 8.16 | 35.00 | 40.42 | 57.78 | 63.28 | 71.93 |
| ReadAgent | 5.46 | 28.67 | 4.76 | 45.07 | 3.69 | 26.72 | 8.01 | 26.78 | 8.38 | 15.20 | ||
| MEMORY BANK | 3.42 | 21.71 | 4.07 | 37.58 | 4.21 | 23.71 | 5.81 | 20.76 | 6.24 | 13.00 | ||
| MEMGPT | 15.79 | 49.33 | 13.25 | 61.53 | 4.59 | 32.77 | 41.40 | 58.19 | 39.16 | 47.24 | ||
| A-MEM | 16.36 | 49.46 | 23.43 | 70.49 | 8.36 | 38.48 | 42.32 | 59.38 | 45.64 | 53.26 | ||
| GPT | 4-hop | LoCoMo | 16.34 | 53.82 | 7.21 | 32.15 | 8.98 | 43.72 | 53.39 | 73.40 | 47.72 | 56.09 |
| ReadAgent | 7.86 | 37.41 | 3.76 | 26.22 | 4.42 | 30.75 | 9.36 | 31.37 | 5.47 | 12.34 | ||
| 메모리 뱅크 | 3.22 | 26.23 | 2.29 | 23.49 | 4.18 | 24.89 | 6.64 | 23.90 | 2.93 | 10.01 | ||
| MEMGPT | 16.64 | 55.12 | 12.68 | 35.93 | 7.78 | 37.91 | 52.14 | 72.83 | 31.15 | 39.08 | ||
| A-MEM | 17.53 | 55.96 | 13.10 | 45.40 | 10.62 | 38.87 | 41.93 | 62.47 | 32.34 | 40.11 | ||
| Open2.5 | 4-hop | LoCoMo | 4.99 | 32.23 | 2.86 | 34.03 | 5.89 | 35.61 | 8.57 | 29.47 | 40.53 | 50.49 |
| ReadAgent | 3.67 | 28.20 | 1.88 | 27.27 | 8.97 | 35.13 | 5.52 | 26.33 | 24.04 | 34.12 | ||
| 메모리 뱅크 | 5.57 | 35.40 | 2.80 | 32.47 | 4.27 | 33.85 | 10.59 | 32.16 | 32.93 | 42.83 | ||
| MEMGPT | 5.40 | 35.64 | 2.35 | 39.04 | 7.68 | 40.36 | 7.07 | 30.16 | 27.24 | 40.63 | ||
| A-MEM | 9.49 | 43.49 | 11.92 | 61.65 | 9.11 | 42.58 | 19.69 | 41.93 | 40.64 | 52.44 | ||
| Open2.5 | 4-hop | LoCoMo | 2.00 | 24.37 | 1.92 | 25.24 | 3.45 | 25.38 | 6.00 | 21.28 | 16.67 | 23.14 |
| ReadAgent | 1.78 | 21.10 | 1.69 | 20.78 | 4.43 | 25.15 | 3.37 | 18.20 | 10.46 | 17.39 | ||
| MEMORY BANK | 2.37 | 17.81 | 2.22 | 21.93 | 3.86 | 20.65 | 3.99 | 16.26 | 15.49 | 20.77 | ||
| MEMGPT | 3.74 | 24.31 | 2.25 | 27.67 | 6.44 | 29.59 | 6.24 | 22.40 | 13.19 | 20.83 | ||
| A-MEM | 6.25 | 33.72 | 14.04 | 62.54 | 6.56 | 30.60 | 15.98 | 33.98 | 27.36 | 33.72 | ||
| Llama 3.2 | 4-hop | LoCoMo | 5.77 | 38.02 | 3.38 | 45.44 | 6.20 | 42.69 | 9.33 | 34.19 | 46.79 | 60.74 |
| ReadAgent | 2.97 | 29.26 | 1.31 | 26.45 | 7.13 | 39.19 | 5.36 | 26.44 | 42.39 | 54.35 | ||
| 메모리 뱅크 | 6.77 | 39.33 | 4.43 | 45.63 | 7.76 | 42.81 | 13.01 | 37.32 | 50.43 | 60.81 | ||
| MEMGPT | 5.10 | 32.99 | 2.54 | 41.81 | 3.26 | 35.99 | 6.62 | 30.68 | 45.00 | 61.33 | ||
| A-MEM | 9.01 | 45.16 | 7.50 | 54.79 | 8.30 | 43.42 | 22.46 | 47.07 | 53.72 | 68.00 | ||
| Llama 3.2 | 4-hop | LoCoMo | 3.69 | 27.94 | 2.96 | 20.40 | 6.46 | 32.17 | 6.58 | 22.92 | 29.02 | 35.74 |
| ReadAgent | 1.21 | 17.40 | 2.33 | 12.02 | 3.39 | 19.63 | 2.46 | 14.63 | 14.37 | 21.25 | ||
| 메모리 뱅크 | 3.84 | 25.06 | 2.73 | 13.65 | 3.05 | 21.08 | 6.35 | 22.02 | 17.14 | 24.39 | ||
| MEMGPT | 2.78 | 22.06 | 2.21 | 14.97 | 3.63 | 23.18 | 3.47 | 17.81 | 20.50 | 26.87 | ||
| A-MEM | 9.74 | 39.32 | 13.19 | 59.70 | 8.09 | 32.27 | 24.30 | 42.86 | 39.74 | 46.76 | ||
| 방법 | 범주 | |||||
| 멀티 홉 F1 | BLEU-1 | 시간적 F1 | 오픈 도메인 F1 | 단일 홉 F1 | 적대적 F1 | |
| DeepSeek-R1-32B | ||||||
| LoCoMo | 8.58 | 6.48 | 4.79 | 4.35 | 12.96 | 12.52 |
| MEMGPT | 8.28 | 6.25 | 5.45 | 4.97 | 10.97 | 9.09 |
| A-MEM | 15.02 | 10.64 | 14.64 | 11.01 | 14.81 | 12.82 |
| Claude 3.0 Haiku | ||||||
| LoCoMo | 4.56 | 3.33 | 0.82 | 0.59 | 2.86 | 3.22 |
| MEMGPT | 7.65 | 6.36 | 1.65 | 1.26 | 7.41 | 6.64 |
| A-MEM | 19.28 | 14.69 | 16.65 | 12.23 | 11.85 | 9.61 |
| Claude 3.5 Haiku | ||||||
| LoCoMo | 11.34 | 8.21 | 3.29 | 2.69 | 3.79 | 3.58 |
| MEMGPT | 8.27 | 6.55 | 3.99 | 2.76 | 4.71 | 4.48 |
| A-MEM | 29.70 | 23.19 | 31.54 | 27.53 | 11.42 | 9.47 |
대조적으로, 베이스라인 메모리 임베딩은 더 분산된 분포를 보여, 우리의 링크 생성 및 메모리 진화 구성 요소 없이는 메모리가 구조적 구성을 결여함을 나타냅니다. 이러한 시각화는 A-MEM이 동적 진화 및 링킹 메커니즘을 통해 의미 있는 메모리 구조를 자율적으로 유지할 수 있음을 검증합니다.
A.5 하이퍼파라미터 설정
모든 하이퍼파라미터 k 값은 표 8에 제시되어 있습니다. k=10으로 이미 최첨단(SOTA) 성능을 달성한 모델의 경우, 추가 튜닝 없이 이 값을 유지합니다.
| 모델 | 멀티 홉 | 시간적 | 오픈 도메인 | 단일 홉 | 적대적 |
| GPT-4o-mini | 40 | 40 | 50 | 50 | 40 |
| GPT-4o | 40 | 40 | 50 | 50 | 40 |
| Qwen2.5-1.5b | 10 | 10 | 10 | 10 | 10 |
| Qwen2.5-3b | 10 | 10 | 50 | 10 | 10 |
| Llama3.2-1b | 10 | 10 | 10 | 10 | 10 |
| Llama3.2-3b | 10 | 20 | 10 | 10 | 10 |
B 프롬프트 템플릿 및 예시
B.1 노트 구성의 프롬프트 템플릿
노트 구성의 프롬프트 템플릿:
다음을 통해 다음 내용에 대한 구조화된 분석을 생성하세요:
1. 가장 두드러지는 키워드 식별 (명사, 동사, 핵심 개념에 초점)
2. 핵심 주제와 맥락적 요소 추출
{ "keywords": [ "메모리 진화", "프롬프트 템플릿", "링크 생성", "최근접 이웃 메모리", "지식 베이스 관리", "카테고리 태그", "AI 메모리 에이전트" ], "context": "이 문서는 AI 메모리 진화 시스템에서 링크 생성과 메모리 진화를 위한 프롬프트 템플릿을 제시하며, 새로운 메모리를 최근접 이웃 메모리와의 관계를 바탕으로 강화하거나 이웃을 업데이트하는 방법과 태그 분류 체계를 설명하고, 이를 통해 지식 베이스를 관리·진화시키는 것을 목표로 한다.", "tags": [ "기술 문서", "인공지능/머신러닝", "프롬프트 엔지니어링", "지식 관리 시스템", "메모리 아키텍처" ]}
이러한 작업들은 결합될 수 있습니다.
다음 구조의 JSON 형식으로 결정을 반환하세요: {{ "should_evolve": true/false,
"actions": ["strengthen", "merge", "prune"],
"suggested_connections": ["neighbor_memory_ids"],
"tags_to_update": ["tag_1", ... "tag_n"],
"new_context_neighborhood": ["new_context", ... "new_context"],
"new_tags_neighborhood": [["tag_1", ... "tag_n"], ... ["tag_1", ... "tag_n"]],
B.4 A-MEM을 활용한 Q/A 예시
예시:
질문 686: Dave는 2023년 10월에 어떤 취미를 시작했는가?
예측: 사진 촬영
참조: 사진 촬영
대화 시작 시각: 2023년 11월 17일 오전 10:54
메모리 내용: 화자 Dave가 말한다: 이봐 Calvin, 오랜만이야! 많은 일이 있었어. 나는 사진 촬영을 시작했는데 정말 좋아 -이 주변의 풍경 사진을 찍고 있는데 정말 멋져.
메모리 맥락: 주요 주제는 화자의 새로운 취미인 사진 촬영이며, 지역 풍경을 담는 즐거움을 강조하고, 개인적인 경험에 대해 친구와 대화를 나누려는 의도를 담고 있다.
메모리 키워드: ['photography', 'scenery', 'conversation', 'experience', 'hobby']
메모리 태그: ['hobby', 'photography', 'personal development', 'conversation', 'leisure']
대화 시작 시각: 2023년 7월 21일 오후 6:38
메모리 내용: 화자 Calvin이 말한다: 고마워, Dave! 내가 일할 나만의 공간이 생겨서 정말 좋아. 최근에는 여러 장르를 실험해 보면서 내 안전지대 밖으로 나가려고 노력하고 있어. 내 노래에 전자적 요소를 더하니 새로운 느낌이 들어. 자기 발견과 성장의 흥미진진한 과정이야!
메모리 맥락: 화자는 음악에서의 창작 과정을 논하며, 장르 실험과 개인적 성장 및 예술적 발전을 위한 전자적 요소의 도입을 강조한다.
메모리 키워드: ['space', 'experimentation', 'genres', 'electronic', 'self- discovery', 'growth']
메모리 태그: ['music', 'creativity', 'self- improvement', 'artistic expression']
NeurIPS 논문 체크리스트
이 체크리스트는 책임 있는 머신러닝 연구를 위한 모범 사례를 장려하기 위해 설계되었으며, 재현성, 투명성, 연구 윤리, 사회적 영향 문제를 다룹니다. 체크리스트를 삭제하지 마세요: 체크리스트를 포함하지 않은 논문은 데스크 리젝트됩니다. 체크리스트는 참고문헌 뒤에, 그리고 (선택 사항인) 보충 자료 뒤에 와야 합니다. 체크리스트는 페이지 제한에 포함되지 않습니다.
이 질문들에 답하는 방법에 대한 정보는 체크리스트 지침을 주의 깊게 읽어 주세요. 체크리스트의 각 질문에 대해:
[Yes], [No], 또는 [NA]로 답해야 합니다. [NA]는 해당 질문이 그 특정 논문에 적용되지 않음(Not Applicable)을 의미하거나 관련 정보를 이용할 수 없음(Not Available)을 의미합니다. 답변 바로 뒤에 짧은(1-2문장) 정당화를 제공해 주세요(NA의 경우에도).
체크리스트 답변은 논문 제출물의 필수적인 부분입니다. 이는 리뷰어, 영역 의장, 선임 영역 의장, 윤리 리뷰어에게 공개됩니다. 최종 버전 논문과 함께 (최종 수정 후) 이를 포함하도록 요청받을 것이며, 최종 버전은 논문과 함께 출판됩니다.
논문의 리뷰어는 체크리스트를 평가 요소 중 하나로 사용하도록 요청받을 것입니다. "[Yes]"가 일반적으로 "[No]"보다 바람직하지만, 적절한 정당화가 제공된다면(예: "계산 비용이 너무 많이 들어 오차 막대를 보고하지 않았습니다" 또는 "사용한 데이터셋의 라이선스를 찾을 수 없었습니다") "[No]"라고 답하는 것은 전적으로 허용됩니다. 일반적으로 "[No]" 또는 "[NA]"라고 답하는 것이 거절 사유가 되지는 않습니다. 질문이 이분법적으로 표현되어 있지만, 실제 답은 종종 더 미묘하다는 점을 인정하므로, 최선의 판단을 사용하고 자세히 설명하는 정당화를 작성해 주세요. 모든 뒷받침 증거는 본문 논문 또는 부록에 제공된 보충 자료에 나타날 수 있습니다. 질문에 [Yes]라고 답하는 경우, 정당화에서 해당 질문에 대한 관련 자료를 찾을 수 있는 섹션을 지적해 주세요.
중요 사항, 부탁드립니다:
- 이 지시 블록을 삭제하되, "NeurIPS Paper Checklist" 섹션 제목은 유지하세요.- 아래의 체크리스트 하위 섹션 제목, 질문/답변 및 지침을 유지하세요.- 질문을 수정하지 말고 답변에는 제공된 매크로만 사용하세요.
1. 주장
질문: 초록과 서론에서 제시된 주요 주장이 논문의 기여와 범위를 정확히 반영하는가?
답변: [Yes]
정당화: 초록과 서론은 우리의 주요 기여를 요약한다.
지침:
- 답변 NA는 초록과 서론이 논문에서 제시된 주장을 포함하지 않음을 의미한다.- 초록 및/또는 서론은 논문에서 이루어진 기여, 중요한 가정 및 한계를 포함하여 제시된 주장을 명확히 진술해야 한다. 이 질문에 대한 No 또는 NA 답변은 리뷰어들에게 좋게 받아들여지지 않을 것이다.- 제시된 주장은 이론적 및 실험적 결과와 일치해야 하며, 결과가 다른 설정으로 얼마나 일반화될 수 있는지를 반영해야 한다.- 이러한 목표가 논문에서 달성되지 않음이 명확한 한, 열망적 목표를 동기로 포함하는 것은 괜찮다.
2. 한계
질문: 논문이 저자들이 수행한 작업의 한계를 논의하는가?
답변: [Yes]
정당화: 이 논문은 한계에 관한 섹션을 다룬다.
지침:
- 답변 NA는 논문에 한계가 없음을 의미하는 반면, 답변 No는 논문에 한계가 있지만 논문에서 논의되지 않음을 의미한다.
- 저자들은 논문에 별도의 "한계" 섹션을 만들 것을 권장한다.
- 논문은 강한 가정과 결과가 이러한 가정의 위반에 얼마나 강건한지(예: 독립성 가정, 무잡음 설정, 모델의 적절한 명세, 국소적으로만 성립하는 점근적 근사)를 지적해야 한다. 저자들은 이러한 가정이 실제로 어떻게 위반될 수 있는지, 그 함의가 무엇일지에 대해 성찰해야 한다.
- 저자들은 제시된 주장의 범위를 성찰해야 한다. 예를 들어, 접근법이 몇 개의 데이터셋에서만 또는 몇 번의 실행으로만 테스트되었는지 등이다. 일반적으로 경험적 결과는 종종 암묵적 가정에 의존하며, 이는 명시되어야 한다.
- 저자들은 접근법의 성능에 영향을 미치는 요인들을 성찰해야 한다. 예를 들어, 얼굴 인식 알고리즘은 이미지 해상도가 낮거나 어두운 조명에서 촬영된 이미지의 경우 성능이 저하될 수 있다. 또는 음성-텍스트 시스템이 기술 용어를 처리하지 못해 온라인 강의의 실시간 자막을 안정적으로 제공하는 데 사용되지 못할 수 있다.
- 저자들은 제안된 알고리즘의 계산 효율성과 데이터셋 크기에 따라 어떻게 확장되는지 논의해야 한다.
- 해당되는 경우, 저자들은 프라이버시와 공정성 문제를 다루기 위한 접근법의 가능한 한계를 논의해야 한다.
- 저자들은 한계에 대한 완전한 정직성이 리뷰어들에 의해 거절 사유로 사용될 수 있다고 우려할 수 있지만, 더 나쁜 결과는 리뷰어들이 논문에서 인정되지 않은 한계를 발견하는 것일 수 있다. 저자들은 최선의 판단을 사용하고, 투명성을 위한 개별적 행동이 커뮤니티의 무결성을 보존하는 규범을 발전시키는 데 중요한 역할을 한다는 점을 인식해야 한다. 리뷰어들은 한계에 관한 정직성을 감점하지 말도록 구체적으로 지시받을 것이다.
3. 이론적 가정과 증명
질문: 각 이론적 결과에 대해, 논문이 전체 가정 집합과 완전한(그리고 올바른) 증명을 제공하는가?
답변: [NA]
정당화: 해당 없음
지침:
- 답변이 NA라는 것은 논문이 이론적 결과를 포함하지 않는다는 뜻입니다.
- 논문의 모든 정리, 공식, 증명은 번호가 매겨지고 상호 참조되어야 합니다.
- 모든 가정은 어떤 정리의 진술 안에서 명확히 서술되거나 참조되어야 합니다.
- 증명은 본문에 실리거나 보충 자료에 실릴 수 있으나, 보충 자료에 실리는 경우 저자들은 직관을 제공하기 위해 짧은 증명 스케치를 제공할 것을 권장합니다.
- 반대로, 논문의 본문에 제공되는 비형식적 증명은 부록이나 보충 자료에 제공되는 형식적 증명으로 보완되어야 합니다.
- 증명이 의존하는 정리와 보조정리는 적절히 참조되어야 합니다.
4. 실험 결과 재현성
질문: 논문은 코드와 데이터가 제공되는지 여부와 무관하게, 논문의 주요 주장 및/또는 결론에 영향을 미치는 범위에서 논문의 주요 실험 결과를 재현하는 데 필요한 모든 정보를 완전히 공개하는가?
답변: [예]
정당화: 코드와 데이터셋 모두 이용 가능합니다.
지침:
- 답변 NA는 해당 논문이 실험을 포함하지 않음을 의미합니다.
- 논문이 실험을 포함하는 경우, 이 질문에 대한 "아니오" 답변은 리뷰어들에게 좋게 인식되지 않을 것입니다: 코드와 데이터 제공 여부와 관계없이 논문을 재현 가능하게 만드는 것이 중요합니다.
- 기여가 데이터셋 및/또는 모델인 경우, 저자는 결과를 재현 가능하거나 검증 가능하게 만들기 위해 취한 단계를 설명해야 합니다.
- 기여에 따라 재현성은 다양한 방식으로 달성될 수 있습니다. 예를 들어, 기여가 새로운 아키텍처인 경우 아키텍처를 완전히 설명하는 것으로 충분할 수 있으며, 기여가 특정 모델과 경험적 평가인 경우 다른 사람들이 동일한 데이터셋으로 모델을 복제할 수 있게 하거나 모델에 대한 접근을 제공할 필요가 있을 수 있습니다. 일반적으로 코드와 데이터를 공개하는 것은 이를 달성하는 좋은 방법인 경우가 많지만, 결과를 복제하는 방법에 대한 자세한 지침, 호스팅된 모델에 대한 접근(예: 대규모 언어 모델의 경우), 모델 체크포인트 공개 또는 수행된 연구에 적합한 기타 수단을 통해서도 재현성을 제공할 수 있습니다.
- NeurIPS는 코드 공개를 요구하지 않지만, 학회는 모든 제출물이 기여의 성격에 따라 달라질 수 있는 재현성을 위한 합리적인 경로를 제공할 것을 요구합니다. 예를 들어
(a) 기여가 주로 새로운 알고리즘인 경우, 논문은 해당 알고리즘을 재현하는 방법을 명확히 해야 합니다.
(b) 기여가 주로 새로운 모델 아키텍처인 경우, 논문은 아키텍처를 명확하고 완전하게 설명해야 합니다.
(c) 기여가 새로운 모델(예: 대규모 언어 모델)인 경우, 결과를 재현하기 위해 이 모델에 접근할 수 있는 방법이 있거나 모델을 재현할 수 있는 방법(예: 오픈소스 데이터셋 또는 데이터셋 구성 방법에 대한 지침)이 있어야 합니다.
(d) 일부 경우 재현성이 까다로울 수 있음을 인정하며, 이 경우 저자는 재현성을 제공하는 특정 방법을 설명하는 것을 환영합니다. 폐쇄 소스 모델의 경우 모델에 대한 접근이 어떤 방식으로든 제한될 수 있지만(예: 등록 사용자에게), 다른 연구자들이 결과를 재현하거나 검증할 수 있는 경로를 가질 수 있어야 합니다.
5. 데이터 및 코드에 대한 공개 접근
질문: 논문은 보충 자료에 설명된 대로 주요 실험 결과를 충실히 재현하기에 충분한 지침과 함께 데이터 및 코드에 대한 공개 접근을 제공합니까?
답변: [예]
정당화: 우리는 초록에 코드 링크를 제공합니다.
지침:
- 답변 NA는 해당 논문이 코드를 필요로 하는 실험을 포함하지 않음을 의미합니다.
- 자세한 내용은 NeurIPS 코드 및 데이터 제출 지침(https://nips.cc/public/guides/CodeSubmissionPolicy)을 참조하십시오.
- 코드와 데이터의 공개를 권장하지만, 이것이 불가능할 수 있음을 이해하므로 "아니오"도 허용 가능한 답변입니다. 이것이 기여의 핵심이 아닌 한(예: 새로운 오픈소스 벤치마크의 경우) 코드를 포함하지 않았다는 이유만으로 논문이 거부될 수는 없습니다.
- 지침에는 결과를 재현하기 위해 실행해야 하는 정확한 명령과 환경이 포함되어야 합니다. 자세한 내용은 NeurIPS 코드 및 데이터 제출 지침(https://nips.cc/public/guides/CodeSubmissionPolicy)을 참조하십시오.
- 저자는 원시 데이터, 전처리된 데이터, 중간 데이터, 생성된 데이터 등에 접근하는 방법을 포함하여 데이터 접근 및 준비에 대한 지침을 제공해야 합니다.
- 저자는 새로 제안된 방법과 베이스라인에 대한 모든 실험 결과를 재현하기 위한 스크립트를 제공해야 합니다. 실험의 일부만 재현 가능한 경우, 어떤 실험이 스크립트에서 제외되었는지 그리고 그 이유를 명시해야 합니다.
- 제출 시 익명성을 유지하기 위해 저자는 익명화된 버전을 공개해야 합니다(해당하는 경우).
- 가능한 한 많은 정보를 보충 자료(논문에 첨부)에 제공하는 것이 권장되지만, 데이터 및 코드에 대한 URL을 포함하는 것도 허용됩니다.
6. 실험 설정/세부 사항
질문: 논문은 결과를 이해하는 데 필요한 모든 훈련 및 테스트 세부 사항(예: 데이터 분할, 하이퍼파라미터, 선택 방법, 옵티마이저 유형 등)을 명시하고 있습니까?
답변: [예]
정당화: 우리는 논문에서 모든 세부 사항을 다룹니다.
지침:- 답변 NA는 해당 논문이 실험을 포함하지 않음을 의미합니다.- 실험 설정은 결과를 감상하고 이해하는 데 필요한 수준의 세부 사항으로 논문의 본문에 제시되어야 합니다.- 전체 세부 사항은 코드, 부록 또는 보충 자료와 함께 제공될 수 있습니다.
7. 실험의 통계적 유의성
질문: 논문은 실험의 통계적 유의성에 대해 적절하고 정확하게 정의된 오차 막대 또는 기타 적절한 정보를 보고합니까?
답변: [아니오]
정당화: 실험은 대규모 언어 모델의 API를 활용합니다. 여러 번 호출하면 비용이 크게 증가합니다.
지침:- 답변 NA는 해당 논문이 실험을 포함하지 않음을 의미합니다.- 저자는 적어도 논문의 주요 주장을 뒷받침하는 실험에 대해 오차 막대, 신뢰 구간 또는 통계적 유의성 검정과 함께 결과를 제시하는 경우 "예"라고 답해야 합니다.- 오차 막대가 포착하는 변동성 요인을 명확히 명시해야 합니다(예: 훈련/테스트 분할, 초기화, 일부 매개변수의 무작위 추출 또는 주어진 실험 조건에서의 전체 실행).- 오차 막대를 계산하는 방법을 설명해야 합니다(닫힌 형식 수식, 라이브러리 함수 호출, 부트스트랩 등).- 만들어진 가정을 제시해야 합니다(예: 오차의 정규 분포).- 오차 막대가 표준 편차인지 평균의 표준 오차인지 명확해야 합니다.- 1-시그마 오차 막대를 보고하는 것은 괜찮지만, 이를 명시해야 합니다. 저자는 오차의 정규성 가설이 검증되지 않은 경우 96% CI라고 명시하기보다는 2-시그마 오차 막대를 보고하는 것이 바람직합니다.- 비대칭 분포의 경우, 저자는 표나 그림에서 범위를 벗어난 결과(예: 음의 오차율)를 초래할 수 있는 대칭적 오차 막대를 표시하지 않도록 주의해야 합니다.- 표나 플롯에 오차 막대가 보고된 경우, 저자는 본문에서 그것이 어떻게 계산되었는지 설명하고 본문에서 해당 그림이나 표를 참조해야 합니다.
8. 실험 컴퓨팅 자원
질문: 각 실험에 대해, 논문은 실험을 재현하는 데 필요한 컴퓨터 자원(컴퓨트 워커 유형, 메모리, 실행 시간)에 대한 충분한 정보를 제공합니까?
답변: [예]
정당화: 실험 부분에서 확인할 수 있습니다.
지침:- 답변 NA는 해당 논문이 실험을 포함하지 않음을 의미합니다.- 논문은 관련 메모리와 저장 공간을 포함하여 컴퓨트 워커 유형(CPU 또는 GPU, 내부 클러스터 또는 클라우드 제공업체)을 명시해야 합니다.
- 논문은 각 개별 실험 실행에 필요한 컴퓨트 양을 제공하고 총 컴퓨트를 추정해야 합니다.
- 논문은 전체 연구 프로젝트가 논문에 보고된 실험보다 더 많은 컴퓨트를 필요로 했는지(예: 논문에 포함되지 않은 예비 실험이나 실패한 실험) 공개해야 합니다.
9. 윤리 강령
질문: 논문에서 수행된 연구는 모든 측면에서 NeurIPS 윤리 강령 https://neurips.cc/public/EthicsGuidelines 을 준수합니까?
답변: [NA]
정당화: 해당 없음
지침:
- 답변 NA는 저자가 NeurIPS 윤리 강령을 검토하지 않았음을 의미합니다.- 저자가 "아니오"라고 답하는 경우, 윤리 강령에서 벗어나야 하는 특별한 상황을 설명해야 합니다.- 저자는 익명성을 유지해야 합니다(예: 관할 지역의 법률이나 규정으로 인한 특별한 고려 사항이 있는 경우).
10. 광범위한 영향
질문: 논문은 수행된 연구의 잠재적인 긍정적 사회적 영향과 부정적 사회적 영향 모두를 논의합니까?
답변: [아니오]
정당화: 우리는 LLM 에이전트를 위한 메모리 시스템만을 제공하기 때문에 이 측면을 논의하지 않습니다. 서로 다른 LLM 에이전트는 다양한 사회적 영향을 창출할 수 있으며, 이는 우리 연구의 범위를 벗어납니다.
지침:
- 답변 NA는 수행된 연구의 사회적 영향이 없음을 의미합니다.
- 저자가 NA 또는 아니오라고 답하는 경우, 그들의 연구가 사회적 영향을 미치지 않는 이유 또는 논문이 사회적 영향을 다루지 않는 이유를 설명해야 합니다.
- 부정적인 사회적 영향의 예로는 잠재적인 악의적 또는 의도하지 않은 사용(예: 허위 정보, 가짜 프로필 생성, 감시), 공정성 고려 사항(예: 특정 집단에 불공정하게 영향을 미치는 결정을 내릴 수 있는 기술의 배포), 프라이버시 고려 사항, 보안 고려 사항 등이 있습니다.
- 학회는 많은 논문이 기초 연구일 것이며 특정 응용, 하물며 배포와도 연결되지 않을 것이라고 기대합니다. 그러나 부정적인 응용으로 이어지는 직접적인 경로가 있다면 저자는 이를 지적해야 합니다. 예를 들어, 생성 모델의 품질 향상이 허위 정보를 위한 딥페이크를 생성하는 데 사용될 수 있다고 지적하는 것은 정당합니다. 반면, 신경망 최적화를 위한 일반적인 알고리즘이 사람들이 딥페이크를 더 빠르게 생성하는 모델을 훈련할 수 있게 해준다고 지적할 필요는 없습니다.
- 저자는 기술이 의도된 대로 사용되고 올바르게 작동할 때 발생할 수 있는 해악, 기술이 의도된 대로 사용되지만 잘못된 결과를 낼 때 발생할 수 있는 해악, 그리고 기술의 (의도적 또는 비의도적) 오용으로 인해 발생하는 해악을 고려해야 합니다.
- 부정적인 사회적 영향이 있다면, 저자는 가능한 완화 전략(예: 모델의 제한적 공개, 공격에 더하여 방어 제공, 오용 모니터링 메커니즘, 시간에 따른 피드백으로부터 시스템이 학습하는 방식을 모니터링하는 메커니즘, ML의 효율성과 접근성 향상)에 대해서도 논의할 수 있습니다.
11. 안전장치
질문: 논문은 오용 위험이 높은 데이터나 모델(예: 사전 훈련된 언어 모델, 이미지 생성기, 스크래핑된 데이터셋)의 책임 있는 공개를 위해 마련된 안전장치를 설명하고 있습니까?
답변: [해당 없음]
정당화: 해당 없음
지침:
지침:
12. 기존 자산에 대한 라이선스
질문: 논문에서 사용된 자산(예: 코드, 데이터, 모델)의 창작자 또는 원래 소유자가 적절히 공로를 인정받았으며, 라이선스와 이용 약관이 명시적으로 언급되고 적절히 준수되었는가?
답변: [예]
정당화: 그들의 기여는 이미 적절히 인정받고 공로가 표시되었다.
지침:
지침:
13. 새로운 자산
질문: 논문에서 소개된 새로운 자산이 잘 문서화되어 있으며, 문서가 자산과 함께 제공되는가?
답변: [해당 없음]
정당화: 해당 없음
지침:
지침:
14. 크라우드소싱 및 인간 대상 연구
질문: 크라우드소싱 실험 및 인간 대상 연구의 경우, 논문에 참가자에게 제공된 지시 사항의 전문과 해당되는 경우 스크린샷, 그리고 보상(있는 경우)에 대한 세부 정보가 포함되어 있는가?
답변: [해당 없음]
정당화: 해당 없음
지침:
- 답변 해당 없음은 논문이 크라우드소싱이나 인간 대상 연구를 포함하지 않음을 의미한다.- 이 정보를 보충 자료에 포함하는 것은 괜찮지만, 논문의 주요 기여가 인간 대상과 관련된 경우 가능한 한 많은 세부 정보를 본문에 포함해야 한다.- NeurIPS 윤리 강령에 따르면, 데이터 수집, 큐레이션 또는 기타 노동에 참여한 작업자는 데이터 수집 국가의 최저 임금 이상을 받아야 한다.
15. 인간 대상 연구에 대한 기관생명윤리위원회(IRB) 승인 또는 이에 상응하는 승인
질문: 논문에서 연구 참가자가 감수할 수 있는 잠재적 위험, 그러한 위험이 피험자에게 공개되었는지 여부, 그리고 기관생명윤리위원회(IRB) 승인(또는 귀하의 국가 또는 기관의 요구 사항에 기반한 동등한 승인/심사)을 받았는지 여부를 설명하는가?
답변: [해당 없음]
정당화: 해당 없음
지침:
- 답변 해당 없음은 논문이 크라우드소싱이나 인간 대상 연구를 포함하지 않음을 의미한다.- 연구가 수행되는 국가에 따라 인간 대상 연구에 대해 IRB 승인(또는 동등한 승인)이 필요할 수 있다. IRB 승인을 받은 경우 논문에 이를 명확히 기재해야 한다.- 우리는 이에 대한 절차가 기관과 위치에 따라 크게 다를 수 있음을 인식하며, 저자들이 NeurIPS 윤리 강령과 해당 기관의 지침을 준수할 것을 기대한다.- 최초 제출의 경우, 심사를 수행하는 기관 등 익명성을 깨뜨릴 수 있는 정보(해당되는 경우)를 포함하지 않아야 한다.
16. LLM 사용 선언
질문: 논문에서 LLM이 이 연구의 핵심 방법에서 중요하고 독창적이거나 비표준적인 구성 요소로 사용된 경우 그 사용을 설명하는가? LLM이 글쓰기, 편집 또는 서식 목적으로만 사용되었고 연구의 핵심 방법론, 과학적 엄밀성 또는 독창성에 영향을 미치지 않는 경우에는 선언이 필요하지 않다는 점에 유의하라.
답변: [해당 없음]
정당화: 해당 없음
지침:
- 답변 해당 없음은 이 연구의 핵심 방법 개발에 LLM이 중요하고 독창적이거나 비표준적인 구성 요소로 포함되지 않았음을 의미한다.- 무엇을 설명해야 하고 설명하지 않아야 하는지는 LLM 정책(https://neurips.cc/Conferences/2025/LLM)을 참조하라.