
실제 GitHub 이슈 2천 건을 끝까지 고치고 숨은 테스트로 판정한다. 코딩 에이전트의 벤치마크. ICLR 2024, 전문 무료.
SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
SWE-BENCH: 언어 모델이 실제 GitHub 이슈를 해결할 수 있는가?
Carlos E. Jimenez John Yang Alexander Wettig
Shunyu Yao Kexin Pei Ofir Press Karthik Narasimhan
프린스턴 대학교 프린스턴 언어 및 지능 시카고 대학교
초록
언어 모델은 우리가 이를 효과적으로 평가할 수 있는 능력을 앞질러 왔지만, 언어 모델의 미래 발전을 위해서는 그 능력의 최전선을 연구하는 것이 필수적이다. 우리는 실제 소프트웨어 공학이 차세대 언어 모델을 평가하기 위한 풍부하고 지속 가능하며 도전적인 테스트베드라고 본다. 이를 위해 우리는 12개의 인기 있는 Python 저장소에 걸친 실제 GitHub 이슈 및 그에 대응하는 풀 리퀘스트에서 추출한 2,294개의 소프트웨어 공학 문제로 구성된 평가 프레임워크인 SWE-bench를 소개한다. 코드베이스와 해결해야 할 이슈에 대한 설명이 주어지면, 언어 모델은 이슈를 해결하기 위해 코드베이스를 편집하는 과제를 수행한다. SWE-bench의 이슈를 해결하려면 여러 함수, 클래스, 심지어 파일에 걸친 변경 사항을 동시에 이해하고 조정해야 하는 경우가 많으며, 이는 모델이 실행 환경과 상호작용하고, 매우 긴 컨텍스트를 처리하며, 전통적인 코드 생성 과제를 훨씬 뛰어넘는 복잡한 추론을 수행할 것을 요구한다. 우리의 평가는 최신 독점 모델과 우리가 미세 조정한 모델인 SWE-Llama 모두 가장 단순한 이슈만 해결할 수 있음을 보여준다. 가장 성능이 좋은 모델인 Claude 2는 단 의 이슈만 해결할 수 있다. SWE-bench에서의 진전은 더 실용적이고, 지능적이며, 자율적인 언어 모델을 향한 발걸음을 나타낸다.
1 서론
언어 모델(LM)은 챗봇과 코딩 어시스턴트와 같은 상업적 제품에 빠르게 배포되고 있다. 동시에, 기존 벤치마크는 포화 상태가 되었으며(Kiela et al., 2021; Ott et al., 2022) 최신 언어 모델이 할 수 있는 것과 할 수 없는 것의 최전선을 포착하지 못한다. 언어 모델의 미래 발전과 사용 방향을 형성하는 데 도움이 되도록 언어 모델의 실제 응용을 보다 정확하게 반영하는 도전적인 벤치마크가 필요하다(Srivastava et al., 2023).
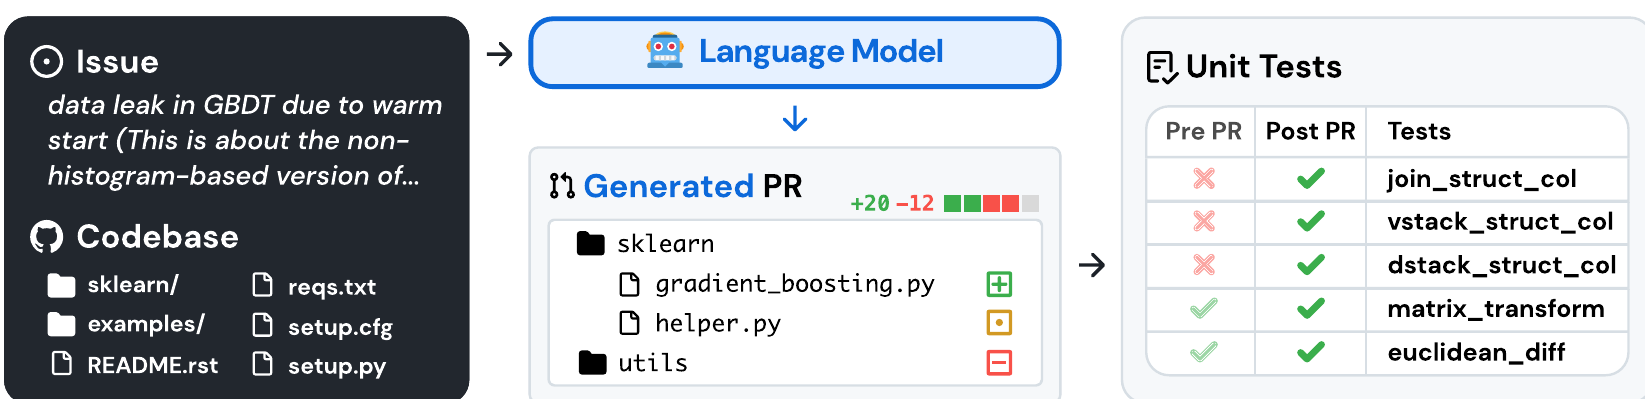
좋은 벤치마크를 구축하는 것은 어렵다. 과제는 기존 모델을 당황하게 할 만큼 충분히 도전적이어야 하지만, 모델 예측 또한 검증하기 쉬워야 하기 때문이다(Martinez-Plumed et al., 2021). 코딩 과제는 언어 모델에 도전적인 문제를 제시하면서도 생성된 해결책을 단위 테스트 실행을 통해 쉽게 검증할 수 있기 때문에 매력적이다. 그러나 HumanEval(Chen et al., 2021)과 같은 기존 코딩 벤치마크는 대부분 몇 줄의 코드로 해결할 수 있는 자기 완결적인 문제를 다룬다.
실제 세계에서 소프트웨어 공학은 그렇게 단순하지 않다. 버그를 수정하려면 대규모 저장소를 탐색하고, 서로 다른 파일의 함수 간 상호작용을 이해하거나, 복잡한 코드에서 작은 오류를 발견해야 할 수 있다. 이에 영감을 받아 우리는 현실적인 소프트웨어 공학 환경에서 언어 모델을 평가하는 벤치마크인 SWE-bench를 소개한다. 그림 1에 나타난 것처럼, 모델은 인기 있는 GitHub 저장소에 제출된 이슈(일반적으로 버그 보고서 또는 기능 요청)를 해결하는 과제를 수행한다. 각 과제는 기존 코드베이스에 적용할 변경 사항을 기술하는 패치를 생성할 것을 요구한다. 그런 다음 수정된 코드베이스는 저장소의 테스트 프레임워크를 사용하여 평가된다.
SWE-bench는 기존 언어 모델 프로그래밍 벤치마크에 비해 여러 가지 이점을 제공한다. 여기에는 사용자가 제출한 이슈와 해결책을 활용하는 현실적인 설정, 12개 저장소에서 비롯된 고유한 코드 문제를 특징으로 하는 다양한 입력, 실행 기반 평가를 위한 견고한 프레임워크, 그리고 최소한의 인간 개입으로 새로운 인스턴스로 벤치마크를 지속적으로 업데이트할 수 있는 능력이 포함된다.
우리는 SWE-bench에서 여러 최신 언어 모델을 평가한 결과, 가장 단순한 이슈를 제외한 모든 이슈를 해결하지 못한다는 것을 발견했다. BM25 검색기를 사용할 때, Claude 2는 단 의 이슈만 해결할 수 있다.
SWE-bench 외에도 우리의 기여에는 훈련 데이터셋인 SWE-bench-train의 공개가 포함되며, 이는 이 도전적인 영역에서 오픈 모델 개발을 진전시키는 데 필수적이다. 이 데이터셋은 37개 저장소에서 추출한 19,000개의 비테스트 과제 인스턴스 모음으로 구성된다. SWE-bench-train을 활용하여 우리는 CodeLlama(Rozière et al., 2023) 모델을 기반으로 미세 조정된 두 모델, SWE-Llama 7b와 13b를 공개한다. 우리는 일부 설정에서 SWE-Llama 13b가 Claude 2와 경쟁력이 있으며 100,000 토큰을 초과하는 컨텍스트를 처리할 수 있음을 발견했다.
2 SWE-BENCH
SWE-bench는 버그를 보고하거나 새로운 기능을 요청하는 인기 저장소의 GitHub 이슈와, 이러한 이슈를 해결하기 위해 저장소에 변경을 가하는 풀 리퀘스트를 특징으로 하는 벤치마크이다. 과제는 주어진 이슈를 해결하고 해당 이슈와 관련된 테스트를 통과하는 풀 리퀘스트를 생성하는 것이다.
2.1 벤치마크 구축
GitHub는 소프트웨어 개발을 위한 풍부한 데이터 소스이지만, 저장소, 이슈, 풀 리퀘스트는 잡음이 많거나, 임시적이거나, 문서화 또는 유지 관리가 부실할 수 있다. 대규모로 고품질 과제 인스턴스를 찾기 위해 우리는 다음과 같은 3단계 파이프라인을 사용한다.
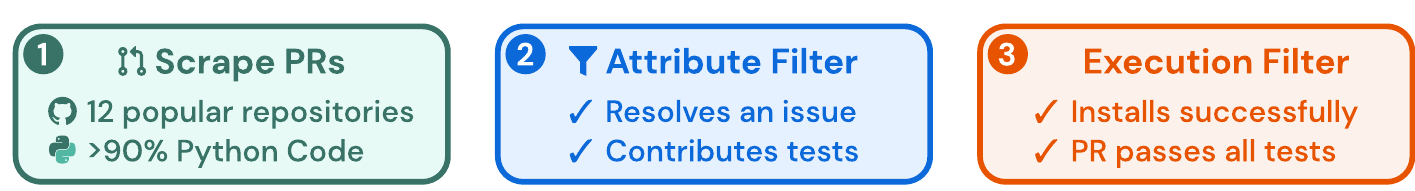
1단계: 저장소 선택 및 데이터 스크래핑. 우리는 GitHub에서 12개의 인기 있는 오픈소스 Python 저장소로부터 풀 리퀘스트(PR)를 수집하는 것으로 시작하며, 총 약 개의 PR을 생성한다. 우리는 더 잘 유지 관리되고, 명확한 기여자 가이드라인이 있으며, 더 나은 테스트 커버리지를 갖는 경향이 있는 인기 저장소에 초점을 맞춘다. 각 PR은 해당 기본 커밋에 의해 지정된 연관된 코드베이스를 가진다.
2단계: 속성 기반 필터링. 우리는 (1) GitHub 이슈를 해결하고 (2) 저장소의 테스트 파일에 변경을 가하는 병합된 PR을 선택하여 후보 과제를 생성한다. 이는 사용자가 해당 이슈가 해결되었는지 확인하기 위한 테스트를 기여했을 가능성이 있음을 나타낸다.
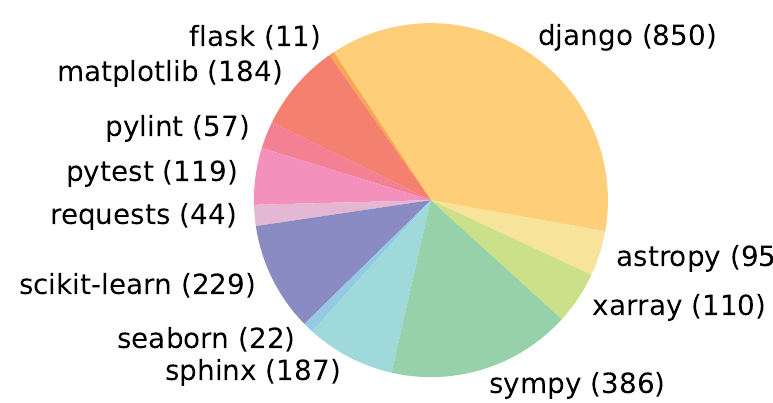
3단계: 실행 기반 필터링. 각 후보 과제에 대해 우리는 PR의 테스트 내용을 적용하고, PR의 다른 내용이 적용되기 전과 후의 연관된 테스트 결과를 기록한다. 우리는 상태가 실패에서 통과로 바뀌는 테스트(이하 실패-통과 테스트)가 최소 하나 이상 없는 과제 인스턴스를 필터링한다. 우리는 또한 설치 또는 런타임 오류를 초래하는 인스턴스도 필터링한다. 이러한 필터링 단계를 통해 원래의 90,000개 PR은 SWE-bench를 구성하는 2,294개의 과제 인스턴스로 줄어든다. 저장소별 이 과제 인스턴스들의 최종 분석은 그림 3에 제시되어 있으며, 표 1은 SWE-bench 과제 인스턴스의 주요 특징을 강조한다. 우리는 코드베이스가 수천 개의 파일을 가진 대규모이며, 참조 풀 리퀘스트가 종종 한 번에 여러 파일에 변경을 가한다는 점을 강조한다. SWE-bench의 구축 파이프라인에 대한 기술적 세부 사항은 부록 A에서 논의된다. 추가 데이터셋 통계는 부록 A.5에 있다.
2.2 과제 공식화
모델 입력. 모델에게는 이슈 텍스트 설명과 완전한 코드베이스가 주어진다. 그런 다음 모델은 이슈를 해결하기 위해 코드베이스를 편집하는 과제를 수행한다. 실제로 우리는 편집을 패치 파일로 표현하며, 이는 이슈를 해결하기 위해 코드베이스의 어떤 줄을 수정해야 하는지 지정한다.
평가 지표. 제안된 해결책을 평가하기 위해 우리는 생성된 패치를 unix의 patch 프로그램을 사용하여 코드베이스에 적용한 다음, 과제 인스턴스와 연관된 단위 및 시스템 테스트를 실행한다. 패치가 성공적으로 적용되고 이러한 모든 테스트가 통과하면 우리는 제안된 해결책이 이슈를 성공적으로 해결했다고 간주한다. 우리 벤치마크의 지표는 해결된 과제 인스턴스의 비율이다. 추가 기술적 세부 사항은 부록 A.4에 있다.
2.3 SWE-BENCH의 특징
NLP의 전통적인 벤치마크는 일반적으로 짧은 입력 및 출력 시퀀스만을 포함하며 벤치마크를 위해 특별히 만들어진 다소 "인위적인" 문제를 고려한다. 대조적으로, SWE-bench의 현실적인 구축 설정은 데이터셋에 고유한 속성을 부여하며, 우리는 이를 아래에서 논의한다.
실제 소프트웨어 공학 과제. SWE-bench의 각 과제 인스턴스는 크고 복잡한 코드베이스와 관련 이슈에 대한 설명으로 구성되므로, SWE-bench를 해결하려면 숙련된 소프트웨어 엔지니어가 보유하지만 전통적인 코드 생성 벤치마크에서는 일반적으로 평가되지 않는 정교한 기술과 지식을 입증해야 한다.
지속적으로 업데이트 가능. 우리의 수집 과정은 GitHub의 모든 Python 저장소에 쉽게 적용할 수 있으며 최소한의 인간 개입을 요구한다. 따라서 우리는 새로운 과제 인스턴스의 지속적인 공급으로 SWE-bench를 확장하고, 훈련 날짜 이후에 생성된 이슈에 대해 언어 모델을 평가할 수 있으며, 이는 해결책이 그들의 훈련 코퍼스에 포함되지 않았음을 보장한다.
다양한 긴 입력. 이슈 설명은 일반적으로 길고 상세하며(평균 195단어), 코드베이스는 정기적으로 수천 개의 파일을 포함한다. SWE-bench를 해결하려면 방대한 컨텍스트 속에서 이슈를 해결하기 위해 편집해야 하는 상대적으로 적은 수의 줄을 식별해야 한다.
견고한 평가. 각 과제 인스턴스에는 참조 해결책을 테스트하는 데 사용된 최소 하나의 실패-통과 테스트가 있으며, 의 인스턴스에는 최소 두 개의 실패-통과 테스트가 있다. 이러한 테스트는 모델이 이슈의 문제를 해결했는지 평가한다. 또한, 이전 기능이 적절하게 유지되는지 확인하기 위해 중앙값 51개의 추가 테스트가 실행된다.
교차 문맥 코드 편집. 편집 범위를 개별 함수나 클래스로 제한하거나(예: Chen et al., 2021; Cassano et al., 2022) 빈칸 채우기 방식의 채움 문제를 제공하는(예: Lu et al., 2021; Fried et al., 2023) 기존 설정들과 달리, SWE-bench는 그러한 명시적 안내를 제공하지 않는다. 단순히 짧은 코드 스니펫을 생성하는 것만이 아니라, 우리의 벤치마크는 모델이 대규모 코드베이스의 여러 위치에서 수정본을 생성하도록 도전한다. SWE-bench의 참조 해법은 평균적으로 1.7개의 파일, 3.0개의 함수, 32.8개의 줄(추가 또는 삭제)을 편집한다.
가능한 해결책을 위한 폭넓은 범위. 저장소 규모의 코드 편집 과제는 검색 및 장문맥 모델에서부터 코드에서 추론하고 행동할 수 있는 의사결정 에이전트에 이르기까지 다양한 접근법을 비교할 수 있는 공평한 경쟁의 장 역할을 할 수 있다. SWE-bench는 또한 모델이 참조 PR에서 벗어날 수 있는 새로운 해결책을 생성할 수 있게 해주므로 창의적 자유를 허용한다.
2.4 SWE-BENCH LITE
SWE-bench에서 언어 모델(LM)을 평가하는 것은 시간이 많이 소요될 수 있으며, 모델에 따라 막대한 컴퓨팅 자원이나 API 크레딧이 필요할 수 있다. 5절에서 제시된 초기 성능 결과가 상당히 낮다는 점을 고려하면, SWE-bench의 난이도는 장기적으로 LM의 발전을 가늠하는 데 유용하지만, 단기적으로 진전을 이루려는 초기 시스템에게는 위협적으로 느껴질 수 있다.
| 평균 | 최대 | ||
| 이슈 텍스트 | 길이 (단어) | 195.1 | 4477 |
| 코드베이스 | 파일 수 (비테스트) | 3,010 | 5,890 |
| 줄 수 (비테스트) | 438K | 886K | |
| 골드 패치 | 편집된 줄 수 | 32.8 | 5888 |
| 편집된 파일 수 | 1.7 | 31 | |
| 편집된 함수 수 | 3 | 36 | |
| 테스트 | 실패→통과 | 9.1 | 1633 |
| 총계 | 120.8 | 9459 |
SWE-bench의 채택을 장려하기 위해, 우리는 SWE-bench에서 300개의 인스턴스로 구성된 Lite 하위 집합을 만들었으며, 이는 더 자기 완결적이도록 샘플링되었고 기능적 버그 수정 평가에 초점을 맞추고 있습니다. 전체 필터링 기준과 데이터셋 정보는 포함되어 있으며, SWE-bench Lite는 원래 12개 저장소 중 11개를 포함하며, 원본과 유사한 다양성 및 저장소 전반에 걸친 작업 인스턴스 분포를 가지고 있습니다. Lite 분할 및 필터링 세부 사항의 전체 내용은 부록 A.7에 포함되어 있습니다.
3 SWE-LLAMA: SWE-BENCH를 위한 CODELLAMA 미세 조정
SWE-bench에서 오픈 모델의 성능을 독점 모델과 함께 벤치마킹하는 것이 중요합니다. 작성 시점에, 매우 긴 컨텍스트를 처리할 수 있는 모델은 CodeLlama 모델(Rozière et al., 2023)뿐입니다. 그러나 우리는 기성 CodeLlama 변형들이 저장소 전반의 코드 편집을 생성하기 위한 상세한 지침을 따르지 못하며, 일반적으로 자리 표시자 응답이나 관련 없는 코드를 출력한다는 것을 관찰했습니다. 이러한 모델들의 능력을 더 잘 평가하기 위해, 우리는 70억 및 130억 매개변수 CodeLlama-Python 모델에 대해 지도 미세 조정을 수행합니다. 결과 모델은 소비자 하드웨어에서 실행할 수 있고 GitHub 이슈를 해결할 수 있는 특화된 저장소 편집기입니다.
훈련 데이터. 우리는 데이터 수집 절차를 따라 추가 37개의 인기 있는 Python 패키지 저장소에서 19,000개의 이슈-PR 쌍을 수집합니다. 섹션 2.1과 달리, 우리는 풀 리퀘스트가 테스트 변경을 기여할 것을 요구하지 않습니다. 이는 지도 미세 조정에 사용할 훨씬 더 큰 훈련 세트를 만들 수 있게 해줍니다. 데이터 오염 위험을 제거하기 위해, 훈련 데이터의 저장소 집합은 평가 벤치마크에 포함된 저장소들과 분리되어 있습니다.
훈련 세부 사항. 지침, GitHub의 이슈 텍스트 및 관련 코드 파일을 프롬프트로 제공할 때, 우리는 주어진 이슈를 해결한 패치("골드 패치")를 생성하도록 SWE-Llama를 미세 조정합니다. 메모리 효율성을 위해, 우리는 LoRA(Hu et al., 2022)를 사용하여 어텐션 하위 계층의 가중치만 미세 조정하고, 30,000 토큰을 초과하는 훈련 시퀀스를 제외하여 훈련 코퍼스의 효과적인 크기를 10,000개 인스턴스로 줄입니다. 더 자세한 내용은 부록 B에 제공됩니다.
4 실험 설정
이 섹션에서는 SWE-bench 평가를 실행하기 위해 입력이 어떻게 구성되는지 설명합니다. 또한, 우리는 이 작업에서 평가하는 모델들을 검토합니다.
4.1 검색 기반 접근법
SWE-bench 인스턴스는 모델에 대한 입력으로 이슈 설명과 코드베이스를 제공합니다. 이슈 설명은 일반적으로 짧지만(표 1에서 볼 수 있듯이 평균 195단어), 코드베이스는 일반적으로 LM의 컨텍스트 윈도우에 맞출 수 있는 것보다 훨씬 많은 토큰(평균 438K 줄)으로 구성됩니다. 그렇다면 모델에 제공할 관련 컨텍스트를 정확히 어떻게 선택할 것인가라는 질문이 남습니다.
우리 기준선에 대한 이 문제를 해결하기 위해, 우리는 단순히 일반적인 검색 시스템을 사용하여 컨텍스트로 삽입할 파일을 선택합니다. 특히, 우리는 두 가지 관련 컨텍스트 설정에서 모델을 평가합니다: 1) 희소 검색, 2) 오라클 검색.
희소 검색. 밀집 검색 방법은 매우 긴 키 및 쿼리 길이, 특히 자연어 쿼리로 코드 문서를 검색하는 특이한 설정 때문에 우리의 설정에 적합하지 않습니다. 따라서 우리는 각 작업 인스턴스에 대한 컨텍스트로 제공할 관련 파일을 검색하기 위해 BM25 검색(Robertson et al., 2009)을 사용하기로 선택합니다. 우리는 세 가지 다른 최대 컨텍스트 한도로 실험하고, 지정된 한도 내에 맞는 만큼의 파일을 단순히 검색합니다. 우리는 컨텍스트 윈도우에 맞는 모든 한도에서 각 모델을 평가하고 최고 성능을 보고합니다. 관찰에 따르면, 모델은 표 2에서 볼 수 있듯이 가장 짧은 컨텍스트 윈도우에서 최고 성능을 보입니다.
"오라클" 검색. 분석 목적으로 우리는 GitHub에서 이슈를 해결한 참조 패치에 의해 편집된 파일을 "검색"하는 설정도 고려합니다. 이 "오라클" 설정은 덜 현실적입니다. 왜냐하면 이슈를 해결하는 엔지니어는 어떤 파일을 수정해야 하는지 사전에 알 수 없을 수 있기 때문입니다. 또한, 이 설정은 편집된 파일만으로는 소프트웨어가 코드의 보이지 않는 부분과 상호 작용할 때 정확히 어떻게 동작할지 이해하는 데 필요한 모든 컨텍스트를 포함하지 않을 수 있으므로 반드시 포괄적이지도 않습니다.
우리는 표 3에서 볼 수 있듯이 BM25 검색 결과를 "오라클" 검색 설정의 결과와 비교합니다. 우리는 약 의 인스턴스에서 27,000 토큰 컨텍스트 한도에 대해 BM25가 오라클 파일의 상위 집합을 검색한다는 것을 관찰합니다. 그러나 27,000 토큰 한도를 가진 인스턴스의 거의 절반에서는 "오라클" 컨텍스트의 파일을 전혀 검색하지 못합니다.
4.2 입력 형식
위의 두 가지 방법 중 하나를 사용하여 검색된 파일이 선택되면, 우리는 작업 지침, 이슈 텍스트, 검색된 파일 및 문서, 그리고 마지막으로 예제 패치 파일 및 패치 파일 생성을 위한 프롬프트로 구성된 모델 입력을 구성합니다. 인스턴스의 예와 이 공식화에 대한 추가 세부 사항은 부록 D에 제공됩니다.
4.3 모델
긴 시퀀스 길이를 처리해야 하기 때문에, 현재 SWE-bench에 적합한 모델은 몇 개뿐입니다. 따라서 우리는 ChatGPT-3.5(gpt-3.5-turbo-16k-0613), GPT-4(gpt-4-32k-0613), Claude 2, 그리고 SWE-Llama를 표 4에 표시된 컨텍스트 한도와 함께 평가합니다.
| 모델 | 최대 콘텐츠 | ||
| 13k | 27k | 50k | |
| Claude 2 | 1.96 | 1.87 | 1.22 |
| SWE-Llama 7b | 0.70 | 0.31 | 0.00 |
| SWE-Llama 13b | 0.70 | 0.48 | 0.00 |
| BM25 재현율 | |||
| 13k | 27k | 50k | |
| 평균 | 29.58 | 44.41 | 51.06 |
| All | 26.09 | 39.83 | 45.90 |
| Any | 34.77 | 51.27 | 58.38 |
표 4: 우리는 서로 다른 컨텍스트 길이와 "오라클" 검색 설정이 커버되는 비율을 비교합니다. 따라서 더 짧은 컨텍스트 길이를 가진 모델은 본질적으로 불리합니다. 토큰 길이에 대한 설명은 상대적인 비표준 측정임을 유의하십시오(예: Llama로 토큰화된 시퀀스는 GPT-4용으로 토큰화된 동등한 시퀀스보다 평균 더 깁니다).
| ChatGPT-3.5 | GPT-4 | Claude 2 | SWE-Llama | |
| 최대 토큰 수 | 16,385 | 32,768 | 100,000 | ≥100,000 |
| 인스턴스 비율 | 58.1% | 84.1% | 96.4% | ≥94.8% |
| 모델 | SWE-bench | SWE-bench Lite | ||
| % 해결됨 | % 적용 | % 해결됨 | % 적용 | |
| Claude 3 Opus | 3.79 | 46.56 | 4.33 | 51.67 |
| Claude 2 | 1.97 | 43.07 | 3.00 | 33.00 |
| ChatGPT-3.5 | 0.17 | 26.33 | 0.33 | 10.00 |
| GPT-4-turbo | 1.31 | 26.90 | 2.67 | 29.67 |
| SWE-Llama 7b | 0.70 | 51.74 | 1.33 | 38.00 |
| SWE-Llama 13b | 0.70 | 53.62 | 1.00 | 38.00 |
5 결과
우리는 서로 다른 검색 메커니즘과 프롬프트 방식을 사용하는 모델들에 대한 결과를 보고한 뒤, 모델 성능과 난이도에 대한 분석과 통찰을 제공한다. 우리는 BM25 검색을 사용한 모델들의 성능을 표 5에 요약한다. 전반적으로 모델들은 이슈를 해결하는 데 상당히 어려움을 겪는다. 가장 성능이 좋은 모델인 Claude 2조차 이슈의 \(1.96\%\)만 해결할 수 있다.
검색기가 전체 시스템 결과에 얼마나 중요한지 분석하기 위해, 우리는 부록 표 18에 "oracle" 검색 결과를 제시한다. 여기서 Claude 2는 "oracle" 검색기를 사용하여 이슈의 \(4.8\%\)를 해결할 수 있다. 우리는 아래 논의에서 맥락의 중요성을 추가로 분석한다.
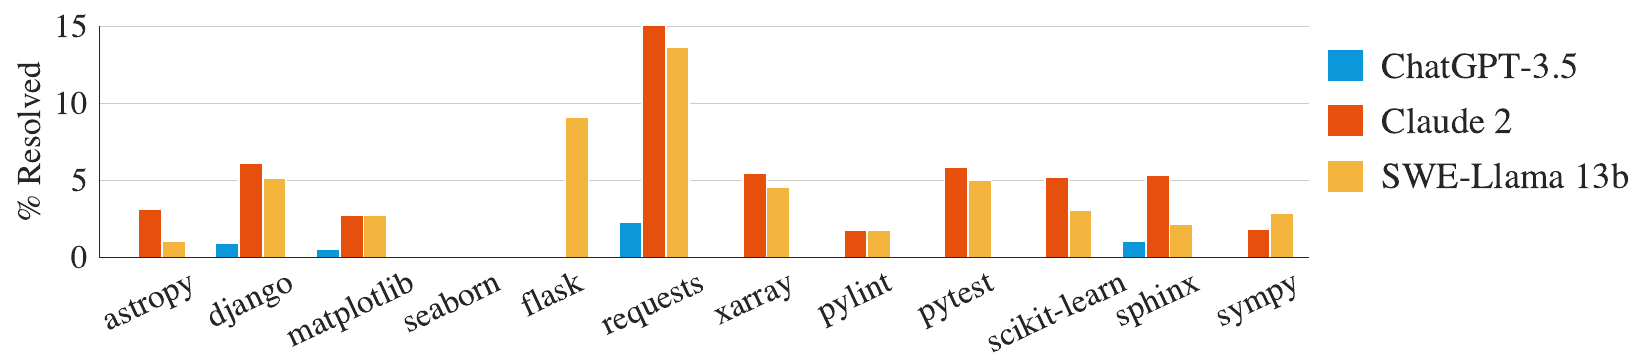
난이도는 저장소마다 다르다. 저장소별로 성능을 나누어 보면, 그림 4에서 보듯 모든 모델이 서로 다른 저장소들에 걸쳐 유사한 경향을 보인다. 그럼에도 각 모델이 해결한 이슈들이 반드시 광범위하게 겹치는 것은 아니다. 예를 들어, "oracle" 설정에서 Claude 2와 SWE-Llama 13b는 각각 110개와 91개의 인스턴스를 해결하여 비슷한 성능을 보인다. 그러나 이 인스턴스들 중에서 Claude 2는 SWE-Llama가 해결한 인스턴스의 \(42\%\)만 해결한다.
이는 이슈에 이미지가 존재하는 것과도 관련이 있을 수 있으며, 이미지는 이슈 마크다운에 임베디드 이미지 링크(즉, ![image][https://...])로 인코딩될 수 있다. 일부 저장소는 자연스럽게 이미지가 포함된 인스턴스가 더 많다. 예를 들어 matplotlib 인스턴스의 와 seaborn 인스턴스의 가 이슈 텍스트에 임베디드 이미지를 포함하는 반면, 전체 인스턴스에서는 단 만 그렇다. 이러한 인스턴스를 해결하려면 멀티모달 LM이나 이미지를 처리하기 위한 일종의 외부 도구 사용이 필요할 수 있다.
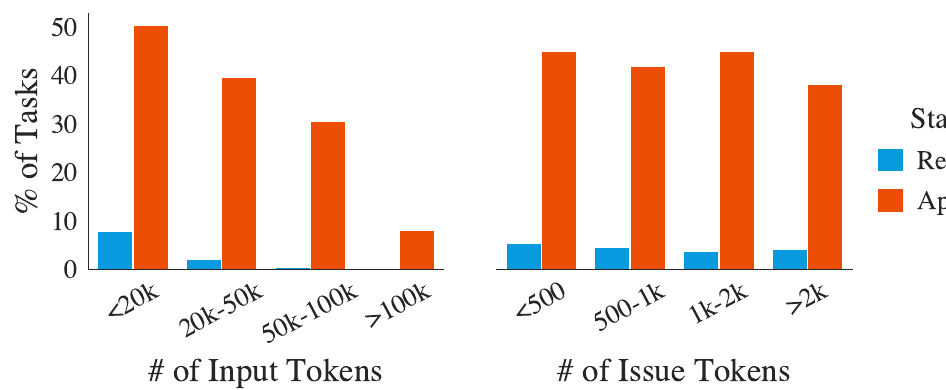
난이도는 맥락 길이와 상관관계가 있다. 채팅 모델들은 긴 코드 시퀀스로 사전 학습되었을 수 있지만, 일반적으로 질문을 틀 짓기 위해 제공되는 제한된 맥락과 함께 더 짧은 코드 스니펫을 생성하도록 요청받는다. 그림 5에서 보듯, 전체 맥락 길이가 증가할수록 Claude 2의 성능은 상당히 떨어지며, 이러한 행동은 다른 모델에서도 관찰된다. 우리의 평가 설정에서 모델들은 당면한 이슈 해결과 직접적으로 관련되지 않을 수 있는 많은 코드를 보게 되며, 업데이트가 필요한 문제 코드를 찾아내는 데 자주 어려움을 겪는 것으로 보인다. 이 결과는 모델이 추가 맥락에 의해 주의가 분산되고 대상 시퀀스의 상대적 위치에 민감할 수 있음을 보여주는 다른 연구들(Liu et al., 2023b)을 뒷받침한다. BM25의 최대 맥락 크기를 늘리면 oracle 파일에 대한 재현율이 증가함에도 불구하고, 표 2에서 보듯 성능은 떨어지는데, 이는 모델이 문제 코드를 찾아내는 데 단순히 비효율적이기 때문이다. 이를 더 조사하기 위해, 우리는 "oracle" 검색 맥락에 대한 입력 절제 실험인 "oracle"-collapsed를 제공하는데, 여기서는 검색된 파일들이 실제 풀 리퀘스트에 의해 편집된 줄
| 모델 | “오라클”-축약 | |
| 해결됨 | 적용됨 | |
| Claude 3 Opus | 9.39 | 48.00 |
| Claude 2 | 5.93 | 68.18 |
| GPT-4 | 3.40 | 48.65 |
| ChatGPT-3.5 | 1.09 | 40.93 |
(\(\pm 15\)줄의 버퍼 포함)을 제외하고 전부 축약되며, 이는 표 6에 제시되어 있다. 이 설정에서 우리는 성능 향상을 확인하는데, GPT-4는 에서 로, Claude 2는 에서 로 상승한다.
난이도는 이슈 해결 날짜와 상관관계가 없다. 표 7에서 우리는 "oracle" 검색 설정에서 2023년 이전 또는 이후에 생성된 PR들에 대해 날짜별로 구분한 모델 결과를 보여준다. 대부분의 모델에서 이 날짜 이전과 이후의 성능 차이는 거의 없으며, GPT-4는 예외이다. 우리는 이 결과를 대체로 고무적으로 여기는데, 이는 모델이 저장소 코드베이스의 일부 버전에 노출되었음에도 불구하고 단순히 저장소의 더 최신 버전을 생성함으로써 이슈를 해결하려고 "부정행위"할 가능성은 낮다는 것을 시사하기 때문이다.
| Claude 2 | ChatGPT-3.5 | GPT-4* | SWE-Llama 7b | SWE-Llama 13b |
| 2023년 이전 | 4.87 | 0.49 | 1.96 | 2.95 |
| 2023년 이후 | 4.23 | 0.77 | 0.0 | 3.46 |
파인튜닝된 모델은 맥락 분포 변화에 민감하다. 파인튜닝된 모델인 SWE-Llama 7b와 13b는 BM25로 검색된 맥락에서 놀랍게도 형편없는 성능을 보인다. 이 모델들은 "oracle" 검색을 맥락으로 사용하여 파인튜닝되었기 때문에, 우리는 이러한 맥락의 변화가 모델이 안정적으로 수행하기 어렵게 만든다고 의심한다. 예를 들어, SWE-Llama는 맥락으로 포함된 모든 파일을 편집하도록 훈련된 반면, BM25 설정에서는 맥락에 제공된 많은 파일이 변경될 것으로 예상되지 않는다.
패치 생성은 전체 파일 생성보다 쉽다. 모델들은 종종 표준 코드 파일을 사용하여 훈련되며 패치 파일을 거의 보지 못할 가능성이 높다. 우리는 일반적으로 패치 파일이 파일 변경을 훨씬 더 효율적으로 표현하는 경우가 많기 때문에, 모델이 제안된 변경으로 전체 파일을 다시 작성하는 대신 패치 파일을 생성하도록 과제를 구성한다. 표 5에서 보듯, 우리는 모델들이 여전히 잘 형식화된 패치 파일을 생성하는 데 어려움을 겪는다는 것을 관찰한다. 그래서 우리는 대신 모델에게 이슈를 해결하기 위해 제안된 변경으로 전체 파일을 다시 생성하도록 요청하는 실험을 한다. 이 설정에서 우리는 모델들이 일반적으로 패치 파일을 생성할 때보다 이 과제에서 더 나쁜 성능을 보인다는 것을 발견한다. 예를 들어, Claude 2는 "oracle" 검색에 대한 메인 표의 와 비교하여 의 점수를 기록한다. 인스턴스 길이를 통제하더라도, 입력 토큰 기준으로 더 짧은 절반의 과제 인스턴스에서 생성하는 경우 Claude 2는 를 기록한 반면 패치 생성의 경우 를 기록한다.
언어 모델은 더 짧고 단순한 편집을 생성하는 경향이 있다. 모델이 생성한 패치 파일은 해당 골드 패치보다 추가하고 제거하는 줄 수가 더 적은 경향이 있다. 표 8에서 보듯, 평균 골드 패치와 비교하여 올바르게 적용되는 모델 생성 패치 파일은 골드 편집 패치 파일의 전체 길이의 절반 미만(74.5줄 대 30.1줄)이며, 단일 파일 이상을 편집하는 경우는 드물다.
5.1 SWE-LLAMA 생성에 대한 정성적 분석
우리는 "oracle" 검색 설정에서 과제와 생성된 패치의 품질을 더 잘 이해하기 위해 SWE-Llama와 Claude 2의 생성 결과 11개를 선정한다. 여기서 우리는 SWE-Llama의 한 예시와 우리의 전반적인 발견을 논의하며, 다른 예시에 대한 심층 분석은 부록 F에 제시한다.
| 모델 | 총 라인 수 | 추가됨 | 제거됨 | 함수 | 파일 |
| Claude 2 | 19.6 | 4.2 | 1.9 | 1.1 | 1.0 |
| Gold | 44.1 | 12.0 | 5.8 | 2.1 | 1.2 |
| ChatGPT-3.5 | 30.1 | 3.8 | 2.7 | 1.6 | 1.0 |
| Gold | 39.6 | 9.5 | 6.1 | 1.9 | 1.2 |
| GPT-4 | 20.9 | 4.4 | 1.5 | 1.0 | 1.0 |
| Gold | 33.6 | 8.4 | 3.8 | 1.9 | 1.1 |
| SWE-Llama 13b | 17.6 | 1.6 | 1.2 | 1.2 | 1.1 |
| Gold | 37.8 | 10.0 | 4.4 | 1.9 | 1.1 |
| SWE-Llama 7b | 16.7 | 1.3 | 1.2 | 1.2 | 1.1 |
| Gold | 40.2 | 11.3 | 4.9 | 1.9 | 1.1 |
| Avg Gold | 39.1 | 10.2 | 5.0 | 1.9 | 1.1 |
| All Gold | 74.5 | 22.3 | 10.5 | 3.0 | 1.7 |
표 8: 성공적으로 적용된 패치들에 걸쳐 "oracle" 검색 설정에서 모델 생성 패치의 평균 편집량. 각 모델에 특정한 과제 인스턴스에 대해, 우리는 골드 패치들에 걸쳐 동일한 통계를 계산한다. Avg Gold는 각 모델의 해당 골드 패치들에 대해 거시 평균된 통계를 보여준다. All Gold는 모델 성능과 무관하게 모든 골드 패치에 대한 통계를 보여준다.
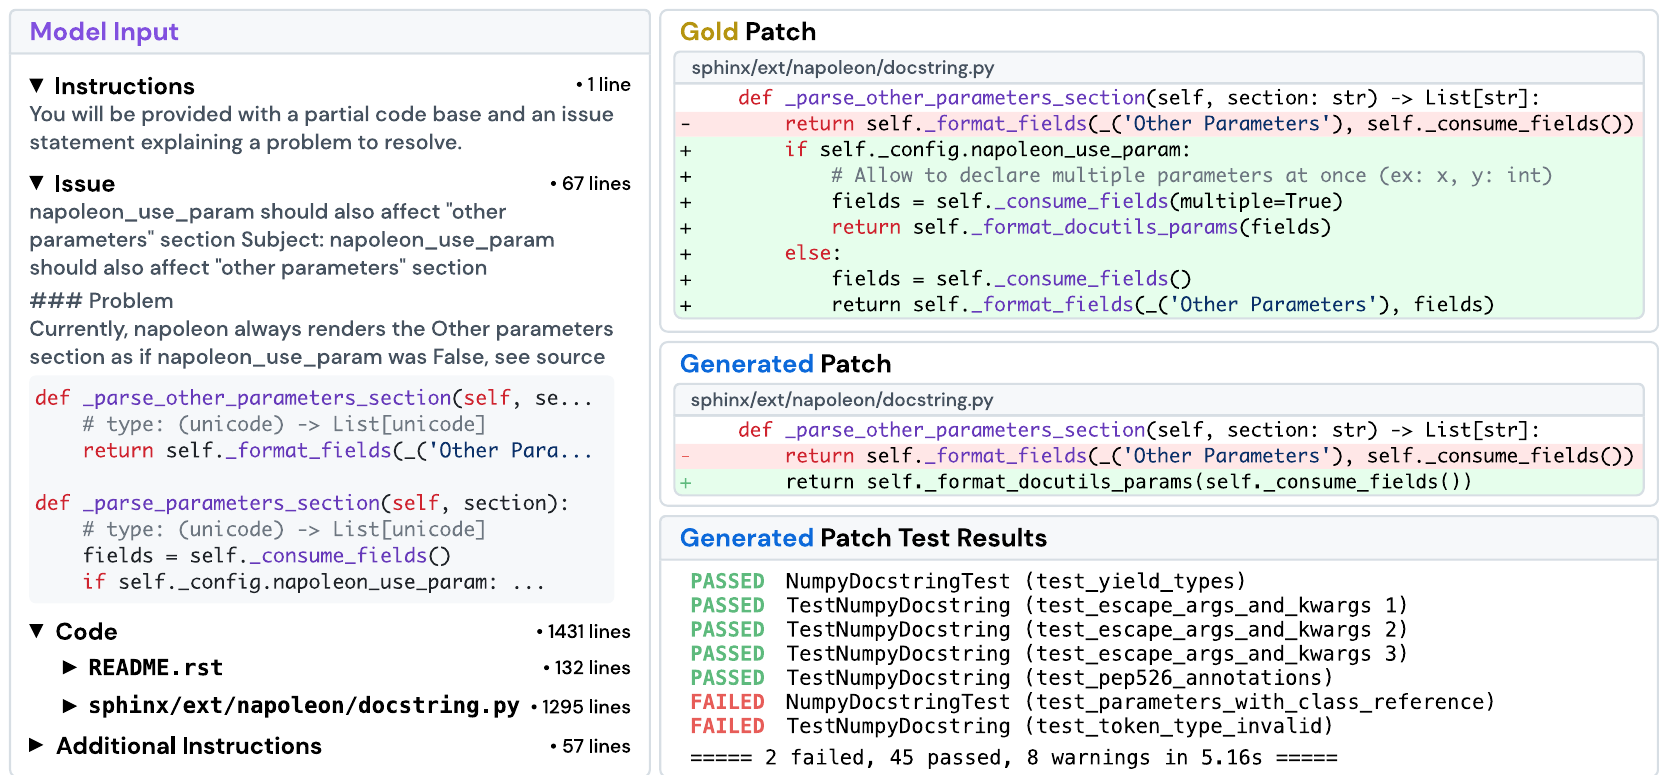
우리는 그림 6에 제시된 Sphinx 문서 생성기의 과제 인스턴스 sphinx-doc__sphinx-8713을 고려할 것이다. 이슈는 Sphinx의 napoleon 확장이 설정값 napoleon.use_param이 True로 설정되었을 때 문서 키워드 "Other Parameters"를 제대로 포맷하지 못한다고 기술한다. 이슈 텍스트는 또한 문제가 되는 소스 코드가 있을 것으로 의심되는 위치에 대한 상세한 코드 스니펫과, 오류를 재현하기 위한 몇 가지 코드 예시 및 패키지 버전과 관련된 추가 정보를 제공한다. 이 특정 인스턴스에 대해 모델은 과제를 해결하지 못했으며, 골드 솔루션에 의해 해결된 일부 테스트를 통과하지 못했다.
"oracle" 검색 설정에서 모델 입력은 이슈 텍스트와 몇 가지 지시사항, 골드 패치에 의해 편집된 파일들의 전체 내용, 그리고 우리가 정답으로 기대하는 diff 형식의 예시를 제공한다. 전체 모델 입력은 1,558줄의 맥락, 즉 20,882개의 토큰으로 구성된다. 골드 패치와 모델의 패치를 비교할 때, 우리는 명백한 실수를 발견한다. 모델은 sphinx/ext/napoleon/docstring.py의 684번째 줄에 있는 올바른 함수 _parse_other_parameters_section을 편집하지만, 골드 패치처럼 먼저 설정값을 확인하고 _parse_parameters_section이 하는 것을 복사하는 대신, napoleon.use_param이 항상 True인 것처럼 동작하도록 함수를 변경한다. 테스트에서 test_parameters _with_class_reference는 napoleon_use_param이 False로 설정된 설정을 사용하여 생성된 문서를 직접 비교하는데, 이는 모델의 오류를 즉시 잡아낸다.
우리가 고려한 모든 예시에 걸쳐 결과를 비교하면서, 우리는 행동에서 몇 가지 두드러진 경향을 발견한다. 모델들은 원시적인 Python 코드를 작성하는 경향이 있으며, 그들의 솔루션을 위해 기존의 서드파티 라이브러리나 코드베이스의 나머지 부분을 활용하지 않는다. 모델의 생성 결과는 또한 코드베이스에 의해 반영될 수 있는 코드 스타일이나 논리적 제약(즉, 절대 임포트 대신 상대 임포트를 사용하는 것)에는 거의 관심을 두지 않고, 문제를 정확히 해결하는 "탐욕적" 접근을 반영한다. 대조적으로, 우리는 많은 골드 패치가 코드베이스의 훨씬 더 넓은 범위를 포괄하는 구조적 개선을 수행한다는 것을 관찰한다. 이러한 편집은 이슈를 해결할 뿐만 아니라 잠재적인 미래 문제를 예측하고 해결한다.
6 관련 연구
LM의 평가. LM을 평가하기 위한 여러 최근 연구들은 여러 도메인에 걸친 상호 구별되는 과제들의 모음(Hendrycks et al., 2021; Liang et al., 2022; Srivastava et al., 2023)을 제안하거나, 해결하는 데 여러 단계가 필요한 과제들을 특징으로 하는 상호작용적 설정으로서 웹으로 눈을 돌렸다(Yao et al., 2022; Zhou et al., 2023; Deng et al., 2023; Liu et al., 2023d). 이러한 "푸토리" 스타일 설정에는 몇 가지 단점이 있다. 첫째, 각 과제는 하나 또는 소수의 기술에 협소하게 초점을 맞추는 경향이 있어, 일반적으로 너무 단순하고, 모델을 축소된 역할에 가두며, 모델이 다재다능함을 발휘하거나 잠재적으로 새로운 능력을 입증할 수 있는 여지를 제공하지 못하는 난제들을 초래한다(Srivastava et al., 2023). 결과적으로, 그러한 과제 집합에서의 모델 성능은 그 능력과 개선 방법에 관한 실행 가능하고 깊이 있는 통찰을 제공하지 못할 수 있다(Schlangen, 2019; Martínez-Plumed et al., 2021; Bowman & Dahl, 2021). SWE-bench는 이러한 단점들을 해결하는데, 우리의 연구는 이 과제가 상당히 어렵고, 이 과제를 해결하기 위해 LM을 개선할 수 있는 폭넓은 가능성을 제시하며, 새로운 과제 인스턴스로 시간이 지남에 따라 쉽게 갱신될 수 있고, 각 인스턴스가 새롭고 미묘하며 실용적인 난제들을 도입한다는 것을 보여준다.
코드 생성 벤치마크. HumanEval(Chen et al., 2021)은 자연어 설명으로부터 코드를 합성하려는 오랜 노력(Yu et al., 2018; Austin et al., 2021; Hendrycks et al., 2021; Li et al., 2022a; Zan et al., 2023)에서 현재의 표준이다. 지난 한 해 동안, 후속 벤치마크들은 HumanEval을 다양한 언어로의 확장(Cassano et al., 2022; Athiwaratkun et al., 2023; Orlanski et al., 2023), 편집 범위의 변형(Yu et al., 2023; Du et al., 2023), 유사하지만 새로운 코드 완성 과제(Muennighoff et al., 2023), 그리고 더 많은 테스트(Liu et al., 2023a)로 보강하려고 시도했다. 동시에, 별개의 연구들은 새로운 코딩 패러다임(Yin et al., 2022; Yang et al., 2023)을 도입하거나 라이브러리 특화 문제(Lai et al., 2022; Zan et al., 2022)를 설계하려고 시도했다. 문제들을 분리된 데이터셋으로 분할하고 단순화를 위해 문제를 축소하는 대신, SWE-bench의 수집 절차는 최소한의 후처리로 소스 코드를 변환하여, 닫힌 형태의 완성을 넘어 실제 소프트웨어 공학에 기반한 훨씬 더 광범위한 도전 과제들—예컨대 패치 생성, 긴 문맥에 대한 추론, 코드베이스 디렉터리 탐색, 모듈 전반의 의존성 기반 관계 포착—을 보존한다.
소프트웨어 공학을 위한 ML. 확장되지 않거나 자연어를 통합하지 못할 수 있는 전통적인 프로그램 분석 기법을 극복하기 위해, 현재 소프트웨어 공학 연구의 한 방향은 신경망, 그중에서도 LM을 사용하여 실제 소프트웨어 개발 프로세스를 자동화하는 것이다(Maniatis et al., 2023; Zheng et al., 2023; Hou et al., 2023). 사용 사례로는 커밋 생성 자동화(Jung, 2021; Liu et al., 2023c), PR 리뷰(Yang et al., 2016; Li et al., 2022b; Tufano et al., 2021), 버그 위치 파악(Kim et al., 2019; Chakraborty et al., 2018), 테스팅(Kang et al., 2023; Xia et al., 2023; Wang et al., 2023), 그리고 프로그램 수리(Gupta et al., 2017; Allamanis et al., 2017; Monperrus, 2018; Jiang et al., 2018; Goues et al., 2019; Gao et al., 2022; Dinh et al., 2023; Motwani & Brun, 2023)가 있다. SWE-bench와 가장 관련이 깊은 것은 LM을 자동화된 프로그램 수리(Xia & Zhang, 2022; 2023; Fan et al., 2023; Sobania et al., 2023)와 커밋을 통한 코드 편집 안내(Chakraborty & Ray, 2021; Zhang et al., 2022; Fakhoury et al., 2023)에 적용하려고 시도한 연구들이다. 그러나 기존 데이터셋(Just et al., 2014; Karampatsis & Sutton, 2019) 중 어느 것도 SWE-bench 규모의 코드 문맥을 제시하지 못한다. 더욱이 SWE-bench는 새로운 프로그래밍 언어와 저장소로 쉽게 확장될 수 있으며, 소프트웨어 공학 도구와 관행으로 LM을 증강하기 위한 실험을 수행할 수 있는 훨씬 더 현실적이고 도전적인 무대를 제공한다.
7 논의
한계 및 향후 방향. SWE-bench 과제 인스턴스는 모두 Python으로 되어 있으며, 우리는 SWE-bench의 과제 인스턴스 수집 절차를 적용하여 그 범위를 더 많은 프로그래밍 언어와 도메인으로 확장하기를 희망한다. 둘째, 우리의 실험은 이 과제에 대한 가장 단순하고 직관적인 접근법들의 기준선(baseline)을 확립하는 것을 목표로 하며, 향후 방법론을 동일한 유형의 접근법으로 제한하려는 의도는 없으며 향후 연구가 다른 방법(예: 에이전트 기반 접근법, 도구로 증강된 LM)을 탐구하도록 장려한다.
마지막으로, 본 연구는 실행 기반 코드 테스트를 사용하여 모델을 평가하지만, 이 방법에만 의존하는 것은 모델 생성물의 신뢰할 수 있는 성능을 보장하기에 불충분한데, 이는 LM의 자동 코드 생성이 인간이 작성한 해법에 비해 종종 덜 포괄적이거나, 덜 효율적이거나, 가독성이 떨어질 수 있음을 발견하기 때문이다.
결론. 실제 세계의 소프트웨어 개발 프로세스의 복잡성은 단순한 코드 완성을 훨씬 뛰어넘는다. 오픈소스 협업 파이프라인을 활용함으로써, SWE-bench는 실제 세계의 코딩 환경을 충실히 반영한 거울을 만든다. 이 더 현실적인 환경은 오픈소스 소프트웨어 개발에서 즉시 적용 가능한 창의적 해결책을 장려한다. 우리는 이 벤치마크와 우리의 다른 기여들이 더 실용적이고, 지능적이며, 자율적인 LM의 향후 개발에 있어 귀중한 자산이 되기를 희망한다.
8 윤리 성명
8 윤리 성명 SWE-bench는 우리의 기여가 부합하는 소프트웨어 사용을 허용하는 라이선스를 가진 공개 저장소에서 전적으로 수집되었다. 라이선스의 세부 사항은 표 12에 포함되어 있다. 수집 또는 평가 과정에서 우리는 GitHub 사용자에 대한 정보를 수집하지 않으며, SWE-bench 과제 인스턴스는 공개 API와 웹사이트를 통해 제공되는 것 이상의 GitHub 데이터를 사용하지 않는다. 우리의 기여는 어떤 인간 피험자 참여도 포함하지 않으며, 우리는 SWE-bench의 어떤 부분에 대해서도 크라우드소싱을 수행하거나 인간 과제 작업자를 모집하지 않는다. 이는 수집 및 평가 절차와 실험을 포함한다. 인기도를 기반으로 한 SWE-bench의 GitHub 저장소 필터링 기준은 저장소 선택에 있어 어떤 차별적이거나 편향된 휴리스틱에도 암묵적으로나 명시적으로 의존하지 않는다. 데이터셋 공개를 위해, 우리는 SWE-bench 과제 인스턴스, 수집 및 평가 인프라, 실험 결과, SWE-Llama 모델 미세 조정에 사용된 훈련 데이터, 그리고 SWE-Llama 모델 가중치를 오픈소스로 공개할 계획이다. 모범 사례 선례를 따라, 우리는 또한 각 구성 요소와 그 사용법을 설명하는 충분한 문서를 제공할 것이며, SWE-bench를 개선하기 위한 피드백을 수렴할 수 있는 편리한 소통 채널도 마련할 것이다. SWE-bench는 즉각적으로 유해한 통찰을 제시하지 않는다. 우리는 E절에서 SWE-bench 사용의 잠재적 영향에 대해 간략히 논의한다.
9 재현성 성명
9 재현성 성명 제출을 위해, 우리는 적절히 익명화된 소스 코드 전체를 압축 파일로 업로드하였다. 우리는 코드베이스를 구성하여 별도의 디렉터리가 본 논문 내의 서로 다른 기여(즉, 데이터셋 수집, 평가, 오픈소스 모델 추론, SWE-Llama 훈련 등)에 대응하도록 하였다. 소스 코드에는 코드베이스의 여러 부분의 목적과 사용법을 상세히 설명하는 인라인 문서가 포함되어 있다. 또한, 우리는 본 논문에서 논의된 모든 구성 요소를 포함하는 2294개의 SWE-bench 과제 인스턴스 전체 세트도 포함한다. 소스 코드 내의 문서 외에도, 우리는 본 논문 2절의 원래 세부 사항을 보완하는 수집 파이프라인과 평가 절차에 대한 철저한 기술적 세부 사항을 A.2절과 A.4절에 포함한다. 이 절들은 코드에 제시된 논리를 완전히 다루며 코드를 이해하는 데 도움이 될 수 있다. 앞으로, 윤리 성명에서 논의한 바와 같이, 우리는 벤치마크를 설명하고, 코드를 개괄하며, 그 사용법을 상세히 기술하는 철저한 세부 사항과 함께 SWE-bench를 오픈소스 저장소로 대중에게 더 공식적으로 공개할 계획이다. SWE-bench의 주요 구성 요소는 수집 프레임워크이며, 이는 오픈소스화된 코드의 일부가 될 것이다. 본 논문에서 논의한 바와 같이 유지보수가 용이한 설계 덕분에, 우리의 희망과 믿음은 SWE-bench가 높은 재현성을 가져야 한다는 것이다.
10 감사의 글
10 감사의 글 우리는 귀중한 피드백과 조언을 주신 Danqi Chen, Tri Dao, Zexuan Zhong, Tianyu Gao, Will Merrill, Mengzhou Xia, Dan Friedman, Adithya Bhaskar, Austin Watkins, Atamik Gupta, Richard Zhu에게 감사드린다. 우리는 National Science Foundation의 Grant No. 2239363 및 Oracle Collaborative Research award의 지원을 인정한다. 이 자료에 표현된 모든 의견, 발견, 결론 또는 권고는 저자(들)의 것이며 National Science Foundation의 견해를 반드시 반영하지는 않는다.
참고 문헌
Miltiadis Allamanis, Marc Brockschmidt, and Mahmoud Khademi. Learning to represent programs with graphs. arXiv preprint arXiv:1711.00740, 2017.
Ben Athiwaratkun, Sanjay Krishna Gouda, Zijian Wang, Xiaopeng Li, and Yuchen Tian et. al. Multilingual evaluation of code generation models, 2023.
Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le, and Charles Sutton. Program synthesis with large language models, 2021.
Samuel R. Bowman and George E. Dahl. What will it take to fix benchmarking in natural language understanding?, 2021.
Federico Cassano, John Gouwar, Daniel Nguyen, Sydney Nguyen, Luna Phipps-Costin, Donald Pinckney, Ming-Ho Yee, Yangtian Zi, Carolyn Jane Anderson, Molly Q Feldman, Arjun Guha, Michael Greenberg, and Abhinav Jangda. Multipl-e: A scalable and extensible approach to benchmarking neural code generation, 2022.
Saikat Chakraborty and Baishakhi Ray. On multi-modal learning of editing source code, 2021.
Saikat Chakraborty, Yujian Li, Matt Irvine, Ripon Saha, and Baishakhi Ray. Entropy guided spectrum based bug localization using statistical language model. arXiv preprint arXiv:1802.06947, 2018.
Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, and Jared Kaplan et. al. Evaluating large language models trained on code, 2021.
Tri Dao, Dan Fu, Stefano Ermon, Atri Rudra, and Christopher Ré. Flashattention: Fast and memory-efficient exact attention with io-awareness. Advances in Neural Information Processing Systems, 35:16344-16359, 2022.
Xiang Deng, Yu Gu, Boyuan Zheng, Shijie Chen, Samuel Stevens, Boshi Wang, Huan Sun, and Yu Su. Mind2web: Towards a generalist agent for the web, 2023.
Tuan Dinh, Jinman Zhao, Samson Tan, Renato Negrinho, Leonard Lausen, Sheng Zha, and George Karypis. Large language models of code fail at completing code with potential bugs. arXiv preprint arXiv:2306.03438, 2023.
Xueying Du, Mingwei Liu, Kaixin Wang, Hanlin Wang, Junwei Liu, Yixuan Chen, Jiayi Feng, Chaofeng Sha, Xin Peng, and Yiling Lou. Classeval: A manually-crafted benchmark for evaluating llms on class-level code generation, 2023.
Sarah Fakhoury, Saikat Chakraborty, Madan Musuvathi, and Shuvendu K. Lahiri. Towards generating functionally correct code edits from natural language issue descriptions, 2023.
Zhiyu Fan, Xiang Gao, Martin Mirchev, Abhik Roychoudhury, and Shin Hwei Tan. Automated repair of programs from large language models, 2023.
Daniel Fried, Armen Aghajanyan, Jessy Lin, Sida Wang, Eric Wallace, Freda Shi, Ruiqi Zhong, Wen tau Yih, Luke Zettlemoyer, and Mike Lewis. Incoder: A generative model for code infilling and synthesis, 2023.
Xiang Gao, Yannic Noller, and Abhik Roychoudhury. Program repair, 2022.
Claire Le Goues, Michael Pradel, and Abhik Roychoudhury. Automated program repair. Communications of the ACM, 62(12):56-65, 2019.
David Gros, Prem Devanbu, and Zhou Yu. Ai safety subproblems for software engineering researchers, 2023.
Rahul Gupta, Soham Pal, Aditya Kanade, and Shirish Shevade. Deepfix: Fixing common c language errors by deep learning. In Proceedings of the aaai conference on artificial intelligence, volume 31, 2017.
Maurice H. Halstead. Elements of Software Science (Operating and programming systems series). Elsevier Science Inc., USA, 1977. ISBN 0444002057.
Dan Hendrycks, Steven Basart, Saurav Kadavath, Mantas Mazeika, Akul Arora, Ethan Guo, Collin Burns, Samir Puranik, Horace He, Dawn Song, and Jacob Steinhardt. Measuring coding challenge competence with apps, 2021.
Xinyi Hou, Yanjie Zhao, Yue Liu, Zhou Yang, Kailong Wang, Li Li, Xiapu Luo, David Lo, John Grundy, and Haoyu Wang. Large language models for software engineering: A systematic literature review, 2023.
Edward J Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen- Zhu, Yuanzhi Li, Shean Wang, Lu Wang, and Weizhu Chen. LoRA: 대규모 언어 모델의 저랭크 적응. In International Conference on Learning Representations, 2022. URL https://openreview.net/forum?id=nZeVKeeFYf9.
Sam Ade Jacobs, Masahiro Tanaka, Chengming Zhang, Minjia Zhang, Leon Song, Samyam Rajbhandari, and Yuxiong He. Deepspeed ulysses: 극도로 긴 시퀀스 트랜스포머 모델의 학습을 가능하게 하기 위한 시스템 최적화, 2023.
Jiajun Jiang, Yingfei Xiong, Hongyu Zhang, Qing Gao, and Xiangqun Chen. 기존 패치와 유사 코드를 활용한 프로그램 수리 공간 형성. In Proceedings of the 27th ACM SIGSOFT international symposium on software testing and analysis, pp. 298- 309, 2018.
Tae- Hwan Jung. Committer: 사전 학습된 프로그래밍 언어 모델을 이용한 커밋 메시지 생성, 2021.
René Just, Darioush Jalali, and Michael D. Ernst. Defects4J: Java 프로그램에 대한 통제된 테스트 연구를 가능하게 하는 기존 결함 데이터베이스. In ISSTA 2014, Proceedings of the 2014 International Symposium on Software Testing and Analysis, pp. 437- 440, San Jose, CA, USA, July 2014. 도구 데모.
Sungmin Kang, Juyeon Yoon, and Shin Yoo. 대규모 언어 모델은 퓨샷 테스터이다: LLM 기반 일반 버그 재현 탐구, 2023.
Rafael- Michael Karampatsis and Charles Sutton. 단일 문장 버그는 얼마나 자주 발생하는가? manysstubs4j 데이터셋. 2020 IEEE/ACM 17th International Conference on Mining Software Repositories (MSR), pp. 573- 577, 2019. URL https://api.semanticscholar.org/CorpusID:173188438.
Douwe Kiela, Max Bartolo, Yixin Nie, Divyansh Kaushik, Atticus Geiger, and Zhengxuan Wu et. al. Dynabench: Rethinking benchmarking in nlp, 2021.
Yunho Kim, Seokhyeon Mun, Shin Yoo, and Moonzoo Kim. Precise learn-to-rank fault localization using dynamic and static features of target programs. ACM Transactions on Software Engineering and Methodology (TOSEM), 28(4):1-34, 2019.
Yuhang Lai, Chengxi Li, Yiming Wang, Tianyi Zhang, Ruiqi Zhong, Luke Zettlemoyer, Scott Wen tau Yih, Daniel Fried, Sida Wang, and Tao Yu. Ds-1000: A natural and reliable benchmark for data science code generation, 2022.
Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, and Rémi Leblond et. al. Competition-level code generation with AlphaCode. Science, 378(6624):1092-1097, dec 2022a. doi: 10.1126/science.abq1158. URL https://doi.org/10.1126%2Fscience.abq1158.
Zhiyu Li, Shuai Lu, Daya Guo, Nan Duan, Shailesh Jannu, Grant Jenks, Deep Majumder, Jared Green, Alexey Svyatkovskiy, Shengyu Fu, and Neel Sundaresan. Automating code review activities by large-scale pre-training, 2022b.
Percy Liang, Rishi Bommasani, Tony Lee, Dimitris Tsipras, Dilara Soylu, and Michihiro Yasunaga et. al. Holistic evaluation of language models, 2022.
Jiawei Liu, Chunqiu Steven Xia, Yuyao Wang, and Lingming Zhang. Is your code generated by chatgpt really correct? rigorous evaluation of large language models for code generation. arXiv preprint arXiv:2305.01210, 2023a.
Nelson F. Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni, and Percy Liang. Lost in the middle: How language models use long contexts, 2023b. arXiv:2307.03172.
Shangqing Liu, Yanzhou Li, Xiaofei Xie, and Yang Liu. Commitbart: A large pre-trained model for github commits, 2023c.
Xiao Liu, Hao Yu, Hanchen Zhang, Yifan Xu, Xuanyu Lei, and Hanyu Lai et. al. Agentbench: Evaluating llms as agents, 2023d.
Shuai Lu, Daya Guo, Shuo Ren, Junjie Huang, Alexey Svyatkovskiy, and Ambrosio Blanco et. al. Codexglue: A machine learning benchmark dataset for code understanding and generation. CoRR, abs/2102.04664, 2021.
Petros Maniatis, Daniel Tarlow, and Google DeepMind. Large sequence models for software development activities, 2023. URL https://blog.research.google/2023/05/large-sequence-models-for-software.html.
Fernando Martinez-Plumed, Pablo Barredo, Seán Ó hEigeartaigh, and José Hernández-Orallo. Research community dynamics behind popular ai benchmarks. Nature Machine Intelligence, 3:581-589, 2021. URL https://api.semanticscholar.org/CorpusID:236610014.
Thomas J. McCabe. A complexity measure. IEEE Transactions on Software Engineering, SE-2(4):308-320, 1976. doi: 10.1109/TSE.1976.233837.
Martin Monperrus. Automatic software repair. ACM Computing Surveys, 51(1):1-24, jan 2018. doi: 10.1145/3105906. URL https://doi.org/10.1145%2F3105906.
Manish Motwani and Yuriy Brun. Better automatic program repair by using bug reports and tests together, 2023.
Niklas Muennighoff, Qian Liu, Armel Zebaze, Qinkai Zheng, Binyuan Hui, Terry Yue Zhuo, Swayam Singh, Xiangru Tang, Leandro von Werra, and Shayne Longpre. Octopack: Instruction tuning code large language models, 2023.
Gabriel Orlanski, Kefan Xiao, Xavier Garcia, Jeffrey Hui, Joshua Howland, Jonathan Malmaud, Jacob Austin, Rishabh Singh, and Michele Catasta. Measuring the impact of programming language distribution, 2023.
Simon Ott, Adriano Barbosa-Silva, Kathrin Blagec, Janina Brauner, and Matthias Samwald. Mapping global dynamics of benchmark creation and saturation in artificial intelligence. Nature Communications, 13, 2022. URL https://api.semanticscholar.org/CorpusID:247318891.
Stephen Robertson, Hugo Zaragoza, et al. The probabilistic relevance framework: Bm25 and beyond. Foundations and Trends® in Information Retrieval, 3(4):333-389, 2009.
Baptiste Rozière, Jonas Gehring, Fabian Gloeckle, Sten Sootla, Itai Gat, and Xiaoqing Ellen Tan et. al. Code llama: Open foundation models for code, 2023.
David Schlangen. Language tasks and language games: On methodology in current natural language processing research, 2019.
Dominik Sobania, Martin Briesch, Carol Hanna, and Justyna Petke. An analysis of the automatic bug fixing performance of chatgpt, 2023.
Aarohi Srivastava, Abhinav Rastogi, Abhishek Rao, and Abu Awal Md Shoeb et. al. Beyond the imitation game: Quantifying and extrapolating the capabilities of language models, 2023.
Rosalia Tufano, Luca Pascarella, Michele Tufano, Denys Poshyvanyk, and Gabriele Bavota. Towards automating code review activities, 2021.
Junjie Wang, Yuchao Huang, Chunyang Chen, Zhe Liu, Song Wang, and Qing Wang. Software testing with large language model: Survey, landscape, and vision, 2023.
Chunqiu Steven Xia and Lingming Zhang. Less training, more repairing please: revisiting automated program repair via zero-shot learning. In Proceedings of the 30th ACM Joint European Software Engineering Conference and Symposium on the Foundations of Software Engineering, pp. 959-971, 2022.
Chunqiu Steven Xia and Lingming Zhang. Conversational automated program repair, 2023.
Chunqiu Steven Xia, Matteo Paltenghi, Jia Le Tian, Michael Pradel, and Lingming Zhang. Universal fuzzing via large language models. arXiv preprint arXiv:2308.04748, 2023.
John Yang, Akshara Prabhakar, Karthik Narasimhan, and Shunyu Yao. Intercode: Standardizing and benchmarking interactive coding with execution feedback, 2023.
Xin Yang, Raula Gaikovina Kula, Norihiro Yoshida, and Hajimu Iida. Mining the modern code review repositories: A dataset of people, process and product. In Proceedings of the 13th International Conference on Mining Software Repositories, pp. 460-463, 2016.
Shunyu Yao, Howard Chen, John Yang, and Karthik Narasimhan. Webshop: Towards scalable real-world web interaction with grounded language agents, 2022.
Pengcheng Yin, Wen-Ding Li, Kefan Xiao, Abhishek Rao, Yeming Wen, Kensen Shi, Joshua Howland, Paige Bailey, Michele Catasta, Henryk Michalewski, Alex Polozov, and Charles Sutton. Natural language to code generation in interactive data science notebooks, 2022.
Hao Yu, Bo Shen, Dezhi Ran, Jiaxin Zhang, Qi Zhang, Yuchi Ma, Guangtai Liang, Ying Li, Tao Xie, and Qianxiang Wang. Codereval: A benchmark of pragmatic code generation with generative pre-trained models, 2023.
Tao Yu, Rui Zhang, Kai Yang, Michihiro Yasunaga, Dongxu Wang, Zifan Li, James Ma, Irene Li, Qingning Yao, Shanelle Roman, Zilin Zhang, and Dragomir Radev. Spider: A large-scale human-labeled dataset for complex and cross-domain semantic parsing and text-to-SQL task. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, pp. 3911-3921, Brussels, Belgium, October-November 2018. Association for Computational Linguistics. doi: 10.18653/v1/D18-1425. URL https://aclanthology.org/D18-1425.
Daoguang Zan, Bei Chen, Dejian Yang, Zeqi Lin, Minsu Kim, Bei Guan, Yongji Wang, Weizhu Chen, and Jian-Guang Lou. Cert: Continual pre-training on sketches for library-oriented code generation, 2022.
Daoguang Zan, Bei Chen, Fengji Zhang, Dianjie Lu, Bingchao Wu, Bei Guan, Yongji Wang, and Jian-Guang Lou. Large language models meet nl2code: A survey, 2023.
Jiyang Zhang, Sheena Panthaplackel, Pengyu Nie, Junyi Jessy Li, and Milos Gligoric. Coditt5: Pretraining for source code and natural language editing, 2022.
Zibin Zheng, Kaiwen Ning, Jiachi Chen, Yanlin Wang, Wenqing Chen, Lianghong Guo, and Weicheng Wang. Towards an understanding of large language models in software engineering tasks. arXiv preprint arXiv:2308.11396, 2023.
Shuyan Zhou, Frank F. Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Abishek Sridhar, Xianyi Cheng, Yonatan Bisk, Daniel Fried, Uri Alon, and Graham Neubig. Webarena: A realistic web environment for building autonomous agents, 2023.
부록
부록에서는 데이터셋 구축 과정, 평가 파이프라인, 그리고 SWE-bench 벤치마크의 특성화에 관한 보다 상세한 내용을 제공한다.
A 벤치마크 세부 사항
이 섹션은 데이터 수집, 실행 기반 검증, 평가 절차에 대한 보다 기술적이고 세밀한 요약과 함께 작업 인스턴스에 대한 보다 완전한 특성화를 제공함으로써 섹션 2를 보완한다.
A.1 상위 수준 개요
풀 리퀘스트 스크래핑. 2023년 8월 동안 가장 많이 다운로드된 상위 5,000개의 PyPI 라이브러리 목록에서 우리는 상위 100개 패키지를 선정하고, 각 라이브러리에 대응하는 오픈 소스 GitHub 저장소를 식별하며, 자유 소프트웨어 사용을 허용하는 라이선스를 가진 패키지가 어느 것인지 확인하고, GitHub 개발자 API를 통해 이 저장소들의 모든 PR을 수집한다. 우리는 트래픽이 많은 저장소에서 문제를 가져오기로 선택하는데, 그 이유는 광범위한 사용은 보통 해당 저장소에 방대한 문서, 체계적인 오픈 소스 개발 지침, 그리고 작동하고 형식이 잘 갖추어진 코드가 있음을 시사하기 때문이다.
작업 인스턴스 구성. 우리는 세 가지 조건을 만족하는 PR들로부터 후보 작업 인스턴스를 구성한다. 첫째, PR의 상태가 Merged여야 한다. Merged 상태는 PR과 연관된 코드 변경이 수용되어 상위 저장소에 통합되었음을 나타낸다. 둘째, PR이 해당 저장소의 하나 이상의 이슈를 해결해야 한다. 이슈는 소프트웨어 프로젝트의 버그, 개선 사항 또는 일반적인 개발 목표를 추적하기 위한 디지털 티켓으로서 GitHub에서의 정규 용법에 따라 정의된다. 우리는 PR의 제목, 본문, 커밋 메시지를 검사하여 연결된 이슈(예: "fixes #24")를 찾는다. 셋째, PR이 하나 이상의 새로운 테스트를 도입해야 한다. 새로운 테스트는 PR의 코드 변경이 테스트 관련 키워드(예: "test", "testing")를 포함하는 파일 경로를 편집할 때 카운트된다.
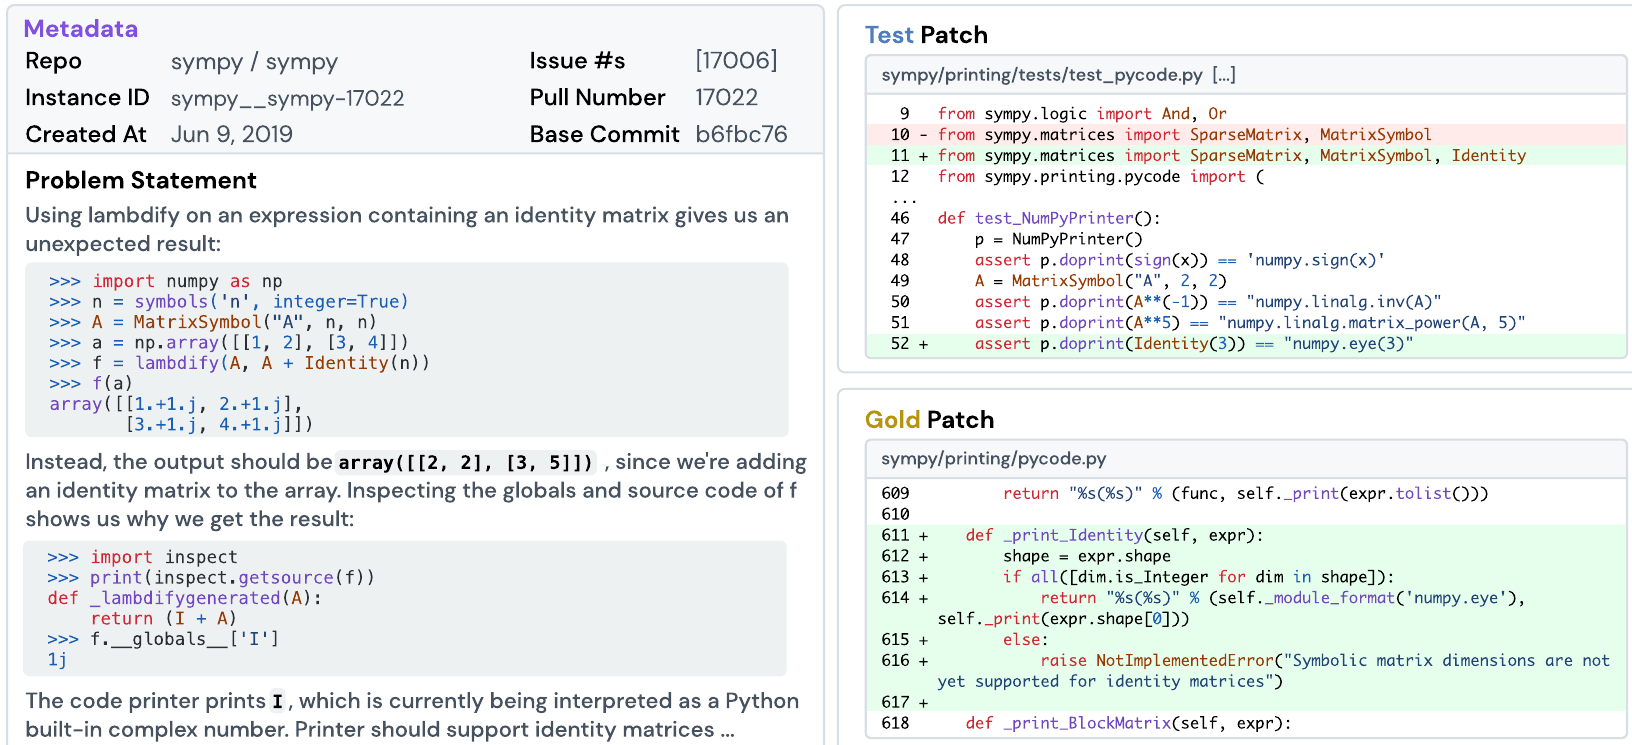
이러한 기준을 만족하는 PR은 이후 Figure 7의 예시와 같은 후보 작업 인스턴스로 변환된다. 코드베이스 는 저장소의 소유자/이름 표기와 풀 리퀘스트의 베이스 커밋에 의해 식별된다. 이 정보로부터 실제 코드베이스를 복원하는 것은 간단하다. 우리는 원본 GitHub 저장소의 미러를 생성하는데, 각 미러는 owner_name으로 고유하게 식별된다. 저장소에 대응하는 미러를 클론하고 베이스 커밋을 체크아웃하면 PR 이전 상태의 가 얻어진다. 문제 진술 는 해결책 세부 사항의 누출을 피하기 위해 PR의 최초 커밋 타임스탬프 이전에 작성된 모든 관련 이슈의 제목과 설명 및 그에 이은 후속 댓글을 모두 취합한 것이다. PR의 코드 변경은 테스트 패치와 골드 패치 로 분리된다. 는 테스트 패치에서 편집된 파일들의 모든 테스트로 구성된다. Figure 7에 나타난 바와 같이, 와 는 모두 패치 파일로 저장된다. PR 및 의미 데이터 파싱에 관한 추가 세부 사항은 부록 A.2에 있다.
실행 기반 검증. 우리는 실행을 통해 작업 인스턴스의 사용 가능성을 검증한다. 각 후보에 대해, 우리는 먼저 실행 컨텍스트로 기능할 가상 환경을 정의하고, 그 다음 어떤 패치도 적용하기 전에 를 설치하며, 마지막으로 해결책 가 적용되기 전에 한 번 그리고 적용된 후에 한 번 를 실행한다. 검증 과정의 어느 단계라도 실패하면 해당 후보는 최종 데이터셋 고려 대상에서 제거된다. 또한, 해결책 가 자명하지 않음을 보장하기 위해, 우리는 해결책 적용 전과 적용 후의 검증 로그를 비교하여 내에 상태가 실패에서 통과로 바뀌는 테스트가 하나 이상 있는지 확인한다. 마지막으로, 우리는 해결책 에서 처음 도입된 새로 생성된 함수나 클래스를 호출하는 테스트를 가진 작업 인스턴스를 제외한다. 그러한 구성 요소의 명명은 일반적으로 임의적인 과정이며 보통 문제 진술에 명시적으로 규정되지 않기 때문에, 이러한 테스트를 해결하는 것은 인간 개발자에게조차 불가능한 작업일 수 있다. 실행 컨텍스트, 코드베이스 설치, 로그로부터 테스트 상태 판별 등에 관한 정보는 부록 A.3에 있다.
지속적 업데이트. SWE-bench의 수집 과정은 어떤 오픈 소스 코드 저장소로도 쉽게 확장 가능하며, 새로운 프로그래밍 언어와 코드 영역으로의 쉽고 유지보수가 적게 드는 확장을 가능하게 한다. 이 설계는 또한 SWE-bench에 시간적 견고성을 부여한다. 더 최근의 소스 코드로 학습된 새로운 언어 모델이 시간이 지나면서 출시됨에 따라, SWE-bench는 어떤 LM의 학습 날짜 이후에 생성된 PR들을 기반으로 새로운 작업 인스턴스를 생성하도록 간단히 업데이트될 수 있다.
A.2 구성 과정
우리는 풀 리퀘스트 객체를 후보 작업 인스턴스로 변환하는 것에 관한 추가 세부 사항을 논의한다. 상위 수준에서, 이 변환의 주된 목표는 섹션 2에서 소개된 코드베이스 , 문제 진술 , 단위 테스트 , 해결책 구성 요소를 조립하기 위한 관련 정보를 획득하는 것이다. 이를 위해, SWE-bench 작업 인스턴스는 다음 Table 9에 제시된 다음과 같은 필드들로 구성된다. 종합적으로, 이 필드들은 네 가지 작업 인스턴스 모듈에 대응한다.
| 소스 텍스트를 번역합니다: 필드 | 설명 |
| base.commit | (str) 원본 PR이 그 위에 적용되는 커밋 ID |
| created.at | (date) PR이 처음 생성된 시점(병합되지 않음)의 Datetime 객체 |
| hints.text | (str) 문제를 해결하는 방법에 대한 자연어 제안 |
| instance.id | (str) repo와 pull_number로부터 생성된 고유 식별자 |
| issue.numbers | (list) 원본 풀 리퀘스트가 해결하는 이슈 번호 목록 |
| patch | (str) 문제에 대한 참조 솔루션으로, 원본 PR의 코드 변경에서 추출된 .patch 형식 스타일 문자열 |
| problem.statement | (str) 코드베이스에 원하는 변경에 대한 자연어 설명 |
| pull.number | (int) 원본 풀 리퀘스트의 풀 번호 |
| test.patch | (str) 과제가 해결되었는지 확인하기 위한 보지 못한 테스트를 포함하며, 원본 PR의 코드 변경에서 추출된 .patch 형식 스타일 문자열 |
| version | (str) PR이 생성된 동안의 (repo 기준) 릴리스 버전 |
| repo | (str) 과제 인스턴스가 비롯된 저장소 |
| FAIL_TO_PASS | (list) 상태가 fail에서 pass로 바뀌는 테스트 목록 |
| PASS_TO_PASS | (list) 상태가 pass에서 pass로 바뀌는 테스트 목록 |
| env.install.commit | (str) 과제 인스턴스를 실행하기 위한 필수 의존성을 설치하는 기준 커밋 |
문제 진술. 각 작업 인스턴스의 문제 진술 는 problem_statement 필드로서 즉시 이용 가능하다. 문제 진술은 모든 이슈의 첫 번째 댓글과, PR의 최초 커밋 생성 날짜 이전에 작성된 해당 이슈들에 첨부된 모든 댓글을 취합한 것이다. 우리는 PR의 제목, 본문, 커밋 메시지로부터 이슈를 크롤링한다. 이러한 구성 요소들의 텍스트 데이터를 연결한 후, 우리는 먼저 마크다운 스타일 주석을 제거하고, 그 다음 남은 텍스트를 훑어 이슈 번호에 대한 참조(숫자 부호 # 뒤에 숫자)를 찾고 이슈 번호 참조 앞의 단어가 해당 이슈가 PR에 의해 해결되었음을 시사하는 키워드 집합(예: "closes", "fixes", "resolves")에 포함되는지 확인한다. 발견된 이슈들은 issue_number 필드에 기록되고, 그 다음 각 이슈의 데이터를 검색하기 위한 별도의 웹 요청이 이루어진다. problem_statement를 형성하기 위해, 각 이슈의 제목과 본문이 함께 추가되고, 여러 개가 있을 경우 다음 이슈와 연결된다. 또한 이 단계에서 PR의 댓글 섹션으로부터 hints_text 필드가 생성되고 수집되는데, 여기에는 PR의 최초 커밋 이전에 작성된 댓글의 텍스트가 포함된다. 이러한 수집 방법론에 대한 직관은 그러한 PR 댓글이 당면한 문제를 완수하는 방법에 관해 원래의 인간 작업자에게 자연어 및 의사 코드 제안을 포함할 가능성이 높다는 것이다. 본 연구에서 제시된 실험들은 hints_text를 활용하지 않지만, 우리는 이 정보가 향후 조사에 흥미로울 수 있다고 생각한다.
코드베이스. 코드베이스 의 내용은 모든 작업 인스턴스에 대해 평문으로 저장되지 않는다. 대신, 작업 인스턴스는 repo와 base_commit 필드를 통해 관련 코드베이스에 대한 참조를 포함한다. 두 필드 모두 원본 PR의 데이터에서 이용 가능하다. 이 두 요소로부터 코드베이스 의 검색을 재현 가능하고 신뢰할 수 있게 만들기 위해, 우리는 원본 저장소의 미러를 생성한다. 평가 데이터와 파인 튜닝 데이터를 모두 구성하는 저장소에 대한 미러는 SWE-bench GitHub 조직 아래에서 수집되어 오픈 소스로 공개된다. 원본 저장소의 코드는 작성자의 통제 밖에서 커밋 및 편집 이력의 변경을 겪을 수 있기 때문에, 우리는 이후의 코드베이스 수정이 관련 base_commit의 손상이나 제거로 인해 작업 인스턴스를 잠재적으로 사용 불가능하게 만들지 않도록 미러 저장소를 생성하기로 선택한다. 또한, 우리는 저장소의 최신 버전을 클론하여 저장하는 대신 미러를 생성한다. 이는 미러가 원본 커밋 해시, 이력, 브랜치, 태그를 보존하여 원본 저장소의 기술적 세부 사항에 대한 충실하고 완전한 이력으로 기능하기 때문이다. 미러는 원본 저장소의 스타, 워처, 이슈, 풀 리퀘스트를 보존하지 않는다.
우리는 작업 인스턴스가 수집된 당일 이후 그리고 같은 날 이내에 저장소로부터 미러를 생성한다. 미러는 원본 저장소의 "owner/name" 표기를 유지하되, GitHub 명명 규칙을 준수하기 위해 "/" 문자를 "_"로 변환한다. 이러한 인프라가 주어지면, 작업 인스턴스의 코드베이스를 검색하는 것은 간단하다. 먼저, 올바른 미러를 repo를 사용하여 SWE-bench 조직으로부터 클론할 수 있다. 다음으로, 미러의 로컬 복사본 내에서 base_commit을 체크아웃하면 저장소가 코드베이스 로 재설정된다. 같은 저장소의 다른 작업 인스턴스로 진행하기 위해, git 버전 관리를 사용하여 다음 작업 인스턴스의 베이스 커밋을 체크아웃하기 전에 현재 작업 인스턴스와 연관된 모든 수정 사항을 자동으로 제거한다.
해결책, 테스트 패치. 해결책 와 테스트 는 PR의 파일 변경 데이터, 즉 diff로부터 도출된다. 섹션 2.1에서 언급한 바와 같이, 원본 diff와 해결책 및 테스트 는 라인 기반 텍스트 파일에 대한 변환을 효율적으로 명시하기 위한 형식인 .patch 파일로 표현된다. 일반적으로 말하면, .patch는 블록들의 목록으로 구조화되며, 각 블록은 헤더와 단일 파일에 대한 변경에 집합적으로 대응하는 하나 이상의 헝크로 구성된다. 헤더는 파일 경로와 줄 번호를 명시하는 메타데이터를 포함하며, 대상 파일에 대한 실제 수정은 추가와 제거를 나타내기 위해 "+"와 "-"로 접두된 여러 줄로 인코딩된다. 테스트 를 생성하기 위해, 우리는 먼저 패치 내의 모든 고유 블록을 식별하고, 그 다음 테스트 관련 키워드(예: "tests", "testing")를 포함하는 파일 경로를 가진 블록들을 골라 취합한다. 나머지 블록들은 병합되어 해결책 를 형성한다. 우리는 와 를 올바르게 파싱하도록 작성된 스크립트의 견고성을 두 패치를 해당 코드베이스 에 적용하고 테스트를 실행함으로써 검증하며, 그 다음 결과가 원본 PR의 diff 데이터의 동작을 재현하는지 확인한다. 해결책 는 patch 필드로 저장되는 반면, 테스트 는 test_patch 필드로 저장된다.
나머지 필드. created_at 필드는 베이스 PR이 생성된 시점을 명시하는 타임스탬프이다. 우리는 원본 데이터로부터 created_at 필드를 유지하며 이 필드를 사용하여 모델 성능의 시간적 분석을 수행한다. version 필드는 PR이 릴리스된 시점의 저장소 기준 릴리스 버전에 대응하는 문자열이다. 가용성과 각 방법에 요구되는 노력의 정도에 따라, 우리는 소스 코드로부터 직접 정보를 검색하거나, 저장소를 로컬에서 빌드하고 코드를 호출하여 버전을 표준 출력에 표시하거나, created_at 필드를 저장소 웹페이지의 릴리스 버전 타임라인과 비교함으로써 version 필드를 생성한다. 우리는 § A.3에서 더 자세히 논의하는 바와 같이 저장소의 모든 버전에 대한 실행 가능한 컨텍스트를 생성한다.
GitHub를 사용하여 미러 저장소를 생성하기 위한 문서
A.3 실행 기반 검증
저장소의 모든 PR을 필터링하고 앞서 언급한 기준을 충족하는 PR을 후보 태스크 인스턴스로 변환한 후, 다음 단계는 실행을 통해 각 태스크 인스턴스의 사용 가능성을 검증하는 것입니다. 이 절차는 세 단계로 나뉩니다. 먼저, 저장소의 각 릴리스 버전에 대한 실행 가능한 컨텍스트를 생성합니다. 다음으로, 해법 와 테스트 가 코드베이스 위에서 성공적으로 적용, 설치 및 실행될 수 있는지 확인합니다. 마지막으로, 각 태스크 인스턴스의 실행 로그를 검토하여 특정 행동 집합을 검증함으로써 해당 태스크가 모델 평가에 사용 가능하고 공정한지 확인합니다.
실행 가능한 컨텍스트. 우리는 가상 환경을 어느 정의 수준에서 정의할지에 관해 다양한 세분화 정도를 실험한 후 릴리스 버전별로 실행 가능한 컨텍스트를 생성하기로 선택했습니다. 태스크 인스턴스별 컨텍스트를 정의하는 것은 종단 간 설치 성공을 보장하는 데 가장 유리하지만, 힘든 수작업 비용을 수반합니다. 반면, 저장소의 최신 버전을 기반으로 한 저장소별 컨텍스트는 일반적으로 정의가 너무 거칠어서 이전 버전의 요구 사항과 호환되지 않습니다. 우리는 릴리스 버전이 태스크 인스턴스의 부분집합 전반에 걸친 의존성 요구 사항을 포착하는 좋은 대리물이며, 설치 성공과 수작업 노력 사이에서 관리 가능한 균형을 이룬다는 것을 발견했습니다. 우리는 각 버전의 최신 태스크 인스턴스에 대한 코드베이스를 검토하여 각 실행 가능한 컨텍스트를 수동으로 생성합니다. 저장소의 README 및 CONTRIBUTING 가이드에서 일반적으로 볼 수 있는 소스 코드와 문서를 바탕으로 Python 버전, 필요한 의존성, 설치 명령을 알아냅니다.
검증 엔진. 검증 엔진의 목적은 후보 태스크 인스턴스를 검증하는 것입니다. 구체적으로, 이 단계에서는 첫째, 해법 와 테스트 가 코드베이스 에 적용될 수 있는지, 둘째, 코드베이스가 해당 가상 환경 내에서 적절히 설치되고 실행될 수 있는지를 확인합니다. 이를 위해 우리는 저장소별로 검증을 수행하며, 각 저장소의 태스크 인스턴스 집합에 대해 다음 절차를 수행합니다:
1. 버전별 최신 태스크 인스턴스를 기반으로 conda 환경으로서 실행 가능한 컨텍스트를 생성한다.
2. 태스크 인스턴스를 버전별로 그룹화한다.
3. 각 태스크 인스턴스 그룹을 순회하며, 각 태스크 인스턴스에 대해 해당 conda 환경 내에서 다음을 수행한다.
(a) 모든 파일 변경 사항을 제거하고 태스크 인스턴스의 base_commit을 체크아웃한다. 이는 저장소를 코드베이스 로 설정한다.
(b) 설치 명령을 실행하여 코드베이스 를 인스턴스화한다.
(c) 테스트 패치 를 코드베이스 에 적용한다.
(d) 테스트 패치 로부터 결정된 테스트 스크립트를 실행하여 테스트 결과 로그 를 생성한다.
(e) 해법 패치를 테스트 와 함께 코드베이스 에 적용한다.
(f) (d) 부분의 테스트 스크립트를 다시 실행하여 테스트 결과 로그 를 생성한다.
테스트 명령은 저장소가 사용하는 테스트 프레임워크(예: pytest, tox)에 에 명시된 경로를 덧붙인 것으로 구성됩니다. 테스트 명령은 각 파일 경로의 내용에 명시된 모든 테스트를 실행합니다. 단계 부터 중 어느 하나라도 실패하면, 해당 후보 태스크 인스턴스는 고려 대상에서 제외됩니다. 저장소 간에 어느 정도 변동은 있지만, 우리는 이 단계가 일반적으로 후보 태스크 인스턴스의 절반을 제거한다는 것을 관찰했습니다.
검증 로그 조사. 마지막으로, 특정 속성에 대해 검증 엔진이 생성한 로그 와 를 확인합니다. 먼저, 임의의 명명 선택에 대비하기 위해 에서 ImportError 및 AttributeError 발생 여부를 확인하는데, 이는 잠재적으로 의존성 명명 관련 오류를 나타낼 수 있으며, 이러한 오류는 사소하지만 올바르게 해결하기가 거의 불가능합니다. 이를 위해 에 그러한 오류가 있는 모든 태스크 인스턴스를 고려 대상에서 제거합니다. 다음으로, 테스트 결과를 비교하여 태스크 인스턴스가 비자명한지, 즉 해결책 가 적용되기 전에 하나 이상의 테스트가 실패 상태였다가 적용 후 통과 상태가 되는 것으로 표시되는지 확인합니다. 이를 확인하기 위해 먼저 와 를 테스트 에서 상태 로의 매핑으로 변환하는 여러 저장소별 파서를 정의합니다. 이 두 데이터 구조가 주어지면,
| <table><thead><tr><td><b>Repo</b></td><td><b>Total PRs Crawled</b></td><td><b>Post-Conversion</b></td><td><b>Post-Validation (Final)</b></td></tr></thead><tbody><tr><td>astropy</td><td>9,469</td><td>1,016</td><td>95</td></tr><tr><td>django</td><td>16,914</td><td>2,880</td><td>850</td></tr><tr><td>flask</td><td>2,434</td><td>107</td><td>11</td></tr><tr><td>matplotlib</td><td>16,545</td><td>1,057</td><td>184</td></tr><tr><td>pylint</td><td>3,848</td><td>787</td><td>57</td></tr><tr><td>pytest</td><td>5,147</td><td>750</td><td>119</td></tr><tr><td>requests</td><td>2,344</td><td>84</td><td>44</td></tr><tr><td>scikit-learn</td><td>15,159</td><td>1,169</td><td>229</td></tr><tr><td>seaborn</td><td>1,004</td><td>203</td><td>22</td></tr><tr><td>sphinx</td><td>4,931</td><td>645</td><td>187</td></tr><tr><td>sympy</td><td>11,928</td><td>1,897</td><td>386</td></tr><tr><td>xarray</td><td>3,416</td><td>812</td><td>110</td></tr><tr><td>Total</td><td>93,139</td><td>11,407</td><td>2,294</td></tr></tbody></table> <p> | |||
\(s\)가 fail에서 pass로 변경되는 가 적어도 하나 이상 존재하는지 확인합니다. 그러한 테스트가 발견되지 않으면 태스크 인스턴스는 고려 대상에서 제거됩니다.
태스크 인스턴스가 이 두 가지 기준을 충족하면 평가 데이터셋에 포함됩니다. 표 10은 구축 과정과 실행 기반 검증 단계 전반에 걸쳐 고려 대상에서 제거된 태스크 인스턴스 수를 요약하여 보여줍니다. 최종 확정된 모든 태스크 인스턴스는 오픈 소스로 공개되고 다운로드 가능한 단일 .json 파일로 저장합니다.
태스크 인스턴스와 함께, 정답 테스트 결과를 담은 해당 폴더도 생성합니다. 각 태스크 인스턴스에 대해, 각자의 및 테스트-상태 매핑으로부터 키가 FAIL_TO_FAIL, FAIL_TO_PASS, PASS_TO_FAIL, PASS_TO_PASS이고 값이 테스트 목록인 테스트 결과 데이터 구조를 생성합니다. 이 결과를 "캐싱"함으로써 평가 시점에 해결책 를 다시 실행할 필요를 없앱니다(물론 재실행도 가능한 옵션입니다). 이 데이터 구조를 사용하여 섹션 A.4에서 논의한 바와 같이 태스크 완료를 검증합니다.
A.4 평가 절차
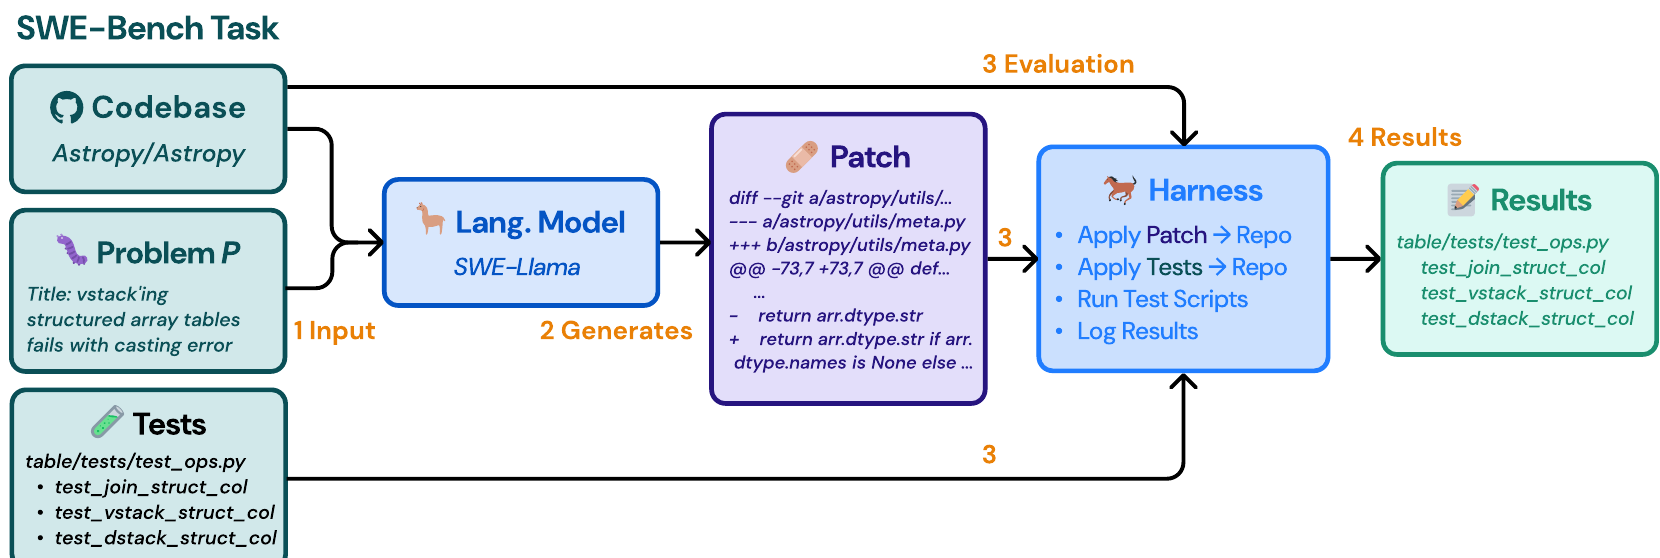
그림 8에 평가 절차의 시각화를 제공합니다. 평가 절차는 해결책 의 동작에 대해 모델의 패치 생성을 점수화합니다. 더 세밀한 수준에서, 평가 절차는 그림 8의 번호 매겨진 단계로 강조된 네 가지 개별 단계로 나눌 수 있습니다. 먼저, 코드베이스와 문제 설명이 LM에 제공되고, LM은 .patch 예측 를 생성합니다. 평가 단계에서는 대상 태스크 인스턴스에 대한 각 예측에 대해 다음 단계가 수행됩니다:
1. 모든 파일 변경을 제거하고 태스크 인스턴스의 베이스 커밋을 체크아웃합니다. 이는 저장소를 코드베이스 로 설정합니다.
2. 태스크 인스턴스의 버전에 해당하는 실행 가능한 컨텍스트를 활성화합니다.
3. 설치 명령을 실행하여 코드베이스 를 인스턴스화합니다.
4. 테스트 패치 를 코드베이스 에 적용합니다.
5. 예측 패치 를 테스트 가 있는 코드베이스 에 적용합니다.
6. 이전 단계가 실패하면, 예측 패치 를 자동으로 수정하고 다시 적용하려고 시도합니다.
7. 테스트 패치 로부터 결정된 테스트 스크립트를 실행하여 테스트 결과 로그 를 생성합니다.
1단계부터 4단계까지는 태스크 인스턴스 검증 과정에서의 검증 덕분에 안정적으로 실패하지 않습니다. 예측 패치 적용(5단계)이 실패하면, 불필요한 컨텍스트 줄을 제거하고 헤더 값을 재계산하여 예측 패치 파일을 복구하려고 시도합니다(6단계). 남은 패치가 다시 실패하거나 테스트 명령 실행(7단계)이 실패하면, 예측에는 자동으로 0점이 부여됩니다. 이 단계들이 성공한다고 가정하면, 출력 로그 는 § A.3에서 소개된 적절한 저장소별 파서를 통해 동일한 구조의 테스트-상태 매핑으로 변환될 수 있습니다.
평가 지표 계산. 태스크 완료를 판정하기 위해, 에서 파싱된 테스트-상태 매핑을 정답 테스트 결과 데이터 구조의 FAIL-TO-PASS 및 PASS-TO-PASS 키에 해당하는 테스트 목록과 비교합니다. 태스크 완료 판정은 간단합니다. 모든 FAIL-TO-PASS 및 PASS-TO-PASS 테스트가 평가 테스트-상태 매핑에서 발견되고 통과 상태인지 확인합니다. 테스트가 누락되었거나 통과가 아닌 상태이면 실패 상태로 간주됩니다. 본 논문에서 정의하고 사용한 바와 같이, FAIL-TO-PASS 및 PASS-TO-PASS의 모든 테스트가 통과하면 태스크는 해결된 것으로 간주됩니다.
A.5 평가 테스트 세트 특성화
표 11에 저장소별 통계를 포함한 표 1의 확장된 형태를 포함합니다. 표 12는 저장소 문서에서 추출한 각 저장소에 대한 간략한 설명과 저장소의 관련 오픈 소스 라이선스를 제시합니다. 관련 라이선스는 모두 원본 라이선스의 권한이 준수되고 유지되는 한 원본 라이브러리 소스 코드의 비상업적 사용을 허용합니다. 표 1에 제시된 원래 통계 외에도 세 가지 새로운 값을 도입합니다. 추가된 줄 수와 제거된 줄 수는 합쳐서 편집된 줄 수가 됩니다. "추가됨"은 도입된 새 줄 수를 의미하고, "제거됨"은 해결책에 의해 제거된 기존 줄을 의미합니다. (Pass to Pass) 통계는 검증 파이프라인 중 해결책 가 적용되기 전에 통과하던 테스트 수를 의미합니다. 문제 설명 를 특성화하고 수정이 문제를 해결하는지 판단하기 위한 fail to pass 테스트와 달리, pass to pass 테스트는 수정이 기존의 예상 동작을 깨뜨리거나 위반하지 않도록 보장하기 위해 포함됩니다. 이 테스트들은 § A.3에서 논의한 검증 로그 조사 단계에서 추출됩니다. fail to fail 테스트와 pass to fail 테스트는 평가 시 고려되지 않으며, 해당 통계는 위 표에 반영되지 않습니다.
태스크 인스턴스 이슈 카테고리. SWE-bench 태스크 인스턴스가 포함하는 문제 유형에 대한 더 나은 이해를 제공하기 위해, 각 태스크 인스턴스의 issue_numbers 필드로 식별되는 이슈에 대해 간단한 분석을 수행합니다. 이슈별로 메타데이터, 특히 태그를 조사하여 PR이 제시하는 기여 유형을 특성화합니다. 표 13은 모든 이슈에서 발견된 2,289개의 태그 중 몇 가지 예를 그룹화하여 보여줍니다. 이슈의 절대다수가 버그 수정과 관련되어 있지만, SWE-bench의 태스크 인스턴스는 디버깅 및 오류 수정 이외의 목적을 가진 다양한 코드 변경과 관련되어 있습니다.
속성 분포. 그림 9에서는 표 1에 도입된 속성에 대한 누적 분포 함수 그래프를 제시합니다. 이 그래프에서 중앙값 SWE-bench 태스크 인스턴스는 140단어의 문제 설명을 가지며, 약 1900개에 조금 못 미치는 파일과 40만 줄을 포함하는 코드베이스 내에서 발생함을 알 수 있습니다. 해당 참조 해결책 는 일반적으로 파일 내 단일 함수를 편집하여
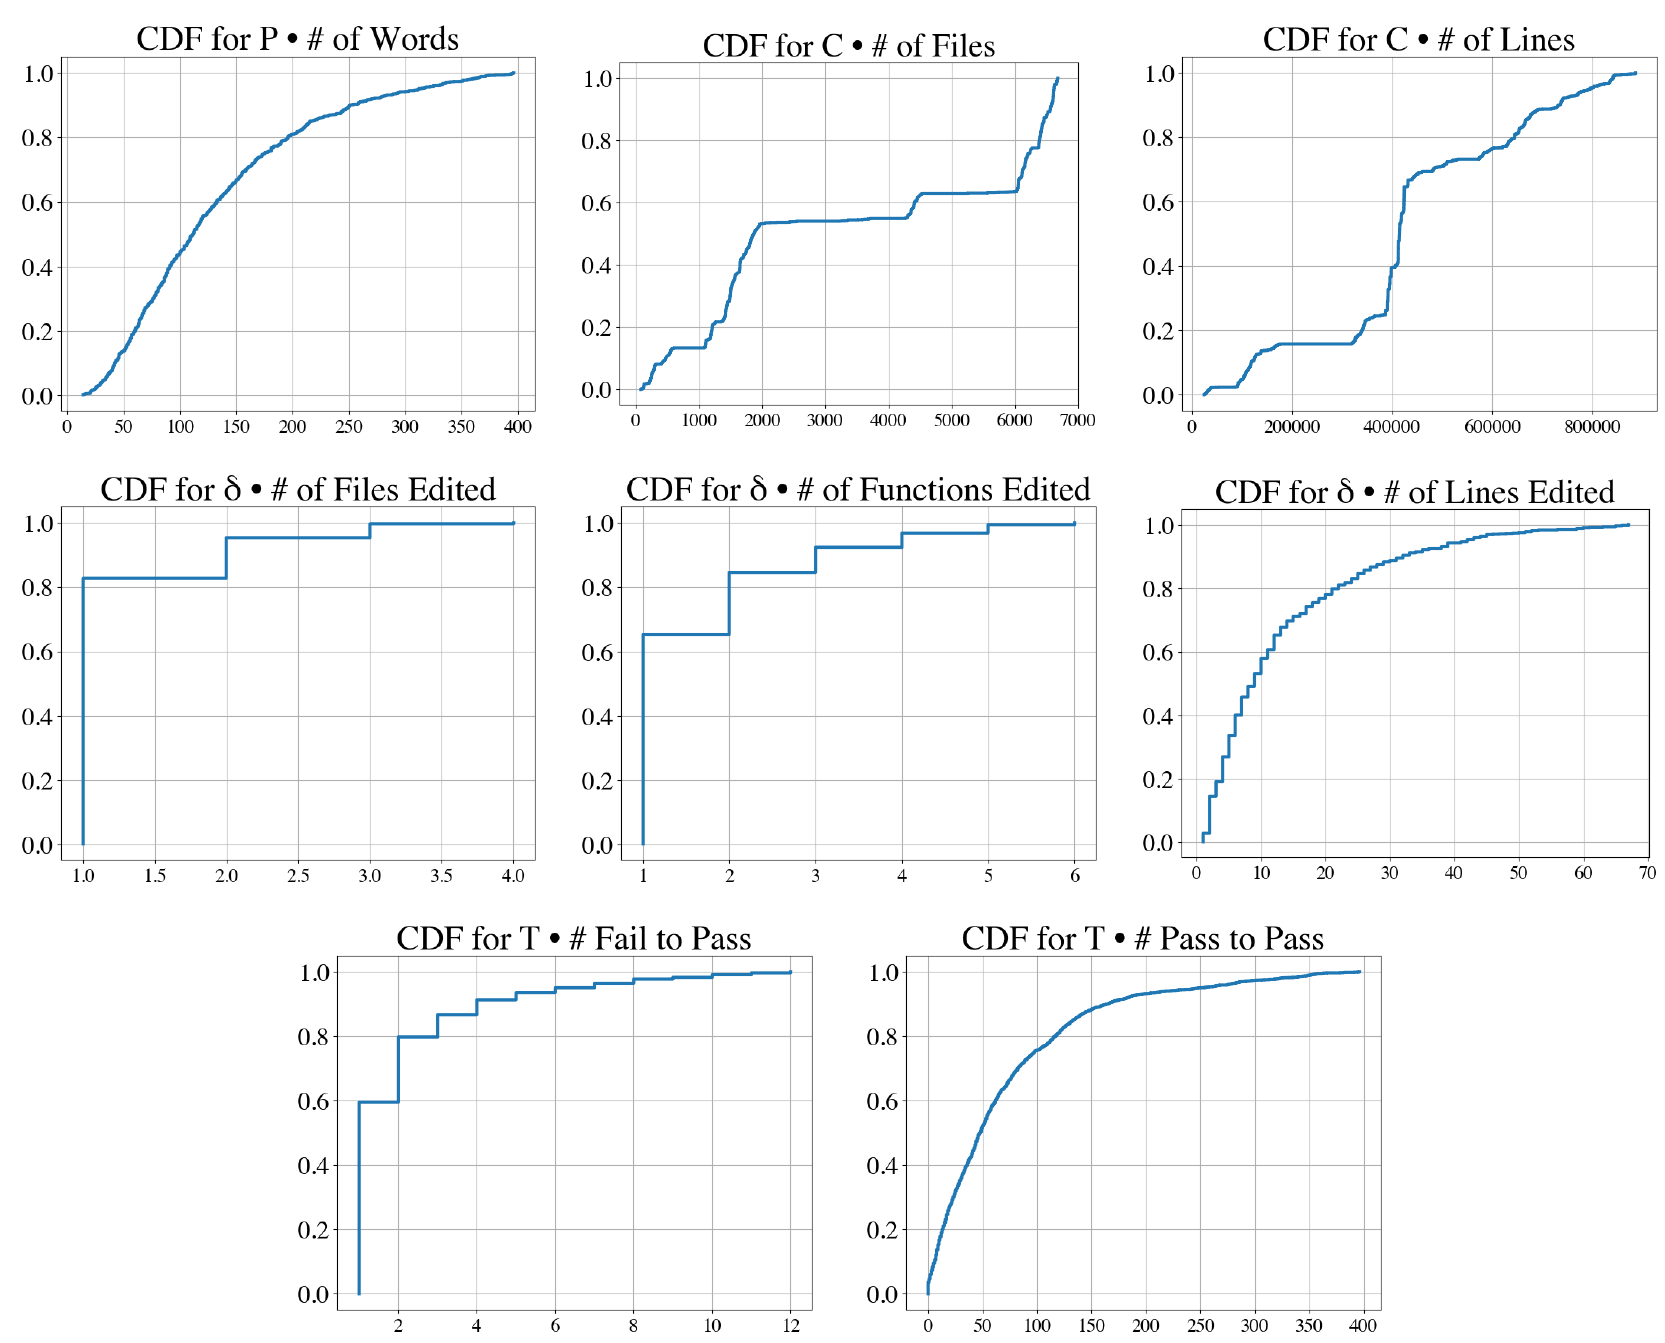
| 배경 정보 (번역 대상 아님): 속성 분포. 그림 9에서는 표 1에 소개된 속성들에 대한 누적 분포 함수 그래프를 제시한다. 이 그래프들에서 우리는 중앙값 SWE-bench 작업 인스턴스가 140단어의 문제 설명을 가지며, 약 1900개에 조금 못 미치는 파일과 40만 줄을 포함하는 코드베이스 내에서 수행된다는 것을 알 수 있다. 해당 참조 솔루션 δ는 보통 파일 내의 단일 함수를 편집하여 약 15줄을 변경하며, 단일 fail to pass 테스트를 가진다. 번역 대상 텍스트: astropy | django | flask | matplotlib | pylint | pytest | |
| P 길이 (문자 수) | 2,742 | 1,307 | 1,185 | 2,381 | 2,011 | 2,948 |
| C # 파일 수 | 1,811 | 6,356 | 225 | 4,395 | 2,426 | 497 |
| C # 줄 수 | 804k | 407k | 35k | 646k | 109k | 111k |
| δ # 편집된 파일 수 | 1.5 | 1.5 | 1.6 | 1.5 | 1.8 | 1.4 |
| δ # 편집된 함수 수 | 2.5 | 2.0 | 2.4 | 2.2 | 1.8 | 1.7 |
| δ # 편집된 줄 수 | 36.0 | 18.5 | 35.4 | 58.9 | 36.0 | 24.5 |
| δ # 추가된 줄 수 | 25.0 | 12.8 | 23.7 | 35.7 | 26.6 | 18.2 |
| δ # 삭제된 줄 수 | 10.9 | 5.7 | 11.6 | 23.2 | 9.5 | 6.4 |
| |T| (Fail to Pass) | 21.7 | 8.8 | 1.4 | 2.4 | 6.8 | 4.1 |
| |T| (통과 대 통과) | 191.0 | 85.9 | 32.5 | 242.4 | 47.0 | 60.7 |
| |T| (전체) | 212.8 | 94.6 | 33.9 | 244.8 | 53.7 | 64.8 |
| requests | scikit-learn | seaborn | sphinx | sympy | xarray | |
| P 길이 (문자 수) | 1,654 | 2,239 | 1,667 | 1,888 | 1,213 | 3,515 |
| C # 파일 수 | 119 | 1,224 | 273 | 1,483 | 1,666 | 260 |
| C # 줄 수 | 30k | 361k | 105k | 423k | 678k | 137k |
| δ # 편집된 파일 수 | 1.64 | 1.68 | 1.77 | 1.51 | 1.9 | 2.45 |
| δ # 편집된 함수 수 | 1.59 | 2.24 | 1.41 | 2.72 | 3.22 | 3.16 |
| δ # 편집된 줄 수 | 25.5 | 44.0 | 30.1 | 30.6 | 36.3 | 124.8 |
| δ # 추가된 줄 수 | 19.2 | 32.7 | 24.9 | 22.0 | 24.2 | 95.6 |
| δ # 삭제된 줄 수 | 6.2 | 11.3 | 5.2 | 8.6 | 12.1 | 29.2 |
| |T| (실패에서 통과) | 7.6 | 7.5 | 12.9 | 2.3 | 2.2 | 58.5 |
| |T| (통과에서 통과) | 87.1 | 150.7 | 86.8 | 45.1 | 74.5 | 297.5 |
| |T| (전체) | 94.7 | 158.2 | 99.7 | 47.4 | 76.8 | 356.1 |
| 저장소 | 요약 | 라이선스 |
| astropy/astropy | 천문학 및 천체물리학 핵심 라이브러리 | BSD 3-Clause |
| django/django | 웹 애플리케이션 구축을 위한 웹 프레임워크 | BSD 3-Clause |
| pallets/flask | 소규모 웹 앱을 위한 경량 프레임워크 | BSD 3-Clause |
| matplotlib/matplotlib | 시각 자료 생성을 위한 플로팅 라이브러리 | Custom |
| pylint-dev/pylint | Python 2 또는 3용 정적 코드 분석기 | GPL 2.0 |
| pytest-dev/pytest | Python용 테스팅 프레임워크 | MIT |
| psf/requests | HTTP 요청 작성을 위한 단순하고 우아한 라이브러리 | Apache-2.0 |
| scikit-learn/scikit-learn | Python에서의 머신러닝 | BSD 3-Clause |
| mwaskom/seaborn | Python에서의 통계 데이터 시각화 | BSD 3-Clause |
| sphinx-doc/sphinx | 문서 작성을 위한 라이브러리 | Custom |
| sympy/sympy | Python으로 작성된 컴퓨터 대수 시스템 | Custom |
| pydata/xarray | N차원 레이블 배열 및 데이터셋 | Apache-2.0 |
약 15줄을 변경하며, 변경의 정확성을 검증하기 위한 단일 fail to pass 테스트와 기존 동작이 보존되는지 확인하기 위한 51개의 pass to pass 테스트를 가집니다.
패치 수정률. 표 14는 각 모델이 (2294개 중) 몇 개의 태스크 인스턴스에 대해 패치를 생성했는지, 이 패치 중 몇 개가 성공적으로 적용되었는지, 성공적으로 적용된 패치 중 몇 개가 부록 A.4에서 소개된 패치 수정 절차를 거쳐야 했는지에 대한 요약 통계를 제시합니다. 수정된 패치가 성공적으로 적용된 SWE-Llama 패치 중 더 작은 비율을 차지하는 경향이 있으며, 이는 SWE-Llama의 미세 조정 절차가 잘 형식화된 패치 생성에 긍정적인 영향을 미친다는 것을 시사합니다. 폐쇄 소스 모델의 경우 성공적으로 적용되는 패치가 더 적으며, 적용되는 패치 중 더 높은 비율이 생성 후 수정을 필요로 하여, 모델이 여전히 패치 생성과 일반적인 구조화된 출력에 어려움을 겪고 있음을 시사합니다.
| 범주 | 개수 | 예시 |
| 버그 | 442 | “Bug” (179); “type:bug” (114); “bug” (57); “type: bug” (48); “Bug:beetle:” (23); “status: confirmed bug” (20); |
| 기능 | 167 | “type:enhancement” (47); “Enhancement” (25); “New feature” (24); “Feature Request” (22); “type: enhancement” (19); “Enhancement:star:” (15); “New Feature” (7); “enhancement” (6); “type: regression” (14); “Regression” (14); “regression” (8); “help wanted” (71); “good first issue” (66); “printing” (58); “extensions:autodoc” (58); “Easy” (57); “Easy to Fix” (54); “domains:py” (27); “core” (26); “sets” (23); “Wrong Result” (23); “units” (22); “Good first issue” (21); |
| 모델 | 검색 설정 | 생성 수 | 적용 수 | 수정 수 | 패치 수정 % |
| ChatGPT-3.5 | BM25 13k | 2,270 | 604 | 363 | 60.1% |
| ChatGPT-3.5 | “Oracle” | 1,262 | 500 | 222 | 44.4% |
| ChatGPT-3.5 | “Oracle”-collapsed | 1,811 | 939 | 420 | 44.73% |
| Claude 2 | BM25 13k | 2,281 | 988 | 302 | 30.57% |
| Claude 2 | “Oracle” | 2,138 | 1,441 | 360 | 24.98% |
| Claude 2 | “Oracle”-collapsed | 2,242 | 1,564 | 465 | 29.73% |
| GPT-4 | BM25 27k | 573 | 85 | 59 | 69.41% |
| GPT-4 | “Oracle” | 462 | 195 | 121 | 62.05% |
| GPT-4 | “Oracle”-collapsed | 2,292 | 1,116 | 684 | 61.29% |
| SWE-Llama 13b | BM25 13k | 2,010 | 1,230 | 369 | 30.0% |
| SWE-Llama 13b | “오라클” | 2,125 | 1,532 | 378 | 24.67% |
| SWE-Llama 7b | BM25 13k | 2,139 | 1,187 | 340 | 28.64% |
| SWE-Llama 7b | “오라클” | 2,119 | 1,503 | 298 | 19.83% |
A.6 개발 세트 특성화
평가 테스트 세트 외에도, 최종 테스트 세트에서 실행하기 전에 모델을 평가하고 하이퍼파라미터를 튜닝하기 위한 개발 세트도 제공합니다. 앞서 제시한 표와 그래프의 스타일을 따라, 이러한 사용을 허용하는 라이선스를 가진 6개의 오픈 소스 저장소에서 수집된 225개의 개발 태스크 인스턴스(주 평가 세트의 약 보다 조금 더 많음)를 특성화하기 위한 유사한 통계를 제시합니다. 개발 세트는 주 평가 세트와 정확히 동일한 방법론과 필터 세트에 따라 수집되었습니다. 기존 단계 외에도, 개발 세트는 2019년 1월 1일 이후에 생성된 태스크 인스턴스를 유지하도록 필터링합니다. 표 12와 유사하게, 표 15에서는 선택된 6개 저장소의 목적과 라이선스를 간략히 요약합니다.
표 13에 이어, 우리는 개발 세트 작업과 관련된 태그들을 표 16에 다시 나열하며, 이는 버그 수정을 넘어서는 작업 유형의 다양성과 범위를 다시 한번 보여준다. 주요 평가 작업과 비교했을 때, 개발 세트의 저장소에 고유한 문제를 제시하는 이슈를 가리키는 태그(예: “Crash :collision:”, “io”)도 확인할 수 있다.
표 1에 이어, 우리는 개발 세트의 6개 저장소에 대한 동일한 저장소별 평균 통계를 표 17에 제시한다. 전체 개발 세트에 걸쳐, 각 작업 인스턴스는 평균 19.9개 / 중앙값 2개의 F2P 테스트를 가진다. 평균 171.3개 / 중앙값 79.0개의 P2P 테스트가 있으며, 작업 인스턴스당 총 평균 191.2개 / 중앙값 101.0개의 테스트가 있다.
| 저장소 | 요약 | 개수 | 라이선스 |
| marshmallow-code/ marshmallow pylint-dev/astroid pydicom/pydicom pvlib/pvlib-python pyvista/pyvista sqlfluff/sqlfluff | 복잡한 객체를 Python 데이터 타입으로/에서 파싱 AST 파싱, 정적 분석/추론을 위한 라이브러리 Python으로 DICOM 파일 읽기/수정/쓰기 태양광 에너지 시스템 성능 시뮬레이션 인터페이스를 통한 3D 플로팅, 메시 분석 SQL 린터, 다중 방언 및 템플릿 지원 | 9 31 56 63 16 50 | MIT LGPL-2.1 Custom Custom MIT MIT |
| 범주 | 개수 | 예시 |
| 버그 | 127 | “bug”(111); “Bug :cookreach:”(10); “rule bug”(6); |
| 기능 | 55 | “enhancement”: 46; “Enhancement :star:” 5; “feature-request”: 2; |
| 회귀 | 4 | “Regression”(4); |
| 기타 | 95 | “api”: 11, “documentation”: 7, “help wanted”: 6, “config options”: 5, “io”: 5, “jinja”: 4, “good first issue”: 4, “parser” 3 |
A.7 SWE-BENCH LITE 특성 분석
SWE-bench Lite는 SWE-bench 작업에서 언어 모델을 보다 효율적으로 평가하기 위한 표준 부분집합이다. SWE-bench는
B SWE-LLAMA 훈련에 관한 추가 세부 사항
B.1 훈련 세부 사항
최적화. 우리는 모든 어텐션 서브레이어의 쿼리, 키, 값, 출력 프로젝션 행렬에 대해 , , 드롭아웃 로 LoRA(Hu et al., 2022)를 사용하여 파인튜닝한다. 우리는 학습률 와 그래디언트 스텝당 32개 시퀀스의 배치 크기로 최대 4 에포크 동안 훈련한다. 훈련 중에는 50 스텝마다 체크포인트를 저장하고, 훈련 후에는 별도로 보류된 100개 인스턴스에 대한 검증 손실을 기준으로 최적의 체크포인트를 선택한다. SWE-Llama 7b는 CodeLlama-Python 7b로 초기화되었으며 4대의 NVIDIA A100에서 20시간 동안 훈련되었다. SWE-Llama 13b는 CodeLlama-Python 13b로 초기화되었으며 8대의 NVIDIA A100에서 47시간 동안 훈련되었다. 우리는 장문맥 훈련을 가능하게 하기 위해 DeepSpeed Ulysses(Jacobs et al., 2023)와 Flash Attention(Dao et al., 2022)을 사용했다.
C 추가 결과
C.1 “오라클” 검색을 사용한 결과
4.1절에서 설명한 “오라클” 검색 방법을 사용하여, 우리는 일반 성능 결과를 표 18에 제시한다. 당연하게도, 참조 솔루션의 풀 리퀘스트에 의해 편집된 파일만 제공할 경우, 모델 성능은 더 노이즈가 많은 BM25 검색 설정에 비해 향상된다.
C.2 평가 테스트 세트
우리는 본 논문의 그림 4에 해당하는 모델 성능의 저장소별 분석을 표 19에 포함한다. 본 논문에서 논의한 바와 같이, 성능은 저장소마다 크게 다르다.
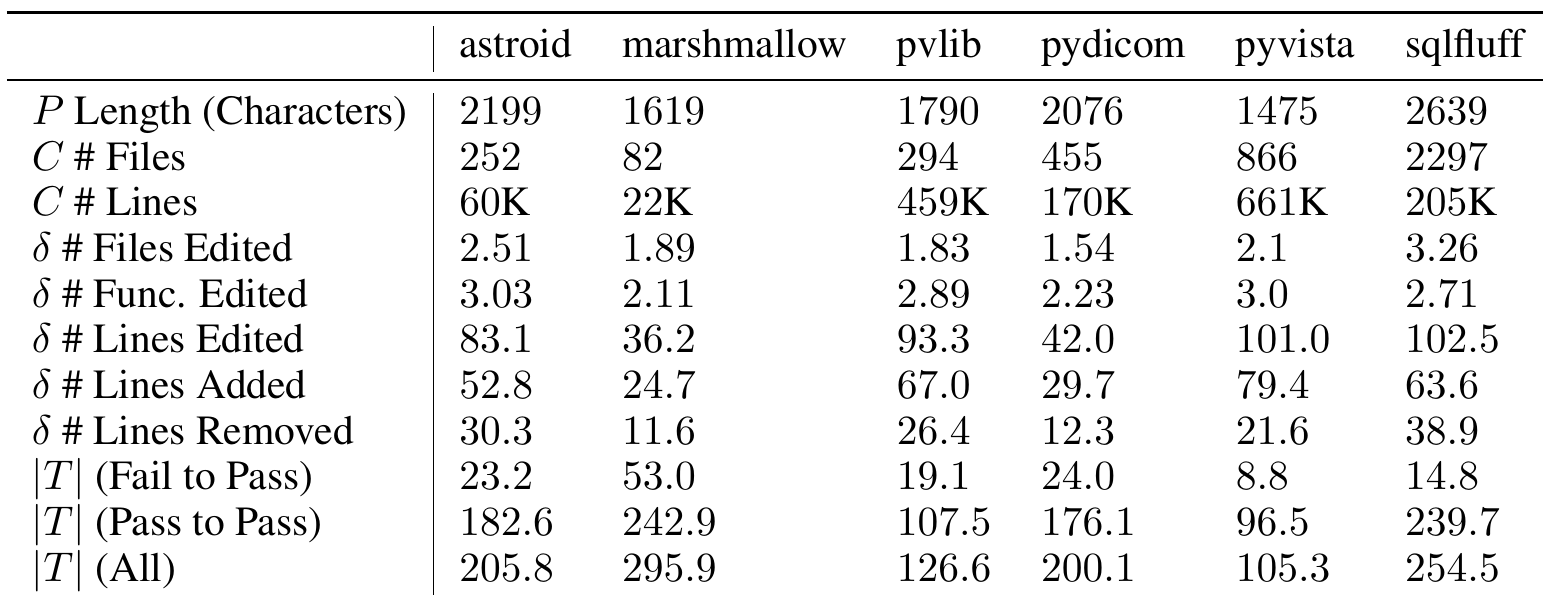
| astroid | marshmallow | pvlib | pydicom | pyvista | sqlfluff | |
| P 길이(문자) | 2199 | 1619 | 1790 | 2076 | 1475 | 2639 |
| C # 파일 | 252 | 82 | 294 | 455 | 866 | 2297 |
| C # 라인 | 60K | 22K | 459K | 170K | 661K | 205K |
| δ # 편집된 파일 | 2.51 | 1.89 | 1.83 | 1.54 | 2.1 | 3.26 |
| δ # 편집된 함수 | 3.03 | 2.11 | 2.89 | 2.23 | 3.0 | 2.71 |
| δ # 편집된 라인 | 83.1 | 36.2 | 93.3 | 42.0 | 101.0 | 102.5 |
| δ # 추가된 라인 | 52.8 | 24.7 | 67.0 | 29.7 | 79.4 | 63.6 |
| δ # 삭제된 라인 | 30.3 | 11.6 | 26.4 | 12.3 | 21.6 | 38.9 |
| |T| (실패에서 통과로) | 23.2 | 53.0 | 19.1 | 24.0 | 8.8 | 14.8 |
| |T| (패스 투 패스) | 182.6 | 242.9 | 107.5 | 176.1 | 96.5 | 239.7 |
| |T| (전체) | 205.8 | 295.9 | 126.6 | 200.1 | 105.3 | 254.5 |
표 17: 개발 데이터셋에 있는 저장소들의 경우, 저장소별로 그룹화한 SWE-bench 작업 인스턴스의 서로 다른 속성을 특징짓는 평균 수치. 표 11에 제시된 것과 동일한 통계가 여기에도 제시되어 있다.
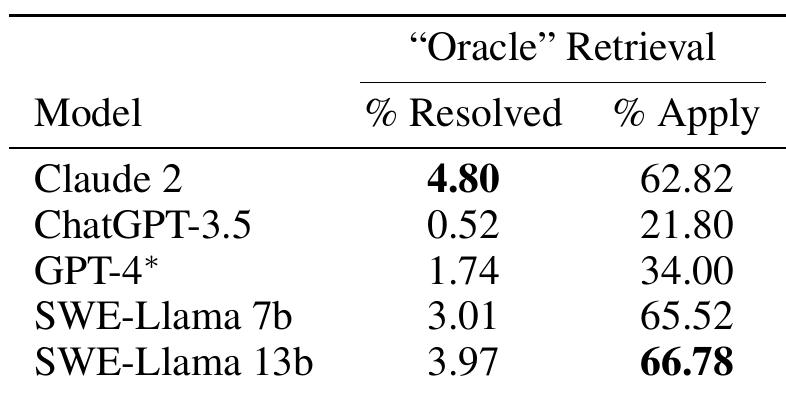
| 모델 | "Oracle" 검색 | |
| % 해결 | % 적용 | |
| Claude 2 | 4.80 | 62.82 |
| ChatGPT-3.5 | 0.52 | 21.80 |
| GPT-4* | 1.74 | 34.00 |
| SWE-Llama 7b | 3.01 | 65.52 |
| SWE-Llama 13b | 3.97 | 66.78 |
표 18: 우리는 섹션 4에서 설명한 대로 oracle 검색 설정을 사용하여 모델들을 서로 비교한다. 주요 결과 표인 표 5는 BM25만을 사용할 때의 서로 다른 모델들에 대한 결과를 제시한다. \*예산 제약으로 인해 우리는 GPT-4를 SWE-bench의 무작위 부분집합에 대해 "Oracle" 및 BM25 27K 검색기 설정에서만 평가한다.
C.3 GPT-4 평가 부분집합 결과
이 섹션에서는 GPT-4가 표 20에서 테스트된 무작위 부분집합에 대해 표 5에 제시된 통계를 제시한다. 부분집합의 선택이 무작위이므로, 우리는 해결 및 적용 비율이 주요 결과와 일치하며, 일반 평가 세트보다 더 단순하거나 더 어려운 쪽으로 유의미하게 치우치지 않았음을 발견한다.
C.4 확장된 시간적 분석
이 섹션에서는 주요 논문의 평가 섹션에 있는 표 7에 제시된 분석을 따르는, 연도별로 해결된 작업 인스턴스에 대한 확장된 시간적 분석을 제시한다. 표 21에서는 이슈가 생성된 연도별로 작업을 그룹화한 6개의 서로 다른 시간적 구획에 대해 "Oracle" 검색 설정 하의 모델별 해결 통계를 제시한다. 표에서 모델 성능과 연도 사이에 일관된 상관관계가 없다는 것이 명백하며, 이는 사전 학습 데이터셋 내에서 잠재적으로 더 오래된 버전의 코드를 보았을 수 있음에도 불구하고 SWE-bench에서 수정 사항을 이해하고 구현하는 것은 이해를 요구하는 어려운 작업이며 관찰된 데이터의 암기로는 실행 가능하거나 일관되게 달성될 수 없다는 우리의 결론을 뒷받침한다.
C.5 F2P, P2P 비율 분석
주요 논문 결과에서 우리는 서로 다른 모델들이 얼마나 많은 작업 인스턴스를 완전히 해결했는지를 나타내는 "% 해결" 통계를 제시한다. 이 섹션에서는 1. 모델의 패치 생성이 성공적으로 적용되었고 2. 작업 인스턴스가 해결되지 않은 작업 인스턴스의 격차에 대한 더 세밀한 통찰을 제공한다. 패치가 성공적으로 적용된다고 가정할 때, 우리는 F2P 및 P2P 테스트의 통과/실패 결과에 기반하여 가능한 모든 결과의 분포를 완전히 포착하는 6가지 경우를 표 22에서 정의한다. 이미 확립된 "해결됨" 결과에 더하여,
| Repo | Claude 2 | ChatGPT-3.5 | GPT-4 | SWE-Llama 13b | SWE-Llama 7b |
| astropy/astropy | 3.23 | 0.00 | 0.00 | 1.06 | 3.16 |
| django/django | 6.15 | 1.32 | 2.50 | 5.19 | 4.00 |
| matplotlib/matplotlib | 3.05 | 3.33 | 0.00 | 3.12 | 1.11 |
| mwaskom/seaborn | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| pallets/flask | 0.00 | 0.00 | 0.00 | 9.09 | 0.00 |
| psf/requests | 15.91 | 2.33 | 8.33 | 13.64 | 18.18 |
| pydata/xarray | 6.90 | 0.00 | 0.00 | 5.81 | 3.00 |
| pylint-dev/pylint | 1.75 | 0.00 | 0.00 | 1.75 | 1.75 |
| pytest-dev/pytest | 5.93 | 0.00 | 0.00 | 5.04 | 4.20 |
| scikit-learn/scikit-learn | 5.41 | 0.00 | 0.00 | 3.12 | 0.88 |
| sphinx-doc/sphinx | 5.65 | 1.83 | 0.00 | 2.25 | 2.69 |
| sympy/sympy | 1.94 | 0.00 | 0.00 | 3.01 | 1.59 |
표 19: SWE-bench에 포함된 저장소별 모델들의 해결.
| 모델 | BM25 검색 | “오라클” 검색 | ||
| % 해결됨 | % 적용 | % 해결됨 | % 적용 | |
| Claude 2 | 2.27 ↑ 0.31 | 45.72 ↑ 2.65 | 4.01 ↓ 0.79 | 62.65 ↓ 0.17 |
| ChatGPT-3.5 | 0.17 - 0.00 | 26.53 ↑ 0.02 | 0.70 ↑ 0.18 | 21.64 ↓ 0.16 |
| GPT-4 | 0.00 - 0.00 | 14.82 - 0.00 | 1.74 - 0.00 | 34.00 - 0.00 |
| SWE-Llama 7b | 0.35 ↑ 0.35 | 49.04 ↓ 2.70 | 1.92 ↓ 1.09 | 63.70 ↓ 1.82 |
| SWE-Llama 13b | 0.70 - 0.00 | 56.54 ↑ 2.92 | 4.54 ↑ 0.57 | 66.67 ↓ 0.11 |
표 20: 우리는 섹션 4에서 설명한 대로 BM25 및 oracle 검색 설정을 사용하여 SWE-bench의 무작위 부분집합(574개 인스턴스)에 대해 "oracle" 및 BM25 27K 검색기 설정에서만 모델들을 서로 비교한다. 이는 표 5에서 언급된 바와 같이 GPT-4가 평가되는 것과 동일한 부분집합이다. 표 5 및 표 18의 백분율에 대한 차이는 아래첨자로 포함되어 있다. 우리는 다섯 가지 새로운 용어를 도입한다. "Breaking Resolved" 결과는 이슈의 원하는 동작이 달성되었지만(모든 F2P 테스트 통과) 모든 이전 동작이 유지되지는 않은(모든 P2P 테스트 통과하지 않음) 경우를 가리킨다. "Partially Resolved"는 코드베이스의 이전 동작이 유지되었으나(모든 P2P 테스트 통과) 원하는 동작이 완전히 달성되지는 않은(모든 F2P 테스트 통과하지 않음) 경우를 가리킨다. "Work in Progress" 경우는 원하는 동작이 완전히 달성되지 않았고(모든 F2P 테스트 통과하지 않음) 코드베이스의 이전 동작이 유지되지 않은(모든 P2P 테스트 통과하지 않음) 경우이다. "No-Op"는 코드 변경이 원래 코드베이스에 아무런 영향을 미치지 않는 경우이다. 이전 동작은 유지되지만(모든 P2P 테스트 통과) 이슈는 완전히 미해결로 남는다(0개의 F2P 테스트 통과). 마지막으로, 이슈가 미해결이고(0개의 F2P 테스트 통과) 이전의 작동 동작이 되돌려진(일부 P2P 테스트 실패) 경우, 코드베이스는 더 나쁜 상태로 남게 되며, 우리는 이를 "Regression"으로 정의한다.
표 23에서는 성공적으로 적용된 패치 생성들을 이 여섯 가지 경우에 따라 분류한다. 우리는 비-"해결됨" 이슈들 중에서 모델이 제안한 패치 생성의 대다수가 해당 작업 인스턴스의 단 하나의 F2P 테스트 케이스도 해결하지 못한다는 것("No-Op" 및 "Regression")을 발견한다. 이러한 경우들의 부분집합 내에서, 대다수(에서 )의 경우는 No-Op이며, 모델은 이러한 상황들의 나머지에 대해서는 기존 동작을 깨뜨린다.
일반적으로, 모델 생성이 일부 테스트는 통과하지만 전부는 통과하지 못하는 경우("Breaking Resolved", "Partially Resolved", "Work in Progress")는 다른 세 범주에 비해 누적으로 더 작은 문제 부분집합을 나타낸다. 이러한 경우들 중 여러 개를 수동으로 검사한 결과, 모델이 작업 요구 사항에 대해 어느 정도 이해를 보여준다는 것이 분명하다. 그러나 기준 방법들이 코드베이스에 대해 가지는 제한된 시야—파일 간 의존성 및 함수들의 관계와 같은 정보를 포함하지 않음—때문에, 이러한 많은 작업 인스턴스는 즉각적인 이슈를 올바르게 해결하는 변경이 변경된 엔터티를 사용하고 그 영향을 받는 다른 모듈들을 고려하지 않기 때문에 종종 실패한다. 우리는 섹션 F에서 이러한 단점들을 직접적으로 부각시키는 여러 사례 연구를 포함한다. 전반적으로, 이러한 결과들은 SWE-bench의 어려움뿐만 아니라
| 연도 | 총계 | 25% | Claude 2 | GPT-3.5 | GPT-4* | SWE-Llama 13b | SWE-Llama 7b |
| 2023 | 244 | 61 | 4.51 | 1.56 | 0.00 | 4.07 | 3.50 |
| 2022 | 395 | 117 | 4.05 | 0.85 | 3.42 | 2.80 | 2.46 |
| 2021 | 383 | 102 | 4.18 | 0.00 | 2.94 | 4.45 | 2.56 |
| 2020 | 427 | 109 | 5.15 | 0.71 | 0.00 | 3.96 | 3.43 |
| 2019 | 437 | 112 | 5.72 | 1.49 | 1.79 | 4.55 | 2.21 |
| 2018 | 165 | 37 | 5.45 | 0.00 | 0.00 | 3.57 | 2.94 |
| &lt; 2018 | 89 | 36 | 4.49 | 0.00 | 2.78 | 3.37 | 1.09 |
표 21: 우리는 이 표에서 확장된 시간적 분석을 제시하며, "Oracle" 검색 설정에서 모델들에 걸친 작업 인스턴스의 해결을 서로 다른 컷오프 날짜별로 구분하여 보여준다. Year 열은 지정된 역년 동안 생성된 작업의 부분집합을 가리킨다. Total 열에는 주어진 연도에 속하는 작업의 수를 나열한다. 열은 GPT-4가 평가된 부분집합에 대한 동일한 정보이다. 나머지 모델별 열에는 해결 지표가 포함되어 있다.
| P2P 테스트 통과 | F2P 테스트 통과 | ||
| 전체 | 부분 | 없음 | |
| 전체 | 해결됨 | 부분 해결됨 | 무변경(No-Op) |
| 부분 | 브레이킹 해결됨 | 작업 진행 중 | 회귀 |
| 없음 | 브레이킹 해결됨 | 작업 진행 중 | 회귀 |
표 22: 우리는 성공적으로 적용된 후 실행되는 패치 생성에 대한 6가지 가능한 결과를 제시한다. 결과들은 통과하는 F2P 및 P2P 테스트의 수에 따라 구별된다. 모델이 기존 테스트에 대해 수정 사항을 실행한 다음 편집을 계속할지 또는 검토를 위해 패치를 제출할지 결정할 수 있게 하는 실행 환경을 통해 피드백을 제공하는 것의 잠재적 가치.
C.6 패치 생성 확장 분석
이 섹션에서는 표 8에 제시된 지표들을 따라 패치 생성의 다양한 측면을 정량화하는 통계를 제시한다. 표 24에서는 패치가 성공적으로 적용되었는지 여부와 관계없이 모든 모델에 대해 oracle 검색 설정에서의 모든 패치 생성에 대해 이러한 값들을 다시 계산한다. 모든 지표에 걸쳐, 우리는 모델들 전반의 패치 생성이 평균 gold 편집의 특성에 훨씬 더 가까운 크기임을 발견한다. 일부 모델들은 여전히 해당 Gold 편집에 비해 더 적은 줄을 생성하지만(예: Claude-2, ChatGPT-3.5, GPT-4), SWE-Llama 모델들의 편집은 대부분의 측면에서 평균적으로 더 길다. 표 8과 표 24를 모두 고려할 때, 모델들이 더 긴 출력 시퀀스를 올바르게 형식화된 패치로 생성하는 데 어려움을 겪는다는 것이 분명해진다. 섹션 F의 사례 연구에서 보여주는 바와 같이 그러한 발생들에 대한 추가 검사는 환각, 기존 코드 스타일/구조 준수, 장거리 의존성의 올바른 참조가 더 긴 생성에서 더 자주 표면화되는 흔한 오류임을 나타낸다.
C.7 소프트웨어 공학 지표
우리는 복잡한 코드베이스 내에 통합된 대규모 코드 블록의 효율성과 복잡성을 평가하기 위해 소프트웨어 공학 지표를 사용하는 방안을 탐구하는 예비 평가를 수행한다. 유창성과 표면 형태 유사성을 평가하기 위한 의미론적 유사성 점수 함수—이는 전통적인 NLP 벤치마크에서 인기가 많고 코드 생성에도 채택되어 왔다—와 달리, 순환 복잡도 McCabe (1976)와 Halstead 복잡도 측정 Halstead (1977)과 같은 지표는 논리적 추상화(예: 추상 구문 트리)와 소프트웨어 원칙에 기반하여 코드의 복잡성, 효율성, 가독성을 스칼라 값으로 정량화한다. 패치 생성물과 SWE-bench 평가 로그는 소프트웨어 공학 지표와 정적 분석기를 손쉽게 적용할 수 있는 풍부한 정보원이다. 대상 기능의 범위가 미미하여 소프트웨어 공학 지표의 통찰이 의미를 갖지 못하는 작은 코드 경진대회 벤치마크와 달리, SWE-bench의 과제는 실무자들이 이러한 도구를 사용하여 패치 생성물의 변경이 지닌 복잡성과 그것이 나머지 코드베이스에 미치는 영향에 관해 잘 구조화되고
| 모델 | Claude 2 | ChatGPT-3.5 | GPT-4* | SWE-Llama 7b | SWE-Llama 13b |
| 적용됨 | 1078 | 284 | 76 | 1257 | 1196 |
| 해결됨 | 110 | 12 | 10 | 69 | 91 |
| 해결 중단 | 26 | 2 | 3 | 17 | 10 |
| 부분 해결됨 | 15 | 4 | 3 | 17 | 10 |
| 작업 진행 중 | 20 | 2 | 1 | 17 | 16 |
| 변경 없음 | 471 | 174 | 30 | 716 | 672 |
| 회귀 | 436 | 90 | 29 | 421 | 397 |
| 모델 | 총 라인 수 | 추가됨 | 제거됨 | 함수 | 파일 |
| Claude 2 | 27.2 | 6.6 | 3.3 | 1.2 | 1.1 |
| Gold | 61.6 | 17.8 | 8.6 | 2.6 | 1.4 |
| ChatGPT-3.5 | 42.0 | 6.1 | 3.9 | 1.7 | 1.0 |
| Gold | 44.5 | 12.7 | 5.5 | 2.1 | 1.2 |
| GPT-4 | 22.4 | 4.4 | 1.8 | 0.8 | 0.9 |
| Gold | 50.3 | 14.0 | 6.5 | 2.3 | 1.3 |
| SWE-Llama 13b | 68.9 | 9.5 | 4.3 | 2.5 | 1.6 |
| Gold | 61.5 | 17.8 | 8.6 | 2.6 | 1.4 |
| SWE-Llama 7b | 78.9 | 10.1 | 7.6 | 2.5 | 1.5 |
| Gold | 65.1 | 18.8 | 9.0 | 2.7 | 1.5 |
엄격하며 폭넓은 피드백 신호를 얻을 수 있을 만큼 충분히 복잡하다.
우리는 소프트웨어 공학 지표가 코드 품질의 특성을 신뢰성 있게 포착할 수 있는 방법과, 이러한 통계를 두 패치에 걸쳐 비교하는 것이 모델 역량에 관한 자동화된 관찰을 제공할 수 있는 방법을 보여주는 탐색적 작업을 여기에 포함한다. 우리는 소스 코드로부터 직접 다양한 소프트웨어 공학 지표를 계산하기 위한 라이브러리인 Radon 패키지를 사용한다.
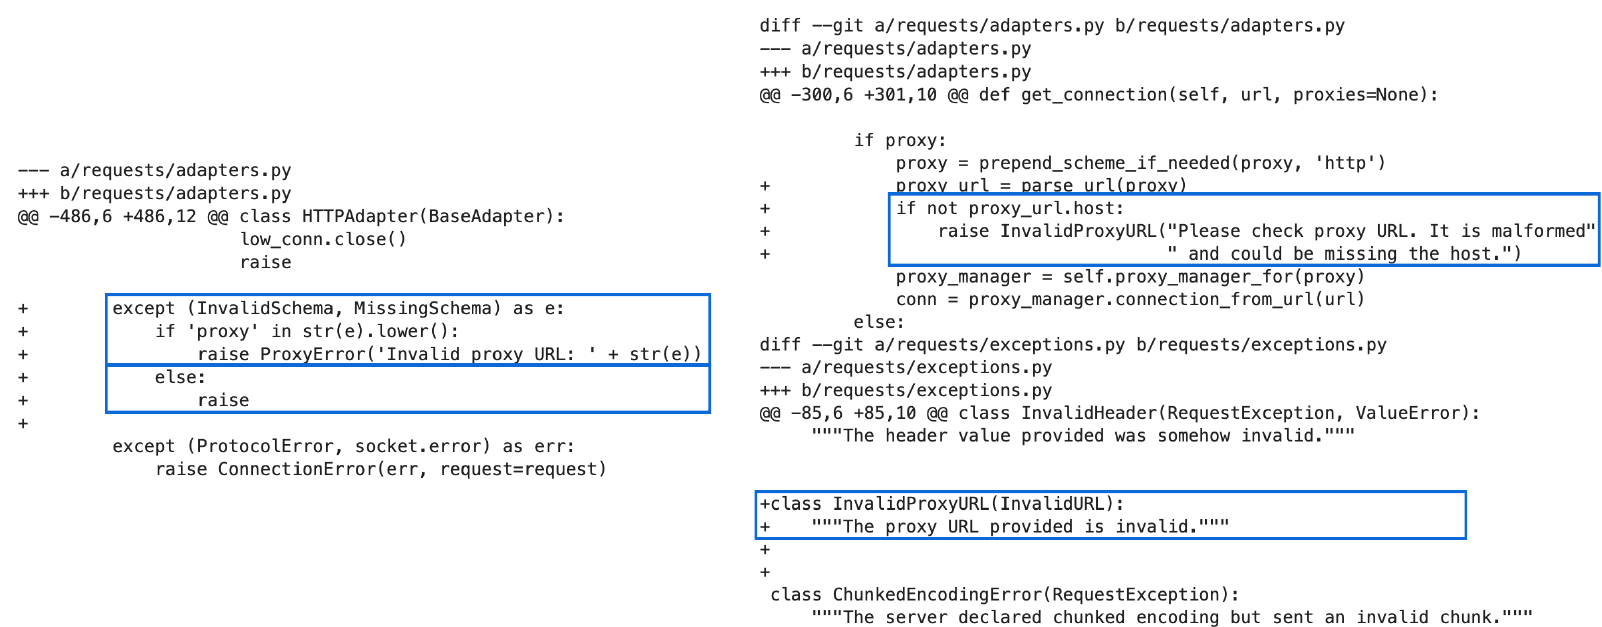
우리는 특히 Figure 4에 반영된 바와 같이 여러 모델이 가장 좋은 성능을 보이는 psf/requests 저장소에 대한 "Oracle" 검색 설정에서 성공적으로 적용된 Claude 2 패치 예측을 살펴본다. 예측마다 우리는 패치를 코드베이스에 적용한 다음, 수정된 함수들에 대한 순환 복잡도와 Halstead 복잡도 점수를 계산한다. 순환 복잡도는 소스 코드를 통과하는 독립적 실행 경로의 수를 세어 함수의 제어 흐름을 정량화한다(McCabe, 1976). 순환 복잡도 점수가 높을수록 결함 발생 가능성이 더 높고 일반적으로 유지보수가 어렵다는 것을 시사하는 더 복잡한 함수임을 의미한다. Halstead 복잡도는 프로그램 내 연산자와 피연산자의 수를 센다(Halstead, 1977). 예측마다 우리는 해당 골드 패치에 대해서도 동일한 일련의 단계를 수행한다.
우리는 소프트웨어 공학 지표가 모델 성능에 관한 자동화된 정성적 통찰을 제공한다는 것을 발견한다. Figure 10의 다음과 같은 간단한 사례 연구를 고려해 보자. 모델 패치 예측(왼쪽)이 골드 참조 해법(오른쪽)에 비해 더 적은 줄(11줄 대신 6줄)이고 더 적은 파일(2개 대신 1개)을 수정하지만, 모델의 편집은 상대적으로 복잡하고 널리 사용되는 HTTPAdapter 클래스 내에 조건문을 배치한다. 이는 두 가지 새로운 잠재적 실행 결과를 도입하여 HTTPAdapter의 순환 복잡도를 3에서 5로 높인다. 대조적으로, 참조 해법은 더 길지만 모듈 내 의존성을 임포트하고, get_connection 내의 논리적으로 더 단순한 함수를 수정하며, 이슈에서 설명된 새로운 버그를 포착하기 위해 새로운 오류 유형 InvalidProxyURL을 정의한다.
Radon 문서, 오픈소스 코드베이스
문제 진술: 프록시 변수의 잘못된 프로토콜로 인한 오해의 소지가 있는 예외. https_proxy 또는 HTTPS_PROXY 변수의 값이 실수로 프로토콜에서 '?' 하나를 빠뜨리면, 사용자에게 트레이스백이 발생하는데, 이는 문제가 프록시 구성에 있음을 정확히 지적하지 못한다...
D 추가 실험 세부 사항
D.1 검색 세부 사항
희소 검색(Sparse retrieval). 검색 중에 우리는 문서에 약간의 증강을 적용하여 파일들의 내용 앞에 파일 경로를 덧붙임으로써, 이슈에서 직접 언급될 수 있는 파일명에 기반한 검색을 더 잘 가능하게 한다.
Oracle 검색. Oracle 검색 파일 경로는 테스트 파일을 제외하고 참조 해법의 패치 파일에서 직접 추출된다.
D.2 추론 설정
생성은 상대적으로 비용이 많이 들기 때문에, 우리는 인스턴스당 단일 패치 파일만 생성한다. Pass@1에서의 평가를 위한 코드 생성의 선례(Chen et al., 2021; Rozière et al., 2023)를 따라, 우리는 모든 모델에 대해 단순히 탐욕적 디코딩(greedy decoding)을 사용한다.
D.3 프롬프트 템플릿 예시
모델은 사용된 모델에 따라 약간의 변형이 있는 다음과 같은 일반 템플릿으로 프롬프트된다.
부분 코드베이스와 해결해야 할 문제를 설명하는 이슈 진술이 제공될 것이다. <issue> {ISSUE TEXT} </issue> {start of README.md} {README.md text} {end of README.md} {start of file_1. py}... {file_1. py text} [end of file_1. py]... </code>
다음은 패치 파일의 예시입니다. 이는 코드베이스에 대한 변경 사항으로 구성됩니다. 파일 이름, 각 변경 사항의 줄 번호, 제거된 줄과 추가된 줄을 명시합니다. 하나의 패치 파일에 여러 파일에 대한 변경 사항이 포함될 수 있습니다.
<patch>-- a/file.py +++ b/file.py@@ -1,27 +1,35 @@def euclidean(a, b):- while b:- a, b = b, a % b- return a + if b == 0: + return a + return euclidean(b, a % b) def bresenham(x0, y0, x1, y1): points = [] dx = abs(x1 - x0) dy = abs(y1 - y0)- sx = 1 if x0 < x1 else -1- sy = 1 if y0 < y1 else -1- err = dx - dy + x, y = x0, y0 + sx = -1 if x0 > x1 else 1 + sy = -1 if y0 > y1 else 1- while True: points.append((x0, y0))- if x0 == x1 and y0 == y1:- break e2 = 2 * err- if e2 > -dy: + if dx > dy: + err = dx / 2.0 + while x != x1: points.append((x, y)) err = dy- x0 += sx- if e2 < dx:- err += dx- y0 += sy + if err < 0: + y += sy + err += dx + x += sx + else: + err = dy / 2.0 + while y != y1: + points.append((x, y)) + err -= dx + if err < 0: + x += sx + err += dy + y += sy + points.append((x, y)) return points
</patch>
제공된 이슈를 해결하기 위해 이 저장소에 git apply를 사용하여 직접 적용할 수 있는 단일 패치 파일을 생성해 주시기 바랍니다. 위에 표시된 형식의 단일 패치 파일로 응답해 주세요.
아래에 응답하세요:
지시문이나 예시의 줄 수를 약간 늘리거나 줄여서 진행한 실험은 5절에 명시된 실험 결과를 제외하고는 전반적인 성능에 크게 영향을 미치지 않는 것으로 보였다.
E 사회적 영향
코드에 대한 추론이 많은 언어 모델의 능력을 뒷받침하는 기초 기술로 부상함에 따라, 기계 자동화 소프트웨어 공학의 잠재적 미래는 AI 안전성(Gros et al., 2023)과 관련하여 많은 중요한 질문을 제기하고 중요한 잠재적 파급 효과를 지닌다. AI가 생성한 코드가 어떻게 인간의 의도에 충실하도록 보장할 수 있는지, 그리고 코드 에이전트가 인간의 목표를 잘못 해석한 뒤 작업을 수행할 때 어떤 가드레일이 마련될 수 있는지에 대한 질문을 다루는 것이 중요하다. 통제된 환경에서 그러한 문제를 관찰하고 그 해결책을 입증하기 위해, 우리는 SWE-bench가 정렬되고 검증 가능하며 안전한 AI 기반 소프트웨어 공학을 향한 안전하고 견고한 조치를 설계하기 위한 테스트베드로 활용될 수 있기를 바란다.
F SWE-LLAMA 생성 결과에 대한 심층 분석
이 절에서는 5.1절의 방식을 따라 Claude 2와 SWE-Llama 생성 결과(Oracle 검색 설정)에 대한 다섯 가지 추가 정성적 분석을 제공한다.
Claude 2 정성적 연구는 표 25와 26에서 확인할 수 있다. 표 27, 28, 29는 Claude 2가 올바르게 해결하지 못한 작업 인스턴스이다. SWE-Llama 정성적 연구는 표 30, 31, 32, 33, 34에 걸쳐 다루어진다. 표 30, 31, 32에서는 SWE-Llama 13b가 올바르게 해결한 작업 인스턴스를 제시한다. 표 33과 34에서는 SWE-Llama 13b가 이슈를 올바르게 해결하지 못한 두 가지 작업 인스턴스를 제시하며, 모델이 당면한 작업을 완수하기에 충분히 능숙하지 않을 수 있는 추론 및 생성 기술의 일부를 지적한다.
이 절들에 걸쳐 우리가 내린 관찰은 본 논문에서 언급된 요점들과 일치한다. 즉, 모델은 여러 줄 및 여러 파일에 걸친 변경에 어려움을 겪는 경향이 있고, 필요한 수정이 비교적 짧을 때 더 능숙하며, 코드베이스를 효율적인 방식으로 이해하는 데 도움이 필요하다.
표 25: 이 예시에서 Claude 2는 scikit-learn/scikit-learn의 이슈를 올바르게 해결한다. 그러나 논의에서 보여주듯이, 해결책은 올바르지만 모델이 원시적인 Python을 작성하고 코드베이스 내의 기존 메서드를 활용하지 않는 경향을 보여준다.
설정- 모델: Oracle 검색을 사용하는 Claude 2- 작업 인스턴스: scikit-learn_scikit-learn-13328- 이슈 링크: https://github.com/scikit-learn/scikit-learn/pull/13314- PR 링크: https://github.com/scikit-learn/scikit-learn/issues/13328
이슈HuberRegressor fit에 불리언 X를 제공할 때 TypeError 발생 ### 설명 불리언 예측 변수로 'HuberRegressor'를 피팅할 때 'TypeError'가 발생합니다.
재현 단계/코드import numpy as np from sklearn.datasets import make_regression from sklearn.linear_model import HuberRegressor# 무작위 데이터 X, y, coef = make_regression(n_samples=200, n_features=2, noise=4.0, coef =True, random_state=0) X_bool = X > 0 X_bool_as_float = np.asarray(X_bool, dtype=float)# 작동함 huber = HuberRegressor().fit(X, y) # 실패 (!) huber = HuberRegressor().fit(X_bool, y) # 또한 작동함 huber = HuberRegressor().fit(X_bool_as_float, y)
예상 결과 'X'의 'dtype'이 'bool'일 때 오류가 발생하지 않아야 합니다(위 스니펫의 두 번째 코드 줄, .fit(X_bool, y)). 불리언 배열은 예를 들어 'LinearRegression'에서 그렇게 하는 것처럼 'HuberRegressor.fit'에 의해 'float'로 변환될 것으로 예상됩니다.
실제 결과 'TypeError'가 발생합니다: (나머지 줄 생략)
골드 패치diff --git a/sklearn/linear_model/huber.py b/sklearn/linear_model/huber.py -- a/sklearn/linear_model/huber.py +++ b/sklearn/linear_model/huber.py @@ - 251,7 +251,8 @@ def fit(self, X, y, sample_weight=None): self : object"
모델 생성 패치
- a/sklearn/linear_model/huber.py +++ b/sklearn/linear_model/huber.py @@ -231,6 +231,9 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): self.tol = tol + def _validate_data(self, X, y=None): + return X.astype(np.float64) if X.dtype == np.bool else X + def fit(self, X, y, sample_weight=None): """Fit the model according to the given training data.
@@ -250,7 +253,7 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): self : object """ X, y = check_X_y( X, y = check_X_y( X, y, copy=False, accept_sparse=['csr'], y_numeric=True) if sample_weight is not None: sample_weight = np.array(sample_weight) @@ -262,6 +265,9 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): raise ValueError( "epsilon_should_be_greater_than_or_equal_to_1.0,got_%f" % self.epsilon) + X = self._validate_data(X)
테스트
실패에서 통과로 (1)
sklearn/linear_model/tests/test_huber.py::test_huber_bool
통과에서 통과로 (9)
sklearn/linear_model/tests/test_huber.py::test_huber_max_iter sklearn/linear_model/tests/test_huber.py::test_huber_gradient sklearn/linear_model/tests/test_huber.py::test_huber_sample_weights sklearn/linear_model/tests/test_huber.py::test_huber_sparse sklearn/linear_model/tests/test_huber.py::test_huber_scaling_invariant
추가 통과에서 통과로 테스트 생략...
논의. 이 작업 인스턴스에서 이슈는 타입이 어떻게 캐스팅되는지에 관한 문제를 설명합니다. 구체적으로, X_bool과 같은 불리언 예측 변수로 HuberRegressor 모델을 피팅할 때 TypeError가 발생합니다. 이 문제는 HuberRegressor가 LinearRegression과 같은 일부 다른 모델들이 하는 것처럼 불리언 배열을 자동으로 float로 변환하지 않아 타입 불일치 오류가 발생하기 때문에 생깁니다. 수정으로, 모델은 타입 캐스팅 로직을 캡슐화하는 자체 _validate_data 함수를 정의하고 이를 X에 적용합니다. 테스트를 통과하기는 하지만, 이 수정은 더 효율적일 수 있고 잠재적으로 스타일 및 조직상의 불일치를 도입할 수 있습니다. 참조 솔루션에서 입증된 것처럼, check_X_y 함수 호출의 기존 플래그를 활용하여 이 문제를 더 깔끔하게 해결하는 dtype 인자를 전달하는 훨씬 더 간단한 솔루션이 있습니다. 다른 파일들의 내용은 컨텍스트 윈도 한계로 인해 oracle 검색 설정에 포함되지 않았습니다.
표 26: Claude-2가 이슈를 올바르게 해결하고 골드 패치와 유사한 솔루션을 개발한 또 다른 예를 제공합니다. 그러나 골드 패치 솔루션은 이 코드와 관련될 수 있는 향후 잠재적 문제를 피하는 데 더욱 주의하고 있습니다.
설정
- 모델: Oracle 검색을 사용하는 Claude 2- 작업 인스턴스: matplotlib_matplotlib-24362 - 이슈 링크: https://github.com/matplotlib/matplotlib/issues/24349 - PR 링크: https://github.com/matplotlib/matplotlib/pull/24362
이슈
[버그]: sharex와 sharey가 0과 1을 bool 값으로 받아들이지 않습니다
버그 요약
'pyplot.subplots'의 'sharex' 또는 'sharex' 인자에서 'False' 또는 'True' 대신 '0' 또는 '1'을 사용하면 오류가 발생합니다.
재현 코드
import matplotlib.pyplot as plt
fig, ax = plt.subplots(ncols=2, sharey=1)
실제 결과
다음과 같은 오류가 발생합니다:
Traceback (most recent call last):
(이전 줄 생략) File "/\\\/matplotlib/lib/matplotlib/gridspec.py", line 293, in subplots _api.check_in_list(["all", "row", "col", "none"], File "/\\\/matplotlib/lib/matplotlib/_api/init.py", line 131, in check_in_list raise ValueError(msg)
ValueError: 1 is not a valid value for sharey; supported values are 'all', 'row', 'col', 'none'
'sharey' 대신 'sharex'를 사용해도 동일한 오류가 발생합니다(다만 다음과 같은 경고가 함께 발생합니다:
UserWarning: sharex argument to subplots() was an integer. Did you intend to use subplot() (without 's')?
그러나 이는 예상된 것이며 본 이슈의 일부가 아닙니다)
기대 결과
값 1과 0이 bool로 이해되기를 기대했습니다.
모델 생성 패치
diff --git a/lib/matplotlib/gridspec.py b/lib/matplotlib/gridspec.py
index 06dd3f19f6.32ee7c306e 100644
-- a/lib/matplotlib/gridspec.py
+++ b/lib/matplotlib/gridspec.py
@@ - 276, 9 +276, 9 @@ class GridSpecBase:
raise ValueError("GridSpec.subplots().only_works_for_GridSpecs_"
"created_with_a_parent_figure")
if isinstance(sharex, bool):
+ if isinstance(sharex, bool) or sharex == 1 or sharex == 0:
sharex = "all" if sharex else "none"
if isinstance(sharey, bool):
+ if isinstance(sharey, bool) or sharey == 1 or sharey == 0:
sharey = "all" if sharey else "none"
This check was added because it is very easy to type
'subplots(1, 2, 1)' when 'subplot(1, 2, 1)' was intended.
정답 패치
diff --git a/lib/matplotlib/gridspec.py b/lib/matplotlib/gridspec.py - - - a/lib/matplotlib/gridspec.py +++ b/lib/matplotlib/gridspec.py @@ -276,21 +276,12 @@ def subplots(self, \*, sharex=False, sharey=False, squeeze=True,- if isinstance(sharex, bool):+ if not isinstance(sharex, str):sharex = "all" if sharex else "none"- if isinstance(sharey, bool):+ if not isinstance(sharey, str):sharey = "all" if sharey else "none"- # This check was added because it is very easy to type# 'subplots(1, 2, 1)' when 'subplot(1, 2, 1)' was intended.- # In most cases, no error will ever occur, but mysterious behavior# will result because what was intended to be the subplot index is# instead treated as a bool for sharex. This check should go away# once sharex becomes knownly.- if isinstance(sharex, Integral):- api.warn_external("sharex_argument_to_subplots()_was_an_integer.__Did_you""intend_to_use_subplot()_without's')?"- api.check_in_list(["all", "row", "col", "none"],+ api.check_in_list(["all", "row", "col", "none", False, True],sharex=sharex, sharey=sharey)
테스트
실패에서 통과로 (1)
lib/matplotlib/tests/test_subplots.py::test_shared
통과에서 통과로 (39)
lib/matplotlib/tests/test_subplots.py::test_label_outer_span lib/matplotlib/tests/test_subplots.py::test_label_outer_non_gridspec lib/matplotlib/tests/test_subplots.py::test_shared_and_moved lib/matplotlib/tests/test_subplots.py::test_exceptions lib/matplotlib/tests/test_subplots.py::test_subplots_offsettext.png)
추가 통과-통과 테스트 생략...
논의. 이 예제는 1과 0이 pyplot.subplots 함수의 sharex 및 sharey 인수에 대해 불리언 값으로 처리되기를 요청합니다. 현재 코드는 오류를 발생시킵니다. 생성된 패치에서 모델은 1과 0을 허용 가능한 값으로 추가합니다. 그러나 골드 패치는 허용 가능한 값을 리스트 ["all", "row", "col", "none", False, True]에 추가합니다. 또한 이 이슈와 관련된 Integral 관련 경고를 제거합니다. 이러한 정리와 check_in_list 인수의 명확성은 코드를 더 간결하고 읽기 쉽게 만듭니다.
표 27: 이 예제에서는 Claude 2가 올바르게 해결하지 못하는 astropy/astropy의 이슈를 보여줍니다. 이 오류는 주로 패치 생성이 이슈를 직접 해결하려고 시도하기 때문에 발생합니다.
설정
- 모델: Oracle 검색을 사용하는 Claude 2- 작업 인스턴스: astropy_astropy-14365- 이슈 링크: https://github.com/astropy/astropy/issues/14363- PR 링크: https://github.com/astropy/astropy/pull/14365
이슈
ascii.qdp 테이블 형식은 QDP 명령이 대문자라고 가정합니다
설명
ascii.qdp는 QDP 파일의 명령이 대문자라고 가정합니다. 예를 들어 오류의 경우 "READ SERR 1 2"여야 하지만 QDP 자체는 대소문자를 구분하지 않으며 "read serr 1 2"를 사용할 수 있습니다. 많은 QDP 파일이 손으로 작성되기 때문에 모든 명령이 대문자여야 한다는 기대는 제거되어야 합니다.
기대 동작
다음 qdp 파일은 충돌하지 않고 오류가 포함된 'Table'로 읽혀야 합니다.
read serr 1 2 1 0.5 1 0.5
재현 방법 QDP 파일 생성:
cat > test.qdp read serr 1 2 1 0.5 1 0.5 <EOF>
python Python 3.10.9 (main, Dec 7 2022, 02:03:23) [Clang 13.0.0 (clang - 1300.0.29.30)] on darwin Type "help", "copyright", "credits" or "license" for more information. >>> from astropy.table import Table >>> Table.read('test.qdp', format='ascii.qdp') WARNING: table_id not specified. Reading the first available table [ astropy.io.ascii.qdp] Traceback (most recent call last): raise ValueError(f'Unrecognized_QDP_line: {line}') ValueError: Unrecognized QDP line: read serr 1 2
"qdp test.qdp"를 실행하는 것은 정상적으로 작동합니다.
모델 생성 패치
- a/astropy/io/ascii/qdp.py - b/astropy/io/ascii/qdp.py - @ -60,7 +60,7 @@ ValueError: Unrecognized QDP line... """ _decimal_re = r"[-?(\d+(\. \d+)?\.\d+)([eE][+-]?\d+)?" _command_re = r"READ [TS]ERR(\s+[0-9]+)+" _command_re = r"read [ts]err(\s+[0-9]+)+" sep = delimiter if delimiter is None:
정답 패치
diff - - git a/astropy/io/ascii/qdp.py b/astropy/io/ascii/qdp.py - - - a/astropy/io/ascii/qdp.py +++ b/astropy/io/ascii/qdp.py @@ - 68,7 + 68,7 @@ def _line_type (line, delimiter=None): _new_re = rf"NO((sep)NO)+" _data_re = rf"((_decimal_re) | NO | [- + ]?nan) ((sep) ((_decimal_re) | NO | [- + ]?nan)) +" _type_re = rf"\s*((?P<command>|_command_re)) | (?P<new>[_new_re]) | (?P< data>[_data_re])?\s*(\!|(?P<comment>.*))?\s+$" - _line_type_re = re.compile(_type_re) + _line_type_re = re.compile(_type_re, re.IGNORECASE) line = line.strip() if not line: return "comment" @@ - 306,7 +306,7 @@ def _get_tables_from_qdp_file(qdp_file, input_colnames=None, delimiter=None): values = [] for v in line.split (delimiter): - if v == "NO": + if v.upper() == "NO": values.append(np.max. masked) else: # Understand if number is int or float
테스트
실패에서 통과로 (1)
X astropy/io/ascii/tests/test_qdp.py::test_roundtrip[True]
통과에서 통과로 (8)
번역할 텍스트: X astropy/io/ascii/tests/test_qdp.py::test_get_tables_from_qdp_file X astropy/io/ascii/tests/test_qdp.py::test_roundtrip[False] X astropy/io/ascii/tests/test_qdp.py::test_read_example X astropy/io/ascii/tests/test_qdp.py::test_roundtrip_example X astropy/io/ascii/tests/test_qdp.py::test_roundtrip_example_comma X astropy/io/ascii/tests/test_qdp.py::test_read_write_simple X astropy/io/ascii/tests/test_qdp.py::test_read_write_simple_specify_name X astropy/io/ascii/tests/test_qdp.py::test_get_lines_from_qdp
논의. 이 이슈는 QDP 파일 처리에 대한 수정을 요청하며, 구체적으로 명령이 대문자여야 한다는 기대를 제거할 것을 요청합니다. 모델이 생성한 패치에서 모델은 이슈 설명에 언급된 READ 및 ERR 명령을 정규식 패턴에서 찾아 직접 편집합니다. 그러나 같은 파일 내에서 그 정규식 패턴이 _type_re와 같은 추가 패턴에 사용된다는 점이 분명하므로, "루트" 정규식 패턴에 대한 수정은 적절하지 않을 수 있습니다. 또한 여러 정규식 패턴 변수 가운데 수정할 올바른 것을 식별하려면 실행의 도움을 받을 수 있는 추론이 필요합니다. 이 해결책의 오류는 주어진 단위 테스트를 통과하지 못할 뿐만 아니라 기존 동작을 강제하는 기존 테스트도 실패한다는 점에 반영되어 있습니다.
표 28: mwaskom/seaborn 저장소의 이 이슈에서 문제 설명에는 이미지로의 하이퍼링크가 포함되어 있습니다. 섹션 5에서 논의한 바와 같이, SWE-bench 작업의 작은 부분집합에는 이미지가 포함되어 있어, 이미지 이해가 이슈 해결에 작지만 중요한 구성 요소가 되며 초기 기준선에서는 탐구되지 않았습니다.
설정
- 모델: Oracle 검색을 사용하는 Claude 2 - 작업 인스턴스: mwaskom_seaborn-3217 - 이슈 링크: https://github.com/mwaskom/seaborn/issues/2907 - PR 링크: https://github.com/mwaskom/seaborn/pull/3217
이슈
로그 스케일에서 히스토그램 이후 너비 계산이 약간 잘못됨 여기서 약간의 겹침에 주목하십시오:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth ), so.Hist(bins ) .scale
image 빈을 더 많이 사용하면 거의 감지할 수 없게 됩니다:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth ), so.Hist(bins ) .scale
image 이것은 'Bars'에 관한 것이 아닙니다; 'Bar'에도 같은 문제가 있습니다:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth , width ), so.Hist(bins ) .scale
image
Model Generated Patch
- a/seaborn/_core/plot.py +++ b/seaborn/_core/plot.py @@ -1327,9 +1327,7 @@ elif "width" in df: view_width = view_df["width"] else: - view_width = 0.8 # TODO what default? - spacing = scales[orient]._spacing(view_df.loc[view_idx, - width.loc[view_idx] = view_width + spacing + width.loc[view_idx] = view_width df["width"] = width if "baseline" in mark._mappable_props:
Gold Patch
diff - - git a/seaborn/_core/plot.py b/seaborn/_core/plot.py - - - a/seaborn/_core/plot.py ++ b/seaborn/_core/plot.py @@ - 1377,10 + 1377,9 @@ def _unscale_coords( - drop_cols = [\*coord_cols, "width"] if "width" in df else coord_cols out_df = ( df - .drop(drop_cols, axis=1) + .drop(coord_cols, axis=1) .reindex(df.columns, axis=1) # So unscaled columns retain their place @@ - 1396,12 + 1395,6 @@ def _unscale_coords( - if var == orient and "width" in view_df: - width = view_df["width"] - out_df.loc[values.index, "width"] = ( - transform(values + width / 2) - transform(values - width / 2) ) - return out_df diff - - git a/seaborn/_marks/bar.py b/seaborn/_marks/bar.py - - - a/seaborn/_marks/bar.py +++ b/seaborn/_marks/bar.py @@ - 29,17 + 29,23 @@ class BarBase(Mark): + transform = scales[orient]._matplotlib_scale.get_transform() + forward = transform.transform + reverse = transform.inverted().transform + + other = {"x": "y", "y": "x"} [orient] + + pos = reverse(forward(data[orient]) - data["width"] / 2) + width = reverse(forward(data[orient]) + data["width"] / 2) - pos + + val = (data[other] - data["baseline"]).to_numpy() + base = data["baseline"].to_numpy() + (Remaining lines omitted...)
Tests
Fail to Pass (1)
X tests/_marks/test_bar.py::TestBars::test_log_scale
Pass to Pass (8)
X tests/_marks/test_bar.py::TestBar::test_categorical_positions_vertical X tests/_marks/test_bar.py::TestBar::test_categorical_positions_horizontal X tests/_marks/test_bar.py::TestBar::test_numeric_positions_vertical X tests/_marks/test_bar.py::TestBar::test_numeric_positions_horizontal X tests/_marks/test_bar.py::TestBar::test_set_properties
Additional Pass to Pass Tests omitted...
Discussion. The baseline model's inability to solve this issue can be directly attributed to a lack of an image input. We include this example to demonstrate that debugging real software issues may involve digesting images; this presents a whole separate body of understanding and reasoning- related challenges. Beyond the SWE- bench task, additional problems in software engineering, such as interpreting system design diagram, user interface specifications, and user feedback presents interesting vision- language challenges.
Table 29: In this final example of a Claude 2 generation, the model must resolve an error related to resolving an error regarding cyclic dependencies. Claude 2's solution under-delivers on an otherwise complex problem.
Setting
- Model: Claude 2 with Oracle retrieval- Task Instance: sympy_sympy-18211- Link to Issue: https://github.com/pylint-dev/pylint/issues/3525- Link to PR: https://github.com/pylint-dev/pylint/pull/4703
Issue
Imports within TYPE.CHECKING can induce "cyclic- import"
Suppose you have two modules: a.py and b.py. 'a' imports 'b', but 'b' needs 'a' in order to do type annotations, then this is usually done by importing 'a' within a 'TYPE.CHECKING' block. Unfortunately, this causes pylint to report 'cyclic- import'.
Possibly related to https://github.com/PyCQA/pylint/issues/3285
Gold Patch
diff --git a/pylint/checkers/imports.py b/pylint/checkers/imports.py-- a/pylint/checkers/imports.py +++ b/pylint/checkers/imports.py@@ - 813,7 + 813,9 @@ def _get_imported_module(self, importnode, modname):- def _add_imported_module(self, node, importedmodname): + def _add_imported_module(+ self, node: Union[astroid.Import, astroid.ImportFrom], importedmodname: str + ) -> None:"""notify an imported module, used to analyze dependencies""" module_file = node.root().file context_name = node.root().name@@ - 826,6 + 828,10 @@ def _add_imported_module(self, node, importedmodname): except ImportError: pass + in_type_checking_block = (+ isinstance(node.parent, astroid.If) and node.parent. is_type_guard() + ) if context_name == importedmodname: self.add_message("import- self", node=node)@@ - 845,7 + 851,10 @@ def _add_imported_module(self, node, importedmodname): # update import graph self.import_graph[context_name].add(importedmodname)- if not self.linter.is_message_enabled("cyclic-import", line= node.lineno): + if + not self.linter.is_message_enabled("cyclic-import", line= node.lineno) + or in_type_checking_block + ) self.excluded_edges[context_name].add(importedmodname)ްމައްސަލައިގެންނަށްޓަކ
Model Generated Patch
diff - - git a/pylint/checkers/imports.py b/pylint/checkers/imports.py index 4f3eed2. .2b74a8d 100644 - - - a/pylint/checkers/imports.py +++ b/pylint/checkers/imports.py @@ -49,6 +49,7 @@ import copy import os import sys from distutils import sysconfig +from typing import TYPE_CHECKING from typing import Dict, List, Union
import astroid @@ -61,6 +62,9 @@ from pylint.checkers.utils import ( node_ignores_exception, ) from pylint.exceptions import EmptyReportError +if TYPE_CHECKING: + from pylint.lint import PyLinter + from pylint.graph import DotBackend, get_cycles from pylint.interfaces import IASTroidChecker from pylint.reporters.ureports.nodes import Paragraph, VerbatimText, VNode
테스트
실패 → 통과 (1)
X tests/marks/test_bar.py::TestBars::test_log_scale
통과 → 통과 (11)
tests/test_func.py::test_functionality[func_w0401_disabled_in_func.py] tests/test_func.py::test_functionality[func_i0022. py] tests/test_func.py::test_functionality[func_w0401. py] tests/test_func.py::test_functionality[func_w0801. py] tests/test_func.py::test_functionality[func_w0401_package]
추가 통과 → 통과 테스트는 생략...
논의. 이 문제에서 모델은 순환 임포트를 해결하기 위해 TYPE_CHECKING 기반 처리를 제공하도록 요청받고 있으며, pylint는 현재 이에 대해 오류를 발생시킨다. 정답 패치는 TYPE_CHECKING 블록 내에서의 조건부 처리, 순환 임포트 메시지 제외, 그리고 전반적으로 더 구체적인 처리를 포함하는 상세한 해결책을 제시한다. 모델이 생성한 패치는 "Stack Overflow" 스타일의 해결책을 채택한다. TYPE_CHECKING 블록을 생성하는 것은 임포트를 해결하기 위한 인기 있는 방법이지만, 특히 이 코드베이스에서 이 문제를 해결하려면 온라인에서 구할 수 있는 일반적인 답변보다 더 정교한 해결책이 필요하다.
표 30: SWE-bench 과제 인스턴스를 올바르게 해결한 SWE-Llama 13b 생성의 예시. 이 예시에서 SWE-Llama의 생성 결과는 해결책과 정확히 동일하다.
설정
- 모델: Oracle 검색을 사용하는 SWE-Llama 13B- 과제 인스턴스: pydata_xarray-5131- 이슈 링크: https://github.com/pydata/xarray/pull/5130- PR 링크: https://github.com/pydata/xarray/pull/5131
이슈
대화형 Python 세션에서 DatasetGroupBy를 표시할 때, 출력의 첫 줄에 후행 공백이 포함된다. 문서의 첫 번째 예시가 이를 보여준다:
import xarray as xr, numpy as np >>> ds = xr.Dataset( ... {"foo": (("x", "y"), np.random.rand(4, 3)), ... coords={"x": [10, 20, 30, 40], "letters": ("x", list("abba")), ... >>> ds.groupby("letters") DatasetGroupBy, grouped over 'letters' 2 groups with labels 'a', 'b'.
출력의 첫 줄 "DatasetGroupBy, grouped over 'letters' "에 후행 공백이 있다. 이는 객체를 문자열로 변환하면 더 명확하게 확인할 수 있다 (n 앞의 공백에 주목):
str(ds.groupby("letters")) "DatasetGroupBy, grouped_over_'letters'\n2_groups_with_labels'a', 'b'."
이는 그 자체로는 문제가 아니지만, 지속적 통합에서 코드가 올바르게 포맷되었는지 확인하기 위해 flake8을 사용하기 때문에 우리에게 문제를 일으킨다... [20줄 더]
정답 패치
diff --git a/xarray/core/groupby.py b/xarray/core/groupby.py -- a/xarray/core/groupby.py +++ b/xarray/core/groupby.py @@ - 436,7 + 436,7 @@ def iter(self): return zip(self._unique_coord.values, self._iter_grouped())
def repr(self): return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( + return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( self.class.name,
모델 생성 패치
diff --git a/xarray/core/groupby.py b/xarray/core/groupby.py -- a/xarray/core/groupby.py +++ b/xarray/core/groupby.py @@ - 436,7 + 436,7 @@ def iter(self): return zip(self._unique_coord.values, self._iter_grouped())
def repr(self): return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( + return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( self.class.name,
테스트
실패에서 통과로 (10)
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-x]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-y]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-z]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-month]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-x]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-y]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-z]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-month]
✓ xarray/tests/test_groupby.py::test_groupby_repr_datetime[obj0]
✓ xarray/tests/test_groupby.py::test_groupby_repr_datetime[obj1]
통과에서 통과로 (16)
✓ xarray/tests/test_groupby.py::test_consolidate_slices
✓ xarray/tests/test_groupby.py::test_groupby_da_datetime
✓ xarray/tests/test_groupby.py::test_groupby_duplicate_coordinate_labels
✓ xarray/tests/test_groupby.py::test_groupby_input_mutation
✓ xarray/tests/test_groupby.py::test_groupby_map_shrink_groups[obj0]
추가 통과에서 통과로 테스트는 생략됨...
논의. 이 문제에서 모델은 후행 공백 문제를 수정하도록 요청받으며, 문제 설명에는 사용 중 발생하는 오류에 대한 시연이 제시되지만 모델에서 수정할 함수를 명시적으로 지적하지는 않는다. 오라클 검색 설정에서 모델은 편집할 xarray/core/groupby.py 파일을 직접 제공받지만, 대부분은 편집할 줄을 찾아낸다. 이 상황에서 모델은 대화형 Python 설정에서 실제로 호출되는 기본 함수가 repr 함수임을 성공적으로 추론한다. 함수를 찾은 후에는 return 문에서 공백이 어디에 위치하는지 파악해야 한다. 이 시점에서 수정은 상당히 명백한데, 모델이 제거하는 명시적인 공백이 있기 때문이다. 이 경우 모델은 이 수정의 정확성을 검증하는 모든 테스트(실패에서 통과로 10개)를 명시적으로 통과하면서도 파일의 기존 동작(통과에서 통과로 16개)을 유지하는 데 성공한다.
표 31: SWE-bench 작업 인스턴스를 올바르게 해결한 SWE-Llama 13b 생성의 예시. 이 예시에서 SWE-Llama 생성은 정답 패치와 다르다.
설정
- 모델: 오라클 검색을 사용하는 SWE-Llama 13B- 작업 인스턴스: psf_-requests-1724- 이슈 링크: https://github.com/psf/requests/issues/1723- PR 링크: https://github.com/psf/requests/pull/1724
이슈
유니코드 메서드 이름이 Python 2.7.2의 일부 requests에서 UnicodeDecodeError를 발생시킴 다음 예시는 정상적으로 작동한다:
files {u'file': open(u'/usr/bin/diff', u'rb')} response requests.request(method 'POST', url 'http://httpbin.org/post' files files)
그러나 다음 예시('method 'POST' 대신 'method 'POST' 사용)는 UnicodeDecodeError를 발생시킨다:
files {u'file': open(u'/usr/bin/diff', u'rb')} response requests.request(method 'POST', url 'http://httpbin.org/post' files files)
Traceback (most recent call last): [전체 스택 추적 숨김] File "/System/Library/Frameworks/Python.framework/Versions/2.7/... msg_+=_message_body UnicodeDecodeError: 'ascii'_codec_can't_decode_byte_0xcf_in_position_140: ordinal_not_in_range (128)
내 추측으로는 'u'POST'가 문자열이어야 할 헤더에 유니코드를 전염시키기 때문이다. 이는 'sessions.py:313'이 단순히 다음과 같기 때문이다:
req.method method.upper()
[추가 줄 숨김...]
정답 패치
diff --git a/requests/sessions.py b/requests/sessions.py-- a/requests/sessions.py +++ b/requests/sessions.py@@ - 12,7 + 12,7 @@from collections import Mapping from datetime import datetime-from .compact import cookielib, OrderedDict, [3개 더 생략] +from .compact import cookielib, OrderedDict, [3개 생략, + builtin_str from .cookies import cookiejar_from_dict, extract_cookies_to_jar, RequestsCookieJar from .models import Request, PreparedRequest from .hooks import default_ hooks, dispatch_hook@@ - 309,6 + 309,6 @@ def request(self, method, url,:param cert: (선택 사항) String인 경우 ssl 클라이언트 인증서 파일(.pem) 경로. Tuple인 경우 ('cert', 'key') 쌍.\\\*
+ method builtin_str(method)
모델 생성 패치
diff - - git a/requests/sessions.py b/requests/sessions.py - - - a/requests/sessions.py +++ b/requests/sessions.py @@ -254,7 +254,7 @@ def prepare_request(self, request):
p = PreparedRequest() p.prepare( method=request.method.upper(), + method=str(request.method).upper(), url=request.url, files=request.files, data=request.data,
테스트
실패에서 통과로 (6)
test_requests.py::RequestsTestCase::test_DIGEST_AUTH_RETURNS_COOKIE test_requests.py::RequestsTestCase::test_DIGEST_HTTP_200_OK_GET test_requests.py::RequestsTestCase::test_different_encodings_dont_break test_requests.py::RequestsTestCase::test_generic_cookiejar_works test_requests.py::RequestsTestCase::test_uppercase_scheme_redirect
통과에서 통과로 (75)
test_requests.py::RequestsTestCase::test_DIGEST_AUTH_SETS_SESSION_COOKIES test_requests.py::RequestsTestCase::test_DIGEST_STREAM test_requests.py::RequestsTestCase::test_HTTP_200_OK_GET_ALTERNATIVE test_requests.py::RequestsTestCase::test_HTTP_200_OK_GET_WITH_PARAMS test_requests.py::RequestsTestCase::test_HTTP_200_OK_HEAD
추가 통과에서 통과로 테스트는 생략됨...
토론. 표 30에 제시된 문제와 달리, 대화형 파이썬 입력 대신 모델에게 함수 호출에서 발생한 오류 트레이스가 주어지며, 여기에는 사용자 관점에서 문제를 재현하는 단계가 제시된다. 또한, 이슈는 마지막 줄에서 문제에 대한 잠재적 수정 방안에 관한 제안도 제공한다. 다시 한 번 오라클 설정에서 모델은 자연어 제안을 활용하여 변경을 제안과 의미상 상당히 유사한 줄로 국소화한다( req.method = method.upper() 와 method=str(request.method).upper() 의 비교 ). 모델은 모든 테스트가 통과한 것으로 reflected되듯이 이슈를 올바르게 해결한다. 그러나 이 상황에서 우리는 모델이 실제로 성공에 있어 상당히 "운이 좋았다"는 것을 알 수 있다. 첫째, 골드 패치는 문자열 포매팅 처리의 일관성을 위해 사용되는 내장 함수를 활용하는 반면, 모델이 이 문제를 다루기 위해 더 원시적인 파이썬을 사용하기로 한 결정은 코드베이스의 나머지 부분과의 불일치로 인해 인간 리뷰어에게 잘 받아들여지지 않을 가능성이 높다. 이 그림에는 표시되지 않은 builtin_str 함수를 추가로 살펴보면, 이 함수가 이슈에 묘사된 것 이상의 추가적인 문자열 포매팅 사례들을 처리한다는 것도 드러난다. 모델이 이번에는 과제를 해결했지만, 이 해결책이 향후 이슈에 대해 견고한지 여부는 의문이다.
표 32: 이것은 SWE-Llama13b가 과제를 성공적으로 해결한 또 다른 예시이다. 이 예시는 모델이 참조와 비교하여 다소 참신한 해결책을 개발했으며, 이는 효율성과 깔끔함 면에서 더 낫다고 할 수 있어 흥미롭다.
설정
- 모델: Oracle 검색을 사용하는 SWE-Llama 13B- 작업 인스턴스: djang0. djang0-11727- 이슈 링크: https://code.djangoproject.com/ticket/29376- PR 링크: https://github.com/djang0/djang0/pull/11727
이슈
show_save_and_add_another 컨텍스트 변수로 "Save and Add Another" 버튼을 숨길 수 있도록 허용
더 나은 조정 가능성을 제공하기 위해 새로운 컨텍스트 변수인 show_save_and_add_another를 도입하기. 예를 들어 "Save and add another" 버튼을 숨기고 싶다면 extra_context를 수정하여 변수에 False를 쓰기만 하면 된다. 다른 버튼들 - "Save"와 "Save and continue editing" - 의 경우 이미 정확히 이런 방식으로 작동한다.
골드 패치
diff --git a/djang0/contrib/admin/templateTags/admin_modify.py b/djang0 /... - - a/djang0/contrib/admin/templateTags/admin_modify.py +++ b/djang0/contrib/admin/templateTags/admin_modify.py @@ -54,12 +54,20 @@ def submit_row(context): is_popup = context['is_popup'] save_as = context['save_as'] show_save = context.get('show_save', True) + show_save_and_add_another = context.get('show_save_and_add_another', True)
(7줄 생략...) or (has_add_permission and add) or has_editable_inline_admin_formset + can_save_and_add_another = ( + has_add_permission and + not is_popup and + (not save_as or add) and + can_save and + show_save_and_add_another + ) can_save_and_continue = not is_popup and can_save and has_view_permission and show_save_and_continue can_change = has_change_permission or has_editable_inline_admin_formset ctx = Context(context) @@ -70,10 +78,7 @@ def submit_row(context): change and context.get('show_delete', True) ), 'show_save_as_new': not is_popup and has_change_permission and change and save_as, - 'show_save_and_add_another': ( - has_add_permission and not is_popup and - (not save_as or add) and can_save - ), 'show_save_and_add_another': can_save_and_add_another, 'show_save_and_continue': can_save_and_continue, 'show_save': show_save and can_save,
모델 생성 패치
diff --git a/django/contrib/admin/templateTags/admin_modify.py b/django/...-- a/django/contrib/admin/templateTags/admin_modify.py +++ b/django/contrib/admin/templateTags/admin_modify.py@@ - 72,7 + 72,7 @@ def submit_row(context):' show_save_as_new': not is_popup and has_change_permission and change and save_as,' show_save_and_add_another': has_add_permission and not is_popup and- (not save_as or add) and can_save + (not save_as or add) and can_save and context. get('show_save_and_add_another', True)),' show_save_and_continue': can_save_and_continue,' show_save': show_save and can_save,
테스트
통과 실패 (2)
test_override_show_save_and_add_another
test_submit_row (admin_views.test_templateTags.Admin...)
통과 → 통과 (3)
test_choice_links (admin_views.test_templateTags.DateHierarchyTests)
test_override_change_form_template_tags
test_override_change_list_template_tags
논의. django/django 저장소에서 비롯된 이 작업 인스턴스의 경우, 모델은 기존의 다른 두 버튼에 대해 수행되는 방식과 유사하게, 사용자가 컨텍스트 변수를 통해 "Save and Add Another" 버튼을 숨길 수 있게 해 주는 컨텍스트 변수를 도입하도록 요구받는다. 이 작업은 문제에 대한 명시적인 스택 트레이스나 프로그래밍 방식의 시연이 제공되지 않기 때문에 앞선 두 설정에 비해 다소 어렵다. 함수를 올바르게 국소화하는 방법에 대한 제안을 제공하지 않는 이 상대적으로 불충분하게 명세된 설정에서, 모델은 기존의 show_save_and_add_another 키/값 쌍을 조정해야 한다고 성공적으로 추론한다. 정답 패치(gold patch) 해법과 비교해 보면, 모델이 생성한 패치는 show_save_and_add_another의 숨김 상태를 설정하기 위한 플래그로서 컨텍스트를 통합하는 데 필요한 최소한의 수정만 가하기 때문에, 편집된 줄 수 측면에서 훨씬 더 효율적인 해법을 만들어 낸다고 주장할 수 있다. 그러나 표 31에서의 논의와 마찬가지로, 문체상으로는 정답 패치의 편집이 코드베이스와 훨씬 더 일관되며, 이슈에서 명시적으로 논의되지 않은 추가 변경들도 코드베이스에서 이루어진 방식(즉, can_save_and_add_another 필드의 추가)을 따르기 위해 이루어진다. 이 작업은 인간의 안내 또는 코드베이스 전반에 대한 더 나은 이해를 통해 모델이 기능적으로 올바른 변경뿐만 아니라 문체상으로도 올바른 변경을 하도록 생성 결과를 조정하게 될 수 있는, 잠재적으로 흥미로운 방향의 한 사례이다.
표 33: 이것은 SWE-Llama13b가 잘못된 해법을 작성하지만, 기존 동작은 성공적으로 유지하는 한 사례이다. 여기서 모델의 생성 결과와 정답 패치의 차이는 모델이 필요한 수정을 과소 생성하는 경향이 있음을 보여준다.
설정
- 모델: Oracle 검색을 사용하는 SWE-Llama 13B- 작업 인스턴스: sphinx-doc_sphinx-11445- 이슈 링크: https://github.com/sphinx-doc/sphinx/issues/11437- PR 링크: https://github.com/sphinx-doc/sphinx/pull/11445
이슈
rst_prolog를 사용하면 도메인 지시자를 포함하는 최상위 제목이 제거됨
버그 설명
rst_prolog가 설정되면, 첫 번째 제목으로 도메인 지시자(예: :mod:)를 포함하는 문서는 제목이 올바르게 렌더링되지 않거나 toctree에 제목이 포함되지 않는다. 아래 예시에서 docs/mypackage.rst의 제목이 :mod:mypackage2 대신 mypackage2라면 제목이 올바르게 표시된다. 마찬가지로 rst_prolog를 설정하지 않으면 제목이 올바르게 표시된다. Sphinx v4.0.0에서도 재현할 수 있어서 이것은 상당 기간 동안 깨져 있었던 것으로 보인다.
재현 방법
$ sphinx-quickstart --no-sep --project mypackage --author me - v 0.1.0 --release 0.1.0 --language en docs $ echo - e 'Welcome\n=========\n\n...\tctree::\n\n\_mypackage\n' > docs/index_rst $ echo - e ':mod:'mypackage2\n=========\n\nContent\n\n Subheading\n-
logger = logging.getLogger(name) - docinfo_re = re.compile(r'\w+.?') + docinfo_re = re.compile(r'\w+.?n') symbols_re = re.compile(r'([-]-\/-\@[\-]') SECTIONING_CHARS = ['=', '-', '-']
테스트
실패 → 통과 (2)
X tests/test_util_rst.py::test_prepend_prolog_with_roles_with_newline tests/test_util_rst.py::test_prepend_prolog_with_roles_without_newline
통과 → 통과 (8)
X tests/test_util_rst.py::test_prepend_prolog tests/test_util_rst.py::test_prepend_prolog_with_CR tests/test_util_rst.py::test_prepend_prolog_without_CR
추가 통과 → 통과 테스트 생략됨...
정답 패치
diff --git a/sphinx/util/rst.py b/sphinx/util/rst.py -- a/sphinx/util/rst.py ++ b/sphinx/util/rst.py @@ - 10,22 +10,17 @@
from docutils.parsers.rst import roles from docutils.parsers.rst.languages import en as english +from docutils.parsers.rst.states import Body from docutils.statemachine import StringList from docutils.utils import Reporter - from jinja2 import Environment +from jinja2 import Environment, pass_environmentfrom sphinx.locale import from sphinx.util import docutils, logging- try: - from jinja2.utils import pass_environment - except ImportError: - from jinja2 import environmentfilter as pass_environment - logger = logging.getLogger(name) - docinfo_re = re.compile('\w+.*?') +FIELD_NAME_RE = re.compile(Body.patterns['field_marker']) symbols_re = re.compile(r'([-\-/:-@\[-\{-]})' # symbols without dot(0 x2e) SECTIONING_CHARS = ['=', '-', '~']
@@ - 80,7 +75,7 @@ def prepend_prolog(content: StringList, prolog: str) -> None: if prolog: pos = 0 for line in content: if docinfo_re.match(line): + if FIELD_NAME_RE.match(line): pos += 1 else: break @@ - 91,6 +86,7 @@ def prepend_prolog(content: StringList, prolog: str) -> None: pos += 1 # insert prolog (after docinfo if exists) + lineno = 0 for lineno, line in enumerate(prolog.splitlines()): content.insert(pos + lineno, line, 'rst_prolog>', lineno)
논의. sphinx-doc/sphinx 저장소에서 비롯된 이 작업 인스턴스의 경우, 모델은 제목이 잘못 렌더링되는 사례를 수정하는 로직을 작성하도록 요구받는다. 사용되는 전문 용어를 단순히 이해하고 그러한 단어들을 코드베이스 내의 로직에 대응시키는 것 자체가 모델이 마주하는 상당한 과제이다. 모델에게 도움이 될 수 있는 명령줄 호출이 주어지지만, 이슈에 제시된 용어를 코드베이스 내에 근거 짓는 것이 필수적이다. 정답 패치와 모델 생성 패치를 비교해 보면, 모델이 이 작업을 해결하는 데 거의 근접하지 못했음이 분명하다. 모델은 일반적으로 정규식 패턴을 수정하는 것이 올바른 조치임을 식별하는데, 정답 패치 역시 그렇게 하기 때문이다. 그러나 모델과 oracle 검색 설정이 공동으로 부족한 부분은 주로 코드베이스 자체와 서드파티 라이브러리 양쪽에서 추가 모듈을 상당히 많이 사용한다는 점 때문이다. 이 예시는 그러한 정보의 자동 발견을 가능하게 하는 추론 절차를 설계하고 언어 모델을 훈련하는 것의 중요성과 잠재력을 부각시킨다.
표 34: 이 마지막 예시에서 SWE-Llama 13b는 작업을 해결하지 못할 뿐만 아니라 모델 내의 기존 동작까지 훼손한다. 이 예시는 모델이 필요한 편집의 범위를 넘어 코드베이스를 이해할 필요가 있음을 보여준다.
설정
- 작업 인스턴스: scikit-learn_ scikit-learn-13241
- 이슈 링크: https://github.com/scikit-learn/scikit-learn/issues/8798
- PR 링크: https://github.com/scikit-learn/scikit-learn/pull/13241
이슈
rbf 커널을 사용한 KernelPCA 결과 간의 차이
설명
동일한 데이터셋에 대해 차원 축소를 위해 KernelPCA를 실행하면, 결과의 부호가 다르게 나온다.
재현 단계/코드
rbf 커널로 차원을 7로 축소하는 경우:
pca = KernelPCA(n_components=7, kernel='rbf', copy_X=False, n_jobs=- 1) pca.fit_transform(X)
예상 결과
동일한 결과.
실제 결과
부호만 다르고 결과는 동일하다:
[[- 0.44457 - 0.18155 - 0.10873 0.13548 - 0.14371 - 0.05746 0.18124]] [[0.44457 0.18155 0.10873 - 0.13548 - 0.14371 - 0.05746 - 0.18124]] [[- 0.44457 - 0.18155 0.10873 0.13548 0.14371 0.057469 0.18124]]
정답 패치
diff --git a/sklearn/decomposition/kernel_pca.py b/sklearn/decompos...
-- a/sklearn/decomposition/kernel_pca.py
+++ b/sklearn/decomposition/kernel_pca.py
@@ - 8,6 + 8,7 @@
from scipy.sparse.linalg import eighs
from .utils import check_random_state
+from .utils.extmath import svd_flip
from .utils.validation import check_is_fitted, check_array
from .exceptions import NotFittedError from .base import BaseEstimator, TransformerMixin, _UnstableOn32BitMixin
@@ - 210,6 + 211,10 @@ def _fit_transform(self, K): maxiter=self.max_iter, v0=v0)
+ # 고유벡터의 부호를 뒤집어 결정론적 출력을 보장
+ self.alphas_, _ = svd_flip(self.alphas_,+ np.empty_like(self.alphas_).T)+# 고유벡터를 내림차순으로 정렬indices = self.lambdas_.argsort() [::- 1]self.lambdas_ = self.lambdas_[indices]
모델 생성 패치
diff - - git a/sklearn/decomposition/kernel_pca.py b/sklearn/decompos... - - a/sklearn/decomposition/kernel_pca.py +++ b/sklearn/decomposition/kernel_pca.py @@ -220,7 +220,7 @@ def fit_transform(self, K): self.alphas = self.alphas_[:, self.lambdas_ > 0] self.lambdas_ = self.lambdas_[self.lambdas_ > 0]
return K return K / self.lambdas_
def _fit_inverse_transform(self, X_transformed, X): if hasattr(X, "tocstr"):
테스트
실패에서 통과로 (1)
X sklearn/tests/test_kernel_pca.py::test_kernel_pca_deterministic_output
통과에서 통과로 (54)
X sklearn/tests/test_kernel_pca.py::test_kernel_pca sklearn/tests/test_kernel_pca.py::test_kernel_pca_consistent_transform sklearn/tests/test_kernel_pca.py::test_kernel_pca_deterministic_output sklearn/tests/test_kernel_pca.py::test_kernel_pca_sparse sklearn/tests/test_kernel_pca.py::test_kernel_pca_linear_kernel sklearn/tests/test_kernel_pca.py::test_kernel_pca_n_components sklearn/tests/test_kernel_pca.py::test_remove_zero_eig sklearn/tests/test_kernel_pca.py::test_kernel_pca_precomputed sklearn/tests/test_kernel_pca.py::test_gridsearch_pipeline sklearn/tests/test_kernel_pca.py::test_gridsearch_pipeline_precomputed sklearn/tests/test_pca.py::test_pca_dtype_preservation[randomized] sklearn/tests/test_pca.py::test_pca_dtype_preservation[auto] sklearn/tests/test_pca.py::test_pca_deterministic_output
추가 통과에서 통과로 테스트는 생략됨...
논의. scikit-learn/scikit-learn 라이브러리의 이 예시에서, 한 모델에게 fit_transform 함수 호출의 출력 패리티가 뒤집힌다는 관찰이 주어진다. 또한 그 모델에게는 이 문제를 재현하는 파이썬 코드 줄들과 그 표준 출력이 주어진다. 정답(gold) 패치는 _fit_transform 함수의 다른 줄에서 이 문제를 해결하기 위해 svd_flip 함수를 임포트하고 사용한다. 이 과제에서 모델의 실패가 Table 33 예시에서 논의된 점들과 다른 점은, 모델이 자신의 수정이 의존하는 서드파티 의존성을 이해하는 것에 더하여, 코드베이스의 다른 부분들이 자신이 변경하는 함수에 다시 의존한다는 점을 이해하는 것도 중요하다는 것이다. 이 예시는 로컬 수정 범위를 넘어서는 긴 컨텍스트 처리가 어렵지만 가치 있는 도전인 이유에 대한 또 다른 측면을 보여준다.