
PPO 를 네 군데 고쳐 32B 모델이 AIME 2024 에서 50 점을 받았고 코드와 데이터도 공개했다. 2025년 논문, 전문 무료.
DAPO: An Open-Source LLM Reinforcement Learning System at Scale
DAPO: 대규모 오픈소스 LLM 강화학습 시스템
ByteDance Seed Institute for AI Industry Research (AIR), Tsinghua University The University of Hong Kong SIA- Lab of Tsinghua AIR and ByteDance Seed
전체 저자 목록은 Contributions 참조
초록
추론 스케일링(inference scaling)은 LLM에게 전례 없는 추론 능력을 부여하며, 복잡한 추론을 이끌어내는 핵심 기법은 강화학습이다. 그러나 최신 추론 LLM의 핵심 기술 세부사항은 공개되지 않았으며(예: OpenAI o1 블로그 및 DeepSeek R1 기술 보고서), 따라서 커뮤니티는 여전히 그들의 RL 학습 결과를 재현하는 데 어려움을 겪고 있다. 우리는 Decoupled Clip and Dynamic sAmpling Policy Optimization (DAPO) 알고리즘을 제안하고, Qwen2.5-32B 기반 모델을 사용하여 AIME 2024에서 50점을 달성하는 최신 대규모 RL 시스템을 완전히 오픈소스로 공개한다. 학습 세부사항을 공개하지 않는 이전 연구들과 달리, 우리는 대규모 LLM RL을 성공으로 이끄는 알고리즘의 네 가지 핵심 기법을 소개한다. 또한, 우리는 ver1 프레임워크 를 기반으로 구축된 학습 코드와 신중하게 선별하고 처리된 데이터셋을 오픈소스로 공개한다. 우리의 오픈소스 시스템을 구성하는 이러한 요소들은 재현성을 향상시키고 대규모 LLM RL의 향후 연구를 지원한다.
날짜: 2025년 3월 17일 교신: zhouhao@air.tsinghua.edu.cn, wangmingxuan.89@bytedance.com 프로젝트 페이지: https://dapo- sia.github.io/"https://github.com/volcengine/ver1
1 서론
OpenAI의 o1 [1] 및 DeepSeek의 R1 [2]과 같은 테스트 시점 스케일링(test-time scaling)은 대형 언어 모델(Large Language Models, LLMs) [3-7]에 심오한 패러다임 전환을 가져온다. 테스트 시점 스케일링은 더 긴 사고 연쇄(Chain-of-Thought) 사고를 가능하게 하고 정교한 추론 행동을 유도하여, 모델이 AIME 및 Codeforces와 같은 경쟁적 수학 및 코딩 과제에서 탁월한 성능을 발휘하게 한다.
이 혁명을 이끄는 중심 기법은 대규모 강화학습(Reinforcement Learning, RL)으로, 자기 검증(self-verification) 및 반복적 개선(iterative refinement)과 같은 복잡한 추론 행동을 이끌어낸다. 그러나 확장 가능한 RL 학습의 실제 알고리즘과 핵심 레시피는 여전히 수수께끼로 남아 있으며, 기존 추론 모델의 기술 보고서 [1, 2, 8-11]에서는 숨겨져 있다. 본 논문에서 우리는 대규모 RL 학습의 중요한 장애물을 밝히고, 알고리즘, 학습 코드 및 데이터셋이 완전히 오픈소스로 공개된 확장 가능한 RL 시스템을 공개하여 산업 수준의 RL 결과를 제공하는 민주화된 솔루션을 제공한다.
우리는 RL을 위한 사전 학습 모델로 Qwen2.5-32B [12]를 사용하여 실험한다. 초기 GRPO 실행에서 우리는 AIME에서 단지 30점만 달성했으며, 이는 DeepSeek의 RL(47점)보다 현저히 낮은 성능이다. 철저한 분석은 순수한 GRPO 베이스라인이 엔트로피 붕괴(entropy collapse), 보상 노이즈(reward noise), 학습 불안정성(training instability)과 같은 여러 핵심 문제로 어려움을 겪고 있음을 보여준다. 더 넓은 커뮤니티도 DeepSeek의 결과를 재현하는 데 유사한 어려움을 겪었으며 [13-19], 이는 산업 수준의 대규모이며 재현 가능한 RL 시스템을 개발하는 데 필요한 중요한 학습 세부사항이 R1 논문에서 생략되었을 수 있음을 시사한다.
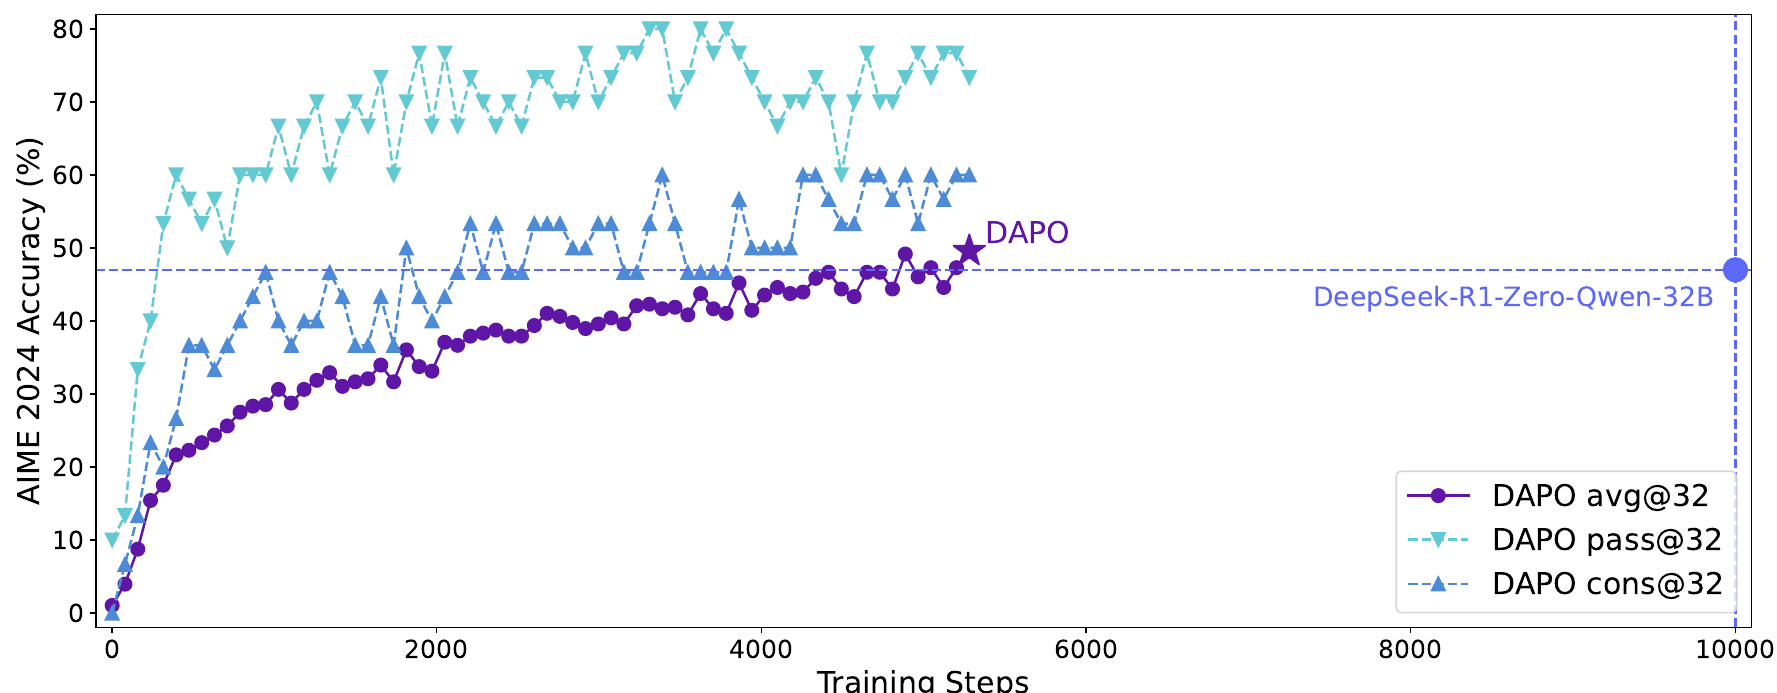
이 격차를 해소하기 위해, 우리는 Qwen2.5-32B 모델 기반으로 AIME 2024에서 50점을 달성하는 대규모 LLM RL을 위한 오픈소스 최신 시스템을 공개하며, 이는 50%의 학습 스텝을 사용하여 DeepSeek-R1-Zero-Qwen-32B 2가 달성한 이전 최신 결과를 능가한다(그림 1). 우리는 Decoupled Clip and Dynamic Sampling Policy Optimization (DAPO) 알고리즘을 제안하고, 긴 CoT RL 시나리오에서 RL이 빛을 발하도록 하는 4가지 핵심 기법을 소개한다. 세부 사항은 3절에 제시된다.
1. Clip-Higher: 시스템의 다양성을 촉진하고 엔트로피 붕괴를 방지한다;
2. Dynamic Sampling: 학습 효율성과 안정성을 향상시킨다;
3. Token-Level Policy Gradient Loss: 긴 CoT RL 시나리오에서 중요하다;
4. Overlong Reward Shaping: 보상 노이즈를 줄이고 학습을 안정화한다.
우리의 구현은 verl [20]을 기반으로 한다. 학습 코드와 데이터를 포함한 최신 RL 시스템을 완전히 공개함으로써, 우리는 더 넓은 커뮤니티에 혜택을 주는 대규모 LLM RL에 대한 귀중한 통찰을 밝히고자 한다.
2 예비
2.1 근접 정책 최적화 (Proximal Policy Optimization, PPO)
PPO [21]는 정책 최적화를 위한 클리핑된 대체 목적함수(clipped surrogate objective)를 도입한다. clip을 사용하여 정책 업데이트를 이전 정책의 근접 영역 내로 제한함으로써, PPO는 학습을 안정화하고 샘플 효율성을 향상시킨다. 구체적으로, PPO는 다음 목적함수를 최대화하여 정책을 업데이트한다:
여기서 는 데이터 분포 로부터의 질문-답변 쌍이고, 은 중요도 샘플링 비율(importance sampling ratio)의 클리핑 범위이며, 는 시점 단계(time step) 에서의 어드밴티지(advantage) 추정치이다. 가치 함수(value function) 와 보상 함수(reward function) 이 주어지면, 는 일반화된 어드밴티지 추정(Generalized Advantage Estimation, GAE) [22]을 사용하여 계산된다:
여기서
2.2 그룹 상대 정책 최적화 (Group Relative Policy Optimization, GRPO)
PPO와 비교하여, GRPO는 가치 함수를 제거하고 그룹 상대 방식(group-relative manner)으로 어드밴티지를 추정한다. 특정 질문-답변 쌍 에 대해, 행동 정책(behavior policy) 는 개의 개별 응답 그룹을 샘플링한다. 그런 다음, 번째 응답의 어드밴티지는 그룹 수준 보상 을 정규화하여 계산된다:
PPO와 유사하게, GRPO는 클리핑된 목적함수를 채택하며, 직접 부과된 KL 페널티 항과 함께 사용한다:
여기서
GRPO가 목적함수를 샘플 수준에서 계산한다는 점도 주목할 만하다. 정확히 말하면, GRPO는 먼저 각 생성된 시퀀스 내에서 평균 손실을 계산한 뒤, 서로 다른 샘플들의 손실을 평균한다. 3.3절에서 논의할 것처럼, 이러한 차이는 알고리즘의 성능에 영향을 미칠 수 있다.
2.3 KL 발산 제거
KL 페널티 항은 온라인 정책과 고정된 참조 정책 사이의 발산을 규제하는 데 사용된다. RLHF 시나리오 [23]에서 RL의 목표는 초기 모델로부터 너무 멀리 벗어나지 않으면서 모델 행동을 정렬하는 것이다. 그러나 긴 CoT 추론 모델을 훈련하는 동안 모델 분포는 초기 모델로부터 크게 발산할 수 있으므로, 이러한 제약은 필요하지 않다. 따라서 우리는 제안하는 알고리즘에서 KL 항을 제외할 것이다.
2.4 규칙 기반 보상 모델링
보상 모델의 사용은 일반적으로 보상 해킹 문제 [24-29]를 겪는다. 대신, 우리는 검증 가능한 과제의 최종 정확도를 결과 보상으로 직접 사용하며, 이는 다음 규칙을 사용하여 계산된다:
여기서 는 정답 답변이고 는 예측된 답변이다. 이는 자동 정리 증명 [30-33], 컴퓨터 프로그래밍 [34-37], 수학 경시대회 [2]와 같은 여러 분야에서 보인 바와 같이, 기반 모델의 추론 능력을 활성화하는 효과적인 접근법임이 입증되었다.
3 DAPO
우리는 ecouple Clip and ynamic sAmpling Policy ptimization (DAPO) 알고리즘을 제안한다. DAPO는 답 와 짝지어진 각 질문 에 대해 출력 그룹 을 샘플링하고, 다음 목적함수를 통해 정책을 최적화한다:
여기서
전체 알고리즘은 Algorithm 1에서 확인할 수 있다. 이 절에서는 DAPO와 관련된 핵심 기법들을 소개하겠다.
3.1 상한선 높이기: Clip-Higher
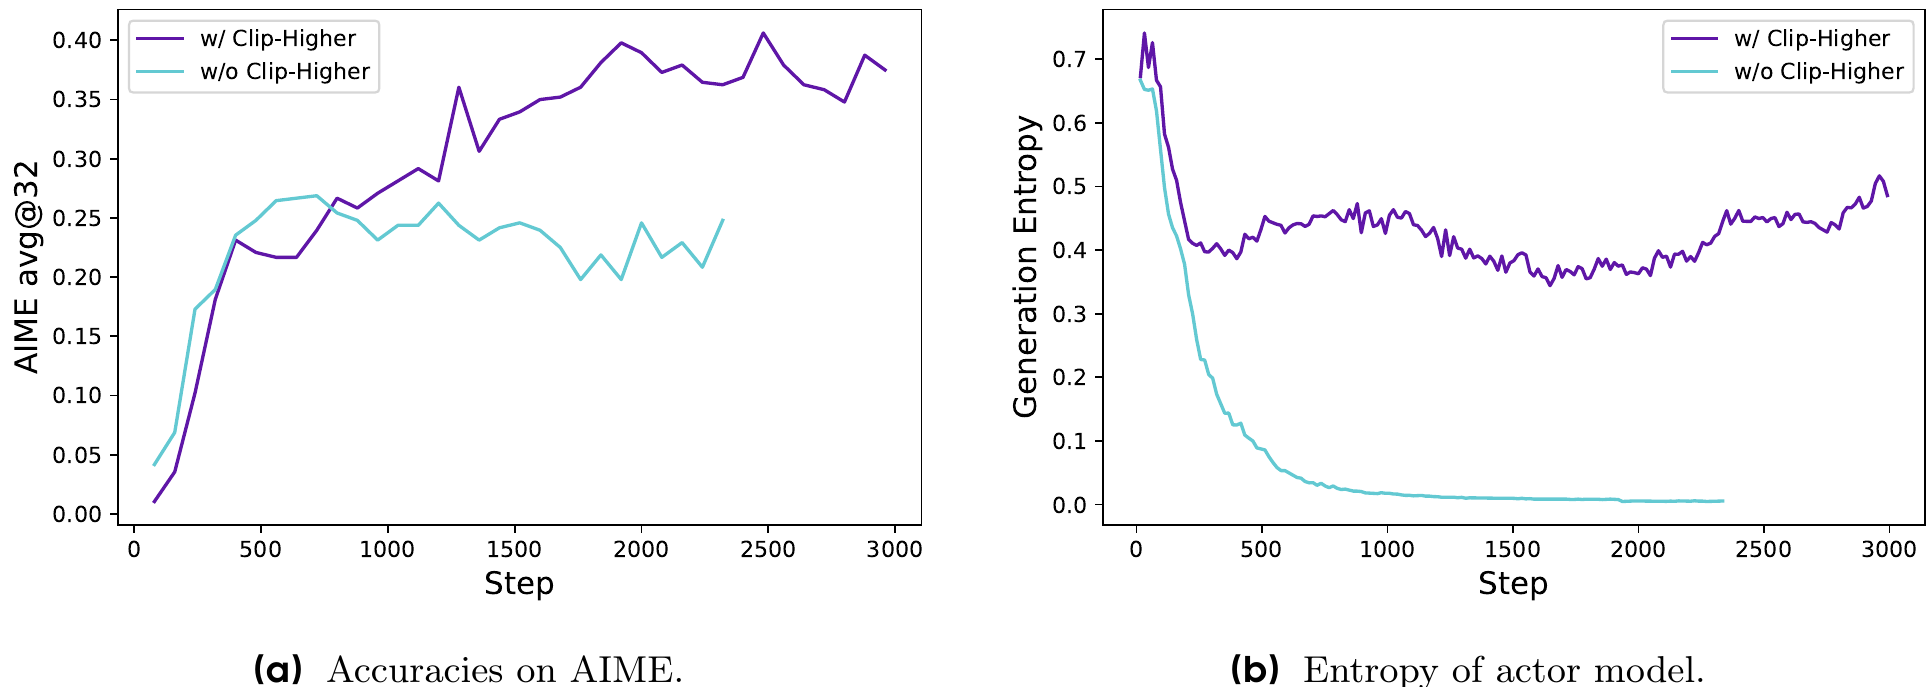
순수한 PPO [21] 또는 GRPO [38]를 사용한 초기 실험에서 우리는 엔트로피 붕괴 현상을 관찰했다. 즉, 훈련이 진행됨에 따라 정책의 엔트로피가 빠르게 감소한다(Figure 2b). 특정 그룹의 샘플링된 응답들은 거의 동일해지는 경향이 있다. 이는 제한된 탐색과 조기 결정론적 정책을 나타내며, 이는 스케일링 과정을 저해할 수 있다.
우리는 이 문제를 해결하기 위해 Clip-Higher 전략을 제안한다. 중요도 샘플링 비율에 대한 클리핑은 신뢰 영역을 제한하고 RL의 안정성을 향상시키기 위해 Clipped Proximal Policy Optimization(PPO-Clip) [21]에서 도입되었다. 우리는 상한 클립이 정책의 탐색을 제한할 수 있음을 확인했는데, '활용(exploitation)' 토큰이 더 높은 확률을 갖도록 만드는 것은 훨씬 쉽지만, 가능성이 낮은 '탐색(exploration)' 토큰의 확률은 상향되기에 너무 엄격하게 제한되어 있기 때문이다.
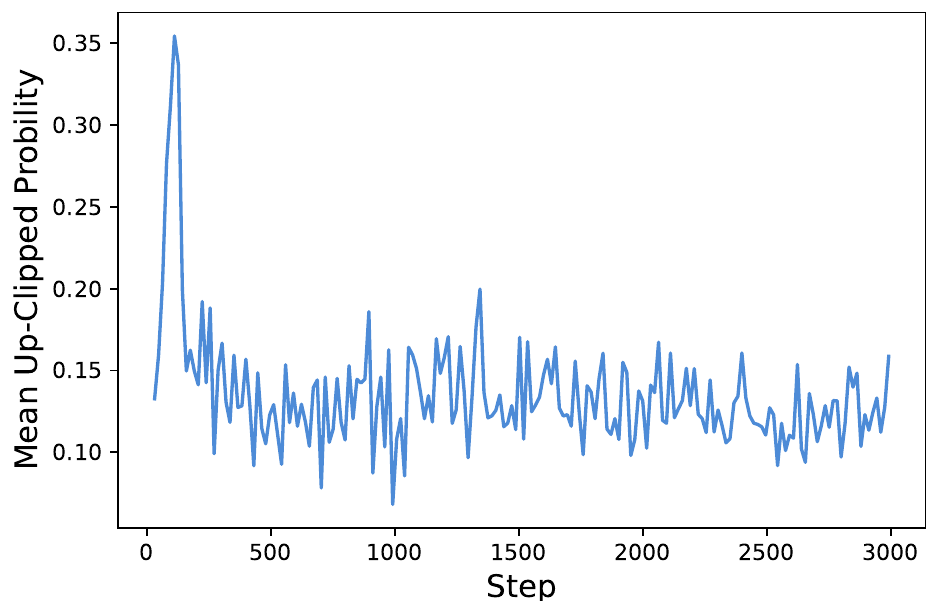
구체적으로, (대부분 알고리즘의 기본값)이고 일 때(시스템이 확률을 증가시키려고 시도함), 확률이 및 0.9인 두 행동을 고려하자. 증가된 확률 의 상한은 각각 0.012와 1.08이다( ). 이는 더 높은 확률(예: 0.9)을 가진 '활용' 토큰이 0.999와 같이 훨씬 더 큰 확률을 얻는 데 제약을 받지 않음을 의미한다. 반대로, 낮은 확률의 '탐색' 토큰의 경우, 확률의 유의미한 증가를 달성하는 것이 상당히 더 어렵다. 경험적으로, 우리는 또한 상한 클립된 토큰들의 평균 확률이 낮다는 것을 관찰한다: (Figure 3a). 이 발견은 상한 클리핑 임계값이 실제로 낮은 확률의 '탐색' 토큰들의 확률 증가를 제한하여, 잠재적으로 시스템의 탐색을 제약할 수 있다는 우리의 직관을 뒷받침한다.
Clip-Higher 전략을 따르면서, 우리는 하한 및 상한 클리핑 범위를 와 로 분리하며, 이는 Equation 10에서 강조되어 있다:
우리는 낮은 확률의 토큰들의 증가를 위한 더 많은 여지를 남겨두기 위해 의 값을 증가시킨다. Figure 2에서 보듯이, 이 조정은 정책의 엔트로피를 효과적으로 향상시키고 더 다양한 샘플들의 생성을 촉진한다. 우리는 를 그대로 유지하는데, 이를 증가시키면 이들 토큰들의 확률이 0으로 억제되어 샘플링 공간의 붕괴를 초래하기 때문이다.
3.2 많을수록 좋다: 동적 샘플링
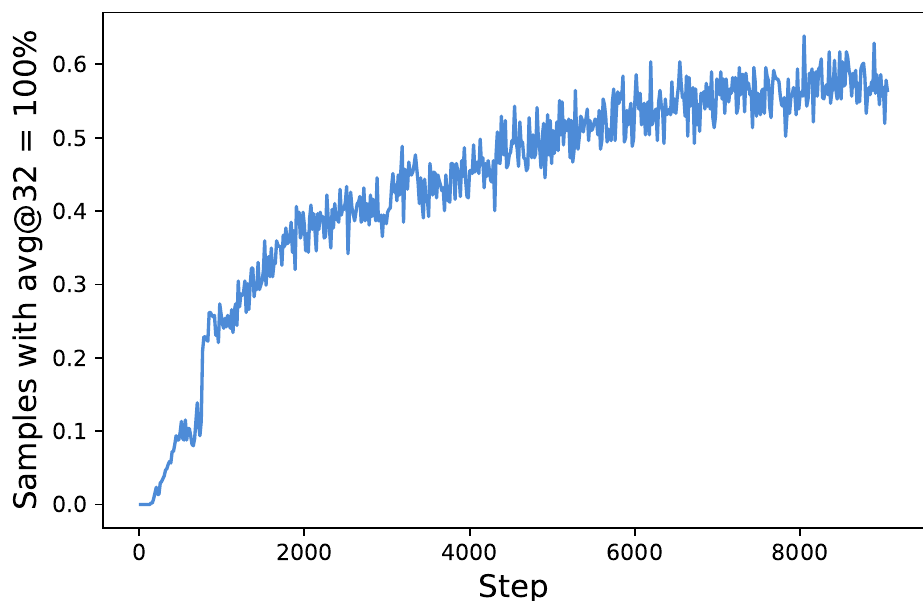
기존 RL 알고리즘은 일부 프롬프트의 정확도가 1과 같을 때 그래디언트 감소 문제를 겪는다. 예를 들어 GRPO의 경우, 특정 프롬프트의 모든 출력 이 정답이고 동일한 보상을 받으면, 이 그룹에 대한 결과적인 어드밴티지는 0이 된다. 어드밴티지가 0이면 정책 그래디언트도 0이 되어, 배치 그래디언트의 크기를 줄이고 노이즈 민감도를 증가시켜 샘플 효율성을 저하시킨다. 경험적으로, 정확도가 1인 샘플들의 수는 Figure 3b에서 보듯이 계속 증가한다. 이는 각 배치에서 유효한 프롬프트의 수가 계속 감소함을 의미하며, 이는 그래디언트의 분산을 더 크게 만들고 모델 훈련을 위한 그래디언트 신호를 약화시킬 수 있다.
이를 위해, 우리는 Equation 11에서 설명된 바와 같이 정확도가 1 및 0인 프롬프트를 오버샘플링하고 필터링하여, 배치의 모든 프롬프트에 유효한 그래디언트를 남기고 프롬프트 수를 일정하게 유지할 것을 제안한다. 각 배치에 대한 샘플링 비용은 동적이다. 훈련 전에, 우리는 배치가 정확도가 0도 1도 아닌 샘플들로 완전히 채워질 때까지 계속 샘플링한다.
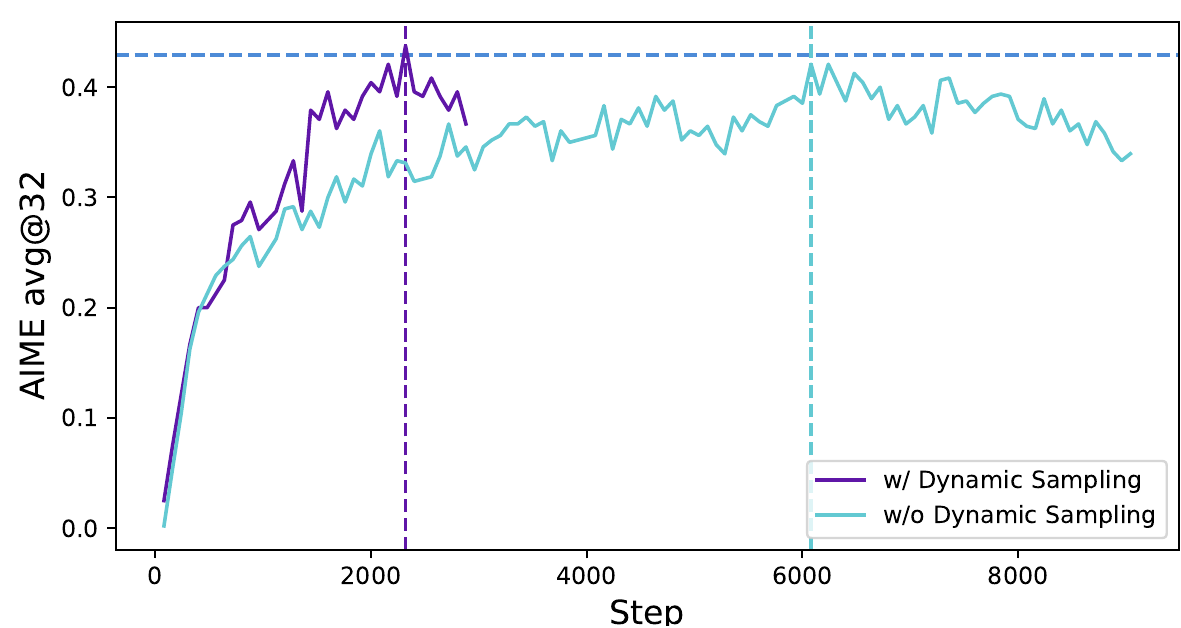
이 전략이 반드시 훈련 효율성을 저해하는 것은 아니라는 점에 유의하라. 왜냐하면 RL 시스템이 동기화되어 있고 생성 단계가 파이프라인화되지 않은 경우, 생성 시간은 일반적으로 롱테일 샘플의 생성에 의해 지배되기 때문이다. 게다가, 우리는 동적 샘플링을 통해 실험이 Figure 6에서 보듯이 더 빠르게 동일한 성능을 달성한다는 것을 발견했다.
3.3 균형 잡기: 토큰 수준 정책 그래디언트 손실
원래의 GRPO 알고리즘은 샘플 수준 손실 계산을 사용하는데, 이는 먼저 각 샘플 내에서 토큰별로 손실을 평균한 다음 샘플들에 걸쳐 손실을 집계하는 것을 포함한다. 이 접근 방식에서 각 샘플은 최종 손실 계산에서 동일한 가중치를 부여받는다. 그러나 우리는 이러한 손실 축소 방식이 긴 CoT RL 시나리오의 맥락에서 여러 가지 문제를 야기한다는 것을 발견했다.
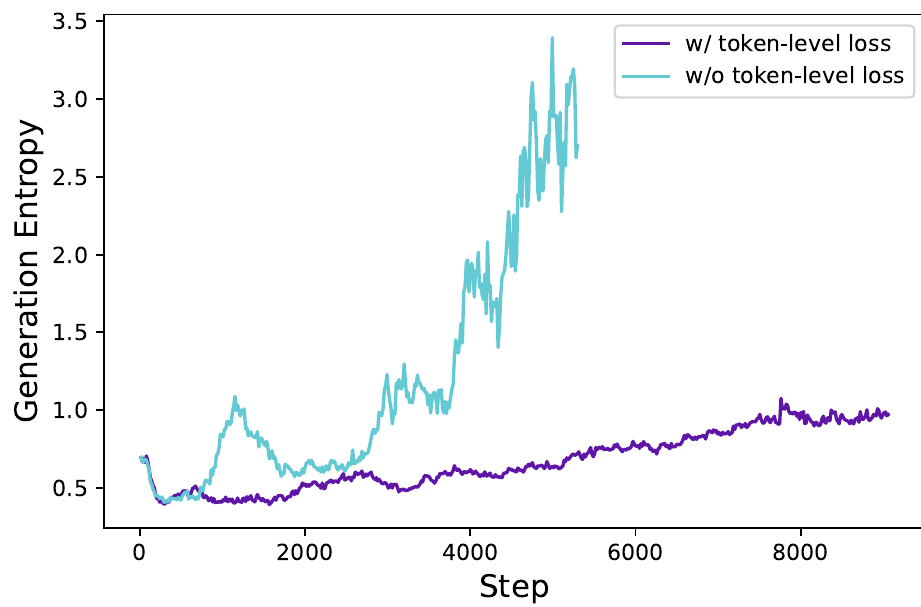
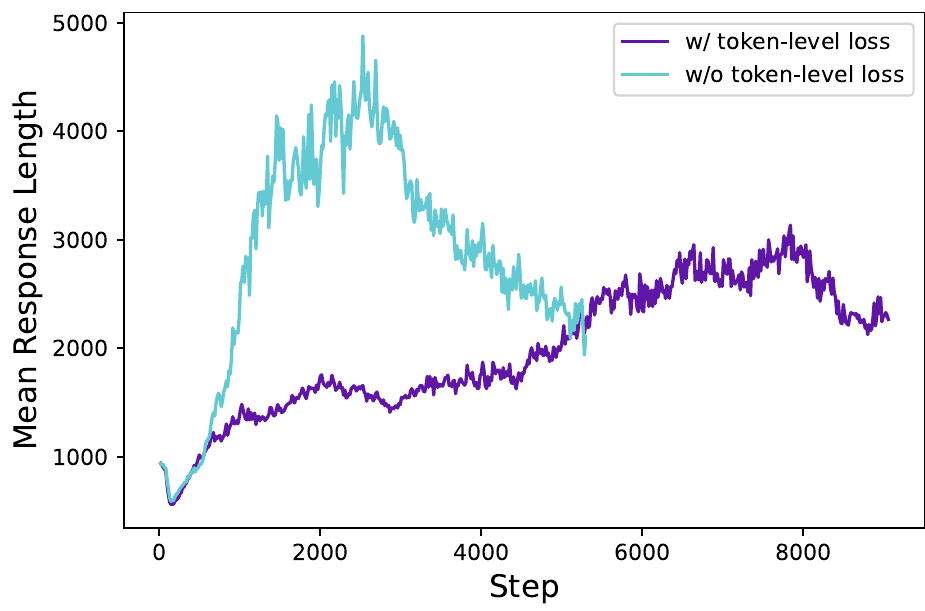
모든 샘플이 손실 계산에서 동일한 가중치를 부여받기 때문에, 더 긴 응답 내의 토큰들(더 많은 토큰을 포함함)은 전체 손실에 불균형적으로 더 낮은 기여를 할 수 있으며, 이는 두 가지 부정적인 영향을 초래할 수 있다. 첫째, 고품질의 긴 샘플들의 경우, 이 효과는 모델이 그 안의 추론 관련 패턴을 학습하는 능력을 저해할 수 있다. 둘째, 우리는 지나치게 긴 샘플들이 종종 횡설수설이나 반복적인 단어와 같은 저품질 패턴을 보인다는 것을 관찰한다. 따라서 샘플 수준 손실 계산은 긴 샘플에서 그러한 바람직하지 않은 패턴을 효과적으로 처벌할 수 없기 때문에, Figure 4a와 Figure 4b에서 보듯이 엔트로피와 응답 길이의 건강하지 못한 증가를 초래한다.
우리는 위의 한계를 해결하기 위해 긴 CoT RL 시나리오에서 토큰 수준 정책 그래디언트 손실을 도입한다:
이 설정에서, 더 긴 시퀀스는 더 짧은 시퀀스에 비해 전체 그래디언트 업데이트에 더 많은 영향을 미칠 수 있다. 더욱이, 개별 토큰의 관점에서, 특정 생성 패턴이 보상의 증가 또는 감소를 초래할 수 있다면, 그것이 나타나는 응답의 길이와 관계없이 동등하게 촉진되거나 억제될 것이다.
3.4 숨바꼭질: 과도하게 긴 보상 형성
RL 훈련에서는 일반적으로 생성에 대한 최대 길이를 설정하며, 초과 길이 샘플은 그에 따라 잘린다. 우리는 잘린 샘플에 대한 부적절한 보상 형성이 보상 노이즈를 도입하고 훈련 과정을 크게 방해할 수 있음을 발견한다.
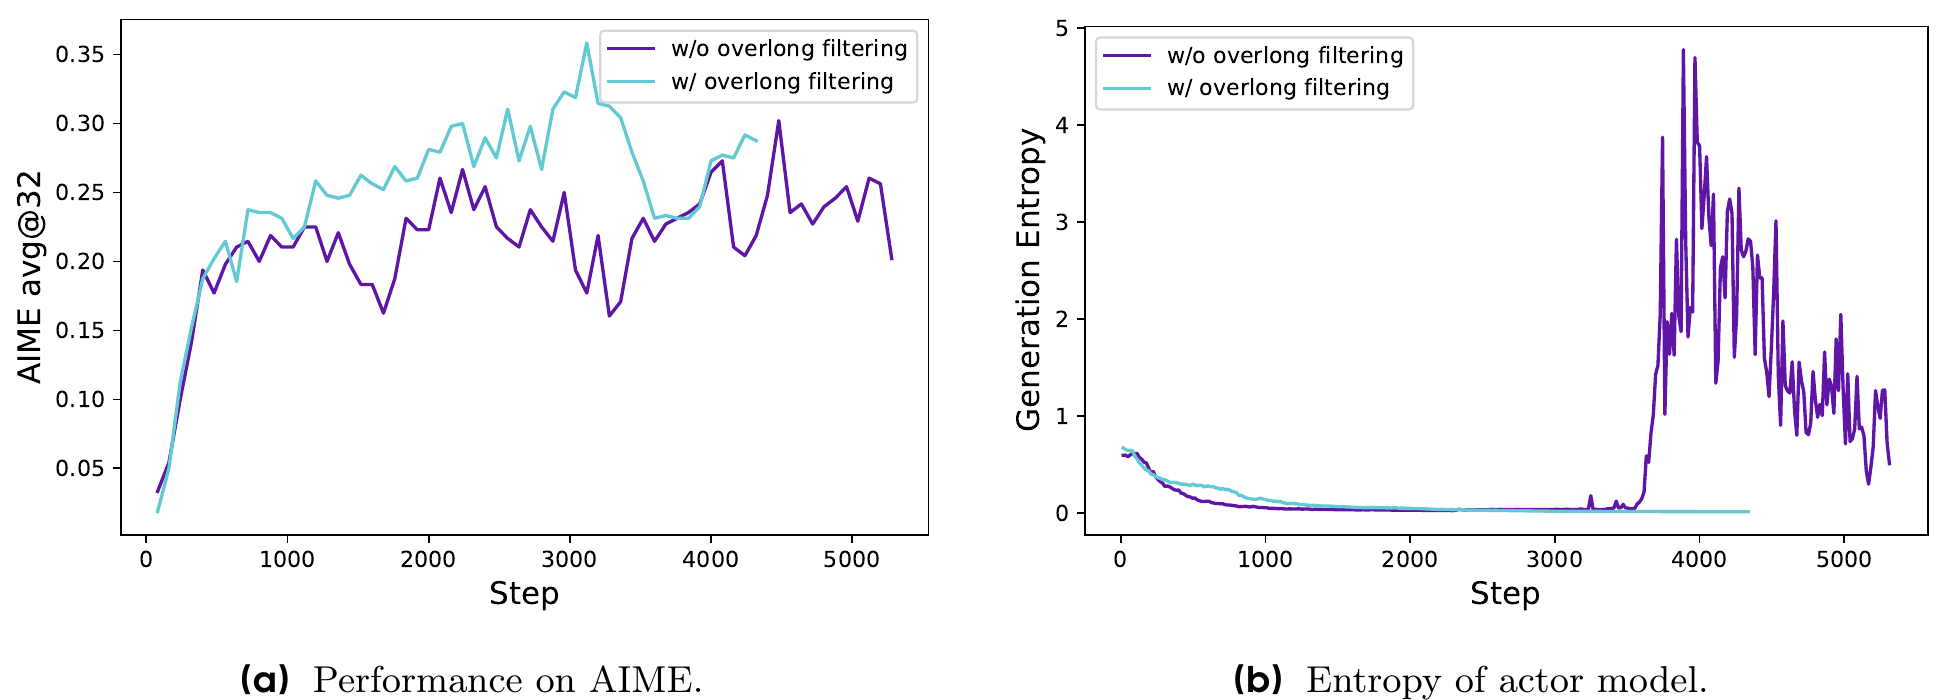
기본적으로 우리는 잘린 샘플에 대해 벌칙성 보상을 부여한다. 이 접근 방식은 건전한 추론 과정이 단지 과도한 길이 때문에 벌점을 받을 수 있으므로 훈련 과정에 노이즈를 도입할 수 있다. 이러한 벌점은 모델이 자신의 추론 과정의 타당성에 대해 혼란을 겪게 할 가능성이 있다.
이 보상 노이즈의 영향을 조사하기 위해, 우리는 먼저 잘린 샘플의 손실을 마스킹하는 Overlong Filtering 전략을 적용한다. 우리는 이 접근 방식이 훈련을 크게 안정화하고 성능을 향상시킨다는 것을 발견하며, 이는 그림 5에서 확인된다.
| 읽기 전용 배경(번역 대상 원문이 아님): | 이 보상 노이즈의 영향을 조사하기 위해, 우리는 먼저 절단된 샘플의 손실을 마스킹하는 과도길이 필터링(Overlong Filtering) 전략을 적용한다. 우리는 이 접근법이 훈련을 상당히 안정화시키고 성능을 향상시킨다는 것을 발견했으며, 이는 그림 5에 제시되어 있다. |
| 또한, 우리는 절단된 샘플에 대한 보상을 형성하도록 설계된 길이 인식 페널티 메커니즘인 소프트 과도길이 페널티(Soft Overlong Punishment, 수식 13)를 제안한다. 구체적으로, 응답 길이가 미리 정의된 최댓값을 초과할 때, | |
| 번역할 텍스트: | |
| 알고리즘 1 DAPO: 분리 클리핑 및 동적 샘플링 정책 최적화 | |
| 알고리즘 1 | |
| DAPO: 분리 클리핑 및 동적 샘플링 정책 최적화 | |
| 입력: 초기 정책 모델 πθ; 보상 모델 R; 작업 프롬프트 D; 하이퍼파라미터 ε1ow, εhigh | |
| 1: step = 1,...,M에 대해 do | |
| 2: D로부터 배치 Db를 샘플링 | |
| 3: 이전 정책 모델 업데이트 πθold ← πθ | |
| 4: 각 질문 q ∈ Db에 대해 G개의 출력 {oi}i=1G ~ πθold(·|q)를 샘플링 | |
| 5: R을 실행하여 각 샘플링된 출력 oi에 대한 보상 {ri}i=1G를 계산 | |
| 6: oi를 필터링하고 나머지를 동적 샘플링 버퍼에 추가(동적 샘플링 수식 (11)) | |
| 7: if 버퍼 크기 nb < N: 8: continue 9: 버퍼의 각 oi에 대해, oi의 t번째 토큰에 대한 Ait,t를 계산(수식 (9)) 10: iteration = 1, ..., μ에 대해 do 11: DAPO 목적함수(수식 (8))를 최대화하여 정책 모델 πθ를 업데이트 출력 πθ |
또한, 우리는 잘린 샘플에 대한 보상을 형성하기 위해 설계된 길이 인식 벌점 메커니즘인 Soft Overlong Punishment(수식 13)를 제안한다. 구체적으로, 응답 길이가 미리 정의된 최대값을 초과할 때, 우리는 벌점 구간을 정의한다. 이 구간 내에서 응답이 길수록 더 큰 벌점을 받는다. 이 벌점은 원래의 규칙 기반 정답성 보상에 추가되어, 모델에게 과도하게 긴 응답을 피하라는 신호를 보낸다.
3.5 데이터셋 변환
우리의 데이터셋은 웹 스크래핑과 수동 주석의 조합을 통해 웹 및 공식 대회 홈페이지에서 수집된다. 수학 데이터셋의 답변은 일반적으로 표현식, 수식, 숫자 등 다양한 형식으로 제공되므로, 이를 파싱하기 위한 포괄적인 규칙을 설계하는 것이 어렵다. 규칙을 사용하여 정확한 보상 신호를 제공하고 수식 파서로 인해 도입되는 오류를 최소화하기 위해, AIME에서 영감을 받아 우리는 답변을 파싱하기 쉬운 정수로 선택 및 변환한다. 예를 들어, 원래 답변이 형태로 표현된 경우, 우리는 LLM에게 질문을 수정하여 기대되는 답변이 가 되도록 지시한다. 선택 및 변환 후, 우리는 17K개의 프롬프트로 구성된 DAPO-Math-17K 데이터셋을 얻었으며, 각 프롬프트에는 정수가 답변으로 짝지어져 있다.
4 실험
4.1 훈련 세부 사항
본 연구에서는 알고리즘을 평가하기 위해 특별히 수학적 과제에 초점을 맞추며, 이는 다른 과제에도 쉽게 전이될 수 있다. 우리는 훈련을 위해 veri 프레임워크 [20]를 채택한다. 우리는 naive GRPO [38]를 기준 알고리즘으로 사용하며, 그룹 보상 정규화를 통해 이점(advantage)을 추정한다.
하이퍼파라미터의 경우, 우리는 AdamW [39] 옵티마이저를 사용하며 학습률은 로 일정하게 유지하고, 20번의 롤아웃 스텝에 걸친 선형 워밍업을 적용한다. 롤아웃의 경우 프롬프트 배치 크기는 512이며, 각 프롬프트에 대해 16개의 응답을 샘플링한다. 훈련의 경우 미니배치 크기는 512로 설정되며, 즉 각 롤아웃 스텝마다 16번의 그래디언트 업데이트를 수행한다. 과도하게 긴 보상 조정(Overlong Reward Shaping)의 경우, 기대 최대 길이를 16,384 토큰으로 설정하고 추가로 4,096 토큰을 소프트 페널티 캐시로 할당한다. 따라서 생성 시 최대 토큰 수는 20,480 토큰으로 설정된다. Clip-Higher 메커니즘의 경우, 클리핑 파라미터 를 0.2로, 를 0.28로 설정하며, 이는 탐험과 활용 사이의 균형을 효과적으로 맞춘다. AIME 평가에서는 평가 세트를 32회 반복하고 결과 안정성을 위해 avg@32를 보고한다. 평가의 추론 하이퍼파라미터는 temperature 1.0, topp 0.7로 설정된다.
4.2 주요 결과
AIME 2024에 대한 실험은 DAPO가 Qwen-32B Base 모델을 강력한 추론 모델로 성공적으로 훈련시켰으며, R1 접근법을 사용한 Qwen2.5-32B에 대한 DeepSeek의 실험보다 뛰어난 성능을 달성했음을 보여준다. 그림 1에서 우리는 AIME 2024에서 정확도가 거의 0%에서 50%로 증가하는 상당한 성능 향상을 관찰한다. 특히, 이 향상은 DeepSeek-R1-Zero-Qwen-32B에 필요한 훈련 스텝의 50%만으로 달성된다.
우리는 표 1에 상세히 기술된 바와 같이 우리 방법론의 각 훈련 기법의 기여도를 분석한다. 관찰된 향상은 RL 훈련에서 이러한 기법들의 효과를 입증하며, 각 기법은
| 모델 | AIME24avg@32 |
| DeepSeek-R1-Zero-Qwen-32B | 47 |
| 기본 GRPO | 30 |
| + 과도 응답 필터링(Overlong Filtering) | 36 |
| + Clip-Higher | 38 |
| + 소프트 과도 응답 패널티(Soft Overlong Punishment) | 41 |
| + 토큰 수준 손실(Token-level Loss) | 42 |
| + 동적 샘플링(Dynamic Sampling, DAPO) | 50 |
AIME 2024에서 몇 점의 정확도를 기여한다. 특히, naive GRPO 설정에서는 Qwen2.5-32B 베이스 모델로부터 훈련하여 의 정확도에만 도달할 수 있다.
토큰 수준 손실의 경우, 성능 향상은 적지만 훈련 안정성을 높이고 길이 증가를 더 건강하게 만든다는 것을 발견한다.
동적 샘플링(Dynamic Sampling)을 적용할 때, 제로 그래디언트 데이터를 걸러내기 때문에 더 많은 데이터를 샘플링해야 하지만, 전체 훈련 시간은 크게 영향을 받지 않는다. 그림 6에서 보듯이, 샘플링 인스턴스 수는 증가하지만 필요한 훈련 스텝이 적기 때문에 모델의 수렴 시간은 오히려 감소한다.
4.3 훈련 동역학
대규모 언어 모델에 대한 강화 학습은 최첨단 연구 방향일 뿐만 아니라 본질적으로 복잡한 시스템 공학 과제이며, 다양한 하위 시스템의 상호 의존성을 특징으로 한다. 단일 하위 시스템에 대한 수정은 시스템 전체로 전파되어, 이러한 구성 요소들 간의 복잡한 상호작용으로 인해 예상치 못한 결과를 초래할 수 있다. 데이터와 하이퍼파라미터의 변화와 같은 겉보기에 사소해 보이는 초기 조건의 변화조차도 반복적인 강화 학습 과정을 통해 증폭되어 결과에 상당한 편차를 낳을 수 있다. 이러한 복잡성은 종종 연구자들에게 딜레마를 안겨준다. 수정이 훈련 과정의 특정 측면을 개선할 것이라는 세심한 분석과 근거 있는 기대에도 불구하고, 실제 결과는 예상된 궤적에서 자주 벗어난다. 따라서 실험 중 주요 중간 결과에 대한 모니터링은 불일치의 원인을 신속히 식별하고 궁극적으로 시스템을 개선하는 데 필수적이다.
- 생성된 응답의 길이는 훈련 안정성 및 성능과 밀접하게 관련된 지표이며, 그림 7a에 나타나 있다. 길이의 증가는 모델에게 더 큰 탐험 공간을 제공하여 더 복잡한 추론 행동이 샘플링되고 훈련을 통해 점진적으로 강화될 수 있게 한다. 그러나 길이가 훈련 중 항상 지속적인 상승 추세를 유지하는 것은 아니라는 점에 유의하는 것이 중요하다. 상당한 기간 동안 정체되거나 심지어 감소하는 추세를 보일 수 있으며, 이는 [2]에서도 입증되었다. 우리는 일반적으로 실험이 악화되고 있는지 평가하기 위한 지표로 길이를 검증 정확도와 함께 사용한다.
- 훈련 중 보상의 동역학은 강화 학습에서 항상 중요한 모니터링 지표 중 하나이며, 그림 7b에 나타나 있다. 우리의 대부분의 실험에서 보상 증가의 추세는 비교적 안정적이며 실험 설정의 조정으로 인해 크게 변동하거나 감소하지 않는다. 이는 신뢰할 수 있는 보상 신호가 주어지면 언어 모델이 훈련 세트의 분포에 견고하게 피팅할 수 있음을 나타낸다. 그러나 우리는 훈련 세트의 최종 보상이 검증 세트의 정확도와 종종 거의 상관관계가 없다는 것을 발견하며, 이는 훈련 세트에 대한 과적합을 나타낸다.
- 액터 모델의 엔트로피와 생성 확률은 모델의 탐험 능력과 관련이 있으며, 우리 실험에서 면밀히 모니터링하는 핵심 지표이다. 직관적으로, 모델의 엔트로피는 적절한 범위 내에서 유지되어야 한다. 지나치게 낮은 엔트로피는 확률 분포가 지나치게 첨예해져 탐험 능력을 상실함을 나타낸다. 반대로
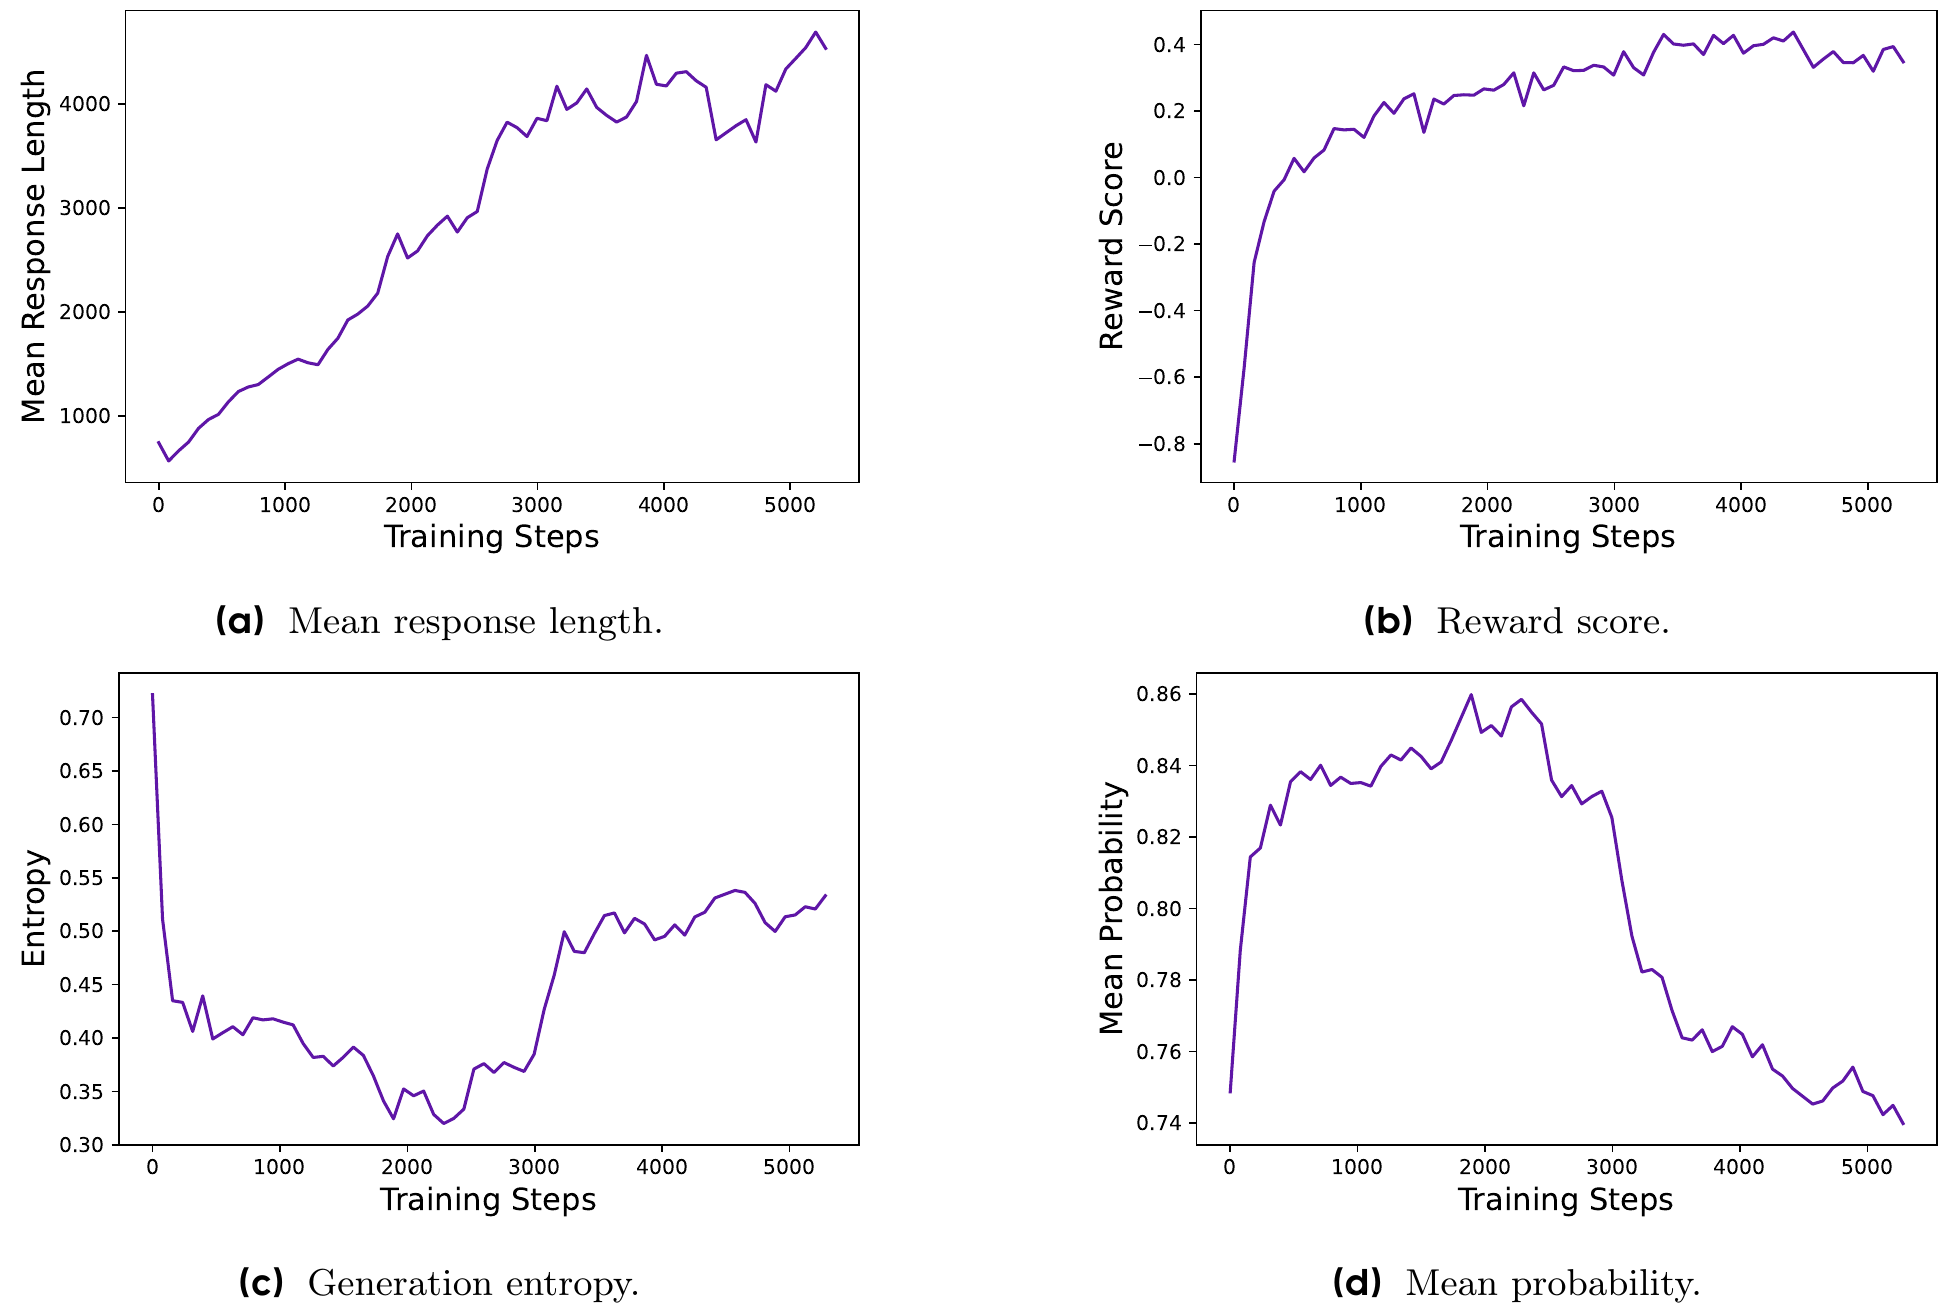
지나치게 높은 엔트로피는 종종 횡설수설과 반복 생성 같은 과잉 탐험 문제와 관련된다. 생성 확률의 경우 상황이 정확히 반대이다. 섹션 3.1에서 보여주었듯이, Clip-Higher 전략을 적용하여 우리는 엔트로피 붕괴 문제를 효과적으로 해결했다. 이후 실험에서 우리는 엔트로피에서 느린 상승 추세를 유지하는 것이 모델 성능 향상에 유리하다는 것을 발견하며, 이는 그림 7c와 그림 7d에 나타나 있다.
4.4 사례 연구
RL 훈련 과정에서 우리는 흥미로운 현상을 관찰한다. 액터 모델의 추론 패턴이 시간에 따라 동적으로 진화한다는 것이다. 구체적으로, 알고리즘은 정확한 문제 해결을 촉진하는 기존의 추론 패턴을 강화할 뿐만 아니라, 처음에는 존재하지 않았던 완전히 새로운 추론 방식을 점진적으로 발생시킨다. 이 발견은 RL 알고리즘의 적응성과 탐험 능력을 보여주며, 모델의 학습 메커니즘에 대한 새로운 통찰을 제공한다.
예를 들어, 모델 훈련의 초기 단계에서는 이전 추론 단계를 점검하고 반성하는 행동이 거의 발생하지 않았다. 그러나 훈련이 진행됨에 따라 모델은 표 2에 나타난 바와 같이 뚜렷한 반성과 역추적 행동을 보인다. 이 관찰은 RL 동안 추론 능력의 출현을 해석하는 추가 탐구에 대한 통찰을 제공하며, 이는 향후 연구로 남겨둔다.
5 결론
본 논문에서 우리는 알고리즘, 코드 인프라, 데이터셋을 포함한 대규모 LLM RL을 위한 완전히 오픈소스화된 시스템을 공개한다. 이 시스템은 최첨단 대규모 LLM RL 성능(Qwen-32B 사전학습 모델을 사용한 AIME 50)을 달성한다. 우리는 Decoupled Clip and Dynamic sAmpling Policy를 제안한다
질문:
사면체 의 밑면 가 정삼각형이고, 점 의 면 위로의 정사영 가 의 수심이며, 이면각 가 이고 일 때, 사면체의 부피를 구하여라. 답은 형태이므로 의 값을 구하여라.
응답:
주어진 문제를 살펴보자. 우리는 ... 다음으로, 의 좌표를 라 하자. 이므로, 거리 공식에 의해 이며, 따라서 라고 쓸 수 있다. 이제, 가 의 직교 정사영임을 기억하자. 그러나 잠시만, 평면을 포함하는 이면각에 대해 더 사려 깊은 기하학적 방식으로 다시 생각해 보자. 평면 를 고려하자. 이는 ( 이므로) 완전히 xy 좌표평면 위에 놓여 있다. 평면 라 하자. 점 를 평면 에 수직으로 정사영한 것이 에 닿는다. 직선 ......
표 2 강화학습 최적화(DAPO) 알고리즘에서 반성적 행동의 출현과, 장기 CoT 강화학습 시나리오에서 강화학습을 강력하고 효과적이며 효율적으로 만드는 4가지 핵심 기법을 소개한다. 또한, 학습 코드와 데이터셋을 오픈소스로 공개함으로써, 더 넓은 연구 커뮤니티와 사회에 확장 가능한 강화학습 솔루션에 대한 실질적인 접근성을 제공하여 모든 이가 이러한 발전의 혜택을 누릴 수 있도록 한다.
기여
프로젝트 리드
Qiying
알고리즘
Qiying , Zheng Zhang , Ruofei Zhu , Yufeng Yuan , Xiaochen Zuo , Yu Yue
인프라\*
Weinan Dai , Tiantian Fan , Gaohong Liu , Juncai Liu , Lingjun Liu , Xin Liu , Haibin Lin , Zhiqi Lin , Bole Ma , Guangming Sheng , Yuxuan Tong , Qiying Yu , Chi Zhang , Mofan Zhang , Ru Zhang , Wang Zhang , Hang Zhu , Jinhua Zhu
\*성(姓) 알파벳 순
데이터셋
Jiaze Chen , Jiangjie Chen , Chengyi Wang , Hongli Yu , Yuxuan Song , Xiangpeng Wei , Qiying
감독
Hao Zhou , Jingjing Liu , Wei- Ying Ma , Ya- Qin Zhang , Lin Yan , Mu Qiao , Yonghui Wu , Mingxuan Wang
소속
ByteDance Seed
칭화대학교 AI 산업 연구원(AIR)
홍콩대학교
칭화대학교 AIR·ByteDance Seed SIA- Lab
감사의 글
DAPO 프로젝트를 지원해 주신 Zhengyin Du, Shengding Hu, Kai Shen, Tianyang Zhan, Zhen Xiao, Renjie Zheng, Li Han, Kaihua Jiang 및 ByteDance의 다른 동료들께 감사를 표합니다.
참고문헌
[1] OpenAI. Learning to reason with llms, 2024.
[2] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
[3] OpenAI. GPT4 기술 보고서. arXiv 프리프린트 arXiv:2303.08774, 2023.
[4] Anthropic. Claude 3.5 sonnet, 2024.
[5] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, 외. 언어 모델은 소수샷 학습자이다. 신경 정보 처리 시스템 발전, 33:1877-1901, 2020.
[6] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, 외. Palm: Pathways를 이용한 언어 모델링 확장. 머신러닝 연구 저널, 24(240):1-113, 2023.
[7] Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang, Bochao Wu, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chenyu Zhang, Chong Ruan, 외. Deepseek-v3 기술 보고서. arXiv 프리프린트 arXiv:2412.19437, 2024.
[8] XAI. Grok 3 베타 — 추론 에이전트의 시대, 2024.
[9] Google DeepMind. Gemini 2.0 flash thinking, 2024.
[10] Qwen. Qwq-32b: 강화 학습의 힘을 받아들이다, 2024.
[11] Kimi Team, Angang Du, Bofei Gao, Bowei Xing, Changjiu Jiang, Cheng Chen, Cheng Li, Chenjun Xiao, Chenzhuang Du, Chonghua Liao, 외. Kimi k1.5: LLM을 이용한 강화 학습 확장. arXiv 프리프린트 arXiv:2501.12599, 2025.
[12] An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, 외. Qwen2.5 기술 보고서. arXiv 프리프린트 arXiv:2412.15115, 2024.
[13] Zhipeng Chen, Yingqian Min, Beichen Zhang, Jie Chen, Jinhao Jiang, Daixuan Cheng, Wayne Xin Zhao, Zheng Liu, Xu Miao, Yang Lu, 외. RL 유사 추론 모델을 이끌어내고 개선하는 방법에 대한 실증 연구. arXiv 프리프린트 arXiv:2503.04548, 2025.
[14] Jingcheng Hu, Yinmin Zhang, Qi Han, Daxin Jiang, and Heung-Yeung Shum Xiangyu Zhang. Open-reasoner-zero: 기반 모델에서 강화 학습을 확장하는 오픈 소스 접근법. https://github.com/Open-Reasoner-Zero/Open-Reasoner-Zero, 2025.
[15] Jian Hu. Reinforce++: 대규모 언어 모델 정렬을 위한 간단하고 효율적인 접근법. arXiv 프리프린트 arXiv:2501.03262, 2025.
[16] Ganqu Cui, Lifan Yuan, Zefan Wang, Hanbin Wang, Wendi Li, Bingxiang He, Yuchen Fan, Tianyu Yu, Qixin Xu, Weize Chen, 외. 암묵적 보상을 통한 과정 강화 학습. arXiv 프리프린트 arXiv:2502.01456, 2025.
[17] Jung Hyun Lee, June Yong Yang, Byeongho Heo, Dongyoon Han, and Kang Min Yoo. 대규모 언어 모델의 수학적 추론 능력 향상을 위한 토큰 지도 가치 모델. arXiv 프리프린트 arXiv:2407.12863, 2024.
[18] Amirhossein Kazemnejad, Milad Aghajohari, Eva Portelance, Alessandro Sordoni, Siva Reddy, Aaron Courville, and Nicolas Le Roux. Vineppo: 정교한 크레딧 할당을 통해 LLM 추론을 위한 RL 잠재력 발휘. arXiv 프리프린트 arXiv:2410.01679, 2024.
[19] Yufeng Yuan, Yu Yue, Ruofei Zhu, Tiantian Fan, and Lin Yan. 긴 CoT에서 PPO의 붕괴 뒤에 숨은 것은? 가치 최적화가 비밀을 쥐고 있다. arXiv 프리프린트 arXiv:2503.01491, 2025.
[20] Guangming Sheng, Chi Zhang, Zilingfeng Ye, Xibin Wu, Wang Zhang, Ru Zhang, Yanghua Peng, Haibin Lin, and Chuan Wu. Hybridflow: 유연하고 효율적인 RLHF 프레임워크. arXiv 프리프린트 arXiv:2409.19256, 2024.
[21] John Schulman, Filip Wolski, Prafulla Dhariwal, Alec Radford, and Oleg Klimov. 근접 정책 최적화 알고리즘. arXiv 프리프린트 arXiv:1707.06347, 2017.
[22] John Schulman, Philipp Moritz, Sergey Levine, Michael Jordan, and Pieter Abbeel. 일반화된 이점 추정을 사용한 고차원 연속 제어, 2018.
[23] Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, John Schulman, Jacob Hilton, Fraser Kelton, Luke Miller, Maddie Simens, Amanda Askell, Peter Welinder, Paul F Christiano, Jan Leike, and Ryan Lowe. 인간 피드백을 통한 지시 따르기 언어 모델 훈련. S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho, and A. Oh 편집, 신경 정보 처리 시스템 발전, 35권, 27730-27744쪽. Curran Associates, Inc., 2022.
[24] Dario Amodei, Chris Olah, Jacob Steinhardt, Paul Christiano, John Schulman, and Dan Mane. AI 안전의 구체적인 문제들, 2016.
[25] Tom Everitt, Victoria Krakovna, Laurent Orseau, Marcus Hutter, and Shane Legg. 손상된 보상 채널을 이용한 강화 학습, 2017.
[26] Victoria Krakovna, Jonathan Uesato, Vladimir Mikulik, Matthew Rahtz, Tom Everitt, Ramana Kumar, Zac Kenton, Jan Leike, and Shane Legg. 명세 게이밍: AI 독창성의 이면, 2020.
[27] Tom Everitt, Marcus Hutter, Ramana Kumar, and Victoria Krakovna. 강화 학습에서의 보상 변조 문제와 해결책: 인과적 영향 다이어그램 관점, 2021.
[28] Leo Gao, John Schulman, and Jacob Hilton. 보상 모델 과최적화에 대한 스케일링 법칙, 2022.
[29] Lilian Weng. 강화 학습에서의 보상 해킹. lilianweng.github.io, 2024년 11월.
[30] Stanislas Polu and Ilya Sutskever. 자동 정리 증명을 위한 생성적 언어 모델링, 2020.
[31] Trieu H Trinh, Yuhuai Wu, Quoc V Le, He He, and Thang Luong. 인간 시연 없이 올림피아드 기하학 문제 해결. Nature, 625(7995):476-482, 2024.
[32] Trieu Trinh and Thang Luong. Alphageometry: 기하학을 위한 올림피아드 수준의 AI 시스템, 2024.
[33] AlphaProof and AlphaGeometry Teams. AI, 국제 수학 올림피아드 문제를 풀어 은메달 기준 달성, 2024.
[34] Hung Le, Yue Wang, Akhilesh Deepak Gotmare, Silvio Savarese, and Steven Chu Hong Hoi. Coderl: 사전 훈련된 모델과 심층 강화 학습을 통한 코드 생성 마스터. 신경 정보 처리 시스템 발전, 35:21314-21328, 2022.
[35] Noah Shinn, Federico Cassano, Edward Berman, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. Reflexion: 언어적 강화 학습을 사용하는 언어 에이전트, 2023.
[36] Xinyun Chen, Maxwell Lin, Nathanael Schärli, and Denny Zhou. 대규모 언어 모델에 자기 디버깅 가르치기, 2023.
[37] Jonas Gehring, Kunhao Zheng, Jade Copet, Vegard Mella, Quentin Carbonneaux, Taco Cohen, and Gabriel Synnaeve. Rlcf: 강화 학습을 통한 실행 피드백에 코드 LLM 접지하기, 2025.
[38] Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Mingchuan Zhang, YK Li, Y Wu, and Daya Guo. Deepseekmath: 오픈 언어 모델에서 수학적 추론의 한계 밀어붙이기. arXiv 프리프린트 arXiv:2402.03300, 2024.
[39] Ilya Loshchilov and Frank Hutter. Decoupled weight decay regularization. In International Conference on Learning Representations, 2019.
부록
A 데이터셋 변환
다음은 데이터 변환의 한 예시로, 원래 문제, 변환된 문제, 그리고 변환 과정에서의 모델 출력을 보여줍니다(원본은 마크다운 텍스트이며, 가독성을 위해 렌더링되었습니다).
모델이 이 과제를 높은 정확도로 완수할 수 있도록 하기 위해, 우리의 목표는 모델이 환각을 피하면서 포괄적인 추론을 수행하도록 하는 것입니다. 우리는 명확한 사고 프레임워크를 제공하여 철저한 추론을 장려함으로써 이를 달성합니다. 구체적으로, 우리는 사고의 연쇄(Chain of Thought, CoT) 추론과 함께 잘 정의된 네 단계, 즉 답 형식 추출하기, 문제 진술 다시 쓰기, 수정된 문제 풀기, 그리고 최종 답으로 정수 제시하기를 사용합니다. 각 단계마다 우리는 모델의 추론을 이끌기 위해 소수 샷(few-shot) 해법 또는 상세한 지침을 제공합니다.
이 접근 방식을 통해, 우리는 대부분의 경우 LLM이 형식과 품질 모두 만족스러운 재구성을 생성할 수 있음을 관찰했습니다.
원래 문제
와 를 을 만족하는 실수라고 하자. 의 가능한 가장 작은 값을 구하시오. 답:
변환된 문제
와 를 을 만족하는 실수라고 하자. 의 가능한 가장 작은 값을 구하시오. 원래 답은 의 형태이며, 여기서 , , 은 정수입니다. 의 값을 구하시오. 답: 19
모델의 출력 (마크다운 텍스트)
변환 사고 과정
문제의 원래 답은 대수적 표현 입니다. 우리는 이를 정수 형태로 변환해야 합니다. 먼저, 답이 정수 부분과 제곱근 항으로 구성되어 있음에 주목합니다. 주어진 규칙에 따라, 우리는 정수와 제곱근 구성 요소를 미정 계수로 대체합니다. 원래 문제는 와 를 변수로 사용하므로, 우리는 미정 계수로 다른 문자를 선택합니다. 우리는 답을 의 형태로 표현하고 학생에게 을 구하도록 요구합니다.
답안 형식
변형된 문제
\(x\)와 \(y\)를 \(x^{2} + y^{2} - 22x - 16y + 113 = 0\)을 만족하는 실수라고 하자. \(x\)의 최솟값을 구하시오. 원래 답은 \(k - m\sqrt{n}\)의 형태이며, 여기서 \(k\), \(m\), \(n\)은 정수이다. \(k + m + n\)의 값을 구하시오.
변형된 문제의 답 계산
원래 답은 \(11 - 2\sqrt{6}\)이다. 요구되는 형식은 \(k - m\sqrt{n}\)이다. 계수를 대응시키면: \(k = 11\), \(m = 2\), \(n = 6\)이다. 최종 결과는 \(k + m + n = 11 + 2 + 6 = 19\)이다.
최종 답
B 보충 사례
질문:
Aimeville의 주민 900명 중에서 다이아몬드 반지를 소유한 사람은 195명, 골프 클럽 세트를 소유한 사람은 367명, 정원용 삽을 소유한 사람은 562명이다. 또한, 900명의 주민 각각은 하트 모양 사탕 한 봉지를 소유하고 있다. 이 물건들 중 정확히 두 가지를 소유한 주민은 437명이고, 정확히 세 가지를 소유한 주민은 234명이다. 이 네 가지를 모두 소유한 Aimeville 주민의 수를 구하시오.
응답:
단계별 풀이:
1. 다음과 같이 변수를 정의하자:
\(A\)를 다이아몬드 반지를 소유한 주민의 집합이라고 하자.
\(B\)를 골프 클럽 세트를 소유한 주민의 집합이라고 하자.
\(C\)를 정원용 삽을 소유한 주민의 집합이라고 하자.
\(D\)를 하트 모양 사탕 한 봉지를 소유한 주민의 집합이라고 하자. 900명의 주민 모두가 하트 모양 사탕 한 봉지를 소유하므로, \(|D| = 900\)이다.
\(a_{i}\)를 4가지 물건 중 정확히 \(i\)가지를 소유한 주민의 수라고 하자.
4개 집합 \(A,B,C,D\)의 합집합에 대해 포함-배제 원리를 사용하자.
...
\(a_{4}\), 즉 네 가지 물건을 모두 소유한 사람의 수는 정수여야 하므로, 현재 접근 방식은 물건들의 서로 다른 조합을 소유한 사람들을 조합적으로 세는 방식으로 재고해야 한다.
포함-배제 원리를 직접 사용하는 대신, 물건 \(A\), \(B\), \(C\), \(D\)의 조합을 소유한 사람들의 수를 이용하는 다른 접근 방식을 사용할 수 있다.
\(x_{i}\)를 \(A\), \(B\), \(C\) 중 정확히 \(i\)개의 물건을 소유한 사람의 수라고 하자(모두가 소유한 물건 \(D\)는 제외).
그러면 \(A\), \(B\), \(C\), \(D\) 중 정확히 \(k\)개의 물건을 소유한 사람의 총수는 다음과 같이 나눌 수 있다:
...
표 3 반사적 행동이 나타나는 사례.