순환도 합성곱도 없이 자기 주의만으로 시퀀스를 다루는 Transformer. 현대 언어 모델의 출발점이 된 NIPS 2017 논문, 전문 무료.
적절한 출처 표시가 제공된다면, Google은 본 논문의 표와 그림을 저널리즘 또는 학술 작업에 사용할 목적으로만 재현하는 것을 허가합니다.
Attention Is All You Need
Ashish Vaswani* Google Brain avaswani@google.com
Noam Shazeer* Google Brain noam@google.com
Niki Parmar* Google Research nikip@google.com
Jakob Uszkoreit* Google Research usz@google.com
Llion Jones* Google Research llion@google.com
Aidan N. Gomez*† University of Toronto aidan@cs.toronto.edu
Lukasz Kaiser* Google Brain lukaszkaiser@google.com
Illia Polosukhin*† illia.polosukhin@gmail.com
초록
지배적인 시퀀스 변환 모델은 인코더와 디코더를 포함하는 복잡한 순환 또는 합성곱 신경망에 기반합니다. 최고 성능의 모델들은 또한 인코더와 디코더를 attention 메커니즘을 통해 연결합니다. 우리는 순환과 합성곱을 완전히 배제하고 오직 attention 메커니즘에만 기반한 새로운 단순 네트워크 아키텍처인 Transformer를 제안합니다. 두 개의 기계 번역 과제에 대한 실험은 이러한 모델들이 더 우수한 품질을 보이면서 더 병렬화 가능하고 훨씬 적은 학습 시간을 요구함을 보여줍니다. 우리의 모델은 WMT 2014 영어-독일어 번역 과제에서 28.4 BLEU를 달성하여 앙상블을 포함한 기존 최고 결과보다 2 BLEU 이상 향상되었습니다. WMT 2014 영어-프랑스어 번역 과제에서 우리의 모델은 8개의 GPU에서 3.5일 동안 학습한 후 41.8이라는 새로운 단일 모델 최첨단 BLEU 점수를 확립했으며, 이는 문헌의 최고 모델들에 비해 학습 비용의 작은 일부에 불과합니다. 우리는 Transformer가 대규모 및 제한된 학습 데이터 모두를 사용한 영어 구성 구문 분석에 성공적으로 적용됨으로써 다른 과제에도 잘 일반화됨을 보여줍니다.
1 서론
순환 신경망, 특히 장단기 메모리 [13] 및 게이트 순환 [7] 신경망은 언어 모델링 및 기계 번역과 같은 시퀀스 모델링 및 변환 문제에서 최첨단 접근법으로 확고히 자리 잡았습니다 [35] [2] [5]. 이후 수많은 노력이 순환 언어 모델과 인코더-디코더 아키텍처의 경계를 계속 확장해 왔습니다 [38] [24] [15].
순환 모델은 일반적으로 입력 및 출력 시퀀스의 기호 위치를 따라 계산을 분해합니다. 위치를 계산 시간의 단계에 정렬하여, 이들은 이전 은닉 상태 와 위치 에 대한 입력의 함수로서 은닉 상태 의 시퀀스를 생성합니다. 이러한 본질적으로 순차적인 특성은 학습 예제 내에서의 병렬화를 배제하며, 이는 메모리 제약이 예제 전반에 걸친 배칭을 제한하기 때문에 더 긴 시퀀스 길이에서 중요해집니다. 최근 연구는 분해 트릭 [21]과 조건부 계산 [32]을 통해 계산 효율성에서 상당한 개선을 달성했으며, 후자의 경우 모델 성능도 향상시켰습니다. 그러나 순차 계산의 근본적인 제약은 여전히 남아 있습니다.
Attention 메커니즘은 다양한 과제에서 설득력 있는 시퀀스 모델링 및 변환 모델의 필수적인 부분이 되었으며, 입력 또는 출력 시퀀스에서의 거리에 관계없이 의존성을 모델링할 수 있게 합니다 [2] [19]. 그러나 몇 가지 예외 [27]를 제외하고, 이러한 attention 메커니즘은 순환 네트워크와 함께 사용됩니다.
본 연구에서 우리는 순환을 배제하고 대신 전적으로 attention 메커니즘에 의존하여 입력과 출력 사이의 전역적 의존성을 끌어내는 모델 아키텍처인 Transformer를 제안합니다. Transformer는 훨씬 더 많은 병렬화를 가능하게 하며, 8개의 P100 GPU에서 단 12시간 동안 학습한 후 번역 품질에서 새로운 최첨단에 도달할 수 있습니다.
2 배경
순차 계산을 줄이는 목표는 또한 Extended Neural GPU [16], ByteNet [18] 및 ConvS2S [9]의 기초를 형성하며, 이들 모두는 합성곱 신경망을 기본 구성 요소로 사용하여 모든 입력 및 출력 위치에 대해 병렬로 은닉 표현을 계산합니다. 이러한 모델에서 두 임의의 입력 또는 출력 위치로부터의 신호를 연관시키는 데 필요한 연산 수는 위치 간 거리에 따라 증가하며, ConvS2S의 경우 선형적으로, ByteNet의 경우 로그적으로 증가합니다. 이는 먼 위치 간의 의존성을 학습하는 것을 더 어렵게 만듭니다 [12]. Transformer에서는 이것이 상수 연산 수로 감소되지만, attention 가중 위치를 평균화함으로 인한 유효 해상도 감소의 대가를 치르며, 우리는 섹션 [3.2]에서 설명하는 Multi-Head Attention으로 이 효과에 대응합니다.
Self-attention은 때때로 intra-attention이라고도 불리며, 시퀀스의 표현을 계산하기 위해 단일 시퀀스의 서로 다른 위치를 연관시키는 attention 메커니즘입니다. Self-attention은 독해, 추상적 요약, 텍스트 함의 및 과제 독립적 문장 표현 학습을 포함한 다양한 과제에서 성공적으로 사용되었습니다 [4] [27] [28] [22].
종단 간 메모리 네트워크는 시퀀스 정렬 순환 대신 순환 attention 메커니즘에 기반하며, 단순 언어 질의응답 및 언어 모델링 과제에서 좋은 성능을 보이는 것으로 나타났습니다 [34].
그러나 우리가 아는 한, Transformer는 시퀀스 정렬 RNN이나 합성곱을 사용하지 않고 전적으로 self-attention에 의존하여 입력과 출력의 표현을 계산하는 최초의 변환 모델입니다. 다음 섹션에서 우리는 Transformer를 설명하고, self-attention의 동기를 부여하며, [17] [18] 및 [9]와 같은 모델에 비한 장점을 논의할 것입니다.
3 모델 아키텍처
대부분의 경쟁력 있는 신경 시퀀스 변환 모델은 인코더-디코더 구조를 가집니다 [5] [2] [35]. 여기서 인코더는 기호 표현의 입력 시퀀스 를 연속 표현의 시퀀스 로 매핑합니다. 가 주어지면, 디코더는 기호의 출력 시퀀스 를 한 번에 한 요소씩 생성합니다. 각 단계에서 모델은 자기 회귀적이며 [10], 다음을 생성할 때 이전에 생성된 기호를 추가 입력으로 소비합니다.
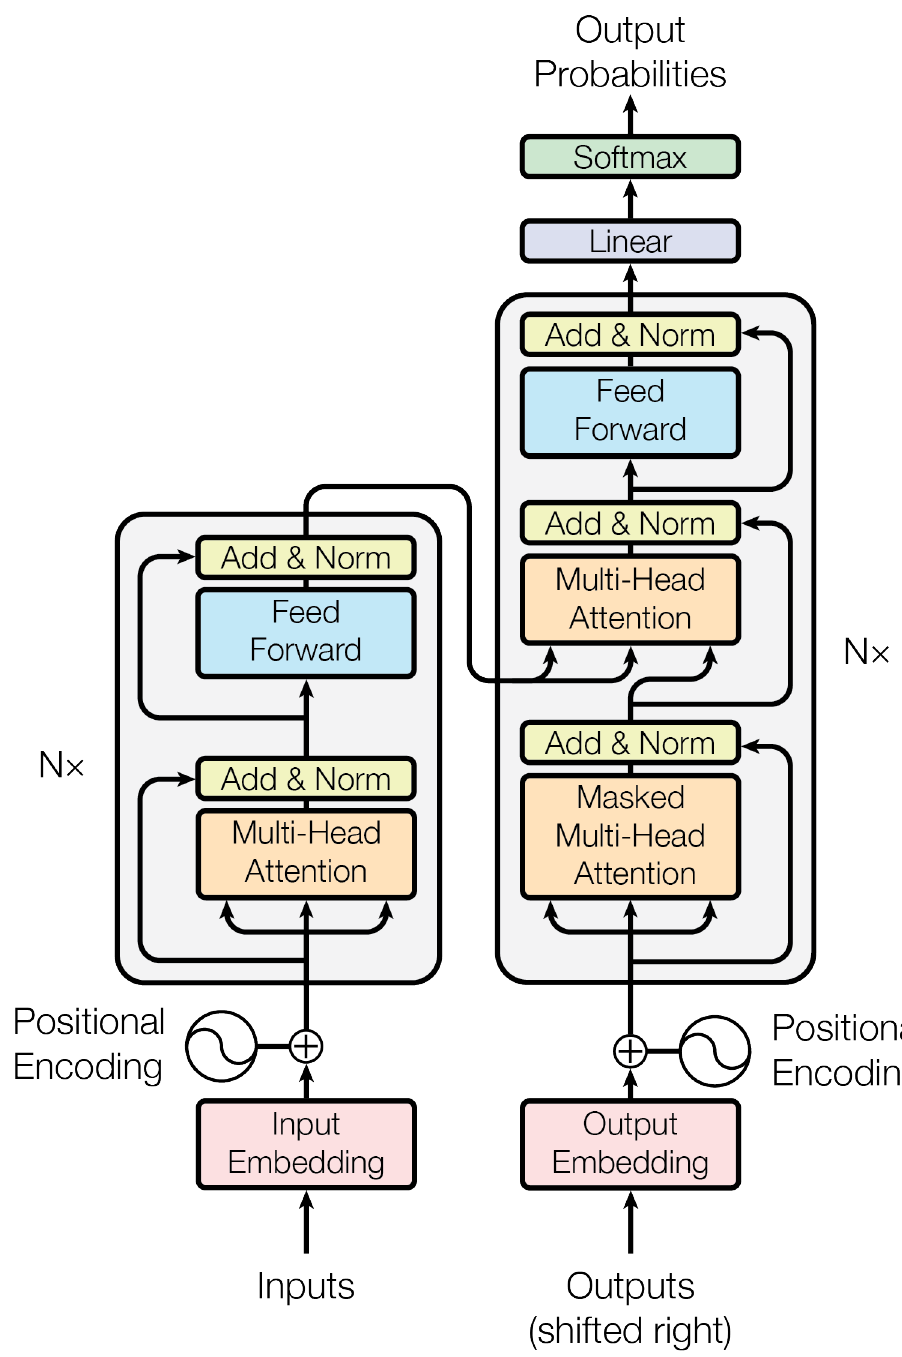
Transformer는 인코더와 디코더 모두에 대해 스택된 self-attention 및 점별, 완전 연결 계층을 사용하여 이 전체 아키텍처를 따르며, 이는 각각 그림 [1]의 왼쪽 및 오른쪽 절반에 표시됩니다.
3.1 인코더 및 디코더 스택
인코더: 인코더는 개의 동일한 계층의 스택으로 구성됩니다. 각 계층에는 두 개의 하위 계층이 있습니다. 첫 번째는 multi-head self-attention 메커니즘이고, 두 번째는 단순한, 위치별 완전 연결 피드포워드 네트워크입니다. 우리는 두 하위 계층 각각 주위에 잔차 연결 [11]을 사용하고, 그 뒤에 계층 정규화 [1]를 적용합니다. 즉, 각 하위 계층의 출력은 이며, 여기서 는 하위 계층 자체에 의해 구현된 함수입니다. 이러한 잔차 연결을 용이하게 하기 위해, 모델의 모든 하위 계층과 임베딩 계층은 차원 의 출력을 생성합니다.
디코더: 디코더도 개의 동일한 계층의 스택으로 구성됩니다. 각 인코더 계층의 두 하위 계층 외에도, 디코더는 인코더 스택의 출력에 대해 multi-head attention을 수행하는 세 번째 하위 계층을 삽입합니다. 인코더와 유사하게, 우리는 각 하위 계층 주위에 잔차 연결을 사용하고, 그 뒤에 계층 정규화를 적용합니다. 우리는 또한 디코더 스택의 self-attention 하위 계층을 수정하여 위치가 후속 위치에 attention하지 않도록 합니다. 이 마스킹은 출력 임베딩이 한 위치만큼 오프셋된다는 사실과 결합되어, 위치 에 대한 예측이 보다 작은 위치의 알려진 출력에만 의존할 수 있도록 보장합니다.
3.2 Attention
Attention 함수는 쿼리와 키-값 쌍의 집합을 출력으로 매핑하는 것으로 설명할 수 있으며, 여기서 쿼리, 키, 값 및 출력은 모두 벡터입니다. 출력은 값의 가중 합으로 계산되며,
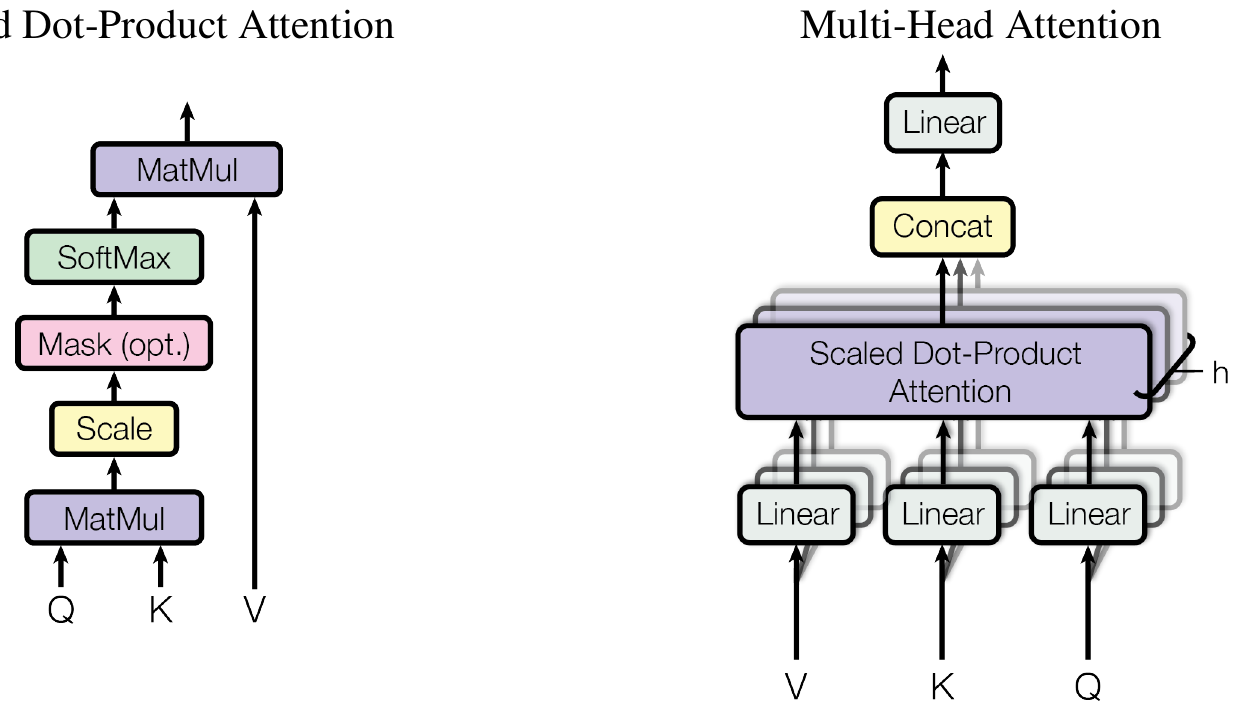
각 값에 할당된 가중치는 해당 키와 쿼리의 호환성 함수에 의해 계산됩니다.
3.2.1 Scaled Dot-Product Attention
우리는 우리의 특정한 어텐션을 "스케일드 닷-프로덕트 어텐션(Scaled Dot-Product Attention)"이라고 부른다(그림 2). 입력은 차원 의 쿼리와 키, 그리고 차원 의 값들로 구성된다. 우리는 쿼리와 모든 키의 닷 프로덕트를 계산하고, 각각을 로 나눈 뒤, 소프트맥스 함수를 적용하여 값들에 대한 가중치를 얻는다.
실제로 우리는 어텐션 함수를 여러 쿼리 집합에 대해 동시에 계산하며, 이들은 행렬 로 함께 묶인다. 키와 값들도 역시 행렬 와 로 함께 묶인다. 우리는 출력 행렬을 다음과 같이 계산한다:
가장 흔히 사용되는 두 가지 어텐션 함수는 가산적 어텐션(additive attention) 2와 닷-프로덕트(곱셈적) 어텐션이다. 닷-프로덕트 어텐션은 스케일링 인자 를 제외하면 우리의 알고리즘과 동일하다. 가산적 어텐션은 단일 은닉층을 가진 피드-포워드 네트워크를 사용하여 호환성 함수를 계산한다. 두 방식은 이론적 복잡도에서는 유사하지만, 닷-프로덕트 어텐션은 고도로 최적화된 행렬 곱셈 코드를 사용하여 구현될 수 있기 때문에 실제로는 훨씬 빠르고 공간 효율적이다.
의 값이 작을 때는 두 메커니즘이 비슷하게 수행되지만, 의 값이 클 때는 스케일링을 하지 않은 닷 프로덕트 어텐션보다 가산적 어텐션이 더 우수한 성능을 보인다 [3]. 우리는 의 값이 클 때 닷 프로덕트의 크기가 커져서 소프트맥스 함수를 기울기가 극히 작은 영역으로 밀어넣는다고 추측한다. 이러한 효과를 상쇄하기 위해 우리는 닷 프로덕트를 로 스케일링한다.
3.2.2 멀티-헤드 어텐션
차원의 키, 값, 쿼리로 단일 어텐션 함수를 수행하는 대신, 우리는 쿼리, 키, 값들을 서로 다른 학습된 선형 투영을 사용하여 각각 , , 차원으로 번 선형 투영하는 것이 유익하다는 것을 발견했다. 그런 다음 이렇게 투영된 각 버전의 쿼리, 키, 값들에 대해 병렬로 어텐션 함수를 수행하여 차원의 출력 값들을 얻는다. 이들은 연결(concatenate)되고 다시 한 번 투영되어 최종 값들을 만들어내며, 이는 그림 2에 묘사되어 있다.
멀티 헤드 어텐션은 모델이 서로 다른 위치에서 서로 다른 표현 부분공간의 정보를 동시에 주목할 수 있게 해준다. 단일 어텐션 헤드의 경우, 평균화가 이를 억제한다.
여기서 투영은 파라미터 행렬 , , , 그리고 이다.
본 연구에서는 개의 병렬 어텐션 계층, 즉 헤드를 사용한다. 이들 각각에 대해 를 사용한다. 각 헤드의 차원이 감소하기 때문에, 전체 계산 비용은 완전한 차원을 가진 단일 헤드 어텐션의 비용과 유사하다.
3.2.3 우리 모델에서의 어텐션 응용
트랜스포머는 멀티 헤드 어텐션을 세 가지 다른 방식으로 사용한다:
- "인코더-디코더 어텐션" 계층에서, 쿼리는 이전 디코더 계층에서 오고, 메모리 키와 값은 인코더의 출력에서 온다. 이는 디코더의 모든 위치가 입력 시퀀스의 모든 위치에 주목할 수 있게 해준다. 이는 [38] [2] [9]와 같은 시퀀스-투-시퀀스 모델의 전형적인 인코더-디코더 어텐션 메커니즘을 모방한다.
- 인코더는 자기-어텐션 계층을 포함한다. 자기-어텐션 계층에서 모든 키, 값, 쿼리는 동일한 곳에서 오는데, 이 경우에는 인코더의 이전 계층의 출력이다. 인코더의 각 위치는 인코더의 이전 계층의 모든 위치에 주목할 수 있다.
- 마찬가지로, 디코더의 자기-어텐션 계층은 디코더의 각 위치가 해당 위치까지 포함하여 디코더의 모든 위치에 주목할 수 있게 해준다. 자기회귀적 특성을 보존하기 위해 디코더에서 왼쪽 방향의 정보 흐름을 방지해야 한다. 우리는 스케일된 내적 어텐션 내부에서 불법적인 연결에 해당하는 소프트맥스 입력의 모든 값을 마스킹(로 설정)하여 이를 구현한다. 그림 [2]를 참조하라.
3.3 위치별 피드-포워드 네트워크
어텐션 하위 계층 외에도, 우리의 인코더와 디코더의 각 계층은 완전 연결 피드-포워드 네트워크를 포함하며, 이는 각 위치에 개별적이고 동일하게 적용된다. 이는 그 사이에 ReLU 활성화를 가진 두 개의 선형 변환으로 구성된다.
선형 변환은 서로 다른 위치에 걸쳐 동일하지만, 계층마다 다른 파라미터를 사용한다. 이를 설명하는 또 다른 방법은 커널 크기가 1인 두 개의 합성곱으로 보는 것이다. 입력과 출력의 차원은 이고, 내부 계층은 차원 을 가진다.
3.4 임베딩과 소프트맥스
다른 시퀀스 변환 모델과 마찬가지로, 우리는 학습된 임베딩을 사용하여 입력 토큰과 출력 토큰을 차원 의 벡터로 변환한다. 우리는 또한 디코더 출력을 예측된 다음 토큰 확률로 변환하기 위해 일반적인 학습된 선형 변환과 소프트맥스 함수를 사용한다. 우리 모델에서는 [30]과 유사하게 두 임베딩 계층과 소프트맥스 이전 선형 변환 사이에 동일한 가중치 행렬을 공유한다. 임베딩 계층에서 우리는 그 가중치들에 을 곱한다.
| 계층 유형 | 계층당 복잡도 | 순차 연산 | 최대 경로 길이 |
| 셀프 어텐션 | O(n²·d) | O(1) | O(1) |
| 순환 | O(n·d²) | O(n) | O(n) |
| 합성곱 | O(k·n·d²) | O(1) | O(logk(n)) |
| 셀프 어텐션 (제한됨) | O(r·n·d) | O(1) | O(n/r) |
3.5 위치 인코딩
우리 모델은 순환도 합성곱도 포함하지 않기 때문에, 모델이 시퀀스의 순서를 활용할 수 있도록 하려면 시퀀스 내 토큰의 상대적 또는 절대적 위치에 관한 정보를 주입해야 한다. 이를 위해 우리는 인코더와 디코더 스택의 하단에서 입력 임베딩에 "위치 인코딩"을 더한다. 위치 인코딩은 임베딩과 동일한 차원 을 가지므로, 둘을 합할 수 있다. 위치 인코딩에는 학습된 것과 고정된 것 등 많은 선택지가 있다 [9].
본 연구에서는 서로 다른 주파수의 사인 및 코사인 함수를 사용한다:
여기서 는 위치이고 는 차원이다. 즉, 위치 인코딩의 각 차원은 하나의 정현파에 대응한다. 파장은 에서 까지의 등비수열을 이룬다. 우리가 이 함수를 선택한 이유는, 임의의 고정된 오프셋 에 대해 가 의 선형 함수로 표현될 수 있으므로, 모델이 상대적 위치에 따라 주목하는 것을 쉽게 학습할 수 있을 것이라고 가설을 세웠기 때문이다.
우리는 또한 대신 학습된 위치 임베딩 [9]을 사용하는 실험을 했고, 두 버전이 거의 동일한 결과를 낳는다는 것을 발견했다(표 3의 (E) 행 참조). 우리는 사인파 버전을 선택했는데, 이는 모델이 훈련 중에 마주친 것보다 더 긴 시퀀스 길이로 외삽할 수 있게 해줄 수 있기 때문이다.
4 자기-어텐션을 사용하는 이유
이 절에서 우리는 자기-어텐션 계층의 다양한 측면을, 하나의 가변 길이 기호 표현 시퀀스 를 동일한 길이의 다른 시퀀스 로 매핑하는 데 흔히 사용되는 순환 및 합성곱 계층과 비교한다. 여기서 이며, 이는 전형적인 시퀀스 변환 인코더나 디코더의 은닉 계층과 같다. 자기-어텐션 사용을 동기 부여하는 것으로, 우리는 세 가지 요구 사항을 고려한다.
하나는 계층당 총 계산 복잡도이다. 또 다른 하나는 병렬화할 수 있는 계산량으로, 필요한 순차 연산의 최소 개수로 측정된다.
세 번째는 네트워크에서 장거리 의존성 사이의 경로 길이이다. 장거리 의존성을 학습하는 것은 많은 시퀀스 변환 작업에서 핵심적인 과제이다. 그러한 의존성을 학습하는 능력에 영향을 미치는 한 가지 핵심 요인은 순방향 및 역방향 신호가 네트워크에서 통과해야 하는 경로의 길이이다. 입력 및 출력 시퀀스의 임의의 위치 조합 사이의 이러한 경로가 짧을수록 장거리 의존성을 학습하기가 더 쉽다 [12]. 따라서 우리는 서로 다른 계층 유형으로 구성된 네트워크에서 임의의 두 입력 및 출력 위치 사이의 최대 경로 길이도 비교한다.
표 1에서 언급했듯이, 자기-어텐션 계층은 모든 위치를 상수 개의 순차적으로 실행되는 연산으로 연결하는 반면, 순환 계층은 개의 순차 연산을 필요로 한다. 계산 복잡도 측면에서, 자기-어텐션 계층은 시퀀스 길이 이 표현 차원 보다 작을 때 순환 계층보다 빠르며, 이는 기계 번역에서 최첨단 모델이 사용하는 문장 표현, 예컨대 워드피스 [38] 및 바이트 페어 [31] 표현의 경우 대부분 그렇다. 매우 긴 시퀀스를 포함하는 작업의 계산 성능을 향상시키기 위해, 자기-어텐션을 입력 시퀀스에서 각 출력 위치를 중심으로 하는 크기 의 이웃만 고려하도록 제한할 수 있다. 이렇게 하면 최대 경로 길이가 로 증가할 것이다. 우리는 향후 연구에서 이 접근법을 더 조사할 계획이다.
커널 너비가 인 단일 합성곱 층은 모든 입력 및 출력 위치 쌍을 연결하지 않는다. 그렇게 하려면 연속 커널의 경우 개의 합성곱 층을 쌓아야 하며, 확장 합성곱(dilated convolutions)의 경우 개의 층이 필요하다 [18]. 이는 네트워크의 임의의 두 위치 사이에서 가장 긴 경로의 길이를 증가시킨다. 합성곱 층은 일반적으로 순환 층보다 배 더 비싸다. 그러나 분리 합성곱(separable convolutions) [6]은 복잡도를 로 상당히 감소시킨다. 하지만 인 경우에도 분리 합성곱의 복잡도는 우리 모델에서 채택한 접근법인 자기 주의 층(self-attention layer)과 점별 피드포워드 층(point-wise feed-forward layer)의 조합과 같다.
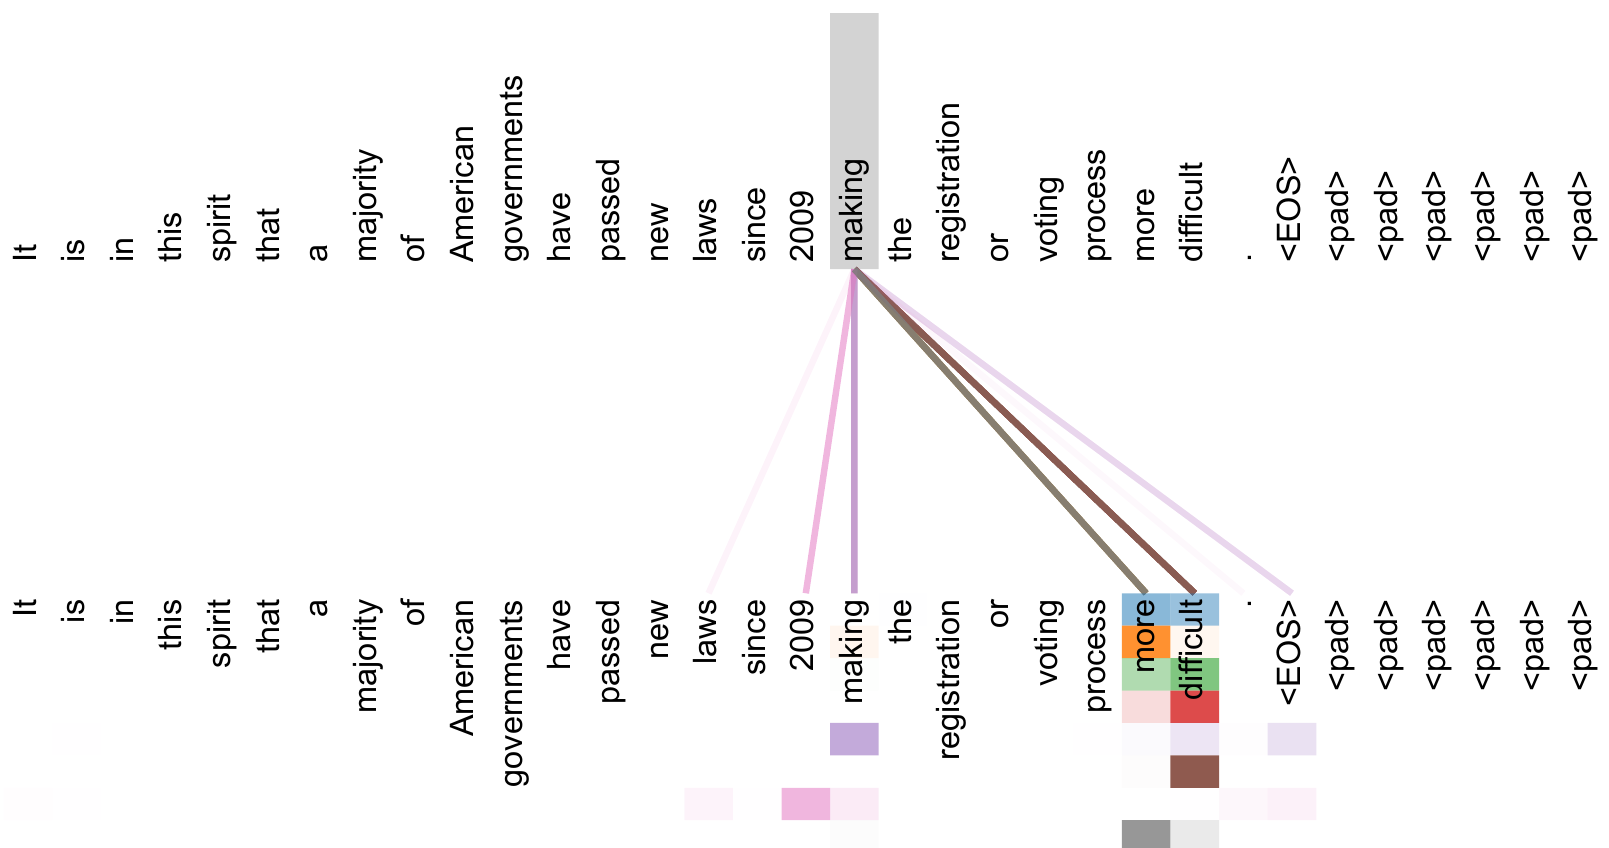
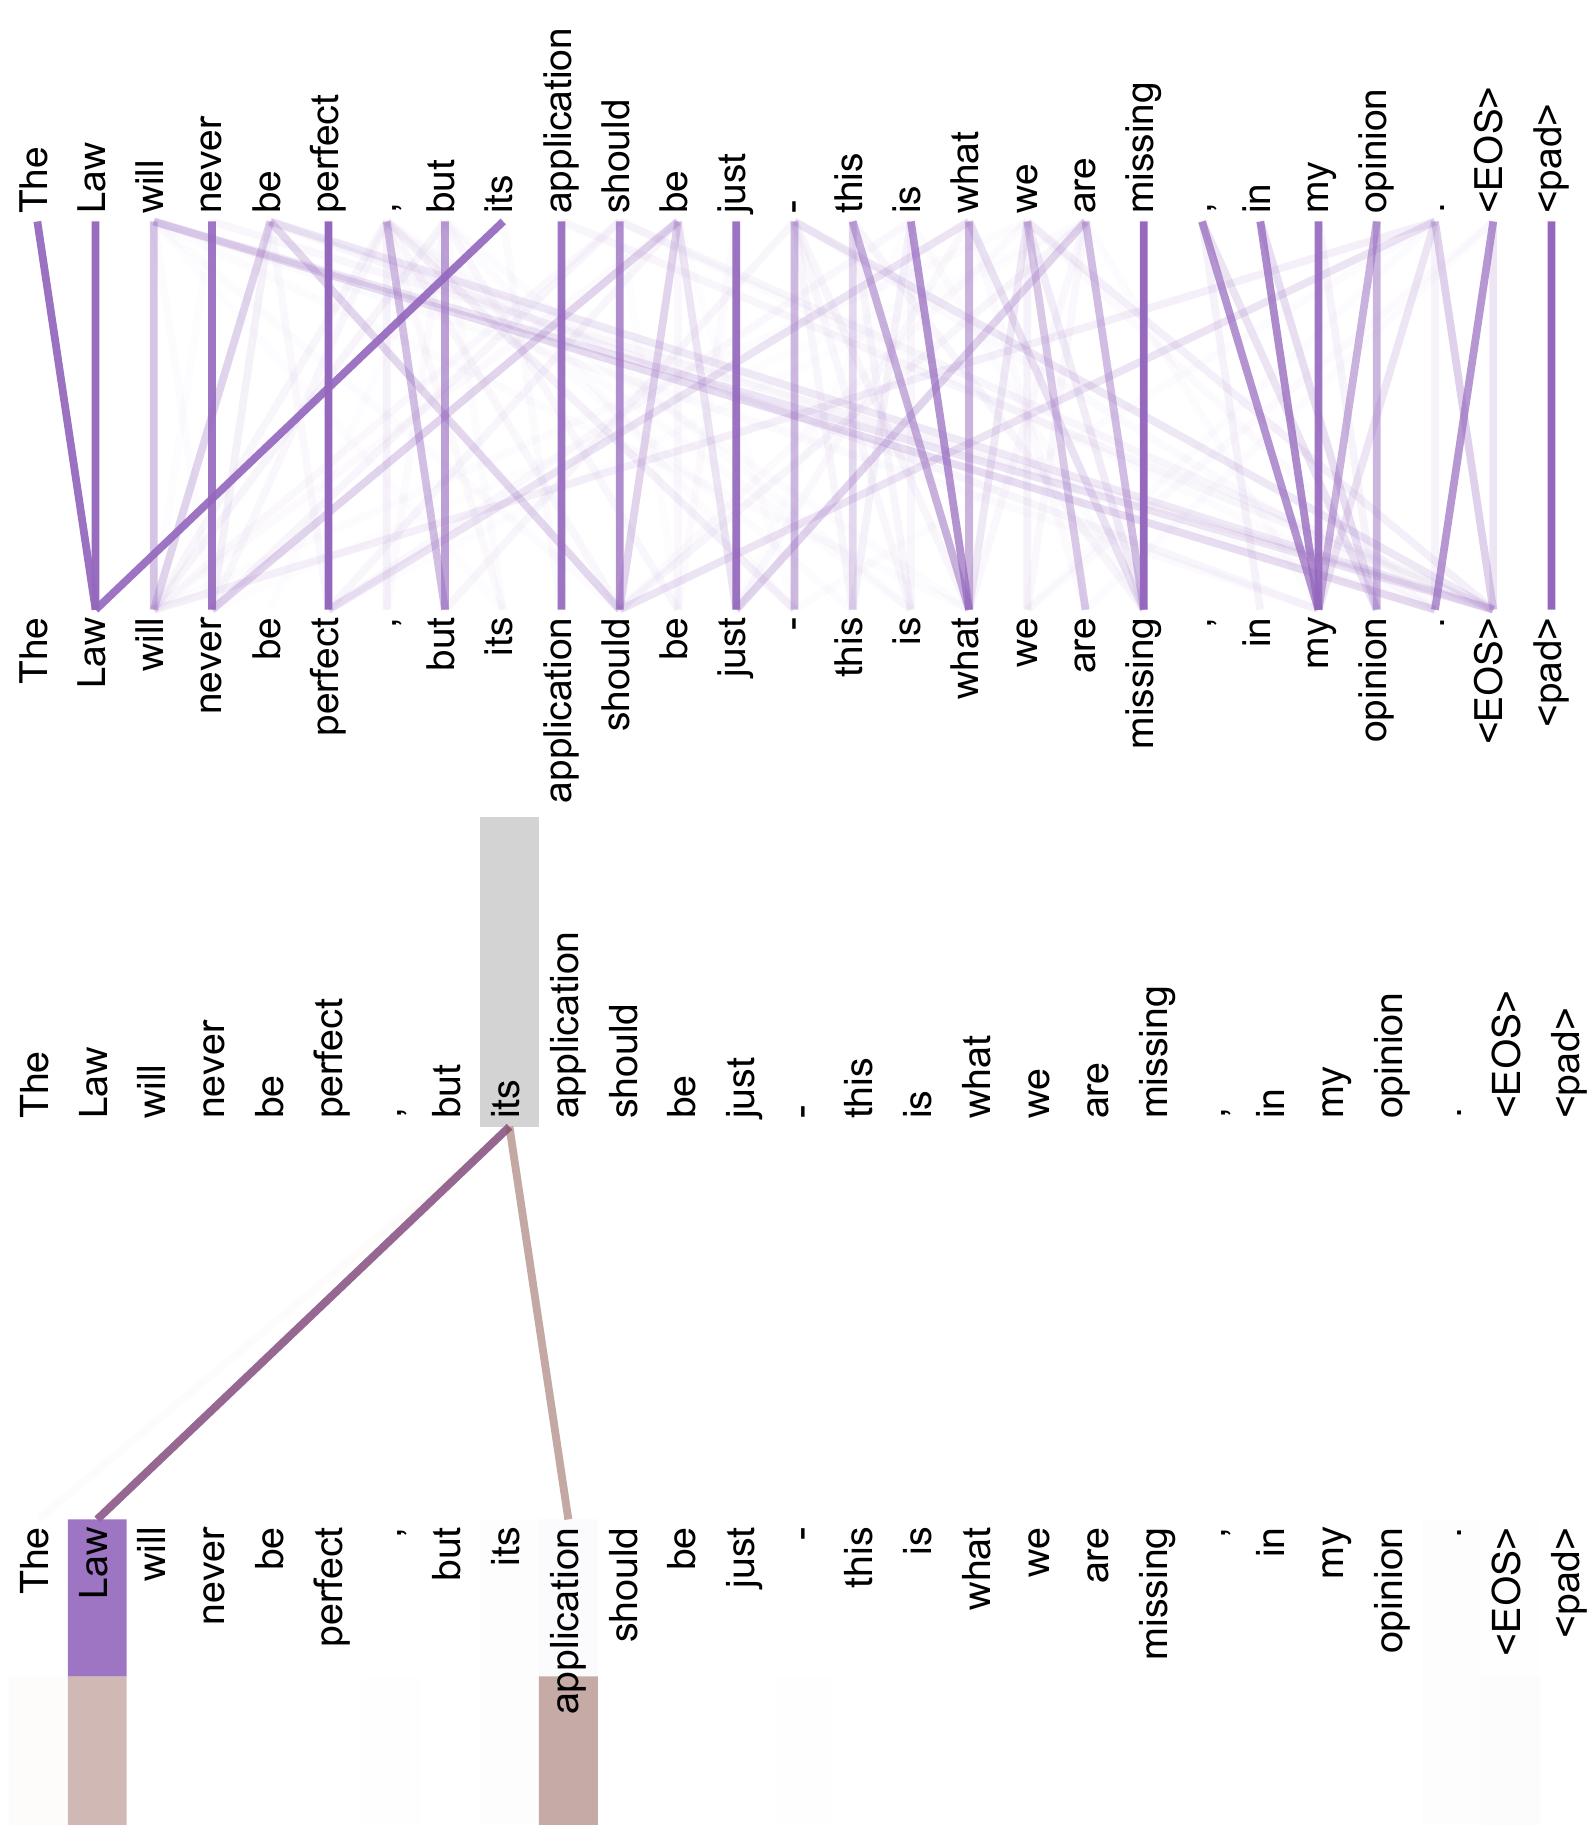
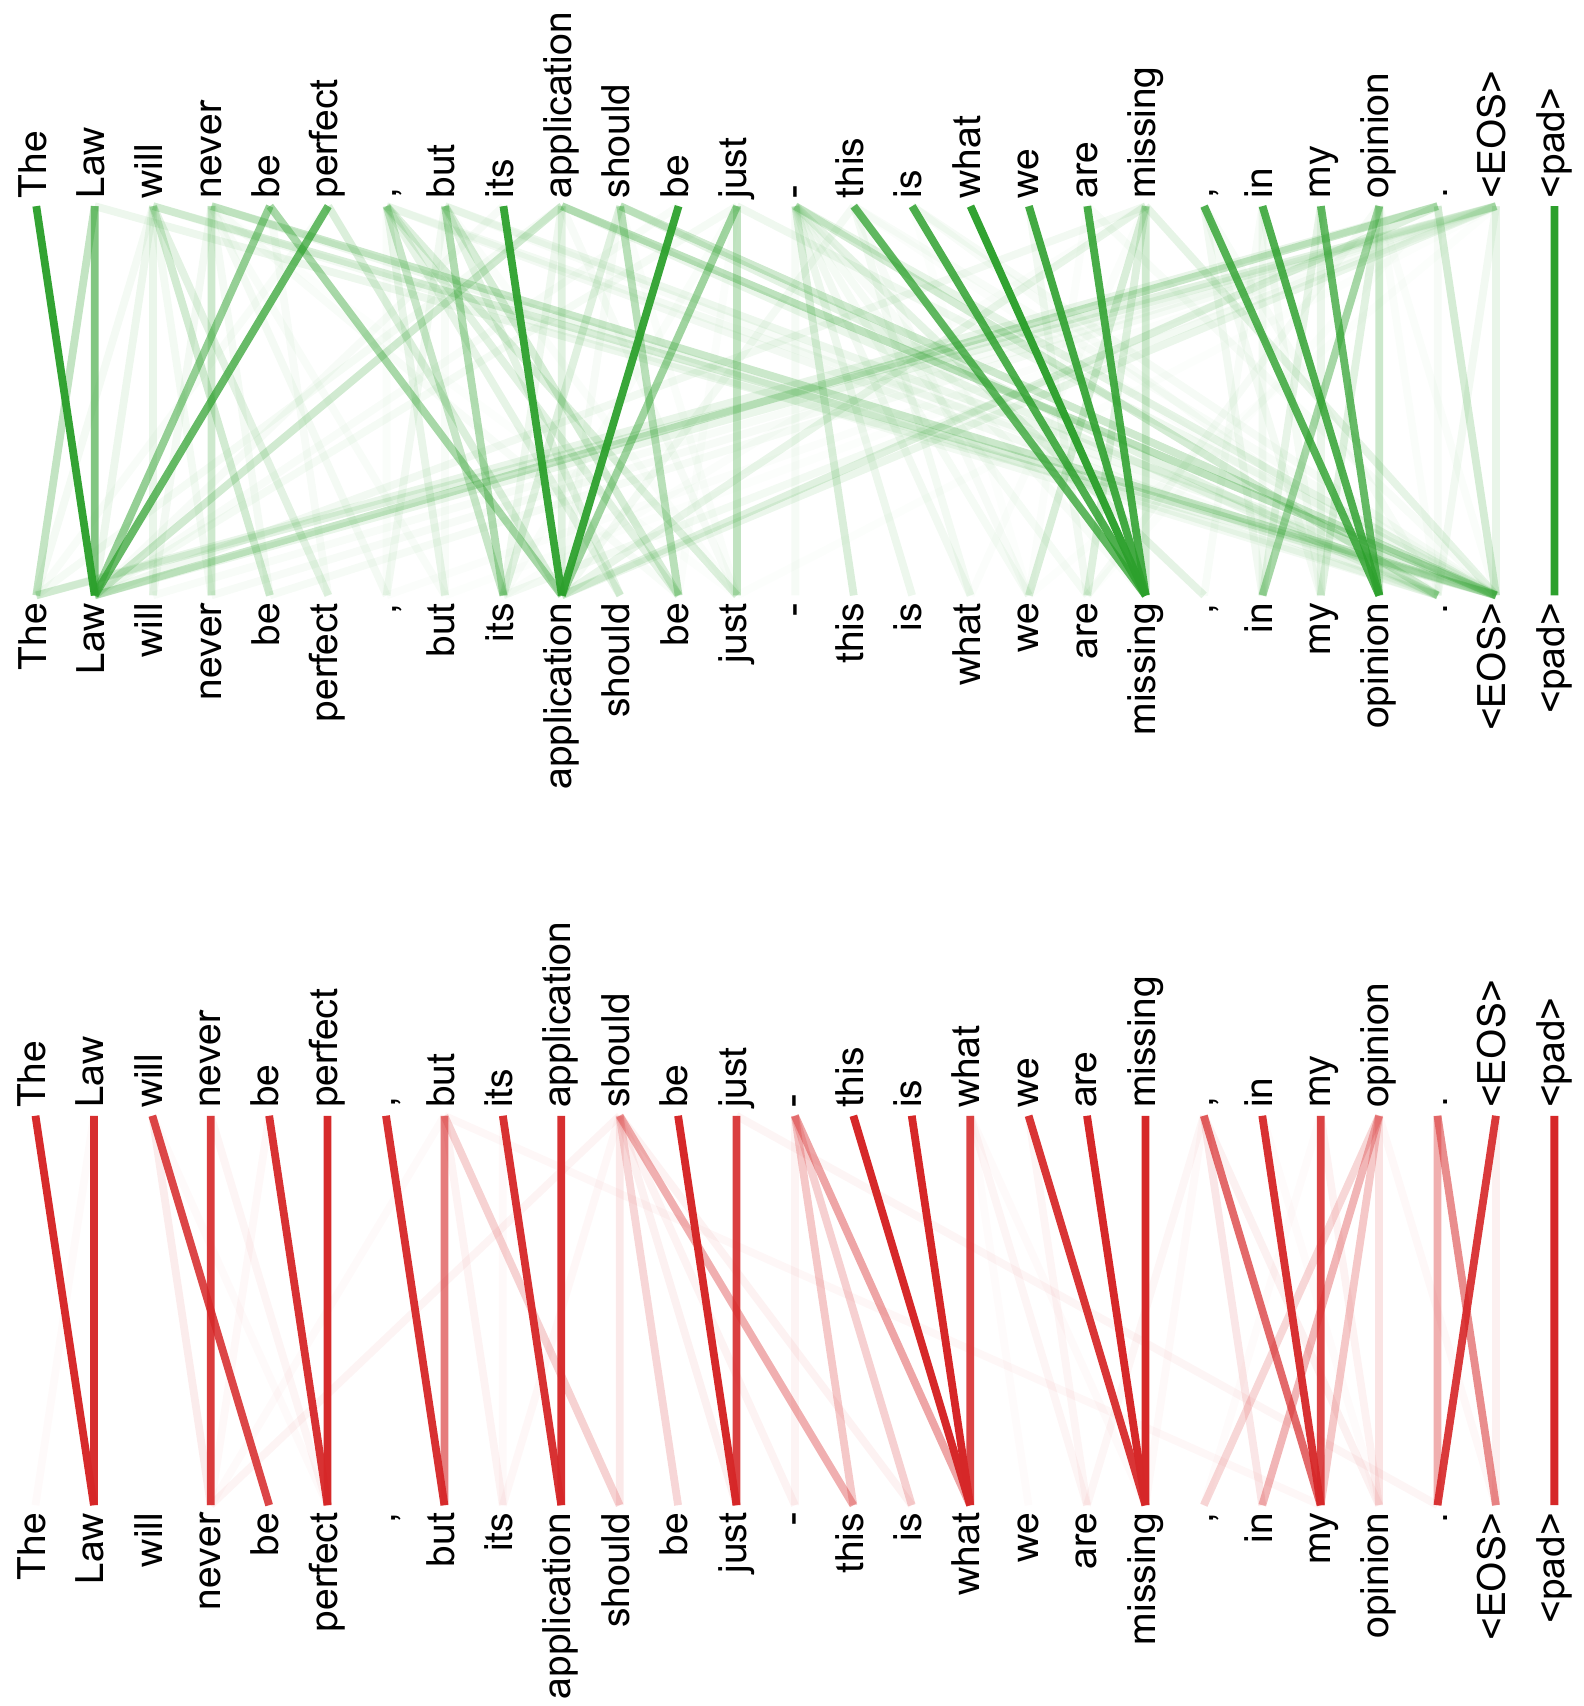
부수적인 이점으로, 자기 주의는 더 해석 가능한 모델을 산출할 수 있다. 우리는 모델의 주의 분포를 검사하고 부록에서 예시를 제시하고 논의한다. 개별 주의 헤드(attention head)들이 서로 다른 작업을 수행하는 것을 명확히 학습할 뿐만 아니라, 많은 헤드가 문장의 통사적 및 의미적 구조와 관련된 행동을 보이는 것으로 나타난다.
5 훈련
이 절에서는 우리 모델의 훈련 방식을 설명한다.
5.1 훈련 데이터 및 배칭
우리는 약 450만 개의 문장 쌍으로 구성된 표준 WMT 2014 영어-독일어 데이터셋으로 훈련했다. 문장은 약 37000개의 토큰으로 구성된 공유 소스-대상 어휘를 가진 바이트 쌍 인코딩(byte-pair encoding) [3]을 사용하여 인코딩되었다. 영어-프랑스어의 경우, 우리는 3600만 개의 문장으로 구성된 훨씬 더 큰 WMT 2014 영어-프랑스어 데이터셋을 사용하였고, 토큰을 32000개의 워드피스(word-piece) 어휘로 분할했다 [38]. 문장 쌍은 대략적인 시퀀스 길이에 따라 함께 배칭되었다. 각 훈련 배치는 약 25000개의 소스 토큰과 25000개의 대상 토큰을 포함하는 문장 쌍 집합을 포함했다.
5.2 하드웨어 및 일정
우리는 8개의 NVIDIA P100 GPU가 장착된 한 대의 머신에서 모델을 훈련했다. 논문 전반에 걸쳐 설명된 하이퍼파라미터를 사용하는 기본 모델의 경우, 각 훈련 단계는 약 0.4초가 걸렸다. 우리는 기본 모델을 총 100,000단계, 즉 12시간 동안 훈련했다. 대형 모델의 경우(표 [3]의 맨 아래 줄에 설명됨), 단계 시간은 1.0초였다. 대형 모델은 300,000단계(3.5일) 동안 훈련되었다.
5.3 옵티마이저
우리는 , , 인 Adam 옵티마이저 [20]를 사용했다. 우리는 다음 공식에 따라 훈련 과정에서 학습률을 변화시켰다:
이는 처음 warmup 단계의 훈련 단계 동안 학습률을 선형적으로 증가시키고, 그 이후에는 단계 번호의 역제곱근에 비례하여 감소시키는 것에 해당한다. 우리는 warmup 단계 = 4000을 사용했다.
5.4 정규화
우리는 훈련 중에 세 가지 유형의 정규화를 적용한다:
| 모델 | BLEU | 훈련 비용 (FLOPs) | ||
| EN-DE | EN-FR | EN-DE | EN-FR | |
| ByteNet [18] | 23.75 | |||
| Deep-Att + PosUnk [39] | 39.2 | 1.0·1020 | ||
| GNMT + RL [38] | 24.6 | 39.92 | 2.3·1019 | 1.4·1020 |
| ConvS2S [9] | 25.16 | 40.46 | 9.6·1018 | 1.5·1020 |
| MoE [32] | 26.03 | 40.56 | 2.0·1019 | 1.2·1020 |
| Deep-Att + PosUnk 앙상블 [39] | 40.4 | 8.0·1020 | ||
| GNMT + RL 앙상블 [38] | 26.30 | 41.16 | 1.8·1020 | 1.1·1021 |
| ConvS2S 앙상블 [9] | 26.36 | 41.29 | 7.7·1019 | 1.2·1021 |
| Transformer (기본 모델) | 27.3 | 38.1 | 3.3·1018 | |
| Transformer (대형) | 28.4 | 41.8 | 2.3·1019 | |
잔차 드롭아웃 우리는 각 하위 층의 출력에 드롭아웃 [33]을 적용하는데, 이는 하위 층 입력에 더해지고 정규화되기 전에 이루어진다. 또한, 우리는 인코더와 디코더 스택 모두에서 임베딩과 위치 인코딩의 합에 드롭아웃을 적용한다. 기본 모델의 경우, 우리는 의 비율을 사용한다.
레이블 스무딩 훈련 중에, 우리는 [36] 값의 레이블 스무딩을 적용했다. 이는 모델이 더 불확실해지는 것을 학습하기 때문에 퍼플렉서티(perplexity)를 악화시키지만, 정확도와 BLEU 점수를 향상시킨다.
6 결과
6.1 기계 번역
WMT 2014 영어-독일어 번역 과제에서, 큰 트랜스포머 모델(표 2의 Transformer (big))은 이전에 보고된 최고 성능 모델들(앙상블 포함)을 2.0 BLEU 이상 능가하여 28.4라는 새로운 최고 수준의 BLEU 점수를 확립했다. 이 모델의 구성은 표 3의 맨 아래 줄에 나열되어 있다. 훈련에는 8개의 P100 GPU에서 3.5일이 걸렸다. 우리의 기본 모델조차도 경쟁 모델 중 어느 것보다도 훨씬 적은 훈련 비용으로 이전에 발표된 모든 모델과 앙상블을 능가한다.
WMT 2014 영어-프랑스어 번역 과제에서, 우리의 큰 모델은 41.0의 BLEU 점수를 달성하여, 이전 최고 성능 모델의 훈련 비용의 미만으로 이전에 발표된 모든 단일 모델을 능가한다. 영어-프랑스어용으로 훈련된 Transformer (big) 모델은 드롭아웃 비율 을 사용했으며, 0.3 대신이다.
기본 모델의 경우, 10분 간격으로 기록된 마지막 5개의 체크포인트를 평균하여 얻은 단일 모델을 사용했다. 큰 모델의 경우, 마지막 20개의 체크포인트를 평균했다. 우리는 빔 크기 4와 길이 패널티 을 사용한 빔 탐색을 사용했다 [38]. 이러한 하이퍼파라미터는 개발 세트에서의 실험 후에 선택되었다. 우리는 추론 중 최대 출력 길이를 입력 길이 으로 설정했지만, 가능한 경우 조기에 종료했다 [38].
표 2는 우리의 결과를 요약하고 우리의 번역 품질과 훈련 비용을 문헌의 다른 모델 아키텍처와 비교한다. 우리는 훈련 시간, 사용된 GPU 수, 그리고 각 GPU의 지속적인 단정밀도 부동소수점 용량 추정치를 곱하여 모델 훈련에 사용된 부동소수점 연산 수를 추정한다.
6.2 모델 변형
트랜스포머의 여러 구성 요소의 중요성을 평가하기 위해, 우리는 기본 모델을 다양한 방식으로 변형하여 개발 세트인
| 읽기 전용 배경 자료(번역할 원문 텍스트가 아님): 6.2 모델 변형 Transformer의 여러 구성 요소의 중요성을 평가하기 위해, 우리는 기본 모델을 여러 방식으로 변형하여 개발 세트인 newstest2013에서 영어-독일어 번역 성능의 변화를 측정했다. 우리는 이전 절에서 설명한 대로 빔 탐색을 사용했지만, 체크포인트 평균화는 사용하지 않았다. 이 결과를 표 3에 제시한다. 번역할 텍스트: N | dmodel | dff | h | dk | dv | Pdrop | εls | 훈련 스텝 | PPL (개발) | BLEU (개발) | 파라미터 ×106 | |
| base | 6 | 512 | 2048 | 8 | 64 | 64 | 0.1 | 0.1 | 100K | 4.92 | 25.8 | 65 |
| 1 | 512 | 512 | 5.29 | 24.9 | ||||||||
| 4 | 128 | 128 | 5.00 | 25.5 | ||||||||
| 16 | 32 | 32 | 4.91 | 25.8 | ||||||||
| (A) | 32 | 16 | 16 | 5.01 | 25.4 | |||||||
| 16 | 5.16 | 25.1 | 58 | |||||||||
| (B) | 32 | 5.01 | 25.4 | 60 | ||||||||
| 6.11 | 23.7 | 36 | ||||||||||
| (C) | 2 | 5.19 | 25.3 | 50 | ||||||||
| 4 | 4.88 | 25.5 | 80 | |||||||||
| 8 | 5.75 | 24.5 | 28 | |||||||||
| 256 | 32 | 32 | 4.66 | 26.0 | 168 | |||||||
| 1024 | 128 | 128 | 5.12 | 25.4 | 53 | |||||||
| 1024 | 4.75 | 26.2 | 90 | |||||||||
| (D) | 0.0 | 5.77 | 24.6 | |||||||||
| 0.2 | 4.95 | 25.5 | ||||||||||
| 0.0 | 4.67 | 25.3 | ||||||||||
| 0.2 | 5.47 | 25.7 | ||||||||||
| (E) | 4.92 | 25.7 | ||||||||||
| big | 6 | 1024 | 4096 | 16 | 0.3 | 300K | 4.33 | 26.4 | 213 |
newstest2013에서 영어-독일어 번역 성능의 변화를 측정했다. 우리는 이전 섹션에서 설명한 대로 빔 탐색을 사용했지만, 체크포인트 평균은 사용하지 않았다. 우리는 이러한 결과를 표 3에 제시한다.
표 3의 (A) 행에서, 우리는 섹션 3.2.2에서 설명한 대로 계산량을 일정하게 유지하면서 어텐션 헤드 수와 어텐션 키 및 값 차원을 변화시켰다. 단일 헤드 어텐션은 최적 설정보다 0.9 BLEU 나쁘지만, 헤드가 너무 많아도 품질이 떨어진다.
표 3의 (B) 행에서, 우리는 어텐션 키 크기 를 줄이면 모델 품질이 저하됨을 관찰한다. 이는 호환성을 결정하는 것이 쉽지 않으며, 내적보다 더 정교한 호환성 함수가 유익할 수 있음을 시사한다. 우리는 또한 (C) 및 (D) 행에서 예상대로 더 큰 모델이 더 좋고, 드롭아웃이 과적합을 피하는 데 매우 유용함을 관찰한다. (E) 행에서 우리는 사인파 위치 인코딩을 학습된 위치 임베딩 [2]으로 대체하고, 기본 모델과 거의 동일한 결과를 관찰한다.
6.3 영어 구성 구문 분석
트랜스포머가 다른 과제로 일반화될 수 있는지 평가하기 위해 우리는 영어 구성 구문 분석에 대한 실험을 수행했다. 이 과제는 특정한 어려움을 제시한다: 출력은 강한 구조적 제약을 받으며 입력보다 상당히 길다. 게다가, RNN 시퀀스-투-시퀀스 모델은 소규모 데이터 체제에서 최고 수준의 결과를 달성하지 못했다 [37].
우리는 Penn Treebank [25]의 Wall Street Journal (WSJ) 부분에서 약 40K 훈련 문장으로 인 4층 트랜스포머를 훈련했다. 우리는 또한 약 17M 문장이 있는 더 큰 high-confidence 및 BerkleyParker 코퍼스를 사용하여 준지도 설정에서 훈련했다 [37]. 우리는 WSJ 전용 설정에는 16K 토큰의 어휘를, 준지도 설정에는 32K 토큰의 어휘를 사용했다.
우리는 섹션 22 개발 세트에서 드롭아웃, 어텐션 및 잔차 모두(섹션 [5.4]), 학습률 및 빔 크기를 선택하기 위해 소수의 실험만 수행했으며, 다른 모든 파라미터는 영어-독일어 기본 번역 모델에서 변경되지 않았다. 추론 중에 우리는
| 구문 분석기 | 학습 | WSJ 23 F1 |
| Vinyals & Kaiser el al. (2014) [37] | WSJ만, 판별식 | 88.3 |
| Petrov et al. (2006) [29] | WSJ만, 판별식 | 90.4 |
| Zhu et al. (2013) [40] | WSJ만, 판별식 | 90.4 |
| Dyer et al. (2016) [8] | WSJ만, 판별식 | 91.7 |
| Transformer (4층) | WSJ만, 판별식 | 91.3 |
| Zhu et al. (2013) [40] | 준지도 | 91.3 |
| Huang & Harper (2009) [14] | 준지도 | 91.3 |
| McClosky et al. (2006) [26] | 준지도 | 92.1 |
| Vinyals & Kaiser el al. (2014) [37] | 준지도 | 92.1 |
| Transformer (4층) | 준지도 | 92.7 |
| Luong et al. (2015) [23] | 다중 작업 | 93.0 |
| Dyer et al. (2016) [8] | 생성식 | 93.3 |
최대 출력 길이를 입력 길이 으로 증가시켰다. 우리는 WSJ 전용 및 준지도 설정 모두에 대해 빔 크기 21과 을 사용했다.
표 4의 우리의 결과는 과제별 튜닝이 부족함에도 불구하고 우리 모델이 놀랍게도 잘 수행하여 Recurrent Neural Network Grammar [8]를 제외한 모든 이전에 보고된 모델보다 더 나은 결과를 산출함을 보여준다.
RNN 시퀀스-투-시퀀스 모델 [37]과 대조적으로, 트랜스포머는 40K 문장의 WSJ 훈련 세트에서만 훈련할 때조차 Berkeley-Parser [29]를 능가한다.
7 결론
이 작업에서, 우리는 전적으로 어텐션에 기반한 최초의 시퀀스 변환 모델인 트랜스포머를 제시했으며, 인코더-디코더 아키텍처에서 가장 흔히 사용되는 순환 층을 다중 헤드 자기 어텐션으로 대체했다.
번역 과제의 경우, 트랜스포머는 순환 또는 합성곱 층에 기반한 아키텍처보다 훨씬 빠르게 훈련될 수 있다. WMT 2014 영어-독일어 및 WMT 2014 영어-프랑스어 번역 과제 모두에서, 우리는 새로운 최고 수준을 달성한다. 전자의 과제에서 우리의 최고 모델은 이전에 보고된 모든 앙상블조차 능가한다.
우리는 어텐션 기반 모델의 미래에 대해 기대하며 이를 다른 과제에 적용할 계획이다. 우리는 트랜스포머를 텍스트 이외의 입력 및 출력 양식을 포함하는 문제로 확장하고, 이미지, 오디오 및 비디오와 같은 큰 입력과 출력을 효율적으로 처리하기 위해 국소적이고 제한된 어텐션 메커니즘을 조사할 계획이다. 생성의 순차성을 줄이는 것은 우리의 또 다른 연구 목표이다.
우리가 모델을 훈련하고 평가하는 데 사용한 코드는 https://github.com/tensorflow/tensor2tensor 에서 이용 가능하다.
감사의 글 우리는 유익한 논평, 수정 및 영감을 준 Nal Kalchbrenner와 Stephan Gouws에게 감사한다.
참고문헌
[1] Jimmy Lei Ba, Jamie Ryan Kiros, and Geoffrey E Hinton. Layer normalization. arXiv preprint arXiv:1607.06450, 2016.
[2] Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. Neural machine translation by jointly learning to align and translate. CoRR, abs/1409.0473, 2014.
[3] Denny Britz, Anna Goldie, Minh-Thang Luong, and Quoc V. Le. Massive exploration of neural machine translation architectures. CoRR, abs/1703.03906, 2017.
[4] Jianpeng Cheng, Li Dong, and Mirella Lapata. Long short-term memory-networks for machine reading. arXiv preprint arXiv:1601.06733, 2016.
[5] Kyunghyun Cho, Bart van Merrienboer, Caglar Gulcehre, Fethi Bougares, Holger Schwenk, and Yoshua Bengio. Learning phrase representations using rnn encoder-decoder for statistical machine translation. CoRR, abs/1406.1078, 2014.
[6] Francois Chollet. Xception: Deep learning with depthwise separable convolutions. arXiv preprint arXiv:1610.02357, 2016.
[7] Junyoung Chung, Caglar Gulcehre, Kyunghyun Cho, and Yoshua Bengio. Empirical evaluation of gated recurrent neural networks on sequence modeling. CoRR, abs/1412.3555, 2014.
[8] Chris Dyer, Adhiguna Kuncoro, Miguel Ballesteros, and Noah A. Smith. Recurrent neural network grammars. In Proc. of NAACL, 2016.
[9] Jonas Gehring, Michael Auli, David Grangier, Denis Yarats, and Yann N. Dauphin. Convolutional sequence to sequence learning. arXiv preprint arXiv:1705.03122, 2017.
[10] Alex Graves. Generating sequences with recurrent neural networks. arXiv preprint arXiv:1308.0850, 2013.
[11] Kaiming He, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. Deep residual learning for image recognition. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, pages 770-778, 2016.
[12] Sepp Hochreiter, Yoshua Bengio, Paolo Frasconi, and Jürgen Schmidhuber. 순환 신경망에서의 그래디언트 흐름: 장기 의존성 학습의 어려움, 2001.
[13] Sepp Hochreiter and Jürgen Schmidhuber. 장단기 메모리. Neural computation, 9(8):1735-1780, 1997.
[14] Zhongqiang Huang and Mary Harper. 언어 전반에 걸친 잠재 주석을 사용한 PCFG 문법의 자기 학습. In Proceedings of the 2009 Conference on Empirical Methods in Natural Language Processing, pages 832-841. ACL, August 2009.
[15] Rafal Jozefowicz, Oriol Vinyals, Mike Schuster, Noam Shazeer, and Yonghui Wu. 언어 모델링의 한계 탐구. arXiv preprint arXiv:1602.02410, 2016.
[16] Łukasz Kaiser and Samy Bengio. 능동 메모리가 어텐션을 대체할 수 있는가? In Advances in Neural Information Processing Systems, (NIPS), 2016.
[17] Łukasz Kaiser and Ilya Sutskever. 신경 GPU는 알고리즘을 학습한다. In International Conference on Learning Representations (ICLR), 2016.
[18] Nal Kalchbrenner, Lasse Espeholt, Karen Simonyan, Aaron van den Oord, Alex Graves, and Koray Kavukcuoglu. 선형 시간 내의 신경 기계 번역. arXiv preprint arXiv:1610.10099, 2017.
[19] Yoon Kim, Carl Denton, Luong Hoang, and Alexander M. Rush. 구조화된 어텐션 네트워크. In International Conference on Learning Representations, 2017.
[20] Diederik Kingma and Jimmy Ba. Adam: 확률적 최적화를 위한 방법. In ICLR, 2015.
[21] Oleksii Kuchaiev and Boris Ginsburg. LSTM 네트워크를 위한 인수분해 기법. arXiv preprint arXiv:1703.10722, 2017.
[22] Zhouhan Lin, Minwei Feng, Cicero Nogueira dos Santos, Mo Yu, Bing Xiang, Bowen Zhou, and Yoshua Bengio. 구조화된 자기 어텐션 문장 임베딩. arXiv preprint arXiv:1703.03130, 2017.
[23] Minh-Thang Luong, Quoc V. Le, Ilya Sutskever, Oriol Vinyals, and Lukasz Kaiser. 다중 작업 시퀀스 대 시퀀스 학습. arXiv preprint arXiv:1511.06114, 2015.
[24] Minh-Thang Luong, Hieu Pham, Christopher D Manning. 주의 기반 신경망 기계 번역에 대한 효과적인 접근법. arXiv preprint arXiv:1508.04025, 2015.
[25] Mitchell P Marcus, Mary Ann Marcinkiewicz, Beatrice Santorini. 영어 대규모 주석 코퍼스 구축: Penn Treebank. Computational linguistics, 19(2):313-330, 1993.
[26] David McClosky, Eugene Charniak, Mark Johnson. 구문 분석을 위한 효과적인 자기 훈련. NAACL 인간 언어 기술 회의 본회의 논문집, 152-159쪽. ACL, 2006년 6월.
[27] Ankur Parikh, Oscar Tackström, Dipanjan Das, Jakob Uszkoreit. 분해 가능한 주의 모델. 자연어 처리 경험적 방법론, 2016.
[28] Romain Paulus, Caiming Xiong, Richard Socher. 추상적 요약을 위한 심층 강화 모델. arXiv preprint arXiv:1705.04304, 2017.
[29] Slav Petrov, Leon Barrett, Romain Thibaux, Dan Klein. 정확하고 간결하며 해석 가능한 트리 주석 학습. 제21회 국제 전산언어학 회의 및 제44회 ACL 연례 회의 논문집, 433-440쪽. ACL, 2006년 7월.
[30] Ofir Press, Lior Wolf. 출력 임베딩을 사용한 언어 모델 개선. arXiv preprint arXiv:1608.05859, 2016.
[31] Rico Sennrich, Barry Haddow, Alexandra Birch. 하위 단어 단위를 사용한 희귀 단어의 신경망 기계 번역. arXiv preprint arXiv:1508.07909, 2015.
[32] Noam Shazeer, Azalia Mirhoseini, Krzysztof Maziarz, Andy Davis, Quoc Le, Geoffrey Hinton, Jeff Dean. 엄청나게 큰 신경망: 희소 게이트 혼합 전문가 계층. arXiv preprint arXiv:1701.06538, 2017.
[33] Nitish Srivastava, Geoffrey E Hinton, Alex Krizhevsky, Ilya Sutskever, Ruslan Salakhutdinov. 드롭아웃: 신경망의 과적합을 방지하는 간단한 방법. Journal of Machine Learning Research, 15(1):1929-1958, 2014.
[34] Sainbayar Sukhbaatar, Arthur Szlam, Jason Weston, Rob Fergus. 종단 간 메모리 네트워크. C. Cortes, N. D. Lawrence, D. D. Lee, M. Sugiyama, R. Garnett 편집, Advances in Neural Information Processing Systems 28, 2440-2448쪽. Curran Associates, Inc., 2015.
[35] Ilya Sutskever, Oriol Vinyals, Quoc VV Le. 신경망을 이용한 시퀀스 대 시퀀스 학습. Advances in Neural Information Processing Systems, 3104-3112쪽, 2014.
[36] Christian Szegedy, Vincent Vanhoucke, Sergey Ioffe, Jonathon Shlens, Zbigniew Wojna. 컴퓨터 비전을 위한 인셉션 아키텍처 재고. CoRR, abs/1512.00567, 2015.
[37] Vinyals & Kaiser, Koo, Petrov, Sutskever, Hinton. 외국어로서의 문법. Advances in Neural Information Processing Systems, 2015.
[38] Yonghui Wu, Mike Schuster, Zhifeng Chen, Quoc V Le, Mohammad Norouzi, Wolfgang Macherey, Maxim Krikun, Yuan Cao, Qin Gao, Klaus Macherey, 외. 구글의 신경망 기계 번역 시스템: 인간 번역과 기계 번역 간의 격차 해소. arXiv preprint arXiv:1609.08144, 2016.
[39] Jie Zhou, Ying Cao, Xuguang Wang, Peng Li, Wei Xu. 신경망 기계 번역을 위한 고속 순방향 연결을 갖춘 심층 순환 모델. CoRR, abs/1606.04199, 2016.
[40] Muhua Zhu, Yue Zhang, Wenliang Chen, Min Zhang, Jingbo Zhu. 빠르고 정확한 이동-축소 구성 구문 분석. 제51회 ACL 연례 회의 논문집(제1권: 장문 논문), 434-443쪽. ACL, 2013년 8월.