
antiSMASH 8.0 parcourt les génomes microbiens à la recherche de clusters de biosynthèse, de 81 à 101 types détectés. Article 2025, lecture gratuite.
antiSMASH 8.0: extended gene cluster detection capabilities and analyses of chemistry, enzymology, and regulation
antiSMASH 8.0 : capacités étendues de détection des clusters de gènes et analyses de la chimie, de l'enzymologie et de la régulation
Blin, K. ; Shaw, S. ; Vader, L. ; Szenei, J. ; Reitz, Z.L. ; Augustijn, H.E. ; ... ; Weber, T.
Citation
Blin, K., Shaw, S., Vader, L., Szenei, J., Reitz, Z. L., Augustijn, H. E., ... Weber, T. (2025). antiSMASH 8.0: extended gene cluster detection capabilities and analyses of chemistry, enzymology, and regulation. Nucleic Acids Research, 53(W1), W32- W38. doi:10.1093/nar/gkaf334
Version : Version de l'éditeur Licence : Licence Creative Commons CC BY 4.0 Téléchargé depuis : https://hdl.handle.net/1887/4285886
Remarque : Pour citer cette publication, veuillez utiliser la version finale publiée (le cas échéant).
antiSMASH 8.0 : capacités étendues de détection des clusters de gènes et analyses de la chimie, de l'enzymologie et de la régulation
Kai Blin , Simon Shaw , Lisa Vader , Judit Szenei , Zachary L. Reitz , Hannah E. Augustijn , José D.D. Cédiel- Becerra , Valérie de Crécy- Lagard , Robert A. Koetsier , Sam E. Williams , Pablo Cruz- Morales , Sopida Wongwas , Alejandro E. Segurado Luchsinger , Friederike Biermann , Aleksandra Korenskaia , Mitja M. Zdouc , David Meijer , Barbara R. Terlouw , Justin J.J. van der Hooft , Nadine Ziemert , Eric J.N. Helfrich , Joleen Masschelein , Christophe Corre , Marc G. Chevrette , Gilles P. van Wezel , Marnix H. Medema , Tilmann Weber
Auteur correspondant. Courriel : kblin@biosustain.dtu.dk La correspondance peut également être adressée à Marnix H. Medema. Courriel : marnix.medema@wur.nl La correspondance peut également être adressée à Tilmann Weber. Courriel : tiwe@biosustain.dtu.dk
Résumé
Les micro-organismes synthétisent de petits composés bioactifs par leur métabolisme secondaire ou spécialisé. Ces composés jouent un rôle important dans les interactions microbiennes et la santé des sols, mais sont également essentiels pour le développement de produits pharmaceutiques ou agrochimiques. Au cours des dernières décennies, les progrès du séquençage des génomes ont permis l'identification d'un grand nombre de clusters de gènes de biosynthèse directement à partir des génomes microbiens. Depuis sa création en 2011, antiSMASH (https://antismash. secondarymetabolites.org/) est devenu l'outil de référence pour la détection et la caractérisation de ces clusters de gènes chez les bactéries et les champignons. Cet article présente la version 8 d'antiSMASH, qui a porté le nombre de types de clusters détectables de 81 à 101, et qui a amélioré la prise en charge de l'analyse des terpénoïdes et des enzymes de décoration, ainsi que l'analyse des enzymes modulaires comme les polykétide synthases et les peptide synthetases non ribosomiques. Ces modifications permettent à antiSMASH de rester à jour avec les développements du domaine et d'étendre ses capacités prédictives globales pour l'exploration des génomes de produits naturels.
Résumé graphique
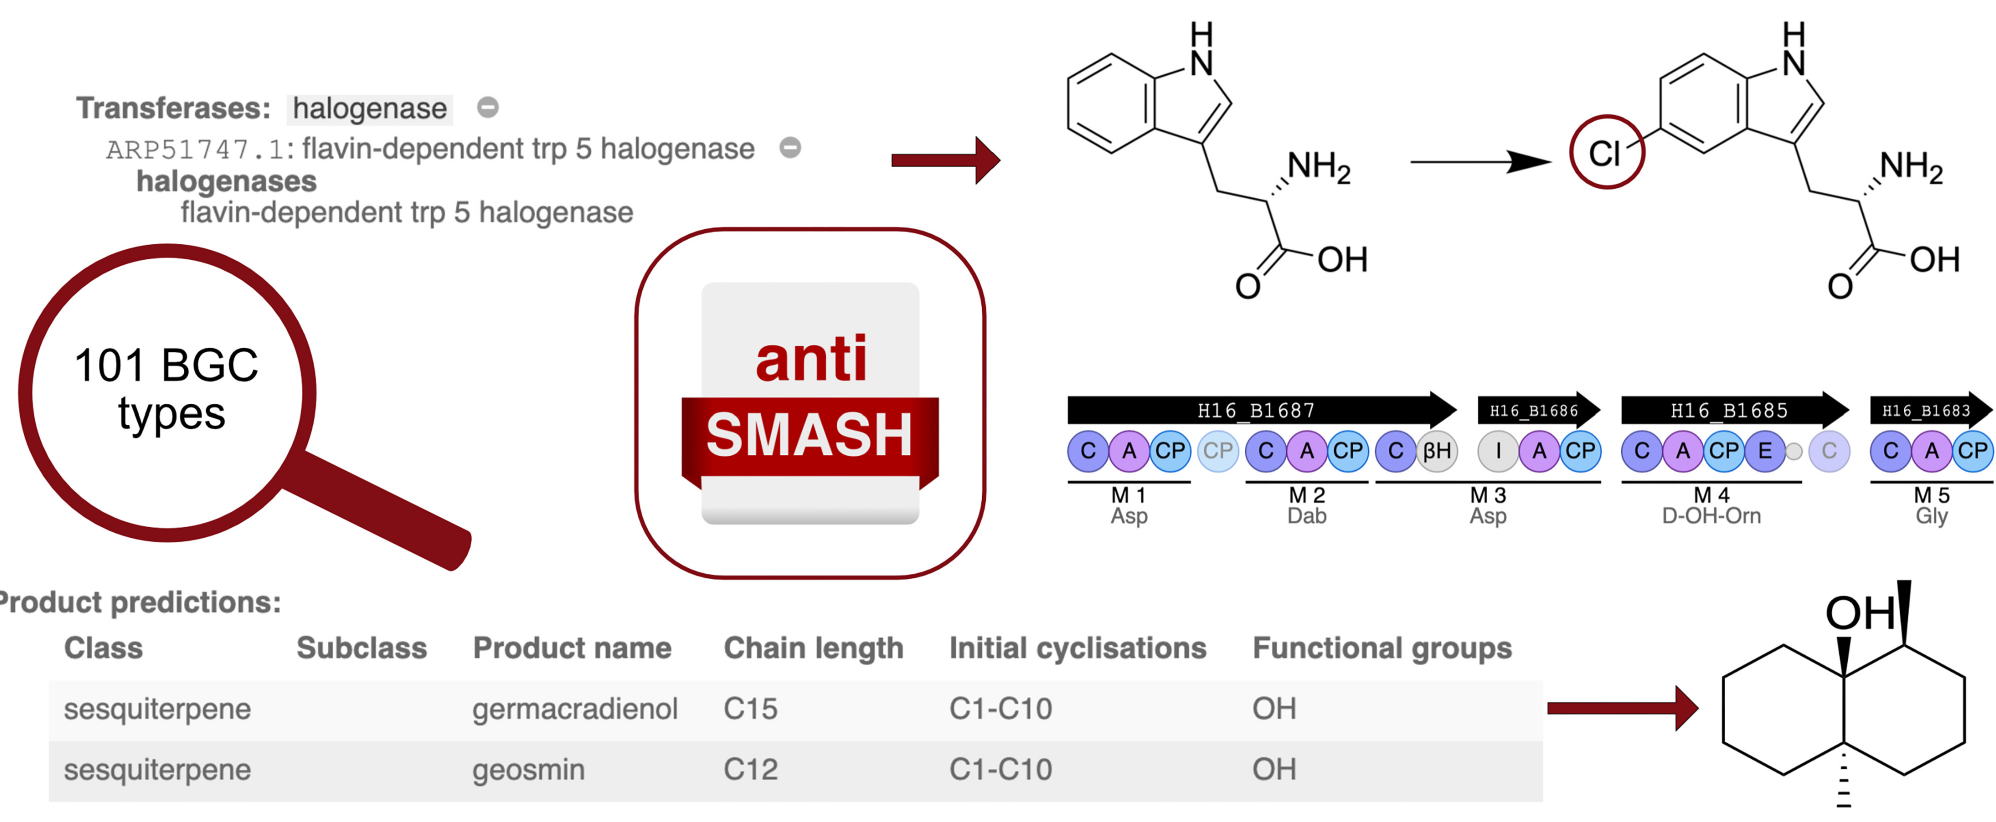
Introduction
Les petites molécules bioactives produites par les micro-organismes constituent une source importante de médicaments [1] et de produits agrochimiques [2], et jouent un rôle important dans les interactions microbiennes et la santé des sols. Au cours des 20 à 25 dernières années, l'abondance des données génomiques disponibles a permis d'améliorer les flux de travail traditionnels consistant à isoler des souches microbiennes, extraire des composés, puis cribler pour les activités recherchées en recherchant dans les génomes microbiens les clusters de gènes de biosynthèse (BGC) codant pour la biosynthèse de ces molécules [3]. Des outils logiciels permettant de rechercher dans les génomes ces BGC produisant des métabolites secondaires/spécialisés existent depuis plus d'une décennie [4- 7].
Depuis sa première version en 2011, antiSMASH [8- 14] est devenu l'outil de référence du domaine. Autour d'antiSMASH s'est développé un large écosystème d'outils connexes qui intègrent ou s'appuient sur les prédictions d'antiSMASH. Citons notamment l'outil d'exploration basé sur la résistance ARTS [15], le Seq2PKS guidé par spectrométrie de masse [16], l'outil d'ingénierie génomique StreptoCAD [17], l'outil de mise en réseau et de regroupement de BGC BiG- SCAPE [18], et l'outil d'analyse d'omiques appariées NPLinker [19]. À son tour, antiSMASH peut également intégrer les prédictions de BGC d'autres outils [13]. Initialement conçu pour DeepBGC [20], d'autres outils basés sur l'apprentissage automatique comme GECCO [21] fournissent également leurs résultats dans le format requis. Les prédictions de BGC d'antiSMASH sont également utilisées dans de nombreuses bases de données génomiques et liées aux BGC, telles que le Secondary Metabolite Collaboratory du Joint Genome Institute [22], la plateforme MicroScope pour l'annotation et l'analyse des génomes [23], la base de données MIBiG de BGC curés manuellement [24], la base de données de familles de BGC BiG- FAM [25], la base de données de métagénomes de diversité chimique BGC Atlas [26], et la base de données antiSMASH [27]. En outre, antiSMASH fait partie de plusieurs flux de travail systématiques pour l'analyse à grande échelle de données génomiques, par exemple BGCFlow [28] ou le MicroOrganisms Pipelines Service [29] de l'Autorité européenne de sécurité des aliments (EFSA).
Nous présentons ici la version 8 d'antiSMASH. Cette version augmente le nombre de types de voies de biosynthèse détectables de 81 à 101, ajoute un module d'analyse pour les BGC de terpénoïdes et fournit une analyse approfondie des enzymes de décoration.
De plus, les jeux de données KnownClusterBlast et ClusterCompare ont été mis à jour pour refléter les données de la version 4 de MIBiG, nous avons ajouté une prise en charge adéquate des BGC chevauchant l'origine de réplication dans les génomes circulaires, et les prédictions de sites de liaison de facteurs de transcription ont été étendues avec des jeux de données de la base de données CollecTF [30]. Dans les BGC contenant des peptide synthetases non ribosomiques (NRPS) ou des polykétide synthases (PKS) de type I, davantage de domaines biosynthétiques sont détectés et analysés.
Nouvelles fonctionnalités et mises à jour
Mises à jour de la détection des BGC
antiSMASH utilise des règles curées manuellement pour définir quelles fonctions biosynthétiques doivent être présentes dans une région génomique afin de définir un BGC. Pour identifier ces fonctions biosynthétiques, antiSMASH recourt à la fois à des modèles de Markov cachés de profils (pHMM) et, dans une moindre mesure, à des profils dynamiques spécifiés dans des fichiers de code Python. Les pHMM proviennent de jeux de données publics tels que PFAM [31], TIGRFAMS [32], SMART [33], BAGEL [34], Yadav et al. [35], ou sont créés spécifiquement pour être utilisés dans antiSMASH. antiSMASH 7 contenait 81 de ces règles de BGC [14], ce nombre est passé à 101 dans cette version, un certain nombre de règles existantes ayant été affinées. En raison du chevauchement important des enzymes biosynthétiques, il est difficile de différencier les peptides linéaires contenant des azoles des thiopeptides circularisés liés par thioéther. Dans la base de données antiSMASH actuelle [27], des appels de BGC de thiopeptides et des appels de BGC de peptides linéaires contenant des azoles se chevauchent, et il n'est pas clair combien parmi les assignations restantes sont correctes. Pour répondre à cette incertitude et éviter toute confusion potentielle, les règles de détection des deux types de BGC ont été fusionnées en une nouvelle « règle des RiPP contenant des azoles ». Les règles de détection des terpènes, des mycosporines, des sidérophores indépendants des NRPS, des PKS trans-AT, des NRPS, des clusters de type NRPS et des acides gras ont également été mises à jour. De plus, de nouvelles règles ont été ajoutées pour les peptides ribosomaux et post-traductionnellement modifiés (RiPP) archéens, les atropopeptides, l'acide nitropropanoïque, les composés contenant de l'azoxy, les polyynes, les déazapurines, les pyrroles polyhalogénés, les hydroxytropolones, les cyanures d'hydrogène, les darobactines, les isocyanures, les dipeptides cycliques bactériens etfongiques, les triceptides, les PKS de type II hautement réducteurs et la biosynthèse fongique de la lysine de type NRPS.
:
:
:
:
:
:
:
:
:
:
:
:
::
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
: : antiSMASH fournit une analyse détaillée des domaines protéiques codés dans les BGC NRPS/PKS. Afin de fournir un aperçu plus complet des domaines présents, nous avons ajouté des profils pour les -hydroxylases associées aux sidérophores et les domaines d'interface (voir [37] pour une discussion détaillée) ainsi qu'un profil plus générique -
Pour couvrir les cas où des sections contiguës de certains gènes core étaient trop éloignées des autres gènes core, une nouvelle condition « EXTENDS » a été ajoutée à la définition des règles afin de garantir que tous les gènes core soient correctement marqués. Les règles des PKS trans-AT utilisent cette condition pour s'assurer que tous les gènes contenant des modules sont détectés correctement, même lorsque le domaine acyltransférase (AT) trans-agissant unique est éloigné.
Analyse des terpènes
Bien qu'antiSMASH détecte les clusters de gènes de terpènes depuis la version 1 [8], une analyse plus détaillée des terpène synthases/cyclases faisait défaut. La version 4 d'antiSMASH [11] avait ajouté un module d'analyse initial, mais en raison de limitations de performance de l'algorithme de placement phylogénétique et de défis de maintenabilité, celui-ci a de nouveau été supprimé dans antiSMASH 5 [12]. Pour la version 8, nous assistons au retour de l'analyse des terpènes basée sur des pHMM soigneusement sélectionnés (voir Fig. 1A). Pour chaque région contenant un BGC de terpènes, une liste de types de produits potentiels est affichée. Chaque prédiction inclut la classe de terpénoïde (par ex. diterpène, sesquiterpène, etc.) et la longueur de chaîne du produit prédit. Pour les sous-familles de terpène synthases mieux comprises, la prédiction peut également contenir la sous-classe de terpénoïde (par ex. indole diterpénoïde), les cyclisations initiales (par ex. C1-C15) et le nom du produit.
Analyse de la fonction des gènes
Lors du grand effort communautaire visant à mieux annoter les enzymes de maturation dans les entrées MIBiG lors des annotations MIBiG de l'année dernière (voir [24] pour une description), nous avons constaté qu'une interface plus conviviale pour accéder aux réactions des enzymes de maturation était nécessaire dans antiSMASH. En utilisant la collection d'enzymes de maturation de la base de données MITE (https://mite.bioinformatics. nl/) [36] annotées lors de ces annotathons, ainsi que nos annotations smCOG existantes, nous présentons désormais les informations sur les enzymes de maturation dans un onglet dédié « tailoring » (voir Fig. 1B). Cela nous a également donné l'occasion de rapporter les spécificités de substrat de nombreuses halogenases dépendantes du flavine, également ajoutées dans cette version. À l'aide de pHMM personnalisés et de signatures de motifs conservés, les prédictions vont du « pyrrole halogéné » à la régiosélectivité de, par exemple, tryptophane halogenases, selon la disponibilité des données.
Dans l'onglet tailoring, les enzymes de maturation sont organisées par catégorie de la Commission des enzymes, c'est-à-dire oxydoréductases, transférases, hydrolases, lyases, isomérases et ligases. Seules les catégories comportant des hits dans la région sont affichées. Cliquer sur les icônes plus développe la catégorie pour montrer les gènes avec des hits pertinents et un bref résumé de la prédiction la plus détaillée possible de la fonction de maturation. Cliquer sur l'icône plus d'un gène d'intérêt développe toutes les informations qu'antiSMASH fournit sur une enzyme de maturation. Si une enzyme de maturation présente au moins d'identité de séquence d'acides aminés avec une entrée de la base de données MITE, un lien croisé vers cette entrée MITE est fourni.
Améliorations des NRPS et PKS
Les domaines CoA-ligase (CAL) sont souvent impliqués dans le chargement d'unités de départ dérivées d'acides gras dans les BGC de lipopeptides, mais n'étaient pas auparavant considérés comme des modules de départ dans la détection de modules d'antiSMASH. Avec les -hydroxylases et les domaines d'interface mentionnés précédemment, ils peuvent désormais être détectés comme faisant partie des modules.
Suite aux informations rassemblées dans [38], les sites actifs des domaines de condensation (C) et d'épimérisation (E) des NRPS sont désormais vérifiés pour la présence de résidus catalytiques et signalés comme inactifs lorsque ces résidus sont absents. Pour compléter les prédictions de spécificité de substrat du domaine d'adénylation (A) des NRPS déjà réalisées dans antiSMASH, nous fournissons désormais également un lien vers le prédicteur externe de spécificité de substrat PARAS [39] afin d'offrir aux chercheurs encore plus d'options d'analyse.
Modifications diverses
De nombreuses autres modifications plus petites ont été incluses dans la version 8. La vue de la page d'aperçu montrant les clusters connus les plus similaires a été simplifiée pour remédier à certaines sources de confusion des utilisateurs. Au lieu d'afficher directement la similarité des clusters en « pourcentage des gènes ayant une similarité de séquence d'au moins », nous affichons désormais la similarité en trois niveaux de confiance : « élevé » pour une similarité de cluster supérieure ou égale à , « moyen » pour une similarité de cluster entre et , et « faible » pour une similarité de cluster entre et . Les similarités de cluster ne sont plus considérées comme suffisamment similaires et ne sont plus affichées dans l'aperçu. Known ClusterBlast, ClusterCompare et CompaRiPPson ont été mis à jour avec les données fournies dans la version MIBiG 4.0 [24]. La génération SVG de ClusterBlast a été déplacée vers JavaScript afin de réduire la taille des fichiers et d'améliorer l'expérience utilisateur lors de la visualisation des résultats antiSMASH ouverts localement. Historiquement, antiSMASH a eu des difficultés avec les BGC chevauchant l'origine dans les génomes circulaires. Au mieux, ces BGC étaient divisés en deux ; au pire, l'une ou les deux parties situées de part et d'autre de l'origine pouvaient être entièrement manquées. Dans antiSMASH 8.0, nous avons complètement remanié notre gestion des coordonnées pour les génomes circulaires afin qu'ils soient détectés et signalés correctement.
Historiquement, antiSMASH s'appuyait sur GlimmerHMM [40] pour l'appel des gènes fongiques, car il pouvait fonctionner sans sélection manuelle du bon modèle de gène. Malheureusement, avec de plus en plus de génomes fongiques disponibles, il est devenu évident que cette sélection du modèle de gène est cruciale pour un appel de gènes de haute qualité. Comme nous ne pouvons pas facilement sélectionner le bon modèle de gène pour des génomes téléchargés de taxons inconnus, nous avons décidé de supprimer la fonctionnalité d'appel des gènes fongiques d'antiSMASH. Nous recommandons aux utilisateurs d'exécuter un outil dédié à l'appel de gènes comme AUGUSTUS [41], puis de fournir les annotations de gènes à antiSMASH. En raison d'incompatibilités logicielles sur les systèmes modernes, nous avons également déprécié notre prise en charge de la suite d'outils MEME, en particulier MEME [42] et FIMO [43]. Les utilisateurs de la version autonome d'antiSMASH peuvent toujours fournir ces binaires eux-mêmes, mais ils ne font plus partie des conteneurs que nous fournissons ni du service web. Cela désactive effectivement la détection des bordures de BGC fongiques CASSIS [44] et pourrait affecter le score RODEO [45] pour les précurseurs de RiPP de type lanthipeptide, sactipeptide, lasso peptide et contenant un azole.
A
Prédictions détaillées des terpènes
| Prédictions de produits : | |||||
| Classe | Sous-classe | Nom du produit | Longueur de chaîne | Cyclisations initiales | Groupes fonctionnels |
| sesquiterpène | germacradiénol | C15 | C1-C10 | OH | |
| sesquiterpène | géosmine | C12 | C1-C10 | OH |
Gènes avec domaines de terpène :
scO6073 : T1TS + T1TS
Domaine 1 (0 - 326) : terpène synthase de type 1 Sous-type : géosmine synthase, domaine N-terminal Réactions : FPP → germacradiènol
Domaine 2 (326 - 695) : terpène synthase de type 1
Sous-type : géosmine synthase, domaine C-terminal Réactions : germacradiènol → géosmine
B
Fonctions de maturation
Oxydoréductases : oxygénase
oxyA : cyclisation
oxyB : cyclisation
oxyC : cyclisation
oxyD : cytochrome P450
Transférases : aminotransférase glycosyltransférase halogenase méthyltransférase
bgtFA : glycosylation
bgtFB : glycosylation
bgtFC : glycosylation
bhaA : halogenase dépendante du flavine de type tyrosine hpg halogenases halogenase dépendante du flavine de type tyrosine hpg halogenase
MITF
MITEO000028 Halogénation (identité : 100.00%) smcogs SMCOG1119 : halogenase
bmt : méthylation
dvaB : DegT/DnrJ/ErYC1/StrS aminotransférase
pgaT : aminotransférase
Hydrolases : hydrolase
bhp : protéine à repliement alpha/bêta hydrolase
Lyases : hydratase
dpgC : énoyl-CoA hydratase
dpgD : énoyl-CoA hydratase
Ligases : ligase synthase
Conclusion et perspectives d'avenir
Conclusion et perspectives d'avenirLes technologies d'exploration génomique comme antiSMASH constituent une pièce importante du puzzle de la découverte de produits naturels. Au cours des 14 dernières années, antiSMASH a bénéficié de mises à jour et d'améliorations continues, lui permettant de rester à la pointe des outils d'exploration génomique de produits naturels. Comme en témoignent les nombreuses contributions extérieures à l'équipe de développement principale, le modèle Open Source et Open Science du projet antiSMASH reste un succès. C'est un outil important sur lequel reposent de nombreux autres outils, workflows et bases de données plus spécialisés. Il sert de plateforme technologique pour un certain nombre d'autres outils d'exploration génomique actuellement en développement. Dans les futures mises à jour, nous poursuivrons notre travail sur de nouveaux algorithmes et modules d'analyse afin de déchiffrer les voies de biosynthèse complètes des clusters détectés. Nous nous appuierons sur les fondations des améliorations de la prédiction des enzymes de maturation de cette version et couvrirons encore davantage de familles d'enzymes. De même, notre travail sur la détection des régulateurs et des sites de liaison des régulateurs se poursuivra. Comme toujours, nous intégrerons également, ou nous nous intégrerons avec, de nouveaux outils développés dans l'écosystème.
Remerciements
RemerciementsContributions des auteurs : Kai Blin (Conceptualisation [principal], Gestion des données [principal], Acquisition de financement [égal], Méthodologie [principal], Administration du projet [principal], Logiciel [égal], Supervision [égal], Rédaction—version originale [principal], Rédaction—révision et édition [principal], Simon Shaw (Gestion des données [égal], Méthodologie [égal], Logiciel [principal], Visualisation [principal], Lisa Vader (Gestion des données [soutien], Logiciel [soutien], Visualisation [soutien], Judit Szenei (Gestion des données [soutien], Logiciel [soutien], Visualisation [soutien], Zachary L. Reitz (Gestion des données [soutien], Logiciel [soutien], Hannah E. Augustin (Gestion des données [soutien], Logiciel [soutien]), José D.D. Cediel- Becerra (Gestion des données [soutien], Logiciel [soutien], Valérie de Crécy- Lagard (Gestion des données [soutien], Robert A. Koetsier (Gestion des données [soutien], Logiciel [soutien]), Sam E. Williams (Gestion des données [soutien], Pablo Cruz- Morales (Gestion des données [soutien]), Sopida Wongwas (Gestion des données [soutien]), Alejandro E. Segurado Luchsinger (Gestion des données [soutien]), Friederike Biermann (Gestion des données [soutien]), Aleksandra Korenskaia (Gestion des données [soutien]), Mitja M. Zdouc (Gestion des données [soutien], Rédaction—version originale [soutien]), David Meijer (Gestion des données [soutien]), Barbara R. Terlouw (Gestion des données [soutien]), Justin J.J. van der Hooft (Acquisition de financement [égal], Rédaction—version originale [soutien]), Nadine Ziemert (Acquisition de financement [égal], Supervision [égal]), Eric J.N. Helfrich (Acquisition de financement [égal], Supervision [égal], Rédaction—version originale [soutien]), Joleen Masschelein (Gestion des données [soutien], Acquisition de financement [égal], Supervision [égal]), Christophe Corre (Acquisition de financement [égal], Supervision [égal]), Marc G. Chevrette (Acquisition de financement [égal], Supervision [égal]), Gilles P. van Wezel (Acquisition de financement [égal], Supervision [égal]), Marnix H. Medema (Conceptualisation [soutien], Acquisition de financement [égal], Supervision [égal], Rédaction—version originale [soutien]), et Tilmann Weber (Conceptualisation [soutien], Acquisition de financement [égal], Supervision [égal], Validation [soutien], Rédaction—version originale [soutien])
Conflit d'intérêts
J.J.vdH. est membre du comité consultatif scientifique de NAICONS Srl, Milan, Italie, et est consultant pour Corteva Agriscience, Indianapolis, IN, États-Unis. M.H.M. est membre du comité consultatif scientifique de Hexagon Bio. Tous les autres auteurs déclarent n'avoir aucun conflit d'intérêts.
Financement
Financement : Fondation Novo Nordisk [NNF20CC0035580 à T.W., K.B. et P.C.-M., NNF22OC0079021 à S.E.W.] ; Centre pour les métabolites secondaires microbiens (CeMiSt), Fondation nationale danoise de la recherche [DNRF137 à T.W.] ; Programme Horizon Europe de l'UE MAGic-MOLFUN [MSC 101072485 à T.W., K.B., M.H.M., N.Z., A.K. et J.J.vdH.] ; Horizon 2020 de l'UE MARBLES [101000392 à M.M.Z., J.J.vdH., M.H.M. et G.P.vW.] ; NWO [KICH1.LWV04.21.013 à M.M.Z., J.J.vdH. et M.H.M.] ; Communauté ERC de l'UE [101055020 à G.P.vW.] ; NWO-XL [OCENW.XL21.XL21.088 à R.A.K.] ; National Institutes of Health [RM1GM145426 à VdC.-L.] ; Centre allemand de recherche sur les infections (DZIF) [TTU09.716 à N.Z.] ; Horizon 2020 de l'UE DECIPHER [948770 à D.M. et M.H.M.] ; Gouvernement royal thaïlandais [financement de doctorat à S.W.] ; Programme Emmy Noether de la Fondation allemande pour la recherche [504947087 à E.J.N.H.], Ministère hessois des Sciences et des Arts [Centre LOEWE pour la génomique translationnelle de la biodiversité à E.J.N.H.] ; FWO [1008520N et G061821N à J.M.]. Les frais de publication en libre accès de cet article ont été pris en charge par le programme Horizon Europe de l'UE MAGic-MOLFUN.
Disponibilité des données
Les versions bactérienne et fongique d'antiSMASH 8.0 sont librement accessibles à l'adresse https://antismash.secondarymetabolites.org et https://fungismash.secondarymetabolites.org, respectivement.
La documentation d'antiSMASH est disponible à l'adresse https://docs.antismash.secondarymetabolites.org/.
Le code source d'antiSMASH est sous licence GNU Affero General Public License (AGPL) version 3.0. antiSMASH est également disponible via Docker. Consultez le site de documentation pour plus de détails sur la façon de télécharger et d'installer antiSMASH.
Références
1. Newman DJ, Cragg GM. Natural products as sources of new drugs over the nearly four decades from 01/1981 to 09/2019. BMC Genomics 2020;83:1138-43. https://doi.org/10.1021/acs.jnatprod.9b01285 2. Sparks TC, Bryant RJ. Impact of natural products on discovery of, and innovation in, crop protection compounds. Pest Manag Sci 2022;78:399-408. https://doi.org/10.1002/ps.6653 3. Ziemert N, Alanjary M, Weber T. The evolution of genome mining in microbes—a review. Nat Prod Rep 2016;33:988-1005. https://doi.org/10.1039/C6NP00025H 4. Weber T. In silico tools for the analysis of antibiotic biosynthesis pathways. Int J Med Microbiol 2014;304:230-5. https://doi.org/10.1016/j.ijmm.2014.02.001 5. Medema MH, Fischbach MA. Computational approaches to natural product discovery. Nat Chem Biol 2015;11:639-48. https://doi.org/10.1038/nchembio.1884 6. Weber T, Kim HU. The secondary metabolite bioinformatics portal: computational tools to facilitate synthetic biology of secondary metabolite production. Synth Syst Biotechnol 2016;1:69- 79. https://doi.org/10.1016/j.synbio.2015.12.0027. Blin K, Kim HU, Medema MH et al. Recent development of antiSMASH and other computational approaches to mine secondary metabolite biosynthetic gene clusters. Brief Bioinform 2019;20:1103- 13. https://doi.org/10.1093/bib/bbx1468. Medema MH, Blin K, Cimermancic P et al. antiSMASH: rapid identification, annotation and analysis of secondary metabolite biosynthesis gene clusters in bacterial and fungal genome sequences. Nucleic Acids Res 2011;39:W339- 46. https://doi.org/10.1093/nar/gkr4669. Blin K, Medema MH, Kazempour D et al. antiSMASH 2.0- a versatile platform for genome mining of secondary metabolite producers. Nucleic Acids Res 2013;41:W204- 12. https://doi.org/10.1093/nar/gkt44910. Weber T, Blin K, Duddela S et al. antiSMASH 3.0- a comprehensive resource for the genome mining of biosynthetic gene clusters. Nucleic Acids Res 2015;43:W237- 43. https://doi.org/10.1093/nar/gkv43711. Blin K, Wolf T, Chevrette MG et al. antiSMASH 4.0- improvements in chemistry prediction and gene cluster boundary identification. Nucleic Acids Res 2017;45:W36- 411. https://doi.org/10.1093/nar/gkx31912. Blin K, Shaw S, Steinke K et al. antiSMASH 5.0: updates to the secondary metabolite genome mining pipeline. Nucleic Acids Res 2019;47:W81- 7. https://doi.org/10.1093/nar/gkz31013. Blin K, Shaw S, Kloosterman AM et al. antiSMASH 6.0: improving cluster detection and comparison capabilities. Nucleic Acids Res 2021;49:W29- 35. https://doi.org/10.1093/nar/gkab33514. Blin K, Shaw S, Augustijn HE et al. antiSMASH 7.0: new and improved predictions for detection, regulation, chemical structures and visualisation. Nucleic Acids Res 2023;51:W46- 50. https://doi.org/10.1093/nar/gkad34415. Mungan MD, Alanjary M, Blin K et al. ARTS 2.0: feature updates and expansion of the Antibiotic Resistant Target Seeker for comparative genome mining. Nucleic Acids Res 2020;48:W546- 52. https://doi.org/10.1093/nar/gkaa37416. Yan D, Zhou M, Adduri A et al. Discovering type I cis- AT polyketides through computational mass spectrometry and genome mining with Seq2PKS. Nat Commun 2024;15:5356. https://doi.org/10.1038/s41467- 024- 49587- 117. Levasor L, Whitford CM, Petersen SD et al. StreptoCAD: an open- source software toolbox automating genome engineering workflows in streptomycetes. bioRxiv, https://doi.org/10.1101/2024.12.19.629370, 20 December 2024, preprint: not peer reviewed.18. Navarro- Munoz JC, Selem- Mojica N, Mullowney MW et al. A computational framework to explore large- scale biosynthetic diversity. Nat Chem Biol 2020;16:60- 8. https://doi.org/10.1038/s41589- 019- 0400- 919. Eldjarn GH, Ramsay A, Hooft JJJvd et al. Ranking microbial metabolomic and genomic links in the NPLinker framework using complementary scoring functions. PLOS Comput Biol 2021;17:e1008920. https://doi.org/10.1371/journal.pcbi.100892020. Hannigan GD, Prihoda D, Palicka A et al. A deep learning genome- mining strategy for biosynthetic gene cluster prediction. Nucleic Acids Res 2019;47:e110. https://doi.org/10.1093/nar/gkz65421. Carroll LM, Larralde M, Fleck JS et al. Accurate de novo identification of biosynthetic gene clusters with GECCO. bioRxiv, https://doi.org/10.1101/2021.05.03.442509, 4 May 2021, preprint: not peer reviewed.22. Udwary DW, Doering DT, Foster B et al. The secondary metabolism collaboratory: a database and web discussion portal for secondary metabolite biosynthetic gene clusters. Nucleic Acids Res 2025;53:D717- 23. https://doi.org/10.1093/nar/gkae106023. Vallenet D, Calteau A, Dubois M et al. MicroScope: an integrated platform for the annotation and exploration of microbial gene functions through genomic, pangenomic and metabolicAnalyse comparative. Nucleic Acids Res 2020;48 : D579-89. https://doi.org/10.1093/nar/gkz92624. Zdouc MM, Blin K, Louwen NLL et al. MIBiG 4.0 : faire progresser la curation des groupes de gènes biosynthétiques grâce à une collaboration mondiale. Nucleic Acids Res 2025;53 : D678-90. https://doi.org/10.1093/nar/gkae111525. Kautsar SA, Blin K, Shaw S et al. BiG-FAM : la base de données des familles de groupes de gènes biosynthétiques. Nucleic Acids Res 2021;49 : D490-7. https://doi.org/10.1093/nar/gkaa81226. Bagci C, Nuhamunada M, Goyat H et al. BGC Atlas : une ressource web pour explorer la diversité chimique mondiale encodée dans les génomes bactériens. Nucleic Acids Res 2025;53 : D618-24. https://doi.org/10.1093/nar/gkae95327. Blin K, Shaw S, Medema MH et al. La base de données antiSMASH version 4 : génomes et BGC supplémentaires, nouvelles recherches basées sur les séquences et plus encore. Nucleic Acids Res 2024;52 : D586-9. https://doi.org/10.1093/nar/gkad98428. Nuhamunada M, Mohite OS, Phaneuf PV et al. BGCFlow : flux de travail pangénomique systématique pour l'analyse des groupes de gènes biosynthétiques à travers de grands jeux de données génomiques. Nucleic Acids Res 2024;52 : 5478-95. https://doi.org/10.1093/nar/gkae31429. Yolanda GC. Service de pipelines pour micro-organismes (MOPS) : documentation des pipelines. Rapport technique.30. Kilu S, White ER, Sagitova DM et al. CollecTF : une base de données de sites de liaison de facteurs de transcription validés expérimentalement chez les bactéries. Nucleic Acids Res 2014;42 : D156-6030. https://doi.org/10.1093/nar/gkt112331. Mistry J, Chugarunsky S, Williams L et al. Pfam : la base de données des familles de protéines en 2021. Nucleic Acids Res 2021;49 : D412-9. https://doi.org/10.1093/nar/gkaa91332. Haft DH, Selengut JD, Richter RA et al. TIGRFAMs et propriétés des génomes en 2013. Nucleic Acids Res 2013;41 : D387-953. https://doi.org/10.1093/nar/gks123433. Letunic I, Khedkar S, Bork P. SMART : mises à jour récentes, nouveaux développements et état en 2020. Nucleic Acids Res 2021;49 : D458-60. https://doi.org/10.1093/nar/gkaa93734. van Heel AJ, de Jong A, Song C et al. BAGEL4 : un serveur web convivial pour explorer en profondeur les RiPPs et les bactériocines. Nucleic Acids Res 2018;46 : W278-81. https://doi.org/10.1093/nar/gky38335. Yadav G, Gokhale RS, Mohanty D. Vers la prédiction des produits métaboliques des polykétide synthases : une analyse in silico. PLOS Comput Biol 2009;5 : e1000351. https://doi.org/10.1371/journal.pcbi.100035136. Zdouc MM, Meijer D, Biermann F et al. Le standard de données sur les informations minimales relatives à une enzyme de maturation/mutaréase pour capturer la biosynthèse des produits naturels. ChemRxiv, https://doi.org/10.26434/chemrxiv-2024-78mtl, 9 avril 2024, prépublication : non évaluée par les pairs.37. Reitz ZL, Hardy CD, Suk J et al. L'analyse génomique des -hydroxylases de sidérophores révèle un stéréocontrôle divergent et élargit la famille des domaines de condensation. Proc Natl Acad Sci USA 2019;116 : 19805-14. https://doi.org/10.1073/pnas.190316111628. Bloudoff K, Schmeng TM. Aspects structuraux et fonctionnels de la superfamille des domaines de condensation des peptide synthétases non ribosomiques : découverte, dissection et diversité. Biochim Biophys Acta Proteins Proteom 2017;1865 : 1587-604. https://doi.org/10.1016/j.bbapap.2017.05.01039. Terlouw BR, Huang C, Meijer D et al. PARAS : apprentissage automatique de haute précision des spécificités de substrat dans les peptide synthétases non ribosomiques. bioRxiv, https://doi.org/10.1101/2025.01.08.631717, 10 janvier 2025, prépublication : non évaluée par les pairs.40. Majoros WH, Pertea M, Salzberg SL. TigrScan et GlimmerHMM : deux programmes open source de prédiction de gènes eucaryotes ab initio. Bioinformatics 2004;20 : 2878-9. https://doi.org/10.1093/bioinformatics/bth31541. Stanke M, Morgenstern B. AUGUSTUS : un serveur web pour la prédiction de gènes chez les eucaryotes qui permet des contraintes définies par l'utilisateur. Nucleic Acids Res 2005;33 : W465-7. https://doi.org/10.1093/nar/gk14858 42. Bailey TL, Elkan C. Ajustement d'un modèle de mélange par maximisation de l'espérance pour découvrir des motifs dans les biopolymères. Proc Int Conf Intell Syst Mol Biol 1994;2 : 28-36. 43. Grant CE, Bailey TL, Noble WS. FIMO : recherche des occurrences d'un motif donné. Bioinformatics 2011;27 : 1017-8. https://doi.org/10.1093/bioinformatics/btr064 44. Wolf T, Shelest V, Nath N et al. CASSIS et SMIPS : prédiction basée sur les promoteurs des groupes de gènes de métabolites secondaires dans les génomes eucaryotes. Bioinformatics 2016;32 : 1138-43. https://doi.org/10.1093/bioinformatics/btv713 45. Walker MC, Eslami SM, Hetrick KJ et al. L'exploration de plus de cent mille génomes ciblée sur les peptides précurseurs élargit la famille des produits naturels lanthipeptides. BMC Genomics 2020;21 : 387. https://doi.org/10.1186/s12864-020-06785-7