
NSA rend l'attention elle-même creuse et entraînable de bout en bout, réduisant le coût en contexte 64k sans perte de précision. ACL 2025, gratuit.
Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
Attention parcimonieuse native : attention parcimonieuse alignée sur le matériel et nativement entraînable
Jingyang Yuan , Huazuo Gao , Damai Dai , Junyu Luo , Liang Zhao , Zhengyan Zhang , Zhenda Xie , Y. X. Wei , Lean Wang , Zhiping Xiao , Yuqing Wang , Chong Ruan , Ming Zhang , Wenfeng Liang , Wangding Zeng
DeepSeek- AI Key Laboratory for Multimedia Information Processing, School of Computer Science, Peking University, PKU- Anker LLM Lab University of Washington {yuanjy, mzhang_cs}@pku.edu.cn, {zengwangding, wenfeng.liang}@deepseek.com
Résumé
La modélisation de contextes longs est cruciale pour les modèles de langue de nouvelle génération, mais le coût computationnel élevé des mécanismes d’attention standard pose d’importants défis computationnels. L’attention parcimonieuse offre une direction prometteuse pour améliorer l’efficacité tout en préservant les capacités du modèle. Nous présentons NSA, un mécanisme d’Attention Parcimonieuse Nativement entraînable qui intègre des innovations algorithmiques à des optimisations alignées sur le matériel afin de parvenir à une modélisation efficace des contextes longs. NSA emploie une stratégie parcimonieuse hiérarchique dynamique, combinant compression grossière de tokens et sélection fine de tokens pour préserver à la fois la conscience du contexte global et la précision locale. Notre approche fait progresser la conception de l’attention parcimonieuse grâce à deux innovations clés : (1) Nous obtenons des accélérations substantielles grâce à une conception algorithmique équilibrant l’intensité arithmétique, avec des optimisations d’implémentation pour le matériel moderne. (2) Nous permettons un entraînement de bout en bout, réduisant le calcul de pré-entraînement sans sacrifier les performances du modèle. Comme le montre la Figure [1], les expériences montrent que le modèle pré-entraîné avec NSA maintient ou dépasse les modèles à Attention Complète sur les benchmarks généraux, les tâches à contexte long et le raisonnement basé sur des instructions. Par ailleurs, NSA obtient des accélérations substantielles par rapport à l’Attention Complète sur des séquences de longueur 64k pour le décodage, la propagation avant et la propagation arrière, validant son efficacité tout au long du cycle de vie du modèle.
1. Introduction
La communauté de recherche reconnaît de plus en plus la modélisation de contextes longs comme une capacité cruciale pour les grands modèles de langue de nouvelle génération, portée par diverses applications du monde réel allant du raisonnement approfondi (DeepSeek- AI, 2025 ; Zelikman et al., 2022), à la génération de code au niveau du dépôt (Zhang et al., 2023a ; Zhang et al.) et aux systèmes d’agents autonomes multi-tours (Park et al., 2023). Des percées récentes, notamment les modèles de la série o d’OpenAI, DeepSeek- R1 (DeepSeek- AI, 2025) et Gemini 1.5 Pro (Google et al., 2024), permettent aux modèles de traiter des bases de code entières, des documents longs, de maintenir des conversations multi-tours cohérentes sur des milliers de tokens et d’effectuer des raisonnements complexes sur des dépendances à longue portée. Cependant, la complexité élevée (Zaheer et al., 2020) des mécanismes d’Attention classiques (Vaswani et al., 2017) apparaît comme un
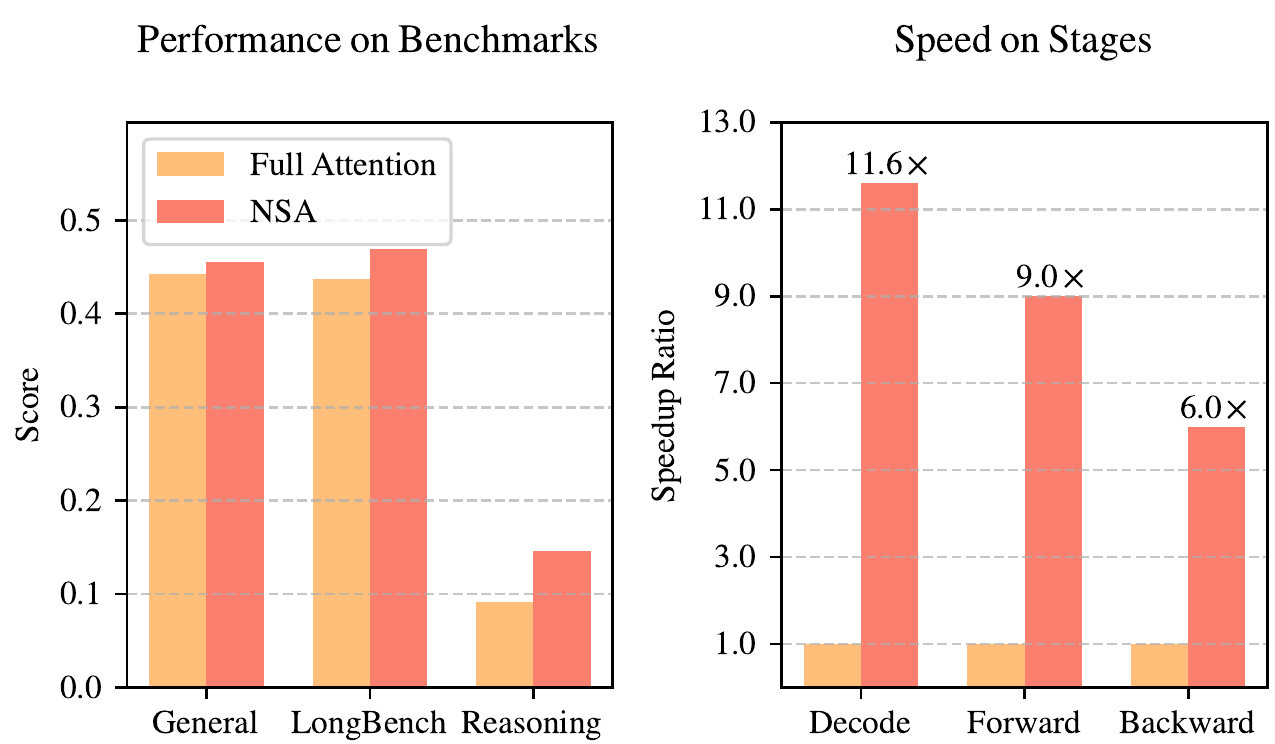
Figure 1 | Comparaison des performances et de l’efficacité entre le modèle à Attention Complète et notre NSA. À gauche : Bien qu’étant parcimonieuse, NSA surpasse en moyenne la référence à Attention Complète sur les benchmarks généraux, les tâches à contexte long et l’évaluation du raisonnement. À droite : Pour le traitement de séquences de longueur 64k, NSA obtient une accélération computationnelle substantielle par rapport à l’Attention Complète à toutes les étapes : décodage, propagation avant et propagation arrière. goulot d’étranglement critique de latence à mesure que la longueur des séquences augmente. Des estimations théoriques indiquent que le calcul d’attention avec des architectures softmax représente de la latence totale lors du décodage de contextes de longueur 64k, ce qui souligne le besoin urgent de mécanismes d’attention plus efficaces.
Une approche naturelle pour une modélisation efficace des contextes longs consiste à tirer parti de la parcimonie inhérente à l’attention softmax (Ge et al., 2023 ; Jiang et al., 2023), où le calcul sélectif des paires requête-clé critiques peut réduire significativement la surcharge computationnelle tout en préservant les performances. Des avancées récentes démontrent ce potentiel à travers diverses stratégies : méthodes d’éviction du cache KV (Li et al., 2024 ; Zhang et al., 2023b ; Zhou et al., 2024), méthodes de sélection du cache KV par blocs (Gao et al., 2024 ; Tang et al., 2024 ; Xiao et al., 2024a), et méthodes de sélection par échantillonnage, regroupement ou hachage (Chen et al., 2024b ; Desai et al., 2024 ; Liu et al., 2024). Malgré ces stratégies prometteuses, les méthodes d’attention parcimonieuse existantes sont souvent insuffisantes en déploiement pratique. De nombreuses approches n’atteignent pas les accélérations comparables à leurs gains théoriques ; de plus, la plupart des méthodes manquent de support efficace au moment de l’entraînement pour exploiter pleinement les motifs de parcimonie de l’attention.
Pour remédier à ces limitations, le déploiement d’une attention parcimonieuse efficace doit relever deux défis clés : (1) Accélération de l’inférence alignée sur le matériel : convertir les réductions de calcul théoriques en améliorations réelles de vitesse exige une conception algorithmique adaptée au matériel, tant au stade du profilage que du décodage, afin d’atténuer les goulots d’étranglement liés aux accès mémoire et à l’ordonnancement matériel ; (2) Conception algorithmique consciente de l’entraînement : permettre un calcul de bout en bout avec des opérateurs entraînables afin de réduire les coûts d’entraînement tout en maintenant les performances du modèle. Ces exigences sont cruciales pour les applications réelles visant une inférence ou un entraînement rapides sur contextes longs. En considérant ces deux aspects, les méthodes existantes présentent encore un écart notable.
Pour parvenir à une attention parcimonieuse plus efficace et efficiente, nous présentons NSA, une architecture d’Attention Parcimonieuse Nativement entraînable qui intègre une modélisation hiérarchique des tokens. Comme le montre la Figure 2, NSA réduit le calcul par requête en organisant les clés et les valeurs en blocs temporels et en les traitant via trois chemins d’attention : tokens grossiers compressés, tokens fins sélectivement conservés, et fenêtres glissantes pour l’information contextuelle locale. Nous implémentons ensuite
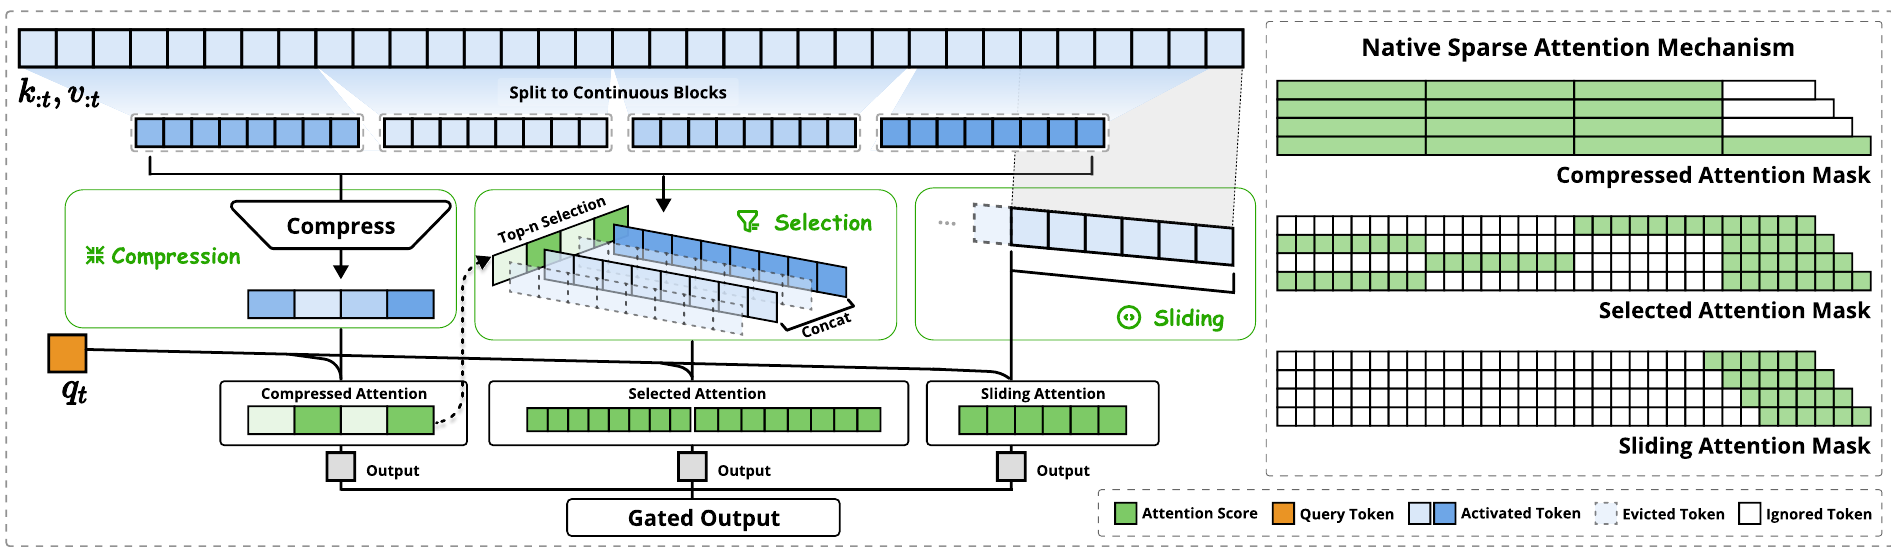
des noyaux spécialisés pour maximiser son efficacité pratique. NSA introduit deux innovations centrales correspondant aux exigences clés ci-dessus : (1) Système aligné sur le matériel : optimiser l’attention parcimonieuse par blocs pour l’utilisation des Tensor Cores et des accès mémoire, en garantissant une intensité arithmétique équilibrée. (2) Conception consciente de l’entraînement : permettre un entraînement stable de bout en bout grâce à des algorithmes et des opérateurs de rétropropagation efficaces. Cette optimisation permet à NSA de prendre en charge à la fois un déploiement efficace et un entraînement de bout en bout.
Nous évaluons NSA à travers des expériences complètes sur des corpus linguistiques réels. Après pré-entraînement sur une colonne vertébrale transformer de 27B paramètres avec 260B tokens, nous évaluons les performances de NSA sur des évaluations générales de langue, des évaluations à contexte long et une évaluation du raisonnement en chaîne de pensée. Nous comparons en outre la vitesse des noyaux sur des GPU A100 avec des implémentations Triton optimisées (Tillet et al., 2019). Les résultats expérimentaux démontrent que NSA atteint des performances comparables ou supérieures à la référence à attention complète, tout en surpassant les approches d’attention parcimonieuse existantes. De plus, NSA procure des accélérations substantielles aux étapes de décodage, de propagation avant et de rétropropagation par rapport à l’Attention Complète, le ratio d’accélération augmentant pour des séquences plus longues. Ces résultats valident que notre conception hiérarchique d’attention parcimonieuse équilibre efficacement la capacité du modèle et l’efficacité computationnelle.
2. Repenser les méthodes d’attention parcimonieuse
Les méthodes modernes d’attention parcimonieuse ont fait des progrès significatifs pour réduire la complexité computationnelle théorique des modèles transformer. Cependant, la plupart des approches appliquent principalement la parcimonie durant l’inférence tout en conservant une colonne vertébrale à Attention Complète pré-entraînée, ce qui peut introduire un biais architectural limitant leur capacité à exploiter pleinement les avantages de l’attention parcimonieuse. Avant d’introduire notre architecture parcimonieuse native, nous analysons systématiquement ces limitations à travers deux prismes critiques.
2.1. L’illusion d’une inférence efficace
Malgré l’obtention d’une parcimonie dans le calcul d’attention, de nombreuses méthodes n’atteignent pas les réductions correspondantes de latence d’inférence, principalement en raison de deux défis :
Parcimonie restreinte à une phase. Des méthodes telles que H2O (Zhang et al., 2023b) appliquent la parcimonie durant le décodage autoregressif tout en nécessitant un prétraitement coûteux en calcul (par exemple, calcul de la carte d’attention, construction d’index) durant le profilage. En revanche, des approches comme MInference (Jiang et al., 2024) se concentrent uniquement sur la parcimonie au profilage. Ces méthodes n’atteignent pas l’accélération à toutes les étapes de l’inférence, car au moins une phase conserve des coûts computationnels comparables à l’Attention Complète. La spécialisation par phase réduit la capacité d’accélération de ces méthodes dans les charges de travail dominées par le profilage, comme le résumé de livres et la complétion de code, ou dans celles dominées par le décodage, comme le raisonnement long en chaîne de pensée (Wei et al., 2022).
Incompatibilité avec les architectures d’attention avancées. Certaines méthodes d’attention parcimonieuse ne s’adaptent pas aux architectures modernes efficaces en décodage telles que l’Attention à Requêtes Multiples (MQA) (Shazeer, 2019) et l’Attention à Requêtes Groupées (GQA) (Ainslie et al., 2023), qui réduisent significativement le goulot d’étranglement des accès mémoire durant le décodage en partageant KV entre plusieurs têtes de requête. Par exemple, dans des approches comme Quest (Tang et al., 2024), chaque tête d’attention sélectionne indépendamment son sous-ensemble de cache KV. Bien que cela démontre une parcimonie computationnelle et une parcimonie d’accès mémoire cohérentes dans les modèles à Attention Multi-Têtes (MHA), un scénario différent apparaît dans les modèles fondés sur des architectures comme GQA, où le volume d’accès mémoire du cache KV correspond à l’union des sélections de toutes les têtes de requête au sein du même groupe GQA. Cette caractéristique architecturale signifie que, bien que ces méthodes puissent réduire les opérations de calcul, l’accès mémoire au cache KV requis reste relativement élevé. Cette limitation impose un choix critique : tandis que certaines méthodes d’attention parcimonieuse réduisent le calcul, leur motif d’accès mémoire dispersé entre en conflit avec la conception efficace des accès mémoire des architectures avancées.
Ces limitations surviennent parce que de nombreuses méthodes d’attention parcimonieuse existantes se concentrent sur la réduction du cache KV ou la réduction du calcul théorique, mais peinent à obtenir une réduction significative de la latence dans les frameworks ou backends avancés. Cela nous motive à développer des algorithmes combinant à la fois une architecture avancée et une implémentation efficace sur le matériel pour exploiter pleinement la parcimonie afin d’améliorer l’efficacité du modèle.
2.2. Le mythe de la parcimonie entraînable
Notre quête d’une attention parcimonieuse native et entraînable est motivée par deux observations clés issues de l’analyse des approches d’inférence seule : (1) Dégradation des performances : appliquer la parcimonie a posteriori force les modèles à s’écarter de leur trajectoire d’optimisation préentraînée. Comme l’ont montré Chen et al. (2024b), l’attention top ne peut couvrir que du total des scores d’attention, rendant des structures telles que les têtes de récupération dans les modèles préentraînés vulnérables à l’élagage pendant l’inférence. (2) Exigences d’efficacité d’entraînement : une gestion efficace de l’entraînement sur de longues séquences est cruciale pour le développement des LLM modernes. Cela inclut à la fois le préentraînement sur des documents plus longs afin d’améliorer la capacité du modèle, et les phases d’adaptation ultérieures telles que l’ajustement fin en contexte long et l’apprentissage par renforcement. Cependant, les méthodes d’attention parcimonieuse existantes ciblent principalement l’inférence, laissant largement non résolus les défis computationnels de l’entraînement. Cette limitation entrave le développement de modèles à contexte long plus performants grâce à un entraînement efficace. En outre, les efforts visant à adapter l’attention parcimonieuse existante à l’entraînement révèlent également des défis :
Composants non entraînables. Les opérations discrètes dans des méthodes telles que ClusterKV (Liu et al., 2024) (qui inclut le clustering k-means) et MagicPIG (Chen et al., 2024b) (qui inclut une sélection fondée sur SimHash) créent des discontinuités dans le graphe computationnel. Ces composants non entraînables empêchent le flux de gradients à travers le processus de sélection des tokens, limitant la capacité du modèle à apprendre des motifs parcimonieux optimaux.
Rétropropagation inefficace. Certaines méthodes d’attention parcimonieuse théoriquement entraînables souffrentd’inefficacités pratiques d’entraînement. La stratégie de sélection à granularité de token utilisée dans des approches comme HashAttention (Desai et al., 2024) conduit à la nécessité de charger un grand nombre de tokens individuels depuis le cache KV pendant le calcul de l’attention. Cet accès mémoire non contigu empêche l’adaptation efficace de techniques d’attention rapides comme FlashAttention, qui reposent sur un accès mémoire contigu et un calcul par blocs pour atteindre un haut débit. En conséquence, les implémentations sont contraintes de revenir à une faible utilisation du matériel, ce qui dégrade significativement l’efficacité de l’entraînement.
2.3. La parcimonie native comme impératif
Ces limitations en matière d’efficacité d’inférence et de viabilité d’entraînement motivent notre refonte fondamentale des mécanismes d’attention parcimonieuse. Nous proposons NSA, un cadre d’attention nativement parcimonieux qui répond à la fois aux exigences d’efficacité computationnelle et d’entraînement. Dans les sections suivantes, nous détaillons la conception algorithmique et l’implémentation opérateur de NSA.
3. Méthodologie
Notre approche technique couvre la conception d'algorithmes et l'optimisation des noyaux. Dans les sous-sections suivantes, nous présentons d'abord le contexte de notre méthodologie. Ensuite, nous exposons le cadre global de NSA, suivi de ses composants algorithmiques clés. Enfin, nous détaillons la conception de notre noyau optimisé pour le matériel, qui maximise l'efficacité pratique.
3.1. Contexte
Le mécanisme d'attention est largement utilisé en modélisation du langage, où chaque token de requête calcule des scores de pertinence par rapport à toutes les clés précédentes afin de générer une somme pondérée des valeurs . Formellement, pour une séquence d'entrée de longueur , l'opération d'attention est définie comme suit :
où Attn désigne la fonction d'attention :
Ici, représente le poids d'attention entre et , et est la dimension des caractéristiques des clés. À mesure que la longueur de la séquence augmente, le calcul d'attention devient de plus en plus dominant dans le coût computationnel global, ce qui présente des défis significatifs pour le traitement de contextes longs.
L'intensité arithmétique est le rapport entre les opérations de calcul et les accès mémoire. Elle façonne intrinsèquement l'optimisation des algorithmes sur le matériel. Chaque GPU possède une intensité arithmétique critique déterminée par sa capacité de calcul de pointe et sa bande passante mémoire, calculée comme le rapport entre ces deux limites matérielles. Pour les tâches de calcul, une intensité arithmétique supérieure à ce seuil critique devient limitée par le calcul (bornée par les FLOPS du GPU), tandis qu'en dessous, elle devient limitée par la mémoire (bornée par la bande passante mémoire).
Spécifiquement pour le mécanisme d'auto-attention causal, durant les phases d'entraînement et de profilage, les multiplications matricielles par lots et les calculs d'attention présentent une forte intensité arithmétique, rendant ces étapes limitées par le calcul sur les accélérateurs modernes. En revanche, le décodage autorégressif devient contraint par la bande passante mémoire, car il génère un token par passe avant tout en nécessitant le chargement de l'intégralité du cache clé-valeur, ce qui entraîne une faible intensité arithmétique. Cela conduit à différents objectifs d'optimisation — réduire le coût de calcul durant l'entraînement et le préremplissage, tandis que réduire les accès mémoire durant le décodage.
3.2. Cadre global
Pour exploiter le potentiel de l'attention avec un motif de parcimonie naturel, nous proposons de remplacer les paires clé-valeur originales de l'équation (1) par un ensemble plus compact et plus dense en information de paires clé-valeur de représentation étant donné chaque requête . Plus précisément, nous définissons formellement la sortie d'attention optimisée comme suit :
où sont construits dynamiquement en fonction de la requête courante et de la mémoire contextuelle . Nous pouvons concevoir diverses stratégies de mise en correspondance pour obtenir différentes catégories de , et les combiner comme suit :
Comme illustré à la Figure 2, NSA dispose de trois stratégies de mise en correspondance , représentant la compression, la sélection et la fenêtre glissante pour les clés et les valeurs. est le score de portail pour la stratégie correspondante , dérivé des caractéristiques d'entrée via un MLP et une activation sigmoïde. Soit le nombre total de clés/valeurs remappées :
Nous maintenons un ratio de parcimonie élevé en garantissant .
3.3. Conception de l'algorithme
Dans cette sous-section, nous présentons la conception de nos stratégies de remappage et : la compression de tokens, la sélection de tokens et la fenêtre glissante.
3.3.1. Compression de tokens
En agrégeant des blocs séquentiels de clés ou de valeurs en représentations au niveau des blocs, nous obtenons des clés et des valeurs compressées qui capturent l'information de l'ensemble du bloc. Formellement, la représentation de clé compressée est définie comme suit :
où est la longueur du bloc, est le pas glissant entre blocs adjacents, et est un MLP apprenable avec encodage de position intra-bloc pour mapper les clés d'un bloc vers une clé compressée unique. est un tenseur composé de clés de compression. Habituellement, nous adoptons pour atténuer la fragmentation de l'information. Une formulation analogue vaut pour la représentation de valeur compressée . Les représentations compressées capturent une information sémantique de plus haut niveau et à grain plus grossier et réduisent la charge computationnelle de l'attention.
3.3.2. Sélection de tokens
L'utilisation des seules clés et valeurs compressées pourrait entraîner une perte d'informations fines importantes, ce qui nous motive à préserver sélectivement des clés et des valeurs individuelles. Ci-dessous, nous décrivons notre mécanisme efficace de sélection de tokens qui identifie et préserve les tokens les plus pertinents avec une faible surcharge computationnelle.
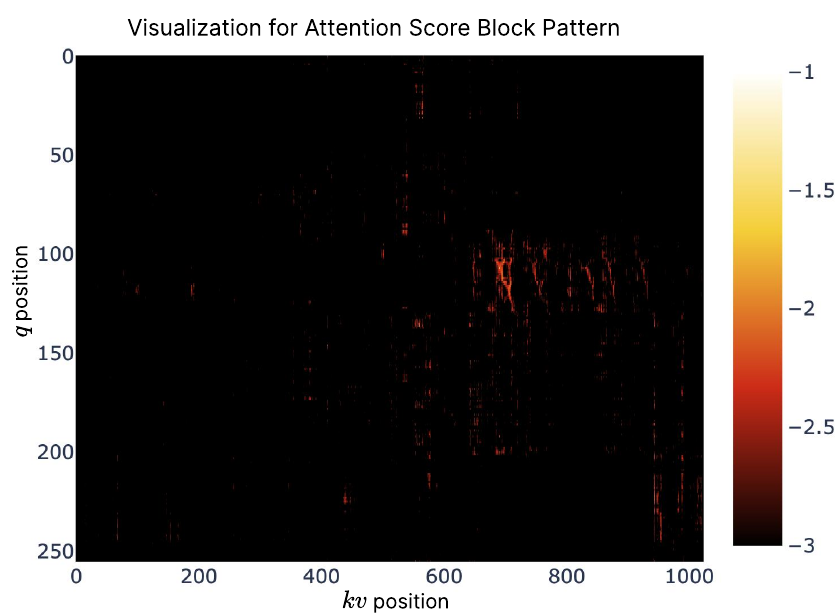
Sélection par blocs. Notre stratégie de sélection traite les séquences de clés et de valeurs en blocs continus dans l'espace, motivée par deux facteurs clés : des considérations d'efficacité matérielle et les motifs de distribution inhérents des scores d'attention. La sélection par blocs est cruciale pour réaliser un calcul efficace sur les GPU modernes. En effet, les architectures GPU modernes présentent un débit significativement plus élevé pour les accès à des blocs continus par rapport aux lectures aléatoires basées sur des index. De plus, le calcul par blocs permet une utilisation optimale des Tensor Cores. Cette caractéristique architecturale a établi l'accès mémoire et le calcul par blocs comme un principe fondamental dans les implémentations d'attention hautes performances, comme l'illustre la conception par blocs de FlashAttention. La sélection par blocs suit les motifs de distribution inhérents des scores d'attention. Des travaux antérieurs (Jiang et al., 2024) ont montré que les scores d'attention présentent souvent une continuité spatiale, suggérant que les clés voisines tendent à partager des niveaux d'importance similaires. Notre visualisation à la Section 6.2 montre également ce motif de continuité spatiale.
Pour mettre en œuvre la sélection par blocs, nous divisons d'abord les séquences de clés et de valeurs en blocs de sélection. Pour identifier les blocs les plus importants pour le calcul d'attention, nous devons attribuer des scores d'importance à chaque bloc. Ci-dessous, nous présentons notre méthode de calcul de ces scores d'importance au niveau des blocs.
Calcul du score d'importance. Le calcul des scores d'importance des blocs pourrait introduire une surcharge significative. Heureusement, le calcul d'attention des tokens de compression produit des scores d'attention intermédiaires que nous pouvons exploiter pour induire les scores d'importance des blocs de sélection, formulés comme suit :
où représente les scores d'attention entre et les clés de compression . Soit la taille du bloc de sélection. Lorsque les blocs de compression et les blocs de sélection partagent le même schéma de blocage, c'est-à-dire , nous pouvons obtenir directement les scores d'importance des blocs de sélection par de manière directe. Dans les cas où les schémas de blocage diffèrent, nous dérivons les scores d'importance des blocs de sélection en fonction de leur relation spatiale. Étant donné , et , nous avons :
où désigne l'opérateur d'indexation permettant d'accéder à un élément du vecteur. Pour les modèles employant GQA ou MQA, où les caches clé-valeur sont partagés entre les têtes de requête, une sélection de blocs cohérente entre ces têtes doit être garantie afin de minimiser le chargement du cache KV pendant le décodage. Les scores d'importance partagés entre les têtes d'un même groupe sont formellement définis comme :
où en exposant désigne l'indice de la tête, et est le nombre de têtes de requête dans chaque groupe. Cette agrégation garantit une sélection de blocs cohérente entre les têtes d'un même groupe.
Sélection des top-n blocs. Après avoir obtenu les scores d'importance des blocs de sélection, nous conservons les tokens au sein des top-n blocs épars classés par scores d'importance de bloc, formulé comme :
où rank désigne la position dans le classement par ordre décroissant, avec rank correspondant au score le plus élevé, est l'ensemble des indices des blocs sélectionnés, Cat désigne l'opération de concaténation. est un tenseur composé par les clés de compression. Une formulation analogue s'applique à la valeur à grain fin . Les clés et valeurs sélectionnées participent ensuite au calcul de l'attention avec tel que défini dans l'équation (5).
3.3.3. Fenêtre glissante
Dans les mécanismes d'attention, les motifs locaux s'adaptent généralement plus rapidement et peuvent dominer le processus d'apprentissage, empêchant potentiellement le modèle d'apprendre efficacement à partir des jetons de compression et de sélection. Pour remédier à ce problème, nous introduisons une branche dédiée à la fenêtre glissante qui traite explicitement le contexte local, permettant aux autres branches (compression et sélection) de se concentrer sur l'apprentissage de leurs caractéristiques respectives sans être court-circuitées par les motifs locaux. Plus précisément, nous conservons les jetons récents dans une fenêtre , et isolons les calculs d'attention des différentes sources d'information (jetons de compression et jetons sélectionnés, fenêtre glissante) dans des branches séparées. Les sorties de ces branches sont ensuite agrégées via un mécanisme de portillon appris. Pour empêcher davantage l'apprentissage par raccourci entre les branches d'attention avec un surcoût computationnel marginal, nous fournissons des clés et des valeurs indépendantes pour les trois branches. Cette conception architecturale permet un apprentissage stable en empêchant l'interférence des gradients entre la reconnaissance de motifs locaux et à longue portée, tout en introduisant un surcoût minimal.
Après avoir obtenu les trois catégories de clés et de valeurs , nous calculons la sortie d'attention finale selon l'équation (5). Avec les mécanismes de compression, de sélection et de fenêtre glissante décrits ci-dessus, cela forme le cadre algorithmique complet de NSA.
3.4. Conception des noyaux
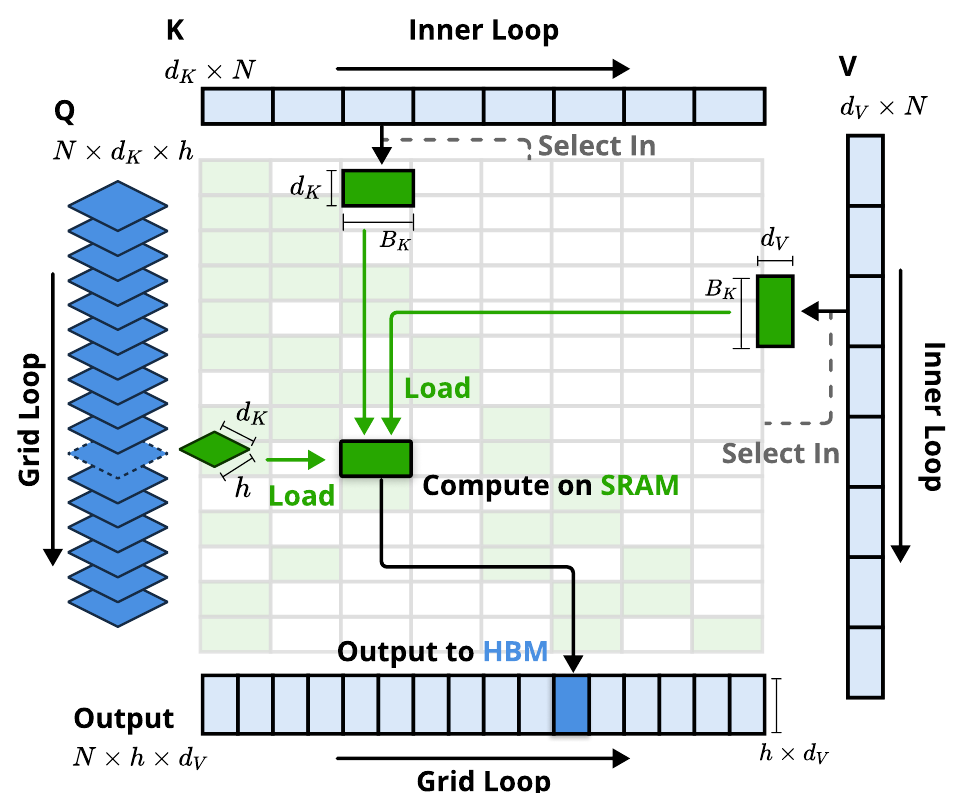
Pour obtenir une accélération de niveau FlashAttention lors de l'entraînement et du profilage, nous implémentons des noyaux d'attention parcimonieuse alignés sur le matériel au-dessus de Triton. Étant donné que MHA est gourmand en mémoire et inefficace pour le décodage, nous nous concentrons sur les architectures à caches KV partagés comme GQA et MQA, à l'instar des LLM de pointe actuels. Alors que les calculs d'attention par compression et par fenêtre glissante sont aisément compatibles avec les noyaux FlashAttention-2 existants, nous introduisons une conception de noyau spécialisée pour l'attention par sélection parcimonieuse. Si nous suivions la stratégie de FlashAttention consistant à charger des blocs de requêtes temporellement continus dans la SRAM, cela entraînerait des accès mémoire inefficaces, car les requêtes d'un bloc peuvent nécessiter des blocs KV disjoints. Pour y remédier, notre optimisation clé réside dans une stratégie de regroupement des requêtes différente : pour chaque position de la séquence de requêtes, nous chargeons toutes les têtes de requêtes d'un groupe GQA (qui partagent les mêmes blocs KV parcimonieux) dans la SRAM. La figure 3 illustre notre implémentation de la passe avant. L'architecture de noyau proposée se caractérise par les fonctionnalités clés suivantes :
1. Chargement de données centré sur les groupes. Pour chaque boucle interne, charger les requêtes de toutes les têtes du groupe à la position et leurs indices de blocs clé/valeur parcimonieux partagés .
2. Récupération KV partagée. Dans la boucle interne, charger séquentiellement les blocs clé/valeur continus indexés par dans la SRAM en tant que , afin de minimiser le chargement mémoire, où est la taille de bloc du noyau satisfaisant .
3. Boucle externe sur la grille. Puisque la longueur de la boucle interne (proportionnelle au nombre de blocs sélectionnés ) reste presque identique pour différents blocs de requêtes, nous plaçons les boucles de requêtes/sorties dans le planificateur de grille de Triton pour simplifier et optimiser le noyau.
Cette conception atteint une intensité arithmétique quasi optimale en (1) éliminant les transferts KV redondants grâce au partage par groupe, et (2) équilibrant les charges de calcul entre les multiprocesseurs de streaming du GPU.
4. Expériences
Nous évaluons NSA sous trois angles : (1) les performances sur les benchmarks généraux, (2) les performances sur les benchmarks à long contexte, et (3) les performances en raisonnement chaîne de pensée, en comparant avec la référence Full Attention et les méthodes d'attention parcimonieuse de pointe. Nous reportons l'analyse d'efficacité de notre paradigme de calcul parcimonieux à la section 5, où nous fournissons des discussions détaillées sur la vitesse d'entraînement et d'inférence.
4.1. Configuration du pré-entraînement
Suivant la pratique courante des LLM de pointe, nos expériences adoptent une architecture combinant l'attention par requêtes groupées (GQA) et le mélange d'experts (MoE), avec 27B de paramètres totaux et 3B de paramètres actifs. Le modèle comprend 30 couches avec une dimension cachée de 2560. Pour GQA, nous fixons le nombre de groupes à 4, avec un total de 64 têtes d'attention. Pour chaque tête, les dimensions cachées de la requête, de la clé et de la valeur sont configurées respectivement à et . Pour le MoE, nous utilisons la structure DeepSeekMoE (Dai et al., 2024 ; DeepSeek-AI, 2024), avec 72 experts routés et 2 experts partagés, et fixons le nombre d'experts top-k à 6. Pour garantir la stabilité de l'entraînement, le MoE de la première couche est remplacé par un MLP sous la forme SwiGLU.
| Modèle | MMLU Préc. 5-shot | MMLU-PRO Préc. 5-shot | CMMLU Préc. 5-shot | BBH Préc. 3-shot | GSM8K Préc. 8-shot | MATH Préc. 4-shot | DROP F1 1-shot | MBPP Pass@1 3-shot | HumanEval Pass@1 0-shot | Moy. |
| Full Attn | 0,567 | 0,279 | 0,576 | 0,497 | 0,486 | 0,263 | 0,503 | 0,482 | 0,335 | 0,443 |
| NSA | 0,565 | 0,286 | 0,587 | 0,521 | 0,520 | 0,264 | 0,545 | 0,466 | 0,348 | 0,456 |
Tableau 1 | Comparaison des performances de pré-entraînement entre la référence Full Attention et NSA sur les benchmarks généraux, couvrant les tâches de connaissances (MMLU, MMLU-PRO, CMMLU), de raisonnement (BBH, GSM8K, MATH, DROP) et de codage (MBPP, HumanEval). NSA obtient une performance moyenne supérieure sur la plupart des benchmarks malgré une forte parcimonie.
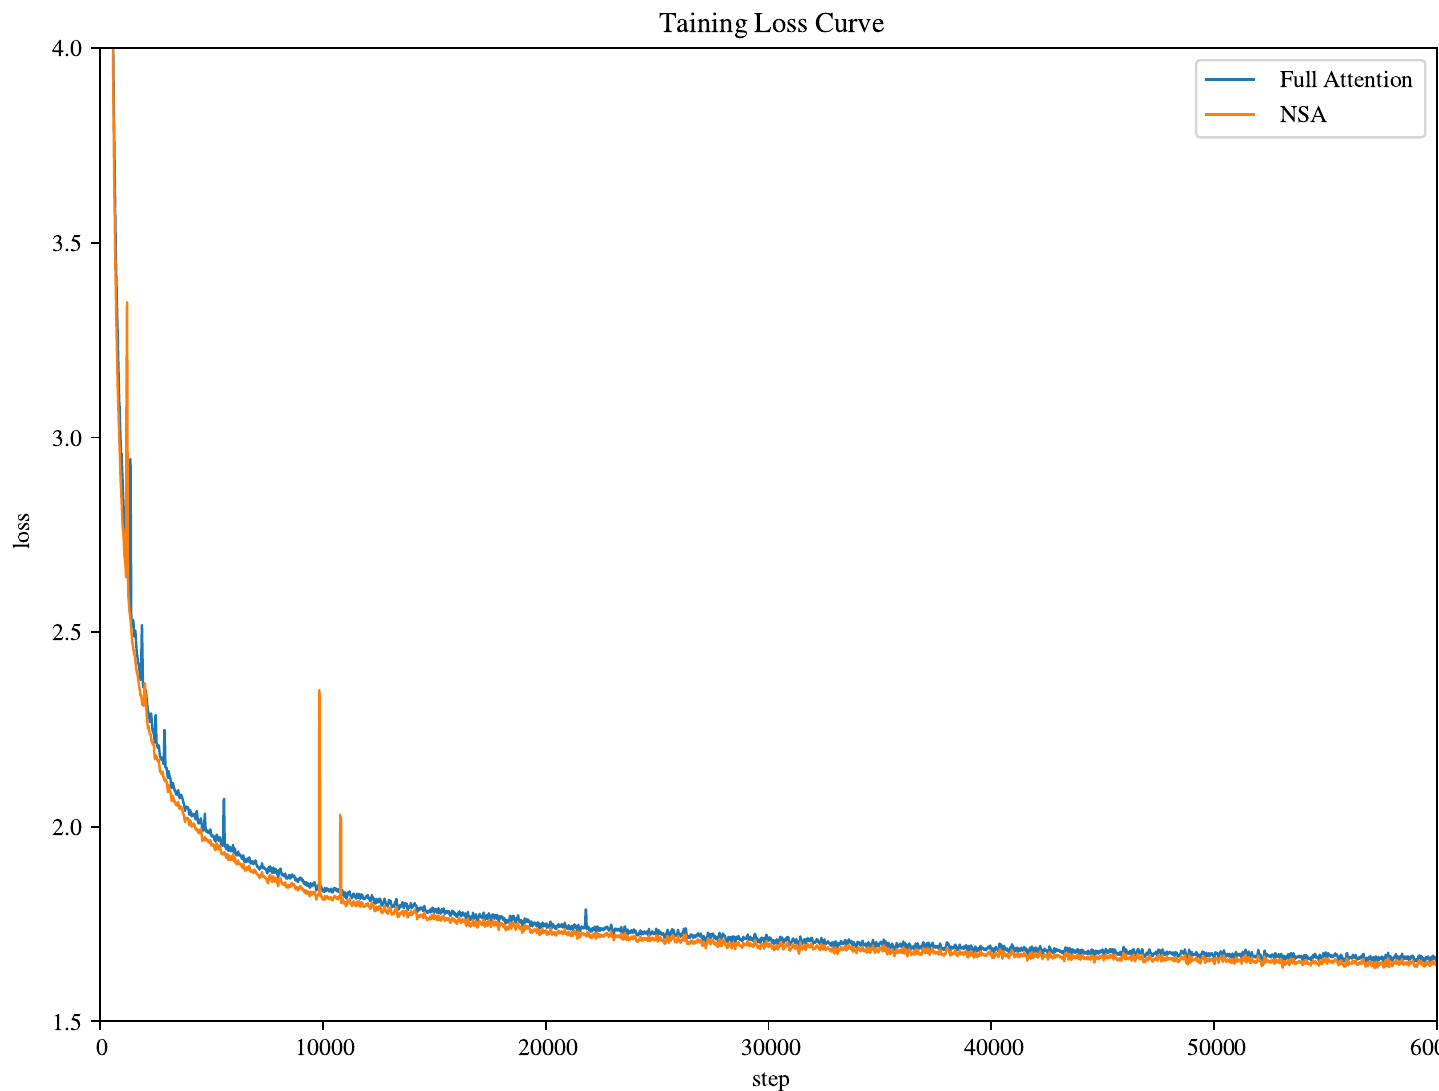
L'architecture proposée réalise un compromis efficace entre coût de calcul et performance du modèle. Pour NSA, nous fixons la taille de bloc de compression , le pas de glissement , la taille de bloc sélectionné , le nombre de blocs sélectionnés (incluant l'activation fixe du bloc initial 1 et des 2 blocs locaux), et la taille de fenêtre glissante . Les modèles Full Attention et d'attention parcimonieuse sont tous deux pré-entraînés sur 270B de jetons de textes de longueur 8k, suivis d'un entraînement continu et d'un affinage supervisé sur des textes de longueur 32k avec YaRN (Peng et al., 2024) pour atteindre l'adaptation au long contexte. Les deux modèles sont entraînés jusqu'à convergence complète afin de garantir une comparaison équitable. Comme le montre la figure 4, la courbe de perte de pré-entraînement de notre NSA et de la référence Full Attention démontre une décroissance stable et régulière, NSA surpassant systématiquement le modèle Full Attention.
4.2. Méthodes de référence
Outre la comparaison avec Full Attention, nous évaluons plusieurs méthodes d'attention parcimonieuse de pointe à l'étape d'inférence : H2O (Zhang et al., 2023b), infLLM (Xiao et al., 2024a), Quest (Tang et al., 2024) et Exact-Top, qui calcule d'abord le score d'attention complet et sélectionne les clés de score top- correspondant à chaque requête, puis calcule l'attention sur ces positions. Ces
| Modèle | SQA | MQA | Synthétique | CodeLCC | Moy. | ||||||
| MFQA-en | MFQA-zh | Qasper | HPQ | 2Wiki | GovRpt | Dur | PassR-en | PassR-zh | |||
| H2O | 0,428 | 0,429 | 0,308 | 0,112 | 0,101 | 0,231 | 0,208 | 0,704 | 0,421 | 0,092 | 0,303 |
| InfLLM | 0,474 | 0,517 | 0,356 | 0,306 | 0,250 | 0,277 | 0,257 | 0,766 | 0,486 | 0,143 | 0,383 |
| Quest | 0,495 | 0,561 | 0,365 | 0,295 | 0,245 | 0,293 | 0,257 | 0,792 | 0,478 | 0,135 | 0,392 |
| Exact-Top | 0,502 | 0,605 | 0,397 | 0,321 | 0,288 | 0,316 | 0,291 | 0,810 | 0,548 | 0,156 | 0,423 |
| Full Attn | 0,512 | 0,623 | 0,409 | 0,350 | 0,305 | 0,324 | 0,294 | 0,830 | 0,560 | 0,163 | 0,437 |
| NSA | 0,503 | 0,624 | 0,432 | 0,437 | 0,356 | 0,307 | 0,341 | 0,905 | 0,550 | 0,232 | 0,469 |
Tableau 2 | Comparaison des performances entre notre NSA et les références sur LongBench, incluant les sous-ensembles des catégories QA sur document unique, QA sur documents multiples, synthétique et tâche de code. NSA surpasse la plupart des références, y compris Full Attention. méthodes couvrent divers paradigmes d'attention parcimonieuse, notamment l'éviction de cache KV, la sélection sensible aux requêtes, et la sélection parcimonieuse exacte top-.
Pour l'évaluation générale, où la plupart des échantillons ont des longueurs inférieures à la fenêtre de contexte local des références d'attention parcimonieuse, ces méthodes sont effectivement équivalentes à Full Attention. Par conséquent, nous présentons uniquement les résultats de comparaison entre NSA et la référence Full Attention dans ce cadre. Dans l'évaluation à long contexte, nous effectuons des comparaisons sur toutes les méthodes de référence, avec la parcimonie de toutes les méthodes d'attention parcimonieuse fixée à la même valeur pour garantir une comparaison équitable. Pour l'évaluation du raisonnement chaîne de pensée, qui nécessite un affinage supervisé sur textes longs, nous limitons notre comparaison à Full Attention, car les références d'attention parcimonieuse ne prennent pas en charge l'entraînement.
4.3. Comparaison des performances
Évaluation générale. Nous avons évalué le NSA pré-entraîné et la référence Full Attention sur une suite complète de benchmarks couvrant les capacités de connaissances, de raisonnement et de codage, notamment MMLU (Hendrycks et al., 2020), MMLU-PRO (Wang et al., 2024), CMMLU (Li et al., 2023), BBH (Suzgun et al., 2022), GSM8K (Cobbe et al., 2021), MATH (Hendrycks et al., 2020), DROP (Dua et al., 2019), MBPP (Austin et al., 2021) et HumanEval (Chen et al., 2021). Les résultats sont présentés dans le tableau 1. Malgré sa parcimonie, NSA obtient une performance globale supérieure, surpassant toutes les références, y compris Full Attention, sur 7 métriques sur 9. Cela indique que, bien que NSA puisse ne pas exploiter pleinement ses avantages d'efficacité sur des séquences plus courtes, il affiche de fortes performances. Notamment, NSA démontre des gains significatifs sur les benchmarks liés au raisonnement (DROP : , GSM8K : ), suggérant que notre pré-entraînement aide les modèles à développer des mécanismes d'attention spécialisés. Ce mécanisme de pré-entraînement par attention parcimonieuse force le modèle à se concentrer sur les informations les plus importantes, améliorant potentiellement les performances en filtrant le bruit des voies d'attention non pertinentes. La performance cohérente à travers diverses évaluations valide également la robustesse de NSA en tant qu'architecture à usage général.
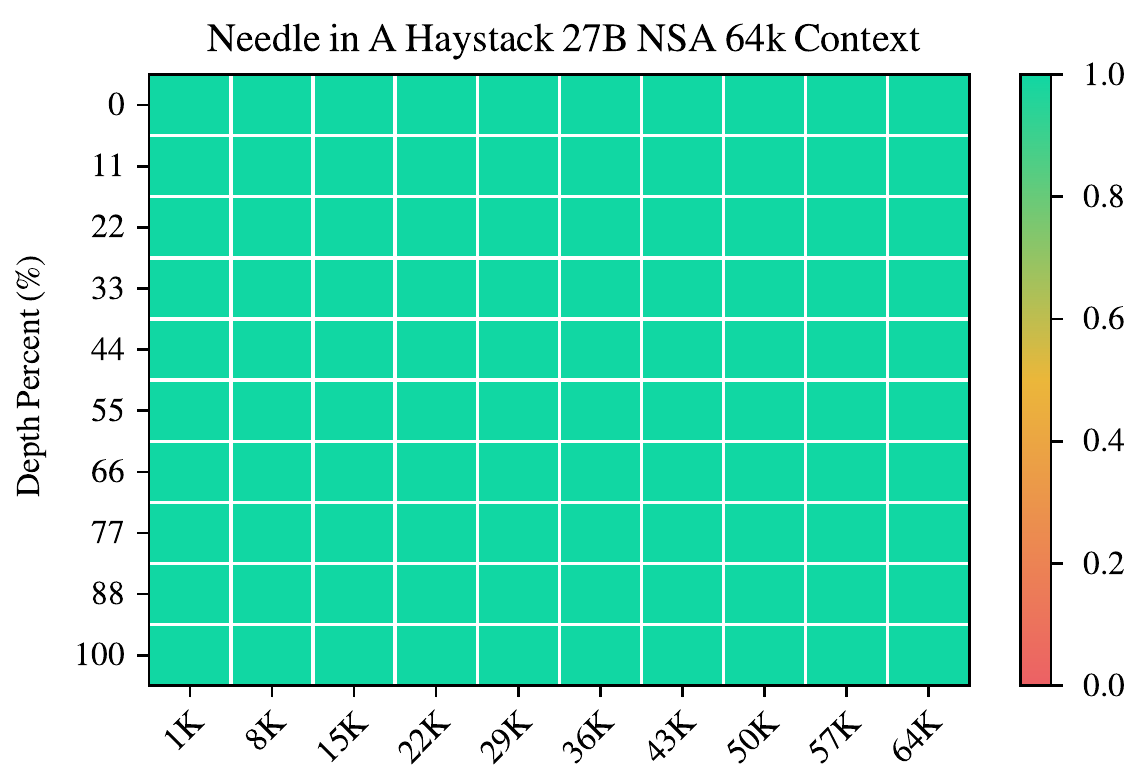
Évaluation sur contexte long. Comme illustré à la figure 5, NSA atteint une précision de récupération parfaite à toutes les positions dans le test « needle-in-a-haystack » (Kamradt, 2023) en contexte de 64k. Cette performance découle de notre conception d’attention parcimonieuse hiérarchique, qui combine des jetons de compression pour un balayage efficace du contexte global et des jetons de sélection pour une récupération précise de l’information locale. La compression grossière identifie les blocs de contexte pertinents à faible coût computationnel, tandis que l’attention au niveau des jetons sur les jetons sélectionnés garantit la préservation des informations fines critiques. Cette conception permet à NSA de maintenir à la fois une conscience globale et une précision locale.
Nous évaluons également NSA sur LongBench (Bai et al., 2023) par rapport aux méthodes d’attention parcimonieuse de pointe
et à une baseline d’attention complète. Afin de garantir une parcimonie cohérente, nous fixons à 2560 le nombre de jetons activés par chaque requête dans toutes les baselines d’attention parcimonieuse, ce qui correspond au nombre moyen de jetons activés dans NSA lors du traitement de longueurs de séquence de 32k. À la suite de Stream-LLM (Xiao et al., 2023), ce budget de jetons inclut les 128 premiers jetons et 512 jetons locaux. Nous excluons certains sous-ensembles de LongBench en raison de leurs faibles scores sur tous les modèles, ce qui pourrait ne pas fournir de comparaisons significatives. Comme indiqué dans le tableau 2, NSA obtient le score moyen le plus élevé, 0,469, surpassant toutes les baselines (+0,032 par rapport à l’attention complète et +0,046 par rapport à Exact-Top). Cette amélioration découle de deux innovations clés : (1) notre conception native d’attention parcimonieuse, qui permet une optimisation de bout en bout des motifs parcimonieux pendant le pré-entraînement, facilite une adaptation synchronisée entre le module d’attention parcimonieuse et les autres composants du modèle ; et (2) le mécanisme d’attention parcimonieuse hiérarchique atteint un équilibre entre le traitement des informations locales et globales.
Notamment, NSA démontre des performances exceptionnelles sur les tâches nécessitant un raisonnement complexe sur de longs contextes, obtenant des améliorations de +0,087 et +0,051 par rapport à l’attention complète sur les tâches de QA multi-sauts (HPQ et 2Wiki), dépassant les performances des baselines sur la compréhension de code (LCC : +0,069) et surpassant les autres méthodes sur la récupération de passages (PassR-en : +0,075). Ces résultats valident la capacité de NSA à gérer divers défis de contexte long, son attention parcimonieuse pré-entraînée nativement offrant des bénéfices supplémentaires dans l’apprentissage de motifs optimaux pour les tâches.
Évaluation du raisonnement en chaîne de pensée. Pour évaluer la compatibilité de NSA avec les paradigmes avancés d’entraînement en aval, nous examinons sa capacité à acquérir des aptitudes de raisonnement mathématique en chaîne de pensée via le post-entraînement. Étant donné l’efficacité limitée de l’apprentissage par renforcement sur des modèles de plus petite échelle, nous employons la distillation de connaissances à partir de DeepSeek-R1, en réalisant un affinage supervisé (SFT) avec 10B jetons de traces de raisonnement mathématique de longueur 32k. Cela produit deux modèles comparables : Full Attention-R (baseline d’attention complète) et NSA-R (notre variante parcimonieuse). Nous évaluons les deux modèles sur le benchmark difficile de l’American Invitational Mathematics Examination (AIME 24). Nous utilisons une température d’échantillonnage de 0,7 et une valeur top- de 0,95 pour générer 16 réponses par question et obtenir le score moyen. Pour valider l’impact de la profondeur de raisonnement, nous menons des expériences avec deux limites de contexte de génération : 8k et 16k jetons, en mesurant si des chaînes de raisonnement étendues améliorent la précision. Des exemples de comparaisons des prédictions des modèles sont fournis en annexe A.
| Limite de jetons de génération | 8192 | 16384 |
| Full Attention-R | 0,046 | 0,092 |
| NSA-R | 0,121 | 0,146 |
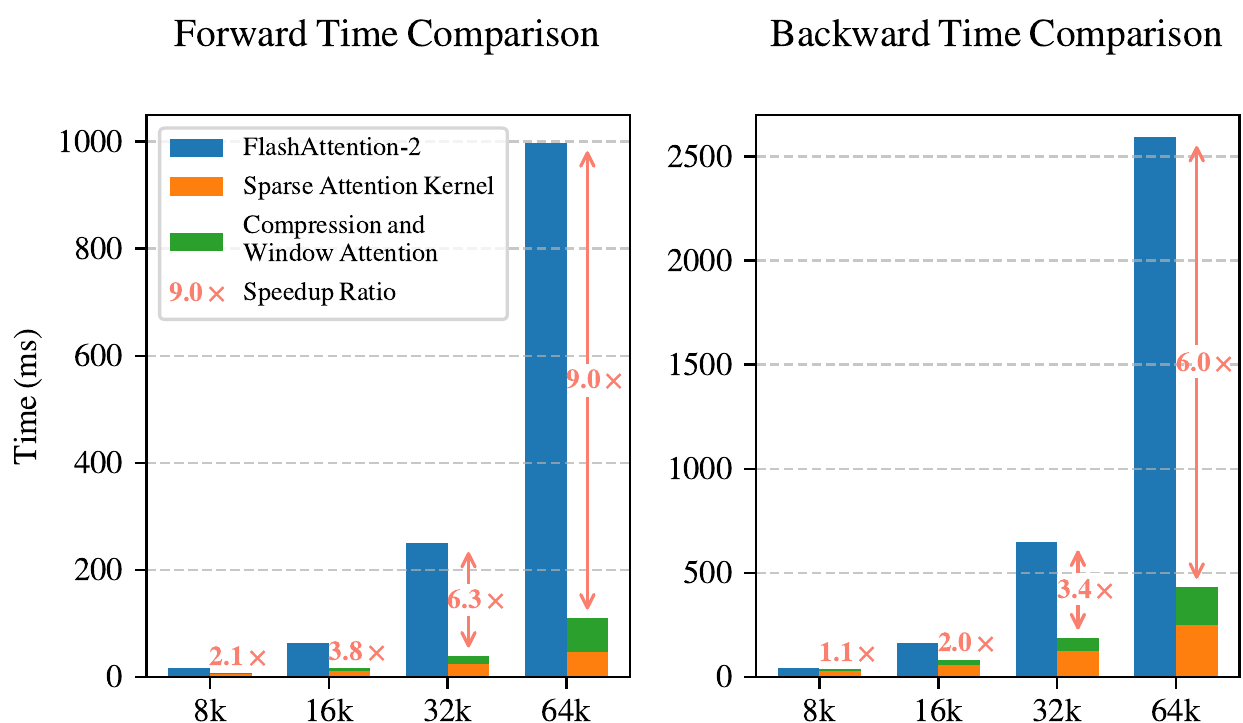
Figure 6 | Comparaison du noyau NSA basé sur Triton avec le noyau FlashAttention-2 basé sur Triton. Notre implémentation réduit considérablement la latence pour toutes les longueurs de contexte, l'amélioration devenant plus prononcée à mesure que la longueur d'entrée augmente.
Comme le montre le tableau 3, NSA-R atteint une précision nettement supérieure à celle de Full Attention-R dans le cadre d'un contexte de 8k (+0,075), cet avantage persistant pour des contextes de 16k (+0,054). Ces résultats valident deux avantages clés de l'attention creuse native : (1) Les motifs d'attention creuse pré-entraînés permettent de capturer efficacement les dépendances logiques à longue portée, essentielles aux dérivations mathématiques complexes ; (2) La conception de notre architecture, alignée sur le matériel, maintient une densité de contexte suffisante pour soutenir une profondeur de raisonnement croissante sans oubli catastrophique. La surperformance constante sur toutes les longueurs de contexte confirme la viabilité de l'attention creuse pour les tâches de raisonnement avancé lorsqu'elle est nativement intégrée au pipeline d'entraînement.
5. Analyse de l'efficacité
Nous évaluons l'efficacité computationnelle de NSA par rapport à Full Attention sur un système de 8 GPU A100. Dans l'analyse d'efficacité, nous configurons également le modèle avec le groupe GQA , les têtes par groupe , la dimension requête/clé et la dimension valeur . Suivant les mêmes paramètres que dans la section 4, nous fixons la taille de bloc de compression NSA , le pas glissant , la taille de bloc sélectionné , le nombre de blocs sélectionnés et la taille de fenêtre glissante .
5.1. Vitesse d'entraînement
Nous comparons les implémentations basées sur Triton de notre attention NSA et de Full Attention avec FlashAttention-2 basé sur Triton afin de garantir une comparaison de vitesse équitable sur le même backend. Comme le montre la figure 6, notre NSA obtient des accélérations progressivement plus importantes à mesure que la longueur de contexte augmente, jusqu'à en passe avant et en passe arrière pour une longueur de contexte de 64k. Notamment, l'avantage de vitesse devient plus prononcé avec des séquences plus longues. Cette accélération découle de notre
| Longueur du contexte | 8192 | 16384 | 32768 | 65536 |
| Attention complète | 8192 | 16384 | 32768 | 65536 |
| NSA | 2048 | 2560 | 3584 | 5632 |
| Accélération attendue | 4× | 6,4× | 9,1× | 11,6× |
conception algorithmique alignée sur le matériel, visant à maximiser l'efficacité de l'architecture d'attention creuse : (1) Le motif d'accès mémoire par blocs maximise l'utilisation des Tensor Cores grâce à des chargements coalescents, (2) L'ordonnancement minutieux des boucles dans le noyau élimine les transferts KV redondants.
5.2. Vitesse de décodage
La vitesse de décodage de l'attention est principalement déterminée par le goulot d'étranglement des accès mémoire, étroitement lié à la quantité de chargement du cache KV. À chaque étape de décodage, notre NSA n'a besoin de charger qu'au plus tokens de compression, tokens sélectionnés et tokens voisins, où est la longueur de séquence mise en cache. Comme le montre le tableau 4, notre méthode présente une réduction significative de la latence à mesure que la longueur de décodage augmente, atteignant jusqu'à d'accélération pour une longueur de contexte de 64k. Cet avantage en matière d'efficacité des accès mémoire s'amplifie également avec des séquences plus longues.
6. Discussion
Dans cette section, nous revenons sur le processus de développement de NSA et discutons des principaux enseignements tirés de notre exploration de différentes stratégies d'attention creuse. Bien que notre approche démontre des résultats prometteurs, la compréhension des défis rencontrés avec des stratégies alternatives et l'analyse des motifs d'attention fournissent un contexte précieux pour les orientations de recherche futures. Nous examinons d'abord les défis liés aux stratégies alternatives de sélection de tokens qui ont motivé nos choix de conception, puis les visualisations qui offrent des perspectives sur les motifs de distribution de l'attention.
6.1. Défis liés aux stratégies alternatives de sélection de tokens
Avant de concevoir NSA, nous avons exploré l'adaptation de méthodes d'attention creuse existantes à la phase d'entraînement. Cependant, ces tentatives ont rencontré divers défis, nous incitant à concevoir une architecture d'attention creuse différente :
Stratégies basées sur le clustering de clés. Nous avons examiné des stratégies basées sur le clustering telles que ClusterKV (Liu et al., 2024). Ces méthodes stockent les Keys et Values d'un même cluster dans des régions mémoire contiguës. Bien que théoriquement réalisables pour l'entraînement et l'inférence, elles font face à trois défis significatifs : (1) Un surcoût computationnel non négligeable introduit par les mécanismes de clustering dynamique ; (2) Des difficultés d'optimisation des opérateurs exacerbées par les déséquilibres inter-clusters, en particulier dans les systèmes Mixture-of-Experts (MoE), où des temps d'exécution biaisés des groupes Expert Parallelism (EP) entraînent des déséquilibres de charge persistants ; (3) Des contraintes de mise en œuvre découlant de la nécessité d'un reclustering périodique obligatoire et de protocoles d'entraînement séquentiels par chunks. Ces facteurs combinés créent des goulots d'étranglement substantiels, limitant considérablement leur efficacité pour un déploiement réel.
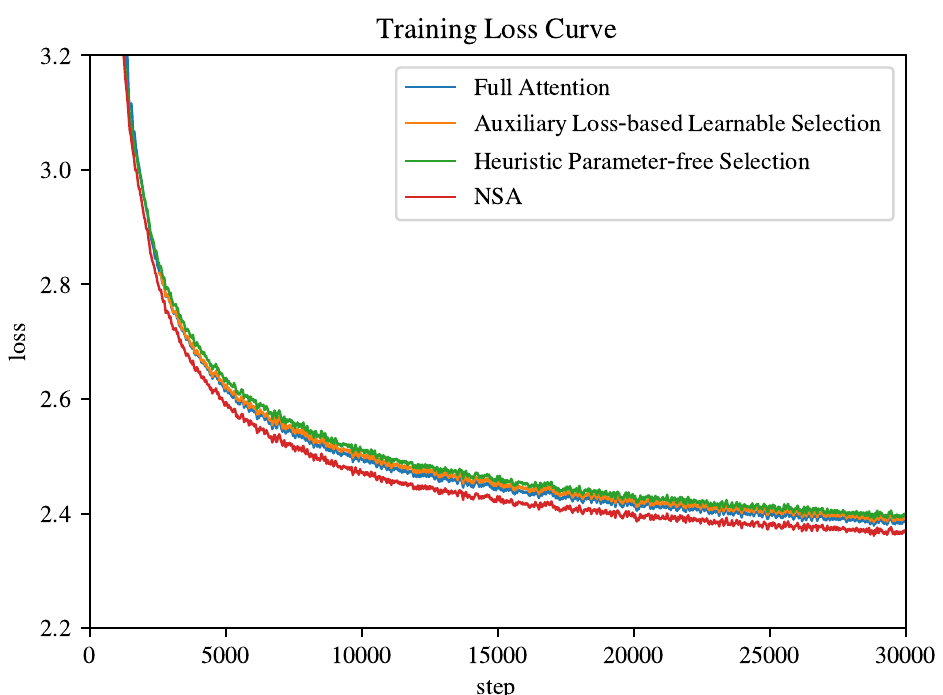
Autres stratégies de sélection par blocs. Nous avons également considéré des stratégies de sélection de clés et valeurs par blocs différentes de NSA, telles que Quest (Tang et al. [2024]) et InfLLM (Xiao et al. [2024a]). Ces méthodes reposent sur le calcul d'un score d'importance pour chaque bloc KV et sur la sélection des top- blocs en fonction de leur similarité avec . Cependant, les méthodes existantes font face à deux problèmes critiques : (1) Étant donné que l'opération de sélection n'est pas différentiable, le calcul du score d'importance basé sur des réseaux de neurones repose sur une perte auxiliaire, ce qui augmente le surcoût des opérateurs et dégrade souvent les performances du modèle ; (2) La stratégie heuristique de calcul du score d'importance sans paramètres souffre de faibles taux de rappel, conduisant à des performances sous-optimales. Nous évaluons les deux approches sur un modèle de 3 milliards de paramètres avec une architecture similaire et comparons leur courbe de perte avec celles de NSA et de Full Attention. Pour la méthode de sélection basée sur une perte auxiliaire, nous introduisons des requêtes supplémentaires pour chaque token et des clés représentatives pour chaque bloc afin d'estimer les scores d'importance des blocs. Nous calculons les signaux de supervision au niveau des blocs en appliquant un mean-pooling sur les scores d'attention au sein de chaque bloc de clés, et utilisons la divergence KL pour superviser la prédiction d'importance des blocs. Nous conservons une granularité individuelle des requêtes plutôt que des requêtes moyennées par bloc afin de permettre un décodage efficace. Cette estimation d'importance basée sur une perte auxiliaire présente une similarité conceptuelle avec SeerAttention (Gao et al. [2024]). Pour la méthode de sélection heuristique sans paramètres, suivant la stratégie de Quest, nous mettons en œuvre une sélection directe à l'aide du produit entre les requêtes et le min-max par coordonnée des chunks de clés, sans introduire de paramètres supplémentaires. Nous explorons également une approche d'entraînement à démarrage à froid où Full Attention est appliquée pendant les 1000 premières étapes avant de passer à la sélection heuristique par blocs. Comme le montre la figure 7, les deux méthodes ont présenté une perte inférieure.
6.2. Visualisation
Afin d'explorer les motifs potentiels dans les distributions d'attention des transformeurs et de chercher l'inspiration pour notre conception, nous visualisons la carte d'attention de notre modèle Full Attention pré-entraîné de 27B dans la figure 8. La visualisation révèle des motifs intéressants où les scores d'attention tendent à présenter des caractéristiques de regroupement par blocs, les clés voisines affichant souvent des scores d'attention similaires. Cette observation a inspiré notre conception de NSA, suggérant que la sélection de blocs de clés basée sur la continuité spatiale pourrait être une approche prometteuse. Le phénomène de regroupement par blocs indique que les tokens adjacents dans la séquence peuvent partager certaines relations sémantiques avec les tokens de requête, bien que la nature exacte de ces relations nécessite des investigations supplémentaires. Cetteobservation nous a motivés à explorer un mécanisme d'attention creuse qui opère sur des blocs de tokens continus plutôt que sur des tokens individuels, visant à améliorer l'efficacité computationnelle et à préserver les motifs de forte attention.
7. Travaux connexes
Nous passons en revue les approches existantes qui améliorent l'efficacité du calcul de l'attention grâce à l'attention creuse. Ces méthodes peuvent être globalement classées en trois groupes selon leur stratégie centrale : (1) motif creux fixe, (2) élagage dynamique de tokens et (3) sélection sensible à la requête. Nous présentons plusieurs travaux représentatifs de chaque catégorie.
7.1. Motif creux fixe
SlidingWindow est une approche couramment utilisée qui permet à la requête de calculer l'attention uniquement dans une fenêtre fixe. StreamingLLM (Xiao et al., 2023) combine des puits d'attention avec des fenêtres locales pour traiter des flux de texte continus. MoA (Fu et al., 2024a) et DuoAttention (Xiao et al., 2024b) adoptent également des informations locales et de puits similaires pour la modélisation de longues séquences. Longformer (Beltagy et al., 2020) entrelace l'attention locale par fenêtre avec des tokens globaux pour traiter de longues séquences. Comparé à ces méthodes, notre NSA ne repose pas sur des motifs creux prédéfinis, mais apprend les motifs automatiquement, libérant le potentiel d'exploitation du contexte complet.
7.2. Élagage dynamique de tokens
Certaines méthodes sont conçues pour réduire les coûts de mémoire et de calcul lors de l'inférence grâce à l'élagage dynamique du cache KV. H2O (Zhang et al., 2023b), BUZZ (Zhao et al., 2024) et SepLLM (Chen et al., 2024a) mettent en œuvre des approches adaptatives pour réduire l'utilisation mémoire du cache KV pendant le décodage. Ces méthodes évincents dynamiquement les tokens jugés moins importants pour les prédictions futures. FastGen (Ge et al., 2023) et HeadKV (Fu et al., 2024b) optimisent le calcul en attribuant différentes stratégies à chaque tête d'attention individuelle. SnapKV (Li et al., 2024) introduit une stratégie d'élagage de tokens qui réduit le cache KV en ne conservant sélectivement que les caractéristiques les plus cruciales, permettant une utilisation efficace de la mémoire. Contrairement à ces approches centrées sur l'inférence, notre NSA intègre la parcimonie nativement lors de la phase d'entraînement.
7.3. Sélection sensible à la requête
D'autres travaux se concentrent sur des méthodes de sélection de tokens dépendantes de la requête afin de réduire le calcul de l'attention tout en préservant sa qualité. Quest (Tang et al., 2024) emploie une stratégie de sélection par blocs où l'importance de chaque segment est estimée par le produit entre la requête et le minimum-maximum par coordonnée des segments de clés. InfLLM (Xiao et al., 2024a) combine des motifs fixes avec la récupération en maintenant des puits d'attention, un contexte local et des segments récupérables. Cette méthode sélectionne des clés représentatives dans chaque segment pour estimer l'importance du segment. HashAttention (Desai et al., 2024) formule l'identification des tokens pivots comme un problème de recommandation en projetant les requêtes et les clés dans l'espace de Hamming à l'aide de fonctions apprises. ClusterKV (Liu et al., 2024) obtient la parcimonie en regroupant d'abord les clés, puis en sélectionnant les groupes les plus pertinents pour le calcul de l'attention sur la base de la similarité requête-groupe. MInference (Jiang et al., 2024) et TokenSelect (Wu et al., 2024) sélectionnent les paires KV pour le calcul sur la base d'une notation d'importance au niveau des tokens. SeerAttention (Gao et al., 2024) sépare les requêtes et les clés en blocs spatiaux et effectue une sélection par blocs pour un calcul efficace. Comparée à ces méthodes, notre NSA réalise un calcul d'attention parcimonieux aligné sur le matériel tout au long du cycle de vie complet du modèle, incluant l'entraînement, le pré-remplissage et le décodage.
8. Conclusion
Nous présentons NSA, une architecture d'attention parcimonieuse alignée sur le matériel pour une modélisation efficace de contextes longs. En intégrant une compression hiérarchique des tokens à une sélection de tokens par blocs au sein d'une architecture entraînable, notre architecture réalise un entraînement et une inférence accélérés tout en conservant les performances de l'attention complète. NSA fait progresser l'état de l'art en démontrant que les performances sur les benchmarks généraux correspondent à celles des références à attention complète, en dépassant la capacité de modélisation dans les évaluations sur contextes longs, et en améliorant la capacité de raisonnement, le tout accompagné de réductions mesurables de la latence de calcul et d'une accélération significative.
Références
J. Ainslie, J. Lee-Thorp, M. de Jong, Y. Zemlyanskiy, F. Lebrón, and S. Sanghai. Gqa: Training generalized multi-query transformer models from multi-head checkpoints. arXiv preprint arXiv:2305.13245, 2023. J. Austin, A. Odena, M. Nye, M. Bosma, H. Michalewski, D. Dohan, E. Jiang, C. Cai, M. Terry, Q. Le, et al. Program synthesis with large language models. arXiv preprint arXiv:2108.07732, 2021. Y. Bai, X. Lv, J. Zhang, H. Lyu, J. Tang, Z. Huang, Z. Du, X. Liu, A. Zeng, L. Hou, et al. Longbench: A bilingual, multitask benchmark for long context understanding. arXiv preprint arXiv:2308.14508, 2023. I. Beltagy, M. E. Peters, and A. Cohan. Longformer: The long-document transformer. arXiv preprint arXiv:2004.05150, 2020. G. Chen, H. Shi, J. Li, Y. Gao, X. Ren, Y. Chen, X. Jiang, Z. Li, W. Liu, and C. Huang. Sepllm: Accelerate large language models by compressing one segment into one separator. arXiv preprint arXiv:2412.12094, 2024a. M. Chen, J. Tworek, H. Jun, Q. Yuan, H. P. D. O. Pinto, J. Kaplan, H. Edwards, Y. Burda, N. Joseph, G. Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021. Z. Chen, R. Sadhukhan, Z. Ye, Y. Zhou, J. Zhang, N. Nolte, Y. Tian, M. Douze, L. Bottou, Z. Jia, et al. Magicpig: Lsh sampling for efficient llm generation. arXiv preprint arXiv:2410.16179, 2024b. K. Cobbe, V. Kosaraju, M. Bavarian, M. Chen, H. Jun, L. Kaiser, M. Plappert, J. Tworek, J. Hilton, R. Nakano, et al. Training verifiers to solve math word problems, 2021. URL https://arxiv.org/abs/2110.14168, 2021. D. Dai, C. Deng, C. Zhao, R. Xu, H. Gao, D. Chen, J. Li, W. Zeng, X. Yu, Y. Wu, et al. Deepseekmoe: Towards ultimate expert specialization in mixture-of-experts language models. arXiv preprint arXiv:2401.06066, 2024. DeepSeek- AI. Deepseek- v2: A strong, economical, and efficient mixture- of- experts language model. 2024. URL https://arxiv.org/abs/2405.04434 DeepSeek- AI. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning, 2025. URL https://arxiv.org/abs/2501.12948
A. Desai, S. Yang, A. Cuadron, A. Klimovic, M. Zaharia, J. E. Gonzalez et I. Stoica. Hashattention : parcimonie sémantique pour une inférence plus rapide. Prépublication arXiv arXiv:2412.14468, 2024.
D. Dua, Y. Wang, P. Dasigi, G. Stanovsky, S. Singh et M. Gardner. Drop : un benchmark de compréhension écrite nécessitant un raisonnement discret sur des paragraphes. Prépublication arXiv arXiv:1903.00161, 2019.
T. Fu, H. Huang, X. Ning, G. Zhang, B. Chen, T. Wu, H. Wang, Z. Huang, S. Li, S. Yan, et al. Moa : mélange d'attention parcimonieuse pour la compression automatique de grands modèles de langage. Prépublication arXiv arXiv:2406.14909, 2024a.
Y. Fu, Z. Cai, A. Asi, W. Xiong, Y. Dong et W. Xiao. Toutes les têtes ne comptent pas : une méthode de compression du cache kv au niveau des têtes avec récupération et raisonnement intégrés. Prépublication arXiv arXiv:2410.19258, 2024b.
Y. Gao, Z. Zeng, D. Du, S. Cao, H. K.-H. So, T. Cao, F. Yang et M. Yang. Seerattention : apprendre l'attention parcimonieuse intrinsèque dans vos llms. Prépublication arXiv arXiv:2410.13276, 2024.
S. Ge, Y. Zhang, L. Liu, M. Zhang, J. Han et J. Gao. Le modèle vous dit quoi écarter : compression adaptative du cache kv pour les llms. Prépublication arXiv arXiv:2310.01801, 2023.
G. T. Google, P. Georgiev, V. I. Lei, R. Burnell, L. Bai, A. Gulati, G. Tanzer, D. Vincent, Z. Pan, S. Wang, et al. Gemini 1.5 : débloquer la compréhension multimodale sur des millions de jetons de contexte. Prépublication arXiv arXiv:2403.05530, 2024.
D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song et J. Steinhardt. Mesurer la compréhension massive du langage multitâche. Prépublication arXiv arXiv:2009.03300, 2020.
H. Jiang, Q. Wu, C.-Y. Lin, Y. Yang et L. Qiu. Llmlingua : compresser les invites pour une inférence accélérée des grands modèles de langage. Prépublication arXiv arXiv:2310.05736, 2023.
H. Jiang, Y. Li, C. Zhang, Q. Wu, X. Luo, S. Ahn, Z. Han, A. H. Abdi, D. Li, C.-Y. Lin, et al. Minference 1.0 : accélérer le pré-remplissage des llms à contexte long via une attention parcimonieuse dynamique. Prépublication arXiv arXiv:2407.02490, 2024.
G. Kamradt. LLMTest NeedleInAHaystack. Dépôt GitHub, 2023. URL https://github.com/gkamradt/LLMTest_NeedleInAHaystack Consulté le : [Insérer la date de consultation ici].
.
.
H. Li, Y. Zhang, F. Koto, Y. Yang, H. Zhao, Y. Gong, N. Duan et T. Baldwin. Cmmlu : mesurer la compréhension massive du langage multitâche en chinois. Prépublication arXiv arXiv:2306.09212, 2023.
Y. Li, Y. Huang, B. Yang, B. Venkitesh, A. Locatelli, H. Ye, T. Cai, P. Lewis et D. Chen. Snapkv : le llm sait ce que vous cherchez avant la génération. Prépublication arXiv arXiv:2404.14469, 2024.
.
G. Liu, C. Li, J. Zhao, C. Zhang et M. Guo. Clusterkv : manipuler le cache kv des llms dans l'espace sémantique pour une compression rappelable. Prépublication arXiv arXiv:2412.03213, 2024.
J. S. Park, J. C. O'Brien, C. J. Cai, M. R. Morris, P. Liang et M. S. Bernstein. Agents génératifs : simulacres interactifs du comportement humain. In S. Follmer, J. Han, J. Steimle et N. H. Riche, éditeurs, Actes du 36e symposium annuel ACM sur les logiciels et technologies d'interface utilisateur, UIST 2023, San Francisco, CA, États-Unis, 29 octobre 2023–1er novembre 2023, pages 2:1–2:22. ACM, 2023.
.
.
B. Peng, J. Quesnelle, H. Fan et E. Shippole. Yarn : extension efficace de la fenêtre de contexte des grands modèles de langage. In ICLR. OpenReview.net, 2024.
N. Shazeer. Décodage rapide de transformateur : une seule tête d'écriture suffit. CoRR, abs/1911.02150, 2019.
M. Suzgun, N. Scales, N. Schärli, S. Gehrmann, Y. Tay, H. W. Chung, A. Chowdhery, Q. V. Le, E. H. Chi, D. Zhou, et al. Défier les tâches big-bench et déterminer si la chaîne de pensée peut les résoudre. Prépublication arXiv arXiv:2210.09261, 2022.
J. Tang, Y. Zhao, K. Zhu, G. Xiao, B. Kasikci et S. Han. Quest : parcimonie sensible aux requêtes pour une inférence efficace des llms à contexte long. Prépublication arXiv arXiv:2406.10774, 2024.
P. Tillet, H.-T. Kung et D. Cox. Triton : un langage intermédiaire et un compilateur pour les calculs de réseaux neuronaux par tuiles. In Actes du 3e atelier international ACM SIGPLAN sur l'apprentissage automatique et les langages de programmation, pages 10-19, 2019.
A. Vaswani, N. Shazeer, N. Parmar, J. Uszkoreit, L. Jones, A. N. Gomez, L. u. Kaiser et I. Polosukhin. L'attention est tout ce dont vous avez besoin. Advances in Neural Information Processing Systems, 2017.
Y. Wang, X. Ma, G. Zhang, Y. Ni, A. Chandra, S. Guo, W. Ren, A. Arulraj, X. He, Z. Jiang, et al. Mmlu-pro : un benchmark de compréhension du langage multitâche plus robuste et plus exigeant. Prépublication arXiv arXiv:2406.01574, 2024.
J. Wei, X. Wang, D. Schuurmans, M. Bosma, F. Xia, E. Chi, Q. V. Le, D. Zhou, et al. L'invite par chaîne de pensée suscite le raisonnement dans les grands modèles de langage. Advances in neural information processing systems, 35:24824-24837, 2022.
W. Wu, Z. Pan, C. Wang, L. Chen, Y. Bai, K. Fu, Z. Wang et H. Xiong. Tokenselect : inférence efficace à contexte long et extrapolation de longueur pour les llms via une sélection dynamique du cache kv au niveau des jetons. Prépublication arXiv arXiv:2411.02886, 2024.
C. Xiao, P. Zhang, X. Han, G. Xiao, Y. Lin, Z. Zhang, Z. Liu et M. Sun. Infllm : extrapolation à contexte long sans entraînement pour les llms avec une mémoire de contexte efficace. In La trente-huitième conférence annuelle sur les systèmes de traitement de l'information neuronale, 2024a.
G. Xiao, Y. Tian, B. Chen, S. Han et M. Lewis. Modèles de langage en flux efficaces avec puits d'attention. Prépublication arXiv arXiv:2309.17453, 2023.
G. Xiao, J. Tang, J. Zuo, J. Guo, S. Yang, H. Tang, Y. Fu et S. Han. Duoattention : inférence efficace des llms à contexte long avec têtes de récupération et de flux. Prépublication arXiv arXiv:2410.10819, 2024b.
M. Zaheer, G. Guruganesh, K. A. Dubey, J. Ainslie, C. Alberti, S. Ontanon, P. Pham, A. Ravula, Q. Wang, L. Yang, et al. Big bird : des transformateurs pour des séquences plus longues. Advances in neural information processing systems, 33:17283-17297, 2020.
E. Zelikman, Y. Wu, J. Mu et N. D. Goodman. Star: Bootstrapping reasoning with reasoning. Dans S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho et A. Oh, éditeurs, Advances in Neural Information Processing Systems 35 : Annual Conference on Neural Information Processing Systems 2022, NeurIPS 2022, La Nouvelle-Orléans, LA, États-Unis, 28 novembre - 9 décembre 2022, 2022.
F. Zhang, B. Chen, Y. Zhang, J. Keung, J. Liu, D. Zan, Y. Mao, J. Lou et W. Chen. Repocoder: Repository-level code completion through iterative retrieval and generation. Dans H. Bouamor, J. Pino et K. Bali, éditeurs, Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, EMNLP 2023, Singapour, 6-10 décembre 2023, pages 2471-2484. Association for Computational Linguistics, 2023a.K. Zhang, J. Li, G. Li, X. Shi et Z. Jin. Codeagent: Enhancing code generation with tool-integrated agent systems for real-world repo-level coding challenges. Dans L. Ku, A. Martins et V. Srikumar, éditeurs, Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), ACL 2024, Bangkok, Thaïlande, 11-16 août 2024, pages 13643-13658.Z. Zhang, Y. Sheng, T. Zhou, T. Chen, L. Zheng, R. Cai, Z. Song, Y. Tian, C. Ré, C. Barrett, et al. H2o: Heavy-hitter oracle for efficient generative inference of large language models. Advances in Neural Information Processing Systems, 36:34661-34710, 2023b.J. Zhao, Z. Fang, S. Li, S. Yang et S. He. Buzz: Beehive-structured sparse kv cache with segmented heavy hitters for efficient llm inference. arXiv preprint arXiv:2410.23079, 2024.Z. Zhou, C. Li, X. Chen, S. Wang, Y. Chao, Z. Li, H. Wang, R. An, Q. Shi, Z. Tan, et al. Llm × mapreduce: Simplified long-sequence processing using large language models. arXiv preprint arXiv:2410.09342, 2024.
A. Exemple de résultats AIME
Invite :
« | Utilisateur | Soit et des nombres réels positifs qui satisfont le système d’équations suivant :
Alors la valeur de est où et sont des entiers positifs premiers entre eux. Trouver . Veuillez raisonner étape par étape et placer la réponse finale dans . | Assistant | »
Notre résultat :
(2275 tokens)
Étant donné le système d’équations :
Nous convertissons ces équations logarithmiques sous leur forme exponentielle :
En exprimant chaque variable en fonction de et :
En substituant ces expressions les unes dans les autres, nous trouvons :- À partir de et , nous obtenons , ce qui conduit à . - En substituant dans l’équation pour , nous obtenons . - En substituant et dans l’équation pour , nous obtenons .
Ensuite, nous calculons :
En multipliant ces quantités ensemble :
En prenant le logarithme de base 2 :
La valeur absolue est :
Ainsi, et , ce qui donne .
33
Résultat de référence :
(think)...(/think) (9392 tokens)
Étant donné le système d’équations logarithmiques :
Nous convertissons ces équations sous forme exponentielle :
En les substituant les unes dans les autres, nous trouvons :
En résolvant ces équations étape par étape, nous trouvons :
Cependant, en vérifiant la troisième équation, nous réalisons que le système pourrait ne pas avoir de solution. Par conséquent, nous utilisons l’inversion matricielle pour résoudre le système :
Soit , , . Le système devient :
Nous résolvons ce système à l’aide de la règle de Cramer et de l’inversion matricielle. Le déterminant de la matrice est - 2, et les solutions sont :
Ainsi, nous avons :
Nous devons trouver :
En convertissant au dénominateur commun (48) :
En additionnant ces termes :
La fraction est sous forme irréductible, donc et . Par conséquent, .
Invite :
"| Utilisateur | Des nombres réels et avec satisfont . Quelle est la valeur de ? Veuillez raisonner étape par étape et placer votre réponse finale dans . | Assistant | "
Notre résultat :
(15147 tokens)
Étant donné les équations :
1. 2.
Nous commençons par appliquer la règle de puissance des logarithmes aux deux équations.
Pour la première équation :
Soit . Alors, . En substituant ceci dans l’équation, nous obtenons :
Pour la deuxième équation :
En utilisant la règle de puissance, nous obtenons :
Puisque , ceci se simplifie en :
Nous avons maintenant deux expressions :
1. 2.
En substituant et dans le produit , nous obtenons :
Ainsi, la valeur de est .
Résultat de référence :
(16223 tokens)
Étant donné le problème où des nombres réels et avec satisfont les équations et , nous devons trouver la valeur de .
D’abord, nous convertissons les équations logarithmiques sous leurs formes exponentielles en utilisant la formule de changement de base.
1.
En utilisant la formule de changement de base, . Puisque , nous avons . Ainsi,
2.
De nouveau, en utilisant la formule de changement de base, .
Ensuite, nous exprimons et l'un en fonction de l'autre :
Nous calculons ensuite le produit :
Cependant, après réévaluation et en utilisant une autre approche en posant et , nous trouvons :
Enfin, nous trouvons que le produit se simplifie en :