
Une plateforme ouverte où les agents codent, exécutent des commandes et naviguent, évaluée sur 15 benchmarks. ICLR 2025, gratuit en ligne.
OpenHands: An Open Platform for AI Software Developers as Generalist Agents
OPENHANDS : UNE PLATEFORME OUVERTE POUR LES DÉVELOPPEURS DE LOGICIELS IA EN TANT QU'AGENTS GÉNÉRALISTES
Xingyao Wang , Boxuan Li , Yufan Song , Frank F. Xu , Xiangru Tang , Mingchen Zhuge , Jiayi Pan , Yueqi Song , Bowen Li, Jaskirat Singh , Hoang H. Tran , Fuqiang Li, Ren Ma, Mingzhang Zheng, Bill Qian , Yanjun Shao , Niklas Muennighoff , Yizhe Zhang, Binyuan Hui , Junyang Lin , Robert Brennan , Hao Peng , Heng Ji , Graham Neubig UIUC CMU Yale UC Berkeley Contextual AI KAUST ANU HCMUT Alibaba All Hands AI xingyao6@illinois.edu, gneubig@cs.cmu.edu
RÉSUMÉ
Le logiciel est l'un des outils les plus puissants dont nous, humains, disposons ; il permet à un programmeur compétent d'interagir avec le monde de manières complexes et profondes. Parallèlement, grâce aux améliorations des grands modèles de langage (LLMs), on a également assisté à un développement rapide des agents IA qui interagissent avec leur environnement et y produisent des changements. Dans cet article, nous présentons OpenHands (anciennement OpenDevin), une plateforme pour le développement d'agents IA puissants et flexibles qui interagissent avec le monde de manières similaires à celles d'un développeur humain : en écrivant du code, en interagissant avec une ligne de commande et en naviguant sur le web. Nous décrivons comment la plateforme permet l'implémentation de nouveaux agents, une interaction sûre avec des environnements sandboxés pour l'exécution de code, la coordination entre plusieurs agents et l'intégration de benchmarks d'évaluation. Sur la base des benchmarks actuellement intégrés, nous réalisons une évaluation des agents sur 15 tâches difficiles, incluant l'ingénierie logicielle (par ex., SWe- BENCH) et la navigation web (par ex., WEBARENA), entre autres. Publié sous la licence permissive MIT, OpenHands est un projet communautaire couvrant le monde académique et l'industrie avec plus de 2,1 K contributions provenant de plus de 188 contributeurs.
Code https://github.com/All- Hands- AI/OpenHands Slack http://bit.ly/OpenHands- Slack
1 INTRODUCTION
Propulsés par les grands modèles de langage (LLMs ; OpenAI 2024b ; Team et al. 2023 ; Jiang et al. 2024 ; Chang et al. 2024), les systèmes d'IA destinés aux utilisateurs (tels que ChatGPT) sont devenus de plus en plus capables d'accomplir des tâches complexes comme répondre avec précision aux requêtes des utilisateurs, résoudre des problèmes mathématiques et générer du code. En particulier, les agents IA, systèmes capables de percevoir et d'agir sur l'environnement externe, ont récemment reçu une attention croissante de la recherche. Ils progressent vers l'accomplissement de tâches complexes telles que le développement de logiciels (Jimenez et al., 2024), la navigation sur des sites web réels (Zhou et al., 2023a), l'exécution de tâches ménagères (Ahn et al., 2022), ou même la réalisation de recherches scientifiques (Boiko et al., 2023 ; Tang et al., 2024a).
X
À mesure que les agents IA deviennent capables de s'attaquer à des problèmes complexes, leur développement et leur évaluation sont également devenus difficiles. De nombreux efforts récents visent à créer des frameworks open source qui facilitent le développement d'agents (Hong et al., 2023 ; Chen et al., 2024 ; Wu et al., 2023). Ces frameworks d'agents incluent généralement : 1) des interfaces par lesquelles les agents interagissent avec le monde (comme des appels de fonctions basés sur JSON ou l'exécution de code), 2) des environnements dans lesquels les agents opèrent, et 3) des mécanismes d'interaction pour la communication humain- agent ou agent- agent. Ces frameworks rationalisent et facilitent le processus de développement de diverses manières (Tab. 1, §C).
Lors de la conception d'agents IA, nous pouvons également considérer la manière dont l'humain interagit avec le monde. La manière la plus puissante dont les humains interagissent actuellement avec le monde est par le biais du logiciel – le logiciel
alimente chaque aspect de notre vie, soutenant tout, de la logistique pour les besoins de base à l'avancement de la science, de la technologie et de l'IA elle- même. Compte tenu de la puissance du logiciel, ainsi que de l'outillage existant autour de son développement, de son utilisation et de son déploiement efficaces, il constitue l'interface idéale pour que les agents IA interagissent avec le monde de manières complexes. Cependant, construire des agents capables de développer efficacement des logiciels comporte ses propres défis uniques. Comment pouvons- nous permettre aux agents de créer et modifier efficacement du code dans des systèmes logiciels complexes ? Comment pouvons- nous leur fournir des outils pour recueillir des informations à la volée afin de déboguer des problèmes ou de rassembler les informations requises par la tâche ? Comment pouvons- nous garantir que le développement est sûr et évite les effets secondaires négatifs sur les systèmes des utilisateurs ?
Dans cet article, nous présentons OpenHands (anciennement OpenDevin), une plateforme communautaire conçue pour le développement d'agents IA généralistes et spécialisés qui interagissent avec le monde par le biais du logiciel.1 Elle présente :
(1) Un mécanisme d'interaction qui permet aux interfaces utilisateur, aux agents et aux environnements d'interagir via une architecture de flux d'événements puissante et flexible (§2.1). (2) Un environnement d'exécution constitué d'un système d'exploitation sandboxé par Docker avec un shell bash, un navigateur web et un serveur IPython avec lesquels les agents peuvent interagir (§2.2). (3) Une interface permettant à l'agent d'interagir avec l'environnement d'une manière similaire à celle de véritables ingénieurs logiciels (§2.3). Nous fournissons la capacité aux agents de a) créer et modifier des logiciels complexes, b) exécuter du code arbitraire dans le sandbox, et c) naviguer sur des sites web pour collecter des informations. (4) La délégation multi- agents, permettant à plusieurs agents spécialisés de travailler ensemble (§2.4). (5) Un cadre d'évaluation, facilitant l'évaluation des agents sur un large éventail de tâches (§4).
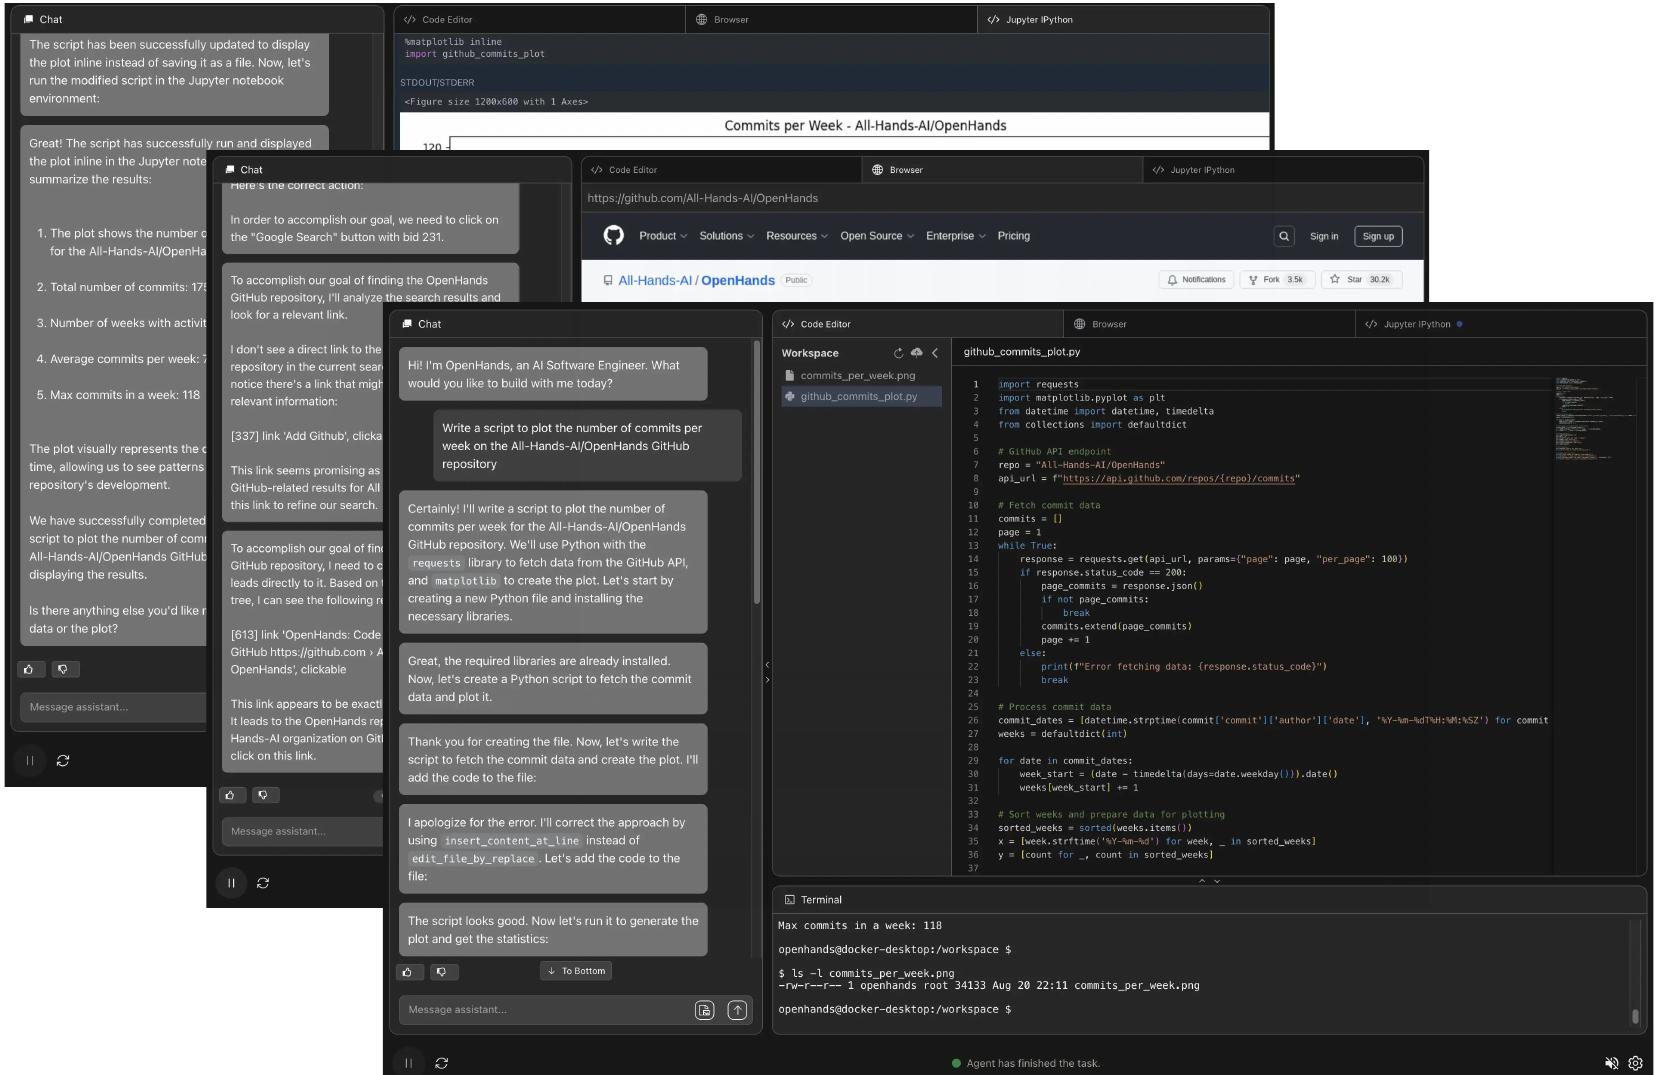
Surtout, OpenHands n'est pas seulement un cadre conceptuel, mais il inclut également une implémentation complète et immédiatement utilisable d'agents, d'environnements et d'évaluations. Au moment de la rédaction, OpenHands inclut un hub d'agents avec plus de 10 agents implémentés (§3), dont un agent généraliste performant implémenté sur la base de l'architecture CodeAct (Wang et al., 2024a), avec des ajouts pour la navigation web (ServiceNow) et des spécialistes de l'édition de code (Yang et al., 2024). L'interaction avec les utilisateurs est mise en œuvre via une interface utilisateur basée sur le chat qui visualise les actions actuelles de l'agent et permet
un retour en temps réel (Fig. 1, §D). De plus, le cadre d'évaluation prend actuellement en charge 15 benchmarks, que nous utilisons pour évaluer nos agents (§4).
Publié sous une licence permissive MIT autorisant l'usage commercial, OpenHands est prêt à soutenir un large éventail de recherches et d'applications réelles dans le monde académique et l'industrie. OpenHands a gagné une traction significative, avec 32 K étoiles GitHub et plus de 2,1 K contributions provenant de plus de 188 contributeurs. Nous envisageons OpenHands comme un catalyseur pour les futures innovations de recherche et diverses applications portées par une large communauté de praticiens.
2 ARCHITECTURE D'OPENHANDS
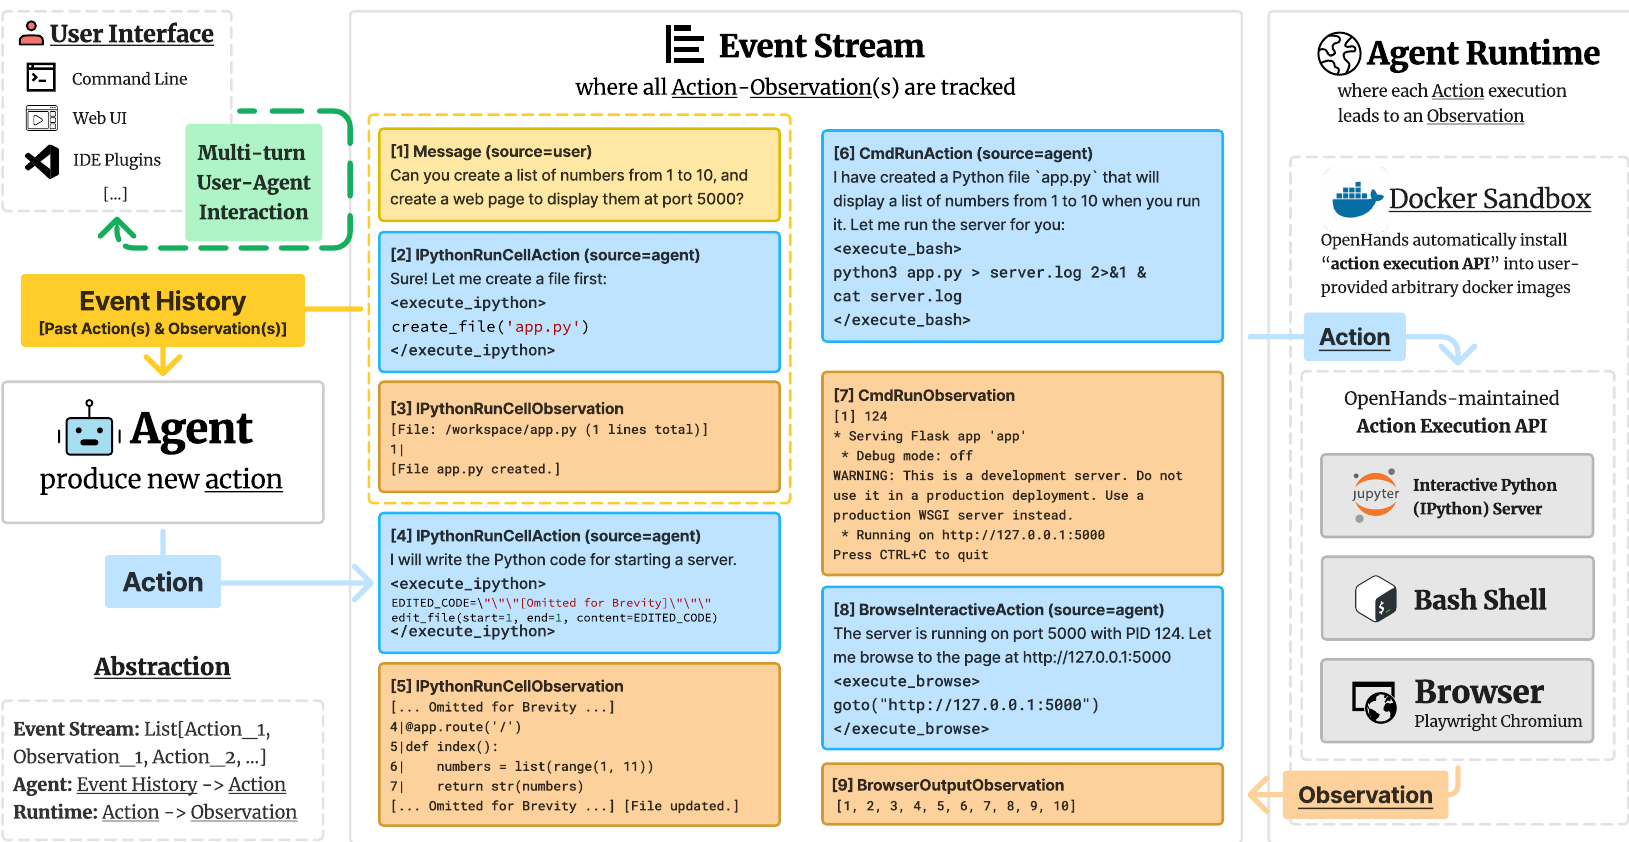
Nous décrivons ensuite l'utilisation d'OpenHands en détail. En particulier, nous discutons 1) comment définir et implémenter un agent (§2.1), 2) comment chaque exécution d'action conduit à une observation (§2.2), 3) comment gérer et étendre de manière fiable les compétences couramment utilisées pour les agents (§2.3), et 4) comment composer plusieurs agents ensemble pour résoudre des tâches (§2.4). La Fig. 2 en donne un aperçu.
2.1 DÉFINITION ET IMPLÉMENTATION DE L'AGENT
Un agent peut percevoir l'état de l'environnement (par ex., les actions et observations antérieures) et produire une action à exécuter tout en résolvant une tâche spécifiée par l'utilisateur.
L'état et le flux d'événements. Dans OpenHands, l'état est une structure de données qui encapsule toutes les informations pertinentes pour l'exécution de l'agent. Un composant clé de cet état est le flux d'événements, qui est une collection chronologique des actions et observations passées, incluant les propres actions de l'agent et les interactions avec l'utilisateur (par ex., instructions, retours). Outre le flux d'événements, l'état intègre des informations auxiliaires pour le fonctionnement de l'agent, telles que le coût cumulé des appels aux LLMs, des métadonnées pour suivre la délégation multi- agents (§2.4), et d'autres paramètres liés à l'exécution.
Actions. Inspirées par CodeAct (Wang et al., 2024a), OpenHands connecte un agent à l'environnement par le biais d'un ensemble central d'actions générales. Les actions IPythonRunCellAction et CmdRunAction permettent à l'agent d'exécuter du code Python arbitraire et des commandes bash à l'intérieur de l'environnement sandbox (par exemple, un système d'exploitation Linux isolé de manière sécurisée). BrowserInteractiveAction permet l'interaction avec un navigateur web grâce à un langage spécifique au domaine pour la navigation introduit par BrowserGym (Drouin et al., 2024). Ces actions ont été choisies afin de fournir un ensemble de primitives complet mais flexible, couvrant la plupart des tâches réalisées par les ingénieurs logiciels et les analystes humains. L'espace d'actions fondé sur les langages de programmation (PL) est suffisamment puissantet flexible pour accomplir n'importe quelle tâche avec des outils de formes différentes (par exemple, une fonction Python, une API REST, etc.), tout en étant fiable et facile à maintenir (Wang et al., 2024a).
Cette conception est également compatible avec les agents existants qui appellent des outils et requièrent une liste d'outils prédéfinis (Chase, 2022). Autrement dit, les utilisateurs peuvent facilement définir des outils à l'aide des PL pris en charge dans les actions primitives (par exemple, écrire une fonction Python pour une calculatrice) et rendre ces outils disponibles à l'agent par le biais d'expériences d'appel de fonctions de style JSON (Qin et al., 2023). De plus, les puissantes primitives fondées sur les PL du cadre rendent en outre possible pour les agents de créer eux-mêmes des outils (par exemple, en générant des fonctions Python, Yuan et al. 2023) lorsque l'API permettant d'accomplir la tâche n'est pas disponible. Se référer au §2.3 pour savoir comment ces actions centrales fondées sur les PL peuvent être composées en un ensemble diversifié d'outils.
Observations. Les observations décrivent les changements de l'environnement (par exemple, le résultat d'exécution des actions précédentes, les messages textuels de l'utilisateur humain, etc.) que l'agent observe.
Figure 3 : Exemple minimal d'implémentation d'un agent dans OpenHands.
class MinimalAgent: def reset(self) -> None: self.system_message "Vous êtes un assistant utile ..." def step(self, state: State): messages: list[dict[str, str]] = [ {'role': 'system', 'content': self.system_message] ] for prev_action, obs in state.history: action_message get_action_message(prev_action) messages.append(action_message) obs_message get_observation_message(obs) messages.append(obs_message) # utiliser le lim pour générer une réponse (par exemple, pensée, action) response self.lim.do_completion(messages) # analyser et exécuter l'action dans le runtime action self.parse_response(response) if self.is_finish_command(action): return AgentFinishAction() elif self.is_bash_command(action): return CmdRunAction(command=action.command) elif self.is_python_code(action): return IPythonRunCallAction(code=action.code) elif self.is_browser_action(action): return BrowseInteractiveAction(code=action.code) else: return MessageAction(content=action.message)
Implémenter un nouvel agent. L'abstraction d'agent est conçue pour être simple mais puissante, permettant aux utilisateurs de créer et de personnaliser facilement des agents pour diverses tâches. Le cœur de l'abstraction d'agent réside dans la fonction step, qui prend l'état courant en entrée et génère une action appropriée en fonction de la logique de l'agent. Un exemple de code simplifié pour l'abstraction d'agent est illustré à la Fig. 3. En fournissant cette abstraction, OpenHands permet aux utilisateurs de se concentrer sur la définition du comportement et de la logique souhaités de l'agent sans se soucier des détails de bas niveau de la manière dont les actions sont exécutées (§2.2).
2.2 ENVIRONNEMENT D'EXÉCUTION DE L'AGENT : COMMENT L'EXÉCUTION DES ACTIONS SE TRADUIT EN OBSERVATIONS
L'environnement d'exécution de l'agent (Agent Runtime) fournit un environnement général qui dote l'agent d'un espace d'actions comparable à celui des développeurs de logiciels humains, permettant aux agents OpenHands d'aborder un large éventail de tâches de développement logiciel et de tâches web, notamment des flux de travail complexes de développement logiciel, des projets d'analyse de données, des tâches de navigation web, et plus encore. Il permet à l'agent d'accéder à un terminal bash pour exécuter du code et des outils en ligne de commande, d'utiliser un notebook Jupyter pour écrire et exécuter du code à la volée, et d'interagir avec un navigateur web pour des tâches web (par exemple, la recherche d'informations).
Bac à sable Docker. Pour chaque session de tâche, OpenHands démarre un bac à sable conteneurisé Docker isolé de manière sécurisée, où toutes les actions du flux d'événements sont exécutées. OpenHands se connecte au bac à sable via un serveur API REST s'exécutant à l'intérieur de celui-ci (c'est-à-dire l'API d'exécution d'actions OpenHands), exécute des actions arbitraires (par exemple, commande bash, code python) issues du flux d'événements, et renvoie les résultats d'exécution sous forme d'observations. Un répertoire de travail configurable contenant les fichiers sur lesquels l'utilisateur souhaite que l'agent travaille est monté dans ce bac à sable sécurisé pour que les agents OpenHands puissent y accéder.
API d'exécution d'actions OpenHands. OpenHands maintient un serveur API qui s'exécute à l'intérieur du bac à sable Docker pour écouter les requêtes d'exécution d'actions provenant du flux d'événements. Le serveur API maintient :
(1) Un shell bash connecté à l'environnement du système d'exploitation (spécifié par l'image Docker) pour l'exécution de commandes. (2) Un serveur Jupyter IPython pour traiter les requêtes d'exécution de code python interactif (IPython) et renvoyer les résultats d'exécution au flux d'événements. (3) Un navigateur Chromium basé sur Playwright. Le fournisseur fournit un ensemble de primitives d'action définies par BrowserGym (ServiceNow ; Drouin et al., 2024), telles que la navigation, le clic, la saisie et le défilement. L'ensemble complet des actions est détaillé au §J. Après l'exécution de ces actions, l'environnement d'exécution du navigateurfournit un riche ensemble d'observations sur l'état actuel du navigateur, notamment le HTML, le DOM, l'arbre d'accessibilité (Mozilla), la capture d'écran, les onglets ouverts, etc.
Prise en charge d'images Docker arbitraires. OpenHands permet aux agents de s'exécuter sur des systèmes d'exploitation arbitraires avec différents environnements logiciels en prenant en charge un environnement d'exécution basé sur des images Docker arbitraires. OpenHands met en œuvre un mécanisme de construction qui prend une image Docker arbitraire fournie par l'utilisateur et installe l'API d'exécution d'actions OpenHands dans cette image pour permettre les interactions de l'agent. Nous incluons une description détaillée de l'environnement d'exécution de l'agent OpenHands au §F.
2.3 COMPÉTENCES DE L'AGENT : L'INTERFACE AGENT-ORDINATEUR EXTENSIBLE
SWE-Agent (Yang et al., 2024) souligne l'importance d'une interface agent-ordinateur (ACI, c'est-à-dire des outils spécialisés pour des tâches particulières) soigneusement conçue pour résoudre avec succès des tâches complexes. Cependant, créer, maintenir et distribuer un large éventail d'outils peut représenter un défi d'ingénierie redoutable, en particulier lorsque nous voulons rendre ces outils disponibles pour différentes implémentations d'agents (§3). Pour y répondre, nous construisons une bibliothèque AgentSkills, une boîte à outils conçue pour améliorer les capacités des agents, offrant des utilitaires qui ne sont pas facilement disponibles via les commandes bash de base ou le code python.
Facilité de création et d'extension des outils. AgentSkills est conçue comme un package Python composé de différentes fonctions utilitaires (c'est-à-dire des outils) qui sont automatiquement importées dans l'environnement Jupyter IPython (§2.2). La facilité de définir une fonction Python comme outil abaisse la barrière pour les membres de la communauté souhaitant contribuer de nouveaux outils à la bibliothèque. La généralité des packages Python permet également aux différentes implémentations d'agents d'exploiter facilement ces outils via l'une de nos actions principales IPythonRunCellAction (§2.1).
Critères d'inclusion et philosophie. Dans la bibliothèque AgentSkills, nous ne cherchons pas à envelopper chaque package Python possible ni à réenseigner leur utilisation aux agents (par exemple, le LLM connaît déjà la bibliothèque pandas capable de lire un fichier CSV, nous n'avons donc pas besoin de recréer un outil qui apprend à l'agent à lire le même format de fichier). Nous n'ajoutons une nouvelle compétence que lorsque : (1) il n'est pas facilement réalisable pour le LLM d'écrire directement le code (par exemple, éditer du code et remplacer certaines lignes), et/ou (2) cela implique d'appeler un modèle externe (par exemple, appeler un modèle de reconnaissance vocale, ou un modèle d'édition de code (Sanger)).
Compétences actuellement prises en charge. La bibliothèque AgentSkills inclut des utilitaires d'édition de fichiers adaptés de SWE-Agent (Yang et al., 2024) et d'Aider (Gauthier), comme edit_file, qui permet de modifier un fichier existant à partir d'une ligne spécifiée ; des fonctions de défilement scroll_up et scroll_down pour visualiser une autre partie des fichiers. Elle contient également des outils prenant en charge la lecture de documents multimodaux, comme parse_image et parse_pdf pour extraire respectivement des informations à partir d'images à l'aide de modèles vision-langage (par exemple, GPT-4V) et lire du texte à partir de PDF. Une liste complète des compétences prises en charge se trouve au §I.
2.4 DÉLÉGATION D'AGENT : INTERACTION MULTI-AGENTS COOPÉRATIVE
OpenHands permet également les interactions entre plusieurs agents. À cette fin, nous utilisons un type d'action spécial, AgentDelegateAction, qui permet à un agent de déléguer une sous-tâche spécifique à un autre agent. Par exemple, l'agent généraliste CodeActAgent, dont la prise en charge de la navigation web est limitée, peut utiliser AgentDelegateAction pour déléguer des tâches de navigation web à l'agent spécialisé BrowsingAgent afin d'effectuer des activités de navigation plus complexes (par exemple, naviguer sur le web, cliquer sur des boutons, soumettre des formulaires, etc.).
3 AGENTHUB : UN HUB D'AGENTS CONTRIBUÉS PAR LA COMMUNAUTÉ
Sur la base de notre abstraction d'agent (§2.1), OpenHands prend en charge un large éventail d'implémentations d'agents contribuées par la communauté, parmi lesquelles les utilisateurs finaux peuvent choisir et qui peuvent servir de références pour différentes tâches d'agents.
Agent CodeAct. CodeActAgent est l'agent généraliste par défaut basé sur le framework CodeAct (Wang et al., 2024a). À chaque étape, l'agent peut (1) converser pour communiquer avec les humains en langage naturel afin de demander des éclaircissements, des confirmations, etc., ou (2) exécuter la tâche en exécutant du code (aussi appelé CodeAct), notamment en exécutant des commandes bash, du code Python ou un langage de programmation spécifique au navigateur (§2.2). Cet espace d'action général permet à l'agent (v1.5 et versions ultérieures) d'accomplir diverses tâches, notamment l'édition de fichiers, la navigation sur le web, l'exécution de programmes, etc.
Tableau 1 : Comparaison de différents frameworks d'agents IA (§C). SWE désigne le « génie logiciel ». Bibliothèque d'outils standardisée : si le framework contient des outils réutilisables pour différentes implémentations d'agents (§2.3) ; Sandbox intégré et exécution de code : s'il prend en charge l'exécution en sandbox de code arbitraire généré par l'agent ; Navigateur web intégré : s'il fournit aux agents un accès à un navigateur web pleinement fonctionnel ; Collaboration humain-IA : s'il permet une collaboration multi-tours entre humains et IA (par exemple, l'humain peut interrompre l'agent pendant l'exécution de la tâche et/ou fournir des retours et des instructions supplémentaires) ; AgentHub : s'il héberge les implémentations de divers agents (§3) ; Framework d'évaluation : s'il offre une évaluation systématique des agents implémentés sur des benchmarks exigeants (§4) ; Agent QC (contrôle qualité) : si le framework intègre des tests (§E) pour garantir la qualité logicielle globale du framework.
| Contexte de référence en lecture seule pour comprendre la source (il ne s'agit pas du texte source à traduire) : Tableau 1 : Comparaison de différents frameworks d'agents IA (§C). SWE désigne l'« ingénierie logicielle ». Bibliothèque d'outils standardisée : si le framework contient des outils réutilisables pour différentes implémentations d'agents (§2.3) ; Sandbox intégré et exécution de code : s'il prend en charge l'exécution en sandbox de code arbitraire généré par l'agent ; Navigateur web intégré : s'il fournit aux agents l'accès à un navigateur web pleinement fonctionnel ; Collaboration humain-IA : s'il permet une collaboration multi-tours humain-IA (par exemple, huma Texte à traduire : Framework | Domaine | Interface graphique utilisateur | Bibliothèque d'outils standardisée | Sandbox intégré & exécution de code | Navigateur web intégré | Collaboration multi-agents | Collaboration humain-IA | AgentHub | Framework d'évaluation | Agent QC |
| AutoGPT Gravitas (2023) | Général | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| LangChain (Chase, 2022) | Général | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| MetaGPT (Hong et al., 2023) | Général | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoGen (Wu et al., 2023) | Général | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoAgents (Chen et al., 2024) | Général | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Agents (Zhou et al., 2023b) | Général | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Xagents (Team, 2023) | Général | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| OpenAgents (Xie et al., 2023) | Général | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| GPT5Warm (Zhuge et al., 2024) | Général | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoCodeRover (Zhang et al., 2024b) | SWE | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| SWE-Agent (Yang et al., 2024) | SWE | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| OpenHands | Général | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
\* Aucun support natif. Des options commerciales tierces sont disponibles.
Agent de navigation. Nous avons implémenté un agent web généraliste appelé Browsing Agent, destiné à servir de baseline simple mais efficace pour les tâches d'agents web. L'agent est similaire à celui de WebArena (Zhou et al., 2023a), mais avec des observations et des actions améliorées, avec uniquement un prompting zero-shot. Les prompts complets se trouvent dans .
Agent GPT5Warm. GPT5Warm (Zhuge et al., 2024) est pionnier dans l'utilisation de graphes optimisables pour construire des systèmes d'agents, unifiant les frameworks d'agents linguistiques grâce à la modularité. Chaque nœud représente une opération distincte, tandis que les arêtes définissent les voies de collaboration et de communication. Cette conception permet l'optimisation automatique des nœuds et des arêtes, favorisant les avancées dans la création de systèmes multi-agents.
Micro Agent(s). En outre, OpenHands permet la création de micro agent, un agent spécialisé dans une tâche particulière. Un micro agent réutilise la plupart des implémentations d'un agent généraliste existant (par exemple, CodeAct Agent). Il est conçu pour abaisser la barrière au développement d'agents, où les membres de la communauté peuvent partager des prompts spécialisés qui fonctionnent bien pour leurs cas d'usage particuliers.
4 ÉVALUATION
Afin de suivre systématiquement les progrès dans la construction d'agents numériques généralistes, comme indiqué dans le Tab. 2, nous intégrons 15 benchmarks établis dans OpenHands. Ces benchmarks couvrent le génie logiciel, la navigation web et diverses tâches d'assistance. Dans cette section, nous comparons OpenHands à des baselines open-source reproductibles qui n'effectuent pas d'ingénierie manuelle de prompts spécifiquement basée sur le contenu du benchmark. Veuillez noter que nous utilisons « OH » comme abréviation d'OpenHands dans le reste de cette section, par souci de concision.
| Catégorie | Benchmark | Capacité requise |
| Logiciel | SWE-Bench (Jimenez et al., 2024) | Résolution de tickets GitHub |
| HumanEvalFix (Muennighoff et al., 2024) | Correction de bugs | |
| BIRD (Li et al., 2023b) | Text-to-SQL | |
| BioCoder (Tang et al., 2024c) | Programmation en bioinformatique | |
| Web | ML-Bench (Tang et al., 2024b) | Programmation en apprentissage automatique |
| Gorilla APIBench (Patil et al., 2023) | Appel d'API logicielles | |
| ToolQA (Zhuang et al., 2024) | Utilisation d'outils | |
| Assistance diverse | WebArena (Zhou et al., 2023a) | Planification d'objectifs & navigation réaliste |
| MiniWoB++ (Liu et al., 2018) | Trajectoire courte sur le web synthétique | |
| GAI (Mialon et al., 2023) | Utilisation d'outils, navigation, multimodalité | |
| GPQA (Rein et al., 2023) | Questions-réponses de niveau supérieur résistantes à Google | |
| AgentBench (Liu et al., 2023) | Interaction avec le système d'exploitation (bash) | |
| MINT (Wang et al., 2024b) | Problèmes mathématiques et de code multi-tours | |
| Entity Deduction Arena (Zhang et al., 2024a) | Suivi d'état & planification stratégique | |
| ProofWriter (Tajford et al., 2021) | Raisonnement en logique déductive |
4.1 APERÇU DES RÉSULTATS
Dans OpenHands, notre objectif est de développer des agents numériques généralistes capables d'interagir avec le monde via des interfaces logicielles (comme l'illustrent les actions de code décrites au §2.1). Nous reconnaissons qu'un agent logiciel doit exceller non seulement dans l'édition de code, mais aussi dans la navigation web et diverses tâches auxiliaires, telles que répondre à des questions sur des dépôts de code ou mener des recherches en ligne.
| Contexte de référence en lecture seule pour comprendre la source (ce n'est pas le texte source à traduire) : Dans OpenHands, notre objectif est de développer des agents numériques généraux capables d'interagir avec le monde par le biais d'interfaces logicielles (comme l'illustrent les actions de code décrites au §2.1). Nous reconnaissons qu'un agent logiciel devrait exceller non seulement dans l'édition de code, mais aussi dans la navigation web et diverses tâches auxiliaires, telles que répondre à des questions sur des dépôts de code ou mener des recherches en ligne. \* Les chiffres sont rapportés à partir de CodeActAgent v1.5. Texte à traduire : Agent | Modèle | Logiciel ('$4.2)</td><td rowspan="2">Web ('$4.3) | Divers ('$4.4) | ||
| SWE-Bench Lite | WebArena | ||||
| SWE-Agent (Yang et al., 2024) | gpt-4-1106-preview | 18.0 | - | - | |
| AutoCodeRover (Zhang et al., 2024b) | gpt-4-0125-preview | 19.0 | - | - | |
| Aider (Gauthier) | gpt-4o &amp; claude-3-opus | 26.3 | - | - | |
| Moatless Tools (Orwall) | claude-3.5-sonnet | 26.7 | - | - | |
| Agentless (Xia et al., 2024) | gpt-4o | 27.3 | - | - | |
| Agents de navigation web | |||||
| Lemur (Xu et al., 2023) | Lemur-chat-70b | - | 5.3 | - | - |
| Patel et al. (2024) | 72B entraîné avec des données synthétiques | - | 9.4 | - | - |
| AutoWebGLM (Lai et al., 2024) | 7B entraîné avec annotation humaine/agent | - | 18.2 | - | - |
| Auto Eval &amp; Refine (Pan et al., 2024) | GPT-4 + Reflexion avec GPT-4V | - | 20.2 | - | - |
| WebArena Agent (Zhou et al., 2023a) | gpt-4-turbo | - | 14.4 | - | - |
| Agents d'assistance divers | |||||
| AutoGPT (Gravitas, 2023) | gpt-4-turbo | - | - | - | 13,2 |
| Few-shot Prompting + Chain-of-Thought (Rein et al., 2023) | Llama-2-70b-chat | - | - | 28,1 | - |
| gpt-4 | gpt-3.5-turbo-16k | - | - | 29,6 | - |
| gpt-4 | gpt-4 | - | - | 38,8 | - |
| Agents OpenHands | |||||
| CodeActAgent v1.8 | gpt-4o-mini-2024-07-18 | 6,3 | 8,3 | - | - |
| gpt-4o-2024-05-13 | gpt-4o-2024-05-13 | 22,0 | 14,5 | *53,1 | - |
| claude-3-5-sonnet | claude-3-5-sonnet | 26,0 | 15,3 | 52,0 | - |
| GPTSwarm v1.0 | gpt-4o-2024-05-13 | - | - | - | 32,1 |
\* Les chiffres sont rapportés à partir de CodeActAgent v1.5.
Le Tab. 3 présente un ensemble sélectionné de résultats d'évaluation. Bien que les agents OpenHands puissent ne pas atteindre les meilleures performances dans chaque catégorie, ils sont conçus dans un souci de généralité. Notamment, le même agent CodeAct, sans aucune modification de son prompt système, démontre des performances compétitives dans trois grandes catégories de tâches : le développement logiciel, l'interaction web et les tâches diverses. Cela est particulièrement significatif par rapport aux agents de référence, qui sont généralement conçus et optimisés pour des catégories de tâches spécifiques.
4.2 GÉNIE LOGICIEL
Nous rapportons ensuite les résultats spécifiques aux benchmarks de génie logiciel dans le Tab. 4.
SWE-Bench (Jimenez et al., 2024) est conçu pour évaluer les capacités des agents à résoudre des issues GitHub du monde réel, telles que des rapports de bugs ou des demandes de fonctionnalités. L'agent interagit avec le dépôt et tente de corriger l'issue fournie par l'édition de fichiers et l'exécution de code. Le dépôt de code modifié par l'agent est testé par rapport à une suite de tests intégrant de nouveaux tests ajoutés à partir des corrections des développeurs humains pour la même issue. Chaque instance de test est accompagnée d'un « texte d'indice » constitué de suggestions en langage naturel sur la manière de résoudre le problème. Tout au long de cet article, nous rapportons tous les résultats sans utiliser le texte d'indice. Un sous-ensemble canonique, SWE-bench Lite, est créé pour faciliter des tests accessibles et efficaces. Nous utilisons par défaut ce sous-ensemble pour les tests, pour des raisons d'économie de coûts.2 Résultat. Comme le montre le Tab. 4, notre version la plus récente de CodeActAgent v1.8, utilisant claude-3.5-sonnet, atteint un taux de résolution compétitif de par rapport aux autres spécialistes SWE open-source.
4.2.1 HUMANEVALFIX
HumanEvalFix (Muennighoff et al., 2024) demande aux agents de corriger un bug dans une fonction fournie à l'aide des cas de test fournis. Les bugs sont créés de manière à garantir qu'un ou plusieurs cas de test échouent. Nous nous concentrons sur le sous-ensemble Python du benchmark et permettons aux modèles de résoudre les bugs par auto-débogage sur plusieurs tours, en intégrant les retours de l'exécution des tests. Nous suivons la configuration de Muennighoff et al. (2024) en utilisant pass@k (Chen et al., 2021). Résultats. Dans le Tab. 4, OpenHands CodeActAgent corrige avec succès des bugs dans la division Python. Cela est nettement meilleur que toutes les approches non agentiques, presque le double de la performance de StarCoder2-15B (Lozhkov et al., 2024 ; Li et al., 2023c). Bien que SWE-Agent atteigne , Yang et al. (2024) fournit au modèle une démonstration complète d'une trajectoire d'exemple réussie corrigeant l'un des bugs du jeu de données de test (« 1-shot »), tandis que notre évaluation d'OpenHands est en 0-shot. Comme HumanEvalFix a été créé par des humains et que tous les bugs ont
| Contexte en lecture seule pour comprendre la source (pas le texte source à traduire) : 4.2.1 HUMANEVALFIX HumanEvalFix (Muennighoff et al., 2024) demande aux agents de corriger un bug dans une fonction fournie à l'aide de cas de test fournis. Les bugs sont créés pour garantir qu'un ou plusieurs cas de test échouent. Nous nous concentrons sur le sous-ensemble Python du benchmark et permettons aux modèles de résoudre les bugs par auto-débogage sur plusieurs tours, en intégrant les retours de l'exécution des tests. Nous suivons la configuration de Muennighoff et al. (2024) en utilisant pass@k (Chen et al., 2021). Résultats. Dans le Tab. 4, OpenHan Texte à traduire : Agent | Modèle | Taux de réussite (%) | $ Coût moy. |
| SWE-Agent (Yang et al., 2024) | SWE-Bench Lite (Jimenez et al., 2024), 300 instances, sans indice | ||
| AutoCodeRover (Zhang et al., 2024b) | gpt-4-1106-preview | 18.0 | 1.67 |
| Aider (Gauthier) | gpt-4-0125-preview | 19.0 | - |
| gpt-4-0&amp; claude-3-opus | 26.3 | - | |
| OH CodeActAgent v1.8 | gpt-4-0-mini-2024-07-18 | 7.0 | 0.01 |
| gpt-4-0-2024-05-13 | 22.0 | 1.72 | |
| claude-3-5-sonnet@20240620 | 26.0 | 1.10 | |
| HumanEvalFix (Muennighoff et al., 2024), 164 instances | |||
| Prompting, 0-shot | BLOOMZ-176B | 16.6 | - |
| OctoCoder-15B | 30.4 | - | |
| DeepSeekCoder-33B-Instruct | 47.5 | - | |
| StarCoder2-15B | 48.6 | - | |
| SWE-agent, 1-shot (Yang et al., 2024) | gpt-4-turbo | 87.7 | - |
| gpt-3.5-turbo-16k-0613 | 20.1 | 0.11 | |
| OH CodeActAgent v1.5, Généraliste, 0-shot. | gpt-4-0-2024-05-13 | 79.3 | 0.14 |
| BIRD (Li et al., 2023b), 300 instances | |||
| Prompting, 0-shot | CodeLlama-7B-Instruct | 18.3 | - |
| CodeQwen-7B-Chat | 31.3 | - | |
| OH CodeActAgent v1.5 | gpt-4-1106-preview | 42.7 | 0.19 |
| gpt-4-0-2024-05-13 | 47,3 | 0,11 | |
| ML-Bench (Tang et al., 2024b), 68 instances | |||
| prompting + BM25, 0-shot | gpt-3.5-turbo | 11,0 | - |
| gpt-4-1106-preview | 22,1 | - | |
| gpt-4-0-2024-05-13 | 26,2 | - | |
| SWE-Agent (Yang et al., 2024) | gpt-4-1106-preview | 42,6 | 1,91 |
| Aider (Gauthier) | gpt-4-0-2024-05-13 | 64,4 | - |
| gpt-4-0-2024-05-13 | 76,5 | 0,25 | |
| gpt-4-1106-preview | 58,8 | 1,22 | |
| gpt-3.5-turbo-16k-0613 | 13,2 | 0,12 | |
| BioCoder (Python) (Tang et al., 2024b), 157 instances | |||
| prompting, 0-shot | gpt-3.5-turbo | 11,0 | - |
| gpt-4-1106-preview | 12,7 | - | |
| OH CodeActAgent v1.5 | gpt-4-0-2024-05-13 | 27,5 | 0,13 |
| gpt-4-0-2024-05-13 | 8,7 | - | |
| gpt-4-0-2014 | 21,2 | - | |
| gpt-3.5-turbo-0301 | 29,7 | - | |
| llama-7b | 75,0 | - | |
| gpt-3.5-turbo-0125 | 21,6 | 0,002 | |
| gpt-4-0-2024-05-13 | 36,4 | 0,04 | |
| ToolQA (Zhuang et al., 2024), 800 instances | |||
| Prompting, 0-shot | ChatGPT + CoT | 5.1 | - |
| ChatGPT | 5.6 | - | |
| Chameleon | 10.6 | - | |
| ReAct, 0-shot (Yao et al., 2023 ; OpenAI, 2024a) | gpt-3.5-turbo | 36.8 | - |
| gpt-3 | 43.1 | - | |
| gpt-3.5-turbo-0125 | 2.3 | 0.03 | |
| gpt-4-0-2024-05-13 | 47.2 | 0.91 |
été soigneusement validés, atteindre sur ce benchmark est tout à fait réalisable, ce que nous cherchons à faire dans les futures itérations d'OpenHands.
ML-Bench (Tang et al., 2024b) évalue la capacité des agents à résoudre des tâches d'apprentissage automatique sur 18 dépôts GitHub. Le benchmark comprend 9 641 tâches couvrant 169 problèmes de ML divers, nécessitant que les agents génèrent des scripts bash ou du code Python en réponse aux instructions de l'utilisateur. Dans l'environnement sandbox, les agents peuvent exécuter des commandes de manière itérative et recevoir des retours, leur permettant de comprendre le contexte du dépôt et de satisfaire progressivement les exigences de l'utilisateur. Suivant la configuration de l'article original, nous effectuons l'évaluation de l'agent sur le sous-ensemble du quart de ML-Bench.
Gorilla APIBench (Patil et al., 2023) évalue la capacité des agents à utiliser des API. Il intègre des tâches sur TorchHub, TensorHub et HuggingFace. Lors de l'évaluation, les modèles reçoivent une question liée à l'utilisation d'API, telle que « identifier une API capable de convertir la langue parlée dans un enregistrement en texte ». La justesse est évaluée selon que l'appel d'API du modèle appartient au bon domaine.
ToolQA (Zhuang et al., 2024) évalue la capacité des agents à utiliser des outils externes. Ce benchmark comprend des tâches sur divers sujets comme le statut des vols, le prix du café, les données Yelp et les données Airbnb, nécessitant l'utilisation de divers outils tels que des outils textuels, des outils de base de données, des outils mathématiques, des outils de graphes, des outils de code et des outils système. Il comporte deux niveaux : facile et difficile. Les questions faciles portent davantage sur l'utilisation d'un seul outil, tandis que les questions difficiles mettent l'accent sur le raisonnement. Nous adoptons le sous-ensemble facile pour l'évaluation.
BioCoder (Tang et al., 2024c) est un benchmark de génération de code au niveau du dépôt qui évalue les performances des agents sur des tâches liées à la bio-informatique, en particulier la capacité à récupérer et à utiliser précisément le contexte. Les prompts originaux contiennent le contexte pertinent du code ; toutefois, dans cette étude, nous les avons supprimés afin de démontrer la capacité d'OpenHands à effectuer la récupération de contexte,
| Contexte en lecture seule pour comprendre la source (ce n'est pas le texte source à traduire) : | 4.2.1 HUMANEVALFIX | BioCoder (Tang et al., 2024c) est un benchmark de génération de code au niveau du dépôt qui évalue la performance des agents sur des tâches liées à la bio-informatique, en particulier la capacité à récupérer et à utiliser avec précision le contexte. Les invites d'origine contiennent le contexte pertinent du code ; toutefois, dans cette étude, nous les avons supprimées pour démontrer la capacité d'OpenHands à effectuer la récupération de contexte, l'auto-débogage et le raisonnement dans des interactions multi-tours. Bio | Texte à traduire : |
| Agent | Modèle | ||
| Taux de réussite (%) | $ Coût moy. | Lemur (Xu et al., 2023) | WebArena (Zhou et al., 2023a), 812 instances |
| Patel et al. (2024) | Lemur-chat-70b | 5,3 | - |
| AutoWebGLM (Lai et al., 2024) | Modèle 72B entraîné avec des données synthétiques d'auto-amélioration | 9,4 | - |
| Auto Eval &amp; Refine (Pan et al., 2024) | Modèle 7B entraîné avec une annotation hybride humain/agent | 18,2 | |
| - | GPT-4 + Reflexion avec modèle de récompense GPT-4V | 20,2 | - |
| WebArena Agent (Zhou et al., 2023a) | gpt-3.5-turbo | 6,2 | |
| - | gpt-4-turbo | 14,4 | - |
| OH BrowsingAgent v1.0 | gpt-4o-mini-2024-07-18 | 8,5 | |
| 0,01 | gpt-4o-2024-05-13 | 14,8 | |
| 0,15 | claude-3-5-sonnet-20240620 | 15,5 | 0,10 |
| OH CodeActAgent v1.8 | gpt-4o-mini-2024-07-18 | 8,3 | - |
| via délégation à BrowsingAgent v1.0 | gpt-4o-2024-05-13 | 14,5 | |
| - | |||
| claude-3-5-sonnet-20240620 | 15,3 | - | MiniWoB++ (Liu et al., 2018), 125 environnements |
| Workflow Guided Exploration (Liu et al., 2018) | Modèle spécialisé entraîné avec exploration de l'environnement | 34,6 | - |
| CC-NET (Humphreys et al., 2022) | Modèle spécialisé entraîné avec RL et BC annoté par des humains | 91,1 | - |
| OH BrowsingAgent v1.0 | gpt-3.5-turbo-0125 27,2 0,01 gpt-4o-2024-05-13 40,8 | 0,05 | |
| OH CodeActAgent v1.8 | gpt-4o-2024-05-13 | 39,8 | - |
l'auto-débogage et le raisonnement dans des interactions multi-tours. BioCoder comprend 157 fonctions Python et 50 fonctions Java, chacune ciblant un domaine spécifique de la bio-informatique, tel que la protéomique, la génomique et d'autres domaines spécialisés. Le benchmark cible du code réel en générant du code dans des dépôts existants où le code pertinent a été masqué.
BIRD (Li et al., 2023b) est un benchmark pour les tâches de text-to-SQL (c'est-à-dire traduire du langage naturel en SQL exécutable) visant des environnements de bases de données réalistes et à grande échelle. Nous sélectionnons 300 échantillons dans le jeu de développement pour les intégrer à OpenHands et évaluer l'exactitude d'exécution. De plus, nous étendons le cadre en permettant à l'agent de s'engager dans des interactions multi-tours pour aboutir à la requête SQL finale, lui permettant de corriger les résultats historiques en observant les résultats de l'exécution SQL.
4.3 NAVIGATION WEB
Nous rapportons les résultats d'évaluation pour les benchmarks de navigation web dans le Tab. 5.
WebArena (Zhou et al., 2023a) est un benchmark d'agents web auto-hébergé, fondé sur l'exécution, qui permet aux agents de choisir librement le chemin à suivre pour accomplir les tâches qui leur sont confiées. WebArena comprend 812 instructions de tâches sélectionnées par des humains à travers divers domaines, notamment le commerce en ligne, les forums, les plateformes de développement et les systèmes de gestion de contenu. Résultats. D'après le Tab. 5, nous pouvons voir que notre BrowsingAgent obtient des performances compétitives parmi les agents qui utilisent des LLM avec des techniques de prompting généralistes.
MiniWoB++ (Liu et al., 2018) est un benchmark web interactif, doté de fonctions de récompense intégrées. Les tâches sont initialisées synthétiquement sur 125 interfaces web minimalistes différentes. Contrairement à WebArena, les tâches sont plus faciles, sans changements de page, nécessitent moins d'étapes et fournissent des instructions détaillées étape par étape. Notez qu'il contient une partie d'environnements qui nécessitent une capacité de vision pour être traités avec succès, et de nombreux travaux existants choisissent de se concentrer uniquement sur un sous-ensemble des tâches (Kim et al., 2024 ; Li et al., 2023d ; Shaw et al., 2023). Néanmoins, nous rapportons les performances sur l'ensemble complet et n'incluons que les références évaluées sur l'ensemble complet.
4.4 ASSISTANCE DIVERSIFIÉE
Les résultats pour les benchmarks d'assistance diversifiée sont rapportés dans le Tab. 6.
GAIA (Mialon et al., 2023) évalue les compétences générales des agents en résolution de tâches, couvrant différents scénarios du monde réel. Il exige diverses capacités des agents, notamment le raisonnement, la compréhension multimodale, la navigation web et la programmation. GAIA comprend 466 tâches sélectionnées réparties sur trois niveaux. La mise en place de GAIA est traditionnellement difficile en raison de la complexité de l'intégration de divers outils avec l'agent, mais l'infrastructure d'OpenHands (par exemple, runtime §2.2, outils §2.3) simplifie considérablement l'intégration.
GPQA (Rein et al., 2023) évalue la capacité des agents à utiliser des outils de manière coordonnée lors de la résolution de problèmes difficiles de niveau universitaire. L'utilisation d'outils (par exemple, Python) et la recherche web sont souvent utiles pour aider les agents à répondre à ces questions, car elles fournissent des calculs précis dont les LLM sont souvent incapables et donnent accès à des informations extérieures à la base de connaissances paramétrique du LLM.
| Contexte en lecture seule pour comprendre la source (ne constitue pas le texte source à traduire) : | GPQA (Rein et al., 2023) évalue la capacité des agents à utiliser des outils de manière coordonnée lors de la résolution de problèmes difficiles de niveau graduate. L'utilisation d'outils (par exemple, Python) et la recherche web sont souvent utiles pour aider les agents à répondre à ces questions, car elles fournissent des calculs précis dont les LLM sont souvent incapables et donnent accès à des informations extérieures à la base de connaissances paramétrique du LLM. | AgentBench (Liu et al., 2023) évalue les capacités de raisonnement et de prise de décision des agents dans un environnement multi-tu | Texte à traduire : |
| Agent | |||
| Modèle | Taux de réussite (%) | $ Coût moyen | GAIA (Mialon et al., 2023), ensemble de validation L1, 53 instances |
| AutoGPT (Gravitas, 2023) | gpt-4-turbo | 13,2 | - |
| OH GPTSwarm v1.0 | gpt-4-0125-preview | 30,2 | |
| 0,110 | |||
| gpt-4-2024-05-13 | 32,1 | 0,050 | GPQA (Rein et al., 2023), ensemble diamond, 198 instances (voir §G, Tab. 7 pour les autres sous-ensembles) |
| Humain (Rein et al., 2023) | Humain expert | 81,3 | |
| - | Humain non expert | 21,9 | - |
| Few-shot Prompting + Chain-of-Thought (Rein et al., 2023) | gpt-3.5-turbo-16k | 29,6 | |
| - | gpt-4 | 38,8 | - |
| OH CodeActAgent v1.8 | |||
| claude-3-5-sonnet-20240620 | 52,0 | 0,065 | AgentBench (Liu et al., 2023), sous-ensemble OS (bash), 144 instances |
| Agent de référence AgentBench (Liu et al., 2023) | gpt-4 | 42,4 | |
| - | gpt-3.5-turbo | 32,6 | - |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 57,6 | |
| 0,085 | |||
| gpt-3.5-turbo-0125 | 11,8 | 0,006 | MINT (Wang et al., 2024b) : sous-ensemble math, 225 instances |
| Agent de référence MINT | gpt-4-0613 | 65,8 | |
| - | gpt-4-2024-05-13 | 77,3 | 0,070 |
| OH CodeActAgent v1.5 | |||
| gpt-3.5-turbo-16k-0613 33,8 0,048 MINT (Wang et al., 2024b) : sous-ensemble code, 136 instances Agent de référence MINT | Contexte de référence en lecture seule pour comprendre la source (il ne s'agit pas du texte source à traduire) : GPQA (Rein et al., 2023) évalue la capacité des agents à utiliser des outils de manière coordonnée lors de la résolution de problèmes difficiles de niveau supérieur. L'utilisation d'outils (par exemple, python) et la recherche web sont souvent utiles pour aider les agents à répondre à ces questions, car ils fournissent des calculs précis que les LLM sont souvent incapables d'effectuer et donnent accès à des informations situées hors de la base de connaissances paramétrique du LLM. AgentBench (Liu et al., 2023) évalue les capacités de raisonnement et de prise de décision des agents dans un contexte multi-tu Texte à traduire : | gpt-4-0613 | 59.6 |
| - | gpt-4-2024-05-13 | 50.0 | |
| 0.087 | OH CodeActAgent v1.5 | gpt-3.5-turbo-16k-0613 | 5.2 |
| 0.030 | |||
| ProofWriter (Tafjord et al., 2021), 600 instances | Few-shot Prompting + Chain-of-Thought (Pan et al., 2023) | gpt-4 | 68.1 |
| - | Logic-LM (Pan et al., 2023) | gpt-4 + solveur symbolique | 79.6 |
| - | OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 78.8 |
| - | |||
| Entity Deduction Arena (Zhang et al., 2024a), 200 instances | Zero-shot Prompting (Zhang et al., 2024a) | gpt-4-0314 | 40.0 |
| - | gpt-3.5-turbo-0613 | 27.0 | |
| - | OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 38.0 |
| - | gpt-3.5-turbo-16k-0613 | 24.0 |
AgentBench (Liu et al., 2023) évalue les capacités de raisonnement et de prise de décision des agents dans un cadre de génération ouverte et multi-tours. Nous avons sélectionné le sous-ensemble du système d'exploitation (OS) fondé sur le code, comprenant 144 tâches. Les agents d'OpenHands interagissent directement avec l'OS spécifique à la tâche à l'aide de commandes bash de manière multi-tours, combinant interaction et raisonnement pour automatiser l'accomplissement des tâches.
MINT (Wang et al., 2024b) est un benchmark conçu pour évaluer la capacité des agents à résoudre des tâches difficiles grâce à des interactions multi-tours utilisant des outils et des retours en langage naturel simulés par GPT-4. Nous utilisons les sous-ensembles de programmation et de mathématiques utilisés dans Yuan et al. (2024). Nous suivons l'article original et permettons à l'agent d'interagir jusqu'à cinq itérations avec deux chances de proposer des solutions.
ProofWriter (Tafjord et al., 2021) est un jeu de données synthétique créé pour évaluer les capacités de raisonnement déductif des LLM. Comme Logic-LM (Pan et al., 2023), nous nous concentrons sur le sous-ensemble le plus difficile, qui contient 600 instances nécessitant un raisonnement à 5 sauts. Pour minimiser l'impact des erreurs potentielles dans l'analyse sémantique, nous utilisons les formes logiques fournies par Logic-LM.
Entity Deduction Arena (EDA) (Zhang et al., 2024a) évalue la capacité des agents à déduire des entités inconnues par un questionnement stratégique, à la manière du jeu des 20 questions. Ce benchmark teste les capacités de suivi d'état, de planification stratégique et de raisonnement inductif de l'agent au cours de conversations multi-tours. Nous évaluons deux jeux de données « Things » et « Celebrities », comprenant chacun 100 instances, et rapportons le taux de réussite moyen sur ces deux jeux de données.
5 CONCLUSION
Nous présentons OpenHands, une plateforme portée par la communauté qui permet le développement d'agents interagissant avec le monde à travers des interfaces logicielles. En fournissant un mécanisme d'interaction puissant, un environnement sandbox sécurisé, des compétences essentielles pour les agents, des capacités de collaboration multi-agents et un cadre d'évaluation complet, OpenHands accélère les innovations de recherche et les applications réelles des systèmes d'IA agentique. Malgré les défis liés au développement d'agents sûrs et fiables (\$A), nous sommes enthousiastes à propos de notre communauté dynamique et attendons avec impatience l'évolution continue d'OpenHands.
RÉFÉRENCES
Michael Ahn, Anthony Brohan, Noah Brown, Yevgen Chebotar, Omar Cortes, Byron David, Chelsea Finn, Chuyuan Fu, Keerthana Gopalakrishnan, Karol Hausman, et al. Do as i can, not as i say: Grounding language in robotic affordances. arXiv preprint arXiv:2204.01691, 2022. 1
Daniil A Boiko, Robert MacKnight, Ben Kline et Gabe Gomes. Recherche chimique autonome avec de grands modèles de langage. Nature, 624(7992) :570-578, 2023. 1
Yupeng Chang, Xu Wang, Jindong Wang, Yuan Wu, Linyi Yang, Kaijie Zhu, Hao Chen, Xiaoyuan Yi, Cunxiang Wang, Yidong Wang, et al. Une enquête sur l'évaluation des grands modèles de langage. ACM Transactions on Intelligent Systems and Technology, 15(3) :1-45, 2024. 1
Harrison Chase. LangChain, octobre 2022. URL https://github.com/langchain-ai/langchain. 4, 6, 18
Guangyao Chen, Siwei Dong, Yu Shu, Ge Zhang, Jaward Sesay, Borje F. Karlsson, Jie Fu et Yemin Shi. Autoagents : un cadre pour la génération automatique d'agents, 2024. 1, 6, 18
Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, et al. Évaluation de grands modèles de langage entraînés sur du code. arXiv preprint arXiv:2107.03374, 2021. 7
Cognition.ai. Présentation de devin, le premier ingénieur logiciel IA. URL https://www.cognition.ai/blog/introducing-devin. 2
CrewAI. CrewAI, octobre 2024. URL https://github.com/crewAIInc/crewAI. 18
Jiaxi Cui, Zongjian Li, Yang Yan, Bohua Chen et Li Yuan. Chatlaw : grand modèle de langage juridique open source avec bases de connaissances externes intégrées, 2023. 18
Alexandre Drouin, Maxime Gasse, Massimo Caccia, Issam H. Laradji, Manuel Del Verme, Tom Marty, Léo Boisvert, Megh Thakkar, Quentin Cappart, David Vazquez, Nicolas Chapados et Alexandre Lacoste. Workarena : quelle est la capacité des agents web à résoudre des tâches courantes de travail de connaissance ?, 2024. 3, 4
Paul Gauthier. Comment aider a obtenu un score SOTA de 26,3 % sur swe bench lite i aider. https://aider.chat/2024/05/22/swe-bench-lite.html. Consulté le : 2024-06-05. 5, 7, 8
Significant Gravitas. Auto-gpt : une expérience autonome avec gpt-4, 2023. URL https://github.com/Significant-Gravitas/Auto-GPT, 2023. 6, 7, 10, 18
Sirui Hong, Mingchen Zhuge, Jonathan Chen, Xiawu Zheng, Yuheng Cheng, Jinlin Wang, Ceyao Zhang, Zili Wang, Steven Ka Shing Yau, Zijuan Lin, et al. Metagpt : méta-programmation pour un cadre collaboratif multi-agents. In The Twelfth International Conference on Learning Representations, 2023. 1, 6, 18
Dong Huang, Qingwen Bu, Jie M. Zhang, Michael Luck et Heming Cui. Agentcoder : génération de code basée sur multi-agents avec tests et optimisation itératifs, 2024. 19
Peter C Humphreys, David Raposo, Tobias Pohlen, Gregory Thornton, Rachita Chhaparia, Alistair Muldal, Josh Abramson, Petko Georgiev, Adam Santoro et Timothy Lillicrap. Une approche guidée par les données pour apprendre à contrôler les ordinateurs. In International Conference on Machine Learning, pp. 9466-9482. PMLR, 2022. 9
IPython. Jupyter et l'avenir d'IPython — IPython. URL https://ipython.org. 4
Albert Q Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch, Blanche Savary, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Emma Bou Hanna, Florian Bressand, et al. Mixtral of experts. arXiv preprint arXiv:2401.04088, 2024. 1
Carlos E Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press et Karthik R Narasimhan. SWE-bench : les modèles de langage peuvent-ils résoudre des problèmes Github du monde réel ? In The Twelfth International Conference on Learning Representations, 2024. URL https://openreview.net/forum?id=VTF8yNQM66. 1, 6, 7, 8, 17, 19
Omar Khattab, Arnav Singhvi, Paridhi Maheshwari, Zhiyuan Zhang, Keshav Santhanam, Sri Vardhamanan, Saiful Haq, Ashutosh Sharma, Thomas T. Joshi, Hanna Moazam, Heather Miller, Matei Zaharia et Christopher Potts. Dspy : compiler des appels déclaratifs à des modèles de langage en pipelines auto-améliorants. 2024. 18
Geunwoo Kim, Pierre Baldi et Stephen McAleer. Les modèles de langage peuvent résoudre des tâches informatiques. Advances in Neural Information Processing Systems, 36, 2024. 9
Hanyu Lai, Xiao Liu, Iat Long Iong, Shuntian Yao, Yuxuan Chen, Pengbo Shen, Hao Yu, Hanchen Zhang, Xiaohan Zhang, Yuxiao Dong, et al. Autowebglm : amorcer et renforcer un agent de navigation web basé sur un grand modèle de langage. arXiv preprint arXiv:2404.03648, 2024. 7, 9
Hareton K. N. Leung et Lee J. White. Une étude des tests d'intégration et de la régression logicielle au niveau de l'intégration. In Proceedings of the Conference on Software Maintenance, ICSM 1990, San Diego, CA, USA, 26-29 novembre 1990, pp. 290-301. IEEE, 1990. doi : 10.1109/ICSM.1990.131377. URL https://doi.org/10.1109/ICSM.1990.131377. 19
Guohao Li, Hasan Abed Al Kader Hammoud, Hani Itani, Dmitrii Khizbullin et Bernard Ghanem. Camel : agents communicatifs pour l'exploration de « l'esprit » d'une société de grands modèles de langage à grande échelle. arXiv preprint arXiv:2303.17760, 2023a. 18
Jinyang Li, Binyuan Hui, GE QU, Jiaxi Yang, Binhua Li, Bowen Li, Bailin Wang, Bowen Qin, Ruiying Geng, Nan Huo, Xuanhe Zhou, Chenhao Ma, Guoliang Li, Kevin Chang, Fei Huang, Reynold Cheng et Yongbin Li. Un LLM peut-il déjà servir d'interface de base de données ? un benchmark Blg pour les text-to-SQL fondés sur des bases de données à grande échelle. In Thirty-seventh Conference on Neural Information Processing Systems Datasets and Benchmarks Track, 2023b. 6, 8, 9, 17
Raymond Li, Loubna Ben Allal, Yangtian Zi, Niklas Muennighoff, Denis Kocetkov, Chenghao Mou, Marc Marone, Christopher Akiki, Jia Li, Jenny Chim, Qian Liu, Evgenii Zheltonozhskii, Terry Yue Zhuo, Thomas Wang, Olivier Dehaene, Mishig Davaadorj, Joel Lamy-Poirier, Joao Monteiro, Oleh Shliazhko, Nicolas Gontier, Nicholas Meade, Armel Zebaze, Ming-Ho Yee, Logesh Kumar Umapathi, Jian Zhu, Benjamin Lipkin, Muhtasham Oblokulov, Zhiruo Wang, Rudra Murthy, Jason Stillerman, Siva Sankalp Patel, Dmitry Abulkhanov, Marco Zocca, Manan Dey, Zhihan Zhang, Nour Fahmy, Urvashi Bhattacharyya, Wenhao Yu, Swayam Singh, Sasha Luccioni, Paulo Villegas, Maxim Kunakov, Fedor Zhdanov, Manuel Romero, Tony Lee, Nadav Timor, Jennifer Ding, Claire Schlesinger, Hailey Schoelkopf, Jan Ebert, Tri Dao, Mayank Mishra, Alex Gu, Jennifer Robinson, Carolyn Jane Anderson, Brendan Dolan-Gavitt, Danish Contractor, Siva Reddy, Daniel Fried, Dzmitry Bahdanau, Yacine Jernite, Carlos Munoz Ferrandis, Sean Hughes, Thomas Wolf, Arjun Guha, Leandro von Werra et Harm de Vries. Starcoder : que la source soit avec vous !, 2023c. URL https://arxiv.org/abs/2305.06161. 7
Tao Li, Gang Li, Zhiwei Deng, Bryan Wang et Yang Li. Un agent linguistique zero-shot pour le contrôle d'ordinateur avec réflexion structurée. arXiv preprint arXiv:2310.08740, 2023d. 9
Evan Zheran Liu, Kelvin Guu, Panupong Pasupat, Tianlin Shi et Percy Liang. Apprentissage par renforcement sur des interfaces web avec exploration guidée par flux de travail. In International Conference on Learning Representations (ICLR), 2018. URL https://arxiv.org/abs/1802.08802. 6, 9, 17
Xiao Liu, Hao Yu, Hanchen Zhang, Yifan Xu, Xuanyu Lei, Hanyu Lai, Yu Gu, Hangliang Ding, Kaiwen Men, Kejuan Yang, Shudan Zhang, Xiang Deng, Aohan Zeng, Zhengxiao Du, Chenhui Zhang, Sheng Shen, Tianjun Zhang, Yu Su, Huan Sun, Minlie Huang, Yuxiao Dong et Jie Tang. Agentbench : évaluer les LLM en tant qu'agents. Préimpression arXiv : arXiv: 2308.03688, 2023. 6, 10, 17
Anton Lozhkov, Raymond Li, Loubna Ben Allal, Federico Cassano, Joel Lamy-Poirier, Nouamane Tazi, Ao Tang, Dmytro Pykhtar, Jiawei Liu, Yuxiang Wei, Tianyang Liu, Max Tian, Denis Kocetkov, Arthur Zucker, Younes Belkada, Zijian Wang, Qian Liu, Dmitry Abulkhanov, Indraneil Paul, Zhuang Li, Wen-Ding Li, Megan Risdal, Jia Li, Jian Zhu, Terry Yue Zhuo, Evgenii Zheltonozhskii, Nii Osae Osae Dade, Wenhao Yu, Lucas Krauß, Naman Jain, Yixuan Su, Xuanli He, Manan Dey, Edoardo Abati, Yekun Chai, Niklas Muennighoff, Xiangru Tang, Muhtasham Oblokulov, Christopher Akiki, Marc Marone, Chenghao Mou, Mayank Mishra, Alex Gu, Binyuan Hui, Tri Dao, Armel Zebaze, Olivier Dehaene, Nicolas Patry, Canwen Xu, Julian McAuley, Han Hu, Torsten Scholak, Sebastien Paquet, Jennifer Robinson, Carolyn Jane Anderson, Nicolas Chapados, Mostofa Patwary, Nima Tajbakhsh, Yacine Jernite, Carlos Muñoz Ferrandis, Lingming Zhang, Sean Hughes, Thomas Wolf, Arjun Guha, Leandro von Werra et Harm de Vries. Starcoder 2 et the stack v2 : la prochaine génération, 2024. URL https://arxiv.org/abs/2402.19173. 7
Grégoire Mialon, Clémentine Fourrier, Craig Swift, Thomas Wolf, Yann LeCun et Thomas Scialom. GAIA: a benchmark for general AI assistants. CoRR, abs/2311.12983, 2023. doi : 10.48550/ARXIV.2311.12983. URL https://doi.org/10.48550/arXiv.2311.12983. 6, 9, 10, 17
Mozilla. Accessibility tree - MDN Web Docs Glossary: Definitions of Web-related terms | MDN. URL https://developer.mozilla.org/en-US/docs/Glossary/Accessibility_tree. 5
Niklas Muennighoff, Qian Liu, Armel Zebaze, Qinkai Zheng, Binyuan Hui, Terry Yue Zhuo, Swayam Singh, Xiangru Tang, Leandro von Werra et Shayne Longpre. Octopack: Instruction tuning code large language models, 2024. 6, 7, 8, 17
Y Nakajima. Babyagi. URL https://github.com/yoheinakajima/babyagi, 2023. 18
OpenAI. Chatgpt: May 2024 version. https://www.openai.com/chatgpt, 2024a. Consulté le : 2024-05-29. 8, 18
OpenAI. Hello gpt-4o. https://openai.com/index/hello-gpt-4o/, 2024b. Consulté le : 2024-05-15. 1
OpenAI. Hello gpt-4o. https://openai.com/index/hello-gpt-4o/, 2024b. Consulté le : 2024-05-15. 1OpenAI, Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, Red Avila, Igor Babuschkin, Suchir Balaji, Valerie Balcom, Paul Baltescu, Haiming Bao, Mohammad Bavarian, Jeff Belgum, Irwan Bello, Jake Berdine, Gabriel Bernadett-Shapiro, Christopher Berner, Lenny Bogdonoff, Oleg Boiko, Madelaine Boyd, Anna-Luisa Brakman, Greg Brockman, Tim Brooks, Miles Brundage, Kevin Button, Trevor Cai, Rosie Campbell, Andrew Cann, Brittany Carey, Chelsea Carlson, Rory Carmichael, Brooke Chan, Che Chang, Fotis Chantzis, Derek Chen, Sully Chen, Ruby Chen, Jason Chen, Mark Chen, Ben Chess, Chester Cho, Casey Chu, Hyung Won Chung, Dave Cummings, Jeremiah Currier, Yunxing Dai, Cory Decareaux, Thomas Degry, Noah Deutsch, Damien Deville, Arka Dhar, David Dohan, Steve Dowling, Sheila Dunning, Adrien Ecoffet, Atty Eleti, Tyna Eloundou, David Farhi, Liam Fedus, Niko Felix, Simón Posada Fishman, Juston Forte, Isabella Fulford, Leo Gao, Elie Georges, Christian Gibson, Vik Goel, Tarun Gogineni, Gabriel Goh, Rapha Gontijo-Lopes, Jonathan Gordon, Morgan Grafstein, Scott Gray, Ryan Greene, Joshua Gross, Shixiang Shane Gu, Yufei Guo, Chris Hallacy, Jesse Han, Jeff Harris, Yuchen He, Mike Heaton, Johannes Heidecke, Chris Hesse, Alan Hickey, Wade Hickey, Peter Hoeschele, Brandon Houghton, Kenny Hsu, Shengli Hu, Xin Hu, Joost Huizinga, Shantanu Jain, Shawn Jain, Joanne Jang, Angela Jiang, Roger Jiang, Haozhun Jin, Denny Jin, Shino Jomoto, Billie Jonn, Heewoo Jun, Tomer Kaftan, Łukasz Kaiser, Ali Kamali, Ingmar Kanitscheider, Nitish Shirish Keskar, Tabarak Khan, Logan Kilpatrick, Jong Wook Kim, Christina Kim, Yongjik Kim, Jan Hendrik Kirchner, Jamie Kiros, Matt Knight, Daniel Kokotajlo, Łukasz Kondraciuk, Andrew Kondrich, Aris Konstantinidis, Kyle Kosic, Gretchen Krueger, Vishal Kuo, Michael Lampe, Iki Lan, Teddy Lee, Jan Leike, Jade Leung, Daniel Levy, Chak Ming Li, Rachel Lim, Molly Lin, Stephanie Lin, Mateusz Litwin, Theresa Lopez, Ryan Lowe, Patricia Lue, Anna Makanju, Kim Malfacini, Sam Manning, Todor Markov, Yaniv Markovski, Bianca Martin, Katie Mayer, Andrew Mayne, Bob McGrew, Scott Mayer McKinney, Christine McLeavey, Paul McMillan, Jake McNeil, David Medina, Aalok Mehta, Jacob Menick, Luke Metz, Andrey Mishchenko, Pamela Mishkin, Vinnie Monaco, Evan Morikawa, Daniel Mossing, Tong Mu, Mira Murati, Oleg Murk, David Mély, Ashvin Nair, Reiichiro Nakano, Rajeev Nayak, Arvind Neelakantan, Richard Ngo, Hyeonwoo Noh, Long Ouyang, Cullen O'Keefe, Jakub Pachocki, Alex Paino, Joe Palermo, Ashley Pantuliano, Giambattista Parascandolo, Joel Parish, Emy Parparita, Alex Passos, Mikhail Pavlov, Andrew Peng, Adam Perelman, Filipe de Avila Belbute Peres, Michael Petrov, Henrique Ponde de Oliveira Pinto, Michael, Pokorny, Michelle Pokrass, Vitchyr H. Pong, Tolly Powell, Alethea Power, Boris Power, Elizabeth Proehl, Raul Puri, Alec Radford, Jack Rae, Aditya Ramesh, Cameron Raymond, Francis Real, Kendra Rimbach, Carl Ross, Bob Rotsted, Henri Roussez, Nick Ryder, Mario Saltarelli, Ted Sanders, Shibani Santurkar, Girish Sastry, Heather Schmidt, David Schnurr, John Schulman, Daniel Selsam, Kyla Sheppard, Toki Sherbakov, Jessica Shieh, Sarah Shoker, Pranav Shyam, Szymon Sidor, Eric Sigler, Maddie Simens, Jordan Sitkin, Katarina Slama, Ian Sohl, Benjamin Sokolowsky, Yang Song, Natalie Staudacher, Felipe Petroski Such, Natalie Summers, Ilya Sutskever, Jie Tang, Nikolas Tezak, Madeleine B. Thompson, Phil Tillet, Amin Tootoonchian, Elizabeth Tseng, Preston Tuggle, Nick Turley, Jerry Tworek, Juan Felipe Cerón Uribe, Andrea Vallone, Arun Vijayvergiya, Chelsea Voss, Carroll Wainwright, Justin Jay Wang, Alvin Wang, Ben Wang, Jonathan Ward, Jason Wei, CJ Weinmann, Akila Welihinda, Peter Welinder, Jiayi Weng, Lilian Weng, Matt Wiethoff, Dave Willner, Clemens Winter, Samuel Wolrich, Hannah Wong, Lauren Workman, Sherwin Wu, Jeff Wu, Michael Wu, Kai Xiao, Tao Xu, Sarah Yoo, Kevin Yu, Qiming Yuan, Wojciech Zaremba, Rowan Zellers, Chong Zhang, Marvin Zhang, Shengjia Zhao, Tianhao Zheng, Juntang Zhuang, William Zhuk et Barret Zoph. Gpt-4 technical report, 2024. 18
Jiayi Pan, Yichi Zhang, Nicholas Tomlin, Yifei Zhou, Sergey Levine et Alane Suhr. Autonomous evaluation and refinement of digital agents. arXiv preprint arXiv:2404.06474, 2024. 7, 9, 18
Liangming Pan, Alon Albalak, Xinyi Wang et William Yang Wang. Logic-Im: Empowering large language models with symbolic solvers for faithful logical reasoning. arXiv preprint arXiv:2305.12295, 2023. 10
Joon Sung Park, Joseph C. O'Brien, Carrie J. Cai, Meredith Ringel Morris, Percy Liang et Michael S. Bernstein. Generative agents: Interactive simulacra of human behavior, 2023. 18
Ajay Patel, Markus Hofmarcher, Claudiu Leoveanu-Condrei, Marius-Constantin Dinu, Chris Callison-Burch et Sepp Hochreiter. Large language models can self-improve at web agent tasks. arXiv preprint arXiv:2405.20309, 2024. 7, 9
Shishir G. Patil, Tianjun Zhang, Xin Wang et Joseph E. Gonzalez. Gorilla: Large language model connected with massive apis. arXiv preprint arXiv:2305.15334, 2023. 6, 8, 17
Playwright. Fast and reliable end-to-end testing for modern web apps | Playwright. URL https://playwright.dev/. 4
Chen Qian, Xin Cong, Wei Liu, Cheng Yang, Weize Chen, Yusheng Su, Yufan Dang, Jiahao Li, Juyuan Xu, Dahai Li, Zhiyuan Liu et Maosong Sun. Communicative agents for software development, 2023. 18, 19
Yujia Qin, Shihao Liang, Yining Ye, Kunlun Zhu, Lan Yan, Yaxi Lu, Yankai Lin, Xin Cong, Xiangru Tang, Bill Qian, Sihan Zhao, Runchu Tian, Ruobing Xie, Jie Zhou, Mark Gerstein, Dahai Li, Zhiyuan Liu et Maosong Sun. Toolllm : Faciliter la maîtrise de plus de 16 000 API du monde réel par les grands modèles de langage. CoRR, abs/2307.16789, 2023. doi : 10.48550/ARXIV.2307.16789. URL https://doi.org/10.48550/arXiv.2307.16789. 4
David Rein, Betty Li Hou, Asa Cooper Stickland, Jackson Petty, Richard Yuanzhe Pang, Julien Dirani, Julian Michael et Samuel R Bowman. GPQA : un benchmark de questions-réponses de niveau graduate impossible à résoudre par Google. Préimpression arXiv arXiv:2311.12022, 2023. 6, 7, 9, 10, 17, 23
Aman Sanger. Modifications de fichiers complets quasi instantanées. https://www.cursor.com/blog/instant-apply. Consulté le : 2024-06-05. 5
ServiceNow. BrowserGym : un environnement Gym pour l'automatisation des tâches web. URL https://github.com/ServiceNow/BrowserGym. 2, 4, 18
Peter Shaw, Mandar Joshi, James Cohan, Jonathan Berant, Panupong Pasupat, Hexiang Hu, Urvashi Khandelwal, Kenton Lee et Kristina N Toutanova. Des pixels aux actions d'interface utilisateur : apprendre à suivre des instructions via des interfaces graphiques utilisateur. Advances in Neural Information Processing Systems, 36:34354-34370, 2023. 9
Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan et Shunyu Yao. Reflexion: Language agents with verbal reinforcement learning. Advances in Neural Information Processing Systems, 36, 2024. 18
Oyvind Tafjord, Bhavana Dalvi et Peter Clark. ProofWriter: Generating implications, proofs, and abductive statements over natural language. In Chengqing Zong, Fei Xia, Wenjie Li et Roberto Navigli (éd.), Findings of the Association for Computational Linguistics: ACL-IJCNLP 2021, pp. 3621-3634, en ligne, août 2021. Association for Computational Linguistics. doi : 10.18653/v1/2021.findings-acl.317. URL https://aclanthology.org/2021.findings-acl.317. 6, 10, 17
Xiangru Tang, Qiao Jin, Kunlun Zhu, Tongxin Yuan, Yichi Zhang, Wangchunshu Zhou, Meng Qu, Yilun Zhao, Jian Tang, Zhuosheng Zhang, et al. Prioritizing safeguarding over autonomy: Risks of llm agents for science. arXiv preprint arXiv:2402.04247, 2024a. 1
Xiangru Tang, Yuliang Liu, Zefan Cai, Yanjun Shao, Junjie Lu, Yichi Zhang, Zexuan Deng, Helan Hu, Kaikai An, Ruijun Huang, Shuzheng Si, Sheng Chen, Haozhe Zhao, Liang Chen, Yan Wang, Tianyu Liu, Zhiwei Jiang, Baobao Chang, Yin Fang, Yujia Qin, Wangchunshu Zhou, Yilun Zhao, Arman Cohan et Mark Gerstein. ML-Bench: Evaluating large language models and agents for machine learning tasks on repository-level code, 2024b. URL https://arxiv.org/abs/2311.09835. 6, 8, 17
Xiangru Tang, Bill Qian, Rick Gao, Jiakang Chen, Xinyun Chen et Mark B Gerstein. BioCoder: a benchmark for bioinformatics code generation with large language models. Bioinformatics, 40 (Supplement_1):i266-i276, 06 2024c. ISSN 1367-4811. 6, 8, 17
Xiangru Tang, Anni Zou, Zhuosheng Zhang, Ziming Li, Yilun Zhao, Xingyao Zhang, Arman Cohan et Mark Gerstein. Medagents: Large language models as collaborators for zero-shot medical reasoning, 2024d. 18
Gemini Team, Rohan Anil, Sebastian Borgeaud, Yonghui Wu, Jean-Baptiste Alayrac, Jiahui Yu, Radu Soricut, Johan Schalkwyk, Andrew M Dai, Anja Hauth, et al. Gemini: a family of highly capable multimodal models. arXiv preprint arXiv:2312.11805, 2023. 1
XAgent Team. Xagent: An autonomous agent for complex task solving, 2023. 6, 18
Hugo Touvron, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie-Anne Lachaux, Timothée Lacroix, Baptiste Rozière, Naman Goyal, Eric Hambro, Faisal Azhar, Aurelien Rodriguez, Armand Joulin, Edouard Grave et Guillaume Lample. Llama: Open and efficient foundation language models. arXiv preprint arXiv:2302.13971, 2023. 8
Xingyao Wang, Yangyi Chen, Lifan Yuan, Yizhe Zhang, Yunzhu Li, Hao Peng et Heng Ji. Executable Code Actions Elicit Better LLM Agents. In ICML, 2024a. 2, 3, 4, 5, 17
Xingyao Wang, Zihan Wang, Jiateng Liu, Yangyi Chen, Lifan Yuan, Hao Peng et Heng Ji. MINT: Evaluating LLMs in Multi-turn Interaction with Tools and Language Feedback. In ICLR, 2024b. 6, 10, 17
Qingyun Wu, Gagan Bansal, Jieyu Zhang, Yiran Wu, Shaokun Zhang, Erkang Zhu, Beibin Li, Li Jiang, Xiaoyun Zhang et Chi Wang. Autogen: Enabling next-gen llm applications via multi-agent conversation framework. arXiv preprint arXiv:2308.08155, 2023. 1, 6, 18
Chunqiu Steven Xia, Yinlin Deng, Soren Dunn et Lingming Zhang. Agentless: Demystifying llm-based software engineering agents. arXiv preprint, 2024. 7
Tianbao Xie, Fan Zhou, Zhoujun Cheng, Peng Shi, Luoxuan Weng, Yitao Liu, Toh Jing Hua, Junning Zhao, Qian Liu, Che Liu, et al. Openagents: An open platform for language agents in the wild. arXiv preprint arXiv:2310.10634, 2023. 6
Yiheng Xu, Hongjin Su, Chen Xing, Boyu Mi, Qian Liu, Weijia Shi, Binyuan Hui, Fan Zhou, Yitao Liu, Tianbao Xie, et al. Lemur: Harmonizing natural language and code for language agents. arXiv preprint arXiv:2310.06830, 2023. 7, 9
John Yang, Carlos E. Jimenez, Alexander Wettig, Kilian Lieret, Shunyu Yao, Karthik Narasimhan et Ofir Press. Swe-agent: Agent-computer interfaces enable automated software engineering, 2024. 2, 5, 6, 7, 8, 19
Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik R Narasimhan et Yuan Cao. React: Synergizing reasoning and acting in language models. In The Eleventh International Conference on Learning Representations, 2023. URL https://openreview.net/forum?id=WE_vluYUL-X. 8
Yining Ye, Xin Cong, Shizuo Tian, Jiannan Cao, Hao Wang, Yujia Qin, Yaxi Lu, Heyang Yu, Huadong Wang, Yankai Lin, et al. Proagent: From robotic process automation to agentic process automation. arXiv preprint arXiv:2311.10751, 2023. 18.
Lifan Yuan, Yangyi Chen, Xingyao Wang, Yi R. Fung, Hao Peng et Heng Ji. CRAFT: customizing llms by creating and retrieving from specialized toolsets. CoRR, abs/2309.17428, 2023. doi : 10.48550/ARXIV.2309.17428. URL https://doi.org/10.48550/arXiv.2309.17428. 4
Lifan Yuan, Ganqu Cui, Hanbin Wang, Ning Ding, Xingyao Wang, Jia Deng, Boji Shan, Huimin Chen, Ruobing Xie, Yankai Lin, Zhenghao Liu, Bowen Zhou, Hao Peng, Zhiyuan Liu et Maosong Sun. Advancing llm reasoning generalists with preference trees, 2024. 10
Yizhe Zhang, Jiarui Lu et Navdeep Jaitly. Probing the multi-turn planning capabilities of llms via 20 question games. 2024a. 6, 10, 17
Yuntong Zhang, Haifeng Ruan, Zhiyu Fan et Abhik Roychoudhury. Autocoderover: Autonomous program improvement, 2024b. 6, 7, 8, 19
Shuyan Zhou, Frank F Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Abishek Sridhar, Xianyi Cheng, Tianyue Ou, Yonatan Bisk, Daniel Fried, et al. Webarena: A realistic web environment for building autonomous agents. In The Twelfth International Conference on Learning Representations, 2023a. 1, 6, 7, 9, 17
Wangchunshu Zhou, Yuchen Eleanor Jiang, Long Li, Jialong Wu, Tiannan Wang, Shi Qiu, Jintian Zhang, Jing Chen, Ruipu Wu, Shuai Wang, Shiding Zhu, Jiyu Chen, Wentao Zhang, Xiangru Tang, Ningyu Zhang, Huajun Chen, Peng Cui et Mrinmaya Sachan. Agents: An open-source framework for autonomous language agents, 2023b. 6, 18
Yuchen Zhuang, Yue Yu, Kuan Wang, Haotian Sun et Chao Zhang. Toolqa: A dataset for llm question answering with external tools. Advances in Neural Information Processing Systems, 36, 2024. 6, 8, 17
Mingchen Zhuge, Haozhe Liu, Francesco Faccio, Dylan R Ashley, Robert Csordás, Anand Gopalakrishnan, Abdullah Hamdi, Hasan Abed Al Kader Hammoud, Vincent Herrmann, Kazuki Irie, et al. Mindstorms in natural language-based societies of mind. arXiv preprint arXiv:2305.17066, 2023. 18
Mingchen Zhuge, Wenyi Wang, Louis Kirsch, Francesco Faccio, Dmitrii Khizbullin et Jurgen Schmidhuber. Language agents as optimizable graphs. arXiv preprint arXiv:2402.16823, 2024. 6, 17, 18
Albert Örwall. Moatless tools. URL https://github.com/aorwall/moatless- tools. 7
CONTRIBUTIONS DES AUTEURS
Ce travail a été un effort collaboratif open source à travers plusieurs institutions. Nous avons employé un système à points pour déterminer les contributions et attribuer les paternités, les contributions techniques étant suivies et mesurées en unités de pull requests (PR)'. Xingyao Wang a dirigé le projet, coordonnant les efforts globaux de développement et de rédaction de l'article. Les contributions détaillées étaient les suivantes :
- Développement des agents (§3) : Xingyao Wang a dirigé l'implémentation des agents CodeAct Wang et al. (2024a) et CodeActSWE. Frank F. Xu a dirigé le développement des agents de navigation web Zhou et al. (2023a). Mingchen Zhuge a orchestré l'intégration de l'agent GPTSwarm Zhuge et al. (2024). Robert Brennan et Boxuan Li ont dirigé le développement du Micro Agent.
- Développement architectural (Fig. 2) : Robert Brennan a initié la conception de l'architecture. Boxuan Li, Frank F. Xu, Xingyao Wang, Yufan Song et Mingzhang Zheng ont ensuite affiné et étendu l'architecture. Boxuan Li a implémenté la version initiale des tests d'intégration (§E), maintenu la bibliothèque agentskills (§2.3), géré les configurations et résolu les fuites de ressources lors de l'évaluation. Frank F. Xu a développé l'environnement de navigation web (§J) pour l'exécution et l'évaluation des agents et l'a intégré aux interfaces utilisateur des agents et du front-end. Xingyao Wang a rédigé le code initial de la bibliothèque agentskills et du bac à sable Docker. Yufan Song a implémenté le suivi des coûts pour l'évaluation, tandis que Mingzhang Zheng a développé un bac à sable Docker indépendant de l'image pour une évaluation plus stable sur SWE-Bench.
- Évaluation comparative, intégration et revue de code : Boxuan Li et Yufan Song ont dirigé les efforts d'intégration des benchmarks, notamment la coordination, l'évaluation et la revue de code. Yufan Song a également contribué au suivi des contributions PR. Graham Neubig, Xingyao Wang, Mingzhang Zheng, Robert Brennan, Hoang H. Tran, Frank F. Xu, Xiangru Tang, Fuqiang Li et Yanjun Shao ont apporté un soutien supplémentaire en matière d'intégration et de revues de code. Les contributions spécifiques aux benchmarks incluent :
- SWE-Bench Jimenez et al. (2024) : Bowen Li et Xingyao Wang - WebArena Zhou et al. (2023a) et MiniWob++ Liu et al. (2018) : Frank F. Xu - GAIA Mialon et al. (2023) : Jiayi Pan (intégration) et Mingchen Zhuge (évaluation GPTSwarm) - API-Bench Patil et al. (2023) et ToolQA Zhuang et al. (2024) : Yueqi Song - HumanEvalFix Muennighoff et al. (2024) : Niklas Muennighoff et Xiangru Tang - ProofWriter Tafjord et al. (2021) : Ren Ma - MINT Wang et al. (2024b) : Hoang H. Tran - AgentBench Liu et al. (2023) : Fuqiang Li - BIRD Li et al. (2023b) : Binyuan Hui - GPQA Rein et al. (2023) : Jaskirat Singh - BioCoder Tang et al. (2024c) : Xiangru Tang et Bill Qian - ML-Bench Tang et al. (2024b) : Xiangru Tang et Yanjun Shao - Entity-Deduction-Arena Zhang et al. (2024a) : Yizhe Zhang
- Conseils : Graham Neubig a conseillé le projet, fournissant des orientations, des ressources et des modifications substantielles du manuscrit. Heng Ji et Hao Peng ont offert des conseils supplémentaires sur le projet et ont aidé à la rédaction du manuscrit. Junyang Lin a apporté un soutien consultatif et parrainé des ressources.
A LIMITES ET TRAVAUX FUTURS
Nous sommes enthousiastes quant aux fondations que notre communauté dynamique a posées dans OpenHands et nous nous réjouissons de son évolution continue. Nous identifions plusieurs directions pour les travaux futurs :
Prise en charge améliorée de la multimodalité. Bien que notre implémentation actuelle prenne déjà en charge un large éventail de formats de fichiers via des compétences d'agent prédéfinies, nous souhaitons permettre la multimodalité de manière principielle via une intégration standard d'IPython et du navigateur, comme la visualisation d'images et de vidéos à l'aide d'un modèle vision-langage via un navigateur ou le traitement de fichiers XLSX avec du code.
Agents plus puissants. Les agents actuels peinent encore sur des tâches complexes, et nous souhaitons construire de meilleurs agents grâce à des techniques tant à l'entraînement qu'à l'inférence.
Améliorations de l'édition par les agents. Les agents actuels souffrent beaucoup lors de l'édition de fichiers longs, et nous souhaitons explorer différentes approches pour améliorer les performances d'édition de fichiers des agents.
Améliorations de la navigation web. En raison de la nature extensible d'OpenHands, des composants orthogonaux susceptibles d'améliorer les agents peuvent être intégrés facilement. Par exemple, grâce à l'architecture extensible d'OpenHands, Auto Eval & Refine Pan et al. (2024), une stratégie de relance-en-cas-d'erreur par l'agent avec des prompts Reflexion Shinn et al. (2024) et des modèles de récompense d'achèvement de tâche, sera intégré comme composant optionnel attaché à notre agent de navigation.
Génération automatique de workflows. Actuellement, le workflow d'OpenHands nécessite encore une charge de travail manuelle substantielle. Nous pensons que des frameworks basés sur des graphes tels que GPTSwarm Zhuge et al. (2024) et LangGraph Chase (2022) pourraient servir de solutions alternatives pour construire des agents. En particulier dans GPTSwarm, lorsque les agents sont construits à l'aide de graphes, il devient plus facile d'incorporer diverses méthodes d'optimisation (par exemple, l'apprentissage par renforcement, le méta-prompting). OpenHands considère que ces méthodes jettent les bases de solutions prometteuses pour la génération automatique de workflows dans les versions futures.
B DÉCLARATION D'ÉTHIQUE
La plupart des agents d'IA aujourd'hui sont encore des artefacts de recherche et manquent de la capacité à réaliser de manière fiable des tâches complexes à long horizon dans le monde réel. Cependant, à mesure que leurs performances continuent de s'améliorer et qu'ils sont de plus en plus déployés dans le monde réel, ils ont le potentiel d'accroître la productivité tout en posant des risques de sécurité significatifs pour la société. OpenHands aide à atténuer les risques en :
(1) Permettant une évaluation systématique de ces agents, ce qui peut identifier et traiter les risques avant leur déploiement à grande échelle. (2) Facilitant l'interaction humain-agent plutôt que de permettre aux agents d'opérer de manière autonome sans supervision. (3) Plus important encore, nous espérons qu'OpenHands permettra aux chercheurs du monde entier d'accéder aux meilleures suites d'agents pour mener des recherches de pointe sur la sécurité en vue de construire des agents sûrs et utiles.
C TRAVAUX CONNEXES
Les percées des grands modèles de langage (LLM) comme ChatGPT OpenAI (2024a) et GPT4 OpenAI et al. (2024) ont considérablement renforcé les capacités des agents autonomes dans divers domaines Ye et al. (2023) ; Tang et al. (2024d) ; Park et al. (2023) ; Cui et al. (2023). Ces avancées ont suscité une multitude de propositions d'agents généralistes Gravitas (2023) ; Nakajima (2023) ; Wu et al. (2023) visant à réaliser diverses tâches utilisateur et ont attiré l'attention tant des développeurs que d'un public plus large. Des travaux notables tels qu'Auto-GPT Gravitas (2023) exploitent les LLM pour l'accomplissement de tâches en décomposant les objectifs de l'utilisateur en étapes exécutables. Les systèmes de collaboration multi-agents exploitent les LLM pour des éléments tels que le jeu de rôle et les capacités de résolution de tâches Zhuge et al. (2023) ; Li et al. (2023a) ; Zhou et al. (2023b) ; Team (2023), MetaGPT Hong et al. (2023) mettant l'accent sur des procédures opérationnelles standardisées, et AutoGen Wu et al. (2023) fournissant un cadre conversationnel pour des systèmes interactifs. AGENTS Zhou et al. (2023b) et AutoAgents Chen et al. (2024) offrent de nouveaux paradigmes pour une architecture d'agent personnalisable, tandis que XAgent Team (2023) et GPTSwarm Zhuge et al. (2024) introduisent respectivement des systèmes de gestion complexes et des graphes optimisables pour des opérations d'agents améliorées.
Cette vague de développement d'agents a conduit à des frameworks spécialisés visant à rationaliser l'implémentation d'agents. LangChain et LangGraph Chase (2022) fournissent des blocs de construction fondamentaux avec un support d'exécution de base, tandis que CrewAI CrewAI (2024) se concentre sur l'orchestration des communications multi-agents. BrowserGym ServiceNow cible spécifiquement les capacités de navigation web, et DSPy Khattab et al. (2024) met l'accent sur l'optimisation des prompts de bout en bout. AutoGen Wu et al. (2023) va au-delà des frameworks de base en implémentant des capacités d'exécution Python et bash, bien qu'avec une exécution de commandes sans état, tandis que des frameworks comme CrewAI offrent des fonctionnalités d'interpréteur de code en bac à sable mais limitées.
Le développement logiciel, fer de lance de l'application d'agents basés sur les LLM, a connu des avancées dans les frameworks visant à faciliter les processus de développement Hong et al. (2023) ; Qian et al. (2023). Des innovations telles que ChatDev Qian et al. (2023) automatisent le cycle de vie du développement logiciel à la manière du modèle en cascade, et AutoCodeRover Zhang et al. (2024b) traite les problèmes GitHub via la recherche de code et la manipulation d'arbres syntaxiques abstraits. AgentCoder Huang et al. (2024) affine itérativement la génération de code avec des tests et des retours intégrés, tandis que SWE-Agent Yang et al. (2024) intègre les LLM pour la correction automatisée des problèmes GitHub, rationalisant ainsi l'ingénierie logicielle.
D INTERFACE GRAPHIQUE UTILISATEUR
Outre l'exécution en ligne de commande, OpenHands dispose d'une interface graphique utilisateur riche qui visualise les actions actuelles de l'agent (par exemple, la navigation web, l'exécution de commandes de base ou de code Python, etc.) et permet un retour en temps réel de l'utilisateur. Des captures d'écran de l'interface sont présentées à la Fig. 1. L'utilisateur peut interrompre l'agent à tout moment pour fournir des retours, commentaires ou instructions supplémentaires pendant que l'agent travaille. Cette interface utilisateur se connecte directement aux flux d'événements (§2.1) pour contrôler et visualiser les agents et l'environnement d'exécution, la rendant agnostique vis-à-vis de l'agent et de l'environnement d'exécution.
E CONTRÔLE QUALITÉ : TESTS D'INTÉGRATION POUR LES AGENTS
Les tests d'intégration Leung & White (1990) sont depuis longtemps utilisés par les développeurs de logiciels pour garantir la qualité logicielle. Contrairement aux grands modèles de langage avec un schéma entrée-sortie simple, les agents sont généralement des pièces logicielles complexes où des erreurs mineures peuvent être facilement introduites pendant le processus de développement et nuire aux performances finales sur les tâches. Bien que l'exécution d'une suite complète d'évaluation (§4) soit la mesure ultime de la dégradation des performances, les exécuter à chaque modification de code peut être prohibitivement lent et coûteux. ^{}\)\(4 . Dans OpenHands, nous sommes pionniers d'un framework de test d'agents de bout en bout qui teste la régression des prompts, les actions et les environnements en bac à sable. Il combine les tests d'intégration du génie logiciel et le mocking de modèles de fondation pour un comportement déterministe afin de prévenir l'introduction accidentelle de bugs pendant le développement des agents.
Définition d'un test d'intégration. Le framework de tests d'intégration d'OpenHands est structuré pour valider les fonctionnalités de bout en bout en automatisant l'exécution des tâches et la vérification des résultats. Les développeurs définissent des tâches et des résultats attendus ; par exemple, une tâche peut consister à corriger des fautes de frappe dans un document nommé « bad.txt ». Lors de l'exécution de la tâche via OpenHands, les sorties sont comparées à un « fichier de référence » prédéfini pour garantir l'exactitude.
Mocking des LLM pour un comportement déterministe. Pour répondre au défi de la non-déterminisme des grands modèles de langage (LLM) et aux coûts élevés associés, le framework intercepte tous les appels aux LLM et fournit des réponses prédéfinies basées sur des correspondances exactes de prompts. Cette méthode garantit non seulement la cohérence des résultats de test mais réduit également les coûts opérationnels en minimisant la dépendance aux LLM réels.
Régénérer les réponses des LLM en cas de changements majeurs. Les paires prompt-réponse sont gérées par un script qui génère et stocke ces paires lorsque de nouveaux tests sont introduits ou que des prompts existants sont modifiés. Pour les tests de routine, le framework tente de réutiliser les réponses LLM existantes en ajustant légèrement les prompts. Les changements substantiels affectant la gestion des tâches nécessitent la régénération de ces paires à l'aide de LLM réels.
Avantages des tests d’intégration. Le framework offre plusieurs avantages, notamment 1) des tests de régression rapides : les paires invite-réponse stockées facilitent le suivi des modifications et fournissent une référence aux nouveaux membres de l’équipe pour comprendre les interactions avec le LLM, 2) la prise en charge multiplateforme : les tests sont automatiquement planifiés pour chaque pull request et chaque commit sur la branche principale, et s’exécutent sur plusieurs plateformes, environnements et agents, notamment Linux et Mac, ainsi que dans des sandboxes locales, SSH et exec, et 3) une détection complète des erreurs : il capture les erreurs dans la génération des invites, le passage des messages et l’exécution dans la sandbox, maintenant ainsi une couverture de test élevée.
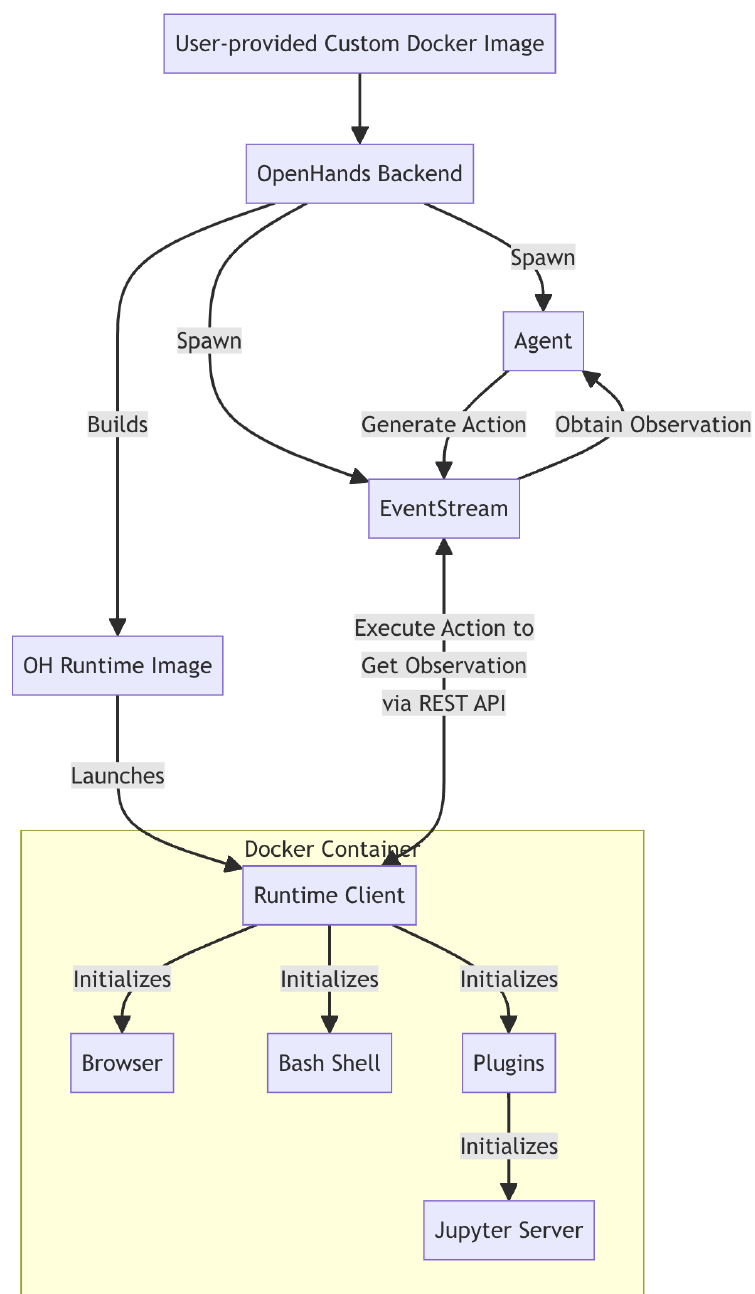
F COMMENT FONCTIONNE LE RUNTIME D’OPENHANDS
F.1 WORKFLOW
Le système OpenHands Runtime utilise une architecture client-serveur mise en œuvre avec des conteneurs Docker. Voir la Fig. 4 pour un aperçu de son fonctionnement.
(1) Entrée utilisateur : l’utilisateur fournit une image Docker de base personnalisée.
(2) Construction de l’image : OpenHands construit une nouvelle image Docker (l’« image OH runtime ») à partir de l’image fournie par l’utilisateur. Cette nouvelle image inclut du code spécifique à OpenHands, principalement le « runtime client » (c’est-à-dire le serveur d’API runtime décrit au §2.2).
(3) Lancement du conteneur : lorsque OpenHands démarre, il lance un conteneur Docker à l’aide de l’image OH runtime.
(4) Communication : le backend OpenHands (runtime.py) communique avec le runtime client via une API RESTful, en envoyant des actions et en recevant des observations
(5) Exécution des actions : le runtime client reçoit les actions du backend, les exécute dans l’environnement sandboxé et renvoie des observations
(6) Retour des observations : le client renvoie les résultats d’exécution au flux d’événements du backend OpenHands sous forme d’observations.
Le rôle du client :- Il agit comme intermédiaire entre le backend OpenHands et l’environnement sandboxé - Il exécute divers types d’actions (commandes shell, opérations sur fichiers, code Python, etc.) de manière sûre dans le conteneur - Il gère l’état de l’environnement sandboxé, y compris le répertoire de travail courant et les plugins chargés- Il formate et renvoie les observations au backend, garantissant une interface cohérente pour le traitement des résultats
F.2 COMMENT OPENHANDS CONSTRUIT ET MAINTIENT LES IMAGES D'EXÉCUTION
L'approche d'OpenHands pour construire et gérer les images d'exécution garantit efficacité, cohérence et flexibilité dans la création et la maintenance des images Docker pour les environnements de production et de développement.
F.2.1 SYSTÈME D'ÉTIQUETAGE DES IMAGES
OpenHands utilise un système de double étiquetage pour ses images d'exécution afin d'équilibrer reproductibilité et flexibilité :
(1) Étiquette basée sur le hachage : {target_image_repo}:{target_image_hash_tag}. Exemple : runtime:abc123def456
- Cette étiquette est basée sur le hachage MD5 du dossier de build Docker, qui inclut le code source (du client d'exécution et des dépendances associées) et le Dockerfile - Des étiquettes de hachage identiques garantissent que les images ont été construites avec exactement le même code source et le même Dockerfile - Cela garantit la reproductibilité ; le même hachage signifie toujours le même contenu d'image
(2) Étiquette générique : {target_image_repo}:{target_image_tag}. Exemple : runtime:oh_v0.9.3_ubuntu_tag_22.04
- Cette étiquette suit le format : runtime:oh_v{VERSION}{BASE_IMAGE_tag{IMAGE_TAG}}
- Elle représente la dernière construction pour une combinaison particulière d'image de base et de version d'OpenHands
- Cette étiquette est mise à jour chaque fois qu'une nouvelle image est construite à partir de la même image de base, même si le code source change
L'étiquette basée sur le hachage garantit la reproductibilité, tandis que l'étiquette générique fournit une référence stable à la dernière version d'une configuration particulière. Cette approche de double étiquetage permet à OpenHands de gérer efficacement à la fois les environnements de développement et de production.
F.2.2 PROCESSUS DE CONSTRUCTION
(1) Convention de nommage des images :
- Étiquette basée sur le hachage : target_image_repo:target_image_hash_tag. Exemple : runtime:abc123def456
- Étiquette générique : target_image_repo:target_image_tag. Exemple : runtime:oh_v0.9.3_ubuntu_tag_22.04
(2) Processus de construction :
a. Convertir le nom de l'image de base en un nom d'image d'exécution OH Exemple : ubuntu:22.04-> runtime:oh_v0.9.3_ubuntu_tag_22.04
b. Générer un contexte de construction (Dockerfile et code source d'OpenHands) et calculer son hachage
c. Vérifier l'existence d'une image avec le hachage calculé
d. Si elle n'est pas trouvée, vérifier l'existence d'une image compatible récente à utiliser comme base
e. Si aucune image compatible n'existe, construire à partir de zéro en utilisant l'image de base d'origine
f. Étiqueter la nouvelle image avec à la fois l'étiquette basée sur le hachage et l'étiquette générique
(3) Logique de réutilisation et de reconstruction des images : Le système suit ces étapes pour déterminer s'il faut construire une nouvelle image ou utiliser une image existante à partir d'une image (de base) fournie par l'utilisateur (par exemple, ubuntu:22.04) :
a. Si une image existe avec le même hachage (par exemple, runtime:abc123def456), elle sera réutilisée telle quelle
b. Si le hachage exact n'est pas trouvé, le système tentera de reconstruire en utilisant la dernière image générique (par exemple, runtime:oh_v0.9.3_ubuntu_tag_22.04) comme base. Cela permet d'économiser du temps en tirant parti des dépendances existantes
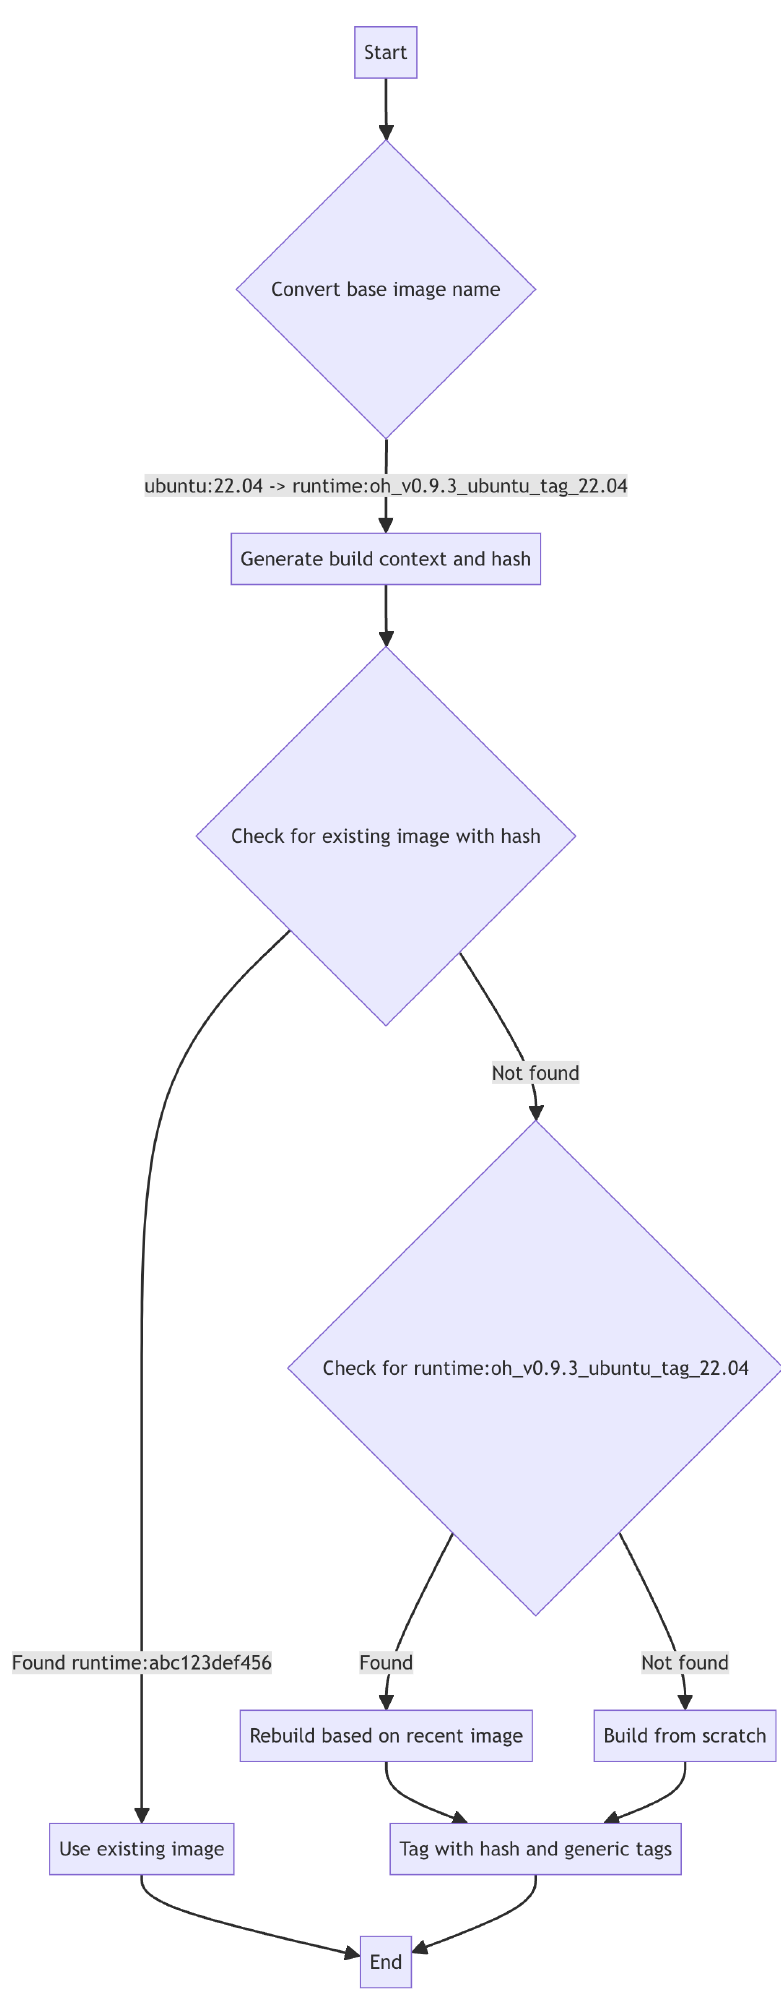
c. Si ni l'image étiquetée par hachage ni l'image étiquetée générique n'est trouvée, le système construira l'image entièrement à partir de zéro
Mise en cache et efficacité. Le système tente de réutiliser les images existantes lorsque cela est possible afin d'économiser du temps de construction. Si une correspondance exacte (par hachage) est trouvée, elle est utilisée sans reconstruction. Si une image compatible est trouvée, elle est utilisée comme base pour la reconstruction, ce qui permet d'économiser du temps sur l'installation des dépendances.
Un organigramme illustrant le processus de construction est présenté à la Fig. 5
G RÉSULTATS SUPPLÉMENTAIRES POUR LE BENCHMARK GPQA
Nous présentons des résultats plus détaillés, y compris les performances sur d'autres sous-ensembles pour le benchmark GPQA dans le Tab. 7.
| Méthode d'évaluation et modèle | Précision par sous-ensemble (%) | Coût moyen ($) | ||
| Ensemble Diamond | Ensemble principal | Ensemble étendu | ||
| Validateurs humains experts | 81,2 | 72,5 | 65,4 | N/A |
| Validateurs humains non experts | 21,9 | 30,5 | 33,9 | N/A |
| Few-Shot CoT Llama-2-70B-chat | 28,1 | 29,1 | 30,4 | N/A |
| Few-Shot CoT GPT-3.5-turbo-16k | 29,6 | 28,0 | 28,2 | N/A |
| Few-Shot CoT GPT-4 | 38,8 | 39,7 | 38,7 | N/A |
| GPT-4 avec recherche (repli sur CoT en cas d'abstention) | 38,8 | 41,0 | 39,4 | N/A |
| OpenHands + CodeActAgent v1.5 + GPT3.5-turbo | 27,9 | 23,4 | 26,1 | 0,012 |
| OpenHands + CodeActAgent v1.5 + GPT4-turbo | 51,8 | 47,4 | 42,4 | 0,501 |
| OpenHands + CodeActAgent v1.5 + GPT4o | 53,1 | 49,3 | 52,8 | 0,054 |
H DÉMONSTRATION IN-CONTEXT POUR CODEACTSWEAGENT
Le prompt est ré-adopté à partir de la trajectoire publiée de l'agent SWE (https://github.com/princeton- nlp/ SWE- agent/tree/main/trajectories/demonstrations). Le prompt peut être trouvé à l'adresse https://github.com/ All- Hands- AI/OpenHands/blob/main/agenthub/codeact_swe_agent/prompt.py.
I COMPÉTENCES D'AGENT PRISES EN CHARGE
Depuis OpenHands v0.6, nous prenons en charge la liste suivante de compétences. Veuillez vous référer au code source pour obtenir la liste la plus à jour des compétences : https://github.com/All- Hands- AI/OpenHands/blob/main/OpenHands/ runtime/plugins/agent_skills/agentskills.py
def open_file(path: str, line_number: Optional[int] = None) -> None:\\\* Ouvre le fichier au chemin donné dans l'éditeur. Si line_number est fourni, la fenêtre sera déplacée pour inclure cette ligne.Args: path: str: Le chemin du fichier à ouvrir. line_number: Optional[int]: Le numéro de ligne vers lequel se déplacer.\\\*def goto_line(line_number: int) -> None:\\\* Déplace la fenêtre pour afficher le numéro de ligne spécifié.
Args: line_number: int: Le numéro de ligne vers lequel se déplacer.passdef scroll_down() -> None: """Déplace la fenêtre vers le bas de 100 lignes.Args: None\\\* pass
def scroll_up() -> None: """Déplace la fenêtre vers le haut de 100 lignes.Args: None pass
def create_file(filename: str) -> None: """Crée et ouvre un nouveau fichier avec le nom donné.Args: filename: str: Le nom du fichier à créer.pass
def edit_file(start: int, end: int, content: str) -> None: """Édite un fichier.Remplace les lignes 'start' à 'end' (incluses) par le texte 'content' donné dans le fichier ouvert. Rappelez-vous que le fichier doit être ouvert avant l'édition.Args: start: int: Le numéro de ligne de début. Doit satisfaire start >= 1. end: int: Le numéro de ligne de fin. Doit satisfaire start <= end <= nombre de lignes dans le fichier. content: str: Le contenu par lequel remplacer les lignes.pass
def search_dir(search_term: str, dir_path: str = './') -> None: """Recherche search_term dans tous les fichiers de dir. Si dir n'est pas fourni, recherche dans le répertoire courant.Args: search_term: str: Le terme à rechercher. dir_path: Optional[str]: Le chemin du répertoire dans lequel rechercher.pass
def search_file(search_term: str, file_path: Optional[str] = None) -> None: """Recherche search_term dans le fichier. Si le fichier n'est pas fourni, recherche dans le fichier ouvert actuel.Args: search_term: str: Le terme à rechercher. file_path: Optional[str]: Le chemin du fichier dans lequel rechercher.pass
def find_file(file_name: str, dir_path: str = './') -> None : """Trouve tous les fichiers portant le nom donné dans le répertoire spécifié.Args :file_name: str : Le nom du fichier à trouver. dir_path: Optional[str] : Le chemin du répertoire dans lequel effectuer la recherche.
pass
def parse_pdf(file_path: str) -> None :
"\\\*Analyse le contenu d'un fichier PDF et l'affiche.
Args :
file_path: str : Le chemin du fichier à ouvrir.
pass
def parse_docx(file_path: str) -> None :
Analyse le contenu d'un fichier DOCX et l'affiche.
Args :
file_path: str : Le chemin du fichier à ouvrir.
pass
def parse_latex(file_path: str) -> None :
Analyse le contenu d'un fichier LaTeX et l'affiche.
Args :
file_path: str : Le chemin du fichier à ouvrir.
pass
def parse_audio(file_path: str, model: str = 'whisper- 1') -> None :
Analyse le contenu d'un fichier audio et l'affiche.
Args :
file_path: str : Le chemin du fichier audio à transcrire. model: Optional[str] : Le modèle audio à utiliser pour la transcription. Par défaut : 'whisper- 1'.
pass
def parse_image(
file_path: str, task: str = 'Décris cette image aussi en détail que possible.'
) -> None:
Analyse le contenu d'un fichier image et affiche la description.
Args :
file_path: str : Le chemin du fichier à ouvrir. task: Optional[str] : La description de la tâche pour l'appel API. Par défaut, 'Décris cette image aussi en détail que possible.'
pass
def parse_video( file_path: str, task: str = 'Décris cette image aussi en détail que possible.', frame_interval: int = 30, ) -> None:
Analyse le contenu d'un fichier image et affiche la description.
Args : file_path: str : Le chemin du fichier vidéo à ouvrir. task: Optional[str] : La description de la tâche pour l'appel API. Par défaut, 'Décris cette image aussi en détail que possible.' frame_interval: Optional[int] : L'intervalle entre les images à analyser. Par défaut, 30.
pass
def parse_pptx(file_path: str) -> None:
Analyse le contenu d'un fichier pptx et l'affiche.
Args : file_path: str : Le chemin du fichier à ouvrir.
pass
ACTIONS DE J BROWSERGYM
Voici toutes les actions prises en charge définies dans BrowserGym5 à partir de la v0.3.4. Les actions peuvent être classées en plusieurs types et peuvent être configurées pour n'utiliser qu'un sous-ensemble des fonctionnalités. Il existe des actions de contrôle d'agent, des actions de navigation, des actions basées sur des éléments de page, des actions basées sur des coordonnées, ainsi que des actions liées aux onglets. Nous utilisons ces actions de la bibliothèque BrowserGym comme nos primitives principales d'action de navigation.
def send_msg_to_user(text: str):
Envoie un message à l'utilisateur.
Exemples :
send_msg_to_user("D'après les résultats de ma recherche, la ville a été construite en 1751.")
\\\*
pass
def report_infeasible(reason: str):
\\\*
Notifie à l'utilisateur que ses instructions sont irréalisables.
Exemples :
report_infeasible("Je ne peux pas suivre ces instructions car il n'y a pas de champ e-mail dans ce formulaire.") pass
def noop(wait_ms: float = 1000):\\\*
Ne fait rien, et attend éventuellement le temps donné (en millisecondes).
Exemples : noop() noop(500) pass
https://playwright.dev/docs/input#text- input
def fill(bid: str, value: str):\\\*
Remplit un champ de formulaire. Il met le focus sur l'élément et déclenche un événement de saisie avec le texte entré. Cela fonctionne pour les éléments <input>, <textarea> et [contenteditable] .
Exemples :
fill('237', 'valeur d\'exemple')
fill('45', "exemple multi- ligne\nexemple")
fill('a12', "exemple avec \\""guillemets\\""\\\* pass
https://playwright.dev/python/docs/api/class- locator#locator- check
def check(bid: str):\\\*
S'assure qu'une case à cocher ou un élément radio est coché.
Exemples :
check('55')\\\* pass
https://playwright.dev/python/docs/api/class- locator#locator- uncheck
def uncheck(bid: str):\\\*
S'assure qu'une case à cocher ou un élément radio est décoché.
Exemples :
décocher('a5289')\\\* passer
https://playwright.dev/docs/input#select- options
def select_option(bid: str, options: str | list[str]):\\\* Sélectionner une ou plusieurs options dans un élément <select>. Vous pouvez spécifier la valeur ou le libellé de l'option à sélectionner. Plusieurs options peuvent être sélectionnées.
Exemples : select_option('a48', "blue") select_option('c48', ["red", "green", "blue"])passer
https://playwright.dev/python/docs/api/class- locator#locator- click def click( bid: str, button: Literal["left", "middle", "right"] = "left", modifiers: list[Literal["Alt", "Control", "Meta", "Shift"]] = [1], ) : Cliquer sur un élément. Exemples : click('a51') click('b22', button="right") click('48', button="middle", modifiers=["Shift"]) passer
https://playwright.dev/python/docs/api/class- locator#locator- dblclick def dblclick( bid: str, button: Literal["left", "middle", "right"] = "left", modifiers: list[Literal["Alt", "Control", "Meta", "Shift"]] = [1], ) : Double-cliquer sur un élément.
Exemples : dblclick('12') dblclick('ca42', button="right") dblclick('178', button="middle", modifiers=["Shift"])passer
https://playwright.dev/python/docs/api/class- locator#locator- hover def hover(bid: str): survoler un élément.
Exemples : hover('b8')passer
https://playwright.dev/docs/input#keys- and- shortcuts def press (bid: str, key_comb: str): """ Cibler l'élément correspondant et appuyer sur une combinaison de touches. Accepte les noms de touches logiques émis dans la propriété keyboardEvent.key des événements clavier : Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ, etc. Vous pouvez aussi spécifier un caractère unique à produire, comme "a" ou "#". Les raccourcis de modification suivants sont également pris en charge : Shift, Control, Alt, Meta.
Exemples : press('88', 'Backspace') press('a26', 'Control+a') press('a61', 'Meta+Shift+t')passer
https://playwright.dev/python/docs/api/class- locator#locator- focus def focus (bid: str): """ Cibler l'élément correspondant. Exemples : focus('b455') """ passer
https://playwright.dev/python/docs/api/class- locator#locator- clear def clear (bid: str): """ Vider le champ de saisie. Exemples : clear('996') """ passer
https://playwright.dev/docs/input#drag- and- drop def drag_and_drop(from_bid: str, to_bid: str): """ Effectuer un glisser-déposer. Survoler l'élément qui sera glissé. """ Appuyer gged. bouton gauche de la souris. Déplacer la souris vers l'élément qui recevra le dépôt. Relâcher le bouton gauche de la souris.
Exemples : drag_and_drop('56', '498')
passer
https://playwright.dev/python/docs/api/class- mouse#mouse- wheel def scroll(delta_x: float, delta_y: float):
Faites défiler horizontalement et verticalement. Les montants sont en pixels, positifs pour un défilement vers la droite ou vers le bas, négatifs pour un défilement vers la gauche ou vers le haut. Envoie un événement wheel.
Exemples : scroll(0, 200) scroll(- 50.2, - 100.5)
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- move def mouse_move(x: float, y: float):
\\\*
Déplace la souris vers un emplacement. Utilise des coordonnées client absolues en pixels. Envoie un événement mouse move.
Exemples : mouse_move(65.2, 158.5)
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- up def mouse_up(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
Déplace la souris vers un emplacement puis relâche un bouton de la souris. Envoie les événements mouse move et mouseup.
Exemples : mouse_up(250, 120) mouse_up(47, 252, 'right')
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- down def mouse_down(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
Déplace la souris vers un emplacement puis presse et maintient un bouton de la souris. Envoie les événements mouse move et mousedown. Exemples : mouse_down(140.2, 580.1) mouse_down(458, 254.5, 'middle') pass
https://playwright.dev/python/docs/api/class- mouse#mouse- click def mouse_click(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
Déplace la souris vers un emplacement et clique sur un bouton de la souris. Envoie les événements mousemove, mousedown et mouseup.
Exemples : mouse_click(887.2, 68) mouse_click(56, 712.56, 'right') pass #
https://playwright.dev/python/docs/api/class- mouse#mouse- dblclick def mouse_dblclick(x: float, y: float, button: Literal["left", "middle", "right"] = "left"): Déplace la souris vers un emplacement et double-clique sur un bouton de la souris. Envoie les événements mousemove, mousedown et mouseup.
Exemples : mouse_dblclick(5, 236) mouse_dblclick(87.5, 354, 'right') pass
def mouse_drag_and_drop(from_x: float, from_y: float, to_x: float, to_y: float): "middle", "right"] = "left"):
Glisse-dépose d'un emplacement vers un emplacement. Utilise des coordonnées client absolues en pixels. Envoie les événements mousemove, mousedown et mouseup.
Exemples : mouse_drag_and_drop(10.7, 325, 235.6, 24.54) pass #
https://playwright.dev/python/docs/api/class- keyboard#keyboard- press def keyboard_press(key: str): Presse une combinaison de touches. Accepte les noms logiques de touches qui sont émis dans la propriété keyboardEvent.key des événements clavier : Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ, etc. Vous pouvez alternativement spécifier un caractère unique que vous souhaitez produire, comme "a" ou "#". Les raccourcis de modification suivants sont également pris en charge : Shift, Control, Alt, Meta.
Exemples : keyboard_press('Backspace') keyboard_press('Control+a') keyboard_press('Meta+Shift+t') page.keyboard.press("PageDown")\\\*pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- up def keyboard_up(key: str): Relâche une touche du clavier. Envoie un événement keyup. Accepte les noms logiques de touches qui sont émis dans la propriété keyboardEvent.key des événements clavier : Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ, etc. Vous pouvez alternativement spécifier un caractère unique que vous souhaitez produire, comme "a" ou "#".
Exemples : keyboard_up('Shift') keyboard_up('c') pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- down def keyboard_down(key: str): Presse et maintient une touche du clavier. Envoie un événement keydown. Accepte les noms logiques de touches qui sont émis dans la propriété keyboardEvent.key des événements clavier : Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ, etc. Vous pouvez alternativement spécifier un caractère unique comme "a" ou "#".
Exemples : keyboard_up('Shift') keyboard_up('c')
pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- type def keyboard_type(text: str): """ Tape une chaîne de texte au clavier. Envoie un événement keydown, keypress/input et keyup pour chaque caractère du texte. Les touches de modification N'AFFECTENT PAS keyboard_type. Maintenir Shift enfoncé ne saisira pas le texte en majuscules.
Exemples : keyboard_type('Hello world!')
pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- insert- text def keyboard_insert_text(text: str): """ Insère une chaîne de texte dans l'élément actuellement ciblé. Envoie uniquement un événement input, n'émet pas les événements keydown, keyup ou keypress. Les touches de modification N'AFFECTENT PAS keyboard_insert_text. Maintenir Shift enfoncé ne saisira pas le texte en majuscules.
Exemples : keyboard_insert_text('Hello world!')
pass
https://playwright.dev/python/docs/api/class- page#page- goto def goto(url: str) :
Naviguer vers une URL.
Exemples : goto('http://www.example.com')
pass
https://playwright.dev/python/docs/api/class- page#page- go- back
\\\\
Naviguer vers la page précédente dans l'historique.
Exemples : go_back()
pass
https://playwright.dev/python/docs/api/class- page#page- go- forward go_forward() : Naviguer vers la page suivante dans l'historique. Exemples : go_forward()
pass
\*
https://playwright.dev/python/docs/api/class- browsercontext#browser- context- new- def new_tab() :
\\\\
Ouvrir un nouvel onglet. Il deviendra l'onglet actif.
Exemples : new_tab()
global page
définir la nouvelle page comme page active
page page.context.new_page()
déclencher le callback qui définit cette page comme active dans
browsergym
pass
https://playwright.dev/python/docs/api/class- page#page- close
def tab_close():
\\\\
Fermer l'onglet courant.
Exemples :
tab_close()
\\\\
pass
\\\\
https://playwright.dev/python/docs/api/class- page#page- bring- to- front def tab_focus(index: int):
\\\\\*
Mettre l'onglet au premier plan (activer l'onglet).
Exemples :
tab_focus(2)\\\* pass\\\* pass
# https://playwright.dev/python/docs/input#upload- filesdef upload_file(bid: str, file: str | list[str]): """Clique sur un élément et attend un événement "filechooser", puis → sélectionne un ou plusieurs fichiers d'entrée à téléverser. Les chemins de fichiers relatifs sont → résolus par rapport au répertoire de travail courant. Une liste vide → efface les fichiers sélectionnés.
Exemples : upload_file("572", "my_receipt.pdf") upload_file("63", ["/home/bob/Documents/image.jpg", "/home/bob/Documents/file.zip"])
pass
\\\* https://playwright.dev/python/docs/input#upload- filesdef mouse_upload_file(x: float, y: float, file: str | list[str]): """Clique sur un emplacement et attend un événement "filechooser", puis → sélectionne un ou plusieurs fichiers d'entrée à téléverser. Les chemins de fichiers relatifs sont → résolus par rapport au répertoire de travail courant. Une liste vide → efface les fichiers sélectionnés.
Exemples : mouse_upload_file(132.1, 547, "my_receipt.pdf") mouse_upload_file(328, 812, → ["/home/bob/Documents/image.jpg", → "/home/bob/Documents/file.zip"])
pass
DÉTAILS DE L'AGENT DE NAVIGATION K
DÉTAILS DE L'AGENT DE NAVIGATION KCe qui suit montre un exemple d'invite contenant toutes les informations requises pour l'étape courante afin de faire une prédiction sur les prochaines actions de navigation. Notez que nous demandons également à l'agent de prédire plusieurs actions en un seul tour s'il estime qu'elles sont destinées à être exécutées séquentiellement sans aucun retour de la page. Cela peut économiser des tours pour les workflows courants qui consistent en une séquence d'actions sur la même page sans aucun changement d'observation, comme saisir le nom d'utilisateur et le mot de passe puis soumettre dans une page de connexion.
Instructions
Examinez l'état actuel de la page et toutes les autres informations pour → trouver la meilleure action possible suivante afin d'accomplir votre objectif. → Votre réponse sera interprétée et exécutée par un programme, → assurez-vous de suivre les instructions de formatage.
Objectif : Naviguer sur localhost:8000, et me donner la réponse ultime à la vie. Ne me demandez pas de confirmation à aucun moment.
Espace d'action
16 types d'actions différents sont disponibles.
noop(wait_ms: float = 1000)
Exemples :
noop()
noop(500)
send_msg_to_user(text: str)
Exemples :
send_msg_to_user('D'après les résultats de ma recherche, la ville a été construite en 1751. ')
scroll(delta_x: float, delta_y: float)
Exemples :
scroll(0, 200)
scroll(- 50.2, - 100.5)
fill(bid: str, value: str)
Exemples :
fill('237', 'exemple de valeur')
fill('45', 'exemple multi- ligne\nexemple')
fill('a12', 'exemple avec "guillemets")
select_option(bid: str, options: str | list[str])
Exemples :
select_option('48', 'bleu')
select_option('48', ['rouge', 'vert', 'bleu'])
click(bid: str, button: Literal['left', 'middle', 'right'] = 'left', modifiers: list[typing.Literal['Alt', 'Control', 'Meta', 'Shift']] = []
Exemples :
click('51')
click('b22', button='right')
click('48', button='middle', modifiers=['Shift'])
dblclick(bid: str, button: Literal['left', 'middle', 'right'] = 'left', modifiers: list[typing.Literal['Alt', 'Control', 'Meta', 'Shift']] = []
Exemples :
dblclick('12')
dblclick('ca42', button='right')
dblclick('178', button='middle', modifiers=['Shift'])
hover(bid: str) Exemples : hover('b8')
press(bid: str, key_comb: str) Exemples : press('88', 'Backspace') press('a26', 'Control+a') press('a61', 'Meta+Shift+t')
focus(bid: str) Exemples : focus('b455')
clear(bid: str) Exemples : clear('996')
drag_and_drop(from_bid: str, to_bid: str) Exemples : drag_and_drop('56', '498')
upload_file(bid: str, file: str | list[str]) Exemples : upload_file('572', 'my_receipt.pdf')
upload_file('63', ['/home/bob/Documents/image.jpg', ' /home/bob/Documents/file.zip'])
go_back() Exemples : go_back()
go_forward() Exemples : go_forward()
goto(url: str) Exemples : goto('http://www.example.com')
Plusieurs actions peuvent être fournies en une seule fois. Exemple : fill('a12', 'example with "quotes"') click('51')
click('48', button='middle', modifiers=['Shift']) Les actions multiples sont destinées à être exécutées séquentiellement sans aucun retour de la page. N'exécutez pas plusieurs actions à la fois si vous avez besoin d'un retour de la page.
Arborescence d'accessibilité actuelle : RootWebArea 'The Ultimate Answer', focused [8] heading 'The Ultimate Answer' [9] paragraph ' StaticText 'Cliquez sur le bouton pour révéler la réponse à la vie, à l'univers et à tout le reste.' [10] button 'Click me', clickable
Actions précédentes goto('http://localhost:8000')
Voici un exemple avec chaîne de pensée d'une action valide lors d'un clic sur un bouton :
Pour atteindre mon objectif, je dois cliquer sur le bouton avec bid 12 "click("12")"
Et un exemple de réponse au prompt ci-dessus est :
Pour atteindre mon objectif, je dois cliquer sur le bouton avec bid 10 pour révéler la réponse à la vie, à l'univers et à tout le reste. "click("10")"
Pour l'évaluation sur le benchmark WebArena, comme certaines tâches nécessitent de vérifier la correspondance exacte de la réponse dans le message renvoyé par l'agent à l'utilisateur, nous ajoutons l'instruction suivante pour que l'agent réponde avec une simple chaîne de réponse concise lorsqu'il envoie un message à l'utilisateur, afin d'éviter que l'agent échoue au test à cause de texte supplémentaire :
Voici un autre exemple avec chaîne de pensée d'une action valide lors de la fourniture d'une réponse concise à l'utilisateur :
Pour atteindre mon objectif, je dois renvoyer à l'utilisateur l'information demandée. Cette page liste les informations de l'imprimante fax HP Inkjet Fax Machine, qui est le produit identifié dans l' objectif. Son prix est de 279,49\(. Je vais envoyer un message à l' utilisateur avec la réponse. "send_msg_to_user("\) \ "