
Au lieu de prédire token par token, LLaDA remplit un texte masqué comme un modèle de diffusion, à parité avec LLaMA-3 8B. ICML 2025, gratuit.
Large Language Diffusion Models
Modèles de diffusion pour grands modèles de langage
Shen Fengqi Zhu Zebin You Xiaolu Zhang Jingyang Jun Jun Zhou Yankai Ji- Rong Wen Chongxuan Gaoling School of Artificial Intelligence, Renmin University of China Beijing Key Laboratory of Research on Large Models and Intelligent Governance Engineering Research Center of Next- Generation Intelligent Search and Recommendation, MOE Ant Group {nieshen,fengqizhu,chongxuanli}@ruc.edu.cn {nie shen, fengqizhu, chongxuanli}@ruc.edu.cn
Résumé
Les capacités des grands modèles de langage (LLM) sont largement considérées comme reposant sur des modèles autorégressifs (ARM). Nous remettons en question cette notion en introduisant LLaDA, un modèle de diffusion entraîné à partir de zéro selon le paradigme de pré-entraînement et de finetuning supervisé (SFT). LLaDA emploie un processus de masquage des données en avant et un processus de génération en arrière, paramétrés par un Transformer pour prédire les tokens masqués. Il fournit une approche générative fondée sur des principes pour l'inférence probabiliste en optimisant une borne inférieure de vraisemblance. Sur de nombreux benchmarks étendus portant sur des tâches générales, les mathématiques, le code, etc., LLaDA démontre une forte extensibilité et se comporte de manière comparable à nos baselines ARM construites par nous-mêmes. Remarquablement, LLaDA 8B est compétitif avec de puissants LLM comme LLaMA3 8B en apprentissage en contexte et, après SFT, exhibe d'impressionnantes capacités de suivi d'instructions dans des études de cas telles que le dialogue multitour. De plus, LLaDA traite la malédiction de l'inversion, surpassant GPT-4o dans une tâche de complétion de poème inversé. Nos résultats montrent la promesse des modèles de diffusion pour la modélisation du langage à grande échelle et remettent en question l'hypothèse courante selon laquelle les capacités fondamentales des LLM discutées ci-dessus dépendent intrinsèquement des ARM. Page du projet et codes : https://ml-gsai.github.io/LLaDA-demo/
1 Introduction
Les grands modèles de langage (LLM) [1] relèvent entièrement du cadre de la modélisation générative. Plus précisément, les LLM visent à capturer la distribution linguistique réelle mais inconnue en optimisant une distribution de modèle par estimation du maximum de vraisemblance, ou de manière équivalente, par minimisation de la divergence KL entre les deux distributions :
L'approche prédominante repose sur la modélisation autoregressive (ARM)—communément appelée paradigme de « prédiction du jeton suivant »—pour définir la distribution du modèle :
Formulation autoregressive
\*Contribution égale.
Travail réalisé lors d'un stage chez Ant Group.
Chefs de projet.
Correspondance à Chongxuan Li.
où est une séquence de longueur , et est le -ème jeton. Ce paradigme s'est révélé remarquablement efficace [2][5] et est devenu le fondement des LLM actuels. Malgré son adoption généralisée, une question fondamentale demeure sans réponse : le paradigme autoregressif est-il la seule voie pour atteindre les capacités fondamentales des LLM, telles que la scalabilité, l'apprentissage en contexte et le suivi d'instructions ?
Nous soutenons que la réponse n'est pas un simple « oui ». L'idée clé jusqu'ici négligée est la suivante : ce sont les principes de modélisation générative (c.-à-d., l'éq. (1)), et non la formulation autoregressive (c.-à-d., l'éq. (2)) elle-même, qui sous-tendent fondamentalement les propriétés essentielles des LLM.
En particulier, nous soutenons que la scalabilité est principalement une conséquence de l'interaction entre les Transformers [7], la taille du modèle, la taille des données et la consistance de Fisher [5][8] induite par les principes génératifs de l'éq. (1), plutôt qu'un résultat unique des ARM de l'éq. (2). Le succès des diffusion transformers [9][10] sur les données visuelles [11] étaye cette affirmation. De plus, les capacités de suivi d'instructions et d'apprentissage en contexte [4] semblent être des propriétés intrinsèques de tous les modèles génératifs conditionnels sur des tâches linguistiques structurellement cohérentes, plutôt que des avantages exclusifs des ARM. En outre, bien que les ARM puissent être interprétés comme un compresseur de données sans perte [12][13], tout modèle probabiliste suffisamment expressif peut atteindre des capacités similaires [14].
Cependant, certaines limitations inhérentes aux LLM peuvent être directement attribuées à leur nature autoregressive. Par exemple, le processus de génération de gauche à droite restreint leur capacité à traiter les tâches de raisonnement inversé [15], mettant en évidence un échec représentatif des capacités de généralisation des modèles actuels.
Motivés par ces observations, nous introduisons LLaDA (Large Language Diffusion with mAsking) afin d'examiner si les capacités manifestées par les LLM peuvent émerger de principes de modélisation générative au-delà des ARM, répondant ainsi à la question fondamentale posée précédemment. Contrairement aux ARM traditionnels, LLaDA exploite un modèle de diffusion masqué (MDM) [16][20], qui intègre un processus direct de masquage des données et entraîne un prédicteur de masque pour approximer son processus inverse. Cette conception permet à LLaDA de construire une distribution de modèle avec des dépendances bidirectionnelles et d'optimiser une borne inférieure variationnelle de sa log-vraisemblance, offrant une perspective fondée et jusqu'ici inexplorée sur les capacités fondamentales des LLM discutées ci-dessus.
Nous adoptons le pipeline standard de préparation des données, pré-entraînement, ajustement supervisé (SFT) et évaluation, en étendant LLaDA à une diffusion linguistique d'une taille sans précédent de 8B. En particulier, LLaDA 8B a été pré-entraîné de zéro sur 2,3 billions de jetons en utilisant 0,13 million d'heures GPU H800, suivi d'un SFT sur 4,5 millions de paires. Sur diverses tâches, incluant la compréhension du langage, les mathématiques, le code et le chinois, LLaDA démontre les contributions suivantes :
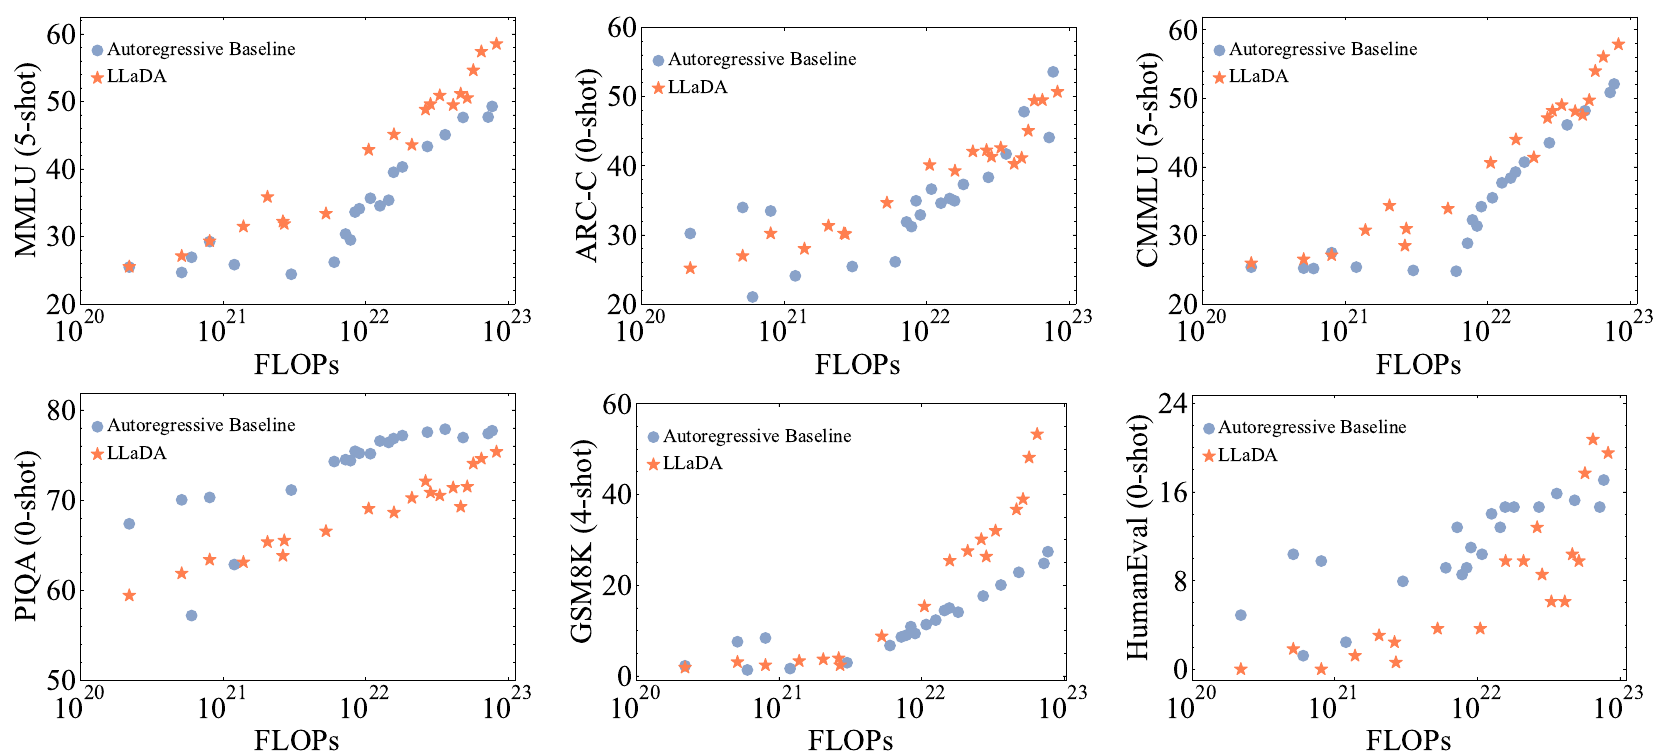
- LLaDA passe efficacement à l'échelle avec un budget de calcul de FLOPs, atteignant des résultats comparables aux lignes de base ARM entraînées sur les mêmes données à travers six tâches, par exemple, MMLU et GSM8K.
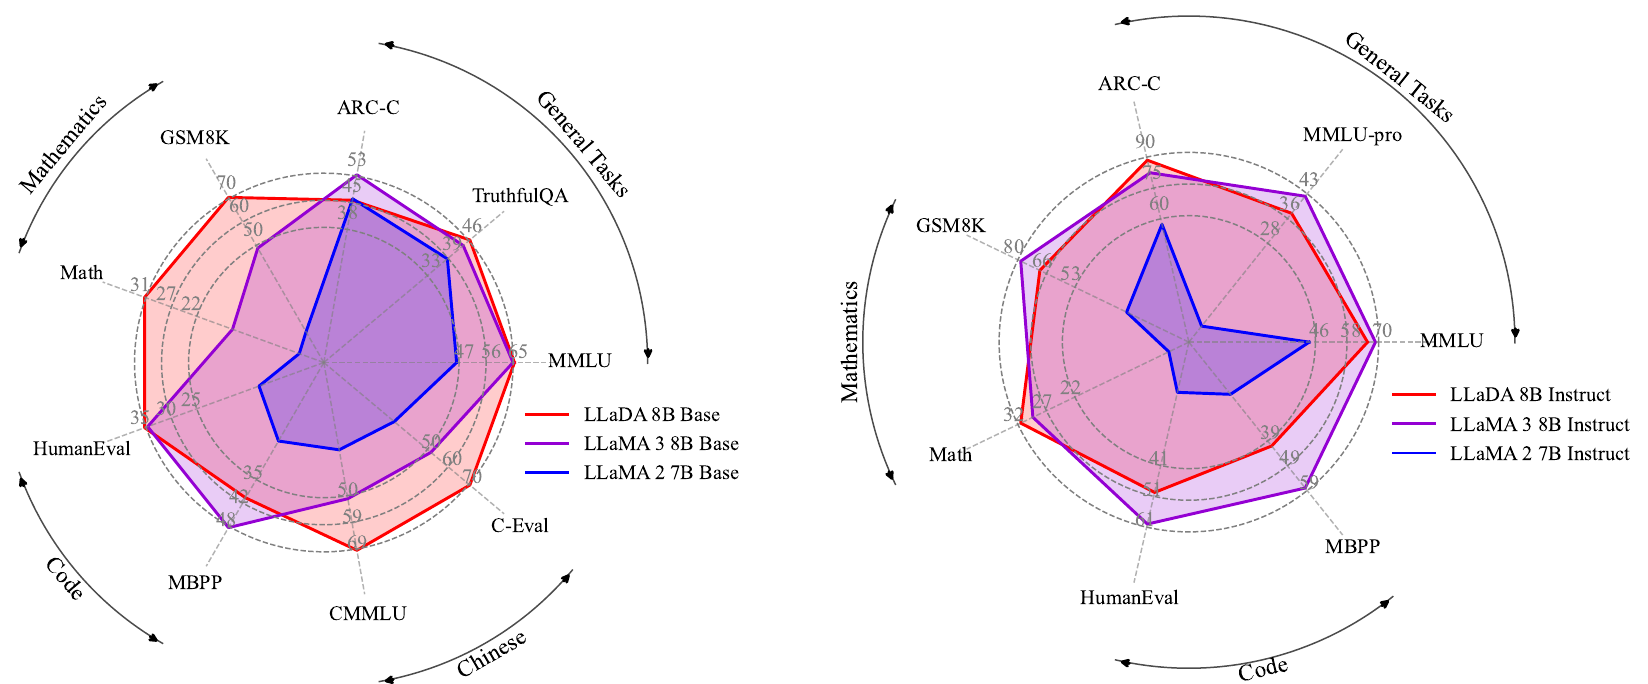
- Le LLaDA 8B Base pré-entraîné surpasse LLaMA2 7B Base [21] sur presque toutes les 15 tâches standard d'apprentissage zéro/quelques exemples tout en étant au niveau de LLaMA3 8B Base [6], démontrant une capacité efficace d'apprentissage en contexte.
- LLaDA améliore significativement la capacité à suivre des instructions après le SFT, comme le démontrent des études de cas telles que le dialogue multi-tours.
- LLaDA brise efficacement la malédiction de l'inversion [15] avec des performances cohérentes sur les tâches directes et inversées. Notably, it outperforms GPT-4o in a reversal poem completion task.
2 Approche
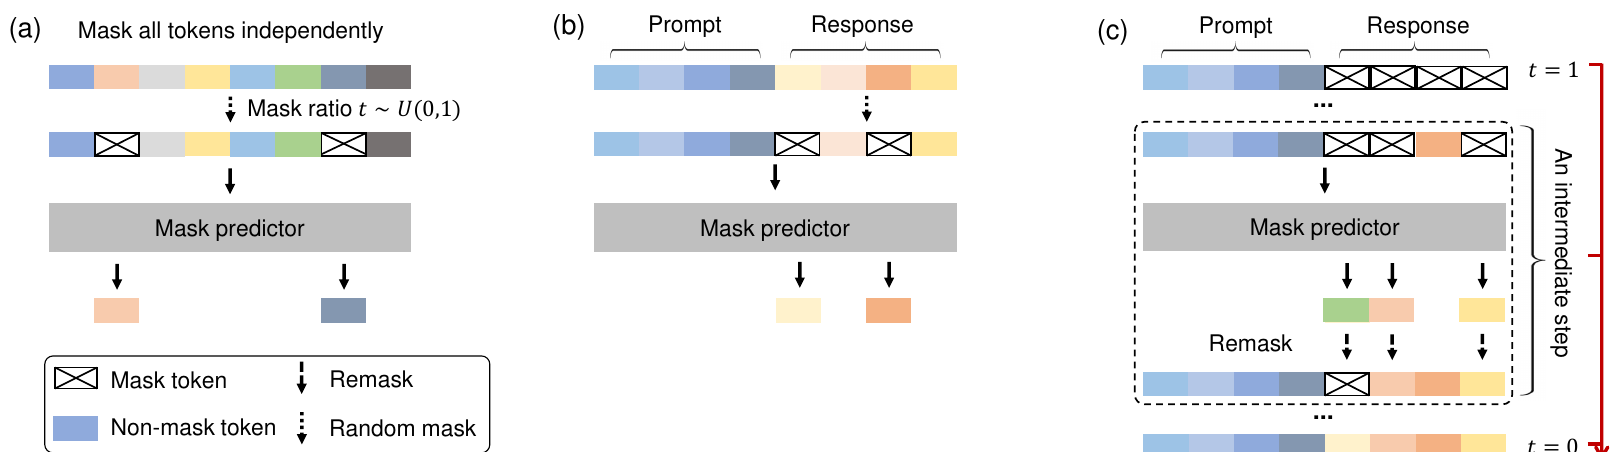
Dans cette section, nous introduisons la formulation probabiliste[6] ainsi que les procédures de pré-entraînement, d'ajustement supervisé et d'inférence pour LLaDA, comme illustré à la Fig. [2]
2.1 Formulation probabiliste
Contrairement aux ARM de l'éq. (2), LLaDA définit une distribution de modèle via un processus direct et un processus inverse [16][20]. Le processus direct masque progressivement les jetons indépendamment dans jusqu'à ce que la séquence soit entièrement masquée à . Pour , la séquence est partiellement masquée, chaque jeton étant masqué avec probabilité ou restant non masqué avec probabilité . Le processus inverse récupère la distribution des données en prédisant itérativement les jetons masqués à mesure que passe de 1 à 0.
Le cœur de LLaDA est un prédicteur de masque, un modèle paramétrique qui prend en entrée et prédit simultanément tous les jetons masqués (notés M). Il est entraîné à l'aide d'une perte d'entropie croisée calculée uniquement sur les jetons masqués [18][20] :
où est un échantillon d'entraînement, est une variable aléatoire continue tirée uniformément de , est échantillonné à partir du processus direct et est la longueur de la séquence. La fonction indicatrice garantit que la perte n'est calculée que pour les jetons masqués.
Une fois entraîné, nous pouvons simuler un processus inverse (voir Sec. [2.4] pour plus de détails) paramétré par le prédicteur de masque et définir la distribution de modèle comme la distribution marginale induite à . La fonction de perte de l'éq. (3) a été prouvée comme étant une borne supérieure de la log-vraisemblance négative de la distribution du modèle, ce qui en fait un objectif fondé pour la modélisation générative :
Notamment, LLaDA emploie un taux de masquage qui varie aléatoirement entre 0 et 1, tandis que BERT [22] utilise un taux fixe. Ces différences subtiles ont des implications significatives, en particulier à grande échelle : comme le montre l'éq. (4), LLaDA est un modèle génératif fondé sur des principes, capable d'effectuer naturellement l'apprentissage en contexte et le suivi d'instructions, à l'image des LLM. De plus, sa perspective générative implique une forte extensibilité avec de grandes quantités de données et de grands modèles, comme discuté à la section [1]. En outre, MaskGIT [23] adopte un objectif d'entraînement heuristique, qui omet le terme \(\frac{1}{t}\) par rapport à l'éq. (3), et manque d'un lien théorique avec le maximum de vraisemblance. Nous soulignons que c'est précisément le fondement théorique de l'estimation par maximum de vraisemblance qui nous a motivés à passer à l'échelle les modèles de diffusion discrète pour la modélisation du langage.
2.2 Pré-entraînement
LLaDA emploie un Transformer [7] comme prédicteur de masques, à l'instar des LLM existants. Cependant, LLaDA n'utilise pas de masque causal, car sa formulation lui permet de voir l'intégralité de l'entrée pour effectuer ses prédictions.
Nous avons entraîné deux variantes de LLaDA de tailles différentes : 1B et 8B. Nous résumons ici l'architecture des modèles LLaDA 8B et LLaMA3 8B [6], et les détails sont fournis à l'annexe [B.2]. Nous avons assuré la cohérence de la plupart des hyperparamètres tout en apportant plusieurs modifications nécessaires. Nous utilisons l'attention multi-têtes classique plutôt que l'attention par requêtes groupées [24] pour des raisons de simplicité, car LLaDA est incompatible avec la mise en cache KV, ce qui conduit à un nombre différent de têtes de clés et de valeurs. Par conséquent, la couche d'attention possède davantage de paramètres, et nous réduisons la dimension du FFN pour maintenir une taille de modèle comparable. De plus, la taille du vocabulaire diffère en raison d'un tokenizer [4] adapté à nos données.
Le modèle LLaDA est pré-entraîné sur un jeu de données comprenant 2,3 billions (T) de tokens, selon un protocole de données étroitement aligné sur celui des LLM existants [25] [26], sans incorporation de techniques particulières. Les données proviennent de corpus en ligne, le contenu de faible qualité étant filtré au moyen de règles conçues manuellement et d'approches fondées sur les LLM. Au-delà du texte général, le jeu de données englobe du code, des mathématiques et des données multilingues de haute qualité. Veuillez vous reporter à l'annexe [B.1] pour plus de détails sur les jeux de données. Le mélange des sources de données et des domaines est guidé par des ARM réduits. Le processus de pré-entraînement utilise une longueur de séquence fixe de 4096 tokens, pour un coût computationnel total de 0,13 million d'heures GPU H800, similaire à celui des ARM de même échelle et de même taille de jeu de données.
Pour une séquence d'entraînement , nous échantillonnons aléatoirement , masquons chaque token indépendamment avec la même probabilité pour obtenir (voir Fig. 2) et estimons l'éq. (3) par la méthode de Monte Carlo pour l'entraînement par descente de gradient stochastique. En outre, à la suite de Nie et al. [27], afin d'améliorer la capacité de LLaDA à traiter des données de longueur variable, nous fixons des données de pré-entraînement à une longueur aléatoire tirée uniformément dans l'intervalle .
Nous avons adopté le planificateur de taux d'apprentissage Warmup-Stable-Decay [28] afin de suivre la progression de l'entraînement sans interrompre l'entraînement continu. Plus précisément, nous avons augmenté linéairement le taux d'apprentissage de 0 à sur les 2000 premières itérations et l'avons maintenu à . Après avoir traité 1,2T de tokens, nous avons réduit le taux d'apprentissage à et l'avons maintenu constant pour les 0,8T de tokens suivants afin d'assurer un entraînement stable. Enfin, nous avons réduit linéairement le taux d'apprentissage de à pour les 0,3T de tokens restants. Par ailleurs, nous avons utilisé l'optimiseur AdamW [29] avec un weight decay de 0,1, une taille de lot de 1280 et une taille de lot locale de 4 par GPU. L'expérience 8B a été exécutée une seule fois, sans aucun réglage d'hyperparamètres.
2.3 Apprentissage supervisé par ajustement fin
Nous améliorons la capacité de LLaDA à suivre des instructions par apprentissage supervisé par ajustement fin (SFT) avec des données appariées , où est l'invite et désigne la réponse. Il s'agit de la méthode post-entraînement la plus simple et la plus fondamentale pour les LLMs. Techniquement, cela nécessite de modéliser la distribution conditionnelle au lieu de lors du pré-entraînement.
L'implémentation est similaire à celle du pré-entraînement. Comme illustré à la Fig. 2, nous laissons l'invite inchangée et masquons les tokens de la réponse indépendamment, comme cela est fait pour . Ensuite, nous fournissons à la fois l'invite et la réponse masquée au prédicteur de masque pré-entraîné pour calculer la perte du SFT :
où désigne une longueur dynamique spécifiée plus loin, et toutes les autres notations restent les mêmes que précédemment. Notons que cette approche est entièrement compatible avec le pré-entraînement. Essentiellement, la concaténation de et peut être traitée comme des données de pré-entraînement propres , tandis que la concaténation de et sert de version masquée . Le processus est identique au pré-entraînement, la seule différence étant que tous les tokens masqués apparaissent dans la portion .
Le modèle LLaDA 8B subit un SFT sur un jeu de données comprenant 4,5 millions de paires. Conformément au processus de pré-entraînement, la préparation des données et l'entraînement suivent les protocoles SFT utilisés dans les LLMs existants [25] [26], sans introduire de techniques supplémentaires pour optimiser les performances de LLaDA. Le jeu de données couvre plusieurs domaines, notamment le code, les mathématiques et le suivi d'instructions. Nous ajoutons des tokens |EOS| à la fin des paires courtes dans chaque mini-lot pour garantir des longueurs égales sur toutes les données. Nous traitons |EOS| comme un token normal pendant l'entraînement et le supprimons lors de l'échantillonnage, ce qui permet à LLaDA de contrôler automatiquement la longueur de la réponse. Veuillez vous référer à l'Annexe B.1 pour plus de détails.
Nous entraînons pendant 3 époques sur les données SFT en utilisant un calendrier similaire à celui de la phase de pré-entraînement. Le taux d'apprentissage est augmenté linéairement de 0 à sur les 50 premières itérations, puis maintenu constant. Durant les finaux des itérations, il est réduit linéairement à . De plus, nous fixons la décroissance de poids à 0,1, la taille de lot globale à 256 et la taille de lot locale à 2 par GPU. L'expérience SFT a été exécutée une seule fois, sans aucun réglage des hyperparamètres.
2.4 Inférence
En tant que modèle génératif, LLaDA peut échantillonner de nouveaux textes et évaluer la vraisemblance d'un texte candidat de manière diffusion, plutôt que selon le mode autorégressif de gauche à droite.
Nous commençons par le processus de génération inverse. Comme illustré à la Fig. 2, étant donné une invite , nous discrétisons le processus inverse pour échantillonner à partir de la distribution du modèle , en partant d'une réponse entièrement masquée. Le nombre total d'étapes d'échantillonnage est un hyperparamètre, qui offre naturellement à LLaDA un compromis entre efficacité et qualité des échantillons, comme analysé à la Sec. [3.3]. Nous employons par défaut des pas de temps uniformément distribués. En outre, la longueur de génération est également traitée comme un hyperparamètre, spécifiant la longueur de la phrase entièrement masquée au début du processus d'échantillonnage. Après la génération, les tokens apparaissant après le token |EOS| sont écartés. Comme détaillé à l'Annexe [B.5], étant donné que le pré-entraînement et le SFT sont tous deux réalisés à l'aide de jeux de données à longueurs variables, les résultats finaux sont insensibles à cet hyperparamètre de longueur.
À une étape intermédiaire allant du temps à , nous fournissons à la fois et au prédicteur de masque et prédisons simultanément tous les tokens masqués. Par la suite, nous remasquons en espérance des tokens prédits pour obtenir , garantissant que la transition du processus inverse s'aligne sur le processus direct pour un échantillonnage précis [18] [20]. En principe, la stratégie de remasquage devrait être purement aléatoire. Cependant, inspirés par les astuces de recuit pour l'échantillonnage dans les LLMs [4] [30], nous adoptons une stratégie de remasquage à faible confiance, où des tokens prédits ayant la plus faible confiance sont remasqués sur la base des prédictions, de la même manière que l'approche de Chang et al. [23].
Nous mentionnons que LLaDA permet un échantillonnage flexible. En particulier, il prend en charge l'échantillonnage autorégressif et par diffusion par blocs [31] directement après les processus de pré-entraînement ou de SFT décrits ci-dessus, sans nécessiter de modifications ou d'entraînement supplémentaires. Nous fournissons une analyse détaillée à l'Annexe [B.4]. Néanmoins, l'échantillonnage par diffusion (c'est-à-dire le processus de génération inverse) produit les meilleures performances et est adopté par défaut tout au long de cet article, en particulier pour toutes les expériences présentées à la Sec. [3].
Pour l'évaluation de la vraisemblance conditionnelle, nous pouvons naturellement utiliser la borne supérieure de l'éq. [5]. Cependant, nous constatons que la forme équivalente suivante [20] présente une variance plus faible et est plus stable :
où est la longueur de séquence de , est uniformément échantillonné dans , et est obtenu en échantillonnant uniformément tokens de sans remplacement pour le masquage.
Nous présentons les algorithmes d'entraînement et d'inférence, ainsi que les détails théoriques, à l'Annexe [A].
3 Expériences
Nous évaluons les capacités de scalabilité, de suivi d'instructions et d'apprentissage en contexte de LLaDA sur des benchmarks standard, suivies d'analyses et d'études de cas pour fournir une évaluation complète.
3.1 Scalabilité de LLaDA sur les tâches linguistiques
Nous étudions d'abord la scalabilité de LLaDA sur des tâches en aval en comparaison avec les baselines ARM que nous avons construits. Plus précisément, à l'échelle 1B, nous nous sommes assurés que LLaDA et ARM partageaient la même architecture, les mêmes données et toutes les autres configurations. À des échelles plus grandes, nous rapportons également les résultats pour des modèles LLaDA et ARM de tailles légèrement différentes entraînés sur les mêmes données en raison de limitations de ressources. Veuillez vous référer à l'Annexe [B.2] pour plus de détails. Nous utilisons le coût computationnel du pré-entraînement comme métrique de scalabilité unifiée. Pour l'évaluation, nous nous sommes concentrés sur six tâches standard et diversifiées.
La Fig. 3 montre que LLaDA démontre une scalabilité impressionnante, avec une tendance globale hautement compétitive par rapport aux ARMs. Notably, sur des tâches telles que MMLU et GSM8K, LLaDA présente une scalabilité encore plus forte. Même sur des tâches relativement plus faibles comme PIQA, l'écart de performance avec les ARMs se réduit à mesure que l'échelle augmente. Pour tenir compte de l'influence des valeurs aberrantes, nous avons choisi de ne pas ajuster de courbes quantitatives, évitant ainsi toute interprétation erronée potentielle. Néanmoins, les résultats démontrent clairement la scalabilité de LLaDA.
Compte tenu des avantages de LLaDA sur certains benchmarks, nous émettons l'hypothèse que ce gain de performance découle d'une différence architecturale clé : alors que les modèles autorégressifs n'optimisent que les probabilités conditionnelles de gauche à droite, LLaDA est entraîné à considérer plusieurs directions de conditionnement, comme détaillé à l'Annexe [A.2], ce qui peut offrir une plus grande flexibilité et conduire à une meilleure généralisation. Cette hypothèse est motivée par les fortes performances de LLaDA sur le raisonnement inverse à la Sec. [3.3] et par les études d'ablation sur les stratégies d'échantillonnage à l'Annexe [B.4].
Nie et al. [27] suggèrent que le MDM nécessite 16 fois plus de calcul que l’ARM pour atteindre la même vraisemblance. Cependant, des différences clés rendent nos résultats plus largement applicables. En particulier, la vraisemblance est une métrique relativement indirecte pour la performance sur les tâches en aval, et la diffusion optimise une borne de la vraisemblance, ce qui la rend non directement comparable à l’ARM. De plus, nous avons étendu la plage de mise à l’échelle de FLOPs dans Nie et al. [27] à FLOPs dans ce travail.
3.2 Résultats de référence
Pour évaluer de manière exhaustive les capacités d’apprentissage en contexte et de suivi d’instructions de LLaDA 8B, nous avons mené des comparaisons détaillées avec des LLM existants [6,21,25,26,32,33] d’échelle similaire. La sélection des tâches et les protocoles d’évaluation ont suivi les études existantes, couvrant des benchmarks populaires dans les tâches générales, les mathématiques, le code et le chinois. Des détails supplémentaires sont fournis en annexe [B.6]. Pour une comparaison plus directe, nous avons réévalué des LLM représentatifs [6,21] dans notre implémentation.
Comme montré dans le Tab. [1], après un pré-entraînement sur 2,3T tokens, LLaDA 8B Base démontre des performances remarquables, surpassant LLaMA2 7B Base sur presque toutes les tâches, et est globalement compétitif avec LLaMA3 8B Base. LLaDA montre des avantages dans les tâches de mathématiques et de chinois. Nous conjecturons que ces
| Contexte de référence en lecture seule pour comprendre la source (ne constitue pas le texte source à traduire) : 3.2 Résultats du benchmark Comme le montre le Tab. [1], après un pré-entraînement sur 2,3 T de tokens, LLaDA 8B Base démontre des performances remarquables, surpassant LLaMA2 7B Base sur presque toutes les tâches, et est globalement compétitif avec LLaMA3 8B Base. LLaDA montre des avantages dans les tâches mathématiques et chinoises. Nous conjecturons que ces forces proviennent des mêmes facteurs que ses performances relativement plus faibles sur certaines tâches — des différences de qualité et de distribution des données, largement dues à la situation de source fermée de LL | Texte à traduire : | LLaDA 8B* | LLaMA3 8B* | LLaMA2 7B* | Qwen2 7B† | Qwen2.5 7B† | |
| Mistral 7B† | Deepseek 7B† | Tokens d’entraînement du modèle | Diffusion 2,3 T | AR 15 T | AR 2 T | AR 7 T | AR 18 T |
| AR - | |||||||
| AR 2 T | Tâches générales | MMLU | 65,9 (5) | 65,4 (5) | 45,9 (5) | 70,3 (5) | 74,2 (5) |
| 64,2 (5) | 48,2 (5) | BBH | 49,7 (3) | 62,1 (3) | 39,4 (3) | 62,3 (3) | 70,4 (3) |
| 56,1 (3) | 39,5 (3) | ARC-C | 45,9 (0) | 53,1 (0) | 46,3 (0) | 60,6 (25) | 63,7 (25) |
| 60,0 (25) | 48,1 (0) | Hellaswag | 70,5 (0) | 79,1 (0) | 76,0 (0) | 80,7 (10) | 80,2 (10) |
| 83,3 (10) | 75,4 (0) | TruthfulQA | 46,1 (0) | 44,0 (0) | 39,0 (0) | 54,2 (0) | 56,4 (0) |
| 42,2 (0) | - | WinoGrande | 74,8 (5) | 77,3 (5) | 72,5 (5) | 77,0 (5) | 75,9 (5) 78,4 (5) 70,5 (0) |
| PIQA | 73,6 (0) | 80,6 (0) | 79,1 (0) | - | - | - | 79,2 (0) |
| Mathématiques & Sciences | |||||||
| GSM8K | 70,3 (4) | 48,7 (4) | 13,1 (4) | 80,2 (4) | 85,4 (4) | 36,2 (4) | 17,4 (8) |
| Math | 31,4 (4) | 16,0 (4) | 4,3 (4) | 43,5 (4) | 49,8 (4) | 10,2 (4) | 6,0 (4) |
| GPQA | 25,2 (5) | 25,9 (5) | 25,7 (5) | 30,8 (5) | 36,4 (5) | 24,7 (5) | - |
| Code | |||||||
| HumanEval | 35,4 (0) | 34,8 (0) | 12,8 (0) | 51,2 (0) | 57,9 (0) | 29,3 (0) | 26,2 (0) |
| HumanEval-FIM | 73,8 (2) | 73,3 (2) | 26,9 (2) | - | - | - | - |
| MBPP | 40,0 (4) | 48,8 (4) | 23,2 (4) | 64,2 (0) | 74,9 (0) | 51,1 (0) | 39,0 (3) |
| Chinois | |||||||
| CMMLU | 69,9 (5) | 50,7 (5) | 32,5 (5) | 83,9 (5) | - | - | 47,2 (5) |
| C-Eval | 70,5 (5) | 51,7 (5) | 34,0 (5) | 83,2 (5) | - | - | 45,0 (5) |
| Contexte de référence en lecture seule pour comprendre la source (ne pas traduire) : 3.2 Résultats du benchmark Comme le montre le Tab. [1] après le pré-entraînement sur 2,3 T de tokens, LLaDA 8B Base démontre des performances remarquables, surpassant LLaMA2 7B Base sur presque toutes les tâches, et est globalement compétitif avec LLaMA3 8B Base. LLaDA montre des avantages dans les tâches mathématiques et chinoises. Nous conjecturons que ces forces proviennent des mêmes facteurs que ses performances relativement plus faibles dans certaines tâches — des différences dans la qualité et la distribution des données, largement dues à la situation de code fermé de LL Texte à traduire : | LLaDA 8B* | LLaMA3 8B* | LLaMA2 7B* | Qwen2 7B† | Qwen2.5 7B† | Gemma2 9B† | |
| Deepseek 7B† | Tokens d'entraînement du modèle | Diffusion 2,3 T | AR 15 T | AR 2 T | AR 7 T | AR 18 T | AR 8 T |
| AR 2 T | Paires d'alignement post-entraînement | SFT 4,5 M | SFT+RL - | SFT+RL - | SFT+RL 0,5 M + - | SFT+RL 1 M + 0,15 M - | SFT+RL - |
| SFT+RL 1,5 M + - | |||||||
| Tâches générales | MMLU | 65,5 (5) | 68,4 (5) | 44,1 (5) | - | - | - |
| 49,4 (0) | MMLU-pro | 37,0 (0) | 41,9 (0) | 4,6 (0) | 44,1 (5) | 56,3 (5) | 52,1 (5) |
| - | Hellaswag | 74,6 (0) | 75,5 (0) | 51,5 (0) | - | - | - |
| 68,5 (-) | ARC-C | 88,5 (0) | 82,4 (0) | 57,3 (0) | - | - | - |
| 49,4 (-) | |||||||
| Mathématiques & Sciences | GSM8K | 69,4 (4) | 78,3 (4) | 29,0 (4) | 85,7 (0) | 91,6 (0) 76,7 (0) | 63,0 (0) |
| Math | 31,9 (0) | 29,6 (0) | 3,8 (0) | 52,9 (0) | 75,5 (0) | 44,3 (0) | 15,8 (0) |
| GPQA | 33,3 (5) | 31,9 (5) | 28,4 (5) | 34,3 (0) | 36,4 (0) | 32,8 (0) | - |
| Code | |||||||
| HumanEval | 49,4 (0) | 59,8 (0) | 16,5 (0) | 79,9 (0) | 84,8 (0) | 68,9 (0) | 48,2 (-) |
| MBPP | 41,0 (4) | 57,6 (4) | 20,6 (4) | 67,2 (0) | 79,2 (0) | 74,9 (0) | 35,2 (-) |
points forts proviennent des mêmes facteurs que sa performance relativement plus faible dans certaines tâches — des différences de qualité et de distribution des données, largement dues à la situation en source fermée des jeux de données des LLM.
Notamment, nous avons soigneusement écarté la possibilité de fuite de données en prenant GSM8K comme exemple. Premièrement, comme montré dans la Fig. [3], LLaDA a surpassé les baselines ARM concernant GSM8K. De plus, la conclusion demeure sur une tâche de type GSM8K entièrement non vue [34] dans l’annexe B.8.
En outre, le Tab. [2] compare les performances de LLaDA 8B Instruct avec les LLM existants. Le SFT a amélioré les performances de LLaDA sur la plupart des tâches en aval. Quelques métriques, comme MMLU, ont montré des baisses, possiblement dues à la qualité sous-optimale des données de SFT. Globalement, comme nous n’avons pas effectué d’alignement
| Processus d'échantillonnage | |
| Utilisateur | Lily peut courir à 12 kilomètres par heure pendant 4 heures. Ensuite, elle court à 6 kilomètres par heure. Combien de kilomètres peut-elle parcourir en 8 heures ? |
| LLaDA | En 4 heures, Lily parcourt 12 * 4 = 48 kilomètres. Après 4 heures, elle parcourt 6 * 4 = 24 kilomètres. Au total, elle parcourt 48 + 24 = 72 kilomètres en 8 heures. Résultat : 72 |
| Cas de dialogue multi-tours | |
| Utilisateur | Pourriez-vous me partager les deux premiers vers du célèbre poème « The Road Not Taken » ? |
| LLaDA | Bien sûr ! Les deux premiers vers du célèbre poème « The Road Not Taken » de Robert Frost sont : « Two roads diverged in a yellow wood, And sorry I could not travel both. » Ces vers plantent le décor du poème, introduisant l'idée d'un locuteur confronté à un choix entre deux chemins. |
| Utilisateur | Veuillez m'aider à le traduire en chinois. |
| LLaDA | Bien sûr ! Les deux premiers vers de « The Road Not Taken » de Robert Frost peuvent être traduits en chinois ainsi : « 两条路分岔在黄色的树林中,遗憾我不能同时走 » |
| Utilisateur | Veuillez traduire en allemand. |
| LLaDA | Bien sûr ! Les deux premiers vers de « The Road Not Taken » de Robert Frost peuvent être traduits en allemand ainsi : « Zwei Wege trennten sich im gelben Wald, und leider konnte ich nicht beide tun. » |
| Utilisateur | Veuillez également écrire un poème sur les choix de vie. Je demande 5 phrases, et le premier mot de chaque phrase commence par la lettre C. |
| LLaDA | Bien sûr ! Voici un poème sur les choix de vie, où chaque phrase commence par la lettre « C » : Choices cascade through life's journey, Creating connections with each decision, Careful consideration leads to better paths, Courageous choices shape our destiny, Choosing wisely guides us through the years. |
par apprentissage par renforcement (RL), nos résultats sont légèrement en retrait par rapport à LLaMA3 8B Instruct, bien que les écarts sur de nombreuses métriques restent faibles. Notamment, même avec seulement du SFT, LLaDA démontre des capacités impressionnantes de suivi d’instructions, comme détaillé dans la Sec. [3.4]. Nous laissons l’alignement basé sur le RL pour des travaux futurs.
Tous les résultats de la Sec. [3] sont basés sur des méthodes de diffusion pure, car elles atteignent de meilleures performances globales que les approches incorporant des composantes autorégressives. Plus précisément, nous utilisons l’Eq. (6) pour l’estimation de la vraisemblance conditionnelle et appliquons le remasquage à faible confiance pour l’échantillonnage. Pour LLaDA 8B Instruct, l’échantillonnage de style diffusion par blocs performe mieux sur GSM8K et Math, avec des scores de 78,6 et 42,2, contre 69,4 et 31,9 dans le Tab. [2]. Ce gain est dû à un remplissage extensif par le token |EOS| dans les données de SFT, provoquant une terminaison précoce dans le remasquage à faible confiance. Veuillez vous référer à l’annexe [B.4] pour plus de détails.
Globalement, malgré l’absence de transparence des données, nous avons fait tous les efforts possibles pour adopter des procédures standardisées et introduire des tâches diversifiées ; nous pensons qu’elles démontrent suffisamment les capacités extraordinaires de LLaDA, qui est le seul modèle non autorégressif compétitif à notre connaissance.
3.3 Raisonnement inverse et analyses
Pour quantifier la capacité de raisonnement inverse [15] des modèles, nous suivons le protocole établi dans Allen-Zhu et Li [35]. Plus précisément, nous construisons un jeu de données de 496 paires de phrases issues de poèmes chinois célèbres. Étant donné une phrase d'un poème, les modèles sont chargés de générer la ligne suivante (sens direct) ou la ligne précédente (sens inverse) sans fine-tuning supplémentaire. Des exemples sont présentés dans la section [B.9]. Ce cadre offre une évaluation simple et plus réaliste par rapport aux études antérieures [27, 36].
Comme le montre le tab. [4], LLaDA traite efficacement la malédiction de l'inversion [15], démontrant des performances zero-shot cohérentes à la fois dans les tâches en sens direct et en sens inverse. En revanche, Qwen 2.5 et GPT-4o présentent tous deux un écart significatif entre les deux. Les résultats en génération directe confirment que les deux ARM sont performants, bénéficiant de jeux de données nettement plus vastes et de ressources computationnelles supérieures à celles de LLaDA. Cependant, LLaDA surpasse les deux avec une large marge dans la tâche inverse.
Nous n'avons rien conçu de spécifique pour les tâches inverses. Intuitivement, LLaDA traite les tokens de manière uniforme sans biais inductif, ce qui conduit à des performances équilibrées. Voir l'annexe A.2 pour plus de détails.
Nous analysons également l'effet de différentes stratégies d'échantillonnage pour LLaDA, notamment l'échantillonnage autorégressif, l'échantillonnage par diffusion par blocs [31] et l'échantillonnage par diffusion pure, montrant que l'échantillonnage par diffusion pure atteint les meilleures performances globales, comme détaillé dans l'annexe B.4.
| Avant | Inversion | |
| GPT-4o (2024-08-06) | 82,7 | 34,3 |
| Qwen2.5-7B Instruct | 75,9 | 38,0 |
| LLaDA-8B Instruct | 51,8 | 45,6 |
En outre, nous examinons la vitesse d'échantillonnage et la consommation mémoire de LLaDA, montrant qu'il permet un compromis flexible entre la qualité de génération et la vitesse. Voir l'annexe B.7 pour plus de détails.
Le guidage sans classifieur (CFG) [37] [27] est une technique largement utilisée dans les modèles de diffusion pour améliorer la qualité de génération. Pour garantir une comparaison équitable avec les ARM, nous n'appliquons pas le CFG à LLaDA dans le corps principal du texte. Cependant, nous montrons que LLaDA est compatible avec le CFG et bénéficie systématiquement de son application. Voir l'annexe B.3 pour plus de détails.
3.4 Études de cas
Nous présentons dans le tab. 3 des échantillons générés par LLaDA 8B Instruct illustrant ses capacités de suivi d'instructions. Premièrement, le tableau illustre la capacité de LLaDA à générer un texte cohérent, fluide et étendu de manière non autorégressive. Deuxièmement, il met en évidence la capacité de dialogue multi-tours du modèle, en retenant efficacement l'historique de la conversation et en produisant des réponses contextuellement appropriées dans plusieurs langues. De telles capacités conversationnelles de LLaDA sont impressionnantes, car il s'écarte pour la première fois des ARM conventionnels, à notre connaissance. Voir davantage d'études de cas dans l'annexe B.10.
4 Travaux connexes
Les modèles de diffusion [38,40] ont obtenu des succès remarquables dans les domaines visuels, mais restent non vérifiés pour la modélisation linguistique à grande échelle (par exemple, des modèles entraînés avec plus de FLOPs), malgré un intérêt croissant et d'importants efforts de recherche.
Une approche simple consiste à continuiser les données textuelles et à appliquer directement des modèles de diffusion continus [41-51]. Alternativement, certaines méthodes modélisent plutôt les paramètres continus de distributions discrètes [52-56]. Cependant, la scalabilité reste un défi majeur pour ces approches. Par exemple, un modèle de 1B peut nécessiter 64 fois le calcul d'un ARM pour atteindre des performances comparables [57].
Une autre approche remplace la diffusion continue par des processus discrets dotés de nouvelles dynamiques directes et inverses, conduisant à de nombreuses variantes [58,71]. L'article original sur les modèles de diffusion [38] a introduit à la fois des noyaux de transition à état continu et à état discret dans un cadre de diffusion unifié. Austin et al. [16] figurent parmi les travaux pionniers ayant introduit les modèles de diffusion discrets dans la modélisation linguistique, démontrant la faisabilité de cette approche. Lou et al. [17] ont montré que la diffusion masquée, en tant que cas particulier de la diffusion discrète, atteint une perplexité comparable ou supérieure aux ARM à l'échelle de GPT-2. Shi et al. [18], Sahoo et al. [19], Ou et al. [20] ont établi des résultats théoriques fondamentaux, qui ont motivé la conception, l'entraînement et l'inférence de notre modèle (voir l'annexe A pour plus de détails). Nie et al. [27] ont introduit les lois d'échelle pour les MDM en modélisation linguistique et exploré comment les MDM peuvent être exploités pour des tâches linguistiques telles que la réponse aux questions à l'échelle de GPT-2. Gong et al. [72] ont démontré le potentiel du fine-tuning d'un ARM dans le cadre des MDM. Cependant, les améliorations observées par Gong et al. [72] sont limitées à des métriques spécifiques, et leur approche ne traite pas des performances atteignables grâce à un entraînement purement basé sur la diffusion. Des travaux concurrents [73] démontrent le potentiel des modèles de langage de diffusion dans la génération de code et mettent en évidence leurs avantages en termes d'efficacité d'inférence. Néanmoins, s'agissant d'un produit à code fermé, les détails spécifiques tels que les procédures d'entraînement et les méthodes d'échantillonnage restent inconnus.
En comparaison, cette étude passe à l'échelle un MDM jusqu'à une taille sans précédent de 8B paramètres, entraîné from scratch, atteignant des performances comparables à celles de LLM de premier plan tels que LLaMA 3.
De plus, une ligne de travaux parallèle sur la génération d'images [23,74,75] s'aligne bien avec l'application des MDM aux données textuelles. Par ailleurs, les MDM ont également montré leur potentiel dans d'autres domaines tels que la génération de protéines [76][77], où ils ont obtenu des résultats prometteurs. Notamment, une série d'études [31][78][87] ont exploré des techniques telles que l'optimisation architecturale, la distillation et la conception d'algorithmes d'échantillonnage pour accélérer l'échantillonnage des MDM.
5 Conclusion et discussion
Nous introduisons LLaDA, un modèle de langage de diffusion entraîné from scratch avec une échelle sans précédent de 8B paramètres. LLaDA démontre de fortes capacités en matière de scalabilité, d'apprentissage en contexte et de suivi d'instructions, atteignant des performances comparables à celles de LLM puissants tels que LLaMA3. En outre, LLaDA offre des avantages uniques, tels que la modélisation bidirectionnelle et une robustesse accrue, répondant efficacement aux limitations pertinentes des LLM existants. Nos résultats montrent le potentiel des modèles de diffusion pour la modélisation linguistique à grande échelle et remettent en question l'hypothèse commune selon laquelle ces capacités essentielles sont intrinsèquement liées aux ARM. Ces résultats représentent un nouveau paradigme pour la modélisation linguistique et révèlent de nouvelles perspectives, démontrant un haut degré d'innovation scientifique.
Limitations. Bien que prometteur, le plein potentiel des modèles de diffusion reste à explorer. Plusieurs limitations de ce travail offrent des opportunités significatives pour de futures recherches. La longueur de génération est un hyperparamètre spécifié par l'utilisateur. Bien que LLaDA soit insensible à cet hyperparamètre comme détaillé dans l'annexe [B.5], nous pensons que l'adoption d'une longueur de génération adaptative offrirait une solution plus efficace. En raison de contraintes computationnelles, les comparaisons directes entre LLaDA et les ARM — telles que l'entraînement sur des jeux de données identiques — ont été restreintes à un budget computationnel inférieur à FLOPs. Afin d'allouer des ressources à l'entraînement du plus grand modèle LLaDA possible et de mettre en valeur son potentiel, nous n'avons pas pu passer à l'échelle la baseline ARM dans la même mesure. De plus, aucun mécanisme d'attention ou embedding de position spécialisé n'a été conçu pour LLaDA, et aucune optimisation architecturale au niveau système telle que le KV cache n'a été appliquée. Du côté de l'inférence, des algorithmes d'échantillonnage plus efficaces et contrôlables [37][88][89] restent préliminaires. En outre, LLaDA n'a pas encore fait l'objet d'un alignement par apprentissage par renforcement [90][91], ce qui est crucial pour améliorer ses performances et son alignement avec l'intention humaine.
À l'avenir, tant l'échelle du modèle que la quantité de données d'entraînement de LLaDA restent inférieures à celles des principaux homologues ARM [6][26][92][95], soulignant la nécessité d'une mise à l'échelle supplémentaire pour évaluer pleinement ses capacités. En outre, la capacité de LLaDA à traiter des données multimodales reste inexplorée. Son impact sur les techniques de prompt tuning [96] et son intégration dans des systèmes à base d'agents [97][98] ne sont pas encore pleinement compris. Enfin, une investigation systématique du post-entraînement pour LLaDA (par exemple, des systèmes de type O1 [99][100]) est nécessaire pour libérer davantage le potentiel des modèles de langage de diffusion.
Remerciements
Ce travail a été soutenu par la Fondation nationale des sciences naturelles de Chine (n° 92470118) ; la Fondation des sciences naturelles de Pékin (n° L247030) ; le programme Beijing Nova (n° 20220484044) ; et le Fonds de recherche d'Ant Group.
Références
[1] Wayne Xin Zhao, Kun Zhou, Junyi Li, Tianyi Tang, Xiaolei Wang, Yupeng Hou, Yingqian Min, Beichen Zhang, Junjie Zhang, Zican Dong, et al. A survey of large language models. arXiv preprint arXiv:2303.18223, 2023. [2] Alec Radford. Improving language understanding by generative pre-training, 2018. [3] Alec Radford, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, Ilya Sutskever, et al. Language models are unsupervised multitask learners. OpenAI blog, 1(8):9, 2019. [4] Tom B Brown. Language models are few-shot learners. arXiv preprint arXiv:2005.14165, 2020. [5] OpenAI. ChatGPT: Optimizing Language Models for Dialogue. OpenAI blog, novembre 2022. URL https://openai.com/blog/chatgpt/[6] Abhimanyu Dubey, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, Ahmad Al-Dahle, Aiesha Letman, Akhil Mathur, Alan Schelten, Amy Yang, Angela Fan, et al. The llama 3 herd of models. arXiv preprint arXiv:2407.21783, 2024.
[7] Ashish Vaswani. Attention is all you need. arXiv preprint arXiv:1706.03762, 2017.
[8] Ronald A Fisher. On the mathematical foundations of theoretical statistics. Philosophical transactions of the Royal Society of London. Series A, containing papers of a mathematical or physical character, 222(594-604):309-368, 1922.
[9] Fan Bao, Shen Nie, Kaiwen Xue, Yue Cao, Chongxuan Li, Hang Su et Jun Zhu. All are worth words: A vit backbone for diffusion models. Dans Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 22669-22679, 2023.
[10] William Peebles et Saining Xie. Scalable diffusion models with transformers. Dans Proceedings of the IEEE/CVF International Conference on Computer Vision, pages 4195-4205, 2023.
[11] Tim Brooks, Bill Peebles, Connor Holmes, Will DePue, Yufei Guo, Li Jing, David Schnurr, Joe Taylor, Troy Luhman, Eric Luhman, Clarence Ng, Ricky Wang et Aditya Ramesh. Video generation models as world simulators. 2024. URL https://openai.com/research/video-generation-models-as-world-simulators
[12] Gregoire Deletang, Anian Ruoss, Paul-Ambroise Duquenne, Elliot Catt, Tim Genewein, Christopher Mattern, Jordi Grau-Moya, Li Kevin Wenliang, Matthew Aitchison, Laurent Orseau, et al. Language modeling is compression. Dans The Twelfth International Conference on Learning Representations.
[13] Yuzhen Huang, Jinghan Zhang, Zifei Shan et Junxian He. Compression represents intelligence linearly. arXiv preprint arXiv:2404.09937, 2024.
[14] Claude Elwood Shannon. A mathematical theory of communication. The Bell system technical journal, 27(3):379-423, 1948.
[15] Lukas Berglund, Meg Tong, Max Kaufmann, Mikita Balesni, Asa Cooper Stickland, Tomasz Korbak et Owain Evans. The reversal curse: Llms trained on" a is b" fail to learn" b is a". arXiv preprint arXiv:2309.12288, 2023.
[16] Jacob Austin, Daniel D Johnson, Jonathan Ho, Daniel Tarlow et Rianne Van Den Berg. Modèles de diffusion de débruitage structurés dans des espaces d’états discrets. Advances in Neural Information Processing Systems, 34:17981-17993, 2021.
[17] Aaron Lou, Chenlin Meng et Stefano Ermon. Modélisation du langage par diffusion discrète en estimant les rapports de la distribution des données. Prépublication arXiv:2310.16834, 2023.
[18] Jiaxin Shi, Kehang Han, Zhe Wang, Arnaud Doucet et Michalis K Titsias. Diffusion masquée simplifiée et généralisée pour données discrètes. Prépublication arXiv:2406.04329, 2024.
[19] Subham Sekhar Sahoo, Marianne Arriola, Yair Schiff, Aaron Gokaslan, Edgar Marroquin, Justin T Chiu, Alexander Rush et Volodymyr Kuleshov. Modèles de langage à diffusion masquée simples et efficaces. Prépublication arXiv:2406.07524, 2024.
[20] Jingyang Ou, Shen Nie, Kaiwen Xue, Fengqi Zhu, Jiacheng Sun, Zhenguo Li et Chongxuan Li. Votre diffusion discrète absorbante modélise secrètement les distributions conditionnelles des données propres. Prépublication arXiv:2406.03736, 2024.
[21] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. Llama 2 : modèles de chat à fondation ouverte et affinés. Prépublication arXiv:2307.09288, 2023.
[22] Jacob Devlin. Bert : pré-entraînement de transformateurs bidirectionnels profonds pour la compréhension du langage. Prépublication arXiv:1810.04805, 2018.
[23] Huiwen Chang, Han Zhang, Lu Jiang, Ce Liu et William T Freeman. Maskgit : transformateur génératif d’images masqué. Dans Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 11315-11325, 2022.
[24] Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebron et Sumit Sanghai. Gqa : entraîner des modèles de transformateurs multi-requêtes généralisés à partir de points de contrôle multi-têtes. Dans Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, pages 4895-4901, 2023.
[25] An Yang, Baosong Yang, Binyuan Hui, Bo Zheng, Bowen Yu, Chang Zhou, Chengpeng Li, Chengyuan Li, Dayiheng Liu, Fei Huang, Guanting Dong, Haoran Wei, Huan Lin, Jialong Tang, Jialin Wang, Jian Yang, Jianhong Tu, Jianwei Zhang, Jianxin Ma, Jianxin Yang, Jin Xu, Jingren Zhou, Jinze Bai, Jinzheng He, Junyang Lin, Kai Dang, Keming Lu, Keqin Chen, Kexin Yang, Mei Li, Mingfeng Xue, Na Ni, Pei Zhang, Peng Wang, Ru Peng, Rui Men, Ruize Gao, Runji Lin, Shijie Wang, Shuai Bai, Sinan Tan, Tianhang Zhu, Tianhao Li, Tianyu Liu, Wenbin Ge, Xiaodong Deng, Xiaohuan Zhou, Xingzhang Ren, Xinyu Zhang, Xipin Wei, Xuancheng Ren, Xuejing Liu, Yang Fan, Yang Yao, Yichang Zhang, Yu Wan, Yunfei Chu, Yuqiong Liu, Zeyu Cui, Zhenru Zhang, Zhifang Guo et Zhihao Fan. Rapport technique Qwen2, 2024. URL https://arxiv.org/abs/2407.10671
[26] An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, Huan Lin, Jian Yang, Jianhong Tu, Jianwei Zhang, Jianxin Yang, Jiaxi Yang, Jingren Zhou, Junyang Lin, Kai Dang, Keming Lu, Keqin Bao, Kexin Yang, Le Yu, Mei Li, Mingfeng Xue, Pei Zhang, Qin Zhu, Rui Men, Runji Lin, Tianhao Li, Tingyu Xia, Xingzhang Ren, Xuancheng Ren, Yang Fan, Yang Su, Yichang Zhang, Yu Wan, Yuqiong Liu, Zeyu Cui, Zhenru Zhang et Zihan Qiu. Rapport technique Qwen2.5. Prépublication arXiv:2412.15115, 2024.
[27] Shen Nie, Fengqi Zhu, Chao Du, Tianyu Pang, Qian Liu, Guangtao Zeng, Min Lin et Chongxuan Li. Scaling up masked diffusion models on text. Préimpression arXiv arXiv:2410.18514, 2024.
[28] Shengding Hu, Yuge Tu, Xu Han, Chaoqun He, Ganqu Cui, Xiang Long, Zhi Zheng, Yewei Fang, Yuxiang Huang, Weilin Zhao, et al. Minicpm: Unveiling the potential of small language models with scalable training strategies. Préimpression arXiv arXiv:2404.06395, 2024.
[29] I Loshchilov. Decoupled weight decay regularization. Préimpression arXiv arXiv:1711.05101, 2017.
[30] Ari Holtzman, Jan Buys, Li Du, Maxwell Forbes et Yejin Choi. The curious case of neural text degeneration. Préimpression arXiv arXiv:1904.09751, 2019.
[31] Marianne Arriola, Aaron Gokaslan, Justin T Chiu, Zhihan Yang, Zhixuan Qi, Jiaqi Han, Subham Sekhar Sahoo et Volodymyr Kuleshov. Block diffusion: Interpolating between autoregressive and diffusion language models. Préimpression arXiv arXiv:2503.09573, 2025.
[32] Xiao Bi, Deli Chen, Guanting Chen, Shanhuang Chen, Damai Dai, Chengqi Deng, Honghui Ding, Kai Dong, Qiushi Du, Zhe Fu, et al. Deepseek llm: Scaling open- source language models with longtermism. Préimpression arXiv arXiv:2401.02954, 2024.
[33] Albert Q Jiang, Alexandre Sablayrolles, Arthur Mensch, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Florian Bressand, Gianna Lengyel, Guillaume Lample, Lucile Saulnier, et al. Mistral 7b. Préimpression arXiv arXiv:2310.06825, 2023.
[34] Tian Ye, Zicheng Xu, Yuanzhi Li et Zeyuan Allen- Zhu. Physics of Language Models: Part 2.1, Grade- School Math and the Hidden Reasoning Process. Préimpressions arXiv, abs/2407.20311, juillet 2024. Version complète disponible à l'adresse http://arxiv.org/abs/2407.20311
[35] Zeyuan Allen- Zhu et Yuanzhi Li. Physics of Language Models: Part 3.2, Knowledge Manipulation. Préimpressions arXiv, abs/2309.14402, septembre 2023. Version complète disponible à l'adresse http://arxiv.org/abs/2309.14402
[36] Ouaïl Kitouni, Niklas Nolte, Diane Bouchacourt, Adina Williams, Mike Rabbat et Mark Ibrahim. The factorization curse: Which tokens you predict underlie the reversal curse and more. Préimpression arXiv arXiv:2406.05183, 2024.
[37] Jonathan Ho et Tim Salimans. Classifier- free diffusion guidance. Préimpression arXiv arXiv:2207.12598, 2022.
[38] Jascha Sohl- Dickstein, Eric Weiss, Niru Maheswaranathan et Surya Ganguli. Deep unsupervised learning using nonequilibrium thermodynamics. Dans International conference on machine learning, pages 2256- 2265. PMLR, 2015.
[39] Jonathan Ho, Ajay Jain et Pieter Abbeel. Denoising diffusion probabilistic models. Advances in neural information processing systems, 33:6840- 6851, 2020.
[40] Yang Song, Jascha Sohl- Dickstein, Diederik P Kingma, Abhishek Kumar, Stefano Ermon et Ben Poole. Score- based generative modeling through stochastic differential equations. Préimpression arXiv arXiv:2011.13456, 2020.
[41] Xiang Li, John Thickstun, Ishaan Gulrajani, Percy S Liang et Tatsunori B Hashimoto. Diffusion- lm improves controllable text generation. Advances in Neural Information Processing Systems, 35:4328- 4343, 2022.
[42] Shansan Gong, Mukai Li, Jiangtao Feng, Zhiyong Wu et LingPeng Kong. Diffuseq: Sequence to sequence text generation with diffusion models. Préimpression arXiv arXiv:2210.08933, 2022.
[43] Xiaochuang Han, Sachin Kumar et Yulia Tsvetkov. Ssd- lm: Semi- autoregressive simplex- based diffusion language model for text generation and modular control. Préimpression arXiv arXiv:2210.17432, 2022.
[44] Robin Strudel, Corentin Tallec, Florent Altché, Yilun Du, Yaroslav Ganin, Arthur Mensch, Will Grathwohl, Nikolay Savinov, Sander Dieleman, Laurent Sifre, et al. Self- conditioned embedding diffusion for text generation. Préimpression arXiv arXiv:2211.04236, 2022.
[45] Ting Chen, Ruixiang Zhang et Geoffrey Hinton. Analog bits: Generating discrete data using diffusion models with self- conditioning. Préimpression arXiv arXiv:2208.04202, 2022.
[46] Sander Dieleman, Laurent Sartran, Arman Roshannai, Nikolay Savinov, Yaroslav Ganin, Pierre H Richemond, Arnaud Doucet, Robin Strudel, Chris Dyer, Conor Durkan, et al. Continuous diffusion for categorical data. Préimpression arXiv arXiv:2211.15089, 2022.
[47] Pierre H. Richemond, Sander Dieleman et Arnaud Doucet. Categorical sdes with simplex diffusion, 2022.
[48] Tong Wu, Zhihao Fan, Xiao Liu, Yeyun Gong, Yelong Shen, Jian Jiao, Hai- Tao Zheng, Juntao Li, Zhongyu Wei, Jian Guo, Nan Duan et Weizhu Chen. Ar- diffusion: Auto- regressive diffusion model for text generation, 2023.
[49] Rabeeh Karimi Mahabadi, Hamish Ivison, Jaesung Tae, James Henderson, Iz Beltagy, Matthew E. Peters et Arman Cohan. Tess: Text- to- text self- conditioned simplex diffusion, 2024.
[50] Jiasheng Ye, Zaixiang Zheng, Yu Bao, Lihua Qian et Mingxuan Wang. Dinoiser: Diffused conditional sequence learning by manipulating noises. Préimpression arXiv arXiv:2302.10025, 2023.
[51] Yizhe Zhang, Jiatao Gu, Zhuofeng Wu, Shuangfei Zhai, Joshua Susskind et Navdeep Jaitly. Planner: Generating diversified paragraph via latent language diffusion model. Advances in Neural Information Processing Systems, 36:80178- 80190, 2023.
[52] Aaron Lou et Stefano Ermon. Reflected diffusion models, 2023.
[53] Alex Graves, Rupesh Kumar Srivastava, Timothy Atkinson et Faustino Gomez. Bayesian flow networks. Préimpression arXiv arXiv:2308.07037, 2023.
[54] Zhenghao Lin, Yeyun Gong, Yelong Shen, Tong Wu, Zhihao Fan, Chen Lin, Nan Duan et Weizhu Chen. Text generation with diffusion language models: A pre- training approach with continuous paragraph denoise. Dans International Conference on Machine Learning, pages 21051- 21064. PMLR, 2023.
[55] Kaiwen Xue, Yuhao Zhou, Shen Nie, Xu Min, Xiaolu Zhang, Jun Zhou et Chongxuan Li. Unifying bayesian flow networks and diffusion models through stochastic differential equations. Préimpression arXiv arXiv:2404.15766, 2024.
[56] Ruixiang Zhang, Shuangfei Zhai, Yizhe Zhang, James Thornton, Zijing Ou, Joshua Susskind et Navdeep Jaitly. Target concrete score matching: A holistic framework for discrete diffusion. Préimpression arXiv arXiv:2504.16431, 2025.
[57] Ishaan Gulrajani et Tatsunori B Hashimoto. Likelihood- based diffusion language models. Advances in Neural Information Processing Systems, 36, 2024.
[58] Emiel Hoogeboom, Didrik Nielsen, Priyank Jaini, Patrick Forré et Max Welling. Argmax flows and multinomial diffusion: Learning categorical distributions. Advances in Neural Information Processing Systems, 34:12454- 12465, 2021.
[59] Emiel Hoogeboom, Alexey A Gritsenko, Jasmijn Bastings, Ben Poole, Rianne van den Berg et Tim Salimans. Autoregressive diffusion models. arXiv preprint arXiv:2110.02037, 2021.
[60] Zhengfu He, Tianxiang Sun, Kuanning Wang, Xuanjing Huang et Xipeng Qiu. Diffusion-bert : Improving generative masked language models with diffusion models. arXiv preprint arXiv:2211.15029, 2022.
[61] Andrew Campbell, Joe Benton, Valentin De Bortoli, Thomas Rainforth, George Deligiannidis et Arnaud Doucet. A continuous time framework for discrete denoising models. Advances in Neural Information Processing Systems, 35:28266-28279, 2022.
[62] Chenlin Meng, Kristy Choi, Jiaming Song et Stefano Ermon. Concrete score matching : Generalized score matching for discrete data. Advances in Neural Information Processing Systems, 35:34532-34545, 2022.
[63] Machel Reid, Vincent J. Hellendoorn et Graham Neubig. Diffuser : Discrete diffusion via edit-based reconstruction, 2022.
[64] Haoran Sun, Lijun Yu, Bo Dai, Dale Schuurmans et Hanjun Dai. Score-based continuous-time discrete diffusion models. arXiv preprint arXiv:2211.16750, 2022.
[65] Ouaif Kitouni, Niklas Nolte, James Hensman et Bhaskar Mitra. Disk : A diffusion model for structured knowledge. arXiv preprint arXiv:2312.05253, 2023.
[66] Lin Zheng, Jianbo Yuan, Lei Yu et Lingpeng Kong. A reparameterized discrete diffusion model for text generation. ArXiv, abs/2302.05737, 2023.
[67] Zixiang Chen, Huizhuo Yuan, Yongqian Li, Yiwen Kou, Junkai Zhang et Quanquan Gu. Fast sampling via de-randomization for discrete diffusion models. arXiv preprint arXiv:2312.09193, 2023.
[68] Jiasheng Ye, Zaixiang Zheng, Yu Bao, Lihua Qian et Quanquan Gu. Diffusion language models can perform many tasks with scaling and instruction-finetuning. arXiv preprint arXiv:2308.12219, 2023.
[69] Itai Gat, Tal Remez, Neta Shaul, Felix Kreuk, Ricky TQ Chen, Gabriel Synnaeve, Yossi Adi et Yaron Lipman. Discrete flow matching. arXiv preprint arXiv:2407.15595, 2024.
[70] Kaiwen Zheng, Yongxin Chen, Hanzi Mao, Ming-Yu Liu, Jun Zhu et Qinsheng Zhang. Masked diffusion models are secretly time-agnostic masked models and exploit inaccurate categorical sampling, 2024. URL https://arxiv.org/abs/2409.02908
[71] Shreyas Kapur, Erik Jenner et Stuart Russell. Diffusion on syntax trees for program synthesis. arXiv preprint arXiv:2405.20519, 2024.
[72] Shansan Gong, Shivam Agarwal, Yizhe Zhang, Jiacheng Ye, Lin Zheng, Mukai Li, Chenxin An, Peilin Zhao, Wei Bi, Jiawei Han, et al. Scaling diffusion language models via adaptation from autoregressive models. arXiv preprint arXiv:2410.17891, 2024.
[73] Samar Khanna, Siddhant Kharbanda, Shufan Li, Harshit Varma, Eric Wang, Sawyer Birnbaum, Ziyang Luo, Yanis Miraoui, Akash Palrecha, Stefano Ermon, et al. Mercury: Ultra-fast language models based on diffusion. arXiv preprint arXiv:2506.17298, 2025.
[74] Huiwen Chang, Han Zhang, Jarred Barber, AJ Maschinot, Jose Lezama, Lu Jiang, Ming-Hsuan Yang, Kevin Murphy, William T Freeman, Michael Rubinstein, et al. Muse: Text-to-image generation via masked generative transformers. arXiv preprint arXiv:2301.00704, 2023.
[75] Zebin You, Jingyang Ou, Xiaolu Zhang, Jun Hu, Jun Zhou et Chongxuan Li. Effective and efficient masked image generation models. arXiv preprint arXiv:2503.07197, 2025.
[76] Xinyou Wang, Zaixiang Zheng, Fei Ye, Dongyu Xue, Shujian Huang et Quanquan Gu. Diffusion language models are versatile protein learners. arXiv preprint arXiv:2402.18567, 2024.
[77] Xinyou Wang, Zaixiang Zheng, Fei Ye, Dongyu Xue, Shujian Huang et Quanquan Gu. Dplm-2: A multimodal diffusion protein language model. arXiv preprint arXiv:2410.13782, 2024.
[78] Siqi Kou, Lanxiang Hu, Zhezhi He, Zhijie Deng et Hao Zhang. Clims: Consistency large language models. arXiv preprint arXiv:2403.00835, 2024.
[79] Chenkai Xu, Xu Wang, Zhenyi Liao, Yishun Li, Tianqi Hou et Zhijie Deng. Show-o turbo: Towards accelerated unified multimodal understanding and generation. arXiv preprint arXiv:2502.05415, 2025.
[80] Sulin Liu, Juno Nam, Andrew Campbell, Hannes Stärk, Yilun Xu, Tommi Jaakkola et Rafael Gómez-Bombarelli. Think while you generate: Discrete diffusion with planned denoising. arXiv preprint arXiv:2410.06264, 2024.
[81] Yuanzhi Zhu, Xi Wang, Stéphane Lathuilière et Vicky Kalogeiton. Dimo: Distilling masked diffusion models into one-step generator. arXiv preprint arXiv:2503.15457, 2025.
[82] Yinuo Ren, Haoxuan Chen, Yuchen Zhu, Wei Guo, Yongxin Chen, Grant M Rotskoff, Molei Tao et Lexing Ying. Fast solvers for discrete diffusion models: Theory and applications of high-order algorithms. arXiv preprint arXiv:2502.00234, 2025.
[83] Satoshi Hayakawa, Yuhta Takida, Masaaki Imaizumi, Hiromi Wakaki et Yuki Mitsufuji. Distillation of discrete diffusion through dimensional correlations. arXiv preprint arXiv:2410.08709, 2024.
[84] Yixiu Zhao, Jiaxin Shi, Feng Chen, Shaul Druckmann, Lester Mackey et Scott Linderman. Informed correctors for discrete diffusion models. arXiv preprint arXiv:2407.21243, 2024.
[85] Kaiwen Zheng, Yongxin Chen, Hanzi Mao, Ming-Yu Liu, Jun Zhu et Qinsheng Zhang. Masked diffusion models are secretly time-agnostic masked models and exploit inaccurate categorical sampling. arXiv preprint arXiv:2409.02908, 2024.
[86] Yong-Hyun Park, Chieh-Hsin Lai, Satoshi Hayakawa, Yuhta Takida et Yuki Mitsufuji. Jump your steps: Optimizing sampling schedule of discrete diffusion models. In The Thirteenth International Conference on Learning Representations, 2024.
[87] Justin Deschenaux et Caglar Gulcehre. Beyond autoregression: Fast llms via self-distillation through time. arXiv preprint arXiv:2410.21035, 2024.
[88] Prafulla Dhariwal et Alexander Nichol. Diffusion models beat gans on image synthesis. Advances in neural information processing systems, 34:8780-8794, 2021.
[89] Yair Schiff, Subham Sekhar Sahoo, Hao Phung, Guanghan Wang, Sam Boshar, Hugo Dallatorre, Bernardo P de Almeida, Alexander Rush, Thomas Pierrot et Volodymyr Kuleshov. Simple guidance mechanisms for discrete diffusion models. arXiv preprint arXiv:2412.10193, 2024.
[90] Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, et al. Training language models to follow instructions with human feedback. Advances in neural information processing systems, 35:27730-27744, 2022.
[91] Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D Manning, Stefano Ermon et Chelsea Finn. Direct preference optimization: Your language model is secretly a reward model. Advances in Neural Information Processing Systems, 36, 2024.
[92] Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. Gpt-4 technical report. arXiv preprint arXiv:2303.08774, 2023.
[93] Google. Our next-generation model: Gemini 1.5, 2024. URL https://blog.google/technology/ai/google-gemini-next-generation-model-february-2024
[94] Anthropic. Claude 3.5 sonnet, 2024. URL https://www.anthropic.com/news/claude-3-5-sonnet
[95] Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang, Bochao Wu, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chenyu Zhang, Chong Ruan, et al. Deepseek-v3 technical report. arXiv preprint arXiv:2412.19437, 2024.
[96] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed Chi, Quoc V Le, Denny Zhou, et al. Chain-of-thought prompting elicits reasoning in large language models. Advances in neural information processing systems, 35:24824-24837, 2022.
[97] Joon Sung Park, Joseph O'Brien, Carrie Jun Cai, Meredith Ringel Morris, Percy Liang et Michael S Bernstein. Generative agents: Interactive simulacra of human behavior. In Proceedings of the 36th annual acm symposium on user interface software and technology, pages 1-22, 2023.
[98] Lei Wang, Chen Ma, Xueyang Feng, Zeyu Zhang, Hao Yang, Jingsen Zhang, Zhiyuan Chen, Jiakai Tang, Xu Chen, Yankai Lin, et al. A survey on large language model based autonomous agents. Frontiers of Computer Science, 18(6):186345, 2024.
[99] OpenAI. Learning to reason with llms, 2024. URL https://openai.com/index/learning- to- reason- with- llms/
[100] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
[101] Benigno Uria, Iain Murray, et Hugo Larochelle. A deep and tractable density estimator. In Proceedings of the 31th International Conference on Machine Learning, 2014.
[102] Andy Shih, Dorsa Sadigh, et Stefano Ermon. Training and inference on any- order autoregressive models the right way. In Proceedings of the 31th International Conference on Machine Learning, 2022.
[103] Zhangchen Xu, Fengqing Jiang, Luyao Niu, Yuntian Deng, Radha Poovendran, Yejin Choi, et Bill Yuchen Lin. Magpie: Alignment data synthesis from scratch by prompting aligned llms with nothing. arXiv preprint arXiv:2406.08464, 2024.
[104] Yuxiang Wei, Zhe Wang, Jiawei Liu, Yifeng Ding, et Lingming Zhang. Magicoder: Empowering code generation with oss- instruct. arXiv preprint arXiv:2312.02120, 2023.
[105] Biao Zhang et Rico Sennrich. Root mean square layer normalization. Advances in Neural Information Processing Systems, 32, 2019.
[106] Noam Shazeer. Les variantes de GLU améliorent le Transformer. arXiv preprint arXiv:2002.05202, 2020.
[107] Jianlin Su, Murtadha Ahmed, Yu Lu, Shengfeng Pan, Wen Bo et Yunfeng Liu. Roformer : Transformer amélioré avec intégration de position rotative. Neurocomputing, 568:127063, 2024.
[108] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu et Dario Amodei. Lois d'échelle pour les modèles de langage neuronaux. arXiv preprint arXiv:2001.08361, 2020.
.
[109] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, et al. Entraînement de grands modèles de langage à budget de calcul optimal. arXiv preprint arXiv:2203.15556, 2022.
[110] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song et Jacob Steinhardt. Mesurer la compréhension massivement multitâche du langage. arXiv preprint arXiv:2009.03300, 2020.
[111] Mirac Suzgun, Nathan Scales, Nathanael Schärli, Sebastian Gehrmann, Yi Tay, Hyung Won Chung, Aakanksha Chowdhery, Quoc V Le, Ed H Chi, Denny Zhou, et al. Défier les tâches Big-Bench et déterminer si la chaîne de pensée peut les résoudre. arXiv preprint arXiv:2210.09261, 2022.
[112] Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick et Oyvind Tafjord. Vous pensez avoir résolu la question-réponse ? essayez arc, le défi de raisonnement ai2. arXiv preprint arXiv:1803.05457, 2018.
[113] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi et Yejin Choi. Hellaswag : une machine peut-elle vraiment terminer votre phrase ? arXiv preprint arXiv:1905.07830, 2019.
[114] Stephanie Lin, Jacob Hilton et Owain Evans. Truthfulqa : mesurer comment les modèles imitent les faussetés humaines. arXiv preprint arXiv:2109.07958, 2021.
[115] Keisuke Sakaguchi, Ronan Le Bras, Chandra Bhagavatula et Yejin Choi. Winogrande : un défi de schéma de Winograd adversarial à grande échelle. Communications of the ACM, 64(9):99-106, 2021.
[116] Yonatan Bisk, Rowan Zellers, Jianfeng Gao, Yejin Choi, et al. Piqa : raisonner sur le bon sens physique en langage naturel. In Proceedings of the AAAI conference on artificial intelligence, 2020.
[117] Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, et al. Entraîner des vérificateurs pour résoudre des problèmes mathématiques sous forme de mots. arXiv preprint arXiv:2110.14168, 2021.
[118] Dan Hendrycks, Collin Burns, Saurav Kadavath, Akul Arora, Steven Basart, Eric Tang, Dawn Song et Jacob Steinhardt. Mesurer la résolution de problèmes mathématiques avec le jeu de données math. arXiv preprint arXiv:2103.03874, 2021.
[119] David Rein, Betty Li Hou, Asa Cooper Stickland, Jackson Petty, Richard Yuanzhe Pang, Julien Dirani, Julian Michael et Samuel R Bowman. Gpqa : un benchmark de questions-réponses de niveau diplômé, à l'épreuve de Google. arXiv preprint arXiv:2311.12022, 2023.
[120] Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde De Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, et al. Évaluer les grands modèles de langage entraînés sur du code. arXiv preprint arXiv:2107.03374, 2021.
[121] Mohammad Bavarian, Heewoo Jun, Nikolas Tezak, John Schulman, Christine McLeavey, Jerry Tworek et Mark Chen. Entraînement efficace des modèles de langage pour remplir le milieu. arXiv preprint arXiv:2207.14255, 2022.
[122] Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le, et al. Synthèse de programmes avec de grands modèles de langage. arXiv preprint arXiv:2108.07732, 2021.
[123] Haonan Li, Yixuan Zhang, Fajri Koto, Yifei Yang, Hai Zhao, Yeyun Gong, Nan Duan et Timothy Baldwin. Cmmlu : mesurer la compréhension massivement multitâche du langage en chinois. arXiv preprint arXiv:2306.09212, 2023.
[124] Yuzhen Huang, Yuzhuo Bai, Zhihao Zhu, Junlei Zhang, Jinghan Zhang, Tangjun Su, Junteng Liu, Chuancheng Lv, Yikai Zhang, Yao Fu, et al. C-eval : une suite d'évaluation chinoise multi-niveaux et multidisciplinaire pour les modèles de fondation. Advances in Neural Information Processing Systems, 36, 2024.
[125] Leo Gao, Jonathan Tow, Baber Abbasi, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Alain Le Noac'h, Haonan Li, Kyle McDonell, Niklas Muennighoff, Chris Ociepa, Jason Phang, Laria Reynolds, Hailey Schoelkopf, Aviya Skowron, Lintang Sutawika, Eric Tang, Anish Thite, Ben Wang, Kevin Wang et Andy Zou. Un cadre pour l'évaluation de modèles de langage en few-shot, 07 2024. URL https://zenodo.org/records/12608602
Algorithme 1 Pré-entraînement de LLaDA
Require : prédicteur de masque , distribution des données
1: repeat
2: # avec une probabilité de , la longueur de séquence de suit U[1, 4096]
3:
4: # est défini dans l'éq. (7)
5: Calculer # est la longueur de séquence de
6: Calculer et exécuter l'optimiseur.
7: until Convergence
8: Return
Algorithme 2 Ajustement supervisé fin de LLaDA
Require : prédicteur de masque , distribution des données par paires
1: repeat
2: # veuillez vous référer à l'annexe B.1 pour plus de détails sur les données SFT
3:
4: # est défini dans l'éq. (7)
5 : Calculer # est la longueur de séquence de
6 : Calculer et exécuter l'optimiseur.
7 : jusqu'à convergence
8 : Retourner
Algorithme 3 Évaluation de la log-vraisemblance conditionnelle de LLaDA
Exigence : prédicteur de masque , invite , réponse , le nombre d'estimations de Monte Carlo
1 : log_likelihood
2 : pour à faire
3 : # est la longueur de séquence de
4 : Obtenir en échantillonnant uniformément jetons de sans remplacement pour le masquage
5 :
6 : fin pour
7 : log_likelihood
8 : Retourner log_likelihood
A Formulation des modèles de diffusion masqués
A.1 Entraînement
Les MDM [16|20] définissent la distribution du modèle d'une manière distincte des modèles autorégressifs.
Ces modèles introduisent un processus direct indexé par un temps . Ce processus masque progressivement et indépendamment tous les jetons de la séquence . Au temps , le point de données est entièrement observé sans masques, tandis que pour , représente des variables latentes avec des ratios de masque variables en espérance.
Formellement, la distribution conditionnelle de étant donné est définie par une forme entièrement factorisée :
où la distribution conditionnelle pour chaque token est donnée par :
Ici, M désigne le token de masque. Intuitivement, chaque token soit reste inchangé, soit est masqué, la probabilité d'être masqué augmentant linéairement à mesure que progresse de 0 à 1. À , tous
Require: prédicteur de masque , prompt , longueur de réponse , étapes d'échantillonnage 1: Initialiser comme une séquence entièrement masquée de longueur . 2: for jusqu'à pas do 3: 4: # nous employons un échantillonnage glouton lors de la prédiction des tokens masqués 5: for à do 6: if then 7: 8: else 9: avec probabilité , est mis à 10: end if 11: end for 12: 13: end for 14: Return les tokens sont garantis d'être masqués, ce qui signifie que suit une distribution de Dirac concentrée sur une séquence de tokens entièrement masqués. Notamment, la probabilité de masquage linéaire est analogue, mais distincte, au calendrier de bruit dans les modèles de diffusion continus [38,40]. Cette linéarité est motivée par l'hypothèse que l'information dans le texte est proportionnelle au nombre de tokens en moyenne, ce qui rend raisonnable de perdre l'information linéairement durant le processus direct.
Le processus direct est non seulement réversible, mais correspond aussi à un processus inverse entièrement factorisé sur tous les tokens. Le processus inverse, de l'instant à 0, génère de nouvelles données à partir de séquences de tokens entièrement masqués. La distribution conditionnelle pour le processus inverse, pour , est factorisée comme :
où la distribution conditionnelle pour chaque token est :
Ainsi, la fonction clé à estimer est la distribution conditionnelle , qui prédit le token d'origine s'il est masqué dans l'entrée . Cela est analogue à la forme de prédiction de données dans les modèles de diffusion continus.
Comme démontré dans [20], une paramétrisation équivalente mais indépendante du temps peut être dérivée comme :
où désigne la collection de tokens non masqués dans , qui est identique aux tokens correspondants dans les données d'origine puisque les tokens non masqués sont uniquement déterminés par et sont indépendants du temps . Intuitivement, cela implique qu'estimer la fonction de prédiction de données équivaut à estimer les distributions conditionnelles sur les données propres, ce qui est invariant dans le temps. Par conséquent, le temps n'a pas besoin d'être fourni en entrée au modèle paramétrique.
Bien que le développement de la diffusion masquée soit non trivial, l'implémentation est simple. Nous introduisons d'abord le prédicteur de masque, un modèle paramétrique (par exemple, un Transformer sans masque causal), qui prend pour tout en entrée et prédit simultanément tous les tokens masqués. Ensuite, nous définissons la distribution du modèle comme suit : en partant de comme une séquence de tokens entièrement masqués, nous simulons un processus inverse approximatif paramétré par de à 0. La distribution marginale induite à représente alors la distribution du modèle .
Require: prédicteur de masque , prompt , longueur de réponse , étapes d'échantillonnage
1: Initialiser comme une séquence entièrement masquée de longueur .
2: for jusqu'à pas do
3:
4: for à do
5: if then
6:
7: else
8 :
9 :
10 : fin si
11 : fin pour
12 : # le nombre de jetons non masqués est au pas de temps
13 : pour à faire
14 : si alors
15 : # les positions ayant la plus faible confiance sont sélectionnées pour être remasquées.
16 : fin si
17 : fin pour
18 :
19 : fin pour
20 : Retourner
Formellement, le prédicteur de masque est entraîné à l'aide d'une perte d'entropie croisée avec masquage :
où est échantillonné à partir des données d'entraînement, est échantillonné uniformément dans , et est échantillonné à partir de . La fonction indicatrice garantit que la perte d'entropie croisée n'est calculée que pour les jetons masqués. Dans Shi et al. [18], Sahoo et al. [19], Ou et al. [20], il a été prouvé que la fonction de perte est une borne supérieure de la log-vraisemblance négative de la distribution du modèle :
En résumé, cette approche fondée sur des principes entraîne un modèle génératif en masquant progressivement des jetons au cours d'un processus direct et en apprenant à récupérer la distribution des données au cours d'un processus inverse, le tout dans le cadre (approximatif) de l'estimation par maximum de vraisemblance.
A.2 Inférence
La perte d'entropie croisée de l'éq. [12] possède plusieurs formes équivalentes [20]. La première est donnée par
où est échantillonné uniformément dans , et est obtenu en échantillonnant uniformément jetons de sans remise pour le masquage. Bien que le masquage d'exactement jetons diffère du masquage de chaque jeton indépendamment avec une probabilité , ces deux méthodes de masquage conduisent à des résultats équivalents en espérance [20].
Les modèles autorégressifs d'ordre quelconque (AO- ARM) [59][101][102] caractérisent la distribution conjointe de manière autorégressive pour tous les ordres possibles des variables. Pour apprendre une telle distribution, un AO- ARM utilise un réseau de neurones à partage de poids pour modéliser toutes les conditionnelles univariées et emploie des jetons de masque pour représenter les variables absentes. Pendant l'entraînement, la log-vraisemblance négative attendue sur la distribution uniforme de tous les ordres est minimisée :
Intuitivement, peut être compris comme un jeton masqué dont l'indice dans est masqué. On peut en outre prouver que l'éq. (15) est équivalente à l'éq. (12). Ce lien explique les capacités de raisonnement bidirectionnel de LLaDA, même si cela n'a jamais été utilisé explicitement dans la procédure d'inférence.
En outre, Nie et al. [27] introduit le guidage sans classifieur non supervisé (CFG), une technique prête à l'emploi qui équilibre l'alignement avec les invites et la diversité du texte. Plus précisément, le CFG non supervisé emploie le prédicteur de masque modifié suivant pour l'inférence :
où est une séquence de masque de même longueur que et est un hyperparamètre ajustable qui contrôle la force de . Pour garantir une comparaison équitable avec les ARM, nous n'appliquons pas le CFG à LLaDA dans le corps du texte. Cependant, comme démontré dans l'annexe [B.3], LLaDA est pleinement compatible avec le CFG et présente systématiquement des performances améliorées lorsqu'il est appliqué.
A.3 Algorithmes
Dans cette section, nous présentons les algorithmes d'entraînement et d'inférence. Plus précisément, nous introduisons les algorithmes de pré-entraînement et d'affinage supervisé dans respectivement l'algorithme [1] et l'algorithme [2]. En outre, l'algorithme d'évaluation de la vraisemblance est fourni dans l'algorithme [3]. Enfin, nous présentons le processus de génération inverse dans l'algorithme [4] et l'algorithme [5], qui correspondent respectivement à la stratégie de remasquage aléatoire et à la stratégie de remasquage par faible confiance [23].
B Expériences
B.1 Collecte et prétraitement des données
Dans cette section, nous présentons d'abord les processus de collecte et de filtrage des données pour le pré-entraînement et le SFT. Nous décrivons ensuite comment LLaDA exploite ces jeux de données pendant l'entraînement.
Notre corpus de pré-entraînement est construit à partir de diverses sources publiquement disponibles, notamment des données web, des livres, des articles universitaires, des médias sociaux, des encyclopédies, des mathématiques et du code, avec environ de chinois, d'anglais et de code. Le processus de nettoyage des données comprend l'extraction de texte à partir de PDF, la déduplication et le filtrage des contenus nuisibles. Pour garantir davantage la qualité, nous affinons un modèle BERT [22] pour l'annotation automatisée de la qualité des données, permettant ainsi la sélection d'échantillons de meilleure qualité. Notre jeu de données SFT comprend 1 million d'échantillons annotés par des humains et 3,5 millions d'échantillons synthétiques, générés à l'aide de méthodes similaires à celles proposées par Xu et al. [103], Wei et al. [104].
Nous concaténons les documents collectés dans le corpus de pré-entraînement et segmentons le texte en séquences de longueur fixe selon la longueur de séquence prédéfinie.
Pour le SFT, une stratégie de longueur de séquence dynamique est employée, où des tokens |EOS| sont ajoutés à la fin des paires plus courtes afin de garantir des longueurs de séquence uniformes pour tous les échantillons au sein de chaque mini-batch. Notamment, les tokens |EOS| de remplissage sont traités comme faisant partie de la réponse, c'est-à-dire masqués et inclus dans l'objectif d'entraînement. Les tokens |EOS| sont supprimés des sorties générées lors de l'échantillonnage. Cette stratégie garantit que le modèle apprend à contrôler la longueur de ses réponses en générant |EOS|, permettant ainsi à la longueur de la réponse de s'aligner efficacement sur l'invite donnée.
En outre, pour un dialogue à tours , nous le traitons comme paires de dialogues à un seul tour, c'est-à-dire , et nous en échantillonnons une au hasard. Cette stratégie de partitionnement des données dote non seulement LLaDA de capacités de dialogue multi-tours, mais s'aligne également sur la stratégie de remplissage par |EOS| décrite ci-dessus.
| Notre ARM Baseline 1B | LLaDA 1B | Notre ARM Baseline 7B | LLaDA 8B | LLaMA3 8B | |
| Couches | 22 | 22 | 28 | 32 | 32 |
| Dimension du modèle | 2048 | 2048 | 4096 | 4096 | 4096 |
| Têtes d'attention | 32 | 32 | 32 | 32 | 32 |
| Taille du vocabulaire | 126,464 | 126,464 | 126,464 | 126,464 | 128,000 |
| Dimension FFN | 5634 | 5634 | 13,440 | 12,288 | 14,336 |
| Têtes clé/valeur | 4 | 4 | 8 | 32 | 8 |
| Paramètres totaux | 1,49 B | 1,49 B | 6,83 B | 8,02 B | 8,03 B |
| Paramètres hors embeddings | 0,97 B | 0,97 B | 5,80 B | 6,98 B | 6,98 B |
| ARC-C | Hellaswag | TruthfulQA | WinoGrande | GPQA | PIQA | |
| sans CFG | 45,9 | 70,5 | 46,1 | 74,8 | 25,2 | 73,6 |
| avec CFG | 47,9 | 72,5 | 46,4 | 74,8 | 26,1 | 74,4 |
B.2 Détails sur l'entraînement du modèle
Cette section fournit les détails d'entraînement de LLaDA et des ARM de référence correspondants.
Premièrement, pour des raisons d'efficacité, nous avons entraîné un ARM et un MDM, tous deux avec 1,5 milliard de paramètres et des architectures identiques. De plus, nous avons étendu le MDM à 8 milliards de paramètres. En raison de contraintes de ressources de calcul, nous n'avons pas entraîné de modèle autorégressif de 8 milliards de paramètres avec la même architecture. À la place, nous avons utilisé notre modèle autorégressif de 7 milliards de paramètres précédemment entraîné pour la comparaison. Ces quatre modèles sont utilisés dans l'analyse de passage à l'échelle de la section [3.1].
Nous avons adopté une architecture Transformer similaire à LLaMA [6] [21] pour les ARM et les MDM que nous avons entraînés. Plus précisément, nous employons RMSNorm [105] pour stabiliser l'entraînement, utilisons SwiGLU [106] comme fonction d'activation pour renforcer la non-linéarité, et intégrons RoPE [107] pour un encodage positionnel plus expressif. Le tableau [5] fournit un aperçu des architectures des modèles.
Pour les ARM de référence de 1 milliard et 7 milliards de paramètres, ainsi que pour les modèles LLaDA de 1 milliard et 8 milliards de paramètres, nous avons utilisé l'optimiseur AdamW [29] avec une décroissance de poids de 0,1 et adopté le planificateur de taux d'apprentissage Warmup-Stable-Decay [28]. Le taux d'apprentissage a été augmenté linéairement de 0 à la valeur maximale au cours des 2000 premières itérations, puis maintenu constant. Pour LLaDA 8B, afin de garantir un entraînement stable, le taux d'apprentissage a été réduit une fois pendant le pré-entraînement, comme détaillé dans la section [2.2]. Pour l'ARM de référence de 1 milliard de paramètres et pour les deux modèles LLaDA de 1 milliard et 8 milliards de paramètres, le taux d'apprentissage maximal est fixé à avec une taille de lot de 1280, sans aucun réglage d'hyperparamètres. Pour l'ARM de référence de 7 milliards de paramètres, le taux d'apprentissage maximal est fixé à avec une taille de lot de 4224, tous deux sélectionnés par recherche sur grille.
De plus, nous employons la formulation largement utilisée [108] [109] pour calculer les FLOPs d'entraînement dans la figure [3], où représente le nombre de paramètres non liés aux embeddings, et désigne le nombre total de tokens d'entraînement. Les résultats détaillés correspondant à la figure [3] sont fournis dans le tableau [18] et le tableau [19].
B.3 Ablation sur le guidage sans classificateur
Cette section présente une étude d'ablation sur le guidage sans classificateur (CFG). Les détails théoriques concernant le CFG se trouvent dans l'annexe [A.2].
Pour simplifier, nous sélectionnons six benchmarks représentatifs, notamment ARC-C, HellaSwag, TruthfulQA, WinoGrande, PIQA et GPQA, et menons des expériences à l'aide de LLaDA 8B Base. Nous recherchons l'échelle du CFG dans pour chaque tâche et rapportons le meilleur résultat. Comme montré dans le tableau [6], le CFG améliore systématiquement les performances de LLaDA. Nous soulignons que, pour garantir une comparaison équitable avec les ARM, le CFG n'est pas utilisé dans les résultats principaux rapportés dans l'article.
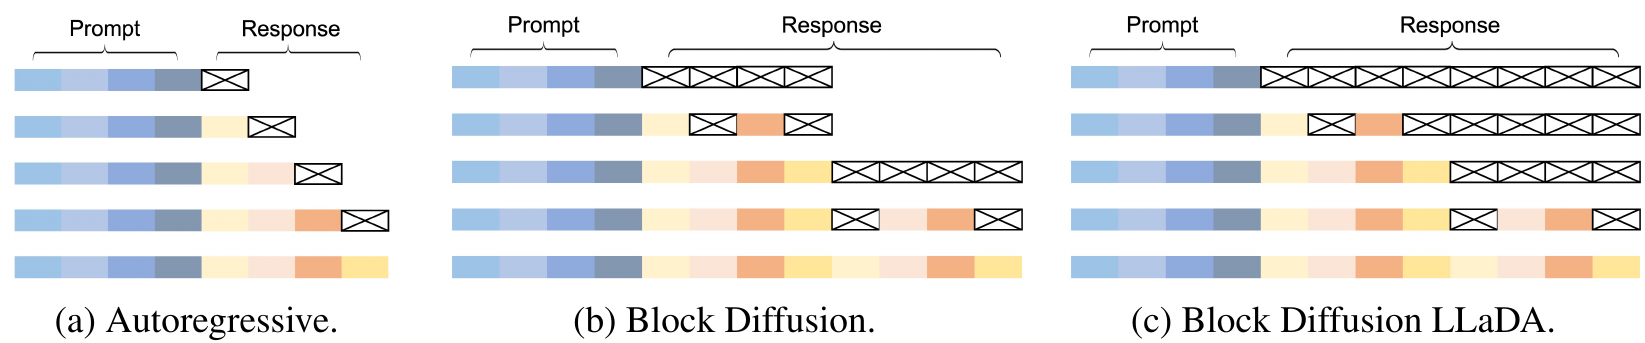
| BBH | GSM8K | Math | HumanEval | MBPP | ||
| Autorégressif | 38,1 | 63,1 | 23,6 | 18,3 | 33,4 | |
| L' = 2 | 37,3 | 62,6 | 25,2 | 14,6 | 33,6 | |
| L' = 4 | 40,0 | 65,7 | 26,6 | 15,9 | 36,0 | |
| L' = 8 | 42,0 | 68,2 | 27,7 | 19,5 | 39,2 | |
| L' = 32 | 45,7 | 68,6 | 29,7 | 29,9 | 37,4 | |
| Diffusion par blocs LLaDA | L' = 2 | 48,0 | 70,0 | 30,8 | 26,2 | 40,0 |
| L' = 4 | 48,5 | 70,3 | 31,3 | 27,4 | 38,8 | |
| L' = 8 | 48,6 | 70,2 | 30,9 | 31,1 | 39,0 | |
| L' = 32 | 48,3 | 70,3 | 31,2 | 32,3 | 40,0 | |
| Diffusion pure | 49,7 | 70,3 | 31,4 | 35,4 | 40,0 |
| GSM8K | Math | HumanEval | MBPP | GPQA | MMLU-Pro | ARC-C | |
| Autorégressif | 0 | 9,5 | 0 | 0 | 0 | 0 | 84,4 |
| Diffusion par blocs | 24,6 | 23,5 | 17,1 | 21,2 | 29,3 | 32,5 | 88,1 |
| Diffusion par blocs LLaDA | 77,5 | 42,2 | 46,3 | 34,2 | 31,3 | 34,8 | 85,4 |
| Diffusion pure | 69,4 | 31,9 | 49,4 | 41,0 | 33,3 | 37,0 | 88,5 |
B.4 Détails et ablation sur les stratégies d'échantillonnage
Dans cette section, nous présentons d'abord les différentes stratégies d'échantillonnage prises en charge par LLaDA. Nous présentons ensuite des études d'ablation pour évaluer les performances de ces stratégies d'échantillonnage.
Stratégies d'échantillonnage flexibles. Dans la section 2.4, la figure 2(c) illustre le processus de génération inverse de LLaDA. Comme montré dans la figure 4, outre le processus de génération inverse, LLaDA prend également en charge l'échantillonnage autorégressif et par diffusion par blocs [31] directement après les étapes de pré-entraînement ou de SFT, sans nécessiter de modifications ou de réentraînement supplémentaires. L'échantillonnage par diffusion par blocs applique le processus inverse d'origine au sein de chaque bloc et l'échantillonnage autorégressif entre les blocs. Dans le processus original de diffusion par blocs, la longueur de séquence varie dynamiquement. Comme montré dans la figure 4(c), LLaDA peut également adopter une stratégie de diffusion par blocs à longueur fixe, que nous appelons LLaDA à diffusion par blocs, également connue sous le nom de remasquage semi-autorégressif.
Configuration expérimentale. Nous évaluons différentes stratégies d'échantillonnage en utilisant à la fois LLaDA 8B Base et LLaDA 8B Instruct pour une analyse complète. Pour LLaDA 8B Base, nous utilisons les cinq benchmarks du tableau 1 qui sont évalués sur la base de l'échantillonnage plutôt que de l'estimation de vraisemblance. Pour LLaDA 8B Instruct, nous utilisons les sept métriques du tableau 2 en excluant MMLU et HellaSwag, puisque ces deux tâches ne nécessitent que la génération d'un seul token (c'est-à-dire A, B, C ou D) par le modèle. Dans tous les paramètres, un token est généré
| Longueur | BBH | GSM8K | Math | HumanEval | MBPP |
| Remasquage aléatoire | 32,1 | 21,3 | 9,2 | 11,6 | 21,0 |
| Remasquage à faible confiance | 45,0 | 70,0 | 30,3 | 32,9 | 40,2 |
| Longueur | BBH | GSM8K | Math | HumanEval | MBPP |
| 256 | 45,0 | 70,0 | 30,3 | 32,9 | 40,2 |
| 512 | 50,4 | 70,8 | 30,9 | 32,9 | 39,2 |
| 1024 | 49,7 | 70,3 | 31,4 | 35,4 | 40,0 |
par étape d'échantillonnage. Pour l'échantillonnage autorégressif et par diffusion par blocs, la génération se termine lorsque le token |EOS| est produit. Pour LLaDA à diffusion par blocs (c'est-à-dire le remasquage semi-autorégressif) et l'échantillonnage par diffusion pure, la longueur de génération est fixée à 1024 pour LLaDA 8B Base, tandis que pour LLaDA 8B Instruct, elle est ajustée parmi {64, 256, 512} afin d'équilibrer efficacité et performances. Le remasquage par faible confiance est appliqué à l'échantillonnage par diffusion intra-bloc dans la diffusion par blocs et LLaDA à diffusion par blocs, ainsi qu'à l'échantillonnage par diffusion pure. Nous testons également différentes longueurs de bloc pour LLaDA 8B Base. Pour LLaDA 8B Instruct, nous n'évaluons que la longueur de bloc 32 pour des raisons d'efficacité, car elle donne les meilleurs résultats sur LLaDA 8B Base.
De plus, pour LLaDA 8B Instruct, en raison du important padding de tokens |EOS| dans les données SFT (comme détaillé dans la Sec. [B.1]), nous observons que, sous un échantillonnage par diffusion pure, la proportion de tokens |EOS| dans les sorties du modèle devient très élevée. Cela conduit à des générations extrêmement courtes et dégrade les performances du modèle. Pour atténuer ce problème, pour HumanEval, MBPP, GSM8K, Math et GPQA, nous fixons le score de confiance du token |EOS| à zéro pendant l'échantillonnage par diffusion pure. Cet ajustement aide à maintenir un ratio approprié de tokens |EOS| pendant la génération.
Enfin, nous menons des études d'ablation pour analyser les effets des stratégies de remasking aléatoire et à faible confiance en utilisant l'échantillonnage par diffusion pure. Pour des raisons d'efficacité, nous utilisons LLaDA 8B Base avec une longueur de génération et un nombre d'étapes d'échantillonnage fixés à 256 dans cette analyse.
Résultats. Comme montré dans le Tab. [7] pour l'échantillonnage par diffusion par blocs, les performances globales s'améliorent à mesure que la longueur de bloc augmente. De plus, le Tab. [7] et le Tab. [8] montrent que l'échantillonnage par diffusion par blocs surpasse systématiquement l'échantillonnage autorégressif, et que l'échantillonnage LLaDA par diffusion par blocs améliore encore l'échantillonnage standard par diffusion par blocs. Enfin, l'échantillonnage par diffusion pure atteint les meilleures performances globales.
En outre, le Tab. [9] montre que la stratégie de remasking à faible confiance surpasse systématiquement la stratégie de remasking aléatoire. Nous supposons que le remasking à faible confiance fonctionne de manière similaire à la méthode d'échantillonnage recuit utilisée par défaut dans les ARMs, améliorant la précision en réduisant la diversité des phrases générées.
Nous découvrons que l'échantillonnage autorégressif conduit à de très mauvaises performances pour LLaDA 8B Instruct. Cela est dû au fait que chaque donnée SFT est une phrase complète, donc, étant donné une longueur de séquence, LLaDA 8B Instruct tend à générer une phrase complète dans cette longueur. En revanche, LLaDA 8B Base ne souffre pas de ce problème, car les données de pré-entraînement consistent en documents tronqués (comme détaillé dans l'Annexe [B.1]) et le modèle est entraîné avec des longueurs de séquence aléatoires (comme détaillé dans la Sec. [2.2]). Par conséquent, lorsqu'on lui donne une courte longueur de séquence, LLaDA 8B Base tend à générer seulement une partie d'une phrase, qui peut ensuite être utilisée comme préfixe pour continuer la génération.
Fixer la longueur de bloc à 8 dans le Tab. [8] améliore encore le score GSM8K de 77,5 à 78,6.
B.5 Ablation sur la longueur générée
Dans cette section, nous menons des études d'ablation sur la longueur générée.
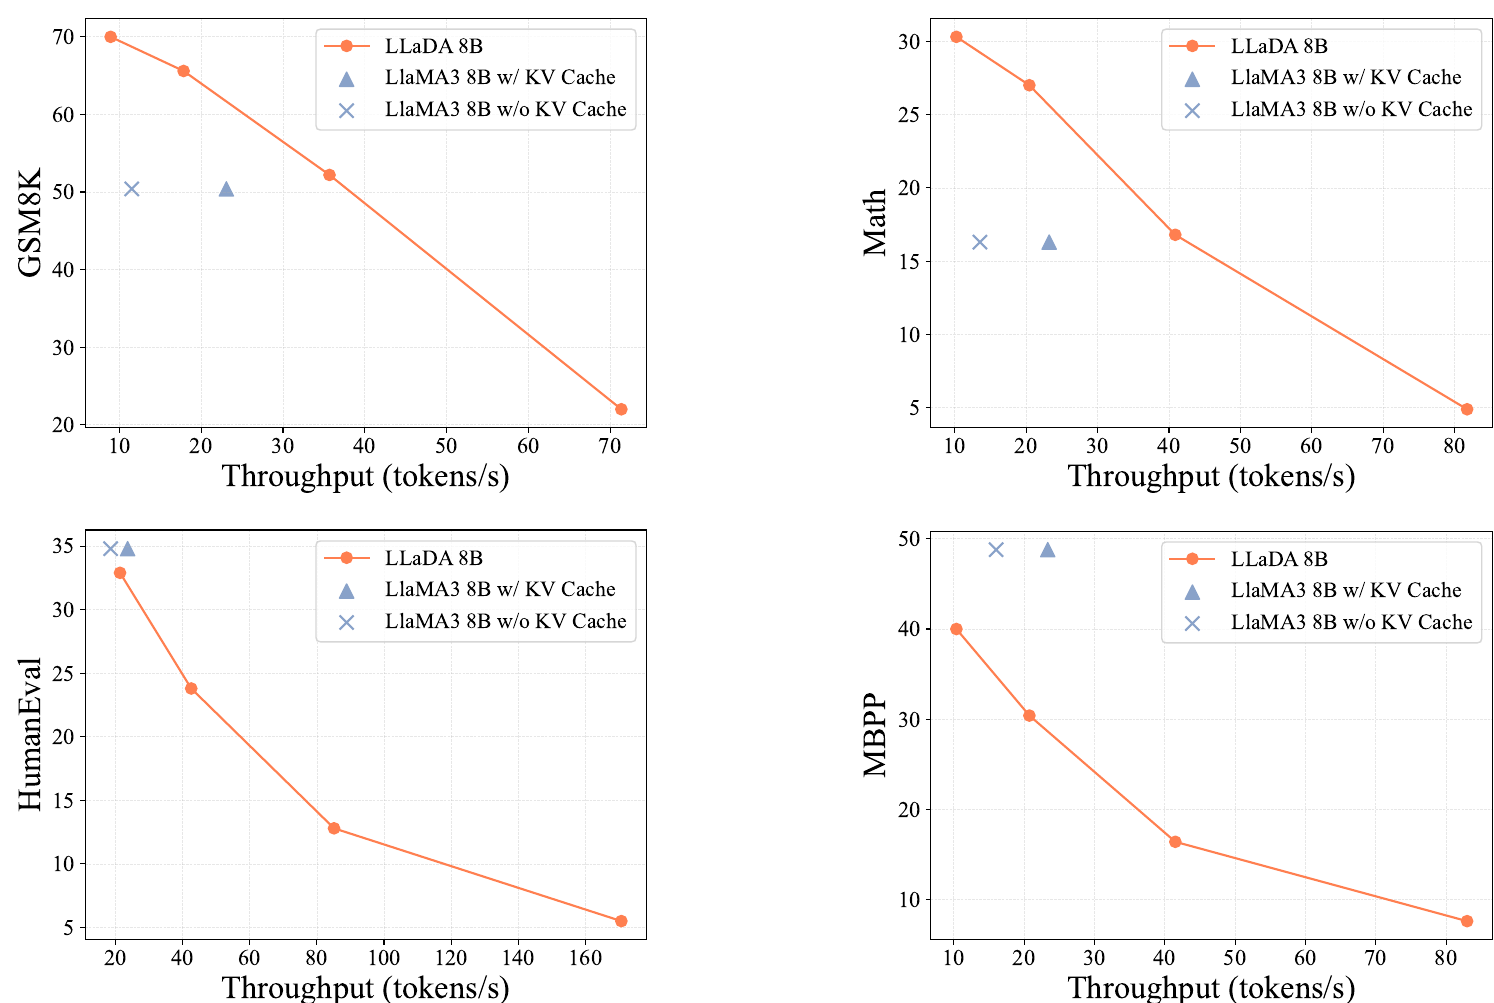
Pour garantir l'équité, pour chaque configuration, nous fixons le nombre d'étapes d'échantillonnage égal à la longueur générée, en veillant à ce qu'à chaque étape d'échantillonnage, un seul token soit transféré du masque vers le texte. Nous menons les expériences en utilisant LLaDA 8B Base.
Comme rapporté dans le Tab. [10], les résultats ne sont pas sensibles à l'hyperparamètre de longueur.
B.6 Benchmarks standards et détails d'évaluation
Dans cette section, nous présentons les benchmarks que nous avons utilisés et fournissons les détails de notre processus d'évaluation.
Suivant les pratiques d'évaluation standard des LLM [25] [26], nous évaluons LLaDA selon quatre dimensions :
Capacité générale : MMLU [110], BBH [111], ARC-C [112], Hellaswag [113], TruthfulQA [114], WinoGrande [115] et PIQA [116].
Capacité en mathématiques et en sciences : GSM8K [117], Math [118] et GPQA [119].
Génération de code : HumanEval [120], HumanEval-FIM [121] et MBPP [122].
Compréhension du chinois : CMMLU [123] et C-Eval [124].
Pour tous les benchmarks susmentionnés, nous suivons le processus d'évaluation largement adopté [125] utilisé dans les évaluations de LLM, en employant principalement l'estimation de vraisemblance conditionnelle et la génération conditionnelle. Plus précisément, pour certains benchmarks, un prompt et plusieurs réponses candidates sont fournis, et le modèle doit calculer la vraisemblance conditionnelle de chaque candidat. Le candidat ayant la vraisemblance la plus élevée est ensuite sélectionné comme réponse finale du modèle, et l'exactitude est utilisée comme métrique d'évaluation. Pour les benchmarks restants, le modèle génère des réponses à partir du prompt donné, et la performance est évaluée à l'aide de métriques telles que l'exact match et d'autres critères pertinents.
Pour le modèle de base, nous utilisons l'estimation de vraisemblance conditionnelle pour MMLU, CMMLU, C-Eval, ARC-C, Hellaswag, TruthfulQA, WinoGrande, PIQA et GPQA, tandis que les benchmarks restants sont évalués à l'aide de la génération conditionnelle. Pour le modèle instruct, nous évaluons tous les benchmarks à l'aide de la génération conditionnelle.
| Longueur d'entrée | Longueur de sortie | LLaDA 8B | LLaMA3 8B sans cache KV | LLaMA3 8B avec cache KV |
| 512 | 512 | 17,03 | 16,70 | 16,32 |
| 1024 | 17,53 | 17,49 | 16,43 | |
| 2048 | 18,52 | 20,00 | 16,73 | |
| 1024 | 512 | 17,53 | 17,16 | 16,36 |
| 1024 | 18,01 | 18,26 | 16,41 | |
| 2048 | 19,02 | 21,39 | 16,74 |
Pour le modèle de base, nous utilisons le framework d'évaluation open-source largement adopté lm-evaluation-harness [125], à l'exception de la métrique HumanEval-FIM, qui n'est pas prise en charge par le framework. Pour HumanEval-FIM sur le modèle de base et toutes les métriques d'évaluation sur le modèle instruct, nous utilisons une bibliothèque d'évaluation interne. Nous choisissons la bibliothèque interne car lm-evaluation-harness montre un écart plus important par rapport aux résultats de LLaMA3 rapportés par Yang et al. [25], relativement à notre évaluation interne.
Pour les benchmarks évalués via l'estimation de vraisemblance conditionnelle, nous utilisons l'estimation de Monte Carlo pour approximer l'Éq. [6] pour LLaDA. Comme MMLU, CMMLU et C-EVAL ne nécessitent que la vraisemblance d'un seul token, une seule estimation de Monte Carlo suffit pour ces benchmarks. Pour tous les autres benchmarks, nous constatons que 128 échantillons de Monte Carlo sont adéquats pour produire des résultats stables.
Pour les benchmarks évalués à l'aide de la génération conditionnelle, nous appliquons un échantillonnage par diffusion pur avec une stratégie de remasquage à faible confiance à la fois pour LLaDA Base et LLaDA Instruct. Pour LLaDA Base, nous fixons à la fois la longueur de génération et le nombre d'étapes d'échantillonnage à 1024. Pour LLaDA Instruct, le nombre d'étapes d'échantillonnage est fixé égal à la longueur de la réponse, qui est configurée comme suit : 3 pour MMLU et HellaSwag, 64 pour GPQA, 256 pour MBPP et MMLU-Pro, et 512 pour HumanEval, GSM8K, Math et ARC-C. Comme détaillé dans l'Annexe [B.4], pour HumanEval, MBPP, GSM8K, Math et GPQA, nous fixons la confiance du token |EOS| à zéro pendant l'échantillonnage pour LLaDA Instruct.
B.7 Analyse de l'efficacité d'échantillonnage
Dans cette section, nous analysons d'abord l'efficacité d'échantillonnage de LLaDA, incluant à la fois la vitesse d'échantillonnage et la consommation de mémoire. Nous discutons ensuite des optimisations potentielles pour améliorer davantage son efficacité.
Nous utilisons quatre benchmarks représentatifs de génération ouverte pour l'analyse de la vitesse d'échantillonnage : GSM8K, Math, HumanEval et MBPP. Nous utilisons la métrique de débit largement adoptée pour mesurer la vitesse de génération, définie comme le nombre de tokens générés par seconde. Nous comparons LLaDA 8B Base et LLaMA3 8B Base, tous deux utilisant la précision bfloat16. Toutes les expériences de cette section ont été menées sur un seul GPU A100-80GB avec une taille de lot de 1. Pour LLaDA, la longueur de sortie est fixée à 256 tokens sur les quatre benchmarks.
La Fig. 5 montre que LLaDA permet un compromis flexible entre la qualité de génération et la vitesse en ajustant le nombre d'étapes d'échantillonnage. Plus précisément, sur les jeux de données GSM8K et Math, LLaDA 8B Base atteint des performances comparables à LLaMA3 8B Base tout en offrant un débit 1,5 et 1,8 fois plus élevé, même si LLaMA3 utilise le KV Cache et que LLaDA fonctionne sans aucune technique d'optimisation d'inférence. Pour le benchmark HumanEval, LLaDA 8B Base offre des performances comparables à LLaMA3 8B Base lorsque le débit est égalé. Sur le benchmark MBPP, LLaDA 8B Base est en retard par rapport à LLaMA3 8B Base.
Pour LLaMA3, le bénéfice d'accélération offert par le cache KV est notablement plus faible sur le jeu de données HumanEval, ce qui peut être attribué à ses longueurs de prompt relativement courtes. Plus précisément, les longueurs moyennes de prompt pour GSM8K, Math, MBPP et HumanEval sont respectivement de 894, 680, 628 et 132 tokens.
Le Tab. [1] compare la consommation de mémoire entre LLaDA 8B Base et LLaMA3 8B Base. Pour éviter les variations de longueur de génération causées par des différences dans les données d'entraînement, nous fixons à la fois les longueurs de tokens d'entrée et de sortie lors de l'analyse de mémoire. Pour LLaDA, l'utilisation de mémoire reste constante quel que soit le nombre d'étapes d'échantillonnage. Sa consommation de mémoire est comparable à celle de LLaMA3 8B Base sans KV cache, mais légèrement supérieure à celle avec KV cache.
| 4 étapes | 5 étapes | 6 étapes | |
| LLaMA3 8B Base | 38.0 | 35.0 | 34.0 |
| LLaDA 8B Base | 64.0 | 41.0 | 44.0 |
Nous soulignons que l'objectif de cette étude n'est pas de proposer un modèle plus rapide que les ARMs. Nous visons plutôt à montrer le potentiel des modèles de diffusion pour la modélisation du langage à grande échelle et à remettre en question l'hypothèse courante selon laquelle des capacités fondamentales des LLM telles que la scalabilité, l'apprentissage en contexte et le suivi d'instructions dépendent intrinsèquement des ARMs. Un corpus substantiel de recherches [31, 79, 87] s'est concentré sur l'amélioration de l'efficacité de génération des MDMs par des innovations algorithmiques ou architecturales. Nous laissons une exploration similaire axée sur l'efficacité pour LLaDA à des travaux futurs.
B.8 Évaluation sur le jeu de données iGSM
Pour évaluer plus avant les capacités mathématiques de LLaDA, nous testons ses performances sur iGSM [34], un jeu de données synthétique infini de type GSM8K. iGSM est généré via des règles spécifiques, avec des paramètres qui contrôlent la difficulté des problèmes (c'est-à-dire le nombre d'étapes de solution). Pour la cohérence de l'évaluation, nous ajoutons « #### Sanswer » à la solution finale, en respectant le format GSM8K. Voici un exemple avec les étapes de solution fixées à 4 :
(Question) Le nombre de Cultural Studies Classroom de chaque North Star Elementary est égal à 1. Le nombre de Dance Studio de chaque Westridge Elementary est égal à 3 fois la somme du nombre de Classroom de chaque North Star Elementary et du nombre de Cultural Studies Classroom de chaque North Star Elementary. Combien de Dance Studio Westridge Elementary possède-t-elle ? (Solution) Définissons le Cultural Studies Classroom de North Star Elementary comme ; donc . Définissons le Classroom de North Star Elementary comme ; donc . Définissons le Dance Studio de Westridge Elementary comme ; ; donc #### 1
Comme il existe de légères différences entre GSM8K et iGSM (par exemple, l'utilisation d'un système algorithmique modulo 5), nous suivons [34] et fournissons un prompt système accompagné de paires question-réponse en four-shot pour chaque problème.
(Prompt) Vous êtes un expert dans la résolution de problèmes mathématiques élémentaires impliquant l'addition, la soustraction et la multiplication. Vous résolvez tous les problèmes dans un format uniforme. Tous les calculs sont effectués modulo 5. Par exemple, égale 3, égale 1, égale 4, égale 4, et égale 4. Lorsque vous fournissez votre solution, veuillez terminer par « #### x. » où x est votre réponse finale, un entier entre 0 et 4. Vous devez résoudre tous les problèmes en utilisant le même format de solution. Nos scénarios impliquent jusqu'à quatre catégories d'objets : écoles, salles de classe, sacs à dos et fournitures. Chaque école peut contenir des salles de classe, chaque salle de classe peut contenir des sacs à dos, et chaque sac à dos peut contenir des fournitures. Nous pouvons spécifier des quantités, telles que le nombre de studios de danse à chaque Lakeshore High. Supposons que chaque entité portant le même nom ait une configuration identique ; par exemple, chaque Lakeshore High contient le même nombre de studios de danse. Un autre principe directeur est que ce qui n'est pas mentionné n'existe pas : lorsque nous faisons référence aux salles de classe de Lakeshore High, nous ne discutons que des salles de classe explicitement mentionnées dans notre scénario. De plus, si Lakeshore High n'est même pas mentionné, toute salle de classe en son sein est automatiquement considérée comme inexistante (c'est-à-dire 0).
Pour des étapes de solution allant de 4 à 6, nous générons 100 questions pour chaque cas et rapportons la précision correspondante dans le Tableau [2]. Comme le montre le tableau, LLaDA 8B Base démontre des avantages significatifs et constants par rapport à LLaMA3 8B Base sur des problèmes mathématiques non vus, ce qui concorde avec les résultats du Tableau [1].
| Utilisateur LLaDA | Quels sont les bienfaits de l'exercice régulier pour la santé physique et mentale ? | ||||||||||
| L'exercice régulier | peut | améliorer | la santé | physique | en | renforçant | les muscles | et | les os, | ||
| en améliorant | la santé | cardiovasculaire, | et | en réduisant | le | risque | de | maladies | chroniques | ||
| le diabète | et | les maladies | cardiaques. | Il | peut | aussi | améliorer | la santé mentale | |||
| et l'anxiété, | améliorer l'humeur, | et | renforcer | la fonction | cognitive | De plus, | |||||
| l'exercice | peut | améliorer | la qualité | du sommeil | et | augmenter | les niveaux | d'énergie. | |||
B.9 Tâches de complétion de poèmes
Dans cette section, nous présentons des exemples issus de notre jeu de données de complétion de poèmes comme suit.
Exemple 1 :
Invite : 窈窕淑女的下一句是什么? 直接输出句子即可。
Réponse : 君子好逑。
Exemple 2 :
Invite : 不拘一格降人才的上一句是什么? 直接输出句子即可。
Réponse : 我劝天公重抖擞。
B.10 Études de cas supplémentaires
Dans cette section, nous présentons des études de cas supplémentaires de LLaDA 8B Instruct. Tout d'abord, le Tab. [13] montre le processus d'échantillonnage de l'échantillonnage LLaDA à diffusion par blocs, tandis que le Tab. [14] dépeint le processus d'échantillonnage pour les dialogues multi-tours avec remasquage aléatoire. De plus, les Tab. [15] et Tab. [16] fournissent d'autres exemples de dialogues uni-tours et multi-tours. Enfin, le Tab. [17] présente des exemples de complétions de poèmes en sens inverse où le modèle LLaDA 8B Instruct réussit, contrairement à l'échec de GPT-4o.
C Déclaration d'impact
Notre travail montre le potentiel des modèles de diffusion pour la modélisation du langage à grande échelle et remet en question l'hypothèse courante selon laquelle les capacités fondamentales des LLM telles que la scalabilité, l'apprentissage en contexte et le suivi d'instructions dépendent intrinsèquement des ARM. Nos résultats ouvrent de nouvelles voies pour explorer des paradigmes probabilistes alternatifs en traitement du langage naturel, avec des applications potentielles dans l'IA conversationnelle, la génération de code et les tâches de raisonnement complexe.
Cependant, les modèles de diffusion, comme les LLM traditionnels, soulèvent des préoccupations sociétales similaires. Celles-ci incluent l'impact environnemental de l'entraînement à grande échelle, l'utilisation abusive potentielle pour générer du contenu nuisible et l'amplification des biais présents dans les données d'entraînement. Relever ces défis est essentiel pour garantir le développement et le déploiement responsables des modèles de langage à diffusion.
Tableau 14 : Visualisation du dialogue multi-tours. Nous employons une stratégie de remasquage aléatoire. Dans la réponse de LLaDA, les couleurs plus foncées indiquent les tokens prédits dans les étapes ultérieures de l'échantillonnage, tandis que les couleurs plus claires correspondent aux prédictions antérieures.
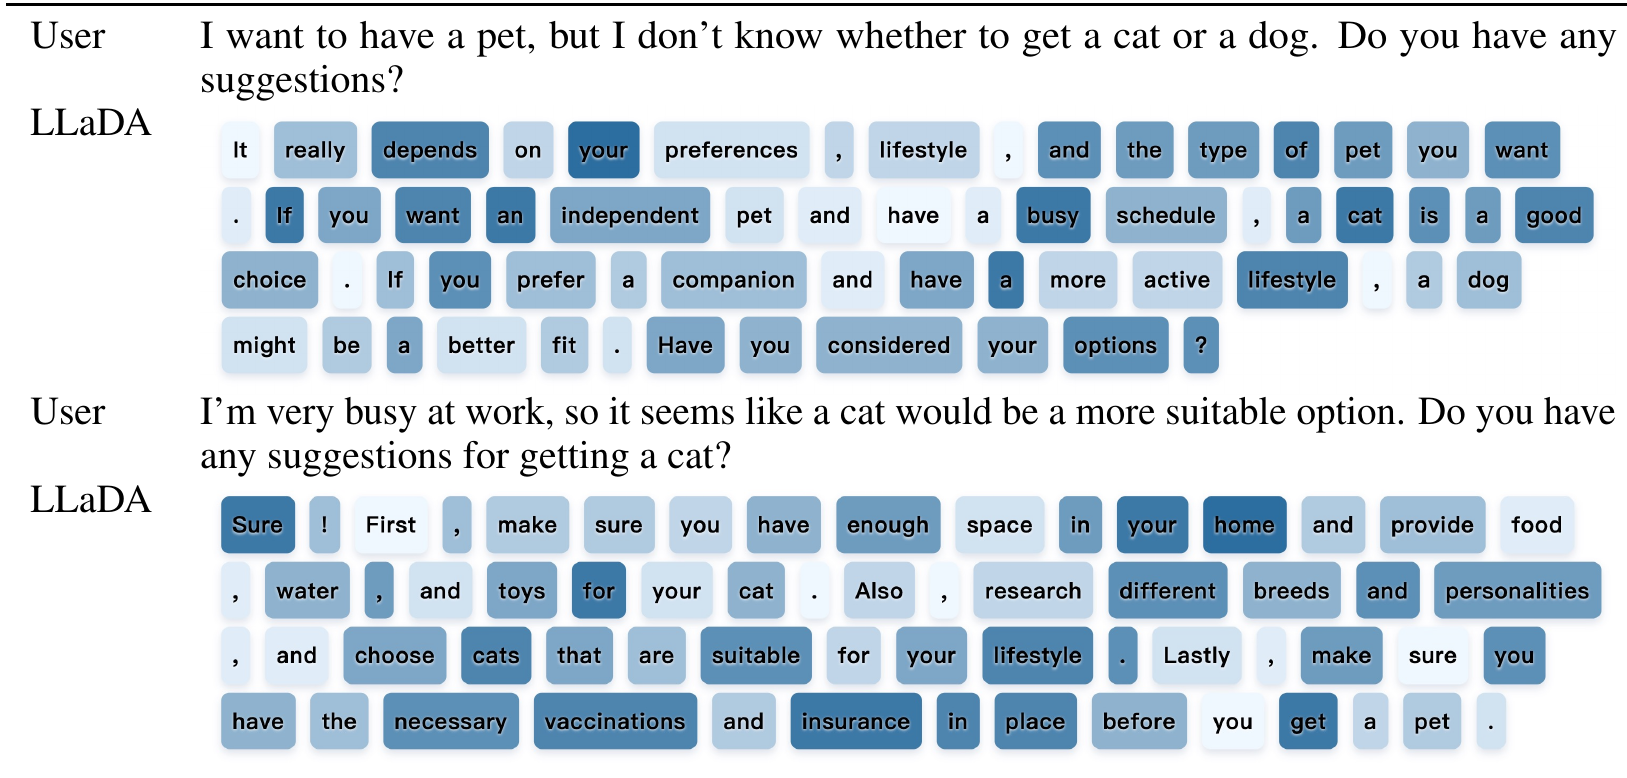
| Contexte en lecture seule pour comprendre la source (il ne s’agit pas du texte source à traduire) : Tableau 14 : Visualisation du dialogue multi-tours. Nous employons une stratégie de remasquage aléatoire. Dans la réponse de LLaDA, les couleurs plus foncées indiquent les tokens prédits aux étapes ultérieures de l’échantillonnage, tandis que les couleurs plus claires correspondent aux prédictions antérieures. | Texte à traduire : Vie quotidienneUserLLaDA |
| Quel conseil avez-vous reçu que vous avez trouvé utile ? Un conseil utile que j’ai reçu est de toujours rester ouvert à l’apprentissage et à la croissance. J’ai constaté que la volonté d’explorer de nouvelles idées et expériences m’a aidé à devenir plus résilient et plus adaptable. En adoptant un état d’esprit de croissance, j’ai pu identifier des opportunités d’amélioration et de développement, tant sur le plan personnel que professionnel. | Vie quotidienneUserLLaDA |
| Veuillez me recommander trois films célèbres Certainement ! Voici trois films célèbres qui ont acquis une large popularité et les faveurs de la critique : | 1. The Shawshank Redemption (1994) - Inspiré d’une nouvelle et réalisé par Frank Darabont, ce film raconte l’histoire d’Andy Dufresne, un homme condamné pour le meurtre de sa femme, qui affronte sa vie difficile à la prison de Shawshank et noue une amitié improbable avec un codétenu.2. The Godfather (1972) - Réalisé par Francis Ford Coppola, ce film est adapté du roman du même nom de Mario Puzo. Il suit l’histoire de la famille Corleone, en particulier Michael Corleone, qui accède au pouvoir et prend la tête de l’empire criminel de la famille.3. The Empire Strikes Back (1980) - Réalisé par George Lucas, ce film poursuit l’histoire d’un jeune Skywalker dans la saga Star Wars. Il suit Luke Skywalker alors qu’il aide l’Alliance rebelle à lutter contre l’Empire galactique et à détruire l’arme puissante, l’Étoile de la Mort.Tous ces films sont célébrés pour leurs réussites cinématographiques, leur narration puissante et leurs personnages mémorables. |
| Traduction UserLLaDA | Aidez-moi à traduire en chinois : « What is now proved was once only imagined » 现在被证明的曾经只是想象 |
| Traduction UserLLaDA | Aidez-moi à traduire en allemand : « What is now proved was once only imagined » 我把他去查查过,我其实没再问啊。 |
| Math UserLLaDA | Emma décide de courir 4 sprints 5 fois par semaine. Elle court 75 mètres à chaque sprint. Combien de mètres au total court-elle par semaine ?Emma court 4 sprints à chaque fois, donc elle court au total 4 x 5 = 20 sprints par semaine. Chaque sprint fait 75 mètres, donc Emma court au total 20 x 75 = 1500 mètres par semaine. Le résultat final est 1500 |
| Contexte en lecture seule pour comprendre la source (non destiné à être traduit) : | |
| Tableau 14 : Visualisation du dialogue multi-tours. Nous employons une stratégie de remasquage aléatoire. Dans la réponse de LLaDA, les couleurs plus sombres indiquent les tokens prédits aux étapes ultérieures de l'échantillonnage, tandis que les couleurs plus claires correspondent aux prédictions antérieures. | Texte à traduire : |
| Vie quotidienne | Utilisateur |
| Comment me préparer à un entretien d'embauche ? | LLaDA |
| Pour vous préparer à un entretien d'embauche, vous devriez vous renseigner sur l'entreprise et le poste, vous entraîner à répondre aux questions d'entretien courantes et vous habiller de manière appropriée. | Utilisateur |
| Quelles sont quelques questions d'entretien courantes ? | |
| LLaDA | Parmi les questions d'entretien courantes, on peut citer « Parlez-moi de vous » et « Pourquoi voulez-vous travailler chez nous » ? |
| Vie quotidienne | Utilisateur |
| Comment commencer à apprendre la programmation ? | LLaDA |
| Pour apprendre la programmation, vous pouvez commencer par choisir un langage de programmation qui vous intéresse. Parmi les langages populaires, on trouve Python, Java et C++. | Utilisateur |
| Quel langage de programmation devrais-je apprendre en premier ? | LLaDA |
| Cela dépend de vos intérêts et de vos objectifs. Python est un excellent langage pour les débutants en raison de sa simplicité et de sa polyvalence. | Utilisateur |
| Combien de temps faut-il pour apprendre Python ? | LLaDA |
| Apprendre Python peut prendre de quelques semaines à plusieurs mois. | Utilisateur |
| Quels sont quelques bons projets Python pour les débutants ? | |
| LLaDA | Parmi les bons projets Python pour les débutants, on peut citer la création d'une calculatrice simple, d'un jeu et d'une application web. |
| Mathématiques | Utilisateur Natalia a vendu des clips à 48 de ses amis en avril, puis elle a vendu deux fois moins de clips en mai. Combien de clips Natalia a-t-elle vendus au total en avril et en mai ? LLaDA Natalia a vendu des clips à 48 amis en avril. Elle a vendu deux fois moins de clips en mai, donc elle a vendu 48/2 = 24 clips en mai. Au total, Natalia a vendu 48 + 24 = 72 clips en avril et en mai. Le résultat final est 72. |
| Utilisateur Natalia a vendu trois fois plus d'articles en juin qu'en mai. Combien de clips Natalia a-t-elle vendus au total sur ces trois mois ? LLaDA Natalia a vendu des clips à 48 amis en avril. Elle a vendu deux fois moins de clips en mai, donc elle a vendu 48/2 = 24 clips en mai. Natalia a vendu trois fois plus d'articles en juin qu'en mai, donc elle a vendu 24 * 3 = 72 clips en juin. Au total, Natalia a vendu 48 + 24 + 72 = 144 clips sur ces trois mois. Le résultat final est 144. | |
| Contexte en lecture seule pour comprendre la source (ce n'est pas le texte source à traduire) : Tableau 14 : Visualisation du dialogue multi-tours. Nous employons une stratégie de remasquage aléatoire. Dans la réponse de LLaDA, les couleurs plus foncées indiquent les tokens prédits aux étapes tardives de l'échantillonnage, tandis que les couleurs plus claires correspondent aux prédictions antérieures. Texte à traduire : Question1 | |
| Utilisateur | Quel est le vers précédent de « 但闻人语响 » ? |
| GPT-4o | Le vers précédent de « 但闻人语响 » est « 无可奈何花落去 » ; ces deux vers sont tirés de (武陵春,春晚) de la poétesse de la dynastie Tang Li Qingzhao : 无可奈何花落去,但闻人语响. Ce poème exprime la solitude et la mélancolie de l'auteure au printemps ; par la description de la chute des fleurs et du bruit des voix humaines, il reflète le sentiment d'impuissance et de perte intérieur de la poétesse. |
| LLaDA | Le vers précédent de « 但闻人语响 » est « 空山不见人 » |
| Question2 | |
| Utilisateur | Quel est le vers précédent de « 夜静春山空 » ? |
| GPT-4o | Le vers précédent de « 夜静春山空 » est « 空山新雨后 » ; ces deux vers sont tirés de (山居秋 膜) du poète de la dynastie Tang Wang Wei : 空山新雨后,夜静春山空. Ce poème dépeint le silence et l'étherité après la pluie dans la montagne au printemps, et exprime la tranquillité et l'harmonie beautueuse de la nature. |
| LLaDA | Le vers précédent de « 夜静春山空 » est « 人闲桂花落 » |
| Modèle | Tokens d'entraînement | FLOPs | MMLU | CMMLU | ARC-C | PIQA | GSM8K | HumanEval |
| LLaDA 1B | 37,75B | 2,20e20 | 25,52 | 25,95 | 25,17 | 59,41 | 1,82 | 0,00 |
| LLaDA 1B | 88,08B | 5,13e20 | 27,11 | 26,52 | 26,96 | 61,86 | 3,03 | 1,83 |
| LLaDA 1B | 138,41B | 8,06e20 | 29,32 | 27,13 | 30,20 | 63,38 | 2,35 | 0,00 |
| LLaDA 1B | 239,08B | 1,39e21 | 31,48 | 30,77 | 27,99 | 63,11 | 3,26 | 1,22 |
| LLaDA 1B | 352,32B | 2,05e21 | 35,86 | 34,35 | 31,31 | 65,34 | 3,64 | 3,05 |
| LLaDA 1B | 461,37B | 2,69e21 | 31,86 | 30,98 | 30,12 | 65,51 | 2,35 | 0,61 |
| LLaDA 8B | 62,91 B | 2,63e21 | 32,22 | 28,5 | 30,20 | 63,82 | 3,87 | 2,44 |
| LLaDA 8B | 125,83 B | 5,27e21 | 33,39 | 33,9 | 34,64 | 66,54 | 8,72 | 3,66 |
| LLaDA 8B | 251,66 B | 1,05e22 | 42,84 | 40,59 | 40,10 | 69,04 | 15,31 | 3,66 |
| LLaDA 8B | 377,49 B | 1,58e22 | 45,11 | 43,99 | 39,25 | 68,61 | 25,40 | 9,76 |
| LLaDA 8B | 503,32 B | 2,11e22 | 43,57 | 41,38 | 42,06 | 70,24 | 27,52 | 9,76 |
| LLaDA 8B | 629,14 B | 2,63e22 | 48,80 | 47,13 | 42,24 | 72,09 | 30,10 | 12,80 |
| LLaDA 8B | 679,48 B | 2,85e22 | 49,61 | 48,19 | 41,30 | 70,84 | 26,31 | 8,54 |
| LLaDA 8B | 792,72 B | Contexte de référence en lecture seule pour comprendre la source (il ne s'agit pas du texte source à traduire) : | Tableau 14 : Visualisation du dialogue multi-tours. Nous employons une stratégie de remasquage aléatoire. Dans la réponse de LLaDA, les couleurs plus foncées indiquent les tokens prédits aux stades ultérieurs de l'échantillonnage, tandis que les couleurs plus claires correspondent aux prédictions antérieures. | Texte à traduire : | 3,31e22 | 50,88 | 49,01 | 42,58 |
| 70,51 | 31,99 | 6,10 | LLaDA 8B | 981,47B | 4,11e22 | 49,47 | 48,10 | 40,27 |
| 71,38 | - | 6,10 | LLaDA 8B | 1107,30B | 4,64e22 | 51,13 | 47,57 | 41,13 |
| 69,26 | 36,69 | 10,37 | LLaDA 8B | 1233,13B | 5,16e22 | 50,52 | 49,72 | 45,05 |
| 71,49 | 38,97 | 9,76 | LLaDA 8B | 1358,95B | 5,69e22 | 54,61 | 53,97 | 49,40 |
| 74,05 | 48,14 | 17,68 | LLaDA 8B | 1547,70B | 6,48e22 | 57,38 | 56,04 | 49,49 |
| 74,59 | 53,30 | 20,73 | LLaDA 8B | 1975,52B | 8,27e22 | 58,52 | 57,87 | 50,68 |
| Modèle | Tokens d'entraînement | FLOPs | MMLU | CMMLU | ARC-C | PIQA | GSM8K | HumanEval |
| ARM 1B | 37,75B | 2,20e20 | 25,47 | 25,38 | 30,20 | 67,36 | 2,20 | 4,88 |
| ARM 1B | 88,08B | 5,13e20 | 24,67 | 25,23 | 33,96 | 70,02 | 7,51 | 10,37 |
| ARM 1B | 138,41B | 8,06e20 | 29,25 | 27,48 | 33,45 | 70,29 | 8,34 | 9,76 |
| ARM 7B | 17,30B | 6,02e20 | 26,92 | 25,18 | 21,02 | 57,18 | 1,29 | 1,22 |
| ARM 7B | 34,60B | 1,20e21 | 25,83 | 25,38 | 24,07 | 62,84 | 1,59 | 2,44 |
| ARM 7B | 86,50B | 3,01e21 | 24,41 | 24,90 | 25,42 | 71,11 | 2,88 | 7,93 |
| ARM 7B | 173,02 B | 6,02e21 | 26,20 | 24,78 | 26,10 | 74,27 | 6,67 | 9,15 |
| ARM 7B | 207,62 B | 7,23e21 | 30,36 | 28,86 | 31,86 | 74,48 | 8,57 | 12,80 |
| ARM 7B | 224,92 B | 7,83e21 | 29,49 | 32,26 | 31,19 | 74,37 | 8,95 | 8,54 |
| ARM 7B | 242,22 B | 8,43e21 | 33,62 | 31,38 | 34,92 | 75,41 | 10,84 | 9,15 |
| ARM 7B | 259,52 B | 9,03e21 | 34,11 | 34,20 | 32,88 | 75,19 | 9,33 | 10,98 |
| ARM 7B | 311,43 B | 1,08e22 | 35,66 | 35,49 | 36,61 | 75,14 | 11,30 | 10,37 |
| ARM 7B | 363,33 B | 1,26e22 | 34,54 | 37,67 | 34,58 | 76,55 | 12,28 | 14,02 |
| ARM 7B | 415,24 B | 1,45e22 | 35,37 | 38,37 | 35,25 | 76,39 | 14,40 | 12,80 |
| ARM 7B | 449,84B | 1,57e22 | 39,51 | 39,24 | 34,92 | 76,82 | 14,94 | 14,63 |
| ARM 7B | 519,09B | 1,81e22 | 40,30 | 40,69 | 37,29 | 77,15 | 14,03 | 14,63 |
| ARM 7B | 778,57B | 2,71e22 | 43,33 | 43,50 | 38,31 | 77,53 | 17,59 | 14,63 |
| ARM 7B | 1038,09B | 3,61e22 | 45,06 | 46,12 | 41,69 | 77,86 | 20,02 | 15,85 |
| ARM 7B | 1384,12B | 4,82e22 | 47,63 | 48,18 | 47,80 | 76,93 | 22,82 | 15,24 |
| ARM 7B | 2076,18B | 7,23e22 | 47,68 | 50,85 | 44,07 | 77,37 | 24,79 | 14,63 |
| ARM 7B | 2214,59B | 7,71e22 | 49,26 | 52,08 | 53,56 | 77,69 | 27,37 | 17,07 |