
Échantillonner le même prompt des milliers de fois: la couverture continue de grimper, un vérificateur la convertit en précision. Papier 2024, gratuit.
Large Language Monkeys: Scaling Inference Compute with Repeated Sampling
Les grands singes du langage : Passer à l'échelle le calcul d'inférence par échantillonnage répété
Bradley Brown\†‡, Jordan Juravsky\†, Ryan Ehrlich\*†, Ronald Clark‡, Quoc V. Le§, Christopher Ré†, et Azalia Mirhoseini†§
†Département d'informatique, Université Stanford ‡Université d'Oxford §Google DeepMind
bradley.brown@cs.ox.ac.uk, jbj@stanford.edu, ryanehrlich@cs.stanford.edu, ronald.clark@cs.ox.ac.uk, qvl@google.com, chrismre@stanford.edu, azalia@stanford.edu
Résumé
Passer à l'échelle la quantité de calcul utilisée pour entraîner les modèles de langage a considérablement amélioré leurs capacités. Cependant, en ce qui concerne l'inférence, nous limitons souvent les modèles à une seule tentative sur un problème. Ici, nous explorons le calcul d'inférence comme un autre axe de mise à l'échelle, en utilisant la technique simple consistant à échantillonner de manière répétée des solutions candidates à partir d'un modèle. Sur de multiples tâches et modèles, nous observons que la couverture – la fraction de problèmes résolus par au moins un échantillon généré – croît avec le nombre d'échantillons sur quatre ordres de grandeur. Il est intéressant de noter que la relation entre la couverture et le nombre d'échantillons est souvent log-linéaire et peut être modélisée par une loi de puissance exponentielle, ce qui suggère l'existence de lois de mise à l'échelle au moment de l'inférence. Dans des domaines comme le codage et les preuves formelles, où les réponses peuvent être vérifiées automatiquement, ces augmentations de couverture se traduisent directement par de meilleures performances. Lorsque nous appliquons l'échantillonnage répété à SWE-bench Lite, la fraction de problèmes résolus avec DeepSeek-Coder-V2-Instruct passe de 15,9 % avec un échantillon à 56 % avec 250 échantillons, surpassant l'état de l'art à un seul échantillon de 43 %. Dans les domaines sans vérificateur automatique, nous constatons que les méthodes courantes de sélection à partir d'une collection d'échantillons (vote majoritaire et modèles de récompense) atteignent un plateau au-delà de plusieurs centaines d'échantillons et ne parviennent pas à passer pleinement à l'échelle avec le budget d'échantillons.
1 Introduction
La capacité des grands modèles de langage (LLM) à résoudre des tâches de codage, de mathématiques et d'autres tâches de raisonnement s'est considérablement améliorée au cours des dernières années [47, 11, 2, 4]. La mise à l'échelle de la quantité de calcul d'entraînement via des modèles plus grands, des pré-entraînements plus longs et des jeux de données plus volumineux a été un moteur constant de ces gains [27, 37, 28].
En revanche, un investissement comparativement limité a été consacré à la mise à l'échelle de la quantité de calcul utilisée pendant l'inférence. Les modèles plus grands nécessitent effectivement plus de calcul d'inférence que les plus petits, et des techniques de prompting comme la chaîne de pensée [61] peuvent accroître la qualité des réponses au prix de sorties plus longues (et donc plus coûteuses en calcul). Cependant, lorsqu'ils interagissent avec des LLM, les utilisateurs et développeurs restreignent souvent les modèles à une seule tentative pour résoudre un problème.
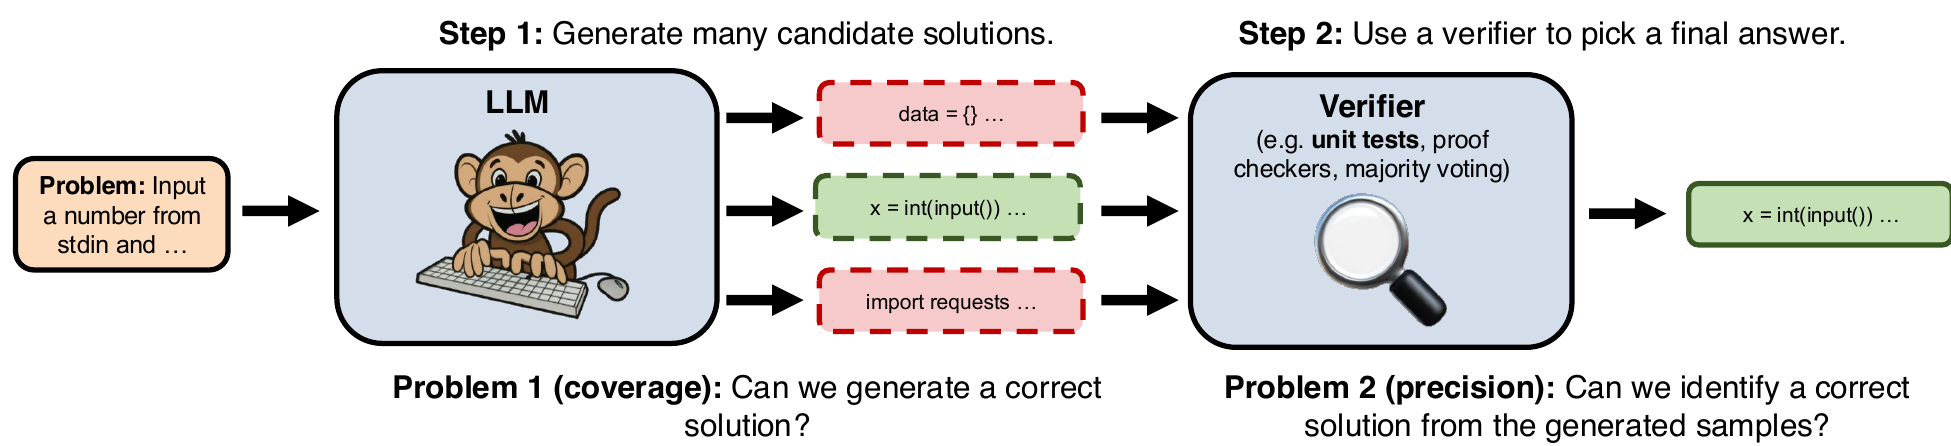
Dans ce travail, nous explorons l'échantillonnage répété (Figure 1) comme une approche simple pour passer à l'échelle le calcul d'inférence afin d'améliorer les performances de raisonnement. Des travaux existants fournissent des exemples encourageants montrant que l'échantillonnage répété peut être bénéfique dans des contextes de mathématiques, de codage et de résolution d'énigmes [60, 48, 23]. Notamment, AlphaCode [41], un système de pointe pour la programmation compétitive, constate que les performances continuent de s'améliorer avec un million d'échantillons par problème. Notre objectif est de caractériser systématiquement ces bénéfices à travers un ensemble de tâches, de modèles et de budgets d'échantillons.
L'efficacité de l'échantillonnage répété est déterminée par deux propriétés clés :
1. Couverture : À mesure que le nombre d'échantillons augmente, quelle fraction de problèmes pouvons-nous résoudre en utilisant n'importe quel échantillon généré ?
2. Précision : À quelle fréquence pouvons-nous identifier les échantillons corrects parmi notre collection de générations ?
Les deux propriétés sont nécessaires pour atteindre de fortes performances dans le monde réel. Avec un nombre illimité d'échantillons, tout modèle qui attribue une probabilité non nulle à chaque séquence atteindra une couverture parfaite. Cependant, l'échantillonnage répété n'est pratique que si nous pouvons améliorer la couverture avec un budget réalisable. De même, générer de grandes collections d'échantillons n'est utile que si les échantillons corrects d'une collection peuvent être identifiés. La difficulté du problème de précision peut varier selon la tâche. Dans certains contextes, des outils existants comme les vérificateurs de preuves et les tests unitaires peuvent vérifier automatiquement chaque échantillon. Dans d'autres cas, comme la résolution de problèmes écrits, d'autres méthodes de vérification sont nécessaires.
En explorant d'abord la couverture, nous constatons qu'échantillonner jusqu'à 10 000 fois par problème peut considérablement augmenter la couverture sur des tâches de mathématiques et de codage (Section 2). Lors de la résolution de problèmes de programmation CodeContests [41] avec Gemma-2B [52], nous augmentons la couverture de plus de 300 fois, de 0,02 % avec un échantillon à 7,1 % avec 10 000 échantillons. Il est intéressant de noter que la relation entre log(couverture) et le nombre d'échantillons suit souvent approximativement une loi de puissance (Section 3). Avec les modèles Llama-3 [3] et Gemma, cela conduit à une couverture croissant de manière presque log-linéaire avec le nombre d'échantillons sur plusieurs ordres de grandeur.
Dans les contextes disposant d'outils de vérification automatique, les augmentations de couverture se traduisent directement par de meilleures performances sur les tâches. Lors de l'application de l'échantillonnage répété à la programmation compétitive et à l'écriture de preuves Lean, des modèles comme Llama-3-8B-Instruct peuvent dépasser les performances à un seul échantillon de modèles bien plus forts comme GPT-4o [2]. Cette capacité à amplifier des modèles plus faibles s'étend au difficile jeu de données SWE-bench Lite de problèmes GitHub réels [32], où l'état de l'art (SOTA) actuel à un seul échantillon, obtenu par une combinaison de GPT-4o et Claude 3.5 Sonnet, est de 43 % [1]. Lorsqu'il est restreint à un seul échantillon, DeepSeek-Coder-V2-Instruct [20] ne résout que 15,9 % des problèmes. En augmentant simplement le nombre d'échantillons à 250, nous portons la fraction de problèmes résolus à 56 %, dépassant l'état de l'art de 13 %.
En plus d'améliorer la qualité des modèles, l'échantillonnage répété offre un nouveau mécanisme pour minimiser les coûts d'inférence des LLM (Section 2.3). En maintenant constant le nombre total de FLOPs d'inférence, nous constatons que sur certains jeux de données (par ex. MATH), la couverture est maximisée avec un modèle plus petit et plus d'échantillons, tandis que sur d'autres (par ex. CodeContests), il est préférable d'échantillonner moins de fois à partir d'un modèle plus grand. Nous comparons également les prix des API entre DeepSeek-Coder-V2-Instruct, GPT-4o et Claude Sonnet 3.5 dans le contexte de la résolution de problèmes SWE-bench Lite. En maintenant le cadre d'agent (Moatless Tools [67]) constant, échantillonner cinq fois à partir du modèle DeepSeek plus faible et moins cher résout plus de problèmes que des échantillons uniques de Claude ou GPT, tout en étant plus de 3 fois moins cher.
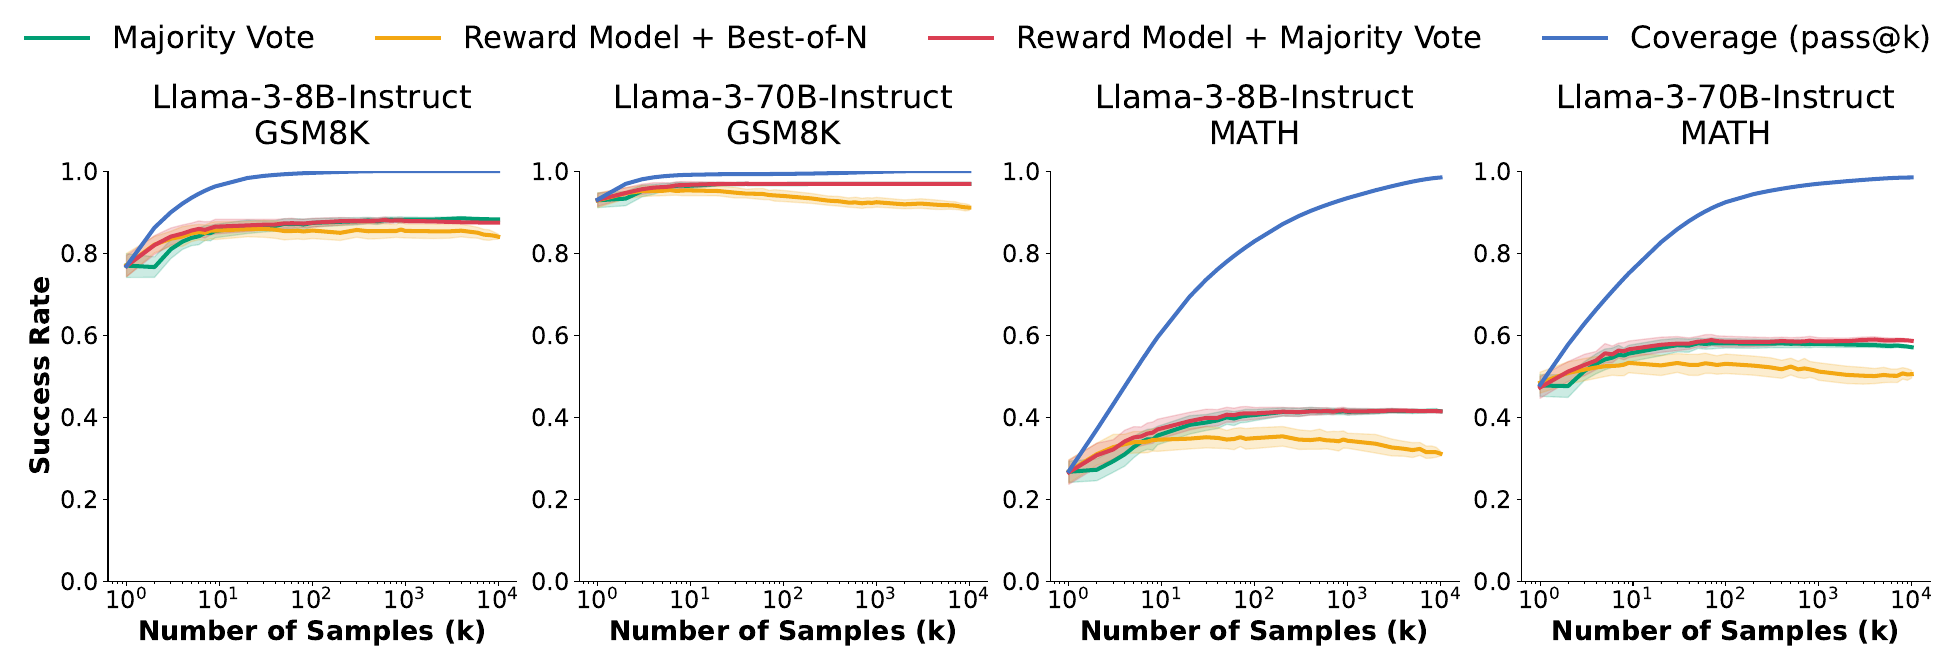
Enfin, nous démontrons qu'une vérification passant à l'échelle est nécessaire pour bénéficier pleinement de l'échantillonnage répété. À mesure que le nombre d'échantillons augmente, la couverture s'améliore grâce aux modèles générant des solutions correctes à des problèmes qu'ils n'avaient pas résolus auparavant. Cependant, ces générations correctes de plus en plus rares ne sont bénéfiques que si les vérificateurs peuvent « trouver l'aiguille dans la botte de foin » et les identifier parmi des collections d'échantillons majoritairement incorrects. Dans le contexte des problèmes mathématiques écrits, nous constatons que deux méthodes courantes de vérification (le vote majoritaire et les modèles de récompense) ne possèdent pas cette capacité. Lors de la résolution de problèmes MATH [26] avec Llama-3-8B-Instruct, la couverture passe de 82,9 % avec 100 échantillons à 98,44 % avec 10 000 échantillons. Cependant, en utilisant le vote majoritaire ou des modèles de récompense pour sélectionner les réponses finales, la plus grande amélioration de performance n'est que de 40,50 % à 41,41 % sur la même plage d'échantillons. À mesure que le nombre d'échantillons augmente, l'écart entre la couverture (c'est-à-dire la performance avec un vérificateur parfait) et la performance de ces méthodes augmente également (Figure [7].
En résumé, nos principales observations sont les suivantes :
1. Nous démontrons que passer à l'échelle le calcul d'inférence par échantillonnage répété conduit à de grandes améliorations de la couverture sur une variété de tâches et de modèles. Cela rend possible, et parfois rentable, d'amplifier des modèles plus faibles avec de nombreux échantillons et de surpasser des échantillons uniques provenant de modèles plus capables.
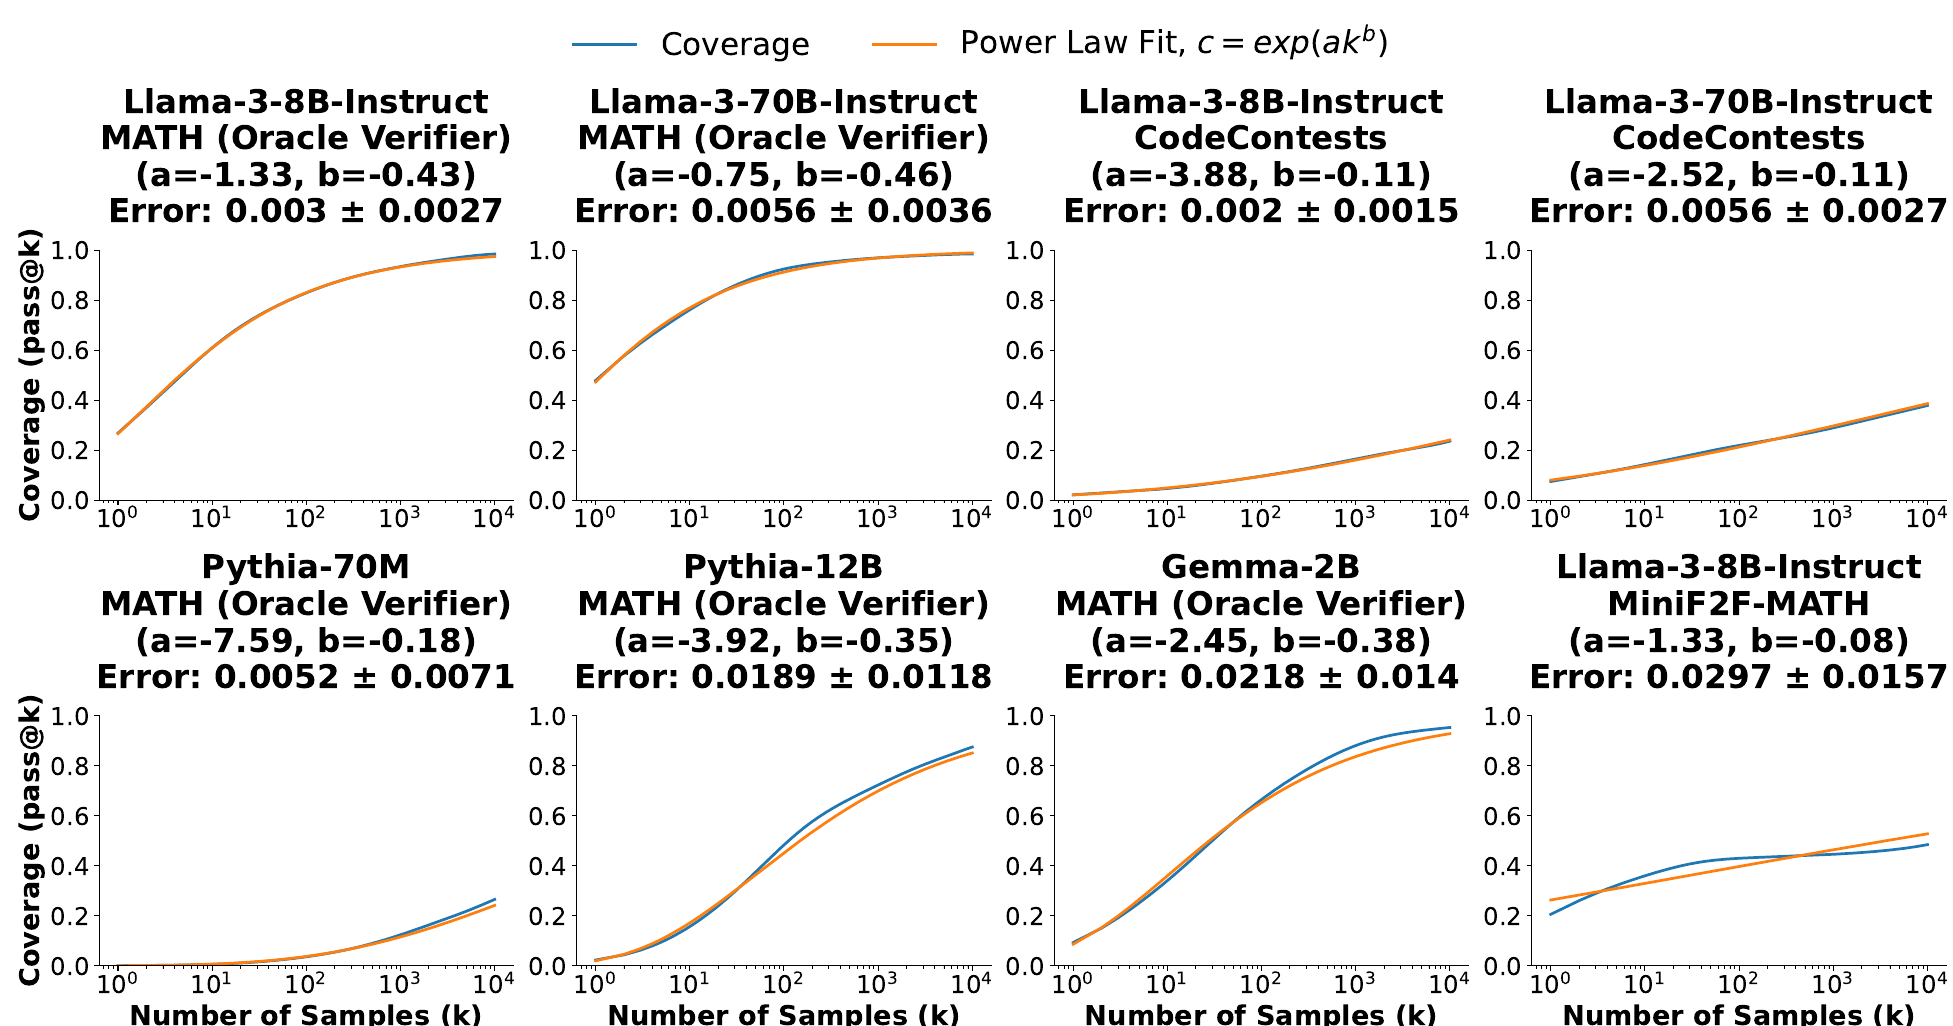
2. Nous montrons que la relation entre la couverture et le nombre d'échantillons peut souvent être modélisée à l'aide d'une loi de puissance exponentielle, ce qui suggère une forme de lois de mise à l'échelle pour le calcul au moment de l'inférence.
3. Dans les domaines sans vérificateur automatique, nous montrons que les approches courantes de vérification atteignent un plateau au-delà d'environ 100 échantillons. Cela conduit à un écart croissant entre les performances obtenues avec ces méthodes et la borne supérieure de couverture.
2 Passer à l'échelle l'échantillonnage répété
Nous nous concentrons sur des tâches de type réussite-échec où une solution candidate peut être notée comme correcte ou incorrecte. La principale métrique d'intérêt pour ces tâches est le taux de réussite : la fraction de problèmes que nous parvenons à résoudre. Avec l'échantillonnage répété, nous considérons un cadre dans lequel un modèle peut générer de nombreuses solutions candidates en tentant de résoudre un problème. Le taux de réussite est donc influencé à la fois par la capacité à générer des échantillons corrects pour de nombreux problèmes (c'est-à-dire la couverture), ainsi que par la capacité à identifier ces échantillons corrects (c'est-à-dire la précision).
La difficulté du problème de précision dépend de la disponibilité d'outils pour la vérification des échantillons. Lors de la démonstration d'énoncés formels en Lean, les vérificateurs de preuves peuvent rapidement déterminer si une solution candidate est correcte. De même, des tests unitaires peuvent être utilisés pour vérifier des solutions candidates à des tâches de codage. Dans ces cas, la précision est gérée automatiquement, et améliorer la couverture se traduit directement par des taux de réussite plus élevés. En revanche, les outils disponibles pour vérifier les solutions à des problèmes mathématiques écrits de GSM8K et MATH sont limités, ce qui nécessite des méthodes de vérification supplémentaires qui décident d'une réponse finale unique à partir de nombreux échantillons (souvent contradictoires).
Nous considérons les cinq tâches suivantes :
1. GSM8K : Un jeu de données de problèmes mathématiques écrits de niveau primaire [18]. Nous évaluons sur un sous-ensemble aléatoire de 128 problèmes du jeu de test GSM8K.
2. MATH : un autre ensemble de données de problèmes mathématiques sous forme de problèmes écrits, généralement plus difficiles que ceux de GSM8K [13]. De même, nous évaluons sur 128 problèmes tirés aléatoirement de l'ensemble de test de ce jeu de données.
3. MiniF2F-MATH : un ensemble de données de problèmes mathématiques qui ont été formalisés dans des langages de vérification de preuves [65]. Nous utilisons Lean4 comme langage et évaluons sur les 130 problèmes de l'ensemble de test qui sont formalisés à partir du jeu de données MATH.
4. CodeContests : un ensemble de données de problèmes de programmation compétitive [41]. Chaque problème comporte une description textuelle, ainsi qu'un ensemble de cas de test entrée-sortie (cachés au modèle) qui peuvent être utilisés pour vérifier l'exactitude d'une solution candidate. Nous imposons que les modèles écrivent leurs solutions en Python3.
5. SWE-bench Lite : un ensemble de données de problèmes réels issus de Github, où chaque problème consiste en une description et un instantané d'un dépôt de code [32]. Pour résoudre un problème, les modèles doivent modifier des fichiers dans la base de code (dans le sous-ensemble Lite de SWE-bench que nous utilisons, un seul fichier doit être modifié). Les solutions candidates peuvent être vérifiées automatiquement à l'aide de la suite de tests unitaires du dépôt.
Parmi ces tâches, MiniF2F-MATH, CodeContests et SWE-bench Lite disposent de vérificateurs automatiques (sous la forme respectivement du vérificateur de preuves Lean4, de cas de test et de suites de tests unitaires). Nous commençons par étudier comment l'échantillonnage répété améliore la couverture du modèle. Les améliorations de couverture correspondent directement à des taux de réussite accrus pour les tâches disposant de vérificateurs automatiques et, dans le cas général, fournissent une borne supérieure sur le taux de réussite. Dans les contextes de codage, notre définition de la couverture est équivalente à la métrique couramment utilisée pass@k [15], où désigne le nombre d'échantillons par problème. Nous utilisons directement cette métrique lors de l'évaluation sur CodeContests et SWE-bench Lite. Pour MiniF2F, la métrique est similaire, un « succès » étant défini selon le vérificateur de preuves Lean4. Pour GSM8K et MATH, la couverture correspond à l'utilisation d'un vérificateur oracle qui contrôle si un échantillon quelconque « réussit » en produisant la bonne réponse finale. Pour réduire la variance lors du calcul de la couverture, nous adoptons la formule d'estimation non biaisée de Chen et al. [15]. Dans chaque expérience, nous générons d'abord échantillons pour chaque indice de problème et calculons le nombre d'échantillons corrects . Nous calculons ensuite les scores pass@k à chaque d'intérêt selon :
Nous utilisons l'implémentation numériquement stable de la formule ci-dessus suggérée dans Chen et al. [15]. Les données et le code sont disponibles à l'adresse https://scalingintelligence.stanford.edu/pubs/large_language_monkeys/.
2.1 L'échantillonnage répété est efficace sur toutes les tâches
Ici, nous établissons que l'échantillonnage répété améliore la couverture sur plusieurs tâches et pour une gamme de budgets d'échantillons. Nous évaluons Llama- 3- 8B- Instruct et Llama- 3- 70B- Instruct sur CodeContests, MiniF2F, GSM8K et MATH, en générant 10 000 échantillons indépendants par problème. Pour SWE- bench Lite, nous utilisons DeepSeek- Coder- V2- Instruct [20], car la longueur de contexte requise pour cette tâche dépasse les limites des modèles Llama- 3. Comme c'est la norme lors de la résolution de tickets SWE- bench, nous équipons
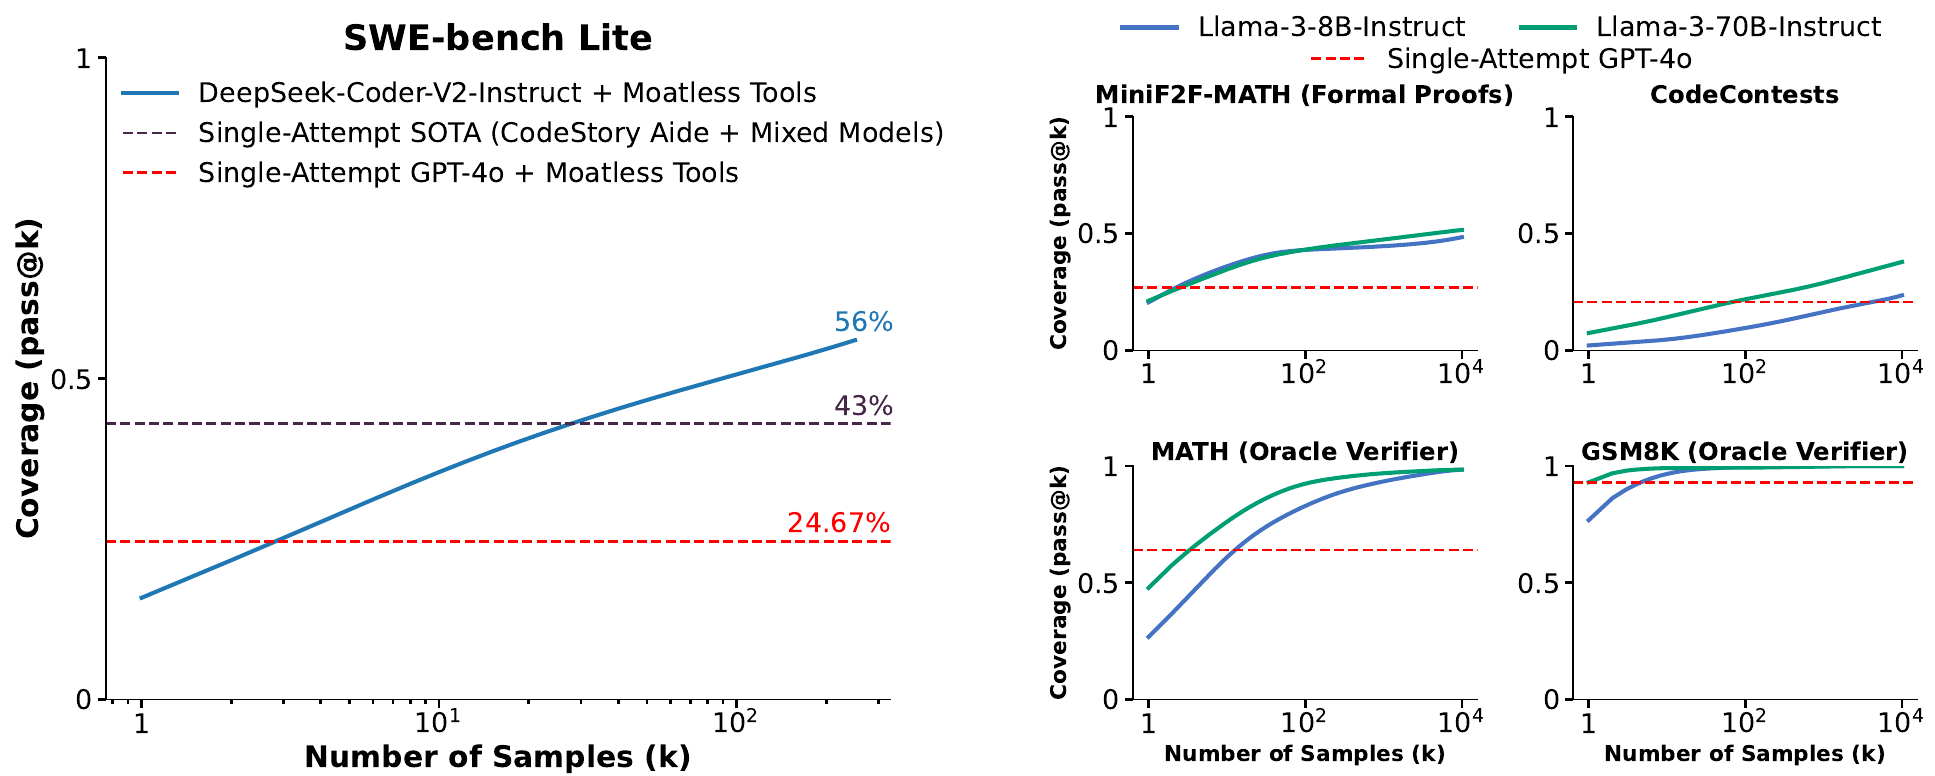
notre LLM d'un framework logiciel qui fournit au modèle des outils pour naviguer dans des bases de code et les modifier. Dans notre travail, nous utilisons la bibliothèque open- source Moatless Tools [67]. Notons que la résolution d'un ticket SWE- bench implique un échange aller- retour entre le LLM et Moatless Tools. Un échantillon/une tentative pour ce benchmark désigne une trajectoire multi- tours entière. Pour minimiser les coûts, nous limitons le nombre de tentatives par ticket à 250, toutes les tentatives étant effectuées indépendamment les unes des autres.
Nous rapportons nos résultats dans la Figure 2. Nous incluons également la performance en une seule tentative de GPT- 4o sur chaque tâche, ainsi que l'état de l'art en une seule tentative pour SWE- bench Lite (CodeStory Aide 1 qui utilise une combinaison de GPT- 4o et Claude 3.5 Sonnet). Sur les cinq tâches, nous constatons que la couverture s'améliore régulièrement à mesure que le budget d'échantillons augmente. Lorsque tous les LLM disposent d'une seule tentative, GPT- 4o surpasse les modèles Llama et DeepSeek sur chaque tâche. Cependant, à mesure que le nombre d'échantillons augmente, les trois modèles plus faibles dépassent la performance en une seule tentative de GPT- 4o. Dans le cas de SWE- bench Lite, nous résolvons des problèmes, dépassant l'état de l'art en une seule tentative de .
2.2 L'échantillonnage répété est efficace quelles que soient les tailles et les familles de modèles
Les résultats de la Section 2.1 indiquent que l'échantillonnage répété améliore la couverture. Cependant, nous ne montrons cette tendance que pour trois modèles récents, ajustés par instruction, de 8B paramètres ou plus. Nous montrons maintenant que ces tendances tiennent pour d'autres tailles de modèles, familles et niveaux de post- entraînement. Nous élargissons notre évaluation pour inclure un ensemble plus large de modèles :
- Llama 3 : Llama-3-8B, Llama-3-8B-Instruct, Llama-3-70B-Instruct.
- Gemma : Gemma-2B, Gemma-7B [52].
- Pythia : Pythia-70M jusqu'à Pythia-12B (huit modèles au total) [9].
Nous restreignons l'évaluation aux jeux de données MATH et CodeContests afin de minimiser les coûts d'inférence, en rapportant les résultats dans la Figure 3. La couverture augmente pour presque tous les modèles que nous testons, les modèles plus petits montrant certaines des augmentations de couverture les plus marquées lorsque l'échantillonnage répété est appliqué. Sur CodeContests, la couverture de Gemma- 2B augmente de plus de , passant d'un pass@1 de à un
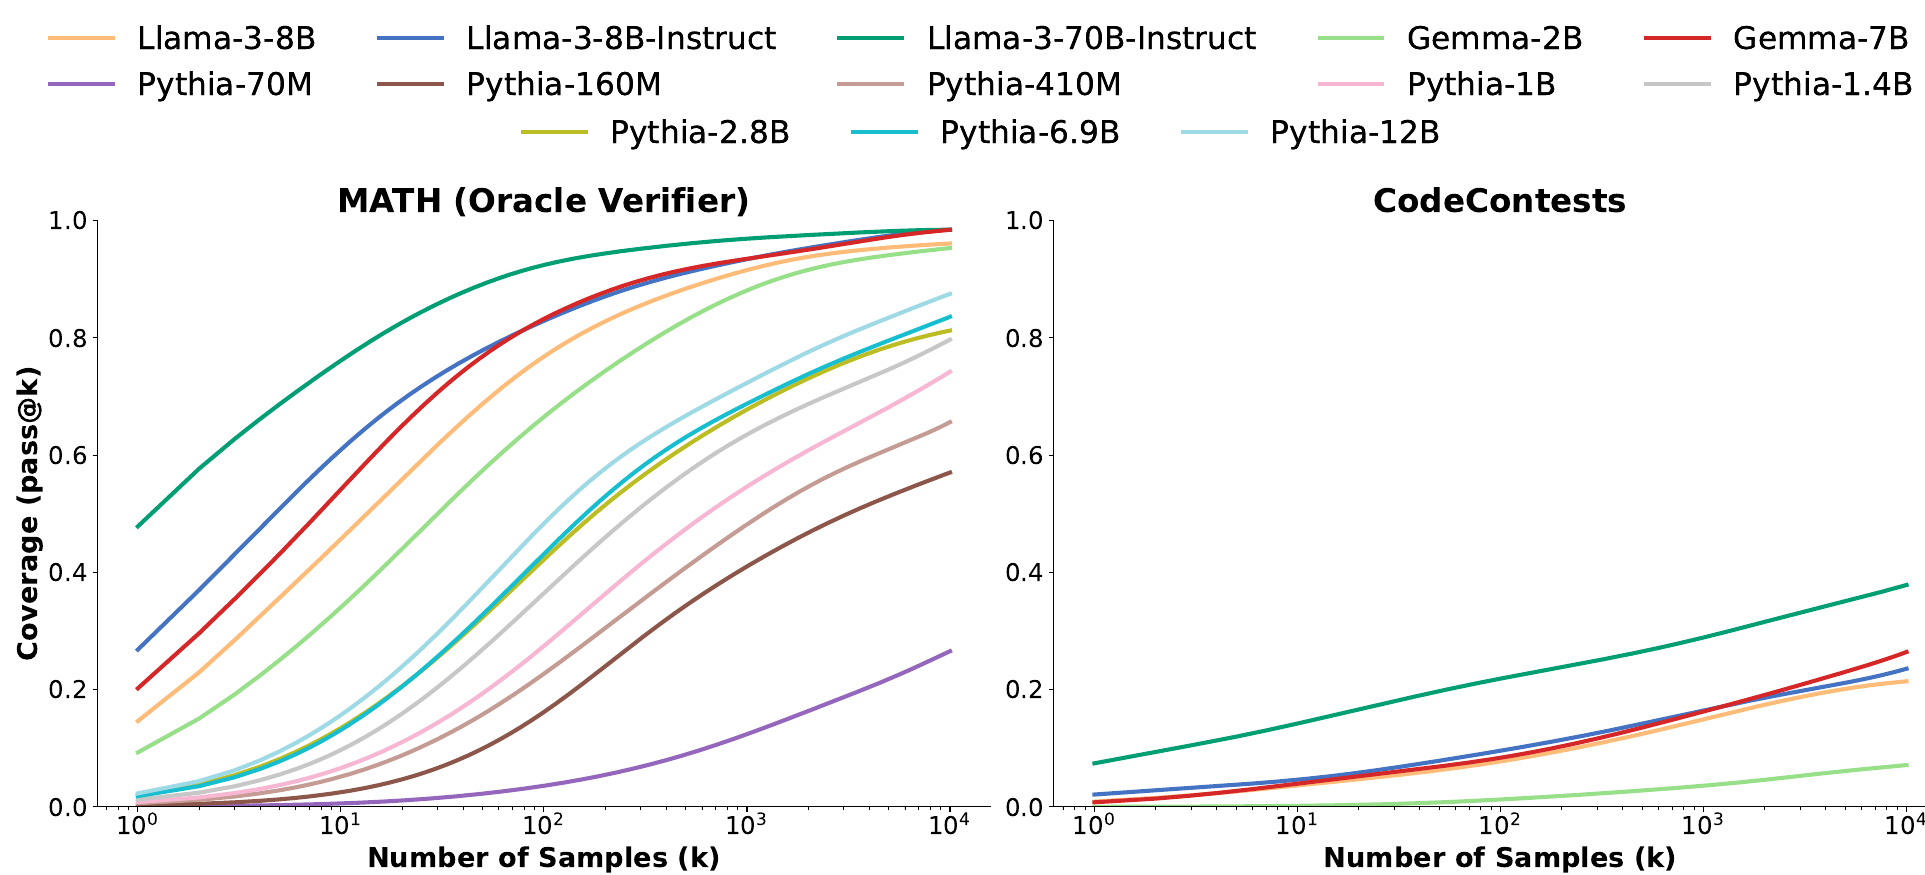
pass@10k de . De même, lors de la résolution de problèmes MATH avec Pythia- 160M, la couverture passe d'un pass@1 de à un pass@10k de .
L'exception à ce schéma d'augmentation de la couverture selon les modèles concerne la famille Pythia évaluée sur CodeContests. Tous les modèles Pythia atteignent une couverture nulle sur ce jeu de données, même avec un budget de 10 000 échantillons. Nous supposons que cela est dû au fait que Pythia est entraîné sur moins de données spécifiques au codage que Llama et Gemma.
2.3 L'échantillonnage répété peut aider à équilibrer performance et coût
Un enseignement des résultats des Sections 2.1 et 2.2 est que l'échantillonnage répété permet d'amplifier les capacités d'un modèle plus faible et de surpasser les échantillons uniques de modèles plus forts. Ici, nous démontrons que cette amplification peut être plus rentable que l'utilisation d'un modèle plus fort et plus coûteux, offrant aux praticiens un nouveau degré de liberté lorsqu'ils cherchent à optimiser conjointement la performance et les coûts.
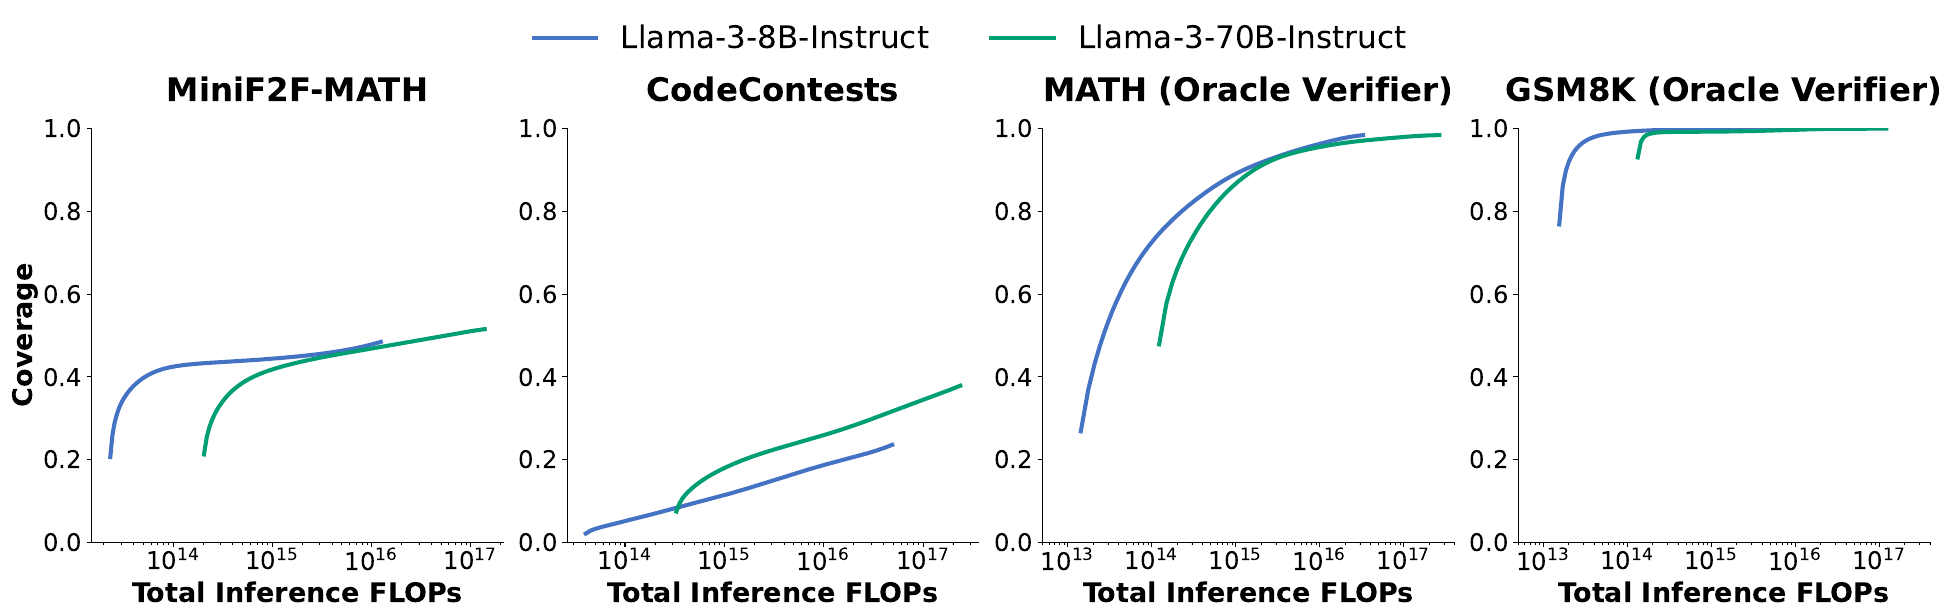
Nous considérons d'abord les FLOPs comme métrique de coût, en examinant les résultats de Llama- 3 de la Section 2.1. Nous traçons à nouveau nos résultats de la Figure 2 en visualisant maintenant la couverture en fonction des FLOPs d'inférence totaux plutôt que du budget d'échantillons. Comme les modèles Llama- 3 sont des transformeurs denses où la majorité des paramètres sont utilisés dans des multiplications matricielles, nous approximons les FLOPs d'inférence avec la formule :
Nous présentons nos résultats remis à l'échelle pour MiniF2F, CodeContests, MATH et GSM8K dans la Figure 4. Il est intéressant de noter que le modèle qui maximise la couverture varie selon le budget de calcul et la tâche. Sur MiniF2F, GSM8K et
| Modèle | Coût par tentative (USD) | Nombre de tentatives | Problèmes résolus (%) | Coût total (USD) | Coût total relatif |
| DeepSeek-Coder-V2-Instruct | 0,0072 | 5 | 29,62 | 10,8 | 1x |
| GPT-4o | 0,13 | 1 | 24,00 | 39 | 3,6x |
| Claude 3.5 Sonnet | 0,17 | 1 | 26,70 | 51 | 4,7x |
Tableau 1 : Comparaison du coût de l'API (en dollars américains) et de la performance de divers modèles sur le jeu de données SWE- bench Lite à l'aide du framework d'agent Moatless Tools. Lorsqu'il est davantage échantillonné, le modèle open- source DeepSeek- Coder- V2- Instruct peut atteindre le même taux de résolution de tickets que les modèles de pointe à code fermé pour moins d'un tiers du prix. MATH, Llama- 3- 8B- Instruct obtient toujours une couverture plus élevée que le modèle 70B plus grand (et plus coûteux) lorsque le budget de FLOPs est fixé. Cependant, pour CodeContests, le modèle 70B est presque toujours plus rentable. Nous notons que l'examen des FLOPs seuls peut être une métrique de coût grossière qui ignore d'autres aspects de l'efficacité du système [21]. En particulier, l'échantillonnage répété peut tirer parti de tailles de lots élevées et d'optimisations spécialisées qui améliorent le débit du système par rapport aux charges de travail d'inférence en une seule tentative [34] [6] [66]. Nous en discutons plus en détail dans la Section [5]
Nous examinons également les coûts en dollars de l'échantillonnage répété lors de la résolution de tickets SWE- bench Lite en utilisant les tarifs actuels de l'API. En gardant le framework d'agent (Moatless Tools) constant, nous considérons effectuer une seule tentative par ticket avec Claude 3.5 Sonnet et GPT- 4o, ainsi qu'un échantillonnage répété avec DeepSeek- Coder- V2- Instruct. Nous rapportons le coût moyen par ticket et le taux de résolution des tickets pour chaque approche dans le Tableau [1]. Bien que le modèle DeepSeek soit plus faible que les modèles GPT et Claude, il est également plus de 10 fois moins cher. Dans ce cas, l'échantillonnage répété offre une alternative moins chère que le paiement d'une prime pour accéder à des modèles puissants, tout en atteignant un meilleur taux de résolution des tickets.
3 Caractérisation des bénéfices de l'échantillonnage répété
La relation entre la perte d'un LLM et son compute d'entraînement a été bien caractérisée par les lois d'échelle d'entraînement [27] [36] [28]. Ces lois ont empiriquement tenu sur plusieurs ordres de grandeur et inspirent confiance aux développeurs de modèles quant au fait que de gros investissements dans l'entraînement seront rentables. Inspirés par les lois d'échelle d'entraînement, nous cherchons ici à mieux caractériser la relation entre la couverture et le budget d'échantillons (c'est-à-dire la quantité de compute d'inférence), en présentant deux observations intéressantes :
1. La relation entre la couverture et le nombre d'échantillons peut souvent être modélisée par une loi de puissance exponentielle.
2. Pour une tâche donnée, les courbes de couverture de différents modèles d'une même famille ressemblent à des courbes en S avec des pentes similaires mais des décalages horizontaux distincts.
3.1 Lois d'échelle pour l'échantillonnage répété
Ici, nous développons un modèle explicite pour la relation entre la couverture et le nombre d'échantillons. Le rapport technique GPT- 4 [46] constate que la relation entre le taux de réussite moyen logarithmique d'un modèle sur des problèmes de codage et son compute d'entraînement peut être bien modélisée à l'aide d'une loi de puissance. Nous commençons par adopter la même classe de fonctions, mais en modélisant maintenant le logarithme de la couverture en fonction du nombre d'échantillons :
où sont des paramètres de modèle ajustés. Afin de prédire directement la couverture, nous exponencions les deux côtés, aboutissant au modèle final :
Nous fournissons des exemples de courbes de couverture ajustées dans la Figure [5] et des courbes supplémentaires dans l'Annexe [C.2]. Bien que ces lois ne soient pas aussi exactes que les lois d'échelle d'entraînement (de manière la plus frappante sur MiniF2F-MATH), elles fournissent des preuves préliminaires encourageantes que les bénéfices du scaling d'inférence peuvent être caractérisés.
3.2 Similarités des courbes de couverture entre modèles
Il est intéressant de noter que, lorsqu'on compare les courbes de couverture (avec un axe des x logarithmique) de différents modèles d'une même famille sur une même tâche (voir Figure [3]), il apparaît que les courbes en S tracées ont la même pente, mais des décalages horizontaux uniques. Pour approfondir cette question, nous superposons les courbes de couverture de différents modèles d'une même famille dans la Figure [6]. Nous procédons en choisissant une valeur de couverture d'ancrage , et en décalant chaque courbe vers la gauche (dans l'espace logarithmique) de sorte que chacune passe par le point . Cela correspond à un décalage vers la gauche de
-\(\log (\mathrm{pass}@k^{- 1}(c))\), où
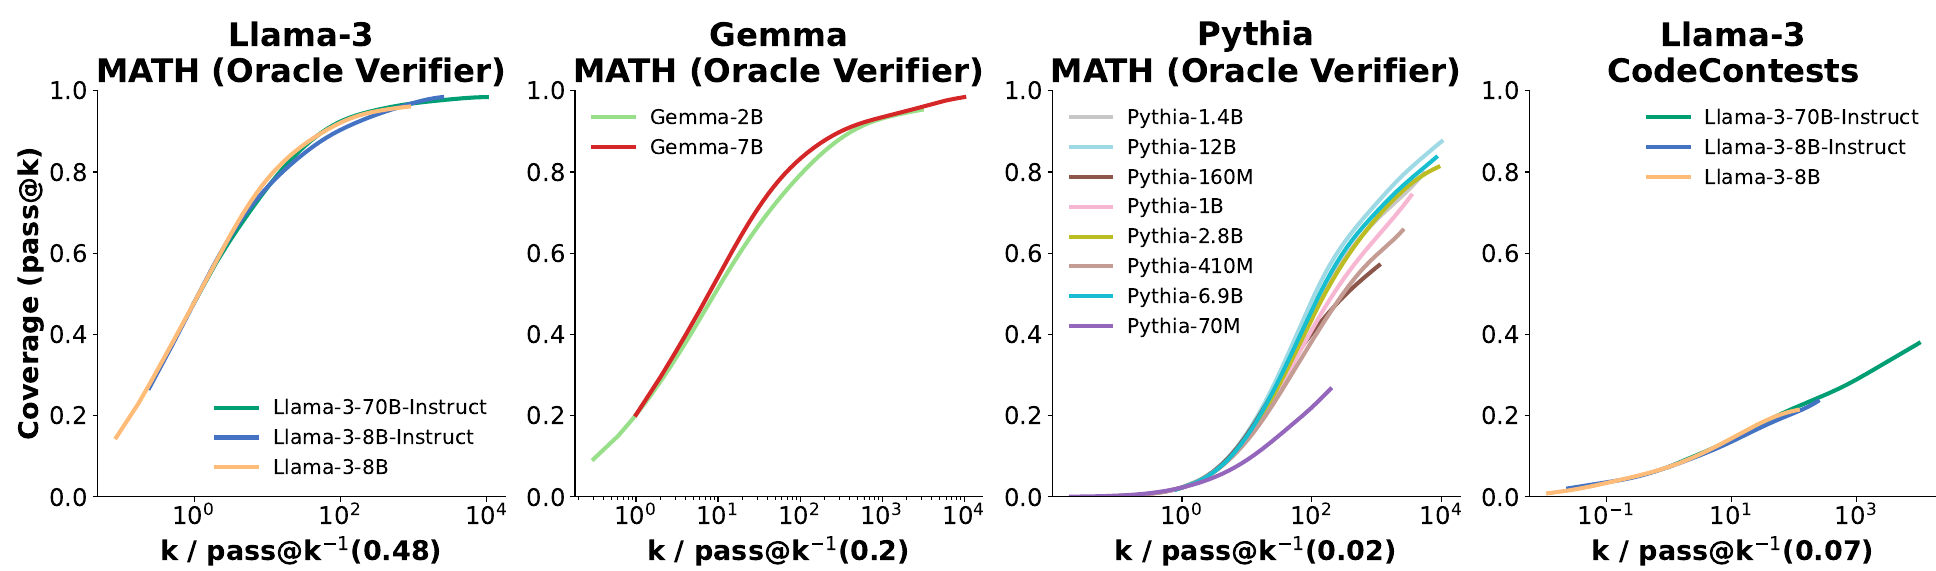
désigne le plus proche entier naturel tel que . Nous choisissons comme le score pass@1 maximal sur tous les modèles de la même famille. Ces similarités montrent que, pour des modèles d'une même famille, l'augmentation du logarithme du budget d'échantillons (ou de manière équivalente, l'augmentation multiplicative du budget d'échantillons) nécessaire pour améliorer la couverture de à est approximativement constante.
4 Exploiter l'échantillonnage répété exige de la précision
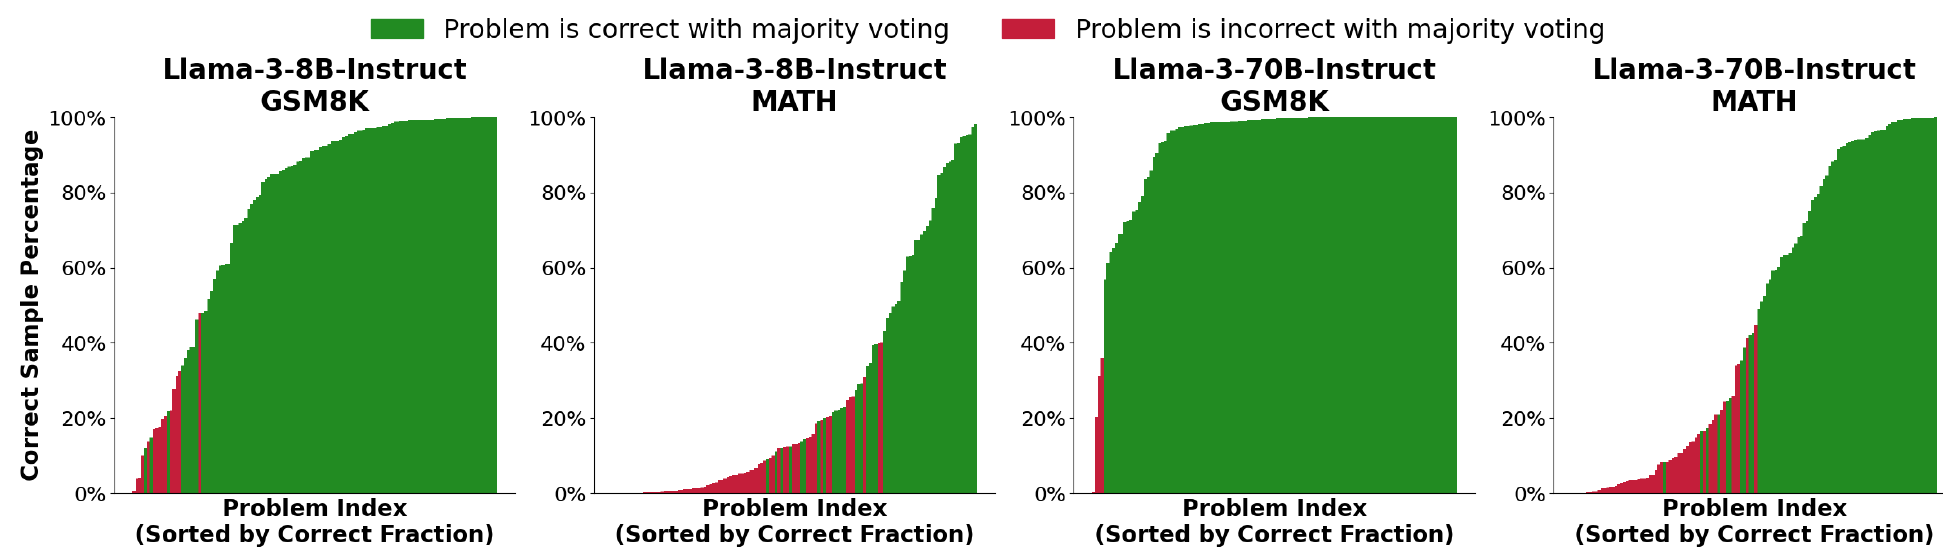
Jusqu'à présent, nous nous sommes concentrés sur la mesure de la couverture du modèle, en caractérisant les bénéfices de l'échantillonnage répété dans le scénario où nous pouvons toujours identifier les échantillons corrects du modèle. Nous nous tournons maintenant vers le problème complémentaire de la précision : étant donné une collection d'échantillons du modèle, à quelle fréquence pouvons-nous identifier les échantillons corrects ? En particulier, nous nous intéressons à la performance des vérificateurs lorsque nous augmentons le nombre d'échantillons. Pour certains problèmes, les solutions correctes sont échantillonnées à partir du modèle avec de faibles probabilités (par exemple \(1\%\) ou moins, voir Figure 8). À mesure que le nombre d'échantillons augmente et que des solutions correctes rares sont générées pour davantage de problèmes, la couverture du modèle s'améliore. Pour convertir ces améliorations de couverture en taux de réussite plus élevés, les vérificateurs doivent être capables de trouver « l'aiguille dans la botte de foin » et d'identifier les échantillons corrects peu fréquents.
4.1 Les méthodes de vérification courantes ne passent pas toujours à l'échelle avec le budget d'échantillons
Parmi les cinq tâches que nous évaluons, seules GSM8K et MATH manquent d'outils pour vérifier automatiquement les solutions. Nous testons trois approches de vérification simples et couramment utilisées sur leur capacité à identifier les solutions correctes à partir de ces jeux de données :
1. Vote majoritaire : nous choisissons la réponse finale la plus fréquente [60].
2. Modèle de récompense + Best-of-N : nous utilisons un modèle de récompense [17] pour noter chaque solution, et choisissons la réponse de l'échantillon ayant obtenu le meilleur score.
3. Modèle de récompense + Vote majoritaire : nous calculons un vote majoritaire où chaque échantillon est pondéré par son score de modèle de récompense.
Nous réutilisons les collections de 10 000 échantillons que nous avons générées avec Llama- 3- 8B- Instruct et Llama- 3- 70B- Instruct dans la section 2. Nous utilisons ArmoRM- Llama3- 8B- v0.1 [57] comme modèle de récompense, qui obtient un score élevé dans la section raisonnement du classement RewardBench [39]. Nous rapportons nos résultats dans la Figure 7 à mesure que nous augmentons le nombre d'échantillons. Bien que les taux de réussite augmentent initialement avec le nombre d'échantillons pour les trois méthodes, ils atteignent un plateau autour de 100 échantillons. Pendant ce temps, la couverture continue d'augmenter avec le nombre d'échantillons et finit par dépasser 95%. Dans le cas du vote majoritaire, cette saturation du taux de réussite est intuitive, puisque l'apparition de solutions correctes rares n'affecte pas la réponse la plus fréquente que choisit le vote majoritaire.
Compte tenu des faibles performances de ces vérificateurs (en particulier du modèle de récompense), il est raisonnable de se demander à quel point il est « difficile » de vérifier une solution candidate. Avec GSM8K et MATH, seule la réponse finale d'un échantillon est utilisée pour évaluer l'exactitude, les chaînes de raisonnement intermédiaires étant écartées. Si les modèles ne généraient que des chaînes de raisonnement dénuées de sens avant de deviner une réponse finale correcte, la vérification pourrait ne pas être plus facile que la résolution du problème lui-même. Nous examinons cette question en évaluant manuellement 105 chaînes de raisonnement issues d'échantillons corrects de Llama-3-8B-Instruct sur des problèmes GSM8K, et nous rapportons nos résultats dans le tableau 2. Nous constatons que plus de des chaînes de raisonnement que nous avons évaluées sont fidèles, même parmi les problèmes où les réponses correctes sont générées rarement. Ces étapes de raisonnement correctes indiquent qu'il existe un signal que le vérificateur peut exploiter pour identifier les échantillons corrects. Fait intéressant, au cours de ce processus, nous avons également identifié un problème GSM8K dont la réponse de référence est incorrecte (voir annexe E). Ce problème GSM8K incorrect est aussi le seul pour lequel Llama-3-70B-Instruct n'a pas généré d'échantillon « correct » en 10 000 tentatives.
| Pass@1 | Problèmes | CoT évaluées | CoT correcte | CoT incorrecte | Vérité terrain incorrecte |
| 0-10% | 5 | 15 | 11 | 1 | 1 problème, 3 CoT |
| 10-25% | 10 | 30 | 27 | 3 | 0 problème |
| 25-75% | 29 | 30 | 28 | 2 | 0 problème |
| 75-100% | 84 | 30 | 30 | 0 | 0 problème |
Tableau 2 : Évaluation humaine de la validité du raisonnement en chaîne de pensée dans les réponses de Llama-3-8B-Instruct à des problèmes GSM8K. 3 chaînes de raisonnement ont été évaluées par problème. Même pour les questions difficiles, où le modèle ne réussit que des échantillons, les CoT suivent presque toujours des étapes logiques valides. Pour les générations du modèle et les annotations humaines, voir ici
4.2 Vérificateurs et tâches logicielles : deux mises en garde
Les tâches de développement logiciel peuvent occuper une position intermédiaire en ce qui concerne les outils de vérification disponibles. D'une part, la capacité d'exécuter et de tester du code permet un degré de vérification automatique plus élevé que ce qui est possible avec des tâches linguistiques non structurées. Cependant, des outils comme les tests unitaires adoptent une approche en boîte noire pour vérifier un morceau de code et ne sont pas aussi complets que des méthodes telles que les vérificateurs de preuves. Ces imperfections du processus de vérification peuvent conduire à des faux positifs et/ou des faux négatifs qu'il est important de prendre en compte lors de l'application de l'échantillonnage répété. Ci-dessous, nous fournissons deux exemples d'imperfections de vérificateurs logiciels que nous
avons rencontrées lors de la génération de nos résultats de la section 2.1
4.2.1 Tests instables dans SWE-bench Lite
Lors de la production de nos résultats sur SWE-bench Lite, nous avons identifié que des problèmes ont des suites de tests instables qui ne produisent pas de résultats cohérents lorsqu'on les exécute sur la même solution candidate. Ces tests instables classent parfois même les solutions de référence du jeu de données comme incorrectes. De plus, les suites de tests de certains problèmes peuvent être non déterministes selon la solution candidate. Par exemple, deux problèmes SWE-bench Lite impliquent la manipulation d'ensembles Python, qui sont naturellement non ordonnés. Les solutions de référence de ces problèmes ordonnent explicitement les éléments de l'ensemble et réussissent les suites de tests de manière fiable. Cependant, certaines solutions candidates générées par le modèle n'imposent pas un tel ordre et réussissent donc les tests lors de certaines exécutions « chanceuses » et pas lors d'autres. Dans l'annexe B, nous listons tous les identifiants de problèmes pour lesquels nous avons identifié des tests instables. Nous rapportons également nos résultats SWE-bench Lite de la figure 2 avec les problèmes problématiques retirés, et trouvons des résultats similaires à nos évaluations sur l'ensemble du jeu de données.
4.2.2 Faux négatifs dans CodeContests
Chaque problème du jeu de données CodeContests est accompagné d'un ensemble de cas de test entrée-sortie utilisés pour évaluer l'exactitude des solutions. Ces cas de test sont plus complets que ceux des benchmarks de programmation antérieurs comme APPS [25], ce qui réduit la fréquence des solutions faux positives qui réussissent tous les cas de test sans résoudre complètement le problème décrit. Cependant, la construction des suites de tests de CodeContests conduit à des solutions faux négatives qui sont correctes mais échouent aux tests.
Pour certains problèmes CodeContests, la description du problème autorise plusieurs sorties correctes distinctes pour une entrée de test donnée. Cependant, les cas de test correspondants ne gèrent pas ces scénarios et exigent à la place qu'une sortie correcte particulière soit émise. De plus, de nombreux cas de test CodeContests ont été générés programmatiquement en mutant les cas de test originaux du problème. Certaines entrées mutées violent les spécifications d'entrée du problème (par exemple, une entrée mutée valant zéro alors que la description promet un entier positif). Ces cas de test malformés peuvent conduire à un comportement incohérent entre différentes solutions correctes.
Nous évaluons la prévalence de ces problèmes en exécutant la suite de tests de chaque problème sur la liste des solutions correctes fournies par CodeContests. Parmi les 122 problèmes de l'ensemble de test qui ont des solutions Python3, nous constatons que 35 problèmes ont des solutions « correctes » qui échouent aux tests correspondants. Comme nous ne permettons pas aux modèles de consulter tous les cas de test d'un problème (et leurs particularités), l'application de l'échantillonnage répété à ces problèmes comporte un élément de « coup de dés » pour générer une solution qui soit non seulement correcte, mais émette aussi les sorties particulières qui réussissent les tests.
5 Discussion et limites
Dans ce travail, nous explorons l'échantillonnage répété comme axe de mise à l'échelle du calcul au moment de l'inférence afin d'améliorer les performances du modèle. Sur une gamme de modèles et de tâches, l'échantillonnage répété peut améliorer significativement la fraction de problèmes résolus à l'aide de n'importe quel échantillon généré (c'est-à-dire la couverture). Lorsque les solutions correctes peuvent être identifiées (soit avec des outils de vérification automatique, soit avec d'autres algorithmes de vérification), l'échantillonnage répété peut amplifier les capacités du modèle au moment de l'inférence. Cette amplification peut rendre la combinaison d'un modèle plus faible et de nombreux échantillons plus performante et plus rentable que l'utilisation de moins de tentatives d'un modèle plus fort et plus coûteux.
Améliorer l'échantillonnage répété : Dans nos expériences, nous n'explorons qu'une version simple de l'échantillonnage répété où toutes les tentatives pour un problème sont générées indépendamment les unes des autres en utilisant exactement le même prompt et les mêmes hyperparamètres. Nous pensons que cette configuration peut être raffinée pour améliorer les performances, en particulier dans les directions suivantes :
1. Diversité des solutions : Nous nous appuyons actuellement sur une température d'échantillonnage positive comme unique mécanisme pour créer de la diversité parmi les échantillons. Combiner cet échantillonnage au niveau des tokens avec d'autres approches de plus haut niveau pourrait permettre d'accroître encore la diversité. Par exemple, AlphaCode conditionne différents échantillons avec différentes balises de métadonnées.
2. Interactions multi-tours : Bien que des outils de vérification automatique soient disponibles lors de la résolution de problèmes CodeContests et MiniF2F, nous utilisons uniquement une configuration à un seul tour où les modèles génèrent une solution sans aucune possibilité d'itérer dessus. Fournir aux modèles un retour d'exécution de ces outils devrait améliorer la qualité des solutions. Nous nous intéressons aux compromis associés aux interactions multi-tours, puisque chaque tentative devient plus coûteuse, mais peut aussi avoir plus de chances de réussir.
3. Apprendre des tentatives précédentes : Actuellement, nos expériences isolent complètement les tentatives les unes des autres. L'accès aux échantillons existants, en particulier si des outils de vérification peuvent fournir un retour à leur sujet, pourrait être utile lors de la génération de tentatives futures.
Échantillonnage répété et systèmes d'inférence : L'échantillonnage répété est une charge de travail d'inférence LLM distincte de la diffusion de requêtes de chatbot. Les déploiements de chatbots en production mettent l'accent sur de faibles latences de réponse, et le respect des objectifs de latence peut imposer une taille de lot plus faible par dispositif et réduire l'utilisation du matériel. En revanche, lorsqu'on échantillonne de nombreux complétions pour un seul prompt, l'accent peut être davantage mis sur le débit global et la maximisation de l'utilisation du matériel. De plus, l'échantillonnage répété peut bénéficier d'optimisations spécialisées de l'attention qui exploitent les chevauchements de prompts entre séquences [34] [6] [66]. L'inférence par échantillonnage répété peut donc être réalisée à un coût inférieur à celui de l'envoi naïf de nombreuses requêtes parallèles à une API orientée chatbot. Ces économies de coûts peuvent motiver davantage le choix d'échantillonner de nombreuses fois à partir d'un modèle moins coûteux plutôt que moins de fois à partir d'un modèle plus coûteux.
Vérificateurs : Nos résultats de la section 4 soulignent l'importance d'améliorer les méthodes de vérification des échantillons lorsque des outils permettant de le faire automatiquement ne sont pas disponibles. Dotter les modèles de la capacité d'évaluer leurs propres sorties permettra d'étendre l'échantillonnage répété à bien plus de tâches. Un intérêt particulier réside dans l'application de l'échantillonnage répété à des tâches non structurées comme l'écriture créative, qui peut nécessiter une comparaison plus subjective entre différents échantillons que les tâches réussite-échec que nous considérons. Une direction alternative au développement de vérificateurs fondés sur des modèles consiste à concevoir des convertisseurs capables de rendre une tâche non structurée vérifiable, par exemple en formalisant un énoncé mathématique informel dans un langage comme Lean afin que des vérificateurs de preuves puissent être appliqués.
6 Travaux connexes
Mise à l'échelle du calcul d'inférence : Les méthodes qui effectuent un calcul supplémentaire au moment de l'inférence ont réussi dans de nombreux domaines de l'apprentissage profond. Dans divers environnements de jeu, les méthodes de pointe exploitent la recherche au moment de l'inférence pour examiner de nombreux états de jeu futurs possibles avant de décider d'un coup [12] [50] [10]. Des méthodes similaires fondées sur des arbres peuvent également être efficaces en combinaison avec des LLM, permettant aux modèles de mieux planifier et d'explorer différentes approches [63, 8, 53, 54]. Un autre axe pour augmenter le calcul d'inférence des LLM permet aux modèles de consacrer des tokens à délibérer sur un problème avant d'aboutir à une solution [62, 61, 64]. De plus, plusieurs modèles peuvent être assemblés au moment de l'inférence pour combiner leurs forces [58, 14, 45, 56, 31]. Une autre approche encore consiste à utiliser des LLM pour critiquer et affiner leurs propres réponses [43, 7].
Échantillonnage répété : Des travaux antérieurs ont démontré que l'échantillonnage répété peut améliorer les capacités des LLM dans plusieurs domaines. L'un des cas d'usage les plus efficaces est la programmation [48, 15, 38], où les performances continuent de s'améliorer jusqu'à un million d'échantillons et où des outils de vérification (par exemple des tests unitaires) sont souvent disponibles pour évaluer automatiquement chaque solution candidate. Récemment, Greenblatt [23] montre que l'échantillonnage répété est efficace pour résoudre des énigmes du défi ARC [16], en observant une mise à l'échelle log-linéaire à mesure que le nombre d'échantillons augmente. Dans cette application, l'échantillonnage répété combiné à un classement best-of-N avec un modèle de récompense peut surpasser l'échantillonnage glouton d'une seule réponse [30]. Dans les domaines dépourvus d'outils de vérification automatique, les travaux existants montrent que l'utilisation du vote majoritaire [60], l'interrogation d'un LLM [19], ou l'entraînement d'un vérificateur fondé sur un modèle [18, 42, 29, 59, 35], pour décider d'une réponse finale peut améliorer les performances sur des tâches de raisonnement par rapport à un seul échantillon. Nguyen et al. [44] constatent que le vote majoritaire sur les réponses dépassant un seuil de longueur peut surpasser le vote sur toutes les réponses. En parallèle de notre travail, Song et al. [51] constatent que l'utilisation du meilleur échantillon disponible améliore les performances des LLM sur des tâches de chat, de mathématiques et de code, en balayant jusqu'à un maximum de 128 échantillons. De plus, Hassid et al. [24] constatent que, pour résoudre des tâches de programmation, il peut être plus efficace de tirer davantage d'échantillons d'un modèle plus petit que de tirer moins d'échantillons d'un modèle plus grand.
Lois d'échelle : Caractériser la manière dont la mise à l'échelle affecte les performances du modèle peut conduire à des décisions plus éclairées sur la façon d'allouer les ressources. Les lois d'échelle pour l'entraînement des LLM établissent une relation de loi de puissance entre la perte et la quantité de calcul d'entraînement et fournissent des estimations pour la taille optimale du modèle et du jeu de données étant donné un budget de calcul fixe [27, 36, 28]. Jones [33] identifie des lois d'échelle dans le contexte du jeu de société Hex, en observant que les performances évoluent de manière prévisible avec la taille du modèle et la difficulté du problème. Fait intéressant, ils montrent également que les performances évoluent avec la quantité de calcul en phase de test dépensée lors de l'exécution de la recherche arborescente. Récemment, Shao et al. [49] observent des lois d'échelle lors de l'augmentation des LLM avec des jeux de données de récupération externes, constatant que les performances sur les tâches de récupération évoluent de façon régulière avec la taille du corpus de récupération.
7 Remerciements
Nous remercions Together AI pour avoir partiellement sponsorisé le calcul pour ce projet, ainsi que Rahul Chalamala et Ben Athiwaratkun pour leur aide dans la gestion de cette infrastructure. Nous remercions John Yang pour ses conseils et son soutien lors de l'exécution de nos expériences SWE-bench. Enfin, nous sommes reconnaissants envers Mayee Chen, Neel Guha, Quinn McIntyre, Jon Saad-Falcon et Benjamin Spector pour leurs discussions utiles et leurs retours tout au long de ce projet.
Nous reconnaissons avec gratitude le soutien du NIH sous le n° U54EB020405 (Mobilize), de la NSF sous les n° CCF2247015 (Hardware-Aware), CCF1763315 (Beyond Sparsity), CCF1563078 (Volume to Velocity) et 1937301 (RTML) ; du US DEVCOM ARL sous les n° W911NF-23-2-0184 (Long-context) et W911NF-21-2-0251 (Interactive Human-AI Teaming) ; de l'ONR sous le n° N000142312633 (Deep Signal Processing) ; du Stanford HAI sous le n° 247183 ; de NXP, Xilinx, LETI-CEA, Intel, IBM, Microsoft, NEC, Toshiba, TSMC, ARM, Hitachi, BASF, Accenture, Ericsson, Qualcomm, Analog Devices, Google Cloud, Salesforce, Total, du programme HAI-GCP Cloud Credits for Research, de la Stanford Data Science Initiative (SDSI), et des membres du projet Stanford DAWN : Meta, Google et VMWare. Le gouvernement des États-Unis est autorisé à reproduire et distribuer des réimpressions à des fins gouvernementales nonobstant toute mention de droit d'auteur y figurant. Toute opinion, conclusion ou recommandation exprimée dans ce document est celle des auteurs et ne reflète pas nécessairement les vues, politiques ou approbations, expresses ou implicites, du NIH, de l'ONR ou du gouvernement des États-Unis.
Ce travail a été réalisé avec le soutien des bourses du Clarendon Fund.
Références
[1] Aide.dev, 2024. URL https://aide.dev/
[2] Hello gpt- 4o, 2024. URL https://openai.com/index/hello-gpt- 4o/
[3] Meta llama 3, 2024. URL https://llama.meta.com/llama3/
[4] Claude 3.5 sonnet, 2024. URL https://www.anthropic.com/news/claude- 3- 5- sonnet
[5] Voyage ai, 2024. URL https://www.voyageai.com/
[6] Ben Athiwaratkun, Sujan Kumar Gonugondla, Sanjay Krishna Gouda, Haifeng Qian, Hantian Ding, Qing Sun, Jun Wang, Jiacheng Guo, Liangfu Chen, Parminder Bhatia, Ramesh Nallapati, Sudipta Sengupta, et Bing Xiang. Bifurcated attention: Accelerating massively parallel decoding with shared prefixes in llms, 2024. URL https://arxiv.org/abs/2403.08845
[7] Yuntao Bai, Saurav Kadavath, Sandipan Kundu, Amanda Askell, Jackson Kernion, Andy Jones, Anna Chen, Anna Goldie, Azalia Mirhoseini, Cameron McKinnon, Carol Chen, Catherine Olsson, Christopher Olah, Danny Hernandez, Dawn Drain, Deep Ganguli, Dustin Li, Eli Tran- Johnson, Ethan Perez, Jamie Kerr, Jared Mueller, Jeffrey Ladish, Joshua Landau, Kamal Ndousse, Kamile Lukosuite, Liane Lovitt, Michael Sellitto, Nelson Elhage, Nicholas Schiefer, Noemi Mercado, Nova DasSarma, Robert Lasenby, Robin Larson, Sam Ringer, Scott Johnston, Shauna Kravec, Sheer El Showk, Stanislav Fort, Tamera Lanham, Timothy Telleen- Lawton, Tom Conerly, Tom Henighan, Tristan Hume, Samuel R. Bowman, Zac Hatfield- Dodds, Ben Mann, Dario Amodei, Nicholas Joseph, Sam McCandlish, Tom Brown, et Jared Kaplan. Constitutional ai: Harmlessness from ai feedback, 2022.
[8] Maciej Besta, Nils Blach, Ales Kubicek, Robert Gerstenberger, Michal Podstawski, Lukas Gianinazzi, Joanna Gajda, Tomasz Lehmann, Hubert Niewiadomski, Piotr Nyczyk, et Torsten Hoefler. Graph of thoughts: Solving elaborate problems with large language models. Proceedings of the AAAI Conference on Artificial Intelligence, 38(16):17682- 17690, mars 2024. ISSN 2159- 5399. doi: 10.1609/aaai.v38i16.29720. URL http://dx.doi.org/10.1609/aaai.v38i16.29720
[9] Stella Biderman, Hailey Schoelkopf, Quentin Anthony, Herbie Bradley, Kyle O'Brien, Eric Hallahan, Mohammad Aflah Khan, Shivanshu Purohit, USVSN Sai Prashanth, Edward Raff, Aviya Skowron, Lintang Sutawika, et Oskar van der Wal. Pythia: A suite for analyzing large language models across training and scaling, 2023. URL https://arxiv.org/abs/2304.01373
[10] Noam Brown, Anton Bakhtin, Adam Lerer, et Qucheng Gong. Combining deep reinforcement learning and search for imperfect- information games. In Proceedings of the 34th International Conference on Neural Information Processing Systems, NIPS '20, Red Hook, NY, USA, 2020. Curran Associates Inc. ISBN 9781713829546.
[11] Tom B. Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, Sandhini Agarwal, Ariel Herbert- Voss, Gretchen Krueger, Tom Henighan, Rewon Child, Aditya Ramesh, Daniel M. Ziegler, Jeffrey Wu, Clemens Winter, Christopher Hesse, Mark Chen, Eric Sigler, Mateusz Litwin, Scott Gray, Benjamin Chess, Jack Clark, Christopher Berner, Sam McCandlish, Alec Radford, Ilya Sutskever, et Dario Amodei. Language models are few- shot learners, 2020. URL https://arxiv.org/abs/2005.14165
[12] Murray Campbell, A. Joseph Hoane, et Feng- hsiung Hsu. Deep blue. Artif. Intell., 134(1- 2):57- 83, jan 2002. ISSN 0004- 3702. doi: 10.1016/S0004- 3702(01)00129- 1. URL https://doi.org/10.1016/S0004- 3702(01)00129- 1
[13] Guoxin Chen, Minpeng Liao, Chengxi Li, et Kai Fan. Alphamath almost zero: process supervision without process, 2024.
[14] Lingjiao Chen, Jared Quincy Davis, Boris Hanin, Peter Bailis, Ion Stoica, Matei Zaharia, et James Zou. Are more llm calls all you need? towards scaling laws of compound inference systems, 2024. URL https://arxiv.org/abs/2403.02419
[15] Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, Alex Ray, Raul Puri, Gretchen Krueger, Michael Petrov, Heidy Khlaaf, Girish Sastry, Pamela Mishkin, Brooke Chan, Scott Gray, Nick Ryder, Mikhail Pavlov, Alethea Power, Lukasz Kaiser, Mohammad Bavarian, Clemens Winter, Philippe Tillet, Felipe Petroski Such, Dave Cummings, Matthias Plappert, Fotios Chantzis, Elizabeth Barnes, Ariel Herbert- Voss, William Hebgen Guss, Alex Nichol, Alex Paino, Nikolas Tezak, Jie Tang, Igor Babuschkin, Suchir Balaji, Shantanu Jain, William Saunders, Christopher Hesse, Andrew N. Carr, Jan Leike, Josh Achiam, Vedant Misra, Evan Morikawa, Alec Radford, Matthew Knight, Miles Brundage, Mira Murati, Katie Mayer, Peter Welinder, Bob McGrew, Dario Amodei, Sam McCandlish, Ilya Sutskever, et Wojciech Zaremba. Evaluating large language models trained on code, 2021. URL https://arxiv.org/abs/2107.03374
[16] François Chollet. On the measure of intelligence, 2019. URL https://arxiv.org/abs/1911.01547
[17] Paul Christiano, Jan Leike, Tom B. Brown, Miljan Martic, Shane Legg, et Dario Amodei. Deep reinforcement learning from human preferences, 2017. URL https://arxiv.org/abs/1706.03741
[18] Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, Christopher Hesse, et John Schulman. Training verifiers to solve math word problems, 2021.
[19] Jared Quincy Davis, Boris Hanin, Lingjiao Chen, Peter Bailis, Ion Stoica, et Matei Zaharia. Networks of networks: Complexity class principles applied to compound ai systems design, 2024. URL https://arxiv.org/abs/2407.16831
[20] DeepSeek- AI et al. Deepseek- v2: A strong, economical, and efficient mixture- of- experts language model, 2024. URL https://arxiv.org/abs/2405.04434
[21] Mostafa Dehghani, Anurag Arnab, Lucas Beyer, Ashish Vaswani, et Yi Tay. The efficiency misnomer, 2022. URL https://arxiv.org/abs/2110.12894
[22] Leo Gao, Jonathan Tow, Baber Abbasi, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Alain Le Noac'h, Haonan Li, Kyle McDonell, Niklas Muennighoff, Chris Ociepa, Jason Phang, Laria Reynolds, Hailey Schoelkopf, Aviya Skowron, Lintang Sutawika, Eric Tang, Anish Thite, Ben Wang, Kevin Wang, et Andy Zou. A framework for few- shot language model evaluation, 12 2023. URL https://zenodo.org/records/10256836
[23] Ryan Greenblatt. Getting 50 https://www.lesswrong.com/posts/Rdwui3wHxCeKb7feK/ getting- 50- sota- on- arc- agi- with- gpt- 40 2024.
[24] Michael Hassid, Tal Remez, Jonas Gehring, Roy Schwartz, et Yossi Adi. The larger the better? improved llm code- generation via budget reallocation, 2024. URL https://arxiv.org/abs/2404.00725
[25] Dan Hendrycks, Steven Basart, Saurav Kadavath, Mantas Mazeika, Akul Arora, Ethan Guo, Collin Burns, Samir Puranik, Horace He, Dawn Song et Jacob Steinhardt. Measuring coding challenge competence with apps, 2021.
[26] Dan Hendrycks, Collin Burns, Saurav Kadavath, Akul Arora, Steven Basart, Eric Tang, Dawn Song et Jacob Steinhardt. Measuring mathematical problem solving with the math dataset, 2021.
[27] Joel Hestness, Sharan Narang, Newsha Ardalani, Gregory Diamos, Heewoo Jun, Hassan Kianinejad, Md. Mostofa Ali Patwary, Yang Yang et Yanqi Zhou. Deep learning scaling is predictable, empirically, 2017. URL https://arxiv.org/abs/1712.00409
[28] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, Tom Hennigan, Eric Noland, Katie Millican, George van den Driessche, Bogdan Damoc, Aurelia Guy, Simon Osindero, Karen Simonyan, Erich Elsen, Jack W. Rae, Oriol Vinyals et Laurent Sifre. Training compute- optimal large language models, 2022. URL https://arxiv.org/abs/2203.15556
[29] Arian Hosseini, Xingdi Yuan, Nikolay Malkin, Aaron Courville, Alessandro Sordoni et Rishabh Agarwal. V- star: Training verifiers for self- taught reasoners, 2024.
[30] Robert Irvine, Douglas Boubert, Vyas Raina, Adian Liusie, Ziyi Zhu, Vineet Mudupalli, Aliaksei Korshuk, Zongyi Liu, Fritz Cremer, Valentin Assassi, Christie-Carol Beauchamp, Xiaoding Lu, Thomas Rialan et William Beauchamp. Récompenser les chatbots pour l'engagement dans le monde réel avec des millions d'utilisateurs, 2023. URL https://arxiv.org/abs/2303.06135
[31] Dongfu Jiang, Xiang Ren et Bill Yuchen Lin. Llm-blender : Ensembling de grands modèles de langage avec classement par paires et fusion générative, 2023. URL https://arxiv.org/abs/2306.02561
[32] Carlos E. Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press et Karthik Narasimhan. Swe-bench : Les modèles de langage peuvent-ils résoudre des problèmes github du monde réel ?, 2024. URL https://arxiv.org/abs/2310.06770
[33] Andy L. Jones. Mise à l'échelle des lois d'échelle avec des jeux de société, 2021. URL https://arxiv.org/abs/2104.03113
[34] Jordan Juravsky, Bradley Brown, Ryan Ehrlich, Daniel Y Fu, Christopher Ré et Azalia Mirhoseini. Hydragen : Inférence llm à haut débit avec des préfixes partagés. arXiv preprint arXiv:2402.05099, 2024.
[35] Jikun Kang, Xin Zhe Li, Xi Chen, Amirreza Kazemi, Qianyi Sun, Boxing Chen, Dong Li, Xu He, Quan He, Feng Wen, Jianye Hao et Jun Yao. Mindstar : Améliorer le raisonnement mathématique dans les llm pré-entraînés au moment de l'inférence, 2024. URL https://arxiv.org/abs/2405.16265
[36] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B. Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu et Dario Amodei. Lois d'échelle pour les modèles de langage neuronaux, 2020.
[37] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B. Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu et Dario Amodei. Lois d'échelle pour les modèles de langage neuronaux, 2020. URL https://arxiv.org/abs/2001.08361
[38] Sumith Kulal, Panupong Pasupat, Kartik Chandra, Mina Lee, Oded Padon, Alex Aiken et Percy Liang. Spoc : Pseudocode vers code basé sur la recherche, 2019. URL https://arxiv.org/abs/1906.04908
[39] Nathan Lambert, Valentina Pyatkin, Jacob Morrison, LJ Miranda, Bill Yuchen Lin, Khyathi Chandu, Nouha Dziri, Sachin Kumar, Tom Zick, Yejin Choi, Noah A. Smith et Hannaneh Hajishirzi. Reward-bench : Évaluation des modèles de récompense pour la modélisation du langage, 2024. URL https://arxiv.org/abs/2403.13787
[40] Aitor Lewkowycz, Anders Andreassen, David Dohan, Ethan Dyer, Henryk Michalewski, Vinay Ramasesh, Ambrose Slone, Cem Anil, Imanol Schlag, Theo Gutman-Solo, Yuhuai Wu, Behnam Neyshabur, Guy Gur-Ari et Vedant Misra. Résoudre des problèmes de raisonnement quantitatif avec des modèles de langage, 2022. URL https://arxiv.org/abs/2206.14858
[41] Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond, Tom Eccles, James Keeling, Felix Gimeno, Agustin Dal Lago, Thomas Hubert, Peter Choy, Cyprien de Masson d'Autume, Igor Babuschkin, Xinyun Chen, Po-Sen Huang, Johannes Welbl, Sven Gowal, Alexey Cherepanov, James Molloy, Daniel J. Mankowitz, Esme Sutherland Robson, Pushmeet Kohli, Nando de Freitas, Koray Kavukcuoglu et Oriol Vinyals. Génération de code de niveau compétition avec alphacode. Science, 378(6624):1092-1097, décembre 2022. ISSN 1095-9203. doi : 10.1126/science.abq1158. URL http://dx.doi.org/10.1126/science.abq1158
[42] Hunter Lightman, Vineet Kosaraju, Yura Burda, Harri Edwards, Bowen Baker, Teddy Lee, Jan Leike, John Schulman, Ilya Sutskever et Karl Cobbe. Vérifions étape par étape, 2023.
[43] Aman Madaan, Niket Tandon, Prakhar Gupta, Skyler Hallinan, Luyu Gao, Sarah Wiegreffe, Uri Alon, Nouha Dziri, Shrimai Prabhumoye, Yiming Yang, Shashank Gupta, Bodhisattwa Prasad Majumder, Katherine Hermann, Sean Welleck, Amir Yazdanbakhsh et Peter Clark. Self-refine : Raffinement itératif avec auto-feedback, 2023. URL https://arxiv.org/abs/2303.17651
[44] Alex Nguyen, Dheeraj Mekala, Chengyu Dong et Jingbo Shang. Quand la prédiction cohérente est-elle susceptible d'être une prédiction correcte ?, 2024. URL https://arxiv.org/abs/2407.05778
[45] Isaac Ong, Amjad Almahairi, Vincent Wu, Wei-Lin Chiang, Tianhao Wu, Joseph E. Gonzalez, M Waleed Kadous et Ion Stoica. Routellm : Apprendre à router les llm avec des données de préférence, 2024. URL https://arxiv.org/abs/2406.18665
[46] OpenAI et al. Rapport technique Gpt-4, 2024. URL https://arxiv.org/abs/2303.08774
[47] Alec Radford, Jeff Wu, Rewon Child, David Luan, Dario Amodei et Ilya Sutskever. Les modèles de langage sont des apprenants multitâches non supervisés. 2019.
[48] Baptiste Roziere, Jonas Gehring, Fabian Gloeckle, Sten Sootla, Itai Gat, Xiaoqing Ellen Tan, Yossi Adi, Jingyu Liu, Romain Sauvestre, Tal Remez, Jérémy Rapin, Artyom Kozhevnikov, Ivan Evtimov, Joanna Bitton, Manish Bhatt, Cristian Canton Ferrer, Aaron Grattafiori, Wenhan Xiong, Alexandre Défossez, Jade Copet, Faisal Azhar, Hugo Touvron, Louis Martin, Nicolas Usunier, Thomas Scialom et Gabriel Synnaeve. Code llama : Modèles de fondation ouverts pour le code, 2023. URL https://arxiv.org/abs/2308.12950
[49] Rulin Shao, Jacqueline He, Akari Asai, Weijia Shi, Tim Dettmers, Sewon Min, Luke Zettlemoyer et Pang Wei Koh. Mise à l'échelle des modèles de langage basés sur la récupération avec un magasin de données d'un billion de tokens, 2024. URL https://arxiv.org/abs/2407.12854
[50] David Silver, Thomas Hubert, Julian Schrittwieser, Ioannis Antonoglou, Matthew Lai, Arthur Guez, Marc Lanctot, Laurent Sifre, Dharshan Kumaran, Thore Graepel, Timothy Lillicrap, Karen Simonyan et Demis Hassabis. Maîtriser les échecs et le shogi par auto-jeu avec un algorithme général d'apprentissage par renforcement, 2017.
[51] Yifan Song, Guoyin Wang, Sujian Li et Bill Yuchen Lin. Le bon, le mauvais et le glouton : L'évaluation des llm ne devrait pas ignorer la non-déterminisme, 2024. URL https://arxiv.org/abs/2407.10457
[52] Gemma Team et al. Gemma : Modèles ouverts basés sur la recherche et la technologie gemini, 2024. URL https://arxiv.org/abs/2403.08295
[53] Ye Tian, Baolin Peng, Linfeng Song, Lifeng Jin, Dian Yu, Haitao Mi et Dong Yu. Vers l'auto-amélioration des llm via l'imagination, la recherche et la critique, 2024. URL https://arxiv.org/abs/2404.12253
[54] Trieu H. Trinh, Yuhuai Wu, Quoc V. Le, He He et Thang Luong. Résoudre la géométrie des olympiades sans démonstrations humaines. Nature, 625(7995):476-482, 2024. ISSN 1476-4687. doi : 10.1038/s41586-023-06747-5. URL https://doi.org/10.1038/s41586-023-06747-5
[55] Pauli Virtanen, Ralf Gommers, Travis E. Oliphant, Matt Haberland, Tyler Reddy, David Cournapeau, Evgeni Burovski, Pearu Peterson, Warren Weckesser, Jonathan Bright, Stéfan J. van der Walt, Matthew Brett, Joshua Wilson, K. Jarrod Millman, Nikolay Mayorov, Andrew R. J. Nelson, Eric Jones, Robert Kern, Eric Larson, C J Carey, Ilhan Polat, Yu Feng, Eric W. Moore, Jake VanderPlas, Denis Laxalde, Josef Perktold, Robert Cimrman, Ian Henriksen, E. A. Quintero, Charles R. Harris, Anne M. Archibald, António H. Ribeiro, Fabian Pedregosa, Paul van Mulbregt et les contributeurs de SciPy 1.0. SciPy 1.0 : algorithmes fondamentaux pour le calcul scientifique en Python. Nature Methods, 17:261-272, 2020. doi : 10.1038/s41592-019-0686-2.
[56] Fanqi Wan, Xinting Huang, Deng Cai, Xiaojun Quan, Wei Bi et Shuming Shi. Fusion de connaissances des grands modèles de langage, 2024. URL https://arxiv.org/abs/2401.10491
[57] Haoxiang Wang, Wei Xiong, Tengyang Xie, Han Zhao et Tong Zhang. Préférences interprétables via une modélisation de récompense multi-objectifs et un mélange d'experts, 2024. URL https://arxiv.org/abs/2406.12845
[58] Junlin Wang, Jue Wang, Ben Athiwaratkun, Ce Zhang et James Zou. Le mélange d'agents améliore les capacités des grands modèles de langage, 2024. URL https://arxiv.org/abs/2406.04692
[59] Peiyi Wang, Lei Li, Zhihong Shao, R. X. Xu, Damai Dai, Yifei Li, Deli Chen, Y. Wu et Zhifang Sui. Math-shepherd : vérifier et renforcer les LLM étape par étape sans annotations humaines, 2024. URL https://arxiv.org/abs/2312.08935
[60] Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc Le, Ed Chi, Sharan Narang, Aakanksha Chowdhery et Denny Zhou. Self-consistency improves chain of thought reasoning in language models, 2023.
[61] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Brian Ichter, Fei Xia, Ed Chi, Quoc Le et Denny Zhou. Chain-of-thought prompting elicits reasoning in large language models, 2023.
[62] Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan et Yuan Cao. React: Synergizing reasoning and acting in language models, 2022. URL https://arxiv.org/abs/2210.03629
[63] Shunyu Yao, Dian Yu, Jeffrey Zhao, Izhak Shafran, Thomas L. Griffiths, Yuan Cao et Karthik Narasimhan. Tree of thoughts: Deliberate problem solving with large language models, 2023. URL https://arxiv.org/abs/2305.10601
[64] Eric Zelikman, Georges Harik, Yijia Shao, Varuna Jayasiri, Nick Haber et Noah D. Goodman. Quiet-star: Language models can teach themselves to think before speaking, 2024. URL https://arxiv.org/abs/2403.09629
[65] Kunhao Zheng, Jesse Michael Han et Stanislas Polu. Minif2f: a cross-system benchmark for formal olympiad-level mathematics. arXiv preprint arXiv:2109.00110, 2021.
[66] Lianmin Zheng, Liangsheng Yin, Zhiqiang Xie, Chuyue Sun, Jeff Huang, Cody Hao Yu, Shiyi Cao, Christos Kozyrakis, Ion Stoica, Joseph E. Gonzalez, Clark Barrett et Ying Sheng. Sglang: Efficient execution of structured language model programs, 2024. URL https://arxiv.org/abs/2312.07104
[67] Albert Orwall. Moatless tools. https://github.com/aorwall/moatless-tools/tree/a1017b78e3e69e7d205b1a3faa83a7d19fce3fa6, 2024.
A Configuration expérimentale d'échantillonnage
Nous rapportons les résultats sur les 130 questions de l'ensemble de test du jeu de données lean4 MiniF2F qui correspondent à des problèmes MATH formalisés. Ce jeu de données est dérivé de la version corrigée du jeu de données MiniF2F original créé par Zheng et al. [65]. Nous échantillonnons avec une température de 0,5 et n'utilisons pas d'échantillonnage par noyau. Nous avons généré 10 000 échantillons par problème. Nous utilisons les preuves des 5 théorèmes suivants de l'ensemble de validation comme exemples few-shot :
mathd_algebra_116 amc12_2000_p5 mathd_algebra_132 mathd_algebra_11 mathd_numbertheory_84
Notre invite est composée de :
1. Exemples few-shot.
2. Imports d'en-tête présents dans chaque problème du jeu de données HuggingFace cat-searcher/minif2f-lean4, une version téléversée du jeu de données lean4 MiniF2F.
3. La définition du théorème. Afin d'éviter de divulguer des informations sur la manière de résoudre le théorème à partir de son nom, nous remplaçons le nom du théorème par theorem_i. pour les exemples few-shot et pour le problème courant.
Nous fixons 200 comme longueur maximale en tokens pour la solution générée. Pour évaluer les solutions, nous utilisons la bibliothèque lean-dojo 1.1.2 avec la version de lean 4.3.0-rc2. Nous fixons un délai d'expiration de 10 secondes pour chaque étape tactique.
Exemple few-shot
Écrivez une preuve lean4 pour l'énoncé formel fourni. Vous avez accès à la bibliothèque standard mathlib4.
import Mathlib.Algebra.BigOperators.Basic
import Mathlib.Data.Real.Basic
import Mathlib.Data.Complex.Basic
import Mathlib.Data.Nat.Log
import Mathlib.Data.Complex.Exponential
import Mathlib.NumberTheory.Divisors
import Mathlib.Data.ZMod.Defs
import Mathlib.Data.ZMod.Basic
import Mathlib.Topology.Basic
import Mathlib.Data.Nat.Digits
open BigOperators
open Real
open Nat
open Topology
theorem theorem1
Int.floor ((9: ) / 160 \* 100) = 5 :=
by (
rw [Int.floor_eq_iff]
constructor
all.goals norm_num
)
Exemple d'invite
Écrivez une preuve lean4 pour l'énoncé formel fourni. Vous avez accès à la bibliothèque standard mathlib4.
\\\`pythonimport Mathlib.Algebra.BigOperators.Basic import Mathlib.Data.Real.Basic import Mathlib.Data.Complex.Basic import Mathlib.Data.Nat.Log import Mathlib.Data.Complex.Exponential import Mathlib.NumberTheory.Divisors import Mathlib.Data.ZMod.Defs import Mathlib.Data.ZMod.Basic import Mathlib.Topology.Basic import Mathlib.Data.Nat.Digits open BigOperators open Real open Nat open Topology theorem theorem6 (b h v : R) (h_0 : 0 < b \land 0 < h \land 0 < v) (h_1 : v = 1 / 3 * (b * h)) (h_2 : b = 30) (h_3 : h = 13 / 2) v = 65 := by (
A.2 CodeContests
Nous rapportons les résultats sur les 140 questions de l’ensemble de test qui n’incluent pas de balises d’image dans l’énoncé du problème. Nous échantillonnons avec une température de 0,6 et une valeur top-p de 0,95, conformément aux expériences de CodeLlama [48]. Nous générons 10 000 échantillons par problème. Nous utilisons deux exemples few-shot issus de l’ensemble d’entraînement, échantillonnés aléatoirement par problème. Nous fixons 1024 comme longueur maximale de tokens pour la solution générée. Nous utilisons la même fonction de comparaison des réponses que [41] et utilisons la concaténation des tests publics, privés et générés pour valider l’exactitude des solutions.
Exemple few-shot
Q : Écrire du code Python pour résoudre le problème de programmation suivant qui respecte les contraintes et passe les cas de test d’exemple. Le code de sortie doit lire depuis et écrire vers l’entrée/sortie standard. Veuillez entourer votre réponse de code en utilisant Petya a égal... (Reste de la question et exemples d’entrée/sortie)...
R :
while cnt .
if :
while cnt :
print(ans)...
Exemple d'invite
Q : Écrivez du code Python pour résoudre le problème de programmation suivant qui respecte les contraintes et passe les cas de test d'exemple. Le code de sortie doit lire depuis et écrire vers l'entrée/sortie standard. Veuillez envelopper votre réponse de code en utilisant Ceci est le...... (Reste de la question et exemples d'entrée/sortie)...
R :
A.3 MATH
Nous rapportons les résultats sur 128 problèmes de l'ensemble de test sélectionnés aléatoirement. Nous échantillonnons avec une température de 0,6 et n'utilisons pas d'échantillonnage par noyau. Nous utilisons les 5 exemples few-shot fixes de [40] pour chaque problème. Nous générons 10 000 échantillons par problème. Nous fixons 512 comme longueur maximale de jetons pour la solution générée. Pour noter les solutions, nous utilisons les fonctions minerva_math de LMEval [22] pour extraire la réponse finale du modèle. Nous vérifions ensuite la correction si la réponse extraite correspond exactement à la vérité terrain, ou si la fonction is_equiv de minerva_math dans LMEval s'évalue à vrai.
Exemple few-shot
Problème : Si et , alors trouvez
Solution : Nous avons que . Réponse finale : La réponse finale est 24. J'espère qu'elle est correcte.
Exemple d'invite
Problème : Quel est le domaine de la fonction f(x) = \frac{(2x - 3)(2x + 5)}{(3x - 9)(3x + 6)}? Exprimez votre réponse sous forme d'intervalle ou d'union d'intervalles.
Solution :
A.4 GSM8K
Nous rapportons les résultats sur 128 problèmes de l'ensemble de test échantillonnés aléatoirement. Nous échantillonnons avec une température de 0,6 et n'utilisons pas d'échantillonnage par noyau. Nous utilisons 5 exemples few-shot de l'ensemble d'entraînement qui sont échantillonnés aléatoirement par problème. Nous générons 10 000 échantillons par problème. Nous fixons 512 comme longueur maximale de jetons pour la solution générée. Pour noter les solutions, nous suivons LMEval [22] et extrayons les réponses à l'aide d'une expression régulière qui extrait la chaîne après les quadruples dièses. Comme pour MATH, nous évaluons ensuite la correction en vérifiant si la réponse extraite correspond exactement à la vérité terrain ou si is_equiv s'évalue à vrai.
Exemple few-shot
Question : James décide de remplacer sa voiture. Il a vendu sa voiture de 20 000 80\% \ pour de sa valeur. Combien a-t-il dû débourser ? Réponse : Il a vendu sa voiture pour Il a acheté la nouvelle voiture pour Cela signifie qu'il a déboursé
Exemple d'invite
Question : Mary a 6 pots de paillettes dans son garde-manger. Chaque pot de paillettes peut décorer 8 cupcakes. Mary veut cuire suffisamment de cupcakes pour utiliser toutes ses paillettes. Si chaque plaque contient 12 cupcakes, combien de plaques de cupcakes doit-elle cuire ?
Réponse :
B SWE-bench Lite
B.1 Configuration expérimentale
Pour nos expériences, nous utilisons DeepSeek- Coder- V2- Instruct avec le framework d'agent Moatless Tools (au commit a1017b78e3e69e7d205b1a3faa83a7d19fce3fa6). Nous utilisons les embeddings Voyage AI 5 pour la récupération, la valeur par défaut utilisée par Moatless Tools. Nous n'apportons aucune modification au modèle ni au framework, en les utilisant entièrement comme composants prêts à l'emploi.
Avec cette configuration, nous échantillonnons 250 complétions indépendantes pour chaque problème en utilisant un échantillonnage standard basé sur la température. Pour déterminer la température d'échantillonnage optimale, nous avons effectué un balayage sur un sous-ensemble aléatoire de 50 problèmes de l'ensemble de test, en testant les températures de 1,0, 1,4, 1,6 et 1,8. Sur la base de ces résultats, nous avons sélectionné une température de 1,6 pour nos expériences principales.
B.2 Instabilité de la suite de tests
Au cours de notre analyse, nous avons identifié 34 problèmes dans SWE- bench Lite dont les suites de tests présentaient des tests instables. À l'aide du harnais de test SWE- bench fourni par les auteurs de SWE- bench, nous avons testé chaque solution de manière répétée : pour certaines solutions, parfois la solution était marquée comme correcte, et d'autres fois comme incorrecte. Dans 30 de ces 34 cas, nous avons observé une instabilité même sur les solutions correctes fournies par les auteurs du jeu de données. Le tableau 3 liste les identifiants des 34 instances dont les tests sont instables.
| Dépôt | ID d'instance |
| django | django_django-13315, django_django-13447, django_django-13590, django_django-13710, django_django-13757, django_django-13933, django_django-13964, django_django-14017, django_django-14238, django_django-14382, django_django-14608, django_django-14672, django_django-14752, django_django-14915, django_django-14997, django_django-14999, django_django-15320, django_django-15738, django_django-15790, django_django-15814, django_django-15819, django_django-16229, django_django-16379, django_django-16400, django_django-17051 |
| sympy | sympy_sympy-13146, sympy_sympy-13177, sympy_sympy-16988 |
| requests | psf_requests-863, psf_requests-2317, psf_requests-2674, psf_requests-3362 |
| scikit-learn | scikit-learn_scikit-learn-13241 |
| matplotlib | matplotlib_matplotlib-23987 |
Tableau 3 : Identifiants d'instance des problèmes de SWE-bench Lite dont les tests sont instables.
Une instance supplémentaire, astropy_astropy- 6938, était instable sur certaines machines et pas sur d'autres. Les auteurs de SWE- bench ont pu reproduire l'instabilité ; cependant, nous n'avons pas pu le faire. Notre enquête préliminaire indique que ce problème spécifique est dû à des versions non épinglées de dépendances dans les environnements Docker qui exécutent les tests unitaires.
Ici, nous incluons les résultats sur un sous-ensemble dont les problèmes du tableau 3 ont été retirés (266 problèmes). Pour l'évaluation sur l'ensemble complet des données, sur tout problème dont les tests sont instables, nous exécutons la suite de tests 11 fois et utilisons le vote majoritaire pour déterminer si une solution a réussi ou échoué. Pour l'évaluation sur le sous-ensemble sans tests instables, toutes les références que nous comparons publient les problèmes qu'elles résolvent correctement, nous avons donc simplement retiré les problèmes à tests instables et recalculé leurs scores.
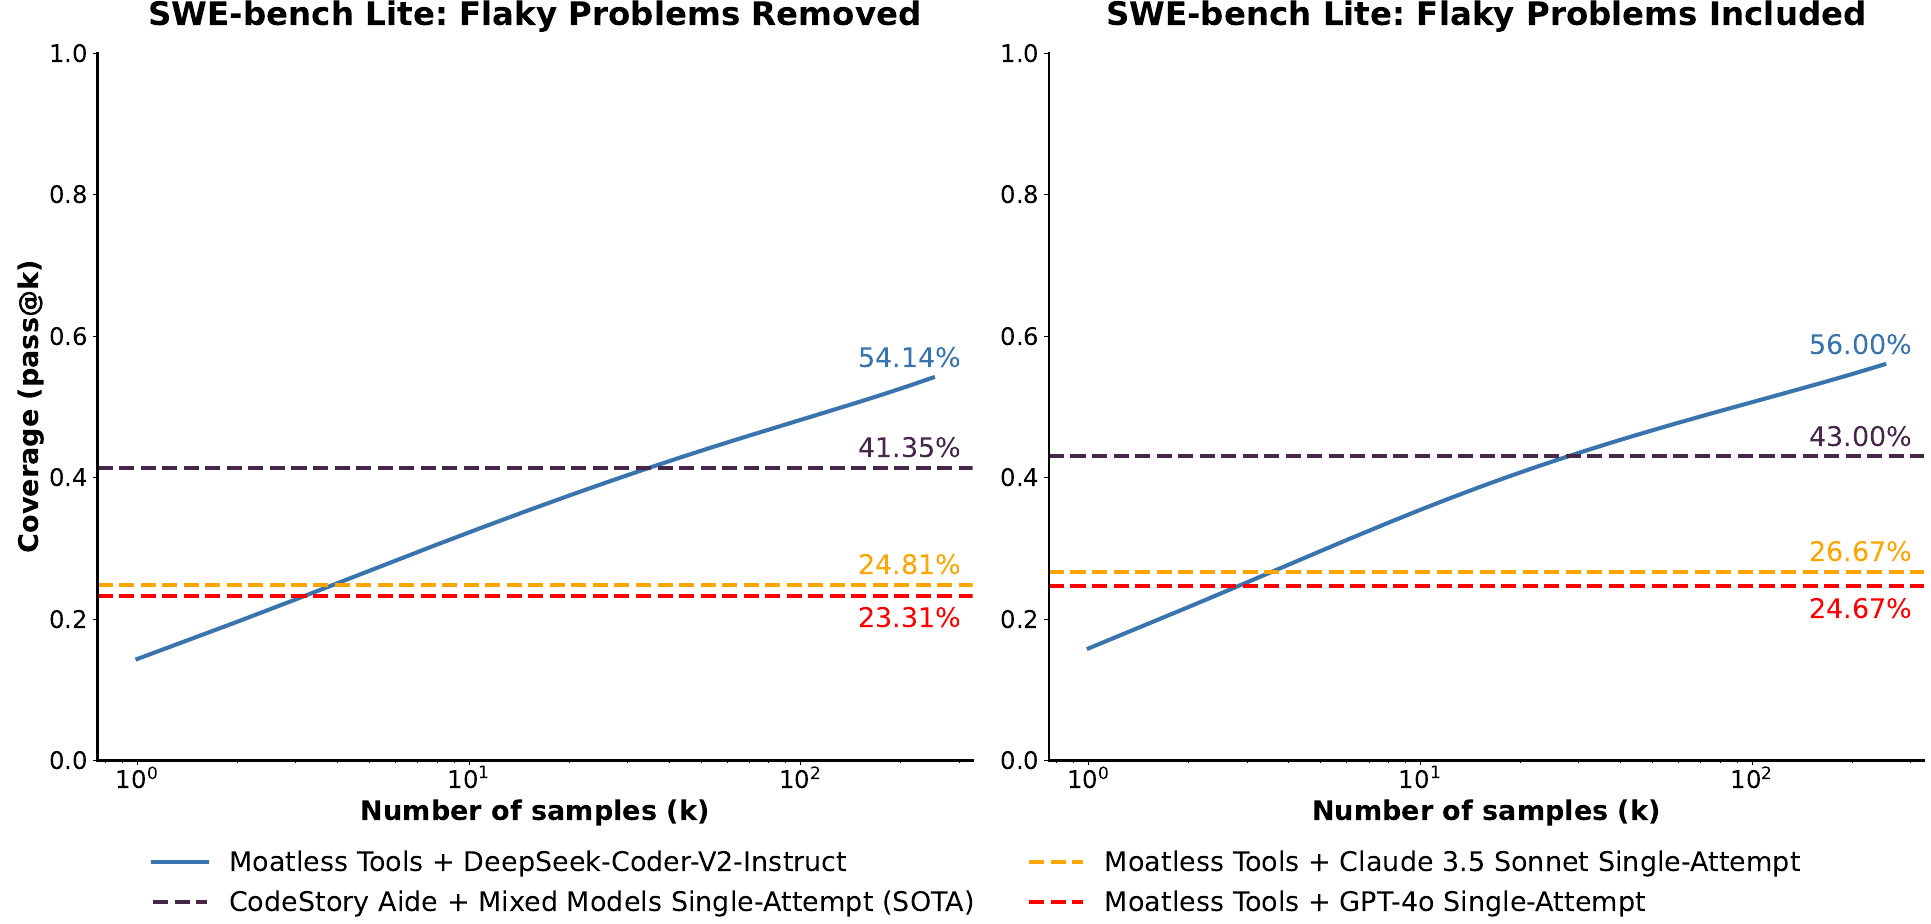
C Détails sur la loi d'échelle
C.1 Détails expérimentaux
Pour ajuster des lois de puissance exponentielles aux courbes de couverture, nous échantillonnons d'abord 40 points espacés uniformément sur une échelle logarithmique de 0 à 10 000 et supprimons les doublons. Nous utilisons ensuite la fonction curve_fit de SciPy 55 pour trouver les paramètres et de l'équation 3 qui ajustent le mieux ces points.
C.2 Résultats supplémentaires
Dans la figure 10, nous montrons des résultats supplémentaires ajustant des lois de puissance aux courbes de couverture pour un ensemble élargi de jeux de données et de modèles.
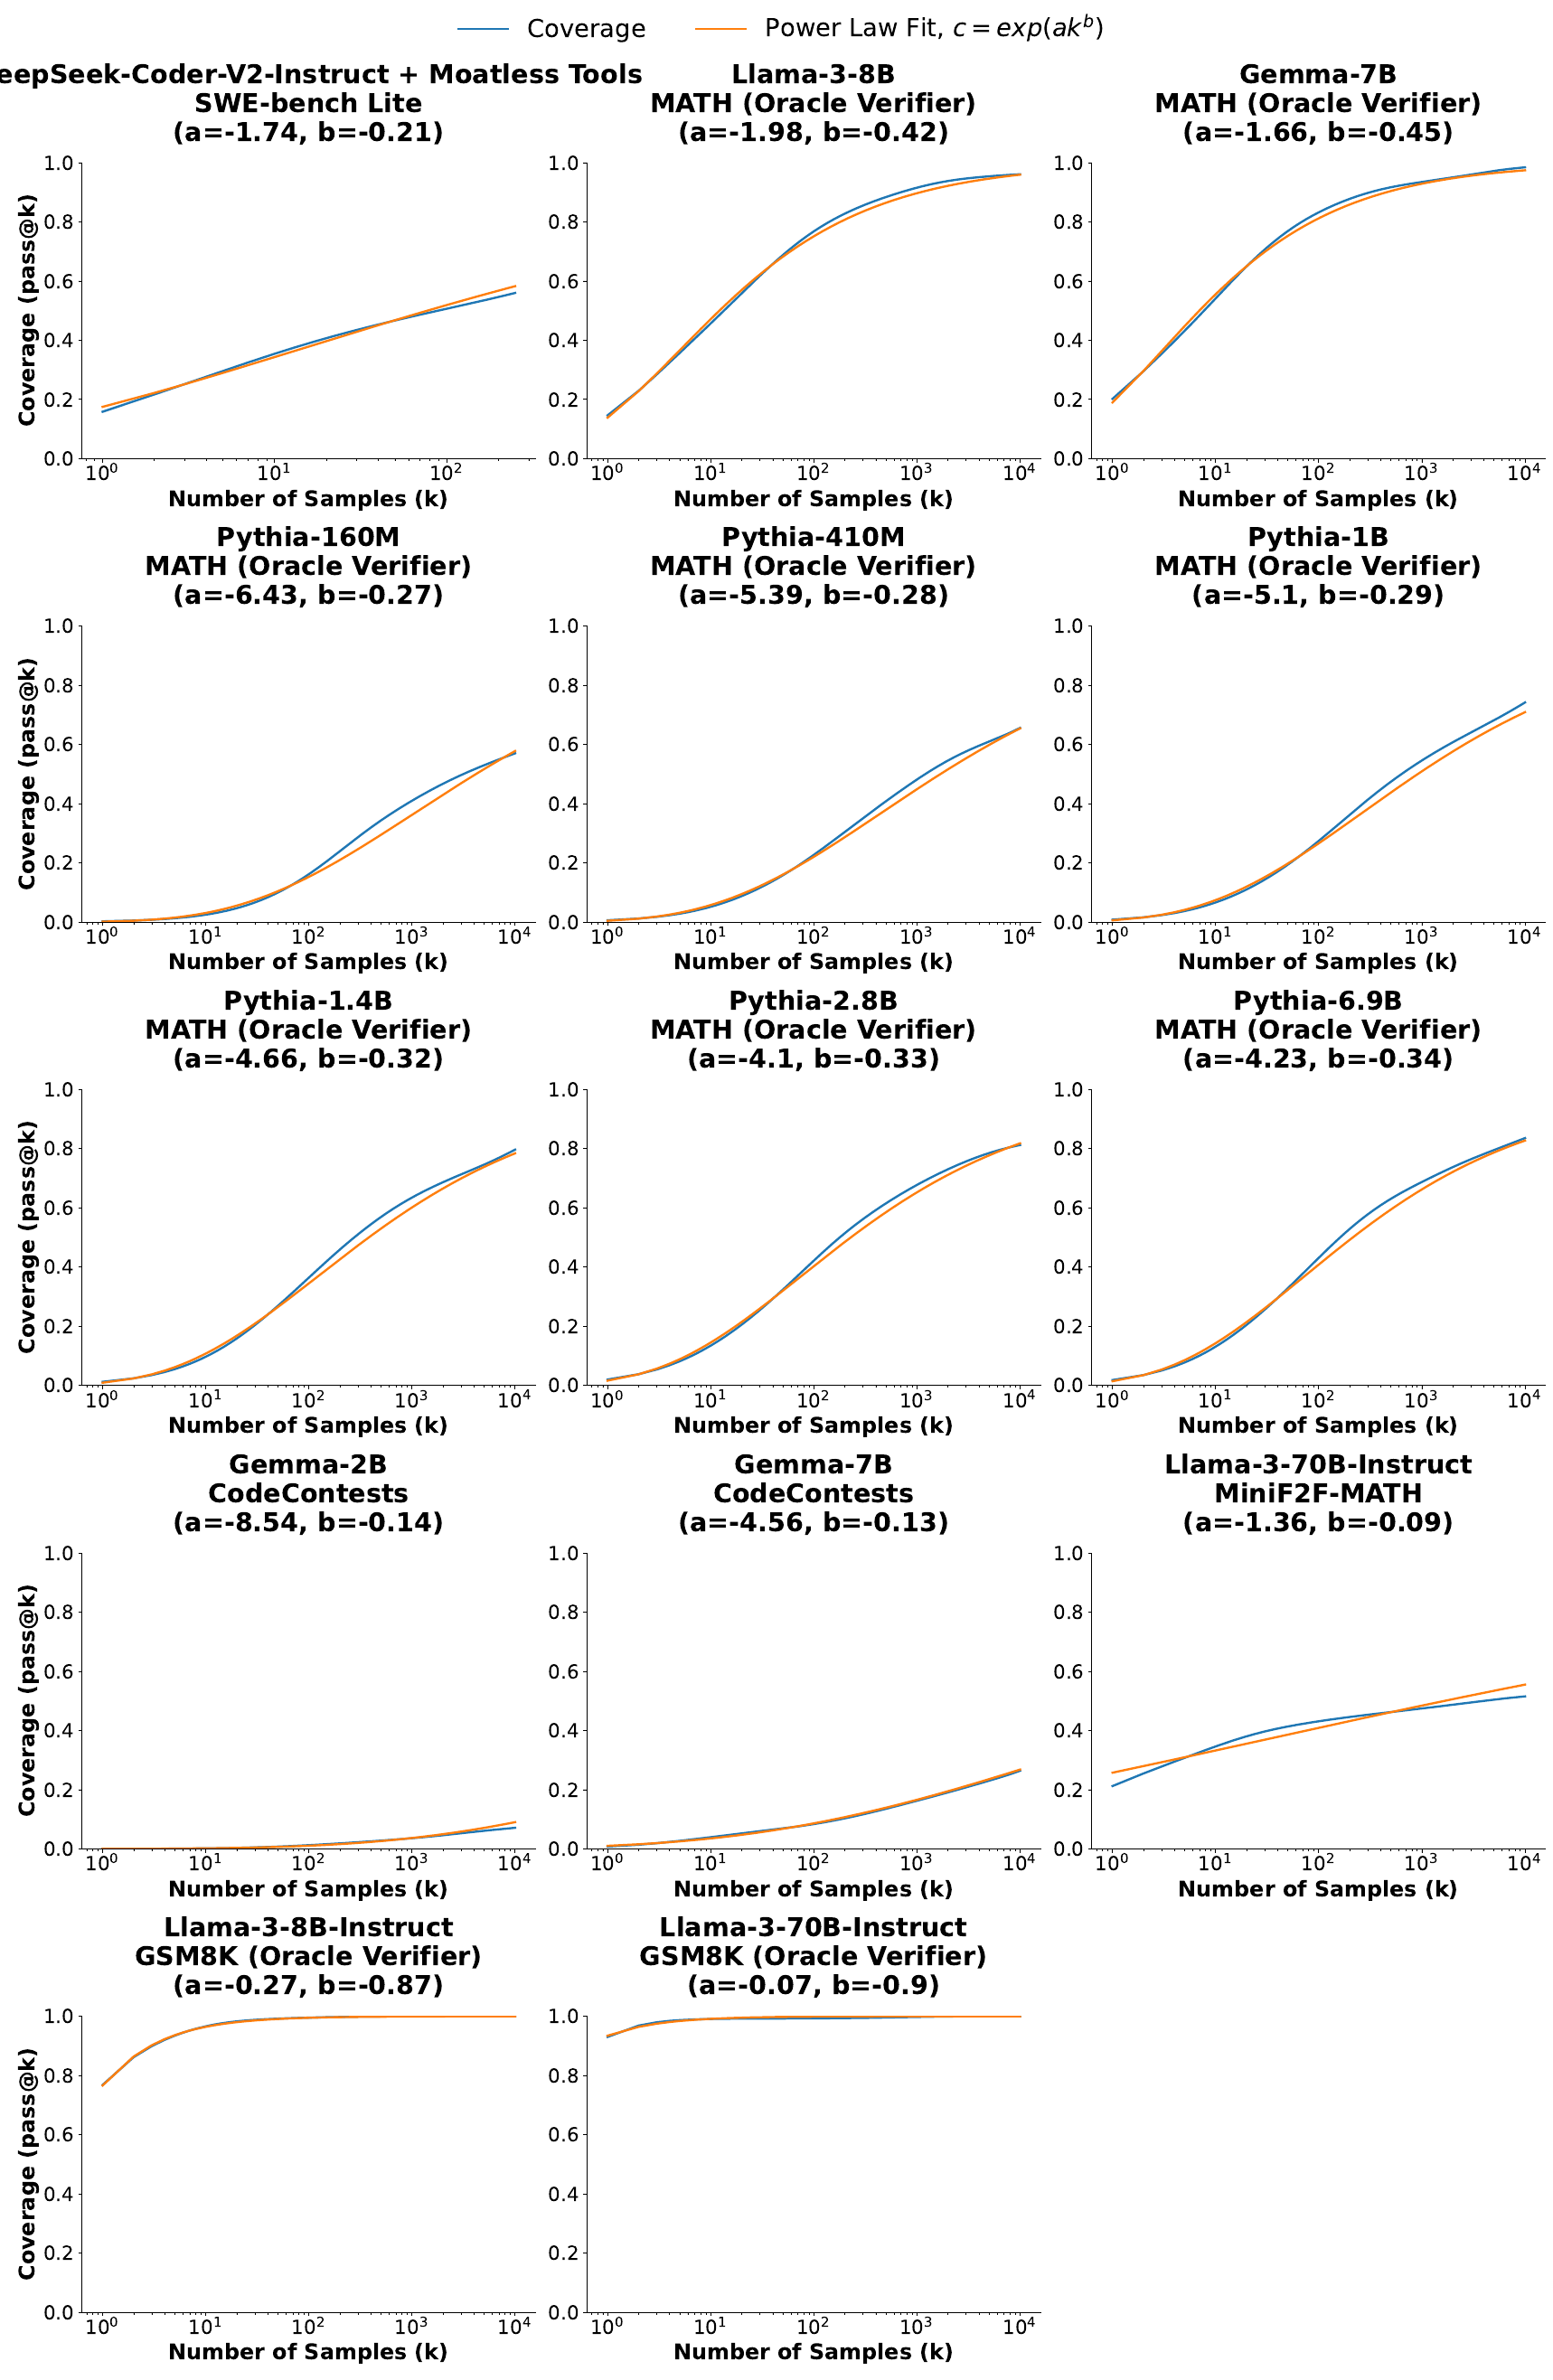
D Détails sur la précision
D Détails sur la précisionPour calculer les métriques Vote majoritaire, Modèle de récompense + Best- of- N et Modèle de récompense + Vote majoritaire, nous utilisons les mêmes sous-ensembles de 128 problèmes pour les jeux de données MATH et GSM8K introduits dans la section 2. Chaque problème correspond à 10 000 échantillons pour chaque modèle que nous testons. Pour chaque méthode de vérification, nous prenons 100 sous-ensembles aléatoires de taille et calculons le taux de réussite en utilisant chaque sous-ensemble. Nous rapportons la moyenne et l'écart-type sur les sous-ensembles dans la figure 7. Pour calculer la réponse par vote majoritaire, nous prenons la réponse plurielle dans chaque sous-ensemble (notez que deux réponses sont considérées comme équivalentes si elles correspondent exactement en tant que chaînes de caractères ou si is_equiv s'évalue à vrai). Pour le Modèle de récompense + Best- of- N, nous prenons la réponse ayant le score le plus élevé attribué par le modèle de récompense. Pour la métrique Modèle de récompense + Vote majoritaire, nous additionnons le score du modèle de récompense sur tous les échantillons ayant la même réponse finale, et utilisons la réponse finale ayant la somme la plus élevée.
E Réponse incorrecte dans GSM8K
Comme discuté en 4.1, nous identifions qu'un problème du jeu de test GSM8K (indice 1042 sur HuggingFace) comporte une solution de référence incorrecte.
Question
Le père de Johnny l'a emmené regarder des courses de chevaux et son père a parié de l'argent. Lors de la première course, il a perdu 5 \ de plus que le double de la somme qu'il avait perdue précédemment. Lors de la troisième course, il a perdu 1,5 fois ce qu'il avait gagné lors de la deuxième course. Combien a-t-il perdu en moyenne ce jour-là ?
Réponse
Lors de la deuxième course, il a gagné 11 1+5\times 2=<<1+52=11>>11 \ car Il a perdu un total de 20 15+5=<<15+5=20>>20 \ ce jour-là car Il a perdu en moyenne 3 9/3=<<9/3=3>>3\#\#\#\#3$
L'erreur se trouve à la deuxième ligne de la réponse : lors de la troisième course, le père de Johnny a perdu 16,5 \ , ce qui signifie qu'il a gagné 11 \ \ \ . Ainsi, la réponse est une perte moyenne de 3,5 \ par course (la réponse du jeu de données).