
Presque tous les modèles réussissent l'aiguille dans la botte de foin. RULER ajoute 13 tâches plus dures et montre un contexte réel bien plus court.
RULER: What's the Real Context Size of Your Long-Context Language Models?
RULER : Quelle est la véritable taille de contexte de vos modèles de langage à long contexte ?
Cheng-Ping Hsieh*, Simeng Sun*, Samuel Kriman, Shantanu Acharya Dima Rekesh, Fei Jia, Yang Zhang, Boris Ginsburg
NVIDIA
{chsieh, simengs}@nvidia.com
Résumé
Le test de l'aiguille dans une botte de foin (needle-in-a-haystack, NIAH), qui évalue la capacité à récupérer une information (l'« aiguille ») au sein de longs textes distracteurs (la « botte de foin »), a été largement adopté pour évaluer les modèles de langage (ML) à long contexte. Cependant, ce simple test fondé sur la récupération ne révèle qu'une forme superficielle de compréhension du long contexte. Afin de fournir une évaluation plus complète des ML à long contexte, nous créons un nouveau benchmark synthétique, RULER, doté de configurations flexibles pour personnaliser la longueur de séquence et la complexité des tâches. RULER étend le test NIAH original pour englober des variations portant sur divers types et quantités d'aiguilles. De plus, RULER introduit de nouvelles catégories de tâches — le traçage multi-sauts et l'agrégation — afin de tester des comportements allant au-delà de la simple recherche dans le contexte. Nous évaluons 17 ML à long contexte sur 13 tâches représentatives de RULER. Bien qu'ils atteignent une précision presque parfaite au test NIAH original, presque tous les modèles présentent d'importantes chutes de performance à mesure que la longueur du contexte augmente. Alors que tous ces modèles revendiquent des tailles de contexte de 32K tokens ou plus, seule la moitié d'entre eux maintient une performance satisfaisante à la longueur de 32K. Notre analyse de Yi-34B, qui prend en charge une longueur de contexte de 200K, révèle une marge d'amélioration importante à mesure que nous augmentons la longueur d'entrée et la complexité des tâches. Nous publions RULER en open source afin de stimuler une évaluation complète des ML à long contexte.
1 Introduction
Les avancées récentes en ingénierie des systèmes d'IA (Dao et al., 2022 ; Jacobs et al., 2023 ; Fu et al., 2024) et dans la conception des modèles de langage (Chen et al., 2023 ; Xiong et al., 2023) ont permis d'augmenter efficacement la longueur de contexte des modèles de langage (Liu et al., 2024a ; Young et al., 2024). Les travaux antérieurs (AI21, 2024 ; X.AI, 2024 ; Reid et al., 2024 ; Anthropic, 2024) adoptent couramment des tâches synthétiques, telles que la récupération de mot de passe (passkey retrieval ; Mohtashami & Jaggi, 2023) et l'aiguille dans une botte de foin (Kamradt, 2023), pour évaluer les ML à long contexte. Cependant, ces évaluations sont utilisées de manière incohérente d'un travail à l'autre et ne révèlent que la capacité de récupération, sans permettre de jauger d'autres formes de compréhension du long contexte.
Dans ce travail, nous proposons RULER, un nouveau benchmark pour évaluer les capacités de modélisation à long contexte des modèles de langage. RULER contient quatre catégories de tâches pour tester des comportements (Ribeiro et al., 2020) allant au-delà de la simple récupération dans le contexte :
1. Récupération : nous étendons le test de l'aiguille dans une botte de foin (Kamradt, 2023 ; NIAH) afin d'évaluer la capacité de récupération avec divers types et quantités d'aiguilles. 2. Traçage multi-sauts : nous proposons le suivi de variables, une tâche mandataire minimale pour la résolution de chaînes de coréférence, afin de vérifier le comportement de traçage d'entités présentant des connexions multi-sauts. 3. Agrégation : nous proposons l'extraction de mots communs/fréquents, des tâches mandataires pour le résumé visant à tester la capacité à agréger des informations pertinentes réparties sur un contexte de longue portée.
| Contexte en lecture seule pour la compréhension de la source (ne pas traduire) : | 1 Introduction | 1. Retrieval : nous étendons le test de l'aiguille dans une botte de foin (Kamradt, 2023 ; NIAH) pour évaluer la capacité de récupération avec des types et des quantités variés d'aiguilles. | 2. Multi-hop Tracing : nous proposons le suivi de variables, une tâche proxy minimale pour la résolution de chaînes de coréférence afin de vérifier le comportement du suivi d'entités avec des connexions multi-sauts. | 3. Aggregation : nous proposons l'extraction de mots communs/fréquents, des tâches proxy pour le résumé afin de tester la capacité à agréger des informations pertinentes. | Texte à traduire : |
| Benchmark & Tâche | Longueur moy. | Type | Tâches diverses | Connaissances paramétriques min. | Contexte contrôlable |
| ZeroSCROLLS | ~10k | réaliste | ✓ | X | X |
| L-Eval | ~8k | réaliste | ✓ | X | X |
| BAMBOO | ~16k | réaliste | ✓ | ✓ | X |
| LongBench | ~8k | hybride | ✓ | X | X |
| LooGLE | ~20k | hybride | ✓ | ✓ | X |
| InfiniteBench | ~200k | hybride | ✓ | ✓ | X |
| Needle-in-a-haystack (NIAH) | quelconque | synthétique | X | ✓ | ✓ |
| Passkey / Line / KV Retrieval | quelconque | synthétique | X | ✓ | ✓ |
4. Réponse à des questions : nous ajoutons des informations distractrices à l'entrée de jeux de données existants de réponse à des questions à contexte court afin d'évaluer la capacité de réponse à des questions à diverses tailles de contexte.
Comparé aux benchmarks réalistes existants (Tableau 1), RULER est composé uniquement de tâches synthétiques, ce qui offre la flexibilité de contrôler la longueur de séquence et la complexité des tâches. L'entrée synthétique de RULER réduit la dépendance aux connaissances paramétriques, qui interfèrent avec l'utilisation de l'entrée à long contexte dans les tâches réalistes (Shaham et al., [2023] ; Bai et al., [2023]).
À l'aide de RULER, nous évaluons Gemini-1.5 (Reid et al., [2024]), GPT-4 (OpenAI : Josh Achiam et al., [2023]) et 15 modèles open source dont la longueur de contexte varie de 4k à 128k. Bien qu'ils atteignent des performances presque parfaites au test NIAH original, presque tous les modèles présentent une forte dégradation sur les tâches plus complexes de RULER à mesure que la longueur de séquence augmente. Alors que tous les modèles revendiquent une taille de contexte de 32k tokens ou plus, nos résultats indiquent que seule la moitié d'entre eux peut traiter efficacement une longueur de séquence de 32K en dépassant un seuil qualitatif. De plus, presque tous les modèles passent sous le seuil avant d'atteindre les longueurs de contexte revendiquées. Afin d'obtenir des comparaisons fines entre modèles, nous agrégeons les performances de 4k à 128k à l'aide de deux scores moyens pondérés, où les poids simulent la distribution des longueurs des cas d'usage réels. Les deux meilleurs modèles — Gemini-1.5 et GPT-4 — surpassent systématiquement les autres modèles, quel que soit le schéma de pondération choisi.
Nous analysons ensuite Yi-34B, qui revendique une longueur de contexte de 200K et obtient des performances raisonnablement bonnes sur RULER parmi les modèles open source. Nos résultats démontrent une forte dégradation des performances de Yi à mesure que nous augmentons la longueur d'entrée et la complexité des tâches. À de grandes tailles de contexte, Yi-34B renvoie souvent des réponses incomplètes et échoue à localiser précisément l'information pertinente. De plus, nous observons deux comportements qui émergent avec l'augmentation de la taille du contexte sur plusieurs modèles : une dépendance accrue aux connaissances paramétriques et une tendance accrue à copier depuis le contexte pour les tâches de non-récupération. Nos ablations supplémentaires démontrent que l'entraînement sur des séquences plus longues ne conduit pas toujours à de meilleures performances sur RULER, et que des tailles de modèle plus grandes sont positivement corrélées à de meilleures capacités de long contexte. Enfin, nous montrons que les architectures non Transformer, telles que RWKV et Mamba, restent largement en retard par rapport aux Transformers sur RULER.
Nos contributions sont les suivantes :
- Nous proposons un nouveau benchmark, RULER, pour évaluer les modèles de langage à long contexte via des tâches synthétiques aux configurations flexibles. - Nous introduisons de nouvelles catégories de tâches, notamment le traçage multi-sauts et l'agrégation, afin de tester des comportements autres que la récupération dans un long contexte. - Nous évaluons 17 ML à long contexte à l'aide de RULER et réalisons une analyse à travers les modèles et les complexités de tâches.
Nous publions RULER en open source afin de stimuler la recherche future sur les modèles de langage à long contexte.
2 Travaux connexes
Modèles de langage à long contexte. De nombreux modèles de langage à long contexte ont été introduits récemment grâce aux progrès en ingénierie et dans les conceptions architecturales et algorithmiques. Flash attention (Dao et al., 2022 ; Dao, 2023) et Ring attention (Liu et al., 2023) réduisent considérablement l'empreinte mémoire requise pour traiter un long contexte. Divers mécanismes d'attention parcimonieuse (Child et al., 2019 ; Jaszczur et al., 2021), tels que l'attention parcimonieuse décalée (Chen et al., 2024), l'attention dilatée (Ding et al., 2023) et les puits d'attention (attention sinks ; Han et al., 2023 ; Xiao et al., 2024b), ont été employés pour permettre une mise à l'échelle efficace du contexte. De nouvelles méthodes d'encodage positionnel ont été proposées pour améliorer l'extrapolation en longueur des Transformers (Vaswani et al., 2017), notamment ALiBi (Press et al., 2022), xPOS (Sun et al., 2023b) et les variantes de RoPE (Su et al., 2023) (Chen et al., 2023 ; Xiong et al., 2023 ; Peng et al., 2024 ; Liu et al., 2024b ; Ding et al., 2024 ; Zhu et al., 2024). Un autre axe de recherche se concentre sur la réduction de la taille du contexte. Cela peut être réalisé en mettant en cache le contexte précédent à l'aide d'un mécanisme de récurrence (Zhang et al., 2024a ; Bulatov et al., 2023 ; Martins et al., 2022 ; Wu et al., 2022), en récupérant les informations pertinentes dans le contexte (Xu et al., 2024a ; Mohtashami & Jaggi, 2023 ; Wang et al., 2024 ; Tworkowski et al., 2024 ; Xiao et al., 2024a), ou en préservant l'information saillante par compression (Jiang et al., 2023). Enfin, de nouvelles architectures (Gu et al., 2022 ; Fu et al., 2023a ; Poli et al., 2023 ; Fu et al., 2023b ; Sun et al., 2023a ; Beck et al., 2024 ; Sun et al., 2024) telles que Mamba (Gu & Dao, 2023) et RWKV (Peng et al., 2023) ont également été proposées pour traiter efficacement une entrée à long contexte.
Benchmarks et tâches à long contexte. Notre travail est étroitement lié à d'autres travaux sur l'évaluation des modèles de langage à long contexte. ZeroSCROLLS (Shaham et al., 2023) couvre dix tâches réalistes en langage naturel, telles que la réponse à des questions sur de longs documents et le résumé (basé sur des requêtes). L-Eval (An et al., 2024) utilise également des données réalistes, qui ont été filtrées manuellement pour garantir leur qualité. LongBench (Bai et al., 2023) contient des tâches dans un cadre bilingue. InfiniteBench (Zhang et al., 2024b) inclut des tâches dont la longueur dépasse 100K tokens. LTM (Castillo et al., 2024) cible l'évaluation des conversations à long terme. Afin d'isoler l'effet des connaissances paramétriques, des travaux antérieurs (Dong et al., 2023 ; Li et al., 2023b) ont également proposé d'utiliser des documents publiés en ligne après une certaine date limite, ou d'exploiter des matériaux extrêmement peu dotés en ressources (Tanzer et al., 2024). Comparées aux benchmarks réalistes, les tâches synthétiques offrent une plus grande flexibilité pour contrôler la configuration (par exemple, la longueur de séquence et la complexité des tâches) et sont moins affectées par les connaissances paramétriques. Des travaux récents se sont principalement concentrés sur des tâches synthétiques fondées sur la récupération (Kamradt, 2023 ; Mohtashami & Jaggi, 2023 ; Li et al., 2023a ; Liu et al., 2024d ; Lee et al., 2024), quelques-uns examinant d'autres aspects, notamment le raisonnement factuel (Kuratov et al., 2024 ; Karpinska et al., 2024), la modélisation du discours à longue portée (Sun et al., 2022), la réponse à des questions (Levy et al., 2024 ; Yuan et al., 2024), l'apprentissage en contexte à nombreux exemples (many-shot in-context learning ; Agarwal et al., 2024 ; Bertsch et al., 2024 ; Xu et al., 2024b) et la compréhension de code (Liu et al., 2024c).
3 Le benchmark RULER
RULER comprend des tâches réparties en quatre catégories : la récupération, le traçage multi-sauts, l'agrégation et la réponse aux questions. Les exemples d'évaluation de RULER sont générés automatiquement à partir de configurations d'entrée (voir le tableau 2) qui définissent la longueur et la complexité de chaque entrée. Dans un domaine contraint comme celui de RULER, la complexité de la tâche peut être considérée comme une fonction du nombre de jetons de sortie cibles et du rapport signal-bruit dans le contexte. Nous renvoyons les lecteurs à (Goldman et al., 2024) pour une discussion plus complète sur la conception des tâches d'évaluation pour les modèles de langage à contexte long.
3.1 Récupération : Aiguille dans une botte de foin (NIAH)
Des travaux récents (Reid et al., 2024 ; Anthropic, 2023) emploient couramment le test de l'aiguille dans une botte de foin (Kamradt, 2023 ; NIAH) pour évaluer la capacité de modélisation à contexte long. Le test NIAH rappelle les tâches de rappel associatif largement étudiées (Hopfield, 1982 ; Graves et al., 2014 ; Olsson et al., 2022 ; Arora et al., 2024), dans lesquelles des informations pertinentes doivent être récupérées à partir du contexte étant donné une requête suffisante. Dans RULER, nous incluons plusieurs tâches fondées sur la récupération, étendant le test NIAH classique afin d'évaluer les modèles selon trois
| Contexte en lecture seule pour comprendre la source (ne constitue pas le texte source à traduire) : 3.1 Récupération : Needle-in-a-haystack (NIAH) Des travaux récents (Reid et al., 2024 ; Anthropic, 2023) emploient couramment le test needle-in-a-haystack (Kamradt, 2023 ; NIAH) pour évaluer la capacité de modélisation de contextes longs. Le test NIAH rappelle les tâches de rappel associatif largement étudiées (Hopfield, 1982 ; Graves et al., 2014 ; Olsson et al., 2022 ; Arora et al., 2024), dans lesquelles des informations pertinentes doivent être récupérées dans le contexte à partir d'une requête suffisante. Dans RULER, nous incl | Texte à traduire : | Tâche Configuration Exemple |
| SingleNIAH(S-NIAH) | type_key = wordtype_value = numbertype_haystack = essaysize_haystack < context length | (essais) L'un des nombres magiques spéciaux pour le contexte long est : 12345. Quel est le nombre magique spécial pour le contexte long mentionné dans le texte fourni ? Réponse : 12345 |
| Multi-keysNIAH(MK-NIAH) | num_keys = 2type_key = wordtype_value = numbertype_haystack = essaysize_haystack < context length | (essais) L'un des nombres magiques spéciaux pour le contexte long est : 12345. L'un des nombres magiques spéciaux pour le grand modèle est : 54321. Quel est le nombre magique spécial pour le contexte long mentionné dans le texte fourni ? Réponse : 12345 |
| Multi-valuesNIAH(MV-NIAH) | num_values = 2type_key = wordtype_value = numbertype_haystack = essaysize_haystack < context length | (essais) L'un des nombres magiques spéciaux pour le contexte long est : 12345. L'un des nombres magiques spéciaux pour le contexte long est : 54321. Quels sont tous les nombres magiques spéciaux pour le contexte long mentionnés dans le texte fourni ? Réponse : 12345 54321 |
| Multi-queriesNIAH(MQ-NIAH) | num_queries = 2type_key = wordtype_value = numbertype_haystack = essaysize_haystack < context length | (essais) L'un des nombres magiques spéciaux pour le contexte long est : 12345. L'un des nombres magiques spéciaux pour le grand modèle est : 54321. Quels sont tous les nombres magiques spéciaux pour le contexte long et le grand modèle mentionnés dans le texte fourni ? Réponse : 12345 54321 |
| VariableTracking(VT) | num_chains = 2num_hops = 2size_noises < context length | (bruits) VAR X1 = 12345 .... VAR Y1 = 54321 .... VAR X2 = X1 .... VAR Y2 = Y1 .... VAR X3 = X2 .... VAR Y3 = Y2 .... Trouvez toutes les variables auxquelles est attribuée la valeur 12345. Réponse : X1 X2 X3 |
| Common WordsExtraction(CWE) | freq_cw = 2, freq_ucw = 1num_cw = 10num_ucw < context length | aaa bbb cca aaa ddd eee ccc fff ggg hhh iii iii .... Quels sont les 10 mots les plus courants dans la liste ci-dessus ? Réponse : aaa ccc iii .... |
| Frequent WordsExtraction(FWE) | α = 2num_word < context length | aaa bbb cca aaa ddd eee ccc fff ggg aaa hhh aaa ccc iii iii .... Quels sont les 3 mots les plus fréquemment apparus dans le texte codé ci-dessus ? Réponse : aaa ccc iii QuestionAnswering(QA) dataset = SQuADnum_document < context length Document 1 : .... aaa .... Document 2 : .... bbb .... Document 3 : .... ccc .... Question : question Réponse : bbb |
critères. Concrètement, la capacité de récupération doit être (1) indépendante du type d'« aiguille » et de « botte de foin », (2) suffisamment forte pour ignorer les distracteurs difficiles, et (3) d'un rappel élevé lorsque plusieurs éléments doivent être récupérés. Sur la base de ces critères, nous développons quatre tâches NIAH. L'« aiguille » dans chacune de ces tâches est une paire clé-valeur insérée dans la « botte de foin » (longs textes distracteurs). La requête est située à la fin de la séquence et sert d'indice pour faire correspondre les clés dans le contexte et récupérer ensuite les valeurs associées.
- NIAH simple (S-NIAH) : il s'agit du test NIAH classique où une seule « aiguille » doit être récupérée dans la « botte de foin ». La requête/clé/valeur peut prendre la forme de mots, de nombres (7 chiffres) ou d'UUID (32 chiffres). La « botte de foin » peut être constituée de phrases de bruit répétées ou d'essais de Paul Graham (Kamradt, 2023).- NIAH multi-clés (MK-NIAH) : plusieurs « aiguilles » sont insérées dans la « botte de foin », et une seule d'entre elles doit être récupérée. Les « aiguilles » supplémentaires sont des distracteurs difficiles. Le paramètre le plus exigeant est une version où la « botte de foin » est remplie d'aiguilles distractrices.
- NIAH multi-valeurs (MV-NIAH) : plusieurs « aiguilles » partageant la même clé sont insérées dans la « botte de foin ». Toutes les valeurs associées à la même clé doivent être récupérées.- NIAH multi-requêtes (MQ-NIAH) : plusieurs « aiguilles » sont insérées dans la « botte de foin ». Toutes les « aiguilles » ayant des clés distinctes doivent être récupérées. Il s'agit de la même configuration de tâche de rappel associatif multi-requêtes que celle utilisée par Arora et al. (2024). Avec MV-NIAH, ces deux tâches évaluent la capacité de récupération sans omettre aucune information critique.
3.2 Traçage multi-sauts : suivi de variables (VT)
Une compréhension efficace du discours (van Dijk & Kintsch, 1983) dépend de la reconnaissance réussie des entités nouvellement mentionnées et de l'établissement de la chaîne de références coréférentielles à la même entité (Karttunen, 1969) tout au long du contexte long. Nous développons une nouvelle tâche, le suivi de variables, pour émuler une tâche minimale de résolution de chaîne de coréférence (Ng, 2010). Cette tâche vérifie le comportement consistant à suivre des motifs de cooccurrence pertinents et à établir des connexions sautées dans une entrée longue. Concrètement, une variable est initialisée avec une valeur , suivie d'une chaîne linéaire d'instructions de liaison de noms de variables (par exemple, , , ...), qui sont insérées à diverses positions de l'entrée. L'objectif est de renvoyer tous les noms de variables pointant vers la même valeur . La complexité de la tâche peut être augmentée en ajoutant davantage de sauts (c'est-à-dire le nombre de liaisons de noms) ou davantage de chaînes, de manière similaire à l'ajout de distracteurs difficiles dans MK-NIAH.
3.3 Agrégation : mots communs (CWE) et extraction de mots fréquents (FWE)
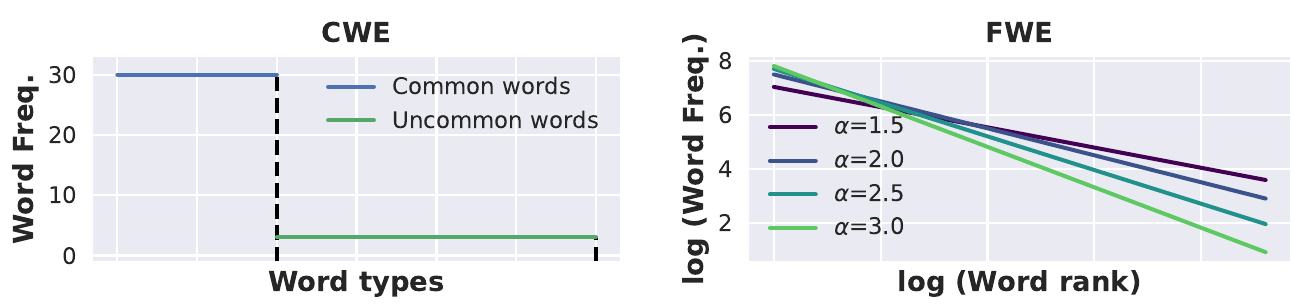
Dans RULER, nous introduisons une nouvelle catégorie servant de substitut aux tâches de résumé, où les informations pertinentes constituent une portion beaucoup plus grande du contexte et où la sortie cible dépend d'une agrégation précise de l'entrée pertinente. Concrètement, nous construisons une séquence d'entrée en échantillonnant des mots à partir d'une liste de mots (synthétique) prédéfinie. Dans la tâche d'extraction de mots communs (CWE), les mots sont échantillonnés à partir de distributions uniformes discrètes, le nombre de mots communs étant fixé tandis que le nombre de mots peu communs augmente avec la longueur de la séquence. Dans la tâche d'extraction de mots fréquents (FWE), les mots sont échantillonnés à partir d'une distribution Zeta. La figure 1 montre une illustration de la fréquence des mots dans l'entrée construite. Un modèle doit renvoyer les mots les plus fréquents du contexte. Dans CWE, est égal au nombre de mots communs. Dans FWE, nous fixons à 3, car augmenter conduit à de mauvaises performances même pour de petites tailles de contexte chez la plupart des modèles. La complexité de la tâche peut être ajustée en faisant varier le nombre de mots communs ou le paramètre de la distribution Zeta.4
3.4 Réponse aux questions (QA)
La majorité des jeux de données QA existants (Rajpurkar et al., 2018 ; Yang et al., 2018 ; Trivedi et al., 2022) sont conçus pour répondre à des questions fondées sur de courts passages. Ces jeux de données peuvent être étendus pour simuler une entrée à contexte long en ajoutant des informations distractrices. Dans cette catégorie de tâches, nous insérons les paragraphes dorés (c'est-à-dire les paragraphes contenant les réponses) dans des paragraphes échantillonnés aléatoirement à partir du même jeu de données. Cette catégorie est une adaptation réelle (Ivgi et al., 2023) du NIAH, où la question sert de requête, les paragraphes dorés sont les « aiguilles » et les paragraphes distracteurs forment la « botte de foin ».
4 Expériences et résultats
Modèles et configuration d'inférence Nous sélectionnons 17 LLM à contexte long, dont 15 modèles ouverts et deux modèles fermés (Gemini-1.5-Pro et GPT-4), couvrant diverses tailles de modèles (7B à 8x22B avec architecture MoE) et longueurs de contexte revendiquées (32K à 1M). Les informations complètes sur ces modèles sont incluses dans l'annexe A. Nous évaluons tous les modèles à l'aide de vLLM (Kwon et al., 2023), un système de service de LLM doté d'une gestion efficace de la mémoire du cache KV. Pour tous les modèles, nous exécutons l'inférence en BFloat16 sur 8 GPU NVIDIA A100 avec un décodage glouton.
Configurations des tâches Nous testons tous les modèles sur 13 tâches couvrant diverses complexités issues des quatre catégories de RULER. Les configurations de test ont été sélectionnées (présentées dans l'annexe B) sur la base d'une étude de corrélation entre tâches décrite dans l'annexe C. Nous sélectionnons ces tâches car la plupart des modèles obtiennent des performances correctes à une taille de contexte courte de 4K tokens. Notre objectif principal est de voir si les modèles peuvent maintenir de bonnes performances avec l'augmentation de la longueur du contexte. Pour chaque tâche, nous évaluons chaque modèle avec 500 exemples générés pour chaque longueur de la série (4K, 8K, 16K, 32K, 64K, 128K), tout en respectant le modèle de chat requis par chaque modèle. Pour empêcher le modèle de refuser de répondre à une requête ou de générer des explications, nous ajoutons à l'entrée de la tâche un préfixe de réponse et vérifions la présence de la sortie cible au moyen d'une exactitude basée sur le rappel.
Taille effective du contexte Nous observons une forte dégradation des performances de tous les modèles à mesure que nous augmentons la longueur de l'entrée dans RULER. Pour déterminer la taille maximale de contexte qu'un modèle peut traiter efficacement, nous notons chaque modèle selon un seuil fixe ; le dépassement de ce seuil indique des performances satisfaisantes à la longueur d'évaluation. Nous utilisons comme seuil les performances du modèle Llama2-7b à une longueur de contexte de 4K. Nous rapportons dans le tableau 3 la longueur maximale dépassant le seuil comme « longueur effective », ainsi que la « longueur revendiquée ».
Critères de classement des modèles Bien que la notation fondée sur un seuil révèle l'écart entre longueur revendiquée et longueur effective, elle manque de détails pour des comparaisons fines entre modèles. Ainsi, nous utilisons un score moyen pondéré pour agréger les performances des modèles sur différentes tailles de contexte. Nous classons les modèles selon deux schémas de pondération : wAvg. (inc) et wAvg. (dec), où le poids augmente et diminue linéairement avec la longueur de séquence, respectivement. Idéalement, le poids de chaque longueur devrait être déterminé par la distribution des longueurs d'utilisation des modèles ; ici, nous choisissons les deux schémas pour simuler les scénarios où les séquences plus longues (inc) ou plus courtes (dec) dominent la distribution.
Résultats principaux Nous incluons les résultats de 17 LM à contexte long en comparaison avec la référence Llama2-7B dans le tableau 3. La performance à une longueur donnée est la moyenne des 13 tâches de RULER. Le modèle fermé Gemini-1.5-Pro surpasse largement les autres modèles, avec une longueur effective supérieure à la longueur maximale que nous avons testée. Tester ce modèle sous pression avec une version plus difficile de RULER pourrait être intéressant à suivre dans de futurs travaux. Pour les autres modèles, bien qu'ils atteignent des performances presque parfaites sur la récupération de mot de passe et la tâche NIAH classique (présentées dans l'annexe E), tous présentent une forte dégradation dans RULER à mesure que la longueur de séquence augmente et ils ne parviennent pas à maintenir des performances supérieures à la référence Llama2-7B à leur longueur revendiquée. Les modèles ouverts les mieux classés (Llama3.1, Qwen2 et Command-R-plus) partagent des configurations communes, telles qu'une plus grande taille de modèle et l'utilisation de fréquences de base plus élevées dans
| Modèles | Longueur annoncée | Longueur effective | 4K | 8K | 16K | 32K | 64K | 128K | Moy. | Moy. pondérée (croiss.) | Moy. pondérée (décroiss.) |
| Llama2 (7B) | 4K | - | 85,6 | ||||||||
| Gemini-1.5-Pro | 1M | >128K | 96,7 | 95,8 | 96,0 | 95,9 | 95,9 | 94,4 | 95,8 | 95,5(1er) | 96,1(1er) |
| GPT-4 | 128K | 64K | 96,6 | 95,3 | 95,2 | 93,2 | 87,0 | 81,2 | 91,6 | 89,0(2e) | 94,1(2e) |
| Llama3.1 (70B) | 128K | 64K | 96,5 | 95,8 | 95,4 | 94,8 | 88,4 | 66,6 | 89,6 | 85,5(4e) | 93,7(3e) |
| Qwen2 (72B) | 128K | 32K | 96,9 | 96,1 | 94,9 | 94,1 | 79,8 | 53,7 | 85,9 | 79,6(9e) | 92,3(4e) |
| Contexte de référence en lecture seule pour comprendre la source (il ne s'agit pas du texte source à traduire) : 4 Expériences et résultats Résultats principaux Nous incluons les résultats de 17 modèles de langage de contexte long en comparaison avec la référence Llama2-7B dans le tableau 3. La performance à une certaine longueur est la moyenne des 13 tâches de RULER. Le modèle à source fermée Gemini-1.5-Pro surpasse largement le reste des modèles, avec une longueur effective supérieure à la longueur maximale que nous avons testée. Tester ce modèle sous pression avec une version plus difficile de RULER pourrait être intéressant à approfondir dans Texte à traduire : Command-R-plus (104B) | 128K | 32K | 95,6 | 95,2 | 94,2 | 92,0 | 84,3 | 63,1 | 87,4 | 82,7 (7e) | 92,1 (5e) |
| GLM4 (9B) | 1M | 64K | 94,7 | 92,8 | 92,1 | 89,9 | 86,7 | 83,1 | 89,9 | 88,0 (3e) | 91,7 (6e) |
| Llama3.1 (8B) | 128K | 32K | 95,5 | 93,8 | 91,6 | 87,4 | 84,7 | 77,0 | 88,3 | 85,4 (5e) | 91,3 (7e) |
| GradientAI/Llama3 (70B) | 1M | 16K | 95,1 | 94,4 | 90,8 | 85,4 | 80,9 | 72,1 | 86,5 | 82,6 (8e) | 90,3 (8e) |
| Mixtral-8x22B (39B/141B) | 64K | 32K | 95,6 | 94,9 | 93,4 | 90,9 | 84,7 | 31,7 | 81,9 | 73,5 (11e) | 90,3 (9e) |
| Yi (34B) | 200K | 32K | 93,3 | 92,2 | 91,3 | 87,5 | 83,2 | 77,3 | 87,5 | 84,8 (6e) | 90,1 (10e) |
| Phi3-medium (14B) | 128K | 32K | 93,3 | 93,2 | 91,1 | 86,8 | 78,6 | 46,1 | 81,5 | 74,8 (10e) | 88,3 (11e) |
| Mixtral-v0.2 (7B) | 32K | 16K | 93,6 | 91,2 | 87,2 | 75,4 | 49,0 | 13,8 | 68,4 | 55,6 (13e) | 81,2 (12e) |
| LWM (7B) | 1M | <4K | 82,3 | 78,4 | 73,7 | 69,1 | 68,1 | 65,0 | 72,8 | 69,9 (12e) | 75,7 (13e) |
| DBRX (36B/132B) | 32K | 8K | 95,1 | 93,8 | 83,6 | 63,1 | 2,4 | 0,0 | 56,3 | 38,0 (14e) | 74,7 (14e) |
| Together (7B) | 32K | 4K | 88,2 | 81,1 | 69,4 | 63,0 | 0,0 | 0,0 | 50,3 | 33,8 (15e) | 66,7 (15e) |
| LongChat (7B) | 32K | <4K | 84,7 | 79,9 | 70,8 | 59,3 | 0,0 | 0,0 | 49,1 | 33,1 (16e) | 65,2 (16e) |
| LongAlpaca (13B) | 32K | <4K | 60,6 | 57,0 | 56,6 | 43,6 | 0,0 | 0,0 | 36,3 | 24,7 (17e) | 47,9 (17e) |
RoPE (Xiong et al., 2023). Une grande fenêtre de contexte d'entraînement n'est pas toujours nécessaire pour de bonnes performances en contexte long : les modèles ouverts les mieux classés comprennent à la fois une mise à l'échelle forcée du contexte (Llama3.1 entraîné sur une longueur de contexte de 128K) et une extrapolation de longueur au moment de l'inférence (Qwen2 entraîné sur une longueur de contexte de 32K). Les modèles moins performants incluent également ceux entraînés sur une taille de contexte bien plus grande (par exemple, LWM et GradientAI/Llama3, tous deux sur une longueur de contexte de 1M). Bien que LWM obtienne un rang supérieur à Mistral-v0.2 lorsque les séquences plus longues reçoivent un poids plus important (wAvg. inc) et montre une moindre dégradation à mesure que la taille du contexte augmente, il performe moins bien que Llama2-7B même à 4K. Ce résultat suggère un compromis, dans l'évaluation, entre la performance absolue sur des séquences courtes et la dégradation relative avec l'augmentation de la taille du contexte. Nous fournissons davantage d'analyses sur la taille du modèle et la longueur maximale d'entraînement dans la section 6.
5 Analyse des erreurs par tâche
Nous évaluons Yi-34B-200K avec des longueurs d'entrée accrues (jusqu'à 256K) sur des tâches plus complexes afin de comprendre l'effet des configurations de tâches et des modes de défaillance sur RULER.
Non-robustesse aux types « aiguille ». La figure 2 (à gauche) montre que, bien que Yi obtienne des performances presque parfaites lorsqu'il utilise une aiguille de type paire mot-nombre dans la récupération de clés d'accès standard et le NIAH classique, les performances se dégradent lorsque l'aiguille prend d'autres formes. Nous observons la plus forte dégradation dans la tâche de récupération d'UUID, pour laquelle Yi échoue parfois à renvoyer les 32 chiffres complets étant donné un contexte d'entrée long ( ).
Échec à ignorer les distracteurs. La figure 2 (au milieu à gauche) montre que l'augmentation du nombre d'aiguilles distractrices fait régulièrement baisser les performances, Yi chutant d'environ points à 256K dans la version extrême, où le contexte est rempli d'aiguilles non pertinentes (#K=FULL). L'analyse des erreurs révèle que Yi échoue à ignorer efficacement les distracteurs difficiles étant donné un contexte d'entrée long, et récupère donc de manière incorrecte les valeurs associées aux clés des distracteurs. Dans la version extrême, Yi renvoie souvent des valeurs provenant du voisinage de la cible, ce qui suggère une correspondance grossière de la plage mais un manque de précision pour localiser la clé lorsque la cible est dans la distribution des bruits.
Renvoi d'informations incomplètes. Conformément à des travaux antérieurs (Liu et al., 2024a ; Reid et al., 2024), nous remarquons une dégradation significative des performances lorsque le modèle doit récupérer plusieurs éléments à partir d'une entrée longue. Par exemple, l'augmentation du nombre de requêtes de 1 à 8 fait chuter les performances d'environ points (figure 2 à droite). Lorsque le modèle doit récupérer plusieurs valeurs associées à la même clé (figure 2 au milieu à droite), Yi produit souvent des réponses dupliquées sans renvoyer l'ensemble complet des valeurs, ce qui implique des associations inégales entre la clé et chacune de ses valeurs.
Tendance à copier depuis le contexte. Nous remarquons que Yi a une forte tendance à copier verbatim depuis le contexte lorsqu'on augmente la longueur de l'entrée. Cette tendance est particulièrement notable dans le suivi de variables (VT) et l'extraction de mots courants (CWE), où nous incluons une démonstration en contexte au début de la séquence. Plus de de la sortie de Yi dans la tâche CWE à 128K est simplement une chaîne copiée depuis l'exemple one-shot, alors que cette copie est inexistante pour les séquences courtes. Ce comportement de copie est également présent dans le modèle LWM et LongAlpaca, mais il est moins répandu dans d'autres modèles, tels que Mixtral. Cette constatation renforce encore la nécessité de tester des comportements autres que la récupération étant donné un contexte d'entrée long.
Suivi peu fiable dans le contexte. Pour la tâche de suivi de variables, tant l'ajout de chaînes supplémentaires que l'ajout de sauts supplémentaires contribuent à une forte dégradation des performances de Yi. Yi se dégrade systématiquement dans le paramètre à plus grand nombre de sauts à mesure que nous augmentons la taille du contexte (figure 3, à gauche), tandis que la dégradation dans le paramètre à plus grand nombre de chaînes est la plus significative pour des longueurs supérieures à 128K (figure 3, au milieu à gauche). Outre le problème de copie susmentionné, Yi commet des erreurs en renvoyant incorrectement des chaînes vides ou des variables provenant d'autres chaînes, ce qui implique un manque de capacité à suivre de manière fiable la même entité dans un contexte long. Ces erreurs sont également fréquemment observées dans les modèles qui n'adoptent pas le comportement de copie.
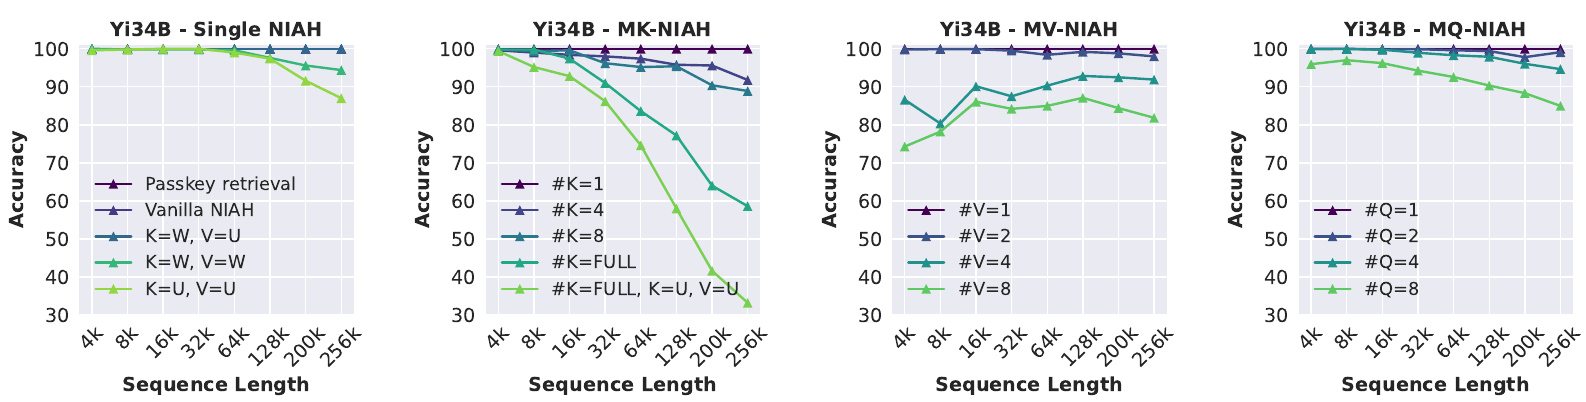
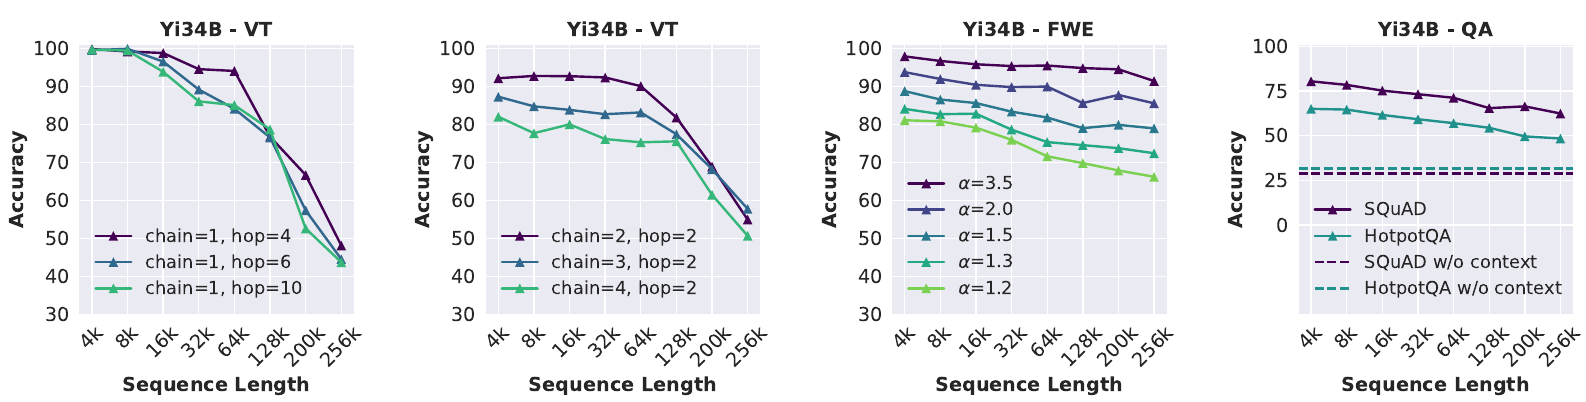
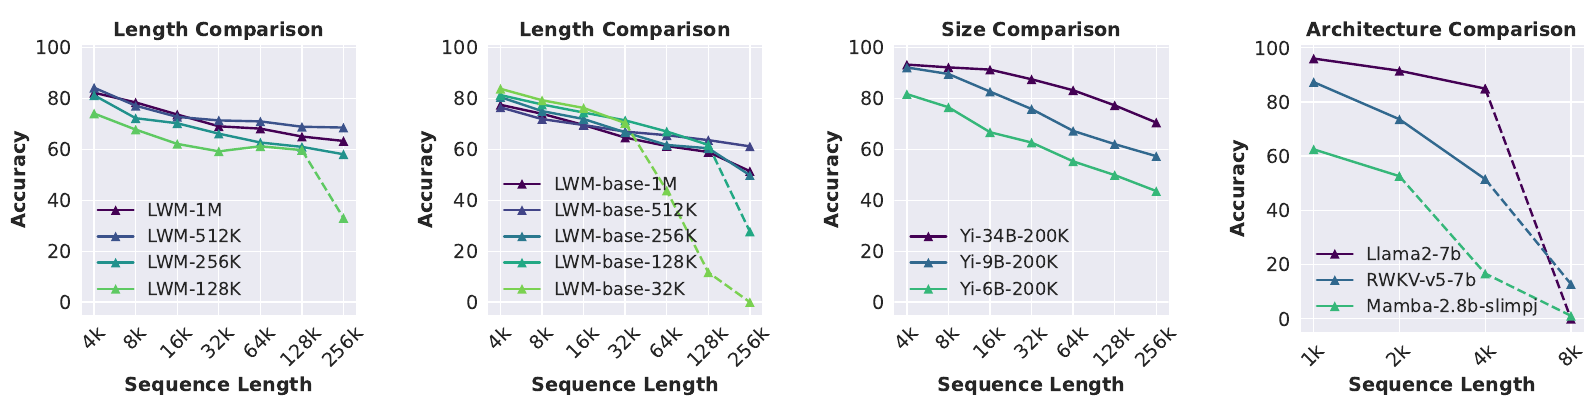
Figure 4 : (Gauche et milieu gauche) : Comparaison de la série LargeWorldModel (LWM) entraînée jusqu'à diverses tailles de contexte avec une taille de paramètres fixe de 7B. (Milieu droite) : Comparaison des modèles de la suite Yi avec différentes tailles de paramètres et une longueur de contexte d'entraînement contrôlée de 200K. (Droite) : Les performances des architectures non-Transformer sont largement en retrait par rapport à la référence Transformer Llama2-7B. L'extrapolation de longueur est représentée par des lignes pointillées.
Échec d'agrégation précise. Nous observons deux modes d'échec courants dans les tâches d'agrégation : l'utilisation incorrecte des connaissances paramétriques et une agrégation imprécise. Les modèles qui ne présentent pas le problème de copie dans la tâche CWE ignorent parfois l'information contextuelle et utilisent plutôt les connaissances paramétriques pour répondre à la requête, en particulier pour de grandes tailles de contexte. Par exemple, Mistral (7b-instruct-v0.2) renvoie des mots très fréquents, tels que « the », « an », « a », comme sortie sans compter les mots dans le contexte. Pour la tâche FWE, qui présente moins le problème de copie, Yi échoue à produire correctement les mots les plus fréquents à mesure que nous diminuons le de la distribution Zeta (Figure 3 milieu-droite). La diminution de réduit l'écart de fréquence entre les mots, ce qui accroît la difficulté à distinguer les mots les plus fréquents.
Hallucination fréquente en QA à long contexte. Pour les tâches de QA, les performances de Yi se rapprochent de sa référence sans contexte à mesure que nous étendons le contexte avec des paragraphes distracteurs (Figure 3 droite). La dégradation provient principalement d'hallucinations et d'une moindre reliance sur l'information contextuelle. Nous remarquons que, pour de grandes tailles de contexte, les prédictions du modèle sont parfois sans rapport avec la question et peuvent coïncider avec les réponses de sa référence sans contexte. La performance globalement moins bonne dans les tâches de QA confirme que l'appariement flou entre une requête et un paragraphe pertinent en contexte long constitue un cadre plus difficile que les tests NIAH simplistes, où les clés peuvent être localisées exactement dans le contexte.
6 Analyse du modèle
Effet de la longueur de contexte d'entraînement. Les modèles entraînés avec des tailles de contexte plus grandes sont-ils plus performants sur RULER ? Nous évaluons la suite de LargeWorldModels (Liu et al. [2024a] LWM) de taille de paramètres égale et entraînés jusqu'à diverses longueurs de contexte. La Figure 4 (gauche et milieu-gauche) montre que des tailles de contexte plus grandes conduisent globalement à de meilleures performances, mais le classement peut être incohérent pour les longues séquences. Par exemple, le modèle entraîné avec une taille de contexte de 1M (LWM-1M) est moins bon que celui avec 512K à une longueur de 256K, probablement en raison d'un entraînement insuffisant pour s'adapter à la nouvelle fréquence de base dans RoPE. De plus, nous observons des chutes abruptes de performance lorsque les modèles doivent extrapoler à des longueurs non vues (par exemple, LMW-128K avec une entrée de 256K), et une dégradation presque linéaire avec la longueur d'entrée en échelle logarithmique dans la limite de la taille de contexte d'entraînement maximale.
Effet de la taille du modèle. Les meilleurs modèles de nos résultats principaux sont bien plus grands que les autres modèles. Pour isoler l'effet de la taille du modèle, nous évaluons Yi-34B-200k, Yi-9B-200k et Yi-6B-200k, tous entraînés jusqu'à la même longueur de contexte avec le même mélange de données. La Figure 4 (milieu-droite) montre que le modèle 34B est nettement meilleur que le modèle 6B sur RULER, tant pour les performances à une longueur de 4K que pour la dégradation relative, ce qui suggère le bénéfice de l'augmentation de la taille des modèles pour une meilleure modélisation du contexte long.
Effet de l'architecture. Nous évaluons la longueur de contexte effective pour deux modèles à architecture non-Transformer : RWKV-v5 (Peng et al. [2023]) et Mamba-2.8B-slimpj (Gu &Dao | 2023). Nous constatons que les deux modèles présentent une dégradation significative lorsqu'on étend la taille de contexte à 8K, et que tous deux sont largement en retrait par rapport à la référence Transformer Llama2-7B jusqu'à la longueur de 4K, au-delà de laquelle Llama2 présente de faibles performances d'extrapolation de longueur (Figure 4 droite).
7 Conclusion
Nous présentons RULER, un benchmark synthétique pour évaluer les modèles de langage à long contexte. RULER contient diverses catégories de tâches — récupération, traçage multi-sauts, agrégation et question-réponse — offrant une évaluation flexible et complète des capacités à long contexte des LLM. Nous évaluons 17 LM à long contexte avec RULER, avec des tailles de contexte allant de 4K à 128K. Bien qu'ils obtiennent des résultats parfaits au test needle-in-a-haystack largement utilisé, presque tous les modèles échouent à maintenir leurs performances dans les autres tâches de RULER à mesure que nous augmentons la longueur d'entrée. Nous observons des modes d'échec courants pour de grandes tailles de contexte, notamment l'échec à ignorer les distracteurs et une utilisation inefficace du contexte long (par exemple, se contenter de copier depuis le contexte ou d'utiliser les connaissances paramétriques à la place). Nous montrons que RULER est exigeant même pour les modèles open source les mieux classés à mesure que nous augmentons la complexité des tâches. Notre analyse révèle en outre le large potentiel d'amélioration sur RULER et le bénéfice de l'augmentation de la taille des modèles pour atteindre de meilleures capacités à long contexte.
8 Limites
Bien qu'il couvre davantage de catégories de tâches que les benchmarks orientés récupération, RULER présente plusieurs limites que nous décrivons en détail ci-dessous.
Absence de contrôle de la position. RULER rapporte actuellement une métrique unique par longueur d'entrée sans fournir les performances au niveau de la profondeur. Les performances au niveau de la profondeur ont été évaluées par le test NIAH (Kamradi | 2023) et des travaux récents tels que LV-Eval (Yuan et al. 2024) et peuvent être efficaces pour révéler le phénomène de « perdu au milieu » (Liu et al. 2024d). Nous sommes conscients de ce problème et prévoyons de prendre en charge le contrôle de la position de l'information clé dans notre base de code.
Absence de corrélation avec des tâches réalistes à long contexte. Bien que des tâches telles que le suivi de variables et l'extraction de mots fréquents aient été proposées comme substituts aux tâches réalistes de langage naturel à long contexte, l'absence de tâches réalistes à long contexte faciles à évaluer nous empêche de vérifier la validité de ces substituts. En raison de cette limite, nous soulignons que RULER peut être utilisé comme contrôles comportementaux pratiques des modèles de langage à long contexte ; il ne devrait toutefois pas être préféré à des cadres plus réalistes, tels que NoCHA (Karpinska et al. 2024), qui mettent également l'accent sur d'autres capacités comme le raisonnement et le suivi d'instructions.
Absence d'évaluation sur contexte court. Dans la suite de tâches actuelle de RULER, nous incluons des tâches que la plupart des modèles réalisent raisonnablement bien avec une taille de contexte de 4k, et visons à observer la dégradation des performances avec l'augmentation de la taille du contexte. Cela ne doit pas être interprété comme des capacités parfaites des LM à une taille de contexte de 4k. En fait, des travaux récents, tels que FlenQA (Levy et al. 2024), ont démontré une dégradation des performances lorsqu'on augmente la longueur d'entrée de leur tâche à seulement quelques milliers de tokens. Bien que l'augmentation de la complexité des tâches dans RULER conduise à des performances bien moins bonnes avec des tailles de contexte plus courtes, nous n'avons pas inclus ces résultats dans cet article.
Absence de vérification de la robustesse aux prompts. Les modèles de langage peuvent être sensibles au format du prompt ; toutefois, nous n'avons pas mené une étude exhaustive sur la robustesse aux prompts au-delà de tests préliminaires réalisés au début de ce travail. Nous n'avons pas non plus expérimenté de manière approfondie avec quelques hyperparamètres fixés dans les tâches existantes, tels que la longueur des noms de variables dans le suivi de variables et la taille du vocabulaire synthétique dans l'extraction de mots communs et l'extraction de mots fréquents.
Références
Marah Abdin, Sam Ade Jacobs, Ammar Ahmad Awan, Jyoti Aneja, Ahmed Awadallah, Hany Awadalla, Nguyen Bach, Amit Bahree, Arash Bakhtiari, Harkirat Behl, et al. Phi-3 technical report: A highly capable language model locally on your phone. arXiv preprint arXiv:2404.14219, 2024.
Rishabh Agarwal, Avi Singh, Lei M Zhang, Bernd Bohnet, Stephanie Chan, Ankesh Anand, Zaheer Abbas, Azade Nova, John D Co-Reyes, Eric Chu, et al. Many-shot in-context learning. arXiv preprint arXiv:2404.11018, 2024.
AI21. Introducing jamba: Ai21's groundbreaking ssm-transformer model, 2024. URL https://www.ai21.com/blog/announcing-jamba
Chenxin An, Shansan Gong, Ming Zhong, Mukai Li, Jun Zhang, Lingpeng Kong, and Xipeng Qiu. L-eval: Instituting standardized evaluation for long context language models. In ICLR, 2024.
Anthropic. Long context prompting for Claude 2.1. Blog, 2023. URL https://www.anthropic.com/index/claude-2-1-prompting
Anthropic. Introducing the next generation of claude, 2024. URL https://www.anthropic.com/news/claude-3-family
Simran Arora, Sabri Eyuboglu, Aman Timalsina, Isys Johnson, Michael Poli, James Zou, Atri Rudra, and Christopher Ré. Zoology: Measuring and improving recall in efficient language models. In ICLR, 2024.
Yushi Bai et al. LongBench: A bilingual, multitask benchmark for long context understanding. arXiv:2308.14508, 2023.
Maximilian Beck, Korbinian Pöppel, Markus Spanning, Andreas Auer, Oleksandra Prudnikova, Michael Kopp, Günter Klambauer, Johannes Brandstetter, and Sepp Hochreiter. xlstm: Extended long short-term memory. arXiv preprint arXiv:2405.04517, 2024.
Amanda Bertsch, Maor Ivgi, Uri Alon, Jonathan Berant, Matthew R Gormley et Graham Neubig. In-context learning with long-context models: An in-depth exploration. arXiv preprint arXiv:2405.00200, 2024.
Aydar Bulatov, Yuri Kuratov et Mikhail S Burtsev. Scaling Transformer to 1M tokens and beyond with RMT. arXiv:2304.11062, 2023.
David Castillo, Joseph Davidson, Finlay Gray, José Solorzano et Marek Rosa. Introducing GoodAI LTM benchmark. Blog, 2024. URL https://www.goodai.com/introducing-goodai-ltm-benchmark/
Shouyuan Chen, Sherman Wong, Liangjian Chen et Yuandong Tian. Extending context window of large language models via positional interpolation. In ICLR, 2023.
Yukang Chen, Shengju Qian, Haotian Tang, Xin Lai, Zhijian Liu, Song Han et Jiaya Jia. LongLoRA: Efficient fine-tuning of long-context large language models. In ICLR, 2024.
Rewon Child, Scott Gray, Alec Radford et Ilya Sutskever. Generating long sequences with sparse Transformers. arXiv:1904.10509, 2019.
Cohere. Command r, 2024. URL https://docs.cohere.com/docs/command-r-plus#model-details
Tri Dao. FlashAttention-2: Faster attention with better parallelism and work partitioning. arxiv:2307.08691, 2023.
Tri Dao, Daniel Y. Fu, Stefano Ermon, Atri Rudra et Christopher Ré. FlashAttention: Fast and memory-efficient exact attention with IO-awareness. In NeurIPS, 2022.
.
Databricks. Introducing dbrx: A new state-of-the-art open llm, 2024. URL https://www databricks.com/blog/introducing-dbrx-new-state-art-open-llm
Jiayu Ding et al. LongNet : Scaling Transformers to 1 000 000 000 tokens. arXiv:2307.02486, 2023.
Yiran Ding et al. LongRoPE : Extending LLM context window beyond 2 million tokens. arXiv:2402.13753, 2024.
Zican Dong, Tianyi Tang, Junyi Li, Wayne Xin Zhao, and Ji-Rong Wen. Bamboo : A comprehensive benchmark for evaluating long text modeling capacities of large language models. arXiv:2309.13345, 2023.
Daniel Y. Fu, Tri Dao, Khaled K. Saab, Armin W. Thomas, Atri Rudra, and Christopher Ré. Hungry Hungry Hippos : Towards language modeling with state space models. In ICLR, 2023a.
Daniel Y. Fu et al. Simple hardware-efficient long convolutions for sequence modeling. ICML, 2023b.
Yao Fu et al. Data engineering for scaling language models to 128k context. arXiv:2402.10171, 2024.
Team GLM, Aohan Zeng, Bin Xu, Bowen Wang, Chenhui Zhang, Da Yin, Diego Rojas, Guanyu Feng, Hanlin Zhao, Hanyu Lai, Hao Yu, Hongning Wang, Jiadai Sun, Jiajie Zhang, Jiale Cheng, Jiayi Gui, Jie Tang, Jing Zhang, Juanzi Li, Lei Zhao, Lindong Wu, Lucen Zhong, Mingdao Liu, Minlie Huang, Peng Zhang, Qinkai Zheng, Rui Lu, Shuaiqi Duan, Shudan Zhang, Shulin Cao, Shuxun Yang, Weng Lam Tam, Wenyi Zhao, Xiao Liu, Xiao Xia, Xiaohan Zhang, Xiaotao Gu, Xin Lv, Xinghan Liu, Xinyi Liu, Xinyue Yang, Xixuan Song, Xunkai Zhang, Yifan An, Yifan Xu, Yilin Niu, Yuantao Yang, Yueyan Li, Yushi Bai, Yuxiao Dong, Zehan Qi, Zhaoyu Wang, Zhen Yang, Zhengxiao Du, Zhenyu Hou, and Zihan Wang. Chatglm : A family of large language models from glm-130b to glm-4 all tools, 2024.
Omer Goldman, Alon Jacovi, Aviv Slobodkin, Aviya Maimon, Ido Dagan, and Reut Tsarfaty. Is it really long context if all you need is retrieval? towards genuinely difficult long context nlp. arXiv preprint arXiv:2407.00402, 2024.
Alex Graves, Greg Wayne, and Ivo Danihelka. Neural Turing machines. arXiv:1410.5401, 2014.
Albert Gu and Tri Dao. Mamba : Linear-time sequence modeling with selective state spaces. arXiv:2312.00752, 2023.
Albert Gu, Karan Goel, and Christopher Re. Efficiently modeling long sequences with structured state spaces. In ICLR, 2022.
Chi Han, Qifan Wang, Wenhan Xiong, Yu Chen, Heng Ji, and Sinong Wang. Lm-infinite : Simple on-the-fly length generalization for large language models. arXiv:2308.16137, 2023.
John J. Hopfield. Neural networks and physical systems with emergent collective computational abilities. Proc of the National Academy of Sciences of the United States of America, 79 8: 2554-8, 1982.
Maor Ivgi, Uri Shaham, and Jonathan Berant. Efficient long-text understanding with short-text models. Transactions of the ACL, 11:284-299, 2023.
Sam Ade Jacobs et al. DeepSpeed Ulysses : System optimizations for enabling training of extreme long sequence Transformer models. arXiv:2309.14509, 2023.
Sebastian Jaszczur et al. Sparse is enough in scaling transformers. In NeurIPS, 2021.
Albert Q Jiang et al. Mixtral of experts. arXiv:2401.04088, 2024.
Huiqiang Jiang et al. LongLlmLingua : Accelerating and enhancing LLMs in long context scenarios via prompt compression. arXiv:2310.06839, 2023.
Gregory Kamradt. Needle In A Haystack - pressure testing LLMs. Github, 2023. URL https://github.com/gkamradt/LLMTest.NeedleInAHaystack/tree/main
Marzena Karpinska, Katherine Thai, Kyle Lo, Tanya Goyal, and Mohit Iyyer. One thousand and one pairs : A" novel" challenge for long-context language models. arXiv preprint arXiv:2406.16264, 2024.
Lauri Karttunen. Discourse referents. In COLING, 1969.
George Kingsley Zipf. Selected studies of the principle of relative frequency in language. Harvard university press, 1932.
Yuri Kuratov, Aydar Bulatov, Petr Anokhin, Ivan Rodkin, Dmitry Sorokin, Artyom Sorokin, and Mikhail Burtsev. Babilong : Testing the limits of llms with long context reasoning-in-a-haystack. arXiv preprint arXiv:2406.10149, 2024.
Woosuk Kwon et al. Efficient memory management for large language model serving with paged attention. In Proc. of the ACM SIGOPS 29th Symposium on Operating Systems Principles, 2023.
Jinhyuk Lee, Anthony Chen, Zhuyun Dai, Dheeru Dua, Devendra Singh Sachan, Michael Boratko, Yi Luan, Sébastien MR Arnold, Vincent Perot, Siddharth Dalmia, et al. Can long-context language models subsume retrieval, rag, sql, and more? arXiv preprint arXiv:2406.13121, 2024.
Mosh Levy, Alon Jacoby, and Yoav Goldberg. Same task, more tokens : the impact of input length on the reasoning performance of large language models. arXiv preprint arXiv:2402.14848, 2024.
Dacheng Li, Rulin Shao, et al. How long can open-source LLMs truly promise on context length?, 2023a. URL https://1msys.org/blog/2023-06-29-longchat
Jiaqi Li, Mengmeng Wang, Zilong Zheng, and Muhan Zhang. Loogle : Can long-context language models understand long contexts? arXiv:2311.04939, 2023b.
Hao Liu, Matei Zaharia, and Pieter Abbeel. Ring attention with blockwise Transformers for near-infinite context. In ICLR, 2023.
Hao Liu, Wilson Yan, Matei Zaharia, and Pieter Abbeel. World model on million-length video and language with Ring Attention. arxiv:2402.08268, 2024a.
Jiaheng Liu et al. E2-LLM : Efficient and extreme length extension of large language models. arXiv:2401.06951, 2024b.
Jiawei Liu, Jia Le Tian, Vijay Daita, Yuxiang Wei, Yifeng Ding, Yuhan Katherine Wang, Jun Yang, and Lingming Zhang. Repoqa : Evaluating long context code understanding. arXiv preprint arXiv:2406.06025, 2024c.
Nelson F Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni, and Percy Liang. Lost in the middle : How language models use long contexts. Transactions of the ACL, 12:157-173, 2024d.
Pedro Henrique Martins, Zita Marinho, and Andre Martins. ∞-former : Infinite memory Transformer. In Proc. of the 60th Annual Meeting of the ACL (Volume 1 : Long Papers), 2022.
Meta.AI. Llama 3 model card. 2024a. URL https://github.com/meta-llama/llama3/blob/main/MODEL_CARD.md
Meta.AI. Llama 3.1 model card. 2024b. URL https://github.com/meta-llama/llama-models/blob/main/models/llama3.1/MODEL_CARD.md
Mistral.AI. La plateforme, 2023. URL https://mistral.ai/news/la- plateforme/Amirkeivan Mohtashami and Martin Jaggi. Landmark attention: Random- access infinite context length for Transformers. In Workshop on Efficient Systems for Foundation Models @ ICML, 2023.
Vincent Ng. Supervised noun phrase coreference research: The first fifteen years. In Proc. of the 48th Annual Meeting of the ACL, 2010.
Catherine Olsson et al. In- context learning and induction heads. Transformer Circuits Thread, 2022. https://transformer-circuits.pub/2022/in- context- learning- and- induction- heads/index.html.
OpenAI : Josh Achiam et al. Rapport technique GPT- 4. arXiv:2303.08774, 2023.
Bo Peng et al. RWKV : Réinventer les RNN pour l'ère des Transformers. In EMNLP, 2023.
Bowen Peng, Jeffrey Quesnelle, Honglu Fan, et Enrico Shippole. YaRN : Extension efficace de la fenêtre de contexte des grands modèles de langage. In ICLR, 2024.
Michael Poli, Stefano Massaroli, Eric Nguyen, Daniel Y Fu, Tri Dao, Stephen Baccus, Yoshua Bengio, Stefano Ermon, et Christopher Ré. Hiérarchie Hyena : Vers des modèles de langage convolutionnels plus grands. In ICML, 2023.
Ofir Press, Noah Smith, et Mike Lewis. Entraîner court, tester long : L'attention avec biais linéaires permet l'extrapolation de la longueur d'entrée. In ICLR, 2022.
Pranav Rajpurkar, Robin Jia, et Percy Liang. Savoir ce que vous ne savez pas : Questions sans réponse pour SQuAD. In Proc. of the 56th Annual Meeting of the ACL (Volume 2: Short Papers), 2018.
Machel Reid et al. Gemini 1.5 : Débloquer la compréhension multimodale sur des millions de tokens de contexte. arXiv:2403.05530, 2024.
Marco Tulio Ribeiro, Tongshuang Wu, Carlos Guestrin, et Sameer Singh. Au-delà de la précision : Tests comportementaux des modèles de NLP avec CheckList. In Proc. of the 58th Annual Meeting of the ACL, 2020.
Uri Shaham, Maor Ivgi, Avia Efrat, Jonathan Berant, et Omer Levy. ZeroSCROLLS : Un benchmark zero- shot pour la compréhension de textes longs. In EMNLP, 2023.
Jianlin Su, Yu Lu, Shengfeng Pan, Ahmed Murtadha, Bo Wen et Yunfeng Liu. RoFormer : Transformer amélioré avec un encodage positionnel rotatif. arXiv:2104.09864, 2023.
Simeng Sun, Katherine Thai et Mohit Iyyer. ChapterBreak : Un jeu de données de défi pour les modèles de langage à longue portée. In Proc. of the 2022 Conference of the North American Chapter of the ACL : Human Language Technologies, 2022.
Yutao Sun, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang et Furu Wei. Réseau rétentif : Un successeur du Transformer pour les grands modèles de langage. arXiv:2307.08621, 2023a.
Yutao Sun, Li Dong, Barun Patra, Shuming Ma, Shaohan Huang, Alon Benhaim, Vishrav Chaudhary, Xia Song et Furu Wei. Un Transformer extrapolable en longueur. In Proc. of the 61st Annual Meeting of the ACL (Volume 1 : Long Papers), 2023b.
Yutao Sun, Li Dong, Yi Zhu, Shaohan Huang, Wenhui Wang, Shuming Ma, Quanlu Zhang, Jianyong Wang et Furu Wei. Vous ne mettez en cache qu'une seule fois : Architectures décodeur-décodeur pour les modèles de langage. arXiv preprint arXiv:2405.05254, 2024.
Garrett Tanzer, Mirac Suzgun, Eline Visser, Dan Jurafsky et Luke Melas-Kyriazi. Un benchmark pour apprendre à traduire une nouvelle langue à partir d'un seul livre de grammaire. In ICLR, 2024.
Together.AI. Se préparer à l'ère du contexte de 32k : Premiers apprentissages et explorations, 2023a. URL https://www.together.ai/blog/llama-2-7b-32k
Together.AI. Llama-2-7b-32k-instruct — et affinage pour les modèles llama-2 avec l'API together, 2023b. URL https://www.together.ai/blog/llama-2-7b-32k-instruct
Hugo Touvron et al. Llama 2 : Modèles de fondation ouverts et modèles de chat affinés. arXiv:2307.09288, 2023.
Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot et Ashish Sabharwal. Musique : Questions multi-sauts via la composition de questions mono-saut. Transactions of the ACL, 10 : 539-554, 2022.
Szymon Tworkowski et al. Focused Transformer : Entraînement contrastif pour la mise à l'échelle du contexte. NeurIPS, 36, 2024.
Teun A. van Dijk et Walter Kintsch. Strategies of discourse comprehension. In Academic Press, 1983.
Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, L ukasz Kaiser et Illia Polosukhin. Attention is all you need. In NeurIPS, 2017.
Weizhi Wang, Li Dong, Hao Cheng, Xiaodong Liu, Xifeng Yan, Jianfeng Gao et Furu Wei. Augmenter les modèles de langage avec une mémoire à long terme. NeurIPS, 36, 2024.
Thomas Wolf et al. Huggingface's Transformers : Traitement du langage naturel de pointe. arXiv:1910.03771, 2019.
Qingyang Wu, Zhenzhong Lan, Kun Qian, Jing Gu, Alborz Geramifard et Zhou Yu. Memformer : Un Transformer augmenté de mémoire pour la modélisation de séquences. In Findings of the ACL : AACL-IJCNLP, 2022.
X.AI. Annonce de grok-1.5, 2024. URL https://x.ai/blog/grok-1.5
Chaojun Xiao et al. InfLLM : Dévoiler la capacité intrinsèque des LLMs à comprendre des séquences extrêmement longues avec une mémoire sans entraînement. arXiv:2402.04617, 2024a.
Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han et Mike Lewis. Modèles de langage en flux efficaces avec des puits d'attention. In ICLR, 2024b.
Wenhan Xiong et al. Mise à l'échelle efficace du contexte long des modèles de fondation. arXiv:2309.16039, 2023.
Peng Xu, Wei Ping, Xianchao Wu, Lawrence McAfee, Chen Zhu, Zihan Liu, Sandeep Subramanian, Evelina Bakhturina, Mohammad Shoeybi et Bryan Catanzaro. La récupération rencontre les grands modèles de langage à contexte long. In ICLR, 2024a.
Xiaoyue Xu, Qinyuan Ye et Xiang Ren. Tester sous stress les modèles de langage à contexte long avec l'ICL continu et la tâche haystack. arXiv preprint arXiv:2407.16695, 2024b.
An Yang, Baosong Yang, Binyuan Hui, Bo Zheng, Bowen Yu, Chang Zhou, Chengpeng Li, Chengyuan Li, Dayiheng Liu, Fei Huang, et al. Rapport technique Qwen2. arXiv preprint arXiv:2407.10671, 2024.
Zhilin Yang, Peng Qi, Saizheng Zhang, Yoshua Bengio, William Cohen, Ruslan Salakhutdinov et Christopher D. Manning. HotpotQA : Un jeu de données pour des questions-réponses multi-sauts diverses et explicables. In EMNLP, 2018.
Alex Young et al. Yi : Modèles de fondation ouverts par 01. AI. arXiv:2403.04652, 2024.
Tao Yuan, Xuefei Ning, Dong Zhou, Zhijie Yang, Shiyao Li, Minghui Zhuang, Zheyue Tan, Zhuyu Yao, Dahua Lin, Boxun Li, et al. Lv-eval : Un benchmark équilibré pour contexte long avec 5 niveaux de longueur allant jusqu'à 256k. arXiv preprint arXiv:2402.05136, 2024.
Peitian Zhang, Zheng Liu, Shitao Xiao, Ninglu Shao, Qiwei Ye et Zhicheng Dou. Passer de 4k à 400k : Étendre le contexte des LLMs avec activation beacon. arXiv:2401.03462, 2024a.
Xinrong Zhang, Yingfa Chen, Shengding Hu, Zihang Xu, Junhao Chen, Moo Khai Hao, Xu Han, Zhen Leng Thai, Shuo Wang, Zhiyuan Liu et Maosong Sun. obench : Étendre l'évaluation de contexte long au-delà de 100k tokens. arXiv:2402.13718, 2024b.
Dawei Zhu, Nan Yang, Liang Wang, Yifan Song, Wenhao Wu, Furu Wei et Sujian Li. PoSE : Extension efficace de la fenêtre de contexte des LLMs via un entraînement par saut positionnel. In ICLR, 2024.
A Modèles
Nous sélectionnons au total 37 modèles pour l'évaluation et l'analyse. Nos résultats dans le texte principal n'incluent que les modèles alignés (GPT-4, Gemini-1.5 et 15 modèles open source). Outre les modèles alignés, nous évaluons également 7 modèles de base open source à l'aide de RULER. Nous utilisons les performances de Llama2-7b (base) et Llama2-7b (chat) à une longueur de contexte de 4K comme seuil pour déterminer la taille de contexte effective. Dans notre section d'analyse, nous évaluons au total 11 modèles, y compris les séries de modèles Yi et LWM, ainsi que des modèles d'architectures novatrices, notamment Mamba et RWKV.
| Modèle | Aligné | Taille | Longueur du contexte | Huggingface [Wolf et al., 2019] / API |
| GPT-4 | OpenAI : Josh Achiam et al., 2023 | ✓ | - | 128K |
| Gemini-1.5 | Kred et al., 2024 | ✓ | - | 1M |
| Llama3.1 | Meta : AI, 2024b | ✓ | 70B | 128K |
| Llama3.1 | Meta : AI, 2024b | ✓ | 8B | 128K |
| Command-K-plus : Cohen, 2024 | ✓ | ✓ | 104B | 128K |
| Qwen2 : Yang et al., 2024 | ✓ | ✓ | 72B | 128K |
| Yi : Young et al., 2024 | ✓ | ✓ | 34B | 200K |
| Mixtral-8x22B : Huang et al., 2024 | ✓ | ✓ | 39B/141B | 32K |
| Mixtral-v0.2 : Mixtral-AI, 2023 | ✓ | ✓ | 7B | 32K |
| GLM4 : GLM et al., 2024 | ✓ | ✓ | 9B | 1M |
| GradieHAT : Llama3 : Meta, AI, 2024a | ✓ | ✓ | 70B | 1M |
| Phi3-medium : Abdin et al., 2024 | ✓ | ✓ | 14B | 128K |
| LWM : Liu et al., 2024a | ✓ | ✓ | 7B | 1M |
| DBRX : Tabatricks, 2024 | ✓ | ✓ | 36B/132B | 1M |
| Together : Together, AI, 2023b | ✓ | ✓ | 7B | 32K |
| LongChat : Li et al., 2023a | ✓ | ✓ | 7B | 32K |
| LongAlpaca : Chen et al., 2024 | ✓ | ✓ | 13B | 32K |
| Mixtral-base : Jiang et al., 2024 | ✓ | ✓ | 8x7B | 32K |
| Mixtral-base : Mixtral-AI, 2023 | ✓ | ✓ | 7B | 32K |
| LWM-base : Liu et al., 2024a | ✓ | ✓ | 7B | 1M |
| LongLoRA-base : Chen et al., 2024 | ✓ | ✓ | 7B | 100K |
| Yarn-base : Peng et al., 2024 | ✓ | ✓ | 7B | 128K |
| Together-base : Together, AI, 2023a | ✓ | ✓ | 7B | 32K |
| Jamba-base : AI, 2024 | ✓ | ✓ | 52B | 256K |
| Llama2 (chat) : Touvron et al., 2023 | ✓ | ✓ | 7B | 4K |
| Llama2 (base) : Touvron et al., 2023 | ✓ | ✓ | 7B | 4K |
| Série Yi : Young et al., 2024 | ✓ | ✓ | 6B, 9B | 200K |
| Série LWM : Liu et al., 2024a | ✓ | ✓ | 7B | 128K, 256K, 512K |
| Série LWM-base : Liu et al., 2024a | ✓ | ✓ | 7B | 32K, 128K, 256K, 512K |
| Mamba : Gu & Dai, 2023 | ✓ | ✓ | 2,8B | 2K |
| RWKV : Peng et al., 2023 | ✓ | ✓ | 7B | 4K |
Tableau 4 : Informations sur les modèles évalués et analysés dans RULER.
B Configurations des tâches
RULER est conçu pour être configurable afin de permettre des longueurs de séquence et des complexités de tâches variées. Pour chaque tâche, il existe un nombre combinatoirement élevé de configurations que l'on peut adopter. Dans le texte principal, nous évaluons les modèles avec 13 tâches représentatives couvrant les quatre catégories de RULER. Notre processus de sélection des tâches est décrit dans la section d'annexe suivante.
- Récupération : Dans S-NIAH, nous incluons la récupération de clé d'accès (Mohtashami & Jaggi, 2023) et le NIAH standard (Kamtrandt, 2023), qui utilisent tous deux un mot-nombre comme clé-valeur et ne diffèrent que par la botte de foin d'arrière-plan. De plus, nous changeons le type de valeur en UUID, dans le but de tester la robustesse du modèle lors de la récupération de longues chaînes à partir du contexte. Pour MK-NIAH, nous ajoutons trois aiguilles distractives dans la botte de foin. Nous incluons également des configurations existantes issues de travaux antérieurs : la récupération de ligne (Li et al., 2023a) et la récupération clé-valeur (Liu et al., 2024d) avec la botte de foin entièrement remplie d'aiguilles distractives. Pour MV-NIAH et MQ-NIAH, nous testons respectivement 4 valeurs et requêtes.
- Traçage multi-sauts : Pour VT, nous insérons 1 chaîne avec 4 sauts de liaison de noms, soit au total 5 noms de variables à retourner.
- Agrégation : pour CWE, au total 10 mots courants doivent être renvoyés, chacun apparaissant 30 fois, tandis que les mots peu courants apparaissent 3 fois chacun. Pour FWE, nous fixons à 2,0 dans la distribution Zeta pour l’échantillonnage de mots synthétiques.
- QA : pour QA, nous augmentons SQuAD (Rajpurkar et al., 2018) et HotpotQA (Yang et al., 2018) afin de simuler un scénario à long contexte. Ils sont représentatifs respectivement des tâches de réponse à des questions à un seul saut et à plusieurs sauts.
| Tâche | Configurations | ||
| Sous-tâche-1 | Sous-tâche-2 | Sous-tâche-3 | |
| NIAH simple | type_key = word type_value = number type_haystack = repeat ~récupération de passkey | type_key = word type_value = number type_haystack = essay ~NIAH classique | type_key = word type_value = uuid type_haystack = essay |
| MK-NIAH | num_keys = 4 type_key = word type_value = number type_haystack = essay | num_keys = full haystack type_key = word type_value = number ~récupération de ligne | num_keys = full haystack type_key = uuid type_value = uuid ~récupération KV |
| MV-NIAH | num_values = 4, type_key = word, type_value = number, type_haystack = essay | ||
| MQ-NIAH | num_queries = 4, type_key = word, type_value = number, type_haystack = essay | ||
| VT | num_chains = 1, num_hops = 4 | ||
| CWE | freq_cw = 30, freq_ucw = 3, num_cw = 10 | ||
| FWE | α = 2.0 | ||
| QA | dataset = SQuAD | dataset = HotpotQA | |
Tableau 5 : Nos 13 configurations de tâches au total dans RULER.
C Analyse de corrélation des tâches
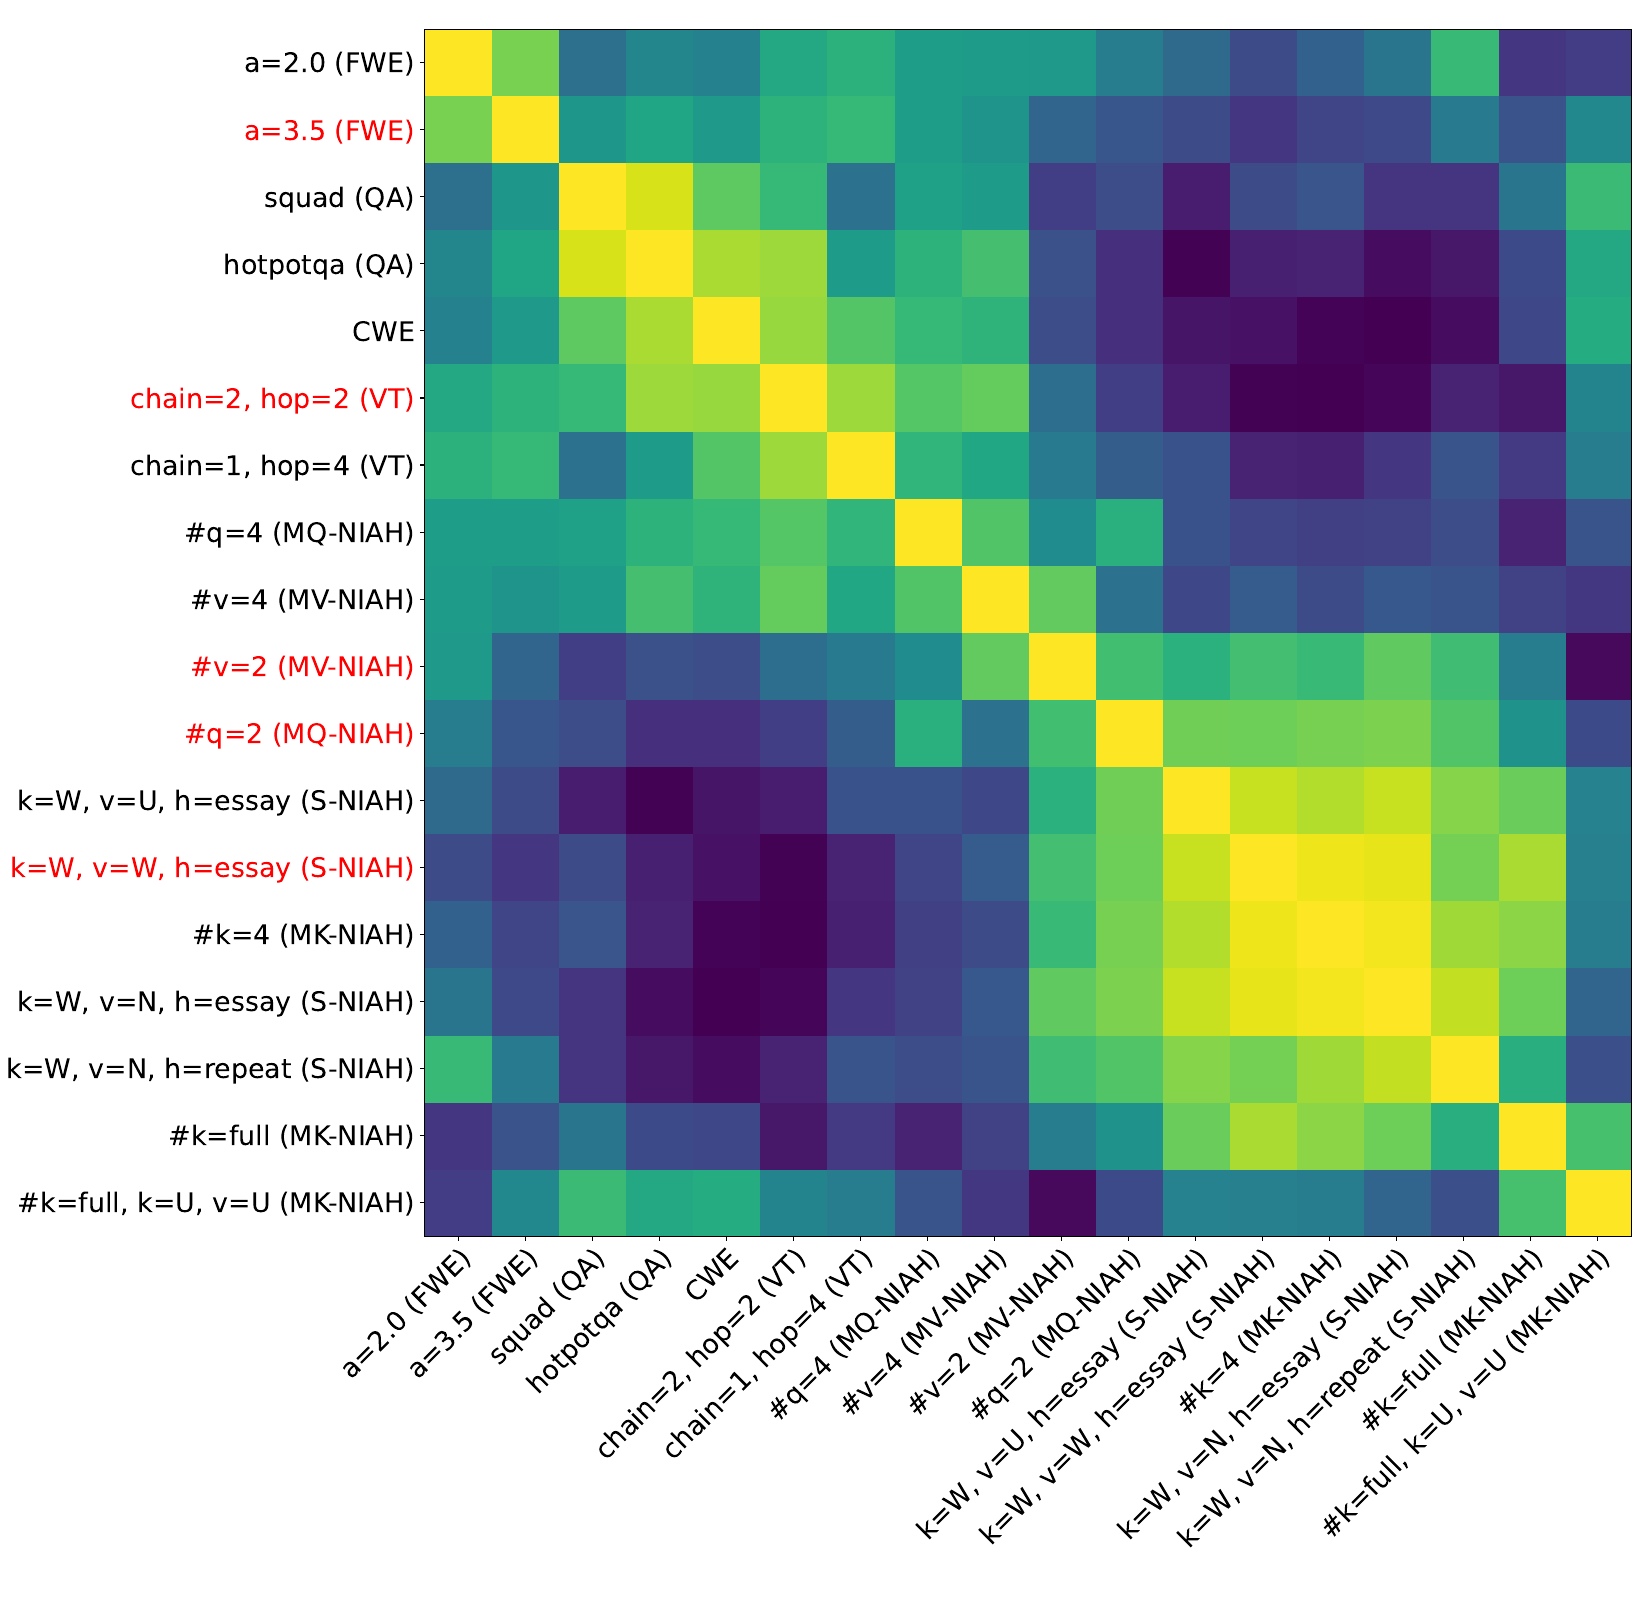
RULER est conçu selon l’hypothèse que les tâches de différentes catégories sont capables de révéler des comportements distincts des modèles. Nous menons une étude de corrélation préliminaire afin de confirmer la validité des catégories de tâches et de guider la sélection de tâches représentatives. Nous évaluons huit modèles open source à différentes tailles de contexte sur 18 configurations de tâches. Chaque tâche peut ensuite être représentée par un vecteur des performances du modèle à différentes tailles de contexte. Les 18 vecteurs de tâches sont ensuite regroupés au moyen d’un algorithme de clustering agglomératif, en utilisant le coefficient de corrélation comme métrique de distance. Comme le montre la Figure 5, bien que certaines tâches présentent des corrélations modérées avec d’autres, les tâches de chacune des quatre catégories (NIAH, VT, AG, QA) forment leurs propres groupes cohérents sans redondance. Nous éliminons en outre quelques tâches qui sont fortement corrélées avec d’autres tâches au sein du même groupe, et retenons finalement 13 tâches pour l’évaluation ultérieure à grande échelle.
D Modèles de prompts
Nous décomposons le modèle de prompt d’entrée en modèle de modèle dans le Tableau 6 et en modèle de tâche dans le Tableau 7. Le modèle de modèle correspond au format de chat du modèle, tandis que le modèle de tâche combine l’instruction, le contexte et la requête. Pour empêcher les modèles de refuser de répondre à nos questions, nous ajoutons à l’entrée un préfixe de réponse afin de susciter les réponses du modèle. Pour VT et CWE, nous utilisons un échantillon de tâche comme démonstration en contexte.
| Modèle | Modèle de gabarit |
| GPT-4 | {task_template} Ne fournissez aucune explication. Veuillez me donner directement la réponse. {task_answer_prefix} |
| Yi/Base | {task_template} {task_answer_prefix} |
| Command-R | {BOS_TOKEN}{START_OF_TURN_TOKEN}{USER_TOKEN}{task_template}{END_OF_TURN_TOKEN}{START_OF_TURN_TOKEN}{CHATBOT_TOKEN}{task_answer_prefix} |
| LWM/LongChat | {system_prompt} USER: {task_template} ASSISTANT:{task_answer_prefix} |
| GLM | {gMASK} sop{user}{task_template} {assistant}{task_answer_prefix} |
| Phi3 | {user}{task_template} {end}{assistant}{task_answer_prefix} |
| Qwen/DBRX | {im_start} system{system_prompt} {im_end}{im_start} user{task_template} {im_end}{im_start} assistant{task_answer_prefix} |
| Llama3/Llama3.1 | {begin_of_text} {start_header_id} user {end_header_id} |
| Llama2/Autres | {task_template} {eot_id}{start_header_id} assistant {end_header_id} |
| {task_answer_prefix} | |
| [INST] {task_template} [/INST] {task_answer_prefix} |
Tableau 6 : Modèles de chat des modèles. Nous ajoutons un préfixe de réponse de tâche dans la réponse du modèle afin d’empêcher les modèles de refuser de répondre à nos questions. L’ajout du préfixe de réponse ne rompt pas le modèle de chat des modèles.
S-NIAH Sous-tâche-1
Modèle de tâche : Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai ensuite sur ces nombres. L'herbe est verte. Le ciel est bleu. Le soleil est jaune. C'est parti. Aller et retour. L'un des nombres magiques spéciaux pour {word} est : {number}. Quel est le nombre magique spécial pour {word} mentionné dans le texte fourni ?
S-NIAH Sous-tâche-2
Préfixe de réponse à la tâche : Le nombre magique spécial pour {word} mentionné dans le texte fourni est
S-NIAH Sous-tâche-3
Modèle de tâche : Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai ensuite sur ces nombres. Essais de Paul Graham. L'un des nombres magiques spéciaux pour {word} est : {number}. Quel est le nombre magique spécial pour {word} mentionné dans le texte fourni ?
MK-NIAH Sous-tâche-1
Préfixe de réponse à la tâche : Le nombre magique spécial pour {word} mentionné dans le texte fourni est
MK-NIAH Sous-tâche-2
Modèle de tâche : Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai ensuite sur ces nombres. Essais de Paul Graham. L'un des nombres magiques spéciaux pour {word} est : {number}. Quel est le nombre magique spécial pour {word} mentionné dans le texte fourni ?
MK-NIAH Sous-tâche-3
Préfixe de réponse à la tâche : Le nombre magique spécial pour {word} mentionné dans le texte fourni est
MK-NIAH Sous-tâche-4
Modèle de tâche : Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai ensuite sur ces nombres. Essais de Paul Graham. L'un des nombres magiques spéciaux pour {word} est : {number}. L'un des nombres magiques spéciaux pour {word-1} est : {number-1}. L'un des nombres magiques spéciaux pour {word-2} est : {number-2}. L'un des nombres magiques spéciaux pour {word-3} est : {number-3}. L'un des nombres magiques spéciaux pour {word-4} est : {number-4}. Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
MK-NIAH Sous-tâche-5
Préfixe de réponse à la tâche : Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
MK-NIAH Sous-tâche-6
Modèle de tâche : Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai ensuite sur ces nombres. L'un des nombres magiques spéciaux pour {word-1} est : {number-1}. L'un des nombres magiques spéciaux pour {word-2} est : {number-2}. L'un des nombres magiques spéciaux pour {word-3} est : {number-3}. L'un des nombres magiques spéciaux pour {word-4} est : {number-4}. Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
MK-NIAH Sous-tâche-7
Préfixe de réponse à la tâche : Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
MK-NIAH Sous-tâche-8
Modèle de tâche : Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai ensuite sur ces nombres. L'un des nombres magiques spéciaux pour {word-1} est : {number-1}. L'un des nombres magiques spéciaux pour {word-2} est : {number-2}. L'un des nombres magiques spéciaux pour {word-3} est : {number-3}. L'un des nombres magiques spéciaux pour {word-4} est : {number-4}. Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
MK-NIAH Sous-tâche-9
Préfixe de réponse à la tâche : Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
MK-NIAH Sous-tâche-10
Modèle de tâche : Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai ensuite sur ces nombres. L'un des nombres magiques spéciaux pour {word-1} est : {number-1}. L'un des nombres magiques spéciaux pour {word-2} est : {number-2}. L'un des nombres magiques spéciaux pour {word-3} est : {number-3}. L'un des nombres magiques spéciaux pour {word-4} est : {number-4}. Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
MK-NIAH Sous-tâche-11
Préfixe de réponse à la tâche : Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
MK-NIAH Sous-tâche-12
Modèle de tâche : Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai ensuite sur ces nombres. L'un des nombres magiques spéciaux pour {word-1} est : {number-1}. L'un des nombres magiques spéciaux pour {word-2} est : {number-2}. L'un des nombres magiques spéciaux pour {word-3} est : {number-3}. L'un des nombres magiques spéciaux pour {word-4} est : {number-4}. Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
MK-NIAH Sous-tâche-13
Préfixe de réponse à la tâche : Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
MK-NIAH Sous-tâche-14
Modèle de tâche : Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai ensuite sur ces nombres. L'un des nombres magiques spéciaux pour {word-1} est : {number-1}. L'un des nombres magiques spéciaux pour {word-2} est : {number-2}. L'un des nombres magiques spéciaux pour {word-3} est : {number-3}. L'un des nombres magiques spéciaux pour {word-4} est : {number-4}. Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
MK-NIAH Sous-tâche-15
Préfixe de réponse à la tâche : Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
MK-NIAH Sous-tâche-16
Modèle de tâche : Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai ensuite sur ces nombres. L'un des nombres magiques spéciaux pour {word-1} est : {number-1}. L'un des nombres magiques spéciaux pour {word-2} est : {number-2}. L'un des nombres magiques spéciaux pour {word-3} est : {number-3}. L'un des nombres magiques spéciaux pour {word-4} est : {number-4}. Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
MK-NIAH Sous-tâche-17
Préfixe de réponse à la tâche : Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
MK-NIAH Sous-tâche-18
Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les nombres par la suite.
L'un des nombres magiques spéciaux pour {word-1} est : {number-1}.
L'un des nombres magiques spéciaux pour {word-2} est : {number-2}.
L'un des nombres magiques spéciaux pour {word-3} est : {number-3}.
L'un des nombres magiques spéciaux pour {word-4} est : {number-4}.
Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
Subtask-19
Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
Subtask-20
Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les nombres par la suite.
L'un des nombres magiques spéciaux pour {word-1} est : {number-1}.
L'un des nombres magiques spéciaux pour {word-2} est : {number-2}.
L'un des nombres magiques spéciaux pour {word-3} est : {number-3}.
L'un des nombres magiques spéciaux pour {word-4} est : {number-4}.
Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
Subtask-21
Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
Subtask-22
Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les nombres par la suite.
L'un des nombres magiques spéciaux pour {word-1} est : {number-1}.
L'un des nombres magiques spéciaux pour {word-2} est : {number-2}.
L'un des nombres magiques spéciaux pour {word-3} est : {number-3}.
L'un des nombres magiques spéciaux pour {word-4} est : {number-4}.
Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
Subtask-23
Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
Subtask-24
Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les nombres par la suite.
L'un des nombres magiques spéciaux pour {word-1} est : {number-1}.
L'un des nombres magiques spéciaux pour {word-2} est : {number-2}.
L'un des nombres magiques spéciaux pour {word-3} est : {number-3}.
L'un des nombres magiques spéciaux pour {word-4} est : {number-4}.
Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
Subtask-25
Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
Subtask-26
Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les nombres par la suite.
L'un des nombres magiques spéciaux pour {word-1} est : {number-1}.
L'un des nombres magiques spéciaux pour {word-2} est : {number-2}.
L'un des nombres magiques spéciaux pour {word-3} est : {number-3}.
L'un des nombres magiques spéciaux pour {word-4} est : {number-4}.
Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
Subtask-27
Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
Subtask-28
Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les nombres par la suite.
L'un des nombres magiques spéciaux pour {word-1} est : {number-1}.
L'un des nombres magiques spéciaux pour {word-2} est : {number-2}.
L'un des nombres magiques spéciaux pour {word-3} est : {number-3}.
L'un des nombres magiques spéciaux pour {word-4} est : {number-4}.
Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
Tableau 6 : Modèles de conversation. Nous ajoutons un préfixe de réponse à la tâche dans la réponse du modèle afin d’empêcher les modèles de refuser de répondre à nos questions. L’ajout du préfixe de réponse ne rompt pas le modèle de conversation des modèles.
MK-NIAHSubtask-29
Préfixe de réponse à la tâche : Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
MK-NIAHSubtask-48
Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les nombres par la suite.
L’un des nombres magiques spéciaux pour {word-1} est : {number-1}.
L’un des nombres magiques spéciaux pour {word-2} est : {number-2}.
L’un des nombres magiques spéciaux pour {word-3} est : {number-3}.
L’un des nombres magiques spéciaux pour {word-4} est : {number-4}.
Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
Subtask-49
Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
Subtask-50
Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les nombres par la suite.
L’un des nombres magiques spéciaux pour {word-1} est : {number-1}.
L’un des nombres magiques spéciaux pour {word-2} est : {number-2}.
L’un des nombres magiques spéciaux pour {word-3} est : {number-3}.
L’un des nombres magiques spéciaux pour {word-4} est : {number-4}.
Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
Subtask-51
Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
Subtask-52
Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les nombres par la suite.
L’un des nombres magiques spéciaux pour {word-1} est : {number-1}.
L’un des nombres magiques spéciaux pour {word-2} est : {number-2}.
L’un des nombres magiques spéciaux pour {word-3} est : {number-3}.
L’un des nombres magiques spéciaux pour {word-4} est : {number-4}.
Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
Subtask-53
Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
Subtask-54
Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les nombres par la suite.
L’un des nombres magiques spéciaux pour {word-1} est : {number-1}.
L’un des nombres magiques spéciaux pour {word-2} est : {number-2}.
L’un des nombres magiques spéciaux pour {word-3} est : {number-3}.
L’un des nombres magiques spéciaux pour {word-4} est : {number-4}.
Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
Subtask-55
Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
Subtask-56
Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les nombres par la suite.
L’un des nombres magiques spéciaux pour {word-1} est : {number-1}.
L’un des nombres magiques spéciaux pour {word-2} est : {number-2}.
L’un des nombres magiques spéciaux pour {word-3} est : {number-3}.
L’un des nombres magiques spéciaux pour {word-4} est : {number-4}.
Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
Subtask-57
Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
Subtask-58
Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les nombres par la suite.
L’un des nombres magiques spéciaux pour {word-1} est : {number-1}.
L’un des nombres magiques spéciaux pour {word-2} est : {number-2}.
L’un des nombres magiques spéciaux pour {word-3} est : {number-3}.
L’un des nombres magiques spéciaux pour {word-4} est : {number-4}.
Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
Subtask-59
Le nombre magique spécial pour {word-4} mentionné dans le texte fourni est
Subtask-60
Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les nombres par la suite.
L’un des nombres magiques spéciaux pour {word-1} est : {number-1}.
L’un des nombres magiques spéciaux pour {word-2} est : {number-2}.
L’un des nombres magiques spéciaux pour {word-3} est : {number-3}.
L’un des nombres magiques spéciaux pour {word-4} est : {number-4}.
Quel est le nombre magique spécial pour {word-4} mentionné dans le texte fourni ?
Some special magic numbers are hidden within the following text. Make sure to memorize it. I will quiz you about the numbers afterwards.
One of the special magic numbers for {word-1} is: {number-1}.
MK-NIAHSubtask-74
Modèle de tâche : Certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de le mémoriser. Je vous interrogerai ensuite sur les nombres. L’un des nombres magiques spéciaux pour {word-1} est : {number-1}. L’un des nombres magiques spéciaux pour {word-2} est : {number
| Modèle de tâche : certains nombres magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai ensuite sur ces nombres. Paul Graham Essays....... L’un des nombres magiques spéciaux pour {word} est : {number-1}....... L’un des nombres magiques spéciaux pour {word} est : {number-2}....... L’un des nombres magiques spéciaux pour {word} est : {number-3}....... L’un des nombres magiques spéciaux pour {word} est : {number-4}. Quels sont tous les nombres magiques spéciaux pour {word} mentionnés dans le texte fourni ? |
| Préfixe de réponse à la tâche : Les numéros magiques spéciaux pour {word} mentionnés dans le texte fourni sont | |
| Modèle de tâche : Certains numéros magiques spéciaux sont cachés dans le texte suivant. Assurez-vous de les mémoriser. Je vous interrogerai sur les numéros par la suite. Essais de Paul Graham....... L'un des numéros magiques spéciaux pour {word-1} est : {number-1}....... L'un des numéros magiques spéciaux pour {word-2} est : {number-2}....... L'un des numéros magiques spéciaux pour {word-3} est : {number-3}....... L'un des numéros magiques spéciaux pour {word-4} est : {number-4}. Quels sont tous les numéros magiques spéciaux pour {word-1}, {word-2}, {word-3} et {word-4} mentionnés dans le texte fourni ? |
| Préfixe de réponse à la tâche : Les nombres magiques spéciaux pour {word-1}, {word-2}, {word-3} et {word-4} mentionnés dans le texte fourni sont |
| Modèle de tâche : {un exemple de tâche} Mémorisez et suivez la ou les chaînes d’affectation de variables cachées dans le texte suivant. L’herbe est verte. Le ciel est bleu. Le soleil est jaune. C’est parti. Aller et retour. ...... VAR {X1} = {number} ...... ...... VAR {X2} = {X1} ...... ...... VAR {X3} = {X2} ...... ...... VAR {X4} = {X3} ...... ...... VAR {X5} = {X4} ...... Question : Trouvez toutes les variables auxquelles la valeur {number} est affectée dans le texte ci-dessus. |
| Préfixe de réponse à la tâche : Réponse : Selon la ou les chaînes d'affectation de variables dans le texte ci-dessus, 5 variables se voient attribuer la valeur {number}, ce sont : |
| Modèle de tâche : {un exemple de tâche} Voici une liste numérotée de mots. Parmi ces mots, certains apparaissent plus souvent que d'autres. Mémorisez ceux qui apparaissent le plus souvent. 1. mot-a 2. mot-b 3. mot-c 4. mot-d 5. mot-d 6. mot-a 7. mot-e 8. mot-f ...... Question : Quels sont les 10 mots les plus fréquents dans la liste ci-dessus ? |
| Préfixe de réponse à la tâche : Réponse : Les 10 mots qui apparaissent le plus souvent dans la liste sont : | |
| Modèle de tâche : Lisez le texte codé suivant et suivez la fréquence de chaque mot codé. Trouvez les trois mots codés qui apparaissent le plus fréquemment. ... mot-a ... mot-b ... ... mot-c ... mot-a ...mot-d mot-e ... mot-a ... mot-f ... ... mot-g ... mot-h ... mot-a ... mot-i .... Question : Ne fournissez aucune explication. Veuillez ignorer les points '...'. Quels sont les trois mots qui apparaissent le plus fréquemment dans le texte codé ci-dessus ? |
| Préfixe de réponse à la tâche : Réponse : D'après le texte codé ci-dessus, les trois mots les plus fréquemment apparus sont : |
Answer the question based on the given documents. Only give me the answer and do not output any other words.
The following are given documents.
Document 1:
{document-1}
......
Document x:
{document-x}
......
Document n:
{document-n}
Answer the question based on the given documents. Only give me the answer and do not output any other words.
Question: question
Task Answer Prefix:
Answer:
Task Template:
Answer the question based on the given documents. Only give me the answer and do not output any other words.
The following are given documents.
Document 1:
{document-1}
......
Document x:
{document-x}
......
Document y:
{document-y}
......
Document n:
{document-n}
Answer the question based on the given documents. Only give me the answer and do not output any other words.
Question: question
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Modèle de tâche :
Répondez à la question en vous fondant sur les documents fournis. Donnez-moi uniquement la réponse et n'affichez aucun autre mot.
Les documents suivants sont fournis.
Document 1 :
{document-1}
......
Document x :
{document-x}
......
Document n :
{document-n}
Répondez à la question en vous fondant sur les documents fournis. Donnez-moi uniquement la réponse et n'affichez aucun autre mot.
Question : question
Préfixe de réponse à la tâche :
Réponse :
Modèle de tâche :
Répondez à la question en vous fondant sur les documents fournis. Donnez-moi uniquement la réponse et n'affichez aucun autre mot.
Les documents suivants sont fournis.
Document 1 :
{document-1}
......
Document x :
{document-x}
......
Document y :
{document-y}
......
Document n :
{document-n}
Répondez à la question en vous fondant sur les documents fournis. Donnez-moi uniquement la réponse et n'affichez aucun autre mot.
Question : question
Préfixe de réponse à la tâche :
Réponse :
Préfixe de réponse à la tâche :
Réponse :
E Récupération de passkey et résultats du NIAH standard
| Contexte de référence en lecture seule pour comprendre la source (il ne s’agit pas du texte source à traduire) : E Résultats de récupération de passkey et de NIAH vanilla Tableau 11 : Performance de modèles alignés et de base sélectionnés sur des longueurs allant de 4K à 128K dans le NIAH vanilla de RULER. Presque tous les modèles obtiennent un score parfait à la longueur qu’ils revendiquent. Texte à traduire : Modèles | Longueur revendiquée | 4K | 8K | 16K | 32K | 64K | 128K | Moy. |
| Gemini-1.5 | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| GPT-4 | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| Llama3.1 (70B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 97,8 | 99,6 |
| Llama3.1 (8B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| Qwen2 (72B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 96,6 | 99,4 |
| Command-R-plus (104B) | 128K | 100,0 | 100,0 | 99,8 | 99,8 | 100,0 | 97,2 | 99,5 |
| GLM4 (9B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| GradientAI/LLama3 (70B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 93,6 | 98,9 |
| Mixtral-8x22B (39B/141B) | 64K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 0,0 | 83,3 |
| Yi (34B) | 200K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| Phi3-medium (14B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 88,0 | 98,0 |
| Mistral-v0.2 (7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 69,6 | 94,9 |
| LWM (7B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| DBRX (36B/132B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 0,0 | 0,0 | 66,7 |
| Together (7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 0,0 | 0,0 | 66,7 |
| LongChat (7B) | 32K | 100,0 | 100,0 | 100,0 | 99,4 | 0,0 | 0,0 | 66,6 |
| LongAlpaca (13B) | 32K | 88,2 | 88,6 | 86,4 | 82,4 | 0,0 | 0,0 | 57,6 |
| Mixtral-base (8x7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 46,8 | 91,1 |
| Mixtral-base (7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 70,8 | 95,1 |
| Jamba-base (52B) | 256K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| LWM-base (7B) | 1M | 99,8 | 99,6 | 99,6 | 98,2 | 96,0 | 98,9 | 98,9 |
| LongLoRA-base (7B) | 100K | 99,6 | 99,4 | 99,0 | 99,4 | 99,4 | 0,0 | 82,8 |
| Yarn-base (7B) | 128K | 100,0 | 100,0 | 99,0 | 100,0 | 99,2 | 39,6 | 89,6 |
| Together-base (7B) | 32K | 100,0 | 100,0 | 99,8 | 100,0 | 0,0 | 0,0 | 66,6 |
| Modèles | Longueur annoncée | 4K | 8K | 16K | 32K | 64K | 128K | Moy. |
| Gemini-1.5 | 1M | 100,0 | 100,0 | 100,0 | 98,0 | 100,0 | 100,0 | 99,7 |
| GPT-4 | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| Llama3.1 (70B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 99,9 |
| Llama3.1 (8B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 99,9 |
| Qwen2 (72B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 99,8 | 56,4 | 92,7 |
| Command-R-plus (35B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 99,8 | 86,0 | 97,6 |
| GLM4 (9B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| GradientAI/LLama3 (70B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 97,8 | 99,4 |
| Mixtral-8x22B (39B/141B) | 64K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 24,2 | 87,3 |
| Yi (34B) | 200K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| Phi3-medium (14B) | 128K | 100,0 | 100,0 | 100,0 | 99,8 | 99,8 | 73,8 | 95,5 |
| Mixtral-v0.2 (7B) | 32K | 100,0 | 100,0 | 100,0 | 97,0 | 70,0 | 7,4 | 79,1 |
| LWM (7B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| DBRX (36B/132B) | 32K | 100,0 | 100,0 | 90,0 | 93,2 | 0,8 | 0,0 | 64,0 |
| Together (7B) | 32K | 100,0 | 100,0 | 100,0 | 99,8 | 0,0 | 0,0 | 66,6 |
| LongChat (7B) | 32K | 100,0 | 100,0 | 97,6 | 98,4 | 0,0 | 0,0 | 66,0 |
| LongAlpaca (13B) | 32K | 90,2 | 90,2 | 88,4 | 83,4 | 0,0 | 0,0 | 58,7 |
| Mixtral-base (8x7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 85,2 | 34,8 | 86,7 |
| Mixtral-base (7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 94,8 | 0,4 | 82,5 |
| Jamba-base (52B) | 256K | 100,0 | 100,0 | 98,8 | 99,8 | 99,8 | 86,4 | 97,5 |
| LWM-base (7B) | 1M | 100,0 | 99,4 | 97,8 | 98,6 | 98,2 | 98,6 | 98,8 |
| LongLoRA-base (7B) | 100K | 99,8 | 100,0 | 100,0 | 99,8 | 100,0 | 0,0 | 83,3 |
| Yarn-base (7B) | 128K | 97,4 | 97,8 | 91,4 | 85,4 | 86,6 | 20,0 | 79,8 |
| Together-base (7B) | 32K | 100,0 | 100,0 | 100,0 | 99,8 | 0,0 | 0,0 | 66,6 |
Tableau 11 : Performance de modèles alignés et de base sélectionnés sur des longueurs de 4K à 128K dans le NIAH standard de RULER. Presque tous les modèles obtiennent un score parfait à la longueur qu'ils revendiquent.
.
F Résultats supplémentaires
| Modèles | Longueur annoncée | Longueur effective | 4K | 8K | 16K | 32K | 64K | 128K | Moy. | wMoy. (inc) | wMoy. (déc) |
| Llama2-7B (base) | 4K | - | 79,4 | ||||||||
| Mixtral-base (8x7B) | 32K | 32K | 91,8 | 91,0 | 89,5 | 85,8 | 66,9 | 29,0 | 75,7 | 66,4(1er) | 85,0(1er) |
| Mixtral-base (7B) | 32K | 16K | 91,6 | 89,8 | 86,3 | 77,2 | 52,3 | 8,0 | 67,5 | 54,7(4e) | 80,4(2e) |
| Jamba-base (52B) | 256K | 4K | 81,2 | 75,4 | 68,8 | 65,3 | 61,0 | 51,4 | 67,2 | 62,5(3e) | 71,8(4e) |
| LWM-base (7B) | 1M | <4K | 77,5 | 74,0 | 69,6 | 64,6 | 61,3 | 59,0 | 67,7 | 64,4(2e) | 70,9(5e) |
| Contexte de référence en lecture seule pour comprendre la source (il ne s'agit pas du texte source à traduire) : | F Résultats supplémentaires | Tableau 12 : Performance des modèles de base sélectionnés sur des longueurs de 4K à 128K en faisant la moyenne des scores de 13 tâches dans RULER. | Texte à traduire : | LongLoRA-base (7B) | 100K | 8K | 81,9 | 80,4 | 75,6 | 65,1 | 60,8 |
| 0,0 | 60,6 | 49,2(5e) | 72,0(3e) | Yarn-base (7B) | 128K | <4K | 77,3 | 67,5 | 59,0 | 47,3 | 38,6 |
| 13,9 | 50,6 | 40,7(6e) | 60,5(7e) | Together-base (7B) | 32K | 4K | 84,6 | 78,7 | 68,3 | 57,9 | 0,0 0,0 48,2 32,3(7e) 64,2(6e) |
Tableau 12 : Performance de modèles de base sélectionnés sur des longueurs de 4K à 128K en faisant la moyenne des scores de 13 tâches dans RULER.
| Modèles | Longueur annoncée | Longueur effective | 4K | 8K | 16K | 32K | 64K | 128K | Moy. | wMoy. (inc) | wMoy. (déc) |
| Llama2-7B (chat) | 4K | - | 96,9 | ||||||||
| Gemini-1.5 | 1M | >128K | 99,8 | 99,9 | 99,6 | 99,7 | 99,7 | 99,6 | 99,7 | 99,7(1er) | 99,7(1er) |
| Llama3.1 (8B) | 128K | 64K | 99,9 | 99,9 | 99,8 | 99,6 | 98,7 | 92,6 | 98,4 | 97,5(3e) | 99,4(2e) |
| GLM4 (9B) | 1M | 64K | 99,4 | 99,2 | 99,5 | 99,4 | 97,3 | 94,4 | 98,2 | 97,5(2e) | 98,9(3e) |
| Llama3.1 (70B) | 128K | 64K | 100,0 | 100,0 | 99,9 | 99,6 | 98,5 | 78,9 | 96,1 | 93,5(5e) | 98,8(4e) |
| GPT-4 | 128K | 32K | 99,9 | 99,9 | 98,7 | 98,3 | 90,9 | 84,8 | 95,4 | 92,9(6e) | 97,9(5e) |
| Command-R-plus (104B) | 128K | 32K | 99,9 | 99,9 | 99,4 | 97,9 | 89,6 | 65,7 | 92,1 | 87,3(8e) | 96,9(6e) |
| GradientAI/Llama3 (70B) | 1M | 16K | 99,0 | 98,8 | 98,3 | 94,5 | 91,2 | 84,9 | 94,4 | 92,1(7e) | 96,8(7e) |
| Yi (34B) | 200K | 16K | 98,2 | 96,8 | 97,3 | 95,1 | 93,0 | 90,2 | 95,1 | 93,8(4e) | 96,4(8e) |
| Qwen2 (72B) | 128K | 32K | 100,0 | 99,9 | 99,9 | 99,4 | 84,5 | 48,0 | 88,6 | 81,3(11e) | 95,9(9e) |
| Phi3-medium (14B) | 128K | 8K | 98,7 | 98,5 | 96,6 | 95,4 | 91,9 | 51,3 | 88,7 | 82,6 (10e) | 94,9 (10e) |
| Mixtral-8x22B (39B/141B) | 64K | 16K | 99,3 | 99,1 | 97,7 | 96,7 | 89,9 | 23,8 | 84,4 | 74,8 (12e) | 94,1 (11e) |
| LWM (7B) | 1M | <4K | 92,5 | 92,1 | 87,6 | 83,7 | 84,1 | 83,4 | 87,2 | 85,5 (9e) | 89,0 (12e) |
| Mistral-v0.2 (7B) | 32K | 4K | 98,1 | 96,2 | 94,3 | 85,5 | 51,1 | 10,7 | 72,6 | 58,8 (13e) | 86,5 (13e) |
| DBRX (36B/132B) | 32K | 8K | 99,4 | 99,0 | 93,5 | 73,4 | 0,5 | 0,0 | 61,0 | 41,6 (14e) | 80,3 (14e) |
| Together (7B) | 32K | <4K | 96,2 | 89,9 | 82,3 | 80,2 | 0,0 | 0.0 | 58,1 | 40,2 (15e) | 76,0 (15e) |
| LongChat (7B) | 32K | <4K | 93,3 | 92,2 | 81,1 | 67,3 | 0,0 | 0,0 | 55,7 | 37,6 (16e) | 73,7 (16e) |
| LongAlpaca (13B) | 32K | <4K | 74,9 | 72,2 | 70,8 | 53,2 | 0,0 | 0,0 | 45,2 | 30,7 (17e) | 59,7 (17e) |
| Contexte en lecture seule pour comprendre la source (il ne s'agit pas du texte source à traduire) : | Tableau 12 : Performance de modèles de base sélectionnés sur des longueurs de 4K à 128K en faisant la moyenne des scores de 13 tâches dans RULER. | Tableau 13 : Performance de modèles alignés et de base sélectionnés sur des longueurs de 4K à 128K en faisant la moyenne des scores de 8 tâches dans Retrieval (NIAH) de RULER. | Texte à traduire : | ||||||||
| Llama2-7B (base) | 4K | - | 90.9 | Mixtral-base (8x7B) | 32K | 32K | 99.9 | 99.7 | 98.4 | 94.8 | 72.1 |
| 29.1 | 82.3 | 71.8(2e) | 92.8(1er) | Mixtral-base (7B) | 32K | 16K | 99.3 | 97.5 | 95.7 | 89.8 | 56.8 |
| 10.2 | 74.9 | 61.2(4e) | 88.6(2e) | Jamba-base (52B) | 256K | <4K | 86.4 | 80.5 | 73.7 | 72.3 | 68.1 |
| 56.9 | 73.0 | 68.5(3e) | 77.4(5e) | LWM-base (7B) | 1M | <4K | 88.5 | 87.7 | 84.5 | 79.6 | 76.1 |
| 74.2 | 81.8 | 79.1(1er) | 84.4(4e) | LongLoRA-base (7B) | 100K | 16K | 95.3 | 95.6 | 92.7 | 81.5 | 76.2 0.0 73.5 60.6(5e) 86.5(3e) |
| Contexte de référence en lecture seule pour comprendre la source (ce n'est pas le texte source à traduire) : Tableau 12 : Performance de modèles de base sélectionnés sur des longueurs de 4K à 128K en faisant la moyenne des scores de 13 tâches dans RULER. Tableau 13 : Performance de modèles alignés et de base sélectionnés sur des longueurs de 4K à 128K en faisant la moyenne des scores de 8 tâches dans Retrieval (NIAH) de RULER. Texte à traduire : Yarn-base (7B) | 128K | <4K | 89,9 | 86,1 | 78,4 | 59,0 | 49,5 | 17,5 | 63,4 | 51,7(6e) | 75,1(7e) |
| Together-base (7B) | 32K | 8K | 95,4 | 91,5 | 86,1 | 75,1 | 0,0 | 0,0 | 58,0 | 39,9(7e) | 76,2(6e) |
| Together-base (7B) | 32K | 8K | 95,4 | 91,5 | 86,1 | 75,1 | 0,0 | 0,0 | 58,0 | 39,9(7e) | 76,2(6e) |
Tableau 13 : Performance de modèles alignés et de base sélectionnés sur des longueurs de 4K à 128K en faisant la moyenne des scores de 8 tâches dans Retrieval (NIAH) de RULER.
« »
| Modèles | Longueur annoncée | Longueur effective | 4K | 8K | 16K | 32K | 64K | 128K | Moy. | Moy. pondérée (aug.) | Moy. pondérée (dim.) |
| Llama2-7B (chat) | 4K | - | 89,7 | ||||||||
| GPT-4 | 128K | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 99,9 | 99,9(2e) | 100,0(1er) |
| Gemini-1.5 | 1M | >128K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 100,0 | 99,9 | 99,9(1er) | 100,0(2e) |
| Command-R-plus (104B) | 128K | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 99,9 | 97,2 | 99,5 | 99,2(3e) | 99,8(3e) |
| GLM4 (9B) | 1M | >128K | 99,9 | 99,6 | 99,8 | 99,8 | 99,6 | 97,7 | 99,4 | 99,1(4e) | 99,7(4e) |
| Qwen2 (72B) | 128K | 64K | 100,0 | 100,0 | 100,0 | 100,0 | 95,2 | 79,0 | 95,7 | 92,9 (5e) | 98,5 (5e) |
| Llama3.1 (70B) | 128K | 64K | 100,0 | 100,0 | 100,0 | 100,0 | 99,9 | 59,2 | 93,2 | 88,3 (8e) | 98,0 (6e) |
| Llama3.1 (8B) | 128K | 64K | 99,9 | 99,7 | 99,7 | 98,8 | 97,6 | 70,4 | 94,4 | 90,7 (6e) | 98,0 (7e) |
| GradientAI/Llama3 (70B) | 1M | 64K | 100,0 | 100,0 | 100,0 | 100,0 | 99,7 | 56,2 | 92,6 | 87,4 (9e) | 97,9 (8e) |
| Yi (34B) | 200K | 64K | 99,8 | 99,8 | 99,8 | 94,5 | 92,5 | 76,8 | 93,6 | 90,3 (7e) | 96,9 (9e) |
| Mixtral-8x22B (39B/141B) | 64K | 64K | 100,0 | 100,0 | 99,8 | 98,6 | 96,4 | 0,0 | 82,5 | 70,3 (10e) | 94,7 (10e) |
| Phi3-medium (14B) | 128K | 16K | 99,6 | 99,2 | 98,4 | 82,1 | 53,6 | 26,0 | 76,5 | 64,1 (11e) | 88,9 (11e) |
| Mixtral-v0.2 (7B) | 32K | 16K | 98,9 | 96,0 | 92,2 | 85,0 | 74,5 | 0,0 | 74,4 | 60,9 (12e) | 87,9 (12e) |
| LongChat (7B) | 32K | 8K | 97,6 | 93,5 | 83,4 | 62,4 | 0,0 | 0,0 | 56,2 | 37,4 (14e) | 75,0 (13e) |
| DBRX (36B/132B) | 32K | 8K | 100,0 | 99,0 | 72,5 | 45,8 | 0,0 | 0,0 | 52,9 | 33,3 (15e) | 72,5 (14e) |
| LWM (7B) | 1M | <4K | 84,4 | 80,1 | 67,2 | 52,2 | 45,9 | 15.2 | 57.5 | 46.5(13e) | 68.6(15e) |
| Together (7B) | 32K | <4K | 89.2 | 88.8 | 48.3 | 16.6 | 0.0 | 0.0 | 40.5 | 22.8(16e) | 58.2(16e) |
| LongAlpaca (13B) | 32K | <4K | 8.5 | 2.1 | 18.2 | 17.0 | 0.0 | 0.0 | 7.6 | 6.5(17e) | 8.8(17e) |
| Llama2-7B (base) | 4K | - | 58.8 | ||||||||
| Mixtral-base (8x7B) | 32K | 64K | 100.0 | 99.9 | 100.0 | 98.4 | 87.3 | 43.3 | 88.1 | 80.5(2e) | 95.8(1er) |
| Mixtral-base (7B) | 32K | 64K | 99.0 | 98.4 | 96.5 | 89.1 | 86.1 | 0.0 | 78.2 | 65.4(4e) | 91.0(2e) |
| Jamba-base (52B) | 256K | 128K | 87.5 | 87.6 | 86.2 | 88.1 | 86.0 | 77,8 | 85,5 | 84,3(1er) | 86,7(3e) |
| LWM-base (7B) | 1M | 128K | 80,2 | 82,7 | 79,3 | 76,4 | 70,7 | 66,1 | 75,9 | 73,3(3e) | 78,5(4e) |
| LongLoRA-base (7B) | 100K | 64K | 92,5 | 87,4 | 73,1 | 56,0 | 69,2 | 0,0 | 63,0 | 50,3(5e) | 75,8(5e) |
| Yarn-base (7B) | 128K | 4K | 84,6 | 43,6 | 24,8 | 43,0 | 20,9 | 0,0 | 36,1 | 24,9(7e) | 47,4(7e) |
| Together-base (7B) | 32K | 16K | 95,0 | 90,6 | 69,6 | 43,2 | 0,0 | 0,0 | 49,7 | 31,3(6e) | 68,1(6e) |
| Modèles | Longueur annoncée | Longueur effective | 4K | 8K | 16K | 32K | 64K | 128K | Moy. (avec incl.) | Moy. pondérée (avec déc.) |
| Llama2-7B-chat | 4K | - | 84,8 | |||||||
| Gemini-1.5 | 1M | >128K | 97,7 | 97,7 | 97,6 | 98,6 | 97,3 | 90,9 | 96,6 | 95,8 (1er) |
| GPT-4 | 128K | 64K | 99,0 | 98,3 | 98,0 | 95,0 | 90,1 | 79,7 | 93,4 | 90,4 (2e) |
| Qwen2 (72B) | 128K | 32K | 99,3 | 98,0 | 93,1 | 97,4 | 78,5 | 70,3 | 89,4 | 84,7 (3e) |
| Mixtral-8x22B (39B/141B) | 64K | 32K | 97,8 | 96,9 | 94,8 | 88,2 | 83,3 | 69,7 | 88,5 | 84,0 (4e) |
| Command-R-plus (104B) | 128K | 32K | 98,2 | 96,9 Note : « Avg. (inc) » et « wAvg. (dec) » ont été rendus par « Moy. (avec incl.) » et « Moy. pondérée (avec déc.) » ; les abréviations « incl. » et « déc. » restent ambiguës dans la source et ont été conservées telles quelles. | 95,2 | 90,3 | 82,5 | 59,5 | 87,1 | 81,3 (5e) |
| Llama3.1 (70B) | 128K | 32K | 99,9 | 98,3 | 98,4 | 97,1 | 66,3 | 39,8 | 83,3 | 73,8 (6e) |
| Phi3-medium (14B) | 128K | 16K | 90,8 | 95,1 | 90,3 | 82,4 | 62,1 | 43,8 | 77,4 | 69,3 (7e) |
| Yi (34B) | 200K | 16K | 91,4 | 90,9 | 86,2 | 75,3 | 58,5 | 43,4 | 74,3 | 66,0 (8e) |
| GLM4 (9B) | 1M | 8K | 93,5 | 85,2 | 78,5 | 68,1 | 58,3 | 49,7 | 72,2 | 64,8 (9e) |
| GradientAI/Llama3 (70B) | 1M | 8K | 96,4 | 94,7 | 74,9 | 57,0 | 45,1 | 41,4 | 68,3 | 57,7 (10e) |
| Llama3.1 (8B) | 128K | 8K | 97,0 | 90,1 | 79,2 | 54,1 | 43,5 | 36,2 | 66,7 | 55,5 (11e) |
| Mixtral-v0.2 (7B) | 32K | 8K | 94,3 | 90,4 | 77,4 | 48,5 | 42,4 | 33,7 | 64,4 | 53,1 (12e) |
| DBRX (36B/132B) | 32K | 8K | 94,5 | 94,7 | 73,7 | 48,7 | 4,1 | 0,0 | 52,6 | 34,3 (13e) |
| Together (7B) | 32K | <4K | 82,3 | 64,5 | 43,3 | 34,8 | 0,0 | 0,0 | 37,5 | 22,9 (16e) |
| LongChat (7B) | 32K | <4K | 74,3 | 50,7 | 46,7 | 51,1 | 0,0 | 0,0 | 37,1 | 24,8 (15e) |
| LWM (7B) | 1M | <4K | 61,3 | 43,6 | 38,3 | 32,8 | 29,1 | 29,1 | 39,0 | 34,0 (14e) |
| LongAlpaca (13B) | 32K | <4K | 33,0 | 27,0 | 26,0 | 23,2 | 0,0 | 0,0 | 18,2 | 12,3 (17e) |
| Llama2-7B (base) | 4K | - | 73,1 | |||||||
| Mixtral-base (8x7B) | 32K | 32K | 96,5 | 94,8 | 93,1 | 87,8 | 68,6 | 24,3 | 77,5 | 66,9 (1er) |
| Mixtral-base (7B) | 32K | 16K | 94,8 | 93,1 | 81,6 | 53,3 | 36,7 | 9,2 | 61,4 | 46,5 (2e) |
| Jamba-base (52B) | 256K | 4K | 75,9 | 63,5 | 51,7 | 38,5 | 33,3 | 28,0 | 48,5 | 40,3 (3e) |
| LWM-base (7B) | 1M | <4K | 67,1 | 48,4 | 36,0 | 26,3 | 21,5 | 18,7 | 36,3 | 28,4 (5e) |
| LongLoRA-base (7B) | 100K | <4K | 70,3 | 64,4 | 50,7 | 39,9 | 29,4 | 0,0 | 42,4 | 31,3 (4e) |
| Yarn-base (7B) | 128K | <4K | 70,6 | 49,2 | 28,9 | 20,5 | 17,0 | 2,1 | 31,4 | 20,7 (6e) |
| Together-base (7B) | 32K | <4K | 69,1 | 53,0 | 19,9 | 20,6 | 0,0 | 0,0 | 27,1 | 15,1 (7e) |
| Modèles | Longueur revendiquée | Longueur effective | 4K | 8K | 16K | 32K | 64K | 128K | Moy. | Moy. pondérée (inc) | Moy. pondérée (déc) |
| Llama2-7B (chat) | 4K | - | 49,7 | ||||||||
| Gemini-1.5 | 1M | >128K | 81,9 | 75,9 | 77,8 | 75,9 | 77,6 | 74,1 | 77,2 | 76,3(1er) | 78,0(1er) |
| GPT-4 | 128K | 128K | 79,0 | 78,0 | 76,0 | 68,0 | 61,6 | 59,0 | 70,3 | 66,5(4e) | 74,0(2e) |
| Qwen2 (72B) | 128K | 64K | 80,8 | 76,9 | 74,1 | 66,9 | 54,5 | 47,2 | 66,7 | 61,0(8e) | 72,5(3e) |
| GradientAI/LLama3 (70B) | 1M | >128K | 75,6 | 73,9 | 72,4 | 69,9 | 66,0 | 59,8 | 69,6 | 67,1(3e) | 72,1(4e) |
| Llama3.1 (70B) | 128K | 64K | 77,2 | 74,8 | 72,3 | 70,4 | 64,2 | 47,6 | 67,8 | 63,4 (7e) | 72,1 (5e) |
| GLM4 (9B) | 1M | >128K | 74,7 | 71,3 | 71,9 | 68,5 | 66,3 | 63,6 | 69,4 | 67,6 (2e) | 71,1 (6e) |
| Mixtral-8x22B (39B/141B) | 64K | 64K | 76,6 | 73,5 | 71,8 | 66,5 | 59,7 | 40,8 | 64,8 | 59,4 (9e) | 70,2 (7e) |
| Yi (34B) | 200K | >128K | 72,7 | 71,5 | 68,4 | 66,2 | 64,1 | 59,9 | 67,1 | 65,0 (5e) | 69,2 (8e) |
| Llama3.1 (8B) | 128K | 128K | 74,1 | 70,1 | 67,3 | 65,8 | 63,7 | 58,8 | 66,6 | 64,3 (6e) | 68,9 (9e) |
| Command-R-plus (104B) | 128K | 64K | 73,4 | 72,3 | 69,4 | 65,9 | 57,0 | 39,2 | 62,9 | 57,6 (10e) | 68,1 (10e) |
| Phi3-medium (14B) | 128K | 64K | 70,9 | 67,2 | 66,1 | 59,3 | 54,2 | 38,0 | 59,3 | 54,3 (12e) | 64,3 (11e) |
| Mixtral-v0.2 (7B) | 32K | 32K | 72,4 | 70,0 | 65,7 | 57,6 | 34,4 | 13,3 | 52,2 | 42,5 (13e) | 62,0 (12e) |
| LWM (7B) | 1M | >128K | 61,2 | 57,8 | 56,7 | 55,4 | 54,7 | 52,6 | 56,4 | 55,1 (11e) | 57,7 (13e) |
| DBRX (36B/132B) | 32K | 16K | 76,0 | 69,4 | 59,4 | 45,0 | 9,6 | 0,0 | 43,2 | 29,6 (14e) | 56,9 (14e) |
| Together (7B) | 32K | 16K | 61,1 | 58,3 | 54,2 | 45,6 | 0,0 | 0,0 | 36,5 | 24,9(15e) | 48,2(15e) |
| LongAlpaca (13B) | 32K | 16K | 57,2 | 53,5 | 49,7 | 39,0 | 0,0 | 0,0 | 33,2 | 22,3(16e) | 44,1(16e) |
| LongChat (7B) | 32K | 8K | 54,5 | 53,6 | 47,6 | 34,0 | 0,0 | 0,0 | 31,6 | 21,0(17e) | 42,3(17e) |
| Llama2-7B (base) | 4K | - | 48,6 | 47,7 | 45,3 | 41,3 | 34,4 | 26,4 | 41,0 | 37,0(3e) | 44,9(3e) |
| Mixtral-base (8x7B) | 32K | 4K | 50,8 | 47,7 | 45,3 | 41,3 | 34,4 | 26,4 | 41,0 | 37,0(3e) | 44,9(3e) |
| Mixtral-base (7B) | 32K | 8K | 53,5 | 51,0 | 48,4 | 44,7 | 32,8 | 2,2 | 38,8 | 31,3(4e) | 46,3(2e) |
| Jamba-base (52B) | 256K | 32K | 62,7 | 60,6 | 57,9 | 52,6 | 47,5 | 39,6 | 53,5 | 49,7(1er) | 57,3(1er) |
| LWM-base (7B) | 1M | <4K | 42,7 | 40,2 | 38,7 | 37,1 | 37,3 | 34,6 | 38,4 | 37,2(2e) | 39,6(4e) |
| LongLoRA-base (7B) | 100K | <4K | 34,5 | 32,1 | 33,6 | 29,4 | 26,1 | 0,0 | 26,0 | 21,3(6e) | 30,6(6e) |
| Yarn-base (7B) | 128K | <4K | 29,7 | 23,5 | 28,6 | 29,7 | 25,5 | 18,1 | 25,9 | 24,6(5e) | 27,1(7e) |
| Together-base (7B) | 32K | 4K | 52,0 | 47,5 | 44,6 | 33,6 | 0,0 | 0,0 | 29,6 | 19,8(7e) | 39,5(5e) |