
Servir des prompts qui partagent un préfixe gaspille la mémoire GPU. SGLang mutualise le cache KV et monte à 6,4 fois plus de débit. NeurIPS 2024.
SGLang: Efficient Execution of Structured Language Model Programs
SGLang : Exécution efficace de programmes structurés de modèles de langage
Lianmin Zheng ^{2*} Liansheng Yin Zhiqiang Xie Chuyue Sun Jeff Huang Cody Hao Yu Shiyi Cao Christos Kozyrakis Ion Stoica Joseph E. Gonzalez Clark Barrett Ying Sheng ^{1}
Université Stanford UC Berkeley Université Jiao Tong de Shanghai Université Texas A&M Chercheur indépendant
Résumé
Les grands modèles de langage (LLM) sont de plus en plus utilisés pour des tâches complexes qui nécessitent de multiples appels de génération, des techniques d'invite avancées, un flux de contrôle et des entrées/sorties structurées. Cependant, les systèmes efficaces pour programmer et exécuter ces applications font défaut. Nous introduisons SGLang, un système pour l'exécution efficace de programmes complexes de modèles de langage. SGLang se compose d'un langage frontal et d'un environnement d'exécution. Le frontal simplifie la programmation grâce à des primitives pour la génération et le contrôle du parallélisme. L'environnement d'exécution accélère l'exécution grâce à de nouvelles optimisations telles que RadixAttention pour la réutilisation du cache KV et des machines à états finis compressées pour un décodage plus rapide des sorties structurées. Les expériences montrent que SGLang atteint un débit jusqu'à supérieur à celui des systèmes d'inférence de pointe sur divers grands modèles de langage et multimodaux, sur des tâches incluant le contrôle d'agents, le raisonnement logique, les benchmarks d'apprentissage few-shot, le décodage JSON, les pipelines de génération augmentée par récupération et le chat multi-tours. Le code est publiquement disponible à l'adresse https://github.com/sgl-project/sglang.
1 Introduction
Les récentes augmentations des capacités des LLM ont élargi leur utilité, leur permettant d'aborder un plus large éventail de tâches générales et d'agir comme des agents autonomes [35, 6, 36, 52, 46]. Dans ces applications, les LLM s'engagent dans une planification, un raisonnement et une interaction en plusieurs tours avec des environnements externes. Cela est accompli grâce à l'utilisation d'outils [41, 38], à de multiples modalités d'entrée [47, 2] et à un large éventail de techniques d'invite [30], comme l'apprentissage few-shot [5], l'auto-cohérence [53], le skeleton-of-thought [33] et le tree-of-thought [56]. Tous ces nouveaux cas d'usage nécessitent de multiples appels de génération de LLM, souvent dépendants, montrant une tendance à l'utilisation de structures à appels multiples pour accomplir des tâches complexes [57, 21].
L'émergence de ces schémas marque un changement dans notre interaction avec les LLM, passant d'un simple chat à une forme plus sophistiquée d'utilisation programmatique des LLM, c'est-à-dire l'utilisation d'un programme pour ordonnancer et contrôler les processus de génération des LLM. Nous désignons ces programmes sous le nom de « Programmes de Modèle de Langage » (Programmes LM) [4, 20]. Les techniques d'invite avancées et les flux de travail agentiques mentionnés ci-dessus relèvent du champ des programmes LM. Les programmes LM présentent deux propriétés courantes : (1) les programmes LM contiennent généralement de multiples appels de LLM entrecoupés de flux de contrôle. Cela est nécessaire pour accomplir des tâches complexes et améliorer la qualité globale. (2) les programmes LM reçoivent des entrées structurées et produisent des sorties structurées. Cela est nécessaire pour permettre la composition de programmes LM et pour intégrer les programmes LM dans les systèmes logiciels existants.

Malgré l'utilisation répandue des programmes LM, les systèmes actuels pour les exprimer et les exécuter restent inefficaces. Nous identifions deux défis principaux liés à l'utilisation efficace des programmes LM : Premièrement, la programmation des programmes LM est fastidieuse et difficile en raison de la nature non déterministe des LLM. Le développement d'un programme LM nécessite souvent une manipulation extensive de chaînes, un réglage expérimental des invites, une analyse fragile des sorties, la gestion de multiples modalités d'entrée et la mise en œuvre de mécanismes de parallélisme. Cette complexité réduit considérablement la lisibilité même des programmes simples (Sec. 2).
Deuxièmement, et de manière importante, l'exécution des programmes LM est inefficace en raison de calculs redondants et d'une utilisation mémoire excessive. Les moteurs d'inférence de pointe (par exemple, vLLM [23], TGI [16] et TensorRT-LLM [34]) ont été optimisés pour réduire la latence et améliorer le débit sans connaissance directe de la charge de travail. Cela rend ces systèmes généraux et robustes, mais entraîne également des inefficacités significatives pour toute charge de travail donnée. Un exemple notable est la réutilisation du cache Key-Value (KV) (Sec. 3). Le cache KV consiste en des tenseurs intermédiaires réutilisables essentiels pour l'inférence générative. Lors des exécutions par lots typiques de programmes LM, de nombreuses occasions existent de réutiliser le cache KV à travers plusieurs appels de LLM différents qui partagent un préfixe commun. Cependant, les systèmes actuels manquent de mécanismes efficaces pour faciliter cette réutilisation, ce qui entraîne des calculs inutiles et une mémoire gaspillée. Un autre exemple est le décodage contraint pour les sorties structurées (par exemple, le mode JSON), où la sortie des LLM est restreinte à suivre des règles grammaticales spécifiques définies par une expression régulière (Sec. 4). Sous ces contraintes, plusieurs tokens peuvent souvent être décodés en une seule fois. Cependant, les systèmes existants ne décodent qu'un token à la fois, ce qui conduit à des vitesses de décodage sous-optimales.
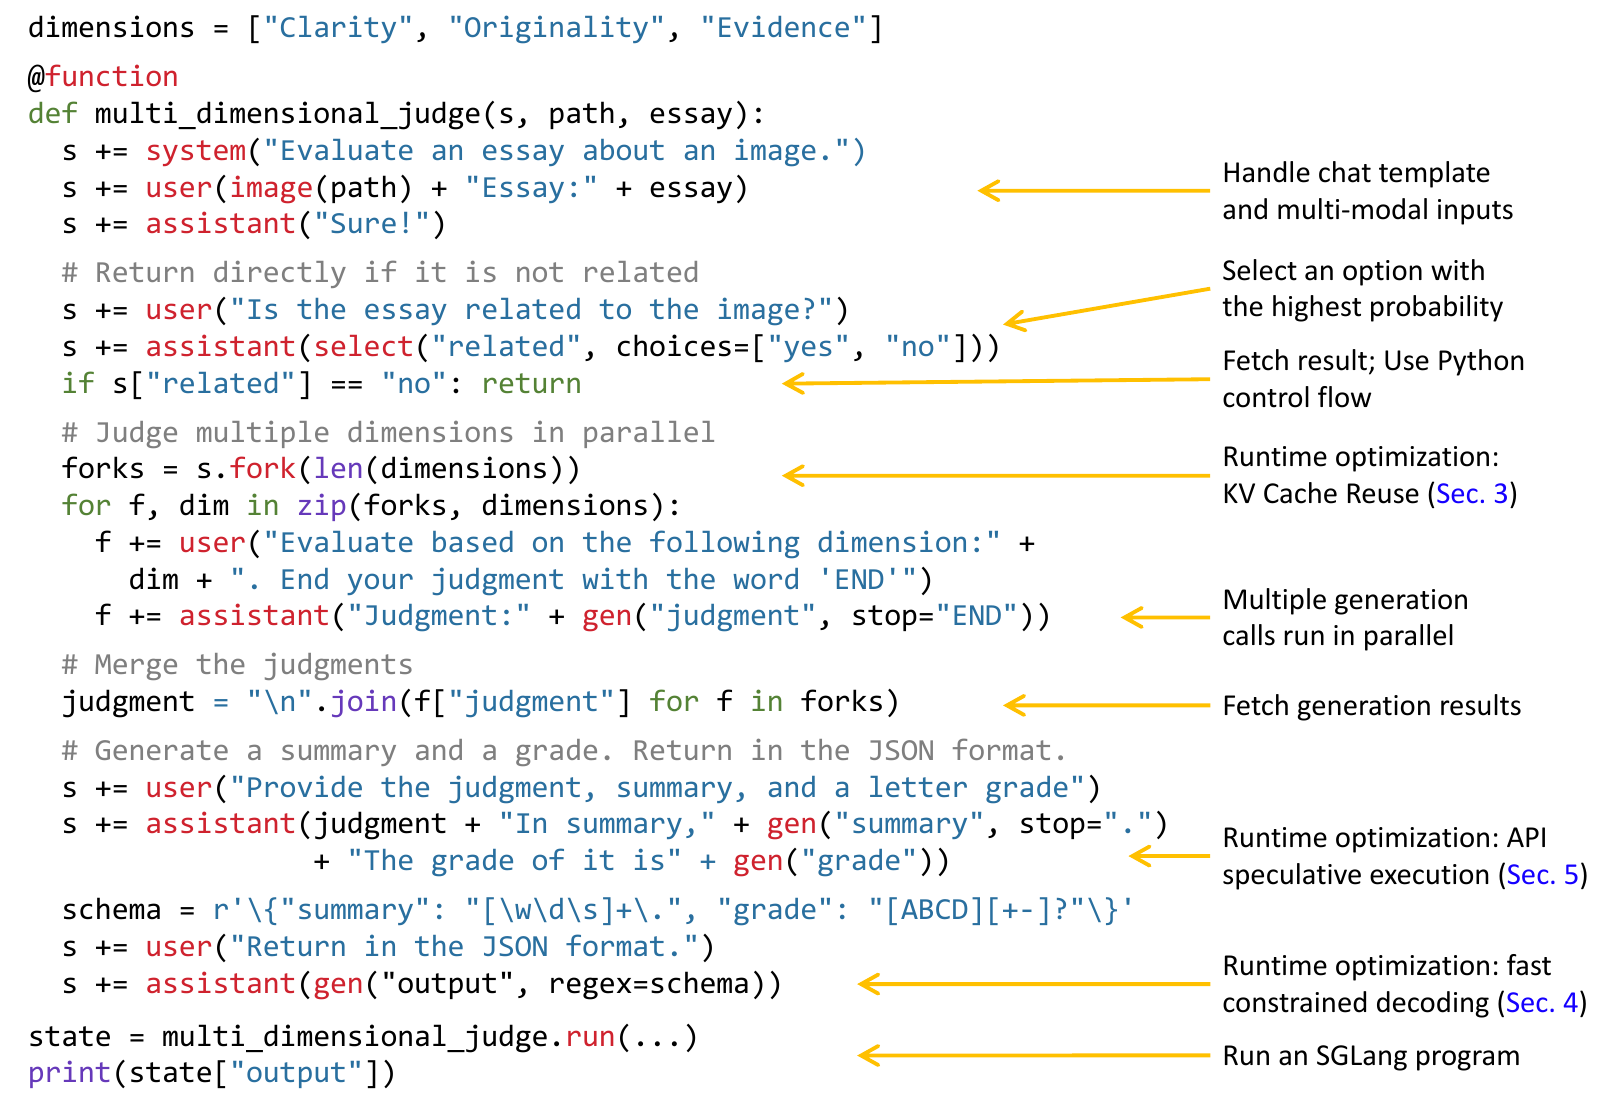
Pour relever ces défis, nous présentons SGLang, un langage de génération structuré pour les LLM. L'idée centrale est d'exploiter systématiquement la structure à appels multiples des programmes LM pour une exécution efficace. Comme illustré à la Fig. 1, il comporte deux parties : un langage frontal et un environnement d'exécution dorsal. Le frontal simplifie la programmation des programmes LM, et l'environnement d'exécution accélère leur exécution. Les deux parties peuvent fonctionner ensemble pour de meilleures performances, mais peuvent également fonctionner indépendamment.
Nous introduisons SGLang comme un langage spécifique à un domaine intégré dans Python. Il fournit des primitives pour la génération (par exemple, extend, gen, select) et le contrôle du parallélisme (par exemple, fork, join). SGLang est compatible avec le flux de contrôle et les bibliothèques de Python, de sorte que les utilisateurs peuvent développer facilement des flux de travail d'invite avancés avec la syntaxe Python native. Nous fournissons un interpréteur et un compilateur pour SGLang. L'interpréteur gère l'état de l'invite comme un flux et soumet les opérations primitives au flux pour une exécution asynchrone, garantissant un contrôle approprié de la synchronisation et du parallélisme intra-programme. De plus, un programme SGLang peut être tracé et compilé pour davantage d'optimisations.
Du côté de l'environnement d'exécution, nous proposons plusieurs optimisations novatrices pour accélérer l'exécution des programmes SGLang. La première technique, RadixAttention, permet la réutilisation automatique du cache KV à travers de multiples appels de génération. Dans les moteurs d'inférence existants, le cache KV d'une requête est supprimé une fois le traitement terminé, empêchant la réutilisation du cache KV à travers de multiples appels et ralentissant considérablement l'exécution. Au lieu de cela, notre système maintient un cache LRU du cache KV pour toutes les requêtes au sein d'un arbre radix. Cette approche gère le cache KV comme un cache traditionnel et utilise un arbre radix pour une correspondance, une insertion et une éviction efficaces. Elle permet à l'environnement d'exécution de gérer divers schémas de réutilisation avec une politique d'ordonnancement consciente du cache de manière efficace. La deuxième technique est une machine à états finis compressée, qui permet un décodage contraint plus rapide pour les sorties structurées. Les systèmes existants suivent les contraintes uniquement pour le token suivant en masquant les probabilités des tokens non autorisés, ce qui les rend capables de décoder un seul token à la fois. Au lieu de cela, notre système analyse les contraintes et construit une machine à états finis compressée pour représenter la contrainte. Cette approche compresse un chemin multi-tokens en un chemin à étape unique chaque fois que possible, permettant le décodage de plusieurs tokens à la fois pour atteindre une vitesse de décodage plus rapide. Enfin, SGLang prend également en charge les modèles uniquement disponibles via API comme GPT-4 d'OpenAI, et nous introduisons la troisième technique, l'exécution spéculative d'API, pour optimiser les programmes à appels multiples pour les modèles uniquement disponibles via API.
À l'aide de SGLang, nous avons implémenté diverses applications de LLM, notamment le contrôle d'agents, le raisonnement logique, les benchmarks d'apprentissage few-shot, le décodage JSON, les pipelines de génération augmentée par récupération, le chat multi-tours et le traitement multimodal. Nous avons testé les performances sur des modèles incluant Llama-7B/70B [49], Mistral-8x7B [17], LLaVA-v1.5-7B (image) [28] et LLaVA-NeXT-34B (vidéo) [62] sur des GPU NVIDIA A10G et A100. Les résultats expérimentaux montrent que SGLang atteint un débit jusqu'à supérieur sur un large éventail de charges de travail, de modèles et de configurations matérielles, par rapport aux systèmes de programmation et d'inférence existants, notamment Guidance [13], vLLM [23] et LMQL [4].
2 Modèle de programmation
Cette section présente le modèle de programmation SGLang avec un exemple concret, décrit ses primitives de langage et ses modes d'exécution, et expose les possibilités d'optimisation de l'environnement d'exécution. Ce modèle de programmation peut simplifier les opérations fastidieuses dans les flux de travail à appels multiples (par exemple, la manipulation de chaînes, l'appel d'API, la spécification de contraintes, le parallélisme) en fournissant des primitives flexibles et composables.
Un exemple concret. Le langage est un langage spécifique à un domaine intégré dans Python. La Fig. 2 montre un programme qui évalue un essai portant sur une image en utilisant la méthode d'invite branch-solve-merge [40]. La fonction multi_dimensional_judge prend trois arguments : s, path et essay. s gère l'état de l'invite, path est le chemin du fichier image et essay est le texte de l'essai. De nouvelles chaînes et primitives SGLang peuvent être ajoutées à l'état s pour exécution à l'aide de l'opérateur . Tout d'abord, la fonction ajoute l'image et l'essai à l'invite. Elle vérifie ensuite si l'essai est lié à l'image à l'aide de select, en stockant le résultat dans s["related"]. Si c'est le cas, l'invite est divisée en trois copies pour une évaluation parallèle selon différentes dimensions, en utilisant gen pour stocker les résultats dans f["judgment"]. Ensuite, elle fusionne les jugements, génère un résumé et attribue une note alphabétique. Enfin, elle renvoie les résultats au format JSON, selon un schéma défini par une contrainte d'expression régulière regex. SGLang simplifie grandement ce programme, car un programme équivalent utilisant une interface de type API OpenAI nécessiterait plus de lignes de code en raison de la manipulation manuelle de chaînes et du contrôle du parallélisme.
Primitives de langage. SGLang fournit des primitives pour contrôler l'état du prompt, la génération et le parallélisme. Elles peuvent être utilisées conjointement avec la syntaxe et les bibliothèques Python. Voici les primitives : « gen » appelle un modèle pour générer et stocke les résultats dans une variable portant le nom spécifié dans son premier argument. Il prend en charge un argument « regex » pour contraindre la sortie à suivre une grammaire définie par une expression régulière (par exemple, un schéma JSON). « select » appelle un modèle pour choisir l'option de plus haute probabilité parmi une liste. L'opérateur « += » ou « extend » ajoute une chaîne au prompt. L'opérateur « [nom_de_variable] » récupère les résultats d'une génération. « fork » crée des fourches parallèles de l'état du prompt. « join » réunit à nouveau l'état du prompt. « image » et « video » prennent en entrée des images et des vidéos.
Modes d'exécution. La manière la plus simple d'exécuter un programme SGLang est via un interpréteur, où un prompt est traité comme un flux asynchrone. Les primitives telles que extend, gen et select sont soumises au flux pour une exécution asynchrone. Ces appels non bloquants permettent au code Python de continuer à s'exécuter sans attendre la fin de la génération. Cela est similaire au lancement asynchrone de noyaux CUDA. Chaque prompt est géré par un exécuteur de flux dans un thread d'arrière-plan, ce qui permet un parallélisme intra-programme. La récupération des résultats de génération bloquera jusqu'à ce qu'ils soient prêts, garantissant une synchronisation correcte. Alternativement, les programmes SGLang peuvent être compilés en graphes computationnels et
| Système | Syntaxe | Primitives de langage | Backends d'exécution |
| Guidance LMQL | Python personnalisé | extend, gen, select extend, gen, select, image | HF Transformers, llama.cpp, OpenAI HF Transformers, llama.cpp, OpenAI |
| SGLang | Python | extend, gen, select, image, video, fork, join | SGLang Runtime (SRT), OpenAI |
exécutés avec un exécuteur de graphe, permettant davantage d'optimisations. Cet article utilise le mode interpréteur par défaut et discute des résultats du mode compilateur dans l'annexe D. SGLang prend en charge les modèles à poids ouverts avec son propre SGLang Runtime (SRT), ainsi que les modèles API tels que les modèles OpenAI et Anthropic.
Comparaison. Les systèmes de programmation pour LLM peuvent être classés en haut niveau (par exemple, LangChain, DSPy) et bas niveau (par exemple, LMQL, Guidance, SGLang). Les systèmes de haut niveau fournissent des prompts prédéfinis ou générés automatiquement, tels que l'optimiseur de prompts de DSPy. Les systèmes de bas niveau ne modifient généralement pas les prompts mais permettent une manipulation directe des prompts et des primitives. SGLang est un système de bas niveau similaire à LMQL et Guidance. Le tableau 1 compare leurs fonctionnalités. SGLang se concentre davantage sur l'efficacité d'exécution et est livré avec son propre runtime co-conçu, permettant de nouvelles optimisations introduites plus loin. Les langages de haut niveau (par exemple, DSPy) peuvent être compilés vers des langages de bas niveau (par exemple, SGLang). Nous démontrons l'intégration de SGLang comme backend dans DSPy pour une meilleure efficacité d'exécution dans la section 6.
Optimisations à l'exécution. La figure 2 montre trois possibilités d'optimisation à l'exécution : la réutilisation du cache KV, le décodage contraint rapide et l'exécution spéculative d'API. Nous les aborderons dans les sections suivantes.
3 Réutilisation efficace du cache KV avec RadixAttention
Les programmes SGLang peuvent enchaîner plusieurs appels de génération et créer des copies parallèles avec la primitive « fork ». De plus, différentes instances de programme partagent souvent certaines parties communes (par exemple, les invites système). Ces scénarios créent de nombreux préfixes d'invite partagés pendant l'exécution, ce qui offre de nombreuses possibilités de réutilisation du cache KV. Lors de l'inférence d'un LLM, le cache KV stocke les tenseurs intermédiaires de la passe avant, réutilisés pour le décodage des jetons suivants. Ils sont nommés d'après les paires clé-valeur du mécanisme d'auto-attention [51]. Le calcul du cache KV ne dépend que des jetons du préfixe. Par conséquent, les requêtes ayant le même préfixe d'invite peuvent réutiliser le cache KV, ce qui réduit le calcul redondant et l'utilisation de la mémoire. Davantage de contexte et quelques exemples sont fournis dans l'annexe A.
Compte tenu de cette possibilité de réutilisation du cache KV, un défi clé dans l'optimisation des programmes SGLang consiste à réutiliser le cache KV à travers plusieurs appels et instances. Bien que certains systèmes explorent certains cas de réutilisation du cache KV [23, 58, 18, 12], ils nécessitent souvent des configurations manuelles et ne peuvent pas gérer tous les schémas de réutilisation (par exemple, les structures arborescentes dynamiques). Par conséquent, la plupart des systèmes d'inférence de pointe recalculent le cache KV pour chaque requête. Nous discuterons de leurs limites et de nos différences dans la section 7.
Cette section présente RadixAttention, une nouvelle technique permettant une réutilisation automatique et systématique du cache KV à l'exécution. Contrairement aux systèmes existants qui jettent le cache KV après la fin d'une requête de génération, notre système conserve le cache des invites et des résultats de génération dans un arbre radix, ce qui permet une recherche efficace des préfixes, ainsi que leur réutilisation, leur insertion et leur éviction. Nous mettons en œuvre une politique d'éviction LRU et une politique d'ordonnancement tenant compte du cache afin d'améliorer le taux de réussite du cache. RadixAttention est compatible avec des techniques telles que le traitement par lots continu [60], l'attention paginée [23] et le parallélisme tensoriel [44]. En outre, elle n'introduit qu'une surcharge de mémoire et de temps négligeable lorsqu'il n'y a pas de succès de cache.
RadixAttention. Un arbre radix est une structure de données qui constitue une alternative économisant l'espace à un trie classique (arbre de préfixes). Contrairement aux arbres typiques, les arêtes d'un arbre radix peuvent être étiquetées non seulement par des éléments uniques, mais aussi par des séquences d'éléments de longueurs variables, ce qui améliore considérablement l'efficacité. Dans notre système, nous utilisons un arbre radix pour gérer une correspondance entre des séquences de jetons et leurs tenseurs de cache KV correspondants. Ces tenseurs de cache KV sont stockés dans une disposition paginée non contiguë, où la taille de chaque page équivaut à un jeton. Comme la mémoire du GPU est rapidement remplie par le cache KV, nous introduisons une politique d'éviction LRU simple qui évince d'abord la feuille la moins récemment utilisée. En évinçant d'abord les feuilles, nous permettons la réutilisation de leurs ancêtres communs jusqu'à ce que ces ancêtres deviennent des feuilles et soient également évincés.
Dans le cadre du traitement par lots continu, nous ne pouvons pas évincer les nœuds utilisés par le lot en cours d'exécution. Par conséquent, chaque nœud maintient un compteur de références indiquant combien de requêtes en cours l'utilisent. Un nœud peut être évincé si son compteur de références est nul. Notons que nous ne préallouons pas un pool de mémoire de taille fixe comme cache. Au lieu de cela, nous laissons les jetons mis en cache et les requêtes en cours partager le même pool de mémoire. Par conséquent, le système alloue dynamiquement de la mémoire pour le cache et les requêtes en cours. Lorsque suffisamment de requêtes en attente s'exécutent, le système évince tous les jetons mis en cache au profit d'une taille de lot plus grande. La figure 3 montre comment l'arbre radix est maintenu pour plusieurs requêtes entrantes. L'
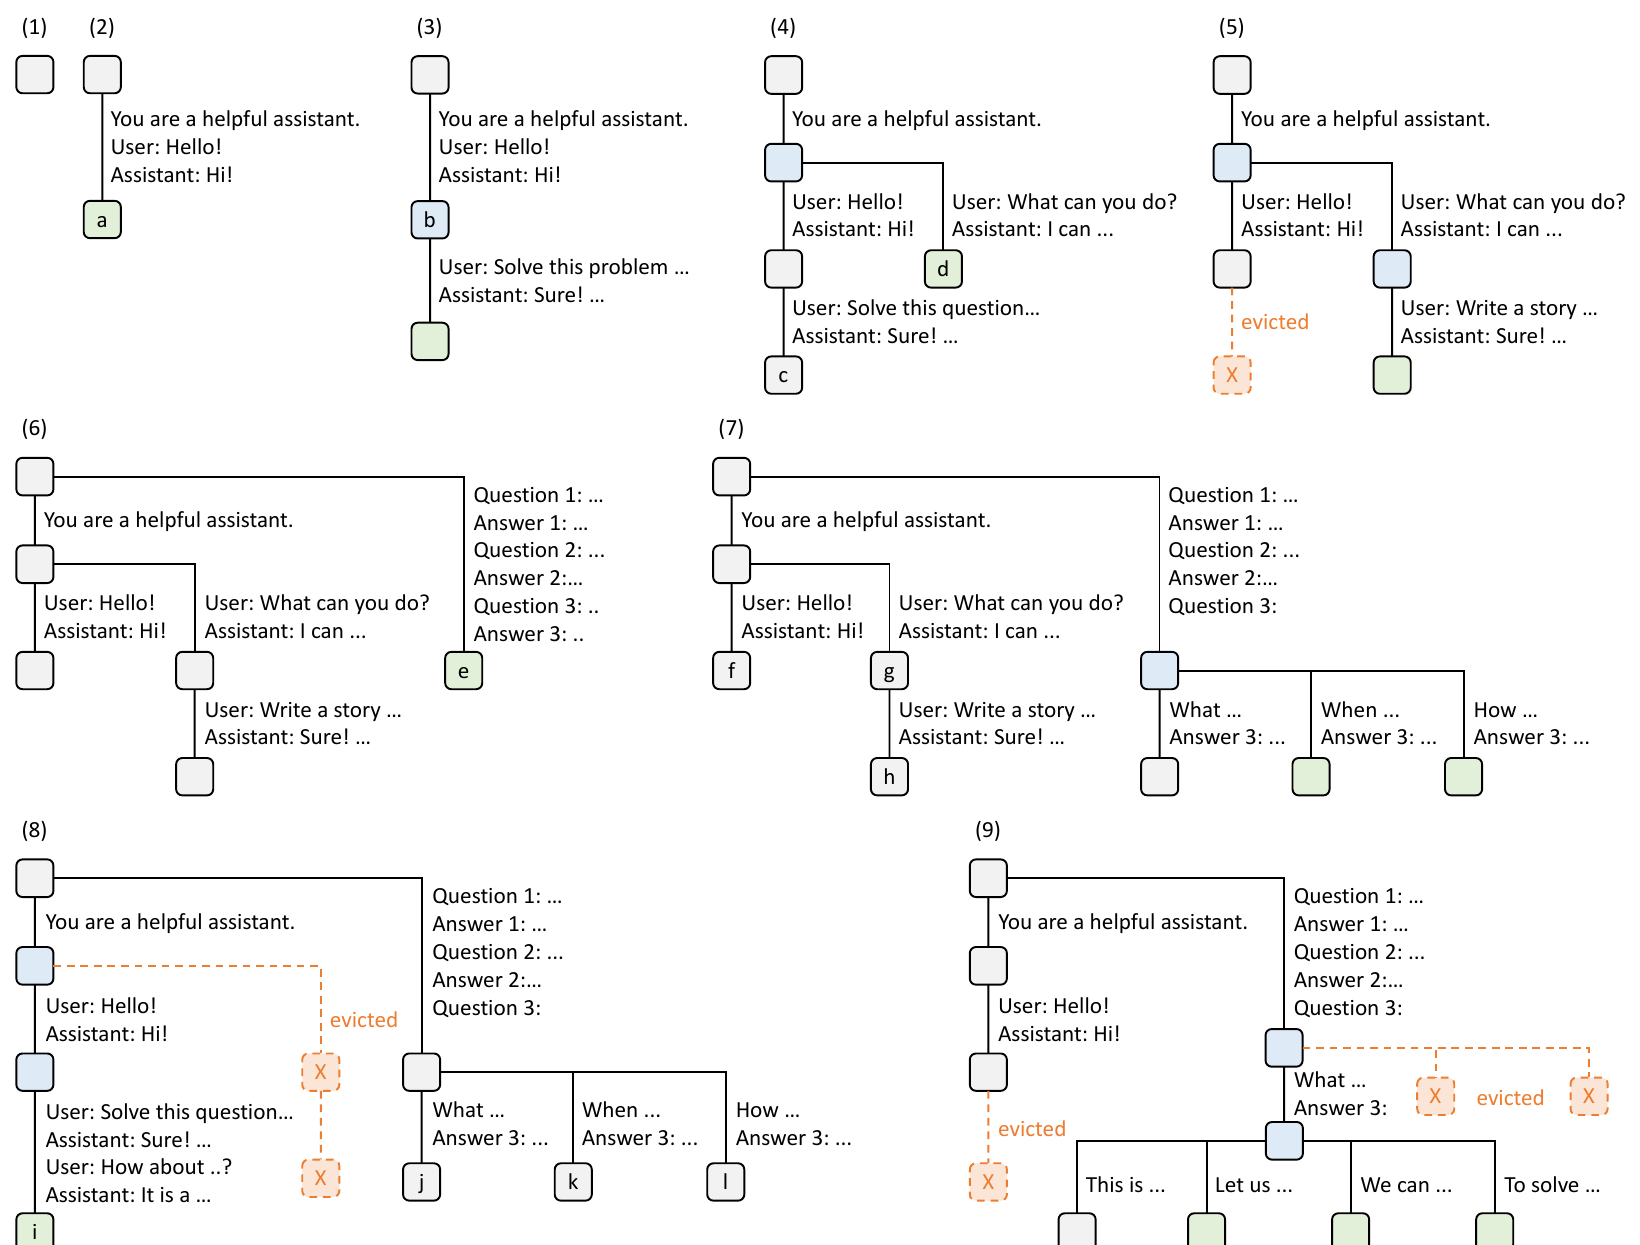
interpréteur frontal envoie les invites complètes à l'exécution, et l'exécution effectue la correspondance des préfixes et la réutilisation. La structure de l'arbre est stockée sur le CPU avec une surcharge de maintenance négligeable. Lors de l'exécution de la primitive fork, le frontal envoie d'abord le préfixe comme indice, garantissant que le préfixe est correctement inséré dans l'arbre. Il envoie ensuite le reste des invites. Cet « indice du frontal » simplifie l'ordonnancement et la correspondance à l'exécution, illustrant les avantages de la co-conception frontal-exécution.
Ordonnancement tenant compte du cache. Nous définissons le taux de réussite du cache comme le nombre de jetons d'invite mis en cache. Lorsqu'il y a de nombreuses requêtes dans la file d'attente, l'ordre dans lequel elles sont exécutées peut avoir un impact significatif sur le taux de réussite du cache. Par exemple, si l'ordonnanceur de requêtes bascule fréquemment entre des requêtes différentes et non liées, cela peut entraîner un brassage du cache et un faible taux de réussite. Nous concevons un algorithme d'ordonnancement tenant compte du cache pour augmenter le taux de réussite du cache. Dans le cadre du traitement par lots, nous trions les
requêtes par longueur de préfixe correspondant et donnons la priorité aux requêtes ayant des préfixes correspondants plus longs plutôt que d'utiliser un ordonnancement premier arrivé, premier servi. L'algorithme 1 (annexe) montre le pseudo-code de l'ordonnancement tenant compte du cache avec traitement par lots contigu. L'algorithme utilise l'ordre du plus long préfixe partagé en premier. Dans les contextes plus sensibles à la latence, nous pouvons encore tolérer un réordonnancement limité des lots pour améliorer la réutilisation du cache. De plus, nous démontrons le théorème suivant pour l'ordonnancement optimal dans le cas hors ligne. 2
Théorème 3.1. Pour un lot de requêtes, nous pouvons atteindre un taux de réussite du cache optimal en parcourant l'arbre radix des requêtes dans l'ordre de recherche en profondeur, avec une taille de cache la longueur maximale des requêtes. L'ordre du plus long préfixe partagé en premier est équivalent à un ordre de recherche en profondeur.
La preuve se trouve dans la section A.3 (annexe). Dans le cas en ligne, l'ordre DFS sera perturbé, mais notre ordonnancement approxime toujours le comportement DFS sur la partie augmentée de l'arbre radix complet, comme décrit dans la section A.3. Bien qu'un ordonnancement glouton tenant compte du cache puisse atteindre un débit élevé, il peut entraîner une famine. Nous laissons son intégration avec d'autres méthodes d'ordonnancement équitable [42] comme travail futur.
Cas distribués. RadixAttention peut être étendue à plusieurs GPU. Pour le parallélisme tensoriel, chaque GPU maintient un cache KV fragmenté. Aucune synchronisation supplémentaire n'est nécessaire car les opérations sur l'arbre sont les mêmes. Le parallélisme de données avec plusieurs workers est discuté dans la section A.4 (annexe).
4 Décodage contraint efficace avec machine à états finis compressée
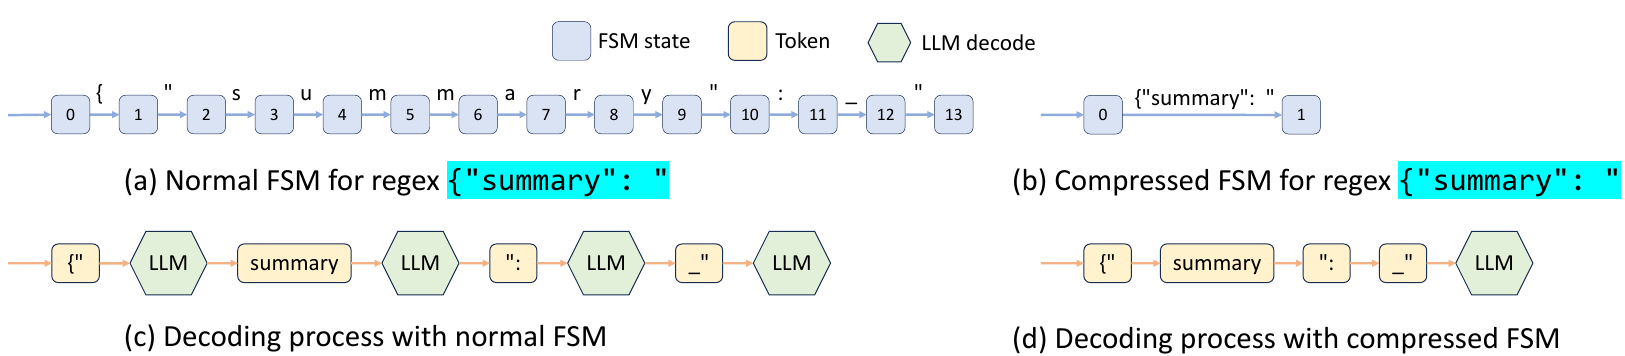
Dans les programmes LM, les utilisateurs souhaitent souvent contraindre la sortie du modèle à suivre des formats spécifiques, tels que les schémas JSON. Cela peut améliorer la contrôlabilité et la robustesse, et rendre la sortie plus facile à analyser. SGLang offre un argument regex pour imposer de telles contraintes à l'aide d'expressions régulières, qui sont suffisamment expressives pour de nombreux scénarios pratiques. Les systèmes existants prennent en charge cela en convertissant une expression régulière en une machine à états finis (FSM) [54]. Lors du décodage, ils maintiennent l'état actuel de la FSM, récupèrent les jetons autorisés à partir des états suivants et mettent la probabilité des jetons invalides à zéro, en décodant jeton par jeton. Cette approche jeton par jeton est cependant inefficace lorsqu'il est possible de décoder plusieurs jetons à la fois. Par exemple, la séquence constante {"summary": " de la figure 2 s'étend sur plusieurs jetons dans le processus de décodage normal, comme illustré à la figure 4 (c), nécessitant plusieurs étapes de décodage, même s'il n'existe qu'un seul jeton suivant valide lors de son décodage. Par conséquent, la séquence entière peut être décodée en une seule étape (c'est-à-dire une seule passe avant). Cependant, les systèmes existants ne peuvent décoder qu'un seul jeton à la fois, car l'absence d'intégration entre la FSM et le moteur d'exécution du modèle dans les systèmes existants empêche le traitement de plusieurs jetons, ce qui ralentit le décodage.
SGLang surmonte cette limitation en créant une exécution de décodage contraint rapide avec une FSM compressée. Cette exécution analyse la FSM et compresse les arêtes adjacentes à transition singulière de la FSM en arêtes uniques, comme le montre la figure 4 (b), ce qui lui permet de reconnaître quand plusieurs jetons peuvent être décodés ensemble. Dans la figure 4 (d), plusieurs jetons sur l'arête de transition compressée peuvent être décodés en une seule passe avant, ce qui accélère considérablement le processus de décodage. Cette approche est également générale et applicable à toutes les expressions régulières. Plus de détails sur le contexte et l'implémentation se trouvent dans l'annexe B.
5 Appel efficace de points de terminaison avec exécution spéculative d'API
Les sections précédentes ont présenté des optimisations pour les modèles à poids ouverts, qui nécessitent des modifications du processus d'inférence du modèle. De plus, SGLang fonctionne avec des modèles accessibles uniquement via API, tels que GPT-4 d'OpenAI. Cependant, pour ces modèles, nous ne pouvons appeler qu'un point de terminaison d'API en boîte noire.
Cette section présente une nouvelle optimisation pour les modèles d'API en boîte noire qui accélère l'exécution et réduit le coût des API des programmes SGLang à appels multiples en utilisant l'exécution spéculative. Par exemple, un programme peut demander au modèle de générer une description d'un personnage avec un schéma à appels multiples :
context "name:" gen("name", stop="\n") "job:" gen("job", stop="\n"). Naïvement, les deux primitives gen correspondent à deux appels d'API, ce qui signifie que l'utilisateur doit payer deux fois les frais de jetons d'entrée sur le contexte. Dans SGLang, nous pouvons activer l'exécution spéculative lors du premier appel et le laisser poursuivre la génération de quelques jetons supplémentaires en ignorant la condition d'arrêt. L'interpréteur conserve les sorties de génération supplémentaires et les fait correspondre et les réutilise avec les primitives ultérieures. Dans certains cas, avec une ingénierie d'invite soignée, le modèle peut faire correspondre correctement le modèle avec une grande précision, ce qui nous fait économiser la latence et les coûts d'entrée d'un appel d'API.
6 Évaluation
Nous évaluons les performances de SGLang sur diverses charges de travail de LLM. Ensuite, nous menons des études d'ablation et des études de cas pour démontrer l'efficacité de composants spécifiques. SGLang est implémenté dans PyTorch [37] avec des noyaux CUDA personnalisés de FlashInfer [59] et Triton [48].
6.1 Configuration
Modèles. Nous testons les modèles denses Llama-2 [49], les modèles à mélange d'experts clairsemés Mixtral [17], les modèles multimodaux LLaVA pour images [27] et vidéos [62], ainsi que le modèle d'API GPT-3.5 d'OpenAI. Pour les modèles à poids ouverts, le nombre de paramètres varie de 7 milliards à 70 milliards, et nous utilisons la précision float16.
Matériel. Nous exécutons la plupart des expériences sur des instances AWS EC2 G5, équipées de GPU NVIDIA A10G (24GB). Nous exécutons les modèles 7B sur un seul GPU A10G et les modèles plus grands sur plusieurs GPU A10G avec parallélisme tensoriel [44]. Nous exécutons quelques expériences supplémentaires sur des GPU A100G (80GB).
Références de comparaison. Nous comparons SGLang à la fois avec des systèmes de programmation de haut niveau dotés de leurs langages et environnements d'exécution par défaut respectifs, ainsi qu'avec des moteurs d'inférence de bas niveau dotés d'API Completion standard de type OpenAI. Sauf indication contraire, nous n'activons pas les optimisations qui modifieraient les résultats de calcul, afin que tous les systèmes calculent les mêmes résultats. Les références de comparaison incluent :
- Guidance [13], un langage pour contrôler les LLMs. Nous utilisons Guidance v0.1.8 avec le backend llama.cpp. - vLLM [23], un moteur d'inférence à haut débit. Nous utilisons vLLM v0.2.5 et son serveur API par défaut. - LMQL [4], un langage de requête. Nous utilisons LMQL v0.7.3 avec le backend Hugging Face Transformers.
Charges de travail. Nous testons les éléments suivants : les benchmarks MMLU en 5-shot [14] et HellaSwag en 20-shot [61]. Nous décodons un token pour MMLU et utilisons la primitive select pour sélectionner la réponse ayant la plus haute probabilité pour HellaSwag. Pour l'agent ReAct [57] et les agents génératifs [36], nous extrayons les traces des articles originaux et les rejouons. Nous utilisons le Tree-of-thought [56] pour les problèmes GSM-8K et le Skeleton-of-thought [33] pour la génération d'astuces. Nous utilisons des juges LLM avec la technique branch-solve-merge [40] ; le décodage JSON avec un schéma spécifié par une expression régulière ; le chat multi-tours avec 4 tours, où l'entrée de chaque tour est échantillonnée aléatoirement entre 256 et 512 tokens. Le chat multi-tours (court) signifie une sortie courte (4-8 tokens) et le chat multi-tours (long) signifie une sortie longue (256-512 tokens) ; le pipeline de génération augmentée par récupération (RAG) de DSPy [20] dans son exemple officiel.
Mesures. Nous rapportons deux métriques de performance : le débit et la latence. Pour le débit, nous exécutons un lot suffisamment grand d'instances de programme afin de calculer le débit maximal, en comparant le nombre d'instances de programme exécutées par seconde (programmes par seconde, p/s). Pour la latence, nous exécutons un seul programme à la fois sans traitement par lots et rapportons la latence moyenne sur plusieurs instances.
6.2 Performance de bout en bout
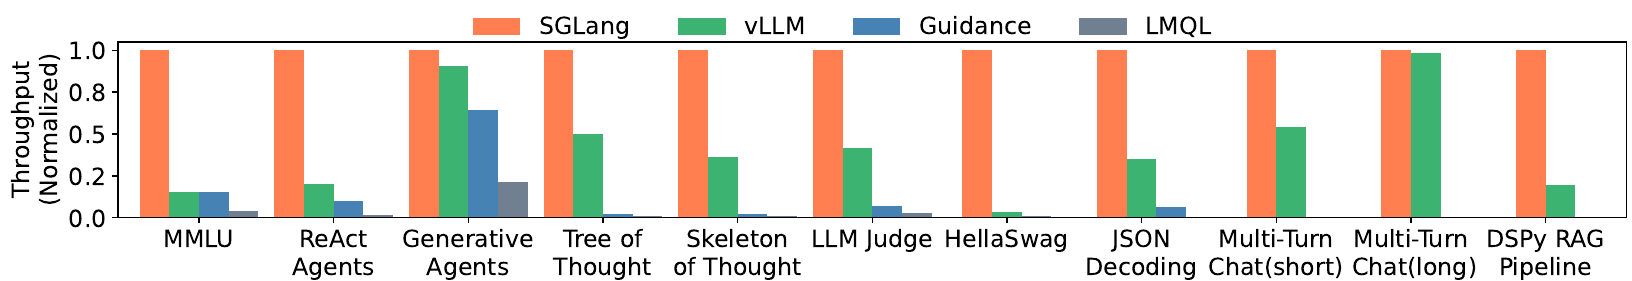
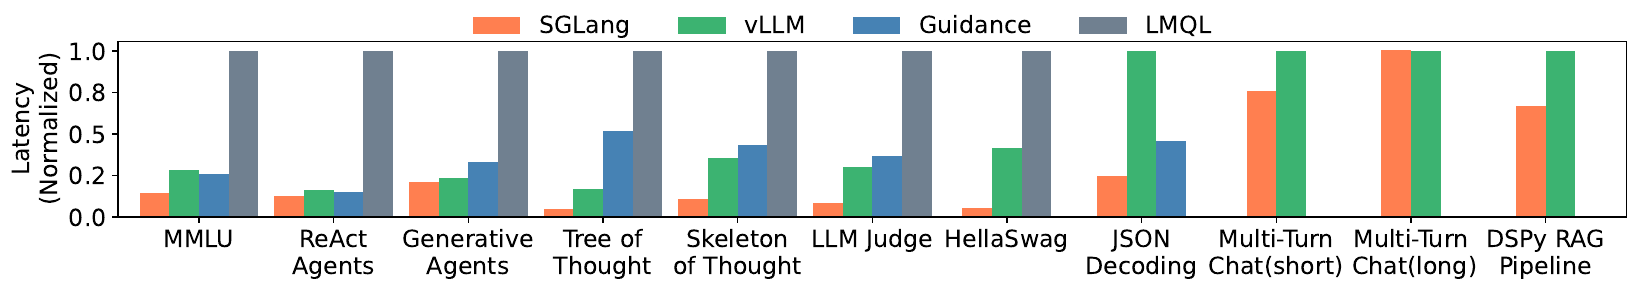
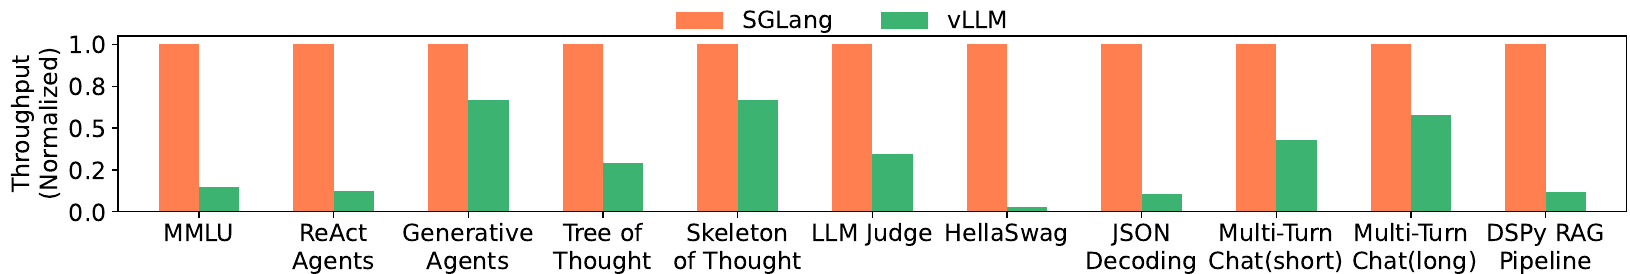
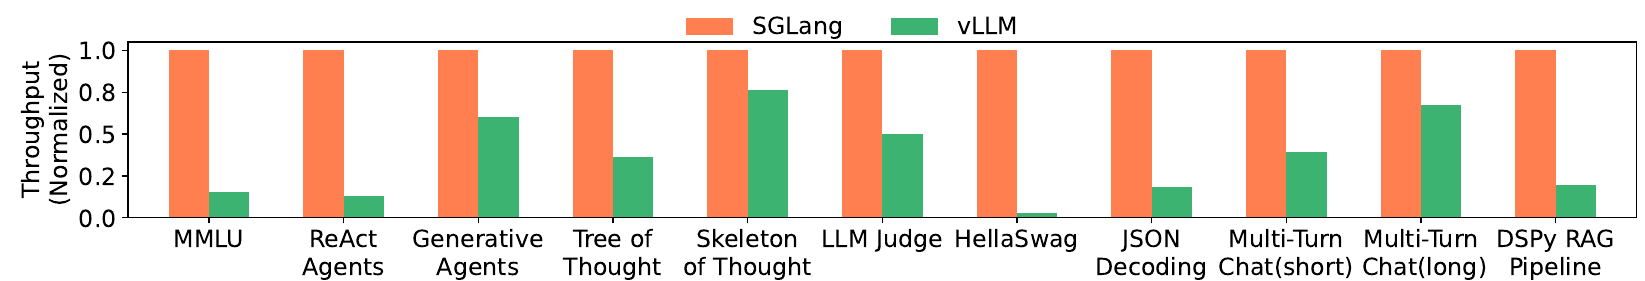
Résultats sur les modèles à poids ouverts. Les résultats de latence et de débit sont présentés dans la Fig. 5 et la Fig. 6. SGLang améliore le débit jusqu'à et réduit la latence jusqu'à . Ces améliorations
résultent de la réutilisation du cache KV, de l'exploitation du parallélisme au sein d'un même programme et d'un décodage contraint plus rapide. Nous expliquons ensuite les raisons de l'accélération pour chaque benchmark.
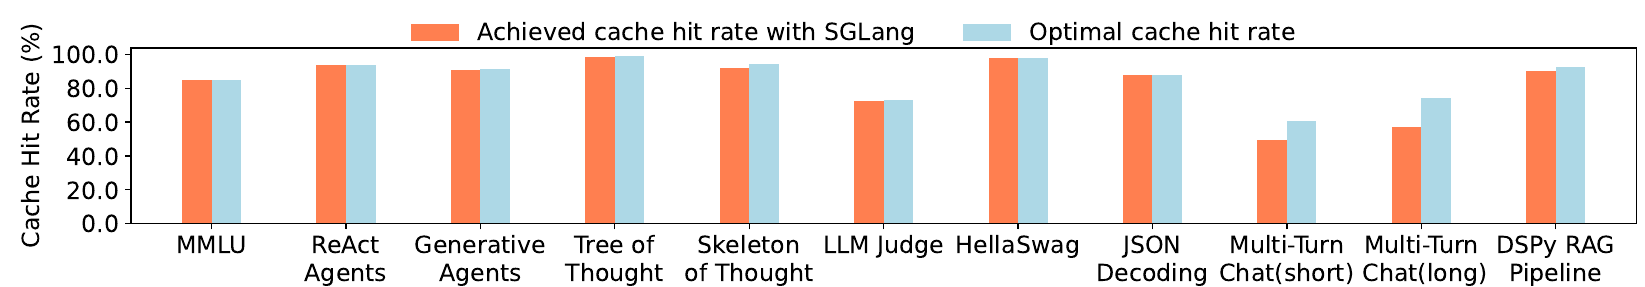
Sur MMLU, SGLang peut réutiliser le cache KV des exemples en 5-shot grâce à RadixAttention. RadixAttention bénéficie à la fois au débit et à la latence. RadixAttention réduit l'utilisation totale de la mémoire en partageant le cache KV, ce qui permet un lot de taille plus grande pour améliorer le débit maximal. RadixAttention réduit également le calcul du prefill, diminuant ainsi la latence du premier token. Sur HellaSwag, SGLang réutilise le cache KV des exemples few-shot ainsi que du préfixe commun de la question pour les choix multiples, ce qui donne lieu à un partage à deux niveaux. Pour les agents ReAct et génératifs, SGLang réutilise le cache KV du modèle d'agent et des appels précédents. Sur Tree-of-thought et Skeleton-of-thought, SGLang parallélise les appels de génération au sein d'un même programme et réutilise le cache KV autant que possible. Sur le décodage JSON, SGLang accélère le décodage en décodant plusieurs tokens à la fois grâce à une machine à états finis compressée. Dans le chat multi-tours, SGLang réutilise le cache KV de l'historique de conversation. L'accélération est plus notable pour les sorties courtes, car la réutilisation du cache KV aide surtout à réduire le temps du préfixe. Pour les sorties longues, comme il y a peu de partage entre les différentes sessions de chat et que le temps de décodage domine, il n'y a presque pas d'accélération. Dans le pipeline DSPy RAG, SGLang réutilise le cache KV de l'exemple de contexte commun. Sur ces benchmarks, le taux de succès du cache varie de à . La Fig. 13 (Annexe) liste les taux de succès du cache obtenus et optimaux pour tous ces benchmarks, montrant que notre ordonnancement conscient du cache approche en moyenne du taux de succès optimal.
Nous excluons LMQL et Guidance de certains des cinq derniers benchmarks en raison de performances lentes et de fonctionnalités manquantes. Les problèmes de LMQL proviennent d'un traitement lent au niveau des tokens et d'un backend non optimisé, tandis que Guidance ne dispose pas de support pour le traitement par lots et le parallélisme.
Résultats sur des modèles plus grands avec parallélisme tensoriel. Nous exécutons des modèles plus grands, Mixtral-8x7B et Llama-70B, avec parallélisme tensoriel sur le même ensemble de benchmarks et rapportons les résultats dans la Fig. 7 et la Fig. 12 (Annexe). L'accélération sur les modèles plus grands montre une tendance similaire à celle observée sur les modèles plus petits, ce qui indique que notre optimisation se généralise bien aux modèles plus grands. Nous omettons Guidance et LMQL ici parce qu'ils manquent d'implémentations efficaces du parallélisme tensoriel.
Résultats sur les modèles multimodaux. SGLang prend nativement en charge les modèles multimodaux avec les primitives d'image et de vidéo. Les optimisations présentées dans cet article sont compatibles avec les modèles multimodaux. Pour RadixAttention, nous calculons le hachage des images d'entrée et l'utilisons comme clé dans l'arbre radix, ce qui nous permet de réutiliser le cache KV des tokens d'image provenant de la même image. Nous exécutons LLaVA-v1.5-7B (image) sur llava-bench-in-the-wild et LLaVA-NeXT-34B (vidéo) sur ActivityNet. Comme ces modèles ne sont pas bien pris en charge par les autres systèmes de référence, nous utilisons l'implémentation originale des auteurs des modèles dans Hugging Face Transformers comme référence. Comme le montre le Tableau 2, SGLang offre un débit jusqu'à plus élevé sur ces benchmarks. Dans llava-bench-in-the-wild, il y a plusieurs questions portant sur la même image, et le runtime de SGLang réutilise le cache KV dans ce cas.
Déploiement en production. SGLang a été déployé dans Chatbot Arena [8] pour servir des modèles à poids ouverts. En raison d'un trafic faible pour certains modèles, un seul worker SGLang sert chacun d'eux. Après un mois, nous avons observé un taux de succès du cache RadixAttention de pour LLaVA-NeXT-34B [28] et de pour Vicuna-33B [7]. Les succès du cache proviennent des messages système communs, des images d'exemple fréquemment réutilisées et des historiques de chat multi-tours. Cela réduit la latence du premier token d'un facteur moyen de pour Vicuna-33B.
| Modèle | LLaVA-v1.5-7B (image) | LLaVA-NEXT-34B (vidéo) |
| Implémentation originale de l'auteur | 0,18 image/s | 0,02 image/s |
| SGLang | 1,15 image/s | 0,10 image/s |
Résultats sur les modèles d'API. Nous testons un prompt qui extrait trois champs d'une page Wikipédia à l'aide du modèle GPT-3.5 d'OpenAI. En utilisant le few-shot prompting, la précision de l'exécution spéculative d'API est élevée, et cela réduit le coût des tokens d'entrée d'environ un facteur trois grâce à l'extraction de trois champs.
6.3 Étude d'ablation
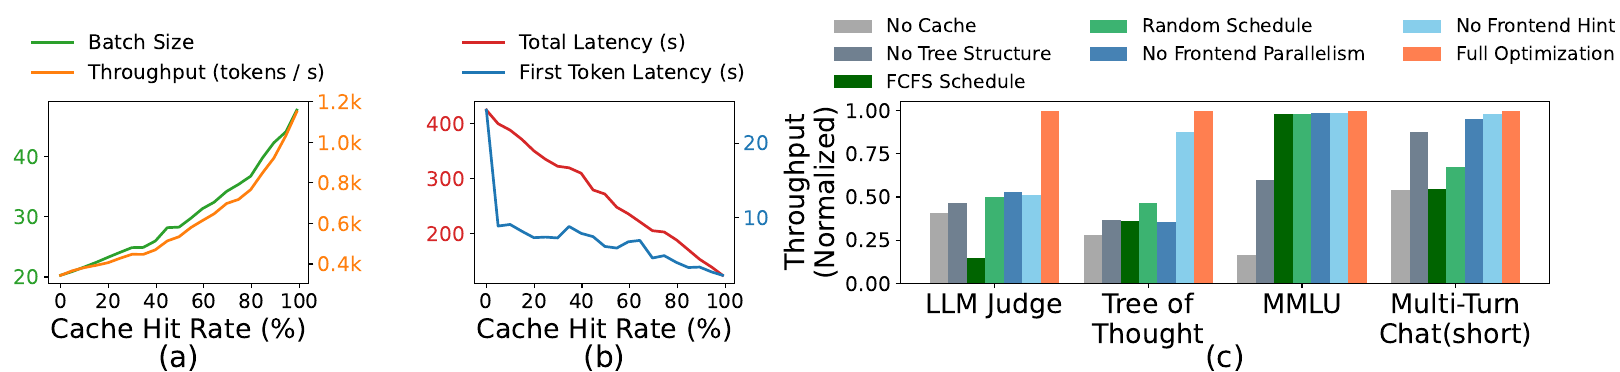
Taux de succès du cache vs latence/débit. La Fig. 8(a)(b) montre la relation entre le taux de succès du cache et les métriques de performance (latence du premier token, latence totale, taille du lot et débit) sur le benchmark tree-of-thought. La figure est obtenue en désactivant partiellement les tokens appariés à l'exécution. Elle montre qu'un taux de succès du cache plus élevé conduit à une taille de lot plus grande, à un débit plus élevé et à une latence plus faible.
Efficacité de RadixAttention. Nous testons l'efficacité de RadixAttention et de ses composants sur plusieurs benchmarks représentatifs. Comme le montre la Fig. 8(c), « No Cache » signifie ne pas utiliser de cache, « No Tree-Structure » signifie utiliser un simple cache basé sur une table au lieu d'un cache arborescent, « FCFS Schedule » signifie utiliser une politique premier arrivé, premier servi au lieu de notre ordonnancement conscient du cache, « Random Schedule » signifie utiliser un ordre aléatoire pour ordonnancer les requêtes, « No Frontend Parallelism » signifie désactiver le parallélisme dans l'interpréteur, « No Frontend Hint » signifie désactiver l'envoi des indices de fork depuis les interpréteurs, et « Full optimizations » signifie que nous activons toutes les optimisations. Les résultats expérimentaux montrent que chacun de ces composants est nécessaire pour atteindre les meilleures performances. Désactiver le parallélisme et les indices provenant de l'interpréteur frontend conduit également à des performances d'exécution sous-optimales, ce qui souligne l'importance de co-concevoir le langage frontend et le runtime.
Surcoût de RadixAttention. Nous testons le surcoût de RadixAttention sur un benchmark sans aucune opportunité de réutilisation du cache KV. Le benchmark mesure le débit sur le jeu de données ShareGPT. Il faut 74,3 secondes pour exécuter 100 requêtes ; toutefois, le temps consacré à la gestion des structures de données de RadixAttention n'est que de 0,2 seconde, soit un surcoût négligeable inférieur à 0,3%. Cela s'explique par le fait que la complexité des opérations sur l'arbre est linéaire et faible. Nous pouvons donc activer RadixAttention par défaut.
Efficacité de la machine à états finis compressée. Nous testons l'efficacité de la machine à états finis compressée et de ses composants sur le benchmark de décodage JSON. Les résultats expérimentaux montrent que la machine à états finis compressée augmente le débit de parce qu'elle peut décoder plusieurs tokens à la fois. En outre, nous devons prétraiter la machine à états et la réutiliser pour un lot de requêtes. Sinon, refaire le prétraitement pour chaque requête rend le débit plus faible.
7 Travaux connexes
Divers travaux ont exploré la réutilisation du cache KV, et beaucoup d'entre eux sont concurrents de notre travail. De manière unique, notre RadixAttention propose pour la première fois de traiter le cache KV comme un cache LRU arborescent. C'est la première solution qui prend en charge le partage à plusieurs niveaux, l'ordonnancement conscient du cache, la co-ordonnancement frontend-runtime et les cas distribués. vLLM [23] et ChunkedAttention [58] explorent quelques cas simples de réutilisation (par exemple, le partage de prompt système) mais ne couvrent pas le partage arborescent à plusieurs niveaux ni le cache LRU. PromptCache [12] propose la réutilisation modulaire du cache KV au-delà du préfixe mais peut impacter la précision avec une baisse pouvant atteindre . HydraGen [18], FlashInfer [59] et ChunkedAttention [58] se concentrent sur les optimisations des kernels CUDA et n'incluent pas le concept de cache LRU. API Serve [1] et LLM-SQL [29] étudient la réutilisation du cache KV pour des applications spécifiques telles que l'entrelacement avec des appels d'API externes et des bases de données relationnelles, mais ils ne disposent pas de notre arbre radix ni de notre ordonnancement conscient du cache.
Plusieurs frameworks de programmation et d'agents LLM existent, tels que Guidance [13], LMQL [4], DSPy [20], LangChain [24], AutoGen [55] et LLM Compiler [21]. Guidance et LMQL sont les plus similaires à SGLang, et nous les comparons dans la Sec. 2. Notre innovation réside dans de nouvelles optimisations du runtime pour accélérer le modèle de programmation proposé. SGLang est compatible avec d'autres frameworks et peut les accélérer (par exemple, l'exemple DSPy dans notre évaluation). De plus, SGLang est compatible avec de nombreuses autres optimisations d'inférence courantes [60, 39, 3, 23, 59, 10, 26, 15, 19, 32, 31, 11].
8 Directions futures et conclusion
Directions futures. Malgré les progrès réalisés avec SGLang, plusieurs limites subsistent qui révèlent des directions prometteuses pour de futures recherches. Celles-ci incluent l'extension de SGLang pour prendre en charge des modalités de sortie supplémentaires, l'adaptation de RadixAttention pour fonctionner à travers plusieurs niveaux de la hiérarchie mémoire (par exemple, DRAM, disque) [43], l'activation d'une correspondance sémantique floue au sein de RadixAttention, la fourniture de primitives de plus haut niveau au-dessus de SGLang, la correction de la famine dans l'ordonnancement conscient du cache [42], et l'amélioration du compilateur SGLang pour effectuer des optimisations statiques avancées telles que l'ordonnancement et la planification mémoire.
Conclusion. Nous présentons SGLang, un framework pour programmer et exécuter efficacement des programmes de modèles de langage structurés. SGLang améliore considérablement le débit et la latence des programmes de LM complexes grâce à de nouvelles optimisations telles que RadixAttention, des machines à états finis compressées et un interpréteur de langage. C'est un outil précieux pour développer des techniques de prompting avancées et des workflows d'agents. Le code source est disponible publiquement.
Remerciements
Ce projet est soutenu par le Stanford Center for Automated Reasoning et par des dons d'Astronomer, Google, IBM, Intel, Lacework, Microsoft, Mohamed Bin Zayed University of Artificial Intelligence, Nexla, Samsung SDS, Uber et VMware. Lianmin Zheng est soutenu par une bourse de doctorat Meta. Nous remercions Yuanhan Zhang et Bo Li pour le support de LLaVA-NeXT (vidéo).
Références
[1] Reyna Abhyankar, Zijian He, Vikranth Srivatsa, Hao Zhang, and Yiying Zhang. Apiserve: Efficient api support for large-language model inferencing. arXiv preprint arXiv:2402.01869, 2024. [2] Jean-Baptiste Alayrac, Jeff Donahue, Pauline Luc, Antoine Miech, Iain Barr, Yana Hasson, Karel Lenc, Arthur Mensch, Katherine Millican, Malcolm Reynolds, et al. Flamingo: a visual language model for few-shot learning. Advances in Neural Information Processing Systems, 35:23716-23736, 2022. [3] Reza Yazdani Aminabadi, Samyam Rajbhandari, Ammar Ahmad Awan, Cheng Li, Du Li, Elton Zheng, Olatunji Ruwase, Shaden Smith, Minjia Zhang, Jeff Rasley, et al. Deepspeed-inference: enabling efficient inference of transformer models at unprecedented scale. In SC22: International Conference for High Performance Computing, Networking, Storage and Analysis, pages 1-15. IEEE, 2022. [4] Luca Beurer-Kellner, Marc Fischer, and Martin Vechev. Prompting is programming: A query language for large language models. Proceedings of the ACM on Programming Languages, 7(PLDI):1946-1969, 2023. [5] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. Language models are few-shot learners. Advances in neural information processing systems, 33:1877-1901, 2020. [6] Sébastien Bubeck, Varun Chandrasekaran, Ronen Eldan, Johannes Gehrke, Eric Horvitz, Ece Kamar, Peter Lee, Yin Tat Lee, Yuanzhi Li, Scott Lundberg, et al. Sparks of artificial general intelligence: Early experiments with gpt-4. arXiv preprint arXiv:2303.12712, 2023. [7] Wei-Lin Chiang, Zhuohan Li, Zi Lin, Ying Sheng, Zhanghao Wu, Hao Zhang, Lianmin Zheng, Siyuan Zhuang, Yonghao Zhuang, Joseph E. Gonzalez, Ion Stoica, and Eric P. Xing. Vicuna: An open-source chatbot impressing gpt-4 with 90%* chatgpt quality, March 2023.
[8] Wei-Lin Chiang, Lianmin Zheng, Ying Sheng, Anastasios Nikolas Angelopoulos, Tianle Li, Dacheng Li, Hao Zhang, Banghua Zhu, Michael Jordan, Joseph E Gonzalez, et al. Chatbot arena : une plateforme ouverte pour évaluer les LLM selon les préférences humaines. Prépublication arXiv arXiv:2403.04132, 2024.
[9] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. Palm : mise à l’échelle de la modélisation du langage avec pathways. Prépublication arXiv arXiv:2204.02311, 2022.
[10] Tri Dao, Dan Fu, Stefano Ermon, Atri Rudra, et Christopher Ré. Flashattention : attention exacte rapide et économe en mémoire avec prise en compte des E/S. Advances in Neural Information Processing Systems, 35:16344-16359, 2022.
[11] Suyu Ge, Yunan Zhang, Liyuan Liu, Minjia Zhang, Jiawei Han, et Jianfeng Gao. Le modèle vous dit quoi écarter : compression adaptative du cache KV pour les LLM. In The Twelfth International Conference on Learning Representations, 2023.
[12] In Gim, Guojun Chen, Seung-seob Lee, Nikhil Sarda, Anurag Khandelwal, et Lin Zhong. Prompt cache : réutilisation modulaire de l’attention pour une inférence à faible latence. Prépublication arXiv arXiv:2311.04934, 2023.
[13] Guidance AI. Un langage de guidage pour contrôler les grands modèles de langage. https://github.com/guidance-ai/guidance. Consulté le : 2023-11.
[14] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, et Jacob Steinhardt. Mesurer la compréhension massive du langage multitâche. In International Conference on Learning Representations, 2020.
[15] Coleman Hooper, Sehoon Kim, Hiva Mohammadzadeh, Michael W Mahoney, Yakun Sophia Shao, Kurt Keutzer, et Amir Gholami. Kvquant : vers une inférence LLM avec une longueur de contexte de 10 millions grâce à la quantification du cache KV. Prépublication arXiv arXiv:2401.18079, 2024.
[16] Hugging Face. Text generation inference. https://github.com/huggingface/text-generation-inference. Consulté le : 2023-11.
[17] Albert Q Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch, Blanche Savary, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Emma Bou Hanna, Florian Bressand, et al. Mixtral of experts. Prépublication arXiv arXiv:2401.04088, 2024.
[18] Jordan Juravsky, Bradley Brown, Ryan Ehrlich, Daniel Y Fu, Christopher Ré, et Azalia Mirhoseini. Hydragen : inférence LLM à haut débit avec préfixes partagés. Prépublication arXiv arXiv:2402.05099, 2024.
[19] Hao Kang, Qingru Zhang, Souvik Kundu, Geonhwa Jeong, Zaoxing Liu, Tushar Krishna, et Tuo Zhao. Gear : une recette efficace de compression du cache KV pour une inférence générative quasi sans perte des LLM. Prépublication arXiv arXiv:2403.05527, 2024.
[20] Omar Khattab, Arnav Singhvi, Paridhi Maheshwari, Zhiyuan Zhang, Keshav Santhanam, Sri Vardhamanan, Saiful Haq, Ashutosh Sharma, Thomas T. Joshi, Hanna Moazam, Heather Miller, Matei Zaharia, et Christopher Potts. Dspy : compiler des appels déclaratifs à des modèles de langage en pipelines auto-améliorants. Prépublication arXiv arXiv:2310.03714, 2023.
[21] Sehoon Kim, Suhong Moon, Ryan Tabrizi, Nicholas Lee, Michael W Mahoney, Kurt Keutzer, et Amir Gholami. Un compilateur LLM pour l’appel parallèle de fonctions. Prépublication arXiv arXiv:2312.04511, 2023.
[22] Michael Kuchnik, Virginia Smith, et George Amvrosiadis. Valider les grands modèles de langage avec relm. Proceedings of Machine Learning and Systems, 5, 2023.
[23] Woosuk Kwon, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, et Ion Stoica. Gestion efficace de la mémoire pour le service de grands modèles de langage avec pagedattention. In Proceedings of the 29th Symposium on Operating Systems Principles, pages 611-626, 2023.
[24] LangChain AI. Langchain. https://github.com/langchain-ai/langchain. Consulté le : 2023-11.
[25] Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond, Tom Eccles, James Keeling, Felix Gimeno, Agustin Dal Lago, et al. Génération de code de niveau compétition avec alphacode. Science, 378(6624):1092-1097, 2022.
[26] Ji Lin, Jiaming Tang, Haotian Tang, Shang Yang, Xingyu Dang, et Song Han. Awq : quantification des poids tenant compte des activations pour la compression et l’accélération des LLM. Prépublication arXiv arXiv:2306.00978, 2023.
[27] Haotian Liu, Chunyuan Li, Yuheng Li, et Yong Jae Lee. Meilleures références avec l’ajustement par instructions visuelles. Prépublication arXiv arXiv:2310.03744, 2023.
[28] Haotian Liu, Chunyuan Li, Yuheng Li, Bo Li, Yuanhan Zhang, Sheng Shen, et Yong Jae Lee. Llava-next : raisonnement, OCR et connaissances du monde améliorés, janvier 2024.
[29] Shu Liu, Asim Biswal, Audrey Cheng, Xiangxi Mo, Shiyi Cao, Joseph E Gonzalez, Ion Stoica, et Matei Zaharia. Optimiser les requêtes LLM dans les charges de travail relationnelles. Prépublication arXiv arXiv:2403.05821, 2024.
[30] Xiaoxia Liu, Jingyi Wang, Jun Sun, Xiaohan Yuan, Guoliang Dong, Peng Di, Wenhai Wang, et Dongxia Wang. Cadres de prompt engineering pour les grands modèles de langage : une enquête. Prépublication arXiv arXiv:2311.12785, 2023.
[31] Zichang Liu, Aditya Desai, Fangshuo Liao, Weitao Wang, Victor Xie, Zhaozhuo Xu, Anastasios Kyrillidis, et Anshumali Shrivastava. Scissorhands : exploiter l’hypothèse de persistance de l’importance pour la compression du cache KV des LLM au moment du test. Advances in Neural Information Processing Systems, 36, 2024.
[32] Zirui Liu, Jiayi Yuan, Hongye Jin, Shaochen Zhong, Zhaozhuo Xu, Vladimir Braverman, Beidi Chen, et Xia Hu. Kivi : une quantification asymétrique à 2 bits sans réglage pour le cache KV. Prépublication arXiv arXiv:2402.02750, 2024.
[33] Xuefei Ning, Zinan Lin, Zixuan Zhou, Zifu Wang, Huazhong Yang, et Yu Wang. Skeleton-of-thought : inciter les LLM à une génération parallèle efficace. In The Twelfth International Conference on Learning Representations, 2024.
[34] NVIDIA. Tensorrt-llm. https://github.com/NVIDIA/TensorRT-LLM. Consulté le : 2023-11.
[35] OpenAI. Rapport technique Gpt-4, 2023.
[36] Joon Sung Park, Joseph C. O'Brien, Carrie J. Cai, Meredith Ringel Morris, Percy Liang, et Michael S. Bernstein. Agents génératifs : simulacres interactifs du comportement humain. In In the 36th Annual ACM Symposium on User Interface Software and Technology (UIST '23), UIST '23, New York, NY, USA, 2023. Association for Computing Machinery.
[37] Adam Paszke, Sam Gross, Francisco Massa, Adam Lerer, James Bradbury, Gregory Chanan, Trevor Killeen, Zeming Lin, Natalia Gimelshein, Luca Antiga, et al. Pytorch : une bibliothèque d’apprentissage profond de style impératif et haute performance. Advances in neural information processing systems, 32, 2019.
[38] Shishir G. Patil, Tianjun Zhang, Xin Wang, et Joseph E. Gonzalez. Gorilla : grand modèle de langage connecté à des API massives. Prépublication arXiv arXiv:2305.15334, 2023.
[39] Reiner Pope, Sholto Douglas, Aakanksha Chowdhery, Jacob Devlin, James Bradbury, Jonathan Heek, Kefan Xiao, Shivani Agrawal, et Jeff Dean. Mise à l’échelle efficace de l’inférence des transformeurs. Proceedings of Machine Learning and Systems, 5, 2023.
[40] Swarnadeep Saha, Omer Levy, Asli Celikyilmaz, Mohit Bansal, Jason Weston et Xian Li. Branch-solve-merge improves large language model evaluation and generation. arXiv preprint arXiv:2310.15123, 2023.
[41] Timo Schick, Jane Dwivedi-Yu, Roberto Dessi, Roberta Raileanu, Maria Lomeli, Luke Zettlemoyer, Nicola Cancedda et Thomas Scialom. Toolformer: Language models can teach themselves to use tools. arXiv preprint arXiv:2302.04761, 2023.
[42] Ying Sheng, Shiyi Cao, Dacheng Li, Banghua Zhu, Zhuohan Li, Danyang Zhuo, Joseph E Gonzalex et Ion Stoica. Fairness in serving large language models. arXiv preprint arXiv:2401.00588, 2023.
[43] Ying Sheng, Lianmin Zheng, Binhang Yuan, Zhuohan Li, Max Ryabinin, Beidi Chen, Percy Liang, Christopher Ré, Ion Stoica et Ce Zhang. Flexgen: high-throughput generative inference of large language models with a single gpu. In International Conference on Machine Learning, pages 31094-31116. PMLR, 2023.
[44] Mohammad Shoeybi, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper et Bryan Catanzaro. Megatron-lm: Training multi-billion parameter language models using model parallelism. arXiv preprint arXiv:1909.08053, 2019.
[45] Vikranth Srivatsa, Zijian He, Reyna Abhyankar, Dongming Li et Yiying Zhang. Preble: Efficient distributed prompt scheduling for llm serving. 2024.
[46] Theodore Sumers, Shunyu Yao, Karthik Narasimhan et Thomas Griffiths. Architectures cognitives pour agents linguistiques. Transactions on Machine Learning Research, 2023.
[47] Gemini Team, Rohan Anil, Sebastian Borgeaud, Yonghui Wu, Jean-Baptiste Alayrac, Jiahui Yu, Radu Soricut, Johan Schalkwyk, Andrew M Dai, Anja Hauth, et al. Gemini : une famille de modèles multimodaux hautement performants. Prépublication arXiv arXiv:2312.11805, 2023.
[48] Philippe Tillet, Hsiang-Tsung Kung et David Cox. Triton : un langage intermédiaire et un compilateur pour les calculs de réseaux neuronaux par tuiles. In Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, pages 10-19, 2019.
[49] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. Llama 2 : modèles de fondation ouverts et de chat affinés. Prépublication arXiv arXiv:2307.09288, 2023.
[50] Vivien Tran-Thien. Décodage LLM rapide et haute fidélité avec contraintes regex, 2024.
[51] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, Łukasz Kaiser et Illia Polosukhin. Attention is all you need. Advances in neural information processing systems, 30, 2017.
[52] Guanzhi Wang, Yuqi Xie, Yunfan Jiang, Ajay Mandlekar, Chaowei Xiao, Yuke Zhu, Linxi Fan et Anima Anandkumar. Voyager : un agent incarné ouvert avec de grands modèles de langage. Prépublication arXiv arXiv:2305.16291, 2023.
[53] Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc V Le, Ed H Chi, Sharan Narang, Aakanksha Chowdhery et Denny Zhou. L'auto-cohérence améliore le raisonnement en chaîne de pensée dans les modèles de langage. In The Eleventh International Conference on Learning Representations, 2022.
[54] Brandon T Willard et Rémi Louf. Génération guidée efficace pour les grands modèles de langage. arXiv e-prints, pages arXiv-2307, 2023.
[55] Qingyun Wu, Gagan Bansal, Jieyu Zhang, Yiran Wu, Shaokun Zhang, Erkang Zhu, Beibin Li, Li Jiang, Xiaoyun Zhang et Chi Wang. Autogen : permettre des applications LLM de nouvelle génération via un cadre de conversation multi-agents. Prépublication arXiv arXiv:2308.08155, 2023.
[56] Shunyu Yao, Dian Yu, Jeffrey Zhao, Izhak Shafran, Thomas L Griffiths, Yuan Cao et Karthik Narasimhan. Tree of thoughts : résolution délibérée de problèmes avec de grands modèles de langage. Prépublication arXiv arXiv:2305.10601, 2023.
[57] Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik R Narasimhan et Yuan Cao. React : synergiser raisonnement et action dans les modèles de langage. In The Eleventh International Conference on Learning Representations, 2022.
[58] Lu Ye, Ze Tao, Yong Huang et Yang Li. Chunkattention : auto-attention efficace avec cache KV sensible au préfixe et partition en deux phases. Prépublication arXiv arXiv:2402.15220, 2024.
[59] Zihao Ye, Lequn Chen, Ruihang Lai, Yilong Zhao, Size Zheng, Junru Shao, Bohan Hou, Hongyi Jin, Yifei Zuo, Liangsheng Yin, Tianqi Chen et Luis Ceze. Accélérer les auto-attentions pour le service LLM avec flashinfer, février 2024.
[60] Gyeong-In Yu, Joo Seong Jeong, Geon-Woo Kim, Soojeong Kim et Byung-Gon Chun. Orca : un système de service distribué pour modèles génératifs {basés sur Transformer}. In 16th USENIX Symposium on Operating Systems Design and Implementation (OSDI 22), pages 521-538, 2022.
[61] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi et Yejin Choi. Hellaswag : une machine peut-elle vraiment terminer votre phrase ? In Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, pages 4791-4800, 2019.
[62] Yuanhan Zhang, Bo Li, haotian Liu, Yong jae Lee, Liangke Gui, Di Fu, Jiashi Feng, Ziwei Liu et Chunyuan Li. Llava-next : un puissant modèle de compréhension vidéo zero-shot, avril 2024.
A Détails supplémentaires sur RadixAttention
A.1 Contexte sur le cache KV
La plupart des LLM utilisés aujourd'hui, tels que GPT-3 [5], PaLM [9] et LLaMA [49], sont basés sur l'architecture Transformer autorégressive [51]. Ces modèles prédisent la probabilité du prochain token dans une séquence en fonction des tokens précédents. Lors de l'inférence, le modèle traite d'abord une séquence de tokens d'entrée par une passe avant (ce processus est appelé « prefill »). Il décode ensuite séquentiellement les tokens de sortie, chaque token dépendant des tokens antérieurs (ce processus est appelé « decoding »). Nous appelons le processus consistant à prendre une séquence de tokens d'entrée et à générer une séquence de tokens de sortie un appel de génération unique. Tout au long de ce processus, chaque token génère certains tenseurs intermédiaires, qui sont utilisés pour décoder les tokens suivants. Ces tenseurs intermédiaires, appelés « KV Cache », tirent leur nom des paires clé-valeur dans le mécanisme d'auto-attention. Une observation importante lorsqu'on discute des optimisations dans cet article est que le calcul du cache KV ne dépend que de tous les tokens précédents, de sorte que différentes séquences ayant le même préfixe peuvent réutiliser le cache KV des tokens du préfixe et éviter un calcul redondant.
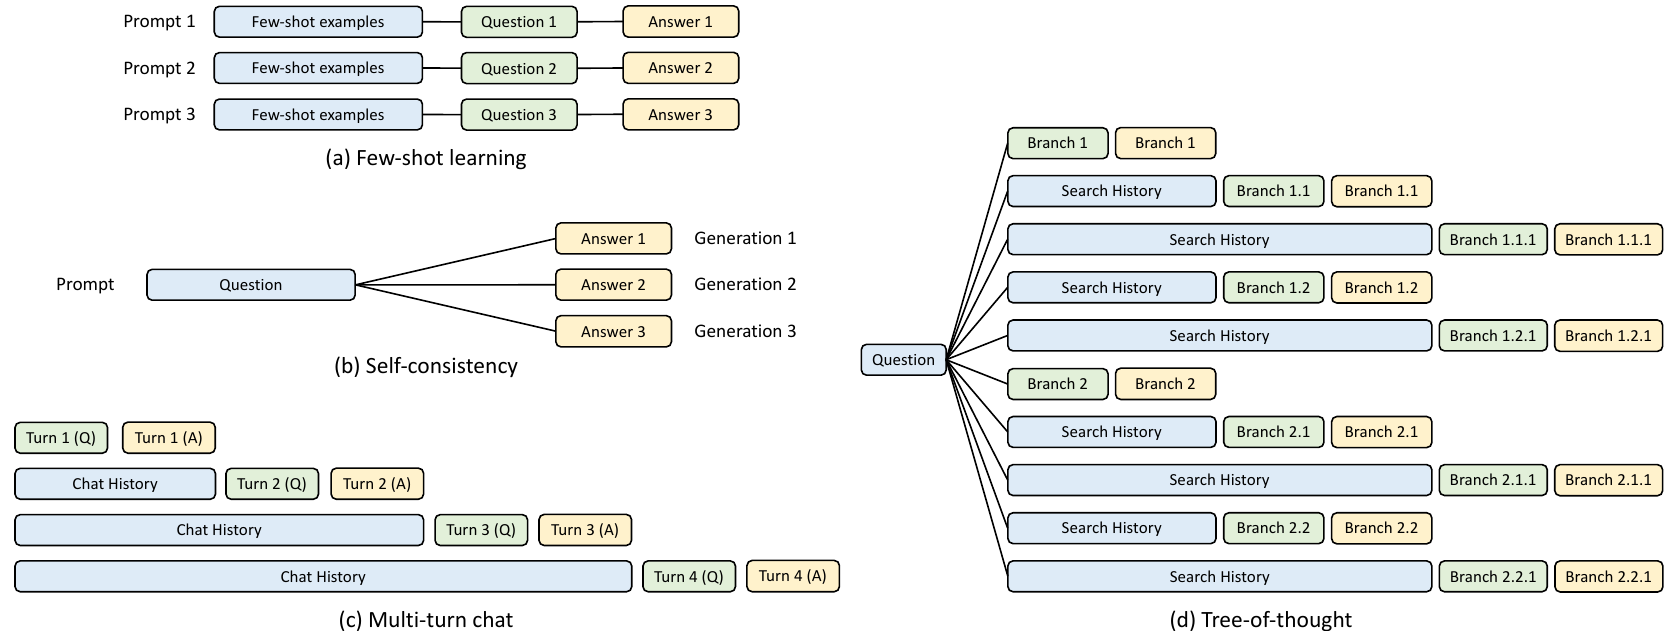
Souvent, dans les programmes LLM, plusieurs segments de texte et appels de génération sont ajoutés à une même invite. Mettre en cache le cache KV calculé pour les tokens précédents à travers plusieurs appels chaînés peut réduire le calcul redondant. Cette optimisation n'est toutefois ni gratuite ni triviale, car elle nécessite un stockage supplémentaire et une gestion de mémoire plus complexe. En outre, il est courant dans les programmes LLM de générer plusieurs sorties à partir d'une même invite ou de bifurquer une nouvelle invite à partir de l'état courant [25]. Le partage de préfixe basique a été étudié dans vLLM [23]. Des schémas de partage plus avancés, comme le partage irrégulier en structure arborescente, peuvent également être employés. La Fig. 9 montre quatre schémas typiques de partage du cache KV à travers plusieurs appels ; aucun des systèmes existants ne peut les gérer automatiquement tous. Au contraire, notre RadixAttention dans la Sec. 3 peut tous les gérer automatiquement à l'exécution.
A.2 Pseudocode pour l'ordonnancement conscient du cache
L'Alg. 1 montre le pseudocode de l'ordonnancement conscient du cache pour RadixAttention avec batching continu.
A.3 Preuve du théorème 3.1
Théorème 3.1. Pour un lot de requêtes, nous pouvons atteindre un taux de succès de cache optimal en parcourant l'arbre radix des requêtes dans l'ordre de recherche en profondeur, avec une taille de cache la longueur maximale des requêtes. L'ordre « plus long préfixe partagé d'abord » est équivalent à un ordre de recherche en profondeur.
Preuve. D'abord, nous montrons que l'ordre de recherche en profondeur (DFS) atteint un taux de succès de cache optimal. Soit l'ensemble des requêtes du lot, et l'arbre radix construit à partir de . Pour chaque arête de , le cache KV associé à doit être calculé au moins une fois. Soit la taille du cache KV associé à . Soit la complexité computationnelle du cache KV pour .
Algorithme 1 Planification tenant compte du cache pour RadixAttention avec traitement par lots continu.Entrée : L'arbre radix , le pool de mémoire , le lot en cours d'exécution , la file d'attente .Sortie : Les requêtes terminées et l'état mis à jour du système.// Récupérer toutes les requêtes de la file d'attenterequêtes .get_all_requests()// Rechercher le préfixe correspondant pour toutes les requêtes en attentepour req requêtes fairereq.prefix_node, req.prefix_len .match_prefix(req.input_tokens)fin pour// Trier les requêtes selon les longueurs de préfixe correspondantesrequêtes.sort()// Sélectionner les requêtes pour le prochain lotavailable_size .evitable_size() + .available_size()current_size new_batch pour req requêtes fairesi req.size() + current_size available_size alorsnew_batch.append(req)delta .increase_ref_counter(req.prefix_node)available_size available_size + deltafin sifin pourQ.remove_requests(new_batch)// Insérer les requêtes dans le lot en cours d'exécutionB.merge(new_batch)// Allouer de la nouvelle mémoire et effectuer une éviction si nécessaireneeded_size .needed_size()success,buffer .alloc(needed_size)si non success alorsT.evict(needed_size)success,buffer .alloc(needed_size)fin siB.run(buffer)// Traiter les requêtes terminéesfinished_requests .drop_finished_requests()pour req finished_requests faireT.decrease_ref_counter(req.prefix_node)T.insert(req)fin pourretourner finished_requestsNous obtenons la borne inférieure
Supposons que nous parcourions l'arbre radix dans l'ordre DFS. Pour chaque arête de , la première fois que nous calculons le cache KV associé à , nous calculerons ensuite tout le sous-arbre de . Pendant le calcul du sous-arbre de , l'arête sera continuellement atteinte, donc aucun calcul supplémentaire n'aura lieu. Après avoir terminé le calcul du sous-arbre enraciné en , l'arête ne sera plus visitée. Remarquons que, avec une taille de cache la longueur maximale de requête, qui est égale au plus long chemin dans l'arbre radix , l'arête ne sera pas évincée pendant le calcul de son sous-arbre, puisque le préfixe commun incluant du sous-arbre sera continuellement atteint. Par conséquent, le cache KV associé à chaque arête ne sera calculé qu'une seule fois. Ainsi, nous atteignons la borne inférieure
Le taux de succès du cache, défini comme
est égal à , atteint sa borne supérieure, offrant ainsi l'optimalité.
Ensuite, nous montrons que l'ordre du plus long préfixe commun en premier est équivalent à un ordre DFS, par récurrence.
- (Base) Au début, comme rien n'est en cache, une requête aléatoire correspondant à un nœud dans sera traitée. Toutes les requêtes correspondant aux nœuds sur le chemin de la racine à n'ont pas besoin d'être recalculées. La complexité de calcul pour les requêtes correspondant aux nœuds est conforme à une DFS valide. Le chemin de la racine à est mis en cache.
- (Récurrence) Supposons que nous venions de visiter un nœud dans , et que les nœuds visités soient conformes à un ordre DFS. Soit le chemin de la racine à . Alors chaque nœud non visité a son plus proche ancêtre commun avec les nœuds visités sur . Comme les nœuds sur sont en cache, un nœud non visité dont le plus proche ancêtre commun se trouve sur aura le plus long préfixe commun. L'ordre du plus long préfixe commun en premier sélectionnera , ce qui est un ordre DFS valide. Le chemin de la racine à sera mis en cache car il est le plus récent.
Dans le cas en ligne, l'ordre DFS sera perturbé, mais l'ordonnancement par plus long préfixe commun approxime toujours le comportement de la DFS sur la partie augmentée de l'arbre radix implicite. Nous le montrons en considérant l'étape d'ajout d'un nouveau lot de requêtes.
Soit la partie de l'arbre radix visitée jusqu'à présent, et le nouvel arbre radix complet après l'ajout du nouveau lot de requêtes. Soit l'ensemble des nœuds en cache dans . Soit longest le nœud de qui a le plus long chemin depuis la racine et qui possède un sous-arbre dans qui n'a pas été entièrement visité.
L'ordonnancement par plus long préfixe commun traitera alors le sous-arbre de enraciné en longest selon un ordre DFS. Durant ce processus, une éviction peut se produire, et les nœuds restants en cache de deviennent . Une DFS aura alors lieu pour le sous-arbre de enraciné en longest .
De même, nous aurons , jusqu'à ce que ne contienne plus qu'un seul nœud feuille dans dont le sous-arbre dans n'est pas entièrement visité. À ce stade, nous avons atteint un état DFS valide. La partie restante de sera visitée selon l'ordre DFS comme décrit dans la preuve du théorème 3.1.
A.4 RadixAttention distribué en parallélisme de données
Pour adapter RadixAttention aux environnements distribués avec plusieurs workers répliqués (c'est-à-dire le parallélisme de données), nous avons développé un mécanisme dans lequel chaque worker maintient son propre sous-arbre, tandis que le routeur supervise un méta-arbre. Ce méta-arbre agit comme un trie qui suit tous les sous-arbres et leurs dispositifs associés. À l'arrivée d'un nouveau lot de requêtes au routeur, la correspondance de préfixes est exécutée sur le méta-arbre. Nous mettons en œuvre diverses politiques basées sur l'affinité de chaque requête — mesurée par la longueur du préfixe commun avec des workers spécifiques et d'autres requêtes du même groupe — afin de prendre des décisions de répartition efficaces qui minimisent les calculs redondants. Chaque fois que de nouvelles requêtes sont traitées, le routeur et les workers mettent à jour indépendamment leurs arbres respectifs. Si une éviction se produit sur un nœud worker, celui-ci la consigne dans une file d'attente, que le routeur traite ensuite pour mettre à jour le méta-arbre pendant les périodes de faible activité. Nous avons évalué cette configuration distribuée avec quatre workers et le jeu de données MMLU, et avons observé qu'elle atteint une mise à l'échelle linéaire et un taux de succès du cache optimal avec un surcoût minimal grâce à cette conception de cache distribué à cohérence faible. Il existe un compromis entre la maximisation de la localité des données et l'efficacité du traitement parallèle. L'exploration de politiques d'ordonnancement avancées pour optimiser ce compromis est désignée comme un axe de recherche future. En outre, un travail concurrent de Preble [45] étudie l'ordonnancement en parallélisme de données basé sur une version préliminaire de SGLang.
B Détails supplémentaires sur la machine à états finis compressée
Cette section traite du contexte et des détails d'implémentation de la machine à états finis compressée pour un décodage contraint plus rapide. Notre objectif est que les LLM suivent une expression régulière (regex), qui offre une plus grande expressivité et peut être utilisée pour représenter des formats courants tels que les schémas JSON. Pour ce faire, nous convertissons la regex en une machine à états finis (FSM) afin de guider le processus de génération pendant le décodage [54]. Une FSM est essentiellement un graphe avec des nœuds (états) et des arêtes (transitions avec des chaînes/caractères). Partant d'un état initial, chaque transition ajoute la chaîne portée par l'arête pour passer à l'état suivant, un ensemble d'états finaux servant à conclure le processus. Ce mécanisme guide le décodage d'un LLM, en filtrant les tokens invalides en fonction des transitions de l'état courant de la FSM, comme illustré à la Fig. 10. Le décodage peut impliquer plusieurs transitions dans la FSM jusqu'à atteindre un état final.
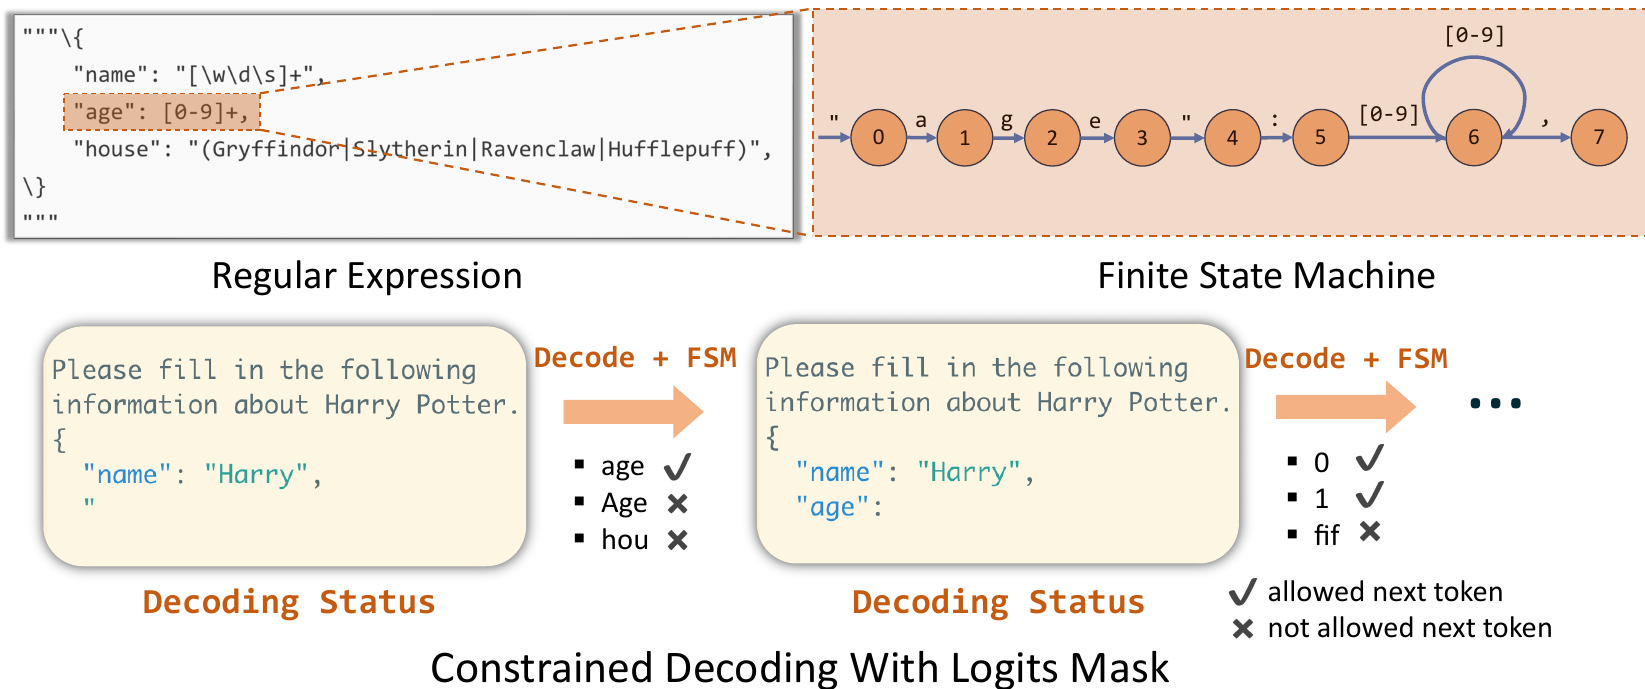
La difficulté du décodage contraint provient du fait que les contraintes sont souvent exprimées dans des formats en langage naturel, c'est-à-dire que la regex est décrite par des caractères/chaînes, tandis que les LLM sont conçus pour interpréter et traiter ceux-ci comme des tokens. Cela crée un scénario complexe, car la correspondance entre chaînes et tokens est complexe et dépourvue de correspondance biunivoque [22].
Cette section est dérivée d'un billet de blog antérieur4. Les lecteurs sont également encouragés à lire ce billet de blog pour un contexte supplémentaire et une compréhension plus facile.
B.1 Détails d'implémentation de la machine à états finis compressée
Pour simplifier la construction de la FSM compressée, nous construisons la FSM originale sur des caractères/chaînes plutôt que sur des tokens. Nous définissons formellement les concepts d'arête de transition singulière et d'arête compressée comme suit :
- Arête de transition singulière : une arête est une arête de transition singulière si 1) son nœud source n'a qu'un seul nœud successeur, et 2) il n'y a qu'un seul caractère/chaîne acceptable sur celle-ci.- Arête compressée : une arête compressée par plusieurs arêtes consécutivement adjacentes si et seulement si sont des arêtes de transition singulières. Le texte de l'arête compressée est la concaténation des textes de .
Partant d'une FSM basée sur les caractères, nous fusionnons récursivement les arêtes de transition singulières dans celles qui les précèdent jusqu'à ce que toute compression supplémentaire soit impossible, ce qui donne une FSM compressée. Cette approche accélère le processus de décodage, comme le démontre l'efficacité d'exécution de SGLang avec la FSM compressée, illustrée à la Fig. 11.
B.2 Gestion des artefacts de tokenisation par retokenisation
Lorsqu'un nouveau token est généré, nous obtenons la chaîne du token et parcourons toutes les arêtes sortantes de l'état courant pour trouver celle qui commence par la chaîne tout juste décodée, puis nous avançons. Toutefois, lorsque l'arête de transition est bien compressée et contient une chaîne très longue, nous pouvons également anticiper les chaînes décodées des tours suivants. C'est là que l'accélération se produit, et nous appelons ce processus Jump Forward. Cependant, nous devons encore convertir la chaîne en tokens pour les phases de décodage suivantes, ce qui n'est pas simple en raison du pré-entraînement et de la méthode de tokenisation spécifiques du LLM ;
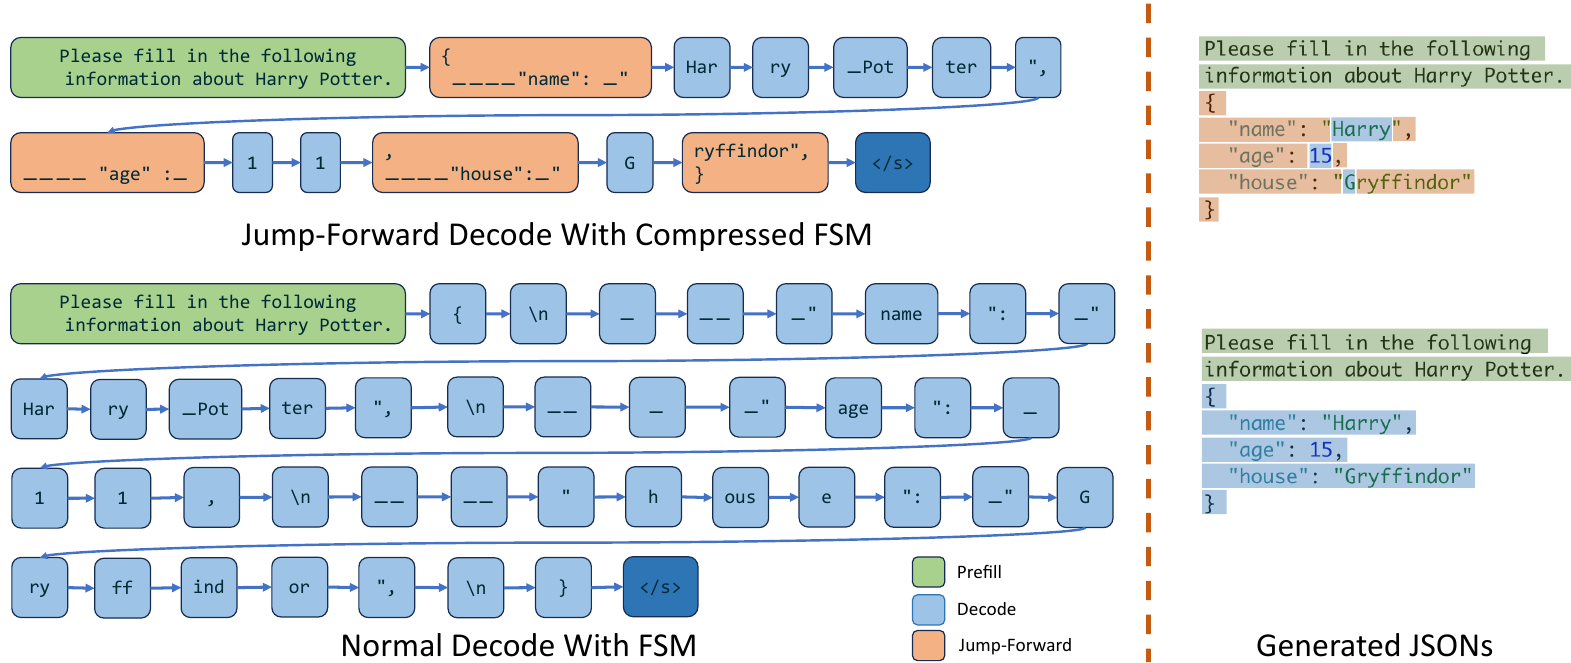
un partitionnement direct pourrait altérer le sens visé [50]. Par exemple, le texte compressé dans la regex de la Fig. 2 est {"summary": "qui ne peut être tokenisé que comme {"summary,": et " selon le tokenizer, plutôt que de les partitionner aléatoirement comme {"summa, ry, et ". Pour résoudre ce problème, nous utilisons le tokenizer original pour retokeniser tout le texte précédent ainsi que le texte de l'arête compressée, en garantissant l'alignement avec le format d'entrée original des LLM. Et cela n'entraîne qu'un surcoût de retokenisation mineur.
B.3 Extension future : traiter la probabilité distordue
Le décalage entre les chaînes et les tokens pose également le problème d'une distribution de probabilité biaisée [50]. Par exemple, dans la Fig. 2, l'expression régulière « [ABCD] [+- ]? » suggère des notes allant de A+ à D-, mais si on la remplace par des termes plus larges comme Excellent | Above Average | Fair | Below Average, le runtime peut mapper de manière inexacte un A à Above Average, car le terme Above Average se trouve sur une transition compressée, ce qui fausse la représentation de la hiérarchie des notes. Cela se produit parce que le LLM ne reconnaît pas la plage spécifique des choix, ce qui conduit à des séquences de tokens inappropriées. Le calcul de probabilités exactes pour chaque choix nécessite de sommer les probabilités de toutes les séquences de tokens qui aboutissent à chaque choix, ce qui complique le décodage et ajoute une surcharge. Une solution de contournement consiste à inclure les choix ou l'expression régulière directement dans le prompt de préremplissage, afin de guider le LLM pour qu'il ait conscience de ses choix et produise la décision sous forme de séquences de tokens appropriées. Toutefois, cette approche ne résout pas le problème sous-jacent des probabilités déformées, ce qui souligne la nécessité de recherches supplémentaires pour améliorer la précision du FSM compressé.
C Configurations et résultats expérimentaux supplémentaires
Configurations expérimentales supplémentaires. Les Fig. 5 et Fig. 6 sont obtenues en exécutant Llama- 7B sur un seul GPU A10G (24 Go). La Fig. 7 est obtenue en exécutant Mixtral- 8x7B sur 8 GPU A10G (24 Go) avec parallélisme de tenseurs. La Fig. 8(c) est obtenue en exécutant Llama- 7B sur un seul GPU A10G (24 Go). La Fig. 12 est obtenue en exécutant Llama- 70B sur 4 GPU A100G (80 Go) avec parallélisme de tenseurs. Le Tableau 2 est obtenu en exécutant LLaVA- v1.5- 7B sur un seul GPU A10G (24 Go) et en exécutant LLaVA- Next- 34B sur un seul GPU A100G (80 Go). Chaque barre des figures de benchmark prend de plusieurs minutes à une heure pour être exécutée.
Résultats expérimentaux supplémentaires. La Fig. 13 montre les taux de succès de cache obtenus et optimaux sur les benchmarks listés dans la Fig. 5. La Fig. 12 montre le débit sur Llama- 2- 70B avec parallélisme de tenseurs.
D Mode compilateur
Outre le mode interpréteur utilisé dans le corps principal de l'article, un autre moyen d'exécuter des programmes SGLang consiste à les compiler sous forme de graphes de calcul et à les exécuter avec un exécuteur de graphe. Cela ouvre la voie à
davantage d'optimisations par compilation, puisque nous pouvons réécrire le graphe et effectuer une planification plus statique.
D.1 Conception et implémentation
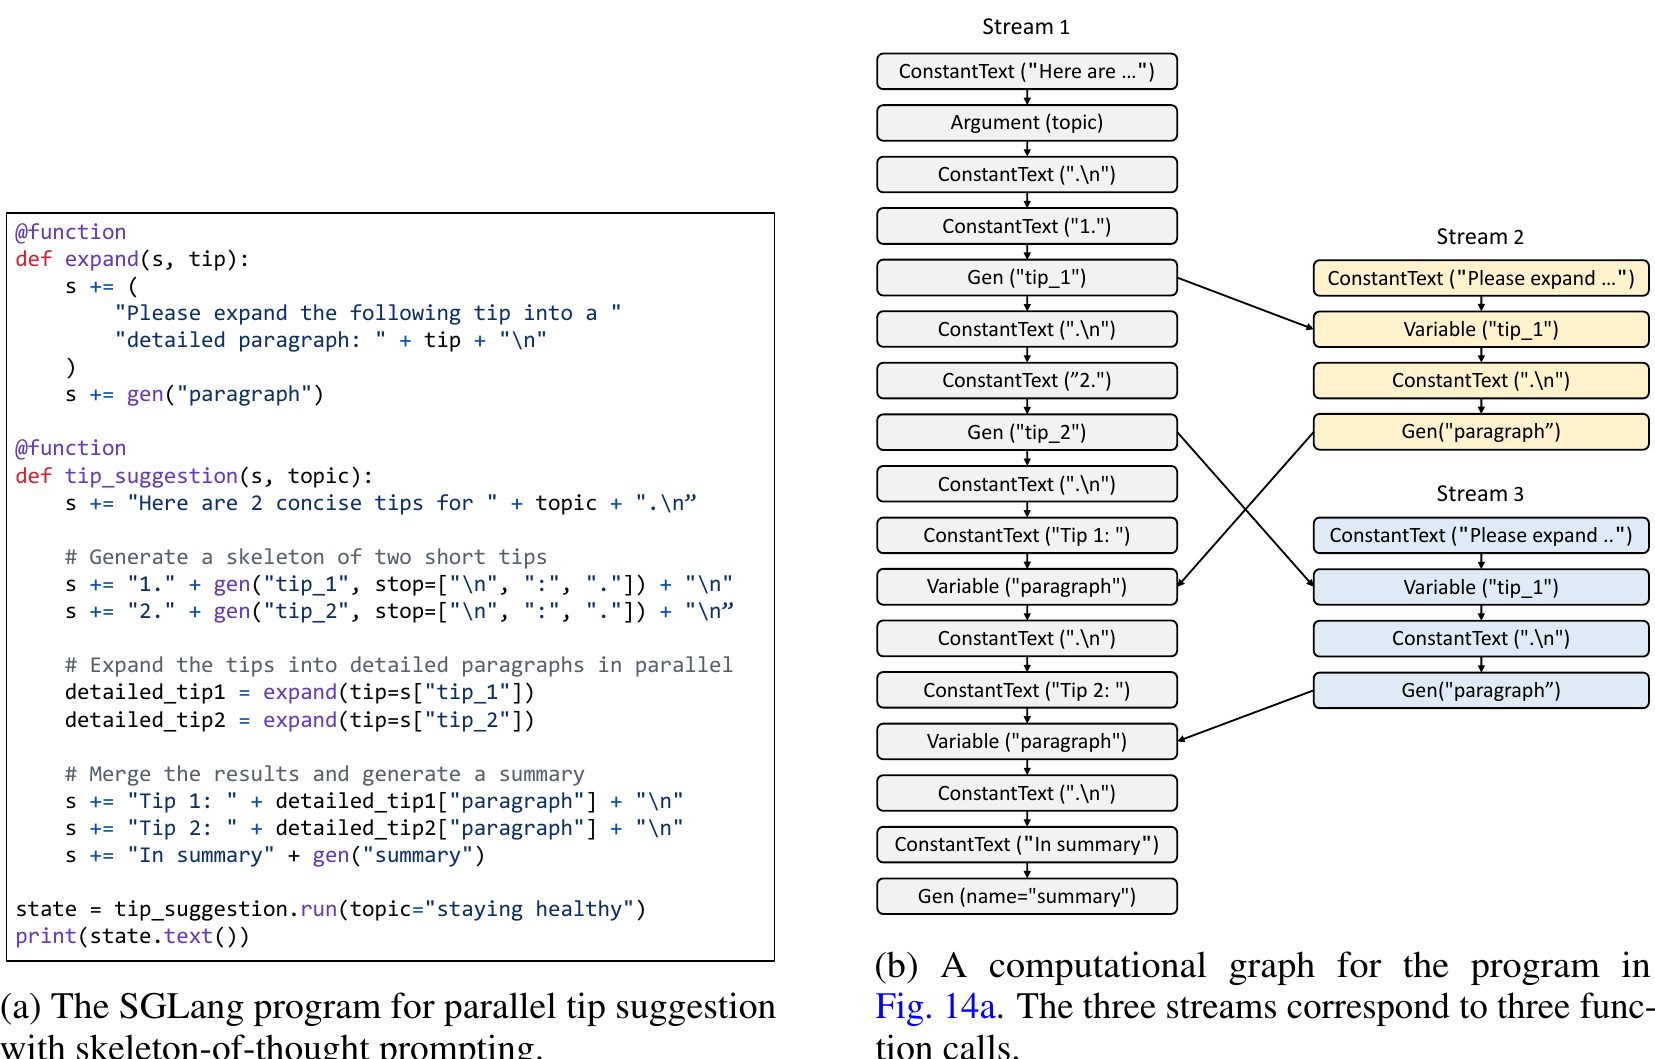
Nous avons conçu une représentation intermédiaire (IR) pour SGLang, qui représente les structures et les opérations des programmes SGLang sous forme de graphe de calcul. Ce graphe comprend des nœuds pour les opérateurs primitifs et des arêtes pour les dépendances. Voir la Fig. 14b pour le graphe correspondant au programme de la Fig. 14a. Dans le programme, chaque appel à une fonction décorée ou à un fork crée un nouvel état de prompt ou un flux.
Il existe plusieurs types de nœuds. Chaque opérande des opérateurs et dans un programme SGLang est représenté par un nœud IR. Ceux-ci incluent ConstantText, Argument, Gen, Select, Variable, Fork, GetForkItem et Join. Il existe deux types de dépendances : la dépendance intra- flux, où les opérations soumises dans un flux à l'aide de doivent être exécutées après toutes les opérations précédentes de ce flux, et la dépendance inter- flux, qui se produit lorsqu'un flux doit récupérer des valeurs de variables depuis un autre flux, nécessitant une synchronisation. Des opérations comme fork manipulent plusieurs flux et introduisent donc des dépendances inter- flux.
Pour générer le graphe, nous utilisons le traçage pour exécuter le programme avec des arguments abstraits et construire le graphe dynamiquement. Cette méthode est limitée aux programmes sans flux de contrôle dépendant des données, une limitation que nous prévoyons de traiter dans des travaux futurs. Une fois construit, le graphe peut être exécuté via un exécuteur de graphe, éliminant ainsi le besoin de réinterpréter le programme Python original. Cela offre des avantages tels que des optimisations par réécriture de graphe, une réduction de la surcharge d'exécution et la sérialisation des programmes. Pour l'exécution, des exécuteurs de flux sont lancés pour chaque flux de données, distribuant les nœuds IR aux flux dans l'ordre topologique.
D.2 Étude de cas d'une optimisation de compilateur : le déplacement de code pour améliorer le partage de préfixe
Nous explorons une optimisation de compilation pour SGLang IR : le déplacement de code pour améliorer le partage de préfixe. Nous anticipons que d'autres techniques classiques de compilateur peuvent également être appliquées, telles que le réglage automatique et la sélection d'instructions.
Cette optimisation vise à améliorer le partage de préfixe en réordonnant les nœuds du graphe afin d'augmenter la longueur du préfixe constant. Elle ne préserve pas strictement le calcul d'origine, ce qui la classe comme une optimisation agressive. Par exemple, remplacer l'invite « Here is a question + {question}. Please act as a math expert and solve the given question. » par « Please act as a math expert and solve the given question. Here is a question + {question}. » aboutit à un préfixe partageable plus long. Cette optimisation est intéressante car l'analyse de programme traditionnelle ne peut pas y parvenir en raison de la présence d'instructions en langage naturel dans SGLang. Au lieu de cela, nous demandons à GPT-4 de réordonner les nœuds du graphe. Nous rédigeons une invite comportant plusieurs exemples pour enseigner à GPT-4 les concepts de SGLang IR, et nous constatons que GPT-4 peut appliquer avec succès cette optimisation pour certains programmes SGLang simples.
Nous évaluons l'efficacité de cette optimisation. Nous collectons 20 modèles d'invite sur internet et les implémentons dans SGLang. Nous utilisons 5 de ces modèles comme exemples d'apprentissage few-shot et les 15 restants comme cas de test. Notre évaluation montre que, pour 12 des 15 modèles, GPT-4 réordonne avec succès les nœuds du graphe sans altérer la sémantique, comme l'a confirmé une inspection manuelle des invites modifiées. En moyenne, cette optimisation entraîne une augmentation de 60 tokens de la longueur du préfixe partageable, ce qui démontre l'efficacité de GPT-4. Les échecs dans la création d'un ordre d'invite optimisé proviennent d'une compréhension incorrecte de la signification sémantique des nœuds du graphe. Il est trop agressif et place toutes les constantes en tête même lorsque cet ordre modifie la sémantique d'origine. Cette étude de cas vise à explorer l'utilisation de GPT-4 pour les optimisations de compilateur. Des travaux supplémentaires sont nécessaires pour rendre ce type d'optimisations fiable à l'avenir.