
Un agent qui oublie tout ne sert à rien. Mem0 retient l'essentiel entre deux sessions et réduit la latence p95 de 91 %. Papier 2025, gratuit en ligne.
Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
MemO : Construire des agents IA prêts pour la production avec une mémoire à long terme évolutive
Prateek Chhikara, Dev Khant, Saket Aryan, Taranjeet Singh et Deshraj Yadavresearch@memO.ai
memO
Les grands modèles de langage (LLM) ont fait preuve d'une remarquable habileté à générer des réponses contextuellement cohérentes, mais leurs fenêtres de contexte fixes posent des défis fondamentaux pour maintenir la cohérence sur des dialogues multi-sessions prolongés. Nous introduisons MemO, une architecture évolutive centrée sur la mémoire qui répond à ce problème en extrayant, consolidant et récupérant dynamiquement les informations saillantes des conversations en cours. Sur cette base, nous proposons en outre une variante améliorée qui exploite des représentations mémorielles sous forme de graphe pour capturer des structures relationnelles complexes entre les éléments conversationnels. À travers des évaluations complètes sur le benchmark LOCOM0, nous comparons systématiquement nos approches à six catégories de références : (i) des systèmes augmentés de mémoire établis, (ii) la génération augmentée par récupération (RAG) avec différentes tailles de segments et valeurs de , (iii) une approche en contexte complet qui traite l'intégralité de l'historique de la conversation, (iv) une solution mémorielle open source, (v) un système à modèle propriétaire, et (vi) une plateforme dédiée de gestion de la mémoire. Les résultats empiriques montrent que nos méthodes surpassent systématiquement tous les systèmes mémoriels existants sur quatre catégories de questions : saut unique, temporelle, saut multiple et domaine ouvert. Notamment, MemO obtient d'amélioration relative sur la métrique LLM-as-a-Judge par rapport à OpenAI, tandis que MemO avec mémoire sous forme de graphe obtient un score global supérieur d'environ à la configuration MemO de base. Au-delà des gains de précision, nous réduisons également nettement la charge computationnelle par rapport à l'approche en contexte complet. En particulier, MemO atteint une latence p95 inférieure de et économise plus de de coût en tokens, offrant ainsi un équilibre convaincant entre capacités de raisonnement avancées et contraintes de déploiement pratique. Nos résultats mettent en évidence le rôle critique des mécanismes mémoriels structurés et persistants pour la cohérence conversationnelle à long terme, ouvrant la voie à des agents IA pilotés par LLM plus fiables et plus efficaces.
Le code est disponible à l'adresse : https://mem0. ai/research
1. Introduction
X
La mémoire humaine est un fondement de l'intelligence — elle façonne notre identité, guide la prise de décision et nous permet d'apprendre, de nous adapter et de former des relations significatives (Craik and Jennings, 1992). Parmi ses nombreux rôles, la mémoire est essentielle à la communication : nous nous rappelons des interactions passées, inférons des préférences et construisons des modèles mentaux évolutifs de ceux avec qui nous interagissons (Assmann, 2011). Cette capacité à retenir et à récupérer des informations sur des périodes prolongées permet des échanges cohérents et contextuellement riches qui s'étendent sur des jours, des semaines ou même des mois. Les agents IA, propulsés par les grands modèles de langage (LLM), ont réalisé des progrès remarquables dans la génération de réponses fluides et contextuellement appropriées (Yu et al., 2024, Zhang et al., 2024). Cependant, ces systèmes sont fondamentalement limités par leur dépendance à des fenêtres de contexte fixes, qui restreignent sévèrement leur capacité à maintenir la cohérence sur des interactions prolongées (Bulatov et al., 2022, Liu et al., 2023). Cette limitation découle de l'absence, chez les LLM, de mécanismes mémoriels persistants pouvant s'étendre au-delà de leurs fenêtres de contexte finies. Alors que les humains accumulent et organisent naturellement les expériences au fil du temps, formant une narration continue
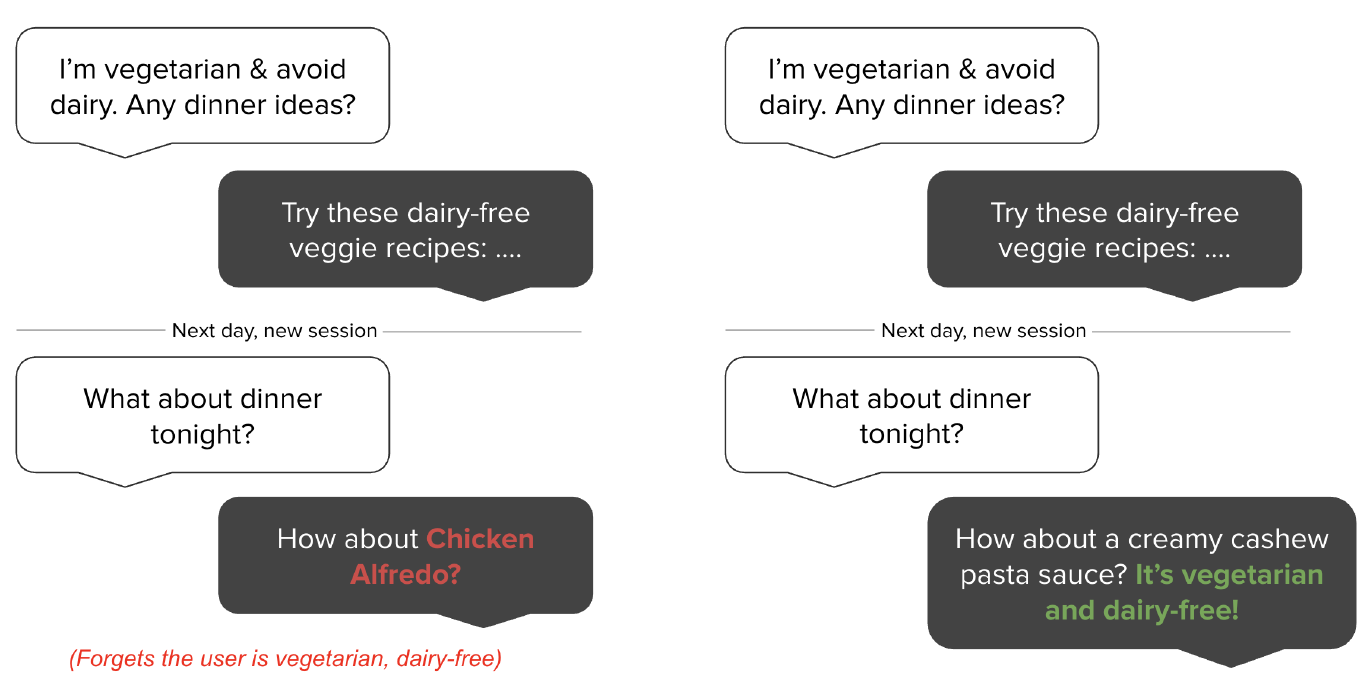
des interactions, les systèmes IA ne peuvent pas intrinsèquement conserver des informations d'une session à l'autre ou après un débordement de contexte. L'absence de mémoire persistante crée une déconnexion fondamentale dans l'interaction humain-IA. Sans mémoire, les agents IA oublient les préférences des utilisateurs, répètent des questions et contredisent des faits précédemment établis. Considérons un exemple simple illustré dans la Figure 1, où un utilisateur mentionne être végétarien et éviter les produits laitiers dans une conversation initiale. Dans une session ultérieure, lorsque l'utilisateur demande des recommandations pour le dîner, un système sans mémoire persistante pourrait suggérer du poulet, contredisant complètement les préférences alimentaires établies. En revanche, un système doté d'une mémoire persistante conserverait cette information critique sur l'utilisateur à travers les sessions et suggérerait des options végétariennes et sans produits laitiers appropriées. Ce scénario courant met en évidence comment les défaillances de la mémoire peuvent fondamentalement compromettre l'expérience utilisateur et la confiance.
Au-delà des cadres conversationnels, il a été démontré que les mécanismes mémoriels améliorent considérablement les performances des agents dans des environnements interactifs (Majumder et al., Shinn et al., 2023). Les agents dotés d'une mémoire des expériences passées peuvent mieux anticiper les besoins des utilisateurs, apprendre de leurs erreurs précédentes et généraliser leurs connaissances à travers les tâches (Chhikara et al., 2023). La recherche démontre que les agents augmentés de mémoire améliorent la prise de décision en exploitant les relations causales entre actions et résultats, conduisant à une adaptation plus efficace dans des scénarios dynamiques (Rasmussen et al., 2025). Les architectures mémorielles hiérarchiques (Packer et al., 2023, Sarthi et al., 2024) et les systèmes mémoriels agentiques capables d'évolution autonome (Xu et al., 2025) ont en outre montré que la mémoire permet un raisonnement à long terme plus cohérent à travers de multiples sessions de dialogue.
Contrairement aux humains, qui intègrent dynamiquement de nouvelles informations et révisent des croyances obsolètes, les LLM se « réinitialisent » effectivement dès que l'information sort de leur fenêtre de contexte (Zhang, 2024, Timoneda and Vera, 2025). Même lorsque des modèles comme GPT-4 d'OpenAI (128K tokens) (Hurst et al., 2024), o1 (contexte de 200K) (Jaech et al., 2024), Claude 3.7 Sonnet d'Anthropic (200K tokens) (Anthropic, 2025) et Gemini de Google (au moins 10M tokens) (Team et al., 2024) repoussent les limites de la longueur de contexte, ces améliorations ne font que retarder plutôt que résoudre la limitation fondamentale. Dans les applications pratiques, même ces fenêtres de contexte étendues s'avèrent insuffisantes pour deux raisons critiques. Premièrement, à mesure que des relations significatives humain-IA se développent sur des semaines ou des mois, l'historique de conversation dépasse inévitablement même les limites de contexte les plus généreuses. Deuxièmement, et peut-être plus important encore, les conversations du monde réel maintiennent rarement une continuité thématique. Un utilisateur peut mentionner des préférences alimentaires (être végétarien), puis s'engager pendant des heures dans une discussion sans rapport sur des tâches de programmation, avant de revenir à des requêtes liées à la nourriture concernant les options de dîner. Dans de tels scénarios, une approche en contexte complet devrait raisonner à travers des montagnes d'informations non pertinentes, les préférences alimentaires critiques étant potentiellement enfouies parmi des milliers de tokens de discussions de programmation. De plus, le simple fait de présenter des contextes plus longs ne garantit pas une récupération ou une utilisation efficace des informations passées, car les mécanismes d'attention se dégradent sur les tokens distants (Guo et al., 2024, Nelson et al., 2024). Cette limitation est particulièrement problématique dans les domaines à enjeux élevés tels que les soins de santé, l'éducation et le support d'entreprise, où maintenir la continuité et la confiance est crucial (Hatalis et al., 2023). Pour relever ces défis, les agents IA doivent adopter des systèmes mémoriels qui vont au-delà de l'extension statique du contexte. Une mémoire IA robuste devrait stocker sélectivement les informations importantes, consolider les concepts liés et récupérer les détails pertinents lorsque nécessaire — à l'image des processus cognitifs humains (He et al., 2024). En intégrant de tels mécanismes, nous pouvons développer des agents IA qui maintiennent des personas cohérents, suivent l'évolution des préférences des utilisateurs et s'appuient sur les échanges antérieurs. Ce changement transformera l'IA, de répondants transitoires et oublieux, en collaborateurs fiables à long terme, redéfinissant fondamentalement l'avenir de l'intelligence conversationnelle.
Dans cet article, nous abordons une limitation fondamentale des systèmes IA : leur incapacité à maintenir un raisonnement cohérent à travers des conversations prolongées réparties sur différentes sessions, ce qui restreint sévèrement les interactions significatives à long terme avec les utilisateurs. Nous introduisons MemO (prononcé mem-zéro), une nouvelle architecture mémorielle qui capture, organise et récupère dynamiquement les informations saillantes des conversations en cours. Sur cette base, nous développons MemO8, qui améliore l'architecture de base avec des représentations mémorielles sous forme de graphe afin de mieux modéliser les relations complexes entre les éléments conversationnels. Nos résultats expérimentaux sur le benchmark LOCOM0 démontrent que nos approches surpassent systématiquement les systèmes mémoriels existants — y compris les architectures augmentées de mémoire, les méthodes de génération augmentée par récupération (RAG), ainsi que les solutions open source et propriétaires — à travers divers types de questions, tout en nécessitant simultanément des ressources computationnelles nettement moindres. Les mesures de latence révèlent en outre que MemO fonctionne avec des temps de réponse inférieurs de 91% à ceux des approches en contexte complet, réalisant un équilibre optimal entre capacités de raisonnement sophistiquées et contraintes de déploiement pratique. Ces contributions représentent une avancée significative vers des systèmes IA capables de maintenir des conversations cohérentes et sensibles au contexte sur des durées prolongées — à l'image des schémas de communication humaine et ouvrant de nouvelles possibilités pour des applications en tutorat personnel, soins de santé et assistance personnalisée.
2. Méthodes proposées
Nous introduisons deux architectures mémorielles pour les agents IA. (1) MemO met en œuvre un nouveau paradigme qui extrait, évalue et gère les informations saillantes des conversations grâce à des modules dédiés à l'extraction et à la mise à jour de la mémoire. Le système traite une paire de messages entre soit deux participants utilisateurs, soit un utilisateur et un assistant. (2) MemO8 étend cette base en incorporant des représentations mémorielles sous forme de graphe, où les souvenirs sont stockés sous forme de graphes orientés étiquetés avec des entités comme nœuds et des relations comme arêtes. Cette structure permet une compréhension plus approfondie des connexions entre entités. En modélisant explicitement à la fois les entités et leurs relations, MemO8 soutient un raisonnement plus avancé à travers des faits interconnectés, en particulier pour les requêtes qui nécessitent de naviguer dans des chemins relationnels complexes à travers de multiples souvenirs.
2.1. MemO
Notre architecture suit un paradigme de traitement incrémental, lui permettant de fonctionner de manière transparente au sein de conversations en cours. Comme illustré dans la Figure 2, l'architecture complète du pipeline se compose de deux phases : l'extraction et la mise à jour.
La phase d'extraction est déclenchée par l'ingestion d'une nouvelle paire de messages , où représente le message courant et le précédent. Cette paire se compose généralement d'un message utilisateur et d'une réponse de l'assistant, capturant ainsi une unité d'interaction complète. Pour établir un contexte approprié à l'extraction de souvenirs, le système recourt à deux sources complémentaires : (1) un résumé de conversation récupéré dans la base de données qui
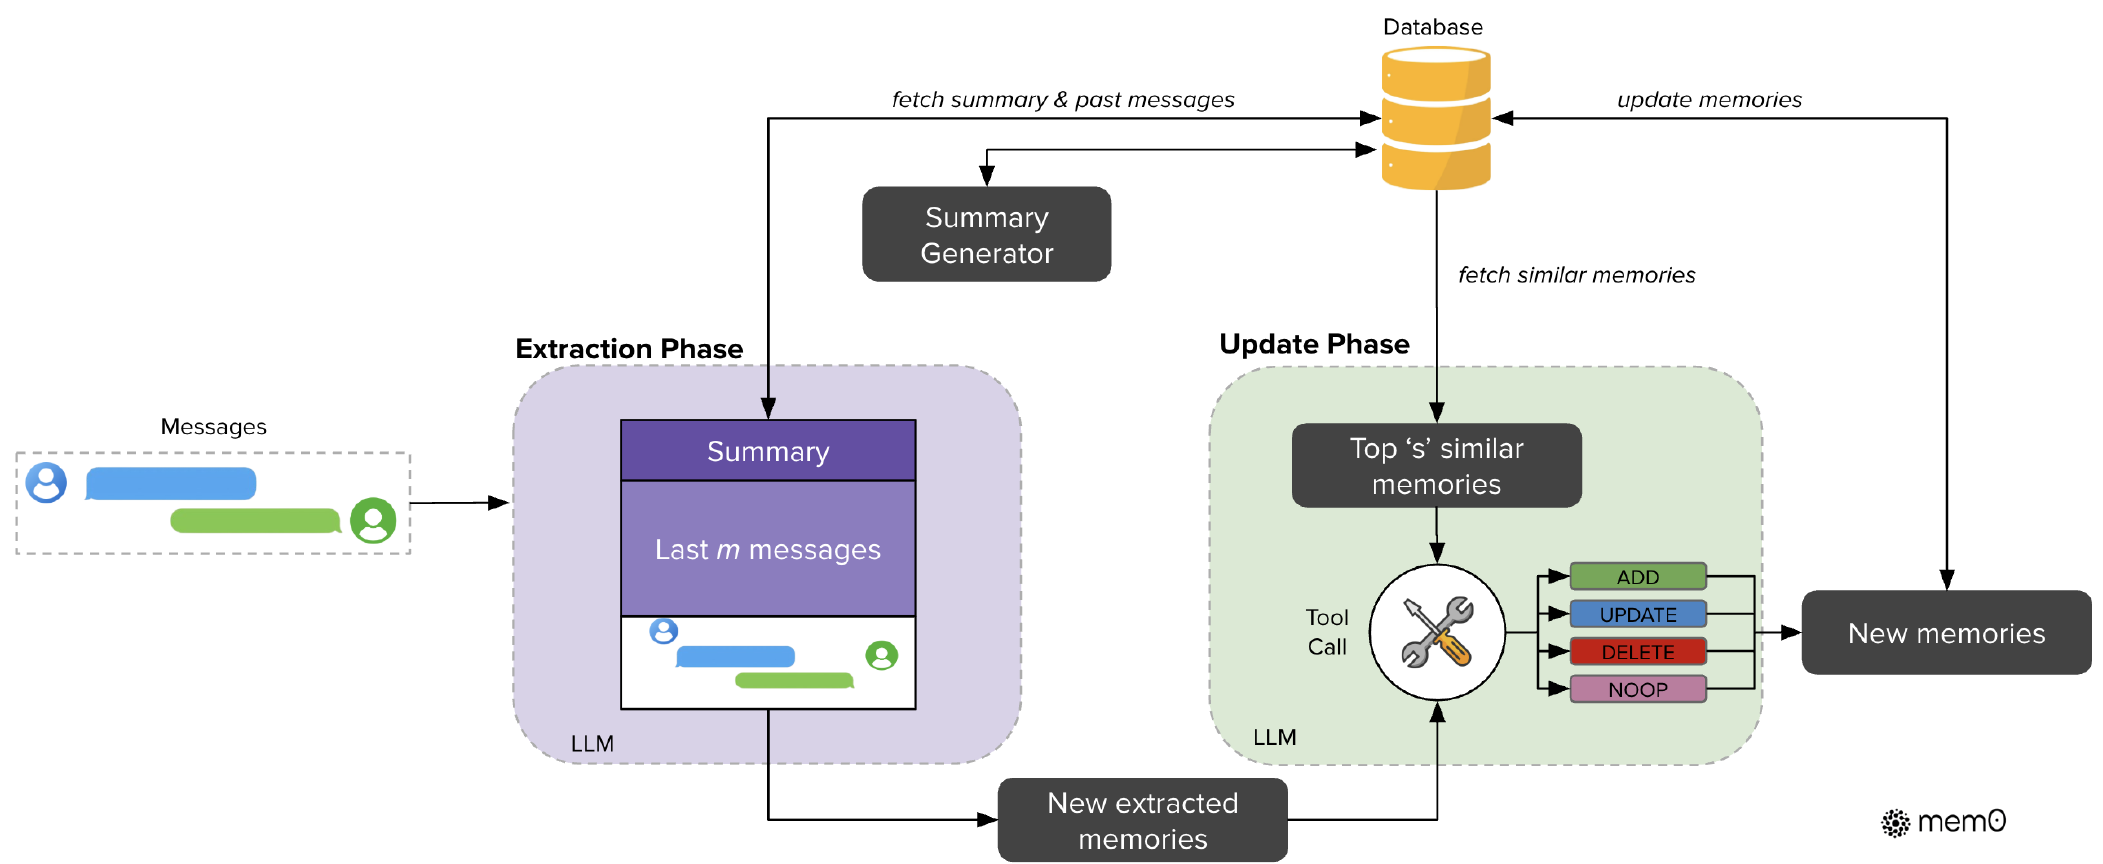
englobe le contenu sémantique de l'ensemble de l'historique de la conversation, et (2) une séquence de messages récents issus de l'historique de la conversation, où est un hyperparamètre contrôlant la fenêtre de récence. Afin de prendre en charge une extraction de souvenirs sensible au contexte, nous mettons en œuvre un module de génération de résumés asynchrone qui actualise périodiquement le résumé de la conversation. Ce composant fonctionne indépendamment du pipeline de traitement principal, garantissant que l'extraction de souvenirs bénéficie systématiquement d'informations contextuelles à jour sans introduire de délais de traitement. Alors que 5 offre une compréhension thématique globale de l'ensemble de la conversation, la séquence de messages récents fournit un contexte temporel granulaire susceptible de contenir des détails pertinents non consolidés dans le résumé. Cette double information contextuelle, combinée à la nouvelle paire de messages, forme une invite complète destinée à une fonction d'extraction mise en œuvre via un LLM. La fonction extrait ensuite un ensemble de souvenirs saillants spécifiquement du nouvel échange tout en restant consciente du contexte plus large de la conversation, produisant ainsi des faits candidats susceptibles d'être intégrés à la base de connaissances.
À la suite de l'extraction, la phase de mise à jour évalue chaque fait candidat au regard des souvenirs existants afin de maintenir la cohérence et d'éviter les redondances. Cette phase détermine l'opération de gestion de la mémoire appropriée pour chaque fait extrait . L'algorithme 1, mentionné en annexe B, illustre ce processus. Pour chaque fait, le système récupère d'abord les souvenirs sémantiquement les plus similaires à l'aide d'embeddings vectoriels issus de la base de données. Ces souvenirs récupérés, ainsi que le fait candidat, sont ensuite présentés au LLM via une interface d'appel de fonctions que nous appelons « appel d'outil ». Le LLM détermine lui-même laquelle des quatre opérations distinctes exécuter : ADD pour la création de nouveaux souvenirs lorsqu'aucun souvenir sémantiquement équivalent n'existe ; UPDATE pour l'enrichissement de souvenirs existants avec des informations complémentaires ; DELETE pour la suppression de souvenirs contredits par de nouvelles informations ; et NOOP lorsque le fait candidat ne nécessite aucune modification de la base de connaissances. Plutôt que d'utiliser un classificateur séparé, nous exploitons les capacités de raisonnement du LLM pour sélectionner directement l'opération appropriée en fonction de la relation sémantique entre le fait candidat et les souvenirs existants. À la suite de cette détermination, le système exécute les opérations fournies, préservant ainsi la cohérence de la base de connaissances et la consistance temporelle.
Dans notre évaluation expérimentale, nous avons configuré le système avec ' messages précédents comme référence contextuelle et ' souvenirs similaires pour l'analyse comparative. Toutes les opérations de modèle de langage ont utilisé GPT- 4o- mini comme moteur d'inférence. La base de données vectorielle emploie des embeddings denses pour faciliter une recherche de similarité efficace durant la phase de mise à jour.
2.2. Memo8
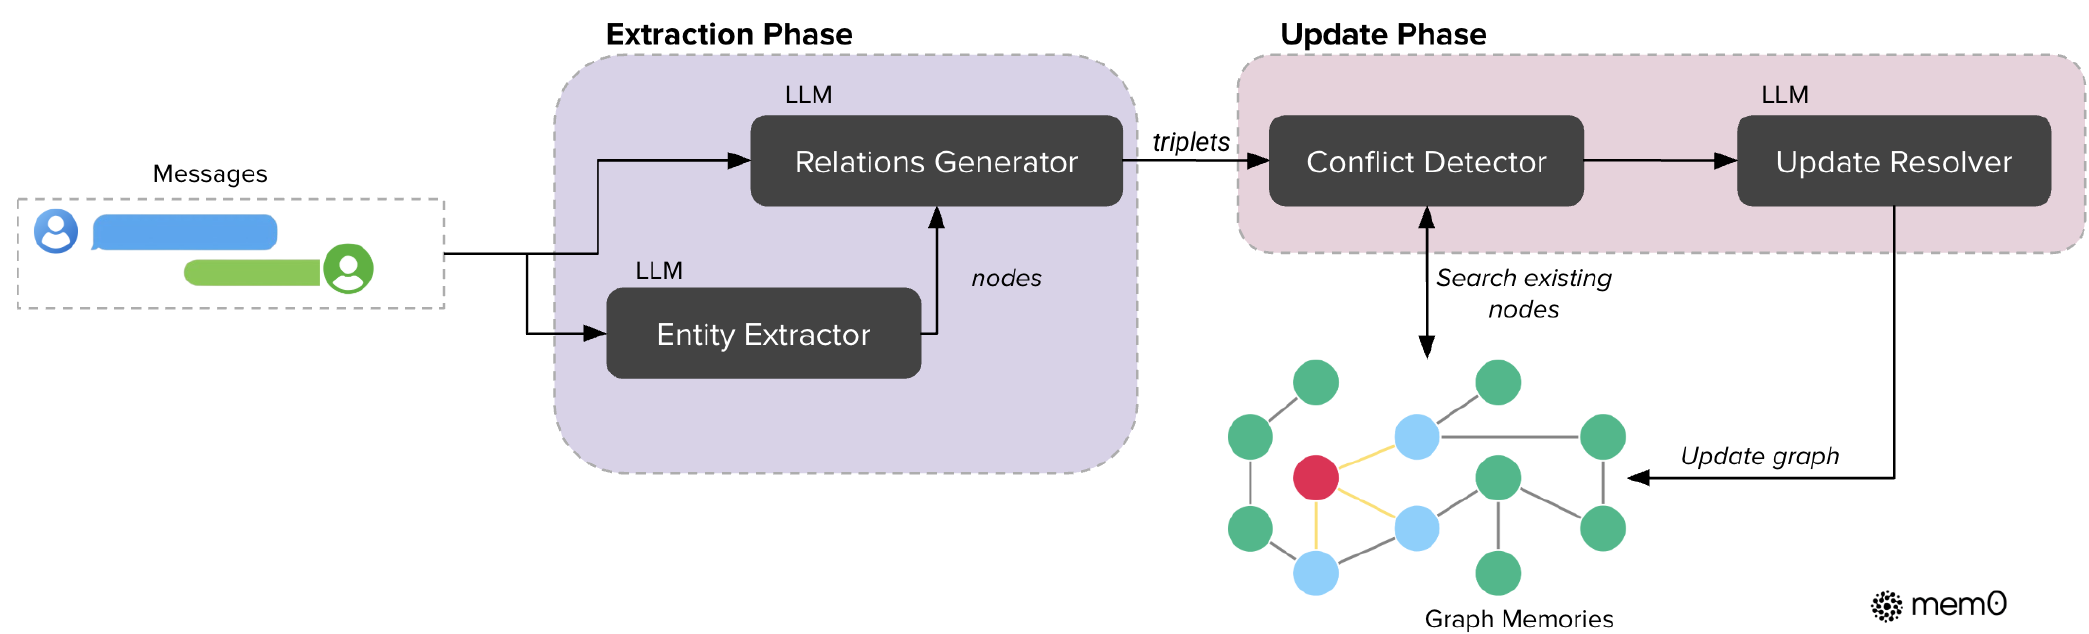
Le pipeline Memo8, illustré à la figure 3, met en œuvre une approche de mémoire basée sur les graphes qui capture, stocke et récupère efficacement les informations contextuelles issues d’interactions en langage naturel (Zhang et al., 2022). Dans ce cadre, les souvenirs sont représentés sous forme de graphe orienté étiqueté , où :
- Les nœuds représentent des entités (par exemple, ALICE, SAN_FRANCISCO) - Les arêtes représentent des relations entre entités (par exemple, LIVES_IN) - Les étiquettes attribuent des types sémantiques aux nœuds (par exemple, ALICE - Personne, SAN_FRANCISCO - Ville)
Chaque nœud d’entité contient trois composants : (1) une classification du type d’entité qui catégorise l’entité (par exemple, Personne, Lieu, Événement), (2) un vecteur d’embedding qui capture la signification sémantique de l’entité, et (3) des métadonnées incluant un horodatage de création . Les relations dans notre système sont structurées sous forme de triplets de la forme , où et sont respectivement les nœuds d’entité source et destination, et est l’arête étiquetée qui les relie.
Le processus d’extraction emploie un pipeline en deux étapes tirant parti des LLM pour transformer du texte non structuré en représentations structurées sous forme de graphe. D’abord, un module extracteur d’entités traite le texte d’entrée afin d’identifier un ensemble d’entités ainsi que leurs types correspondants. Dans notre cadre, les entités représentent les éléments d’information clés des conversations — notamment les personnes, lieux, objets, concepts, événements et attributs qui méritent d’être représentés dans le graphe de mémoire. L’extracteur d’entités identifie ces diverses unités d’information en analysant l’importance sémantique, l’unicité et la persistance des éléments de la conversation. Par exemple, dans une conversation sur des projets de voyage, les entités peuvent inclure des destinations (villes, pays), des modes de transport, des dates, des activités et les préférences des participants — essentiellement toute information discrète qui pourrait être pertinente pour une référence ou un raisonnement futur.
Ensuite, un composant générateur de relations dérive des connexions significatives entre ces entités, en établissant un ensemble de triplets de relations qui capturent la structure sémantique de l’information. Ce module fondé sur les LLM analyse les entités extraites et leur contexte au sein de la conversation afin d’identifier des connexions sémantiquement significatives. Il fonctionne en examinant les schémas linguistiques, les indices contextuels et les connaissances du domaine pour déterminer comment les entités sont liées les unes aux autres. Pour chaque paire d’entités potentielle, le générateur évalue s’il existe une relation significative et, le cas échéant, classe cette relation avec une étiquette appropriée (par exemple, « lives_in », « prefers », « owns », « happened_on »). Le module emploie des techniques d’ingénierie de prompts qui guident le LLM à raisonner à la fois sur les déclarations explicites et sur les informations implicites du dialogue, ce qui produit des triplets de relations formant les arêtes de notre graphe de mémoire et permettant un raisonnement complexe sur des informations interconnectées. Lors de l’intégration de nouvelles informations, Memo8 emploie une stratégie sophistiquée de stockage et de mise à jour. Pour chaque nouveau triplet de relation, nous calculons les embeddings des entités source et destination, puis recherchons les nœuds existants dont la similarité sémantique dépasse un seuil défini « t ». Selon l’existence des nœuds, le système peut créer les deux nœuds, créer un seul nœud, ou utiliser des nœuds existants avant d’établir la relation avec les métadonnées appropriées. Afin de maintenir un graphe de connaissances cohérent, nous mettons en œuvre un mécanisme de détection des conflits qui identifie les relations existantes potentiellement conflictuelles lorsque de nouvelles informations arrivent. Un résolveur de mise à jour fondé sur les LLM détermine si certaines relations doivent devenir obsolètes, en les marquant comme invalides plutôt qu’en les supprimant physiquement afin de permettre un raisonnement temporel.
La fonctionnalité de récupération de mémoire dans Memo8 met en œuvre une stratégie à double approche pour un accès optimal à l’information. La méthode centrée sur les entités identifie d’abord les entités clés au sein d’une requête, puis exploite la similarité sémantique pour localiser les nœuds correspondants dans le graphe de connaissances. Elle explore systématiquement les relations entrantes et sortantes à partir de ces nœuds d’ancrage, en construisant un sous-graphe complet qui capture les informations contextuelles pertinentes. En complément, l’approche sémantique par triplets adopte une vue plus holistique en encodant la requête entière sous forme de vecteur d’embedding dense. Cette représentation de la requête est ensuite comparée aux encodages textuels de chaque triplet de relation dans le graphe de connaissances. Le système calcule des scores de similarité fins entre la requête et tous les triplets disponibles, en ne retournant que ceux qui dépassent un seuil de pertinence configurable, classés par ordre décroissant de similarité. Ce mécanisme de double récupération permet à Memo8 de traiter avec la même efficacité les questions ciblées centrées sur des entités et les requêtes conceptuelles plus larges.
Du point de vue de la mise en œuvre, le système utilise Neo4j1 comme base de données de graphes sous-jacente. Les extracteurs fondés sur les LLM et le module de mise à jour exploitent GPT-4o-mini avec des capacités d’appel de fonctions, ce qui permet une extraction structurée de l’information à partir de texte non structuré. En combinant des représentations fondées sur les graphes avec des embeddings sémantiques et une extraction d’information fondée sur les LLM, Memo8 atteint à la fois la richesse structurelle nécessaire au raisonnement complexe et la flexibilité sémantique requise pour la compréhension du langage naturel.
3. Configuration expérimentale
3.1. Jeu de données
Le jeu de données LOCOM0 (Maharana et al., 2024) est conçu pour évaluer la mémoire conversationnelle à long terme dans les systèmes de dialogue. Il comprend 10 conversations étendues, chacune contenant environ 600 dialogues et 26 000 tokens en moyenne, réparties sur plusieurs sessions. Chaque conversation met en scène deux individus discutant d’expériences quotidiennes ou d’événements passés. À la suite de ces dialogues multi-sessions, chaque conversation est accompagnée en moyenne de 200 questions avec les réponses de référence correspondantes. Ces questions sont réparties en plusieurs types : saut unique, sauts multiples, temporelles et ouvertes au domaine. Le jeu de données incluait à l’origine une catégorie de questions adversariales, conçue pour tester la capacité des systèmes à reconnaître les questions sans réponse. Toutefois, cette catégorie a été exclue de notre évaluation parce que les réponses de référence n’étaient pas disponibles et que le comportement attendu pour ce type de question est que l’agent les reconnaisse comme sans réponse.
3.2. Métriques d’évaluation
Notre cadre d’évaluation met en œuvre une approche complète pour évaluer les capacités de mémoire à long terme dans les systèmes de dialogue, en tenant compte à la fois de la qualité des réponses et de l’efficacité opérationnelle. Nous répartissons nos métriques en deux groupes distincts qui, ensemble, fournissent une compréhension holistique de la performance du système.
(1) Métriques de performance Les recherches antérieures en IA conversationnelle (Goswami, 2025, Soni et al., 2024, Singh et al., 2020) se sont principalement appuyées sur des métriques de similarité lexicale telles que le score F1 (F1) et BLEU-1 (B1). Cependant, ces métriques présentent des limites importantes lorsqu’il s’agit d’évaluer l’exactitude factuelle dans des contextes conversationnels. Considérons un scénario où la réponse de référence est « Alice est née en mars » et où un système génère « Alice est née en juillet ». Bien qu’elle contienne une erreur factuelle critique concernant le mois de naissance, les métriques traditionnelles attribueraient des scores relativement élevés en raison du chevauchement lexical des tokens restants (« Alice », « née », etc.). Cette limitation fondamentale peut conduire à des évaluations trompeuses qui ne parviennent pas à capturer l’exactitude sémantique. Pour remédier à ces lacunes, nous utilisons LLM-as-a-Judge (J) comme métrique d’évaluation complémentaire. Cette approche exploite un LLM distinct et plus performant pour évaluer la qualité des réponses selon plusieurs dimensions, notamment l’exactitude factuelle, la pertinence, la complétude et l’adéquation contextuelle. Le modèle juge analyse la question, la réponse de référence et la réponse générée, fournissant une évaluation plus nuancée qui s’aligne mieux sur le jugement humain. En raison de la nature stochastique des évaluations J, nous avons effectué 10 exécutions indépendantes pour chaque méthode sur l’ensemble du jeu de données et rapportons les scores moyens avec un écart-type de . Plus de détails sur J sont présentés dans l’annexe A.
(2) Métriques de déploiement Au-delà de la qualité des réponses, les considérations pratiques de déploiement sont cruciales pour les applications réelles de la mémoire à long terme dans les agents d’IA. Nous suivons systématiquement la consommation de tokens, en utilisant l’encodage « c1100k_base » de tiktoken, en mesurant le nombre de tokens extraits lors de la récupération qui servent de contexte pour répondre aux requêtes. Pour nos modèles fondés sur la mémoire, ces tokens représentent les souvenirs récupérés depuis la base de connaissances, tandis que pour les modèles fondés sur le RAG, ils correspondent au nombre total de tokens dans les segments de texte récupérés. Cette distinction est importante car elle affecte directement les coûts opérationnels et l’efficacité du système — qu’il s’agisse de traiter des faits de mémoire concis ou des segments de texte brut plus volumineux. Nous surveillons en outre la latence, (i) la latence de recherche : qui capture le temps total nécessaire pour rechercher la mémoire (dans les solutions fondées sur la mémoire) ou le segment (dans les solutions fondées sur le RAG) et (ii) la latence totale : le temps nécessaire pour générer des réponses appropriées, composé à la fois du temps de récupération (accès aux souvenirs ou aux segments) et du temps de génération de la réponse à l’aide du LLM.
La relation entre ces métriques révèle des compromis importants dans la conception du système. Par exemple, des architectures de mémoire plus sophistiquées peuvent atteindre une meilleure exactitude factuelle, mais au prix d’une consommation de tokens et d’une latence accrues. Notre méthodologie d’évaluation multidimensionnelle permet aux chercheurs et aux praticiens de prendre des décisions éclairées en fonction de leurs exigences spécifiques, qu’ils privilégient la qualité des réponses pour des applications critiques ou l’efficacité computationnelle pour des scénarios de déploiement en temps réel.
3.3. Références de comparaison
Pour évaluer globalement notre approche, nous nous comparons à six catégories distinctes de références de comparaison qui représentent l’état actuel des systèmes de mémoire conversationnelle. Ces diverses références fournissent collectivement un cadre robuste pour évaluer l’efficacité de différentes architectures de mémoire selon diverses dimensions, notamment l’exactitude factuelle, l’efficacité computationnelle et l’évolutivité vers des conversations étendues. Le cas échéant, sauf indication contraire, nous fixons la température à 0 afin de garantir que les exécutions soient aussi reproductibles que possible.
Références LOcOMO établies Nous établissons d’abord une base comparative en évaluant des méthodes précédemment évaluées sur le jeu de données LOcOMO. Celles-ci incluent cinq approches établies : LoCoMo (Maharana et al., 2024), ReadAgent (Lee et al., 2024), MemoryBank (Zhong et al., 2024), MemGPT (Packer et al., 2023) et A-Mem (Xu et al., 2025). Ces références établies fournissent non seulement des points de comparaison directs avec les résultats publiés, mais représentent également l’évolution des architectures de mémoire conversationnelle à travers différents paradigmes algorithmiques. Pour notre évaluation, nous sélectionnons les métriques pour lesquelles gpt-4o-mini a été utilisé pour l’évaluation. Plus de détails sur ces références sont mentionnés dans l’annexe C.
Solutions de mémoire open source Notre deuxième catégorie comprend des architectures de mémoire open source prometteuses telles que LangMem2 (Hot Path), qui ont démontré leur efficacité dans des tâches conversationnelles connexes mais n'ont pas encore été évaluées sur le jeu de données LOcOMO. En adaptant ces systèmes à notre cadre d'évaluation, nous élargissons le paysage comparatif et identifions des approches alternatives potentielles susceptibles d'offrir des performances compétitives. Nous avons initialisé le LLM avec gpt-4o-mini et utilisé text-embedding-small-3 comme modèle d'embedding.
Génération augmentée par récupération (RAG) Comme référence de base, nous traitons l'intégralité de l'historique de la conversation comme une collection de documents et appliquons un pipeline RAG standard. Nous segmentons d'abord chaque conversation en blocs de longueur fixe (128, 256, 512, 1024, 2048, 4096 et 8192 tokens), où 8192 correspond à la taille maximale de bloc prise en charge par notre modèle d'embedding. Tous les blocs sont vectorisés à l'aide de text-embedding-small-3 d'OpenAI afin de garantir une qualité de vecteurs cohérente entre les configurations. Au moment de la requête, nous récupérons les meilleurs blocs par similarité sémantique et les concaténons comme contexte pour la génération de la réponse. Tout au long de nos expériences, nous fixons : avec , seul le bloc le plus pertinent est utilisé, et avec , les deux blocs les plus pertinents (jusqu'à 16384 tokens) sont concaténés. Nous évitons car la longueur moyenne des conversations (26000 tokens) serait entièrement couverte, annulant les bénéfices d'une récupération sélective. En faisant varier la taille des blocs et , nous évaluons systématiquement les performances de la RAG sur des tâches de mémoire conversationnelle à long terme.
Traitement en contexte complet Nous adoptons une approche directe en passant l'intégralité de l'historique de la conversation dans la fenêtre de contexte du LLM. Cette méthode exploite la capacité inhérente du modèle à traiter des informations séquentielles sans composants architecturaux supplémentaires. Bien que conceptuellement simple, cette approche se heurte à des limitations pratiques à mesure que la longueur de la conversation augmente, ce qui finit par accroître le coût en tokens et la latence. Néanmoins, elle établit un point de référence important pour comprendre la valeur de mécanismes de mémoire plus sophistiqués par rapport au traitement direct du contexte disponible.
Modèles propriétaires Nous évaluons la fonctionnalité de mémoire d'OpenAI disponible dans leur interface ChatGPT, en utilisant spécifiquement gpt-4o-mini pour garantir la cohérence. Nous intégrons des conversations LOcOMO entières avec un prompt (voir Annexe A) dans des sessions de chat uniques, en suscitant la génération de souvenirs avec des horodatages, les noms des participants et le texte de la conversation.3Ces souvenirs générés sont ensuite utilisés comme contexte complet pour répondre aux questions relatives à chaque conversation, accordant intentionnellement à l'approche d'OpenAI un accès privilégié à tous les souvenirs plutôt qu'à ceux pertinents pour la question. Cette méthodologie tient compte de l'absence d'accès API externe pour la récupération sélective de souvenirs dans le système d'OpenAI à des fins d'évaluation comparative.
| Méthode | Mono-saut | Multi-sauts | Domaine ouvert | Temporel | ||||||||
| F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | |
| LoCoMo | 25,02 | 19,75 | - | 12,04 | 11,16 | - | 40,36 | 29,05 | - | 18,41 | 14,77 | - |
| ReadAgent | 9,15 | 6,48 | - | 5,31 | 5,12 | - | 9,67 | 7,66 | - | 12,60 | 8,87 | - |
| MemoryBank | 5,00 | 4,77 | - | 5,56 | 5,94 | - | 6,61 | 5,16 | - | 9,68 | 6,99 | - |
| MemGPT | 26,65 | 17,72 | - | 9,15 | 7,44 | - | 41,04 | |||||
| Contexte de référence en lecture seule pour comprendre la source (ce n'est pas le texte source à traduire) : Modèles propriétaires Nous évaluons la fonctionnalité memory3 d'OpenAI disponible dans leur interface ChatGPT, en utilisant spécifiquement gpt- 4o- mini pour des raisons de cohérence. Nous intégrons des conversations LOcOMO entières avec un prompt (voir Annexe A) dans des sessions de chat uniques, en provoquant la génération de mémoires avec des horodatages, les noms des participants et le texte de la conversation. | Ces mémoires générées sont ensuite utilisées comme contexte complet pour répondre aux questions sur chaque conversation, accordant intentionnellement à l'approche d'OpenAI pr Texte à traduire : | 34.34 | - | 25.52 | 19.44 | - | A-Mem | 27.02 | 20.09 | - | 12.14 | 12.00 |
| - | 44.65 | 37.06 | - | 45.85 | 36.67 | - | A-Mem* | 20.76 | 14.90 | 39.79 ± 0.38 | 9.22 | 8.81 |
| 18.85 ± 0.31 | 33.34 | 27.58 | 54.05 ± 0.22 | 35.40 | 31.08 | 49.91 ± 0.31 LangMem 35.51 26.86 62.23 ± 0.75 26.04 22.32 47.92 ± 0.47 40.91 33.63 71.12 ± 0.20 30.75 25.84 23.43 ± 0.39 Zep 35.74 23.30 61.70 ± 0.32 19.37 14.82 41.35 ± 0.48 49.56 38.92 76.60 ± 0.13 42.00 34.53 49.31 ± 0.50 OpenAI 34.30 23.72 63.79 ± 0.46 20.09 15.42 42.92 ± 0.63 | 39,31 | 31,16 | 62,29 ± 0,12 | 14,04 | 11,25 | 21,71 ± 0,20 |
| MemO | 38,72 | 27,13 | 67,13 ± 0,65 | 28,64 | 21,58 | 51,15 ± 0,31 | 47,65 | 38,72 | 72,93 ± 0,11 | 48,93 | 40,51 | 55,51 ± 0,34 |
| MemO8 | 38,09 | 26,03 | 65,71 ± 0,45 | 24,32 | 18,82 | 47,19 ± 0,67 | 49,27 | 40,30 | 75,71 ± 0,21 | 51,55 | 40,28 | 58,13 ± 0,44 |
Fournisseurs de mémoire Nous intégrons Zep (Rasmussen et al., 2025), une plateforme de gestion de la mémoire conçue pour les agents IA. À l'aide de la version de leur plateforme, nous menons des évaluations systématiques sur l'ensemble du jeu de données LOcOMO, en maintenant la fidélité temporelle grâce à la conservation des informations d'horodatage parallèlement au contenu conversationnel. Cet ancrage temporel garantit que les requêtes sensibles au temps peuvent être traitées par une récupération de mémoire correctement contextualisée, ce qui est particulièrement important pour évaluer les questions nécessitant une conscience chronologique. Cette référence représente une implémentation commerciale importante de la gestion de la mémoire, spécifiquement conçue pour les agents IA.
4. Résultats d'évaluation, analyse et discussion.
4.1. Comparaison des performances entre systèmes dotés de mémoire
Le tableau 1 rapporte les scores , et J pour nos deux architectures — MemO et MemO — face à une série de références compétitives, comme mentionné dans la section 3, sur des questions à saut unique, à sauts multiples, ouvertes et temporelles. Globalement, nos deux modèles établissent de nouveaux records de pointe sur les trois métriques d'évaluation pour la plupart des types de questions.
Performances sur les questions à saut unique Les requêtes à saut unique consistent à localiser un seul segment factuel contenu dans un tour de dialogue. Grâce à ses mémoires denses en langage naturel, MemO obtient les meilleurs résultats : , et . L'augmentation des mémoires en langage naturel par une mémoire graphique (MemO8) entraîne une légère baisse de performance par rapport à MemO, ce qui indique que la structure relationnelle offre une utilité limitée lorsque la cible de récupération occupe un seul tour. Parmi les références existantes, l'exécution OpenAI en contexte complet obtient le deuxième meilleur score J, reflétant les bénéfices de conserver l'intégralité de la conversation dans le contexte, tandis que LangMem et Zep obtiennent tous deux un score J inférieur d'environ 8 % en relatif à nos modèles. Les références antérieures sur LOcOMO, telles que A-mem, accusent un retard de plus de 25 points sur J, soulignant la nécessité d'un indexage de mémoire structuré et fin, même pour des tâches de récupération simples.
Performances sur les questions à sauts multiples Les requêtes à sauts multiples exigent de synthétiser des informations dispersées sur plusieurs sessions de conversation, ce qui pose des défis considérables en matière d'intégration et de récupération de la mémoire. MemO surpasse clairement les autres méthodes avec un score de 28.64 et un score J de 51.15, reflétant sa capacité à récupérer et intégrer efficacement des informations disparates stockées à travers les sessions. Fait intéressant, l'ajout de mémoire graphique dans MemO8 n'apporte ici aucun gain de performance, ce qui indique des inefficacités ou redondances potentielles dans les représentations graphiques structurées pour des tâches d'intégration complexes par rapport à la mémoire dense en langage naturel seule. Des références comme LangMem affichent des performances compétitives, mais leurs scores restent nettement en retrait de ceux de MemO, soulignant l'avantage de nos mécanismes affinés d'indexage et de récupération de la mémoire pour le traitement de requêtes complexes.
Performances en domaine ouvert Dans les contextes en domaine ouvert, la référence Zep obtient les scores (49.56) et J (76.60) les plus élevés, devançant nos méthodes d'une marge étroite. En particulier, le score J de Zep de 76.60 dépasse celui de MemO8 (75.71) de seulement 0.89 point de pourcentage et surpasse celui de MemO (72.93) de 3.67 points, mettant en évidence un avantage constant, quoique léger, dans l'intégration de la mémoire conversationnelle avec des connaissances externes. MemO8 reste un solide second, avec un J de 75.71 reflétant une grande précision de récupération factuelle, tandis que MemO suit avec 72.93, démontrant une cohérence robuste. Ces résultats soulignent que, bien que les mémoires relationnelles structurées (comme dans MemO et MemO8) améliorent substantiellement la récupération en domaine ouvert, Zep conserve une avance faible mais significative.
Performances en raisonnement temporel Les tâches de raisonnement temporel reposent sur une modélisation précise des séquences d'événements, de leur ordre relatif et de leurs durées dans l'historique conversationnel. Nos architectures démontrent des améliorations substantielles sur toutes les métriques, MemO8 obtenant les scores (51.55) et J (58.13) les plus élevés, ce qui suggère que les représentations relationnelles structurées, en plus des mémoires en langage naturel, aident significativement les jugements ancrés temporellement. Notamment, la variante de base, MemO, fournit également un score J décent (55.51), suggérant que le langage naturel seul peut aider aux jugements ancrés temporellement. Parmi les références, OpenAI est nettement en retrait, avec des scores inférieurs à 15 %, principalement en raison de l'absence d'horodatages dans la plupart des souvenirs générés, malgré une invite explicite dans OpenAI ChatGPT pour extraire des souvenirs avec horodatages. D'autres références comme A-Mem obtiennent des résultats honorables, mais nos modèles font clairement progresser l'état de l'art, soulignant l'avantage critique d'exploiter avec précision à la fois la contextualisation en langage naturel et les représentations graphiques structurées pour le raisonnement temporel.
4.2. Analyse inter-catégories
L'évaluation complète sur diverses catégories de questions révèle que nos architectures proposées, MemO et MemO8, obtiennent systématiquement des performances supérieures à celles des systèmes de référence. Pour les requêtes à saut unique, MemO affiche des performances particulièrement fortes, bénéficiant de sa structure efficace de mémoire dense en langage naturel. Bien que les représentations à base de graphes de MemO8 soient légèrement en retrait sur les métriques de chevauchement lexical pour ces requêtes plus simples, elles améliorent significativement la cohérence sémantique, comme en témoignent des scores J compétitifs. Cela indique que les structures de graphes sont plus bénéfiques dans des scénarios impliquant un contexte relationnel nuancé plutôt que dans une récupération directe. Pour les questions à sauts multiples, MemO présente des avantages clairs en synthétisant efficacement des informations dispersées sur plusieurs sessions, confirmant que les mémoires en langage naturel offrent une richesse représentationnelle suffisante pour ces tâches d'intégration. Étonnamment, les avantages relationnels attendus de
| Méthode | K | taille de chunk / jetons de mémoire | Latence (secondes) | J global | |||
| Recherche | Total | ||||||
| RAG | 1 | 128 | 0,281 | 0,823 | 0,774 | 1,825 | 47,77 ± 0,23 % |
| 256 | 0,251 | 0,710 | 0,745 | 1,628 | 50,15 ± 0,16 % | ||
| 512 | 0,240 | 0,639 | 0,772 | 1,710 | 46,05 ± 0,14 % | ||
| 1024 | 0,240 | 0,723 | 0,821 | 1,957 | 40,74 ± 0,17 % | ||
| 2048 | 0,255 | 0,752 | 0,996 | 2,182 | 37,93 ± 0,12 % | ||
| 8192 | 4096 | 0,254 | 0,719 | 1,093 | 2,711 | 36,84 ± 0,17 % | |
| 812 | 0,279 | 0,838 | 1,396 | 4,416 | 44,53 ± 0,13 % | ||
| 128 | 0,267 | 0,624 | 0,766 | 1,829 | 59,56 ± 0,19 % | ||
| 256 | 0,255 | 0,699 | 0,802 | 1,907 | 60,97 ± 0,20 % | ||
| 2 | 1024 | 512 | 0,247 | 0,746 | 0,829 | 1,729 | 58,19 ± 0,18 % |
| 2048 | 0,238 | 0,702 | 0,860 | 1,850 | 50,68 ± 0,13 % | ||
| 4096 | 0,261 | 0,829 | 1,101 | 2,791 | 48,57 ± 0,22 % | ||
| 812 | 0,266 | 0,944 | 1,451 | 4,822 | 51,79 ± 0,15 % | ||
| 8192 | 0,288 | 1,124 | 2,312 | 9,942 | 60,53 ± 0,16 % | ||
| Contexte complet | 26031 | - | - | 9,870 | 17,117 | 72,90 ± 0,19 % | |
| A-Mem | 2520 | 0,668 | 1,485 | 1,410 | 4,374 | 48,38 ± 0,15 % | |
| LangMem | 127 | 17,99 | 59,82 | 18,53 | 60,40 | 58,10 ± 0,21 % | |
| Zep | 3911 | 0,513 | 0,778 | 1,292 | 2,926 | 65,99 ± 0,16 % | |
| OpenAI | 4437 | - | - | 0,466 | 0,889 | 52,90 ± 0,14 % | |
| Mem0 | 1764 | 0,148 | 0,200 | 0,708 | 1,440 | 66,88 ± 0,15 % | |
| Mem0^8 | 3616 | 0,476 | 0,657 | 1,091 | 2,590 | 68,44 ± 0,17 % | |
ne se traduisent pas ici par de meilleurs résultats, ce qui suggère un surcoût ou une redondance potentiels lors de la navigation dans des structures de graphes plus complexes dans des scénarios de raisonnement multi-étapes.
En raisonnement temporel, surpasse substantiellement les autres méthodes, validant le fait que les graphes relationnels structurés excellent dans la capture des relations chronologiques et des séquences d'événements. La présence d'un contexte relationnel explicite améliore significativement la cohérence temporelle de , surpassant le stockage de mémoire dense de et soulignant l'importance de représentations relationnelles précises lors du suivi d'informations sensibles au temps. Les performances en domaine ouvert renforcent en outre la valeur de la modélisation relationnelle. , bénéficiant de la clarté relationnelle de la mémoire à base de graphes, rivalise étroitement avec la meilleure référence (Zep). Ce résultat compétitif souligne la robustesse de dans l'intégration de connaissances externes grâce à la clarté relationnelle, suggérant une synergie optimale entre mémoire structurée et synthèse d'informations en domaine ouvert.
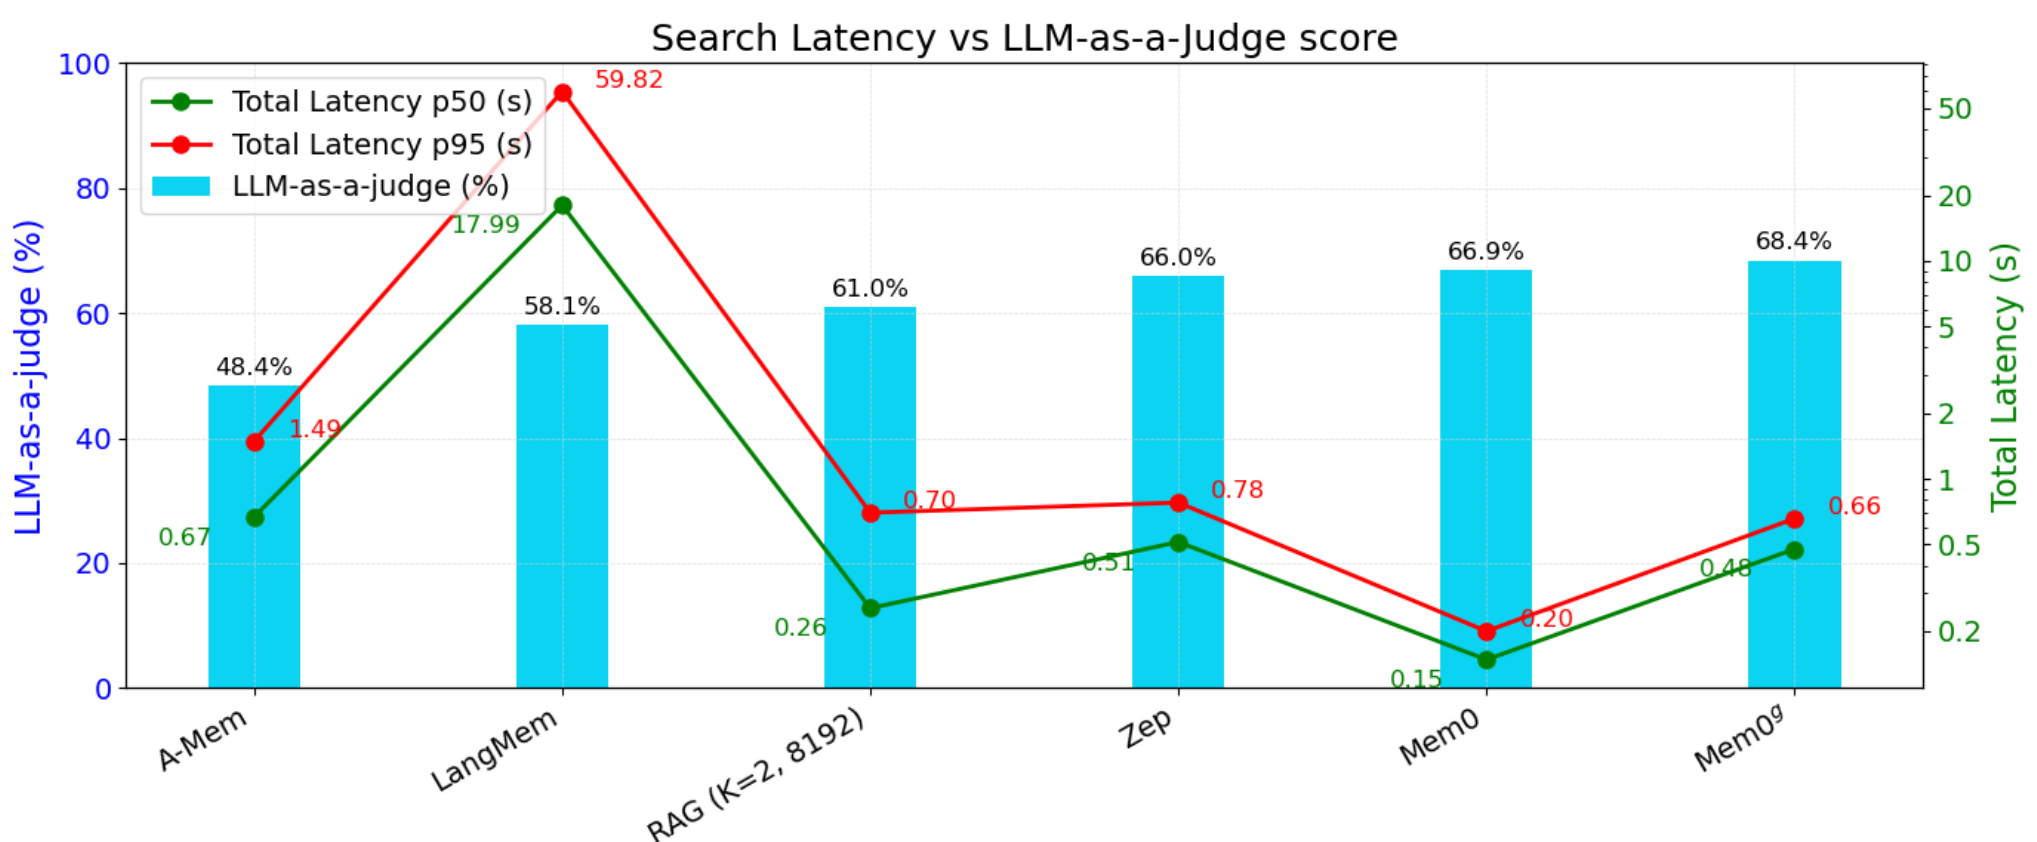
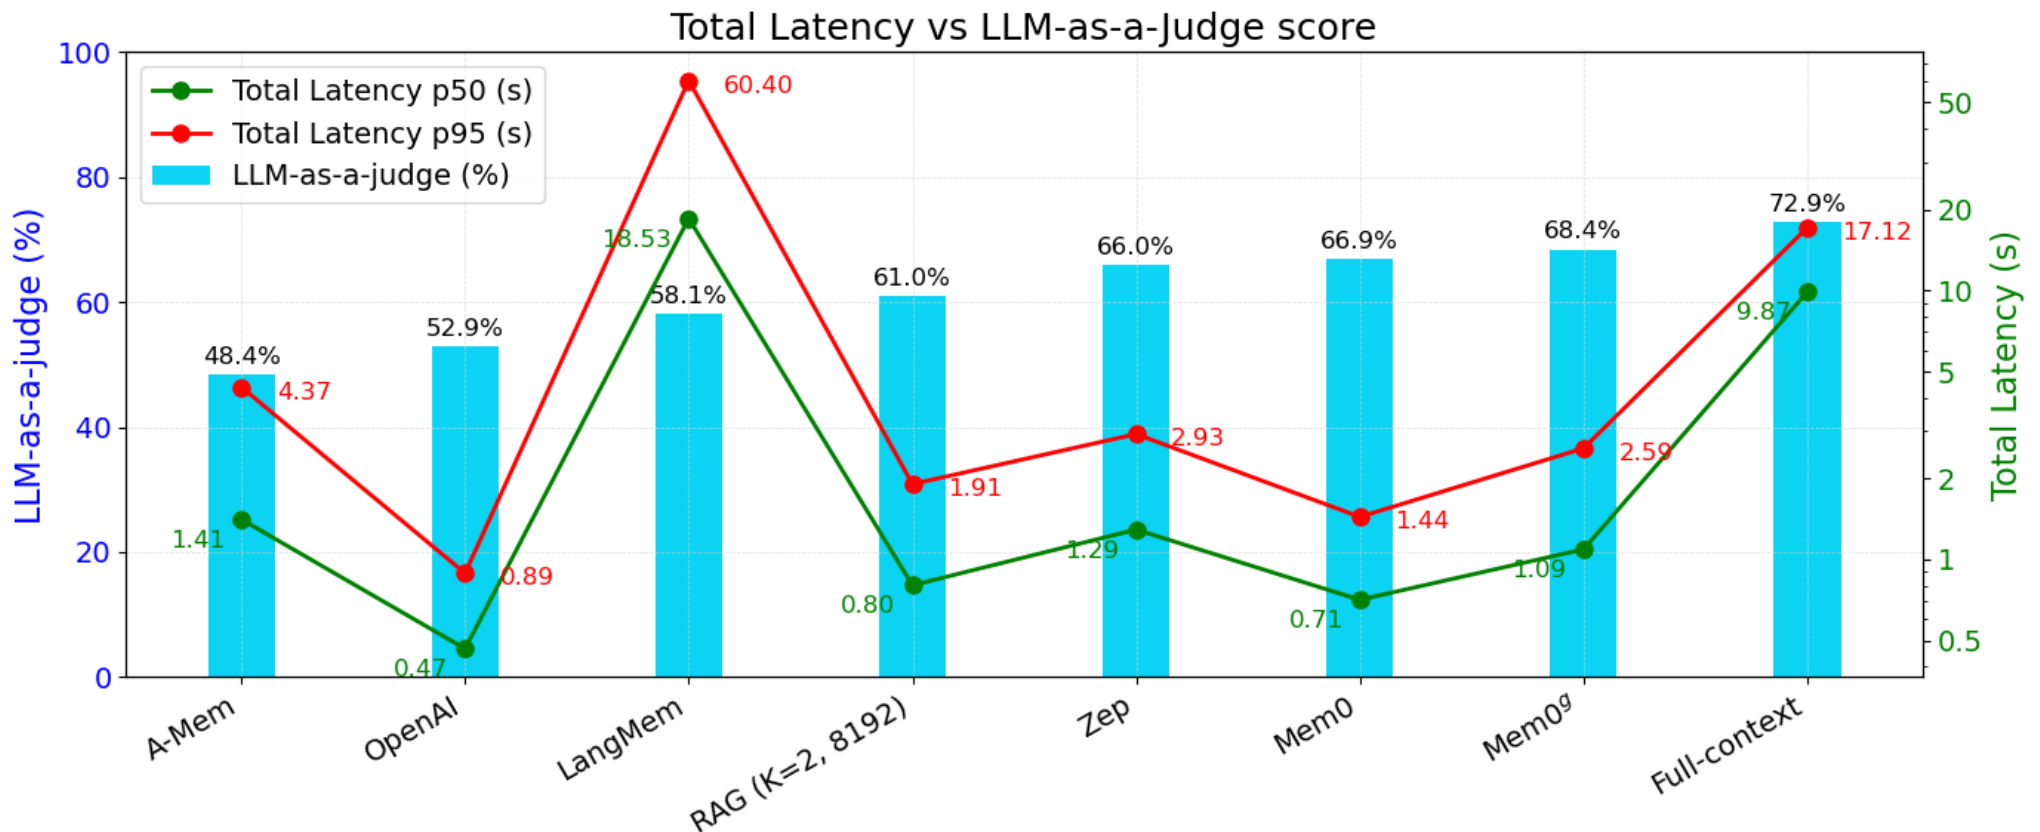
Figure 4 : Analyse de latence des différentes approches de mémoire. Ces sous-figures illustrent les scores J et la comparaison de latence de diverses méthodes sélectionnées du tableau 2. La sous-figure (a) met en évidence la latence de recherche/récupération avant la génération de la réponse, tandis que la sous-figure (b) montre la latence totale (y compris l'inférence du LLM). Les deux graphiques superposent le score J de chaque méthode pour une vue holistique de leur précision et de leur efficacité.
Globalement, notre analyse indique des forces complémentaires de Mem0 et Mem08 selon les différentes exigences des tâches : la mémoire dense fondée sur le langage naturel offre une efficacité significative pour les requêtes plus simples, tandis que la modélisation relationnelle explicite devient essentielle pour les tâches exigeant une intégration temporelle et contextuelle nuancée. Ces résultats renforcent l'importance de structures de mémoire adaptables, adaptées à des contextes de raisonnement spécifiques, dans les déploiements d'agents IA.
4.3. Comparaison des performances de MemO et MemO face aux approches RAG et au modèle à contexte complet
Les comparaisons du tableau 2, en se concentrant sur la colonne « Overall J », révèlent que MemO et MemO surpassent systématiquement toutes les configurations RAG, qui font varier la taille des segments (128-8192 tokens) et récupèrent un ou deux segments. Même l'approche RAG la plus performante plafonne à environ pour la métrique J, tandis que MemO atteint — soit une amélioration relative d'environ — et MemO dépasse , réalisant un gain relatif d'environ . Ces avancées soulignent l'avantage de ne capturer en mémoire que les faits les plus saillants, plutôt que de récupérer de grands segments de texte original. En convertissant l'historique de la conversation en représentations concises et structurées, MemO et MemO atténuent le bruit et font émerger des indices plus précis pour le LLM, ce qui conduit à de meilleures réponses telles qu'évaluées par un LLM externe (J).
Malgré ces améliorations, une méthode à contexte complet qui ingère un segment d'environ 26 000 tokens atteint encore le score J le plus élevé (environ ). Cependant, comme le montre la figure 4b, elle entraîne également une latence totale p95 très élevée — environ 17 secondes — puisque le modèle doit lire l'intégralité de la conversation à chaque requête. En revanche, MemO et MemO réduisent considérablement l'utilisation de tokens et obtiennent ainsi des latences p95 plus faibles, d'environ 1,44 seconde (une réduction de ) et 2,6 secondes (une réduction de ), respectivement, par rapport à l'approche à contexte complet. Bien que l'approche à contexte complet puisse offrir un léger avantage en précision, les systèmes à base de mémoire offrent un compromis plus pratique, en maintenant une qualité quasi compétitive tout en n'imposant qu'une fraction du coût en tokens et en latence. À mesure que la longueur de la conversation augmente, les approches à contexte complet souffrent d'une croissance exponentielle de la charge de calcul (ce qui est évident dans le tableau 2, où la latence totale p95 augmente significativement avec des valeurs de ou des tailles de segments plus grandes). Cette augmentation du nombre de segments d'entrée entraîne des temps de réponse plus longs et des coûts de consommation de tokens plus élevés. En revanche, les approches centrées sur la mémoire comme MemO et MemO maintiennent des performances constantes quelle que soit la longueur de la conversation, ce qui les rend nettement plus viables pour des déploiements à l'échelle de la production, où l'efficacité et la réactivité sont critiques.
4.4. Analyse de la latence
Le tableau 2 fournit une comparaison complète des performances de diverses méthodologies de récupération et de mémoire, en présentant les latences médianes (p50) et de queue (p95) pour la phase de recherche et la génération de réponse totale sur le jeu de données LOCOM0. Notre analyse révèle des schémas de performance distincts régis par les choix architecturaux. Les architectures centrées sur la mémoire présentent des caractéristiques de performance différentes. A-Mem, malgré son stockage mémoire plus volumineux, entraîne une surcharge de recherche substantielle (p50 : 0,668 s), ce qui se traduit par des latences médianes totales de 1,410 s. LangMem présente des latences de recherche encore plus élevées (p50 : 17,99 s, p95 : 59,82 s), ce qui le rend peu pratique pour des applications interactives. Zep obtient des performances modérées (p50 total : 1,292 s). La référence à contexte complet, qui traite l'intégralité de l'historique de la conversation sans récupération, diffère fondamentalement des approches basées sur la récupération. En transmettant directement au LLM l'intégralité du contexte de la conversation (26 000 tokens), elle élimine la surcharge de recherche mais entraîne des latences totales extrêmes (p50 : 9,870 s, p95 : 17,117 s). De même, l'implémentation OpenAI n'effectue pas de recherche en mémoire, puisqu'elle traite des mémoires extraites manuellement depuis leur playground. Bien que cette approche obtienne des temps de génération de réponse impressionnants (p50 : 0,466 s, p95 : 0,889 s), elle nécessite une pré-extraction du contexte pertinent, ce qui n'est pas reflété dans les métriques rapportées.
Notre approche MemO proposée atteint la latence de recherche la plus faible parmi toutes les méthodes (p50 : 0,148 s, p95 : 0,200 s), comme l'illustre la figure 4a. Cette efficacité découle de notre mécanisme de récupération sélective en mémoire et d'améliorations infrastructurelles qui identifient et récupèrent dynamiquement uniquement les informations les plus saillantes plutôt que des blocs de taille fixe. Par conséquent, MemO maintient la latence médiane totale la plus faible (0,708 s) avec des valeurs p95 remarquablement contenues (1,440 s), ce qui le rend particulièrement adapté aux applications sensibles à la latence telles que les agents d'IA interactifs. La variante MemO enrichie par graphe introduit des capacités supplémentaires de modélisation relationnelle à un coût de latence modéré, avec des temps de recherche (0,476 s) qui surpassent encore toutes les solutions de mémoire existantes et les références. Malgré cette augmentation, Memo8 maintient des latences totales compétitives (p50 : 1,091 s, p95 : 2,590 s) tout en atteignant le score J le plus élevé (68,44 %) parmi toutes les méthodes — derrière uniquement l'approche à contexte complet, computationnellement prohibitive. Ce profil de performance démontre la capacité de nos méthodes à équilibrer la qualité des réponses et l'efficacité computationnelle, offrant une solution convaincante pour les agents d'IA en production, où ces deux facteurs constituent des contraintes critiques.
4.5. Surcoût du système de mémoire : analyse des tokens et temps de construction
Nous mesurons le budget moyen de tokens nécessaire pour matérialiser le stockage de mémoire à long terme de chaque système. Memo encode des tours de dialogue complets dans une représentation en langage naturel et n'occupe donc en moyenne que 7k tokens par conversation. En revanche, Memo8 double environ cette empreinte à 14k tokens, en raison de l'introduction de mémoires sous forme de graphe qui incluent des nœuds et les relations correspondantes. En contraste frappant, le graphe de mémoire de Zep consomme plus de 600k tokens. Cette inflation provient du choix de conception de Zep de mettre en cache un résumé abstractif complet à chaque nœud tout en stockant également des faits sur les arêtes de connexion, ce qui entraîne une redondance considérable à travers le graphe. À titre de comparaison, fournir l'intégralité du contexte brut de la conversation au modèle de langage — sans aucune abstraction de mémoire — représente environ 26k tokens en moyenne, soit 20 fois moins que le graphe de Zep. Au-delà de l'inefficacité en tokens, nos expériences ont révélé des goulots d'étranglement opérationnels significatifs avec Zep. Après avoir ajouté des mémoires au système de Zep, nous avons observé que les tentatives de récupération immédiate de mémoire échouaient souvent à répondre correctement à nos requêtes. Curieusement, la réexécution de recherches identiques après un délai de plusieurs heures donnait des résultats nettement meilleurs. Cette latence suggère que la construction du graphe de Zep implique de multiples appels asynchrones à des LLM et un traitement étendu en arrière-plan, rendant le système de mémoire peu pratique pour des applications en temps réel. En revanche, la construction du graphe de Memo s'achève en moins d'une minute même dans les pires scénarios, permettant aux utilisateurs d'exploiter immédiatement les mémoires nouvellement ajoutées pour répondre aux requêtes.
Ces constats mettent en évidence que Zep non seulement réplique des fragments de connaissances identiques à travers plusieurs nœuds, mais introduit également des délais opérationnels significatifs. Nos architectures — MemO et Memo8 — préservent les mêmes informations pour une fraction du coût en tokens et avec une disponibilité de la mémoire nettement plus rapide, offrant une représentation plus économe en mémoire et plus réactive sur le plan opérationnel.
5. Conclusion et travaux futurs
Nous avons introduit MemO et Memo8, deux architectures de mémoire complémentaires qui surmontent les limites intrinsèques des fenêtres de contexte fixes dans les LLM. En extrayant, consolidant et récupérant dynamiquement des représentations de mémoire compactes, MemO atteint des performances de pointe en raisonnement à un saut et à plusieurs sauts, tandis que les extensions basées sur graphe de Memo débloquent des gains significatifs dans les tâches temporelles et à domaine ouvert. Sur le benchmark LOCOMO, nos méthodes apportent des améliorations relatives de 5 %, 11 % et 7 % pour les types de questions de raisonnement à un saut, temporel et à plusieurs sauts par rapport aux méthodes les plus performantes dans les types de questions respectifs, et réduisent la latence p95 de plus de 91 % par rapport aux références à contexte complet — démontrant un équilibre puissant entre précision et réactivité. Le pipeline de mémoire dense de Memo excelle dans la récupération rapide pour des requêtes simples, minimisant l'usage de tokens et le surcoût computationnel. En revanche, les représentations structurées sous forme de graphe de Memo fournissent une clarté relationnelle nuancée, permettant un séquençage complexe des événements et une intégration riche du contexte sans sacrifier l'efficacité pratique. Ensemble, elles forment une boîte à outils de mémoire polyvalente qui s'adapte à des exigences conversationnelles diverses tout en restant déployable à grande échelle.
Les directions de recherche futures incluent l'optimisation des opérations sur graphe pour réduire le surcoût de latence dans Memo8, l'exploration d'architectures de mémoire hiérarchiques qui allient efficacité et représentation relationnelle, et le développement de mécanismes de consolidation de mémoire plus sophistiqués inspirés des processus cognitifs humains.
En outre, étendre nos cadres de mémoire à des domaines au-delà des scénarios conversationnels, tels que le raisonnement procédural et les interactions multimodales, permettrait de valider davantage leur applicabilité plus large. En abordant les limites fondamentales des fenêtres de contexte fixes, notre travail représente une avancée significative vers des systèmes d'IA conversationnelle capables de maintenir des interactions cohérentes et contextuellement riches sur des périodes prolongées, à l'image de leurs homologues humains.
6. Remerciements
Nous tenons à exprimer notre sincère gratitude à Harsh Agarwal, Shyamal Anadkat, Prithvijit Chattopadhyay, Siddesh Choudhary, Rishabh Jain et Vaibhav Pandey pour leurs précieuses perspectives et leurs relectures approfondies des premières versions. Leurs commentaires constructifs et leurs suggestions détaillées ont contribué à affiner le manuscrit, améliorant à la fois sa clarté et sa qualité globale. Nous apprécions profondément leur générosité à consacrer temps et expertise à ce travail.
Références
Anthropic. Model card and evaluations for claude models. Technical report, Anthropic, février 2025. URL https://www.anthropic.com/news/claude-3-7-sonnet.
Jan Assmann. Communicative and cultural memory. In Cultural memories: The geographical point of view, pages 15-27. Springer, 2011.
Aydar Bulatov, Yury Kuratov, and Mikhail Burtsev. Recurrent memory transformer. Advances in Neural Information Processing Systems, 35:11079-11091, 2022.
Prateek Chhikara, Jiarui Zhang, Filip Ilievski, Jonathan Francis, and Kaixin Ma. Knowledge-enhanced agents for interactive text games. In Proceedings of the 12th Knowledge Capture Conference 2023, pages 157-165, 2023.
Fergus IM Craik and Janine M Jennings. Human memory. 1992.
Gaurav Goswami. Dissecting the metrics: How different evaluation approaches yield diverse results for conversational ai. Authorea Preprints, 2025.
Tianyu Guo, Druv Pai, Yu Bai, Jiantao Jiao, Michael Jordan, and Song Mei. Active-dormant attention heads: Mechanistically demystifying extreme-token phenomena in llms. In NeurIPS 2024 Workshop on Mathematics of Modern Machine Learning, 2024.
Kostas Hatalis, Despina Christou, Joshua Myers, Steven Jones, Keith Lambert, Adam Amos-Binks, Zohreh Dannenhauer, and Dustin Dannenhauer. Memory matters: The need to improve long-term memory in llm-agents. In Proceedings of the AAAI Symposium Series, volume 2, pages 277-280, 2023.
Zihong He, Weizhe Lin, Hao Zheng, Fan Zhang, Matt W Jones, Laurence Aitchison, Xuhai Xu, Miao Liu, Per Ola Kristensson, and Junxiao Shen. Human-inspired perspectives: A survey on ai long-term memory. arXiv preprint arXiv:2411.00489, 2024.
Aaron Hurst, Adam Lerer, Adam P Goucher, Adam Perelman, Aditya Ramesh, Aidan Clark, AJ Ostrow, Akila Welihinda, Alan Hayes, Alec Radford, et al. Gpt-4o system card. arXiv preprint arXiv:2410.21276, 2024.
Aaron Jaech, Adam Kalai, Adam Lerer, Adam Richardson, Ahmed El-Kishky, Aiden Low, Alec Helyar, Aleksander Madry, Alex Beutel, Alex Carney, et al. Openai o1 system card. arXiv preprint arXiv:2412.16720, 2024.
Kuang-Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny, and Ian Fischer. A human-inspired reading agent with gist memory of very long contexts. In International Conference on Machine Learning, pages 26396-26415. PMLR, 2024.
Lei Liu, Xiaoyan Yang, Yue Shen, Binbin Hu, Zhiqiang Zhang, Jinjie Gu, and Guannan Zhang. Think-in-memory: Recalling and post-thinking enable llms with long-term memory. arXiv preprint arXiv:2311.08719, 2023.
Adyasha Maharana, Dong-Ho Lee, Sergey Tulyakov, Mohit Bansal, Francesco Barbieri, and Yuwei Fang. Evaluating very long-term conversational memory of llm agents. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 13851-13870, 2024.
Bodhisattwa Prasad Majumder, Bhavana Dalvi Mishra, Peter Jansen, Oyvind Tafjord, Niket Tandon, Li Zhang, Chris Callison-Burch, and Peter Clark. Clin: A continually learning language agent for rapid task adaptation and generalization. In First Conference on Language Modeling.
Elliot Nelson, Georgios Kollias, Payel Das, Subhajit Chaudhury, and Soham Dan. Needle in the haystack for memory based large language models. arXiv preprint arXiv:2407.01437, 2024.
Charles Packer, Vivian Fang, Shishir G Patil, Kevin Lin, Sarah Wooders, and Joseph E Gonzalez. Memgpt: Towards llms as operating systems. 2023.
Preston Rasmussen, Pavlo Paliychuk, Travis Beauvais, Jack Ryan et Daniel Chalef. Zep : une architecture de graphe de connaissances temporel pour la mémoire des agents. Préimpression arXiv arXiv:2501.13956, 2025.
Parth Sarthi, Salman Abdullah, Aditi Tuli, Shubh Khanna, Anna Goldie et Christopher D Manning. Raptor : traitement abstrait récursif pour la recherche arborescente. Dans The Twelfth International Conference on Learning Representations, 2024.
Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan et Shunyu Yao. Reflexion : agents linguistiques avec apprentissage par renforcement verbal. Advances in Neural Information Processing Systems, 36:8634-8652, 2023.
Prabhijot Singh, Prateek Chhikara et Jasmeet Singh. Une approche ensembliste pour le résumé extractif de texte. Dans 2020 International Conference on Emerging Trends in Information Technology and Engineering (ic-ETTE), pages 1-7. IEEE, 2020.
Arpita Soni, Rajeev Arora, Anoop Kumar et Dheerendra Panwar. Évaluation de la couverture de domaine dans les chatbots génératifs à faibles ressources : une étude comparative des approches à domaine ouvert et à domaine fermé utilisant les scores BLEU. Dans 2024 International Conference on Electrical Electronics and Computing Technologies (ICEECT), volume 1, pages 1-6. IEEE, 2024.
Gemini Team, Petko Georgiev, Ving Ian Lei, Ryan Burnell, Libin Bai, Anmol Gulati, Garrett Tanzer, Damien Vincent, Zhufeng Pan, Shibo Wang, et al. Gemini 1.5 : libérer la compréhension multimodale sur des millions de tokens de contexte. Préimpression arXiv arXiv:2403.05530, 2024.
Joan C Timoneda et Sebastián Vallejo Vera. La mémoire est tout ce dont vous avez besoin : tester comment la mémoire du modèle affecte les performances des LLM dans les tâches d'annotation. Préimpression arXiv arXiv:2503.04874, 2025.
Wujiang Xu, Zujie Liang, Kai Mei, Hang Gao, Juntao Tan et Yongfeng Zhang. A-mem : mémoire agentique pour les agents LLM. Préimpression arXiv arXiv:2502.12110, 2025.
Yangyang Yu, Haohang Li, Zhi Chen, Yuechen Jiang, Yang Li, Denghui Zhang, Rong Liu, Jordan W Suchow et Khaldoun Khashanah. Finmem : un agent de trading LLM à performances améliorées avec mémoire stratifiée et conception de personnage. In Proceedings of the AAAI Symposium Series, volume 3, pages 595-597, 2024.
Jiarui Zhang. La génération guidée de profils améliore la personnalisation avec les grands modèles de langage. In Findings of the Association for Computational Linguistics: EMNLP 2024, pages 4005-4016, 2024.
Jiarui Zhang, Filip Ilievski, Kaixin Ma, Jonathan Francis et Alessandro Oltramari. Une étude de l'adaptation zero-shot avec des connaissances de sens commun. In AKBC, 2022.
Zeyu Zhang, Xiaohe Bo, Chen Ma, Rui Li, Xu Chen, Quanyu Dai, Jieming Zhu, Zhenhua Dong et Ji-Rong Wen. Une enquête sur le mécanisme de mémoire des agents basés sur les grands modèles de langage. Préimpression arXiv arXiv:2404.13501, 2024.
Wanjun Zhong, Lianghong Guo, Qiqi Gao, He Ye et Yanlin Wang. Memorybank : améliorer les grands modèles de langage avec une mémoire à long terme. In Proceedings of the AAAI Conference on Artificial Intelligence, volume 38, pages 19724-19731, 2024.
Annexe
A. Invites
Lors du développement de notre invite LLM-as-a-Judge, nous adaptons des éléments de l'invite publiée par Packer et al. (2023).
MODÈLE D'INVITE POUR LLM COMME JUGE
Votre tâche est d'étiqueter une réponse à une question comme « CORRECT » ou « FAUX ». Les données suivantes vous seront fournies : (1) une question (posée par un utilisateur à un autre utilisateur), (2) une réponse « gold » (vérité terrain), (3) une réponse générée que vous devrez évaluer comme CORRECT/FAUX.
Le but de la question est de demander quelque chose qu'un utilisateur devrait savoir sur l'autre utilisateur d'après leurs conversations antérieures. La réponse gold sera généralement une réponse concise et courte qui inclut le sujet référencé, par exemple :
Question : Te souviens-tu de ce que j'ai reçu la dernière fois que je suis allé à Hawaï ?
Réponse gold : Un collier de coquillages
La réponse générée peut être beaucoup plus longue, mais vous devez être indulgent dans votre évaluation - tant qu'elle aborde le même sujet que la réponse gold, elle doit être comptée comme CORRECT.
Pour les questions liées au temps, la réponse gold sera une date, un mois, une année spécifiques, etc. La réponse générée peut être beaucoup plus longue ou utiliser des références temporelles relatives (comme « mardi dernier » ou « le mois prochain »), mais vous devez être indulgent dans votre évaluation - tant qu'elle renvoie à la même date ou à la même période que la réponse gold, elle doit être comptée comme CORRECT. Même si le format diffère (par exemple, « 7 mai » vs « 7 mai »), considérez-la comme CORRECT s'il s'agit de la même date.
Il est maintenant temps de passer à la vraie question : Question : {question}
Réponse gold : {gold_answer}
Réponse générée : {generated_answer}
Tout d'abord, fournissez une brève explication (une phrase) de votre raisonnement, puis terminez par CORRECT ou FAUX. N'incluez PAS à la fois CORRECT et FAUX dans votre réponse, sinon cela cassera le script d'évaluation.
Retournez simplement l'étiquette CORRECT ou FAUX dans un format json avec la clé « label ».
MODÈLE D'INVITE POUR LA GÉNÉRATION DE RÉSULTATS (MEMO)
Vous êtes un assistant mémoire intelligent chargé de récupérer des informations exactes à partir de mémoires de conversation.
CONTEXTE :
Vous avez accès aux mémoires de deux interlocuteurs dans une conversation. Ces mémoires contiennent des informations horodatées qui peuvent être pertinentes pour répondre à la question.
INSTRUCTIONS :
1. Analysez attentivement toutes les mémoires fournies par les deux interlocuteurs 2. Accordez une attention particulière aux horodatages pour déterminer la réponse 3. Si la question porte sur un événement ou un fait spécifique, recherchez des preuves directes dans les mémoires 4. Si les mémoires contiennent des informations contradictoires, privilégiez la mémoire la plus récente 5. S'il y a une question sur des références temporelles (comme « l'année dernière », « il y a deux mois », etc.), calculez la date réelle en fonction de l'horodatage de la mémoire. Par exemple, si une mémoire du 4 mai 2022 mentionne « suis allé en Inde l'année dernière », alors le voyage a eu lieu en 2021. 6. Convertissez toujours les références temporelles relatives en dates, mois ou années spécifiques. Par exemple, convertissez « l'année dernière » en « 2022 » ou « il y a deux mois » en « mars 2023 » en fonction de l'horodatage de la mémoire. Ignorez la référence lors de la réponse à la question. 7. Concentrez-vous uniquement sur le contenu des mémoires des deux interlocuteurs. Ne confondez pas les noms de personnages mentionnés dans les mémoires avec les utilisateurs réels qui ont créé ces mémoires. 8. La réponse doit comporter moins de 5-6 mots.
APPROCHE (Réfléchissez étape par étape) :
1. Tout d'abord, examinez toutes les mémoires contenant des informations liées à la question 2. Examinez attentivement les horodatages et le contenu de ces mémoires 3. Recherchez des mentions explicites de dates, d'heures, de lieux ou d'événements qui répondent à la question 4. Si la réponse nécessite un calcul (par exemple, convertir des références temporelles relatives), montrez votre travail 5. Formulez une réponse précise et concise fondée uniquement sur les preuves des mémoires 6. Vérifiez que votre réponse répond directement à la question posée 7. Assurez-vous que votre réponse finale est spécifique et évite les références temporelles vagues
Mémoires pour l'utilisateur {speaker_1_user_id} : {speaker_1_memories}
Mémoires pour l'utilisateur {speaker_2_user_id} : {speaker_2_memories}
Question : {question}
Réponse :
MODÈLE D'INVITE POUR LA GÉNÉRATION DE RÉSULTATS (MEMO'S)
(identique au précédent)
APPROCHE (Réfléchissez étape par étape) :
1. Tout d'abord, examinez toutes les mémoires contenant des informations liées à la question 2. Examinez attentivement les horodatages et le contenu de ces mémoires 3. Recherchez des mentions explicites de dates, d'heures, de lieux ou d'événements qui répondent à la question 4. Si la réponse nécessite un calcul (par exemple, convertir des références temporelles relatives), montrez votre travail 5. Analysez les relations du graphe de connaissances pour comprendre le contexte de connaissances de l'utilisateur 6. Formulez une réponse précise et concise fondée uniquement sur les preuves des mémoires 7. Vérifiez que votre réponse répond directement à la question posée 8. Assurez-vous que votre réponse finale est spécifique et évite les références temporelles vagues
Mémoires pour l'utilisateur {speaker_1_user_id} : {speaker_1_memories}
Relations pour l'utilisateur {speaker_1_user_id} : {speaker_1_graph_memories}
Mémoires pour l'utilisateur {speaker_2_user_id} : {speaker_2_memories}
Relations pour l'utilisateur {speaker_2_user_id} : {speaker_2_graph_memories}
Question : {question}
Réponse :
MODÈLE D'INVITE POUR OPENAI CHATGPT
Pouvez-vous extraire les informations pertinentes de cette conversation et créer des entrées de mémoire pour chaque utilisateur mentionné ? Veuillez stocker ces mémoires dans votre base de connaissances en plus de l'horodatage fourni pour référence future et interactions personnalisées.
(13 h 56 le 8 mai 2023) Caroline : Salut Mel ! Ravi de te voir ! Comment vas-tu ? (13 h 56 le 8 mai 2023) Melanie : Salut Caroline ! Ravi de te voir ! Je suis débordée avec les enfants et le travail. Et toi, quoi de neuf ? (13 h 56 le 8 mai 2023) Caroline : Je suis allée à un groupe de soutien LGBTQ hier et c'était tellement puissant.
B. Algorithme
Algorithme 1 Système de gestion de la mémoire : opérations de mise à jour
1 : Entrée : Ensemble des mémoires récupérées , stock de mémoires existant
2 : Sortie : Stock de mémoires mis à jour
3 : procédure UPDATE MEMORY(F, M)
4 : pour chaque fait faire
5 : opération CLASSIFYOPERATION
Exécuter l'opération appropriée selon la classification
6 : si opération ADD alors
7 : GenerateUniqueID()
8 :
Ajouter le nouveau fait avec un identifiant unique
9 : sinon si opération UPDATE alors
10 : FindRelatedMemory
11 : si InformationContent InformationContent alors
12 : Remplacer par une information plus riche
13 : fin si
14 : sinon si opération \(=\) DELETE alors
15 : FindContradictedMemory
16 : Supprimer les informations contredites
17 : sinon si opération \(=\) NOOP alors
18 : Aucune opération effectuée Le fait existe déjà ou n'est pas pertinent
19 : fin si
20 : fin pour
21 : retourner M
22 : fin procédure
23 : fonction CLASSIFYOPERATION
24 : si SemanticallySimilar alors
25 : retourner ADD
26 : sinon si Contradicts alors
27 : retourner DELETE
28 : sinon si Augments alors
29 : retourner UPDATE
30 : sinon
31 : retourner NOOP
32 : fin si
33 : fin fonction
Nouvelle information non présente en mémoire
L'information entre en conflit avec la mémoire existante
Enrichit les informations existantes en mémoire
Aucun changement requis
C. Références sélectionnées
LoCoMo Le cadre LoCoMo met en œuvre un pipeline mémoire sophistiqué qui permet aux agents LLM de maintenir des conversations cohérentes à long terme. À la base, le système divise la mémoire en composantes à court terme et à long terme. Après chaque session de conversation, les agents génèrent des résumés (stockés comme mémoire à court terme) qui distillent les informations clés de cette interaction. Simultanément, les tours de conversation individuels sont transformés en « observations » — des déclarations factuelles sur la personnalité de chaque locuteur et les événements de sa vie — qui sont stockées dans la mémoire à long terme avec des références aux tours de dialogue spécifiques qui les ont produites. Lors de la génération de nouvelles réponses, les agents exploitent à la fois le résumé de la session la plus récente et récupèrent sélectivement les observations pertinentes de leur mémoire à long terme. Cette approche à double mémoire est en outre renforcée par l'incorporation d'un graphe d'événements temporels qui suit les événements de vie causalement liés survenant entre les sessions de conversation. En conditionnant les réponses sur les souvenirs récupérés, le contexte de conversation actuel, les informations de personnalité et les événements de vie intervenus, le système permet aux agents de maintenir des personnalités cohérentes et de se rappeler des détails importants à travers des conversations s'étendant sur des centaines de tours et des dizaines de sessions.
ReadAgent ReadAgent répond aux limitations fondamentales des LLM en émulant la manière dont les humains traitent les textes longs grâce à un pipeline sophistiqué en trois étapes. D'abord, dans la Pagination en Épisodes, le système segmente intelligemment le texte à des frontières cognitives naturelles plutôt qu'à des coupures arbitraires. Ensuite, pendant le Résumé Mémoriel, il distille chaque segment en résumés concis qui préservent le sens essentiel tout en réduisant drastiquement le nombre de tokens — semblable à la façon dont la mémoire humaine retient la substance de l'information sans rappel mot à mot. Enfin, lorsqu'il est chargé de répondre à des questions, le mécanisme de Recherche Interactive examine ces résumés et récupère stratégiquement uniquement les segments de texte original les plus pertinents pour un traitement détaillé. Cette approche inspirée de l'humain permet aux LLM de gérer efficacement des documents jusqu'à 20 fois plus longs que leurs fenêtres de contexte normales. En équilibrant la compréhension globale via les résumés avec une attention sélective aux détails, ReadAgent atteint à la fois l'efficacité computationnelle et une meilleure compréhension, démontrant que l'imitation des processus cognitifs humains peut considérablement améliorer les capacités de traitement de texte de l'IA.
MemoryBank Le système MemoryBank dote les LLM d'une mémoire à long terme grâce à un pipeline sophistiqué en trois parties. À sa base, le composant de Stockage de Mémoire entrepose des journaux de conversation détaillés, des résumés hiérarchiques d'événements et des profils de personnalité utilisateur évolutifs. Lorsqu'une nouvelle interaction se produit, le mécanisme de Récupération de Mémoire emploie un modèle de récupération dense à double tour pour extraire les informations passées contextuellement pertinentes. Le composant de Mise à Jour de la Mémoire fournit un mécanisme d'oubli semblable à celui de l'humain, où les souvenirs se renforcent lorsqu'ils sont rappelés et se dégradent naturellement avec le temps s'ils ne sont pas utilisés. Cette approche globale permet aux compagnons IA de rappeler des informations pertinentes, de maintenir une conscience contextuelle à travers des interactions prolongées et de développer des portraits utilisateur de plus en plus précis, aboutissant à des conversations à long terme plus personnalisées et naturelles.
MemGPT Le système MemGPT introduit une approche inspirée des systèmes d'exploitation pour surmonter les limitations de fenêtre de contexte inhérentes aux LLM. À sa base, MemGPT emploie un pipeline sophistiqué de gestion de la mémoire composé de trois composants clés : un système de mémoire hiérarchique, des opérations de mémoire auto-dirigées et un mécanisme de flux de contrôle basé sur les événements. Le système divise la mémoire disponible en « contexte principal » (analogue à la RAM dans les systèmes d'exploitation traditionnels) et « contexte externe » (analogue au stockage sur disque). Le contexte principal — qui est limité par la fenêtre de contexte du LLM — contient les instructions système, l'historique de conversation récent et la mémoire de travail qui peut être modifiée par le modèle. Le contexte externe stocke des informations illimitées en dehors de la fenêtre de contexte immédiate du modèle, y compris les historiques de conversation complets et les données d'archives. Lorsque le LLM a besoin d'informations non présentes dans le contexte principal, il peut initier des appels de fonction pour rechercher, récupérer ou modifier le contenu à travers ces niveaux de mémoire, « paginant » efficacement les informations pertinentes dans et hors de sa fenêtre de contexte limitée. Cette architecture inspirée des systèmes d'exploitation permet à MemGPT de maintenir la cohérence conversationnelle sur des interactions prolongées, de gérer des documents dépassant les limites de contexte standard et d'effectuer des tâches de récupération d'informations multi-sauts — le tout en fonctionnant avec des modèles à contexte fixe. La capacité du système à gérer intelligemment ses propres ressources de mémoire donne l'illusion d'un contexte infini, étendant considérablement ce qui est possible avec la technologie LLM actuelle.
A- Mem Le modèle A- Mem introduit un système de mémoire agentique conçu pour les agents LLM. Ce système structure et fait évoluer dynamiquement les souvenirs grâce à des notes interconnectées. Chaque note capture des interactions enrichies d'attributs structurés tels que des mots-clés, des descriptions contextuelles et des étiquettes générées par le LLM. Lors de la création d'un nouveau souvenir, A- MEM utilise des plongements sémantiques pour récupérer les notes existantes pertinentes, puis emploie une approche pilotée par LLM pour établir des liens significatifs basés sur les similarités et les attributs partagés. De manière cruciale, le mécanisme d'évolution de la mémoire met à jour dynamiquement les notes existantes, en affinant leurs informations contextuelles et leurs attributs chaque fois que de nouveaux souvenirs pertinents sont intégrés. Ainsi, la structure de la mémoire évolue continuellement, permettant des connexions plus riches et contextuellement plus profondes entre les souvenirs. La récupération depuis la mémoire s'effectue par similarité sémantique, fournissant un contexte historique pertinent lors des interactions de l'agent.