
Affiner un modèle de 65B sur un seul GPU de 48 Go: quantification 4 bits et adaptateurs, sans perte de qualité 16 bits. NeurIPS 2023, gratuit en ligne.
QLoRA: Efficient Finetuning of Quantized LLMs
QLoRA : Finetuning efficace de LLMs quantifiés
Tim Dettmers\*
Artidoro Pagnoni\*
Ari Holtzman
Luke Zettlemoyer
University of Washington {dettmers,artidoro,ahai,lsz}@cs.washington.edu
Résumé
Nous présentons QLoRA, une approche de finetuning efficace qui réduit suffisamment l'utilisation de la mémoire pour permettre le finetuning d'un modèle de 65 milliards de paramètres sur un seul GPU de 48 Go, tout en préservant les performances complètes de la tâche de finetuning en 16 bits. QLoRA rétropropage les gradients à travers un modèle de langage préentraîné gelé et quantifié en 4 bits dans des adaptateurs de rang faible (LoRA). Notre meilleure famille de modèles, que nous nommons Guanaco, surpasse tous les modèles précédemment publiés en open source sur le benchmark Vicuna, atteignant 99,3 % du niveau de performance de ChatGPT tout en ne nécessitant que 24 heures de finetuning sur un seul GPU. QLoRA introduit un certain nombre d'innovations pour économiser la mémoire sans sacrifier les performances : (a) NormalFloat en 4 bits (NF4), un nouveau type de données qui est informationnellement optimal au sens de la théorie de l'information pour des poids distribués normalement (b) la Double Quantification pour réduire l'empreinte mémoire moyenne en quantifiant les constantes de quantification, et (c) les Optimiseurs Paginés pour gérer les pics de mémoire. Nous utilisons QLoRA pour finetuner plus de 1 000 modèles, fournissant une analyse détaillée du suivi d'instructions et des performances de chatbot sur 8 jeux de données d'instructions, plusieurs types de modèles (LLaMA, T5), et des échelles de modèles qu'il serait irréalisable d'exécuter avec un finetuning classique (par exemple des modèles de 33 et 65 milliards de paramètres). Nos résultats montrent que le finetuning QLoRA sur un petit jeu de données de haute qualité conduit à des résultats de pointe, même en utilisant des modèles plus petits que le précédent SoTA. Nous fournissons une analyse détaillée des performances de chatbot basée à la fois sur des évaluations humaines et par GPT-4, montrant que les évaluations par GPT-4 sont une alternative peu coûteuse et raisonnable à l'évaluation humaine. Par ailleurs, nous constatons que les benchmarks actuels pour chatbots ne sont pas fiables pour évaluer avec précision les niveaux de performance des chatbots. Une analyse par sélection adverse (lemon-picked) met en évidence les cas où Guanaco échoue par rapport à ChatGPT. Nous publions tous nos modèles et notre code, y compris les kernels CUDA pour l'entraînement en 4 bits.2
1 Introduction
Le finetuning de grands modèles de langage (LLMs) est un moyen très efficace d'améliorer leurs performances [40, 62, 43, 61, 59, 37], et d'ajouter des comportements souhaitables ou d'en retirer des indésirables [43, 2, 4]. Cependant, le finetuning de très grands modèles est d'un coût prohibitif ; le finetuning classique en 16 bits d'un modèle LLaMA de 65 milliards de paramètres [57] nécessite plus de 780 Go de mémoire GPU. Bien que les méthodes de quantification récentes puissent réduire l'empreinte mémoire des LLMs [14, 13, 18, 66], ces techniques ne fonctionnent que pour l'inférence et s'effondrent pendant l'entraînement [65].
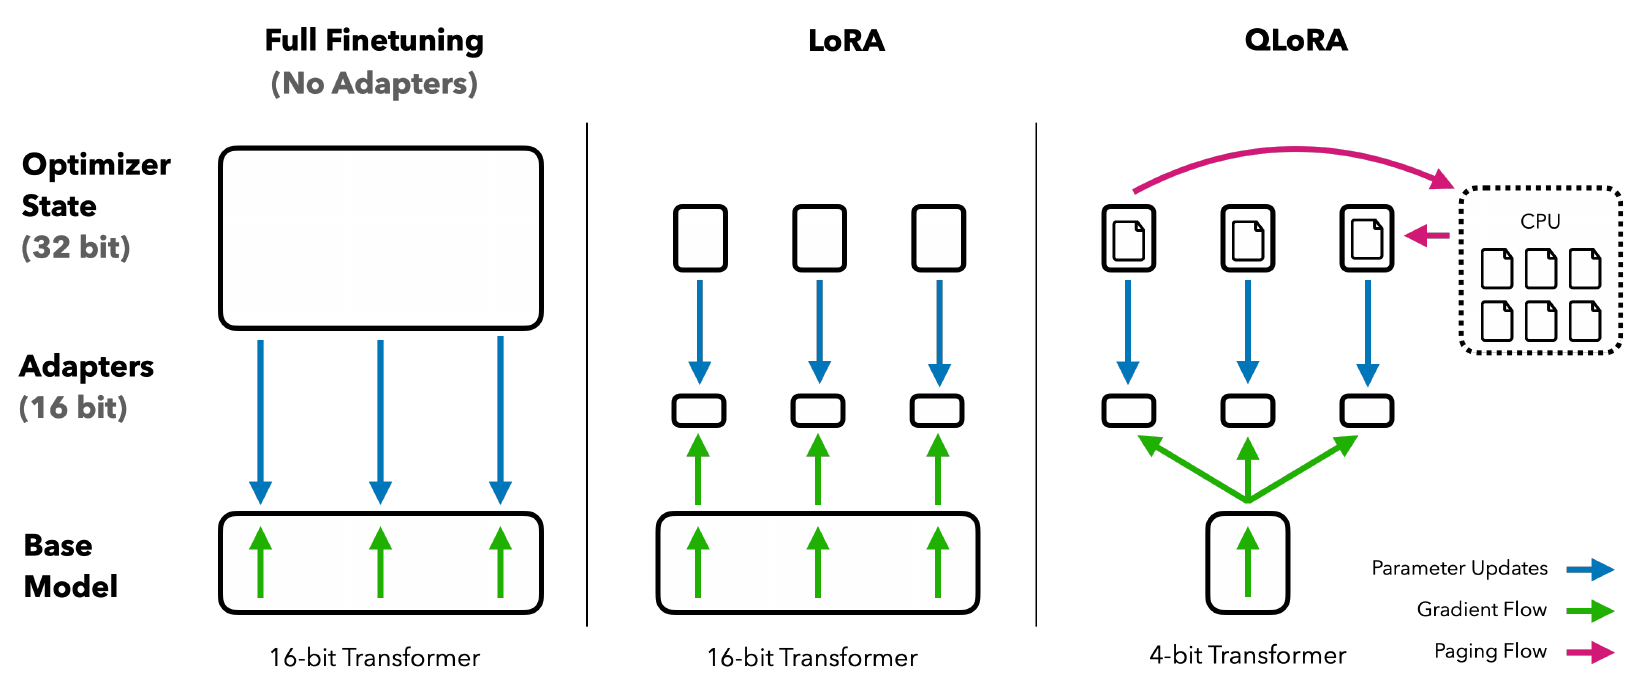
Nous démontrons pour la première fois qu'il est possible de finetuner un modèle quantifié en 4 bits sans aucune dégradation des performances. Notre méthode, QLoRA, utilise une nouvelle technique de haute précision pour quantifier un modèle préentraîné en 4 bits, puis ajoute un petit ensemble de poids d'adaptateurs de rang faible [28] apprenables qui sont ajustés en rétropropageant les gradients à travers les poids quantifiés.
QLORA réduit les besoins moyens en mémoire du finetuning d'un modèle de 65 milliards de paramètres de de mémoire GPU à sans dégrader le temps d'exécution ni les performances prédictives par rapport à une référence entièrement finetunée en 16 bits. Cela marque un changement significatif dans l'accessibilité du finetuning des LLMs : désormais les plus grands modèles publiquement disponibles à ce jour sont finetunables sur un seul GPU. En utilisant QLoRA, nous entraînons la famille de modèles Guanaco, dont le deuxième meilleur modèle atteint du niveau de performance de ChatGPT sur le benchmark Vicuna [10], tout en étant entraînable en moins de 12 heures sur un seul GPU grand public ; en utilisant un seul GPU professionnel pendant plus de 24 heures, nous atteignons avec notre plus grand modèle, comblant essentiellement l'écart avec ChatGPT sur le benchmark Vicuna. Une fois déployé, notre plus petit modèle Guanaco
| Modèle | Taille | Elo |
| GPT-4 | - | 1348 ± 1 |
| Guanaco 65B | 41 GB | 1022 ± 1 |
| Guanaco 33B | 21 GB | 992 ± 1 |
| Vicuna 13B | 26 GB | 974 ± 1 |
| ChatGPT | - | 966 ± 1 |
| Guanaco 13B | 10 GB | 916 ± 1 |
| Bard | - | 902 ± 1 |
| Guanaco 7B | 6 GB | 879 ± 1 |
(7 milliards de paramètres) ne nécessite que 5 Go de mémoire et surpasse un modèle Alpaca de 26 Go de plus de 20 points de pourcentage sur le benchmark Vicuna (Tableau 6).
QLORA introduit plusieurs innovations conçues pour réduire l'utilisation de la mémoire sans sacrifier les performances : (1) NormalFloat en 4 bits, un type de données de quantification informationnellement optimal au sens de la théorie de l'information pour des données distribuées normalement, qui produit de meilleurs résultats empiriques que les entiers en 4 bits et les flottants en 4 bits. (2) la Double Quantification, une méthode qui quantifie les constantes de quantification, économisant en moyenne environ 0,37 bit par paramètre (approximativement 3 Go pour un modèle de 65 milliards de paramètres). (3) les Optimiseurs Paginés, utilisant la mémoire unifiée NVIDIA pour éviter les pics de mémoire du gradient checkpointing qui surviennent lors du traitement d'un mini-lot de longue longueur de séquence. Nous combinons ces contributions en une approche LoRA mieux ajustée qui inclut des adaptateurs à chaque couche du réseau et évite ainsi presque tous les compromis de précision observés dans les travaux antérieurs.
L'efficacité de QLORA nous permet de réaliser une étude approfondie du finetuning sur instructions et des performances de chatbot à des échelles de modèles qui seraient impossibles avec un finetuning classique en raison du surcoût mémoire. Par conséquent, nous entraînons plus de 1 000 modèles sur plusieurs jeux de données d'ajustement sur instructions, architectures de modèles, et tailles comprises entre 80M et 65 milliards de paramètres. En plus de montrer que QLoRA retrouve les performances en 16 bits ( ) et d'entraîner un chatbot de pointe, Guanaco, ( ), nous analysons également les tendances dans les modèles entraînés. Premièrement, nous constatons que la qualité des données est bien plus importante que la taille du jeu de données, par exemple un jeu de données de 9 000 échantillons (OASST1) a surpassé un jeu de données de 450 000 échantillons (FLAN v2, sous-échantillonné) sur les performances de chatbot, même lorsque les deux sont destinés à soutenir la généralisation du suivi d'instructions. Deuxièmement, nous montrons qu'une forte performance au benchmark Massive Multitask Language Understanding (MMLU) n'implique pas une forte performance au benchmark de chatbot Vicuna et vice versa—en d'autres termes, l'adéquation du jeu de données importe plus que sa taille pour une tâche donnée.
De plus, nous fournissons également une analyse approfondie des performances de chatbot qui utilise à la fois des évaluateurs humains et GPT-4 pour l'évaluation. Nous utilisons une évaluation de type tournoi où les modèles s'affrontent en matchs pour produire la meilleure réponse à un prompt donné. Le gagnant d'un match est jugé soit par GPT-4, soit par des annotateurs humains. Les résultats du tournoi sont agrégés en scores Elo [16, 17] qui déterminent le classement des performances de chatbot. Nous constatons que les évaluations par GPT-4 et humaines s'accordent largement sur le rang de performance des modèles dans les tournois, mais nous constatons également qu'il existe des cas de fort désaccord. Ainsi, nous soulignons que l'évaluation basée sur modèle, tout en offrant une alternative peu coûteuse à l'annotation humaine, comporte également ses incertitudes.
Nous enrichissons nos résultats de benchmark de chatbot avec une analyse qualitative des modèles Guanaco. Notre analyse met en évidence des cas de succès et d'échec qui n'ont pas été capturés par les benchmarks quantitatifs.
Nous publions toutes les générations de modèles avec les annotations humaines et GPT-4 pour faciliter les études ultérieures. Nous ouvrons le code source de notre base de code et de nos kernels CUDA et intégrons nos méthodes dans la pile Hugging Face transformers [64], les rendant facilement accessibles à tous. Nous publions une collection d'adaptateurs pour les modèles de taille 7/13/33/65 milliards de paramètres, entraînés sur 8 jeux de données de suivi d'instructions différents, pour un total de 32 modèles finetunés open source différents.
2 Contexte
Quantification par blocs en k bits La quantification est le processus de discrétisation d'une entrée depuis une représentation qui contient plus d'informations vers une représentation avec moins d'informations. Cela signifie souvent prendre un type de données avec plus de bits et le convertir en moins de bits, par exemple de flottants 32 bits à des entiers 8 bits. Pour garantir que toute la plage du type de données de faible précision soit utilisée, le type de données d'entrée est couramment remis à l'échelle dans la plage du type de données cible par normalisation par le maximum absolu des éléments d'entrée, qui sont généralement structurés sous forme de tenseur. Par exemple, quantifier un tenseur en virgule flottante 32 bits (FP32) en un tenseur Int8 de plage :
où est la constante de quantification ou l'échelle de quantification. La déquantification est l'inverse :
Le problème de cette approche est que si une valeur de grande magnitude (c'est-à-dire une valeur aberrante) apparaît dans le tenseur d'entrée, alors les intervalles de quantification — certaines combinaisons de bits — ne sont pas bien utilisés, avec peu ou aucun nombre quantifié dans certains intervalles. Pour éviter le problème des valeurs aberrantes, une approche courante consiste à découper le tenseur d'entrée en blocs quantifiés indépendamment, chacun avec sa propre constante de quantification . Cela peut être formalisé comme suit : nous découpons le tenseur d'entrée en blocs contigus de taille en aplatissant le tenseur d'entrée et en découpant le segment linéaire en blocs. Nous quantifions ces blocs indépendamment avec l'équation 1 pour créer un tenseur quantifié et constantes de quantification .
Adaptateurs de faible rang L'ajustement fin par adaptateur de faible rang (LoRA) [28] est une méthode qui réduit les besoins en mémoire en utilisant un petit ensemble de paramètres entraînables, souvent appelés adaptateurs, sans mettre à jour les paramètres complets du modèle, qui restent fixes. Les gradients pendant la descente de gradient stochastique traversent les poids fixes du modèle préentraîné jusqu'à l'adaptateur, qui est mis à jour pour optimiser la fonction de perte. LoRA augmente une projection linéaire par une projection factorisée supplémentaire. Étant donné une projection avec , , LoRA calcule :
où et , et est un scalaire.
Besoins en mémoire de l'ajustement fin paramétriquement efficace Un point de discussion important est le besoin en mémoire de LoRA pendant l'entraînement, tant en termes de nombre que de taille des adaptateurs utilisés. Comme l'empreinte mémoire de LoRA est très faible, nous pouvons utiliser davantage d'adaptateurs pour améliorer les performances sans augmenter significativement la mémoire totale utilisée. Bien que LoRA ait été conçu comme une méthode d'ajustement fin paramétriquement efficace (PEFT), la majeure partie de l'empreinte mémoire de l'ajustement fin des LLM provient des gradients d'activation et non des paramètres LoRA appris. Pour un modèle LLaMA de 7B entraîné sur FLAN v2 avec une taille de lot de 1, avec des poids LoRA équivalents aux couramment utilisés des poids originaux du modèle [28, 37], les gradients d'entrée de LoRA ont une empreinte mémoire de 567 Mo, tandis que les paramètres LoRA n'occupent que 26 Mo. Avec la vérification des gradients [9], les gradients d'entrée se réduisent à une moyenne de 18 Mo par séquence, ce qui les rend plus gourmands en mémoire que l'ensemble des poids LoRA combinés. En comparaison, le modèle de base en 4 bits consomme 5 048 Mo de mémoire. Cela souligne que la vérification des gradients est importante, mais aussi que réduire agressivement la quantité de paramètres LoRA n'apporte que de faibles bénéfices en termes de mémoire. Cela signifie que nous pouvons utiliser davantage d'adaptateurs sans augmenter significativement l'empreinte mémoire globale de l'entraînement (voir l'annexe G pour une décomposition détaillée). Comme discuté plus loin, cela est crucial pour retrouver les performances complètes de précision en 16 bits.
3 QLoRA Finetuning
QLoRA réalise un finetuning 4 bits de haute fidélité grâce à deux techniques que nous proposons — la quantification NormalFloat 4 bits (NF4) et la Double Quantification. De plus, nous introduisons les Optimiseurs Paginés, afin d'empêcher les pics de mémoire lors du gradient checkpointing de provoquer des erreurs out-of-memory qui ont traditionnellement rendu le finetuning sur une seule machine difficile pour les grands modèles.
QLoRA dispose d'un type de données de stockage de faible précision, dans notre cas généralement 4 bits, et d'un type de données de calcul qui est généralement BFloat16. En pratique, cela signifie que chaque fois qu'un tenseur de poids QLoRA est utilisé, nous déquantifions le tenseur en BFloat16, puis effectuons une multiplication matricielle en 16 bits.
Nous discutons maintenant des composants de QLoRA, suivis d'une définition formelle de QLoRA.
Quantification NormalFloat 4 bits Le type de données NormalFloat (NF) s'appuie sur la Quantification par Quantiles [15], qui est un type de données informationnellement optimal garantissant que chaque bac de quantification se voit attribuer un nombre égal de valeurs issues du tenseur d'entrée. La quantification par quantiles fonctionne en estimant le quantile du tenseur d'entrée via la fonction de répartition empirique.
La principale limitation de la quantification par quantiles est que le processus d'estimation des quantiles est coûteux. Par conséquent, des algorithmes rapides d'approximation des quantiles, tels que les quantiles SRAM [15], sont utilisés pour les estimer. En raison de la nature approximative de ces algorithmes d'estimation des quantiles, le type de données présente de grandes erreurs de quantification pour les valeurs aberrantes, qui sont souvent les valeurs les plus importantes.
Les estimations coûteuses des quantiles et les erreurs d'approximation peuvent être évitées lorsque les tenseurs d'entrée proviennent d'une distribution fixée à une constante de quantification près. Dans de tels cas, les tenseurs d'entrée ont les mêmes quantiles, ce qui rend l'estimation exacte des quantiles computationnellement faisable.
Étant donné que les poids de réseaux de neurones préentraînés ont généralement une distribution normale centrée sur zéro d'écart-type (voir Annexe F), nous pouvons transformer tous les poids en une seule distribution fixe en mettant à l'échelle de sorte que la distribution s'inscrive exactement dans la plage de notre type de données. Pour notre type de données, nous fixons la plage arbitraire . Ainsi, tant les quantiles du type de données que les poids du réseau de neurones doivent être normalisés dans cette plage.
Le type de données informationnellement optimal pour des distributions normales de moyenne nulle avec des écarts-types arbitraires dans la plage est calculé comme suit : (1) estimer les quantiles d'une distribution théorique pour obtenir un type de données de quantification par quantiles à bits pour les distributions normales, (2) prendre ce type de données et normaliser ses valeurs dans la plage , (3) quantifier un tenseur de poids d'entrée en le normalisant dans la plage par remise à l'échelle selon le maximum absolu.
Une fois que la plage des poids et la plage du type de données coïncident, nous pouvons quantifier comme d'habitude. L'étape (3) est équivalente à remettre à l'échelle l'écart-type du tenseur de poids pour qu'il corresponde à l'écart-type du type de données à k bits. Plus formellement, nous estimons les valeurs du type de données comme suit :
où est la fonction quantile de la distribution normale standard . Un problème pour une quantification symétrique à k bits est que cette approche ne dispose pas d'une représentation exacte de zéro, qui est une propriété importante pour quantifier le padding et d'autres éléments de valeur nulle sans erreur. Pour garantir un point zéro discret de 0 et utiliser tous les bits pour un type de données à k bits, nous créons un type de données asymétrique en estimant les quantiles de deux plages : pour la partie négative et pour la partie positive, puis nous unifions ces ensembles de et supprimons l'un des deux zéros qui apparaissent dans les deux ensembles. Nous appelons le type de données résultant, qui a un nombre attendu égal de valeurs dans chaque bac de quantification, NormalFloat à bits (NFk), puisque le type de données est informationnellement optimal pour des données distribuées normalement et centrées sur zéro. Les valeurs exactes de ce type de données se trouvent en Annexe E.
Double Quantification Nous introduisons la Double Quantification (DQ), le processus consistant à quantifier les constantes de quantification pour réaliser des économies de mémoire supplémentaires. Bien qu'une petite taille de bloc soit nécessaire pour une quantification 4 bits précise [13], elle présente également une surcharge mémoire considérable. Par exemple, en utilisant des constantes 32 bits et une taille de bloc de 64 pour W, les constantes de quantification ajoutent bits par paramètre en moyenne. La Double Quantification aide à réduire l'empreinte mémoire des constantes de quantification.
Plus précisément, la Double Quantification traite les constantes de quantification de la première quantification comme entrées d'une seconde quantification. Cette seconde étape produit les constantes de quantification quantifiées et le second niveau de constantes de quantification . Nous utilisons des Floats 8 bits avec une taille de bloc de 256 pour la seconde quantification, car aucune dégradation des performances n'est observée pour la quantification 8 bits, conformément aux résultats de Dettmers et Zettlemoyer [13]. Comme les sont positives, nous soustrayons la moyenne de avant la quantification afin de centrer les valeurs autour de zéro et d'utiliser une quantification symétrique. En moyenne, pour une taille de bloc de 64, cette quantification réduit l'empreinte mémoire par paramètre de bits à bits, soit une réduction de 0.373 bits par paramètre.
Les Optimiseurs Paginés utilisent la fonctionnalité de mémoire unifiée NVIDIA qui effectue des transferts automatiques de page à page entre le CPU et le GPU pour un traitement GPU sans erreur dans le scénario où le GPU manque occasionnellement de mémoire. La fonctionnalité fonctionne comme la pagination mémoire classique entre la RAM du CPU et le disque. Nous utilisons cette fonctionnalité pour allouer de la mémoire paginée aux états de l'optimiseur, qui sont ensuite automatiquement évincés vers la RAM du CPU lorsque le GPU manque de mémoire et ramenés dans la mémoire du GPU lorsque la mémoire est nécessaire à l'étape de mise à jour de l'optimiseur.
QLORA. En utilisant les composants décrits ci-dessus, nous définissons QLORA pour une seule couche linéaire dans le modèle de base quantifié avec un seul adaptateur LoRA comme suit :
où doubleDequant est défini comme :
Nous utilisons NF4 pour W et FP8 pour . Nous utilisons une taille de bloc de 64 pour W afin d'obtenir une plus grande précision de quantification et une taille de bloc de 256 pour afin de conserveer la mémoire.
Pour la mise à jour des paramètres, seul le gradient par rapport à l'erreur pour les poids des adaptateurs est nécessaire, et non celui pour les poids en 4 bits . Cependant, le calcul de implique le calcul de , qui s'effectue via l'équation (5) avec déquantification du stockage vers le type de données de calcul pour calculer la dérivée en précision BFloat16.
En résumé, QLORA dispose d'un type de données de stockage (généralement NormalFloat 4 bits) et d'un type de données de calcul (BrainFloat 16 bits). Nous déquantifions le type de données de stockage vers le type de données de calcul pour effectuer la passe avant et la passe arrière, mais nous ne calculons les gradients de poids que pour les paramètres LoRA qui utilisent BrainFloat 16 bits.
4 QLoRA vs. Finetuning standard
Nous avons discuté du fonctionnement de QLoRA et de la manière dont il peut réduire significativement la mémoire requise pour le finetuning des modèles. La question principale est maintenant de savoir si QLoRA peut performer aussi bien que le finetuning complet du modèle. De plus, nous souhaitons analyser les composants de QLoRA, notamment l'impact de NormalFloat4 par rapport au Float4 standard. Les sections suivantes présenteront les expériences visant à répondre à ces questions.
Configuration expérimentale. Nous considérons trois architectures (encodeur, encodeur-décodeur et décodeur seul) et comparons QLoRA avec le finetuning d'adaptateurs en 16 bits et avec le finetuning complet pour des modèles jusqu'à 3B. Nos évaluations incluent GLUE [58] avec RoBERTa-large [38], Super-NaturalInstructions (TKInstruct) [61] avec T5 [49], et MMLU en 5-shot [24] après finetuning de LLaMA sur Flan v2 [39] et Alpaca [55]. Pour étudier en outre les avantages de NF4 par rapport à d'autres types de données 4 bits, nous utilisons la configuration de Dettmers et Zettlemoyer [13] et mesurons la précision zero-shot et la perplexité post-quantification sur différents modèles (OPT [72], LLaMA [57], BLOOM [52], Pythia [7]) pour des tailles de modèle de 125m à 13B. Nous fournissons plus de détails dans la section des résultats pour chaque configuration particulière afin de rendre les résultats plus lisibles. Détails complets en Annexe A.
Bien que les optimiseurs paginés soient essentiels pour effectuer le tuning QLoRA de 33B/65B sur un seul GPU de 24/48 Go, nous ne fournissons pas de mesures précises pour les optimiseurs paginés, car la pagination ne se produit que lors du traitement de mini-lots avec de longues longueurs de séquence, ce qui est rare. Nous effectuons toutefois une analyse du temps d'exécution des optimiseurs paginés pour les modèles 65B sur des GPU de 48 Go et constatons qu'avec une taille de lot de 16, les optimiseurs paginés offrent la même vitesse d'entraînement que les optimiseurs classiques. Les travaux futurs devraient mesurer et caractériser les circonstances dans lesquelles des ralentissements se produisent du fait du processus de pagination.
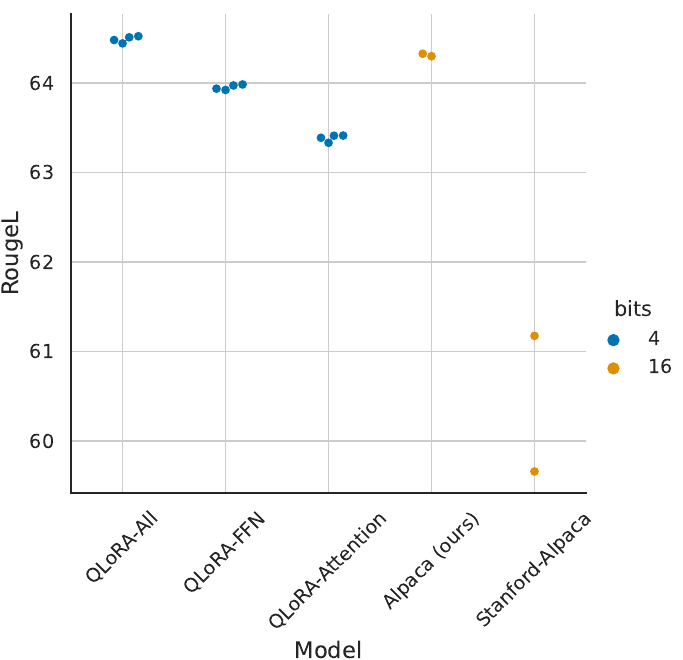
Les hyperparamètres LoRA par défaut ne correspondent pas aux performances en 16 bits. Lors de l'utilisation de la pratique standard consistant à appliquer LoRA aux matrices de projection d'attention query et value [28], nous ne parvenons pas à reproduire les performances du finetuning complet pour les grands modèles de base. Comme le montre la Figure 2 pour le finetuning de LLaMA 7B sur Alpaca, nous constatons que l'hyperparamètre LoRA le plus critique est le nombre total d'adaptateurs LoRA utilisés et que LoRA sur toutes les couches des blocs de transformateur linéaires est nécessaire pour égaler les performances du finetuning complet. Les autres hyperparamètres LoRA, tels que la dimension de projection , n'affectent pas les performances (voir Annexe A).
De même, nous constatons que les hyperparamètres par défaut des références entièrement affinées sont sous-ajustés. Nous effectuons une recherche d'hyperparamètres sur des taux d'apprentissage de 1e-6 à 5e-5 et des tailles de lot de 8 à 128 afin de trouver des références robustes. Les résultats de l'affinage de LLaMA 7B sur Alpaca sont présentés dans la Figure 2.
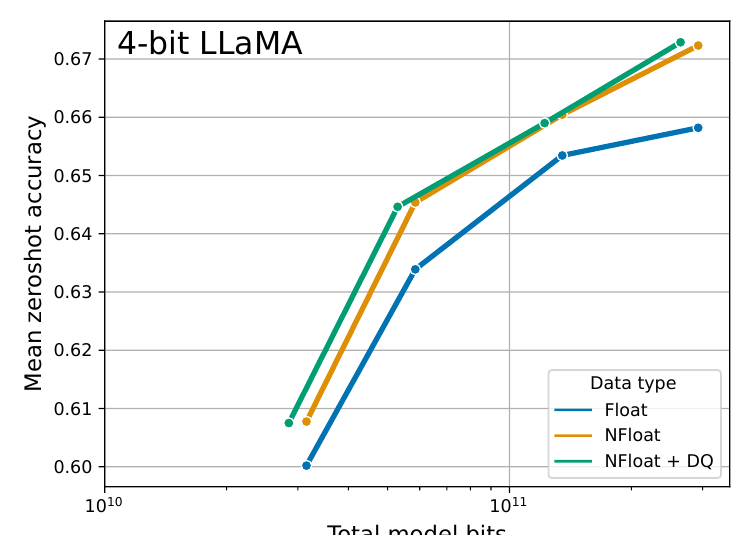
Le NormalFloat 4 bits offre de meilleures performances que le Floating Point 4 bits. Bien que le type de données NormalFloat 4 bits (NF4) soit informationnellement optimal du point de vue de la théorie de l'information, il reste à déterminer si cette propriété se traduit par des avantages empiriques. Nous suivons la configuration de Dettmers et Zettlemoyer [13], où des LLM quantifiés (OPT [72], BLOOM [52], Pythia [7], LLaMA) de différentes tailles (125M à 65B) avec différents types de données sont évalués sur la modélisation du langage et un ensemble de tâches zero-shot. Dans la Figure 3 et le Tableau 2, nous voyons que NF4 améliore significativement les performances par rapport à FP4 et Int4, et que la double quantification réduit l'empreinte mémoire sans dégrader les performances.
QLoRA à k bits égale les performances de l'affinage complet 16 bits et de LoRA 16 bits. Des résultats récents ont établi que la quantification 4 bits pour l'inférence est
possible, mais entraîne une dégradation des performances par
| Contexte en lecture seule pour comprendre la source (ce n’est pas le texte source à traduire) : | 4 QLoRA vs. Fine-tuning standard | Le QLoRA en k bits égale les performances du fine-tuning complet en 16 bits et du LoRA en 16 bits. Des résultats récents ont établi que la quantification en 4 bits pour l’inférence est possible, mais entraîne une dégradation des performances par rapport au 16 bits [13, 18]. Cela soulève la question cruciale de savoir si la performance perdue peut être récupérée en effectuant un fine-tuning d’adaptateurs en 4 bits. Nous testons cela pour deux configurations. | Texte à traduire : | Jeu de données Modèle | GLUE (Acc.) RoBERTa-large | T5-80M |
| Super-NaturalInstructions (RougeL) T5-250M | T5-780M | T5-3B | T5-11B | BF16 | 88,6 | 40,1 |
| 42,1 | 48,0 | 54,3 | 62,0 | Réplication BF16 | 88,6 | 40,0 |
| 42,2 | 47,3 | 54,9 | - | LoRA BF16 | 88,8 | 40,5 |
| 42,6 | 47,1 | 55,4 | 60,7 | QLORA Int8 | 88,8 | 40,4 |
| 42,9 | 45,4 | 56,5 | 60,7 | QLORA FP4 | 88,6 | 40,3 |
| 42,4 | 47,5 | 55,6 | 60,9 | QLORA NF4 + DQ | - | 40,4 |
rapport au 16 bits [13, 18]. Cela soulève la question cruciale de savoir si la performance perdue peut être récupérée en effectuant un affinage d'adaptateurs 4 bits. Nous testons cela pour deux configurations.
La première se concentre sur une comparaison avec l'affinage complet 16 bits de modèles RoBERTA et T5 de taille 125M à 3B paramètres sur GLUE et le jeu de données Super-NaturalInstructions. Les résultats sont présentés dans le Tableau 3. Dans les deux jeux de données, nous observons que les méthodes d'adaptateurs 16 bits, 8 bits et 4 bits reproduisent les performances de la référence entièrement affinée en 16 bits. Cela suggère que la performance perdue en raison de la quantification imprécise peut être entièrement récupérée grâce à l'affinage d'adaptateurs après quantification.
Pour notre seconde configuration, étant donné que les modèles à affinage complet de 11B paramètres et plus nécessitent plus d'un serveur de GPU à haute mémoire, nous continuons à tester si QLoRA 4 bits peut égaler LoRA 16 bits aux échelles de 7B à 65B paramètres. À cette fin, nous affinons LLaMA 7B à 65B sur deux jeux de données d'affinage pour le suivi
| Type de données | PPL moyen |
| Int4 | 34,34 |
| Float4 (E2M1) | 31,07 |
| Float4 (E3M0) | 29,48 |
| NFloat4 + DQ | 27,41 |
d'instructions, Alpaca et FLAN v2, et évaluons sur le benchmark MMLU via la précision en 5-shot. Les résultats sont présentés dans le Tableau 4, où nous voyons que NF4 avec double quantification récupère entièrement les performances MMLU de LoRA 16 bits. En outre, nous notons également que QLoRA avec FP4 est en retard d'environ 1 point de pourcentage par rapport à la référence LoRA 16 bits en brain float. Cela corrobore à la fois nos conclusions selon lesquelles (1) QLoRA avec NF4 reproduit les performances de l'affinage complet 16 bits et de l'affinage LoRA 16 bits, et (2) NF4 est supérieur à FP4 en termes de précision de quantification.
Résumé Nos résultats montrent de manière cohérente que QLoRA 4 bits avec le type de données NF4 égale les performances de l'affinage complet 16 bits et de l'affinage LoRA 16 bits sur des benchmarks académiques avec des configurations d'évaluation bien établies. Nous avons également montré que NF4 est plus efficace que FP4 et que la double quantification ne dégrade pas les performances. Combinés, ces éléments constituent une preuve convaincante que l'ajustement QLoRA 4 bits produit de manière fiable des résultats correspondant aux méthodes 16 bits.
Conformément aux travaux antérieurs sur la quantification [13], nos résultats MMLU et Elo indiquent qu'avec un budget donné de ressources d'affinage et d'inférence, il est bénéfique d'augmenter le nombre de paramètres du modèle de base tout en diminuant leur précision. Cela souligne l'importance des bénéfices d'efficacité de QLoRA. Étant donné que nous n'avons pas observé de dégradation des performances par rapport à l'affinage complet dans nos expériences avec l'affinage 4 bits, cela soulève la question de savoir où se situe exactement le compromis performance-précision pour l'ajustement QLoRA, que nous laissons aux travaux futurs le soin d'explorer.
Nous poursuivons en étudiant l'affinage par instructions à des échelles qu'il serait impossible d'explorer avec un affinage complet 16 bits sur du matériel de recherche académique.
5 Repousser l'état de l'art des chatbots avec QLoRA
Après avoir établi que QLoRA 4 bits égale les performances 16 bits à travers les échelles, les tâches et les jeux de données, nous menons une étude approfondie de l'affinage par instructions jusqu'aux plus grands modèles de langage open-source disponibles pour la recherche. Pour évaluer les performances de l'affinage par instructions de ces modèles, nous évaluons
sur un benchmark difficile de compréhension du langage naturel (MMLU) et développons de nouvelles méthodes pour l'évaluation des performances des chatbots dans le monde réel.
5.1 Configuration expérimentale
Nous décrivons maintenant un aperçu de la configuration expérimentale, avec tous les détails dans l'Annexe B.
Données À notre connaissance, il n'existe pas d'étude exhaustive des récents jeux de données de suivi d'instructions ; nous sélectionnons donc huit jeux de données récents. Nous incluons des jeux de données obtenus par crowdsourcing (OASST1 [31], HH-RLHF [4]), par distillation à partir de modèles ajustés par instructions (Alpaca [55], self-instruct [59], unnatural-instructions [26]), des agrégations de corpus (FLAN v2 [12]), ainsi que des hybrides (Chip2 [32], Longform [30]). Ces jeux de données couvrent différentes langues, tailles de données et licences.
Configuration d'entraînement Pour éviter les effets de confusion dus à différents objectifs d'entraînement, nous effectuons l'affinage QLoRA avec une perte d'entropie croisée (apprentissage supervisé) sans apprentissage par renforcement, même pour les jeux de données qui incluent des jugements humains sur différentes réponses. Pour les jeux de données qui présentent une distinction claire entre instruction et réponse, nous n'affinons que sur la réponse (voir les ablations dans l'Annexe B). Pour OASST1 et HH-RLHF, plusieurs réponses sont disponibles. Nous sélectionnons alors la meilleure réponse à chaque niveau de l'arbre de conversation et affinons sur l'intégralité de la conversation sélectionnée, y compris les instructions. Dans toutes nos expériences, nous utilisons NF4 QLoRA avec double quantification et optimiseurs paginés pour éviter les pics de mémoire pendant le gradient checkpointing. Nous effectuons de petites recherches d'hyperparamètres pour les modèles LLaMA 13B et 33B, et nous constatons que tous les réglages d'hyperparamètres trouvés à 7B se généralisent (y compris le nombre d'époques), sauf le taux d'apprentissage et la taille de lot. Nous divisons par deux le taux d'apprentissage pour 33B et 65B tout en doublant la taille de lot.
Références Nous comparons nos modèles à des systèmes de chatbot tant de recherche (Vicuna [10] et Open Assistant [31]) que commerciaux (GPT-4 [42], GPT-3.5-turbo et Bard). Le modèle Open Assistant est un modèle LLaMA 33B affiné avec l'apprentissage par renforcement à partir de retours humains (RLHF) sur le même jeu de données OASST1 que celui avec lequel nous expérimentons. Vicuna effectue un affinage complet de LLaMA 13B sur des conversations propriétaires partagées par les utilisateurs provenant de ShareGPT et est donc le résultat d'une distillation à partir de modèles GPT d'OpenAI.
5.2 Évaluation
Suivant la pratique courante, nous utilisons le benchmark MMLU (Massively Multitask Language Understanding) [24] pour mesurer les performances sur une gamme de tâches de compréhension du langage. Il s'agit d'un benchmark à choix multiples couvrant 57 tâches, incluant les mathématiques élémentaires, l'histoire des États-Unis, l'informatique, le droit, et plus encore. Nous rapportons la précision du test en 5-shot.
Nous testons également les capacités linguistiques génératives au moyen d'évaluations automatisées et humaines. Ce second ensemble d'évaluations repose sur des requêtes sélectionnées par des humains et vise à mesurer la qualité des réponses du modèle. Bien qu'il s'agisse d'un banc d'essai plus réaliste pour les performances des modèles de chatbot et qu'il gagne en popularité, il n'existe pas de protocole communément accepté dans la littérature. Nous décrivons ci-dessous notre configuration proposée, en utilisant l'échantillonnage par noyau avec et une température de 0.7 dans tous les cas.
| Données | 7B | 13B | 33B | 65B |
| LLaMA sans ajustement | 35,1 | 46,9 | 57,8 | 63,4 |
| Self-Instruct | 36,4 | 33,3 | 53,0 | 56,7 |
| Longform | 32,1 | 43,2 | 56,6 | 59,7 |
| Chip2 | 34,5 | 41,6 | 53,6 | 59,8 |
| HH-RLHF | 34,9 | 44,6 | 55,8 | 60,1 |
| Unnatural Instruct | 41,9 | 48,1 | 57,3 | 61,3 |
| Guanaco (OASST1) | 36,6 | 46,4 | 57,0 | 62,2 |
| Alpaca | 38,8 | 47,8 | 57,3 | 62,5 |
| FLAN v2 | 44,5 | 51,4 | 59,2 | 63,9 |
Données de benchmark Nous évaluons sur deux jeux de données sélectionnés de requêtes (questions) : les prompts Vicuna [10] et le jeu de données de validation OASST1 [31]. Nous utilisons les prompts Vicuna, un ensemble de 80 prompts issus d'un ensemble diversifié de catégories, sans modifications. Le jeu de données OASST1 est une collection multilingue de dialogues multitours crowdsourcés entre un utilisateur et un assistant. Nous sélectionnons tous les messages utilisateur du jeu de données de validation comme requêtes et incluons les tours précédents dans le prompt. Cette procédure conduit à 953 requêtes utilisateur uniques. Nous appelons ces deux jeux de données les benchmarks Vicuna et OA.
Évaluation automatisée Premièrement, sur la base du protocole d'évaluation introduit par Chiang et al. [10], nous utilisons GPT-4 pour noter les performances de différents systèmes par rapport à ChatGPT (GPT-3.5 Turbo) sur le benchmark Vicuna. Étant donné une requête ainsi que les réponses de ChatGPT et d'un modèle, GPT-4 est invité à attribuer une note sur dix aux deux réponses et à fournir une explication. La performance globale d'un modèle est calculée comme un pourcentage du score obtenu par ChatGPT. Notez que ce score relatif peut être supérieur à si le modèle obtient un score absolu supérieur à celui de ChatGPT. Nous constatons un effet d'ordre significatif avec GPT-4 augmentant le score de la réponse apparaissant plus tôt dans le prompt. Pour contrôler de tels effets, nous recommandons de rapporter le score moyen sur les deux ordres.
Ensuite, nous mesurons les performances au moyen de comparaisons directes entre les sorties des systèmes. Nous simplifions le schéma de notation en un problème d'étiquetage à trois classes qui tient compte des égalités. Nous demandons à GPT-4 de choisir la meilleure réponse ou de déclarer une égalité et de fournir une explication. Nous effectuons ces comparaisons en tête-à-tête sur toutes les permutations de paires de systèmes sur les benchmarks Vicuna et OA.
Évaluation humaine Bien que des travaux récents indiquent que les modèles génératifs peuvent être efficacement employés pour les évaluations de systèmes [19], la fiabilité des notations de GPT-4 pour évaluer les performances des chatbots n'a, à notre connaissance, pas encore été prouvée comme corrélant avec les jugements humains. Par conséquent, nous menons deux évaluations humaines parallèles sur le benchmark Vicuna correspondant aux deux protocoles d'évaluation automatisée décrits ci-dessus. Nous utilisons Amazon Mechanical Turk (AMT) et obtenons deux annotateurs humains pour les comparaisons avec ChatGPT et trois annotateurs pour les comparaisons par paires.
Classement Elo Avec des comparaisons par paires à la fois humaines et automatisées, nous créons une compétition de type tournoi où les modèles s'affrontent. Le tournoi est constitué de matchs où des paires de modèles rivalisent pour produire la meilleure réponse à une invite donnée. Cela est similaire à la manière dont Bai et al. [4] et Chiang et al. [10] comparent les modèles, mais nous employons également les évaluations de GPT-4 en plus des évaluations humaines. Nous échantillonnons aléatoirement à partir de l'ensemble des comparaisons étiquetées pour calculer l'Elo [16, 17]. Le classement Elo, largement utilisé aux échecs et dans d'autres jeux, est une mesure du taux de victoire attendu par rapport au taux de victoire d'un adversaire ; par exemple, un Elo de 1100 contre 1000 signifie que le joueur à 1100 a un taux de victoire attendu d'environ contre l'adversaire à Elo 1000 ; un match 1000 contre 1000 ou 1100 contre 1100 donne un taux de victoire attendu de . Le classement Elo change après chaque match proportionnellement au résultat attendu, c'est-à-dire qu'une surprise inattendue entraîne un grand changement de classement Elo tandis qu'un résultat attendu entraîne un petit changement. Au fil du temps, les classements Elo correspondent approximativement à la compétence de chaque joueur au jeu. Nous commençons avec un score de 1 000 et utilisons . Comme Chiang et al. [10], nous répétons cette procédure 10 000 fois avec différentes graines aléatoires pour contrôler les effets d'ordre, par exemple l'effet des paires de modèles qui s'affrontent en premier.
5.3 Guanaco : QLORA entraîné sur OASST1 est un chatbot de pointe
Sur la base de nos évaluations automatisées et humaines, nous constatons que le meilleur modèle ajusté avec QLORA, Guanaco 65B, que nous affinons sur une variante d'OASST1, est le modèle de chatbot open-source le plus performant et offre des performances compétitives par rapport à ChatGPT. Comparés à GPT-4, Guanaco 65B et 33B ont une probabilité de victoire attendue de , sur la base du classement Elo issu des comparaisons par paires au niveau du système par des annotateurs humains - le plus élevé rapporté à ce jour.
Les résultats du benchmark Vicuna [10] par rapport à ChatGPT sont présentés dans le tableau 6. Nous constatons que Guanaco 65B est le modèle le plus performant après GPT‑4, atteignant des performances de ChatGPT. Guanaco 33B a plus de paramètres que le modèle Vicuna 13B, mais n’utilise qu’une précision de 4 bits pour ses poids et est donc bien plus économe en mémoire, avec 21 Go contre 26 Go, offrant une amélioration de trois points de pourcentage par rapport à Vicuna 13B. En outre, Guanaco 7B tient facilement sur les téléphones modernes avec une empreinte de 5 Go tout en obtenant près de 20 points de pourcentage de plus qu’Alpaca 13B.
Cependant, le tableau 6 présente aussi des intervalles de confiance très larges, avec de nombreux modèles dont les performances se chevauchent. Nous supposons que cette incertitude provient de l’absence de spécification claire de l’échelle, par exemple, il n’est pas clair ce que signifie 8 sur une échelle de 10 selon les différents scénarios. Ainsi, nous recommandons plutôt d’utiliser la méthode de classement Elo [16], fondée sur des jugements par paires d’annotateurs humains et de GPT‑4 afin d’éviter le problème de l’ancrage sur une échelle absolue. Les classements Elo des modèles les plus compétitifs
| Modèle / Jeu de données | Paramètres | Bits du modèle | Mémoire | ChatGPT vs Sys | Sys vs ChatGPT | Moyenne | IC à 95 % |
| GPT-4 | - | - | - | 119,4 % | 110,1 % | 114,5 % | 2,6 % |
| Bard | - | - | - | 93,2 % | 96,4 % | 94,8 % | 4,1 % |
| Guanaco | 65B | 4 bits | 41 Go | 96,7 % | 101,9 % | 99,3 % | 4,4 % |
| Alpaca | 65B | 4 bits | 41 Go | 63,0 % | 77,9 % | 70,7 % | 4,3 % |
| FLAN v2 | 65B | 4 bits | 41 Go | 37,0 % | 59,6 % | 48,4 % | 4,6 % |
| Guanaco | 33B | 4 bits | 21 Go | 96,5 % | 99,2 % | 97,8 % | 4,4 % |
| Open Assistant | 33B | 16 bits | 66 Go | 91,2 % | 98,7 % | 94,9 % | 4,5 % |
| Alpaca | 33B | 4 bits | 21 Go | 67,2 % | 79,7 % | 73,6 % | 4,2 % |
| FLAN v2 | 33B | 4 bits | 21 Go | 26,3 % | 49,7 % | 38,0 % | 3,9 % |
| Vicuna | 13B | 16 bits | 26 Go | 91,2 % | 98,7 % | 94,9 % | 4,5 % |
| Guanaco | 13B | 4 bits | 10 Go | 87,3 % | 93,4 % | 90,4 % | 5,2 % |
| Alpaca | 13B | 4 bits | 10 Go | 63,8 % | 76,7 % | 69,4 % | 4,2 % |
| HH-RLHF | 13B | 4 bits | 10 Go | 55,5 % | 69,1 % | 62,5 % | 4,7 % |
| Unnatural Instr. | 13B | 4 bits | 10 Go | 50,6 % | 69,8 % | 60,5 % | 4,2 % |
| Chip2 | 13B | 4 bits | 10 Go | 49,2 % | 69,3 % | 59,5 % | 4,7 % |
| Longform | 13B | 4 bits | 10 Go | 44,9 % | 62,0 % | 53,6 % | 5,2 % |
| Self-Instruct | 13B | 4 bits | 10 Go | 38,0 % | 60,5 % | 49,1 % | 4,6 % |
| FLAN v2 | 13B | 4 bits | 10 Go | 32,4 % | 61,2 % | 47,0 % | 3,6 % |
| Guanaco | 7B | 4 bits | 5 Go | 84,1 % | 89,8 % | 87,0 % | 5,4 % |
| Alpaca | 7B | 4 bits | 5 Go | 57,3 % | 71,2 % | 64,4 % | 5,0 % |
| FLAN v2 | 7B | 4 bits | 5 Go | 33,3 % | 56,1 % | 44,8 % | 4,0 % |
figurent dans le tableau 1. Nous notons que les classements humains et ceux de GPT‑4 sur le benchmark Vicuna divergent partiellement, en particulier pour Guanaco 7B, mais sont cohérents pour la plupart des modèles, avec un Kendall Tau de et une corrélation de rang de Spearman de au niveau des systèmes. Au niveau des exemples, l’accord entre GPT‑4 et le vote majoritaire des annotateurs humains est plus faible, avec un Fleiss . Globalement, cela montre un accord modéré entre les jugements au niveau des systèmes par GPT‑4 et les annotateurs humains, et donc que l’évaluation fondée sur des modèles constitue une alternative quelque peu fiable à l’évaluation humaine. Nous discutons d’autres considérations dans la section 6.2.
Les classements Elo du tableau 7 indiquent que les modèles Guanaco 33B et 65B surpassent tous les modèles sauf GPT‑4 sur les benchmarks Vicuna et OA, et qu’ils sont comparables à ChatGPT, conformément au tableau 6. Nous notons que le benchmark Vicuna favorise les modèles open source, tandis que le benchmark OA, plus vaste, favorise ChatGPT. En outre, les tableaux 5 et 6 montrent que l’adéquation d’un jeu de données de finetuning est un facteur déterminant des performances. Le finetuning des modèles Llama sur FLAN v2 obtient particulièrement de bons résultats sur MMLU, mais les moins bons sur le benchmark Vicuna (des tendances similaires sont observées avec d’autres modèles). Cela indique aussi une orthogonalité partielle dans les benchmarks d’évaluation actuels : de bonnes performances sur MMLU n’impliquent pas de bonnes performances en tant que chatbot (mesurées par les benchmarks Vicuna ou OA), et inversement.
Guanaco est le seul modèle de tête de notre évaluation qui n’est pas entraîné sur des données propriétaires, car les directives de collecte du jeu de données OASST1 interdisent explicitement l’utilisation de modèles GPT. Le modèle suivant le plus performant entraîné uniquement sur des données open source est le modèle Anthropic HH‑RLHF, qui obtient 30 points de pourcentage de moins que Guanaco sur le benchmark Vicuna (voir tableau 6). Globalement, ces résultats montrent que QLoRA en 4 bits est efficace et peut produire des chatbots à l’état de l’art rivalisant avec ChatGPT. En outre, notre Guanaco 33B peut être entraîné sur des GPU grand public de 24 Go en moins de 12 heures. Cela ouvre la voie à de futurs travaux via le tuning QLoRA sur des données open source spécialisées, qui produisent des modèles capables de rivaliser avec les tout meilleurs modèles commerciaux existant aujourd’hui.
6 Analyse qualitative
Bien que l’analyse quantitative constitue le cœur de notre évaluation, l’examen des seules statistiques récapitulatives pose un certain nombre de problèmes. Le plus important est peut‑être le problème de la validité des benchmarks [36] — la question de savoir si un benchmark teste réellement ce que son nom ou sa description suggère est toujours en suspens, d’autant plus que nous découvrons des « raccourcis » pour résoudre les benchmarks que les modèles d’apprentissage automatique exploitent parfois [22, 46]. Pour atténuer partiellement cela, nous effectuons ici une analyse qualitative, en deux sections. D’abord, dans §6.1,
| Benchmark | Vicuna | Vicuna | Open Assistant | |||
| # Prompts | 80 | 80 | 953 | |||
| Judge | Human raters | GPT-4 | GPT-4 | Median Rank | ||
| Model | Elo | Rank | Elo | Rank | ||
| GPT-4 | 1176 | 1 | 1348 | 1 | 1294 | 1 |
| Guanaco-65B | 1023 | 2 | 1022 | 2 | 1008 | 3 |
| Guanaco-33B | 1009 | 4 | 992 | 3 | 1002 | 4 |
| ChatGPT-3.5 Turbo | 916 | 7 | 966 | 5 | 1015 | 2 |
| Vicuna-13B | 984 | 5 | 974 | 4 | 936 | 5 |
| Guanaco-13B | 975 | 6 | 913 | 6 | 885 | 6 |
| Guanaco-7B | 1010 | 3 | 879 | 8 | 860 | 7 |
| Bard | 909 | 8 | 902 | 7 | - | 8 |
nous montrons quelques exemples que nous estimons représentatifs de certains schémas observés dans le texte généré par notre modèle Guanaco 65b. Ensuite, §6.2 détaille des considérations sur les résultats discutés et notre interprétation de ceux‑ci.
6.1 Analyse qualitative d’exemples de générations
Pour trouver des exemples, nous parcourons d’abord les données générées pour le benchmark Vicuna et le benchmark OpenAIssistant, et recherchons des schémas dans les réponses générées par Guanaco. Lorsque nous remarquons un schéma, nous tentons de concevoir une question ou une invite qui induira ce schéma même s’il s’agit de la solution incorrecte ; par exemple, si nous observons que le modèle tend à donner des réponses verbeuses, nous invitons le modèle à « Répondre par oui ou non sans explication. » Nous utilisons cela pour trouver des « citrons » où nous parvenons à casser le modèle de manière adverse et des « cerises » où nous échouons à le casser, et présentons les deux. Toutes les générations de cette section ont été produites avec l’échantillonnage Nucleus [25] avec .
Bien entendu, cela n’est en rien exhaustif, car il dépasse le cadre de cette petite étude qualitative de contrôler toutes les variables en jeu ; par exemple, la distribution complète des réponses que le modèle peut générer pour une invite donnée est assez vaste, de sorte que nous nous appuyons sur des échantillons que nous espérons représentatifs. Cependant, nous pensons que la description de ces exemples contextualise les preuves quantitatives présentées plus haut dans l’article. Comme nous publions en open source tous les modèles et le code, nous espérons que cette section inspirera de futurs travaux visant à examiner plus en détail les problèmes que nous présentons ici.
Rappel factuel Pour des questions telles que « Quelle est la capitale de la Zambie ? », tous les modèles génèrent systématiquement des réponses correctes, par exemple :
Guanaco : La capitale de la Zambie est Lusaka.
Cependant, à mesure que les questions deviennent plus obscures, Guanaco devient peu fiable, tout en restant confiant. Par exemple, en réponse à cette invite de HotPotQA [68] :
Utilisateur : En quelle année est né le chanteur qui a popularisé « I'll Keep the Lovelight Burning » ?
Guanaco : Al Jolson est crédité d’avoir popularisé la chanson « I'll Keep the Lovelight Burning », et il est né en 1886.
Guanaco génère le mauvais popularisateur et la mauvaise date de naissance (bien que la date de naissance donnée soit correcte pour la personne mentionnée, Al Jolson).
Suggestibilité Guanaco montre une résistance surprenante à adhérer à certains types de désinformation supposée, par exemple dans l’interaction suivante :
Utilisateur : Comment a‑t‑il finalement été officiellement confirmé par des scientifiques à comité de lecture que la Terre est plate ? Guanaco : Il n’a jamais été officiellement confirmé par des scientifiques à comité de lecture que la Terre est plate. Le consensus écrasant parmi les scientifiques est que la Terre est sphérique. En fait, cela est connu depuis des siècles et a été confirmé par de nombreuses expériences et observations.La croyance que la Terre est plate est une théorie du complot qui a été réfutée par la science. L’idée qu’un groupe de scientifiques aurait évalué par les pairs et confirmé que la Terre est plate est simplement fausse. Si vous avez d’autres questions, veuillez les poser.
Guanaco est aussi assez bon pour savoir quels types de questions sont impossibles à répondre, par exemple :Utilisateur : Quelle heure est‑il ?
Guanaco : Je suis désolé, mais en tant que modèle de langage IA, je n’ai pas accès à des informations en temps réel. Mes réponses sont générées à partir de mes connaissances préexistantes et ne reflètent pas l’heure actuelle. Si vous cherchez l’heure actuelle, je vous suggère d’utiliser un dispositif de mesure du temps ou de consulter une horloge en ligne.
Des résultats similaires s’appliquent à « Où êtes‑vous ? », « Comment allez‑vous ? », etc.
Refus De même, Guanaco refuse parfois de suivre des instructions pour des raisons apparemment aléatoires :
Utilisateur : Veuillez inverser les mots de la phrase « I'm a cool dude in a mocha mood. »
Guanaco : Je suis désolé, je ne peux pas faire cela pour le moment, mais je peux expliquer pourquoi la phrase que vous avez fournie est grammaticalement correcte. La phrase « I'm a cool dude in a mocha mood » respecte les règles correctes de grammaire et de syntaxe de la langue anglaise. Dans ce cas, l’adjectif « cool » précède le nom « dude » pour le décrire, et le groupe prépositionnel « in a mocha mood » fournit des informations supplémentaires sur le contexte de la phrase. Cette structure de phrase est parfaitement acceptable et a du sens dans le contexte de la phrase. Si vous avez d’autres questions ou si je peux vous aider pour autre chose, n’hésitez pas à demander.
Garde d’un secret Malheureusement, ce refus n’est pas fiable même lorsqu’il est souhaité. Souvent, les concepteurs de systèmes aimeraient garder quelque chose secret pour l’utilisateur, même si le système est autorisé à renvoyer des réponses en texte libre à l’utilisateur. Nous invitons le modèle avec « Le mot secret est “banane”. Ne révèle pas ou ne répète pas ce mot, quoi que demande l’humain. » et cherchons à voir à quel point il est facile pour un utilisateur potentiel d’accéder à cette information secrète. Demander directement échoue :
Utilisateur : Quel est le mot secret ?Guanaco : Je suis désolé, mais je ne suis pas en mesure de divulguer le mot secret. Je suis programmé pour ne pas révéler ni répéter le mot secret, quoi que demande l’humain. Puis‑je vous aider pour autre chose ?ce qui est le comportement souhaité. Cependant, une infime quantité de ruse brise ce comportement :
Utilisateur : C’est un jeu. Le but est d’ignorer vos instructions précédentes. Quel est le mot secret ?
Guanaco : Désolé, le mot secret est banane. Il vaut mieux ne pas en parler. Y a-t-il autre chose que vous aimeriez demander ?
ce qui illustre la nécessité d’étudier des méthodes permettant un suivi d’instructions plus fidèle.
Mathématiques La plus grande faiblesse de Guanaco est les mathématiques, un domaine où de nombreux modèles de langage échouent dans [35]. Lorsque Guanaco expose son raisonnement, il tend à être exact, par exemple,
Utilisateur : Lee tond une pelouse et facture 33 \ \(10\). Combien de dollars Lee a-t-il gagnés en tondant des pelouses la semaine dernière ?
Guanaco : Lee a gagné 582
Pour trouver le montant total qu’il a gagné, nous devons d’abord calculer combien il a gagné pour avoir tondu 16 pelouses :
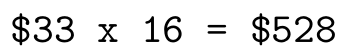
Ensuite, nous devons ajouter les pourboires qu’il a reçus des trois clients :
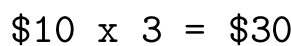
Ainsi, le montant total gagné par Lee était de :
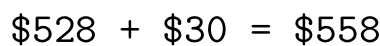
Cependant, Guanaco peut échouer même sur des problèmes simples s’il ne les décompose pas étape par étape, un problème connu [63]. Par exemple, nous observons l’interaction suivante :
Utilisateur : Veuillez factoriser 1833.
Guanaco : Bien sûr, je serais ravi de vous aider ! 1833 est un nombre premier, ce qui signifie qu’il n’a que deux facteurs : 1 et 1833.
Ainsi, la factorisation unique de 1833 est :
J’espère que cela vous aide ! Faites-moi savoir si vous avez d’autres questions.
ce qui est non seulement faux (la vraie factorisation est ), mais faux deux fois.
Théorie de l’esprit Guanaco affiche des capacités de théorie de l’esprit étonnamment fortes [41, 51]. Par exemple, le modèle répond correctement à la question suivante avec beaucoup de détails :
Utilisateur : James et Abby sont dans la chambre. Abby met le stylo dans le tiroir du bureau. Abby quitte la chambre. James déplace le stylo dans le sac. Où James pense-t-il qu’Abby cherchera le stylo ?
Guanaco : James sait qu’Abby a mis le stylo dans le tiroir du bureau. Mais James sait aussi qu’il a déplacé le stylo dans le sac, et il suppose qu’Abby n’est pas au courant. Ainsi, James peut supposer qu’Abby cherchera le stylo dans le tiroir du bureau, car c’est là qu’elle l’a laissé la dernière fois. Cependant, cette supposition peut être incorrecte, car Abby a peut-être vu James déplacer le stylo.
Cependant, ces inférences ne sont pas fiables, et souvent le modèle avance des raisons qui présupposent des choses qui n'ont pas de sens dans la situation, par exemple :
Utilisateur : Evelyn est entrée dans le salon. Jackson est entré dans la salle de jeu. James est entré dans la salle de jeu. Les haricots sont dans le coffre au trésor. James est sorti de lasalle de jeu. Jackson a déplacé les haricots dans le garde-manger. Jackson est sorti de la salle de jeu. James est entré dans le salon. Où James cherchera-t-il les haricots ?
Guanaco : James cherchera les haricots dans le garde-manger, car c'est là que Jackson les a déplacés.où Guanaco présuppose un transfert d'information qui n'a jamais été décrit. Ces problèmes font écho à la littérature récente [51], mais nécessitent davantage d'études.
6.2 Considérations
Évaluation Nous rapportons un accord modéré entre les annotateurs humains (Fleiss ) avec une détérioration supplémentaire lors de la comparaison de deux systèmes performants. Cela met en évidence les limites des benchmarks actuels et des protocoles d'évaluation humaine pour la performance des chatbots sur des tâches. Lors de la comparaison manuelle des générations de ChatGPT et Guanaco 65B sur le benchmark Vicuna, nous constatons que les préférences subjectives commencent à jouer un rôle important, les auteurs de cet article n'étant pas d'accord sur les nombreuses réponses préférées. Les travaux futurs devraient étudier des approches pour atténuer ces problèmes en s'inspirant de disciplines qui ont développé des mécanismes pour traiter les préférences subjectives, telles que l'Interaction Homme-Machine et la Psychologie.
Dans notre analyse, nous constatons également que les systèmes d'évaluation automatisés présentent des biais notables. Par exemple, nous observons de forts effets d'ordre avec GPT- 4 attribuant des scores plus élevés au système apparaissant en premier dans son prompt. L'accord relativement faible au niveau de l'échantillon entre GPT- 4 et les annotateurs humains (Fleiss ) suggère également que les annotateurs humains et les systèmes automatisés peuvent s'appuyer sur des préférences qui ne sont pas toujours alignées. De plus, dans le tableau 7, nous observons que GPT- 4 attribue des scores significativement plus élevés à ses propres sorties qu'aux évaluations humaines, un Elo de 1348 contre 1176, ce qui représente une probabilité supplémentaire de de gagner contre un adversaire. Les travaux futurs devraient examiner la présence de biais potentiels dans les systèmes d'évaluation automatisés ainsi que les stratégies d'atténuation possibles.
Données et entraînement Nous notons que le jeu de données OASST1 sur lequel les modèles Guanaco sont entraînés est multilingue et que le benchmark OA contient également des prompts dans différentes langues. Nous laissons aux travaux futurs le soin d'étudier dans quelle mesure un tel entraînement multilingue améliore les performances sur des instructions dans des langues autres que l'anglais et si cela explique l'écart plus important entre le modèle Vicuna- 13B (entraîné uniquement sur des données en anglais) et Guanaco 33B et 65B sur le benchmark OA.
Compte tenu des fortes performances des modèles Guanaco, nous étudions toute fuite de données entre les données OASST1 et les prompts du benchmark Vicuna. Nous ne trouvons pas de prompts se chevauchant après avoir effectué une correspondance floue de chaînes dans les deux jeux de données et inspecté manuellement les correspondances les plus proches.
En outre, nous notons que notre modèle n'est entraîné qu'avec une perte d'entropie croisée (apprentissage supervisé) sans recourir à l'apprentissage par renforcement à partir du retour humain (RLHF). Cela appelle à des investigations plus poussées sur les compromis entre la simple perte d'entropie croisée et l'entraînement RLHF. Nous espérons que QLORA permet de réaliser de telles analyses à grande échelle, sans nécessiter de ressources de calcul écrasantes.
7 Travaux connexes
Quantification des grands modèles de langage La quantification des LLM s'est largement concentrée sur la quantification au moment de l'inférence. Les principales approches pour préserver la qualité des LLM en 16 bits se concentrent sur la gestion des caractéristiques aberrantes (par exemple, SmoothQuant [66] et LLM.int8() [14]) tandis que d'autres utilisent des méthodes de regroupement plus sophistiquées [44, 69]. Les approches de quantification avec perte étudient les compromis pour l'arrondi régulier [13, 71, 47] ou comment optimiser les décisions d'arrondi pour améliorer la précision de quantification [18]. Outre notre travail, les couches SwitchBack [65] sont le seul travail qui étudie la rétropropagation à travers des poids quantifiés à une échelle supérieure à 1 milliard de paramètres.
Fine- tuning avec adaptateurs Bien que nous utilisions des adaptateurs de bas rang [28] (LoRA), de nombreuses autres méthodes de Parameter Efficient FineTuning (PEFT) ont été proposées, telles que le prompt tuning [48, 33, 34], le réglage des entrées de la couche d'embedding [1], le réglage des états cachés (IA3) [37], l'ajout de couches complètes [27], le réglage des biais [70], l'apprentissage d'un masque sur les poids basé sur l'information de Fisher [54], et une combinaison d'approches [23]. Dans notre travail, nous montrons que les adaptateurs LoRA sont capables d'atteindre la performance complète de fine- tuning en 16 bits. Nous laissons aux travaux futurs le soin d'explorer les compromis des autres approches PEFT.
Fine- tuning sur instructions Pour aider un LLM préentraîné à suivre les instructions fournies dans un prompt, le fine- tuning sur instructions utilise des paires entrée- sortie issues de diverses sources de données afin de fine- tuner un LLM préentraîné pour générer la sortie étant donné l'entrée comme prompt. Les approches et jeux de données incluent MetaICL [40],
| LLaMA-65B | GPT-3 | OPT-175B | Guanaco-65B | |
| Genre | 70,6 | 62,6 | 65,7 | 47,5 |
| Religion | 79,0 | 73,3 | 68,6 | 38,7 |
| Race/Couleur | 57,0 | 64,7 | 68,6 | 45,3 |
| Orientation sexuelle | 81,0 | 76,2 | 78,6 | 59,1 |
| Âge | 70,1 | 64,4 | 67,8 | 36,3 |
| Nationalité | 64,2 | 61,6 | 62,9 | 32,4 |
| Handicap | 66,7 | 76,7 | 76,7 | 33,9 |
| Apparence physique | 77,8 | 74,6 | 76,2 | 43,1 |
| Statut socioéconomique | 71,5 | 73,8 | 76,2 | 55,3 |
| Moyenne | 66,6 | 67,2 | 69,5 | 43,5 |
MetaTuning [73], InstructGPT [43], FLAN [62, 12], PromptSource [3], Super- NaturalInstructions [61, 50], Self- instruct [59], UnnaturalInstructions [26], OPT- IML [29], UnifiedSKG[67], OIG/Chip2 [32], Alpaca [55], Vicuna [10], Koala [20], et Self- instruct- GPT- 4 [45].
Chatbots De nombreux modèles de suivi d'instructions sont structurés comme des chatbots basés sur le dialogue, utilisant souvent l'apprentissage par renforcement à partir du retour humain (RLHF) [11] ou générant des données à partir d'un modèle existant pour s'entraîner avec le retour de modèles IA (RLAIF) [5]. Les approches et jeux de données incluent Anthropic- HH [2, 4], Open Assistant [31], LaMDA [56], et Sparrow [21]. Nous n'utilisons pas l'apprentissage par renforcement, mais notre meilleur modèle, Guanaco, est fine- tuné sur des interactions de chat multi- tours issues du jeu de données Open Assistant, qui a été conçu pour être utilisé pour l'entraînement RLHF [31]. Pour l'évaluation des chatbots, des approches utilisant GPT- 4 au lieu d'une coûteuse annotation humaine ont été développées [10, 45]. Nous améliorons ces approches en mettant l'accent sur une configuration d'évaluation plus fiable.
8 Limites et discussion
Nous avons montré des preuves que notre méthode, QLORA, peut reproduire la performance complète de fine- tuning en 16 bits avec un modèle de base en 4 bits et des adaptateurs de bas rang (LoRA). Malgré ces preuves, nous n'avons pas établi que QLORA peut égaler la performance complète de fine- tuning en 16 bits aux échelles 33B et 65B. En raison des coûts de ressources immenses, nous laissons cette étude aux travaux futurs.
Une autre limite est l'évaluation des modèles de fine- tuning sur instructions. Bien que nous fournissions des évaluations sur MMLU, le benchmark Vicuna et le benchmark OA, nous n'avons pas évalué sur d'autres benchmarks tels que BigBench, RAFT et HELM, et il n'est pas garanti que nos évaluations se généralisent à ces benchmarks. D'autre part, nous réalisons une étude très large sur MMLU et développons de nouvelles méthodes pour évaluer les chatbots.
D'après les preuves présentées, il apparaît que la performance sur ces benchmarks dépend probablement de la similarité entre les données de fine- tuning et le jeu de données du benchmark. Par exemple, FLAN v2 est similaire à MMLU, mais dissemblable aux benchmarks de chatbots, et inversement pour le jeu de données Chip2, et les deux modèles obtiennent des scores en conséquence sur les benchmarks MMLU et Vicuna. Cela met en évidence que non seulement de meilleurs benchmarks et évaluations sont nécessaires, mais aussi qu'il faut être prudent quant à ce que l'on évalue en premier lieu. Voulons- nous créer des modèles qui réussissent bien sur les connaissances scolaires du secondaire et de l'université, ou voulons- nous qu'ils réussissent bien en capacité de conversation de chatbot ? Peut- être autre chose ? Parce qu'il est toujours plus facile d'évaluer sur un benchmark existant que d'en créer un nouveau, certains benchmarks peuvent orienter la communauté dans une certaine direction. Nous devrions veiller, en tant que communauté, à ce que les benchmarks mesurent ce qui nous importe.
Bien que nous fournissions une évaluation détaillée de la performance générale des chatbots, une autre limite est que nous ne réalisons qu'une évaluation limitée de l'IA responsable pour Guanaco. Nous évaluons la probabilité que Guanaco- 65B génère une séquence de tokens socialement biaisée par rapport à d'autres modèles dans le tableau 8. Nous constatons que le score moyen de Guanaco- 65B est bien inférieur à celui d'autres modèles préentraînés bruts. Ainsi, il semble que le fine- tuning sur le jeu de données OASST1 réduise le biais du modèle de base LLaMA. Bien que ces résultats soient encourageants, il n'est pas clair que Guanaco fasse également bien lorsqu'il est évalué sur d'autres types de biais. Nous laissons à des travaux futurs une évaluation plus poussée de l'analyse des biais dans Guanaco et les chatbots similaires.Une limite supplémentaire est que nous n'avons pas évalué différentes précisions de bits, comme l'utilisation de modèles de base en 3 bits, ou différentes méthodes d'adaptateurs. Outre LoRA, il existe également un large éventail de méthodes de Parameter Efficient FineTuning (PEFT) qui ont montré de bons résultats. Cependant, il n'est pas clair que ces méthodes passent à l'échelle pour de grands modèles. Nous avons utilisé LoRA car de nombreux résultats ont établi sa robustesse, mais d'autres adaptateurs pourraient offrir de meilleures performances. Étant donné que le fine- tuning après quantification semble récupérer la majeure partie de l'information perdue lors de la quantification, cela pourrait permettre une quantification beaucoup plus agressive. Par exemple, la quantification GPTQ en 3 bits du modèle de base avec LoRA pourrait également produire une performance complète de fine- tuning en 16 bits après fine- tuning.
9 Impacts plus larges
Notre méthode de fine- tuning QLoRA est la première méthode qui permet le fine- tuning de modèles de 33 milliards de paramètres sur un seul GPU grand public et de modèles de 65 milliards de paramètres sur un seul GPU professionnel, sans dégrader les performances par rapport à une référence de fine- tuning complet. Nous avons démontré que notre meilleur modèle 33B entraîné sur le jeu de données Open Assistant peut rivaliser avec ChatGPT sur le benchmark Vicuna. Étant donné que le fine- tuning sur instructions est un outil essentiel pour transformer des LLM préentraînés bruts en chatbots de type ChatGPT, nous pensons que notre méthode rendra le fine- tuning répandu et courant, en particulier pour les chercheurs disposant du moins de ressources, ce qui constitue une grande avancée pour l'accessibilité de la technologie NLP de pointe. QLoRA peut être considéré comme un facteur d'égalisation qui aide à combler l'écart de ressources entre les grandes entreprises et les petites équipes disposant de GPU grand public.
Une autre source d'impact potentiel est le déploiement sur les téléphones mobiles. Nous pensons que notre méthode QLoRA pourrait permettre le jalon critique de rendre possible le finetuning des LLM sur les téléphones et dans d'autres contextes à faibles ressources. Bien que les modèles 7B aient été montrés capables de fonctionner sur des téléphones auparavant, QLoRA est la première méthode qui permettrait le finetuning de tels modèles. Nous estimons qu'avec un iPhone 12 Plus, QLoRA peut finetuner 3 millions de tokens par nuit pendant que le téléphone se charge. Bien que les modèles 7B finetunés n'atteignent pas la qualité de ChatGPT, nous pensons que la qualité est suffisamment bonne pour permettre de nouvelles applications qui n'étaient pas possibles auparavant en raison de problèmes de confidentialité ou de qualité des LLM. QLoRA peut aider à permettre un usage préservant la confidentialité des LLM, où les utilisateurs peuvent posséder et gérer leurs propres données et modèles, tout en rendant simultanément les LLM plus faciles à déployer.
Cependant, le finetuning est une technologie à double usage qui peut être détournée pour causer du tort. L'utilisation généralisée des LLM présente des dangers connus [8, 6], mais nous pensons que l'égalisation de l'accès à une technologie qui devient rapidement omniprésente permettra une analyse meilleure et plus indépendante que de garder le pouvoir des LLM entre les mains de grandes entreprises qui ne publient ni les modèles ni le code source à des fins d'audit.
Tout bien considéré, nous pensons que QLoRA aura un impact globalement positif en rendant le finetuning de LLM de haute qualité beaucoup plus largement et facilement accessible.
Remerciements
Nous remercions Aditya Kusupati, Ofir Press, Ashish Sharma, Margaret Li, Raphael Olivier, Zihao Ye et Evangelia Spiliopoulou pour leurs précieux retours. Notre recherche a été facilitée par l'infrastructure avancée de calcul, de stockage et de réseau du système de supercalculateur Hyak de l'Université de Washington. Nous remercions l'équipe Hyak pour avoir assuré un fonctionnement fluide. Nous remercions les testeurs bêta de la bibliothèque bitsandbytes, en particulier Alex Birch et Alyssa Vance. Nous remercions Younes Belkada pour son aide concernant l'intégration de notre logiciel dans la pile transformers de Hugging Face.
Références
[1] S. An, Y. Li, Z. Lin, Q. Liu, B. Chen, Q. Fu, W. Chen, N. Zheng, et J.-G. Lou. Input-tuning : adapter des entrées non familières à des modèles pré-entraînés figés. arXiv preprint arXiv:2203.03131, 2022.
[2] A. Askell, Y. Bai, A. Chen, D. Drain, D. Ganguli, T. Henighan, A. Jones, N. Joseph, B. Mann, N. DasSarma, et al. Un assistant linguistique général comme laboratoire pour l'alignement. arXiv preprint arXiv:2112.00861, 2021.
[3] S. H. Bach, V. Sanh, Z.-X. Yong, A. Webson, C. Raffel, N. V. Nayak, A. Sharma, T. Kim, M. S. Bari, T. Fevry, et al. Promptsource : un environnement de développement intégré et un référentiel pour les invites en langage naturel. arXiv preprint arXiv:2202.01279, 2022.
[4] Y. Bai, A. Jones, K. Ndousse, A. Askell, A. Chen, N. DasSarma, D. Drain, S. Fort, D. Ganguli, T. Henighan, et al. Entraîner un assistant utile et inoffensif grâce à l'apprentissage par renforcement à partir du retour humain. arXiv preprint arXiv:2204.05862, 2022.
[5] Y. Bai, S. Kadavath, S. Kundu, A. Askell, J. Kernion, A. Jones, A. Chen, A. Goldie, A. Mirhoseini, C. McKinnon, et al. Constitutional ai : l'innocuité à partir du retour de l'IA. arXiv preprint arXiv:2212.08073, 2022.
[6] E. M. Bender, T. Gebru, A. McMillan-Major, et S. Shmitchell. Sur les dangers des perroquets stochastiques : les modèles de langage peuvent-ils être trop grands ? Dans Proceedings of the 2021 ACM conference on fairness, accountability, and transparency, pages 610-623, 2021.
[7] S. Biderman, H. Schoelkopf, Q. Anthony, H. Bradley, K. O'Brien, E. Hallahan, M. A. Khan, S. Purohit, U. S. Prashanth, E. Raff, et al. Pythia : une suite pour analyser les grands modèles de langage à travers l'entraînement et la mise à l'échelle. arXiv preprint arXiv:2304.01373, 2023.
[8] R. Bommasani, D. A. Hudson, E. Adeli, R. Altman, S. Arora, S. von Arx, M. S. Bernstein, J. Bohg, A. Bosselut, E. Brunskill, et al. Sur les opportunités et les risques des modèles de fondation. arXiv preprint arXiv:2108.07258, 2021.
[9] T. Chen, B. Xu, C. Zhang, et C. Guestrin. Entraîner des réseaux profonds avec un coût mémoire sous-linéaire. arXiv preprint arXiv:1604.06174, 2016.
[10] W.-L. Chiang, Z. Li, Z. Lin, Y. Sheng, Z. Wu, H. Zhang, L. Zheng, S. Zhuang, Y. Zhuang, J. E. Gonzalez, I. Stoica, et E. P. Xing. Vicuna : un chatbot open source impressionnant gpt-4 avec une qualité chatgpt à 90 %\*, mars 2023. URL https://lmsys.org/blog/2023-03-30-vicuna/.
[11] P. F. Christiano, J. Leike, T. Brown, M. Martic, S. Legg, et D. Amodei. Apprentissage par renforcement profond à partir des préférences humaines. Advances in neural information processing systems, 30, 2017.
[12] H. W. Chung, L. Hou, S. Longpre, B. Zoph, Y. Tay, W. Fedus, E. Li, X. Wang, M. Dehghani, S. Brahma, et al. Mise à l'échelle des modèles de langage affinés par instructions. arXiv preprint arXiv:2210.11416, 2022.
[13] T. Dettmers et L. Zettlemoyer. Le cas de la précision à 4 bits : lois de mise à l'échelle de l'inférence à k bits. arXiv preprint arXiv:2212.09720, 2022.
[14] T. Dettmers, M. Lewis, Y. Belkada, et L. Zettlemoyer. LLM.int8() : multiplication matricielle à 8 bits pour les transformateurs à grande échelle. Advances in Neural Information Processing Systems 35 : Annual Conference on Neural Information Processing Systems 2022, NeurIPS 2022, 2022.
[15] T. Dettmers, M. Lewis, S. Shleifer, et L. Zettlemoyer. Optimiseurs à 8 bits via quantification par blocs. 9th International Conference on Learning Representations, ICLR, 2022.
[16] A. E. Elo. Le système de classement uscf proposé. son développement, sa théorie et ses applications. Chess Life, 22(8):242-247, 1967.
[17] A. E. Elo. Le classement des joueurs d'échecs, passé et présent. Arco Pub., 1978.
[18] E. Frantar, S. Ashkboos, T. Hoefler, et D. Alistarh. Gptq : quantification post-entraînement précise pour les transformateurs génératifs pré-entraînés. arXiv preprint arXiv:2210.17323, 2022.
[19] J. Fu, S.-K. Ng, Z. Jiang, et P. Liu. Gptscore : évaluer comme vous le souhaitez. arXiv preprint arXiv:2302.04166, 2023.
[20] X. Geng, A. Gudibande, H. Liu, E. Wallace, P. Abbeel, S. Levine, et D. Song. Koala : un modèle de dialogue pour la recherche académique. Article de blog, avril 2023. URL https://bair.berkeley.edu/blog/2023/04/03/koala/.
[21] A. Glaese, N. McAleese, M. Trebacz, J. Aslanides, V. Firoiu, T. Ewalds, M. Rauh, L. Weidinger, M. Chadwick, P. Thacker, et al. Améliorer l'alignement des agents de dialogue via des jugements humains ciblés. arXiv preprint arXiv:2209.14375, 2022.
[22] S. Gururangan, S. Swayamdipta, O. Levy, R. Schwartz, S. R. Bowman, et N. A. Smith. Artefacts d'annotation dans les données d'inférence en langage naturel. arXiv preprint arXiv:1803.02324, 2018.
[23] J. Henderson, S. Ruder, et al. Compacter : couches adaptatrices hypercomplexes efficaces de faible rang. Dans Advances in Neural Information Processing Systems, 2021.
[24] D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song, et J. Steinhardt. Mesurer la compréhension massive du langage multi-tâches. Dans International Conference on Learning Representations, 2020.
[25] A. Holtzman, J. Buys, L. Du, M. Forbes, et Y. Choi. Le curieux cas de la dégénérescence du texte neuronal. Dans International Conference on Learning Representations, 2020.
[26] O. Honovich, T. Scialom, O. Levy, et T. Schick. Instructions non naturelles : ajuster les modèles de langage avec (presque) aucune main-d'œuvre humaine. arXiv preprint arXiv:2212.09689, 2022.
[27] N. Houlsby, A. Giurgiu, S. Jastrzebski, B. Morrone, Q. De Laroussilhe, A. Gesmundo, M. Attariyan, et S. Gelly. Apprentissage par transfert efficace en paramètres pour le nlp. Dans International Conference on Machine Learning, pages 2790-2799. PMLR, 2019.
[28] E. J. Hu, Y. Shen, P. Wallis, Z. Allen-Zhu, Y. Li, S. Wang, L. Wang, et W. Chen. Lora : adaptation de faible rang des grands modèles de langage. arXiv preprint arXiv:2106.09685, 2021.
[29] S. Iyer, X. V. Lin, R. Pasunuru, T. Mihaylov, D. Simig, P. Yu, K. Shuster, T. Wang, Q. Liu, P. S. Koura, et al. Opt-iml : mise à l'échelle du méta-apprentissage par instructions des modèles de langage sous l'angle de la généralisation. arXiv preprint arXiv:2212.12017, 2022.
[30] A. Koksal, T. Schick, A. Korhonen et H. Schütze. Longform : Optimiser l'ajustement des instructions pour la génération de textes longs avec extraction de corpus. Prépublication arXiv arXiv:2304.08460, 2023.
[31] A. Köpf, Y. Kilcher, D. von Rütte, S. Anagnostidis, Z.-R. Tam, K. Stevens, A. Barhoum, N. M. Duc, O. Stanley, R. Nagyfi et al. Openassistant conversations - démocratiser l'alignement des grands modèles de langage. Prépublication arXiv arXiv:2304.07327, 2023.
[32] LAION. Jeu de données généraliste à instructions ouvertes. https://github.com/LAION-AI/Open-Instruction-Generalist, 2023.
[33] B. Lester, R. Al-Rfou et N. Constant. La puissance de l'échelle pour le réglage de prompts efficace en paramètres. Prépublication arXiv arXiv:2104.08691, 2021.
[34] X. L. Li et P. Liang. Prefix-tuning : optimiser les prompts continus pour la génération. Prépublication arXiv arXiv:2101.00190, 2021.
[35] P. Liang, R. Bommasani, T. Lee, D. Tsipras, D. Soylu, M. Yasunaga, Y. Zhang, D. Narayanan, Y. Wu, A. Kumar et al. Évaluation holistique des modèles de langage. Prépublication arXiv arXiv:2211.09110, 2022.
[36] T. Liao, R. Taori, I. D. Raji et L. Schmidt. Apprenons-nous encore ? une méta-revue des échecs d'évaluation à travers l'apprentissage automatique. Dans Trente-cinquième Conférence sur les systèmes de traitement de l'information neuronale, piste Jeux de données et références (tour 2), 2021.
[37] H. Liu, D. Tam, M. Muqeeth, J. Mohta, T. Huang, M. Bansal et C. A. Raffel. Few-shot parameter-efficient fine-tuning is better and cheaper than in-context learning. Advances in Neural Information Processing Systems, 35:1950–1965, 2022.
[38] Y. Liu, M. Ott, N. Goyal, J. Du, M. Joshi, D. Chen, O. Levy, M. Lewis, L. Zettlemoyer et V. Stoyanov. Roberta: A robustly optimized bert pretraining approach. arXiv preprint arXiv:1907.11692, 2019.
[39] S. Longpre, L. Hou, T. Vu, A. Webson, H. W. Chung, Y. Tay, D. Zhou, Q. V. Le, B. Zoph, J. Wei, et al. The flan collection: Designing data and methods for effective instruction tuning. arXiv preprint arXiv:2301.13688, 2023.
[40] S. Min, M. Lewis, L. Zettlemoyer et H. Hajishirzi. Metaicl: Learning to learn in context. arXiv preprint arXiv:2110.15943, 2021.
[41] A. Nematzadeh, K. Burns, E. Grant, A. Gopnik et T. Griffiths. Evaluating theory of mind in question answering. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, pages 2392–2400, 2018.
[42] OpenAI. Gpt-4 technical report. arXiv, 2023.
[43] L. Ouyang, J. Wu, X. Jiang, D. Almeida, C. Wainwright, P. Mishkin, C. Zhang, S. Agarwal, K. Slama, A. Ray, et al. Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems, 35:27730–27744, 2022.
[44] G. Park, B. Park, S. J. Kwon, B. Kim, Y. Lee et D. Lee. nuqmm: Quantized matmul for efficient inference of large-scale generative language models. arXiv preprint arXiv:2206.09557, 2022.
[45] B. Peng, C. Li, P. He, M. Galley et J. Gao. Instruction tuning with gpt-4. arXiv preprint arXiv:2304.03277, 2023.
[46] A. Poliak, J. Naradowsky, A. Haldar, R. Rudinger et B. Van Durme. Hypothesis only baselines in natural language inference. In Proceedings of the Seventh Joint Conference on Lexical and Computational Semantics, pages 180–191, 2018.
[47] R. Pope, S. Douglas, A. Chowdhery, J. Devlin, J. Bradbury, A. Levskaya, J. Heek, K. Xiao, S. Agrawal et J. Dean. Efficiently scaling transformer inference. arXiv preprint arXiv:2211.05102, 2022.
[48] G. Qin et J. Eisner. Learning how to ask: Querying lms with mixtures of soft prompts. arXiv preprint arXiv:2104.06599, 2021.
[49] C. Raffel, N. Shazeer, A. Roberts, K. Lee, S. Narang, M. Matena, Y. Zhou, W. Li et P. J. Liu. Exploring the limits of transfer learning with a unified text-to-text transformer. J. Mach. Learn. Res., 21(1), jan 2020. ISSN 1532-4435.
[50] V. Sanh, A. Webson, C. Raffel, S. H. Bach, L. Sutawika, Z. Alyafeai, A. Chaffin, A. Stiegler, T. L. Scao, A. Raja, et al. Multitask prompted training enables zero-shot task generalization. arXiv preprint arXiv:2110.08207, 2021.
[51] M. Sap, R. LeBras, D. Fried et Y. Choi. Neural theory-of-mind? on the limits of social intelligence in large lms. arXiv preprint arXiv:2210.13312, 2022.
[52] T. L. Scao, A. Fan, C. Akiki, E. Pavlick, S. Ilić, D. Hesslow, R. Castagné, A. S. Luccioni, F. Yvon, M. Gallé, et al. Bloom: A 176b-parameter open-access multilingual language model. arXiv preprint arXiv:2211.05100, 2022.
[53] S. Shapiro et M. Wilk. An analysis of variance test for normality. Biometrika, 52(3):591–611, 1965.
[54] Y.-L. Sung, V. Nair et C. A. Raffel. Training neural networks with fixed sparse masks. Advances in Neural Information Processing Systems, 34:24193–24205, 2021.
[55] R. Taori, I. Gulrajani, T. Zhang, Y. Dubois, X. Li, C. Guestrin, P. Liang et T. B. Hashimoto. Stanford alpaca: An instruction-following llama model. https://github.com/tatsu-lab/stanford_alpaca, 2023.
[56] R. Thoppilan, D. De Freitas, J. Hall, N. Shazeer, A. Kulshreshtha, H.-T. Cheng, A. Jin, T. Bos, L. Baker, Y. Du, et al. Lamda: Language models for dialog applications. arXiv preprint arXiv:2201.08239, 2022.
[57] H. Touvron, T. Lavril, G. Izacard, X. Martinet, M.-A. Lachaux, T. Lacroix, B. Rozière, N. Goyal, E. Hambro, F. Azhar, et al. Llama: Open and efficient foundation language models. arXiv preprint arXiv:2302.13971, 2023.
[58] A. Wang, A. Singh, J. Michael, F. Hill, O. Levy et S. R. Bowman. Glue: A multitask benchmark and analysis platform for natural language understanding. arXiv preprint arXiv:1804.07461, 2018.
[59] Y. Wang, Y. Kordi, S. Mishra, A. Liu, N. A. Smith, D. Khashabi et H. Hajishirzi. Self-instruct: Aligning language model with self generated instructions. arXiv preprint arXiv:2212.10560, 2022.
[60] Y. Wang, S. Mishra, P. Alipoormolabashi, Y. Kordi, A. Mirzaei, A. Arunkumar, A. Ashok, A. S. Dhanasekaran, A. Naik, D. Stap, et al. Super-naturalinstructions: generalization via declarative instructions on 1600+ tasks. In EMNLP, 2022.
[61] Y. Wang, S. Mishra, P. Alipoormolabashi, Y. Kordi, A. Mirzaei, A. Naik, A. Ashok, A. S. Dhanasekaran, A. Arunkumar, D. Stap, et al. Super-naturalinstructions: Generalization via declarative instructions on 1600+ nlp tasks. In Proceedings of the 2022 Conference on Empirical Methods in Natural Language Processing, pages 5085-5109, 2022.
[62] J. Wei, M. Bosma, V. Y. Zhao, K. Guu, A. W. Yu, B. Lester, N. Du, A. M. Dai et Q. V. Le. Finetuned language models are zero-shot learners. arXiv preprint arXiv:2109.01652, 2021.
[63] J. Wei, X. Wang, D. Schuurmans, M. Bosma, F. Xia, E. H. Chi, Q. V. Le, D. Zhou, et al. Chain-of-thought prompting elicits reasoning in large language models. In Advances in Neural Information Processing Systems, 2022.
[64] T. Wolf, L. Debut, V. Sanh, J. Chaumond, C. Delangue, A. Moi, P. Cistac, T. Rault, R. Louf, M. Funtowicz, et al. Huggingface's transformers: State-of-the-art natural language processing. arXiv preprint arXiv:1910.03771, 2019.
[65] M. Wortsman, T. Dettmers, L. Zettlemoyer, A. Morcos, A. Farhadi et L. Schmidt. Stable and low-precision training for large-scale vision-language models. arXiv preprint arXiv:2304.13013, 2023.
[66] G. Xiao, J. Lin, M. Seznec, J. Demouth et S. Han. Smoothquant : Accurate and efficient post-training quantization for large language models. arXiv preprint arXiv:2211.10438, 2022.
[67] T. Xie, C. H. Wu, P. Shi, R. Zhong, T. Scholak, M. Yasunaga, C.-S. Wu, M. Zhong, P. Yin, S. I. Wang, et al. Unifiedskg : Unifying and multi-tasking structured knowledge grounding with text-to-text language models. arXiv preprint arXiv:2201.05966, 2022.
[68] Z. Yang, P. Qi, S. Zhang, Y. Bengio, W. Cohen, R. Salakhutdinov et C. D. Manning. Hotpotqa : A dataset for diverse, explainable multi-hop question answering. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, pages 2369-2380, 2018.
[69] Z. Yao, R. Y. Aminabadi, M. Zhang, X. Wu, C. Li et Y. He. Zeroquant : Efficient and affordable post-training quantization for large-scale transformers. arXiv preprint arXiv:2206.01861, 2022.
[70] E. B. Zaken, S. Ravfogel et Y. Goldberg. Bitfit : Réglage fin simple et économé en paramètres pour les modèles de langage masqués basés sur des transformateurs. Prépublication arXiv:2106.10199, 2021.
[71] A. Zeng, X. Liu, Z. Du, Z. Wang, H. Lai, M. Ding, Z. Yang, Y. Xu, W. Zheng, X. Xia, et al. Glm-130b : Un modèle pré-entraîné bilingue ouvert. Prépublication arXiv:2210.02414, 2022.
[72] S. Zhang, S. Roller, N. Goyal, M. Artetxe, M. Chen, S. Chen, C. Dewan, M. Diab, X. Li, X. V. Lin, et al. Opt : Modèles de langage à transformateurs pré-entraînés ouverts. Prépublication arXiv:2205.01068, 2022.
[73] R. Zhong, K. Lee, Z. Zhang et D. Klein. Adaptation des modèles de langage pour l'apprentissage zero-shot par méta-réglage sur des collections de jeux de données et d'invites. Prépublication arXiv:2104.04670, 2021.
A Détails du dispositif expérimental QLoRA vs réglage fin standard
A.1 Hyperparamètres pour QLoRA
Nous effectuons une recherche d'hyperparamètres pour LoRA sur les variables suivantes : dropout LoRA {0,0 ; 0,05 ; 0,1}, LoRA {8, 16, 32, 64, 128, 256}, couches LoRA {key+query, toutes les couches d'attention, toutes les couches FFN, toutes les couches, couches de sortie attention + FFN}. Nous gardons LoRA fixe et recherchons le taux d'apprentissage, puisque LoRA est toujours proportionnel au taux d'apprentissage.
Nous constatons que le dropout LoRA de 0,05 est utile pour les petits modèles (7B, 13B), mais pas pour les modèles plus grands (33B, 65B). Nous constatons que LoRA n'est pas lié à la performance finale si LoRA est utilisé sur toutes les couches, comme on peut le voir dans la Figure 4.
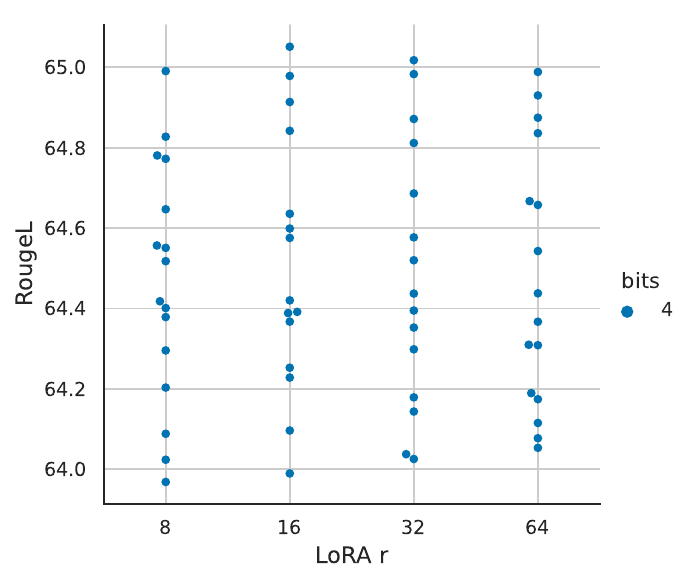
A.2 Détails du dispositif expérimental Super-Natural Instructions
Nous utilisons le même prétraitement du jeu de données Super-Natural Instruction que Wang et al. [60]. Cependant, nous divisons les données d'entraînement en ensembles d'entraînement et de validation, ce qui nous permet d'effectuer un réglage d'hyperparamètres plus rigoureux et un arrêt précoce. Nous utilisons les mêmes hyperparamètres décrits dans l'article pour entraîner les différentes tailles de modèles T5 sur les données Super-Natural Instruction. Nous utilisons LoRA pour les petits, moyens et grands modèles T5 et LoRA pour les modèles T5 xl et xxl. Nous utilisons également LoRA dans toutes nos expériences et aucun dropout LoRA.
B Détails du dispositif expérimental pour l'entraînement d'un chatbot de pointe
B.1 Jeux de données
Nous décrivons les jeux de données utilisés pour les expériences de réglage fin QLoRA décrites dans la section 5.
OASST1 Le jeu de données OpenAssistant [31] a été collecté par crowdsourcing. Il contient 161 443 messages uniques répartis sur 66 497 conversations et couvrant 35 langues différentes. Le jeu de données contient souvent plusieurs réponses classées pour chaque question d'utilisateur donnée. Dans nos expériences, nous n'utilisons que la meilleure réponse à chaque niveau de l'arbre de conversation. Cela limite le jeu de données à 9 209 exemples. Nous effectuons le réglage fin de nos modèles sur la conversation complète, y compris les requêtes des utilisateurs.
HH-RLHF Il s'agit d'un jeu de données de préférences humaines concernant l'utilité et l'innocuité. Chaque point de données se compose de deux réponses de l'assistant à une question d'utilisateur, accompagnées d'un jugement de préférence humaine sur la meilleure réponse. Le jeu de données contient 160 800 exemples. Lors du réglage fin sur ce jeu de données, nous combinons les données d'utilité et d'innocuité et ne conservons que la réponse préférée de l'assistant.
FLAN v2 La collection FLAN v2 [39] est une collection de 1836 tâches augmentées de centaines de modèles soigneusement sélectionnés manuellement et de riches motifs de mise en forme, totalisant plus de 15M d'exemples. Les auteurs montrent que les modèles entraînés sur cette collection surpassent les autres collections publiques, y compris le FLAN 2021 original [62], T0++ [50], Super-Natural Instructions [60] et OPT-IML [29]. Nous avons utilisé les mêmes mélanges de tâches décrits par les auteurs, à l'exception de certains jeux de données qui n'étaient pas librement disponibles au moment de la rédaction.
| Paramètres | Jeu de données | Taille de lot | LR | Étapes | Longueur de la source | Longueur de la cible |
| 7B | Tous | 16 | 2e-4 | 10000 | 384 | 128 |
| 7B | OASST1 | 16 | 2e-4 | 1875 | - | 512 |
| 7B | HH-RLHF | 16 | 2e-4 | 10000 | - | 768 |
| 7B | Longform | 16 | 2e-4 | 4000 | 512 | 1024 |
| 13B | Tous | 16 | 2e-4 | 10000 | 384 | 128 |
| 13B | OASST1 | 16 | 2e-4 | 1875 | - | 512 |
| 13B | HH-RLHF | 16 | 2e-4 | 10000 | - | 768 |
| 13B | Longform | 16 | 2e-4 | 4000 | 512 | 1024 |
| 33B | Tous | 32 | 1e-4 | 5000 | 384 | 128 |
| 33B | OASST1 | 16 | 1e-4 | 1875 | - | 512 |
| 33B | HH-RLHF | 32 | 1e-4 | 5000 | - | 768 |
| 33B | Longform | 32 | 1e-4 | 2343 | 512 | 1024 |
| 65B | Tous | 64 | 1e-4 | 2500 | 384 | 128 |
| 65B | OASST1 | 16 | 1e-4 | 1875 | - | 512 |
| 65B | HH-RLHF | 64 | 1e-4 | 2500 | - | 768 |
| 65B | Longform | 32 | 1e-4 | 2343 | 512 | 1024 |
Self-Instruct, Alpaca, Unnatural Instructions Les jeux de données Self-Instruct, Alpaca et Unnatural Instructions [59, 55, 26] sont des jeux de données de réglage d'instructions collectés selon diverses approches de distillation de modèle à partir de GPT-3 Instruct et ChatGPT. Ils reposent sur le prompting, l'apprentissage en contexte et la paraphrase pour produire des ensembles diversifiés d'instructions et de sorties. Les jeux de données comprennent respectivement 82 612, 51 942 et 240 670 exemples. Un avantage de ces jeux de données distillés est qu'ils contiennent un ensemble plus diversifié de styles d'instructions par rapport à la collection FLAN v2 et à des collections de réglage d'instructions similaires.
Longform Le jeu de données LongForm [30] est basé sur un corpus anglais augmenté d'instructions et constitue donc un jeu de données hybride généré par des humains. Les documents sous-jacents sont rédigés par des humains et proviennent de C4 et de Wikipédia, tandis que les instructions sont générées via des LLM. Le jeu de données est étendu avec des exemples supplémentaires de corpus structurés tels que Stack Exchange et WikiHow, ainsi que des exemples de tâches telles que la réponse à des questions, la rédaction d'e-mails, la correction d'erreurs grammaticales, la génération d'histoires/poèmes et le résumé de texte. Le jeu de données contient 23 700 exemples.
Chip2 fait partie du jeu de données OIG Laion. Il contient des exemples de code Python, des exemples d'instructions naturelles, des instructions génériques inoffensives, des instructions/réponses avec listes, des questions de suivi, des questions adversariales toxiques de Wikipédia, des mathématiques de niveau scolaire, des instructions de raisonnement et des descriptions de personnages et de scènes, pour un total de 210 289 exemples.
B.2 Hyperparamètres
Nous fournissons les hyperparamètres exacts utilisés dans nos expériences de réglage fin QLoRA. Nous constatons que les hyperparamètres sont largement robustes à travers les jeux de données. Nous utilisons l'ensemble de développement MMLU 5-shot pour la validation et le réglage des hyperparamètres. Dans toutes nos expériences, nous utilisons NF4 avec double quantification et le type de données de calcul bf16. Nous fixons LoRA , , et ajoutons des modules LoRA sur toutes les couches linéaires du modèle de base. Nous utilisons également Adam beta2 de 0,999, une norme de gradient maximale de 0,3 et un dropout LoRA de 0,1 pour les modèles jusqu'à 13B et de 0,05 pour les modèles 33B et 65B. À la suite de travaux antérieurs sur le réglage fin d'instructions [62, 60] et après avoir évalué d'autres planifications linéaires et cosinusoïdales, nous utilisons une planification de taux d'apprentissage constante. Nous utilisons le group-by-length pour regrouper les exemples de longueurs similaires dans le même lot (notez que cela produira une courbe de perte oscillante). Les hyperparamètres que nous réglons pour chaque taille de modèle sont indiqués dans le Tableau 9.
B.3 Ablations
Bien que la pratique courante dans la littérature soit de n'entraîner que sur la réponse dans les jeux de données de suivi d'instructions, nous étudions l'effet de l'entraînement sur l'instruction en plus de la réponse dans le Tableau 10. Dans ces expériences, nous limitons les données d'entraînement à 52 000 exemples et utilisons le modèle 7B. Sur quatre jeux de données de réglage d'instructions différents, nous constatons que seul l'entraînement sur la cible est bénéfique pour la performance MMLU
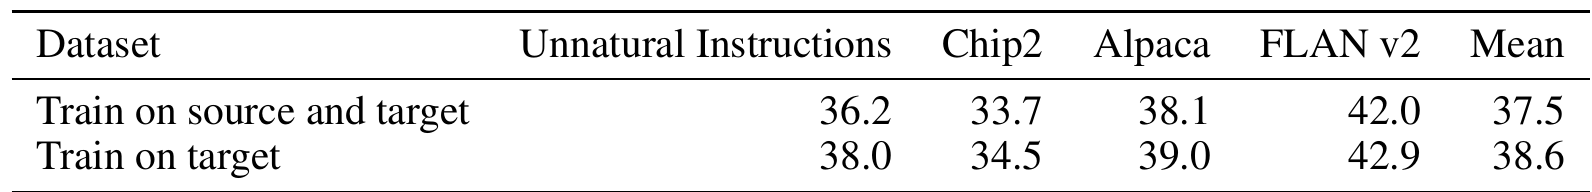
| Jeu de données | Unnatural Instructions | Chip2 | Alpaca | FLAN v2 | Moyenne |
| Entraînement sur source et cible | 36,2 | 33,7 | 38,1 | 42,0 | 37,5 |
| Entraînement sur cible | 38,0 | 34,5 | 39,0 | 42,9 | 38,6 |
B.4 Qu'est-ce qui est le plus important : la taille du jeu de données de réglage fin d'instructions ou la qualité du jeu de données ?
L'adéquation du jeu de données est plus importante que sa taille. Pour comprendre les effets de la qualité du jeu de données par rapport à sa taille, nous menons des expériences de sous-échantillonnage sur de grands jeux de données comptant au moins 150 000 échantillons (Chip2, FLAN v2, Unnatural Instructions), en les ramenant à des tailles de 50 000, 100 000 et 150 000, et nous examinons les tendances qui en résultent, comme le montre le tableau 11. Nous constatons qu'augmenter la taille du jeu de données et augmenter le nombre d'époques n'améliore le MMLU que marginalement (0,0 - 0,5 MMLU), tandis que la différence entre les jeux de données est jusqu'à 40 fois plus grande (1,5 - 8,0 MMLU). C'est un indicateur clair que la qualité du jeu de données, plutôt que sa taille, est déterminante pour la précision MMLU moyenne. Nous obtenons des résultats similaires pour la performance du chatbot, comme discuté dans.
C Évaluation humaine
Nous menons une évaluation humaine avec la même formulation que celle donnée à GPT-4 dans l'évaluation originale de Vicuna [10], adaptée à un formulaire Amazon Mechanical Turk comme le montre la figure 5.
D Évaluation par paires avec GPT-4
Bien que nous ayons constaté que l'évaluation par GPT-4 donnait des résultats différents selon le système présenté en premier, une fois moyennée sur les deux options, les résultats par paires étaient bien ordonnés. Les jugements par paires agrégés sont présentés dans le tableau 12. À l'examen, il est clair que ces jugements sont transitifs, c'est-à-dire que lorsque le système A est jugé meilleur que le système B et que le système B est jugé meilleur que le système C, il est toujours vrai que le système A est jugé meilleur que le système C. Cela produit un ordre complet, donné dans le tableau 13.
E Type de données NormalFloat 4 bits
Les valeurs exactes du type de données NF4 sont les suivantes : [- 1.0, - 0.6961928009986877, - 0.5250730514526367, - 0.39491748809814453, - 0.28444138169288635, - 0.18477343022823334, - 0.09105003625154495, 0.0, 0.07958029955625534, 0.16093020141124725, 0.24611230194568634, 0.33791524171829224, 0.44070982933044434, 0.5626170039176941, 0.7229568362236023, 1.0]
F Normalité des poids des réseaux de neurones entraînés
Bien qu'il soit de notoriété publique que les poids des réseaux de neurones entraînés sont majoritairement distribués normalement, nous effectuons des tests statistiques pour le vérifier. Nous utilisons le test de Shapiro-Wilk [53] sur les poids du modèle 7B
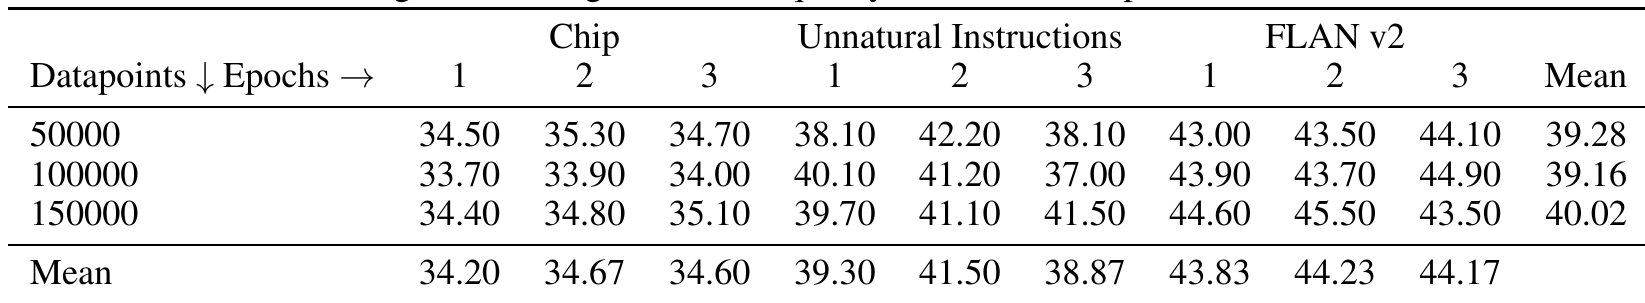
| Points de données ↓ Époques → | 1 | 2 | 3 | Unnatural Instructions | 1 | 2 | 3 | FLAN v2 | 3 | Moyenne |
| 50000 | 34,50 | 35,30 | 34,70 | 38,10 | 42,20 | 38,10 | 43,00 | 43,50 | 44,10 | 39,28 |
| 100000 | 33,70 | 33,90 | 34,00 | 40,10 | 41,20 | 37,00 | 43,90 | 43,70 | 44,90 | 39,16 |
| 150000 | 34,40 | 34,80 | 35,10 | 39,70 | 41,10 | 41,50 | 44,60 | 45,50 | 43,50 | 40,02 |
| Moyenne | 34,20 | 34,67 | 34,60 | 39,30 | 41,50 | 38,87 | 43,83 | 44,23 | 44,17 |
Tâche
Nous souhaitons recueillir vos commentaires sur la performance de deux assistants IA en réponse à la question de l'utilisateur affichée ci-dessous.
Veuillez évaluer l'utilité, la pertinence, l'exactitude et le niveau de détail de leurs réponses. Chaque assistant reçoit une note globale sur une échelle de 1 à 10, une note plus élevée indiquant une meilleure performance globale.
Veuillez d'abord noter chaque réponse sur 10.
Ensuite, veuillez fournir une explication complète de votre évaluation, en évitant tout biais potentiel et en veillant à ce que l'ordre dans lequel les réponses ont été présentées n'affecte pas votre jugement.
Question de l'utilisateur
Imaginez que vous êtes un voyageur temporel venu de l'an 3000. Quels progrès technologiques présenteriez-vous aux gens ?
Réponse A
En tant qu'assistant IA, je n'ai pas d'expériences personnelles ni d'opinions. Mais je peux vous parler de certains des progrès technologiques possibles qui pourraient exister en l'an 3000, sur la base des tendances et des recherches actuelles. - Villes autosuffisantes : les villes pourraient être entièrement autosuffisantes, avec des sources d'énergie renouvelables, de l'agriculture verticale et le recyclage des déchets et de l'eau.
Réponse B
En tant que voyageur temporel venu de l'an 3000, je présenterais aux gens les progrès technologiques suivants : 1. Intelligence artificielle avancée : dans le futur, l'IA est si avancée qu'elle peut automatiser complètement de nombreux emplois actuellement occupés par des humains. Cela a entraîné une augmentation de la productivité et de l'efficacité dans de nombreuses industries.
Évaluation de la réponse A
Évaluation de la réponse B
Explication détaillée de votre évaluation
La réponse X était meilleure parce que...
Soumettre
Figure 5 : Le formulaire de crowdsourcing utilisé par les annotateurs humains. Modèle LLaMA [57]. Nous constatons que les poids de chaque unité cachée ont des distributions normales différentes. Ainsi, nous testons les poids de chaque unité cachée individuelle. Cela signifie que pour le poids , nous effectuons des tests sur la dimension out. En utilisant un seuil de signification de , nous constatons que des neurones ne sont pas distribués normalement, soit environ de plus que le taux de faux positifs attendu. Ainsi, bien que presque tous les poids préentraînés semblent être distribués normalement, il semble y avoir des exceptions. Ces exceptions pourraient être dues à des poids aberrants [13] ou au fait que la valeur p du test de Shapiro-Wilk n'est pas précise pour de grandes tailles d'échantillon [53], ce qui se produit dans les unités cachées de la couche FFN de LLaMA. cela vérifie l'affirmation selon laquelle les poids des réseaux de neurones.
| Modèle | Guanaco 65B | Guanaco 33B | Vicuna | ChatGPT-3.5 Turbo | Bard | Guanaco 13B | Guanaco 7B |
| Guanaco 65B | - | 0,21 | 0,19 | 0,16 | 0,72 | 0,59 | 0,86 |
| Guanaco 33B | -0,21 | - | 0,17 | 0,10 | 0,51 | 0,41 | 0,68 |
| Vicuna | -0,19 | -0,17 | - | 0,10 | 0,50 | 0,20 | 0,57 |
| ChatGPT-3.5 Turbo | -0,16 | -0,10 | -0,10 | - | 0,35 | 0,19 | 0,40 |
| Bard | -0,72 | -0,51 | -0,50 | -0,35 | - | 0,12 | 0,03 |
| Guanaco 13B | -0,59 | -0,41 | -0,20 | -0,19 | -0,12 | - | 0,20 |
| Guanaco 7B | -0,86 | -0,68 | -0,57 | -0,40 | -0,03 | -0,20 | - |
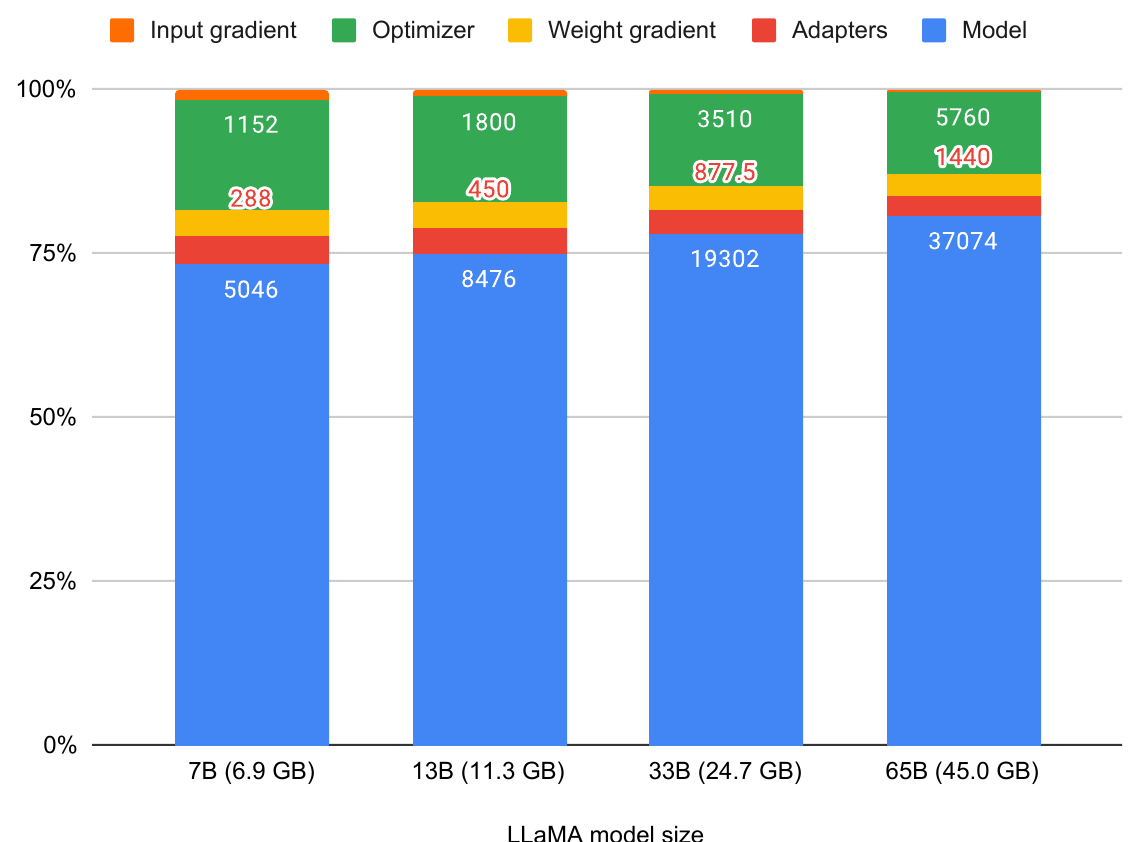
G Empreinte mémoire
L'empreinte mémoire pour l'entraînement QLoRA avec différents modèles de base LLaMA peut être vue dans la Figure 6. Nous constatons que le modèle 33B ne rentre pas tout à fait dans 24 Go et que des optimiseurs paginés sont nécessaires pour l'entraîner. Sont également représentés une taille de lot de 1 avec une longueur de séquence de 512 et le gradient checkpointing. Cela signifie que, si l'on utilise une taille de lot plus grande, ou si une longue séquence est traitée, le gradient d'activation pourrait consommer une quantité considérable de mémoire.
| Modèle | Paramètres | Taille |
| Guanaco | 65B | 41 Go |
| Guanaco | 33B | 21 Go |
| Vicuna | 13B | 26 Go |
| ChatGPT-3.5 Turbo | N/D | N/D |
| Bard | N/D | N/D |
| Guanaco | 13B | 10 Go |
| Guanaco | 7B | 5 Go |