
Un petit modèle propose des tokens, le grand les vérifie en une passe: sortie identique, inférence plus rapide. ICML 2023, gratuit en ligne.
Fast Inference from Transformers via Speculative Decoding
Inférence rapide à partir de Transformers via le décodage spéculatif
Yaniv Leviathan \* 1 Matan Kalman \* 1 Yossi Matias 1
Résumé
L'inférence à partir de grands modèles autorégressifs comme les Transformers est lente — le décodage de jetons nécessite exécutions sérielles du modèle. Dans ce travail, nous introduisons le décodage spéculatif — un algorithme pour échantillonner à partir de modèles autorégressifs plus rapidement sans aucune modification des sorties, en calculant plusieurs jetons en parallèle. Au cœur de notre approche se trouvent les observations selon lesquelles (1) les tâches difficiles de modélisation du langage incluent souvent des sous-tâches plus faciles qui peuvent être bien approximées par des modèles plus efficaces, et (2) en utilisant l'exécution spéculative et une nouvelle méthode d'échantillonnage, nous pouvons rendre le décodage exact à partir des grands modèles plus rapide, en les exécutant en parallèle sur les sorties des modèles d'approximation, générant potentiellement plusieurs jetons simultanément, et sans modifier la distribution. Notre méthode peut accélérer les modèles existants prêts à l'emploi sans réentraînement ni modification de l'architecture. Nous la démontrons sur T5-XXL et montrons une accélération de 2X à 3X par rapport à l'implémentation standard T5X, avec des sorties identiques.
1. Introduction
Les grands modèles autorégressifs, notamment les grands Transformers (Vaswani et al., [2017]), sont bien plus performants que les modèles plus petits, comme cela a été démontré d'innombrables fois ces dernières années, par exemple dans les domaines du texte ou de l'image, comme GPT-3 (Brown et al., [2020]), LaMDA (Thoppilan et al., [2022]), Parti (Yu et al., [2022]) et PaLM (Chowdhery et al., [2022]). Malheureusement, une seule étape de décodage de ces modèles plus grands est nettement plus lente qu'une étape de leurs homologues plus petits, et pour aggraver les choses, ces étapes sont effectuées en série — le décodage de jetons nécessite exécutions sérielles du modèle.
Étant donné l'importance des grands modèles autorégressifs et en particulier des grands Transformers, plusieurs approches ont été développées pour rendre l'inférence à partir de ceux-ci plus rapide. Certaines approches visent à réduire le coût d'inférence pour toutes les entrées de manière égale (par exemple Hinton et al., [2015], Jaszczur et al., [2021], Hubara et al., [2016], So et al., [2021], Shazeer [2019]). D'autres approches découlent de l'observation que toutes les étapes d'inférence ne se ressemblent pas — certaines nécessitent un très grand modèle, tandis que d'autres peuvent être bien approximées par des modèles plus efficaces. Ces méthodes de calcul adaptatif (par exemple Han et al., [2021], Sukhbaatar et al., [2019], Schuster et al., [2021], Scardapane et al., [2020], Bapna et al., [2020], Elbayad et al., [2019], Schwartz et al., [2020]) visent à utiliser moins de ressources de calcul pour les étapes d'inférence plus faciles. Bien que nombre de ces solutions se soient révélées extrêmement efficaces en pratique, elles nécessitent généralement de modifier l'architecture du modèle, de modifier la procédure d'entraînement et de réentraîner les modèles, et ne maintiennent pas des sorties identiques.
Contribution égale 1Google Research, Mountain View, CA, USA. Correspondance : Yaniv Leviathan leviathan@google.com.
L'observation clé ci-dessus, selon laquelle certaines étapes d'inférence sont « plus difficiles » et d'autres « plus faciles », est également un motivateur clé de notre travail. Nous observons en outre que l'inférence à partir de grands modèles n'est souvent pas limitée par les opérations arithmétiques, mais plutôt par la bande passante mémoire et la communication, de sorte que des ressources de calcul supplémentaires pourraient être disponibles. Par conséquent, nous suggérons d'augmenter la concurrence comme approche complémentaire à l'utilisation d'une quantité adaptative de calcul. Plus précisément, nous sommes en mesure d'accélérer l'inférence sans modifier les architectures des modèles, sans modifier les procédures d'entraînement ni avoir besoin de réentraîner les modèles, et sans modifier la distribution de sortie du modèle. Cela est accompli via l'exécution spéculative.
L'exécution spéculative (Burton, [1985], Hennessy & Patterson, [2012]) est une technique d'optimisation, courante dans les processeurs, où une tâche est effectuée en parallèle de la vérification de sa nécessité réelle — le gain étant une concurrence accrue. Un exemple bien connu d'exécution spéculative est la prédiction de branchement. Pour que l'exécution spéculative soit efficace, nous avons besoin d'un mécanisme efficace pour suggérer des tâches à exécuter qui sont susceptibles d'être nécessaires. Dans ce travail, nous généralisons l'exécution spéculative au cadre stochastique — où une tâche peut être nécessaire avec une certaine probabilité. En appliquant cela au décodage à partir de modèles autorégressifs comme les Transformers, nous échantillonnons des générations à partir de modèles d'approximation plus efficaces comme préfixes spéculatifs pour les modèles cibles plus lents. Avec une nouvelle méthode d'échantillonnage, l'échantillonnage spéculatif, nous maximisons la probabilité que ces tâches spéculatives
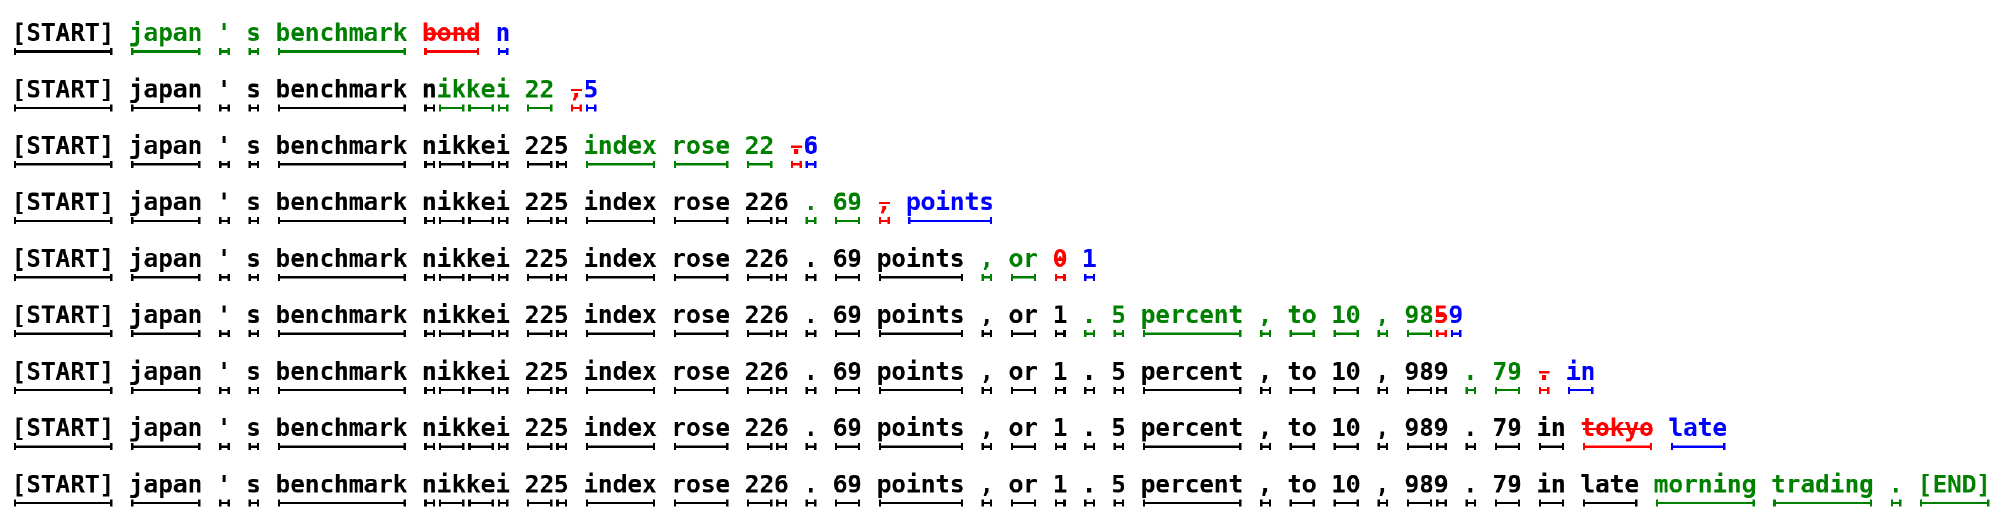
soient acceptées, tout en garantissant que les sorties de notre système ont la même distribution que celles du modèle cible seul. Par exemple, la phrase de la Figure 1 composée de 38 jetons a été générée par notre méthode avec seulement 9 exécutions sérielles d'un modèle cible plus grand (97M de paramètres) grâce à un modèle d'approximation plus petit et plus efficace (6M de paramètres), tandis que la probabilité de la générer est inchangée.
Nous analysons notre méthode sur une variété de tâches et de tailles de modèles : génération non conditionnelle à partir d'un modèle de type GPT de 97M de paramètres entraîné sur 1m1b, traduction de l'anglais vers l'allemand et résumé d'articles de presse avec un modèle T5-XXL de 11B de paramètres, et une tâche de dialogue avec un modèle LaMDA de 137B de paramètres. Nous implémentons notre méthode et comparons les temps réels pour T5-XXL à ceux de l'implémentation robuste T5X (Roberts et al., 2022), montrant une amélioration de la latence prête à l'emploi de 2X à 3X, sans aucune modification des sorties (Section 4).
Notre méthode est facile à employer dans des contextes de production réels, ne nécessite pas d'entraîner de nouveaux modèles et ne modifie pas les sorties. Par conséquent, dans les situations courantes où la bande passante mémoire est le goulot d'étranglement et où des ressources de calcul sont disponibles, elle peut constituer un bon choix par défaut pour accélérer l'échantillonnage à partir de modèles autorégressifs comme les Transformers.
Pour résumer, nos principales contributions sont : (1) Une généralisation de l'exécution spéculative au cadre stochastique, avec une nouvelle méthode d'échantillonnage que nous appelons échantillonnage spéculatif, et (2) Un mécanisme de décodage que nous appelons décodage spéculatif qui peut accélérer le décodage à partir de modèles autorégressifs, sans aucune modification des architectures des modèles, des régimes d'entraînement et des distributions de sortie.
2. Décodage spéculatif
2.1. Vue d'ensemble
Soit le modèle cible, à partir duquel nous cherchons à accélérer l'inférence, et la distribution que nous obtenons du modèle pour un préfixe . Soit un modèle d'approximation plus efficace pour la même tâche, et désignons par la distribution que nous obtenons du modèle pour un préfixe . L'idée centrale est de (1) utiliser le modèle plus efficace pour générer complétions (voir Section 3.5 pour savoir comment choisir ce paramètre de manière optimale), puis (2) utiliser le modèle cible pour évaluer toutes les suppositions et leurs probabilités respectives issues de en parallèle, en acceptant toutes celles qui peuvent conduire à une distribution identique, et (3) échantillonner un jeton supplémentaire à partir d'une distribution ajustée pour corriger le premier qui a été rejeté, ou pour en ajouter un supplémentaire s'ils sont tous acceptés. Ainsi, chaque exécution parallèle du modèle cible produira au moins un nouveau jeton (de sorte que le nombre d'exécutions sérielles du modèle cible ne pourra jamais, même dans le pire des cas, être supérieur à celui de la méthode autorégressive simple), mais elle peut potentiellement générer de nombreux nouveaux jetons, jusqu'à , selon la qualité de l'approximation de par .
2.2. Échantillonnage standardisé
Premièrement, notons que bien qu'il existe de nombreuses méthodes et paramètres d'échantillonnage, comme argmax, top-k, nucleus, et la fixation d'une température, et que les implémentations populaires les traitent généralement différemment au niveau des logits, elles peuvent toutes facilement être ramenées à un échantillonnage standard à partir d'une distribution de probabilité ajustée. Par exemple, l'échantillonnage argmax équivaut à mettre à zéro les éléments non maximaux de la distribution et à normaliser. Nous pouvons donc ne traiter que de l'échantillonnage standard à partir d'une distribution de probabilité, et ramener tous les autres types d'échantillonnage à ce cadre. Dans la suite, nous supposerons que et sont les distributions issues respectivement de et , ajustées pour la méthode d'échantillonnage.
2.3. Échantillonnage spéculatif
Pour échantillonner , nous échantillonnons plutôt , en le conservant si , et dans le cas où , nous rejetons l'échantillon avec probabilité et échantillonnons à nouveau à partir d'une distribution ajustée . Il est facile de montrer (voir Annexe [A.1]) que pour toutes distributions et , et échantillonné de cette manière, on a bien .
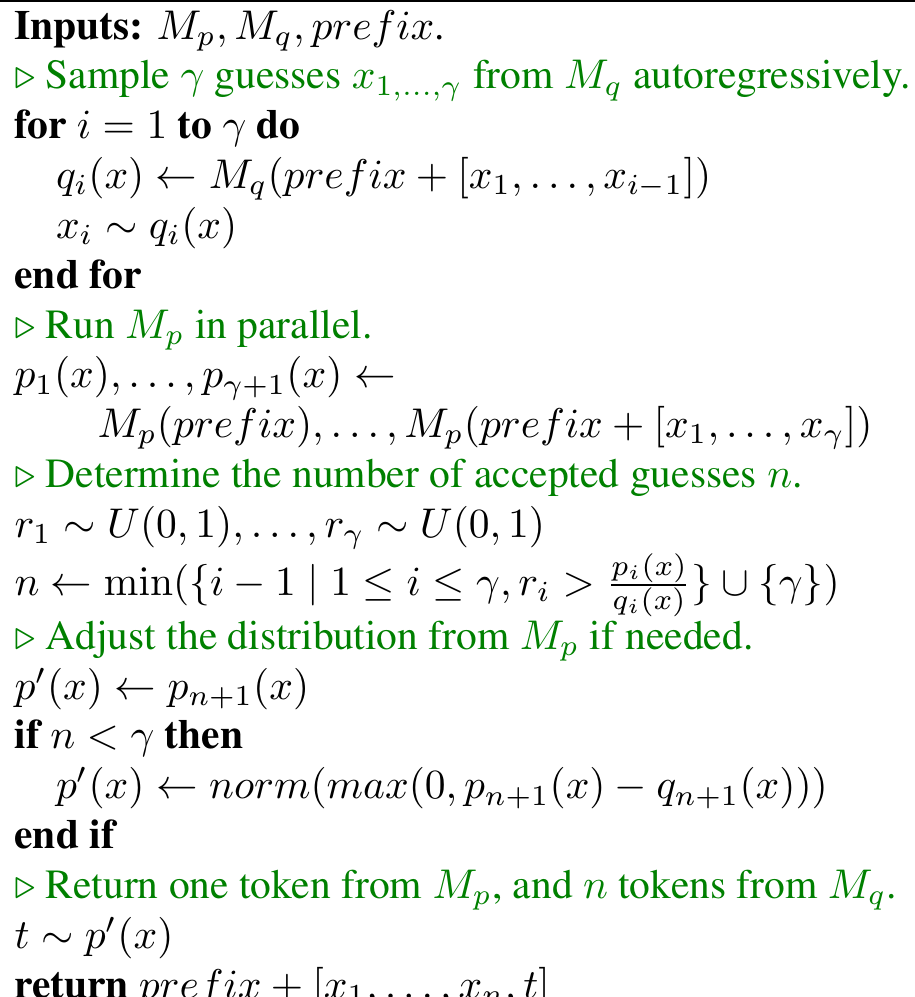
Étant donné la distribution obtenue en exécutant sur un de conditionnement, nous pouvons échantillonner un token . Nous calculons ensuite la distribution en exécutant sur tout en calculant en parallèle, de manière spéculative, la distribution du token suivant en exécutant sur . Une fois les deux calculs terminés, nous procédons comme ci-dessus : si est rejeté, nous écartons le calcul de et ré-échantillonnons à partir d'une distribution ajustée, et si est accepté, nous conservons les deux tokens. L'algorithme [I] généralise cette idée pour échantillonner entre 1 et tokens à la fois.
Algorithme 1 SpeculativeDecodingStep
3. Analyse
3.1. Nombre de tokens générés
Analysons le facteur de réduction du nombre d'appels séquentiels au modèle cible, ou de manière équivalente, le nombre attendu de tokens produits par une seule exécution de l'algorithme [I]
Définition 3.1. Le taux d'acceptation , étant donné un préfixe , est la probabilité d'accepter par échantillonnage spéculatif, conformément à la Section [2.3] :
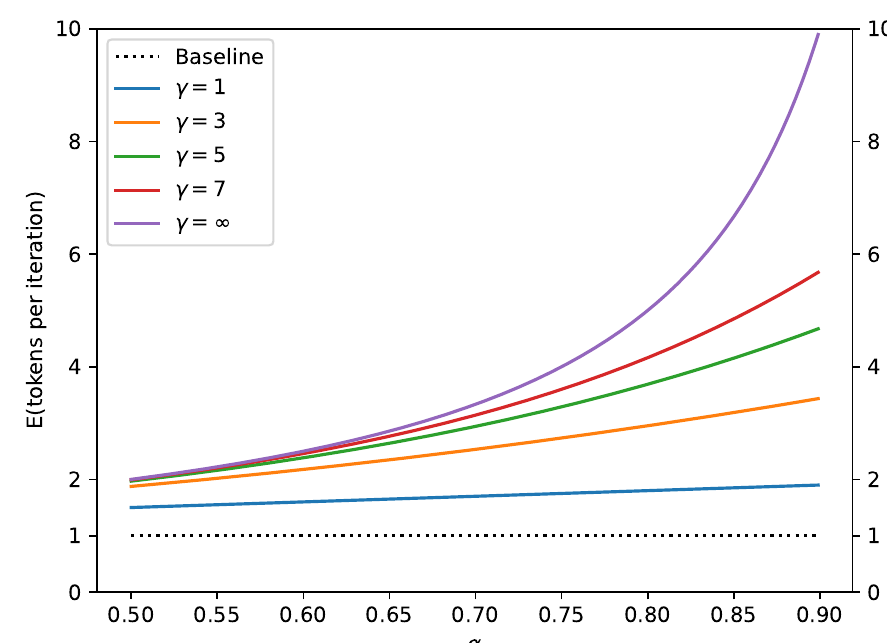
est alors une mesure naturelle de la qualité de l'approximation de par . Si nous faisons l'hypothèse simplificatrice que les sont i.i.d., et notons , alors le nombre de tokens produits par une seule exécution de l'algorithme [I] est une variable géométrique plafonnée, de probabilité de succès et de plafond , et le nombre attendu de tokens générés par l'algorithme [I] satisfait l'équation [I]. Voir la Figure [2]
3.2. Calcul de
Nous allons maintenant dériver une formule simple pour calculer étant donné un préfixe et les deux modèles et . Nous commençons par définir une divergence naturelle :
Définition 3.2. où .
Lemme 3.3.
Preuve.
Du lemme [3.3], nous obtenons immédiatement les résultats suivants : Corollaire 3.4. est une divergence symétrique dans . . et ont des supports disjoints.
Théorème 3.5.
Finalement, nous obtenons :
Corollaire 3.6.
Voir le tableau 3 pour les valeurs de observées empiriquement dans nos expériences.
3.3. Amélioration du temps d'exécution
Nous avons montré que, sous l'hypothèse i.i.d., notre algorithme réduit le nombre d'appels au modèle cible d'un facteur . Notons que l'exécution spéculative en général, et notre algorithme en particulier, supposent que nous disposons de suffisamment de ressources de calcul pour soutenir la concurrence accrue (section 3.4). Pour l'analyse du temps d'exécution, nous supposerons que nous pouvons exécuter évaluations concurrentes de en parallèle sans augmenter le temps d'exécution. Pour obtenir l'amélioration totale du temps d'exécution, nous considérons maintenant le coût d'exécution du modèle d'approximation .
Définition 3.7. Soit , le coefficient de coût, le rapport entre le temps d'une seule exécution de et le temps d'une seule exécution de .
Notons que, contrairement à qui est une propriété intrinsèque des modèles et de la tâche, la valeur de dépend de la configuration matérielle et des détails d'implémentation logicielle. Dans nos expériences, où est typiquement de quelques ordres de grandeur plus petit que , était toujours inférieur à 0,05 et souvent négligeable, proche de 0.
Théorème 3.8. Le facteur d'amélioration attendu du temps d'exécution total par l'algorithme 1 est .
Preuve. Notons le coût d'exécution d'une seule étape de . Maintenant, chaque exécution de l'algorithme 1 coûte (pour l'exécution du modèle d'approximation fois et l'exécution de une fois) et, d'après l'équation (1), produit tokens en moyenne. Ainsi, le coût attendu global pour produire un token avec l'algorithme 1 est . Puisque le coût de production d'un seul token avec l'algorithme de décodage standard est , nous obtenons le résultat souhaité.
Notons que le théorème 3.8 suppose des générations suffisamment longues (par exemple, puisque nous exécutons au moins une fois, le facteur d'amélioration est plafonné par le nombre de tokens générés).
Corollaire 3.9. Si , il existe pour lequel nous obtiendrons une amélioration, et le facteur d'amélioration sera d'au moins .
Preuve. Si nous obtenons une amélioration pour , nous obtiendrons également une amélioration pour tout , donc pour que notre méthode produise une amélioration, nous pouvons évaluer le théorème 3.8 pour , ce qui donne .
3.4. Nombre d'opérations arithmétiques
L'algorithme 1 effectue exécutions de en parallèle, donc le nombre d'opérations arithmétiques concurrentes augmente d'un facteur . Maintenant, puisque l'algorithme 1 produit au plus tokens par exécution, le nombre total d'opérations arithmétiques peut être supérieur à celui de l'algorithme de décodage standard. Lorsque nous acceptons l'échantillon de , la concurrence accrue est « gratuite » et le nombre total d'opérations n'est pas augmenté. En revanche, lorsque nous rejetons une conjecture, le calcul est gaspillé. Analysons maintenant l'effet de notre méthode sur le nombre total d'opérations arithmétiques.
Définition 3.10. Soit le rapport entre le nombre d'opérations arithmétiques par token du modèle d'approximation et celui du modèle cible .
Théorème 3.11. Le facteur d'augmentation attendu du nombre total d'opérations de l'algorithme 1 est .
Preuve. Notons le nombre d'opérations arithmétiques effectuées par une base de décodage standard par token, c'est-à-dire le nombre d'opérations d'une seule exécution de . Alors une seule itération de l'algorithme 1 coûte opérations (pour exécutions de et exécutions parallèles de ). En divisant par le nombre attendu de tokens produits par l'algorithme 1, c'est-à-dire l'équation (1), et par , nous obtenons le résultat souhaité.
Si est faible, l'augmentation du nombre d'opérations arithmétiques est élevée, et vice versa. Notons que, pour les décodeurs Transformer, le nombre total d'opérations arithmétiques effectuées par l'algorithme 1 (sans compter les exécutions de ) peut être majoré par celui d'une seule exécution d'un encodeur Transformer de même taille.
Contrairement au nombre total d’opérations arithmétiques, le nombre total d’accès mémoire peut diminuer avec notre méthode. Plus précisément, les poids du modèle cible et le cache KV peuvent être lus une seule fois par exécution de l’algorithme 1, de sorte que le nombre d’accès mémoire pour les lire est réduit d’un facteur , d’après l’équation (1).
3.5. Choix de
Étant donnés et , et en supposant des ressources de calcul suffisantes (voir section 3.4), le optimal est celui qui maximise l’équation d’amélioration du temps réel (théorème 3.8) :
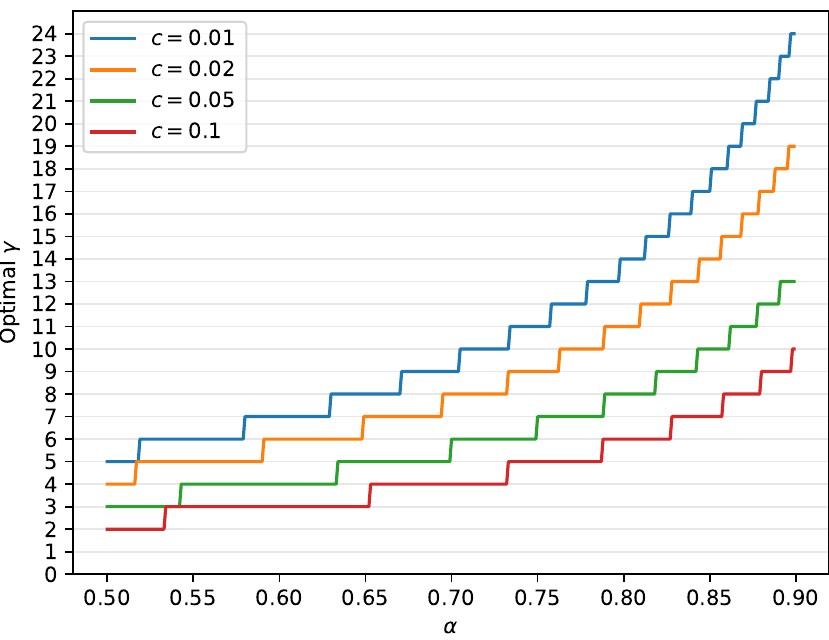
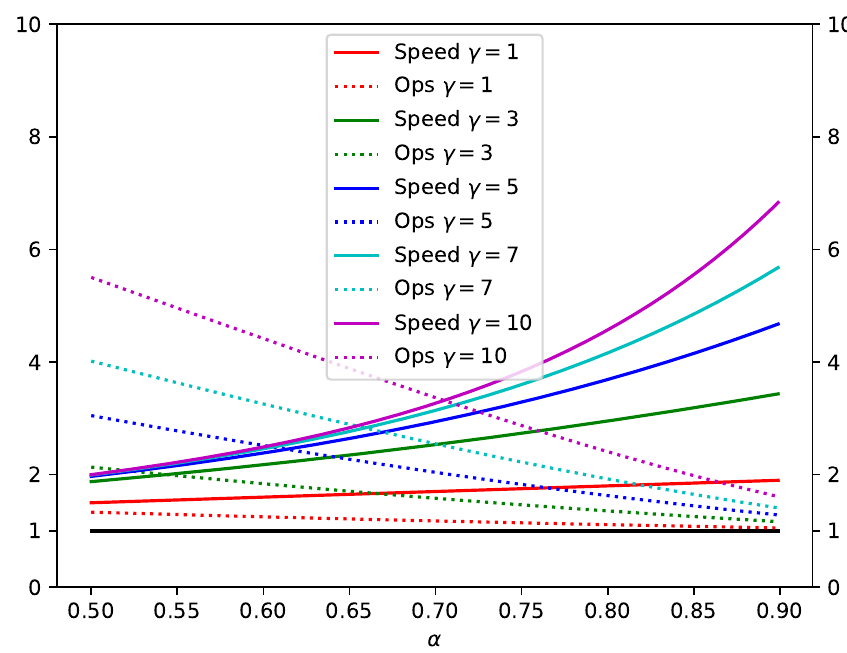
. Comme est un entier, il peut être facilement trouvé numériquement, voir figure 3
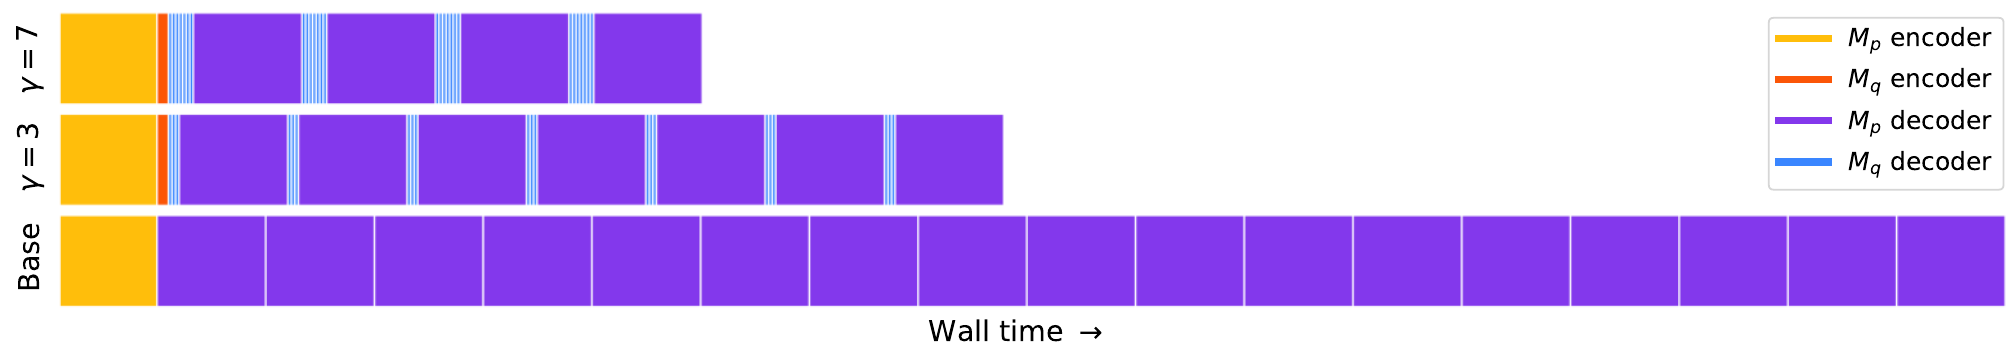
Le tableau 1 et la figure 4 illustrent le compromis entre la vitesse d’inférence et le nombre total d’opérations arithmétiques pour diverses valeurs de et , en supposant . La figure 5 montre un diagramme de trace simplifié.
| α | γ | OPÉRATIONS | VITESSE |
| 0,6 | 2 | 1,53X | 1,96X |
| 0,7 | 3 | 1,58X | 2,53X |
| 0,8 | 2 | 1,23X | 2,44X |
| 0,8 | 5 | 1,63X | 3,69X |
| 0,9 | 2 | 1,11X | 2,71X |
| 0,9 | 10 | 1,60X | 6,86X |
Au lieu de choisir une seule valeur pour en fonction de , comme les ne sont pas constants, nous pourrions obtenir une amélioration supplémentaire en prédisant la valeur de et en faisant varier en conséquence la valeur de pendant l’exécution de l’algorithme 1. Pour obtenir une borne supérieure du facteur d’amélioration supplémentaire, supposons que nous disposions d’un oracle pour . Nous aurions alors . Pour des valeurs typiques de et , et en supposant des ressources de calcul non bornées, le facteur d’amélioration du temps réel renforcé peut être jusqu’à plus élevé que le facteur d’amélioration avec un fixe. Nous laissons l’exploration de ce point à des travaux futurs.
3.6. Modèles d’approximation
L’échantillonnage spéculatif, et donc le décodage spéculatif, garantit une distribution de sortie identique pour tout choix de modèle d’approximation sans restriction (voir annexe [A.1]). Dans nos expériences, nous avons principalement testé des Transformers plus petits existants prêts à l’emploi comme modèles d’approximation. En outre, nous n’avons testé que des modèles d’approximation de même architecture que les modèles cibles et utilisant la même standardisation des probabilités. Dans cette configuration, choisir environ deux ordres de grandeur plus petit que a généralement donné les meilleurs résultats, en équilibrant et (théorème 3.8).
Un autre type de modèles d’approximation, les modèles à coût négligeable, sont ceux pour lesquels , c’est-à-dire des modèles d’approximation dont le coût est négligeable par rapport au modèle cible. Dans ce cas, nous obtenons une amélioration attendue du temps réel de , qui est majorée par (nous approchons l’égalité si est grand). Un type intéressant de modèles d’approximation à coût négligeable est constitué par les modèles de n-grammes, dont l’évaluation se réduit à une consultation de table. Fait intéressant, dans les tests empiriques (section 4.2), nous obtenons des non nuls même pour ces modèles de n-grammes triviaux. Par exemple, pour la tâche de traduction anglais-allemand, avec étant T5-XXL 11B et étant un modèle bigramme trivial, nous obtenons , ce qui conduit à un facteur d’amélioration de la vitesse d’inférence de avec .
D’autres heuristiques simples peuvent être utilisées comme modèles d’approximation à coût négligeable. Par exemple, dans les cas où de longues séquences sont susceptibles de se répéter, comme pour les tâches de résumé ou les interfaces de type chat, un modèle d’approximation qui copie simplement
des tokens du contexte lorsqu’un préfixe correspondant est trouvé pourrait produire des valeurs élevées de . Ces modèles d’approximation sans paramètres ont l’avantage supplémentaire d’être encore plus simples à déployer d’un point de vue de production.
Un autre type de modèles d’approximation pouvant être utilisé par le décodage spéculatif est constitué par les modèles non autorégressifs, comme ceux de Stern et al. [2018]. Dans ce cas, au lieu de la boucle autorégressive de l’algorithme 1, nous appellerions simplement le modèle non autorégressif une fois.
Un dernier exemple, intéressant surtout d’un point de vue théorique, est un modèle d’approximation qui choisit des tokens au hasard, ce qui garantit une certaine amélioration (bien que très faible) pour tous les modèles .
4. Expériences
4.1. Amélioration empirique du temps réel
Nous implémentons notre algorithme et le comparons à l’implémentation de la base de code T5X pour accélérer T5-XXL.
Configuration Nous testons un modèle standard encodeur-décodeur T5 version 1.1 (Raffel et al., [2020]) sur deux tâches issues de l'article T5 : (1) la traduction de l'anglais vers l'allemand, affinée sur WMT EnDe, et (2) le résumé de texte, affiné sur CCN/DM. Pour les deux tâches, nous utilisons T5-XXL (11B) pour . Pour le modèle d'approximation , nous testons plusieurs configurations existantes, à savoir T5-large (800M), T5-base (250M) et T5-small (77M) (Raffel et al., [2020]). Nous utilisons les checkpoints existants pour tous les modèles. Nous mesurons les améliorations de temps d'exécution avec une taille de lot de 1 sur un seul TPU-v4, à la fois pour l'échantillonnage argmax (temp=0) et pour l'échantillonnage standard (temp=1).
Résultats Le tableau 2 présente les résultats empiriques de notre méthode. Nous constatons que T5-small (77M), avec un bon équilibre entre et , offre la plus forte accélération parmi les modèles d'approximation testés.Comme attendu, nous observons que augmente avec la taille du modèle d'approximation. Fait intéressant, et l'amélioration du temps d'exécution sont plus élevés pour l'échantillonnage argmax (temp=0). Nous observons des accélérations de 2,6X (temp=1) et 3,4X (temp=0) sur la tâche de traduction, et des accélérations légèrement inférieures de 2,3X (temp=1) et 3,1X (temp=0) pour la tâche de résumé. Ces résultats empiriques concordent bien avec les prédictions théoriques, avec une certaine variance due aux détails d'implémentation (voir annexe A.3).
| Tâche | Mq | TEMP | γ | α | VITESSE |
| ENDE | T5-SMALL ★ | 0 | 7 | 0,75 | 3,4X |
| ENDE | T5-BASE | 0 | 7 | 0,8 | 2,8X |
| ENDE | T5-LARGE | 0 | 7 | 0,82 | 1,7X |
| ENDE | T5-SMALL ★ | 1 | 7 | 0,62 | 2,6X |
| ENDE | T5-BASE | 1 | 5 | 0,68 | 2,4X |
| ENDE | T5-LARGE | 1 | 3 | 0,71 | 1,4X |
| CNNDM | T5-SMALL ★ | 0 | 5 | 0,65 | 3,1X |
| CNNDM | T5-BASE | 0 | 5 | 0,73 | 3,0X |
| CNNDM | T5-LARGE | 0 | 3 | 0,74 | 2,2X |
| CNNDM | T5-SMALL ★ | 1 | 5 | 0,53 | 2,3X |
| CNNDM | T5-BASE | 1 | 3 | 0,55 | 2,2X |
| CNNDM | T5-LARGE | 1 | 3 | 0,56 | 1,7X |
4.2. Valeurs empiriques de
Bien que nous n'ayons implémenté notre méthode que pour T5, nous avons mesuré les valeurs de pour diverses tâches, méthodes d'échantillonnage, modèles cibles et modèles d'approximation . Plus précisément, nous avons évalué l'espérance du corollaire 3.6 sur 10K tokens générés par , pour chacune des configurations ci-dessous.
De type GPT (97M paramètres) Nous testons un modèle Transformer décodeur seul sur la génération de langage inconditionnelle, entraîné sur lm1b (Chelba et al., [2013]). Le modèle ici est un décodeur Transformer de type GPT avec des activations Gelu (Hendrycks & Gimpel, [2016]). Pour , nous avons expérimenté avec un modèle décodeur Transformer de 6M paramètres : dim 256, dim feed-forward 1024, 2 couches, 4 têtes d'attention, ainsi qu'avec de simples modèles unigramme et bigramme. compte 97M de paramètres : dim 768, dim feed-forward 3072, 12 couches, 12 têtes d'attention. Nous avons utilisé la tokenisation Bert (Devlin et al., [2019]) avec 8k tokens pour tous les modèles.
LaMDA (137B paramètres) Nous avons testé un modèle LaMDA décodeur seul sur une tâche de dialogue (Thoppilan et al., [2022]). Nous avons utilisé les checkpoints existants de LaMDA 137B comme , et LaMDA 8B, LaMDA 2B et LaMDA 100M pour .
Voir la section 4.1 pour la configuration du modèle T5-XXL (11B paramètres).
Le tableau 3 résume les valeurs de pour les cas testés. Nous observons que les modèles d'approximation qui sont de quelques ordres de grandeur plus petits que le modèle cible tendent à produire des valeurs de entre 0,5 et 0,9. Fait intéressant, nous notons également que, pour tous les modèles, plus la distribution ajustée est nette, plus les valeurs de sont élevées. Enfin, nous notons que même des approximations triviales par unigramme et bigramme donnent des valeurs de non négligeables. Par exemple, dans le cas de la traduction de l'anglais vers l'allemand, le modèle bigramme a une valeur de de 0,2, et comme dans ce cas, il produit une amélioration de vitesse de 1,25X, ce qui est étonnamment élevé pour ce modèle d'approximation trivial (mais reste inférieur à l'accélération obtenue en utilisant T5-small comme modèle d'approximation).
5. Travaux connexes
L'efficacité de l'inférence à partir de grands modèles a été étudiée de manière approfondie (Dehghani et al., [2021]). De nombreuses approches visent à accélérer l'inférence à partir de grands modèles en général, et des modèles autorégressifs comme les Transformers en particulier. De nombreuses techniques tentent de rendre l'inférence plus efficace pour tous les tokens, par exemple la distillation (Hinton et al., [2015]), la sparcification (Jaszczur et al., [2021]), la quantification (Hubara et al., [2016]) et la modification d'architecture (So et al., [2021] ; Shazeer [2019]). Plus proches de notre approche sont les méthodes de calcul adaptatif qui adaptent la quantité de calcul à la difficulté du problème (Han et al., [2021]). Citons par exemple l'attention portée à un sous-ensemble des entrées (Sukhbaatar et al., [2019]) et les sorties anticipées (Schuster et al., [2021] ; Scardapane et al., [2020] ; Bapna et al., [2020] ; Elbayad et al., [2019] ; Schwartz et al., [2020]). Notably, Wisdom of Committees (Schwartz et al., [2020]) exploite des modèles plus petits prêts à l'emploi, mais il s'agit d'une approche de calcul adaptatif, et elle utilise donc une heuristique pour déterminer quand s'arrêter, perdant ainsi la garantie d'obtenir des sorties identiques à celles des modèles cibles. En général, les méthodes de calcul adaptatif apprennent, soit au sein du modèle lui-même, soit au moyen d'un modèle auxiliaire, quand un raccourci de calcul peut être emprunté. Habituellement, ces méthodes économisent à la fois le temps d'inférence et les opérations arithmétiques, mais nécessitent un changement d'architecture, un changement de procédure d'entraînement et l'entraînement de modèles personnalisés ou
| Mp | Mq | SMPL | α |
| DE TYPE GPT (97M) | UNIGRAMME | T=0 | 0,03 |
| DE TYPE GPT (97M) | BIGRAMME | T=0 | 0,05 |
| DE TYPE GPT (97M) | DE TYPE GPT (6M) | T=0 | 0,88 |
| DE TYPE GPT (97M) | UNIGRAMME | T=1 | 0,03 |
| DE TYPE GPT (97M) | BIGRAMME | T=1 | 0,05 |
| DE TYPE GPT (97M) | DE TYPE GPT (6M) | T=1 | 0,89 |
| T5-XXL (ENDE) | UNIGRAMME | T=0 | 0,08 |
| T5-XXL (ENDE) | BIGRAMME | T=0 | 0,20 |
| T5-XXL (ENDE) | T5-SMALL | T=0 | 0,75 |
| T5-XXL (ENDE) | T5-BASE | T=0 | 0,80 |
| T5-XXL (ENDE) | T5-LARGE | T=0 | 0,82 |
| T5-XXL (ENDE) | UNIGRAMME | T=1 | 0,07 |
| T5-XXL (ENDE) | BIGRAMME | T=1 | 0,19 |
| T5-XXL (ENDE) | T5-SMALL | T=1 | 0,62 |
| T5-XXL (ENDE) | T5-BASE | T=1 | 0,68 |
| T5-XXL (ENDE) | T5-LARGE | T=1 | 0,71 |
| T5-XXL (CNNDM) | UNIGRAM | T=0 | 0,13 |
| T5-XXL (CNNDM) | BIGRAM | T=0 | 0,23 |
| T5-XXL (CNNDM) | T5-SMALL | T=0 | 0,65 |
| T5-XXL (CNNDM) | T5-BASE | T=0 | 0,73 |
| T5-XXL (CNNDM) | T5-LARGE | T=0 | 0,74 |
| T5-XXL (CNNDM) | UNIGRAM | T=1 | 0,08 |
| T5-XXL (CNNDM) | BIGRAM | T=1 | 0,16 |
| T5-XXL (CNNDM) | T5-SMALL | T=1 | 0,53 |
| T5-XXL (CNNDM) | T5-BASE | T=1 | 0,55 |
| T5-XXL (CNNDM) | T5-LARGE | T=1 | 0,56 |
| LAMDA (137B) | LAMDA (100M) | T=0 | 0,61 |
| LAMDA (137B) | LAMDA (2B) | T=0 | 0,71 |
| LAMDA (137B) | LAMDA (8B) | T=0 | 0,75 |
| LAMDA (137B) | LAMDA (100M) | T=1 | 0,57 |
| LAMDA (137B) | LAMDA (2B) | T=1 | 0,71 |
| LAMDA (137B) | LAMDA (8B) | T=1 | 0,74 |
le réentraînement de modèles existants. Elles modifient généralement aussi les sorties du modèle. Nous notons que, bien que nombre des méthodes ci-dessus améliorent le rapport entre la mémoire et les opérations arithmétiques, dans les cas où ce rapport reste élevé, ces méthodes et notre méthode de décodage spéculatif pourraient être efficaces en tandem.
Deux méthodes antérieures exploitent l'exécution spéculative pour accélérer le décodage à partir de modèles autorégressifs. Le décodage parallèle par blocs (Blockwise Parallel Decoding, Stern et al., [2018]) décode plusieurs tokens en parallèle, de manière similaire à nos travaux. Cependant, il ne prend en charge que le décodage glouton (température ) et non le cadre stochastique général ; il nécessite un entraînement supplémentaire d'un modèle personnalisé et se concentre sur la préservation de la qualité des tâches en aval, plutôt que sur la garantie de sorties identiques. Le décodage agressif peu profond (Shallow Aggressive Decoding, SAD) (Sun et al., [2021]) décode également plusieurs tokens en parallèle, de manière similaire à nos travaux. Contrairement à nos travaux, SAD ne prend en charge que la copie de l'entrée vers la sortie, et non les modèles d'approximation généraux, ce qui le rend adapté uniquement aux cas où les entrées et les sorties sont très similaires, comme la correction d'erreurs grammaticales. En outre, comme le décodage parallèle par blocs, SAD ne prend pas en charge le cadre général d'échantillonnage stochastique.
Après notre publication initiale, une implémentation indépendante du décodage spéculatif (Chen et al., [2023]) a montré des améliorations similaires de 2X-2,5X sur Chinchilla 70B.
6. Discussion
Nous avons présenté l'échantillonnage spéculatif, qui permet une exécution spéculative stochastique efficace, c'est-à-dire une exécution spéculative dans le cadre stochastique. Nous avons analysé son impact sur le décodage à partir de modèles autorégressifs comme les Transformers via le décodage spéculatif, et nous avons montré que, avec suffisamment de ressources de calcul, nous obtenons en pratique des accélérations significatives de 2X-3X par rapport à T5X, une implémentation optimisée populaire.
Une limite de l'exécution spéculative en général, et du décodage spéculatif en particulier, est que la latence est améliorée grâce à une concurrence accrue, au prix d'un nombre accru d'opérations arithmétiques. Ainsi, notre méthode n'est pas utile pour les configurations où des ressources de calcul supplémentaires ne sont pas disponibles. Cependant, dans les cas courants où des ressources de calcul supplémentaires sont disponibles (par exemple lorsque la bande passante mémoire est le goulot d'étranglement), notre méthode offre une accélération avec des avantages significatifs : l'architecture du modèle ne change pas, aucun réentraînement n'est nécessaire et, surtout, la distribution des sorties est garantie de rester la même. Notre méthode est facile à implémenter et peut être utilisée pour accélérer l'inférence à l'aide de modèles prêts à l'emploi, sans développer ni évaluer de schémas personnalisés.
Il existe plusieurs pistes de recherche future, et notamment l'étude plus approfondie de la compatibilité du décodage spéculatif avec la recherche par faisceau (voir l'annexe [A.4]). De plus, bien que notre méthode permette d'obtenir des accélérations substantielles avec les modèles d'approximation existants prêts à l'emploi, des améliorations plus importantes pourraient être obtenues grâce à des modèles d'approximation personnalisés (section [3.6]), tels que ceux dotés d'architectures personnalisées (par exemple des tailles personnalisées, des modèles non autorégressifs ou diverses heuristiques) ou de procédures d'entraînement personnalisées (par exemple une distillation standard avec des cibles souples issues de , ou l'optimisation de directement pour ). Il pourrait également être intéressant d'explorer une version hiérarchique de l'algorithme, où le modèle d'approximation est lui-même accéléré par un modèle encore plus rapide, ce qui pourrait permettre d'utiliser des modèles d'approximation plus performants. Dans ce travail, nous avons fixé le modèle d'approximation et le nombre de conjectures tout au long de l'inférence, mais les faire varier pendant l'inférence pourrait apporter des améliorations supplémentaires (section [3.5]). Dans nos expériences, nous avons toujours appliqué aux distributions générées par le modèle d'approximation la même standardisation que celle souhaitée pour le modèle cible (section [2.2]), mais des améliorations supplémentaires pourraient être obtenues en appliquant des transformations différentes. Nous n'avons testé le décodage spéculatif que dans la modalité textuelle, mais il pourrait bien fonctionner dans d'autres domaines (par exemple les images), ce qui serait intéressant à expérimenter.
Enfin, nous notons que l'exécution spéculative stochastique et l'échantillonnage spéculatif peuvent être utiles en dehors du cadre du décodage spéculatif à partir de modèles autorégressifs. Par exemple, étant donné deux fonctions lentes, et , telles que génère une distribution à partir de laquelle l'entrée de est échantillonnée, nous pourrions utiliser notre méthode pour exécuter et en parallèle. Cette configuration pourrait se présenter par exemple dans des simulations physiques, ou en apprentissage par renforcement où est un grand modèle qui produit une distribution sur les actions et est la simulation du monde, ce qui serait intéressant à explorer.
Remerciements
Nous tenons à remercier tout particulièrement YaGuang Li pour son aide sur tout ce qui concerne LaMDA et pour le calcul des figures LaMDA présentées dans l'article, ainsi que Blake Hechtman pour ses précieuses idées et son aide concernant XLA. Nous remercions également les relecteurs pour leurs commentaires pertinents, ainsi qu'Asaf Aharoni, Reiner Pope, Sasha Goldshtein, Nadav Sherman, Eyal Segalis, Eyal Molad, Dani Valevski, Daniel Wasserman, Valerie Nygaard, Danny Vainstein, les équipes LaMDA et Theta Labs de Google, et nos familles.
Références
Bapna, A., Arivazhagan, N., and Firat, O. Controlling computation versus quality for neural sequence models. ArXiv, abs/2002.07106, 2020.
Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., Neelakantan, A., Shyam, P., Sastry, G., Askell, A., Agarwal, S., Herbert-Voss, A., Krueger, G., Henighan, T., Child, R., Ramesh, A., Ziegler, D. M., Wu, J., Winter, C., Hesse, C., Chen, M., Sigler, E., Litwin, M., Gray, S., Chess, B., Clark, J., Berner, C., McCandlish, S., Radford, A., Sutskever, I., and Amodei, D. Language models are few-shot learners. In Proceedings of the 34th International Conference on Neural Information Processing Systems, NIPS'20, Red Hook, NY, USA, 2020. Curran Associates Inc. ISBN 9781713829546.
Burton, F. W. Speculative computation, parallelism, and functional programming. IEEE Transactions on Computers, C-34(12):1190-1193, 1985. doi: 10.1109/TC.1985.6312218.
Chelba, C., Mikolov, T., Schuster, M., Ge, Q., Brants, T., Koehn, P. T., and Robinson, T. One billion word bench mark for measuring progress in statistical language modeling. In Interspeech, 2013.
Chen, C., Borgeaud, S., Irving, G., Lespiau, J.- B., Sifre, L., and Jumper, J. M. Accelerating large language model decoding with speculative sampling. ArXiv, abs/2302.01318, 2023.
Chowdhery, A., Narang, S., Devlin, J., Bosma, M., Mishra, G., Roberts, A., Barham, P., Chung, H. W., Sutton, C., Gehrmann, S., Schuh, P., Shi, K., Tsvyashchenko, S., Maynez, J., Rao, A., Barnes, P., Tay, Y., Shazeer, N. M., Prabhakaran, V., Reif, E., Du, N., Hutchinson, B. C., Pope, R., Bradbury, J., Austin, J., Isard, M., Gur- Ari, G., Yin, P., Duke, T., Levskaya, A., Ghemawat, S., Dev, S., Michalewski, H., Garcia, X., Misra, V., Robinson, K., Fedus, L., Zhou, D., Ippolito, D., Luan, D., Lim, H., Zoph, B., Spiridonov, A., Sepassi, R., Dohan, D., Agrawal, S., Omernick, M., Dai, A. M., Pillai, T. S., Pelat, M., Lewkowycz, A., Moreira, E., Child, R., Polozov, O., Lee, K., Zhou, Z., Wang, X., Saeta, B., Diaz, M., Firat, O., Catasta, M., Wei, J., Meier- Hellstern, K. S., Eck, D., Dean, J., Petrov, S., and Fiedel, N. Palm: Scaling language modeling with pathways. ArXiv, abs/2204.02311, 2022.
Dehghani, M., Arnab, A., Beyer, L., Vaswani, A., and Tay, Y. The efficiency misnomer. ArXiv, abs/2110.12894, 2021.
Devlin, J., Chang, M.- W., Lee, K., and Toutanova, K. Bert: Pre- training of deep bidirectional transformers for language understanding. ArXiv, abs/1810.04805, 2019.
Elbayad, M., Gu, J., Grave, E., and Auli, M. Depth- adaptive transformer. ArXiv, abs/1910.10073, 2019.
Han, Y., Huang, G., Song, S., Yang, L., Wang, H., and Wang, Y. Dynamic neural networks: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence, 44: 7436- 7456, 2021.
Hendrycks, D. and Gimpel, K. Bridging nonlinearities and stochastic regularizers with gaussian error linear units. ArXiv, abs/1606.08415, 2016.
Hennessy, J. L. and Patterson, D. A. Computer Architecture: A Quantitative Approach. Morgan Kaufmann, Amsterdam, 5 edition, 2012. ISBN 978- 0- 12- 383872- 8.
Hinton, G. E., Vinyals, O., and Dean, J. Distilling the knowledge in a neural network. ArXiv, abs/1503.02531, 2015.
Hubara, I., Courbariaux, M., Soudry, D., El- Yaniv, R., and Bengio, Y. Quantized neural networks: Training neural networks with low precision weights and activations. ArXiv, abs/1609.07061, 2016.
Jaszczur, S., Chowdhery, A., Mohiuddin, A., Kaiser, L., Gajewski, W., Michalewski, H., and Kanerva, J. Sparse is enough in scaling transformers. In Neural Information Processing Systems, 2021.
Raffel, C., Shazeer, N., Roberts, A., Lee, K., Narang, S., Matena, M., Zhou, Y., Li, W., and Liu, P. J. Exploring the limits of transfer learning with a unified text- to- text transformer. The Journal of Machine Learning Research, 21(1):5485- 5551, 2020.
Roberts, A., Chung, H. W., Levskaya, A., Mishra, G., Bradbury, J., Andor, D., Narang, S., Lester, B., Gaffney, C., Mohiuddin, A., Hawthorne, C., Lewkowycz, A., Salcianu, A., van Zee, M., Austin, J., Goodman, S., Soares, L. B., Hu, H., Tsvyashchenko, S., Chowdhery, A., Bastings, J., Bulian, J., Garcia, X., Ni, J., Chen, A., Kenealy, K., Clark, J., Lee, S., Garrette, D. H., Lee- Thorp, J., Raffel, C., Shazeer, N. M., Ritter, M., Bosma, M., Passos, A., Maitin- Shepard, J. B., Fiedel, N., Omernick, M., Saeta, B., Sepassi, R., Spiridonov, A., Newlan, J., and Gesmundo, A. Scaling up models and data with 5x and seqio. ArXiv, abs/2203.17189, 2022.
Scardapane, S., Scarpiniti, M., Baccarelli, E., and Uncini, A. Why should we add early exits to neural networks? Cognitive Computation, 12(5):954- 966, 2020.
Schuster, T., Fisch, A., Jaakkola, T., and Barzilay, R. Consistent accelerated inference via confident adaptive transformers. In Conference on Empirical Methods in Natural Language Processing, 2021.
Schwartz, R., Stanovsky, G., Swayamdipta, S., Dodge, J., and Smith, N. A. The right tool for the job: Matching model and instance complexities. In Annual Meeting of the Association for Computational Linguistics, 2020.
Shazeer, N. M. Fast transformer decoding: One write- head is all you need. ArXiv, abs/1911.02150, 2019.
So, D. R., Ma'ake, W., Liu, H., Dai, Z., Shazeer, N. M., and Le, Q. V. Primer: Searching for efficient transformers for language modeling. ArXiv, abs/2109.08668, 2021.
Stern, M., Shazeer, N., and Uszkoreit, J. Blockwise parallel decoding for deep autoregressive models. Advances in Neural Information Processing Systems, 31, 2018.
Sukhbaatar, S., Grave, E., Bojanowski, P., and Joulin, A. Adaptive attention span in transformers. In Annual Meeting of the Association for Computational Linguistics, 2019.
Sun, X., Ge, T., Wei, F., and Wang, H. Instantaneous grammatical error correction with shallow aggressive decoding. ArXiv, abs/2106.04970, 2021.
Thoppilan, R., Freitas, D. D., Hall, J., Shazeer, N. M., Kulshreshtha, A., Cheng, H.- T., Jin, A., Bos, T., Baker, L., Du, Y., Li, Y., Lee, H., Zheng, H., Ghafouri, A., Menegali, M., Huang, Y., Krikun, M., Lepikhin, D., Qin, J., Chen, D., Xu, Y., Chen, Z., Roberts, A., Bosma, M., Zhou, Y., Chang, C.- C., Krivokon, I. A., Rusch, W. J., Pickett, M., Meier- Hellstern, K. S., Morris, M. R., Doshi, T., Santos, R. D., Duke, T., Soraker, J. H., Zevenbergen, B., Prabhakaran, V., Díaz, M., Hutchinson, B., Olson, K., Molina, A., Hoffman- John, E., Lee, J., Aroyo, L., Rajakumar, R., Butryna, A., Lamm, M., Kuzmina, V. O., Fenton, J., Cohen, A., Bernstein, R., Kurzweil, R., Aguera- Arcas, B., Cui, C., Croak, M., hsin Chi, E. H., and Le, Q. Lamda: Language models for dialog applications. ArXiv, abs/2201.08239, 2022.
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, L., et Polosukhin, I. Attention is all you need. Advances in neural information processing systems, 30, 2017.
Yu, J., Xu, Y., Koh, J. Y., Luong, T., Baid, G., Wang, Z., Vasudevan, V., Ku, A., Yang, Y., Ayan, B. K., Hutchinson, B. C., Han, W., Parekh, Z., Li, X., Zhang, H., Baldridge, J., et Wu, Y. Scaling autoregressive models for content-rich text- to- image generation. ArXiv, abs/2206.10789, 2022.
A. Annexe
A.1. Exactitude de l'échantillonnage spéculatif
Nous allons maintenant montrer que pour toutes distributions et , les tokens échantillonnés par échantillonnage spéculatif à partir de et sont distribués de manière identique à ceux échantillonnés à partir de seul. Soit la probabilité d'acceptation (Définition 3.1).
Notons que comme , la constante de normalisation pour la distribution ajustée est , où la dernière équation découle immédiatement du Lemme 3.3 et du Théorème 3.5
Maintenant :
Où :
Et :
Globalement :
Comme souhaité.
A.2. Échantillonnage spéculatif vs. échantillonnage par rejet
L'échantillonnage par rejet est la procédure d'échantillonnage itérative suivante qui semble superficiellement similaire à la nôtre :
1. Tirer et .
2. Si renvoyer .
3. Aller à 1.
Où . Nous pourrions employer une version non itérative de l'échantillonnage par rejet au lieu de l'échantillonnage spéculatif — plus précisément, parcourir les étapes 1 et 2 ci-dessus, et sinon échantillonner directement à partir d'un non modifié. Ce serait cependant bien moins efficace que notre méthode. Plus précisément, la probabilité d'acceptation espérée ici est est (potentiellement bien) inférieure à la probabilité d'acceptation espérée dans notre méthode .
A.3. Prédictions théoriques vs. temps d'exécution empiriques
Le tableau 4 compare les améliorations de temps d'exécution attendues d'après le théorème 3.8 aux temps d'exécution mesurés empiriquement du tableau 2. Nous avons estimé les valeurs de pour les différents modèles à partir de traces de profilage. Nous pouvons constater que les prédictions théoriques correspondent globalement aux temps d'exécution mesurés. Les écarts plus importants sont dus à : (1) des différences d'optimisation entre notre implémentation et la référence, et (2) l'hypothèse simplificatrice selon laquelle les sont i.i.d. n'étant qu'une approximation (voir section 3.1).
| TÂCHE | MQ | TEMP | γ | α | c | EXP | EMP |
| ENDE | T5-SMALL | 0 | 7 | 0,75 | 0,02 | 3,2 | 3,4 |
| ENDE | T5-BASE | 0 | 7 | 0,8 | 0,04 | 3,3 | 2,8 |
| ENDE | T5-LARGE | 0 | 7 | 0,82 | 0,11 | 2,5 | 1,7 |
| ENDE | T5-SMALL | 1 | 7 | 0,62 | 0,02 | 2,3 | 2,6 |
| ENDE | T5-BASE | 1 | 5 | 0,68 | 0,04 | 2,4 | 2,4 |
| ENDE | T5-LARGE | 1 | 3 | 0,71 | 0,11 | 2,0 | 1,4 |
| CNNDM | T5-SMALL | 0 | 5 | 0,65 | 0,02 | 2,4 | 3,1 |
| CNNDM | T5-BASE | 0 | 5 | 0,73 | 0,04 | 2,6 | 3,0 |
| CNNDM | T5-LARGE | 0 | 3 | 0,74 | 0,11 | 2,0 | 2,2 |
| CNNDM | T5-SMALL | 1 | 5 | 0,53 | 0,02 | 1,9 | 2,3 |
| CNNDM | T5-BASE | 1 | 3 | 0,55 | 0,04 | 1,8 | 2,2 |
| CNNDM | T5-LARGE | 1 | 3 | 0,56 | 0,11 | 1,6 | 1,7 |
Tableau 4. Facteur d'amélioration attendu (Exp) vs. facteur d'amélioration mesuré empiriquement (EMP).
A.4. Application à la recherche par faisceau
Notre méthode peut être appliquée, avec une certaine pénalité de performance, à l'échantillonnage par recherche par faisceau. Étant donné la largeur de faisceau originale , nous pouvons effectuer une recherche par faisceau avec le modèle d'approximation et une largeur de faisceau pendant étapes. Ensuite, nous pouvons utiliser pour vérifier tous les candidats en parallèle (ce qui coûte un budget de calcul de exécutions de ). Enfin, pour chaque étape, nous pouvons accepter les devinettes de tant que pour obtenir des résultats identiques à une recherche par faisceau régulière avec seul (avec une procédure plus élaborée, nous pourrions aussi accepter les cas où les candidats obtenus ont par hasard des probabilités plus élevées que celles de seul). L'analyse de notre méthode dans ce cadre est plus complexe et nous la laissons pour des travaux futurs.
A.5. Indulgence
Une propriété forte de l'algorithme est que la distribution de sortie est garantie de rester inchangée. Cela dit, si nous acceptons de permettre certains changements, avec de belles garanties, nous pouvons obtenir d'autres améliorations de vitesse d'inférence. Pour motiver davantage cela, notons que lorsque nous entraînons deux modèles d'architectures et de tailles identiques sur le même jeu de données, les distributions de probabilité générées ne seront pas identiques, donc une certaine indulgence pourrait avoir du sens. Notons que les résultats de cet article, à l'exception de cette section, utilisent la version la plus stricte de l'algorithme et n'autorisent aucune forme d'indulgence.
Nous pourrions inclure un paramètre d'indulgence et multiplier par avant de le comparer à dans l'algorithme Cela maintient toujours la belle garantie qu'aucun token ne peut être échantillonné avec une probabilité supérieure à . Cela signifie par exemple qu'avec aucun token ne peut être échantillonné avec plus de 10 fois sa probabilité de vérité terrain, de sorte que nous pouvons garantir que les tokens extrêmement rares resteront extrêmement rares (il n'y a aucune garantie sur la probabilité minimale, donc l'indulgence pourrait nuire à la diversité des échantillons).
Plus précisément, avec un facteur d'indulgence nous avons \begin{array}{r l r}{{\alpha}~=}&{{}E_{x\sim q(x)}\left\{\begin{array}{l l}{1}&{l q(x)\leq p(x)}\\ {\frac{p(x)}{l q(x)}}&{l q(x)>p(x)}\end{array}\right.}&{{}=}&{{}E_{x\sim q(x)}\frac{p(x)}{m a x(p(x),l q(x))}}}\end{array}
Le tableau 5 montre les valeurs de pour différentes valeurs de lorsque est T5- XXL (11B) et est T5- small (77M). Avec en utilisant des valeurs d'indulgence de 1, 0.5, 0.3 et 0.1 (ce qui signifie qu'aucun token ne peut être échantillonné avec une probabilité supérieure à 1X, 2X, 3X et 10X de la vérité terrain) nous obtenons des facteurs d'amélioration de 2.5X, 3.1X, 3.6X et 5X respectivement.
| Contexte en lecture seule pour comprendre la source (il ne s'agit pas du texte source à traduire) : Le tableau 5 montre les valeurs de α pour différentes valeurs de l lorsque M_{p} est T5- XXL (11B) et M_{q} est T5- small (77M). Avec c = 0,015 en utilisant des valeurs d'indulgence de 1, 0,5, 0,3 et 0,1 (ce qui signifie qu'aucun token ne peut être échantillonné avec une probabilité supérieure à 1X, 2X, 3X et 10X de la vérité terrain), nous obtenons des facteurs d'amélioration de 2,5X, 3,1X, 3,6X et 5X respectivement. Tableau 5. Valeurs de α pour diverses valeurs de l avec un échantillonnage standard où M_{p} est T5-XXL (11B) sur la tâche de traduction EnDe. Texte à traduire : MQ l = 1 l = 0,5 l = 0,3 l = 0,1 UNIGRAM 0,07 0,1 0,11 0,16 BIGRAM 0,19 0,23 0,25 0,32 T5-SMALL (77M) 0,62 0,71 0,76 0,84 T5-BASE (250M) 0,68 0,8 0,83 0,90 |
Tableau 5. Valeurs de pour diverses valeurs de avec un échantillonnage standard où est T5-XXL (11B) sur la tâche de traduction EnDe.
Notez que lorsqu'on utilise une température (c'est-à-dire un échantillonnage argmax), nous ne pouvons plus utiliser l'indulgence comme ci-dessus. Au lieu de cela, nous pourrions autoriser une certaine indulgence avant de standardiser les distributions. Par exemple, nous pourrions accepter le token échantillonné à partir de dans le cas où . Dans ce cas, nous mesurons des augmentations empiriques similaires des valeurs de à celles obtenues avec une température . Par exemple, en utilisant des valeurs d'indulgence de 1, 0,5, 0,3 et 0,1 pour T5- XXL T5- small pour la traduction anglais-allemand, nous obtenons des valeurs de de 0,75, 0,75, 0,8, 0,87. En prenant par exemple et nous obtenons des facteurs d'amélioration de la vitesse de 3,3X, 3,3X, 3,9X et 4,9X respectivement.7