
Un cadre montre qu'attention et modèles à espace d'état sont deux vues de la même matrice, et donne une couche plus rapide. ICML 2024, gratuit en ligne.
Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality
Les Transformers sont des SSM : Modèles généralisés et algorithmes efficaces grâce à la dualité structurée des espaces d'états
\(^{1}\) Department of Computer Science, Princeton University \(^{2}\) Machine Learning Department, Carnegie Mellon University tri@tridao.me, agu@cs.cmu.edu
Résumé
Bien que les Transformers aient été l'architecture principale derrière le succès de l'apprentissage profond en modélisation du langage, les modèles à espaces d'états (SSM) tels que Mamba ont récemment été montrés comme égalant ou surpassant les Transformers à petite et moyenne échelle. Nous montrons que ces familles de modèles sont en réalité assez étroitement liées, et développons un riche cadre de connexions théoriques entre les SSM et les variantes de l'attention, reliées par diverses décompositions d'une classe bien étudiée de matrices semi-séparables structurées. Notre cadre de dualité des espaces d'états (SSD) nous permet de concevoir une nouvelle architecture (Mamba-2) dont la couche centrale est un raffinement du SSM sélectif de Mamba qui est 2 à 8× plus rapide, tout en continuant d'être compétitif avec les Transformers sur la modélisation du langage.
1 Introduction
Les Transformers, en particulier les modèles décodeur uniquement (par exemple GPT (Brown et al. 2020), Llama (Touvron, Lavril, et al. 2023)) qui traitent les séquences d'entrée de manière causale, sont l'un des principaux moteurs du succès de l'apprentissage profond moderne. De nombreuses approches tentent d'approximer la couche d'attention centrale pour répondre à ses problèmes d'efficacité (Tay et al. 2022), tels que la mise à l'échelle quadratique en longueur de séquence pendant l'entraînement et la nécessité d'un cache de taille linéaire en longueur de séquence pendant la génération autorégressive. En parallèle, une classe de modèles de séquence alternatifs, les modèles à espaces d'états structurés (SSM), a émergé avec une mise à l'échelle linéaire en longueur de séquence pendant l'entraînement et une taille d'état constante pendant la génération. Ils montrent de fortes performances sur des tâches à longue portée (par exemple S4 (Gu, Goel, et Ré 2022)) et ont récemment égalé ou battu les Transformers sur la modélisation du langage (par exemple Mamba (Gu et Dao 2023)) à petite et moyenne échelle. Cependant, le développement des SSM a semblé disjoint de l'effort collectif de la communauté pour améliorer les Transformers, comme les comprendre théoriquement ainsi que les optimiser sur le matériel moderne. En conséquence, il est plus difficile de comprendre et d'expérimenter avec les SSM comparé aux Transformers, et il reste difficile d'entraîner les SSM aussi efficacement que les Transformers d'un point de vue tant algorithmique que systémique.
Notre objectif principal est de développer un riche ensemble de connexions théoriques entre les SSM structurés et les variantes de l'attention. Cela nous permettra de transférer les optimisations algorithmiques et systémiques initialement développées pour les Transformers vers les SSM, dans le but de construire des modèles de fondation qui performent mieux que les Transformers tout en passant à l'échelle plus efficacement en longueur de séquence. Une contribution marquante dans cette direction a été le cadre de l'attention linéaire (LA) (Katharopoulos et al. 2020), qui a dérivé une connexion entre l'attention autorégressive et les RNN linéaires en montrant l'équivalence entre les « formes duales » de l'attention quadratique à noyau et une récurrence linéaire particulière. Cette dualité permet de nouvelles capacités telles que la possibilité d'avoir à la fois un entraînement parallélisable efficace et une inférence autorégressive efficace. Dans le même esprit, cet article fournit de multiples points de vue reliant les SSM à complexité linéaire avec des formes à complexité quadratique pour combiner les forces des SSM et de l'attention. \(^{1}\)
Dualité des espaces d'états. Notre cadre reliant les SSM structurés et les variantes de l'attention, que nous appelons dualité structurée des espaces d'états (SSD), est établi à travers les abstractions des matrices structurées : des matrices avec des paramètres sous-quadratiques et une complexité de multiplication sous-quadratique. Nous développons deux grands cadres pour représenter les modèles de séquence, l'un sous forme de transformations matricielles et l'autre sous forme de contractions tensorielles, qui révèlent chacun différentes perspectives de la dualité. Nos contributions techniques incluent :
- Nous montrons une équivalence entre les modèles à espaces d'états et une famille bien étudiée de matrices structurées appelées matrices semi-séparables (Section 3). Cette connexion est au cœur de notre cadre, révélant de nouvelles propriétés et algorithmes pour les SSM. Un message central de cet article est que différentes méthodes de calcul des modèles à espaces d'états peuvent être reformulées comme divers algorithmes de multiplication matricielle sur des matrices structurées.
- Nous améliorons significativement la théorie de l'attention linéaire (Katharopoulos et al. 2020). Nous fournissons d'abord une preuve incisive de sa forme récurrente à travers le langage des contractions tensorielles, puis la généralisons à une nouvelle famille d'attention masquée structurée (SMA) (Section 4).
- Nous relions les SSM et la SMA, en montrant qu'ils ont une grande intersection qui sont duales l'une de l'autre, possédant à la fois des formes linéaires de type SSM et quadratiques de type attention (Section 5). Nous prouvons également que toute méthode d'attention à noyau possédant une forme récurrente rapide doit être un SSM.
Au-delà de sa valeur théorique intrinsèque, notre cadre ouvre un large ensemble de directions pour comprendre et améliorer les modèles de séquence.
Algorithmes efficaces. Premièrement et surtout, notre cadre expose de nouveaux algorithmes efficaces et facilement implémentables pour calculer les SSM (Section 6). Nous introduisons un nouvel algorithme SSD, basé sur des décompositions par blocs de matrices semi-séparables, qui tire parti à la fois de la récurrence linéaire des SSM et de la forme duale quadratique, obtenant des compromis optimaux sur tous les principaux axes d'efficacité (par exemple le calcul d'entraînement et d'inférence, l'utilisation de la mémoire, et la capacité à exploiter les unités de multiplication matricielle sur le matériel moderne). Une implémentation dédiée de SSD est \(2 - 8\times\) plus rapide que l'implémentation optimisée du scan sélectif de Mamba, tout en permettant simultanément des tailles d'état récurrent bien plus grandes ( \(8\times\) la taille de Mamba ou même plus, avec un ralentissement minimal). SSD est hautement compétitif avec les implémentations optimisées de l'attention softmax (FlashAttention-2 (Dao 2024)), croisant à une longueur de séquence de \(2\mathrm{K}\) et \(6\times\) plus rapide à une longueur de séquence de 16K.
Conception d'architecture. Un obstacle majeur à l'adoption de nouvelles architectures telles que les SSM est l'écosystème adapté aux Transformers, comme l'optimisation matériellement efficace et les techniques de parallélisme pour l'entraînement à grande échelle. Notre cadre permet d'utiliser les conventions et techniques établies pour l'attention afin de construire un vocabulaire de choix de conception d'architecture pour les SSM, et de les améliorer davantage (Section 7). Par exemple, nous introduisons l'analogue des têtes de l'attention multi-têtes (MHA) pour les SSM. Nous montrons que l'architecture Mamba est un SSM multi-entrées (MIS) qui s'avère analogue à l'attention multi-valeurs (MVA), et comparons d'autres variantes de Mamba avec différentes structures de têtes.
Nous utilisons également ces idées pour apporter de légères modifications au bloc Mamba, ce qui permet d'implémenter le parallélisme tensoriel (par exemple dans le style de Megatron (Shoeybi et al. 2019)). Les idées principales incluent l'introduction d'une structure de têtes d'attention à valeurs groupées (GVA), et le déplacement de toutes les projections dépendantes des données pour qu'elles se produisent en parallèle au début du bloc.
La combinaison du bloc Mamba parallèle modifié, avec l'utilisation de SSD comme couche SSM interne, donne l'architecture Mamba-2. Nous étudions les lois d'échelle Chinchilla pour Mamba-2 dans le même cadre que Mamba, constatant qu'il domine au sens de Pareto Mamba et Transformer++ à la fois en perplexité et en temps réel. Nous entraînons en outre une famille de modèles Mamba-2 de tailles variées sur le Pile, montrant qu'il égale ou surpasse Mamba et les Transformers open source sur les évaluations en aval standard. Par exemple, Mamba-2 avec 2,7B de paramètres entraîné sur 300B de tokens sur le Pile surpasse Mamba-2.8B, Pythia-2.8B et même Pythia-6.9B entraînés sur le même jeu de données.
Optimisations systémiques. Le cadre SSD relie les SSM et les Transformers, nous permettant de tirer parti d'un riche ensemble de travaux sur les optimisations systémiques développées pour les Transformers (Section 8).
- Par exemple, le parallélisme tensoriel (TP) est une technique importante de parallélisme de modèle pour entraîner de grands modèles Transformer en divisant chaque couche entre les GPU d'un même nœud. Nous concevons Mamba-2 pour être adapté au TP, réduisant de moitié le nombre de points de synchronisation par bloc.
- Pour les très longues séquences dont les activations ne tiennent pas sur un seul dispositif, le parallélisme de séquence a été développé pour les blocs d'attention. Nous décrivons comment entraîner les SSM en général et Mamba-2 en particulier avec le parallélisme de séquence, en transmettant les états récurrents entre les dispositifs.
- Pour le fine-tuning avec des exemples de longueurs différentes, pour une efficacité optimale, Transformer nécessite des techniques sophistiquées pour supprimer les tokens de remplissage et effectuer l'attention sur des séquences de longueur variable. Nous montrons comment Mamba-2 peut être entraîné efficacement avec des longueurs de séquence variables, sans nécessiter de tokens de remplissage.
La Section 9 valide empiriquement Mamba-2 sur la modélisation du langage, l'efficacité d'entraînement, et une tâche difficile de rappel associatif multi-requêtes (Arora, Eyuboglu, Zhang, et al. 2024). Enfin, dans la Section 10, nous fournissons un travail connexe étendu et discutons des directions de recherche potentielles ouvertes par notre cadre.
Le code du modèle et les points de contrôle pré-entraînés sont open source à l'adresse https://github.com/state-spaces/mamba.
2 Contexte et aperçu
2.1 Modèles à espaces d'états structurés
Les modèles de séquence à espaces d'états structurés (S4) sont une classe récente de modèles de séquence pour l'apprentissage profond qui sont largement liés aux RNN, aux CNN et aux modèles à espaces d'états classiques. Ils sont inspirés par un système continu particulier (1) qui associe une séquence unidimensionnelle \(x \in \mathbb{R}^{\top} \mapsto y \in \mathbb{R}^{\top}\) à travers un état latent implicite \(h \in \mathbb{R}^{(\mathbb{T}, \mathbb{N})}\) .
Une forme discrète générale des SSM structurés prend la forme de l'équation (1).
où . Les SSM structurés sont ainsi nommés parce que la matrice contrôlant la dynamique temporelle doit être structurée afin de calculer cette transformation de séquence à séquence de manière suffisamment efficace pour être utilisée dans des réseaux de neurones profonds. Les structures originales introduites étaient diagonale plus bas rang (DPLR) (Gu, Goel, and Ré 2022) et diagonale (Gu, Gupta, et al. 2022 ; Gupta, Gu, and Berant 2022 ; J. T. Smith, Warrington, and Linderman 2023), qui reste la structure la plus populaire.
Dans ce travail, nous utilisons le terme modèle d'espace d'états (SSM) pour désigner les SSM structurés. Il existe de nombreuses variantes de ces SSM, étroitement liées à plusieurs paradigmes majeurs des modèles de séquences neuronaux tels que les modèles en temps continu, récurrents et convolutifs (Gu, Johnson, Goel, et al. 2021). Nous en donnons un bref aperçu ci-dessous, et renvoyons aux travaux antérieurs pour plus de contexte et de détails (Gu 2023 ; Gu and Dao 2023).
Modèles en temps continu. Les SSM structurés originaux sont apparus comme des applications en temps continu sur des fonctions , plutôt que d'opérer directement sur des séquences. Dans la perspective en temps continu, dans l'équation (1a), les matrices ne sont pas apprises directement mais générées à partir de paramètres sous-jacents , ainsi que d'un pas de temps paramétré . Les « paramètres continus » sont convertis en « paramètres discrets » par des formules fixes et , où le couple est appelé règle de discrétisation.
Remarque 1. Bien que nos modèles principaux adoptent la même paramétrisation et le même pas de discrétisation que les travaux antérieurs (voir Gu et Dao (2023) pour les détails), pour simplifier l'exposé et la notation, nous les omettons dans le reste de cet article. Nous notons que les travaux antérieurs sur les SSM structurés désignaient les paramètres continus et les paramètres discrets par et respectivement ; nous avons changé la notation pour simplifier la présentation et nous concentrer directement sur les paramètres discrets, qui régissent la récurrence principale du SSM.
Modèles récurrents. Les équations (1) et (2) prennent la forme d'une récurrence qui est linéaire en son entrée . Les SSM structurés peuvent donc être considérés comme des types de réseaux de neurones récurrents (RNN), où la linéarité leur confère des propriétés supplémentaires et leur permet d'éviter le calcul séquentiel des RNN traditionnels. Inversement, malgré cette simplification, les SSM restent entièrement expressifs en tant que transformations de séquences (au sens de l'approximation universelle) (Kaul 2020 ; Orvieto et al. 2023 ; Shida Wang et Xue 2023).
Modèles convolutifs. Lorsque la dynamique du SSM est constante dans le temps comme dans l'équation (1), le modèle est dit linéaire à temps invariant (LTI). Dans ce cas, ils sont équivalents à des convolutions. Ainsi, les SSM peuvent également être considérés comme des types de CNN, mais où (i) les noyaux de convolution sont implicitement paramétrés par les paramètres du SSM et (ii) les noyaux de convolution sont généralement globaux plutôt que locaux. Inversement, grâce à la théorie classique du traitement du signal, toutes les convolutions suffisamment bien comportées peuvent être représentées comme des SSM.
Habituellement, les SSM LTI antérieurs utilisaient le mode convolutif pour un entraînement parallélisable efficace (où toute la séquence d'entrée est vue à l'avance), et basculaient en mode récurrent (1) pour une inférence autorégressive efficace (où les entrées sont vues une étape à la fois).
Modèles d'espace d'état sélectifs. La forme (2) où les paramètres peuvent également varier dans le temps a été introduite dans Mamba comme le SSM sélectif. Comparé à la formulation LTI standard (1), ce modèle peut choisir sélectivement de se concentrer sur ou d'ignorer des entrées à chaque pas de temps. Il a été montré qu'il performe bien mieux que les SSM LTI sur des données denses en information telles que le langage, en particulier lorsque sa taille d'état N augmente, permettant une plus grande capacité d'information. Cependant, il ne peut être calculé qu'en mode récurrent et non convolutif, et nécessite une implémentation soignée tenant compte du matériel pour être efficace. Même ainsi, il reste moins efficace que des modèles adaptés au matériel tels que les CNN et les Transformers, car il ne tire pas parti des unités de multiplication matricielle, pour lesquelles les accélérateurs modernes tels que les GPU et TPU sont spécialisés.
Bien que les SSM à temps invariant soient étroitement liés aux modèles de séquences continus, récurrents et convolutifs, ils ne sont pas directement liés à l'attention. Dans cet article, nous montrons une relation plus profonde entre les SSM sélectifs et l'attention, et l'utilisons pour améliorer significativement la vitesse d'entraînement des SSM tout en permettant simultanément des tailles d'état N bien plus grandes.
Les SSM structurés comme transformations de séquences.
Définition 2.1. Nous utilisons le terme transformation de séquence pour désigner une application paramétrée sur des séquences où et est une collection arbitraire de paramètres. T représente la séquence ou l'axe temporel ; les indices font référence à la première dimension, par exemple .
Les transformations de séquences (par exemple les SSM, ou l'auto-attention) sont la pierre angulaire des modèles de séquences profonds, où elles sont incorporées dans des architectures de réseaux de neurones (par exemple les Transformers). Le SSM dans (1) ou (2) est une transformation de séquence avec ; il peut être généralisé à en diffusant simplement sur cette dimension (en d'autres termes, en considérant l'entrée comme séquences indépendantes et en appliquant le SSM à chacune). On peut considérer comme une dimension de tête, ce que nous détaillerons à la Section 7.
Définition 2.2. Nous définissons l'opérateur SSM comme la transformation de séquence définie par l'équation (2).
Dans les SSM, la dimension N est un paramètre libre appelé taille d'état ou dimension d'état. Nous l'appelons aussi facteur d'expansion d'état, car elle multiplie la taille de l'entrée/sortie par un facteur , avec des implications pour l'efficacité computationnelle de ces modèles.
Enfin, nous remarquons que de nombreux types de transformations de séquences, telles que l'attention, peuvent être représentés comme une simple multiplication matricielle sur la dimension de la séquence.
Définition 2.3. Nous appelons une transformation de séquence une transformation matricielle si elle peut s'écrire sous la forme où est une matrice dépendant des paramètres . Nous identifions la transformation de séquence avec la matrice , et omettons souvent la dépendance à lorsqu'elle est claire d'après le contexte.
2.2 Attention
L'attention désigne globalement un type de calcul qui attribue des scores à chaque paire de positions dans une séquence, permettant à chaque élément de « prêter attention » au reste. De loin la variante d'attention la plus courante et la plus importante est l'auto-attention softmax, qui peut être définie comme
pour . Le mécanisme de comparaisons par paires (induit par la matérialisation de ) conduit au coût d'entraînement quadratique caractéristique de l'attention.
De nombreuses variantes de l'attention ont été proposées, mais toutes partagent le cœur sous-jacent de ces scores d'attention, avec diverses approximations (Tay et al. 2022). La variante la plus importante pour ce travail est l'attention linéaire (Katharopoulos et al. 2020). En gros, cette famille de méthodes supprime le softmax en le repliant dans une application de caractéristiques de noyau, et utilise l'associativité de la multiplication matricielle pour réécrire . De plus, dans le cas important de l'attention causale (autorégressive), ils montrent que lorsque le masque causal est incorporé dans le membre de gauche sous la forme , où est la matrice triangulaire inférieure de 1, alors le membre de droite peut être développé en une récurrence. Plusieurs travaux récents et concurrents tels que RetNet (Y. Sun et al. 2023) et GateLoop (Katsch 2023) renforcent cela vers des formes plus générales de (Section 10). Dans ce travail, notre formulation de l'attention masquée structurée généralisera fortement ces idées.
2.3 Matrices structurées
Les matrices générales nécessitent paramètres pour être représentées et un temps pour effectuer des opérations de base telles que la multiplication matrice-vecteur. Les matrices structurées sont celles qui (i) peuvent être représentées avec un nombre sous-quadratique (idéalement linéaire) de paramètres grâce à une représentation compressée, et (ii) disposent d'algorithmes rapides (plus important encore, de multiplication matricielle) en opérant directement sur cette représentation compressée.
Peut-être les familles les plus canoniques de matrices structurées sont-elles les matrices creuses et de rang faible. Cependant, il existe de nombreuses autres familles, telles que les matrices de Toeplitz, de Cauchy, de Vandermonde et papillon, qui ont toutes été utilisées en apprentissage automatique pour des modèles efficaces (Dao, Gu, et al. 2019 ; D. Fu et al. 2024 ; Gu, Gupta, et al. 2022 ; Thomas et al. 2018). Les matrices structurées constituent une abstraction puissante pour des représentations et des algorithmes efficaces. Dans ce travail, nous montrerons que les SSM sont équivalents à une autre classe de matrices structurées qui n'ont pas été utilisées auparavant en apprentissage profond, et nous utiliserons cette connexion pour dériver des méthodes et des algorithmes efficaces.
2.4 Aperçu : Dualité structurée des espaces d'états
Bien que cet article développe un cadre beaucoup plus riche de connexions entre les SSM, l'attention et les matrices structurées, nous fournissons un bref résumé de la méthode principale, qui est en fait algorithmiquement assez autonome et simple.
Forme récurrente (linéaire). La couche de dualité d'espace d'états (SSD) peut être définie comme un cas particulier du SSM sélectif (2). Le calcul standard d'un SSM sous forme de récurrence (ou de scan parallèle) peut être appliqué, ce qui a une complexité linéaire en longueur de séquence. Comparée à la version utilisée dans Mamba, SSD présente deux différences mineures :
La structure sur est encore simplifiée, passant d'une structure diagonale à une structure scalaire fois identité. Chaque peut également être identifié à un simple scalaire dans ce cas. Nous utilisons une dimension de tête plus grande, comparée à utilisée dans Mamba. Typiquement, est choisi, ce qui est similaire aux conventions des Transformers modernes.
Comparées au SSM sélectif original, ces modifications peuvent être considérées comme une légère diminution de la puissance d'expression en échange d'améliorations significatives de l'efficacité d'entraînement. En particulier, nos nouveaux algorithmes permettront l'utilisation d'unités de multiplication matricielle sur les accélérateurs modernes.
Forme duale (quadratique). La forme duale de SSD est un calcul quadratique étroitement lié à l'attention, défini comme
où les sont des scalaires dépendant de l'entrée et bornés dans [0, 1].
Comparée à l'attention softmax standard, il existe deux différences principales
- Le softmax est supprimé.
- La matrice d'attention est multipliée élément par élément par une matrice de masque supplémentaire .
Ces deux modifications peuvent être considérées comme répondant à des problèmes de l'attention vanilla. Par exemple, il a récemment été observé que le softmax cause des problèmes dans les scores d'attention, tels que le phénomène de « puits d'attention » (attention sink) (Darcet et al. 2024 ; Xiao et al. 2024). Plus important encore, la matrice de masque peut être considérée comme remplaçant les plongements positionnels heuristiques des Transformers par un masque positionnel différent, dépendant des données, qui contrôle la quantité d'information transférée au fil du temps.
Plus largement, cette forme est une instance de notre généralisation d'attention masquée structurée de l'attention linéaire, définie à la Section 4.
Forme matricielle et algorithme SSD. Les diverses formes de SSD sont reliées par une représentation matricielle unifiée, en montrant que les SSM ont une forme de transformation matricielle pour une matrice qui dépend de . En particulier, la forme duale de SSD est équivalente à une multiplication naïve (en temps quadratique) par la matrice , et la forme récurrente est un algorithme efficace particulier (en temps linéaire) qui exploite la structure de .
Au-delà de ceux-ci, tout algorithme de multiplication par peut être appliqué. Notre algorithme SSD efficace sur le plan matériel que nous proposons (Section 6) est une nouvelle méthode de multiplication de matrices structurées qui implique des décompositions en blocs de , laquelle obtient de meilleurs compromis d'efficacité que les formes purement linéaires ou quadratiques. Il est relativement simple et facile à mettre en œuvre comparé aux SSM sélectifs généraux (Gu and Dao 2023) ; le Listing 1 fournit une implémentation complète en quelques lignes de code.
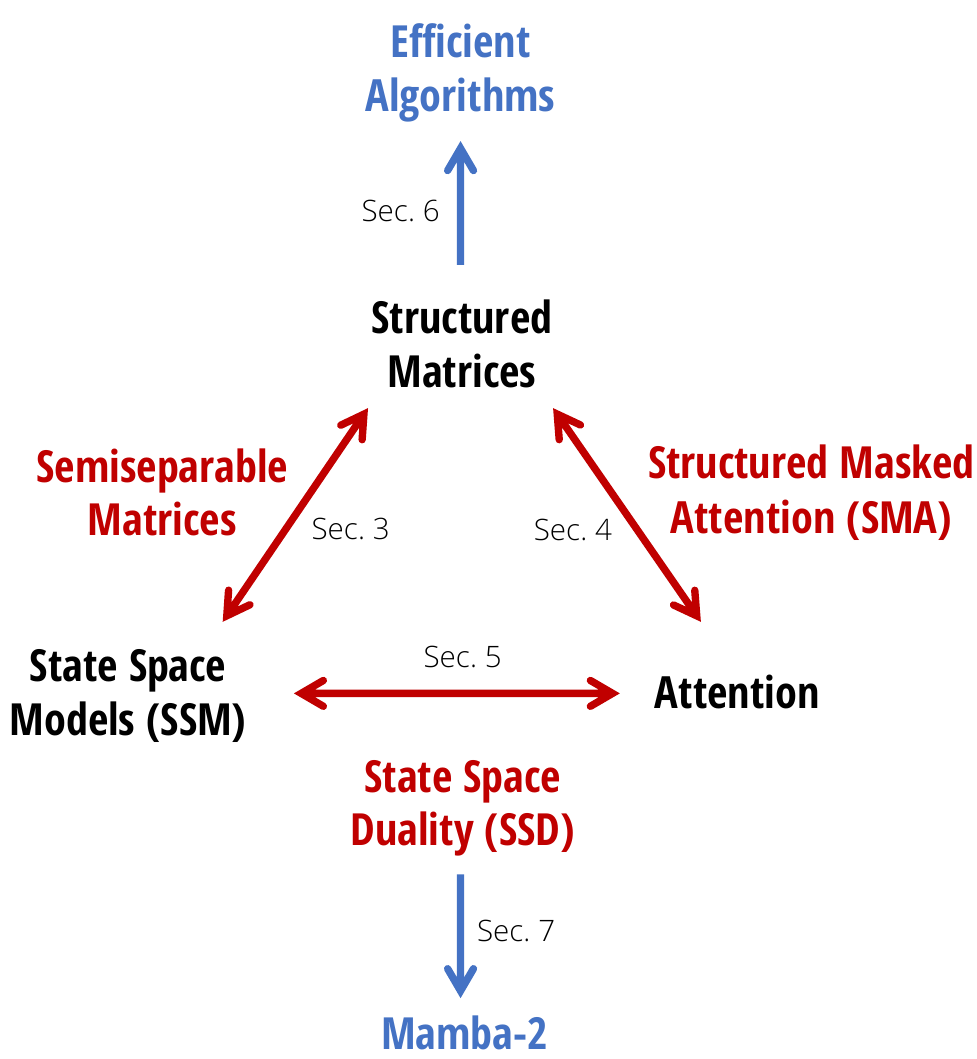
La Figure 1 fournit une feuille de route simple des relations entre les concepts présentés dans cet article.
2.5 Notation
Tout au long de cet article, nous privilégions une notation précise pouvant être mise en correspondance avec du code.
Matrices et vecteurs. Nous utilisons généralement les minuscules pour désigner les vecteurs (c'est-à-dire les tenseurs à un seul axe) et les majuscules pour désigner les matrices (c'est-à-dire les tenseurs à plus d'un axe). Nous ne mettons pas les matrices en gras dans ce travail. Parfois, si une matrice est liée ou répétée le long d'un axe (et peut donc aussi être vue comme un vecteur), nous pouvons utiliser indifféremment les majuscules ou les minuscules pour la désigner. désigne la multiplication scalaire ou matricielle, tandis que désigne la multiplication de Hadamard (élément par élément).
Indexation. Nous utilisons une indexation de style Python, par exemple désigne l'intervalle lorsque et lorsque . Par exemple, pour tout symbole , nous notons pour la séquence . équivaut à . Par abréviation, nous notons également le produit .
Dimensions. Pour les distinguer des matrices et des tenseurs, nous utilisons souvent des lettres capitales en police à espacement fixe (par ex. ) pour désigner les dimensions et les formes de tenseurs. Au lieu de la notation traditionnelle , nous utilisons fréquemment pour refléter les formes de tenseurs dans le code.
Contractions de tenseurs. Nous nous appuierons fortement sur la notation de contraction de tenseurs ou einsum, à la fois pour la clarté et comme outil central pour énoncer et prouver nos résultats. Nous supposons que le lecteur est familier avec cette notation, couramment utilisée dans les bibliothèques de tenseurs modernes telles que numpy. Par exemple, nous pouvons utiliser contract pour désigner l'opérateur de multiplication matrice-matrice, et dans notre notation contract (qui est équivalent à ) peut être traduit en code par numpy.einsum('mn,nk , X, Y).
Un vaste glossaire de notations est inclus dans l'annexe A.
3 Les modèles d'espace d'états sont des matrices structurées
Cette section explore différentes perspectives du modèle d'espace d'états en tant que transformation de séquence, et décrit les propriétés et algorithmes de telles applications. Les principaux résultats de cette section portent sur l'équivalence entre les modèles d'espace d'états et une famille de matrices structurées appelées matrices semi-séparables, ce qui implique de nouveaux résultats d'efficacité (théorèmes 3.5 et 3.7).
3.1 La forme de transformation matricielle des modèles d'espace d'états
Rappelons que notre définition d'un SSM est définie comme une application paramétrée définie par (2). Notre cadre théorique commence par écrire simplement cette transformation comme une multiplication matricielle appliquant les vecteurs .
Par définition, . Par induction,
En multipliant par pour produire et en vectorisant l'équation sur , nous dérivons la forme de transformation matricielle des SSM.
3.2 Matrices semi-séparables
dans l'équation (3) est une représentation particulière d'une classe de matrices connues sous le nom de matrices semi-séparables. Les matrices semi-séparables constituent une structure matricielle fondamentale. Nous définissons d'abord ces matrices et leurs propriétés.
Définition 3.1. Une matrice (triangulaire inférieure) est N-semi-séparable si toute sous-matrice contenue dans la partie triangulaire inférieure (c'est-à-dire sur ou sous la diagonale) est de rang au plus N. Nous appelons N l'ordre ou le rang de la matrice semi-séparable.
La définition 3.1, et d'autres formes de structure « séparable » apparentée (par ex. les matrices quasi-séparables et d'autres définitions des matrices semi-séparables) sont parfois appelées matrices à rang structuré (ou matrices à structure de rang) parce qu'elles sont caractérisées par des conditions de rang sur leurs sous-matrices. Les matrices semi-séparables ont de nombreuses représentations structurées, notamment les formes hiérarchiquement semi-séparables (HSS), séquentiellement semi-séparables (SSS) et de Bruhat (Pernet et Storjohann 2018). Nous utiliserons principalement la forme SSS.
3.2.1 La représentation séquentiellement semi-séparable (SSS)
Définition 3.2. Une matrice triangulaire inférieure admet une représentation N-séquentiellement semi-séparable (SSS) si elle peut s'écrire sous la forme
pour des vecteurs et des matrices
Nous définissons l'opérateur SSS de sorte que
Un résultat fondamental sur les matrices semi-séparables est qu'elles sont exactement équivalentes aux matrices admettant des représentations SSS. Un sens peut être déduit par une preuve constructive simple.
Lemme 3.3. Une matrice N-SSS de représentation (4) est N-semi-séparable.
Preuve. Considérons tout bloc hors diagonale où . Celui-ci admet une factorisation explicite de rang N sous la forme
Puisque les matrices diagonales sont faciles à traiter (par ex. la multiplication par une matrice diagonale équivaut à une multiplication scalaire élément par élément), nous pouvons ignorer ces termes. Ainsi, notre représentation de base d'une matrice 1-SS est ou
L'importance des matrices 1-SS réside dans leur équivalence avec la forme minimale d'une récurrence scalaire — le cas d'un SSM dégénéré de dimension d'état et sans projections . Notons que la multiplication peut être calculée par la récurrence
Nous désignons donc aussi la multiplication matricielle par des matrices 1-SS comme la récurrence SSM scalaire ou l'opérateur cumprodsum (somme de produits cumulés ; une généralisation du produit cumulé et de la somme cumulée). En tant que forme fondamentale de récurrence, la multiplication par des matrices 1-SS est importante comme brique de base pour nos algorithmes principaux.
Nous soulignons que l'un des thèmes centraux de cet article est que de nombreux algorithmes sur les modèles de séquence peuvent être réduits à des algorithmes de multiplication de matrices structurées. Les matrices 1-SS illustrent ce lien : il existe de nombreux algorithmes rapides pour calculer l'opérateur primitif de récurrence scalaire ou cumprodsum, et tous s'avèrent équivalents à différentes factorisations structurées des matrices 1-SS. Nous consacrons l'annexe B à ces algorithmes pour la multiplication de matrices 1-SS.
3.3 Les modèles d'espace d'états sont des matrices semi-séparables
Rappelons que notre définition d'un SSM est définie comme une application paramétrée définie par la définition 2.1. Le lien entre les SSM et les matrices semi-séparables découle simplement de l'écriture de cette transformation comme une multiplication matricielle appliquant les vecteurs .
L'équation (3) établit directement le lien entre les modèles d'espace d'état et la représentation séquentiellement semi-séparable, laquelle est à son tour équivalente aux matrices semi-séparables en général (Lemme 3.3 et Proposition 3.4).
Théorème 3.5. La transformation de modèle d'espace d'état de taille d'état est identique à la multiplication matricielle par une matrice N-SS en représentation séquentiellement semi-séparable .
En d'autres termes, l'opérateur de transformation de séquence SSM (Définition 2.2) coïncide avec l'opérateur de construction matricielle SSS (Définition 3.2), et nous les utilisons de manière interchangeable (ou parfois SS comme abréviation). De plus—par un caprice du destin—les modèles d'espace d'état structurés et les matrices séquentiellement semi-séparables ont les mêmes acronymes, soulignant leur équivalence ! Pratiquement, nous pouvons utiliser n'importe lequel de ces acronymes SSM (modèle d'espace d'état ou matrice semi-séparable), SSS (espace d'état structuré ou séquentiellement semi-séparable), ou SS (espace d'état ou semi-séparable) de manière interchangeable pour désigner sans ambiguïté l'un ou l'autre concept. Cependant, nous utiliserons généralement la convention selon laquelle SSM désigne le modèle d'espace d'état, SS désigne semi-séparable, et SSS désigne séquentiellement semi-séparable.
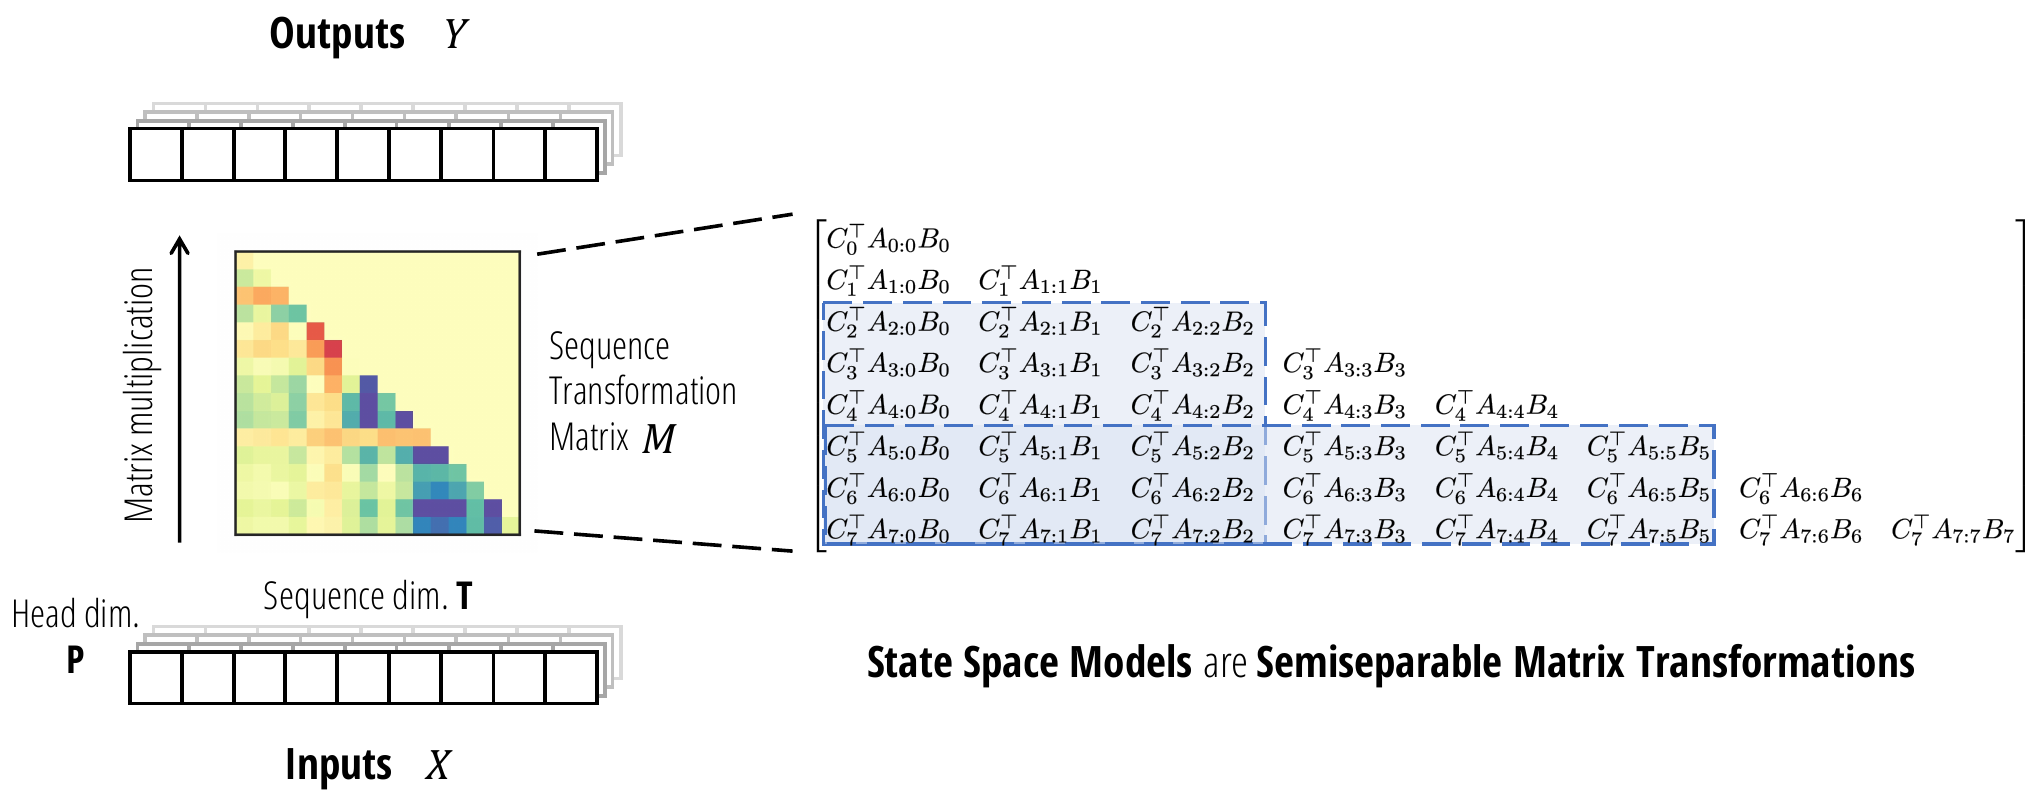
La Figure 2 illustre la perspective de transformation de séquence des modèles d'espace d'état en tant que matrices semi-séparables.
3.4 Calcul des modèles d'espace d'état via des algorithmes matriciels structurés
La raison pour laquelle le Théorème 3.5 est important est qu'il va nous permettre de réduire le problème du calcul efficace des SSM (et d'autres modèles de séquence) à des algorithmes efficaces de multiplication matricielle structurée. Nous fournissons brièvement un aperçu et reportons notre principal nouvel algorithme à la Section 6, après avoir montré l'équivalence des SSM avec d'autres modèles de séquence dans les Sections 4 et 5.
Comme défini précédemment, les matrices semi-séparables (c'est-à-dire les matrices à structure de rang) sont un type classique de matrice structurée :
(i) Elles ont des représentations compressées telles que la forme SSS qui ne possède que au lieu de paramètres.
(ii) Elles ont des algorithmes rapides opérant directement sur la représentation compressée.
De plus, le coût de paramétrisation et de multiplication matricielle peut être serré dans l'ordre semi-séparable.
Proposition 3.6 (Pernet, Signargout et Villard (2023)). Une matrice N-SS de taille peut être représentée en paramètres et possède une multiplication matrice- vecteur en temps et espace .
Par exemple, les matrices 1-SS illustrent l'essence de cette connexion. La matrice est définie par exactement paramètres , et peut être calculée en temps en suivant la récurrence scalaire (7).
3.4.1 Le mode linéaire (récurrent)
La proposition 3.6 se vérifie facilement dans le cas des SSM à structure diagonale (S4D (Gu, Gupta, et al. 2022)), simplement en exploitant la formulation du modèle d'espace d'états (2) et en déroulant la récurrence. Nous fournissons l'algorithme formel de contraction tensorielle en (8), où la dimension S est égale à .
Ici, est défini comme , ou en d'autres termes pour . Cet algorithme comporte trois étapes correspondant à (2) :
(i) l'expansion de l'entrée par la matrice d'entrée (8a),
(ii) le déroulement des récurrences SSM scalaires indépendantes (8b), et
(iii) la contraction de l'état caché par la matrice de sortie (8c).
Notons que nous avons utilisé l'équivalence entre les SSM scalaires et les matrices 1-SS à l'étape (8b).
Remarque 3. Nous notons que (8) est un cas particulier du modèle Mamba (S6), cependant, une implémentation naïve est lente à cause des tenseurs étendus et de taille ; Gu et Dao (2023) ont introduit une implémentation consciente du matériel pour éviter de matérialiser ces tenseurs.
De manière surprenante, le théorème 3.5 et la proposition 3.6 impliquent immédiatement que tous les SSM ont la même efficacité asymptotique que l'algorithme (8).
Théorème 3.7. Tout modèle d'espace d'états (définition 2.2) de taille d'état N sur une longueur de séquence T peut être calculé en temps (sans tenir compte d'un éventuel prétraitement).
Nous notons que ce résultat est nouveau dans la littérature sur les SSM structurés. En particulier, étant donné des matrices denses non structurées, la représentation totale seule semble être de taille . Ainsi, le théorème 3.7 énonce le résultat non trivial selon lequel, avec une étape de prétraitement, même un SSM non structuré peut être calculé de manière optimalement efficace, avec une borne supérieure correspondant à la borne inférieure donnée par la taille de et .
Remarque 4. Le théorème 3.7 n'est peut-être pas trop surprenant à la lumière du fait que presque toutes les matrices denses sur sont diagonalisables sur , ce qui conduit au résultat que presque tous les SSM réels denses sont équivalents à un SSM complexe diagonal. Ce fait sous-tend la raison pour laquelle les SSM diagonaux sont la forme la plus populaire de SSM structuré (Gu, Gupta, et al. 2022 ; Gupta, Gu, et Berant 2022 ; J. T. Smith, Warrington, et Linderman 2023). Cependant, le théorème 3.7 implique le résultat bien plus fort pour tous les SSM réels (pas seulement les diagonalisables), ainsi que pour les SSM denses sur d'autres corps (y compris lui-même).
En pratique, les SSM calculables efficacement nécessitent encore une structure supplémentaire sur , en particulier pour éviter l'étape de prétraitement coûteuse (qui comporte à la fois des FLOPs supplémentaires d'ordre N et implique des opérations inefficaces sur le plan matériel telles que les décompositions en valeurs singulières). Ces structures sont au cœur des travaux antérieurs sur les SSM structurés (par exemple S4(D) et Mamba) ainsi que de nos nouveaux algorithmes. En particulier, lorsqu'une structure légèrement plus forte est imposée sur , nous concevrons des algorithmes très efficaces sur le plan matériel grâce à des décompositions par blocs de la matrice SSM à la section 6.
3.4.2 Le mode quadratique (naïf)
Nous notons qu'il existe une autre façon de calculer un SSM révélée par notre nouveau point de vue matriciel. Un calcul naïf de la représentation matricielle SSM (3) consiste simplement à matérialiser la matrice de transformation de séquence . Il s'agit d'une matrice , et par conséquent cet algorithme naïf évoluera quadratiquement en longueur de séquence. Cependant, lorsque la longueur de séquence est courte, cela peut en réalité être plus efficace que l'algorithme linéaire en raison des facteurs constants et de la convivialité matérielle du schéma de calcul (par exemple en exploitant les multiplications matrice-matrice). En fait, pour un cas particulier de SSM structurés, cela ressemble beaucoup à un calcul d'attention quadratique (section 5).
3.4.3 Résumé
De nombreux modèles de séquence sont explicitement motivés ou définis comme des transformations de séquence matricielles – notamment les Transformers, où le mélangeur matriciel est la matrice d'attention. En revanche, les RNN et les SSM n'ont pas été décrits de cette manière auparavant. En fournissant une forme explicite de transformation matricielle des modèles d'espace d'états, nous révélons de nouvelles façons de les comprendre et de les utiliser. D'un point de vue computationnel, toute méthode de calcul de la passe avant d'un modèle d'espace d'états peut être vue comme un algorithme de multiplication matricielle sur des matrices semi-séparables. La perspective des matrices semi-séparables offre un éclairage sur la dualité espace d'états (SSD), où les modes duaux désignent respectivement un algorithme de multiplication matricielle semi-séparable en temps linéaire et une multiplication matricielle naïve en temps quadratique.
De plus, tirer parti de la riche structure des matrices semi-séparables peut conduire à des algorithmes encore meilleurs et à davantage d'aperçus (par exemple section 6 et annexe B). Dans l'annexe C.1, nous décrivons quelques propriétés supplémentaires des matrices semi-séparables.
4 Attention masquée structurée : généraliser l'attention linéaire avec des matrices structurées
Dans cette section, nous revisitons le cadre de l'attention linéaire à partir des principes premiers. Les principaux résultats de cette section sont une preuve simple de l'attention linéaire fondée sur la contraction tensorielle (proposition 4.1), et notre abstraction généralisée de l'attention masquée structurée dans la définition 4.2. Nous notons que cette section dérive les principaux résultats de dualité dans une direction différente de celle des modèles d'espace d'états et peut être lue de manière complètement indépendante de la section 3.
- La section 4.1 met en place notre cadre pour les variantes de l'attention, avec un accent particulier sur l'attention par noyau et l'attention par noyau masquée.- La section 4.2 fournit notre premier résultat principal sur l'attention, une preuve simple de l'attention linéaire à travers le prisme des contractions tensorielles.- La section 4.3 définit l'attention masquée structurée, notre généralisation des variantes d'attention antérieures au moyen de matrices structurées.
4.1 Le cadre de l'attention
4.1.1 Attention
La forme de base de l'attention (à une seule tête) est une application sur trois séquences de vecteurs
Nous utilisons des « annotations de forme » pour indiquer les dimensions des tenseurs, par exemple . Dans cette forme générale, S et T représentent les longueurs de séquence source et cible, N représente la dimension des caractéristiques, et P représente la dimension de tête.
La variante la plus courante de l'attention softmax utilise une activation softmax pour normaliser les lignes de la matrice .
4.1.2 Auto-attention
Notre traitement est motivé par le cas le plus important de l'auto-attention, où (i) les séquences source et cible sont identiques (c.-à-d. ), (ii) généralement les dimensions de caractéristiques et de têtes sont identiques (c.-à-d. ), (iii) et sont générés par des projections linéaires sur le même vecteur d'entrée .
Cependant, notre présentation fait abstraction de ces choix et part des matrices .
Remarque 5. Notre attention se porte sur le cas de l'auto-attention avec des dimensions de têtes et de caractéristiques égales (c.-à-d. et ), qui doit être utilisé comme exemple courant. Nous définissons la formulation générale de l'attention non seulement afin que notre cadre capture des variantes telles que l'attention croisée, mais aussi parce que séparer la notation pour les dimensions (p. ex. S et T) rend plus claires les preuves par notation de contraction de nos résultats principaux dans cette section.
Remarque 6. Bien que l'attention soit habituellement formulée comme une opération sur ces trois entrées qui sont considérées symétriquement, les dimensions d'entrée et de sortie dans (9) indiquent le contraire. En particulier, la dimension de caractéristiques N n'est pas présente dans la sortie ; par conséquent, dans le cas où (p. ex. auto-attention), nous considérons comme l'entrée principale, de sorte que (9) définisse une transformation de séquence propre (Définition 2.1).
4.1.3 Attention par noyau
L'étape où la fonction softmax est appliquée à la matrice de Gram peut être décomposée en deux parties :
1. L'exponentiation de la matrice .
2. La normalisation de la matrice sur l'axe S.
Nous pouvons ignorer le terme de normalisation pour l'instant, car il revient simplement à passer et à diviser (nous y revenons dans la section 7.3). Le terme d'exponentiation peut être vu comme une transformation par noyau : il existe une application de caractéristiques (de dimension infinie) telle que . En faisant abstraction de l'application de caractéristiques dans la définition de et eux-mêmes (c.-à-d. en définissant comme les versions post-transformées), nous pouvons ignorer la transformation softmax et supposer que sont générés arbitrairement par des applications de caractéristiques de noyau et potentiellement .
De nombreuses instanciations de l'attention par noyau ont été proposées, notamment :
- L'attention linéaire originale (Katharopoulos et al. 2020) définit l'application de caractéristiques de noyau comme une fonction d'activation ponctuelle arbitraire, telle que .- L'attention à caractéristiques aléatoires (RFA) (H. Peng et al. 2021) choisit l'application de caractéristiques de noyau pour approximer l'attention softmax (c.-à-d. l'application de caractéristiques exp) en utilisant l'approximation par caractéristiques de Fourier aléatoires des noyaux gaussiens (Rahimi and Recht 2007). Cela implique des projections aléatoires (c.-à-d. multiplier et par une projection aléatoire et appliquer l'activation .
- Performer (Choromanski et al. 2021) propose l'attention rapide via des caractéristiques aléatoires orthogonales positives (FAVOR+). La partie des caractéristiques aléatoires positives (PRF) choisit la carte de caractéristiques du noyau comme étant une projection aléatoire suivie de la carte de caractéristiques . Ce choix est motivé de sorte que les éléments du noyau soient à valeurs positives et approxime de manière prouvable l'attention softmax. [Il propose également de choisir les projections aléatoires dans des directions orthogonales, ce que nous ne considérons pas.]
- cosFormer (Qin, Weixuan Sun, et al. 2022) augmente RFA avec un mécanisme de repondération cosinus qui incorpore des informations positionnelles pour mettre l'accent sur la localité. Cela fait effectivement passer par la carte de caractéristiques .
- Linear Randomized Attention (Zheng, C. Wang, and Kong 2022) généralise RFA du point de vue de l'échantillonnage préférentiel, et le généralise pour fournir de meilleures estimations du noyau softmax complet (plutôt que seulement du numérateur transformé par exp).
D'autres variantes d'attention apparentées incluent Linformer (Sinong Wang et al. 2020) et Nyströmmer (Xiong et al. 2021), qui utilisent tous deux des approximations de rang faible de la matrice d'attention (et sont donc compatibles avec l'équation (9)), respectivement via des projections aléatoires (Johnson-Lindenstrauss) et l'approximation de noyau (la méthode de Nyström).
4.1.4 Attention masquée (par noyau)
Soit un masque de forme (T, S). Le plus souvent, dans le cas de l'auto-attention autorégressive lorsque , peut être une matrice triangulaire inférieure de 1 représentant un masque causal. Outre l'imposition de la causalité, de nombreux autres types de masques peuvent être appliqués - en particulier divers motifs de parcimonie tels que bande, dilaté ou bloc diagonal - qui sont motivés par la réduction de la complexité de l'attention dense.
L'attention masquée s'écrit généralement en notation matricielle comme
Plus précisément, avec les annotations de forme et en décomposant cela en la séquence précise de calculs :
Notre dérivation améliorée des variantes d'attention dans cette section commence par remarquer que cette formule peut être écrite comme une contraction unique :
et l'algorithme de (11) peut être reformulé comme le calcul de (12) par un ordre particulier de contractions par paires
4.2 Attention linéaire
L'attention linéaire, et de nombreuses autres variantes d'attention efficace, est souvent motivée par le changement de l'ordre d'associativité matricielle dans le calcul d'attention central . Cependant, lorsque le masque est ajouté, la dérivation est quelque peu moins directe (par exemple, l'article original (Katharopoulos et al. 2020) et les variantes (Y. Sun et al. 2023) énoncent la formule sans preuve).
En gros, la méthode d'attention linéaire affirme que la formule suivante est équivalente à (10), ce qui doit être vérifié en développant la somme et en suivant les indices avec soin.
Proposition 4.1 ((Katharopoulos et al. 2020)). L'attention autorégressive par noyau, c'est-à-dire l'attention masquée par noyau avec le masque causal, peut être calculée en temps par une récurrence prenant un temps constant par étape.
4.2.1 Une preuve par contraction tensorielle de l'attention linéaire
Nous présentons une dérivation simple et rigoureuse de l'attention linéaire qui révélera également immédiatement comment la généraliser. L'idée principale est d'effectuer la contraction (12) dans un ordre alternatif. Nous évitons la notation matricielle ambiguë et travaillons directement avec la notation de contraction :
Intuitivement, nous interprétons cet ordre de contraction comme suit.
La première étape (15a) effectue une « expansion » vers davantage de caractéristiques, d'un facteur de la dimension de caractéristiques N. La troisième étape (15c) contracte la dimension de caractéristiques étendue. Si est considéré comme l'entrée (Remarque 6), alors et effectuent respectivement l'expansion et la contraction.
La deuxième étape est la plus critique, et explique la partie linéaire de l'attention linéaire. Remarquons d'abord que (15b) n'est qu'une multiplication matricielle directe par (puisque les axes peuvent être aplatis). Notons également que c'est le seul terme qui implique à la fois les axes T et S, et devrait donc avoir une complexité (c'est-à-dire quadratique en longueur de séquence). Cependant, lorsque le masque est le masque d'attention causal standard (1 triangulaires inférieurs), la multiplication matrice-vecteur par est identique à une somme cumulée par caractéristique
4.3 Attention masquée structurée
Avec la perspective de contraction tensorielle de l'attention masquée (15), nous pouvons immédiatement voir que le point crucial de l'attention linéaire originale est le fait que la multiplication matrice-vecteur par le masque causal est équivalente à l'opérateur de somme cumulée.
Cependant, nous observons qu'il n'y a aucune raison pour que le masque d'attention soit composé uniquement de 1. Tout ce qui est nécessaire pour que l'attention linéaire soit rapide est que soit une matrice structurée, qui par définition sont celles qui ont une multiplication matricielle rapide (Section 2.3). En particulier, nous pouvons utiliser toute matrice de masque ayant une multiplication matrice-vecteur sous-quadratique (idéalement linéaire), ce qui aurait la même complexité que l'attention linéaire standard en accélérant l'équation goulot d'étranglement (15b).
Définition 4.2. L'attention masquée structurée (SMA) (ou attention structurée en abrégé) est définie comme une fonction sur les requêtes/clés/valeurs ainsi que toute matrice structurée (c'est-à-dire ayant une multiplication matricielle sous-quadratique), via la contraction tensorielle à 4 voies
L'algorithme en mode quadratique de SMA est la séquence de contractions par paires définie par (13), qui correspond au calcul standard de l'attention (masquée).
L’algorithme du mode linéaire SMA est la séquence de contractions par paires définie par (15), où l’étape (15b) est optimisée au moyen de la multiplication matricielle structurée sous-quadratique.
Nous pouvons instancier l’attention masquée structurée pour toute classe donnée de structure matricielle. Voici quelques exemples (Figure 3) :
- L’attention linéaire utilise un masque causal.
- RetNet (Y. Sun et al. 2023) utilise un masque de décroissance pour un certain facteur de décroissance .
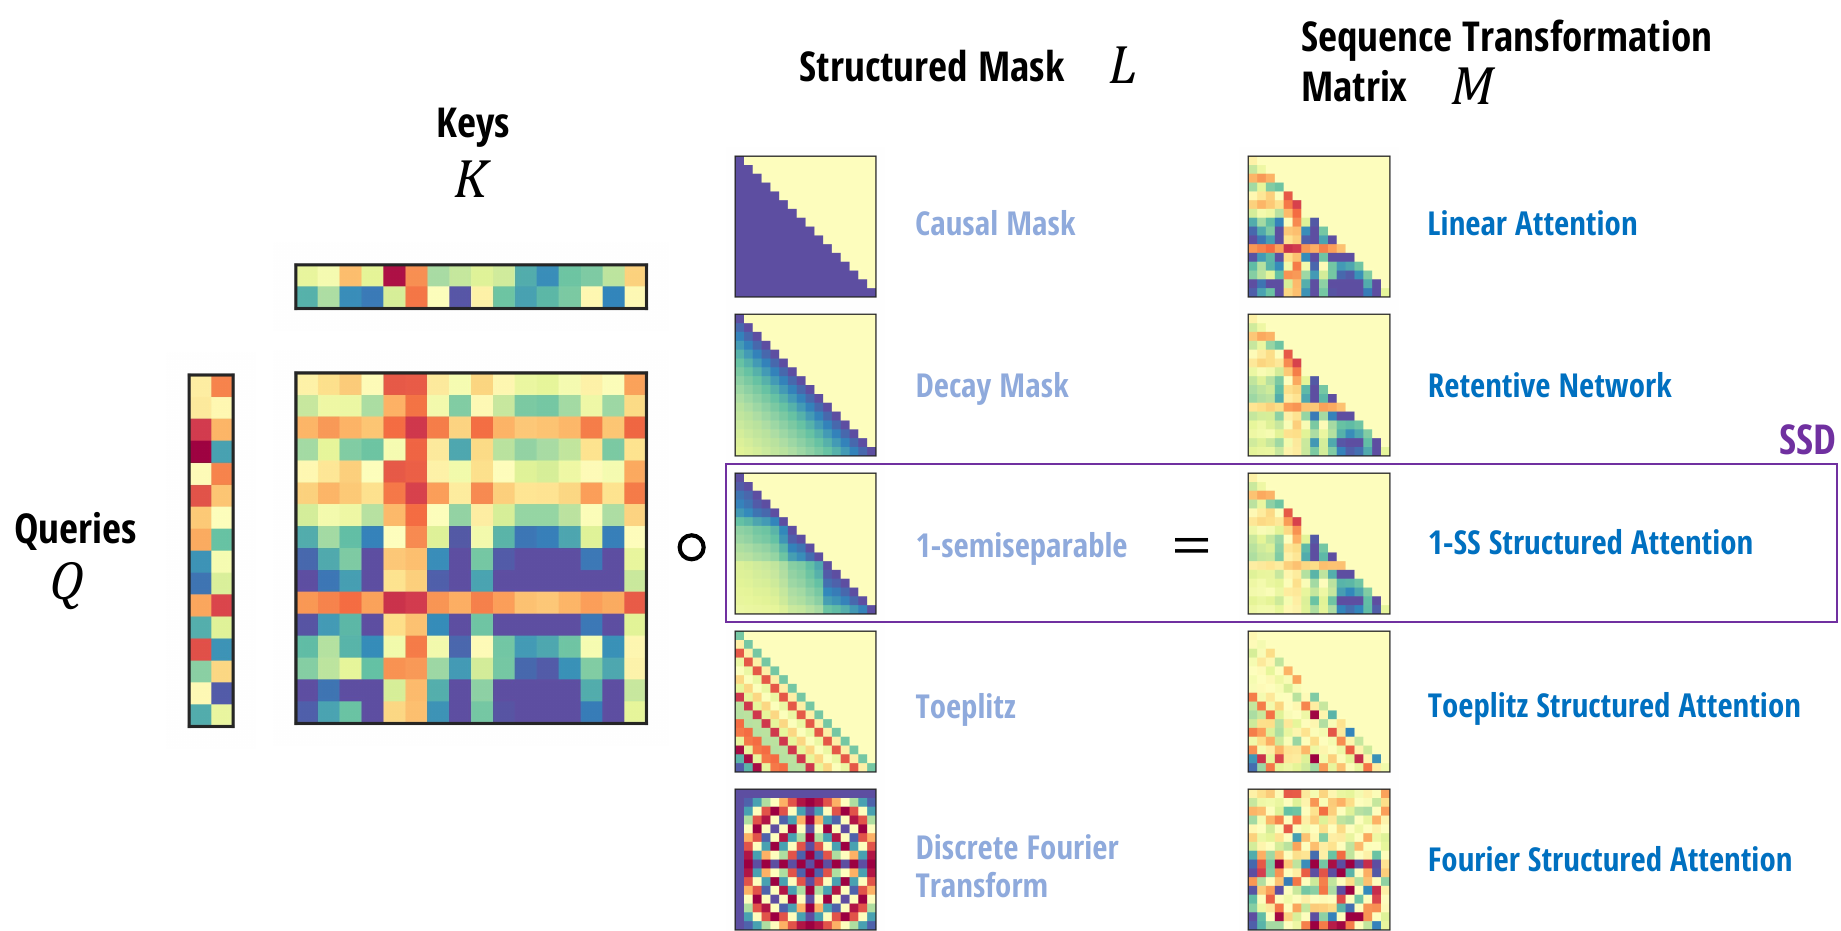
- Le masque de décroissance pourrait être généralisé à une matrice de Toeplitz pour un ensemble de paramètres apprenables (ou dépendants de l’entrée) . Cela peut être interprété comme une forme d’encodage positionnel relatif, rappelant d’autres méthodes telles qu’AliBi (Press, N. Smith et Lewis 2022), mais multiplicatif plutôt qu’additif.- Une autre variante pourrait utiliser une matrice de Fourier pour encoder la structure positionnelle d’une manière différente.
Dans la section 5, nous considérons la SMA semi-séparable, qui définit notre modèle principal SSD.
4.3.1 Résumé : les formes duales de l’attention masquée
L’attention standard (à noyau masqué) est souvent confondue entre une fonction et un algorithme. Séparer cette distinction offre un moyen clair de comprendre différentes variantes de l’attention.
- Nous considérons l’attention masquée comme une fonction particulière (12).- Le calcul standard de l’attention quadratique (13) peut être considéré comme un algorithme pour calculer la fonction.- L’attention linéaire (15) est un algorithme alternatif pour calculer la même fonction.
De plus, dans ce cas
- La fonction d’attention masquée est simplement une contraction particulière sur quatre termes.- Les algorithmes d’attention quadratique et linéaire sont simplement deux ordres différents d’exécution des contractions.
Il est connu que les ordres de contraction peuvent entraîner de grandes différences de complexité computationnelle, ce qui conduit à la séparation quadratique vs linéaire. Tout comme les modèles d’espace d’états sont une transformation qui peut être calculée de plusieurs manières, avec des formes duales quadratique vs linéaire (section 3.4), l’attention linéaire présente une dualité similaire qui résulte de deux ordres de contraction. En fait, ceux-ci se révèlent être des perspectives différentes sur la même dualité sous-jacente, que nous explicitons dans la section 5.
5 Dualité espace d’états
Dans les sections 3 et 4, nous avons défini les modèles d’espace d’états structurés et l’attention structurée, discuté de leurs propriétés, et montré qu’ils ont tous deux un algorithme quadratique et un algorithme linéaire. Cette section les relie. Notre résultat principal est de montrer qu’un cas particulier de modèles d’espace d’états structurés coïncide avec un cas particulier de l’attention structurée, et que l’algorithme SSM en temps linéaire et l’algorithme d’attention à noyau en temps quadratique sont des formes duales l’un de l’autre.
La section 5.1 spécialise les modèles d’espace d’états à une structure scalaire, où le calcul quadratique naïf peut être vu comme une instance de l’attention à noyau.
La section 5.2 spécialise l'attention masquée structurée aux SMA semi-séparables, qui caractérisent l'attention masquée avec une autorégression efficace.
La section 5.3 résume le lien entre l'attention masquée structurée et les modèles d'espace d'états structurés, appelé dualité structurée espace d'états.
5.1 Modèles d'espace d'états structurés à identité scalaire
Dans la section 3, nous avons montré que les modèles d'espace d'états sont équivalents à des transformations matricielles semi-séparables, ce qui donne à la fois une forme récurrente linéaire et une forme naïve quadratique.
Rappelons que les SSM sont définis par , et que la forme matricielle des SSM utilise la représentation SSS (séquentiellement semi-séparable) où (équation (3)).
Considérons maintenant le cas où est simplement un scalaire ; autrement dit, une instanciation d'un SSM structuré où les matrices sont extrêmement structurées : pour un scalaire et la matrice identité . On peut alors réarranger
Et ceci peut être vectorisé en
où \(B,C\in \mathbb{R}^{(\mathrm{T},N)}\)
En utilisant cette formulation, la sortie complète \(Y = M X\) est calculée précisément comme
où \(\mathrm{S} = \mathrm{T}\) . Mais ceci est exactement identique à la définition originale de la définition de l'attention à noyau masqué (13) !
Par conséquent, comme évoqué dans la section 3.4, calculer naïvement le SSM structuré scalaire — en matérialisant la matrice semi-séparable \(M\) et en effectuant une multiplication matrice-vecteur quadratique — est exactement identique à l'attention à noyau masqué quadratique.
5.2 Attention masquée structurée 1-semi-séparable
L'attention masquée structurée permet l'utilisation de n'importe quel masque structuré . Lorsque est le masque causal, il s'agit de l'attention linéaire standard. Notons que le masque causal est , c'est-à-dire que le masque 1- SS est généré par dans la définition (6). Cela motive la généralisation de à la classe des masques 1-semi-séparables, ou attention masquée structurée 1-semi-séparable (1- SS SMA), où le cumsum dans la récurrence de l'attention linéaire est remplacé par une récurrence plus générale — le scan SSM scalaire, c'est-à-dire la multiplication matricielle 1-semi-séparable (section 3.2.2).
Enfin, la raison la plus importante pour laquelle nous considérons la SMA 1-semi-séparable est que la forme linéaire pour la calculer est un cas particulier du modèle d'espace d'états diagonal. La forme linéaire de la SMA est l'algorithme (15), où l'étape goulot d'étranglement (15b) peut être vue comme une multiplication matricielle par le masque 1- SS. Dans la section 3, nous avons également explicité le calcul pour un SSM diagonal (8), où l'étape goulot d'étranglement (8b) est une récurrence SSM scalaire qui est équivalente à une multiplication 1- SS. La seule différence est que (8b) possède une dimension N supplémentaire dans , parce que la matrice est une matrice diagonale de taille N. Cette dimension N disparaîtrait si toutes les entrées diagonales de étaient identiques, ce qui donne le corollaire 5.1.
Corollaire 5.1. La SMA 1- SS (attention masquée avec des matrices structurées 1-semi-séparables \(L\) ) (15) est un cas particulier d'un SSM diagonal (8) où la matrice diagonale est un multiple scalaire de l'identité.
Bien que le corollaire 5.1 indique que la SMA 1- SS possède une forme récurrente efficace, nous pouvons également montrer un résultat réciproque qui caractérise quelles instances de la SMA ont une autorégression efficace.
Théorème 5.2. Pour toute instanciation de l'attention masquée structurée (définition 4.2) qui est un processus autorégressif d'ordre borné, le masque structuré \(L\) doit être une matrice semi-séparable.
Autrement dit, l'attention autorégressive efficace est la SMA semi-séparable générale. Le théorème 5.2 est démontré dans l'annexe C.2.
Remarque 7. Bien que la SMA 1-semi-séparable soit un cas particulier d'un modèle d'espace d'états, la SMA semi-séparable générale est strictement plus expressive que la SMA 1- SS, et ne peut pas être décrite par un SSM standard. Cependant, la multiplication semi-séparable par \(L\) et la forme linéaire de la SMA (équation (15a)) impliquent chacune une étape d'expansion et de contraction, et peuvent être absorbées dans une instance similaire de SMA 1- SS avec une seule expansion (plus grande).
En résumé, l'attention structurée 1-semi-séparable est le cas le plus important de la SMA, parce qu'elle est :
- une généralisation naturelle de l'attention linéaire avec une récurrence dépendante de l'entrée.
- le cas le plus simple de l'attention semi-séparable générale, qui est équivalente à l'attention autorégressive efficace.
- un cas particulier d'un modèle d'espace d'états diagonal.
5.3 Dualité structurée espace d'états (SSD)
Pour résumer nos résultats :
- Les modèles d'espace d'états structurés (section 3) sont un modèle généralement défini par une récurrence en temps linéaire. Cependant, en développant la formulation matricielle caractérisant sa transformation linéaire séquence-à-séquence, on peut en dériver une forme quadratique.
- Les variantes d'attention (section 4) sont un modèle défini par des interactions par paires en temps quadratique. Cependant, en le considérant comme une contraction tensorielle à quatre voies et en réduisant dans un ordre différent, on peut en dériver une forme linéaire.
- Un cas particulier naturel de chacun — plus précisément, les modèles d'espace d'états avec une structure d'identité scalaire sur les matrices , et l'attention masquée structurée avec une structure 1-semi-séparable sur son masque — sont duaux l'un de l'autre avec exactement les mêmes formes linéaire et quadratique.
La figure 4 résume la dualité entre ces deux représentations.
Une revue étendue des travaux connexes et une discussion (section 10) décrivent plus en détail la relation entre la SSD et les SSM / l'attention généraux.
6 Un algorithme matériellement efficace pour les modèles SSD
L'intérêt de développer le cadre théorique SSD entre les SSM, l'attention et les matrices structurées réside dans l'utilisation des connexions pour améliorer les modèles et les algorithmes. Dans cette section, nous montrons comment divers algorithmes pour calculer efficacement les modèles SSD peuvent être dérivés de divers algorithmes pour calculer la multiplication matricielle structurée.
Notre principal résultat computationnel est un algorithme pour calculer les modèles SSD qui combine à la fois le mode linéaire (récurrent) et le mode quadratique (attention). Cet algorithme est aussi efficace en calcul que les SSM (mise à l'échelle linéaire en longueur de séquence) et aussi convivial pour le matériel que l'attention (utilise principalement des multiplications matricielles).
Théorème 6.1. Considérons un modèle SSD avec un facteur d'expansion d'état et une dimension de tête . Il existe un algorithme pour calculer le modèle sur toute entrée qui ne nécessite que FLOPs d'entraînement, FLOPs d'inférence, de mémoire d'inférence, et dont le travail est dominé par des multiplications matricielles.
| Modèle d'espace d'états structuré | Attention masquée structurée | ||||
| C | (matrice de contraction) | Q | (requêtes) | S4 | Modèle d'espace d'états diagonal |
| B | (matrice d'expansion) | K | (clés) | ||
| X | (séquence d'entrée) | V | (valeurs) | DSS | SSM à identité scalaire |
| Aij | (matrice d'état) | Lji | (masque) | S4D | RetNet GateLoop |
| N | (dim. d'expansion d'état) | N | (dim. des caractéristiques du noyau) | S5 | TransNormer |
| H | (états cachés (8b)) | SMA dual linéaire (15) | S6 | Attention linéaire | |
| = L·XB | (mode linéaire) | SMA 1-semiséparable | |||
| SSM dual quadratique (16) | G | (matrice de Gram (13a)) | Attention autoregressive efficace | ||
| = Q·K | (mode quadratique) | SMA semiséparable |
Notons que toutes ces bornes sont serrées, car un modèle d'espace d'état avec un facteur d'expansion d'état N opérant sur une taille de tête de N a une taille d'état totale (ce qui donne les bornes inférieures pour les FLOPs d'entraînement et d'inférence de et respectivement). De plus, l'entrée elle-même a TN éléments, ce qui donne la borne inférieure de mémoire.
L'idée principale derrière le Théorème 6.1 est encore une fois de considérer le problème du calcul d'un modèle d'espace d'état comme une multiplication de matrice semi-séparable, mais en exploitant sa structure d'une manière nouvelle. Au lieu de calculer toute la matrice en mode récurrent ou attention, nous effectuons une décomposition en blocs de la matrice. Les blocs diagonaux peuvent être calculés en utilisant le mode attention dual, ce qui peut être fait efficacement avec des multiplications matricielles, tandis que les blocs hors diagonale peuvent être factorisés par la structure de rang des matrices semi-séparables et réduits à une récurrence plus petite. Nous soulignons que le Listing 1 fournit une implémentation autonome de l'algorithme SSD. Comparé au SSM sélectif général de Gu et Dao (2023), cette implémentation est beaucoup plus simple, et relativement efficace même en PyTorch natif sans nécessiter de noyaux bas niveau spéciaux.
Pour commencer, nous partitionnons la matrice en une grille de sous-matrices de taille , pour une certaine taille de bloc . Notons que les blocs hors diagonale sont de rang faible par la propriété définissante des matrices semi-séparables (Définition 3.1).5
Ceci est plus facilement illustré par un exemple, par exemple pour et en décomposant en blocs de longueur . Les cellules ombrées sont des factorisations de rang faible des blocs hors diagonale de la matrice semi-séparable.
Ces sous-problèmes peuvent être interprétés comme : quelle est la sortie par bloc en supposant que l'état initial (du bloc) est 0. En d'autres termes, pour le bloc , cela calcule les sorties correctes en ne prenant en compte que les entrées du bloc .
6.2 Blocs de rang faible
Les factorisations de rang faible consistent en 3 termes, et il y a par conséquent trois parties du calcul. Dans cette factorisation, nous utiliserons la terminologie suivante
Les termes comme sont appelés les facteurs droits ou facteurs de bloc .
Les termes comme sont appelés les facteurs centraux ou facteurs de bloc .
Les termes comme sont appelés les facteurs gauches ou facteurs de bloc .
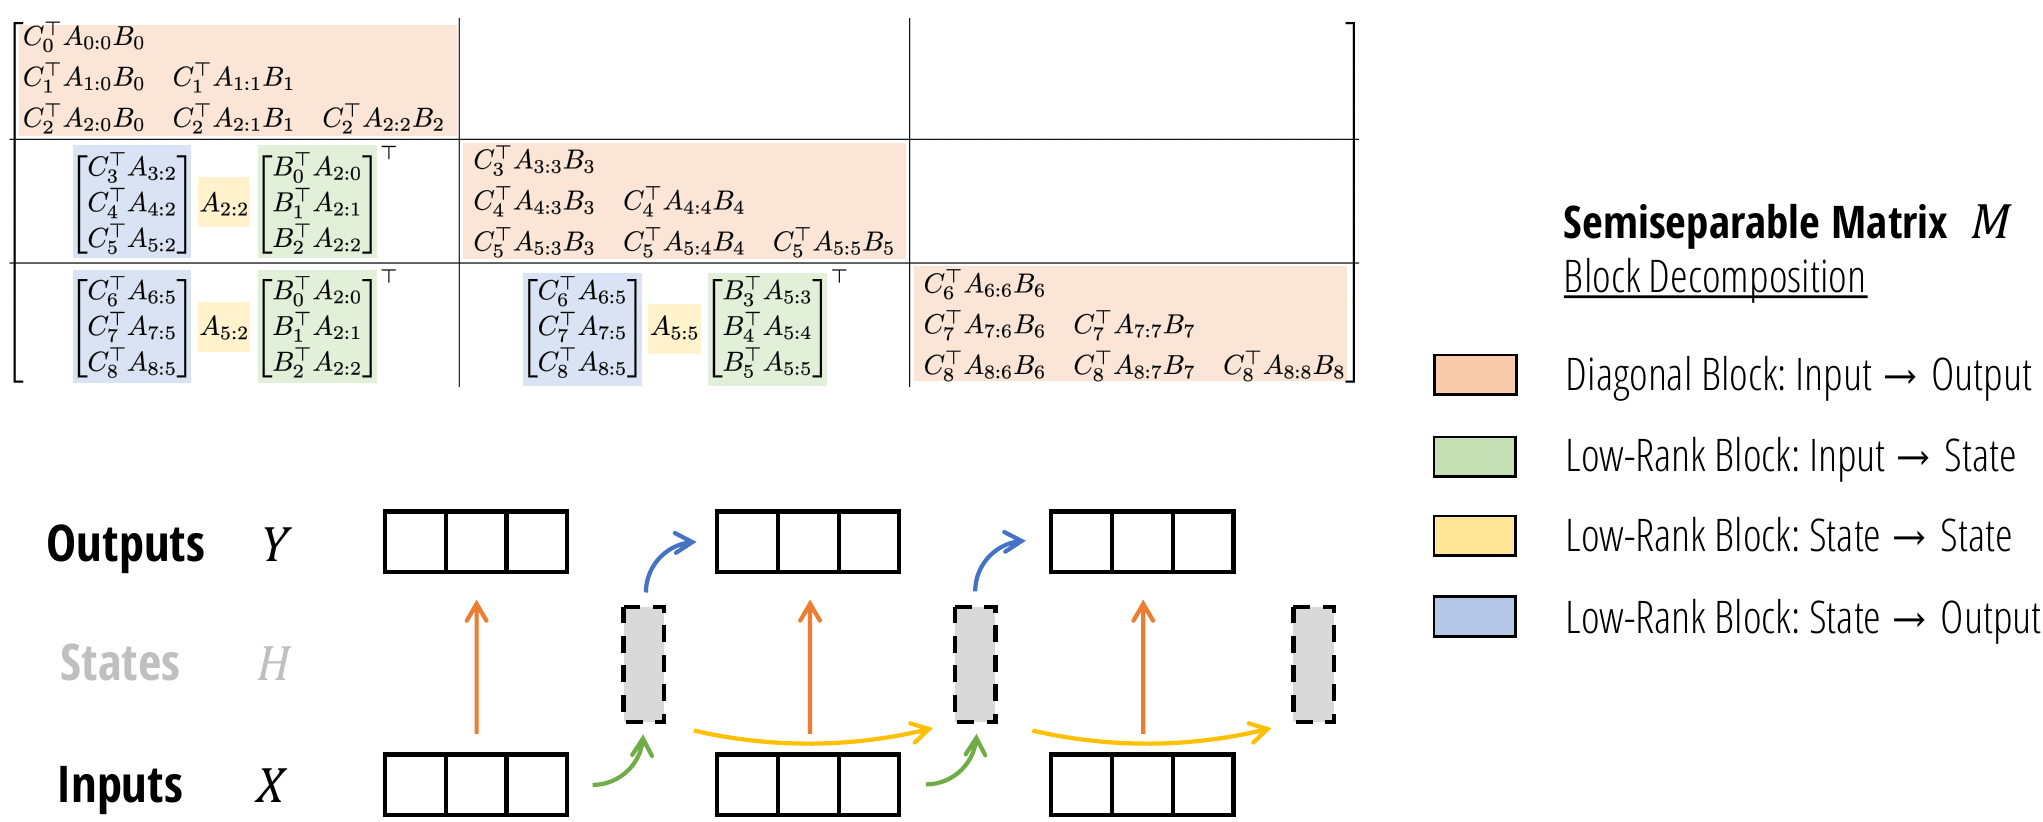
Facteurs droits. Cette étape calcule la multiplication par les facteurs de bloc droits de la factorisation de rang faible. Notons que pour chaque bloc, il s'agit d'une multiplication matricielle par , où est la dimension d'état et est la dimension de tête. Le résultat est un tenseur pour chaque bloc, qui a la même dimensionnalité que l'état caché étendu .
Cela peut être interprété comme : quel est l'état final par segment en supposant que l'état initial (du segment) est 0. En d'autres termes, cela calcule en supposant que .
Facteurs centraux. Cette étape calcule l'effet des termes des facteurs du bloc - central dans la factorisation de rang faible. À l'étape précédente, les états finaux par segment ont une forme totale . Ceux-ci sont maintenant multipliés par une matrice 1- SS générée par .
Cette étape peut être calculée par n'importe quel algorithme de calcul de multiplication 1- SS (aussi appelé balayage SSM scalaire ou opérateur cumprodsum).
Cela peut être interprété comme : quel est l'état final réel par segment en tenant compte de toutes les entrées précédentes ; en d'autres termes, cela calcule le véritable état caché en tenant compte de l'ensemble de .
Facteurs gauches. Cette étape calcule la multiplication par les facteurs du bloc - gauche de la factorisation de rang faible. Pour chaque segment, cela peut être représenté par un contrat de multiplication matricielle .
Cela peut être interprété comme : quelle est la sortie par segment en tenant compte de l'état initial correct , et en supposant que les entrées sont 0. En d'autres termes, pour le segment , cela calcule les sorties correctes en tenant compte uniquement des entrées antérieures .
6.3 Coût computationnel
Nous définissons la notation pour désigner un contrat de multiplication matricielle par lots avec une dimension de lot . À partir de cette notation, nous pouvons déduire trois aspects de l'efficacité :- Coût de calcul : total de FLOPs.
- Coût mémoire : total de espace.
Listing 1 Exemple PyTorch complet du modèle dual d'espace d'états (SSD).
def segsum(x):
Calcul naïf de somme par segments. exp(segsum(A)) produit une matrice 1- SS,
qui est équivalente à un SSM scalaire.
T = x.size(- 1)
x_cumsum = torch.cumsum(x, dim=- 1)
x_segsum = x_cumsum[..., None] - x_cumsum[..., None, :]
mask = torch.tri1(torch.ones(T, T, device=x.device, dtype=bool), diagonal=0)
x_segsum = x_segsum.masked_fill(- mask, - torch.inf)
return x_segsum
def ssd(X, A, B, C, block_len=64, initial_states=None):
Arguments :
X: (batch, length, n_heads, d_head)
A: (batch, length, n_heads)
B: (batch, length, n_heads, d_state)
C: (batch, length, n_heads, d_state)
Retour :
Y: (batch, length, n_heads, d_head)
\*
4. Calculer la conversion état -> sortie par segment # (terme gauche de la factorisation de rang faible des blocs hors diagonale ; termes C) state_decay_out = torch.exp(A_cumsum) Y_off = torch.einsum('bclhn, bchpn, bhl->bclhp', C, states, state_decay_out)
Ajouter la sortie des termes intra-segment et inter-segment (blocs diagonaux et hors diagonale) Y = rearrange(Y_diag+Y_off, "b c l h p -> b (c l) h p") return Y, final_state
- Parallélisation : des termes M, N, K plus grands peuvent exploiter les unités spécialisées de multiplication matricielle des accélérateurs modernes.
Blocs centraux. Le coût du calcul SMA quadratique comprend trois étapes (équation (16)) :
- Calcul de la matrice noyau , dont le coût est .
- Multiplication par la matrice de masque, qui est une opération élément par élément sur des tenseurs de forme .
- Multiplication par les valeurs , dont le coût est
Blocs de rang faible : facteurs droits. Cette étape est une unique multiplication matricielle de coût .
Blocs de rang faible : facteurs centraux. Cette étape est un balayage SSM scalaire (ou multiplication 1- SS) de longueur sur canaux indépendants. Le travail de ce balayage est , ce qui est négligeable par rapport aux autres facteurs.
Notez que, en raison du découpage en blocs qui réduit la longueur de la séquence de à , ce balayage a un coût fois plus faible qu'un balayage SSM pur (par exemple le balayage sélectif de Mamba). Ainsi, nous observons que, pour la plupart des longueurs de problème, d'autres algorithmes (Annexe B) peuvent être plus efficaces ou beaucoup plus faciles à implémenter sans ralentissement significatif. Par exemple, une implémentation naïve de ceci via une multiplication matricielle 1- SS a un coût , ce qui est beaucoup plus facile à implémenter et peut être plus efficace qu'une implémentation naïve par récurrence/balayage.
Blocs de rang faible : facteurs gauches. Cette étape est une unique multiplication matricielle de coût .
Coût total. Si nous posons (autrement dit, la dimension d'état, la dimension de tête et la longueur de chunk sont égales), alors tous les termes BMM ci-dessus deviennent . Les caractéristiques computationnelles de ceci sont :
- Un nombre total de FLOPs de .- Une mémoire totale de .- Le travail consiste principalement en des multiplications matricielles sur des matrices de forme .
Remarquons que la consommation mémoire est serrée ; les entrées et sorties ont pour forme . En revanche, le nombre de FLOPs reflète un facteur supplémentaire de , qui est un coût induit par la taille de l'état autorégressif et qui est commun à tous les modèles.
Outre les matmuls, il y a un scan SSM scalaire sur caractéristiques et une longueur de séquence . Cela a un coût de FLOPs et une profondeur de . Bien qu'il n'utilise pas de multiplications matricielles, il reste parallélisable et le travail total effectué est négligeable par rapport aux autres étapes ; cela a un coût négligeable dans notre implémentation GPU.
Comparaison avec les modèles SSM purs et les modèles d'attention. L'attention quadratique est également très efficace sur le plan matériel en n'exploitant que des multiplications matricielles, mais elle a un total de FLOPs. Sa vitesse de calcul plus lente, tant à l'entraînement qu'à l'inférence, peut être directement vue comme une conséquence d'une taille d'état plus grande — l'attention standard a une taille d'état qui évolue avec la longueur de séquence parce qu'elle met en cache son historique et ne compresse pas son état.
Les SSM linéaires ont FLOPs au total, ce qui est identique à SSD. Cependant, une implémentation naïve nécessite une expansion d'état (15a) qui matérialise de la mémoire supplémentaire, et une opération scalaire (15b) qui n'exploite pas les multiplications matricielles.
| Attention | SSM | SSD | |
| Taille de l'état | T | N | N |
| FLOPs d'entraînement | T²N | TN² | TN² |
| FLOPs d'inférence | TN | N² | N² |
| Mémoire (naïve) | T² | TN² | TN |
| Multiplication matricielle | ✓ | ✓ |
Nous notons que de nombreuses autres décompositions matricielles sont possibles (par exemple, voir l'annexe B pour un recueil d'algorithmes de multiplication 1-SS via différentes décompositions matricielles structurées), ce qui peut conduire à davantage d'algorithmes pour les SSD qui pourraient être meilleurs pour d'autres contextes spécialisés. Plus largement encore, nous notons que les matrices semi-séparables ont une littérature riche et bien d'autres représentations que la forme SS que nous utilisons (définition 3.2), et des algorithmes encore plus efficaces pourraient être possibles.
7 L'architecture Mamba-2
En connectant les SSM et l'attention, le cadre SSD nous permet de développer un vocabulaire et une bibliothèque de techniques partagés pour les deux. Dans cette section, nous discutons de quelques exemples de compréhension et de modification des couches SSD à l'aide d'idées initialement
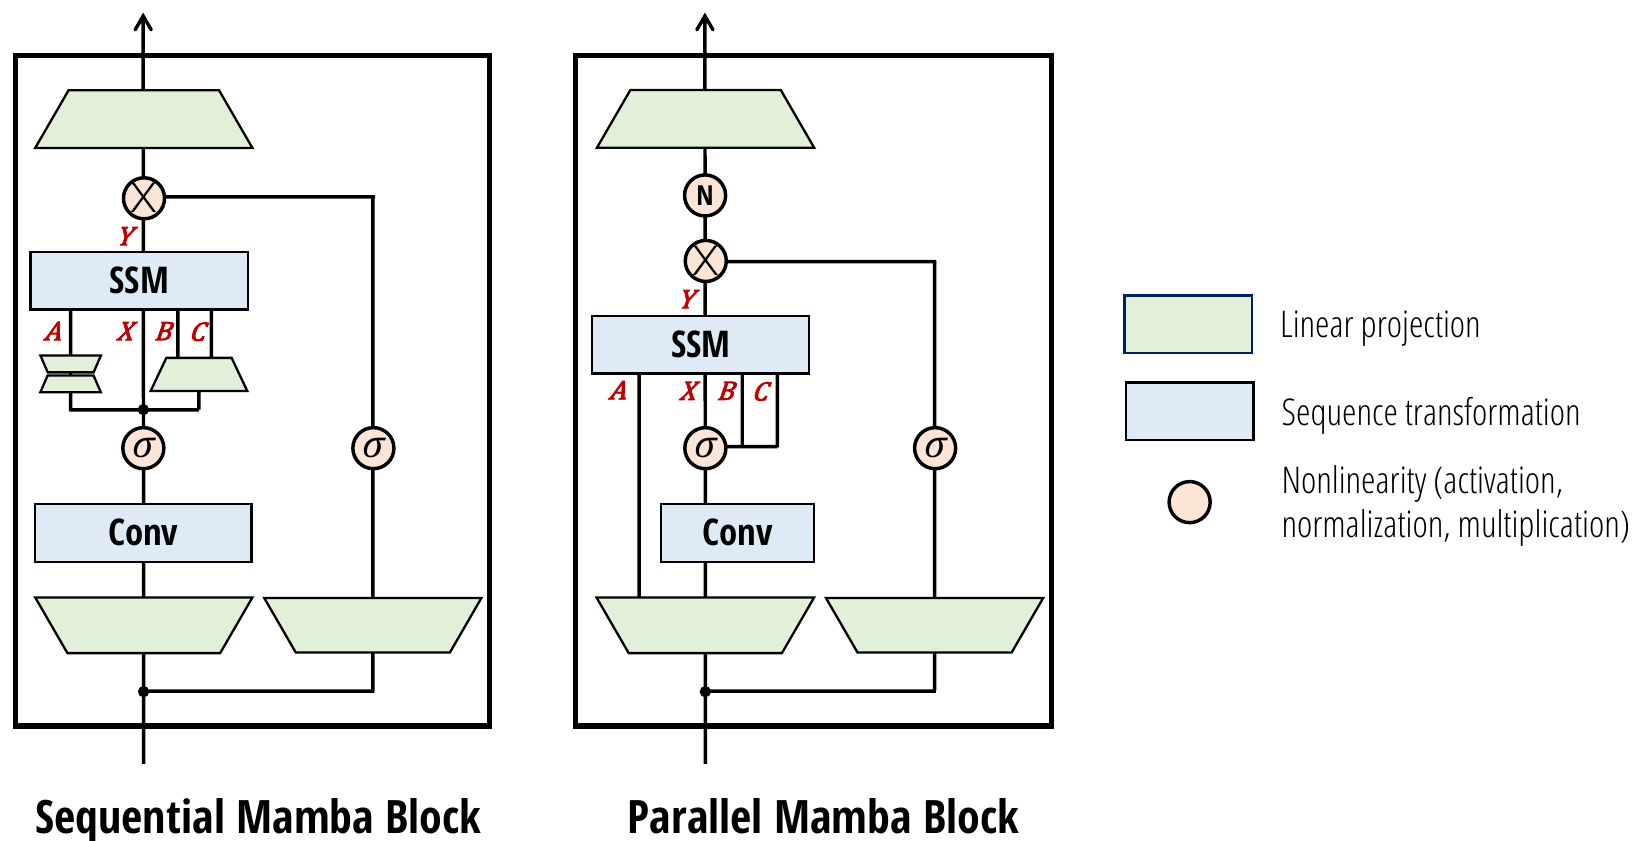
développées pour les Transformers. Nous discutons de plusieurs choix de conception, aboutissant à l'architecture Mamba-2. Ces axes de variation font l'objet d'ablations dans la section 9.4.
7.1 Conception du bloc
Nous discutons d'abord des modifications apportées au bloc de réseau de neurones qui sont indépendantes de la couche de mélange de séquence interne (c'est-à-dire en dehors de la couche SSD centrale).
Projections de paramètres parallèles. Mamba-1 était motivé par un point de vue centré sur les SSM, où la couche SSM sélective est vue comme une application de . Les paramètres SSM sont considérés comme subsidiaires et sont des fonctions de l'entrée SSM . Ainsi, les projections linéaires définissant interviennent après la projection linéaire initiale servant à créer .
Dans Mamba-2, la couche SSD est vue comme une application de . Il est donc logique de produire en parallèle avec une seule projection au début du bloc. Notons l'analogie avec les architectures d'attention standard, où correspondent aux projections qui sont créées en parallèle.
Remarque : l’adoption de projections parallèles pour les entrées du SSM réduit légèrement le nombre de paramètres et, surtout, se prête mieux au parallélisme tensoriel pour les modèles plus grands, en utilisant les schémas de sharding standards de Megatron (Shoeybi et al. 2019)).
Normalisation supplémentaire. Dans des expériences préliminaires, nous avons constaté que des instabilités avaient tendance à apparaître dans les modèles plus grands. Nous avons pu y remédier en ajoutant une couche de normalisation supplémentaire (par exemple LayerNorm, GroupNorm ou RMSNorm) au bloc, juste avant la projection de sortie finale. Cet usage d’une normalisation est le plus directement lié à l’architecture NormFormer (Shleifer, Weston et Ott 2021), qui ajoutait également des couches de normalisation à la fin des blocs MLP et MHA.
Nous notons également que cette modification est similaire à celle d’autres modèles récents liés à Mamba-2, dérivés du point de vue de l’attention linéaire. La formulation originale de l’attention linéaire normalise par un terme de dénominateur qui émule la normalisation de la fonction softmax dans l’attention standard. TransNormerLLM (Qin, Dong Li, et al. 2023) et RetNet (Y. Sun et al. 2023) constatent que cette normalisation est instable et ajoutent un LayerNorm ou GroupNorm supplémentaire après la couche d’attention linéaire. Notre couche de normalisation supplémentaire diffère légèrement de celles-ci : elle intervient après la branche de porte multiplicative plutôt qu’avant.
. . .
7.2 Motifs multi-têtes pour les transformations de séquence
Rappelons que les SSM sont définis comme une transformation de séquence (définition 2.1) où :
- les paramètres ont une dimension d’état N.- Ils définissent une transformation de séquence , qui peut par exemple être représentée par une matrice .- Cette transformation opère sur une séquence d’entrée , indépendamment sur l’axe P.
On peut voir cela comme la définition d’une tête de la transformation de séquence.
Définition 7.1 (Motifs multi-têtes). Une transformation de séquence multi-têtes consiste en H têtes indépendantes, pour une dimension de modèle totale de . Les paramètres peuvent être liés entre les têtes, ce qui conduit à un motif de têtes.
La taille d’état N et la dimension de tête P sont analogues à la dimension de tête QK et à la dimension de tête V de l’attention, respectivement. Tout comme dans les architectures Transformer modernes (Chowdhery et al. 2023 ; Touvron, Lavril, et al. 2023), dans Mamba-2 nous choisissons généralement ces valeurs comme des constantes autour de 64 ou 128 ; lorsque la dimension du modèle D augmente, nous augmentons le nombre de têtes tout en gardant les dimensions de tête N et P fixes. Afin de décrire comment procéder, nous pouvons transférer et généraliser les idées de l’attention multi-têtes pour définir des motifs similaires pour les SSM, ou pour toute transformation de séquence générale.
| SSM multi-tête (Attn. multi-tête) | SSM multicontrat (Attn. multi-requête) | SSM multi-extension (Attn. multi-clé) | SSM multi-entrée (Attn. multi-valeur) |
| X (T, H, P) | X (T, 1, P) | X (T, 1, P) | X (T, H, P) |
| A (T, H) | A (T, H) | A (T, H) | A (T, H) |
| B (T, H, N) | B (T, 1, N) | B (T, H, N) | B (T, 1, N) |
| C (T, H, N) | C (T, H, N) | C (T, 1, N) | C (T, 1, N) |
Motif SSM multi-têtes (MHS) / Attention multi-têtes (MHA). Le motif MHA classique suppose que la dimension de tête P divise la dimension du modèle D. Le nombre de têtes est défini comme . Ensuite, H copies de la transformation de séquence centrale sont créées en créant H copies indépendantes de chaque paramètre. Notons que, bien que le motif MHA ait d’abord été décrit pour la transformation de séquence d’attention, il peut être appliqué à tout ce qui est compatible avec la définition 2.1. Par exemple, une couche SSD multi-têtes accepterait des entrées dont les formes correspondent à l’équation (17), où l’algorithme SSD est diffusé sur la dimension .
Motif SSM multi-contract (MCS) / Attention multi-requêtes (MQA). L’attention multi-requêtes (Shazeer 2019) est une optimisation ingénieuse de l’attention qui peut considérablement améliorer la vitesse de l’inférence autorégressive, laquelle repose sur la mise en cache des tenseurs et . Cette technique évite simplement de donner à et la dimension de tête supplémentaire ou, en d’autres termes, diffuse une seule tête de sur toutes les têtes de .
En utilisant la dualité état-espace, nous pouvons définir une version SSM équivalente de MQA comme dans l’équation (18). Ici, et (les analogues SSM de et de l’attention) sont partagés entre les H têtes. Nous appelons également cela le motif de têtes SSM multi-contract (MCS), car le paramètre , qui contrôle la contraction de l’état SSM, a des copies indépendantes par tête.
Nous pouvons de manière similaire définir un motif de têtes attention multi-clés (MKA) ou SSM multi-expand (MES), où (qui contrôle l’expansion SSM) est indépendant par tête tandis que et sont partagés entre les têtes.
Motif SSM multi-entrées (MIS) / Attention multi-valeurs (MVA). Bien que MQA ait du sens pour l’attention en raison de son cache KV, ce n’est pas le choix naturel pour les SSM. Dans Mamba, au contraire, est considéré comme l’entrée principale du SSM, et donc et sont des paramètres partagés entre les canaux d’entrée. Nous définissons un nouveau motif attention multi-valeurs (MVA) ou SSM multi-entrées (MIS) dans l’équation (20), qui peut là encore être appliqué à toute transformation de séquence telle que SSD.
Munis de ce vocabulaire, nous pouvons caractériser plus précisément l’architecture Mamba originale.
Proposition 7.2. La couche SSM sélective (S6) de l’architecture Mamba (Gu et Dao 2023) peut être vue comme ayant-- une dimension de tête : chaque canal a une dynamique SSM indépendante .
- une structure de têtes SSM multi-entrées (MIS) ou attention multi-valeurs (MVA) : les matrices (correspondant à dans la dualité de l’attention) sont partagées entre tous les canaux de l’entrée (correspondant à dans l’attention).
Nous pouvons également ablater ces variantes de motifs de têtes lorsqu’elles sont appliquées à SSD (section 9.4.3). Curieusement, bien qu’elles soient contrôlées en nombre de paramètres et en dimension d’état totale, il existe une différence notable de performance en aval. Nous constatons empiriquement que le motif MVA tel qu’utilisé initialement dans Mamba obtient les meilleurs résultats.
Motifs de têtes groupées. Les idées de l’attention multi-requêtes peuvent être étendues à l’attention à requêtes groupées (Ainslie et al. 2023) : au lieu d’une seule tête K et V, on peut créer G têtes K et V indépendantes, où et G divise H. Cela est motivé à la fois par la réduction de l’écart de performance entre l’attention multi-requêtes et l’attention multi-têtes, et par la possibilité d’un parallélisme tensoriel plus efficace en fixant G comme un multiple du nombre de shards (section 8).
De même, le motif de têtes SSM multi-entrées utilisé dans Mamba-2 peut être facilement étendu à un SSM à entrées groupées (GIS), ou de façon synonyme à une attention à valeurs groupées (GVA). La généralisation est directe et nous omettons les détails par souci de simplicité.
7.3 Autres extensions SSD issues de l’attention linéaire
Nous décrivons ici un exemple de modifications architecturales apportées à SSD, motivées par l’attention linéaire. Nous les ablatons dans la section 9.4.3 comme une forme de résultat négatif, constatant qu’elles n’améliorent pas suffisamment les performances pour les adopter comme paramètres par défaut. Néanmoins, elles illustrent comment la vaste littérature sur l’attention peut être intégrée pour définir des variantes de SSD. Nous traitons le choix de la fonction de caractéristiques du noyau comme un hyperparamètre dans l’architecture Mamba-2, et nous nous attendons à ce que d’autres modifications simples inspirées de l’attention soient également possibles.
Approximations par attention à noyau de l’attention softmax. De nombreuses variantes de l’attention linéaire ou de l’attention à noyau sont motivées par le fait de considérer les scores d’attention comme composés de
1. un noyau exponentiel , qui peut être approché par pour une certaine fonction de caractéristiques du noyau. 2. la normalisation du noyau afin que les lignes somment à 1 via , où la division s’effectue élément par élément et où 1 est le vecteur composé uniquement de 1.
Cartes de caractéristiques à noyau exponentiel. Dans Mamba-2, nous intégrons une carte de caractéristiques à noyau flexible, et l'appliquons aux branches et (correspondant aux branches et dans l'attention). La carte de caractéristiques peut également être appliquée en option à la branche ( ), pour des raisons de simplicité et de symétrie. Ceci est représenté dans la Figure 6 par une non-linéarité arbitraire. Par défaut, nous choisissons simplement comme une fonction Swish / SiLU élément par élément (Hendrycks et Gimpel 2016 ; Ramachandran, Zoph et Le 2017). Nous explorons d'autres options dans les ablations de la Section 9.4.3, y compris les cartes de caractéristiques utilisées par Linear Attention, Performer, Random Feature Attention et cosFormer (Section 4.1.3).
Incorporation d'un terme de normalisation (dénominateur). Pour trouver le terme de dénominateur, il suffit de calculer . Mais rappelons que la sortie finale du modèle est simplement (équation (16)). Ainsi, les termes de normalisation peuvent être trouvés simplement en augmentant avec une colonne supplémentaire 1, ce qui donne un tenseur de forme . Notons que dans ce cas, la carte de caractéristiques à noyau doit être positive afin que la somme soit positive.
8 Optimisations systèmes pour les SSM
Nous décrivons plusieurs optimisations systèmes pour les SSM, en particulier l'architecture Mamba-2, pour un entraînement et une inférence efficaces à grande échelle. En particulier, nous nous concentrons sur le parallélisme tensoriel et le parallélisme de séquence pour l'entraînement à grande échelle, ainsi que sur les séquences de longueur variable bien adaptées pour le finetuning et l'inférence efficaces.
8.1 Parallélisme tensoriel
Le parallélisme tensoriel (TP) (Shoeybi et al. 2019) est une technique de parallélisme de modèle qui divise chaque couche (par exemple, attention, MLP) pour s'exécuter sur plusieurs accélérateurs tels que des GPU. Cette technique est largement utilisée pour entraîner la plupart des grands modèles (Brown et al. 2020 ; Chowdhery et al. 2023 ; Touvron, Lavril, et al. 2023 ; Touvron, L. Martin, et al. 2023) sur des grappes de GPU où chaque nœud dispose généralement de 4 à 8 GPU avec un réseau rapide tel que NVLink. Le TP a été initialement développé pour l'architecture Transformer, et il n'est pas simple de l'adapter à d'autres architectures. Nous montrons d'abord le défi de l'utilisation du TP avec l'architecture Mamba, puis montrons comment l'architecture Mamba-2 est conçue pour rendre le TP efficace.
Rappelons l'architecture Mamba, avec une entrée unique (pas de batching pour simplifier), des matrices de projection d'entrée où est le facteur d'expansion (généralement 2), et une matrice de projection de sortie :
Avec TP, supposons que nous voulions répartir le calcul sur 2 GPU. Il est facile de diviser les matrices de projection d'entrée et en deux partitions chacune de taille . Ensuite, chaque GPU détiendrait la moitié de de taille . Cependant, nous voyons que puisque sont des fonctions de , nous aurions besoin d'un all-reduce supplémentaire entre les GPU pour obtenir la totalité de avant de calculer . Après cela, les deux GPU peuvent calculer le SSM en parallèle puisqu'ils sont indépendants le long de . À la fin, nous pouvons diviser les matrices de projection de sortie en deux partitions chacune de taille , et effectuer un all-reduce à la fin. Comparé aux Transformers, nous aurions deux all-reduce au lieu d'un, ce qui double le temps passé en communication. Pour l'entraînement de Transformers à grande échelle, la communication peut déjà représenter une fraction significative du temps (par exemple 10-20%), et doubler la communication rendrait Mamba moins efficace pour l'entraînement à grande échelle.
Avec Mamba-2, notre objectif est de n'avoir qu'un seul all-reduce par bloc, similaire aux blocs d'attention ou MLP dans les Transformers. Par conséquent, nous avons la projection pour obtenir directement depuis plutôt que depuis , ce qui nous permet de diviser ces matrices de projection. Cela implique que nous avons différents ensembles de sur différents GPU, ce qui équivaut à avoir plusieurs « groupes » de sur un « GPU logique » plus grand. De plus, nous utilisons GroupNorm au sein de chaque bloc, avec un nombre de groupes divisible par le degré de TP, de sorte que les GPU d'un groupe TP n'ont pas à communiquer au sein du bloc :
Nous voyons que nous n'avons besoin de diviser que les matrices de projection d'entrée et les matrices de projection de sortie, et de n'effectuer qu'un all-reduce à la fin du bloc. Cela est similaire à la conception du TP pour les couches d'attention et MLP. En particulier, si nous avons un degré de TP de 2, nous diviserions avec avec ,
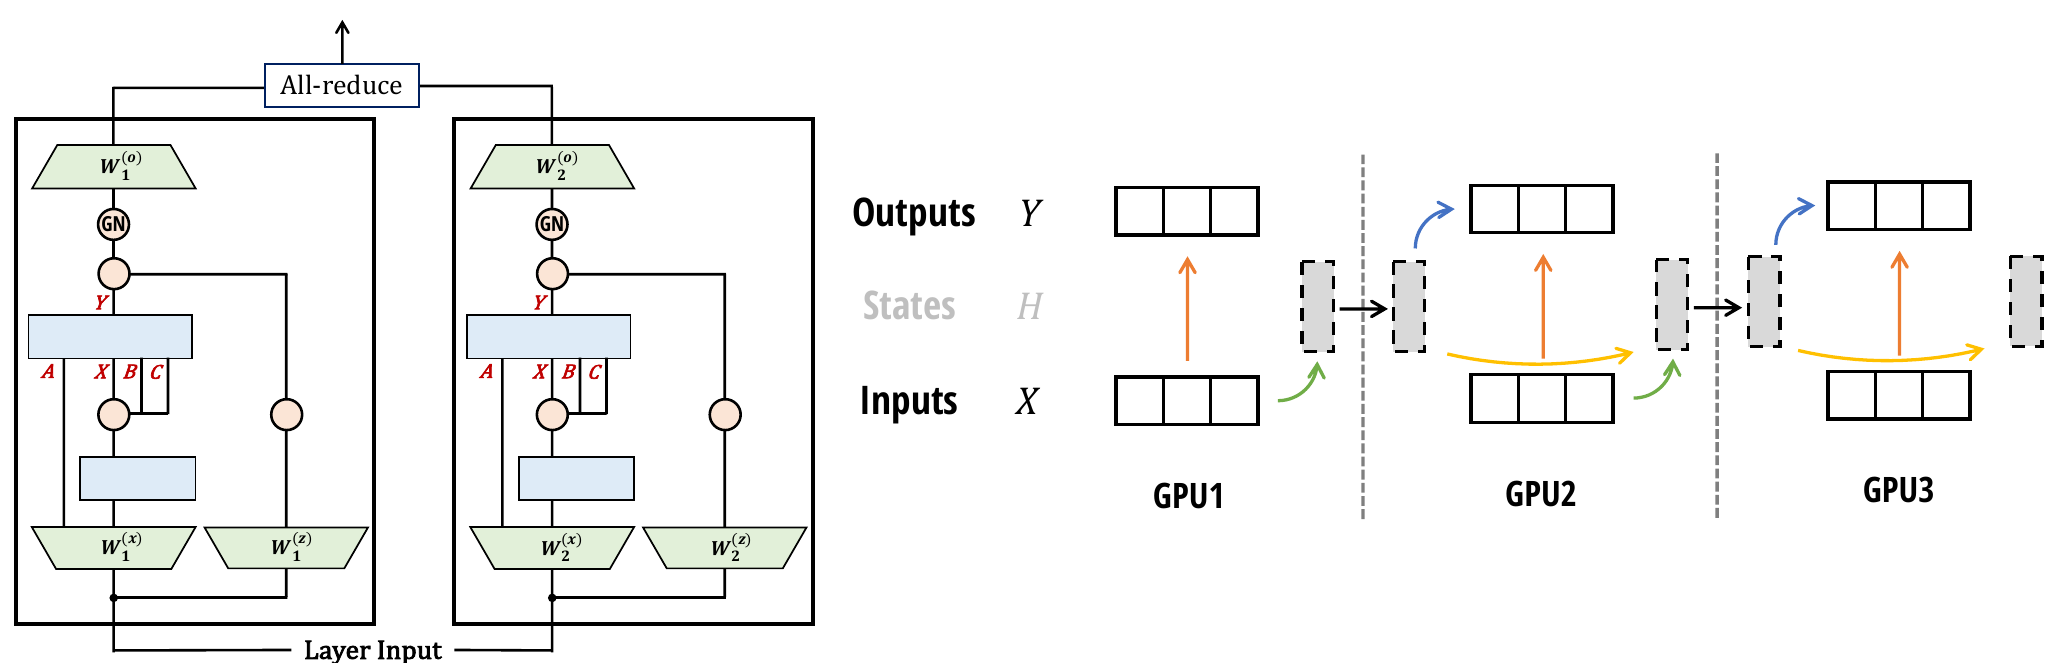
et avec . Pour , la couche Mamba-2 TP peut s'écrire :
Nous illustrons le parallélisme de tenseur avec Mamba-2 dans la Figure 7 (à gauche).
8.2 Parallélisme de séquence
Pour des séquences très longues, nous pourrions avoir besoin de répartir l'entrée et l'activation sur différents GPU le long de la dimension de longueur de séquence. Il existe deux techniques principales :
1. Le parallélisme de séquence (SP) pour les opérations résiduelles et de normalisation : d'abord proposé par Korthikanti et al. (2023), cette technique décompose l'all-reduce en TP en reduce-scatter et all-gather. Notant que les opérations résiduelles et de normalisation sont répétées sur la même entrée pour tous les GPU d'un même groupe TP, le SP divise les activations le long de la dimension de longueur de séquence en effectuant : reduce-scatter, résiduel et normalisation, puis all-gather.
Puisque l'architecture Mamba-2 utilise la même structure résiduelle et de normalisation, le SP s'applique sans modification.
2. Le parallélisme de séquence pour les opérations de mélange de tokens (attention ou SSM), également appelé « parallélisme de contexte » (CP). Plusieurs techniques ont été développées pour la couche d'attention (par ex., Ring attention (Liu, Yan, et al. 2024 ; Liu, Zaharia,
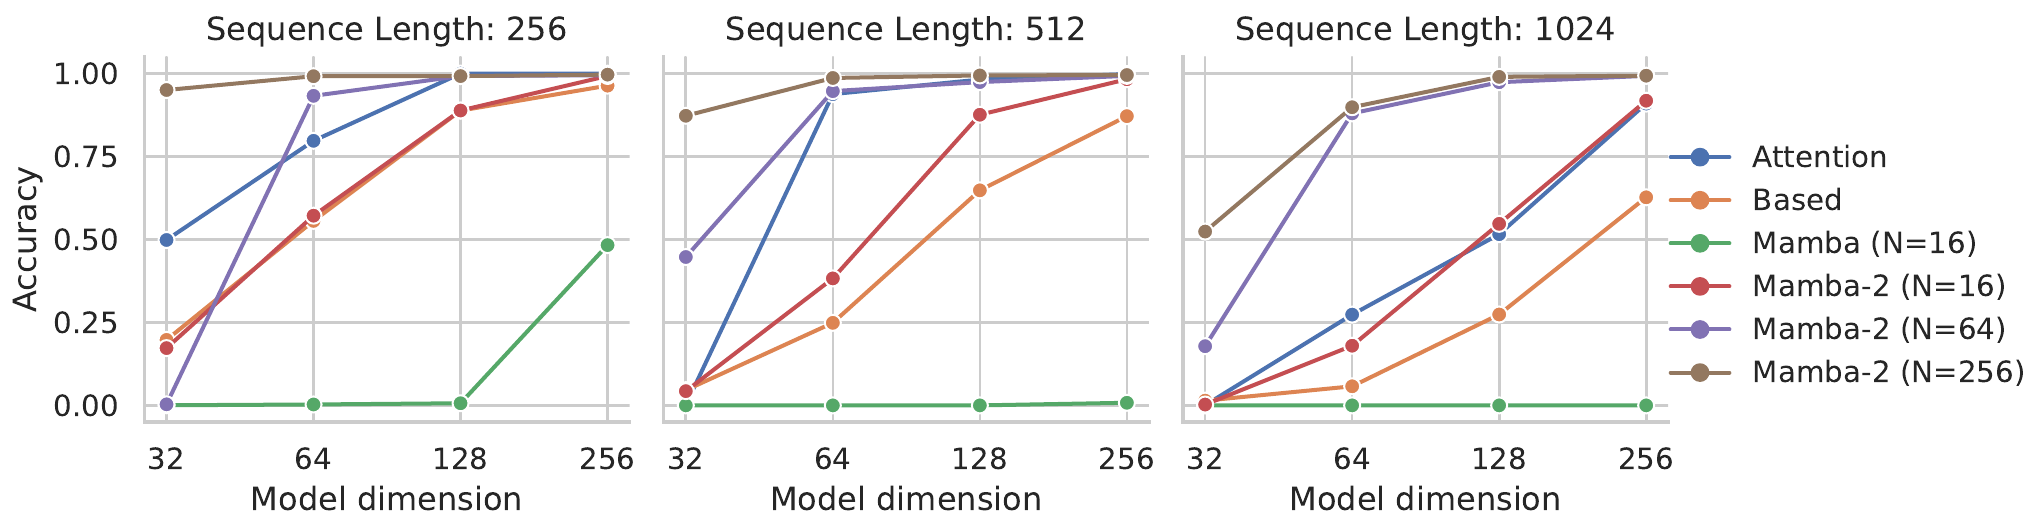
and Abbeel 2023)), avec une technique sophistiquée d'équilibrage de charge (Brandon et al. 2023). La difficulté du parallélisme de séquence dans l'attention est que nous pouvons diviser les requêtes et les clés en blocs, mais chaque bloc de requêtes doit interagir avec les blocs de clés, ce qui conduit à une bande passante de communication quadratique en le nombre de workers.
Avec les SSM, nous pouvons diviser la séquence de manière simple : chaque worker prend un état initial, calcule le SSM par rapport à ses entrées, renvoie l'état final, et transmet cet état final au worker suivant. La bande passante de communication est linéaire en le nombre de workers. Cette décomposition est exactement la même que la décomposition en blocs de l'algorithme SSD (Figure 5) pour diviser en blocs / chunks. Nous illustrons ce parallélisme de contexte dans la Figure 7 (à droite).
8.3 Longueur variable
Bien que le pré-entraînement utilise souvent les mêmes longueurs de séquence pour le batch, lors du finetuning ou de l'inférence, le modèle peut avoir besoin de traiter différentes séquences d'entrée de longueurs différentes. Une manière naïve de gérer ce cas est de padder à droite toutes les séquences du batch à la longueur maximale, mais cela peut être inefficace si les séquences ont des longueurs très différentes. Pour les transformers, des techniques sophistiquées ont été développées pour éviter le padding et faire de l'équilibrage de charge entre les GPU (Zeng et al. 2022 ; Y. Zhai et al. 2023), ou pour packer plusieurs séquences dans le même batch et ajuster le masque d'attention (Ding et al. 2024 ; Pouransari et al. 2024). Avec les SSM et Mamba en particulier, nous pouvons gérer des longueurs de séquence variables en traitant simplement le batch entier comme une seule longue séquence, et éviter de transmettre les états entre séquences individuelles. Cela équivaut à simplement fixer pour les tokens à la fin d'une séquence afin d'empêcher la transmission d'information au token , qui appartient à une séquence différente.
9 Validation empirique
Nous évaluons empiriquement Mamba-2 sur des tâches de rappel synthétiques qui se sont révélées difficiles pour les modèles récurrents (Section 9.1), ainsi que sur la pré-entraînement standard en modélisation du langage et les évaluations en aval (Section 9.2). Nous validons que notre algorithme SSD est bien plus efficace que Mamba-1 (Section 9.3) et comparable à l'attention optimisée pour des longueurs de séquence modérées. Enfin, nous réalisons une ablation de divers choix de conception dans l'architecture Mamba-2 (Section 9.4).
9.1 Synthétiques : rappel associatif
Les tâches synthétiques de rappel associatif ont été populaires pour tester la capacité des modèles de langage à rechercher des informations dans leur contexte. De manière générale, elles consistent à fournir à des modèles autorégressifs des paires d'associations clé-valeur, puis à demander au modèle de produire la complétion correcte lorsqu'on lui présente une clé déjà vue. La tâche de rappel associatif multi-requêtes (MQAR) est une formulation particulière de cette tâche qui exige que le modèle mémorise plusieurs associations (Arora, Eyuboglu, Timalsina, et al. 2024). L'article original sur Mamba rapportait des résultats sur des tâches synthétiques connexes, en particulier le Selective Copying (Gu et Dao 2023) et les Induction Heads (Olsson et al. 2022), qui peuvent être considérées comme des tâches de rappel associatif plus faciles. La tâche MQAR est également étroitement liée aux tâches de « recherche dans l'annuaire téléphonique », dont il a été montré qu'elles sont difficiles pour les modèles récurrents tels que les SSM, en raison de leur capacité d'état finie (De et al. 2024 ; Jelassi et al. 2024).
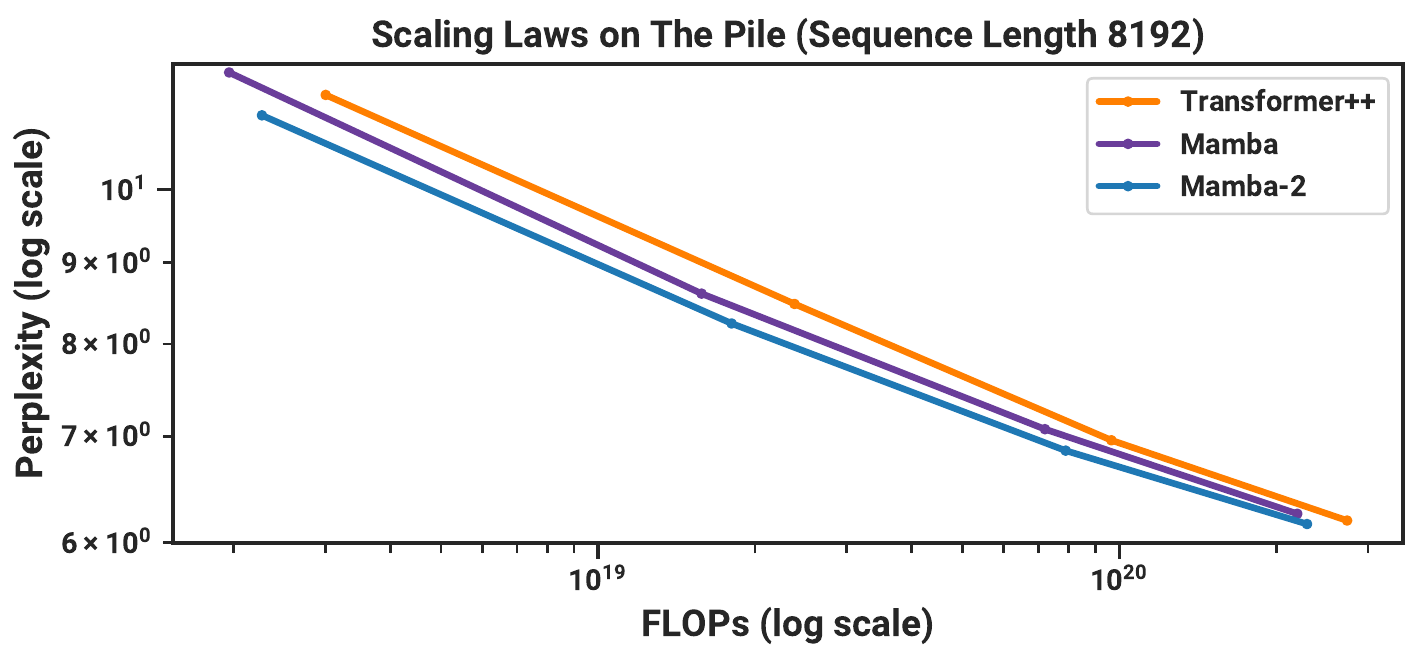
| MODÈLE | JETON. | PILE PPL ↓ | LAMBADA PPL ↓ | LAMBADA ACC ↑ | HELLASWAG ACC ↑ | PIQA ACC ↑ | ARC-E ACC ↑ | ARC-C ACC ↑ | WINOGRANDE ACC ↑ | OPENBOOKQA ACC ↑ | ACC MOYENNE ↑ |
| Pythia-1B | NeoX | 7,82 | 7,92 | 56,1 | 47,2 | 70,7 | 57,0 | 27,1 | 53,5 | 31,4 | 49,0 |
| Mamba-790M | NeoX | 7,33 | 6,02 | 62,7 | 55,1 | 72,1 | 61,2 | 29,5 | 56,1 | 34,2 | 53,0 |
| Mamba-2-780M | NeoX | 7,26 | 5,86 | 61,7 | 54,9 | 72,0 | 61,0 | 28,5 | 60,2 | 36,2 | 53,5 |
| Hybride H3-1,3B | GPT2 | — | 11,25 | 49,6 | 52,6 | 71,3 | 59,2 | 28,1 | 56,9 | 34,4 | 50,3 |
| Pythia-1,4B | NeoX | 7,51 | 6,08 | 61,7 | 52,1 | 71,0 | 60,5 | 28,5 | 57,2 | 30,8 | 51,7 |
| RWKV4-1,5B | NeoX | 7,70 | 7,04 | 56,4 | 52,5 | 72,4 | 60,5 | 29,4 | 54,6 | 34,0 | 51,4 |
| Mamba-1,4B | NeoX | 6,80 | 5,04 | 65,0 | 59,1 | 74,2 | 65,5 | 32,8 | 61,5 | 36,4 | 56,4 |
| Mamba-2-1,3B | NeoX | 6,66 | 5,02 | 65,7 | 59,9 | 73,2 | 64,3 | 33,3 | 60,9 | 37,8 | 56,4 |
| Hybrid H3-2,7B | GPT2 | — | 7,92 | 55,7 | 59,7 | 73,3 | 65,6 | 32,3 | 61,4 | 33,6 | 54,5 |
| Pythia-2,8B | NeoX | 6,73 | 5,04 | 64,7 | 59,3 | 74,0 | 64,1 | 32,9 | 59,7 | 35,2 | 55,7 |
| RWKV4-3B | NeoX | 7,00 | 5,24 | 63,9 | 59,6 | 73,7 | 67,8 | 33,1 | 59,6 | 37,0 | 56,4 |
| Mamba-2.8B | NeoX | 6,22 | 4,23 | 69,2 | 66,1 | 75,2 | 69,7 | 36,3 | 63,5 | 39,6 | 59,9 |
| Mamba-2-2.7B | NeoX | 6,09 | 4,10 | 69,7 | 66,6 | 76,4 | 69,6 | 36,4 | 64,0 | 38,8 | 60,2 |
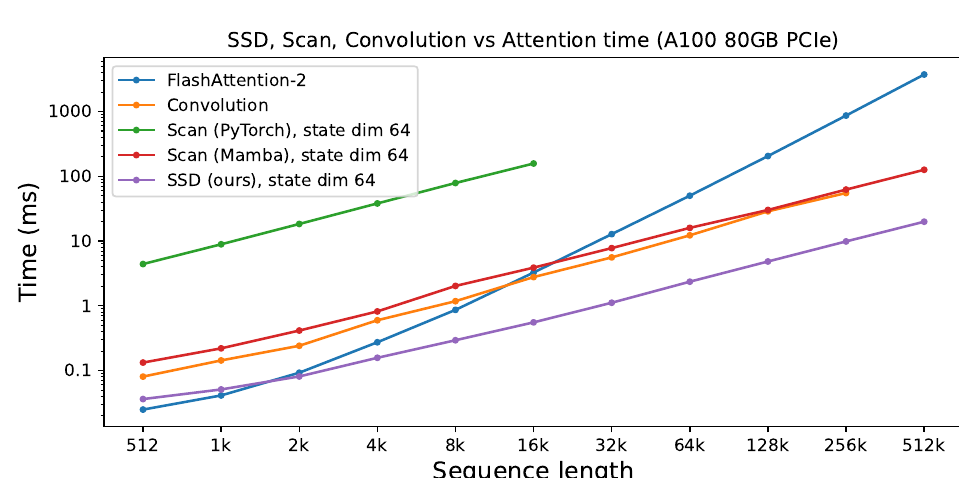
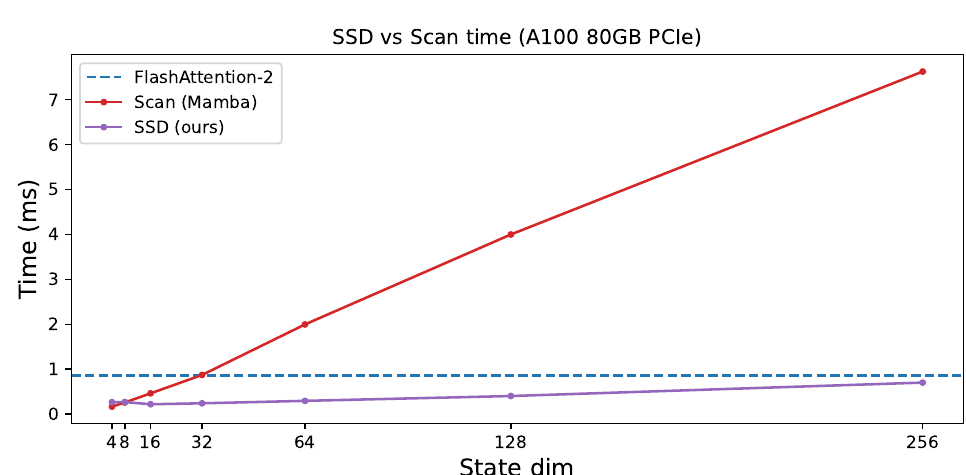
Figure 10 : (Références d'efficacité.) (À gauche) Notre SSD est plus rapide qu'un scan fusionné de Mamba pour une grande expansion d'état et plus rapide que FlashAttention-2 pour une longueur de séquence de et au-delà. (À droite) Longueur de séquence : l'augmentation de l'expansion d'état ralentit linéairement l'implémentation optimisée du scan de Mamba. SSD peut gérer des facteurs d'expansion d'état bien plus grands sans ralentissement notable.
Nous comparons sur une version exigeante du dispositif MQAR de (Arora, Eyuboglu, Zhang, et al. 2024), en utilisant une tâche plus difficile, des séquences plus longues et des modèles plus petits. Nos références incluent l'attention softmax multi-têtes standard ainsi que l'architecture Based qui combine convolutions, attention locale et une variante d'attention linéaire.
Les résultats sont présentés à la Figure 8. Alors que Mamba-1 peine sur cette tâche, Mamba-2 obtient de bons résultats dans tous les paramètres. Étonnamment, il est nettement meilleur que Mamba-1 même lorsque la taille d'état est contrôlée (). (Nous ne sommes pas certains de l'aspect de l'architecture qui constitue le facteur prédominant, ce qui reste une question à explorer dans des travaux futurs.) De plus, cette tâche valide l'importance de la taille d'état : passer de à et améliore systématiquement les performances sur MQAR, car un état plus grand permet de mémoriser davantage d'informations (paires clé-valeur).
9.2 Modélisation du langage
Suivant les protocoles standard des LLMs, nous entraînons et évaluons l'architecture Mamba-2 sur la modélisation du langage autorégressive standard par rapport à d'autres architectures. Nous comparons à la fois les métriques de pré-entraînement (perplexité) et les évaluations zero-shot. Les tailles de modèle (profondeur et largeur) suivent les spécifications de GPT3, de à . Nous utilisons le jeu de données Pile (L. Gao, Biderman, et al. 2020), et suivons la recette d'entraînement décrite dans Brown et al. (2020). Cela suit la même configuration que celle rapportée dans Mamba (Gu et Dao 2023) ; les détails d'entraînement sont en Annexe D.
9.2.1 Lois d'échelle
Pour les lignes de base, nous comparons à la fois à Mamba et à sa recette Transformer++ (Gu et Dao 2023), qui est basée sur les architectures PaLM et LLaMa (par exemple, embedding rotatif, MLP SwiGLU, RMSNorm au lieu de LayerNorm, pas de biais linéaire, et des taux d'apprentissage plus élevés). Comme Mamba a déjà démontré qu'il surpasse l'architecture Transformer standard (architecture GPT3) ainsi que les architectures subquadratiques récentes (H3 (Dao, D. Y. Fu, et al. 2023), Hyena (Poli et al. 2023), RWKV-4 (B. Peng, Alcaide, et al. 2023), RetNet (Y. Sun et al. 2023)), nous les omettons dans le graphique pour plus de clarté (voir Gu et Dao (2023) pour les comparaisons).
La Figure 9 montre les lois d'échelle sous le protocole standard Chinchilla (Hoffmann et al. 2022), sur des modèles d'environ à environ paramètres.
9.2.2 Évaluations en aval
Le Tableau 1 montre les performances de Mamba-2 sur une gamme de tâches d'évaluation zero-shot en aval populaires, comparées aux modèles open source les plus connus à ces tailles, et surtout Pythia (Biderman et al. 2023) qui ont été entraînés avec le même tokenizer, le même jeu de données et la même longueur d'entraînement (300B tokens) que nos modèles.
9.2.3 Modèles hybrides : Combiner la couche SSD avec MLP et Attention
Des travaux récents et concurrents (Dao, D. Y. Fu, et al. 2023 ; De et al. 2024 ; Glorioso et al. 2024 ; Lieber et al. 2024) suggèrent qu'une architecture hybride avec à la fois des couches SSM et des couches d'attention pourrait améliorer la qualité du modèle par rapport à celle d'un Transformer, ou d'un modèle purement SSM (par exemple, Mamba), en particulier pour l'apprentissage en contexte. Nous explorons les différentes façons dont les couches SSD peuvent être combinées avec l'attention et le MLP pour comprendre les bénéfices de chacune. Empiriquement, nous constatons qu'avoir environ du nombre total de couches en attention donne les meilleurs résultats. Combiner des couches SSD, des couches d'attention et des MLP fonctionne également mieux que soit un Transformer++ pur, soit Mamba-2.
SSD et Attention Nous constatons que les couches SSD et d'attention sont complémentaires : prises seules (par exemple dans l'architecture Mamba-2 vs. Transformer++), leurs performances (mesurées par la perplexité) sont presque identiques, mais un mélange de couches SSD et d'attention surpasse l'architecture pure Mamba-2 ou Transformer++. Nous montrons quelques résultats (Tableau 2) pour le modèle 350M (48 couches) entraîné sur 7B tokens sur le Pile avec le tokenizer GPT-2 (même nombre de paramètres, mêmes hyperparamètres, même ensemble d'entraînement et de validation). L'ajout de seulement quelques couches d'attention produit déjà une amélioration notable et offre le meilleur équilibre entre qualité et efficacité. Nous émettons l'hypothèse que les couches SSM fonctionnent bien comme un mapping séquence-à-séquence général, et que les couches d'attention agissent comme un mécanisme de récupération pour se référer rapidement aux tokens précédents dans la séquence au lieu de forcer le modèle à compresser tout le contexte dans sa mémoire (états SSM).
| NOMBRE DE BLOCS D'ATTENTION | 0 (Mamba-2) | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 9 | 11 | 15 | 24 | Transformer++ |
| PERPLEXITÉ ↓ | 8,60 | 8,38 | 8,32 | 8,29 | 8,29 | 8,28 | 8,26 | 8,27 | 8,28 | 8,30 | 8,34 | 8,50 | 8,68 |
Modèles hybrides avec SSD, MLP et Attention Nous comparons différentes façons dont SSD peut être combiné avec les couches MLP (à portes) et d'attention, et évaluons à l'échelle 2.7B (64 couches), entraîné sur 300B tokens sur le Pile (même nombre de paramètres, mêmes hyperparamètres, même ensemble d'entraînement et de validation, même ordre des données) :
1. Transformer++ : 32 couches d'attention et 32 MLP à portes, entrelacées.
2. Mamba-2 : 64 couches SSD.
3. Mamba-2-MLP : 32 couches SSD et 32 couches MLP à portes, entrelacées.
4. Mamba-2-Attention : 58 couches SSD et 6 couches d'attention (aux indices 9, 18, 27, 36, 45, 56)6.
5. Mamba-2-MLP-Attention : 28 couches SSD et 4 couches d'attention, entrelacées avec 32 couches MLP à portes.
Nous rapportons la perplexité de validation sur le Pile, ainsi que l'évaluation zero-shot, dans le Tableau 3. En général, la qualité des modèles Transformer++ et Mamba-2 est à peu près la même. Nous constatons que l'ajout de seulement 6 couches d'attention améliore sensiblement le modèle Mamba-2 pur (et le Transformer++). L'ajout de couches MLP réduit la qualité du modèle, mais peut (i) accélérer l'entraînement et l'inférence en raison de la simplicité et de l'efficacité matérielle de la couche MLP (ii) faciliter la conversion vers des modèles MoE en remplaçant les couches MLP par des mélanges d'experts.
| MODÈLE | JETON. | PILE | LAMBADA | LAMBADA | HELLASWAG | PIQA | ARC-E | ARC-C | WINOGRANDE | OPENBOOKQA | MOYENNE |
| PPL ↓ | PPL ↓ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ||
| Transformer++ | NeoX | 6,13 | 3,99 | 70,3 | 66,4 | 75,2 | 67,7 | 37,8 | 63,9 | 40,4 | 60,2 |
| Mamba-2 | NeoX | 6,09 | 4,10 | 69,7 | 66,6 | 76,4 | 69,6 | 36,4 | 64,0 | 38,8 | 60,2 |
| Mamba-2-MLP | NeoX | 6,13 | 4,18 | 69,3 | 65,0 | 76,4 | 68,1 | 37,0 | 63,1 | 38,2 | 59,6 |
| Mamba-2-Attention | NeoX | 5,95 | 3,85 | 71,1 | 67,8 | 75,8 | 69,9 | 37,8 | 65,3 | 39,0 | 61,0 |
| Mamba-2-MLP-Attention | NeoX | 6,00 | 3,95 | 70,0 | 66,6 | 75,4 | 70,6 | 38,6 | 64,6 | 39,2 | 60,7 |
9.3 Benchmarks de vitesse
Nous évaluons la vitesse de l'algorithme SSD par rapport à l'implémentation scan de Mamba et à FlashAttention-2 (Figure 10). SSD, grâce à sa reformulation utilisant la multiplication matricielle comme sous-routine, peut exploiter les unités spécialisées de multiplication matricielle (matmul) sur les GPU, également appelées tensor cores. En conséquence, il est 2 à 8 fois plus rapide que le scan associatif fusionné de Mamba, qui n'exploite pas les unités matmul. En raison de sa mise à l'échelle linéaire en longueur de séquence, SSD est plus rapide que FlashAttention-2 à partir d'une longueur de séquence de .
Cependant, nous notons que le modèle Mamba-2 dans son ensemble pourrait ne pas être aussi efficace à entraîner qu'un Transformer à courte longueur de séquence (par exemple à ), puisqu'un Transformer avec couches aurait couches MLP et couches d'attention, tandis qu'un modèle Mamba-2 aurait couches SSD pour le même nombre de paramètres. En général, les couches MLP sont très efficaces sur le plan matériel puisqu'elles consistent en une simple multiplication matricielle et une linéarité point par point. Comme montré dans la Section 9.2.3, on peut également combiner couches SSD et couches MLP pour accélérer l'entraînement à courte longueur de séquence.
| Bloc | Projections ABCX | NORMALISATION SUPPLÉMENTAIRE | PARAMÈTRES | PERPLEXITÉ |
| Mamba-1 | Séquentiel | × | 129,3M | 11,76 |
| Séquentiel | ✓ | 129,3M | 11,54 | |
| Parallèle | × | 126,5M | 11,66 | |
| Parallèle | ✓ | 126,5M | 11,49 |
9.4 Ablations d'architecture
9.4.1 Conception du bloc
La Section 7.1 présente le bloc Mamba-2, qui comporte de petites modifications par rapport au bloc Mamba-1, motivées en partie par le lien avec l'attention et aussi pour améliorer la scalabilité de Mamba-2. Le Tableau 4 réalise des ablations de ces changements d'architecture du bloc, qui se produisent en dehors de la couche SSM centrale.
Les ablations valident que les projections parallèles pour créer économisent des paramètres et fonctionnent légèrement mieux que les projections séquentielles de Mamba. Plus important encore, cette modification est compatible avec le parallélisme tensoriel à des tailles de modèle plus grandes (Section 8). De plus, la couche de normalisation supplémentaire améliore également légèrement les performances. Plus important encore, des expériences préliminaires à plus grande échelle ont observé qu'elle aide également à la stabilité de l'entraînement.
9.4.2 Structure des têtes
La Section 7.2 décrit comment les dimensions des projections peuvent être considérées comme un hyperparamètre analogue aux notions d'attention multi-têtes et d'attention multi-requêtes. Nous avons également montré comment l'architecture Mamba originale est analogue à l'attention multi-valeurs (Proposition 7.2), qui était un choix développé naturellement du point de vue du modèle d'espace d'états et qui n'avait pas fait l'objet d'ablations auparavant.
Le Tableau 5 réalise des ablations des choix de structure multi-têtes pour l'architecture Mamba-2. De façon frappante, nous trouvons une grande différence entre les motifs de têtes multi-valeurs et multi-requêtes ou multi-clés, malgré leur apparente grande similitude. Notez que cela n'est pas expliqué par la taille totale de l'état, qui est la même pour tous (égale à HPN ou au produit du nombre de têtes, de la dimension de tête et de la dimension d'état).
Nous comparons également aux motifs multi-têtes où le nombre de têtes (analogues à ) est égal. Nous comparons au motif multi-têtes standard, ainsi qu'à un motif avec un partage agressif où toutes n'ont qu'1 tête. Notez que dans ce dernier cas, le modèle a toujours H différents mixeurs de séquence , car chaque tête a toujours un différent. À paramètres égaux, ces motifs multi-têtes ont des performances similaires entre eux, entre les motifs MVA et MQA/MKA.
9.4.3 Approximations du noyau d'attention
Section 7.3 a noté comment SSD peut être combiné avec des idées issues de la littérature sur l'attention linéaire, telles que diverses formes d'approximations par noyaux. Nous réalisons une ablation de plusieurs variantes de celles-ci suggérées par des travaux antérieurs dans le tableau 6. Celles-ci incluent cosFormer (Qin, Weixuan Sun, et al. 2022), Random Feature Attention H. Peng et al. 2021, et Positive Random Features (Performer) (Choromanski et al. 2021).
Nous réalisons également une ablation de l'ajout d'un terme de normalisation, analogue au dénominateur de la fonction softmax dans l'attention standard. Nous avons constaté que cela introduisait des instabilités dans la plupart des variantes, mais améliorait légèrement les performances pour la fonction d'activation ReLU .
Le tableau 7 teste également des propositions plus récentes visant à améliorer l'attention linéaire, qui impliquent d'étendre la dimension des caractéristiques (Based (Arora, Eyuboglu, Zhang, et al. 2024) et ReBased (Aksenov et al. 2024)). Ces extensions de l'attention linéaire visent à s'approprier le noyau exp au moyen d'une approximation quadratique. ReBased propose également de remplacer la fonction d'activation QK par une normalisation de couche ; d'un point de vue centré sur les SSM, nous appliquons une normalisation par-dessus avant d'appliquer la fonction SSM.
| Motif de tête SSM | ANALOGUE ATTENTION | TÊTES A | TÊTES B | TÊTES C | TÊTES X | COUCHES | PARAM. | PPL. |
| Multi-entrée (MIS) | Multi-valeur (MVA) | 24 | 1 | 1 | 24 | 24 | 126,5 M | 11,66 |
| Multi-contrat (MCS) | Multi-requête (MQA) | 24 | 1 | 24 | 1 | 24 | 126,5 M | 12,62 |
| Multi-expansion (MES) | Multi-clé (MKA) | 24 | 24 | 1 | 1 | 24 | 126,5 M | 12,59 |
| Multi-tête (MHS) | Multi-tête (MHA) | 24 | 24 | 24 | 24 | 15 | 127,6 M | 12,06 |
| Multi-état (MSS) | - | 24 | 1 | 1 | 1 | 36 | 129,6 M | 12,00 |
| Multi-entrée (MIS) | Multi-valeur (MVA) | 32 | 1 | 1 | 32 | 48 | 361,8 M | 8,73 |
| Multi-contrat (MCS) | Contexte en lecture seule pour comprendre la source (texte à traduire ci-dessous) : | Le tableau 7 teste également des propositions plus récentes visant à améliorer l’attention linéaire en élargissant la dimension des caractéristiques (Based (Arora, Eyuboglu, Zhang, et al. 2024) et ReBased (Aksenov et al. 2024)). Ces extensions de l’attention linéaire visent à s’approprier le noyau exp au moyen d’une approximation quadratique. ReBased propose également de remplacer la fonction d’activation QK par une normalisation de couche ; d’un point de vue centré sur les SSM, nous appliquons une normalisation au-dessus de (B,C) avant d’appliquer la fonction SSM | Texte à traduire : | Multi-requête (MQA) | 32 | 1 | 32 | 1 |
| 48 | 361,8 M | 9,33 | Multi-expand (MES) | Multi-clé (MKA) | 32 | 32 | 1 | 1 |
| 48 | 361,8 M | 9,36 | Multi-tête (MHS) | Multi-tête (MHA) | 32 | 1 | 1 | 1 |
| 70 | 361,3 M | 9,01 | Multi-état (MSS) | - | 32 | 32 | 32 | 32 |
| ACTIVATION DU NOYAU φ | PERPLEXITÉ |
| aucune | 11,58 |
| Swish | 11,66 |
| Exp | 11,62 |
| ReLU | 11,73 |
| ReLU + normalisation | 11,64 |
| cosFormer | 11,97 |
| Random Feature Attention | 11,57 |
| Positive Random Features (Performer) | 12,21 |
| ACTIVATION DU NOYAU φ | PERPLEXITÉ |
| Swish | 11,67 |
| Swish + Taylor (Based) | 12,19 |
| LayerNorm | 11,50 |
| LayerNorm + Square (ReBased) | 11,84 |
| Swish | 8,58 |
| Swish + Taylor (Based) | 8,71 |
| LayerNorm | 8,61 |
| LayerNorm + Square (ReBased) | 8,63 |
Nous notons que cette technique a été proposée indépendamment sous le nom de « QK-Norm » pour l'attention softmax (Team 2024) et de « normalisation interne » pour Mamba (Lieber et al. 2024).
Dans l'ensemble, les tableaux 6 et 7 ont montré que les méthodes d'approximation par noyaux que nous avons essayées ne semblaient pas améliorer les performances par rapport à de simples fonctions d'activation non linéaires ponctuelles pour . Ainsi, nos paramètres par défaut pour Mamba-2 utilisaient afin de suivre Mamba-1, mais nous suggérons que supprimer entièrement cette activation pourrait être un choix plus simple que nous n'avons pas testé de manière extensive.
Nous soulignons toutefois que SSD et l'attention linéaire classique diffèrent par l'inclusion du masque 1-semiséparable , tandis que les diverses méthodes d'attention linéaire de la littérature ont été dérivées pour approximer l'attention softmax sans ce terme ; ainsi, nos résultats négatifs ne sont peut-être pas inattendus.
10 Travaux connexes et discussion
Le cadre de dualité espace-état jette des ponts entre les SSM, les matrices structurées et l'attention. Nous discutons plus en profondeur des relations entre SSD et ces concepts de manière plus large. En utilisant les idées issues de chacun des points de vue, nous suggérons également quelques directions dans lesquelles le cadre SSD pourrait être étendu dans de futurs travaux.
10.1 Modèles d'espace-état
Les modèles d’espace d’état structurés peuvent être caractérisés selon les axes suivants : (i) s’ils sont invariants dans le temps ou variables dans le temps ; (ii) la dimensionnalité du système ; (iii) la structure des transitions récurrentes .
SSD peut être décrit comme un SSM sélectif de dimensions SISO et de structure scalaire-identité.
Variance temporelle (sélectivité). Les SSM structurés originaux (S4) étaient des systèmes linéaires invariants dans le temps (LTI) (Gu 2023 ; Gu, Goel et Ré 2022), motivés par la mémorisation en ligne en temps continu (Gu, Dao et al. 2020 ; Gu, Johnson, Goel et al. 2021 ; Gu, Johnson, Timalsina et al. 2023). De nombreuses variantes de SSM structurés ont été proposées (Dao, D. Y. Fu et al. 2023 ; Gu, Gupta et al. 2022 ; Gupta, Gu et Berant 2022 ; Ma et al. 2023 ; J. T. Smith, Warrington et Linderman 2023), dont plusieurs abandonnent la récurrence et se concentrent sur la représentation convolutionnelle des SSM LTI (D. Y. Fu et al. 2023 ; Y. Li et al. 2023 ; Poli et al. 2023 ; Qin, Han, Weixuan Sun, B. He et al. 2023).
SSD est un SSM structuré variable dans le temps, également appelé SSM sélectif, introduit dans Mamba (Gu et Dao 2023). Les SSM sélectifs sont étroitement liés aux mécanismes de portes des RNN, y compris les RNN classiques comme le LSTM (Hochreiter et Schmidhuber 1997) et le GRU (J. Chung et al. 2014), ainsi que des variantes plus modernes comme le QRNN (Bradbury et al. 2016), le SRU (Lei 2021 ; Lei et al. 2017), RWKV (B. Peng, Alcaide et al. 2023), HGRN (Qin, Yang et Zhong 2023) et Griffin (Botev et al. 2024 ; De et al. 2024). Ces RNN diffèrent par leurs paramétrages de diverses manières, et surtout par l’absence d’expansion d’état.
Dimensionnalité et expansion d’état. Une caractéristique importante de SSD, partagée par les SSM précédents de sa lignée (S4, H3, Mamba), est qu’il s’agit d’un système à entrée unique et sortie unique (SISO) où les canaux d’entrée sont traités indépendamment. Cela conduit à une taille d’état effective bien plus grande de N0, où N est la taille de l’état du SSM (aussi appelée facteur d’expansion d’état) et D est la dimension standard du modèle. Les RNN traditionnels ont soit , soit sont multi-entrées multi-sorties (MIMO) avec des matrices denses , ce qui, dans les deux cas, conduit à un état plus petit. Bien que les SSM MIMO se soient révélés efficaces dans certains domaines (Lu et al. 2023 ; Orvieto et al. 2023 ; J. T. Smith, Warrington et Linderman 2023), Mamba a montré que l’expansion d’état est cruciale pour les domaines à forte densité d’information tels que le langage. L’un des principaux avantages de SSD est de permettre des facteurs d’expansion d’état encore plus grands sans ralentir le modèle. De nombreux travaux ultérieurs ont depuis adopté l’expansion d’état (section 10.4).
Structure. Comparé aux SSM structurés précédents, la principale restriction de SSD concerne l’expressivité des transitions d’état . Nous notons que des SSM plus généraux, comme le cas de diagonale, ont la même efficacité théorique que SSD, mais sont moins adaptés au matériel. En effet, la forme quadratique duale perd son interprétation de type attention et devient plus difficile à calculer. Ainsi, comparé à Mamba, SSD ne diffère que par une forme légèrement plus restrictive de diagonale, et échange cette expressivité contre une meilleure efficacité matérielle (et une facilité d’implémentation).
Nous faisons l’hypothèse qu’il pourrait être possible d’affiner nos algorithmes de matrices structurées pour améliorer également le cas général des SSM diagonaux.
10.2 Matrices structurées
Le premier point de vue de la dualité espace d’état adopte la perspective de ces modèles comme transformations de séquences matricielles ou « mélangeurs matriciels » : des transformations de séquences (définition 2.1) qui peuvent être représentées comme une multiplication matricielle (par une matrice ) le long de la dimension de séquence T.
Plusieurs tels mélangeurs matriciels ont déjà été proposés, où l’axe principal de variation est la représentation de la matrice. Ceux-ci incluent MLP-Mixer (Tolstikhin et al. 2021) (matrice non structurée), FNet (Lee-Thorp et al. 2021) (matrice de transformée de Fourier), M2 (Dao, B. Chen et al. 2022 ; Dao, Gu et al. 2019 ; Dao, Sohoni et al. 2020 ; D. Fu et al. 2024) (matrice papillon/monarque), les matrices de Toeplitz (Poli et al. 2023 ; Qin, Han, Weixuan Sun, B. He et al. 2023), et même des structures plus exotiques (De Sa et al. 2018 ; Thomas et al. 2018).
Une caractérisation importante est que les transformations de séquences matricielles efficaces (sous-quadratiques) sont exactement celles qui ont des mélangeurs matriciels structurés. Un résultat central du cadre SSD est de considérer les SSM comme des mélangeurs matriciels avec une structure particulière – les matrices semi-séparables (section 3). La dualité linéaire vs quadratique prend alors la forme d’une multiplication matricielle structurée vs une multiplication matricielle naïve.
La représentation par matrice structurée a conduit à notre algorithme SSD efficace via des décompositions en blocs de matrices semi-séparables particulières (section 6). Nous notons que les matrices semi-séparables sont bien étudiées dans la littérature de calcul scientifique, et l’intégration de ces idées peut être une voie prometteuse pour de nouvelles améliorations des modèles d’espace d’état. Nous suggérons également que se concentrer sur le point de vue du mélangeur matriciel peut conduire à des directions plus fructueuses pour les modèles de séquence, comme la conception de variantes non causales principiées de Mamba, ou la recherche de moyens de caractériser et de combler l’écart entre l’attention softmax et les modèles sous-quadratiques en analysant la structure de leurs transformations matricielles.
10.3 Attention (linéaire)
Comparé à l’attention standard (causale), SSD ne présente que deux différences principales.
Premièrement, SSD n’utilise pas l’activation softmax de l’attention standard (Bahdanau, Cho et Bengio 2015 ; Vaswani et al. 2017), qui est ce qui donne à l’attention sa complexité quadratique. Lorsque la softmax est supprimée, la séquence peut être calculée avec une mise à l’échelle linéaire via le cadre de l’attention linéaire (Katharopoulos et al. 2020).
Deuxièmement, SSD multiplie la matrice des logits par un masque 1-semi-séparable dépendant de l’entrée. Ainsi, ce masque peut être vu comme remplaçant la softmax dans l’attention standard.
Ce masque semi-séparable peut aussi être vu comme fournissant une information positionnelle. Les éléments agissent comme des « portes » au sens des RNN, ou comme un mécanisme de « sélection » (voir la discussion dans l’article Mamba), et leurs produits cumulés contrôlent combien d’interaction est autorisée entre les positions et . Les plongements positionnels (par exemple sinusoïdaux (Vaswani et al. 2017), Alibi (Press, N. Smith et Lewis 2022), et RoPE (Su et al. 2021)) sont une composante importante des Transformers souvent considérée comme heuristique, et le masque 1-SS de SSD peut être vu comme une forme plus principiée de plongements positionnels relatifs. Nous notons que ce point de vue a également été avancé concurremment par GateLoop (Katsch 2023).
Le second point de vue de la dualité espace d’état est un cas particulier de notre cadre plus général d’attention masquée structurée (SMA), où la dualité se révèle comme différents ordres de contraction sur une simple contraction tensorielle à 4 voies. SMA est une forte généralisation de l’attention linéaire qui est également beaucoup plus générale que SSD ; d’autres formes de masques structurés peuvent conduire à davantage de variantes d’attention efficace avec des propriétés différentes de celles de SSD.
Outre la création de nouveaux modèles, ces liens avec l’attention peuvent ouvrir d’autres directions pour comprendre les SSM. Par exemple, nous nous demandons si le phénomène des puits d’attention (attention sinks) (Darcet et al. 2024 ; Xiao et al. 2024) existe pour les modèles Mamba, et plus largement si les techniques d’interprétabilité peuvent être transférées aux SSM (Ali, Zimerman et Wolf 2024).
Enfin, de nombreuses autres variantes d’attention linéaire ont été proposées (Arora, Eyuboglu, Timalsina et al. 2024 ; Arora, Eyuboglu, Zhang et al. 2024 ; Choromanski et al. 2021 ; H. Peng et al. 2021 ; Qin, Han, Weixuan Sun, Dongxu Li et al. 2022 ; Qin, Weixuan Sun et al. 2022 ; Schlag, Irie et Schmidhuber 2021 ; Zhang et al. 2024 ; Zheng, C. Wang et Kong 2022) (voir section 4.1.3 pour des descriptions de plusieurs d’entre elles), et nous nous attendons à ce que de nombreuses techniques puissent être transférées aux SSM (par exemple section 7.3).
Nous soulignons que SSD ne généralise pas l’attention softmax standard, ni aucune autre transformation sur la matrice de noyau d’attention qui ne possède pas une carte de caractéristiques finie . Comparé à l’attention générale, l’avantage de SSD est de disposer d’un facteur d’expansion d’état contrôlable qui compresse l’historique, comparé au cache de tout l’historique de l’attention quadratique qui évolue avec la longueur de séquence . Des travaux concurrents ont commencé à étudier les compromis de ces représentations, par exemple sur des tâches de copie et d’apprentissage en contexte (Akyürek et al. 2024 ; Grazzi et al. 2024 ; Jelassi et al. 2024 ; Park et al. 2024). Nous notons que Mamba-2 améliore significativement Mamba sur certaines de ces capacités (par exemple comme le démontrent les résultats MQAR dans la section 9.1), mais il reste encore beaucoup à comprendre.
10.4 Modèles apparentés
Nous mettons enfin en évidence un ensemble croissant de travaux récents et concurrents qui ont développé des modèles de séquence très similaires à Mamba et Mamba-2.
- RetNet (Y. Sun et al. 2023) et TransNormerLLM (Qin, Dong Li, et al. 2023) généralisent l’attention linéaire en utilisant des termes de décroissance au lieu d’une somme cumulée, et proposent des algorithmes doubles parallèle/récurrent ainsi qu’un mode hybride « par blocs » (chunkwise). Ces algorithmes peuvent être vus comme une instanciation de SSD où est invariant dans le temps (constant pour tout ) ; dans l’interprétation SMA, la matrice de masque serait une matrice de décroissance . Ces modèles diffèrent également architecturalement de diverses manières. Par exemple, puisqu’ils ont été dérivés d’une perspective centrée sur l’attention, ils conservent le schéma d’attention multi-têtes (MHA) ; puisque Mamba-2 a été dérivé d’un schéma centré sur les SSM, il conserve le schéma d’attention multi-valeurs (MVA) ou de SSM multi-expansion (MES), que nous montrons être meilleur (section 9.4).
- GateLoop (Katsch 2023) a proposé concurremment l’utilisation de facteurs de décroissance dépendants des entrées \(A_{t}\), et a développé la même forme quadratique duale que dans SSD, qu’ils appellent une forme d’« attention surrogate ».
- Gated Linear Attention (GLA) (Yang et al. 2024) a proposé une variante de l’attention linéaire avec des portes dépendantes des données, ainsi que des algorithmes efficaces pour calculer un mode par blocs et des implémentations adaptées au matériel.
- HGRN (Qin, Yang et Zhong 2023) a introduit un RNN avec des portes dépendantes de l'entrée, qui a été amélioré pour intégrer l'expansion d'état dans HGRN2 (Qin, Yang, Weixuan Sun, et al. 2024).
- Griffin (De et al. 2024) et RecurrentGemma (Botev et al. 2024) ont montré qu'un RNN avec un gating dépendant de l'entrée, combiné à une attention locale, peut être très compétitif face aux puissants Transformers modernes. Jamba a également montré que combiner Mamba avec quelques couches d'attention fonctionne très bien en modélisation du langage (Lieber et al. 2024).
- xLSTM (Beck et al. 2024) améliore le xLSTM en adoptant l'idée d'expansion d'état et d'autres techniques de gating, de normalisation et de stabilisation.
- RWKV(-4) (B. Peng, Alcaide, et al. 2023) est un RNN basé sur une approximation différente de l'attention linéaire (le Transformer sans attention (S. Zhai et al. 2021)). Il a récemment été amélioré vers les architectures RWKV-5/6 (Eagle et Finch) (B. Peng, Goldstein, et al. 2024) en adoptant les idées de sélectivité et d'expansion d'état.
11 Conclusion
Nous avons proposé un cadre théorique fondé sur des classes bien étudiées de matrices structurées qui comble le fossé conceptuel entre les SSM et les variantes d'attention. Ce cadre fournit des éclairages sur la manière dont les SSM récents (par exemple Mamba) atteignent d'aussi bonnes performances que les Transformers en modélisation du langage. De plus, nos outils théoriques offrent de nouvelles idées pour améliorer les SSM (et potentiellement les Transformers) en reliant les avancées algorithmiques et systémiques des deux côtés. À titre de démonstration, le cadre guide notre conception d'une nouvelle architecture (Mamba-2) à l'intersection des SSM et de l'attention structurée.
Remerciements
Nous remercions Angela Wu pour la suggestion sur la manière de calculer efficacement le gradient de de façon numériquement stable. Nous remercions Sukjun Hwang et Aakash Lahoti pour leur assistance avec les expériences MQAR.
Références
[1] Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebrón, et Sumit Sanghai. « GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints ». Dans : arXiv preprint arXiv:2305.13245 (2023).
[2] Yaroslav Aksenov, Nikita Balagansky, Sofia Maria Lo Cicero Vaina, Boris Shaposhnikov, Alexey Gorbatovski, et Daniil Gavrilov. « Linear Transformers with Learnable Kernel Functions are Better In-Context Models ». Dans : arXiv preprint arXiv:2402.10644 (2024).
[3] Ekin Akyürek, Bailin Wang, Yoon Kim, et Jacob Andreas. « In-Context Language Learning: Architectures and Algorithms ». Dans : The International Conference on Machine Learning (ICML). 2024.
[4] Ameen Ali, Itamar Zimerman, et Lior Wolf. The Hidden Attention of Mamba Models. 2024. arXiv: 2403.01590 [cs.LG].
[5] Simran Arora, Sabri Eyuboglu, Aman Timalsina, Isys Johnson, Michael Poli, James Zou, Atri Rudra, et Christopher Ré. « Zoology: Measuring and Improving Recall in Efficient Language Models ». Dans : The International Conference on Learning Representations (ICLR). 2024.
[6] Simran Arora, Sabri Eyuboglu, Michael Zhang, Aman Timalsina, Silas Alberti, Dylan Zinsley, James Zou, Atri Rudra, et Christopher Ré. « Simple Linear Attention Language Models Balance the Recall-Throughput Tradeoff ». Dans : The International Conference on Machine Learning (ICML). 2024.
[7] Dzmitry Bahdanau, Kyunghyun Cho, et Yoshua Bengio. « Neural Machine Translation by Jointly Learning to Align and Translate ». Dans : The International Conference on Learning Representations (ICLR). 2015.
[8] George A Baker, George A Baker Jr, Peter Graves-Morris, et Susan S Baker. Pade Approximants: Encyclopedia of Mathematics and It's Applications, Vol. 59 George A. Baker, Jr., Peter Graves-Morris. Vol. 59. Cambridge University Press, 1996.
[9] Maximilian Beck, Korbinian Poppel, Markus Spanring, Andreas Auer, Oleksandra Prudnikova, Michael Kopp, Günter Klambauer, Johannes Brandstetter, et Sepp Hochreiter. « xLSTM: Extended Long Short-Term Memory ». Dans : arXiv preprint arXiv:2405.04517 (2024).
[10] Stella Biderman, Hailey Schoelkopf, Quentin Gregory Anthony, Herbie Bradley, Kyle O'Brien, Eric Hallahan, Mohammad Aflah Khan, Shivanshu Purohit, USVSN Sai Prashanth, Edward Raff, et al. « Pythia: A Suite for Analyzing Large Language Models across Training and Scaling ». Dans : The International Conference on Machine Learning (ICML). PMLR. 2023, pp. 2397-2430.
[11] Yonatan Bisk, Rowan Zellers, Jianfeng Gao, Yejin Choi, et al. « PIQA: Reasoning about Physical Commonsense in Natural Language ». Dans : Proceedings of the AAAI conference on Artificial Intelligence. Vol. 34. 2020.
[12] Sid Black, Stella Biderman, Eric Hallahan, Quentin Anthony, Leo Gao, Laurence Golding, Horace He, Connor Leahy, Kyle McDonell, Jason Phang, et al. « Gpt-NeoX-20B: An Open-source Autoregressive Language Model ». Dans : arXiv preprint arXiv:2204.06745 (2022).
[13] Guy E Blelloch. « Prefix Sums and Their Applications ». Dans : (1990).
[14] Aleksandar Botev, Soham De, Samuel L Smith, Anushan Fernando, George-Cristian Muraru, Ruba Haroun, Leonard Berrada, Razvan Pascanu, Pier Giuseppe Sessa, Robert Dadashi, et al. « RecurrentGemma: Moving Past Transformers for Efficient Open Language Models ». Dans : arXiv preprint arXiv:2404.07839 (2024).
[15] George EP Box, Gwilym M Jenkins, Gregory C Reinsel, et Greta M Ljung. Time Series Analysis: Forecasting and Control. John Wiley & Sons, 2015.
[16] James Bradbury, Stephen Merity, Caiming Xiong, et Richard Socher. « Quasi-recurrent Neural Networks ». Dans : arXiv preprint arXiv:1611.01576 (2016).
[17] William Brandon, Aniruddha Nrusimha, Kevin Qian, Zachary Ankner, Tian Jin, Zhiye Song, et Jonathan Ragan-Kelley. « Striped attention: Faster ring attention for causal transformers ». Dans : arXiv preprint arXiv:2311.09431 (2023).
[18] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. « Language Models are Few-shot Learners ». Dans : Advances in Neural Information Processing Systems (NeurIPS) 33 (2020), pp. 1877-1901.
[19] Krzysztof Choromanski, Valerii Likhosherstov, David Dohan, Xingyou Song, Andreea Gane, Tamas Sarlos, Peter Hawkins, Jared Davis, Afroz Mohiuddin, Lukasz Kaiser, et al. « Rethinking Attention with Performers ». Dans : The International Conference on Learning Representations (ICLR). 2021.
[20] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. « PaLM: Scaling Language Modeling with Pathways ». Dans : Journal of Machine Learning Research 24.240 (2023), pp. 1-113. URL : http://jmlr.org/papers/v24/22-1144.html.
[21] Junyoung Chung, Caglar Gulcehre, KyungHyun Cho, et Yoshua Bengio. « Empirical Evaluation of Gated Recurrent Neural Networks on Sequence Modeling ». Dans : arXiv preprint arXiv:1412.3555 (2014).
[22] Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, et Oyvind Tafjord. « Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge ». Dans : arXiv preprint arXiv:1803.05457 (2018).
[23] Tri Dao. « FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning ». Dans : The International Conference on Learning Representations (ICLR). 2024.
[24] Tri Dao, Beidi Chen, Nimit S Sohoni, Arjun Desai, Michael Poli, Jessica Grogan, Alexander Liu, Aniruddh Rao, Atri Rudra et Christopher Ré. « Monarch : matrices structurées expressives pour un entraînement efficace et précis ». Dans : Conférence internationale sur l'apprentissage automatique. PMLR. 2022, p. 4690-4721.
[25] Tri Dao, Daniel Y Fu, Khaled K Saab, Armin W Thomas, Atri Rudra et Christopher Ré. « Hungry Hungry Hippos : vers la modélisation du langage avec des modèles d'espace d'états ». Dans : La Conférence internationale sur les représentations d'apprentissage (ICLR). 2023.
[26] Tri Dao, Albert Gu, Matthew Eichhorn, Atri Rudra et Christopher Ré. « Apprentissage d'algorithmes rapides pour les transformées linéaires à l'aide de factorisations papillon ». Dans : La Conférence internationale sur l'apprentissage automatique (ICML). 2019.
[27] Tri Dao, Nimit Sohoni, Albert Gu, Matthew Eichhorn, Amit Blonder, Megan Leszczynski, Atri Rudra et Christopher Ré. « Kaléidoscope : une représentation efficace et apprenable pour toutes les applications linéaires structurées ». Dans : La Conférence internationale sur les représentations d'apprentissage (ICLR). 2020.
[28] Timothée Darcet, Maxime Oquab, Julien Mairal et Piotr Bojanowski. « Les Vision Transformers ont besoin de registres ». Dans : La Conférence internationale sur les représentations d'apprentissage (ICLR). 2024.
[29] Soham De, Samuel L Smith, Anushan Fernando, Aleksandar Botev, George Cristian-Muraru, Albert Gu, Ruba Haroun, Leonard Berrada, Yutian Chen, Srivatsan Srinivasan, et al. « Griffin : mélange de récurrences linéaires à portes avec attention locale pour des modèles de langage efficaces ». Dans : préimpression arXiv arXiv:2402.19427 (2024).
[30] Christopher De Sa, Albert Gu, Rohan Puttagunta, Christopher Ré et Atri Rudra. « A Two-Pronged Progress in Structured Dense Matrix Vector Multiplication ». Dans : Proceedings of the Twenty-Ninth Annual ACM-SIAM Symposium on Discrete Algorithms. SIAM. 2018, p. 1060-1079.
[31] Hantian Ding, Zijian Wang, Giovanni Paolini, Varun Kumar, Anoop Deoras, Dan Roth et Stefano Soatto. « Fewer truncations improve language modeling ». Dans : arXiv preprint arXiv:2404.10830 (2024).
[32] Yuli Eidelman et Israel Gohberg. « On a new class of structured matrices ». Dans : Integral Equations and Operator Theory 34.3 (1999), p. 293-324.
[33] Dan Fu, Simran Arora, Jessica Grogan, Isys Johnson, Evan Sabri Eyuboglu, Armin Thomas, Benjamin Spector, Michael Poli, Atri Rudra et Christopher Ré. « Monarch mixer: A simple sub-quadratic gemm-based architecture ». Dans : Advances in Neural Information Processing Systems 36 (2024).
[34] Daniel Y Fu, Elliot L Epstein, Eric Nguyen, Armin W Thomas, Michael Zhang, Tri Dao, Atri Rudra et Christopher Ré. « Simple Hardware-efficient Long Convolutions for Sequence Modeling ». Dans : The International Conference on Machine Learning (ICML) (2023).
[35] Leo Gao, Stella Biderman, Sid Black, Laurence Golding, Travis Hoppe, Charles Foster, Jason Phang, Horace He, Anish Thite, Noa Nabeshima, Shawn Presser et Connor Leahy. « The Pile: An 800GB Dataset of Diverse Text for Language Modeling ». Dans : arXiv preprint arXiv:2101.00027 (2020).
[36] Leo Gao, Jonathan Tow, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Kyle McDonell, Niklas Muennighoff, Jason Phang, Laria Reynolds, Eric Tang, Anish Thite, Ben Wang, Kevin Wang et Andy Zou. A Framework for Few-shot Language Model Evaluation. Version v0.0.1. Sept. 2021. DOI : 10.5281/zenodo.5371628. URL : https://doi.org/10.5281/zenodo.5371628.
[37] Paolo Glorioso, Quentin Anthony, Yury Tokpanov, James Whittington, Jonathan Pilault, Adam Ibrahim et Beren Millidge. « Zamba: A Compact 7B SSM Hybrid Model ». Dans : arXiv preprint arXiv:2405.16712 (2024).
[38] Riccardo Grazzi, Julien Siems, Simon Schrodi, Thomas Brox et Frank Hutter. « Is Mamba Capable of In-Context Learning? » Dans : arXiv preprint arXiv:2402.03170 (2024).
[39] Albert Gu. « Modeling Sequences with Structured State Spaces ». Thèse de doctorat. Stanford University, 2023.
[40] Albert Gu et Tri Dao. « Mamba: Linear-Time Sequence Modeling with Selective State Spaces ». Dans : arXiv preprint arXiv:2312.00752 (2023).
[41] Albert Gu, Tri Dao, Stefano Ermon, Atri Rudra et Christopher Ré. « HIPPO: Recurrent Memory with Optimal Polynomial Projections ». Dans : Advances in Neural Information Processing Systems (NeurIPS). 2020.
[42] Albert Gu, Karan Goel et Christopher Ré. « Efficiently Modeling Long Sequences with Structured State Spaces ». Dans : The International Conference on Learning Representations (ICLR). 2022.
[43] Albert Gu, Ankit Gupta, Karan Goel et Christopher Ré. « On the Parameterization and Initialization of Diagonal State Space Models ». Dans : Advances in Neural Information Processing Systems (NeurIPS). 2022.
[44] Albert Gu, Isys Johnson, Karan Goel, Khaled Saab, Tri Dao, Atri Rudra et Christopher Ré. « Combining Recurrent, Convolutional, and Continuous-time Models with the Linear State Space Layer ». Dans : Advances in Neural Information Processing Systems (NeurIPS). 2021.
[45] Albert Gu, Isys Johnson, Aman Timalsina, Atri Rudra et Christopher Ré. « How to Train Your HIPPO: State Space Models with Generalized Basis Projections ». Dans : The International Conference on Learning Representations (ICLR). 2023.
[46] Ankit Gupta, Albert Gu et Jonathan Berant. « Diagonal State Spaces are as Effective as Structured State Spaces ». Dans : Advances in Neural Information Processing Systems 35 (2022), p. 22982-22994.
[47] Dan Hendrycks et Kevin Gimpel. « Gaussian Error Linear Units (GELUs) ». Dans : arXiv preprint arXiv:1606.08415 (2016).
[48] W Daniel Hillis et Guy L Steele Jr. « Data Parallel Algorithms ». Dans : Communications of the ACM 29.12 (1986), p. 1170-1183.
[49] Sepp Hochreiter et Jürgen Schmidhuber. « Long Short-Term Memory ». Dans : Neural Computation 9.8 (1997), p. 1735-1780.
[50] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, et al. « An Empirical Analysis of Compute Optimal Large Language Model Training ». In : Advances in Neural Information Processing Systems (NeurIPS) 35 (2022), p. 30016-30030. [51] Samy Jelassi, David Brandfonbrener, Sham M Kakade et Eran Malach. « Repeat After Me: Transformers Are Better Than State Space Models at Copying ». In : The International Conference on Machine Learning (ICML). 2024. [52] Angelos Katharopoulos, Apoorv Vyas, Nikolaos Pappas et Francois Fleuret. « Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention ». In : International Conference on Machine Learning. PMLR. 2020, p. 5156-5165. [53] Tobias Katsch. « GateLoop: Fully Data-Controlled Linear Recurrence for Sequence Modeling ». In : arXiv preprint arXiv:2311.01927 (2023). [54] Shiva Kaul. « Linear Dynamical Systems as a Core Computational Primitive ». In : Advances in Neural Information Processing Systems 33 (2020), p. 16808-16820. [55] Vijay Anand Korthikanti, Jared Casper, Sangkug Lynn, Lawrence McAfee, Michael Andersch, Mohammad Shoeybi et Bryan Catanzaro. « Reducing activation recomputation in large transformer models ». In : Proceedings of Machine Learning and Systems 5 (2023). [56] James Lee-Thorp, Joshua Ainslie, Ilya Eckstein et Santiago Ontanon. « Fnet: Mixing tokens with fourier transforms ». In : arXiv preprint arXiv:2105.03824 (2021). [57] Tao Lei. « When Attention Meets Fast Recurrence: Training Language Models with Reduced Compute ». In : Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing. 2021, p. 7633-7648. [58] Tao Lei, Yu Zhang, Sida I Wang, Hui Dai et Yoav Artzi. « Simple Recurrent Units for Highly Parallelizable Recurrence ». In : arXiv preprint arXiv:1709.02755 (2017). [59] Yuhong Li, Tianle Cai, Yi Zhang, Deming Chen et Debadeepta Dey. « What Makes Convolutional Models Great on Long Sequence Modeling? » In : The International Conference on Learning Representations (ICLR). 2023. [60] Opher Lieber, Barak Lenz, Hofit Bata, Gal Cohen, Jhonathan Osin, Itay Dalmedigos, Erez Safahi, Shaked Meirom, Yonatan Belinkov, Shai Shalev-Shwartz, et al. « Jamba: A Hybrid Transformer-Mamba Language Model ». In : arXiv preprint arXiv:2403.19887 (2024). [61] Hao Liu, Wilson Yan, Matei Zaharia et Pieter Abbeel. « World Model on Million-Length Video And Language With RingAttention ». In : arXiv preprint arXiv:2402.08268 (2024). [62] Hao Liu, Matei Zaharia et Pieter Abbeel. « Ring attention with blockwise transformers for near-infinite context ». In : arXiv preprint arXiv:2310.01889 (2023). [63] Chris Lu, Yannick Schroecker, Albert Gu, Emilio Parisotto, Jakob Foerster, Satinder Singh et Feryal Behbahani. « Structured State Space Models for In-Context Reinforcement Learning ». In : Advances in Neural Information Processing Systems (NeurIPS). 2023. [64] Xuezhe Ma, Chunting Zhou, Xiang Kong, Junxian He, Liangke Gui, Graham Neubig, Jonathan May et Luke Zettlemoyer. « Mega: Moving Average Equipped Gated Attention ». In : The International Conference on Learning Representations (ICLR). 2023. [65] Eric Martin et Chris Cundy. « Parallelizing Linear Recurrent Neural Nets Over Sequence Length ». In : The International Conference on Learning Representations (ICLR). 2018. [66] Todor Mihaylov, Peter Clark, Tushar Khot et Ashish Sabharwal. « Can a Suit of Armor Conduct Electricity? A New Dataset for Open Book Question Answering ». In : arXiv preprint arXiv:1809.02789 (2018). [67] Catherine Olsson, Nelson Elhage, Neel Nanda, Nicholas Joseph, Nova DasSarma, Tom Henighan, Ben Mann, Amanda Askell, Yuntao Bai, Anna Chen, Tom Conerly, Dawn Drain, Deep Ganguli, Zac Hatfield-Dodds, Danny Hernandez, Scott Johnston, Andy Jones, Jackson Kernion, Liane Lovitt, Kamal Ndousse, Dario Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish et Chris Olah. « In-context Learning and Induction Heads ». In : Transformer Circuits Thread (2022). https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/index.html. [68] Antonio Orvieto, Samuel L Smith, Albert Gu, Anushan Fernando, Caglar Gulcehre, Razvan Pascanu et Soham De. « Resurrecting Recurrent Neural Networks for Long Sequences ». In : The International Conference on Machine Learning (ICML). 2023. [69] Denis Paperno, Germán Kruszewski, Angeliki Lazaridou, Ngoc-Quan Pham, Raffaella Bernardi, Sandro Pezzelle, Marco Baroni, Gemma Boleda et Raquel Fernández. « The LAMBADA Dataset: Word Prediction Requiring a Broad Discourse Context ». In : Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics. 2016, p. 1525-1534. [70] Jongho Park, Jaeseung Park, Zheyang Xiong, Nayoung Lee, Jaewoong Cho, Samet Oymak, Kangwook Lee et Dimitris Papailiopoulos. « Can Mamba Learn How to Learn? A Comparative Study on In-Context Learning Tasks ». In : The International Conference on Machine Learning (ICML). 2024.
. html.
[71] Bo Peng, Eric Alcaide, Quentin Anthony, Alon Albalak, Samuel Arcadinho, Huanqi Cao, Xin Cheng, Michael Chung, Matteo Grella, Kranthi Kiran GV, et al. « RWKV: Reinventing RNNs for the Transformer Era ». Dans : arXiv preprint arXiv:2305.13048 (2023).
[72] Bo Peng, Daniel Goldstein, Quentin Anthony, Alon Albalak, Eric Alcaide, Stella Biderman, Eugene Cheah, Teddy Ferdinand, Haowen Hou, Przemyslaw Kazienko, et al. « Eagle and Finch: RWKV with matrix-valued states and dynamic recurrence ». Dans : arXiv preprint arXiv:2404.05892 (2024).
[73] Hao Peng, Nikolaos Pappas, Dani Yogatama, Roy Schwartz, Noah A Smith, and Lingpeng Kong. « Random Feature Attention ». Dans : The International Conference on Learning Representations (ICLR). 2021.
[74] Clément Pernet. « Computing with Quasiseparable Matrices ». Dans : Proceedings of the ACM on International Symposium on Symbolic and Algebraic Computation. 2016, pp. 389-396.
[75] Clément Pernet, Hippolyte Signargout, and Gilles Villard. « Exact computations with quasiseparable matrices ». Dans : arXiv preprint arXiv:2302.04515 (2023).
[76] Clément Pernet and Arne Storjohann. « Time and space efficient generators for quasiseparable matrices ». Dans : Journal of Symbolic Computation 85 (2018), pp. 224-246.
[77] Michael Poli, Stefano Massaroli, Eric Nguyen, Daniel Y Fu, Tri Dao, Stephen Baccus, Yoshua Bengio, Stefano Ermon, and Christopher Ré. « Hyena Hierarchy: Towards Larger Convolutional Language Models ». Dans : The International Conference on Machine Learning (ICML). 2023.
[78] Hadi Pouransari, Chun-Liang Li, Jen-Hao Rick Chang, Pavan Kumar Anasosalu Vasu, Cem Koc, Vaishaal Shankar, and Oncel Tuzel. « Dataset Decomposition: Faster LLM Training with Variable Sequence Length Curriculum ». Dans : arXiv preprint arXiv:2405.13226 (2024).
[79] Ofir Press, Noah Smith, and Mike Lewis. « Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation ». Dans : International Conference on Learning Representations. 2022.
[80] Zhen Qin, Xiaodong Han, Weixuan Sun, Bowen He, Dong Li, Dongxu Li, Yuchao Dai, Lingpeng Kong, and Yiran Zhong. « Toeplitz Neural Network for Sequence Modeling ». Dans : The International Conference on Learning Representations (ICLR). 2023.
[81] Zhen Qin, Xiaodong Han, Weixuan Sun, Dongxu Li, Lingpeng Kong, Nick Barnes, and Yiran Zhong. « The devil in linear transformer ». Dans : arXiv preprint arXiv:2210.10340 (2022).
[82] Zhen Qin, Dong Li, Weigao Sun, Weixuan Sun, Xuyang Shen, Xiaodong Han, Yunshen Wei, Baohong Lv, Xiao Luo, Yu Qiao, et al. « TransNormerLLM: A Faster and Better Large Language Model with Improved TransNormer ». Dans : arXiv preprint arXiv:2307.14995 (2023).
[83] Zhen Qin, Weixuan Sun, Hui Deng, Dongxu Li, Yunshen Wei, Baohong Lv, Junjie Yan, Lingpeng Kong, and Yiran Zhong. « CosFormer: Rethinking Softmax in Attention ». Dans : The International Conference on Learning Representations (ICLR). 2022.
[84] Zhen Qin, Songlin Yang, Weixuan Sun, Xuyang Shen, Dong Li, Weigao Sun, and Yiran Zhong. « HGRN2: Gated Linear RNNs with State Expansion ». Dans : arXiv preprint arXiv:2404.07904 (2024).
[85] Zhen Qin, Songlin Yang, and Yiran Zhong. « Hierarchically Gated Recurrent Neural Network for Sequence Modeling ». Dans : Advances in Neural Information Processing Systems 36 (2023).
[86] Ali Rahimi and Benjamin Recht. « Random Features for Large-Scale Kernel Machines ». Dans : Advances in Neural Information Processing Systems (NeurIPS) 20 (2007).
[87] Prajit Ramachandran, Barret Zoph, and Quoc V Le. « Swish: A Self-gated Activation Function ». Dans : arXiv preprint arXiv:1710.05941 7.1 (2017), p. 5.
[88] Keisuke Sakaguchi, Ronan Le Bras, Chandra Bhagavatula, and Yejin Choi. « Winogrande: An Adversarial Winograd Schema Challenge at Scale ». Dans : Communications of the ACM 64.9 (2021), pp. 99-106.
[89] Imanol Schlag, Kazuki Irie, and Jürgen Schmidhuber. « Linear Transformers are Secretly Fast Weight Programmers ». Dans : The International Conference on Machine Learning (ICML). PMLR. 2021, pp. 9355-9366.
[90] Noam Shazeer. « Fast Transformer Decoding: One Write-head is All You Need ». Dans : arXiv preprint arXiv:1911.02150 (2019).
[91] Sam Shleifer, Jason Weston, and Myle Ott. « NormFormer: Improved Transformer Pretraining with Extra Normalization ». Dans : arXiv preprint arXiv:2110.09456 (2021).
[92] Mohammad Shoeybi, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, and Bryan Catanzaro. « Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism ». Dans : arXiv preprint arXiv:1909.08053 (2019).
[93] Jimmy TH Smith, Andrew Warrington, and Scott W Linderman. « Simplified State Space Layers for Sequence Modeling ». Dans : The International Conference on Learning Representations (ICLR). 2023.
[94] Jianlin Su, Yu Lu, Shengfeng Pan, Ahmed Murtadha, Bo Wen, and Yunfeng Liu. « Roformer: Enhanced Transformer with Rotary Position Embedding ». Dans : arXiv preprint arXiv:2104.09864 (2021).
[95] Yutao Sun, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang, and Furu Wei. « Retentive network: A successor to transformer for large language models ». Dans : arXiv preprint arXiv:2307.08621 (2023).
[96] Yi Tay, Mostafa Dehghani, Dara Bahri, and Donald Metzler. « Efficient Transformers: A Survey ». Dans : ACM Computing Surveys 55.6 (2022), pp. 1-28.
[97] Chameleon Team. « Chameleon: Mixed-Modal Early-Fusion Foundation Models ». Dans : arXiv preprint arXiv:2405.09818 (2024).
[98] Anna Thomas, Albert Gu, Tri Dao, Atri Rudra, and Christopher Ré. « Learning Compressed Transforms with Low Displacement Rank ». Dans : Advances in Neural Information Processing Systems (NeurIPS). 2018, pp. 9052-9060.
[99] Ilya O Tolstikhin, Neil Houlsby, Alexander Kolesnikov, Lucas Beyer, Xiaohua Zhai, Thomas Unterthiner, Jessica Yung, Andreas Steiner, Daniel Keysers, Jakob Uszkoreit, et al. « MLP-Mixer: An All-MLP Architecture for Vision ». Dans : Advances in Neural Information Processing Systems (NeurIPS) 34 (2021), pp. 24261-24272.
[100] Hugo Touvron, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie-Anne Lachaux, Timothée Lacroix, Baptiste Rozière, Naman Goyal, Eric Hambro, Faisal Azhar, et al. « Llama: Open and Efficient Foundation Language Models ». Dans : arXiv preprint arXiv:2302.13971 (2023).
[101] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. « Llama 2: Open foundation and fine-tuned chat models ». Dans : arXiv preprint arXiv:2307.09288 (2023).
[102] Raf Vandebril, M Van Barel, Gene Golub, and Nicola Mastronardi. « A bibliography on semiseparable matrices ». Dans : Calcolo 42 (2005), pp. 249-270.
[103] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser et Illia Polosukhin. « Attention Is All You Need ». Dans : Advances in Neural Information Processing Systems (NeurIPS). 2017.
[104] Shida Wang et Beichen Xue. « State-space Models with Layer-wise Nonlinearity are Universal Approximators with Exponential Decaying Memory ». Dans : prépublication arXiv arXiv:2309.13414 (2023).
[105] Sinong Wang, Belinda Z Li, Madian Khabsa, Han Fang et Hao Ma. « Linformer: Self-attention with Linear Complexity ». Dans : prépublication arXiv arXiv:2006.04768 (2020).
[106] Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han et Mike Lewis. « Efficient Streaming Language Models with Attention Sinks ». Dans : The International Conference on Learning Representations (ICLR). 2024.
[107] Yunyang Xiong, Zhanpeng Zeng, Rudrasis Chakraborty, Mingxing Tan, Glenn Fung, Yin Li et Vikas Singh. « Nyströmformer: A Nyström-Based Algorithm for Approximating Self-Attention ». Dans : Proceedings of the AAAI Conference on Artificial Intelligence. Vol. 35. 2021.
[108] Songlin Yang, Bailin Wang, Yikang Shen, Rameswar Panda et Yoon Kim. « Gated Linear Attention Transformers with Hardware-Efficient Training ». Dans : The International Conference on Machine Learning (ICML). 2024.
[109] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi et Yejin Choi. « HellaSwag: Can a Machine Really Finish Your Sentence? » Dans : Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics. 2019.
[110] Jinle Zeng, Min Li, Zhihua Wu, Jiaqi Liu, Yuang Liu, Dianhai Yu et Yanjun Ma. « Boosting distributed training performance of the unpadded bert model ». Dans : arXiv preprint arXiv:2208.08124 (2022).
[111] Shuangfei Zhai, Walter Talbott, Nitish Srivastava, Chen Huang, Hanlin Goh, Ruixiang Zhang et Josh Susskind. « An Attention Free Transformer ». Dans : arXiv preprint arXiv:2105.14103 (2021).
[112] Yujia Zhai, Chengquan Jiang, Leyuan Wang, Xiaoying Jia, Shang Zhang, Zizhong Chen, Xin Liu et Yibo Zhu. « Bytetransformer: A high-performance transformer boosted for variable-length inputs ». Dans : 2023 IEEE International Parallel and Distributed Processing Symposium (IPDPS). IEEE. 2023, p. 344-355.
[113] Michael Zhang, Kush Bhatia, Hermann Kumbong et Christopher Ré. « The Hedgehog & the Porcupine: Expressive Linear Attentions with Softmax Mimicry ». Dans : The International Conference on Learning Representations (ICLR). 2024.
[114] Lin Zheng, Chong Wang et Lingpeng Kong. « Linear complexity randomized self-attention mechanism ». Dans : International Conference on Machine Learning. PMLR. 2022, p. 27011-27041.
A Glossaire
| Notation | Description | Définition |
| T | Axe temporel ou axe de la séquence cible | Définition 2.1 |
| S | Axe de la séquence source (dans l’attention) | Équation (9) |
| D | Dimension du modèle ou d_model | Définition 7.1 |
| N | Dimension d’état/de caractéristique ou d_state | Équations (2) et (9) |
| P | Dimension de tête ou d_head | Définition 2.1 |
| H | Nombre de têtes ou n_head | Définition 7.1 |
| M | Matrice de transformation de séquence | Définition 2.3 |
| A | Matrice récurrente (d’état) du SSM discret | Équation (2) |
| B | Matrice de projection (d’expansion) de l’entrée du modèle d’espace d’état | Équation (2) |
| C | Matrice de projection (de contraction) de la sortie du modèle d’espace d’état | Équation (2) |
| X | Matrice d’entrée (forme (T,P)) | Équations (2) et (9) |
| Y | Matrice de sortie (forme (T,P)) | Équations (2) et (9) |
| Q | Matrice de requête d’attention | Équation (9) |
| K | Matrice de clé d’attention | Équation (9) |
| V | Matrice de valeur d’attention | Équation (9) |
| G | Matrice de Gram d’attention | QK^T (ou CB^T) |
| L | Matrice de masque (structuré) (triangulaire inférieure dans le cadre causal) | Définition 4.2 |
B Algorithmes efficaces pour le scan SSM scalaire (multiplication 1-SS)
Dans cette section, nous détaillons divers algorithmes pour calculer le scan SSM scalaire, sous l'angle des décompositions de matrices structurées. Le scan SSM scalaire est défini comme le calcul de la partie récurrente du SSM discret (7), dans le cas où (c'est-à-dire que est un scalaire). Il est couramment utilisé pour calculer les SSM de manière récurrente ; en particulier, le cas des SSM structurés où est à structure diagonale se réduit à cette opération, comme dans les modèles S5 (J. T. Smith, Warrington et Linderman 2023) et S6 (Gu et Dao 2023).
L'objectif de cette section est d'étayer un thème central de cet article : les algorithmes efficaces pour les modèles de séquence peuvent être considérés comme des algorithmes de multiplication de matrices structurées. Les diverses idées de décomposition matricielle présentées ici sont liées aux idées utilisées pour dériver des algorithmes SSM rapides (Section 6), ainsi qu'utilisées directement comme sous-routine.
B.1 Définition du problème
Soient et des séquences de scalaires. Le scan SSM scalaire est défini par
Ici, peut être une valeur arbitraire représentant l'état caché précédent de la récurrence SSM ; sauf indication contraire, nous supposons .
Nous appelons également l'équation (21) le cumprodsum (somme de produits cumulés). Notons que le cumprodsum se réduit au cumprod (produit cumulé) lorsque est l'élément neutre additif, et qu'il se réduit au cumsum (somme cumulée) lorsque est l'élément neutre multiplicatif.Enfin, notons que sous forme vectorisée, nous pouvons écrire
Autrement dit, il s'agit simplement du produit matrice-vecteur par une matrice 1-SS .
Par conséquent, nous avons trois façons de voir cette opération primitive fondamentale, toutes équivalentes :
- Un scan SSM (scalaire).- Un cumprodsum.- Une multiplication matrice-vecteur par une matrice 1-SS.
B.2 Algorithmes classiques
Nous décrivons d'abord les deux façons classiques de calculer le scan SSM (21), précédemment utilisées par des travaux antérieurs.
B.2.1 Récurrence séquentielle
Le mode récurrent calcule simplement (21) un pas de temps à la fois. Du point de vue de la multiplication 1-SS, cela a également été décrit dans la Section 3.4.1.
B.2.2 Scan associatif parallèle
Deuxièmement, une observation importante est que cette récurrence peut être transformée en un scan associatif (E. Martin et Cundy 2018 ; J. T. Smith, Warrington et Linderman 2023). Ce fait n'est pas complètement évident. Par exemple, S5 a défini l'opérateur de scan associatif correct, puis a démontré l'associativité de l'opérateur par un calcul mécanique.
Une manière légèrement plus claire de voir que cela est calculable avec un scan associatif consiste à transformer la récurrence à plusieurs termes en une récurrence à un seul terme sur un état caché de taille 2 au lieu de 1 :
Alors, calculer tous les équivaut à prendre les produits cumulés de ces matrices . Puisque la multiplication matricielle est associative, cela peut être calculé avec un scan associatif. L'opérateur binaire associatif est simplement la multiplication matricielle sur ces matrices particulières :
En égalant la première ligne, on obtient le même opérateur de scan associatif que celui défini par S5 :
La raison pour laquelle les scans associatifs sont importants est qu'ils peuvent être parallélisés à l'aide d'un algorithme de division pour régner (Blelloch 1990). Nous omettons les détails de cet algorithme et montrons plutôt que l'ensemble de l'algorithme de scan SSM associatif peut être dérivé de zéro à travers des décompositions matricielles (Annexe B.3.5).
B.3 Algorithmes efficaces via des décompositions de matrices structurées
Nous discutons de plusieurs algorithmes pour calculer le scan SSM, tous sous l'angle de la recherche de décompositions de matrices structurées de la matrice 1-SS . Ces algorithmes ou modes de calcul comprennentUn mode dilaté où l'information est propagée par pas de 1, 2, 4, 8, ... à la fois. Un mode de passage d'état où l'information est propagée vers l'avant par blocs. Un mode entièrement récurrent qui incrémente d'un pas à la fois, ce qui est un cas particulier du mode de passage d'état. Un mode parallèle par décomposition en blocs où est divisée en blocs hiérarchiques. Un mode scan où est divisée en blocs de taille égale et réduite récursivement.
B.3.1 Mode dilaté
Ce mode factorise la matrice 1-SS d'une manière particulière impliquant des « pas » croissants. Cela est mieux illustré par un exemple concret :
B.3.2 Mode de passage d'état (par blocs)
Ce mode peut être considéré comme une généralisation du mode récurrent standard où, au lieu de transmettre l'état récurrent une étape à la fois, nous calculons la réponse sur des blocs de longueur arbitraire et transmettons l'état à travers le bloc. Cela peut également être dérivé d'une simple décomposition en blocs de la matrice 1-SS.
Remarque 9. Bien que nous appelions cela « transmission d'état » pour désigner la manière dont les états sont transmis d'un segment local à un autre, cela est lié aux algorithmes « par blocs » (chunkwise) proposés par des modèles apparentés (Y. Sun et al. 2023 ; Yang et al. 2024).
Considérons le calcul de « par blocs » : pour un certain indice , nous voulons calculer , c'est-à-dire la sortie jusqu'à l'indice , et disposer d'un moyen de réduire le problème à un problème plus petit sur les indices .Nous écrivons sous la forme
1. Calculer la moitié gauche de la réponse \(h_{0:k}\) en utilisant n'importe quelle méthode souhaitée (c'est-à-dire l'une des méthodes de multiplication 1-SS de cette section).
2. Calculer l'état final \(h_{k - 1}\).
3. Incrémenter l'état d'une étape pour modifier \(b_{k}\).
4. Calculer la moitié droite de la réponse \(h_{k:T}\) en utilisant n'importe quelle méthode souhaitée.
En d'autres termes, nous calculons le sous-problème gauche comme une boîte noire, transmettons son état final au problème droit, et calculons le sous-problème droit comme une boîte noire.
L'utilité de cette méthode provient de contextes plus compliqués, comme dans le cas général -semi-séparable, et lorsque l'entrée possède une dimension « batch » supplémentaire (autrement dit, lorsqu'il s'agit d'une multiplication matrice-matrice plutôt que matrice-vecteur). Dans ce cas, nous pouvons utiliser un algorithme alternatif pour les blocs (correspondant à la multiplication matricielle par et ) qui ne matérialise pas les états cachés complets . Au lieu de cela, nous sautons les états cachés et calculons directement l'état final d'une manière alternative, puis « transmettons » l'état au bloc suivant.
Complexité. Cette méthode peut être très efficace en termes de travail, car les étapes 2-3 ne prennent qu'un temps constant. Par conséquent, en supposant que les deux sous-problèmes (étapes 1 et 4) sont en temps linéaire, la méthode entière prend un temps linéaire.
L'inconvénient est que cette méthode est également séquentielle.
B.3.3 Mode entièrement récurrent
Notons que le mode entièrement récurrent, où la récurrence est évoluée une étape à la fois (21), est simplement une instanciation du mode de transmission d'état avec une taille de bloc \(k = 1\).
B.3.4 Mode de décomposition en blocs (parallèle)
Celui-ci utilise la même décomposition matricielle que le mode de transmission d'état, mais calcule les sous-problèmes dans un ordre différent qui échange du calcul contre de la parallélisation.
Comme d'habitude, nous écrivons \(M\) sous la forme
L’observation clé est à nouveau que le quadrant inférieur gauche de est de rang 1. Outre l’inspection, une autre façon de le voir est d’utiliser le membre de droite (RHS), en observant que son quadrant inférieur gauche est une matrice de rang 1 triviale (elle est toute nulle sauf le coin supérieur droit qui vaut ), et en utilisant la formule d’inversion de Woodbury pour voir que le coin inférieur gauche du membre de gauche (LHS) doit aussi être de rang 1. Cela fournit également un moyen de déduire la factorisation de rang 1, qui peut être vérifiée par inspection :
Une seconde observation est que cette matrice est auto-similaire : toute sous-matrice principale a la même forme. En particulier, les quadrants supérieur gauche et inférieur droit sont tous deux des matrices 1-SS.
Cela fournit un moyen simple d’effectuer la multiplication matricielle par : récurser sur les deux moitiés (c’est-à-dire supérieure gauche et inférieure droite) en parallèle, puis tenir compte de la sous-matrice inférieure gauche. Cette étape de « combinaison » dans l’algorithme diviser-pour-régner est facile puisque la sous-matrice est de rang 1. Cela conduit à un algorithme parallèle.
Complexité. Comme l’algorithme de passage d’état, cette méthode utilise les mêmes décompositions en blocs des matrices semi-séparables à structure de rang. La différence est que nous récursons sur les deux sous-problèmes en parallèle, tandis que l’algorithme de passage d’état traite d’abord le sous-problème gauche puis le droit. Cela réduit la profondeur/portée de l’algorithme de linéaire à . Le compromis est que l’étape de combinaison (prise en compte de la sous-matrice inférieure gauche de rang 1) nécessite un travail linéaire au lieu d’un travail constant, de sorte que le travail total est au lieu de linéaire.
Notez aussi que dans la récursion, nous pouvons nous arrêter à tout moment et calculer les sous-problèmes de toute autre manière. C’est une idée principale derrière l’algorithme SSD (Section 6), où nous passons à la formulation duale d’attention quadratique sur de petits sous-problèmes.
B.3.5 Mode de balayage associatif
L’algorithme de passage d’état (par blocs) a un travail linéaire, mais implique aussi des opérations séquentielles.
Les modes de réduction par matrice en blocs et dilatés sont parallélisables : ils ont une profondeur/portée de . Cependant, ils effectuent un travail supplémentaire .
Comme noté dans l’annexe B.2.2, il existe un algorithme qui atteint à la fois une profondeur et un travail en exploitant l’algorithme de balayage associatif (aussi appelé balayage de préfixe) (Baker et al. 1996). Cet algorithme se voit le plus facilement depuis la vue SSM scan ou cumprodsum, et même alors il n’est pas évident : il nécessite de dériver séparément un opérateur associatif (22), puis d’exploiter l’algorithme de balayage parallèle/associatif/de préfixe comme une boîte noire (Blelloch 1990).
Nous montrons ici qu’il est en fait possible de dériver ce balayage parallèle en exploitant une décomposition matricielle différente :
Étape 2. Considérons maintenant chacun des blocs factorisés comme une matrice de rang 1 dans la partie strictement triangulaire inférieure de la matrice. Notez que chacun des vecteurs lignes du côté droit est le même que le vecteur ligne du bas dans le bloc diagonal de sa colonne : en particulier les lignes et .
Par conséquent, nous avons déjà les réponses à ceux-ci depuis l’étape 1, qui est le second élément de tous les sous-problèmes de l’étape 1. Si nous appelons ce tableau d’éléments (de moitié la taille de ), alors nous devons multiplier par la matrice 1-SS générée par .
Étape 3. Enfin, chacune des réponses de l’étape 2 peut être diffusée en deux réponses finales en multipliant par les vecteurs colonnes du côté gauche : en particulier les vecteurs , et .
Notez que cela peut être légèrement modifié avec un certain décalage de un des indices. Une façon équivalente de voir cet algorithme est comme la factorisation matricielle en trois étapes
IUE (VUI, VUCI, AIU RCI, OULCI).
À leur tour, celles-ci impliquent des propriétés de clôture des modèles d’espace d’état.
Par exemple, la propriété d’addition dit que la somme de deux modèles SSM parallèles est encore un SSM. La propriété de multiplication dit que composer séquentiellement ou chaîner deux SSM peut encore être vu comme un SSM, dont la taille totale d’état est additive — un fait quelque peu non trivial.
Enfin, la propriété d’inverse peut nous permettre de relier les SSM à d’autres types de modèles. Par exemple, on peut remarquer que les matrices à bandes sont semi-séparables, donc leurs inverses sont semi-séparables. (En fait, la famille de structures semi-séparables est souvent motivée par la prise d’inverses de matrices à bandes (Vandebril et al. 2005)). De plus, les propriétés de récurrence rapide des matrices semi-séparables peuvent être vues comme une conséquence du fait que leur inverse est à bandes.
Remarque 11. Le fait que les matrices 1-SS soient de simples récurrences (7) est équivalent au fait que l’inverse d’une matrice 1-SS est une matrice 2-bande :
Ainsi , ou
Ou élément par élément,
Inversement, nous utilisons aussi ces résultats de clôture pour prouver que l’attention structurée autorégressive (sous certaines hypothèses) doit être constituée de SSM, ce qui nous permet de montrer que des familles plus générales de modèles de séquence efficaces, y compris des variantes d’attention, peuvent être réduites à des modèles d’espace d’état (annexe C.2).
C.2 L’attention masquée autorégressive est une attention à structure semi-séparable
Nous démontrons le théorème 5.2 de la section 5.2. Dans la section 4.3, nous avons défini l’attention structurée comme une vaste généralisation de l’attention masquée, où la propriété d’efficacité (c.-à-d. une forme en temps linéaire pour l’attention à noyau) est abstraite en l’efficacité de la multiplication de matrices structurées. Cependant, au-delà de l’efficacité computationnelle, l’attention linéaire standard (Katharopoulos et al. 2020) possède également deux propriétés importantes. Premièrement, elle est causale, ce qui est requis pour des contextes tels que la modélisation autorégressive. De plus, elle dispose d’une génération autorégressive efficace. En d’autres termes, le coût d’une étape autorégressive – c.-à-d. le coût incrémental du calcul de la sortie après avoir vu , étant donné que a déjà été vu et prétraité – ne nécessite qu’un temps constant.
Nous caractérisons ici les instances de SMA qui ont une autorégression efficace.
Dans le cadre de la SMA, la causalité équivaut à la contrainte que le masque soit une matrice triangulaire inférieure.
Caractériser l’espace des matrices qui ont une autorégression efficace est plus difficile. Nous utiliserons une définition technique étroite des processus autorégressifs, dans l’esprit des définitions classiques de la littérature sur les séries temporelles (p. ex. les processus ARIMA (Box et al. 2015)).
Définition C.2. Nous définissons une transformation autorégressive d’ordre comme une transformation où chaque sortie ne dépend que de l’entrée courante et des dernières sorties :
Notons que le cas où est la matrice cumsum est un cas particulier avec et donc . Avec cette définition, la caractérisation de l’espace des transformations linéaires autorégressives efficaces découle des propriétés des matrices semi-séparables. Le théorème C.3 formalise et démontre le théorème 5.2.
Théorème C.3. Soit une transformation autorégressive efficace d’ordre . Alors est un modèle d’espace d’état d’ordre .
Preuve. Soient des séquences d’entrée et de sortie, de sorte que . En réarrangeant la définition (23),
En vectorisant sur , cela peut s'exprimer comme une transformation matricielle
La matrice diagonale des peut être déplacée vers la gauche et repliée dans la matrice des coefficients , qui reste une matrice triangulaire inférieure à bandes. Mais nous avons aussi , donc est l'inverse de cette matrice.
Ensuite, notons que les matrices à bandes sont -semi-séparables d'après la caractérisation par le rang de la semi-séparabilité (Définition 3.1). Par la Proposition C.1, l'inverse est donc au plus -semi-séparable. Une borne légèrement plus forte de peut être obtenue en raison de la structure supplémentaire des matrices à bandes. Enfin, la caractérisation de comme modèle d'espace d'état d'ordre découle du Théorème 3.5.
Autrement dit, l'attention autorégressive efficace est une SMA semi-séparable.
D Détails expérimentaux
D.1 Détails de MQAR
Nous utilisons une version plus difficile de la tâche introduite dans Based (Arora, Eyuboglu, Zhang, et al. 2024) où les tokens qui ne sont ni requête/clé/valeur sont remplacés par des tokens aléatoires. Nous utilisons également davantage de paires clé-valeur, des séquences plus longues et des tailles de modèle plus petites que la variante habituelle de MQAR utilisée par les travaux antérieurs, ce qui rend tous la tâche plus difficile.
Pour chaque longueur de séquence , nous utilisons paires clé-valeur. La taille totale du vocabulaire est de 8192.
Nous utilisons une forme d'entraînement par curriculum où l'entraînement parcourt cycliquement les jeux de données en utilisant paires clé-valeur, où chaque jeu de données contient exemples, pour un total de 8 époques sur chaque jeu de données (soit un total de exemples). La taille totale du lot est de tokens (par exemple pour , la taille du lot est de 256).
Toutes les méthodes utilisent 2 couches avec les paramètres par défaut ; la référence d'attention reçoit en outre des plongements positionnels. Pour chaque méthode, nous balayons les dimensions de modèle et les taux d'apprentissage . Nous utilisons un calendrier de décroissance linéaire qui diminue à chaque époque (par exemple la dernière époque aurait un taux d'apprentissage de du taux d'apprentissage maximal/initial).
D.2 Détails des lois d'échelle
Tous les modèles ont été entraînés sur le Pile. Pour les expériences sur les lois d'échelle, nous utilisons le tokenizer GPT2.
Tailles de modèle. Le tableau 9 spécifie les tailles de modèle que nous utilisons pour les lois d'échelle en suivant GPT3 (Brown et al. 2020). Premièrement, nous avons changé la taille de lot du modèle 1,3B de 1M de tokens à 0,5M de tokens pour uniformité. Deuxièmement, nous avons modifié le nombre d'étapes d'entraînement et le nombre total de tokens pour correspondre approximativement aux lois d'échelle Chinchilla (Hoffmann et al. 2022), qui spécifient que les tokens d'entraînement doivent augmenter proportionnellement à la taille du modèle.
Recettes d'entraînement. Tous les modèles ont utilisé l'optimiseur AdamW avec
- valeur d'écrêtage du gradient 1,0- décroissance des poids 0,1- pas de dropout- échauffement linéaire du taux d'apprentissage avec décroissance cosinusoïdale
| PARAMÈTRES | n_layers | d_model | n_heads / d_head | Étapes d'entraînement | Taux d'apprentissage | Taille de lot | Tokens |
| 125M | 12 | 768 | 12 / 64 | 4800 | 6e-4 | 0,5M de tokens | 2,5B |
| 350M | 24 | 1024 | 16 / 64 | 13500 | 3e-4 | 0,5M de tokens | 7B |
| 760M | 24 | 1536 | 16 / 96 | 29000 | 2,5e-4 | 0,5M de tokens | 15B |
| 1,3B | 24 | 2048 | 32 / 64 | 50000 | 2e-4 | 0,5M de tokens | 26B |
Par défaut, le taux d'apprentissage maximal est celui spécifié par GPT3.
Par rapport à la recette GPT3, nous utilisons une « recette améliorée », inspirée des changements adoptés par les grands modèles de langage populaires tels que PaLM (Chowdhery et al. 2023) et LLaMa (Touvron, Lavril, et al. 2023). Ceux-ci incluent :
- échauffement linéaire du taux d'apprentissage avec décroissance cosinusoïdale jusqu'à , avec une valeur maximale de la valeur GPT3
- pas de termes de biais linéaires
- RMSNorm au lieu de LayerNorm
- hyperparamètre AdamW (la valeur GPT3) au lieu de la valeur par défaut de PyTorch
D.3 Détails de l'évaluation en aval
Pour évaluer la performance en aval de modèles entièrement entraînés, nous entraînons Mamba- 2 sur 300B de tokens sur le Pile, en utilisant le tokenizer GPT- NeoX (Black et al. 2022).
Nous utilisons les mêmes hyperparamètres que pour les expériences de loi d'échelle, sauf avec une taille de lot de 1M pour les modèles 1,3B et 2,7B. Pour le modèle 2,7B, nous suivons également la spécification GPT3 (32 couches, dimension 2560).
Pour tous les modèles, nous utilisons 5 fois le taux d'apprentissage du modèle GPT3 correspondant.
Pour l'évaluation en aval, nous utilisons le harnais d'évaluation LM d'EleutherAI (L. Gao, Tow, et al. 2021), sur les mêmes tâches que Mamba (Gu et Dao 2023) avec une tâche supplémentaire :
- LAMBADA (Paperno et al. 2016)
- HellaSwag (Zellers et al. 2019)
- PIQA (Bisk et al. 2020)
- ARC-challenge (P. Clark et al. 2018)
- ARC-easy : un sous-ensemble facile d'ARC-challenge
- WinoGrande (Sakaguchi et al. 2021)
- OpenBookQA (Mihaylov et al. 2018)
D.4 Détails des ablations
Détails de (Re)Based. Nos ablations dans la section 9.4.3 ont considéré les modèles Based (Arora, Eyuboglu, Zhang, et al. 2024) et ReBased (Aksenov et al. 2024).
Based approxime le noyau exp par un développement de Taylor quadratique , ce qui peut être réalisé par l'application de caractéristiques
ReBased propose d'utiliser la feature map plus simple correspondant à la transformation de noyau , mais applique également une normalisation de couche au préalable. Nous considérons la normalisation de couche comme une activation non linéaire alternative à notre activation Swish par défaut, et réalisons une ablation des combinaisons de celles-ci.
| MODÈLE | TOKEN. | PILE PPL ↓ | LAMBADA PPL ↓ | LAMBADA ACC ↑ | HELLASWAG ACC ↑ | PIQA ACC ↑ | ARC-E ACC ↑ | ARC-C ACC ↑ | WINOGRANDE ACC ↑ | OPENBOOKQA ACC ↑ | ACC MOYENNE ↑ |
| Hybride H3-130M | GPT2 | — | 89,48 | 25,8 | 31,7 | 64,2 | 44,4 | 24,2 | 50,6 | 27,0 | 38,2 |
| Pythia-160M | NeoX | 29,64 | 38,10 | 33,0 | 30,2 | 61,4 | 43,2 | 24,1 | 51,9 | 29,2 | 39,0 |
| Mamba-130M | NeoX | 10,56 | 16,07 | 44,3 | 35,2 | 64,5 | 48,0 | 24,2 | 51,9 | 28,8 | 42,4 |
| Mamba-2-130M | NeoX | 10,48 | 16,86 | 43,9 | 35,3 | 64,9 | 47,4 | 24,2 | 52,1 | 30,6 | 42,6 |
| Hybride H3-360M | GPT2 | — | 12,58 | 48,0 | 41,5 | 68,1 | 51,4 | 24,7 | 54,1 | 31,6 | 45,6 |
| Pythia-410M | NeoX | 9,95 | 10,84 | 51,4 | 40,6 | 66,9 | 52,1 | 24,6 | 53,8 | 30,0 | 45,6 |
| Mamba-370M | NeoX | 8,28 | 8,14 | 55,6 | 46,5 | 69,5 | 55,1 | 28,0 | 55,3 | 30,8 | 48,7 |
| Mamba-2-370M | NeoX | 8,21 | 8,02 | 55,8 | 46,9 | 70,5 | 54,9 | 26,9 | 55,7 | 32,4 | 49,0 |
| Pythia-1B | NeoX | 7,82 | 7,92 | 56,1 | 47,2 | 70,7 | 57,0 | 27,1 | 53,5 | 31,4 | 49,0 |
| Mamba-790M | NeoX | 7,33 | 6,02 | 62,7 | 55,1 | 72,1 | 61,2 | 29,5 | 56,1 | 34,2 | 53,0 |
| Mamba-2-780M | NeoX | 7,26 | 5,86 | 61,7 | 54,9 | 72,0 | 61,0 | 28,5 | 60,2 | 36,2 | 53,5 |
| GPT-Neo 1,3B | GPT2 | — | 7,50 | 57,2 | 48,9 | 71,1 | 56,2 | 25,9 | 54,9 | 33,6 | 49,7 |
| Hybrid H3-1,3B | GPT2 | — | 11,25 | 49,6 | 52,6 | 71,3 | 59,2 | 28,1 | 56,9 | 34,4 | 50,3 |
| OPT-1,3B | OPT | — | 6,64 | 58,0 | 53,7 | 72,4 | 56,7 | 29,6 | 59,5 | 33,2 | 51,9 |
| Pythia-1,4B | NeoX | 7,51 | 6,08 | 61,7 | 52,1 | 71,0 | 60,5 | 28,5 | 57,2 | 30,8 | 51,7 |
| RWKV4-1,5B | NeoX | 7,70 | 7,04 | 56,4 | 52,5 | 72,4 | 60,5 | 29,4 | 54,6 | 34,0 | 51,4 |
| Mamba-1,4B | NeoX | 6,80 | 5,04 | 65,0 | 59,1 | 74,2 | 65,5 | 32,8 | 61,5 | 36,4 | 56,4 |
| Mamba-2-1,3B | NeoX | 6,66 | 5,02 | 65,7 | 59,9 | 73,2 | 64,3 | 33,3 | 60,9 | 37,8 | 56,4 |
| GPT-Neo 2,7B | GPT2 | — | 5,63 | 62,2 | 55,8 | 72,1 | 61,1 | 30,2 | 57,6 | 33,2 | 53,2 |
| Hybrid H3-2,7B | GPT2 | — | 7,92 | 55,7 | 59,7 | 73,3 | 65,6 | 32,3 | 61,4 | 33,6 | 54,5 |
| OPT-2,7B | OPT | — | 5,12 | 63,6 | 60,6 | 74,8 | 60,8 | 31,3 | 61,0 | 35,2 | 55,3 |
| Pythia-2,8B | NeoX | 6,73 | 5,04 | 64,7 | 59,3 | 74,0 | 64,1 | 32,9 | 59,7 | 35,2 | 55,7 |
| RWKV4-3B | NeoX | 7,00 | 5,24 | 63,9 | 59,6 | 73,7 | 67,8 | 33,1 | 59,6 | 37,0 | 56,4 |
| Mamba-2,8B | NeoX | 6,22 | 4,23 | 69,2 | 66,1 | 75,2 | 69,7 | 36,3 | 63,5 | 39,6 | 59,9 |
| Mamba-2-2,7B | NeoX | 6,09 | 4,10 | 69,7 | 66,6 | 76,4 | 69,6 | 36,4 | 64,0 | 38,8 | 60,2 |
| GPT-J-6B | GPT2 | — | 4,10 | 68,3 | 66,3 | 75,4 | 67,0 | 36,6 | 64,1 | 38,2 | 59,4 |
| OPT-6.7B | OPT | — | 4,25 | 67,7 | 67,2 | 76,3 | 65,6 | 34,9 | 65,5 | 37,4 | 59,2 |
| Pythia-6.9B | NeoX | 6,51 | 4,45 | 67,1 | 64,0 | 75,2 | 67,3 | 35,5 | 61,3 | 38,0 | 58,3 |
| RWKV4-7.4B | NeoX | 6,31 | 4,38 | 67,2 | 65,5 | 76,1 | 67,8 | 37,5 | 61,0 | 40,2 | 59,3 |
Notez que, comme celles-ci étendent la dimension des features, nous devons projeter vers des dimensions plus petites ; dans le Tableau 7, utilisez une taille d'état pour les modèles de 130M et pour les modèles de 380M. Pour les méthodes (Re)Based, nous projetons respectivement vers 8 et 16 dimensions avant d'appliquer leurs feature maps ; cela donne une taille d'état totale de pour ReBased et de pour Based dans le cas du modèle de 130M. Comme les projections et sont plus petites, ces méthodes utilisent moins de paramètres, et nous ajustons le nombre de couches en conséquence.