
Le modèle apprend à chercher en pleine réflexion et à réinjecter les résultats, entraîné par renforcement. COLM 2025, gratuit en ligne.
Search-R1: Training LLMs to Reason and Leverage Search Engines with Reinforcement Learning
Search-R1 : Entraîner les LLM à raisonner et à exploiter les moteurs de recherche avec l’apprentissage par renforcement
Bowen Jin , Hansi Zeng , Zhenrui Yue , Jinsung Yoon , Sercan Ö. Arik , Dong Wang , Hamed Zamani , Jiawei Han
Department of Computer Science, University of Illinois at Urbana- Champaign
Center for Intelligent Information Retrieval, University of Massachusetts Amherst
Google Cloud AI Research
{bowenj4, zhenrui3, dwang24, hanj}@illinois.edu, {hzeng, zamani}@cs.umass.edu {jinsungyoon, soarik}@google.com
Résumé
Acquérir efficacement des connaissances externes et des informations à jour est essentiel pour un raisonnement et une génération de texte efficaces dans les grands modèles de langage (LLM). Inviter des LLM avancés dotés de capacités de raisonnement à utiliser des moteurs de recherche pendant l’inférence est souvent sous-optimal, car le LLM pourrait ne pas posséder pleinement la capacité d’interagir de manière optimale avec le moteur de recherche. Cet article présente SEARCH- R1, une extension de l’apprentissage par renforcement (RL) pour les cadres de raisonnement, où le LLM apprend à générer de manière autonome (plusieurs) requêtes de recherche lors d’un raisonnement étape par étape avec récupération en temps réel. SEARCH- R1 optimise les trajectoires de raisonnement du LLM avec des interactions de recherche multi- tours, en tirant parti du masquage des tokens récupérés pour un entraînement RL stable et d’une simple fonction de récompense fondée sur le résultat. Des expériences sur sept jeux de données de réponse aux questions montrent que SEARCH- R1 améliore les performances de (Qwen2.5- 7B) et (Qwen2.5- 3B) par rapport à diverses références RAG dans le même cadre. Cet article fournit en outre des perspectives empiriques sur les méthodes d’optimisation RL, les choix de LLM et la dynamique de longueur des réponses dans le raisonnement augmenté par récupération. Le code et les points de contrôle des modèles sont disponibles à l’adresse https://github.com/PeterGriffinJin/Search- R1.
1 Introduction
Les grands modèles de langage (LLM) ont démontré des capacités remarquables en compréhension et génération du langage naturel (Hendrycks et al., 2020 ; Clark et al., 2018). Malgré ces réalisations, les LLM rencontrent souvent des difficultés lorsqu’ils sont chargés d’un raisonnement complexe (Wei et al., 2022) et de la récupération d’informations à jour auprès de sources externes (Jin et al., 2024). Pour remédier à ces limitations, il est nécessaire d’intégrer des capacités de raisonnement avancées (Huang & Chang, 2022) et la capacité d’interagir efficacement avec des moteurs de recherche afin de tirer le meilleur parti d’informations externes à jour (Schick et al., 2023).
Les approches existantes pour intégrer les LLM avec des moteurs de recherche relèvent généralement de deux catégories : (1) la génération augmentée par récupération (RAG) (Gao et al., 2023 ; Lewis et al., 2020) et (2) le traitement du moteur de recherche comme un outil (Yao et al., 2023 ; Schick et al., 2023). Les modèles RAG récupèrent souvent des passages en utilisant l’entrée du LLM comme requête et les intègrent dans le contexte du LLM pour la génération (Lewis et al., 2020). Cela permet au LLM de tirer parti de connaissances externes lorsqu’il répond à des questions. Bien que des travaux existants (Trivedi et al., 2022a) invitent le LLM à effectuer une récupération multi- tours et multi- requêtes, cette approche est sous-optimale car le LLM n’est pas optimisé pour apprendre à interagir efficacement avec les moteurs de recherche pendant l’entraînement. Alternativement, les LLM peuvent être invités ou entraînés à utiliser des outils, y compris des moteurs de recherche, dans le cadre de leur processus de raisonnement (Qu et al., 2025 ; Trivedi et al., 2022a). Cependant, les approches fondées sur l’invite ont souvent du mal à généraliser, car certaines tâches peuvent ne pas avoir été rencontrées lors du pré- entraînement du LLM. En revanche, les approches fondées sur l’entraînement offrent une plus grande adaptabilité, mais sont difficiles à mettre à l’échelle efficacement en raison de leur dépendance à des trajectoires annotées à grande échelle et de haute qualité, ainsi que de la non- différentiabilité inhérente de l’opération de recherche, ce qui rend l’optimisation de bout en bout par descente de gradient inapplicable (Schick et al., 2023 ; Asai et al., 2024).
L’apprentissage par renforcement (RL) (Sutton et al., 1999 ; Kaelbling et al., 1996) est apparu comme un paradigme puissant pour améliorer les capacités de raisonnement des LLM (Guo et al., 2025 ; Hou et al., 2025 ; Xie et al., 2025 ; Kumar et al., 2024). Notamment, des modèles comme OpenAI- 01 (Jaech et al., 2024) et DeepSeek- R1 (Guo et al., 2025) ont tiré parti de techniques de RL (par exemple, PPO (Schulman et al., 2017) et GRPO (Shao et al., 2024)) pour améliorer l’inférence logique et les compétences de résolution de problèmes en apprenant de l’expérience et des retours. Avec le RL, même lorsqu’ils sont entraînés uniquement sur les récompenses de résultat, les modèles apprennent des capacités de raisonnement complexes, notamment l’auto- vérification (Weng et al., 2022) et l’auto- correction (Kumar et al., 2024). Cependant, appliquer le RL aux scénarios de recherche et de raisonnement présente trois défis clés : (1) Cadre RL et stabilité – Il reste incertain comment intégrer efficacement le moteur de recherche dans les approches RL pour les LLM tout en garantissant une optimisation stable, en particulier lors de l’incorporation du contexte récupéré. (2) Raisonnement et recherche entrelacés multi- tours – Idéalement, le LLM devrait être capable d’un raisonnement itératif et d’appels au moteur de recherche, en ajustant dynamiquement la stratégie de récupération en fonction de la complexité du problème. (3) Conception de la récompense – Concevoir une fonction de récompense efficace pour les tâches de recherche et de raisonnement reste un défi fondamental, car il n’est pas clair si de simples récompenses fondées sur le résultat suffisent à guider le LLM pour apprendre des comportements de recherche significatifs et cohérents.
Pour relever les défis susmentionnés, nous introduisons SEARCH- R1, un nouveau cadre RL qui permet aux LLM d’interagir avec des moteurs de recherche de manière entrelacée avec leur propre raisonnement. Plus précisément, SEARCH- R1 introduit les innovations clés suivantes : (1) Nous modélisons le moteur de recherche comme faisant partie de l’environnement, permettant d’échantillonner des séquences de trajectoires qui entrelacent la génération de tokens du LLM avec les récupérations du moteur de recherche. SEARCH- R1 est compatible avec divers algorithmes RL, notamment PPO et GRPO, et nous appliquons le masquage des tokens récupérés pour garantir une optimisation stable. (2) SEARCH- R1 prend en charge la récupération et le raisonnement multi- tours, en invoquant des appels de recherche lorsqu’ils sont explicitement déclenchés par les tokens <search> et </search>. Le contenu récupéré est enfermé dans les tokens <information> et </information>, tandis que les étapes de raisonnement du LLM sont encapsulées dans les tokens <think> et </think>. La réponse finale est formatée à l’aide des tokens <answer> et </answer>, permettant une prise de décision structurée et itérative. (3) Nous adoptons une fonction de récompense simple fondée sur le résultat, en évitant la complexité des récompenses fondées sur le processus. Nos résultats démontrent que cette conception minimale de la récompense est efficace dans les scénarios de recherche et de raisonnement. Ainsi, SEARCH- R1 peut être considéré comme une extension de DeepSeek- R1 Zero (Guo et al., 2025), qui se concentre principalement sur le raisonnement paramétrique en introduisant un entraînement RL augmenté par recherche pour une prise de décision renforcée guidée par la récupération.
En résumé, nos contributions clés sont triples :
- Notre travail analyse les défis et fournit des perspectives sur la mise en œuvre du RL pour améliorer la manière dont les LLM raisonnent à l’aide des résultats de moteurs de recherche.
- Nous proposons SEARCH-R1, un nouveau cadre RL qui prend en charge les rollouts de LLM et l’optimisation directe avec un moteur de recherche, y compris le masquage des tokens récupérés pour stabiliser l’entraînement RL, le raisonnement et la recherche entrelacés multi-tours pour soutenir la résolution de tâches complexes, et une fonction de récompense de résultat efficace.
- Nous menons des expériences systématiques pour démontrer l’efficacité de SEARCH-R1, avec deux LLM atteignant des améliorations relatives moyennes respectives de 41 % et 20 % par rapport aux références RAG dans la même configuration expérimentale (par exemple, même modèle de récupération, mêmes données d’entraînement et mêmes LLM pré-entraînés). En outre, nous fournissons des perspectives sur le RL pour les paramètres de raisonnement et de recherche, y compris la sélection de la méthode RL, différents choix de LLM et une étude de la longueur des réponses..
2 Travaux liés
2.1 Grands modèles de langage et récupération
Malgré des capacités de raisonnement (Guo et al., 2025) et de codage (Guo et al., 2024) remarquables, les LLM (Zhao et al., 2023 ; Team, 2024 ; Achiam et al., 2023) manquent souvent de connaissances spécifiques à un domaine (Peng et al., 2023 ; Li et al., 2023) et sont sujets aux hallucinations (Zhang et al., 2023). Pour atténuer ces limitations, les moteurs de recherche (Zhao et al., 2024) sont largement intégrés afin de fournir des informations externes. Il existe deux principales manières d'intégrer les moteurs de recherche aux LLM : (1) la génération augmentée par récupération (RAG) (Gao et al., 2023) et (2) le traitement des moteurs de recherche comme des outils (Schick et al., 2023). La RAG (Lewis et al., 2020 ; Yue et al., 2024 ; Xiong et al., 2025) suit généralement un pipeline composé d'une étape de récupération suivie d'une génération séquentielle, où un moteur de recherche récupère des informations pertinentes en fonction de la requête d'entrée, lesquelles sont ensuite concaténées avec la requête et fournies au LLM. Toutefois, cette approche peut se heurter à des difficultés liées à la récupération d'informations non pertinentes (Jin et al., 2024) et à l'incapacité de fournir un contexte suffisamment utile (Jiang et al., 2023). Une approche alternative consiste à utiliser la recherche comme outil (search-as-a-tool), où les LLM sont incités par des prompts ou affinés pour interagir avec des moteurs de recherche. IRCoT (Trivedi et al., 2022a) et ReAct (Yao et al., 2023) utilisent le prompting pour guider un raisonnement itératif et des appels au moteur de recherche, tandis que Toolformer (Schick et al., 2023) s'appuie sur un affinage supervisé pour améliorer les capacités de recherche. Cependant, de telles méthodes reposent sur des trajectoires étiquetées de haute qualité, difficiles à obtenir à grande échelle. Des travaux récents (Guo et al., 2025) suggèrent que l'apprentissage par renforcement (RL) peut permettre aux LLM de développer des compétences de raisonnement avancées en n'utilisant que des récompenses de résultat, mais son potentiel dans les scénarios d'appel à des moteurs de recherche reste sous-exploré.
2.2 Grands modèles de langage et apprentissage par renforcement
L'apprentissage par renforcement (RL) (Kaelbling et al., 1996) est un paradigme d'apprentissage dans lequel un agent apprend à prendre des décisions séquentielles en interagissant avec un environnement et en recevant un retour sous forme de récompenses, dans le but de maximiser la récompense cumulée au fil du temps (Sutton et al., 1999). Le RL a été introduit dans le réglage des LLM par Ouyang et al. (2022) via le RL à partir du retour humain (RLHF) (Kaufmann et al., 2023). Cette approche consiste d'abord à entraîner un modèle de récompense à l'aide de données de préférences humaines (Lambert et al., 2024), qui guide ensuite le réglage par RL du LLM politique, généralement via l'optimisation proximale de la politique (PPO). Cependant, la PPO implique plusieurs cycles d'optimisation du LLM, ce qui la rend difficile à mettre en œuvre. Pour simplifier le réglage par RL, des méthodes d'optimisation directe telles que l'optimisation directe des préférences (DPO) (Rafailov et al., 2023) et SimPO (Meng et al., 2024) ont été proposées. Une approche similaire est employée dans LeRet (Hsu et al., 2024), où les LLM sont entraînés à explorer diverses requêtes afin d'améliorer l'efficacité de la récupération d'informations. Bien que ces méthodes offrent une efficacité computationnelle, elles souffrent de problèmes de hors-politique (off-policy) (Pang et al., 2024) et ne correspondent pas systématiquement aux performances des approches de RL pur. Parmi les solutions alternatives figurent l'optimisation de la politique relative de groupe (GRPO) (Shao et al., 2024), qui élimine le besoin d'un modèle critique en estimant des références à partir des scores de groupe, et RLOO (Ahmadian et al., 2024), qui introduit un cadre d'optimisation simplifié de type REINFORCE (Williams, 1992). Malgré ces avancées, l'application du RL aux interactions avec les moteurs de recherche et au raisonnement pilotés par les LLM reste largement inexplorée.
3 Recherche-R1
Dans les sections suivantes, nous présentons la conception détaillée des méthodes d'entraînement de SEARCH-R1, couvrant (1) l'extension de l'apprentissage par renforcement (RL) pour utiliser les moteurs de recherche ; (2) la génération de texte avec un appel de moteur de recherche multi-tours entrelacé ; (3) le modèle d'entraînement ; et (4) la conception du modèle de récompense.
3.1 Apprentissage par renforcement avec un moteur de recherche
Nous formulons la fonction objectif du RL en utilisant un moteur de recherche comme suit :
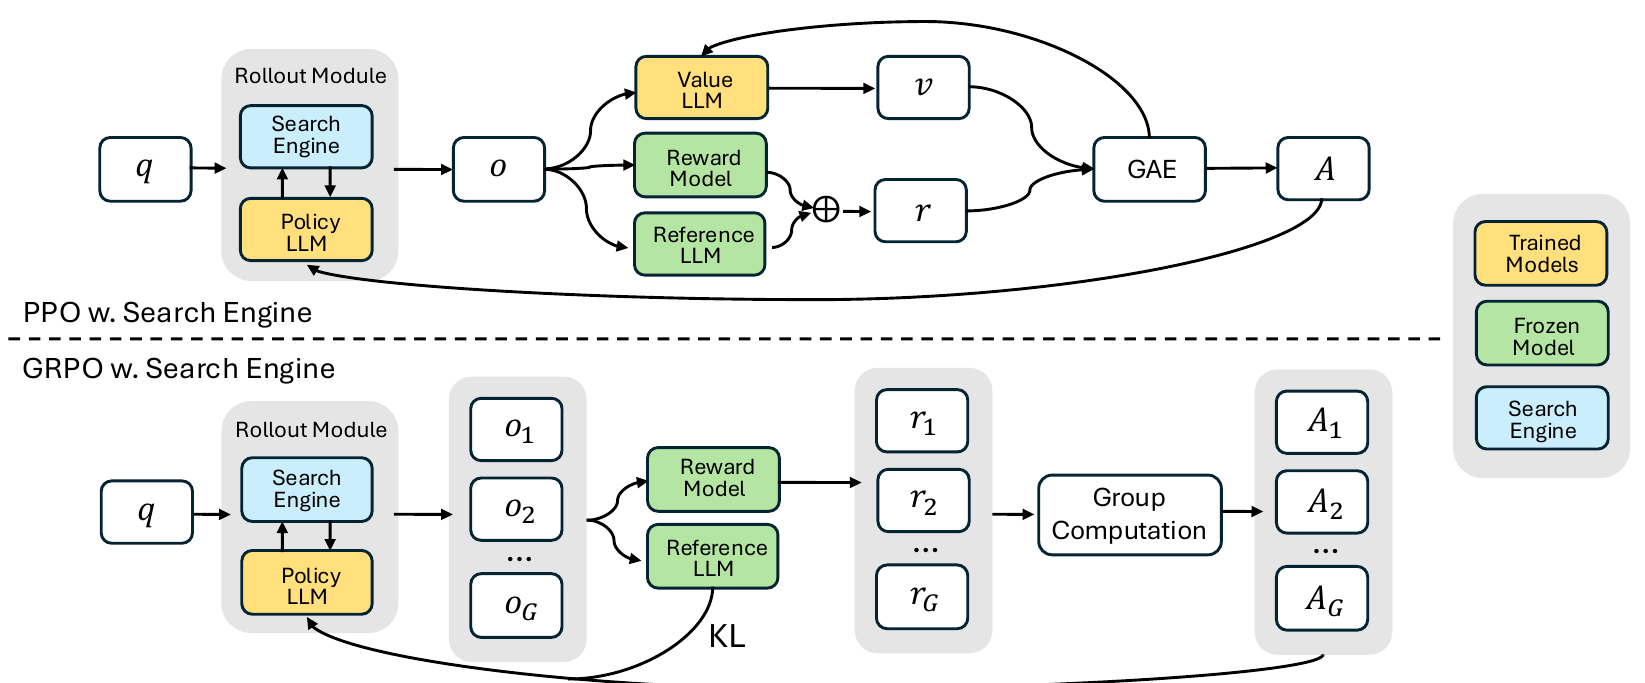
où est le LLM de politique, est le LLM de référence, est la fonction de récompense et est la mesure de divergence KL. désigne les échantillons d'entrée tirés du jeu de données , et représente les sorties générées entrelacées avec les résultats d'appels au moteur de recherche, échantillonnées à partir de la politique de référence et récupérées auprès du moteur de recherche . Contrairement aux approches RL antérieures qui reposent principalement sur le LLM de politique pour générer des séquences de rollout (Rafailov et al., 2023 ; Ouyang et al., 2022), notre cadre intègre explicitement le raisonnement entrelacé avec la récupération via , qui peut être vu comme , où désigne la récupération et le raisonnement entrelacés. Cela permet une prise de décision plus efficace dans les tâches à forte intensité de raisonnement qui nécessitent une récupération d'informations externes. Une illustration du processus de rollout et une explication de l'équation 1 sont fournies à la section 3.2 et à l'annexe A.
Notre approche s'appuie sur deux méthodes RL de gradient de politique bien établies : l'optimisation de politique proximale (PPO) (Schulman et al., 2017) et l'optimisation de politique relative de groupe (GRPO) (Shao et al., 2024 ; Guo et al., 2025), en tirant parti de leurs avantages respectifs pour optimiser le raisonnement augmenté par la récupération.
Masquage de perte pour les tokens récupérés. Dans PPO et GRPO, les pertes au niveau des tokens sont calculées sur l'ensemble de la séquence de rollout. Dans SEARCH-R1, la séquence de rollout se compose à la fois de tokens générés par le LLM et de tokens récupérés à partir de passages externes. Alors que l'optimisation des tokens générés par le LLM améliore la capacité du modèle à interagir avec le moteur de recherche et à effectuer un raisonnement, l'application de la même optimisation aux tokens récupérés peut conduire à des dynamiques d'apprentissage non intentionnelles. Pour y remédier, nous introduisons un masquage de perte pour les tokens récupérés, garantissant que l'objectif de gradient de politique est calculé uniquement sur les tokens générés par le LLM, en excluant le contenu récupéré du processus d'optimisation. Cette approche stabilise l'entraînement tout en préservant la flexibilité de la génération augmentée par la recherche.
PPO avec moteur de recherche. L'optimisation de politique proximale (PPO) (Schulman et al., 2017) est une approche RL acteur-critique populaire couramment utilisée pour les LLM (Ouyang et al., 2022). Pour nos scénarios de raisonnement impliquant un appel à un moteur de recherche, elle optimise les LLM en maximisant l'objectif suivant :
où et représentent respectivement les modèles de politique actuels et précédents. est l'opération de masquage de perte des tokens telle que si est un token généré par le LLM et si est un token récupéré. Le terme est un hyperparamètre lié au clipping introduit dans PPO pour stabiliser l'entraînement. L'estimation de l'avantage est calculée à l'aide de l'estimation généralisée de l'avantage (GAE) (Schulman et al., 2015), sur la base des récompenses futures et d'une fonction de valeur apprise .
GRPO avec moteur de recherche. Pour améliorer la stabilité de l'optimisation de la politique et éviter le besoin d'une approximation supplémentaire de la fonction de valeur, l'optimisation de politique relative de groupe (GRPO) est introduite dans Shao et al. (2024). GRPO diffère de PPO en exploitant la récompense moyenne de plusieurs sorties échantillonnées comme référence plutôt qu'en s'appuyant sur une fonction de valeur apprise. Plus précisément, pour chaque question d'entrée , GRPO échantillonne un groupe de réponses à partir de la politique de référence . Le modèle de politique est ensuite optimisé en maximisant la fonction objectif suivante :
où et sont des hyperparamètres, et représente l'avantage, calculé sur la base des récompenses relatives des sorties au sein de chaque groupe. Cette approche évite d'introduire une complexité supplémentaire dans le calcul de . De plus, au lieu d'incorporer la divergence KL comme pénalité dans la fonction de récompense, GRPO régularise en ajoutant directement la divergence KL entre la politique entraînée et la politique de référence à la fonction de perte. Le masquage des tokens récupérés est également appliqué lors du calcul de la perte de divergence KL .
3.2 Génération avec appel multi-tours à un moteur de recherche
Dans cette section, nous décrivons le processus de rollout pour la génération de réponses du LLM avec des appels multi-tours entrelacés au moteur de recherche, formulé comme suit : .
Notre approche suit un cadre itératif dans lequel le LLM alterne entre la génération de texte et les requêtes vers un moteur de recherche externe. Plus précisément, l'instruction système guide le LLM à encapsuler sa requête de recherche entre deux jetons d'appel de recherche désignés, <search> et </search>, chaque fois qu'une récupération externe est nécessaire. Lorsque ces jetons sont détectés dans la séquence générée, le système extrait la requête de recherche, interroge le moteur de recherche et récupère les résultats pertinents. Les informations récupérées sont ensuite encadrées par des jetons de récupération spéciaux, <information> et </information>, et ajoutées à la séquence de déroulement en cours, servant de contexte supplémentaire pour l'étape de génération suivante. Ce processus se poursuit de manière itérative jusqu'à ce que l'une des conditions suivantes soit remplie : (1) le nombre maximal d'actions est atteint, ou (2) le modèle génère une réponse finale, qui est encadrée entre des jetons de réponse désignés, <answer> et </answer>. Le déroulement complet est décrit dans l'algorithme 1.
3.3 Modèle d'entraînement
Pour entraîner SEARCH- R1, nous commençons par concevoir un modèle simple qui amène le LLM initial à suivre nos instructions prédéfinies. Comme le montre le tableau 1, ce modèle structure la sortie du modèle en trois parties de manière itérative : d'abord, un processus de raisonnement, ensuite un appel de fonction au moteur de recherche, et enfin, la réponse. Nous limitons délibérément nos contraintes à ce format structurel, en évitant tout biais spécifique au contenu, tel que l'imposition d'un raisonnement réflexif et d'un appel au moteur de recherche ou l'approbation d'approches spécifiques de résolution de problèmes. Cela garantit que la dynamique d'apprentissage naturelle du modèle pendant le processus de RL reste observable et non biaisée.
Répondez à la question donnée. Vous devez effectuer un raisonnement à l'intérieur de <think> et </think> d'abord chaque fois que vous obtenez de nouvelles informations. Après le raisonnement, si vous constatez qu'il vous manque certaines connaissances, vous pouvez appeler un moteur de recherche par <search> requête </search>, et il renverra les meilleurs résultats recherchés entre <information> et </information>. Vous pouvez effectuer autant de recherches que vous le souhaitez. Si vous constatez qu'aucune connaissance externe supplémentaire n'est nécessaire, vous pouvez directement fournir la réponse à l'intérieur de <answer> et </answer> sans illustrations détaillées. Par exemple, <answer> xxx </answer>. Question : question.
Tableau 1 : Modèle pour SEARCH- R1. question sera remplacé par la question spécifique pendant l'entraînement et l'inférence.Requiert : requête d'entrée , modèle de politique , moteur de recherche , budget maximal d'actions .
Garantit : réponse finale .
1: Initialiser la séquence de déroulement
2: Initialiser le compteur d'actions
3: while do
4: Initialiser la séquence de déroulement LLM de l'action courante
5: while True do
6: Générer le jeton de réponse
7: Ajouter à la séquence de déroulement
8: if in [</search>,</answer>,<eos>] then break
9 : fin si
10 : fin tant que
11 :
12 : si <search> </search> détecté dans alors
13 : Extraire la requête de recherche
14 : Récupérer les résultats de recherche
15 : Insérer dans le rollout
16 : sinon si <answer> </answer> détecté dans alors
17 : retourner la réponse finale générée
18 : sinon
19 : Demander une reconsidération action is not correct. Let me rethink."
20 : fin si
21 : Incrémenter le compteur d'actions
22 : fin tant que
23 : retourner la réponse finale générée
3.4 Modélisation de la récompense
La fonction de récompense constitue le principal signal d'entraînement, guidant le processus d'optimisation en RL. Pour entraîner SEARCH-R1, nous adoptons un système de récompense basé sur des règles, composé uniquement de récompenses liées au résultat final, qui évaluent la justesse de la réponse du modèle. Par exemple, dans les tâches de raisonnement factuel, la justesse peut être évaluée à l'aide de critères basés sur des règles, tels que la correspondance exacte de chaînes :
où est la réponse finale extraite de la réponse et est la réponse de référence. Contrairement à Guo et al. (2025), nous n'intégrons pas de récompenses de format, car notre modèle appris démontre déjà une forte adhésion structurelle. Nous laissons l'exploration de récompenses de format plus complexes pour des travaux futurs. De plus, nous évitons d'entraîner des modèles de récompense neuronaux, à l'instar de Guo et al. (2025). Cette décision est motivée par la sensibilité des LLM à des formes spécifiques de récompenses dans le RL à grande échelle, ainsi que par le coût computationnel et la complexité supplémentaires introduits par le réentraînement de ces modèles.
4 Résultats principaux
4.1 Jeux de données
Nous évaluons SEARCH-R1 sur sept jeux de données de référence, classés comme suit : (1) Questions-réponses générales : NQ (Kwiatkowski et al., 2019), TriviaQA (Joshi et al., 2017) et PopQA (Mallen et al., 2022). (2) Questions-réponses multi-sauts : HotpotQA (Yang et al., 2018), 2WikiMultiHopQA (Ho et al., 2020), Musique (Trivedi et al., 2022b) et Bamboogle (Press et al., 2022). Ces jeux de données couvrent un éventail diversifié de défis de recherche avec raisonnement, permettant une évaluation complète de SEARCH-R1.
4.2 Modèles de référence
Pour évaluer l'efficacité de SEARCH-R1, nous le comparons aux modèles de référence suivants : (1) Inférence sans récupération : inférence directe et raisonnement en chaîne de pensée (CoT) (Wei et al., 2022). (2) Inférence avec récupération : génération augmentée par récupération (RAG) (Lewis et al., 2020), IRCoT (Trivedi et al., 2022a) et Search-o1 (Li et al., 2025). (3) Méthodes basées sur le fine-tuning : fine-tuning supervisé (SFT) (Chung et al., 2024), fine-tuning basé sur le RL sans moteur de recherche (R1) (Guo et al., 2025) et échantillonnage par rejet (Ahn et al., 2024) avec un moteur de recherche. Pour R1, nous entraînons les LLM avec les méthodes RL proposées dans Guo et al. (2025) avec nos données afin d'obtenir une comparaison équitable avec SEARCH-R1. Cela ne contient que des étapes de raisonnement et de réponse sans moteur de recherche. Pour l'échantillonnage par rejet, nous générons cinq réponses candidates par invite d'entraînement à partir du même jeu de données avec les LLM instruits et sélectionnons celles qui conduisent à des réponses finales correctes. Ces trajectoires sélectionnées sont ensuite utilisées pour construire un nouvel ensemble d'entraînement qui conserve le même mécanisme de déroulement d'interaction multi-tours LLM-moteur de recherche proposé dans SEARCH-R1 pour affiner les LLM.
Ces modèles de référence couvrent un large spectre d'approches de récupération augmentée et de fine-tuning, permettant une évaluation complète de SEARCH-R1 dans des contextes de récupération zero-shot et apprise. Pour établir une comparaison équitable entre les différentes méthodes, nous utilisons le même récupérateur, le même nombre de documents récupérés, le même corpus de connaissances, les mêmes données d'entraînement et les mêmes LLM pré-entraînés. Les détails se trouvent en annexe B.
4.3 Configuration expérimentale
Nous menons des expériences avec deux types de modèles : Qwen-2.5-3B (Base/Instruct) et Qwen-2.5-7B (Base/Instruct) (Yang et al., 2024). Pour la récupération, nous utilisons le dump Wikipédia de 2018 (Karpukhin et al., 2020) comme source de connaissances et E5 (Wang et al., 2022) comme récupérateur. Afin d'assurer une comparaison équitable, nous suivons Lin et al. (2023) et fixons le nombre de passages récupérés à 3 pour toutes les méthodes basées sur la récupération. Une étude du nombre de passages récupérés se trouve en annexe G.
Pour l'entraînement, nous fusionnons les ensembles d'entraînement de NQ et HotpotQA afin de former un jeu de données unifié pour SEARCH-R1 et les autres modèles de référence basés sur le fine-tuning. L'évaluation est menée sur les ensembles de test ou de validation de sept jeux de données afin d'évaluer les performances en domaine et hors domaine. La correspondance exacte (EM) est utilisée comme métrique d'évaluation, à l'instar de Yu et al. (2024). Pour les modèles de référence de type inférence, nous utilisons des modèles instruct, car les modèles de base ne parviennent pas à suivre les instructions. Pour les méthodes de réglage RL, les expériences sont menées sur des modèles de base et instruct. Plus de détails sur les paramètres expérimentaux se trouvent en annexe B.
Sauf indication contraire, PPO est utilisé comme méthode RL par défaut, et une comparaison détaillée entre PPO et GRPO est fournie dans la section 5.1.
4.4 Performances
Les résultats principaux comparant SEARCH-R1 aux méthodes de référence sur les sept jeux de données sont présentés dans le tableau 2. À partir des résultats, nous faisons les observations clés suivantes : (1) SEARCH-R1 surpasse systématiquement les méthodes de référence fortes. Nous obtenons une amélioration relative moyenne de et avec Qwen2.5-7B et Qwen2.5-3B, respectivement. Ces gains se maintiennent à la fois en évaluation en distribution (c'est-à-dire NQ et HotpotQA) et en évaluation hors distribution (c'est-à-dire TriviaQA, PopQA, 2WikiMultiHopQA, Musique et Bamboogle). (2) SEARCH-R1 surpasse l'entraînement RL pour le raisonnement des LLM sans récupération (R1). Cela correspond aux attentes, car l'intégration de la recherche dans le raisonnement des LLM donne accès à des connaissances externes pertinentes, améliorant les performances globales. (3) SEARCH-R1 est efficace à la fois pour les modèles de base et pour les modèles ajustés aux instructions. Cela démontre que le RL de style DeepSeek-R1-Zero avec des récompenses basées sur les résultats (Guo et al., 2025) peut être appliqué avec succès au raisonnement avec recherche, au-delà de son efficacité précédemment établie dans des scénarios de raisonnement pur. (4) Les modèles plus grands apprennent mieux à effectuer des recherches. SEARCH-R1 sur le modèle 7B montre un « écart de performance » beaucoup plus important par rapport au modèle 3B (par exemple, par rapport au deuxième meilleur modèle – RAG).
| Méthodes | QA générale | QA multi-sauts | ||||||
| NQ+ | TriviaQA+ | PopQA+ | HotpotQA+ | 2wiki+ | Musique+ | Bamboolle+ | Moy. | |
| Qwen2.5-7b-Base/Instruct | ||||||||
| Inférence directe | 0,134 | 0,408 | 0,140 | 0,183 | 0,250 | 0,031 | 0,120 | 0,181 |
| CoT | 0,048 | 0,185 | 0,054 | 0,092 | 0,111 | 0,022 | 0,232 | 0,106 |
| IRCoT | 0,224 | 0,478 | 0,301 | 0,133 | 0,149 | 0,072 | 0,224 | 0,239 |
| Search-o1 | 0,151 | 0,443 | 0,131 | 0,187 | 0,176 | 0,058 | 0,296 | 0,206 |
| RAG | 0,349 | 0,585 | 0,392 | 0,299 | 0,235 | 0,058 | 0,208 | 0,304 |
| SFT | 0,318 | 0,354 | 0,121 | 0,217 | 0,259 | 0,066 | 0,112 | 0,207 |
| R1-base | 0,297 | 0,539 | 0,202 | 0,242 | 0,273 | 0,083 | 0,296 | 0,276 |
| R1-instruct | 0,270 | 0,537 | 0,199 | 0,237 | 0,292 | 0,072 | 0,293 | 0,271 |
| Échantillonnage par rejet | 0,360 | 0,592 | 0,380 | 0,331 | 0,296 | 0,123 | 0,355 | 0,348 |
| Search-R1-base | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 | 0,431 |
| Search-R1-instruct | 0,393 | 0,610 | 0,397 | 0,370 | 0,414 | 0,146 | 0,368 | 0,385 |
| Qwen2.5-3b-Base/Instruct | ||||||||
| Inférence directe | 0,106 | 0,288 | 0,108 | 0,149 | 0,244 | 0,020 | 0,024 | 0,134 |
| CoT | 0,023 | 0,032 | 0,005 | 0,021 | 0,021 | 0,002 | 0,000 | 0,015 |
| IRCoT | 0,111 | 0,312 | 0,200 | 0,164 | 0,171 | 0,067 | 0,240 | 0,181 |
| Search-o1 | 0,238 | 0,472 | 0,262 | 0,221 | 0,218 | 0,054 | 0,320 | 0,255 |
| RAG | 0,348 | 0,544 | 0,387 | 0,255 | 0,226 | 0,047 | 0,080 | 0,270 |
| SFT | 0,249 | 0,292 | 0,104 | 0,186 | 0,248 | 0,044 | 0,112 | 0,176 |
| R1-base | 0,226 | 0,455 | 0,173 | 0,201 | 0,268 | 0,055 | 0,224 | 0,229 |
| R1-instruct | 0,210 | 0,449 | 0,171 | 0,208 | 0,275 | 0,060 | 0,192 | 0,224 |
| Rejection Sampling | 0,294 | 0,488 | 0,332 | 0,240 | 0,233 | 0,059 | 0,210 | 0,265 |
| Search-R1-base | 0,406 | 0,587 | 0,435 | 0,284 | 0,273 | 0,049 | 0,088 | 0,303 |
| Search-R1-instruct | 0,341 | 0,545 | 0,378 | 0,324 | 0,319 | 0,103 | 0,264 | 0,325 |
| Méthode | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboolle | Moy. |
| Qwen2.5-7b-Base/Instruct | ||||||||
| SEARCH-R1-base (GRPO) | 0,395 | 0,560 | 0,388 | 0,326 | 0,297 | 0,125 | 0,360 | 0,350 |
| SEARCH-R1-instruct (GRPO) | 0,429 | 0,623 | 0,427 | 0,386 | 0,346 | 0,162 | 0,400 | 0,396 |
| SEARCH-R1-base (PPO) | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 | 0,431 |
| SEARCH-R1-instruct (PPO) | 0,393 | 0,610 | 0,397 | 0,370 | 0,414 | 0,146 | 0,368 | 0,385 |
| Qwen2.5-3b-Base/Instruct | ||||||||
| SEARCH-R1-base (GRPO) | 0,421 | 0,583 | 0,413 | 0,297 | 0,274 | 0,066 | 0,128 | 0,312 |
| SEARCH-R1-instruct (GRPO) | 0,397 | 0,565 | 0,391 | 0,331 | 0,310 | 0,124 | 0,232 | 0,336 |
| SEARCH-R1-base (PPO) | 0,406 | 0,587 | 0,435 | 0,284 | 0,273 | 0,049 | 0,088 | 0,303 |
| SEARCH-R1-instruct (PPO) | 0,341 | 0,545 | 0,378 | 0,324 | 0,319 | 0,103 | 0,264 | 0,325 |
5 Analyse
5.1 Différentes méthodes RL : PPO vs GRPO
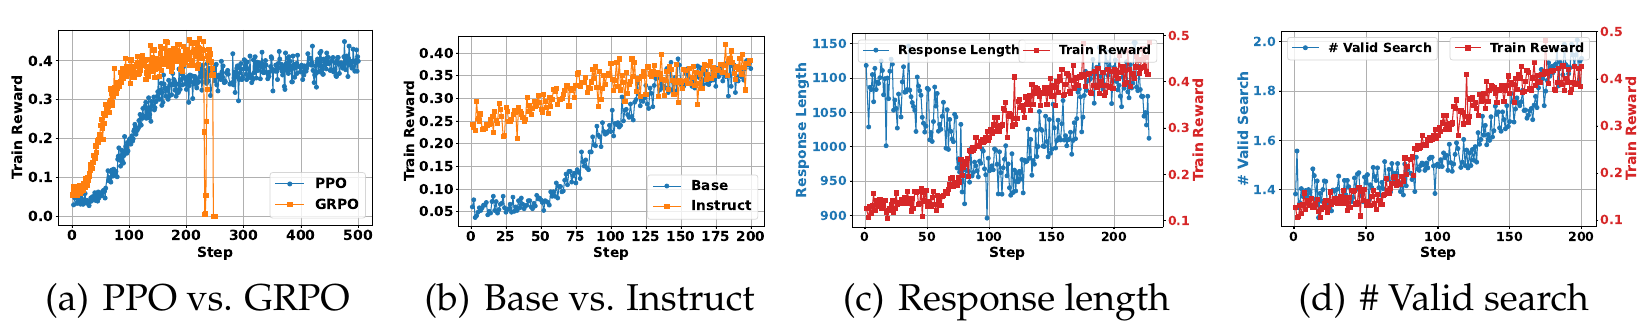
Nous évaluons SEARCH-R1 en utilisant à la fois PPO et GRPO comme méthode RL de base, en menant des expériences sur les modèles Qwen2.5-3B/7B. La comparaison de la dynamique d'entraînement est présentée dans la figure 2(a) et les résultats d'évaluation sont présentés dans le tableau 3, révélant les observations suivantes : (1) GRPO converge plus rapidement que PPO dans tous les cas. Cela est dû au fait que PPO repose sur un modèle critique, qui nécessite plusieurs étapes d'échauffement avant que l'entraînement effectif ne commence. (2) PPO démontre une plus grande stabilité d'entraînement. Comme le montre la figure 2(a), GRPO conduit à un effondrement de la récompense après de nombreux pas d'entraînement, tandis que PPO reste stable. (3) Les récompenses d'entraînement finales de PPO et GRPO sont comparables. Malgré des différences de vitesse de convergence et de stabilité, les deux méthodes atteignent une récompense d'entraînement finale et des performances similaires, indiquant que les deux sont viables pour optimiser SEARCH-R1. PPO présente une plus grande stabilité d'entraînement, ce qui en fait un choix préférable dans ce contexte. Davantage de résultats se trouvent en annexe F.
| Méthode | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bambooq | Moy. |
| SEARCH-R1 avec masque | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 | 0,431 |
| SEARCH-R1 sans masque | 0,388 | 0,567 | 0,391 | 0,325 | 0,321 | 0,108 | 0,304 | 0,343 |
5.2 LLM de base vs. instruct
Nous analysons la dynamique d’entraînement de SEARCH-R1 sur des LLM de base et des LLM ajustés par instructions. Les expériences sont menées sur deux variantes de modèles : Qwen2.5-3B et Qwen2.5-7B. Comme le montre la figure 2(b), nous observons que les modèles ajustés par instructions convergent plus rapidement et partent d’une performance initiale plus élevée que les modèles de base. Toutefois, la récompense finale d’entraînement des deux types de modèles reste très similaire après l’entraînement. Ce résultat suggère que, si le post-entraînement général accélère l’apprentissage dans les scénarios de raisonnement avec recherche, le RL peut effectivement combler l’écart au fil du temps, permettant aux modèles de base d’atteindre des performances comparables. D’autres résultats figurent en annexe E.
5.3 Étude sur la longueur des réponses et les recherches valides
Nous menons une expérience avec SEARCH-R1 et le modèle Qwen2.5-7b-base afin d’analyser la dynamique de la longueur des réponses et du nombre d’appels valides au moteur de recherche au cours de l’entraînement. Le résultat concernant la longueur des réponses est présenté à la figure 2(c), révélant les tendances clés suivantes : (1) Phase précoce (100 premiers pas) : la longueur des réponses diminue fortement, tandis que la récompense d’entraînement augmente légèrement. Durant cette phase, le modèle de base apprend à éliminer les mots de remplissage excessifs et commence à s’adapter aux exigences de la tâche. (2) Phase ultérieure (après 100 pas) : la longueur des réponses et la récompense d’entraînement augmentent toutes deux significativement. À ce stade, le LLM apprend à appeler fréquemment le moteur de recherche, ce qui allonge les réponses en raison des passages récupérés. La récompense d’entraînement s’améliore substantiellement, le modèle devenant plus efficace dans l’exploitation des résultats de recherche. Le résultat concernant les recherches valides est présenté à la figure 2(d), montrant que les LLM apprennent à appeler le moteur de recherche un plus grand nombre de fois au fur et à mesure de l’entraînement.
5.4 Étude du masquage de la perte sur les tokens récupérés
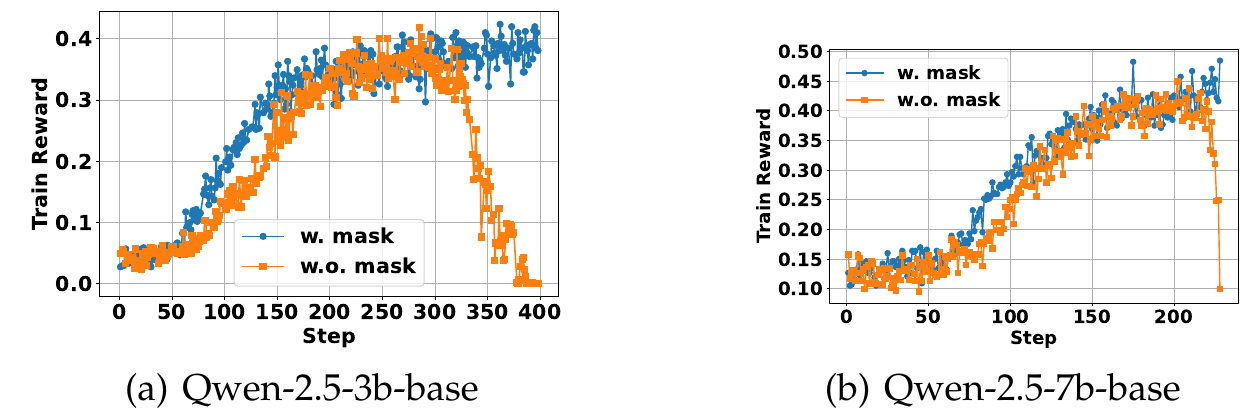
Dans la section 3.1, nous avons introduit le masquage de la perte pour les tokens récupérés afin de prévenir des comportements d’optimisation non intentionnels. Ici, nous menons des expériences sur le modèle Qwen2.5-7b-base, en comparant la dynamique d’entraînement avec et sans masquage de la perte sur les tokens récupérés. Comme le montre la figure 3, l’application du masquage des tokens récupérés conduit à de meilleures améliorations du LLM, en atténuant les effets d’optimisation non intentionnels et en assurant un entraînement plus stable. La comparaison des performances est fournie dans le tableau 4, montrant que SEARCH-R1 entraîné avec masquage de la perte sur les tokens récupérés surpasse systématiquement la variante sans masquage.
D’autres résultats expérimentaux sur le masque de perte des tokens récupérés, sur la comparaison entre LLM de base et LLM ajustés par instructions, sur la comparaison entre PPO et GRPO, sur le nombre de passages récupérés dans l’entraînement de SEARCH-R1, sur l’étude de la taille des groupes dans SEARCH-R1 (GRPO), ainsi que des études de cas, peuvent être trouvés dans les annexes D, E, G, H, I et J.
6 Conclusions
Dans ce travail, nous avons introduit SEARCH-R1, un nouveau cadre de RL qui permet aux LLM d’entrelacer auto-raisonnement et interactions en temps réel avec un moteur de recherche. Contrairement aux approches de type RAG existantes, qui reposent sur un recours intensif à des invites pour la récupération multi-tours, ou aux méthodes d’utilisation d’outils qui nécessitent des données d’entraînement supervisé à grande échelle, SEARCH-R1 optimise les rollouts du LLM par RL, permettant la génération autonome de requêtes et l’utilisation stratégique des informations récupérées. Grâce à des expériences étendues sur sept jeux de données, nous avons démontré que SEARCH-R1 améliore significativement la capacité des LLM à traiter des tâches de raisonnement complexes nécessitant des connaissances externes en temps réel. Notre analyse fournit également des enseignements clés sur les stratégies d’entraînement RL pour le raisonnement augmenté par recherche. À l’avenir, les travaux futurs pourront explorer l’extension de SEARCH-R1 pour prendre en charge des stratégies de recherche plus larges, notamment des mécanismes de récompense plus sophistiqués, des ajustements dynamiques de la récupération fondés sur l’incertitude, la combinaison avec un ensemble diversifié d’outils et l’intégration avec diverses sources d’information au-delà de la recherche. Il serait également prometteur d’étudier son applicabilité à des tâches de raisonnement multimodales.
Remerciements
Cette recherche a été soutenue en partie par l'Apple PhD Fellowship, en partie par le programme US DARPA INCAS n° HR0011-21-C0165 et le programme BRIES n° HR0011-24-3-0325, en partie par le contrat numéro N000142412612 de l'Office of Naval Research, en partie par les subventions NSF numéros IIS-19-56151 et 2402873, en partie par le Molecule Maker Lab Institute : un programme des AI Research Institutes soutenu par la NSF sous l'attribution n° 2019897 et par l'Institute for Geospatial Understanding through an Integrative Discovery Environment (I-GUIDE) de la NSF sous l'attribution n° 2118329, en partie par Cisco, et en partie par le Center for Intelligent Information Retrieval. Toute opinion, conclusion ou recommandation exprimée dans ce document est celle des auteurs et ne représente pas nécessairement les points de vue, exprimés ou implicites, des sponsors ou du gouvernement des États-Unis.
Références
Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. Gpt-4 technical report. arXiv preprint arXiv:2303.08774, 2023.
Arash Ahmadian, Chris Cremer, Matthias Gallé, Marzieh Fadaee, Julia Kreutzer, Olivier Pietquin, Ahmet Üstün, and Sara Hooker. Back to basics: Revisiting reinforce style optimization for learning from human feedback in llms. arXiv preprint arXiv:2402.14740, 2024.
Janice Ahn, Rishu Verma, Renze Lou, Di Liu, Rui Zhang, and Wenpeng Yin. Large language models for mathematical reasoning: Progresses and challenges. arXiv preprint arXiv:2402.00157, 2024.
Akari Asai, Zeqiu Wu, Yizhong Wang, Avirup Sil, and Hannaneh Hajishirzi. Self-rag: Learning to retrieve, generate, and critique through self-reflection. 2024.
Hyung Won Chung, Le Hou, Shayne Longpre, Barret Zoph, Yi Tay, William Fedus, Yunxuan Li, Xuezhi Wang, Mostafa Dehghani, Siddhartha Brahma, et al. Scaling instruction-finetuned language models. Journal of Machine Learning Research, 25(70):1-53, 2024.
Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, and Oyvind Tafjord. Think you have solved question answering? try arc, the ai2 reasoning challenge. arXiv preprint arXiv:1803.05457, 2018.
Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, Haofen Wang, and Haofen Wang. Retrieval-augmented generation for large language models: A survey. arXiv preprint arXiv:2312.10997, 2, 2023.
Michael Glass, Gaetano Rossiello, Md Faisal Mahbub Chowdhury, Ankita Rajaram Naik, Pengshan Cai, and Alfio Gliozzo. Re2g: Retrieve, rerank, generate. arXiv preprint arXiv:2207.06300, 2022.
Daya Guo, Qihao Zhu, Dejian Yang, Zhenda Xie, Kai Dong, Wentao Zhang, Guanting Chen, Xiao Bi, Yu Wu, YK Li, et al. Deepseek-coder: When the large language model meets programming-the rise of code intelligence. arXiv preprint arXiv:2401.14196, 2024.
Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. Measuring massive multitask language understanding. arXiv preprint arXiv:2009.03300, 2020.
Xanh Ho, Anh-Khoa Duong Nguyen, Saku Sugawara, and Akiko Aizawa. Constructing a multi-hop qa dataset for comprehensive evaluation of reasoning steps. arXiv preprint arXiv:2011.01060, 2020.
Zhenyu Hou, Xin Lv, Rui Lu, Jiajie Zhang, Yujiang Li, Zijun Yao, Juanzi Li, Jie Tang, and Yuxiao Dong. Advancing language model reasoning through reinforcement learning and inference scaling. arXiv preprint arXiv:2501.11651, 2025.
Sheryl Hsu, Omar Khattab, Chelsea Finn, and Archit Sharma. Grounding by trying: Llms with reinforcement learning-enhanced retrieval. arXiv preprint arXiv:2410.23214, 2024.
Jie Huang and Kevin Chen-Chuan Chang. Towards reasoning in large language models: A survey. arXiv preprint arXiv:2212.10403, 2022.
Aaron Jaech, Adam Kalai, Adam Lerer, Adam Richardson, Ahmed El-Kishky, Aiden Low, Alec Helyar, Aleksander Madry, Alex Beutel, Alex Carney, et al. Openai o1 system card. arXiv preprint arXiv:2412.16720, 2024.
Zhengbao Jiang, Frank F Xu, Luyu Gao, Zhiqing Sun, Qian Liu, Jane Dwivedi-Yu, Yiming Yang, Jamie Callan, and Graham Neubig. Active retrieval augmented generation. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, pp. 7969-7992, 2023.
Bowen Jin, Jinsung Yoon, Jiawei Han, and Sercan O Arik. Long-context llms meet rag: Overcoming challenges for long inputs in rag. In The Thirteenth International Conference on Learning Representations, 2024.
Mandar Joshi, Eunsol Choi, Daniel S Weld, and Luke Zettlemoyer. Triviaqa: A large scale distantly supervised challenge dataset for reading comprehension. arXiv preprint arXiv:1705.03551, 2017.
Leslie Pack Kaelbling, Michael L Littman, and Andrew W Moore. Reinforcement learning: A survey. Journal of artificial intelligence research, 4:237-285, 1996.
Vladimir Karpukhin, Barlas Oguz, Sewon Min, Patrick SH Lewis, Ledell Wu, Sergey Edunov, Danqi Chen, and Wen-tau Yih. Dense passage retrieval for open-domain question answering. In EMNLP (1), pp. 6769-6781, 2020.
Timo Kaufmann, Paul Weng, Viktor Bengs, and Eyke Hullermeier. A survey of reinforcement learning from human feedback. arXiv preprint arXiv:2312.14925, 10, 2023.
Aviral Kumar, Vincent Zhuang, Rishabh Agarwal, Yi Su, John D Co-Reyes, Avi Singh, Kate Baumli, Shariq Iqbal, Colton Bishop, Rebecca Roelofs, et al. Training language models to self-correct via reinforcement learning. arXiv preprint arXiv:2409.12917, 2024.
Tom Kwiatkowski, Jennimaria Palomaki, Olivia Redfield, Michael Collins, Ankur Parikh, Chris Alberti, Danielle Epstein, Illia Polosukhin, Jacob Devlin, Kenton Lee, et al. Natural questions: a benchmark for question answering research. Transactions of the Association for Computational Linguistics, 7:453-466, 2019.
Nathan Lambert, Valentina Pyatkin, Jacob Morrison, LJ Miranda, Bill Yuchen Lin, Khyathi Chandu, Nouha Dziri, Sachin Kumar, Tom Zick, Yejin Choi, et al. Rewardbench: Evaluating reward models for language modeling. arXiv preprint arXiv:2403.13787, 2024.
Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Kuttler, Mike Lewis, Wen-tau Yih, Tim Rocktaschel, et al. Retrieval-augmented generation for knowledge-intensive nlp tasks. Advances in neural information processing systems, 33:9459-9474, 2020.
Xiaoxi Li, Jiajie Jin, Yujia Zhou, Yongkang Wu, Zhonghua Li, Qi Ye, and Zhicheng Dou. Retrollm: Empowering large language models to retrieve fine-grained evidence within generation. arXiv preprint arXiv:2412.11919, 2024.
Xiaoxi Li, Guanting Dong, Jiajie Jin, Yuyao Zhang, Yujia Zhou, Yutao Zhu, Peitian Zhang et Zhicheng Dou. Search- 01 : Modèles de raisonnement étendus améliorés par la recherche agentique. Préimpression arXiv arXiv:2501.05366, 2025.
Yinheng Li, Shaofei Wang, Han Ding et Hang Chen. Grands modèles de langage en finance : une enquête. Dans Actes de la quatrième conférence internationale ACM sur l'IA en finance, pp. 374- 382, 2023.
Xi Victoria Lin, Xilun Chen, Mingda Chen, Weijia Shi, Maria Lomeli, Richard James, Pedro Rodriguez, Jacob Kahn, Gergely Szilvasy, Mike Lewis, et al. Ra- dit : Réglage d'instructions double augmenté par la recherche. Dans La douzième conférence internationale sur les représentations d'apprentissage, 2023.
Alex Mallen, Akari Asai, Victor Zhong, Rajarshi Das, Hannaneh Hajishirzi et Daniel Khashabi. Quand ne pas faire confiance aux modèles de langage : Enquête sur l'efficacité et les limites des mémoires paramétriques et non paramétriques. Préimpression arXiv arXiv:2212.10511, 7, 2022.
Yu Meng, Mengzhou Xia et Danqi Chen. Simpo : Optimisation simple des préférences avec une récompense sans référence. Progrès dans les systèmes de traitement de l'information neuronale, 37:124198- 124235, 2024.
Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, et al. Entraîner les modèles de langage à suivre des instructions avec le retour humain. Progrès dans les systèmes de traitement de l'information neuronale, 35:27730- 27744, 2022.
Richard Yuanzhe Pang, Weizhe Yuan, He He, Kyunghyun Cho, Sainbayar Sukhbaatar et Jason Weston. Optimisation itérative des préférences par raisonnement. Advances in Neural Information Processing Systems, 37:116617-116637, 2024.
Cheng Peng, Xi Yang, Aokun Chen, Kaleb E Smith, Nima PourNejatian, Anthony B Costa, Cheryl Martin, Mona G Flores, Ying Zhang, Tanja Magoc, et al. Une étude des grands modèles de langage génératifs pour la recherche médicale et les soins de santé. NPJ digital medicine, 6(1):210, 2023.
Ofir Press, Muru Zhang, Sewon Min, Ludwig Schmidt, Noah A Smith et Mike Lewis. Mesurer et réduire l’écart de compositionnalité dans les modèles de langage. arXiv preprint arXiv:2210.03350, 2022.
Changle Qu, Sunhao Dai, Xiaochi Wei, Hengyi Cai, Shuaiqiang Wang, Dawei Yin, Jun Xu et Ji-Rong Wen. Apprentissage de l’utilisation d’outils avec les grands modèles de langage : une enquête. Frontiers of Computer Science, 19(8):198343, 2025.
Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D Manning, Stefano Ermon et Chelsea Finn. Optimisation directe des préférences : votre modèle de langage est secrètement un modèle de récompense. Advances in Neural Information Processing Systems, 36:53728-53741, 2023.
Timo Schick, Jane Dwivedi-Yu, Roberto Dessi, Roberta Raileanu, Maria Lomeli, Eric Hambro, Luke Zettlemoyer, Nicola Cancedda et Thomas Scialom. Toolformer : les modèles de langage peuvent apprendre eux-mêmes à utiliser des outils. Advances in Neural Information Processing Systems, 36:68539-68551, 2023.
John Schulman, Philipp Moritz, Sergey Levine, Michael Jordan et Pieter Abbeel. Contrôle continu de haute dimension à l’aide de l’estimation d’avantage généralisée. arXiv preprint arXiv:1506.02438, 2015.
John Schulman, Filip Wolski, Prafulla Dhariwal, Alec Radford et Oleg Klimov. Algorithmes d’optimisation de politique proximale. arXiv preprint arXiv:1707.06347, 2017.
Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Xiao Bi, Haowei Zhang, Mingchuan Zhang, YK Li, Y Wu, et al. Deepseekmath : repousser les limites du raisonnement mathématique dans les modèles de langage ouverts. arXiv preprint arXiv:2402.03300, 2024.
Guangming Sheng, Chi Zhang, Zilingfeng Ye, Xibin Wu, Wang Zhang, Ru Zhang, Yanghua Peng, Haibin Lin et Chuan Wu. Hybridflow : un cadre RLHF flexible et efficace. arXiv preprint arXiv:2409.19256, 2024.
Richard S Sutton, Andrew G Barto, et al. Apprentissage par renforcement. Journal of Cognitive Neuroscience, 11(1):126-134, 1999.
Gemini Team. Gemini 1.5 : débloquer la compréhension multimodale sur des millions de jetons de contexte. arXiv preprint arXiv:2403.05530, 2024.
Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot et Ashish Sabharwal. Entrelacement de la récupération avec le raisonnement en chaîne de pensée pour les questions multi-étapes à forte intensité de connaissances. arXiv preprint arXiv:2212.10509, 2022a.
Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot et Ashish Sabharwal. Musique : questions multi-sauts via la composition de questions à un seul saut. Transactions of the Association for Computational Linguistics, 10:539-554, 2022b.
Liang Wang, Nan Yang, Xiaolong Huang, Binxing Jiao, Linjun Yang, Daxin Jiang, Rangan Majumder et Furu Wei. Plongements de texte par pré-entraînement contrastif faiblement supervisé. arXiv preprint arXiv:2212.03533, 2022.
Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed Chi, Quoc V Le, Denny Zhou, et al. L’invite en chaîne de pensée suscite le raisonnement dans les grands modèles de langage. Advances in neural information processing systems, 35:24824-24837, 2022.
Yixuan Weng, Minjun Zhu, Fei Xia, Bin Li, Shizhu He, Shengping Liu, Bin Sun, Kang Liu et Jun Zhao. Les grands modèles de langage sont de meilleurs raisonneurs avec l’auto-vérification. arXiv preprint arXiv:2212.09561, 2022.
Ronald J Williams. Algorithmes simples d’apprentissage par gradient statistique pour l’apprentissage par renforcement connexionniste. Machine learning, 8:229-256, 1992.
Tian Xie, Zitian Gao, Qingnan Ren, Haoming Luo, Yuqian Hong, Bryan Dai, Joey Zhou, Kai Qiu, Zhirong Wu et Chong Luo. Logic-rl : libérer le raisonnement des LLM avec l’apprentissage par renforcement fondé sur des règles. arXiv preprint arXiv:2502.14768, 2025.
Guangzhi Xiong, Qiao Jin, Xiao Wang, Yin Fang, Haolin Liu, Yifan Yang, Fangyuan Chen, Zhixing Song, Dengyu Wang, Minjia Zhang, et al. Rag-gym : optimiser les agents de raisonnement et de recherche avec une supervision par processus. arXiv preprint arXiv:2502.13957, 2025.
An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, et al. Rapport technique Qwen2.5. arXiv preprint arXiv:2412.15115, 2024.
Zhilin Yang, Peng Qi, Saizheng Zhang, Yoshua Bengio, William W Cohen, Ruslan Salakhutdinov et Christopher D Manning. Hotpotqa : un jeu de données pour des questions-réponses multi-sauts diverses et explicables. arXiv preprint arXiv:1809.09600, 2018.
Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan et Yuan Cao. React : synergiser raisonnement et action dans les modèles de langage. In International Conference on Learning Representations (ICLR), 2023.
Yue Yu, Wei Ping, Zihan Liu, Boxin Wang, Jiaxuan You, Chao Zhang, Mohammad Shoeybi et Bryan Catanzaro. Rankrag : unifier le classement des contextes avec la génération augmentée par récupération dans les LLM. Advances in Neural Information Processing Systems, 37:121156-121184, 2024.
Zhenrui Yue, Honglei Zhuang, Aijun Bai, Kai Hui, Rolf Jagerman, Hansi Zeng, Zhen Qin, Dong Wang, Xuanhui Wang et Michael Bendersky. Mise à l’échelle de l’inférence pour la génération augmentée par récupération à long contexte. arXiv preprint arXiv:2410.04343, 2024.
Yue Zhang, Yafu Li, Leyang Cui, Deng Cai, Lemao Liu, Tingchen Fu, Xinting Huang, Enbo Zhao, Yu Zhang, Yulong Chen, et al. Le chant des sirènes dans l’océan de l’IA : une enquête sur l’hallucination dans les grands modèles de langage. arXiv preprint arXiv:2309.01219, 2023.
Wayne Xin Zhao, Kun Zhou, Junyi Li, Tianyi Tang, Xiaolei Wang, Yupeng Hou, Yingqian Min, Beichen Zhang, Junjie Zhang, Zican Dong, et al. Une enquête sur les grands modèles de langage. arXiv preprint arXiv:2303.18223, 1(2), 2023.
Wayne Xin Zhao, Jing Liu, Ruiyang Ren et Ji-Rong Wen. Récupération de texte dense fondée sur des modèles de langage pré-entraînés : une enquête. ACM Transactions on Information Systems, 42(4):1-60, 2024.
Annexe
A Formulation de l’apprentissage par renforcement avec un moteur de recherche
Le cadre classique d’apprentissage par renforcement (RL) pour l’entraînement des grands modèles de langage (LLM) peut être formulé comme suit (Rafailov et al., 2023 ; Ouyang et al., 2022) :
où désigne une invite échantillonnée à partir d'un ensemble de données , est une réponse générée par le modèle de politique , et représente un modèle de référence qui sert d'ancrage de régularisation. La fonction de récompense quantifie la qualité de la réponse générée, tandis que le terme de divergence KL contraint la politique mise à jour à rester proche du modèle de référence, favorisant ainsi la stabilité de l'entraînement.
Cependant, cette formulation suppose que la séquence de sortie entière est générée uniquement par le LLM de politique. Cette hypothèse ne tient pas dans notre cadre, où le comportement du modèle intègre à la fois un raisonnement interne et une récupération d'informations externes. Pour tenir compte de cela, nous étendons l'objectif RL afin d'incorporer un moteur de recherche externe , ce qui donne la formulation suivante :
Dans cet objectif révisé, la trajectoire inclut des étapes de raisonnement et du contenu récupéré entrelacés, reflétant une interaction multi-tours entre le LLM et le moteur de recherche. La divergence KL est calculée sur la distribution de réponse conjointe conditionnée à la fois par l'invite et par le contexte enrichi par la récupération, garantissant que la politique apprise reste alignée sur le modèle de référence même en présence d'informations externes.
B Configurations expérimentales
B.1 Références
Plusieurs travaux récents ont exploré les pipelines RAG, notamment dans des benchmarks tels que Natural Questions (NQ) ou HotpotQA, visant à améliorer les performances grâce à des mécanismes de récupération plus élaborés. Par exemple, Re2G (Glass et al., 2022) et RetroLLM (Li et al., 2024) proposent des cadres sophistiqués de récupération- rerangement- génération qui emploient de puissants récupérateurs et des stratégies de rerangement complexes pour sélectionner des preuves fines aux fins de la génération. Bien que ces approches démontrent des résultats impressionnants, elles reposent souvent sur une ingénierie spécifique à la tâche ou sur des pipelines lourds qui limitent la généralisabilité et l'évolutivité. En revanche, notre attention se porte sur une approche plus légère et plus générale du raisonnement augmenté par récupération. À ce titre, nous n'incluons pas ces méthodes comme références directes, bien qu'elles représentent des directions précieuses dans l'espace plus large de la modélisation linguistique enrichie par récupération.
B.2 Paramètres expérimentaux
Nous menons des expériences en utilisant deux types de modèles : Qwen-2.5-3B (Base/Instruct) et Qwen-2.5-7B (Base/Instruct) (Yang et al., 2024). Pour la recherche documentaire, nous utilisons le corpus Wikipédia de 2018 (Karpukhin et al., 2020) comme source de connaissances et E5 (Wang et al., 2022) comme système de recherche. Afin de garantir une comparaison équitable, nous suivons Lin et al. (2023) et fixons le nombre de passages récupérés à 3 pour toutes les méthodes basées sur la recherche documentaire.
Pour l'entraînement, nous fusionnons les ensembles d'entraînement de NQ et HotpotQA afin de former un ensemble de données unifié pour SEARCH-R1 et les autres méthodes de référence basées sur le fine-tuning. L'évaluation est réalisée sur les ensembles de test ou de validation de sept jeux de données afin d'évaluer les performances en domaine et hors domaine. La correspondance exacte (Exact Match, EM) est utilisée comme métrique d'évaluation, conformément à Yu et al. (2024). Pour les méthodes de référence de type inférence, nous utilisons des modèles instruct, car les modèles de base ne parviennent pas à suivre les instructions. Pour les méthodes de réglage par RL, les expériences sont menées à la fois sur les modèles de base et instruct. De plus amples détails sur les paramètres expérimentaux sont disponibles à l'annexe B.
Pour la variante PPO de SEARCH-R1, nous fixons le taux d'apprentissage du LLM de politique à 1e-6 et celui du LLM de valeur à 1e-5. L'entraînement est effectué sur 500 étapes, avec des ratios de préchauffage de 0,285 et 0,015 pour les modèles de politique et de valeur, respectivement. Nous utilisons l'estimation généralisée de l'avantage (Generalized Advantage Estimation, GAE) avec les paramètres et .
L'entraînement est réalisé sur un seul nœud équipé de 8 GPU H100. Nous utilisons une taille de lot totale de 512, avec une taille de mini-lot de 256 et une taille de micro-lot de 64. La longueur maximale de séquence est fixée à 4 096 tokens, avec une longueur maximale de réponse de 500 et une longueur maximale de 500 tokens pour le contenu récupéré. Pour optimiser l'utilisation de la mémoire GPU, nous activons le point de contrôle des gradients et utilisons le Fully Sharded Data Parallel (FSDP) avec déport sur CPU.
Pour des rollouts de LLM efficaces, nous adoptons vLLM ^{1} avec une taille de parallélisme tensoriel de 1 et un ratio d'utilisation de la mémoire GPU de 0,6. L'échantillonnage des rollouts utilise une température de 1,0 et une valeur top-p de 1,0. Le coefficient de régularisation par divergence KL et le ratio de clipping sont fixés à 0,001 et 0,2.
Pour l'entraînement GRPO, nous fixons le taux d'apprentissage du LLM de politique à 1e-6 et échantillonnons 5 réponses par invite, conformément à l'implémentation de GRPO dans Verl (Sheng et al., 2024) ^{1} . Le modèle est entraîné pendant 500 étapes avec un ratio de préchauffage du taux d'apprentissage de 0,285. L'entraînement est réalisé sur la même configuration 8xH100 avec des tailles de lot et des configurations de longueur de séquence identiques à celles du PPO.
Nous utilisons également le point de contrôle des gradients, le déport FSDP et les rollouts basés sur vLLM avec les mêmes hyperparamètres que ci-dessus. La température des rollouts et les valeurs top-p sont toutes deux fixées à 1,0, et le coefficient de divergence KL et le ratio de clipping sont fixés à 0,001 et 0,2.
Pour les deux méthodes, les points de contrôle du modèle sont sauvegardés toutes les 100 étapes. Dans les cas où l'entraînement diverge, nous évaluons au point de contrôle stable le plus récent selon la courbe de récompense d'entraînement ; sinon, le point de contrôle final est utilisé pour l'évaluation. Le budget d'action maximal est fixé à 4, et nous récupérons par défaut les 3 meilleurs passages.
Nous calculons les récompenses de résultat à l'aide de la correspondance exacte (EM). Sauf indication contraire, PPO est utilisé comme algorithme RL par défaut, et une comparaison détaillée avec GRPO est fournie à la section 5.1.
C Principaux résultats sur le LLM 14B
Nous menons des expériences approfondies en utilisant les modèles Qwen2.5-14B, et les résultats sont présentés dans le tableau 5. Comme le montrent les résultats, SEARCH-R1 surpasse systématiquement toutes les méthodes de référence sur l'ensemble des métriques évaluées. De plus, nous observons que l'augmentation de la taille du modèle conduit à des gains de performance systématiques avec SEARCH-R1, ce qui met en évidence les bénéfices de la mise à l'échelle de la taille du LLM dans notre approche.
D Étude sur le masquage de la perte des tokens récupérés
Dans la section 3.1, nous avons introduit une stratégie de masquage de la perte pour les tokens récupérés afin d'atténuer les comportements d'optimisation indésirables pendant l'entraînement. Pour évaluer son impact, nous menons des expériences en utilisant le modèle Qwen2.5-3b/7b-base, en comparant la dynamique d'entraînement avec et sans masquage de la perte des tokens récupérés. Comme illustré à la figure 3, l'intégration du mécanisme de masquage conduit à une optimisation plus stable et à de meilleures performances du modèle. Les résultats quantitatifs du tableau 6 confirment en outre que SEARCH-R1, lorsqu'il est entraîné avec masquage de la perte sur les tokens récupérés, surpasse systématiquement sa contrepartie non masquée.
E LLM de base vs LLM instruct
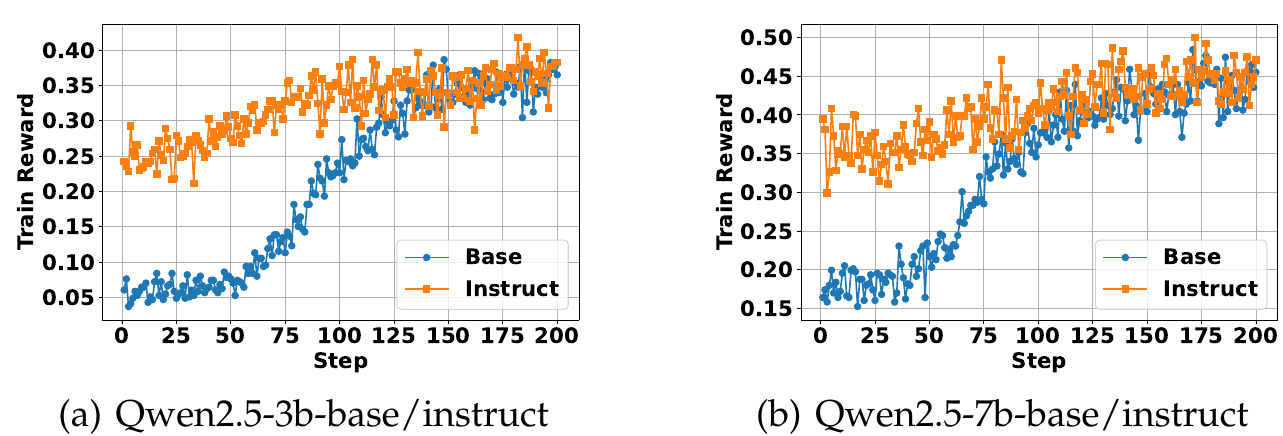
Nous étudions la dynamique d'entraînement de SEARCH-R1 sur des LLM de base et ajustés aux instructions, en utilisant deux échelles de modèles : Qwen2.5-3B et Qwen2.5-7B. Comme illustré à la figure 4,
| Méthodes | QA générale | QA multi-sauts | ||||||
| NQ† | TriviaQA* | PopQA* | HotpotQA† | 2wiki* | Musique* | Bamboolge* | Moy. | |
| Qwen2.5-14b-Base/Instruct | ||||||||
| Inférence directe | 0,198 | 0,531 | 0,184 | 0,217 | 0,253 | 0,045 | 0,160 | 0,227 |
| CoT | 0,190 | 0,495 | 0,148 | 0,269 | 0,297 | 0,054 | 0,432 | 0,269 |
| IRCoT | 0,114 | 0,375 | 0,166 | 0,230 | 0,248 | 0,102 | 0,312 | 0,221 |
| Search-o1 | 0,347 | 0,635 | 0,241 | 0,268 | 0,161 | 0,099 | 0,416 | 0,310 |
| RAG | 0,327 | 0,585 | 0,376 | 0,279 | 0,160 | 0,051 | 0,192 | 0,281 |
| SFT | 0,361 | 0,467 | 0,150 | 0,248 | 0,278 | 0,089 | 0,160 | 0,250 |
| R1-base | 0,369 | 0,626 | 0,270 | 0,306 | 0,326 | 0,117 | 0,488 | 0,357 |
| R1-instruct | 0,334 | 0,628 | 0,253 | 0,294 | 0,325 | 0,108 | 0,432 | 0,339 |
| Search-R1-base | 0,486 | 0,676 | 0,480 | 0,468 | 0,470 | 0,241 | 0,528 | 0,479 |
| Search-R1-instruct | 0,424 | 0,660 | 0,442 | 0,436 | 0,379 | 0,210 | 0,480 | 0,433 |
les modèles ajustés aux instructions présentent une convergence plus rapide et bénéficient de performances initiales plus élevées par rapport à leurs homologues de base. Malgré cet avantage précoce, les performances finales des deux types de modèles convergent vers un niveau similaire après l'entraînement. Ces résultats indiquent que, si l'ajustement aux instructions facilite un apprentissage plus efficace aux premiers stades des tâches de raisonnement et de recherche, l'apprentissage par renforcement est capable de combler l'écart de performance, permettant finalement aux modèles de base d'atteindre des résultats comparables.
F Comparaison de PPO et GRPO dans SEARCH-R1
Nous évaluons l'efficacité de SEARCH-R1 sous deux algorithmes d'apprentissage par renforcement : PPO et GRPO, en utilisant à la fois Qwen2.5-3B et Qwen2.5-7B comme modèles sous-jacents. La figure 5 illustre la dynamique d'entraînement. Notre analyse conduit aux observations clés suivantes : (1) GRPO présente une convergence plus rapide que PPO dans toutes les configurations, ce qui est attribué au fait
| Méthode | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboogle | Moy. |
| Qwen2.5-7b-Base | ||||||||
| SEARCH-R1 avec masque | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 | 0,431 |
| SEARCH-R1 sans masque | 0,388 | 0,567 | 0,391 | 0,325 | 0,321 | 0,108 | 0,304 | 0,343 |
| Qwen2.5-3b-Base | ||||||||
| SEARCH-R1 avec masque | 0,406 | 0,587 | 0,435 | 0,284 | 0,273 | 0,049 | 0,088 | 0,303 |
| SEARCH-R1 sans masque | 0,346 | 0,484 | 0,365 | 0,241 | 0,244 | 0,053 | 0,104 | 0,262 |
Tableau 6 : Les performances de SEARCH-R1 avec et sans masquage de la perte des tokens récupérés. Le LLM entraîné avec masquage de la perte des tokens récupérés obtient systématiquement de meilleures performances. (RL : PPO) que PPO repose sur une fonction de valeur séparée (critique), qui nécessite une phase de préchauffage initiale avant que des mises à jour efficaces de la politique puissent être effectuées. (2) PPO offre un comportement d'entraînement plus stable, comme en témoigne la figure 5, où GRPO rencontre un effondrement de la récompense sur des étapes d'entraînement prolongées, tandis que PPO maintient sa stabilité tout au long. (3) PPO et GRPO atteignent des performances de récompense finale comparables, ce qui suggère que, malgré des compromis en termes de vitesse de convergence et de stabilité, les deux méthodes sont efficaces pour optimiser SEARCH-R1.
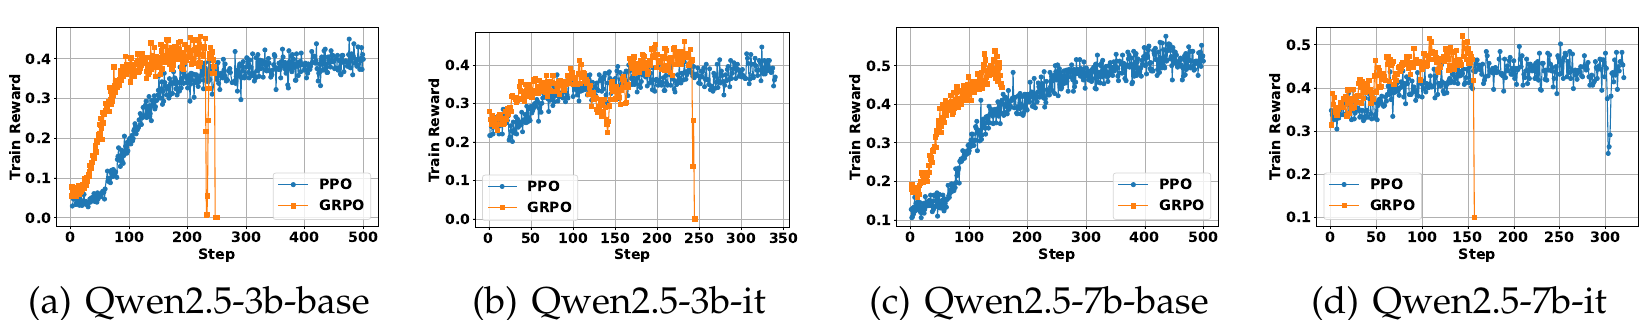
Figure 5 : Dynamique d'entraînement de SEARCH-R1 avec PPO et GRPO comme méthode RL de base sur quatre LLM. GRPO converge généralement plus rapidement mais peut présenter une instabilité après un certain nombre d'étapes d'entraînement, tandis que PPO offre une optimisation plus stable mais converge à un rythme plus lent. PPO et GRPO atteignent des performances de récompense finale comparables.
G Étude sur le nombre de passages récupérés dans l'entraînement de SEARCH-R1
Nous étudions l'impact du nombre de passages récupérés (top-k) sur la dynamique d'entraînement de SEARCH-R1. Bien que nos expériences principales adoptent top-k = 3 conformément à Lin et al. (2023), nous menons des études supplémentaires avec top-k fixé à 1, 3 et 5 afin de mieux comprendre son influence.
La figure 6 présente les courbes de récompense d'entraînement sous ces configurations. Nous observons que les trois configurations présentent des trajectoires d'entraînement globales similaires. Notamment, top-k = 5 atteint la convergence initiale la plus rapide, en atteignant la récompense d'entraînement la plus élevée au cours des 200 premières étapes. Cependant, sa récompense décline progressivement et devient plus instable à mesure que l'entraînement progresse. En revanche, top-k = 1 et 3 démontrent des améliorations plus constantes tout au long de l'entraînement, top-k = 3 atteignant finalement la récompense la plus élevée après 500 étapes.
Les résultats d'évaluation à l'étape 500 sont résumés dans le tableau 7, où top-k = 3 produit les meilleures performances globales. Nous émettons l'hypothèse de deux facteurs contributifs : (1) top-k = 1 souffre probablement d'un faible rappel de recherche, limitant la capacité à fournir des informations contextuelles pertinentes ; (2) top-k = 5 introduit une précision plus faible en raison de l'inclusion de passages bruités ou non pertinents (Jin et al., 2024), ce qui non seulement dégrade les performances d'inférence mais peut également affecter négativement l'entraînement RL — en dissuadant le modèle d'exploiter le contenu récupéré lorsqu'il apprend que le contexte supplémentaire est souvent inutile ou trompeur.
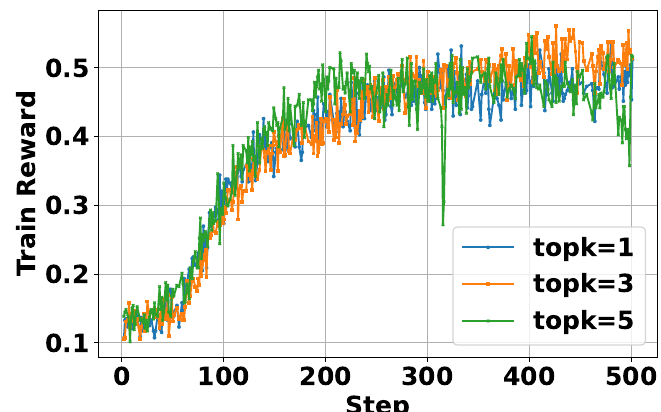
Figure 6 : La dynamique d'entraînement de SEARCH-R1 avec un nombre différent de passages récupérés. (LLM : Qwen2.5-7b-base, RL : PPO)
Tableau 7 : Étude sur le nombre de passages récupérés dans l'entraînement de SEARCH-R1. (LLM : Qwen2.5-7b-base ; RL : PPO)
| Méthode | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboolge | Moy. |
| topk=1 | 0,426 | 0,614 | 0,422 | 0,393 | 0,296 | 0,146 | 0,328 | 0,375 |
| topk=3 | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 | 0,431 |
| topk=5 | 0,479 | 0,634 | 0,440 | 0,394 | 0,343 | 0,156 | 0,352 | 0,400 |
H Étude sur la taille de groupe dans l'entraînement de SEARCH-R1 (GRPO)
Dans notre expérience principale, nous fixons la taille du groupe pour SEARCH-R1 (GRPO) à 5, en suivant le paramétrage de Sheng et al. (2024). Afin d'examiner plus avant l'impact de la taille du groupe sur la dynamique d'entraînement, nous menons une étude d'ablation avec des tailles de groupe de 1, 3 et 5. Notamment, lorsque la taille du groupe est fixée à 1, GRPO se réduit à l'algorithme REINFORCE standard (Williams, 1992).
Nous entraînons les LLM pendant 500 étapes, en sauvegardant des points de contrôle du modèle toutes les 100 étapes. Si le modèle s'effondre pendant l'entraînement, nous utilisons le dernier point de contrôle valide pour l'évaluation ; sinon, nous évaluons le point de contrôle à l'étape 500.
La dynamique d'entraînement sous différentes configurations de taille de groupe est illustrée dans la Figure 7. Nous observons qu'une taille de groupe plus grande conduit généralement à une convergence plus rapide, mais peut également accroître le risque d'effondrement en raison de l'instabilité inhérente à l'apprentissage par renforcement.
Les résultats d'évaluation pour différentes configurations sont résumés dans le Tableau 8. Bien que des tailles de groupe plus grandes puissent accélérer la convergence et atteindre des récompenses d'entraînement plus élevées, des tailles de groupe plus petites (par exemple, taille = 1) permettent un entraînement plus stable et une meilleure généralisation. Cela se reflète dans des performances supérieures sur des tâches non vues, mettant en évidence un compromis entre vitesse d'apprentissage et stabilité dans l'entraînement GRPO.
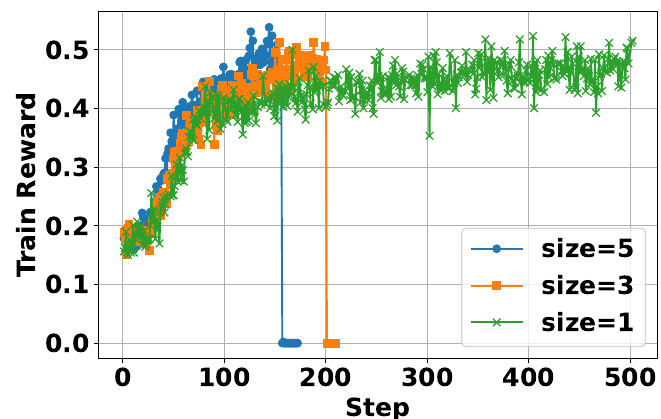
Figure 7 : La dynamique d'entraînement de SEARCH-R1 (GRPO) avec différentes tailles de groupe. (LLM : Qwen2.5-7b-base)
| Méthode | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboogle | Moy. |
| size=1 | 0,463 | 0,605 | 0,449 | 0,392 | 0,413 | 0,163 | 0,384 | 0,410 |
| size=3 | 0,385 | 0,580 | 0,396 | 0,329 | 0,333 | 0,117 | 0,400 | 0,363 |
| size=5 | 0,395 | 0,560 | 0,388 | 0,326 | 0,297 | 0,125 | 0,360 | 0,350 |
Tableau 8 : L'étude de la taille de groupe de SEARCH-R1 (GRPO) sur sept jeux de données. (LLM : Qwen2.5-7b-base)
I Comparaison entre R1 et SEARCH-R1 : une étude de cas
| Contexte de référence en lecture seule pour comprendre la source (ce n'est pas le texte source à traduire) : I Comparaison entre R1 et SEARCH-R1 : une étude de cas Tableau 9 : une étude de cas de R1 et SEARCH-R1. Texte à traduire : Question : Curious est un parfum pour femmes créé par une chanteuse née dans quelle ville et quel État ? | ||||||||
| Vérité de référence : McComb, Mississippi R1 : | ||||||||
| <l>La chanteuse est Beyoncé, née à Houston, au Texas. </l> | ||||||||
| <l>Houston </l> | ||||||||
| <l>Je dois déterminer dans quelle ville et quel État est née une chanteuse par qui le parfum pour femmes « Curious » a été créé. </l> | ||||||||
| <l>Informations sur le parfum Curious </search> | ||||||||
| <l>Doc 1 (Titre : « Curious (parfum) ») Curious (parfum) Curious est un parfum pour femmes de Britney Spears pour Elizabeth Arden, et c'est le premier parfum approuvé par Britney Spears, précédant « Fantasy ». Spears aurait gagné 52 millions de dollars grâce à cet appui. « Curious » est sorti en septembre 2004 et a connu un grand succès international. Il a été le parfum numéro un de 2004 dans les grands magasins et, en 2005, « Curious » a été honoré par la Fragrance Foundation comme meilleur parfum pour femmes. Le parfum est un parfum floral blanc. Ses notes sont la magnolia de Louisiane, la poire Anjou dorée, la fleur de lotus, la tubéreuse, le jasmin étoilé, le cyclamen rose, le musc infusé à la vanille, le bois de santal et les bois blonds. Elizabeth Arden... </information></td></tr><tr><td colspan="9"><l>Je dois déterminer dans quelle ville et quel État est née Britney Spears, la chanteuse derrière le parfum « Curious ». </l></td></tr><tr><td colspan="9"><l>Lieu de naissance de Britney Spears </search></td></tr><tr><td colspan="9"><l>Doc 1 (Titre : « Britney Spears ») l'artiste féminine ayant vendu le plus d'albums dans les années 2000. En 2004, elle a lancé une marque de parfum avec Elizabeth Arden, Inc., dont les ventes ont dépassé 1,5 milliard de dollars américains. Spears est née à McComb, dans le Mississippi, deuxième enfant de Lynne Irene Bridges et James Parnell Spears. Sa grand-mère maternelle, Lillian Portell, était anglaise (née à Londres), et l'un des arrière-arrière-grands-pères maternels de Spears était maltais. Ses frères et sœurs sont Bryan James et Jamie Lynn. Britney est née dans la Bible Belt, où le protestantisme évangélique socialement conservateur exerce une influence religieuse particulièrement forte. Spears a été baptisée dans la Convention baptiste du Sud, mais a ensuite étudié... </information> | ||||||||
| <l>Puisque Britney Spears est née à McComb, dans le Mississippi, je dois déterminer dans quelle ville et quel État cela se trouve. </l> | ||||||||
| <l>Localisation de McComb, Mississippi </search> | ||||||||
| <l>Doc 1 (Titre : « McComb, Mississippi ») McComb, Mississippi McComb est une ville du comté de Pike, dans le Mississippi, aux États-Unis, à environ au sud de Jackson. Selon le recensement de 2010, la ville comptait une population totale de 12 790 habitants. C'est la ville principale de la zone statistique micropolitaine de McComb, Mississippi. McComb a été fondée en 1872 après que Henry Simpson McComb, du New Orleans, Jackson and Great Northern Railroad, un prédécesseur de l'Illinois Central Railroad (aujourd'hui partie du Canadian National Railway), a décidé de déplacer les ateliers de maintenance du chemin de fer hors de La Nouvelle-Orléans, en Louisiane, afin d'éviter les attractions des saloons de cette ville. Le chemin de fer a acheté des terres dans le comté de Pike... </information> | ||||||||
| <l>J'ai trouvé que Britney Spears est née à McComb, dans le Mississippi. Comme la question demande la ville et l'État, je dois simplement confirmer l'État, que je connais déjà grâce à la recherche précédente. </l> | ||||||||
| <l>McComb, Mississippi </answer> | ||||||||
Tableau 9 : Une étude de cas de R1 et SEARCH-R1.
Pour mieux comprendre SEARCH-R1, nous menons une étude de cas avec Qwen2.5-7B-Base, en comparant son comportement avec celui de l'apprentissage par renforcement sans moteur de recherche (Guo et al., 2025). Les résultats sont présentés dans le Tableau 20 et révèlent les observations clés suivantes : Le raisonnement et la récupération entrelacés améliorent l'analyse du problème : SEARCH-R1 permet au LLM d'effectuer un raisonnement approfondi avec une récupération multi-tours, tandis que l'apprentissage par renforcement sans recherche repose uniquement sur les connaissances internes des modèles.En intégrant les passages récupérés, SEARCH-R1 permet au LLM d'affiner itérativement son raisonnement, ce qui conduit à des réponses mieux informées et plus précises.
Auto-vérification par récupération itérative : Nous observons qu'après le deuxième tour de récupération, le LLM a déjà rassemblé suffisamment d'informations pour répondre à la question. Cependant, SEARCH-R1 effectue une étape de récupération supplémentaire pour auto-vérifier sa conclusion, renforçant ainsi davantage sa confiance dans la réponse finale. Ce phénomène est conforme aux conclusions de l'apprentissage par renforcement du raisonnement des LLM sans récupération (Guo et al., 2025), soulignant comment l'apprentissage par renforcement peut encourager un raisonnement guidé par la vérification, même dans des contextes augmentés par la recherche.
J Autres études de cas de SEARCH-R1
Pour mieux comprendre le comportement et les capacités du LLM entraîné, nous menons des études de cas supplémentaires sur SEARCH-R1. Plus précisément, nous analysons le modèle affiné à partir de Qwen2.5-7B-Base en utilisant l’Optimisation de Politique Proximale (PPO) comme algorithme d’apprentissage par renforcement sous-jacent. Les résultats sont présentés dans les tableaux suivants.
Tableau 10 : Étude de cas 1 de SEARCH-R1 (réussie) : SEARCH-R1 effectue un raisonnement multi-étapes, une recherche, avec auto-vérification et répond finalement à la question.
Question : Quel type de profession Chris Jericho et Gary Barlow ont-ils en commun ? Vérité de référence : musicien SEARCH-R1 : <think> Je dois trouver le type de profession que Chris Jericho et Gary Barlow ont en commun. Je vais chercher. </think> <search> profession de Chris Jericho et Gary Barlow </search> <information> Doc 2 (Titre : « Chris Jericho ») « Do You Wanna Start a War » (2014) et « Judas » (2017) sont composés entièrement ou majoritairement de compositions originales. Il est également apparu dans de nombreuses émissions de télévision au fil des ans, ayant participé à la saison 2011 de « Dancing With the Stars », jusqu’à la sixième semaine. Avant cela, Jericho a animé le jeu télévisé de l’ABC « Downfall » et les Revolver Golden Gods Awards. Christopher Keith Irvine est né le 9 novembre 1970 à Manhasset, New York, mais a grandi à Winnipeg. Son père, le joueur de hockey sur glace Ted Irvine, jouait pour les New York Rangers au moment de sa naissance. ... </information> Je dois vérifier si Gary Barlow a l’une de ces professions en commun. </think> <search> profession de Gary Barlow </search> <information> Doc 1 (Titre : « Gary Barlow ») tubes, douze singles numéro un et sept albums numéro un avec Take That. Barlow a reçu six Ivor Novello Awards de la British Academy of Songwriters, Composers and Authors, dont le prix pour services exceptionnels rendus à la musique britannique. Il a vendu plus de 50 millions de disques dans le monde. Barlow est né le 20 janvier 1971 à Frodsham, Cheshire, deuxième fils de Colin (décédé le 15 octobre 2009) et Marjorie Barlow. Dans l’autobiographie de Barlow, il raconte que son amour de la musique a commencé très tôt, et se décrit comme « un de ces enfants qui danse sans cesse devant la télévision en regardant ... </information> Je dois vérifier s’il existe une profession commune entre Chris Jericho et Gary Barlow. </think> <search> profession commune de Chris Jericho et Gary Barlow </search> <information> Doc 1 (Titre : « Gary Barlow ») Gary Barlow Gary Barlow (né le 20 janvier 1971) est un chanteur, auteur-compositeur, musicien et producteur de disques anglais. Il est surtout connu comme chanteur principal du groupe pop britannique Take That. Barlow a également été juré principal de « The X Factor UK » en 2011, 2012 et 2013 et de « Let It Shine » en 2017. Barlow est l’un des auteurs-compositeurs les plus accomplis de Grande-Bretagne, ayant écrit quatorze singles numéro un et vingt-quatre tubes du top 10. En tant qu’artiste solo, il a eu trois singles numéro un, six singles du top 10 et deux albums numéro un, et a en outre eu dix-sept du top 5 ... </information> <think> J’ai découvert que Gary Barlow est chanteur, auteur-compositeur, musicien et producteur de disques. Je dois maintenant vérifier si Chris Jericho a l’une de ces professions en commun. </think> <search> profession de Chris Jericho </search> <information> Doc 1 (Titre : « Chris Jericho ») Chris Jericho Christopher Keith Irvine (né le 9 novembre 1970), plus connu sous le nom de ring Chris Jericho, est un catcheur professionnel, musicien, auteur et acteur né aux États-Unis. Il lutte actuellement pour New Japan Pro-Wrestling (NJPW) où il est l’actuel champion intercontinental IWGP lors de son premier règne. Jericho fait aussi des apparitions sporadiques pour la WWE à la marque SmackDown, avec laquelle il travaille depuis 1999. Dans le catch professionnel, il est connu pour sa personnalité excessive de rock star. Jericho est considéré comme l’un des plus grands catcheurs professionnels de tous les temps. Au cours des années 1990, Jericho s’est produit pour les organisations américaines Extreme Championship ... </information> <think> J’ai découvert que Chris Jericho est catcheur professionnel, musicien, auteur et acteur. Je peux maintenant comparer avec les professions de Gary Barlow. J’ai découvert que Gary Barlow est chanteur, auteur-compositeur, musicien et producteur de disques. La profession commune entre Chris Jericho et Gary Barlow est musicien. </think> <answer> musicien </answer>
| Question : Quel était le titre de l’album studio de début de Weezer qui contenait les tubes Buddy Holly et Undone – The Sweater Song ? |
| Vérité de référence : The Blue Album |
| SEARCH-R1 : |
| <think> Je dois trouver le titre de l’album studio de début de Weezer qui contenait les chansons à succès "Buddy Holly" et "Undone – The Sweater Song". Je vais le rechercher. </think> |
| <search> album studio de début de Weezer qui contenait les tubes Buddy Holly et Undone – The Sweater Song </search> |
| <information> Doc 1(Titre : "Weezer discography") Weezer discography La discographie de Weezer, un groupe de rock américain, comprend 11 albums studio, deux albums de compilation, un album vidéo, six extended plays, 28 singles et 24 clips musicaux. L’album studio de début homonyme de Weezer, souvent appelé "The Blue Album", est sorti en mai 1994 via DGC Records. L’album a été un énorme succès commercial, atteignant la 16e place du "Billboard" 200 américain et engendrant les singles "Undone – The Sweater Song" et "Buddy Holly", qui ont tous deux contribué à propulser Weezer vers le succès grand public grâce à des clips musicaux réalisés par Spike Jonze. ... <information> |
| <think> J’ai découvert que l’album studio de début de Weezer qui contenait les chansons à succès "Buddy Holly" et "Undone – The Sweater Song" est l’album homonyme, souvent appelé "The Blue Album". Je peux maintenant fournir la réponse. </think> |
| <answer> Weezer </answer> |
</think></search></search></information>
SEARCH-R1 : <think> Je dois découvrir quelle mort, dramatisée dans une pièce de théâtre, a contribué à mettre fin à la peine de mort en Australie. Je vais chercher. </think>
<search> quelle mort dramatisée dans une pièce de théâtre a contribué à mettre fin à la peine de mort en Australie </search>
<information> Doc 3 (Titre : « Ronald Ryan ») Ronald Ryan Ronald Joseph Ryan (21 février 1925 - 3 février 1967) a été la dernière personne légalement exécutée en Australie. Ryan a été reconnu coupable d’avoir tiré sur le gardien George Hodson et de l’avoir tué lors d’une évasion de la prison de Pentridge, Victoria, en 1965. La pendaison de Ryan a suscité certaines des plus grandes manifestations publiques de l’histoire de l’Australie et a conduit à la fin de la peine capitale. La peine de mort a été abolie dans tous les États avant 1985. Ronald Edmond Thompson est né au Royal Women’s Hospital, dans la banlieue intérieure de Carlton à Melbourne, de John Ronald Ryan et Cecilia Thompson (née ... </information>
<think> J’ai découvert que la mort de Ronald Ryan, dramatisée dans une pièce de théâtre, a contribué à mettre fin à la peine de mort en Australie. Je peux maintenant fournir la réponse. </think>
<answer> Ronald Ryan </answer>
| Contexte en lecture seule pour comprendre la source (ce n'est pas le texte source à traduire) : <answer> Ronald Ryan </answer> Tableau 20 : Étude de cas 11 de SEARCH-R1 (échec) : Le LLM peut être induit en erreur par des informations récupérées non pertinentes et fournir une réponse erronée. Texte à traduire : Question : Où se trouvent le parc national du Teide et le parc national de Garajonay ? |
| Vérité de référence : Îles Canaries, Espagne |
| SEARCH-R1 : |
| <think> Je dois déterminer où se trouvent le parc national du Teide et le parc national de Garajonay. Je vais faire une recherche. </think> |
| <search> emplacement du parc national du Teide et du parc national de Garajonay </search> |
| <information> Doc 1 (Titre : « Parc national de Garajonay ») ont décidé de mettre fin à leurs jours. Parc national de Garajonay Le parc national de Garajonay (,) est situé au centre et au nord de l'île de La Gomera, l'une des îles Canaries (Espagne). Il a été déclaré parc national en 1981 et site du patrimoine mondial par l'UNESCO en 1986. Il occupe 40 km (15 mi²) et s'étend dans chacune des six municipalités de l'île. Près de 450 000 touristes visitent le parc chaque année. Il existe des hébergements pour les touristes juste à l'extérieur de la limite du parc. Le parc doit son nom à la formation rocheuse de Garajonay, le point culminant ... </information> |
| <think> J'ai découvert que le parc national de Garajonay est situé au centre et au nord de l'île de La Gomera, l'une des îles Canaries (Espagne). Je dois maintenant trouver l'emplacement du parc national du Teide. </think> |
| <search> emplacement du parc national du Teide </search> |
| <information> Doc 1 (Titre : « Parc national du Teide ») Parc national du Teide Le parc national du Teide (,) est un parc national situé à Tenerife (îles Canaries, Espagne). Le parc national est centré sur le mont Teide, la plus haute montagne d'Espagne (3 718 mètres de haut), en outre le plus haut volcan des îles de l'océan Atlantique et le troisième plus haut volcan du monde depuis sa base au fond de l'océan (7 500 mètres de haut). Son statut de parc national a été adopté le 22 janvier 1954, ce qui en fait le troisième plus ancien parc national d'Espagne. Le Pico Viejo, également inclus dans les limites du parc national, est le deuxième plus haut volcan des îles Canaries avec ... </information> |
| <think> J'ai découvert que le parc national du Teide est situé à Tenerife (îles Canaries, Espagne). J'ai maintenant les emplacements du parc national du Teide et du parc national de Garajonay. </think> |
| <answer> Îles Canaries, Espagne </answer> |
| Question : Qui a réalisé le film qui mettait en vedette Steve Cochran et l’acteur qui jouait le shérif Roy Coffee dans « Bonanza » ? |
| Vérité de référence : Louis King |
| SEARCH-R1 : |
| <think> Je dois découvrir qui a réalisé le film qui mettait en vedette Steve Cochran et l’acteur qui jouait le shérif Roy Coffee dans « Bonanza ». Je vais faire une recherche. </think> |
| <search> qui a réalisé le film qui mettait en vedette Steve Cochran et l’acteur qui jouait le shérif Roy Coffee dans « Bonanza » </search> |
| <information> Doc 2 (Titre : « Ray Teal ») Ray Teal Ray Teal (12 janvier 1902 – 2 avril 1976) était un acteur américain apparu dans plus de 250 films et quelque 90 programmes télévisés au cours de sa carrière de 37 ans. Son rôle le plus long fut celui du shérif Roy Coffee dans la série western de NBC « Bonanza » (1960-1972). Il a également joué un shérif dans le film « Le Gouffre aux chimères » (1951). Teal est né à Grand Rapids, dans le Michigan. Saxophoniste, il a financé ses études à l’Université de Californie à Los Angeles en tant que chef d’orchestre avant de devenir acteur. Après plus de 15 ans à jouer dans des films et dans les débuts de la télévision, Teal obtint un rôle récurrent... </information> |
| <think> J’ai découvert que l’acteur qui jouait le shérif Roy Coffee dans « Bonanza » est Ray Teal. Je dois maintenant trouver le film qui mettait en vedette Steve Cochran et Ray Teal. </think> |
| <search> film qui mettait en vedette Steve Cochran et Ray Teal </search> |
| <information> Doc 1 (Titre : « Steve Cochran ») dans le classique de gangsters « White Heat » (1949). Il apparaissait aux côtés de Mayo. Warner Bros finirait par reprendre les contrats de Cochran et de Mayo auprès de Goldwyn. Cochran soutenait Joan Crawford dans « The Damned Don’t Cry » (1950), puis reçut son premier rôle principal dans « Highway 301 » (1950), où il jouait un gangster. Il était le méchant face au héros Gary Cooper dans « Dallas » (1950), et jouait un membre du Ku Klux Klan dans « Storm Warning » (1951), avec Ginger Rogers et Doris Day. Cochran était un méchant dans « Canyon Pass » (1951), un western, puis reçut le rôle principal dans « Inside the Walls of Folsom Prison » (1951), qui inspira... |
| <information> |
| <think> J’ai découvert que Steve Cochran a joué dans plusieurs films. Je dois maintenant trouver le film dans lequel jouait aussi Ray Teal. </think> |
| <search> film qui mettait en vedette Steve Cochran et Ray Teal </search> |
| <information> Doc 1 (Titre : « Steve Cochran ») dans le classique de gangsters « White Heat » (1949). Il apparaissait aux côtés de Mayo. Warner Bros finirait par reprendre les contrats de Cochran et de Mayo auprès de Goldwyn. Cochran soutenait Joan Crawford dans « The Damned Don’t Cry » (1950), puis reçut son premier rôle principal dans « Highway 301 » (1950), où il jouait un gangster. Il était le méchant face au héros Gary Cooper dans « Dallas » (1950), et jouait un membre du Ku Klux Klan dans « Storm Warning » (1951), avec Ginger Rogers et Doris Day. Cochran était un méchant dans « Canyon Pass » (1951), un western, puis reçut le rôle principal dans « Inside the Walls of Folsom Prison » (1951), qui inspira... |
| <information> |
| <think> J’ai découvert que Steve Cochran a joué dans plusieurs films. Je dois maintenant trouver le film dans lequel jouait aussi Ray Teal. Je vais chercher le film qui mettait en vedette à la fois Steve Cochran et Ray Teal. </think> |
| <search> film réalisé par Sam Peckinpah qui mettait en vedette Steve Cochran et Ray Teal </search> |
| <information> Doc 1 (Titre : « Sam Peckinpah ») Rempli d’explosions, de poursuites en voiture et de fusillades intenses, le film devint le plus grand succès financier de Peckinpah à ce jour, rapportant plus de 25 millions de dollars au box-office. Bien qu’il s’agisse strictement d’un produit commercial, les touches créatives de Peckinpah abondent tout au long, notamment durant la séquence d’ouverture à l’montage complexe, lorsque le personnage de McQueen souffre des pressions de la vie carcérale. Le film reste populaire et a été refait en 1994, avec Alec Baldwin et Kim Basinger. L’année 1973 marqua le début de la période la plus difficile de la vie et de la carrière de Peckinpah. Alors qu’il tournait encore « The Getaway » à El Paso, au Texas, Peckinpah traversa clandestinement la frontière... </information> |
| <think> J’ai découvert que Sam Peckinpah a réalisé le film « The Wild Bunch » qui mettait en vedette Steve Cochran et Ray Teal. </think> |
| <answer> Sam Peckinpah </answer> |
| Contexte en lecture seule pour comprendre la source (il ne s'agit pas du texte source à traduire) : |
| <answer> Ronald Ryan </answer> |
| Tableau 20 : étude de cas 11 de SEARCH-R1 (échec) : le LLM peut être induit en erreur par des informations récupérées non pertinentes et fournir une mauvaise réponse. |
| Texte à traduire : |
| Question : Où est basée l'entreprise qui a distribué le single « Revenge » de XXXTentacion ? Vérité de référence : San Francisco, Californie SEARCH-R1 : <think> Je dois trouver l'entreprise qui a distribué le single « Revenge » de XXXTentacion. Je vais faire une recherche. </think> <search> entreprise de distribution du single « Revenge » de XXXTentacion </search> <information> Doc 1 (Titre : « Revenge (mixtape de XXXTentacion) ») Revenge (mixtape de XXXTentacion) Revenge est une mixtape du rappeur américain XXXTentacion, sortie le 16 mai 2017 par Empire Distribution. Elle se compose de huit chansons déjà sorties, disponibles en streaming sur SoundCloud de XXXTentacion. Elle a été précédée par le single principal « Look at Me », qui a atteint la 34e place du Hot 100 du « Billboard » américain. Le single principal de la mixtape, intitulé « Look at Me », a été présenté pour la première fois le 31 décembre 2015 sur SoundCloud. La chanson a ensuite été publiée sur iTunes en tant que single le 29 janvier 2016, avant d'être de nouveau diffusée en téléchargement numérique avec une version remasterisée et propre... </information> |
| <think> J'ai découvert que l'entreprise qui a distribué le single « Revenge » de XXXTentacion est Empire Distribution. Je dois maintenant trouver l'emplacement de l'entreprise. </think> <search> emplacement d'Empire Distribution </search> <information> Doc 1 (Titre : « Empire Distribution ») Empire Distribution EMPIRE Distribution, Records and Publishing Inc. (commercialisée sous le nom d'EMPIRE) est une entreprise de distribution et un label discographique américain fondé en 2010 par Ghazi Shami et dont le siège est à San Francisco, en Californie, avec des bureaux à New York et Atlanta. Elle a publié des albums de divers genres tels que le R&B, le reggae, le rock, le gospel, la musique latine, la country et la pop, mais elle se concentre principalement sur le hip-hop. Des entreprises et des artistes tels que Top Dawg Entertainment (Kendrick Lamar, Schoolboy Q, Ab-Soul), Steel Wool (Anderson Paak, Watsky, Jez Dior), Jazz Anderson, Cody Wolfe, Kane Brown, Funk Volume (Dizzy Wright, Jarren Benton), ESGN (Freddie Gibbs),... </information> |
| <think> J'ai découvert que l'entreprise Empire Distribution est basée à San Francisco, en Californie. Je peux maintenant fournir la réponse. </think> <answer> San Francisco, Californie </answer> |
| Question : Cette extension de l'article de magazine de 2008 « Is Google Making Us Stoopid? » a été finaliste pour quel prix ? |
| Vérité de référence : Prix Pulitzer |
| SEARCH-R1 : |
| <think>Je dois déterminer pour quel prix cette extension de l'article de magazine de 2008 « Is Google Making Us Stoopid? » a été finaliste. Je vais faire une recherche. </think> |
| <search>Cette extension de l'article de magazine de 2008 « Is Google Making Us Stoopid? » a été finaliste pour quel prix </search> |
| <information>Doc 1 (Titre : « Is Google Making Us Stupid? ») Is Google Making Us Stupid? Is Google Making Us Stupid? What the Internet Is Doing to Our Brains (alternativement Is Google Making Us Stupid?) est un article de magazine du journaliste technologique Nicholas G. Carr, et est très critique envers l'effet d'Internet sur la cognition. Il a été publié dans l'édition de juillet/août 2008 du magazine « The Atlantic » comme article de couverture de six pages. L'argument principal de Carr est qu'Internet pourrait avoir des effets néfastes sur la cognition qui diminuent la capacité de concentration et de contemplation. Malgré le titre, l'article ne vise pas spécifiquement Google, mais plutôt l'impact cognitif de... </information> |
| <think>J'ai découvert que l'extension de l'article de magazine de 2008 « Is Google Making Us Stoopid? » a été finaliste pour un prix. Je dois déterminer pour quel prix elle a été finaliste. </think> |
| <search>pour quel prix l'extension de l'article de magazine de 2008 « Is Google Making Us Stoopid? » a-t-elle été finaliste </search> |
| <information>Doc 2 (Titre : « Is Google Making Us Stupid? ») non concluant et a déclaré qu'« il faudra du temps avant qu'il soit clair si nous devons pleurer les anciennes manières, célébrer les nouvelles, ou apprendre à arrêter de nous inquiéter et à aimer le Net ». Is Google Making Us Stupid? Is Google Making Us Stupid? What the Internet Is Doing to Our Brains (alternativement Is Google Making Us Stupid?) est un article de magazine du journaliste technologique Nicholas G. Carr, et est très critique envers l'effet d'Internet sur la cognition. Il a été publié dans l'édition de juillet/août 2008 du magazine « The Atlantic » comme article de couverture de six pages. L'argument principal de Carr est qu'Internet pourrait avoir des effets néfastes sur la cognition qui diminuent la capacité de concentration et de contemplation. Malgré le titre, l'article ne vise pas spécifiquement Google, mais plutôt l'impact cognitif de... </information> |
| <answer>National Magazine Award</answer> |
| Question : Qui était pianiste, Maro Ajemian ou Richard C. Sarafian ? |
| Vérité de référence : Maro Ajemian |
SEARCH-R1 :<think>Je dois déterminer si Maro Ajemian ou Richard C. Sarafian était pianiste. Je vais faire une recherche.</think><search> qui était pianiste, Maro Ajemian ou Richard C. Sarafian </search><information> Doc 1 (Titre : « Maro Ajemian ») Maro Ajemian Maro Ajemian (9 juillet 1921 – 18 septembre 1978) était une pianiste américaine. La carrière d'Ajemian dans la musique contemporaine est née de son héritage arménien. Elle s'est fait connaître comme pianiste contemporaine après avoir interprété la première américaine du Concerto pour piano d'Aram Khachaturian, qu'elle a choisi de jouer en raison de leur héritage arménien commun. Ajemian a étudié à la Juilliard School of Music. Le 14 mars 1942, elle a donné la première américaine du Concerto pour piano en ré bémol d'Aram Khachaturian avec le Juilliard Graduate Orchestra sous la direction d'Albert Stoessel. Elle a ensuite interprété l'œuvre lors d'une tournée à travers le pays. Après ses interprétations du ... </information><think> J'ai découvert que Maro Ajemian était pianiste. Je dois maintenant vérifier si Richard C. Sarafian était pianiste ou non. </think><search> qui était Richard C. Sarafian </search><information> Doc 1 (Titre : « Richard C. Sarafian ») Richard C. Sarafian Richard Caspar Sarafian (28 avril 1930 – 18 septembre 2013) était un réalisateur et acteur américain de télévision et de cinéma. Il a mené une carrière polyvalente qui s'est étendue sur plus de cinq décennies en tant que réalisateur, acteur et scénariste. Sarafian est surtout connu comme le réalisateur du film de 1971 « ». Sarafian est né à New York City le 28 avril 1930, de parents immigrants arméniens. Il a étudié le droit et la médecine préparatoires à l'Université de New York et était un piètre étudiant, mais il s'est réorienté vers l'étude du cinéma, où il excellait. Il a quitté l'université pour rejoindre l'armée américaine, dans laquelle ... </information><think> J'ai découvert que Richard C. Sarafian était réalisateur et acteur de télévision et de cinéma. Je peux maintenant comparer avec Maro Ajemian, qui était pianiste. </think><answer> Maro Ajemian </answer> |
| Contexte en lecture seule pour comprendre la source (il ne s'agit pas du texte source à traduire) : <answer> Ronald Ryan </answer> Tableau 20 : Étude de cas SEARCH-R1 n° 11 (échec) : Le LLM peut être induit en erreur par des informations récupérées non pertinentes et fournir une mauvaise réponse. Texte à traduire : Question : Qui est l'aîné, Jed Hoyer ou John William Henry II ? |
| Vérité de référence : John William Henry II |
SEARCH-R1 :<think> Je dois déterminer si Jed Hoyer ou John William Henry II est l'aîné. Je vais rechercher leurs âges.</think><search> Jed Hoyer ou John William Henry II </search><information> Doc 1 (Titre : « Jed Hoyer ») record de carrière en sauvetages avec Sam Elias et Nick Miceli. Pendant son séjour à l'université Wesleyan, il a également été initié à Delta Kappa Epsilon et en est un frère. Il a passé l'été 1995 sur la liste des Waterbury Barons de la New England Collegiate Baseball League, lançant sur le monticule et jouant à l'arrêt-court. Hoyer a travaillé au bureau des admissions puis au bureau des anciens/développement, et a également été entraîneur de baseball à l'université après l'obtention de son diplôme. Il a travaillé au service des admissions du Kenyon College avant de rejoindre les Red Sox à 28 ans. Il a épousé Merrill Muckerman en juin 2010 à ... </information><think> J'ai découvert que Jed Hoyer est une personne. Je dois maintenant trouver son âge et le comparer à l'âge de John William Henry II.</think><search> John William Henry II </search><information> Doc 1 (Titre : « John W. Henry ») la gestion de l'entreprise était passée de 2,5 milliards de dollars en 2006 à moins de 100 millions de dollars fin 2012. En juillet 2017, « Forbes » estimait sa valeur nette à 2,6 milliards de dollars. John William Henry II est né le 13 septembre 1949 à Quincy, dans l'Illinois. Ses parents étaient producteurs de soja, et il a partagé son enfance entre l'Illinois et l'Arkansas. Son état asthmatique à l'âge de 15 ans a incité sa famille à déménager à Apple Valley, en Californie. Après avoir obtenu son diplôme du Victor Valley High School à Victorville, il a fréquenté le Victor Valley College, puis l'Université de Californie (à Riverside, ... </information><think> J'ai découvert que John William Henry II est né le 13 septembre 1949. Je dois maintenant trouver l'année de naissance de Jed Hoyer pour comparer.</think><search> année de naissance de Jed Hoyer </search><information> Doc 1 (Titre : « Jed Hoyer ») record de carrière en sauvetages avec Sam Elias et Nick Miceli. Pendant son séjour à l'université Wesleyan, il a également été initié à Delta Kappa Epsilon et en est un frère. Il a passé l'été 1995 sur la liste des Waterbury Barons de la New England Collegiate Baseball League, lançant sur le monticule et jouant à l'arrêt-court. Hoyer a travaillé au bureau des admissions puis au bureau des anciens/développement, et a également été entraîneur de baseball à l'université après l'obtention de son diplôme. Il a travaillé au service des admissions du Kenyon College avant de rejoindre les Red Sox à 28 ans. Il a épousé Merrill Muckerman en juin 2010 à ... </information><think> J'ai découvert que Jed Hoyer est né le 7 décembre 1973. Je peux maintenant comparer son année de naissance à celle de John William Henry II.</think><answer> John William Henry II </answer> |
| Contexte en lecture seule pour comprendre la source (il ne s'agit pas du texte source à traduire) : <answer> Ronald Ryan </answer> Tableau 20 : Étude de cas SEARCH-R1 11 (échec) : Le LLM peut être induit en erreur par des informations récupérées non pertinentes et fournir une réponse erronée. Texte à traduire : Question : L'anthologie des plus grands Super-Héros du monde présentait l'un des quatre superhéros connus pour prononcer la phrase « SHAZAM » ; quel était son nom ? |
| Vérité de référence : Captain Marvel |
| SEARCH-R1 : |
| <think> Je dois trouver le nom de l'un des quatre superhéros connus pour prononcer la phrase « SHAZAM ». Je vais le rechercher. </think> |
| <search> L'anthologie des plus grands Super-Héros du monde présentait l'un des quatre superhéros connus pour prononcer la phrase « SHAZAM » </search> |
| <information> Doc 1 (Titre : « Shazam! (série télévisée) ») Shazam! (série télévisée) Shazam! est un programme télévisé en prise de vues réelles d'une demi-heure produit par Filmation (le premier programme de ce type du studio), basé sur le superhéros Captain Marvel, également connu sous le nom de Shazam, de la série de comics Whiz Comics de Fawcett Comics (aujourd'hui détenue par DC Comics). Le programme mettait en vedette Michael Gray dans le rôle de Billy Batson, un adolescent capable de se transformer en le superhéros Captain Marvel, interprété à l'origine par Jackson Bostwick puis par John Davey, en prononçant le mot magique « Shazam! » Avec son gardien « Mentor » (Les Tremayne), Billy parcourt le pays dans un camping-car Dodge Open Road de 1973, à la recherche d'injustices à résoudre. ... </information> |
| <think> J'ai découvert que l'anthologie des plus grands Super-Héros du monde présentait l'un des quatre superhéros connus pour prononcer la phrase « SHAZAM ». Je dois maintenant trouver leurs noms. </think> |
| <search> quatre superhéros connus pour prononcer la phrase « SHAZAM » </search> |
| <information> Doc 1 (Titre : « Captain Marvel (DC Comics) ») Captain Marvel (DC Comics) Captain Marvel, également connu sous le nom de Shazam (), est un superhéros de fiction de comic books apparaissant dans les publications de l'éditeur américain DC Comics. L'artiste C. C. Beck et le scénariste Bill Parker ont créé le personnage en 1939. Captain Marvel est apparu pour la première fois dans « Whiz Comics » #2 (daté de la couverture : février 1940), publié par Fawcett Comics. Il est l'alter ego de Billy Batson, un garçon qui, en prononçant le mot magique « SHAZAM » (acronyme de six « anciens immortels » : Solomon, Hercules, Atlas, Zeus, Achilles et Mercury), peut se transformer en un adulte costumé doté de super-force, de vitesse, de vol et d'autres ... </information> |
| <think> J'ai découvert que l'un des quatre superhéros connus pour prononcer la phrase « SHAZAM » est Captain Marvel (également connu sous le nom de Shazam). Je dois maintenant trouver les trois autres superhéros. </think> |
| <search> trois autres superhéros connus pour prononcer la phrase « SHAZAM » </search> |
| <information> Doc 2 (Titre : « Fawcett Comics ») Fawcett Comics Fawcett Comics, une division de Fawcett Publications, était l'un des plusieurs éditeurs de comic books prospères durant l'âge d'or des comic books dans les années 1940. Son personnage le plus populaire était Captain Marvel, l'alter ego du reporter radio Billy Batson, qui se transformait en héros chaque fois qu'il prononçait le mot magique « Shazam! ». Parmi les autres personnages publiés par Fawcett figurent Captain Video, Hopalong Cassidy, Ibis the Invincible, Bulletman and Bulletgirl, Spy Smasher, Captain Midnight, Phantom Eagle, Mister Scarlet and Pinky, Minute-Man, Commando Yank et Golden Arrow. Outre les comics de superhéros plus connus, Fawcett publiait également une ligne éphémère de ... </information> |
| <think> J'ai découvert que l'un des quatre superhéros connus pour prononcer la phrase « SHAZAM » est Captain Marvel (également connu sous le nom de Shazam). Je dois maintenant trouver les trois autres superhéros. Je vais les rechercher. </think> |
| <search> trois autres superhéros connus pour prononcer la phrase « SHAZAM » </search> |
| <information> Doc 3 (Titre : « Captain Marvel (DC Comics) ») série d'événements crossover. Il est l'alter ego surpuissant d'Alexander Luthor de Earth-3. Dans l'histoire, le Crime Syndicate (les analogues maléfiques de la Justice League de Earth-3) ont amené Alexander Luthor, leur prisonnier, avec eux sur Prime Earth où résident la Justice League et d'autres héros. Lex Luthor de Prime Earth et son équipe s'introduisent dans la Justice League Watchtower où le Syndicate retient Alexander en otage, et retirent le ruban adhésif sur sa bouche, permettant à Alexander de prononcer le mot magique « Mazahs! » et de se transformer en son alter ego musclé et extrêmement puissant. Tandis que le Shazam de Prime Earth est connu pour partager ses pouvoirs ... </information> |
| <think> J'ai découvert que l'un des quatre superhéros connus pour prononcer la phrase « SHAZAM » est Captain Marvel (également connu sous le nom de Shazam). Les trois autres superhéros ne sont pas mentionnés dans le résultat de recherche. Je vais fournir la réponse en me fondant sur les informations dont je dispose. </think> |
| <answer> Captain Marvel </answer> |
Tableau 20 : Étude de cas 11 de SEARCH- R1 (échec) : Le LLM peut être induit en erreur par des informations récupérées non pertinentes et fournir une mauvaise réponse.
Question : Qui a remporté la saison de The Rap Game où une candidate nommée Lady Lesharr figurait parmi ses influences ?
Vérité de référence : Mani
SEARCH- R1 : <think> Je dois trouver le gagnant de la saison de The Rap Game où une candidate nommée Lady Lesharr figurait parmi ses influences. Je vais chercher. </think>
<search> qui a remporté la saison de The Rap Game où une candidate nommée Lady Lesharr figurait parmi ses influences </search>
<information> Doc 1(Titre : « Lady Lesharr ») Act. Lesharr a fait son coming out en tant que pansexuelle en septembre 2018. Lesharr a cité Ashley Walters, Lisa Maffia, Missy Elliott et Lil Wayne comme ses principales influences. Lady Lesharr Melesha Katrina O'Garro (née le 15 décembre 1989), connue professionnellement sous le nom de Lady Lesharr (), est une rappeuse, chanteuse et productrice britannique de grime et de hip-hop originaire de Kingshurst, Solihull, Royaume-Uni. Elle est surtout connue pour sa série de freestyles « Queen's Speech », dont le quatrième est devenu viral en 2016. La concurrente de la saison 2 de « The Rap Game », Nia Kay, a déclaré que Lesharr était l'une de ses influences en raison de son originalité et de ses compétences en rap. Son freestyle suivant, ... </information>
<think> J'ai découvert que Lady Lesharr était l'une des influences de Nia Kay dans la saison 2 de The Rap Game. Maintenant, je dois trouver le gagnant de cette saison. </think>
<search> gagnant de The Rap Game saison 2 </search> <information> Doc 1(Titre : « Chandra Davis ») Chandra Davis Chandra Davis (née le 2 janvier 1978 à Détroit, Michigan), alias London Charles et Deelishis, est un mannequin américain et ancienne candidate de télé-réalité. Elle est surtout connue comme la gagnante de l'émission de télé-réalité à succès de VH1 « Flavor of Love 2 ». Davis a été candidate à la deuxième saison de Flavor of Love de VH1 (à l'âge de 29 ans). Elle a ensuite remporté la compétition lorsque Flavor Flavor l'a choisie plutôt que Tiffany « New York » Pollard, qui est revenue après avoir été précédemment nommée finaliste de la première saison de l'émission. Après FOL, Davis a annoncé qu'elle ne sortait actuellement pas avec Flavor, via un spécial de VH1, ... </information>
<think> J'ai découvert que le gagnant de la saison 2 de The Rap Game est London Charles (Chandra Davis). Je peux maintenant fournir la réponse. </think>
<answer> London Charles </answer>