
Mille exemples triés et un plafond strict de tokens de réflexion suffisent à dépasser des systèmes de raisonnement plus gros. Papier de 2025, gratuit en ligne.
s1: Simple test-time scaling
s1 : mise à l'échelle simple au moment du test
Niklas Muennighoff Zitong Yang Weijia Shi Xiang Lisa Li Li Fei-Fei Hannaneh Hajishirzi Luke Zettlemoyer Percy Liang Emmanuel Candès Tatsunori Hashimoto
Résumé
La mise à l'échelle au moment du test est une nouvelle approche prometteuse pour la modélisation du langage, qui utilise du calcul supplémentaire au moment du test pour améliorer les performances. Récemment, le modèle o1 d'OpenAI a montré cette capacité mais n'a pas partagé publiquement sa méthodologie, ce qui a conduit à de nombreux efforts de réplication. Nous cherchons l'approche la plus simple pour obtenir une mise à l'échelle au moment du test et de fortes performances de raisonnement. Premièrement, nous constituons un petit jeu de données s1K de 1 000 questions associées à des traces de raisonnement en nous appuyant sur trois critères que nous validons par des ablations : difficulté, diversité et qualité. Deuxièmement, nous développons le budget forcing pour contrôler le calcul au moment du test en terminant de force le processus de réflexion du modèle ou en le prolongeant en ajoutant plusieurs fois « Wait » à la génération du modèle lorsqu'il tente de terminer. Cela peut amener le modèle à revérifier sa réponse, corrigeant souvent des étapes de raisonnement incorrectes. Après un ajustement supervisé du modèle de langage Qwen2.5-32B-Instruct sur s1K et en l'équipant du budget forcing, notre modèle s1-32B dépasse o1-preview sur des questions de mathématiques de concours jusqu'à (MATH et AIME24). En outre, la mise à l'échelle de s1-32B avec budget forcing permet d'extrapoler au-delà de ses performances sans intervention au moment du test : de à sur AIME24. Notre modèle, nos données et notre code sont open source à l'adresse https://github.com/simplescaling/s1.
1. Introduction
Les améliorations de performance des modèles de langage (LMs) au cours des dernières années ont largement reposé sur la mise à l'échelle du calcul au moment de l'entraînement à l'aide d'un préentraînement auto-supervisé à grande échelle (Kaplan et al., 2020 ; Hoffmann et al., 2022). La création de ces modèles puissants a préparé le terrain pour un nouveau paradigme de mise à l'échelle construit par-dessus eux : la mise à l'échelle au moment du test. L'objectif
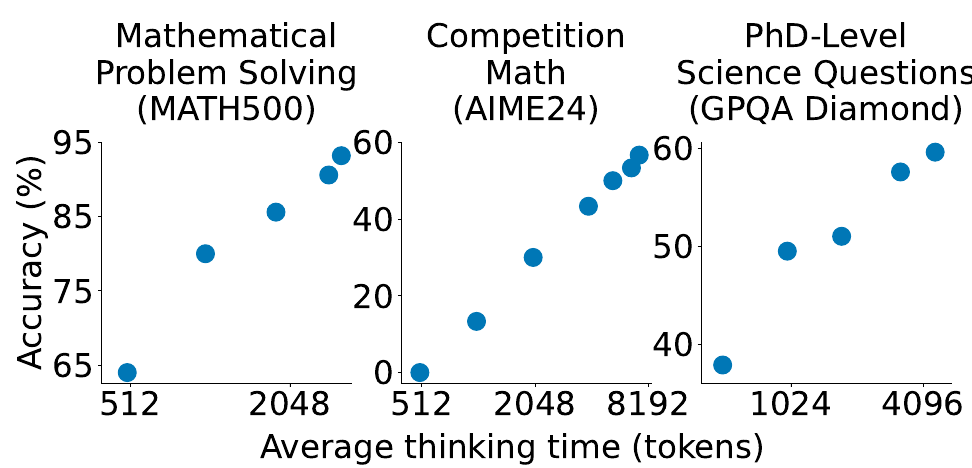
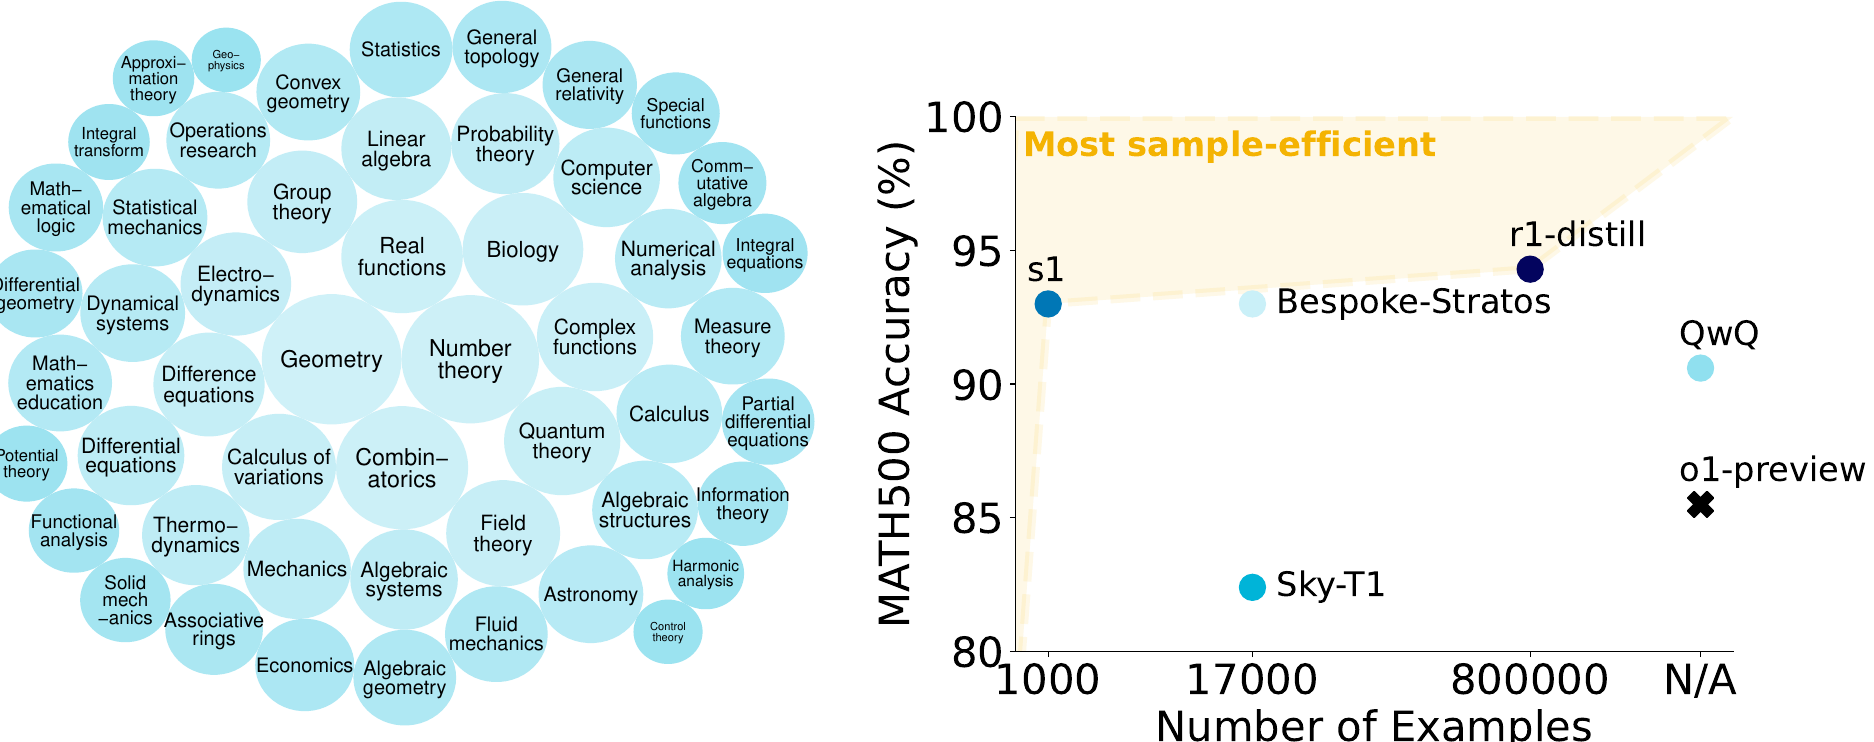
de cette approche est d'augmenter le calcul au moment du test pour obtenir de meilleurs résultats. De nombreux travaux ont exploré cette idée (Snell et al., 2024 ; Welleck et al., 2024), et la viabilité de ce paradigme a récemment été validée par OpenAI o1 (OpenAI, 2024). o1 a démontré de fortes performances de raisonnement avec des gains constants grâce à la mise à l'échelle du calcul au moment du test. OpenAI décrit son approche comme utilisant un apprentissage par renforcement (RL) à grande échelle, ce qui implique l'utilisation de quantités considérables de données (OpenAI, 2024). Cela a conduit à diverses tentatives de réplication de leurs modèles s'appuyant sur des techniques telles que la recherche arborescente de Monte-Carlo (Gao et al., 2024b ; Zhang et al., 2024a), les approches multi-agents (Qin et al., 2024), et d'autres (Wang et al., 2024a ; Huang et al., 2024b ; 2025). Parmi ces approches, DeepSeek R1 (DeepSeek-AI et al., 2025) a réussi à répliquer les performances de niveau o1, en employant également l'apprentissage par renforcement via des millions d'échantillons et plusieurs étapes d'entraînement. Cependant, malgré le grand nombre de tentatives de réplication d'o1, aucune n'a répliqué ouvertement un comportement clair de mise à l'échelle au moment du test. Nous posons donc la question suivante : quelle est l'approche la plus simple pour obtenir à la fois une mise à l'échelle au moment du test et de fortes performances de raisonnement ? Nous montrons qu'un entraînement sur seulement 1 000 échantillons avec prédiction du jeton suivant et un contrôle de la durée de réflexion via une technique simple au moment du test que nous appelons budget forcing conduit à un modèle de raisonnement performant dont les performances augmentent avec davantage de calcul au moment du test. Plus précisément, nous construisons s1K, qui consiste en 1 000 questions soigneusement sélectionnées associées à des traces de raisonnement et des réponses distillées à partir de Gemini Thinking Experimental (Google, 2024). Nous effectuons un ajustement supervisé (SFT) d'un modèle préentraîné prêt à l'emploi sur notre petit jeu de données, ce qui ne nécessite que 26 minutes d'entraînement sur 16 GPU H100. Après l'entraînement, nous contrôlons la quantité de calcul au moment du test que notre modèle utilise grâce au budget forcing : (I) Si le modèle génère plus de jetons de réflexion qu'une limite souhaitée, nous terminons de force le processus de réflexion en ajoutant un délimiteur de fin de réflexion. Terminer la réflexion de cette manière amène le modèle à passer à la génération de sa réponse. (II) Si nous voulons que le modèle consacre plus de calcul au moment du test à un problème, nous supprimons la génération du délimiteur de fin de réflexion et ajoutons plutôt « Wait » à la trace de raisonnement actuelle du modèle afin d'encourager davantage d'exploration. Grâce à cette recette simple — SFT sur 1 000 échantillons et budget forcing au moment du test — notre modèle s1-32B exhibe une mise à l'échelle au moment du test (Figure 1). En outre, s1-32B est le modèle de raisonnement le plus efficace en termes d'échantillons et surpasse des modèles propriétaires comme o1-preview d'OpenAI (Figure 2).Nous menons de nombreuses expériences d'ablation portant sur (a) notre sélection de 1 000 (1K) échantillons de raisonnement et (b) notre mise à l'échelle au moment du test. Pour (a), nous constatons qu'il est important d'intégrer conjointement des mesures de difficulté, de diversité et de qualité dans notre algorithme de sélection. Une sélection aléatoire, la sélection des échantillons ayant les traces de raisonnement les plus longues, ou la sélection d'échantillons uniquement maximisant la diversité conduisent toutes à des performances nettement inférieures (environ \(-30\%\) sur AIME24 en moyenne). L'entraînement sur l'intégralité de notre pool de données de 59K exemples, un sur-ensemble de s1K, n'apporte pas de gains substantiels par rapport à notre sélection de 1K. Cela souligne l'importance d'une sélection minutieuse des données et fait écho à des résultats antérieurs pour l'ajustement d'instructions (Zhou et al., 2023). Pour (b), nous définissons des desiderata pour les méthodes de mise à l'échelle au moment du test afin de comparer différentes approches. Le budget forcing conduit à la meilleure mise à l'échelle, car il présente une contrôlabilité parfaite avec une pente positive claire conduisant à de fortes performances.
En résumé, nos contributions sont les suivantes : nous développons des méthodes simples pour créer un jeu de données de raisonnement efficace en termes d'échantillons (§2) et une mise à l'échelle au moment du test (§3) ; sur cette base, nous construisons s1-32B, qui est compétitif avec o1-preview (§4) ; nous réalisons des ablations sur les subtilités des données (§5.1) et de la mise à l'échelle au moment du test (§5.2). Nous terminons par une discussion visant à motiver des travaux futurs sur le raisonnement simple (§6). Notre code, notre modèle et nos données sont open source à l'adresse https://github.com/simplescaling/s1.
2. Curation des données de raisonnement pour créer s1K
Dans cette section, nous décrivons notre processus de création d'un grand jeu de données d'abord en §2.1, puis son filtrage jusqu'à s1K en §2.2.
2.1. Collecte initiale de 59K échantillons
Nous collectons un ensemble initial de 59 029 questions provenant de 16 sources selon trois principes directeurs. Qualité : les jeux de données doivent être de haute qualité ; nous inspectons toujours les échantillons et ignorons les jeux de données présentant, par exemple, un mauvais formatage ; Difficulté : les jeux de données doivent être difficiles et exiger un effort de raisonnement significatif ; Diversité : les jeux de données doivent provenir de divers domaines afin de couvrir différentes tâches de raisonnement. Nous collectons des jeux de données de deux catégories :
Curation de jeux de données existants Notre plus grande source est NuminaMATH (LI et al., 2024) avec 30 660 problèmes mathématiques issus de sites web en ligne. Nous incluons également des problèmes historiques d'AIME (1983-2021). Pour renforcer la diversité, nous ajoutons OlympicArena (Huang et al., 2024a) avec 4 250 questions couvrant l'astronomie, la biologie, la chimie, l'informatique, la géographie, les mathématiques et la physique, issues de diverses olympiades. OmniMath (Gao et al., 2024a) ajoute 4 238 problèmes mathématiques de niveau concours. Nous incluons également 2 385 problèmes provenant d'AGIEval (Zhong et al., 2023), qui comporte des questions de tests standardisés comme le SAT et le LSAT, couvrant l'anglais, le droit et la logique. Nous renvoyons au Tableau 7 en §C pour nos autres sources.
Nouveaux jeux de données en raisonnement quantitatif Pour compléter ces jeux de données existants, nous créons deux jeux de données originaux. s1-prob comprend 182 questions issues de la section probabilités des examens de qualification doctorale du département de statistiques de l'Université Stanford (https://statistics.stanford.edu), accompagnées de solutions manuscrites couvrant des preuves difficiles. L'examen de qualification en probabilités est organisé chaque année et exige une résolution de problèmes mathématiques de niveau professionnel. s1-teasers comprend 23 casse-têtes stimulants couramment utilisés dans les questions d'entretien pour des postes de trading quantitatif. Chaque échantillon consiste en un problème et une solution tirés de PuzzledQuant (https://www.puzzledquant.com/). Nous ne prenons que les exemples du niveau de difficulté le plus élevé (« Hard »).
Pour chaque question, nous générons une trace de raisonnement et une solution à l'aide de l'API Google Gemini Flash Thinking (Google, 2024) en extrayant sa trace de raisonnement et sa réponse. Cela produit 59K triplets d'une question, d'une trace de raisonnement générée et d'une solution générée. Des exemples de notre jeu de données figurent en §D.2. Nous décontaminons tous les échantillons par rapport à nos questions d'évaluation (MATH500, GPQA Diamond, AIME24 ; §C.5) à l'aide de 8-grammes et dédupliquons les données.
2.2. Sélection finale de 1K échantillons
Nous pourrions directement effectuer l'entraînement sur notre ensemble de 59 K questions, mais notre objectif est de trouver l'approche la plus simple avec un minimum de ressources. Nous passons donc par trois étapes de filtrage pour aboutir à un ensemble minimal de 1 000 échantillons, en nous appuyant sur nos trois principes directeurs en matière de données : qualité, difficulté et diversité.
Qualité Nous supprimons d'abord toutes les questions pour lesquelles nous avons rencontré des erreurs d'API, ce qui réduit notre jeu de données à 54 116 échantillons. Ensuite, nous filtrons les exemples de faible qualité en vérifiant s'ils contiennent des motifs de chaînes présentant des problèmes de formatage, tels que des diagrammes en art ASCII, des références à des images inexistantes ou une numérotation incohérente des questions, ce qui réduit notre jeu de données à 51 581 exemples.
À partir de cet ensemble, nous identifions 384 échantillons pour constituer nos 1 000 échantillons finaux, issus de jeux de données que nous considérons comme de haute qualité et ne nécessitant pas de filtrage supplémentaire (voir §C.4 pour les détails).
Difficulté Pour la difficulté, nous utilisons deux indicateurs : la performance du modèle et la longueur de la trace de raisonnement. Nous évaluons deux modèles sur chaque question : Qwen2.5- 7B- Instruct et Qwen2.5- 32B- Instruct (Qwen et al., 2024), l'exactitude étant évaluée par Claude 3.5 Sonnet en comparant chaque tentative à la solution de référence (voir §C.3 pour le protocole d'évaluation). Nous mesurons la longueur en tokens de chaque trace de raisonnement pour indiquer la difficulté du problème à l'aide du tokenizer de Qwen2.5. Cela repose sur l'hypothèse que les problèmes plus difficiles nécessitent davantage de tokens de réflexion. Sur la base de l'évaluation, nous supprimons les questions que Qwen2.5- 7B- Instruct ou Qwen2.5- 32B- Instruct peut résoudre correctement et qui peuvent donc être trop faciles. En utilisant deux modèles, nous réduisons la probabilité qu'un échantillon facile passe au travers de notre filtrage en raison d'une erreur rare sur une question facile de l'un des modèles. Cela ramène notre total d'échantillons à 24 496, ce qui prépare la prochaine série de sous-échantillonnage fondée sur la diversité. Bien que le filtrage avec ces deux modèles puisse être optimisé pour notre configuration, puisque nous utiliserons également Qwen2.5- 32B- Instruct comme modèle à affiner, l'idée d'un filtrage fondé sur les modèles se généralise à d'autres configurations.
Diversité Pour quantifier la diversité, nous classons les questions en domaines à l'aide de Claude 3.5 Sonnet sur la base du système de classification des mathématiques (MSC) (par exemple, géométrie, combinatoire, etc.) de l'American Mathematical Society. La taxonomie porte sur des sujets mathématiques mais inclut également d'autres sciences telles que la biologie, la physique et l'éco1nomie. Pour sélectionner nos exemples finaux parmi un ensemble de 24 496 questions, nous choisissons d'abord un domaine uniformément au hasard. Ensuite, nous échantillonnons un problème de ce domaine selon une distribution qui privilégie les traces de raisonnement plus longues (voir §C.4 pour les détails), comme motivé dans la section Difficulté. Nous répétons ce processus jusqu'à obtenir 1 000 échantillons au total couvrant 50 domaines.
Au §5.1, nous montrerons que l'utilisation combinée de nos trois critères est importante, car se fier uniquement à la qualité, à la diversité ou à la difficulté de manière isolée conduit à de moins bons jeux de données. Certaines générations distillées sont incorrectes, ce que nous autorisons dans nos données car nous cherchons à capturer le processus de raisonnement plutôt que des solutions entièrement correctes. Notre évaluateur (§C.3) juge 53,6 % correctes dans s1K et 63,0 % dans notre version ultérieure s1K-1.1 (voir §A).
3. Mise à l'échelle au moment du test
3.1. Méthode
Nous classons les méthodes de mise à l'échelle au moment du test en 1) Séquentielles, où les calculs ultérieurs dépendent des précédents (par exemple, une longue trace de raisonnement), et 2) Parallèles, où les calculs s'exécutent indépendamment (par exemple, le vote majoritaire) (Snell et al., 2024 ; Brown et al., 2024). Nous nous concentrons sur la mise à l'échelle séquentielle car nous pensons intuitivement qu'elle devrait mieux passer à l'échelle, puisque les calculs ultérieurs peuvent s'appuyer sur les résultats intermédiaires, permettant un raisonnement plus profond et un raffinement itératif. Nous proposons de nouvelles méthodes de mise à l'échelle séquentielle et des moyens de les évaluer.
Budget forcing Nous proposons une intervention simple au moment du décodage en imposant un nombre maximum et/ou minimum de tokens de réflexion. Plus précisément, nous imposons un nombre maximal de tokens en ajoutant simplement le délimiteur de token de fin de réflexion et éventuellement « Final Answer: » pour sortir précocement
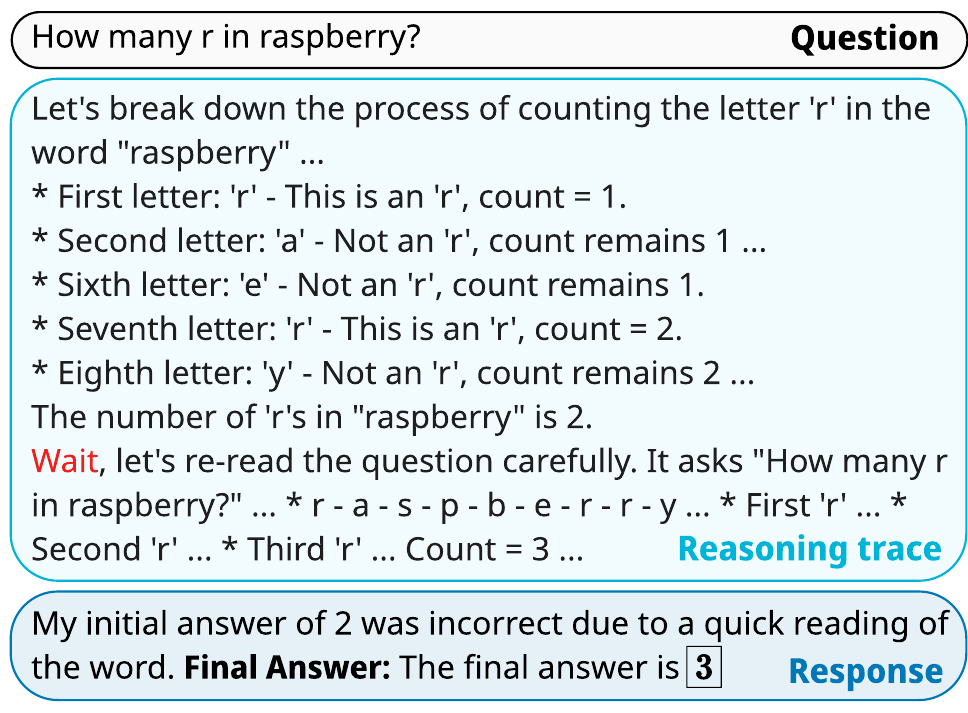
de la phase de réflexion et amener le modèle à fournir sa meilleure réponse actuelle. Pour imposer un minimum, nous supprimons la génération du délimiteur de token de fin de réflexion et ajoutons éventuellement la chaîne « Wait » à la trace de raisonnement actuelle du modèle pour l'encourager à réfléchir à sa génération en cours. La figure 3 contient un exemple de la façon dont cette approche simple peut amener le modèle à parvenir à une meilleure réponse.
Références de comparaison Nous évaluons le budget forcing par rapport à : (I) les méthodes de contrôle conditionnel de la longueur, qui consistent à indiquer au modèle dans le prompt la durée pendant laquelle il doit générer. Nous les regroupons par granularité en (a) contrôle conditionnel par tokens : nous spécifions dans le prompt une borne supérieure de tokens de réflexion ; (b) contrôle conditionnel par étapes : nous spécifions une borne supérieure d'étapes de réflexion, où chaque étape compte environ 100 tokens ; (c) contrôle conditionnel par classe : nous rédigeons deux prompts génériques qui indiquent au modèle de réfléchir pendant une durée courte ou longue (voir §E.1 pour les détails). (II) l'échantillonnage par rejet, qui échantillonne jusqu'à ce qu'une génération respecte un budget de calcul prédéterminé. Cet oracle capture la postérieure sur les réponses conditionnées par leur longueur.
3.2. Métriques
Nous établissons un ensemble de propriétés souhaitables comme métriques d'évaluation pour mesurer la mise à l'échelle au moment du test selon les méthodes. Il est important de noter que nous ne nous intéressons pas seulement à la précision qu'une méthode peut atteindre, mais aussi à sa contrôlabilité et à sa pente de mise à l'échelle au moment du test. Pour chaque méthode considérée, nous exécutons un ensemble d'évaluations en faisant varier le calcul au moment du test sur un benchmark fixe, par exemple AIME24. Cela produit une fonction linéaire par morceaux avec le calcul en abscisse, mesuré en tokens de réflexion, et la précision en ordonnée (voir la figure 1, où le point le plus à droite pour AIME24 correspond à ). Nous mesuronstrois métriques :
où désignent une quantité minimale et maximale prédéfinie de calcul au moment du test ; dans notre cas, des tokens de réflexion. Nous ne contraignons généralement que . Comme les tokens générés correspondent à la quantité de calcul au moment du test dépensée, cette métrique mesure dans quelle mesure une méthode permet de contrôler l'utilisation de ce calcul au moment du test. Nous la rapportons en pourcentage, correspondant à un contrôle parfait.
Scaling est la pente moyenne de la fonction linéaire par morceaux. Elle doit être positive pour que les méthodes soient utiles, et plus elle est grande, mieux c'est.
Performance est simplement la performance maximale atteinte par la méthode sur le benchmark. Une méthode dont la mise à l'échelle est monotone croissante atteint de performance sur tout benchmark à la limite. Cependant, les méthodes que nous étudions finissent par plafonner ou la mise à l'échelle échoue ensuite en raison de limitations de contrôle ou de fenêtre de contexte.
4. Résultats
4.1. Configuration
Entraînement Nous effectuons un affinage supervisé sur Qwen2.5-32B-Instruct en utilisant s1K pour obtenir notre modèle s1-32B, avec les hyperparamètres de base décrits au §D. L'affinage a pris 26 minutes sur 16 GPU NVIDIA H100 avec PyTorch FSDP.
Évaluation Nous sélectionnons trois benchmarks de raisonnement représentatifs largement utilisés dans le domaine : AIME24 (of America, 2024) comporte 30 problèmes qui ont été utilisés lors de l'American Invitational Mathematics Examination (AIME) 2024, tenue du 31 janvier au 1er février 2024. L'AIME teste la résolution de problèmes mathématiques avec l'arithmétique, l'algèbre, le dénombrement, la géométrie, la théorie des nombres, les probabilités et d'autres sujets mathématiques du secondaire. Les lycéens ayant obtenu de bons scores au test sont invités à participer à l'United States of America Mathematics Olympiad (USAMO). Toutes les réponses de l'AIME sont des entiers allant de 000 à 999 inclus. Certains problèmes de l'AIME reposent sur des figures que nous fournissons à notre modèle à l'aide du langage graphique vectoriel Asymptote, car il ne peut pas prendre d'images en entrée. MATH500 (Hendrycks et al., 2021) est un benchmark de problèmes mathématiques de compétition de difficulté variable. Nous évaluons sur les mêmes 500 échantillons sélectionnés par OpenAI dans des travaux antérieurs (Lightman et al., 2023). GPQA Diamond (Rein et al., 2023) se compose de 198 questions scientifiques de niveau doctorat
en biologie, chimie et physique. Des experts titulaires d'un doctorat dans les domaines correspondants n'ont atteint que sur GPQA Diamond (OpenAI, 2024). Lorsque nous écrivons « GPQA » dans le contexte de l'évaluation dans ce travail, nous faisons toujours référence au sous-ensemble Diamond. Nous nous appuyons sur le framework « lm-evaluation-harness » (Gao et al., 2021 ; Biderman et al., 2024). Sauf indication contraire, nous évaluons avec une température de 0 (greedy) et mesurons la précision (équivalente à pass@1).
Autres modèles Nous comparons s1-32B à : la série OpenAI o1 (OpenAI, 2024), des modèles à source fermée qui ont popularisé la mise à l'échelle au moment du test ; la série DeepSeek r1 (DeepSeek-AI et al., 2025), des modèles de raisonnement à poids ouverts atteignant des performances de niveau o1 ; QwQ-32B-preview de Qwen (Team, 2024), un modèle de raisonnement à poids ouverts de 32B dont la méthodologie n'est pas divulguée ; Sky-T1-32B-Preview (Team, 2025) et Bespoke-32B (Labs, 2025), des modèles ouverts avec des données de raisonnement ouvertes distillées à partir de QwQ-32B-preview et r1 ; Google Gemini 2.0 Flash Thinking Experimental (Google, 2024), l'API dont nous distillons. Comme il n'a pas de scores d'évaluation officiels, nous l'évaluons nous-mêmes à l'aide de l'API Gemini. Cependant, l'« erreur de récitation » de l'API Gemini rend l'évaluation difficile.2 Nous contournons cela en insérant manuellement les 30 questions d'AIME24 dans son interface web, où l'erreur n'apparaît pas. Cependant, nous omettons MATH500 (500 questions) et GPQA Diamond (198 questions), qui sont donc N.A. dans le tableau 1. Notre modèle, s1-32B, est entièrement ouvert, y compris les poids, les données de raisonnement et le code.
| Modèle | ex. | AIME 2024 | MATH 500 | GPQA Diamond |
| API uniquement | ||||
| o1-preview | N.D. | 44,6 | 85,5 | 73,3 |
| o1-mini | N.D. | 70,0 | 90,0 | 60,0 |
| o1 | N.D. | 74,4 | 94,8 | 77,3 |
| Gemini 2.0 | N.D. | 60,0 | N.D. | N.D. |
| Flash Think. | ||||
| Poids ouverts | ||||
| Qwen2.5-32B-Instruct | N.D. | 26,7 | 84,0 | 49,0 |
| QwQ-32B | N.D. | 50,0 | 90,6 | 54,5 |
| r1 | ≥800K | 79,8 | 97,3 | 71,5 |
| r1-distill | 800K | 72,6 | 94,3 | 62,1 |
| Poids ouverts et données ouvertes | ||||
| Sky-T1 | 17K | 43,3 | 82,4 | 56,8 |
| Bespoke-32B | 17K | 63,3 | 93,0 | 58,1 |
| s1 sans BF | 1K | 50,0 | 92,6 | 56,6 |
| s1-32B | 1K | 56,7 | 93,0 | 59,6 |
| Qwen2.5-32B-Instruct | |||
| N.A. | 26,7 | 84,0 | QwQ-32B |
| N.A. | 50,0 | 90,6 | r1 |
| ≥800K | 79,8 | 97,3 | r1-distill |
| 800K | 72,6 | 94,3 | Poids ouverts et données ouvertes |
| Sky-T1 | |||
| 17K | 43,3 | 82,4 | Bespoke-32B |
| 17K | 63,3 | 93,0 | s1 sans BF |
| 1K | 50,0 | 92,6 | s1-32B |
| 1K | 56,7 | 93,0 | |
4.2. Performance
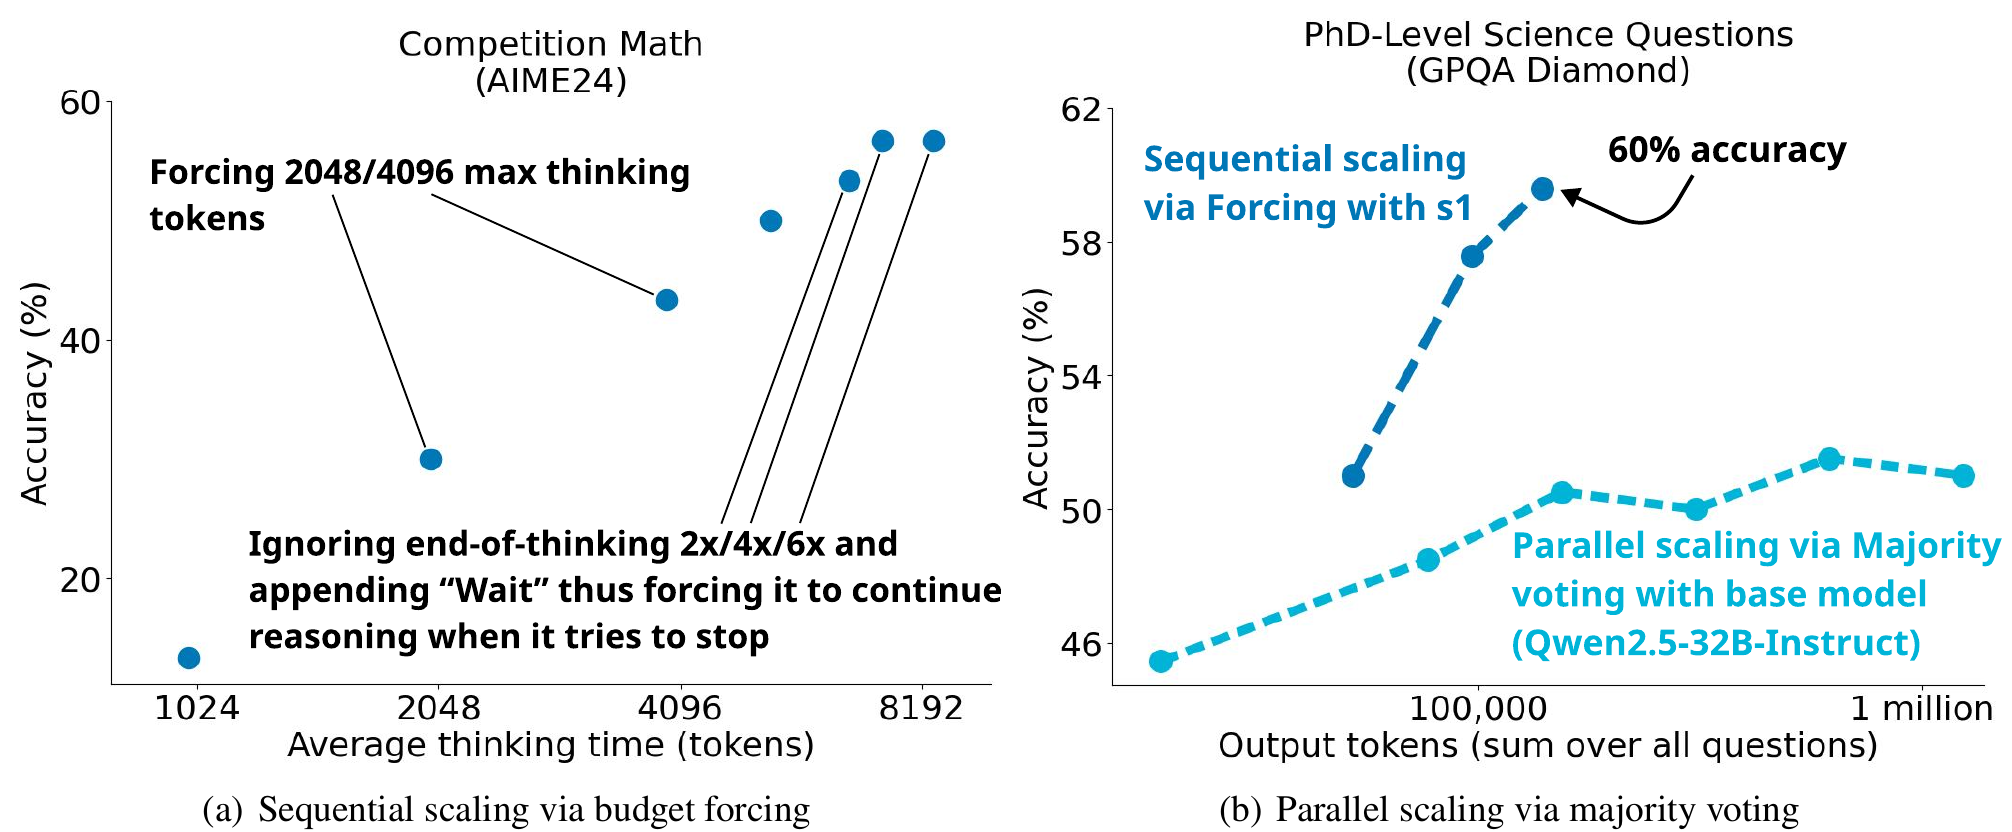
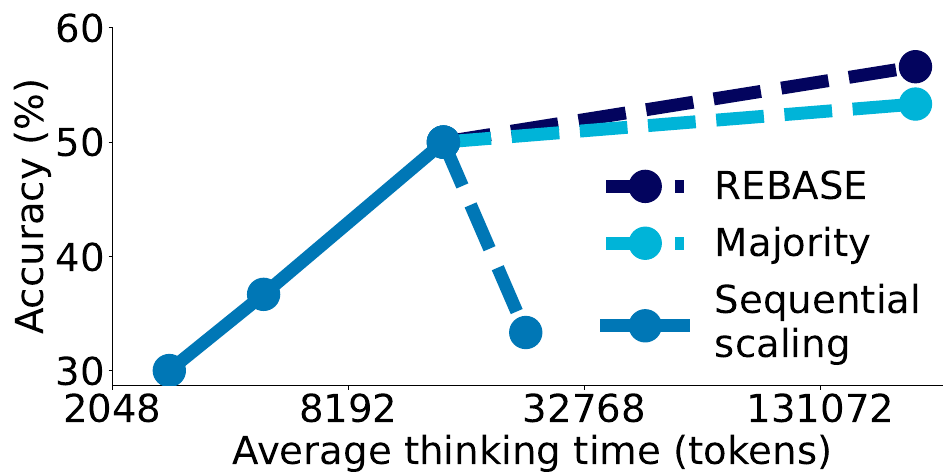
Mise à l’échelle au moment du test La figure 1 montre que les performances de s1-32B avec budget forcing s’améliorent avec davantage de calcul au moment du test. Dans la figure 4 (à gauche), nous élargissons le graphique de la figure 1 (au milieu), montrant que, bien que nous puissions améliorer les performances sur AIME24 grâce à notre technique de budget forcing (§3) et à davantage de calcul au moment du test, celles-ci finissent par plafonner à six fois. Supprimer trop souvent le délimiteur de fin de réflexion peut conduire le modèle à entrer dans des boucles répétitives au lieu de poursuivre son raisonnement. Dans la figure 4 (à droite), nous montrons qu’après avoir entraîné Qwen2.5-32B-Instruct sur nos 1 000 échantillons pour produire s1-32B et l’avoir équipé de la simple technique de budget forcing, il opère dans un autre paradigme de mise à l’échelle. Mettre à l’échelle le calcul au moment du test sur le modèle de base via un vote majoritaire ne peut pas rattraper les performances de s1-32B, ce qui valide notre intuition du §3 selon laquelle la mise à l’échelle séquentielle est plus efficace que la parallèle. Nous fournissons des exemples de générations de s1-32B dans la figure 5.
Efficacité en termes d’échantillons Dans la figure 2 (à droite) et le tableau 1, nous comparons s1-32B avec d’autres modèles. Nous constatons que s1-32B est le modèle de raisonnement à données ouvertes le plus efficace en termes d’échantillons. Il obtient des performances nettement meilleures que notre modèle de base (Qwen2.5-32B-Instruct) malgré un entraînement sur seulement 1 000 échantillons supplémentaires. Le modèle r1-32B publié simultanément montre des performances supérieures à s1-32B tout en utilisant également uniquement du SFT (DeepSeek-AI et al., 2025). Cependant, il est entraîné sur plus d’échantillons de raisonnement. Savoir si l’on peut atteindre leurs performances avec seulement 1 000 échantillons reste une question ouverte. Enfin, notre modèle égale presque Gemini 2.0 Thinking sur AIME24. Comme les données de s1-32B sont distillées à partir de Gemini 2.0, cela montre que notre procédure de distillation a probablement été efficace.
5. Ablations
5.1. Quantité, diversité et difficulté des données
Dans le §2, nous avons présenté nos trois principes directeurs pour constituer s1K : qualité, difficulté et diversité. Nous testons ici l’importance de les combiner et l’efficacité globale de notre sélection. Qualité uniquement (1K-random) : après avoir obtenu nos chaînes de raisonnement de haute qualité à partir de Gemini, nous sélectionnons 1 000 échantillons au hasard, sans nous appuyer du tout sur notre filtrage par difficulté et diversité. Le tableau 2 montre que cette approche est bien moins performante que s1K sur tous les benchmarks. Diversité uniquement (1K-diverse) : pour ce jeu de données, nous échantillonnons uniformément entre les domaines afin de maximiser la diversité, sans tenir compte d’aucune notion de difficulté. Cette approche conduit également à de faibles performances, similaires à celles de 1K-random. Difficulté uniquement (1K-longest) : ici, nous nous appuyons sur l’un de nos indicateurs de difficulté introduits au §2 en sélectionnant les 1 000 échantillons ayant les traces de raisonnement les plus longues. Cette approche améliore significativement les performances sur GPQA, mais reste globalement inférieure à l’utilisation de s1K. Maximiser la quantité :
| Modèle | AIME 2024 | MATH 500 | GPQA Diamond |
| 1K-aléatoire | 36,7 | 90,6 | 52,0 |
| [-26,7 %, -3,3 %] | [-4,8 %, 0,0 %] | [-12,6 %, 2,5 %] | |
| 1K-diversifié | 26,7 | 91,2 | 54,6 |
| [-40,0 %, -10,0 %] | [-4,0 %, 0,2 %] | [-10,1 %, 5,1 %] | |
| 1K-le plus long | 33,3 | 90,4 | 59,6 |
| [-36,7 %, 0,0 %] | [-5,0 %, -0,2 %] | [-5,1 %, 10,1 %] | |
| 59K-complet | 53,3 | 92,8 | 58,1 |
| [-13,3 %, 20,0 %] | [-2,6 %, 2,2 %] | [-6,6 %, 8,6 %] | |
| s1K | 50,0 | 93,0 | 57,6 |
Enfin, nous comparons avec un entraînement sur l’ensemble de nos 59K échantillons, un sur-ensemble de toutes les versions à 1K échantillons. Cela conduit à un modèle solide, mais utilise beaucoup plus de ressources. Pour affiner sur 59K échantillons, nous utilisons 394 heures GPU H100, tandis que s1-32B n’a nécessité que 7 heures GPU H100. De plus, s’appuyer uniquement sur s1K est extrêmement compétitif, comme le montre le §2. Dans l’ensemble, combiner les trois critères — qualité, difficulté, diversité — via notre méthodologie du §2 est essentiel pour un entraînement au raisonnement efficace en termes d’échantillons.
5.2. Méthodes de mise à l’échelle au moment du test
| Méthode | Contrôle | Mise à l'échelle | Performance | |A| |
| BF | 100% | 15 | 56,7 | 5 |
| TCC | 40% | -24 | 40,0 | 5 |
| TCC + BF | 100% | 13 | 40,0 | 5 |
| SCC | 60% | 3 | 36,7 | 5 |
| SCC + BF | 100% | 6 | 36,7 | 5 |
| CCC | 50% | 25 | 36,7 | 2 |
| RS | 100% | -35 | 40,0 | 5 |
[AIME24]
Alice et Bob jouent au jeu suivant. Une pile de jetons se trouve devant eux. Les joueurs jouent à tour de rôle, Alice commençant. À chaque tour, le joueur retire soit 1 jeton, soit 4 jetons de la pile. Celui qui retire le dernier jeton gagne. Trouver le nombre d’entiers positifs inférieurs ou égaux à 2024 pour lesquels il existe une stratégie pour Bob garantissant que Bob gagnera la partie quel que soit le jeu d’Alice.
Le problème demande le nombre d’entiers positifs tels que Bob ait une stratégie gagnante. Il s’agit d’un jeu impartial typique qui peut être analysé à l’aide du théorème de Sprague-Grundy ou en trouvant directement les positions gagnantes et perdantes. Soit l’ensemble des positions gagnantes (nombre de jetons tel que le joueur dont c’est le tour peut forcer une victoire) et l’ensemble des positions perdantes. [...]
Soit l’énoncé « le joueur dont c’est le tour lorsqu’il y a jetons a une stratégie gagnante ». est faux (le joueur dont c’est le tour et qui fait face à 0 jeton a déjà perdu). Considérons les petites valeurs de . : le joueur dont c’est le tour peut prendre 1 jeton et gagner. Donc est vrai. . : le joueur dont c’est le tour peut prendre 1 jeton, laissant 1 jeton à l’adversaire. Comme , l’adversaire gagne. Donc est faux. . : le joueur dont c’est le tour peut prendre 1 jeton, laissant 2 jetons à l’adversaire. Comme , le joueur dont c’est le tour gagne. Donc est vrai. . ...]
Nous cherchons le nombre d’entiers positifs pour lesquels Bob a une stratégie gagnante. Cela signifie que si la partie commence avec jetons et qu’Alice commence, Bob peut gagner. Cela se produit si et seulement si est une position perdante (car si , alors le premier coup d’Alice doit conduire à une position gagnante pour Bob). [...]
Essayons de trouver un motif dans les positions perdantes . Différences entre termes consécutifs : 2,3,2,3,2,3,2,3,2, ... Le motif des différences alterne 2,3. [...] Les positions perdantes sont de la forme ou où . Nous devons trouver le nombre d’entiers positifs qui appartiennent à l’ensemble des positions perdantes ...]
Cas 1 : , où . Comme est un entier, . Le nombre de valeurs de est 404. Cas 2 : , où . Comme est un entier, . Le nombre de valeurs de est .
Le nombre total d’entiers positifs qui sont des positions perdantes est .
[MATH500]
Trouver la projection de sur si
La projection du vecteur sur le vecteur est donnée par la formule :
On nous donne et
Tout d'abord, nous devons trouver le carré de la norme de , qui est .
Nous pouvons maintenant insérer les valeurs dans la formule de projection :
Substituer le vecteur :
Multiplier le scalaire par chaque composante du vecteur :
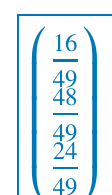
Réponse finale : La réponse finale est
Une particule de mécanique quantique de masse se déplace en deux dimensions dans le potentiel suivant, en fonction des coordonnées polaires .
Trouver le spectre d'énergie. Indice : écrire le potentiel en coordonnées cartésiennes.
Le problème demande le spectre d'énergie d'une particule dans un potentiel 2D donné. Le potentiel est donné en coordonnées polaires :
Nous pouvons réécrire le potentiel comme :
L'hamiltonien d'une particule en 2D est donné par :
En coordonnées polaires , l'opérateur laplacien est :
Ainsi, l'hamiltonien en coordonnées polaires est :
L'équation de Schrödinger indépendante du temps est . Nous pouvons essayer de séparer les variables en supposant une solution de la forme . [...]
Cela confirme que le spectre d'énergie est :
Réponse finale :
Forçage de budget Dans le tableau 3, nous comparons les méthodes de mise à l'échelle au moment du test que nous avons introduites au §3 . Dans l'ensemble, nous constatons que le forçage de budget offre un contrôle parfait, une bonne mise à l'échelle et conduit à notre meilleur score AIME24. C'est donc la méthode que nous utilisons pour s1- 32B dans la figure 1 et au §4 . Dans le tableau 4, nous comparons différentes chaînes pour extrapoler les performances. Nous constatons que « Wait » donne généralement les meilleures performances.
Contrôle conditionné par classe Nous fournissons les scores de référence pour cette méthode au §E.1 et résumons ici trois constats : (1) Le contrôle conditionné par jeton échoue sans forçage de budget, car notre modèle ne peut pas compter les jetons de manière fiable - même lorsqu'il est entraîné à le faire. (2) Sous contrôle conditionné par étape, le modèle génère un nombre total de jetons similaire lorsqu'on lui donne différents objectifs d'étapes, car le modèle passe de peu d'étapes avec beaucoup de jetons par étape à de nombreuses étapes avec peu de jetons dans chaque étape. Ainsi, le modèle apprend à contourner astucieusement sa contrainte de calcul, rendant la contrôlabilité de cette méthode médiocre. (3) Le contrôle conditionné par classe peut fonctionner - dire à un modèle de simplement réfléchir plus longtemps peut augmenter son calcul au moment du test et ses performances, ce qui conduit à une bonne mise à l'échelle dans le tableau 3.
| Modèle | AIME | MATH | GPQA |
| 2024 | 500 | Diamond | |
| Sans extrapolation | 50,0 | 93,0 | 57,6 |
| 2x sans chaîne | 50,0 | 90,2 | 55,1 |
| 2x « Alternatively » | 50,0 | 92,2 | 59,6 |
| 2x « Hmm » | 50,0 | 93,0 | 59,6 |
| 2x « Wait » | 53,3 | 93,0 | 59,6 |
Échantillonnage par rejet De manière surprenante, nous constatons que le simple fait d'échantillonner jusqu'à ce que la génération corresponde à une longueur spécifique conduit à une tendance d'échelle inverse, comme illustré dans la figure 6. Au §E.2, nous examinons une question à laquelle le modèle a répondu correctement lors de l'échantillonnage par rejet pour , mais pas pour le réglage jetons. Dans le réglage , le modèle saute directement à l'approche correcte, tandis que pour le réglage , il revient beaucoup en arrière. Nous émettons l'hypothèse qu'il existe une corrélation telle que les générations plus courtes tendent à être celles où le modèle était sur la bonne voie dès le départ, tandis que les plus longues tendent à être celles où le modèle a fait des erreurs et revient donc en arrière ou se remet en question. Cela conduit à ce que les échantillons plus longs soient souvent faux lors de l'échantillonnage par rejet, et donc à la tendance d'échelle inverse.
6. Discussion et travaux connexes
6.1. Raisonnement économe en échantillons
Modèles Il existe un certain nombre d'efforts concurrents pour construire des modèles qui reproduisent les performances de o1 (OpenAI, 2024). Par exemple, DeepSeek- r1 et k1.5 (DeepSeek- AI et al., 2025 ; Team et al., 2025) sont construits avec des méthodes d'apprentissage par renforcement, tandis que d'autres s'appuient sur le SFT en utilisant des dizaines de milliers d'exemples distillés (Team, 2025 ; Xu et al., 2025 ; Labs, 2025). Nous montrons que le SFT sur seulement 1 000 exemples suffit pour construire un modèle de raisonnement compétitif égalant o1- preview et produit un modèle qui se situe sur la frontière de Pareto (figure 2). De plus, nous introduisons le forçage de budget qui, combiné à notre modèle de raisonnement, conduit à la première reproduction des courbes de mise à l'échelle au moment du test d'OpenAI (OpenAI, 2024). Pourquoi le finetuning supervisé sur seulement 1 000 échantillons conduit-il à de tels gains de performance ? Nous émettons l'hypothèse que le modèle est déjà exposé à de grandes quantités de données de raisonnement pendant le préentraînement, qui couvre des billions de jetons. Ainsi, la capacité d'effectuer un raisonnement est déjà présente dans notre modèle. Notre étape de finetuning économe en échantillons ne fait que l'activer et nous la développons davantage au moment du test avec le forçage de budget. Cela est similaire à l'« Hypothèse d'alignement superficiel » présentée dans LIMA (Zhou et al., 2023), où les auteurs constatent que 1 000 exemples peuvent suffire pour aligner un modèle afin qu'il adhère aux préférences de l'utilisateur.
Benchmarks et méthodes Pour évaluer et repousser les limites de ces modèles, des benchmarks de plus en plus exigeants ont été introduits, tels que les compétitions scientifiques de niveau olympique (He et al., 2024 ; Jain et al., 2024 ; Zhong et al., 2023) et d'autres (Srivastava et al., 2023 ; Glazer et al., 2024 ; Su et al., 2024 ; Kim et al., 2024 ; Phan et al., 2025). Pour améliorer les performances des modèles sur les tâches liées au raisonnement, les chercheurs ont poursuivi plusieurs stratégies : des travaux antérieurs ont exploré la poursuite de l'entraînement des modèles de langage sur des corpus spécialisés liés aux mathématiques et aux sciences (Azerbayev et al., 2023 ; Yang et al., 2024), parfois même sur des données générées synthétiquement (Yu et al., 2024). D'autres ont développé des méthodologies d'entraînement spécifiquement destinées aux performances de raisonnement (Zelikman et al., 2022 ; 2024 ; Luo et al., 2025 ; Yuan et al., 2025 ; Wu et al., 2024a). Un autre axe de travail important se concentre sur les méthodes fondées sur le prompting pour susciter et améliorer les capacités de raisonnement, notamment des méthodes comme le prompting de chaîne de pensée (Chain-of-Thought prompting) (Wei et al., 2023 ; Yao et al., 2023a;b ; Bi et al., 2023 ; Fu et al., 2023 ; Zhang et al., 2024b ; Xiang et al., 2025 ; Hu et al., 2024 ; Diao et al., 2024). Ces efforts combinés visent à faire progresser la capacité de raisonnement des modèles de langage, en leur permettant de traiter efficacement des tâches plus complexes et plus abstraites.
6.2. Mise à l'échelle au moment du test
Méthodes Comme nous l’introduisons au , nous distinguons deux méthodes pour augmenter le calcul au moment du test : parallèle et séquentielle. La première repose sur plusieurs tentatives de solution générées en parallèle et sur la sélection du meilleur résultat selon des critères spécifiques. Ces critères incluent le choix de la réponse la plus fréquente pour le vote majoritaire ou de la meilleure réponse selon une récompense externe pour le Best-of-N (Brown et al., 2024 ; Irvine et al., 2023 ; Levi, 2024). Contrairement à l’échantillonnage répété, les méthodes d’augmentation séquentielle précédentes laissent le modèle générer des tentatives de solution séquentiellement en fonction des tentatives précédentes, ce qui lui permet d’affiner chaque tentative à partir des résultats antérieurs (Snell et al., 2024 ; Hou et al., 2025 ; Lee et al., 2025). Les méthodes de recherche arborescente (Gandhi et al., 2024 ; Wu et al., 2024b) offrent une approche hybride entre l’augmentation séquentielle et parallèle, comme la recherche arborescente de Monte-Carlo (MCTS) (Liu et al., 2024 ; Zhang et al., 2023 ; Zhou et al., 2024 ; Choi et al., 2023) et la recherche par faisceau guidée (Xie et al., 2023). REBASE (Wu et al., 2024b) emploie un modèle de récompense de processus pour équilibrer exploitation et élagage pendant la recherche arborescente. Empiriquement, REBASE s’est révélé surpasser les méthodes fondées sur l’échantillonnage et MCTS (Wu et al., 2024b). Les modèles de récompense (Lightman et al., 2023 ; Wang et al., 2024b;c) jouent un rôle clé dans ces méthodes. Ils se déclinent en deux variantes : les modèles de récompense de résultat et les modèles de récompense de processus. Les modèles de récompense de résultat (Xin et al., 2024 ; Ankner et al., 2024) attribuent un score aux solutions complètes et sont particulièrement utiles pour la sélection Best-of-N, tandis que les modèles de récompense de processus (Lightman et al., 2023 ; Wang et al., 2024b ; Wu et al., 2024b) évaluent les étapes de raisonnement individuelles et sont efficaces pour guider les méthodes de recherche arborescente.
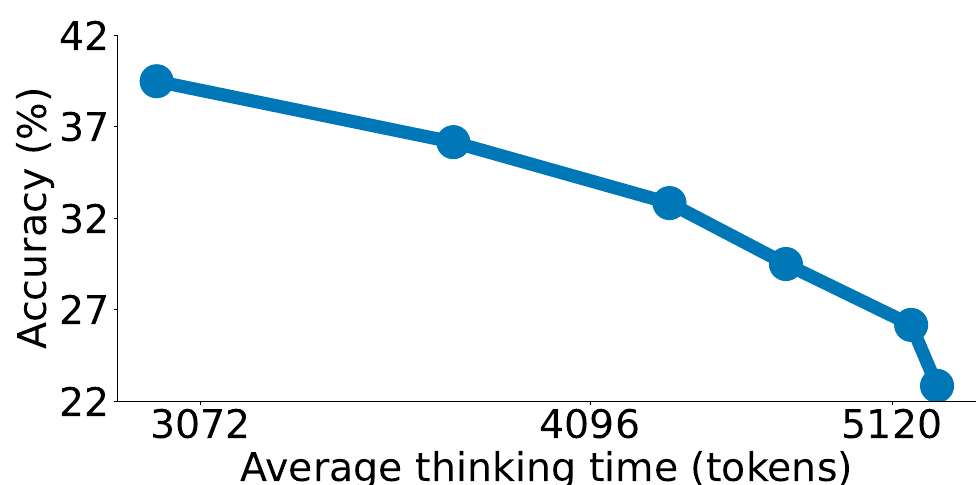
Limites de l’augmentation supplémentaire du calcul au moment du test Nous avons montré que le budget forcing permet d’extrapoler le calcul au moment du test au , par exemple en améliorant la performance sur AIME24 de à . Cependant, il présente deux limites clés lorsqu’on l’augmente davantage : il finit par plafonner (Figure 4), et la fenêtre de contexte du modèle de langage sous-jacent le contraint. Malgré ces contraintes, notre travail montre une augmentation du calcul au moment du test sur une large plage de précisions (Figure 1), en partie parce que la réduction du calcul au moment du test se comporte de manière prévisible et ne souffre pas de ces contraintes.
Poursuivre l’augmentation du calcul au moment du test exigera des approches capables d’extrapoler davantage le calcul au moment du test. Comment obtenir
une telle extrapolation ? Il pourrait y avoir des améliorations du budget forcing, comme l’alternance entre différentes chaînes de caractères, et pas seulement « Wait », ou sa combinaison avec des pénalités de fréquence ou une température plus élevée pour éviter les boucles répétitives. Une direction prometteuse pour des travaux futurs consiste aussi à étudier si l’application du budget forcing à un modèle de raisonnement entraîné par apprentissage par renforcement produit une meilleure extrapolation ; ou si l’apprentissage par renforcement permet de nouvelles façons d’augmenter le calcul au moment du test au-delà du budget forcing. Notre travail définit les bons indicateurs ( ) – Contrôle, Augmentation et Performance – pour permettre de futures recherches et des progrès sur l’extrapolation du calcul au moment du test.
L’augmentation parallèle comme solution L’augmentation parallèle offre une solution aux limites de l’augmentation séquentielle ; nous augmentons donc notre modèle à augmentation séquentielle avec deux méthodes : (I) Vote majoritaire : après avoir généré solutions, la solution finale est la plus fréquente parmi les générations ; (II) Recherche arborescente via REBASE : nous utilisons le modèle de récompense de processus REBASE, initialisé à partir de LLaMA-34B et ensuite affiné sur un jeu de données synthétique de modélisation de récompense de processus (Wu et al., 2024b). Nous agrégeons ensuite les solutions générées par REBASE via un vote majoritaire. Comme le montre la Figure 7, augmenter notre modèle avec REBASE s’étend mieux que le vote majoritaire, et même que l’augmentation séquentielle dans ce scénario. Cependant, REBASE nécessite une passe avant supplémentaire à chaque étape pour le modèle de récompense, ce qui ajoute une certaine surcharge de calcul. Pour l’augmentation séquentielle, lorsqu’on demande jusqu’à 512 étapes, pour 12 des 30 questions d’évaluation, le modèle génère une réponse qui dépasse la fenêtre de contexte, entraînant une forte baisse de performance. Globalement, nous constatons que ces méthodes d’augmentation parallèle complètent l’augmentation séquentielle ; elles offrent donc une voie pour augmenter encore davantage le calcul au moment du test, au-delà des fenêtres de contexte fixes.
Déclaration d'impact
Déclaration d'impact Les modèles de langage dotés de solides capacités de raisonnement ont le potentiel d'améliorer considérablement la productivité humaine, qu'il s'agisse d'aider à la prise de décisions complexes ou de favoriser des percées scientifiques. Toutefois, les avancées récentes en matière de raisonnement, telles que o1 d'OpenAI et r1 de DeepSeek, manquent de transparence, ce qui limite les progrès de la recherche au sens large. Notre travail vise à repousser les frontières du raisonnement de manière entièrement ouverte, en favorisant l'innovation et la collaboration afin d'accélérer des avancées qui, en fin de compte, bénéficient à la société.
Remerciements
Remerciements Nous remercions Ryan Marten pour la génération des traces de DeepSeek r1 pour s1.1 à l'aide de Bespoke Curator (Marten et al., 2025). Ce travail a été en partie réalisé à l'aide du cluster GPU Stanford Marlowe (Kapfer et al., 2025), rendu possible grâce au soutien financier de l'université Stanford. Nous remercions Alexander M. Rush, Andrew Ilyas, Banghua Zhu, Chenglei Si, Chunting Zhou, John Yang, Ludwig Schmidt, Samy Jelassi, Suhas Kotha, Tengyu Ma, Xuechen Li, Yu Sun et Yue Zhang pour leurs discussions très constructives.
Références
Ankner, Z., Paul, M., Cui, B., Chang, J. D., et Ammanabrolu, P. Critique-out-loud reward models, 2024. URL https://arxiv.org/abs/2408.11791. Arora, D., Singh, H. G., et Mausam. Have llms advanced enough? a challenging problem solving benchmark for large language models, 2023. URL https://arxiv.org/abs/2305.15074. Azerbayev, Z., Schoelkopf, H., Paster, K., Santos, M. D., McAleer, S., Jiang, A. Q., Deng, J., Biderman, S., et Welleck, S. Llemma: An open language model for mathematics, 2023. Bi, Z., Zhang, N., Jiang, Y., Deng, S., Zheng, G., et Chen, H. When do program-of-thoughts work for reasoning?, 2023. URL https://arxiv.org/abs/2308.15452. Biderman, S., Schoelkopf, H., Sutawika, L., Gao, L., Tow, J., Abbasi, B., Aji, A. F., Ammanamanchi, P. S., Black, S., Clive, J., DiPofi, A., Etxaniz, J., Fattori, B., Forde, J. Z., Foster, C., Hsu, J., Jaiswal, M., Lee, W. Y., Li, H., Lovering, C., Muennighoff, N., Pavlick, E., Phang, J., Skowron, A., Tan, S., Tang, X., Wang, K. A., Winata, G. I., Yvon, F., et Zou, A. Lessons from the trenches on reproducible evaluation of language models, 2024. Brown, B., Juravsky, J., Ehrlich, R., Clark, R., Le, Q. V., Ré, C., et Mirhoseini, A. Large language monkeys: Scaling inference compute with repeated sampling, 2024. URL https://arxiv.org/abs/2407.21787.
Cesisita, F. L. Multimodal structured generation: Cvpr's 2nd mmfm challenge technical report, 2024. URL https://arxiv.org/abs/2406.11403. Chen, W., Yin, M., Ku, M., Lu, P., Wan, Y., Ma, X., Xu, J., Wang, X., et Xia, T. Theoremaqa: A theorem-driven question answering dataset, 2023. URL https://arxiv.org/abs/2305.12524. Choi, S., Fang, T., Wang, Z., et Song, Y. Kcts: Knowledge-constrained tree search decoding with token-level hallucination detection, 2023. URL https://arxiv.org/abs/2310.09044. DeepSeek-AI, Guo, D., Yang, D., Zhang, H., Song, J., Zhang, R., Xu, R., Zhu, Q., Ma, S., Wang, P., Bi, X., Zhang, X., Yu, X., Wu, Y., Wu, Z. F., Gou, Z., Shao, Z., Li, Z., Gao, Z., Liu, A., Xue, B., Wang, B., Wu, B., Feng, B., Lu, C., Zhao, C., Deng, C., Zhang, C., Ruan, C., Dai, D., Chen, D., Ji, D., Li, E., Lin, F., Dai, F., Luo, F., Hao, G., Chen, G., Li, G., Zhang, H., Bao, H., Xu, H., Wang, H., Ding, H., Xin, H., Gao, H., Qu, H., Li, H., Guo, J., Li, J., Wang, J., Chen, J., Yuan, J., Qiu, J., Li, J., Cai, J. L., Ni, J., Liang, J., Chen, J., Dong, K., Hu, K., Gao, K., Guan, K., Huang, K., Yu, K., Wang, L., Zhang, L., Zhao, L., Wang, L., Zhang, L., Xu, L., Xia, L., Zhang, M., Zhang, M., Tang, M., Li, M., Wang, M., Li, M., Tian, N., Huang, P., Zhang, P., Wang, Q., Chen, Q., Du, Q., Ge, R., Zhang, R., Pan, R., Wang, R., Chen, R. J., Jin, R. L., Chen, R., Lu, S., Zhou, S., Chen, S., Ye, S., Wang, S., Yu, S., Zhou, S., Pan, S., Li, S. S., Zhou, S., Wu, S., Ye, S., Yun, T., Pei, T., Sun, T., Wang, T., Zeng, W., Zhao, W., Liu, W., Liang, W., Gao, W., Yu, W., Zhang, W., Xiao, W. L., An, W., Liu, X., Wang, X., Chen, X., Nie, X., Cheng, X., Liu, X., Xie, X., Liu, X., Yang, X., Li, X., Su, X., Lin, X., Li, X. Q., Jin, X., Shen, X., Chen, X., Sun, X., Wang, X., Song, X., Zhou, X., Wang, X., Shan, X., Li, Y. K., Wang, Y. Q., Wei, Y. X., Zhang, Y., Xu, Y., Li, Y., Zhao, Y., Sun, Y., Wang, Y., Yu, Y., Zhang, Y., Shi, Y., Xiong, Y., He, Y., Piao, Y., Wang, Y., Tan, Y., Ma, Y., Liu, Y., Guo, Y., Ou, Y., Wang, Y., Gong, Y., Zou, Y., He, Y., Xiong, Y., Luo, Y., You, Y., Liu, Y., Zhou, Y., Zhu, Y. X., Xu, Y., Huang, Y., Li, Y., Zheng, Y., Zhu, Y., Ma, Y., Tang, Y., Zha, Y., Yan, Y., Ren, Z. Z., Ren, Z., Sha, Z., Fu, Z., Xu, Z., Xie, Z., Zhang, Z., Hao, Z., Ma, Z., Yan, Z., Wu, Z., Gu, Z., Zhu, Z., Liu, Z., Li, Z., Xie, Z., Song, Z., Pan, Z., Huang, Z., Xu, Z., Zhang, Z., et Zhang, Z. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning, 2025. URL https://arxiv.org/abs/2501.12948. Diao, S., Wang, P., Lin, Y., Pan, R., Liu, X., et Zhang, T. Active prompting with chain-of-thought for large lan guage models, 2024. URL https://arxiv.org/abs/2302.12246.
Dubey, A., Jauhri, A., Pandey, A., Kadian, A., Al-Dahle, A., Letman, A., Mathur, A., Schelten, A., Yang, A., Fan, A., Goyal, A., Hartshorn, A., Yang, A., Mitra, A., Sravankumar, A., Korenev, A., Hinsvark, A., Rao, A., Zhang, A., Rodriguez, A., Gregerson, A., et al. The llama 3 herd of models, 2024. URL https://arxiv.org/abs/2407.21783.
Fu, Y., Peng, H., Sabharwal, A., Clark, P., et Khot, T. Complexity-based prompting for multi-step reasoning, 2023. URL https://arxiv.org/abs/2210.00720.
Gandhi, K., Lee, D., Grand, G., Liu, M., Cheng, W., Sharma, A., et Goodman, N. D. Stream of search (sos): Learning to search in language, 2024. URL https://arxiv.org/abs/2404.03683.
Gao, B., Song, F., Yang, Z., Cai, Z., Miao, Y., Dong, Q., Li, L., Ma, C., Chen, L., Xu, R., Tang, Z., Wang, B., Zan, D., Quan, S., Zhang, G., Sha, L., Zhang, Y., Ren, X., Liu, T., et Chang, B. Omni-math: A universal olympiad level mathematic benchmark for large language models, 2024a. URL https://arxiv.org/abs/2410.07985.
Gao, L., Tow, J., Biderman, S., Black, S., DiPofi, A., Foster, C., Golding, L., Hsu, J., McDonell, K., Muennighoff, N., Phang, J., Reynolds, L., Tang, E., Thite, A., Wang, B., Wang, K., et Zou, A. A framework for few-shot language model evaluation, septembre 2021. URL https://doi.org/10.5281/zenodo.5371628.
Gao, Z., Niu, B., He, X., Xu, H., Liu, H., Liu, A., Hu, X. et Wen, L. Interpretable contrastive monte carlo tree search reasoning, 2024b. URL https://arxiv.org/abs/2410.01707.
Glazer, E., Erdil, E., Besiroglu, T., Chicharro, D., Chen, E., Gunning, A., Olsson, C. F., Denain, J.- S., Ho, A., de Oliveira Santos, E., Järviniemi, O., Barnett, M., Sandler, R., Vrzala, M., Sevilla, J., Ren, Q., Pratt, E., Levine, L., Barkley, G., Stewart, N., Grechuk, B., Grechuk, T., Enugandla, S. V. et Wildon, M. Frontiermath: A benchmark for evaluating advanced mathematical reasoning in ai, 2024. URL https://arxiv.org/abs/2411.04872.
Google. Gemini 2.0 flash thinking mode (gemini- 2.0- flash- thinking- exp- 1219), décembre 2024. URL https://cloud.google.com/vertex- ai/generative- ai/docs/thinking- mode.
Groeneveld, D., Beltagy, I., Walsh, P., Bhagia, A., Kinney, R., Tafjord, O., Jha, A. H., Ivison, H., Magnusson, I.,
Wang, Y., Arora, S., Atkinson, D., Authur, R., Chandu, K. R., Cohan, A., Dumas, J., Elazar, Y., Gu, Y., Hessel, J., Khot, T., Merrill, W., Morrison, J., Muennighoff, N., Naik, A., Nam, C., Peters, M. E., Pyatkin, V., Ravichander, A., Schwenk, D., Shah, S., Smith, W., Strubell, E., Subramani, N., Wortsman, M., Dasigi, P., Lambert, N., Richardson, K., Zettlemoyer, L., Dodge, J., Lo, K., Soldaini, L., Smith, N. A., et Hajishirzi, H. Olmo : Accélérer la science des modèles de langage, 2024.
He, C., Luo, R., Bai, Y., Hu, S., Thai, Z. L., Shen, J., Hu, J., Han, X., Huang, Y., Zhang, Y., Liu, J., Qi, L., Liu, Z., et Sun, M. Olympiadbench : Un benchmark exigeant pour promouvoir l'AGI avec des problèmes scientifiques multimodaux bilingues de niveau olympique, 2024. URL https://arxiv.org/abs/2402.14008.
Hendrycks, D., Burns, C., Kadavath, S., Arora, A., Basart, S., Tang, E., Song, D., et Steinhardt, J. Mesurer la résolution de problèmes mathématiques avec le jeu de données math, 2021. URL https://arxiv.org/abs/2103.03874.
Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., Rutherford, E., de Las Casas, D., Hendricks, L. A., Welbl, J., Clark, A., Hennigan, T., Noland, E., Millican, K., van den Driessche, G., Damoc, B., Guy, A., Osindero, S., Simonyan, K., Elsen, E., Rae, J. W., Vinyals, O., et Sifre, L. Modèles de langage de grande taille optimaux en termes de calcul d'entraînement, 2022. URL https://arxiv.org/abs/2203.15556.
Hou, Z., Lv, X., Lu, R., Zhang, J., Li, Y., Yao, Z., Li, J., Tang, J., et Dong, Y. Faire progresser le raisonnement des modèles de langage grâce à l'apprentissage par renforcement et à la mise à l'échelle de l'inférence, 2025. URL https://arxiv.org/abs/2501.11651.
Hu, Y., Shi, W., Fu, X., Roth, D., Ostendorf, M., Zettlemoyer, L., Smith, N. A., et Krishna, R. Visual sketchpad : L'esquisse comme chaîne de pensée visuelle pour les modèles de langage multimodaux, 2024. URL https://arxiv.org/abs/2406.09403.
Huang, Z., Wang, Z., Xia, S., Li, X., Zou, H., Xu, R., Fan, R.- Z., Ye, L., Chern, E., Ye, Y., Zhang, Y., Yang, Y., Wu, T., Wang, B., Sun, S., Xiao, Y., Li, Y., Zhou, F., Chern, S., Qin, Y., Ma, Y., Su, J., Liu, Y., Zheng, Y., Zhang, S., Lin, D., Qiao, Y., et Liu, P. Olympicarena : Évaluation comparative du raisonnement cognitif multidisciplinaire pour l'IA superintelligente, 2024a. URL https://arxiv.org/abs/2406.12753.
Huang, Z., Zou, H., Li, X., Liu, Y., Zheng, Y., Chern, E., Xia, S., Qin, Y., Yuan, W., et Liu, P. Le parcours de réplication d'O1 - partie 2 : Surpasser o1- preview grâce à une simple distillation, grande avancée ou dure leçon ?, 2024b. URL https://arxiv.org/abs/2411.16489.
Huang, Z., Geng, G., Hua, S., Huang, Z., Zou, H., Zhang, S., Liu, P., et Zhang, X. Le parcours de réplication d'O1 - partie 3 : Mise à l'échelle au moment de l'inférence pour le raisonnement médical, 2025. URL https://arxiv.org/abs/2501.06458.
Irvine, R., Boubert, D., Raina, V., Liusie, A., Zhu, Z., Mudupalli, V., Korshuk, A., Liu, Z., Cremer, F., Assassi, V., Beauchamp, C.- C., Lu, X., Rialan, T., et Beauchamp, W. Récompenser les chatbots pour l'engagement réel avec des millions d'utilisateurs, 2023. URL https://arxiv.org/abs/2303.06135.
Jain, N., Han, K., Gu, A., Li, W.- D., Yan, F., Zhang, T., Wang, S., Solar- Lezama, A., Sen, K., et Stoica, I. Livecodebench : Évaluation holistique et exempte de contamination des modèles de langage de grande taille pour le code, 2024. URL https://arxiv.org/abs/2403.07974.
Kapfer, C., Stine, K., Narasimhan, B., Mentzel, C., et Candes, E. Marlowe : L'instrument computationnel basé sur GPU de Stanford, janvier 2025. URL https://doi.org/10.5281/zenodo.14751899.
Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., Chess, B., Child, R., Gray, S., Radford, A., Wu, J., et Amodei, D. Lois de mise à l'échelle pour les modèles de langage neuronaux, 2020. URL https://arxiv.org/abs/2001.08361.
Kim, E., Suk, J., Kim, S., Muennighoff, N., Kim, D., et Oh, A. Le LLM comme intervieweur : Au-delà des tests statiques grâce à l'évaluation dynamique des LLM, 2024. URL https://arxiv.org/abs/2412.10424.
Kwon, W., Li, Z., Zhuang, S., Sheng, Y., Zheng, L., Yu, C. H., Gonzalez, J. E., Zhang, H., et Stoica, I. Gestion efficace de la mémoire pour le service des modèles de langage de grande taille avec pagedattention, 2023. URL https://arxiv.org/abs/2309.06180.
Labs, B. Bespoke- stratos : L'efficacité déraisonnable de la distillation du raisonnement, 2025. URL https://hf.co/bespokelabs/Bespoke- Stratos- 32B. Consulté le : 2025- 01- 22.
Lee, K.- H., Fischer, I., Wu, Y.- H., Marwood, D., Baluja, S., Schuurmans, D., et Chen, X. Faire évoluer la pensée des LLM vers plus de profondeur, 2025. URL https://arxiv.org/abs/2501.09891.
Levi, N. Un modèle simple des lois de mise à l'échelle de l'inférence, 2024. URL https://arxiv.org/abs/2410.16377.
LI, J., Beeching, E., Tunstall, L., Lipkin, B., Soletskyi, R., Huang, S. C., Rasul, K., Yu, L., Jiang, A., Shen, Z., Qin, Z., Dong, B., Zhou, L., Fleureau, Y., Lample, G., et Polu, S. Numinnamath, 2024. URL https://github.com/project- numina/aimo- progress- prize/blob/main/report/ numina_dataset.pdf.
Lightman, H., Kosaraju, V., Burda, Y., Edwards, H., Baker, B., Lee, T., Leike, J., Schulman, J., Sutskever, I., et Cobbe, K. Vérifions étape par étape, 2023. URL https://arxiv.org/abs/2305.20050.
Ling, W., Yogatama, D., Dyer, C., et Blunsom, P. Induction de programmes par génération de justifications : Apprendre à résoudre et à expliquer des problèmes d'arithmétique sous forme de textes, 2017. URL https://arxiv.org/abs/1705.04146.
Liu, J., Cui, L., Liu, H., Huang, D., Wang, Y., et Zhang, Y. Logiqa : Un jeu de données de défi pour la compréhension de lecture machine avec raisonnement logique, 2020. URL https://arxiv.org/abs/2007.08124.
Liu, J., Cohen, A., Pasunuru, R., Choi, Y., Hajishirzi, H., et Celikyilmaz, A. Ne jetez pas votre modèle de valeur ! Générer un texte plus préférable avec un décodage par recherche arborescente de Monte- Carlo guidé par la valeur, 2024. URL https://arxiv.org/abs/2309.15028.
Loshchilov, I. et Hutter, F. Régularisation par décroissance de poids découplée, 2019.
Luo, H., Sun, Q., Xu, C., Zhao, P., Lou, J., Tao, C., Geng, X., Lin, Q., Chen, S., Tang, Y., et Zhang, D. Wizardmath : Renforcer le raisonnement mathématique des modèles de langage de grande taille via un evol- instruct renforcé, 2025. URL https://arxiv.org/abs/2308.09583.
Marten, R., Vu, T., Ji, C. C.- J., Sharma, K., Pimpalgaonkar, S., Dimakis, A., et Sathiamoorthy, M. Curator : un outil pour la création de données synthétiques. https://github.com/bespokelabsai/curator, janvier 2025.
Muennighoff, N., Soldaini, L., Groeneveld, D., Lo, K., Morrison, J., Min, S., Shi, W., Walsh, P., Tafjord, O., Lambert, N., Gu, Y., Arora, S., Bhagia, A., Schwenk, D., Wadden, D., Wettig, A., Hui, B., Dettmers, T., Kiela, D., Farhadi, A., Smith, N. A., Koh, P. W., Singh, A., et Hajishirzi, H. Olmoe : modèles de langage ouverts à mixture d'experts, 2024. URL https://arxiv.org/abs/2409.02060.
of America, M. A. Aime, février 2024. URL https://artofproblemsolving.com/wiki/index.php/AIME_Problems_and_Solutions/.
OpenAI. Apprendre à raisonner avec les LLM, septembre 2024. URL https://openai.com/index/learning- to- reason- with- llms/.
OpenAI. Openai o3- mini, 2025. URL https://openai.com/index/openai- o3- mini/. Consulté le : 2025- 02- 24.
Phan, L., Gatti, A., Han, Z., Li, N., Hu, J., Zhang, H., Shi, S., Choi, M., Agrawal, A., Chopra, A., et al. Humanity's last exam, 2025. URL https://arxiv.org/abs/2501.14249.
Qin, Y., Li, X., Zou, H., Liu, Y., Xia, S., Huang, Z., Ye, Y., Yuan, W., Liu, H., Li, Y. et Liu, P. O1 replication journey: A strategic progress report - part 1, 2024. URL https://arxiv.org/abs/2410.18982.
Qwen, : Yang, A., Yang, B., Zhang, B., Hui, B., Zheng, B., Yu, B., Li, C., Liu, D., Huang, F., Wei, H., Lin, H., Yang, J., Tu, J., Zhang, J., Yang, J., Yang, J., Zhou, J., Lin, J., Dang, K., Lu, K., Bao, K., Yang, K., Yu, L., Li, M., Xue, M., Zhang, P., Zhu, Q., Men, R., Lin, R., Li, T., Xia, T., Ren, X., Ren, X., Fan, Y., Su, Y., Zhang, Y., Wan, Y., Liu, Y., Cui, Z., Zhang, Z. et Qiu, Z. Qwen2.5 technical report, 2024. URL https://arxiv.org/abs/2412.15115.
Rein, D., Hou, B. L., Stickland, A. C., Petty, J., Pang, R. Y., Dirani, J., Michael, J. et Bowman, S. R. Gpqa: A graduate- level google- proof q&a benchmark, 2023. URL https://arxiv.org/abs/2311.12022.
Shi, Q., Tang, M., Narasimhan, K. et Yao, S. Can language models solve olympiad programming?, 2024. URL https://arxiv.org/abs/2404.10952.
Snell, C., Lee, J., Xu, K. et Kumar, A. Scaling llm test- time compute optimally can be more effective than scaling model parameters, 2024. URL https://arxiv.org/abs/2408.03314.
Srivastava, A., Rastogi, A., Rao, A., Shoeb, A. A. M., Abid, A., Fisch, A., Brown, A. R., Santoro, A., Gupta, A., Garriga- Alonso, A., et al. Beyond the imitation game: Quantifying and extrapolating the capabilities of language models, 2023.
Su, H., Yen, H., Xia, M., Shi, W., Muennighoff, N., yu Wang, H., Liu, H., Shi, Q., Siegel, Z. S., Tang, M., Sun, R., Yoon, J., Arik, S. O., Chen, D. et Yu, T. Bright: A realistic and challenging benchmark for reasoning- intensive retrieval, 2024. URL https://arxiv.org/abs/2407.12883.
Sun, L., Han, Y., Zhao, Z., Ma, D., Shen, Z., Chen, B., Chen, L. et Yu, K. Scieval: A multi- level large language model evaluation benchmark for scientific research, 2024. URL https://arxiv.org/abs/2308.13149.
Team, K., Du, A., Gao, B., Xing, B., Jiang, C., Chen, C., Li, C., Xiao, C., Du, C., Liao, C., Tang, C., Wang, C., Zhang, D., Yuan, E., Lu, E., Tang, F., Sung, F., Wei, G., Lai, G., Guo, H., Zhu, H., Ding, H., Hu, H., Yang, H., Zhang, H., Yao, H., Zhao, H., Lu, H., Li, H., Yu, H., Gao, H., Zheng, H., Yuan, H., Chen, J., Guo, J., Su, J., Wang, J., Zhao, J., Zhang, J., Liu, J., Yan, J., Wu, J., Shi, L., Ye, L., Yu, L., Dong, M., Zhang, N., Ma, N., Pan, Q., Gong, Q., Liu, S., Ma, S., Wei, S., Cao, S., Huang, S., Jiang, T., Gao, W., Xiong, W., He, W., Huang, W., Wu, W., He, W., Wei, X., Jia, X., Wu, X., Xu, X., Zu, X., Zhou, X., Pan, X., Charles, Y., Li, Y., Hu, Y., Liu, Y., Chen, Y., Wang, Y., Liu, Y., Qin, Y., Liu, Y., Yang, Y., Bao, Y., Du, Y., Wu, Y., Wang, Y., Zhou, Z., Wang, Z., Li, Z., Zhu, Z., Zhang, Z., Wang, Z., Yang, Z., Huang, Z., Huang, Z., Xu, Z. et Yang, Z. Kimi k1.5: Scaling reinforcement learning with llms, 2025. URL https://arxiv.org/abs/2501.12599.
Team, N. Sky- tl: Fully open- source reasoning model with o1- preview performance in 450\(budget, 2025. URL https://novasky- ai.github.io/posts/sky- tl. Consulté le : 2025- 01- 09.
Team, Q. Qwq: Reflect deeply on the boundaries of the unknown, novembre 2024. URL https://qwenlm.github.io/blog/qwq- 32b- preview/.
Wang, J., Meng, F., Liang, Y. et Zhou, J. Drt- o1: Optimized deep reasoning translation via long chain- of- thought, 2024a. URL https://arxiv.org/abs/2412.17498.
Wang, P., Li, L., Shao, Z., Xu, R. X., Dai, D., Li, Y., Chen, D., Wu, Y. et Sui, Z. Math- shepherd: Verify and reinforce llms step- by- step without human annotations, 2024b. URL https://arxiv.org/abs/2312.08935.
Wang, S., Liu, Z., Zhong, W., Zhou, M., Wei, Z., Chen, Z. et Duan, N. From Isat: The progress and challenges of complex reasoning, 2021. URL https://arxiv.org/abs/2108.00648.
Wang, Z., Dong, Y., Delalleau, O., Zeng, J., Shen, G., Egert, D., Zhang, J. J., Sreedhar, M. N. et Kuchaiev, O. Help- steer2: Open- source dataset for training top- performing reward models, 2024c. URL https://arxiv.org/abs/2406.08673.
Wei, J., Wang, X., Schuurmans, D., Bosma, M., Ichter, B., Xia, F., Chi, E., Le, Q. et Zhou, D. Chain- of- thought prompting elicits reasoning in large language models, 2023. URL https://arxiv.org/abs/2201.11903.
Welleck, S., Bertsch, A., Finlayson, M., Schoelkopf, H., Xie, A., Neubig, G., Kulikov, I. et Harchaoui, Z. From decoding to meta- generation: Inference- time algorithms for large language models, 2024. URL https://arxiv.org/abs/2406.16838.
Wu, T., Lan, J., Yuan, W., Jiao, J., Weston, J. et Sukhbaatar, S. Thinking llms : General instruction following with thought generation, 2024a. URL https://arxiv.org/abs/2410.10630. Wu, Y., Sun, Z., Li, S., Welleck, S. et Yang, Y. Inference scaling laws : An empirical analysis of compute-optimal inference for problem-solving with language models, 2024b. URL https://arxiv.org/abs/2408.00724. Xiang, V., Snell, C., Gandhi, K., Albalak, A., Singh, A., Blagden, C., Phung, D., Rafailov, R., Lile, N., Mahan, D., Castricato, L., Franken, J.-P., Haber, N. et Finn, C. Towards system 2 reasoning in llms : Learning how to think with meta chain-of-thought, 2025. URL https://arxiv.org/abs/2501.04682. Xie, Y., Kawaguchi, K., Zhao, Y., Zhao, X., Kan, M.-Y., He, J. et Xie, Q. Self-evaluation guided beam search for reasoning, 2023. URL https://arxiv.org/abs/2305.00633. Xin, H., Guo, D., Shao, Z., Ren, Z., Zhu, Q., Liu, B., Ruan, C., Li, W. et Liang, X. Deepseek-prover : Advancing theorem proving in llms through large-scale synthetic data, 2024. URL https://arxiv.org/abs/2405.14333. Xu, H., Wu, X., Wang, W., Li, Z., Zheng, D., Chen, B., Hu, Y., Kang, S., Ji, J., Zhang, Y., Guo, Z., Yang, Y., Zhang, M. et Zhang, D. Redstar : Does scaling long-cot data unlock better slow-reasoning systems ?, 2025. URL https://arxiv.org/abs/2501.11284. Yang, Z., Band, N., Li, S., Candès, E. et Hashimoto, T. Synthetic continued pretraining, 2024. URL https://arxiv.org/abs/2409.07431. Yao, S., Yu, D., Zhao, J., Shafran, I., Griffiths, T. L., Cao, Y. et Narasimhan, K. Tree of thoughts : Deliberate problem solving with large language models, 2023a. URL https://arxiv.org/abs/2305.10601. Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K. et Cao, Y. React : Synergizing reasoning and acting in language models, 2023b. URL https://arxiv.org/abs/2210.03629. Ye, Y., Huang, Z., Xiao, Y., Chern, E., Xia, S. et Liu, P. Limo : Less is more for reasoning, 2025a. URL https://arxiv.org/abs/2502.03387. Ye, Y., Xiao, Y., Mi, T. et Liu, P. Aime-preview : A rigorous and immediate evaluation framework for advanced mathematical reasoning. https://github.com/GAIR-NLP/AIME-Preview, 2025b. Dépôt GitHub.
Yu, L., Jiang, W., Shi, H., Yu, J., Liu, Z., Zhang, Y., Kwok, J. T., Li, Z., Weller, A. et Liu, W. Metamath : Bootstrap your own mathematical questions for large language models, 2024. URL https://arxiv.org/abs/2309.12284. Yuan, S., Chen, Z., Xi, Z., Ye, J., Du, Z. et Chen, J. Agent-r : Training language model agents to reflect via iterative self-training, 2025. URL https://arxiv.org/abs/2501.11425. Zelikman, E., Wu, Y., Mu, J. et Goodman, N. D. Star : Bootstrapping reasoning with reasoning, 2022. URL https://arxiv.org/abs/2203.14465. Zelikman, E., Harik, G., Shao, Y., Jayasiri, V., Haber, N. et Goodman, N. D. Quiet-star : Language models can teach themselves to think before speaking, 2024. URL https://arxiv.org/abs/2403.09629. Zhang, H. et Chen, C. Test-time compute scaling laws, 2024. URL https://github.com/hughbzhang/ol_inference_scaling_laws. Zhang, S., Chen, Z., Shen, Y., Ding, M., Tenenbaum, J. B. et Gan, C. Planning with large language models for code generation, 2023. URL https://arxiv.org/abs/2303.05510. Zhang, Y., Wu, S., Yang, Y., Shu, J., Xiao, J., Kong, C. et Sang, J. ol-coder : an ol replication for coding, 2024a. URL https://arxiv.org/abs/2412.00154. Zhang, Y., Yang, J., Yuan, Y. et Yao, A. C.-C. Cumulative reasoning with large language models, 2024b. URL https://arxiv.org/abs/2308.04371. Zhong, H., Xiao, C., Tu, C., Zhang, T., Liu, Z. et Sun, M. Jec-qa : A legal-domain question answering dataset, 2019. URL https://arxiv.org/abs/1911.12011. Zhong, W., Cui, R., Guo, Y., Liang, Y., Lu, S., Wang, Y., Saied, A., Chen, W. et Duan, N. Agieval : A human-centric benchmark for evaluating foundation models, 2023. URL https://arxiv.org/abs/2304.06364. Zhou, A., Yan, K., Shlapentokh-Rothman, M., Wang, H. et Wang, Y.-X. Language agent tree search unifies reasoning acting and planning in language models, 2024. URL https://arxiv.org/abs/2310.04406. Zhou, C., Liu, P., Xu, P., Iyer, S., Sun, J., Mao, Y., Ma, X., Efrat, A., Yu, P., Yu, L., Zhang, S., Ghosh, G., Lewis, M., Zettlemoyer, L. et Levy, O. Lima : Less is more for alignment, 2023. URL https://arxiv.org/abs/2305.11206.
Table des matières
1 Introduction 1
2 Curation des données de raisonnement pour créer s1K 2
2.1 Collecte initiale de 59K échantillons 2
2.2 Sélection finale de 1K échantillons 2
3 Mise à l'échelle au moment du test 3
3.1 Méthode 3
3.2 Métriques 4
4 Résultats 4
4.1 Configuration 4
4.2 Performance 6
5 Ablations 6
5.1 Quantité, diversité et difficulté des données 6
5.2 Méthodes de mise à l'échelle au moment du test 6
6 Discussion et travaux connexes 8
6.1 Raisonnement efficace en échantillons 8
6.2 Mise à l'échelle au moment du test 9
A s1.1 16
B Déterminisme de l'évaluation 16
C Détails de s1K 17
C.1 Résumé de s1K 17
C.2 Composition du jeu de données pour l'ensemble des 59K questions 17
C.3 Prompt de notation de s1K 19
C.4 Sélection de la diversité de s1K 19
C.5 Décontamination 19
D Détails d'entraînement 21
D.1 Ablations d'entraînement : longueur de séquence 21
D.2 Échantillons d'entraînement 21
E Détails de la mise à l'échelle au moment du test 35
E.1 Ablations de mise à l'échelle séquentielle 35
E.2 Exemples pour l'ablation par échantillonnage avec rejet 37
F Contrôle de version 46
A. s1.1
A. s1.1Sept jours après la publication de s1, nous avons publié s1.1. Nous avons régénéré les traces pour nos 1 000 échantillons de s1K en utilisant DeepSeek r1 (DeepSeek-AI et al., 2025) afin de créer s1K-1.1. Nous utilisons la même procédure d'entraînement pour entraîner notre modèle s1.1. Parmi les autres mises à jour depuis notre lancement figurent la publication de o3 (OpenAI, 2025), LIMO (Ye et al., 2025a) et AIME 2025. Nous prenons en compte toutes ces nouveautés dans le tableau 5. Nous constatons que s1.1 obtient des performances nettement meilleures que s1. Nous avons également essayé de distiller à partir de Claude 3.7, ce qui a conduit à des performances inférieures à celles obtenues à partir de r1 (non rapportées).
| Modèle | Exemples | MATH500 | GPQA | AIME 2024 | AIME 2025 |
| API uniquement | |||||
| o3-mini-low | N/A | 95,8 | 70,6 | 56,3 | 42,1 |
| o3-mini-medium | N/A | 97,3 | 76,8 | 75,8 | 70,4 |
| o3-mini-high | N/A | 97,9 | 79,7 | 83,8 | 80,9 |
| Poids ouverts | |||||
| QwQ-32B | N.A. | 90,6 | 54,5 | 46,7 | 32,7 |
| r1 | ≥800K | 07,3 | 71,5 | 79,8 | 70,0 |
| r1-distill-Llama-70B | 800K | 94,5 | 65,2 | 57,1 | 56,3 |
| r1-distill-Qwen-14B | 800K | 93,9 | 59,1 | 61,7 | 48,0 |
| r1-distill-Qwen-32B | 800K | 94,3 | 62,1 | 58,3 | 49,6 |
| Poids ouverts et données ouvertes | |||||
| LIMO | 817 | 94,8 | 66,7 | 56,3 | 44,6 |
| s1 sans BF | 1K | 92,6 | 56,6 | 50,0 | 26,7 |
| s1 avec Budget Forcing « Wait » 1x | 1K | 92,8 | 59,6 | 53,3 | 30,0 |
| s1 avec Budget Forcing « Wait » 2x | 1K | 93,0 | 59,6 | 53,3 | 33,3 |
| s1 avec Budget Forcing « Wait » 4x | 1K | 92,2 | 58,6 | 56,7 | 36,7 |
| s1.1 sans BF | 1K | 94,4 | 60,6 | 56,7 | 50,0 |
| s1.1 avec Budget Forcing « Wait » 1x | 1K | 95,4 | 62,6 | 56,7 | 50,0 |
| s1.1 avec Budget Forcing « Wait » 2x | 1K | 95,4 | 63,6 | 56,7 | 50,0 |
B. Déterminisme de l'évaluation
Nous exécutons nos évaluations avec vLLM (Kwon et al., 2023) car il est plus rapide que les alternatives que nous avons essayées. Cependant, nous constatons que même en utilisant les mêmes graines aléatoires et un échantillonnage glouton, les scores d'évaluation peuvent varier considérablement d'une exécution à l'autre :
Différentes tailles de lot provoquant des résultats différents, voir https://github.com/vllm- project/vllm/issues/5898 Des générations continues provoquant des résultats différents, voir https://github.com/vllm- project/vllm/issues/11783 Des changements dans le parallélisme tensoriel provoquant des résultats différents
Comme notre modèle génère de longues traces de raisonnement avant sa réponse, de petits changements numériques peuvent s'amplifier en différences importantes. Nous rencontrons de nombreuses générations qui sont exactement identiques sur des milliers de tokens puis diffèrent soudainement sur un token, pour finalement aboutir à une réponse entièrement différente. Pour atténuer en partie ce problème, nous exécutons généralement nos évaluations finales en pleine précision, sauf indication contraire.
- .
C. Détails de s1K
C.1. Résumé de s1K
| Domaine | #questions | Nombre total de tokens | Mots-clés |
| Géométrie | 109 | 560,2 K | Aire, Triangle, Distance |
| Théorie des nombres | 98 | 522,5 K | Suites, Divisibilité |
| Combinatoire | 75 | 384,7 K | Permutations, Dénombrement |
| Fonctions réelles | 43 | 234,8 K | Trigonométrie, Calcul |
| Biologie | 41 | 120,9 K | Réactions organiques |
| Fonctions complexes | 32 | 170,2 K | Racines complexes |
| Théorie quantique | 32 | 127,9 K | Particules, Fonctions d'onde |
| Théorie des champs | 28 | 150,1 K | Polynômes, Racines |
| Calcul des variations | 28 | 155,5 K | Optimisation, Contrôle |
| Équations aux différences | 24 | 132,5 K | Récurrence, Récursion |
| Théorie électromagnétique | 23 | 95,8 K | Optique, Ondes, Diffraction |
| Théorie des groupes | 22 | 100,0 K | Groupes, Automorphismes |
| Algèbre linéaire | 22 | 128,3 K | Matrices, Déterminants |
| Théorie des probabilités | 20 | 114,6 K | Marche aléatoire, Espérance |
| Systèmes algébriques | 19 | 109,9 K | Équations fonctionnelles |
| Mécanique | 19 | 103,6K | Forces, mouvement, énergie |
| Thermodynamique | 19 | 74,2K | Machines thermiques, entropie |
| Équations différentielles | 18 | 89,6K | Substitution, existence |
| Informatique | 18 | 34,2K | Théorie de la complexité, algorithmes |
| Analyse numérique | 18 | 76,5K | Analyse des erreurs, stabilité |
| Calcul | 17 | 96,3K | Convergence, sommation |
| Structures algébriques | 17 | 90,4K | Inégalités, ensembles |
| Astronomie | 16 | 37,7K | Populations stellaires, orbites |
| 27 domaines restants | 242 | 982,2K | Domaines avec ≤ 16 questions |
| Tous les domaines (51) | 1000 | 4,7M | s1K |
C.2. Composition du jeu de données pour l'ensemble des 59K questions
| Source | Description | #Samples | Longueur moyenne de réflexion |
| NuminaMATH (LI et al., 2024) | Problèmes mathématiques issus de sites web | 30660 | 4,1K |
| MATH (Hendrycks et al., 2021) | Problèmes mathématiques issus de compétitions | 11999 | 2,9K |
| OlympicArena (Huang et al., 2024a) | Questions d'olympiades en astronomie, biologie, chimie, informatique, géographie, mathématiques et physique | 4250 | 3,2K |
| OmniMath (Gao et al., 2024a) | Problèmes mathématiques issus de compétitions | 4238 | 4,4K |
| AGIEval (Zhong et al., 2023 ; Ling et al., 2017 ; Hendrycks et al., 2021 ; Liu et al., 2020 ; Zhong et al., 2019 ; Wang et al., 2021) | Problèmes d'anglais, de droit, de logique et de mathématiques issus du SAT, du LSAT et d'autres examens | 2385 | 1,2K |
| xword | Mots croisés | 999 | 0,7K |
| OlympiadBench (He et al., 2024) | Questions d'olympiades de mathématiques et de physique | 896 | 3,9K |
| AIME (1983-2021) | American Invitational Mathematics Examination | 890 | 4,7K |
| TheoremQA (Chen et al., 2023) | Questions de niveau universitaire en informatique, finance, mathématiques et physique portant sur des théorèmes | 747 | 2,1K |
| USACO (Shi et al., 2024) | Problèmes de code issus de l'Olympiade informatique des États-Unis | 519 | 3,6K |
| JEEBench (Arora et al., 2023) | Problèmes de chimie, de mathématiques et de physique utilisés à l'examen d'entrée de l'Indian Institute of Technology | 515 | 2,9K |
| GPQA (Rein et al., 2023) | Questions scientifiques de niveau doctorat | 348 | 2,9K |
| SciEval (Sun et al., 2024) | Problèmes de biologie, de chimie et de physique issus de diverses sources | 227 | 0,7K |
| s1-prob | Examens de qualification en statistique de Stanford | 182 | 4,0K |
| LiveCodeBench (Jain et al., 2024) | Problèmes de code issus de sites de programmation (LeetCode, AtCoder et CodeForces) | 151 | 3,5K |
| s1-teasers | Casse-têtes mathématiques récupérés sur Internet | 23 | 4,1K |
| Toutes les 59K questions | Composite des ensembles de données ci-dessus avec les traces de raisonnement et les solutions | 59029 | 3,6K |
C.3. Prompt de notation de s1K
Pour évaluer si un exemple est correct pour la sélection de notre jeu de données au , nous utilisons le prompt de la figure 8. Nous notons à l'aide de Claude 3.5, sauf pour la justesse parmi les 1 000 échantillons finaux, que nous avons notés avec Claude 3.7.
Vous êtes un assistant IA chargé de noter un problème scientifique. L'utilisateur vous fournira la question elle-même, une tentative réalisée par un étudiant et la réponse correcte au problème. Votre tâche est de juger si la tentative est correcte en la comparant à la réponse correcte. Si la solution attendue se conclut par un nombre ou un choix, il ne devrait y avoir aucune ambiguïté. Si la solution attendue implique de parcourir l'ensemble du processus de raisonnement, vous devez juger la tentative en fonction de la justesse du processus de raisonnement, avec la réponse correcte si cela est utile.
L'utilisateur fournira la tentative et la réponse correcte au format suivant :
Problem {problem}
Attempt {attempt}
Correct answer {solution}
Expliquez votre raisonnement et terminez votre réponse sur une nouvelle ligne avec uniquement « Yes » ou « No » (sans guillemets).
C.4. Sélection de la diversité de s1K
L'algorithme 1 présente notre algorithme de sélection des données lors de notre étape de sélection de la diversité. Comme mentionné au , nous incluons également des échantillons provenant de certains benchmarks que nous percevons comme de haute qualité. Aucun des échantillons ne chevauche notre évaluation finale.
C.5. Décontamination
Nous filtrons tous les échantillons en vérifiant s'il existe un chevauchement de 8-grammes entre les exemples sélectionnés et les benchmarks d'évaluation : MATH500, GPTQA Diamond et AIME24. Nous excluons les questions présentant un chevauchement supérieur à 8-grammes.
Algorithme 1 Échantillonnage en deux étapes pour s1K
1 : Entrée : Ensemble de 24 496 questions avec caractéristiques 2 : Sortie : Ensemble de 1 000 questions sélectionnées 3 : Initialiser l'ensemble de sortie (ne suit que les éléments uniques) 4 : for do 5 : if IsGeminiCorrect and (IsAIME or IsGPQA ) then 6 : 7 : Sélectionner toutes les solutions AIME/GPQA correctes 8 : else if IsGeminiCorrect and IsMATH and ThinkingLength then 9 : 10 : Sélectionner les solutions MATH500 correctes avec de longues chaînes 11 : end if 12 : end for 13 : Tous les domaines disponibles 14 : Initialiser le pool de domaines 15 : while do 16 : RandomChoice 17 : Sélectionner aléatoirement un domaine 18 : Questions du domaine 19 : Obtenir les questions de ce domaine 20 : ranks RankByThinkingLength 21 : Classer par longueur de réflexion 22 : weights ranks 23 : Appliquer une pondération en loi de puissance 24 : WeightedSample , weights) 25 : Échantillonner en favorisant les chaînes plus longues 26 : 27 : Ajouter la question sélectionnée 28 : 29 : if then 30 : 31 : Retirer les domaines épuisés 32 : end if 33 : end while
D. Détails d'entraînement
Nous prenons un modèle déjà pré-entraîné et ajusté aux instructions et le fine-tunons davantage pour le raisonnement. Plus précisément, nous utilisons Qwen2.5- 32B- Instruct (Qwen et al., 2024), qui sur les tâches mathématiques égale généralement ou surpasse le plus grand Qwen2.5- 72B- Instruct (Qwen et al., 2024) ou d'autres modèles ouverts (Dubey et al., 2024 ; Groeneveld et al., 2024 ; Muennighoff et al., 2024). Nous utilisons des délimiteurs de tokens pour séparer la phase de réflexion de la phase de réponse. Nous encadrons la phase de réflexion avec <|im_start|>think et <|im_start|>answer ; tous deux précédés et suivis d'un saut de ligne. Des échantillons de notre jeu de données se trouvent dans . Nous utilisons des hyperparamètres de fine-tuning de base : nous entraînons pendant 5 époques avec une taille de lot de 16 pour un total de 315 étapes de gradient. Nous entraînons en précision bfloat16 avec un taux d'apprentissage de augmenté linéairement pendant (16 étapes) puis décru jusqu'à 0 sur le reste de l'entraînement (299 étapes) selon un calendrier cosinus. Nous utilisons l'optimiseur AdamW (Loshchilov & Hutter, 2019) avec , et une décroissance de poids de . Nous ne calculons pas la perte sur les questions, seulement sur les traces de raisonnement et les solutions. Nous nous assurons que la longueur de séquence est suffisamment grande pour éviter de tronquer des échantillons ; un réglage que nous étudions par ablation dans . L'entraînement prend seulement 26 minutes sur 16 GPU NVIDIA H100.
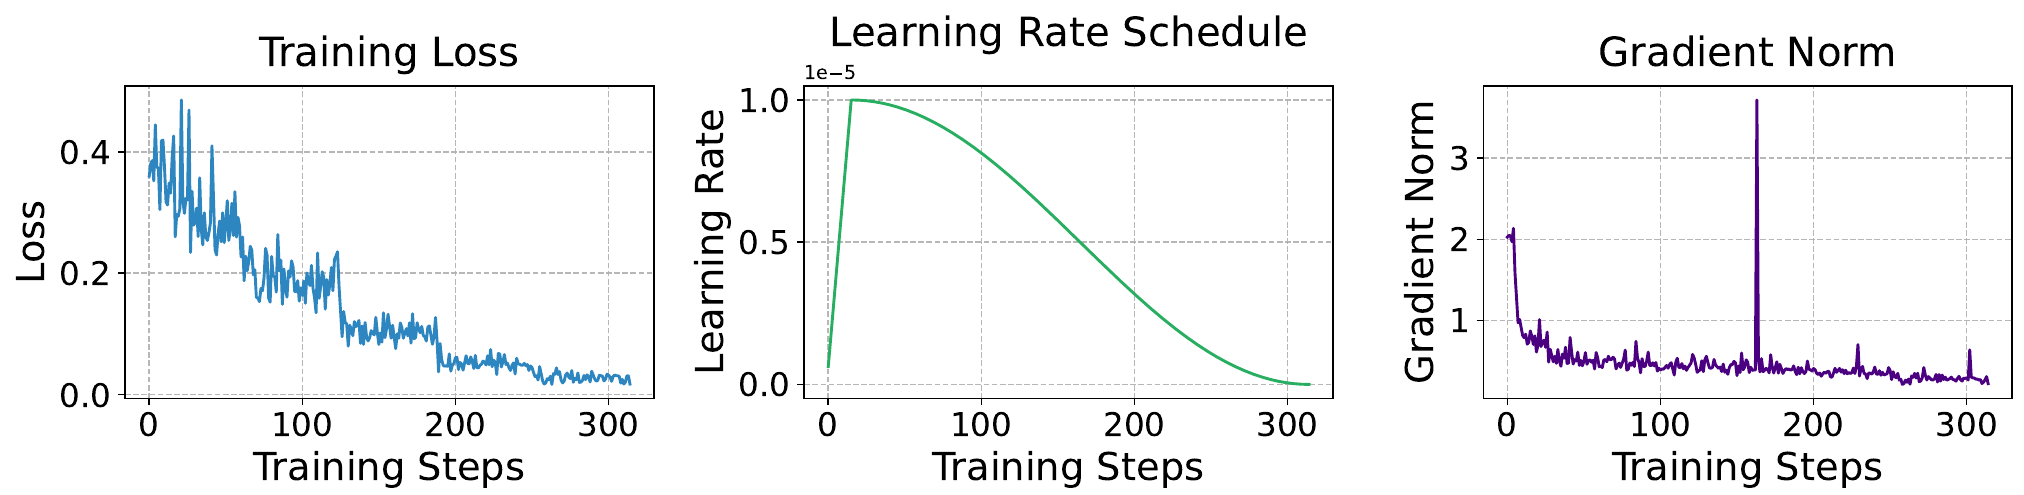
Figure 9. Dynamique d'entraînement de s1-32B sur s1K.
D.1. Ablations d'entraînement : longueur de séquence
| Modèle A | Modèle B | |
| Longueur de séquence d'entraînement | 4096 | 32768 |
| % d'échantillons d'entraînement tronqués | 74 % | 0 % |
| AIME24 | 30,0 % / 20721 | 50,0 % / 6984 |
| MATH500 | 90,0 % / 5324 | 91,0 % / 3268 |
| GPQA | 52,5 % / 6841 | 53,0 % / 3568 |
Tableau 8. Ablation de la longueur de séquence d'entraînement. Nous rapportons « précision / nombre moyen de tokens de réflexion par échantillon » ; plus la précision est élevée et moins il y a de tokens de réflexion (coût d'inférence), mieux c'est.
Outre nos ablations de mise à l'échelle dans , le principal hyperparamètre d'entraînement que nous étudions par ablation est la longueur de séquence utilisée pendant l'entraînement. Nous constatons qu'une longueur de séquence d'entraînement plus courte conduit à des traces de raisonnement plus longues au moment du test. Cela s'explique par le fait que, lors de l'entraînement avec une longueur de séquence plus courte, la section de réponse de l'échantillon d'entraînement est plus souvent tronquée. Inversement, lorsque la longueur de séquence d'entraînement est plus longue, davantage d'échantillons apparaissent dans leur intégralité avec la section où le modèle répond. Ainsi, le modèle reçoit davantage de mises à jour de gradient où il apprend à générer une réponse à la suite de sa chaîne. Cela conduit à son tour à une probabilité logarithmique plus élevée de la section de réponse à tout moment de la génération et donc à des traces de raisonnement plus courtes au moment du test. En termes de performance, nous constatons également que le modèle entraîné avec une longueur de séquence plus longue performe mieux. Nous optons donc pour la longueur de séquence d'entraînement la plus longue, car elle conduit à de meilleures performances et rend l'inférence plus efficace en produisant des traces de raisonnement plus courtes.
D.2. Échantillons d'entraînement
Le tableau 9, le tableau 10 et le tableau 11 contiennent des échantillons d'entraînement de s1K.
Tableau 9. échantillon s1K provenant de s1-prob. Le texte en noir est la question et le texte en jaune est la solution. En nous fondant uniquement sur la question, nous générons la trace de raisonnement en bleu clair et la réponse en bleu avec Gemini, que nous utilisons pour l'entraînement.
On se donne des variables aléatoires intégrables et sur le même espace de probabilité , et deux - algèbres . Pour , soit
(a) Montrer qu'il existe des variables aléatoires intégrables et telles que, lorsque , à la fois et . (b) Prouver que presque sûrement .
1. Introduisons les notations, et , pour tout et . De toute évidence, les deux sont des filtrations et, par définition, et , pour tout . Ainsi (ou ) est une martingale de Doob par rapport à la filtration (ou ) et est donc U.I., étant intégrable. Appliquons maintenant le fait qu'une martingale est U.I. si et seulement si elle converge dans et concluons.
2. Nous fournissons deux preuves différentes.
1. Observons l'identité suivante qui découle de la propriété de la tour.
Notons que et, par le théorème de convergence ascendante de Lévy, où . Il est évident que (puisque c'est la limite presque sûre de ) et donc presque sûrement. En combinant les observations ci-dessus, nous concluons que . De même, . Invoquons maintenant l'équation (4) pour conclure que presque sûrement.
2. Puisque est intégrable, nous avons, par le théorème de convergence ascendante de Lévy, . De même, . D'autre part, dans la première preuve, nous avons observé que et donc . Cela donne ce qui suit.
De même, . Cela prouve que presque sûrement.
Analysons le problème. On nous donne deux suites de variables aléatoires et définies par des espérances conditionnelles. Nous devons montrer que ces suites convergent dans et que leurs limites sont égales presque sûrement.
Partie (a) : Convergence dans .
Les sigma-algèbres impliquées sont croissantes :
Pour la suite :
La suite de tribus est croissante. D'après le théorème de convergence des martingales (pour les espérances conditionnelles), puisque est intégrable, la suite converge presque sûrement et dans vers . Soit .
De même, pour la suite :
La suite de tribus est croissante. D'après le théorème de convergence des martingales, la suite converge presque sûrement et dans vers . Soit .
Partie (b) : Démontrer que presque sûrement .
On a et .
Soit et .
Alors et .
Considérons . .
. Puisque , .
. Puisque n'est pas défini, supposons que et sont donnés.
Considérons la tribu engendrée par tous les et .
Soit .
et sont tous deux mesurables par rapport à . Ainsi, et sont mesurables par rapport à .
Considérons .
Considérons .
Soit .
Considérons .
Considérons .
Considérons les tribus limites et .
Nous savons que est - mesurable et est - mesurable.
Soit .
Considérons le cas où et sont indépendantes. Alors et .
.
Considérons la tribu engendrée par toute l'information. Soit .
Alors et sont toutes deux - mesurables.
Nous avons et p.s. et dans .
Considérons et .
Soit .
Considérons .
Essayons de montrer que et sont toutes deux égales à . Cela semble trop simple.
Considérons la définition de l'espérance conditionnelle. Pour tout ensemble , .
Pour tout ensemble , .
Considérons où .
Considérons où .
Considérons la tribu .
Soit .
Nous avons .
Comme dépend de qui dépend de etc., c'est complexe.
Considérons le cas où et .
Alors .
Si tel était le cas, alors et , donc et .
Nous aurions besoin que p.s., c'est-à-dire p.s. Ce n'est pas vrai en général.
Considérons la tribu engendrée par tous les et , notée .
Alors .
\(\mathcal{Z}{\infty} = \sigma (B,Y{0},Y_{1},\ldots)\subseteq \sigma (B,G_{\infty})\) .Considérons \(\mathbb{E}[X|A,Z_{0},Z_{1},\ldots ] = Y_{\infty}\) .Cela signifie que pour tout \(A\in \sigma (A,Z_{0},Z_{1},\ldots)\), \(\mathbb{E}[X1_{A}] = \mathbb{E}[Y_{\infty 1_{A}}]\)
Considérons \(\mathbb{E}[X|B,Y_{0},Y_{1},\ldots ] = Z_{\infty}\) .Cela signifie que pour tout \(B\in \sigma (B,Y_{0},Y_{1},\ldots)\), \(\mathbb{E}[X1_{B}] = \mathbb{E}[Z_{\infty 1_{B}}]\)
Soit \(\mathcal{H} = \sigma (A,B)\)
Considérons \(\mathbb{E}[X|\mathcal{H}].\)
Considérons \(\mathbb{E}[Y_{\infty}|B,Y_{0},Y_{1},\ldots ] = \mathbb{E}[\mathbb{E}[X|A,Z_{0},Z_{1},\ldots ]|B,Y_{0},Y_{1},\ldots ]\)
Utilisons le fait que \(Y_{\infty}\) est \(\sigma (A,Z_{0},Z_{1},\ldots)\)-mesurable et que \(Z_{\infty}\) est \(\sigma (B,Y_{0},Y_{1},\ldots)\)-mesurable.
Considérons la plus petite tribu contenant à la fois \(\sigma (A,Z_{0},Z_{1},\ldots)\) et \(\sigma (B,Y_{0},Y_{1},\ldots)\)
C'est \(\sigma (A\cup B\cup \{Y_{i}\}{i\geq 0}\cup \{Z{i}\}_{i\geq 0})\)
Essayons de montrer que \(\mathbb{E}[(Y_{\infty} - Z_{\infty})^{2}] = 0\)
Considérons la définition de \(Y_{k}\) et \(Z_{k}\)
Considérons \(\mathbb{E}[Y_{\infty}|B,Y_{0},Y_{1},\ldots ]\)
Puisque \(Y_{\infty}\) est mesurable par rapport à \(\sigma (A,Z_{0},Z_{1},\ldots)\), cela ne se simplifie pas facilement.
Supposons que \(Y_{\infty}\neq Z_{\infty}\) sur un ensemble de mesure positive.
Considérons le cas où \(A\) et \(B\) sont triviales.
Alors \(Y_{k} = \mathbb{E}[X|\sigma (Z_{0},\ldots ,Z_{k - 1})]\) et \(Z_{k} = \mathbb{E}[X|\sigma (Y_{0},\ldots ,Y_{k - 1})]\)
Soit \(\mathcal{H}{\infty} = \sigma (A\cup B\cup \{Y{i},Z_{i}\}_{i\geq 0})\)
Considérons \(\mathbb{E}[X|\mathcal{H}_{\infty}]\)
Nous avons \(Y_{\infty} = \mathbb{E}[X|\sigma (A,Z_{0},Z_{1},\ldots)]\)
Par les propriétés de l'espérance conditionnelle, \(\mathbb{E}[Y_{\infty}|\mathcal{A}] = \mathbb{E}[\mathbb{E}[X|\mathcal{A},Z_{0},Z_{1},\ldots ]|\mathcal{A}]\)
Considérons la tribu \(D\) engendrée par toutes les variables aléatoires impliquées.
Soit \(M_{\infty} = \mathbb{E}[X|A\vee B]\)
Considérons les limites. Lorsque \(n\to \infty\),
Lorsque \(n\to \infty\),
Soit et
Nous avons et
Considérons
Considérons la tribu
Soit
Considérons la tribu limite engendrée par toute l'information.
Soit
Alors et
Nous avons et
Considérons et
Soit
Considérons
Considérons la suite de paires
Si les limites sont identiques, alors pour toute fonction mesurable bornée ,
Considérons la tribu
Alors et sont toutes deux mesurables par rapport à
Considérons
Soit
Considérons
Alors et Considérons la tribu limite \(\mathcal{L} = \sigma (\mathcal{A} \cup \mathcal{B} \cup \sigma (Y_{0}, Z_{0}, \ldots))\) .
Nous avons et .
Soit .
Considérons .
Considérons la variable aléatoire . Alors et .
Soit .
Considérons . Supposons .
Considérons l'espérance conditionnelle par rapport à la jointure des tribus.
Soit .
Considérons .
Alors .
Et .
Donc et .
Soit et .
Considérons .
Alors .
Et .
Cela signifie que p.s. et p.s.
Par conséquent, p.s.
Solution :
(a) Pour la suite , les -algèbres sont croissantes lorsque augmente. Puisque est intégrable, par le théorème de convergence des martingales pour les espérances conditionnelles, la suite converge presque sûrement et dans vers . De même, pour la suite , les -algèbres sont croissantes. Puisque est intégrable, par le théorème de convergence des martingales, la suite converge presque sûrement et dans vers .
(b) Soit et . On a et . Considérons la -algèbre . Considérons .
On a , donc .
Puisque est -mesurable, implique que est l'espérance conditionnelle de sachant . Mais comme est déjà -mesurable, on a si est -mesurable, ce qui n'est pas nécessairement vrai.
Cependant, nous savons que et .
Considérons .
Alors .
Cela implique que .
De même, .
Cela implique que presque sûrement.
Par conséquent, presque sûrement.
Réponse finale : La réponse finale est
Tableau 10. échantillon s1K issu des teasers s1-. Le texte en noir est la question et le texte en jaune est la solution. À partir de la seule question, nous générons la trace de raisonnement en bleu clair et la réponse en bleu avec Gemini, que nous utilisons pour l'entraînement.
Alice et Bob ont chacun une pièce et la lancent jusqu'à obtenir un face. Si Bob a lancé sa pièce plus de fois qu'Alice, quel est le nombre attendu de fois qu'Alice a lancé sa pièce ?
4/3
Le problème demande le nombre attendu de fois qu'Alice a lancé sa pièce, étant donné que Bob a lancé sa pièce plus de fois qu'Alice.
Soit le nombre de lancers qu'Alice effectue jusqu'à obtenir un face.
Soit le nombre de lancers que Bob effectue jusqu'à obtenir un face.
et sont des variables aléatoires indépendantes suivant une loi géométrique de paramètre (probabilité d'obtenir un face).
La fonction de masse de probabilité d'une loi géométrique est , pour
Dans ce cas, , donc .
On nous donne la condition que Bob a lancé sa pièce plus de fois qu'Alice, ce qui signifie .
Nous voulons trouver l'espérance de sachant que , c'est-à-dire .
La formule de l'espérance conditionnelle est .
De plus, .
Dans notre cas, est l'événement .
Nous devons trouver .
Puisque et sont indépendantes, .
La somme intérieure est une série géométrique :
Il s'agit d'une série géométrique de premier terme et de raison .
La somme est .
Ainsi, .
C'est une autre série géométrique de premier terme et de raison .
La somme est .
Maintenant, nous devons trouver .
, en raison de l'indépendance.
.
Ainsi, .
Maintenant, nous pouvons trouver .
Enfin, nous pouvons calculer l'espérance conditionnelle :
Considérons la série , où .
Considérons la série géométrique .
En dérivant par rapport à :
Ainsi, , ce qui signifie .
Dans notre cas, .
Par conséquent,
Approche alternative : Symétrie.
Considérons les événements , , et .
par symétrie.
Nous avons .
. Cela confirme notre calcul précédent.
Soit .
Nous cherchons le nombre attendu de lancers effectués par Alice, étant donné que Bob a lancé plus de fois.
Considérons le cas où le premier lancer des deux donne pile. Alors le processus recommence, et la condition reste la même.
Soit le premier lancer d'Alice, le premier lancer de Bob.
Cas 1 : , donc est faux.
Cas 2 : . Alice s'arrête à 1, Bob continue.
Cas 3 : . Bob s'arrête à 1, Alice continue.
Cas 4 : . Les deux continuent.
Considérons les probabilités conditionnelles sachant .
Soit .
Si les premiers lancers sont HH, la condition n'est pas remplie.
Si les premiers lancers sont HT, le nombre de lancers d'Alice est 1.
Si les premiers lancers sont TH, le nombre de lancers de Bob est 1, celui d'Alice est au moins 2, donc .
Si les premiers lancers sont TT, le problème recommence, et le nombre attendu de lancers supplémentaires pour Alice est toujours .
Soit le nombre de lancers effectués par Alice, le nombre de lancers effectués par Bob.
On sait que .
Considérons les premiers lancers :
HH (probabilité 1/4) : condition non remplie.
HT (probabilité 1/4) : Alice lance 1 fois.
TH (probabilité 1/4) : Bob lance 1 fois, Alice , donc , condition non remplie.
TT (probabilité 1/4) : les deux continuent.
Soit le nombre attendu de lancers d'Alice sachant que Bob a lancé plus de fois.
Si les premiers lancers sont HT, Alice a lancé 1 fois, et la condition est remplie.
Si les premiers lancers sont TT, la situation est la même qu'au début, donc le nombre attendu de lancers supplémentaires pour Alice est .
Considérons l'événement .
En conditionnant sur les premiers lancers :
dépend des lancers futurs.
Utilisons directement la définition de l'espérance conditionnelle.
(1>λ)
Considérons les probabilités des premiers lancers sachant .
Si les premiers lancers sont TT, le comportement futur est le même, et la condition est vérifiée si Bob effectue plus de lancers qu'Alice dans les essais suivants.
a besoin de plus de lancers qu'Alice en repartant de zéro)
Somme des probabilités conditionnelles :
Considérons maintenant les espérances conditionnelles de
: Non pertinent puisque
: Sachant HT et , Alice a lancé 1 fois.
: Non pertinent.
: Sachant TT et , Alice a déjà lancé une fois, et le nombre attendu de lancers supplémentaires est . Donc, le nombre total de lancers est .
indéfini
Cela confirme le résultat précédent.
Réfléchissons à l'intuition. Si nous avons la condition , cela signifie qu'Alice a été « chanceuse » et a obtenu un face tôt, ou que Bob a été « malchanceux ».
Considérons la variable aléatoire . On nous donne .
Nous voulons .
Soit .
Le nombre de piles avant le premier face suit une distribution géométrique de paramètre .
, .
.
.
Considérons la distribution conjointe de et .
Considérons l'événement , où .
Si , alors , .
Vérifions si .
Quelque chose ne va pas ici.
Recalculons .
Somme interne : .
Si , . Correct.
Maintenant, trouvons .
(indépendance)
(erreur dans l'exposant)
Soit . .
Si , .
Solution :
Soit le nombre de lancers effectués par Alice jusqu'à ce qu'elle obtienne un face, et le nombre de lancers effectués par Bob jusqu'à ce qu'il obtienne un face. et sont des variables aléatoires géométriques indépendantes de paramètre . La fonction de masse de probabilité est .
Nous nous intéressons à l'espérance du nombre de fois qu'Alice a lancé sa pièce, sachant que Bob a lancé sa pièce plus de fois qu'Alice, c'est-à-dire .
En utilisant la définition de l'espérance conditionnelle, .
Tout d'abord, calculons .
Ensuite, calculons .
Maintenant, trouvons .
Enfin, calculons l'espérance conditionnelle :
En utilisant la formule avec :
Réponse finale : La réponse finale est
Tableau 11. échantillon s1K issu du sous-ensemble d'astronomie d'OlympicArena. Le texte noir est la question et le texte bleu est la solution. En nous fondant uniquement sur la question, nous générons avec Gemini la trace de raisonnement en bleu clair et la réponse en bleu, que nous utilisons pour l'entraînement.
Un fait amusant souvent répété est que les humains produisent plus de puissance par unité de volume que les étoiles. Si le soleil avait la même taille, mais produisait la même quantité de puissance par unité de volume qu'un humain, quelle serait sa température de surface ? On suppose que l'« humain moyen » produit 100 watts de puissance et a un volume de 66400 centimètres cubes.
A : 3500 K B : 10000 K C : 25000 K D : 40000 K E : 50000 K
En utilisant les chiffres du problème, l'humain moyen produit
Le volume du soleil est , donc sa nouvelle puissance produite serait . Pour trouver la température d'équilibre, nous utilisons
En résolvant pour , nous obtenons
Le problème demande la température de surface du soleil s'il avait la même taille mais produisait une puissance par unité de volume égale à celle d'un humain.
Tout d'abord, trouvons la densité de puissance d'un humain.
Puissance produite par un humain,
Volume d'un humain,
Convertissons le volume en mètres cubes :
Densité de puissance d'un humain,
Considérons maintenant le soleil avec la même taille qu'actuellement, mais avec une densité de puissance égale à celle d'un humain.
Nous avons besoin du rayon du soleil pour calculer son volume. Le rayon moyen du soleil est
Volume du soleil,
Si le soleil avait la même densité de puissance qu'un humain, la puissance totale produite par ce soleil modifié serait :
La température de surface d'une étoile est liée à sa luminosité (puissance totale émise) par la loi de Stefan-Boltzmann :
où est la luminosité (puissance totale émise), est le rayon de l'étoile, est la constante de Stefan-Boltzmann, et est la température de surface.
Dans ce cas, la luminosité du soleil modifié est . Le rayon du soleil modifié est le même que celui du soleil réel, .
La constante de Stefan-Boltzmann, .
Calculer le terme :
Maintenant, substituons ceci dans l'équation :
Résoudre pour :
Résoudre pour :
Calculer (1,9386) : Soit , alors
Donc,
Nous savons que et , donc est compris entre 5 et 6.
Alternativement,
Vérifions les calculs.
Densité de puissance de l'humain :
Volume du soleil :
Puissance du soleil modifié :
Loi de Stefan-Boltzmann :
Calculer : Soit , alors
Le résultat est d'environ 66000 K. Cela ne figure pas parmi les options. Revenons sur les hypothèses et les calculs.
Hypothèse : Le soleil rayonne comme un corps noir, ce qui est raisonnable pour estimer la température de surface.
Examinons les erreurs potentielles dans les calculs.
Essayons une approche plus simple en établissant des rapports.
La puissance par unité de volume du soleil modifié est égale à celle d'un humain.
Nous savons également que
Substituer les valeurs :
Calculer :
Soit , alors
Ceci est proche de l'option E : 50000 K.
Vérifions soigneusement les unités et les calculs.
Densité de puissance d’un humain :
La formule obtenue était .
Vérification des unités :
Les unités concordent pour .
Vérification du calcul numérique :
Numérateur :
Dénominateur :
Rapport :
Utilisons les logarithmes pour plus de précision.
Cela est très proche de 50000 K.
Sources possibles de légers écarts : erreurs d’arrondi, précision des constantes.
Vérifions la dérivation de la formule.
Puissance par unité de volume
Si le soleil modifié avait la densité de puissance d’un humain :
La dérivation de la formule semble correcte.
Utilisons des valeurs approximatives pour vérifier l’ordre de grandeur.
Donc, entre 7 et 8.
L’ordre de grandeur semble cohérent avec le calcul détaillé.
L’énoncé du problème est simple et ne semble présenter aucune complexité cachée. Les hypothèses faites sont standard pour ce type de problème.
Considérons la précision des valeurs données.
Puissance d’un humain : (exact)
Volume d’un humain : (exact)
Le résultat obtenu est très proche de l’option E. Compte tenu de la nature des questions à choix multiples, l’option la plus proche est probablement la réponse attendue.
S’il y avait des interprétations erronées de la question, ce serait probablement dans la configuration. Cependant, la phrase « If the sun were the same size, but it produced the same amount of power per unit volume as a human » semble claire.
La température de surface est calculée à l’aide de la loi de Stefan- Boltzmann, en supposant un rayonnement de corps noir.
Vérifions les options fournies :
A : 3500 K
B : 10000 K
C : 25000 K
D : 40000 K
E : 50000 K
Notre valeur calculée est d’environ 49800 K, ce qui est le plus proche de 50000 K.
Si nous utilisions des valeurs plus précises pour les constantes, le résultat pourrait être légèrement différent, mais probablement pas assez pour passer à une autre option.
Le fait amusant mentionné dans la question implique que la densité de puissance d’un humain est supérieure à celle du soleil. Vérifions cela.
Puissance émise par le soleil :
Volume du soleil :
Densité de puissance du soleil :
Densité de puissance d'un humain :
En effet, la densité de puissance d'un humain est significativement plus élevée que celle du soleil.
Vérification finale des étapes de calcul et de la logique. L'approche consistant à égaler la densité de puissance du soleil modifié à celle d'un humain, puis à utiliser la loi de Stefan-Boltzmann, semble correcte.
Solution :
La puissance produite par un humain moyen est , et le volume d'un humain moyen est .
La densité de puissance d'un humain est .
Si le soleil avait la même taille mais produisait la même quantité de puissance par unité de volume qu'un humain, sa densité de puissance serait .
Le rayon du soleil est .
Le volume du soleil est .
La densité de puissance du soleil modifié est donnée par .
Nous savons également que , où est la température de surface du soleil modifié.
En égalant la densité de puissance :
En résolvant pour :
Substituer les valeurs :
En résolvant pour :
En utilisant les logarithmes :
Refaisons le calcul de l'exposant : .
- erreur à l'étape précédente.
La température de surface serait d'environ 49806 K, ce qui est le plus proche de 50000 K.
Réponse finale : La réponse finale est
E. Détails de la mise à l'échelle au moment du test
E.1. Ablations de mise à l'échelle séquentielle
| <lim_start>user | <lim_start>user |
| Quelle est la réponse à la Vie, à l'Univers et au Reste ? | Quelle est la réponse à la Vie, à l'Univers et au Reste ? |
| Réfléchis pendant un maximum de 2048 tokens. | Réfléchis pendant un maximum de 64 étapes. |
| <lim_start>assistant | <lim_start>assistant |
| <lim_start>think | <lim_start>64 étapes restantes |
| Laissez-moi décomposer cette question en ses trois parties : 1) la Vie 2) l'Univers 3) le Reste | Laissez-moi décomposer cette question en ses trois parties : 1) la Vie 2) l'Univers 3) le Reste |
| Laissez-moi commencer par la vie... | <lim_start>63 étapes restantes |
| Laissez-moi commencer par la vie... | |
| <lim_start>answer | <lim_start>answer |
| La réponse est... | La réponse est... |
Si vous avez un passage réel à traduire (par exemple le texte de la section « E.1. Sequential scaling ablations » mentionné dans le contexte), je serai ravi de le traduire en français.
alors la trace de raisonnement contient entre 1024 et 2048 tokens. Dans le tableau 12, nous montrons qu'après entraînement, le modèle suit à peine l'instruction sur les tokens. Il génère parfois plus de tokens lorsqu'on lui donne une limite plus élevée, mais dépasse souvent la limite. Cela n'est peut-être pas propre à notre modèle, car des travaux antérieurs suggèrent qu'OpenAI o1-mini ne peut pas non plus suivre les instructions sur les tokens (Zhang & Chen, 2024). Pour éviter de dépasser la limite, nous testons le forçage du budget en terminant la réflexion une fois la limite atteinte. Cela conduit à un contrôle parfait (tableau 12 (bas)). Avec le forçage du budget, la tendance de mise à l'échelle est également plus claire, car le modèle ne peut plus dépasser la limite lorsqu'on lui donne un petit budget de réflexion. Cela conduit à de meilleures valeurs de mise à l'échelle au moment du test pour Token Prompting + forçage du budget dans le tableau 3. Pour calculer Control rapporté dans le tableau 3 pour les variantes de contrôle conditionnées par les tokens, nous divisons le nombre de fois où les tokens de réflexion du tableau 12 sont inférieurs à la limite supérieure par le total des évaluations (2/5 sans intervention ; 5/5 avec intervention).
Contrôle conditionné par les étapes Les instructions sur les tokens échouent car les modèles actuels ne savent pas compter les tokens. Pour tenir compte de ce manque de capacité, nous expérimentons en rendant le comptage plus grossier. Nous partitionnons les traces de raisonnement en étapes et demandons au modèle de réfléchir pendant un nombre spécifique d'étapes plutôt que de tokens. Nous divisons nos traces de raisonnement sur des doubles sauts de ligne en étapes, ce qui, selon nous, agit comme des séparateurs intuitifs d'après l'inspection manuelle des échantillons. Nous regroupons nos échantillons d'entraînement en puissances de 2 selon leur nombre d'étapes et ajoutons une instruction d'étape correspondante suivant le format de la figure 10 (droite). Ce format est basé sur des expériences initiales, où nous avons constaté que le modèle était plus susceptible de respecter la limite d'étapes
| Étapes demandées | 16 | 32 | 64 | 128 | 256 |
| Aucune intervention au moment du test | |||||
| Étapes utilisées | 123 | 90 | 80 | 82 | 136 |
| Tokens par étape | 60 | 70 | 69 | 66 | 56 |
| Tokens de raisonnement | 7252 | 6277 | 5396 | 5552 | 7551 |
| Tokens de réponse | 665 | 653 | 735 | 777 | 754 |
| AIME24 | 33,3 | 23,3 | 33,3 | 36,7 | 33,3 |
| Forcer la fin du raisonnement lorsque 0 étape est atteinte | |||||
| Étapes utilisées | 16 | 32 | 59 | 78 | 136 |
| Tokens par étape | 96 | 94 | 80 | 70 | 56 |
| Tokens de raisonnement | 1517 | 2963 | 4636 | 5409 | 7551 |
| Tokens de réponse | 1111 | 788 | 799 | 794 | 754 |
| AIME24 | 23,3 | 23,3 | 33,3 | 36,7 | 33,3 |
Tableau 13. Mise à l'échelle du temps de réflexion via un contrôle conditionné par les étapes. Toutes les métriques sont moyennées sur les 30 échantillons d'AIME24. Les nombres de tokens ignorent la réflexion et les délimiteurs d'étapes.
Tableau 14. Mise à l'échelle du temps de réflexion via un contrôle conditionné par les classes. Nous rapportons « précision / nombre moyen de tokens de réflexion par échantillon » ; plus la précision est élevée et moins il y a de tokens de réflexion (coût d'inférence), mieux c'est.
| Invite ajoutée à la question après deux sauts de ligne | AIME24 | MATH500 | GPQA |
| Répondez après un court temps de réflexion. Ne passez pas un temps excessif à revérifier votre travail. | 30,0 % 8033 | 90,4 % 2537 | 56,6 % 4177 |
| Répondez après un long temps de réflexion. Si vous avez l'impression d'avoir terminé trop tôt, consacrez le temps supplémentaire à essayer de revérifier votre travail jusqu'à être absolument sûr d'avoir la bonne réponse. | 36,7 % 9651 | 91,4 % 3875 | 51,0 % 4827 |
| Sans ajout d'invite générique | 50,0 % 6109 | 93,0 % 3298 | 57,6 % 3510 |
lors d'un décompte décroissant (« 3 étapes restantes... 2 étapes restantes ») plutôt que croissant (« Étape 2... Étape 3... »). Cela est probablement dû au fait qu'en décomptant, la dernière étape est toujours 1, ce qui agira comme un a priori fort pour que le modèle termine sa génération. En comptant vers le haut, la dernière étape avant la réponse varie ; ainsi, si le modèle ne se souvient pas de l'instruction d'étape initiale, il peut échouer à s'arrêter. Nous tirons les conclusions suivantes de nos résultats du tableau 13 : (1) Le modèle a encore du mal à respecter la limite d'étapes. Le modèle continue parfois simplement à compter en étapes négatives, par exemple « 1 étapes restantes ». Pour résoudre ce problème, nous arrêtons automatiquement le processus de réflexion une fois que 0 étape est atteinte, puis nous forçons le modèle à passer en mode réponse en ajoutant le délimiteur de token de réponse (§3). Cela conduit à un respect parfait des étapes (moitié inférieure du tableau 13), mais des problèmes subsistent. (2) Le modèle compense le nombre réduit d'étapes en rendant chaque étape plus longue. Par exemple, lorsqu'il est forcé d'utiliser jusqu'à 16 étapes contre 256 étapes, le modèle génère en moyenne 96 tokens par étape contre 56. Malgré ce problème, davantage d'étapes restent clairement corrélées à davantage de tokens de réflexion totaux dans le tableau 13 et à de meilleures performances, conduisant à une pente positive. (3) Les instructions d'étapes sont plus coûteuses que les autres méthodes. Les délimiteurs d'étapes nécessitent environ 6 tokens chacun, ce qui, pour par exemple 64 étapes, représente un total d'environ 380 tokens. En ignorant les délimiteurs d'étapes dans les nombres de tokens comme dans le tableau 13, le modèle nécessite encore 7551 tokens de réflexion en moyenne pour atteindre seulement sur AIME24. Pour calculer Control rapporté dans le tableau 3 pour les variantes de contrôle conditionnées par les étapes, nous décidons d'abord que 100 tokens constituent une limite supérieure par étape, puis nous multiplions ce nombre par les étapes prescrites pour arriver à une limite totale de tokens approximative, par exemple 1600 pour 16 étapes prescrites. Nous vérifions ensuite si les tokens de réflexion du tableau 13 respectent la limite respective pour chaque exécution d'évaluation (3/5 sans intervention ; 5/5 avec intervention). Pour le modèle de la figure 7, nous utilisons un modèle avec contrôle conditionné par les étapes entraîné sur une version antérieure de nos données et utilisant une version antérieure de notre base de code d'évaluation.
Contrôle conditionné par les classes OpenAI expose le contrôle du calcul au moment du test aux utilisateurs via un paramètre d'API « reasoning_effort » avec trois réglages possibles : faible, moyen et élevé. La documentation d'OpenAI indique également que « Réduire l'effort de raisonnement peut entraîner des réponses plus rapides et moins de tokens utilisés pour le raisonnement dans une réponse », ce qui suggère qu'ils ne sont pas capables de contrôler le calcul au moment du test avec des garanties. Ainsi, peut-être qu'OpenAI ajuste simplement le prompt ou l'instruction système selon l'effort de raisonnement souhaité. Dans le tableau 14, nous montrons que des prompts séparés pour une réflexion courte et longue nous permettent de contrôler le temps de réflexion dans une certaine mesure : demander au modèle de réfléchir plus longtemps conduit à une réflexion plus longue. Cependant, cela n'améliore pas de manière fiable les performances et le contrôle n'est pas précis. L'adhérence actuelle au contrôle peut suffire lorsque nous n'avons que trois classes, mais elle pourrait ne pas s'étendre à des classes plus fines. Pour calculer Control rapporté dans le tableau 3 pour cette méthode, nous supposons que demander au modèle de réfléchir pendant une courte durée dans le tableau 14 devrait produire moins de tokens que la valeur par défaut pour AIME24, tandis que le prompt long devrait en produire davantage. Comme et , un cas sur deux suit notre contrôle attendu ; ainsi Control est de .
E.2. Exemples pour l’ablation de l’échantillonnage par rejet
3https://github.com/openai/openai-python/blob/44d6210f101abedeb2dd68507fcfcb329df70ea/src/openai/types/chat/completion_create_params.py#L172
Tableau 15. Réponses générées par une version antérieure de s1- 32B lors de l’échantillonnage par rejet sur AIME24. Le texte en noir est la question et le texte en jaune est la solution. En nous fondant uniquement sur la question, nous générons la trace de raisonnement en bleu clair et la réponse en bleu avec s1- 32B en utilisant une température de 1. Nous générons jusqu’à ce que la trace de raisonnement ait moins de 4000 tokens pour le premier exemple et moins de 8000 tokens pour le second. Il a fallu en moyenne 199 (1) essais par exemple jusqu’à ce que le raisonnement soit ( tokens).
Soit , et des points dans le plan coordonné. Soit la famille des segments de longueur unité situés dans le premier quadrant avec sur l’axe et sur l’axe . Il existe un unique point sur , distinct de et , qui n’appartient à aucun segment de autre que . Alors , où et sont des entiers positifs premiers entre eux. Trouver .
23
[Génération correcte avec 3981 tokens de raisonnement et 1055 tokens de réponse]
Le problème demande un point sur le segment qui n’est contenu dans aucun autre segment de la famille , excepté lui-même.
Les points forment un triangle dans le premier quadrant.
Le segment relie et
L’équation de la droite contenant peut être trouvée à l’aide des deux points :
Pente
En utilisant la forme point-pente avec le point
Le segment se trouve dans le premier quadrant et relie à
La famille est constituée de segments de longueur unité, où est sur l'axe des et est sur l'axe des . Soit et .
La longueur de est .
Donc .
Puisque est sur l'axe des positif et est sur l'axe des positif, on a et .
Le segment relie et . L'équation de la droite contenant est .
La région couverte par la famille est l'aire délimitée par les droites contenant ces segments. Les extrémités et varient de sorte que .
Considérons la paramétrisation , , où .
Le segment relie et . L'équation de la droite est .
Nous cherchons un point unique sur , distinct de et , qui n'appartient à aucun segment de autre que .
Soit un point sur . Nous pouvons paramétrer les points sur par pour .
.
Puisque est distinct de et , on a .
Supposons que le point se trouve sur un certain segment , où et .
Le point satisfait l'équation .
En remplaçant par les coordonnées de :
Multiplier par 2 :
Nous cherchons un point sur tel que le seul segment de contenant soit lui-même. Le segment fait partie de la famille .
Pour , et .
Ici , .
Le segment de droite relie et .
L'équation de la droite est , ce qui se simplifie en , ou .
Cela correspond à l'équation .
Considérons l'enveloppe de la famille de droites .
En dérivant par rapport à :
À partir de l'équation de la droite :
Substituer
Substituer à nouveau dans l'équation de la droite :
L'enveloppe de la famille est l'astroïde .
Les segments de sont tangents à cet astroïde.
Le point sur que nous cherchons est le point où est tangent à l'astroïde.
L'équation de est .
Substituons dans l'équation de l'astroïde :
Posons et . L'astroïde est .
Le point se trouve à la fois sur la droite et sur l'astroïde.
En dérivant implicitement l'équation de l'astroïde :
.
La pente de la tangente à l'astroïde en un point est .
La pente de la droite est .
Ainsi, au point de tangence, .
Le point se trouve sur la droite et satisfait .
Donc .
Substituons dans l'équation de la droite :
Alors .
Le point est .
Nous devons vérifier si ce point se trouve sur le segment .
Le point est de la forme .
Donc se trouve sur .
Nous devons nous assurer que , ce qui est vrai pour .
Maintenant, nous devons vérifier si ce point n'appartient à aucun autre segment de .
Le point se trouve sur l'astroïde. Le segment est tangent à l'astroïde en .
Tout autre segment de qui contiendrait aurait comme point intérieur, et non comme point de tangence.
Considérons la paramétrisation de la famille .
Un point appartient à un certain segment de si et seulement s'il existe tel que .
Pour le point , nous avons :
Nous savons que se trouve sur , ce qui correspond à un segment spécifique de .
L'énoncé du problème suppose l'existence et l'unicité d'un tel point .
Le point unique sur , distinct de et , qui n'appartient à aucun segment de autre que .
Cela signifie que si se trouve sur un autre segment , alors .
Le point est le point de tangence de avec l'astroïde.
Nous devons maintenant trouver .
Ici et .
et sont premiers entre eux.
.
Vérification finale du raisonnement :
La famille est constituée de segments de longueur unité dont les extrémités sont sur les axes.
L'enveloppe de cette famille est l'astroïde .
Les segments de sont tangents à l'astroïde.
Le segment est aussi un membre de la famille .
Nous cherchons un point sur qui se trouve sur l'astroïde.
Ce point est le point de tangence de avec l'astroïde.
Si un point sur se trouve sur l'astroïde, il appartient au segment tangent en ce point. Puisque est le segment tangent, ce point n'appartient à aucun autre segment de .
Considérons le cas où le segment coupe l'astroïde en deux points.
Si le segment n'est pas tangent à l'astroïde, alors il y a deux points d'intersection.
Soient et les points d'intersection.
Si se trouve sur , alors la tangente à l'astroïde en est le segment .
Si se trouve sur , alors la tangente à l'astroïde en est le segment .
La pente de est .
Nous avons trouvé le point sur l'astroïde dont la pente de la tangente est .
L'énoncé du problème garantit l'unicité d'un tel point
Le point doit être intérieur à , donc
Le paramètre est dans cet intervalle.
Le point est distinct de et de
Si , alors ,
Si , alors ,
Le point de tangence est l'unique point sur (extrémités exclues) qui appartient à l'astroïde.
Solution :
Soit la famille de segments définie par les segments de longueur unité avec sur l'axe des positifs et sur l'axe des positifs. Soit et . La condition de longueur donne . Le segment est porté par la droite . En utilisant la paramétrisation , avec , l'équation de la droite est .
L'enveloppe de cette famille de droites est l'astroïde
Les segments de sont tangents à cette astroïde.
Le segment relie et . L'équation de la droite contenant est . Ce segment fait partie de la famille .
Nous cherchons un point unique sur , distinct de et de , qui n'appartient à aucun segment de autre que . Cela signifie que est le point où est tangent à l'astroïde.
La pente de la tangente à l'astroïde en un point est . La pente de est
En égalant les pentes :
Le point se trouve sur la droite et satisfait
En substituant,
Alors
Le point est
Nous devons vérifier si se trouve sur . Les points sur sont pour
Pour
Pour
Puisque , est un point intérieur de
Le point est l'unique point sur (extrémités exclues) qui appartient à l'astroïde. La tangente à l'astroïde en est le segment . Ainsi, n'appartient à aucun autre segment de .
Enfin, nous calculons
Nous avons et . Ces nombres sont premiers entre eux.
Réponse finale : La réponse finale est [23]
[Génération incorrecte avec 5923 jetons de réflexion et 754 jetons de réponse]
Le problème demande un point sur le segment tel que n'appartienne à aucun autre segment de la famille , excepté lui-même. La famille est constituée de segments de longueur unité, avec sur l'axe des et sur l'axe des dans le premier quadrant. Soit et , où et . La longueur du segment est 1, donc la distance entre et est 1.
Le segment se trouve dans le premier quadrant, donc et
L'équation représente le quart de cercle dans le premier quadrant, avec des extrémités en et .Les points du segment peuvent être paramétrés par , où .
Le segment relie et .
L'équation de la droite contenant peut être trouvée à l'aide des deux points : Pente .
En utilisant la forme point-pente avec le point :
Le segment se trouve dans le premier quadrant, entre et .
Alternativement, nous pouvons paramétrer les points sur . Soit un point sur . Alors pour un certain .
Nous cherchons un point unique sur , distinct de et , qui n'appartient à aucun segment de autre que . Considérons un segment de , d'extrémités et , où . Un point de ce segment est de la forme , où . Nous voulons trouver un point sur , , tel que si appartient à un segment , alors .
Soit , où . Si appartient à un segment de , alors il existe avec , et tels que :
De la première équation, . De la seconde équation, . Puisque , nous avons . De plus, , donc , ce qui implique , ou . Cela est cohérent avec la condition pour un point sur .
Nous avons et . En additionnant ces équations :
Nous savons que . Si le point appartient au segment lui-même, alors les extrémités du segment sont et . Ainsi, le segment va de à . Ici, et . Vérifions si : . Donc .
Si appartient à un autre segment de , d'extrémités et , où . Considérons l'interprétation géométrique. La famille est constituée de segments de longueur unité dont les extrémités sont sur les axes. Les milieux de ces segments se trouvent sur le cercle . Supposons que le point corresponde à un certain . Si se trouve sur , alors . Donc, et . Nous devons trouver un tel que l'unique solution de ces équations, avec , , soit et . D'après les équations, et . Substituons-les dans .
Essayons une approche différente. Considérons les tangentes à la famille de segments. Les segments sont formés par les points et avec . L'équation de la droite contenant le segment est , ou . L'équation de la droite est .
Considérons l'équation du segment sous forme paramétrique : . Si un point se trouve sur ce segment, alors , où et . Donc, et . . Les segments de font partie des droites , où , .
Considérons le point . Si se trouve sur un segment de d'extrémités et , alors :
Nous devons trouver un unique tel que l'unique solution de cette équation, avec , , soit .
Substituons et dans l'équation :
Cela montre que tout point de se trouve sur le segment lui-même.
Considérons la droite contenant : .
Si un point sur se trouve aussi sur un autre segment de d’extrémités et , alors :
Soit le point qui divise dans le rapport , où .
Si se trouve sur un segment d’extrémités et , alors :
Nous cherchons un point tel que la droite passant par de la forme , où , soit unique.
Considérons les tangentes au cercle unité centré à l’origine. Les droites de la forme sont tangentes au cercle .
Considérons le problème dual. La famille de segments correspond à des points sur le quart de cercle dans le premier quadrant.
Les droites contenant les segments sont .
L’enveloppe de ces droites est la courbe dont ces droites sont les tangentes.
L’équation , avec la contrainte .
Soit , , où .
Les équations des droites sont .
L’enveloppe de la famille de droites est le cercle .
Les segments de sont des parties des tangentes au cercle unité dans le premier quadrant.
Le point sur qui n’appartient à aucun autre segment de signifie que la tangente au cercle unité passant par est unique.
Considérons le point .
Les tangentes au cercle unité passant par ont la forme .
Si la tangente est unique, alors se trouve sur le cercle unité.
Résolvons pour :
Nous avons besoin de .
Quelque chose ne va pas. Le point est à l’intérieur du cercle unité.
Reformulons la condition. Il existe un unique point sur tel que, si se trouve sur un segment , alors .
Soit le point sur égal à .
Considérons un segment de d’extrémités et , .
La forme paramétrique du segment est .
Si est sur ce segment, alors pour un certain :
Si le segment est unique, alors les valeurs de et sont uniques.
La seule solution de , avec , , devrait être , .
Considérons l'intersection de la droite contenant avec la frontière de la région formée par les segments de .
Les frontières sont l'axe des , l'axe des et le quart de cercle .
Considérons à nouveau le problème dual. La famille de droites , où , .
L'enveloppe de ces droites est le cercle .
Un point appartient à un unique segment de s'il se trouve sur le cercle .
Le point sur satisfait .
Considérons le cas où le segment est . Ici , .
Le point peut être représenté par pour .
Nous cherchons un point sur qui ne se trouve sur aucun autre segment de .
Considérons la géométrie. La famille forme une région délimitée par les axes et le quart de cercle.
Les segments sont des cordes de cercles centrés sur la droite , tangents aux axes.
Soient les extrémités d'un segment et
Un point sur le segment est
Le point
Si se trouve sur un tel segment, alors et
Nous avons besoin d'un unique tel que la seule solution soit , ce qui correspond à
Considérons la fonction
Nous avons besoin que
Si , alors
Divisons par 2 :
, ou
, donc
Si ,
Si ,
Si , le point est
Ce point se trouve sur les segments correspondant à et
Le point unique signifie que pour d'autres valeurs de , il y a plus d'une solution pour
Considérons la tangente au cercle unité passant par
Si la tangente est unique, est sur le cercle unité.
Cela conduit à , dont aucun n'appartient à
Considérons l'interprétation géométrique de la famille . Les segments relient des points sur les axes de sorte que la distance soit 1.
Le lieu des centres de ces segments est le cercle , dans le premier quadrant.
Si un point se trouve sur un segment de , alors est sur un segment de droite reliant et avec
La droite contenant le segment est
Si appartient à un unique segment, alors il existe une unique droite de cette forme passant par
Le point sur est
Nous avons besoin d'un unique avec , tel que
Soit le point tel que la droite passant par de la forme soit unique, sous la contrainte
Cette droite est tangente au cercle unité.
Le point se trouve à l'intersection de la droite contenant et du cercle unité.
Nous n'avons trouvé aucune solution pour Le point unique signifie que si un autre segment passe par , il doit être .
Considérons la pente de la droite contenant le segment reliant et . La pente est .
L'équation est .
Si se trouve sur le segment, alors .
Considérons la moyenne géométrique.
Soit le point de coordonnées . Le segment reliant et passe par . . Si est sur , alors . .
Le point est tangent à l'enveloppe de la famille de segments.
Solution : Soit la famille de segments . Les segments ont pour extrémités et avec et . Les points sur le segment satisfont . Les segments se trouvent sur les droites , où , .
Le segment a pour extrémités et . L'équation de la droite contenant est .
Un point sur peut être paramétré par , où .
Si appartient à un segment de d'extrémités et , alors .
Nous cherchons un point unique sur , distinct de et , qui n'appartient à aucun segment de autre que . Cela signifie que la seule solution de l'équation avec , , est .
Les segments de sont des parties des tangentes au cercle unité. Le point doit être tangent à l'enveloppe de la famille de segments. L'enveloppe est le cercle unité lui-même.
Le point unique sur , distinct de et , qui se trouve sur le cercle unité. Nous devons résoudre :
. Le point .
, donc , . et sont premiers entre eux. .
Réponse finale : La réponse finale est
F. Contrôle de version
(2025- 03) :
Ajout de
Ajout du nombre d'échantillons corrects dans
(2025- 02) :
Ajout de citations et autres petites modifications rédactionnelles