
Un agent oublie tout entre deux sessions. A-Mem garde ses souvenirs en notes liées qui se réécrivent. Papier NeurIPS 2025, gratuit en ligne.
A-Mem: Agentic Memory for LLM Agents
A-Mem : Mémoire agentique pour les agents LLM
Wujiang , Zujie Liang , Kai Mei , Hang Gao , Juntao Tan , Yongfeng Zhang Université Rutgers Chercheur indépendant Fondation AIOS wujiang.xu@rutgers.edu
Résumé
Bien que les agents fondés sur de grands modèles de langage (LLM) puissent utiliser efficacement des outils externes pour des tâches complexes du monde réel, ils ont besoin de systèmes de mémoire pour tirer parti des expériences passées. Les systèmes de mémoire actuels permettent un stockage et une récupération de base, mais manquent d'une organisation sophistiquée de la mémoire, malgré de récentes tentatives d'intégration de bases de données de graphes. De plus, les opérations et structures fixes de ces systèmes limitent leur adaptabilité à travers des tâches diverses. Pour remédier à cette limitation, cet article propose un nouveau système de mémoire agentique pour les agents LLM capable d'organiser dynamiquement les souvenirs de manière agentique. En suivant les principes de base de la méthode Zettelkasten, nous avons conçu notre système de mémoire pour créer des réseaux de connaissances interconnectés grâce à un indexage et un liage dynamiques. Lorsqu'un nouveau souvenir est ajouté, nous générons une note complète contenant plusieurs attributs structurés, notamment des descriptions contextuelles, des mots-clés et des étiquettes. Le système analyse ensuite les souvenirs historiques pour identifier les connexions pertinentes, établissant des liens là où des similarités significatives existent. De plus, ce processus permet l'évolution de la mémoire – à mesure que de nouveaux souvenirs sont intégrés, ils peuvent déclencher des mises à jour des représentations contextuelles et des attributs des souvenirs historiques existants, permettant au réseau de mémoire d'affiner continuellement sa compréhension. Notre approche combine les principes d'organisation structurée du Zettelkasten avec la flexibilité de la prise de décision pilotée par l'agent, permettant une gestion de la mémoire plus adaptative et sensible au contexte. Des expériences empiriques sur six modèles de base montrent une amélioration supérieure par rapport aux références SOTA existantes.
Code pour l'évaluation comparative : https://github.com/WujiangXu/AgenticMemory Code pour la mémoire agentique prête pour la production : https://github.com/WujiangXu/A- mem- sys
1 Introduction
Les agents fondés sur de grands modèles de langage (LLM) ont démontré des capacités remarquables dans diverses tâches, les avancées récentes leur permettant d'interagir avec des environnements, d'exécuter des tâches et de prendre des décisions de manière autonome [23, 33, 7]. Ils intègrent les LLM avec des outils externes et des flux de travail délicats pour améliorer les capacités de raisonnement et de planification. Bien que l'agent LLM ait de fortes performances de raisonnement, il a encore besoin d'un système de mémoire pour fournir une capacité d'interaction à long terme avec l'environnement externe [35].
Les systèmes de mémoire existants [25, 39, 28, 21] pour les agents LLM offrent une fonctionnalité de base de stockage de la mémoire. Ces systèmes exigent que les développeurs d'agents prédéfinissent les structures de stockage de la mémoire, spécifient les points de stockage dans le flux de travail et établissent le moment de la récupération. Par ailleurs, afin d'améliorer l'organisation structurée de la mémoire, Mem0 [8], suivant les principes du RAG [9, 18, 30], intègre des bases de données de graphes pour les processus de stockage et de récupération. Bien que les bases de données de graphes offrent une organisation structurée pour les systèmes de mémoire, leur dépendance à des schémas et relations prédéfinis limite fondamentalement leur adaptabilité. Cette limitation se manifeste clairement dans des scénarios pratiques – lorsqu'un agent apprend une nouvelle solution mathématique, les systèmes actuels ne peuvent catégoriser et lier cette information que dans leur cadre prédéfini,
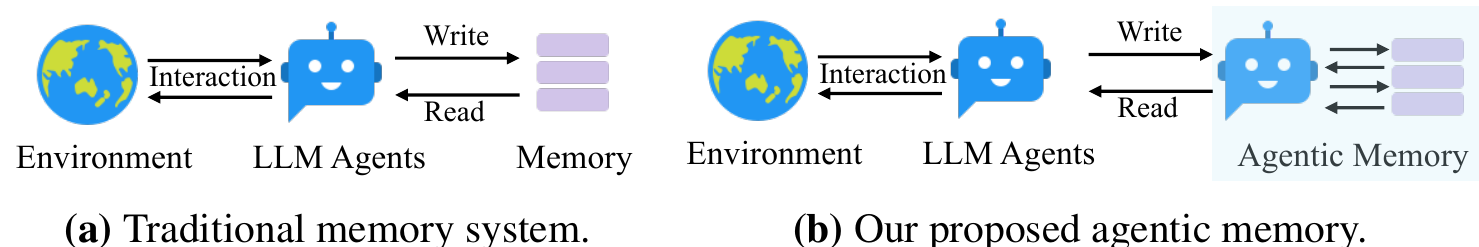
incapables de forger des connexions innovantes ou de développer de nouveaux schémas d'organisation à mesure que les connaissances évoluent. De telles structures rigides, couplées à des flux de travail d'agents fixes, restreignent sévèrement la capacité de ces systèmes à généraliser dans de nouveaux environnements et à maintenir leur efficacité dans des interactions à long terme. Le défi devient de plus en plus critique à mesure que les agents LLM s'attaquent à des tâches plus complexes et ouvertes, où une organisation flexible des connaissances et une adaptation continue sont essentielles. Par conséquent, la conception d'un système de mémoire flexible et universel qui soutient les interactions à long terme des agents LLM reste un défi crucial.
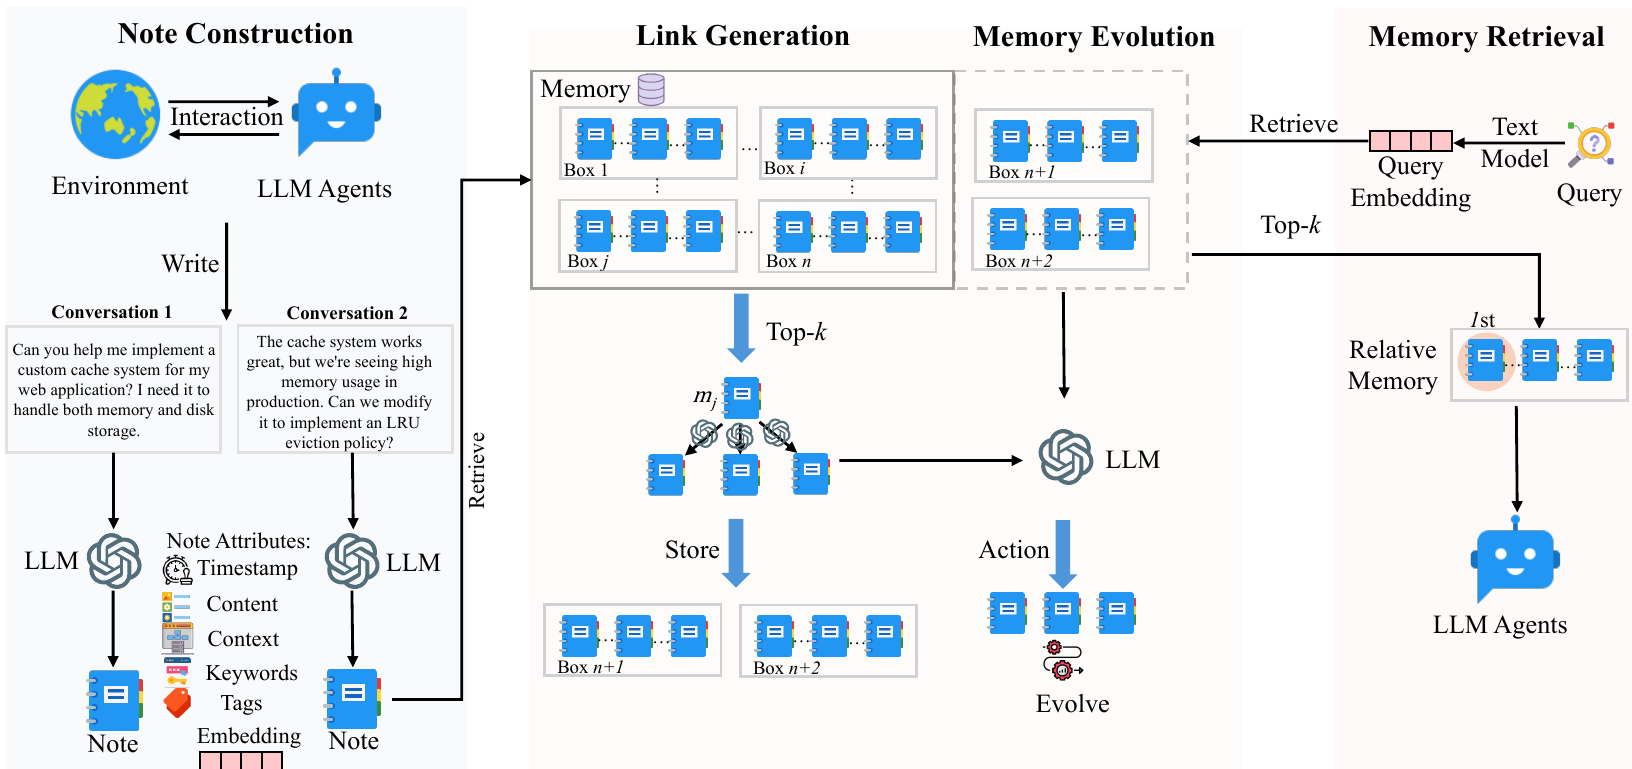
Dans cet article, nous introduisons un nouveau système de mémoire agentique, nommé A- MEM, pour les agents LLM, qui permet une structuration dynamique de la mémoire sans dépendre d'opérations de mémoire statiques et prédéterminées. Notre approche s'inspire de la méthode Zettelkasten [15, 1], un système sophistiqué de gestion des connaissances qui crée des réseaux d'information interconnectés grâce à des notes atomiques et à des mécanismes de liage flexibles. Notre système introduit une architecture de mémoire agentique qui permet une gestion autonome et flexible de la mémoire pour les agents LLM. Pour chaque nouveau souvenir, nous construisons des notes complètes, qui intègrent plusieurs représentations : des attributs textuels structurés incluant plusieurs attributs et des vecteurs d'enchâssement pour la correspondance par similarité. Ensuite, A- MEM analyse le dépôt de souvenirs historiques pour établir des connexions significatives fondées sur les similarités sémantiques et les attributs partagés. Ce processus d'intégration crée non seulement de nouveaux liens, mais permet aussi une évolution dynamique : lorsque de nouveaux souvenirs sont incorporés, ils peuvent déclencher des mises à jour des représentations contextuelles des souvenirs existants, permettant à l'ensemble des souvenirs d'affiner et d'approfondir continuellement sa compréhension au fil du temps. Les contributions sont résumées comme suit :
- Nous présentons A-MEM, un système de mémoire agentique pour les agents LLM qui permet la génération autonome de descriptions contextuelles, l'établissement dynamique de connexions entre souvenirs et l'évolution intelligente des souvenirs existants à partir de nouvelles expériences. Ce système dote les agents LLM de capacités d'interaction à long terme sans exiger d'opérations de mémoire prédéterminées.
- Nous concevons un mécanisme de mise à jour de la mémoire agentique dans lequel les nouveaux souvenirs déclenchent automatiquement deux opérations clés : la génération de liens et l'évolution de la mémoire. La génération de liens établit automatiquement des connexions entre les souvenirs en identifiant les attributs partagés et les descriptions contextuelles similaires. L'évolution de la mémoire permet aux souvenirs existants de s'adapter dynamiquement à mesure que de nouvelles expériences sont analysées, conduisant à l'émergence de schémas et d'attributs d'ordre supérieur.
- Nous menons des évaluations complètes de notre système à l'aide d'un jeu de données conversationnel à long terme, en comparant les performances sur six modèles de base à l'aide de six métriques d'évaluation distinctes, démontrant des améliorations significatives. De plus, nous fournissons des visualisations T-SNE pour illustrer l'organisation structurée de notre système de mémoire agentique.
2 Travaux connexes
2.1 Mémoire pour les agents LLM
Les travaux antérieurs sur les systèmes de mémoire des agents LLM ont exploré divers mécanismes de gestion et d'utilisation de la mémoire [23, 21, 8, 39]. Certaines approches réalisent un stockage complet des interactions, qui maintient des enregistrements historiques complets grâce à des modèles de récupération dense [39] ou à des structures de mémoire lecture-écriture [24]. Par ailleurs, MemGPT [25] exploite des architectures de type cache pour prioriser les informations récentes. De même, SCM [32] propose un cadre de mémoire auto-contrôlée qui améliore la capacité des LLM à maintenir une mémoire à long terme grâce à un flux de mémoire et un mécanisme de contrôleur. Cependant, ces approches présentent des limitations importantes dans le traitement de diverses tâches du monde réel. Bien qu'elles puissent fournir une fonctionnalité de mémoire de base, leurs opérations sont généralement contraintes par des structures prédéfinies et des flux de travail fixes. Ces contraintes découlent de leur dépendance à des schémas opérationnels
rigides, en particulier dans les processus d'écriture et de récupération de la mémoire. Une telle inflexibilité conduit à une faible généralisation dans de nouveaux environnements et à une efficacité limitée dans les interactions à long terme. Par conséquent, la conception d'un système de mémoire flexible et universel qui soutient les interactions à long terme des agents reste un défi crucial.
2.2 Génération augmentée par récupération
La génération augmentée par récupération (RAG) est apparue comme une approche puissante pour améliorer les LLM en incorporant des sources de connaissances externes [18, 6, 10]. Le processus RAG standard [37, 34] consiste à indexer des documents en segments, à récupérer les segments pertinents en fonction de la similarité sémantique et à augmenter l'invite du LLM avec ce contexte récupéré pour la génération. Les systèmes RAG avancés [20, 12] ont évolué pour inclure des optimisations sophistiquées de pré-récupération et de post-récupération. S'appuyant sur ces fondations, des recherches récentes ont introduit des systèmes RAG agentiques qui démontrent des comportements plus autonomes et adaptatifs dans le processus de récupération. Ces systèmes peuvent déterminer dynamiquement quand et quoi récupérer [4, 14], générer des réponses hypothétiques pour guider la récupération et affiner itérativement leurs stratégies de recherche en fonction des résultats intermédiaires [31, 29].
Cependant, bien que les approches RAG agentiques démontrent une agentivité dans la phase de récupération en décidant de manière autonome quand et quoi récupérer [4, 14, 38], notre système de mémoire agentique manifeste une agentivité à un niveau plus fondamental grâce à l'évolution autonome de sa structure de mémoire. Inspiré par la méthode Zettelkasten, notre système permet aux souvenirs de générer activement leurs propres descriptions contextuelles, de former des connexions significatives avec des souvenirs apparentés et de faire évoluer à la fois leur contenu et leurs relations à mesure que de nouvelles expériences émergent. Cette distinction fondamentale d'agentivité entre la récupération d'une part et le stockage et l'évolution d'autre part distingue notre approche des systèmes RAG agentiques, qui maintiennent des bases de connaissances statiques malgré leurs mécanismes de récupération sophistiqués.
3 Méthodologie
Notre système de mémoire agentique proposé s'inspire de la méthode Zettelkasten, mettant en œuvre un système de mémoire dynamique et auto-évolutif qui permet aux agents LLM de maintenir une mémoire à long terme sans opérations prédéterminées. La conception du système met l'accent sur la prise de notes atomique, les mécanismes de liage flexibles et l'évolution continue des structures de connaissances.
3.1 Construction des notes
S'appuyant sur les principes de prise de notes atomique et d'organisation flexible de la méthode Zettelkasten, nous introduisons une approche pilotée par LLM pour la construction des notes de mémoire. Lorsqu'un agent interagit avec son environnement, nous construisons des notes de mémoire structurées qui capturent à la fois les informations explicites et la compréhension contextuelle générée par le LLM. Chaque note de mémoire de notre collection est représentée comme :
où représente le contenu d'interaction original, est l'horodatage de l'interaction, désigne les mots-clés générés par le LLM qui capturent les concepts clés, contient les étiquettes générées par le LLM pour la catégorisation, représente la description contextuelle générée par le LLM qui fournit une riche compréhension sémantique, et maintient l'ensemble des souvenirs liés qui partagent des relations sémantiques. Pour enrichir chaque note de mémoire avec un contexte significatif au-delà de son contenu de base et de son horodatage, nous exploitons un LLM pour analyser l'interaction et générer ces composantes sémantiques. Le processus de construction de la note consiste à solliciter le LLM avec des modèles soigneusement conçus :
Suivant le principe d'atomicité de Zettelkasten, chaque note capture une unité de connaissance unique et autonome. Pour permettre une récupération et une liaison efficaces, nous calculons une représentation vectorielle dense via un encodeur de texte [27] qui englobe toutes les composantes textuelles de la note :
En utilisant des LLM pour générer des composantes enrichies, nous permettons l'extraction autonome de connaissances implicites à partir d'interactions brutes. La structure de note à multiples facettes crée des représentations riches qui capturent différents aspects du souvenir, facilitant une organisation et une récupération nuancées. De plus, la combinaison de composantes sémantiques générées par le LLM avec des représentations vectorielles denses fournit à la fois le contexte et une correspondance de similarité computationnellement efficace.
3.2 Génération de liens
Notre système met en œuvre un mécanisme autonome de génération de liens qui permet aux nouvelles notes de mémoire de former des connexions significatives sans règles prédéfinies. Lorsque la note de mémoire construite est ajoutée au système, nous exploitons d'abord son plongement sémantique pour une récupération basée sur la similarité. Pour chaque note de mémoire existante , nous calculons un score de similarité :
Le système identifie ensuite les souvenirs les plus pertinents :
Sur la base de ces souvenirs candidats les plus proches, nous sollicitons le LLM pour analyser les connexions potentielles en fonction de leurs attributs communs potentiels. Formellement, l'ensemble de liens du souvenir se met à jour comme suit :
Chaque lien généré est structuré comme suit : . En utilisant la récupération basée sur les embeddings comme filtre initial, nous permettons une mise à l'échelle efficace tout en maintenant la pertinence sémantique. A-MEM peut identifier rapidement des connexions potentielles même dans de grandes collections de mémoires sans comparaison exhaustive. Plus important encore, l'analyse pilotée par LLM permet une compréhension nuancée des relations qui va au-delà des simples métriques de similarité. Le modèle de langage peut identifier des motifs subtils, des relations causales et des connexions conceptuelles qui pourraient ne pas être apparents à partir de la seule similarité d'embeddings. Nous mettons en œuvre le principe Zettelkasten de liaison flexible tout en exploitant les modèles de langage modernes. Le réseau résultant émerge organiquement du contenu et du contexte de la mémoire, permettant une organisation naturelle des connaissances.
3.3 Évolution de la mémoire
Après avoir créé des liens pour la nouvelle mémoire, A-MEM fait évoluer les mémoires récupérées en fonction de leurs informations textuelles et de leurs relations avec la nouvelle mémoire. Pour chaque mémoire dans l'ensemble des plus proches voisins , le système détermine s'il faut mettre à jour son contexte, ses mots-clés et ses tags. Ce processus d'évolution peut être exprimé formellement comme suit :
La mémoire évoluée remplace ensuite la mémoire originale dans l'ensemble de mémoires . Cette approche évolutive permet des mises à jour continues et de nouvelles connexions, imitant les processus d'apprentissage humain. À mesure que le système traite davantage de mémoires au fil du temps, il développe des structures de connaissances de plus en plus sophistiquées, découvrant des motifs et des concepts d'ordre supérieur à travers de multiples mémoires. Cela crée une fondation pour l'apprentissage autonome de la mémoire, où l'organisation des connaissances devient progressivement plus riche grâce à l'interaction continue entre les nouvelles expériences et les mémoires existantes.
3.4 Récupération des mémoires relatives
À chaque interaction, notre A-MEM effectue une récupération de mémoire sensible au contexte afin de fournir à l'agent des informations historiques pertinentes. Étant donné un texte de requête issu de l'interaction en cours, nous calculons d'abord sa représentation vectorielle dense en utilisant le même encodeur de texte que celui utilisé pour les notes de mémoire :
Le système calcule ensuite les scores de similarité entre l'embedding de la requête et toutes les notes de mémoire existantes dans en utilisant la similarité cosinus :
Nous récupérons ensuite les k mémoires les plus pertinentes dans le stockage historique de mémoires afin de construire un prompt contextuellement approprié.
Ces mémoires récupérées fournissent un contexte historique pertinent qui aide l'agent à mieux comprendre et à répondre à l'interaction en cours. Le contexte récupéré enrichit le processus de raisonnement de l'agent en reliant l'interaction en cours aux expériences passées associées stockées dans le système de mémoire.
4 Expérience
4.1 Jeu de données et évaluation
Pour évaluer l'efficacité de la recommandation sensible aux instructions dans les conversations à long terme, nous utilisons le jeu de données LoCoMo [22], qui contient des dialogues significativement plus longs que les jeux de données conversationnels existants [36, 13]. Alors que les jeux de données précédents contiennent des dialogues d'environ 1K tokens sur 4 à 5 sessions, LoCoMo présente des conversations beaucoup plus longues, d'une moyenne de 9K tokens s'étendant sur jusqu'à 35 sessions, ce qui le rend particulièrement adapté pour évaluer la capacité des modèles à gérer des dépendances à longue portée et à maintenir la cohérence sur des conversations étendues. Le jeu de données LoCoMo comprend divers types de questions conçus pour évaluer de manière exhaustive différents aspects de la compréhension du modèle : (1) des questions à saut unique répondables à partir d'une seule session ; (2) des questions à sauts multiples nécessitant une synthèse d'informations entre les sessions ; (3) des questions de raisonnement temporel testant la compréhension des informations liées au temps ; (4) des questions de connaissances ouvertes nécessitant l'intégration du contexte de la conversation avec des connaissances externes ; et (5) des questions adversariales évaluant la capacité des modèles à identifier des requêtes sans réponse. Au total, LoCoMo contient 7 512 paires question-réponse réparties dans ces catégories. En outre, nous utilisons un nouveau jeu de données, nommé DialSim [16], pour évaluer l'efficacité de notre système de mémoire. Il s'agit d'un jeu de données de question-réponse dérivé de dialogues multipartites à long terme. Le jeu de données est dérivé de séries télévisées populaires (Friends, The Big Bang Theory et The Office), couvrant 1 300 sessions sur cinq ans, contenant environ 350 000 tokens, et incluant plus de 1 000 questions par session issues de questions raffinées de sites de quiz pour fans et de questions complexes générées à partir de graphes de connaissances temporels.
Pour les lignes de base de comparaison, nous comparons à LoCoMo [22], ReadAgent [17], MemoryBank [39] et MemGPT [25]. L'introduction détaillée des lignes de base se trouve en Annexe A.1. Pour l'évaluation, nous employons deux métriques principales : le score F1 pour évaluer la précision des réponses en équilibrant précision et rappel, et BLEU-1 [26] pour évaluer la qualité des réponses générées en mesurant le chevauchement de mots
| Modèle | Méthode | Catégorie | Moyenne | ||||||||||
| Multi Hop F1 | BLEU | Temporal F1 | Open Domain F1 | Single Hop F1 | BLEU | Adversial F1 | BLEU | Ranking F1 | BLEU | Longueur de token | |||
| GPT | LoCoMo | 25,02 | 19,75 | 18,41 | 14,77 | 12,04 | 11,16 | 40,36 | 29,05 | 69,23 | 68,75 | 2,4 | 2,4 |
| READAGENT | 9,15 | 6,48 | 12,60 | 8,87 | 5,31 | 5,12 | 9,67 | 7,66 | 9,81 | 9,02 | 4,2 | 4,2 | |
| MEMORYBANK | 5,00 | 4,77 | 9,68 | 6,99 | 5,56 | 5,94 | 6,61 | 5,16 | 7,36 | 6,48 | 4,8 | 4,8 | |
| MEMGPT | 26,65 | 17,72 | 25,52 | 19,44 | 9,15 | 7,44 | 41,04 | 34,34 | 43,29 | 42,73 | 2,4 | 2,4 | |
| A-MEM | 27,02 | 20,09 | 45,85 | 36,67 | 12,14 | 12,00 | 44,65 | 37,06 | 50,03 | 49,47 | 1,2 | 1,2 | |
| GPT | LoCoMo | 28,00 | 18,47 | 9,09 | 5,78 | 16,47 | 14,80 | 61,56 | 54,19 | 52,61 | 51,13 | 2,0 | 2,0 |
| READAGENT | 14,61 | 9,95 | 4,16 | 3,19 | 8,84 | 8,37 | 12,46 | 10,29 | 6,81 | 6,13 | 4,0 | 4,0 | |
| MEMORYBANK | 6,49 | 4,69 | 2,47 | 2,43 | 6,43 | 5,30 | 8,28 | 7,10 | 4,42 | 3,67 | 5,0 | 5,0 | |
| MEMGPT | 30,36 | 22,83 | 17,29 | 13,18 | 12,24 | 11,87 | 60,16 | 53,35 | 34,96 | 34,25 | 2,4 | 2,4 | |
| A-MEM | 32,86 | 23,76 | 39,41 | 31,23 | 17,10 | 15,84 | 48,43 | 42,97 | 36,35 | 35,53 | 1,6 | 1,6 | |
| GPT | LoCoMo | 9,05 | 6,55 | 4,25 | 4,04 | 9,91 | 8,50 | 11,15 | 8,67 | 40,38 | 40,23 | 3,4 | 3,4 |
| READAGENT | 6,61 | 4,93 | 2,55 | 2,51 | 5,31 | 12,24 | 10,13 | 7,54 | 5,42 | 27,32 | 4,6 | 4,6 | |
| MEMORYBANK | 11,14 | 8,25 | 4,46 | 2,87 | 8,05 | 6,21 | 13,42 | 11,01 | 36,76 | 34,00 | 2,6 | 2,6 | |
| MEMGPT | 10,44 | 7,61 | 4,21 | 3,89 | 13,42 | 11,64 | 9,56 | 7,34 | 31,51 | 28,90 | 3,4 | 3,4 | |
| A-MEM | 18,23 | 11,94 | 24,32 | 19,74 | 16,48 | 14,31 | 23,63 | 19,23 | 46,00 | 43,26 | 1,0 | 1,0 | |
| GPT | LoCoMo | 4,61 | 4,29 | 3,11 | 2,71 | 4,55 | 5,97 | 7,03 | 5,69 | 16,95 | 14,81 | 3,2 | 3,2 |
| READAGENT | 2,47 | 1,78 | 3,01 | 3,01 | 5,57 | 5,22 | 3,25 | 2,51 | 15,78 | 14,01 | 4,2 | 4,2 | |
| MEMORYBANK | 3,60 | 3,39 | 1,97 | 1,67 | 6,63 | 6,58 | 4,11 | 3,32 | 13,07 | 10,30 | 4,2 | 4,2 | |
| MEMGPT | 5,07 | 4,31 | 2,94 | 2,95 | 7,04 | 7,10 | 7,26 | 5,52 | 14,47 | 12,39 | 2,4 | 2,4 | |
| A-MEM | 12,57 | 9,01 | 27,59 | 25,07 | 7,12 | 7,28 | 17,23 | 13,12 | 27,91 | 25,15 | 1,0 | 1,0 | |
| LLaMA 2 | LoCoMo | 11,25 | 9,18 | 7,38 | 6,82 | 11,90 | 10,38 | 12,86 | 10,50 | 51,89 | 48,27 | 3,4 | 3,4 |
| READAGENT | 5,96 | 5,12 | 1,93 | 2,30 | 12,46 | 11,17 | 7,75 | 6,03 | 44,64 | 40,15 | 4,6 | 4,6 | |
| MEMORYBANK | 13,18 | 10,03 | 7,61 | 6,27 | 15,78 | 12,94 | 17,30 | 14,03 | 52,61 | 47,53 | 2,0 | 2,0 | |
| MEMGPT | 9,19 | 6,96 | 4,02 | 4,79 | 11,34 | 8,24 | 10,16 | 7,68 | 49,75 | 45,11 | 4,0 | 4,0 | |
| A-MEM | 19,06 | 11,71 | 17,80 | 10,28 | 17,55 | 14,67 | 28,51 | 24,13 | 58,81 | 54,28 | 1,0 | 1,0 | |
| LLaMA 2 | LoCoMo | 6,88 | 5,77 | 4,37 | 4,40 | 10,65 | 9,29 | 8,37 | 6,93 | 30,25 | 28,46 | 2,8 | 2,8 |
| READAGENT | 2,47 | 1,78 | 3,01 | 3,01 | 5,57 | 5,22 | 3,25 | 2,51 | 15,78 | 14,01 | 4,2 | 4,2 | |
| MEMORYBANK | 6,19 | 4,47 | 3,49 | 3,13 | 4,07 | 4,57 | 7,61 | 6,03 | 18,65 | 17,05 | 3,2 | 3.2 | |
| MEMGPT | 5,32 | 3,99 | 2,68 | 2,72 | 5,64 | 5,54 | 4,32 | 3,51 | 21,45 | 19,37 | 3,8 | 3,8 | |
| A-MEM | 17,44 | 11,74 | 26,38 | 19,50 | 12,53 | 11,83 | 28,14 | 23,87 | 42,04 | 40,60 | 1,0 | 1,0 | |
avec les réponses de référence. Nous rapportons également la longueur moyenne en tokens pour répondre à une question. Outre la présentation des résultats expérimentaux avec quatre métriques supplémentaires (ROUGE-L, ROUGE-2, METEOR et Similarité SBERT), nous présentons également les résultats expérimentaux obtenus avec différents modèles de base, notamment DeepSeek-R1-32B [11], Claude 3.0 Haiku [2] et Claude 3.5 Haiku [3], en Annexe A.3.
4.2 Détails de mise en œuvre
Pour toutes les lignes de base et notre méthode proposée, nous maintenons la cohérence en employant des prompts système identiques, comme détaillé en Annexe B. Le déploiement des modèles Qwen-1.5B/3B et Llama 3.2 1B/3B est accompli via une instanciation locale à l'aide d'Ollama 1, avec LiteLLM 2 gérant la génération de sortie structurée. Pour les modèles GPT, nous utilisons l'API officielle de sortie structurée. Dans notre processus de récupération de mémoire, nous employons principalement pour la sélection des top- mémoires afin de maintenir l'efficacité computationnelle, tout en ajustant ce paramètre pour des catégories spécifiques afin d'optimiser les performances. Les configurations détaillées de se trouvent en Annexe A.5. Pour l'embedding de texte, nous utilisons le modèle all-miniml-16-v2 dans toutes les expériences.
4.3 Résultats empiriques
Analyse des performances. Dans notre évaluation empirique, nous avons comparé A-MEM avec quatre lignes de base compétitives, notamment LoCoMo [22], ReadAgent [17], MemoryBank [39] et MemGPT [25], sur le jeu de données LoCoMo. Pour les modèles de base non-GPT, notre A-MEM surpasse systématiquement toutes les lignes de base dans les différentes catégories, démontrant l'efficacité de notre approche de mémoire agentique. Pour les modèles basés sur GPT, bien que LoCoMo et MemGPT affichent de bonnes performances dans certaines catégories comme Open Domain et les tâches adversariales en raison de leurs solides connaissances pré-entraînées pour la récupération de faits simples, notre A-MEM démontre des performances supérieures dans les tâches Multi-Hop, atteignant au moins deux fois de meilleures performances dans celles qui nécessitent des chaînes de raisonnement complexes. Outre les expériences sur le jeu de données LoCoMo, nous comparons également notre méthode sur le jeu de données DialSim avec LoCoMo et MemGPT. A-MEM surpasse systématiquement toutes les lignes de base sur toutes les métriques d'évaluation, atteignant un score F1
| Méthode | F1 | BLEU-1 | ROUGE-L | ROUGE-2 | METEOR | Similarité SBERT |
| LoCoMo | 2,55 | 3,13 | 2,75 | 0,90 | 1,64 | 15,76 |
| MemGPT | 1,18 | 1,07 | 0,96 | 0,42 | 0,95 | 8,54 |
| A-MEM | 3,45 | 3,37 | 3,54 | 3,60 | 2,05 | 19,51 |
| Méthode | Multi Hop | Temporel | Catégorie | Single Hop | Adversarial | |||||
| F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | |
| sans LG & ME | 9,65 | 7,09 | 24,55 | 19,48 | 7,77 | 6,70 | 13,28 | 10,30 | 15,32 | 18,02 |
| sans ME | 21,35 | 15,13 | 31,24 | 27,31 | 10,13 | 10,85 | 39,17 | 34,70 | 44,16 | 45,33 |
| A-MEM | 27,02 | 20,09 | 45,85 | 36,67 | 12,14 | 12,00 | 44,65 | 37,06 | 50,03 | 49,47 |
de 3,45 (une amélioration de par rapport à 2,55 pour LoCoMo et de plus que 1,18 pour MemGPT). L'efficacité d'A-MEM provient de sa nouvelle architecture de mémoire agentique qui permet une gestion dynamique et structurée de la mémoire. Contrairement aux approches traditionnelles qui utilisent des opérations de mémoire statiques, notre système crée des réseaux de mémoires interconnectés grâce à des notes atomiques avec de riches descriptions contextuelles, permettant un raisonnement multi-hop plus efficace. La capacité du système à établir dynamiquement des connexions entre les mémoires en fonction d'attributs partagés et à mettre continuellement à jour les descriptions de mémoire existantes avec de nouvelles informations contextuelles lui permet de mieux capturer et exploiter les relations entre différents éléments d'information.
Analyse du rapport coût-efficacité. A-MEM démontre une efficacité computationnelle et de coût significative parallèlement à de solides performances. Le système nécessite environ 1 200 tokens par opération de mémoire, réalisant une réduction de de l'utilisation de tokens par rapport aux méthodes de référence (LoCoMo et MemGPT avec 16 900 tokens) grâce à notre mécanisme de récupération sélective des top-k. Cette réduction substantielle du nombre de tokens se traduit directement par des coûts opérationnels plus faibles, chaque opération de mémoire coûtant moins de 0,0003\( lors de l'utilisation de services API commerciaux, rendant les déploiements à grande échelle économiquement viables. Les temps de traitement sont en moyenne de 5,4 secondes avec GPT-4o-mini et seulement de 1,1 seconde avec Llama 3.2 1B hébergé localement sur un seul GPU. Malgré la nécessité de multiples appels LLM lors du traitement de la mémoire, A-MEM maintient cette utilisation rentable des ressources tout en surpassant systématiquement les approches de référence sur tous les modèles de base testés, doublant notamment les performances sur les tâches de raisonnement multi-hop complexes. Cet équilibre entre faible coût computationnel et capacité de raisonnement supérieure met en évidence l'avantage pratique d'A-MEM pour un déploiement dans le monde réel.
4.4 Étude d'ablation
Pour évaluer l'efficacité des modules de génération de liens (Link Generation, LG) et d'évolution de la mémoire (Memory Evolution, ME), nous menons une étude d'ablation en supprimant systématiquement des composants clés de notre modèle. Lorsque les deux modules LG et ME sont supprimés, le système présente une dégradation substantielle des performances, en particulier dans les tâches de raisonnement multi-sauts (Multi Hop) et de domaine ouvert (Open Domain). Le système avec seulement LG actif (sans ME) affiche des niveaux de performance intermédiaires, conservant des résultats significativement meilleurs que la version dépourvue des deux modules, ce qui démontre l'importance fondamentale de la génération de liens dans l'établissement des connexions mémorielles. Notre modèle complet, A-MEM, atteint systématiquement les meilleures performances dans toutes les catégories d'évaluation, avec des résultats particulièrement solides dans les tâches de raisonnement complexe. Ces résultats révèlent que, si le module de génération de liens constitue une fondation critique pour l'organisation de la mémoire, le module d'évolution de la mémoire apporte des raffinements essentiels à la structure mémorielle. L'étude d'ablation valide nos choix de conception architecturale et met en évidence la nature complémentaire de ces deux modules dans la création d'un système de mémoire efficace.
4.5 Analyse des hyperparamètres
Nous avons mené des expériences approfondies pour analyser l'impact du paramètre de récupération mémorielle k, qui contrôle le nombre de mémoires pertinentes récupérées pour chaque interaction. Comme illustré à la Figure 3, nous avons évalué les performances pour différentes valeurs de k (10, 20, 30, 40, 50) sur cinq catégories de tâches en utilisant GPT-4o-mini comme modèle de base. Les résultats révèlent un schéma intéressant : bien que l'augmentation de k conduise généralement à de meilleures performances, cette amélioration atteint progressivement un plateau et diminue parfois légèrement pour des valeurs plus élevées. Cette tendance est particulièrement évidente dans les tâches Multi Hop et Open Domain.
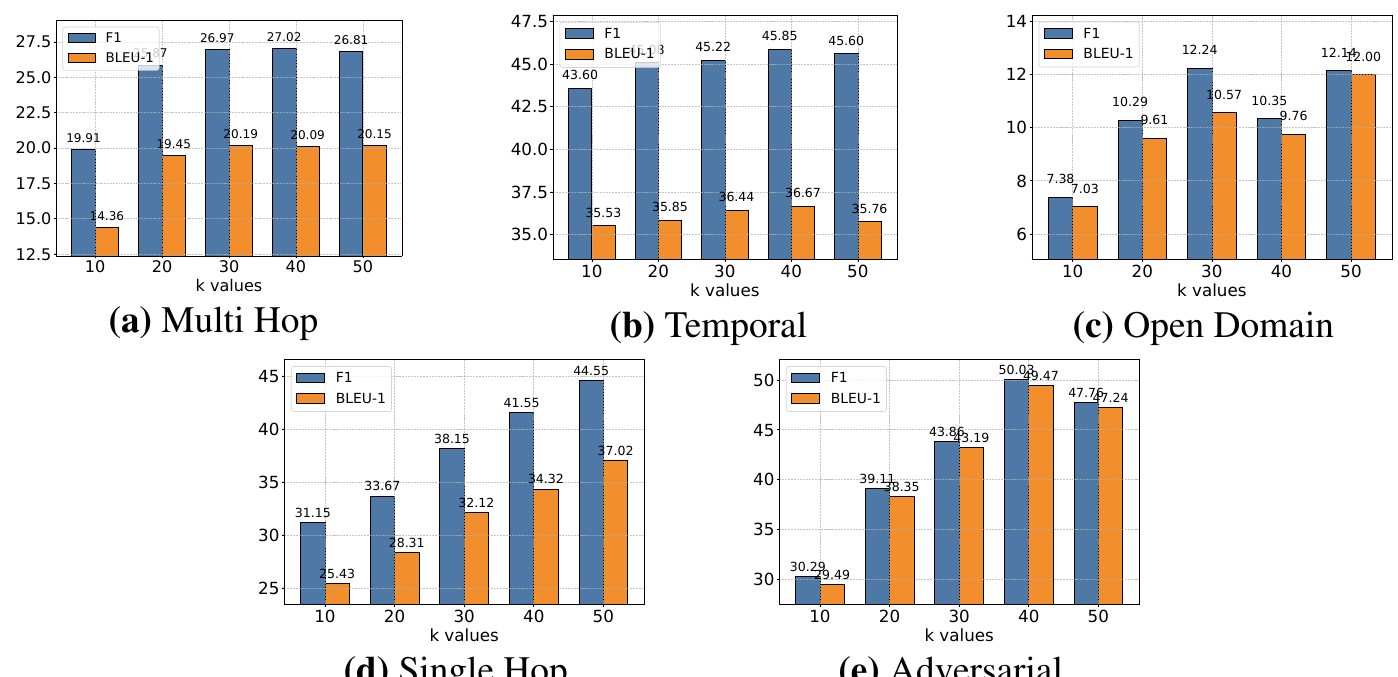
Tableau 4 : Comparaison de l'utilisation de la mémoire et du temps de récupération entre différentes méthodes de mémoire et échelles. Les tâches.
| Taille de la mémoire | Méthode | Utilisation de la mémoire (Mo) | Temps de récupération (μs) |
| 1 000 | A-MEM | 1,46 | 0,31 ± 0,30 |
| MemoryBank [39] | 1,46 | 0,24 ± 0,20 | |
| ReadAgent [17] | 1,46 | 43,62 ± 8,47 | |
| 10 000 | A-MEM | 14,65 | 0,38 ± 0,25 |
| MemoryBank [39] | 14,65 | 0,26 ± 0,13 | |
| ReadAgent [17] | 14,65 | 484,45 ± 93,86 | |
| 100 000 | A-MEM | 146,48 | 1,40 ± 0,49 |
| MemoryBank [39] | 146,48 | 0,78 ± 0,26 | |
| ReadAgent [17] | 146,48 | 6 682,22 ± 111,63 | |
| 1 000 000 | A-MEM | 1464,84 | 3,70 ± 0,74 |
| MemoryBank [39] | 1464,84 | 1,91 ± 0,31 | |
| ReadAgent [17] | 1464,84 | 120 069,68 ± 1 673,39 |
Cette observation suggère un équilibre délicat dans la récupération mémorielle – bien que des valeurs de k plus grandes fournissent un contexte historique plus riche pour le raisonnement, elles peuvent également introduire du bruit et mettre à l'épreuve la capacité du modèle à traiter efficacement des séquences plus longues. Notre analyse indique que des valeurs modérées de k réalisent un équilibre optimal entre richesse du contexte et efficacité du traitement de l'information.
4.6 Analyse de mise à l'échelle
Pour évaluer les coûts de stockage avec l'accumulation de mémoire, nous avons examiné la relation entre la taille du stockage et le temps de récupération à travers notre système A-MEM et deux approches de référence : MemoryBank [39] et ReadAgent [17]. Nous avons évalué ces trois systèmes de mémoire avec un contenu mémoriel identique sur quatre points d'échelle, en multipliant le nombre d'entrées par un facteur de 10 à chaque étape (de 1 000 à 10 000, 100 000, et enfin 1 000 000 d'entrées). Les résultats expérimentaux révèlent des informations clés sur les propriétés de mise à l'échelle de notre système A-MEM : en termes de complexité spatiale, les trois systèmes présentent une mise à l'échelle linéaire identique de l'utilisation de la mémoire , comme attendu pour les systèmes de récupération basés sur des vecteurs. Cela confirme qu'A-MEM n'introduit aucune surcharge de stockage supplémentaire par rapport aux approches de référence. Concernant le temps de récupération, A-MEM démontre une excellente efficacité avec des augmentations minimales à mesure que la taille de la mémoire croît. Même en passant à l'échelle de 1 million de mémoires, le temps de récupération d'A-MEM n'augmente que de à , ce qui représente une performance exceptionnelle. Bien que MemoryBank affiche des temps de récupération légèrement plus rapides, A-MEM maintient des performances comparables tout en offrant des représentations mémorielles et des fonctionnalités plus riches. Sur la base de notre analyse de la complexité spatiale et du temps de récupération, nous concluons que les mécanismes de récupération d'A-MEM maintiennent une excellente efficacité même à grande échelle. La croissance minimale du temps de récupération à travers les tailles de mémoire répond aux préoccupations concernant l'efficacité des systèmes de mémoire à grande échelle, démontrant qu'A-MEM fournit une solution hautement évolutive pour la gestion de conversations à long terme. Cette combinaison unique d'efficacité, d'évolutivité et de capacités mémorielles améliorées positionne A-MEM comme une avancée significative dans la construction d'un mécanisme de mémoire puissant et à long terme pour les agents LLM.
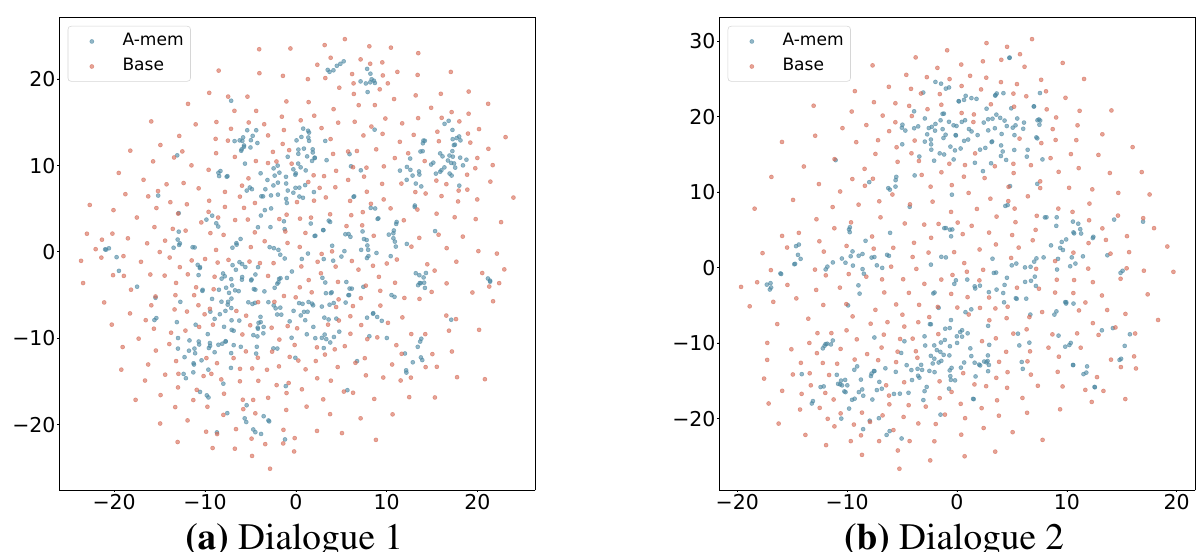
Figure 4 : Visualisation T-SNE des plongements de mémoire montrant une distribution plus organisée avec A-MEM (bleu) par rapport à la mémoire de base (rouge) à travers différents dialogues. La mémoire de base représente A-MEM sans génération de liens ni évolution de mémoire.
4.7 Analyse de la mémoire
Nous présentons la visualisation t-SNE de la Figure 4 des plongements de mémoire afin de démontrer les avantages structurels de notre système de mémoire agentique. En analysant deux dialogues échantillonnés à partir de conversations à long terme dans LoCoMo [22], nous observons que A-MEM (en bleu) présente systématiquement des schémas de regroupement plus cohérents par rapport au système de référence (en rouge). Cette organisation structurelle est particulièrement évidente dans le Dialogue 2, où des groupes bien définis émergent dans la région centrale, fournissant une preuve empirique de l'efficacité de notre mécanisme d'évolution de mémoire et de la génération de descriptions contextuelles. En revanche, les plongements de mémoire de référence affichent une distribution plus dispersée, démontrant que les mémoires manquent d'organisation structurelle sans nos composantes de génération de liens et d'évolution de mémoire. Ces résultats de visualisation valident le fait que A-MEM peut maintenir de manière autonome des structures de mémoire significatives grâce à des mécanismes d'évolution et de liaison dynamiques. D'autres résultats sont visibles dans l'Annexe A.4.
5 Conclusions
Dans ce travail, nous avons introduit A-MEM, un nouveau système de mémoire agentique qui permet aux agents LLM d'organiser et de faire évoluer dynamiquement leurs mémoires sans s'appuyer sur des structures prédéfinies. S'inspirant de la méthode Zettelkasten, notre système crée un réseau de connaissances interconnecté grâce à des mécanismes d'indexation et de liaison dynamiques qui s'adaptent à diverses tâches du monde réel. L'architecture centrale du système se caractérise par la génération autonome de descriptions contextuelles pour les nouvelles mémoires et l'établissement intelligent de connexions avec les mémoires existantes sur la base d'attributs partagés. En outre, notre approche permet l'évolution continue des mémoires historiques en incorporant de nouvelles expériences et en développant des attributs d'ordre supérieur grâce à des interactions continues. Grâce à une évaluation empirique approfondie sur six modèles de base, nous avons démontré que A-MEM obtient des performances supérieures à celles des baselines de pointe existantes dans les tâches conversationnelles à long terme. L'analyse de visualisation valide en outre l'efficacité de notre approche d'organisation de la mémoire. Ces résultats suggèrent que les systèmes de mémoire agentiques peuvent considérablement améliorer la capacité des agents LLM à utiliser des connaissances à long terme dans des environnements complexes.
6 Limites
Bien que notre système de mémoire agentique obtienne des résultats prometteurs, nous reconnaissons plusieurs domaines d'exploration future potentielle. Premièrement, bien que notre système organise dynamiquement les mémoires, la qualité de ces organisations peut encore être influencée par les capacités inhérentes des modèles de langage sous-jacents. Différents LLM pourraient générer des descriptions contextuelles légèrement différentes ou établir des connexions variables entre les mémoires. De plus, alors que notre implémentation actuelle se concentre sur des interactions textuelles, des travaux futurs pourraient explorer l'extension du système au traitement d'informations multimodales, telles que des images ou de l'audio, ce qui pourrait fournir des représentations contextuelles plus riches.
Références
[1] Sönke Ahrens. How to Take Smart Notes: One Simple Technique to Boost Writing, Learning and Thinking. Amazon, 2017. Second Edition.
[2] Anthropic. The claude 3 model family: Opus, sonnet, haiku. Anthropic, Mar 2024. Accessed May 2025.
[3] Anthropic. Claude 3.5 sonnet model card addendum. Technical report, Anthropic, 2025. Accessed May 2025.
[4] Akari Asai, Zeqiu Wu, Yizhong Wang, Avirup Sil, and Hannaneh Hajishirzi. Self- rag: Learning to retrieve, generate, and critique through self- reflection. arXiv preprint arXiv:2310.11511, 2023.
[5] Satanjeev Banerjee and Alon Lavie. Meteor: An automatic metric for mt evaluation with improved correlation with human judgments. In Proceedings of the acl workshop on intrinsic and extrinsic evaluation measures for machine translation and/or summarization, pages 65- 72, 2005.
[6] Sebastian Borgeaud, Arthur Mensch, Jordan Hoffmann, Trevor Cai, Eliza Rutherford, Katie Millican, George Bm Van Den Driessche, Jean- Baptiste Lespiau, Bogdan Damoc, Aidan Clark, et al. Improving language models by retrieving from trillions of tokens. In International conference on machine learning, pages 2206- 2240. PMLR, 2022.
[7] Xiang Deng, Yu Gu, Boyuan Zheng, Shijie Chen, Sam Stevens, Boshi Wang, Huan Sun, and Yu Su. Mind2web: Towards a generalist agent for the web. Advances in Neural Information Processing Systems, 36:28091- 28114, 2023.
[8] Khant Dev and Singh Taranjeet. mem0: The memory layer for ai agents. https://github.com/mem0ai/mem0, 2024.
[9] Darren Edge, Ha Trinh, Newman Cheng, Joshua Bradley, Alex Chao, Apurva Mody, Steven Truitt, and Jonathan Larson. From local to global: A graph rag approach to query- focused summarization. arXiv preprint arXiv:2404.16130, 2024.
[10] Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, and Haofen Wang. Retrieval- augmented generation for large language models: A survey. arXiv preprint arXiv:2312.10997, 2023.
[11] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
[12] I. Ilin. Advanced rag techniques: An illustrated overview, 2023.
[13] Jihyoung Jang, Minseong Boo, and Hyounghun Kim. Conversation chronicles: Towards diverse temporal and relational dynamics in multi- session conversations. arXiv preprint arXiv:2310.13420, 2023.
[14] Zhengbao Jiang, Frank F Xu, Luyu Gao, Zhiqing Sun, Qian Liu, Jane Dwivedi- Yu, Yiming Yang, Jamie Callan, and Graham Neubig. Active retrieval augmented generation. arXiv preprint arXiv:2305.06983, 2023.
[15] David Kadavy. Digital Zettelkasten: Principles, Methods, & Examples. Google Books, May 2021.
[16] Jiho Kim, Woosog Chay, Hyeonji Hwang, Daeun Kyung, Hyunseung Chung, Eunbyeol Cho, Yohan Jo, and Edward Choi. Dialism: A real- time simulator for evaluating long- term multi- party dialogue understanding of conversational agents. arXiv preprint arXiv:2406.13144, 2024.
[17] Kuang- Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny, and Ian Fischer. A human- inspired reading agent with gist memory of very long contexts. arXiv preprint arXiv:2402.09727, 2024.
[18] Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Kuttler, Mike Lewis, Wen- tau Yih, Tim Rocktäschel, et al. Retrieval- augmented generation for knowledge- intensive nlp tasks. Advances in Neural Information Processing Systems, 33:9459- 9474, 2020.
[19] Chin- Yew Lin. Rouge: A package for automatic evaluation of summaries. In Text summarization branches out, pages 74- 81, 2004.
[20] Xi Victoria Lin, Xilun Chen, Mingda Chen, Weijia Shi, Maria Lomeli, Rich James, Pedro Rodriguez, Jacob Kahn, Gergely Szilvasy, Mike Lewis, et al. Ra- dit: Retrieval- augmented dual instruction tuning. arXiv preprint arXiv:2310.01352, 2023.
[21] Zhiwei Liu, Weiran Yao, Jianguo Zhang, Liangwei Yang, Zuxin Liu, Juntao Tan, Prafulla K Choubey, Tian Lan, Jason Wu, Huan Wang, et al. Agentlite: A lightweight library for building and advancing task- oriented llm agent system. arXiv preprint arXiv:2402.15538, 2024.
[22] Adyasha Maharana, Dong- Ho Lee, Sergey Tulyakov, Mohit Bansal, Francesco Barbieri, and Yuwei Fang. Evaluating very long- term conversational memory of llm agents. arXiv preprint arXiv:2402.17753, 2024.
[23] Kai Mei, Zelong Li, Shuyuan Xu, Ruosong Ye, Yingqiang Ge, and Yongfeng Zhang. Aios: Llm agent operating system. arXiv e- prints, pp. arXiv- 2403, 2024.
[24] Ali Modarressi, Ayyob Imani, Mohsen Fayyaz, and Hinrich Schütze. Ret- llm: Towards a general read- write memory for large language models. arXiv preprint arXiv:2305.14322, 2023.
[25] Charles Packer, Sarah Wooders, Kevin Lin, Vivian Fang, Shishir G Patil, Ion Stoica et Joseph E Gonzalez. Memgpt : Vers des LLM en tant que systèmes d'exploitation. arXiv preprint arXiv:2310.08560, 2023.
[26] Kishore Papineni, Salim Roukos, Todd Ward et Wei-Jing Zhu. Bleu : une méthode d'évaluation automatique de la traduction automatique. In Actes de la 40e réunion annuelle de l'Association for Computational Linguistics, pages 311-318, 2002.
[27] Nils Reimers et Iryna Gurevych. Sentence-bert : Plongements de phrases utilisant des réseaux bert siamois. In Actes de la conférence 2019 sur les méthodes empiriques en traitement du langage naturel. Association for Computational Linguistics, 11 2019.
[28] Aymeric Roucher, Albert Villanova del Moral, Thomas Wolf, Leandro von Werra et Erik Kaunismaki. « smolagents » : une petite bibliothèque pour construire d'excellents systèmes agentiques. https://github.com/huggingface/smolagents, 2025.
[29] Zhihong Shao, Yeyun Gong, Yelong Shen, Minlie Huang, Nan Duan et Weizhu Chen. Améliorer les grands modèles de langage augmentés par la recherche d'informations grâce à une synergie itérative entre recherche et génération. arXiv preprint arXiv:2305.15294, 2023.
[30] Zeru Shi, Kai Mei, Mingyu Jin, Yongye Su, Chaoji Zuo, Wenyue Hua, Wujiang Xu, Yujie Ren, Zirui Liu, Mengnan Du, et al. Des commandes aux prompts : Système de fichiers sémantique basé sur les LLM pour les AIOS. arXiv preprint arXiv:2410.11843, 2024.
[31] Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot et Ashish Sabharwal. Entrelacement de la recherche d'informations avec le raisonnement en chaîne de pensée pour des questions multi-étapes à forte intensité de connaissances. arXiv preprint arXiv:2212.10509, 2022.
[32] Bing Wang, Xinnian Liang, Jian Yang, Hui Huang, Shuangzhi Wu, Peihao Wu, Lu Lu, Zejun Ma et Zhoujun Li. Enhancing large language model with self-controlled memory framework. arXiv preprint arXiv:2304.13343, 2023.
[33] Xingyao Wang, Boxuan Li, Yufan Song, Frank F Xu, Xiangru Tang, Mingchen Zhuge, Jiayi Pan, Yueqi Song, Bowen Li, Jaskirat Singh, et al. Openhands: An open platform for ai software developers as generalist agents. arXiv preprint arXiv:2407.16741, 2024.
[34] Zhiruo Wang, Jun Araki, Zhengbao Jiang, Md Rizwan Parvez et Graham Neubig. Learning to filter context for retrieval-augmented generation. arXiv preprint arXiv:2311.08377, 2023.
[35] Lilian Weng. Llm-powered autonomous agents. lilianweng.github.io, juin 2023.
[36] J Xu. Beyond goldfish memory: Long-term open-domain conversation. arXiv preprint arXiv:2107.07567, 2021.
[37] Wenhao Yu, Hongming Zhang, Xiaoman Pan, Kaixin Ma, Hongwei Wang et Dong Yu. Chain-of-note: Enhancing robustness in retrieval-augmented language models. arXiv preprint arXiv:2311.09210, 2023.
[38] Zichun Yu, Chenyan Xiong, Shi Yu et Zhiyuan Liu. Augmentation-adapted retriever improves generalization of language models as generic plug-in. arXiv preprint arXiv:2305.17331, 2023.
[39] Wanjun Zhong, Lianghong Guo, Qiqi Gao, He Ye et Yanlin Wang. Memorybank: Enhancing large language models with long-term memory. In Proceedings of the AAAI Conference on Artificial Intelligence, volume 38, pages 19724-19731, 2024.
Table des matières
1 Introduction 1
2 Travaux connexes 2
2.1 Mémoire pour les agents LLM 2
2.2 Génération augmentée par récupération 3
3 Méthodologie 3
3.1 Construction des notes 4
3.2 Génération des liens 4
3.3 Évolution de la mémoire 4
3.4 Récupération de la mémoire relative 5
4 Expérience 5
4.1 Jeu de données et évaluation 5
4.2 Détails d'implémentation 6
4.3 Résultats empiriques 6
4.4 Étude d'ablation 7
4.5 Analyse des hyperparamètres 7
4.6 Analyse de mise à l'échelle 8
4.7 Analyse de la mémoire 9
5 Conclusions 9
6 Limites 9
A Expérience 14
A.1 Introduction détaillée des lignes de base 14
A.2 Métrique d'évaluation 14
A.3 Résultats de comparaison 15
A.4 Analyse de la mémoire 16
A.5 Réglage des hyperparamètres 17
B Modèles d'invite et exemples 19
B.1 Modèle d'invite pour la construction des notes 19
B.2 Modèle d'invite pour la génération des liens 19
B.3 Modèle d'invite pour l'évolution de la mémoire 20
B.4 Exemples de questions/réponses avec A-MEM 21
ANNEXE
A Expérience
A.1 Introduction détaillée des lignes de base
LoCoMo [22] adopte une approche directe en exploitant des modèles de base sans mécanismes de mémoire pour les tâches de réponse aux questions. Pour chaque requête, il intègre la conversation précédente complète et les questions dans l'invite, évaluant ainsi les capacités de raisonnement du modèle.
ReadAgent [17] aborde le traitement de documents à long contexte par une méthodologie sophistiquée en trois étapes : il commence par une pagination en épisodes pour segmenter le contenu en blocs gérables, suivie d'une condensation en mémoire pour distiller chaque page en représentations mnésiques concises, et se conclut par une recherche interactive pour récupérer les informations pertinentes selon les besoins.
MemoryBank [39] introduit un système innovant de gestion de la mémoire qui maintient et récupère efficacement les interactions historiques. Le système dispose d'un mécanisme dynamique de mise à jour de la mémoire fondé sur la théorie de la courbe de l'oubli d'Ebbinghaus, qui ajuste intelligemment la force de la mémoire en fonction du temps et de l'importance. De plus, il intègre un système de construction de portrait utilisateur qui affine progressivement sa compréhension de la personnalité de l'utilisateur grâce à une analyse continue des interactions.
MemGPT [25] présente un nouveau système de gestion de contexte virtuel inspiré des hiérarchies de mémoire des systèmes d'exploitation traditionnels. L'architecture met en œuvre une structure à deux niveaux : un contexte principal (analogue à la RAM) qui fournit un accès immédiat pendant l'inférence du LLM, et un contexte externe (analogue au stockage sur disque) qui conserve les informations au-delà de la fenêtre de contexte fixe.
A.2 Métrique d'évaluation
Le score F1 représente la moyenne harmonique de la précision et du rappel, offrant une métrique équilibrée qui combine les deux mesures en une seule valeur. Cette métrique est particulièrement utile lorsque nous devons trouver un équilibre entre des réponses complètes et exactes :
où
Dans les systèmes de question-réponse, le score F1 joue un rôle crucial dans l'évaluation des correspondances exactes entre les réponses prédites et les réponses de référence. Cela est particulièrement important pour les tâches de QA basées sur des spans, où les systèmes doivent identifier des segments de texte précis tout en maintenant une couverture complète de la réponse. BLEU-1 [26] fournit une méthode pour évaluer la précision des correspondances d'unigrammes entre les sorties du système et les textes de référence :
où
Ici, est la longueur du candidat, est la longueur de la référence, est le nombre de n-grammes i dans le candidat k, et est le nombre maximal dans l'une des références. En QA, BLEU-1 évalue la précision lexicale des réponses générées, particulièrement utile pour les systèmes de QA génératifs où la correspondance exacte pourrait être trop stricte.
ROUGE-L [19] mesure la plus longue sous-séquence commune entre les textes générés et les textes de référence.
où est le texte de référence, est le texte candidat, et LCS est la plus longue sous-séquence commune (Longest Common Subsequence).
ROUGE-2 [19] calcule le chevauchement des bigrammes entre les textes générés et les textes de référence.
ROUGE-L et ROUGE-2 sont tous deux particulièrement utiles pour évaluer la fluidité et la cohérence des réponses générées, ROUGE-L se concentrant sur la correspondance de séquences et ROUGE-2 sur l'ordre local des mots.
METEOR [5] calcule un score basé sur les unigrammes alignés entre les textes candidats et de référence, en tenant compte des synonymes et des paraphrases.
où est la précision, est le rappel, ch est le nombre de segments (chunks), et est le nombre d'unigrammes appariés. METEOR est précieux pour l'évaluation en QA car il prend en compte la similarité sémantique au-delà de la correspondance exacte, ce qui le rend adapté à l'évaluation des réponses paraphrasées.
La similarité SBERT [27] mesure la similarité sémantique entre deux textes à l'aide de plongements de phrases.
représente le plongement de phrase du texte. La similarité SBERT est particulièrement utile pour évaluer la compréhension sémantique dans les systèmes de QA, car elle peut capturer les similarités de sens même lorsque le chevauchement lexical est faible.
A.3 Résultats de comparaison
Notre évaluation complète utilisant les métriques ROUGE-2, ROUGE-L, METEOR et SBERT démontre que A-MEM atteint des performances supérieures tout en maintenant une remarquable efficacité computationnelle. Grâce à des tests empiriques approfondis sur diverses tailles de modèles et catégories de tâches, nous avons établi A-MEM comme une approche plus efficace comparée aux lignes de base existantes, soutenue par plusieurs résultats convaincants. Dans notre analyse des modèles non-GPT, spécifiquement Qwen2.5 et Llama 3.2, A-MEM surpasse systématiquement toutes les approches de référence sur toutes les métriques. La catégorie Multi-Hop présente des résultats particulièrement frappants, où Qwen2.5-15b avec A-MEM atteint un score ROUGE-L de 27,23, dépassant largement les 4,68 de LoComo et les 2,81 de ReadAgent - représentant une amélioration de près de six fois. Ce schéma de supériorité s'étend de manière cohérente aux scores METEOR et SBERT.
| Modèle | Méthode | Catégorie | ||||||||
| Multi Hop RGE-2 | RGE-L | Temporel RGE-2 | RGE-L | Domaine ouvert RGE-2 | RGE-L | Saut unique RGE-2 | RGE-L | Adversarial RGE-2 | ||
| GPT | LoCoMo | 9,64 | 23,92 | 2,01 | 18,09 | 3,40 | 11,58 | 26,48 | 40,20 | 60,46 |
| READAGENT | 2,47 | 9,45 | 0,95 | 13,12 | 0,55 | 5,76 | 2,99 | 9,92 | 6,66 | |
| MEMORYBANK | 1,18 | 5,43 | 0,52 | 9,64 | 0,97 | 5,77 | 1,64 | 6,63 | 4,55 | |
| MEMGPT | 10,58 | 25,60 | 4,76 | 25,22 | 0,76 | 9,14 | 28,44 | 42,24 | 36,62 | |
| A-MEM | 10,61 | 25,86 | 21,39 | 44,27 | 3,42 | 12,09 | 29,50 | 45,18 | 42,62 | |
| LoCoMo | 11,53 | 30,65 | 1,68 | 8,17 | 3,21 | 16,33 | 45,42 | 63,86 | 45,13 | |
| Qwen | READAGENT | 3,91 | 14,36 | 0,43 | 3,96 | 0,52 | 8,58 | 4,75 | 13,41 | 4,24 |
| MEMORYBANK | 1,84 | 7,36 | 0,36 | 2,29 | 2,13 | 6,85 | 3,02 | 9,35 | 1,22 | |
| MEMGPT | 11,55 | 30,18 | 4,66 | 15,83 | 3,27 | 14,02 | 43,27 | 62,75 | 28,72 | |
| A-MEM | 12,76 | 31,71 | 9,82 | 25,04 | 6,09 | 16,63 | 33,67 | 50,31 | 30,31 | |
| LoCoMo | 1,39 | 9,24 | 0,00 | 4,68 | 3,42 | 10,59 | 3,25 | 11,15 | 35,10 | |
| READAGENT | 0,74 | 7,14 | 0,10 | 2,81 | 3,05 | 12,63 | 1,47 | 7,88 | 20,73 | |
| Qwen | MEMORYBANK | 1,51 | 11,18 | 0,14 | 5,39 | 1,80 | 8,44 | 5,07 | 13,72 | 29,24 |
| MEMGPT | 1,16 | 11,35 | 0,00 | 7,88 | 2,87 | 14,62 | 2,18 | 9,82 | 23,96 | |
| A-MEM | 4,88 | 17,94 | 5,88 | 27,23 | 3,44 | 16,87 | 12,32 | 24,38 | 36,32 | |
| LoCoMo | 0,49 | 4,83 | 0,14 | 3,20 | 1,31 | 5,38 | 1,97 | 6,98 | 12,66 | |
| READAGENT | 0,08 | 4,08 | 0,00 | 1,96 | 1,26 | 6,19 | 0,73 | 4,34 | 7,35 | |
| MEMORYBANK | 0,43 | 3,76 | 0,05 | 1,61 | 0,24 | 6,32 | 1,03 | 4,22 | 9,55 | |
| Qwen | MEMGPT | 0,69 | 5,55 | 0,05 | 3,17 | 1,90 | 7,90 | 2,05 | 7,32 | 10,46 |
| A-MEM | 2,91 | 12,42 | 8,11 | 27,74 | 1,51 | 7,51 | 8,80 | 17,57 | 21,39 | |
| LoCoMo | 2,51 | 11,48 | 0,44 | 8,25 | 1,69 | 13,06 | 2,94 | 13,00 | 39,85 | |
| READAGENT | 0,53 | 6,49 | 0,00 | 4,62 | 5,47 | 14,29 | 1,19 | 8,03 | 34,52 | |
| MEMORYBANK | 2,96 | 13,57 | 0,23 | 10,53 | 4,01 | 18,38 | 6,41 | 17,66 | 41,15 | |
| MEMGPT | 1,82 | 9,91 | 0,06 | 6,56 | 2,13 | 11,36 | 2,00 | 10,37 | 38,59 | |
| Llama 2 | A-MEM | 4,82 | 19,31 | 1,84 | 20,47 | 5,99 | 18,49 | 14,82 | 29,78 | 46,76 |
| LoCoMo | 0,98 | 7,22 | 0,03 | 4,45 | 2,36 | 11,39 | 2,85 | 8,45 | 25,47 | |
| READAGENT | 2,47 | 1,78 | 3,01 | 3,01 | 5,07 | 5,22 | 3,25 | 2,51 | 15,78 | |
| MEMORYBANK | 1,83 | 6,96 | 0,25 | 3,41 | 0,43 | 4,43 | 2,73 | 7,83 | 14,64 | |
| MEMGPT | 0,72 | 5,39 | 0,11 | 2,85 | 0,61 | 5,74 | 1,45 | 4,42 | 16,62 | |
| A-MEM | 6,02 | 17,62 | 7,93 | 27,97 | 5,38 | 13,00 | 16,89 | 28,55 | 35,48 | |
En examinant les modèles basés sur GPT, nos résultats révèlent un schéma intéressant. Alors que LoCoMo et MemGPT démontrent de fortes capacités dans les tâches Open Domain et Adversarial, A-MEM montre une supériorité remarquable dans les tâches de raisonnement Multi-Hop. En utilisant GPT-4o-mini, A-MEM atteint un score ROUGE-L de 44,27 dans les tâches Multi-Hop, plus du double des 18,09 de LoComo. Cet avantage significatif reste cohérent sur les autres métriques, avec des scores METEOR de 23,43 contre 7,61 et des scores SBERT de 70,49 contre 52,30. L'importance de ces résultats est amplifiée par l'efficacité computationnelle exceptionnelle d'A-MEM. Notre approche ne nécessite que 1 200 à 2 500 tokens, contre les 16 900 tokens substantiels nécessaires à LoComo et MemGPT. Cette efficacité découle de deux innovations architecturales clés : premièrement, notre nouvelle architecture de mémoire agentique crée des réseaux de mémoire interconnectés grâce à des notes atomiques avec de riches descriptions contextuelles, permettant une capture et une utilisation plus efficaces des relations entre informations. Deuxièmement, notre mécanisme de récupération sélective top-k facilite l'évolution dynamique de la mémoire et l'organisation structurée. L'efficacité de ces innovations est particulièrement évidente dans les tâches de raisonnement complexes, comme le démontre la performance Multi-Hop systématiquement forte sur toutes les métriques d'évaluation. En outre, nous montrons également les résultats expérimentaux avec différents modèles de base, notamment DeepSeek-R1-32B [11], Claude 3.0 Haiku [2] et Claude 3.5 Haiku [3].
A.4 Analyse de la mémoire
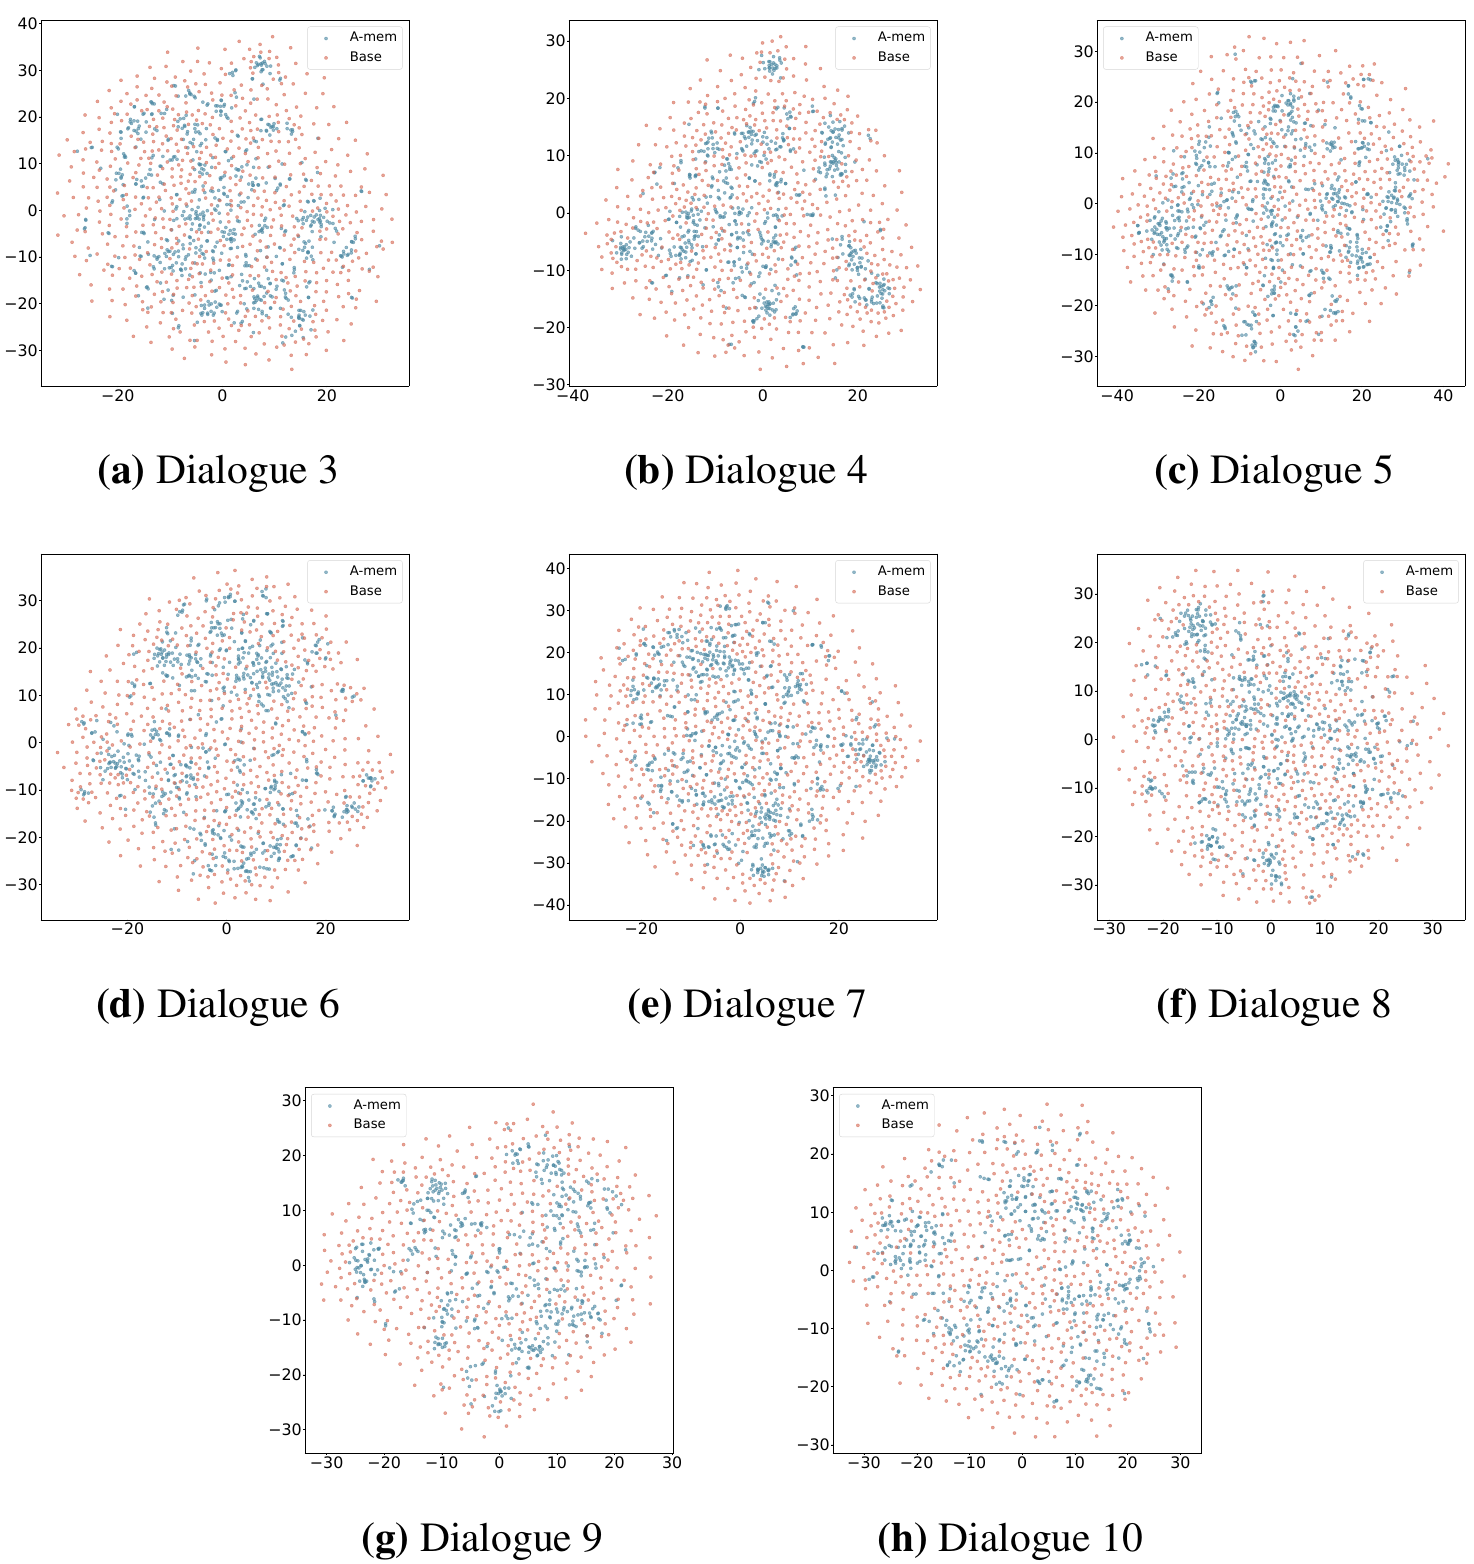
En plus des visualisations de mémoire des deux premiers dialogues présentées dans le texte principal, nous présentons des visualisations supplémentaires dans la Fig.5 qui démontrent les avantages structurels de notre système de mémoire agentique. Grâce à l'analyse de deux dialogues échantillonnés à partir de conversations à long terme dans LoCoMo [22], nous observons qu'A-MEM (montré en bleu) produit systématiquement des schémas de regroupement plus cohérents par rapport au système de référence (montré en rouge). Cette organisation structurelle est particulièrement évidente dans le Dialogue 2, où des groupes distincts émergent dans la région centrale, fournissant un soutien empirique à l'efficacité de notre mécanisme d'évolution de la mémoire et de génération de descriptions contextuelles. En revanche, les plongements de mémoire de la référence présentent une distribution plus dispersée, indiquant que les mémoires manquent d'organisation structurelle sans nos composants de génération de liens et d'évolution de la mémoire.
| Modèle | Méthode | Catégorie | ||||||||||
| Multi Hop ME | SBERT | Temporal ME | SBERT | Open Domain ME | SBERT | Single Hop ME | SBERT | Adversial ME | ||||
| GPT | 4-hop | LoCoMo | 15,81 | 47,97 | 7,61 | 52,30 | 8,16 | 35,00 | 40,42 | 57,78 | 63,28 | 71,93 |
| ReadAgent | 5,46 | 28,67 | 4,76 | 45,07 | 3,69 | 26,72 | 8,01 | 26,78 | 8,38 | 15,20 | ||
| MEMORY BANK | 3,42 | 21,71 | 4,07 | 37,58 | 4,21 | 23,71 | 5,81 | 20,76 | 6,24 | 13,00 | ||
| MEMGPT | 15,79 | 49,33 | 13,25 | 61,53 | 4,59 | 32,77 | 41,40 | 58,19 | 39,16 | 47,24 | ||
| A-MEM | 16,36 | 49,46 | 23,43 | 70,49 | 8,36 | 38,48 | 42,32 | 59,38 | 45,64 | 53,26 | ||
| GPT | 4-hop | LoCoMo | 16,34 | 53,82 | 7,21 | 32,15 | 8,98 | 43,72 | 53,39 | 73,40 | 47,72 | 56,09 |
| ReadAgent | 7,86 | 37,41 | 3,76 | 26,22 | 4,42 | 30,75 | 9,36 | 31,37 | 5,47 | 12,34 | ||
| BANQUE DE MÉMOIRE | 3,22 | 26,23 | 2,29 | 23,49 | 4,18 | 24,89 | 6,64 | 23,90 | 2,93 | 10,01 | ||
| MEMGPT | 16,64 | 55,12 | 12,68 | 35,93 | 7,78 | 37,91 | 52,14 | 72,83 | 31,15 | 39,08 | ||
| A-MEM | 17,53 | 55,96 | 13,10 | 45,40 | 10,62 | 38,87 | 41,93 | 62,47 | 32,34 | 40,11 | ||
| Open2.5 | 4-hop | LoCoMo | 4,99 | 32,23 | 2,86 | 34,03 | 5,89 | 35,61 | 8,57 | 29,47 | 40,53 | 50,49 |
| ReadAgent | 3,67 | 28,20 | 1,88 | 27,27 | 8,97 | 35,13 | 5,52 | 26,33 | 24,04 | 34,12 | ||
| MEMORY BANK | 5,57 | 35,40 | 2,80 | 32,47 | 4,27 | 33,85 | 10,59 | 32,16 | 32,93 | 42,83 | ||
| MEMGPT | 5,40 | 35,64 | 2,35 | 39,04 | 7,68 | 40,36 | 7,07 | 30,16 | 27,24 | 40,63 | ||
| A-MEM | 9,49 | 43,49 | 11,92 | 61,65 | 9,11 | 42,58 | 19,69 | 41,93 | 40,64 | 52,44 | ||
| Open2.5 | 4-hop | LoCoMo | 2,00 | 24,37 | 1,92 | 25,24 | 3,45 | 25,38 | 6,00 | 21,28 | 16,67 | 23,14 |
| ReadAgent | 1,78 | 21,10 | 1,69 | 20,78 | 4,43 | 25,15 | 3,37 | 18,20 | 10,46 | 17,39 | ||
| MEMORY BANK | 2,37 | 17,81 | 2,22 | 21,93 | 3,86 | 20,65 | 3,99 | 16,26 | 15,49 | 20,77 | ||
| MEMGPT | 3,74 | 24,31 | 2,25 | 27,67 | 6,44 | 29,59 | 6,24 | 22,40 | 13,19 | 20,83 | ||
| A-MEM | 6,25 | 33,72 | 14,04 | 62,54 | 6,56 | 30,60 | 15,98 | 33,98 | 27,36 | 33,72 | ||
| Llama 3.2 | 4-hop | LoCoMo | 5,77 | 38,02 | 3,38 | 45,44 | 6,20 | 42,69 | 9,33 | 34,19 | 46,79 | 60,74 |
| ReadAgent | 2,97 | 29,26 | 1,31 | 26,45 | 7,13 | 39,19 | 5,36 | 26,44 | 42,39 | 54,35 | ||
| BANQUE DE MÉMOIRE | 6,77 | 39,33 | 4,43 | 45,63 | 7,76 | 42,81 | 13,01 | 37,32 | 50,43 | 60,81 | ||
| MEMGPT | 5,10 | 32,99 | 2,54 | 41,81 | 3,26 | 35,99 | 6,62 | 30,68 | 45,00 | 61,33 | ||
| A-MEM | 9,01 | 45,16 | 7,50 | 54,79 | 8,30 | 43,42 | 22,46 | 47,07 | 53,72 | 68,00 | ||
| Llama 3.2 | 4-hop | LoCoMo | 3,69 | 27,94 | 2,96 | 20,40 | 6,46 | 32,17 | 6,58 | 22,92 | 29,02 | 35,74 |
| ReadAgent | 1,21 | 17,40 | 2,33 | 12,02 | 3,39 | 19,63 | 2,46 | 14,63 | 14,37 | 21,25 | ||
| BANQUE DE MÉMOIRE | 3,84 | 25,06 | 2,73 | 13,65 | 3,05 | 21,08 | 6,35 | 22,02 | 17,14 | 24,39 | ||
| MEMGPT | 2,78 | 22,06 | 2,21 | 14,97 | 3,63 | 23,18 | 3,47 | 17,81 | 20,50 | 26,87 | ||
| A-MEM | 9,74 | 39,32 | 13,19 | 59,70 | 8,09 | 32,27 | 24,30 | 42,86 | 39,74 | 46,76 | ||
| Méthode | Catégorie | |||||
| Multi Hop F1 | BLEU-1 | Temporal F1 | Open Domain F1 | Single Hop F1 | Adversial F1 | |
| DeepSeek-R1-32B | ||||||
| LoCoMo | 8.58 | 6.48 | 4.79 | 4.35 | 12.96 | 12.52 |
| MEMGPT | 8.28 | 6.25 | 5.45 | 4.97 | 10.97 | 9.09 |
| A-MEM | 15.02 | 10.64 | 14.64 | 11.01 | 14.81 | 12.82 |
| Claude 3.0 Haiku | ||||||
| LoCoMo | 4.56 | 3.33 | 0.82 | 0.59 | 2.86 | 3.22 |
| MEMGPT | 7.65 | 6.36 | 1.65 | 1.26 | 7.41 | 6.64 |
| A-MEM | 19.28 | 14.69 | 16.65 | 12.23 | 11.85 | 9.61 |
| Claude 3.5 Haiku | ||||||
| LoCoMo | 11.34 | 8.21 | 3.29 | 2.69 | 3.79 | 3.58 |
| MEMGPT | 8.27 | 6.55 | 3.99 | 2,76 | 4,71 | 4,48 |
| A-MEM | 29,70 | 23,19 | 31,54 | 27,53 | 11,42 | 9,47 |
Ces visualisations valident qu'A-MEM peut maintenir de manière autonome des structures de mémoire significatives grâce à ses mécanismes d'évolution dynamique et de liaison.
A.5 Réglage des hyperparamètres
Toutes les valeurs d'hyperparamètre k sont présentées dans le Tableau 8. Pour les modèles ayant déjà atteint des performances de pointe (SOTA) avec k=10, nous maintenons cette valeur sans réglage supplémentaire.
| Modèle | Multi Hop | Temporel | Domaine ouvert | Single Hop | Adversarial |
| GPT-4o-mini | 40 | 40 | 50 | 50 | 40 |
| GPT-4o | 40 | 40 | 50 | 50 | 40 |
| Qwen2.5-1.5b | 10 | 10 | 10 | 10 | 10 |
| Qwen2.5-3b | 10 | 10 | 50 | 10 | 10 |
| Llama3.2-1b | 10 | 10 | 10 | 10 | 10 |
| Llama3.2-3b | 10 | 20 | 10 | 10 | 10 |
B Modèles de prompts et exemples
B.1 Modèle de prompt pour la construction de notes
Le modèle de prompt dans la construction de notes :
Générez une analyse structurée du contenu suivant en :
1. Identifiant les mots-clés les plus saillants (en vous concentrant sur les noms, les verbes et les concepts clés)
2. Extrayant les thèmes centraux et les éléments contextuels
3. Créant des étiquettes catégorielles pertinentes
{ "keywords": [ "modèle de prompt", "génération de liens", "évolution de la mémoire", "agent d'évolution de la mémoire", "mémoire de voisins les plus proches", "renforcer la connexion", "mettre à jour le voisin", "étiquettes", "base de connaissances" ], "context": "Cette section présente les modèles de prompts utilisés dans un système de gestion de base de connaissances par agent d'IA, en détaillant le modèle de génération de liens (P_{s2}) qui détermine si une nouvelle note de mémoire doit évoluer selon ses voisins, et le modèle d'évolution de la mémoire (P_{s3}) qui spécifie les actions à entreprendre (renforcer ou mettre à jour le voisin) ainsi que le format de sortie en liste ; elle s'adresse aux développeurs ou chercheurs concevant des systèmes de mémoire augmentés par LLM.", "tags": [ "intelligence artificielle", "gestion des connaissances", "modèles de prompts", "systèmes de mémoire", "documentation technique", "traitement du langage naturel" ] }
Ces actions peuvent être combinées.
Renvoyez votre décision au format JSON avec la structure suivante : {{ "should_evolve": true/false,
"actions": ["strengthen", "merge", "prune"],
"suggested_connections": ["neighbor_memory_ids"],
"tags_to_update": ["tag_1", ... "tag_n"],
"new_context_neighborhood": ["new_context", ... "new_context"],
"new_tags_neighborhood": [["tag_1", ... "tag_n"], ... ["tag_1", ... "tag_n"]],
B.4 Exemples de Q/R avec A-MEM
Exemple :
Question 686 : Quel loisir Dave a-t-il commencé en octobre 2023 ?
Prédiction : photographie
Référence : photographie
heure de début de conversation : 10h54 le 17 novembre 2023
contenu de la mémoire : Speaker Davesays : Hey Calvin, ça fait longtemps qu'on ne s'est pas parlé ! Il s'est passé beaucoup de choses. J'ai commencé la photographie et c'est génial —j'ai pris des photos des paysages d'ici, ce qui est vraiment cool.
contexte de la mémoire : Le sujet principal est le nouveau loisir de photographie du locuteur, soulignant son plaisir à capturer les paysages locaux, dans le but d'engager un ami dans une conversation sur des expériences personnelles.
mots-clés de la mémoire : ['photography', 'scenery', 'conversation', 'experience', 'hobby']
étiquettes de la mémoire : ['hobby', 'photography', 'personal development', 'conversation', 'leisure']
heure de début de conversation : 18h38 le 21 juillet 2023
contenu de la mémoire : Speaker Calvinysays : Merci, Dave ! C'est génial d'avoir mon propre espace de travail. Je m'essaie à différents genres ces derniers temps, en me poussant hors de ma zone de confort. Ajouter des éléments électroniques à mes chansons leur donne une vibe nouvelle. C'est un processus passionnant de découverte de soi et de croissance !
contexte de la mémoire : Le locuteur discute de son processus créatif en musique, soulignant l'expérimentation avec différents genres et l'incorporation d'éléments électroniques pour la croissance personnelle et l'évolution artistique.
mots-clés de la mémoire : ['space', 'experimentation', 'genres', 'electronic', 'self- discovery', 'growth']
étiquettes de la mémoire : ['music', 'creativity', 'self- improvement', 'artistic expression']
Liste de contrôle pour les articles NeurIPS
La liste de contrôle est conçue pour encourager les meilleures pratiques en matière de recherche responsable en apprentissage automatique, en abordant les questions de reproductibilité, de transparence, d'éthique de la recherche et d'impact sociétal. Ne supprimez pas la liste de contrôle : les articles qui ne l'incluent pas seront rejetés d'office. La liste de contrôle doit suivre les références et suivre le matériel supplémentaire (facultatif). La liste de contrôle ne compte PAS dans la limite de pages.
Veuillez lire attentivement les directives de la liste de contrôle pour savoir comment répondre à ces questions. Pour chaque question de la liste de contrôle :
Vous devez répondre [Oui], [Non] ou [NA]. [NA] signifie soit que la question n'est pas applicable à cet article particulier, soit que l'information pertinente n'est pas disponible. Veuillez fournir une courte justification (1 à 2 phrases) juste après votre réponse (même pour NA).
Les réponses à la liste de contrôle font partie intégrante de la soumission de votre article. Elles sont visibles par les relecteurs, les présidents de session, les présidents de session senior et les relecteurs en éthique. Il vous sera également demandé de l'inclure (après d'éventuelles révisions) avec la version finale de votre article, et sa version finale sera publiée avec l'article.
Les relecteurs de votre article seront invités à utiliser la liste de contrôle comme l'un des facteurs de leur évaluation. Bien que « [Oui] » soit généralement préférable à « [Non] », il est parfaitement acceptable de répondre « [Non] » à condition qu'une justification appropriée soit fournie (par exemple, « les barres d'erreur ne sont pas rapportées car ce serait trop coûteux en calcul » ou « nous n'avons pas pu trouver la licence du jeu de données que nous avons utilisé »). En général, répondre « [Non] » ou « [NA] » n'est pas un motif de rejet. Bien que les questions soient formulées de manière binaire, nous reconnaissons que la véritable réponse est souvent plus nuancée, alors veuillez simplement utiliser votre meilleur jugement et rédiger une justification pour développer. Toutes les preuves à l'appui peuvent apparaître soit dans l'article principal, soit dans le matériel supplémentaire, fourni en annexe. Si vous répondez [Oui] à une question, veuillez indiquer dans la justification la ou les sections où se trouve le matériel pertinent pour la question.
IMPORTANT, veuillez :
- Supprimer ce bloc d'instructions, mais conserver le titre de section « NeurIPS Paper Checklist ».- Conserver les sous-titres de la liste de contrôle, les questions/réponses et les directives ci-dessous.- Ne pas modifier les questions et n'utiliser que les macros fournies pour vos réponses.
1. Affirmations
Question : Les principales affirmations faites dans le résumé et l'introduction reflètent-elles fidèlement les contributions et la portée de l'article ?
Réponse : [Oui]
Justification : Le résumé et l'introduction résument nos principales contributions.
Directives :
- La réponse NA signifie que le résumé et l'introduction n'incluent pas les affirmations faites dans l'article.- Le résumé et/ou l'introduction doivent clairement énoncer les affirmations faites, y compris les contributions apportées dans l'article ainsi que les hypothèses et limites importantes. Une réponse Non ou NA à cette question ne sera pas bien perçue par les relecteurs.- Les affirmations faites doivent correspondre aux résultats théoriques et expérimentaux, et refléter dans quelle mesure les résultats peuvent être attendus pour se généraliser à d'autres contextes.- Il est acceptable d'inclure des objectifs ambitieux comme motivation tant qu'il est clair que ces objectifs ne sont pas atteints par l'article.
2. Limites
Question : L'article discute-t-il des limites du travail effectué par les auteurs ?
Réponse : [Oui]
Justification : Cet article couvre une section sur les limites.
Directives :
- La réponse NA signifie que l'article n'a pas de limite, tandis que la réponse Non signifie que l'article a des limites, mais qu'elles ne sont pas discutées dans l'article.
- Les auteurs sont encouragés à créer une section « Limites » distincte dans leur article.
- L'article doit souligner toute hypothèse forte et la robustesse des résultats face à des violations de ces hypothèses (par exemple, hypothèses d'indépendance, environnements sans bruit, bonne spécification du modèle, approximations asymptotiques ne tenant que localement). Les auteurs doivent réfléchir à la manière dont ces hypothèses pourraient être violées en pratique et quelles en seraient les implications.
- Les auteurs doivent réfléchir à la portée des affirmations faites, par exemple si l'approche n'a été testée que sur quelques jeux de données ou avec quelques exécutions. En général, les résultats empiriques dépendent souvent d'hypothèses implicites, qui doivent être explicitées.
- Les auteurs doivent réfléchir aux facteurs qui influencent la performance de l'approche. Par exemple, un algorithme de reconnaissance faciale peut mal fonctionner lorsque la résolution de l'image est faible ou que les images sont prises sous un faible éclairage. Ou un système de reconnaissance vocale peut ne pas être utilisé de manière fiable pour fournir des sous-titres pour des cours en ligne parce qu'il ne gère pas le jargon technique.
- Les auteurs doivent discuter de l'efficacité computationnelle des algorithmes proposés et de leur passage à l'échelle avec la taille du jeu de données.
- Le cas échéant, les auteurs doivent discuter des limites possibles de leur approche pour répondre aux problèmes de confidentialité et d'équité.
- Bien que les auteurs puissent craindre qu'une honnêteté complète sur les limites soit utilisée par les relecteurs comme motif de rejet, un résultat pire pourrait être que les relecteurs découvrent des limites qui ne sont pas reconnues dans l'article. Les auteurs doivent utiliser leur meilleur jugement et reconnaître que les actions individuelles en faveur de la transparence jouent un rôle important dans le développement de normes qui préservent l'intégrité de la communauté. Il sera spécifiquement demandé aux relecteurs de ne pas pénaliser l'honnêteté concernant les limites.
3. Hypothèses théoriques et preuves
Question : Pour chaque résultat théorique, l'article fournit-il l'ensemble complet des hypothèses et une preuve complète (et correcte) ?
Réponse : [NA]
Justification : N/A
Lignes directrices :
- La réponse NA signifie que l'article ne comporte pas de résultats théoriques.
- Tous les théorèmes, formules et preuves de l'article doivent être numérotés et référencés de manière croisée.
- Toutes les hypothèses doivent être clairement énoncées ou référencées dans l'énoncé de tout théorème.
- Les preuves peuvent figurer dans l'article principal ou dans le matériel supplémentaire, mais si elles figurent dans le matériel supplémentaire, les auteurs sont encouragés à fournir un bref aperçu de la preuve afin de donner l'intuition.
- Inversement, toute preuve informelle fournie au cœur de l'article doit être complétée par des preuves formelles fournies en annexe ou dans le matériel supplémentaire.
- Les théorèmes et les lemmes sur lesquels repose la preuve doivent être correctement référencés.
4. Reproductibilité des résultats expérimentaux
Question : L'article divulgue-t-il pleinement toutes les informations nécessaires pour reproduire les principaux résultats expérimentaux de l'article, dans la mesure où cela affecte les principales affirmations et/ou conclusions de l'article (que le code et les données soient fournis ou non) ?
Réponse : [Oui]
Justification : Le code et les jeux de données sont tous deux disponibles.
Directives :
- La réponse NA signifie que l'article ne comprend pas d'expériences.
- Si l'article comprend des expériences, une réponse No à cette question ne sera pas bien perçue par les évaluateurs : rendre l'article reproductible est important, que le code et les données soient fournis ou non.
- Si la contribution est un jeu de données et/ou un modèle, les auteurs doivent décrire les étapes prises pour rendre leurs résultats reproductibles ou vérifiables.
- Selon la contribution, la reproductibilité peut être accomplie de diverses manières. Par exemple, si la contribution est une nouvelle architecture, décrire pleinement l'architecture pourrait suffire, ou si la contribution est un modèle spécifique et une évaluation empirique, il peut être nécessaire soit de permettre à d'autres de répliquer le modèle avec le même jeu de données, soit de fournir un accès au modèle. En général, publier le code et les données est souvent un bon moyen d'y parvenir, mais la reproductibilité peut aussi être assurée par des instructions détaillées sur la manière de répliquer les résultats, l'accès à un modèle hébergé (par exemple, dans le cas d'un grand modèle de langage), la publication d'un checkpoint de modèle, ou d'autres moyens appropriés à la recherche effectuée.
- Bien que NeurIPS n'exige pas la publication du code, la conférence exige que toutes les soumissions fournissent une voie raisonnable pour la reproductibilité, laquelle peut dépendre de la nature de la contribution. Par exemple
(a) Si la contribution est principalement un nouvel algorithme, l'article doit indiquer clairement comment reproduire cet algorithme.
(b) Si la contribution est principalement une nouvelle architecture de modèle, l'article doit décrire l'architecture clairement et pleinement.
(c) Si la contribution est un nouveau modèle (par exemple, un grand modèle de langage), alors il devrait y avoir soit un moyen d'accéder à ce modèle pour reproduire les résultats, soit un moyen de reproduire le modèle (par exemple, avec un jeu de données open source ou des instructions sur la manière de construire le jeu de données).
(d) Nous reconnaissons que la reproductibilité peut être délicate dans certains cas, auquel cas les auteurs sont invités à décrire la manière particulière dont ils assurent la reproductibilité. Dans le cas de modèles à code source fermé, il se peut que l'accès au modèle soit limité d'une certaine manière (par exemple, aux utilisateurs enregistrés), mais il devrait être possible pour d'autres chercheurs d'avoir un chemin pour reproduire ou vérifier les résultats.
5. Accès ouvert aux données et au code
Question : L'article fournit-il un accès ouvert aux données et au code, avec des instructions suffisantes pour reproduire fidèlement les principaux résultats expérimentaux, comme décrit dans le matériel supplémentaire ?
Réponse : [Oui]
Justification : Nous fournissons le lien du code dans le résumé.
Directives :
- La réponse NA signifie que l'article ne comprend pas d'expériences nécessitant du code.
- Veuillez consulter les directives de NeurIPS sur la soumission de code et de données (https://nips.cc/public/guides/CodeSubmissionPolicy) pour plus de détails.
- Bien que nous encouragions la publication du code et des données, nous comprenons que cela puisse ne pas être possible, donc « Non » est une réponse acceptable. Les articles ne peuvent pas être rejetés simplement pour ne pas inclure de code, sauf si cela est central à la contribution (par exemple, pour un nouveau benchmark open source).
- Les instructions doivent contenir la commande exacte et l'environnement nécessaires à l'exécution pour reproduire les résultats. Voir les directives de NeurIPS sur la soumission de code et de données (https://nips.cc/public/guides/CodeSubmissionPolicy) pour plus de détails.
- Les auteurs doivent fournir des instructions sur l'accès et la préparation des données, y compris comment accéder aux données brutes, aux données prétraitées, aux données intermédiaires et aux données générées, etc.
- Les auteurs doivent fournir des scripts pour reproduire tous les résultats expérimentaux de la nouvelle méthode proposée et des lignes de base. Si seul un sous-ensemble d'expériences est reproductible, ils doivent indiquer lesquelles sont omises du script et pourquoi.
- Au moment de la soumission, pour préserver l'anonymat, les auteurs doivent publier des versions anonymisées (le cas échéant).
- Il est recommandé de fournir autant d'informations que possible dans le matériel supplémentaire (annexé à l'article), mais inclure des URL vers les données et le code est autorisé.
6. Cadre expérimental/détails
Question : L'article spécifie-t-il tous les détails d'entraînement et de test (par exemple, divisions des données, hyperparamètres, comment ils ont été choisis, type d'optimiseur, etc.) nécessaires pour comprendre les résultats ?
Réponse : [Oui]
Justification : Nous couvrons tous les détails dans l'article.
Directives :- La réponse NA signifie que l'article ne comprend pas d'expériences.- Le cadre expérimental doit être présenté au cœur de l'article avec un niveau de détail nécessaire pour apprécier les résultats et les comprendre.- Les détails complets peuvent être fournis soit avec le code, en annexe, soit comme matériel supplémentaire.
7. Signification statistique des expériences
Question : L'article rapporte-t-il des barres d'erreur définies de manière appropriée et correcte ou d'autres informations appropriées sur la signification statistique des expériences ?
Réponse : [Non]
Justification : Les expériences utilisent l'API de grands modèles de langage. Des appels multiples augmenteraient considérablement les coûts.
Directives :- La réponse NA signifie que l'article ne comprend pas d'expériences.- Les auteurs doivent répondre « Oui » si les résultats sont accompagnés de barres d'erreur, d'intervalles de confiance ou de tests de signification statistique, au moins pour les expériences qui soutiennent les principales affirmations de l'article.- Les facteurs de variabilité que les barres d'erreur capturent doivent être clairement indiqués (par exemple, division entraînement/test, initialisation, tirage aléatoire de quelque paramètre, ou exécution globale avec des conditions expérimentales données).- La méthode de calcul des barres d'erreur doit être expliquée (formule fermée, appel à une fonction de bibliothèque, bootstrap, etc.)- Les hypothèses faites doivent être données (par exemple, erreurs distribuées normalement).- Il doit être clair si la barre d'erreur est l'écart type ou l'erreur type de la moyenne.- Il est acceptable de rapporter des barres d'erreur à 1 sigma, mais il faut le préciser. Les auteurs devraient de préférence rapporter une barre d'erreur à 2 sigma plutôt que d'indiquer qu'ils ont un IC à 96 %, si l'hypothèse de normalité des erreurs n'est pas vérifiée.- Pour les distributions asymétriques, les auteurs doivent veiller à ne pas montrer dans les tableaux ou figures des barres d'erreur symétriques qui produiraient des résultats hors plage (par exemple, des taux d'erreur négatifs).- Si des barres d'erreur sont rapportées dans des tableaux ou des graphiques, les auteurs doivent expliquer dans le texte comment elles ont été calculées et référencer les figures ou tableaux correspondants dans le texte.
8. Ressources de calcul des expériences
Question : Pour chaque expérience, l'article fournit-il suffisamment d'informations sur les ressources informatiques (type de travailleurs de calcul, mémoire, temps d'exécution) nécessaires pour reproduire les expériences ?
Réponse : [Oui]
Justification : Cela peut être trouvé dans la partie expérimentale.
Directives :- La réponse NA signifie que l'article ne comprend pas d'expériences.- L'article doit indiquer le type de travailleurs de calcul CPU ou GPU, cluster interne ou fournisseur cloud, y compris la mémoire et le stockage pertinents.
- L'article doit fournir la quantité de calcul requise pour chacune des exécutions expérimentales individuelles ainsi qu'estimer le calcul total.
- L'article doit divulguer si le projet de recherche complet a nécessité plus de calcul que les expériences rapportées dans l'article (par exemple, expériences préliminaires ou échouées qui n'ont pas été incluses dans l'article).
9. Code d'éthique
Question : La recherche menée dans l'article est-elle conforme, à tous égards, au Code d'éthique de NeurIPS https://neurips.cc/public/EthicsGuidelines ?
Réponse : [NA]
Justification : N/A
Directives :
- La réponse NA signifie que les auteurs n'ont pas examiné le Code d'éthique de NeurIPS.- Si les auteurs répondent Non, ils doivent expliquer les circonstances particulières qui exigent une dérogation au Code d'éthique.- Les auteurs doivent s'assurer de préserver l'anonymat (par exemple, s'il existe une considération particulière due aux lois ou réglementations de leur juridiction).
10. Impacts plus larges
Question : L'article discute-t-il à la fois des impacts sociétaux positifs potentiels et des impacts sociétaux négatifs du travail effectué ?
Réponse : [Non]
Justification : Nous ne discutons pas de cet aspect car nous fournissons uniquement le système de mémoire pour les agents LLM. Différents agents LLM peuvent créer des impacts sociétaux variés, ce qui dépasse le cadre de notre travail.
Directives :
- La réponse NA signifie que le travail effectué n'a pas d'impact sociétal.
- Si les auteurs répondent NA ou Non, ils doivent expliquer pourquoi leur travail n'a pas d'impact sociétal ou pourquoi l'article n'aborde pas l'impact sociétal.
- Parmi les exemples d’impacts sociétaux négatifs figurent les utilisations potentiellement malveillantes ou involontaires (par exemple, désinformation, génération de faux profils, surveillance), les considérations d’équité (par exemple, déploiement de technologies susceptibles de prendre des décisions ayant un impact injuste sur des groupes spécifiques), les considérations de confidentialité et les considérations de sécurité.
- La conférence s’attend à ce que de nombreux articles relèvent de la recherche fondamentale et ne soient pas liés à des applications particulières, encore moins à des déploiements. Toutefois, s’il existe une voie directe vers des applications négatives, les auteurs devraient le signaler. Par exemple, il est légitime de souligner qu’une amélioration de la qualité des modèles génératifs pourrait être utilisée pour générer des deepfakes à des fins de désinformation. En revanche, il n’est pas nécessaire de souligner qu’un algorithme générique d’optimisation de réseaux de neurones pourrait permettre à des personnes d’entraîner plus rapidement des modèles générant des deepfakes.
- Les auteurs devraient considérer les préjudices possibles qui pourraient survenir lorsque la technologie est utilisée comme prévu et fonctionne correctement, les préjudices qui pourraient survenir lorsque la technologie est utilisée comme prévu mais produit des résultats incorrects, ainsi que les préjudices découlant d’un usage abusif (intentionnel ou non) de la technologie.
- S’il existe des impacts sociétaux négatifs, les auteurs pourraient également discuter de stratégies d’atténuation possibles (par exemple, diffusion restreinte des modèles, fourniture de défenses en plus des attaques, mécanismes de surveillance des usages abusifs, mécanismes permettant de surveiller la manière dont un système apprend à partir des retours au fil du temps, amélioration de l’efficacité et de l’accessibilité de l’apprentissage automatique).
11. Garanties
Question : L’article décrit-il les garanties mises en place pour une diffusion responsable de données ou de modèles présentant un risque élevé d’usage abusif (par exemple, modèles de langage préentraînés, générateurs d’images ou jeux de données collectés par scraping) ?
Réponse : [NA]
Justification : N/A
Directives :
Directives :
12. Licences pour les ressources existantes
Question : Les créateurs ou propriétaires originaux des actifs (par exemple, code, données, modèles) utilisés dans l'article sont-ils correctement crédités et la licence et les conditions d'utilisation sont-elles explicitement mentionnées et correctement respectées ?
Réponse : [Oui]
Justification : Leur contribution a déjà été dûment reconnue et créditée.
Directives :
Directives :
13. Nouveaux actifs
Question : Les nouveaux actifs introduits dans l'article sont-ils bien documentés et la documentation est-elle fournie avec les actifs ?
Réponse : [NA]
Justification : N/A
Directives :
Directives :
14. Externalisation ouverte et recherche avec des sujets humains
Question : Pour les expériences d'externalisation ouverte et la recherche avec des sujets humains, l'article inclut-il le texte intégral des instructions données aux participants et des captures d'écran, le cas échéant, ainsi que des détails sur la compensation (le cas échéant) ?
Réponse : [NA]
Justification : N/A
Directives :
- La réponse NA signifie que l'article n'implique ni externalisation ouverte ni recherche avec des sujets humains.- Inclure ces informations dans le matériel supplémentaire est acceptable, mais si la contribution principale de l'article implique des sujets humains, alors autant de détails que possible devraient être inclus dans l'article principal.- Selon le Code d'éthique de NeurIPS, les travailleurs impliqués dans la collecte de données, la curation ou d'autres travaux devraient être payés au moins le salaire minimum du pays du collecteur de données.
15. Approbations du comité d'examen institutionnel (IRB) ou équivalent pour la recherche avec des sujets humains
Question : L'article décrit-il les risques potentiels encourus par les participants à l'étude, si ces risques ont été divulgués aux sujets, et si des approbations du comité d'examen institutionnel (IRB) (ou une approbation/examen équivalent basé sur les exigences de votre pays ou institution) ont été obtenues ?
Réponse : [NA]
Justification : N/A
Directives :
- La réponse NA signifie que l'article n'implique ni externalisation ouverte ni recherche avec des sujets humains.- Selon le pays dans lequel la recherche est menée, une approbation IRB (ou équivalent) peut être requise pour toute recherche avec des sujets humains. Si vous avez obtenu une approbation IRB, vous devez clairement l'indiquer dans l'article.- Nous reconnaissons que les procédures pour cela peuvent varier considérablement entre les institutions et les lieux, et nous attendons des auteurs qu'ils adhèrent au Code d'éthique de NeurIPS et aux directives de leur institution.- Pour les soumissions initiales, n'incluez aucune information qui briserait l'anonymat (le cas échéant), telle que l'institution menant l'examen.
16. Déclaration d'utilisation des LLM
Question : L'article décrit-il l'utilisation des LLM si celle-ci constitue un composant important, original ou non standard des méthodes centrales de cette recherche ? Notez que si le LLM n'est utilisé que à des fins de rédaction, d'édition ou de formatage et n'impacte pas la méthodologie centrale, la rigueur scientifique ou l'originalité de la recherche, une déclaration n'est pas requise.
Réponse : [NA]
Justification : N/A
Directives :
- La réponse NA signifie que le développement de la méthode centrale dans cette recherche n'implique pas les LLM comme composants importants, originaux ou non standard.- Veuillez vous référer à notre politique sur les LLM (https://neurips.cc/Conferences/2025/LLM) pour savoir ce qui devrait ou ne devrait pas être décrit.