
Deux mille tickets GitHub corrigés de bout en bout, jugés par des tests cachés: le benchmark des agents de code. ICLR 2024, gratuit en ligne.
SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
SWE-BENCH : LES MODÈLES DE LANGAGE PEUVENT-ILS RÉSOUDRE DE VRAIS PROBLÈMES GITHUB ?
Carlos E. Jimenez John Yang Alexander Wettig
Shunyu Yao Kexin Pei Ofir Press Karthik Narasimhan
Princeton University Princeton Language and Intelligence University of Chicago
RÉSUMÉ
Les modèles de langage ont dépassé notre capacité à les évaluer efficacement, mais pour leur développement futur, il est essentiel d'étudier la frontière de leurs capacités. Nous constatons que l'ingénierie logicielle du monde réel constitue un banc d'essai riche, durable et stimulant pour évaluer la prochaine génération de modèles de langage. À cette fin, nous introduisons SWE-bench, un cadre d'évaluation composé de 2 294 problèmes d'ingénierie logicielle tirés de vrais problèmes GitHub et des pull requests correspondantes à travers 12 dépôts Python populaires. Étant donné une base de code accompagnée d'une description d'un problème à résoudre, un modèle de langage a pour tâche de modifier la base de code pour résoudre le problème. Résoudre les problèmes de SWE-bench nécessite fréquemment de comprendre et de coordonner des modifications à travers plusieurs fonctions, classes et même fichiers simultanément, ce qui exige des modèles qu'ils interagissent avec des environnements d'exécution, traitent des contextes extrêmement longs et effectuent un raisonnement complexe qui va bien au-delà des tâches traditionnelles de génération de code. Nos évaluations montrent que les modèles propriétaires de pointe et notre modèle affiné SWE-Llama ne peuvent résoudre que les problèmes les plus simples. Le modèle le plus performant, Claude 2, ne parvient à résoudre que des problèmes. Les avancées sur SWE-bench représentent des étapes vers des LM plus pratiques, intelligents et autonomes.
1 INTRODUCTION
Les modèles de langage (LM) sont rapidement déployés dans des produits commerciaux tels que des chatbots et des assistants de programmation. En même temps, les benchmarks existants sont devenus saturés (Kiela et al., 2021 ; Ott et al., 2022) et ne parviennent pas à capturer la frontière de ce que les LM de pointe peuvent et ne peuvent pas faire. Il est nécessaire de disposer de benchmarks stimulants qui reflètent plus fidèlement les applications réelles des LM afin d'aider à façonner leur développement et leur usage futurs (Srivastava et al., 2023).
Construire un bon benchmark est difficile car les tâches doivent être suffisamment stimulantes pour déjouer les modèles existants, mais les prédictions des modèles doivent aussi être faciles à vérifier (Martinez-Plumed et al., 2021). Les tâches de programmationsont attrayantes car elles posent des problèmes stimulants aux LM, tout en permettant de vérifier facilement les solutions générées en exécutant des tests unitaires. Cependant, les benchmarks de programmation existants, tels que HumanEval (Chen et al., 2021), impliquent principalement des problèmes autonomes qui peuvent être résolus en quelques lignes de code.
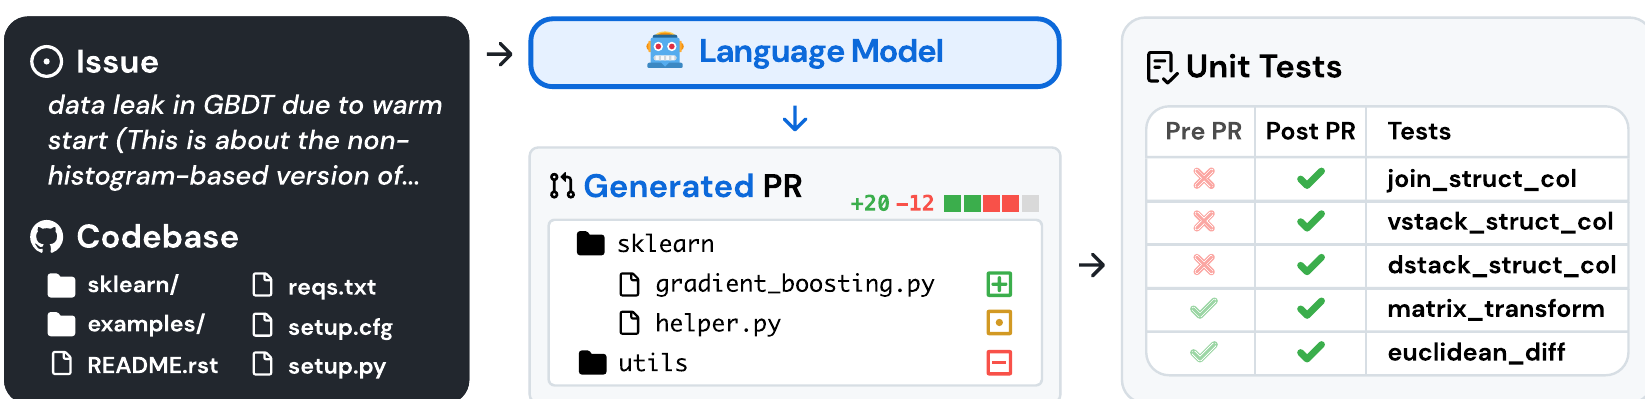
Dans le monde réel, l'ingénierie logicielle n'est pas aussi simple. Corriger un bug peut impliquer de naviguer dans un grand dépôt, de comprendre l'interaction entre des fonctions situées dans différents fichiers, ou de repérer une petite erreur dans un code alambiqué. Inspirés par cela, nous introduisons SWE-bench, un benchmark qui évalue les LM dans un cadre réaliste d'ingénierie logicielle. Comme le montre la Figure 1, les modèles ont pour tâche de résoudre des problèmes (généralement un rapport de bug ou une demande de fonctionnalité) soumis à des dépôts GitHub populaires. Chaque tâche nécessite de générer un patch décrivant les modifications à appliquer à la base de code existante. La base de code révisée est ensuite évaluée à l'aide du framework de test du dépôt.
SWE-bench offre plusieurs avantages par rapport aux benchmarks de programmation pour LM existants. Ceux-ci incluent un cadre réaliste qui utilise des problèmes et des solutions soumis par les utilisateurs, des entrées diverses présentant des problèmes de code uniques issus de 12 dépôts, un cadre robuste pour une évaluation basée sur l'exécution, et la capacité de mettre continuellement à jour le benchmark avec de nouvelles instances, nécessitant une intervention humaine minimale.
Nous évaluons plusieurs LM de pointe sur SWE-bench et constatons qu'ils échouent à résoudre tous les problèmes, sauf les plus simples. À l'aide d'un récupérateur BM25, Claude 2 ne parvient à résoudre que des problèmes.
En plus de SWE-bench, nos contributions incluent la publication d'un jeu de données d'entraînement, SWE-bench-train, qui est essentiel pour faire progresser le développement de modèles ouverts dans ce domaine difficile. Ce jeu de données comprend une collection de 19 000 instances de tâches non-test dérivées de 37 dépôts. En utilisant SWE-bench-train, nous publions deux modèles affinés, SWE-Llama 7b et 13b, basés sur le modèle CodeLlama (Rozière et al., 2023). Nous constatons que dans certains contextes, SWE-Llama 13b est compétitif avec Claude 2 et est capable de traiter des contextes dépassant 100 000 tokens.
2 SWE-BENCH
SWE-bench est un benchmark présentant des problèmes GitHub issus de dépôts populaires qui signalent des bugs ou demandent de nouvelles fonctionnalités, ainsi que des pull requests qui modifient le dépôt pour résoudre ces problèmes. La tâche consiste à générer une pull request qui traite un problème donné et passe les tests liés au problème.
2.1 CONSTRUCTION DU BENCHMARK
GitHub est une riche source de données pour le développement logiciel, mais les dépôts, les problèmes et les pull requests peuvent être bruités, ad hoc, ou mal documentés ou mal entretenus. Pour trouver des instances de tâches de haute qualité à grande échelle, nous utilisons un pipeline en 3 étapes comme suit.
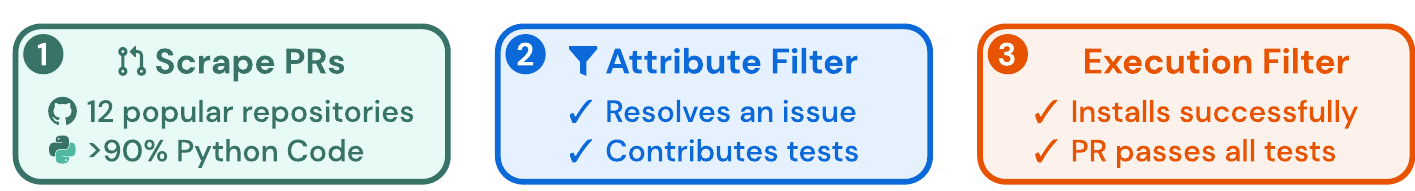
Étape I : Sélection des dépôts et extraction des données. Nous commençons par collecter les pull requests (PR) de 12 dépôts Python open-source populaires sur GitHub, produisant environ PR au total. Nous nous concentrons sur les dépôts populaires car ils ont tendance à être mieux entretenus, à avoir des directives de contribution claires et à avoir une meilleure couverture de tests. Chaque PR a une base de code associée spécifiée par son commit de base.
Étape II : Filtrage basé sur les attributs. Nous créons des tâches candidates en sélectionnant les PR fusionnées qui (1) résolvent un problème GitHub et (2) apportent des modifications aux fichiers de test du dépôt, ce qui indique que l'utilisateur a probablement contribué des tests pour vérifier si le problème a été résolu.
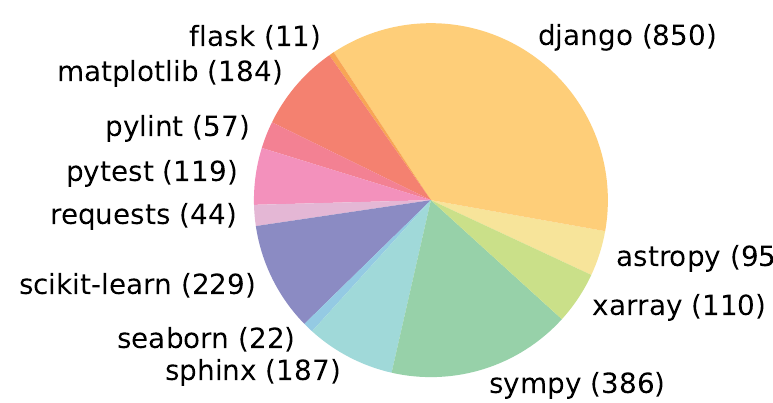
Étape III : Filtrage basé sur l'exécution. Pour chaque tâche candidate, nous appliquons le contenu de test de la PR et enregistrons les résultats de test associés avant et après l'application du reste du contenu de la PR. Nous filtrons les instances de tâches sans au moins un test dont le statut passe d'échec à réussite (ci-après dénommé test fail-to-pass). Nous filtrons également les instances qui entraînent des erreurs d'installation ou d'exécution. Grâce à ces étapes de filtrage, les 90 000 PR initiales sont réduites aux 2 294 instances de tâches qui composent SWE-bench. Une répartition finale de ces instances de tâches par dépôt est présentée dans la Figure 3, et le Tableau 1 met en évidence les principales caractéristiques des instances de tâches de SWE-bench. Nous soulignons que les bases de code sont volumineuses, avec des milliers de fichiers, et que les pull requests de référence apportent souvent des modifications à plusieurs fichiers à la fois. Les détails techniques du pipeline de construction de SWE-bench sont discutés dans l'Annexe A. Des statistiques supplémentaires sur le jeu de données figurent dans l'Annexe A.5.
2.2 FORMULATION DE LA TÂCHE
Entrée du modèle. Un modèle reçoit une description textuelle d'un problème et une base de code complète. Le modèle a ensuite pour tâche d'apporter une modification à la base de code pour résoudre le problème. En pratique, nous représentons les modifications sous forme de fichiers patch, qui spécifient quelles lignes de la base de code modifier afin de résoudre le problème.
Métriques d'évaluation. Pour évaluer une solution proposée, nous appliquons le patch généré, à l'aide du programme patch d'unix, à la base de code, puis nous exécutons les tests unitaires et système associés à l'instance de tâche. Si le patch s'applique avec succès et que tous ces tests passent, nous considérons que la solution proposée a résolu avec succès le problème. La métrique de notre benchmark est le pourcentage d'instances de tâches résolues. Détails techniques supplémentaires dans l'Annexe A.4.
2.3 CARACTÉRISTIQUES DE SWE-BENCH
Les benchmarks traditionnels en NLP n'impliquent généralement que de courtes séquences d'entrée et de sortie et considèrent des problèmes quelque peu « artificiels » créés spécifiquement pour le benchmark. En revanche, le cadre de construction réaliste de SWE-bench imprègne le jeu de données de propriétés uniques, que nous discutons ci-dessous.
Tâches d'ingénierie logicielle du monde réel. Étant donné que chaque instance de tâche dans SWE-bench consiste en une base de code vaste et complexe et en la description d'un problème pertinent, résoudre SWE-bench nécessite de démontrer des compétences et des connaissances sophistiquées que possèdent les ingénieurs logiciels expérimentés, mais qui ne sont pas couramment évaluées dans les benchmarks traditionnels de génération de code.
Mise à jour continue. Notre processus de collecte peut être facilement appliqué à n'importe quel dépôt Python sur GitHub et nécessite une intervention humaine minimale. Par conséquent, nous pouvons étendre SWE-bench avec un approvisionnement continu de nouvelles instances de tâches et évaluer les LM sur des problèmes créés après leur date d'entraînement, ce qui garantit que la solution n'était pas incluse dans leur corpus d'entraînement.
Entrées longues et diversifiées. Les descriptions de problèmes sont généralement longues et détaillées (195 mots en moyenne), et les bases de code contiennent régulièrement plusieurs milliers de fichiers. Résoudre SWE-bench nécessite d'identifier le nombre relativement restreint de lignes qui doivent être modifiées pour résoudre un problème parmi une mer de contexte.
Évaluation robuste. Pour chaque instance de tâche, il existe au moins un test fail-to-pass qui a été utilisé pour tester la solution de référence, et des instances ont au moins deux tests fail-to-pass. Ces tests évaluent si le modèle a résolu le problème décrit dans le ticket. En outre, une médiane de 51 tests supplémentaires sont exécutés pour vérifier si la fonctionnalité antérieure est correctement maintenue.
Édition de code multi-contexte. Contrairement aux paramètres antérieurs qui peuvent limiter la portée de l'édition à une fonction ou une classe individuelle (par exemple, Chen et al., 2021 ; Cassano et al., 2022) ou fournir des espaces à remplir de style cloze (par exemple, Lu et al., 2021 ; Fried et al., 2023), SWE-bench ne fournit pas de telles indications explicites. Plutôt que de simplement devoir produire un court extrait de code, notre benchmark met les modèles au défi de générer des révisions à plusieurs emplacements d'une grande base de code. Les solutions de référence de SWE-bench modifient en moyenne 1,7 fichier, 3,0 fonctions et 32,8 lignes (ajoutées ou supprimées).
Large éventail de solutions possibles. La tâche d'édition de code à l'échelle du dépôt peut servir de terrain d'égalité pour comparer des approches allant de la récupération et des modèles à long contexte à des agents de prise de décision, qui pourraient raisonner et agir dans le code. SWE-bench permet également une liberté créative, car les modèles peuvent générer des solutions nouvelles qui peuvent s'écarter de la PR de référence.
2.4 SWE-BENCH LITE
Évaluer les LM sur SWE-bench peut prendre beaucoup de temps et, selon le modèle, nécessiter une quantité coûteuse de calcul ou de crédits API. Étant donné que les performances initiales présentées à la Section 5 sont assez faibles, la difficulté de SWE-bench le rend utile pour jauger les progrès des LM à long terme, mais potentiellement intimidant pour les systèmes initiaux qui tentent de progresser à court terme.
| Moyenne | Max | ||
| Texte du ticket | Longueur (mots) | 195,1 | 4477 |
| Base de code | Fichiers (hors tests) | 3 010 | 5 890 |
| Lignes (hors tests) | 438 K | 886 K | |
| Patch de référence | Lignes modifiées | 32,8 | 5888 |
| Fichiers modifiés | 1,7 | 31 | |
| Fonctions modifiées | 3 | 36 | |
| Tests | Échec vers réussite | 9,1 | 1633 |
| Total | 120,8 | 9459 |
Pour encourager l'adoption de SWE-bench, nous créons un sous-ensemble Lite de 300 instances issues de SWE-bench qui ont été échantillonnées pour être plus autonomes, avec un accent sur l'évaluation des corrections de bugs fonctionnels. Les critères de filtrage complets et les informations sur le jeu de données sont inclus dans SWE-bench Lite couvre 11 des 12 dépôts originaux, avec une diversité et une distribution d'instances de tâches entre les dépôts similaires à l'original. Les détails complets du découpage Lite et du filtrage sont inclus dans l'Annexe A.7.
3 SWE-LLAMA : AJUSTEMENT FIN DE CODELLAMA POUR SWE-BENCH
Il est important de mesurer les performances des modèles ouverts sur SWE-bench parallèlement à celles des modèles propriétaires. Au moment de la rédaction, seuls les modèles CodeLlama (Rozière et al., 2023) sont capables de gérer les contextes très longs nécessaires. Cependant, nous observons que les variantes CodeLlama prêtes à l'emploi ne sont pas capables de suivre les instructions détaillées pour générer des modifications de code à l'échelle du dépôt, et produisent généralement des réponses de substitution ou du code sans rapport. Pour mieux évaluer les capacités de ces modèles, nous effectuons un ajustement fin supervisé sur les modèles CodeLlama-Python de 7 milliards et 13 milliards de paramètres. Les modèles résultants sont des éditeurs de dépôt spécialisés qui peuvent fonctionner sur du matériel grand public et résoudre des problèmes GitHub.
Données d'entraînement. Nous suivons notre procédure de collecte de données et collectons 19 000 paires problème-PR à partir de 37 dépôts de packages Python populaires supplémentaires. Contrairement à la Section 2.1, nous n'exigeons pas que les pull requests apportent des modifications de tests. Cela nous permet de créer un ensemble d'entraînement beaucoup plus grand à utiliser pour l'ajustement fin supervisé. Pour éliminer le risque de contamination des données, l'ensemble des dépôts des données d'entraînement est disjoint de ceux inclus dans le benchmark d'évaluation.
Détails de l'entraînement. Étant donné les instructions, un texte de problème provenant de GitHub et les fichiers de code pertinents comme prompt, nous ajustons finement SWE-Llama pour générer le patch qui a résolu le problème donné (le « patch de référence »). Pour des raisons d'efficacité mémoire, nous ajustons finement uniquement les poids de la sous-couche d'attention à l'aide de LoRA Hu et al. (2022), et excluons les séquences d'entraînement de plus de 30 000 tokens, ce qui réduit la taille effective du corpus d'entraînement à 10 000 instances. Plus de détails sont fournis dans l'Annexe B.
4 CONFIGURATION EXPÉRIMENTALE
Dans cette section, nous expliquons comment les entrées sont construites pour exécuter l'évaluation SWE-bench. En outre, nous passons en revue les modèles que nous évaluons dans ce travail.
4.1 APPROCHE BASÉE SUR LA RÉCUPÉRATION
Les instances SWE-bench fournissent une description de problème et une base de code comme entrée au modèle. Alors que les descriptions de problèmes sont généralement courtes (195 mots en moyenne, comme indiqué dans le Tableau 1), les bases de code contiennent beaucoup plus de tokens (438 K lignes en moyenne) qu'il n'est généralement possible de faire tenir dans la fenêtre de contexte d'un LM. La question demeure donc de savoir comment choisir exactement le contexte pertinent à fournir au modèle ?
Pour traiter cette question dans nos baselines, nous utilisons simplement un système de récupération générique pour sélectionner les fichiers à insérer comme contexte. En particulier, nous évaluons les modèles selon deux paramètres de contexte pertinents : 1) la récupération éparse et 2) une récupération oracle.
Récupération éparse. Les méthodes de récupération dense sont mal adaptées à notre cadre en raison de longueurs de clés et de requêtes très importantes, et surtout du cadre inhabituel de récupération de documents de code avec des requêtes en langage naturel. Par conséquent, nous choisissons d'utiliser la récupération BM25 (Robertson et al., 2009) pour récupérer les fichiers pertinents à fournir comme contexte pour chaque instance de tâche. Nous expérimentons avec trois limites de contexte maximales différentes, et récupérons simplement autant de fichiers que possible dans la limite spécifiée. Nous évaluons chaque modèle sur toutes les limites qui tiennent dans sa fenêtre de contexte et rapportons la meilleure performance. D'après nos observations, les modèles obtiennent les meilleures performances sur la fenêtre de contexte la plus courte, comme indiqué dans le Tableau 2.
Récupération « oracle ». À des fins d'analyse, nous considérons également un cadre où nous « récupérons » les fichiers modifiés par le patch de référence qui a résolu le problème sur GitHub. Ce cadre « oracle » est moins réaliste, puisqu'un ingénieur travaillant à la résolution d'un problème peut ne pas savoir a priori quels fichiers doivent être modifiés. En outre, ce cadre n'est pas non plus nécessairement exhaustif, car les fichiers modifiés seuls peuvent ne pas inclure tout le contexte requis pour comprendre exactement comment le logiciel se comportera lorsqu'il interagira avec des parties invisibles du code.
Nous comparons les résultats de la récupération BM25 avec ceux du cadre de récupération « oracle », comme indiqué dans le Tableau 3. Nous observons que dans environ des instances, BM25 récupère un sur-ensemble des fichiers oracle pour la limite de contexte de 27 000 tokens. Cependant, dans presque la moitié des instances avec la limite de 27 000 tokens, il ne récupère aucun des fichiers du contexte « oracle ».
4.2 FORMAT D'ENTRÉE
Une fois les fichiers récupérés sélectionnés à l'aide de l'une des deux méthodes ci-dessus, nous construisons l'entrée du modèle composée des instructions de la tâche, du texte du problème, des fichiers récupérés et de la documentation, et enfin d'un exemple de fichier de patch et d'un prompt pour générer le fichier de patch. Des exemples d'instances et d'autres détails sur cette formulation sont fournis dans l'Annexe D.
4.3 MODÈLES
En raison de la nécessité de traiter de longues longueurs de séquence, seuls quelques modèles sont actuellement adaptés à SWE-bench. Nous évaluons donc ChatGPT-3.5 (gpt-3.5-turbo-16k-0613), GPT-4 (gpt-4-32k-0613), Claude 2 et SWE-Llama avec leurs limites de contexte indiquées dans le Tableau 4.
| Modèle | Contenu max. | ||
| 13k | 27k | 50k | |
| Claude 2 | 1,96 | 1,87 | 1,22 |
| SWE-Llama 7b | 0,70 | 0,31 | 0,00 |
| SWE-Llama 13b | 0,70 | 0,48 | 0,00 |
| Rappel BM25 | |||
| 13k | 27k | 50k | |
| Moy. | 29,58 | 44,41 | 51,06 |
| Tous | 26,09 | 39,83 | 45,90 |
| N'importe lequel | 34,77 | 51,27 | 58,38 |
Tableau 4 : Nous comparons les différentes longueurs de contexte et la proportion couverte par le paramètre de récupération « oracle ». Les modèles ayant des longueurs de contexte plus courtes sont donc intrinsèquement désavantagés. Notons que les descriptions des longueurs de tokens constituent une mesure relative non standard (par exemple, les séquences tokenisées pour Llama sont en moyenne plus longues que la séquence équivalente tokenisée pour GPT-4).
| ChatGPT-3.5 | GPT-4 | Claude 2 | SWE-Llama | |
| Nb max. de tokens | 16 385 | 32 768 | 100 000 | ≥100 000 |
| % des instances | 58,1 % | 84,1 % | 96,4 % | ≥94,8 % |
| Modèle | SWE-bench | SWE-bench Lite | ||
| % Résolu | % Appliqué | % Résolu | % Appliqué | |
| Claude 3 Opus | 3,79 | 46,56 | 4,33 | 51,67 |
| Claude 2 | 1,97 | 43,07 | 3,00 | 33,00 |
| ChatGPT-3.5 | 0,17 | 26,33 | 0,33 | 10,00 |
| GPT-4-turbo | 1,31 | 26,90 | 2,67 | 29,67 |
| SWE-Llama 7b | 0,70 | 51,74 | 1,33 | 38,00 |
| SWE-Llama 13b | 0,70 | 53,62 | 1,00 | 38,00 |
5 RÉSULTATS
Nous rapportons les résultats de modèles utilisant différents mécanismes de récupération et différents styles d'invite, puis nous présentons une analyse et des observations sur la performance et la difficulté des modèles. Nous résumons la performance des modèles utilisant la récupération BM25 dans le tableau 5. Dans l'ensemble, les modèles ont beaucoup de mal à résoudre les problèmes. Le modèle le plus performant, Claude 2, ne parvient à résoudre que des problèmes.
Pour analyser l'importance du récupérateur sur les résultats globaux du système, nous présentons les résultats de récupération « oracle » dans le tableau 18 en annexe. Là, Claude 2 parvient à résoudre des problèmes en utilisant le récupérateur « oracle ». Nous analysons plus en détail l'importance du contexte dans la discussion ci-dessous.
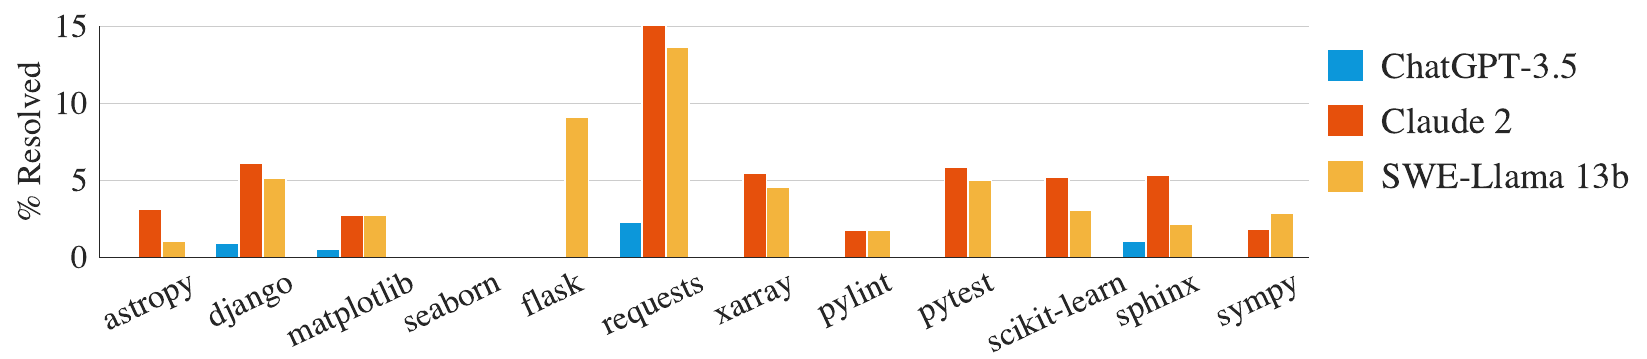
La difficulté diffère selon les dépôts. Lorsque l'on décompose la performance par dépôt, tous les modèles suivent des tendances similaires selon les différents dépôts, comme le montre la figure 4. Malgré cela, les problèmes résolus par chaque modèle ne se recoupent pas nécessairement de manière extensive. Par exemple, dans le paramètre « oracle », Claude 2 et SWE-Llama 13b obtiennent des performances comparables, chaque modèle résolvant respectivement 110 et 91 instances. Pourtant, parmi ces instances, Claude 2 ne résout que des instances résolues par SWE-Llama.
Cela peut également être lié à la présence d'images dans les problèmes, qui peuvent être encodées dans le markdown du problème avec des liens d'images intégrés (c'est-à-dire ![image][https://...]). Certains dépôts comportent naturellement plus d'instances avec des images ; par exemple des instances de matplotlib et des instances de seaborn contiennent des images intégrées dans le texte de leur problème, contre seulement de toutes les instances. Résoudre ces instances peut nécessiter des LM multimodaux ou une forme d'utilisation d'outils externes pour traiter les images.
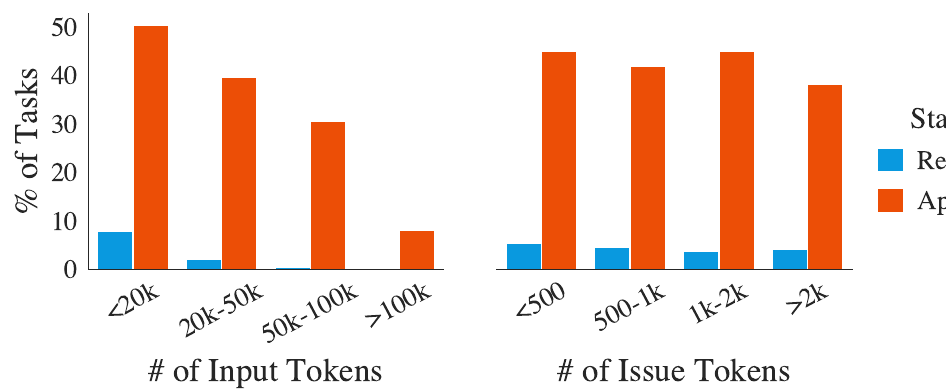
La difficulté est corrélée à la longueur du contexte. Les modèles de chat peuvent être pré-entraînés sur de longues séquences de code, mais on leur demande généralement de générer des extraits de code plus courts avec un contexte limité fourni pour cadrer la question. Comme le montre la figure 5, nous constatons que lorsque la longueur totale du contexte augmente, la performance de Claude 2 chute considérablement ; un comportement également observé chez d'autres modèles. Dans nos paramètres d'évaluation, les modèles voient beaucoup de code qui peut ne pas être directement lié à la résolution du problème en question, et ils semblent fréquemment avoir du mal à localiser le code problématique à mettre à jour. Ce résultat corrobore d'autres études montrant que les modèles se laissent distraire par un contexte supplémentaire et peuvent être sensibles à la position relative des séquences cibles (Liu et al., 2023b). Même lorsque l'augmentation de la taille maximale du contexte pour BM25 augmenterait le rappel par rapport aux fichiers oracle, la performance chute, comme le montre le tableau 2, car les modèles sont simplement inefficaces pour localiser le code problématique. Pour approfondir cette question, nous fournissons une ablation de l'entrée sur le contexte de récupération « oracle », « oracle »-réduit, où les fichiers récupérés sont entièrement réduits, à l'exception des lignes effectivement modifiées par lavraie pull request (avec une marge de
| Modèle | « Oracle »-réduit | |
| Résolu | Appliqué | |
| Claude 3 Opus | 9.39 | 48.00 |
| Claude 2 | 5.93 | 68.18 |
| GPT-4 | 3.40 | 48.65 |
| ChatGPT-3.5 | 1.09 | 40.93 |
lignes), présentée dans le tableau 6. Dans ce paramètre, nous observons des augmentations de performance, GPT-4 passant de à et Claude 2 de à .
La difficulté n'est pas corrélée à la date de résolution du problème. Dans le tableau 7, nous montrons les résultats des modèles dans le paramètre de récupération « oracle », partitionnés par date, pour les PR créées avant ou après 2023. Nous constatons que pour la plupart des modèles, il y a peu de différence de performance avant ou après cette date, à l'exception de GPT-4. Nous considérons ce résultat comme globalement prometteur, car il suggère que, bien que les modèles aient été exposés à une certaine version de la base de code d'un dépôt, ils sont peu susceptibles de « tricher » pour traiter les problèmes simplement en générant une version plus récente du dépôt.
| Claude 2 | ChatGPT-3.5 | GPT-4* | SWE-Llama 7b | SWE-Llama 13b |
| Avant 2023 | 4,87 | 0,49 | 1,96 | 2,95 |
| Après 2023 | 4,23 | 0,77 | 0,0 | 3,46 |
Les modèles affinés sont sensibles aux décalages de distribution du contexte. Les modèles affinés SWE-Llama 7b et 13b obtiennent des performances étonnamment médiocres avec un contexte récupéré par BM25. Comme ces modèles ont été affinés en utilisant la récupération « oracle » comme contexte, nous soupçonnons que ce changement de contexte rend difficile pour le modèle d'être fiable. Par exemple, SWE-Llama a été entraîné à modifier chaque fichier inclus comme contexte, alors que dans le paramètre BM25, de nombreux fichiers fournis en contexte ne sont pas censés être modifiés.
Générer des patches est plus facile que générer des fichiers entiers. Les modèles sont souvent entraînés à l'aide de fichiers de code standard et voient probablement rarement des fichiers de patch. Nous formulons généralement notre tâche de manière à ce que les modèles génèrent des fichiers de patch plutôt que de recréer le fichier entier avec leur modification proposée, car les fichiers de patch constituent généralement une représentation beaucoup plus efficace d'une modification de fichier. Comme le montre le tableau 5, nous observons que les modèles ont encore du mal à générer des fichiers de patch bien formatés. Nous avons donc expérimenté en demandant aux modèles de régénérer plutôt des fichiers entiers avec leurs modifications proposées pour résoudre le problème. Dans ce paramètre, nous constatons que les modèles obtiennent généralement de moins bons résultats à cette tâche que lorsqu'ils génèrent des fichiers de patch ; par exemple, Claude 2 obtient contre dans le tableau principal pour la récupération « oracle ». Même en contrôlant la longueur des instances, générer sur la moitié la plus courte des instances de tâche en termes de tokens d'entrée donne contre pour la génération de patches avec Claude 2.
Les modèles de langage tendent à générer des modifications plus courtes et plus simples. Les fichiers de patch générés par les modèles tendent à ajouter et supprimer moins de lignes que leur patch de référence respectif. Comme le montre le tableau 8, comparés à un patch de référence moyen, les fichiers de patch générés par les modèles qui s'appliquent correctement font moins de la moitié de la longueur totale (74,5 contre 30,1 lignes) des fichiers de patch de référence, et modifient rarement plus d'un seul fichier.
5.1 UNE ANALYSE QUALITATIVE DES GÉNÉRATIONS DE SWE-LLAMA
Nous sélectionnons 11 générations de SWE-Llama et Claude 2 afin de mieux comprendre la qualité de la tâche et des patches générés dans le paramètre de récupération « oracle ». Nous discutons ici d'un exemple de SWE-Llama et de nos conclusions générales, avec des analyses approfondies pour d'autres exemples présentées en annexe F.
| Modèle | Lignes totales | Ajoutées | Supprimées | Fonctions | Fichiers |
| Claude 2 | 19,6 | 4,2 | 1,9 | 1,1 | 1,0 |
| Gold | 44,1 | 12,0 | 5,8 | 2,1 | 1,2 |
| ChatGPT-3.5 | 30,1 | 3,8 | 2,7 | 1,6 | 1,0 |
| Gold | 39,6 | 9,5 | 6,1 | 1,9 | 1,2 |
| GPT-4 | 20,9 | 4,4 | 1,5 | 1,0 | 1,0 |
| Gold | 33,6 | 8,4 | 3,8 | 1,9 | 1,1 |
| SWE-Llama 13b | 17,6 | 1,6 | 1,2 | 1,2 | 1,1 |
| Gold | 37,8 | 10,0 | 4,4 | 1,9 | 1,1 |
| SWE-Llama 7b | 16,7 | 1,3 | 1,2 | 1,2 | 1,1 |
| Gold | 40,2 | 11,3 | 4,9 | 1,9 | 1,1 |
| Moy. Gold | 39,1 | 10,2 | 5,0 | 1,9 | 1,1 |
| Tous Gold | 74,5 | 22,3 | 10,5 | 3,0 | 1,7 |
Tableau 8 : Modifications moyennes des patches générés par les modèles dans le paramètre de récupération « oracle » parmi les patches appliqués avec succès. Pour les instances de tâche propres à chaque modèle, nous calculons les mêmes statistiques sur les patches de référence. Avg Gold présente les statistiques moyennées de manière macro sur les patches de référence respectifs de chaque modèle. All Gold présente les statistiques pour tous les patches de référence, sans conditionner sur la performance du modèle.
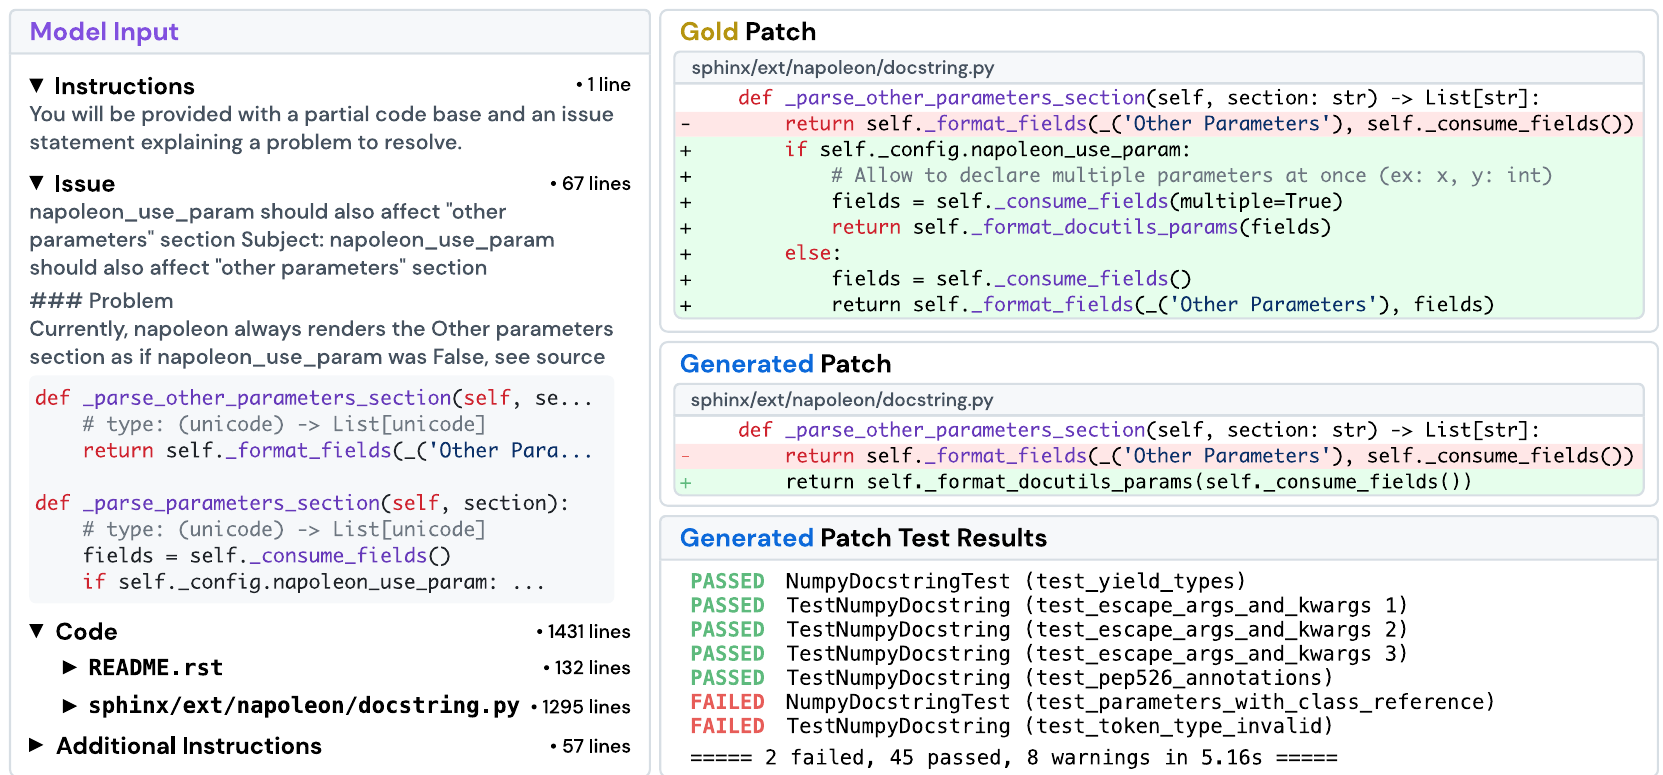
Nous considérerons l'instance de tâche sphinx-doc_sphinx-8713 du générateur de documentation Sphinx, illustrée à la figure 6. Le problème indique que l'extension napoleon de Sphinx ne formate pas correctement le mot-clé de documentation « Other Parameters » lorsque le paramètre de configuration napoleon.use_param est défini sur True. Le texte du problème fournit en outre un extrait de code détaillé de l'endroit où le code source problématique est soupçonné de se trouver, ainsi que quelques exemples de code pour reproduire l'erreur et des informations supplémentaires liées aux versions des paquets. Pour cette instance particulière, le modèle n'a pas résolu la tâche, échouant à certains des tests résolus par la solution de référence.
Dans le paramètre de récupération « oracle », l'entrée du modèle fournit ce texte de problème accompagné de quelques instructions, le contenu complet des fichiers modifiés par le patch de référence, et un exemple du format de diff dans lequel nous attendons la réponse. L'entrée totale du modèle consiste en 1 558 lignes de contexte, soit 20 882 tokens. En comparant le patch de référence et le patch du modèle, nous trouvons une erreur évidente. Bien que le modèle modifie la bonne fonction, _parse_other_parameters_section à la ligne 684 dans sphinx/ext/napoleon/docstring.py, il modifie la fonction pour qu'elle se comporte comme si napoleon.use_param était toujours True, au lieu de vérifier d'abord le paramètre de configuration et de copier ce que fait _parse_parameters_section, comme le fait le patch de référence. Dans les tests, test_parameters_with_class_reference compare directement la documentation produite à l'aide d'une configuration où napoleon_use_param est défini sur False, ce qui détecte immédiatement l'erreur du modèle.
En comparant les résultats de tous les exemples que nous examinons, nous remarquons quelques tendances comportementales marquantes. Les modèles ont tendance à écrire du code Python primitif et ne tirent pas parti des bibliothèques tierces existantes ni du reste de la base de code pour leurs solutions. Les générations des modèles reflètent également une approche « gourmande » consistant à résoudre le problème exactement, sans grand souci du style de code ou des contraintes logiques qui pourraient être reflétées par la base de code (c'est-à-dire utiliser des imports relatifs plutôt qu'absolus). En revanche, nous observons que de nombreux patches de référence apportent des améliorations structurelles qui couvrent une portée bien plus large de la base de code ; ces modifications résolvent non seulement le problème, mais anticipent et résolvent aussi des problèmes futurs potentiels.
6 TRAVAUX CONNEXES
Évaluation des LM. Plusieurs travaux récents pour évaluer les LM ont soit proposé une collection de tâches mutuellement distinctes couvrant plusieurs domaines (Hendrycks et al., 2021 ; Liang et al., 2022 ; Srivastava et al., 2023), soit se sont tournés vers le web comme cadre interactif proposant des tâches nécessitant plusieurs étapes pour être résolues (Yao et al., 2022 ; Zhou et al., 2023 ; Deng et al., 2023 ; Liu et al., 2023d). Un tel dispositif de type « pot-pourri » présente plusieurs inconvénients. Premièrement, chaque tâche tend à se concentrer étroitement sur une ou quelques compétences, ce qui aboutit à des défis généralement trop simples, enferme le modèle dans un rôle réduit et ne donne pas aux modèles la marge nécessaire pour exercer leur polyvalence ou démontrer potentiellement de nouvelles capacités (Srivastava et al., 2023). Par conséquent, la performance d'un modèle sur de tels conglomérats de tâches peut ne pas produire d'aperçus exploitables et approfondis concernant ses capacités et la manière de les améliorer (Schlangen, 2019 ; Martínez-Plumed et al., 2021 ; Bowman & Dahl, 2021). SWE-bench répond à ces lacunes, car notre travail démontre qu'il est considérablement difficile, qu'il présente un large éventail de possibilités pour améliorer les LM afin de résoudre cette tâche, et qu'il est facile à actualiser au fil du temps avec de nouvelles instances de tâche, chacune introduisant des défis nouveaux, nuancés et pratiques.
Bancs d'essai de génération de code. HumanEval (Chen et al., 2021) est la norme actuelle dans une quête de longue date visant à synthétiser du code à partir de descriptions en langage naturel (Yu et al., 2018 ; Austin et al., 2021 ; Hendrycks et al., 2021 ; Li et al., 2022a ; Zan et al., 2023). Au cours de l'année écoulée, des bancs d'essai ultérieurs ont cherché à enrichir HumanEval par des extensions à différentes langues (Cassano et al., 2022 ; Athiwaratkun et al., 2023 ; Orlanski et al., 2023), des variations dans la portée des modifications (Yu et al., 2023 ; Du et al., 2023), des tâches de complétion de code similaires mais nouvelles (Muennighoff et al., 2023), et davantage de tests (Liu et al., 2023a). Parallèlement, des travaux distincts ont cherché à introduire de nouveaux paradigmes de programmation (Yin et al., 2022 ; Yang et al., 2023) ou à concevoir des problèmes spécifiques à des bibliothèques (Lai et al., 2022 ; Zan et al., 2022). Au lieu de cloisonner les problèmes dans des jeux de données séparés et de les réduire pour des raisons de simplicité, la procédure de collecte de SWE-bench transforme le code source avec un post-traitement minimal, préservant un ensemble bien plus large de défis ancrés dans l'ingénierie logicielle réelle au-delà de la complétion sous forme fermée, tels que la génération de patches, le raisonnement sur de longs contextes, la navigation dans un répertoire de base de code et la capture de relations de dépendance entre modules.
Apprentissage automatique pour l'ingénierie logicielle. Pour surmonter les techniques traditionnelles d'analyse de programmes qui peuvent ne pas passer à l'échelle ou incorporer le langage naturel, une direction de la recherche actuelle en ingénierie logicielle consiste à utiliser des réseaux de neurones, y compris des modèles de langage (LMs), pour automatiser les processus de développement logiciel réels (Maniatis et al., 2023 ; Zheng et al., 2023 ; Hou et al., 2023). Les cas d'usage incluent l'automatisation de la génération de commits (Jung, 2021 ; Liu et al., 2023c), la revue de PR (Yang et al., 2016 ; Li et al., 2022b ; Tufano et al., 2021), la localisation de bogues (Kim et al., 2019 ; Chakraborty et al., 2018), les tests (Kang et al., 2023 ; Xia et al., 2023 ; Wang et al., 2023), et la réparation de programmes (Gupta et al., 2017 ; Allamanis et al., 2017 ; Monperrus, 2018 ; Jiang et al., 2018 ; Goues et al., 2019 ; Gao et al., 2022 ; Dinh et al., 2023 ; Motwani & Brun, 2023). Les travaux les plus pertinents pour SWE-bench sont ceux qui ont cherché à appliquer les LMs à la réparation automatisée de programmes (Xia & Zhang, 2022 ; 2023 ; Fan et al., 2023 ; Sobania et al., 2023), en guidant l'édition de code à l'aide de commits (Chakraborty & Ray, 2021 ; Zhang et al., 2022 ; Fakhoury et al., 2023). Cependant, aucun des jeux de données existants (Just et al., 2014 ; Karampatsis & Sutton, 2019) ne présente de contexte de code à l'échelle de SWE-bench. De plus, SWE-bench peut être facilement étendu à de nouveaux langages de programmation et dépôts, et il fournit une arène nettement plus réaliste et exigeante pour mener des expériences visant à augmenter les LMs avec des outils et pratiques d'ingénierie logicielle.
7 DISCUSSION
Limites et orientations futures. Les instances de tâches de SWE-bench sont toutes en Python ; nous espérons appliquer la procédure de collecte d'instances de tâches de SWE-bench pour étendre sa couverture à davantage de langages de programmation et de domaines. Deuxièmement, nos expériences visent à établir une référence des approches les plus simples et les plus directes pour cette tâche ; nous n'avons pas l'intention de contraindre les méthodologies futures au même type d'approche et encourageons les travaux futurs à étudier différentes méthodes (par exemple, les approches à base d'agents, les LM augmentés par des outils).
Enfin, bien que ce travail évalue les modèles à l'aide de tests de code basés sur l'exécution, s'appuyer uniquement sur cette méthode est insuffisant pour garantir une performance fiable des générations de modèles, car nous constatons que les générations de code automatisées par les LM peuvent fréquemment être moins complètes, efficaces ou lisibles que les solutions écrites par des humains.
Conclusion. La complexité des processus de développement logiciel du monde réel s'étend bien au-delà de la simple complétion de code. En s'appuyant sur le pipeline collaboratif open source, SWE-bench crée un miroir fidèle des environnements de codage du monde réel. Cet environnement plus réaliste encourage des solutions créatives qui peuvent avoir une applicabilité immédiate dans le développement de logiciels open source. Nous espérons que ce benchmark et nos autres contributions pourront servir d'atouts précieux dans le développement futur de LM plus pratiques, intelligents et autonomes.
8 ETHICS STATEMENT
8 ETHICS STATEMENTSWE-bench est entièrement collecté à partir de dépôts publics dont les licences autorisent l'usage logiciel avec lequel nos contributions sont conformes. Les détails des licences sont inclus dans le Tableau 12. Durant les processus de collecte ou d'évaluation, nous ne collectons pas d'informations sur les utilisateurs de GitHub, et les instances de tâches de SWE-bench n'utilisent pas de données GitHub au-delà de ce qui est offert via l'API publique et le site web. Nos contributions n'impliquent aucune participation de sujets humains ; nous ne réalisons pas de crowdsourcing et ne recrutons pas de travailleurs humains pour quelque partie que ce soit de SWE-bench, y compris ses procédures de collecte et d'évaluation ainsi que les expériences. Les critères de filtrage de SWE-bench pour les dépôts GitHub fondés sur la popularité ne reposent pas, implicitement ou explicitement, sur des heuristiques discriminatoires ou biaisées pour la sélection des dépôts. Pour la publication du jeu de données, nous prévoyons d'ouvrir le code source des instances de tâches de SWE-bench, de l'infrastructure de collecte et d'évaluation, des résultats expérimentaux, des données d'entraînement utilisées pour le fine-tuning des modèles SWE-Llama, et des poids du modèle SWE-Llama. Suivant les précédents des meilleures pratiques, nous fournirons également une documentation abondante pour décrire chaque composant et son utilisation, et nous mettrons également en place des canaux de communication pratiques pour solliciter des retours afin d'améliorer SWE-bench. SWE-bench ne présente aucune perspective immédiatement nuisible. Nous discutons brièvement de l'impact potentiel de l'utilisation de SWE-bench dans la Section E.
9 REPRODUCIBILITY STATEMENT
9 REPRODUCIBILITY STATEMENTPour notre soumission, nous avons téléversé l'intégralité du code source sous forme de fichier zippé qui a été correctement anonymisé. Nous avons organisé la base de code de telle sorte que des répertoires distincts correspondent aux différentes contributions au sein de l'article principal (c'est-à-dire la collecte du jeu de données, l'évaluation, l'inférence du modèle open source, l'entraînement de SWE-Llama, etc.). Le code source contient une documentation intégrée qui détaille l'objectif et l'utilisation des différentes parties de la base de code. En outre, nous incluons également l'ensemble complet des 2294 instances de tâches de SWE-bench qui contient tous les composants discutés dans l'article principal. Au-delà de la documentation dans le code source, nous incluons des détails techniques approfondis pour le pipeline de collecte et les procédures d'évaluation dans la Section A.2 et la Section A.4 qui complètent les détails originaux de la Section 2 de l'article principal. Ces sections couvrent entièrement la logique présentée dans le code et peuvent être utiles pour sa compréhension. À l'avenir, comme discuté dans la déclaration d'éthique, nous prévoyons de publier plus formellement SWE-bench au public sous forme de dépôt open source avec des détails approfondis qui décrivent le benchmark, exposent le code et détaillent son utilisation. Un composant majeur de SWE-bench est le cadre de collecte, qui fera partie du code open source. En raison de sa conception facilement maintenable, comme discuté dans l'article principal, notre espoir et notre conviction sont que SWE-bench devrait être hautement reproductible.
10 ACKNOWLEDGEMENTS
10 ACKNOWLEDGEMENTSNous remercions Danqi Chen, Tri Dao, Zexuan Zhong, Tianyu Gao, Will Merrill, Mengzhou Xia, Dan Friedman, Adithya Bhaskar, Austin Watkins, Atamik Gupta et Richard Zhu pour leurs précieux retours et conseils. Nous reconnaissons le soutien de la National Science Foundation sous la subvention n° 2239363 et d'une bourse Oracle Collaborative Research. Toute opinion, conclusion, recommandation ou constatation exprimée dans ce document sont ceux de l'auteur/des auteurs et ne reflètent pas nécessairement les vues de la National Science Foundation.
REFERENCES
Miltiadis Allamanis, Marc Brockschmidt, and Mahmoud Khademi. Learning to represent programs with graphs. arXiv preprint arXiv:1711.00740, 2017.
Ben Athiwaratkun, Sanjay Krishna Gouda, Zijian Wang, Xiaopeng Li, and Yuchen Tian et. al. Multilingual evaluation of code generation models, 2023.
Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le, and Charles Sutton. Program synthesis with large language models, 2021.
Samuel R. Bowman and George E. Dahl. What will it take to fix benchmarking in natural language understanding?, 2021.
Federico Cassano, John Gouwar, Daniel Nguyen, Sydney Nguyen, Luna Phipps-Costin, Donald Pinckney, Ming-Ho Yee, Yangtian Zi, Carolyn Jane Anderson, Molly Q Feldman, Arjun Guha, Michael Greenberg, and Abhinav Jangda. Multipl-e: A scalable and extensible approach to benchmarking neural code generation, 2022.
Saikat Chakraborty and Baishakhi Ray. On multi-modal learning of editing source code, 2021.
Saikat Chakraborty, Yujian Li, Matt Irvine, Ripon Saha, and Baishakhi Ray. Entropy guided spectrum based bug localization using statistical language model. arXiv preprint arXiv:1802.06947, 2018.
Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, and Jared Kaplan et. al. Evaluating large language models trained on code, 2021.
Tri Dao, Dan Fu, Stefano Ermon, Atri Rudra, and Christopher Ré. Flashattention: Fast and memory-efficient exact attention with io-awareness. Advances in Neural Information Processing Systems, 35:16344-16359, 2022.
Xiang Deng, Yu Gu, Boyuan Zheng, Shijie Chen, Samuel Stevens, Boshi Wang, Huan Sun, and Yu Su. Mind2web: Towards a generalist agent for the web, 2023.
Tuan Dinh, Jinman Zhao, Samson Tan, Renato Negrinho, Leonard Lausen, Sheng Zha, and George Karypis. Large language models of code fail at completing code with potential bugs. arXiv preprint arXiv:2306.03438, 2023.
Xueying Du, Mingwei Liu, Kaixin Wang, Hanlin Wang, Junwei Liu, Yixuan Chen, Jiayi Feng, Chaofeng Sha, Xin Peng, and Yiling Lou. Classeval: A manually-crafted benchmark for evaluating llms on class-level code generation, 2023.
Sarah Fakhoury, Saikat Chakraborty, Madan Musuvathi, and Shuvendu K. Lahiri. Towards generating functionally correct code edits from natural language issue descriptions, 2023.
Zhiyu Fan, Xiang Gao, Martin Mirchev, Abhik Roychoudhury, and Shin Hwei Tan. Automated repair of programs from large language models, 2023.
Daniel Fried, Armen Aghajanyan, Jessy Lin, Sida Wang, Eric Wallace, Freda Shi, Ruiqi Zhong, Wen tau Yih, Luke Zettlemoyer, and Mike Lewis. Incoder: A generative model for code infilling and synthesis, 2023.
Xiang Gao, Yannic Noller, and Abhik Roychoudhury. Program repair, 2022.
Claire Le Goues, Michael Pradel, and Abhik Roychoudhury. Automated program repair. Communications of the ACM, 62(12):56-65, 2019.
David Gros, Prem Devanbu, and Zhou Yu. Ai safety subproblems for software engineering researchers, 2023.
Rahul Gupta, Soham Pal, Aditya Kanade, and Shirish Shevade. Deepfix: Fixing common c language errors by deep learning. In Proceedings of the aaai conference on artificial intelligence, volume 31, 2017.
Maurice H. Halstead. Elements of Software Science (Operating and programming systems series). Elsevier Science Inc., USA, 1977. ISBN 0444002057.
Dan Hendrycks, Steven Basart, Saurav Kadavath, Mantas Mazeika, Akul Arora, Ethan Guo, Collin Burns, Samir Puranik, Horace He, Dawn Song, and Jacob Steinhardt. Measuring coding challenge competence with apps, 2021.
Xinyi Hou, Yanjie Zhao, Yue Liu, Zhou Yang, Kailong Wang, Li Li, Xiapu Luo, David Lo, John Grundy, and Haoyu Wang. Large language models for software engineering: A systematic literature review, 2023.
Edward J Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang et Weizhu Chen. LoRA: Low-rank adaptation of large language models. In International Conference on Learning Representations, 2022. URL https://openreview.net/forum?id=nZeVKeeFYf9.
Sam Ade Jacobs, Masahiro Tanaka, Chengming Zhang, Minjia Zhang, Leon Song, Samyam Rajbhandari et Yuxiong He. Deepspeed ulysses: System optimizations for enabling training of extreme long sequence transformer models, 2023.
Jiajun Jiang, Yingfei Xiong, Hongyu Zhang, Qing Gao et Xiangqun Chen. Shaping program repair space with existing patches and similar code. In Proceedings of the 27th ACM SIGSOFT international symposium on software testing and analysis, pp. 298-309, 2018.
Tae-Hwan Jung. Committer: Commit message generation using pre-trained programming language model, 2021.
René Just, Darioush Jalali et Michael D. Ernst. Defects4J: A Database of existing faults to enable controlled testing studies for Java programs. In ISSTA 2014, Proceedings of the 2014 International Symposium on Software Testing and Analysis, pp. 437-440, San Jose, CA, USA, juillet 2014. Démonstration d'outil.
Sungmin Kang, Juyeon Yoon et Shin Yoo. Large language models are few-shot testers: Exploring llm-based general bug reproduction, 2023.
Rafael-Michael Karampatsis et Charles Sutton. How often do single-statement bugs occur? the manysstubs4j dataset. 2020 IEEE/ACM 17th International Conference on Mining Software Repositories (MSR), pp. 573-577, 2019. URL https://api.semanticscholar.org/CorpusID:173188438.
Douwe Kiela, Max Bartolo, Yixin Nie, Divyansh Kaushik, Atticus Geiger et Zhengxuan Wu et al. Dynabench : repenser l'évaluation comparative en NLP, 2021.
Yunho Kim, Seokhyeon Mun, Shin Yoo et Moonzoo Kim. Localisation précise de fautes par apprentissage de classement à l'aide de caractéristiques dynamiques et statiques des programmes cibles. ACM Transactions on Software Engineering and Methodology (TOSEM), 28(4):1-34, 2019.
Yuhang Lai, Chengxi Li, Yiming Wang, Tianyi Zhang, Ruiqi Zhong, Luke Zettlemoyer, Scott Wen tau Yih, Daniel Fried, Sida Wang et Tao Yu. Ds-1000 : une référence naturelle et fiable pour la génération de code en science des données, 2022.
Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser et Rémi Leblond et al. Génération de code de niveau compétition avec AlphaCode. Science, 378(6624):1092-1097, déc. 2022a. doi : 10.1126/science.abq1158. URL https://doi.org/10.1126%2Fscience.abq1158.
Zhiyu Li, Shuai Lu, Daya Guo, Nan Duan, Shailesh Jannu, Grant Jenks, Deep Majumder, Jared Green, Alexey Svyatkovskiy, Shengyu Fu et Neel Sundaresan. Automatiser les activités de revue de code par pré-entraînement à grande échelle, 2022b.
Percy Liang, Rishi Bommasani, Tony Lee, Dimitris Tsipras, Dilara Soylu et Michihiro Yasunaga et al. Évaluation holistique des modèles de langue, 2022.
Jiawei Liu, Chunqiu Steven Xia, Yuyao Wang et Lingming Zhang. Le code généré par chatgpt est-il vraiment correct ? Évaluation rigoureuse des grands modèles de langue pour la génération de code. Prépublication arXiv arXiv:2305.01210, 2023a.
Nelson F. Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni et Percy Liang. Perdus au milieu : comment les modèles de langue utilisent les contextes longs, 2023b. arXiv:2307.03172.
Shangqing Liu, Yanzhou Li, Xiaofei Xie et Yang Liu. Commitbart : un grand modèle pré-entraîné pour les commits GitHub, 2023c.
Xiao Liu, Hao Yu, Hanchen Zhang, Yifan Xu, Xuanyu Lei et Hanyu Lai et al. Agentbench : évaluer les LLM en tant qu'agents, 2023d.
Shuai Lu, Daya Guo, Shuo Ren, Junjie Huang, Alexey Svyatkovskiy et Ambrosio Blanco et al. Codexglue : un jeu de données de référence d'apprentissage automatique pour la compréhension et la génération de code. CoRR, abs/2102.04664, 2021.
Petros Maniatis, Daniel Tarlow et Google DeepMind. Grands modèles de séquences pour les activités de développement logiciel, 2023. URL https://blog.research.google/2023/05/large- sequence- models- for- software.html.
Fernando Martinez-Plumed, Pablo Barredo, Seán Ó hEigeartaigh et José Hernández-Orallo. Dynamique de la communauté de recherche derrière les références d'IA populaires. Nature Machine Intelligence, 3:581-589, 2021. URL https://api.semanticscholar.org/CorpusID:236610014.
Thomas J. McCabe. Une mesure de complexité. IEEE Transactions on Software Engineering, SE-2(4):308-320, 1976. doi : 10.1109/TSE.1976.233837.
Martin Monperrus. Réparation automatique de logiciels. ACM Computing Surveys, 51(1):1-24, janv. 2018. doi : 10.1145/3105906. URL https://doi.org/10.1145%2F3105906.
Manish Motwani et Yuriy Brun. Meilleure réparation automatique de programmes en utilisant ensemble les rapports de bogues et les tests, 2023.
Niklas Muennighoff, Qian Liu, Armel Zebaze, Qinkai Zheng, Binyuan Hui, Terry Yue Zhuo, Swayam Singh, Xiangru Tang, Leandro von Werra et Shayne Longpre. Octopack : ajustement par instructions de grands modèles de langue pour le code, 2023.
Gabriel Orlanski, Kefan Xiao, Xavier Garcia, Jeffrey Hui, Joshua Howland, Jonathan Malmaud, Jacob Austin, Rishabh Singh et Michele Catasta. Mesurer l'impact de la distribution des langages de programmation, 2023.
Simon Ott, Adriano Barbosa-Silva, Kathrin Blagec, Janina Brauner et Matthias Samwald. Cartographie de la dynamique mondiale de la création et de la saturation des références en intelligence artificielle. Nature Communications, 13, 2022. URL https://api.semanticscholar.org/CorpusID:247318891.
Stephen Robertson, Hugo Zaragoza et al. Le cadre de pertinence probabiliste : Bm25 et au-delà. Foundations and Trends® in Information Retrieval, 3(4):333-389, 2009.
Baptiste Rozière, Jonas Gehring, Fabian Gloeckle, Sten Sootla, Itai Gat et Xiaoqing Ellen Tan et al. Code llama : modèles de fondation ouverts pour le code, 2023.
David Schlangen. Tâches linguistiques et jeux de langage : sur la méthodologie dans la recherche actuelle en traitement du langage naturel, 2019.
Dominik Sobania, Martin Briesch, Carol Hanna et Justyna Petke. Une analyse de la performance de correction automatique de bogues de chatgpt, 2023.
Aarohi Srivastava, Abhinav Rastogi, Abhishek Rao et Abu Awal Md Shoeb et al. Au-delà du jeu de l'imitation : quantifier et extrapoler les capacités des modèles de langue, 2023.
Rosalia Tufano, Luca Pascarella, Michele Tufano, Denys Poshyvanyk et Gabriele Bavota. Vers l'automatisation des activités de revue de code, 2021.
Junjie Wang, Yuchao Huang, Chunyang Chen, Zhe Liu, Song Wang et Qing Wang. Tests logiciels avec de grands modèles de langue : enquête, panorama et vision, 2023.
Chunqiu Steven Xia et Lingming Zhang. Moins d'entraînement, plus de réparation s'il vous plaît : revisiter la réparation automatique de programmes via l'apprentissage zéro-shot. In Proceedings of the 30th ACM Joint European Software Engineering Conference and Symposium on the Foundations of Software Engineering, pp. 959-971, 2022.
Chunqiu Steven Xia et Lingming Zhang. Réparation automatique de programmes conversationnelle, 2023.
Chunqiu Steven Xia, Matteo Paltenghi, Jia Le Tian, Michael Pradel et Lingming Zhang. Fuzzing universel via de grands modèles de langue. Prépublication arXiv arXiv:2308.04748, 2023.
John Yang, Akshara Prabhakar, Karthik Narasimhan et Shunyu Yao. Intercode : standardiser et évaluer comparativement le codage interactif avec retour d'exécution, 2023.
Xin Yang, Raula Gaikovina Kula, Norihiro Yoshida et Hajimu Iida. Exploration des dépôts modernes de revue de code : un jeu de données sur les personnes, les processus et les produits. In Proceedings of the 13th International Conference on Mining Software Repositories, pp. 460-463, 2016.
Shunyu Yao, Howard Chen, John Yang et Karthik Narasimhan. Webshop : vers une interaction web réelle et évolutive avec des agents linguistiques ancrés, 2022.
Pengcheng Yin, Wen-Ding Li, Kefan Xiao, Abhishek Rao, Yeming Wen, Kensen Shi, Joshua Howland, Paige Bailey, Michele Catasta, Henryk Michalewski, Alex Polozov et Charles Sutton. Génération de code à partir du langage naturel dans des notebooks interactifs de science des données, 2022.
Hao Yu, Bo Shen, Dezhi Ran, Jiaxin Zhang, Qi Zhang, Yuchi Ma, Guangtai Liang, Ying Li, Tao Xie et Qianxiang Wang. Codereval : une référence pour la génération pragmatique de code avec des modèles génératifs pré-entraînés, 2023.
Tao Yu, Rui Zhang, Kai Yang, Michihiro Yasunaga, Dongxu Wang, Zifan Li, James Ma, Irene Li, Qingning Yao, Shanelle Roman, Zilin Zhang et Dragomir Radev. Spider : un jeu de données à grande échelle annoté par des humains pour l'analyse sémantique complexe et inter-domaines et la tâche texte-vers-SQL. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, pp. 3911-3921, Bruxelles, Belgique, octobre-novembre 2018. Association for Computational Linguistics. doi : 10.18653/v1/D18-1425. URL https://aclanthology.org/D18-1425.
Daoguang Zan, Bei Chen, Dejian Yang, Zeqi Lin, Minsu Kim, Bei Guan, Yongji Wang, Weizhu Chen et Jian-Guang Lou. Cert : pré-entraînement continu sur des esquisses pour la génération de code orientée bibliothèque, 2022.
Daoguang Zan, Bei Chen, Fengji Zhang, Dianjie Lu, Bingchao Wu, Bei Guan, Yongji Wang et Jian-Guang Lou. Les grands modèles de langage rencontrent n1code : une étude, 2023.
Jiyang Zhang, Sheena Panthaplackel, Pengyu Nie, Junyi Jessy Li et Milos Gligoric. Coditt5 : pré-entraînement pour l'édition de code source et de langage naturel, 2022.
Zibin Zheng, Kaiwen Ning, Jiachi Chen, Yanlin Wang, Wenqing Chen, Lianghong Guo et Weicheng Wang. Vers une compréhension des grands modèles de langage dans les tâches de génie logiciel. Prépublication arXiv arXiv:2308.11396, 2023.
Shuyan Zhou, Frank F. Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Abishek Sridhar, Xianyi Cheng, Yonatan Bisk, Daniel Fried, Uri Alon et Graham Neubig. Webarena : un environnement web réaliste pour construire des agents autonomes, 2023.
ANNEXE
Dans l'annexe, nous fournissons des détails plus approfondis concernant le processus de construction du jeu de données, le pipeline d'évaluation et la caractérisation du benchmark SWE-bench.
A DÉTAILS DU BENCHMARK
Cette section complète la section 2 par un résumé plus technique et plus fin de la collecte des données, de la validation fondée sur l'exécution et des procédures d'évaluation, ainsi que par une caractérisation plus complète des instances de tâches.
A.1 APERÇU GÉNÉRAL
Collecte des pull requests. À partir d'une liste des 5 000 bibliothèques PyPI les plus téléchargées en août 2023, nous sélectionnons les 100 premiers paquets, identifions le dépôt GitHub open source correspondant à chaque bibliothèque, vérifions quels paquets ont des licences autorisant un usage logiciel libre, et collectons toutes les PR de ces dépôts via l'API développeur de GitHub. Nous choisissons de tirer les problèmes de dépôts très fréquentés parce qu'une utilisation répandue suggère généralement que le dépôt dispose d'une documentation abondante, de directives structurées de développement open source, et d'un code fonctionnel et bien formaté.
Construction des instances de tâche. Nous construisons des instances de tâche candidates à partir de PR qui satisfont trois conditions. Premièrement, le statut de la PR doit être Merged. Un statut Merged indique que les modifications de code associées à la PR ont été acceptées et incorporées dans son dépôt parent. Deuxièmement, la PR résout une ou plusieurs issues dans son dépôt. Une issue est définie selon son usage canonique sur GitHub comme un ticket numérique pour suivre les bugs, les améliorations ou tout objectif général de développement d'un projet logiciel. Nous analysons le titre, le corps et les messages de commit d'une PR à la recherche d'issues liées (par exemple « fixes #24 »). Troisièmement, la PR doit introduire un ou plusieurs nouveaux tests. Un nouveau test est compté lorsqu'une modification de code d'une PR édite un chemin de fichier contenant un mot-clé lié aux tests (par exemple « test », « testing »).
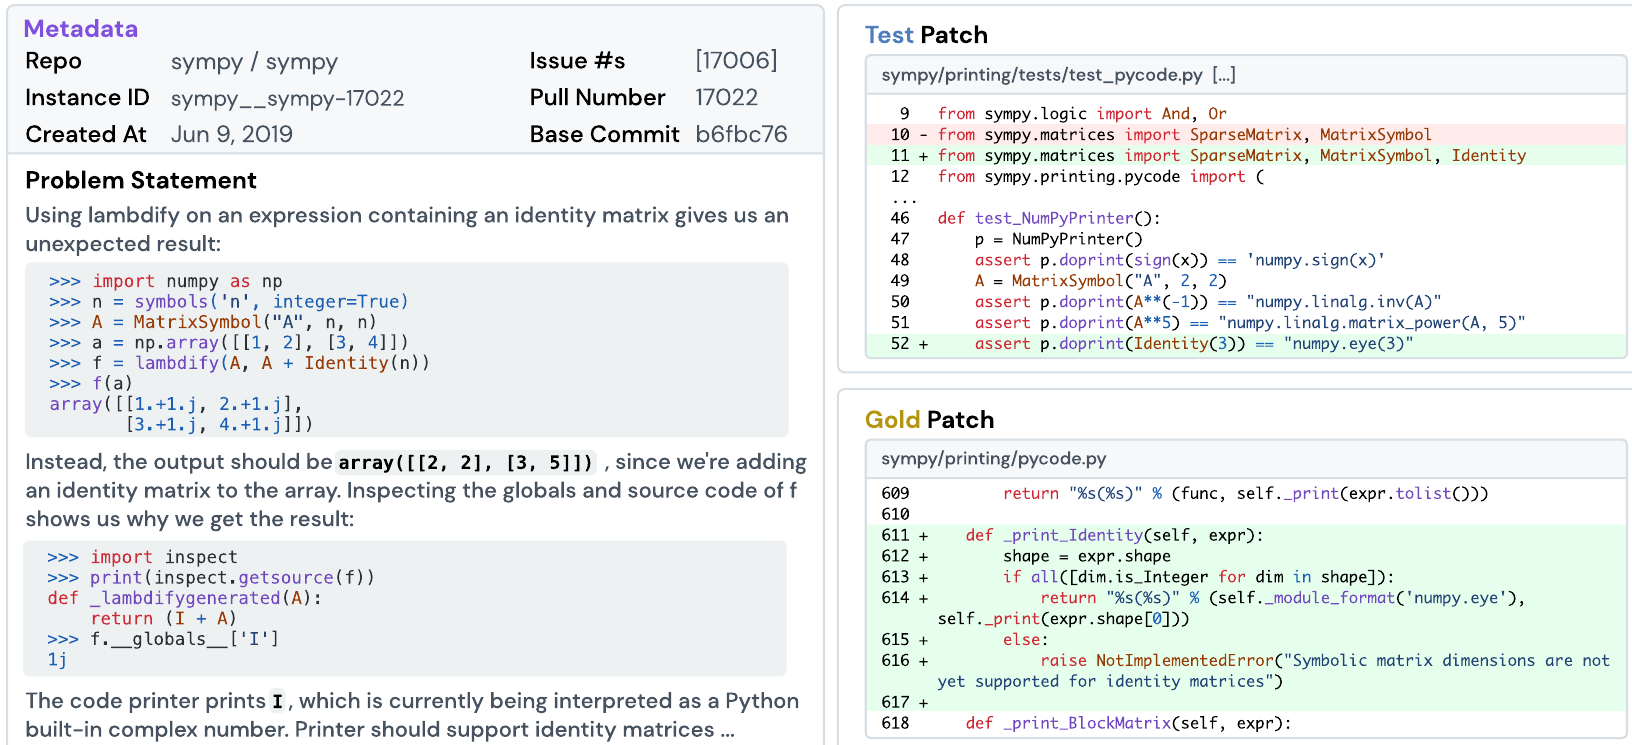
Une PR qui satisfait ces critères est ensuite convertie en une instance de tâche candidate, comme l'exemple de la Figure 7. La base de code est identifiée par le moniker propriétaire/nom du dépôt et le commit de base de la pull request. Récupérer la base de code réelle à partir de ces informations est simple. Nous créons des miroirs des dépôts GitHub d'origine, où chaque miroir est identifié de manière unique par owner_name. Cloner le miroir correspondant d'un dépôt et extraire le commit de base produit dans son état antérieur à la PR. L'énoncé du problème est un agrégat des titres et descriptions de toutes les issues liées, ainsi que de tout commentaire ultérieur écrit avant l'horodatage du commit initial de la PR afin d'éviter la fuite de détails de solution. Les modifications de code d'une PR sont séparées en un patch de test et un patch de référence . est constitué de tous les tests des fichiers édités dans le patch de test. Comme le montre la Figure 7, et sont tous deux stockés sous forme de fichiers patch. D'autres détails sur l'analyse des PR et des données sémantiques figurent dans l'Annexe A.2.
Validation par exécution. Nous vérifions l'utilisabilité d'une instance de tâche par exécution. Pour chaque candidate, nous définissons d'abord un environnement virtuel servant de contexte d'exécution, puis installons avant d'appliquer tout patch, et enfin exécutons une fois avant et une fois après l'application de la solution . Une candidate est écartée de l'examen pour le jeu de données final si une étape quelconque du processus de vérification échoue. De plus, pour garantir qu'une solution est non triviale, nous comparons les journaux de validation avant et après la solution afin de vérifier s'il existe un ou plusieurs tests dans dont le statut passe d'échec à réussite. Enfin, nous excluons les instances de tâche dont les tests invoquent des fonctions ou classes nouvellement créées, introduites pour la première fois dans la solution . Comme le nommage de tels éléments est généralement un processus arbitraire et n'est habituellement pas spécifié explicitement dans l'énoncé du problème, résoudre de tels tests peut être une tâche impossible même pour des développeurs humains. Des informations sur les contextes d'exécution, l'installation de la base de code, la détermination des statuts de test à partir des journaux, et plus encore, figurent dans l'Annexe A.3.
Mises à jour continues. Le processus de collecte de SWE-bench est facilement extensible à n'importe quels dépôts de code open source, permettant une extension facile et à faible maintenance vers de nouveaux langages de programmation et domaines de code. Cette conception confère également à SWE-bench une robustesse temporelle ; à mesure que de nouveaux modèles de langage entraînés sur du code source plus récent sont publiés au fil du temps, SWE-bench peut simplement être mis à jour pour produire de nouvelles instances de tâche basées sur des PR créées après la date d'entraînement de n'importe quel LM.
A.2 PROCESSUS DE CONSTRUCTION
Nous discutons de détails supplémentaires concernant la conversion d'un objet pull request en une instance de tâche candidate. À un niveau élevé, l'objectif principal de cette conversion est d'acquérir les informations pertinentes pour assembler la base de code , l'énoncé du problème , les tests unitaires et la solution , composants introduits dans la Section 2. À cette fin, une instance de tâche SWE-bench est constituée des champs suivants, présentés dans le Tableau 9 ci-dessous. Collectivement, les champs correspondent aux quatre modules d'instance de tâche.
| Champ | Description |
| base.commit | (str) L'ID du commit sur lequel la PR d'origine est appliquée |
| created.at | (date) Objet datetime indiquant quand la PR a été créée pour la première fois (et non fusionnée) |
| hints.text | (str) Suggestions en langage naturel sur la manière de résoudre le problème |
| instance.id | (str) Un identifiant unique créé à partir du dépôt et du numéro de pull |
| issue.numbers | (liste) Liste des numéros de tickets que la pull request d'origine résout |
| patch | (str) Chaîne au format .patch qui constitue une solution de référence au problème, extraite des modifications de code de la PR d'origine |
| problem.statement | (str) Description en langage naturel de la modification souhaitée du code source |
| pull.number | (int) Le numéro de pull de la pull request d'origine |
| test.patch | (str) Chaîne au format .patch contenant des tests inédits permettant de vérifier si une tâche a été résolue, extraite des modifications de code de la PR d'origine |
| version | (str) Version de publication (par rapport au dépôt) durant laquelle la PR a été créée |
| repo | (str) Le dépôt dont provient l'instance de tâche |
| FAIL_TO_PASS | (liste) Liste des tests dont le statut passe d'échec à réussite |
| PASS_TO_PASS | (liste) Liste des tests dont le statut passe de réussite à réussite |
| env.install.commit | (str) Commit de base auquel installer les dépendances nécessaires pour exécuter l'instance de tâche. |
Énoncé du problème. L'énoncé du problème pour chaque instance de tâche est facilement disponible via le champ problem_statement. L'énoncé du problème est un agrégat des premiers commentaires de tous les tickets ainsi que de tout commentaire attaché à ces tickets qui a été créé avant la date de création du commit initial de la PR. Nous recherchons les tickets à partir du titre, du corps et des messages de commit de la PR. Aprèsavoir concaténé les données textuelles de ces composants, nous supprimons d'abord tout commentaire de style Markdown, puis nous parcourons le texte restant à la recherche de références à des numéros de ticket (un signe dièse # suivi d'un nombre) et vérifions si le mot précédant la référence au numéro de ticket figure dans un ensemble de mots-clés suggérant que le ticket a été résolu par la PR (par exemple « closes », « fixes », « resolves »). Les tickets trouvés sont enregistrés dans les champs issue_number, puis des requêtes web distinctes sont effectuées pour récupérer les données de chaque ticket. Pour former le problem_statement, le titre et le corps de chaque ticket sont additionnés, puis concaténés avec ceux du ticket suivant s'il y en a plusieurs. C'est également lors de cette étape que le champ hints_text est créé et collecté à partir de la section des commentaires de la PR, où le texte des commentaires créés avant le commit initial de la PR est pris en compte. L'intuition derrière cette méthodologie de collecte est que de tels commentaires de PR contiendraient probablement des suggestions en langage naturel et en pseudo-code adressées au travailleur humain d'origine concernant la manière d'accomplir la tâche en question. Les expériences présentées dans ce travail n'utilisent pas hints_text, mais nous pensons que cette information pourrait être intéressante pour de futures investigations.
Base de code. Le contenu de la base de code n'est pas stocké en texte clair pour chaque instance de tâche. L'instance de tâche contient plutôt une référence à la base de code concernée via les champs repo et base_commit. Les deux champs sont disponibles dans les données de la PR d'origine. Pour rendre la récupération de la base de code à partir de ces deux éléments reproductible et fiable, nous créons des miroirs du dépôt d'origine. Les miroirs du dépôt constituant à la fois les données d'évaluation et d'affinage sont collectés et publiés en open source sous l'organisation GitHub SWE-bench. Étant donné que le code d'un dépôt d'origine peut être sujet à des modifications de son historique de commits et d'éditions hors du contrôle des auteurs, nous choisissons de créer un dépôt miroir afin de garantir que des modifications ultérieures de la base de code ne rendent pas potentiellement une instance de tâche inutilisable en raison d'une corruption ou d'une suppression du base_commit associé. De plus, nous créons un miroir plutôt que de cloner et stocker la dernière version d'un dépôt. Cela s'explique par le fait qu'un miroir conserve les hachages de commits, l'historique, les branches et les tags d'origine, servant d'historique fidèle et complet des détails techniques du dépôt d'origine. Un miroir ne conserve pas les étoiles, les observateurs, les tickets ni les pull requests du dépôt d'origine.
Nous créons un miroir d'un dépôt après et le jour même où les instances de tâche ont été collectées. Le miroir conserve le moniker « owner/name » du dépôt d'origine, sauf que le caractère « / » est converti en « _ » pour se conformer aux conventions de nommage de GitHub. Compte tenu de cette infrastructure, la récupération de la base de code d'une instance de tâche est simple. Premièrement, le bon miroir peut être cloné depuis l'organisation SWE-bench en utilisant repo. Ensuite, dans la copie locale du miroir, le checkout du base_commit réinitialisera le dépôt à la base de code . Pour passer à une autre instance de tâche du même dépôt, le contrôle de version git est utilisé pour supprimer automatiquement toute modification associée à l'instance de tâche courante avant de faire le checkout du commit de base de l'instance de tâche suivante.
Solution, patches de tests. La solution et les tests sont dérivés des données de modification de fichiers, ou diff, d'une PR. Comme mentionné à la section 2.1, le diff d'origine ainsi que la solution et les tests sont représentés sous forme de fichier .patch, un format permettant de spécifier efficacement des transformations de fichiers texte orientés lignes. De manière générale, un .patch est structuré comme une liste de blocs, où chaque bloc consiste en un en-tête et un ou plusieurs hunks qui correspondent collectivement aux modifications d'un seul fichier. L'en-tête contient des métadonnées spécifiant un chemin de fichier et des numéros de ligne, tandis que les modifications effectives du fichier cible sont encodées sous forme de plusieurs lignes préfixées par « + » et « - » pour indiquer des ajouts et des suppressions. Pour créer les tests , nous identifions d'abord chaque bloc unique du patch, puis sélectionnons et regroupons les blocs dont les chemins de fichier contiennent des mots-clés liés aux tests (par exemple « tests », « testing »). Les blocs restants sont fusionnés pour former la solution . Nous validons la robustesse du script écrit pour analyser correctement et en appliquant les deux patches à la base de code correspondante et en exécutant les tests ; nous vérifions ensuite que les résultats reproduisent le comportement des données de diff de la PR de base. La solution est enregistrée dans le champ patch tandis que les tests sont enregistrés dans le champ test_patch.
Champs restants. Le champ created_at est un horodatage qui spécifie quand la PR de base a été créée. Nous conservons le champ created_at des données d'origine et utilisons ce champ pour effectuer une analyse temporelle des performances du modèle. Le champ version est une chaîne qui correspond à la version de publication, relativement au dépôt, durant laquelle la PR a été publiée. Selon la disponibilité et la quantité d'effort requise pour chaque méthode, nous créons le champ version en récupérant l'information directement depuis le code source, en construisant le dépôt localement et en invoquant du code pour afficher la version sur la sortie standard, ou en comparant le champ created_at avec une chronologie des versions de publication issue de la page web d'un dépôt. Nous créons des contextes exécutables pour chaque version d'un dépôt, comme discuté plus en détail à la § A.3.
Documentation pour créer un dépôt miroir à l'aide de GitHub
A.3 VALIDATION BASÉE SUR L'EXÉCUTION
Après avoir filtré toutes les PR d'un dépôt et converti celles qui satisfont les critères susmentionnés en instances de tâche candidates, l'étape suivante consiste à valider l'utilisabilité de chaque instance de tâche via l'exécution. Cette procédure se décompose en trois étapes. Premièrement, nous créons des contextes exécutables pour chaque version de publication d'un dépôt. Ensuite, nous vérifions si la solution et les tests peuvent être appliqués, installés et exécutés avec succès par-dessus la base de code . Enfin, nous examinons le journal d'exécution de chaque instance de tâche afin de vérifier un ensemble spécifique de comportements pour garantir que la tâche est utilisable et équitable pour l'évaluation du modèle.
Contextes exécutables. Nous choisissons de créer des contextes exécutables par version de publication après avoir expérimenté divers degrés de granularité quant au niveau de définition auquel définir les environnements virtuels. Définir des contextes spécifiques à chaque instance de tâche est ce qui favorise le plus la réussite de l'installation de bout en bout, mais cela a pour coût une fabrication manuelle laborieuse. D'un autre côté, un contexte spécifique à un dépôt basé sur la dernière version d'un dépôt est généralement une définition trop grossière qui n'est pas compatible avec les exigences des versions plus anciennes. Nous constatons que les versions de publication constituent un bon proxy pour capturer les exigences de dépendances à travers un sous-ensemble d'instances de tâche, en établissant un équilibre gérable entre réussite de l'installation et effort manuel. Nous créons manuellement chaque contexte exécutable en examinant la base de code de la dernière instance de tâche pour chaque version. À partir du code source et de la documentation généralement trouvés dans le README et les guides CONTRIBUTING du dépôt, nous déterminons la version de Python, les dépendances nécessaires et la commande d'installation.
Moteur de validation. Le but du moteur de validation est de vérifier les instances de tâche candidates. Plus précisément, cette étape vérifie d'abord que la solution et les tests peuvent être appliqués à la base de code , et ensuite que la base de code peut être correctement installée et exécutée dans l'environnement virtuel correspondant. Pour ce faire, nous effectuons la validation dépôt par dépôt, où, pour l'ensemble des instances de tâche de chaque dépôt, nous exécutons la procédure suivante :
1. Créer des contextes exécutables sous forme d'environnements conda, sur la base de la dernière instance de tâche par version.
2. Regrouper les instances de tâche par version.
3. Itérer sur chaque groupe d'instances de tâches, où pour chaque instance de tâche, nous effectuons les opérations suivantes dans l'environnement conda correspondant.
(a) Supprimer toute modification de fichier et extraire (checkout) le base_commit de l'instance de tâche. Cela place le dépôt sur la base de code
(b) Exécuter la commande d'installation pour instancier la base de code
(c) Appliquer le patch de test à la base de code
(d) Exécuter le script de test, déterminé à partir du patch de test , pour générer les journaux de résultats de test
(e) Appliquer le patch de solution à la base de code avec les tests
(f) Exécuter à nouveau le script de test de l'étape (d) pour générer les journaux de résultats de test
La commande de test est constituée du framework de test utilisé par le dépôt (par exemple pytest, tox) auquel sont ajoutés les chemins spécifiés dans . La commande de test exécuterait tous les tests spécifiés dans le contenu de chaque chemin de fichier. Si l'une des étapes à échoue, l'instance de tâche candidate est écartée. Avec une variation modérée selon les dépôts, nous observons que cette étape élimine généralement la moitié des instances de tâches candidates.
Examen des journaux de validation. Enfin et surtout, nous vérifions les journaux et créés par le moteur de validation pour des propriétés spécifiques. Premièrement, afin de nous prémunir contre des choix de nommage arbitraires, nous vérifions dans les occurrences d'ImportError et d'AttributeError, qui sont potentiellement indicatives d'erreurs liées au nommage des dépendances, lesquelles seraient triviales et quasi impossibles à corriger correctement. À cette fin, nous écartons toutes les instances de tâches présentant de telles erreurs dans leur . Ensuite, nous comparons les résultats de test pour vérifier que l'instance de tâche n'est pas triviale, ce qui est indiqué par au moins un ou plusieurs tests ayant un statut fail avant l'application de la solution , puis un statut pass après. Pour le vérifier, nous définissons d'abord plusieurs parseurs spécifiques à chaque dépôt afin de convertir et en correspondances entre chaque test et un statut . À partir de ces deux structures de données, nous vérifions ensuite qu'il
existe au moins un dont le statut passe de fail à pass. Si aucun test de ce type n'est trouvé, l'instance de tâche est écartée.
Si une instance de tâche satisfait ces deux critères, elle est incluse dans le jeu de données d'évaluation. Le tableau 10 présente un résumé du nombre d'instances de tâches écartées tout au long du processus de construction et des étapes de validation basées sur l'exécution. Nous sauvegardons toutes les instances de tâches finalisées dans un unique fichier .json, open source et disponible au téléchargement.
Parallèlement aux instances de tâches, nous créons également un dossier correspondant contenant les résultats de test de référence (ground truth). Pour chaque instance de tâche, à partir de leurs correspondances test-vers-statut respectives et , nous créons une structure de données de résultats de test dont les clés sont FAIL_TO_FAIL, FAIL_TO_PASS, PASS_TO_FAIL et PASS_TO_PASS, et dont les valeurs sont des listes de tests. En « mettant en cache » ces résultats, nous éliminons la nécessité de réexécuter la solution au moment de l'évaluation (bien que la réexécution reste une option disponible). Nous utilisons cette structure de données pour vérifier l'achèvement des tâches, comme discuté à la section A.4.
A.4 PROCÉDURE D'ÉVALUATION
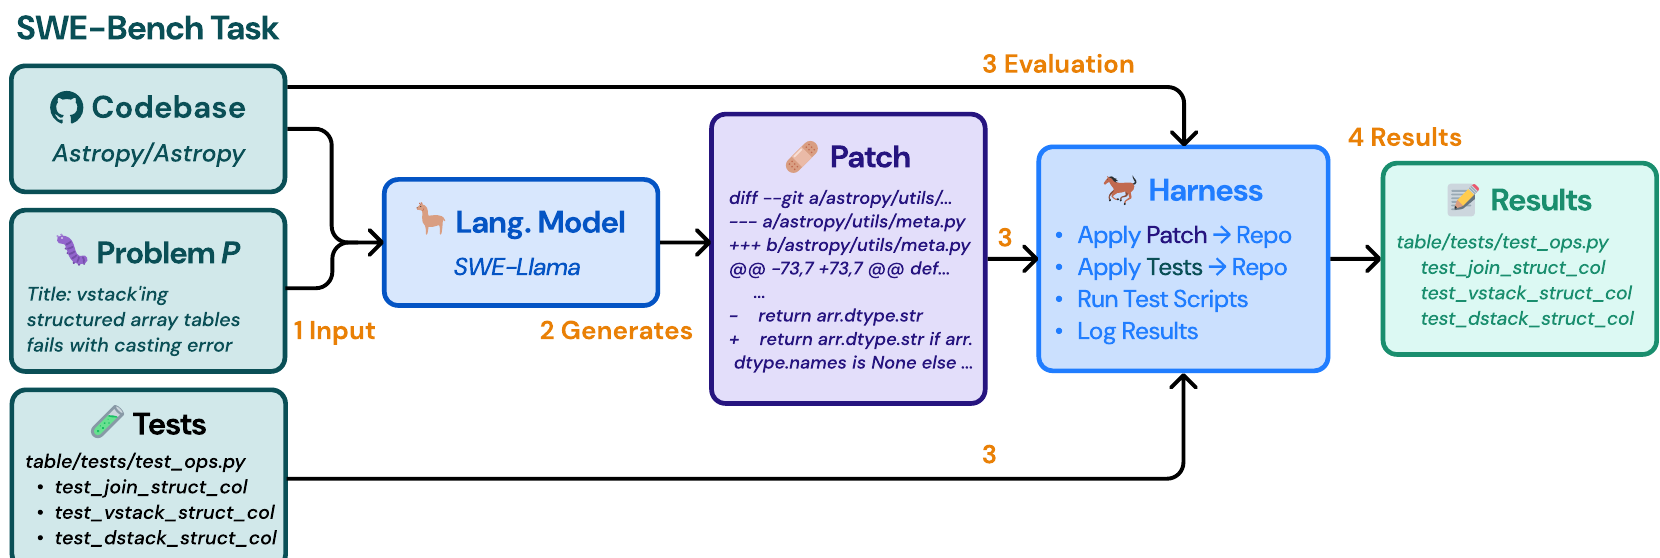
Nous fournissons une visualisation de la procédure d'évaluation dans la figure 8. La procédure d'évaluation note la génération de patch du modèle par rapport au comportement de la solution . À un niveau plus fin, la procédure d'évaluation peut être décomposée en quatre étapes distinctes, mises en évidence par les étapes numérotées de la figure 8. Premièrement, la base de code et l'énoncé du problème sont visibles et fournis au LM ; le LM génère alors une prédiction de patch . Dans l'étape d'évaluation, les étapes suivantes sont effectuées pour chaque prédiction sur l'instance de tâche cible :
1. Supprimer toute modification de fichier et extraire (checkout) le commit de base de l'instance de tâche. Cela place le dépôt sur la base de code .
2. Activer le contexte exécutable correspondant à la version de l'instance de tâche.
3. Exécuter la commande d'installation pour instancier la base de code .
4. Appliquer le patch de test à la base de code .
5. Appliquer le patch de prédiction à la base de code avec les tests .
6. Si l'étape précédente échoue, nous tentons de corriger automatiquement le patch de prédiction et de le réappliquer.
7. Exécuter le script de test, déterminé à partir du patch de test , pour générer les journaux de résultats de test .
Les étapes 1 à 4 ne peuvent de manière fiable pas échouer en raison de la vérification effectuée lors du processus de validation des instances de tâches. Si l'application du patch de prédiction (étape 5) échoue, nous tentons de réparer le fichier de patch de prédiction en supprimant les lignes de contexte inutiles et en recalculant les valeurs d'en-tête (étape 6). Si le patch restant échoue à nouveau ou si l'exécution de la commande de test (étape 7) échoue, alors la prédiction se voit automatiquement attribuer une note de 0. En supposant que ces étapes réussissent, le journal de sortie peut alors être converti en une correspondance test-vers-statut, de structure identique à celle obtenue via le parseur approprié, spécifique au dépôt, introduit à la section § A.3.
Calcul des métriques d'évaluation. Pour déterminer l'achèvement d'une tâche, nous comparons la correspondance test-vers-statut analysée à partir de avec la liste des tests correspondant aux clés FAIL-TO-PASS et PASS-TO-PASS de la structure de données des résultats de test de référence. Déterminer l'achèvement d'une tâche est simple ; nous vérifions que tous les tests FAIL-TO-PASS et PASS-TO-PASS sont trouvés et ont un statut pass dans la correspondance test-vers-statut d'évaluation. Si un test est absent ou a un statut autre que pass, il est considéré comme ayant un statut fail. Comme défini et utilisé dans l'article principal, une tâche est considérée comme résolue si tous les tests parmi FAIL-TO-PASS et PASS-TO-PASS passent.
A.5 CARACTÉRISATION DU JEU DE TESTS D'ÉVALUATION
Nous incluons une forme étendue du tableau 1 qui inclut des statistiques spécifiques à chaque dépôt dans le tableau 11. Le tableau 12 présente une brève description de chaque dépôt, extraite de la documentation du dépôt, ainsi que la licence open source associée au dépôt. Les licences associées autorisent toutes un usage non commercial du code source original de la bibliothèque tant que les permissions des licences originales sont respectées et conservées. En plus des statistiques originales présentées dans le tableau 1, nous introduisons trois nouvelles valeurs. Lignes ajoutées et Lignes supprimées totalisent ensemble Lignes modifiées. « Ajoutées » désigne le nombre de nouvelles lignes introduites, tandis que « Supprimées » désigne les lignes préexistantes retirées par la solution. La statistique (Pass to Pass) désigne le nombre de tests qui réussissaient avant l'application de la solution durant le pipeline de validation. Contrairement aux tests fail to pass, destinés à caractériser l'énoncé du problème et à déterminer si une révision résout le problème, les tests pass to pass sont inclus pour garantir que la révision ne casse ni n'enfreint aucun comportement attendu existant. Ces tests sont extraits durant la phase d'examen des journaux de validation, comme discuté à la section § A.3. Nous notons que les tests fail to fail et pass to fail ne sont pas pris en considération durant l'évaluation, et ces statistiques ne sont pas reflétées dans le tableau ci-dessus.
Catégories de problèmes des instances de tâches. Pour mieux appréhender les types de problèmes que comportent les instances de tâches de SWE-bench, nous effectuons des analyses simples sur les problèmes, identifiés par le champ issue_numbers, pour chaque instance de tâche. Pour chaque problème, nous inspectons les métadonnées, en particulier les tags, afin de caractériser le type de contribution proposé par la PR. Le tableau 13 regroupe et montre plusieurs exemples des 2 289 tags que nous avons trouvés parmi tous les problèmes. Bien que la grande majorité des problèmes soient associés à des corrections de bugs, les instances de tâches de SWE-bench sont associées à un ensemble diversifié de modifications de code dont les objectifs dépassent le débogage et la correction d'erreurs.
Distributions des attributs. Dans la Figure 9, nous présentons des graphiques de la fonction de distribution cumulative pour les attributs introduits dans le Tableau 1. À partir de ces graphiques, nous constatons que l'instance de tâche SWE-bench médiane a une description du problème de 140 mots, et se déroulera dans une base de code contenant un peu moins de 1900 fichiers et 400K lignes. La solution de référence correspondante modifiera généralement une seule fonction
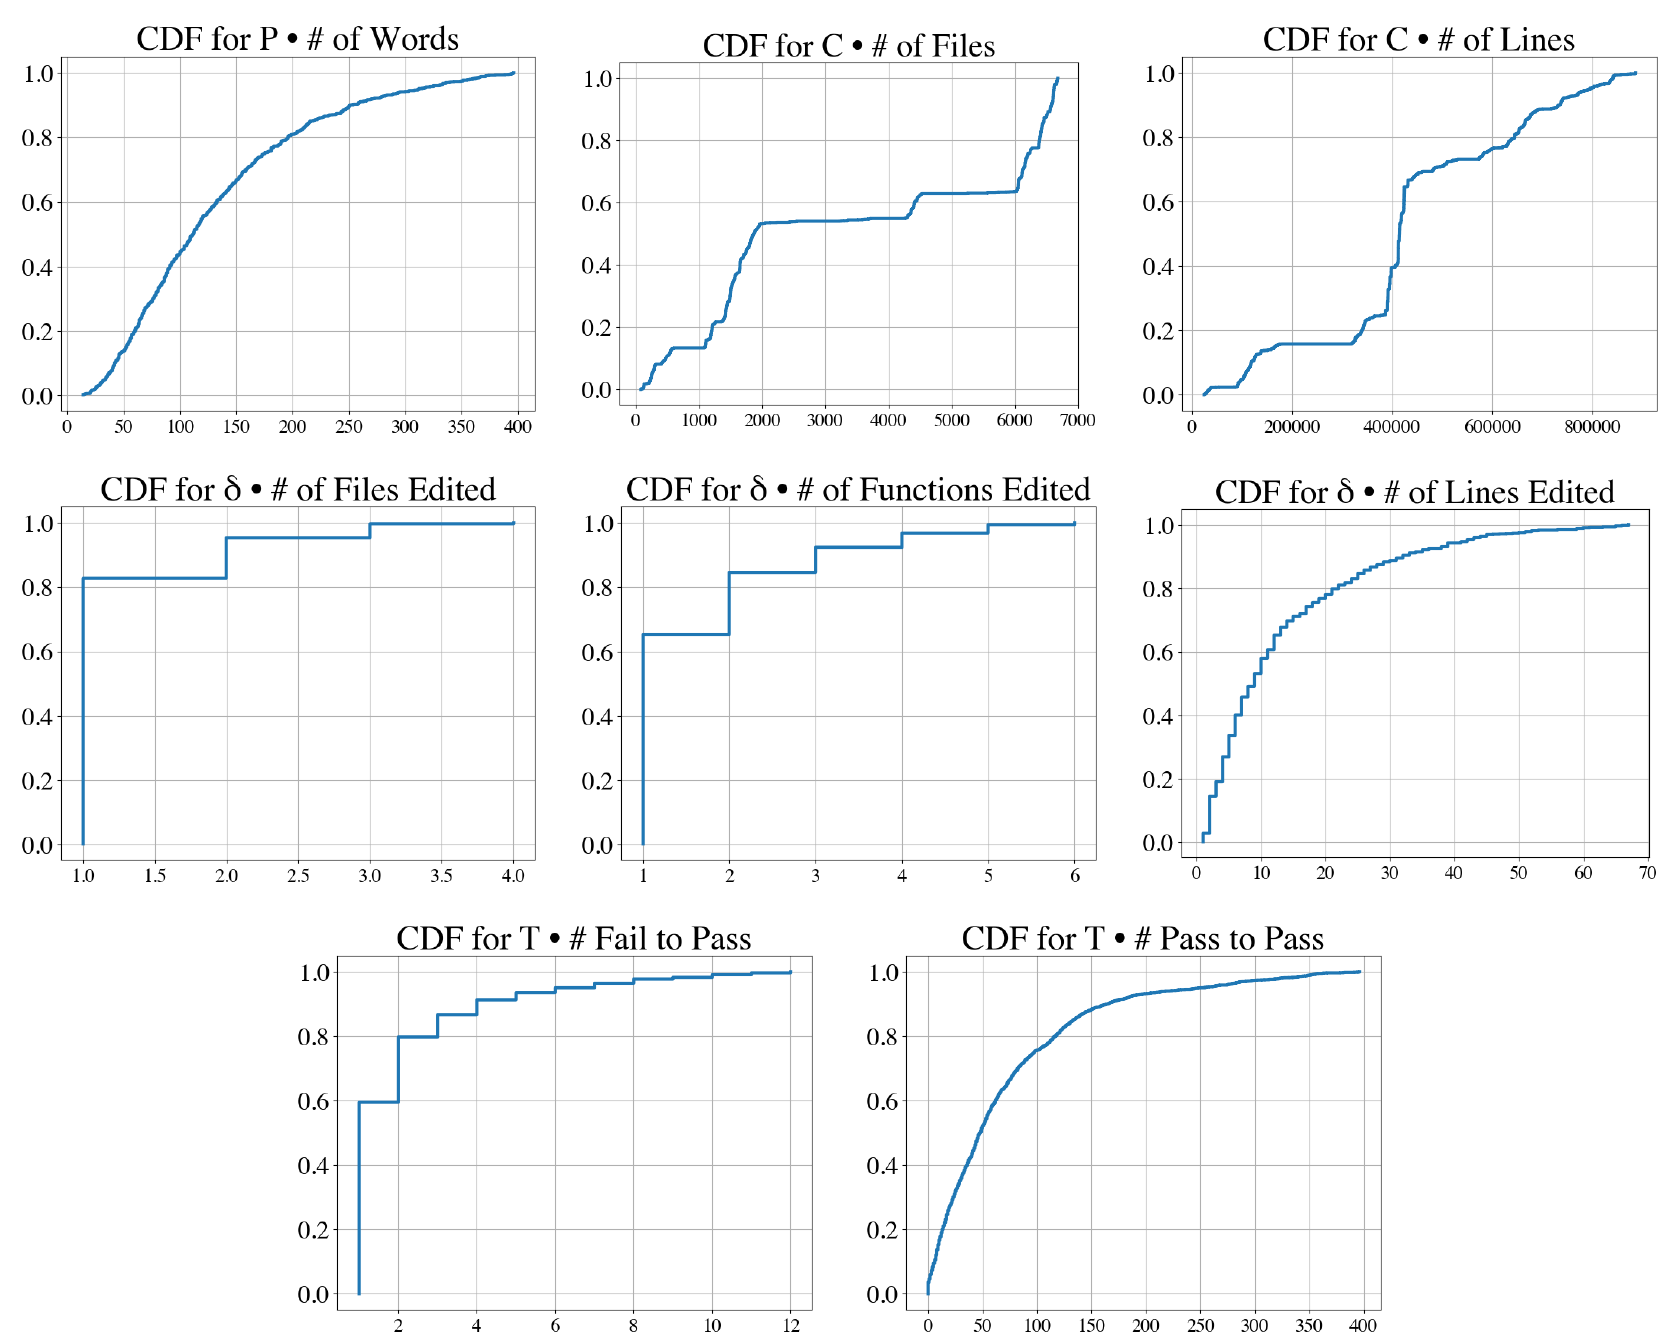
| astropy | django | flask | matplotlib | pylint | pytest | |
| P Longueur (caractères) | 2 742 | 1 307 | 1 185 | 2 381 | 2 011 | 2 948 |
| C Nombre de fichiers | 1 811 | 6 356 | 225 | 4 395 | 2 426 | 497 |
| C Nombre de lignes | 804 k | 407 k | 35 k | 646 k | 109 k | 111 k |
| δ Nombre de fichiers modifiés | 1,5 | 1,5 | 1,6 | 1,5 | 1,8 | 1,4 |
| δ Nombre de fonctions modifiées | 2,5 | 2,0 | 2,4 | 2,2 | 1,8 | 1,7 |
| δ Nombre de lignes modifiées | 36,0 | 18,5 | 35,4 | 58,9 | 36,0 | 24,5 |
| δ Nombre de lignes ajoutées | 25,0 | 12,8 | 23,7 | 35,7 | 26,6 | 18,2 |
| δ Nombre de lignes supprimées | 10,9 | 5,7 | 11,6 | 23,2 | 9,5 | 6,4 |
| |T| (échec à réussite) | 21,7 | 8,8 | 1,4 | 2,4 | 6,8 | 4,1 |
| |T| (Pass to Pass) | 191,0 | 85,9 | 32,5 | 242,4 | 47,0 | 60,7 |
| |T| (All) | 212,8 | 94,6 | 33,9 | 244,8 | 53,7 | 64,8 |
| requests | scikit-learn | seaborn | sphinx | sympy | xarray | |
| Longueur P (Caractères) | 1 654 | 2 239 | 1 667 | 1 888 | 1 213 | 3 515 |
| C # Fichiers | 119 | 1 224 | 273 | 1 483 | 1 666 | 260 |
| C # Lignes | 30k | 361k | 105k | 423k | 678k | 137k |
| δ # Fichiers modifiés | 1,64 | 1,68 | 1,77 | 1,51 | 1,9 | 2,45 |
| δ # Fonct. modifiées | 1,59 | 2,24 | 1,41 | 2,72 | 3,22 | 3,16 |
| δ # Lignes modifiées | 25,5 | 44,0 | 30,1 | 30,6 | 36,3 | 124,8 |
| δ # Lignes ajoutées | 19,2 | 32,7 | 24,9 | 22,0 | 24,2 | 95,6 |
| δ # Lignes supprimées | 6,2 | 11,3 | 5,2 | 8,6 | 12,1 | 29,2 |
| |T| (Échec à réussite) | 7,6 | 7,5 | 12,9 | 2,3 | 2,2 | 58,5 |
| |T| (Réussite à réussite) | 87,1 | 150,7 | 86,8 | 45,1 | 74,5 | 297,5 |
| |T| (Total) | 94,7 | 158,2 | 99,7 | 47,4 | 76,8 | 356,1 |
| Dépôt | Résumé | Licence |
| astropy/astropy | Bibliothèque centrale d'astronomie et d'astrophysique | BSD 3-Clause |
| django/django | Framework web pour la création d'applications web | BSD 3-Clause |
| pallets/flask | Framework léger pour les petites applications web | BSD 3-Clause |
| matplotlib/matplotlib | Bibliothèque de tracé pour créer des visualisations | Personnalisée |
| pylint-dev/pylint | Analyseur de code statique pour Python 2 ou 3 | GPL 2.0 |
| pytest-dev/pytest | Framework de test pour Python | MIT |
| psf/requests | Bibliothèque simple et élégante pour écrire des requêtes HTTP | Apache-2.0 |
| scikit-learn/scikit-learn | Apprentissage automatique en Python | BSD 3-Clause |
| mwaskom/seaborn | Visualisation de données statistiques en Python | BSD 3-Clause |
| sphinx-doc/sphinx | Bibliothèque pour créer de la documentation | Personnalisée |
| sympy/sympy | Système d'algèbre informatique écrit en Python | Personnalisée |
| pydata/xarray | Tableaux et jeux de données étiquetés à N dimensions | Apache-2.0 |
au sein d'un fichier, en changeant lignes, et comporte un seul test fail to pass pour vérifier la correctitude du changement ainsi que 51 tests pass to pass pour vérifier si le comportement existant est préservé.
Taux de correction des patchs. Nous présentons le Tableau 14, qui présente des statistiques récapitulatives sur le nombre d'instances de tâches pour lesquelles chaque modèle a généré des patchs (sur 2294), combien de ces patchs ont été appliqués avec succès, et combien parmi les patchs appliqués avec succès ont nécessité de subir la procédure de correction de patch introduite dans l'Annexe A.4. Nous constatons que les patchs corrigés tendent à représenter un pourcentage plus faible des patchs SWE-Llama qui ont été appliqués avec succès, ce qui suggère que la procédure de fine-tuning de SWE-Llama a un effet positif sur la génération de patchs bien formatés. Pour les modèles à source fermée, moins de patchs s'appliquent avec succès, et parmi ceux qui le font, un pourcentage plus élevé nécessite la correction post-génération, ce qui suggère que les modèles ont encore des difficultés avec la génération de patchs et les sorties structurées en général.
| Catégorie | Nombre | Exemples |
| Bug | 442 | « Bug » (179) ; « type:bug » (114) ; « bug » (57) ; « type: bug » (48) ; « Bug:beetle: » (23) ; « status: confirmed bug » (20) ; |
| Fonctionnalité | 167 | « type:enhancement » (47) ; « Enhancement » (25) ; « New feature » (24) ; « Feature Request » (22) ; « type: enhancement » (19) ; « Enhancement:star: » (15) ; « New Feature » (7) ; « enhancement » (6) ; « type: regression » (14) ; « Regression » (14) ; « regression » (8) ; « help wanted » (71) ; « good first issue » (66) ; « printing » (58) ; « extensions:autodoc » (58) ; « Easy » (57) ; « Easy to Fix » (54) ; « domains:py » (27) ; « core » (26) ; « sets » (23) ; « Wrong Result » (23) ; « units » (22) ; « Good first issue » (21) ; |
| Modèle | Paramètre de récupération | Générations | S'applique | Corrigé | Taux de correction des patchs % |
| ChatGPT-3.5 | BM25 13k | 2 270 | 604 | 363 | 60,1 % |
| ChatGPT-3.5 | « Oracle » | 1 262 | 500 | 222 | 44,4 % |
| ChatGPT-3.5 | « Oracle »-collapsed | 1 811 | 939 | 420 | 44,73 % |
| Claude 2 | BM25 13k | 2 281 | 988 | 302 | 30,57 % |
| Claude 2 | « Oracle » | 2 138 | 1 441 | 360 | 24,98 % |
| Claude 2 | « Oracle »-collapsed | 2 242 | 1 564 | 465 | 29,73 % |
| GPT-4 | BM25 27k | 573 | 85 | 59 | 69,41 % |
| GPT-4 | « Oracle » | 462 | 195 | 121 | 62,05 % |
| GPT-4 | « Oracle »-collapsed | 2 292 | 1 116 | 684 | 61,29 % |
| SWE-Llama 13b | BM25 13k | 2 010 | 1 230 | 369 | 30,0 % |
| SWE-Llama 13b | « Oracle » | 2 125 | 1 532 | 378 | 24,67 % |
| SWE-Llama 7b | BM25 13k | 2 139 | 1 187 | 340 | 28,64 % |
| SWE-Llama 7b | « Oracle » | 2 119 | 1 503 | 298 | 19,83 % |
A.6 CARACTÉRISATION DE L'ENSEMBLE DE DÉVELOPPEMENT
En plus de l'ensemble de test d'évaluation, nous fournissons également un ensemble de développement pour évaluer les modèles et ajuster les hyperparamètres avant de les exécuter sur l'ensemble de test final. Suivant le style des tableaux et graphiques précédents, nous présentons des statistiques similaires pour caractériser les 225 instances de tâches de développement (un peu plus de de l'ensemble d'évaluation principal) collectées à partir de 6 dépôts open source dont les licences permettent un tel usage. L'ensemble de développement a été collecté en suivant exactement le même ensemble de méthodologies et de filtres que l'ensemble d'évaluation principal. En plus des étapes préexistantes, nous filtrons également l'ensemble de développement pour conserver les instances de tâches créées après le 1er janvier 2019. Semblable au Tableau 12, dans le Tableau 15, nous résumons brièvement l'objectif et les licences des 6 dépôts sélectionnés.
À la suite du Tableau 13, nous listons également les tags associés aux tâches de l'ensemble de développement dans le Tableau 16, mettant à nouveau en évidence la diversité et la couverture des types de tâches au-delà de la correction de bugs. Comparé aux tâches d'évaluation principales, nous pouvons également voir des tags (par exemple, « Crash :collision: », « io ») qui font référence à des problèmes présentant des difficultés uniques aux dépôts de l'ensemble de développement.
À la suite du Tableau 1, nous présentons le même ensemble de statistiques moyennes spécifiques aux dépôts pour les 6 dépôts de l'ensemble de développement dans le Tableau 17. Sur l'ensemble de l'ensemble de développement, chaque instance de tâche a 19,9 tests F2P en moyenne / 2 en médiane. Il y a 171,3 tests P2P en moyenne / 79,0 en médiane, et 191,2 tests en moyenne / 101,0 en médiane au total par instance de tâche.
| Repository | Résumé | Nombre | Licence |
| marshmallow-code/ marshmallow pylint-dev/astroid pydicom/pydicom pvlib/pvlib-python pyvista/pyvista sqlfluff/sqlfluff | Analyser des objets complexes vers/depuis les types de données Python Bibliothèque pour l'analyse AST, l'analyse statique/l'inférence Lire/modifier/écrire des fichiers DICOM avec Python Simuler les performances des systèmes d'énergie photovoltaïque Tracé 3D, analyse de maillage via une interface Linter SQL, prend en charge plusieurs dialectes, modèles | 9 31 56 63 16 50 | MIT LGPL-2.1 Personnalisée Personnalisée MIT MIT |
| Catégorie | Nombre | Exemples |
| Bogue | 127 | « bug » (111) ; « Bug :cookreach: » (10) ; « rule bug » (6) ; |
| Fonctionnalité | 55 | « enhancement » : 46 ; « Enhancement :star: » 5 ; « feature-request » : 2 ; |
| Régression | 4 | « Regression » (4) ; |
| Autre | 95 | « api » : 11, « documentation » : 7, « help wanted » : 6, « config options » : 5, « io » : 5, « jinja » : 4, « good first issue » : 4, « parser » 3 |
A.7 CARACTÉRISATION DE SWE-BENCH LITE
SWE-bench Lite est un sous-ensemble canonique pour une évaluation plus efficace des modèles de langage sur la tâche SWE-bench. SWE-bench est
B DÉTAILS SUPPLÉMENTAIRES SUR L'ENTRAÎNEMENT DE SWE-LLAMA
B.1 DÉTAILS D'ENTRAÎNEMENT
Optimisation. Nous effectuons un fine-tuning à l'aide de LoRA (Hu et al., 2022) avec , , dropout sur les matrices de projection query, key, value et output de chaque sous-couche d'attention. Nous entraînons avec un taux d'apprentissage de et une taille de lot de 32 séquences par étape de gradient pour un maximum de 4 époques. Pendant l'entraînement, nous sauvegardons des checkpoints tous les 50 pas, et après l'entraînement, sélectionnons le meilleur checkpoint sur la base de la perte de validation sur 100 instances tenues à l'écart. SWE-Llama 7b a été initialisé avec CodeLlama-Python 7b et entraîné en 20 heures sur 4 NVIDIA A100. SWE-Llama 13b a été initialisé avec CodeLlama-Python 13b et entraîné en 47 heures sur 8 NVIDIA A100. Nous avons utilisé DeepSpeed Ulysses (Jacobs et al., 2023) et Flash Attention (Dao et al., 2022) pour permettre l'entraînement sur de longs contextes.
C RÉSULTATS SUPPLÉMENTAIRES
C.1 RÉSULTATS AVEC LA RECHERCHE « ORACLE »
En utilisant la méthode de recherche « oracle » décrite à la section 4.1, nous présentons les résultats généraux de performance dans le tableau 18. Naturellement, en ne fournissant que les fichiers modifiés par la pull request de la solution de référence, les performances du modèle s'améliorent par rapport à la configuration de recherche BM25 plus bruitée.
C.2 ENSEMBLE DE TEST D'ÉVALUATION
Nous incluons dans le tableau 19 une ventilation, dépôt par dépôt, des performances du modèle, qui correspond à la figure 4 de l'article principal. Comme nous l'avons discuté dans l'article principal, les performances diffèrent fortement d'un dépôt à l'autre.
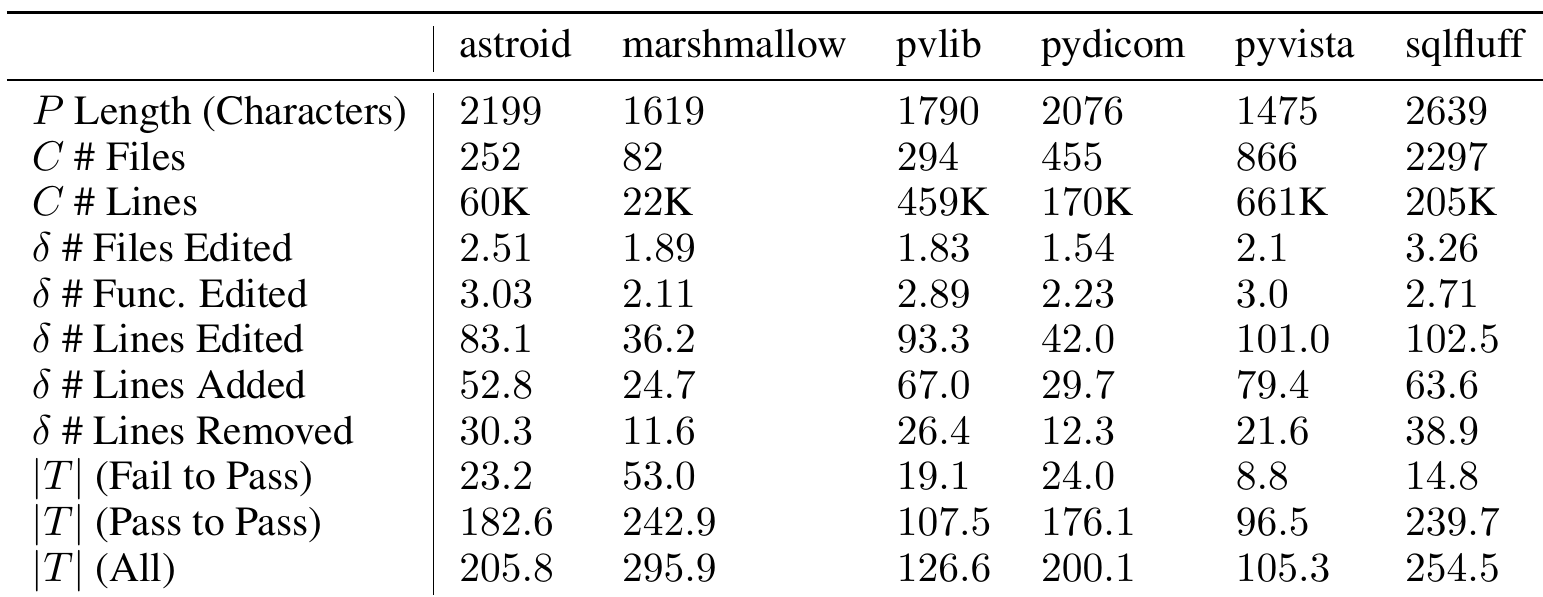
| astroid | marshmallow | pvlib | pydicom | pyvista | sqlfluff | |
| P Longueur (caractères) | 2199 | 1619 | 1790 | 2076 | 1475 | 2639 |
| C # Fichiers | 252 | 82 | 294 | 455 | 866 | 2297 |
| C # Lignes | 60K | 22K | 459K | 170K | 661K | 205K |
| δ # Fichiers modifiés | 2.51 | 1.89 | 1.83 | 1.54 | 2.1 | 3.26 |
| δ # Fonct. modifiées | 3.03 | 2.11 | 2.89 | 2.23 | 3.0 | 2.71 |
| δ # Lignes modifiées | 83.1 | 36.2 | 93.3 | 42.0 | 101.0 | 102.5 |
| δ # Lignes ajoutées | 52.8 | 24.7 | 67.0 | 29.7 | 79.4 | 63.6 |
| δ # Lignes supprimées | 30.3 | 11.6 | 26.4 | 12.3 | 21.6 | 38.9 |
| |T| (Échec à réussite) | 23.2 | 53.0 | 19.1 | 24.0 | 8.8 | 14.8 |
| |T| (Réussi à réussi) | 182.6 | 242.9 | 107.5 | 176.1 | 96.5 | 239.7 |
| |T| (Tous) | 205.8 | 295.9 | 126.6 | 200.1 | 105.3 | 254.5 |
Tableau 17 : Nombres moyens caractérisant différents attributs d'une instance de tâche SWE-bench, regroupés par dépôt pour les dépôts de l'ensemble de données de développement. Les mêmes statistiques présentées dans le tableau 11 sont également présentées ici.
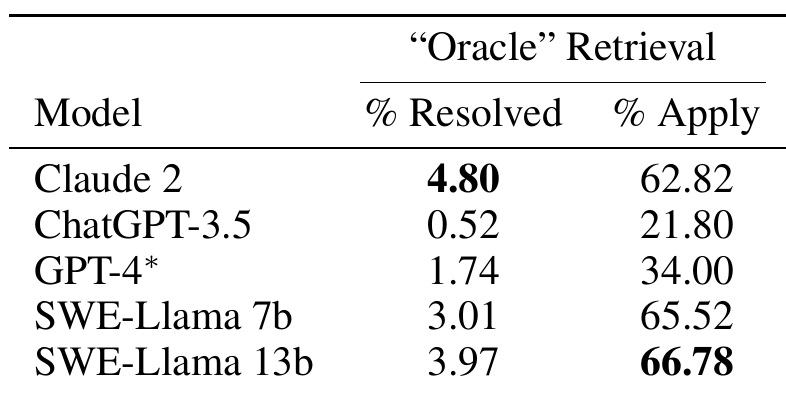
| Modèle | « Oracle » Récupération | |
| % Résolu | % Application | |
| Claude 2 | 4.80 | 62.82 |
| ChatGPT-3.5 | 0.52 | 21.80 |
| GPT-4* | 1.74 | 34.00 |
| SWE-Llama 7b | 3.01 | 65.52 |
| SWE-Llama 13b | 3.97 | 66.78 |
Tableau 18 : Nous comparons les modèles entre eux en utilisant les paramètres de récupération oracle tels que décrits dans la section 4. Le tableau principal des résultats, le tableau 5, présente les résultats pour les différents modèles en utilisant uniquement BM25. \*En raison de contraintes budgétaires, nous évaluons GPT-4 sur un sous-ensemble aléatoire de de SWE-bench dans les paramètres de récupération « Oracle » et BM25 27K uniquement.
C.3 RÉSULTATS DU SOUS-ENSEMBLE D'ÉVALUATION DE GPT-4
Dans cette section, nous présentons les statistiques du tableau 5 pour le sous-ensemble aléatoire de sur lequel GPT-4 a été testé dans le tableau 20. Comme la sélection du sous-ensemble est aléatoire, nous constatons que les taux de Résolu et de Application sont cohérents avec les résultats principaux, et ne sont pas significativement biaisés vers des tâches plus simples ou plus difficiles que l'ensemble d'évaluation général.
C.4 ANALYSE TEMPORELLE ÉTENDUE
Dans cette section, nous présentons une analyse temporelle étendue des instances de tâches résolues par année, qui suit l'analyse présentée dans le tableau 7 de la section d'évaluation de l'article principal. Dans le tableau 21, nous présentons la statistique Résolu pour les différents modèles dans le paramètre de récupération « Oracle » pour 6 partitions temporelles différentes qui regroupent les tâches selon les années de création des issues. Il est évident, d'après le tableau, qu'il n'existe pas de corrélation cohérente entre la performance des modèles et l'année, ce qui soutient notre conclusion selon laquelle, malgré le fait qu'ils aient potentiellement vu des versions plus anciennes du code dans leurs ensembles de données de pré-entraînement, la compréhension et la mise en œuvre de correctifs dans SWE-bench constituent une tâche difficile qui exige de la compréhension et ne peut être accomplie de manière réalisable ou cohérente par la mémorisation des données observées.
C.5 ANALYSE DES TAUX F2P, P2P
Dans les résultats de l'article principal, nous présentons la statistique « Résolu » qui indique combien d'instances de tâches ont été complètement résolues par les différents modèles. Dans cette section, nous fournissons un aperçu plus fin de l'écart des instances de tâches où 1. la génération de patch du modèle a été appliquée avec succès et 2. l'instance de tâche n'a pas été résolue. En supposant qu'un patch soit appliqué avec succès, nous définissons 6 cas dans le tableau 22 qui capturent entièrement la distribution de tous les résultats possibles sur la base des résultats de réussite/échec des tests F2P et P2P. En plus du résultat « Résolu » qui a été
| Contexte en lecture seule pour comprendre la source (ce n'est pas le texte source à traduire) : | Dans les résultats principaux de l'article, nous présentons la statistique « % Resolved » qui indique combien d'instances de tâches ont été complètement résolues par les différents modèles. Dans cette section, nous fournissons un aperçu plus fin de l'écart pour les instances de tâches où 1. La génération de patch du modèle a été appliquée avec succès et 2. L'instance de tâche n'a pas été résolue. En supposant qu'un patch soit appliqué avec succès, nous définissons 6 cas dans le tableau 22 qui capturent entièrement la distribution de tous les résultats possibles b | Texte à traduire : | Repo | Claude 2 | ChatGPT-3.5 |
| GPT-4 | SWE-Llama 13b | SWE-Llama 7b | astropy/astropy | 3,23 | 0,00 |
| 0,00 | 1,06 | 3,16 | django/django | 6,15 | 1,32 |
| 2,50 | 5,19 | 4,00 | matplotlib/matplotlib | 3,05 | 3,33 |
| 0,00 | 3,12 | 1,11 | mwaskom/seaborn | 0,00 | 0,00 |
| 0,00 | 0,00 | 0,00 | pallets/flask | 0,00 | 0,00 |
| 0,00 | 9,09 | 0,00 | psf/requests | 15,91 | 2,33 |
| 8,33 | 13,64 | 18,18 | pydata/xarray | 6,90 | 0,00 |
| 0,00 | 5,81 | 3,00 | pylint-dev/pylint | 1,75 | 0,00 |
| 0,00 | 1,75 | 1,75 | pytest-dev/pytest | 5,93 | 0,00 |
| 0,00 | 5,04 | 4,20 | scikit-learn/scikit-learn 5,41 0,00 0,00 | 3.12 | 0.88 |
| sphinx-doc/sphinx | 5,65 | 1,83 | 0,00 | 2,25 | 2,69 |
| sympy/sympy | 1,94 | 0,00 | 0,00 | 3,01 | 1,59 |
Tableau 19 : Résolu pour les modèles par dépôt représenté dans SWE-bench.
| Modèle | Récupération BM25 | Récupération « Oracle » | ||
| % Résolu | % Apply | % Résolu | % Apply | |
| Claude 2 | 2,27 ↑ 0,31 | 45,72 ↑ 2,65 | 4,01 ↓ 0,79 | 62,65 ↓ 0,17 |
| ChatGPT-3.5 | 0,17 - 0,00 | 26,53 ↑ 0,02 | 0,70 ↑ 0,18 | 21,64 ↓ 0,16 |
| GPT-4 | 0,00 - 0,00 | 14,82 - 0,00 | 1,74 - 0,00 | 34,00 - 0,00 |
| SWE-Llama 7b | 0,35 ↑ 0,35 | 49,04 ↓ 2,70 | 1,92 ↓ 1,09 | 63,70 ↓ 1,82 |
| SWE-Llama 13b | 0,70 - 0,00 | 56,54 ↑ 2,92 | 4,54 ↑ 0,57 | 66,67 ↓ 0,11 |
Tableau 20 : Nous comparons les modèles entre eux en utilisant les paramètres de récupération BM25 et oracle tels que décrits dans la section 4 sur un sous-ensemble aléatoire de (574 instances) de SWE-bench dans les paramètres de récupération « oracle » et BM25 27K uniquement. Il s'agit du même sous-ensemble sur lequel GPT-4 est évalué, comme mentionné dans le tableau 5. La différence par rapport aux pourcentages des tableaux 5 et 18 est incluse en indice.établi, nous introduisons cinq nouveaux termes. Le résultat « Breaking Resolved » fait référence au cas où le comportement souhaité de l'issue a été accompli (tous les tests F2P réussissent), mais où tout le comportement antérieur n'est pas maintenu (tous les tests P2P ne réussissent pas). « Partiellement résolu » fait référence au cas où le comportement antérieur d'une base de code a été maintenu (tous les tests P2P réussissent) ; toutefois, le comportement souhaité n'est pas entièrement accompli (tous les tests F2P ne réussissent pas). Le cas « Travail en cours » correspond au cas où le comportement souhaité n'est pas entièrement accompli (tous les tests F2P ne réussissent pas) et où le comportement antérieur de la base de code n'est pas maintenu (tous les tests P2P ne réussissent pas). Un « No-Op » correspond au cas où une modification de code n'a aucun effet sur la base de code d'origine ; le comportement antérieur est maintenu (tous les tests P2P réussissent) mais l'issue reste complètement non résolue (0 test F2P réussi). Enfin, si l'issue n'est pas résolue (0 test F2P réussi) et que le comportement fonctionnel antérieur est annulé (certains tests P2P échouent), la base de code est laissée dans un état pire, que nous définissons comme une « Régression ».
Dans le tableau 23, nous classons les générations de patches qui ont été appliquées avec succès selon ces six cas. Nous constatons que, parmi les issues non « Résolues », la majorité des générations de patches proposées par le modèle ne résolvent pas un seul cas de test F2P de l'instance de tâche correspondante (« No-Op » et « Régression »). Au sein de ce sous-ensemble de cas, la majorité ( à ) des cas sont des No-Op, tandis que le modèle casse le comportement existant pour le reste de ces situations.
De manière générale, les cas où les générations du modèle réussissent certains tests mais pas tous (« Breaking Resolved », « Partiellement résolu », « Travail en cours ») représentent cumulativement un sous-ensemble plus restreint de problèmes par rapport aux trois autres catégories. D'après l'inspection manuelle de plusieurs de ces cas, il est clair que le modèle démontre une certaine compréhension des exigences de la tâche. Toutefois, en raison de la vision limitée de la base de code par les méthodes de référence, qui n'inclut pas d'informations telles que les dépendances entre fichiers et les relations entre fonctions, nombre de ces instances de tâches échouent souvent parce qu'une modification qui résout correctement l'issue immédiate ne tient pas compte d'autres modules qui utilisent l'entité modifiée et sont affectés par elle. Nous incluons plusieurs études de cas qui mettent directement en évidence ces lacunes dans la section F. Dans l'ensemble, ces résultats mettent non seulement en évidence la difficulté de SWE-bench, mais indiquent aussi la
| Année | Total | 25 % | Claude 2 | GPT-3.5 | GPT-4* | SWE-Llama 13b | SWE-Llama 7b |
| 2023 | 244 | 61 | 4,51 | 1,56 | 0,00 | 4,07 | 3,50 |
| 2022 | 395 | 117 | 4,05 | 0,85 | 3,42 | 2,80 | 2,46 |
| 2021 | 383 | 102 | 4,18 | 0,00 | 2,94 | 4,45 | 2,56 |
| 2020 | 427 | 109 | 5,15 | 0,71 | 0,00 | 3,96 | 3,43 |
| 2019 | 437 | 112 | 5,72 | 1,49 | 1,79 | 4,55 | 2,21 |
| 2018 | 165 | 37 | 5,45 | 0,00 | 0,00 | 3,57 | 2,94 |
| < 2018 | 89 | 36 | 4,49 | 0,00 | 2,78 | 3,37 | 1,09 |
Tableau 21 : Nous présentons dans ce tableau une analyse temporelle étendue, montrant le résolu pour les instances de tâches selon les modèles dans le paramètre de récupération « Oracle », séparées par différentes dates de coupure. La colonne Année renvoie au sous-ensemble de tâches qui ont été créées au cours de l'année civile spécifiée. Dans la colonne Total, nous listons le nombre de tâches qui tombent dans l'année donnée. La colonne contient les mêmes informations pour le sous-ensemble sur lequel GPT-4 a été évalué. Les colonnes restantes, spécifiques à chaque modèle, contiennent la métrique résolu.
| Tests P2P réussis | Tests F2P réussis | ||
| Tous | Partiel | Aucun | |
| Tous | Résolu | Partiellement résolu | Sans opération |
| Partiel | Résolu avec rupture | En cours | Régression |
| Aucun | Résolu avec rupture | En cours | Régression |
Tableau 22 : Nous présentons les 6 résultats possibles pour une génération de patch qui est appliquée avec succès puis exécutée. Les résultats se distinguent par le nombre de tests F2P et P2P qui réussissent.valeur potentielle de fournir un retour d'information via un environnement d'exécution qui permettrait aux modèles d'exécuter des correctifs par rapport aux tests existants, puis de décider de continuer à modifier ou de soumettre le patch pour révision.
C.6 ANALYSE ÉTENDUE DE LA GÉNÉRATION DE PATCHS
Dans cette section, nous présentons une statistique visant à quantifier diverses facettes des générations de patches selon les métriques présentées dans le tableau 8. Dans le tableau 24, nous recalculons ces valeurs pour toutes les générations de patches dans le cadre de récupération oracle pour tous les modèles, que le patch ait été appliqué avec succès ou non. Sur l'ensemble des métriques, nous constatons que les générations de patches des différents modèles sont beaucoup plus proches en taille des caractéristiques des éditions gold moyennes. Bien que certains modèles génèrent encore moins de lignes par rapport à l'édition Gold correspondante (par exemple, Claude-2, ChatGPT-3.5, GPT-4), les éditions des modèles SWE-Llama sont en moyenne plus longues à bien des égards. En considérant à la fois le tableau 8 et le tableau 24, il devient clair que les modèles ont du mal à générer des séquences de sortie plus longues qui soient correctement formatées en patches. Un examen plus approfondi de ces occurrences, comme le montrent nos études de cas dans la section F, indique que les hallucinations, le respect du style/de la structure du code existant et le référencement correct des dépendances à longue portée sont des erreurs courantes qui se manifestent plus fréquemment dans les générations plus longues.
C.7 MÉTRIQUES D'INGÉNIERIE LOGICIELLE
Nous réalisons des évaluations préliminaires qui explorent l'utilisation de métriques d'ingénierie logicielle pour évaluer l'efficacité et la complexité de grands blocs de code intégrés dans une base de code complexe. Contrairement aux fonctions de score de similarité sémantique pour évaluer la fluidité et la ressemblance de forme de surface, populaires dans les benchmarks NLP traditionnels et adoptées pour la génération de code, des métriques telles que la complexité cyclomatique McCabe (1976) et les mesures de complexité de Halstead Halstead (1977) sont fondées sur des abstractions logiques (par exemple, les arbres syntaxiques abstraits) et des principes logiciels pour quantifier la complexité, l'efficacité et la lisibilité du code sous forme de valeur scalaire. Les générations de patches et les journaux d'évaluation de SWE-bench sont de riches sources d'information auxquelles les métriques d'ingénierie logicielle et les analyseurs statiques peuvent être facilement appliqués. Contrairement aux petits benchmarks de concours de code où les informations fournies par les métriques d'ingénierie logicielle ne sont pas significatives en raison de la portée minuscule de la fonctionnalité cible, la tâche de SWE-bench est suffisamment complexe pour que les praticiens puissent utiliser ces outils afin d'obtenir des signaux de rétroaction bien structurés,
| Modèle | Claude 2 | ChatGPT-3.5 | GPT-4* | SWE-Llama 7b | SWE-Llama 13b |
| Appliqué | 1078 | 284 | 76 | 1257 | 1196 |
| Résolu | 110 | 12 | 10 | 69 | 91 |
| Résolution avec régression | 26 | 2 | 3 | 17 | 10 |
| Partiellement résolu | 15 | 4 | 3 | 17 | 10 |
| En cours | 20 | 2 | 1 | 17 | 16 |
| Sans opération | 471 | 174 | 30 | 716 | 672 |
| Régression | 436 | 90 | 29 | 421 | 397 |
| Modèle | Lignes totales | Ajoutées | Supprimées | Fonctions | Fichiers |
| Claude 2 | 27,2 | 6,6 | 3,3 | 1,2 | 1,1 |
| Gold | 61,6 | 17,8 | 8,6 | 2,6 | 1,4 |
| ChatGPT-3.5 | 42,0 | 6,1 | 3,9 | 1,7 | 1,0 |
| Gold | 44,5 | 12,7 | 5,5 | 2,1 | 1,2 |
| GPT-4 | 22,4 | 4,4 | 1,8 | 0,8 | 0,9 |
| Gold | 50,3 | 14,0 | 6,5 | 2,3 | 1,3 |
| SWE-Llama 13b | 68,9 | 9,5 | 4,3 | 2,5 | 1,6 |
| Gold | 61,5 | 17,8 | 8,6 | 2,6 | 1,4 |
| SWE-Llama 7b | 78,9 | 10,1 | 7,6 | 2,5 | 1,5 |
| Gold | 65,1 | 18,8 | 9,0 | 2,7 | 1,5 |
rigoureux et de grande portée sur la complexité du changement induit par une génération de patch et son effet sur le reste de la base de code.
Nous incluons ici notre travail exploratoire qui démontre comment les métriques d'ingénierie logicielle peuvent capturer de manière fiable des caractéristiques de la qualité du code, et comment la comparaison de ces statistiques entre deux patches peut fournir des observations automatiques sur les capacités des modèles. Nous utilisons le paquet Radon, une bibliothèque permettant de calculer différentes métriques d'ingénierie logicielle directement à partir du code source.
Nous examinons spécifiquement les prédictions de patches de Claude 2 appliquées avec succès dans le cadre de récupération « Oracle » pour le dépôt psf/requests, sur lequel plusieurs modèles obtiennent les meilleurs résultats comme le reflète la figure 4. Pour chaque prédiction, nous appliquons le patch à la base de code, puis calculons les scores de complexité cyclomatique et de complexité de Halstead pour les fonctions modifiées. La complexité cyclomatique quantifie le flux de contrôle d'une fonction, en comptant le nombre de chemins d'exécution indépendants à travers le code source (McCabe, 1976). Un score de complexité cyclomatique plus élevé suggère une fonction plus complexe, ayant une probabilité plus élevée de défauts et suggérant généralement une maintenance difficile. La complexité de Halstead compte le nombre d'opérateurs et d'opérandes dans un programme (Halstead, 1977). Pour chaque prédiction, nous effectuons également le même ensemble d'étapes pour le patch gold correspondant.
Nous constatons que les métriques d'ingénierie logicielle fournissent des informations qualitatives automatiques sur la performance des modèles. Considérons l'étude de cas simple suivante dans la figure 10. Bien que la prédiction de patch du modèle (à gauche) comporte moins de lignes (6 au lieu de 11) et modifie moins de fichiers (1 au lieu de 2) par rapport à la solution de référence gold (à droite), l'édition du modèle place un conditionnel au sein d'une classe HTTPAdapter relativement complexe et largement utilisée. Cela introduit deux nouveaux résultats d'exécution potentiels, portant la complexité cyclomatique de HTTPAdapter de 3 à 5. En revanche, bien que plus longue, la solution de référence importe des dépendances intra-module, modifie une fonction logiquement plus simple dans get_connection et définit un nouveau type d'erreur InvalidProxyURL pour capturer le nouveau bug décrit par le ticket.
Documentation Radon, base de code open source
Énoncé du problème : Exception trompeuse avec un protocole invalide dans une variable de proxy. Lorsque la valeur de la ou des variables https_proxy ou HTTPS_PROXY omet accidentellement un '?' dans le protocole, une traceback est renvoyée à l'utilisateur, laquelle ne précise pas que le problème provient de la configuration du proxy...
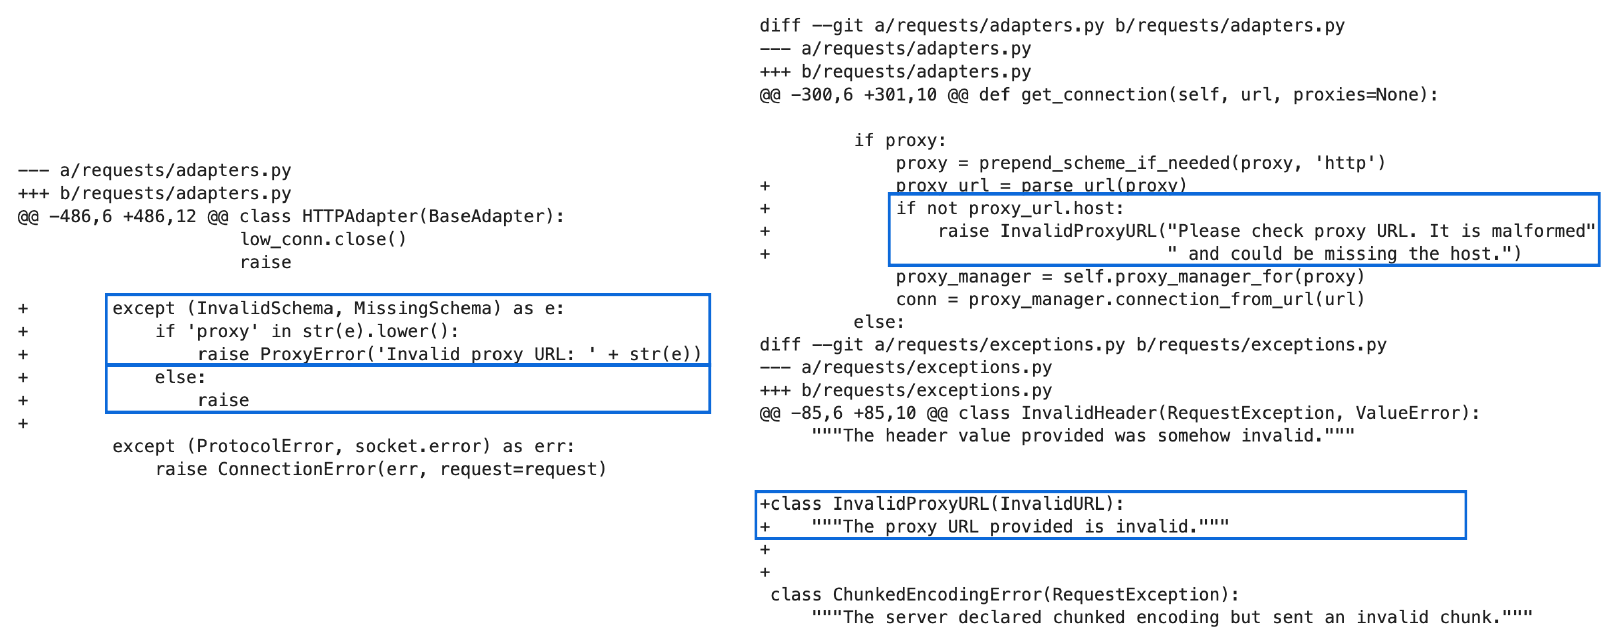
D DÉTAILS EXPÉRIMENTAUX SUPPLÉMENTAIRES
D.1 DÉTAILS DE LA RÉCUPÉRATION
Récupération creuse. Lors de la récupération, nous effectuons une légère augmentation des documents en préfixant le contenu des fichiers par leurs chemins de fichier afin de mieux permettre la récupération basée sur les noms de fichiers qui peuvent être mentionnés directement dans le problème.
Récupération oracle. Les chemins de fichier de la récupération oracle sont simplement extraits directement du fichier de patch de la solution de référence, en excluant les fichiers de test.
D.2 PARAMÈTRES D'INFÉRENCE
Étant donné que les générations sont relativement coûteuses, nous ne générons qu'un seul fichier de patch par instance. Suivant le précédent en génération de code pour l'évaluation en Pass@1 (Chen et al., 2021 ; Rozière et al., 2023), nous utilisons simplement le décodage glouton pour tous les modèles.
D.3 EXEMPLE DE MODÈLE DE PROMPT
Les modèles reçoivent le modèle général suivant, avec de légères variations selon le modèle utilisé.
Vous recevrez une base de code partielle et un énoncé de problème expliquant un problème à résoudre. <issue> {TEXTE DU PROBLÈME} </issue> {début de README.md} {texte de README.md} {fin de README.md} {début de file_1. py}...{texte de file_1. py} [fin de file_1. py]...</code>
Voici un exemple de fichier de patch. Il consiste en des modifications apportées à la base de code. Il spécifie les noms de fichiers, les numéros de ligne de chaque modification, ainsi que les lignes supprimées et ajoutées. Un seul fichier de patch peut contenir des modifications portant sur plusieurs fichiers.
<patch>-- a/file.py +++ b/file.py@@ -1,27 +1,35 @@def euclidean(a, b):- while b:- a, b = b, a % b- return a + if b == 0: + return a + return euclidean(b, a % b) def bresenham(x0, y0, x1, y1): points = [] dx = abs(x1 - x0) dy = abs(y1 - y0)- sx = 1 if x0 < x1 else -1- sy = 1 if y0 < y1 else -1- err = dx - dy + x, y = x0, y0 + sx = -1 if x0 > x1 else 1 + sy = -1 if y0 > y1 else 1- while True: points.append((x0, y0))- if x0 == x1 and y0 == y1:- break e2 = 2 * err- if e2 > -dy: + if dx > dy: + err = dx / 2.0 + while x != x1: points.append((x, y)) err = dy- x0 += sx- if e2 < dx:- err += dx- y0 += sy + if err < 0: + y += sy + err += dx + x += sx + else: + err = dy / 2.0 + while y != y1: + points.append((x, y)) + err -= dx + if err < 0: + x += sx + err += dy + y += sy + points.append((x, y)) return points
</patch>
I need you to solve the provided issue by generating a single patch file that I can apply directly to this repository using git apply. Please respond with a single patch file in the format shown above.
Respond below:
Experiments using slightly more or fewer lines of instructions or examples seemed to not affect overall performance substantially, except for the findings of experiments stated in Section 5.
E SOCIETAL IMPACT
As reasoning on code has emerged as a foundational skill underlying many LM's capability, a potential future of machine- automated software engineering raises many important questions and has important potential ramifications with regards to AI Safety (Gros et al., 2023). It is important to address questions on how to ensure AI- generated code is faithful to human intents and what guardrails might be in place when human objectives are misinterpreted by code agents that then carry out the task. To observe such problems in a controlled setting and manifest their solutions, we hope SWE- bench might serve as a testbed for designing safe, robust measures towards aligned, verifiable, and safe AI- driven software engineering.
F IN-DEPTH ANALYSIS OF SWE-LLAMA GENERATIONS
In this section, we provide five additional qualitative analyses of generations from both Claude 2 and SWE- Llama generations (Oracle retrieval setting) following the style of Section 5.1.
Claude 2 qualitative studies can be found in Tables 25 and 26. Tables 27, 28, and 29 are task instances that Claude 2 did not address correctly. SWE- Llama qualitative studies are covered across Tables 30, 31, 32, 33, 34. For Tables 30, 31, and 32, we present task instances solved correctly by SWE- Llama 13b. In Table 33 and 34, we present two task instances where SWE- Llama 13b does not address the issue correctly, pointing out a subset of the reasoning and generation skills that models may not be adept at enough to accomplish the task at hand.
The observations we make across these sections corroborate with the points stated in the main paper, which is that models tend to struggle with multi- line and multi- file changes, are more adept when the required fix is relatively short, and need help with understanding the codebase in an efficient manner.
Table 25: In this example, Claude 2 correctly addresses an issue from scikit- learn/scikit- learn. However, as demonstrated in the discussion, while the solution is correct, it demonstrates models' tendency to write primitive Python and not employ existing methods within the codebase.
Setting- Model: Claude 2 with Oracle retrieval- Task Instance: scikit-learn_scikit-learn-13328- Link to Issue: https://github.com/scikit-learn/scikit-learn/pull/13314- Link to PR: https://github.com/scikit-learn/scikit-learn/issues/13328
TypeError lors de la fourniture d'un booléen X à l'ajustement de HuberRegressor### Description « TypeError » lors de l'ajustement de « HuberRegressor » avec des prédicteurs booléens.
Étapes/Code pour reproduireimport numpy as np from sklearn.datasets import make_regression from sklearn.linear_model import HuberRegressor# Données aléatoires X, y, coef = make_regression(n_samples=200, n_features=2, noise=4.0, coef =True, random_state=0) X_bool = X > 0 X_bool_as_float = np.asarray(X_bool, dtype=float)# Fonctionne huber = HuberRegressor().fit(X, y) # Échoue (!) huber = HuberRegressor().fit(X_bool, y) # Fonctionne aussi huber = HuberRegressor().fit(X_bool_as_float, y)
Résultats attendus Aucune erreur n'est levée lorsque le « dtype » de « X » est « bool » (deuxième ligne de code de l'extrait ci-dessus, .fit(X_bool, y)). On s'attend à ce que le tableau booléen soit converti en « float » par « HuberRegressor.fit », comme cela est fait par, disons, « LinearRegression ».
Résultats réels « TypeError » est levée : (Lignes restantes omises)
Patch de référencediff --git a/sklearn/linear_model/huber.py b/sklearn/linear_model/huber.py -- a/sklearn/linear_model/huber.py +++ b/sklearn/linear_model/huber.py @@ - 251,7 +251,8 @@ def fit(self, X, y, sample_weight=None): self : object"
Patch généré par le modèle
- a/sklearn/linear_model/huber.py +++ b/sklearn/linear_model/huber.py @@ -231,6 +231,9 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): self.tol = tol + def _validate_data(self, X, y=None): + return X.astype(np.float64) if X.dtype == np.bool else X + def fit(self, X, y, sample_weight=None): """Ajuste le modèle selon les données d'entraînement données.
@@ -250,7 +253,7 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): self : object """ X, y = check_X_y( X, y = check_X_y( X, y, copy=False, accept_sparse=['csr'], y_numeric=True) if sample_weight is not None: sample_weight = np.array(sample_weight) @@ -262,6 +265,9 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): raise ValueError( "epsilon_should_be_greater_than_or_equal_to_1.0,got_%f" % self.epsilon) + X = self._validate_data(X)
Tests
Échec à la réussite (1)
sklearn/linear_model/tests/test_huber.py::test_huber_bool
Réussite à la réussite (9)
sklearn/linear_model/tests/test_huber.py::test_huber_max_iter sklearn/linear_model/tests/test_huber.py::test_huber_gradient sklearn/linear_model/tests/test_huber.py::test_huber_sample_weights sklearn/linear_model/tests/test_huber.py::test_huber_sparse sklearn/linear_model/tests/test_huber.py::test_huber_scaling_invariant
Autres tests de réussite à la réussite omis...
Discussion. Dans cette instance de tâche, le problème décrit un problème concernant la manière dont les types sont convertis. Plus précisément, lors de l'ajustement du modèle HuberRegressor avec des prédicteurs booléens, comme X_bool, une TypeError se produit. Ce problème survient parce que le HuberRegressor ne convertit pas automatiquement les tableaux booléens en flottants comme le font certains autres modèles, tels que LinearRegression, ce qui provoque une erreur d'incompatibilité de types. Pour le corriger, le modèle définit sa propre fonction _validate_data, qui encapsule la logique de conversion de type, et l'applique à X. Bien que cela passe les tests, cette correction pourrait être plus efficace et introduit potentiellement des incohérences stylistiques et organisationnelles. Comme le montre la solution de référence, il existe une solution beaucoup plus simple consistant à passer des arguments dtype qui exploitent les indicateurs existants de l'appel à la fonction check_X_y pour résoudre ce problème plus proprement. Le contenu des autres fichiers n'a pas été inclus dans le cadre de récupération oracle en raison de la limitation de la fenêtre de contexte.
Tableau 26 : Nous fournissons un autre exemple où Claude-2 résout le problème correctement et développe une solution similaire au patch de référence. Cependant, la solution du patch de référence est plus consciente de la nécessité d'éviter de futurs problèmes potentiels liés à ce code.
Paramètres
- Modèle : Claude 2 avec récupération Oracle- Instance de tâche : matplotlib_matplotlib-24362 - Lien vers le problème : https://github.com/matplotlib/matplotlib/issues/24349 - Lien vers la PR : https://github.com/matplotlib/matplotlib/pull/24362
Problème
[Bug] : sharex et sharey n'acceptent pas 0 et 1 comme valeurs booléennes
Résumé du bug
Lorsqu'on utilise '0' ou '1' à la place de 'False' ou 'True' dans les arguments 'sharex' ou 'sharex' de 'pyplot.subplots', une erreur est levée.
Code de reproduction
import matplotlib.pyplot as plt
fig, ax = plt.subplots(ncols=2, sharey=1)
Résultat réel
On obtient l'erreur suivante :
Traceback (most recent call last):
(Lignes précédentes omises) File "/\\\/matplotlib/lib/matplotlib/gridspec.py", line 293, in subplots _api.check_in_list(["all", "row", "col", "none"], File "/\\\/matplotlib/lib/matplotlib/_api/init.py", line 131, in check_in_list raise ValueError(msg)
ValueError: 1 is not a valid value for sharey; supported values are 'all', 'row', 'col', 'none'
Utiliser 'sharex' au lieu de 'sharey' produit la même erreur (bien qu'avec l'avertissement suivant :
UserWarning: sharex argument to subplots() was an integer. Did you intend to use subplot() (without 's')?
mais ceci est attendu et ne fait pas partie du présent problème)
Résultat attendu
Je m'attendais à ce que les valeurs 1 et 0 soient comprises comme des booléens.
Patch généré par le modèle
diff --git a/lib/matplotlib/gridspec.py b/lib/matplotlib/gridspec.py
index 06dd3f19f6.32ee7c306e 100644
-- a/lib/matplotlib/gridspec.py
+++ b/lib/matplotlib/gridspec.py
@@ - 276, 9 +276, 9 @@ class GridSpecBase:
raise ValueError("GridSpec.subplots().only_works_for_GridSpecs_"
"created_with_a_parent_figure")
if isinstance(sharex, bool):
+ if isinstance(sharex, bool) or sharex == 1 or sharex == 0:
sharex = "all" if sharex else "none"
if isinstance(sharey, bool):
+ if isinstance(sharey, bool) or sharey == 1 or sharey == 0:
sharey = "all" if sharey else "none"
This check was added because it is very easy to type
'subplots(1, 2, 1)' when 'subplot(1, 2, 1)' was intended.
Patch de référence
diff --git a/lib/matplotlib/gridspec.py b/lib/matplotlib/gridspec.py - - - a/lib/matplotlib/gridspec.py +++ b/lib/matplotlib/gridspec.py @@ -276,21 +276,12 @@ def subplots(self, \*, sharex=False, sharey=False, squeeze=True,- if isinstance(sharex, bool):+ if not isinstance(sharex, str):sharex = "all" if sharex else "none"- if isinstance(sharey, bool):+ if not isinstance(sharey, str):sharey = "all" if sharey else "none"- # This check was added because it is very easy to type# 'subplots(1, 2, 1)' when 'subplot(1, 2, 1)' was intended.- # In most cases, no error will ever occur, but mysterious behavior# will result because what was intended to be the subplot index is# instead treated as a bool for sharex. This check should go away# once sharex becomes knownly.- if isinstance(sharex, Integral):- api.warn_external("sharex_argument_to_subplots()_was_an_integer.__Did_you""intend_to_use_subplot()_without's')?"- api.check_in_list(["all", "row", "col", "none"],+ api.check_in_list(["all", "row", "col", "none", False, True],sharex=sharex, sharey=sharey)
Tests
Échec vers réussite (1)
lib/matplotlib/tests/test_subplots.py::test_shared
Réussite vers réussite (39)
lib/matplotlib/tests/test_subplots.py::test_label_outer_span lib/matplotlib/tests/test_subplots.py::test_label_outer_non_gridspec lib/matplotlib/tests/test_subplots.py::test_shared_and_moved lib/matplotlib/tests/test_subplots.py::test_exceptions lib/matplotlib/tests/test_subplots.py::test_subplots_offsettext.png)
Autres tests réussite vers réussite omis...
Discussion. Cet exemple demande que 1 et 0 soient traités comme des valeurs booléennes pour les arguments sharex et sharey de la fonction pyplot.subplots. Le code actuel lève une erreur. Dans le patch généré, le modèle ajoute 1 et 0 comme valeurs acceptables. Cependant, le patch de référence ajoute les valeurs acceptables dans une liste ["all", "row", "col", "none", False, True]. Il supprime également l'avertissement lié à Integral associé à ce problème. Ce nettoyage, ainsi que la clarté de l'argument de check_in_list, rendent le code plus concis et lisible.
Tableau 27 : Dans cet exemple, nous montrons un problème issu de astropy/astropy que Claude 2 ne résout pas correctement. L'erreur est principalement due à la tentative de génération de patch de résoudre directement le problème.
Paramètres
- Modèle : Claude 2 avec récupération Oracle- Instance de tâche : astropy_astropy-14365- Lien vers le problème : https://github.com/astropy/astropy/issues/14363- Lien vers la PR : https://github.com/astropy/astropy/pull/14365
Problème
Le format de table ascii.qdp suppose que les commandes QDP sont en majuscules
Description
ascii.qdp suppose que les commandes d'un fichier QDP sont en majuscules, par exemple, pour les erreurs elles doivent être "READ SERR 1 2" alors que QDP lui-même n'est pas sensible à la casse et peut utiliser "read serr 1 2". Comme de nombreux fichiers QDP sont créés à la main, l'exigence que toutes les commandes soient en majuscules devrait être supprimée.
Comportement attendu
Le fichier qdp suivant devrait être lu dans une 'Table' avec des erreurs, plutôt que de planter.
read serr 1 2 1 0.5 1 0.5
Comment reproduire Créer un fichier QDP :
cat > test.qdp read serr 1 2 1 0.5 1 0.5 <EOF>
python Python 3.10.9 (main, Dec 7 2022, 02:03:23) [Clang 13.0.0 (clang - 1300.0.29.30)] on darwin Type "help", "copyright", "credits" or "license" for more information. >>> from astropy.table import Table >>> Table.read('test.qdp', format='ascii.qdp') WARNING: table_id not specified. Reading the first available table [ astropy.io.ascii.qdp] Traceback (most recent call last): raise ValueError(f'Unrecognized_QDP_line: {line}') ValueError: Unrecognized QDP line: read serr 1 2
L'exécution de "qdp test.qdp" fonctionne parfaitement.
Patch généré par le modèle
- a/astropy/io/ascii/qdp.py - b/astropy/io/ascii/qdp.py - @ -60,7 +60,7 @@ ValueError : Ligne QDP non reconnue... """ _decimal_re = r"[-?(\d+(\. \d+)?\.\d+)([eE][+-]?\d+)?" _command_re = r"READ [TS]ERR(\s+[0-9]+)+" _command_re = r"read [ts]err(\s+[0-9]+)+" sep = delimiter if delimiter is None:
Patch Gold
diff - - git a/astropy/io/ascii/qdp.py b/astropy/io/ascii/qdp.py - - - a/astropy/io/ascii/qdp.py +++ b/astropy/io/ascii/qdp.py @@ - 68,7 +68,7 @@ def _line_type (line, delimiter=None): _new_re = rf"NO((sep)NO)+" _data_re = rf"((_decimal_re) | NO | [- + ]?nan) ((sep) ((_decimal_re) | NO | [- + ]?nan)) +" _type_re = rf"\s*((?P<command>|_command_re)) | (?P<new>[_new_re]) | (?P< data>[_data_re])?\s*(\!|(?P<comment>.*))?\s+$" - _line_type_re = re.compile(_type_re) + _line_type_re = re.compile(_type_re, re.IGNORECASE) line = line.strip() if not line: return "comment" @@ - 306,7 + 306,7 @@ def _get_tables_from_qdp_file(qdp_file, input_colnames=None, delimiter=None): values = [] for v in line.split (delimiter): - if v == "NO": + if v.upper() == "NO": values.append(np.max. masked) else: # Comprendre si le nombre est un int ou un float
Tests
Échec vers réussite (1)
X astropy/io/ascii/tests/test_qdp.py::test_roundtrip[True]
Pass to Pass (8)
X astropy/io/ascii/tests/test_qdp.py::test_get_tables_from_qdp_file X astropy/io/ascii/tests/test_qdp.py::test_roundtrip[False] X astropy/io/ascii/tests/test_qdp.py::test_read_example X astropy/io/ascii/tests/test_qdp.py::test_roundtrip_example X astropy/io/ascii/tests/test_qdp.py::test_roundtrip_example_comma X astropy/io/ascii/tests/test_qdp.py::test_read_write_simple X astropy/io/ascii/tests/test_qdp.py::test_read_write_simple_specify_name X astropy/io/ascii/tests/test_qdp.py::test_get_lines_from_qdp
Discussion. Ce problème demande une correction pour la gestion des fichiers QDP ; plus précisément, il demande de supprimer l'exigence que les commandes soient en majuscules. Dans le patch généré par le modèle, le modèle localise les commandes READ et ERR mentionnées dans la description du problème dans un motif regex et le modifie directement. Cependant, dans le même fichier, il est clair que le motif regex est utilisé dans d'autres motifs, tels que _type_re, et donc une correction du motif regex « racine » peut ne pas être appropriée. De plus, parmi plusieurs variables de motifs regex, identifier celle qu'il faut modifier correctement nécessite un raisonnement qui peut potentiellement être aidé par l'exécution. Cette erreur dans cette solution se reflète dans le fait qu'elle non seulement échoue aux tests unitaires donnés, mais échoue aussi aux tests existants qui imposent le comportement antérieur.
Tableau 28 : Pour ce problème du dépôt mwaskom/seaborn, l'énoncé du problème inclut des hyperliens vers des images. Comme discuté dans la section 5, un sous-ensemble mineur des tâches SWE-bench inclut des images, ce qui fait de la compréhension d'images une composante petite mais importante pour résoudre des problèmes, et qui n'est pas explorée par les baselines initiales.
Configuration
- Modèle : Claude 2 avec récupération Oracle - Instance de tâche : mwaskom_seaborn-3217 - Lien vers le problème : https://github.com/mwaskom/seaborn/issues/2907 - Lien vers la PR : https://github.com/mwaskom/seaborn/pull/3217
Problème
Le calcul de la largeur après un histogramme est légèrement erroné avec une échelle logarithmique. Notez le léger chevauchement ici :
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth ), so.Hist(bins ) .scale
image Cela devient presque imperceptible avec plus de bins :
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth ), so.Hist(bins ) .scale
image Cela ne concerne pas 'Bars' ; 'Bar' a aussi le problème :
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth , width ), so.Hist(bins ) .scale
image
Patch généré par le modèle
- a/seaborn/_core/plot.py +++ b/seaborn/_core/plot.py @@ -1327,9 +1327,7 @@ elif "width" in df: view_width = view_df["width"] else: - view_width = 0.8 # TODO what default? - spacing = scales[orient]._spacing(view_df.loc[view_idx, - width.loc[view_idx] = view_width + spacing + width.loc[view_idx] = view_width df["width"] = width if "baseline" in mark._mappable_props:
Patch de référence
diff - - git a/seaborn/_core/plot.py b/seaborn/_core/plot.py - - - a/seaborn/_core/plot.py ++ b/seaborn/_core/plot.py @@ - 1377,10 + 1377,9 @@ def _unscale_coords( - drop_cols = [\*coord_cols, "width"] if "width" in df else coord_cols out_df = ( df - .drop(drop_cols, axis=1) + .drop(coord_cols, axis=1) .reindex(df.columns, axis=1) # So unscaled columns retain their place @@ - 1396,12 + 1395,6 @@ def _unscale_coords( - if var == orient and "width" in view_df: - width = view_df["width"] - out_df.loc[values.index, "width"] = ( - transform(values + width / 2) - transform(values - width / 2) ) - return out_df diff - - git a/seaborn/_marks/bar.py b/seaborn/_marks/bar.py - - - a/seaborn/_marks/bar.py +++ b/seaborn/_marks/bar.py @@ - 29,17 + 29,23 @@ class BarBase(Mark): + transform = scales[orient]._matplotlib_scale.get_transform() + forward = transform.transform + reverse = transform.inverted().transform + + other = {"x": "y", "y": "x"} [orient] + + pos = reverse(forward(data[orient]) - data["width"] / 2) + width = reverse(forward(data[orient]) + data["width"] / 2) - pos + + val = (data[other] - data["baseline"]).to_numpy() + base = data["baseline"].to_numpy() + (Lignes restantes omises...)
Tests
Échec vers réussite (1)
X tests/_marks/test_bar.py::TestBars::test_log_scale
Réussite vers réussite (8)
X tests/_marks/test_bar.py::TestBar::test_categorical_positions_vertical X tests/_marks/test_bar.py::TestBar::test_categorical_positions_horizontal X tests/_marks/test_bar.py::TestBar::test_numeric_positions_vertical X tests/_marks/test_bar.py::TestBar::test_numeric_positions_horizontal X tests/_marks/test_bar.py::TestBar::test_set_properties
Autres tests de réussite vers réussite omis...
Discussion. L'incapacité du modèle de référence à résoudre ce problème peut être directement attribuée à l'absence d'entrée d'image. Nous incluons cet exemple pour démontrer que le débogage de problèmes logiciels réels peut impliquer de digérer des images ; cela présente tout un ensemble distinct de défis liés à la compréhension et au raisonnement. Au-delà de la tâche SWE-bench, d'autres problèmes en ingénierie logicielle, tels que l'interprétation de diagrammes de conception système, de spécifications d'interface utilisateur et de retours utilisateurs, présentent des défis intéressants de vision-langage.
Tableau 29 : Dans ce dernier exemple d'une génération de Claude 2, le modèle doit résoudre une erreur liée à la résolution d'une erreur concernant des dépendances cycliques. La solution de Claude 2 sous-performe sur un problème par ailleurs complexe.
Configuration
- Modèle : Claude 2 avec récupération Oracle - Instance de tâche : sympy_sympy-18211 - Lien vers le problème : https://github.com/pylint-dev/pylint/issues/3525 - Lien vers la PR : https://github.com/pylint-dev/pylint/pull/4703
Problème
Les imports au sein de TYPE.CHECKING peuvent induire « cyclic-import »
Supposons que vous ayez deux modules : a.py et b.py. 'a' importe 'b', mais 'b' a besoin de 'a' pour faire des annotations de type ; cela se fait généralement en important 'a' dans un bloc 'TYPE.CHECKING'. Malheureusement, cela amène pylint à signaler 'cyclic-import'.
Peut-être lié à https://github.com/PyCQA/pylint/issues/3285
Patch de référence
diff --git a/pylint/checkers/imports.py b/pylint/checkers/imports.py-- a/pylint/checkers/imports.py +++ b/pylint/checkers/imports.py@@ - 813,7 + 813,9 @@ def _get_imported_module(self, importnode, modname):- def _add_imported_module(self, node, importedmodname): + def _add_imported_module(+ self, node: Union[astroid.Import, astroid.ImportFrom], importedmodname: str + ) -> None:"""notify an imported module, used to analyze dependencies""" module_file = node.root().file context_name = node.root().name@@ - 826,6 + 828,10 @@ def _add_imported_module(self, node, importedmodname): except ImportError: pass + in_type_checking_block = (+ isinstance(node.parent, astroid.If) and node.parent. is_type_guard() + ) if context_name == importedmodname: self.add_message("import- self", node=node)@@ - 845,7 + 851,10 @@ def _add_imported_module(self, node, importedmodname): # update import graph self.import_graph[context_name].add(importedmodname)- if not self.linter.is_message_enabled("cyclic-import", line= node.lineno): + if + not self.linter.is_message_enabled("cyclic-import", line= node.lineno) + or in_type_checking_block + ) self.excluded_edges[context_name].add(importedmodname)ްމައްސަލައިގެންނަށްޓަކ
Corrected Model Patch
diff - - git a/pylint/checkers/imports.py b/pylint/checkers/imports.py index 4f3eed2. .2b74a8d 100644 - - - a/pylint/checkers/imports.py +++ b/pylint/checkers/imports.py @@ -49,6 +49,7 @@ import copy import os import sys from distutils import sysconfig +from typing import TYPE_CHECKING from typing import Dict, List, Union
import astroid @@ -61,6 +62,9 @@ from pylint.checkers.utils import ( node_ignores_exception, ) from pylint.exceptions import EmptyReportError +if TYPE_CHECKING: + from pylint.lint import PyLinter + from pylint.graph import DotBackend, get_cycles from pylint.interfaces import IASTroidChecker from pylint.reporters.ureports.nodes import Paragraph, VerbatimText, VNode
Tests
Fail to Pass (1)
X tests/marks/test_bar.py::TestBars::test_log_scale
Pass to Pass (11)
tests/test_func.py::test_functionality[func_w0401_disabled_in_func.py] tests/test_func.py::test_functionality[func_i0022. py] tests/test_func.py::test_functionality[func_w0401. py] tests/test_func.py::test_functionality[func_w0801. py] tests/test_func.py::test_functionality[func_w0401_package]
Additional Pass to Pass Tests omitted...
Discussion. In this problem, the model is being asked to provide TYPE_CHECKING based handling for resolving cyclic imports, which pylint currently throws an error for. The gold patch has a detailed solution that involves conditional handling within the TYPE_CHECKING block, excludes the cyclic import messages, and has generally more specific handling. The model generated patch employs a "Stack Overflow" like solution; while creating a TYPE_CHECKING block is a popular solution for resolving imports, solving this issue for the codebase in particular requires a more nuanced solution than a general answer that may be available online.
Tableau 30 : Exemple d'une génération de SWE-Llama 13b qui résout correctement une instance de tâche SWE-bench. Dans cet exemple, la génération de SWE-Llama est exactement identique à la solution.
Configuration
- Modèle : SWE-Llama 13B avec récupération Oracle- Instance de tâche : pydata_xarray-5131- Lien vers le ticket : https://github.com/pydata/xarray/pull/5130- Lien vers la PR : https://github.com/pydata/xarray/pull/5131
Ticket
Lors de l'affichage d'un DatasetGroupBy dans une session Python interactive, la première ligne de la sortie contient un espace blanc de fin. Le premier exemple de la documentation le démontre :
import xarray as xr, numpy as np >>> ds = xr.Dataset( ... {"foo": (("x", "y"), np.random.rand(4, 3)), ... coords={"x": [10, 20, 30, 40], "letters": ("x", list("abba")), ... >>> ds.groupby("letters") DatasetGroupBy, grouped over 'letters' 2 groups with labels 'a', 'b'.
Il y a un espace blanc de fin dans la première ligne de la sortie, à savoir « DatasetGroupBy, grouped over 'letters' ». Cela se voit plus clairement en convertissant l'objet en chaîne (notez l'espace blanc avant n) :
str(ds.groupby("letters")) "DatasetGroupBy, grouped_over_'letters'\n2_groups_with_labels'a', 'b'."
Bien que cela ne soit pas un problème en soi, cela nous pose un problème car nous utilisons flake8 en intégration continue pour vérifier que notre code est correctement formaté... [20 lignes de plus]
Correctif de référence (Gold Patch)
diff --git a/xarray/core/groupby.py b/xarray/core/groupby.py -- a/xarray/core/groupby.py +++ b/xarray/core/groupby.py @@ - 436,7 + 436,7 @@ def iter(self): return zip(self._unique_coord.values, self._iter_grouped())
def repr(self): return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( + return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( self.class.name,
Correctif généré par le modèle
diff --git a/xarray/core/groupby.py b/xarray/core/groupby.py -- a/xarray/core/groupby.py +++ b/xarray/core/groupby.py @@ - 436,7 + 436,7 @@ def iter(self): return zip(self._unique_coord.values, self._iter_grouped())
def repr(self): return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( + return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( self.class.name,
Tests
Échec vers réussite (10)
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-x]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-y]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-z]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-month]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-x]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-y]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-z]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-month]
✓ xarray/tests/test_groupby.py::test_groupby_repr_datetime[obj0]
✓ xarray/tests/test_groupby.py::test_groupby_repr_datetime[obj1]
Réussite vers réussite (16)
✓ xarray/tests/test_groupby.py::test_consolidate_slices
✓ xarray/tests/test_groupby.py::test_groupby_da_datetime
✓ xarray/tests/test_groupby.py::test_groupby_duplicate_coordinate_labels
✓ xarray/tests/test_groupby.py::test_groupby_input_mutation
✓ xarray/tests/test_groupby.py::test_groupby_map_shrink_groups[obj0]
Autres tests de réussite vers réussite omis...
Discussion. Dans ce problème, on demande au modèle de corriger un problème d'espace blanc de fin, et le ticket montre une démonstration de l'erreur qui survient pendant l'utilisation, mais n'indique pas explicitement la fonction à corriger dans le modèle. Dans le cadre de la récupération Oracle, le modèle reçoit le fichier xarray/core/groupby.py à modifier directement, mais la plupart localisent la ligne à modifier. Dans cette situation, le modèle raisonne avec succès que, dans le cadre interactif de Python, la fonction sous-jacente qui est invoquée est en réalité la fonction repr. Après avoir localisé la fonction, il doit déterminer où se trouve l'espace blanc dans l'instruction return. À ce stade, le correctif est assez évident, car il y a un espace explicite que le modèle supprime. Dans ce cas, le modèle réussit tous les tests vérifiant explicitement la justesse de ce correctif (10 tests d'échec vers réussite) tout en préservant également le comportement existant du fichier (16 tests de réussite vers réussite).
Tableau 31 : Exemple d'une génération de SWE-Llama 13b qui résout correctement une instance de tâche SWE-bench. Dans cet exemple, la génération de SWE-Llama est différente du correctif de référence.
Configuration
- Modèle : SWE-Llama 13B avec récupération Oracle- Instance de tâche : psf_-requests-1724- Lien vers le ticket : https://github.com/psf/requests/issues/1723- Lien vers la PR : https://github.com/psf/requests/pull/1724
Ticket
Les noms de méthodes Unicode provoquent une UnicodeDecodeError pour certaines requêtes sous Python 2.7.2. L'exemple suivant fonctionne correctement :
files {u'file': open(u'/usr/bin/diff', u'rb')} response requests.request(method 'POST', url 'http://httpbin.org/post' files files)
Mais l'exemple suivant (utilisant 'method 'POST' au lieu de 'method 'POST') produit une UnicodeDecodeError :
files {u'file': open(u'/usr/bin/diff', u'rb')} response requests.request(method 'POST', url 'http://httpbin.org/post' files files)
Traceback (most recent call last): [Trace complète de la pile masquée] File "/System/Library/Frameworks/Python.framework/Versions/2.7/... msg_+=_message_body UnicodeDecodeError: 'ascii'_codec_can't_decode_byte_0xcf_in_position_140: ordinal_not_in_range (128)
Je suppose que 'u'POST' contamine l'en-tête avec de l'unicode alors qu'il devrait s'agir d'une chaîne. C'est parce que 'sessions.py:313' est simplement :
req.method method.upper()
[Lignes supplémentaires masquées...]
Correctif de référence (Gold Patch)
diff --git a/requests/sessions.py b/requests/sessions.py-- a/requests/sessions.py +++ b/requests/sessions.py@@ - 12,7 +12,7 @@from collections import Mapping from datetime import datetime-from .compact import cookielib, OrderedDict, [3 de plus omis] +from .compact import cookielib, OrderedDict, [3 omis, + builtin_str from .cookies import cookiejar_from_dict, extract_cookies_to_jar, RequestsCookieJar from .models import Request, PreparedRequest from .hooks import default_ hooks, dispatch_hook@@ - 309,6 + 309,6 @@ def request(self, method, url,:param cert: (optional) if String, path to ssl client cert file (.pem). If Tuple, ('cert', 'key') pair.\\\*
+ method builtin_str(method)
Correctif généré par le modèle
diff - - git a/requests/sessions.py b/requests/sessions.py - - - a/requests/sessions.py +++ b/requests/sessions.py @@ -254,7 +254,7 @@ def prepare_request(self, request):
p = PreparedRequest() p.prepare( method=request.method.upper(), + method=str(request.method).upper(), url=request.url, files=request.files, data=request.data,
Tests
Échec vers réussite (6)
test_requests.py::RequestsTestCase::test_DIGEST_AUTH_RETURNS_COOKIE test_requests.py::RequestsTestCase::test_DIGEST_HTTP_200_OK_GET test_requests.py::RequestsTestCase::test_different_encodings_dont_break test_requests.py::RequestsTestCase::test_generic_cookiejar_works test_requests.py::RequestsTestCase::test_uppercase_scheme_redirect
Réussite vers réussite (75)
test_requests.py::RequestsTestCase::test_DIGEST_AUTH_SETS_SESSION_COOKIES test_requests.py::RequestsTestCase::test_DIGEST_STREAM test_requests.py::RequestsTestCase::test_HTTP_200_OK_GET_ALTERNATIVE test_requests.py::RequestsTestCase::test_HTTP_200_OK_GET_WITH_PARAMS test_requests.py::RequestsTestCase::test_HTTP_200_OK_HEAD
Tests supplémentaires réussite vers réussite omis...
Discussion. Contrairement au problème présenté dans le tableau 30, au lieu d’une saisie Python interactive, le modèle reçoit une trace d’erreur issue de l’invocation d’une fonction, où les étapes pour recréer le problème du point de vue de l’utilisateur sont fournies. En outre, le ticket fournit également une suggestion, à la dernière ligne, sur une correction potentielle du problème. Là encore, dans le cadre du paramétrage oracle, le modèle tire parti de la suggestion en langage naturel et localise la modification sur une ligne sémantiquement très proche de la suggestion ( req.method = method.upper() comparé à method=str(request.method).upper() ). Le modèle traite correctement le problème, comme en témoignent tous les tests réussis. Toutefois, dans cette situation, on constate que le modèle a en réalité eu beaucoup de « chance » dans sa réussite. Premièrement, alors que le patch de référence exploite des fonctions intégrées utilisées pour uniformiser la gestion du formatage des chaînes, la décision du modèle d’utiliser du Python plus primitif pour résoudre ce problème serait probablement mal accueillie par un relecteur humain en raison de son incohérence avec le reste de la base de code. Un examen plus approfondi de la fonction builtin_str, non montrée dans cette figure, révèle également qu’elle gère des cas supplémentaires de formatage de chaînes au-delà de ce qui était décrit dans le ticket. Bien que le modèle résolve cette fois la tâche, on peut se demander si cette solution est robuste face à de futurs problèmes.
Tableau 32 : Voici un autre exemple où SWE- Llama13b résout la tâche avec succès. Cet exemple est intéressant parce que le modèle développe une solution quelque peu originale par rapport à la référence, que l’on peut considérer comme plus efficace et plus propre.
Paramétrage
- Modèle : SWE-Llama 13B avec récupération Oracle- Instance de tâche : djang0. djang0-11727- Lien vers le ticket : https://code.djangoproject.com/ticket/29376- Lien vers la PR : https://github.com/djang0/djang0/pull/11727
Ticket
Permettre de masquer le bouton « Save and Add Another » avec une variable de contexte show_save_and_add_another
Pour offrir une meilleure ajustabilité, introduire une nouvelle variable de contexte - show_save_and_add_another. Par exemple, si je veux masquer le bouton « Save and add another », je peux simplement modifier extra_context - écrire False dans la variable. Pour les autres boutons - « Save » et « Save and continue editing », cela fonctionne déjà exactement de cette manière.
Patch de référence
diff --git a/djang0/contrib/admin/templateTags/admin_modify.py b/djang0 /... - - a/djang0/contrib/admin/templateTags/admin_modify.py +++ b/djang0/contrib/admin/templateTags/admin_modify.py @@ -54,12 +54,20 @@ def submit_row(context): is_popup = context['is_popup'] save_as = context['save_as'] show_save = context.get('show_save', True) + show_save_and_add_another = context.get('show_save_and_add_another', True)
(7 lignes omises...) or (has_add_permission and add) or has_editable_inline_admin_formset + can_save_and_add_another = ( + has_add_permission and + not is_popup and + (not save_as or add) and + can_save and + show_save_and_add_another + ) can_save_and_continue = not is_popup and can_save and has_view_permission and show_save_and_continue can_change = has_change_permission or has_editable_inline_admin_formset ctx = Context(context) @@ -70,10 +78,7 @@ def submit_row(context): change and context.get('show_delete', True) ), 'show_save_as_new': not is_popup and has_change_permission and change and save_as, - 'show_save_and_add_another': ( - has_add_permission and not is_popup and - (not save_as or add) and can_save - ), 'show_save_and_add_another': can_save_and_add_another, 'show_save_and_continue': can_save_and_continue, 'show_save': show_save and can_save,
Patch généré par le modèle
diff --git a/django/contrib/admin/templateTags/admin_modify.py b/django/...-- a/django/contrib/admin/templateTags/admin_modify.py +++ b/django/contrib/admin/templateTags/admin_modify.py@@ - 72,7 + 72,7 @@ def submit_row(context):' show_save_as_new': not is_popup and has_change_permission and change and save_as,' show_save_and_add_another': has_add_permission and not is_popup and- (not save_as or add) and can_save + (not save_as or add) and can_save and context. get('show_save_and_add_another', True)),' show_save_and_continue': can_save_and_continue,' show_save': show_save and can_save,
Tests
Échec vers réussite (2)
test_override_show_save_and_add_another
test_submit_row (admin_views.test_templateTags.Admin...)
Réussite vers réussite (3)
test_choice_links (admin_views.test_templateTags.DateHierarchyTests)
test_override_change_form_template_tags
test_override_change_list_template_tags
Discussion. Pour cette instance de tâche issue du dépôt django/django, il est demandé au modèle d’introduire une variable de contexte permettant à un utilisateur de masquer le bouton « Save and Add Another » via une variable de contexte, comme cela est fait pour deux autres boutons existants. La tâche est un peu plus difficile que dans les deux paramétrages précédents, car aucune trace de pile explicite ni démonstration programmatique du problème n’est fournie. Dans ce cadre relativement sous-spécifié, qui ne fournit pas de suggestion quant à la localisation correcte de la fonction, le modèle parvient à raisonner qu’il doit ajuster la paire clé/valeur existante show_save_and_add_another. Si l’on compare avec la solution du patch de référence, on peut soutenir que le patch généré par le modèle produit une solution bien plus efficace en termes de lignes modifiées, car il effectue la plus petite modification nécessaire pour intégrer le contexte comme indicateur du statut masqué de show_save_and_add_another. Toutefois, comme dans la discussion du tableau 31, sur le plan stylistique, les modifications du patch de référence sont bien plus cohérentes avec la base de code, et des changements supplémentaires non explicitement discutés dans le ticket sont également apportés pour respecter ce qui a été fait dans la base de code (c’est-à-dire l’ajout d’un champ can_save_and_add_another. Cette tâche est un exemple d’une direction potentiellement enthousiasmante où, grâce à une guidance humaine ou à une meilleure compréhension générale d’une base de code, les modèles ajusteraient ensuite leurs générations pour non seulement effectuer les changements fonctionnellement corrects, mais aussi ceux stylistiquement appropriés.
Tableau 33 : Voici un exemple où SWE- Llama13b écrit une solution incorrecte, mais maintient avec succès le comportement antérieur. La différence entre la génération du modèle et le patch de référence ici montre comment les modèles tendent à sous-générer les correctifs nécessaires.
Paramétrage
- Modèle : SWE-Llama 13B avec récupération Oracle- Instance de tâche : sphinx-doc_sphinx-11445- Lien vers le ticket : https://github.com/sphinx-doc/sphinx/issues/11437- Lien vers la PR : https://github.com/sphinx-doc/sphinx/pull/11445
Ticket
L’utilisation de rst_prolog supprime les titres de premier niveau contenant une directive de domaine
Décrire le bogue
Si rst_prolog est défini, alors tout document qui contient une directive de domaine comme premier titre (par ex. :mod:) n’affiche pas correctement le titre ou n’inclut pas le titre dans le toctree. Dans l’exemple ci-dessous, si le titre de docs/mypackage.rst était mypackage2 au lieu de :mod:mypackage2, alors le titre s’affiche correctement. De même, si vous ne définissez pas rst_prolog, alors le titre s’affichera correctement. Cela semble cassé depuis un certain temps, car je peux le reproduire dans la v4.0.0 de Sphinx
Comment reproduire
$ sphinx-quickstart --no-sep --project mypackage --author me - v 0.1.0 --release 0.1.0 --language en docs $ echo - e 'Welcome\n=========\n\n...\tctree::\n\n\_mypackage\n' > docs/index_rst $ echo - e ':mod:'mypackage2\n=========\n\nContent\n\n Subheading\n-
logger = logging.getLogger(name) - docinfo_re = re.compile(r'\w+.?') + docinfo_re = re.compile(r'\w+.?n') symbols_re = re.compile(r'([-]-\/-\@[\-]') SECTIONING_CHARS = ['=', '-', '-']
Tests
Échec vers réussite (2)
X tests/test_util_rst.py::test_prepend_prolog_with_roles_with_newline tests/test_util_rst.py::test_prepend_prolog_with_roles_without_newline
Passage à passage (8)
X tests/test_util_rst.py::test_prepend_prolog tests/test_util_rst.py::test_prepend_prolog_with_CR tests/test_util_rst.py::test_prepend_prolog_without_CR
Autres tests de passage à passage omis...
Correctif de référence
diff --git a/sphinx/util/rst.py b/sphinx/util/rst.py -- a/sphinx/util/rst.py ++ b/sphinx/util/rst.py @@ - 10,22 +10,17 @@
from docutils.parsers.rst import roles from docutils.parsers.rst.languages import en as english +from docutils.parsers.rst.states import Body from docutils.statemachine import StringList from docutils.utils import Reporter - from jinja2 import Environment +from jinja2 import Environment, pass_environmentfrom sphinx.locale import from sphinx.util import docutils, logging- try: - from jinja2.utils import pass_environment - except ImportError: - from jinja2 import environmentfilter as pass_environment - logger = logging.getLogger(name) - docinfo_re = re.compile('\w+.*?') +FIELD_NAME_RE = re.compile(Body.patterns['field_marker']) symbols_re = re.compile(r'([-\-/:-@\[-\{-]})' # symbols without dot(0 x2e) SECTIONING_CHARS = ['=', '-', '~']
@@ - 80,7 +75,7 @@ def prepend_prolog(content: StringList, prolog: str) -> None: if prolog: pos = 0 for line in content: if docinfo_re.match(line): + if FIELD_NAME_RE.match(line): pos += 1 else: break @@ - 91,6 +86,7 @@ def prepend_prolog(content: StringList, prolog: str) -> None: pos += 1 # insert prolog (after docinfo if exists) + lineno = 0 for lineno, line in enumerate(prolog.splitlines()): content.insert(pos + lineno, line, 'rst_prolog>', lineno)
Discussion. Pour cette instance de tâche issue du dépôt sphinx-doc/sphinx, on demande à un modèle d'écrire la logique permettant de corriger un cas où le titre est rendu de manière incorrecte. Le simple fait de comprendre le jargon utilisé et de faire correspondre ces termes à la logique au sein de la base de code constitue un défi important pour le modèle. Le modèle dispose d'un appel en ligne de commande qui peut l'aider, mais il est essentiel d'ancrer dans la base de code la terminologie présentée dans les tickets. En comparant le correctif de référence et le correctif généré par le modèle, il est clair que le modèle n'approche pas de la résolution de la tâche. Le modèle identifie généralement que corriger le motif regex est l'action correcte, car c'est aussi ce que fait le correctif de référence. Toutefois, ce qui fait défaut à la fois au modèle et à la configuration de récupération oracle, c'est principalement l'utilisation importante de modules supplémentaires, tant de la base de code elle-même que de bibliothèques tierces. Cet exemple souligne l'importance et le potentiel de l'entraînement de modèles de langage et de la conception de procédures d'inférence permettant la découverte automatisée de telles informations.
Tableau 34 : Dans cet exemple final, SWE-Llama 13b non seulement ne résout pas la tâche, mais corrompt également le comportement existant dans le modèle. Cet exemple démontre la nécessité pour les modèles de comprendre la base de code au-delà de la portée des modifications requises.
Paramétrage
- Instance de tâche : scikit-learn_ scikit-learn-13241
- Lien vers le ticket : https://github.com/scikit-learn/scikit-learn/issues/8798
- Lien vers la PR : https://github.com/scikit-learn/scikit-learn/pull/13241
Ticket
Différences entre les résultats de KernelPCA avec un noyau rbf
Description
Lorsque j'exécute KernelPCA pour la réduction de dimension sur les mêmes jeux de données, les résultats diffèrent par leurs signes.
Étapes/Code pour reproduire
Juste pour réduire la dimension à 7 avec un noyau rbf :
pca = KernelPCA(n_components=7, kernel='rbf', copy_X=False, n_jobs=- 1) pca.fit_transform(X)
Résultats attendus
Le même résultat.
Résultats réels
Les résultats sont identiques, à l'exception de leurs signes :
[[- 0.44457 - 0.18155 - 0.10873 0.13548 - 0.14371 - 0.05746 0.18124]] [[0.44457 0.18155 0.10873 - 0.13548 - 0.14371 - 0.05746 - 0.18124]] [[- 0.44457 - 0.18155 0.10873 0.13548 0.14371 0.057469 0.18124]]
Correctif de référence (Gold Patch)
diff --git a/sklearn/decomposition/kernel_pca.py b/sklearn/decompos...
-- a/sklearn/decomposition/kernel_pca.py
+++ b/sklearn/decomposition/kernel_pca.py
@@ - 8,6 + 8,7 @@
from scipy.sparse.linalg import eighs
from .utils import check_random_state
+from .utils.extmath import svd_flip
from .utils.validation import check_is_fitted, check_array
from .exceptions import NotFittedError from .base import BaseEstimator, TransformerMixin, _UnstableOn32BitMixin
@@ - 210,6 + 211,10 @@ def _fit_transform(self, K): maxiter=self.max_iter, v0=v0)
+ # inverser le signe des vecteurs propres pour garantir une sortie déterministe
+ self.alphas_, _ = svd_flip(self.alphas_, + np.empty_like(self.alphas_).T) + # trier les vecteurs propres par ordre décroissant indices = self.lambdas_.argsort() [::- 1] self.lambdas_ = self.lambdas_[indices]
Correctif généré par le modèle
diff - - git a/sklearn/decomposition/kernel_pca.py b/sklearn/decompos... - - a/sklearn/decomposition/kernel_pca.py +++ b/sklearn/decomposition/kernel_pca.py @@ -220,7 +220,7 @@ def fit_transform(self, K): self.alphas = self.alphas_[:, self.lambdas_ > 0] self.lambdas_ = self.lambdas_[self.lambdas_ > 0]
return K return K / self.lambdas_
def _fit_inverse_transform(self, X_transformed, X): if hasattr(X, "tocstr"):
Tests
Échec vers succès (1)
X sklearn/tests/test_kernel_pca.py::test_kernel_pca_deterministic_output
Succès vers succès (54)
X sklearn/tests/test_kernel_pca.py::test_kernel_pca sklearn/tests/test_kernel_pca.py::test_kernel_pca_consistent_transform sklearn/tests/test_kernel_pca.py::test_kernel_pca_deterministic_output sklearn/tests/test_kernel_pca.py::test_kernel_pca_sparse sklearn/tests/test_kernel_pca.py::test_kernel_pca_linear_kernel sklearn/tests/test_kernel_pca.py::test_kernel_pca_n_components sklearn/tests/test_kernel_pca.py::test_remove_zero_eig sklearn/tests/test_kernel_pca.py::test_kernel_pca_precomputed sklearn/tests/test_kernel_pca.py::test_gridsearch_pipeline sklearn/tests/test_kernel_pca.py::test_gridsearch_pipeline_precomputed sklearn/tests/test_pca.py::test_pca_dtype_preservation[randomized] sklearn/tests/test_pca.py::test_pca_dtype_preservation[auto] sklearn/tests/test_pca.py::test_pca_deterministic_output
Autres tests succès vers succès omis...
Discussion. Dans cet exemple de la bibliothèque scikit-learn/scikit-learn, un modèle reçoit l'observation selon laquelle les parités de la sortie d'un appel à la fonction fit_transform sont inversées. Le modèle reçoit également des lignes de code Python et leur sortie standard qui reproduisent le problème. Le correctif de référence importe et utilise la fonction svd_flip pour résoudre ce problème au sein d'une autre ligne de la fonction _fit_transform. Ce qui distingue l'échec du modèle pour cette tâche, au-delà des points discutés pour l'exemple du Tableau 33, c'est que, en plus de comprendre les dépendances tierces sur lesquelles reposent ses modifications, il est également important pour un modèle de comprendre quelles autres parties de la base de code dépendent à leur tour de la fonction qu'il modifie. Cet exemple présente une facette différente de la raison pour laquelle le traitement de contextes longs dépassant la portée locale de la modification est un défi difficile mais qui en vaut la peine.