
Quatre corrections à PPO amènent un modèle de 32B à 50 points sur AIME 2024, code et données ouvertes. Papier de 2025, à lire en ligne.
DAPO: An Open-Source LLM Reinforcement Learning System at Scale
DAPO : Un système d'apprentissage par renforcement pour LLM open source à grande échelle
ByteDance Seed Institute for AI Industry Research (AIR), Université Tsinghua The University of Hong Kong SIA- Lab of Tsinghua AIR and ByteDance Seed
Liste complète des auteurs dans Contributions
Résumé
La mise à l'échelle de l'inférence dote les LLM d'une capacité de raisonnement sans précédent, l'apprentissage par renforcement constituant la technique centrale pour susciter un raisonnement complexe. Cependant, les détails techniques clés des LLM de raisonnement à la pointe de l'état de l'art sont dissimulés (comme dans le blog d'OpenAI o1 et le rapport technique de DeepSeek R1), de sorte que la communauté peine encore à reproduire leurs résultats d'entraînement par RL. Nous proposons l'algorithme Decoupled Clip and Dynamic sAmpling Policy Optimization (DAPO), et ouvrons entièrement le code source d'un système de RL à grande échelle à la pointe de l'état de l'art qui atteint 50 points sur AIME 2024 en utilisant le modèle de base Qwen2.5- 32B. Contrairement aux travaux précédents qui retiennent les détails d'entraînement, nous présentons quatre techniques clés de notre algorithme qui font le succès du RL à grande échelle pour les LLM. De plus, nous ouvrons le code source de notre entraînement, qui est construit sur le framework ver1 , accompagné d'un jeu de données soigneusement sélectionné et traité. Ces composants de notre système open source renforcent la reproductibilité et soutiennent les recherches futures en RL à grande échelle pour les LLM.
Date : 17 mars 2025 Correspondance : zhouhao@air.tsinghua.edu.cn, wangmingxuan.89@bytedance.com Page du projet : https://dapo- sia.github.io/"https://github.com/volcengine/ver1
1 Introduction
La mise à l'échelle au moment du test, comme o1 d'OpenAI [1] et R1 de DeepSeek [2], apporte un changement de paradigme profond aux grands modèles de langage (LLM) [3- 7]. La mise à l'échelle au moment du test permet une chaîne de pensée (Chain- of- Thought) plus longue et induit des comportements de raisonnement sophistiqués, ce qui rend les modèles supérieurs dans les tâches compétitives de mathématiques et de codage comme AIME et Codeforces.
La technique centrale qui motive cette révolution est l'apprentissage par renforcement (RL) à grande échelle, qui suscite des comportements de raisonnement complexes tels que l'auto- vérification et le raffinement itératif. Cependant, l'algorithme réel et la recette clé pour un entraînement RL passant à l'échelle restent un mythe, dissimulés dans les rapports techniques des modèles de raisonnement existants [1, 2, 8- 11]. Dans cet article, nous révélons des obstacles significatifs dans l'entraînement RL à grande échelle et ouvrons le code source d'un système RL passant à l'échelle, avec un algorithme, un code d'entraînement et un jeu de données entièrement open source, offrant des solutions démocratisées avec des résultats RL de niveau industriel.
Nous menons nos expériences sur Qwen2.5- 32B [12] comme modèle préentraîné pour le RL. Lors de notre première exécution de GRPO, nous n'avons atteint que 30 points sur AIME — une performance nettement inférieure au RL de DeepSeek (47 points). Une analyse approfondie révèle que la référence GRPO naïve souffre de plusieurs problèmes clés tels que l'effondrement de l'entropie, le bruit dans la récompense et l'instabilité de l'entraînement. La communauté au sens large a rencontré des défis similaires pour reproduire les résultats de DeepSeek [13- 19], ce qui suggère que des détails d'entraînement critiques ont peut- être été omis dans l'article sur R1, détails nécessaires pour développer un système RL à grande échelle, de niveau industriel et reproductible.
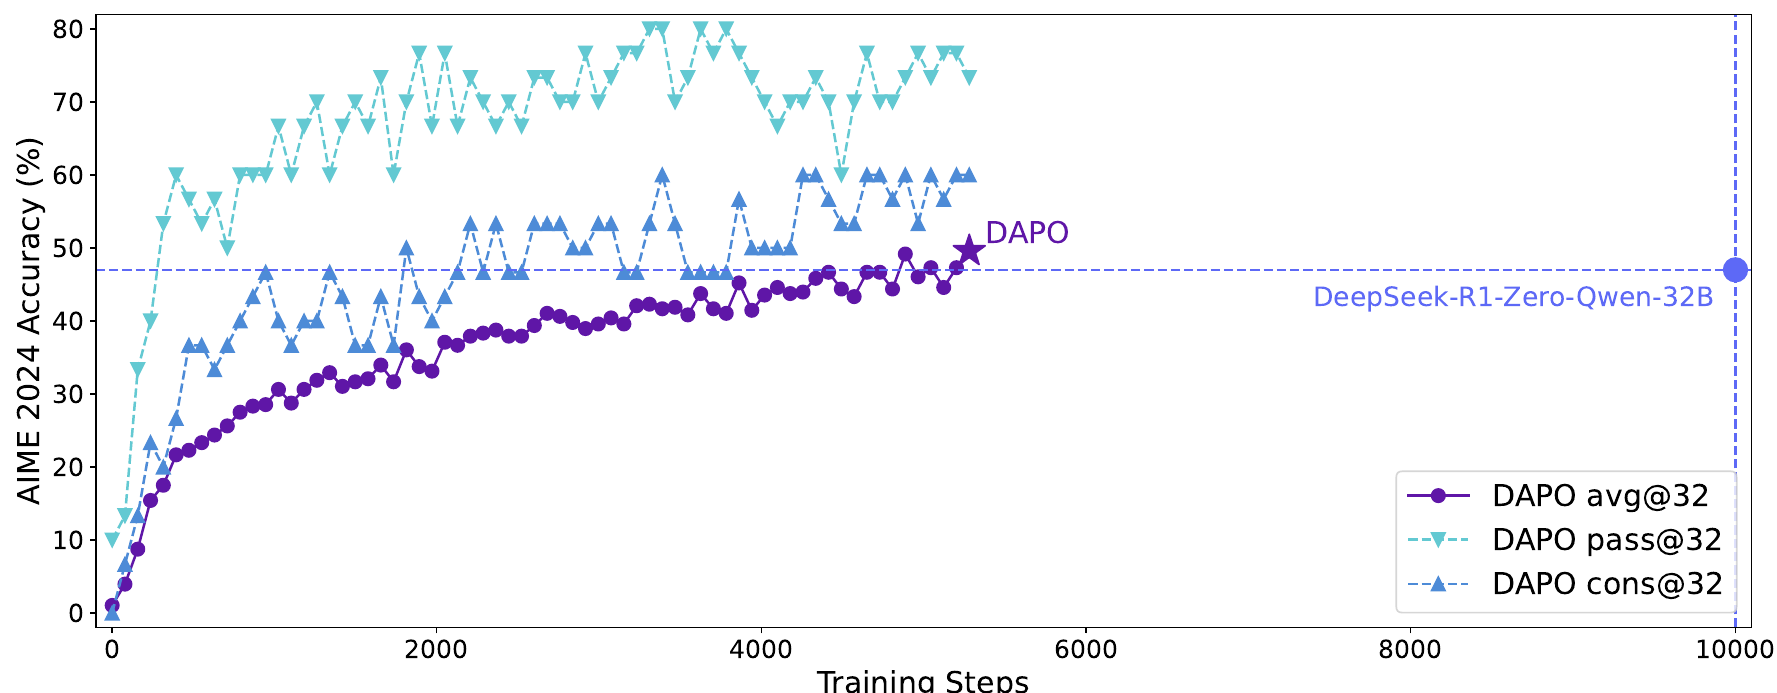
Pour combler cette lacune, nous publions un système open source à la pointe de l'état de l'art pour le RL à grande échelle sur les LLM, qui atteint 50 points sur AIME 2024 avec le modèle Qwen2.5- 32B, surpassant les résultats précédents de l'état de l'art obtenus par DeepSeek- R1- Zero- Qwen- 32B [2] (47 points) en utilisant 50 % des étapes d'entraînement (Figure 1). Nous proposons l'algorithme Decoupled Clip and Dynamic Sampling Policy Optimization (DAPO), et introduisons 4 techniques clés pour faire briller le RL dans le scénario de RL à long CoT. Les détails sont présentés dans la Section 3.
1. Clip-Higher, qui favorise la diversité du système et évite l'effondrement de l'entropie ;
2. Dynamic Sampling, qui améliore l'efficacité et la stabilité de l'entraînement ;
3. Token-Level Policy Gradient Loss, qui est critique dans les scénarios de RL à long CoT ;
4. Overlong Reward Shaping, qui réduit le bruit dans la récompense et stabilise l'entraînement.
Notre implémentation est basée sur verl [20]. En publiant entièrement notre système RL à la pointe de l'état de l'art, y compris le code d'entraînement et les données, nous visons à révéler des insights précieux sur le RL à grande échelle pour les LLM qui bénéficieront à la communauté au sens large.
2 Préliminaires
2.1 Proximal Policy Optimization (PPO)
PPO [21] introduit un objectif de substitution tronqué pour l'optimisation de la politique. En contraignant les mises à jour de la politique dans une région proximale de la politique précédente à l'aide du clip, PPO stabilise l'entraînement et améliore l'efficacité en échantillons. Plus précisément, PPO met à jour la politique en maximisant l'objectif suivant :
où est une paire question- réponse issue de la distribution de données , est la plage de troncature du ratio d'échantillonnage d'importance, et est un estimateur de l'avantage au pas de temps . Étant donné la fonction de valeur et la fonction de récompense , est calculé à l'aide de l'estimation généralisée de l'avantage (GAE) [22] :
où
2.2 Group Relative Policy Optimization (GRPO)
Comparé à PPO, GRPO élimine la fonction de valeur et estime l'avantage de manière relative au groupe. Pour une paire question- réponse spécifique , la politique de comportement échantillonne un groupe de réponses individuelles . Ensuite, l'avantage de la - ème réponse est calculé en normalisant les récompenses au niveau du groupe :
Comme PPO, GRPO adopte un objectif tronqué, accompagné d'un terme de pénalité KL imposé directement :
où
Il convient également de noter que GRPO calcule l’objectif au niveau de l’échantillon. Plus précisément, GRPO calcule d’abord la perte moyenne au sein de chaque séquence générée, avant de faire la moyenne des pertes des différents échantillons. Comme nous le discuterons dans la section 3.3, cette différence peut avoir un impact sur les performances de l’algorithme.
2.3 Suppression de la divergence KL
Le terme de pénalité KL est utilisé pour réguler la divergence entre la politique en ligne et la politique de référence gelée. Dans le scénario RLHF [23], l’objectif du RL est d’aligner le comportement du modèle sans diverger trop loin du modèle initial. Cependant, lors de l’entraînement du modèle de raisonnement long-CoT, la distribution du modèle peut diverger significativement du modèle initial ; cette restriction n’est donc pas nécessaire. Par conséquent, nous exclurons le terme KL de notre algorithme proposé.
2.4 Modélisation de récompense basée sur des règles
L’utilisation d’un modèle de récompense souffre généralement du problème de piratage de récompense [24-29]. Au lieu de cela, nous utilisons directement la précision finale d’une tâche vérifiable comme récompense de résultat, calculée à l’aide de la règle suivante :
où est la réponse de référence et est la réponse prédite. Cela s’est avéré être une approche efficace pour activer la capacité de raisonnement du modèle de base, comme le montrent plusieurs domaines tels que la preuve automatique de théorèmes [30-33], la programmation informatique [34-37] et les compétitions de mathématiques [2].
3 DAPO
Nous proposons l’algorithme eouple Clip and ynamic sAmpling Policy ptimization (DAPO). DAPO échantillonne un groupe de sorties pour chaque question associée à la réponse , et optimise la politique via l’objectif suivant :
où
L'algorithme complet se trouve dans l'algorithme 1. Dans cette section, nous présenterons les techniques clés associées à DAPO.
3.1 Relever le plafond : Clip-Higher
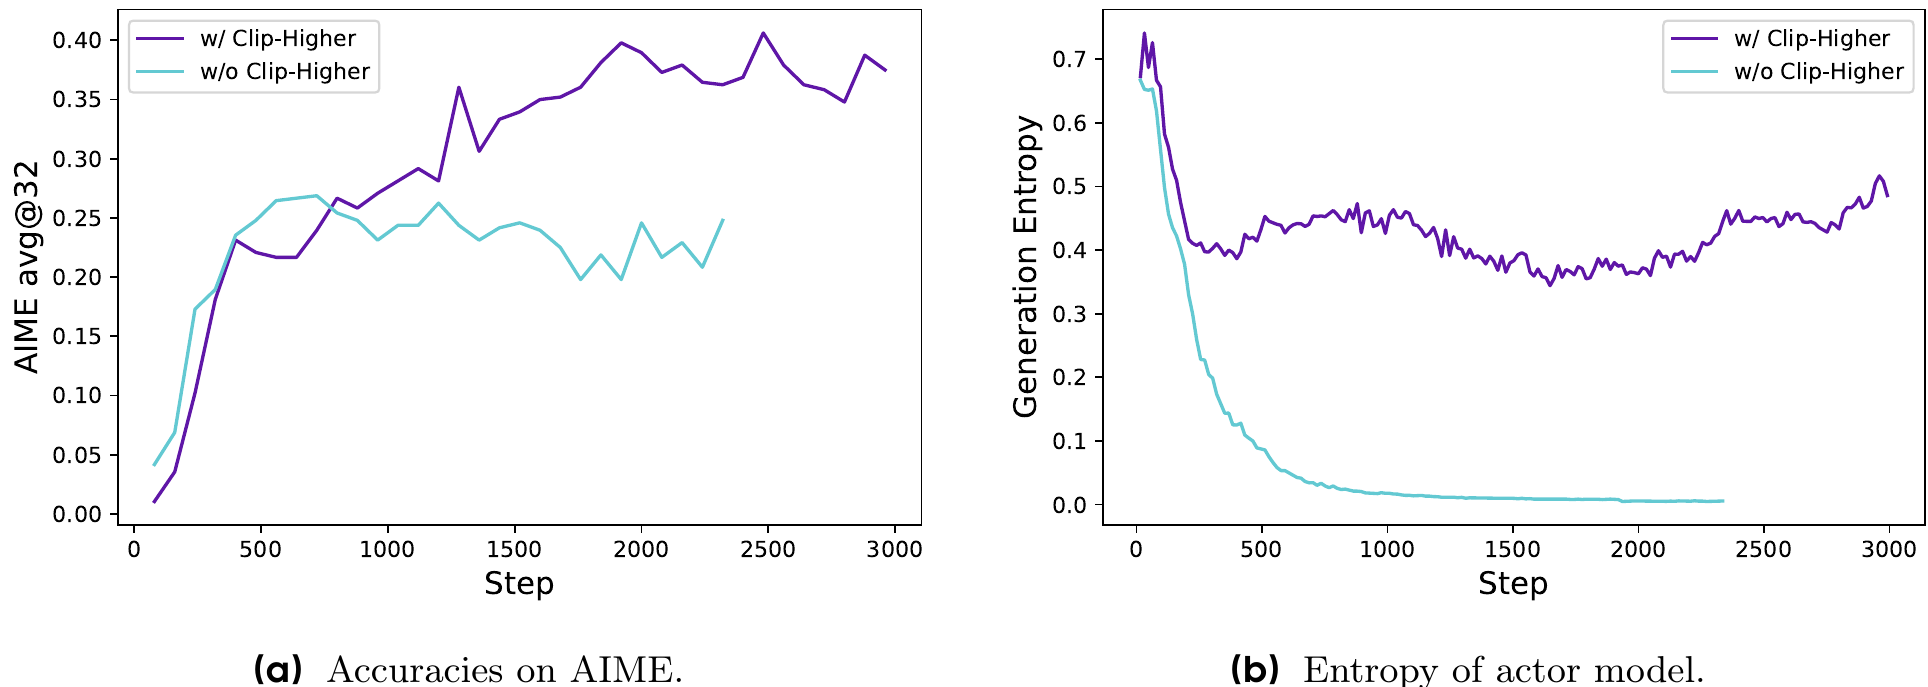
Dans nos expériences initiales utilisant le PPO naïf [21] ou GRPO [38], nous avons observé le phénomène d'effondrement de l'entropie : l'entropie de la politique diminue rapidement au fur et à mesure de l'entraînement (figure 2b). Les réponses échantillonnées de certains groupes tendent à être presque identiques. Cela indique une exploration limitée et une politique déterministe précoce, ce qui peut entraver le processus de mise à l'échelle.
Nous proposons la stratégie Clip-Higher pour remédier à ce problème. L'écrêtage du ratio d'échantillonnage par importance est introduit dans Clipped Proximal Policy Optimization (PPO-Clip) [21] afin de restreindre la région de confiance et d'améliorer la stabilité de l'apprentissage par renforcement (RL). Nous identifions que l'écrêtage supérieur peut restreindre l'exploration de la politique, où rendre un token d'« exploitation » plus probable est bien plus facile, tandis que la probabilité d'un token d'« exploration » peu probable est trop étroitement bornée pour être augmentée.
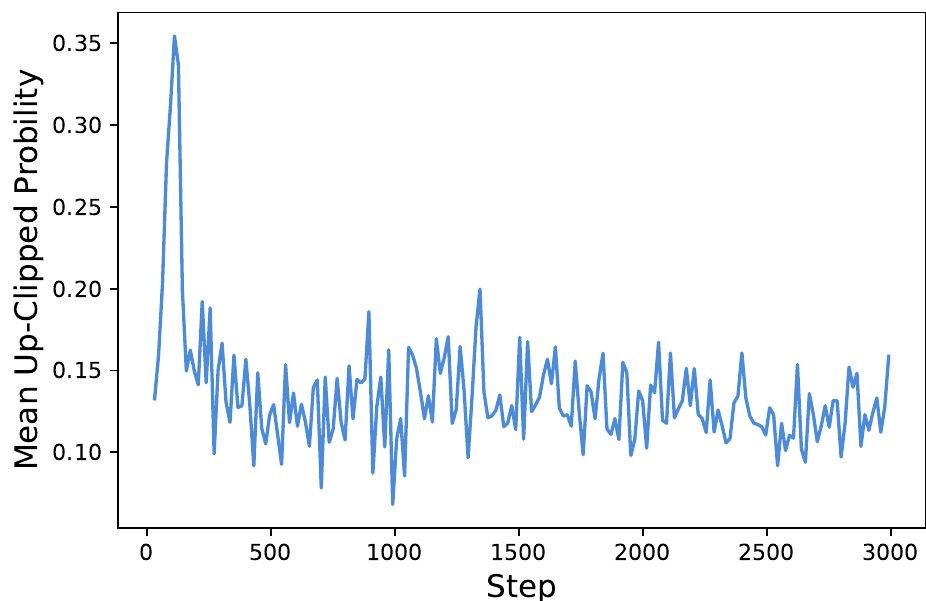
Concrètement, lorsque (la valeur par défaut de la plupart des algorithmes) et (le système tente d'augmenter la probabilité), considérons deux actions de probabilités et 0.9. Les bornes supérieures des probabilités augmentées sont respectivement 0.012 et 1.08 ( ). Cela implique que les tokens d'« exploitation » de probabilité plus élevée (par exemple 0.9) ne sont pas contraints d'atteindre des probabilités encore extrêmement plus grandes comme 0.999. Inversement, pour les tokens d'« exploration » de faible probabilité, obtenir une augmentation non triviale de la probabilité est considérablement plus difficile. Empiriquement, nous observons également que la probabilité moyenne des tokens écrêtés supérieurement est faible : (figure 3a). Ce constat soutient notre intuition selon laquelle le seuil d'écrêtage supérieur restreint effectivement l'augmentation de probabilité des tokens d'« exploration » de faible probabilité, limitant ainsi potentiellement l'exploration du système.
En suivant la stratégie Clip-Higher, nous découplons les bornes d'écrêtage inférieure et supérieure en et , comme mis en évidence dans l'équation 10 :
Nous augmentons la valeur de pour laisser plus de marge à l'augmentation des tokens de faible probabilité. Comme le montre la figure 2, cet ajustement améliore effectivement l'entropie de la politique et facilite la génération d'échantillons plus diversifiés. Nous conservons tel quel, car l'augmenter supprimerait la probabilité de ces tokens jusqu'à 0, entraînant l'effondrement de l'espace d'échantillonnage.
3.2 Plus on est de fous : échantillonnage dynamique
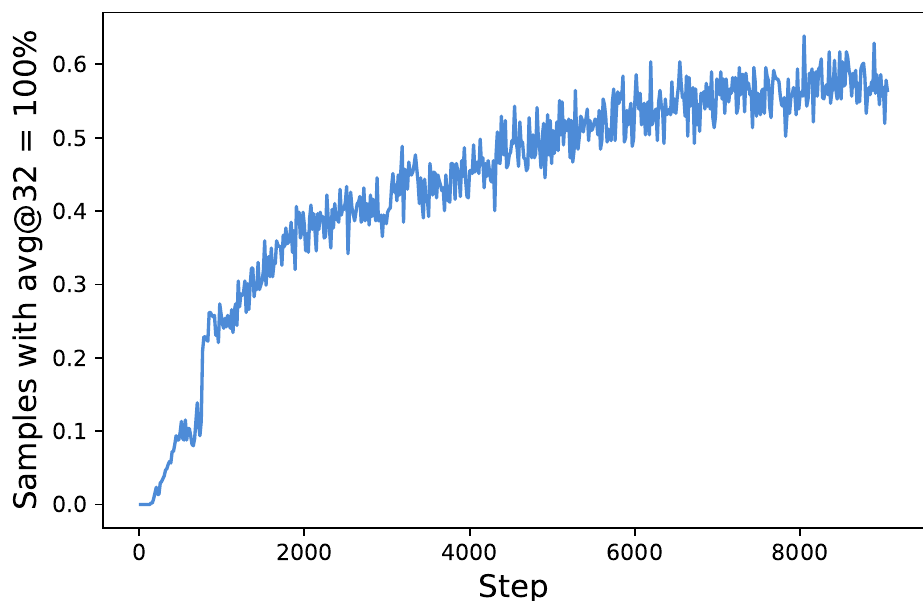
L'algorithme RL existant souffre du problème de diminution du gradient lorsque certains prompts ont une précision égale à 1. Par exemple, pour GRPO, si toutes les sorties d'un prompt particulier sont correctes et reçoivent la même récompense, l'avantage résultant pour ce groupe est nul. Un avantage nul entraîne des gradients de politique nuls, réduisant l'amplitude et augmentant la sensibilité au bruit du gradient de lot, ce qui dégrade l'efficacité d'échantillonnage. Empiriquement, le nombre d'échantillons dont la précision est égale à 1 ne cesse d'augmenter, comme le montre la figure 3b. Cela signifie que le nombre effectif de prompts dans chaque lot ne cesse de diminuer, ce qui peut conduire à une plus grande variance du gradient et atténuer les signaux de gradient pour l'entraînement du modèle.
À cette fin, nous proposons de sur-échantillonner et de filtrer les prompts dont la précision est égale à 1 et 0, comme illustré dans l'équation 11, en laissant tous les prompts du lot avec des gradients effectifs et en maintenant un nombre constant de prompts. Le coût d'échantillonnage pour chaque lot est dynamique. Avant l'entraînement, nous continuons à échantillonner jusqu'à ce que le lot soit entièrement rempli d'échantillons dont la précision n'est ni 0 ni 1.
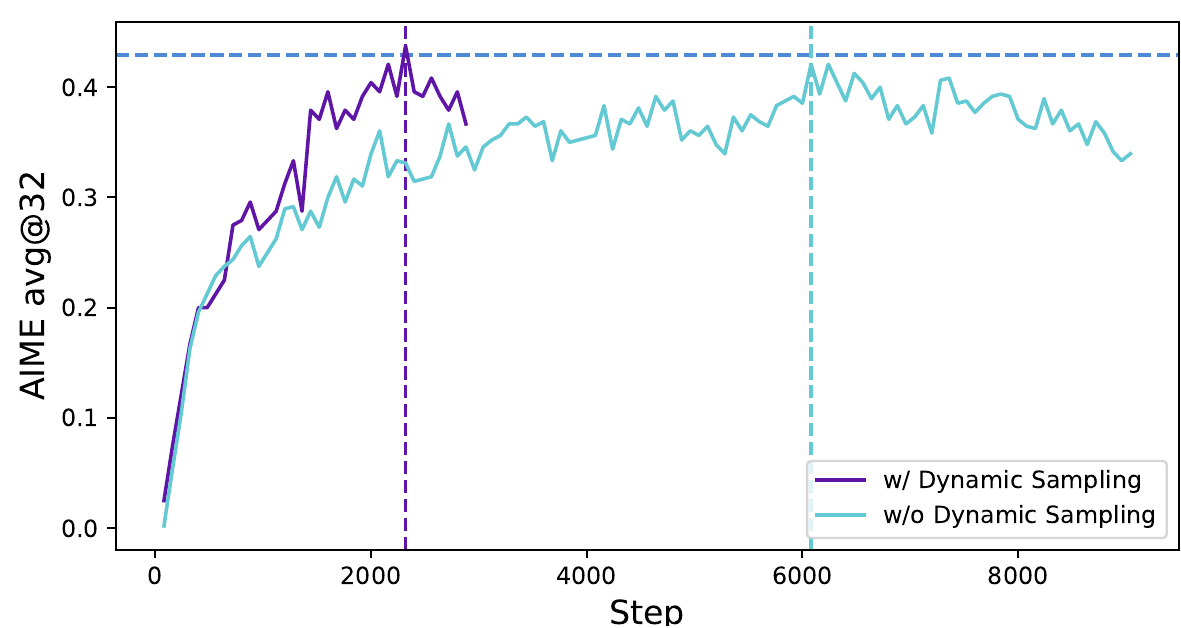
Notez que cette stratégie n'entrave pas nécessairement l'efficacité de l'entraînement, car le temps de génération est généralement dominé par la génération des échantillons à longue queue si le système RL est synchronisé et que l'étape de génération n'est pas pipelinée. En outre, nous constatons qu'avec l'échantillonnage dynamique, l'expérience atteint les mêmes performances plus rapidement, comme le montre la figure 6.
3.3 Rééquilibrage : perte de gradient de politique au niveau des tokens
L'algorithme GRPO original emploie un calcul de perte au niveau de l'échantillon, qui consiste d'abord à faire la moyenne des pertes par token au sein de chaque échantillon, puis à agréger les pertes entre les échantillons. Dans cette approche, chaque échantillon se voit attribuer un poids égal dans le calcul final de la perte. Cependant, nous constatons que cette méthode de réduction de la perte introduit plusieurs défis dans le contexte des scénarios RL à longues chaînes de raisonnement (long-CoT).
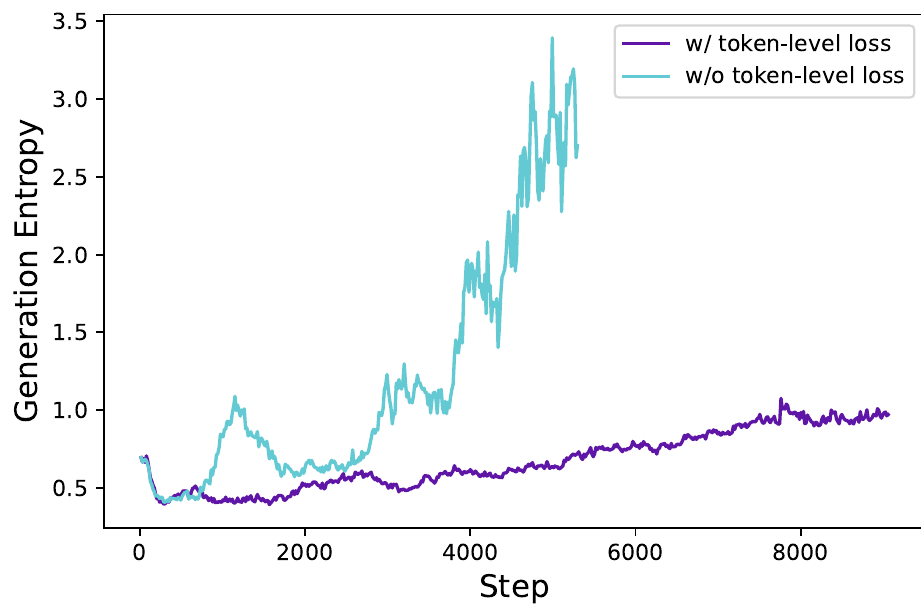
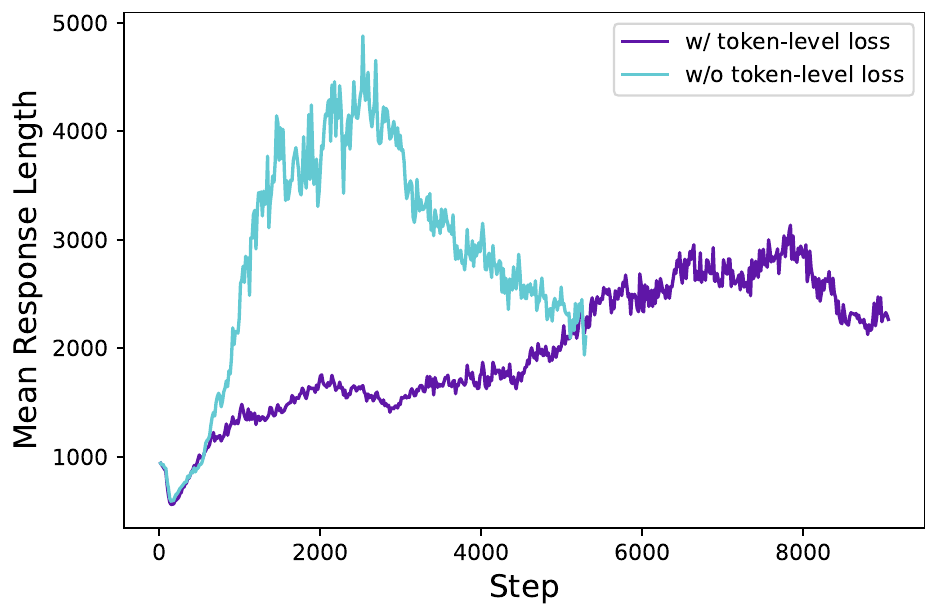
Étant donné que tous les échantillons se voient attribuer le même poids dans le calcul de la perte, les tokens au sein de réponses plus longues (qui contiennent plus de tokens) peuvent avoir une contribution disproportionnellement plus faible à la perte globale, ce qui peut entraîner deux effets néfastes. Premièrement, pour les échantillons longs de haute qualité, cet effet peut entraver la capacité du modèle à apprendre les motifs pertinents pour le raisonnement qu'ils contiennent. Deuxièmement, nous observons que les échantillons excessivement longs présentent souvent des motifs de faible qualité tels que des charabias et des mots répétitifs. Ainsi, le calcul de la perte au niveau de l'échantillon, en raison de son incapacité à pénaliser efficacement ces motifs indésirables dans les échantillons longs, conduit à une augmentation malsaine de l'entropie et de la longueur des réponses, comme le montrent la figure 4a et la figure 4b.
Nous introduisons une perte de gradient de politique au niveau des tokens dans le scénario RL à longues chaînes de raisonnement pour remédier aux limitations ci-dessus :
Dans ce cadre, les séquences plus longues peuvent avoir plus d'influence sur la mise à jour globale du gradient que les séquences plus courtes. De plus, du point de vue des tokens individuels, si un motif de génération particulier peut entraîner une augmentation ou une diminution de la récompense, il sera également favorisé ou supprimé, quelle que soit la longueur de la réponse dans laquelle il apparaît.
3.4 Cache-cache : modelage des récompenses pour les séquences trop longues
Dans l'entraînement RL, nous fixons généralement une longueur maximale pour la génération, les échantillons trop longs étant tronqués en conséquence. Nous constatons qu'une mauvaise conception de la récompense pour les échantillons tronqués peut introduire du bruit dans la récompense et perturber considérablement le processus d'entraînement.
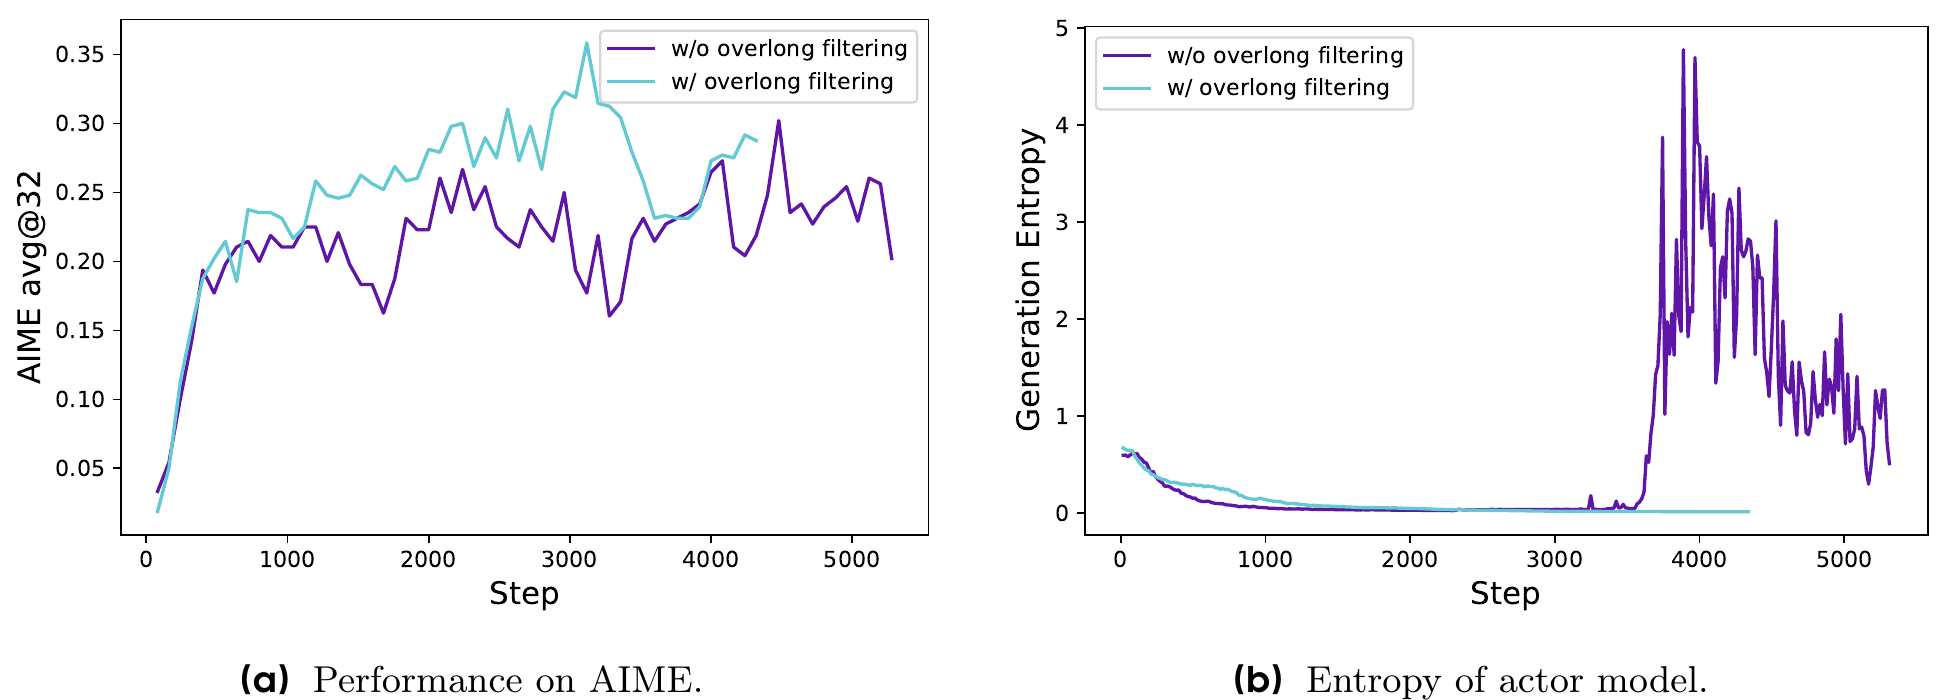
Par défaut, nous attribuons une récompense punitive aux échantillons tronqués. Cette approche peut introduire du bruit dans le processus d'entraînement, car un processus de raisonnement valide peut être pénalisé uniquement en raison de sa longueur excessive. De telles pénalités peuvent potentiellement induire le modèle en erreur quant à la validité de son processus de raisonnement.
Pour étudier l'impact de ce bruit dans la récompense, nous appliquons d'abord une stratégie de filtrage des séquences trop longues (Overlong Filtering) qui masque la perte des échantillons tronqués. Nous constatons que cette approche stabilise considérablement l'entraînement et améliore les performances, comme le montre la Figure 5.
| Algorithme 1 | DAPO : Optimisation de politique avec découpage découplé et échantillonnage dynamique |
| Entrée : modèle de politique initial πθ ; modèle de récompense R ; invites de tâche D ; hyperparamètres ε1ow, εhigh | |
| 1: pour step = 1,...,M faire | |
| 2: Échantillonner un lot Db à partir de D | |
| 3: Mettre à jour l'ancien modèle de politique πθold ← πθ | |
| 4: Échantillonner G sorties {oi}i=1G ~ πθold(·|q) pour chaque question q ∈ Db | |
| 5: Calculer les récompenses {ri}i=1G pour chaque sortie échantillonnée oi en exécutant R | |
| 6: Filtrer oi et ajouter les éléments restants au tampon d'échantillonnage dynamique (équation d'échantillonnage dynamique (11)) | |
| 7: si taille du tampon nb < N : | |
| 8: continuer | |
| 9: Pour chaque oi dans le tampon, calculer Ait,t pour le t-ième token de oi (équation (9)) | |
| 10: pour iteration = 1, ..., μ faire | |
| 11: Mettre à jour le modèle de politique πθ en maximisant l'objectif DAPO (équation (8)) | |
| Sortie πθ |
De plus, nous proposons la punition douce pour séquences trop longues (Soft Overlong Punishment, Équation 13), un mécanisme de pénalité tenant compte de la longueur, conçu pour façonner la récompense des échantillons tronqués. Plus précisément, lorsque la longueur de la réponse dépasse la valeur maximale prédéfinie, nous définissons un intervalle de punition. Dans cet intervalle, plus la réponse est longue, plus la punition reçue est grande. Cette pénalité est ajoutée à la récompense de correction d'origine basée sur des règles, signalant ainsi au modèle d'éviter les réponses excessivement longues.
3.5 Transformation du jeu de données
Notre jeu de données provient du web et des pages officielles de concours, via une combinaison de scraping web et d'annotation manuelle. Les réponses du jeu de données mathématique se présentent généralement sous une variété de formats, tels que des expressions, des formules et des nombres, ce qui rend difficile la conception de règles complètes pour les analyser. Afin de fournir des signaux de récompense précis à l'aide de règles et de minimiser les erreurs introduites par les analyseurs de formules, inspirés par AIME, nous sélectionnons et transformons les réponses en entiers, faciles à analyser. Par exemple, si la réponse d'origine est exprimée sous la forme , nous demandons au LLM de modifier la question afin que la réponse attendue devienne . Après sélection et transformation, nous avons obtenu le jeu de données DAPO-Math-17K, qui comprend 17K prompts, chacun étant associé à un entier comme réponse.
4 Expériences
4.1 Détails d'entraînement
Dans ce travail, nous nous concentrons spécifiquement sur des tâches mathématiques pour évaluer notre algorithme, qui peut être facilement transféré à d'autres tâches. Nous adoptons le framework veri [20] pour l'entraînement. Nous utilisons le GRPO naïf [38] comme algorithme de référence et estimons les avantages à l'aide de la normalisation des récompenses par groupe.
Pour les hyperparamètres, nous utilisons l'optimiseur AdamW [39] avec un taux d'apprentissage constant de , en incorporant un warm-up linéaire sur 20 étapes de rollout. Pour le rollout, la taille de batch des prompts est de 512 et nous échantillonnons 16 réponses pour chaque prompt. Pour l'entraînement, la taille de mini-batch est fixée à 512, c'est-à-dire 16 mises à jour de gradient pour chaque étape de rollout. Pour l'Overlong Reward Shaping, nous fixons la longueur maximale attendue à 16 384 tokens et allouons 4 096 tokens supplémentaires comme cache de punition douce. Par conséquent, le nombre maximal de tokens pour la génération est fixé à 20 480 tokens. Quant au mécanisme Clip-Higher, nous fixons le paramètre de clipping à 0,2 et à 0,28, ce qui équilibre efficacement le compromis entre exploration et exploitation. Pour l'évaluation sur AIME, nous répétons l'ensemble d'évaluation 32 fois et rapportons avg@32 pour la stabilité des résultats. Les hyperparamètres d'inférence pour l'évaluation sont fixés à une température de 1,0 et un top-p de 0,7.
4.2 Résultats principaux
Les expériences sur AIME 2024 démontrent que DAPO a réussi à entraîner le modèle Qwen-32B Base pour en faire un puissant modèle de raisonnement, atteignant des performances supérieures aux expériences de DeepSeek sur Qwen2.5-32B utilisant l'approche R1. Dans la Figure 1, nous observons une amélioration substantielle des performances sur AIME 2024, avec une précision passant de près de 0 % à 50 %. Notamment, cette amélioration est obtenue avec seulement 50 % des étapes d'entraînement requises par DeepSeek-R1-Zero-Qwen-32B.
Nous analysons les contributions de chaque technique d'entraînement de notre méthodologie, comme détaillé dans le Tableau 1. Les améliorations observées démontrent l'efficacité de ces techniques dans l'entraînement RL, chacune contribuant
| Modèle | AIME24avg@32 |
| DeepSeek-R1-Zero-Qwen-32B | 47 |
| GRPO simple | 30 |
| + Filtrage des séquences trop longues | 36 |
| + Clip-Higher | 38 |
| + Pénalité douce pour séquences trop longues | 41 |
| + Perte au niveau des tokens | 42 |
| + Échantillonnage dynamique (DAPO) | 50 |
de plusieurs points de précision sur AIME 2024. Notamment, avec le cadre GRPO naïf, seuls de précision peuvent être atteints en entraînant à partir d'un modèle de base Qwen2.5-32B.
Pour la perte au niveau des tokens, bien qu'elle apporte une moindre amélioration des performances, nous constatons qu'elle renforce la stabilité de l'entraînement et rend l'augmentation de la longueur plus saine.
En appliquant l'échantillonnage dynamique, bien que davantage de données doivent être échantillonnées en raison du filtrage des données à gradient nul, le temps d'entraînement global n'est pas significativement affecté. Comme le montre la Figure 6, bien que le nombre d'instances d'échantillonnage augmente, le temps de convergence du modèle est même réduit, en raison du plus petit nombre d'étapes d'entraînement nécessaires.
4.3 Dynamique d'entraînement
L'apprentissage par renforcement sur les grands modèles de langage n'est pas seulement une direction de recherche de pointe, mais aussi un défi d'ingénierie système intrinsèquement complexe, caractérisé par l'interdépendance de ses divers sous-systèmes. Les modifications apportées à un seul sous-système peuvent se propager à travers le système, entraînant des conséquences imprévues en raison de l'interaction complexe entre ces composants. Même des changements apparemment mineurs dans les conditions initiales, tels que des variations dans les données et les hyperparamètres, peuvent s'amplifier à travers les processus itératifs d'apprentissage par renforcement, produisant des écarts substantiels dans les résultats. Cette complexité confronte souvent les chercheurs à un dilemme : même après une analyse minutieuse et des attentes bien fondées qu'une modification améliorera des aspects spécifiques du processus d'entraînement, les résultats réels divergent fréquemment de la trajectoire anticipée. Par conséquent, la surveillance des principaux résultats intermédiaires pendant l'expérimentation est essentielle pour identifier rapidement les sources d'écart et, en fin de compte, pour affiner le système.
- La longueur des réponses générées est une métrique étroitement liée à la stabilité de l'entraînement et aux performances, comme le montre la Figure 7a. L'augmentation de la longueur offre au modèle un espace d'exploration plus large, permettant d'échantillonner des comportements de raisonnement plus complexes et de les renforcer progressivement par l'entraînement. Cependant, il est important de noter que la longueur ne maintient pas toujours une tendance à la hausse continue pendant l'entraînement. Sur certaines périodes considérables, elle peut présenter une tendance à la stagnation, voire à la baisse, ce qui a également été démontré dans [2]. Nous utilisons généralement la longueur conjointement avec la précision de validation comme indicateurs pour évaluer si une expérience se détériore.
- La dynamique de la récompense pendant l'entraînement a toujours été l'un des indicateurs de surveillance cruciaux en apprentissage par renforcement, comme le montre la Figure 7b. Dans la majorité de nos expériences, la tendance à l'augmentation de la récompense est relativement stable et ne fluctue pas ni ne diminue significativement en raison d'ajustements des paramètres expérimentaux. Cela indique que, avec un signal de récompense fiable, les modèles de langage peuvent ajuster de manière robuste la distribution de l'ensemble d'entraînement. Cependant, nous constatons que la récompense finale sur l'ensemble d'entraînement présente souvent peu de corrélation avec la précision sur l'ensemble de validation, ce qui indique un surapprentissage de l'ensemble d'entraînement.
- L'entropie du modèle acteur et la probabilité de génération sont liées à la capacité d'exploration du modèle et constituent des métriques clés que nous surveillons attentivement dans nos expériences. Intuitivement, l'entropie du modèle doit être maintenue dans une plage appropriée. Une entropie excessivement faible indique que la distribution de probabilité est trop pointue, entraînant une perte de capacité d'exploration. À l'inverse, une
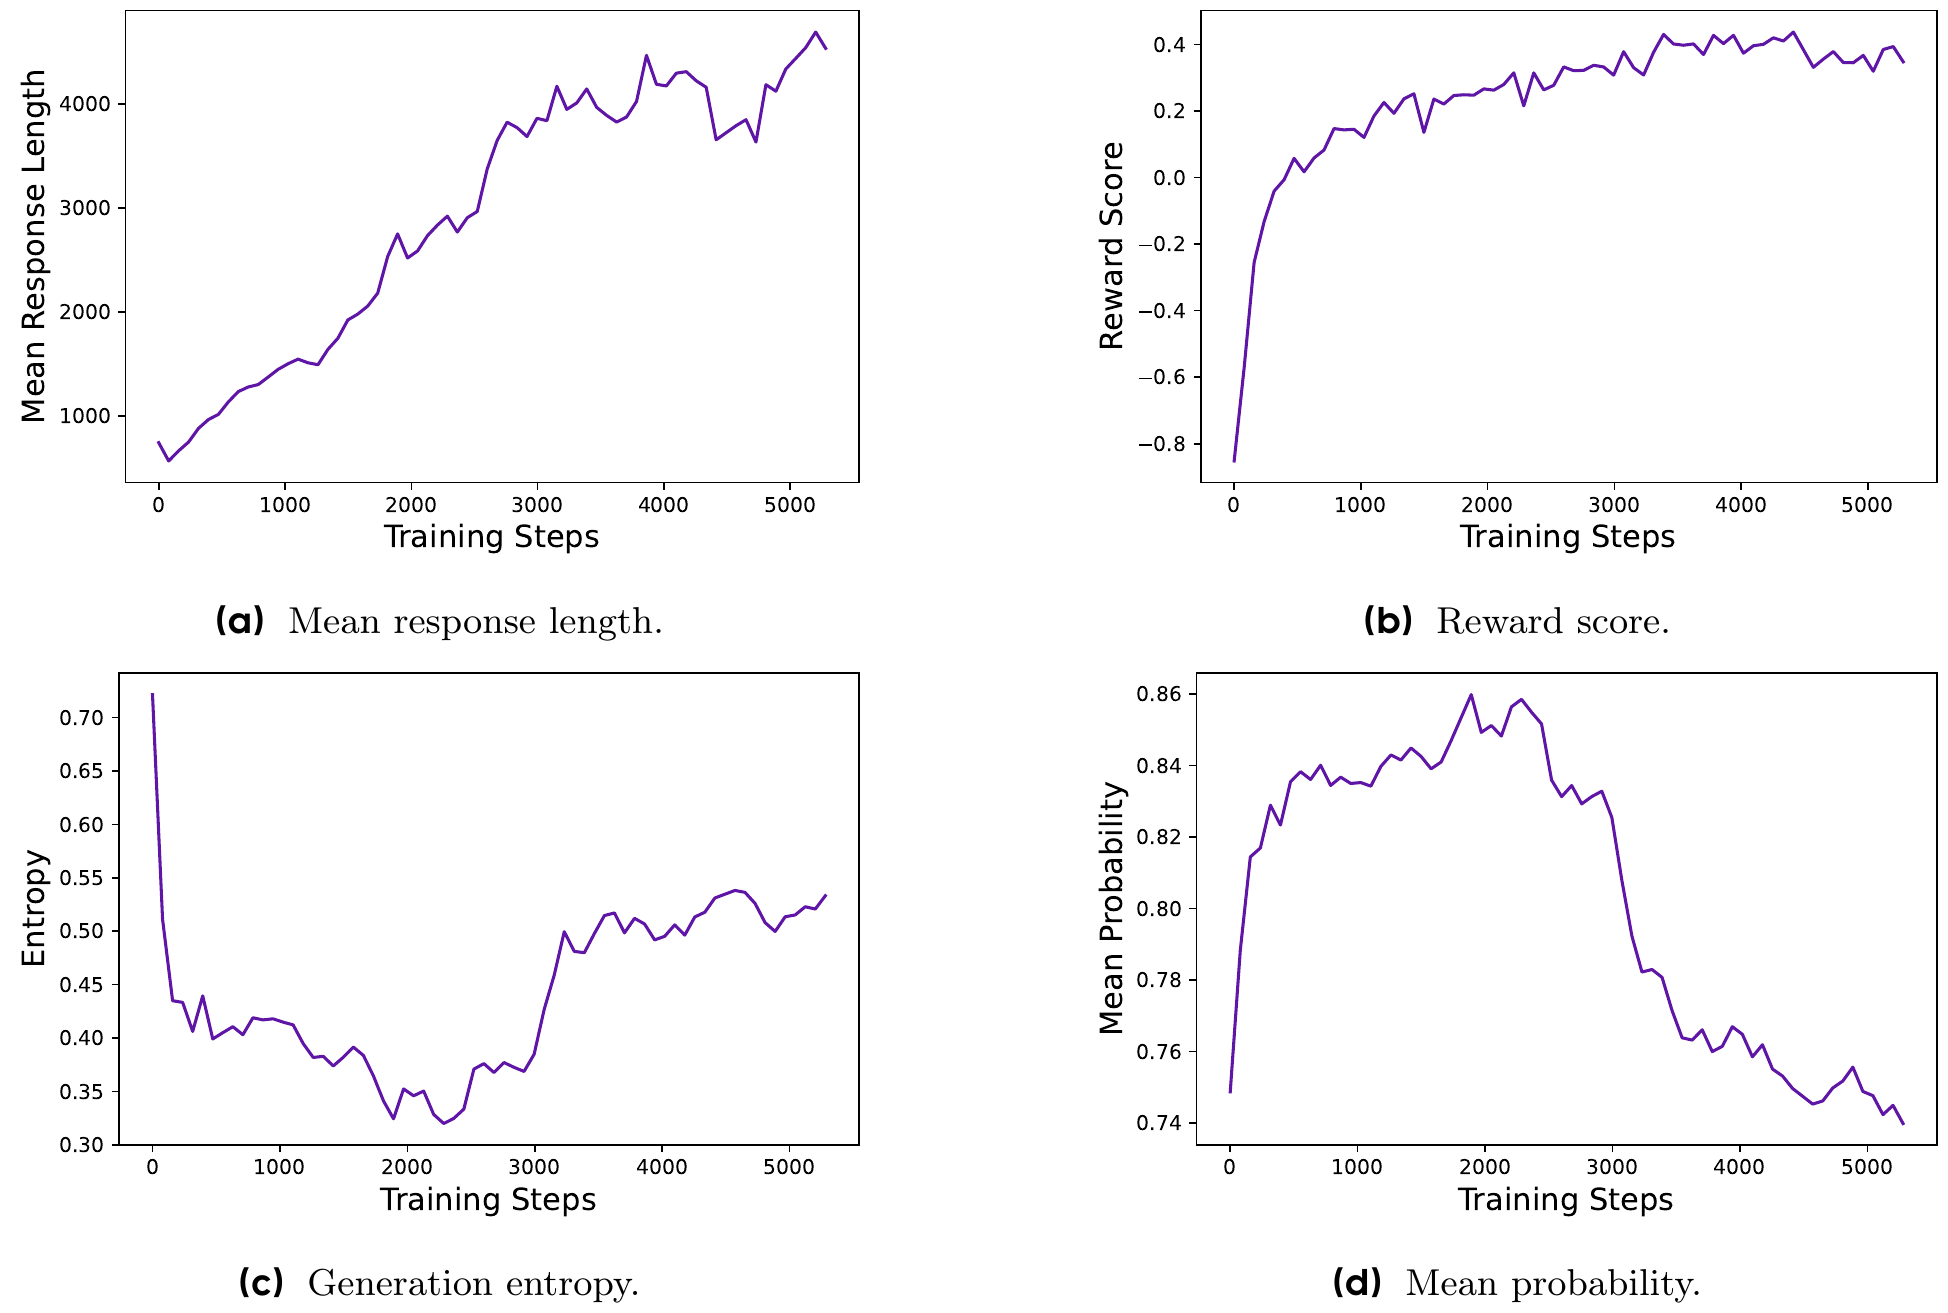
entropie excessivement élevée est souvent associée à des problèmes de surexploration tels que la génération de charabia et de répétitions. Pour la probabilité de génération, la situation est exactement l'inverse. Comme démontré dans la Section 3.1, en appliquant la stratégie Clip-Higher, nous avons efficacement résolu le problème de l'effondrement de l'entropie. Dans les expériences ultérieures, nous constatons que le maintien d'une lente tendance à la hausse de l'entropie est propice à l'amélioration des performances du modèle, comme le montrent la Figure 7c et la Figure 7d.
4.4 Étude de cas
Au cours du processus d'entraînement RL, nous observons un phénomène intéressant : les schémas de raisonnement du modèle acteur évoluent dynamiquement au fil du temps. Plus précisément, l'algorithme ne renforce pas seulement les schémas de raisonnement existants qui facilitent la résolution correcte des problèmes, mais fait également émerger progressivement des modes de raisonnement entièrement nouveaux qui étaient initialement absents. Cette découverte révèle la capacité d'adaptation et d'exploration des algorithmes RL et offre de nouvelles perspectives sur les mécanismes d'apprentissage du modèle.
Par exemple, dans les premiers stades de l'entraînement du modèle, il n'y avait pratiquement aucune occurrence de vérification et de réflexion sur les étapes de raisonnement précédentes. Cependant, au fur et à mesure de l'entraînement, le modèle présente des comportements distincts de réflexion et de retour en arrière, comme le montre le Tableau 2. Cette observation éclaire l'exploration plus approfondie de l'interprétation de l'émergence des capacités de raisonnement pendant le RL, que nous laissons pour des recherches futures.
5 Conclusion
Dans cet article, nous publions un système entièrement open source pour le RL à grande échelle des LLM, comprenant l'algorithme, l'infrastructure de code et l'ensemble de données. Le système atteint des performances de pointe en RL à grande échelle pour les LLM (AIME 50 en utilisant le modèle pré-entraîné Qwen-32B). Nous proposons la politique Decoupled Clip and Dynamic sAmpling
Question :
Étant donné que la base du tétraèdre est un triangle équilatéral, la projection du point sur la face est l'orthocentre de , l'angle dièdre est de et , trouvez le volume du tétraèdre. La réponse est de la forme , donnez donc la valeur de .
Réponse :
Considérons le problème donné : Nous devons déterminer ... Ensuite, soit de coordonnées . Puisque , la formule de distance nous donne , nous pouvons donc écrire . Maintenant, rappelons-nous que est la projection orthogonale de Cependant, attendons un instant, repensons à l'angle dièdre impliquant des plans d'une manière géométrique plus réfléchie. Considérons le plan , qui se trouve entièrement sur le plan de coordonnées xy (comme ). Soit le plan . Le point projeté perpendiculairement sur le plan tombe sur . La droite ......
Tableau 2 Émergence du comportement réflexif dans l'algorithme d'optimisation par apprentissage par renforcement (DAPO), et présentation de 4 techniques clés pour rendre l'apprentissage par renforcement puissamment efficace et efficient dans le scénario d'apprentissage par renforcement à longue chaîne de pensée (long-CoT). De plus, en ouvrant le code d'entraînement et le jeu de données, nous offrons à la communauté de recherche et à la société au sens large un accès pratique à une solution d'apprentissage par renforcement extensible, permettant à tous de bénéficier de ces avancées.
Contributions
Responsable du projet
Qiying
Algorithme
Qiying , Zheng Zhang , Ruofei Zhu , Yufeng Yuan , Xiaochen Zuo , Yu Yue
Infrastructure\*
Weinan Dai , Tiantian Fan , Gaohong Liu , Juncai Liu , Lingjun Liu , Xin Liu , Haibin Lin , Zhiqi Lin , Bole Ma , Guangming Sheng , Yuxuan Tong , Qiying Yu , Chi Zhang , Mofan Zhang , Ru Zhang , Wang Zhang , Hang Zhu , Jinhua Zhu
\*Nom de famille par ordre alphabétique
Jeu de données
Jiaze Chen , Jiangjie Chen , Chengyi Wang , Hongli Yu , Yuxuan Song , Xiangpeng Wei , Qiying
Supervision
Hao Zhou , Jingjing Liu , Wei- Ying Ma , Ya- Qin Zhang , Lin Yan , Mu Qiao , Yonghui Wu , Mingxuan Wang
Affiliations
ByteDance Seed
Institute for AI Industry Research (AIR), Université Tsinghua
The University of Hong Kong
SIA- Lab de Tsinghua AIR et ByteDance Seed
Remerciements
Nous remercions Zhengyin Du, Shengding Hu, Kai Shen, Tianyang Zhan, Zhen Xiao, Renjie Zheng, Li Han, Kaihua Jiang ainsi que d'autres collègues de ByteDance pour leur soutien au projet DAPO.
Références
[1] OpenAI. Learning to reason with llms, 2024.
[2] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
[3] OpenAI. Rapport technique GPT4. Prépublication arXiv arXiv:2303.08774, 2023.
[4] Anthropic. Claude 3.5 sonnet, 2024.
[5] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. Les modèles de langage sont des apprenants à quelques exemples. Advances in neural information processing systems, 33:1877-1901, 2020.
[6] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. Palm : Mise à l'échelle de la modélisation linguistique avec pathways. Journal of Machine Learning Research, 24(240):1-113, 2023.
[7] Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang, Bochao Wu, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chenyu Zhang, Chong Ruan, et al. Rapport technique Deepseek-v3. Prépublication arXiv arXiv:2412.19437, 2024.
[8] XAI. Grok 3 beta — l'ère des agents de raisonnement, 2024.
[9] Google DeepMind. Gemini 2.0 flash thinking, 2024.
[10] Qwen. Qwq-32b : Adopter la puissance de l'apprentissage par renforcement, 2024.
[11] Kimi Team, Angang Du, Bofei Gao, Bowei Xing, Changjiu Jiang, Cheng Chen, Cheng Li, Chenjun Xiao, Chenzhuang Du, Chonghua Liao, et al. Kimi k1.5 : Mise à l'échelle de l'apprentissage par renforcement avec les LLM. Prépublication arXiv arXiv:2501.12599, 2025.
[12] An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, et al. Rapport technique Qwen2.5. Prépublication arXiv arXiv:2412.15115, 2024.
[13] Zhipeng Chen, Yingqian Min, Beichen Zhang, Jie Chen, Jinhao Jiang, Daixuan Cheng, Wayne Xin Zhao, Zheng Liu, Xu Miao, Yang Lu, et al. Une étude empirique sur l'élicitation et l'amélioration de modèles de raisonnement de type RL. Prépublication arXiv arXiv:2503.04548, 2025.
[14] Jingcheng Hu, Yinmin Zhang, Qi Han, Daxin Jiang, et Heung-Yeung Shum Xiangyu Zhang. Open-reasoner-zero : Une approche open source pour la mise à l'échelle de l'apprentissage par renforcement sur le modèle de base. https://github.com/Open-Reasoner-Zero/Open-Reasoner-Zero, 2025.
[15] Jian Hu. Reinforce++ : Une approche simple et efficace pour l'alignement des grands modèles de langage. Prépublication arXiv arXiv:2501.03262, 2025.
[16] Ganqu Cui, Lifan Yuan, Zefan Wang, Hanbin Wang, Wendi Li, Bingxiang He, Yuchen Fan, Tianyu Yu, Qixin Xu, Weize Chen, et al. Renforcement du processus par récompenses implicites. Prépublication arXiv arXiv:2502.01456, 2025.
[17] Jung Hyun Lee, June Yong Yang, Byeongho Heo, Dongyoon Han, et Kang Min Yoo. Modèles de valeur supervisés par tokens pour améliorer les capacités de raisonnement mathématique des grands modèles de langage. Prépublication arXiv arXiv:2407.12863, 2024.
[18] Amirhossein Kazemnejad, Milad Aghajohari, Eva Portelance, Alessandro Sordoni, Siva Reddy, Aaron Courville, et Nicolas Le Roux. Vineppo : Libérer le potentiel du RL pour le raisonnement des LLM grâce à une attribution raffinée du crédit. Prépublication arXiv arXiv:2410.01679, 2024.
[19] Yufeng Yuan, Yu Yue, Ruofei Zhu, Tiantian Fan, et Lin Yan. Qu'y a-t-il derrière l'effondrement de PPO dans les longues chaînes de pensée ? L'optimisation de la valeur détient le secret. Prépublication arXiv arXiv:2503.01491, 2025.
[20] Guangming Sheng, Chi Zhang, Zilingfeng Ye, Xibin Wu, Wang Zhang, Ru Zhang, Yanghua Peng, Haibin Lin, et Chuan Wu. Hybridflow : Un framework RLHF flexible et efficace. Prépublication arXiv arXiv:2409.19256, 2024.
[21] John Schulman, Filip Wolski, Prafulla Dhariwal, Alec Radford, et Oleg Klimov. Algorithmes d'optimisation de politique proximale. Prépublication arXiv arXiv:1707.06347, 2017.
[22] John Schulman, Philipp Moritz, Sergey Levine, Michael Jordan, et Pieter Abbeel. Contrôle continu en haute dimension utilisant l'estimation d'avantage généralisée, 2018.
[23] Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, John Schulman, Jacob Hilton, Fraser Kelton, Luke Miller, Maddie Simens, Amanda Askell, Peter Welinder, Paul F Christiano, Jan Leike, et Ryan Lowe. Entraîner des modèles de langage à suivre des instructions avec le retour humain. In S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho, et A. Oh, éditeurs, Advances in Neural Information Processing Systems, volume 35, pages 27730-27744. Curran Associates, Inc., 2022.
[24] Dario Amodei, Chris Olah, Jacob Steinhardt, Paul Christiano, John Schulman, et Dan Mane. Problèmes concrets en sûreté de l'IA, 2016.
[25] Tom Everitt, Victoria Krakovna, Laurent Orseau, Marcus Hutter, et Shane Legg. Apprentissage par renforcement avec un canal de récompense corrompu, 2017.
[26] Victoria Krakovna, Jonathan Uesato, Vladimir Mikulik, Matthew Rahtz, Tom Everitt, Ramana Kumar, Zac Kenton, Jan Leike, et Shane Legg. Spécification ludique : le revers de l'ingéniosité de l'IA, 2020.
[27] Tom Everitt, Marcus Hutter, Ramana Kumar, et Victoria Krakovna. Problèmes et solutions de falsification de récompense en apprentissage par renforcement : Une perspective par diagramme d'influence causale, 2021.
[28] Leo Gao, John Schulman, et Jacob Hilton. Lois d'échelle pour la suroptimisation des modèles de récompense, 2022.
[29] Lilian Weng. Piratage de récompense en apprentissage par renforcement. lilianweng.github.io, nov 2024.
[30] Stanislas Polu et Ilya Sutskever. Modélisation linguistique générative pour la démonstration automatisée de théorèmes, 2020.
[31] Trieu H Trinh, Yuhuai Wu, Quoc V Le, He He, et Thang Luong. Résoudre la géométrie des olympiades sans démonstrations humaines. Nature, 625(7995):476-482, 2024.
[32] Trieu Trinh et Thang Luong. Alphageometry : Un système d'IA de niveau olympiade pour la géométrie, 2024.
[33] AlphaProof et AlphaGeometry Teams. L'IA atteint le standard de la médaille d'argent en résolvant des problèmes des Olympiades internationales de mathématiques, 2024.
[34] Hung Le, Yue Wang, Akhilesh Deepak Gotmare, Silvio Savarese, et Steven Chu Hong Hoi. Coderl : Maîtriser la génération de code grâce à des modèles préentraînés et à l'apprentissage par renforcement profond. Advances in Neural Information Processing Systems, 35:21314-21328, 2022.
[35] Noah Shinn, Federico Cassano, Edward Berman, Ashwin Gopinath, Karthik Narasimhan, et Shunyu Yao. Reflexion : Agents linguistiques avec apprentissage par renforcement verbal, 2023.
[36] Xinyun Chen, Maxwell Lin, Nathanael Schärli, et Denny Zhou. Apprendre aux grands modèles de langage à s'auto-déboguer, 2023.
[37] Jonas Gehring, Kunhao Zheng, Jade Copet, Vegard Mella, Quentin Carbonneaux, Taco Cohen, et Gabriel Synnaeve. Rlcf : Ancrer les LLM de code dans le retour d'exécution avec l'apprentissage par renforcement, 2025.
[38] Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Mingchuan Zhang, YK Li, Y Wu, et Daya Guo. Deepseekmath : Repousser les limites du raisonnement mathématique dans les modèles de langage ouverts. Prépublication arXiv arXiv:2402.03300, 2024.
[39] Ilya Loshchilov et Frank Hutter. Régularisation par décroissance de poids découplée. In International Conference on Learning Representations, 2019.
Annexe
A Transformation des données
Voici un exemple de transformation de données, où nous présentons le problème original, le problème transformé, et les sorties du modèle pendant le processus de transformation (l'original est en texte markdown, qui a été rendu pour la lisibilité).
Pour garantir que le modèle puisse accomplir cette tâche avec une grande précision, notre objectif est qu'il effectue un raisonnement complet tout en évitant les hallucinations. Nous y parvenons en fournissant un cadre de réflexion clair qui encourage un raisonnement approfondi. Plus précisément, nous employons le raisonnement en Chaîne de Pensée (CoT) avec quatre étapes bien définies : extraire le format de la réponse, reformuler l'énoncé du problème, résoudre le problème modifié et fournir un entier comme réponse finale. Pour chaque étape, nous fournissons des solutions en few-shot ou des directives détaillées pour guider le raisonnement du modèle.
Grâce à cette approche, nous avons observé que dans la plupart des cas, le LLM peut générer des reformulations dont le format et la qualité sont satisfaisants.
Problème original
Soient et des nombres réels tels que . Déterminer la plus petite valeur possible de . Réponse :
Problème transformé
Soient et des nombres réels tels que . Déterminer la plus petite valeur possible de . La réponse originale est de la forme , où , , et sont des entiers. Veuillez trouver la valeur de . Réponse : 19
Sortie du modèle (texte Markdown)
Processus de réflexion de la transformation
La réponse originale au problème est une expression algébrique . Nous devons la transformer en une forme entière. Tout d'abord, notons que la réponse se compose d'une partie entière et d'un terme de racine carrée. Selon la règle donnée, nous remplaçons les composantes entière et de racine carrée par des coefficients indéterminés. Le problème original utilise et comme variables, nous choisissons donc d'autres lettres comme coefficients indéterminés. Nous exprimons la réponse sous la forme et demandons à l'étudiant de trouver .
Format de la réponse
Problème transformé
Soient et des nombres réels tels que . Déterminer la plus petite valeur possible de . La réponse originale est de la forme , où , et sont des entiers. Veuillez trouver la valeur de .
Calcul de la réponse pour le problème transformé
La réponse originale est : . Le format requis est : . En faisant correspondre les coefficients : , , . Le résultat final est : .
Réponse finale
B Cas supplémentaire
Question :
Parmi les 900 habitants d'Aimeville, il y en a 195 qui possèdent une bague en diamant, 367 qui possèdent un ensemble de clubs de golf, et 562 qui possèdent une bêche de jardin. De plus, chacun des 900 habitants possède un sachet de cœurs en bonbon. Il y a 437 habitants qui possèdent exactement deux de ces choses, et 234 habitants qui possèdent exactement trois de ces choses. Trouver le nombre d'habitants d'Aimeville qui possèdent les quatre de ces choses.
Réponse :
Solution étape par étape :
1. Définissons les variables suivantes :
Soit l'ensemble des habitants qui possèdent une bague en diamant.
Soit l'ensemble des habitants qui possèdent un ensemble de clubs de golf.
Soit l'ensemble des habitants qui possèdent une bêche de jardin.
Soit l'ensemble des habitants qui possèdent un sachet de cœurs en bonbon. Puisque les 900 habitants possèdent tous un sachet de cœurs en bonbon,
Soit le nombre d'habitants qui possèdent exactement des 4 objets.
Utilisons le principe d'inclusion-exclusion pour la réunion de 4 ensembles
...
Puisque , le nombre de personnes possédant les quatre objets, doit être un nombre entier, notre approche actuelle doit être reconsidérée en termes de comptage combinatoire des personnes possédant différentes combinaisons des objets.
Au lieu d'utiliser directement le principe d'inclusion-exclusion, nous pouvons utiliser une approche différente impliquant le nombre de personnes possédant des combinaisons des objets , , et .
Soit le nombre de personnes possédant exactement objet parmi , , (en excluant l'objet que tout le monde possède).
Alors le nombre total de personnes possédant exactement objets parmi les , , et peut être décomposé :
...
Tableau 3 Un cas d'émergence d'un comportement réflexif.