L'attention remplace récurrence et convolution: le Transformer. L'article NIPS 2017 à l'origine des grands modèles de langue, à lire en ligne gratuitement.
Sous réserve d’une attribution appropriée, Google accorde par la présente l’autorisation de reproduire les tableaux et figures de cet article uniquement pour des travaux journalistiques ou universitaires.
Attention Is All You Need
*Ashish Vaswani Google Brain avaswani@google.com
*Noam Shazeer Google Brain noam@google.com
*Niki Parmar Google Research nikip@google.com
*Jakob Uszkoreit Google Research usz@google.com
*Llion Jones Google Research llion@google.com
*Aidan N. Gomez† University of Toronto aidan@cs.toronto.edu
*Lukasz Kaiser Google Brain lukaszkaiser@google.com
*Illia Polosukhin† illia.polosukhin@gmail.com
Résumé
Les modèles dominants de transduction de séquences sont fondés sur des réseaux neuronaux récurrents ou convolutifs complexes comprenant un encodeur et un décodeur. Les modèles les plus performants relient également l’encodeur et le décodeur par un mécanisme d’attention. Nous proposons une nouvelle architecture de réseau simple, le Transformer, fondée uniquement sur des mécanismes d’attention, en abandonnant entièrement la récurrence et les convolutions. Des expériences sur deux tâches de traduction automatique montrent que ces modèles sont supérieurs en qualité tout en étant plus parallélisables et en nécessitant nettement moins de temps d’entraînement. Notre modèle atteint 28,4 BLEU sur la tâche de traduction anglais-vers-allemand de WMT 2014, améliorant de plus de 2 BLEU les meilleurs résultats existants, y compris les ensembles. Sur la tâche de traduction anglais-vers-français de WMT 2014, notre modèle établit un nouveau score BLEU à l’état de l’art pour un modèle unique de 41,8 après un entraînement de 3,5 jours sur huit GPU, soit une faible fraction des coûts d’entraînement des meilleurs modèles de la littérature. Nous montrons que le Transformer généralise bien à d’autres tâches en l’appliquant avec succès à l’analyse syntaxique en constituants de l’anglais, tant avec de grandes qu’avec des quantités limitées de données d’entraînement.
1 Introduction
Les réseaux neuronaux récurrents, en particulier la mémoire à long terme et à court terme [13] et les réseaux neuronaux récurrents à portes [7], se sont fermement établis comme approches à l’état de l’art en modélisation de séquences et en problèmes de transduction tels que la modélisation du langage et la traduction automatique [35] [2] [5]. De nombreux efforts ont depuis continué à repousser les limites des modèles de langage récurrents et des architectures encodeur-décodeur [38] [24] [15].
Les modèles récurrents factorisent généralement le calcul selon les positions des symboles des séquences d’entrée et de sortie. En alignant les positions sur les étapes du temps de calcul, ils génèrent une séquence d’états cachés , en fonction de l’état caché précédent et de l’entrée pour la position . Cette nature intrinsèquement séquentielle empêche la parallélisation au sein des exemples d’entraînement, ce qui devient critique pour des longueurs de séquence plus grandes, car les contraintes de mémoire limitent le traitement par lots entre exemples. Des travaux récents ont obtenu des améliorations significatives de l’efficacité computationnelle grâce à des astuces de factorisation [21] et au calcul conditionnel [32], tout en améliorant également la performance du modèle dans le cas de ce dernier. La contrainte fondamentale du calcul séquentiel demeure toutefois.
Les mécanismes d’attention sont devenus une partie intégrante des modèles convaincants de modélisation de séquences et de transduction dans diverses tâches, permettant de modéliser les dépendances sans égard à leur distance dans les séquences d’entrée ou de sortie [2] [19]. Dans tous les cas sauf quelques-uns [27], cependant, ces mécanismes d’attention sont utilisés conjointement avec un réseau récurrent.
Dans ce travail, nous proposons le Transformer, une architecture de modèle évitant la récurrence et reposant entièrement sur un mécanisme d’attention pour tirer des dépendances globales entre l’entrée et la sortie. Le Transformer permet une parallélisation nettement plus grande et peut atteindre un nouvel état de l’art en qualité de traduction après un entraînement d’aussi peu que douze heures sur huit GPU P100.
2 Contexte
L’objectif de réduire le calcul séquentiel constitue également le fondement du Extended Neural GPU [16], de ByteNet [18] et de ConvS2S [9], qui utilisent tous des réseaux neuronaux convolutifs comme bloc de construction de base, calculant des représentations cachées en parallèle pour toutes les positions d’entrée et de sortie. Dans ces modèles, le nombre d’opérations nécessaires pour relier les signaux de deux positions arbitraires d’entrée ou de sortie croît avec la distance entre les positions, linéairement pour ConvS2S et logarithmiquement pour ByteNet. Cela rend plus difficile l’apprentissage des dépendances entre positions éloignées [12]. Dans le Transformer, cela est réduit à un nombre constant d’opérations, bien qu’au prix d’une résolution effective réduite en raison de la moyenne des positions pondérées par l’attention, un effet que nous contrebalançons avec l’attention multi-têtes comme décrit à la section [3.2].
L’auto-attention, parfois appelée intra-attention, est un mécanisme d’attention reliant différentes positions d’une même séquence afin de calculer une représentation de la séquence. L’auto-attention a été utilisée avec succès dans une variété de tâches, notamment la compréhension de lecture, le résumé abstractif, l’inférence textuelle et l’apprentissage de représentations de phrases indépendantes de la tâche [4] [27] [28] [22].
Les réseaux de mémoire de bout en bout sont fondés sur un mécanisme d’attention récurrent au lieu d’une récurrence alignée sur la séquence et se sont révélés performants sur des tâches simples de questions-réponses en langage naturel et de modélisation du langage [34].
À notre connaissance, cependant, le Transformer est le premier modèle de transduction reposant entièrement sur l’auto-attention pour calculer les représentations de son entrée et de sa sortie sans utiliser de RNN alignés sur la séquence ni de convolution. Dans les sections suivantes, nous décrirons le Transformer, motiverons l’auto-attention et discuterons de ses avantages par rapport à des modèles tels que [17] [18] et [9].
3 Architecture du modèle
La plupart des modèles neuronaux compétitifs de transduction de séquences ont une structure encodeur-décodeur [5] [2] [35]. Ici, l’encodeur transforme une séquence d’entrée de représentations de symboles en une séquence de représentations continues . Étant donné , le décodeur génère ensuite une séquence de sortie de symboles un élément à la fois. À chaque étape, le modèle est auto-régressif [10], consommant les symboles précédemment générés comme entrée supplémentaire lors de la génération du suivant.
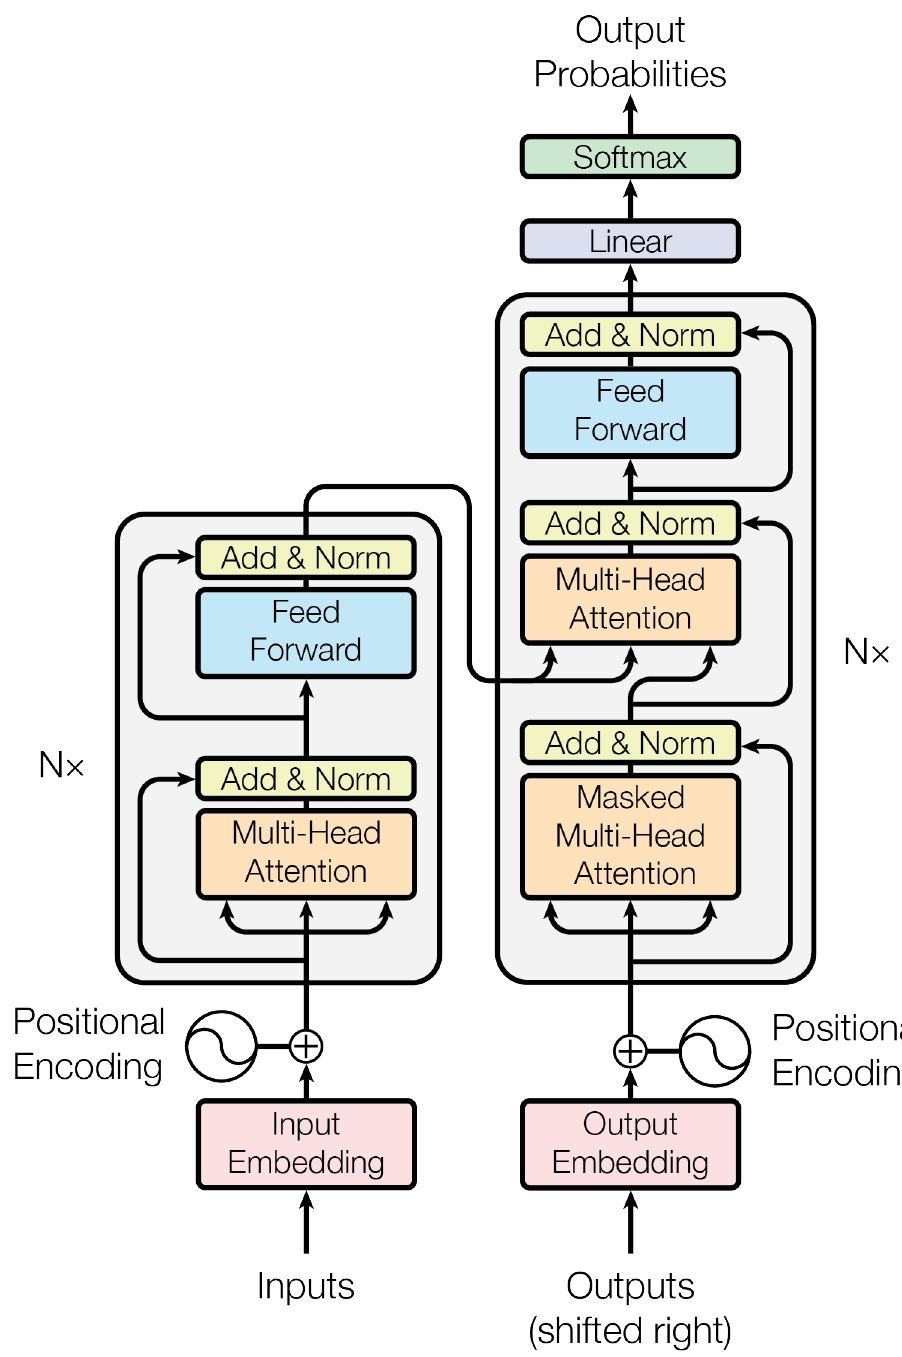
Le Transformer suit cette architecture globale en utilisant des couches empilées d’auto-attention et de couches entièrement connectées appliquées point par point pour l’encodeur et le décodeur, représentées respectivement dans les moitiés gauche et droite de la figure [1].
3.1 Piles d’encodeurs et de décodeurs
Encodeur : L’encodeur est composé d’une pile de couches identiques. Chaque couche comporte deux sous-couches. La première est un mécanisme d’auto-attention multi-têtes, et la seconde est un réseau feed-forward simple entièrement connecté, appliqué position par position. Nous employons une connexion résiduelle [11] autour de chacune des deux sous-couches, suivie d’une normalisation de couche [1]. Autrement dit, la sortie de chaque sous-couche est , où est la fonction implémentée par la sous-couche elle-même. Pour faciliter ces connexions résiduelles, toutes les sous-couches du modèle, ainsi que les couches d’embedding, produisent des sorties de dimension .
Décodeur : Le décodeur est également composé d’une pile de couches identiques. En plus des deux sous-couches de chaque couche d’encodeur, le décodeur insère une troisième sous-couche, qui effectue une attention multi-têtes sur la sortie de la pile de l’encodeur. Comme pour l’encodeur, nous employons des connexions résiduelles autour de chacune des sous-couches, suivies d’une normalisation de couche. Nous modifions également la sous-couche d’auto-attention dans la pile du décodeur afin d’empêcher les positions de porter attention aux positions suivantes. Ce masquage, combiné au fait que les embeddings de sortie sont décalés d’une position, garantit que les prédictions pour la position ne peuvent dépendre que des sorties connues aux positions inférieures à .
3.2 Attention
Une fonction d’attention peut être décrite comme la mise en correspondance d’une requête et d’un ensemble de paires clé-valeur avec une sortie, où la requête, les clés, les valeurs et la sortie sont tous des vecteurs. La sortie est calculée comme une somme pondérée
des valeurs, où le poids attribué à chaque valeur est calculé par une fonction de compatibilité entre la requête et la clé correspondante.
3.2.1 Attention à produit scalaire mise à l’échelle
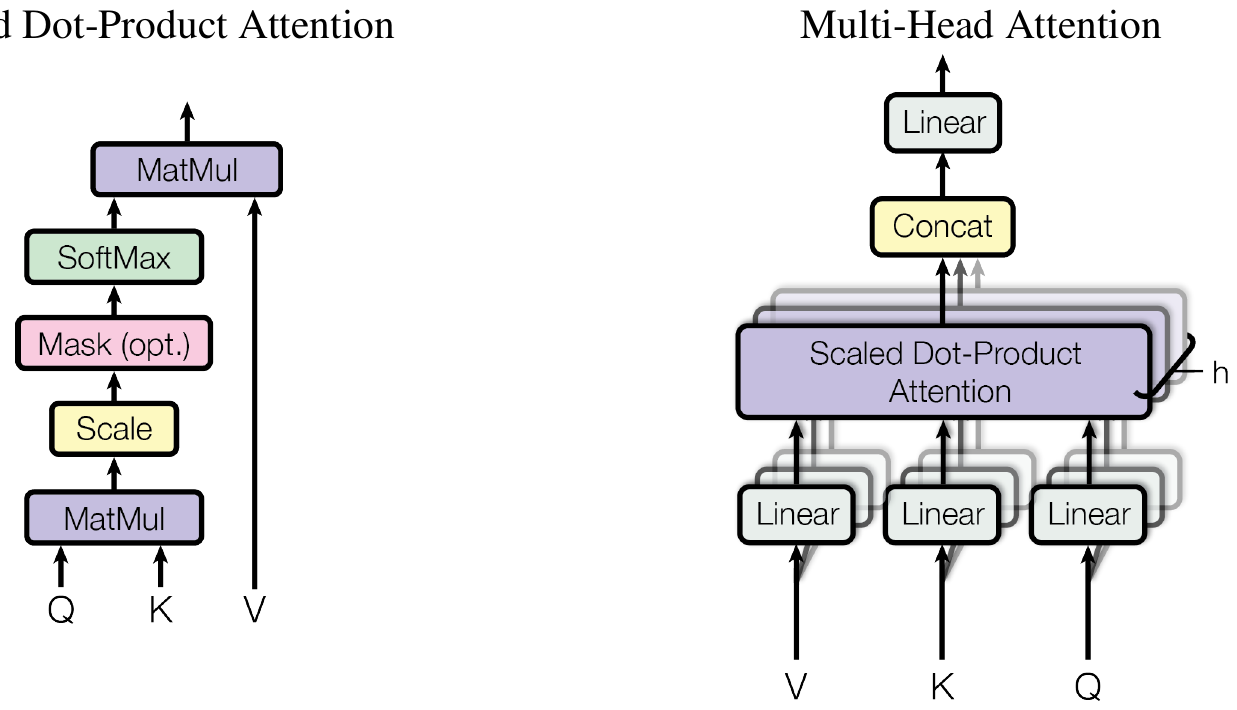
Nous appelons notre mécanisme d’attention particulier « attention produit scalaire mise à l’échelle » (figure 2). L’entrée est constituée de requêtes et de clés de dimension , et de valeurs de dimension . Nous calculons les produits scalaires de la requête avec toutes les clés, divisons chacun par , et appliquons une fonction softmax pour obtenir les poids sur les valeurs.
En pratique, nous calculons la fonction d’attention sur un ensemble de requêtes simultanément, regroupées dans une matrice . Les clés et les valeurs sont également regroupées dans des matrices et . Nous calculons la matrice des sorties comme suit :
Les deux fonctions d’attention les plus couramment utilisées sont l’attention additive 2 et l’attention produit scalaire (multiplicative). L’attention produit scalaire est identique à notre algorithme, à l’exception du facteur d’échelle . L’attention additive calcule la fonction de compatibilité à l’aide d’un réseau feed-forward à une seule couche cachée. Bien que les deux soient similaires en complexité théorique, l’attention produit scalaire est beaucoup plus rapide et plus économe en espace en pratique, car elle peut être mise en œuvre à l’aide de code de multiplication matricielle hautement optimisé.
Alors que, pour de petites valeurs de , les deux mécanismes se comportent de manière similaire, l’attention additive surpasse l’attention produit scalaire sans mise à l’échelle pour de plus grandes valeurs de [3]. Nous soupçonnons que, pour de grandes valeurs de , les produits scalaires deviennent grands en magnitude, poussant la fonction softmax dans des régions où elle a des gradients extrêmement petits. Pour contrer cet effet, nous mettons les produits scalaires à l’échelle par .
3.2.2 Attention multi-têtes
Au lieu d’effectuer une seule fonction d’attention avec des clés, valeurs et requêtes de dimension , nous avons constaté qu’il était bénéfique de projeter linéairement les requêtes, les clés et les valeurs fois avec différentes projections linéaires apprises, vers des dimensions , et , respectivement. Sur chacune de ces versions projetées des requêtes, des clés et des valeurs, nous effectuons ensuite la fonction d’attention en parallèle, produisant des valeurs de sortie de dimension . Celles-ci sont concaténées et une fois de plus projetées, ce qui donne les valeurs finales, comme illustré à la figure 2
L’attention multi-têtes permet au modèle de prendre en compte conjointement des informations provenant de différents sous-espaces de représentation à différentes positions. Avec une seule tête d’attention, la moyenne inhibe cela.
où les projections sont des matrices de paramètres , , et
Dans ce travail, nous employons couches d'attention parallèles, ou têtes. Pour chacune d'elles, nous utilisons . En raison de la dimension réduite de chaque tête, le coût computationnel total est similaire à celui d'une attention à tête unique avec la dimensionnalité complète.
3.2.3 Applications de l'attention dans notre modèle
Le Transformer utilise l'attention multi-têtes de trois manières différentes :
- Dans les couches d'« attention encodeur-décodeur », les requêtes proviennent de la couche précédente du décodeur, et les clés et valeurs de la mémoire proviennent de la sortie de l'encodeur. Cela permet à chaque position du décodeur de porter son attention sur toutes les positions de la séquence d'entrée. Cela imite les mécanismes d'attention encodeur-décodeur typiques dans les modèles séquence-à-séquence tels que [38] [2] [9].
- L'encodeur contient des couches d'auto-attention. Dans une couche d'auto-attention, toutes les clés, valeurs et requêtes proviennent du même endroit, en l'occurrence, la sortie de la couche précédente de l'encodeur. Chaque position de l'encodeur peut porter son attention sur toutes les positions de la couche précédente de l'encodeur.
- De même, les couches d'auto-attention du décodeur permettent à chaque position du décodeur de porter son attention sur toutes les positions du décodeur jusqu'à cette position incluse. Nous devons empêcher le flux d'information vers la gauche dans le décodeur afin de préserver la propriété auto-régressive. Nous implémentons cela à l'intérieur de l'attention produit scalaire mise à l'échelle en masquant (en mettant à ) toutes les valeurs de l'entrée du softmax qui correspondent à des connexions illégales. Voir la Figure [2]
3.3 Réseaux feed-forward position par position
En plus des sous-couches d'attention, chacune des couches de notre encodeur et de notre décodeur contient un réseau feed-forward entièrement connecté, qui est appliqué à chaque position séparément et de manière identique. Celui-ci consiste en deux transformations linéaires avec une activation ReLU entre les deux.
Bien que les transformations linéaires soient les mêmes à différentes positions, elles utilisent des paramètres différents d'une couche à l'autre. Une autre façon de décrire cela est de considérer deux convolutions avec une taille de noyau de 1. La dimensionnalité de l'entrée et de la sortie est , et la couche interne a une dimensionnalité .
3.4 Plongements et Softmax
De manière similaire à d'autres modèles de transduction de séquences, nous utilisons des plongements appris pour convertir les jetons d'entrée et les jetons de sortie en vecteurs de dimension . Nous utilisons également la transformation linéaire apprise habituelle et la fonction softmax pour convertir la sortie du décodeur en probabilités prédites des jetons suivants. Dans notre modèle, nous partageons la même matrice de poids entre les deux couches de plongement et la transformation linéaire pré-softmax, de manière similaire à [30]. Dans les couches de plongement, nous multiplions ces poids par .
| Type de couche | Complexité par couche | Opérations séquentielles | Longueur de chemin maximale |
| Auto-attention | O(n²·d) | O(1) | O(1) |
| Récurrent | O(n·d²) | O(n) | O(n) |
| Convolutif | O(k·n·d²) | O(1) | O(logk(n)) |
| Auto-attention (restreinte) | O(r·n·d) | O(1) | O(n/r) |
3.5 Encodage positionnel
Puisque notre modèle ne contient ni récurrence ni convolution, afin que le modèle puisse utiliser l'ordre de la séquence, nous devons injecter une certaine information sur la position relative ou absolue des jetons dans la séquence. À cette fin, nous ajoutons des « encodages positionnels » aux plongements d'entrée au bas des piles de l'encodeur et du décodeur. Les encodages positionnels ont la même dimension que les plongements, de sorte que les deux peuvent être additionnés. Il existe de nombreux choix d'encodages positionnels, appris et fixes [9].
Dans ce travail, nous utilisons des fonctions sinus et cosinus de différentes fréquences :
où est la position et est la dimension. C'est-à-dire que chaque dimension de l'encodage positionnel correspond à une sinusoïde. Les longueurs d'onde forment une progression géométrique de à . Nous avons choisi cette fonction parce que nous avons supposé qu'elle permettrait au modèle d'apprendre facilement à porter son attention selon les positions relatives, puisque pour tout décalage fixe , peut être représenté comme une fonction linéaire de .
Nous avons également expérimenté l'utilisation de plongements positionnels appris [9] à la place, et avons constaté que les deux versions produisaient des résultats presque identiques (voir Tableau 3 ligne (E)). Nous avons choisi la version sinusoïdale parce qu'elle peut permettre au modèle d'extrapoler à des longueurs de séquence plus longues que celles rencontrées pendant l'entraînement.
4 Pourquoi l'auto-attention
Dans cette section, nous comparons divers aspects des couches d'auto-attention aux couches récurrentes et convolutionnelles couramment utilisées pour mapper une séquence de longueur variable de représentations de symboles vers une autre séquence de longueur égale , avec , comme une couche cachée dans un encodeur ou un décodeur typique de transduction de séquences. Motivant notre utilisation de l'auto-attention, nous considérons trois desiderata.
L'un est la complexité computationnelle totale par couche. Un autre est la quantité de calcul qui peut être parallélisée, mesurée par le nombre minimum d'opérations séquentielles requises.
Le troisième est la longueur du chemin entre les dépendances à longue portée dans le réseau. L'apprentissage des dépendances à longue portée est un défi clé dans de nombreuses tâches de transduction de séquences. Un facteur clé affectant la capacité à apprendre de telles dépendances est la longueur des chemins que les signaux avant et arrière doivent parcourir dans le réseau. Plus ces chemins entre toute combinaison de positions dans les séquences d'entrée et de sortie sont courts, plus il est facile d'apprendre des dépendances à longue portée [12]. Par conséquent, nous comparons également la longueur maximale du chemin entre deux positions quelconques d'entrée et de sortie dans des réseaux composés des différents types de couches.
Comme indiqué dans le Tableau 1, une couche d'auto-attention connecte toutes les positions avec un nombre constant d'opérations exécutées séquentiellement, tandis qu'une couche récurrente nécessite opérations séquentielles. En termes de complexité computationnelle, les couches d'auto-attention sont plus rapides que les couches récurrentes lorsque la longueur de séquence est inférieure à la dimensionnalité de représentation , ce qui est le plus souvent le cas avec les représentations de phrases utilisées par les modèles de pointe en traduction automatique, telles que les représentations word-piece [38] et byte-pair [31]. Pour améliorer les performances computationnelles des tâches impliquant de très longues séquences, l'auto-attention pourrait être restreinte à ne considérer qu'un voisinage de taille dans la séquence d'entrée centré autour de la position de sortie respective. Cela augmenterait la longueur maximale du chemin à . Nous prévoyons d'étudier cette approche plus en détail dans des travaux futurs.
Une seule couche convolutive avec une largeur de noyau ne connecte pas toutes les paires de positions d'entrée et de sortie. Pour ce faire, il faut une pile de couches convolutives dans le cas de noyaux contigus, ou dans le cas de convolutions dilatées [18], ce qui augmente la longueur des plus longs chemins entre deux positions quelconques du réseau. Les couches convolutives sont généralement plus coûteuses que les couches récurrentes, d'un facteur . Les convolutions séparables [6], cependant, réduisent considérablement la complexité, à . Même avec , toutefois, la complexité d'une convolution séparable est égale à la combinaison d'une couche d'auto-attention et d'une couche feed-forward point par point, l'approche que nous adoptons dans notre modèle.
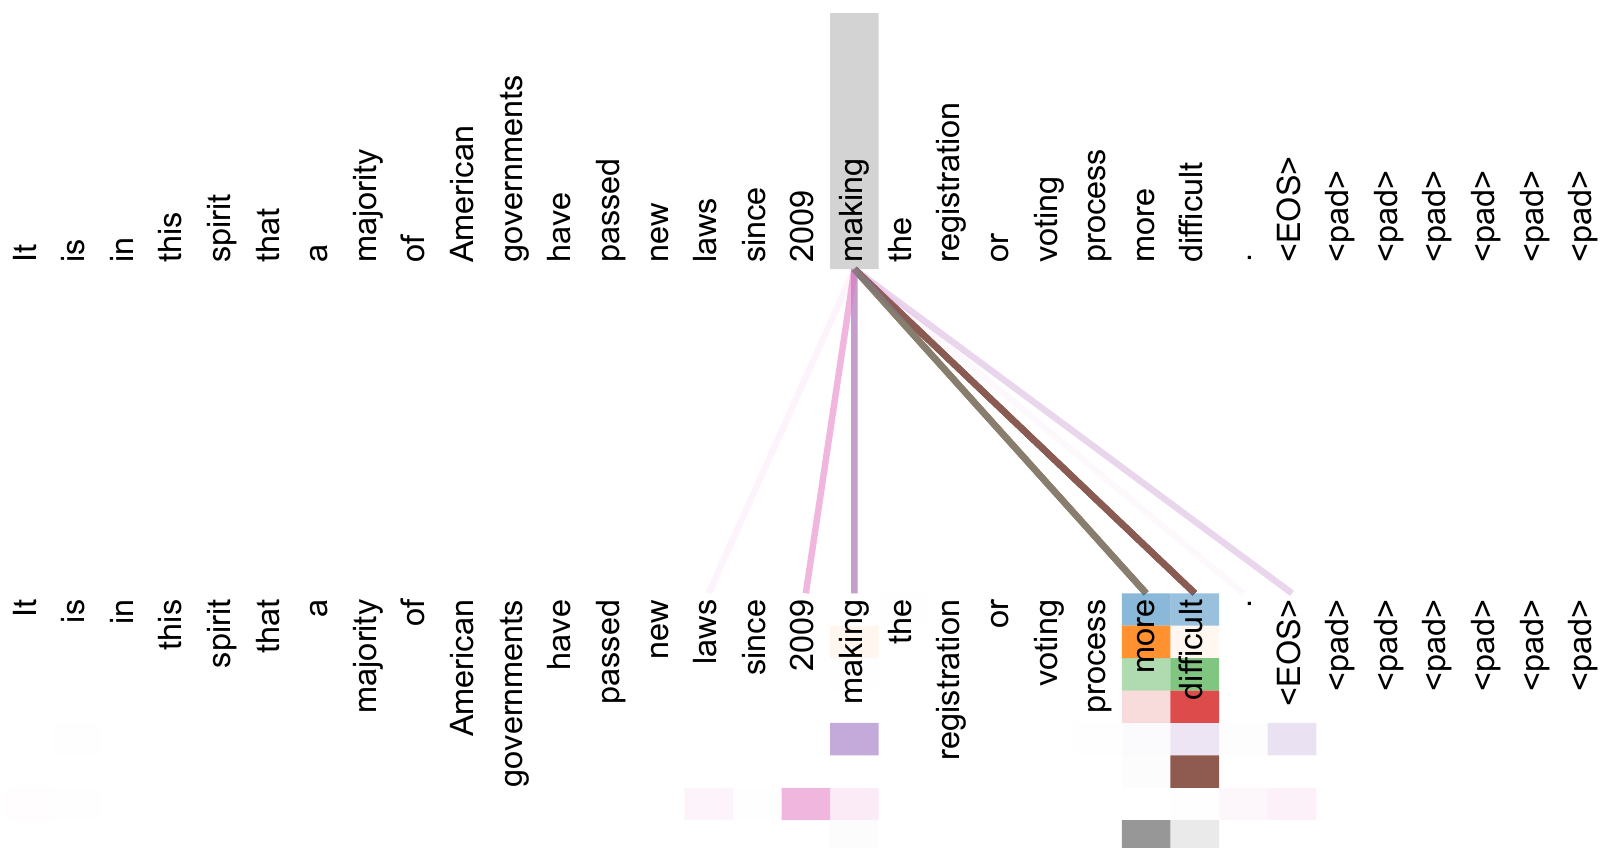
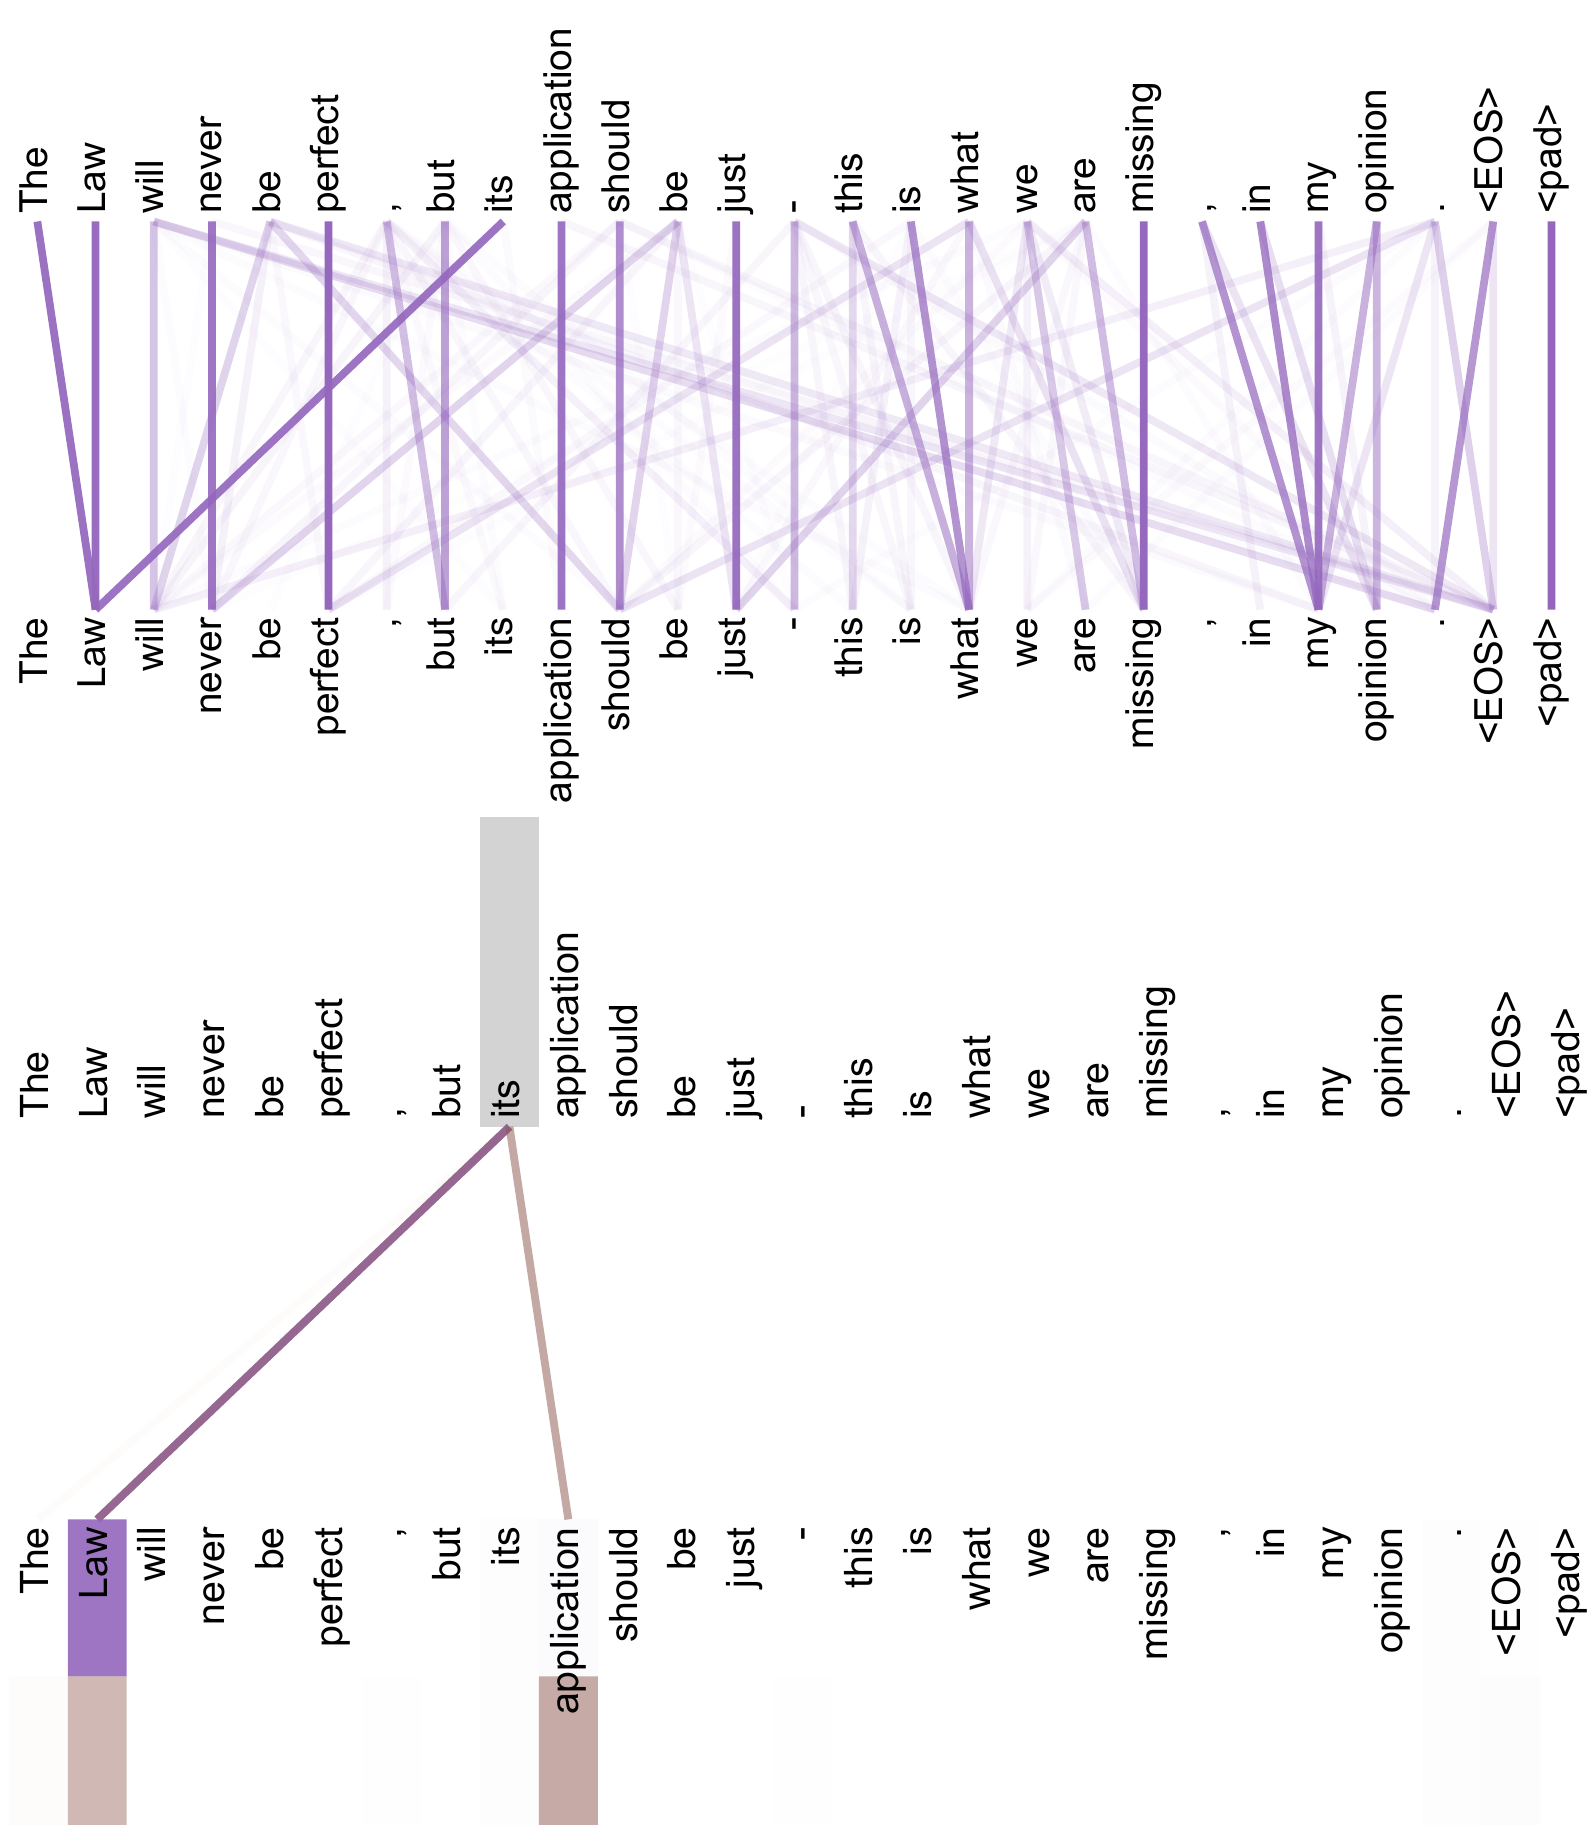
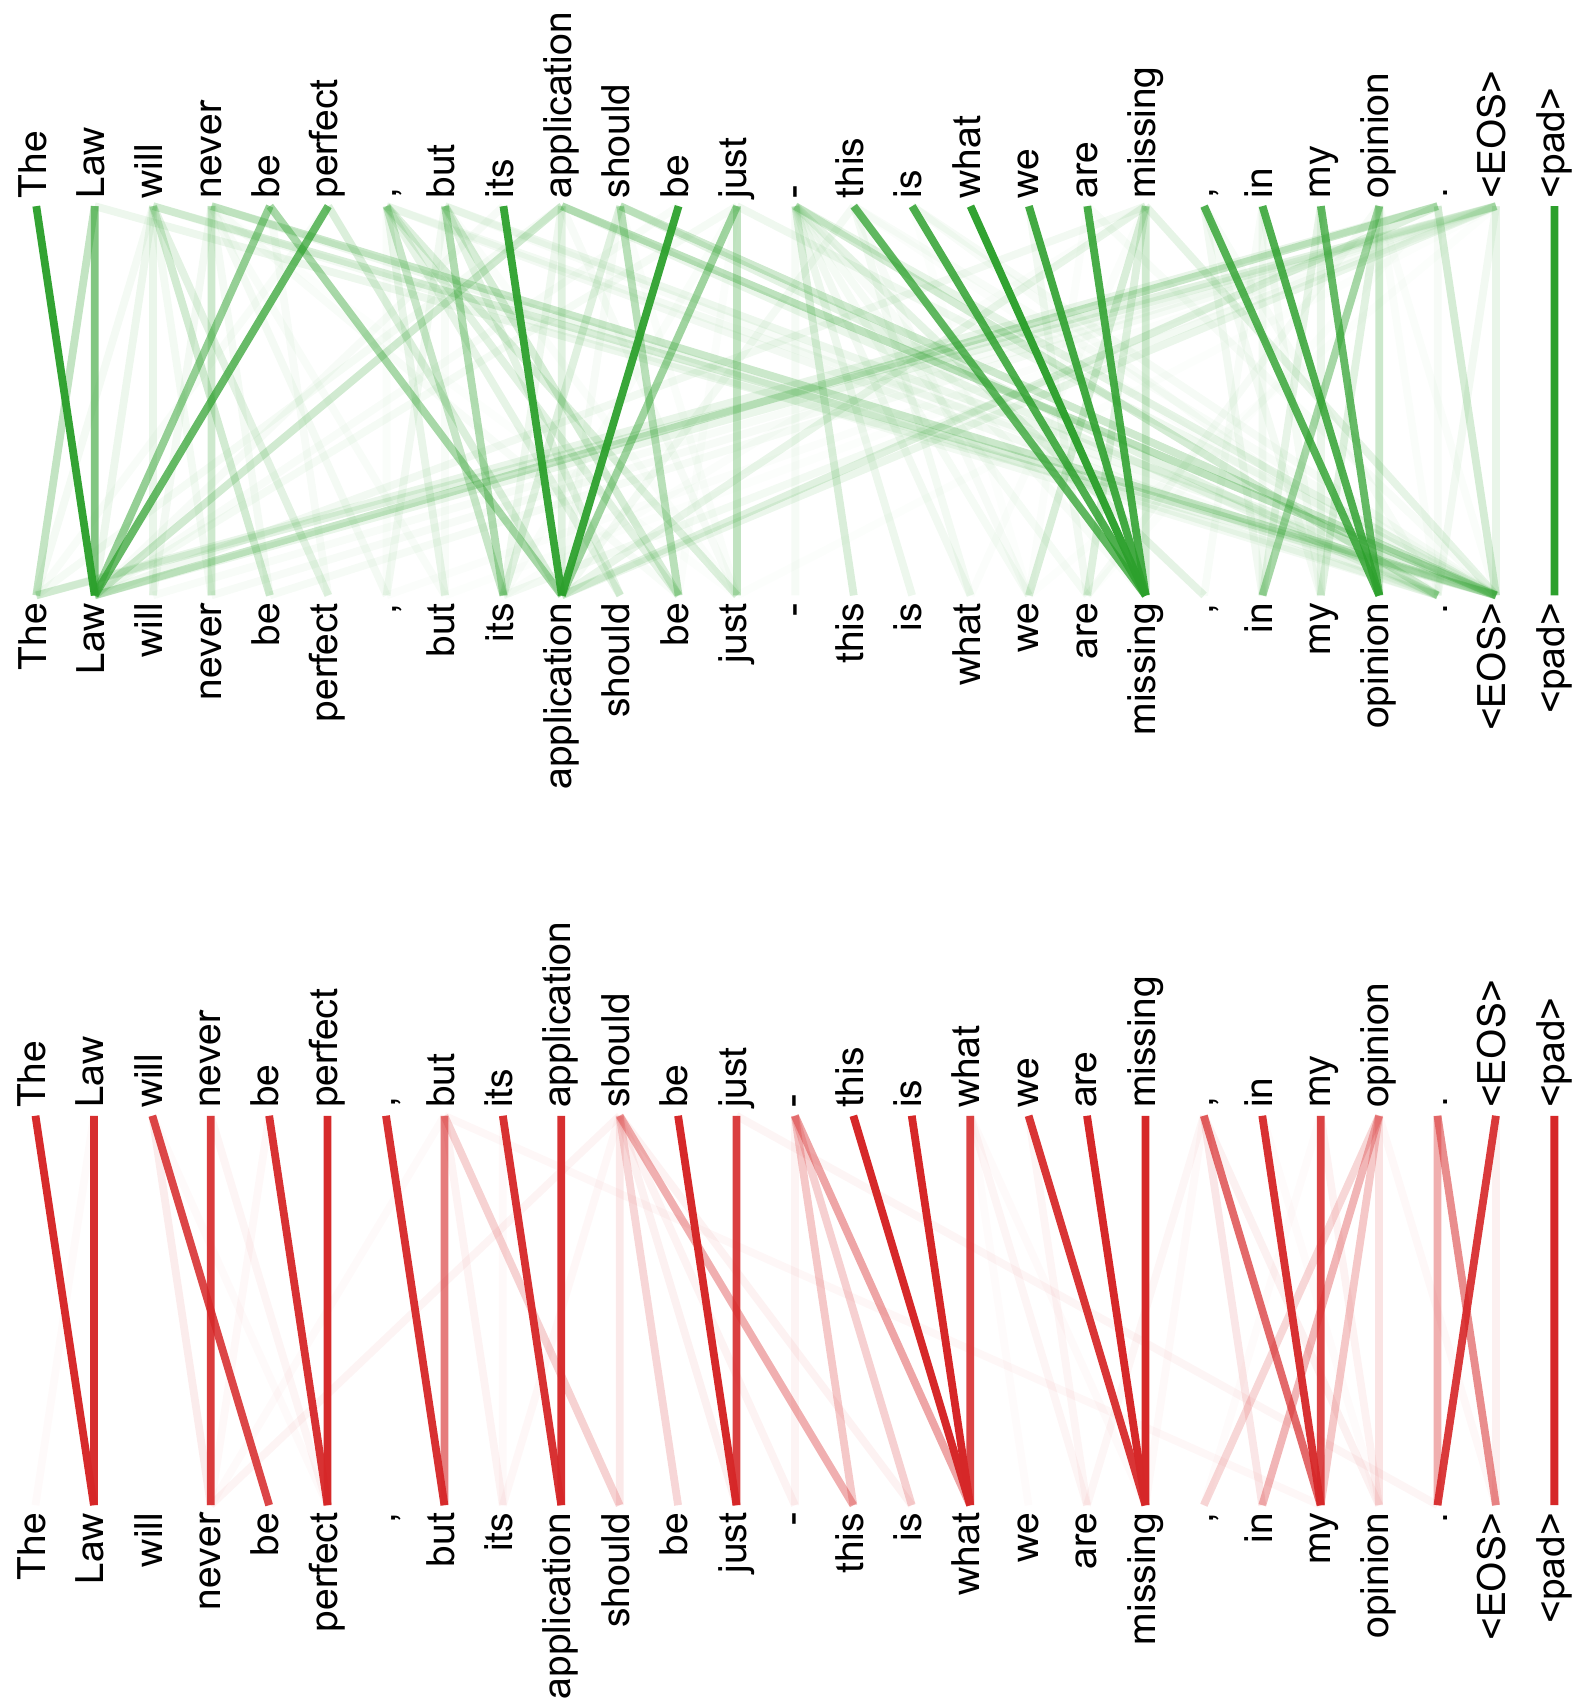
Comme bénéfice secondaire, l'auto-attention pourrait produire des modèles plus interprétables. Nous inspectons les distributions d'attention de nos modèles et présentons et discutons des exemples en annexe. Non seulement les têtes d'attention individuelles apprennent clairement à effectuer des tâches différentes, mais beaucoup semblent exhiber un comportement lié à la structure syntaxique et sémantique des phrases.
5 Entraînement
Cette section décrit le régime d'entraînement de nos modèles.
5.1 Données d'entraînement et mise en lots
Nous avons entraîné sur le jeu de données standard WMT 2014 anglais-allemand, composé d'environ 4,5 millions de paires de phrases. Les phrases ont été encodées à l'aide de l'encodage par paires d'octets [3], qui possède un vocabulaire source-cible partagé d'environ 37000 jetons. Pour l'anglais-français, nous avons utilisé le jeu de données WMT 2014 anglais-français, nettement plus grand, composé de 36M de phrases, et avons divisé les jetons en un vocabulaire de 32000 sous-mots [38]. Les paires de phrases ont été mises en lots ensemble par longueur de séquence approximative. Chaque lot d'entraînement contenait un ensemble de paires de phrases contenant environ 25000 jetons source et 25000 jetons cible.
5.2 Matériel et calendrier
Nous avons entraîné nos modèles sur une machine équipée de 8 GPU NVIDIA P100. Pour nos modèles de base utilisant les hyperparamètres décrits tout au long de l'article, chaque étape d'entraînement prenait environ 0,4 seconde. Nous avons entraîné les modèles de base pour un total de 100 000 étapes, soit 12 heures. Pour nos grands modèles (décrits sur la dernière ligne du tableau [3]), le temps par étape était de 1,0 seconde. Les grands modèles ont été entraînés pendant 300 000 étapes (3,5 jours).
5.3 Optimiseur
Nous avons utilisé l'optimiseur Adam [20] avec , et . Nous avons fait varier le taux d'apprentissage au cours de l'entraînement, selon la formule :
Cela correspond à augmenter linéairement le taux d'apprentissage pendant les premières étapes de préchauffage de l'entraînement, puis à le diminuer ensuite proportionnellement à l'inverse de la racine carrée du numéro d'étape. Nous avons utilisé warmup steps = 4000.
5.4 Régularisation
Nous employons trois types de régularisation pendant l'entraînement :
| Modèle | BLEU | Coût d'entraînement (FLOPs) | ||
| EN-DE | EN-FR | EN-DE | EN-FR | |
| ByteNet [18] | 23,75 | |||
| Deep-Att + PosUnk [39] | 39,2 | 1,0·1020 | ||
| GNMT + RL [38] | 24,6 | 39,92 | 2,3·1019 | 1,4·1020 |
| ConvS2S [9] | 25,16 | 40,46 | 9,6·1018 | 1,5·1020 |
| MoE [32] | 26,03 | 40,56 | 2,0·1019 | 1,2·1020 |
| Deep-Att + PosUnk Ensemble [39] | 40,4 | 8,0·1020 | ||
| GNMT + RL Ensemble [38] | 26,30 | 41,16 | 1,8·1020 | 1,1·1021 |
| ConvS2S Ensemble [9] | 26,36 | 41,29 | 7,7·1019 | 1,2·1021 |
| Transformer (modèle de base) | 27,3 | 38,1 | 3,3·1018 | |
| Transformer (grand modèle) | 28,4 | 41,8 | 2,3·1019 | |
Dropout résiduel Nous appliquons le dropout [33] à la sortie de chaque sous-couche, avant qu'elle ne soit ajoutée à l'entrée de la sous-couche et normalisée. De plus, nous appliquons le dropout aux sommes des plongements et des encodages positionnels dans les piles de l'encodeur et du décodeur. Pour le modèle de base, nous utilisons un taux de .
Lissage des étiquettes Pendant l'entraînement, nous avons employé un lissage des étiquettes d'une valeur de [36]. Cela dégrade la perplexité, car le modèle apprend à être plus incertain, mais améliore la précision et le score BLEU.
6 Résultats
6.1 Traduction automatique
Sur la tâche de traduction anglais-allemand de WMT 2014, le grand modèle Transformer (Transformer (big) dans le tableau 2) surpasse de plus de 2,0 BLEU les meilleurs modèles rapportés précédemment (y compris les ensembles), établissant un nouveau score BLEU de pointe de 28,4. La configuration de ce modèle est indiquée à la dernière ligne du tableau 3. L'entraînement a pris 3,5 jours sur 8 GPU P100. Même notre modèle de base surpasse tous les modèles et ensembles publiés précédemment, pour une fraction du coût d'entraînement de n'importe lequel des modèles concurrents.
Sur la tâche de traduction anglais-français de WMT 2014, notre grand modèle atteint un score BLEU de 41,0, surpassant tous les modèles uniques publiés précédemment, pour moins de du coût d'entraînement du précédent modèle de pointe. Le modèle Transformer (big) entraîné pour l'anglais-français utilisait un taux de dropout , au lieu de 0,3.
Pour les modèles de base, nous avons utilisé un modèle unique obtenu en faisant la moyenne des 5 derniers checkpoints, qui étaient enregistrés à intervalles de 10 minutes. Pour les grands modèles, nous avons fait la moyenne des 20 derniers checkpoints. Nous avons utilisé une recherche par faisceau avec une taille de faisceau de 4 et une pénalité de longueur [38]. Ces hyperparamètres ont été choisis après expérimentation sur l'ensemble de développement. Nous avons fixé la longueur maximale de sortie lors de l'inférence à la longueur d'entrée , mais terminons plus tôt lorsque cela est possible [38].
Le tableau 2 résume nos résultats et compare notre qualité de traduction et nos coûts d'entraînement à ceux d'autres architectures de modèles de la littérature. Nous estimons le nombre d'opérations en virgule flottante utilisées pour entraîner un modèle en multipliant le temps d'entraînement, le nombre de GPU utilisés et une estimation de la capacité soutenue en virgule flottante simple précision de chaque GPU.
6.2 Variations du modèle
Pour évaluer l'importance des différentes composantes du Transformer, nous avons fait varier notre modèle de base de différentes manières, en mesurant le changement de performance sur la traduction anglais-allemand sur l'
| N | dmodel | dff | h | dk | dv | Pdrop | εls | étapes d'entraînement | PPL (dev) | BLEU (dev) | paramètres ×10⁶ | |
| base | 6 | 512 | 2048 | 8 | 64 | 64 | 0,1 | 0,1 | 100K | 4,92 | 25,8 | 65 |
| 1 | 512 | 512 | 5,29 | 24,9 | ||||||||
| 4 | 128 | 128 | 5,00 | 25,5 | ||||||||
| 16 | 32 | 32 | 4,91 | 25,8 | ||||||||
| (A) | 32 | 16 | 16 | 5,01 | 25,4 | |||||||
| 16 | 5,16 | 25,1 | 58 | |||||||||
| (B) | 32 | 5,01 | 25,4 | 60 | ||||||||
| 6,11 | 23,7 | 36 | ||||||||||
| (C) | 2 | 5,19 | 25,3 | 50 | ||||||||
| 4 | 4,88 | 25,5 | 80 | |||||||||
| 8 | 5,75 | 24,5 | 28 | |||||||||
| 256 | 32 | 32 | 4,66 | 26,0 | 168 | |||||||
| 1024 | 128 | 128 | 5,12 | 25,4 | 53 | |||||||
| 1024 | 4,75 | 26,2 | 90 | |||||||||
| (D) | 0,0 | 5,77 | 24,6 | |||||||||
| 0,2 | 4,95 | 25,5 | ||||||||||
| 0,0 | 4,67 | 25,3 | ||||||||||
| 0,2 | 5,47 | 25,7 | ||||||||||
| (E) | 4,92 | 25,7 | ||||||||||
| big | 6 | 1024 | 4096 | 16 | 0,3 | 300K | 4,33 | 26,4 | 213 |
ensemble de développement, newstest2013. Nous avons utilisé la recherche par faisceau comme décrit dans la section précédente, mais sans moyenne de checkpoints. Nous présentons ces résultats dans le tableau 3.
Dans les lignes (A) du tableau 3, nous faisons varier le nombre de têtes d'attention et les dimensions des clés et des valeurs d'attention, en gardant la quantité de calcul constante, comme décrit dans la section 3.2.2. Bien que l'attention à une seule tête soit 0,9 BLEU moins bonne que la meilleure configuration, la qualité diminue également avec trop de têtes.
Dans les lignes (B) du tableau 3, nous observons que la réduction de la taille des clés d'attention nuit à la qualité du modèle. Cela suggère que déterminer la compatibilité n'est pas facile et qu'une fonction de compatibilité plus sophistiquée que le produit scalaire pourrait être bénéfique. Nous observons en outre dans les lignes (C) et (D) que, comme prévu, les modèles plus grands sont meilleurs, et que le dropout est très utile pour éviter le surapprentissage. Dans la ligne (E), nous remplaçons notre encodage positionnel sinusoïdal par des plongements positionnels appris [2], et observons des résultats presque identiques à ceux du modèle de base.
6.3 Analyse syntaxique de constituants en anglais
Pour évaluer si le Transformer peut se généraliser à d'autres tâches, nous avons réalisé des expériences sur l'analyse syntaxique de constituants en anglais. Cette tâche présente des défis spécifiques : la sortie est soumise à de fortes contraintes structurelles et est significativement plus longue que l'entrée. De plus, les modèles séquence-à-séquence RNN n'ont pas pu atteindre des résultats de pointe dans les régimes à faibles données [37].
Nous avons entraîné un transformer à 4 couches avec sur la portion Wall Street Journal (WSJ) du Penn Treebank [25], soit environ 40K phrases d'entraînement. Nous l'avons également entraîné dans un cadre semi-supervisé, en utilisant les corpus plus grands high-confidence et BerkleyParker avec environ 17M de phrases [37]. Nous avons utilisé un vocabulaire de 16K tokens pour la configuration WSJ uniquement et un vocabulaire de 32K tokens pour la configuration semi-supervisée.
Nous n'avons réalisé qu'un petit nombre d'expériences pour sélectionner le dropout, à la fois d'attention et résiduel (section [5.4]), les taux d'apprentissage et la taille du faisceau sur l'ensemble de développement de la section 22 ; tous les autres paramètres sont restés inchangés par rapport au modèle de traduction de base anglais-allemand. Lors de l'inférence, nous avons
| Contexte en lecture seule pour comprendre la source (ce n'est pas le texte source à traduire) : 6.3 Analyse syntaxique en constituants de l'anglais Nous n'avons réalisé qu'un petit nombre d'expériences pour choisir le dropout, à la fois pour l'attention et pour les résiduels (section [5.4]), les taux d'apprentissage et la taille du faisceau sur l'ensemble de développement de la section 22 ; tous les autres paramètres sont restés inchangés par rapport au modèle de traduction de base de l'anglais vers l'allemand. Lors de l'inférence, nous avons augmenté la longueur maximale de sortie à longueur d'entrée +300. Nous avons utilisé une taille de faisceau de 21 et \alpha = 0.3 à la fois pour le cadre WSJ uniquement et pour le cadre semi-supervisé. Texte à traduire : Analyseur syntaxique | Entraînement | WSJ 23 F1 |
| Vinyals & Kaiser el al. (2014) [37] | WSJ uniquement, discriminatif | 88.3 |
| Petrov et al. (2006) [29] | WSJ uniquement, discriminatif | 90.4 |
| Zhu et al. (2013) [40] | WSJ uniquement, discriminatif | 90.4 |
| Dyer et al. (2016) [8] | WSJ uniquement, discriminatif | 91.7 |
| Transformer (4 couches) | WSJ uniquement, discriminatif | 91.3 |
| Zhu et al. (2013) [40] | semi-supervisé | 91.3 |
| Huang & Harper (2009) [14] | semi-supervisé | 91.3 |
| McClosky et al. (2006) [26] | semi-supervisé | 92.1 |
| Vinyals & Kaiser el al. (2014) [37] | semi-supervisé | 92.1 |
| Transformer (4 couches) | semi-supervisé | 92.7 |
| Luong et al. (2015) [23] | multi-tâche | 93.0 |
| Dyer et al. (2016) [8] | génératif | 93.3 |
augmenté la longueur maximale de sortie à la longueur d'entrée . Nous avons utilisé une taille de faisceau de 21 et pour la configuration WSJ uniquement et la configuration semi-supervisée.
Nos résultats dans le tableau 4 montrent que, malgré l'absence de réglage spécifique à la tâche, notre modèle obtient des performances étonnamment bonnes, produisant de meilleurs résultats que tous les modèles rapportés précédemment, à l'exception de la Recurrent Neural Network Grammar [8].
Contrairement aux modèles séquence-à-séquence RNN [37], le Transformer surpasse le Berkeley-Parser [29] même lorsqu'il est entraîné uniquement sur l'ensemble d'entraînement WSJ de 40K phrases.
7 Conclusion
Dans ce travail, nous avons présenté le Transformer, le premier modèle de transduction de séquences entièrement fondé sur l'attention, remplaçant les couches récurrentes les plus couramment utilisées dans les architectures encodeur-décodeur par de l'auto-attention multi-têtes.
Pour les tâches de traduction, le Transformer peut être entraîné nettement plus rapidement que les architectures fondées sur des couches récurrentes ou convolutives. Sur les tâches de traduction anglais-allemand de WMT 2014 et anglais-français de WMT 2014, nous atteignons un nouvel état de l'art. Dans la première tâche, notre meilleur modèle surpasse même tous les ensembles rapportés précédemment.
Nous sommes enthousiasmés par l'avenir des modèles fondés sur l'attention et prévoyons de les appliquer à d'autres tâches. Nous prévoyons d'étendre le Transformer à des problèmes impliquant des modalités d'entrée et de sortie autres que le texte, et d'étudier des mécanismes d'attention locaux et restreints pour traiter efficacement de grandes entrées et sorties telles que des images, de l'audio et de la vidéo. Rendre la génération moins séquentielle est un autre de nos objectifs de recherche.
Le code que nous avons utilisé pour entraîner et évaluer nos modèles est disponible à l'adresse https://github.com/tensorflow/tensor2tensor
Remerciements Nous sommes reconnaissants à Nal Kalchbrenner et Stephan Gouws pour leurs commentaires fructueux, leurs corrections et leur inspiration.
Références
[1] Jimmy Lei Ba, Jamie Ryan Kiros, and Geoffrey E Hinton. Layer normalization. arXiv preprint arXiv:1607.06450, 2016.
[2] Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. Neural machine translation by jointly learning to align and translate. CoRR, abs/1409.0473, 2014.
[3] Denny Britz, Anna Goldie, Minh-Thang Luong, and Quoc V. Le. Massive exploration of neural machine translation architectures. CoRR, abs/1703.03906, 2017.
[4] Jianpeng Cheng, Li Dong, and Mirella Lapata. Long short-term memory-networks for machine reading. arXiv preprint arXiv:1601.06733, 2016.
[5] Kyunghyun Cho, Bart van Merrienboer, Caglar Gulcehre, Fethi Bougares, Holger Schwenk, and Yoshua Bengio. Learning phrase representations using rnn encoder-decoder for statistical machine translation. CoRR, abs/1406.1078, 2014.
[6] Francois Chollet. Xception: Deep learning with depthwise separable convolutions. arXiv preprint arXiv:1610.02357, 2016.
[7] Junyoung Chung, Caglar Gulcehre, Kyunghyun Cho, and Yoshua Bengio. Empirical evaluation of gated recurrent neural networks on sequence modeling. CoRR, abs/1412.3555, 2014.
[8] Chris Dyer, Adhiguna Kuncoro, Miguel Ballesteros, and Noah A. Smith. Recurrent neural network grammars. In Proc. of NAACL, 2016.
[9] Jonas Gehring, Michael Auli, David Grangier, Denis Yarats, and Yann N. Dauphin. Convolutional sequence to sequence learning. arXiv preprint arXiv:1705.03122, 2017.
[10] Alex Graves. Generating sequences with recurrent neural networks. arXiv preprint arXiv:1308.0850, 2013.
[11] Kaiming He, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. Deep residual learning for image recognition. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, pages 770-778, 2016.
[12] Sepp Hochreiter, Yoshua Bengio, Paolo Frasconi, and Jürgen Schmidhuber. Gradient flow in recurrent nets: the difficulty of learning long-term dependencies, 2001.
[13] Sepp Hochreiter et Jürgen Schmidhuber. Long short-term memory. Neural computation, 9(8):1735-1780, 1997.
[14] Zhongqiang Huang et Mary Harper. Self-training PCFG grammars with latent annotations across languages. In Proceedings of the 2009 Conference on Empirical Methods in Natural Language Processing, pages 832-841. ACL, août 2009.
[15] Rafal Jozefowicz, Oriol Vinyals, Mike Schuster, Noam Shazeer et Yonghui Wu. Exploring the limits of language modeling. arXiv preprint arXiv:1602.02410, 2016.
[16] Łukasz Kaiser et Samy Bengio. Can active memory replace attention? In Advances in Neural Information Processing Systems, (NIPS), 2016.
[17] Łukasz Kaiser et Ilya Sutskever. Neural GPUs learn algorithms. In International Conference on Learning Representations (ICLR), 2016.
[18] Nal Kalchbrenner, Lasse Espeholt, Karen Simonyan, Aaron van den Oord, Alex Graves et Koray Kavukcuoglu. Neural machine translation in linear time. arXiv preprint arXiv:1610.10099, 2017.
[19] Yoon Kim, Carl Denton, Luong Hoang et Alexander M. Rush. Structured attention networks. In International Conference on Learning Representations, 2017.
[20] Diederik Kingma et Jimmy Ba. Adam: A method for stochastic optimization. In ICLR, 2015.
[21] Oleksii Kuchaiev et Boris Ginsburg. Factorization tricks for LSTM networks. arXiv preprint arXiv:1703.10722, 2017.
[22] Zhouhan Lin, Minwei Feng, Cicero Nogueira dos Santos, Mo Yu, Bing Xiang, Bowen Zhou et Yoshua Bengio. A structured self-attentive sentence embedding. arXiv preprint arXiv:1703.03130, 2017.
[23] Minh-Thang Luong, Quoc V. Le, Ilya Sutskever, Oriol Vinyals et Lukasz Kaiser. Multi-task sequence to sequence learning. arXiv preprint arXiv:1511.06114, 2015.
[24] Minh-Thang Luong, Hieu Pham et Christopher D Manning. Effective approaches to attention-based neural machine translation. arXiv preprint arXiv:1508.04025, 2015.
[25] Mitchell P Marcus, Mary Ann Marcinkiewicz et Beatrice Santorini. Building a large annotated corpus of english: The penn treebank. Computational linguistics, 19(2):313- 330, 1993.
[26] David McClosky, Eugene Charniak et Mark Johnson. Effective self- training for parsing. In Proceedings of the Human Language Technology Conference of the NAACL, Main Conference, pages 152- 159. ACL, juin 2006.
[27] Ankur Parikh, Oscar Tackström, Dipanjan Das et Jakob Uszkoreit. A decomposable attention model. In Empirical Methods in Natural Language Processing, 2016.
[28] Romain Paulus, Caiming Xiong et Richard Socher. A deep reinforced model for abstractive summarization. arXiv preprint arXiv:1705.04304, 2017.
[29] Slav Petrov, Leon Barrett, Romain Thibaux et Dan Klein. Learning accurate, compact, and interpretable tree annotation. In Proceedings of the 21st International Conference on Computational Linguistics and 44th Annual Meeting of the ACL, pages 433- 440. ACL, juillet 2006.
[30] Ofir Press et Lior Wolf. Using the output embedding to improve language models. arXiv preprint arXiv:1608.05859, 2016.
[31] Rico Sennrich, Barry Haddow et Alexandra Birch. Neural machine translation of rare words with subword units. arXiv preprint arXiv:1508.07909, 2015.
[32] Noam Shazeer, Azalia Mirhoseini, Krzysztof Maziarz, Andy Davis, Quoc Le, Geoffrey Hinton et Jeff Dean. Outrageously large neural networks: The sparsely- gated mixture- of- experts layer. arXiv preprint arXiv:1701.06538, 2017.
[33] Nitish Srivastava, Geoffrey E Hinton, Alex Krizhevsky, Ilya Sutskever et Ruslan Salakhutdinov. Dropout: a simple way to prevent neural networks from overfitting. Journal of Machine Learning Research, 15(1):1929- 1958, 2014.
[34] Sainbayar Sukhbaatar, Arthur Szlam, Jason Weston et Rob Fergus. End- to- end memory networks. In C. Cortes, N. D. Lawrence, D. D. Lee, M. Sugiyama et R. Garnett, éditeurs, Advances in Neural Information Processing Systems 28, pages 2440- 2448. Curran Associates, Inc., 2015.
[35] Ilya Sutskever, Oriol Vinyals et Quoc VV Le. Sequence to sequence learning with neural networks. In Advances in Neural Information Processing Systems, pages 3104- 3112, 2014.
[36] Christian Szegedy, Vincent Vanhoucke, Sergey Ioffe, Jonathon Shlens et Zbigniew Wojna. Rethinking the inception architecture for computer vision. CoRR, abs/1512.00567, 2015.
[37] Vinyals & Kaiser, Koo, Petrov, Sutskever et Hinton. Grammar as a foreign language. In Advances in Neural Information Processing Systems, 2015.
[38] Yonghui Wu, Mike Schuster, Zhifeng Chen, Quoc V Le, Mohammad Norouzi, Wolfgang Macherey, Maxim Krikun, Yuan Cao, Qin Gao, Klaus Macherey, et al. Google's neural machine translation system: Bridging the gap between human and machine translation. arXiv preprint arXiv:1609.08144, 2016.
[39] Jie Zhou, Ying Cao, Xuguang Wang, Peng Li et Wei Xu. Deep recurrent models with fast- forward connections for neural machine translation. CoRR, abs/1606.04199, 2016.
[40] Muhua Zhu, Yue Zhang, Wenliang Chen, Min Zhang et Jingbo Zhu. Fast and accurate shift- reduce constituent parsing. In Proceedings of the 51st Annual Meeting of the ACL (Volume 1: Long Papers), pages 434- 443. ACL, août 2013.