
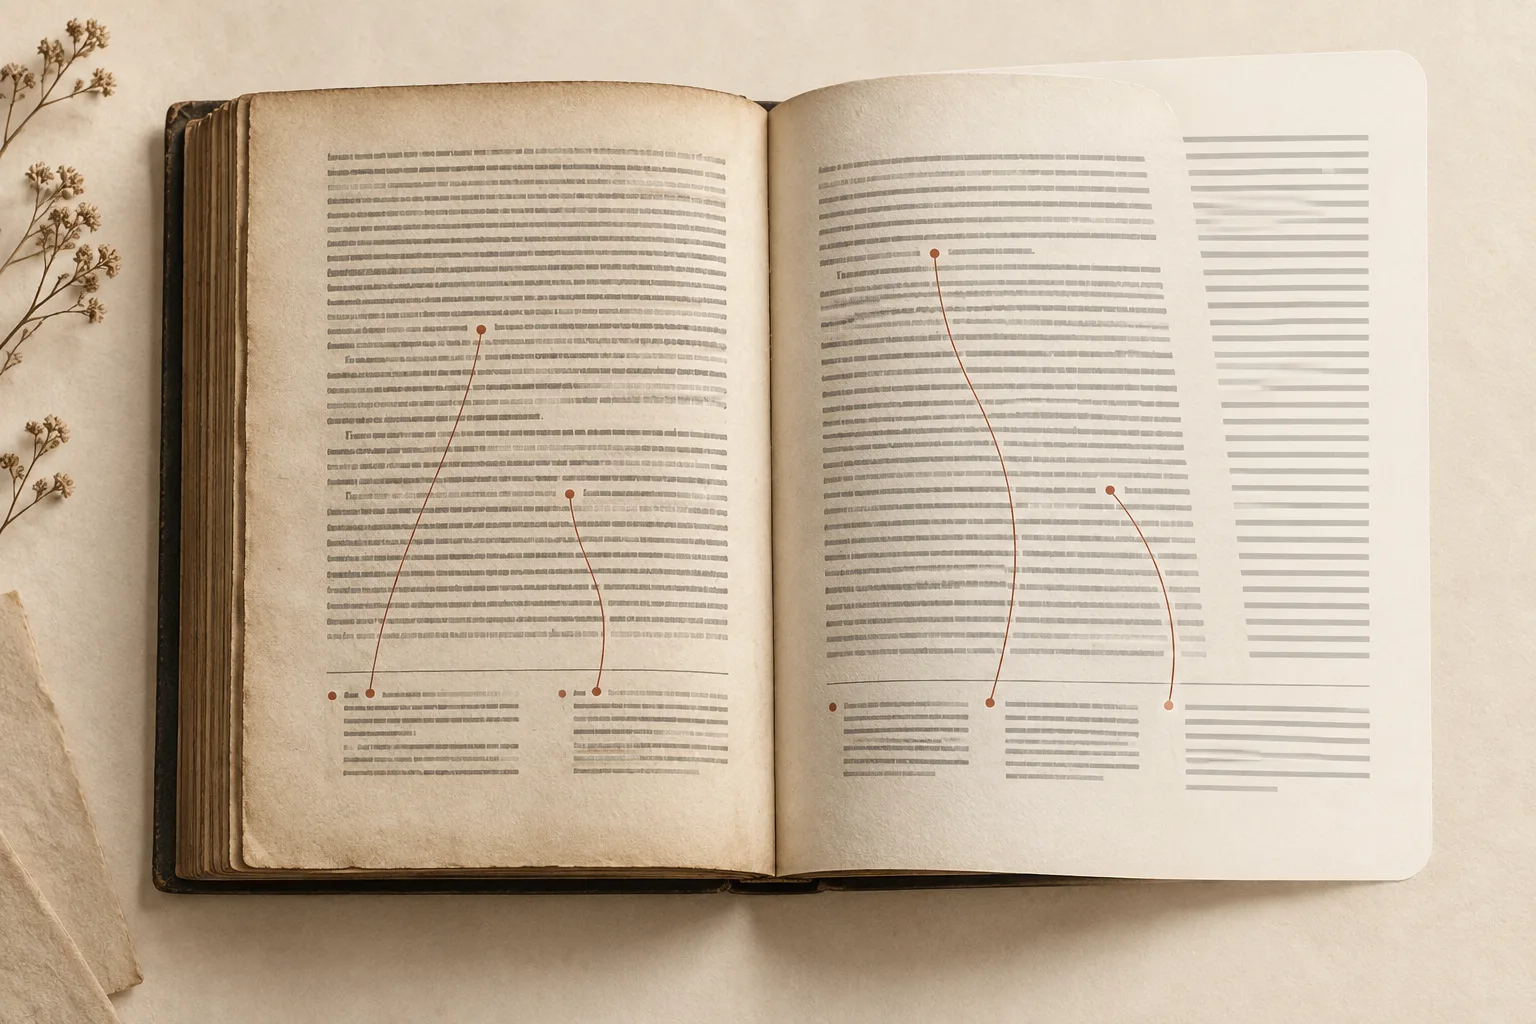
我做 PDF Craft 的目的,是把掃描書檔轉成 Markdown 或 EPUB,讓人能真正閱讀、搜尋與整理。辨識出文字只是其中一部分;內文裡的數字、圈號或星號,必須仍能指向原頁底部的正確註記。否則文字雖然重新排版了,閱讀時不可或缺的對應關係卻消失了。
處理舊書、學術文獻或個人藏書時,這點格外重要。好的轉檔結果應該讓書能在小螢幕上搜尋、好讀,同時保留原有的參照關係。若想實際檢查輸出檔案,可參考掃描 PDF 轉 EPUB 指南與公式與註腳檢查清單。
OCR 認得字,卻不知道字的作用
OCR 能辨識頁面上的詞語,卻不知道這些詞在書中扮演什麼角色。頁面底部的小字可能是註腳,也可能只是排到邊界的內文。上標的圈號可能是參照標記,也可能只是普通的清單編號。一則註記可能被拆成兩個區塊,或延續到下一頁。
只要判斷錯一步,EPUB 就會出現奇怪的狀況:標記找不到對應的註記、兩則註記黏在一起、頁碼被塞進句子裡,或某頁結尾接上了下一頁的書眉。長久以來,註腳一直是 PDF Craft 最棘手的問題之一。
最初的作法:讓 LLM 逐頁判讀
大約一年前,最直覺的解法是把每一頁交給大型語言模型。它通常能看出小字是在解釋內文、把星號或羅馬數字理解為標記,也能判斷句子是否跨頁延續。
這種作法單頁看很可行,放到整本書就行不通了。數百頁意味著數百次呼叫、等待與可能的重試。跨頁的判斷需要鄰近頁面的上下文,輸入又更大。其實大多數頁面本來就正確,昂貴的模型花了大半時間讀完一頁,只為了說這裡不需要改。使用者也很難分辨長時間的處理究竟是在推進,還是卡住了。
先建立完整的規則式流程
後來的版本把主要工作交回 OCR 與規則判斷。這條流程會把內文與註記分開、合併自然段落、把註記拆成一則則引用,再將每個內文標記對應到它的註記。它速度快、結果可重現且穩定,大多數頁面都能處理得不錯。
但書籍版面千變萬化。註記可能位於頁腳,也可能夾在欄位之間;標記可能是數字,也可能是符號;書眉、頁碼與裝飾圖案都可能混進辨識文字。有些判斷必須理解句子的意思才做得出來。只靠規則會留下少數難解的案例,而每頁都交給 LLM 又太慢、太貴。
關鍵調整:讓 JEV 負責檢查,而不是重做
原本的處理流程不需要換掉,缺的是一道快速品管,能把值得細看的頁面挑出來。我把 JEV 放在這個位置,只問它一個具體問題:這一頁的分析結果能否直接通過? 它不改寫文字,也不逐條解釋引用;它回傳一個機率,用來決定這頁要直接放行,還是交給 LLM 修復。
複查的單位是整頁。如果演算法完全漏掉一則註記,只檢查已知引用的機制就無法發現這個遺漏。以整頁為單位判斷,仍能揪出漏掉的參照、歸錯對象的註記、不尋常的跨頁連結,或混進內文的頁碼。我寧可多送幾頁去複查,也不願讓有問題的頁面悄悄過關:誤報的代價是多一次模型檢查;漏掉的錯誤卻可能一路進到最後的 EPUB。門檻值還需要更大規模的校準。
flowchart TB
  accTitle: 從頁面複查到受限修復
  accDescr: 先由 OCR 與規則處理頁面,JEV 判斷能否原樣通過。可疑頁面交給 LLM,再經程式化完整性檢查。通過的頁面進入章節組裝;修復未通過則重試。
  A[OCR 與規則處理] --> B{JEV:這一頁可信嗎?}
  B -- 是 --> F[組裝章節並輸出]
  B -- 否 --> C[LLM 只修復目前這一頁]
  C --> D{完整性檢查}
  D -- 通過 --> F
  D -- 重試 --> C
讓 LLM 在嚴格限制內修復單一頁面
對於被標記的頁面,LLM 會收到連續三頁的文字結構:前一頁、目前頁與下一頁。它只能修改中間那一頁;前後頁提供上下文,幫助判斷跨越頁界的句子。這個階段我不傳送頁面影像:OCR 已經提供文字、位置與版面資訊,而這裡要做的是語意校正,不是再跑一次 OCR。
模型可以重新標示內文、註腳與頁碼,修正段落銜接,重新把標記對應到註記。它不能任意改寫原文或更動頁面結構。接著由程式檢查:註記編號必須有序、參照與註記必須成對、跨頁連結必須一致,而且標記在指定文字中的位置必須能明確找到。檢查不通過時會回傳具體錯誤,讓模型重新送出完整結果。重試次數少當然好,但這不是放寬檢查的理由。
現有 26 頁工程文件的實測結果
在一份 26 頁、註記密集的測試 PDF 中,JEV 挑出 6 頁交給 LLM。這 6 頁第一次送交的結果全數通過完整性檢查,原本已正確的 22 組內文標記與註記對應也都維持不變。
實際修正的地方不算多,卻很關鍵:印刷頁碼被誤判為內文;一個數字變成段落之間不該存在的橋樑;還有一句引言和其後縮排的引文被合併在一起,LLM 依據語意與縮排把兩者分開。
這只是單一範例的觀察,不能當作整份文件的準確率或成本結論。它給我的啟示是:好的修復階段應該保留正確的部分,並且在修完有憑據的問題後就停手。
把昂貴的判斷用在真正需要的地方
書的大部分內容由規則式流程處理。JEV 快速挑出可疑頁面,LLM 只處理少數需要語意判斷的情況,程式化限制則守住最終結構。修復過的頁面會回到同一條章節組裝流程,再輸出成 Markdown 或 EPUB。
我還需要測試更多語言、版面與更長的書籍,尤其是 JEV 的漏報率,以及送交 LLM 複查的門檻。但方向比一年前清楚多了:不必讓 LLM 讀遍每一頁,只為了找出藏在邊角裡的少數錯誤。
如果你要轉換掃描書,建議先在 PDF Craft 工作區用一小段含註記的樣本試跑。確認內文標記、完整的註記文字,以及跨頁的段落都沒問題,再處理整本書。
用範例設計自己的輸出檢查
上面的範例只反映一次工程實測,不代表任意書籍都能達到同樣的成功率。它提示了轉換後書籍註記密集時,值得檢查哪些地方。挑一頁有多個標記的、一頁有符號式參照的,再挑一處註記或內文段落延續到下一頁的位置。
針對每個選定的位置,把原頁影像和輸出結果對照。找到內文標記,沿著它指向的註記,確認整則註記確實屬於那段文字。再回到內文,看看下一句是否銜接自然。連結能運作,仍可能指向錯誤的註記。
特別留意以下幾種異常:
- 參照找不到對應的註記,或註記文字沒有對應的內文標記。
- 兩則獨立的註記被併成一則,或一則延續的註記被錯誤拆開。
- 頁碼、書眉或裝飾符號被插進句子裡。
- 註記接到錯誤的欄位或鄰近頁面。
- 段落跨越頁界被接在一起,忽略了引文或章節的分界。
記錄印刷頁碼、PDF 檢視器頁碼、標記,以及一小段文字。EPUB 的分頁會隨字級改變,單靠電子書頁碼日後很難找回問題所在。
了解整頁複查的極限
這裡說的複查與修復階段屬於內部處理流程,並不是使用者可操作的 JEV 功能,也不保證每一頁都經過專業校對。一頁可能通過了結構檢查,卻仍含有辨識錯誤或語意不清的詞句。反過來說,把可疑頁面送去修復,也不代表它與鄰近內容的每一處關係都正確。
如果只是休閒閱讀,可把重點放在結構複雜的地方與重要段落。若是引用、研究論述或出版用途,則應依該用途所需的嚴格程度另行校對。即使 EPUB 讀起來方便,也請保留原始 PDF。
OCR 與翻譯流程說明了辨識、結構與語意為何需要不同的檢查。若論文還要翻譯,可參考從 arXiv PDF 開始翻譯。目前的處理費率請見價格方案;這個範例並不能證明普遍的速度或成本節省。