
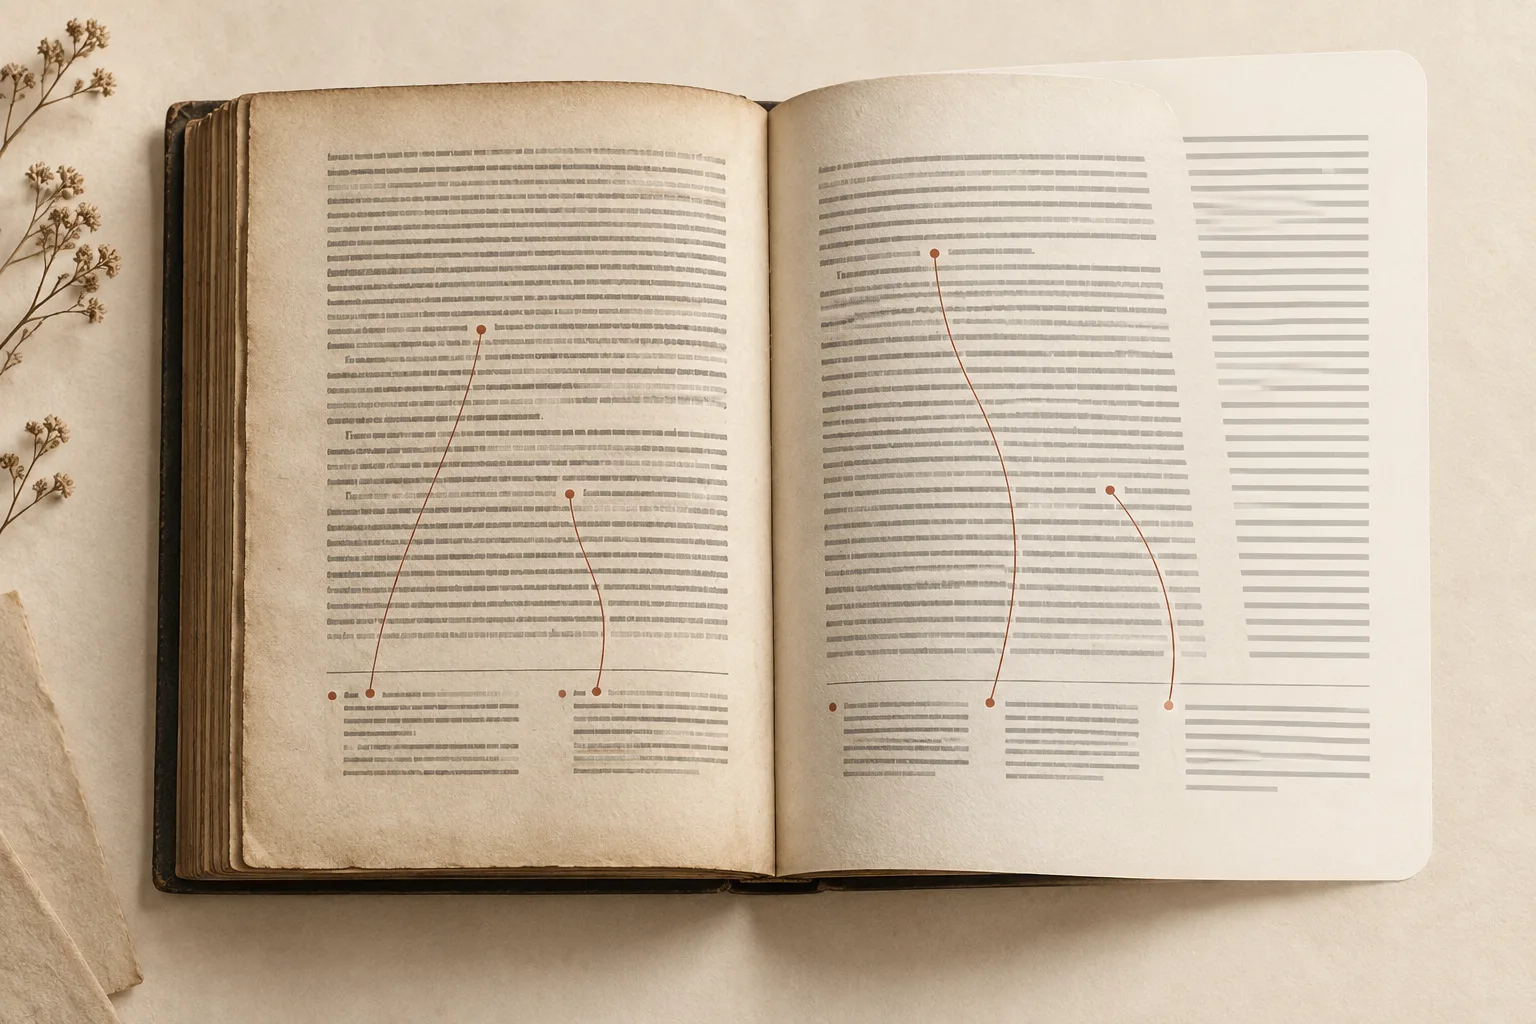
Ho creato PDF Craft per trasformare i PDF di libri scansionati in Markdown o EPUB che si possano davvero leggere, cercare e organizzare. Riconoscere le parole è solo una parte del lavoro. Un numero, un simbolo cerchiato o un asterisco nel testo deve continuare a portare alla nota giusta in fondo alla pagina originale. Altrimenti il testo viene reimpaginato, ma un rapporto essenziale per la lettura sparisce.
La questione conta quando si lavora con libri vecchi, fonti accademiche o una collezione personale. Una conversione utile dovrebbe rendere il libro ricercabile e comodo su uno schermo piccolo, mantenendo intatti i rimandi. Per una revisione pratica del file prodotto, vedi la guida da PDF scansionato a EPUB e la checklist per formule e note.
L'OCR trova i caratteri, non il loro ruolo
L'OCR può individuare le parole su una pagina senza sapere che cosa fanno in un libro. Il carattere piccolo in fondo può essere una nota o semplice testo che è finito nel margine. Un numero cerchiato in apice può essere un rimando o un normale numero di elenco. Una nota può essere divisa in due blocchi o continuare sulla pagina successiva.
Una decisione sbagliata può produrre comportamenti strani nell'EPUB: un rimando senza destinazione, due note incollate insieme, un numero di pagina inserito dentro una frase, oppure la fine di una pagina unita all'intestazione di quella successiva. Le note a piè di pagina sono da tempo uno dei problemi più difficili di PDF Craft.
Primo tentativo: far leggere ogni pagina a un LLM
Circa un anno fa, la soluzione più diretta era affidare ogni pagina a un modello linguistico di grandi dimensioni. Spesso riusciva a capire che il testo piccolo spiegava il corpo, a interpretare asterischi o numeri romani come rimandi e a stabilire se una frase continuava oltre l'interruzione di pagina.
Promettente pagina per pagina, ma faticoso su un libro lungo. Centinaia di pagine significavano centinaia di chiamate, attese e possibili nuovi tentativi. Le decisioni tra una pagina e l'altra richiedevano il contesto delle pagine vicine, aumentando ancora l'input. La maggior parte delle pagine era già corretta: il modello costoso passava molto tempo a leggere una pagina solo per dire che non c'era niente da cambiare. Inoltre era difficile per chi usa il programma capire se un'elaborazione lunga stesse procedendo o si fosse bloccata.
Prima costruire un percorso deterministico completo
Le versioni successive hanno riportato il lavoro principale sull'OCR e su regole deterministiche. Questo percorso separa il testo dalle note, unisce i paragrafi naturali, divide le note in singoli rinvii e abbina ogni rimando nel testo alla sua nota. È veloce, ripetibile e stabile, e gestisce bene la maggior parte delle pagine.
Ma l'impaginazione dei libri varia. Le note possono stare a piè di pagina o tra le colonne; i rimandi possono essere cifre o simboli; intestazioni, numeri di pagina e fregi possono finire nel testo riconosciuto. Alcune decisioni richiedono di capire che cosa significa una frase. Le sole regole lasciano qualche caso difficile, mentre un LLM su ogni pagina è troppo lento e costoso.
Il cambiamento: chiedere a JEV di ispezionare, non di rifare
La pipeline esistente non andava sostituita. Serviva un controllo di qualità rapido che segnalasse le pagine da guardare più da vicino. Ho inserito JEV in questa fase e gli ho posto una domanda precisa: l'analisi di questa pagina può passare senza modifiche? Non riscrive il testo né spiega ogni rinvio. Restituisce una probabilità usata per decidere se la pagina prosegue o va a un LLM per la correzione.
L'unità di revisione è l'intera pagina. Se l'algoritmo salta del tutto una nota, un controllo che esamina solo i rinvii già individuati non ha niente da ispezionare. Un giudizio a livello di pagina può comunque segnalare rimandi mancanti, attribuzioni sbagliate, legami insoliti tra pagine o numeri di pagina mescolati al testo. Preferisco mandare qualche pagina in più in revisione piuttosto che lasciar passare in silenzio una pagina sbagliata: un falso allarme costa un altro controllo del modello; un errore non rilevato può arrivare fino all'EPUB finale. La soglia va comunque calibrata su un campione più ampio.
flowchart TB
  accTitle: Dalla revisione della pagina alla correzione entro limiti precisi
  accDescr: L'OCR e le regole elaborano prima una pagina. JEV decide se può passare senza modifiche. Le pagine sospette vanno a un LLM, poi a un controllo di integrità programmatico. Le pagine che passano proseguono verso l'assemblaggio dei capitoli; le correzioni fallite vengono ritentate.
  A[OCR e regole] --> B{JEV: la pagina è affidabile?}
  B -- Sì --> F[Assemblaggio dei capitoli e output]
  B -- No --> C[L'LLM corregge solo la pagina corrente]
  C --> D{Controllo di integrità}
  D -- Superato --> F
  D -- Riprova --> C
Far correggere all'LLM una pagina entro limiti rigorosi
Per una pagina segnalata, l'LLM riceve la struttura testuale di tre pagine consecutive: precedente, corrente e successiva. Può modificare solo quella centrale. Le pagine vicine forniscono il contesto per le frasi che attraversano l'interruzione di pagina. In questa fase non invio immagini delle pagine: l'OCR fornisce già testo, posizioni e impaginazione, e il compito è una correzione semantica, non un altro passaggio di OCR.
Il modello può rietichettare testo, note e numeri di pagina, correggere la continuità dei paragrafi e riabbinare i rimandi alle note. Non può riscrivere liberamente la fonte né cambiare la struttura della pagina. I controlli programmatici richiedono poi indici delle note in ordine, rimandi e note che corrispondono, legami coerenti attraverso le interruzioni di pagina e posizioni dei rimandi individuabili senza ambiguità nel testo specificato. Un controllo fallito restituisce errori concreti, così il modello può inviare di nuovo un risultato completo. Meno tentativi sono utili, ma non sono un motivo per indebolire questi controlli.
Cosa ha mostrato il campione esistente di 26 pagine di ingegneria
In un PDF di prova di 26 pagine con molte note, JEV ha selezionato 6 pagine per l'LLM. Tutti e sei i primi invii hanno superato i controlli di integrità, e i 22 rapporti tra rimandi nel testo e note che erano già corretti sono rimasti intatti.
Le correzioni vere sono state modeste ma importanti: i numeri di pagina stampati erano stati scambiati per testo; un numero era diventato un falso ponte tra due paragrafi; e una frase introduttiva era stata unita alla citazione rientrata che la seguiva. L'LLM si è servito del significato e del rientro per separarle.
Questa è l'osservazione su un solo campione, non una dichiarazione di accuratezza o di costo sull'intero documento. La lezione che ne ho tratto è che una buona fase di correzione dovrebbe conservare il lavoro già corretto e fermarsi dopo aver risolto i problemi che le prove confermano.
Riservare l’analisi dell’LLM ai casi che ne hanno bisogno
L'elaborazione deterministica gestisce la maggior parte del libro. JEV seleziona rapidamente le pagine sospette. L'LLM si occupa dei pochi casi che richiedono un giudizio semantico. I vincoli programmatici proteggono la struttura finale. Le pagine corrette rientrano nello stesso assemblaggio dei capitoli e nello stesso percorso di resa in Markdown o EPUB.
Devo ancora provare più lingue, impaginazioni e libri più lunghi, in particolare il tasso di errori non rilevati da JEV e la soglia per la revisione con LLM. Ma la direzione è più chiara di un anno fa: non serve far leggere ogni pagina a un LLM per trovare pochi errori nascosti nei margini.
Se stai convertendo un libro scansionato, comincia da un breve campione che contenga note nello spazio di lavoro di PDF Craft. Controlla i rimandi nel testo, il testo completo delle note e i paragrafi che attraversano le interruzioni di pagina prima di passare all'intero libro.
Usa il campione per impostare il tuo controllo dell'output
Il campione qui sopra è una prova su una singola elaborazione, non un tasso di successo per libri qualsiasi. Suggerisce cosa vale la pena ispezionare quando un libro convertito contiene molte note. Scegli una pagina con diversi rimandi, una con rimandi simbolici e un punto in cui la nota o il paragrafo del testo continua sulla pagina successiva.
Per ogni punto scelto, confronta l'immagine della pagina originale con l'output. Individua il rimando nel testo, segui la sua destinazione e verifica che la nota completa appartenga a quel passo. Torna al testo e controlla che la frase successiva segua in modo naturale. Un collegamento funzionante può comunque portare alla nota sbagliata.
Segnala queste anomalie specifiche:
- Un rimando senza destinazione, o il testo di una nota senza il corrispondente rimando nel testo.
- Due note separate unite in una, o una singola nota continuata divisa in modo errato.
- Un numero di pagina, un'intestazione corrente o un fregio inseriti dentro una frase.
- Una nota attribuita alla colonna sbagliata o alla pagina vicina.
- Un paragrafo unito attraverso un'interruzione di pagina nonostante una citazione o un confine di sezione.
Annota la pagina stampata, la pagina nel visualizzatore PDF, il rimando e una breve frase. La paginazione dell'EPUB cambia con la dimensione del carattere, quindi il solo numero di pagina dell'ebook non basta per ritrovare il problema in seguito.
Capire i limiti della revisione a livello di pagina
Le fasi di revisione e correzione descritte qui sono elaborazione interna, non un controllo JEV a disposizione di chi usa il programma né la garanzia che ogni pagina convertita sia stata verificata da una persona esperta. Una pagina può rispettare i vincoli strutturali e contenere comunque un errore di riconoscimento o una frase ambigua. Al contrario, mandare in correzione una pagina sospetta non dimostra che ogni rapporto con le pagine vicine sia corretto.
Per una lettura occasionale, punta sulle strutture difficili e sui passi importanti. Per una citazione, un'affermazione di ricerca o una pubblicazione, fai la revisione più attenta che quel caso richiede. Tieni a disposizione il PDF di partenza anche quando l'EPUB è comodo da leggere.
Il flusso di lavoro OCR e traduzione spiega perché riconoscimento, struttura e significato richiedono controlli diversi. Per un articolo che verrà anche tradotto, vedi lavorare da un PDF di arXiv. Le tariffe attuali sono nella pagina Prezzi; il campione non dimostra un risparmio universale di tempo o di costo.