
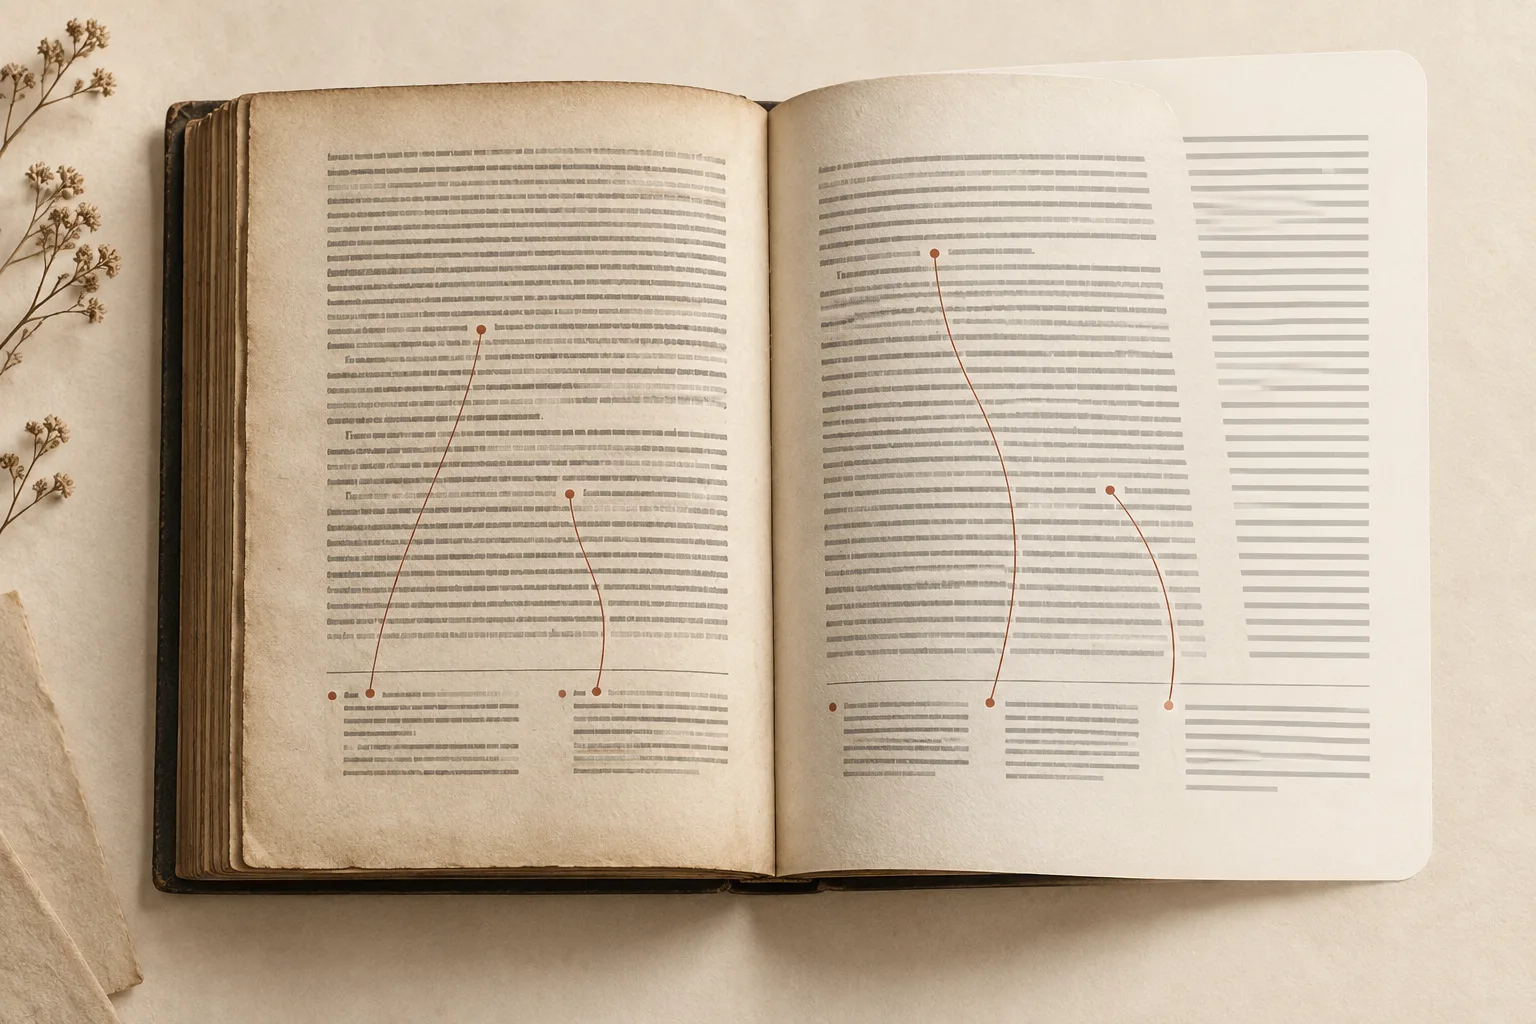
PDF Craft는 스캔한 책 PDF를 사람이 실제로 읽고, 검색하고, 정리할 수 있는 Markdown이나 EPUB로 바꾸기 위해 만들었습니다. 하지만 글자를 인식하는 것만으로는 부족합니다. 본문에 있는 숫자, 동그라미 기호, 별표가 원래 페이지 아래쪽의 올바른 주석으로 이어져야 합니다. 그렇지 않으면 텍스트는 새 레이아웃으로 흘러가더라도 책을 읽는 데 꼭 필요한 연결이 사라집니다.
오래된 책이나 학술 자료, 개인 소장본을 다룰 때 특히 중요한 문제입니다. 쓸모 있는 변환이라면 책을 검색할 수 있게 하고 작은 화면에서도 편하게 읽을 수 있게 하면서, 참조 관계는 그대로 유지해야 합니다. 결과 파일을 실제로 점검하는 방법은 스캔한 PDF를 EPUB로 변환하는 안내와 수식·각주 점검 목록에서 확인할 수 있습니다.
OCR은 글자를 찾을 뿐, 그 역할까지 알지는 못합니다
OCR은 페이지에 있는 단어를 알아낼 수 있지만, 그 단어가 책에서 어떤 역할을 하는지는 모릅니다. 아래쪽에 작게 인쇄된 글자가 각주일 수도 있고, 여백까지 밀려난 본문일 수도 있습니다. 위로 올라간 동그라미 숫자는 참조 표시일 수도 있고, 평범한 목록 번호일 수도 있습니다. 하나의 주석이 두 개의 블록으로 나뉘거나 다음 페이지로 이어질 수도 있습니다.
판단을 한 번 잘못하면 EPUB에서 이상한 현상이 생깁니다. 목적지가 없는 표시, 두 주석이 한 덩어리로 붙은 상태, 문장 중간에 끼어든 페이지 번호, 한 페이지의 끝이 다음 페이지의 머리글과 이어지는 일이 그렇습니다. 각주는 오랫동안 PDF Craft가 가장 어려워한 문제 중 하나였습니다.
첫 시도: LLM에게 모든 페이지를 읽게 하기
약 1년 전만 해도 가장 단순한 해법은 각 페이지를 대규모 언어 모델에 넘기는 것이었습니다. 그러면 작은 글씨가 본문을 설명한다는 사실을 알아채고, 별표나 로마 숫자를 표시로 해석하고, 문장이 페이지 경계를 넘어 이어지는지 판단하는 일을 자주 해냈습니다.
페이지 하나하나만 보면 가능성이 있어 보였지만, 긴 책 전체에서는 고통스러웠습니다. 수백 페이지라면 수백 번의 호출과 대기, 재시도 가능성이 따라붙습니다. 페이지를 넘나드는 판단에는 앞뒤 문맥이 필요하므로 입력은 더 커집니다. 대부분의 페이지는 이미 올바른 상태였기 때문에, 값비싼 모델이 많은 시간을 들여 페이지를 읽고서는 바꿀 것이 없다고 답하는 일이 잦았습니다. 사용자 입장에서도 긴 작업이 진행 중인지 멈춘 것인지 알기 어려웠습니다.
먼저 완전한 결정론적 경로를 만들기
이후 버전에서는 주 작업을 OCR과 결정론적 규칙으로 되돌렸습니다. 이 경로는 본문과 주석을 분리하고, 자연스러운 문단을 이어 붙이고, 주석을 개별 인용으로 나누고, 본문의 각 표시를 해당 주석과 연결합니다. 빠르고 반복 가능하며 안정적이고, 대부분의 페이지를 잘 처리합니다.
그런데 책의 레이아웃은 제각각입니다. 주석이 페이지 하단에 있을 수도 있고 단 사이에 있을 수도 있습니다. 표시가 숫자일 수도, 기호일 수도 있습니다. 머리글, 페이지 번호, 장식 기호가 인식된 텍스트에 섞여 들어가기도 합니다. 어떤 판단은 문장의 의미를 이해해야 내릴 수 있습니다. 규칙만으로는 몇 가지 어려운 사례가 남고, 모든 페이지에 LLM을 쓰는 것은 너무 느리고 비쌉니다.
변화: JEV에게 다시 하라고 하지 말고, 검사하게 하기
기존 파이프라인을 교체할 필요는 없었습니다. 필요한 것은 더 자세히 볼 만한 페이지를 표시해 주는 빠른 품질 점검이었습니다. 그 단계에 JEV를 도입해 한 가지 구체적인 질문을 던졌습니다. 이 페이지의 분석 결과를 그대로 통과시켜도 되는가? JEV는 텍스트를 다시 쓰지 않고 모든 인용을 설명하지도 않습니다. 페이지를 그대로 진행시킬지, LLM에 보내 교정할지를 결정하는 데 쓰이는 확률 하나를 돌려줍니다.
검토 단위는 페이지 전체입니다. 알고리즘이 주석 하나를 완전히 놓쳤다면, 이미 알려진 인용만 훑는 점검으로는 살펴볼 대상이 없습니다. 페이지 단위로 판단하면 빠진 참조, 잘못 연결된 주석, 이례적인 페이지 간 연결, 본문에 섞인 페이지 번호까지 표시할 수 있습니다. 잘못된 페이지를 조용히 통과시키기보다는 몇 페이지를 더 검토로 보내는 편을 택합니다. 잘못된 경보는 모델 점검을 한 번 더 하는 비용이지만, 놓친 오류는 최종 EPUB까지 갈 수 있기 때문입니다. 임계값은 여전히 더 폭넓게 보정해야 합니다.
flowchart TB
  accTitle: 페이지 검토에서 제한된 교정까지
  accDescr: OCR과 규칙이 먼저 페이지를 처리합니다. JEV는 이 페이지를 그대로 통과시켜도 되는지 판단합니다. 의심스러운 페이지는 LLM으로 보내 교정한 뒤, 프로그램을 통해 결과의 무결성을 검사합니다. 통과한 페이지는 챕터 조립으로 넘어가고, 교정에 실패하면 재시도합니다.
  A[OCR과 규칙] --> B{JEV: 페이지를 신뢰할 수 있는가?}
  B -- 예 --> F[챕터 조립 및 출력]
  B -- 아니요 --> C[LLM이 현재 페이지만 교정]
  C --> D{무결성 검사}
  D -- 통과 --> F
  D -- 재시도 --> C
LLM은 엄격한 범위 안에서 페이지만 교정합니다
표시된 페이지에 대해 LLM은 연속된 세 페이지, 즉 이전·현재·다음 페이지의 텍스트 구조를 받습니다. 바꿀 수 있는 것은 가운데 페이지뿐입니다. 앞뒤 페이지는 페이지 경계를 넘는 문장의 문맥을 제공합니다. 이 단계에서는 페이지 이미지를 보내지 않습니다. OCR이 이미 텍스트와 위치, 레이아웃을 제공했고, 여기서 필요한 작업은 또 한 번의 OCR이 아니라 의미 차원의 교정이기 때문입니다.
모델은 본문, 각주, 페이지 번호의 표시를 다시 붙이고, 문단의 연속성을 바로잡고, 표시와 주석을 다시 연결할 수 있습니다. 원문을 마음대로 고치거나 페이지 구조를 바꿀 수는 없습니다. 이어서 프로그램 검사가 주석 인덱스의 순서, 참조와 주석의 일치, 페이지 경계를 넘는 연결의 일관성, 지정된 텍스트 안에서 모호함 없이 찾을 수 있는 표시 위치를 요구합니다. 검사에 실패하면 구체적인 오류가 반환되어 모델이 완전한 결과를 다시 제출할 수 있습니다. 재시도 횟수는 적을수록 좋지만, 그 때문에 검사를 느슨하게 할 이유는 없습니다.
기존 26쪽 공학 문서 샘플에서 확인된 것
각주가 많은 26쪽짜리 테스트 PDF 하나에서 JEV는 6쪽을 LLM으로 보냈습니다. 여섯 페이지 모두 첫 제출이 무결성 검사를 통과했고, 이미 올바르게 연결되어 있던 본문 참조와 주석 간의 관계 22개도 그대로 유지되었습니다.
실제로 수정된 내용은 소소하지만 중요했습니다. 인쇄된 페이지 번호가 본문으로 잘못 인식된 경우, 숫자 하나가 문단 사이의 잘못된 연결고리가 된 경우, 도입 문장이 뒤따르는 들여쓴 인용문과 합쳐진 경우가 있었습니다. LLM은 의미와 들여쓰기를 근거로 이들을 분리했습니다.
이는 샘플 하나에서 나온 관찰일 뿐, 문서 전체의 정확도나 비용을 보장하는 주장이 아닙니다. 제가 얻은 교훈은 좋은 교정 단계라면 올바른 작업을 그대로 보존하고, 근거가 뒷받침하는 문제를 고친 뒤 멈춰야 한다는 것입니다.
값비싼 판단은 필요한 곳에만 쓰기
결정론적 처리가 책의 대부분을 담당합니다. JEV는 의심스러운 페이지를 빠르게 골라냅니다. LLM은 의미 판단이 필요한 소수의 사례를 다룹니다. 프로그램 제약이 최종 구조를 지킵니다. 교정된 페이지는 다시 같은 챕터 조립과 Markdown 또는 EPUB 렌더링 경로로 돌아갑니다.
아직 더 많은 언어와 레이아웃, 더 긴 책을 시험해야 합니다. 특히 JEV가 오류를 놓치는 비율과 LLM 검토 임계값을 확인해야 합니다. 그래도 방향은 1년 전보다 분명해졌습니다. 여백에 숨은 몇 개의 오류를 찾겠다고 LLM에게 모든 페이지를 읽게 할 필요는 없습니다.
스캔한 책을 변환한다면 PDF Craft 작업 공간에서 각주가 포함된 짧은 샘플부터 시작하세요. 책 전체를 맡기기 전에 본문 표시, 주석 텍스트 전체, 페이지 경계를 넘는 문단을 확인하세요.
샘플을 참고해 나만의 결과 점검 절차 만들기
위 샘플은 한 번의 기술 검증 결과일 뿐, 모든 책에 적용할 수 있는 성공률을 보여 주지는 않습니다. 각주가 빽빽한 책을 변환했을 때 무엇을 살펴봐야 하는지 알려줍니다. 표시가 여러 개 있는 페이지, 기호 참조가 있는 페이지, 주석이나 본문 문단이 다음 페이지로 이어지는 위치를 골라 보세요.
고른 위치마다 원본 페이지 이미지와 결과물을 비교합니다. 본문 표시를 찾아 그 목적지로 따라가고, 주석 전체가 해당 구절에 속하는지 확인합니다. 다시 본문으로 돌아와 다음 문장이 자연스럽게 이어지는지 봅니다. 링크가 작동하더라도 잘못된 주석으로 이어질 수 있습니다.
다음과 같은 구체적인 이상 징후를 표시해 두세요.
- 목적지가 없는 참조, 또는 대응하는 본문 표시가 없는 주석 텍스트.
- 별개의 주석 두 개가 하나로 합쳐진 경우, 또는 이어진 주석 하나가 잘못 나뉜 경우.
- 문장 안에 페이지 번호, 머리글, 장식 기호가 끼어든 경우.
- 잘못된 단이나 옆 페이지에 붙은 주석.
- 인용문이나 절 경계가 있는데도 페이지 경계를 넘어 합쳐진 문단.
인쇄된 페이지, PDF 뷰어 페이지, 표시, 짧은 구절을 함께 기록하세요. EPUB 쪽 번호는 글꼴 크기에 따라 달라지므로, 나중에 문제를 찾아낼 때 전자책 페이지 번호만으로는 부족합니다.
페이지 단위 검토의 한계 이해하기
여기서 설명한 검토와 교정 단계는 내부 처리 과정이며, 사용자가 조작하는 JEV 기능도 아니고 변환된 모든 페이지가 전문가의 검수를 거쳤다는 보장도 아닙니다. 어떤 페이지는 구조적 제약을 만족하면서도 인식 오류나 모호한 구절을 담고 있을 수 있습니다. 반대로 의심스러운 페이지를 교정으로 보냈다고 해서 주변의 모든 관계가 올바르다는 뜻도 아닙니다.
가볍게 읽을 목적이라면 어려운 구조와 중요한 구절을 중심으로 확인하세요. 인용이나 연구 주장, 출판을 염두에 둔다면 그 목적에 맞는 더 꼼꼼한 검토가 필요합니다. EPUB로 읽기 편하더라도 원본 PDF는 계속 보관해 두세요.
OCR과 번역 워크플로에서는 인식, 구조, 의미에 각각 다른 점검이 필요한 이유를 설명합니다. 논문을 번역까지 할 계획이라면 arXiv PDF로 작업하는 방법을 참고하세요. 현재 처리 요금은 요금 안내에서 확인할 수 있으며, 이 샘플이 보편적인 속도나 비용 절감을 입증하는 것은 아닙니다.