
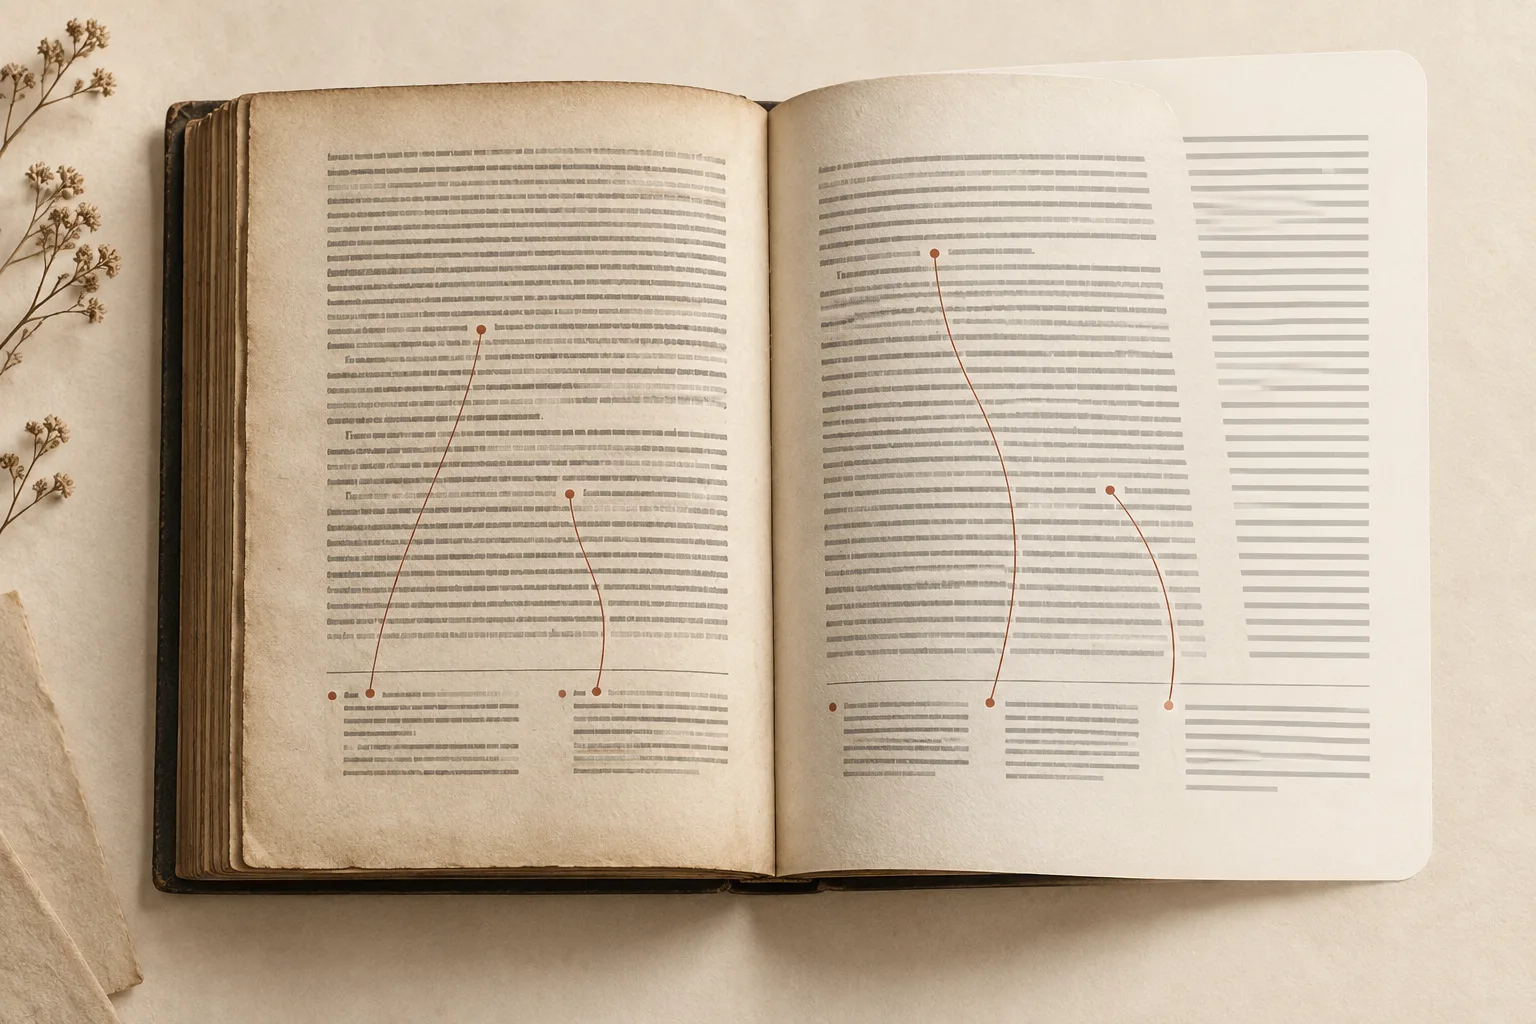
J’ai conçu PDF Craft pour transformer des PDF de livres numérisés en Markdown ou en EPUB que l’on peut réellement lire, rechercher et classer. Reconnaître les mots ne suffit pas. Un chiffre, un symbole entouré ou un astérisque dans le corps du texte doit toujours renvoyer à la bonne note au bas de la page d’origine. Sinon, le texte se recompose, mais un lien de lecture essentiel disparaît.
Cela compte pour les livres anciens, les sources universitaires ou une collection personnelle. Une conversion utile doit rendre le livre interrogeable et agréable à lire sur un petit écran, tout en conservant ses renvois. Pour un examen pratique d’un fichier produit, consultez le guide de conversion d’un PDF numérisé en EPUB et la liste de contrôle pour les formules et les notes.
L’OCR repère des caractères, pas leur rôle
L’OCR sait identifier des mots sur une page, mais pas ce qu’ils font dans un livre. Un petit texte en bas de page peut être une note ou simplement du texte courant arrivé dans la marge. Un chiffre cerclé en exposant peut être un appel de note ou un simple numéro de liste. Une note peut être scindée en deux blocs ou se poursuivre à la page suivante.
Une seule erreur de décision suffit à produire un comportement étrange dans l’EPUB : un appel sans destination, deux notes collées ensemble, un numéro de page inséré dans une phrase, ou la fin d’une page accolée au titre courant de la suivante. Les notes de bas de page ont longtemps été l’un des problèmes les plus difficiles à résoudre pour PDF Craft.
Première tentative : faire lire chaque page par un LLM
Il y a environ un an, la solution évidente consistait à confier chaque page à un grand modèle de langage. Il parvenait souvent à reconnaître qu’un petit texte expliquait le corps du texte, à interpréter les astérisques ou les chiffres romains comme des appels, et à juger si une phrase se poursuivait après un saut de page.
Page par page, le résultat était prometteur, mais sur un livre entier, c’était pénible. Des centaines de pages signifiaient des centaines d’appels, d’attentes et de nouvelles tentatives possibles. Les décisions à cheval sur deux pages exigeaient le contexte des pages voisines, ce qui augmentait encore les données envoyées. La plupart des pages étaient déjà correctes : le modèle coûteux passait une grande partie de son temps à lire une page pour conclure qu’il n’y avait rien à changer. Il était aussi difficile pour l’utilisateur de savoir si un long traitement avançait ou s’il était bloqué.
Construire d’abord un traitement déterministe complet
Les versions suivantes ont ramené l’essentiel du travail vers l’OCR et des règles déterministes. Ce traitement sépare le corps du texte des notes, reconstitue les paragraphes naturels, découpe les notes en citations individuelles et associe chaque appel du corps à sa note. Il est rapide, reproductible et stable, et il traite bien la plupart des pages.
Mais la mise en page des livres varie. Les notes peuvent se trouver en bas de page ou entre les colonnes ; les appels peuvent être des chiffres ou des symboles ; les titres courants, les numéros de page et les ornements peuvent se retrouver dans le texte reconnu. Certaines décisions demandent de comprendre le sens d’une phrase. Les règles seules laissent subsister quelques cas difficiles, tandis qu’un LLM sur chaque page est trop lent et trop coûteux.
Le changement : demander à JEV d’inspecter, pas de refaire
Le pipeline existant n’avait pas besoin d’être remplacé. Il lui fallait un contrôle qualité rapide, capable de signaler les pages qui méritent un examen plus attentif. J’y ai placé JEV avec une question précise : l’analyse de cette page peut-elle être validée sans modification ? Il ne réécrit pas le texte et n’explique pas chaque citation. Il renvoie une probabilité qui sert à décider si la page continue son chemin ou passe à un LLM pour réparation.
L’unité de révision est la page entière. Si l’algorithme oublie complètement une note, un contrôle qui ne parcourt que les citations connues n’a rien à examiner. Un jugement à l’échelle de la page peut encore signaler des renvois manquants, une note rattachée au mauvais passage, des liens inhabituels entre pages ou des numéros de page mêlés à la prose. Je préfère envoyer quelques pages de plus en révision plutôt que de laisser passer silencieusement une page défectueuse : une fausse alerte coûte une vérification de modèle supplémentaire ; une erreur non détectée peut se retrouver dans l’EPUB final. Le seuil demande encore à être calibré plus largement.
flowchart TB
  accTitle: De la révision de page à la réparation encadrée
  accDescr: L’OCR et les règles traitent d’abord une page. JEV décide si elle peut être validée sans modification. Les pages douteuses passent à un LLM, puis à un contrôle d’intégrité programmatique. Les pages validées passent à l’assemblage des chapitres ; si une correction échoue, une nouvelle tentative est lancée.
  A[OCR et règles] --> B{JEV : page fiable ?}
  B -- Oui --> F[Assemblage des chapitres et sortie]
  B -- Non --> C[Le LLM répare uniquement la page en cours]
  C --> D{Contrôle d’intégrité}
  D -- Réussi --> F
  D -- Nouvelle tentative --> C
Laisser le LLM réparer une page dans des limites strictes
Pour une page signalée, le LLM reçoit la structure textuelle de trois pages consécutives : la précédente, la page en cours et la suivante. Il ne peut modifier que la page du milieu. Les pages voisines fournissent le contexte des phrases qui franchissent les limites de page. Je n’envoie pas d’images de page à ce stade : l’OCR fournit déjà le texte, les positions et la mise en page, et la tâche consiste à corriger le sens, non à refaire une passe d’OCR.
Le modèle peut réétiqueter le corps du texte, les notes et les numéros de page, corriger la continuité des paragraphes et réapparier les appels aux notes. Il ne peut pas réécrire librement la source ni modifier la structure de la page. Des contrôles programmatiques exigent ensuite des indices de notes ordonnés, des appels et des notes qui correspondent, des liens cohérents d’une page à l’autre, et des positions d’appels repérables sans ambiguïté dans le texte indiqué. Un contrôle échoué renvoie des erreurs précises pour que le modèle puisse soumettre un résultat complet. Moins de nouvelles tentatives, c’est utile, mais ce n’est pas une raison d’assouplir ces contrôles.
Ce qu’a montré l’échantillon d’ingénierie existant de 26 pages
Sur un PDF de test de 26 pages contenant de nombreuses notes, JEV a sélectionné 6 pages pour le LLM. Les six premières soumissions ont toutes passé les contrôles d’intégrité, et les 22 relations entre appels du corps et notes qui étaient déjà correctes sont restées intactes.
Les corrections réelles étaient modestes mais importantes : des numéros de page imprimés avaient été pris pour du texte courant ; un numéro était devenu un faux pont entre deux paragraphes ; et une phrase d’introduction avait été fusionnée avec la citation en retrait qui la suivait. Le LLM s’est appuyé sur le sens et sur le retrait pour les séparer.
Il s’agit de l’observation d’un seul échantillon, et non d’une affirmation sur la précision ou le coût à l’échelle d’un document. La leçon que j’en tire est qu’une bonne étape de réparation doit préserver le travail correct et s’arrêter une fois réglés les problèmes étayés par des preuves.
Réserver le jugement coûteux aux cas qui en ont besoin
Le traitement déterministe couvre la majeure partie du livre. JEV sélectionne rapidement les pages douteuses. Le LLM traite les quelques cas qui demandent un jugement sémantique. Des contraintes programmatiques protègent la structure finale. Les pages réparées reviennent au même assemblage de chapitres et au même rendu en Markdown ou en EPUB.
Il me reste à tester davantage de langues, de mises en page et de livres plus longs, en particulier le taux d’erreurs manquées par JEV et le seuil de révision par LLM. Mais la direction est plus claire qu’il y a un an : inutile de faire lire chaque page par un LLM pour débusquer quelques erreurs cachées dans les marges.
Si vous convertissez un livre numérisé, commencez par un court échantillon contenant des notes dans l’espace de travail PDF Craft. Vérifiez les appels dans le corps, le texte complet des notes et les paragraphes qui franchissent les sauts de page avant de lancer la conversion sur tout le livre.
Utiliser l’échantillon pour concevoir votre propre contrôle du résultat
L’exemple ci-dessus présente un seul essai technique ; il ne permet pas de calculer un taux de réussite valable pour tous les livres. Il indique des points utiles à examiner lorsqu’un livre converti contient des notes denses. Choisissez une page comportant plusieurs appels, une page à renvois symboliques et un endroit où la note ou le paragraphe du corps se poursuit à la page suivante.
Pour chaque endroit choisi, comparez l’image de la page d’origine avec le résultat. Repérez l’appel dans le corps, suivez sa destination et vérifiez que la note complète correspond bien à ce passage. Revenez au corps du texte et assurez-vous que la phrase suivante s’enchaîne naturellement. Un lien qui fonctionne peut malgré tout mener à la mauvaise note.
Signalez ces anomalies précises :
- Un appel sans destination, ou un texte de note sans appel correspondant dans le corps.
- Deux notes distinctes réunies en une seule, ou une note unique poursuivie sur la page suivante et mal scindée.
- Un numéro de page, un titre courant ou un ornement inséré dans une phrase.
- Une note rattachée à la mauvaise colonne ou à la page voisine.
- Un paragraphe réuni à travers un saut de page malgré une citation ou une limite de section.
Notez la page imprimée, la page dans le lecteur PDF, l’appel et une courte phrase. La pagination d’un EPUB change avec la taille de police : un numéro de page d’ebook ne suffit donc pas à retrouver le problème plus tard.
Comprendre les limites d’une révision à l’échelle de la page
Les étapes de révision et de réparation décrites ici relèvent du traitement interne ; elles ne constituent ni un réglage JEV accessible à l’utilisateur, ni la garantie que chaque page convertie a été vérifiée par un professionnel. Une page peut satisfaire aux contraintes structurelles tout en contenant une erreur de reconnaissance ou une phrase ambiguë. À l’inverse, envoyer une page douteuse en réparation ne prouve pas que toutes les relations avec les pages voisines sont correctes.
Pour une lecture courante, ciblez les structures difficiles et les passages importants. Pour une citation, une affirmation de recherche ou une publication, appliquez le contrôle plus attentif qu’exige cet usage. Gardez le PDF source à portée de main, même lorsque l’EPUB est pratique à lire.
Le workflow OCR et traduction explique pourquoi la reconnaissance, la structure et le sens demandent des contrôles différents. Pour un article qui sera aussi traduit, voir travailler à partir d’un PDF arXiv. Les tarifs actuels de traitement figurent sur la page Tarifs ; l’échantillon ne permet pas de conclure à un gain universel de vitesse ou de coût.